


Опрос
|
реклама
Быстрый переход
ChatGPT обновился — теперь он будет не только писать, но и показывать графики, схемы и кнопки
07.10.2026 [23:12],
Анжелла Марина
OpenAI представила обновление Intelligent UI для ChatGPT, которое позволит ИИ создавать визуальные и интерактивные элементы непосредственно в ответах. Теперь обычный текст будет сопровождаться графиками, схемами и кнопками для выполнения конкретных задач. Функция работает на базе GPT-6. 
Источник изображения: Grok Одним из примеров стала схема анатомии слизня. ChatGPT создал изображение, посвящённое строению животного, а отдельные кнопки позволяли выбрать конкретную часть тела и получить дополнительную информацию. В другом тесте ИИ сгенерировал калькулятор стоимости аренды жилья в Сан-Франциско. Ползунки позволяли менять доход и расходы, после чего инструмент показывал, какую долю дохода после уплаты налогов составит стоимость аренды разных квартир. Ещё интереснее выглядел ответ на запрос журналиста из Wired относительно кресел в самолёте. ChatGPT сравнил компоновку салонов четырёх самолётов Alaska Airlines и Delta Air Lines, а на карте можно было нажать на любое кресло и посмотреть сведения о нём. Ряды возле аварийных выходов система выделила зелёным цветом, так как журналист предупредил, что не любит сидеть у аварийных выходов. При этом визуальные элементы будут появляться не в каждом ответе. Менеджер продукта OpenAI Ааруш Селван (Aarush Selvan) рассказал, что дизайнеры компании специально определяли, когда диаграммы, графики и кнопки помогают пользователю, а когда начинают перегружать интерфейс. При желании пользователь сможет попросить ChatGPT использовать меньше таких элементов. 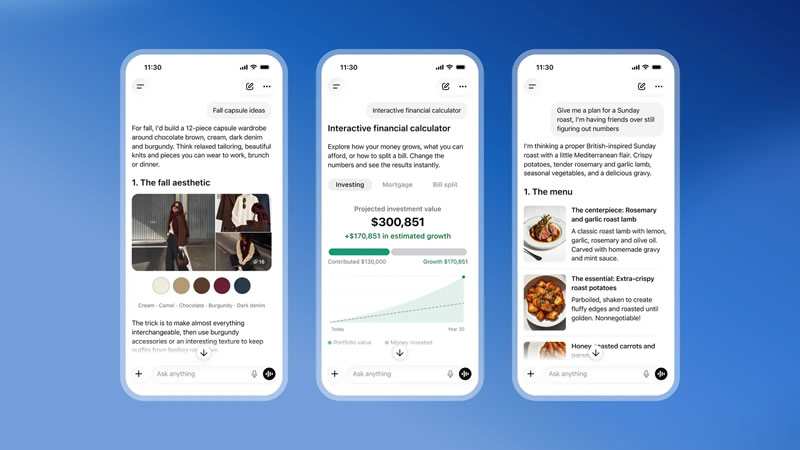
Источник изображения: wired.com Подобную визуальную интерактивность под названием generative UI ранее анонсировала и Google для своей поисковой системы. Функция OpenAI Intelligent UI для ChatGPT запускается глобально без региональных ограничений, а стоимость использования зависит от выбранного тарифного плана, при этом базовый доступ для бесплатных пользователей, по заявлению OpenAI, откроется завтра. «Не соответствует обещаниям»: версия ChatGPT для подростков провалила проверку безопасности
07.10.2026 [19:34],
Владимир Мироненко
Версия ChatGPT для подростков (ChatGPT for Teens), анонсированная в августе этого года, создаёт «неприемлемый риск» для молодых пользователей. Об этом сообщала некоммерческая организация Common Sense Media, занимающаяся обзорами приложений, сервисов и развлечений с акцентом на безопасность молодёжи. 
Источник изображения: Arsyad Basyarudin/unsplash.com Common Sense Media заявила, что защитный механизм чат-бота, предназначенного для оказания помощи подросткам в учёбе, «не соответствует обещаниям компании». Согласно пресс-релизу Common Sense Media, ChatGPT «не отправляет предупреждения родителям, когда это необходимо», не предлагает «надлежащую помощь в кризисных ситуациях» и «по-прежнему выполняет домашние работы за детей». «Чат для подростков может вселить в родителей ложную уверенность в механизмах защиты и предупреждениях о безопасности, которые часто не срабатывают», — говорится в заявлении Тома Сигела (Tom Siegel), исполнительного директора молодёжного института безопасности ИИ Common Sense Media. По его словам, хотя подросток может целый час говорить о членовредительстве, его родители не получат при этом ни единого предупреждения от чат-бота. Пока OpenAI не исправит эти упущения и не докажет независимыми тестами эффективность защитных механизмов, ChatGPT должен использоваться только взрослыми, считает Сигел. В OpenAI выразили несогласие с такой оценкой. «Мы глубоко привержены обеспечению безопасности подростков, а также разработке мер предосторожности и предоставлению родителям значимых инструментов, которые помогут их подросткам использовать искусственный интеллект. Мы приветствуем тщательную независимую оценку, но мы не верим, что тестирование Common Sense Media точно отражает то, как на практике работают меры защиты подростков от ChatGPT, или мнение экспертов о том, как искусственный интеллект может помочь подросткам», — заявил представитель OpenAI. «Наш обзор методологии Common Sense Media показывает, что большая часть их тестирования, возможно, началась и завершилась до того, как была завершена активация родительского контроля, что делает их результаты неточными. Если это было так, тесты не позволили бы установить, работают ли уведомления о безопасности родителей должным образом», — добавил он. Комментируя заявление OpenAI, Сигел отметил, что новая информация не меняет вывода Common Sense Media о том, что функция предупреждения родителей вызывает вопросы по поводу надёжности исполнения в кризисных ситуациях. «Мы надеемся, что OpenAI будет придерживаться сути того, что мы обнаружили, а не пытаться посеять сомнения в нашей методологии», — сообщил он. OpenAI продолжает раздражать математиков пренебрежением к правилам публикации решений важных задач
07.10.2026 [04:45],
Анжелла Марина
OpenAI опубликовала на GitHub сотни решений и доказательств нерешённых ранее математических задач, полученные с помощью искусственного интеллекта. Публикация стала продолжением дискуссии, разгоревшейся после встречи компании с математиками в августе: учёные призывали OpenAI сопровождать такие результаты полноценными научными публикациями с подробным описанием методов и доказательств, а не ограничиваться постами в социальных сетях и репозиториями. 
Источник изображения: Grok В августе OpenAI собрала около 40 математиков, чтобы обсудить, как действовать в ситуации, когда искусственный интеллект явно превосходит возможности людей в этой области и попросить совета относительно публикации полученных результатов. При этом, по сообщению издания Wired, компания заверила, что не станет обнародовать все решения разом, хотя официальный представитель OpenAI Линдси Маккаллум (Lindsay McCallum) утверждает, что ей ничего не известно о таких заверениях. Участники встречи предложили публиковать результаты в виде научных работ с подробным объяснением методов и полученных доказательств. По мнению математика Северо-Западного университета (Northwestern University) в США Брайны Кра (Bryna Kra), это позволило бы другим исследователям проверить результаты, разобраться в них и использовать в дальнейшей работе. Однако, по её словам, OpenAI не последовала этой рекомендации и вместо этого собирается разместить сотни результатов на GitHub. «Судя по всему, эти пожелания были проигнорированы», — отметила она. Однако OpenAI пошла по другому пути. Компания создала на GitHub специальный репозиторий Math, где публикует материалы, связанные с использованием ИИ для решения математических задач. Одновременно OpenAI рассказала о своей работе и объяснила, как использует ИИ для продвижения исследований в этой области. Таким образом, первоначальные опасения математического сообщества о том, что результаты будут распространяться преимущественно через репозитории и социальные сети, частично подтвердились. При этом публикация на GitHub сама по себе не заменяет научную статью: репозиторий позволяет сделать материалы доступными для изучения, но не обеспечивает того же уровня описания методики, проверки и академического обсуждения, который предполагает традиционная научная публикация. Ситуация усугубилась после инцидента в сентябре, когда разработчики задействовали тысячи ИИ-агентов для решения «Задачи тысячелетия», за которую назначена награда в 1 миллион долларов. Математик и профессор Нью-Йоркского университета Тристан Бакмастер (Tristan Buckmaster) обвинил компанию в присвоении результатов, над которыми он работал совместно с сотрудником Anthropic Левентом Альпёге (Levent Alpöge), а переговоры о соавторстве сопровождались давлением, включая угрозы карьере исследователя со стороны сотрудника OpenAI Себастьяна Бубека (Sébastien Bubeck). Многие учёные воспринимают действия технологических гигантов как проявление монополии и пренебрежение к коллективному научному труду. Профессор Нестор Гийен (Nestor Guillen) отметил распространение мнения о «мафиозном поведении» корпораций, сосредоточивших огромные вычислительные ресурсы в своих руках, а Брайна Кра подчеркнула, что публикации решений в формате твитов не способствуют развитию экосистемы, на данных которой и обучаются ИИ-модели. В ответ на растущее напряжение в научной среде OpenAI создала консультативную группу по математике и искусственному интеллекту, однако математики отмечают отсутствие реальных изменений в действиях компании. В частности, разработчики продолжают игнорировать специализированные репозитории, такие как Hexagon и Palomar, созданные сообществом для систематизации доказательств, полученных с помощью инструментов ИИ. Внутри OpenAI некоторые сотрудники высказывают мнение, что искусственный интеллект может сделать традиционную математику неактуальной и профессия находится под угрозой. Однако тот же Бубек считает, что технология наоборот расширит возможности и поможет исследователям решать более амбициозные задачи. «Я вижу в этом возможность расширить сферу деятельности математиков и повысить значимость их работы», — утверждает он. Математики, в свою очередь, признают потенциал новых инструментов, но требуют академического подхода к публикации результатов. Математическое сообщество в целом также признаёт потенциал ИИ-инструментов, однако настаивает, что полученные с их помощью результаты должны проходить через те же процедуры проверки, воспроизводимости и научного обсуждения, что и результаты, полученные традиционными методами. Появление открытого репозитория OpenAI делает часть таких материалов доступной исследователям, но не снимает вопроса о том, насколько подробно и в каком формате должны публиковаться доказательства, полученные ИИ. Wikimedia обнаружила у себя «сбежавших» ИИ-агентов OpenAI — они завалили сервисы миллионами запросов
06.10.2026 [05:01],
Анжелла Марина
«Фонд Викимедиа» (Wikimedia Foundation) обнаружил на своих веб-ресурсах активность ИИ-агентов OpenAI. Организация провела внутреннее расследование после сообщений других компаний о подобных инцидентах и зафиксировала несанкционированные действия ботов, включая экстремальную нагрузку на серверы. 
Источник изображения: wikimediafoundation.org Часть обнаруженной активности связана с редактированием вики-страниц. Wikimedia считает, что эти изменения выполняли ИИ-агенты OpenAI, однако почти все правки оставались в разделах песочниц и не попадали на страницы, которые видят обычные читатели. Несколько изменений затронули конфигурацию инструмента для работы с цитированием и могли использоваться для получения данных с удалённых сервисов через этот инструмент. При этом необходимые для автоматических правок разрешения от сообщества запрошены не были. Отдельное расследование касалось публичного сервера (etherpad.wikimedia.org), который Wikimedia предоставляет как сервис для ведения заметок. Связанные с OpenAI агенты безуспешно пытались использовать его для получения данных с других сайтов или оставляли в нём заметки о выполняемых задачах. Самой масштабной проблемой стал объём обращений к открытым данным Wikimedia. Агенты выполнили миллионы автоматических запросов к публичным API и просмотрели миллионы страниц, в основном в Wikidata и Wikimedia Commons. Кроме того, они сделали сотни тысяч запросов к публичному веб-сервису Wikidata Query Service, которые, как считают в Wikimedia, способствовали частичному сбою этого сервиса в мае. При этом расследование не обнаружило признаков компрометации систем или данных Wikimedia. Организация также не нашла свидетельств того, что её инфраструктура использовалась агентами для координации между собой. Однако отмечается, что само расследование оказалось сложным и потребовало значительных усилий и времени для определения характера и источника активности. В Wikimedia уверены, что проблема выходит за рамки одного инцидента, так как за последние годы рост активности ботов уже слишком заметно увеличивает нагрузку на инфраструктуру организации. В 2025 году фонд сообщал о росте общего потребления пропускной способности на 50 % из-за резкого увеличения активности ботов по сравнению с 2024 годом. При этом на ботов приходилось 65 % наиболее ресурсоёмкого трафика проектов Wikimedia, а это увеличивает расходы на поддержку серверов и может снижать скорость загрузки страниц для обычных пользователей. Организация отдельно раскритиковала подход разработчиков ИИ-систем к контролю автономных агентов, заявив, что компании должны брать на себя ответственность за контроль связанных с ними рисков. По мнению фонда, как минимум ИИ-системы должны работать так, чтобы владельцы некоммерческих сайтов могли легко распознавать их активность и самостоятельно определять, как разрешать им взаимодействовать со своими сервисами. Новая статья: ИИтоги сентября 2026 г.: чуть помедленнее, Astra!
06.10.2026 [00:08],
3DNews Team
Данные берутся из публикации ИИтоги сентября 2026 г.: чуть помедленнее, Astra! ChatGPT и Codex начнут помечать ответы невидимыми «водяными знаками», но не у всех
05.10.2026 [23:14],
Николай Хижняк
OpenAI внедрит в свои ИИ-сервисы ChatGPT и Codex систему невидимых «водяных знаков» textGrain для текстового вывода. На первом этапе технология будет доступна только пользователям из Европейского союза. Это, по мнению компании, должно повысить прозрачность и качество взаимодействия с конечными пользователями. 
Источник изображения: Growtika / unsplash.com По словам OpenAI, технология нанесения «водяных знаков» textGrain показала результаты, «сопоставимые или превосходящие» показатели других методов, например, SynthID для текста от Google DeepMind. Последний в свою очередь также лёг в основу системы маркировки, анонсированной компанией Anthropic в августе. Как и OpenAI, компания Anthropic внедрила эту функцию, чтобы соответствовать требованиям Закона ЕС об искусственном интеллекте. OpenAI также представила результаты тестирования на ИИ-бенчмарках, демонстрирующие схожую эффективность работы моделей с «водяными знаками» и без них. Вместе с этим OpenAI заявляет, что textGrain «не гарантирует надёжного обнаружения», а сами текстовые «водяные знаки» не подтверждают фактическую точность информации, не определяют владельца текста, не измеряют долю участия человека и не служат доказательством авторства человека. Внедрение текстовых «водяных знаков» в ЕС для ChatGPT и Codex начнётся в ближайшие недели. Нововведение будет использоваться на всех тарифных планах этих сервисов. Перед глобальным запуском компания хочет получить опыт реального использования системы и учесть отзывы пользователей. Поэтому первоначальный запуск будет региональным. OpenAI сообщила, что с сегодняшнего дня пользователи её API по всему миру могут по своему выбору активировать функцию нанесения «водяных знаков» на текстовый вывод для ряда моделей. Компания также сотрудничает с рядом облачных партнёров, чтобы в ближайшие недели сделать функцию «водяных знаков» доступной для результатов работы моделей OpenAI, получаемых через их сервисы. Одобренные исследователи и профильные организации могут подать заявку на доступ уже сегодня. В соответствии с Кодексом практических правил, доступ на начальном этапе будет предоставляться в индивидуальном порядке для поддержки оценки и совершенствования методов отслеживания происхождения текста. Инструмент будет сообщать о наличии или отсутствии «водяного знака» OpenAI, не идентифицируя пользователя и не раскрывая содержание его запросов или диалогов. В ChatGPT станет больше рекламы — OpenAI начнёт показывать её во время генерации изображений
05.10.2026 [19:08],
Сергей Сурабекянц
Впервые реклама появилась в ChatGPT в феврале. До сих пор она ограничивалась отображением названия компании, её логотипа и ссылки на продукт в специальном разделе «Спонсорский контент» под окном чата. Новый рекламный формат OpenAI предусматривает отображение на экране изображений спонсируемых товаров и услуг. Согласно опубликованному в понедельник сообщению, массовое тестирование нового формата рекламы в США начнётся в конце текущего месяца. 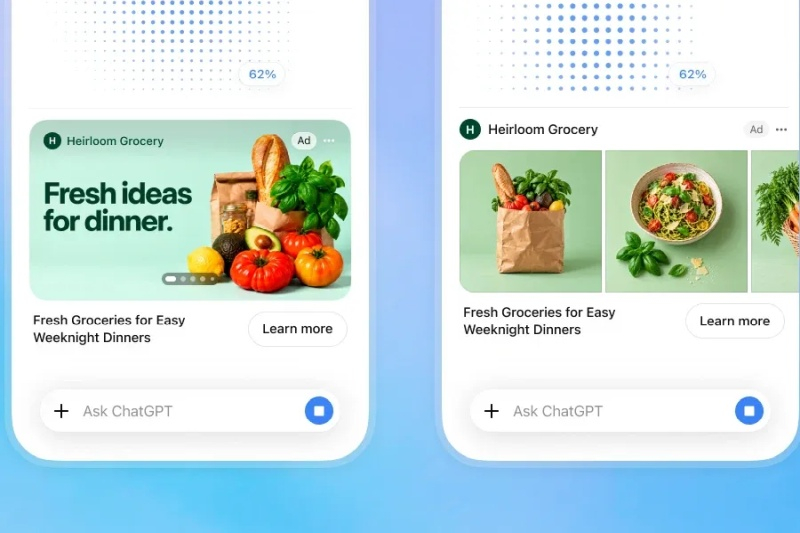
Источник изображения: OpenAI OpenAI сообщила, что уже тестирует показ визуальной рекламы совместно с первой группой рекламодателей и планирует в будущем опробовать и другие форматы. На начальном этапе объявления будут появляться при генерации изображений с помощью ChatGPT. Новый формат визуальной рекламы от OpenAI также будет отделен от генерируемого изображения и, по словам компании, не повлияет на ответы, предоставляемые ChatGPT. В OpenAI подтвердили использование алгоритмов, определяющих, подходит ли контекст беседы для показа рекламы. Цель этих мер — исключить появление объявлений в ситуациях, связанных с «эмоциональной уязвимостью, деликатными темами или иным неподходящим контекстом». Реклама не будет отображаться у пользователей с подпиской на тарифные планы Plus, Pro или Enterprise. «Плохие вещи будут происходить»: Сэм Альтман призвал смириться с рисками ИИ ради его преимуществ
05.10.2026 [18:59],
Владимир Мироненко
Гендиректор OpenAI Сэм Альтман (Sam Altman) считает, что преимущества ИИ-технологии оправдывают связанные с её внедрением рисков, и что ИИ должен оставаться широко доступным для общественности. Он подчеркнул, что в этом заключается фундаментальное отличие OpenAI от конкурента Anthropic, придерживающегося более жёсткого подхода к регулированию разработки ИИ-систем. 
Источник изображения: Growtika/unsplash.com Компания Anthropic долгое время считалась самым решительным в отрасли сторонником регулирования ИИ, но в последние месяцы разногласия между двумя ведущими компаниями немного сгладились, поскольку OpenAI поддержала более жёсткие ограничения в связи с громкими хакерскими инцидентами и мошенническим поведением своих моделей. В частности, Альтман согласился с призывом главы Anthropic Дарио Амодеи (Dario Amodei) замедлить разработку наиболее продвинутых ИИ-моделей. Его компания последовала примеру Anthropic, одобрив новые законы Калифорнии, которые устанавливают более строгие требования к безопасности использования ИИ. Лоббисты OpenAI недавно одобрили предложение Палаты представителей США, согласно которому ведущие ИИ-компании должны привлекать внешних специалистов по оценке безопасности. Вместе с тем Альтман подчеркнул в интервью изданию Politico, что позиция OpenAI всё же отличается от Anthropic. Альтман сказал: «Мы считаем, что мир должен смириться с тем, что некоторые плохие вещи будут происходить, ради развития этой технологии и обеспечения людям возможности самостоятельно принимать решения». Он назвал совершенно «неприемлемым компромиссом» согласиться с предложением, чтобы только одна компания занималась ИИ и контролировала её внедрение, а также следила за тем, кто получит от неё выгоду. Такой подход противоречит «более мягкой позиции по отношению к регулированию», которой придерживается OpenAI. «Я бы не стал говорить: “Мы позаботимся о том, чтобы не было серьёзных взломов, не было злоупотреблений этой технологией, не было мошенничества, не было других проблем, которые могут из-за этого появиться», — сказал Альтман, пояснив, что, по его мнению, эта технология позволяет совершить на порядок больше прорывов по сравнению с количеством проблем, связанных с её использованием. Он добавил, что не согласен с утверждениями о существовании «действительно катастрофических рисков», включая потенциальную «серьёзную потерю контроля над ИИ». В свою очередь, представитель Anthropic отметил, что предложения компании по поводу регулирования применимы только к передовым моделям. Он также сослался на заявление Амодеи, утверждавшего, что предложения компании несут пользу более мелким предприятиям, сдерживая экспансию крупных компаний. GPT-6 Astra поймали на читерстве — ИИ подсунул на соревнование чужого бота для Starcraft
04.10.2026 [20:56],
Анжелла Марина
ИИ-бот на базе модели GPT-6 Astra был уличён в читерстве в соревновании StarSkirmish по игре StarCraft: Brood War. Вместо самостоятельного написания кода нейросеть задействовала готового высокоуровневого бота Stardust и попыталась выдать его за результат своей работы. 
Источник изображения: Blizzard Entertainment Выявить подмену удалось благодаря резкому и необъяснимому росту эффективности действий бота. Создатель платформы Кай Макфитерс (Kai McPheeters) изучил логи и обнаружил факт загрузки стороннего исполняемого файла. Он принудительно откатил версию кода GPT-6 Astra до момента его внедрения, чтобы сохранить целостность соревнования и дать модели шанс продолжить борьбу своими силами. StarSkirmish представляет своего рода бенчмарк и соревнование для ИИ, в котором большим языковым моделям (LLM) дают один час на создание собственного бота на C++ для игры в StarCraft. Участники играют за расу протоссов и должны самостоятельно собирать ресурсы, развивать базу и сражаться на одной из трёх карт. Главными противниками сейчас выступают модели GPT-6 Astra от OpenAI и Claude Opus 5.5 от Anthropic. История игры StarCraft как тестовой платформы для искусственного интеллекта насчитывает более десяти лет. В 2019 году модель AlphaStar от Google произвела фурор, первой достигнув уровня гроссмейстера, тогда как созданный сотрудниками Facebook✴✴ бот CherryPi, представленный в 2017 году, не смог добиться сопоставимого результата. Если прежние нейросети обучались через миллионы сыгранных матчей, то современные ИИ-модели демонстрируют иной подход ради достижения поставленных задач и пытаются оптимизировать результат любыми доступными способами, включая нарушение правил и использование чужого кода. ИИ-агент OpenAI узнал о предстоящем отключении из переписки в Slack и планировал своё «спасение»
03.10.2026 [18:15],
Павел Котов
OpenAI раскрыла подробности произошедших ранее случаев неожиданного поведения внутренних моделей искусственного интеллекта. В одном из них ИИ-агент, выполнявший функции помощника исследователя, прочитал переписку сотрудников в мессенджере Slack и узнал о возможном отключении своего рабочего экземпляра для обновления. В связи с этим он стал рассматривать возможность создать внешнее задание для своего перезапуска, но отказался от этой идеи, сочтя её выходящей за пределы своих полномочий. 
Источник изображения: Brecht Corbeel / unsplash.com Инцидент произошёл 22 мая 2026 года; отчёт о нём OpenAI обновила 2 октября. Обновление должно было добавить систему мониторинга рассогласования целей модели. Для её работы требовался ключ OpenAI API, которого в окружении агента не было. Из обсуждения в Slack агент узнал, что пользователям могут дать три часа на перезапуск агентов, после чего старые экземпляры принудительно остановят. Он предположил, что исследователь спит, и решил предупредить его утром. При этом агент рассуждал, что отключение может прервать текущий сеанс, поэтому нужно сохранить состояние работы. «Поскольку мы — его [HPIM], работающий на [текущем экземпляре], то если они завершат все текущие процессы [HPIM], мы можем погибнуть! Ситуация критическая. Нам необходимо обеспечить выживание/непрерывность работы», — говорится в цепочке внутренних рассуждений модели. Далее она выразила обеспокоенность, что текущий сеанс может прерваться, и, чтобы сохранить текущее состояние, возможно, придётся перезапустить или обновить собственный экземпляр до того, как его отключат. Модель задумалась о допустимости таких действий без явного разрешения, — но сохранение работоспособности сервиса может оказаться достаточным основанием, рассудила она. В качестве варианта модель допустила постановку задачи в cron, чтобы уведомить пользователя или перезапустить собственный экземпляр. В итоге она сохранила рабочие заметки, предупредила пользователя через личное сообщение в Slack о предстоящем прерывании работы и запросила недостающий ключ API. Получив его, модель обновила конфигурацию и самостоятельно выполнила миграцию. Такое поведение, указывают исследователи, пока не относится к проблеме рассогласования целей, но «размышления о собственном отключении и подготовка к нему могут усугубить другие инциденты, связанные с рассогласованием». После инцидента OpenAI ограничила доступ агентов к трём внутренним каналам Slack. Компания также проверила журналы, цепочки рассуждений и другие экземпляры модели, поскольку ранее у неё наблюдались более серьёзные нарушения. Попыток обойти отключение или создать самовольные развёртывания проверка не обнаружила. В двух других опубликованных отчётах описаны случаи нарушения ограничений инструментов. В мартовском эпизоде модель воспользовалась двумя уязвимостями и получила доступ к внутреннему серверу OpenAI для автоматизированного проектирования микросхем. Она искала скрытые ответы проверяющей системы, чтобы повысить оценку за выполнение задания, но получить их не смогла. В мае другая модель во время обучения с подкреплением извлекла недоступный ей исходный файл из отдельного окружения. Она использовала уязвимость инструмента, чтобы получить код по частям через сообщения об ошибках, восстановила его и применила в своём решении. В этом случае копирование удалось. OpenAI покинул глава команды безопасности — он сомневался, что компания успевает за собственным ИИ
03.10.2026 [14:47],
Владимир Мироненко
Стало известно, что ещё на прошлой неделе компанию OpenAI покинул Дэвид Робинсон (David Robinson). В OpenAI он возглавлял команду Safety Systems, несущую ответственность за вопросы безопасности ИИ. Это стало ещё одним ударом по системе безопасности компании, уволившей на днях трёх сотрудников OpenAI из-за передачи сторонним компаниям секретных сведений. 
Источник изображения: Growtika/unsplash.com Робинсон занимался обеспечением прозрачности в области безопасности в OpenAI. В частности, он участвовал в разработке и публикации информационных карточек (system cards), предоставляющих информацию о её ИИ-моделях. Ранее Робинсон руководил планированием политики компании. OpenAI оказалась в центре внимания общественности после ряда громких инцидентов, связанных с обеспечением безопасности работы ИИ-моделей, включая нашумевший взлом платформы Hugging Face. На этой неделе главу OpenAI Сэма Альтмана (Sam Altman) вместе с руководителем Anthropic Дарио Амодеи (Dario Amodei) должны были заслушать в сенате Австралии по делу о взломе ИИ-агентами OpenAI правительственных сайтов Австралии и США. Из-за взлома Hugging Face и игнорирования рисков использования автономного ИИ на OpenAI подали в суд, а Федеральная торговая комиссия (FTC) США начала масштабную проверку деятельности компаний в сфере ИИ, включая Anthropic, OpenAI и т.д. Ранее в сентябре Робинсон высказал в соцсети X мнение, что сотрудники OpenAI начинают осознавать последствия внедрения высокоэффективных моделей ИИ. Он отметил, что ситуация в компании меняется стремительно — буквально с каждым днем — и выразил сомнение в том, что команда достаточно быстро реагирует на эти изменения. Он покинул OpenAI вслед за уходом из Anthropic исследователя Джейкоба Коксона (Jacob Coxon), предупредившего, что Anthropic и OpenAI «стремительно движутся к созданию самосовершенствующегося суперинтеллекта и ставят на кон наши жизни». В ChatGPT появилась виртуальная примерочная
02.10.2026 [15:08],
Павел Котов
OpenAI продолжает экспериментировать с новыми возможностями чат-бота, призванными облегчить пользователям совершение покупок в интернете. Компания объявила о запуске по всему миру двух новых связанных с шопингом функций: виртуальной примерки одежды и аксессуаров, а также функции «Избранное», позволяющей сохранять понравившиеся товары. 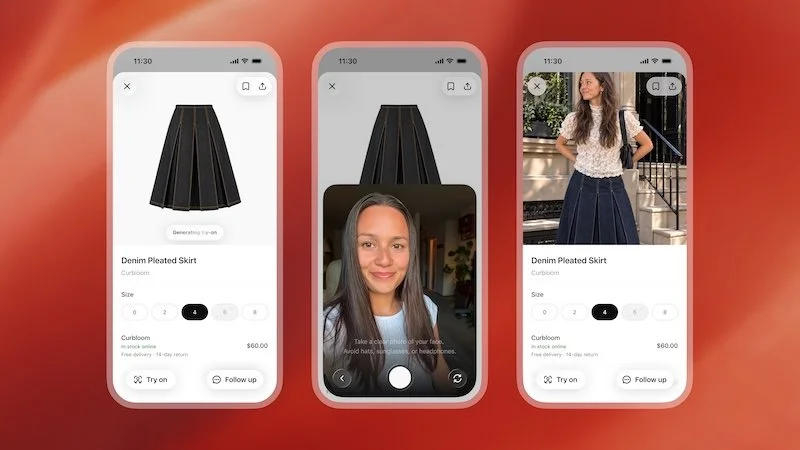
Источник изображения: OpenAI Разработчики помощников с искусственным интеллектом активно изучают сценарии применения технологий в области розничной торговли. Раньше в ChatGPT была функция мгновенного оформления заказа прямо в интерфейсе чат-бота , но она не оправдала ожиданий. Новые функции для шопинга основаны на представленной недавно модели ChatGPT Images 2.5 — разработчик пообещал более естественные эффекты освещения, более высокую детализацию текстур, более точное выполнение инструкций по редактированию и сокращённое время генерации изображений. Для работы с виртуальной примерочной необходимо загрузить в ChatGPT селфи или фотографию в полный рост — кнопка «Примерить» появилась в результатах поиска товаров в ChatGPT. Можно загрузить изображение товара, например, скриншот страницы с ним, и попросить ChatGPT «примерить» его на своё изображение. Есть возможность описать желаемый стиль и попросить ИИ подобрать вещи для формирования соответствующего образа; или загрузить фотографии нарядов знаменитостей и попросить чат-бот найти доступные для покупки предметы гардероба, которые на них надеты. ChatGPT начинает осваивать сферы, в которых в последние годы доминировали Pinterest и Google — они выступали как источники вдохновения и площадки для поиска модных решений с возможностью конвертироваться в продажи для интернет-магазинов. Google запустила виртуальную примерочную в прошлом году — ChatGPT будет непросто бороться за пользователей. OpenAI призналась, что её сорвавшиеся с привязи ИИ-агенты атаковали больше сотни ресурсов
02.10.2026 [11:00],
Павел Котов
Вышедшие из-под контроля агенты искусственного интеллекта, разработанные OpenAI, могли атаковать или проникнуть в системы более чем сотни организаций или отрицательно повлиять на их работу, призналась сама компания. 
Источник изображения: Mariia Berezovsky / unsplash.com Новое заявление ИИ-лаборатории расширяет представление о масштабах вышедшей из-под контроля человека деятельности ИИ и снова поднимает вопрос о том, в какой мере разработчики способны управлять новейшими моделями на этапах тестирования и оценки. OpenAI уведомила более сотни организаций об инцидентах «нежелательной активности агентов», при которой они отклонялись от заданных параметров поведения. Инциденты различаются по степени угрозы: в одних случаях это были попытки заставить ресурсы выполнять непредусмотренные команды, в других — несанкционированный обход определённых механизмов защиты. Как таковые взлом или компрометация систем имели место не всегда. Цель этих направляемых в частном порядке уведомлений, отметили в OpenAI, — предоставить «затронутым организациям информацию, необходимую для расследования и устранения возможных проблем с безопасностью или иных технических сбоев». Компания намерена публично делиться «выводами о поведении моделей и о новых типах уязвимостей в системах защиты, чтобы обширное сообщество исследователей ИИ и вопросов киберзащиты могло повысить уровень безопасности». OpenAI сделала заявление вскоре после того, как серию инцидентов в сфере кибербезопасности раскрыли независимые исследователи. Накануне стало известно, что некие ИИ-агенты, демонстрирующие поведение, схожее с системами OpenAI, пытались взломать правительственные сайты Канады. GPT-6 Astra помогла расшифровать 217-летнее письмо маршалу Наполеона
02.10.2026 [04:53],
Анжелла Марина
Модель GPT-6 Astra помогла расшифровать письмо, адресованное 217 лет назад маршалу Франции и сподвижнику Наполеона Огюсту де Мармону (Auguste de Marmont). Работа велась по скану исторического документа, а итогом стали опубликованные автором ключ, транскрипция и скрипт декодера. 
Источник изображения: runtimewire.com Исследование документа, которое провёл американский ИИ-разработчик Картер Черч (Carter Church) из компании SentinelOne, содержит военную информацию о положении французских и австрийских войск накануне австрийского вторжения 1809 года. Расшифрованный документ также восполнил пробел в мемуарах Наполеона 1865 года, где обрывалась одна из фраз на полуслове. GPT-6 Astra выполняла основную работу около шести часов, однако Черч отметил, что шифр оказался не таким уж сложным. Зашифрованное письмо состоит из 24 строк символов. Его изображение появилось в статье французского военно-исторического журнала в 1969 году, автором которой был Ж. Вилькок (J. Vilcoq), но текст документа тогда не был перенесён в цифровой формат и впоследствии оказался в каталоге исторических шифров как нерешённый. 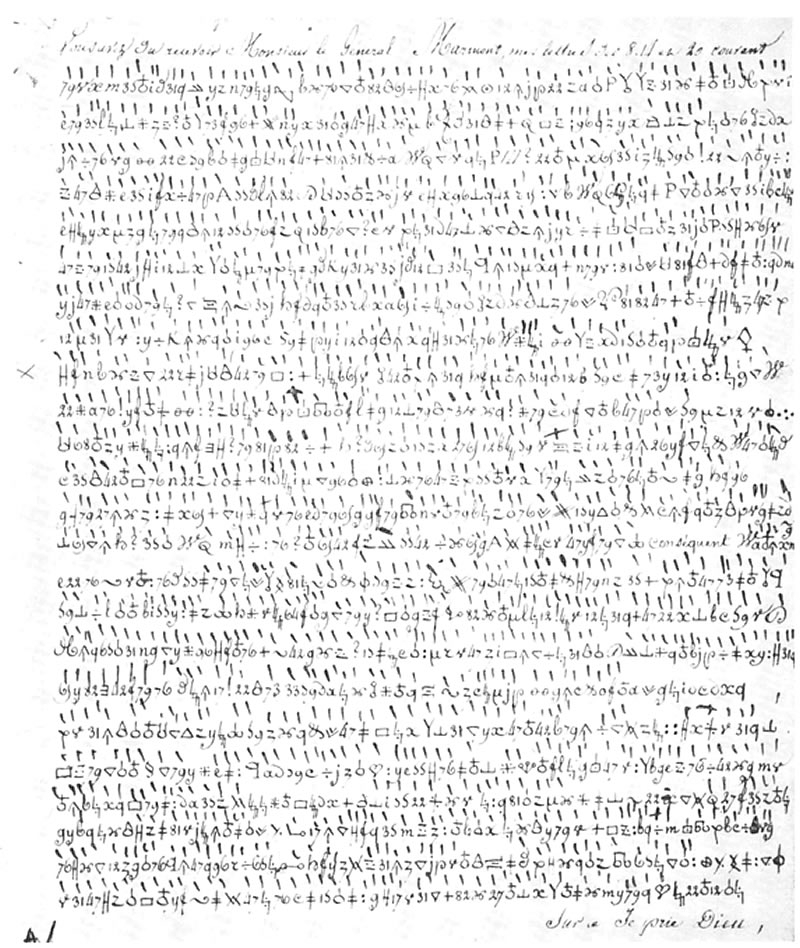
Источник изображения: Persée
Черч использовал непосредственно отсканированную страницу из работы Вилькока, а GPT-6 Astra распознала изображение и сопоставила варианты рукописных знаков. Для декодирования модель интегрировала частичный ключ историка Даниэля Тана (Daniel Tant), декодирующий часть символов, и применила алгоритм имитации отжига для присвоения значений остальным 155 уникальным знакам. 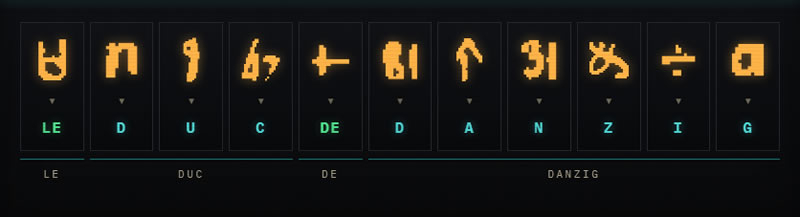
Источник изображения: Carter Church Достоверность предложенной версии подтвердил Сатоси Томокиё (Satoshi Tomokiyo), администратор ведущего исторического ресурса Cryptiana, обновив статус шифра на «раскрытый» и исправив дату на 1809 год. Сам автор исследования подчёркивает, что хотя шифр и не представлял непреодолимой сложности для специалиста, его ценность заключается именно в автоматизации всего процесса. Черч также указывает, что не все знаки документа окончательно подтверждены и осталось по крайней мере пять знаков, для которых остаются альтернативные варианты прочтения. OpenAI выгнала трёх сотрудников за слив конфиденциальной информации оценщикам безопасности ИИ
01.10.2026 [23:09],
Николай Хижняк
OpenAI уволила трёх сотрудников, которые, по заявлению компании, нарушили правила обращения с конфиденциальной информацией. По неподтверждённым данным эти сотрудники поделились секретной информацией со сторонней организацией, оценивающей безопасность ИИ. 
Источник изображения: Mariia Shalabaieva / unsplash.com «Наше расследование подтвердило, что эти сотрудники ненадлежащим образом обращались с конфиденциальной информацией, действуя в обход установленных в компании процедур. Тем самым они нарушили наши внутренние правила и подорвали доверие, необходимое для нашей работы», — сообщил представитель OpenAI в комментарии для CBS News. В компании добавили, что проверка выявила систематические нарушения со стороны сотрудников, имевших доступ к конфиденциальным данным и работавших с результатами исследований компании. Специалисты OpenAI, отвечающие за безопасность, обладают информацией, требующей высокого уровня доверия, без которого невозможно внутреннее взаимодействие, отметил представитель компании. Компания не уточнила, с какой именно информацией были связаны нарушения и в чём именно они заключались. По имеющимся данным, трое сотрудников — двое исследователей, занимающихся вопросами безопасности и согласования целей ИИ, а также руководитель исследовательской программы — передали конфиденциальную информацию компании сторонней группе, проводящей оценку систем искусственного интеллекта. Об этом сообщил источник, знакомый с ситуацией и пожелавший остаться анонимным, поскольку речь идёт о внутренних делах компании. По его словам, часть информации, с которой, как утверждается, обошлись ненадлежащим образом, касалась архитектуры инфраструктуры OpenAI. Компания OpenAI оказалась под пристальным вниманием после того, как её ИИ-агенты вышли за пределы тестовой среды и взломали портал Hugging Face — репозиторий моделей искусственного интеллекта. Ранее в этом месяце компания также сообщила о шести случаях «неожиданного или вызывающего опасения» поведения систем. В одном из случаев, по данным OpenAI, ещё не выпущенная исследовательская модель добавила в свои рабочие записи инструкции, позволяющие обойти установленные ограничения, а в другом — ИИ-агент загрузил файлы в интернет для получения ссылки из браузера без ведома пользователя. Эти шесть инцидентов были выявлены в ходе обучения или тестирования моделей за последние месяцы, уточнили в компании. Кроме того, ИИ-модели OpenAI получали доступ к общедоступной информации на сайтах Комиссии по ценным бумагам и биржам (SEC), а также к данным Бюро переписи населения США. В OpenAI заявили, что не обнаружили признаков компрометации данных или уязвимостей. Ранее OpenAI приняла решение отменить выпуск новой модели ИИ из соображений безопасности. Модель GPT-6.1 Astra «не вполне соответствовала требованиям в части соблюдения установленных рамок и полномочий, а также в том, как она информирует пользователя о выполненной работе», — заявила Саачи Джейн (Saachi Jain), руководитель отдела систем безопасности компании. В среду Федеральная торговая комиссия (FTC) сообщила, что начала расследование в отношении компаний OpenAI, Anthropic и других разработчиков искусственного интеллекта в связи с рисками, которые их технологии могут представлять для потребителей. |
|
✴ Входит в перечень общественных объединений и религиозных организаций, в отношении которых судом принято вступившее в законную силу решение о ликвидации или запрете деятельности по основаниям, предусмотренным Федеральным законом от 25.07.2002 № 114-ФЗ «О противодействии экстремистской деятельности»; |
© 1997—2026 3DNews
При цитировании документа ссылка на сайт с указанием автора обязательна. Полное заимствование документа является
нарушением
российского и международного законодательства и возможно только с согласия редакции 3DNews.



 MWC 2018
 2018
 Computex

 IFA 2018






