


Опрос
|
реклама
Быстрый переход
Kepler Computing придумала, как побороть дефицит памяти без новых фабрик — но быстро вряд ли получится
09.09.2026 [18:51],
Павел Котов
Новый подход к проектированию чипов и запатентованный материал помогут устранить узкие места в цепочках поставок, спровоцировавшие рост цен на память, утверждает молодая компания Kepler Computing. Но только в том случае, если эту технологию удастся внедрить в массовое производство, пишет Wired. 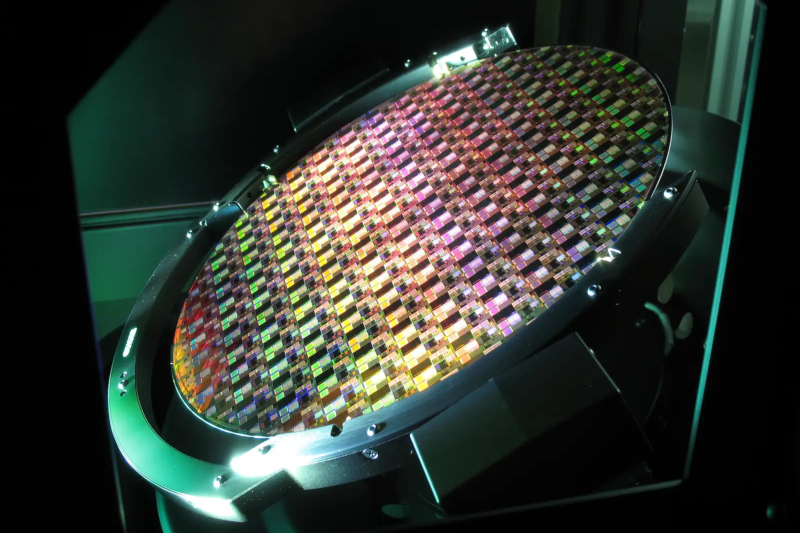
Источник изображений: keplercompute.com Инженеры основанного в 2018 году американского стартапа Kepler Computing заявили о разработке новой архитектуры высокоскоростной памяти HBM. Производители чипов обычно используют дорогую EUV-литографию, позволяющую уменьшать размеры транзисторов и размещать больше компонентов на той же площади; Kepler же утверждают, что их метод 3D-компоновки и новый запатентованный материал помогают увеличить плотность и без EUV, причём эту технологию можно развернуть на существующих полупроводниковых предприятиях. Аналогичных успехов удалось добиться и в сфере высокоскоростной кеш-памяти (SRAM), которая используется в центральных, графических и специализированных процессорах. За последние несколько лет Kepler привлекла $468 млн от крупных инвесторов, включая GlobalFoundries, Intel Capital, AMD Ventures; и даже минторг США согласился выделить ей до $245 млн на «разработку в США нового класса высокопроизводительной памяти для систем искусственного интеллекта на основе инновационных 3D и сегнетоэлектрических технологий». Испытания проходят преимущественно в Сингапуре, где расположено предприятие компании GlobalFoundries — производственного партнёра и инвестора, вложившего в проект $50 млн. Kepler за два года построила «мини-заводы», где производит свои чипы памяти совместно с GlobalFoundries, используя её 28-нм технологию; испытания также проводились на мощностях GlobalFoundries в американском Вермонте. Отказавшись от EUV-литографии, Kepler пытается обойти одно из главных узких мест в полупроводниковой отрасли — компания заявляет, что способна выпускать SRAM с плотностью элементов, сопоставимой с показателями техпроцессов 2 и 3 нм без инвестиций в дорогое оборудование. Идея стартапа в том, что рынку высокопроизводительных вычислений не обязательно ждать, когда построят новые заводы по производству памяти, чтобы удовлетворить растущий спрос. Увеличить объёмы поставок можно за счёт внедрения новых методов производства памяти на уже существующих мощностях. Kepler заявила о разработке инновационной технологии 3D-производства, позволяющей размещать больше чипов памяти на той же площади — благодаря этому вычислительный блок можно размещать ближе к памяти и снизить энергозатраты на передачу данных между ними. Компания стремится обеспечить передачу данных HBM с энергозатратами, сравнимыми со SRAM, но при сохранении объёмов HBM.  Kepler, по её утверждению, смогла повысить плотность размещения ячеек SRAM за счёт использования сегнетоэлектриков, позволяющих считывать и записывать данные при более низком напряжении по сравнению с механизмами, которые традиционно применяются в полупроводниковых компонентах для обработки и хранения информации — для этого компания разработала новый композитный материал. Инженеры перебрали 35 вариантов композитов, прежде чем остановились на классе материалов, которые могут упростить и удешевить производство чипов памяти. В ходе первых совместных проектов с GlobalFoundries представители стартапа переоборудовали предприятие по производству полупроводников за восемь месяцев — обычно на это уходят до двух лет. Kepler рассчитывает, что дополнительные расходы на новые материалы и переоснащение существующих фабрик будут значительно ниже $20–40 млрд, необходимых для строительства новых предприятий и их оснащение оборудованием на сотни миллионов долларов. Но до выхода на крупномасштабное производство ещё пройдёт некоторое время, если это вообще случится. Пока технологию удалось опробовать лишь на 2000 пластин. Первые образцы чипов HBM появятся в этом году, нарастить объёмы производства в Сингапуре планируется в следующем, и только в 2028 году, возможно, будет налажен выпуск в США. В GlobalFoundries в отношении проекта настроены оптимистично: «Фундаментальные прорывы уже совершены. Теперь осталось лишь добиться стабильно высоких результатов при обработке тысяч пластин и производстве миллионов компонентов». Некоторые аспекты, однако, представляются проблемными, например, наличие железа в составе композита. По словам представителя GlobalFoundries, железо — сложный загрязнитель для производственной линии: технологию придётся запускать на специализированном оборудовании либо полностью изолировать материал, чтобы он не мог попасть наружу. Поэтому главным испытанием технологии станет возможность адаптировать её для массового выпуска. Дженсен Хуанг объяснил на CES 2026, почему SRAM не вытеснит дорогую HBM в ИИ-ускорителях
08.01.2026 [06:52],
Анжелла Марина
Глава Nvidia Дженсен Хуанг (Jensen Huang) объяснил, почему SRAM не заменит высокоскоростную память HBM в системах искусственного интеллекта. Выступая на сессии вопросов и ответов в рамках CES 2026 в Лас-Вегасе (США), он ответил на предположение о возможном отказе компании от дорогостоящей HBM в пользу более дешёвой компонентной базы. 
Источник изображения: Tom's Hardware Как пишет Tom's Hardware, Хуанг изложил видение, согласно которому ключевым требованием для аппаратного обеспечения ИИ является не узкая специализация, а гибкость, которую как раз и обеспечивает память HBM. Главный его аргумент строится вокруг нестабильной и постоянно меняющейся природы рабочих нагрузок ИИ. Модели быстро эволюционируют, внедряются новые архитектуры и модальности, что делает оптимизацию оборудования под одну конкретную задачу малоэффективной в долгосрочной перспективе. Хотя Хуанг признал, что решения с упором на SRAM могут показывать невероятную скорость в определенных сценариях и избегать задержек, присущих внешней памяти, они сталкиваются с жёсткими ограничениями по ёмкости при масштабировании. В контролируемых тестах такие ускорители выглядят привлекательно, но в реальном применении они не могут обеспечить тот баланс пропускной способности и плотности, который даёт HBM. Глава Nvidia также затронул тему открытых ИИ-моделей, чьё распространение, как предполагается, может снизить зависимость от дорогих GPU. Он признал их ценность, но подчеркнул, что открытость архитектуры не отменяет инфраструктурных ограничений. Обучение и обслуживание современных моделей, независимо от лицензии, по-прежнему требуют огромных вычислительных ресурсов и больших объёмов памяти. Более того, развитие открытых моделей с увеличением контекстных окон и добавлением мультимодальности лишь усиливает потребность в высокопроизводительной и гибкой памяти, такой как HBM. Таким образом, позиция Nvidia заключается в том, что разнообразие и постоянная изменчивость рабочих нагрузок ИИ делают универсальность и адаптивность ключевыми экономическими факторами. Специализированные ускорители, ориентированные на конкретные задачи, могут демонстрировать впечатляющие результаты в тестах, но в условиях быстро меняющегося ландшафта ИИ они рискуют устареть. Компания готова мириться с высокой стоимостью HBM и сложностью систем, поскольку это позволяет сохранить возможность адаптации к новым архитектурам моделей и сценариям развёртывания. По мнению Дженсена Хуанга, момент, когда модели стабилизируются настолько, чтобы сделать специализированные решения более выгодными, чем гибкие платформы, ещё не наступил. TSMC застопорилась при масштабировании памяти SRAM — переход на 2-нм техпроцесс не даст улучшений
08.12.2025 [10:13],
Алексей Разин
Так называемый «закон Мура», который предписывает удвоение плотности размещения транзисторов на полупроводниковых кристаллах каждые полтора или два года, обеспечивает прогресс далеко не во всех сферах. В частности, улучшить масштабирование при производстве ячеек памяти типа SRAM новый 2-нм техпроцесс не поможет. 
Источник изображения: TSMC Об этом со ссылкой на полученные от TSMC данные сообщил ресурс ComputerBase.de. Проблема замедления масштабирования геометрии полупроводниковых элементов давно известна в отрасли, и на передовой 2-нм техпроцесс возлагались определённые надежды, но TSMC дала понять, что в случае с SRAM на улучшение рассчитывать не придётся. По крайней мере, здесь всё осталось на одном уровне с техпроцессами N3 и N5. В рамках 3-нм и 5-нм техпроцессов площадь одной ячейки памяти SRAM составляла идентичные 0,021 квадратных микрометра. Для сравнения, более зрелый техпроцесс N7 обеспечивал площадь одной ячейки на уровне 0,026 квадратных микрометра. Ячейки SRAM остаются важным строительным элементом современных чипов. Они используются для формирования кеш-памяти различных уровней, и порой занимают существенную часть площади кристалла. Чем плотнее их можно размещать, тем лучше для производительности чипа. С учётом слабого прогресса в масштабировании SRAM, в также появлением новых крупных функциональных блоков, нередко связанных с ИИ, тенденция к увеличению площади современных процессоров никуда не денется, как резюмируют источники. Если говорить о техпроцессе N3P в исполнении TSMC, который будет использоваться и для производства ускорителей Nvidia Vera Rubin, то его освоение идёт не так гладко, как рассчитывала компания. Имеются проблемы с уровнем брака, поэтому N3P наверняка перейдёт на новую ревизию, прежде чем с его использованием можно будет массово выпускать чипы. Впрочем, и при освоении N3 первого поколения TSMC потратила почти год на устранение всех дефектов, и это не особо ей навредило в условиях почти полного отсутствия конкурентов в сегменте. Крупные чипы со сложной структурой обычно мигрируют на передовые техпроцессы с некоторой задержкой относительно более простой продукции, поэтому некоторые заказчики в таких условиях предпочтут подождать. |
© 1997—2026 3DNews
При цитировании документа ссылка на сайт с указанием автора обязательна. Полное заимствование документа является
нарушением
российского и международного законодательства и возможно только с согласия редакции 3DNews.



 MWC 2018
 2018
 Computex

 IFA 2018







