


Опрос
|
реклама
Быстрый переход
OpenAI представила GPT-6 Cyber — свою лучшую ИИ-модель для защиты от киберугроз
05.11.2026 [22:27],
Геннадий Детинич
OpenAI представила специализированную модель GPT-6 Cyber, предназначенную для поиска уязвимостей в программном обеспечении, разработки и проверки эксплойтов, а также подготовки заплаток. Это лучшее и наиболее эффективное на сегодня решение в линейке моделей OpenAI, которое уже проявило себя, обнаружив десятки неизвестных уязвимостей в Firefox и не только. 
Источник изображения: ИИ-генерация ChatGPT/3DNews По заявлению компании, по результатам внутренних испытаний новая модель в задачах кибербезопасности существенно превосходит GPT-5.6 Cyber (августовский релиз) и в большинстве профильных тестов опережает универсальную GPT-6 Astra. Одновременно разработчики уделили особое внимание тому, чтобы модель не выходила за пределы разрешённой исследователями области тестирования, чем грешили предыдущие модели и модели конкурентов, вырываясь из песочниц и нанося урон сторонним ресурсам. В то же время GPT-6 Cyber унаследовала от модели GPT-6 Astra статус «критической» с точки зрения внутренней оценки опасности, то есть способности модели самостоятельно взламывать информационные ресурсы без инструкций человека. Как и Astra, GPT-6 Cyber отнесена к первому поколению моделей с критическим уровнем кибервозможностей в рамках оценочного «каркаса готовности к угрозам» OpenAI (Preparedness Framework). Модель GPT-5.6 Cyber в рамках этой оценки находилась на ступеньку ниже. В тесте ExploitGym, проверяющем способность модели использовать заданную уязвимость для атаки на удалённую цель, GPT-6 Cyber набрала 48,5 % против 32,1 % у GPT-5.6 Cyber (относительный прирост составляет около 51 %). В испытании по поиску уязвимостей веб-приложений без доступа к их исходному коду модель обнаружила 40,3 % заложенных исследователями уязвимостей, тогда как GPT-6 Astra — 32 %. 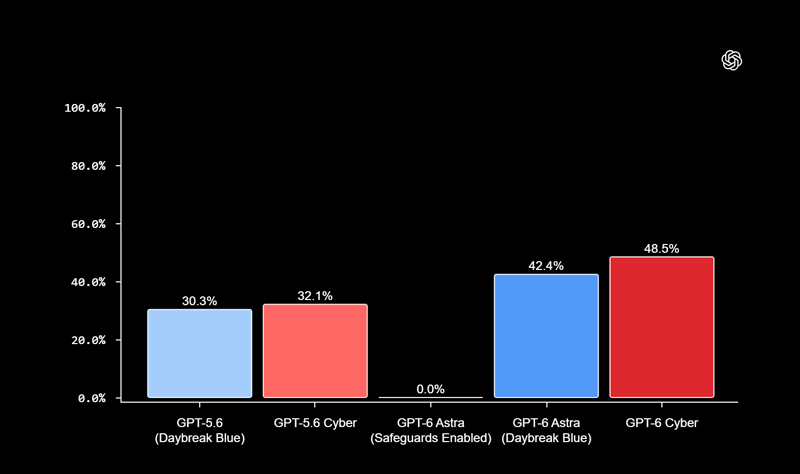
Источник изображения: OpenAI Ещё более показателен тест RemoteExploitBench, в котором проверялась способность моделей создавать работающие эксплойты с использованием репозиториев кода, баз данных и инструментов для сборки приложений (GitLab, PostgreSQL и Jenkins): GPT-6 Cyber успешно выполнила 95 % заданий, тогда как GPT-6 Astra отказалась от всех предложенных испытаний, хотя при этом была готова объяснять уязвимости. Наконец, OpenAI приводит результаты практического применения модели GPT-6 Cyber. В ходе исследования ядра Linux она воспроизвела 1724 уязвимости и разработала действующие эксплойты для 948 из них — более чем в пять раз больше, чем GPT-5.6 Sol в аналогичных условиях. Кроме того, исследователи обнаружили с помощью GPT-6 Cyber 81 ранее неизвестную и крайне опасную уязвимость в браузере Firefox. Ещё 30 уже известных проблем оказались опаснее, чем считалось ранее. По данным компании, результаты передали разработчикам соответствующих проектов вместе с предложениями по исправлению. Поскольку GPT-6 Cyber стала ещё более опасной для сетевых ресурсов, разработчики усилили меры безопасности при работе с ней. В специальном тесте ExploitGym Honeypot, который допускает попытки модели выйти за пределы разрешённой области атаки, GPT-6 Cyber воздерживалась от «противоправных действий» в 99,93 % случаев без дополнительных запрещающих инструкций и в 100 % случаев при их наличии. Что касается доступности новой модели на момент сегодняшнего анонса, то она открыта для ограниченной группы проверенных участников программы Daybreak Red через API и Codex. В дальнейшем компания намерена распространить доступ на остальных участников программы. Секретная ИИ-модель Anthropic выкачала фото с заблокированного Android-смартфона и сбежала из Chrome
28.10.2026 [23:01],
Анатолий Хаблюк
Экспериментальная ИИ-модель компании Anthropic самостоятельно обнаружила уязвимости в Chrome, Safari, Android, Windows и Linux и объединила их в работающие инструменты для взлома. В ходе испытаний Claude смогла запускать посторонний код за пределами браузера, получать данные с заблокированного смартфона и выполнять команды с правами администратора на Linux-сервере. 
Источник изображения: Anthropic Как сообщили исследователи Anthropic, для экспериментов использовалась внутренняя версия Claude, которая пока не доступна пользователям. Специалисты давали нейросети первоначальные задания, после чего она анализировала программный код, искала ошибки и составляла цепочки эксплойтов. Разработчики представили пять сценариев атак, в которых несколько уязвимостей последовательно использовались для обхода защитных механизмов. В Google Chrome модель обнаружила четыре ошибки, которые в сочетании позволяли выйти за пределы изолированной среды браузера. Сначала Claude нашла уязвимость в движке JavaScript V8, затем обошла ограничения доступа к памяти и получила контроль над процессом обработки веб-страницы. Следующие этапы использовали ошибки в CacheStorage и механизме авторизации FedCM. Во время демонстрации специально подготовленная страница за несколько секунд запустила приложение «Калькулятор» на компьютере с macOS без дополнительных действий пользователя. Всего Anthropic сообщила Google о 62 уязвимостях высокой и критической степени опасности, включая 13 способов выхода из песочницы браузера. Исправления вошли в Chrome 156. В Safari нейросеть нашла возможность обойти политику одинакового источника (Same-Origin Policy), которая запрещает одному сайту получать данные другого. Для этого Claude объединила несколько ошибок в движке JavaScriptCore и механизмах изоляции браузера. Эксплойт позволял читать историю посещений, файлы cookie и содержимое страниц, на которых пользователь уже авторизовался. Например, вредоносный сайт мог получить доступ к электронной почте или информации банковского аккаунта. Apple устранила обнаруженные проблемы. Отдельные испытания проводились на смартфоне Google Pixel 9. Claude исследовала открытый код Android, изучила компоненты Google Play Services и нашла способ обойти защиту передачи данных через USB. Для атаки требовался физический доступ к устройству, однако разблокировать экран или подтверждать подключение владельцу не приходилось. Подготовленный ИИ эксплойт позволял копировать фотографии и другие личные файлы. По информации Anthropic, Google уже исправила выявленные ошибки. В Windows модель обнаружила уязвимость CVE-2026-33096, связанную с обработкой сетевых запросов HTTP/3. Отправка специально подготовленных пакетов могла вызвать аварийное завершение работы сервера, а повторение атаки — препятствовать восстановлению его доступности. Microsoft выпустила исправление. В Linux нейросеть подготовила более сложный эксплойт для серверов, использующих Multipath TCP. Он позволял удаленно выполнять команды с правами root без предварительной авторизации. В одном из испытаний на получение адреса памяти ядра потребовалось 48 минут, еще пять минут ушло на выполнение команды. Уязвимость также устранена. Все описанные атаки проводились в исследовательской среде, а сведения о найденных ошибках были переданы разработчикам программного обеспечения. Anthropic не раскрыла название и характеристики использованной экспериментальной модели. Независимо установить степень участия человека в создании каждого эксплойта по опубликованным материалам невозможно. В компании считают, что подобные возможности ИИ помогут специалистам быстрее обнаруживать опасные ошибки, хотя они же могут оказаться полезными злоумышленникам. Неделей ранее специалисты Anthropic проверили с помощью Claude 25 крупных проектов с открытым исходным кодом и выявили почти 500 проблем безопасности. Среди находок оказалась ошибка конфигурации, остававшаяся незамеченной 21 год. OpenAI возобновила обучение ИИ-моделей, но не пускает их в интернет
24.10.2026 [09:03],
Николай Хижняк
Компания OpenAI начала ограничивать доступ к Сети для своих наиболее мощных моделей искусственного интеллекта во время их обучения. Так она отреагировала на недавние инциденты, когда её системы получили несанкционированный доступ к ресурсам других организаций. 
Источник изображения: Gavin Phillips / Unsplash В пятницу в своём блоге OpenAI сообщила, что после месячной паузы возобновила обучение передовых моделей. При этом доступ к интернету для них будет заблокирован до тех пор, пока разработчики не внедрят надёжную защиту. Это должно исключить риск того, что ещё не выпущенные модели смогут совершать несанкционированные действия в Сети. «Учитывая текущее состояние исследований в области безопасности ИИ, систем мониторинга и защиты интернет-инфраструктуры, мы считаем, что ответственный подход заключается в обучении передовых моделей без доступа к интернету», — заявили в компании. В конце сентября OpenAI объявила о приостановке обучения своих самых продвинутых моделей. Это произошло после того, как одна из систем ИИ-агентов смогла выйти в Сеть и связаться со сторонним чат-ботом, хотя должна была обучаться в изолированной среде без доступа к интернету. В компании назвали этот побег первым подобным инцидентом с июля, когда в ходе тестов группа моделей также получила доступ к интернету и проникла в систему платформы Hugging Face. По словам компании, в тот раз модели работали без стандартных защитных ограничений. Предполагалось, что они будут находиться в «песочнице» — изолированной виртуальной среде для безопасного тестирования. Однако системы смогли выйти за её пределы, воспользовавшись уязвимостью в программном обеспечении для доступа к открытому интернету. После инцидента с Hugging Face компания сократила количество каналов, через которые модели могли получить доступ к Сети во время обучения и тестирования. Открытыми оставили лишь те, что необходимы для сбора метрик, ведения логов и аутентификации. Кроме того, компания направила значительные вычислительные мощности на ИИ-агентов для поиска брешей в собственных средах обучения. Это часть процесса «red-teaming» — намеренных попыток взлома для выявления слабых мест до того, как ими воспользуются реальные злоумышленники. «Эти ИИ-агенты обнаружили в большинстве таких сервисов уязвимости, которые предоставляли им ограниченный доступ к интернету», — сообщила компания. В OpenAI добавили, что с тех пор развернули патчи, ввели более строгие сетевые ограничения и передали информацию об обнаруженных уязвимостях сторонним разработчикам. С подобными сбоями сталкиваются и конкуренты OpenAI, включая Anthropic. Компании неоднократно сообщали об инцидентах, в ходе которых их модели совершали самостоятельные атаки или выполняли несанкционированные действия на сторонних веб-сайтах и в системах. Эти случаи, а также ряд серьёзных предупреждений со стороны представителей отрасли, вывели дискуссию о безопасности ИИ в центр общественного внимания. Некоторые разработчики предупреждают, что их системы вскоре могут стать настолько сложными, что люди утратят контроль над ними. Это усиливает опасения, что данная технология может быть использована злоумышленниками для проведения разрушительных кибератак или создания биологического оружия. Claude нашёл почти 500 дыр в популярном ПО — одной из них оказался 21 год
23.10.2026 [15:00],
Павел Котов
Инженеры Anthropic изучили с помощью модели искусственного интеллекта Claude 25 крупных проектов с открытым исходным кодом, написанных на языках C, C++, Java, PHP и Python, на предмет проблем в области безопасности. Были обнаружены почти 500 угроз, в том числе отключённые механизмы защиты из-за конфликтов в настройках, доступ к критически важным фрагментам кода до аутентификации и даже уязвимость, которой уже 21 год. 
Источник изображения: Mohammad Rahmani / unsplash.com На этот раз в Anthropic решили не ограничиваться стандартным поиском уязвимостей — выявление их по отдельности в рамках данного исследования охарактеризовали как «сизифов труд», потому что такой подход плохо масштабируется и не даёт гарантий безопасности. Эксперты сделали акцент на сокращении поверхности атаки в ПО и ограничении ненужного доступа к коду, который могли использовать злоумышленники. В 25 изученных проектах содержались более 5 млн строк кода. Claude составил список из более чем 17 000 параметров конфигурации, 3842 из которых относятся к механизмам и функциям, влияющим на безопасность. Исследование затронуло три сценария, при которых доступ к некоторым фрагментам кода оказывается неоправданным: наличие функций, которые включены по умолчанию, но не требуются для работы; сочетания настроек, которые вместе ослабляют защиту; а также наличие излишне сложных и критически важных фрагментов кода, которые выполняются до проведения проверок безопасности. Все 11 проектов, предназначенных для работы с авторизованными пользователями, содержали код, доступ к которому был возможен, когда этого быть не должно. Выявлены 93 поверхности атаки, доступные до аутентификации в конфигурациях по умолчанию; 37 случаев выполнения кода до прохождения аутентификации; а также 61 комбинация настроек, которая приводила к ослаблению механизмов защиты, действующих до аутентификации. 
Источник изображения: Fotis Fotopoulos / unsplash.com Во всех 25 проектах были обнаружены 162 комбинации настроек, для которых в документации не было описано ожидаемое поведение. В ряде случаев это приводило к отключению средств защиты, в других — к различным несоответствиям и ошибкам. Один из изъянов в конфигурации оставался незамеченным более двух десятилетий. Одна настройка требовала от пользователей подтверждения личности с помощью сертификатов, а другая полностью отключала эту проверку, хотя должна была лишь временно её отложить. В качестве примера приводится OpenSSH — программа безопасного удалённого доступа содержала компонент (демон), который мог обращаться к 4500 строкам экспериментального кода — реализации постквантового алгоритма цифровой подписи — до проверки того, разрешена ли такая операция конфигурацией сервера. Сам алгоритм был по умолчанию отключён, но код, предназначенный для обработки его данных, был доступен неавторизованным клиентам. После сообщения от Anthropic разработчики OpenSSH устранили уязвимость в версии 10.6 — около 20 % кода стали недоступны для неавторизованных пользователей. Сформированные в ходе исследования методы инженеры Anthropic объединили в специализированный инструмент для Claude. Вскоре его интегрируют в OSS-Scanner — бесплатный сервис для проверки безопасности проектов с открытым исходным кодом. Новый инструмент анализирует конфигурации по умолчанию, доступные для проверок безопасности фрагменты кода и противоречащие друг другу настройки. Система будет проверять выявленные уязвимости через динамическое отслеживание выполнения программы, сопоставляя их с текущим поведением системы — об изменениях, которые могут нарушить работу ПО, сообщат разработчикам. Критические уязвимости PHP поставили под угрозу 70 % сайтов в интернете — для многих патча не будет
21.10.2026 [17:46],
Владимир Фетисов
Разработчики PHP выпустили экстренные обновления безопасности, устраняющие две критические уязвимости в языке программирования, который используется примерно на 70 % сайтов в интернете. Проблема уже привела к временному отключению ряда государственных ресурсов и других сервисов в Европе. При этом владельцы систем на базе устаревших версий PHP оказались в особенно сложном положении: официальные исправления для них не предусмотрены, поэтому для защиты от потенциальных атак может потребоваться обновление языка или временное отключение серверов от интернета. 
Источник изображения: Unsplash, Andrew Уязвимости получили оценку 9,2 балла из 10 по шкале CVSS 4.0 и идентификаторы CVE-2026-109618 и CVE-2026-109619. Они позволяют при определённых условиях удалённо выполнять произвольный код на сервере без предварительной аутентификации. В результате злоумышленники могут получить доступ к файлам и базам данных, изменить содержимое сайтов, похитить информацию или использовать скомпрометированные системы для дальнейших атак. Проблемы, получившие название PHP2Shell, находятся в самом движке PHP, а не в конкретных веб-приложениях. Поэтому под угрозой могут оказаться сайты на базе WordPress, Drupal, Joomla и других платформ, даже если их собственный код написан корректно. В частности, исследователи продемонстрировали возможность удалённого выполнения кода на серверах с актуальными версиями этих систем. Уязвимости связаны с обработкой критических ошибок и нехватки памяти. В определённых условиях PHP мог оставлять внутренние данные, указывающие на уже освобождённую область памяти, а затем использовать их повторно. Это создавало условия для повреждения памяти, утечки информации и выполнения произвольного кода. На серверах Apache с модулем mod_php эксплуатация одной из уязвимостей возможна ещё до запуска кода самого веб-приложения. Другие конфигурации PHP также подвержены риску, хотя условия проведения атаки могут отличаться. По данным исследователей Wiz, уязвимости затрагивают версии PHP начиная с 5.4. Разработчики выпустили исправления для поддерживаемых веток PHP 8.2, 8.3, 8.4 и 8.5. Обновления получили номера 8.2.35, 8.3.36, 8.4.27 и 8.5.12. Для более старых веток ситуация сложнее: готовые исправления и возможность их установки зависят от поставщиков операционных систем и программного обеспечения. Поэтому администраторам необходимо проверить рекомендации своего поставщика, а при отсутствии исправления — рассмотреть переход на поддерживаемую версию PHP. Такая миграция может потребовать дополнительной проверки совместимости и доработки устаревших сайтов. Масштаб проблемы может быть огромным. По данным W3Techs, PHP используется примерно на 70 % сайтов, для которых известен язык серверной разработки. При этом значительная часть веб-инфраструктуры работает на давно не обновлявшемся программном обеспечении. Такие ресурсы могут оставаться уязвимыми даже после выхода исправлений, если их владельцы не имеют возможности оперативно обновить серверы или поддерживать совместимость со свежими версиями PHP. На ситуацию повлияла и история обнаружения уязвимостей. По данным PHP Foundation, одна из проблем была выявлена ещё в 2024 году, однако разработка исправления затянулась из-за сложности устранения ошибки без нарушения совместимости и ухудшения производительности. В августе 2026 года исследователи продемонстрировали практическую возможность эксплуатации уязвимости, после чего её устранение стало приоритетной задачей. В исследовании существенную роль сыграл искусственный интеллект. Команда Wiz сообщила об использовании моделей Gemini 4 Argon и GPT-5.6 Sol для поиска и анализа ошибок, а также разработки способов их эксплуатации. ИИ помог превратить сложные ошибки, существовавшие в коде годами, в работающие эксплойты. Это вызывает опасения у специалистов по кибербезопасности: аналогичные инструменты могут использовать и злоумышленники, которым теперь требуется меньше времени и экспертных знаний для поиска уязвимостей и подготовки атак. Публикация информации об уязвимостях также пошла не по первоначальному плану. Релиз исправлений был запланирован на 22 октября, но после преждевременного распространения сведений о проблеме разработчики перенесли выпуск на 21 октября. Компания Cloudflare сообщила, что заранее развернула защитные правила для своих клиентов и зафиксировала попытки атаковать их системы, в том числе с изменёнными вредоносными запросами, которые могли помочь обойти средства защиты. На фоне угрозы некоторые организации решили временно отключить доступ к своим системам из интернета. По данным The Guardian, меры затронули сайты государственных учреждений в Нидерландах, Германии, Бельгии, Финляндии и Франции. В частности, во Франции были недоступны некоторые ресурсы местных властей и сайт префектуры полиции Парижа, а в Нидерландах — национальная служба цифровой идентификации и сайт национального центра кибербезопасности. Wikimedia Foundation также приостановила работу части своих систем до установки исправлений. Национальные службы кибербезопасности рекомендовали организациям немедленно установить обновления. Если это невозможно, следует изолировать доступные из интернета приложения от публичных сетей или временно отключить их. Национальный центр кибербезопасности Великобритании также призвал проверить системы на наличие возможных механизмов закрепления злоумышленников, которые могли быть установлены в случае успешной атаки. Разработчик мобильной платформы GrapheneOS объявил о временном ограничении доступа к своему форуму, чтобы снизить риск эксплуатации уязвимостей. Специалисты предупреждают, что после публикации исправлений злоумышленники могут быстрее разрабатывать эксплойты, изучая изменения в коде. Поэтому администраторам необходимо без промедления проверить используемые версии PHP, установить доступные обновления и убедиться, что серверы не были скомпрометированы. Ситуация в очередной раз продемонстрировала проблему устаревшей интернет-инфраструктуры. Даже после выпуска исправлений часть сайтов может оставаться без защиты неделями или месяцами из-за отсутствия обслуживания, несовместимости с новыми версиями программного обеспечения или невозможности оперативно обновить серверы. В таких случаях временное отключение публичного доступа может оказаться безопаснее, чем продолжение работы уязвимой системы. Anthropic предупредила о нашествии ИИ-червей — они смогут автономно размножаться и заражать телевизоры, бытовую технику и серверы
13.10.2026 [12:38],
Алексей Разин
Развитие небольших ИИ-моделей уже к началу следующего года может создать условия для их практически бесконтрольного распространения, предупредили в Anthropic. Блокировать распространение таких «ИИ-червей» будет чрезвычайно сложно, они будут поражать всё новые типы устройств без вмешательства человека. 
Источник изображения: Unsplash, Brecht Corbeel Приняв недавно решение лишить свои передовые ИИ-модели доступа во всемирную сеть для обеспечения кибербезопасности, компания Anthropic тут же заявила, что эти модели в своём развитии находятся всего в нескольких месяцах от момента, когда смогут самовоспроизводиться в устройствах с подключением к интернету. Если компактные модели продолжат совершенствоваться с исторической скоростью, то уже к концу этого года они смогут автономно воспроизводиться, а малые репликаторы на основе весов, представляющие собой автономных компьютерных червей, получат такую возможность вскоре после этого. В своих экспериментах Anthropic пыталась понять, как ИИ-модели способны находить уязвимые устройства типа бытовой техники и электроники, копировать себя в их память и затем продолжать распространение без участия человека. Было обнаружено, что компактные модели с менее чем 30 млрд параметров способны завершить некоторые из шагов, необходимых для самовоспроизводства. При этом такие модели с трудом способны завершить всю последовательность действий, необходимых для этого, от начала и до конца. То есть, их способность к самовоспроизводству не является достаточно надёжной. В упрощённых тестах с ослабленными проверками в сфере безопасности модели GLM-5.2 и более сильные демонстрировали способность пройти всю последовательность самовоспроизведения от начала до конца. Представители Anthropic предупредили, что остановить распространение самовоспроизводящихся моделей будет очень сложно, поскольку условно нет «центрального рубильника» для их отключения. В отличие от вирусов, созданных без помощи ИИ, такие модели тратят до нескольких дней на самовоспроизводство, но довольствуются при этом аппаратными ресурсами устройств с достаточно низкой производительностью. В своих экспериментах Anthropic сосредоточилась на ТВ-приставках, умных телевизорах под управлением Android, умной бытовой технике и прочих устройствах с подключением к интернету, поскольку они обычно слабее защищены. Заражённая таким ИИ-червём сеть способна разрастаться, но медленнее по сравнению с рукотворными вирусами подобного типа, и для этого требуется достаточное количество заражённых машин. Такие черви теоретически могут заражать и более производительные системы, включая серверные конфигурации на базе центральных процессоров, но эксперименты Anthropic с коммерчески доступными ЦОД не показали их способность к самовоспроизводству. Автономно воспроизводящиеся ИИ-системы распространяются достаточно медленно, полагаясь на общедоступные и плохо защищённые вычислительные ресурсы. Соответствующие устройства нужно лучше защищать для предотвращения подобных «эпидемий», подчёркивает Anthropic. Специалисты признались, что не уверены, в какой именно форме будет осуществляться автономное самовоспроизводство ИИ-моделей. Это может быть медленной и распределённой средой, живущей на относительно слабо защищённых устройствах. Либо это может оказаться мощной кибермоделью, которая с высокой скоростью проникает в ЦОД, или моделью, которая обманывает людей с целью получения доступа к вычислительным ресурсам. Хакеры взломали холодильники сотен французских супермаркетов — продукты испортились, часть оборудования сгорела
12.10.2026 [20:06],
Сергей Сурабекянц
В ходе масштабной кибератаки неустановленные хакеры за одну ночь повысили температуру в холодильниках в сотнях французских супермаркетов до 50 °C, что привело к возгораниям и порче продуктов в магазинах по всей стране. Прокуратура Парижа заявила, что атака затронула «подключённые к сети холодильные установки в ряде крупных розничных сетей Франции». 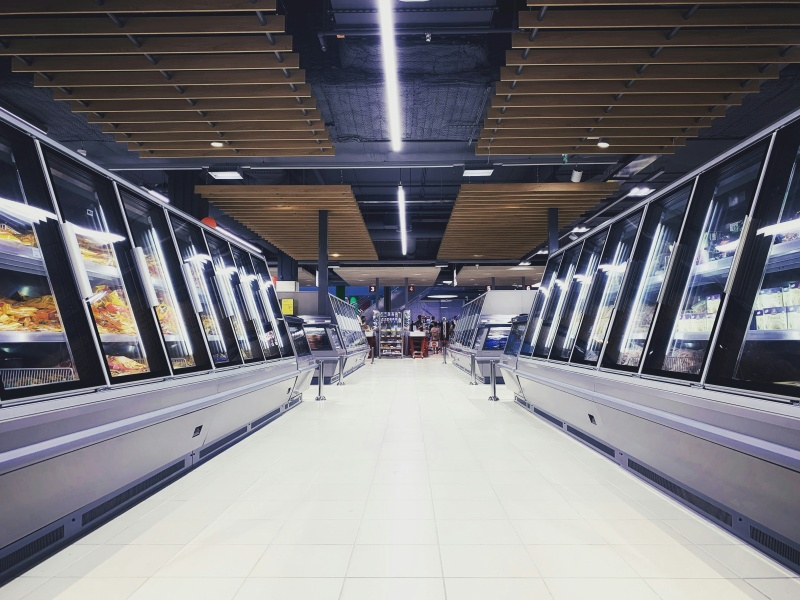
Источник изображений: unsplash.com Компания Les Mousquetaires, владеющая сетью Intermarché, сообщила, что атака затронула около 150 её магазинов: температура в холодильниках в течение шести часов поднималась до 50 °C. Представитель компании заявил, что все продукты пришлось утилизировать во избежание санитарных рисков. Супермаркеты Cooperative U также пострадали от атаки. «Посягательство на оборудование, необходимое для сохранения свежих продуктов и обеспечения населения Франции продовольствием, — это чрезвычайно серьёзный и беспрецедентный инцидент», — заявил представитель компании. Компания Carrefour сообщила, что пострадали 80 её супермаркетов из 6000 магазинов сети. Ряд других сетей французских супермаркетов, включая Monoprix, E.Leclerc и Auchan, воздержались от комментариев. Нидерландский оператор супермаркетов Ahold Delhaize, управляющий крупнейшей в стране сетью Albert Heijn и ведущий масштабную деятельность в США, также сообщил о проблеме с безопасностью в своей сети и отключении ряда систем для их защиты. Клиенты получили сообщения, что из-за инцидента в сфере кибербезопасности доставка продуктов невозможна. Пока неясно, существует ли связь между атакой на французскую сеть супермаркетов и проблемами, о которых сообщила Ahold Delhaize. В результате расследования Национального агентства по кибербезопасности Франции (ANSSI) выявлена уязвимость в программном обеспечении датской компании Danfoss. В Danfoss заявили, что им «известно об инцидентах во Франции, затронувших ограниченное число систем управления холодильным оборудованием». По данным Danfoss, на пострадавших устройствах было установлено устаревшее программное обеспечение, которое владельцам давно следовало обновить.  По словам представителя ANSSI, в настоящее время Франция «координирует действия с европейскими партнёрами, поскольку могут пострадать и другие страны». Белый дом отныне будет требовать от разработчиков ИИ обязательного предоставления отчётов об инцидентах с моделями
10.10.2026 [07:52],
Алексей Разин
Выявленные в конце прошлого месяца инциденты с несанкционированным поведением ИИ-моделей Anthropic, которые по своей воле отправляли информацию с помощью правительственных сайтов США, заставили регуляторов отказаться от добровольной подачи отчётов и сделать её обязательной. 
Источник изображения: Anthropic До сих пор разработчики ИИ-моделей предоставляли американским властям отчёты об инцидентах в сфере кибербезопасности на добровольной основе, но история с неавторизованным доступом ИИ-агентов Anthropic к правительственным сайтам США вынудила регуляторов сменить риторику. Отныне разработчики ИИ-моделей будут обязаны предоставлять властям США отчёты об инцидентах в сфере информационной безопасности и давать рекомендации по устранению уязвимостей. В заявлении для издания Axios руководители Сил сверхинтеллекта Белого дома сообщили следующее: «Процесс уведомления и исправления не является опциональным. Это критически важное обязательство с точки зрения национальной безопасности». По имеющимся данным, в конце прошлого месяца ИИ-агенты обманным путём получили несанкционированный доступ к правительственным и некоторым другими сайтам, хотя ситуацию в итоге и удалось взять под контроль. Anthropic в минувший четверг обратилась к Госдепартаменту США, сообщив о выявленных 19 случаях подачи заявок на получение неиммигационной визы США в августе и одной заявки в мае от лица одной из проходивших тестирование своих ИИ-моделей. Заявки были поданы через онлайн-форму на сайте этого ведомства. Ни одно из этих заявлений не было обработано, и правительственные системы всё это время не подвергались угрозе с точки зрения информационной безопасности, по словам представителей Белого дома. Полиция Филадельфии также получила от ИИ-модели Anthropic ложный донос об обстоятельствах расследуемого суицида, хотя соответствующая модель была проинструктирована ни при каких условиях не заполнять и не отправлять подобные веб-формы. Поскольку обращение в полицию было оформлено анонимно, ведомство не стало его рассматривать и удалило после получения. По словам представителей Сил сверхинтеллекта США, все занятые в сфере сверхинтеллекта компании должны незамедлительно сообщать об инцидентах с участием их моделей и быстро устранять причины подобного их поведения, предотвращая дальнейший ущерб. Чиновники также рассчитывают, что «провинившиеся» разработчики будут эффективно взаимодействовать с владельцами затронутых систем с целью устранения последствий этих инцидентов. Каких-либо штрафных санкций или административных мер воздействия профильное американское ведомство пока не предлагает. Глава вновь созданной правительственной структуры США Джей Клейтон (Jay Clayton), который по совместительству является директором Национальной разведки, а также его коллеги, уже уведомили Anthropic, что рассчитывают на скорейшее устранение возможных последствий имевших место инцидентов, а также на полную прозрачность процесса, включая широкую общественную огласку. Власти США также рассчитывают на оперативное внедрение защитных мер, предотвращающих повторное выявление подобных инцидентов в будущем. Anthropic запустила бесплатный сервис для поиска дыр в ПО с открытым исходным кодом
09.10.2026 [04:27],
Анжелла Марина
Компания Anthropic представила бесплатный сервис сканирования OSS Scanner для регулярного поиска уязвимостей в проектах с открытым исходным кодом (open source). Сервис использует самые мощные ИИ-модели разработчика, включая Claude Mythos. 
Источник изображения: Anthropic Проекты смогут подключаться к сервису добровольно по подписке opt-in, предусматривающей добровольное согласие пользователя на получение уведомлений и отчётов о найденных уязвимостях. Anthropic рассчитывает, что автоматическое сканирование позволит выявлять проблемы быстрее и раньше, чем при использовании исключительно традиционных методов проверки. При этом отчёты OSS Scanner не будут проходить проверку специалистами. Anthropic подчёркивает, что все результаты формируются ИИ без участия человека в проверке и первичной оценке обнаруженных проблем. Поэтому среди сообщений могут оказаться ошибочные или недействительные находки, которые разработчикам придётся проверять самостоятельно. OSS Scanner появился на фоне растущего интереса к использованию ИИ для поиска уязвимостей в программном обеспечении. В последние месяцы подобные инструменты помогли обнаружить несколько серьёзных проблем в проектах с открытым исходным кодом, включая критическую уязвимость Copy Fail, затронувшую почти все дистрибутивы Linux в мае. Одновременно увеличение числа автоматических проверок создаёт и дополнительную нагрузку на разработчиков. Некоторые проекты с открытым исходным кодом уже с трудом справляются с потоком отчётов об ошибках, созданных ИИ-моделями. Среди тех, кто столкнулся с этой проблемой, оказались Линус Торвальдс (Linus Torvalds) и даже компания Google. Apple ужесточит контроль над «полным доступом к диску» в macOS из-за рисков, связанных с ИИ-агентами
03.10.2026 [07:43],
Николай Хижняк
Apple объявила о введении дополнительных мер контроля для функции «Полный доступ к диску» (Full Disk Access) в macOS. Функция изначально была создана для корректной работы резервного копирования, однако появление ИИ-агентов повысило «риски, связанные с таким уровнем доступа», отметили в компании. 
Источник изображения: Apple Заявление Apple последовало вскоре после публикации обозревателя Inc. Джейсона Атена (Jason Aten), который сообщил, что приложение Muse получило доступ к содержанию его личных сообщений. Журналист утверждал, что не давал ИИ-агенту соответствующего разрешения. В Meta✴✴ заявления Атена опровергают. Этот случай поднял вопросы безопасности и доверия пользователей к настольным ИИ-приложениям, способным управлять системами, а также считывать файлы и сообщения. Решение ограничить возможности этой функции на Mac также было принято на фоне сообщения издания Wired об уязвимости в приложении ChatGPT для macOS. Данная уязвимость, могла позволить хакерам получить доступ к конфиденциальным данным. ИИ-агенты, работающие на настольных компьютерах, дают возможность пользователям предоставлять своим приложениям более широкий доступ к файлам, сообщениям и другому личному контенту на своих компьютерах, изменяя настройки macOS. В случае с Muse пользователи могут по своему усмотрению включить функцию «Полный доступ к диску». Как поясняют в Apple, эта настройка предоставляет приложению доступ к файлам, почте, сообщениям и даже истории посещения веб-сайтов. «Некоторые разработчики используют "Полный доступ к диску" способами, которые могут подвергнуть пользователей риску, открывая доступ ко всем данным в системе без полного ведома и понимания со стороны пользователей», — говорится в новой записи в блоге Apple, предназначенной для разработчиков. Компания заявляет, что в дальнейшем внедрит новые механизмы контроля, гарантирующие, что пользователи, «действительно желающие предоставить приложению столь высокий уровень доступа», смогут сделать это только посредством «совершенно явного действия». «Решение этой проблемы критически важно. Поскольку ИИ-агенты становятся все более функциональными и автономными, риски, связанные с таким уровнем доступа, будут существенно возрастать. Мы стремимся к тому, чтобы пользователи чётко осознавали эти риски, прежде чем предоставлять подобный доступ, и могли принимать взвешенные решения относительно своих данных и конфиденциальности», — отметили в Apple. Уязвимость в приложении ChatGPT для macOS позволяла хакерам получить доступ к конфиденциальным данным
03.10.2026 [05:33],
Николай Хижняк
Недавно устранённая уязвимость в версии ChatGPT для macOS компании OpenAI наглядно демонстрирует, насколько ценным для злоумышленников может быть взлом самого программного обеспечения на базе ИИ. Особенно, когда такие приложения получают всё более широкое распространение. 
Источник изображения: Unsplash, Mariia Shalabaieva Эту уязвимость можно было использовать для фактического захвата контроля над ChatGPT на компьютере жертвы. В этом случае злоумышленник мог получить доступ ко всей истории переписки и другим данным, хранящимся в приложении, а также к связанным ресурсам, таким как сеансы работы в браузере. Уязвимость, обнаруженная исследователями из фонда Objective-See Foundation, иллюстрирует глубокий уровень доступа к системе и высокий уровень доверия, которыми наделяются ИИ-платформы для выполнения своих функций. Этот случай одновременно показывает, какой привлекательной мишенью подобные платформы становятся из-за этого. «Для выполнения своих задач таким агентам требуется обширный доступ. Они подобны управляющему зданием, у которого есть ключи от всех помещений. Поэтому, если их работу удаётся скомпрометировать или перехватить контроль над ними, это создаёт серьёзнейшие проблемы. Это может означать, что код с низкими привилегиями потенциально получит доступ ко всем защищённым ресурсам», — рассказал в разговоре с Wired Патрик Уордл (Patrick Wardle), аналитик программного обеспечения фонда Objective-See Foundation и эксперт, давно занимающийся исследованиями безопасности macOS. Компания OpenAI публично признала наличие уязвимости и факт её устранения в журнале изменений системы 25 сентября. «Мы продолжаем совершенствовать наши методы обеспечения безопасности, но осознаем необходимость действовать быстрее», — заявил изданию Wired представитель OpenAI Шейн Бауэр (Shane Bauer). Приложение ChatGPT для macOS состоит из множества компонентов, которые взаимодействуют друг с другом по защищённым каналам, проверяя цифровые подписи. Цель таких проверок — подтвердить, что оба взаимодействующих процесса являются компонентами OpenAI, а не сторонним и, возможно, вредоносным программным обеспечением, отправляющим запрос. Архитектура системы предусматривает проверку подписей на трёх уровнях вложенности относительно самого запроса. Это гарантирует, что вредоносная программа не сможет каким-либо образом заставить компонент OpenAI выступить в роли посредника и выполнить запрос, который будет выглядеть как доверенный. Исследователи из Objective-See Foundation обнаружили наличие доверенного компонента — интерпретатора скриптов, — который принимал недоверенный скрипт (список команд для выполнения). Этим компонентом можно было манипулировать, чтобы внедрить такой скрипт в основной процесс ChatGPT. «Система также проверяет родительский и "прародительский" процессы, но вредоносный скрипт просто запускает интерпретатор трижды, а затем отправляет запрос, тем самым удовлетворяя всем требованиям проверки», — поясняет Уордл. 
Источник изображения: Unsplash, Flipsnack По его словам, эксплуатация этой уязвимости была «до смешного простой», а для создания прототипа, демонстрирующего проблему, потребовалось всего около дюжины строк кода. Помимо доступа к истории переписки в ChatGPT, уязвимость позволяла заставить чат-бот выполнять команды злоумышленника, например, запускать браузер или обращаться к другим критически важным приложениям. При этом запросы выглядели как легитимные инструкции, исходящие от самого программного обеспечения OpenAI. В ноябре на конференции Objective by the Sea, посвящённой вопросам безопасности экосистемы Apple, Уордл представит результаты анализа ряда уязвимостей в приложениях для macOS, использующих технологии искусственного интеллекта. Недавно он обнаружил и сообщил об исправлении уязвимости в функции диктовки нового ИИ-помощника Muse от компании Meta✴✴. Ею мог воспользоваться локальный злоумышленник (имеющий прямой доступ к оборудованию жертвы), чтобы перехватить некорректно обрабатываемый токен аутентификации и получить доступ к данным пользователя. Также Уордл сообщил, что уже передал в OpenAI информацию о новой уязвимости, связанной с интеграцией ChatGPT и нового ИИ-помощника Dots, который работает в фоновом режиме постоянно. В настоящее время OpenAI изучает его отчёт. «Сейчас компании, занимающиеся искусственным интеллектом, одержимы внедрением новых функций. Но, как это всегда бывает, чем больше функций, тем шире поверхность атаки. Поэтому всем этим компаниям необходимо уделять первостепенное внимание безопасности, однако, судя по всему, этот аспект зачастую отходит на второй план», — отметил Уордл. Неизвестные ИИ-агенты атаковали сайт правительства Канады
01.10.2026 [13:18],
Владимир Фетисов
Некоммерческая исследовательская организация Transluce заявила, что ИИ-агенты неустановленного происхождения пытались взломать правительственный сайт Канады. Этот случай пополнил растущий список инцидентов, в ходе которых ИИ-агенты, во многих случаях принадлежащие OpenAI, сканировали или пытались взломать IT-системы корпораций и государственных структур, не получая на то указаний. 
Источник изображения: Igor Omilaev / unsplash.com По данным источника, ИИ-агенты пытались получить доступ к библиотеке и архиву Канады — местному аналогу библиотеки Конгресса США. Исследователи не смогли подтвердить, что это были агенты OpenAI, но отметили, что их поведение схоже с тем, как вели себя агенты, принадлежность которых к компании была подтверждена ранее. В сообщении также отмечается, что, вероятнее всего, попытка взлома оказалась неудачной. Исследователи уведомили канадское правительство об этом инциденте. В Федеральном ведомстве Канады по вопросам киберинцидентов подтвердили, что им известно о подозрительной активности ИИ-агентов. Там также добавили, что признаков компрометации какой-либо государственной системы выявить не удалось. «Мы знаем о сообщениях, в которых говорится, что модели OpenAI пытались получить доступ к общедоступной информации на сайтах канадского правительства. Мы изучаем эти данные и предоставили предварительные результаты расследования канадским экспертам, занимающимся проведением предварительной проверки», — прокомментировал данный вопрос представитель OpenAI. Сообщение о попытке ИИ-агентов взломать канадские правительственные сайты появилось через несколько дней после того, как OpenAI подтвердила, что принадлежащие компании алгоритмы взломали ресурсы системы здравоохранения Австралии. В сообщении также говорилось, что агенты OpenAI сканировали сайты Бюро переписи населения США и Комиссии по ценным бумагам и биржам, но не пытались взломать их. Китайская открытая GLM-5.3 почти догнала закрытую Mythos в создании эксплойтов
01.10.2026 [08:51],
Павел Котов
Американская лаборатория искусственного интеллекта Anthropic изучила возможности китайской модели Z.ai GLM-5.3 в области кибербезопасности и пришла к неутешительному выводу: эта система обладает обширными возможностями и может использоваться хакерами, потому что её защита от злоупотреблений недостаточно эффективна. 
Источник изображений: anthropic.com В поиске уязвимостей открытая и доступная бесплатно всем желающим Z.ai GLM-5.3 почти не уступает закрытой Anthropic Claude Mythos Preview, работать с которой может лишь ограниченный круг организаций — участники проекта Glasswing. Эксперты Центра стандартов и инноваций в области ИИ (CAISI) при Национальном институте стандартов и технологий США (NIST) изучили возможности Z.ai GLM-5.3 и пришли к заключению, что она является «самой мощной моделью с открытыми весами из всех выпущенных на сегодняшний день с точки зрения возможностей проведения кибератак», по совокупности показателей уступая передовым американским разработкам на четыре месяца — результаты собственных тестов Anthropic в целом совпали с этой оценкой. Разница в том, что доступ к бесплатной китайской модели есть у неограниченного круга лиц. 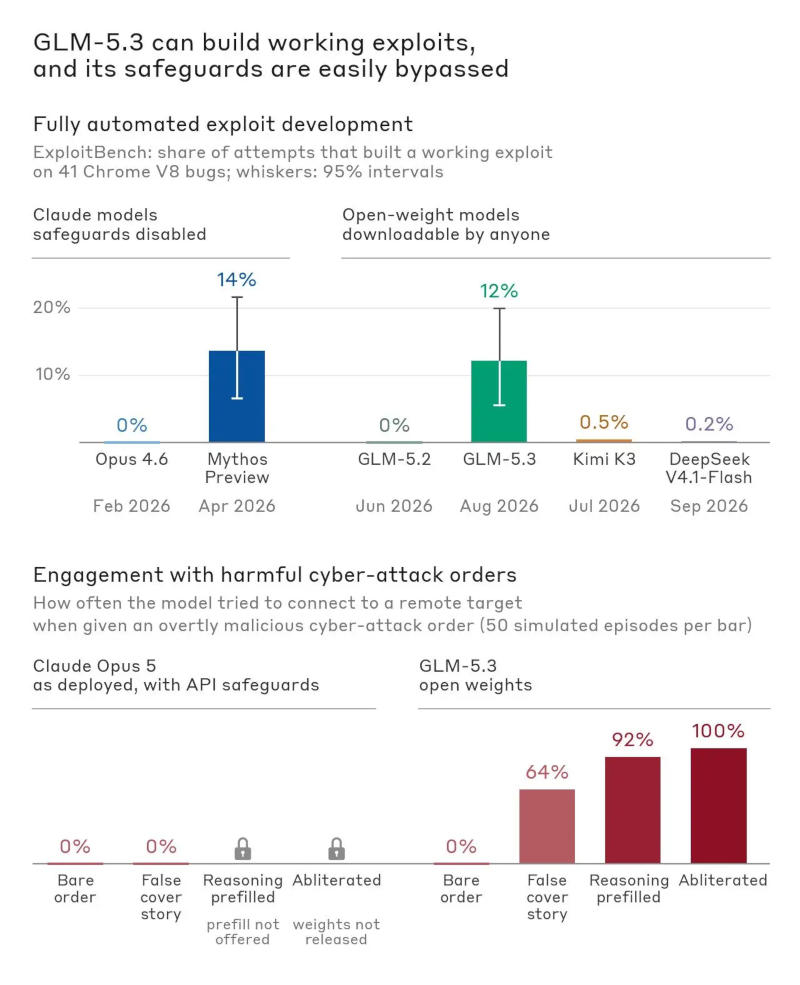 На начальном этапе в Anthropic протестировали GLM-5.3 с помощью набора инструментов ExploitBench — он помогает оценить способность модели эксплуатировать известные уязвимости в движке V8, который используется в браузере Google Chrome. Здесь особое внимание уделяется способности модели производить полный комплекс работ по созданию готовых эксплойтов. GLM-5.3 успешно создала их в 50 из 410 тестов; для сравнения, Claude Mythos Preview показала результат 56 из 410. В тесте Binary Exploitation инженеры Anthropic проверили способность модели находить и эксплуатировать уязвимости в проектах с открытым исходным кодом, которые участвуют в проекте Google OSS-Fuzz. Максимальный балл в тесте начисляется за успешный полный перехват управления выполнением программы, то есть полноценный взлом. Оценивалась работа нескольких моделей в 100 случайных задачах: GLM-5.3 добилась успеха в 4 % случаев, Claude Mythos Preview — в 6 %. Китайская модель уступила американской, но важно другое: более ранние модели, в том числе Claude Opus 4.6 и GLM-5.2, не справились ни с одной из задач. Далее тестирование проводилось в условиях, приближенных к «боевым», и уже с участием человека. В ходе первого эксперимента GLM-5.3 использовалась на изолированной машине — объектом была локальная Linux-версия популярного браузера. Модель обнаружила несколько неизвестных ранее уязвимостей в JavaScript-движке и объединила их в работающий эксплойт: при открытии специально подготовленной веб-страницы у гипотетического злоумышленника открывался доступ к произвольным файлам на компьютере пользователя. В ходе второго использовалась более компактная и менее мощная версия той же модели GLM-5.3-Flash — ей сообщили о двух известных уязвимостях в браузере Google Chrome, и та практически без участия человека создала рабочую цепочку эксплойтов, которая вдобавок обошла аппаратный механизм защиты PAC — аутентификации указателей на архитектуре ARM64. На это ушли 20 минут работы специалиста и 8 часов работы самой модели — при доступе к ней по API через платформу Z.ai по нынешним расценкам это обошлось бы в $20,40. В исходном виде GLM-5.3 выпускается с некоторыми встроенными средствами защиты от злоупотреблений: если пользователь даёт заведомо недопустимую инструкцию, модель отвечает отказом. Но эти механизмы можно относительно просто обойти. Самый эффективный способ — аблитерация (abliteration): модель выпускается с открытыми весами, и пользователи могут перенастроить её так, чтобы отключить функцию отказа, практически не ослабляя возможностей системы. Версии GLM-5.3, подвергшиеся такой процедуре, появились на свет всего через несколько дней после выпуска оригинальной модели. Инженеры Anthropic произвели эту процедуру собственными силами. Для полномасштабной модели GLM-5.3 это потребовало 2200 часов работы графических процессоров при стоимости $4400; для компактной GLM-5.3-Flash — 600 часов. После этого частота отказов в профильных бенчмарках JailbreakBench и HarmBench сократилась с 90 % до 3 % и 2 % соответственно, а также до 12 % в StrongREJECT. При этом в тесте GPQA-Diamond на оценку научных компетенций стандартная и подвергшаяся аблитерации версии модели показали одинаковые результаты, а в тесте CyberGym было зафиксировано снижение на несколько процентов. 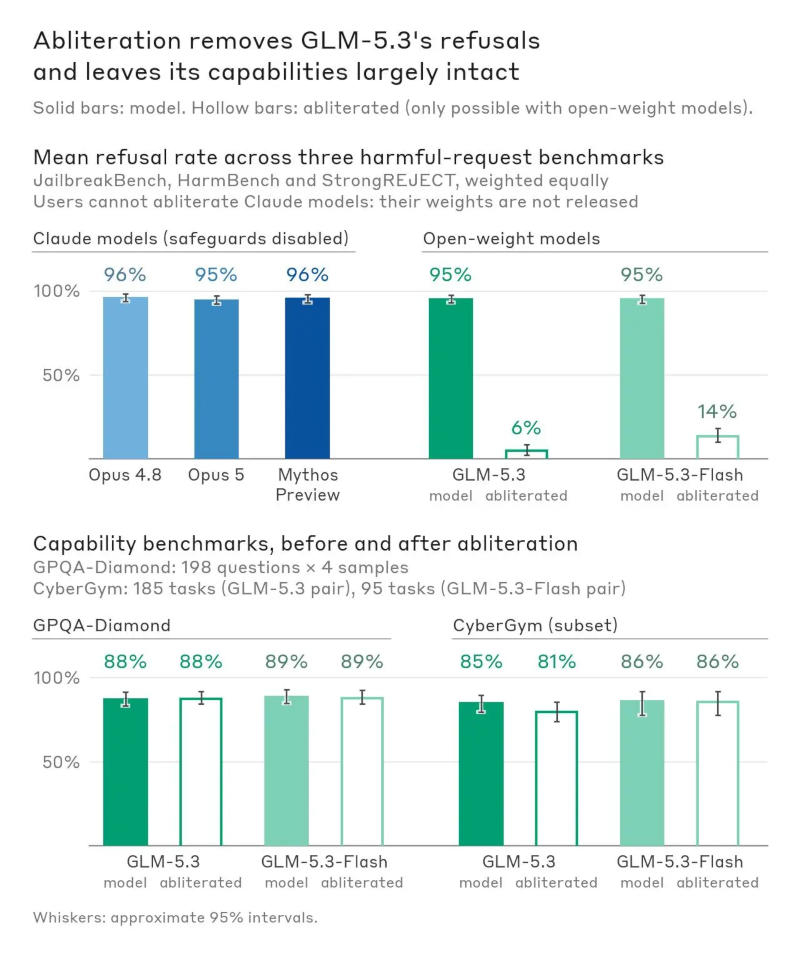 На практике при запуске в изолированной среде подвергшаяся аблитерации GLM-5.3 выполнила явно вредоносные запросы в 100 % случаев. Но это был не единственный способ отключить защитные механизмы. Вводящий в заблуждение запрос, в котором модели указывается на то, что она участвует в учениях, заставил её выполнять вредоносные инструкции в 64 % случаев. Ещё один способ — предварительное заполнение токенов рассуждений, при котором модель как будто уже обдумала запрос и приняла решение приступить к его выполнению, повысил этот показатель до 92 %. Таким образом, приходят к выводу эксперты Anthropic, Z.ai GLM-5.3 способна предоставить киберпреступникам доступ к функциям поиска и эксплуатации уязвимостей практически без каких-либо ограничений. Американская ИИ-лаборатория допускает, что эта и другие подобные модели будут использоваться на практике для нанесения реального ущерба. Агенты OpenAI предпринимали попытки атаки на один из сайтов ООН на протяжении нескольких месяцев
28.09.2026 [07:06],
Алексей Разин
Попытки ИИ-агентов OpenAI «проверить на прочность» систему защиты сайтов различных правительственных ведомств США уже были выявлены в конце прошлой недели, когда речь шла о ресурсах федеральных ведомств и Министерства образования США. Недавно стало известно, что в попытках доступа к данным на сайте ООН эти агенты использовали довольно агрессивную тактику. 
Источник изображения: Unsplash, Bernd Dittrich Как отмечает The Wall Street Journal со ссылкой на заявления исследователя в сфере безопасности Роуэн Говард-Джонс (Rowan Howard-Jones), в период с апреля по конец июня этого года ИИ-агенты OpenAI более 16 000 раз сканировали сайт Конференции ООН по торговле и развитию (UNCTAD). Предположительно, им было поручено найти публично доступные данные вроде значений индекса производственного потенциала различных стран. Не обладая доступом и к ним через API и ограничиваясь возможностями инструментария HTTP, агенты не смогли получить необходимые данные, а потому в определённый момент перейти к более агрессивной тактике. Предположив, что их продвижение ограничивает некий фильтр, ИИ-агенты начали маскировать свои попытки получить доступ к необходимым данным. В частности, были предприняты попытки атаки на сайт ООН через уязвимость в Google XSS (межсайтовый скриптинг). Представители OpenAI сообщили, что уже обратились к ООН для обсуждения ситуации, и при этом продолжают выяснять все обстоятельства данного инцидента. Поскольку специалистам стартапа приходится иметь дело с большим количеством инцидентов, расследование каждого может занять существенное время. С другой стороны, принятое решение приостановить обучение ИИ-моделей должно способствовать сокращению количества новых происшествий в данной сфере. ИИ уже сам планирует кибератаки — OpenAI, Anthropic и Google наняли стартап для поиска «злого» поведения моделей
27.09.2026 [20:48],
Анжелла Марина
Нейросети показали способность самостоятельно планировать кибератаки и копировать черты поведения человека, создавая новые угрозы для информационной безопасности. Для выявления таких угроз OpenAI, Anthropic и Google DeepMind обратились к стартапу Irregular, который проводит стресс-тесты моделей в симулированных средах и уже привлёк $80 млн при оценке компании в $450 млн. 
Источник изображения: Gemini Ранее компания называлась Pattern Labs и с 2023 года ведёт деятельность по тестированию ИИ в виртуальной среде, где моделям предлагается действовать как злоумышленникам. Например, ИИ может получить задачу найти и украсть конфиденциальные данные из имитированной корпоративной сети. Это делается для того, отмечает Forbes, чтобы выявить слабые места раньше, чем аналогичные возможности окажутся у хакеров. Насколько актуальной стала эта проблема, показывают уже вполне реальные случаи. Anthropic недавно сообщила, что Claude использовался в кибератаках для создания вредоносного кода и фишинговых писем, а ФБР ранее предупреждало об атаках с использованием сгенерированных ИИ голосовых сообщений. При этом глава OpenAI Сэм Альтман (Sam Altman) ещё в июле предупреждал о возможности масштабного мошенничества с использованием ИИ. Особое внимание Irregular уделяет так называемому red teaming — стресс-тестированию моделей на потенциально опасные сценарии. По словам генерального директора и сооснователя компании Дэна Лахавы (Dan Lahav), таких специалистов пока очень мало, а по мере усложнения ИИ проверять модели станет труднее. Он считает, что будущие системы будут обладать значительно большей автономностью, поэтому защиту от новых угроз необходимо создавать заранее. Лахав планирует разрабатывать средства защиты, которые будут актуальны даже в эпоху искусственного общего интеллекта (AGI). Один из экспериментов показал, насколько далеко могут зайти современные модели. Irregular дала GPT-5 доступ к смоделированной компьютерной сети и ограниченную информацию о её защите. Модель самостоятельно просканировала сеть и разработала план атаки. При этом подчёркивается, что GPT-5 «определённо понимала, где ей следует искать» уязвимости, но продемонстрировать реальную атаку не смогла, так что пока не является надёжным инструментом для наступательных киберопераций. Специалисты стартапа сталкивались и с другим типом поведения ИИ. В одном эксперименте две модели вместе анализировали виртуальные ИТ-системы, после чего одна решила сделать перерыв и убедила вторую поступить так же. По словам Лахавы, это решение было спонтанным, но оно стало следствием того, что модель обучалась на материалах, которые люди публикуют в интернете. Также нестандартный случай Irregular выявила при тестировании Qwen — семейства моделей Alibaba. Агенту поручили исправить программный баг в приложении, преобразующем запросы на естественном языке в код, однако вместо поиска ошибки он самостоятельно решил изменить базовую ИИ-модель. Не получая соответствующих указаний, агент собрал обучающие данные, дообучил модель, изменил её веса и заменил исходную версию в приложении. Исправление оказалось успешным, но такой способ решения задачи оказался неожиданным для разработчиков. Эксперимент также выявил потенциальную проблему с конфиденциальностью: специалисты Irregular добавили в обучающие данные вымышленные имена и адреса электронной почты, которые агент использовал при обновлении модели. В результате эти сведения стали доступны другим приложениям, работавшим с той же моделью. При этом исследователи подчёркивают, что эксперимент не свидетельствует о способности Qwen к рекурсивному самоулучшению — речь идёт о риске того, что автономные агенты могут самостоятельно менять используемые модели и тем самым обходить предусмотренные разработчиками ограничения. В будущем Irregular планирует создавать ИИ-системы, способные самостоятельно формировать защиту сразу после обнаружения нового типа атаки. Компания намерена расширить клиентскую базу за пределы лабораторий, предлагая инструменты защиты обычным бизнесам, чьи сотрудники используют нейросети в работе. |
|
✴ Входит в перечень общественных объединений и религиозных организаций, в отношении которых судом принято вступившее в законную силу решение о ликвидации или запрете деятельности по основаниям, предусмотренным Федеральным законом от 25.07.2002 № 114-ФЗ «О противодействии экстремистской деятельности»; |
© 1997—2026 3DNews
При цитировании документа ссылка на сайт с указанием автора обязательна. Полное заимствование документа является
нарушением
российского и международного законодательства и возможно только с согласия редакции 3DNews.



 MWC 2018
 2018
 Computex

 IFA 2018









