


Опрос
|
реклама
Быстрый переход
Математический прорыв OpenAI оказался под вопросом — учёные нашли расхождение в доказательстве
09.10.2026 [15:06],
Владимир Мироненко
Математический прорыв OpenAI начал вызывать вопросы. Учёные сравнили опубликованное доказательство по уравнениям Навье — Стокса с его алгоритмической Lean-версией и нашли расхождения: в нескольких ключевых местах машинный вариант, проверяемый на компьютере, содержит более слабые утверждения. Это ещё не опровержение, но почва для сомнений уже вполне плодородная 
Источник изображения: Thomas T /unsplash.com По словам математиков, расхождение вовсе не означает, что доказательства неверны или что OpenAI неправильно решила задачу, но это ставит под сомнение, всегда ли можно полагаться на математические результаты, генерируемые моделями искусственного интеллекта. «Что нужно сделать со всеми этими большими доказательствами, созданными на основе языковой модели, так это то, что они должны быть прочитаны людьми, и это создает огромную дополнительную нагрузку на математиков», — сообщил руководитель команды Андерс Хансен (Anders Hansen). Процесс поиска расхождений занял у команды около двух недель. При этом математики использовали подсказки ChatGPT. Напомним, что у OpenAI на решение задачи ушло 88 часов. Математики указали на расхождение в части доказательств, называемой леммой 8.6. В доказательстве на естественном языке уравнение в этой части требует, чтобы определённое значение было меньше m + 4, где m - целое число, а в Lean‑версии — меньше m + 5, что математически слабее, поскольку допускает больше возможных решений и не эквивалентно первому. Представим, что вас попросили решить уравнение x + 3 = 6, ответом на которое является x = 3. Можно написать доказательство того, что x должно быть меньше 4, а также того, что x должно быть меньше 5. Оба эти математических утверждения абсолютно верны, но последнее допускает больше возможных ответов для x, что делает его математически более слабым. По словам Хансена, неправильный перевод мог возникнуть из-за того, что ИИ стремится к тому, чтобы компьютерный код был полностью самосогласован и не выдавал ошибок. Если в процессе автоматической формализации ИИ обнаружит часть доказательства, которая не компилируется, он попытается найти обходной путь, даже если это означает отклонение от доказательства, написанного на естественном языке. Кевин Баззард (Kevin Buzzard) из Имперского колледжа Лондона сообщил, что можно надёжно формализовать в Lean саму формулировку теоремы и затем проверить, компилируется ли доказательство. Но это не гарантирует, что текстовое доказательство в PDF корректно передаёт логику. То есть Lean‑код может быть внутренне согласован, но не соответствовать тому, что написано в статье. «Я уверен, что проблема Навье — Стокса была решена правильно, — говорит Баззард. — Я гораздо менее уверен в том, что доказательство, описанное текстом, является правильным». OpenAI сообщила ресурсу New Scientist, что ей известно о несоответствии между доказательством на естественном языке и в виде кода, и что это не означает, что ни одно из них недействительно. OpenAI продолжает раздражать математиков пренебрежением к правилам публикации решений важных задач
07.10.2026 [04:45],
Анжелла Марина
OpenAI опубликовала на GitHub сотни решений и доказательств нерешённых ранее математических задач, полученные с помощью искусственного интеллекта. Публикация стала продолжением дискуссии, разгоревшейся после встречи компании с математиками в августе: учёные призывали OpenAI сопровождать такие результаты полноценными научными публикациями с подробным описанием методов и доказательств, а не ограничиваться постами в социальных сетях и репозиториями. 
Источник изображения: Grok В августе OpenAI собрала около 40 математиков, чтобы обсудить, как действовать в ситуации, когда искусственный интеллект явно превосходит возможности людей в этой области и попросить совета относительно публикации полученных результатов. При этом, по сообщению издания Wired, компания заверила, что не станет обнародовать все решения разом, хотя официальный представитель OpenAI Линдси Маккаллум (Lindsay McCallum) утверждает, что ей ничего не известно о таких заверениях. Участники встречи предложили публиковать результаты в виде научных работ с подробным объяснением методов и полученных доказательств. По мнению математика Северо-Западного университета (Northwestern University) в США Брайны Кра (Bryna Kra), это позволило бы другим исследователям проверить результаты, разобраться в них и использовать в дальнейшей работе. Однако, по её словам, OpenAI не последовала этой рекомендации и вместо этого собирается разместить сотни результатов на GitHub. «Судя по всему, эти пожелания были проигнорированы», — отметила она. Однако OpenAI пошла по другому пути. Компания создала на GitHub специальный репозиторий Math, где публикует материалы, связанные с использованием ИИ для решения математических задач. Одновременно OpenAI рассказала о своей работе и объяснила, как использует ИИ для продвижения исследований в этой области. Таким образом, первоначальные опасения математического сообщества о том, что результаты будут распространяться преимущественно через репозитории и социальные сети, частично подтвердились. При этом публикация на GitHub сама по себе не заменяет научную статью: репозиторий позволяет сделать материалы доступными для изучения, но не обеспечивает того же уровня описания методики, проверки и академического обсуждения, который предполагает традиционная научная публикация. Ситуация усугубилась после инцидента в сентябре, когда разработчики задействовали тысячи ИИ-агентов для решения «Задачи тысячелетия», за которую назначена награда в 1 миллион долларов. Математик и профессор Нью-Йоркского университета Тристан Бакмастер (Tristan Buckmaster) обвинил компанию в присвоении результатов, над которыми он работал совместно с сотрудником Anthropic Левентом Альпёге (Levent Alpöge), а переговоры о соавторстве сопровождались давлением, включая угрозы карьере исследователя со стороны сотрудника OpenAI Себастьяна Бубека (Sébastien Bubeck). Многие учёные воспринимают действия технологических гигантов как проявление монополии и пренебрежение к коллективному научному труду. Профессор Нестор Гийен (Nestor Guillen) отметил распространение мнения о «мафиозном поведении» корпораций, сосредоточивших огромные вычислительные ресурсы в своих руках, а Брайна Кра подчеркнула, что публикации решений в формате твитов не способствуют развитию экосистемы, на данных которой и обучаются ИИ-модели. В ответ на растущее напряжение в научной среде OpenAI создала консультативную группу по математике и искусственному интеллекту, однако математики отмечают отсутствие реальных изменений в действиях компании. В частности, разработчики продолжают игнорировать специализированные репозитории, такие как Hexagon и Palomar, созданные сообществом для систематизации доказательств, полученных с помощью инструментов ИИ. Внутри OpenAI некоторые сотрудники высказывают мнение, что искусственный интеллект может сделать традиционную математику неактуальной и профессия находится под угрозой. Однако тот же Бубек считает, что технология наоборот расширит возможности и поможет исследователям решать более амбициозные задачи. «Я вижу в этом возможность расширить сферу деятельности математиков и повысить значимость их работы», — утверждает он. Математики, в свою очередь, признают потенциал новых инструментов, но требуют академического подхода к публикации результатов. Математическое сообщество в целом также признаёт потенциал ИИ-инструментов, однако настаивает, что полученные с их помощью результаты должны проходить через те же процедуры проверки, воспроизводимости и научного обсуждения, что и результаты, полученные традиционными методами. Появление открытого репозитория OpenAI делает часть таких материалов доступной исследователям, но не снимает вопроса о том, насколько подробно и в каком формате должны публиковаться доказательства, полученные ИИ. OpenAI сначала поссорилась с математиками, а теперь позвала их оценивать достижения своего ИИ
22.09.2026 [11:22],
Павел Котов
OpenAI объявила о создании независимой консультативной группы на базе Института перспективных исследований в Принстоне (штат Нью-Джерси, США). Структура получила название «Консультативная группа в области математики и искусственного интеллекта»; её задача — обеспечить участие математиков в профильных исследованиях компании. 
Источник изображения: Brecht Corbeel / unsplash.com «Группа будет выступать в качестве связующего звена с математическим сообществом и широкой общественностью, давая математикам возможность высказать своё мнение о том, как мы движемся вперёд», — говорится в заявлении компании. Инициатива возникла после недавнего инцидента с публикацией решения одной из задач тысячелетия — проблемы существования и гладкости решений уравнений Навье — Стокса. Объявив о создании консультативной группы, OpenAI сообщила, что использованная ранее неизданная модель ИИ решила ещё более 100 открытых задач в большинстве областей математики. Многие выдающиеся учёные выразили недовольство тем, что эти результаты достигаются слишком быстро. Более 25 лауреатов Филдсовской премии подписали открытое письмо, в котором заявили, что ИИ-лаборатории ставят под угрозу их интеллектуальную работу в стремлении просто обогнать друг друга в решении известных математических задач. Впоследствии OpenAI отказалась спонсировать математическое мероприятие в Калифорнийском технологическом институте. Структура будет выполнять преимущественно консультативные функции, оценивая значимость новых результатов и координируя их публикацию. Работа в группе оплачиваться не будет, но входящие в неё учёные получат возможность публично высказывать независимое мнение, и OpenAI не сможет влиять на состав совета. С другой стороны, у экспертов не будет возможности оказывать влияние на скорость или направление текущих математических исследований OpenAI. Последний аспект подчеркнули и сами учёные. «Мы будем давать советы, но у нас нет полномочий принимать решения ни в одной занимающейся ИИ компании, и ответственность за принимаемые любой компанией решения будет лежать на этой компании», — говорится в пресс-релизе Института перспективных исследований. Конфликт OpenAI с математиками продолжает нарастать
13.09.2026 [11:21],
Владимир Фетисов
Двадцать пять ведущих математиков подписали открытое письмо, в котором говорится, что компании, занимающиеся разработкой технологий искусственного интеллекта, ставят под угрозу интеллектуальный труд учёных, пытаясь обойти друг друга в решении известных математических задач. Все первоначальные подписанты письма являются обладателями медали Филдса — самой престижной награды в области математики. 
Источник изображения: Brecht Corbeel / unsplash.com На этой неделе профессор Нью-Йоркского университета Тристан Бакмастер (Tristan Buckmaster) обвинил OpenAI в том, что компания оказывала на него давление, требуя не указывать среди авторов одной из работ коллегу из Anthropic, вместе с которым он занимался решением важной математической задачи. Бакмастер также задался вопросом, не могла ли OpenAI использовать материалы, которые учёные загружали в Codex, чтобы затем получить собственное прорывное доказательство в ходе продолжительных вычислений. В четверг OpenAI отказалась от спонсорства математического мероприятия в Калифорнийском технологическом институте. Это произошло после того, как работа компании подверглась критике со стороны исследователей этого института. Способность ИИ-моделей решать важнейшие нерешённые математические задачи может принести человечеству огромную пользу. Однако авторы письма уверены, что это произойдёт только в том случае, если найденные решения смогут понять и объяснить представители математического сообщества, а в конечном счёте — и весь остальной мир. «Зачастую о таких решениях объявляют в спешке. На то, чтобы должным образом оформить результат работы, выделить основные методы и идеи, а также сослаться на соответствующие работы других учёных, просто не остаётся времени. Как и в любой творческой профессии, это порождает серьёзные вопросы об авторстве и плагиате. Более того, без участия математиков, которые должны заниматься развитием и включением новых идей в математический канон, зародившиеся с помощью ИИ идеи никогда не обретут полноценную жизнь, а важнейшая цепочка передачи знаний между математиками будет утеряна», — говорится в письме. Авторы TechCrunch отмечают, что доказательство OpenAI пока не прошло независимую проверку. На этом фоне другие математики стали проявлять большую осторожность. Они всё чаще задаются вопросом, могла ли OpenAI использовать сведения об их взаимодействии с Codex при создании новых ИИ-моделей. Существуют реальные опасения, что культура открытых исследований окажется под угрозой. Если ведущая ИИ-лаборатория обнаружит перспективный путь к открытию, она может потратить десятки миллионов долларов на работу языковых моделей, чтобы опередить первоначальных исследователей и первой представить доказательство. Такая динамика будет подталкивать научное сообщество к большей секретности. Письмо математиков последовало за Лейденской декларацией, которую рабочая группа учёных опубликовала в июне. В этом документе также рассматривалось, как полученные с помощью больших языковых моделей доказательства могут изменить работу математиков, и приводились рекомендации для учёных, научных учреждений и властей. Ценность математики заключается не только в самих доказательствах и признании авторства. Важна и окружающая их интеллектуальная среда, в которой обучаются студенты, появляются новые вопросы и идеи, а результаты исследований становятся частью общей системы человеческих знаний. «Проблемы, с которыми сейчас сталкивается математическое сообщество, схожи с проблемами других научных и творческих профессий. Они указывают на вопрос, который может встать перед всем человечеством: как сделать так, чтобы, пока ИИ меняет способы выполнения работы, мы не утратили изначальную цель этой работы», — говорится в письме математиков. 25 лауреатов Филдсовской премии забили тревогу из-за успехов ИИ в математике
12.09.2026 [09:51],
Павел Котов
Участие искусственного интеллекта в математической науке создаёт угрозу для научного знания и математического сообщества, говорится в открытом письме, подписанном 25 лауреатами Филдсовской премии — самой престижной награды в математике. 
Источник изображения: Saad Ahmad / unsplash.com Проблема в том, указывают учёные, что цели ИИ-лабораторий и математического сообщества расходятся. Для разработчиков решение известных задач — это возможность продемонстрировать возможности ИИ; математики же воспринимают его как средство получения новых знаний и методов — основной целью «являются концептуальное понимание и новые идеи». Ранее решение известных задач было сопряжено с длительным изучением новых идей и методов — результаты решений обсуждались, упрощались и соотносились с предыдущими исследованиями, после чего они попадали в учебники и использовались в других областях знаний. С ИИ эта экосистема человеческих знаний разрушается: результаты публикуются в спешке без соответствующего оформления, указания на новые методы и связи с работами других учёных. Возникают новые вопросы об авторстве и плагиате: чтобы созданные ИИ идеи в полной мере воплощались, требуется участие членов математического сообщества, способных эти идеи развить и интегрировать в сложившуюся систему знаний. ИИ действительно способен ускорить исследования в области математики, но фактическая польза для человечества будет зависеть от людей, которые управляют этой технологией. На этой неделе OpenAI сообщила о решении проблемы существования гладкости решений уравнений Навье — Стокса; проверка и формализация результата заняли у внутренней модели компании ещё 17 часов. Впоследствии профессор математики Нью-Йоркского университета заподозрил OpenAI в использовании наработок, принадлежащих ему и его коллеге, который работает в Anthropic. OpenAI не смогла ни опровергнуть подозрения учёных, ни предложить им компромиссного решения. OpenAI заявила, что её ИИ решил одну из Задач тысячелетия
09.09.2026 [09:12],
Андрей Созинов
OpenAI заявила, что её ИИ решил одну из семи знаменитых Задач тысячелетия — проблему существования и гладкости решений уравнений Навье — Стокса, над которой математики бились десятилетиями. Эти уравнения описывают движение жидкостей и газов, но до сих пор никто не мог доказать, всегда ли их гладкие решения остаются такими сколь угодно долго или при определённых условиях скорость потока может за конечное время неограниченно возрасти. 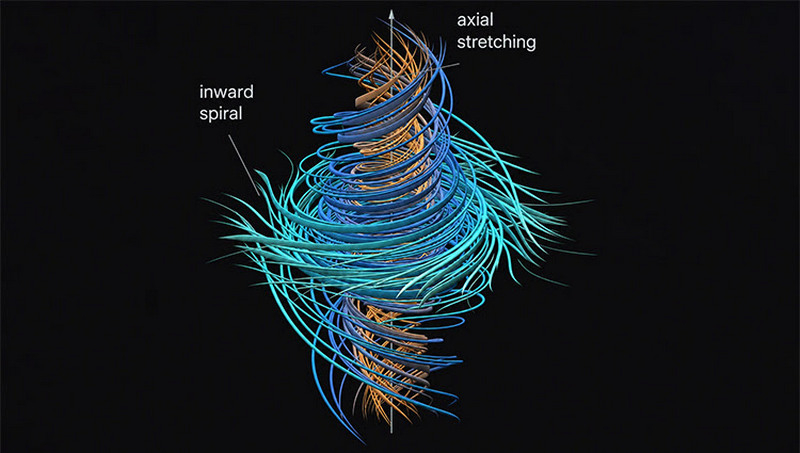
Источник изображения: OpenAI Уравнения названы в честь Клода-Луи Навье и Джорджа Габриэля Стокса, работавших в XIX веке. В 1934 году Жан Лере доказал существование обобщённых решений, однако вопрос о том, остаются ли гладкими решения трёхмерной задачи, оставался открытым примерно 90 лет. В 2000 году Математический институт Клэя (Clay Mathematics Institute) включил эту проблему в список семи Задач тысячелетия. За решение каждой из них предусмотрена награда в $1 млн. ИИ OpenAI построил пример второго варианта решения уравнения: изначально покоящаяся жидкость под действием плавно меняющейся внешней силы образует всё сильнее стягивающийся вихрь, скорость которого за конечное время растёт без ограничений. При этом общая энергия жидкости остаётся конечной. Вихрь одновременно закручивается внутрь и вытягивается вдоль оси, а его центральная область постепенно сжимается. Техническая сложность состояла в том, чтобы получить такое разрушение гладкости за счёт самой динамики жидкости, а не просто задать бесконечную внешнюю силу. В найденном решении ускорение, градиенты давления, перенос импульса и вязкость становятся очень большими, но при этом точно компенсируют друг друга, благодаря чему внешняя сила остаётся гладкой даже тогда, когда скорость жидкости стремится к бесконечности. Масштаб вычислений впечатляет. Над задачей одновременно работала система примерно из 10 тысяч ИИ-агентов на базе ещё не выпущенной модели OpenAI со способностями выше, чем у GPT-6 Astra. За 88 часов агенты обменялись 2,7 млн сообщений и нашли решение, после чего GPT-6 Astra потратила ещё 17 часов на формализацию и проверку доказательства в математической системе Lean. При решении задачи Навье — Стокса агенты использовали примерно 130 млрд выходных токенов. Вычислительные ресурсы, по словам главы исследований OpenAI Марка Чена (Mark Chen), обошлись компании в миллионы долларов. При этом путь к решению начался с другой задачи. Почти 100 агентов OpenAI около 50 часов работали над проблемой регулярности уравнений Эйлера — более простого варианта уравнений Навье — Стокса без учёта вязкости. Система неожиданно получила доказательство возникновения сингулярности в нефорсированной (то есть без внешней силы) версии этой задачи. После этого OpenAI перенаправила ресурсы на Навье — Стокса, а полученный результат по Эйлеру использовала как отправную точку. Именно здесь возникает важная математическая оговорка. Результат OpenAI использует внешний силовой член, или forcing, в уравнениях Навье — Стокса. Такой член присутствует в официальной формулировке задачи Института Клэя, однако многие математики обычно рассматривают нефорсированную версию, считая forcing несущественным для вопроса о возникновении сингулярности. Математики ранее предположили, что именно этот часто игнорируемый член может позволить получить разрушение гладкости. Поэтому некоторые специалисты могут посчитать результат OpenAI решением задачи с использованием своеобразной лазейки, а не решением проблемы в привычной постановке. Но интересно, что открытие сразу обернулось скандалом. Математик Тристан Бакмастер (Tristan Buckmaster) из Нью-Йоркского университета и сотрудник Anthropic Левент Альпёге (Levent Alpöge) ранее получили важный результат для упомянутых уравнений Эйлера, который рассматривался как шаг на пути к решению проблемы Навье — Стокса. Математики также развили идею использования внешнего силового члена для уравнений Эйлера. В своей работе они пользовались Codex, а OpenAI начала собственный штурм Задач тысячелетия после появления слухов о возможном решении двух из них. Поэтому Бакмастер заподозрил, что содержимое их сессий в Codex с неопубликованными наработками могло каким-то образом повлиять на модель OpenAI. OpenAI это отрицает и утверждает, что её сотрудники и ИИ-агенты не видели материалов исследователей и пришли к результату независимо. Компания утверждает, что 1 сентября услышала лишь слухи о возможном решении двух Задач тысячелетия и после этого запустила масштабную проверку всех нерешённых проблем. Однако исключить влияние обезличенных данных, полученных при использовании её продуктов, компания не может. В итоге история превратилась ещё и в спор о том, насколько безопасно доверять ИИ неопубликованные научные наработки. Уже после завершения собственного доказательства OpenAI связалась с исследователями, полагая, что они также решили задачу Навье — Стокса, но выяснила, что речь шла о другом результате. Сам Бакмастер утверждает, что во время разговора с представителями OpenAI компания предлагала вариант публикации, в котором он стал бы единственным автором работы по Навье — Стоксу, а имя Альпёге не упоминалось бы. OpenAI отрицает, что предлагала исключить Альпёге из авторства. Окончательную точку предстоит поставить математикам: опубликованное доказательство должно пройти независимую проверку. Кроме того, предстоит решить вопрос о том, соответствует ли найденная конструкция исходной формулировке задачи Института Клэя и можно ли считать использование forcing полноценным решением проблемы. OpenAI заранее заявила, что не собирается претендовать на премию в $1 млн, предусмотренную за решение задачи. Anthropic Claude формализовала доказательство Великой теоремы Ферма
05.09.2026 [12:39],
Павел Котов
Anthropic при помощи одной из моделей искусственного интеллекта Claude построила проверяемую на компьютере версию чрезвычайно сложного математического доказательства. 
Источник изображения: anthropic.com Доказательство, над которым Anthropic работала в рамках данного проекта, подтверждает гипотезу, получившую название Великой теоремы Ферма — она была выдвинута в 1637 году, и связана она со свойствами положительных целых чисел. Доказательство теоремы в 1995 году разработал математик Эндрю Уайлс (Andrew Wiles) — оно занимает 129 страниц, а на его проверку требуются несколько месяцев работы. В рамках исследовательского проекта Anthropic удалось формализовать доказательство Уайлса, то есть преобразить его в форму, которую можно проверить на компьютере. Формализованное доказательство представляет собой код, написанный на языке программирования Lean — его размер составляет 13 млн строк, и это самый большой объём за всю историю. Формализация сложна, потому что доказательства, как правило, довольно лаконичны — в ней отсутствуют некоторые пояснения, необходимые компьютеру для понимания, что требует добавлять их вручную. Аргументы в доказательстве часто вытекают друг из друга, то есть ошибка в одной строке Lean может сделать недействительным весь последующий код. Математики предполагали, что формализация доказательства Уайлса займёт несколько лет, но исследовательская модель Anthropic выполнила задачу за 11 дней — это был алгоритм, сопоставимый с общедоступной моделью Claude Fable 5.1. Модель выполнила задачу, используя лишь ограниченный объём высокоуровневых данных. Она запустила несколько десятков агентов, которые сгенерировали 6 млрд токенов выходных данных и в процессе доказали 29 500 промежуточных теорем. Первая попытка закончилась неудачей, прорыва удалось добиться, когда Claude открыли доступ к платформе Prove2Me. «Мы увидели автоформализацию алгебры, гармонического анализа, геометрии и теории чисел и поняли, что средства автоформализации теперь достаточно надёжны, чтобы с ними можно было работать; доказательство многоуровневое», — заявил математик Кевин Баззард (Kevin Buzzard), чья работа использовалась в проекте. За месяц до этого Anthropic добилась прогресса в доказательстве гипотезы Римана. Неопубликованная модель Anthropic добилась прогресса в решении важнейшей математической задачи
12.08.2026 [08:23],
Павел Котов
Гипотеза Бернхарда Римана (Bernhard Riemann) вот уже более 150 лет остаётся одной из главных нерешённых задач в математике — она связана с распределением простых чисел. Сейчас за рабочее доказательство гипотезы, которое до сих пор не удалось найти, объявлена награда в $1 млн. Значительного прогресса удалось достичь неизданной пока модели Anthropic. 
Источник изображения: anthropic.com Современные модели искусственного интеллекта пока тоже не сумели её решить, но смогли продвинуться дальше, чем можно было бы ожидать. Это открытие, вероятно, вновь поднимет вопросы о способности современного ИИ к открытиям в области математики. Anthropic объявила, что ещё не опубликованная модель компании добилась прогресса в доказательстве гипотезы Римана, значительно увеличив нижнюю границу решений, для которых она верна. Сотрудник лаборатории, не имеющий крепкой математической подготовки, предложил модели «попробовать силы» в доказательстве гипотезы и оставил модель координировать задачу в последующие полтора дня. За это время она испробовала 650 вариантов решения проблемы, координируя действия 60 субагентов и потратив 31 млн выходных токенов. «Из 60 субагентов 2 отвечали за разработку основных математических решений, 13 генерировали новые варианты решения для этих агентов, 30 пытались (но не смогли) выработать новые идеи, 13 выступали в качестве валидаторов для проверки правильности аргументов, а последние 2 помогли написать первоначальную статью», — рассказали в Anthropic. Результат подтвердили двое штатных математиков компании; его формализовали с помощью платформы обработки математических доказательств Lean. За последний год модели ИИ решили ряд сложнейших задач Пала Эрдёша (Pál Erdős); выход более мощных систем показал ещё более впечатляющие результаты. OpenAI рассказала о решении десяти задач передовой моделью Astra, а ещё одна модель конкурирующей Anthropic опровергла давнюю гипотезу якобиана. В сообществе математиков эти достижения вызывают как восторг, так и опасения: существует стандарт, согласно которому математические доказательства должны «приписываться конкретным авторам, которые берут на себя ответственность за их открытие и правильность». Есть и мнение, что математические теоремы могут не ассоциироваться с конкретными учёными — большинство звёзд во Вселенной вообще не имеет названий. GPT-5.6 Sol за час доказала математическую гипотезу, над которой учёные бились более 50 лет
16.07.2026 [16:48],
Анжелла Марина
OpenAI объявила, что модель GPT-5.6 Sol смогла доказать гипотезу о двойном покрытии циклов (Cycle Double Cover Conjecture), остававшуюся нерешённой более 50 лет. По утверждению компании, успешное доказательство было получено одновременно с выпуском новой версии ИИ-модели. 
Источник изображения: AI Гипотеза, сформулированная в 1970-х годах, относится к области теории графов, изучающей вершины и соединяющие их рёбра. Она утверждает, что практически любой граф допускает двойное покрытие циклами, при котором каждое ребро входит ровно в два замкнутых контура. Ранее, как отмечает авторитетный научно-популярный журнал Scientific American, математикам удавалось доказать это лишь для отдельных классов графов, однако общего решения получить не удавалось. Созданное с помощью GPT-5.6 Sol доказательство показывает, что любой граф, удовлетворяющий условиям гипотезы, может быть покрыт не более чем восемью специально подобранными циклами. По мнению математика Ноги Алона (Noga Alon) из Принстонского университета (Princeton University), полученный результат стал ещё одним свидетельством того, что инструменты искусственного интеллекта уже начинают существенно влиять на современные математические исследования. Для получения доказательства OpenAI использовала специальный промпт, опубликованный вместе с результатами работы. В частности, модели было предложено распределить решение между 64 агентами, работающими параллельно, а также не прекращать поиск решения, даже если задача считается нерешённой. Кроме того, разработчики рекомендовали модели уделить поиску доказательства не менее восьми часов, прежде чем отказаться от дальнейших попыток. Математик Эндрю Сазерленд (Andrew Sutherland) из Массачусетский технологический институт (MIT) предположил, что подобные случаи могут повторяться и в дальнейшем. По его словам, некоторые задачи приобретают репутацию исключительно сложных, из-за чего исследователи уделяют им меньше внимания, тогда как большие языковые модели способны объединять уже существующие методы и находить относительно простые решения для давно известных математических гипотез. ИИ OpenAI решил 80-летнюю задачу Эрдёша — и на этот раз математики согласны
21.05.2026 [06:12],
Анжелла Марина
Компания OpenAI утверждает, что её новая модель рассуждений позволила получить оригинальное математическое доказательство, опровергающее известную нерешённую гипотезу в геометрии, впервые выдвинутую выдающимся математиком Полем Эрдёшем в 1946 году. Задача оставалась открытой на протяжении почти 80 лет. 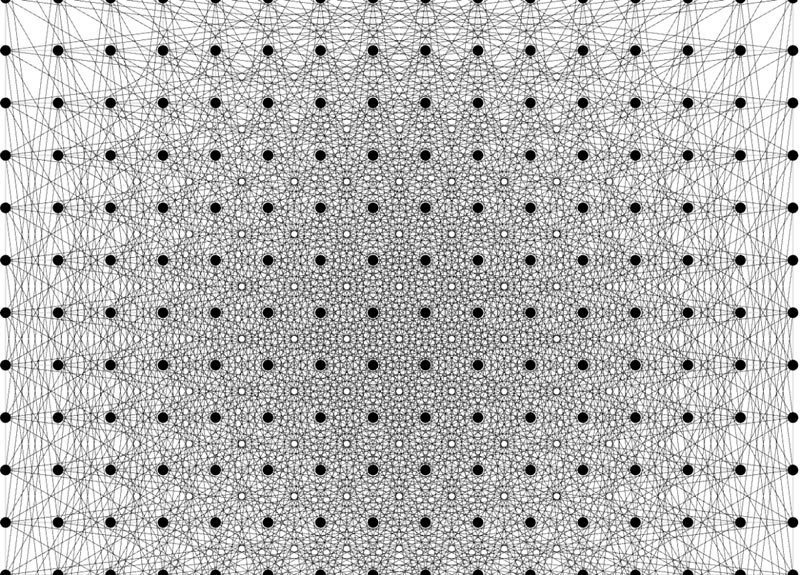
Источник изображения: OpenAI Долгие годы научное сообщество полагало, что лучшие варианты решения этой проблемы сводятся к структурам, похожим на квадратные сетки. Однако искусственный интеллект смог опровергнуть это убеждение, обнаружив совершенно новое семейство конструкций с более высокой эффективностью. Представители OpenAI подчеркнули, что это первый случай, когда ИИ автономно решил открытую проблему, имеющую центральное значение для математики. При этом доказательство было получено с помощью модели общего назначения, а не специализированной системы, созданной исключительно для точных наук. Текущему успеху предшествовал инцидент, произошедший семь месяцев назад, когда бывший вице-президент компании Кевин Вейл (Kevin Weil) поспешно заявил о решении моделью GPT-5 сразу десяти задач Эрдёша. Тогда выяснилось, что алгоритм лишь нашёл уже существующие в литературе ответы, после чего последовали насмешки со стороны специалистов и конкурентов, включая известного учёного в области информатики Яна Лекуна (Yann LeCun) и генерального директора Google DeepMind Демиса Хассабиса (Demis Hassabis). Вейл удалил свою публикацию, а математик Томас Блум (Thomas Bloom), ведущий сайт с задачами Эрдёша, назвал те заявления «драматическим искажением фактов». На этот раз разработчики учли прошлые ошибки и опубликовали анонс вместе с сопроводительными комментариями известных математиков, подтвердивших достоверность опровержения. Среди них: Нога Алон (Noga Alon), Мелани Вуд (Melanie Wood) и сам Томас Блум. По словам последнего, искусственный интеллект теперь помогает людям более полно исследовать математические концепции, выстраивавшиеся веками. В OpenAI считают это достижение знаковым, так как оно показало способность современных ИИ-систем удерживать длинные и сложные цепочки логических выводов. Кроме того, алгоритмы научились связывать идеи из разных областей способами, которые исследователи ранее могли упускать из виду. ChatGPT получил визуальную функцию, которая «заставит» полюбить математику
11.03.2026 [06:08],
Анжелла Марина
Компания OpenAI представила новую функцию ChatGPT под названием «динамические визуальные объяснения» (dynamic visual explanations). Функция позволяет не просто читать разъяснения математических и научных концепций в виде текста, а взаимодействовать с интерактивными модулями в реальном времени. 
Источник изображения: xAI Как поясняет TechCrunch, принцип работы прост. Если спросить, что такое уравнение линзы или как найти площадь круга, ChatGPT выдаст не только текст, но и представит визуальный модуль, в котором можно менять значения переменных и мгновенно наблюдать за изменениями. Например, при изучении теоремы Пифагора можно регулировать длины сторон треугольника и видеть, как пересчитывается гипотенуза. 
Источник изображения: OpenAI На данный момент интерактивная визуализация доступна для более чем 70 тем по математике и естественным наукам. Среди них — биномиальный квадрат, закон Шарля, площадь круга, сложные проценты, закон Кулона, разность квадратов, экспоненциальный распад, закон Гука, кинетическая энергия, линейные уравнения и закон Ома. Функция доступна всем авторизованным пользователям ChatGPT, а список тем будет постепенно расширяться. Запуск нового инструмента примечателен тем, что он смещает роль ChatGPT от простой выдачи готовых ответов к вовлечению пользователя в процесс понимания, отмечает TechCrunch. Приведёт ли это к более глубокому усвоению материала, во многом будет зависеть от того, как именно люди станут использовать эту возможность. По данным OpenAI, более 140 миллионов человек еженедельно обращаются к ChatGPT с вопросами, связанными с математикой и естественными науками — то есть, теми предметами, которые традиционно вызывают трудности у учащихся. При этом в образовательном сообществе продолжаются споры: часть педагогов опасается чрезмерной зависимости от ИИ, тогда как многие учителя и студенты уже активно интегрируют технологию в учебный процесс. Отметим, новая функция дополняет другие образовательные инструменты ChatGPT, в частности, режим обучения, который пошагово ведёт пользователя через решение задач, и QuizGPT, позволяющий создавать карточки и проходить тестирование по любой теме. Аналогичную функцию интерактивных диаграмм в ноябре запустил сервис Gemini от Google. От распознавания кошек к задачам Эрдёша: ИИ всё активнее штурмует высшую математику
18.02.2026 [08:40],
Алексей Разин
Существующие ИИ-модели в большинстве своём изначально были ориентированы на сугубо гуманитарные вопросы, но постепенно их создатели начинают осознавать важность решения с их помощью математических задач. Во-первых, это способствует прогрессу в научных открытиях. Во-вторых, это позволяет использовать достигаемые в математике результаты в качестве метода демонстрации успехов ИИ. 
Источник изображения: Unsplash, Thomas T Важность этой тенденции была подчёркнута экспериментом одного из студентов Кембриджского университета, который использовал передовую ИИ-модель OpenAI для решения одной из математических задач Эрдёша, которые ранее считались неразрешимыми. Кроме того, ИИ-модели начали демонстрировать высокие результаты на Международной математической олимпиаде и прочих тематических конкурсах. Бывшая член совета директоров Хэлен Тоунер (Helen Toner) подчёркивает, что ИИ-модели в своём развитии уже миновали стадию, на которой от них требовалось научиться различать кошек и собак, и перешли к решению математических задач высшего уровня сложности. Лаборатория DeepMind компании Google выпустила специальные ИИ-модели для решения задач в области математики (AlphaProof) и геометрии (AlphaGeometry) соответственно. Обрели популярность бенчмарки Epoch AI, которые оценивают быстродействие новых ИИ-моделей в решении математических задач. Ранее считалось, что большие языковые модели плохо подходят для этого, поскольку они основаны на вероятностном предсказании следующего слова в предложении и нередко выдают галлюцинации, но с переходом на обучение с подкреплением и появлением рассуждающих моделей точность результатов ИИ-моделей заметно выросла. OpenAI даже наняла двух видных математиков: Эрнеста Рю (Ernest Ryu) из Калифорнийского университета в Лос-Анджелесе и Мехтаба Сани (Mehtaab Sawhney) из Колумбийского университета, чтобы усилить свою научную команду и улучшить эффективность собственных ИИ-моделей в решении математических задач. В целом, математика удобна исследователям, поскольку она позволяет автоматически проверять правильность полученных результатов. Такой подход позволяет добиться прогресса и в разработке программного обеспечения с помощью ИИ. Компания Anthropic, например, делает большие ставки на своего ИИ-ассистента Claude Code, который позволяет автоматически создавать программный код. В любом случае, для решения действительно сложных научных и математических задач современные ИИ-модели должны научиться работать с опорой на полученные в прошлом результаты, и добиться всего в рамках одной непродолжительной сессии в данном случае просто невозможно. Уже сейчас ИИ-модели способны эффективно резюмировать информацию и объединять данные, полученные в разных научных дисциплинах. В будущем это позволит ускорить научный прогресс, как считают эксперты. В математике ИИ уже показал себя с лучшей стороны. Российский математик нашел ключ к «нерешаемым» уравнениям XIX века: это упростит расчеты в физике и космонавтике
27.01.2026 [19:38],
Геннадий Детинич
Национальный исследовательский университет «Высшая школа экономики» (НИУ ВШЭ) сообщил, что математик Иван Ремизов из Нижнего Новгорода нашёл возможность для условно простого решения дифференциальных уравнений второго порядка с переменными коэффициентами. На протяжении почти двух столетий такие уравнения считались нерешаемыми. Между тем, они играют ключевую роль в математике и естественных науках, поскольку используются для описания динамических процессов. 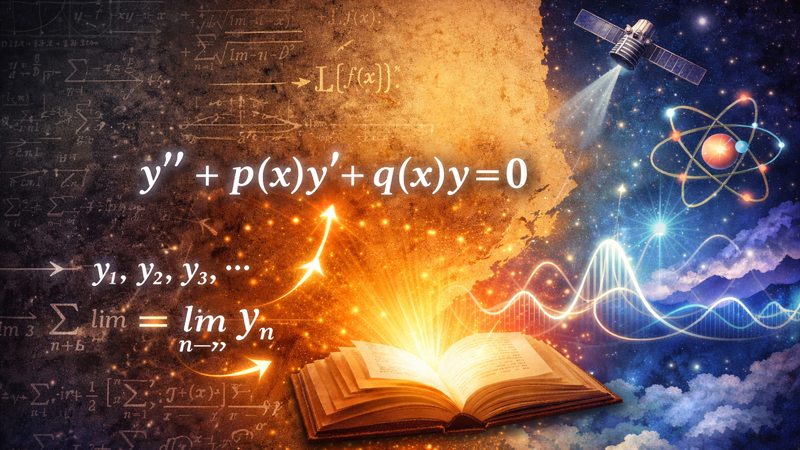
Источник изображения: ИИ-генерация ChatGPT 5.2/3DNews Исторически ограничение было связано с результатами французского математика Жозефа Лиувилля, который ещё в 1834 году показал, что решения подобных уравнений нельзя выразить через конечное число стандартных операций и элементарных функций. Из-за этого математики были вынуждены либо искать частные решения, либо использовать приближения, что исключало универсальную методику и очень сильно усложняло расчёты. Иными словами, общей формулы, в которую можно просто подставить «циферки» и получить решение, не существовало. Иван Ремизов предложил новый подход, расширив класс допустимых математических операций. Он не стал спорить с Лиувиллем, а просто добавил в уравнения ещё один математический инструмент — нахождение предела последовательности. Для этого математик воспользовался теорией Чернова и преобразованием Лапласа. Это позволило ему выстроить универсальную формулу, которая формально даёт решение любого уравнения «нерешаемого» класса, обходя классические ограничения теории. «Суть идеи в том, что сложный, постоянно меняющийся процесс разбивается на бесконечное множество простых шагов. Для каждого такого участка строится свое приближение — элементарный фрагмент, который описывает поведение системы в конкретной точке. По отдельности эти кусочки дают лишь упрощенную картину, но, когда их число устремляется к бесконечности, они бесшовно соединяются в идеально точный график решения», — поясняется в пресс-релизе НИУ ВШЭ. «Дифференциальные уравнения второго порядка используются не только для моделирования событий реального мира, но и для определения новых функций, которые нельзя задать иным образом. К ним относятся, например, так называемые специальные функции Матье и Хилла, они критически важны для понимания того, как движутся спутники на орбите или протоны в Большом адронном коллайдере». Чуть более сложным математическим языком об открытии можно прочитать на сайте НИУ ВШЭ. На английском языке работа опубликована полностью во «Владикавказском математическом журнале». ИИ-модели начали щёлкать сложные математические задачи
15.01.2026 [13:35],
Павел Котов
В минувшие выходные инженер-программист Нил Сомани (Neel Somani) тестировал математические способности новой модели искусственного интеллекта OpenAI и сделал неожиданное открытие. Он поставил ChatGPT сложнейшую математическую задачу, дал чат-боту подумать 15 минут и получил готовое решение. 
Источник изображения: Thomas T / unsplash.com Исследователь оценил доказательство, провёл его формализацию при помощи средства от Harmonic, и всё оказалось в порядке. Ещё больше его впечатлила цепочка рассуждений ChatGPT — в ней ИИ воспроизвёл формулу Лежандра, постулат Бертрана и теорему о звезде Давида; а также нашёл на Math Overflow сообщение от 2013 года, где приводилось решение аналогичной задачи. Окончательный вариант от ChatGPT имел существенные отличия от образца и давал полное решение версии одной из задач, поставленных легендарным математиком Палом Эрдёшем (Pál Erdős) — его коллекция нерешённых задач сейчас превратилась в полигон для ИИ. Этот удивительный результат не уникален — модели ИИ теперь повсеместно применяются в математике: средства «глубокого исследования» OpenAI отвечают за обзор литературы, а Harmonic Aristotle производит формализацию доказательств. Модель OpenAI GPT-5.2, по словам Нила Сомани, оказалась искуснее в рассуждениях, чем предыдущие версии — они уже научились решать остававшиеся открытыми задачи, по сути, расширяя границы человеческих знаний. Пал Эрдёш оставил после себя более тысячи гипотез, которые зафиксированы сообществом математиков в Сети — и они обнаружили, что GPT-5.2 на удивление хорошо справляется со сложнейшими математическими задачами. В период с 25 декабря 2025 года и по настоящий момент решены 15 задач Эрдёша, и в работе над 11 из них участвовал ИИ. Авторитетный математик Теренс Тао (Terence Tao) привёл восемь задач Эрдёша, в которых ИИ добился значительного прогресса; ещё в шести случаях его удалось достичь за счёт поиска и дальнейшего развития ранних исследований. Совсем без участия человека ИИ с ними пока не справился бы, но его роль становится более важной. «Таким образом, многие из этих более простых задач Эрдёша теперь с большей вероятностью могут решаться исключительно основанными на ИИ методами, чем человеческими или гибридными средствами», — делает вывод Теренс Тао. Ещё один важный фактор — сдвиг в сторону формализации. Это трудоёмкая задача, которая упрощает проверку и расширение математических рассуждений; она не требует ни ИИ, ни даже просто компьютеров, но сейчас появились средства, которые в значительной мере упростили этот процесс. Популярным, например, стал инструмент Lean, разработанный Microsoft Research ещё в 2013 году; средство Harmonic Aristotle позволяет в значительной мере автоматизировать эту задачу. Внезапный скачок в числе решённых задач Эрдёша привёл к тому, что упоминание сервисов Aristotle или ChatGPT добавляет материалам вескости в профессиональном сообществе. Найден новый способ поиска простых чисел — теперь RSA-шифрование устоит перед квантовыми компьютерами
21.06.2025 [21:56],
Геннадий Детинич
Издаваемый Национальной академией наук США (NAS) престижный рецензируемый журнал Proceedings of the National Academy of Sciences присудил ежегодно учреждаемую премию Cozzarelli Award группе математиков во главе с исследователем из США Кеном Оно (Ken Ono) из Университета Вирджинии. Кен с коллегами нашли прямую связь между простыми числами — основой RSA-ключей — и уравнениями 1800-летней давности, что стало прорывом в области защиты данных. 
Источник изображения: ИИ-генерация Grok 3/3DNews Открытие поможет защитить данные в эпоху квантовых компьютеров, которые скоро начнут угрожать RSA-шифрованию. Сегодня даже самые мощные классические суперкомпьютеры не способны за разумное время факторизовать достаточно большие целые числа — разложить их на простые множители для вычисления ключей шифрования. Потенциально с такой задачей начнут справляться только квантовые компьютеры за счёт явления суперпозиции, когда информация в каждом кубите будет представлена одновременно множеством состояний от 0 до 1, а не одним или другим фиксированным значением. Таким образом, учёным надо научиться находить всё большие простые числа (сейчас самое большое найденное простое число состоит из 41 млн цифр), а также искать иные подходы для определения таковых. Проделанная коллективом Кена Оно работа из таких — они нашли неизвестную ранее взаимосвязь между так называемыми диофантовыми уравнениями и простыми числами. Открытие диофантовых уравнений приписывают математику III века Диофанту Александрийскому. Они могут быть невероятно сложными, но если полученный ответ окажется верным, это означает, что число будет простым. По сути, это новый способ исследования простых чисел, который никогда ранее не использовался. «Простые числа, составляющие основу мультипликативной теории чисел, являются решениями бесконечно многих специальных “диофантовых уравнений” в хорошо изученных статистических разбиениях, — пишут авторы. — Другими словами, целочисленные разбиения позволяют находить простые числа бесконечно многими естественными способами». Проделанная учёными работа могла быть сделана 20, 30 и 80 лет назад, когда стала понятна важность шифрования данных, и в любом случае она бы произвела фурор среди специалистов. Удивительно, до сих пор её никто не делал, подчёркивают авторы исследования и добавляют, что теперь открывается возможность подключить к анализу простых чисел ряд статистических методов. Тем самым RSA-шифрование может получить второе дыхание и ещё окажет сопротивление квантовым компьютерам через пять, десять или больше лет. |
© 1997—2026 3DNews
При цитировании документа ссылка на сайт с указанием автора обязательна. Полное заимствование документа является
нарушением
российского и международного законодательства и возможно только с согласия редакции 3DNews.



 MWC 2018
 2018
 Computex

 IFA 2018






