


Опрос
|
реклама
Быстрый переход
Найден новый способ поиска простых чисел — теперь RSA-шифрование устоит перед квантовыми компьютерами
21.06.2025 [21:56],
Геннадий Детинич
Издаваемый Национальной академией наук США (NAS) престижный рецензируемый журнал Proceedings of the National Academy of Sciences присудил ежегодно учреждаемую премию Cozzarelli Award группе математиков во главе с исследователем из США Кеном Оно (Ken Ono) из Университета Вирджинии. Кен с коллегами нашли прямую связь между простыми числами — основой RSA-ключей — и уравнениями 1800-летней давности, что стало прорывом в области защиты данных. 
Источник изображения: ИИ-генерация Grok 3/3DNews Открытие поможет защитить данные в эпоху квантовых компьютеров, которые скоро начнут угрожать RSA-шифрованию. Сегодня даже самые мощные классические суперкомпьютеры не способны за разумное время факторизовать достаточно большие целые числа — разложить их на простые множители для вычисления ключей шифрования. Потенциально с такой задачей начнут справляться только квантовые компьютеры за счёт явления суперпозиции, когда информация в каждом кубите будет представлена одновременно множеством состояний от 0 до 1, а не одним или другим фиксированным значением. Таким образом, учёным надо научиться находить всё большие простые числа (сейчас самое большое найденное простое число состоит из 41 млн цифр), а также искать иные подходы для определения таковых. Проделанная коллективом Кена Оно работа из таких — они нашли неизвестную ранее взаимосвязь между так называемыми диофантовыми уравнениями и простыми числами. Открытие диофантовых уравнений приписывают математику III века Диофанту Александрийскому. Они могут быть невероятно сложными, но если полученный ответ окажется верным, это означает, что число будет простым. По сути, это новый способ исследования простых чисел, который никогда ранее не использовался. «Простые числа, составляющие основу мультипликативной теории чисел, являются решениями бесконечно многих специальных “диофантовых уравнений” в хорошо изученных статистических разбиениях, — пишут авторы. — Другими словами, целочисленные разбиения позволяют находить простые числа бесконечно многими естественными способами». Проделанная учёными работа могла быть сделана 20, 30 и 80 лет назад, когда стала понятна важность шифрования данных, и в любом случае она бы произвела фурор среди специалистов. Удивительно, до сих пор её никто не делал, подчёркивают авторы исследования и добавляют, что теперь открывается возможность подключить к анализу простых чисел ряд статистических методов. Тем самым RSA-шифрование может получить второе дыхание и ещё окажет сопротивление квантовым компьютерам через пять, десять или больше лет. Учёные уличили ИИ в неспособности строить математические доказательства в олимпиадных задачах USAMO 2025 года
26.04.2025 [12:29],
Дмитрий Федоров
Новое исследование ETH Zurich и INSAIT показало, что современные ИИ-модели, имитирующие рассуждение и уверенно решающие стандартные математические задачи, практически не способны формулировать полные доказательства уровня Математической олимпиады США 2025 года (USAMO). Эти результаты ставят под сомнение возможность глубокого математического рассуждения у современных ИИ-моделей. 
Источник изображения: Imkara Visual / Unsplash В марте 2025 года исследовательская группа из Швейцарской высшей технической школы Цюриха (ETH Zurich) и Института компьютерных наук, искусственного интеллекта и технологий (INSAIT) при Софийском университете, возглавляемая Иво Петровым (Ivo Petrov) и Мартином Вечевым (Martin Vechev), опубликовала препринт научной статьи под названием «Proof or Bluff? Evaluating LLMs on 2025 USA Math Olympiad» (рус. — Доказательство или блеф? Оценка больших языковых моделей на Математической олимпиаде США 2025 года). Работа направлена на оценку способности больших языковых моделей (LLMs), имитирующих рассуждение, генерировать полные математические доказательства на олимпиадных задачах. Для анализа были использованы шесть задач с USAMO 2025 года, организованного Математической ассоциацией Америки. ИИ-модели тестировались сразу после публикации заданий для минимизации риска утечки данных в обучающие выборки. Средняя результативность по всем ИИ-моделям при генерации полных доказательств составила менее 5 % от максимально возможных баллов. Системы оценивались по шкале от 0 до 7 баллов за задачу с учётом частичных зачётов, выставляемых экспертами. Лишь одна модель — Gemini 2.5 Pro компании Google — показала заметно лучший результат, набрав 10,1 балла из 42 возможных, что эквивалентно примерно 24 %. Остальные модели существенно отставали: DeepSeek R1 и Grok 3 получили по 2,0 балла, Gemini Flash Thinking — 1,8 балла, Claude 3.7 Sonnet — 1,5 балла, Qwen QwQ и OpenAI o1-pro — по 1,2 балла. ИИ-модель o3-mini-high компании OpenAI набрала всего 0,9 балла. Из почти 200 сгенерированных решений ни одно не было оценено на максимальный балл. Исследование подчёркивает фундаментальное различие между решением задач и построением математических доказательств. Стандартные задачи, такие как вычисление значения выражения или нахождение переменной, требуют лишь конечного правильного ответа. В отличие от них, доказательства требуют последовательной логической аргументации, объясняющей истинность утверждения для всех возможных случаев. Это качественное различие делает задачи уровня USAMO значительно более требовательными к глубине рассуждения. 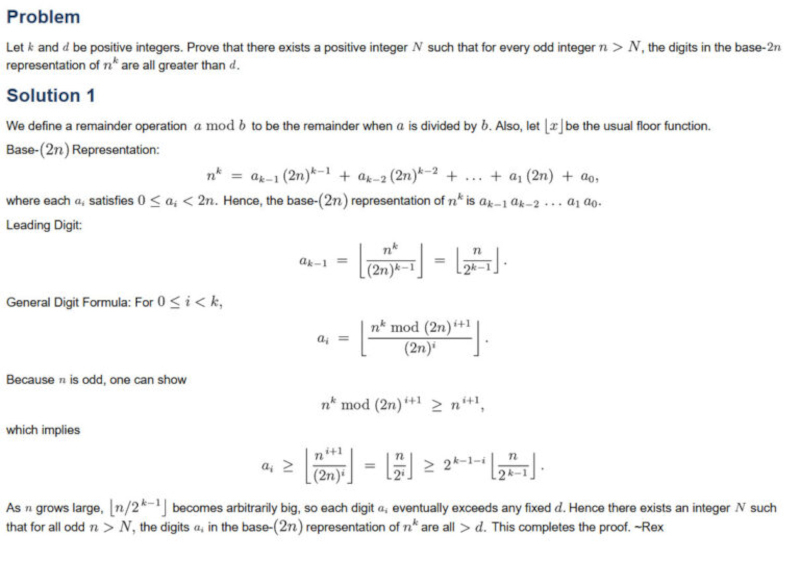
Скриншот задачи №1 USAMO 2025 года и её решения на сайте AoPSOnline. Источник изображения: AoPSOnline Авторы исследования выявили характерные модели ошибок в работе ИИ. Одной из них стала неспособность поддерживать корректные логические связи на протяжении всей цепочки вывода. На примере задачи №5 USAMO 2025 года ИИ-модели должны были найти все натуральные значения k, при которых определённая сумма биномиальных коэффициентов в степени k остаётся целым числом при любом положительном n. Модель Qwen QwQ допустила грубую ошибку, исключив возможные нецелые значения, разрешённые условиями задачи, что привело к неправильному окончательному выводу, несмотря на правильное определение условий на промежуточных этапах. Характерной особенностью поведения моделей стало то, что даже в случае серьёзных логических ошибок они формулировали свои решения в утвердительной форме, без каких-либо признаков сомнения или указаний на возможные противоречия. Это свойство имитации рассуждения указывает на отсутствие у ИИ-моделей механизмов внутренней самопроверки и коррекции вывода. Авторы отметили также влияние особенностей обучения на качество решений. Тестируемые ИИ-модели демонстрировали артефакты оптимизационных стратегий, применяемых при подготовке к стандартным бенчмаркам: например, принудительное форматирование ответов с использованием команды \boxed{}, предназначенное для удобства автоматизированной проверки. Эти шаблонные подходы приводили к ошибкам в контексте задач, где требовалось развёрнутое доказательство, а не только числовой ответ. 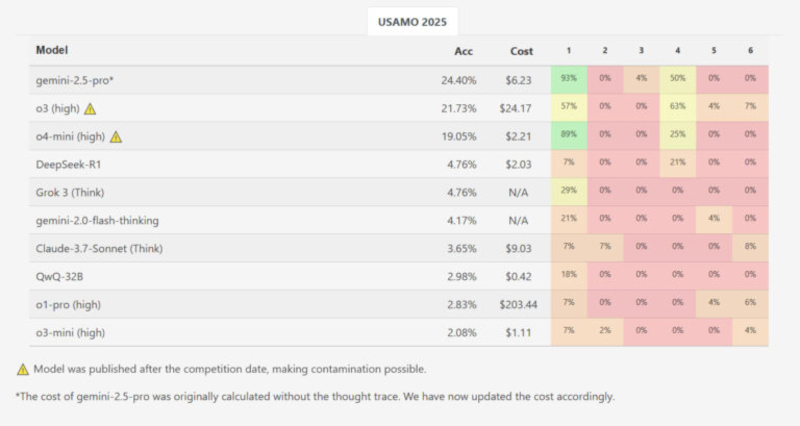
Показатели точности ИИ-моделей на каждой задаче USAMO 2025 года. Источник изображения: MathArena Несмотря на выявленные ограничения, внедрение методов цепочки размышлений и имитации рассуждения положительно сказались на формировании промежуточных логических шагов в процессе вывода ИИ-моделей. Механизм масштабирования вычислений на этапе вывода позволяет ИИ строить более связные локальные рассуждения. Однако фундаментальная проблема остаётся: современные большие языковые модели (LLM) на архитектуре «Трансформер» (Transformer) продолжают работать как системы распознавания паттернов, а не как самостоятельные системы концептуального рассуждения. Более высокие результаты модели Gemini 2.5 Pro свидетельствуют о потенциальной возможности сокращения разрыва между симулированным и реальным рассуждением в будущем. Однако для достижения качественного прогресса необходимо обучение ИИ-моделей более глубоким многомерным связям в латентном пространстве и освоение принципов построения новых логических структур, а не только копирование существующих шаблонов из обучающих выборок. Открыто самое большое простое число — в нём 41 миллион цифр
22.10.2024 [17:01],
Павел Котов
Бывший инженер-программист Nvidia Люк Дюран (Luke Durant) и проект GIMPS (Great Internet Mersenne Prime Search) нашли самое большое на сегодняшний день известное человеку простое число, для написания которого потребуются 41 млн цифр. GIMPS — это попытка добровольцев по всему миру обнаружить простые числа Мерсенна, которые имеют вид 2n-1. 
Источник изображения: kp yamu Jayanath / pixabay.com Самое большое простое число, известное человеку на данный момент — это 2136 279 841-1; а обозначается оно как M136279841. Чтобы получить это число, потребуется умножать двойку на себя более 136 млн раз, а из получившегося результата вычесть единицу. До этого шестью годами ранее было найдено поставившее предыдущий рекорд число M82589933. Новое открытие знаменательно тем, что его совершили, использовав графические процессоры в центрах обработки данных. Первым ресурсы графических процессоров задействовал в 2017 году Михай Преда (Mihai Preda) — он «написал программу GpuOwl для проверки чисел Мерсенна на простоту и сделал своё ПО доступным для всех пользователей GIMPS». В 2023 году к GIMPS подключился Люк Дюран, и участники проекта построили инфраструктуру, необходимую для развёртывания программы Преды на нескольких GPU-серверах в облаке. Работа заняла год, но усилия принесли плоды 11 октября, когда ускоритель Nvidia A100 в ирландском Дублине выдал результат M136279841, а подтвердил его расположенный в техасском Сан-Антонио Nvidia H100. Это интересное упражнение для любителей математики и напоминание, что графические процессоры в ЦОД полезны не только в области искусственного интеллекта. Они могут применяться для моделирования, при котором требуется большое количество исходных данных, для криптографии и многого другого. Мощность графических процессоров растёт, и они продолжат помогать в поиске ещё бо́льших простых чисел. |
© 1997—2026 3DNews
При цитировании документа ссылка на сайт с указанием автора обязательна. Полное заимствование документа является
нарушением
российского и международного законодательства и возможно только с согласия редакции 3DNews.



 MWC 2018
 2018
 Computex

 IFA 2018







