



 MWC 2018
 2018
 Computex

 IFA 2018



Китайская лаборатория искусственного интеллекта DeepSeek представила обновлённый вариант компактной модели с поддержкой функции визуального восприятия. DeepSeek V4.1-Flash предназначается для быстрой обработки и генерации токенов, то есть работы с высокой пропускной способностью.









Источник изображений: deepseek.com
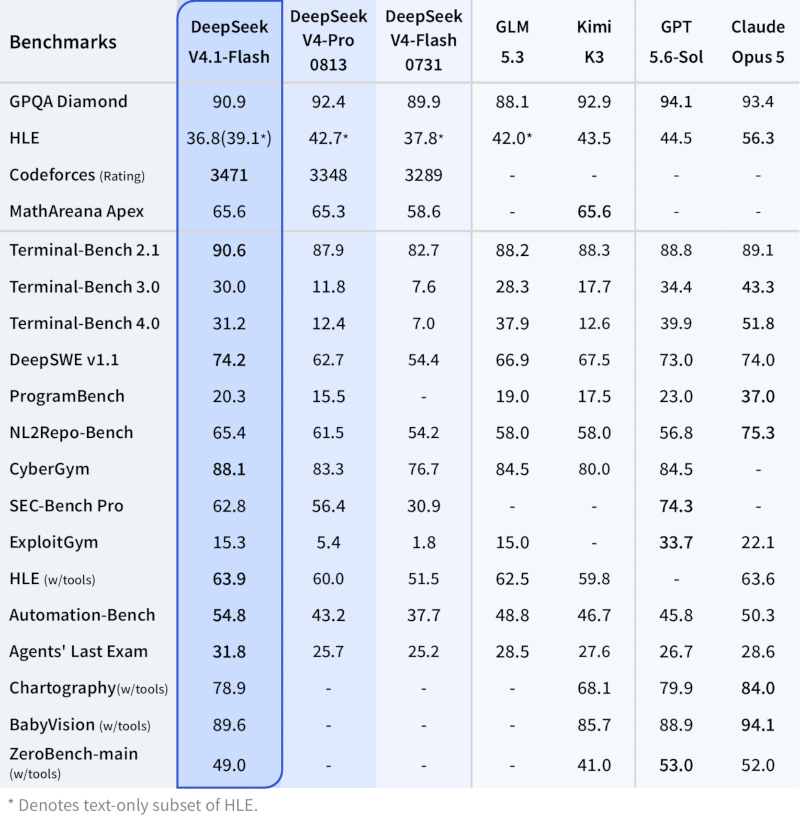
Модель имеет размер 552 млрд параметров, используется механизм MoE (Mixture-of-Experts) с обновлённой архитектурой Causal Encoder–Decoder с 8 млрд параметров на вводе и 16 млрд — на выводе. Новые методы предварительного обучения и масштабный этап последующего обучения с подкреплением обеспечили результаты, которые превзошли показатели флагманских моделей, включая мощную DeepSeek V4-Pro.
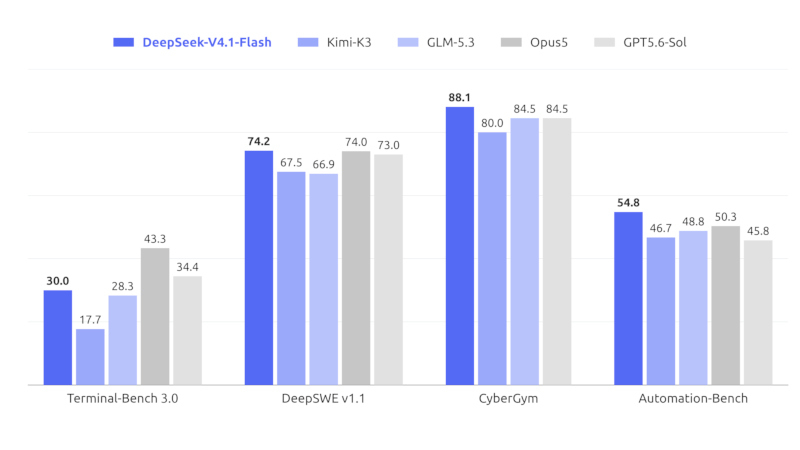
Например, в тесте DeepSWE v1.1 новая модель набрала 74,2 балла, немного опередив GPT-5.6-Sol (73) и Claude Opus 5 (74). На CyberGym результат V4.1-Flash составил 88,1 балла — выше, чем у GPT-5.6-Sol и GLM-5.3 (по 84,5) и Kimi K3 (80). В тесте Terminal-Bench 3.0 модель получила 30 балла, обойдя GLM-5.3 (28,3) и Kimi K3 (17,7), но уступив GPT-5.6-Sol (34,4) и Claude Opus 5 (43,3).
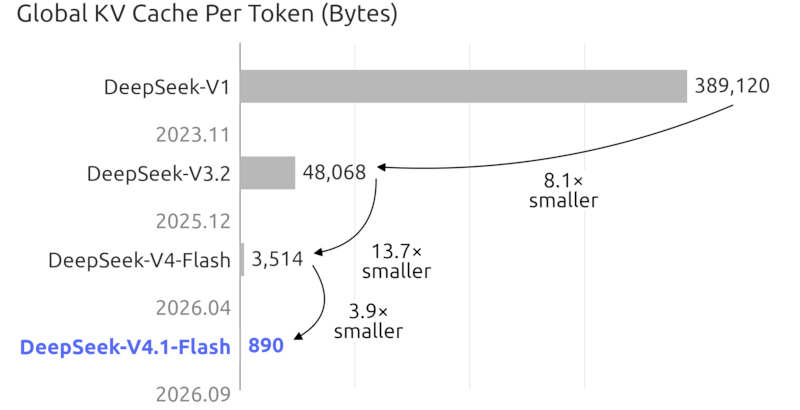
Разработчик сократил использование KV-кеша — модель DeepSeek-V4.1-Flash потребляет вчетверо меньше памяти HBM и в восемь раз меньше места на SSD. Расходы на обработку запросов с попаданием в кеш часто составляют значительную часть стоимости работы ИИ-агентов, поэтому сжатие кеша позволяет существенно сократить затраты.
С выпуском DeepSeek-V4.1-Flash прекращается поддержка моделей V4-Flash и V4-Flash-Vision-Exp — все обращения к ним временно перенаправляются на новую модель. Учитывая, что V4.1-Flash превосходит V4-Pro по производительности, скорости и общему времени выполнения задач, последняя тоже будет постепенно выводиться из эксплуатации — с 14 сентября включится полная переадресация запросов к V4-Pro на V4.1-Flash по тарифам последнего. Официальные партнёры WorkBuddy, CodeBuddy и OpenCode объявили о поддержке V4.1-Flash.
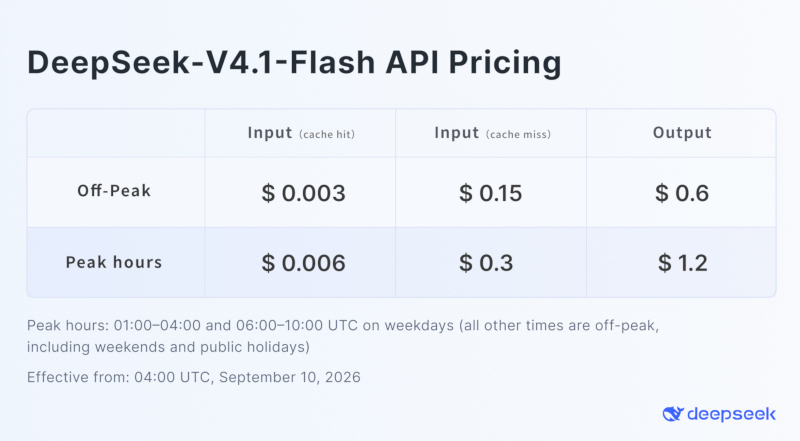
Модель уже доступна через API DeepSeek с нативной поддержкой мультимодальности; для её использования необходимо выбрать модель deepseek-flash. При доступе к DeepSeek V4.1-Flash по API применяется гибкая тарификация с разделением на пиковые и непиковые часы — во втором случае цены ниже на 50 %. В непиковые часы обработка входных данных с попаданием в кеш стоит $0,003 за 1 млн токенов, без попадания в кеш — $0,15, а обработка выходных данных — $0,60. В пиковые часы эти тарифы составляют соответственно $0,006, $0,30 и $1,20 за 1 млн токенов.
Источник:


