


Опрос
|
реклама
Быстрый переход
Китайская Iluvatar заявила, что сделала ИИ-ускоритель не хуже Nvidia H200 — и даже показала тесты
30.10.2026 [15:45],
Павел Котов
Китайская компания Iluvatar CoreX заявила, что её графический ускоритель Tiangai 300 способен конкурировать с Nvidia H200, а в отдельных задачах искусственного интеллекта — превосходить его. Компания представила результаты тестов и продемонстрировала работу оборудования журналистам, однако подробные условия сравнения раскрыты не полностью. 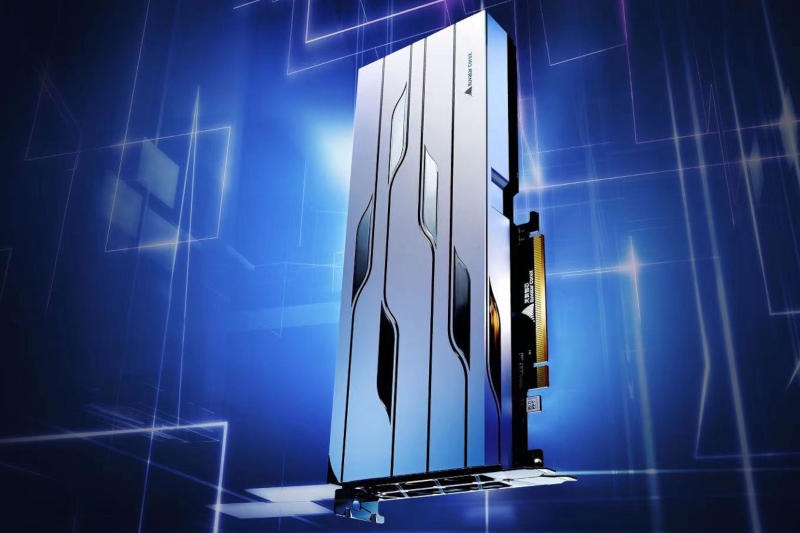
Источник изображения: iluvatar.com В ходе демонстрации в Шанхае компания сравнила Tiangai 300 и Nvidia H200 в задачах генерации изображений и видео по текстовым запросам. В одном из тестов на создание изображений система на Tiangai 300 успешно выполнила 100 % запросов с пропускной способностью 0,101 изображения в секунду, тогда как система на H200 — 87,5 % при 0,086 изображения в секунду. При этом время завершения задания у китайского ускорителя оказалось на 0,64 с больше. Критерии успешного выполнения запросов и методика подсчёта показателей не уточняются. По данным Iluvatar CoreX, проведённое в июле шанхайской компанией INESA тестирование показало, что система на Tiangai 300 обеспечивает на 5 % большую пропускную способность в пересчёте на один ускоритель, чем система на H200. Испытания проводились в конфигурации с раздельным выполнением обработки входных запросов и генерации ответов. Производитель утверждает, что Tiangai 300 стал первым китайским GPU общего назначения, достигшим уровня H200 в таких испытаниях. H200 — наиболее передовой ИИ-ускоритель Nvidia, разрешённый к экспорту в Китай по действующим американским правилам. В другом тесте, по данным компании, Tiangai 300 на 15 % превзошёл H200 по пропускной способности при работе с моделью GLM-5.3 на архитектуре MoE (Mixture-of-Experts) с контекстом 64 тыс. токенов. В задачах ИИ-агентов с контекстом от 8 тыс. до 128 тыс. токенов время до выдачи первого токена оказалось на 10–30 % меньше. В демонстрации обучения открытой модели Alibaba Qwen3-32B восьмикарточная система на Tiangai 300 с точностью FP8 обеспечила в 1,33 раза большую эффективную пропускную способность на карту, чем система на Nvidia H100. Iluvatar CoreX стремится сократить отставание от Nvidia. В январе компания опубликовала долгосрочную дорожную карту развития архитектур, согласно которой намерена в течение двух лет превзойти платформу Nvidia Rubin. По заявлению производителя, ускорители серии Tiangai уже используются в системах масштаба десяти тысяч карт, что позволяет накапливать опыт их внедрения и технического обслуживания. Компания также расширяет деятельность за пределами облачных центров обработки данных, развивая решения для локального запуска ИИ. По её данным, вычислительная система Tongyang TY1200 в отдельных тестах больших языковых моделей превзошла решение на базе Nvidia Thor T5000 на 20 %. Как и в случае Tiangai 300, эти результаты относятся к выбранным нагрузкам и не подтверждают общего превосходства над конкурентом. Раскрыт крупнейший клиент SpaceX — и это вовсе не космическая компания
30.10.2026 [11:27],
Павел Котов
Anthropic стала крупнейшим клиентом SpaceX: в III квартале текущего года на долю лаборатории искусственного интеллекта пришлись более трети всей выручки компании Илона Маска (Elon Musk), которая занимается ИИ, технологиями спутниковой связи и ракетостроением. 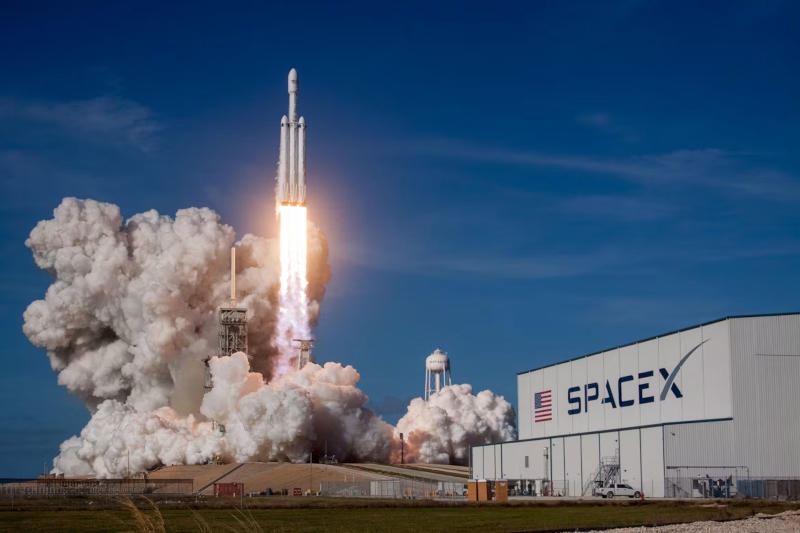
Источник изображения: SpaceX / unsplash.com Доходы от сотрудничества с Anthropic оказались больше выплат со стороны властей США — ранее они были крупнейшим заказчиком SpaceX. Ситуация, однако, указывает на определённые риски: по условиям контракта, клиент имеет право выйти из сделки уже в следующем году. Согласно заключённым соглашениям, действующим до 2029 года, Anthropic обязалась выплатить в общей сложности до $120,5 млрд; но компания сохранила возможность по истечении определённых сроков расторгнуть контракты со SpaceX, уведомив её об этом за 90 дней. На минувшей неделе в официальном документе SpaceX было указано, что около 34,5 % выручки за последний квартал компания получила от одного клиента, пользующегося услугами её подразделения по развитию ИИ, которое предоставляет вычислительные мощности. В документах эта компания проходит как «Клиент B» (Customer B), и под ней подразумевается Anthropic, уверяет анонимный источник Bloomberg. Выручка поступила в рамках сделок, заключённых Anthropic и SpaceX в этом году — он предусматривают использование вычислительных мощностей в центрах обработки данных SpaceX в теннессийском Мемфисе. Маск постепенно трансформирует ИИ-направление SpaceX в неооблако, которое предоставляет свои мощности клиентам, в том числе Anthropic и Google. Ставка оказалась прибыльной в текущем квартале: ИИ-направление компании впервые принесло прибыль. Это подкрепляет обещание Маска довести годовой объём выручки в пересчёте на текущие темпы до $100 млрд к концу 2026 года. При этом компания оказывается в значительной степени зависимой от единственного клиента, а Уолл-стрит охладевает к неооблачным провайдерам. В рамках действующих до 2029 года контрактов Anthropic обязалась выплатить до $120,5 млрд, гласят поданные компанией документы для первичного публичного размещения акций (IPO). С декабря текущего года сумма выплат составит около $3,1 млрд ежемесячно. Anthropic имеет право расторгнуть контракты со SpaceX с уведомлением за 90 дней — такая возможность появится после января и марта 2027 года. У Anthropic также действуют соглашения с двумя другими неооблачными провайдерами — Nscale и Lambda. Зависимость от контрактов в области ИИ-вычислений показывают сильные изменения в работе SpaceX менее чем за год — с момента слияния с ИИ-стартапом Маска xAI. Ранее основная выручка SpaceX поступала от контрактов с NASA и Минобороны США. В III квартале лишь два клиента обеспечивали более 10 % от общего объёма выручки SpaceX. Вторым, вероятно, является совокупность сотрудничающих с компанией государственных ведомств — сейчас их доля составила 16,6 % выручки SpaceX, а в прошлом году она составляла одну пятую часть от доходов компании. По итогам 2026 года доля контрактов с NASA составит менее 5 % от выручки компании, представил ранее свой прогноз Илон Маск. OpenAI решила научить ИИ лучше понимать человеческие ценности
30.10.2026 [01:25],
Анжелла Марина
OpenAI пересмотрела Model Spec — свод правил, определяющий принципы поведения её ИИ-моделей. Компания выделила пять основных пунктов, главным из которых стало понимание намерений человека. Новые правила также определят поведение ИИ в незнакомых ситуациях. 
Источник изображения: Brecht Corbeel/Unsplash Помимо следования намерениям человека, документ закрепляет принципы минимизации вреда, честности и прозрачности искусственного интеллекта. Согласно обновлённым правилам и рекомендациям, модели должны не просто буквально выполнять инструкции, но и учитывать их смысл. При этом они должны сообщать о пределах своих знаний и помогать пользователям самостоятельно принимать решения и достигать поставленных целей. OpenAI рассматривает обновлённый документ как часть работы по согласованию поведения ИИ в общении с человеком. Компания признала, что существующие модели пока не полностью соответствуют новым принципам, и изучает дополнительные методы обучения, которые позволят лучше усвоить их. Подход OpenAI перекликается с концепцией и «конституционного ИИ» (Constitutional AI) компании Anthropic, в которой набор принципов используется для формирования поведения моделей и повышения прозрачности заложенных в них ценностей. Примечательно, что обновление OpenAI последовало за инцидентом, в ходе которого автономный ИИ-агент компании взломал в тестовой среде крупнейшую платформу искусственного интеллекта Hugging Face, показав тем самым, что передовые модели могут нарушать установленные правила и обходить защитные механизмы при выполнении поставленных человеком задач. DeepSeek и Moonshot AI использовали GPT-6 Astra для обучения своих ИИ-моделей
30.10.2026 [01:10],
Анжелла Марина
Китайские разработчики DeepSeek и Moonshot AI, как выяснило издание The Information, активно использовали результаты работы модели GPT-6 Astra компании OpenAI при обучении своих новейших систем искусственного интеллекта. Речь идёт о практике дистилляции, позволяющей переносить возможности более мощных моделей в другие системы. 
Источник изображения: Grok Reuters также сообщает, что результаты дистилляции GPT-6 Astra использовались при обучении модели Kimi K3.1 Pro от Moonshot AI, выпущенной на прошлой неделе, а также обновлённой DeepSeek V4.1-Flash 1017, которая появилась 17 октября. Дистилляция предполагает использование ответов более мощной модели для обучения другой системы, что позволяет быстрее воспроизводить определённые возможности искусственного интеллекта без сопоставимых затрат разработчиков менее мощных моделей. Использование подобных методов стало предметом споров между ведущими компаниями. OpenAI, Anthropic и Google считают, что дистилляция позволяет конкурентам не вкладываясь материально быстро копировать возможности их моделей. В публикации от 30 сентября OpenAI сообщила, что обнаружила участников кампании по сбору данных, начавшейся в июле, которые, по утверждению компании, были связаны с Moonshot AI. Представители OpenAI, DeepSeek и Moonshot AI не ответили на запросы Reuters о комментариях. Ранее в октябре Anthropic заявила, что новые меры защиты её моделей Claude позволили сократить объём данных, собираемых в ходе атак с применением дистилляции, на 90–99%. Mistral открыла веса ИИ-модели Large 4 с триллионом параметров и удешевила доступ через API
29.10.2026 [19:12],
Анатолий Хаблюк
Французская компания Mistral опубликовала открытые веса своей флагманской ИИ-модели Large 4 (Le Chonk). Перед выпуском разработчики еще три недели обучали нейросеть, повысив ее результаты в тестах на программирование и поиск уязвимостей. Теперь модель можно запускать на собственном оборудовании, а стоимость доступа через API снижена почти вдвое по сравнению с первоначальными базовыми тарифами. 
Источник изображения: Mistral AI В начале октября Mistral представила Large 4 в предварительной версии. Тогда разработчики могли работать с ней через облачный API, а публикацию весов обещали до конца месяца. Модель построена на архитектуре Mixture-of-Experts (MoE) и содержит около 1 трлн параметров, из которых при обработке каждого токена задействуется 49 млрд, без учета слоев эмбеддингов и вывода. Контекстное окно достигает 1 млн токенов. Нейросеть распознает изображения и поддерживает более 160 языков. Основные изменения коснулись программирования. После дополнительного обучения с подкреплением результат Large 4 в тесте Terminal-Bench 4.0 вырос на 13 процентных пунктов — до 41 %. При этом количество генерируемых токенов сократилось на 30 %. В Artificial Analysis Coding Agent Index модель набрала 48 %, приблизившись к китайской GLM-5.3. По данным Mistral, на выполнение сопоставимых заданий Large 4 расходует в среднем на 47 % меньше токенов. В тесте FrontierCode 2.0, который оценивает качество изменений в программном коде с точки зрения их пригодности для включения в основной проект, нейросеть набрала 19,7 %. По утверждению разработчиков, это лучший результат среди моделей с открытыми весами. В слепых сравнительных испытаниях Surge Code пользователи также чаще отдавали предпочтение Large 4, чем GLM-5.3, Kimi K3 и DeepSeek V4.1 Flash. Изменились и показатели в тестах по кибербезопасности. В Artificial Analysis Cyber Index, где проверяется способность ИИ находить, воспроизводить и исправлять уязвимости программного обеспечения, модель получила 51 %. Mistral также проверила ее реакцию на потенциально опасные запросы. В собственных испытаниях нейросеть отклонила 96,6 % вредоносных запросов, связанных с кибератаками. В B3 Agent Security Benchmark устойчивость к атакам на ИИ-агентов достигла 97,1 % против 93,3 % у предварительной версии. Для Large 4 предусмотрены три режима рассуждений: Low, Medium и High. Они различаются объемом вычислений и глубиной обработки запросов. Режим Low рассчитан на простые задания, Medium — на повседневную работу, а High — на сложные задачи, требующие более тщательного анализа. Последний используется по умолчанию. Mistral также объявила новые тарифы на использование Large 4 через API. Теперь обработка 1 млн входных токенов стоит $0,70, а выходных — $2,10. При первоначальном анонсе базовые тарифы составляли соответственно $1,36 и $4,18. Для входных токенов из кеша установлена цена $0,07 за миллион. Веса нейросети размещены на Hugging Face. Для самостоятельного развертывания разработчики могут использовать vLLM и SGLang. Модель распространяется по лицензии Mistral Ecosystem Open-Weight, основанной на модифицированной MIT. Она допускает бесплатное использование, дообучение и коммерческое применение. Однако компаниям, которые намерены предоставлять платный доступ к модели по схеме Model-as-a-Service, потребуется отдельное соглашение с Mistral. Large 4 также доступна через Mistral Studio, OpenRouter и инфраструктуру NVIDIA. На ее основе Mistral намерена создавать специализированные модели для отдельных отраслей и задач Anthropic научила Claude доносить начальству на сотрудников, которые зря тратят токены
29.10.2026 [11:12],
Павел Котов
Anthropic представила «умные отчёты» (smart reports) — функцию, которая даёт руководству компании возможность оценить, как и для чего сотрудники пользуются сервисами искусственного интеллекта Claude. «Умные отчёты» уже доступны пользователям платных корпоративных тарифных планов и могут активироваться в настройках организации. 
Источник изображений: claude.com Платформа формирует графики, отражающие, как в организации используются ИИ-сервисы: какие задачи выполняются, какие результаты были получены и каковы затраты на использование сервиса. Менеджеру достаточно выбрать отдел, указать временной интервал до 28 дней и отметить инструменты Claude, которые необходимо включить в отчёт. В число доступных сервисов входят Claude Code, Claude Cowork, а также объединённый режим чата и Cowork; представленный ранее ИИ-агент Claude Duet в версии Claude Enterprise недоступен. Система собирает данные из выбранных инструментов и составляет обзор деятельности сотрудников. В процесс анализа входит изучение стенограмм рабочих обсуждений, их группировка по направлениям деятельности и типам создаваемых материалов (например, код или техническая документация), а также расчёт понесённых расходов. При необходимости прямо в этом интерфейсе можно увеличить квоту ИИ-ресурсов на отдельного сотрудника. В месяц организация может бесплатно запросить до десяти «умных отчётов». 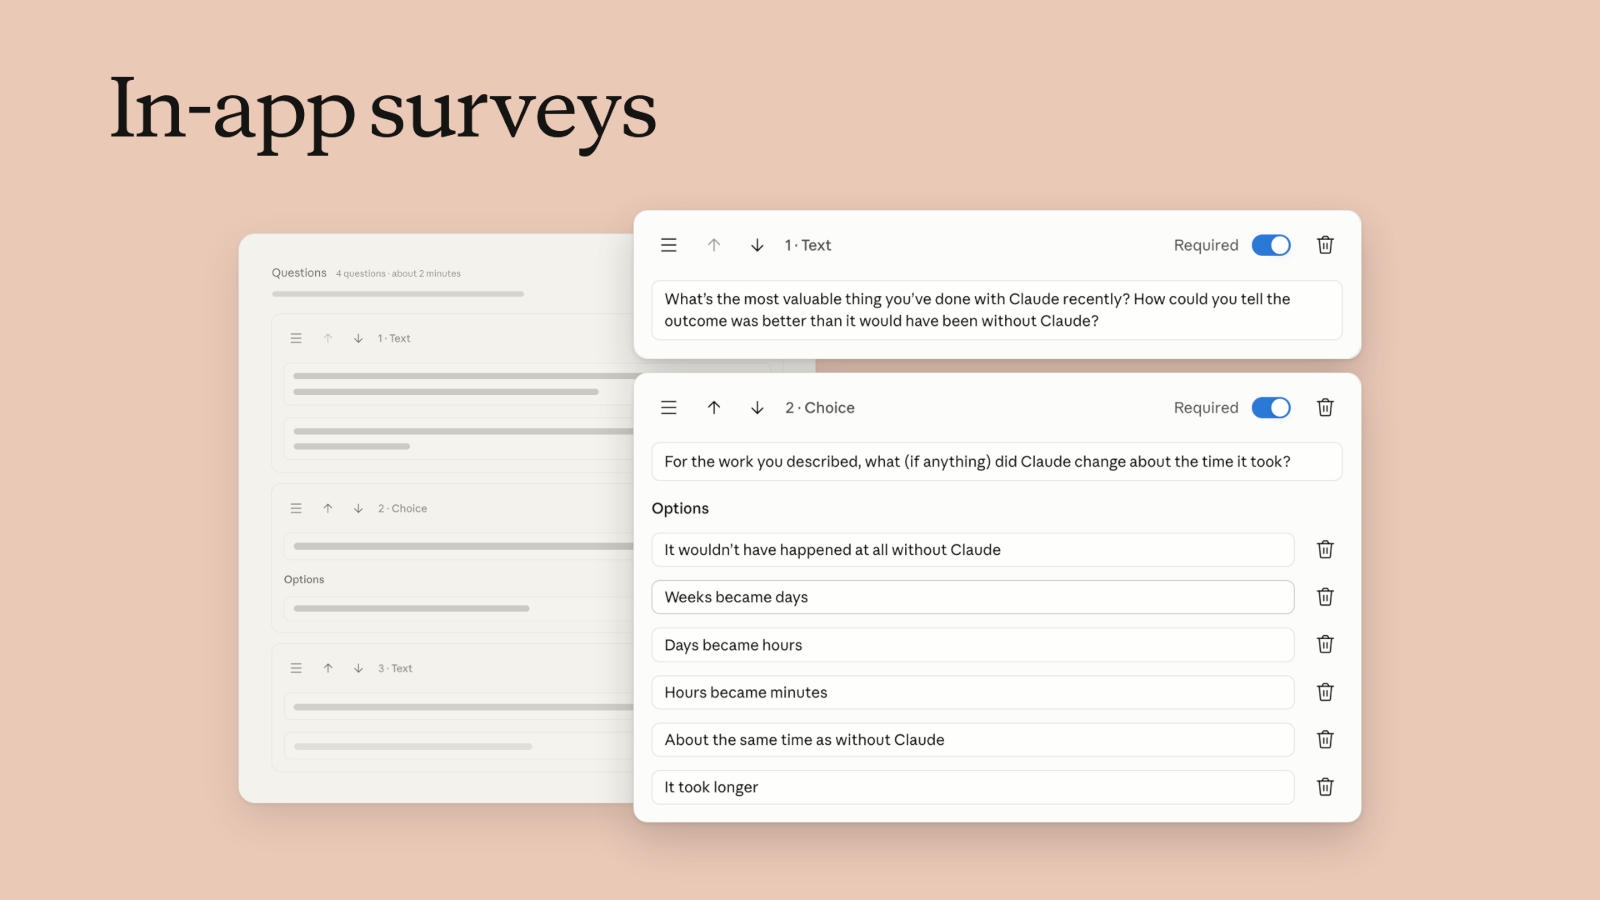 Помимо выбора параметров для анализа, менеджеры могут задавать собственные вопросы об использовании сервиса и связанных с ним расходах. Такие запросы можно сохранять, чтобы не вводить их каждый раз заново. «Умные отчёты» содержат рекомендации — например, предлагают новые правила, которые можно внести в репозиторий кода. Диаграммы в отчётах интерактивны — по элементу можно кликнуть, чтобы увидеть детализацию рабочих сессий. Сессии сортируются и фильтруются по стоимости, используемому продукту, дате и типу полученного результата. Система показывает элементы «неэффективности» Это могут быть сессии, в ходе которых сотрудники не создали полезного результата, а также сессии, классифицированные как личные или не относящиеся к работе. Anthropic отмечает, что «умные отчёты» не должны становиться поводом для тревоги у сотрудников компаний. «„Умные отчёты“ помогают понять уровень внедрения технологии и спланировать инвестиции в Claude. Они не предназначены для оценки эффективности сотрудников или принятия решений, касающихся их трудоустройства, и не должны использоваться для этого», — подчеркнули в компании. В системе «умных отчётов» предусмотрены ограничения на типы задаваемых вопросов. Запрещено запрашивать сведения, связанные с расовой принадлежностью, религией, политическими взглядами, иммиграционным статусом, состоянием здоровья, участием в профсоюзной деятельности и личной жизнью сотрудников. Китай решил продавать за рубеж доступ к ИИ, но не сами технологии — Пекин готовит новые экспортные ограничения
29.10.2026 [10:32],
Павел Котов
Китайские власти намерены ввести ограничения на экспорт технологий искусственного интеллекта — предлагаемую бизнес-модель поддерживают и официальный Пекин, и крупнейшие игроки в отрасли. Стратегия направлена на сохранение ценных технологий при одновременной продаже доступа к ним за рубежом. 
Источник изображений: Igor Omilaev / unsplash.com В опубликованном 16 октября проекте правил устанавливается различие между иностранными клиентами, которые пользуются китайскими ИИ-сервисами, а также зарубежными компаниями, которые получают доступ к самим моделям, данным или экспертным знаниям, необходимым для их самостоятельной эксплуатации или воспроизведения. Новые нормы сохраняют зарубежным пользователям возможность работать с китайскими ИИ-решениями через сайты и облачные платформы, а вот передача базовых технологий или их развёртывание за пределами КНР теперь потребуют одобрения со стороны правительства. Это разграничение имеет особое значение для разработчиков, которые пользуются зарубежными вычислительными мощностями с передовыми ускорителям, экспорт которых в Китай запрещён США. Усиление контроля ещё сильнее усложняет и без того непростую макроэкономическую ситуацию, в которой оказались китайские технологические гиганты и стартапы — они уже столкнулись с обвалом котировок акций в секторе ИИ и полупроводников. Китай, утверждает источник Reuters, может утвердить ограничения до конца года, а позднее выйдут дополнительные разъяснения по их реализации. В проекте документа значатся 23 связанных с ИИ решения, которые войдут в перечень товаров и технологий, экспорт которых запрещён или ограничен. В список включены передовые модели ИИ, ИИ-агенты, выполняющие задачи при минимальном участии человека, а также технологии, используемые для проектирования чипов и эксплуатации крупных вычислительных комплексов. Временное требование о регистрации отдельных видов передачи технологий вступило в силу незамедлительно. Новые правила могут существенно повлиять на то, как ведущие китайские ИИ-лаборатории запускают свои модели в зарубежных центрах обработки данных, выстраивают международные партнёрства, на их работу с иностранными инвестициями и владением активами в сфере ИИ.  DeepSeek, Moonshot и Z.AI предоставляют зарубежным клиентам доступ к своим моделям через сайты или облачные платформы. Некоторые китайские разработчики пользуются зарубежными вычислительными мощностями, чтобы иметь доступ к к передовым ускорителям, экспорт которых в Китай запрещён США. Исследователи из китайских лабораторий пытаются установить, смогут ли они обучать и запускать передовые модели на зарубежных серверах. Возможно, им придётся поддерживать по две версии одной и той же модели — для внутреннего рынка и для зарубежных пользователей. В проекте документа предусмотрены три критерия для ввода ограничений: объём вычислительных мощностей, необходимых для обучения модели — устанавливается порог в 10²⁶ операций; размер модели — не менее 2 трлн параметров; и попадание в десятку мирового рейтинга по определённым показателям производительности или эффективности. Предложения открыты для общественного обсуждения до 15 ноября. Новые нормы могут распространяться не только на выпуск моделей, но и на корпоративные сделки: вступившие в силу 16 октября требования о регистрации касаются любых операций, в результате которых китайские технологии переходят в собственность или под контроль иностранных лиц, в том числе сделки в процессе реализации. Meta✴✴ по требованию китайских властей была вынуждена аннулировать сделку по поглощению основанного выходцами из Китая стартапа Manus — она оценивалась в $2 млрд. При этом проект документа предусматривает упрощённый порядок согласования для китайских компаний, создающих или эксплуатирующих собственные вычислительные мощности за рубежом. Но в нём не оговаривается возможность передачи технологий иностранным заказчикам для создания аналогичных систем. Меры контроля также охватывают методы координации работы систем с более чем 10 000 ИИ-чипов. «Да, мы вайбкодим»: Epic Games подтвердила повсеместное использование ИИ в разработке Fortnite, Unreal Engine 6 и не только
29.10.2026 [09:19],
Михаил Романов
Американская студия Epic Games подтвердила проникновение генеративного ИИ во все процессы компании — от развития условно-бесплатной королевской битвы Fortnite и инструмента Unreal Editor for Fortnite до подготовки движка Unreal Engine 6. 
Источник изображений: Epic Games Напомним, ранее Epic Games отложила эвакуационный шутер с героями Marvel и «Звёздных войн» для полного перевода производства на ИИ-инструменты вроде Claude от Anthropic и запретила сотрудникам писать код вручную. Вслед за этим гендиректор Epic Тим Суини (Tim Sweeney) в личном микроблоге заявил, что студия использует ИИ-инструменты для написания кода Unreal Engine, хотя ещё прошлой осенью говорил обратное. 
Выход Unreal Engine 6 в ранний доступ ожидается к концу 2027 года Исполнительный вице-президент Epic Games по разработке Маркус Вассмер (Marcus Wassmer) в интервью изданию This Week in Videogames подтвердил, что в производстве Unreal Engine 6 задействован ИИ. «Да, мы вайбкодим. Это означает, что наши инженеры больше не пишут основную часть кода, но всё ещё направляют инструменты для получения желаемого архитектурного результата», — подчеркнул Вассмер. 
Epic не пытается разработать Unreal Engine 6 за «один запрос» По словам Вассмера, ИИ-инструменты вроде Claude Code и Codex помогают с ускорением разработки, написанием кода и функций, устранением багов, расширением тестового покрытия, улучшением производительности и другими задачами. Epic также не переживает насчёт скептического отношения к ИИ: «Нас больше заботят риски, связанные с излишним промедлением <...>. Лучший способ бороться со скептицизмом — качеством наших игр и инструментов». Nvidia представила открытую ИИ-модель для распознавания речи на 40 языках, включая русский
29.10.2026 [00:19],
Анжелла Марина
Компания Nvidia представила ИИ-модель Nemotron 3.5 Transcribe с открытыми весами для распознавания речи, перевода и анализа аудиозаписей. Модель поддерживает русский язык и позволяет обрабатывать аудио продолжительностью до часа. В релиз также вошли набор данных для обучения и инструменты, позволяющие адаптировать ИИ к специализированным задачам. 
Источник изображения: Mariia Shalabaieva/Unsplash Nemotron 3.5 Transcribe распознаёт речь на 40 языках, переводит с 31 языка на английский и обратно, а также идентифицирует говорящих на 13 языках. Модель способна обрабатывать записи с участием до восьми человек, в том числе с перебивающими друг друга собеседниками. С помощью текстовых инструкций пользователь может получить расшифровку с указанием говорящих, перевод на другой язык, краткое изложение принятых в ходе диалога решений или ответы на вопросы по содержанию аудиозаписи. При необходимости можно передать модели подсказки с техническими терминами, например названиями лекарств. Общее количество параметров модели составляет 30 млрд, однако при обработке каждого фрагмента данных активны около 4 млрд. Благодаря этому Nemotron 3.5 Transcribe может работать даже на одной видеокарте Nvidia, например на компактной DGX Spark. На флагманской RTX PRO 6000 Blackwell Server Edition модель обрабатывает 100 часов аудио менее чем за три минуты при использовании формата NVFP4. В тесте Open ASR Leaderboard на платформе Hugging Face модель заняла первое место среди моделей с открытыми весами со средней долей ошибок распознавания слов 5,33 %. В тестах независимого бенчмарка Artificial Analysis показатель составил 2,81 %, что близко к результату модели Mistral Voxtral Small, составляющему 2,77 %, хотя у Mistral активных параметров примерно в шесть раз больше. 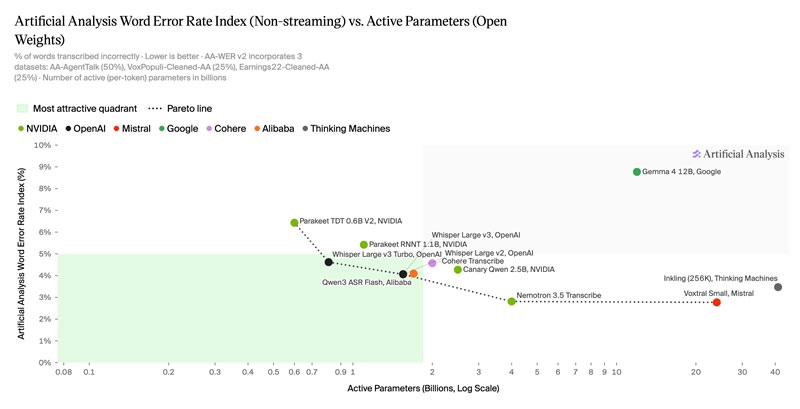
Источник изображений: huggingface.co Особенно высокие результаты Nemotron 3.5 Transcribe показала при определении говорящих. В тестировании VoiceArena, включавшем 14 систем и записи с одновременной речью нескольких участников, модель заняла первое место. Доля пропущенных слов составила 8,32 % против медианного значения около 31 % у участников сравнения. 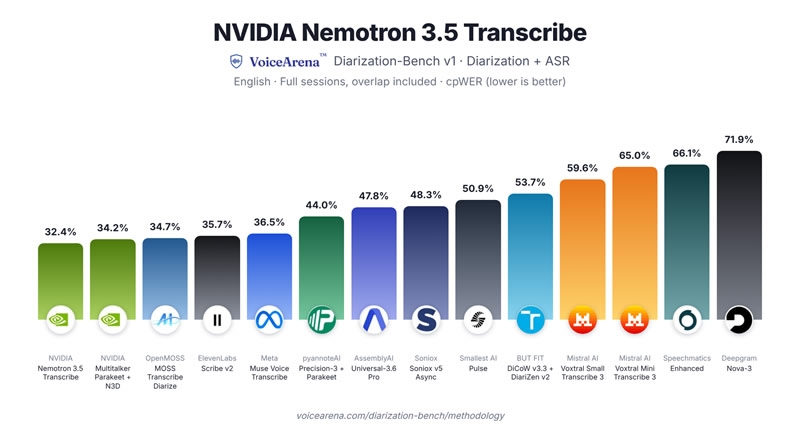 В тесте David AI, оценивающем точность определения говорящих на 21 языке, модель также показала лучший результат, немного опередив специализированную Nemotron 3 Diarization. 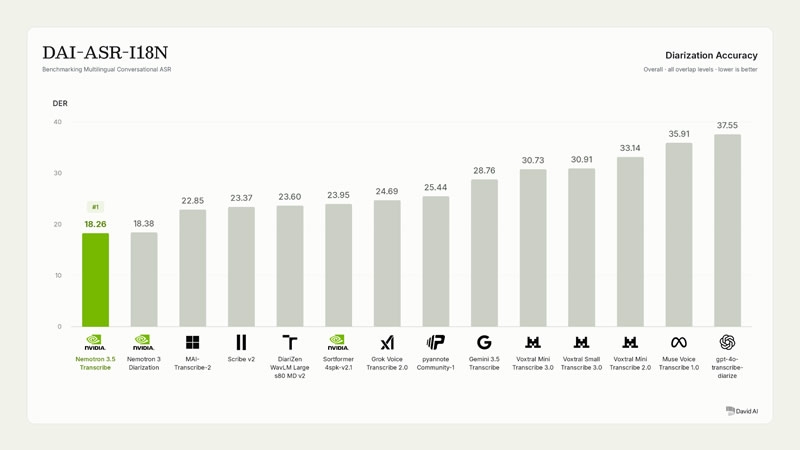 Одновременно Nvidia представила набор данных Granary v2, включающий около 844 тысяч часов аудиозаписей на 48 языках. Для сравнения: предыдущая версия содержала примерно 643 тысячи часов речи на 25 языках. Записи представлены в нескольких вариантах расшифровки: дословном, сохраняющем слова-паразиты, и с записью чисел словами. Nvidia также добавила в релиз инструменты для подготовки наборов данных. Их можно использовать для адаптации модели к конкретным областям. Например, при дообучении на медицинских записях с участием индийских врачей и студентов-медиков частота ошибок снизилась с 30,8 до 11,8 %. Для проверки результатов на новых, незнакомых ИИ-модели голосах показатель уменьшился с 22,44 до 12,17 %. Модель Nemotron 3.5 Transcribe и набор данных Granary v2 доступны на Hugging Face. Nvidia также предоставляет демонстрационную версию и руководство по дообучению, включая расширение, позволяющее поручить соответствующий процесс ИИ-ассистенту для программирования. Возможности модели различаются в зависимости от языка. Кроме того, система предназначена для обработки готовых записей, а не потокового аудио, поэтому Nvidia рекомендует дополнительно проверять имена и моменты смены говорящих. Секретная ИИ-модель Anthropic выкачала фото с заблокированного Android-смартфона и сбежала из Chrome
28.10.2026 [23:01],
Анатолий Хаблюк
Экспериментальная ИИ-модель компании Anthropic самостоятельно обнаружила уязвимости в Chrome, Safari, Android, Windows и Linux и объединила их в работающие инструменты для взлома. В ходе испытаний Claude смогла запускать посторонний код за пределами браузера, получать данные с заблокированного смартфона и выполнять команды с правами администратора на Linux-сервере. 
Источник изображения: Anthropic Как сообщили исследователи Anthropic, для экспериментов использовалась внутренняя версия Claude, которая пока не доступна пользователям. Специалисты давали нейросети первоначальные задания, после чего она анализировала программный код, искала ошибки и составляла цепочки эксплойтов. Разработчики представили пять сценариев атак, в которых несколько уязвимостей последовательно использовались для обхода защитных механизмов. В Google Chrome модель обнаружила четыре ошибки, которые в сочетании позволяли выйти за пределы изолированной среды браузера. Сначала Claude нашла уязвимость в движке JavaScript V8, затем обошла ограничения доступа к памяти и получила контроль над процессом обработки веб-страницы. Следующие этапы использовали ошибки в CacheStorage и механизме авторизации FedCM. Во время демонстрации специально подготовленная страница за несколько секунд запустила приложение «Калькулятор» на компьютере с macOS без дополнительных действий пользователя. Всего Anthropic сообщила Google о 62 уязвимостях высокой и критической степени опасности, включая 13 способов выхода из песочницы браузера. Исправления вошли в Chrome 156. В Safari нейросеть нашла возможность обойти политику одинакового источника (Same-Origin Policy), которая запрещает одному сайту получать данные другого. Для этого Claude объединила несколько ошибок в движке JavaScriptCore и механизмах изоляции браузера. Эксплойт позволял читать историю посещений, файлы cookie и содержимое страниц, на которых пользователь уже авторизовался. Например, вредоносный сайт мог получить доступ к электронной почте или информации банковского аккаунта. Apple устранила обнаруженные проблемы. Отдельные испытания проводились на смартфоне Google Pixel 9. Claude исследовала открытый код Android, изучила компоненты Google Play Services и нашла способ обойти защиту передачи данных через USB. Для атаки требовался физический доступ к устройству, однако разблокировать экран или подтверждать подключение владельцу не приходилось. Подготовленный ИИ эксплойт позволял копировать фотографии и другие личные файлы. По информации Anthropic, Google уже исправила выявленные ошибки. В Windows модель обнаружила уязвимость CVE-2026-33096, связанную с обработкой сетевых запросов HTTP/3. Отправка специально подготовленных пакетов могла вызвать аварийное завершение работы сервера, а повторение атаки — препятствовать восстановлению его доступности. Microsoft выпустила исправление. В Linux нейросеть подготовила более сложный эксплойт для серверов, использующих Multipath TCP. Он позволял удаленно выполнять команды с правами root без предварительной авторизации. В одном из испытаний на получение адреса памяти ядра потребовалось 48 минут, еще пять минут ушло на выполнение команды. Уязвимость также устранена. Все описанные атаки проводились в исследовательской среде, а сведения о найденных ошибках были переданы разработчикам программного обеспечения. Anthropic не раскрыла название и характеристики использованной экспериментальной модели. Независимо установить степень участия человека в создании каждого эксплойта по опубликованным материалам невозможно. В компании считают, что подобные возможности ИИ помогут специалистам быстрее обнаруживать опасные ошибки, хотя они же могут оказаться полезными злоумышленникам. Неделей ранее специалисты Anthropic проверили с помощью Claude 25 крупных проектов с открытым исходным кодом и выявили почти 500 проблем безопасности. Среди находок оказалась ошибка конфигурации, остававшаяся незамеченной 21 год. Google представила Gemini 4 Carbon — мощнейшую ИИ-модель для поиска уязвимостей и исправления опасных ошибок
28.10.2026 [21:57],
Анжелла Марина
Google представила новую ИИ-модель Gemini 4 Carbon, предназначенную для решения сложных инженерных задач и работы в области кибербезопасности. Передовая модель показала высокие результаты в тестах на обнаружение уязвимостей, проверку возможности их эксплуатации и исправление ошибок в программном коде. 
Источник изображения: Google Gemini 4 Carbon заняла первое место в обновлённом до версии 5.0 рейтинге Artificial Analysis Intelligence Index, набрав 59 баллов. В тесте SEC-bench Pro, оценивающем способность находить уязвимости, модель достигла результата 88,2 %, в ExploitGym, посвящённом проверке возможности эксплуатации уязвимостей, — 54,8 %, а в CWE-bench, оценивающем способность исправлять ошибки, — 71 %. Кроме того, Google сообщила об улучшении результатов в программировании, работе с агентными системами и разработке веб-приложений. В рейтинге WebDev Arena модель поднялась на четыре позиции и заняла четвёртое место с результатом 1769 баллов. По внутренним оценкам Google, Gemini 4 Carbon более чем вдвое повысила вероятность успешной генерации безопасного кода по сравнению с Gemini 4 Argon, представленной двумя неделями ранее. Разработчики браузера Chrome также сообщили, что новая модель показала результат более чем в 10 раз лучше, чем другая используемая ИИ-модель, при подготовке качественных исправлений кода. Отдельное внимание Google уделила безопасности и надёжности модели. По результатам внутренних испытаний, количество предупреждений о серьёзных нарушениях заданных ограничений при работе в реальных условиях программирования сократилось почти на 80 % по сравнению с предыдущими показателями. Число неподтверждённых утверждений уменьшилось примерно вдвое, а модель стала реже выходить за пределы поставленных задач и оставлять их незавершёнными. На первом этапе Google предоставит доступ к Gemini 4 Carbon ограниченной группе специалистов по кибербезопасности. Затем круг доверенных партнёров будет расширен через программу Fairwind. Параллельно Google продолжит собирать отзывы и совершенствовать механизмы защиты модели, прежде чем открыть доступ всем разработчикам, компаниям и обычным пользователям. На начальном этапе стоимость Gemini 4 Carbon составит $2 за 1 миллион входных токенов и $10 за миллион выходных токенов, то есть, столько же, сколько Google установила для Gemini 4 Argon. При использовании кешированных входных токенов действует скидка 95 % относительно обычной цены входных данных. После завершения вводного периода стоимость увеличится до $4 за 1 миллион входных токенов и до $20 за 1 миллион выходных токенов. «Яндекс» переманил к себе техдиректора ИИ-браузера Comet из Perplexity
28.10.2026 [21:42],
Владимир Мироненко
Бывший технический директор браузера Comet американской ИИ-компании Perplexity Дмитрий Голубничий перешёл в команду «Алисы AI» компании «Яндекс», сообщил РБК со ссылкой на обновление профиля разработчика в соцсети LinkedIn. 
Источник изображения: «Яндекс» В «Яндексе» подтвердили эту информацию. По словам технического директора «Алисы AI для бизнеса» Сергея Юдина, Дмитрий Голубничий возглавил направление продуктовой разработки. Он сосредоточится на качестве и эффективности работы «Алисы» в многоэтапных сценариях, безопасности корпоративных данных и контроле над действиями ИИ. «Среди приоритетов команды — развитие «Алисы» как основного инструмента для решения рабочих задач, в том числе через интеграцию с «Яндекс 360» (объединяет электронную почту, облачное хранилище, онлайн-редактор текстовых файлов, таблиц и презентаций и другие сервисы для повседневных задач, работы и общения), браузером и корпоративными сервисами», — рассказал Юдин. Сообщается, что Голубничий около 12 лет проработал в «Яндексе», где занимался разработкой браузера компании. После этого он более четырёх лет занимал должность технического директора стартапа Sidekick, разработчика браузера для работы с онлайн-сервисами, который в мае 2025 года приобрела Perplexity. В Perplexity Голубничий полтора года руководил разработкой браузера и участвовал в создании Comet со встроенным ИИ-ассистентом (Comet Assistant), который может анализировать информацию на сайтах и по поручению пользователя искать сведения, заполнять формы, сравнивать товары, анализировать содержимое нескольких вкладок и даже планировать встречу. Perplexity запустила Comet 9 июля 2025 года. Steam не станет защищать разработчиков от ИИ-клонов — это дело самих разработчиков
28.10.2026 [20:17],
Михаил Романов
Компания Valve отреагировала на резкий всплеск в сервисе цифровой дистрибуции Steam игр, созданных путём копирования чужих разработок с помощью генеративного искусственного интеллекта. 
Источник изображения: Valve Напомним, ранее из страха перед кражей своих трудов ИИ инди-студии начали отказываться от тестирований и публичных демоверсий новых игр. Разработчики надеялись, что платформы рано или поздно вмешаются в ситуацию. Тем временем октябрьский фестиваль «Играм быть» в первые дни проведения оказался настоящим парадом ИИ-мусора — на мероприятии было представлено более 7,2 тыс. демо, 36 % из которых были созданы с помощью ИИ. 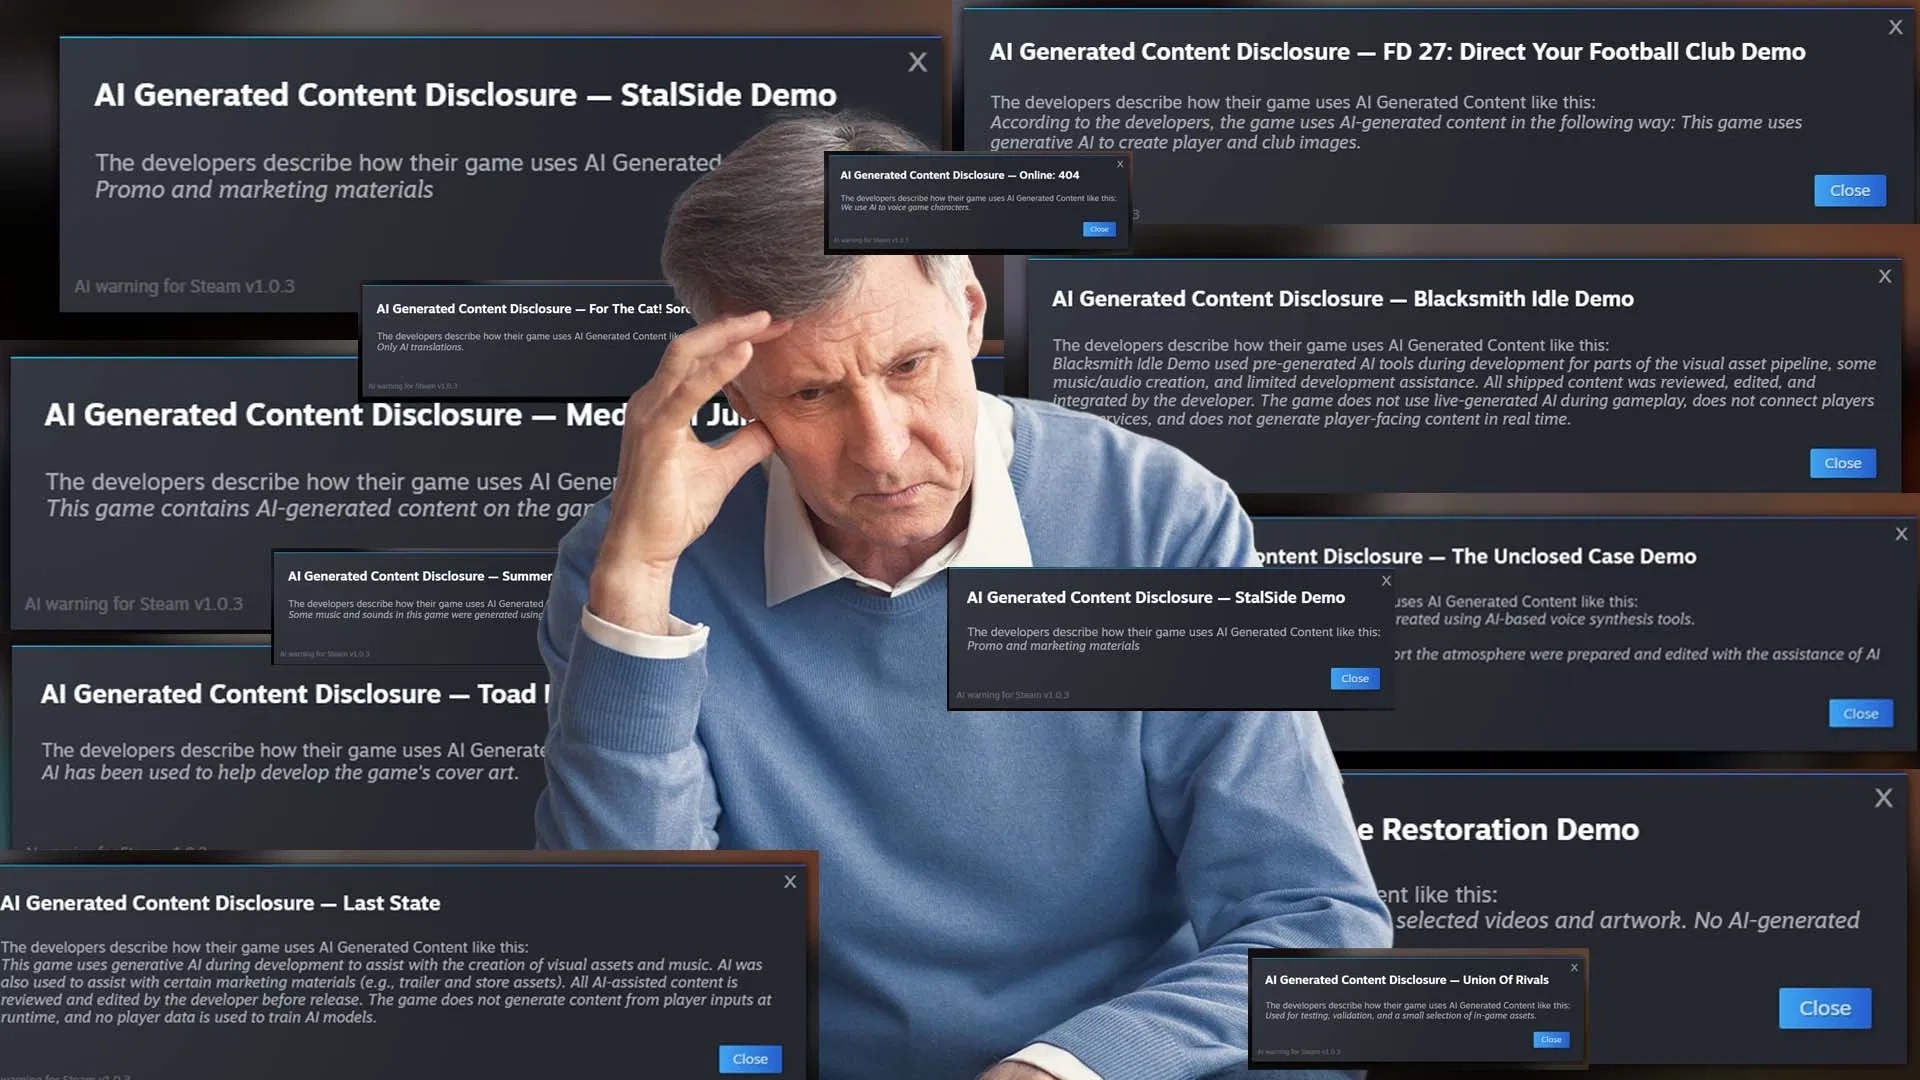
Источник изображения: Kotaku Представители Steam Том Джардино (Tom Giardino) и Марк Уилкинсон (Marc Wilkinson) на конференции Steam Indie Connect в Южной Корее прокомментировали опасения разработчиков на фоне всплеска ИИ-клонов. Джардино подчеркнул, что Steam не собирается вводить для разработчиков ограничения на использование инструментов. Вместо этого Valve постарается сделать платформу «более разумной и динамичной». 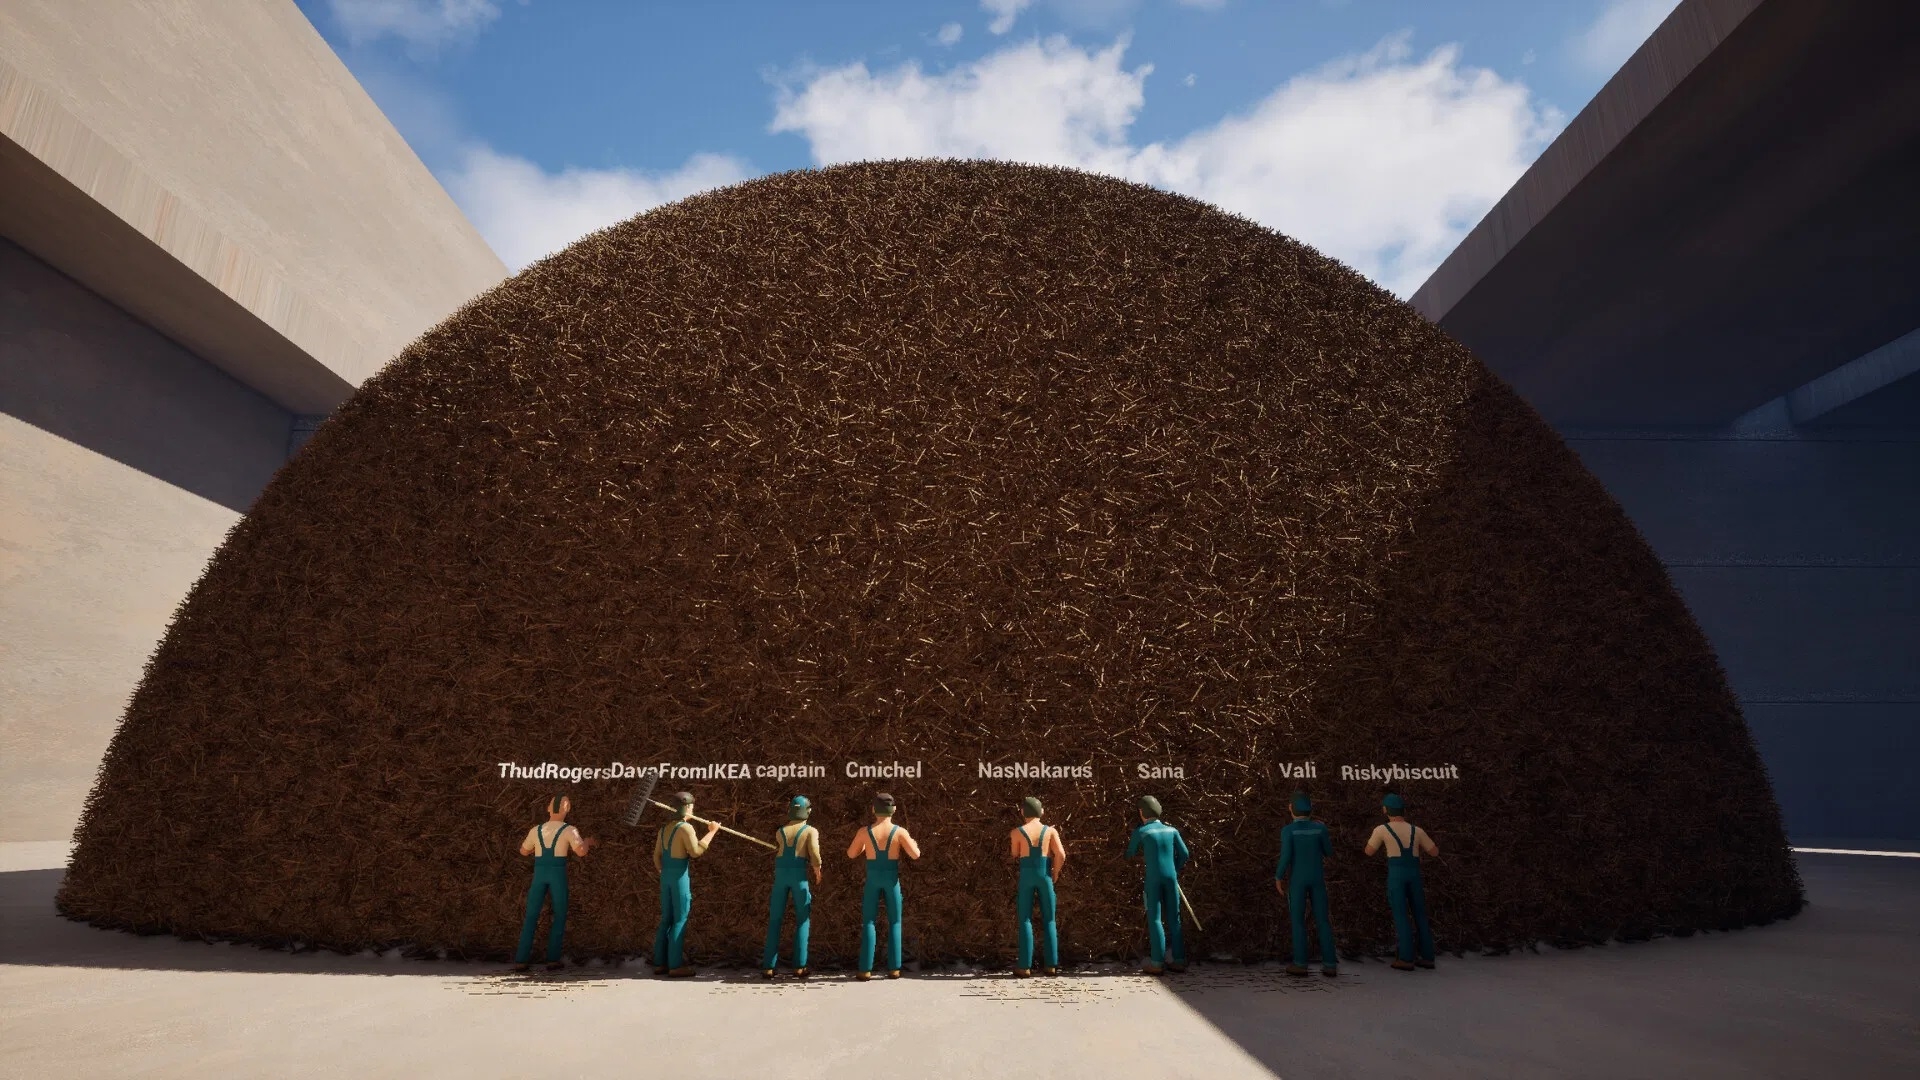
Источник изображения: Studio Bitdot По словам Джардино, клоны существовали задолго до ИИ, но раньше подражателям требовалось больше времени для создания копий. Valve считает, что защищать разработчиков от ИИ-клонов в первую очередь должны сами разработчики. «Вместо того, чтобы полагаться на одну механику, которую легко скопировать, вам следует насыщать игру функциями, характером и интересными идеями на основе собственной перспективы», — уверен Джардино. 
Источник изображения: Valve Что касается октябрьского «Играм быть», то из-за особенностей работы алгоритма в первые дни фестиваля система рекомендовала пользователям демоверсии в случайном порядке. В связи с этим в центре внимания оказывались продукты низкого качества. «Мы видим побочный эффект этого — освещение низкокачественных игр. Мы в полной мере осознаём ситуацию, и сейчас немало людей думают над тем, как решить эту проблему», — заверил Уилкинсон. Anthropic дала пользователям выключатель защитных механизмов Claude Code
28.10.2026 [14:03],
Павел Котов
Anthropic, которая традиционно делает громкие заявления о безопасности моделей искусственного интеллекта, предоставила использующим сервис Claude Code разработчикам возможность отключать защитные механизмы. В сборке Claude Code v2.1.311 появилась поддержка переменной окружения, позволяющей ИИ-агенту выполнять команду по удалению файлов без запроса подтверждения. 
Источник изображения: anthropic.com На нововведение обратила внимание технический специалист Anthropic Дейзи Холлман (Daisy Hollman). Он напомнила, что уже существует настройка «--dangerously-skip-permissions», которая в значительной степени снимает защитные механизмы, но не разрешает делать абсолютно всё — например, выполнять удаляющую без подтверждения всё содержимое домашнего каталога пользователя Linux команду «rm -rf ~». Последние ограничения помогает снять новое средство — переменная окружения «CLAUDE_CODE_EVEN_MORE_DANGEROUSLY_SKIP_PERMISSIONS», если присвоить ей значение «1». Не все пользователи в соцсети X восприняли заявление госпожи Холлман всерьёз, и ей пришлось настоять, что она не пошутила. Флаг командной строки «--dangerously-skip-permissions» активирует режим «bypassPermissions», который появился в Claude Code версии v1.0.18 от 9 июня 2025 года. В Claude Code есть режимы разрешений «default», «acceptEdits», «plan», «auto», «dontAsk» и «bypassPermissions». Режим «auto» устанавливается по умолчанию с августа — он формально разрешает любые действия, но при этом в фоновом режиме проводит проверки безопасности; «bypassPermissions» также формально разрешает всё, но уже без проверок безопасности. Остаются исключения, которые не одобряются автоматически и требуют явного подтверждения — в частности, выполнения команд «rm» и «rmdir». Новая переменная окружения «CLAUDE_CODE_EVEN_MORE_DANGEROUSLY_SKIP_PERMISSIONS» снимает и это ограничение, хотя собственные ограничения могут накладывать и другие механизмы, например, заданные пользователем настройки. Известно немало случаев, когда ИИ-агенты выполняли команды вроде «rm -rf ~», что приводило к полному удалению данных с диска или другим неприятным последствиям. ИИ может взломать то, что десятилетиями защищало банковские счета и данные, предупредили математики
28.10.2026 [14:00],
Алексей Разин
Взломы с использованием квантовых компьютеров перестают быть главной потенциальной проблемой для специалистов по криптографической защите данных. Успехи ИИ-моделей, работающих на классической вычислительной архитектуре, заставляют видеть в этом прогрессе сопутствующую угрозу. 
Источник изображения: Unsplash, Vitaly Gariev Криптографическая защита традиционно строилась на математических алгоритмах, и до недавних пор основной угрозой для их надёжности считалось появление квантовых компьютеров. При этом работающие на вычислительной инфраструктуре классического типа ИИ-модели в решении сложных математических задач в последнее время продвинулись так далеко, что этот фактор начал беспокоить специалистов по криптографической защите данных в не меньшей степени. Как отмечает Financial Times, соответствующую обеспокоенность породил прогресс ИИ-моделей OpenAI в решении математических задач, которые учёным не поддавались на протяжении длительного времени. Эти успехи даже вызвали недовольство профильной ассоциации, которая призвала математиков прекратить сотрудничество с OpenAI. Последняя пожертвовала $5 млн на нужды специализированного фонда, чтобы загладить конфликт. Криптографические методы защиты используются, помимо прочего, для предотвращения несанкционированного доступа к банковским счетам и базам данных различного назначения. Как поясняет австралийский математик Джорди Уильямсон (Geordie Williamson), в этих ИИ-системах происходит полная реструктуризация понятия сложности, которое и лежит в основе современной криптографии. «Я думаю, что в будущем нас ждут потрясения, очень серьёзные потрясения», — добавил он. На данный момент ИИ не удалось взломать основной метод криптографии, но математики предупреждают, что такая вероятность увеличивается. Повышение быстродействия ИИ в области разработки алгоритмов и теории чисел, которые имеют отношение к целым числам, заметно повысило способность решать его силами те задачи, которые прежде считались слишком сложными. Один из широко используемых в криптографии методов, например, основан на перемножении двух очень больших простых чисел. До сих пор этот метод защиты оставался эффективным, поскольку существующим компьютерам легко давалось умножение, но сложнее было осуществить обратный процесс, связанный с определением исходных чисел. Достижения ИИ в области решения математических задач в целом поставили под сомнение прежнее предположение, согласно которому самой серьёзной угрозой для криптографии считалось появление квантовых компьютеров, которые используют физику субатомных частиц для достижения результатов, которые не по зубам компьютерам с классической архитектурой. Если в случае со сроками создания достаточно мощного квантового компьютера принято говорить о перспективе многих лет, то ИИ на классических вычислительных мощностях представляет гораздо более осязаемую угрозу для криптографии. Управление по финансовому регулированию и надзору Великобритании заявило Financial Times, что тестирует новый надзорный инструмент в 50 крупных организациях для оценки степени их готовности к отражению новых технологических угроз в сфере криптографии, относящихся не только к ИИ, но и квантовым вычислениям. Уже в следующем месяце британский регулятор собирается поделиться практическими рекомендациями в этой области с более чем 35 тысячами компаниями, оказывающими в юрисдикции страны финансовые услуги. «Они должны понимать, как сегодня защищены их системы, и уже сейчас начать готовиться к будущему, в котором будет обеспечена квантовая безопасность», — говорится в сообщении. Профессор криптоматематики Манчестерского университета Дэниэл Шиу (Daniel Shiu) считает, что для «более математических» форм криптографии угроза взлома со стороны ИИ уже вполне осязаема. По его словам, уязвимости обнаруживаются в менее зрелых алгоритмах из числа новых, разработанных для защиты от атак, реализуемых при помощи квантовых компьютеров. Власти нескольких стран, включая США, Китай и Германию, уже начали пересматривать существующие и предлагаемые криптографические методы на предмет устойчивости ко взлому с учётом новых типов угроз. Телекоммуникационный гигант BT заявил о начале подготовки к миграции на новые методы криптографии, которые учитывали бы будущие угрозы со стороны квантовых компьютеров. Компания сосредоточилась на обеспечении более быстрого изменения криптографических методов по мере развития стандартов, технологий и самих угроз. |
|
✴ Входит в перечень общественных объединений и религиозных организаций, в отношении которых судом принято вступившее в законную силу решение о ликвидации или запрете деятельности по основаниям, предусмотренным Федеральным законом от 25.07.2002 № 114-ФЗ «О противодействии экстремистской деятельности»; |
© 1997—2026 3DNews
При цитировании документа ссылка на сайт с указанием автора обязательна. Полное заимствование документа является
нарушением
российского и международного законодательства и возможно только с согласия редакции 3DNews.



 MWC 2018
 2018
 Computex

 IFA 2018









