


Опрос
|
реклама
Быстрый переход
Tesla замахнулась на 80-кратный прирост мощности ИИ-чипов и переименовала их в ускорители суперинтеллекта
06.11.2026 [18:52],
Владимир Мироненко
Tesla представила обновлённую дорожную карту выпуска ИИ-ускорителей, сменив их название на SI. Ожидается, что чипы шестого поколения SI6 обеспечат 80-кратный прирост вычислительной мощности, а система Dojo 3 также будет использоваться в космосе. 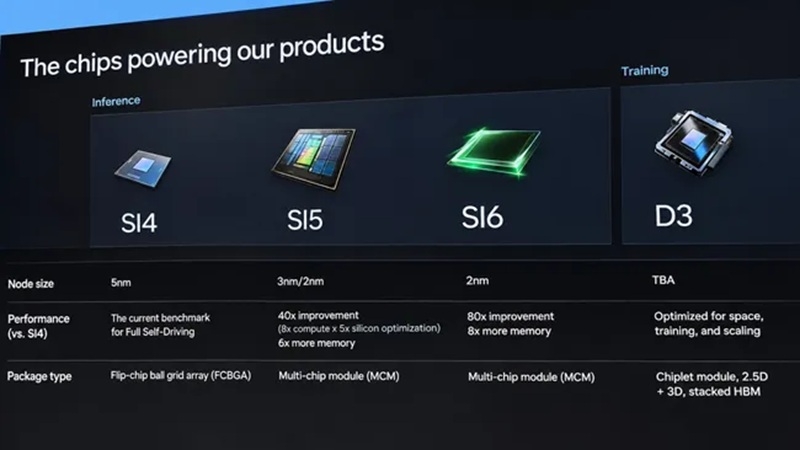
Источник изображения: Tesla/Tom's Hardware Согласно дорожной карте, ускоритель шестого поколения SI6 для инференса получит в 80 раз более высокую производительность по сравнению с чипом четвёртого поколения. А в ускорителе для обучения моделей Dojo 3 (D3) будет использоваться многочиплетная архитектура со стековой памятью HBM. Также компания сменила брендинг ускорителей: теперь они будут выпускаться под названием SI (Super Intelligence, «суперинтеллект»), которое заменит термин AI (искусственный интеллект). Ранее Илон Маск (Elon Musk) подтвердил, что по той же причине проект SpaceXAI будет переименован в SpaceXSI. Dojo 3 (D3), как сообщается, объединяет технологии 2.5D- и 3D-компоновки со стековой памятью HBM, что означает значительный отход от первоначальной архитектуры Dojo D1 с использованием памяти SRAM. Вместе с тем данные о вычислительной мощности, объёме памяти, техпроцессе или сроках разработки D3 пока не сообщаются. Как ожидается, D3 будет оптимизирован для работы в космосе, что, вероятно, означает его радиационную стойкость. Что касается SI6, то на данный момент известно, что он превышает по производительности по производительности SI4 (W4) в 80 раз, а объём памяти — в 9 раз. Речь идет о показателях в диапазоне 17 280–46 080 TOPS или 17,28–46,08 POPS — в зависимости от того, как измеряется производительность, отметил ресурс Tom's Hardware. Используемый в современных автомобилях Tesla чип SI4 (HW4) производится Samsung Foundry по 7-нм техпроцессу. Как ожидается, чип пятого поколения SI5, который будут выпускать TSMC (3 нм) и Samsung Foundry (2 нм), получит 40-кратный прирост производительности по сравнению с HW4. Компания Tesla уже заключила с Samsung Foundry соглашение о производстве ускорителей шестого поколения для инференса, которое будет действовать до 2033 года. Согласно представленным материалам, чипы SI6 будут изготавливаться с применением техпроцесса класса 2 нм. При этом в планах Tesla не предусмотрено использование для производства чипа SI6 мощностей Intel (Terafab) и техпроцесса Intel 14A в 2030-х годах. Учитывая сроки выхода (2029–2030 годы) и обновлённую дорожную карту Samsung Foundry, речь, вероятно, идёт о техпроцессах SF2A (автомобильного класса), SF2P (с повышенной производительностью) или даже SF2Z, предположил Tom's Hardware. Китайские ИИ-гиганты выстроились за видеокартами Nvidia, но получат лишь 1 % от заказанного
05.11.2026 [00:35],
Владимир Фетисов
Китайские ИИ-разработчики ожидают получить лишь небольшую долю от общего объёма заказанных ими ускорителей Nvidia в течение следующих нескольких месяцев. Это связано с тем, что американская компания сосредоточена на расширении производства передовых ускорителей, а высокий спрос на них не позволяет увеличить поставки менее мощных видеокарт в КНР. 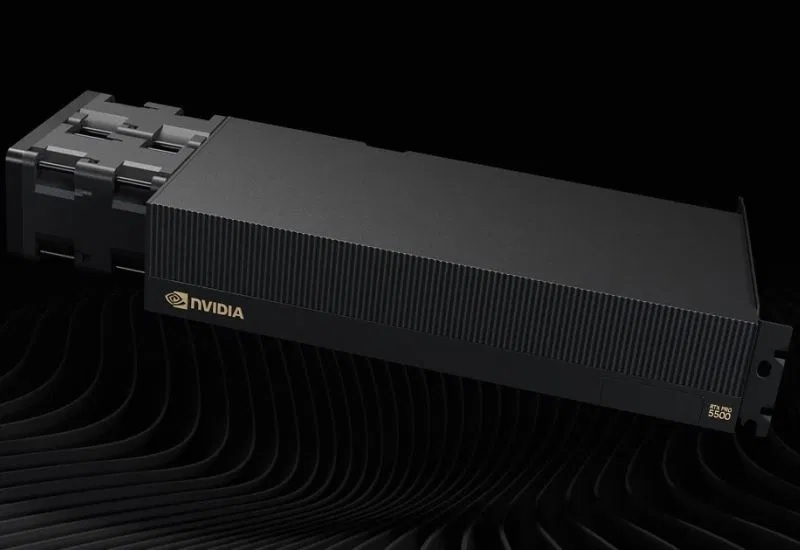
Источник изображения: Nvidia По данным источника, Alibaba Group Holding Ltd., Tencent Holdings Ltd., ByteDance Ltd. и другие китайские компании в сфере ИИ и облачных вычислений суммарно заказали около 6 млн профессиональных видеокарт Nvidia RTX Pro 5500. Однако, по прогнозам компаний, в течение следующих четырёх месяцев им удастся получить лишь несколько десятков тысяч ускорителей, или около 1 % от общего объёма заказов. При цене более $11 000 за видеокарту общая стоимость размещённых заказов в настоящее время оценивается примерно в $70 млрд. Высокий спрос на эти ускорители со стороны китайских ИИ-разработчиков подчёркивает острую нехватку вычислительных мощностей для сферы ИИ внутри КНР. На это также указывает ограниченность возможностей местных производителей оборудования, несмотря на достигнутый ими технологический прогресс. Ограниченные поставки ускорителей усложнят задачу китайским компаниям, стремящимся догнать западных конкурентов в сфере ИИ. Американские власти по-прежнему запрещают Nvidia поставлять в Китай свои передовые ускорители, однако видеокарты RTX Pro 5500 недостаточно мощные, чтобы подпадать под эти ограничения. Тем не менее в КНР этот продукт относится к числу лучших доступных ИИ-ускорителей. Местные производители, такие как Huawei Technologies Co. и T-Head (подразделение Alibaba), пока уступают американскому конкуренту по производительности и технологическим возможностям. Китайские ИИ-разработчики рассчитывают, что первая партия из нескольких тысяч видеокарт RTX Pro 5500 будет поставлена к концу нынешнего года, а следующая партия, насчитывающая несколько десятков тысяч ускорителей, ожидается в феврале. Осведомлённый источник, пожелавший сохранить анонимность, сообщил, что на данный момент это единственные подтверждённые поставки. По оценкам китайских ИИ-разработчиков, к концу 2027 года они могут получить около 700 тыс. ускорителей RTX Pro 5500. Такие ожидания связаны с наращиванием объёмов производства со стороны Nvidia. Однако фактические объёмы поставок могут измениться в зависимости от корректировки производственных мощностей американской компании. Китайская Iluvatar заявила, что сделала ИИ-ускоритель не хуже Nvidia H200 — и даже показала тесты
30.10.2026 [15:45],
Павел Котов
Китайская компания Iluvatar CoreX заявила, что её графический ускоритель Tiangai 300 способен конкурировать с Nvidia H200, а в отдельных задачах искусственного интеллекта — превосходить его. Компания представила результаты тестов и продемонстрировала работу оборудования журналистам, однако подробные условия сравнения раскрыты не полностью. 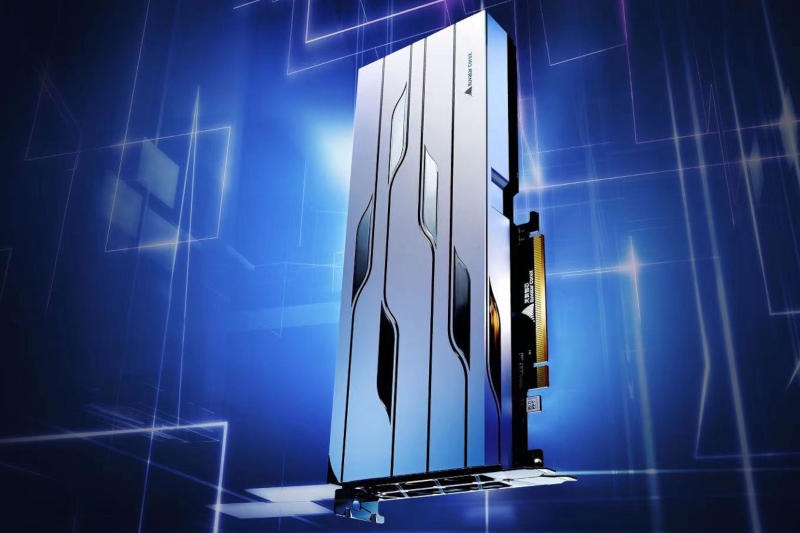
Источник изображения: iluvatar.com В ходе демонстрации в Шанхае компания сравнила Tiangai 300 и Nvidia H200 в задачах генерации изображений и видео по текстовым запросам. В одном из тестов на создание изображений система на Tiangai 300 успешно выполнила 100 % запросов с пропускной способностью 0,101 изображения в секунду, тогда как система на H200 — 87,5 % при 0,086 изображения в секунду. При этом время завершения задания у китайского ускорителя оказалось на 0,64 с больше. Критерии успешного выполнения запросов и методика подсчёта показателей не уточняются. По данным Iluvatar CoreX, проведённое в июле шанхайской компанией INESA тестирование показало, что система на Tiangai 300 обеспечивает на 5 % большую пропускную способность в пересчёте на один ускоритель, чем система на H200. Испытания проводились в конфигурации с раздельным выполнением обработки входных запросов и генерации ответов. Производитель утверждает, что Tiangai 300 стал первым китайским GPU общего назначения, достигшим уровня H200 в таких испытаниях. H200 — наиболее передовой ИИ-ускоритель Nvidia, разрешённый к экспорту в Китай по действующим американским правилам. В другом тесте, по данным компании, Tiangai 300 на 15 % превзошёл H200 по пропускной способности при работе с моделью GLM-5.3 на архитектуре MoE (Mixture-of-Experts) с контекстом 64 тыс. токенов. В задачах ИИ-агентов с контекстом от 8 тыс. до 128 тыс. токенов время до выдачи первого токена оказалось на 10–30 % меньше. В демонстрации обучения открытой модели Alibaba Qwen3-32B восьмикарточная система на Tiangai 300 с точностью FP8 обеспечила в 1,33 раза большую эффективную пропускную способность на карту, чем система на Nvidia H100. Iluvatar CoreX стремится сократить отставание от Nvidia. В январе компания опубликовала долгосрочную дорожную карту развития архитектур, согласно которой намерена в течение двух лет превзойти платформу Nvidia Rubin. По заявлению производителя, ускорители серии Tiangai уже используются в системах масштаба десяти тысяч карт, что позволяет накапливать опыт их внедрения и технического обслуживания. Компания также расширяет деятельность за пределами облачных центров обработки данных, развивая решения для локального запуска ИИ. По её данным, вычислительная система Tongyang TY1200 в отдельных тестах больших языковых моделей превзошла решение на базе Nvidia Thor T5000 на 20 %. Как и в случае Tiangai 300, эти результаты относятся к выбранным нагрузкам и не подтверждают общего превосходства над конкурентом. Nvidia заткнёт деньгами узкие места в производстве ИИ-чипов — чтобы через три года выпускать в 2,5 раза больше ИИ-ускорителей
22.10.2026 [00:00],
Анжелла Марина
Nvidia договорилась на GTC Berlin с ключевыми партнёрами по цепочке поставок о расширении производства компонентов, необходимых для выпуска ИИ-ускорителей и вычислительных систем. Компания профинансирует развитие мощностей поставщиков, включая строительство новых заводов и закупку оборудования. 
Источник изображений: Nvidia За три года Nvidia планирует увеличить в 2,5 раза производственные мощности по выпуску подложек для своих продуктов, очевидно с намереньем в той же степени нарастить выпуск и самих чипов. Для этого будут заключены соглашения с производителями из Японии, Южной Кореи и Тайваня с предоставлением авансового финансирования и резервированием будущих объёмов производства. В частности, Nvidia выделит несколько миллиардов долларов на расширение завода Ibiden в японском Оно, мощности которого к 2028 году должны вырасти втрое относительно текущего уровня. Samsung Electro-Mechanics подключится к цепочке поставок Nvidia за счёт действующих производств в Южной Корее и расширения предприятий в Седжоне и Пусане.  Передовая упаковка полупроводников и тестирование чипов являются отдельным направлением. Вместе с Amkor Nvidia намерена более чем втрое увеличить мощности по выпуску пластин с интерпозерами к концу 2028 года. Общие мощности по тестированию полупроводников компания рассчитывает удвоить с 2026 по 2027 год. На развитие этого направления в США Nvidia предоставит компании King Yuan Electronics (KYEC) аванс в размере $1,1 млрд для резервирования производственных мощностей. Запуск массового тестирования на новых американских площадках намечен на апрель 2027 года, а в Сингапуре новые мощности должны выйти на этот этап в феврале того же года. Кроме того, Nvidia и Siliconware Precision Industries (SPIL) расширят производство оптических модулей на Тайване для систем с ко-упакованной оптикой (CPO), которая улучшает передачу данных между компонентами вычислительных комплексов. К середине 2027 года мощности в этом направлении планируется увеличить в 15 раз, а к концу 2028 года — удвоить эти показатели. По итогу, на фоне роста спроса на ИИ-инфраструктуру, расширение производства должно обеспечить Nvidia необходимыми компонентами для текущих и будущих поколений вычислительных платформ в достаточной мере. GTC Berlin — это крупная международная конференция по искусственному интеллекту и ускоренным вычислениям, организованная компанией Nvidia (проходит с 20 по 22 октября 2026 года в Берлине). Ранее 3DNews сообщал, что Nvidia не допустила некоторых партнёров на эту конференцию за использование чипов AMD и Google. Intel вырезала из GPU блоки 3D-графики и трассировки лучей ради ИИ — представлен D270 с поддержкой до 480 Гбайт LPDDR5X
12.10.2026 [23:56],
Николай Хижняк
Компания Intel официально представила графические ускорители серии D на саммите Open Compute Project (OCP) 2026. Ранее известная под кодовым названием Crescent Island новинка теперь значится на официальном сайте компании как Intel GPU D270. Ускоритель построен на архитектуре Xe3P и предназначен для задач инференса (вывода) ИИ, а не для игр. 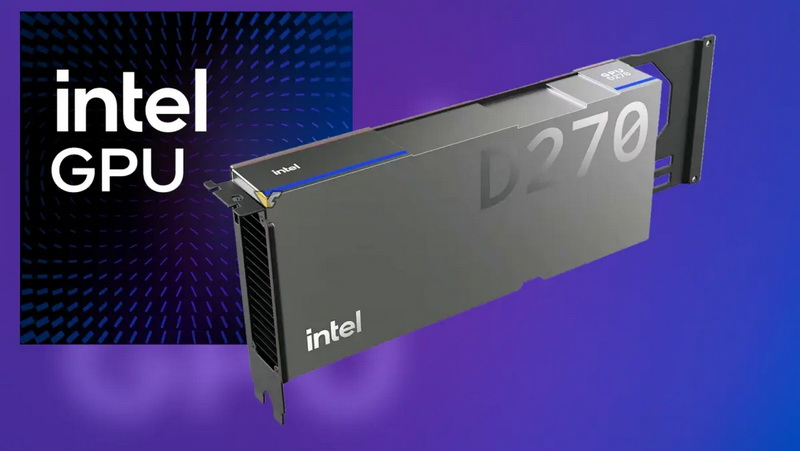
Источник изображений: VideoCardz / Intel Intel подтвердила показатели производительности D270. Графический процессор в его составе обеспечивает вычислительную мощность до 1,3 Пфлопс (в формате FP8) и пропускную способность памяти 1,5 Тбайт/с. Эти данные дополняют технические характеристики, ранее озвученные Intel на конференции Hot Chips 2026. Из предварительного анонса стало известно, что Crescent Island оснащён 32 ядрами Xe3P, 256 блоками XMX и 32 Мбайт унифицированной кеш-памяти L2. Intel отказалась от использования в этом устройстве аппаратных блоков для традиционной 3D-графики и трассировки лучей, выделив освободившуюся площадь кристалла под вычислительные операции. 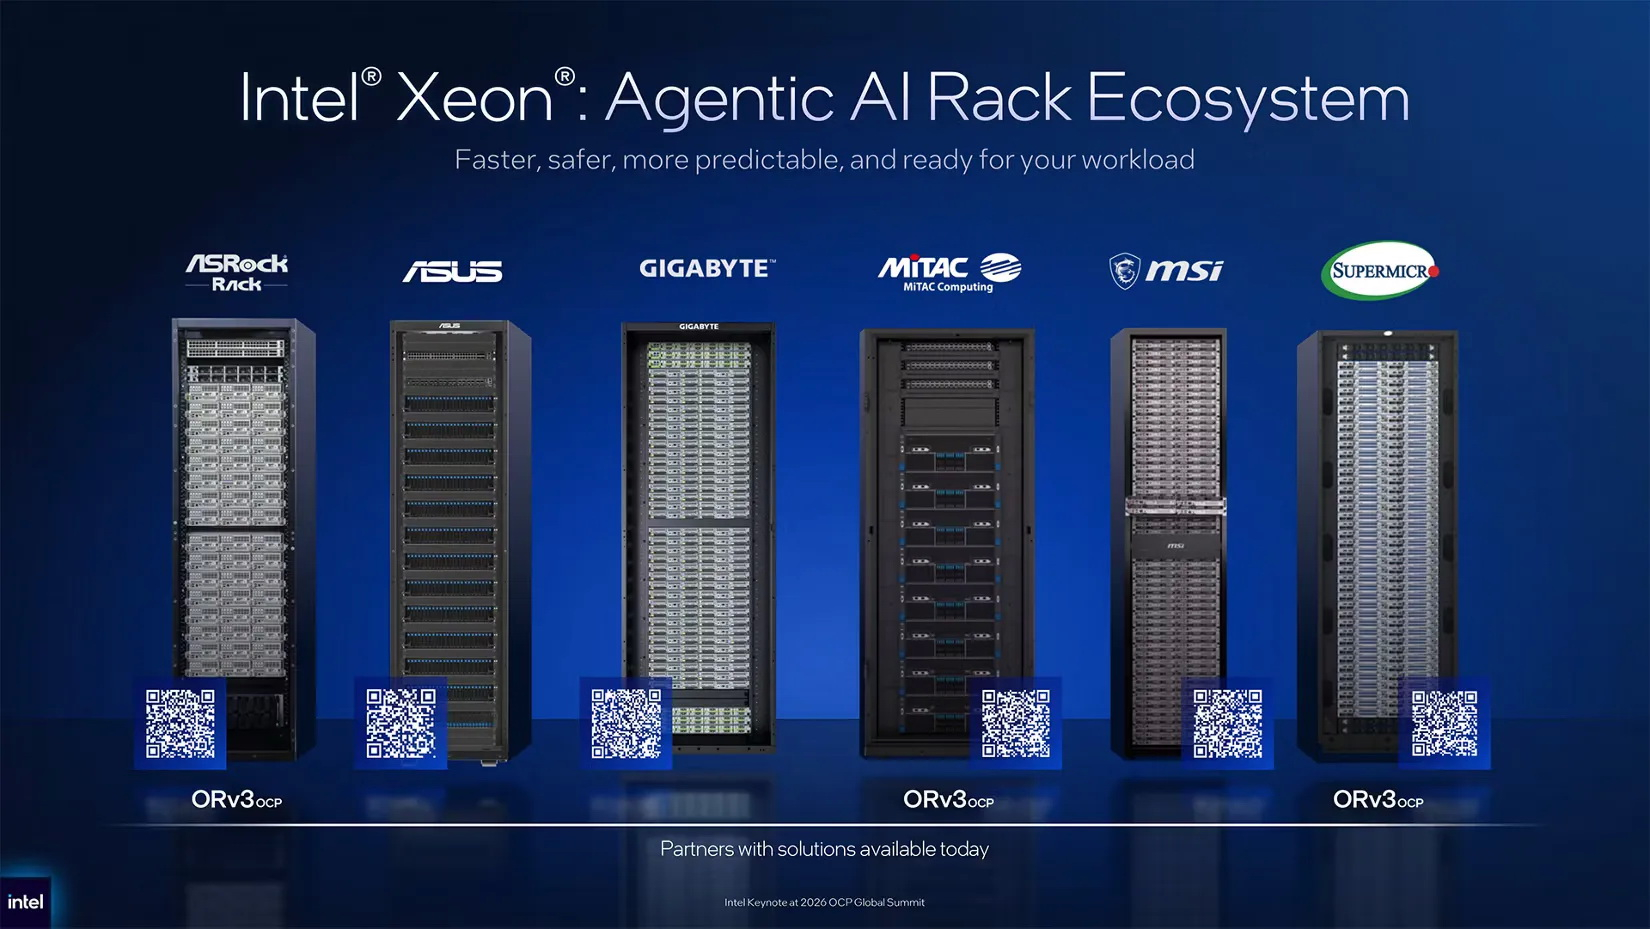 Эталонный вариант ускорителя от Intel с интерфейсом PCIe будет оснащаться 160 Гбайт памяти LPDDR5X. При этом партнёры-производители (ODM) смогут создавать конфигурации с объёмом памяти до 480 Гбайт. Ускоритель использует интерфейс PCIe 5.0, а его расчётная мощность составляет 350 Вт. Intel сделала выбор в пользу пассивного воздушного охлаждения и стандартной серверной инфраструктуры, отказавшись от специализированных систем жидкостного охлаждения. 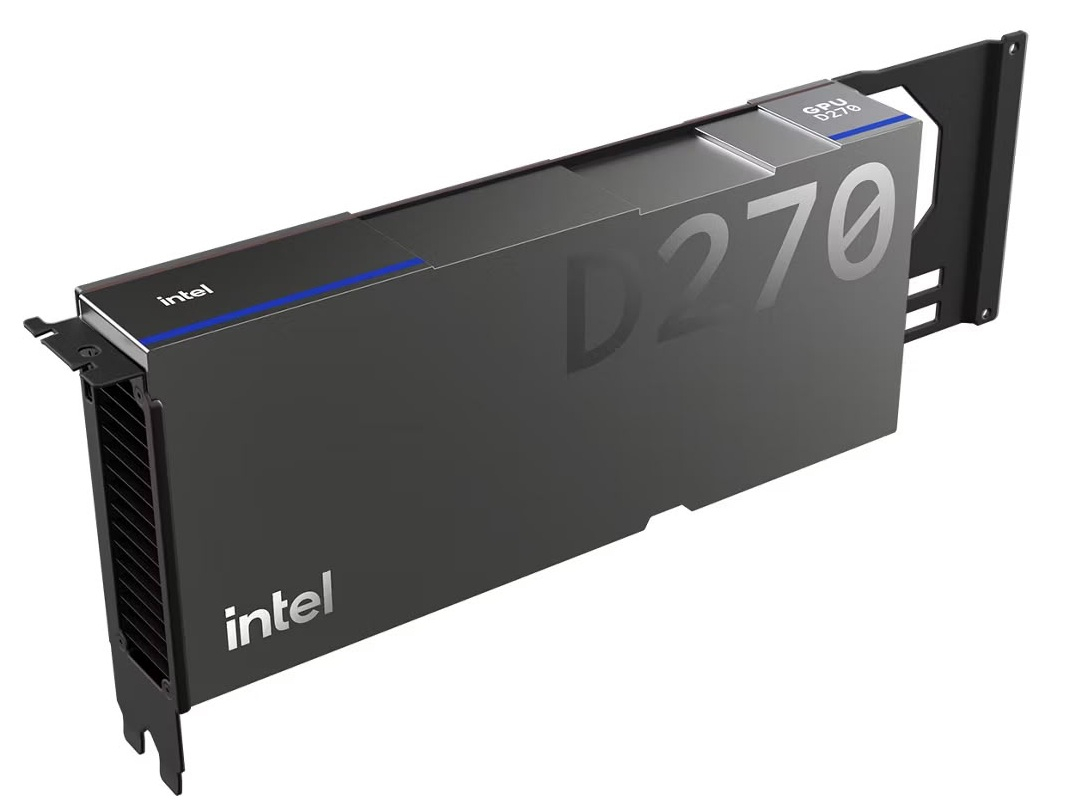 По заявлению Intel, один ускоритель серии D способен поддерживать работу ИИ-моделей с количеством параметров до 300 млрд. Система из восьми таких графических процессоров рассчитана на работу с моделями, насчитывающими более одного триллиона параметров. Однако компания пока не предоставила результаты независимых тестов или подробные конфигурации моделей, подтверждающие эти возможности. Intel также сообщила, что поставки образцов D270 заказчикам уже начались. Информация о стоимости и сроках выхода продукта в широкую продажу пока не объявлена. ИИ не заменил инженеров, но ускорил их втрое — OpenAI раскрыла секреты создания Jalapeno
29.09.2026 [09:59],
Алексей Разин
В июне OpenAI представила свой ИИ-чип Jalapeno, в разработке которого принимали активное участие специалисты Broadcom. Вице-президент OpenAI по аппаратному обеспечению Ричард Хо (Richard Ho) в своём интервью Tom’s Hardware рассказал о том, как велась разработка Jalapeno, и чем полученный опыт может быть полезен для всей полупроводниковой отрасли. 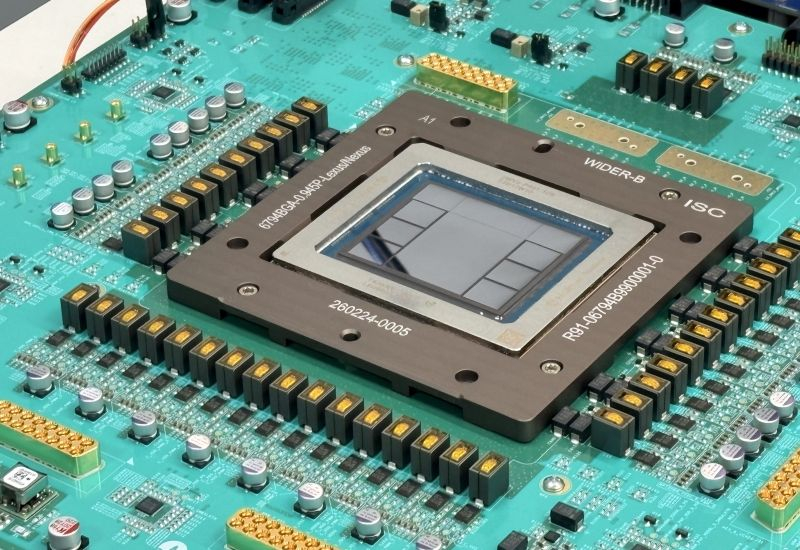
Источник изображения: OpenAI Во-первых, как отметил представитель OpenAI, активное использование ИИ на этапе проектирования чипа позволило сократить затраты времени на весь процесс с традиционных 18–24 месяцев до девяти. Говорить о замене искусственным интеллектом труда инженеров при этом преждевременно, поскольку небольшая по численности команда специалистов в итоге стала более производительной. Пришлось пойти и на определённые компромиссы с точки зрения архитектуры, поскольку сжатые сроки проектирования были приоритетом. В дальнейшем, если потребуется создать более сложный чип, OpenAI сможет сделать это быстрее, чем при использовании традиционных методов, опираясь на ИИ и уже существующий дизайн. По словам Хо, к созданию собственного чипа OpenAI подтолкнуло стремление поднять эффективность вычислительной инфраструктуры, поскольку в условиях нехватки вычислительных ресурсов в сфере ИИ распоряжаться ими надо более рационально. В этом смысле ИИ-чипы для инференса в современных условиях максимально определяют пользовательский опыт, а потому Jalapeno заточен именно под эти цели, снижая задержки при обработке запросов. При этом Jalapeno должен хорошо проявлять себя при работе с ИИ-моделями разных поставщиков, а не только собственными OpenAI. По сути, под эффективную работу с чипом можно за пару месяцев адаптировать даже те модели, которые при его создании даже не учитывались. При этом Хо считает, что потенциал внутреннего спроса OpenAI на вычислительные ресурсы настолько велик, что говорить об использовании Jalapeno внешними заказчиками не придётся ещё очень долго. Полученным при разработке Jalapeno с помощью ИИ опытом OpenAI готова делиться с прочими участниками рынка, поскольку она заинтересована в более быстром выходе на рынок новых моделей чипов других поставщиков, которые тоже использует в своей инфраструктуре. OpenAI не станет отказываться от компонентов других разработчиков, типа AMD и Nvidia, продолжив использовать их в своей вычислительной инфраструктуре. Главное, чтобы в итоге аппаратная конфигурация ЦОД была эффективной с точки зрения обеспечиваемой производительности при определённом уровне затрат. Новые поколения собственных чипов OpenAI собирается выводить на рынок по мере готовности, и в этой сфере нет каких-то заранее определённых требований по ритмичности таких анонсов. Каждое новое поколение при этом должно обеспечивать видимый прирост производительности относительно предыдущего, поэтому их смена не будет излишне частой. Alibaba представила самый мощный в Китае ИИ-ускоритель Zhenwu V900 — и пообещала ИИ-модели на 5–10 трлн параметров
22.09.2026 [11:30],
Владимир Мироненко
Компания Alibaba представила ИИ-ускоритель Zhenwu V900, который позиционируется как «самый мощный чип для ИИ в Китае на сегодняшний день». По данным компании, новый ускоритель в три раза превосходит по производительности своего предшественника — Zhenwu M890. 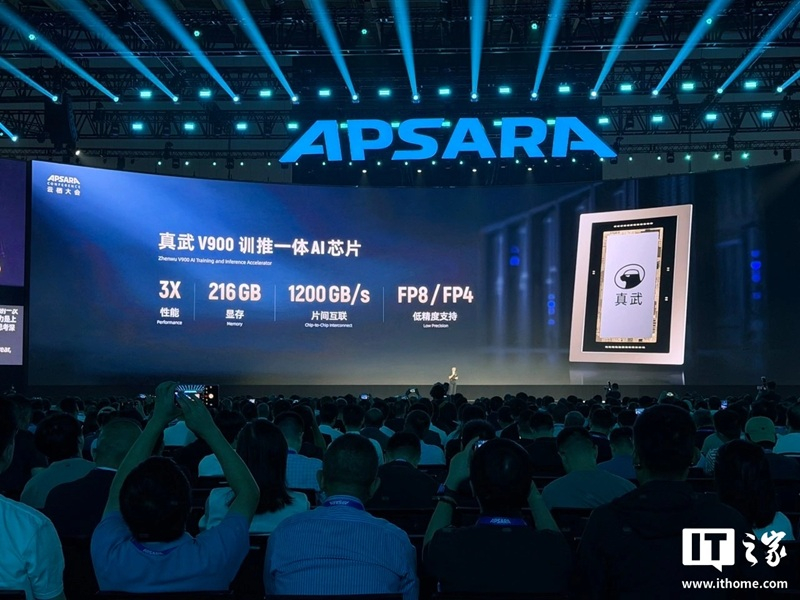
Источник изображения: ithome Разработанный подразделением T-Head Semiconductor ИИ-ускоритель Zhenwu V900 оснащён 216 Гбайт памяти HBM, поддерживает вычисления в формате FP8/FP4 и обеспечивает пропускную способность межчипового интерконнекта 1,2 Тбайт/с. По словам Гао Хуэя (Gao Hui), вице-президента T-Head, начало серийного производства и выхода продукта на рынок запланировано на первый квартал 2027 года. Вычислительные кластеры на базе V900 могут включать до 500 тыс. чипов для решения задач обучения и инференса. T-Head также сообщила о подготовке ИИ-ускорителя следующего поколения Zhenwu J900, выпуск которого намечен на третий квартал 2028 года. Также подразделение планирует создание собственных центральных процессоров (CPU) нового поколения, оптимизированных для задач агентного искусственного интеллекта, — Yitian 720 и Yitian 730, выход которых ожидается в 2027 году. Сообщается, что Yitian 730 станет первым процессором T-Head, созданным на базе собственной микроархитектуры. Генеральный директор Alibaba У Юнмин (Wu Yongming) также представил план развития компании, выделив «ИИ-модели, ИИ-чипы и ИИ-облако» в качестве трёх краеугольных камней эпохи машинного интеллекта. В рамках разработки искусственного сверхинтеллекта (Artificial Super Intelligence, ASI) команда разработчиков Qwen планирует обучить модель Qwen 5 с 5–10 трлн параметров, предназначенную для выполнения сложных задач в течение длительного времени. Для сравнения, у флагманской модели Alibaba Qwen 3.8-Max насчитывается 2,4 трлн параметров, в то время как Kimi K3 от Moonshot AI — крупнейшая в Китае модель с открытыми весами — имеет 2,8 трлн параметров. Кроме того, Alibaba запустила Qwen Intelligence — комплексную платформу для создания ИИ-агентов, которая обеспечит производителям смартфонов доступ к инструментам на базе Qwen. Meta✴ заставит ИИ работать дешевле — фирменные ускорители потеснят Nvidia в ЦОД уже в 2027 году
15.09.2026 [20:54],
Владимир Фетисов
Meta✴✴ Platforms планирует начать использование новых ИИ-ускорителей собственной разработки в центрах обработки данных в первой половине следующего года. В компании заявили, что это позволить сэкономить денежные средства и энергию при работе с ИИ-моделями. 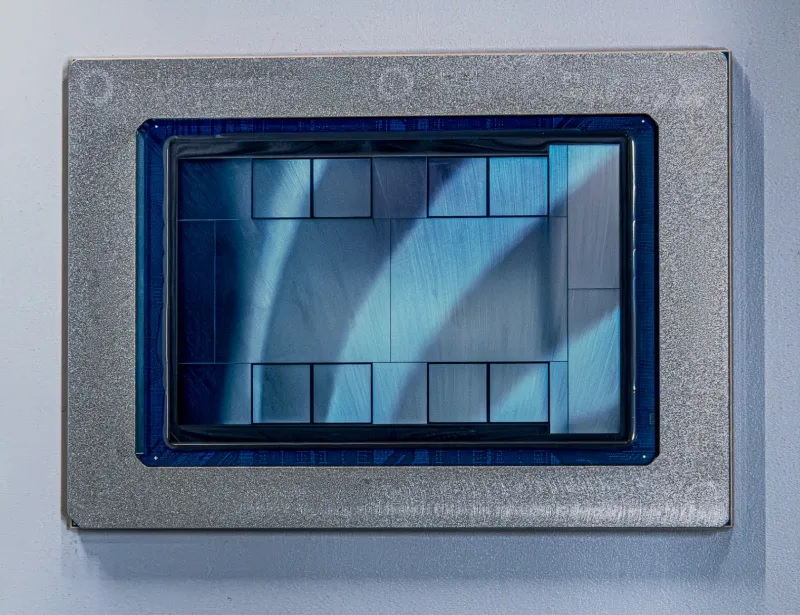
Источник изображений: Meta✴✴ Впервые о планах по созданию собственных ИИ-ускорителей Meta✴✴ объявила ещё в 2023 году. В настоящее время проходит тестирование третьего поколения ускорителей линейки — MTIA 450 (Meta✴✴ Training and Inference Accelerator, он же Arke). Проектирование следующего ускорителя MTIA 500, который разрабатывается под кодовым именем Astrid, завершится примерно через месяц, а его эксплуатация в центрах обработки данных начнётся в конце следующего года. «С каждым новым ускорителем мы берём на себя чуть больший технологический риск и получаем более высокую производительность», — прокомментировал данный вопрос вице-президент Meta✴✴ по инженерным вопросам Йи Джун Сон (Yee Jiun Song). По его словам, речь идёт о повышении производительности на каждый затраченный ватт энергии и на каждый потраченный доллар. Meta✴✴, являющаяся владельцем Facebook✴✴, Instagram✴✴ и WhatsApp, разрабатывает собственные ускорители в рамках реализации масштабной программы по созданию обширной ИИ-инфраструктуры. В части проектирования гигант соцсетей сотрудничает с Broadcom, а в области производства — с TSMC. Этот проект призван снизить зависимость Meta✴✴ от продукции Nvidia, которая является лидером в сфере разработки ИИ-ускорителей. Если оценивать по энергопотреблению, ключевому показателю для индустрии ИИ-ЦОД, Meta✴✴ планирует в течение года задействовать ускорителей, суммарной мощностью более гигаватта. После этого, по словам Сона, который курирует программу Meta✴✴ по разработке собственных чипов, «ожидается ускорение темпов». Он добавил, что такой прогноз будет актуальным при условии, что не произойдёт обвала рынка ИИ или падения спроса. 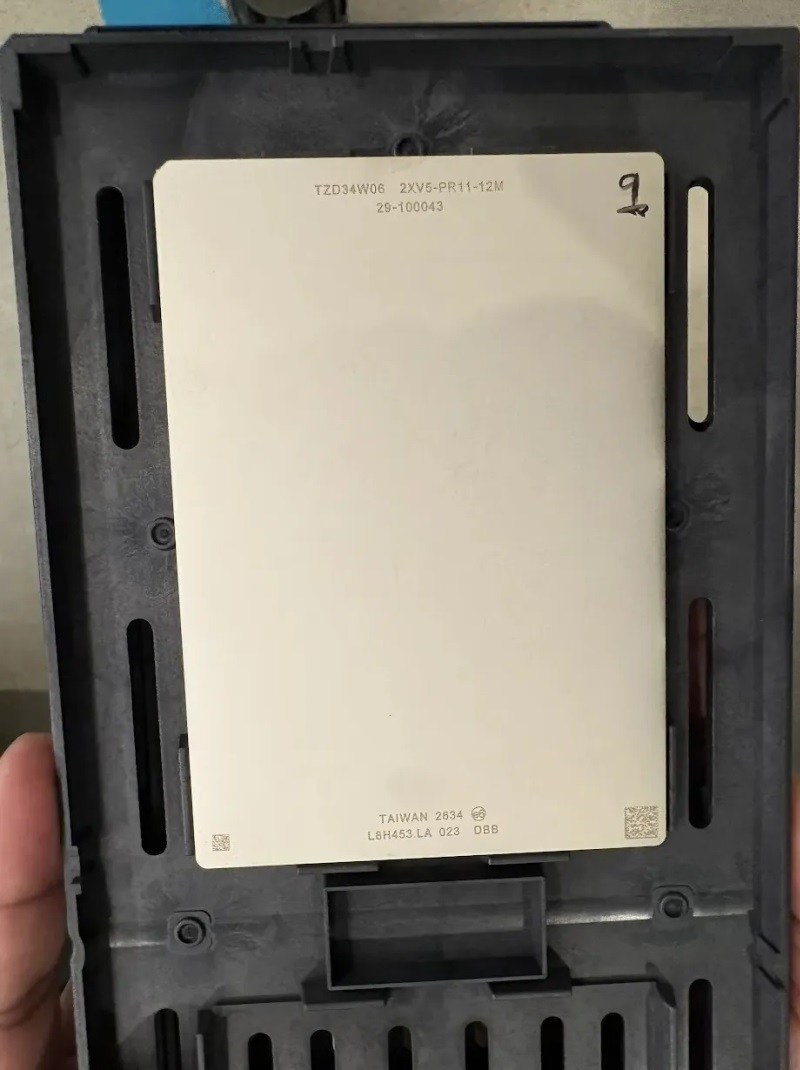
MTIA 450 / Источник изображения: Meta✴✴ ИИ-подразделение Meta✴✴ Superintelligence Labs помогает дорабатывать будущие ИИ-ускорители. Разработчики предоставляют информацию о будущих ИИ-моделях и требованиях к оборудованию для их запуска. Сон отметил, что такой подход помогает делать ускорители при запуске ИИ-моделей более эффективными, чем «то, что сейчас поставляет Nvidia». По его словам, это происходит «просто потому, что мы сами выполняем большую часть инженерной работы». По данным источника, TSMC передала Meta✴✴ 12 новых ускорителей 1 сентября. Их производительность соответствует прогнозам и отклоняется всего на 2-3 % от результатов симуляций. В тот же день инженеры задействовали ускорители для работы с ИИ-моделями Meta✴✴, а также алгоритмами от DeepSeek и Alibaba. Первичные тесты показали, что в конструкции новых ускорителей нет проблем. Однако впереди ещё много работы, связанной с испытанием и настройкой новых устройств. Это займёт несколько месяцев, а параллельно будет наращиваться объём производства ИИ-ускорителей. Все четыре поколения ускорителей Meta✴✴ в основном используют память с высокой пропускной способностью и не рассчитаны на сегмент, где от ИИ-моделей ожидается предельно быстрая реакция. «Это рабочие лошадки, которые мы планируем использовать для инференса общего назначения», — рассказал Сон. Ранее компания планировала использовать ИИ-ускорители, которые разрабатывались под кодовым именем Olympus и которые должны были подходить для обучения ИИ-моделей, а также для инференса. Ускоритель должен был появиться в 2028-2029 годах, но Meta✴✴ отказалась от этого проекта, в том числе по финансовым соображениям. «Когда вы начинаете наращивать мощности на уровне гигаватт и гигаватт, стоимость действительно имеет огромное значение. Если ускоритель, который справляется и с обучением, и с инференсом, потенциально будет на 30 % дороже, это становится совершенно неприемлемым», — отметил Сон. Уход Nvidia озолотил Biren — выручка китайского разработчика ИИ-чипов взлетела на 2000 %
10.09.2026 [17:44],
Сергей Сурабекянц
Китайский поставщик ИИ-ускорителей Biren Technology продемонстрировал в первой половине 2026 года колоссальный рост выручки — почти на 2000 % в годовом исчислении. Продажи начали стремительно расти во второй половине 2025 года после того, как американские компании во главе с Nvidia прекратили поставки своих графических процессоров для ИИ в КНР из-за мер экспортного контроля США и запретов, введённых самим Китаем на американское оборудование для ИИ. 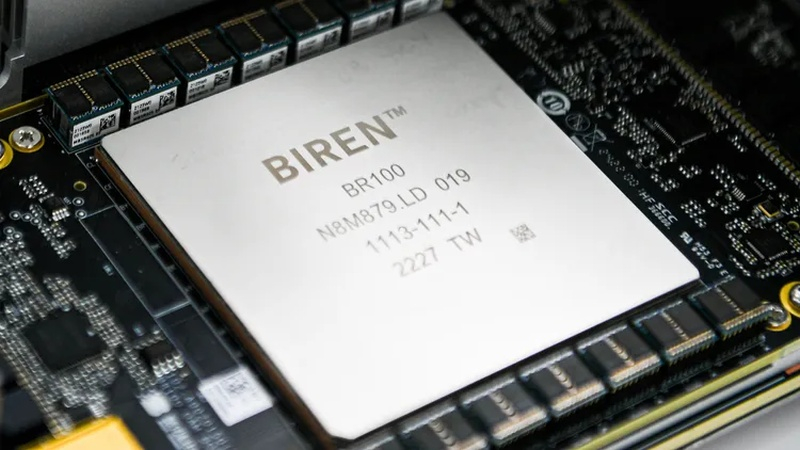
Источник изображения: Biren Technology Выручка Biren за первое полугодие составила $183,9 млн, что на 1998 % больше $8,665 млн за аналогичный период 2025 года. Валовая прибыль компании выросла до $78,552 млн, а рентабельность достигла 42,7 %. Тем не менее, компания получила убыток в размере $56,2 млн долларов в связи с инвестициями в новые продукты, включая ускорители ИИ, решения стоечного уровня с оптическими межсоединениями и программное обеспечение. Рост выручки Biren начался во второй половине 2025 года, по итогам года объём продаж составил $154,17 млн, а доля компании на китайском рынке ИИ-ускорителей оставалась ниже 3 %. Biren Technology, судя по заявленным характеристикам, готова составить конкуренцию решениям AMD и Nvidia. Компания разработала как минимум три высокопроизводительных графических процессора для ИИ — BR106, BR110 и BR166. В настоящее время в разработке находятся ускорители серий BR20X, BR30X и BR31X. Кроме того, Biren создала собственный программный стек Birensupa, призванный конкурировать с платформой Nvidia CUDA, и ведёт разработку решения стоечного уровня. До последнего времени спрос на отечественные ускорители ИИ в Китае был относительно низким, поскольку даже урезанные версии передовых графических процессоров Nvidia для ИИ обеспечивали более высокую производительность и лучшее программное обеспечение. Nvidia продавала свои ускорители H20 в КНР по цене $12 000–15 000 за единицу. До вступления в силу экспортных ограничений США в мае 2025 года компания успела поставила в страну около 2,2 млн таких устройств. Biren за весь 2025 год поставила не более нескольких десятков тысяч ускорителей ИИ. Даже сегодня объёмы поставок Biren исчезающе малы по сравнению с показателями Nvidia за 2025 год. Улучшение финансовых показателей Biren впечатляет, однако оно достигнуто на фоне крайне низких исходных показателей первой половины 2025 года. Теперь компания должна наладить выпуск достаточного количества ускорителей, чтобы удовлетворить спрос клиентов и существенно увеличить свою долю на рынке. Многое зависит от того, сможет ли Biren получить достаточные производственные мощности на заводах SMIC или у других производителей, чтобы конкурировать с более крупными китайскими компаниями, такими как Huawei, Kunlunxin и Cambricon. Huawei вытесняет Nvidia из инфраструктуры DeepSeek — новый ЦОД получит 160 000 китайских ускорителей
04.09.2026 [17:26],
Павел Котов
DeepSeek планирует развернуть не менее 160 000 новейших ускорителей Huawei в крупном центре обработки данных, который строится во Внутренней Монголии. Объект может стать одним из крупнейших известных кластеров ИИ-ускорителей Huawei и очередным шагом Китая на пути отказа от оборудования Nvidia. 
Источник изображения: Solen Feyissa / unsplash.com Для запуска моделей DeepSeek намерена использовать ускорители нового поколения Huawei Ascend 950DT, сообщает Bloomberg со ссылкой на информированные источники. Для обучения использовать их компания пока не планирует, хотя эти ускорители разрабатывались в том числе для подобных задач. DeepSeek уже пыталась обучать модели на оборудовании Huawei, но в итоге для этих целей всё-таки использовала продукцию Nvidia. Разработчик ИИ хочет закупить больше передовых ускорителей Huawei, однако у китайского гиганта электроники пока недостаточно производственных мощностей — из-за дефицита памяти компания может выпускать лишь несколько сотен тысяч единиц в год. Huawei приходится распределять продукцию между клиентами и одновременно выполнять зарубежные заказы, поэтому поставка необходимого DeepSeek количества ускорителей может занять более года. Если проект удастся реализовать в соответствии с планом, объект во Внутренней Монголии станет важной частью инфраструктуры DeepSeek, на развитие которой компания пытается привлечь миллиарды долларов. К моменту ввода объекта в эксплуатацию в Китае может появиться уже несколько кластеров сопоставимого размера. В прошлом году сообщалось, что в 2026 году Huawei может выпустить до 1,6 млн ИИ-ускорителей Ascend, в том числе 600 000 мощных 910C и небольшое число передовых 950DT, которые по производительности находятся на уровне Nvidia Hopper. Но даже создание кластера из 160 000 таких ускорителей станет серьёзным прогрессом для компании. В июне китайский гигант в области доставки еды Meituan сообщил, что обучил модель ИИ на 50 000 китайских ускорителей. Z.ai завершила строительство ЦОД мощностью 1 ГВт, который планирует заполнить исключительно китайскими чипами, хотя пока в её распоряжении находится лишь 10 000 ускорителей. При этом китайские технологические гиганты Alibaba и Tencent предпочитают оборудование Nvidia — они уже разместили крупные заказы на её ускорители. Пока же местные компании нередко арендуют вычислительные мощности за рубежом, что не является нарушением американских санкций. Для непосредственного импорта ускорителей Nvidia им приходится получать разрешение Пекина, которое власти выдают неохотно. Мощность ЦОД DeepSeek во Внутренней Монголии составит несколько гигаватт — такого количества электроэнергии хватило бы для снабжения примерно 750 000 домов. При этом 160 000 ускорителей Huawei Ascend 950DT займут лишь часть доступных вычислительных мощностей объекта. По некоторым данным, DeepSeek вопреки американским санкциям также закупила передовые ускорители Nvidia Blackwell, однако подтвердить эту информацию пока не удалось. Intel раскрыла устройство Crescent Island — ИИ-ускорителя с огромным объёмом дешёвой памяти
25.08.2026 [00:13],
Андрей Созинов
В рамках конференции Hot Chips 2026 компания Intel раскрыла новые подробности об устройстве ускорителя Crescent Island, предназначенного для выполнения задач ИИ-инференса в центрах обработки данных. Компания впервые подробно рассказала о вычислительной части GPU: он получит 32 ядра Xe3P и 256 матричных движков XMX. Ранее Intel уже сообщала, что Crescent Island будет выпускаться в виде PCIe-карт с воздушным охлаждением и сможет оснащаться до 480 Гбайт памяти LPDDR5X. 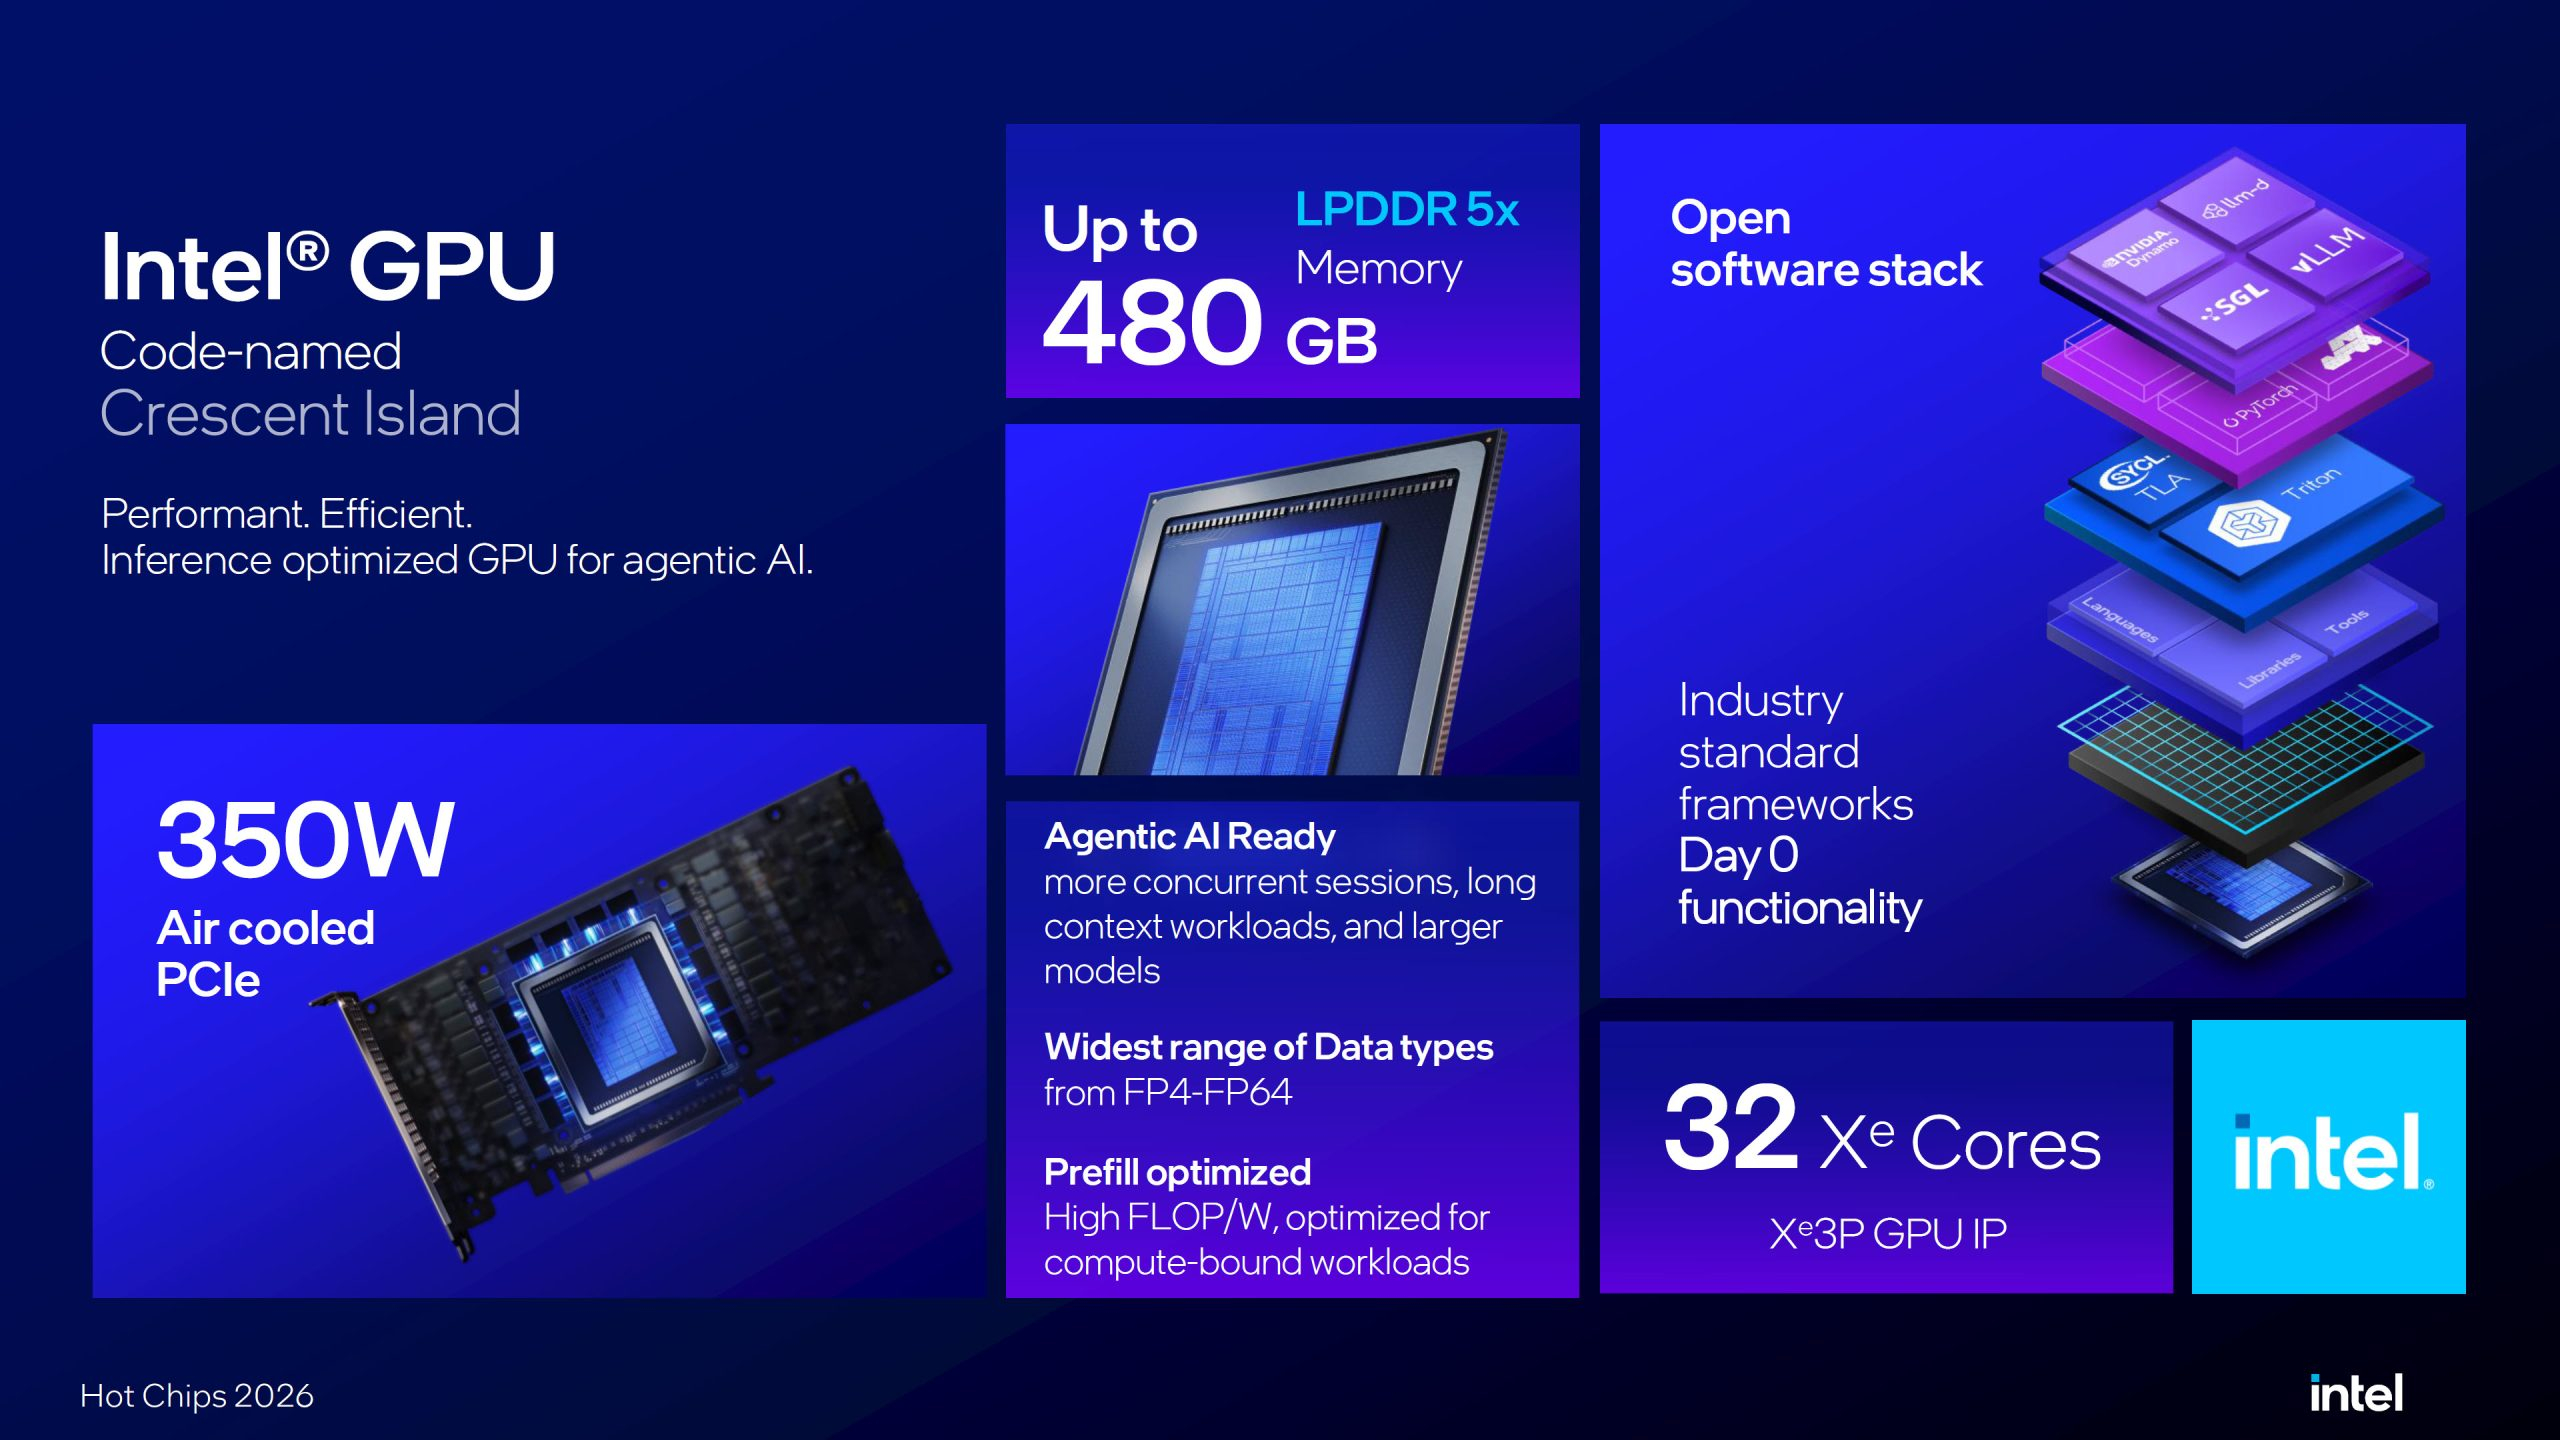 Вычислительная часть Crescent Island разделена на четыре блока Compute Slice, каждый из которых объединяет по восемь ядер Xe. В сумме GPU располагает 32 ядрами Xe3P, 256 векторными движками и таким же количеством матричных движков XMX, отвечающих за ускорение операций, используемых нейросетями. Каждое ядро Xe располагает 512 Кбайт объединённого кеша L1 и локальной памяти SLM, поэтому их суммарный объём достигает 16 Мбайт. Кроме того, в GPU предусмотрено 32 Мбайт общего кеша второго уровня. Архитектура Xe3P представляет собой специализированное развитие Xe3 с упором на производительность и энергоэффективность при вычислительных нагрузках. В Crescent Island Intel отказалась от блоков, необходимых для обработки традиционной 3D-графики, направив освободившийся транзисторный бюджет на вычислительные ресурсы. Ускоритель поддерживает широкий набор форматов данных от FP4, ориентированного на ИИ-инференс, до FP64, необходимого для высокоточных вычислений. Одной из наиболее необычных особенностей Crescent Island станет подсистема памяти. Вместо дорогой HBM, которую используют современные ускорители Nvidia и AMD, Intel выбрала LPDDR5X. Эталонная карта самой Intel получит 160 Гбайт памяти, тогда как партнёры смогут создавать ускорители с объёмом до 480 Гбайт. Такой подход обеспечивает меньшую пропускную способность по сравнению с HBM, однако позволяет существенно увеличить объём памяти при умеренной стоимости и энергопотреблении. Большой объём памяти должен позволить размещать на одном ускорителе крупные языковые модели, обслуживать более длинный контекст и одновременно выполнять запросы большего числа ИИ-агентов. 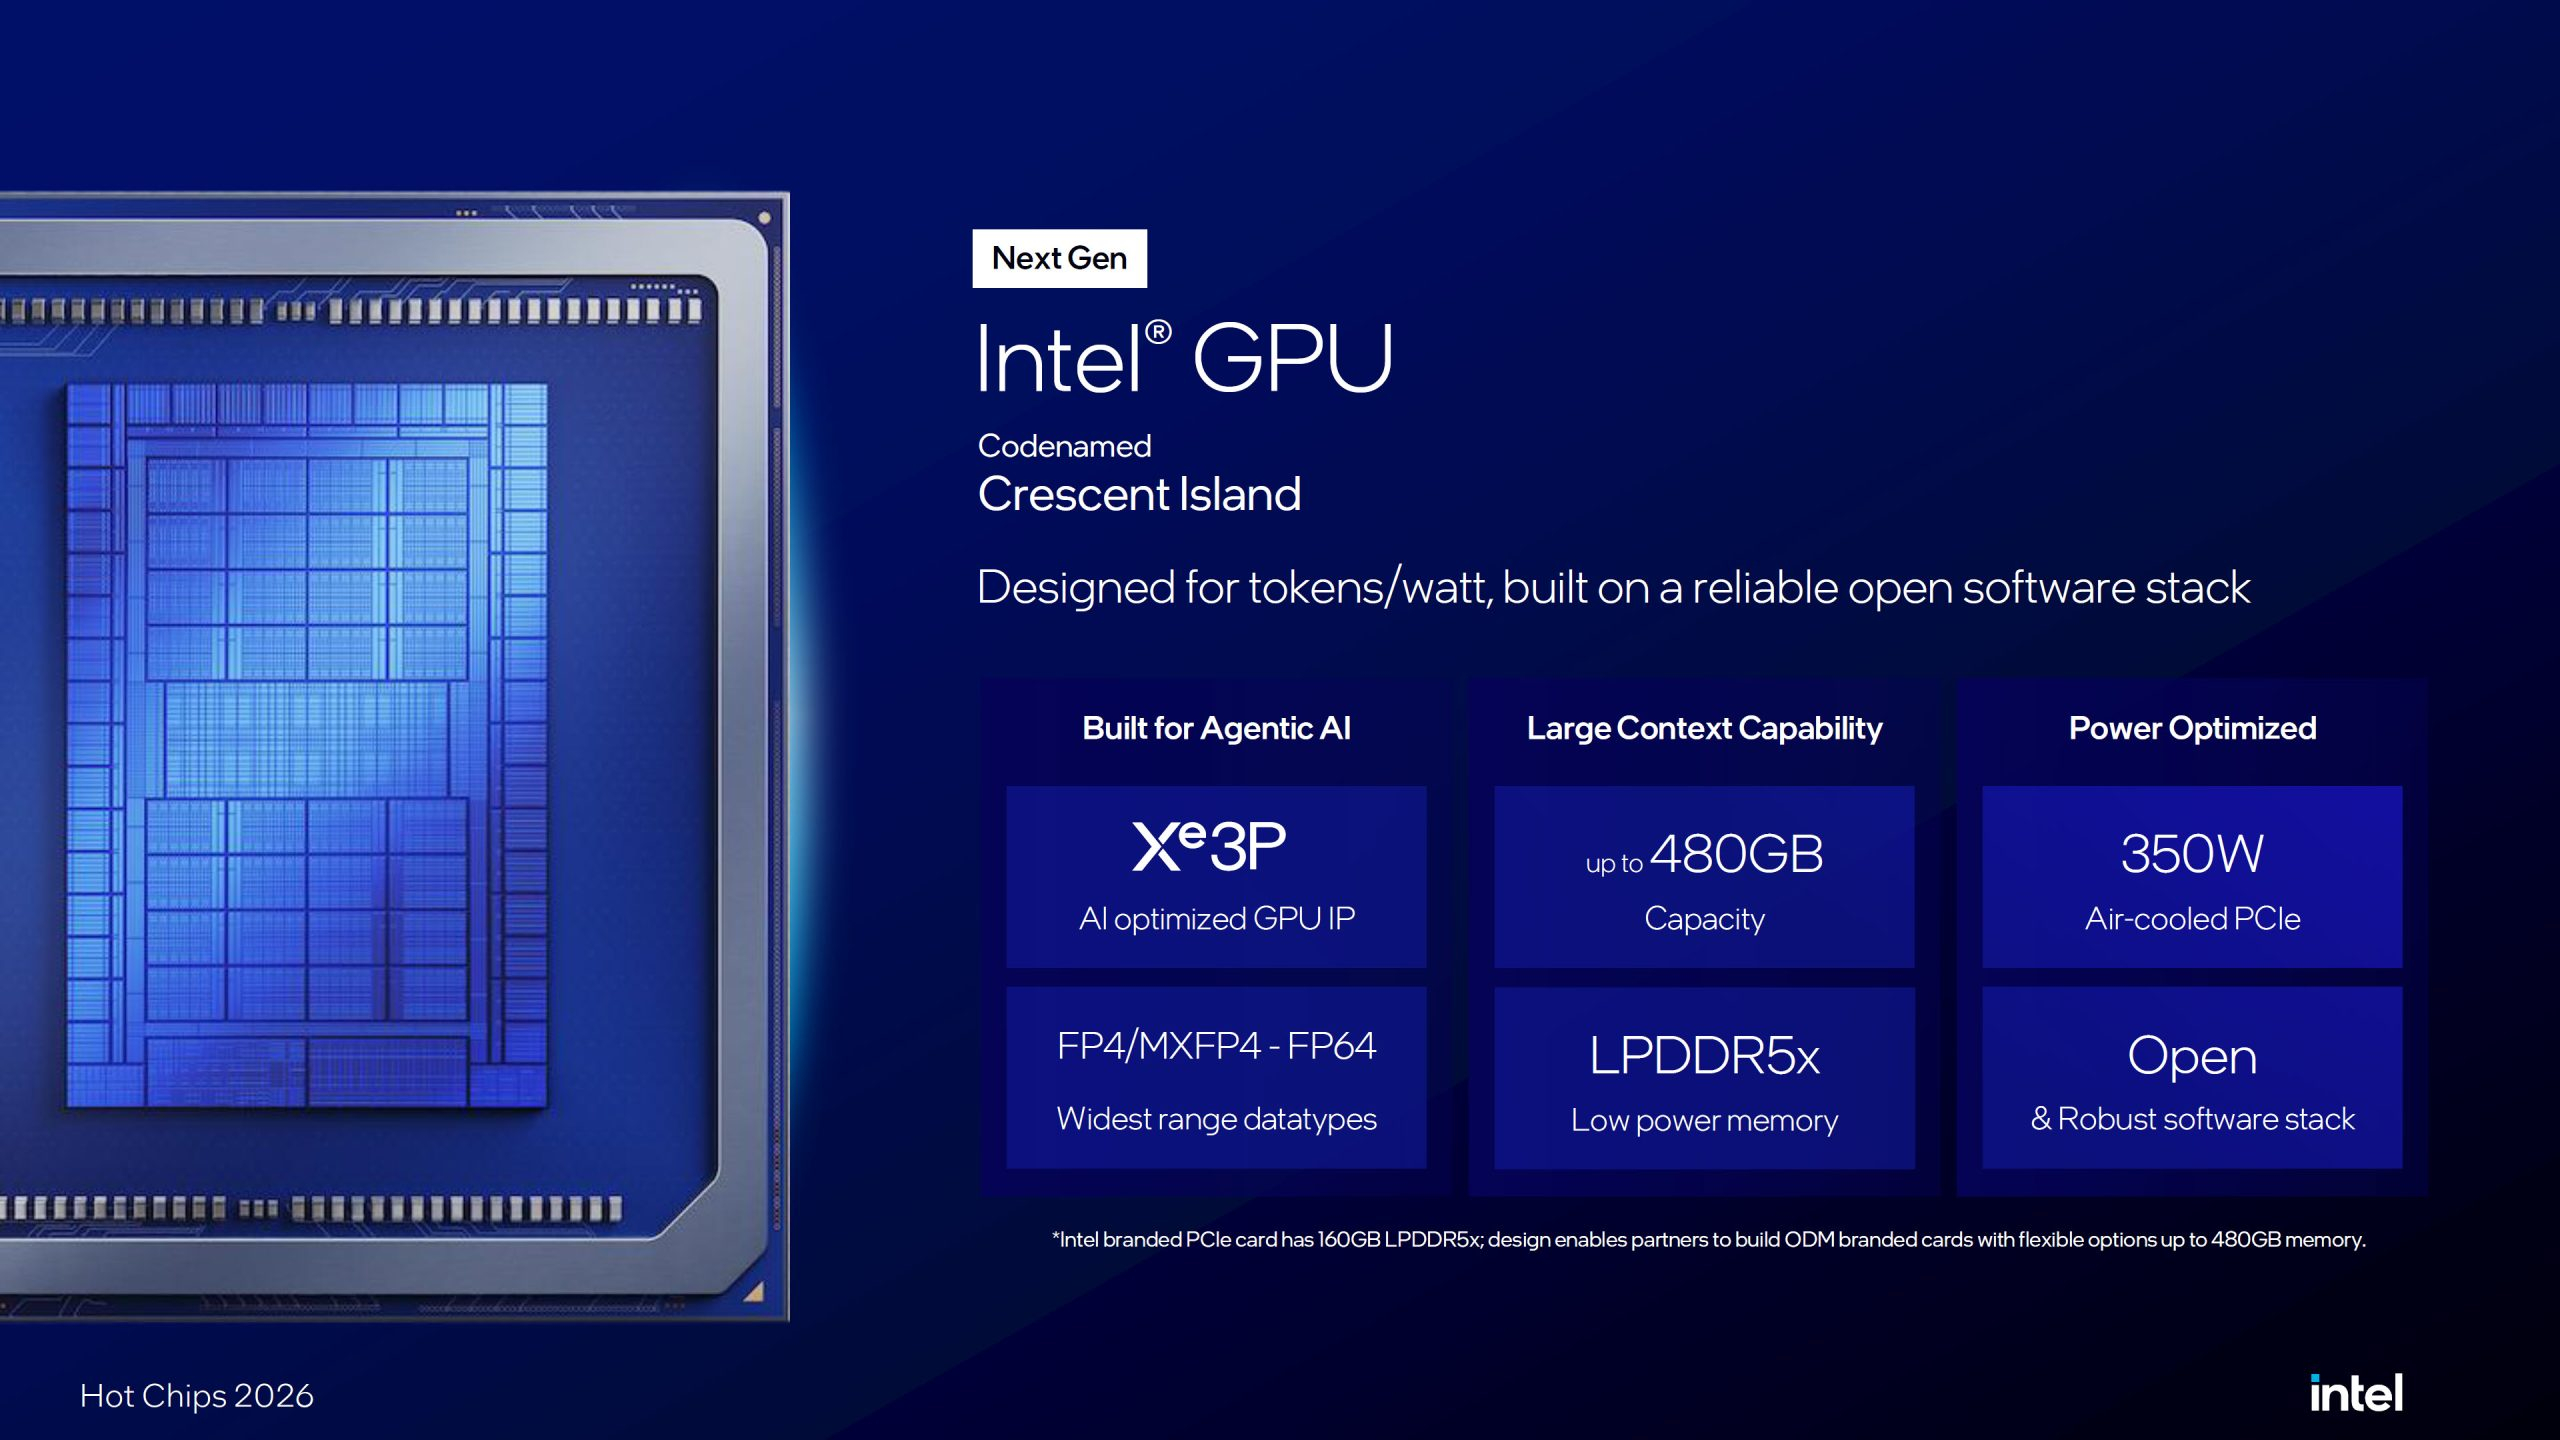 При этом Crescent Island рассчитан не на конкуренцию с наиболее производительными ускорителями для обучения нейросетей, а прежде всего на экономичное выполнение уже обученных моделей. Intel делает особый акцент на стоимости генерации токенов и возможности устанавливать новые ускорители в существующие серверы без перехода на жидкостное охлаждение. Эталонная PCIe-карта Crescent Island имеет энергопотребление 350 Вт и рассчитана на обычное воздушное охлаждение. Фактически Intel пытается занять отдельную нишу на быстро растущем рынке ИИ-ускорителей: вместо максимальной вычислительной мощности Crescent Island предлагает сочетание большого объёма относительно дешёвой памяти, умеренного энергопотребления и специализированных вычислительных блоков. Такой подход особенно интересен для инференса крупных моделей, где возможность целиком разместить модель и её контекст в памяти ускорителя зачастую оказывается не менее важна, чем пиковая вычислительная производительность. Crescent Island был впервые анонсирован Intel осенью прошлого года с 160 Гбайт LPDDR5X, а весной компания расширила спецификацию платформы, разрешив партнёрам создавать версии с объёмом памяти до 480 Гбайт. Первые образцы ускорителей должны поступить клиентам во второй половине 2026 года. Данные о производительности Crescent Island и сроки начала серийных поставок Intel пока не раскрыла. Nvidia поднимет цены на ИИ-ускорители на более чем 15 % со следующего года
23.08.2026 [06:26],
Алексей Разин
Продукция Nvidia оснащена более или менее публичной информацией о рекомендованных розничных ценах только в случае с игровыми видеокартами, причём и она не актуализируется с течением времени. Серверные решения Nvidia в этом отношении остаются в тени, и лишь публикация Bloomberg позволяет узнать, что с нового года стоимость отдельных ИИ-ускорителей поднимется на величину более 15 %. 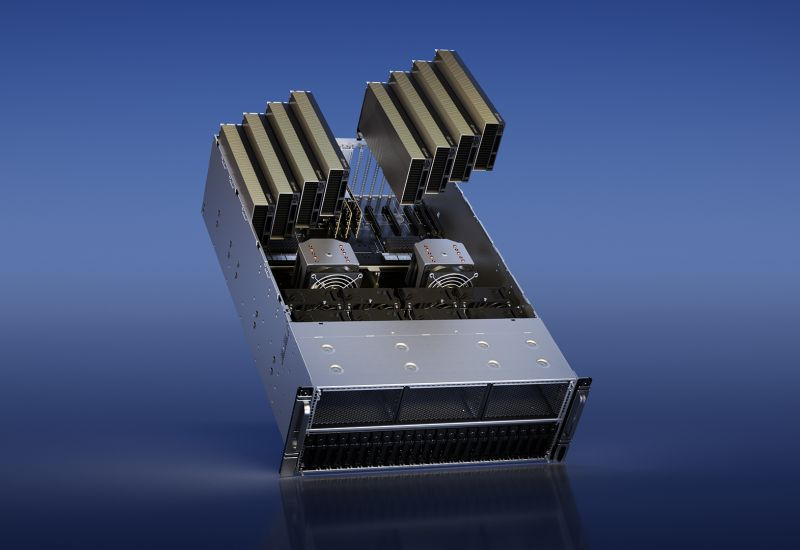
Источник изображения: Nvidia Серверные системы, содержащие ускорители вычислений семейств Vera Rubin и Grace Blackwell, которые будут отгружаться с начала следующего года, окажутся дороже на указанную величину, как поясняет Bloomberg со ссылкой на источники, осведомлённые о планах Nvidia. Повышение цен не будет равномерным, оно будет зависеть от поколения самих графических процессоров и конфигурации памяти ускорителя. Собственно, именно рост цен на память является основным фактором, вызывающим подорожание ускорителей вычислений Nvidia. Клиенты компании уже получили соответствующее уведомление. По сути, это подтверждает неспособность крупных производителей электронных устройств типа Apple и Nvidia бесконечно противостоять повышению цен на микросхемы памяти. Пусть и не всегда публично, они вынуждены признать, что будут переносить растущие издержки на стоимость продукции для конечных клиентов. При этом очевидно, что работать в убыток Nvidia тоже не будет, поскольку её норма прибыли в последнее время достигала 75 %. Это меньше, чем у производителей памяти, что в некотором роде закономерно, но всё равно очень высоко по меркам отрасли. Недавно также сообщалось, что цены на игровые решения Nvidia тоже выросли в рознице по всему миру. В случае с серверным сегментом рост цен на компоненты Nvidia может затруднить реализацию многочисленных без того затратных проектов по строительству ЦОД. Nvidia финансирует собственный рынок сбыта и ничуть этого не стесняется: она обеспечит до $105 млрд на новый дата-центр OpenAI
18.08.2026 [06:45],
Анжелла Марина
Nvidia согласилась поддержать строительство крупного дата-центра в Огайо, который будет арендовать OpenAI, взяв на себя обязательства по обеспечению финансирования проекта на сумму до $105 млрд. Проект должен предоставить компании до 8 ГВт вычислительных мощностей и частично будет запущен через два года. 
Источник изображения: wikipedia.org По сообщению Bloomberg, OpenAI заключила соглашение на получение вычислительных мощностей в комплексе округа Пайк (Pike County), общая мощность которого может достичь 8 ГВт. Первые 800 МВт планируется ввести в эксплуатацию к 2028 году. При этом Nvidia будет поддерживать строительство объекта поэтапно в период с 2028 по 2030 годы, уточняя, что её обязательства на $105 млрд относятся только к первой части комплекса мощностью 4,25 ГВт, тогда как на второй этап ещё в 3,75 ГВт она может взять дополнительные обязательства. Дата-центр будет оснащён чипами и вычислительными системами Nvidia, а сам проект станет частью значительно более крупной сделки между двумя компаниями. По прогнозам Nvidia, закупки её оборудования со стороны OpenAI в совокупности могут принести около $600 млрд выручки к 2030 году. При этом Nvidia не гарантирует финансирования всего комплекса или всех обязательств OpenAI по аренде, а сама OpenAI начнёт платить только после того, как соответствующие мощности станут доступны для аренды. Структура сделки уже привлекает внимание на фоне опасений вокруг так называемых кольцевых сделок, при которых поставщик инвестирует в компанию, а та затем направляет полученные средства на закупку его продукции. Глава Nvidia Дженсен Хуанг (Jensen Huang) заявил, что соглашение с OpenAI не предполагает подобного механизма, поскольку аренду будет оплачивать сама OpenAI. Отдельно Nvidia согласилась инвестировать $1,5 млрд в американскую энергетическую и инфраструктурную компанию SB Energy, которая при поддержке SoftBank Group займётся строительством и эксплуатацией дата-центра. Bloomberg отмечает, что проект в Огайо может стать одним из крупнейших дата-центров в мире и уже рассматривается как важная часть расширения инфраструктуры для развития искусственного интеллекта. Хотя Nvidia ранее предоставляла финансовую поддержку CoreWeave и инвестировала непосредственно в OpenAI и Anthropic, данное соглашение стало для производителя чипов крупнейшей сделкой такого рода. Акции чипмейкера в понедельник выросли менее чем на 1 % до $225,47, прибавив около 21 % с начала года. ИИ-банк Nvidia будет обеспечивать минимальную остаточную стоимость GPU для кредиторов
13.08.2026 [07:11],
Алексей Разин
Когда на этой неделе стало известно о создании под крылом Nvidia консорциума институциональных инвесторов, которые направят на финансирование проектов в сфере ИИ до $500 млрд в общей сложности, условия участия самой компании описывались лишь поверхностно. Как выяснилось сейчас, Nvidia за счёт своих средств берётся обеспечить минимальную остаточную стоимость своих GPU, которую можно будет учитывать в залоге. 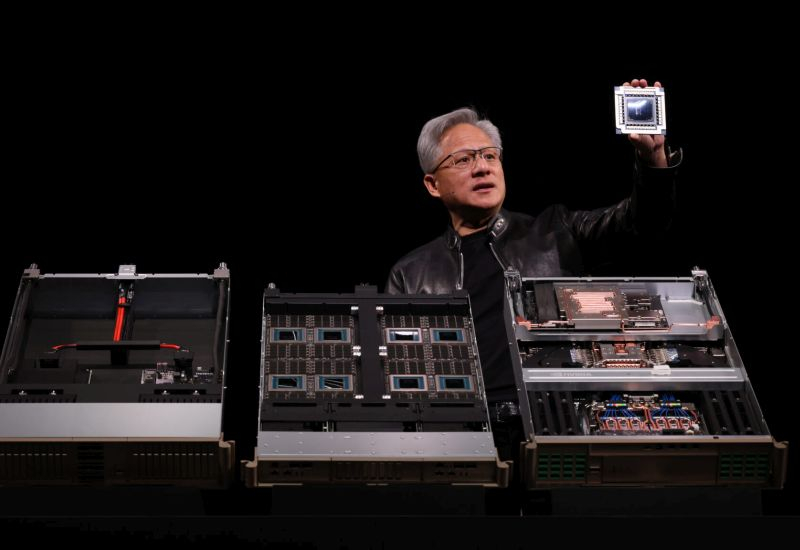
Источник изображения: Nvidia По информации Financial Times, традиционно кредиторы предоставляют свои средства клиентам сроком на три или пять лет, исходя из почти полной амортизации стоимости основных средств, которые учитываются в залоге. В случае с проектами в сфере инфраструктуры ИИ будет учитываться стоимость зданий ЦОД и устанавливаемых в них ускорителей вычислений. С оценкой остаточной стоимости GPU как раз у многих возникают проблемы. Традиционно компоненты вычислительных систем обесценивались довольно быстро, и в случае с продукцией Nvidia всё усугубляется тем, что компания перешла к ежегодному выпуску более производительных вычислительных средств. Уже эксплуатируемые клиентами ускорители в таких условиях должны быстро терять остаточную стоимость. Тем не менее, руководство Nvidia регулярно продвигает мысль о том, что в условиях бума ИИ высоким спросом пользуются даже ускорители прежних поколений. Об этом можно судить хотя бы по актуальным ценам на аренду ускорителей семейства H100, которые относятся к не самому передовому поколению Hopper. Более того, по словам основателя Nvidia Дженсена Хуанга (Jensen Huang), даже более древние A100 с архитектурой Ampere до сих пор активно эксплуатируются, хотя их расчётный жизненный цикл уже завершился. Соответственно, Nvidia настаивает на том, что амортизация расходов на покупку её ускорителей клиентами может осуществляться дольше тех самых типовых пяти лет. Чтобы поддерживать устаревшие чипы в строю, Nvidia регулярно обновляет подходящее для них программное обеспечение CUDA. При этом по условиям соглашения с партнёрами по инвестиционному консорциуму, Nvidia всё равно берётся обеспечить 25 % остаточной стоимости своих ускорителей на протяжении всего срока действия кредита для клиентов. Грубо говоря, если проект не оправдает надежд инвесторов, Nvidia придётся понести убытки в размере не менее 25 % от стоимости поставленных под его реализацию ускорителей вычислений. При этом инвестиционные партнёры в рамках консорциума будут нужны Nvidia, чтобы расширить доступ к источникам капитала. Предполагается, что они будут перепродавать долговые обязательства участников проектов, более равномерно распределяя инвестиционные риски. До сих пор Nvidia самой приходилось финансировать часть проектов по строительству ЦОД, даже если это не афишировалось. Теперь эта долговая нагрузка будет перенесена с баланса компании. К финансированию проектов в сфере ИИ опосредованно смогут подключиться частные инвесторы, приобретающие долговые обязательства участвующих в консорциуме компаний. Впрочем, опасения по поводу раздувания «ИИ-пузыря» на финансовом рынке данная схема всё равно устранить не сможет. Google планирует за пару лет расширить выпуск ИИ-чипов TPU до 12–15 млн в год — прямо как Nvidia
31.07.2026 [16:39],
Павел Котов
Google в ближайшие годы намеревается резко нарастить производство собственных чипов для искусственного интеллекта и выйти на уровень производства компании Nvidia. По неофициальной информации, в 2028 году Google рассчитывает развернуть от 12 млн до 15 млн новейших ускорителей TPU v9. 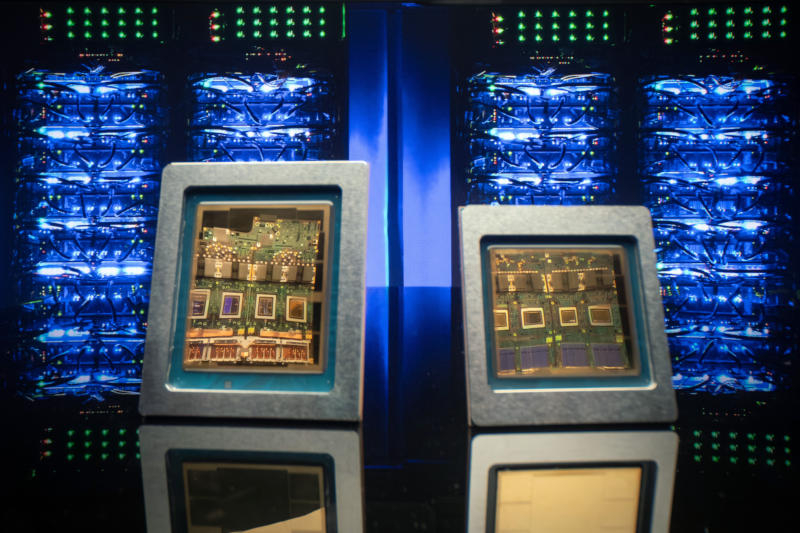
Источник изображения: cloud.google.com Если эти цифры подтвердятся, Google действительно достигнет показателей Nvidia: по оценкам аналитиков, в течение 2026 года Nvidia поставит 8,2 млн графических процессоров для центров обработки данных, и к 2028 году этот показатель может вырасти до 12,4 млн. Таким образом, один облачный провайдер готов выпускать ИИ-ускорители в объёмах, сопоставимых с ведущим поставщиком коммерческих чипов. В Google TPU девятого поколения, которые дебютируют как раз в 2028 году, будут использоваться четыре вычислительных кристалла, что соответствует общеотраслевому тренду на чиплетную компоновку; запланированный объём производства, как ожидается, более чем вдвое превысит потребности по сравнению с уровнем 2027 года. Размещение нескольких больших кристаллов на одном чипе требует передовых технологий межсоединений и упаковки, а их выпуск в больших масштабах усложняет задачу. Ограничивающим фактором грозят стать производственные мощности: TSMC в одиночку с таким заказом не справится, и, возможно, придётся подключать производственное подразделение Intel. Технологии упаковки у разных производителей отличаются, и используемые Intel EMIB или EMIB-T не имеют прямой совместимости с CoWoS-L. Google разрабатывает собственные чипы уже около десяти лет, и их роль в инфраструктуре увеличивается. Первоначально это был способ поддержать рабочие нагрузки, а сейчас речь идёт о широкой стратегии облачного бизнеса. Если Google в 2028 году достигнет своей цели, она может стать крупнейшим пользователем ИИ-ускорителей. Это не значит, что закупки у Nvidia придётся прекратить, но у Google будет значительно больше контроля над собственный вычислительной инфраструктурой и поставками. Сравнительных тестов Google TPU девятого поколения с Nvidia Rubin и Rubin Ultra пока нет. Масштаб планов поискового гиганта указывает, что конкуренция на рынке оборудования для ИИ всё больше зависит от объёмов развёртывания, а не только от производительности чипов. |
|
✴ Входит в перечень общественных объединений и религиозных организаций, в отношении которых судом принято вступившее в законную силу решение о ликвидации или запрете деятельности по основаниям, предусмотренным Федеральным законом от 25.07.2002 № 114-ФЗ «О противодействии экстремистской деятельности»; |
© 1997—2026 3DNews
При цитировании документа ссылка на сайт с указанием автора обязательна. Полное заимствование документа является
нарушением
российского и международного законодательства и возможно только с согласия редакции 3DNews.



 MWC 2018
 2018
 Computex

 IFA 2018









