


Опрос
|
реклама
Быстрый переход
Anthropic запустила бесплатный сервис для поиска дыр в ПО с открытым исходным кодом
09.10.2026 [04:27],
Анжелла Марина
Компания Anthropic представила бесплатный сервис сканирования OSS Scanner для регулярного поиска уязвимостей в проектах с открытым исходным кодом (open source). Сервис использует самые мощные ИИ-модели разработчика, включая Claude Mythos. 
Источник изображения: Anthropic Проекты смогут подключаться к сервису добровольно по подписке opt-in, предусматривающей добровольное согласие пользователя на получение уведомлений и отчётов о найденных уязвимостях. Anthropic рассчитывает, что автоматическое сканирование позволит выявлять проблемы быстрее и раньше, чем при использовании исключительно традиционных методов проверки. При этом отчёты OSS Scanner не будут проходить проверку специалистами. Anthropic подчёркивает, что все результаты формируются ИИ без участия человека в проверке и первичной оценке обнаруженных проблем. Поэтому среди сообщений могут оказаться ошибочные или недействительные находки, которые разработчикам придётся проверять самостоятельно. OSS Scanner появился на фоне растущего интереса к использованию ИИ для поиска уязвимостей в программном обеспечении. В последние месяцы подобные инструменты помогли обнаружить несколько серьёзных проблем в проектах с открытым исходным кодом, включая критическую уязвимость Copy Fail, затронувшую почти все дистрибутивы Linux в мае. Одновременно увеличение числа автоматических проверок создаёт и дополнительную нагрузку на разработчиков. Некоторые проекты с открытым исходным кодом уже с трудом справляются с потоком отчётов об ошибках, созданных ИИ-моделями. Среди тех, кто столкнулся с этой проблемой, оказались Линус Торвальдс (Linus Torvalds) и даже компания Google. У США появилась своя открытая ИИ-модель Beam, способная конкурировать с китайскими DeepSeek, Qwen и Z.ai
06.10.2026 [04:55],
Николай Хижняк
Американская компания Reflection представила Beam — свою первую передовую модель искусственного интеллекта с открытыми весами. Стартап, созданный два года назад, заявляет, что Beam не уступает ведущим китайским открытым моделям в тестах на сложные логические рассуждения, но при этом обходится значительно дешевле. Это заявление может обострить конкуренцию в создании западного аналога китайских моделей DeepSeek, Qwen и Z.ai. 
Источник изображения: Reflection.ai В понедельник компания опубликовала подробный материал в блоге, где описала Beam как текстовую модель с архитектурой «смесь экспертов» (mixture-of-experts, MoE). Она прошла обучение с использованием методов обучения с подкреплением, требующих больших вычислительных мощностей. По словам разработчиков, модель обладает высокой эффективности в задачах логического вывода, написании кода и выполнении агентских функций. Reflection заявляет, что со всем этим модель справляется «лишь при доле затрат на токены и вычислительные ресурсы для инференса» по сравнению с конкурентами. ИИ-модель Beam поддерживает 501 млрд параметров, из которых 23 млрд являются активными. Она прошла предварительное обучение на массиве из 23,8 трлн токенов и поддерживает контекстное окно объёмом 1 млн токенов. Для сравнения, модель GLM-5.2 китайской Z.ai имеет около 744 млрд параметров, из которых 40 млрд — активные. Заявления Reflection о производительности пока не прошли независимую проверку. Компания утверждает, что в тестах на сложные логические рассуждения Beam показывает результаты на уровне GLM-5.2 от Z.ai и превосходит ведущие западные модели с открытым кодом, потребляя при этом «в 3–4 раза меньше вычислительных ресурсов при инференсе». Reflection называет Beam «рабочей лошадкой» для корпоративного сектора, государственных организаций и разработчиков. Reflection позиционирует себя как конкурента закрытым ИИ-лабораториям, таким как Anthropic и OpenAI, популярным моделям китайских разработчиков, а также западным игрокам, включая Mistral, Meta✴✴ и Cohere. Вероятно, самым прямым конкурентом компании в США является Thinking Machines Lab. Этот американский стартап был основан бывшим техническим директором OpenAI Мирой Мурати (Mira Murati) и в июле представил свою первую ИИ-модель Inkling. Согласно собственным тестам Reflection, Beam превосходит Inkling в четырёх тестах на написание кода, результаты которых были опубликованы для обеих моделей. Однако следует учитывать, что Inkling представляет собой мультимодальную модель (поддерживает разные форматы), тогда как Beam работает только с текстом. Компания Reflection была основана в 2024 году двумя бывшими исследователями Google DeepMind. По данным PitchBook, она привлекла около $4,7 млрд от таких инвесторов, как Nvidia, Sequoia Capital и Lightspeed Venture Partners. В ходе последнего раунда финансирования оценка компании (без учета привлечённых средств) составила $25 млрд. Стартап также активно резервирует вычислительные мощности — ключевой ресурс, необходимый для обучения передовых моделей, способных переманить клиентов у компаний Anthropic и OpenAI с их закрытыми системами, а также у китайских разработчиков, предлагающих более дешевые модели с открытыми весами. Этим летом Reflection заключила с компаниями SpaceX и Nebius соглашения на общую сумму более $7 млрд, обеспечив себе доступ к чипам Nvidia GB300 вплоть до 2029 года. Reflection ориентирует модель Beam и свои будущие разработки на корпоративный сектор и суверенный ИИ. Основная идея заключается в создании «фабрик ИИ» — продукта, позволяющего организациям создавать собственные специализированные локальные системы искусственного интеллекта путём дообучения моделей Reflection на их закрытых корпоративных данных. Генеральный директор Nvidia Дженсен Хуанг (Jensen Huang), чья компания инвестирует в Reflection, давно продвигает концепцию «фабрик ИИ» и выступает за укрепление открытой экосистемы ИИ. Такой подход выгоден и самой Nvidia, поскольку именно её графические процессоры будут обеспечивать работу этих систем. В числе организаций, заинтересованных в создании подобных систем, также значатся хедж-фонды и торговые фирмы. Reflection уже начала тестировать концепцию партнёрства по созданию «суверенной фабрики ИИ» совместно с южнокорейской группой Shinsegae Group. Компания также заявила, что в этом месяце опубликует веса модели Beam и полные технические характеристики. На момент запуска распространение будет осуществляться через гиперскейлеров и провайдеров облачных услуг нового поколения, а также будет обеспечена интеграция с библиотеками с открытым исходным кодом. ИИ завалил Google фальшивыми уязвимостями — компания приостановила приём сообщений об ошибках
05.10.2026 [13:56],
Алексей Разин
Google приостановила приём сообщений по поводу уязвимостей по своём программном обеспечении с открытым кодом, поскольку из-за активности ИИ в этой сфере зачастую такие сообщения содержат технические галлюцинации и поднимают ложную тревогу. 
Источник изображения: Unsplash, Andrew Фирменная инициатива носит название Open Source Software Vulnerability Rewards Program, она подразумевает выплату вознаграждений сторонним специалистам, которые обнаружат в программном обеспечении Google с открытым исходным кодом уязвимости. По мере развития ИИ-моделей, способных искать слабые места в программном коде, Google оказалась буквально завалена автоматически генерируемыми обращениями в рамках данной программы. По словам представителей компании, эти обращения зачастую содержат ложную информацию или откровенные «галлюцинации» ИИ-моделей, а потому поток этих данных решено было перекрыть на время. На паузу рассмотрение новых обращений поставлено с 1 октября, а новые сведения о сроках перезапуска программы появятся не ранее первого квартала следующего года. При этом аналогичные инициативы Google в сегментах, имеющих отношение к другим видам ПО, продолжают работать. Китайский ИИ завоёвывает корпоративную Америку: компании США всё чаще используют открытые ИИ-модели ради экономии
28.09.2026 [13:48],
Алексей Разин
На рынке ИИ-систем складывается сложная ситуация. Готовящиеся к выходу на IPO американские лидеры рынка заинтересованы демонстрировать положительную динамику выручки, но китайские конкуренты не позволяют им поднимать цены. В США корпоративные пользователи всё чаще опираются на открытые ИИ-модели, чтобы сэкономить без значительного ущерба для прогресса в своём бизнесе. 
Источник изображения: Unsplash, Aerps.com По данным Financial Times, об ориентации американского корпоративного сектора на модели с открытым исходным кодом или открытыми весами может говорить хотя бы тот факт, что эти термины руководство американских компаний в период с августа по сентябрь этого года стало упоминать в своих публичных выступлениях в шесть раз чаще в годовом сравнении. Примечательно, что даже далёкие от сферы собственно информационных технологий компании всё чаще интересуются внедрением открытых ИИ-моделей: такое поведение замечено у представителей сегмента финансовых услуг, логистики и тяжёлого машиностроения. В сфере открытых по тому или иному критерию ИИ-моделей начали доминировать китайские компании, но подобный подход исповедуют и некоторые западные разработчики, включая американскую Nvidia, французскую Mistral, стартапы Reflection AI и Thinking Machines Lab. Доля открытых моделей в статистике использования токенов к августу достигла 56 %, если опираться на данные Vercel, тогда как в декабре прошлого года этот показатель ограничивался 7 %. По статистике OpenRouter, китайские ИИ-лаборатории сейчас входят в десятку самых крупных по интенсивности использования токенов. 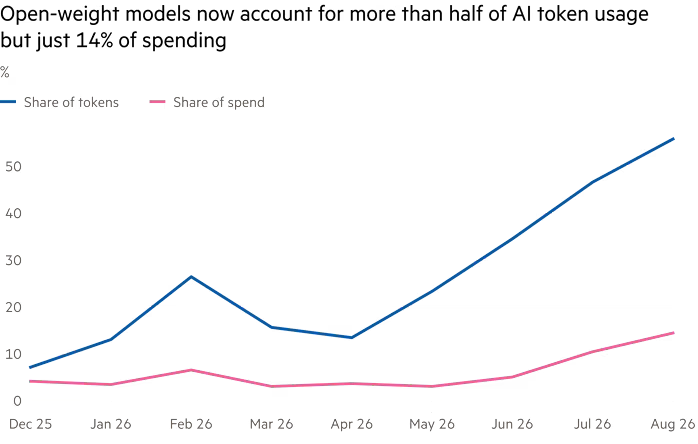
Источник изображения: Financial Times, Vercel Разработчики приложения Tinder, по словам технического директора Виная Курувилы (Vinay Kuruvila), уже начали перенаправлять часть внутренних запросов второстепенного характера на ИИ-модели с открытыми весами. Дело в том, что если в январе расходы компании достигли $1 млн в годовом выражении, то к июлю они выросли в десять раз, и сохранение подобной динамики в Tinder хотят предотвратить. Как подчеркнул представитель компании Match Group, передовые модели Astra и Claude американской разработки способны покрыть 90 % её потребностей, и если к этому уровню подтянутся открытые, то использовать первые в прежних объёмах уже будет не нужно. OpenAI и Anthropic на прошлой неделе были вынуждены предложить более доступные по цене версии своих моделей, чтобы как-то защитить себя от экспансии «открытых» конкурентов. Директор телекоммуникационного гиганта AT&T по данным и ИИ Энди Маркус (Andy Markus) заявил, что компания уже сейчас 40 % своих ИИ-нагрузок покрывает открытыми моделями, а в течение ближайшего года собирается довести их долю до 70 %. По словам Маркуса, компания обрабатывает до 45 млрд токенов в день, и при таких масштабах использования расходы становятся важной составляющей. Если переход на открытые модели позволит урезать расходы без ущерба для точности результатов, то AT&T не будет сомневаться в необходимости такой миграции. Внутренние тесты показали, что в ряде случаев открытые модели не уступают, а иногда даже превосходят по эффективности и быстродействию своих «закрытых» конкурентов. Более того, модели с открытыми весами пользователи могут запускать в собственной инфраструктуре, а это позволяет значительно повысить информационную безопасность. Intel не стала хоронить шрифт для программистов — даже эпоха вайб-кодинга его не убила
14.09.2026 [13:37],
Алексей Разин
Разгар эпохи «вайб-кодинга», по мнению корпорации Intel, не является достаточной причиной для отказа от инициативы по созданию шрифта One Mono, позволяющего повысить разборчивость текста программного кода в восприятии человека, занимающегося его разработкой. Проект почти заглох с середины 2024 года, но в последнее время продемонстрировал признаки жизни. 
Источник изображения: Intel Об этом сообщил ресурс Phoronix, заодно приведя краткую историческую справку. Этот проект с открытыми исходными компонентами Intel запустила в 2023 году, подчеркнув ориентацию шрифта One Mono на нужды и специфику работы создателей программного обеспечения, которые анализируют большие объёмы текстовой информации. На прошлой неделе Intel сперва отправила проект в архив на ресурсе GitHub, но буквально через пару дней решила вернуть его к жизни. Компания вынуждена экономить средства, а потому сворачивает многие Open Source-проекты, но One Mono избежал этой участи в силу каких-то неясных мотивов. Одноимённый шрифт изначально был разработан с учётом простоты зрительного восприятия текста. Все символы в этом шрифте имеют одинаковую ширину по горизонтали, разница в высоте между строчными и заглавными буквами сделана хорошо заметной, написание схожих символов типа «e» и «G» также проработано с целью выделения индивидуальных особенностей. При тестировании шрифта привлекались специалисты с серьёзными нарушениями зрения, они указывали на проблемные моменты, Intel проводила «работу над ошибками» и делала этот шрифт максимально удобочитаемым. Попутно были разработаны варианты написания символов этим шрифтом, включая курсив и жирный. Открытый доступ позволяет всем желающим скачивать файлы шрифта и модифицировать его на своё усмотрение. Хотя проект не демонстрировал особого прогресса с прошлого года, отказ Intel от его архивации в GitHub может говорить о сохранении интереса к нему со стороны разработчиков. Российским вайб-кодерам заблокировали доступ к сервису Cursor
10.09.2026 [12:51],
Владимир Фетисов
Американский сервис Cursor, являющийся одним из передовых западных инструментов для генерации программного кода с помощью ИИ, закрыл доступ для россиян. Платформа перестала работать в России 4 сентября без каких-либо официальных заявлений по данному вопросу. 
Источник изображения: Rubaitul Azad / unsplash.com За день до этого в пользовательском соглашении Cursor появился пункт об экспортном контроле США. Отметим также, что в середине августа SpaceX закрыла сделку по покупке компании Anysphere, являющейся разработчиком Cursor, за $60 млрд. На этом фоне OpenAI уведомила SpaceX о намерении прекратить предоставление доступа к своим ИИ-моделям, которые обеспечивают работоспособность Cursor. В заявлении OpenAI говорилось, что расторжение контракта может произойти 12 сентября. Такое решение компания приняла из-за опасений по поводу того, что SpaceX может задействовать ИИ-модели с нарушением условий предоставления услуг. В заявлении отмечалось, что подобные нарушения уже допускали другие компании, владельцем которых является Илон Маск (Elon Musk). По мнению опрошенных экспертов, блокировка Cursor не изменит рынок кардинально. В MWS AI сообщили, что разработчики продолжают пользоваться сервисами Claude Code и Codex. Независимый эксперт рынка ИБ Алексей Лукацкий добавил, что пользователи уже научились обходить блокировки. Некоторым разработчикам придётся уйти в серый доступ, другие перейдут на работу с ИИ-моделями с открытым исходным кодом, а некоторые — на отечественные сервисы, считает директор по развитию технологий ИИ «Сбербанка» Сергей Марков. Отметим, что ранее россиянам заблокировали доступ к некоторым другим зарубежным ИИ-сервисам. Так OpenAI закрыла доступ к своей платформе в 2024 году, а Google заблокировала доступ к Gemini в 2025 году. Весной этого года Anthropic стала массово блокировать аккаунты Claude российских пользователей, а с июля начала применять обязательную идентификацию через сервис Persona. «Набор кода вручную безнадёжно устарел»: в Microsoft рассказали, что роль программистов изменится
08.09.2026 [16:13],
Павел Котов
«Набор кода вручную безнадёжно устарел», — заявил инженер Microsoft Дэвид Фаулер (David Fowler). По его мнению, традиционные разработчики в ориентированном на искусственный интеллект мире уходят в прошлое. 
Источник изображения: Mohammad Rahmani / unsplash.com Автор ставшего сенсационным поста в соцсети X в действительности подразумевал, что роли программистов изменятся, но не исчезнут совсем. Сейчас разработчик всё чаще занимается контролем ИИ-агентов и проверкой результатов их работы: создание ПО теперь предполагает постановку задачи, получение выходных данных и отладку кода, а не его написание с нуля. ИИ не просто пишет код — агентские приложения класса GitHub Copilot доказали, что справляются с гораздо большей частью рабочего процесса: это создание программной части, запуск тестирования и проверка на наличие сбоев — и только после этого продукт передаётся человеку. Microsoft также сделала собственную платформу Aspire удобнее для работы ИИ-агентов: в версии 13.2 появилась поддержка протокола MCP и подходящий для ИИ-агентов интерфейс командной строки. Ещё в прошлом году гендиректор Microsoft Сатья Наделла (Satya Nadella) заявил, что 30 % кода компании генерируется ИИ, и сегодня этот показатель, очевидно, гораздо выше. Одним из неприятных последствий нового формата работы стало снижение качества кода — ИИ-агенты теряют в точности в долгосрочных задачах, показало собственное исследование Microsoft. Сгенерированный ИИ код в среднем содержит в 1,4 раза больше критических и в 1,7 раза больше серьёзных проблем, чем эквивалентный код, созданный человеком. До 45 % разработок ИИ содержат уязвимости, хотя код может быть и рабочим. Конечно, качество ИИ-кода со временем будет расти, но ошибки едва ли получится изжить полностью; и хотя человеку, возможно, со временем не придётся писать код самому, его услуги так и останутся востребованными. Debian наполнится кодом, который сгенерировал ИИ
01.09.2026 [13:36],
Павел Котов
Участники сообщества Debian проголосовали за то, чтобы разрешить использовать инструменты на основе искусственного интеллекта при «разработке, поддержке и [написании] документации» к дистрибутиву Linux. 
Источник изображения: Lukas / unsplash.com Новая политика Debian в отношении ИИ признает, что «ответственное» использование этих средств может повысить производительность разработчиков. «Генеративный ИИ не освобождается от правил и не предусматривает особых норм, помимо стандартов, уже ожидаемых от участников проекта Debian», — говорится в решении. Участники голосования рассмотрели несколько предложений по поводу действий в отношении ИИ-материалов, в том числе варианты, предусматривающие их полный запрет. В отдельных случаях реакция участников проекта на использование ИИ была резко отрицательной. Администрация проекта Debian не требует, чтобы участники раскрывали информацию об использовании ИИ, но они по-прежнему несут ответственность за всё, что передают проекту. Независимо от того, каким образом были созданы материалы, они должны отвечать одним и тем же стандартам качества, корректности, поддерживаемости и соответствия законодательству. Предполагается, что участники проекта понимают, проверяют, тестируют и при необходимости дорабатывают созданные ИИ материалы — принятие и пересылка их вслепую противоречит правилам проекта. Указание на использование ИИ поощряется, но не является требованием. Почти 9 из 10 сайтов уличили в несоблюдении веб-стандартов
18.08.2026 [16:08],
Павел Котов
Созданный независимым французским разработчиком Тео Дюкре (Théo Ducreux) проект ValidateHTML изучил содержимое по адресам 5000 наиболее популярных доменов, проанализировал их на валидность кода и обнаружил ошибки почти в девяти из десяти. 
Источник изображения: Mohammad Rahmani / unsplash.com Из выборки только 2656 оказались предназначены для человека, остальные использовались как технические домены, например, «gstatic» компании Google. Подавляющее большинство из них, вне зависимости от наличия понятной для людей домашней страницы, показывают некорректный код HTML, идущий вразрез со стандартами Всемирного консорциума веб-технологий (W3C) и Рабочей группы по технологиям веб-гипертекстовых приложений (WHATWG). Эти стандарты созданы для того, чтобы браузеры и устройства для чтения с экрана выводили запрошенные страницы более или менее одинаково. На всех сайтах из выборки обнаружены в общей сложности 100 305 нарушений корректности HTML-кода, включая самые последние спецификации HTML5, а также 18 863 ошибки CSS. Как минимум в одном месте 87,2 % сайтов нарушили веб-спецификации, только у 12,8 % сайтов был корректный HTML-код, и лишь 2,6 % оказались полностью «чистыми», не выдав ни одной ошибки и не показав ни одного предупреждения. Более трети сайтов не прошли проверку доступности, то есть они некорректно обрабатываются средствами для чтения с экрана, которыми пользуются люди, испытывающие проблемы со зрением. Альтернативный текст для изображений, который часто содержит важную информацию, отсутствует на 20,4 % сайтов. На 41,6 % страниц в коде отсутствуют метки ARIA, которые идентифицируют области страницы. Эксперты назвали двух виновников сложившейся непростой ситуации: разработчики и браузеры. Невалидный код, в частности, может появляться при работе с фротенд-фреймворками: самая распространённая ошибка — некорректная вложенность тегов. А неприхотливость современных браузеров позволяет разработчикам не обращать на это внимания: любой непонятный код браузеры попросту игнорируют, а ошибки исправляют, восстанавливая нужную картинку. К сожалению, программы для чтения экрана такой стойкостью не обладают. Nvidia всерьёз включилась в гонку открытых ИИ-моделей и выпустила Nemotron 3.5 Lightning, которой достаточно одного GPU
12.08.2026 [04:55],
Алексей Разин
ИИ-модели семейства Nemotron с открытыми весами компания Nvidia продвигает с прошлого года, но недавно оно пополнилось версией 3.5 Lightning, которая предлагает открытый исходный код и для своей работы способна довольствоваться вычислительными ресурсами единственного GPU, расположенного в ноутбуке или настольном ПК. 
Источник изображения: Nvidia В конце июля, как напоминает CNBC, основатель и генеральный директор Nvidia Дженсен Хуанг (Jensen Huang) со страниц социальной сети X выступил в поддержку ИИ-моделей с открытым исходным кодом, обозначив собственную позицию в вопросе, который начинает занимать умы многих представителей отрасли. Теперь, менее трёх недель спустя, его компания представила «легковесную» модель Nemotron 3.5 Lightning, которая обходится единственным GPU. Корпоративные клиенты Nvidia могут свободно скачивать эту модель, использовать её и модифицировать без согласования с ней. Выгода Nvidia заключается в том, что клиентам для работы с Nemotron 3.5 Lightning всё равно потребуется графический процессор в составе ускорителя вычислений или даже игровой видеокарты, а их она продаёт за немалые деньги. В прошлом месяце Дженсен Хуанг заявил, что «бесплатный ИИ пойдёт на пользу аппаратному обеспечению и чипам». По мнению основателя Nvidia, модели с открытыми весами позволяют компаниям лучше контролировать своё будущее, стимулируют конкуренцию и снижают цены. Кроме того, они усиливают сферу кибербезопасности и суверенитет целых стран. Nvidia присоединилась к консорциуму вместе с Microsoft, который будет продвигать использование открытых моделей и ПО с открытым исходным кодом в сфере кибербезопасности. Недавно в поддержку моделей с открытым исходным кодом выступил и основатель Meta✴✴ Platforms Марк Цукерберг (Mark Zuckerberg). Он считает, что подобные модели американской разработки должны стать лучшими в мире. Возвращаясь к Nemotron 3.5 Lightning, следует добавить, что Nvidia ориентирует её на создание агентских приложений. Её уже протестировали и адаптировали для своих нужд CrowdStrike, CodeRabbit и Harvey. Эта модель будет доступна как на Hugging Face, так и на собственном сайте Nvidia. Компания также предлагает утилиту NeMo Switchyard, которая позволяет определить оптимальную ИИ-модель для решения конкретной задачи. Свою легковесную модель 3.5 Lightning специалисты Nvidia усилили возможностям старших представителей семейства Nemotron через дистилляцию. Цукерберг раскритиковал закрытые ИИ-модели и поддержал принцип открытости исходного кода
10.08.2026 [15:52],
Алексей Разин
На рынке систем ИИ развернулась бурная полемика между сторонниками ИИ-моделей с открытым исходным кодом и разработчиками проприетарных решений, которые демонстрируют разные подходы к монетизации своих услуг. Глава Meta✴✴ Марк Цукерберг (Mark Zuckerberg) дал понять, что делает ставку на максимальную доступность ИИ для широкого круга пользователей и открытый исходный код. 
Источник изображения: Anthropic На сайте своей компании её основатель опубликовал небольшое эссе, в котором заявил о недопустимости концентрации ИИ в руках правительств и небольшой группы ключевых игроков. Meta✴✴ Platforms раскрыла на этой неделе веса ИИ-модели Muse Glimmer, а также пообещала сделать аналогичный шаг в отношении более мощной своей модели Muse Spark в течение нескольких ближайших недель. Цукерберг призывает предоставить доступ к производительным системам ИИ «миллиардам людей», изменив тем самым баланс мировых сил. Сторонники закрытого исходного кода, по мнению главы Meta✴✴, обслуживают ограниченный круг организаций и государственных органов. Если они будут доминировать в сегменте ИИ, то и частные лица проиграют, не получив доступа к передовым системам. Meta✴✴, по его словам, предпочитает придерживаться открытого подхода к распространению ИИ-моделей. Что характерно, ранее в этом году компания отказалась раскрыть весовые коэффициенты своей модели Muse Spark, сославшись на угрозу безопасности, но теперь, похоже, изменила своё мнение. Одновременно Meta✴✴ основала фонд, который в общей сложности направит $1 млрд на улучшение условий жизни людей, вынужденных соседствовать со строящимися в США центрами обработки данных компании. Такое соседство оборачивается для местных жителей повышенным уровнем шума, ростом тарифов на электроэнергию и ухудшением доступа к водным ресурсам. Основной вектор собственного развития в сегменте ИИ компания Meta✴✴ видит в создании программных агентов, которые будут выполнять различную работу за человека. Цукерберг пояснил, что не видит смысла в ограничении доступа к передовым ИИ-моделям, поскольку открытый подход позволяет большему количеству людей участвовать в обеспечении их безопасности. Стартап Hugging Face, по словам Цукерберга, полагался именно на открытые модели, когда возникла необходимость устранить уязвимости в своей системе защиты. Глава Meta✴✴ даже счёл уместным поддержать практику дистилляции ИИ-моделей другими компаниями: «Важно защищать принцип, согласно которому вы можете обучаться на основе всего, что видите». С этой точки зрения дистилляция не является вредной, убеждён Цукерберг. Оценивать безопасность собственных ИИ-моделей компания собирается силами независимого совета директоров. Цукерберг также упрекнул конкурентов в формировании мрачной картины будущего: «Убеждение в опасности ИИ, которую можно сдержать только через экстремальную концентрацию его силы в одних руках, неверно по своей природе. По мере того как все получают более мощные инструменты, каждый человек получит больше возможностей для формирования будущего, а не меньше». Разработана технология передачи данных через быструю смену QR-кодов — 60 FPS обеспечивают до 190 Кбайт/с
01.08.2026 [16:42],
Павел Котов
Энтузиаст под псевдонимом Bashalarmistalt создал экспериментальную технологию Decimen Optical Transfer для передачи данных между устройствами без необходимости подключать их к одной беспроводной сети — достаточно показывать череду QR-кодов, которые меняются с частотой 60 кадров в секунду. 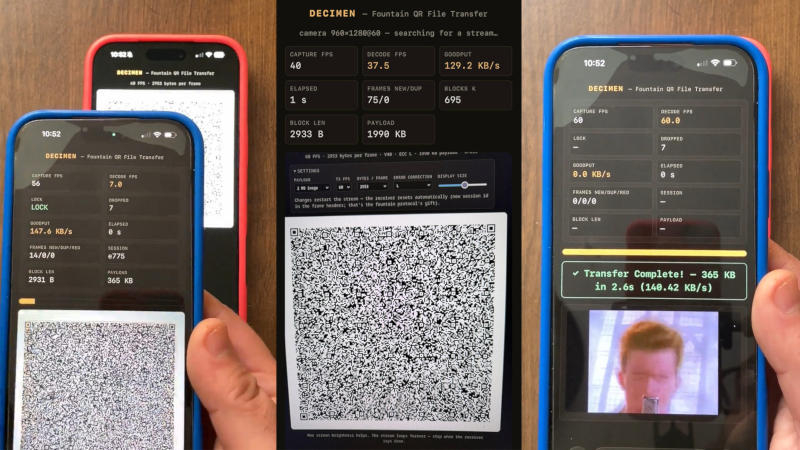
Источник изображения: github.com/bashalarmistalt Основу технологии составило кешируемое веб-приложение, которое работает на смартфонах через движок браузера и требует доступа к камере. Код, сообщил энтузиаст, разработал помощник программиста с искусственным интеллектом Anthropic Claude Code. Закодировав данные в последовательность QR-кодов, которые меняются со скоростью 60 кадров в секунду, автор проекта добился передачи данных со скоростью до 190 Кбайт/с. Идея технологии Decimen Optical Transfer посетила его, когда он обдумывал варианты с передачей данных между смартфонами без необходимости подключать их к одной сети. Решение предусматривает механизм защиты от ошибок: каждый QR-код содержит подробные метаданные о самом себе — в заголовок длиной 20 байтов уместились идентификатор сессии, порядковый номер кода, размер блока и их количество, а также длина файла и хеш. Подобный проект ранее разработали для iPhone с камерой Apple ProMotion, но тогда удалось добиться скорости около 128 кбайт/с — показатель можно было увеличивать до 186 Кбайт/с, если расположить передающее и принимающее устройства полностью неподвижно относительно друг друга. Код Decimen Optical Transfer опубликован на GitHub под демократичной лицензией MIT. Появился сервис по очистке программного кода от ИИ-мусора — за $10 000 его сделают в разы компактнее
09.07.2026 [05:59],
Анжелла Марина
Команда разработчиков Slopfix запустила сервис по оптимизации проектов, созданных с помощью искусственного интеллекта. За фиксированную стоимость в $10 000 специалисты берутся за недельный срок сократить объём исходного кода, сохранив при этом работоспособность приложения. 
Источник изображения: AI Перед началом работы Slopfix бесплатно анализирует репозиторий клиента, после чего принимает решение о целесообразности проведения работ. Далее команда составляет подробное описание работы приложения и передаёт заказчику обновлённую кодовую базу, документацию, набор правил для предотвращения повторного разрастания проекта, а также двухнедельную гарантию. Оплата зависит от того, насколько удалось достичь заранее согласованной цели по сокращению объёма кода. В качестве примера компания приводит уменьшение проекта со 100 000 до 35 000 строк без потери функциональности. Основатель компании, известный на Hacker News под псевдонимом zie1ony, сообщил, что стоимость услуги зависит от достижения заранее согласованной цели по сокращению объёма кода. При этом инженеры используют ИИ-агентов для поиска повторяющихся фрагментов и их объединения, подчёркивая, что окончательные решения принимают специалисты, а не автоматизированные инструменты. Появление подобных услуг связывают с быстрым ростом объёмов ИИ-сгенерированного кода. Согласно данным GitClear Maintainability Gap за 2026 год, о которых сообщает издание Tom's Hardware, количество дублирующихся фрагментов кода увеличилось на 81 % по сравнению с 2023 годом, тогда как доля операций по рефакторингу сократилась с 21 % всех изменённых строк в 2022 году до менее чем 4 % в 2026 году, вследствие чего разработчики стали примерно в пять раз чаще копировать код, чем перерабатывать существующий. Создан самый маленький QR-код в истории — он состоит из отдельных атомов серебра
12.06.2026 [10:57],
Павел Котов
Учёные из Школы физики и астрономии при Университете Монаша (Австралия) и Чешской академии наук, возможно, побили рекорд Гиннесса по размеру QR-кода, создав модель, которая почти в 800 раз меньше предыдущего рекордсмена. 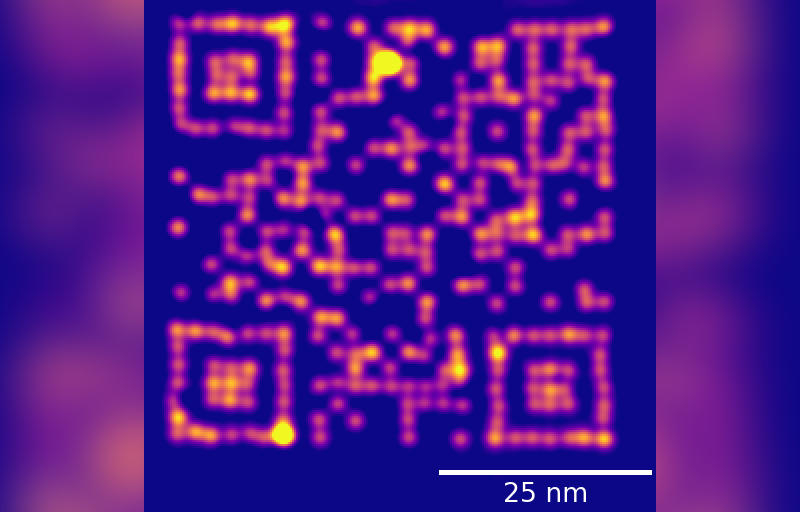
Источник изображения: spmprotips.com Каждый пиксель этого QR-кода представляет собой атом серебра, установленный с помощью сверхточного туннельного микроскопа — весь QR-код в тысячу раз меньше толщины человеческого волоса. При этом он полностью функционален, и его можно отсканировать с помощью смартфона. Актуальный мировой рекорд был зафиксирован в феврале этого года — это была совместная работа учёных Технического университета Вены (TU Wien) и компании Cerabyte. При пикселях размером по 49 нм весь QR-код имеет размер 1,98 мкм². Новый самый маленький QR-код имеет полный размер 50 × 50 нм, то есть он целиком лишь немногим крупнее одного пикселя предыдущего — размером примерно с вирус COVID-19. Для создания объекта потребовались условия сверхвысокого вакуума и криогенных температур. Чтобы разместить атомы серебра на местах, использовался сверхтонкий зонд с наконечником шириной несколько атомов — частицы серебра помещались на позиции при помощи эффекта квантового туннелирования. При создании изображения использовались средства сверхточной автоматизации, и чтобы сделать QR-код полностью сканируемым, пришлось дополнительно выравнивать и регулировать атомы. Авторы проекта подали заявку на регистрацию рекорда Гиннесса, но редакция издания пока её не подтвердила. В пользу текущего рекордсмена, утверждают в Cerabyte, говорят не только размеры, но также стабильность и долговечность изображения — не требуются энергоёмкие условия вакуума и охлаждения до сверхнизких температур. Google начала скупать исходный код приложений из «Play Маркета» для обучения ИИ
04.06.2026 [12:01],
Павел Котов
Одним из лучших вариантов применения больших языковых моделей искусственного интеллекта сегодня является генерация программного кода. Поэтому Google начала обучать свои модели ИИ на реальном исходном коде приложений для Android, чьим разработчикам она за это платит. 
Источник изображения: John Doe / unsplash.com В рамках «конфиденциальной» программы Google начала без лишней огласки скупать исходный код Android-приложений у их разработчиков в «Play Маркете», чтобы обучать на этих материалах ИИ, сообщил ресурс 404 Media. В направленном разработчикам электронном письме компания описала инициативу как «пилотный проект по предоставлению конфиденциальных материалов», выступающий возможностью «получить дополнительный доход от ваших приложений». Приобретённый в рамках данной программы код, заверили в компании, будет использоваться «для улучшения инструментов и продуктов Google для разработчиков», а ссылка в электронном письме ведёт на страницу о «партнёрствах для улучшения наших продуктов ИИ». Но в самом письме ИИ не упоминается вообще. Созданный человеком контент часто используется для обучения моделей ИИ — ярким примером являются материалы веб-сайтов. Компании вроде Google нечасто выражают готовность платить за такие материалы, но код приложений для Android технически является интеллектуальной собственностью, и в интернете он обычно не публикуется в исходном виде. |
|
✴ Входит в перечень общественных объединений и религиозных организаций, в отношении которых судом принято вступившее в законную силу решение о ликвидации или запрете деятельности по основаниям, предусмотренным Федеральным законом от 25.07.2002 № 114-ФЗ «О противодействии экстремистской деятельности»; |
© 1997—2026 3DNews
При цитировании документа ссылка на сайт с указанием автора обязательна. Полное заимствование документа является
нарушением
российского и международного законодательства и возможно только с согласия редакции 3DNews.



 MWC 2018
 2018
 Computex

 IFA 2018






