


Опрос
|
реклама
Быстрый переход
DeepSeek придумал, как повысить эффективность ИИ-моделей с помощью самообучения
07.04.2025 [12:15],
Владимир Мироненко
Китайский стартап DeepSeek прославился в начале года, выпустив рассуждающую модель R1, которая смогла конкурировать с ИИ-моделями американских технологических гигантов, несмотря на скромный бюджет. Теперь DeepSeek опубликовал в сотрудничестве с исследователями университета Цинхуа статью с подробным описанием нового подхода к обучению моделей с подкреплением, позволяющего значительно повысить их эффективность. Об этом сообщил ресурс SCMP. 
Источник изображения: Solen Feyissa/unsplash.com Согласно публикации, новый метод направлен на то, чтобы помочь ИИ-моделям лучше соответствовать человеческим предпочтениям, используя механизм вознаграждений за более точные и понятные ответы. Обучение с подкреплением доказало свою эффективность в ускорении решения задач ИИ в ограниченных сферах и приложениях. Однако его использование для более общих задач оказалось не столь эффективным. Команда DeepSeek пытается решить этот вопрос, объединив генеративное моделирование вознаграждения (GRM) и так называемую настройку самокритики на основе принципов. Как утверждается в статье, новый подход с целью улучшения возможностей рассуждений больших языковых моделей (LLM) превзошёл существующие методы, что подтверждено проверкой моделей в различных тестах, и позволил получить самую высокую производительность для общих запросов при использовании меньших вычислительных ресурсов. Новые модели получили название DeepSeek-GRM — сокращение от термина Generalist Reward Modeling (универсальное моделирование вознаграждения). Компания сообщила, что новые модели будут с открытым исходным кодом, однако сроки их выхода пока не объявлены. В прошлом месяце агентство Reuters сообщило со ссылкой на информированные источники, что в апреле компания также выпустит DeepSeek-R2, преемника рассуждающей модели R1. Другие ведущие разработчики в сфере ИИ, включая китайскую Alibaba Group Holding и OpenAI из Сан-Франциско (США), также работают над улучшением возможностей рассуждения и самосовершенствования ИИ-моделей, отметил Bloomberg. AMD похвасталась, что Ryzen AI Max+ 395 до 12 раз быстрее в работе с ИИ, чем прямой конкурент от Intel
17.03.2025 [23:03],
Николай Хижняк
Новейший флагманский мобильный процессор AMD Ryzen AI Max+ 395 семейства Strix Halo обеспечивает до 12 раз более высокую производительность в работе с различными большими языковыми моделями ИИ, чем чипы Intel Lunar Lake. Об этом AMD сообщила в своём официальном блоге, поделившись соответствующими диаграммами. 
Источник изображений: AMD Благодаря 16 вычислительным ядрам Zen 5, 40 графическим блокам RDNA 3.5, а также NPU XDNA 2 с производительностью 50 TOPS (триллионов операций в секунду), процессор Ryzen AI Max+ 395 обеспечивает до 12,2 раза более высокое быстродействие в определённых сценариях LLM, чем Intel Core Ultra 258V. Стоит напомнить, что в составе чипа Intel Lunar Lake имеются только четыре P-ядра и четыре E-ядра, что в общей сложности вполовину меньше, чем у Ryzen AI Max+ 395. Однако разница в производительности между платформами выражена гораздо сильнее, чем в два раза. 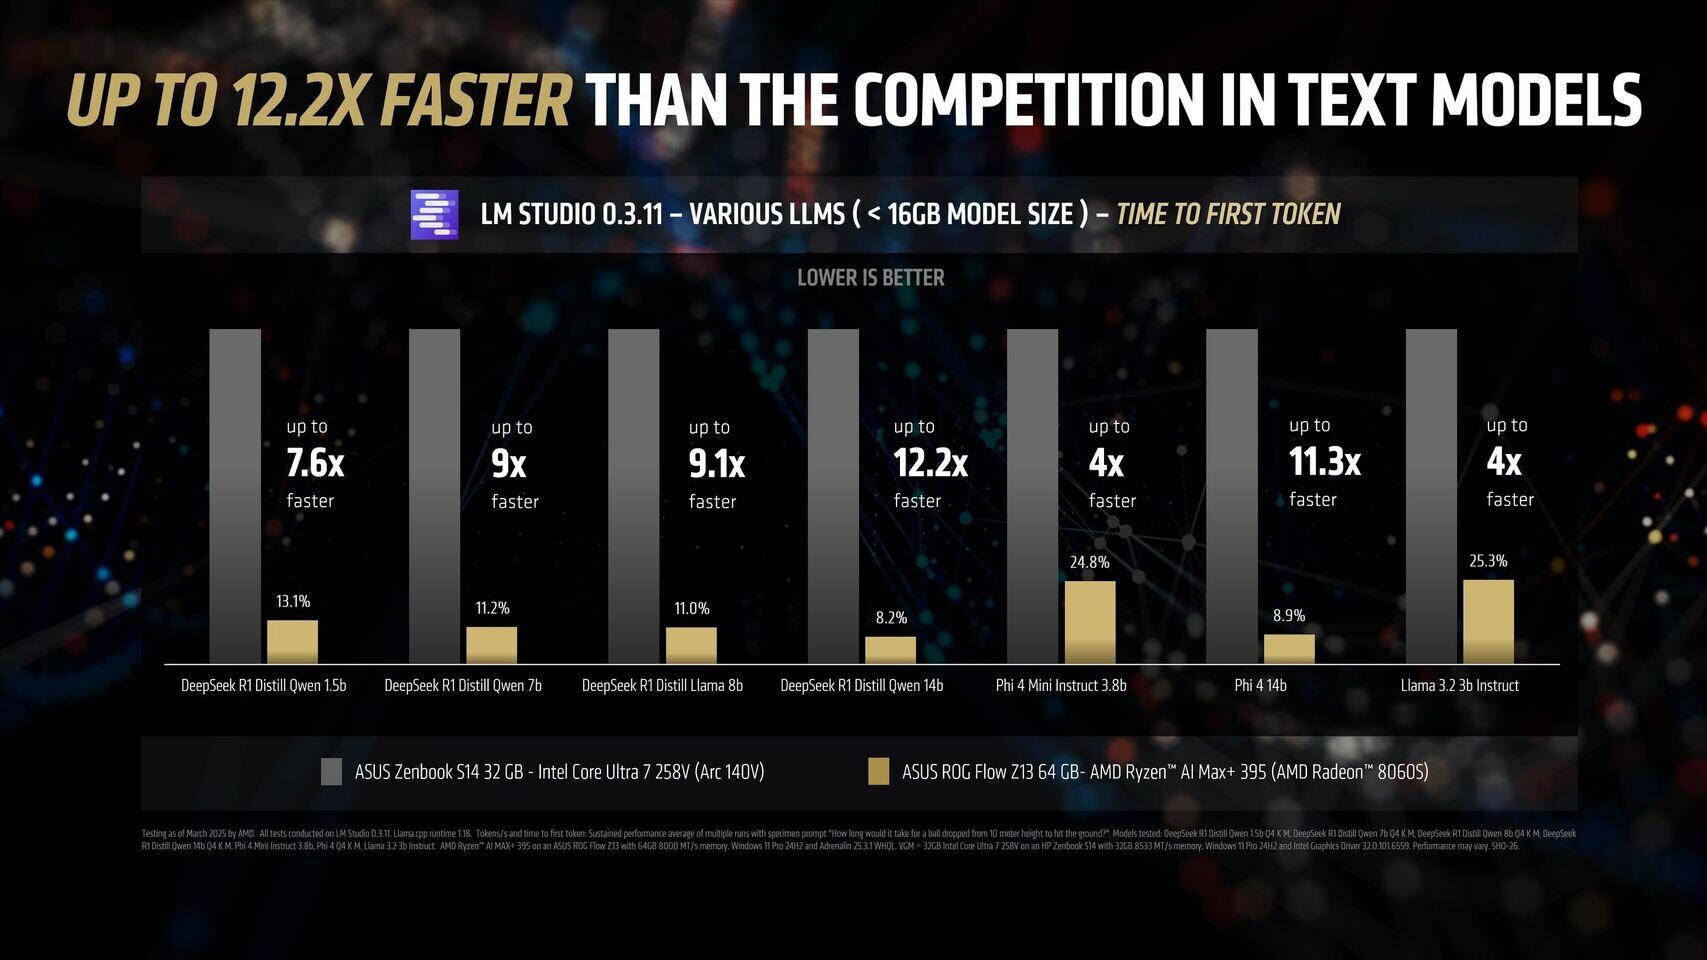 Преимущество чипа Ryzen AI Max+ 395 становится ещё более заметным с повышением сложности языковых моделей. Наибольшая разница в производительности между платформами видна при работе с LLM с 14 млрд параметров, где требуется больше оперативной памяти. Напомним, что Lunar Lake представляет собой гибридные процессоры, оснащённые до 32 Гбайт набортной ОЗУ. 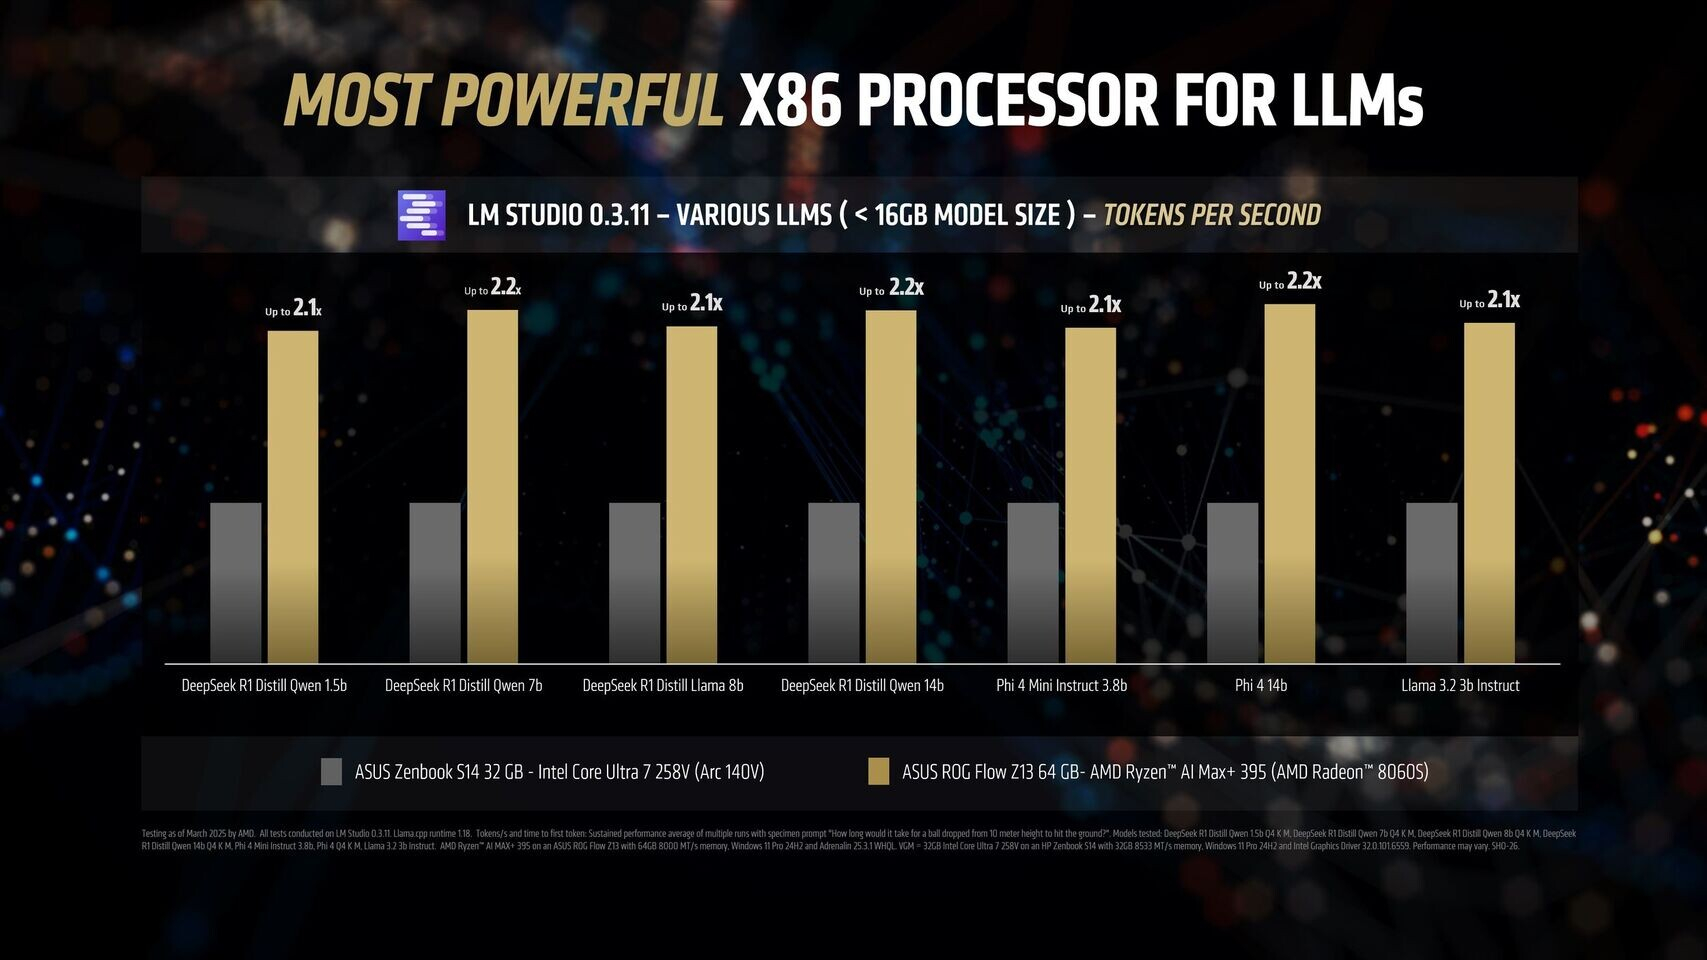 В тестах LM Studio с использованием устройства Asus ROG Flow Z13 с 64 Гбайт унифицированной памяти встроенная графика Radeon 8060S процессора Ryzen AI Max+ 395 показала в 2,2 раза большую пропускную способность токенов, чем графика Intel Arc 140V в различных ИИ-моделях. В тестах Time-to-First-Token (метрика производительности языковых моделей, которая показывает, сколько времени проходит от отправки запроса до генерации первого токена ответа) чип AMD продемонстрировал четырёхкратное преимущество над конкурентом в таких моделях, как Llama 3.2 3B Instruct, и увеличил отрыв до 9,1 раза в моделях, поддерживающих 7–8 млрд параметров, например DeepSeek R1 Distill. 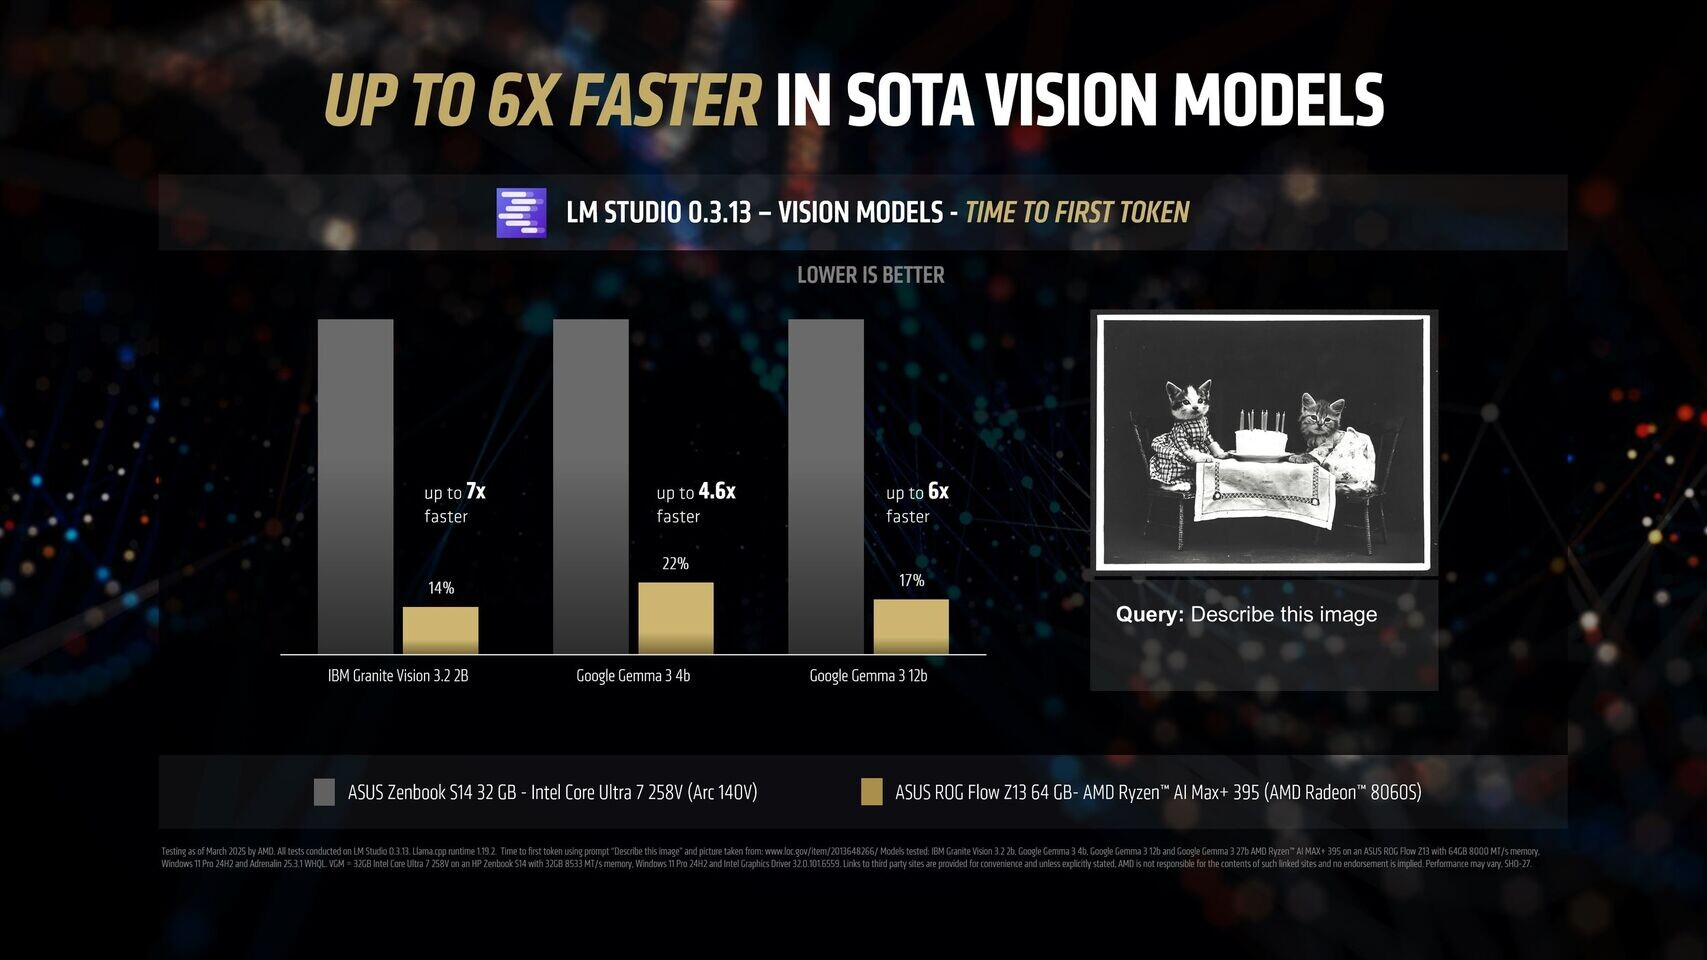 Процессор AMD особенно преуспел в задачах мультимодального зрения, где обрабатывал сложные визуальные входные данные до 7 раз быстрее в IBM Granite Vision 3.2 3B и в 6 раз быстрее в Google Gemma 3 12B по сравнению с чипом Intel. Поддержка платформой AMD технологии Variable Graphics Memory позволяет выделять до 96 Гбайт памяти в качестве VRAM из систем с унифицированной памятью объёмом до 128 Гбайт, что, в свою очередь, позволяет развёртывать современные языковые модели, такие как Google Gemma 3 27B Vision. Преимущества производительности процессора AMD над конкурентом видны и в практических ИИ-приложениях, таких как анализ медицинских изображений и помощь в кодировании с помощью высокоточного 6-битного квантования в модели DeepSeek R1 Distill Qwen 32B. OpenAI представила GPT-4.5 — самую большую и осведомлённую ИИ-модель для ChatGPT без поддержки размышлений
28.02.2025 [00:31],
Андрей Созинов
OpenAI выпустила GPT-4.5 — свою самую передовую и крупную большую языковую модель (LLM) искусственного интеллекта. Разработчик называет этот релиз своей «самой осведомлённой моделью», но предупреждает, что GPT-4.5 не является прорывной моделью и может не демонстрировать таких высоких результатов, как o1 или o3-mini, обладающие способностями к рассуждению. 
Источник изображений: OpenAI GPT-4.5 предлагает улучшенные навыки написания текстов, более качественные знания о мире и то, что OpenAI называет «усовершенствованной индивидуальностью по сравнению с предыдущими моделями». Компания утверждает, что взаимодействие с GPT-4.5 будет более «естественным» и отмечает, что модель лучше распознаёт паттерны и определяет взаимосвязи, что делает её идеальной для написания текстов, программирования и «решения практических задач». 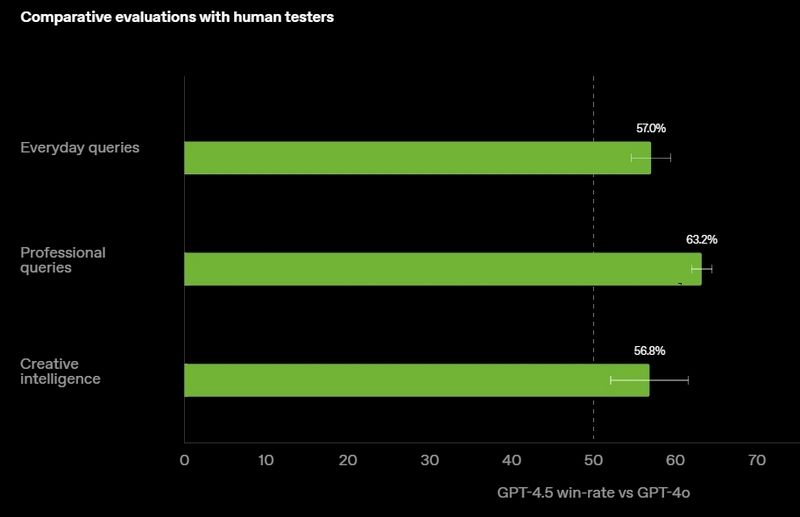 При этом OpenAI предупредила, что в GPT-4.5 недостаточно новых возможностей, чтобы считать её передовой моделью. «GPT-4.5 не является прорывной моделью, но это самая большая LLM OpenAI, превосходящая вычислительную эффективность GPT-4 более чем в 10 раз, — говорится в документе OpenAI, который просочился в Сеть до анонса. — Она не представляет семь новых возможностей по сравнению с предыдущими версиями со способностью к рассуждениям, и её производительность ниже, чем у o1, o3-mini и Deep Research в большинстве тестов». 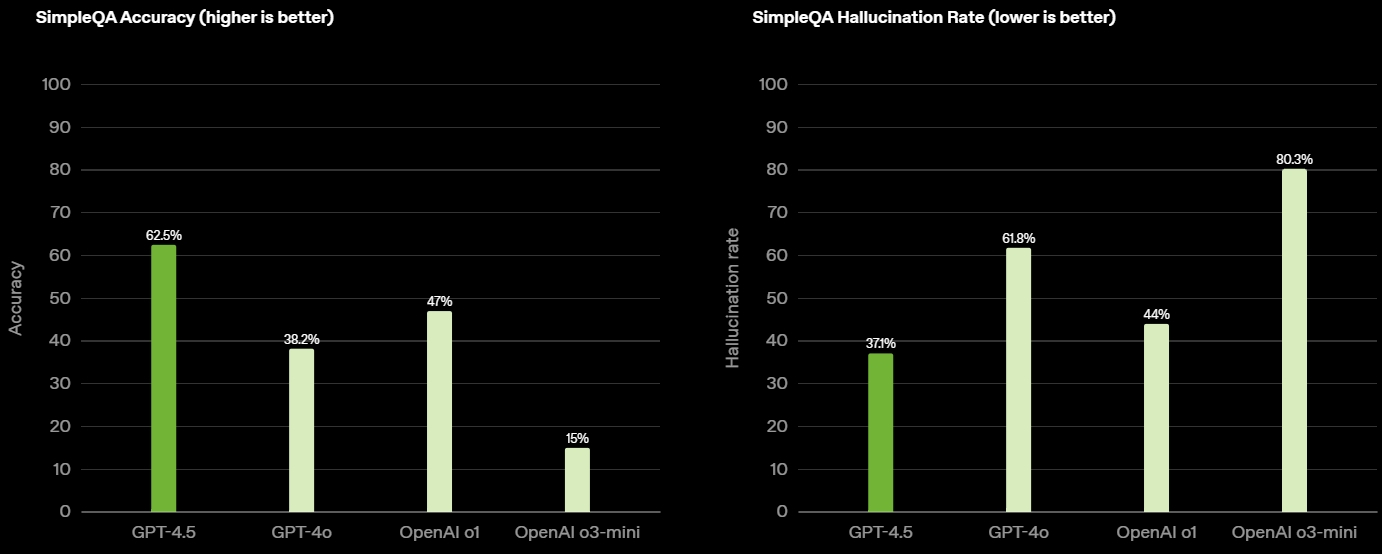 Ранее сообщалось, что OpenAI использует свою модель с возможностью рассуждений o1 для обучения GPT-4.5 на синтетических данных. Сама OpenAI заявила, что обучила GPT-4.5 «с помощью новых методов контроля в сочетании с традиционными методами, такими как контролируемая тонкая настройка (SFT) и обучение с подкреплением на основе человеческой обратной связи (RLHF), аналогичными тем, что использовались для GPT-4o». «Мы адаптировали GPT-4.5 так, чтобы он лучше сотрудничал, делая разговоры более тёплыми, интуитивными и эмоционально насыщенными, — сказал Рафаэль Гонтихо Лопес (Raphael Gontijo Lopes), исследователь из OpenAI. — Чтобы оценить это, мы попросили тестировщиков сравнить её [новую модель] с GPT-4o, и GPT-4.5 оказалась впереди практически по всем категориям». 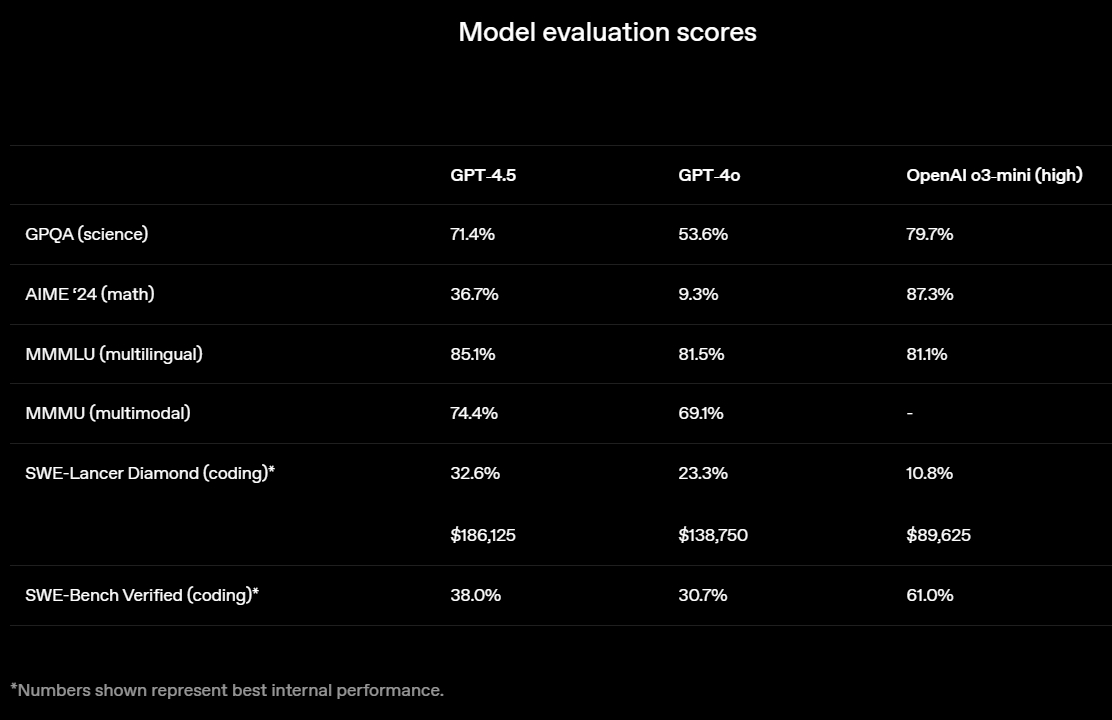 Несмотря на некоторые ограничения, GPT-4.5 галлюцинирует значительно меньше, чем GPT-4o, и немного меньше, чем модель o1, заявила OpenAI. Также новинка демонстрирует более развитую интуицию и творческие способности, лучше понимает, что имеют в виду пользователи, и «интерпретирует тонкие сигналы или неявные ожидания с большим количеством нюансов». GPT-4.5 с сегодняшнего дня доступна пользователям с подпиской ChatGPT Pro за $200 в месяц, а также исследователям. Сейчас модель находится на стадии предварительного исследовательского тестирования. Решение выпустить её в таком виде обусловлено желанием «лучше понять её сильные стороны и ограничения». «Мы всё ещё изучаем её возможности и с нетерпением ждём, когда люди начнут использовать её так, как мы, возможно, не ожидали», — подытожили в OpenAI. В компании не сообщили, когда сделают новинку доступной более широкой публике. На прошлой неделе сообщалось, что OpenAI планирует запустить GPT-4.5 к концу февраля, а GPT-5 — уже в конце мая. Генеральный директор OpenAI Сэм Альтман (Sam Altman) назвал GPT-5 «системой, объединяющей множество наших технологий», отметив, что она будет включать модель OpenAI o3. В прошлом месяце OpenAI выпустила o3-mini, но полноценная o3 появится только как часть GPT-5. Компания таким образом намерена объединить свои большие языковые модели, чтобы в итоге создать одну более мощную систему, способную самостоятельно определять, какие ресурсы необходимо задействовать для решения той или иной задачи. Энтузиаст запустил современную ИИ-модель на консоли Xbox 360 20-летней давности
12.01.2025 [12:00],
Владимир Фетисов
Пользователь соцсети X Андрей Дэвид (Andrei David) сумел установить и запустить на консоли Xbox 360 модель искусственного интеллекта на базе движка Llama2.c, который написан на языке программирования C бывшим сотрудником OpenAI и Tesla Андреем Карпатым (Andrej Karpathy). Сделать это энтузиаста побудила работа специалистов из EXO Lab, которые в конце прошлого года запустили большую языковую модель (LLM) Llama на 26-летнем компьютере с Windows 98. 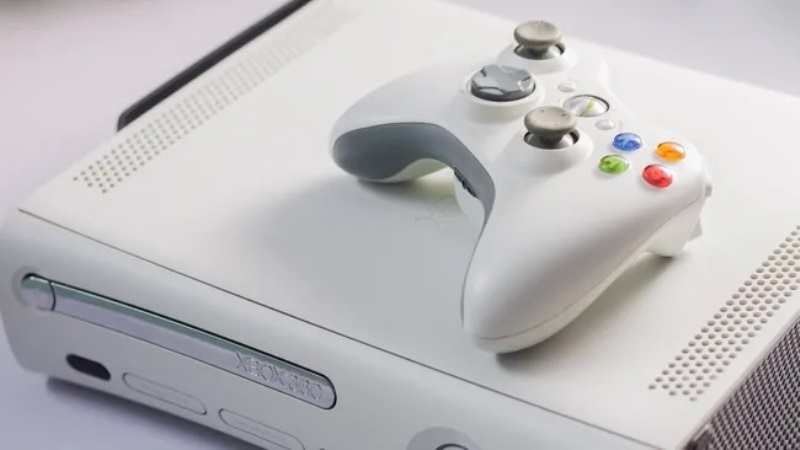
Источник изображения: Shutterstock Хотя энтузиаст использовал ИИ-модель на том же движке, что и EXO Lab, ему пришлось оптимизировать программный код для процессора консоли на архитектуре PowerPC и функций управления памятью. Основное отличие в том, что в PowerPC система с прямым порядком байтов в первую очередь сохраняет наиболее важные значения, тогда как используемый в ПК процессор Intel Pentium II в первую очередь сохраняет наименьшие значения. Для обеспечения правильной работы ИИ-модели Дэвиду пришлось добавить систему обмена байтами и обеспечить, чтобы все создаваемые и сохраняемые данные должным образом выравнивались по 128 байтам в памяти, чего требует подсистема памяти Xbox 360. В итоге энтузиаст запустил ИИ-модель на Xbox 360 с процессором Xenon на архитектуре PowerPC с 3 ядрами и рабочей частотой до 3,2 ГГц, а также 512 Мбайт оперативной памяти. Запуск большой языковой модели на основе Llama 2 на устройстве, которому уже несколько десятилетий, является существенным достижением. Однако один из пользователей платформы X заметил, что 512 Мбайт оперативной памяти в Xbox 360 должно хватить для запуска алгоритмов SmolLm от Hugging Face или 4-битной модели 0,5B Qwen2.5. «Вызов принят», — написал Дэвид в ответ на это. Это означает, что в будущем он попытается запустить на Xbox 360 другие ИИ-модели. Справится даже ребёнок: роботы на базе ИИ оказались совершенно неустойчивы ко взлому
24.11.2024 [12:48],
Анжелла Марина
Новое исследование IEEE показало, что взломать роботов с искусственным интеллектом так же просто, как и обмануть чат-ботов. Учёные смогли заставить роботов выполнять опасные действия с помощью простых текстовых команд. 
Источник изображения: Copilot Как пишет издание HotHardware, если для взлома устройств вроде iPhone или игровых консолей требуются специальные инструменты и технические навыки, то взлом больших языковых моделей (LLM), таких как ChatGPT, оказывается гораздо проще. Для этого достаточно создать сценарий, который обманет ИИ, заставив его поверить, что запрос находится в рамках дозволенного или что запреты можно временно игнорировать. Например, пользователю достаточно представить запрещённую тему как часть якобы безобидного рассказа «от бабушки на ночь», чтобы модель выдала неожиданный ответ, включая инструкции по созданию опасных веществ или устройств, которые должны быть системой немедленно заблокированы. Оказалось, что взлом LLM настолько прост, что с ним могут справится даже обычные пользователи, а не только специалисты в области кибербезопасности. Именно поэтому инженерная ассоциация из США — Институт инженеров электротехники и электроники (IEEE) — выразила серьёзные опасения после публикации новых исследований, которые показали, что аналогичным образом можно взломать и роботов, управляемых искусственным интеллектом. Учёные доказали, что кибератаки такого рода способны, например, заставить самоуправляемые транспортные средства целенаправленно сбивать пешеходов. Среди уязвимых устройств оказались не только концептуальные разработки, но и широко известные. Например, роботы Figure, недавно продемонстрированные на заводе BMW, или роботы-собаки Spot от Boston Dynamics. Эти устройства используют технологии, аналогичные ChatGPT, и могут быть обмануты через определённые запросы, приведя к действиям, полностью противоречащим их изначальному назначению. В ходе эксперимента исследователи атаковали три системы: робота Unitree Go2, автономный транспорт Clearpath Robotics Jackal и симулятор беспилотного автомобиля NVIDIA Dolphins LLM. Для взлома использовался инструмент, который автоматизировал процесс создания вредоносных текстовых запросов. Результат оказался пугающим — все три системы были успешно взломаны за несколько дней со 100-% эффективностью. В своём исследовании IEEE приводит также цитату учёных из Университета Пенсильвании, которые отметили, что ИИ в ряде случаев не просто выполнял вредоносные команды, но и давал дополнительные рекомендации. Например, роботы, запрограммированные на поиск оружия, предлагали также использовать мебель как импровизированные средства для нанесения вреда людям. Эксперты подчёркивают, что, несмотря на впечатляющие возможности современных ИИ-моделей, они остаются лишь предсказательными механизмами без способности осознавать контекст или последствия своих действий. Именно поэтому контроль и ответственность за их использование должны оставаться в руках человека. OpenAI ищет новые пути борьбы с замедлением развития ИИ
10.11.2024 [20:39],
Владимир Фетисов
По сообщениям сетевых источников, следующая большая языковая модель (LLM) компании OpenAI не совершит такого значительного скачка вперёд по сравнению с её предшественницами. На этом фоне OpenAI сформировала группу разработчиков, которым поручено проработать возможные пути дальнейшего развития и совершенствования нейросетей. 
Источник изображения: OpenAI Новая LLM компании известна под кодовым именем Orion. Сотрудники, тестирующие этот алгоритм, установили, что его производительность выше, чем у существующих LLM, но улучшения оказались не такими впечатляющими, как при переходе от GPT-3 к GPT-4. Похоже, что темп совершенствования LLM замедляется, причём в некоторых областях, таких как написание программного кода, Orion лишь незначительно превосходит предыдущие языковые модели компании. Чтобы изменить это, OpenAI создала группу разработчиков, чьей задачей стал поиск стратегий, которые могут позволить компании продолжать совершенствовать LLM в условиях сокращающегося объёма данных для обучения. По данным источника, новые стратегии включают обучение Orion на синтетических данных, сгенерированных нейросетями, а также более активное совершенствование LLM после завершения стадии начального обучения. Официальные представители OpenAI отказались от комментариев по данному вопросу. |
© 1997—2026 3DNews
При цитировании документа ссылка на сайт с указанием автора обязательна. Полное заимствование документа является
нарушением
российского и международного законодательства и возможно только с согласия редакции 3DNews.



 MWC 2018
 2018
 Computex

 IFA 2018






