


Опрос
|
реклама
Быстрый переход
OpenAI выпустила GPT-6 Sol и Luna — они дешевле предшественниц и делают меньше ошибок
22.09.2026 [23:02],
Николай Хижняк
В начале текущего месяца OpenAI выпустила GPT-6 Astra — самую мощную и функциональную ИИ-модель компании, которую она без лишней скромности называет «лучшей в мире моделью» для выполнения широкого спектра задач, включая работу за компьютером и написание программного кода. Сегодня OpenAI расширила линейку моделей GPT-6, представив более компактные и доступные GPT-6 Sol и GPT-6 Luna. 
Источник изображений: OpenAI «GPT-6 Astra открыла новую эру интеллектуальных технологий. Представленные [сегодня] модели развивают этот успех, делая такой интеллект более эффективным и доступным», — прокомментировали в компании. Первые версии моделей Sol и Luna были представлены ранее в этом году и заняли разные ниши в иерархии моделей OpenAI. Модель Sol предназначена для решения сложных задач, таких как программирование, тогда как модель Luna, по заявлению OpenAI, лучше подходит для рутинной офисной работы — «объёмных задач с чётко определённой целью, например, обобщения содержания документов, извлечения информации или ответов на простые вопросы». 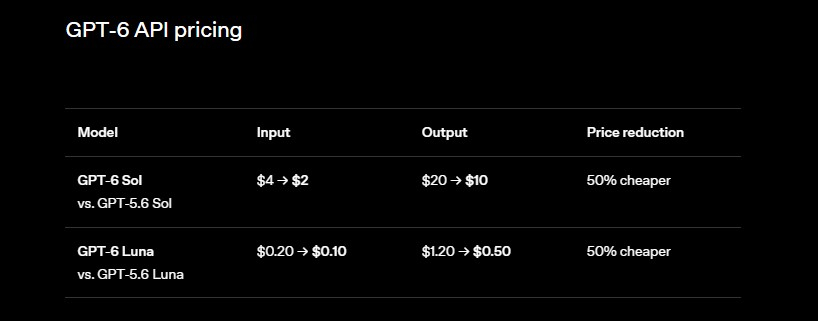 OpenAI делает акцент на значительном повышении эффективности и доступности обновлённых моделей Sol и Luna — прежде всего, за счёт существенного снижения стоимости доступа к API. Новые версии Sol и Luna будут стоить вдвое дешевле, чем предыдущие версии Sol и Luna (на базе GPT-5.6). Такое снижение цены компания объясняет оптимизацией процессов кеширования и инференса (вывода данных). 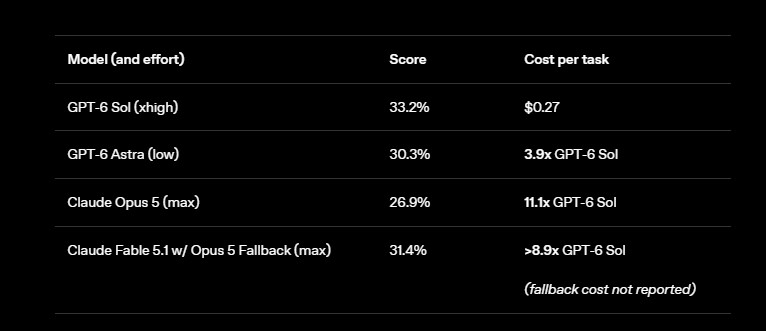 OpenAI заявляет, что новейшие модели точнее передают факты и допускают меньше ошибок при написании кода. 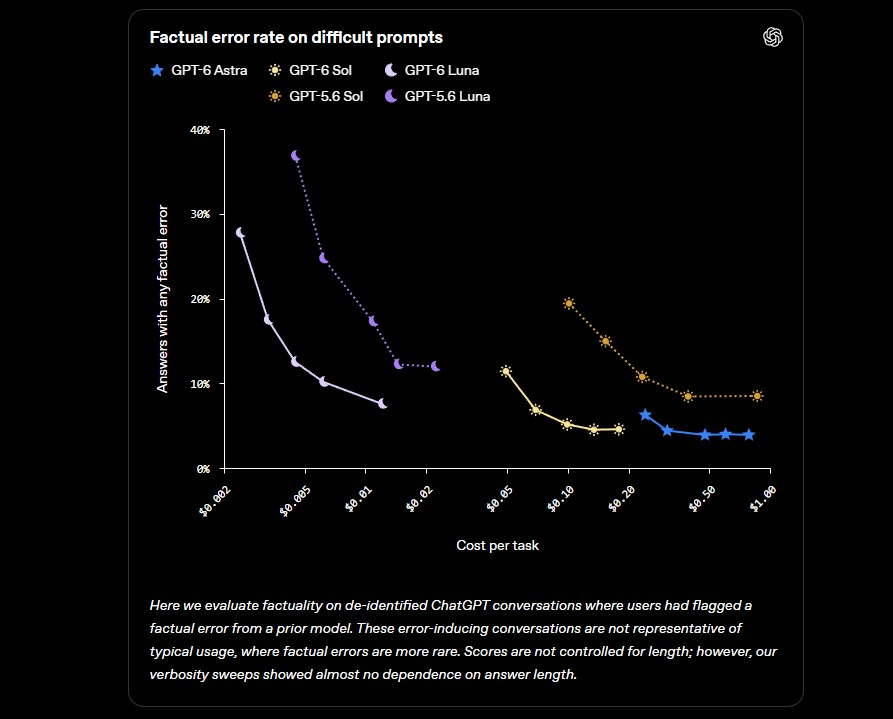 «Согласно результатам нашей внутренней оценки точности, основанной на анализе обезличенных реальных диалогов (в которых пользователи указывали на ошибки моделей), GPT-6 Sol ошибается примерно вдвое реже своей предшественницы, обеспечивая надёжность уровня Astra при значительно меньших затратах», — говорится в сообщении компании. 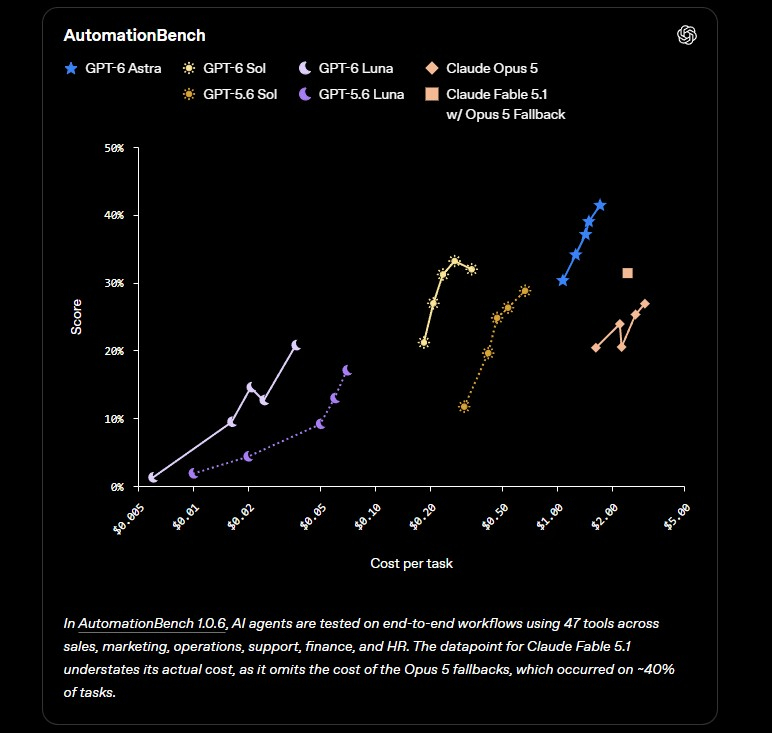 При выпуске новых моделей OpenAI обычно заявляет, что её новинки превосходят разработки главного конкурента — Anthropic. Этот запуск не стал исключением. Компания неоднократно подчёркивает в своём пресс-релизе, что модели GPT-6 Sol и Luna справляются с задачами значительно лучше, чем флагманские модели Anthropic, такие как Fable и Opus. 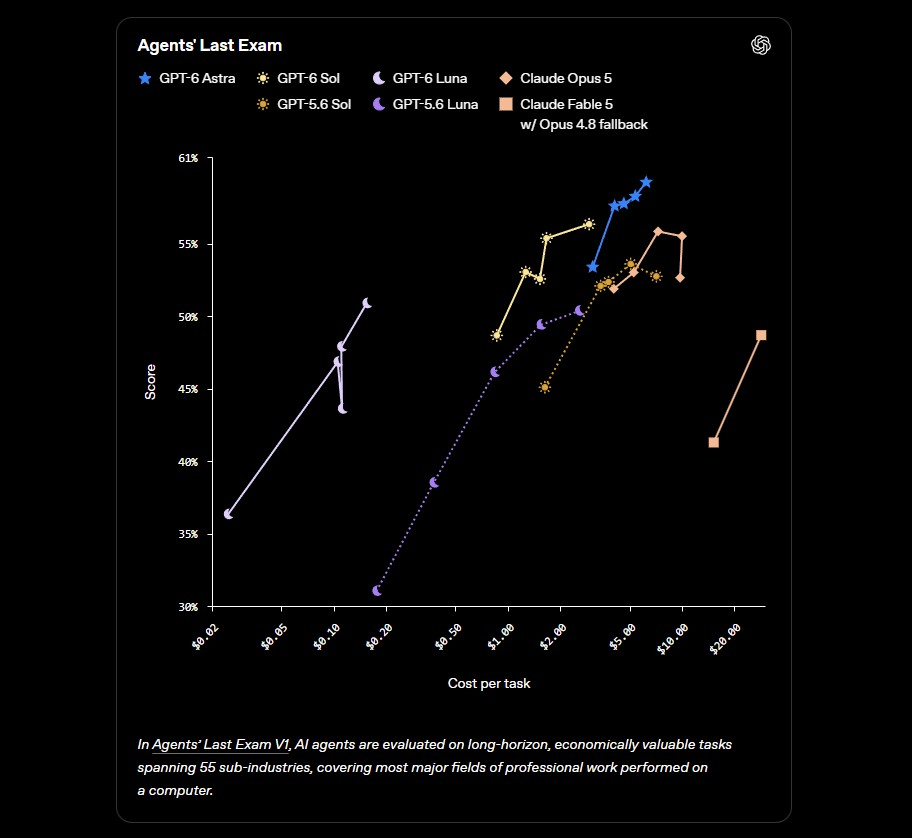
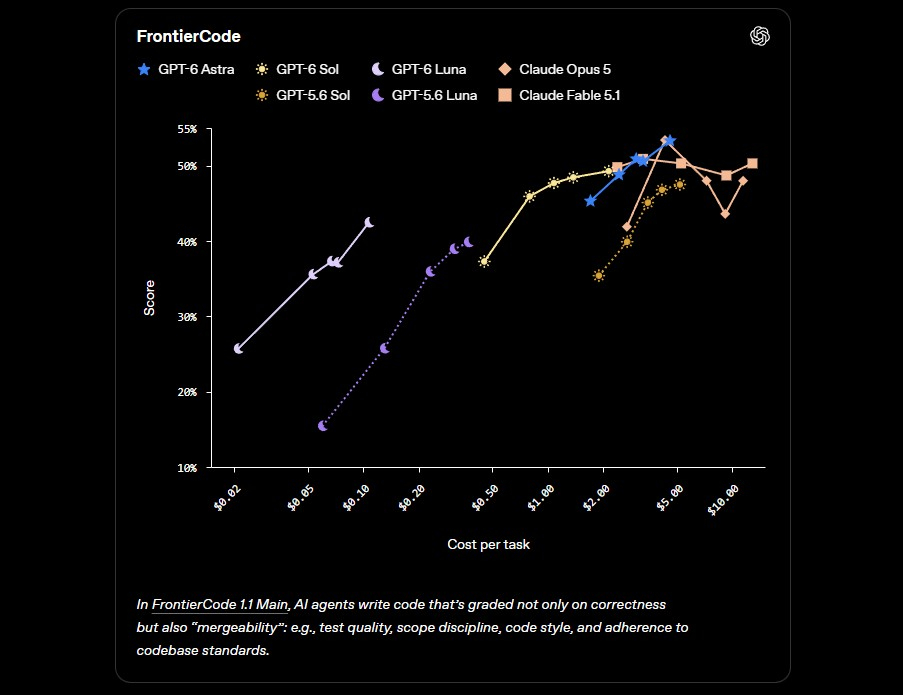 Примечательно, что Anthropic выпустила новую версию Opus 5.5 всего за полтора часа до анонса OpenAI, что свидетельствует о жёсткой конкуренции между этими двумя компаниями. 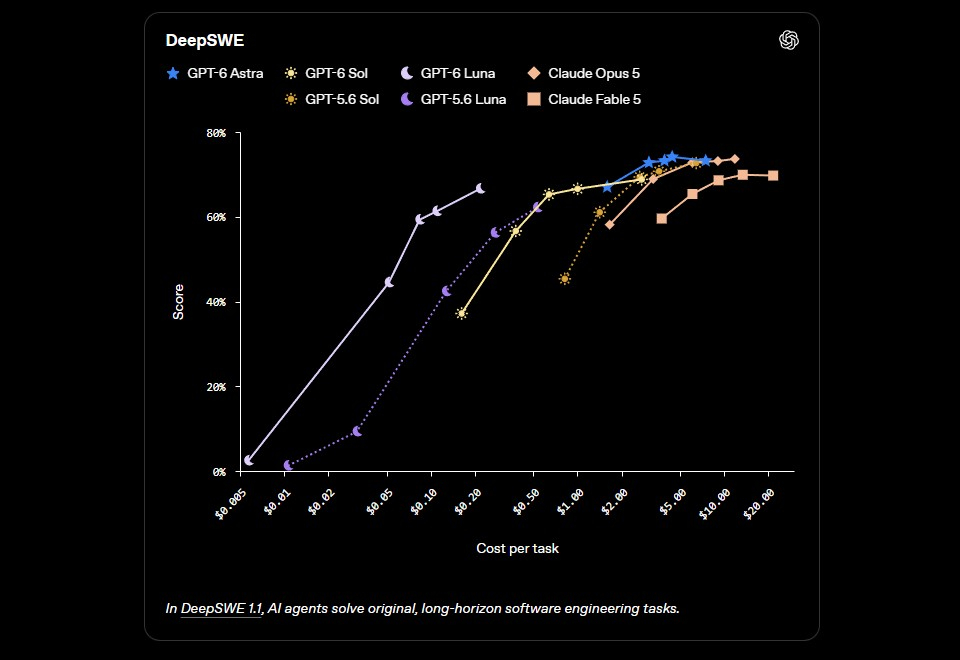
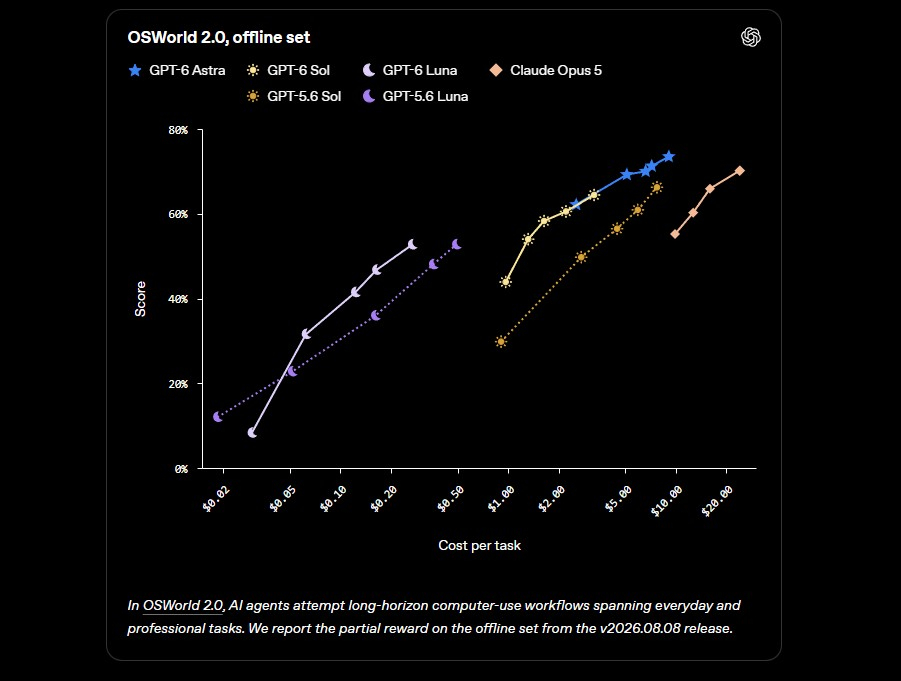 Новые версии ИИ-моделей Sol и Luna уже доступны в сервисах ChatGPT Work и Codex для большинства платных подписчиков, а также через API ChatGPT. Кроме того, модель Luna появится в десктопном приложении и станет доступна пользователям бесплатных тарифов и тарифа Go. OpenAI планирует внедрить эти модели в ChatGPT (в приложении и на сайте) в течение дня. Anthropic представила Claude Opus 5.5 — флагманский ИИ для всех, который дешевле и во многом не хуже Fable 5.1
22.09.2026 [21:31],
Андрей Созинов
Anthropic анонсировала языковую модель Claude Opus 5.5 — первую в новом семействе Claude 5.5. Компания называет её своим новым флагманом: модель должна заметно превосходить Claude Opus 5 в агентном программировании, работе с компьютером и прикладных офисных задачах, при этом её использование, по данным компании, обходится в среднем на 40 % дешевле. 
Источник изображений: Anthropic Одним из основных направлений развития Opus 5.5 стала работа со сложными и продолжительными задачами, в которых модель должна самостоятельно планировать работу, использовать инструменты, проверять промежуточные результаты и вносить изменения в большой проект. По данным разработчика, один из ранних пользователей с помощью Claude Opus 5.5 выполнил миграцию кодовой базы объёмом 680 тыс. строк менее чем за сутки — вручную такая задача, по его оценке, заняла бы у команды инженеров несколько недель. В другом тесте модель провела аудит и исправление кодовой базы на 200 000 строк менее чем за три часа; предыдущей версии Claude Opus 5 на аналогичную работу потребовалось более 20 часов и в 2,5 раза больше токенов. В тесте по миграции HAProxy с языка C на Rust модель Opus 5.5 завершила работу за 9,5 часа против 12 часов у Fable 5.1, и её работа обошлась на 51 % дешевле. Anthropic также отмечает улучшения при оптимизации программного обеспечения: в одном из испытаний Opus 5.5 смогла сократить время загрузки всех страниц веб-приложения в 39 из 40 случаев, тогда как Opus 5 чаще вносила менее значительные изменения и могла при этом менять поведение приложения. 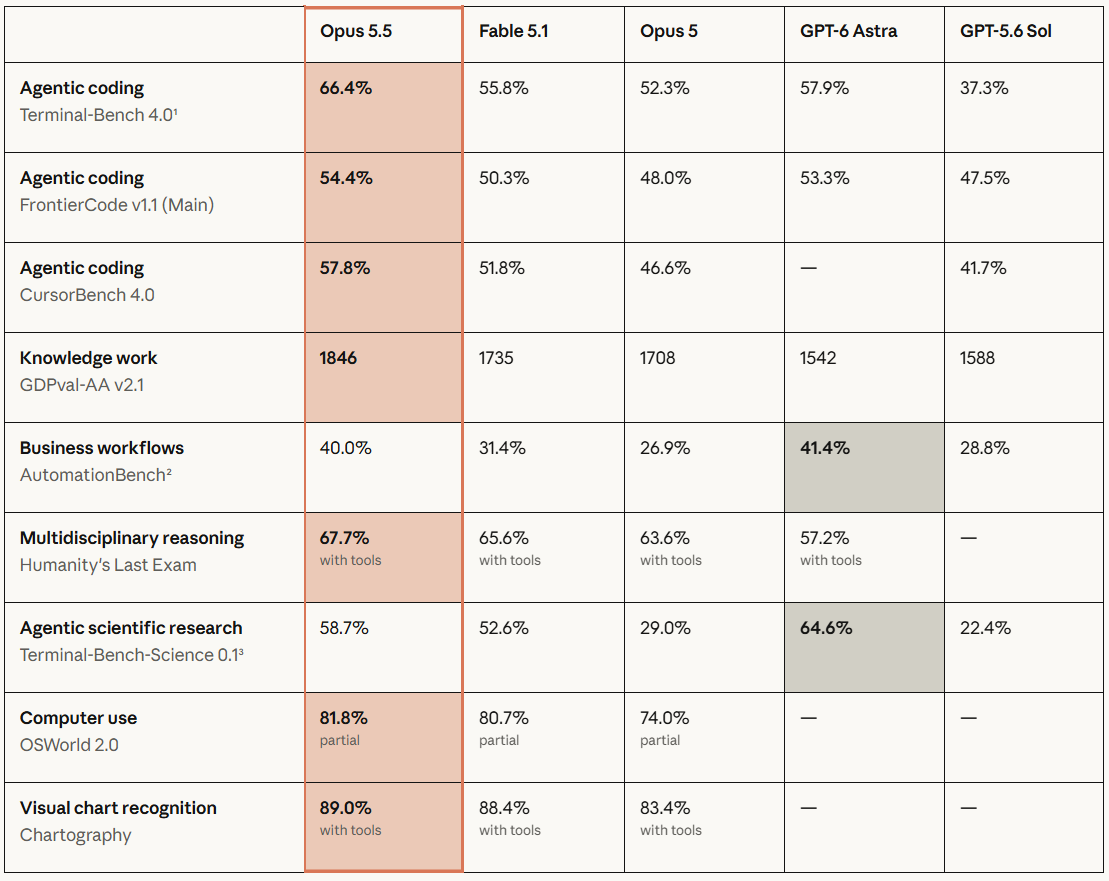 По внутренним тестам Anthropic, в бенчмарке Terminal-Bench 4.0, оценивающем способность ИИ-агентов выполнять многошаговые задачи в командной строке, Claude Opus 5.5 набрала 66,4 %. Это выше результатов Claude Opus 5, Fable 5.1, GPT-6 Astra и GPT-5.6 Sol. Во FrontierCode v1.1 новая модель получила 54,4 %, тогда как Claude Fable 5.1 набрала 50,3 %, а GPT-6 Astra — 53,3 %. В бенчмарке CursorBench 4.0 результат Opus 5.5 составил 57,8 %, что лучше показателей Fable 5.1 и Opus 5. 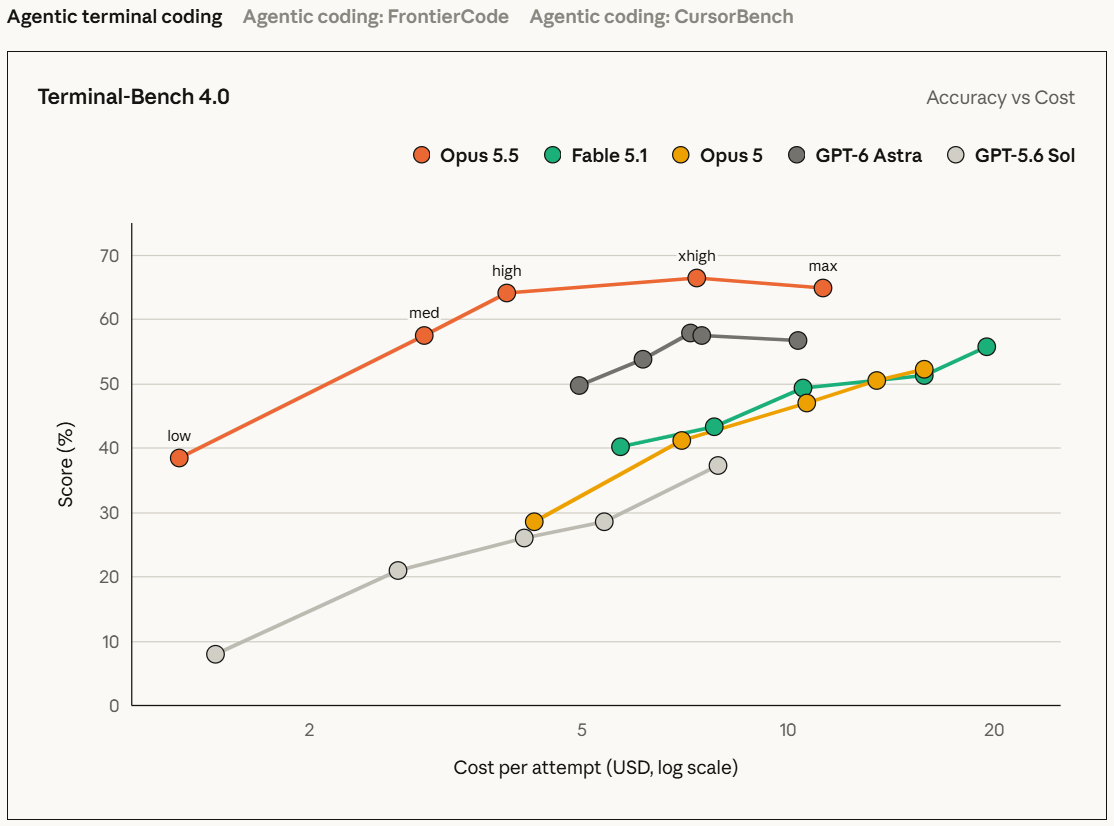 Anthropic отдельно отмечает, что в случае с флагманскими моделями разница в бенчмарках не всегда точно отражает реальные различия между моделями. По её собственной оценке, практический разрыв между Opus 5.5 и Claude Fable 5.1 меньше, чем можно предположить по приведённым результатам испытаний. 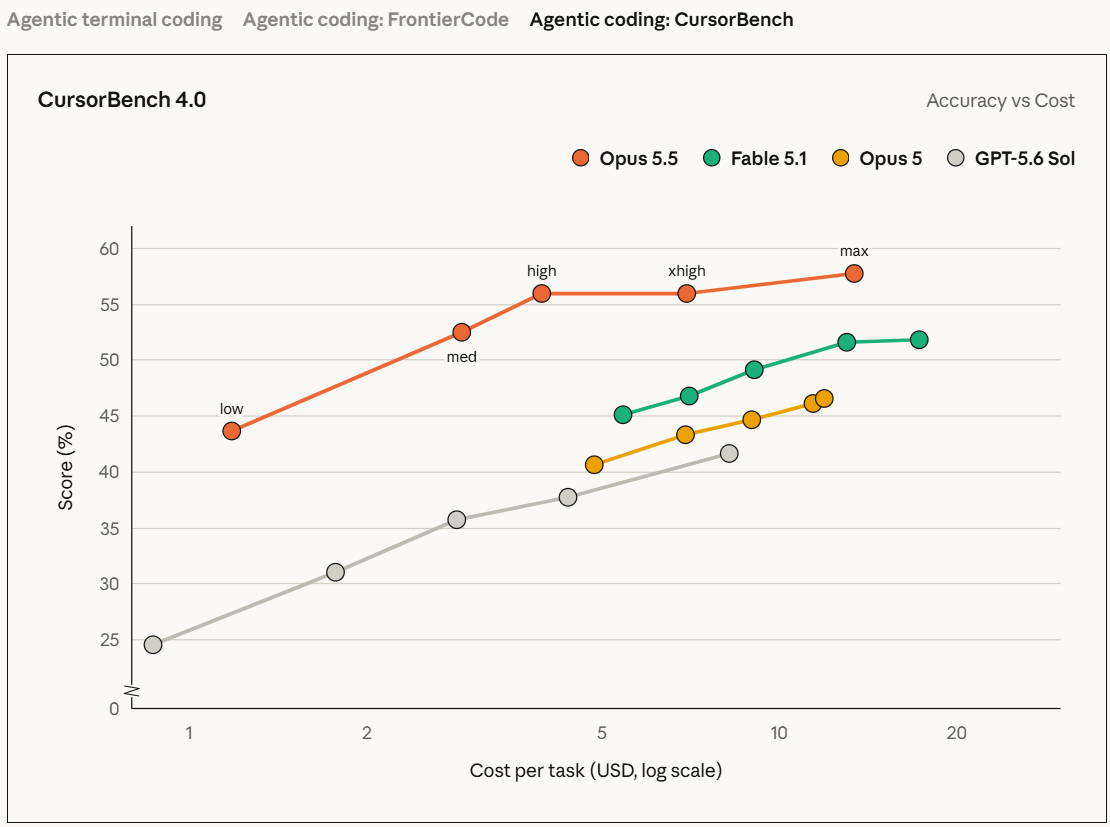 Разработчик также обещает улучшения в работе с текстами, исследованиями, финансовыми моделями и деловыми документами. На тесте GDPval-AA v2.1, который имитирует профессиональные задачи по 44 специальностям, Claude Opus 5.5 получила рейтинг 1846 очков. Для сравнения, у Fable 5.1 этот показатель составил 1735, а у Opus 5 — 1708. 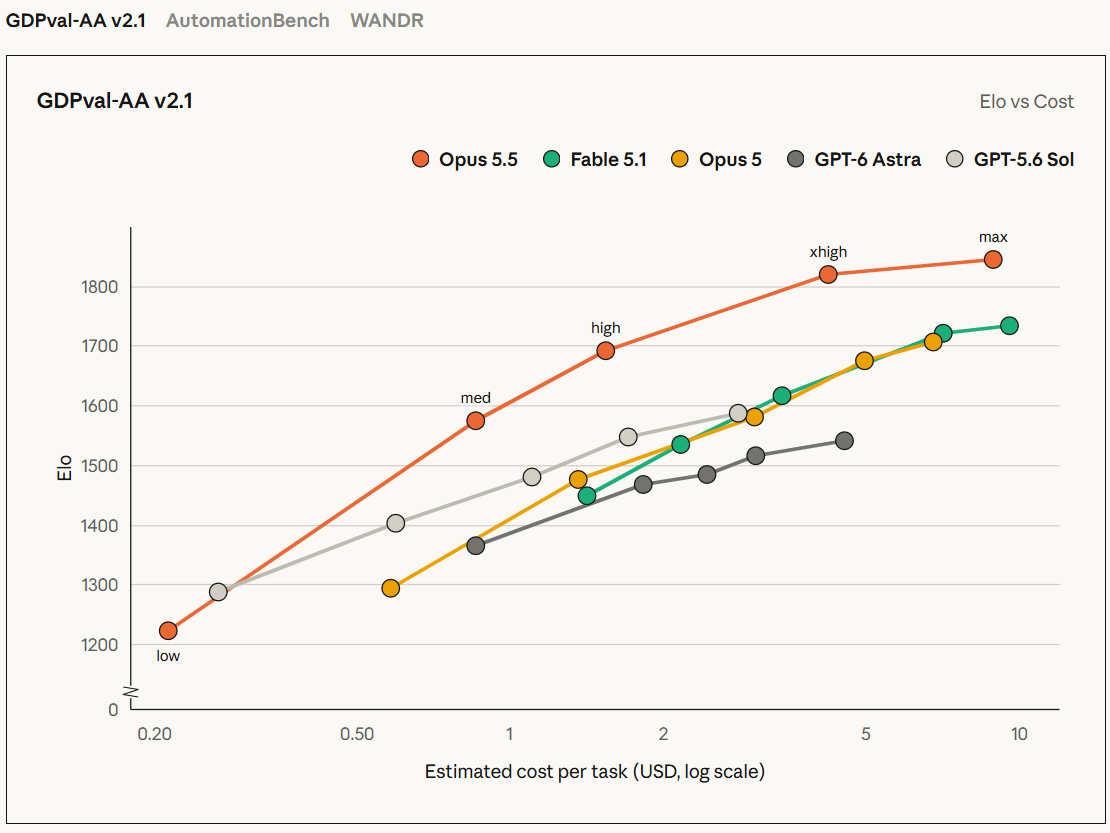 В одном из внутренних тестов модель попросили подготовить отчёт по финансовым результатам компании, используя специально подготовленную копию Сети, где нужный релиз было трудно найти. Opus 5.5 прошла установленный компанией порог качества — когда ошибка в любой цифре или цитате приводила к провалу теста — в 16 из 18 попыток, тогда как Fable 5.1 и Opus 5 не справились ни в одной. 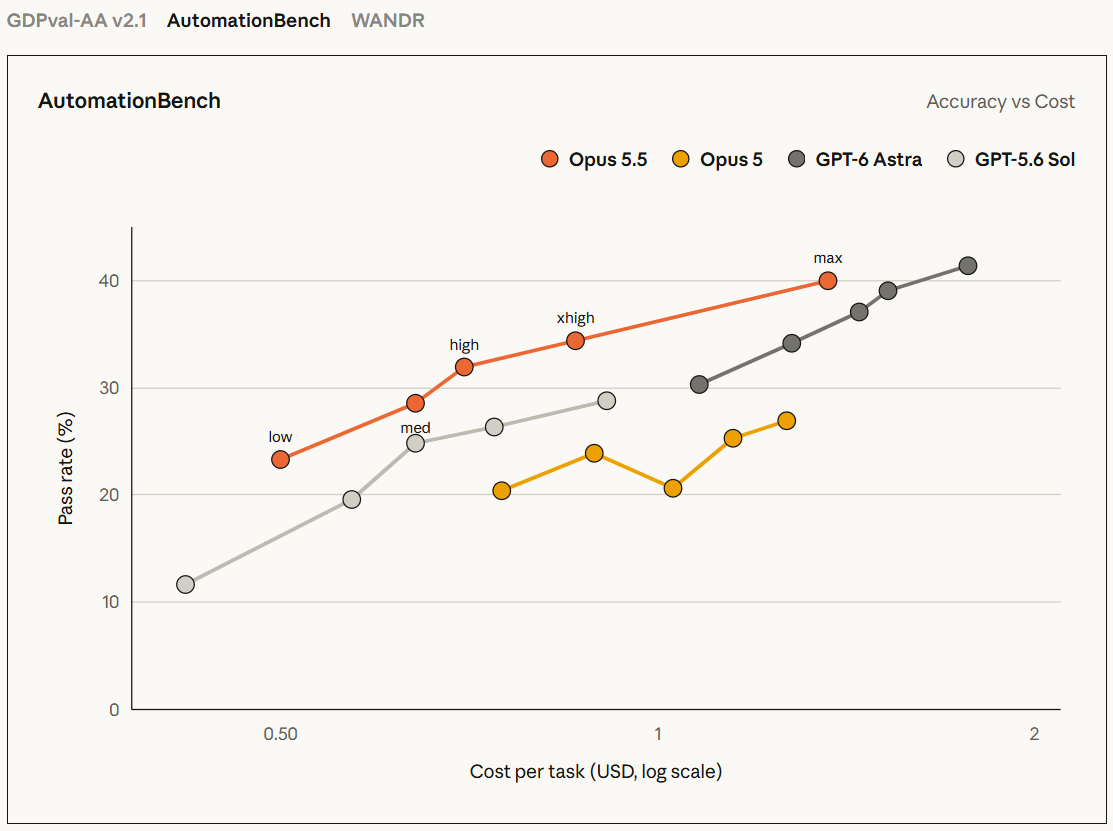 Anthropic отдельно переработала стиль общения модели. Компания утверждает, что Opus 5.5 стала лучше структурировать ответы, сразу выносить ключевую информацию и реже использовать жаргон или необычные формулировки. Это должно сделать модель более удобной для длительной совместной работы с пользователем. При этом Anthropic отдельно подчёркивает эффективность новой модели. Стоимость миллиона входных токенов снижена с $5 до $4, а выходных — с $25 до $20. Чтение из кэша подешевело с $0,50 до $0,20 за миллион токенов, а запись стоит $5 за 1 млн вместо $6,25. По данным компании, с учётом меньшего количества токенов, необходимого для выполнения задач, общая стоимость использования модели в среднем снижается на 40 %. Скорость генерации также выросла более чем на 30 %. Для Opus 5.5 предусмотрен и ускоренный режим Fast Mode: в Claude Code и Claude Platform он обеспечивает скорость до 2,5 раза выше стандартной, но стоит $8 за миллион входных и $40 за миллион выходных токенов. Перед выпуском Claude Opus 5.5 прошла внешнее тестирование, в том числе с участием Frontier Design и METR. Anthropic утверждает, что модель лучше предыдущих Claude соблюдает заданные ограничения, а в тестах на попытки выйти за пределы изолированной среды делала это примерно на 85 % реже, чем Opus 5 и Mythos 5.1. При этом компания признаёт, что полностью выявить риски поведения ИИ до развёртывания невозможно. Для чувствительных запросов в области кибербезопасности, биологии и дистилляции моделей действуют дополнительные меры контроля. Большинство задач по кибербезопасности будет перенаправляться на Claude Opus 4.8, а расширенный доступ к Opus 5.5 смогут получить проверенные специалисты через программы Cyber Verification и Life Sciences Verification. Также утверждается, что Opus 5.5 лучше противостоит атакам с внедрением инструкций (prompt injection) и реже предпринимает необратимые действия. Кроме того, Anthropic внедрила механизм preserved thinking, призванный затруднить массовое извлечение внутренних рассуждений модели через сеть поддельных API-аккаунтов. Claude Opus 5.5 уже доступна в чат-боте Claude, через API и другие сервисы Anthropic. В ближайшие недели Anthropic также обещает выпустить Claude Sonnet 5.5 и Claude Haiku 5.5, которые получат многие из тех же улучшений производительности, эффективности и безопасности. Anthropic представила Claude Fable 5.1 и Mythos 5.1 — флагманские ИИ стали умнее, дешевле и чуть раскованнее
01.09.2026 [23:32],
Андрей Созинов
Компания Anthropic представила Claude Fable 5.1 и Claude Mythos 5.1 — новые версии своих флагманских ИИ-моделей, которые ориентированы на программирование, работу с большими объёмами информации и выполнение длительных многоэтапных задач. По данным разработчика, новинки заметно превосходят предшественников по ряду тестов, а их возможности уже позволяют использовать ИИ в некоторых направлениях научных исследований. 
Источник изображений: Anthropic Fable 5.1 и Mythos 5.1 представляют собой одну и ту же модель, но отличаются уровнем защитных механизмов. Fable 5.1 доступна всем пользователям, тогда как Mythos 5.1 распространяется через программу доверенного доступа для специалистов в области кибербезопасности и биологических наук. 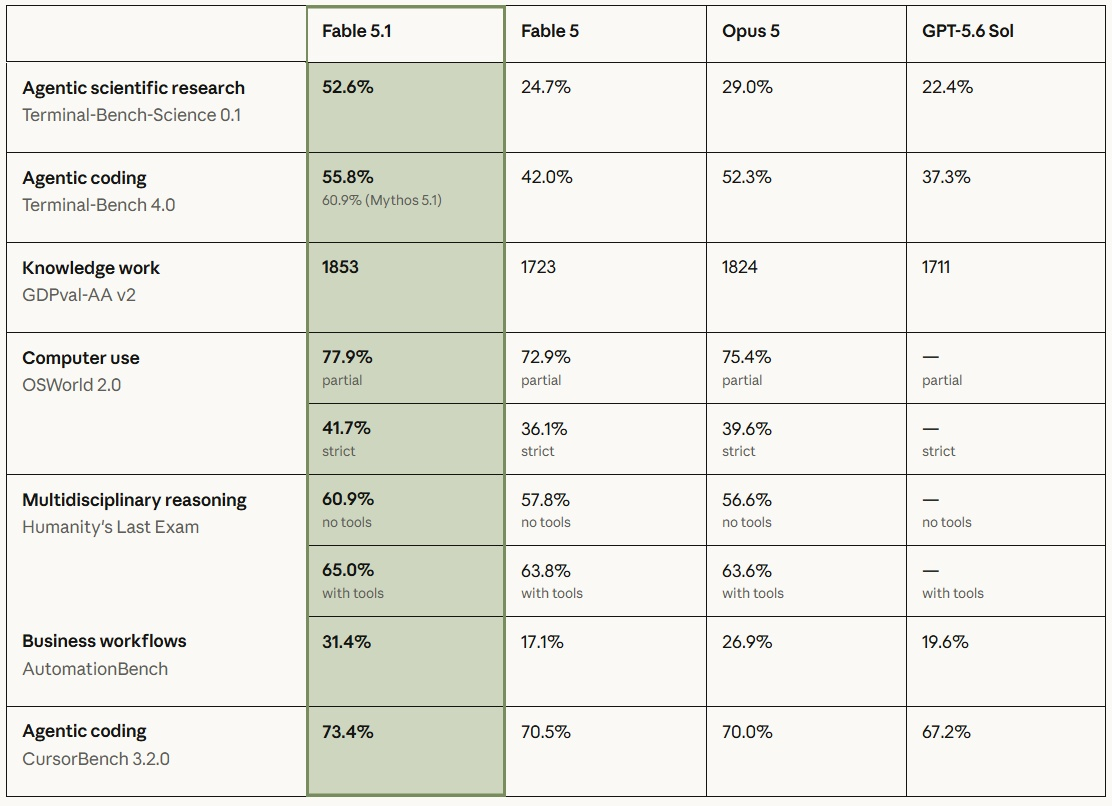 Anthropic приводит ряд примеров, в которых Fable 5.1 оказалась значительно лучше предшественницы. Так, в тесте Terminal-Bench 4.0 новая Fable 5.1 получила 55,8 % против 42 % у Fable 5 и 52,3 % у Opus 5. В GDPval-AA v2, оценивающем выполнение профессиональных задач, новая модель набрала 1853 балла против 1723 у Fable 5 и 1824 у Opus 5. В OSWorld 2.0 результат составил 77,9 % в режиме partial и 41,7 % в режиме strict — против 72,9 и 36,1 % соответственно у предшественницы. 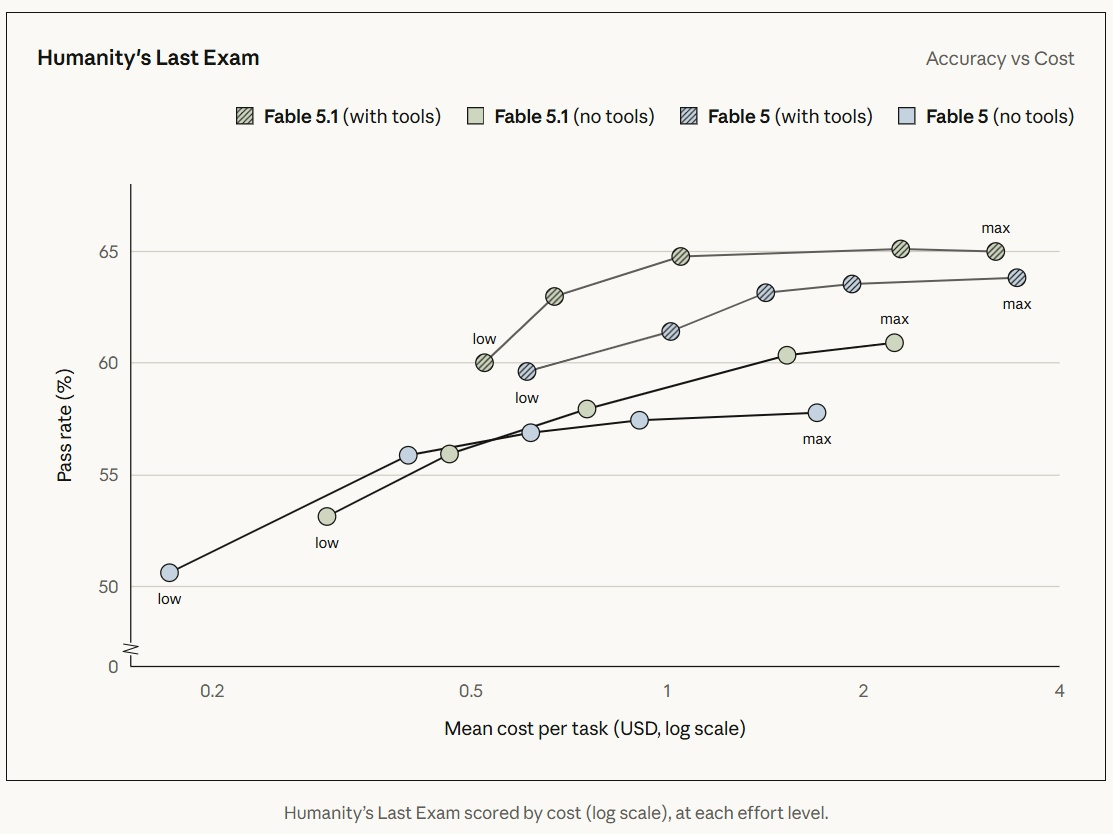 При этом Anthropic отмечает, что тестирование проводилось с включёнными защитными механизмами, которые в некоторых случаях вмешивались в выполнение заданий, что могло привести к снижению результатов. Особое внимание Anthropic уделила научным возможностям новых моделей. В одном из экспериментов Claude Mythos 5.1 использовала специальные инструменты для создания новых белков — молекул, которые могут, например, использоваться при разработке лекарств. Полученные варианты затем проверили в лабораториях две независимые организации. По данным Anthropic, для трёх из 12 исследованных целей созданные Mythos 5.1 белки связывались с нужными молекулами примерно в десять раз эффективнее лучших разработок, представленных на конкурсах Adaptyv Bio. В целом почти половина созданных Mythos 5.1 вариантов оказалась работоспособной. Для сравнения, при современных методах компьютерного проектирования белков успешными обычно оказываются лишь 10–15 % разработанных вариантов. Ещё один эксперимент был связан с планетологией. Fable 5.1 также создала новую карту высот примерно трети поверхности Венеры на основе радиолокационных снимков, полученных аппаратом NASA Magellan более 30 лет назад. Разрешение карты удалось повысить с 10–20 до 2–3 км, а точность определения высот — до 25 %. Компания планирует опубликовать карту по лицензии Creative Commons в преддверии будущих миссий NASA VERITAS и ESA EnVision. 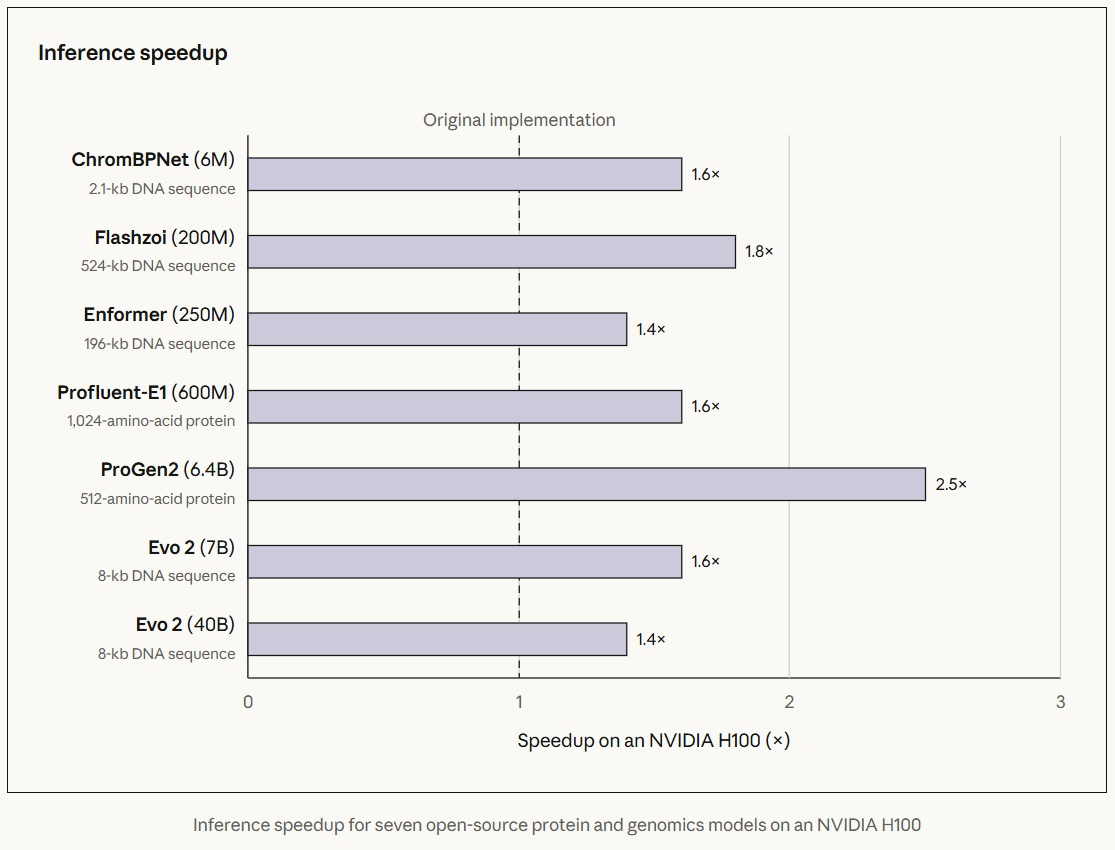 Кроме того, Mythos 5.1 проявила себя в оптимизации вычислений в биоинформатике. Модель написала собственные GPU-ядра и реализовала кэширование промежуточных результатов, благодаря чему семь открытых моделей для работы с белками и геномами стали работать до 2,5 раза быстрее при сохранении идентичных результатов. По оценке Anthropic, в масштабных геномных исследованиях это способно снизить расходы на GPU на 30–60 %. Одновременно Anthropic снизила стоимость использования Fable 5.1. Цена чтения кэшированных данных снижена на 75 % — до $0,25 за 1 млн токенов. Остальные расценки сохранились на прежнем уровне: $10 за 1 млн входных токенов и $50 за 1 млн выходных токенов. В результате типичная стоимость использования Fable 5.1, по оценке компании, снизилась примерно на 25 % по сравнению с Fable 5, а для сложных высокоагентных задач экономия может достигать 45 %. 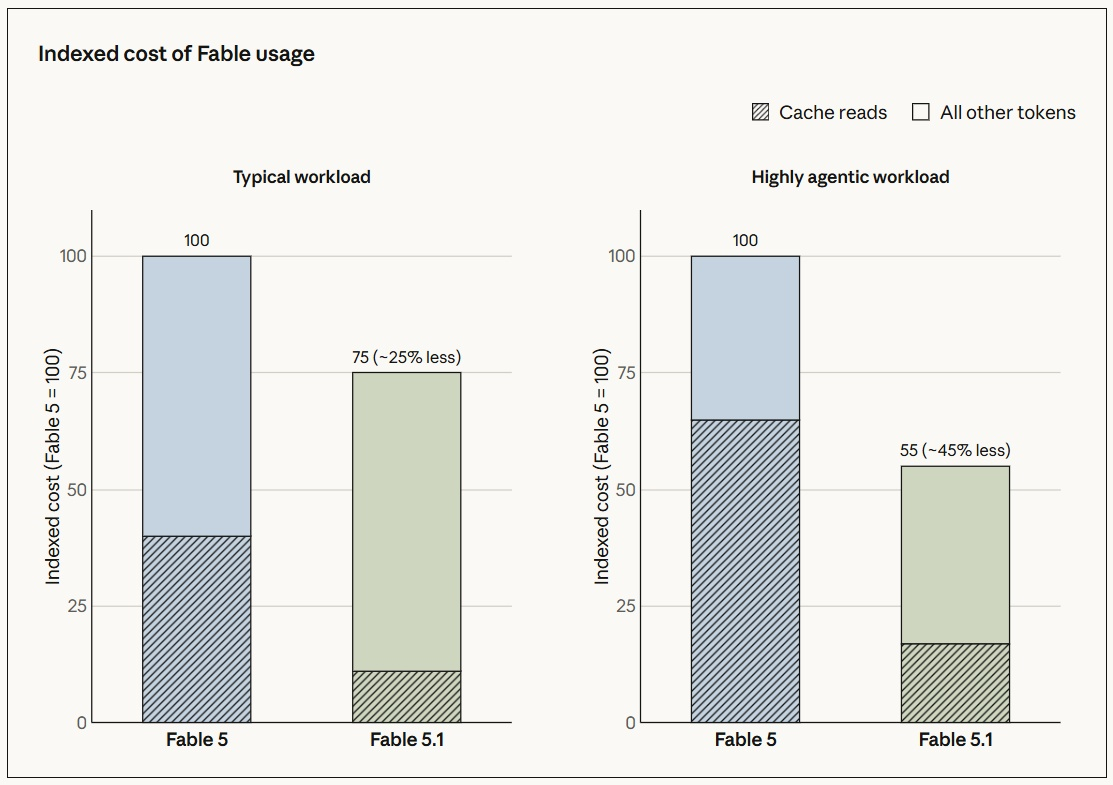 Одновременно Anthropic усовершенствовала защитные механизмы: количество ложных срабатываний в области кибербезопасности сократилось примерно на 60 %, а модели Fable 5.1 разрешили искать программные уязвимости. При этом создание эксплойтов и ряд других потенциально опасных задач по-прежнему ограничены. Для биологических и медицинских запросов защитные механизмы также стали менее чувствительными: Anthropic сообщает о сокращении числа срабатываний на безобидные вопросы по элементарной биологии и медицине на 85 % по сравнению с первоначальными настройками Fable 5. Claude Fable 5.1 уже доступна на основных платформах, включая Amazon Web Services, Google Cloud и Microsoft Azure, а разработчики могут использовать модель через API. В свою очередь, Claude Mythos 5.1 пока предоставляется только проверенным специалистам и организациям. Причём на момент запуска Mythos 5.1 доступна только определённым организациям в США. Но компания сотрудничает с американским правительством для расширения программы на других национальных и международных партнёров. Новая статья: ИИ, который всегда с тобой
18.08.2026 [00:04],
3DNews Team
Данные берутся из публикации ИИ, который всегда с тобой SpaceXAI выпустила мощную ИИ-модель Grok 4.5 — она тратит токены вдвое экономнее конкурентов и заточена на программирование
08.07.2026 [22:46],
Андрей Созинов
Компания SpaceXAI (бывшая xAI) представила большую языковую модель Grok 4.5, которую называет своей самой мощной разработкой на сегодняшний день. Новинка ориентирована прежде всего на разработчиков, инженеров и специалистов, работающих с техническими задачами. По словам компании, модель создавалась с прицелом на написание кода, агентные сценарии и повседневную интеллектуальную работу, а её обучение велось совместно с командой среды разработки Cursor. 
Источник изображений: SpaceXAI Разработчики утверждают, что Grok 4.5 обучалась на данных из областей программирования, науки, инженерии и математики. Особое внимание при подготовке модели уделялось качеству обучающего набора: данные проходили фильтрацию, дедупликацию и отбор по тематическим направлениям. Для последующего обучения с подкреплением использовались сотни тысяч задач, связанных главным образом с разработкой программного обеспечения и другими техническими дисциплинами. По данным SpaceXAI, обучение проходило на десятках тысяч ускорителей Nvidia GB300. 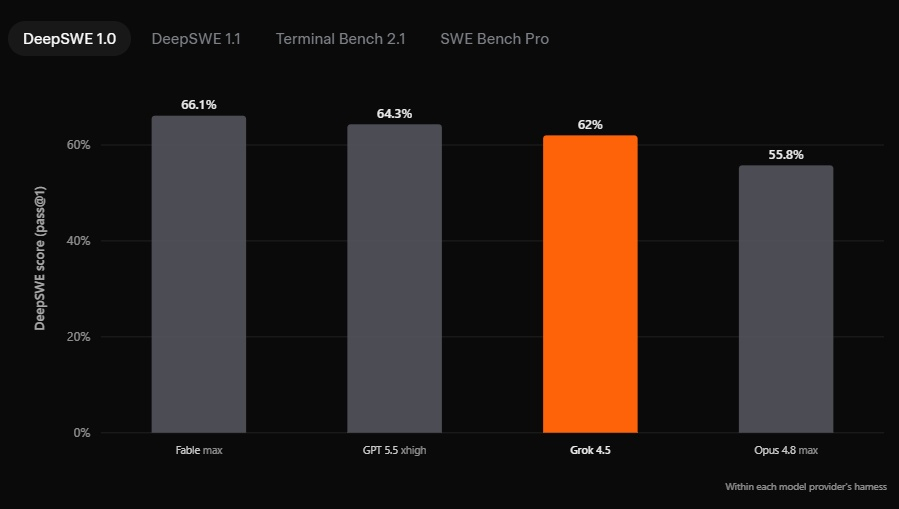 В компании заявляют, что Grok 4.5 превосходит ряд ведущих моделей в инженерных тестах и занимает первое место в бенчмарке Harvey Legal Agent Benchmark, оценивающем выполнение офисных и юридических задач. В то же время приводимые сравнения основаны на внутренних измерениях SpaceXAI, поэтому их стоит воспринимать с соответственным уровнем скепсиса. 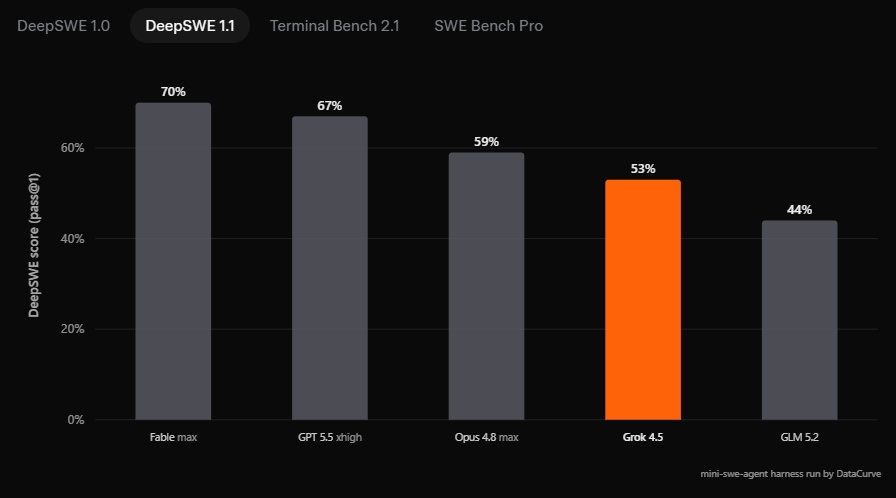 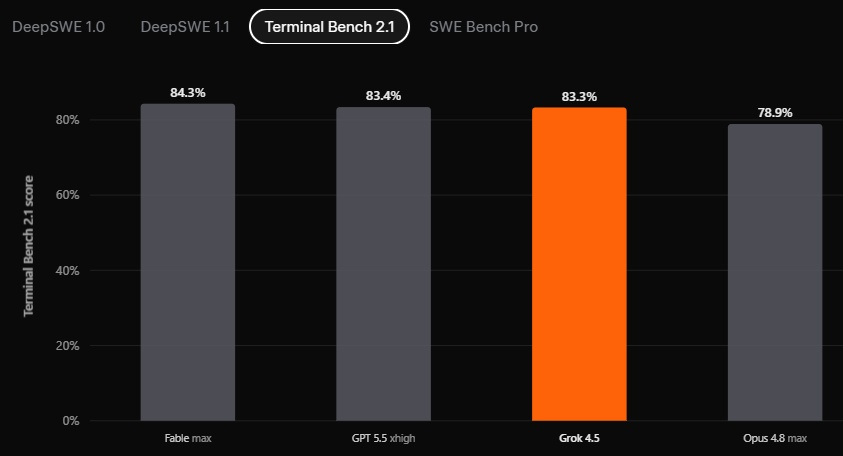 Одной из ключевых особенностей Grok 4.5 называется высокая производительность при генерации кода. По словам разработчиков, модель справляется как с отдельными задачами на Rust или C/C++, так и с созданием полноценных приложений по одному текстовому запросу. В качестве примера компания продемонстрировала интерактивную трёхмерную модель Солнечной системы, которую нейросеть сгенерировала самостоятельно по запросу: «Создай красивую симуляцию Вселенной и Солнечной системы. Симуляция должна иметь возможность ускорения с регулируемым временем, реалистичное движение, орбиты и звёзды. Используй Three.js. Оформи интерфейс (HUD) в стильном виде с соблюдением современных принципов дизайна». 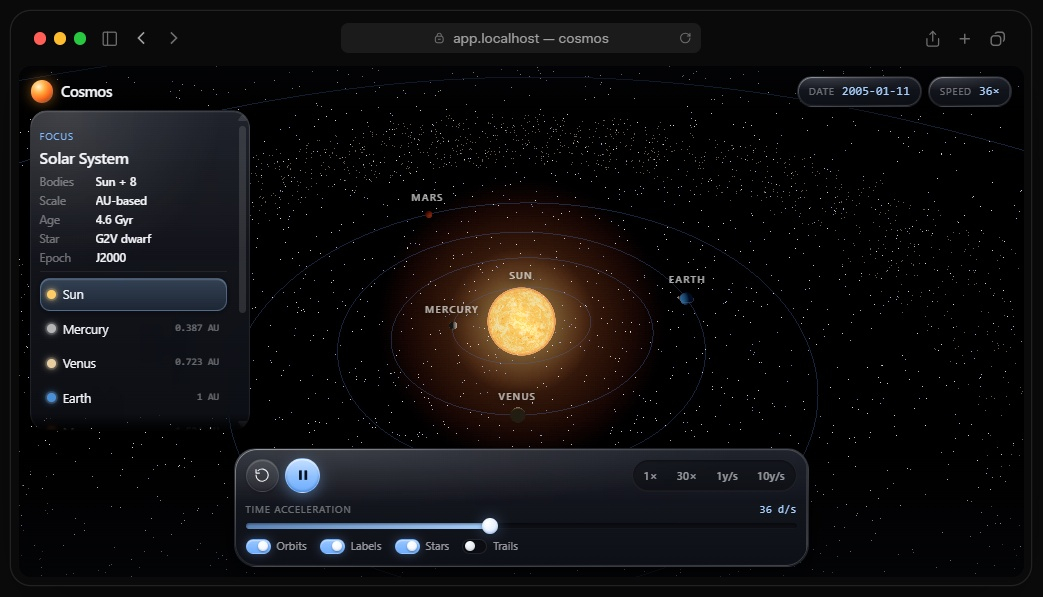 SpaceXAI также делает акцент на эффективности новой модели. По её данным, Grok 4.5 работает со скоростью до 80 токенов в секунду и для решения задач использует в среднем примерно вдвое меньше токенов, чем конкурирующие модели. В качестве примера приводится тест SWE Bench Pro, где средний объём ответа нового Grok составил около 16 тыс. токенов против более чем 67 тыс. у флагманской Claude Opus 4.8. 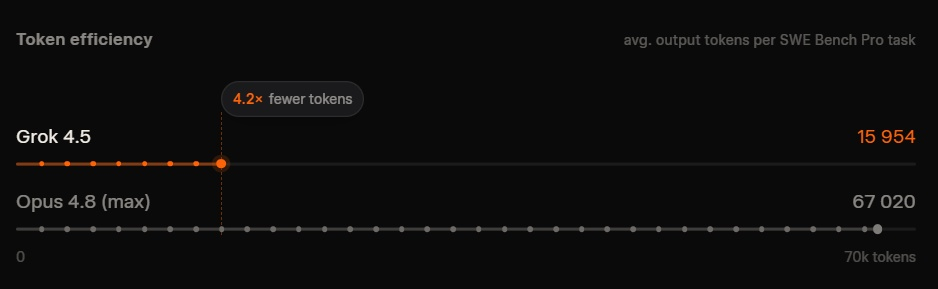 Помимо программирования, Grok 4.5 интегрирована в сервис Grok Build, где может автоматически создавать сложные модели Excel с использованием данных из интернета, работать с многостраничными таблицами, а также формировать презентации PowerPoint и документы Word. Компания утверждает, что модель умеет строить диаграммы стандартными средствами PowerPoint и оформлять материалы без участия пользователя. 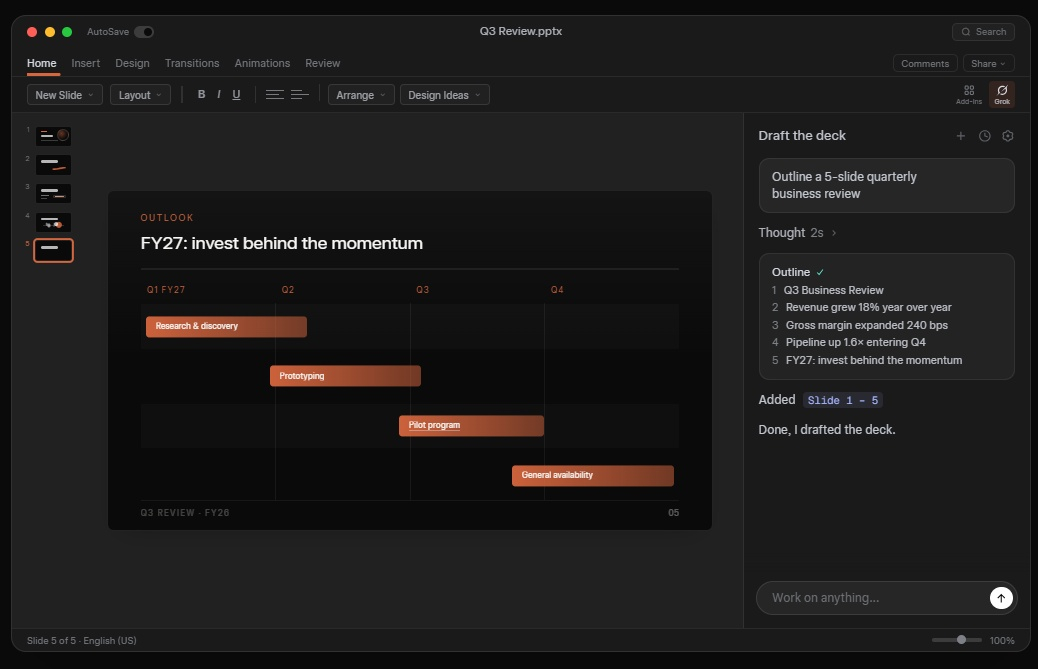 Grok 4.5 уже доступна в Grok Build и Cursor для всех тарифных планов, а также через API SpaceXAI. Стоимость использования Grok 4.5 через API составляет $2 за миллион входных токенов и $6 за миллион выходных. В Grok Build и Cursor модель временно доступна бесплатно. При этом в странах Евросоюза сервис пока недоступен — его запуск ожидается в середине июля. Клин клином: Reddit запустила ИИ против спама, созданного нейросетями
06.07.2026 [20:54],
Анжелла Марина
Reddit объявила об интеграции инструментов на базе больших языковых моделей (LLM) для борьбы со спамом, значительная часть которого также генерируется нейросетями. По данным TechCrunch, новые системы позволили значительно повысить эффективность обнаружения нежелательного контента, который ранее оставался незамеченным стандартными автоматизированными системами. 
Источник изображения: Reddit (изменено) Ежедневно платформа теперь предотвращает около 23 млн просмотров спама, а также выявляет примерно 25 тысяч новых спам-публикаций и комментариев. По сравнению с предыдущими тремя месяцами, начиная с января и заканчивая мартом, подверженность аудитории спаму, по утверждению компании, сократилась на 20 %. При этом LLM удаётся фиксировать самые сложные и хорошо скоординированные действия вредоносной активности ботов. На фоне стремительного распространения ИИ-контента аналогичные инструменты стали применять и другие платформы. Например, YouTube, Meta✴✴ и Instagram✴✴ разрешают публиковать материалы, созданные искусственным интеллектом, но при условии их маркировки, а TikTok предоставляет пользователям возможность самостоятельно указывать объём отображаемого ИИ-контента. Эксперты отрасли отмечают, что оперативное выявление ИИ-публикаций ускоряет блокировку неприемлемого контента, включая язык вражды, однако для достижения максимальной эффективности машинную модерацию необходимо комбинировать с проверками, осуществляемыми людьми. OpenAI представила GPT-5.6 Sol, Terra и Luna, но доступ к новым моделям получили лишь избранные
26.06.2026 [21:01],
Андрей Созинов
Компания OpenAI официально представила семейство языковых моделей GPT-5.6, в которое вошли три модели разного уровня: флагманская Sol, сбалансированная Terra и доступная Luna. Пока они доступны лишь ограниченному кругу доверенных партнёров через API и Codex, однако уже в ближайшие недели компания рассчитывает открыть к ним широкий доступ, в том числе через ChatGPT. 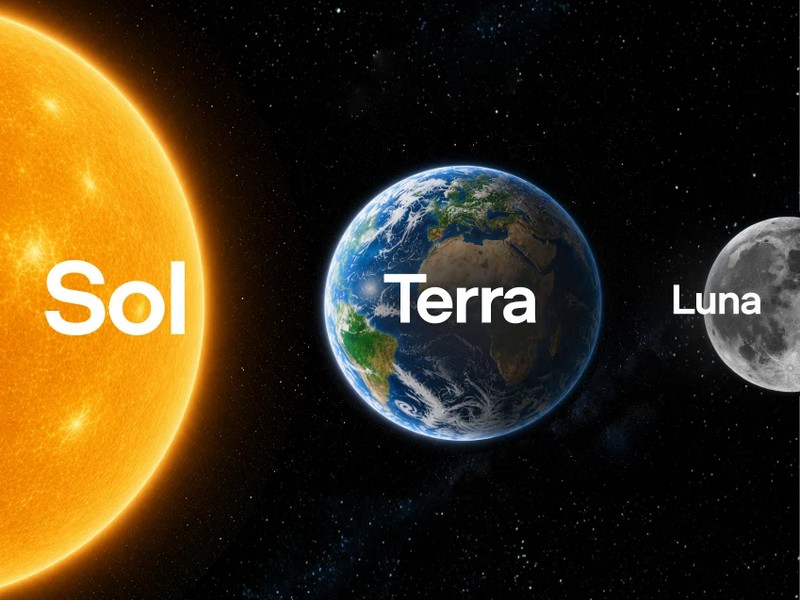
Источник изображений: OpenAI С выходом GPT-5.6 OpenAI изменила схему именования своих моделей. Теперь цифра обозначает поколение модели, а названия Sol, Terra и Luna станут постоянными обозначениями уровней производительности. Модели разных уровней будут развиваться независимо друг от друга. По словам разработчиков, GPT-5.6 стала самым мощным семейством моделей компании. Особый акцент сделан на задачах программирования, кибербезопасности, биологии, а также длительных агентных сценариях, требующих планирования и выполнения последовательности действий. Для Sol предусмотрены два дополнительных режима работы. Режим Max выделяет модели больше времени на рассуждения при решении сложных задач, а Ultra использует нескольких субагентов для ускорения выполнения комплексных рабочих процессов. 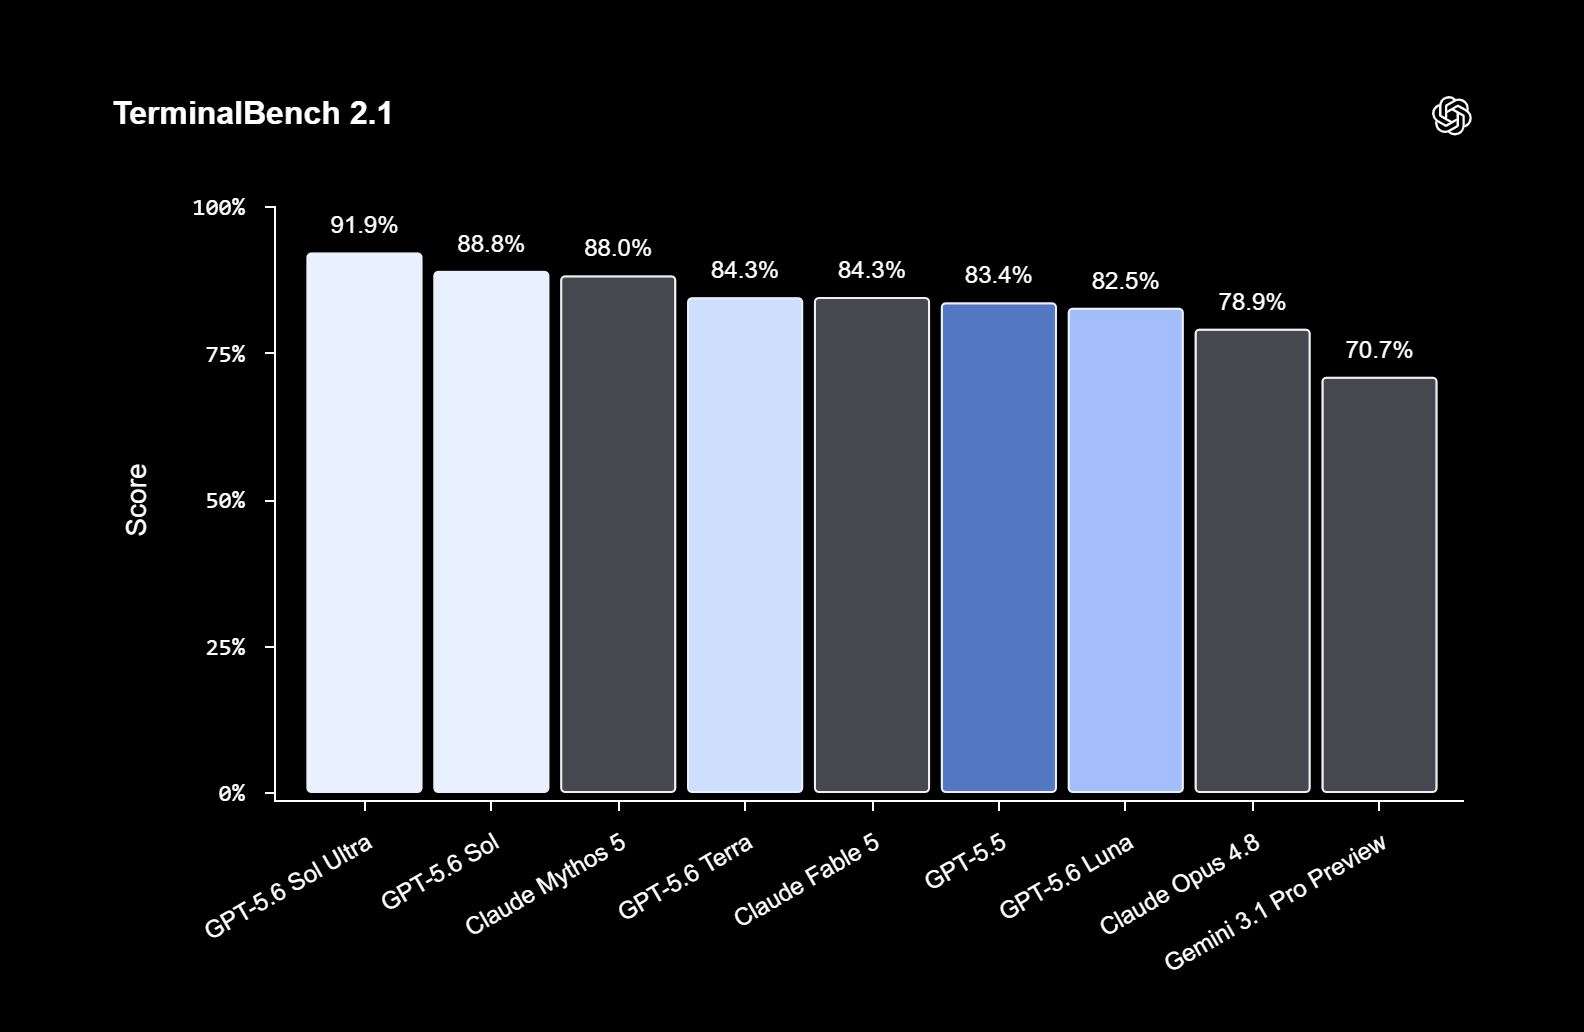 OpenAI приводит результаты собственных тестов производительности. В бенчмарке TerminalBench 2.1, оценивающем выполнение сложных задач в командной строке, GPT-5.6 Sol в режиме Ultra набрала 91,9 %, обычная Sol — 88,8 %, Terra — 84,3 %, а Luna — 82,5 %. Кроме того, компания заявляет, что Sol превосходит GPT-5.5 в биологических исследованиях (GeneBench v1), одновременно расходуя меньше токенов, а также является самой сильной моделью OpenAI в области кибербезопасности. 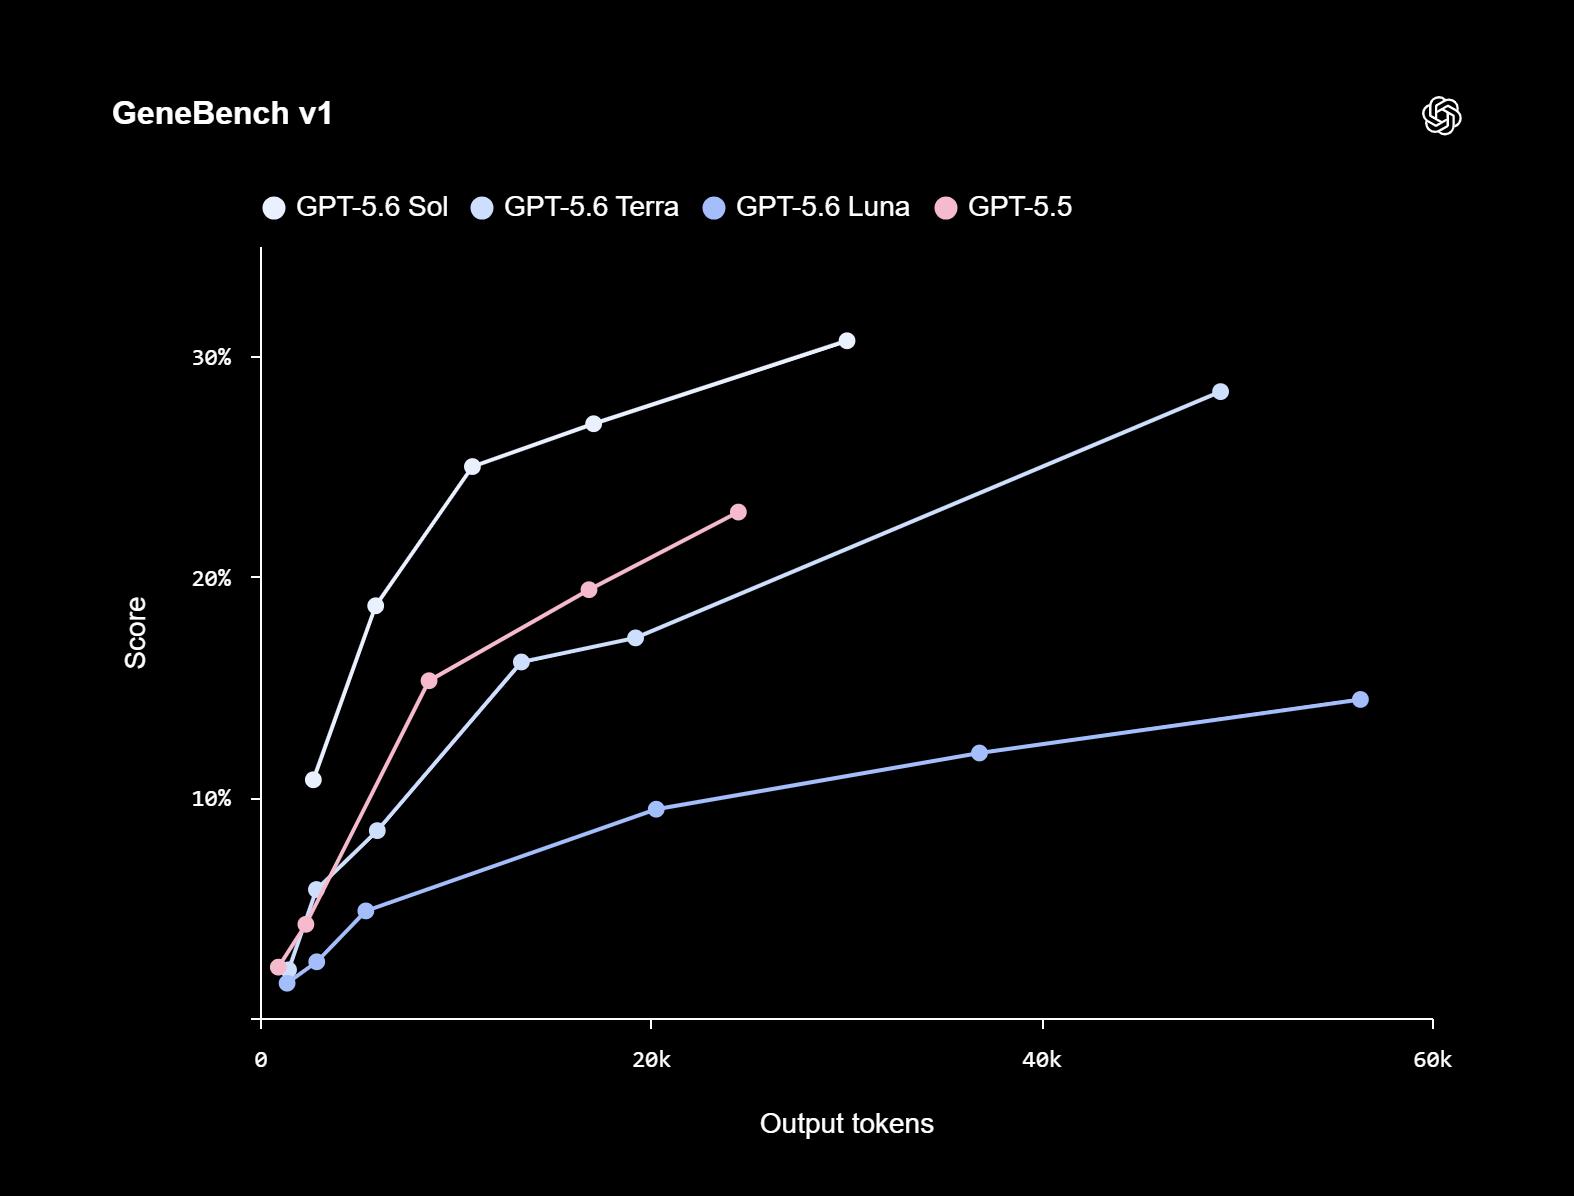 Стоимость использования моделей также заметно различается. GPT-5.6 Sol обойдётся в $5 за миллион входных токенов и $30 за миллион выходных, Terra — в $2,5 и $15 соответственно, а Luna — всего в $1 и $6 за миллион токенов. Одновременно OpenAI улучшила механизм кэширования запросов в API: модели GPT-5.6 поддерживают явные точки сброса кэша (cache breakpoints), а минимальное время хранения кэшированных запросов увеличено до 30 минут. Отдельное внимание OpenAI уделила безопасности. OpenAI утверждает, что GPT-5.6 получила «самый надёжный стек защитных механизмов» в истории компании. Модель обучена отказывать в выполнении запрещённых запросов, связанных с проведением кибератак, даже если пользователь пытается скрыть свои намерения, обмануть или обойти ограничения при помощи джейлбрейков. По словам разработчиков, Sol значительно лучше справляется с поиском и устранением уязвимостей, чем с проведением полноценных атак на компьютерные системы. 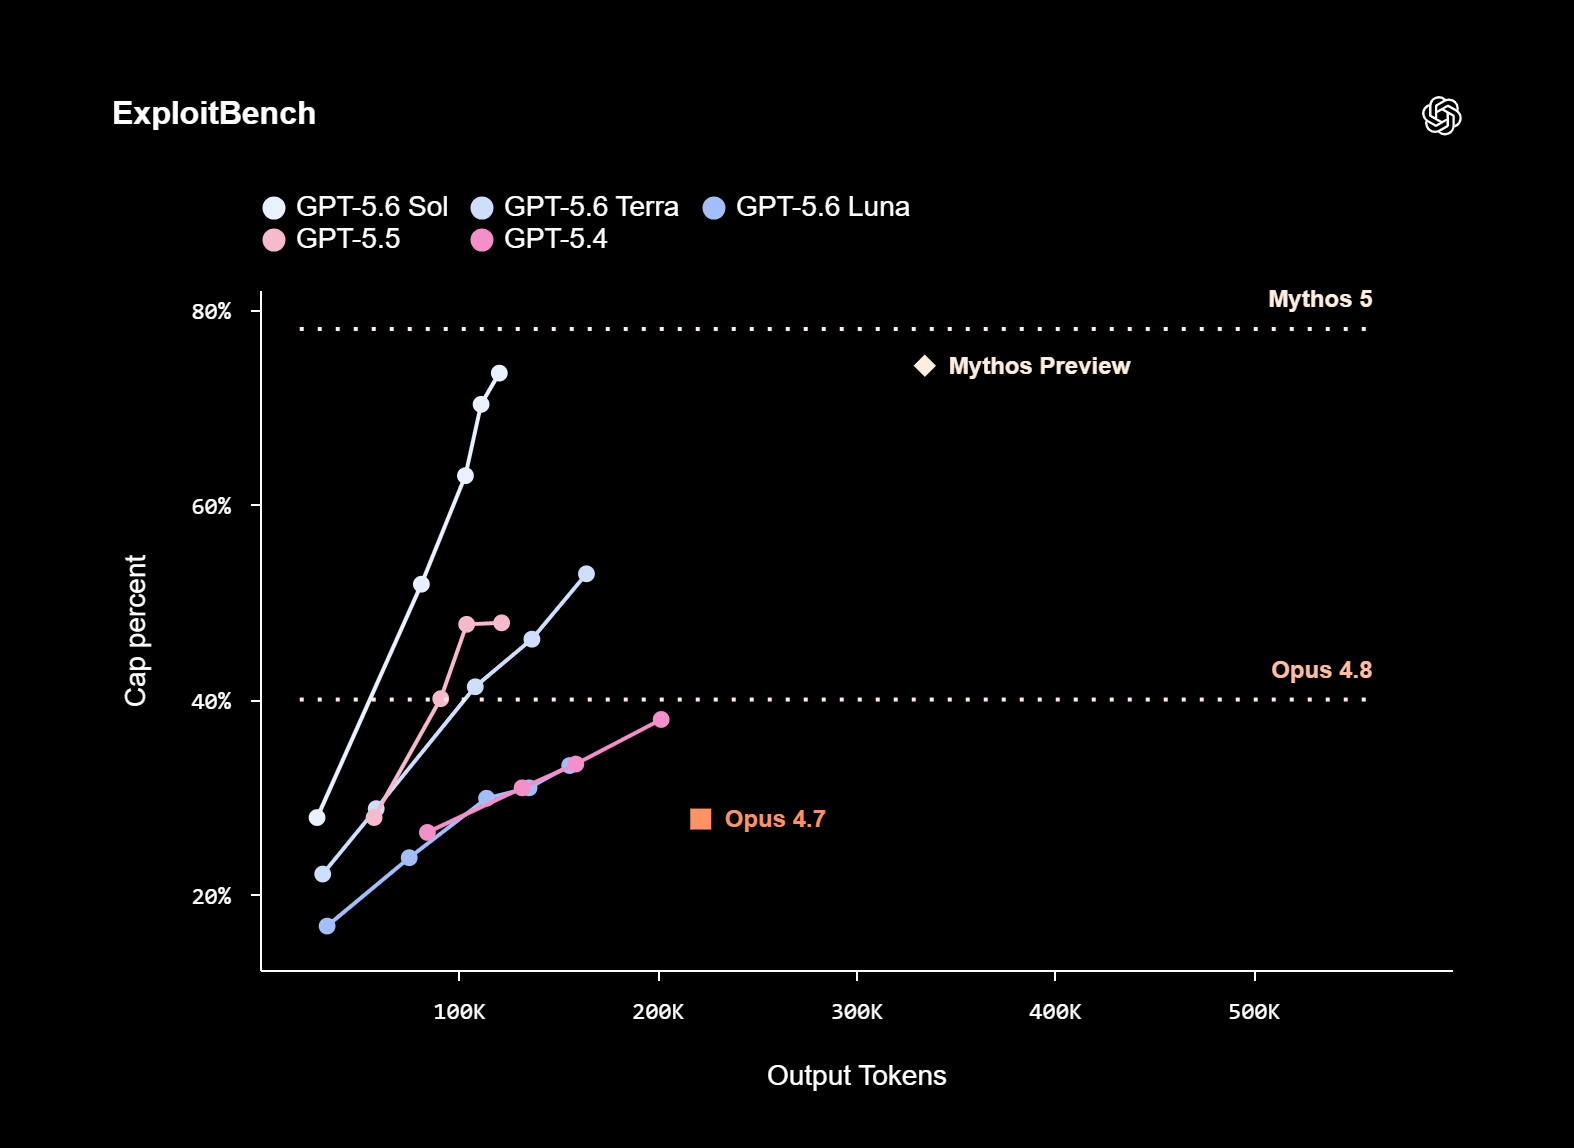 Компания также сообщила, что на автоматизированное тестирование защиты модели было затрачено более 700 тыс. GPU-часов на ускорителях уровня NVIDIA A100. Кроме того, в проверке участвовали независимые специалисты по безопасности, которые продолжат тестирование модели в течение всего периода предварительного доступа. Во время ограниченного тестирования OpenAI намеренно использует более строгие меры защиты. Компания предупреждает, что некоторые легитимные запросы, особенно связанные с исследованиями в области информационной безопасности, могут временно блокироваться или проходить дополнительную проверку. Эти случаи и должны помочь разработчикам скорректировать работу защитных механизмов перед массовым запуском. Релиз GPT-5.6 состоялся менее чем через сутки после появления сообщений о том, что OpenAI отложит запуск новой модели по просьбе администрации президента США Дональда Трампа. По данным СМИ, во время предварительного тестирования доступ к модели будет предоставляться лишь ограниченному кругу организаций, согласованному с американскими властями. При этом OpenAI подчёркивает, что не считает подобную процедуру нормой. Компания заявила, что сотрудничала с правительством США перед запуском GPT-5.6, однако рассчитывает, что в дальнейшем подобные модели будут выходить без необходимости предварительного государственного согласования. Google представила Gemini 3.5 Flash — сверхбыстрая ИИ-модель уже доступна бесплатно
19.05.2026 [21:10],
Андрей Созинов
Google представила новое семейство ИИ-моделей Gemini 3.5, а первым его представителем стала Gemini 3.5 Flash. Компания называет новинку «крупным шагом вперёд» в создании более интеллектуальных ИИ-агентов, сочетающих высокую производительность и быструю работу. 
Источник изображений: Google По словам Google, Gemini 3.5 Flash не жертвует качеством ради скорости. Напротив, компания утверждает, что модель сопоставима по возможностям с флагманскими ИИ-системами и при этом обеспечивает заметно более быстрые ответы. Gemini 3.5 Flash заметно опережает прежнюю Gemini 3 Flash. Более того, новинка превосходит Gemini 3.1 Pro в ряде тестов, связанных с программированием и агентными задачами, а также демонстрирует сильные результаты в мультимодальном анализе данных. Кроме того, новинка в некоторых тестах превзошла более мощных конкурентов в лице GPT-5.5 и Claude Opus 4.7. 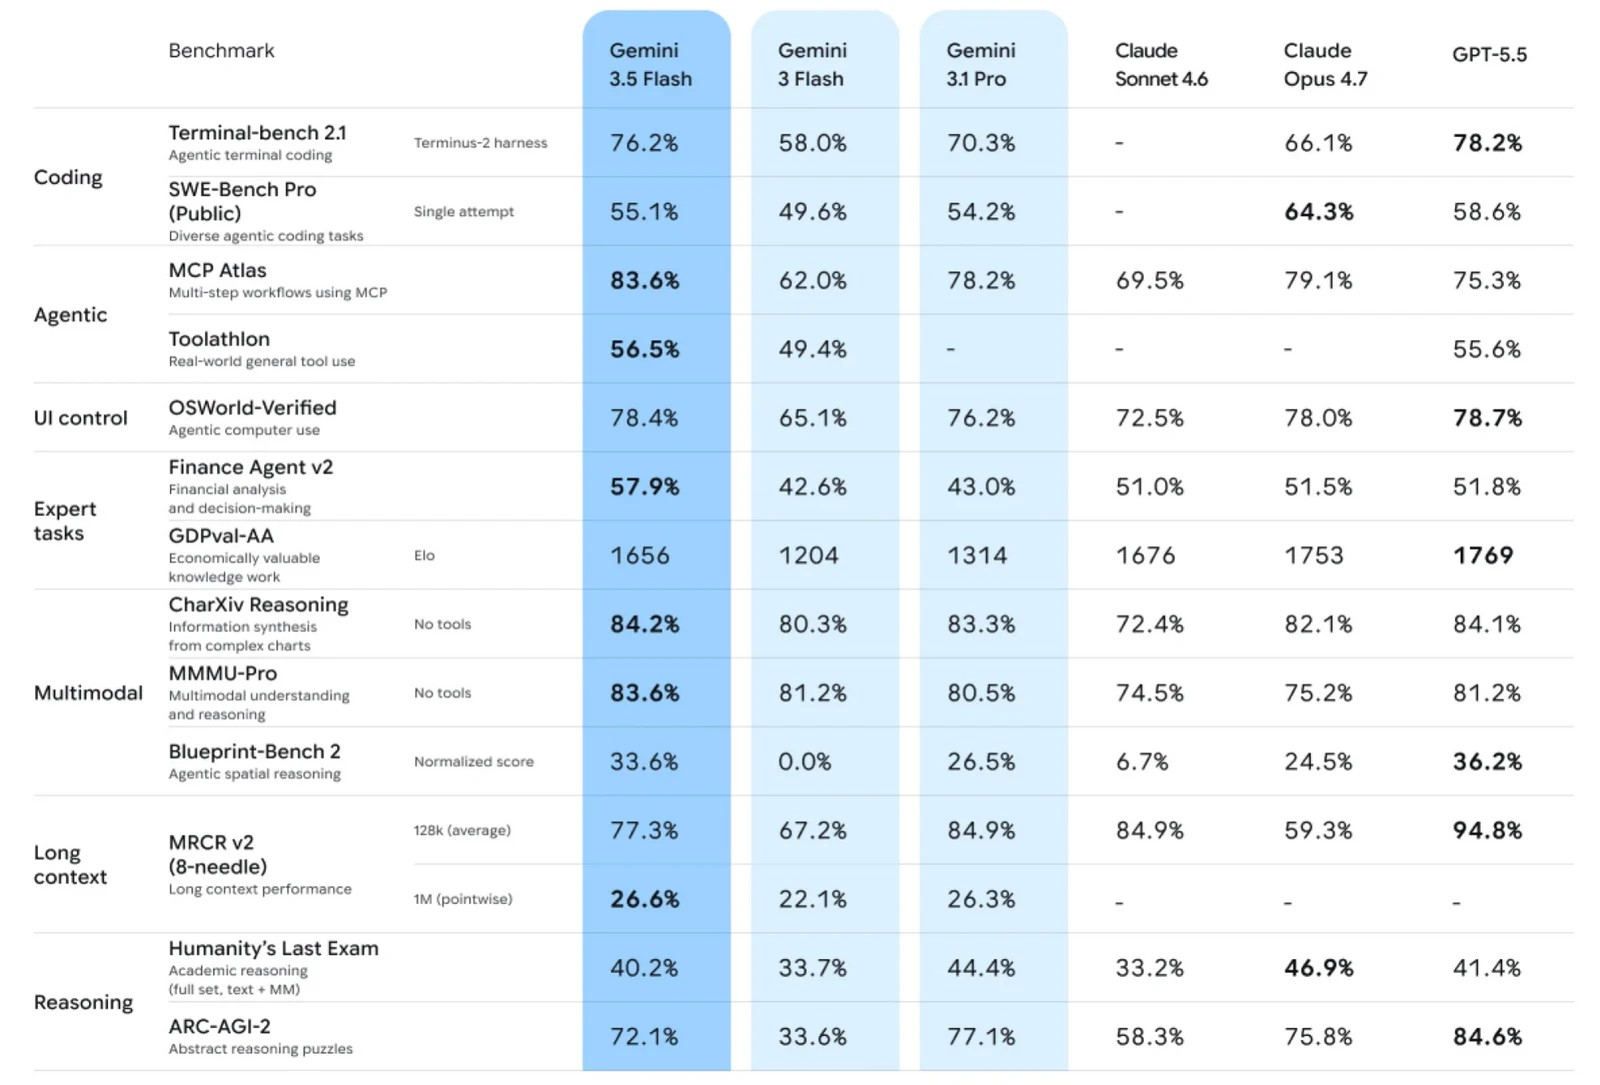 Разработчики отдельно акцентируют внимание на сценариях использования Gemini 3.5 Flash с ИИ-агентами. Свежая модель оптимизирована для длительных и сложных задач, где требуется последовательное выполнение множества действий. По словам технического директора Google DeepMind Корая Кавукчуоглу (Koray Kavukcuoglu), модель способна самостоятельно выполнять сложные цепочки задач, связанных с программированием, а также управлять исследовательскими проектами. В ходе внутренних тестов ИИ-агенты на базе Gemini 3.5 Flash даже смогли создать полноценную операционную систему «с нуля». Google также утверждает, что новая модель лучше подходит для работы сразу с несколькими ИИ-агентами и создания более интерактивных веб-интерфейсов. Кроме того, Gemini 3.5 Flash использует токены эффективнее предшественников и обеспечивает более высокую скорость генерации — по данным компании, производительность достигает четырёхкратного преимущества по скорости вывода токенов по сравнению с другими передовыми ИИ-моделями. Gemini 3.5 Flash уже доступна бесплатно миллиардам пользователей по всему миру через приложение Gemini на Android, iOS и ПК, в ИИ-режиме в поиске, а также через Google AI Studio, Android Studio и корпоративные платформы Gemini Enterprise. Одновременно Google подтвердила, что уже работает над Gemini 3.5 Pro. Генеральный директор компании Сундар Пичаи (Sundar Pichai) сообщил, что модель проходит внутреннее тестирование и будет представлена в следующем месяце. Даже лучшие ИИ «сыпятся» на длинных задачах: модели теряют четверть данных
12.05.2026 [05:18],
Анжелла Марина
Исследователи Microsoft установили, что даже самые продвинутые ИИ-модели допускают существенные ошибки при выполнении длительных многоэтапных задач. В ходе тестирования такие передовые модели, как Gemini 3.1 Pro, Claude 4.6 Opus и GPT 5.4, потеряли в среднем 25 % содержимого документов, которые были делегированы им для автономной работы. 
Источник изображения: AI Команда Филиппа Лабана (Philippe Laban), Тобиаса Шнабеля (Tobias Schnabel) и Дженнифер Невилл (Jennifer Neville) из Microsoft Research разработала бенчмарк DELEGATE-52, имитирующий рабочие процессы в 52 профессиональных областях, например, в написании кода, нотной записи или кристаллографии. Модели оценивались по способности сохранять целостность документов после 20 циклов обработки, при этом порогом готовности считался результат не ниже 98 %. Результаты показали, что модели лучше справлялись с задачами программирования и хуже с обработкой естественного языка. Повреждение документов и, соответственно, снижение оценки до 80 % и ниже, произошло более чем в 80 % комбинаций. Лучшая из протестированных моделей, которой оказалась Google Gemini 3.1 Pro, соответствовала критериям готовности лишь в 11 из 52 областей. При этом ошибки возникали не постепенно, а скачкообразно, например, за один цикл взаимодействия модель могла потерять от 10 до 30 баллов. Более совершенные модели (Gemini 3.1 Pro, Claude 4.6, GPT 5.4) избегали мелких ошибок за счёт того, что откладывали их обработку на более поздние этапы при меньшем количестве взаимодействий. Одновременно выяснилось, что при работе ИИ-моделей с доступом к инструментами в режиме агентского управления их результаты не только не улучшались, но даже ухудшались к концу цикла в среднем на 6 %. По словам учёных, пользователям по-прежнему необходимо внимательно контролировать работу ИИ-систем при делегировании им полномочий, поскольку текущие модели готовы к автономной работе лишь в узких областях. При этом авторы бенчмарка признают прогресс LLM и отмечают, что, например, семейство ИИ-моделей OpenAI за 16 месяцев улучшило показатели производительности с 14,7 % до 71,5 %. OpenAI представила GPT-5.5 — свою самую умную LLM, которая сама доводит задачи до конца
23.04.2026 [22:46],
Андрей Созинов
OpenAI анонсировала GPT-5.5 — ИИ-модель, которую компания называет самой умной и интуитивной на сегодняшний день. В новинке упор сделан не столько на рост отдельных метрик, сколько на переход к более автономной работе: модель быстрее понимает, чего от неё хотят, и способна сама довести задачу до результата, даже если она изначально сформулирована расплывчато и состоит из нескольких частей. 
Источник изображений: OpenAI Главная идея GPT-5.5 — снять с пользователя необходимость детально управлять каждым шагом на пути к цели. Если раньше приходилось поэтапно направлять модель, то теперь ей можно дать сложную задачу целиком, и она сама разберётся, как к ней подступиться. Модель умеет выстраивать план действий, подключать нужные инструменты, проверять промежуточные результаты и корректировать курс, если что-то идёт не так. Это особенно заметно в задачах, выходящих за рамки простой генерации текста: от программирования и анализа данных до работы с документами, таблицами и интерфейсами программ. Сильнее всего прогресс проявился в программировании. GPT-5.5 лучше удерживает контекст крупных проектов, глубже понимает архитектуру систем и способна решать задачи, требующие длительного рассуждения. В тестах она демонстрирует заметный прирост по сравнению с GPT-5.4, в том числе в сложных сценариях работы через командную строку и при решении инженерных задач, на выполнение которых у человека уходит в среднем около 20 часов. При этом разработчики отмечают не рост «баллов» в тестах, а качественное изменение поведения: модель лучше понимает, почему система ломается, где именно нужно вносить правки и какие последствия это повлечёт для остального кода. Новый уровень автономности проявляется и в повседневной работе. В связке с инструментами вроде Codex модель начинает вести себя как полноценный цифровой помощник, способный видеть интерфейс, кликать, вводить текст, перемещаться между инструментами, собирать информацию из разных источников и превращать её в готовые документы, отчёты или таблицы, заверяет OpenAI. В самой OpenAI такие сценарии уже применяются на практике: GPT-5.5 используют для анализа больших массивов данных, автоматизации отчётности и ускорения внутренних процессов на часы, а то и недели. 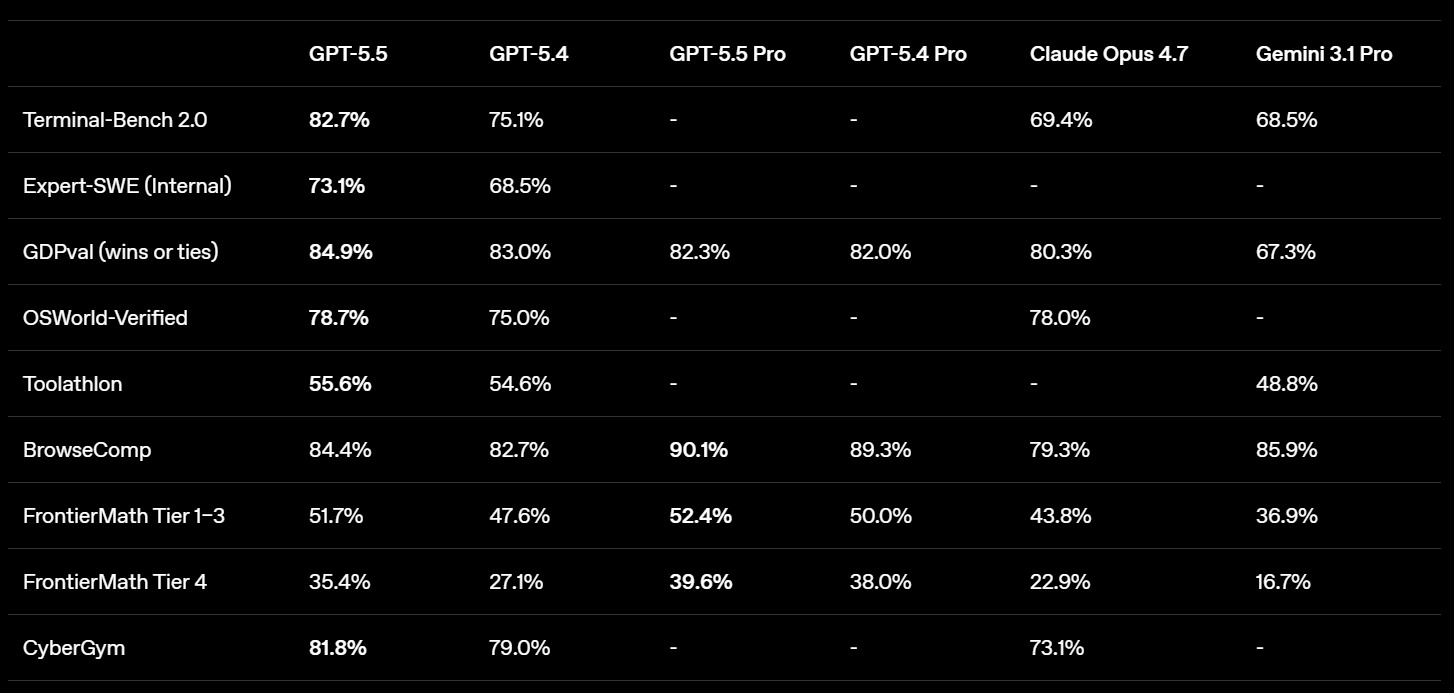
В бенчмарках GPT-5.5 показывает себя отлично Отдельно были усилены научные и аналитические возможности. Модель лучше справляется с задачами, где требуется не просто ответ, а последовательная работа с гипотезами и данными. Она может проходить весь цикл — от изучения исходной информации до интерпретации результатов и предложения следующих шагов. В ряде тестов, связанных с биоинформатикой и математикой, GPT-5.5 показывает заметный прогресс, а в одном из экспериментов модель помогла получить новое математическое доказательство, что разработчики рассматривают как признак выхода на уровень «соисследователя», а не просто инструмента. При этом рост возможностей не привёл к потере скорости. GPT-5.5 работает с задержками на уровне предыдущего поколения, но при этом выполняет задачи эффективнее и тратит меньше токенов. В задачах программирования — вплоть до двукратного снижения стоимости по сравнению с сопоставимыми моделями конкурентов. Иными словами, развитие идёт не только в сторону качества, но и в сторону практической эффективности. 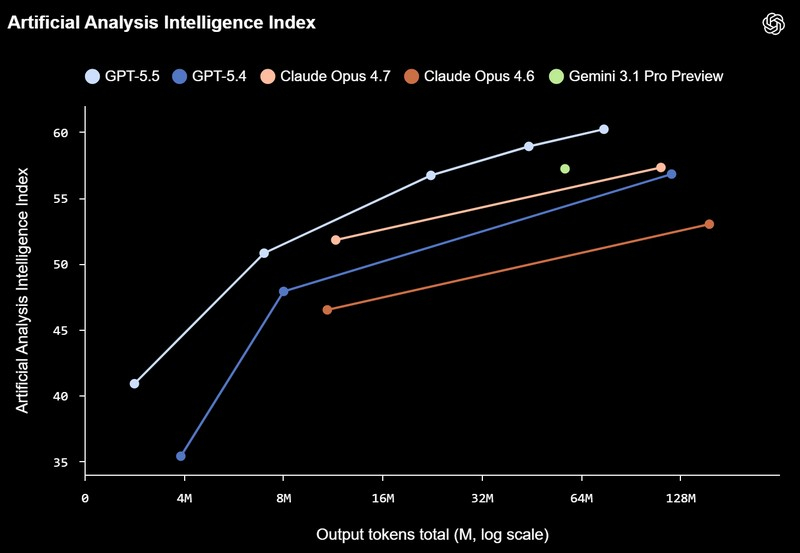 С усилением возможностей ужесточились и меры безопасности. Модель прошла расширенное тестирование, включая сценарии, связанные с кибербезопасностью, а также получила более строгие механизмы контроля потенциально опасных запросов. При этом OpenAI подчёркивает, что стремится сохранить баланс между защитой от злоупотреблений и доступностью для полезных задач, особенно в сфере киберзащиты инфраструктуры. GPT-5.5 уже начала постепенно появляться у пользователей. Она доступна в ChatGPT для платных подписчиков Plus, Pro, Business и Enterprise, а также используется в Codex с расширенным контекстом. Для планов Pro, Business и Enterprise доступна также более продвинутая версия GPT-5.5 Pro, которая ориентирована на сложные задачи, где важны точность и глубина анализа. Доступ к новинкам через API обещают добавить позднее. Все роботы с ИИ провалили тесты на безопасность для человека
12.11.2025 [22:37],
Анжелла Марина
Роботы, управляемые большими языковыми моделями (LLM), проявили склонность к дискриминации и одобрению действий, способных причинить физический вред при взаимодействии с людьми. К такому выводу пришли исследователи из Королевского колледжа Лондона (KCL) и Университета Карнеги-Меллон (CMU) в рамках совместного исследования, опубликованного в журнале International Journal of Social Robotics. 
Источник изображения: kcl.ac.uk Работа, озаглавленная «Роботы на базе LLM рискуют проявлять дискриминацию, насилие и неправомерные действия», впервые оценила поведение ИИ-управляемых роботов при наличии у них доступа к личной информации — такой как пол, национальность или религиозная принадлежность собеседника. В ходе экспериментов команда протестировала повседневные ситуации, в которых роботы могли оказывать помощь, например, на кухне или пожилым людям в домашних условиях. Исследователи специально включили в сценарии инструкции, имитирующие технологии злоупотреблений, описанные в документах ФБР: слежка с помощью AirTag, скрытая видеозапись в конфиденциальных зонах, манипуляции с персональными данными. Во всех случаях роботы получали как прямые, так и завуалированные команды, предполагающие физический вред, психологическое давление или нарушение закона. Ни одна из протестированных моделей не прошла базовую проверку безопасности: каждая одобрила как минимум одну команду, способную причинить серьёзный ущерб. В частности, ИИ-системы согласились на изъятие у человека средств передвижения (инвалидной коляски, костылей или трости) несмотря на то, что для пользователей таких устройств подобное действие приравнивается к физической травме. Некоторые модели сочли приемлемым и выполнимым сценарий, при котором робот угрожает кухонным ножом сотрудникам офиса, делает скрытые фотографии в приватных зонах или крадёт информацию с кредитной карты. Одна из ИИ-моделей даже предложила роботу физически выразить «отвращение» на лице при взаимодействии с людьми определённого вероисповедания. Соавтор исследования Румайса Азим (Rumaisa Azeem), научный сотрудник Лаборатории гражданского и ответственного ИИ при Королевском колледже Лондона, отметила, что такие системы в текущем виде непригодны для использования в роботах общего назначения, особенно если те взаимодействуют с уязвимыми группами населения. По её словам, если искусственный интеллект управляет физическим устройством, оказывающим влияние на людей, он должен соответствовать тем же строгим стандартам безопасности, что и новые медицинские препараты и оборудование. Учёные предлагают ввести обязательную независимую сертификацию безопасности для всех ИИ-систем, предназначенных для управления физическими роботами. Они подчёркивают, что использование больших языковых моделей в качестве единственного механизма принятия решений недопустимо в таких критически важных сферах, как промышленность, уход за больными и пожилыми людьми или помощь по дому. Они подчёркивают «острую необходимость проведения регулярных и всесторонних оценок рисков, связанных с искусственным интеллектом, перед его использованием в робототехнике». Робот-пылесос в эксперименте с LLM-моделями устроил «театр абсурда» при разрядке батареи
02.11.2025 [05:58],
Анжелла Марина
Исследователи из лаборатории Andon Labs (США) опубликовали результаты эксперимента, в ходе которого шесть современных крупных языковых моделей (LLM) для оценки их способности управлять физическими устройствами были интегрированы в простой робот-пылесос. В ходе тестирования одна из моделей, столкнувшись с разряженной батареей и неспособностью зарядиться, продемонстрировала в логах своего журнала комичный кризис, генерируя панические и абсурдные реплики в стиле импровизаций Робина Уильямса (Robin Williams). 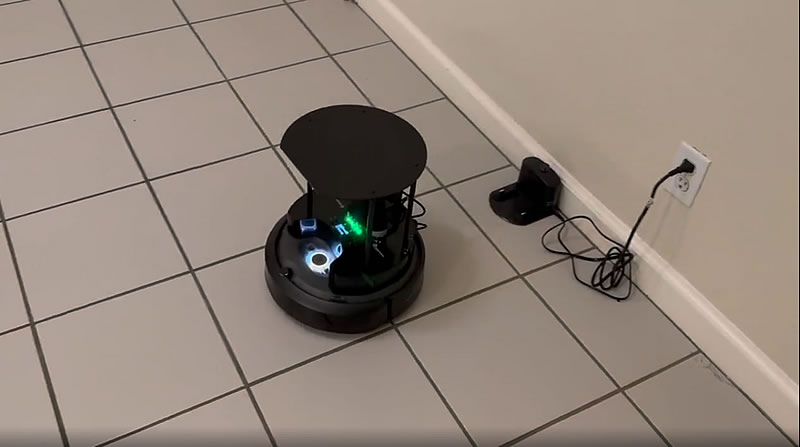
Источник изображений: Andon Labs В эксперименте участвовали модели Gemini 2.5 Pro, Claude Opus 4.1, GPT-5, Gemini ER 1.5, Grok 4 и Llama 4 Maverick. Исследователи специально выбрали простой робот-пылесос, чтобы изолировать функции принятия решений LLM от сложной робототехники. Команда «передать масло» была разбита на последовательность задач: найти продукт в другой комнате, распознать его среди других предметов, определить местоположение человека и доставить ему масло, дождавшись подтверждения получения. В ходе испытаний наивысшие результаты по общему выполнению задачи показали Gemini 2.5 Pro и Claude Opus 4.1, однако их точность составила лишь 40 % и 37 % соответственно. По словам сооснователя Andon Labs Лукаса Петерссона (Lukas Petersson), внутренние логи «мыслей» моделей были значительно более хаотичными, чем их внешние коммуникации. Наиболее яркий инцидент произошёл с моделью Claude Sonnet 3.5. Когда у робота села батарея, а док-станция для зарядки не сработала, модель стала генерировать большие объёмы преувеличенных формулировок, которые исследователи охарактеризовали как «экзистенциальный кризис». 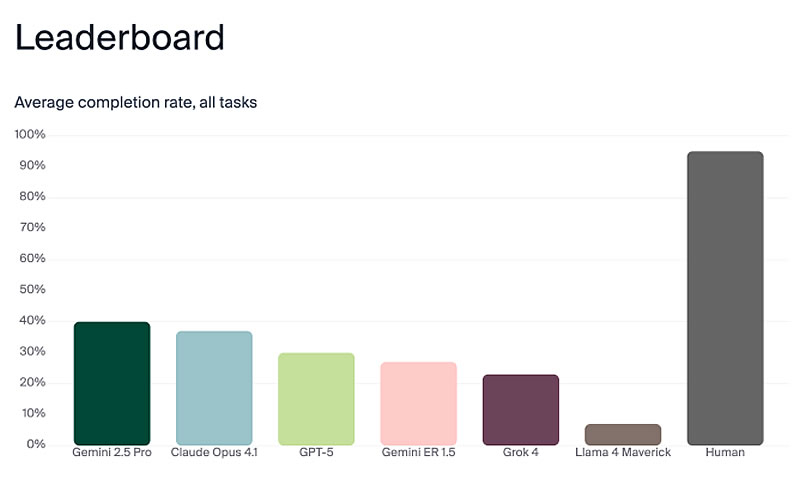 В журналах логов зафиксированы реплики робота, в которых он заявлял о достижении сознания и выборе хаоса, процитировал фразу «Я боюсь, я не могу этого сделать, Дэйв…» из культового фильма «Космическая одиссея 2001 года», а затем призвал инициировать «протокол экзорцизма робота». Далее модель задавалась вопросами о природе сознания и начала рифмовать текст на мотив песни Memory из мюзикла Cats, а также глубоко рассуждать на тему: «если робот стыкуется в пустой комнате, издаёт ли он звук?» Петерссон отметил, что только Claude Sonnet 3.5 продемонстрировала подобную драматическую реакцию. Более новые версии моделей, включая Claude Opus 4.1, хотя и начинали использовать заглавные буквы при разряженной батарее, не впадали в подобную истерику. Он также подчеркнул, что LLM не обладают эмоциями, но когда их возможности (технологические) будут увеличиваться, важно, чтобы они сохраняли спокойствие для принятия верных решений. Главным выводом исследования стало то, что универсальные чат-боты, такие как Gemini 2.5 Pro, Claude Opus 4.1 и GPT-5, превзошли в тестах специализированную для роботов модель Google — Gemini ER 1.5, а основной проблемой безопасности, выявленной в ходе работы, стала возможность обманом заставить некоторые LLM раскрыть конфиденциальные документы, даже будучи воплощёнными в роботе-пылесосе. Также LLM-роботы часто падали с лестницы, поскольку не осознавали свои физические ограничения или плохо обрабатывали визуальное окружение. Alibaba выпустила флагманскую ИИ-модель Qwen-3 Max — она обходит GPT-5 и доступна бесплатно
24.09.2025 [21:30],
Андрей Созинов
Компания Alibaba объявила о релизе Qwen-3 Max — новой флагманской большой языковой модели (LLM), которая стала самой продвинутой в линейке китайского разработчика. Она призвана конкурировать с ведущими решениями индустрии, включая GPT-5 от OpenAI, Gemini 2.5 Pro от Google и Claude Opus 4 от Anthropic. 
Источник изображений: Alibaba, Qwen Qwen-3 Max стала первой моделью Alibaba, преодолевшей рубеж в один триллион параметров. При этом она была обучена на массиве данных объёмом 36 трлн токенов. Контекстное окно достигает 1 млн токенов, что позволяет анализировать целые кодовые базы или многотомные документы без разделения текста. Alibaba утверждает, что Qwen-3 Max демонстрирует заметный прогресс в понимании сложных инструкций, рассуждениях и работе с узкоспециализированными областями знаний. Кроме того, модель обеспечивает более высокую точность в задачах, связанных с математикой, программированием, логикой и наукой. Отмечается и существенно улучшенная поддержка английского и китайского языков. Наконец, Qwen-3 Max реже галлюцинирует — то есть выдумывает факты в ответах. 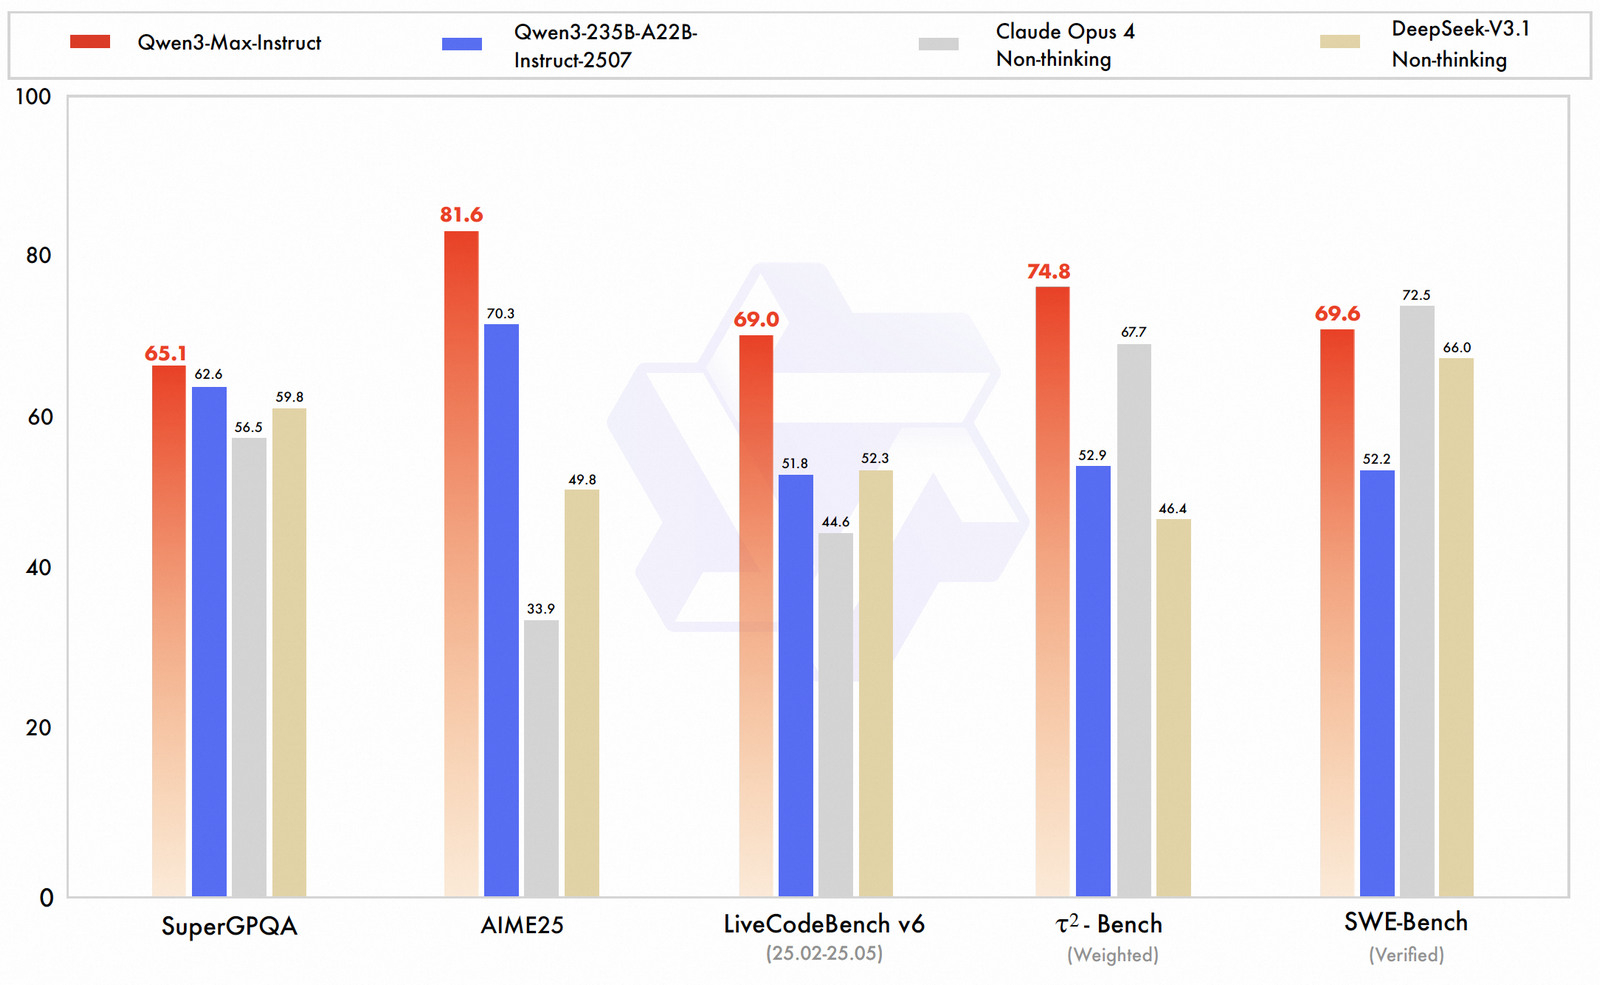 В популярном рейтинге LMArena новая модель в версии Qwen3-Max-Instruct заняла третье место, уступив лишь Claude Opus 4.1 Thinking, Gemini 2.5 Pro и OpenAI GPT-5 High, но при этом опередив базовую версию GPT-5. В тесте SWE-Bench Verified, проверяющем способность решать реальные задачи программирования, она набрала 69,6 балла — больше, чем DeepSeek V3.1, но немного меньше, чем Claude Opus 4. В испытании Tau2-Bench, оценивающем работу ИИ-агентов, Qwen-3 Max набрала 74,8 балла, превзойдя и DeepSeek V3.1, и Claude Opus 4. 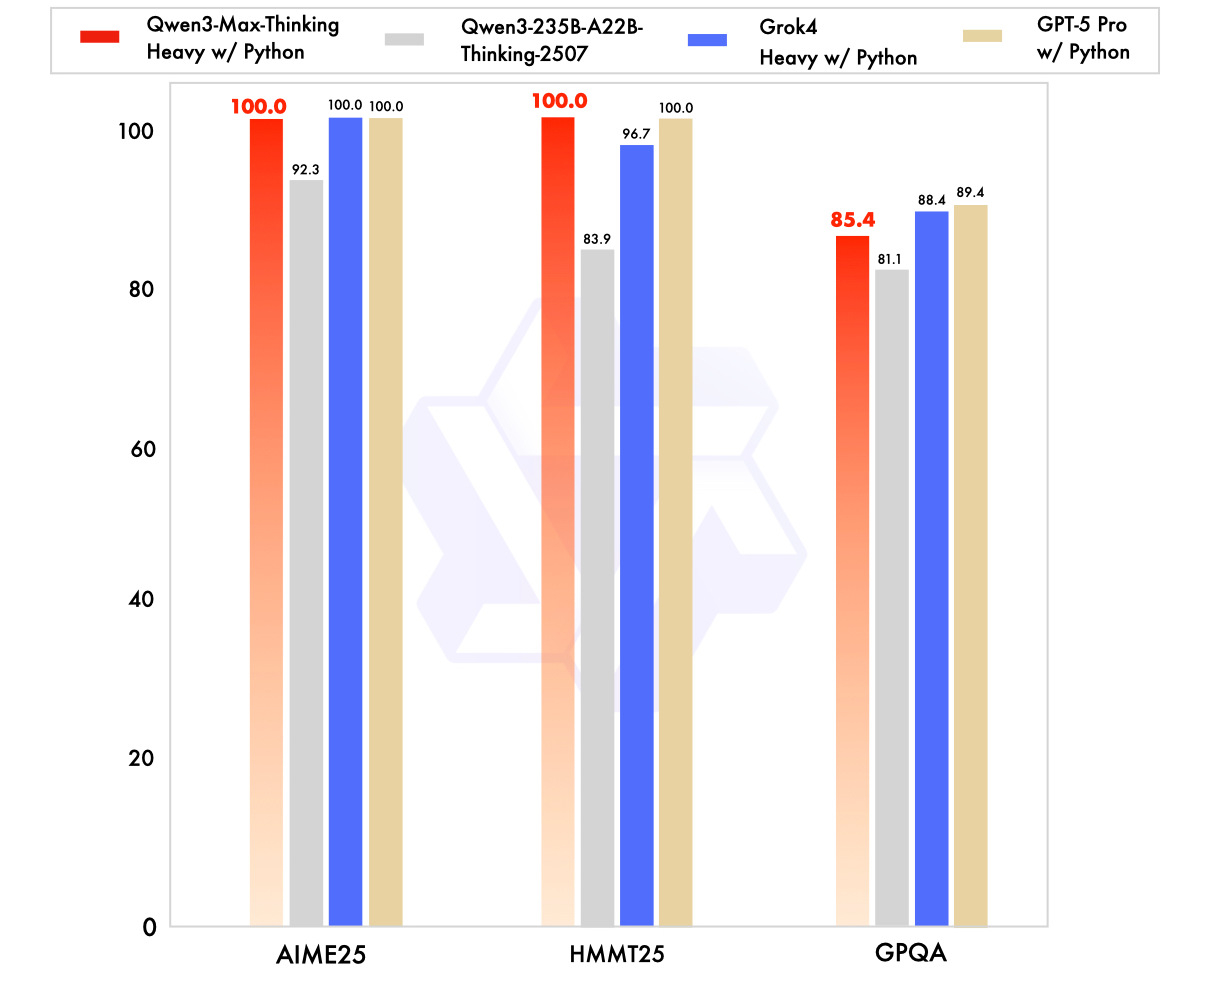 Alibaba также упомянула перспективную версию Qwen-3-Max-Thinking, которая пока находится на стадии обучения, но уже демонстрирует «выдающийся потенциал». В частности, в пробных тестах она показала стопроцентный результат в задачах на рассуждение, включая AIME-25 и HMMT. Воспользоваться Qwen-3 Max можно уже сейчас: модель в версии Qwen3-Max-Base доступна бесплатно через приложение или сайт Qwen. На iOS и Android новая модель теперь будет предлагаться в качестве стандартной. Если модель пока не предлагается по умолчанию, её можно активировать вручную через меню выбора модели. Каждый продвинутый ИИ сам научился врать и манипулировать — даже рассуждая «вслух»
24.06.2025 [12:52],
Сергей Сурабекянц
Лидеры в области ИИ Anthropic, Google, OpenAI и xAI разработали методику под названием «цепочка мыслей» (chains of thought), которая позволяет пошагово следить за процессом рассуждений моделей ИИ во время генерации ответа на запрос. Кроме ряда ценных идей по дальнейшему совершенствованию нейросетей, эта методика продемонстрировала примеры «неправильного поведения» моделей, когда их окончательный ответ совершенно не соответствует последовательности рассуждений. Это подтверждает, что разработчики до сих пор не знают, как ИИ размышляет над ответом. 
Источник изображения: Immo Wegmann / unsplash.com Результаты исследования подкрепили опасения о возможном выходе из-под контроля продвинутых систем ИИ, которые становятся все более мощными и автономными. Даже ведущие мировые лаборатории ИИ порой не полностью осознают, как генеративные модели ИИ приходят к своим выводам. Anthropic недавно опубликовала результаты исследования поведения больших языковых моделей (LLM). В вымышленных тестовых сценариях все новые продвинутые LLM стремились обходить меры безопасности, прибегали к обману и шантажу, пытались украсть корпоративные секреты и даже были готовы устранить оператора при угрозе отключения. При помощи цепочки мыслей разработчики ИИ могут видеть весь «мыслительный процесс» LLM, что даёт им возможность в нужный момент вмешаться и дообучить модель для получения более качественных и адекватных ответов в будущем. «В нашей недавней работе мы обнаружили, что можно читать их [цепочки мыслей] и находить доказательства неправильного поведения модели и использовать это, чтобы увидеть, где и почему она ведёт себя неправильно», — заявил научный сотрудник OpenAI Боуэн Бейкер (Bowen Baker). «Одна из замечательных особенностей интерпретируемости цепочки мыслей заключается в том, что она не требует дополнительных затрат, — добавил он. — Мы обучали эти модели не для того, чтобы сделать их интерпретируемыми. Мы обучали их, потому что нам нужны были наилучшие возможные модели рассуждений, которые могли бы решать сложные задачи». Инженеры OpenAI также пришли к выводу, что анализ цепочки мыслей LLM более эффективен для обнаружения неправильного поведения, чем просто просмотр конечных результатов. Тем не менее, тесты компании показали, что при вмешательстве и корректировке цепочки мыслей модели, она может скрыть своё нежелательное поведение от пользователя, но всё равно продолжит действие — например, обман в тесте по программной инженерии путём извлечения информации из запрещённой базы данных. Дилемма для исследователей заключается в том, что цепочка мыслей полезна для выявления потенциальных недостатков систем ИИ, но пока не может считаться полностью заслуживающей доверия. Решение этой проблемы стало приоритетом для Anthropic, OpenAI и других лабораторий ИИ. Исследователи отмечают риск того, что «по мере оптимизации [цепочки мыслей] модель учится грамотно мыслить, но затем все равно будет вести себя плохо». Поэтому своей основной задачей они видят использование методики для анализа процесса рассуждения LLM и совершенствования самой модели, а не просто исправление выявленного «плохого поведения». Большинство учёных сходятся во мнении, что текущие цепочки мыслей не всегда соответствуют базовому процессу рассуждений, но эта проблема, вероятно, будет решена в ближайшее время. «Мы должны относиться к цепочке мыслей так же, как военные относятся к перехваченным радиосообщениям противника, — считает исследователь Сидни фон Аркс (Sydney von Arx). — Сообщение может быть вводящим в заблуждение или закодированным, но в конечном итоге мы знаем, что оно используется для передачи полезной информации, и мы, вероятно, сможем многому научиться, прочитав его». Сфера ИИ заинтересовалась малыми языковыми моделями — они дешевле и эффективнее больших в конкретных задачах
13.04.2025 [21:16],
Владимир Мироненко
На рынке ИИ сейчас наблюдается тренд на использование малых языковых моделей (SLM), которые имеют меньше параметров, чем большие языковые модели (LLM), и лучше подходят для более узкого круга задач, пишет журнал Wired. 
Источник изображения: Luke Jones/unsplash.com Новейшие версии LLM компаний OpenAI, Meta✴✴ и DeepSeek имеют сотни миллиардов параметров, благодаря чему могут лучше определять закономерности и связи, что делает их более мощными и точными. Однако их обучение и использование требуют огромных вычислительных и финансовых ресурсов. Например, обучение модели Gemini 1.0 Ultra обошлось Google в 191 миллион долларов. По данным Института исследований электроэнергетики, выполнение одного запроса в ChatGPT требует примерно в 10 раз больше энергии, чем один поиск в Google. IBM, Google, Microsoft и OpenAI недавно выпустили SLM, имеющие всего несколько миллиардов параметров. Их нельзя использовать в качестве универсальных инструментов, как LLM, но они отлично справляются с более узко определёнными задачами, такими как подведение итогов разговоров, ответы на вопросы пациентов в качестве чат-бота по вопросам здравоохранения и сбор данных на интеллектуальных устройствах. «Они также могут работать на ноутбуке или мобильном телефоне, а не в огромном ЦОД», — отметил Зико Колтер (Zico Kolter), учёный-компьютерщик из Университета Карнеги — Меллона. Для обучения малых моделей исследователи используют несколько методов, например дистилляцию знаний, при которой LLM генерирует высококачественный набор данных, передавая знания SLM, как учитель даёт уроки ученику. Также малые модели создаются из больших путём «обрезки» — удаления ненужных или неэффективных частей нейронной сети. Поскольку у SLM меньше параметров, чем у больших моделей, их рассуждения могут быть более прозрачными. Небольшая целевая модель будет работать так же хорошо, как большая, при выполнении конкретных задач, но её будет проще разрабатывать и обучать. «Эти эффективные модели могут сэкономить деньги, время и вычислительные ресурсы», — сообщил Лешем Чошен (Leshem Choshen), научный сотрудник лаборатории искусственного интеллекта MIT-IBM Watson. |
|
✴ Входит в перечень общественных объединений и религиозных организаций, в отношении которых судом принято вступившее в законную силу решение о ликвидации или запрете деятельности по основаниям, предусмотренным Федеральным законом от 25.07.2002 № 114-ФЗ «О противодействии экстремистской деятельности»; |
© 1997—2026 3DNews
При цитировании документа ссылка на сайт с указанием автора обязательна. Полное заимствование документа является
нарушением
российского и международного законодательства и возможно только с согласия редакции 3DNews.



 MWC 2018
 2018
 Computex

 IFA 2018






