


Опрос
|
реклама
Быстрый переход
В Солнечной системе пополнение: за Плутоном нашли потенциальную новую планету
29.10.2026 [12:01],
Геннадий Детинич
Двадцать лет назад Плутон лишили права называться планетой, низведя его до статуса карликовой планеты. Сегодня обсерватория имени Веры Рубин нашла ему братика или сестричку, если кандидат будет подтверждён и получит имя. Им стал самый яркий из обнаруженных объектов за орбитой Плутона — 2026 ED138, диаметр которого оценивается в диапазоне от 600 до 1500 км. 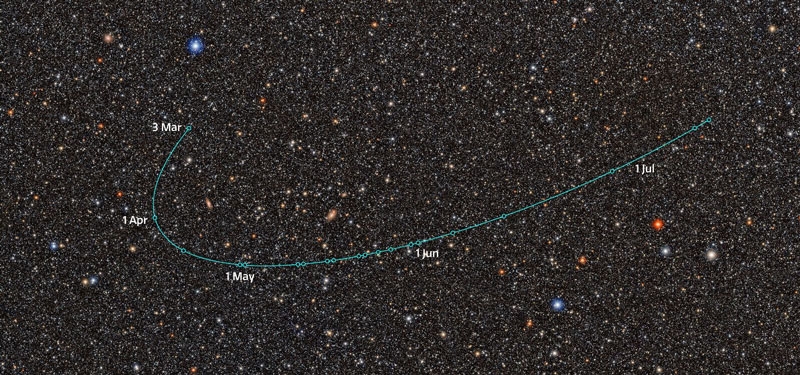
Источник изображений: NSF–DOE Vera C. Rubin Observatory Открытие было сделано в рамках большого обзора неба LSST (Legacy Survey of Space and Time), начатого обсерваторией «Рубин» в июле 2026 года и рассчитанного на десять лет наблюдений. Сама обсерватория приступила к научной работе годом ранее — в июне 2025 года. Проверка архивов «Рубин», а также подключение данных наблюдений с других обсерваторий позволили обнаружить объект на снимках начиная с 2016 года, что дало возможность установить часть его орбитального движения за десять лет. Объект получил предварительное обозначение 2026 ED138 и относится к транснептуновым телам — небесным телам, обращающимся вокруг Солнца за орбитой Нептуна. По предварительным оценкам, его диаметр составляет от 600 до 1500 км. Если эти оценки подтвердятся и наблюдения покажут, что объект обладает достаточной массой для приобретения округлой формы под действием собственной гравитации, ED138 может пополнить скудный список признанных карликовых планет Солнечной системы. Объект обнаружил астрофизик Мэтью Холман (Matthew Holman), когда анализировал данные, собранные обсерваторией «Рубин» в первой половине 2026 года. По сути, он в очередной раз проверял разработанный им совместно с коллегами алгоритм, который сопоставляет миллиарды зарегистрированных камерой телескопа движущихся объектов, чтобы определить, какие из них принадлежат одному и тому же небесному телу. После обнаружения объекта исследователи дополнительно проверили архивы, и нашли ещё 30 его наблюдений. 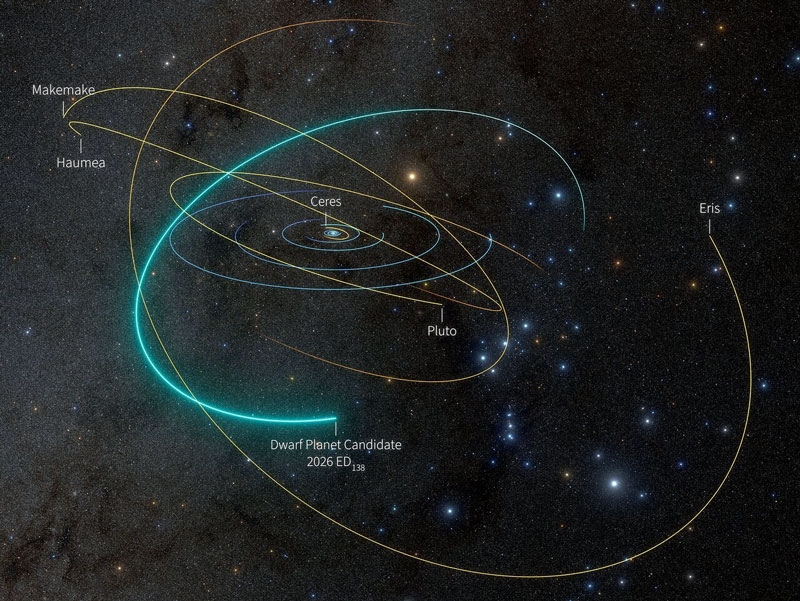 Сейчас ED138 находится примерно в 46 астрономических единицах от Солнца, то есть в 46 раз дальше от него, чем Земля. Для сравнения, среднее расстояние Плутона от Солнца составляет около 40 а. е. Орбита нового объекта наклонена почти на 25 градусов к плоскости Солнечной системы, поэтому его относят к классическим транснептуновым объектам горячей популяции. По мнению исследователей, такое положение орбиты может указывать на то, что гравитационные взаимодействия с Нептуном изменили первоначальную орбиту тела. Важно отметить, что ED138 обнаружили в области неба, близкой к плоскости Млечного Пути, где многочисленные фоновые звёзды традиционно затрудняют поиск тусклых объектов. Тем самым обсерватория «Рубин» наглядно подтвердила данное ей неофициальное прозвище самого зоркого телескопа Земли. Один кадр телескопа «Рубин» охватывает участок неба примерно на 45 полных лун, а его камера содержит 3,2 гигапикселя. Пока ED138 остаётся кандидатом в карликовые планеты: оценка диаметра основана на расстоянии до объекта, его яркости и предполагаемом альбедо — доле солнечного света, отражаемого поверхностью. Для уточнения размеров необходимы дополнительные наблюдения в инфракрасном диапазоне, которые помогут определить отражательную способность и тепловое излучение тела. Следовательно, диапазон 600–1500 км — это предварительная оценка, а не установленный диаметр. Если статус карликовой планеты подтвердится, ED138 сможет влиться в семью из пяти таких же объектов, официально признанных Международным астрономическим союзом: Цереры, Плутона, Эриды, Хаумеи и Макемаке. Nvidia не смогла выпустить Vera Rubin, которые обещала: память HBM4 замедлилась, а местами даже ужалась
27.10.2026 [21:40],
Николай Хижняк
Nvidia пересмотрела технические характеристики своей ИИ-платформы Vera Rubin, снизив заявленные показатели пропускной способности памяти HBM4 и скорости работы интерфейса NVLink шестого поколения. Изменения коснулись отдельных графических процессоров Rubin, стоечной системы Vera Rubin NVL72 и платформы HGX Rubin NVL8. Наиболее существенное сокращение затронуло совокупную пропускную способность памяти HBM4 в системе с восемью графическими процессорами. 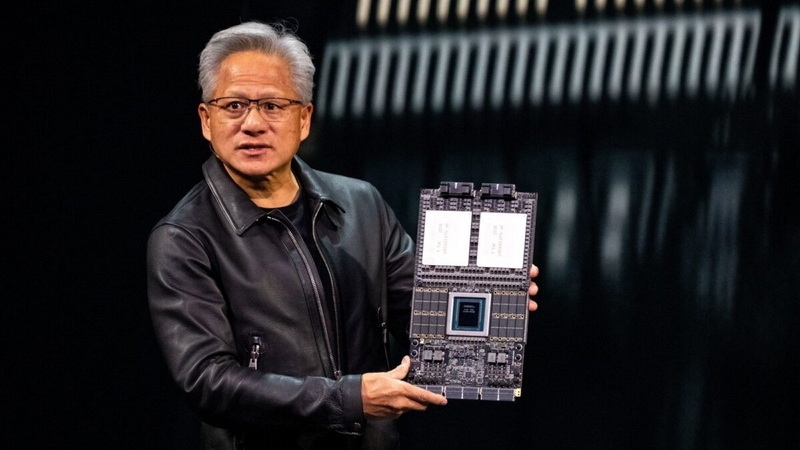
Источник изображений: Nvidia На момент анонса в январе в спецификациях системы Nvidia Vera Rubin NVL72 для каждого графического процессора заявлялось наличие 288 Гбайт памяти HBM4 с пропускной способностью 22 Тбайт/с. С тех пор компания снизила заявленные характеристики: объём памяти остался прежним, а вот пропускная способность снизилась до 19,2 Тбайт/с (на 12,7 %). Пропускная способность интерфейса NVLink 6 также сократилась — с 3,6 до 3 Тбайт/с на один GPU (на 16,7 %). 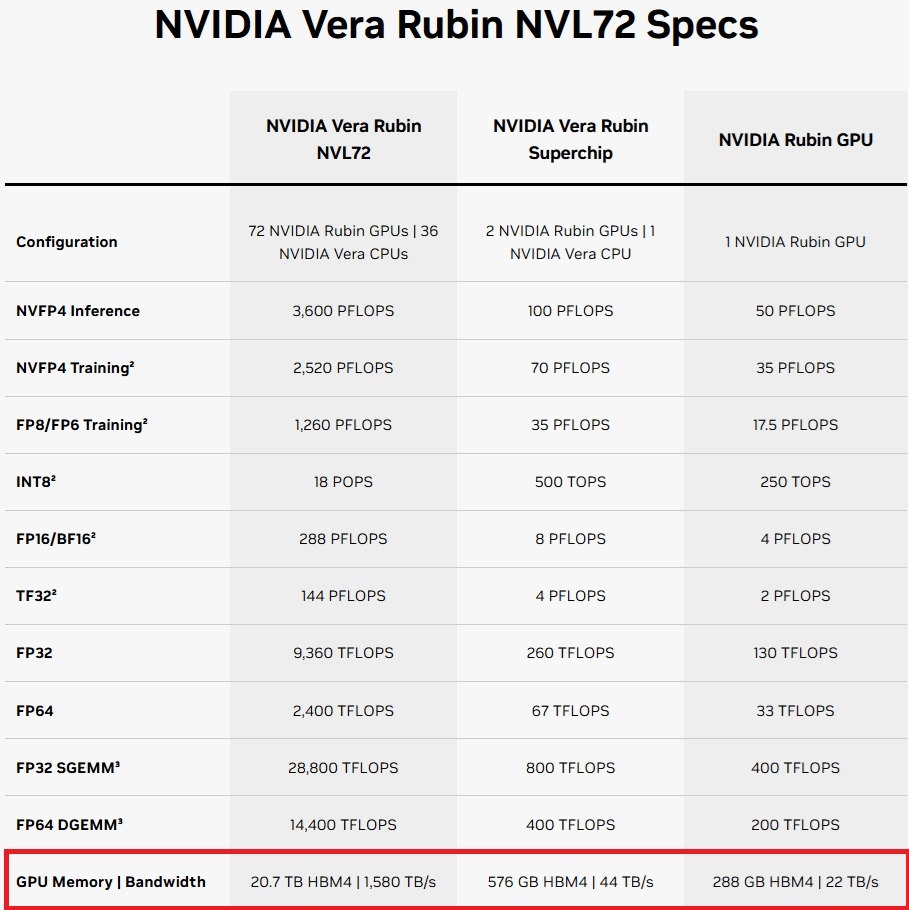
Vera Rubin NVL72 раньше Система Vera Rubin NVL72, объединяющую 72 графических процессора Rubin и 36 центральных процессоров Vera, соответственно тоже потеряла в характеристиках. Раньше Nvidia указывала для неё совокупную пропускную способность HBM4 на уровне 1580 Тбайт/с, а пропускную способность NVLink — 260 Тбайт/с. Теперь эти показатели составляют 1400 и 216 Тбайт/с соответственно. Отметим, что пропускная способность интерфейсов для объединения нескольких системы в кластеры (scale-out networking) при этом увеличилась. 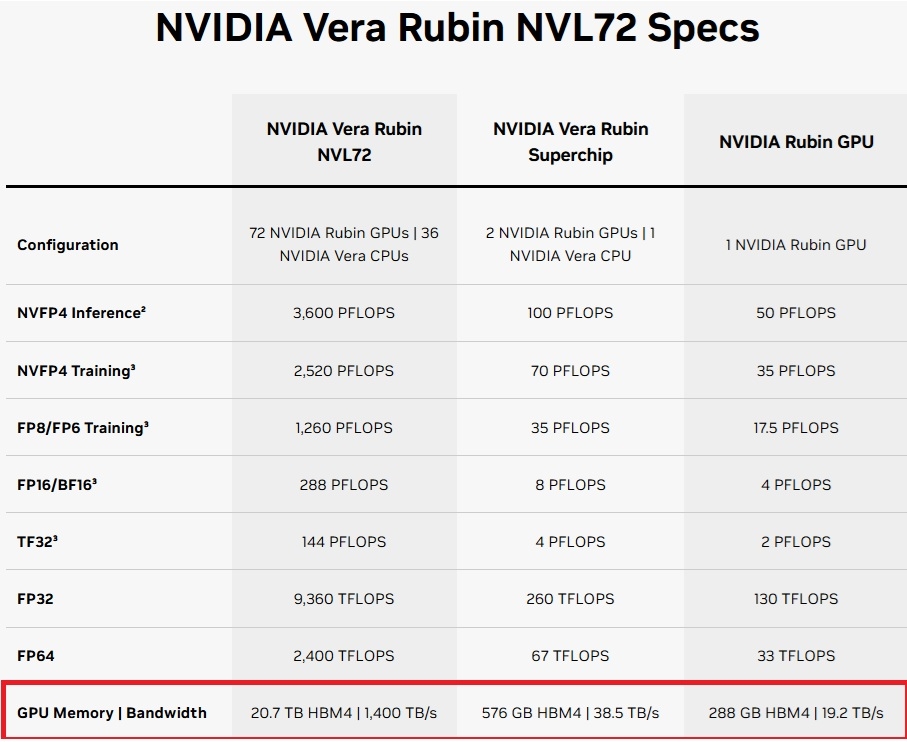
Vera Rubin NVL72 теперь Для платформы HGX Rubin NVL8, включающей восемь графических процессоров Rubin, корректировки оказались ещё более значительными. Заявленный объём памяти HBM4 уменьшился с 2,3 до 2 Тбайт, а пропускная способность памяти — со 176 до 130 Тбайт/с. Пропускная способность коммутаторов NVLink Switch также снизилась — с 28,8 до 24 Тбайт/с. Кроме того, Nvidia скорректировала показатели производительности при обучении моделей. Для формата NVFP4 она снизилась с 280 до 270 Пфлопс, а для форматов FP8/FP6 — со 140 до 130 Пфлопс. На странице продукта HGX Rubin NVL8 теперь указаны обновлённые, сниженные технические характеристики системы, однако в таблице для отдельного графического процессора Rubin по-прежнему значатся прежние показатели: 22 Тбайт/с для памяти HBM4 и 3,6 Тбайт/с для интерфейса NVLink. На отдельной странице, посвящённой DGX Rubin NVL8, также по-прежнему заявлены 2,3 Тбайт памяти и пропускная способность 176 Тбайт/с. В Nvidia не пояснили, связаны ли эти расхождения с наличием различных конфигураций или с использованием устаревшей документации. Изучение архивных версий спецификаций Nvidia, проведённое ресурсом Wccftech, показало, что изменения для системы NVL72 были внесены в период с 1 по 11 сентября. Впрочем, вряд ли подобные корректировки как-то повлияют на продажи Rubin. Судя по всему, у Nvidia в любом случае выстроилась длинная очередь из клиентов, ожидающих выхода продукта. ИИ-фабрика за 14 дней: Nvidia представила модульные дата-центры на Vera Rubin в контейнерах
21.10.2026 [20:56],
Анатолий Хаблюк
Компания Nvidia представила проект модульных центров обработки данных DSX POD на базе вычислительной платформы Vera Rubin. По утверждению разработчика, предварительная сборка и проверка оборудования на заводе позволят сократить срок развёртывания ИИ-фабрики на подготовленной площадке с шести месяцев до 14 дней. Анонс состоялся на конференции GTC в Берлине. 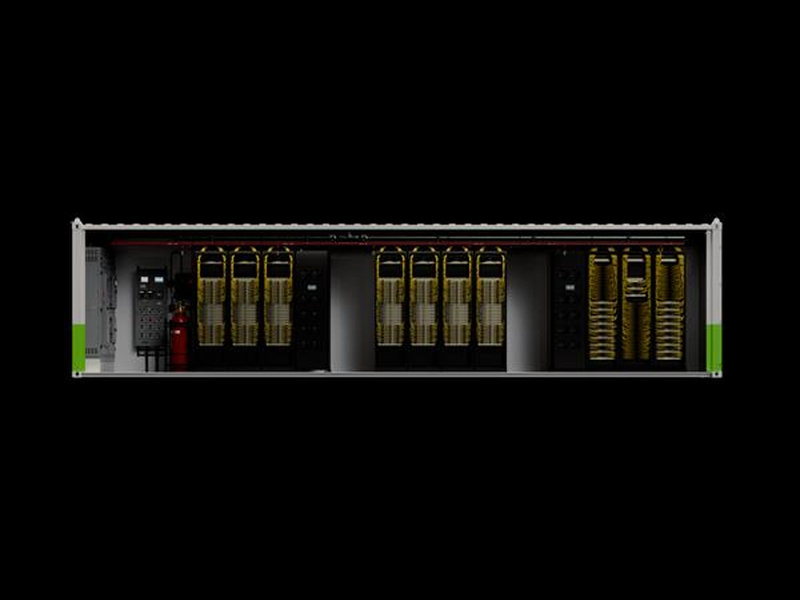
Источник изображения: Nvidia DSX POD представляет собой эталонную конструкцию ИИ-фабрики, которую партнеры Nvidia смогут собирать в стандартных транспортных контейнерах. Еще на производстве в них устанавливают серверы, сетевое оборудование, системы питания и жидкостного охлаждения, прокладывают кабели и трубопроводы. Перед отправкой заказчику готовые блоки проходят проверку работоспособности. Такой подход позволяет выполнять монтаж и тестирование оборудования одновременно с подготовкой площадки. После доставки модули останется подключить к электроснабжению, охлаждению и сетевой инфраструктуре. Nvidia рассчитывает сократить объем строительных и монтажных работ непосредственно в ЦОД, а также снизить риск задержек из-за несогласованности поставок комплектующих и ошибок при установке. Основой модульных комплексов станет платформа Vera Rubin. Ранее Nvidia представила её аппаратные компоненты, включая ускорители Rubin, центральные процессоры Vera и сетевые решения нового поколения. DSX POD объединяет вычислительную технику и необходимую инженерную инфраструктуру в готовых блоках, предназначенных для обучения нейросетей и выполнения запросов к ИИ-моделям. По словам генерального директора Nvidia Дженсена Хуанга (Jensen Huang), экономическая отдача от ИИ-фабрики начинается тогда, когда оборудование приступает к обработке рабочих запросов. Поэтому компания предлагает переносить как можно больше операций по сборке и настройке в заводские условия, чтобы заказчики могли раньше запускать вычислительные мощности. В разработке и подготовке модульных решений участвуют Dell Technologies, HPE, Lenovo, Schneider Electric, Vertiv, Bull, Foxconn, Quanta Cloud Technology и другие партнеры. Начало поставок DSX POD на мировом рынке намечено на начало 2027 года. Обещанные 14 дней относятся к развертыванию на заранее подготовленной площадке, а не ко всему циклу строительства дата-центра с нуля. Vera Rubin ещё толком не вышла, но уже принесёт Nvidia около $20 млрд за квартал
28.08.2026 [14:08],
Алексей Разин
Для Nvidia уходящая неделя оказалась важной: квартальный отчёт позволил руководству убедить инвесторов в продолжении бума ИИ и сохранении высоких темпов роста выручки. Одним из главных двигателей дальнейшего роста должна стать новая серверная платформа Vera Rubin, которая уже в текущем квартале обеспечит около 20 % всей выручки Nvidia в сегменте ЦОД. Компания рассчитывает, что это станет самым быстрым выводом нового продукта на рынок в её истории. 
Источник изображения: Nvidia Об этом на квартальном отчётном мероприятии Nvidia заявила финансовый директор Колетт Кресс (Colette Kress): «Мы видим, что Vera Rubin будет отвечать примерно за 20 % выручки в сегменте ЦОД в третьем квартале. Мы уже получили заказы от всех крупных гиперскейлеров, операторов облачных ИИ-сервисов и OEM-производителей и ожидаем, что экспансия Vera Rubin станет самой быстрой в истории Nvidia». Массовое производство компонентов Vera Rubin начало наращиваться только весной, а первые коммерческие поставки стоечных систем VR200 NVL72 стартовали в августе. Microsoft, по словам её руководителя Сатьи Наделлы (Satya Nadella), стала первым крупным клиентом, развернувшим такие системы. Таким образом, практически с нулевой выручки в предыдущем квартале Vera Rubin должна всего за три месяца добраться примерно до 20 % серверного бизнеса Nvidia. В прошлом квартале на сегмент ЦОД пришлось около 92 % всей выручки Nvidia, а в третьем квартале компания рассчитывает получить в общей сложности около $108 млрд. При сохранении аналогичных пропорций выручка от семейства Vera Rubin может приблизиться к $20 млрд всего за один квартал. При этом Vera Rubin представляет собой не отдельный ускоритель, а целую вычислительную платформу, объединяющую процессоры Vera, ускорители Rubin, сетевые компоненты и DPU BlueField 4, а также готовые стоечные системы VR200 NVL72. Глава и основатель Nvidia Дженсен Хуанг (Jensen Huang) также продемонстрировал, как с каждым новым поколением растёт стоимость оборудования Nvidia, необходимого для оснащения ИИ-ЦОД определённой мощности. Для систем поколения Hopper компания оценивает этот показатель примерно в $18 млрд на 1 ГВт, для Grace Blackwell — в $25 млрд, а для новейшего Vera Rubin — уже в $40 млрд на 1 ГВт. На первый взгляд получается, что стоимость вычислительного оборудования растёт чрезвычайно быстро, но одновременно значительно увеличивается и его производительность. Поэтому клиенты, по логике Nvidia, получают всё больше вычислительной мощности на каждый доступный им гигаватт электроэнергии. Для самой Nvidia переход на новые поколения тоже оказывается чрезвычайно выгодным: один и тот же энергетический бюджет ЦОД позволяет ей продавать клиентам всё более дорогое оборудование. Иными словами, Vera Rubin должна одновременно решить две задачи: резко увеличить производительность ИИ-инфраструктуры в условиях, когда доступная электрическая мощность становится одним из главных ограничений отрасли, и заметно увеличить выручку Nvidia с каждого строящегося гигаватта ЦОД. Дефицит HBM4E вынудит Nvidia урезать объём памяти в ускорителях Rubin Ultra уже в 2027 году
05.08.2026 [14:07],
Алексей Разин
Большинство участников рынка микросхем памяти сходится во мнении, что дефицит предложения сохранится на протяжении следующего года. По мнению аналитиков TrendForce, в случае с ускорителями Rubin Ultra он вынудит Nvidia уменьшить объём памяти HBM4E, устанавливаемой на них в большинстве конфигураций. 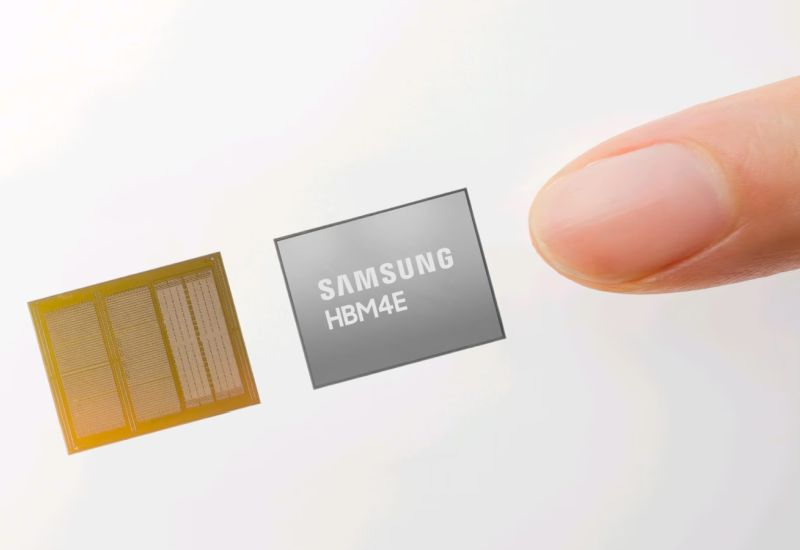
Источник изображения: Samsung Electronics С текущего квартала Nvidia приступила к оценке вероятных конфигураций памяти ускорителей семейства Rubin Ultra. Помимо первоначального варианта с 12-ярусным стеком HBM4E, предполагается наличие 8-ярусного HBM4E, а также двух вариантов HBM4 с 8 и 12 ярусами соответственно. Окончательные спецификации пока не определены. Nvidia является не единственным разработчиком ИИ-ускорителей, готовым умерить аппетиты в сфере использования HBM на фоне дефицита микросхем памяти — на аналогичные меры готовы пойти и облачные гиганты, разрабатывающие собственные ускорители. Производители серверного оборудования и их облачные клиенты уже сократили объёмы памяти в исполнении RDIMM, которую собирались устанавливать в свои системы в первой половине текущего года. Nvidia решила вдвое сократить объём устанавливаемой в модули Vera Rubin Superchip памяти в исполнении SOCAMM, также руководствуясь ожиданием дефицита памяти типа LPDDR5X на протяжении всего 2027 года. В этом полугодии Nvidia решила урезать и конфигурации HBM4E для ускорителей Rubin Ultra. Во-первых, из-за общего дефицита памяти таких чипов может быть выпущено меньше, чем потребовалось бы Nvidia. Во-вторых, пока нет уверенности, что к моменту начала поставок Rubin Ultra все производители памяти успеют сертифицировать свои 12-ярусные стеки HBM4E. Возможно, часть ассортимента придётся закрывать 8-ярусными. В случае с ускорителями Rubin Ultra именно увеличение пропускной способности является приоритетом, а наращивание объёмов поставок GPU вторично. Если Nvidia будет вынуждена экономить на памяти, то она сократит количество ярусов в устанавливаемых чипах, но не станет жертвовать скоростью передачи информации. Из памяти HBM4 ускорители Rubin Ultra смогут от силы выжать 12 Гбит/с, тогда как HBM4E должна позволить поднять планку до 14 или 16 Гбит/с. Как считают эксперты TrendForce, даже если объёмы поставок HBM в следующем году вырастут на 50–60 %, то этого всё равно не хватит для удовлетворения возросшего спроса. Цены на память данного типа в таких условиях будут расти и в 2027 году. Для производителей ИИ-ускорителей это станет дополнительной проблемой, помимо дефицита памяти как такового. SpaceX выбрала Nvidia для ИИ будущего — вместе они построят дата-центры на орбите
05.08.2026 [14:02],
Алексей Разин
На квартальной отчётной конференции SpaceX, которая больше месяца считается публичной компанией, её глава Илон Маск (Elon Musk) признался, что отныне в части строительства инфраструктуры ИИ она сосредоточится на использовании компонентов Nvidia. Кроме того, было заявлено, что последняя поможет SpaceX с созданием орбитальных центров обработки данных. 
Источник изображения: SpaceX Попутно было сказано, что SpaceX рассчитывает подойти к концу 2026 года с 2 ГВт вычислительных мощностей, а уже к концу 2027 года они вырастут до 20 ГВт. Правда, столь высокие темпы строительства ЦОД требуют от компании стремительного увеличения капитальных затрат — во втором квартале они выросли в шесть раз по сравнению с аналогичным периодом прошлого года, до $18,4 млрд. По поводу сотрудничества с Nvidia Илон Маск заявил следующее: «Мы считаем, что архитектура Vera Rubin является лучшей. Мы считаем, что это лучший ИИ-компьютер, и глубоко ценим тесное сотрудничество с Nvidia на разных уровнях, поэтому и используем исключительно её продукцию». SpaceX и Nvidia будут сотрудничать в сфере создания орбитального ЦОД Starmind AI1, как пояснил Илон Маск. Каждый профильный спутник будет нести на борту GPU класса Rubin и центральные процессоры Vera. В январе этого года Nvidia приобрела долю в капитале SpaceX за $20 млрд, получив пропорциональное количество акций компании. Пока никому не удалось продемонстрировать способность ЦОД работать в условиях космоса, поэтому намерения SpaceX довести их количество до 1 млн штук вызывают сомнения у многих экспертов, особенно с учётом сопутствующих рисков для окружающей среды. Nvidia утверждает, что все её крупнейшие клиенты уже используют серверы на основе Vera Rubin
22.07.2026 [08:51],
Алексей Разин
Компания Nvidia на этой неделе провела мероприятия для прессы, клиентов и партнёров, целью которых была демонстрация её готовности поставлять потребителям новейшие серверные компоненты и готовые системы. Решения на основе ускорителей поколения Vera Rubin, по словам руководства Nvidia, уже доставлены основным крупным клиентам компании и начинают использоваться. 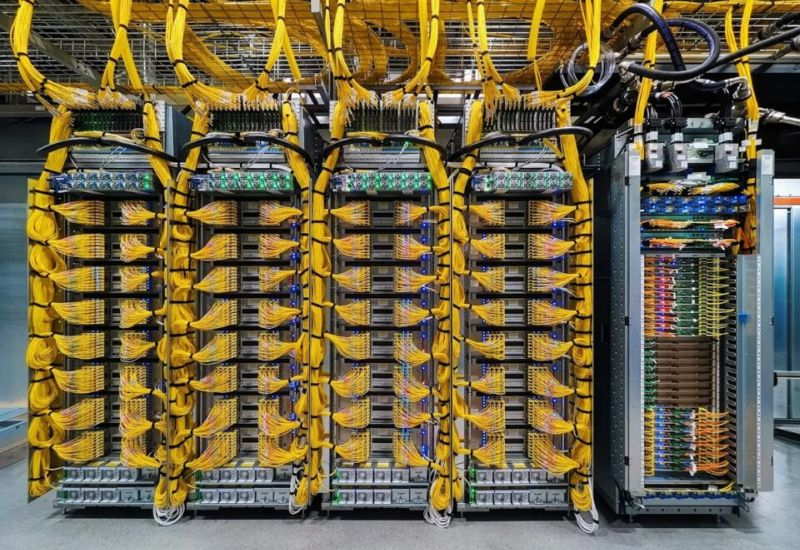
Источник изображения: Nvidia Данные комментарии прозвучали из уст вице-президента Nvidia Иэна Бака (Ian Buck), который в компании отвечает за направление центров обработки данных. Во время брифинга в штаб-квартире Nvidia он заявил: «Мы абсолютно находимся на стадии полномасштабного производства. Это оборудование уже установлено у всех наших крупнейших потребителей». Инвесторы и клиенты Nvidia с некоторым опасением следили за этапом масштабирования производства серверных систем поколения Vera Rubin, поскольку новая продукция всегда таит вероятные сложности и потенциальные задержки. Представители Nvidia заявляют, что в этом отношении переживать не о чем. Оборудование нового поколения будет не только производительнее предыдущего, его будет проще вводить в эксплуатацию. Более того, компоновка новых серверов рассчитана с учётом упрощения процедуры сборки: количество кабельных подключений максимально сокращено, чтобы перевести операции на использование роботов, а не людей. Система жидкостного охлаждения также сокращает потребность в свободном пространстве внутри корпуса и количестве установленных вентиляторов. Один из лидеров рынка ИИ — американский стартап OpenAI, собирается начать масштабную эксплуатацию систем семейства Vera Rubin в текущем квартале, как отметили представители Nvidia. Уже сейчас эти системы используются компаниями Google, CoreWeave, Microsoft, Meta✴✴ Platforms и Dell Technologies. В окрестностях штаб-квартиры Nvidia в Калифорнии построена специальная экспериментальная площадка с новейшим серверным оборудованием, которое клиенты могут протестировать и оценить на пригодность к своим нуждам. OpenAI как раз сейчас проводит подобные испытания. По данным CoreWeave, системы поколения Vera Rubin способны выдавать в десять раз больше токенов по сравнению с предшественниками. Представители Nvidia также настаивают, что центральные процессоры Vera оказываются в 1,8 раза быстрее в программировании на Python по сравнению с конкурирующими AMD Turin. Представители последней из компаний возразили, что сравнение с более новыми процессорами Venice не будет демонстрировать подобного разрыва. Тайваньская Wistron начнёт выпускать для Nvidia в США серверы с новейшими чипами Vera Rubin
22.07.2026 [07:01],
Алексей Разин
Нынешний президент США Дональд Трамп (Donald Trump) пытался привлечь тайваньского контрактного производителя электроники Foxconn на американскую землю ещё в 2017 году, и ту попытку нельзя назвать удачной. Тем не менее, сейчас производством серверного оборудования на территории США готова заниматься не только Foxconn, но и конкурирующая Wistron, которая построила завод в Техасе. 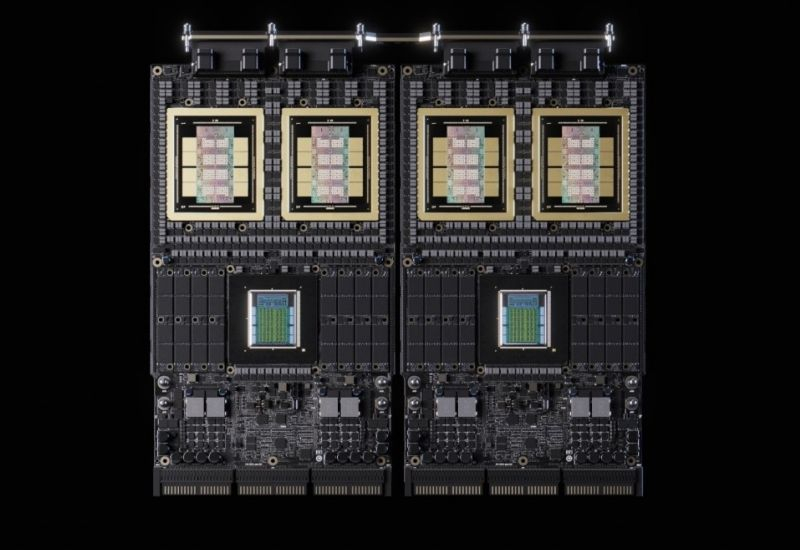
Источник изображения: Nvidia Как сообщает Nikkei Asian Review, техасская площадка Wistron занимает площадь более 30 000 квадратных метров, и это первое предприятие компании на территории США. На его строительство было потрачено $700 млн. На церемонии открытия завода представители Wistron продемонстрировали первый модуль Nvidia GB300, собранный на его территории. Сперва здесь будет освоен выпуск серверных систем на основе Grace Blackwell, а позже завод начнёт выпускать решения поколения Vera Rubin. В течение пары лет данное предприятие станет одним из самых важных в инфраструктуре Wistron, по словам представителей компании. Глава и основатель Nvidia Дженсен Хуанг (Jensen Huang) также посетил церемонию открытия завода Wistron в Техасе, подчеркнул, что спрос на ИИ-серверы невероятно высок, а потому они должны производиться повсеместно. Компании сообща восстанавливают передовое производство на территории США, создают квалифицированные рабочие места и развивают локальные цепочки поставок, по словам главы Nvidia. Компании Foxconn и Wistron являются главными производителями печатных плат с ускорителями вычислений Nvidia, до недавних пор американские клиенты последней были вынуждены полагаться на поставки с Тайваня. На предприятии Wistron будут выпускаться не только печатные платы и готовые ускорители на базе GPU, но и целые серверные системы. Конкурирующая Foxconn также вскоре собирается запустить своё локальное предприятие по выпуску серверного оборудования для Nvidia в Хьюстоне, штат Техас. Площадка Wistron располагается в городе Форт-Уэрт. Если учесть, что TSMC развивает обработку кремниевых пластин в Аризоне, и там же будет заниматься упаковкой ИИ-чипов, на территории США появится почти самодостаточная инфраструктура для изготовления компонентов вычислительных систем. Правда, среди поставщиков памяти типа HBM полным циклом производства в США обладает только Micron, но она тоже расширяет свои мощности, да и местные власти собираются принудить корейских Samsung и SK hynix локализовать производство памяти в стране. Samsung запустила массовое производство SSD с PCIe 6.0 — они не для ПК
08.07.2026 [11:13],
Павел Котов
Samsung начала массовый выпуск передовых твердотельных накопителей для центров обработки данных — они будут использоваться в оборудовании на платформе Nvidia Vera Rubin. Новинки предлагают ёмкость до 64 Тбайт и скоростной интерфейс PCIe 6.0. 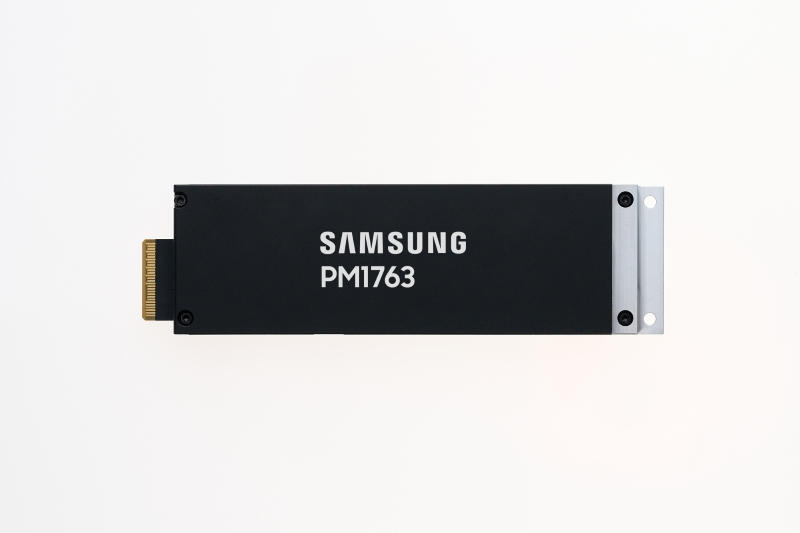
Источник изображений: sasmung.com Твердотельный накопитель корпоративного класса Samsung PM1763 был представлен на конференции Nvidia GTC. Компания Samsung продемонстрировала его вместе с высокоскоростной памятью нового поколения HBM4 и модулем SOCAMM2 с низким потреблением энергии — они вошли в комплексный пакет для ЦОД с системами искусственного интеллекта. 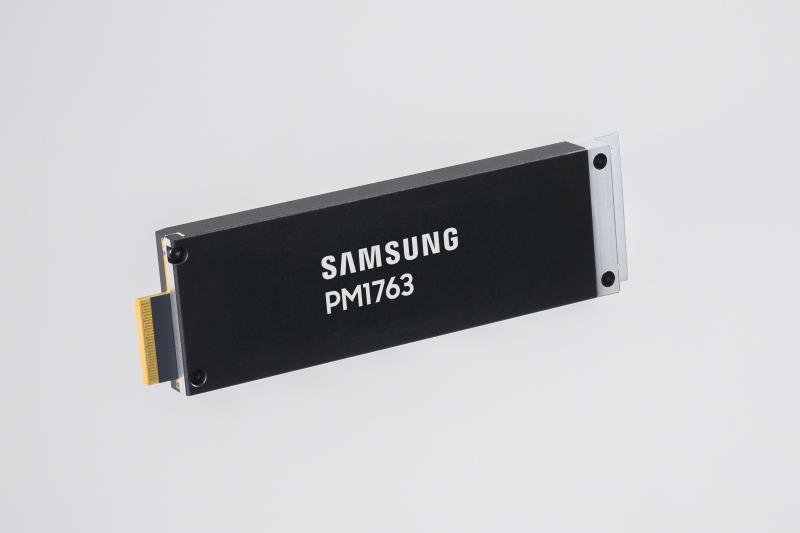 В накопителе используются новейшие чипы флеш-памяти Samsung V-NAND типа TLC и контроллер, который производится по нормам 4 нм и обеспечивает скорость записи более чем вдвое выше, чем у предшественника, отметил корейский производитель. SSD Samsung PM1763 разработан для снижения задержки данных в системах с современными процессорами и ИИ-ускорителями. Для поддержания высоких скоростей во время обучения и инференса ИИ накопитель предусматривает систему жидкостного охлаждения. PM1763 оснащены интерфейсом PCIe 6.0. В основу положены чипы флеш-памяти TLC NAND. Заявлена скорость последовательного чтения до 28 400 Мбайт/с, и скорость последовательной записи до 21 000 Мбайт/с. Скорость операций ввода/вывода в секунду при произвольном чтении данных блоками по 4 Кбайт составляет до 6,8 млн IOPS, при произвольной записи — до 950 тыс. IOPS. По итогам I квартала Samsung, по данным TrendForce, занимала наибольшую долю на рынке корпоративных SSD — 35 %. За ней следовали SK hynix, Micron, Kioxia и её партнёр в лице Sandisk. Nvidia и SK hynix подписали соглашение о долгосрочном сотрудничестве в «широком спектре технологий»
08.06.2026 [04:46],
Алексей Разин
Основатель и бессменный лидер Nvidia Дженсен Хуанг (Jensen Huang) во время своего визита в Южную Корею не стал ограничиваться заявлениями о том, что все три крупнейших поставщика HBM4 прошли сертификацию и будут снабжать ускорители Vera Rubin эти типом памяти. Компания SK hynix была выделена из числа партнёров Nvidia, поскольку именно с ней было заключено долгосрочное соглашение о сотрудничестве. 
Источник изображения: Nvidia Стороны будут на протяжении нескольких лет сотрудничать в сфере разработки и производства чипов, как можно понять из публикации Bloomberg. По всей видимости, данное соглашение усиливает роль SK hynix в создании новых поколений HBM и других видов памяти, которые Nvidia сочтёт привлекательными для применения. К слову, данные новости не уберегли акции SK hynix от снижения в цене на 10 % на торгах в понедельник, поскольку коррекция на фондовом рынке, которая в США наблюдалась в пятницу, эхом отразилась на азиатских площадках в первый рабочий день новой недели. По словам Хуанга, сотрудничество между Nvidia и SK hynix будет охватывать широкий спектр технологий, от передовых ИИ-моделей до агентских решений и физического воплощения ИИ. Все эти задачи потребуют использования памяти, причём разных типов. Центральные процессоры Vera, как добавил глава Nvidia, также будут использовать память DRAM производства SK hynix. Второе полугодие и весь следующий год, по словам Хуанга, будут очень насыщенными с точки зрения взаимодействия Nvidia и SK hynix. SK hynix за ближайшие пять лет удвоит производственные мощности по выпуску памяти
02.06.2026 [11:18],
Алексей Разин
Значимость производителей памяти подчёркивается хотя бы тем фактом, что председатель совета директоров южнокорейской SK Group Чхэ Тхэ Вон (Chey Tae-won) оказался приглашён на отраслевую выставку Computex 2026 на Тайване, где сделал несколько важных заявлений. В частности, он пообещал удвоить мощности SK hynix по производству памяти за последующие пять лет. 
Источник изображения: SK hynix Он же в марте этого года, как напоминает Reuters, сообщил о возможности сохранения дефицита памяти на мировом рынке до 2030 года. SK hynix, которая в составе упоминаемого южнокорейского конгломерата занимается выпуском памяти, нуждается в расширении круга своих партнёров на Тайване, и дело не должно ограничиваться одной лишь TSMC, как отметил глава холдинга. Чхэ Тхэ Вон выразил надежду, что SK hynix сможет остаться крупнейшим поставщиком HBM для ускорителей Nvidia Vera Rubin. Как известно, на этот статус претендует конкурирующая Samsung Electronics, но SK hynix явно не собирается сдаваться без боя. На прошлой неделе капитализация SK hynix впервые в истории превысила $1 трлн, что говорит об уверенности инвесторов в способности этого производителя памяти развивать бизнес в условиях бума ИИ. По данным Counterpoint Research, в первом квартале текущего года SK hynix сохраняла за собой 58 % мирового рынка HBM, а Samsung и Micron досталось по 21 %. Память в серверах Nvidia подорожала на 435 % при переходе от Blackwell к Vera Rubin — стойку оценили в $7,8 млн
22.05.2026 [12:18],
Павел Котов
Одна серверная стойка Nvidia VR200 NVL72 нового поколения на архитектуре Vera Rubin обойдётся облачному оператору примерно в $7,8 млн, подчитали в Morgan Stanley. Для сравнения, GB300 NVL72 стоит около $4 млн. Стойка нового поколения VR200 NVL72 содержит больше DRAM и NAND — на память приходятся около 25 % общей стоимости. 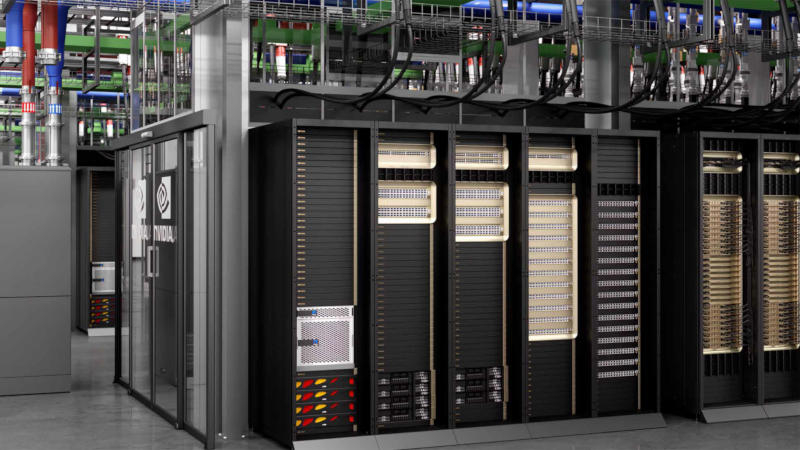
Источник изображения: Nvidia В корпусах VR200 NVL72 компания Nvidia намеревается продавать процессоры Vera по $5000 и ускорители искусственного интеллекта Rubin по $55 000 за штуку. В стойках используются уже знакомые клиентам корпуса Oberon, но внутри установлены более сложные компоненты коммутации, сетевых подключений, печатные платы, системы охлаждения, изменились даже технологии упаковки чипов — всё это влияет на стоимость систем и складывается в ценник $7,8 млн за стойку. Только компоненты памяти в стойке VR200 NVL72 обходятся около $2 млн или на 435 % больше, чем в GB300 NVL72. 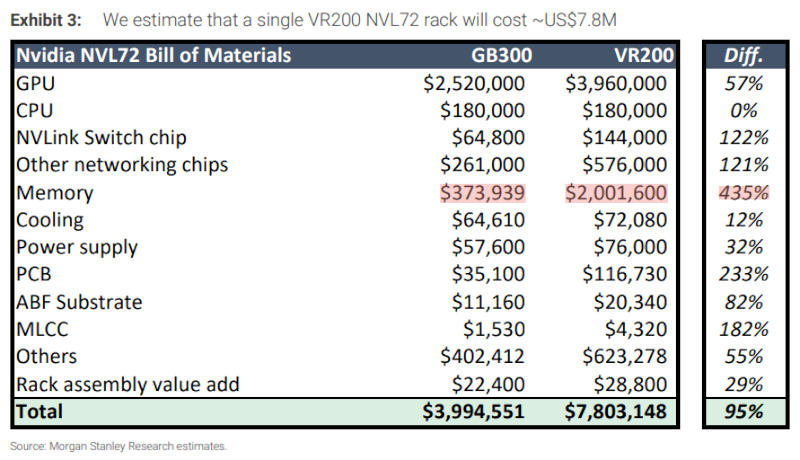
Источник изображения: x.com/Aaronwei3n На каждую стойку нового поколения приходятся 54 Тбайт памяти LPDDR5X — втрое больше, чем 17 Тбайт у GB200 NVL72. Nvidia, по оценкам SemiAnalysis, в I квартале платила по $8 за 1 Гбайт LPDDR5X, и дальше этот показатель может только вырасти, особенно если речь идёт о дорогих в производстве и тестировании модулях SOCAMM2. Таким образом, память для GB200 NVL72 обходится в $136 000 на каждую машину; в случае VR200 NVL72 это уже $408 000, а при росте цены до $10 за 1 Гбайт это будут уже $540 000 — даже без учёта наценки самой Nvidia. Кроме того, в каждой стойке VR200 NVL72 содержится память 3D NAND на сумму не менее $1 млн, тогда как в GB200 NVL72 её практически не было. В результате $2 млн за память на стойку Vera Rubin NVL72 представляется вполне предсказуемым показателем: здесь есть большие объёмы LPDDR5X и 3D NAND, не говоря уже о высокоскоростной HBM4 на самих ускорителях Rubin — и это в условиях дефицита и колоссальных цен на чипы памяти. ИИ продолжает раздувать бизнес Nvidia — квартальная выручка взлетела на 85 % до небывалых $81,6 млрд
21.05.2026 [05:58],
Алексей Разин
Квартальный отчёт Nvidia стоит особняком не только хронологически, он также позволяет оценить динамику бума ИИ, который толкает выручку компании вверх с конца 2022 года. По итогам прошлого квартала Nvidia нарастила свою выручку на 85 % до рекордных $81,6 млрд, превзойдя ожидания аналитиков. В сегменте ЦОД выручка выросла на 92 % до $75,2 млрд. 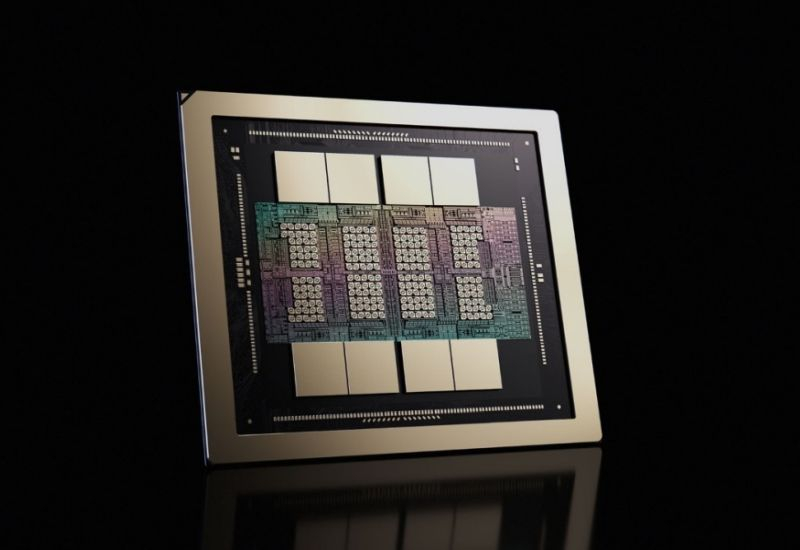
Источник изображений: Nvidia Таким образом, серверное направление бизнеса Nvidia в очередной раз побило рекорд, последовательно увеличив выручку на 21 %. Общая выручка также выросла на 20 % по сравнению с предыдущим кварталом, поэтому именно серверный сегмент определял динамику развития всего бизнеса компании в первом фискальном квартале, завершившемся в конце апреля. Соответственно, на серверный сегмент пришлось более 92 % общей выручки Nvidia. 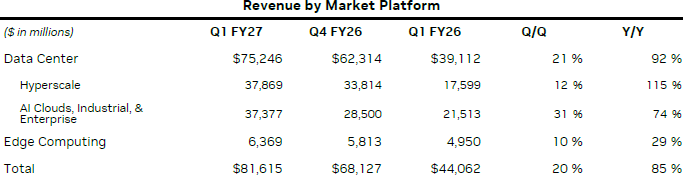 Внутри сегмента ЦОД выручка почти поровну разделилась между гиперскейлерами ($37,9 млрд) и всеми прочими клиентами ($37,3 млрд), включая корпоративных, облачных, государственных и промышленных. В первом случае выручка увеличилась год к году на 115 %, во втором — на 74 %. Помимо ЦОД, компания в своей отчётности упоминает и сегменте периферийных вычислений, выручка в котором увеличилась на 29 % до $6,4 млрд. По словам финансового директора компании Колетт Кресс (Colette Kress), если спрос на рабочие станции с решениями семейства Blackwell был высоким, то дефицит памяти навредил продажам ПК своими высокими ценами. Сетевые решения для ЦОД увеличили профильную выручку Nvidia в три раза до рекордных $14,8 млрд. Поставки ускорителей семейства Vera Rubin компания планирует начать во второй половине текущего года. Генеральный директор Nvidia признался, что эти ускорители наверняка будут в дефиците на протяжении основной части своего жизненного цикла. Отдельно подчёркивается, что за прошедший квартал в Китай не было поставлено ни одного ускорителя с архитектурой Hopper, тогда как год назад соответствующая выручка достигла $4,6 млрд. Несмотря на принципиальное согласие властей США на поставку в КНР ускорителей H200, китайская сторона не разрешила их импорт. Тем не менее, китайский рынок в целом принёс Nvidia в прошлом квартале $4,55 млрд — на 53 % меньше, чем годом ранее. Для сравнения, американская выручка Nvidia за год почти утроилась до $63,8 млрд, и это закономерно с учётом высокой концентрации в США облачных гигантов, которые закупают компоненты Nvidia для своих ЦОД. Колетт Кресс добавила, что не уверена, будет ли разрешён импорт ускорителей H200 в Китай. 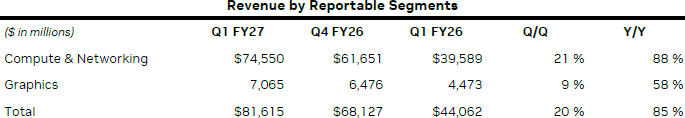 Если рассматривать разделение по функциональным сегментам, то вычислительные и сетевые решения увеличили выручку Nvidia на 88 % до $74,6 млрд, а направление графических решений прибавило 58 % до $7,1 млрд. В этом году Nvidia рассчитывает выручить $20 млрд на поставках центральных процессоров, что сделает одним из крупнейших поставщиков этого вида компонентов в денежном выражении. Ёмкость всего рынка CPU руководство компании оценивает в $200 млрд, и эта сумма не входит в тот $1 трлн, который Nvidia рассчитывает выручить на поставках ускорителей Blackwell и Rubin в период с 2025 по 2027 годы. Основатель Nvidia Дженсен Хуанг (Jensen Huang) ожидает, что центральные процессоры Vera станут вторым по величине источником выручки после ускорителей Blackwell и Rubin. В текущем квартале Nvidia рассчитывает выручить до $91 млрд, и это в среднем выше консенсус-прогноза аналитиков, но в данные ожидания компания не закладывает каких-либо поступлений от реализации серверных решений на китайском рынке. Норма прибыли Nvidia в текущем квартале сохранится на уроне 75 %. Было бы неверно утверждать, что операционные расходы компании не увеличиваются — в минувшем квартале они возросли на 52 %, но операционная прибыль всё равно увеличилась на 147 % до $53,5 млрд, а чистая прибыль достигла $58,3 млрд по методике GAAP, взлетев более чем в три раза в годовом сравнении. По итогам текущего года Nvidia может выручить более $370 млрд, если верить некоторым прогнозам. Это будет в 22 раза больше, чем за шесть лет до этого. SRAM какой-то: Nvidia представила чип Groq 3 LPU для ускорения инференса ИИ-моделей на уровне токенов
17.03.2026 [14:45],
Дмитрий Федоров
На прошедшей в этом году конференции GTC генеральный директор Nvidia Дженсен Хуанг (Jensen Huang) сообщил, что в этом году платформа Vera Rubin получит расширение. Nvidia использует для этого интеллектуальную собственность, приобретённую у Groq. В состав Rubin вошёл новый чип Nvidia Groq 3 LPU. Компания определяет его как ускоритель инференса. Его задача — выдавать токены в большом объёме и с низкой задержкой. 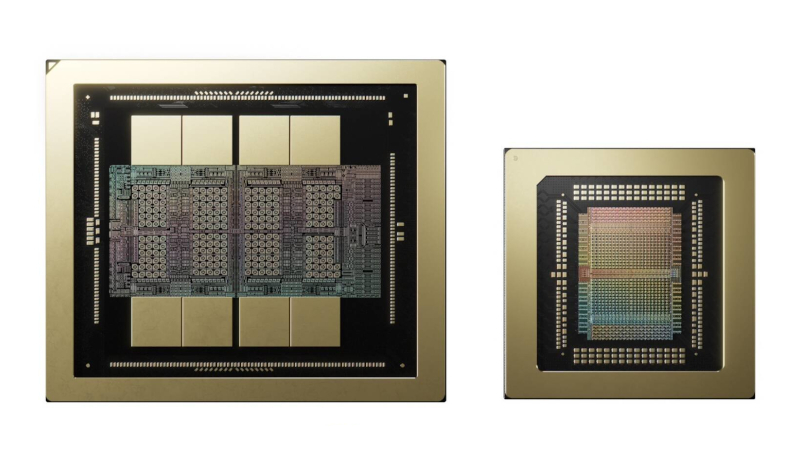
Источник изображений: Nvidia Платформа Rubin уже включает шесть компонентов, из которых Nvidia собирает стоечные системы и затем масштабирует их до ИИ-фабрик. Это GPU Rubin, CPU Vera, коммутаторы внутрисистемного масштабирования NVLink 6, интеллектуальный сетевой адаптер ConnectX-9, процессор обработки данных BlueField-4 и коммутатор межсистемного масштабирования Spectrum-X с совместно интегрированной оптикой. Groq 3 LPU стал новым элементом этой платформы и ещё одним строительным блоком Rubin при масштабном развёртывании. 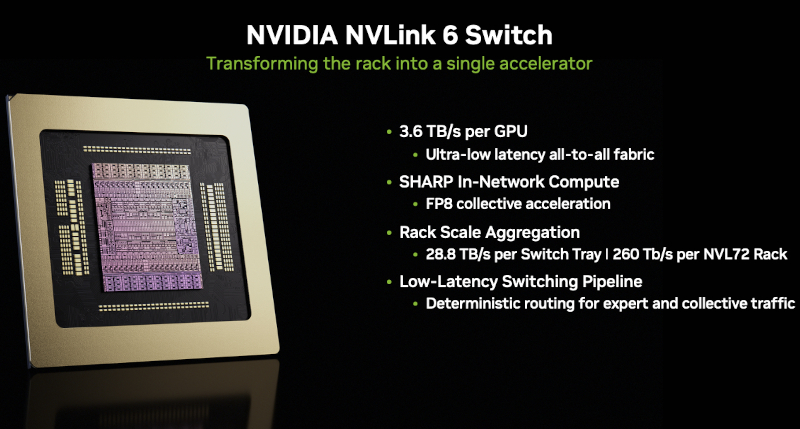 Groq 3 LPU отличается от большинства ИИ-ускорителей схемой памяти. Обычно такие системы используют HBM в качестве рабочего уровня памяти. Каждый Groq 3 LPU содержит 500 Мбайт SRAM. Для сравнения, каждый GPU Rubin оснащён 288 Гбайт HBM4. По ёмкости разница велика. По пропускной способности соотношение иное: SRAM обеспечивает до 150 Тбайт/с, а HBM4 — около 22 Тбайт/с. Для ИИ-задач, чувствительных к пропускной способности, рост этого показателя даёт преимущество при инференсе. Именно поэтому Nvidia вводит Groq 3 в состав Rubin. 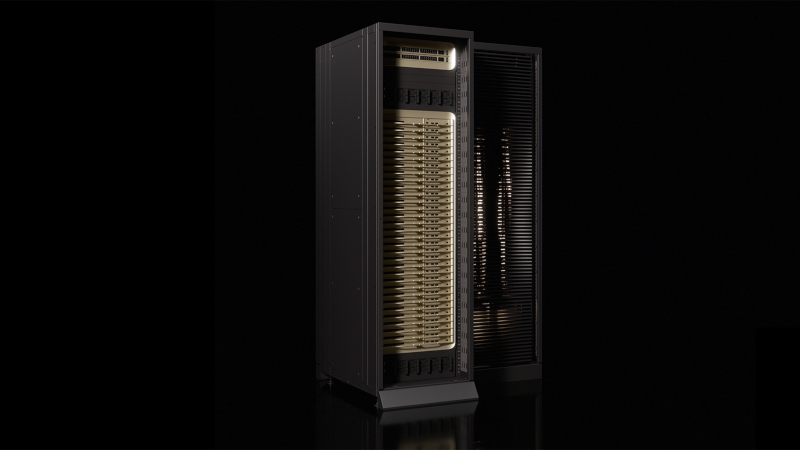 Стойка Groq 3 LPX включает 256 чипов Groq 3 LPU. Такая система располагает 128 Гбайт SRAM. Её суммарная пропускная способность достигает 40 Пбайт/с. Для объединения чипов внутри стойки предусмотрен выделенный интерфейс внутрисистемного масштабирования. Его пропускная способность составляет 640 Тбайт/с на стойку. 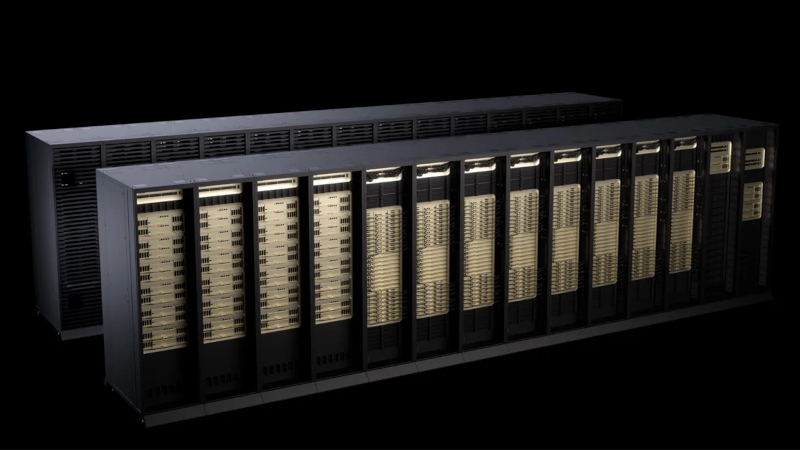 Вице-президент Nvidia по гипермасштабируемым решениям Иэн Бак (Ian Buck) назвал Groq LPX сопроцессором для Rubin. По его словам, он повысит производительность декодирования «на каждом слое ИИ-модели на каждом токене». Nvidia связывает это решение со следующим рубежом ИИ — мультиагентными системами. Речь идёт о сценариях, где нужно обеспечивать интерактивную работу при инференсе моделей с триллионами параметров и окнами контекста в миллионы токенов. 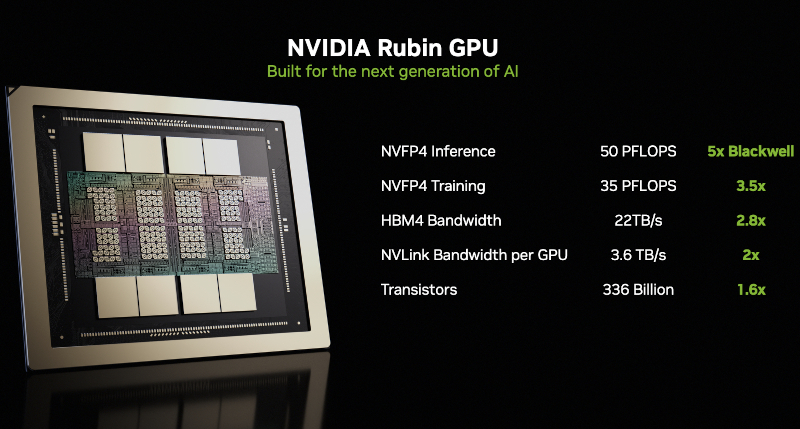 Когда ИИ-агенты всё чаще обмениваются данными друг с другом, а не с человеком в окне чат-бота, меняется и порог приемлемого отклика. Скорость, достаточная для человека, оказывается слишком низкой для ИИ-агента. Бак описывает переход от мира, где разумным считался уровень 100 токенов в секунду, к уровню 1 500 токенов в секунду и выше для межагентного обмена. 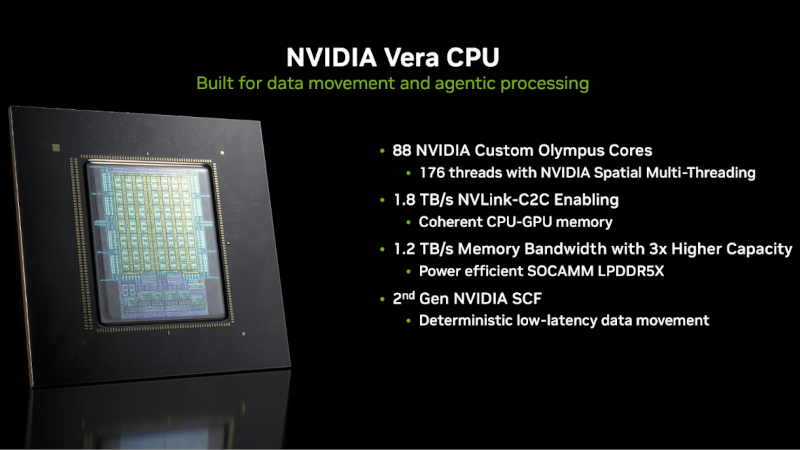 Добавление Groq 3 LPU должно усилить позиции Rubin в сегменте низколатентного инференса. В тексте в качестве конкурента названа Cerebras. Компания использует процессоры Wafer-Scale Engine (WSE), выполненные на целой кремниевой пластине, где большие объёмы SRAM объединены с вычислениями для низколатентного инференса на продвинутых моделях. OpenAI также привлекала мощности Cerebras для обслуживания части передовых моделей из-за выгодных характеристик задержки этой платформы. 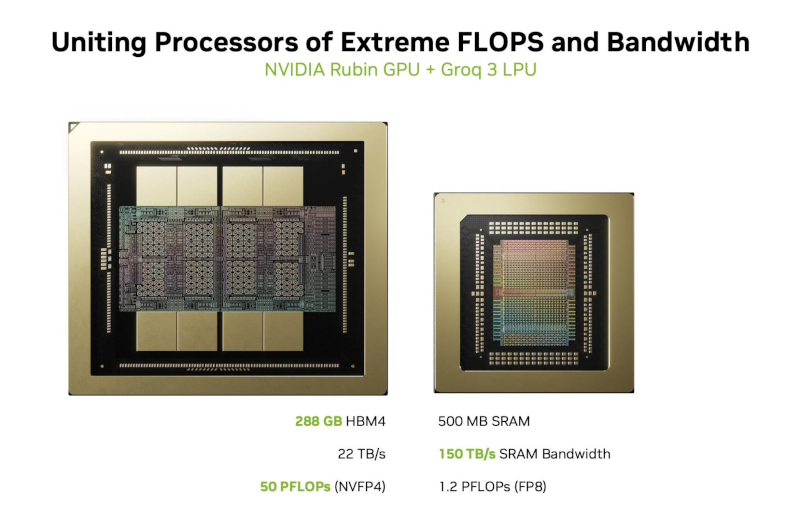 Иэн Бак также допустил, что появление Groq 3 LPU может сократить роль ускорителя инференса Rubin CPX. Он сказал, что сейчас Nvidia сосредоточена на интеграции стойки Groq 3 LPX с Rubin. Дополнительных подробностей он не привёл. При этом оба чипа рассчитаны на сходное усиление инференса, но Groq LPU не требует большого объёма памяти GDDR7, который нужен каждому модулю Rubin CPX. Micron запустила массовое производство памяти HBM4 для Nvidia Vera Rubin
17.03.2026 [10:41],
Алексей Разин
Поскольку на этой неделе Nvidia официально представила свою ИИ-платформу Vera Rubin, компания Micron Technology не нашла причин для дальнейшего сокрытия факта сотрудничества с ней в области поставок памяти типа HBM4. Было объявлено, что этот третий по счёту поставщик приступил к серийному производству микросхем HBM4 в 12-ярусном исполнении. 
Источник изображения: Micron Technology В одном стеке HBM4 при такой компоновке содержится 36 Гбайт памяти, которая способна передавать информацию со скоростью более 1 Гбит/с на контакт, обеспечивая совокупную пропускную способность на уровне 2,8 Тбайт/с. По сравнению с HBM3E той же марки, это соответствует росту пропускной способности в 2,3 раза и улучшению энергетической эффективности более чем на 20 %, как отмечает Tom’s Hardware. Micron Technology также отправила своим клиентам образцы 16-ярусных чипов HBM4 объёмом 48 Гбайт. По сравнению с 12-ярусным стеком, они обеспечивают увеличение удельной ёмкости на 33 %. Одновременно Micron объявила о начале массового производства твердотельных накопителей семейства 9650, обеспечивающих поддержку новейшего интерфейса PCI Express 6.0. Данные накопители обеспечивают скорость последовательного чтения до 28 Гбайт/с и 5,5 млн операций ввода-вывода в секунду на операциях произвольного чтения. По сравнению с накопителями, оснащаемыми интерфейсом PCI Express 5.0, это обеспечивает вдвое более высокое быстродействие на операциях чтения, энергоэффективность также увеличивается в два раза. Данные накопители оптимизированы для использования в составе стоек BlueField-4 STX, относящихся к платформе Vera Rubin. Кроме того, Micron представила модули памяти типа SOCAMM2 объёмом 192 Гбайт, также оптимизированные для решений Nvidia семейства Vera Rubin, включая стойки NVL72 и обособленные платформы на основе центральных процессоров Vera. Эти модули памяти будут предлагаться в диапазоне ёмкостей от 48 до 256 Гбайт. Платформа Vera Rubin поддерживает до 2 Тбайт оперативной памяти, а пропускная способность на один процессор достигает 1,2 Тбайт/с при использовании данной памяти. Все три новинки Micron уже производятся серийно и могут поставляться для нужд Nvidia и её партнёров, выпускающих решения семейства Vera Rubin. |
|
✴ Входит в перечень общественных объединений и религиозных организаций, в отношении которых судом принято вступившее в законную силу решение о ликвидации или запрете деятельности по основаниям, предусмотренным Федеральным законом от 25.07.2002 № 114-ФЗ «О противодействии экстремистской деятельности»; |
© 1997—2026 3DNews
При цитировании документа ссылка на сайт с указанием автора обязательна. Полное заимствование документа является
нарушением
российского и международного законодательства и возможно только с согласия редакции 3DNews.



 MWC 2018
 2018
 Computex

 IFA 2018









