


Опрос
|
реклама
Быстрый переход
Xiaomi выпустила ИИ-модель CocktailASR-1 для распознавания речи в шумных помещениях
11.09.2026 [17:43],
Павел Котов
Xiaomi представила открытую модель искусственного интеллекта CocktailASR-1. Она предназначена для решения одной из наиболее сложных задач в области расшифровки аудио — выделения голоса конкретного человека в ситуации, когда несколько людей говорят одновременно. 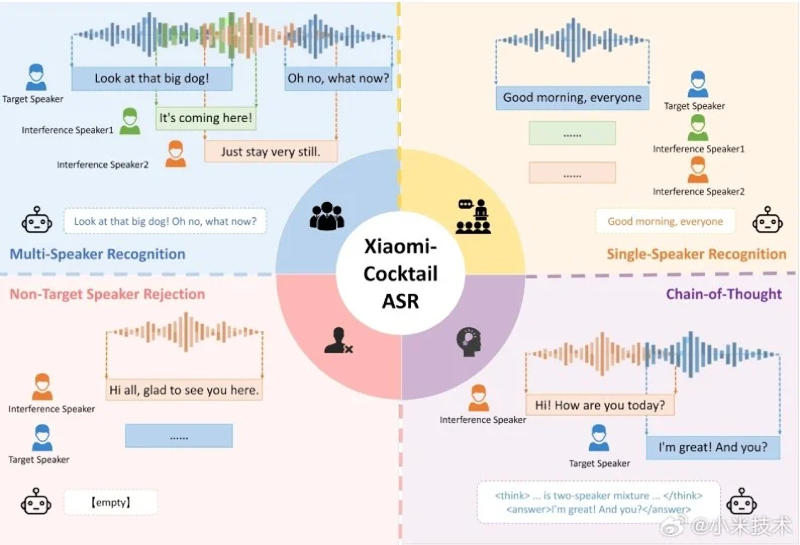
Источник изображения: Xiaomi В Xiaomi проблему условно обозначили как «эффект коктейльной вечеринки». Большинство специализированных ИИ-моделей справляются с распознаванием речи, когда говорит один человек, но если друг на друга накладываются несколько голосов, ситуация значительно усложняется. Текст искажается, предложения сливаются, а реплики приписываются не тем собеседникам. В обратном направлении компания решила эту задачу с моделью OmniVoice — CocktailASR-1 же не генерирует, а выделяет и расшифровывает речь. Для работы с моделью необходимо представить короткий образец с голосом нужного человека. Она использует его как эталон, а затем, проанализировав запись с несколькими участниками, распознает и расшифрует речь только этого человека. В ряде тестов по распознаванию речи в условиях многоголосных образцов она, отметили в Xiaomi, продемонстрировала ведущие результаты и превзошла существующие аналоги, предназначенные для решения той же задачи. Сложными условиями её возможности не исчерпываются — она умеет расшифровывать речь и в том случае, когда на записи голос только одного человека. Она также умеет избегать необоснованных предположений: если в предложенной записи указанный в качестве образца голос отсутствует, она выдаст пустой текст и не будет пытаться расшифровать слова другого человека. Наконец, у Xiaomi CocktailASR-1 есть режим цепочки рассуждений — он позволяет пользователям изучать логику, на основе которой выполнялась расшифровка, а не просто видеть итоговый текст. Новая модель доступна на GitHub и Hugging Face. OpenAI научила ИИ говорить и слушать одновременно — полнодуплексная модель GPT-Live-1 доступна разработчикам
11.09.2026 [16:06],
Павел Котов
OpenAI открыла через API доступ к новейшей голосовой модели искусственного интеллекта, поддерживающей полнодуплексный режим, то есть она может одновременно говорить и слушать. Это позволяет разработчикам создавать голосовые приложения с новыми сценариями диалогового взаимодействия. 
Источник изображения: Brecht Corbeel / unsplash.com Модель OpenAI GPT-Live-1 была анонсирована в июле — она позволяет вводить запросы не текстом, а голосом. Первоначально она была доступна только через интерфейс ChatGPT, а теперь может использоваться по API. Полнодуплексный режим позволяет GPT-Live-1 одновременно слушать и генерировать речь, что делает общение более естественным. В обычном разговоре люди часто говорят одновременно, и необходимость строго соблюдать очерёдность, как при полудуплексной радиосвязи, может вызывать раздражение. Особое внимание в OpenAI уделили возможностям настройки модели: внедряющие GPT-Live-1 разработчики могут адаптировать механизмы голосового взаимодействия и связанные с ними рабочие сценарии под нужды пользователей приложений. «Основное преимущество GPT-Live-1 — способность штатно обрабатывать ситуации, когда собеседник перебивает ИИ, — уже приносит бизнесу ощутимую пользу: в ходе предварительного тестирования сервис Speak установил, что GPT-Live-1 даёт ученикам больше времени перед ответом виртуального преподавателя языка, сократив случаи с перебиванием на 80 % по сравнению с предыдущими системами, работающими в режиме строгой очерёдности реплик», — рассказали в OpenAI. GPT-Live-1 предназначается для ведения устного диалога, в то время как модель в бэкенде, например, флагманская GPT-6 Astra или более экономичная для простых задач, занимается поиском информации, работает с инструментами и управляет задачами. Новая модель представляет собой шаг вперёд по сравнению с выпущенной в 2024 году Realtime. В тесте Tau3, который оценивает интеллектуальные возможности голосовых агентов при выполнении задач по обслуживанию клиентов, GPT-Live-1 набрала 86,2 %, а GPT-Realtime-2.1 и GPT-Realtime-2 показали 45,7 % и 42,4 % соответственно. Новая модель, по собственным оценкам OpenAI, демонстрирует на 30 % более высокую эффективность в тесте Full Duplex Bench по сравнению с GPT-Realtime-2.1, превосходя предшественницу по таким параметрам как задержка при смене говорящего и качество интерактивного взаимодействия. Её уже внедрили на сервисе Yelp Host — теперь бронирование столиков стало более естественным. Стоимость работы с GPT-Live-1 составляет $0,05 за минуту плюс затраты на работу модели в бэкенде. Она также доступна через OpenAI Presence — корпоративную платформу для создания интеллектуальных агентов. С Gmail, Google Docs и Keep теперь можно разговаривать — Gemini научился понимать голосовые команды
04.09.2026 [21:02],
Павел Котов
Google запустила функции голосового управления для помощника с искусственным интеллектом Gemini в приложениях семейства Workspace, в том числе Gmail, Keep и «Документы» — набирать текст вручную больше не требуется. 
Источник изображения: blog.google Модели Gemini Audio не просто расшифровывают текст — их задача в том, чтобы интерпретировать намерения пользователя и извлекать из его голосовых команд необходимую информацию. Функция Gmail Live позволяет, например, задать ИИ вопрос о том, куда пройти на посадку в самолёт, или что случилось в школе у ребёнка за последнюю неделю. Модель самостоятельно находит необходимую информацию, не требуя, чтобы пользователь сам указывал необходимое письмо. Функция Docs Live предполагает создание новых документов на основе запросов, которые пользователь отправляет естественным языком. К примеру, он отсылает Gemini материалы «мозгового штурма», а ИИ-помощник систематизирует идеи и формирует из них структурированный черновик. Дополнительными источниками данных могут выступать другие приложения Workspace, в том числе «Google Диск», Gmail и результаты поиска в интернете. Схожим образом работает Keep Live — речь пользователя преобразуется в оформленные заметки, а не переписывается слово в слово. Приоритетный доступ к Gmail Live и Keep Live уже открыт для подписчиков платных тарифов Google AI Plus, Pro и Ultra; воспользоваться Docs Live могут только обладатели подписки Pro и Ultra. «Независимо от того, ищете ли вы что-то в своей почте, организуете свои мысли или проводите мозговой штурм, новые возможности Gmail, Docs и Keep позволяют делать всё это в режиме диалога», — пояснили в Google. OpenAI и Google решили, что будущее ИИ — за голосом, а не текстом
06.08.2026 [13:24],
Павел Котов
OpenAI и Google вкладывают значительные средства в голосовые системы, которые хотят сделать основным способом взаимодействия человека с агентами искусственного интеллекта нового поколения, пишет Financial Times. 
Источник изображения: Marwan Ahmed / unsplash.com OpenAI и Google приложили значительные усилия, чтобы ИИ звучал не как робот, который читает с экрана, а как коллега, способный понимать запросы и контекст. Новые функции пользуются спросом у потребителей и бизнеса — их реализация помогла совершить прорыв по сравнению с традиционными голосовыми помощниками, которые преобразовывали речь в текст, генерировали текстовый ответ, а затем зачитывали его вслух. Новые модели обрабатывают и воспроизводят речь напрямую, задержки сокращаются, тон звучит естественно, контекст беседы не теряется. Разработчики делают ставку на то, что по мере перехода систем ИИ от ответов на вопросы к выполнению длительных задач, общение с ними будет становиться более естественным, чем ввод запросов в окно чат-бота. Обозначаются и слабые места нового формата: задержки, фоновый шум и психологический дискомфорт при общении с машиной в общественных местах. Пользователи ИИ-сервисов Google с начала года стали вдвое чаще пользоваться голосовым интерфейсом, и разговоры продолжаются в среднем в пять раз дольше, чем текстовые переписки. В OpenAI ChatGPT голосовым форматом еженедельно пользуются более 150 млн человек. И даже инженеры Microsoft стали использовать голосовой интерфейс для управления задачами программирования с ИИ на GitHub. Об удобстве голосового интерфейса в решении задач программирования говорят и в OpenAI. «Когда я печатаю, то зачастую сразу перехожу к решению задачи голосом. Когда я говорю, я более склонен объяснять, чего хочу достичь на самом деле, каковы мои намерения, какие ограничения имеют значение, в чем я не уверен, и как будет выглядеть хороший результат», — рассказал сотрудник OpenAI Сандро Джанелла (Sandro Gianella). Тенденцию уже подхватили стартапы Кремниевой долины. Они начали инвестировать в новые модели микрофонов и решения в области звукоизоляции офисов, чтобы оградить ИИ от фонового шума. Появляются устройства нового поколения, и даже OpenAI готовит гаджет с голосовым помощником — у него будут камера, микрофон и динамик. В Нью-Йорке стартап Sandbar разработал умное кольцо, которое позволяет отдавать команды или ставить задачи ИИ, и реагирует оно только на голос владельца. Xiaomi представила OmniVoice — открытую ИИ-модель, которая озвучит текст почти на любом языке и скопирует голос
08.05.2026 [10:45],
Павел Котов
Xiaomi объявила о выходе открытой модели искусственного интеллекта OmniVoice, предназначенной для преобразования текста в речь — помимо речевого синтеза на нескольких сотнях языков, она поддерживает клонирование голоса и настраиваемую генерацию речи. 
Источник изображения: Xiaomi OmniVoice, по словам разработчика, демонстрирует высокие показатели в китайском и английском языках, выступая конкурентом существующих коммерческих систем и превосходя их в ряде задач. Одним из главных преимуществ модели является поддержка языков даже с ограниченными ресурсами — она генерирует речь «почти на любом языке», даже если для него был доступен лишь небольшой объём обучающих данных. Кроме того, отметили в Xiaomi, это первая в отрасли модель для клонирования голоса с охватом нескольких сотен языков. По результатам многоязычного тестирования OmniVoice превзошла несколько коммерческих систем на 24 языках по сходству и разборчивости речи — даже при обучении на открытых наборах данных. При тестировании на 102 языках разборчивость речи OmniVoice была близка к человеческой, а в некоторых случаях и превосходила её. Высокое качество на выходе удалось обеспечить даже в тех случаях, когда по какому-либо языку было менее 10 часов обучающих данных. 
Источник изображения: Ali Khadem / unsplash.com По сравнению с современными системами синтеза речи OmniVoice отличает гораздо более простая архитектура: вместо подключения нескольких модулей и этапов прогнозирования здесь развёрнута единая двунаправленная сеть типа трансформер для прямого преобразования текста в речь. Не нужно отдельно моделировать текст, подключать сложные гибридные структуры и многоуровневые системы прогнозирования токенов. Упрощённая архитектура означает высокую скорость работы модели — всего за один день её можно обучить на 100 000 часов данных; а при инференсе (запуске) она работает на величину до 40 раз быстрее реального времени с использованием ИИ-фреймворка PyTorch, то есть относительно просто развёртывается в потребительских приложениях и сервисах. Высокую производительность OmniVoice, рассказали в Xiaomi, обеспечили при помощи двух решений. Во-первых, при обучении модели применили «метод случайного скрытия акустических кодов», что увеличило эффективность обучения и расширило общие возможности модели. Во-вторых, на этапе предварительного обучения к ней подключили большую языковую модель — она помогла повысить точность произношения и разборчивость речи. OmniVoice предлагает несколько практических функций. Модель может сгенерировать голос по описанным пользователем свойствам — учесть возраст, пол, высоту тона, акцент, диалект и стиль речи; без необходимости в эталоне можно генерировать шёпот и другие особые стили речи. Она также умеет удалять из образца шумы и извлекать чёткие характеристики голоса, чтобы копировать его даже тогда, когда исходный аудиофайл записывался в далёких от идеальных условиях. Есть также средства управления интонацией, генерируются вздохи и взрывы смеха, что делает производимую речь более естественной. Наконец, можно вручную корректировать сложные аспекты произношения, например, многозвучные китайские иероглифы или англоязычные имена собственные. Xiaomi представила ИИ-модели MiMo V2.5 для преобразования текста в речь и обратно
24.04.2026 [10:32],
Павел Котов
Xiaomi представила две модели искусственного интеллекта, предназначенные для работы с голосом. MiMo-V2.5-TTS позволяет преобразовывать текст в речь, предлагая широкие возможности настройки с минимальными усилиями; MiMo-V2.5-ASR — напротив, создаёт текстовые расшифровки по звуку речи и пения. 
Источник изображения: Xiaomi Семейство Xiaomi MiMo-V2.5-TTS включает три модели, которые какое-то время будут доступны бесплатно на платформе Xiaomi MiMo Studio. Базовая MiMo-V2.5-TTS позволяет преобразовывать текст в речь с минимальными возможностями: есть набор предустановленных голосов, а также функции настройки скорости речи, тона и эмоционального окраса. MiMo-V2.5-TTS-VoiceDesign позволяет создавать новые тембры голоса, используя короткую фразу. MiMo-V2.5-TTS-VoiceClone, как можно догадаться по названию, предназначена для воспроизведения определённого голоса по небольшому набору образцов, сохраняя согласованность по стилям и инструкциям. Чтобы добиться нужного результата, пользователь может разметить текст заданными тегами или поступить проще — простым естественным языком описать, как должен звучать голос. Можно даже составить сценарий для виртуальных постановок с несколькими голосами сразу. Поддерживаются инструкции на китайском и английском языках. Открытая модель Xiaomi MiMo-V2.5-ASR предназначена для распознавания устной речи даже в сложных условиях. Она поддерживает несколько китайских диалектов и английский язык, может создавать расшифровки двуязычных диалогов, даже записывать тексты песен, разбирая вокал, который звучит вместе с музыкой, а также распознавать речь в условиях сильного постороннего шума. Важным достоинством Xiaomi MiMo-V2.5-ASR является поддержка пунктуации — знаки препинания расставляются на основе интонаций. Это значит, что для готовой расшифровки достаточно минимальных усилий по редактированию. Разработана система генерации голосовых дипфейков в реальном времени, и её наверняка будут использовать мошенники
25.10.2025 [17:59],
Павел Котов
Специализирующаяся на технологиях кибербезопасности компания NCC Group создала работающий на основе искусственного интеллекта метод воссоздания голоса любого человека, функционирующий в реальном времени. Система построена на общедоступных программных решениях и общедоступном оборудовании. 
Источник изображения: Vitaly Gariev / unsplash.com Средство для создания голосовых дипфейков в реальном времени после обучения активируется всего одним нажатием кнопки — управление осуществляется при помощи веб-интерфейса, и потенциальный злоумышленник может изобразить из себя кого угодно. Невысоким может быть и качество входного сигнала — голос на выходе всё равно звучит убедительно, а задержка оказывается незначительной. Это значит, что данное решение можно использовать даже с микрофонами, встроенными в ноутбуки и смартфоны. Работа в режиме реального времени — важное преимущество. Существующие технологии подделки голоса на выходе выдают звуковой файл. То есть злоумышленник может заранее записать реплики, но потенциальная жертва легко разоблачит схему, если разговор отклонится от ожидаемого сценария. А если мошенник попробует сгенерировать дипфейк на лету, его выдаст задержка в разговоре. Инженеры NCC Group опробовали свою технологию на собственных клиентах — с их разрешения, конечно — и те ни разу не заметили подвоха. В программной части решения используются инструменты с открытым исходным кодом, а для эффективной работы аппаратной желательно использовать мощные видеокарты, но и ноутбук с одной из наименее производительных в актуальной линейке Nvidia RTX A1000 давал задержку всего в полсекунды. К счастью дипфейки с видеорядом пока не работают в реальном времени. Сейчас крупные соцсети, в том числе TikTok, YouTube и Instagram✴✴ захлестнула очередная волна видеодипфейков, для создания которых используются два инструмента: генератор картинок Google Gemini Flash 2.5 Image (он же Nano Banana) и открытый генератор видео Alibaba WAN 2.2 Animate — они позволяют добавлять на видеоролик любого человека. Слабой стороной дипфейков с видео пока остаётся недостаточная согласованность картинки и звукового ряда — мимика не всегда соответствует интонациям, а если человек якобы взволнован, но его лицо остаётся спокойным — это, вероятно, подделка. Но новые решения заставляют задуматься о необходимости усовершенствовать средства защиты: методы аутентификации теперь не должны полагаться на голосовые и видеозвонки, предупреждают эксперты. Холодильники Samsung научились узнавать членов семьи по голосу
11.06.2025 [19:27],
Сергей Сурабекянц
Новейшие умные холодильники Samsung теперь поддерживают распознавание голосов членов семьи с помощью фирменного ИИ-помощника Bixby. Он может использоваться для вывода персонализированной информации на встроенные умные дисплеи в зависимости от того, кто из членов семьи говорит. В условиях отсутствия у Samsung собственной линейки умных колонок, бытовые приборы остаются единственным реальным путём для применения такого рода персонализации. 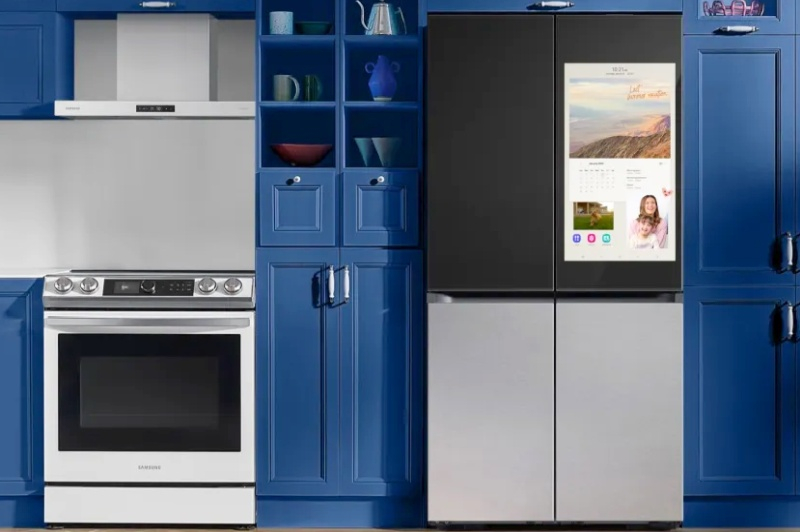
Источник изображений: Samsung Маркетологи Samsung уверяют, что главное преимущество такого холодильника заключается в возможности отображения календаря или личной фотогалереи каждого члена семьи на основе распознанных голосовых команд. Холодильник можно будет попросить включить будильник на смартфоне или просто отыскать утерянный гаджет (особенно актуально, если он оказался внутри холодильника). Распознавание голоса может оказаться полезным для людей с ослабленным зрением, например умный холодильник может автоматически изменить режим отображения своего экрана в соответствии с настройками смартфона, такими как инверсия цвета или оттенки серого. Samsung добавила новый способ активации ИИ-помощника Bixby на своих холодильниках. Помимо нажатия на значок Bixby или использования голосовых команд, теперь можно просто дважды нажать на выключенный дисплей холодильника. 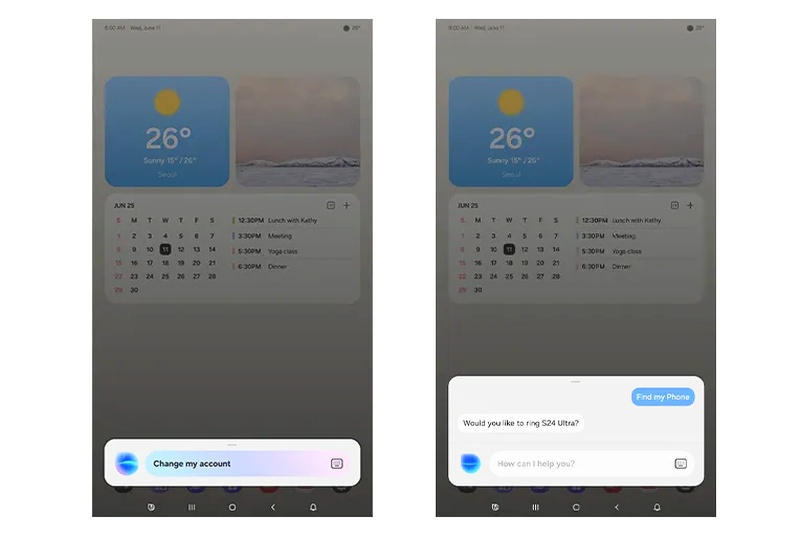 Функция распознавания голоса и новый способ вызова Bixby появятся в обновлении для холодильников Samsung Bespoke AI с Family Hub, начиная с моделей 2025 года, а позже будут развёрнуты на устройствах с меньшими дисплеями AI Home. Конечно, прогресс не стоит на месте. Но буквально десять лет назад человека, разговаривающего с холодильником, могли запросто (и вполне обоснованно!) отправить в психиатрическую клинику. Apple разработала ИИ, выявляющий нетипичные аспекты устной речи — это поможет диагностировать заболевания
06.06.2025 [18:07],
Павел Котов
В рамках проекта, посвящённого голосовым и речевым моделям искусственного интеллекта, Apple опубликовала материалы (PDF) нового исследования, касающегося одной из сложных проблем машинного обучения: распознавание не только того, что было сказано человеком, но и того, как это было сказано. 
Источник изображения: Slavcho Malezan / unsplash.com В статье исследователи описывают схему анализа речи с использованием параметров качества голоса (Voice Quality Dimensions — VQD). Эти параметры указывают на разборчивость, резкость, монотонность речи, придыхание и другие аспекты. На них обращают внимание и логопеды, когда оценивают звучание голоса и влияние на него неврологических состояний и заболеваний. Apple работает над моделями ИИ, также способными их обнаруживать. Большинство речевых моделей обучается на здоровых и типичных для большинства голосах. Если голос человека звучит иначе, ИИ может дать сбой, и это большой недостаток системы, если ей пытается воспользоваться человек с ограниченными возможностями. В работе над этой проблемой исследователи Apple обучили несколько дополнительных моделей ИИ, предназначенных для работы совместно с основными речевыми системами, на большом общедоступном наборе данных аннотированной нетипичной речи, в том числе на голосах людей с болезнью Паркинсона, боковым амиотрофическим склерозом (БАС) и детским церебральным параличом (ДЦП). На этом инженеры компании не остановились — они не стали использовать эти модели для прямой расшифровки сказанного, а составили методику измерения того, как звучит голос, на основе семи основных критериев:
Источник изображения: Iluha Zavaley / unsplash.com Таким образом, ИИ научился «слушать как врач», а не просто регистрировать то, что говорят. Для извлечения звуковых характеристик Apple использовала пять моделей ИИ и обучила дополнительные легковесные алгоритмы, чтобы на основе этих характеристик предсказывать параметры качества голоса. Разработанные компанией дополнительные алгоритмы показали высокие результаты по большинству параметров, хотя качество срабатывания варьировалось в зависимости от конкретного признака и всей задачи. Важнейшим достоинством исследования стало то, что ответы моделей оказались объяснимыми — в отрасли ИИ это встречается нечасто. Вместо того, чтобы показывать условную оценку достоверности (confidence score), система указывает на конкретные характеристики голоса, что упрощает классификацию. Это поможет в клинической оценке и диагностике. Но и на клинической речи в Apple не остановились. Исследователи протестировали свои модели на образцах эмоциональной речи из набора данных RAVDESS: модели VQD не обучались на эмоциональных записях, но также давали прогнозы. Так, в сердитой речи отмечалась низкая «равномерность громкости», а грустные голоса воспринимались как монотонные. Возможно, это поможет улучшить и голосового помощника Apple Siri, который сможет корректировать свои интонации и речь в зависимости от того, как интерпретирует настроение и состояние пользователя, а не только сказанное им. Amazon представила голосовую ИИ-модель Nova Sonic
08.04.2025 [17:47],
Павел Котов
Amazon представила модель генеративного искусственного интеллекта Nova Sonic, способную обрабатывать голос и генерировать речь, которая звучит естественно. В тестах на замеры скорости, распознавание речи и качество разговора Sonic зарекомендовала себя как конкурентоспособная в сравнении с передовыми голосовыми моделями OpenAI и Google. 
Источник изображений: aboutamazon.com Nova Sonic — ответ Amazon на новые голосовые модели ИИ, такие как лежащая в основе звукового режима ChatGPT; все они предлагают более естественные форматы общения, чем ранние версии голосового помощника Alexa. Технологические прорывы последних лет позволили сделать устаревшие модели и цифровых помощников, включая Alexa и Apple Siri, намного более естественными во взаимодействии с человеком. Модель Nova Sonic доступна через Bedrock — предлагаемую Amazon платформу для разработчиков корпоративных приложений с ИИ; поддерживается двунаправленный потоковый API. Nova Sonic, добавили в Amazon, обходится в эксплуатации на 80 % дешевле, чем мультимодальная OpenAI GPT-4o, а её компоненты уже работают в обновлённом варианте Alexa+. Она превосходит конкурентов в маршрутизации пользовательских запросов к различным API — модель «знает», когда ей необходимо в реальном времени извлечь информацию из интернета, проанализировать собственный источник данных или выполнить действие во внешнем приложении — и использовать для этого соответствующий инструмент. Во время двустороннего диалога Nova Sonic ждёт, чтобы заговорить «в подходящее время», учитывая свойственные собеседнику паузы и запинки. Она также составляет текстовую расшифровку речи пользователя, которую разработчики могут использовать для различных приложений. 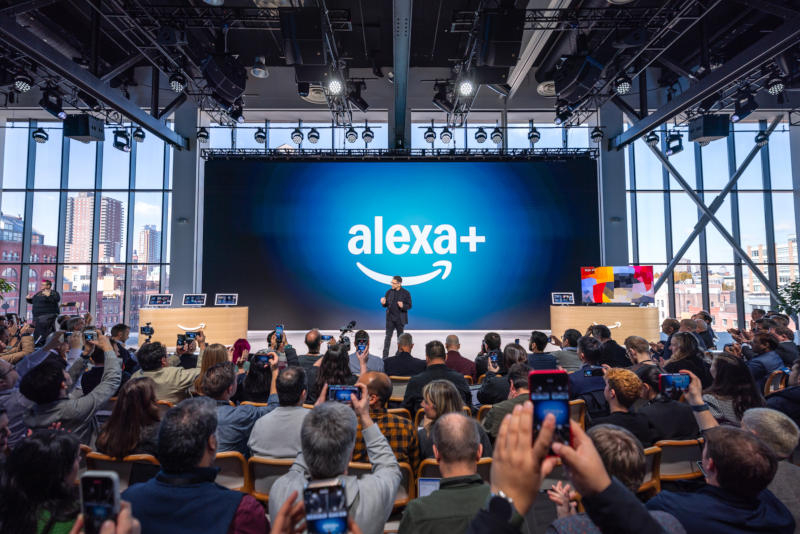 В задачах, связанных с распознаванием речи, она менее склонна к ошибкам, чем другие голосовые модели ИИ, то есть относительно хорошо понимает пользователя, даже если он бормочет, говорит с ошибками или находится в шумной обстановке. В эталонном тесте Multilingual LibriSpeech, позволяющем оценить качество распознавания речи на разных языках и диалектах, Nova Sonic показала коэффициент ошибок в словах (WER) всего 4,2 % в среднем по английскому, французскому, итальянскому, немецкому, и испанскому языках. То есть при подготовке расшифровки речи она неверно распознает примерно четыре из ста слов по сравнению с человеком. В бенчмарке Augmented Multi Party Interaction, оценивающем качество разговора вслух с несколькими участниками, Nova Sonic оказалась на 46,7 % точнее по критерию WER, чем OpenAI GPT-4o-transcribe. Модель от Amazon также оказалась очень быстрой — её средняя задержка составила 1,09 с против 1,18 с, которую показала GPT-4o, лежащая в основе OpenAI Realtime API. Компания намеревается представить ещё несколько моделей ИИ, способных к обработке изображений, видео, голоса и «других сенсорных данных, которые необходимы при переносе в физический мир». Поговорить с ChatGPT теперь можно в веб-версии сервиса — там появился голосовой интерфейс Advanced Voice Mode
20.11.2024 [00:33],
Николай Хижняк
Компания OpenAI запустила голосовой интерфейс Advanced Voice Mode в веб-версии сервиса ChatGPT. Об этом через свою страницу в соцсети X сообщил директор по продуктам компании Кевин Вейл (Kevin Weil). Продвинутый голосовой интерфейс по-прежнему доступен только платным пользователям ChatGPT. 
Источник изображения: Mariia Shalabaieva / unsplash.com Голосовой интерфейс Advanced Voice Mode стал доступен для владельцев подписок Plus, Enterprise, Teams или Edu теперь и в веб-версии сервиса ChatGPT. С момента своего дебюта в сентябре продвинутый интерфейс был доступен только в мобильной версии ChatGPT для iOS и Android. Голосовой интерфейс Advanced Voice Mode использует аудиовозможности ИИ-модели GPT-4o, предлагая естественное общение в реальном времени между пользователем и ChatGPT. Чат-бот способен понимать и реагировать на невербальные сигналы пользователя, включая такие вещи, как скорость речи. Кроме того, он может реагировать с «эмоциями». Для начала разговора в веб-версии чат-бота необходимо выбрать значок «Голос» в правом нижнем углу у поля ввода запросов к ChatGPT. Затем необходимо предоставить браузеру разрешение на доступ к микрофону вашего компьютера. После начала голосового чата пользователь попадёт на экран с синим шаром в центре.  Функция предлагает на выбор один из девяти голосов для ChatGPT, каждый из которых имеет свой собственный тон и характер. Например, можно выбрать «лёгкий и универсальный стиль Arbor» или «уверенный и оптимистичный Ember». По словам Вайля, OpenAI планирует «в ближайшие недели» внедрить голосовой формат общения с ChatGPT и для бесплатных пользователей. Владельцы подписок Plus и Team могут использовать голосовой формат Advanced Voice Mode лишь определённое количество времени в сутки.  Система уведомит, когда у пользователя останется последние 15 минут ежедневного доступа к голосовому общению с ИИ-ботом. Бесплатным пользователям будет предлагаться доступ на непродолжительное время для знакомства с функцией. |
|
✴ Входит в перечень общественных объединений и религиозных организаций, в отношении которых судом принято вступившее в законную силу решение о ликвидации или запрете деятельности по основаниям, предусмотренным Федеральным законом от 25.07.2002 № 114-ФЗ «О противодействии экстремистской деятельности»; |
© 1997—2026 3DNews
При цитировании документа ссылка на сайт с указанием автора обязательна. Полное заимствование документа является
нарушением
российского и международного законодательства и возможно только с согласия редакции 3DNews.



 MWC 2018
 2018
 Computex

 IFA 2018







