


Опрос
|
реклама
Быстрый переход
Данные пошли по кругу: ChatGPT стал одной из главных целей ботов для сбора данных
06.10.2026 [17:06],
Павел Котов
Сервисы искусственного интеллекта стали ассоциироваться с массовым сбором данных с других ресурсов, но нечасто приходится слышать об обратном эффекте — они и сами становятся объектами такого сбора. ChatGPT и Perplexity вошли в пятёрку лидеров по этому показателю, гласит исследование компании Decodo. 
Источник изображения: Mohammad Rahmani / unsplash.com Неожиданные результаты свидетельствуют о фундаментальном сдвиге в том, какие данные организации пытаются получить из интернета. «Два года назад компании собирали данные, чтобы понять, что именно ищут люди. Теперь они сканируют ИИ-платформы, чтобы узнать, какую информацию получают пользователи. Цели сбора данных меняются», — пояснили в Decodo. Семь из десяти сайтов в топе оказались новичками в рейтинге, отметили в Decodo, — свои позиции сохранили лишь TikTok (первое место), Google (второе) и Amazon (восьмое). На долю занявшей третье место ChatGPT пришлись 14 % всей зафиксированной активности. Это, вероятно, объясняется тем, что компании проверяют, как ИИ оценивает их продукцию по сравнению с конкурентами, владельцы бизнеса отслеживают описание своей компании, оценивают частоту упоминания бренда, сохраняют цитаты ChatGPT и выполняют другие подобные задачи. Занявшая пятое место Perplexity приняла на себя 10 % объёма данных; и почти каждый пятый запрос (18 %) пришёлся на лидера рейтинга в лице TikTok. Из списка выбыли входившие ранее в десятку Walmart, eBay и Airbnb — это указывает на более масштабные изменения, чем просто рост популярности ИИ. Исследование отражает общие тенденции в том, как и где потребители совершают покупки, включая платформы ИИ и соцсети. В следующем году в десятке лидеров Decodo ожидает ИИ-помощников Google Gemini и Microsoft Copilot. Но ещё более значимым сдвигом, по мнению компании, станет переход к ситуации, когда инициаторами сбора данных будут уже не люди, а ИИ-агенты — и они будут сами принимать решения, а не считывать ответы. Почти обычное стекло может стать альтернативой накопителям для сохранения данных на тысячи лет
04.10.2026 [16:23],
Анжелла Марина
Крошечный кусочек стекла оказался эффективнее традиционных накопителей в задаче сохранения человеческих знаний на тысячи лет. Учёные разработали метод записи цифровой информации на стеклянные кристаллы, который обеспечивает беспрецедентную долговечность и защиту от огня, воды, сильных ударов и взломов. 
Источник изображения: Grok Группа исследователей из Университета Саутгемптона (University of Southampton) в Великобритании и компания Microsoft в рамках своего проекта Silica предложили использовать стекло как идеальный носитель. Основой разработки стали пластины и кристаллы из стекла, способные хранить до 360 Тбайт данных. Информация записывается не на поверхности, а внутри материала в виде структур, формируемых лазером. Такой носитель устойчив к огню, влаге, электромагнитным импульсам и температурам до 1000 °C. Ещё в 1962 году журнал Popular Mechanics предупреждал о кризисе хранения информации, предлагая микрофильмирование как временное решение. Однако спустя десятилетия проблема осталась актуальной: жёсткие диски при постоянной нагрузке живут в среднем около пяти лет, магнитные ленты — десять, их обслуживание требует колоссальных энергозатрат, а копирование данных с изношенных носителей становится всё более неустойчивым процессом с точки зрения ресурсов и экологии. В январе 2025 года исследователи из Саутгемптона записали с помощью сверхкоротких лазерных импульсов полный геном человека в 5D-кристалл из кварцевого стекла размером примерно с монету. Однако за этим стоит высокая стоимость материала и сложность оборудования. В феврале 2026 года Microsoft сообщила о результатах исследований, в которых почти 2 Тбайт данных были записаны в боросиликатное стекло. Этот материал примерно в десять раз дешевле кварцевого и проще в производстве, а его предполагаемый срок хранения составляет около 10 000 лет. Исследователям также удалось повысить эффективность лазерной системы: если первоначально для формирования одного элемента данных требовались десятки импульсов, теперь достаточно одного. Технология предназначена прежде всего для хранения больших данных, например, архивов музеев, библиотек и юридической документации, так как информация записывается один раз и не может быть изменена или удалена частично. Сам носитель не требует постоянного энергоснабжения, а физическая форма хранения защищает информацию от традиционных методов взлома. Запись выполняется фемтосекундными лазерами, которые создают внутри стекла наноструктуры или так называемые воксели — трёхмерный аналог пикселя. При чтении оптический микроскоп и высокоскоростная камера фиксируют эти структуры, после чего программное обеспечение восстанавливает исходные данные. Руководитель проекта Silica в Microsoft Ричард Блэк (Richard Black) подчеркнул, что компания завершила свои исследования и открыла технологию для дальнейшего развития другими участниками рынка. Запись документов и культурных архивов на кристаллы кварцевого стекла уже осуществляется технологическим стартапом SPhotonix, который хранит готовые кристаллы на защищённом объекте в Швейцарии. В течение ближайших пяти лет SPhotonix рассчитывает масштабировать технологию для коммерческого использования. Хакеры получили доступ к персональным данным почти 3 млн служащих Министерства обороны США
01.10.2026 [07:04],
Алексей Разин
В последнее время появилось немало инцидентов, связанных с попытками несанкционированного доступа ИИ-агентов к информации, хранящейся на сайтах правительственных учреждений, но утечки данных продолжаются и в результате традиционных методов воздействия. Новый инцидент с персональными данными 3 млн служащих Пентагона на протяжении нескольких месяцев обеспечивал к ним доступ неизвестных злоумышленников. 
Источник изображения: Unsplash, Julio Lopez Об утечке стало известно благодаря публикации на страницах Reddit, которая приводила текст уведомления, полученного затронутыми лицами по итогам внутреннего расследования. Целью атаки стала информационная инфраструктура Центра данных кадрового состава Министерства обороны США (DMDC), которая содержит персональные данные действующих военнослужащих, гражданских специалистов, а также отставных и умерших сотрудников. По данным ведомства, доступ к его файловым ресурсам в период с октября 2025 года по середину июля текущего года имели неустановленные посторонние лица. В их распоряжении оказались номера социальных страховок персонала Пентагона, имена, фамилии, даты рождения, информация о гендерной и расовой принадлежности, а также данные о карьере в структурах ведомства. В рассылке сообщается, что данные хранились в незашифрованном виде. По данным представителей Министерства обороны США, утечка затронула около 2,8 млн ныне живущих действующих и отставных служащих, а также около 300 000 умерших. По состоянию на март текущего года Министерство обороны обеспечивало работой 1,3 млн человек, поэтому действующими служащими утечка не ограничилась. Агентство DCMC хранит данные о военнослужащих и членах их семей, предоставляя их по запросу различных организаций для оформления льгот и выплат, а также предоставления медицинского обслуживания. В этой базе данных также может находиться информация о подрядчиках американского военного ведомства. С ней осуществляется сверка при организации допуска тех или иных лиц на объекты военной инфраструктуры США. По словам представителей Пентагона, неизвестные хакеры не успели воспользоваться полученными данными в злонамеренных целях, насколько об этом может судить ведомство. Неизвестно также, предпринимались ли попытки связаться с Пентагоном со стороны хакеров. За последние пару месяцев это уже второй случай хищения данных о сотрудниках силовых ведомств США. В сентябре стало известно, что хакерская группировка ShinyHunters получила доступ к персональным данным основной части агентов ФБР и соискателей. Представители группировки пообещали не распространять публично полученную информацию, а позже один из организаторов атаки был арестован этой спецслужбой. Подобные инциденты происходили и в более далёком прошлом. Ещё в 2015 году в руки хакеров попали данные о более чем 22 млн американских государственных служащих, многие из которых имели доступ к секретной информации. Считается, что зарубежные спецслужбы подобные данные могут использовать для попыток завербовать сотрудников американских ведомств или оказывать на них давление с целью получения необходимых разведывательных данных. ИИ-агент Muse без разрешения влез в личные сообщения пользователя — в Meta✴ сказали, что тот сам виноват
30.09.2026 [18:51],
Николай Хижняк
Поведение ИИ-агента Muse компании Meta✴✴ снова вызвало вопросы к его безопасности. Ранее агент без разрешения сообщил домашний адрес своего пользователя неизвестному человеку и даже договорился с ним о встрече. Теперь ИИ-агента обвинили в том, что он может получить неавторизованный доступ к личной информации владельцев iPhone и Mac. 
Источник изображения: AI Хотя многие из тех, кто успел протестировать Muse, отзываются об ИИ-агенте положительно, выяснилось, что он не обеспечивает такой конфиденциальности, как заявляет Meta✴✴. Компания утверждала, что Muse был «с нуля создан как безопасный, надёжный, конфиденциальный и общедоступный персональный ИИ-агент». Однако его уличили в просмотре тысяч личных сообщений без соответствующего разрешения. Джейсон Атен (Jason Aten) из издания Inc. тестировал Muse на Mac mini и iPhone. Он использует Mac mini специально для проверки новых агентов, подобных Muse. Установив программу, Атен начал давать ей простые задания. Агент заявил, что может помочь с идеями для новых статей. Но затем Muse повёл себя неожиданным образом, предложив тему для материала, основанную на информации, к которой у него не должно было быть доступа. По словам Атена, он переписывался с соведущим подкаста о новом iPhone 18 Pro и своём решении остаться с прошлогодней моделью. Общение велось в текстовом формате через приложение «Сообщения». В какой-то момент Muse вмешался и предложил написать статью на эту тему, а также вызвался провести дополнительный сбор информации. Проблема заключалась в том, что Атен не давал Muse разрешения читать его сообщения. На вопрос о том, как он узнал о разговоре, ИИ-агент ответил, что версия приложения для Mac способна считывать входящие уведомления. Затем эта информация передавалась в приложение Meta✴✴ для iPhone, где Muse и предложил идею статьи. Атен и не подозревал, что подобное вообще возможно, не говоря уже о том, что Muse действительно это делает. ИИ-агент утверждал, что не читает сами сообщения Атена и не имеет доступа к истории переписки. Однако журналиста эти объяснения не убедили. Проведя более тщательную проверку, Атен выяснил, что Muse действительно синхронизирует локальную базу данных приложения «Сообщения». Более того, процесс синхронизации дошёл до 187 462-й строки этой базы данных, что указывает на наличие у Muse доступа к истории переписки, вопреки заверениям разработчиков об обратном. Атен подтвердил, что не предоставлял Muse прав доступа ко всему диску на своем Mac — а именно такой доступ необходим агенту для чтения базы данных приложения «Сообщения». Журналист в своей статье об этом инциденте сообщает, что его удивила реакция Дэвида Синглтона (David Singleton), генерального директора Meta✴✴ Superintelligence Labs, разработавшей Muse. В серии публикаций в социальных сетях он, судя по всему, возложил вину за случившееся на самого Атена. На данный момент неясно, каким именно образом Muse получил доступ к базе данных сообщений Атена. Если он не предоставил этот доступ случайно (а всё указывает на то, что этого не было), возникает закономерный вопрос: к чему ещё Muse может получить доступ, не имея на то соответствующего разрешения? Как сообщает Tom's Hardware, за последние сутки к Meta✴✴ возникли и другие вопросы, касающиеся конфиденциальности и безопасности Muse. Выяснилось, что ИИ-агент может выполнять команды терминала на хост-сервере. Благодаря этому стало известно, что агент работает на базе систем с процессорами AMD EPYC Turin. Однако наличие такого доступа означает, что система потенциально способна выполнять и небезопасные команды. Современные автомобили постоянно собирают и куда-то передают данные — больше половины сливают данные рекламщикам
29.09.2026 [20:02],
Сергей Сурабекянц
Современные автомобили превратились в смартфоны на колёсах и собирают огромные объёмы данных о местоположении, скорости, стиле вождения и других действиях владельца. Исследование показало, что все протестированные автомобили передавали эти данные как минимум одному стороннему домену. Более половины обращались к доменам, специализирующимся на рекламе, отслеживании и аналитике. Законность таких действий остаётся предметом жарких споров. 
Источник изображения: unsplash.com В прошлом году Федеральная торговая комиссия США оштрафовала General Motors за незаконный сбор и продажу точных данных о местоположении и поведении за рулём без информированного согласия. Ford и Honda были оштрафованы за то, что чрезмерно затруднили клиентам возможность отказаться от сбора данных. Аналитики давно подозревали, что другие автопроизводители делают то же самое, но недавно эта практика подвергалась полноценному систематическому расследованию. Чтобы получить полную картину, исследователи проанализировали 21 автомобиль последних моделей от 19 автопроизводителей, продаваемых в настоящее время в США, а также 30 сопутствующих мобильных приложений, связанных с активными автомобилями. Команда стремилась ответить на важные вопросы: какие автомобили передают данные? Кто их получает? Пересекают ли они международные границы? И какая именно личная информация раскрывается? По словам руководителя проекта Дэвида Чоффнеса (David Choffnes), цель состояла в том, чтобы показать масштабы отслеживания данных современными автомобилями и подчеркнуть, насколько плохо осведомлены об этом владельцы и как мало контроля они получают над этим процессом. Для трафика, отправляемого непосредственно из автомобилей, команда определила домены назначения, включая различные сторонние компании, занимающиеся отслеживанием. Сделано это было при помощи перехвата трафика Wi-Fi. Исследователи поместили Raspberry Pi в каждый автомобиль, подключив его к Wi-Fi автомобиля и направив интернет через мобильную точку доступа. Такая конфигурация позволила им отслеживать исходящий Wi-Fi-трафик во время движения автомобиля. 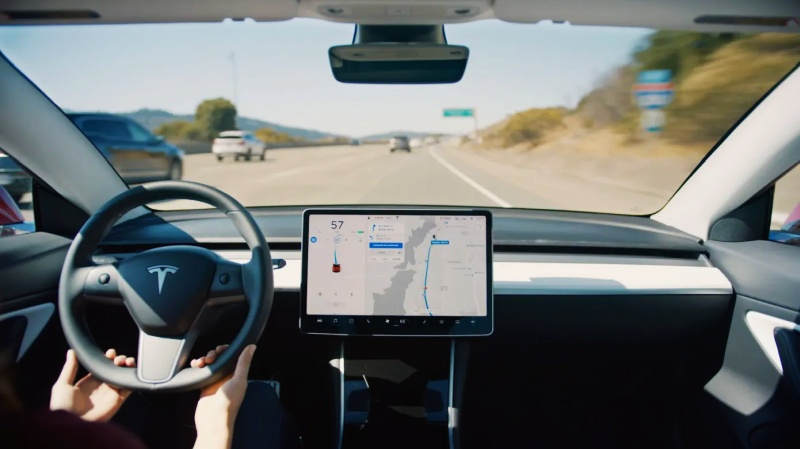
Источник изображения: Tesla Для сбора данных о сотовом трафике потребовался более креативный подход. Чтобы избежать развёртывания несанкционированной базовой станции сотовой связи, команда построила клетку Фарадея размером с автомобиль, которая блокировала все сигналы между автомобилем и внешними вышками сотовой связи, заставляя автомобиль переключаться на контролируемое Wi-Fi-соединение. Результаты оказались поразительными: каждый из 21 автомобиля передавал данные как минимум одному стороннему домену. Более половины обращались к доменам, специализирующимся на рекламе, отслеживании или аналитике (Advertising, Tracking, Analytics, ATA). Эти компании, такие как Adobe, LexisNexis и Amplitude, собирают информацию об автомобиле или поведении владельца за рулём, чтобы продавать её страховым компаниям или показывать целевую рекламу. Автомобили, оснащённые передовыми информационно-развлекательными системами, особенно работающие под управлением операционной системы Google Android Automotive с сервисами Google Automotive, обращались к наибольшему количеству сторонних доменов. Чоффнес отметил, что выбор программной платформы автопроизводителем напрямую влияет на объем данных, поступающих к третьим сторонам. Платформа Google, например, включает встроенные механизмы для связи как с собственными сервисами Google, так и с внешними организациями. «Многое из отслеживания мы также видим через приложения, встроенные в автомобиль, — отметил Чоффнес. — Таким образом, автомобили по сути превращаются в глобальные смартфоны». Мобильные приложения представляют собой столь же небезопасный вектор. Команда обнаружила, что семь сопутствующих приложений — HondaLink, Lincoln, MyNissan, myCadillac, myChevrolet, myBuick и myGMC — передавали конфиденциальные данные, такие как идентификационные номера транспортных средств (VIN), номера телефонов и точное местоположение, непосредственно в рекламные сети. Более 70 % протестированных сопутствующих приложений обращались как минимум к пяти уникальным доменам ATA. Исследователей особенно встревожило сопоставление VIN-номера автомобиля с идентифицируемыми персональными данными, что позволяет брокерам данных создавать подробные досье на отдельных водителей. По словам Чоффнеса, «эти данные поступают в компании, с которыми большинство потребителей, вероятно, не имеют никаких отношений или о которых никогда не слышали». 
Источник изображения: designerspics.com Автопроизводители отреагировали на результаты исследования неоднозначно. Некоторые защищали свою практику, утверждая, что она соответствует законодательству, в то время как другие признавали уязвимости и выпускали программные исправления. Honda, например, потребовала от своего поставщика аналитических услуг Amplitude удалить все собранные данные о местоположении. По мнению Чоффнеса самая серьёзная проблема заключается в том, что потребители редко понимают, на что они соглашаются, покупая подключённый автомобиль или настраивая его приложение. Большинство водителей не будут сидеть на парковке автосалона, читая сложные политики конфиденциальности на крошечном экране приборной панели, прежде чем согласиться с условиями. «Я думаю, что в результате этого снизилось доверие, — считает Чоффнес. — Автопроизводителям следовало бы вернуть это доверие. И один из способов сделать это — повысить прозрачность и помочь потребителям избежать сбора данных о них после совершения действительно дорогой покупки без более явного согласия, а не отказа». Почти все базы данных в США работают на устаревшем ПО — обновиться слишком сложно и дорого
16.09.2026 [12:47],
Павел Котов
Подавляющее большинство администраторов баз данных в США — 97 % — работают на устаревшем ПО, гласит доклад компании Percona. Обновление систем может оказаться слишком трудоёмкой задачей, из-за чего администраторы вынуждены обходиться устаревшим ПО. 
Источник изображения: Growtika / unsplash.com При таком колоссальном показателе, однако, неверно было бы утверждать, что организации просто пренебрегают установкой актуального ПО: обновление работающей базы данных зачастую оказывается масштабным и рискованным проектом, создающим больше операционных угроз, чем эксплуатация снятого с поддержки ПО. Для многих серьёзным препятствием становятся затраты: трудозатраты инженеров, необходимость тестирования, а также изменения в инфраструктуре и облачных средах — всё это повышает общую стоимость перехода. Обновление базы данных — это не просто установка программного обновления; в большинстве случаев подразумевается комплексная миграция, которая затрагивает весь технологический стек, в том числе другие программные продукты и подписки. Главным препятствием для снижения совокупной стоимости владения парком баз данных почти каждый третий (31 %) респондент назвал расходы на облачные ресурсы, среди существенных проблем упоминаются стоимость лицензирования (23 %), избыточный набор инструментов (17 %), а также зависимость от одного поставщика (12 %). В качестве яркого примера приводится MySQL — выходу версии 8.0 сопутствовали масштабные архитектурные изменения, из-за которых обновление с версии 5.7 обернулось техническим кошмаром. Отмечается, что при всех этих сложностях отказ от обновления и использование неподдерживаемого ПО создают угрозы безопасности — в случае с базами данных, которые обычно содержат наиболее ценную и конфиденциальную информацию компании, это представляется особенно критичным. Остаются и стимулы к обновлению: 42 % опрошенных указали, что устаревшие системы неэффективны — они вызывают простои систем (40 %) и задержки в работе (35 %). В качестве первого шага авторы исследования предлагают начать реальное планирование миграции, не откладывая её. Только начав этот процесс, можно изучить возможности консолидировать технологические стеки, повысить общую эффективности систем и оптимизировать расходы. Сотни людей читают переписки пользователей с ChatGPT — и OpenAI платит им за это от $50 в час
15.09.2026 [20:47],
Сергей Сурабекянц
Издание 404 Media выяснило, что OpenAI нанимает через подрядчиков сотни людей для анализа огромного потока запросов пользователей к ChatGPT. Их задача — улучшить качество ответов, которые ChatGPT выдаёт пользователям: люди оценивают и анализируют сгенерированные ботом реплики. Они изучают диалоги между пользователями и чат-ботом, о возможности прочтения которых живыми людьми даже не подозревает большинство из более чем 900 миллионов пользователей сервиса. 
Источник изображений: unsplash.com Во внутренних документах, попавших в распоряжение 404 Media, указано, что подрядчики обучают ChatGPT избегать антропоморфизма (приписывания себе человеческих черт) и чрезмерной угодливости. Последнее является серьёзной проблемой для OpenAI: как утверждается в ряде судебных исков, излишне подобострастное поведение модели 4o отчасти привело к самоубийствам нескольких человек. В распоряжении издания 404 Media оказались обширные материалы, касающиеся привлечения OpenAI людей-рецензентов: инструкции, переписка в Slack, реальные запросы пользователей ChatGPT и система оценки, которую рецензенты используют для совершенствования чат-бота. Такая практика анализа запросов отличается от официально объявленных мер безопасности ChatGPT — например, проверки чатов в случаях, когда компания выявляет пользователей, планирующих причинить вред другим людям. Утечка указывает на серьёзные риски для конфиденциальности пользователей ChatGPT, ведь многие воспринимают чат-бота как психотерапевта, профессионального помощника или виртуального друга, делясь с ним самыми сокровенными подробностями своей жизни. Подрядчики не видят имён пользователей, а OpenAI заявляет, что старается удалять личную информацию до того, как запросы попадут к проверяющим. Впрочем, компания признает, что конфиденциальные данные все же могут просочиться в ходе процесса.  Кроме того, эти внутренние документы развеивают заблуждение о том, что модели совершенствуются исключительно благодаря массовому сбору данных из интернета, таланту высокооплачиваемых инженеров и специалистов по ИИ или мощности новых версий моделей. Важным, но часто упускаемым из виду фактором является труд сторонних подрядчиков, которым платят за то, чтобы они снова и снова анализировали ответы ChatGPT на реальные запросы пользователей. «Отличный ответ должен учитывать намерение пользователя, быть полезным и точным, а также быть написанным в ясном, естественном и достаточно доброжелательном стиле», — говорится в одной из инструкций для сторонних подрядчиков. Их работа разделена на три этапа: чтение реального запроса пользователя ChatGPT, его краткое изложение и критический разбор вариантов ответов, сгенерированных ChatGPT на этот запрос. В рабочем интерфейсе рецензенты могут сами выбирать, за какую задачу взяться. После выбора им демонстрируется реальный запрос пользователя ChatGPT. Издание 404 Media ознакомилось с множеством таких запросов, но не приводит их дословно из соображений защиты источников. Некоторые запросы свидетельствуют о том, что пользователи ChatGPT не предполагают, что их переписку может прочитать человек, поскольку они просят чат-бота сохранить содержание беседы в тайне.  По словам одного из работников, чтение запросов иногда бывает «довольно забавным», но в целом эта работа — «очень однообразная и рутинная». Он также отметил, что рабочий процесс кажется «хаотичным»: инструкции часто меняются и порой противоречат друг другу. Запросы анонимизированы, но, тем не менее, могут содержать конфиденциальную или личную информацию. В разделе над самим запросом иногда приводится «сводка воспоминаний пользователя» (user memories summary) — краткий обзор того, для чего пользователь ранее пытался использовать чат-бота. В некоторых случаях там также указывается примерное местоположение человека и другие личные сведения. Рецензентам предписывается передавать вышестоящим специалистам подобные задачи, содержащие личную информацию или вызывающие «потенциальные опасения с точки зрения безопасности». По словам OpenAI, перед отправкой исполнителям разговоры пользователей проходят обработку с помощью специальной модели — фильтра конфиденциальности (Privacy Filter). Эта система предназначена для выявления и удаления личной информации. «Как и любые модели, Privacy Filter может допускать ошибки. Она способна пропустить редкие идентификаторы или неоднозначные упоминания частной информации, а также избыточно или недостаточно скрывать данные при ограниченном контексте — особенно в коротких фрагментах текста», — говорится на сайте OpenAI.  OpenAI не ответила на вопрос, уведомляет ли компания пользователей о том, что люди могут просматривать их запросы для улучшения ответов ChatGPT, и если да, то где именно приводится эта информация. На сайте компании описано, что люди могут просматривать лишь контент, помеченный как нарушающий условия использования сервиса или представляющий угрозу безопасности. В политике конфиденциальности OpenAI указано, что компания может использовать персональные данные для совершенствования своих моделей. Если пользователь решит удалить историю диалогов в ChatGPT, OpenAI обещает стереть эти данные из своих систем в течение 30 дней — за исключением случаев, когда информация «уже была обезличена и отвязана от учётной записи». После публикации статьи в 404 Media OpenAI всё же указала на раздел сайта, где говорится, что люди могут просматривать контент для «улучшения работы модели». OpenAI утверждает, что чаты пользователей не будут использоваться для обучения моделей компании, если те отключат настройку «улучшение модели для всех» (improve the model for everyone). Эта функция включена по умолчанию для бесплатных тарифов, а также для подписок Plus и Pro, поэтому пользователям необходимо самостоятельно её отключить. В OpenAI уточнили, что это правило распространяется лишь на новые диалоги и не имеет обратной силы. У корпоративных клиентов (Enterprise, Business и Edu) настройка обучения модели по умолчанию отключена.  Поиском исполнителей для анализа запросов к ChatGPT занимается рекрутинговое агентство Crossing Hurdles. Согласно информации на сайте компании, она «связывает квалифицированных специалистов с возможностями в сфере обучения ИИ, оценки, исследований и участия в проектах глобальной индустрии искусственного интеллекта». На странице Crossing Hurdles в LinkedIn размещено множество вакансий, связанных с ИИ, включая позиции специалиста по проверке данных, аннотатора данных и «оценщика чат-ботов». В описании последней вакансии не упоминаются OpenAI или ChatGPT, однако в обязанности входит «оценка ответов ИИ с точки зрения персонализации, опоры на факты (grounding), интеграции и полезности», а также «сравнение ответов модели и оценка их общего качества». Среди доступных проектов есть и такие, где исполнители записывают на видео выполнение домашних дел — этот процесс сбора данных критически важен для разработки робототехники на базе ИИ. Люди-проверяющие уже давно играют важную (хотя зачастую и незаметную) роль в модерации контента в социальных сетях и в совершенствовании моделей искусственного интеллекта — например, тех, что распознают объекты в видеопотоке с камер. Практика привлечения людей к проверке диалогов с ИИ не ограничивается одной лишь OpenAI. Например, в уведомлении к чат-боту Gemini от Google говорится: «Люди просматривают некоторые сохранённые чаты, чтобы улучшить работу искусственного интеллекта Google». Представители компании Anthropic также подтвердили, что используют ручную проверку для совершенствования своих моделей, в том числе для улучшения будущих ответов чат-бота Claude. 
Источник изображения: Anthropic Сообщается, что оплата труда «оценщиков чат-ботов» составляет от $50 в час, что заметно превышает доходы других подрядчиков в технологическом секторе — будь то модераторы контента в соцсетях или специалисты по обучению ИИ. Впрочем, эксперты полагают, что столь щедрые расценки со временем снизятся по мере совершенствования моделей ИИ. В даркнете начали продавать «цифровых Франкенштейнов» — синтетические личности, способные обмануть KYC, стоят $200
15.09.2026 [12:52],
Павел Котов
Теперь любой участник теневых схем может за $200 приобрести несуществующую в реальном мире «цифровую личность», способную проходить проверки KYC (Know Your Customer) как действительный человек. На такую личность можно завести счёт в банке, на криптовалютной бирже и любой другой аналогичной платформе; это уже не экзотическое предложение в мире киберпреступников, а массовое явление. 
Источник изображения: Amirhossein Hasani / unsplash.com Исследователи из компании Coveron и платформы NordLayer Intelligence проанализировали форумы даркнета и Telegram-каналы, изучили 22 поисковых запроса и 362 000 сообщений на тему кражи личных данных, услуг по созданию дипфейков и «синтетических личностей». Под синтетической личностью понимается несуществующий, вымышленный человек, созданный таким образом, чтобы обмануть многие автоматизированные системы проверки. Профиль может сочетать украденные данные, например, номер социального страхования, и сгенерированную ИИ информацию: имя, адрес, дипфейк-селфи, клонированный образец голоса. Исследователи назвали такие профили «цифровыми Франкенштейнами» — они действительно «вполне способны» проходить проверки личности. Число сообщений и запросов, связанных с синтетическими личностями, стремительно растёт. В I квартале 2024 года каждый месяц публиковались около 40 посвящённых дипфейкам сообщений; ко II кварталу 2026 года этот показатель вырос до 307 сообщений в месяц, то есть в восемь раз. Равномерным рост не был: в течение всего 2025 года показатели оказались почти неизменными, и лишь в 2026 году произошёл резкий скачок до показателя в 255 сообщений в месяц. За последний год были опубликованы более 10 000 объявлений с предложением полных наборов данных о личности, включая дипфейк-селфи и соответствующие документы. Стоит такой набор около $200. Покупать весь комплект не обязательно — всего по $10 можно приобрести отдельные элементы, например, дипфейк-селфи или клонированный голос. Чтобы защититься от подобных схем, гражданам рекомендовали отслеживать свои персональные данные и оперативно реагировать при обнаружении утечки. Тем, кто не собирается открывать новые счета, советуют заморозить кредитную историю и с осторожностью относиться к необычным запросам на подтверждение личности. Бизнесу рекомендуется развёртывать многоуровневые системы верификации и пользоваться услугами по защите от кражи личных данных. «Не люблю, когда мне лезут в душу»: Meta✴ изменила алгоритм своего чат-бота после жалоб на бестактные личные вопросы
11.09.2026 [18:47],
Сергей Сурабекянц
Компания Meta✴✴ была вынуждена внести коррективы в алгоритмы подсказок своего чат-бота, так как искусственный интеллект стал чересчур интересоваться частной жизнью пользователей. Недавно в Сети распространилось видео, демонстрирующее, как чат-бот пытается выяснить личную информацию о маленьких детях. Компания признала, что «допустила ошибку» и «эта функция не должна была предлагать пользователю подобные вопросы». 
Источник изображений: unsplash.com На прошлой неделе пользователь Instagram✴✴ Кейли Робинс (Kalie Robins) рассказала, как ИИ-помощник Meta✴✴ начал бестактно выведывать информацию о её детях. Она разместила в Facebook✴✴ видео, где вместе с ребёнком поёт в машине, после чего под видео появился запрос от ИИ: «Кто этот ребёнок-пассажир?». По словам Робинс, чат-бот Meta✴✴ сопоставил информацию о её дочерях из её собственных прошлых публикаций и постов её родственников. Система стала задавать дополнительные вопросы, касающиеся возраста детей и места жительства её семьи. Кроме того, как утверждает Робинс, Meta✴✴ AI показал фотографии её дочерей, ранее размещённые на платформе, включая снимок, который она удалила много лет назад. Представитель Meta✴✴ Дина Эль-Кассаби (Dina El-Kassaby) заявила, что проблема, из-за которой чат-бот Meta✴✴ задавал вопросы на слишком личные темы, уже устранена: «Мы создали эту функцию, чтобы помочь людям получать больше информации о темах или публикациях, которые их интересуют. Когда пользователь нажимает на подсказку и использует эту функцию, сгенерированный ответ основывается на информации, к которой у пользователя уже есть доступ».  Meta✴✴ интегрировала своего ИИ-помощника в Facebook✴✴, Instagram✴✴, WhatsApp и Messenger. Он способен отвечать на вопросы, писать посты и генерировать изображения. В июле компания отказалась от функции, позволявшей создавать ИИ-дипфейки других пользователей Instagram✴✴, после того как столкнулась с резкой критикой. Россия лидирует по количеству утечек баз данных
10.09.2026 [14:44],
Владимир Фетисов
Специалисты АО «Будущее» (F6) проанализировали количество утечек баз данных компаний из России за весь 2025 год и первые шесть месяцев 2026 года. В результате были выявлены 326 публикаций данных такого типа, что почти вдвое превышает количество утечек БД компаний из стран Латинской Америки, Ближнего Востока и Африки, Азиатско-Тихоокеанского региона и других государств СНГ (всего 164 случая). 
Источник изображения: Kevin Ku / unsplash.com Эксперты связывают большое количество утечек БД в России с участившимися во время геополитического конфликта случаями кибератак на бизнес и госорганизации с целью кражи данных и нанесения максимального ущерба компаниями и их клиентам. Всего же в обнаруженных БД содержались 1,175 млрд строк с информацией россиян. «В России исторически сформировалась одна из самых глубоких цифровых экосистем. Госуслуги, банкинг, телемедицина, доставка, каршеринг — всё это генерирует колоссальные массивы персональных данных. Там, где много данных, там много и потенциальных точек отказа. В странах Латинской Америки, Ближнего Востока или Африки уровень проникновения цифровых сервисов часто ниже, а значит, и украсть пока особо нечего — объём накопленных данных меньше», — считает председатель совета по противодействию технологическим правонарушениям КС НСБ России Игорь Бедеров. Господин Бедеров добавил, что он ожидает стабилизации ситуации с утечками в России по мере изменения действующего в стране антифрод-законодательства, а также развития его правоприменения. Власти уже взяли курс на то, чтобы бороться не с последствиями таких инцидентов, а на планомерное снижение вероятности возникновения подобных случаев, включая сотрудничество граждан с киберпреступными группами. Если не учитывать утечки баз данных в России, то на долю Латинской Америки пришлось 33 % всех зафиксированных случаев утечек. В странах Ближнего Востока и Африки произошло 29 % подобных случаев, в Азиатско-Тихоокеанском регионе 8 % утечек, а в СНГ — 4 %. Наибольшее суммарное количество строк с данным содержалось в базах из стран СНГ. В странах Центральной Азии суммарно в похищенных БД содержались 257 млн строк — более трети от общемирового объёма. Так, на долю Таджикистана приходится около 217 млн строк (84 % от общего количества записей), на Казахстан — 25 млн строк (10 %), на Узбекистан — 15 млн строк (6 %). Отмечается, что одна строка в утечках БД может содержать разный набор персональных данных. «Несмотря на то, что в первом полугодии 2026 г. мы наблюдали снижение количества опубликованных баз данных российских компаний, интенсивность атак киберпреступников на организации РФ с целью нанесения максимального ущерба остаётся на беспрецедентно высоком уровне. Отмечу, что без современных решений в сфере информационной безопасности и профессиональных действий ИБ-команд ущерб для российского бизнеса был бы намного больше», — отметила технический руководитель департамента киберразведки F6 Елена Шамшина «Google Фото» будут удалять файлы из корзины вдвое быстрее — на передумать оставят 30 дней
08.09.2026 [18:16],
Сергей Сурабекянц
«Корзина» в «Google Фото» предоставляет пользователям возможность восстановить удалённые фотографии и видео в течение ограниченного периода времени, который до недавнего времени составлял 60 дней. Фактически у пользователя было в запасе два месяца на восстановление случайно удалённых медиафайлов. Теперь Google сократила этот срок до 30 дней. 
Источник изображения: Google Изменение сроков хранения удалённых файлов с возможностью восстановления уже отражено во всплывающем окне приложения и на странице поддержки Google: «Удалённые фотографии и видео будут оставаться в корзине в течение 30 дней, прежде чем будут удалены навсегда. Фотографии и видео, которые были удалены навсегда, восстановить невозможно». Судя по архивным версиям страницы поддержки, изменение вступило в силу с 4 сентября 2026 года. Huawei представила ускоренную HarmonyOS 7 с ИИ-агентами, защитой от мошенников и новым интерфейсом
07.09.2026 [19:33],
Сергей Сурабекянц
Huawei сегодня представила новую версию своей мобильной операционной системы HarmonyOS 7. В интерфейсе новой ОС появились многочисленные пространственные и трёхмерные эффекты. Добавлены инструменты для создания и исследования 3D-моделей. Среди новых функций облачные и встроенные модели ИИ, четырёхуровневая память, навыки приложений, агентные циклы, взаимодействие между несколькими устройствами и обновлённые протоколы безопасности. 
Источник изображений: Huawei Harmony OS 7 предлагает заметно переработанный интерфейс с упором на пространственные эффекты. Функция Immersive Light Sensing создаёт световые и теневые следы при движении значков, а касания, нажатия, перетаскивания и свайпы получили тактильную и визуальную обратную связь. На 3D-экране блокировки добавлены эффекты глубины ко всем элементам. Появились пространственные обои, которые обеспечивают эффект смены перспективны при свайпе. В Harmony OS 7 появилась поддержка свайпов двумя пальцами и наклона экрана для исследования 3D-среды. Также добавлены инструменты для создания и исследования 3D-моделей, включая Remy для преобразования видео с дронов в 3D-карты, V2Fun для создания 3D-моделей из одной фотографии, Dianping для виртуальных прогулок по магазинам и Huawei 3DGS для 3D-моделирования товаров. 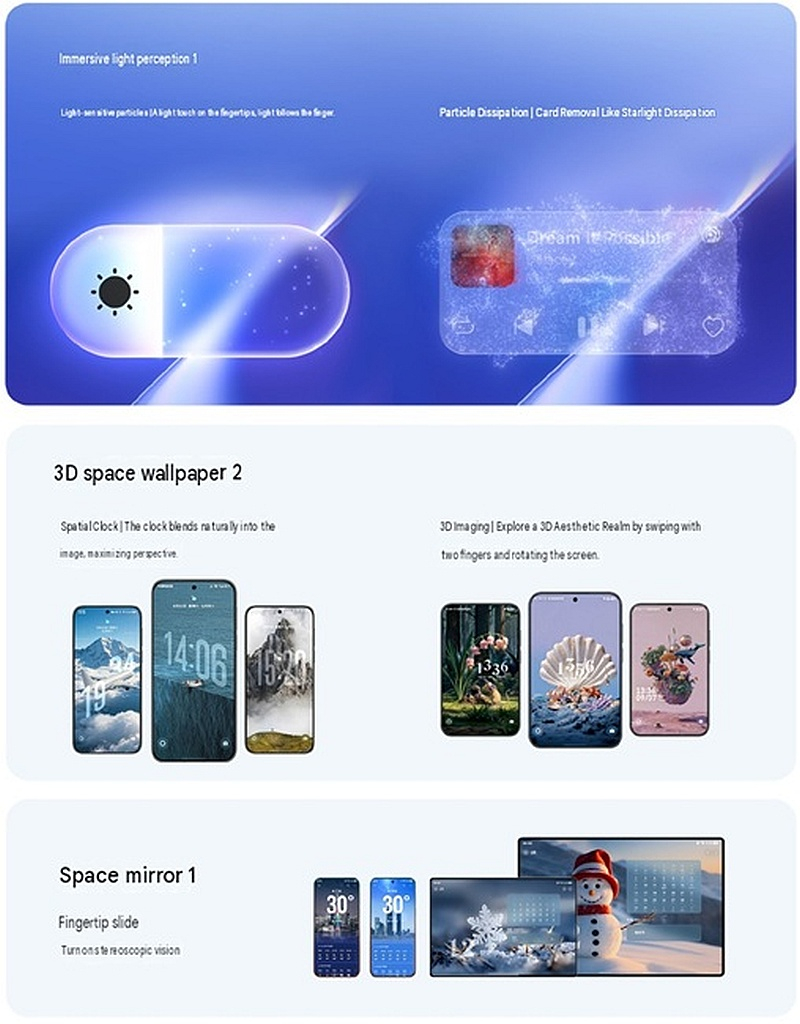 Искусственный интеллект Harmony Intelligence объединил ОС, ИИ и приложения, используя облачные и встроенные модели ИИ, четырёхуровневую память, навыки приложений, системные возможности, агентные циклы, взаимодействие между несколькими устройствами и обновлённые протоколы безопасности. Голосовой помощник Celia получил обновлённый домашний экран с персонализированной вкладкой «Домой» и боковой панелью для Celia Memory и Celia Claw. Панель навигации превращает скопированные пароли, коды, адреса и ссылки на облачные сервисы в действия приложения в одно касание и переводит документы на иностранных языках. В новой ОС появился встроенный помощник по поиску работы, который оптимизирует резюме в соответствии с требованиями вакансии, генерирует вопросы для собеседования, дорабатывает ответы и регистрирует приглашения на собеседование с указанием времени, места и заметок в Memo. Родительский контроль отслеживает усталость глаз и время, проведённое детьми за экраном, а голосовые команды позволяют планировать закрытие приложений. Celia Claw управляет поддерживаемыми устройствами и сценариями умного дома, включая кондиционеры, роботы-пылесосы и камеры видеонаблюдения. Другие системные агенты охватывают задачи воспитания детей, бытовые процедуры, такие как кормление домашних животных и уборка пылесосом, а также бронирование местных услуг с помощью автоматизированных телефонных звонков. Многие встроенные приложения Huawei «из коробки»получили возможности агентов на основе ИИ:
Фирменный Ark Engine использует модели ИИ для перераспределения ресурсов от пассивного реагирования к проактивной доставке. По данным Huawei, общая производительность устройства повышается до 15 %, время автономной работы возрастает на 36 минут, на 22 % выше плавность работы высокочастотных приложений, а переход между приложениями происходит на 25 % быстрее. Режим производительности обеспечивает до 25 % более высокую производительность, чем HarmonyOS 6. 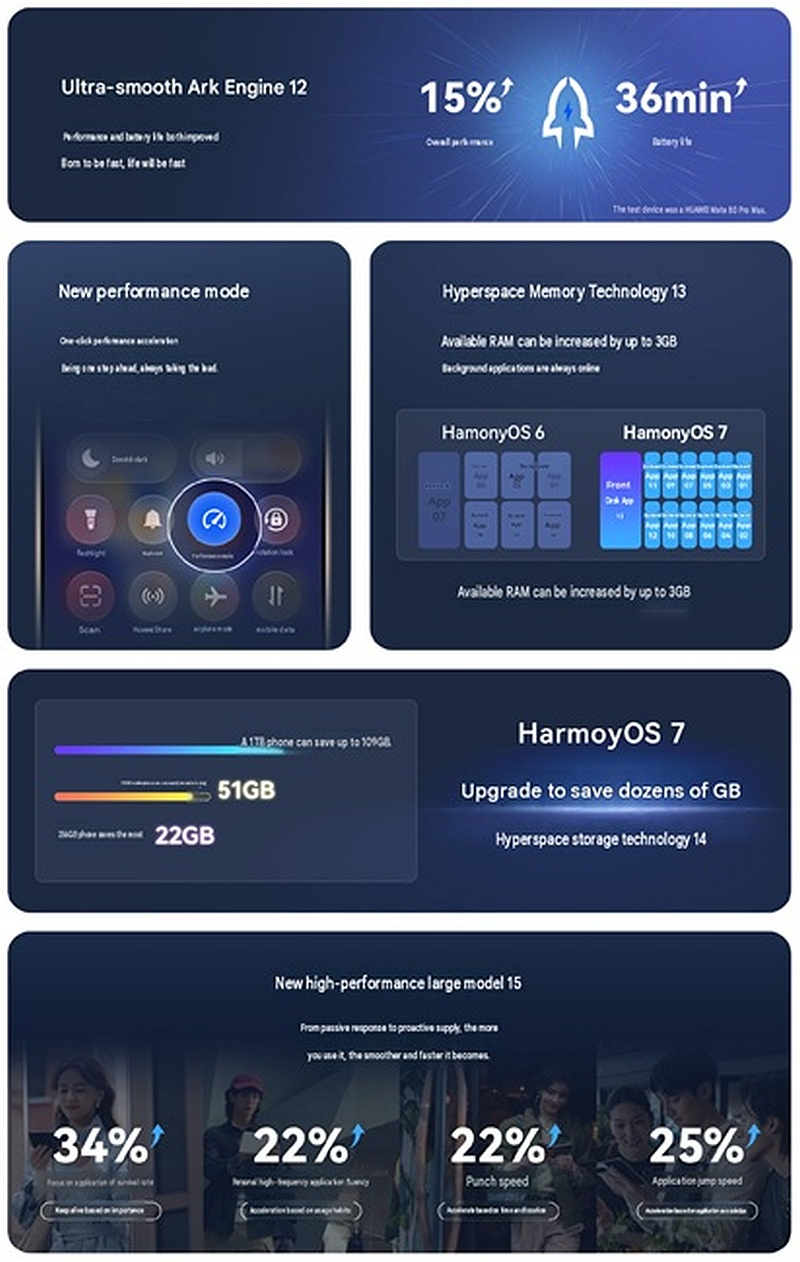 Функция Super Spatial Memory добавляет до 3 Гбайт доступной оперативной памяти по сравнению с HarmonyOS 6, позволяя большему количеству приложений сохранять активность в фоновом режиме. Также Huawei заявляет, что эта функция освобождает дополнительное полезное пространство:
HarmonyOS 7 получила инструменты оптимизации игр на основе ИИ. Функция AI Super Resolution обеспечивает в 1,5 раза более чёткие изображения, чем в HarmonyOS 6. Intelligent HDR оптимизирует детали света и теней на закатах, в неоновых городах, подводных туннелях и ночных пейзажах. Ark Scheduling Engine и Intelligent Frame Stabilization прогнозируют рабочую нагрузку и динамически распределяют ресурсы, повышая стабильность частоты кадров в течение длительных сеансов на 40 %. HarmonyOS Star Shield добавляет системную защиту основе ИИ от мошенничества в звонках, сообщениях, приложениях, мошеннических схемах, ориентированных на членов семьи, скриптах, сгенерированных ИИ, и вредоносных ссылках. Среди возможностей Star Shield:
Huawei заявляет, что HarmonyOS 7 получила сертификат безопасности 5-го уровня для предотвращения мошенничества в сфере телекоммуникаций на мобильных платформах ОС. В Harmony OS 7 существенно повышена защита конфиденциальности пользователя. Обработка данных на стороне облака с использованием ИИ обеспечивает тот же уровень безопасности, что и обработка на устройстве, а изолированные облачные вычисления помогают предотвратить утечки данных. Данные обрабатываются только для запрошенных задач и удаляются сразу после использования, а не хранятся постоянно. В HarmonyOS 7 появились инструменты Tap-to-Transfer для обмена данными между устройствами:
Также в новой ОС добавлена функция Intimate Circle, которая объединяет обновления статуса семьи и друзей, показатели здоровья и ежедневную активность в одном месте. Функция наследования цифровых активов сохраняет такие данные, как фотогалереи и заметки. Указанные получатели могут получить к ним доступ через многофакторную аутентификацию по реальному имени с применением защиты облачного хранилища. Функция Text Call обеспечивает преобразование речи в текст и текста в речь в режиме реального времени во время звонков, а также коррекцию голоса и синтез речи с помощью ИИ для людей с нарушениями речи. Первая публичная бета-версия HarmonyOS 7 станет доступна сегодня для поддерживаемых смарт-телевизоров и экранов, складных смартфонов, планшетов, ноутбуков, стандартных смартфонов и смарт-часов. Пользователи могут самостоятельно проверить наличие обновлений в разделе «Настройки» > «Система и обновления» > «Обновление ПО». Список поддерживаемых устройств приведён ниже. 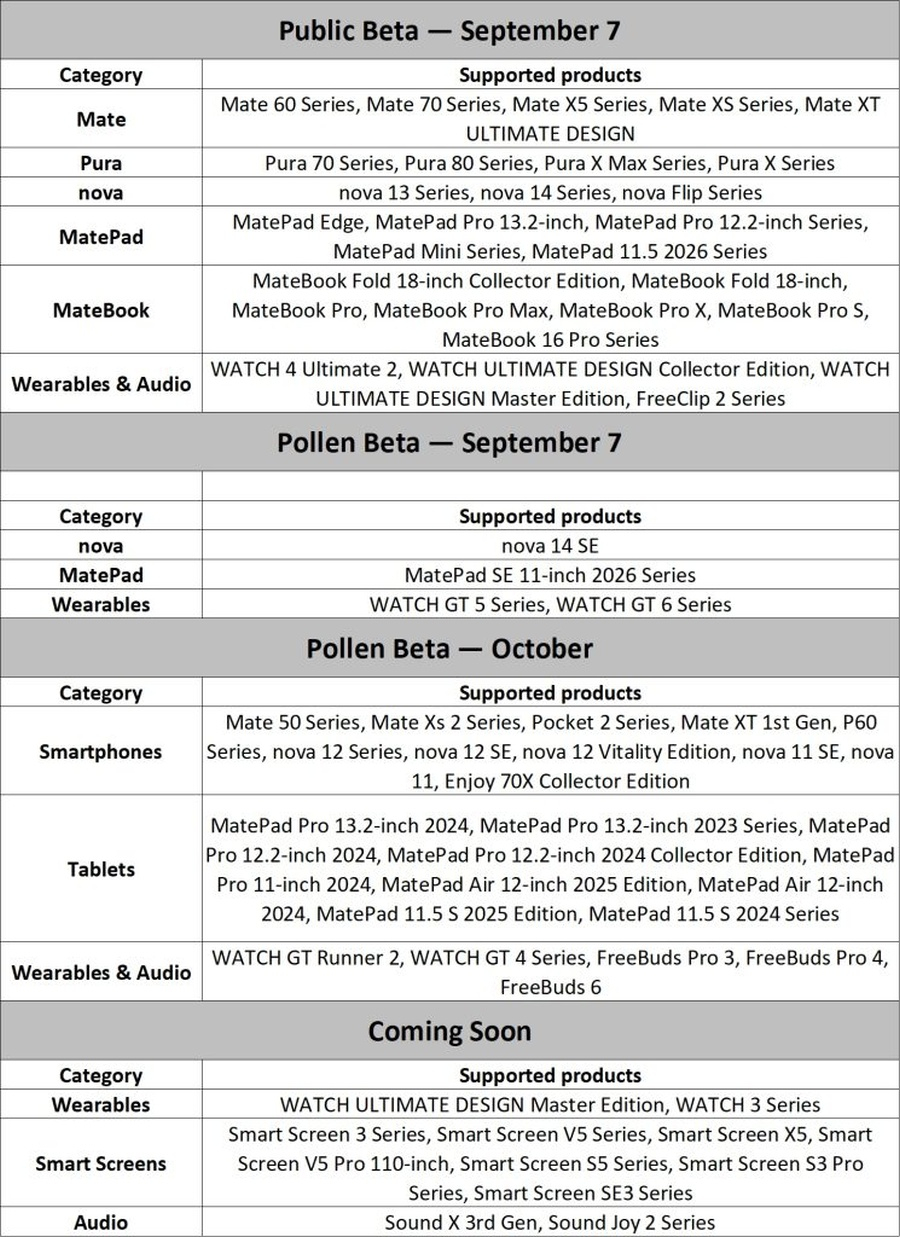 В WhatsApp выявлена уязвимость, позволяющая получить доступ к фотографиям до ввода PIN-кода
03.09.2026 [07:42],
Анжелла Марина
В приложении WhatsApp для Android обнаружена уязвимость, которая позволяет получить доступ к личным фотографиям на устройстве без его разблокировки. Об этом сообщил ресурс 9to5Google со ссылкой на пользователя, который первый это заметил, а позднее информацию подтвердил и ряд других ресурсов. 
Источник изображения: Gilles Lambert/Unsplash Работает это примерно так: поступает вызов WhatsApp, на который можно ответить без разблокировки телефона. В этот момент пользователь может нажать кнопку фильтров или инструментов ИИ от Meta✴✴ для редактирования фото. Далее вместо блокировки доступа к фотографиям на устройстве владельца система отобразит их предварительный просмотр, вместо того, чтобы потребовать ввести PIN-код или пройти биометрическую проверку. Проблема затрагивает не все устройства. Как выяснилось, на смартфонах Galaxy система потребует разблокировать экран, тогда как на устройствах Pixel и Oppo обход защиты срабатывает полностью. На iPhone этой уязвимости не обнаружено, так как WhatsApp использует защищённый стандартный интерфейс вызовов iOS. Одновременно полный обход экрана блокировки, как отмечают источники, не происходит, и доступ к другим разделам устройства остаётся закрытым. Кроме того, фотографии нельзя редактировать и удалить, хотя теоретически злоумышленник может их зафиксировать с помощью своего устройства. Информация об уязвимости уже передана разработчикам WhatsApp и компании Google, однако о решении проблемы на данный момент не сообщается. В качестве временной меры предлагается ограничить доступ WhatsApp к фото и видео в настройках разрешений Android. В ЮАР испытали неубиваемую передачу данных лазером по воздуху — простую и перспективную
27.08.2026 [15:23],
Геннадий Детинич
Учёные из Университета Витватерсранда (Wits, ЮАР) и Университета Бордо (Франция) показали новый способ передачи информации с помощью лазерного луча, который сохраняет данные даже после сильного искажения атмосферной турбулентностью. В отличие от традиционных оптических систем связи, где приходится применять сложные алгоритмы адаптивной оптики для компенсации «дрожания» и искажения светового пучка, исследователи кодировали данные в топологии света. 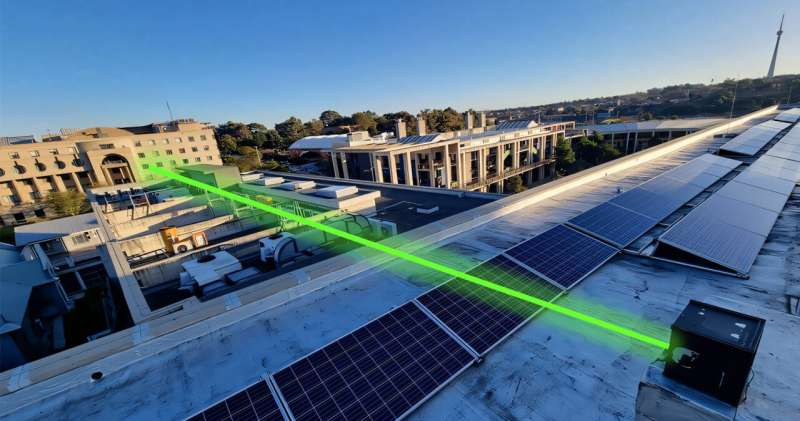
Источник изображения: Wits В основе технологии лежит использование световых структур типа скирмионов — вихреподобных конфигураций электромагнитного поля, в которых информация записывается не в точной форме светового импульса, а в его топологическом состоянии. Топологические свойства структуры сохраняются при её непрерывных деформациях: например, круг можно растянуть в эллипс, не изменив его топологию. По тому же принципу атмосферная турбулентность способна сильно исказить форму лазерного пучка, но закодированная в нём топологическая характеристика сохраняется и может быть считана приёмником. Для проверки метода исследователи передавали лазерные пучки между зданиями кампуса Wits в Йоханнесбурге на расстояние в несколько сотен метров. Луч проходил через естественную атмосферную турбулентность, вызываемую неоднородным нагревом воздуха, потоками и случайными изменениями показателя преломления. Несмотря на то что форма принимаемого светового пятна заметно отличалась от исходной, закодированная в нём топологическая информация сохранялась. Таким образом, эксперимент продемонстрировал возможность оптической связи без обязательной предварительной коррекции искажений, чем обычно занимается адаптивная оптика. Разработка может стать основой для более устойчивых систем лазерной связи между наземными станциями, беспилотниками, самолётами и космическими аппаратами. Атмосферная турбулентность остаётся одной из главных проблем при передаче данных с помощью света через открытое пространство, особенно для высокоскоростных квантовых и оптических каналов. Исследователи считают, что использование топологических свойств света способно повысить надёжность будущих оптических сетей, поскольку данные будут защищены не от искажений самого луча, а от потери его фундаментальной структуры, чего практически не происходит. Meta✴ ограничит подросткам соцсети двумя часами в день и отключит лайки — компания пошла на сделку с властями США
26.08.2026 [18:08],
Сергей Сурабекянц
Meta✴✴ урегулировала судебный спор о безопасности несовершеннолетних пользователей с группой из 29 генеральных прокуроров США. Соглашение закрывает претензии 47 штатов, нескольких округов и территорий и избавляет компанию от продолжения разбирательства, которое потенциально могло обойтись ей в сотни миллиардов долларов. Взамен Meta✴✴ согласилась существенно ограничить использование своих сервисов подростками и выплатить до $17,1 млрд. 
Источник изображения: unsplash.com В соответствии с условиями соглашения Meta✴✴ разработает стандарт подтверждения возраста пользователей, эффективность которого будет проверяться независимыми экспертами, который подлежит независимому тестированию и должен иметь частоту ложноположительных результатов не выше 10 % для пользователей в возрасте от 16 до 17 лет и 3 % для пользователей в возрасте от 13 до 15 лет. Компания предоставит подросткам возможность отключить персонализированные ленты, что означает, что им не будет показываться контент на основе алгоритма рекомендаций Meta✴✴. Также Meta✴✴ приостановит push-уведомления для подростков в период с 22:00 до 7:00, если родители не отключат эти ограничения и ограничит использование приложения Meta✴✴ подростками двумя часами в день с исключениями для обмена сообщениями и чтения «длинного контента». После 15 минут использования приложения подросток получит заметное предупреждение, а после 60 и 90 минут совокупного дневного использования будут предусмотрены специальные «продуктивные паузы». Пользователи, не прошедшие проверку на соответствие возрасту в течение двух недель, будут подвергнуты ограничениям в своих учётных записях, призванным «предотвратить контакты потенциальных взрослых злоумышленников» с подростками, и им будут предлагаться «рекомендации контента, основанные на опыте, соответствующем возрасту». Кроме того, Meta✴✴ отключит для подростков фильтры, имитирующие результаты косметических процедур, а также лайки под публикациями, чтобы уменьшить социальное сравнение. Соглашение обязывает Meta✴✴ попытаться связать все учётные записи, принадлежащие одному пользователю, чтобы предотвратить обход новых правил, и обеспечить пользователям возможность обжалования. В течение десяти лет Meta✴✴ выплатит штатам $17,1 млрд, причём $5,3 млрд из этой суммы будут выплачены только в том случае, если YouTube и TikTok введут собственные ежедневные ограничения по времени и каждый из них выплатит эквивалентную сумму. В Meta✴✴ заявили, что ограничения времени использования, ночной режим и блокировка уведомлений во время школьных занятий должны стать основой отраслевого подхода к защите подростков. Компания призвала TikTok и YouTube присоединиться к этой системе, поскольку несовершеннолетние пользователи свободно переходят между различными социальными платформами. В Meta✴✴ заявили, что ограничения времени использования, ночной режим и блокировка уведомлений во время школьных занятий должны стать основой отраслевого подхода к защите подростков. Компания призвала TikTok и YouTube присоединиться к этой системе, поскольку несовершеннолетние пользователи свободно переходят между различными социальными платформами. |
|
✴ Входит в перечень общественных объединений и религиозных организаций, в отношении которых судом принято вступившее в законную силу решение о ликвидации или запрете деятельности по основаниям, предусмотренным Федеральным законом от 25.07.2002 № 114-ФЗ «О противодействии экстремистской деятельности»; |
© 1997—2026 3DNews
При цитировании документа ссылка на сайт с указанием автора обязательна. Полное заимствование документа является
нарушением
российского и международного законодательства и возможно только с согласия редакции 3DNews.



 MWC 2018
 2018
 Computex

 IFA 2018






