


Опрос
|
реклама
Быстрый переход
DeepSeek создала «ИИ-суперагента» — конкурент Claude Code сам читает чаты разработчиков и предлагает решения задач
01.11.2026 [20:35],
Николай Хижняк
Компания DeepSeek представила прототип автономного ИИ-агента для программирования, стремясь составить конкуренцию популярному инструменту Claude Code от компании Anthropic. 
Источник изображения: DeepSeek Новое решение с открытым исходным кодом, получившее название Super-Agent, может самостоятельно отслеживать групповые чаты разработчиков, выявлять сообщения о проблемах с кодом и предлагать решения без необходимости его вызова. Об этом команда DeepSeek Harness сообщила в субботу в социальной сети WeChat. В руководстве пользователя, опубликованном на платформе GitHub, представители DeepSeek отмечают, что цель нового агента — «требовать минимум внимания со стороны человека, принося при этом максимум пользы». Ранее в этом году в DeepSeek было сформировано подразделение Harness. Оно занимается созданием ИИ-агентов, способных выполнять задачи по написанию кода аналогично инструментам, предлагаемым ведущими американскими лабораториями, в том числе Anthropic. Термин «harness» (в переводе — «оснастка» или «каркас») обозначает программную оболочку вокруг большой языковой модели, которая позволяет ИИ-агентам справляться с более сложными задачами. Разработчики, включая специалистов Anthropic, создают подобные каркасы, чтобы сделать своё программное обеспечение более эффективным в оптимизации процессов написания кода и других рабочих задач. Китайские компании ведут острую конкурентную борьбу с американскими разработчиками, стремясь создавать более совершенные и при этом доступные инструменты на базе искусственного интеллекта. И хотя именно чат-бот ChatGPT от OpenAI дал старт глобальной «гонке ИИ», многие компании впоследствии переключили внимание на перспективный и прибыльный рынок ИИ-агентов, способных автоматизировать работу разработчиков и бизнес-специалистов. Чтобы укрепить свои позиции в конкуренции с Anthropic и OpenAI, компания DeepSeek привлекла около 100 млрд юаней ($15 млрд) в ходе последнего раунда финансирования — одного из крупнейших в истории Китая. Это произошло в преддверии планируемого первичного публичного размещения акций (IPO) компании. Спрос на ИИ-инженеров в Китае взлетел на 1523 % — лучшие получают почти $150 тысяч в год
26.10.2026 [13:32],
Геннадий Детинич
За последние пару лет специальность инженера передового развёртывания (forward-deployed engineer, FDE), предполагающая разработку ИИ-приложений под конкретные бизнес-задачи, стала одной из самых быстрорастущих по спросу в мире. В Китае сегодня на этой должности можно получать не менее 1 млн юаней в год, что позволит за 7–8 лет стать долларовым миллионером. 
Источник изображения: ИИ-генерация ChatGPT/3DNews Китайские технологические компании постоянно расширяют набор инженеров с такими навыками и готовы платить им по максимальным ставкам. Согласно свежему обзору рынка профессий, ByteDance, Tencent и Alibaba предлагают таким специалистам годовое вознаграждение, приближающееся к 1 млн юаней (около $150 тыс.). На таких должностях специалисты работают непосредственно с заказчиками. Они выясняют потребности компаний, подбирают подходящие ИИ-инструменты, разрабатывают решения и интегрируют их в существующие рабочие процессы. «В связи с растущим интересом к ИИ многие компании ищут помощи по индивидуальному практическому внедрению, — сказал представитель Alibaba Cloud. — Это обусловливает устойчивый спрос на инженеров по передовому развёртыванию, которые помогут воплотить стратегии искусственного интеллекта в реальные результаты». По данным китайской платформы подбора вакансий Maimai, в январе–июле 2026 года число вакансий для специалистов FDE в Китае увеличилось на 1523 % по сравнению с аналогичным периодом 2025 года. Это наиболее быстрорастущая техническая специализация в сфере ИИ. В объявлениях ByteDance, размещённых на китайском сервисе поиска работы Boss Zhipin, указывается зарплата от 35 000 до 65 000 юаней в месяц. При выплате за 15 месяцев (с тремя дополнительными бонусными начислениями в год сверх обычной зарплаты) верхняя граница соответствует 975 000 юаней в год. Месячная зарплата такого инженера примерно равна средней годовой зарплате по Китаю. Спрос на специальность FDE отражает изменение требований к специалистам по искусственному интеллекту: им необходимо сочетать навыки программирования в сфере ИИ с пониманием отраслевой специфики и умением работать с заказчиками. Это относительно новая специальность, которая, очевидно, требует сертификации. Так, в 2026 году Tencent Cloud ввела отдельную сертификацию FDE для специалистов, работающих с платформой Agent Development Platform (ADP), предназначенной для создания ИИ-приложений. В августе компания официально объявила о запуске новой сертификации, которая действует параллельно с уже существующей сертификацией инженеров ИИ-приложений. Ещё один фактор — поддержка со стороны государства. По данным источника, в конце августа Министерство промышленности и информатизации КНР (Ministry of Industry and Information Technology) выпустило уведомление, призывающее компании создавать инженерные команды, которые помогают внедрять ИИ непосредственно на предприятиях-заказчиках. Это согласуется с более широкой государственной программой интеграции ИИ в промышленность и бизнес-процессы, представленной министерством в сентябре 2026 года. ИИ добрался до древнего кода: OpenAI научилась переносить программы с COBOL с точностью 97,9 %
21.10.2026 [19:58],
Анатолий Хаблюк
OpenAI научила свои ИИ-модели гораздо лучше справляться с устаревшими языками программирования, на которых до сих пор работают банки, корпорации и государственные системы. В тестах GPT-6.1 Sol перенесла программы с COBOL на современные языки с сохранением их работы в 97,9 % случаев. Это может заметно упростить модернизацию старого ПО, которое годами считалось слишком сложным и дорогим для переписывания. 
Источник изображения: OpenAI Главная сложность работы с такими языками заключается в недостатке доступного программного кода и документации для обучения нейросетей. Многие приложения были созданы десятилетия назад, а их первоначальные разработчики давно покинули компании. В некоторых случаях важные бизнес-процессы описаны исключительно в исходном коде. Поэтому при переносе программы на другой язык необходимо не просто переписать ее, но и сохранить особенности обработки данных и вычислений. Для оценки новых возможностей OpenAI разработала тест MultiLangBench, в котором нейросеть должна самостоятельно создать совместимый с SQLite движок базы данных на одном из 20 языков программирования. Модель GPT-6 Astra при максимальном уровне рассуждений успешно прошла в среднем 87,4 % проверок против 26,8 % у GPT-5.6 Sol. Особенно заметно улучшились результаты на COBOL — с 10,9 до 72,1 %, Fortran — с 21,4 до 83,5 %, а также Visual Basic — с 27,5 до 89,4 %. В 19 из 20 языков показатель Astra превысил 83 %. Более доступная GPT-6 Luna также превзошла предыдущую модель, набрав в среднем 40,3 % в MultiLangBench. Стоимость выполнения одного задания через API составила около $0,77 против $3,48 у GPT-5.6 Sol. Таким образом, затраты снизились примерно на 78 %, хотя точность Luna осталась заметно ниже, чем у Astra. Отдельное испытание было посвящено переносу программ с COBOL на C++, Java, Kotlin, Python и Rust. Для успешного прохождения теста преобразованная программа должна была полностью повторять поведение оригинала, включая правила округления и обработку отсутствующих записей. При минимальном уровне рассуждений GPT-6.1 Sol справилась с 86,6 % заданий против 5,4 % у GPT-5.6 Sol, причем стоимость обработки оказалась на 39 % ниже. При повышении уровня рассуждений результат новой модели достиг 97,9 %. Интерес к модернизации COBOL растет и среди конкурентов OpenAI. В феврале компания Anthropic заявила о возможности автоматизировать часть работ по анализу и обновлению старого программного обеспечения с помощью Claude Code. На фоне этого заявления акции IBM, чьи мейнфреймы широко используются для выполнения подобных программ, резко подешевели. ИИ генерирует столько кода, что Anthropic не успевает его обрабатывать — пришлось изобретать собственный Git
14.10.2026 [14:42],
Павел Котов
Модели искусственного интеллекта Anthropic Claude стали генерировать столько программного кода, что существующая инфраструктура разработки в компании перестала справляться с нагрузкой. Решением проблемы стала собственная система контроля версий Scion. 
Источник изображения: anthropic.com Для Anthropic написание кода перестало быть узким местом, ограничивающим темпы работы компании; главная проблема сместилась в сторону управления кодом после его создания: контроль версий, системы сборки и непрерывной интеграции. Если в мае в среде разработки Anthropic было около 2500 слияний в день, то к сентябрю этот показатель достиг 30 000. Темпы разработки только нарастают, «и устранение любого препятствия немедленно приводит к дальнейшему увеличению объёма создаваемого кода», отметили в компании. В Anthropic разработали собственную систему контроля версий Scion на базе монорепозитория; процесс миграции занял пять месяцев. Высокая продуктивность Claude в написании кода не только породила проблему, но и послужила подсказкой к её решению — потребовались масштабируемые инструменты инфраструктуры. Помимо Scion, ИИ создал интерфейс для код-ревью Antique, средство поиска по коду и систему управления правами доступа к исходному коду. Реализованный в Git децентрализованный подход оптимален для большинства репозиториев; но в самой компании основная ветка репозитория имеет размер около 100 Гбайт, а сжатая рабочая копия — около четверти этого объёма. Каждый день производятся более 25 млн операций по извлечению кода, и при обычном подходе к загрузке объём трафика Git превысил бы 600 Пбайт в сутки. Систему Scion разработали с учётом потребностей ИИ-агентов, поэтому значительную часть работы пришлось переложить с клиентской на серверную часть. Запросы к системе осуществляются через API, благодаря чему внутренние инструменты обходятся без локального репозитория — потребность в синхронизации снижается, а требования к скорости работы сервера, напротив, повышаются. Работу над системой Scion начали в январе, и когда внутри компании появился доступ к модели Claude Mythos Preview, инженеры Anthropic поручили ей переписать первоначальный конвейер переноса данных из Git в Scion — та создала версию, которая потребляла в 20 раз меньше памяти и работала вчетверо быстрее. Инженеры компании спокойно относятся к тому, что ИИ стал писать код лучше их. Сейчас их задача — контролировать работу ИИ и пресекать её инициативы, которые нарушают заданные ограничения. Выпускать Scion как проект с открытым исходным кодом в Anthropic не планируют, но допускают, что с похожей проблемой могут столкнуться в обозримом будущем и другие организации, поэтому компания решила поделиться своим подходом. «Набор кода вручную безнадёжно устарел»: в Microsoft рассказали, что роль программистов изменится
08.09.2026 [16:13],
Павел Котов
«Набор кода вручную безнадёжно устарел», — заявил инженер Microsoft Дэвид Фаулер (David Fowler). По его мнению, традиционные разработчики в ориентированном на искусственный интеллект мире уходят в прошлое. 
Источник изображения: Mohammad Rahmani / unsplash.com Автор ставшего сенсационным поста в соцсети X в действительности подразумевал, что роли программистов изменятся, но не исчезнут совсем. Сейчас разработчик всё чаще занимается контролем ИИ-агентов и проверкой результатов их работы: создание ПО теперь предполагает постановку задачи, получение выходных данных и отладку кода, а не его написание с нуля. ИИ не просто пишет код — агентские приложения класса GitHub Copilot доказали, что справляются с гораздо большей частью рабочего процесса: это создание программной части, запуск тестирования и проверка на наличие сбоев — и только после этого продукт передаётся человеку. Microsoft также сделала собственную платформу Aspire удобнее для работы ИИ-агентов: в версии 13.2 появилась поддержка протокола MCP и подходящий для ИИ-агентов интерфейс командной строки. Ещё в прошлом году гендиректор Microsoft Сатья Наделла (Satya Nadella) заявил, что 30 % кода компании генерируется ИИ, и сегодня этот показатель, очевидно, гораздо выше. Одним из неприятных последствий нового формата работы стало снижение качества кода — ИИ-агенты теряют в точности в долгосрочных задачах, показало собственное исследование Microsoft. Сгенерированный ИИ код в среднем содержит в 1,4 раза больше критических и в 1,7 раза больше серьёзных проблем, чем эквивалентный код, созданный человеком. До 45 % разработок ИИ содержат уязвимости, хотя код может быть и рабочим. Конечно, качество ИИ-кода со временем будет расти, но ошибки едва ли получится изжить полностью; и хотя человеку, возможно, со временем не придётся писать код самому, его услуги так и останутся востребованными. Meta✴ представила ИИ-модель Muse Spark 1.1 — она умеет искать сложные ошибки в коде и работать с агентами
09.07.2026 [20:18],
Анжелла Марина
Meta✴✴ представила ИИ-модель Muse Spark 1.1, ориентированную на задачи программирования, одновременно запустив новый API для её интеграции в сторонние сервисы. На первом этапе доступ к API открыт разработчикам из США в рамках публичного предварительного тестирования. 
Источник изображения: James Harrison/Unsplash По утверждению компании, Muse Spark 1.1 стала заметным развитием модели первого поколения, получив улучшения на основе отзывов разработчиков. Среди заявленных возможностей — поиск и исправление сложных ошибок в программном коде, поддержка агентных сценариев разработки, включая мультиагентные системы, а также встроенная мультимодальная обработка изображений, видео и документов. Новая модель, по сообщению The Verge, уже доступна в режиме Thinking («режим размышления») через приложение Meta✴✴ AI и веб-версию сервиса. Одновременно компания открыла предварительный доступ к новому API (Meta✴✴ Model API), предоставив каждому новому аккаунту кредит в размере $20 для тестирования возможностей платформы. Запуск Muse Spark 1.1 последовал за выходом модели генерации изображений Muse Image, вызвавшей споры из-за способности использовать контент других пользователей Instagram✴✴ при создании изображений. Как отмечает сама компания, развитие линейки моделей является частью стратегии Meta✴✴, направленной на укрепление позиций в сфере искусственного интеллекта на фоне конкуренции с OpenAI, Google и Anthropic. Появился сервис по очистке программного кода от ИИ-мусора — за $10 000 его сделают в разы компактнее
09.07.2026 [05:59],
Анжелла Марина
Команда разработчиков Slopfix запустила сервис по оптимизации проектов, созданных с помощью искусственного интеллекта. За фиксированную стоимость в $10 000 специалисты берутся за недельный срок сократить объём исходного кода, сохранив при этом работоспособность приложения. 
Источник изображения: AI Перед началом работы Slopfix бесплатно анализирует репозиторий клиента, после чего принимает решение о целесообразности проведения работ. Далее команда составляет подробное описание работы приложения и передаёт заказчику обновлённую кодовую базу, документацию, набор правил для предотвращения повторного разрастания проекта, а также двухнедельную гарантию. Оплата зависит от того, насколько удалось достичь заранее согласованной цели по сокращению объёма кода. В качестве примера компания приводит уменьшение проекта со 100 000 до 35 000 строк без потери функциональности. Основатель компании, известный на Hacker News под псевдонимом zie1ony, сообщил, что стоимость услуги зависит от достижения заранее согласованной цели по сокращению объёма кода. При этом инженеры используют ИИ-агентов для поиска повторяющихся фрагментов и их объединения, подчёркивая, что окончательные решения принимают специалисты, а не автоматизированные инструменты. Появление подобных услуг связывают с быстрым ростом объёмов ИИ-сгенерированного кода. Согласно данным GitClear Maintainability Gap за 2026 год, о которых сообщает издание Tom's Hardware, количество дублирующихся фрагментов кода увеличилось на 81 % по сравнению с 2023 годом, тогда как доля операций по рефакторингу сократилась с 21 % всех изменённых строк в 2022 году до менее чем 4 % в 2026 году, вследствие чего разработчики стали примерно в пять раз чаще копировать код, чем перерабатывать существующий. ИИ-агенты скоро станут дороже живых программистов, подсчитали аналитики Gartner
25.06.2026 [15:02],
Павел Котов
Разработчики агентов искусственного интеллекта начали переводить клиентов с фиксированных тарифов на оплату по объёму потребляемых токенов, в результате чего цены на эти продукты резко выросли. Вскоре ИИ-помощники могут оказаться дороже состоящих в штате компаний программистов, пишет The Register со ссылкой на исследование Gartner. 
Источник изображения: Arif Riyanto / unsplash.com Компании, которые занимаются разработкой ПО, столкнулись с резким ростом затрат, указывают аналитики Gartner: если раньше помогающие программистам ИИ-агенты обходились от $20 до $100 в месяц на рабочее место, то теперь цены выросли до $2000–5000, а в некоторых случаях и до $20 000 — тоже в месяц за рабочее место. При этом разработчики ПО не получают достаточно информации о том, как рассчитываются и выставляются счета за потребление токенов, что затрудняет программирование и контроль затрат. Создатели ИИ-сервисов не предоставляют встроенных функций, позволяющих разработчикам оптимизировать затраты на ИИ-агентов — в результате расходы увеличиваются бесконтрольно. Более того, указывают аналитики, создатели систем ИИ переходят к концепции «максимизации токенов», исходя из тезиса, что это даст более качественный результат в работе, хотя прямой связи между объёмом потребления вычислительных ресурсов и повышением качества работы установить не удалось. Для решения проблемы аналитики Gartner рекомендуют оптимизировать потребление токенов: повышать качество входного контекста, который подаётся на модели ИИ, а также применять маршрутизацию моделей, отправляя повседневные задачи более простым и используя передовые только для самых сложных задач. Другими словами, если между объёмом потребления вычислительных ресурсов и качеством результата работы прямой связи нет, то между оптимизацией потребления и качеством результатов она есть. В отсутствие штатных средств оптимизации некоторые компании стали тратить больше средств на ИИ, чем зарабатывать, и если так пойдёт дальше, то уже к 2028 году затраты на используемых в написании кода ИИ-агентов превысят уровень зарплаты программистов. Учитывая, что стоимость работы ИИ-агентов одинакова во всех регионах, за те же деньги в Индии можно будет нанять инженера с опытом работы от четырёх до шести лет, делают неутешительный вывод аналитики Gartner. Учёные построили первый в мире кремниевый спинтронный чип для вероятностных ИИ-вычислений
03.06.2026 [22:04],
Геннадий Детинич
Полку «ленивых» процессоров прибыло. Международная группа учёных создала первый в мире чип на принципах термодинамических вычислений используя такую квантовую характеристику элементарных частиц, как спин. Термодинамические или, в более широком смысле, вероятностные вычисления уже изучаются для задач ИИ, что обещает серьёзно снизить энергопотребление. Используя для этого спиновые свойства частиц можно пойти в этом ещё дальше. 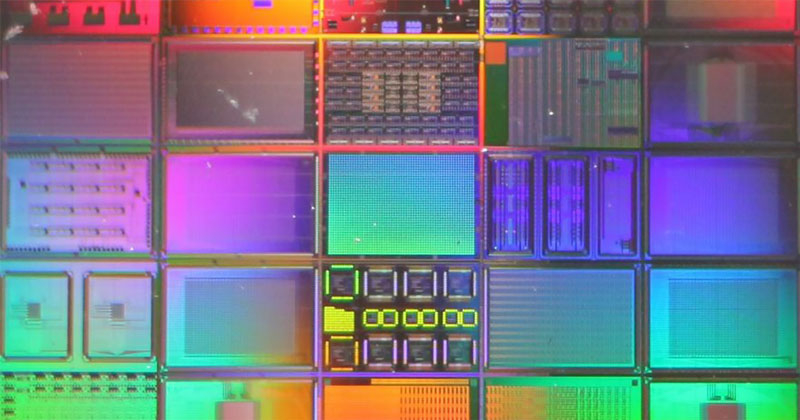
Источник изображений: Tohoku University О разработке сообщила группа учёных из Университета Тохоку (Tohoku University) и Национального института стандартов и технологий США (NIST). Забегая вперёд, добавим, что производством чипа занималась редко упоминаемая в новостях компания SkyWater — спин-офф известного разработчика чипов Cypress Semiconductor. SkyWater тесно сотрудничает с американским ВПК, и весьма примечательно, что она засветилась в этой работе. Пентагон активно интересуется малопотребляющими альтернативами для реализации физических воплощений ИИ, делая ставку на роботизацию боевых операций. Созданный группой Тохоку—NIST чип опирается на так называемый вероятностный бит (p-bit, probabilistic bit) — он же пит (pIT). Питы почти как кубиты — они тоже представлены вероятностными состояниями, однако не одновременно во всех возможных состояниях от 0 до 1, а в зависимости от входных сигналов в каждый момент времени. Причём побуждение к действию пита, или вероятность того или иного его состояния, может определяться случайной величиной, например тепловым шумом. Поэтому в общем случае речь идёт о термодинамических вычислениях. Кстати, для лучшего погружения в тему крайне рекомендуем прочесть свежую статью на нашем сайте, как раз посвящённую этому вопросу: «Термодинамические вычислители — это нормально». В качестве термодинамической составляющей спинтронного чипа выступает крошечный магнит, который может менять свою намагниченность под воздействием теплового шума. Тем самым p-bit постоянно случайным образом «скачет» между состояниями 0 и 1, используя случайную намагниченность самого устройства в каждый момент времени. Собственно, в этом проявляется его спинтронная сущность, поскольку флуктуации намагниченности происходят на уровне ориентации спинов атомов. В этом процессе заключается вся суть вероятностных вычислений, эффективных для задач, которые требуют не последовательного перебора, а быстрого исследования огромного пространства возможных состояний. Обычные компьютеры хорошо исполняют строго предписанные инструкции, но хуже подходят для задач, где приходится работать с заранее неопределёнными значениями. Питы в такой архитектуре являются физическим источником управляемой случайности: элемент сам «прыгает» между 0 и 1, а внешним напряжением можно смещать вероятность того, какое состояние будет встречаться чаще. Это примерно похоже на управление весовыми коэффициентами, хотя на практике всё происходит сложнее. Поэтому подобные элементы и архитектуры всё чаще рассматривают как основу для аппаратных ускорителей ИИ и вероятностных моделей.  В этой конкретной работе был реализован суперпарамагнитный туннельный переход — наноразмерный магнитный элемент, который не способен удерживать одно состояние намагниченности, а естественным образом флуктуирует из-за тепловых и магнитных колебаний. Базовые транзисторы и соединения между элементами были изготовлены с использованием 130-нм КМОП-процесса компании SkyWater Technology. В стенах Университета Тохоку к ним сверху были добавлены спинтронные наноустройства и электроды. По большому счёту, это была попытка совместить спинтронный элемент с обычной кремниевой логикой, что в целом удалось, как показала последующая проверка схемы. Исследователи подтвердили два ключевых признака работы питов: вероятностные флуктуации выходного напряжения во времени и возможность управлять средним выходным значением питов, используя входное напряжение. Иными словами, устройство не просто шумит, а выдаёт управляемую вероятность — основу для будущих сетей из питов. На следующем этапе группа намерена перейти от производства одиночных спинтронных питов к созданию схем на их основе. ИИ теперь пишет 60 % нового кода Airbnb — и сам решает 40 % запросов в техподдержку
08.05.2026 [17:49],
Павел Котов
Значительную часть брифинга после финансового отчёта по итогам I квартала 2026 года Airbnb посвятила вопросам использования ИИ в программировании, поддержке клиентов и поиске. Как выяснилось, 60 % кода, созданного инженерами компании в этом квартале, было написано с помощью ИИ. Активнее применять эти инструменты стали также в Google, Microsoft и Spotify. 
Источник изображения: Oberon Copeland / unspalsh.com Особенно полезным ИИ компания считает для создания инструментов для своих партнёров, которые подключаются по API и управляют объектами недвижимости с помощью различного ПО. От них постоянно поступают запросы на более эффективные средства работы, и здесь, рассказал гендиректор Airbnb Брайан Чески (Brian Chesky), ИИ даёт огромные преимущества. Если раньше для реализации новой функции требовался отдел из 20 инженеров, то теперь хватает одного, который контролирует работу ИИ-агентов. Компания активно развёртывает ИИ и для функции поддержки клиентов: сейчас чат-боту удаётся разрешать 40 % вопросов без перевода клиентов на оператора — только в начале этого года данный показатель составлял 33 %. Airbnb активно экспериментирует с ИИ и в поисковом разделе. Указал господин Чески и на некоторые недостатки чат-ботов с ИИ применительно к особенностям работы платформы. Пользователям неудобно работать с текстом — специфика сервиса предусматривает приоритет фотографий. Нет простых средств управления — людям было бы удобнее не перечислять параметры, а двигать ползунки на экране. Отсутствуют удобные средства сравнения, а в одной ветке может быть до тысячи вариантов. Наконец, большинство бронирований — это многопользовательские процессы, а чат-боты в основном работают только с одним пользователем одновременно и на нативном уровне не поддерживают операции с картами. Половину программного кода Google уже пишет ИИ — и его станет больше
23.04.2026 [15:54],
Павел Котов
Сервисы программирования с использованием искусственного интеллекта продолжают набирать популярность, и в наиболее успешном на этом рынке агенте Anthropic Claude Code компания Google увидела для себя угрозу, которой придётся противостоять. Поисковый гигант намерен улучшить внутренние средства ИИ-программирования, узнал The Information. 
Источник изображения: Emile Perron / unsplash.com Google решила сформировать «оперативную группу», в которую войдут исследователи и инженеры — им будет поручена разработка более совершенных ИИ-моделей для написания кода. Отдел возглавит Себастьян Боржо (Sebastian Borgeaud), инженер-исследователь из Google DeepMind, ранее курировавший направление предварительного обучения. В проекте также примут участие технический директор Google DeepMind Корай Кавукчуоглу (Koray Kavukcuoglu) и соучредитель Google Сергей Брин (Sergey Brin). В компании пришли к выводу, что новейшие модели Anthropic Claude Code превосходят аналоги Gemini, и это надо изменить. Google займётся разработкой моделей ИИ для внутреннего использования, а также расширит возможности агентов. ИИ-модели для внутреннего употребления будут обучаться на собственной кодовой базе Google, что позволит инженерам компании повысить производительность труда, но выкладывать их в открытый доступ компания по той же причине не сможет. Сейчас ИИ пишет до половины кода в проектах Google, и компания намеревается повысить его долю. Она будет отслеживать интенсивность использования внутренних средств написания кода, которые называются Jetski — поставлена задача выяснить, какие сотрудники пользуются им наиболее активно, проводить обучающие сессии и сформулировать требования к использованию для определённых задач. «Огромное распространение» этих средств наблюдается уже сейчас, подтвердил представитель Google и добавил: «Их применение значительно ускоряет разработку наших моделей и инструментов ИИ — мы по-настоящему на этом сосредоточены». ИИ-агент OpenAI Codex получил многие улучшения в новой версии
17.04.2026 [04:52],
Алексей Разин
Написание программного кода стало той очевидной сферой автоматизации, в которой активно применяется генеративный искусственный интеллект. Anthropic исторически смогла продвинуться на этом направлении дальше со своим Claude Code, но навёрстывающая упущенное OpenAI не собирается сдаваться, а потому Codex недавно обзавёлся многими важными обновлениями. 
Источник изображения: OpenAI Прежде всего, как поясняет TechCrunch, теперь Codex может работать на ПК в фоновом режиме, самостоятельно запуская любые приложения и осуществляя операции, подразумевающие управление курсором и вводом текста с клавиатуры. Теоретически, пользователь может параллельно запустить нескольких агентов, которые не будут мешать пользователю заниматься своими делами на том же компьютере. Агенту можно поручить разного рода второстепенные задачи, сосредоточившись на главной. По сути, Codex претендует на внимание не только разработчиков ПО, чей труд он может сделать более продуктивным, но и более широкой корпоративной аудитории. Обозреватели отметили, что многие новые функции Codex напоминают те, что ранее уже появились в Anthropic Claude Code. Внутри самого Codex появился браузер, позволяющий пользователю отдавать команды, транслируемые затем на конкретные веб-приложения. В дальнейшем эту функцию планируется развивать, предоставляя Codex больше контроля не только над веб-приложениями. В Codex была добавлена функция «памяти», позволяющая обращаться к предыдущим сессиям работы и учитывать специфику работы конкретного пользователя. Появилась и возможность генерации изображений, которая позволит создавать слайды, эскизы и схемы. На уровне плагинов была реализована интеграция со 111 сторонними инструментами типа CodeRabbit и GitLab Issues. У ИИ-агента Codex появились и функции персонального ассистента, он может просматривать каналы Slack или календарь Google, резюмируя перечень важных задач на каждый день. Кроме того, платить за использование Codex теперь можно по мере использования соответствующего инструмента, для периодических обращений такая схема выгоднее фиксированной абонентской платы. Anysphere выпустил ИИ-помощника по написанию программного кода Cursor 3
03.04.2026 [17:08],
Владимир Мироненко
Стартап Anysphere представил новую версию ИИ-помощника для написания программного кода — Cursor 3. Инструмент использует большие языковые модели, такие как Claude, а также алгоритмы собственной разработки стартапа. 
Источник изображения: Chris Ried/unsplash.com В новой версии Cursor 3 добавлен интерфейс чат-бота, который позволяет разработчикам вводить описание функции, которую они хотят создать, на естественном языке и указывать языковую модель, которая должна выполнить задачу. Cursor 3 генерирует запрошенный код вместе с демонстрационным видео, показывающим, как он работает. Работу чат-бота обеспечивают несколько ИИ-агентов. Некоторые из них работают в облаке, а другие установлены на локальных компьютерах пользователей. Разработчики могут управлять всеми ИИ-агентами через недавно добавленную боковую панель. Облачные агенты Cursor имеют доступ к большему количеству аппаратных ресурсов, чем локальные агенты. Благодаря этому они могут работать параллельно, ускоряя выполнение трудоёмких задач. Десктопные агенты работают медленнее, но при этом позволяют разработчикам локально открывать генерируемый код, редактировать его вручную и запускать тесты. Пользователи Cursor 3 могут переключаться между двумя режимами, например, использовать набор облачных агентов для генерации фрагмента кода, а затем отправить фрагмент десктопному агенту для локального редактирования. Стартап утверждает, что модель Composer 2, представленная им в прошлом месяце, особенно хорошо подходит для таких задач. Данная модель более экономична, чем другие LLM, поддерживаемые платформой. Чтобы ускорить рабочий процесс редактирования пользовательского интерфейса, разработчики могут активировать недавно добавленный режим проектирования. Эта функция позволяет выбирать элементы интерфейса и добавлять текст на естественном языке с указанием, какие изменения следует внести. Cursor 3 предоставляет пошаговый обзор каждой выполненной задачи. ИИ-помощник сопровождает объяснением на естественном языке каждый этап выполнения задачи, выделяет возникшие ошибки и предоставляет скриншоты своей работы. Разработчики могут оперативно корректировать ход процесса, вводя обратную связь. Cursor 3 также получил ряд других улучшений. Например, новый ярлык позволяет разработчикам отправлять запрос нескольким LLM и выбирать наилучший ответ. Ещё одно улучшение ускоряет процесс проверки изменений кода перед их внедрением в производство. ИИ поможет обнаруживать ошибки в коде проектов на GitHub
26.03.2026 [12:29],
Павел Котов
Администрация GitHub развернёт функцию сканирования кода с использованием искусственного интеллекта в сервисе Code Security — она поможет обнаруживать уязвимости вне службы статического анализа CodeQL, охватив большее число языков и фреймворков. 
Источник изображения: github.blog Новая мера призвана выявлять проблемы безопасности там, где традиционные методы статического анализа не справляются: CodeQL продолжит работать в областях, для которых реализована поддержка, а ИИ обеспечит расширенный охват: Shell/Bash, Dockerfiles, Terraform, PHP и других экосистем. Публичное тестирование новой гибридной модели стартует в начале II квартала 2026 года. Набор инструментов GitHub Code Security интегрируется непосредственно в репозитории и рабочие процессы GitHub. Для публичных репозиториев он доступен бесплатно, хотя и с некоторыми ограничениями; подписчики платных тарифов могут работать с расширенным пакетом GitHub Advanced Security (GHAS). Сервис предлагает сканирование кода на наличие известных уязвимостей, сканирование зависимостей и обнаружение уязвимых открытых библиотек, обнаружение утечек учётных данных в общедоступных ресурсах, а также оповещения о безопасности с рекомендациями по устранению проблем на основе ИИ-помощника Copilot. Инструменты безопасности срабатывают на уровне запросов на слияние (pull request), платформа выбирает соответствующий инструмент — CodeQL или ИИ, — что позволяет выявлять угрозы до включения потенциально проблемного кода. При обнаружении уязвимостей, таких как слабое шифрование, неверная конфигурация или небезопасные SQL-запросы, оповещения отображаются непосредственно в запросах на слияние. В рамках внутреннего тестирования система обработала более 170 000 инцидентов за 30 дней, разработчики оставили 80 % положительных отзывов, подтвердив обоснованность предполагаемых проблем. Администрация GitHub также указала на важную функцию Copilot Autofix, которая предлагает решения проблем, выявленных с помощью GitHub Code Security. По итогам 2025 года Autofix обработала более 460 000 оповещений о безопасности — решения удалось находить в среднем за 0,66 часа, а когда Autofix не использовался, этот показатель возрастал в среднем до 1,29 часа. Популярный лайфхак для ИИ оказался вредным: просьба «представь себя экспертом» ухудшает ответы
24.03.2026 [14:25],
Павел Котов
Запросы к системам искусственного интеллекта, в которых чат-ботам предлагается примерить на себя образ профессионала, могут снизить качество генерируемого контента, в том числе программного кода. К такому выводу пришли учёные Университета Южной Калифорнии в своём исследовании. 
Источник изображения: Steve Johnson / unsplash.com Ещё в 2023 году, в момент становления бума ИИ, исследователи рекомендовали начинать запрос к чат-ботам на генерацию программного кода с фраз вроде: «Ты — опытный программист в области машинного обучения». Считалось, что это способно повысить качество программного кода в ответе. Подобные рекомендации встречаются и теперь, но в новом исследовании учёные установили, что эффективность запросов с установкой ролевой модели зависит от поставленной задачи. Если речь идёт о задачах, связанных с материалами предварительного обучения, такими как математика или программирование, то качество ответа может, напротив, снизиться. Причина заключается в том, что упоминание профессиональной роли в запросе на самом деле не добавляет ей никаких экспертных знаний — объёмы обучающих данных остаются теми же. А при обращении к материалам, полученным на этапе предварительного обучения, установка ролевой модели может стать даже препятствием. Это подтвердилось при прохождении популярного теста MMLU (Massive Multitask Language Understanding): с установкой роли эксперта в запросе качество ответов снизилось по всем четырём категориям, а общая точность снизилась с 71,6 % до 68,0 %. Выбор ролевой модели повышает вероятность того, что ИИ даст ответ, которого ожидает пользователь, и это может отрицательно сказаться на качестве непосредственно поставленной задачи, потому что ИИ больше стремится соответствовать поставленной роли. В случае написания программного кода ролевая модель, однако, способствует более детальной и качественной проработке пользовательского интерфейса, архитектуры проекта и выбору инструментов. Для решения поставленной проблемы учёные предложили схему PRISM (Persona Routing via Intent-based Self-Modeling), при которой ИИ автоматически выбирает ролевую модель или просто генерирует контент по запросу — в зависимости от типа поставленной задачи подключается механизм основе низкоранговой адаптации LoRA. «Если вам важнее соответствие требованиям (безопасности, правилам, установленной структуре и т. д.), конкретизируйте их; если же важнее точность и факты, просто отправляйте запрос», — заключили учёные. |
|
✴ Входит в перечень общественных объединений и религиозных организаций, в отношении которых судом принято вступившее в законную силу решение о ликвидации или запрете деятельности по основаниям, предусмотренным Федеральным законом от 25.07.2002 № 114-ФЗ «О противодействии экстремистской деятельности»; |
© 1997—2026 3DNews
При цитировании документа ссылка на сайт с указанием автора обязательна. Полное заимствование документа является
нарушением
российского и международного законодательства и возможно только с согласия редакции 3DNews.



 MWC 2018
 2018
 Computex

 IFA 2018









