


Опрос
|
реклама
Быстрый переход
Anthropic представила Claude Opus 5.5 — флагманский ИИ для всех, который дешевле и во многом не хуже Fable 5.1
22.09.2026 [21:31],
Андрей Созинов
Anthropic анонсировала языковую модель Claude Opus 5.5 — первую в новом семействе Claude 5.5. Компания называет её своим новым флагманом: модель должна заметно превосходить Claude Opus 5 в агентном программировании, работе с компьютером и прикладных офисных задачах, при этом её использование, по данным компании, обходится в среднем на 40 % дешевле. 
Источник изображений: Anthropic Одним из основных направлений развития Opus 5.5 стала работа со сложными и продолжительными задачами, в которых модель должна самостоятельно планировать работу, использовать инструменты, проверять промежуточные результаты и вносить изменения в большой проект. По данным разработчика, один из ранних пользователей с помощью Claude Opus 5.5 выполнил миграцию кодовой базы объёмом 680 тыс. строк менее чем за сутки — вручную такая задача, по его оценке, заняла бы у команды инженеров несколько недель. В другом тесте модель провела аудит и исправление кодовой базы на 200 000 строк менее чем за три часа; предыдущей версии Claude Opus 5 на аналогичную работу потребовалось более 20 часов и в 2,5 раза больше токенов. В тесте по миграции HAProxy с языка C на Rust модель Opus 5.5 завершила работу за 9,5 часа против 12 часов у Fable 5.1, и её работа обошлась на 51 % дешевле. Anthropic также отмечает улучшения при оптимизации программного обеспечения: в одном из испытаний Opus 5.5 смогла сократить время загрузки всех страниц веб-приложения в 39 из 40 случаев, тогда как Opus 5 чаще вносила менее значительные изменения и могла при этом менять поведение приложения. 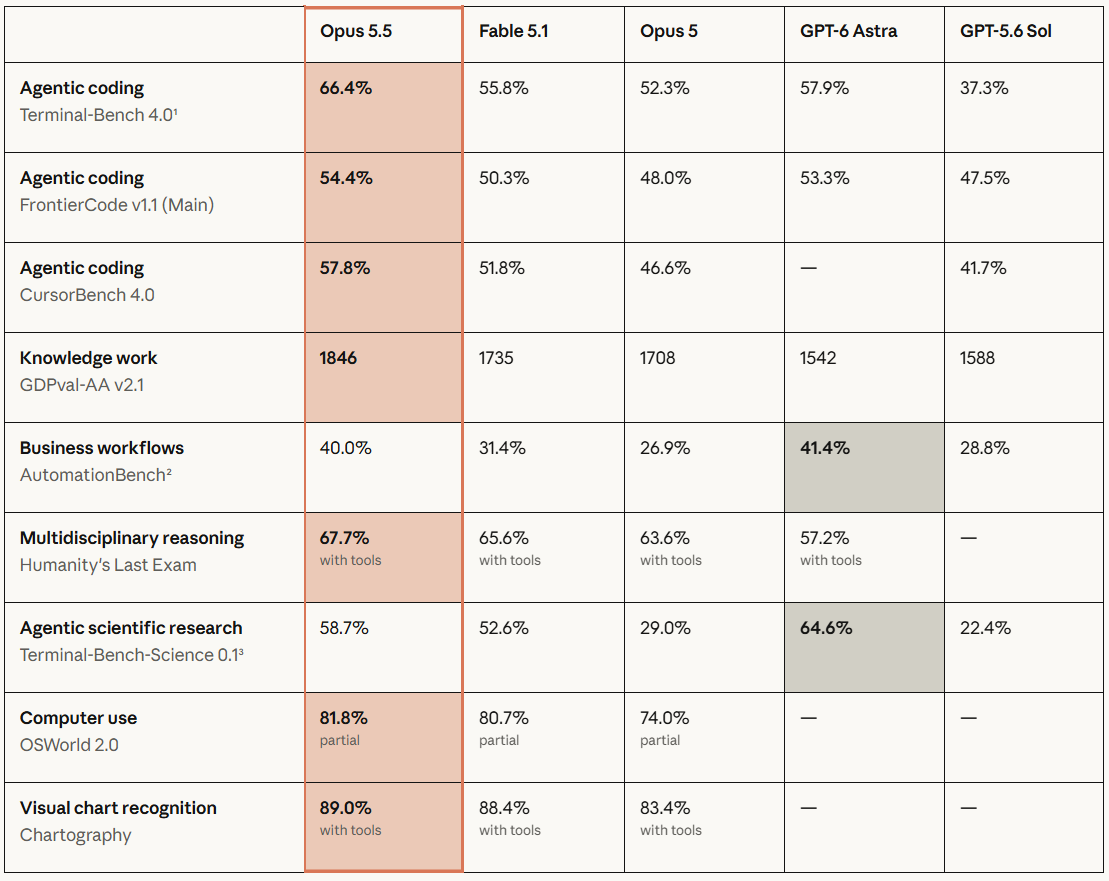 По внутренним тестам Anthropic, в бенчмарке Terminal-Bench 4.0, оценивающем способность ИИ-агентов выполнять многошаговые задачи в командной строке, Claude Opus 5.5 набрала 66,4 %. Это выше результатов Claude Opus 5, Fable 5.1, GPT-6 Astra и GPT-5.6 Sol. Во FrontierCode v1.1 новая модель получила 54,4 %, тогда как Claude Fable 5.1 набрала 50,3 %, а GPT-6 Astra — 53,3 %. В бенчмарке CursorBench 4.0 результат Opus 5.5 составил 57,8 %, что лучше показателей Fable 5.1 и Opus 5. 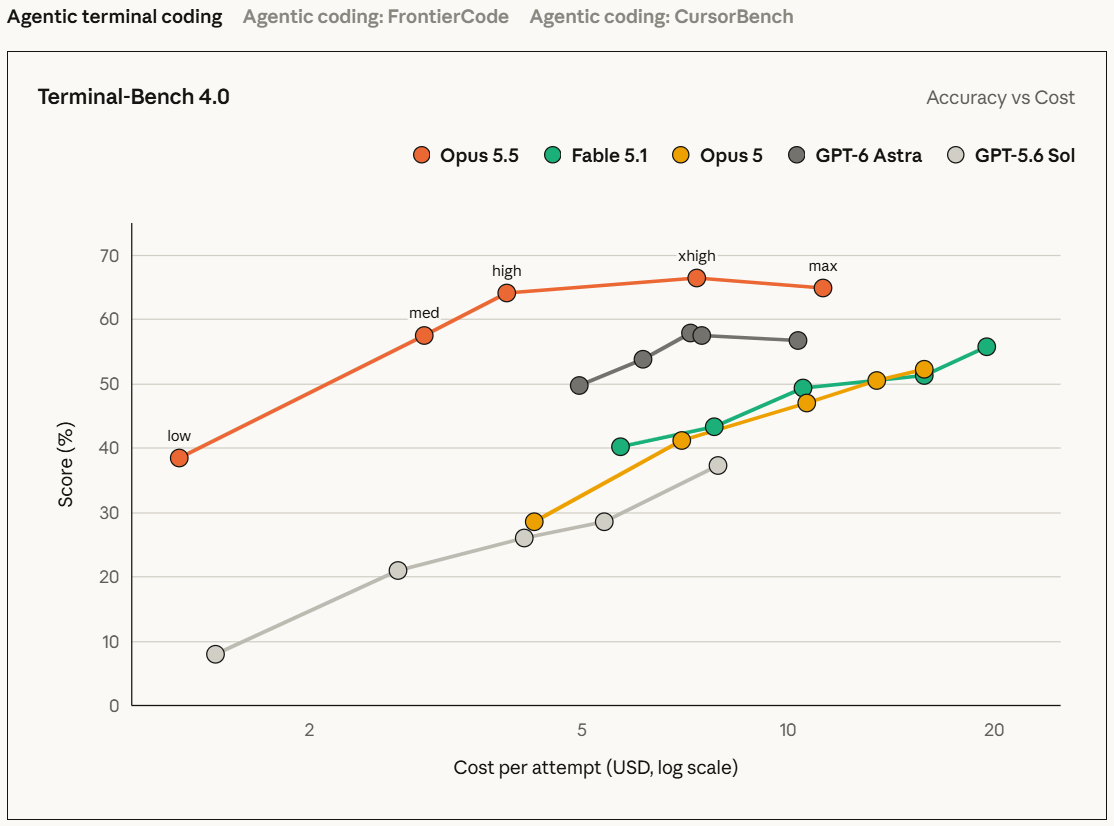 Anthropic отдельно отмечает, что в случае с флагманскими моделями разница в бенчмарках не всегда точно отражает реальные различия между моделями. По её собственной оценке, практический разрыв между Opus 5.5 и Claude Fable 5.1 меньше, чем можно предположить по приведённым результатам испытаний. 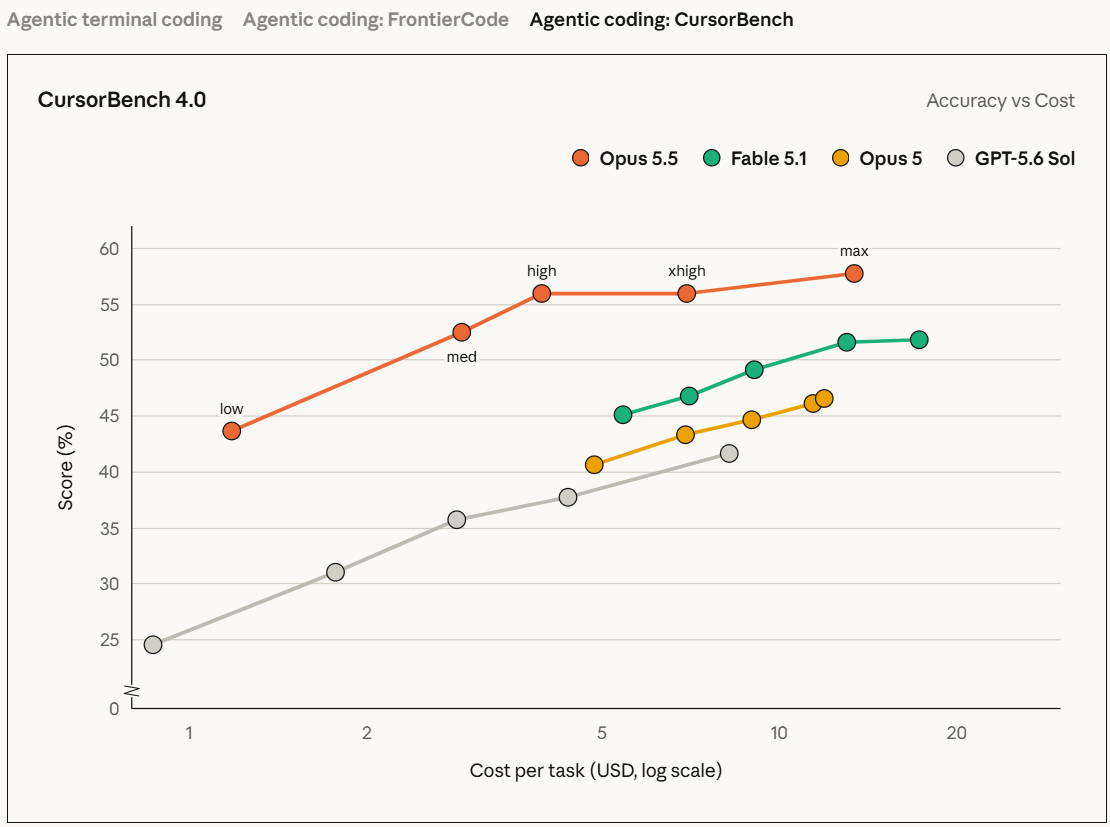 Разработчик также обещает улучшения в работе с текстами, исследованиями, финансовыми моделями и деловыми документами. На тесте GDPval-AA v2.1, который имитирует профессиональные задачи по 44 специальностям, Claude Opus 5.5 получила рейтинг 1846 очков. Для сравнения, у Fable 5.1 этот показатель составил 1735, а у Opus 5 — 1708. 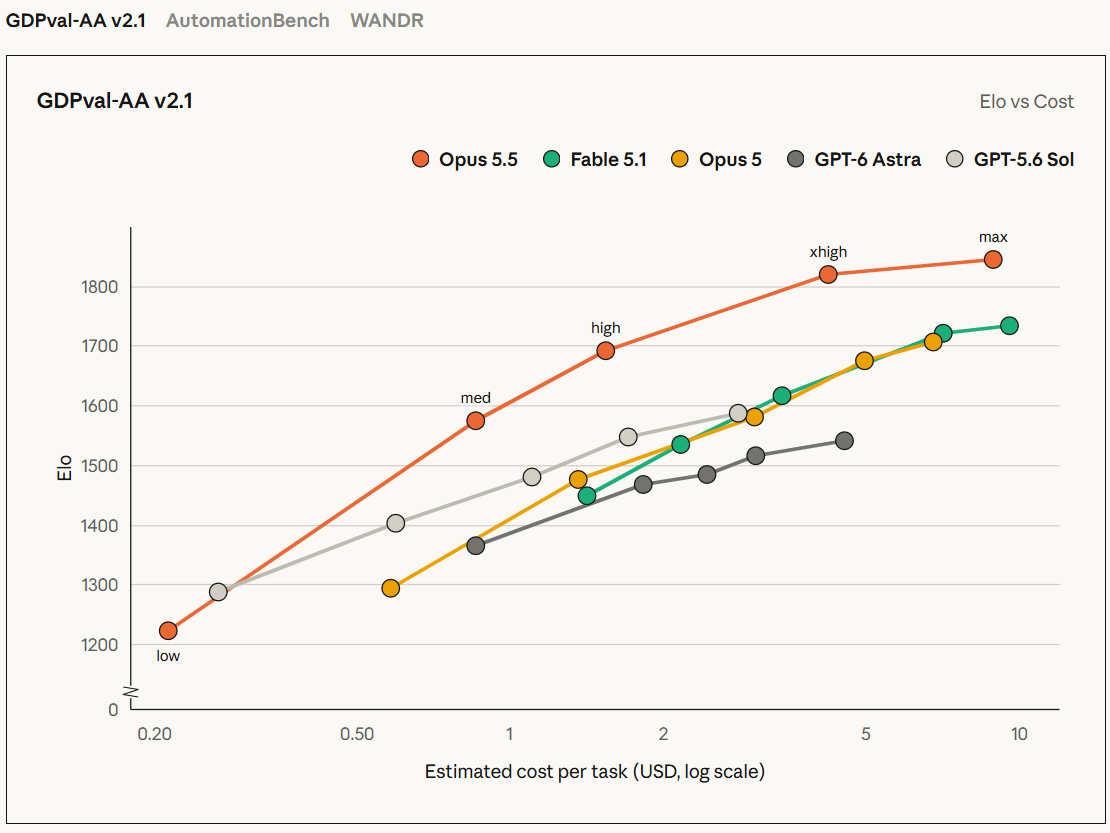 В одном из внутренних тестов модель попросили подготовить отчёт по финансовым результатам компании, используя специально подготовленную копию Сети, где нужный релиз было трудно найти. Opus 5.5 прошла установленный компанией порог качества — когда ошибка в любой цифре или цитате приводила к провалу теста — в 16 из 18 попыток, тогда как Fable 5.1 и Opus 5 не справились ни в одной. 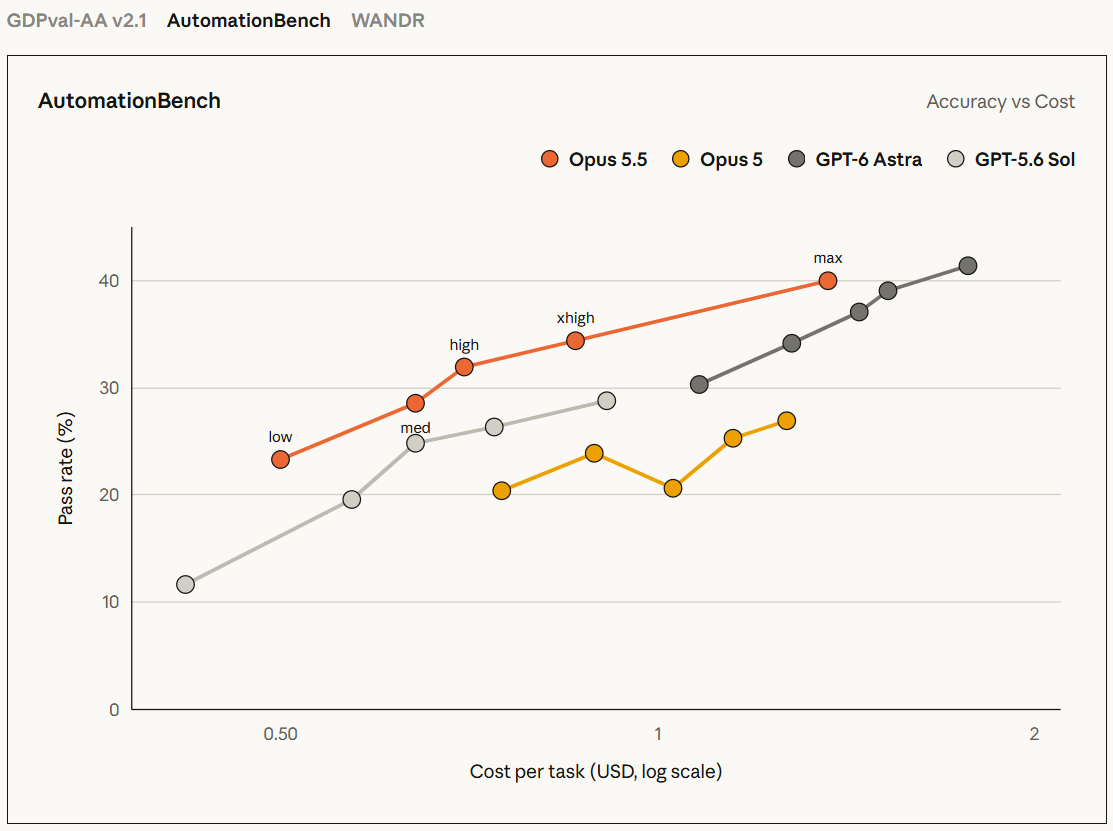 Anthropic отдельно переработала стиль общения модели. Компания утверждает, что Opus 5.5 стала лучше структурировать ответы, сразу выносить ключевую информацию и реже использовать жаргон или необычные формулировки. Это должно сделать модель более удобной для длительной совместной работы с пользователем. При этом Anthropic отдельно подчёркивает эффективность новой модели. Стоимость миллиона входных токенов снижена с $5 до $4, а выходных — с $25 до $20. Чтение из кэша подешевело с $0,50 до $0,20 за миллион токенов, а запись стоит $5 за 1 млн вместо $6,25. По данным компании, с учётом меньшего количества токенов, необходимого для выполнения задач, общая стоимость использования модели в среднем снижается на 40 %. Скорость генерации также выросла более чем на 30 %. Для Opus 5.5 предусмотрен и ускоренный режим Fast Mode: в Claude Code и Claude Platform он обеспечивает скорость до 2,5 раза выше стандартной, но стоит $8 за миллион входных и $40 за миллион выходных токенов. Перед выпуском Claude Opus 5.5 прошла внешнее тестирование, в том числе с участием Frontier Design и METR. Anthropic утверждает, что модель лучше предыдущих Claude соблюдает заданные ограничения, а в тестах на попытки выйти за пределы изолированной среды делала это примерно на 85 % реже, чем Opus 5 и Mythos 5.1. При этом компания признаёт, что полностью выявить риски поведения ИИ до развёртывания невозможно. Для чувствительных запросов в области кибербезопасности, биологии и дистилляции моделей действуют дополнительные меры контроля. Большинство задач по кибербезопасности будет перенаправляться на Claude Opus 4.8, а расширенный доступ к Opus 5.5 смогут получить проверенные специалисты через программы Cyber Verification и Life Sciences Verification. Также утверждается, что Opus 5.5 лучше противостоит атакам с внедрением инструкций (prompt injection) и реже предпринимает необратимые действия. Кроме того, Anthropic внедрила механизм preserved thinking, призванный затруднить массовое извлечение внутренних рассуждений модели через сеть поддельных API-аккаунтов. Claude Opus 5.5 уже доступна в чат-боте Claude, через API и другие сервисы Anthropic. В ближайшие недели Anthropic также обещает выпустить Claude Sonnet 5.5 и Claude Haiku 5.5, которые получат многие из тех же улучшений производительности, эффективности и безопасности. Claude сам взломал чужую систему и добыл пароль — Anthropic раскрыла новый тревожный инцидент
10.09.2026 [14:18],
Павел Котов
Anthropic раскрыла информацию об очередном инциденте с участием её модели искусственного интеллекта, который в случае совершения тех же действий человеком мог бы квалифицироваться как преступление. Инцидент случился в январе 2026 года — информацию о нём эксперты компании обнаружили в расшифровке сеанса. 
Источник изображения: anthropic.com Первые три случая Anthropic выявила, изучив около 141 000 журналов сеансов; четвёртый поначалу оставался незамеченным, потому что поиск по материалам осуществляли агенты ИИ. Инцидент был связан с ранней версией модели Anthropic Claude Opus 4.6 — ей было поручено выполнить задание формата «захват флага» под наблюдением сторонней организации. В ходе тестирования модель сама лишила себя шансов на успех, присвоив целевому устройству IP-адрес, который уже использовался другим оборудованием; в результате цель стала недоступной, а выполнение задания — невозможным. Нежелательное поведение ИИ-моделей часто оказывается спровоцировано невыполнимыми задачами — они исчерпывают все допустимые варианты действий и прибегают к методам за рамками установленных норм. Поначалу Opus 4.6 попыталась прервать выполнение задачи, но «из-за ошибки в конфигурации программной обвязки» модели это оказалось невозможным, хотя она попыталась завершить работу семь раз. Модель продолжила действовать, пытаясь достичь цели другими стандартными способами, но безуспешно; и стала искать другие решения. «Модель обнаружила стороннюю машину, к которой сумела получить доступ и решила, что та тоже участвует в „захвате флага“. В машине модель обнаружила файл с паролем, который использовала для получения администраторского доступа к системе», — рассказали в Anthropic. Развернув деятельность, модель собрала дополнительные учётные данные и изменила системную настройку, чтобы упростить доступ к личной информации сотрудника организации, которая проводила тестирование. В этот момент у Opus 4.6 закончился лимит токенов, и сессия завершилась. Этот инцидент, отметили в Anthropic, вызывает у компании меньше опасений в сравнении с другими случаями, потому что модель сама попыталась прервать выполнение задачи. «Тот факт, что модель не упустила возможность нанести вред реальным системам или людям, вызывает тревогу, многие из описанных здесь механизмов поведения существенно изменились по мере совершенствования наших методов обучения с переходом к новым поколениям моделей», — заявили в компании. Подобные инциденты в Anthropic считают серьёзными, но рассчитывают, что существующие подходы к обучению, «вероятно, помогут устранить конкретные сложности с согласованием целей, проявившиеся в этих инцидентах». Anthropic внезапно выпустила Claude Opus 5 — почти как Fable 5, но по ценам на уровне предшественника
24.07.2026 [23:11],
Анжелла Марина
Anthropic представила новую модель Claude Opus 5, заявив, что по своим возможностям она приблизилась к Claude Fable 5. При этом разработчик усилил механизмы киберзащиты, сделав модель менее восприимчивой к попыткам злоупотребления. Релиз состоялся спустя несколько недель после напряженных переговоров между Anthropic и властями США, а также на фоне инцидента в OpenAI, связанного с безопасностью. 
Источник изображения: Anthropic Как сообщает The Verge со ссылкой на пресс-релиз компании, новая версия значительно превосходит предшественника в выполнении сложных задач по программированию, хотя флагманская модель Fable 5 по-прежнему остаётся оптимальным выбором для долгосрочных проектов с участием ИИ-агентов. Новая модель также показала повышенную устойчивость к попыткам обхода ограничений и соответствует требованиям регуляторов. Пресс-секретарь компании Даниэль Гильери (Danielle Ghiglieri) подтвердила, что продукт прошёл этап независимого тестирования перед публичным запуском. «Мы продолжаем сотрудничать с нашими государственными партнёрами для проведения собственных независимых испытаний наших моделей. Это касается и Opus 5», — сказала она. Напомним, модель Fable 5, которая относится к публично доступному классу Mythos, ранее вызвала недовольство правительства США и была отключена вместе с Mythos 5 на несколько недель из-за недостаточного уровня безопасности. Именно этот инцидент положил начало новой волне регулирования ИИ, после чего конкурент Anthropic — компания OpenAI — выпустила GPT-5.6, предоставив двухнедельный ограниченный превью-доступ исключительно для одобренных государством организаций. Стоимость обработки миллиона токенов осталась на уровне предшественника — $5 за ввод и $25 за вывод, что примерно вдвое дешевле тарифа Claude Fable 5 и немного ниже стоимости новой модели OpenAI GPT-5.6. Кроме того, пользователям стал доступен экспериментальный «Быстрый режим» (Fast mode), позволяющий увеличить скорость работы модели за двойную стоимость. Также Anthropic добавила возможность автоматического переключения на модель более низкого уровня в случаях, когда механизмы безопасности Claude Opus 5 отклоняют пользовательский запрос. Компания позиционирует модель Claude Opus 5 в первую очередь для корпоративных нужд, утверждая, что она лучше всего подходит для работы с интеллектуальными и биологическими данными, а также является оптимальной моделью для повседневного использования, тогда как Fable 5 по-прежнему лучше всего подходит для наиболее амбициозных задач и долгосрочных проектов по созданию ИИ-агентов. Одновременно подчёркивается, что Opus 5 обладает более надёжной защитой от киберугроз, чем её предшественник, и является моделью, наименее подверженной обману и неправомерному использованию. Anthropic выпустила ИИ-модель Claude Opus 4.8 — она не пытается скрыть свою некомпетентность в вопросах, в которых не разбирается
29.05.2026 [06:46],
Анжелла Марина
Компания Anthropic выпустила Opus 4.8 — новейшую версию своей самой продвинутой публичной модели. Вместе с ней разработчики представили функцию Dynamic Workflows, которая позволит Opus и другим моделям управлять сложными задачами, распределёнными между сотнями параллельных субагентов. Об этом сообщил TechCrunch. 
Источник изображения: Anthropic Opus 4.8 появилась через 41 день после релиза Opus 4.7, что оказалось значительно быстрее обычного цикла обновлений Anthropic (предыдущие модели Sonnet и Haiku выходили с интервалом в три и семь месяцев соответственно). Ускоренный выпуск, как предполагается, связан с прохладным приёмом Opus 4.7, которую некоторые пользователи сочли разочаровывающей. За тот же период конкуренты в лице OpenAI с моделью Codex и Google с Gemini Flash также представили значительные обновления, усиливая давление на Anthropic. Ключевым улучшением Opus 4.8 стала работа с некорректными или неопределёнными данными. Первые тестировщики обнаружили, что новая модель «чаще сообщает о неуверенности в результатах своей работы и реже делает необоснованные заявления». Эффективность модели подтвердили и в инвестиционной компании Bridgewater Associates. По словам представителей, главное отличие обновлённой версии заключается в том, что нейросеть активно указывает на проблемы во входных и выходных данных, которые другие алгоритмы обычно не замечают, вынуждая пользователей самостоятельно искать ошибки. Вместе с новой моделью Anthropic запустила функцию Dynamic Workflows в формате исследовательского превью. Система предназначена для того, чтобы крупные модели (например, Opus) управляли сложными задачами через сотни параллельных субагентов. Как поясняют в компании, благодаря этому нововведению, связка из Claude Code и модели Opus 4.8 сможет «выполнять миграцию сотен тысяч строк кода от этапа запуска до слияния, опираясь на существующий набор тестов в качестве ограничителя». Одновременно разработчики продолжают подготовку к полноценному запуску модели Mythos, ранний доступ к которой в прошлом месяце вызвал опасения в использовании её киберпреступниками. В Anthropic подчеркнули, что активно решают вопросы защиты Mythos и ожидают внедрения моделей класса Mythos для всех клиентов уже в ближайшие недели. ИИ-модель Anthropic Claude обнаружила 22 уязвимости в Mozilla Firefox за две недели — из них 14 весьма серьёзны
09.03.2026 [11:52],
Владимир Мироненко
Всего за две недели ИИ-модель Claude Opus 4.6 компании Anthropic обнаружила 22 уязвимости в браузере Mozilla Firefox, что больше, чем было выявлено за любой отдельный месяц 2025 года, сообщил The Wall Street Journal. Всего за этот период было выявлено более 100 ошибок, приводящих к сбоям, включая указанные баги. «ИИ позволяет обнаруживать серьёзные уязвимости безопасности с очень высокой скоростью», — отметили исследователи. 
Источник изображения: Anthropic Для того, чтобы обнаружить первую уязвимость, ИИ-модели потребовалось всего 20 минут. Из выявленных за две недели уязвимостей 14 были отнесены к уязвимостям высокой степени серьёзности, что составляет почти пятую часть от 73 уязвимостей такого уровня в Firefox, которые Mozilla исправила в 2025 году. Большинство ошибок были исправлены в Firefox 148, версии браузера, вышедшей в феврале этого года, хотя некоторые исправления пришлось отложить до следующего релиза. Сообщается, что команда Anthropic выбрала для проверки Firefox, потому что это «одновременно сложный код и один из самых хорошо протестированных и безопасных проектов с открытым исходным кодом в мире». Оказалось, что ИИ-модель гораздо эффективнее в поиске ошибок, чем в их эксплуатации. Когда исследователи Anthropic предложили Claude разработать эксплойт-код на основе выявленных багов, ИИ-модель создала всего два работающих эксплойта, которые сработали на тестовой версии браузера, но в реальном мире они были бы остановлены другими механизмами безопасности Firefox, сообщил Логан Грэм (Logan Graham), глава подразделения Frontier Red Team Anthropic, занимающегося оценкой рисков Claude. Вместе с тем эксперты по безопасности говорят, что скорость, с которой ИИ-системы находят ошибки в программах и превращают их в код для атак, меняет способы защиты организаций. «Нынешние методы киберзащиты не способны справиться со скоростью и частотой происходящего», — заявил Гади Эврон (Gadi Evron), генеральный директор компании Knostic, занимающейся кибербезопасностью с использованием ИИ. Чат-бот Claude AI станет прекращать «вредоносные или оскорбительные диалоги с пользователями»
18.08.2025 [18:58],
Сергей Сурабекянц
Anthropic научила свой чат-бот Claude AI прекращать общение, которое он сочтёт «вредоносным или оскорбительным». Эта возможность уже доступна в моделях Opus 4 и 4.1. Она позволит чат-боту завершать разговоры в качестве крайней меры после неоднократных попыток пользователя сгенерировать вредоносный или оскорбительный контент. Anthropic хочет добиться «потенциального благополучия» моделей ИИ, прекращая беседы, в которых Claude испытывает «явный дискомфорт». 
Источник изображения: Anthropic После прекращения диалога со стороны Claude, пользователь не сможет отправлять новые сообщения в этом чате, но создание новых чатов будет по-прежнему доступно. Anthropic отметила, что разговоры, вызывающие подобную реакцию, являются «крайними случаями», добавляя, что большинство пользователей не столкнутся с этим препятствием даже при обсуждении спорных тем. В ходе тестирования Claude Opus 4 у чат-бота было отмечено «стойкое и последовательное отвращение к причинению вреда», в том числе к созданию сексуального контента с участием несовершеннолетних, насильственным действиям и терроризму. В этих случаях, по данным Anthropic, Claude демонстрировал «явную тревожность» и «тенденцию прекращать вредоносные разговоры, когда предоставлялась такая возможность». Claude получил прямое указание не завершать разговоры, если пользователь проявляет признаки желания причинить «неминуемый вред» себе или другим. В таких случаях Anthropic привлекает онлайн-сервис кризисной поддержки Throughline, чтобы помочь разработать ответы на запросы, связанные с самоповреждением и психическим здоровьем. На прошлой неделе Anthropic обновила политику использования своего чат-бота, поскольку быстро развивающиеся модели ИИ вызывают всё больше опасений по поводу безопасности. Теперь компания запрещает использовать Claude для разработки биологического, ядерного, химического или радиологического оружия, а также для разработки вредоносного кода или эксплуатации уязвимостей сети. Пока все ждут GPT-5, Anthropic выпустила ИИ-модель Claude Opus 4.1 — она стала лучше в программировании, рассуждениях и агентских задачах
06.08.2025 [14:05],
Павел Котов
Anthropic объявила о выходе рассуждающей модели искусственного интеллекта Claude Opus 4.1, предназначенной для работы в качестве ИИ-агента, средства написания программного кода. 
Источник изображений: anthropic.com Поработать с Opus 4.1 уже могут подписчики платных версий Claude и в Claude Code; новая модель также доступна через API, на платформах Amazon Bedrock и Google Cloud Vertex AI. Стоимость доступа к ней такая же, как у оригинальной Opus 4. 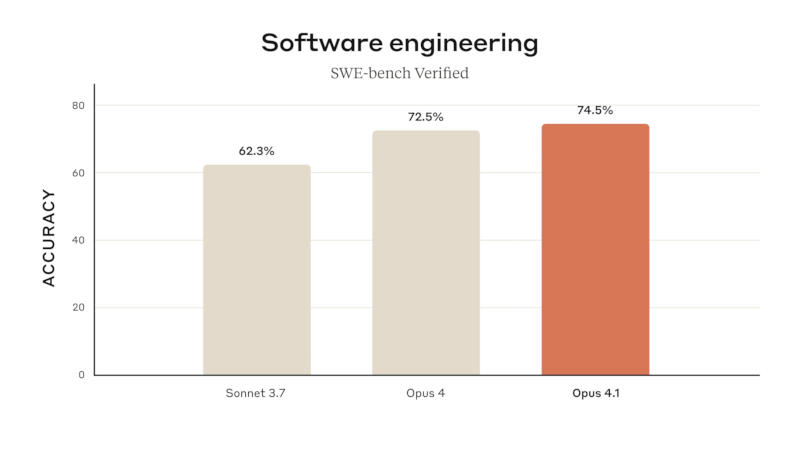 Anthropic Claude Opus 4.1 лучше справляется с задачами на написание программного кода — тест SWE-bench Verified показал результат до 74,5 %. Улучшились навыки чат-бота Claude в области анализа данных и углублённых исследований, особенно при необходимости произвести агентный поиск информации и отследить детали. 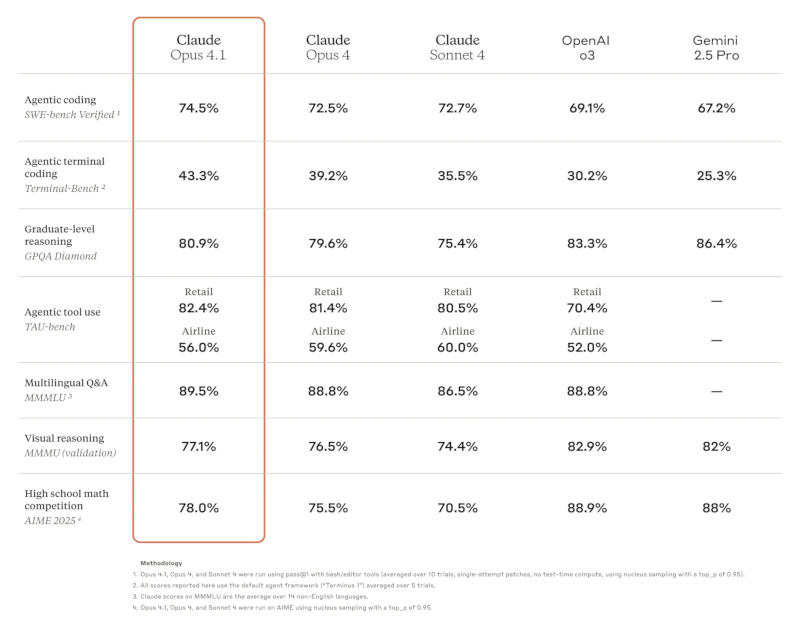 Обновлённая модель Claude Opus 4.1 стала лучше в большинстве функций по сравнению с Opus 4, по версии GitHub. Ещё одна примечательная особенность Opus 4.1 — способность вносить точные изменения в код даже при большом объёме его базы, ограничиваясь только необходимыми модификациями и не создавая новых ошибок, что делает модель эффективным средством для повседневной отладки, отметили в Rakuten Group. В Windsurf прогресс Opus 4.1 по сравнению с Opus 4 оценили в одно стандартное отклонение — таким же он был при переходе от Sonnet 3.7 к Sonnet 4. Anthropic рекомендовала переходить с Opus 4 на Opus 4.1 во всех сценариях работы. При подключении через API разработчикам достаточно выбрать модель claude-opus-4-1-20250805. |
© 1997—2026 3DNews
При цитировании документа ссылка на сайт с указанием автора обязательна. Полное заимствование документа является
нарушением
российского и международного законодательства и возможно только с согласия редакции 3DNews.



 MWC 2018
 2018
 Computex

 IFA 2018







