



 MWC 2018
 2018
 Computex

 IFA 2018



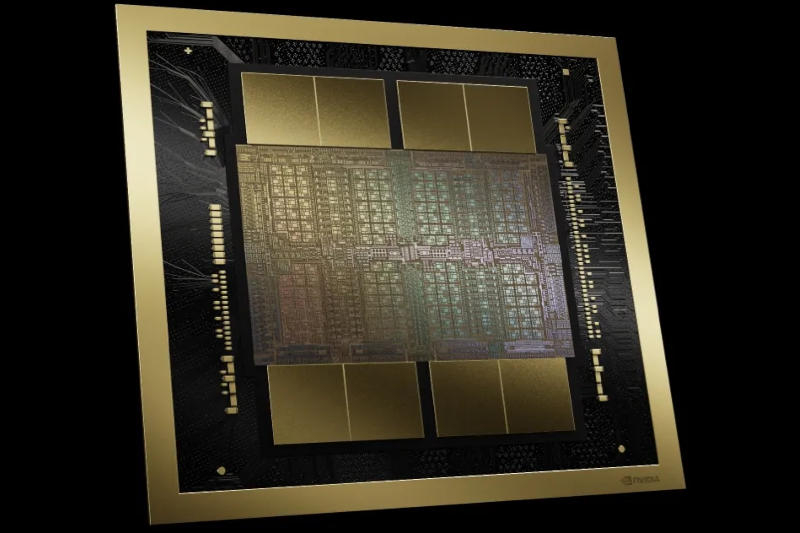
Nvidia опубликовала подробную информацию об ускорителе искусственного интеллекта GB300 Blackwell Ultra. От предшественника в лице GB200 его отличают увеличенные число ядер и объём памяти, более быстрый интерфейс и более высокая мощность. В основе Nvidia GB300 лежат два кристалла с суммарным числом 208 млрд транзисторов — они производятся по технологии TSMC 4NP и работают как единый графический процессор (GPU) за счёт интерконнекта NV-HBI со скоростью 10 Тбайт/с.









Источник изображений: nvidia.com
GPU содержит 160 потоковых мультипроцессоров (Streaming Multiprocessors), на каждый из которых приходится по 128 ядер CUDA — всего 20 480 ядер, а также тензорные ядра пятого поколения с поддержкой вычислений на числах FP8, FP6 и нового формата NVFP4. Каждый потоковый мультипроцессор располагает 256 Кбайт тензорной памяти (TMEM) — всего 40 Мбайт. Предусмотрены также дополнительные аппаратные блоки для проведения трансцендентных вычислений и операций, оптимизированных для вычислительных ядер.
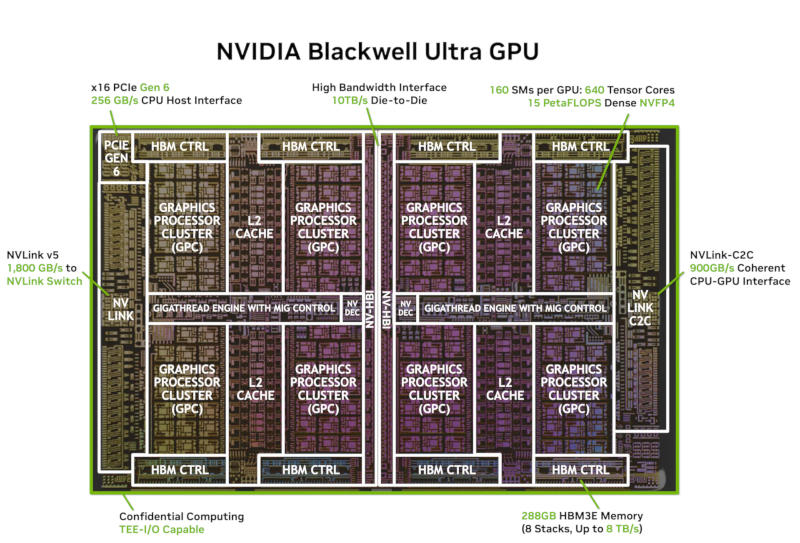
Память организована в восемь 12-слойных стеков HBM3E общим объёмом 288 Гбайт. Пропускная способность памяти у Nvidia GB300 в сравнении с GB200 не изменилась — она составляет 8 Тбайт/с, будучи организованной в 16 каналов по 512 бит (8192-битный интерфейс). Увеличенный объём памяти позволяет размещать на чипе ИИ-модель целиком, а также хранить большие объёмы кеша ключей и значений без выгрузки во внешние ресурсы. Показатель TGP вырос до 1400 Вт.
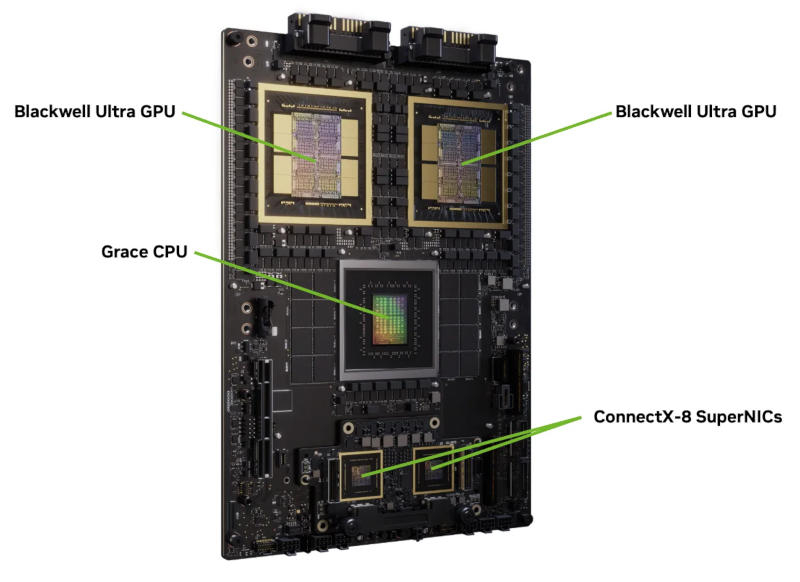
За связь между графическими процессорами отвечает интерфейс NVLink 5 с двунаправленной скоростью передачи данных 1,8 Тбайт/с на каждый GPU. Связь между GPU и центральным процессором Grace реализована через интерфейс NVLink-C2C со скоростью 900 Гбайт/с и поддержкой единого адресного пространства. Для подключения к хосту используется шина PCIe 6.0 x16 с двунаправленной полосой пропускания 256 Гбайт/с — этот интерфейс Nvidia применила впервые. Ускорители могут устанавливаться в стойку GB300 NVL72 с 72 графическими процессорами, до 20,7 Тбайт памяти HBM3E и общей полосой пропускания HBM 576 Тбайт/с. На стойку также приходится 72 Arm-ядра Grace Superchip и до 480 Гбайт LPDDR5X с полосой пропускания 512 Гбайт/с.
NVFP4 — это новый формат данных с низкой точностью, реализованный в тензорных ядрах. Он обеспечивает точность, сравнимую с FP8, но позволяет использовать в 1,8 раза меньше памяти. Массовое производство ускорителей Nvidia GB300 уже стартовало, и первые клиенты их получили.
Источник:


