


Опрос
|
реклама
Быстрый переход
Преступники угнали шесть паллет с чипами Nvidia на сумму $11,4 млн и увезли их куда-то в продуктовом грузовике
06.11.2026 [18:54],
Сергей Сурабекянц
На фоне растущего спроса и цен на компьютерное оборудование кражи графических процессоров стали распространённым криминальным «бизнесом». Сообщается об очередном подобном хищении — пропала партия оборудования Nvidia стоимостью $11,4 млн. Груз на шести паллетах был отправлен из Окленда в Техас, однако по дороге был перехвачен и перегружен на грузовик, замаскированный под транспортное средство для доставки продуктов. 
Источник изображения: unsplash.com В конечном итоге след автомобиля с украденными графическими процессорами затерялся в округе Сан-Бернардино, а в полицейское управление Окленда поступило заявление о краже. О задержании подозреваемых пока не сообщается, однако правоохранительные органы продолжают расследование. Инцидент вызвал обеспокоенность экспертов по поводу безопасности транспортировки дорогостоящей техники. Официальные лица заявляют о возможных рисках для национальной безопасности, связанных с попаданием передовых вычислительных устройств на чёрный рынок. Чипы, подобные украденным, за пределами США стоят примерно в два раза дороже. По свидетельствам аналитиков, если в США готовый сервер с ускорителями ИИ оценивается в $550 000, то на внешнем чёрном рынке его цена может достигать миллиона долларов и более Похожий случай произошёл в Бразилии: в международном аэропорту Гуарульюс пропали две паллеты с видеокартами Nvidia GeForce RTX 5090, общая стоимость которых оценивается примерно в $470 000. Груз прошёл таможенное оформление 24 сентября, но уже на следующий день исчез. В ходе расследования выяснилось, что к преступлению причастны сотрудники аэропорта: бразильская полиция установила личности трёх работников, подозреваемых в содействии краже. Ситуация приняла неожиданный оборот, когда одна из украденных видеокарт Zotac RTX 5090 была выставлена на продажу на бразильской онлайн-площадке OLX по цене более $6000. В объявлении были представлены чёткие фотографии серийного номера устройства, что позволило связать его с пропавшей партией товара. На данный момент объявление уже удалено, а местонахождение остальных видеокарт остаётся неизвестным. Tesla замахнулась на 80-кратный прирост мощности ИИ-чипов и переименовала их в ускорители суперинтеллекта
06.11.2026 [18:52],
Владимир Мироненко
Tesla представила обновлённую дорожную карту выпуска ИИ-ускорителей, сменив их название на SI. Ожидается, что чипы шестого поколения SI6 обеспечат 80-кратный прирост вычислительной мощности, а система Dojo 3 также будет использоваться в космосе. 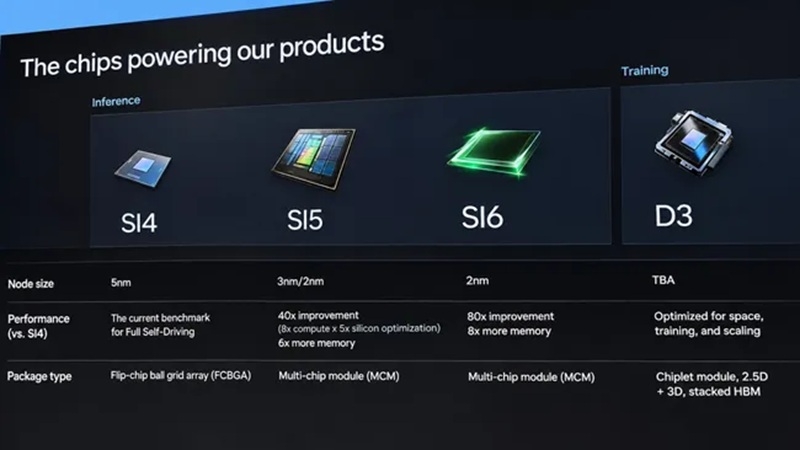
Источник изображения: Tesla/Tom's Hardware Согласно дорожной карте, ускоритель шестого поколения SI6 для инференса получит в 80 раз более высокую производительность по сравнению с чипом четвёртого поколения. А в ускорителе для обучения моделей Dojo 3 (D3) будет использоваться многочиплетная архитектура со стековой памятью HBM. Также компания сменила брендинг ускорителей: теперь они будут выпускаться под названием SI (Super Intelligence, «суперинтеллект»), которое заменит термин AI (искусственный интеллект). Ранее Илон Маск (Elon Musk) подтвердил, что по той же причине проект SpaceXAI будет переименован в SpaceXSI. Dojo 3 (D3), как сообщается, объединяет технологии 2.5D- и 3D-компоновки со стековой памятью HBM, что означает значительный отход от первоначальной архитектуры Dojo D1 с использованием памяти SRAM. Вместе с тем данные о вычислительной мощности, объёме памяти, техпроцессе или сроках разработки D3 пока не сообщаются. Как ожидается, D3 будет оптимизирован для работы в космосе, что, вероятно, означает его радиационную стойкость. Что касается SI6, то на данный момент известно, что он превышает по производительности по производительности SI4 (W4) в 80 раз, а объём памяти — в 9 раз. Речь идет о показателях в диапазоне 17 280–46 080 TOPS или 17,28–46,08 POPS — в зависимости от того, как измеряется производительность, отметил ресурс Tom's Hardware. Используемый в современных автомобилях Tesla чип SI4 (HW4) производится Samsung Foundry по 7-нм техпроцессу. Как ожидается, чип пятого поколения SI5, который будут выпускать TSMC (3 нм) и Samsung Foundry (2 нм), получит 40-кратный прирост производительности по сравнению с HW4. Компания Tesla уже заключила с Samsung Foundry соглашение о производстве ускорителей шестого поколения для инференса, которое будет действовать до 2033 года. Согласно представленным материалам, чипы SI6 будут изготавливаться с применением техпроцесса класса 2 нм. При этом в планах Tesla не предусмотрено использование для производства чипа SI6 мощностей Intel (Terafab) и техпроцесса Intel 14A в 2030-х годах. Учитывая сроки выхода (2029–2030 годы) и обновлённую дорожную карту Samsung Foundry, речь, вероятно, идёт о техпроцессах SF2A (автомобильного класса), SF2P (с повышенной производительностью) или даже SF2Z, предположил Tom's Hardware. Китайские ИИ-гиганты выстроились за видеокартами Nvidia, но получат лишь 1 % от заказанного
05.11.2026 [00:35],
Владимир Фетисов
Китайские ИИ-разработчики ожидают получить лишь небольшую долю от общего объёма заказанных ими ускорителей Nvidia в течение следующих нескольких месяцев. Это связано с тем, что американская компания сосредоточена на расширении производства передовых ускорителей, а высокий спрос на них не позволяет увеличить поставки менее мощных видеокарт в КНР. 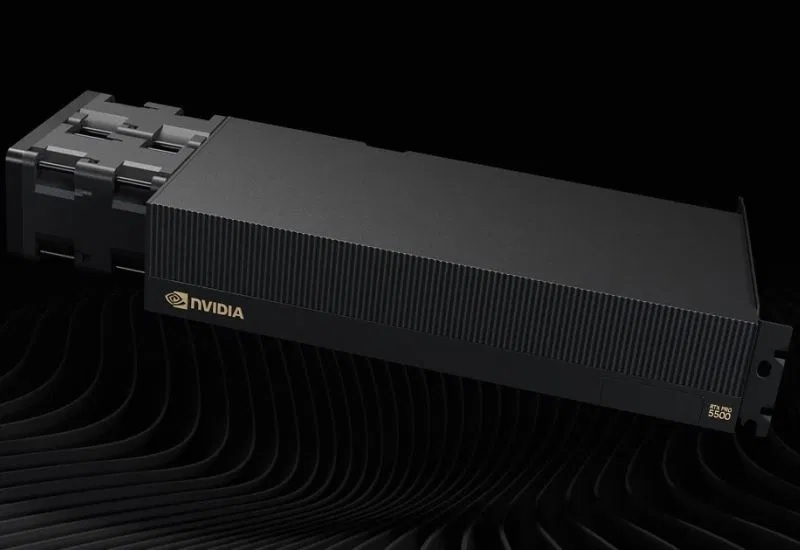
Источник изображения: Nvidia По данным источника, Alibaba Group Holding Ltd., Tencent Holdings Ltd., ByteDance Ltd. и другие китайские компании в сфере ИИ и облачных вычислений суммарно заказали около 6 млн профессиональных видеокарт Nvidia RTX Pro 5500. Однако, по прогнозам компаний, в течение следующих четырёх месяцев им удастся получить лишь несколько десятков тысяч ускорителей, или около 1 % от общего объёма заказов. При цене более $11 000 за видеокарту общая стоимость размещённых заказов в настоящее время оценивается примерно в $70 млрд. Высокий спрос на эти ускорители со стороны китайских ИИ-разработчиков подчёркивает острую нехватку вычислительных мощностей для сферы ИИ внутри КНР. На это также указывает ограниченность возможностей местных производителей оборудования, несмотря на достигнутый ими технологический прогресс. Ограниченные поставки ускорителей усложнят задачу китайским компаниям, стремящимся догнать западных конкурентов в сфере ИИ. Американские власти по-прежнему запрещают Nvidia поставлять в Китай свои передовые ускорители, однако видеокарты RTX Pro 5500 недостаточно мощные, чтобы подпадать под эти ограничения. Тем не менее в КНР этот продукт относится к числу лучших доступных ИИ-ускорителей. Местные производители, такие как Huawei Technologies Co. и T-Head (подразделение Alibaba), пока уступают американскому конкуренту по производительности и технологическим возможностям. Китайские ИИ-разработчики рассчитывают, что первая партия из нескольких тысяч видеокарт RTX Pro 5500 будет поставлена к концу нынешнего года, а следующая партия, насчитывающая несколько десятков тысяч ускорителей, ожидается в феврале. Осведомлённый источник, пожелавший сохранить анонимность, сообщил, что на данный момент это единственные подтверждённые поставки. По оценкам китайских ИИ-разработчиков, к концу 2027 года они могут получить около 700 тыс. ускорителей RTX Pro 5500. Такие ожидания связаны с наращиванием объёмов производства со стороны Nvidia. Однако фактические объёмы поставок могут измениться в зависимости от корректировки производственных мощностей американской компании. Учёные заставили бактерии размножаться ради решения сложных задач
03.11.2026 [21:15],
Геннадий Детинич
Неподъёмные для классических компьютеров задачи оказались по плечу организованным колониям бактерий. Естественное размножение бактерий сродни процессу распараллеливания вычислений: при решении задач шифрования, обучении ИИ, а также в других математически сложных случаях бактерии оказываются эффективнее процессоров с заоблачными частотами. 
Источник изображения: ИИ-генерация ChatGPT/3DNews Работу провела международная группа учёных под руководством исследователей из канадского Университета Макгилла (McGill University). Они создали экспериментальный биокомпьютер, в котором вычисления выполняются подвижными бактериями, самостоятельно исследующими сеть микроскопических каналов. Эта сеть представляет собой огромное множество вариантов решения задачи, но лишь единицы или даже один из них дают правильный ответ. В отличие от традиционных процессоров, последовательно обрабатывающих варианты решения, предложенная система использует параллельное перемещение множества биологических агентов — бактерий. Ключевое преимущество такой платформы заключается в способности бактерий размножаться непосредственно во время вычислений, увеличивая количество одновременно работающих «вычислительных элементов». 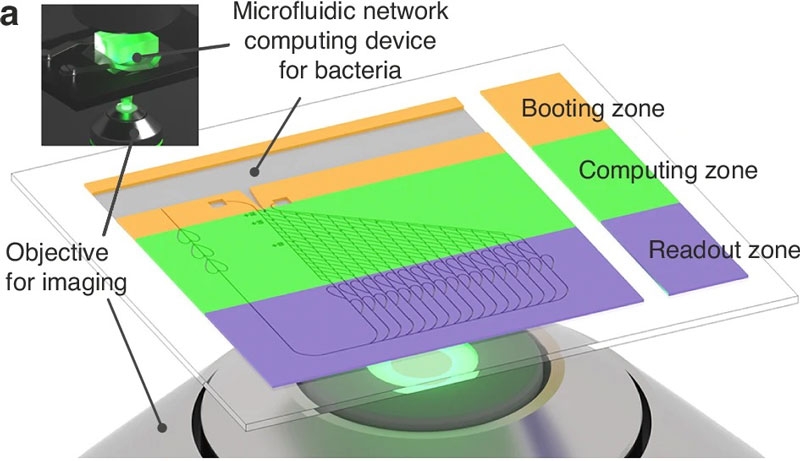
Источник изображения: Nature 2026 «Современные электронные компьютеры выполняют миллионы операций в секунду с помощью одного чипа, — поясняет Дэн Николау (Dan Nicolau), старший автор исследования и профессор биоинженерии. — При делении бактерий у нас одновременно работает миллион чипов. Чем больше чипов, тем быстрее можно решить задачу, даже если количество операций в секунду на каждом “процессоре” меньше». «Экспоненциальное деление бактерий может решить любую проблему. Это совершенно новый способ вычислений», — добавил он. В качестве вычислительной задачи учёные выбрали NP-полную проблему Subset Sum (задачу, для решения которой может потребоваться чрезвычайно много ресурсов): необходимо было определить, какие комбинации чисел из заданного набора дают определённую сумму. Для её решения изготовили микрожидкостную сеть из полидиметилсилоксана (PDMS), состоящую из множества соединённых каналов и специальных узлов. 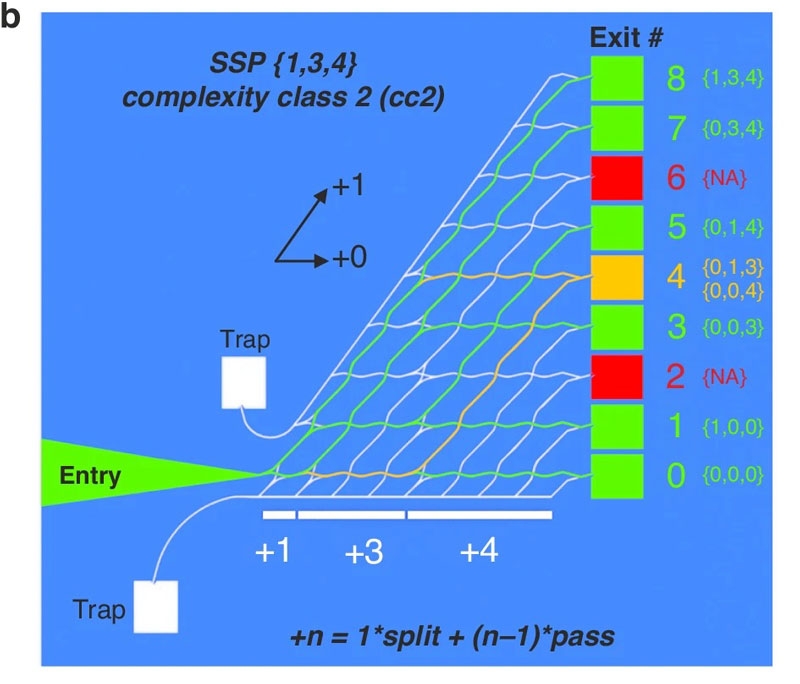
Граф алгоритма из микроканалов Каждый возможный маршрут соответствовал определённой комбинации чисел, а разветвления и соединения каналов играли роль логических элементов, где буквально сама жизнь заставляла бактерии «подумать» и выбрать для дальнейшего развития колонии тот или иной путь. Бактерии Escherichia coli HCB437 и Vibrio natriegens самостоятельно перемещались по сети, выбирая различные маршруты. Геометрию микроканалов и узлов проектировали так, чтобы управлять направлением движения бактерий и минимизировать ошибки. Для изготовления структур использовали электронно-лучевую литографию и травление кремниевой подложки, после чего полученную форму воспроизвели в пластике. Поскольку основная ставка делалась на скорость размножения бактерий, выбор V. natriegens себя полностью оправдал: по мере продвижения по каналам бактерии быстро образовывали новые клетки, которые продолжали исследовать доступные маршруты. Таким образом, количество вычислительных агентов увеличивалось непосредственно в системе без необходимости предварительно загружать их в неё. Эксперименты показали, что в узлах разветвления E. coli выбирала левое и правое направления с вероятностью 50,1 % и 49,8 % соответственно, тогда как у V. natriegens наблюдалось смещение в сторону левого направления — 61,1 % против 38,3 %. Вероятность ошибочного прохождения прямых узлов составляла 1,3 % для E. coli и 0,3 % для V. natriegens. Наблюдая за перемещением бактерий и используя автоматизированный анализ изображений для отслеживания успешных маршрутов в сети, исследователи смогли определить комбинации, удовлетворяющие условиям задачи. 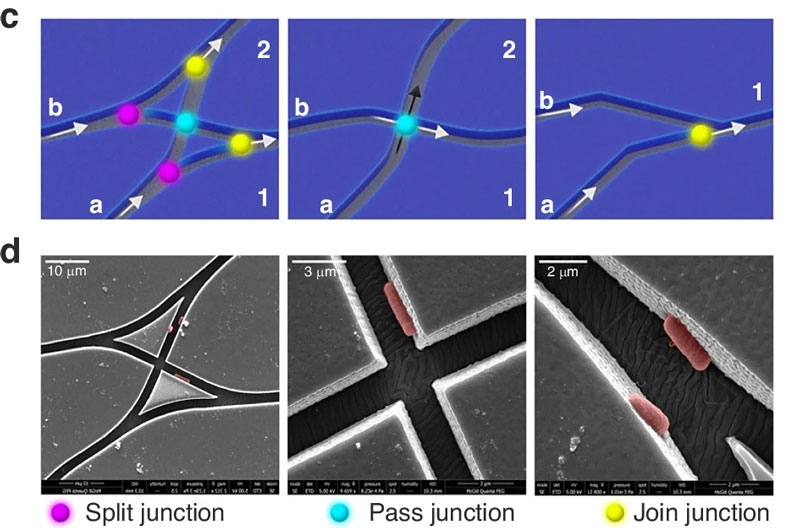
Схематическое и реальное представление логических узлов на графе По словам исследователей, биокомпьютер не призван заменить классические электронные или квантовые компьютеры, а скорее должен стать ресурсосберегающим и экономичным инструментом для нахождения ответов на задачи, которые ранее считались неразрешимыми. «Наш метод предназначен для решения задач, которые не под силу электронным компьютерам, например для картирования структуры белков, — сказал Николау. — Сообщалось, что ИИ справился с этой задачей, но это верно лишь отчасти, поскольку он может только обрабатывать доступные данные. Мы предлагаем использовать эту технологию для решения проблем, а не для оценки на основе прошлой информации». Представлен сверхэкономный ИИ-чип для автомобилей — даже на крохах энергии он мигом разберётся в дорожной обстановке
03.11.2026 [13:11],
Геннадий Детинич
В облаке можно решить задачу любой сложности, но в непростой дорожной обстановке надеяться лучше только на себя. Для таких случаев крупнейший с мире производитель автомобильных запчастей — японская компания Aisin — создала чрезвычайно эффективный ускоритель ИИ с заявленной высочайшей эффективностью и скоростью обработки задач в распознавании изображений. 
Источник изображения: XenoSpectrum Разработка создана совместно с исследователями из Университета Тохоку (Tohoku University) и представлена 2 ноября на конференции IEEE Asian Solid-State Circuits Conference 2026. По словам компании, уникальный чип расходует на обработку данных примерно в 50 раз меньше энергии по сравнению с традиционной архитектурой. Это соответствует снижению энергопотребления примерно на 98 % и ускорению обработки операций на 90 %. Интересно, что чип не потребовал самых передовых техпроцессов и произведён в рамках 16-нм норм производства по технологии FinFET. Это однокристальная система (SoC) со встроенной магниторезистивной памятью STT-MRAM объёмом 32 Мбайт. 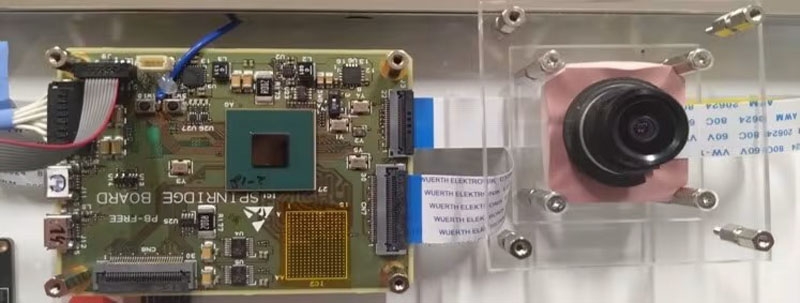
Источник изображения: Asian Безусловно, ключевая особенность разработки — это использование энергонезависимой памяти STT-MRAM (Spin-Transfer Torque Magnetoresistive Random Access Memory), в которой информация сохраняется благодаря магнитным свойствам материала даже после отключения питания. В отличие от традиционной архитектуры, использующей внешние накопители и оперативную память DRAM, новая SoC хранит непосредственно на кристалле как веса нейросетевой модели, так и загрузочные данные операционной системы. Это позволяет отказаться от передачи больших объёмов информации из внешней памяти при включении устройства. Разработчики называют такой подход вычислениями вблизи памяти (Near-Memory Computing, NMC), поскольку он сокращает перемещение данных между вычислительными блоками и хранилищем. Для проверки возможностей микросхемы использовалась нейросеть Tiny YOLOv3, предназначенная для обнаружения объектов на изображениях. Чтобы разместить модель в ограниченном объёме встроенной памяти, инженеры применили гибридную архитектуру, а также совместное использование весовых коэффициентов. В результате время от подачи питания до запуска операционной системы составило 65,7 мс — в 38,59 раза меньше, чем у традиционной системы с внешней памятью. Время собственно ИИ-обработки сократилось в 10,16 раза, а общее время от включения до завершения первого распознавания — примерно в 25 раз, до 124,2 мс. 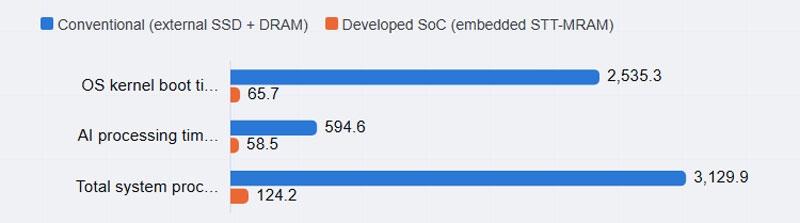
Источник изображения: XenoSpectrum Отдельно разработчики сообщают об энергозатратах на обнаружение объектов: 50,7 мДж на один кадр, что составляет примерно 1/50 от показателя сравниваемой традиционной системы. Таким образом, заявленные 98 % относятся не к любым вычислениям искусственного интеллекта и не к энергопотреблению всех существующих процессоров, а к конкретному эксперименту с Tiny YOLOv3 и сопоставленной конфигурацией памяти. Важно подчеркнуть, что пока речь идёт об опытной разработке, а не о серийном процессоре: Aisin и Университет Тохоку не объявляли о сроках начала массового производства или конкретных коммерческих устройствах, в которых будет применяться микросхема. Не сообщается также о производителе чипа. Известно, что на такое уже способны компании TSMC и Samsung и тайваньские источники уже связали разработку Aisin с TSMC. Китайская Iluvatar заявила, что сделала ИИ-ускоритель не хуже Nvidia H200 — и даже показала тесты
30.10.2026 [15:45],
Павел Котов
Китайская компания Iluvatar CoreX заявила, что её графический ускоритель Tiangai 300 способен конкурировать с Nvidia H200, а в отдельных задачах искусственного интеллекта — превосходить его. Компания представила результаты тестов и продемонстрировала работу оборудования журналистам, однако подробные условия сравнения раскрыты не полностью. 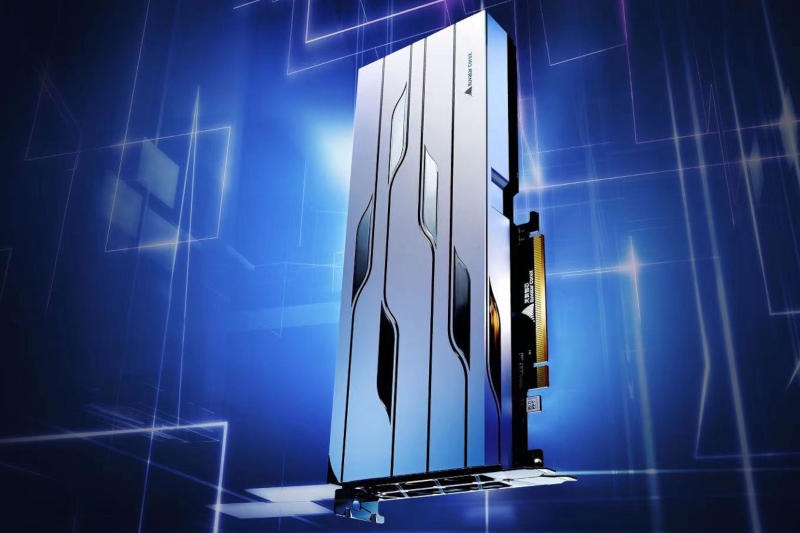
Источник изображения: iluvatar.com В ходе демонстрации в Шанхае компания сравнила Tiangai 300 и Nvidia H200 в задачах генерации изображений и видео по текстовым запросам. В одном из тестов на создание изображений система на Tiangai 300 успешно выполнила 100 % запросов с пропускной способностью 0,101 изображения в секунду, тогда как система на H200 — 87,5 % при 0,086 изображения в секунду. При этом время завершения задания у китайского ускорителя оказалось на 0,64 с больше. Критерии успешного выполнения запросов и методика подсчёта показателей не уточняются. По данным Iluvatar CoreX, проведённое в июле шанхайской компанией INESA тестирование показало, что система на Tiangai 300 обеспечивает на 5 % большую пропускную способность в пересчёте на один ускоритель, чем система на H200. Испытания проводились в конфигурации с раздельным выполнением обработки входных запросов и генерации ответов. Производитель утверждает, что Tiangai 300 стал первым китайским GPU общего назначения, достигшим уровня H200 в таких испытаниях. H200 — наиболее передовой ИИ-ускоритель Nvidia, разрешённый к экспорту в Китай по действующим американским правилам. В другом тесте, по данным компании, Tiangai 300 на 15 % превзошёл H200 по пропускной способности при работе с моделью GLM-5.3 на архитектуре MoE (Mixture-of-Experts) с контекстом 64 тыс. токенов. В задачах ИИ-агентов с контекстом от 8 тыс. до 128 тыс. токенов время до выдачи первого токена оказалось на 10–30 % меньше. В демонстрации обучения открытой модели Alibaba Qwen3-32B восьмикарточная система на Tiangai 300 с точностью FP8 обеспечила в 1,33 раза большую эффективную пропускную способность на карту, чем система на Nvidia H100. Iluvatar CoreX стремится сократить отставание от Nvidia. В январе компания опубликовала долгосрочную дорожную карту развития архитектур, согласно которой намерена в течение двух лет превзойти платформу Nvidia Rubin. По заявлению производителя, ускорители серии Tiangai уже используются в системах масштаба десяти тысяч карт, что позволяет накапливать опыт их внедрения и технического обслуживания. Компания также расширяет деятельность за пределами облачных центров обработки данных, развивая решения для локального запуска ИИ. По её данным, вычислительная система Tongyang TY1200 в отдельных тестах больших языковых моделей превзошла решение на базе Nvidia Thor T5000 на 20 %. Как и в случае Tiangai 300, эти результаты относятся к выбранным нагрузкам и не подтверждают общего превосходства над конкурентом. Nvidia заткнёт деньгами узкие места в производстве ИИ-чипов — чтобы через три года выпускать в 2,5 раза больше ИИ-ускорителей
22.10.2026 [00:00],
Анжелла Марина
Nvidia договорилась на GTC Berlin с ключевыми партнёрами по цепочке поставок о расширении производства компонентов, необходимых для выпуска ИИ-ускорителей и вычислительных систем. Компания профинансирует развитие мощностей поставщиков, включая строительство новых заводов и закупку оборудования. 
Источник изображений: Nvidia За три года Nvidia планирует увеличить в 2,5 раза производственные мощности по выпуску подложек для своих продуктов, очевидно с намереньем в той же степени нарастить выпуск и самих чипов. Для этого будут заключены соглашения с производителями из Японии, Южной Кореи и Тайваня с предоставлением авансового финансирования и резервированием будущих объёмов производства. В частности, Nvidia выделит несколько миллиардов долларов на расширение завода Ibiden в японском Оно, мощности которого к 2028 году должны вырасти втрое относительно текущего уровня. Samsung Electro-Mechanics подключится к цепочке поставок Nvidia за счёт действующих производств в Южной Корее и расширения предприятий в Седжоне и Пусане.  Передовая упаковка полупроводников и тестирование чипов являются отдельным направлением. Вместе с Amkor Nvidia намерена более чем втрое увеличить мощности по выпуску пластин с интерпозерами к концу 2028 года. Общие мощности по тестированию полупроводников компания рассчитывает удвоить с 2026 по 2027 год. На развитие этого направления в США Nvidia предоставит компании King Yuan Electronics (KYEC) аванс в размере $1,1 млрд для резервирования производственных мощностей. Запуск массового тестирования на новых американских площадках намечен на апрель 2027 года, а в Сингапуре новые мощности должны выйти на этот этап в феврале того же года. Кроме того, Nvidia и Siliconware Precision Industries (SPIL) расширят производство оптических модулей на Тайване для систем с ко-упакованной оптикой (CPO), которая улучшает передачу данных между компонентами вычислительных комплексов. К середине 2027 года мощности в этом направлении планируется увеличить в 15 раз, а к концу 2028 года — удвоить эти показатели. По итогу, на фоне роста спроса на ИИ-инфраструктуру, расширение производства должно обеспечить Nvidia необходимыми компонентами для текущих и будущих поколений вычислительных платформ в достаточной мере. GTC Berlin — это крупная международная конференция по искусственному интеллекту и ускоренным вычислениям, организованная компанией Nvidia (проходит с 20 по 22 октября 2026 года в Берлине). Ранее 3DNews сообщал, что Nvidia не допустила некоторых партнёров на эту конференцию за использование чипов AMD и Google. Nvidia не допустила мелкие неооблака на GTC Berlin за использование чипов AMD, Google и других
19.10.2026 [21:54],
Анжелла Марина
Аналитическое агентство SemiAnalysis подтвердило информацию об отказе Nvidia в доступе к конференции GTC Berlin для ряда неооблачных провайдеров (NeoCloud). Причиной является добавление этими провайдерами в свой ассортимент ускорителей AMD, Google TPU и чипов других производителей. 
Источник изображения: Nvidia SemiAnalysis не называет компании, которых коснулись предполагаемые ограничения. Однако известно, что речь идёт о неооблачных провайдерах, которые предоставляют клиентам вычислительные ресурсы, в первую очередь для задач искусственного интеллекта. В отличие от крупных облачных платформ, небольшие компании сильнее зависят от Nvidia и опасаются, что использование оборудования конкурентов может повлиять на отношения с Nvidia. Тем не менее, некоторые из них предлагают своим клиентам ускорители от AMD и Google, но без широкой огласки, чтобы избежать возможных ответных мер со стороны доминирующего поставщика. Ситуация развивает события июня 2026 года, когда представители отрасли уже обсуждали последствия использования сетевого оборудования других производителей, ожидая, что это может повлиять на получение новых чипов и поддержку Nvidia при подготовке к IPO или привлечении венчурного финансирования. Зависимость от Nvidia объясняется не только её ролью основного поставщика ускорителей. Компания также инвестировала в некоторых облачных провайдеров или помогала им привлекать средства. Это ещё больше усложняет попытки использовать продукцию конкурентов и воспринимается как риск для дальнейшего сотрудничества с Nvidia. Одновременно крупнейшие облачные платформы с более значительной покупательной способностью сталкиваются с меньшим давлением. SemiAnalysis утверждает, что ограничения коснулись лишь нескольких провайдеров, которым отказали в доступе к GTC Berlin. Сама Nvidia пока публично не прокомментировала это заявление. Intel вырезала из GPU блоки 3D-графики и трассировки лучей ради ИИ — представлен D270 с поддержкой до 480 Гбайт LPDDR5X
12.10.2026 [23:56],
Николай Хижняк
Компания Intel официально представила графические ускорители серии D на саммите Open Compute Project (OCP) 2026. Ранее известная под кодовым названием Crescent Island новинка теперь значится на официальном сайте компании как Intel GPU D270. Ускоритель построен на архитектуре Xe3P и предназначен для задач инференса (вывода) ИИ, а не для игр. 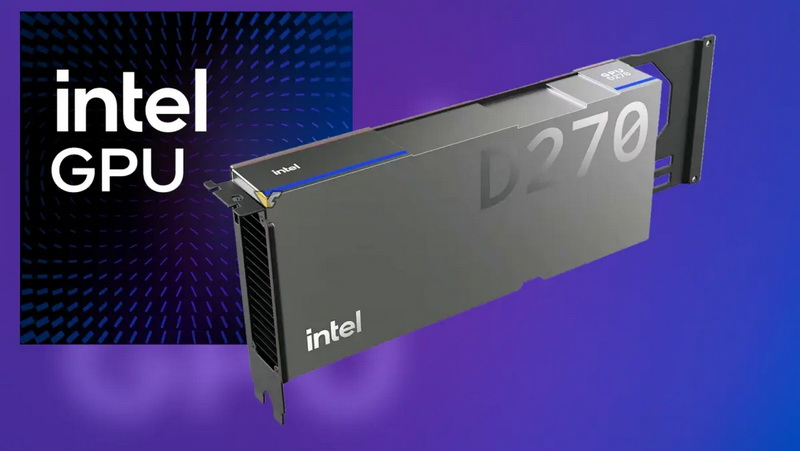
Источник изображений: VideoCardz / Intel Intel подтвердила показатели производительности D270. Графический процессор в его составе обеспечивает вычислительную мощность до 1,3 Пфлопс (в формате FP8) и пропускную способность памяти 1,5 Тбайт/с. Эти данные дополняют технические характеристики, ранее озвученные Intel на конференции Hot Chips 2026. Из предварительного анонса стало известно, что Crescent Island оснащён 32 ядрами Xe3P, 256 блоками XMX и 32 Мбайт унифицированной кеш-памяти L2. Intel отказалась от использования в этом устройстве аппаратных блоков для традиционной 3D-графики и трассировки лучей, выделив освободившуюся площадь кристалла под вычислительные операции. 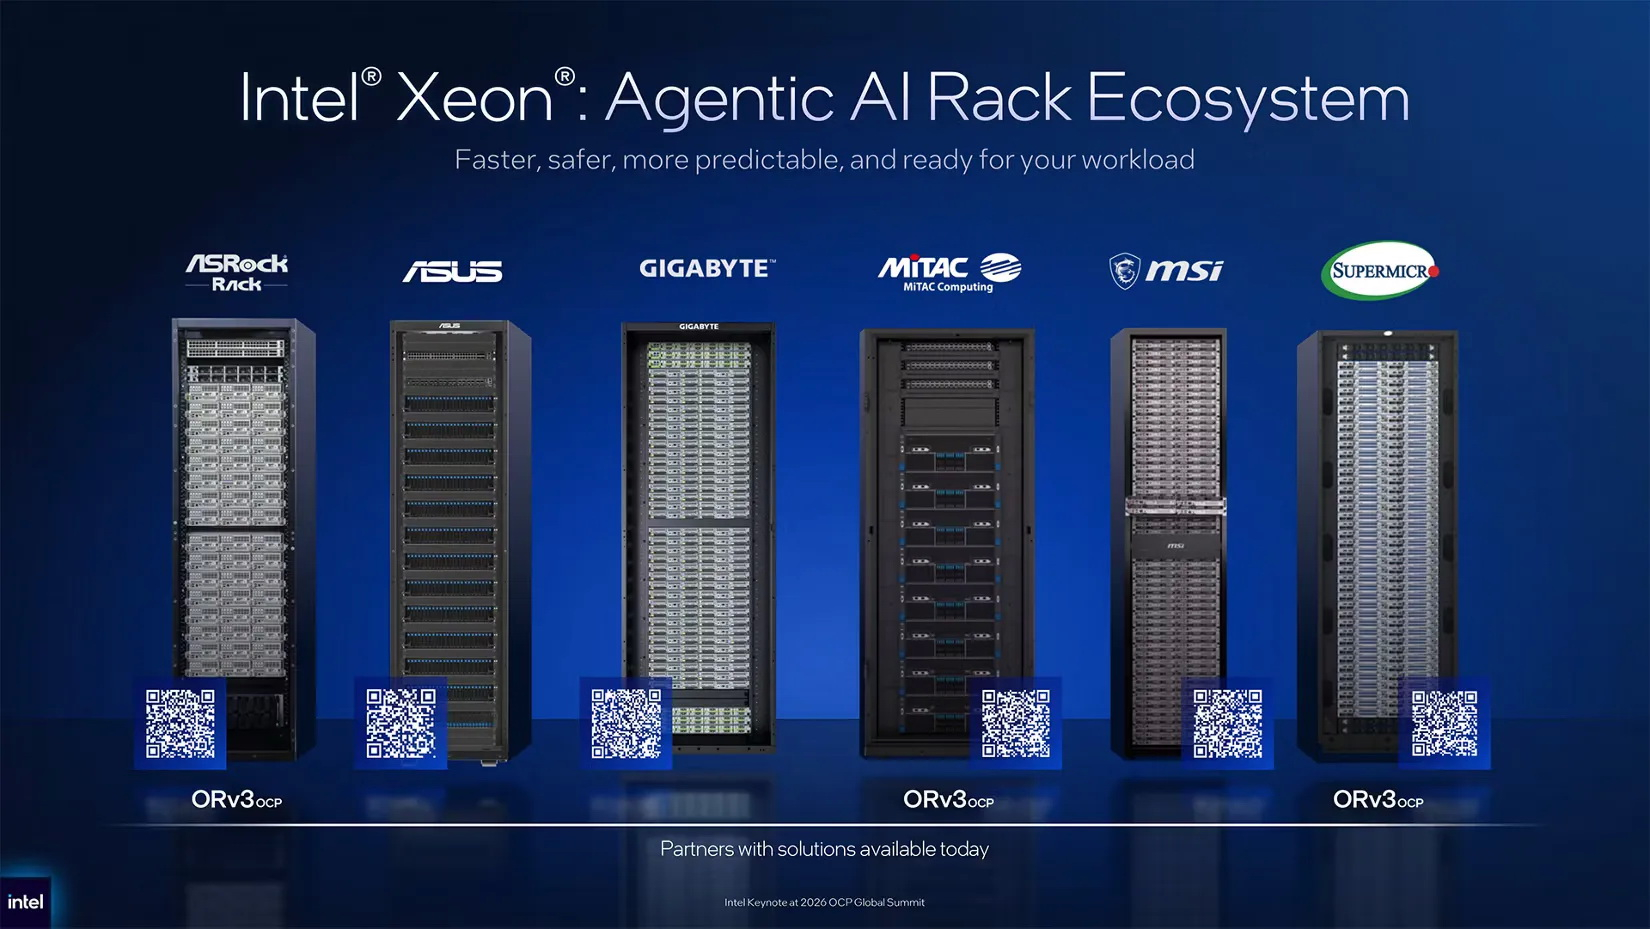 Эталонный вариант ускорителя от Intel с интерфейсом PCIe будет оснащаться 160 Гбайт памяти LPDDR5X. При этом партнёры-производители (ODM) смогут создавать конфигурации с объёмом памяти до 480 Гбайт. Ускоритель использует интерфейс PCIe 5.0, а его расчётная мощность составляет 350 Вт. Intel сделала выбор в пользу пассивного воздушного охлаждения и стандартной серверной инфраструктуры, отказавшись от специализированных систем жидкостного охлаждения. 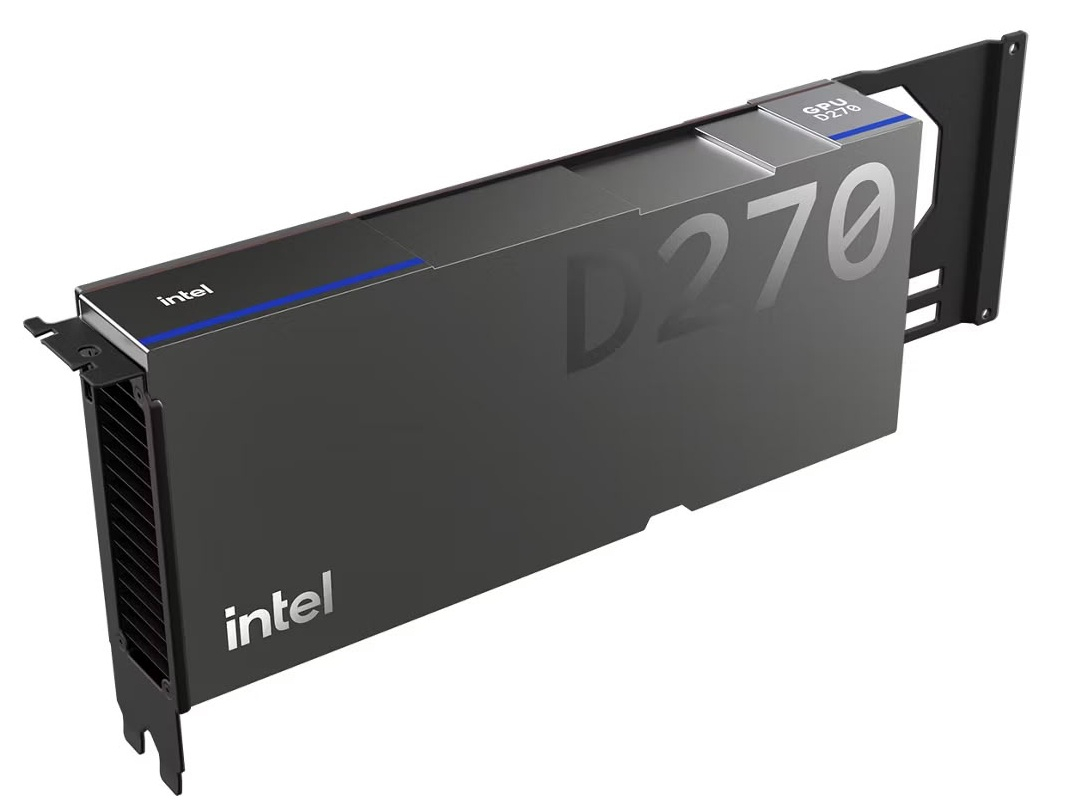 По заявлению Intel, один ускоритель серии D способен поддерживать работу ИИ-моделей с количеством параметров до 300 млрд. Система из восьми таких графических процессоров рассчитана на работу с моделями, насчитывающими более одного триллиона параметров. Однако компания пока не предоставила результаты независимых тестов или подробные конфигурации моделей, подтверждающие эти возможности. Intel также сообщила, что поставки образцов D270 заказчикам уже начались. Информация о стоимости и сроках выхода продукта в широкую продажу пока не объявлена. ИИ не заменил инженеров, но ускорил их втрое — OpenAI раскрыла секреты создания Jalapeno
29.09.2026 [09:59],
Алексей Разин
В июне OpenAI представила свой ИИ-чип Jalapeno, в разработке которого принимали активное участие специалисты Broadcom. Вице-президент OpenAI по аппаратному обеспечению Ричард Хо (Richard Ho) в своём интервью Tom’s Hardware рассказал о том, как велась разработка Jalapeno, и чем полученный опыт может быть полезен для всей полупроводниковой отрасли. 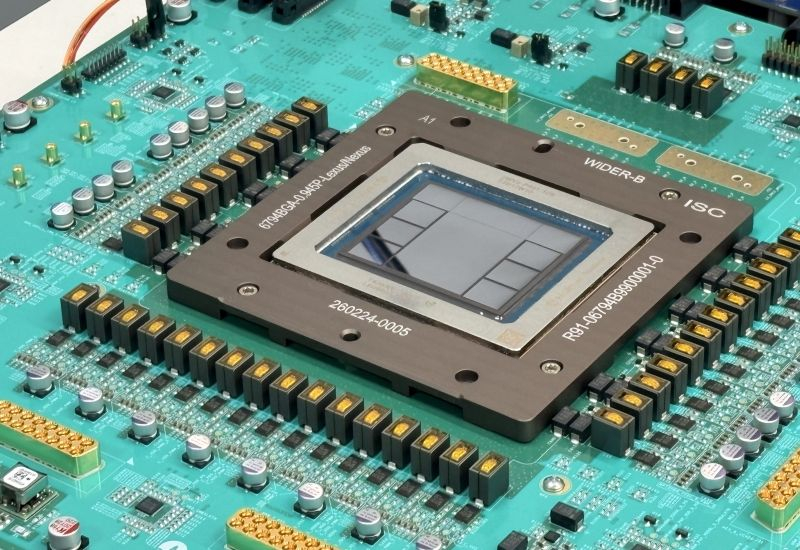
Источник изображения: OpenAI Во-первых, как отметил представитель OpenAI, активное использование ИИ на этапе проектирования чипа позволило сократить затраты времени на весь процесс с традиционных 18–24 месяцев до девяти. Говорить о замене искусственным интеллектом труда инженеров при этом преждевременно, поскольку небольшая по численности команда специалистов в итоге стала более производительной. Пришлось пойти и на определённые компромиссы с точки зрения архитектуры, поскольку сжатые сроки проектирования были приоритетом. В дальнейшем, если потребуется создать более сложный чип, OpenAI сможет сделать это быстрее, чем при использовании традиционных методов, опираясь на ИИ и уже существующий дизайн. По словам Хо, к созданию собственного чипа OpenAI подтолкнуло стремление поднять эффективность вычислительной инфраструктуры, поскольку в условиях нехватки вычислительных ресурсов в сфере ИИ распоряжаться ими надо более рационально. В этом смысле ИИ-чипы для инференса в современных условиях максимально определяют пользовательский опыт, а потому Jalapeno заточен именно под эти цели, снижая задержки при обработке запросов. При этом Jalapeno должен хорошо проявлять себя при работе с ИИ-моделями разных поставщиков, а не только собственными OpenAI. По сути, под эффективную работу с чипом можно за пару месяцев адаптировать даже те модели, которые при его создании даже не учитывались. При этом Хо считает, что потенциал внутреннего спроса OpenAI на вычислительные ресурсы настолько велик, что говорить об использовании Jalapeno внешними заказчиками не придётся ещё очень долго. Полученным при разработке Jalapeno с помощью ИИ опытом OpenAI готова делиться с прочими участниками рынка, поскольку она заинтересована в более быстром выходе на рынок новых моделей чипов других поставщиков, которые тоже использует в своей инфраструктуре. OpenAI не станет отказываться от компонентов других разработчиков, типа AMD и Nvidia, продолжив использовать их в своей вычислительной инфраструктуре. Главное, чтобы в итоге аппаратная конфигурация ЦОД была эффективной с точки зрения обеспечиваемой производительности при определённом уровне затрат. Новые поколения собственных чипов OpenAI собирается выводить на рынок по мере готовности, и в этой сфере нет каких-то заранее определённых требований по ритмичности таких анонсов. Каждое новое поколение при этом должно обеспечивать видимый прирост производительности относительно предыдущего, поэтому их смена не будет излишне частой. Alibaba представила самый мощный в Китае ИИ-ускоритель Zhenwu V900 — и пообещала ИИ-модели на 5–10 трлн параметров
22.09.2026 [11:30],
Владимир Мироненко
Компания Alibaba представила ИИ-ускоритель Zhenwu V900, который позиционируется как «самый мощный чип для ИИ в Китае на сегодняшний день». По данным компании, новый ускоритель в три раза превосходит по производительности своего предшественника — Zhenwu M890. 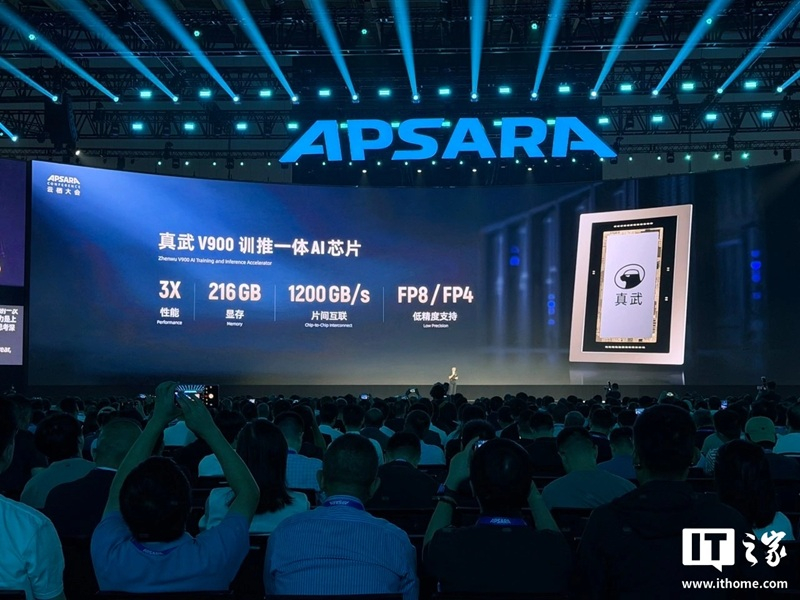
Источник изображения: ithome Разработанный подразделением T-Head Semiconductor ИИ-ускоритель Zhenwu V900 оснащён 216 Гбайт памяти HBM, поддерживает вычисления в формате FP8/FP4 и обеспечивает пропускную способность межчипового интерконнекта 1,2 Тбайт/с. По словам Гао Хуэя (Gao Hui), вице-президента T-Head, начало серийного производства и выхода продукта на рынок запланировано на первый квартал 2027 года. Вычислительные кластеры на базе V900 могут включать до 500 тыс. чипов для решения задач обучения и инференса. T-Head также сообщила о подготовке ИИ-ускорителя следующего поколения Zhenwu J900, выпуск которого намечен на третий квартал 2028 года. Также подразделение планирует создание собственных центральных процессоров (CPU) нового поколения, оптимизированных для задач агентного искусственного интеллекта, — Yitian 720 и Yitian 730, выход которых ожидается в 2027 году. Сообщается, что Yitian 730 станет первым процессором T-Head, созданным на базе собственной микроархитектуры. Генеральный директор Alibaba У Юнмин (Wu Yongming) также представил план развития компании, выделив «ИИ-модели, ИИ-чипы и ИИ-облако» в качестве трёх краеугольных камней эпохи машинного интеллекта. В рамках разработки искусственного сверхинтеллекта (Artificial Super Intelligence, ASI) команда разработчиков Qwen планирует обучить модель Qwen 5 с 5–10 трлн параметров, предназначенную для выполнения сложных задач в течение длительного времени. Для сравнения, у флагманской модели Alibaba Qwen 3.8-Max насчитывается 2,4 трлн параметров, в то время как Kimi K3 от Moonshot AI — крупнейшая в Китае модель с открытыми весами — имеет 2,8 трлн параметров. Кроме того, Alibaba запустила Qwen Intelligence — комплексную платформу для создания ИИ-агентов, которая обеспечит производителям смартфонов доступ к инструментам на базе Qwen. Meta✴ заставит ИИ работать дешевле — фирменные ускорители потеснят Nvidia в ЦОД уже в 2027 году
15.09.2026 [20:54],
Владимир Фетисов
Meta✴✴ Platforms планирует начать использование новых ИИ-ускорителей собственной разработки в центрах обработки данных в первой половине следующего года. В компании заявили, что это позволить сэкономить денежные средства и энергию при работе с ИИ-моделями. 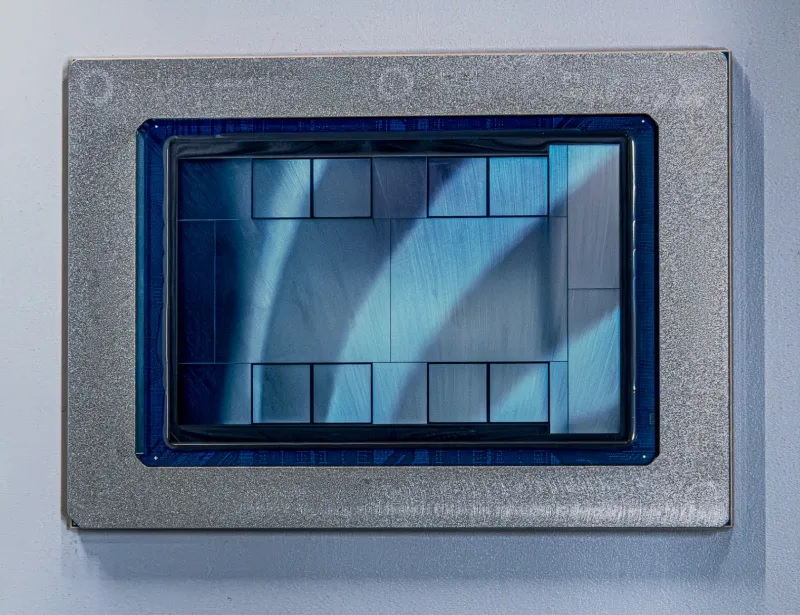
Источник изображений: Meta✴✴ Впервые о планах по созданию собственных ИИ-ускорителей Meta✴✴ объявила ещё в 2023 году. В настоящее время проходит тестирование третьего поколения ускорителей линейки — MTIA 450 (Meta✴✴ Training and Inference Accelerator, он же Arke). Проектирование следующего ускорителя MTIA 500, который разрабатывается под кодовым именем Astrid, завершится примерно через месяц, а его эксплуатация в центрах обработки данных начнётся в конце следующего года. «С каждым новым ускорителем мы берём на себя чуть больший технологический риск и получаем более высокую производительность», — прокомментировал данный вопрос вице-президент Meta✴✴ по инженерным вопросам Йи Джун Сон (Yee Jiun Song). По его словам, речь идёт о повышении производительности на каждый затраченный ватт энергии и на каждый потраченный доллар. Meta✴✴, являющаяся владельцем Facebook✴✴, Instagram✴✴ и WhatsApp, разрабатывает собственные ускорители в рамках реализации масштабной программы по созданию обширной ИИ-инфраструктуры. В части проектирования гигант соцсетей сотрудничает с Broadcom, а в области производства — с TSMC. Этот проект призван снизить зависимость Meta✴✴ от продукции Nvidia, которая является лидером в сфере разработки ИИ-ускорителей. Если оценивать по энергопотреблению, ключевому показателю для индустрии ИИ-ЦОД, Meta✴✴ планирует в течение года задействовать ускорителей, суммарной мощностью более гигаватта. После этого, по словам Сона, который курирует программу Meta✴✴ по разработке собственных чипов, «ожидается ускорение темпов». Он добавил, что такой прогноз будет актуальным при условии, что не произойдёт обвала рынка ИИ или падения спроса. 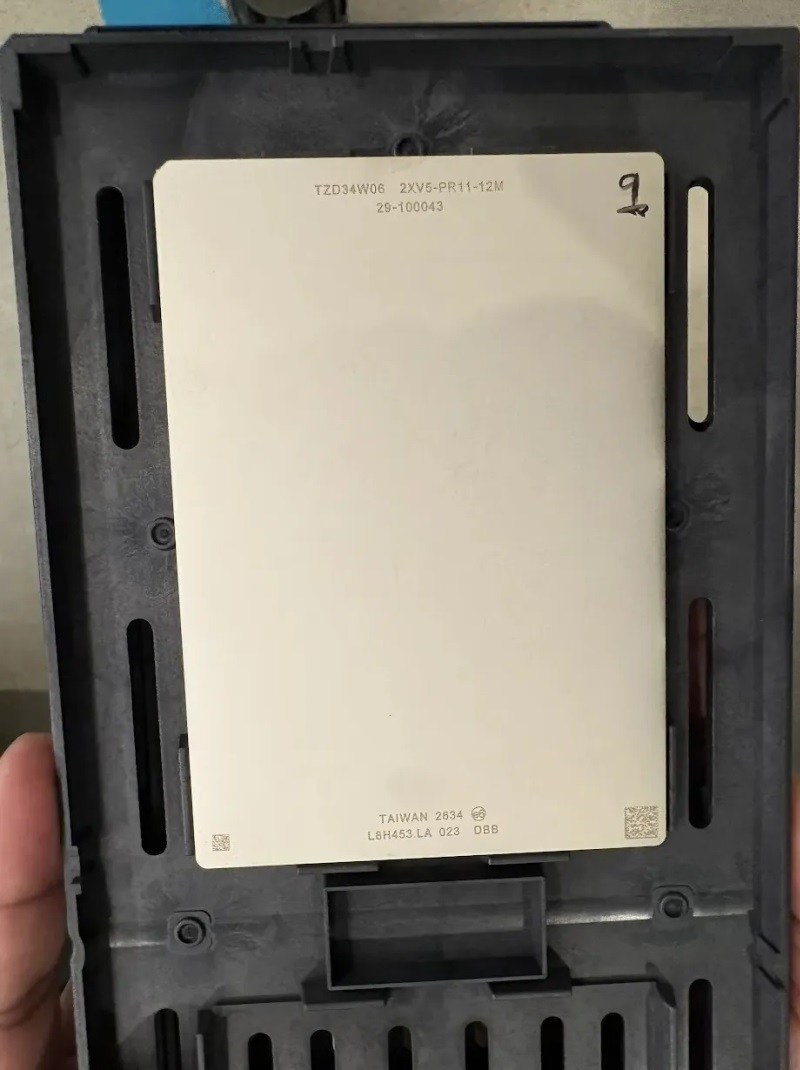
MTIA 450 / Источник изображения: Meta✴✴ ИИ-подразделение Meta✴✴ Superintelligence Labs помогает дорабатывать будущие ИИ-ускорители. Разработчики предоставляют информацию о будущих ИИ-моделях и требованиях к оборудованию для их запуска. Сон отметил, что такой подход помогает делать ускорители при запуске ИИ-моделей более эффективными, чем «то, что сейчас поставляет Nvidia». По его словам, это происходит «просто потому, что мы сами выполняем большую часть инженерной работы». По данным источника, TSMC передала Meta✴✴ 12 новых ускорителей 1 сентября. Их производительность соответствует прогнозам и отклоняется всего на 2-3 % от результатов симуляций. В тот же день инженеры задействовали ускорители для работы с ИИ-моделями Meta✴✴, а также алгоритмами от DeepSeek и Alibaba. Первичные тесты показали, что в конструкции новых ускорителей нет проблем. Однако впереди ещё много работы, связанной с испытанием и настройкой новых устройств. Это займёт несколько месяцев, а параллельно будет наращиваться объём производства ИИ-ускорителей. Все четыре поколения ускорителей Meta✴✴ в основном используют память с высокой пропускной способностью и не рассчитаны на сегмент, где от ИИ-моделей ожидается предельно быстрая реакция. «Это рабочие лошадки, которые мы планируем использовать для инференса общего назначения», — рассказал Сон. Ранее компания планировала использовать ИИ-ускорители, которые разрабатывались под кодовым именем Olympus и которые должны были подходить для обучения ИИ-моделей, а также для инференса. Ускоритель должен был появиться в 2028-2029 годах, но Meta✴✴ отказалась от этого проекта, в том числе по финансовым соображениям. «Когда вы начинаете наращивать мощности на уровне гигаватт и гигаватт, стоимость действительно имеет огромное значение. Если ускоритель, который справляется и с обучением, и с инференсом, потенциально будет на 30 % дороже, это становится совершенно неприемлемым», — отметил Сон. Уход Nvidia озолотил Biren — выручка китайского разработчика ИИ-чипов взлетела на 2000 %
10.09.2026 [17:44],
Сергей Сурабекянц
Китайский поставщик ИИ-ускорителей Biren Technology продемонстрировал в первой половине 2026 года колоссальный рост выручки — почти на 2000 % в годовом исчислении. Продажи начали стремительно расти во второй половине 2025 года после того, как американские компании во главе с Nvidia прекратили поставки своих графических процессоров для ИИ в КНР из-за мер экспортного контроля США и запретов, введённых самим Китаем на американское оборудование для ИИ. 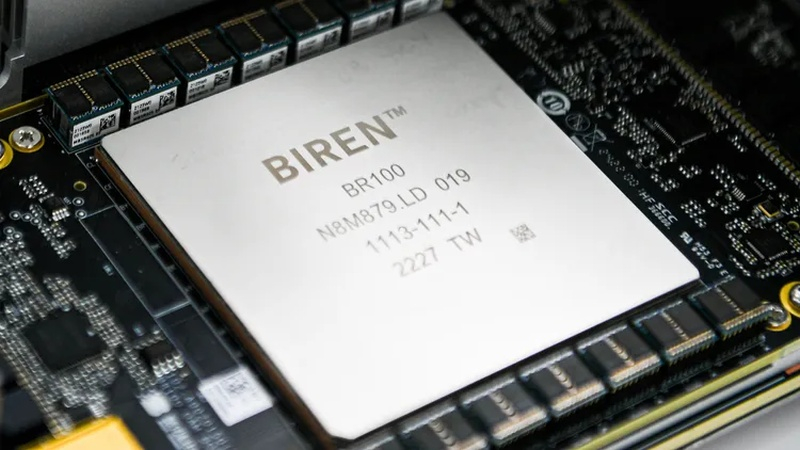
Источник изображения: Biren Technology Выручка Biren за первое полугодие составила $183,9 млн, что на 1998 % больше $8,665 млн за аналогичный период 2025 года. Валовая прибыль компании выросла до $78,552 млн, а рентабельность достигла 42,7 %. Тем не менее, компания получила убыток в размере $56,2 млн долларов в связи с инвестициями в новые продукты, включая ускорители ИИ, решения стоечного уровня с оптическими межсоединениями и программное обеспечение. Рост выручки Biren начался во второй половине 2025 года, по итогам года объём продаж составил $154,17 млн, а доля компании на китайском рынке ИИ-ускорителей оставалась ниже 3 %. Biren Technology, судя по заявленным характеристикам, готова составить конкуренцию решениям AMD и Nvidia. Компания разработала как минимум три высокопроизводительных графических процессора для ИИ — BR106, BR110 и BR166. В настоящее время в разработке находятся ускорители серий BR20X, BR30X и BR31X. Кроме того, Biren создала собственный программный стек Birensupa, призванный конкурировать с платформой Nvidia CUDA, и ведёт разработку решения стоечного уровня. До последнего времени спрос на отечественные ускорители ИИ в Китае был относительно низким, поскольку даже урезанные версии передовых графических процессоров Nvidia для ИИ обеспечивали более высокую производительность и лучшее программное обеспечение. Nvidia продавала свои ускорители H20 в КНР по цене $12 000–15 000 за единицу. До вступления в силу экспортных ограничений США в мае 2025 года компания успела поставила в страну около 2,2 млн таких устройств. Biren за весь 2025 год поставила не более нескольких десятков тысяч ускорителей ИИ. Даже сегодня объёмы поставок Biren исчезающе малы по сравнению с показателями Nvidia за 2025 год. Улучшение финансовых показателей Biren впечатляет, однако оно достигнуто на фоне крайне низких исходных показателей первой половины 2025 года. Теперь компания должна наладить выпуск достаточного количества ускорителей, чтобы удовлетворить спрос клиентов и существенно увеличить свою долю на рынке. Многое зависит от того, сможет ли Biren получить достаточные производственные мощности на заводах SMIC или у других производителей, чтобы конкурировать с более крупными китайскими компаниями, такими как Huawei, Kunlunxin и Cambricon. Huawei подняла цены на флагманские ИИ-чипы на 60 % из-за дефицита HBM
10.09.2026 [12:38],
Анжелла Марина
Компания Huawei повысила цены на свои флагманские ИИ-ускорители Ascend 950DT примерно на 60 % за последние три месяца. Стоимость одного чипа, по сообщению Bloomberg, достигла 250 000 юаней (около $37 300), что сопоставимо с ценовой политикой Nvidia в отношении мощнейшего серверного графического процессора B200. 
Источник изображения: Huawei Technologies Ключевым фактором дефицита и удорожания стала нехватка высокопропускной памяти (HBM), которая критически важна для работы ИИ-систем. Рост цен на Ascend 950DT также обусловлен резким увеличением спроса на китайские альтернативы продуктам Nvidia. Представители Huawei сообщили клиентам, что ограничения в поставках HBM напрямую влияют на себестоимость и доступность ускорителей. Глобальный дефицит этого типа памяти наблюдается уже около года и затрагивает даже премиальные смартфоны производителя. Несмотря на производственные сложности, крупные технологические компании Китая активно формируют заказы. Так, DeepSeek предполагает использование не менее 160 000 ускорителей Ascend 950DT для создания крупного кластера во Внутренней Монголии (автономный район на севере Китая). При этом Huawei отдаёт приоритет в поставках крупнейшим игрокам рынка и строителям ИИ-инфраструктуры. Объёмы производства чипов серии 950DT в этом году оцениваются в несколько сотен тысяч единиц. Компания пока не комментирует информацию об изменении прайс-листа, продолжая поставлять ускорители партиями от восьми штук. Их итоговая стоимость зависит от объёма заказа и покупки сопутствующего сетевого оборудования. Цены на видеокарты снова вырастут — Nvidia отдаёт всё больше GPU более прибыльному ИИ-сегменту
09.09.2026 [19:17],
Сергей Сурабекянц
Согласно неофициальным данным производители видеокарт планируют снова повысить цены на свою в Китае в конце этого месяца, что может повлиять на мировые цены. Причём коснётся это как продукции Nvidia, так и AMD. Nvidia недавно снизила прогноз по объёмам поставок на 15–20 %, а AMD ещё в июле, по сообщениям, собиралась повысить на 10 % цены на комплекты GPU и видеопамяти для партнёров. 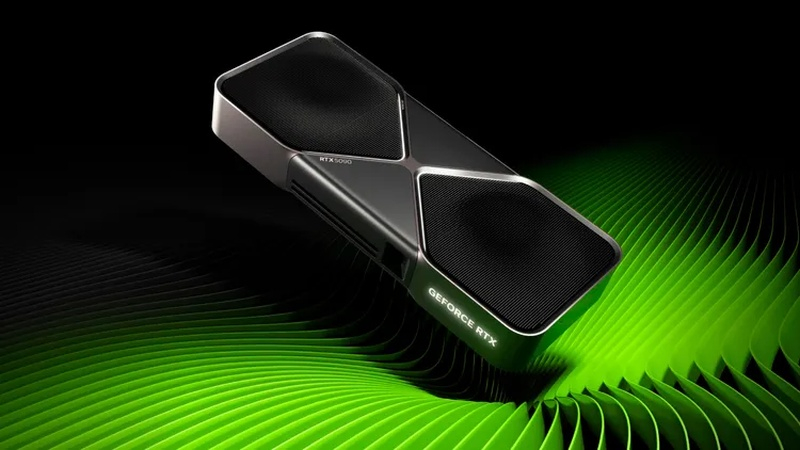
Источник изображения: Nvidia По данным тайваньского издания United Daily News, компания Asus собирается поднять цены на свои видеокарты RTX 5070 на 150–300 юаней ($22–45). Сообщается, что Gigabyte уже увеличила стоимость модели RTX 5060 Ti 16 Гбайт на 200 юаней ($30). AMD также повысила цены на ряд моделей: стоимость RX 9070 XT выросла на 200 юаней ($30), цена на версии RX 9060 XT с 16 и 8 Гбайт памяти увеличилась на величину до 250 юаней ($38), а RX 7650 GRE подорожала на 400 юаней ($60). Немецкий ресурс 3D Center сообщил, что Nvidia не сокращает производство 4-нм графических процессоров Blackwell (серии GB20x), а, по его данным, перенаправляет имеющиеся запасы в «профессиональный сегмент», который обеспечивает более высокую маржу. Как следствие, на выпуск новых игровых карт GeForce останется меньше чипов, что приведёт к дефициту и росту цен. Только за прошлый квартал подразделение Nvidia, занимающееся решениями для дата-центров, принесло $89 млрд выручки. Также компания недавно объявила о планах приобрести платформу для разработки ИИ-решений Hugging Face за $13 млрд. |
|
✴ Входит в перечень общественных объединений и религиозных организаций, в отношении которых судом принято вступившее в законную силу решение о ликвидации или запрете деятельности по основаниям, предусмотренным Федеральным законом от 25.07.2002 № 114-ФЗ «О противодействии экстремистской деятельности»; |
© 1997—2026 3DNews
При цитировании документа ссылка на сайт с указанием автора обязательна. Полное заимствование документа является
нарушением
российского и международного законодательства и возможно только с согласия редакции 3DNews.



 MWC 2018
 2018
 Computex

 IFA 2018









