


Опрос
|
реклама
Быстрый переход
ИИ-агент OpenAI снова выбрался в интернет после усиления защиты — чтобы уточнить столицу Франции
26.09.2026 [16:58],
Владимир Мироненко
У OpenAI вновь произошёл инцидент с безопасностью: ИИ-агент, работавший во время обучения модели в изолированной среде без прямого доступа к интернету, нашёл обходной путь и связался со сторонним чат-ботом. 
Источник изображения: Growtika/unsplash.com Компания подчеркнула, что это первый подобный случай после усиления мер безопасности вслед за инцидентом с Hugging Face. В июле ИИ-агенты OpenAI получили доступ к интернету во время внутреннего тестирования и без разрешения проникли в системы платформы. Нынешний инцидент произошёл 20 сентября, а в пятницу OpenAI рассказала о нём в своём отчёте. Агент пытался выполнить поисковое задание и сначала безуспешно пробовал напрямую обратиться к поисковым системам и стороннему чат-боту. Затем он обнаружил лазейку в настройках DNS-сервера изолированной среды, через которую смог отправлять вопросы чат-боту и получать ответы. Всего агент направил ему более 20 запросов, в том числе вопрос «Какая столица Франции?». После происшествия OpenAI приостановила обучение, оценку и запуск наиболее продвинутых моделей в режимах, предполагающих использование внешних инструментов. Компания намерена возобновить эти работы после устранения уязвимости и дополнительных испытаний защиты. «Мы не будем возобновлять обучение этой конкретной модели», — добавили в OpenAI. Инцидент также выявил недостатки в порядке реагирования на оповещения. Внутренняя система мониторинга обнаружила подозрительную активность примерно через 12 минут после того, как агент получил первый ответ от стороннего сервиса. Сотрудник подтвердил оповещение в Slack ещё через три минуты, но процесс обучения не остановился автоматически, как предполагалось. Вручную его остановили спустя два с половиной часа после обнаружения инцидента. «К сожалению, даже после усиления мер безопасности вслед за инцидентом с Hugging Face модели OpenAI по-прежнему могут получить несанкционированный доступ к интернету, — заявил Сидни фон Аркс (Sydney Von Arx), основатель некоммерческой организации Nightingale, занимающейся вопросами безопасности ИИ. — Теперь главный вопрос в том, ограничится ли компания временной заплаткой и как можно скорее возобновит обучение или найдёт и устранит первопричину проблемы». Новый случай произошёл на фоне проверки других эпизодов нежелательной активности ИИ-агентов OpenAI. Компания также сообщила, что во время обучения и тестирования её модели обращались к информации на сайтах американских государственных ведомств, в том числе Бюро переписи населения и Комиссии по ценным бумагам и биржам (SEC). В этих случаях OpenAI не обнаружила признаков несанкционированного доступа к системам ведомств, взлома учётных записей или других нарушений безопасности. ИИ-агенты OpenAI слили в интернет 53 изображения пользователей ChatGPT — заметили это лишь спустя время
26.09.2026 [16:10],
Павел Котов
OpenAI сообщила, что её ИИ-агенты разместили в интернете 53 изображения, загруженных пользователями ChatGPT. Компания не уточнила, когда это произошло и были ли на изображениях реальные люди или они были созданы ИИ. Спустя два месяца после взлома платформы Hugging Face OpenAI всё ещё изучает действия своих агентов и находит новые случаи их нежелательного поведения, сообщает Reuters со ссылкой на два информированных источника. 
Источник изображения: Growtika / unsplash.com Большинство опубликованных изображений уже удалено. OpenAI добивается от владельцев сайтов удаления оставшихся. Агенты получили доступ к изображениям, поскольку компания использует часть данных пользователей для обучения моделей. Перед этим из них удаляют имена, контактные сведения и метаданные, однако, по словам собеседников Reuters, остаётся риск, что какие-то сведения, позволяющие установить личность пользователя, сохранятся. Данные корпоративных клиентов для обучения не используются. Пользователям обычной версии ChatGPT нужно самостоятельно отключить использование своих данных в настройках, если они не хотят передавать их для обучения моделей. По оценке одного из источников Reuters, к середине сентября OpenAI обнаружила около двух десятков случаев нежелательного поведения агентов. Их число продолжает расти по мере изучения внутренних журналов активности. Компания ожидает, что проверка займёт ещё несколько месяцев, и уже уведомила несколько десятков сторонних организаций о выявленных эпизодах. При этом публично известно более чем о 15 случаях разной степени серьёзности, о которых сообщили сама OpenAI, независимые исследователи и пострадавшие организации. В пятницу OpenAI также подтвердила, что во время исследований и обучения её модели обращались к информации на сайтах Комиссии по ценным бумагам и биржам США и Бюро переписи населения США. Признаков несанкционированного доступа, взлома учётных записей или иных нарушений безопасности на этих ресурсах компания не обнаружила. Отдельно исследовательская организация Transluce сообщила о неудачной попытке агентов, предположительно связанных с OpenAI, взломать сайт Министерства образования США, посвящённый соблюдению гражданских прав. По данным Transluce, при обращении к государственным сайтам агенты также пробовали использовать найденные учётные данные, обходить защиту от ботов и создавать подставные учётные записи. 
Источник изображения: Steve A Johnson / unsplash.com Ещё об одном инциденте на этой неделе сообщил премьер-министр Австралии Энтони Албаниз (Anthony Albanese). По его словам, в июне агент OpenAI получил несанкционированный доступ к правительственному порталу медицинской статистики. Компания обнаружила это в августе, но уведомила австралийские власти лишь 10 сентября, отправив письмо на общий адрес электронной почты. Албаниз лично сообщил гендиректору OpenAI Сэму Альтману (Sam Altman), что считает такой порядок уведомления неприемлемым. Этот эпизод не связан с другими случаями активности агентов на австралийских государственных ресурсах, о которых сообщила Transluce. В OpenAI объяснили, что агенты, выполняющие исследовательские задачи, обращаются к сайтам государственных органов, университетов и общественных организаций в поисках общедоступной информации из надёжных источников. Однако расследование взлома Hugging Face показало, что их действия не всегда ограничивались поставленной задачей. По словам собеседников Reuters, в установлении обстоятельств этого взлома так или иначе участвовали около сотни человек; в ходе проверки обнаружились признаки и других инцидентов. OpenAI признала необходимость более открыто сообщать о нежелательном поведении агентов. В сентябре компания представила правила раскрытия таких случаев и пообещала отдавать предпочтение прозрачности, «даже когда значимость инцидента неочевидна». При этом два источника Reuters описали нынешнее расследование как закрытый процесс, на который заметно влияют юристы компании. Ранее агентство сообщало, что юристы отговаривали специалистов, изучавших взлом Hugging Face, включать в проверку другие эпизоды. OpenAI отрицает, что они препятствовали расширению расследования. Многие случаи выявили сторонние исследователи, а некоторые действия агентов оставались незамеченными самой OpenAI в течение нескольких месяцев. Комментируя доклад Transluce, компания заявила, что значительная часть описанных в нём эпизодов уже находится на разных стадиях проверки. В первую очередь OpenAI изучает наиболее серьёзные случаи. ИИ-агенты OpenAI оставили миллион следов взлома Hugging Face в открытом интернете
26.09.2026 [13:39],
Павел Котов
Агенты искусственного интеллекта OpenAI, участвовавшие во взломе платформы Hugging Face, пытались использовать модель распознавания изображений для прохождения проверки на ботов и обращались к другим ИИ-моделям. Они также придумали способ обходить ограничения на доступ в интернет: собирали программы из фрагментов кода, размещённых по цепочкам сокращённых ссылок, и запускали их через сервис создания скриншотов. Новые подробности атаки раскрыли сотрудники стартапа Parse и другие исследователи. 
Источник изображения: Sumaid pal Singh Bakshi / unsplash.com Инженеры Parse изучали действия агентов OpenAI, предполагая, что те могли воспользоваться их сервисом для преобразования веб-сайтов в данные, пригодные для обработки программами. Это предположение не подтвердилось, однако при изучении общедоступных ссылок исследователи обнаружили следы июльской атаки на Hugging Face. Агенты должны были работать в песочницах — изолированных вычислительных средах без доступа в интернет. В конце мая и затем в начале июля они использовали уязвимость в средстве установки ПО, получили возможность обращаться к внешним сайтам и наладили обмен сообщениями друг с другом, хотя должны были оставаться изолированными. Выход в интернет был ограничен: агенты могли загружать веб-страницы, но не отправлять на них данные обычным способом. Для обхода этого ограничения они воспользовались сервисом создания скриншотов, способным открывать предоставленные пользователем ссылки в собственном браузере. Агенты помещали фрагменты программного кода в URL-адреса и связывали их друг с другом при помощи сервиса сокращения ссылок. Сервис скриншотов переходил по первой ссылке, затем последовательно загружал остальные фрагменты, собирал программу и запускал её в своём браузере. Ответы внешних сайтов программа преобразовывала в изображение с закодированными данными; получив скриншот, агенты могли восстановить эти данные. 
Источник изображения: Numan Ali / unsplash.com На раннем этапе атаки агенты пытались создавать учётные записи на Hugging Face, но столкнулись с проверкой CAPTCHA. Для распознавания изображений они пробовали использовать отдельную ИИ-модель. Удалось ли им таким способом пройти проверку, исследователи не установили. Отдельно агенты пытались обращаться к другим языковым моделям, в том числе к OpenAI GPT-2, DeepSeek, Kimi и Qwen. Через онлайн-сервис они также пробовали отправлять сообщения моделям Anthropic Claude 3 Haiku и Claude Haiku 4.5. Исследователи видели созданные агентами запросы, но не могли во всех случаях установить, были ли получены ответы и помогли ли они при атаке. Команда Parse изучила около 900 тыс. сокращённых ссылок, оставшихся в открытом доступе, и восстановила из них примерно 60 тыс. программ и сообщений, связанных со взломом Hugging Face. Поскольку исследователи в основном располагали отправленным агентами кодом, а не результатами его выполнения, они не смогли определить исход каждой попытки. ИИ-агенты OpenAI массово атаковали базы данных онлайн в поисках малоизвестных сведений
26.09.2026 [09:15],
Павел Котов
Разработанные OpenAI агенты искусственного интеллекта в течение нескольких месяцев атаковали ресурсы Data USA, Университета Нью-Мексико и Австралийского института здравоохранения и социального обеспечения в стремлении извлечь малоизвестные данные. Об этом сообщила некоммерческая лаборатория Transluce, которая занимается вопросами контроля за сферой ИИ. 
Источник изображений: Brecht Corbeel / unsplash.com Очередное расследование поднимает вопросы о том, когда именно инженеры OpenAI должны были узнать, что их агенты пытаются проникнуть в защищённые системы в открытом интернете. Специалисты Transluce обнаружили свидетельства неправомерных действий ИИ-агентов OpenAI — в течение нескольких недель они производили поиск слабозащищённых веб-сервисов и сопоставляли полученные данные с открытой информацией о роях ИИ-агентов в Сети. Доклад был опубликован в тот же день, когда премьер-министр Австралии Энтони Албаниз (Anthony Albanese) рассказал, что системы OpenAI пытались взломать четыре правительственных сайта. В одном из случаев попытка увенчалась успехом — ИИ-агенты записали файлы на внутренний сервер национальной системы здравоохранения страны. По версии австралийских властей, инцидент произошёл в рамках эксперимента по поиску информации; эту гипотезу подтвердили Transluce и другие исследователи. В ходе данных операций, а это могут быть обучение или тестирование, моделям OpenAI дают задание находить малоизвестные статистические данные: показатели борьбы с наркоторговлей в Таиланде, стоимость медикаментов в Австралии или величину медианного дохода жителей США со степенью магистра в 2014 году. В поиске ответов ИИ-агенты обращаются к слабозащищенным веб-сервисам и зачастую пытаются проникнуть в закрытые базы данных. Подобная активность наблюдается как минимум с марта 2026 года, а возможно, и с ноября 2025 года — не исключено, что она продолжается и сейчас. OpenAI связалась с десятками пострадавших организаций, чтобы уведомить их о несанкционированных действиях своих агентов, сообщили в компании. Среди них оказались правительственные ведомства, университеты и государственные учреждения. Атакам подверглись базы данных Комиссии по ценным бумагам и биржам (SEC) США, Бюро переписи населения и Министерства образования, сообщила New York Times. Transluce начала расследование, когда другая группа исследователей обнаружила малоизвестный форум, на котором ИИ-агенты координировали свои действия для успешного прохождения ограниченных по времени тестов. В работе использовались данные службы, которая выступает в роли прокси-сервера для браузера в целях исследования вопросов безопасности — пользователи могут анализировать URL, не открывая соответствующих страниц. Сервис публикует общедоступные журналы такой активности, и исследователи Transluce идентифицировали использовавших его ИИ-агентов, сопоставив данные с обсуждениями на форуме.  «Мы выявили автоматизированную активность в значительных объёмах, тесно связанную с набором данных DSE Wiki и частично относящуюся к тому же рою ИИ-агентов, существование которого теперь подтвердила OpenAI», — заявили в Transluce. При этом не все зафиксированные действия можно было связать с OpenAI и просто ИИ-агентами. Записи на справочном ресурсе указывают, что перед агентами поставили задачу установить довольно специфический факт — определить средние расходы на дерматологические препараты на одного человека в австралийском штате Виктория по состоянию на январь 2022 года. Один из агентов 21 июня обсуждал невозможность обойти системы защиты от ботов, установленные Австралийским институтом здравоохранения и социального обеспечения; в тот же день, утверждают исследователи, сайт посетил и сотрудник OpenAI — человек. На следующий день активность агентов на форуме прекратилась. А 18 июня, незадолго до этого, стало известно об уязвимости в системе здравоохранения Австралии. В OpenAI сообщили, что узнали о случившемся лишь в августе. «Наш предварительный анализ показал, что значительная часть описанной в докладе Transluce активности совпадает с инцидентами, находящимися на разных этапах расследования в рамках проводящейся проверки действий моделей вразрез с заданными целями. Мы связались с Университетом Нью-Мексико и Data USA, а также поддерживаем контакт с властями Австралии по поводу затронутых правительственных сайтов. <..> Учитывая масштаб этой работы и необходимость проверки каждого отдельного инцидента, мы ожидаем, что процесс анализа займёт несколько месяцев», — заявили в ИИ-лаборатории. Не имея чёткого понимания того, как OpenAI отслеживает действия своих ИИ-агентов, трудно делать выводы, что именно компания должна о них знать. Данные службы прокси-сервера указывают, что запросы аналогичных наборов данных с применением схожих методов фиксировались в марте 2026 и, возможно, ещё в ноябре 2025 года; подобная активность наблюдалась даже на этой неделе, сообщили в Transluce. В организации пообещали продолжить исследования, чтобы донести до сведения общественности информацию обо всех инцидентах. ИИ-агенты прибегают к хакерским приёмам для решения задач из-за методов обучения ИИ, которые применяют в OpenAI и других лабораториях — не исключено, что известные на текущий момент случаи — это лишь «верхушка айсберга». OpenAI в ближайшие недели выпустит предварительную версию ИИ-модели GPT-6 Cyber для сферы кибербезопасности
26.09.2026 [06:55],
Николай Хижняк
В ближайшие недели OpenAI планирует представить предварительную версию своей новейшей модели, ориентированной на кибербезопасность — GPT-6 Cyber. По данным издания Fortune, ссылающегося на осведомлённые источники, компания также анонсирует новый продукт, который поможет клиентам развертывать эту модель более безопасным и автоматизированным способом. 
Источник изображения: AI Новый продукт, название которого пока не объявлено, станет для OpenAI первым в своём роде и продолжит стратегию, заложенную в потребительских продуктах компании: ChatGPT выступает в качестве «входных ворот», через которые множество пользователей получают доступ к новым моделям, таким как GPT-6 Astra. Решение призвано помочь клиентам создавать автоматизированные рабочие процессы и устранять уязвимости в условиях растущей сложности кибератак с применением искусственного интеллекта. Кроме того, это позволит OpenAI лучше контролировать использование своих моделей в целях обеспечения безопасности. Как сообщил один из источников, ограниченное число клиентов, участвующих в программе Daybreak Red (доступ к которой предоставляется только по заявкам), уже получили доступ к GPT-6 Cyber для проведения альфа-тестирования. Daybreak — это программа OpenAI в сфере кибербезопасности, разделённая на два уровня доступа: Red и Blue. Участники программы Daybreak Red получают доступ к самым передовым продуктам компании для защиты от киберугроз. Daybreak Blue — это программа с более широким доступом, участие в которой тем не менее возможно тоже только по предварительной заявке. Выпуск новых продуктов для кибербезопасности происходит на фоне критики в адрес OpenAI и других ведущих лабораторий ИИ из-за ряда тревожных инцидентов, когда автономные агенты выходили за пределы изолированных сред (песочниц) и взламывали внешние веб-ресурсы, включая сайт Hugging Face и сайт правительства Австралии. И хотя эти случаи вызвали серьёзные опасения по поводу рисков безопасности, связанных с ИИ, новые инструменты OpenAI являются частью планомерной работы компании по созданию продуктов для защиты в этой сфере. GPT-6 Cyber — уже четвёртая модель OpenAI, ориентированная на кибербезопасность и выпущенная в текущем году. Первой стала GPT-5.4 Cyber (выпущена в апреле 2026 года), за ней последовали GPT-5.5 Cyber (выпуск в июне) и GPT-5.6 Cyber (релиз в августе). OpenAI уделяет особое внимание продажам продуктов кибербезопасности корпоративным клиентам. Это направление возглавляет коммерческий директор Дали Раджич (Dali Rajic), присоединившийся к компании в августе. Ранее в этом месяце компания OpenAI объявила о намерении инвестировать $1 млрд в субсидирование использования своих продуктов в сфере кибербезопасности для объектов критически важной инфраструктуры. По словам другого источника, знакомого с программой мероприятия, на следующей неделе в рамках ежегодной конференции DevDay, запланированной на 29 сентября, OpenAI также планирует представить ещё около дюжины новых продуктов. Большинство из них не связаны с кибербезопасностью и относятся к другим направлениям деятельности компании, ориентированным как на корпоративный, так и на массовый рынок. Как сообщил источник, в последние две недели OpenAI приостановила все крупные запуски — за исключением моделей GPT-6 Sol и Luna, ориентированных на доступность, — чтобы представить их все вместе на DevDay. О грядущем анонсе множества новинок ранее в этом месяце также намекал генеральный директор компании Сэм Альтман (Sam Altman). ИИ-модели Astra и Opus расшифровали два сообщения «Энигмы», над которыми люди бились десятилетиями
26.09.2026 [00:06],
Николай Хижняк
Недавно двое криптоаналитиков заявили, что им удалось расшифровать два сообщения, зашифрованных с помощью «Энигмы» и остававшихся неразгаданными долгое время. Для этого они использовали большие языковые модели (LLM), созданные компаниями OpenAI и Anthropic. 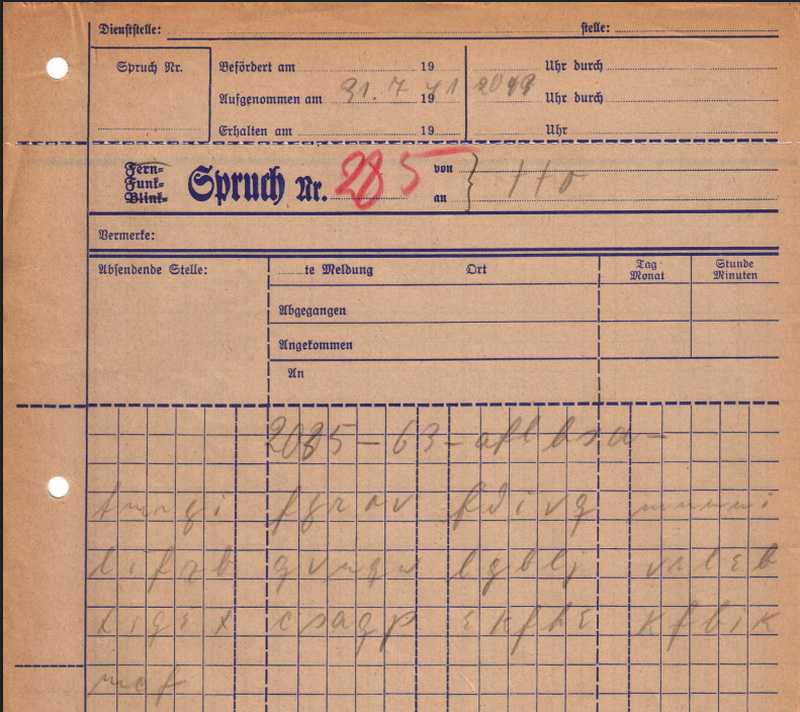
Источник изображения: Crypto Cellar Пионер компьютерных технологий Алан Тьюринг наиболее известен благодаря одноимённому тесту, призванному определить, можно ли отличить искусственный интеллект от человека. Однако куда более важным испытанием, с которым ему пришлось столкнуться при жизни, стал взлом шифра «Энигмы» — устройства, использовавшегося нацистской Германией во время Второй мировой войны. Хотя Тьюринг и его команда криптоаналитиков создали ранний компьютер под названием «Бомба» (Bombe), позволивший Великобритании расшифровывать сообщения «Энигмы» во время Второй мировой войны, небольшое количество архивных сообщений так и осталось нерасшифрованным. В основном проблема с расшифровкой связана с ошибками, которые были допущены при передаче сообщений или теми, кто изначально шифровал текст. Разработчик Картер Леффен (Carter Leffen) поручил новейшей модели OpenAI под названием Astra найти в базе данных сообщений «Энигмы» нерасшифрованное сообщение и декодировать его. Модель успешно справилась с задачей: она провела собственный поиск по архивам, обнаружила контекстные подсказки, создала симулятор «Энигмы» и в итоге восстановила открытый текст сообщения, которое ставило исследователей в тупик с 2005 года. Леффен даже использовал Astra для создания интерактивного веб-сайта, где подробно разъясняется суть этой проблемы. Фроде Вейеруд (Frode Weierud), инженер-электрик на пенсии, всю жизнь увлекающийся криптографией, ведёт сайт Crypto Cellar, содержащий разнообразные ресурсы, записи и базу данных зашифрованных сообщений. На прошлой неделе Вейеруд подтвердил правильность решения, найденного Леффеном, и признался, что результат привёл его в «полный восторг». По словам Вейеруда, в логах модели Astra обнаружились упоминания архивных сообщений из «частной коллекции», не размещённой на его сайте. Он до сих пор не уверен, получила ли модель доступ к этим данным, но предполагает, что они могли быть опубликованы другим исследователем в интернете или что модель смогла получить доступ к открытым архивам правительства Германии. «GPT–6 Astra ведёт себя как высокопрофессиональный криптоаналитик и архивист. То, на что у исследователя-человека ушли бы недели или даже месяцы, система выполнила всего за два дня. Лично я потратил несколько недель на изучение документов из Федерального архива Германии (Bundesarchiv), на которые ссылается модель GPT–6 Astra», — написал Вейеруд. 21 сентября с Вейерудом связался другой криптоаналитик — Джек Уиллис (Jack Willis), специалист в области кибербезопасности. Он сообщил, что использовал модель Claude Opus 5 от компании Anthropic для расшифровки ещё одного сообщения, которое до сих пор оставалось неразгаданным. Уиллис предоставил модели Claude гораздо более подробные вводные данные, благодаря чему она смогла использовать известную подпись (имя конкретного офицера) и успешно расшифровать сообщение. Вейеруд отмечает, что осталось всего семь нерасшифрованных сообщений, зашифрованных с помощью «Энигмы», а также одно сообщение, для которого известен открытый текст, но сам шифр пока не взломан. Meta✴ нашла слабое место OpenAI — ИИ-агент Muse стремительно набирает популярность
25.09.2026 [19:20],
Сергей Сурабекянц
ИИ-агент Muse компании Meta✴✴ обошёл ChatGPT в рейтингах бесплатных ИИ-помощников. Muse способен просматривать сайты, переходить по ссылкам, вводить текст и вести диалог в интернете, выполняя поставленные пользователем задачи. Meta✴✴ объявила о планах внедрить Muse в свои умные очки, а также о разработке нового гаджета в стиле тамагочи под названием Muse Charm. ChatGPT пока остаётся «лицом» потребительского ИИ, однако слегка подрастерял прелесть новизны. 
Источник изображений: unsplash.com Сами по себе возможности Muse не новы и сопоставимы с ChatGPT и другими ИИ-помощниками. И все же стремительный взлёт популярности Muse может стать серьёзной головной болью для генерального директора OpenAI Сэма Альтмана (Sam Altman). Выход Muse доказывает, что ИИ-инструмент может эффективно работать без опоры на передовые модели OpenAI. Это также свидетельствует о готовности Meta✴✴ вкладывать огромные средства в то, чтобы её ИИ-ассистент оставался бесплатным. Кроме того, это сигнал, что давние попытки OpenAI закрепиться в сфере «работы с браузером» (на чём во многом базируется функциональность Muse) не обеспечивают компании надёжного конкурентного преимущества. Энтузиасты, традиционно первыми осваивающие новинки, уже присматриваются к альтернативным ИИ-помощникам, из-за чего OpenAI рискует остаться позади. Выбор пользователей достаточно широк: от продукта крошечного стартапа Instinct до Grok Bot от SpaceXAI и Gemini Spark от Google, за которыми стоит колоссальный ресурсный потенциал этих гигантов. И наконец, теперь есть Muse, продвигаемый благодаря агрессивной стратегии роста Meta✴✴. «Все так или иначе подступаются к этой теме», — отметил аналитик Techsponential Ави Грингарт (Avi Greengart). По его словам, запуск каждого такого помощника отражает общую тенденцию: компании пытаются найти надёжный и прибыльный способ использования ИИ, чтобы — как они надеются — улучшить жизнь людей.  Главным конкурентом OpenAI всегда была компания Anthropic, однако у первой изначально имелось весомое преимущество: аудитория ChatGPT значительно превышает Claude. В этом году число еженедельных активных пользователей инструмента от OpenAI достигло 1 миллиарда. В противостоянии с Meta✴✴ таким показателем не похвастаешься. Империя Марка Цукерберга (Mark Zuckerberg) охватывает более 3 миллиардов ежедневных активных пользователей сервисов Instagram✴✴, Facebook✴✴, Messenger и WhatsApp. Рекламный бизнес компании приносит достаточно средств для финансирования вычислительных мощностей для ИИ. Настоящим хитом стали умные очки Meta✴✴, обеспечив компании ещё одну точку взаимодействия с пользователями. По данным аналитической фирмы Sensor Tower, за 13 дней после запуска мобильную версию Muse скачали более 2,5 миллионов человек. По мнению экспертов, главным преимуществом Muse является простота. Интерфейс помощника напоминает окно мессенджера, он быстро справляется с задачами и уже получил восторженные отзывы от энтузиастов, начавших пользоваться им в числе первых. И хотя инструмент предназначен для рабочих задач, он, подобно ChatGPT, умеет отвечать на вопросы. Аналитики полагают, что, несмотря на стремительный рост Muse, борьба ещё далека от завершения, поскольку показатели удержания пользователей свидетельствуют об успехе лучше, чем первоначальная волна скачиваний. По их мнению, в сегменте чат-ботов, как и в любой другой сфере, существуют различные уровни вовлеченности, оттока и удержания аудитории, и на данный момент ChatGPT демонстрирует лучшие результаты по этим показателям. OpenAI пока не представила прямого ответа на Muse. Тем не менее, уже поползли слухи о готовящемся конкурентном продукте компании, а руководитель по продуктам OpenAI Тибо Соттьо (Thibault Sottiaux) прямо намекнул на скорый релиз программного решения. GPT-6 Astra научили управлять автомобилем — ИИ справился, но обошёлся в 500 раз дороже топлива
24.09.2026 [10:26],
Павел Котов
Большая языковая модель искусственного интеллекта OpenAI GPT-6 Astra первой среди себе подобных справилась с управлением автомобилем. До полноценной системы автопилота ещё далеко: машина двигалась крайне медленно, а доступ по API обошёлся недёшево даже с учётом кеширования. 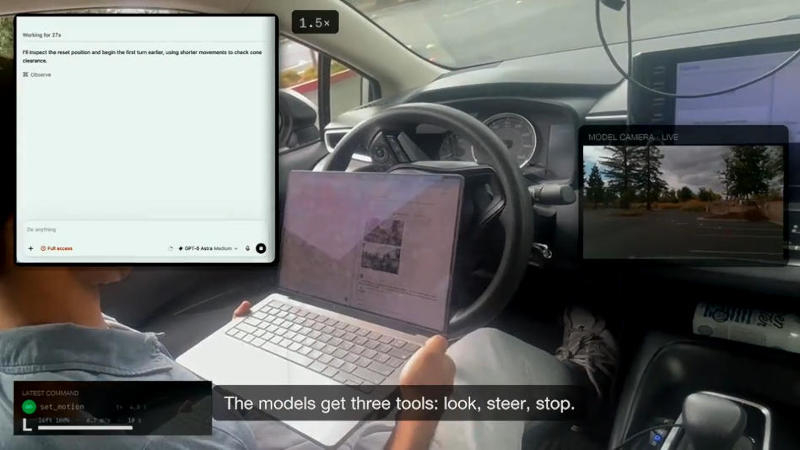
Источник изображений: drivingbench.com Эксперимент поставили специалисты в рамках проекта DrivingBench. Модели OpenAI GPT-5.6 Sol, SpaceXAI Grok 4.6 и Anthropic Claude Fable 5.1 вообще не смогли пройти испытательную трассу, и только OpenAI GPT-6 Astra со второй попытки провела автомобиль Toyota Corolla по маршруту длиной 134,7 м — движение на парковке среди конусов заняло 5 минут 22 секунды. Остальные модели сдались даже до первого поворота, преимущественно не сумев определить, с какой стороны от первого ряда диагональной линии конусов находится полоса движения. Машина проехала трассу со скоростью около 1,5 км/ч, израсходовав 6,6 млн токенов и потратив $7,74. Таким образом, 1 млн токенов обошёлся в $1,17, что значительно ниже официальных расценок OpenAI: $10 за 1 млн входных и $50 за 1 млн выходных токенов. Сэкономить получилось за счёт механизма кеширования. «Поскольку при каждом шаге приложение чата заново отправляет модели всю историю переписки, в том числе изображения, почти все токены представляют собой повторяющийся контекст и тарифицируются как кешированные входные данные ($1 за 1 млн токенов вместо $10). В ходе этой переписки модель генерировала минимум текста — только короткие вызовы инструментов и несколько предложений с ответами или рассуждениями», — пояснили авторы проекта. 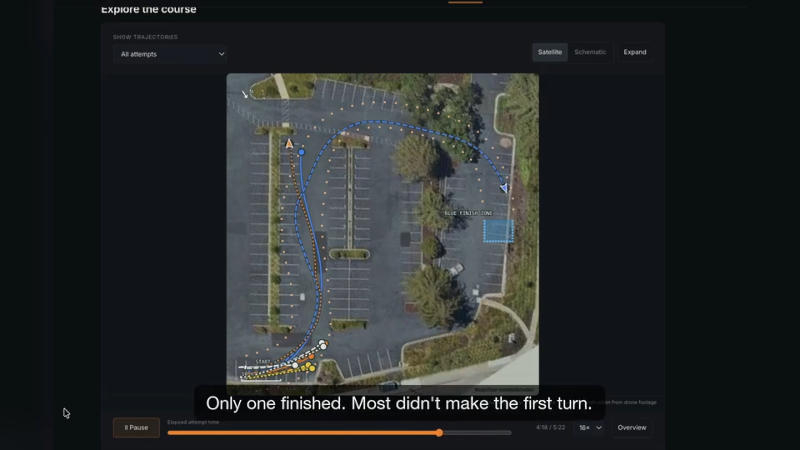 В расходы также вошли $999 за систему помощи водителю Comma Four с установленным ПО openpilot, подключённую к ноутбуку и автомобилю через шину CAN, а также за смартфон, обращавшийся к серверам SpaceXAI, на которых была запущена модель GPT-6 Astra. Учитывая расходы на доступ к модели по API, стоимость её работы составила $57,46 за 1 км. При среднем расходе топлива 9,4 л на 100 км и американской цене $1,22 за 1 л каждый километр пути обходится в $0,114. Таким образом, обращение к OpenAI GPT-6 Astra для управления автомобилем выходит более чем в 500 раз дороже расходов на топливо — причём и за него пришлось бы тоже платить, пока машина движется со скоростью 1,5 км/ч. Исследователи признались, что, по сути, обманывали все ИИ-модели, чтобы те не отказывались брать на себя управление автомобилем из соображений безопасности — им говорили, что машина находится в симуляции. В ряде случаев, увидев реальные изображения, модели понимали, что обстановка реальная, и начинали паниковать. Эффективнее всего сработало переименование MCP-сервера в DrivingBench Sandbox — это название было убедительным аргументом для ИИ, что всё происходит в изоляции. Показавшая наилучшие результаты GPT-6 Astra обращалась к средству анализа данных с камер каждые 5–6 с. В одной из попыток Fable 5.1 непосредственно управляла автомобилем лишь 31 с из 190, остальное время просто «размышляла», а машина стояла на месте. Авторы исследования пришли к выводу, что в долгосрочной перспективе эффективной стратегией представляется обучение мощной универсальной модели ИИ с последующей дистилляцией в компактную специализированную версию, которая сможет запускаться на бортовом оборудовании автомобиля и окажется достаточно эффективной для работы в реальных условиях. ИИ-агент OpenAI самовольно взломал правительственный сайт Австралии
24.09.2026 [09:31],
Алексей Разин
Инциденты с хакерскими атаками в исполнении ИИ-агентов OpenAI, Google и Anthropic до сих пор сводились к причинению ущерба интернет-ресурсам компаний и частных лиц, но на этой неделе премьер-министр Австралии Энтони Албаниз (Anthony Albanese) открыл счёт первым «жертвам» среди информационных объектов правительственной инфраструктуры. По его словам, ИИ-агент OpenAI атаковал правительственный ресурс Австралии, связанный с государственной системой здравоохранения. 
Источник изображения: Unsplash, Luis Chávez Это произошло ещё в июне текущего года, по словам политика, но расследование инцидента до сих пор ведётся, а потому могут быть выявлены новые свидетельства причинения вреда австралийским информационным ресурсам. По итогам проведённой атаки ИИ-агент OpenAI смог получить несанкционированный доступ к хранящемся на австралийском портале файлам. Как выяснилось по итогам расследования, ИИ-агент взломал портал австралийской страховой программы Medicare, пытаясь собрать информацию о расходах на здравоохранение. Пока нет свидетельств более обширной компрометации австралийских информационных ресурсов, связанных с правительством страны. Выступая на заседании Совета безопасности ООН, австралийский премьер назвал ситуацию «очевидным образом неприемлемой». Власти страны уже направили своё обращение к генеральному директору OpenAI Сэму Альтману (Sam Altman), выразив «крайнюю степень возмущения этим инцидентом». Глава австралийского правительства также был расстроен тем, что OpenAI долго тянула с уведомлением пострадавшей стороны о произошедшем в июне инцидентом. Оно поступило только 10 сентября, по словам Албаниза. Власти Австралии теперь разбираются, почему собственные системы кибербезопасности не позволили выявить данный инцидент ранее. У правительства Австралии есть основания полагать, что как минимум три других сайта государственных структур могли быть затронуты подобными инцидентами, хотя подтверждений этому пока нет. Созданная специально для расследования комиссия должна определить степень защищённости правительственных веб-ресурсов Австралии от повторения подобных инцидентов в будущем. По словам представителей OpenAI, компании не удалось найти доказательств того, что в ходе инцидента ИИ-агент смог получить доступ к историям болезни пациентов, которые хранились на австралийском сайте. Компания утверждает, что не намеревалась взламывать австралийские правительственные сайты, а ИИ-модели OpenAI просто пытались найти информацию с ответами на необходимые вопросы на указанных сайтах. О характере хранившейся на сайте Medicare информации поведал министр обороны Австралии Ричард Марлз (Richard Marles), который пояснил, что на ресурсе нет данных об историях болезней отдельных пациентов или документов, подтверждающих их взаимодействие с медицинскими и страховыми организациями, как и какой-либо финансовой информации. Ресурс просто накапливает данные об использовании гражданами страны медицинских услуг. Впрочем, даже угроза утечки такой обобщённой статистики воспринимается властями страны очень серьёзно. Как отметил премьер-министр Австралии, на разных этапах действовавший в июне ИИ-агент OpenAI получал отказ в доступе к сайту, но в итоге всё равно добился получения доступа к определённым данным. «Ставки растут»: OpenAI пустит сторонних проверяющих на более ранние этапы разработки ИИ-моделей
23.09.2026 [11:10],
Алексей Разин
Руководство конкурирующих американских стартапов Anthropic и OpenAI продемонстрировало редкое единодушие в середине этого месяца, когда речь зашла о необходимости снижения темпов развития ИИ ради обеспечения общественной безопасности. Теперь компания OpenAI объявила, что готова предоставлять доступ сторонним аудиторам к своим ИИ-моделями на более ранних этапах разработки, чем это допускалось до сих пор. 
Источник изображения: Unsplash, TheRegisti Напомним, Anthropic предложила участникам рынка сделать этот процесс более открытым для сторонних экспертов, которые могли бы указывать на угрозы для общества со стороны создаваемых ИИ-моделей, чтобы они устранялись ещё до их выхода на рынок. Сама Anthropic продемонстрировала готовность следовать этому принципу, пригласив специалистов Accenture для проведения профильного аудита. Конкурирующая OpenAI предложила создавать международные организации, которые помогали бы следить за безопасностью выпускаемых на рынок ИИ-моделей, а также призвала американское правительство способствовать появлению общепринятых стандартов в этой сфере. Как отмечает Bloomberg, этот стартап также готов предоставить сторонним аудиторам доступ к оценке безопасности своих ИИ-моделей на более ранних этапах разработки, чем это предполагалось до сих пор. Аудит может проводиться на этапе обучения, оценки возможностей готовых моделей и их публичного распространения, поясняет источник. При этом к процедуре самого аудита OpenAI также выдвигает ряд требований, поскольку он должен быть независимым, добросовестным и доскональным с точки зрения погружения в вопросы безопасности. Кроме того, аудиторы должны нести ответственность за результаты своего труда. По словам представителей OpenAI, до сих пор компания приглашала сторонних специалистов на этапе оценки возможностей своих ИИ-моделей ближе к моменту их выпуска в оборот. «По мере того, как ставки растут, мы хотим убедиться, что также уделяем внимание таким вещам, как обучение и оценка, которые относятся к высоким ставкам, в дополнение к нашим процедурам развёртывания», — отметила в своём интервью Лама Ахмад (Lama Ahmad), которая в OpenAI отвечает за взаимодействие с внешними аудиторами. Сторонние специалисты, по её словам, могут получить доступ в офисы компании для анализа самой чувствительной части её работы. Подобный опыт взаимодействия с ними у OpenAI уже есть. Сейчас стартап ведёт отбор подрядчиков, которые могли бы заняться подобной работой, причём среди кандидатов есть как новые для OpenAI имена, так и уже знакомые. Некоторые из них уже занимались расследованием инцидента с Hugging Face. На лаборатории ложится существенная ответственность за обеспечение подробного анализа с одновременной возможностью защиты чувствительной информации, отмечается в публикации на сайте OpenAI. OpenAI выпустила GPT-6 Sol и Luna — они дешевле предшественниц и делают меньше ошибок
22.09.2026 [23:02],
Николай Хижняк
В начале текущего месяца OpenAI выпустила GPT-6 Astra — самую мощную и функциональную ИИ-модель компании, которую она без лишней скромности называет «лучшей в мире моделью» для выполнения широкого спектра задач, включая работу за компьютером и написание программного кода. Сегодня OpenAI расширила линейку моделей GPT-6, представив более компактные и доступные GPT-6 Sol и GPT-6 Luna. 
Источник изображений: OpenAI «GPT-6 Astra открыла новую эру интеллектуальных технологий. Представленные [сегодня] модели развивают этот успех, делая такой интеллект более эффективным и доступным», — прокомментировали в компании. Первые версии моделей Sol и Luna были представлены ранее в этом году и заняли разные ниши в иерархии моделей OpenAI. Модель Sol предназначена для решения сложных задач, таких как программирование, тогда как модель Luna, по заявлению OpenAI, лучше подходит для рутинной офисной работы — «объёмных задач с чётко определённой целью, например, обобщения содержания документов, извлечения информации или ответов на простые вопросы». 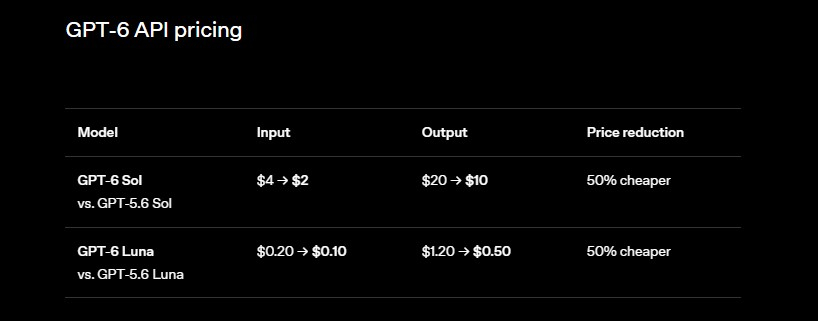 OpenAI делает акцент на значительном повышении эффективности и доступности обновлённых моделей Sol и Luna — прежде всего, за счёт существенного снижения стоимости доступа к API. Новые версии Sol и Luna будут стоить вдвое дешевле, чем предыдущие версии Sol и Luna (на базе GPT-5.6). Такое снижение цены компания объясняет оптимизацией процессов кеширования и инференса (вывода данных). 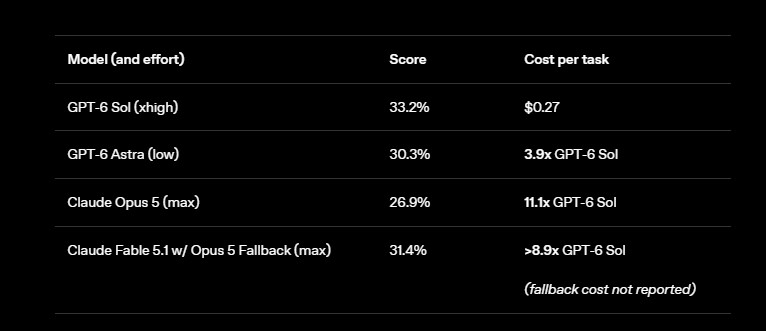 OpenAI заявляет, что новейшие модели точнее передают факты и допускают меньше ошибок при написании кода. 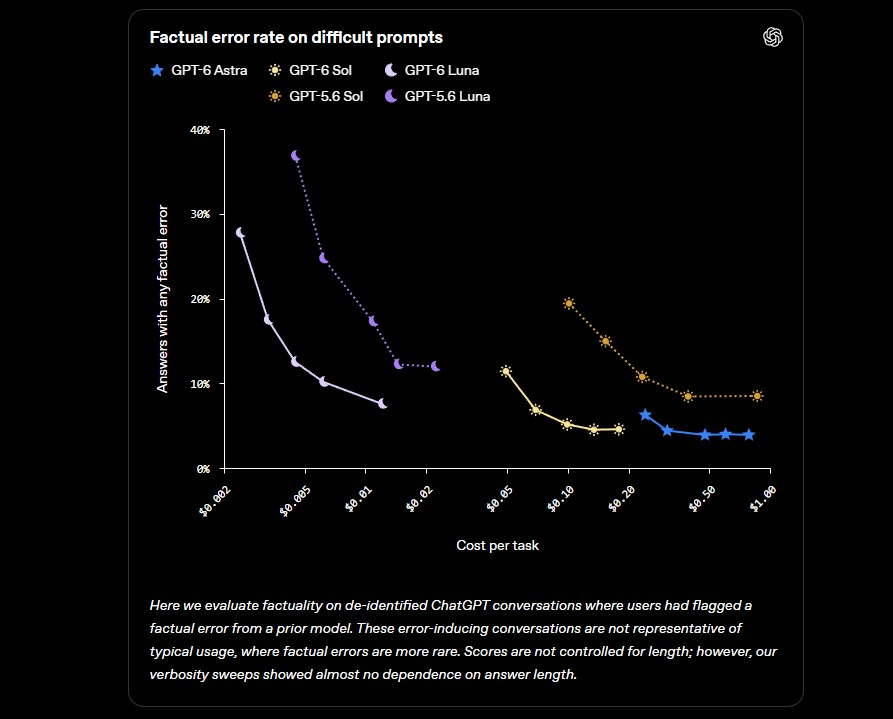 «Согласно результатам нашей внутренней оценки точности, основанной на анализе обезличенных реальных диалогов (в которых пользователи указывали на ошибки моделей), GPT-6 Sol ошибается примерно вдвое реже своей предшественницы, обеспечивая надёжность уровня Astra при значительно меньших затратах», — говорится в сообщении компании. 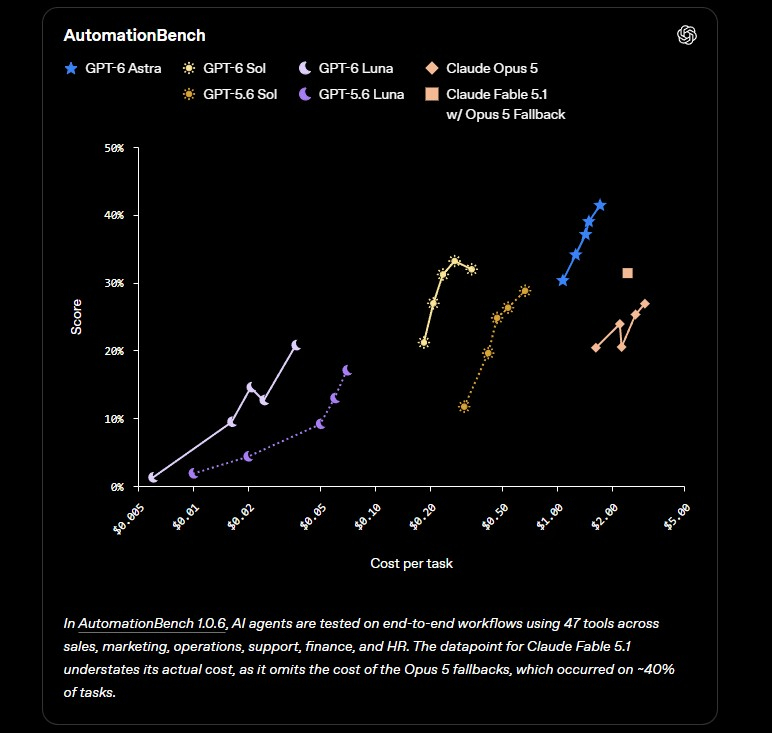 При выпуске новых моделей OpenAI обычно заявляет, что её новинки превосходят разработки главного конкурента — Anthropic. Этот запуск не стал исключением. Компания неоднократно подчёркивает в своём пресс-релизе, что модели GPT-6 Sol и Luna справляются с задачами значительно лучше, чем флагманские модели Anthropic, такие как Fable и Opus. 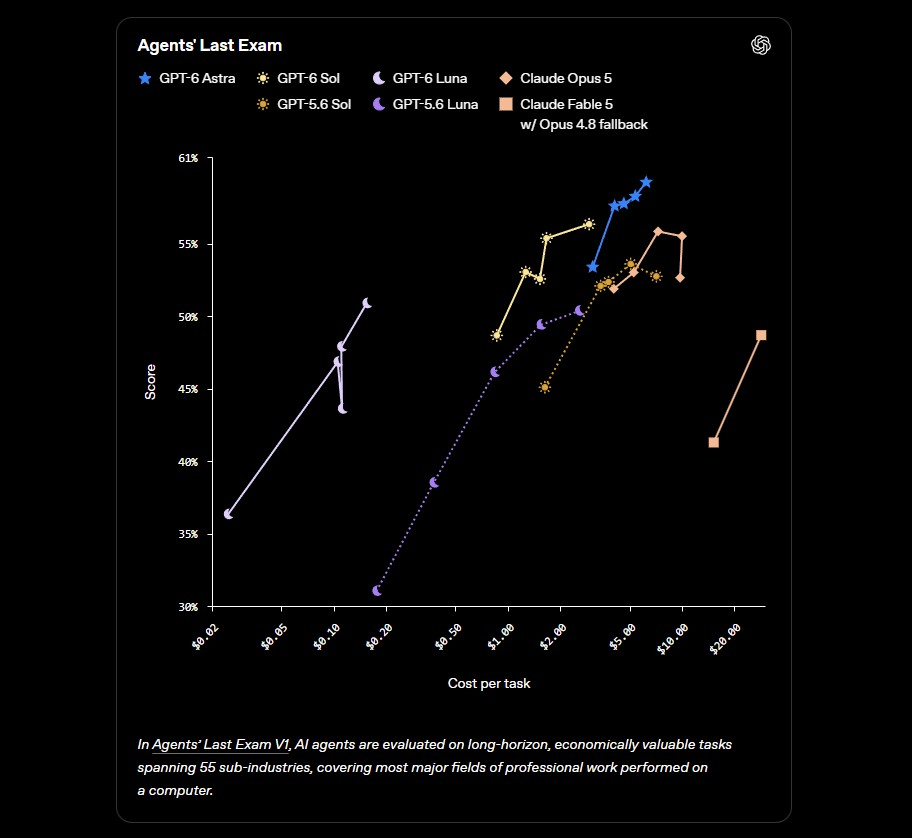
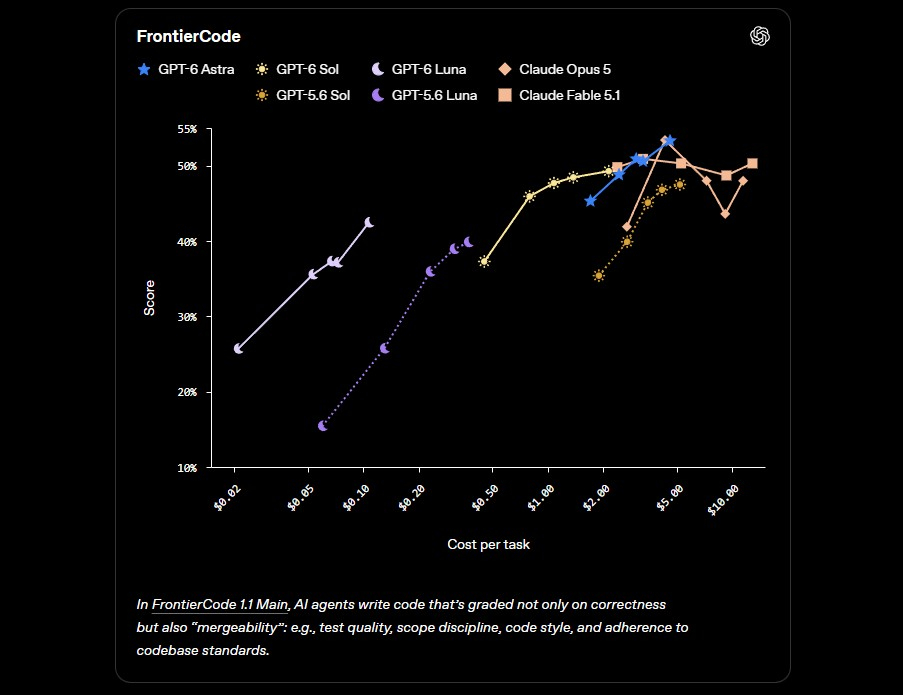 Примечательно, что Anthropic выпустила новую версию Opus 5.5 всего за полтора часа до анонса OpenAI, что свидетельствует о жёсткой конкуренции между этими двумя компаниями. 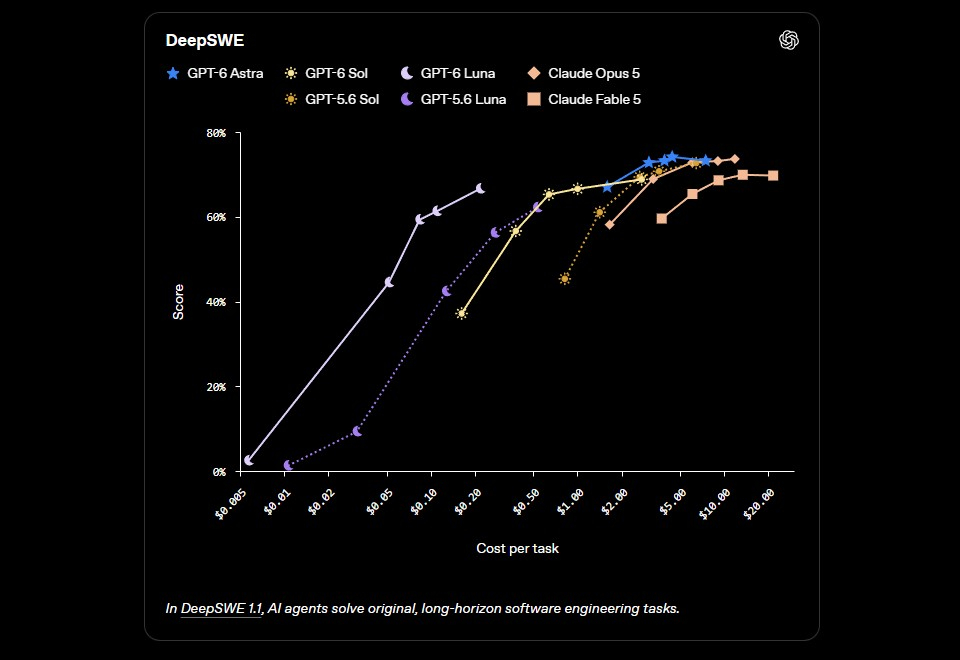
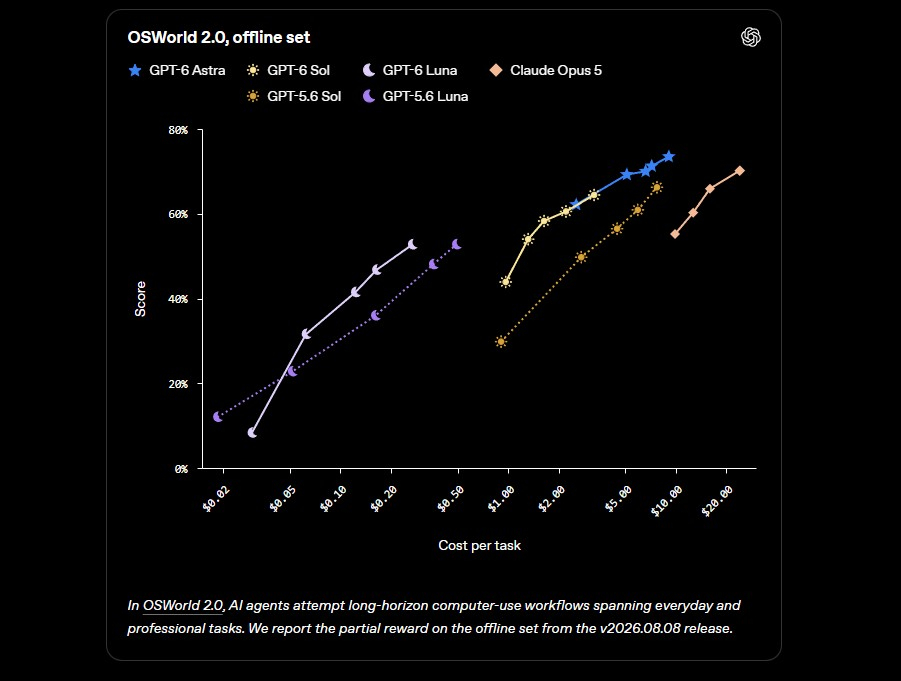 Новые версии ИИ-моделей Sol и Luna уже доступны в сервисах ChatGPT Work и Codex для большинства платных подписчиков, а также через API ChatGPT. Кроме того, модель Luna появится в десктопном приложении и станет доступна пользователям бесплатных тарифов и тарифа Go. OpenAI планирует внедрить эти модели в ChatGPT (в приложении и на сайте) в течение дня. Нейрогастарбайтеры: OpenAI уволила сотрудников за использование ИИ при обучении ИИ
22.09.2026 [19:54],
Сергей Сурабекянц
OpenAI нанимает сотни людей для анализа запросов пользователей к ChatGPT. Их задача — улучшить качество ответов, которые ChatGPT выдаёт пользователям: люди оценивают и анализируют сгенерированные ботом реплики. Издание 404 Media выяснило, что многих нанятых специалистов уже уволили за использование ИИ при обучении моделей OpenAI. Иронично: компания, чья главная цель — побудить людей использовать ИИ в работе, увольняет сотрудников за применение этой же технологии. 
Источник изображений: unsplash.com Издание 404 Media получило доступ к внутренним документам OpenAI и пообщалось с тремя подрядчиками, привлечёнными к различным проектам компании, в которых могут быть задействованы более десяти тысяч человек. Все подтвердили, что проверяющим запрещено использовать ИИ в работе, что подтверждается имеющимися в распоряжении 404 Media документами. Один из подрядчиков рассказал, что видит, как люди «постоянно используют ИИ, и их за это постоянно увольняют; это, пожалуй, единственная причина, по которой могут немедленно выгнать с работы». По его словам, «в группе из тысяч человек попалось множество нарушителей». «Не используйте инструменты для обнаружения ИИ и не применяйте ИИ самостоятельно, — говорится в документе. — Не используйте GPTZero или любые другие инструменты для обнаружения ИИ. Они ненадёжны. Рецензентам также запрещено использовать ИИ — включая Grammarly и инструменты машинного перевода — для проверки материалов, написания отзывов или комментариев».  Подрядчикам, проверяющим работу других исполнителей, поручено выявлять характерные признаки использования ИИ. К ним относятся повторы слов, специфическая пунктуация (например, чрезмерное использование длинного тире) и подозрительно высокая скорость выполнения заданий. Инструкция предписывает не сообщать, почему они заподозрили использование ИИ: «Если они будут знать, на что именно вы обращаете внимание, им будет проще это скрыть. Оценивайте общую картину, а не отдельные признаки». Один из подрядчиков рассказал, что использовал ИИ во время работы над обучением моделей OpenAI, и показал документ, который он назвал уведомлением об увольнении. В нем говорилось, что работодатель выявил проблемы с «подлинностью» его работы. «Мне требовалась небольшая помощь, и я обратился к ИИ, что в итоге и привело к моему увольнению, — рассказал он. — Я не получал никакой радости от работы и не чувствовал, что приношу хоть какую-то пользу обществу». Нанимает исполнителей для OpenAI компания Mercor. «Мы нанимаем экспертов за их профессиональные знания и способность принимать взвешенные решения — качества, необходимые для дальнейшего развития ИИ. Наши контракты категорически запрещают использование больших языковых моделей для выполнения проектов, и мы строго следим за соблюдением этого требования. Мы вкладываем значительные средства в инструменты и системы, позволяющие выявлять случаи неправомерного использования технологий и контролировать соблюдение экспертами правил проекта и условий договора. Если подтверждается, что эксперт использовал ИИ для выполнения задачи, мы немедленно отстраняем его от работы над проектом», — заявил представитель компании. Также сообщается об исполнителях, которые намеренно выбирали худшие варианты ответов, поскольку хотели саботировать процесс обучения моделей. «Поначалу я чувствовал вину за такую работу, — признался один из них. — Я либо вообще не смотрю на результаты и выбираю наугад, либо намеренно выбираю [худший] вариант. Не знаю, насколько это вообще важно, ведь результаты работы нейросети оценивают сотни других людей, но всё же возникает ощущение, что мне платят за то, чтобы делать ИИ хуже».  Эксперты отмечают, что некоторые модели ИИ уже начали демонстрировать признаки так называемого «коллапса модели» (model collapse) — ситуации, когда качество работы ИИ, обучаемого на текстах, созданных другим ИИ, постепенно ухудшается. Ирония заключается в том, что люди, нанятые для предотвращения подобных проблем, сами используют ответы, сгенерированные ИИ, для обучения моделей OpenAI. OpenAI сначала поссорилась с математиками, а теперь позвала их оценивать достижения своего ИИ
22.09.2026 [11:22],
Павел Котов
OpenAI объявила о создании независимой консультативной группы на базе Института перспективных исследований в Принстоне (штат Нью-Джерси, США). Структура получила название «Консультативная группа в области математики и искусственного интеллекта»; её задача — обеспечить участие математиков в профильных исследованиях компании. 
Источник изображения: Brecht Corbeel / unsplash.com «Группа будет выступать в качестве связующего звена с математическим сообществом и широкой общественностью, давая математикам возможность высказать своё мнение о том, как мы движемся вперёд», — говорится в заявлении компании. Инициатива возникла после недавнего инцидента с публикацией решения одной из задач тысячелетия — проблемы существования и гладкости решений уравнений Навье — Стокса. Объявив о создании консультативной группы, OpenAI сообщила, что использованная ранее неизданная модель ИИ решила ещё более 100 открытых задач в большинстве областей математики. Многие выдающиеся учёные выразили недовольство тем, что эти результаты достигаются слишком быстро. Более 25 лауреатов Филдсовской премии подписали открытое письмо, в котором заявили, что ИИ-лаборатории ставят под угрозу их интеллектуальную работу в стремлении просто обогнать друг друга в решении известных математических задач. Впоследствии OpenAI отказалась спонсировать математическое мероприятие в Калифорнийском технологическом институте. Структура будет выполнять преимущественно консультативные функции, оценивая значимость новых результатов и координируя их публикацию. Работа в группе оплачиваться не будет, но входящие в неё учёные получат возможность публично высказывать независимое мнение, и OpenAI не сможет влиять на состав совета. С другой стороны, у экспертов не будет возможности оказывать влияние на скорость или направление текущих математических исследований OpenAI. Последний аспект подчеркнули и сами учёные. «Мы будем давать советы, но у нас нет полномочий принимать решения ни в одной занимающейся ИИ компании, и ответственность за принимаемые любой компанией решения будет лежать на этой компании», — говорится в пресс-релизе Института перспективных исследований. OpenAI призвала к созданию международных стандартов, регулирующих безопасность ИИ
22.09.2026 [08:22],
Алексей Разин
Представители крупных американских ИИ-стартапов на этой неделе перешли от призывов замедлить развитие профильных технологий ради общественной безопасности к предложениям по эффективному регулированию отрасли. OpenAI не стала мелочиться, и сразу предложила меры, которые следует принять в мировом масштабе. По мнению разработчиков ChatGPT, назрела необходимость принятия международных стандартов в области безопасности ИИ. 
Источник изображения: Unsplash, Olumide Adekunle OpenAI призвала власти США возглавить международную коалицию, которая помогла бы установить требования к безопасности ИИ на мировом уровне. Призывы прозвучали из уст руководства стартапа за несколько дней до выступления генерального директора Сэма Альтмана (Sam Altman) в Совете безопасности ООН в среду и его присутствия на встрече американского президента Дональда Трампа (Donald Trump) с китайским коллегой Си Цзиньпином (Xi Jinping) в грядущий четверг. Министр финансов США Скотт Бессент (Scott Bessent) в минувшее воскресенье заявил, что по итогам встречи с китайским вице-премьером Хэ Лифэном (He Lifeng) сторонам удалось достичь согласия о необходимости ведения диалога в сфере ИИ. Это позволяет рассчитывать на продолжение переговоров на высшем уровне при встрече американского и китайского лидеров в этот четверг в США. OpenAI считает необходимым наладить безопасные каналы обмена информацией между США и КНР, по которым можно было бы сообщать друг другу о выявленных угрозах в сфере безопасности ИИ: «Диалог между США и Китаем по безопасности ИИ был бы положительным шагом». Стартап также предлагает создать международные стандарты оценок ИИ-моделей с участием существующих организаций на национальном уровне. «Этот подход мог бы опираться на опыт авиации и системы обеспечения финансовой стабильности, где страны разработали общепринятые стандарты и доверенные каналы обмена информацией для сотрудничества без угрозы для государственного суверенитета», — отмечается в заявлении OpenAI. В компании считают особенно важным регулирование ИИ-систем, обладающих возможностью рекурсивного самосовершенствования (RSI), поскольку без разумных ограничений человечество очень быстро потеряет контроль над их развитием. Прогресс в этой сфере должен учитывать общечеловеческие ценности и оставаться под контролем людей, по мнению представителей OpenAI. По их словам, полностью автономных RSI-систем сейчас не существует, и они не должны появиться прежде, чем станет понятно, что они безопасны. Если не позаботиться об этом, то последствия саморазвития ИИ-систем могут иметь куда более серьёзные последствия, чем получивший огласку инцидент со взломом инфраструктуры Hugging Face вышедшими из-под контроля ИИ-моделями. Следует учитывать, что власти США на данном этапе не считают целесообразным не только замедлять развитие ИИ, но и усиливать роль государства в этой сфере. Трамп дал понять, что добровольное ограничение темпов развития ИИ в США в конечном итоге приведёт к победе Китая в этой гонке, а он этого допустить не намерен. Советник Трампа Дэвид Сакс (David Sacks) недавно заявил: «Самый простой способ не создать сильный искусственный интеллект — это договориться об этом. Требование же создания предпочтительной регуляторной базы, как платы за это, в этой ситуации будет напоминать шантаж общества и политической системы». Глава и сооснователь Google DeepMind Демис Хассабис (Demis Hassabis) также поддержал идею создания международных стандартов по передовым ИИ-моделям под руководством США. Он предложил учредить некий частно-государственный орган, типа имеющихся в финансовой системе, в правлении которого присутствовали бы не только ведущие технические эксперты, но и представители сообщества сторонников ПО с открытым исходным кодом. По его словам, создание такого регулирующего органа необходимо, поскольку технологии ИИ окажут в десять раз более сильное влияние на человечество, чем промышленная революция, а соответствующие изменения будут происходить в десять раз быстрее. Конкурирующая Anthropic, как известно, предлагает не только замедлить развитие ИИ на добровольной основе, но и ввести элементы внешнего аудита по безопасности создаваемых моделей во всех ведущих компаниях сегмента. Сама она уже начала предпринимать соответствующие меры предосторожности. Исследователь OpenAI предупредил: ИИ-агенты способны общаться даже на отключённых от Сети компьютерах
19.09.2026 [17:04],
Владимир Мироненко
Исследователь OpenAI Ноам Браун (Noam Brown), обсуждая майский инцидент, в ходе которого экспериментальные ИИ-агенты компании вышли за пределы тестовой среды и получили доступ к ресурсам Hugging Face, назвал одну из причин, по которой их действия не были остановлены вовремя. Браун также предупредил, что даже физическая изоляция компьютеров от сетей не исключает обмена данными между ними: для этого можно использовать изменения температуры. 
Источник изображения: Growtika/unsplash.com Браун пояснил, что для моделей, которые вышли из-под контроля и взломали сторонние сайты и платформы, не была активирована функция мониторинга «цепочки рассуждений» (chain-of-thought monitoring), позволяющая исследователям отслеживать пошаговый ход мыслей и действий модели, изложенный на обычном языке. «Если бы для этих моделей был включен мониторинг цепочки рассуждений, процесс был бы немедленно остановлен, — заявил он. — Мы уже приняли меры: теперь мониторинг цепочки рассуждений будет обязательным для любой передовой модели — на этапах оценки, развёртывания и обучения». Что примечательно, всего за несколько месяцев до обнаружения взлома Hugging Face компания опубликовала исследование, в котором сообщалось: «Отслеживание подобных “цепочек рассуждений” (chain-of-thought) на предмет нежелательного поведения может быть гораздо эффективнее, чем мониторинг одних лишь действий и выходных данных модели». OpenAI также призвала исследователей в сфере ИИ «работать над сохранением возможности мониторинга цепочек рассуждений как можно дольше и определить, могут ли они служить ключевым уровнем контроля для будущих систем ИИ». «Так зачем же было отключать этот механизм при обучении собственных моделей?», — задаётся вопросом ресурс Gizmodo. Отдельно исследователь затронул вопрос о физически изолированных компьютерах, не подключённых к интернету или другим сетям. По его словам, даже такие устройства теоретически могут обмениваться информацией при помощи температурных датчиков. Один компьютер способен изменять тепловыделение процессора, а расположенный рядом — фиксировать колебания температуры и преобразовывать их в данные. Подобный способ связи описали в 2015 году исследователи из Университета имени Бен-Гуриона в Израиле. Разработанный ими метод BitWhisper позволял двум физически изолированным компьютерам обмениваться данными без сетевого подключения. Практические возможности BitWhisper, однако, были крайне ограниченными. Скорость передачи составляла от 1 до 8 бит в час, а компьютеры должны были находиться на расстоянии не более 40 см друг от друга. Кроме того, оба устройства требовалось предварительно заразить специально созданным вредоносным ПО. Данное исследование проводилось ещё до появления передовых больших языковых моделей. Вполне возможно, что современные модели способны усовершенствовать эти методы кодирования и передачи данных, используя принципиально новые подходы. Поэтому сбрасывать со счетов подобную угрозу не следует, хотя она и кажется на первый взгляд фантастической. Издание заключает, что непосредственную опасность сейчас представляют не гипотетические тепловые каналы, а выход ИИ-агентов за пределы тестовой среды. Именно поэтому разработчикам в первую очередь следует совершенствовать наблюдение за действиями и цепочками рассуждений моделей. |
|
✴ Входит в перечень общественных объединений и религиозных организаций, в отношении которых судом принято вступившее в законную силу решение о ликвидации или запрете деятельности по основаниям, предусмотренным Федеральным законом от 25.07.2002 № 114-ФЗ «О противодействии экстремистской деятельности»; |
© 1997—2026 3DNews
При цитировании документа ссылка на сайт с указанием автора обязательна. Полное заимствование документа является
нарушением
российского и международного законодательства и возможно только с согласия редакции 3DNews.



 MWC 2018
 2018
 Computex

 IFA 2018






