



 MWC 2018
 2018
 Computex

 IFA 2018



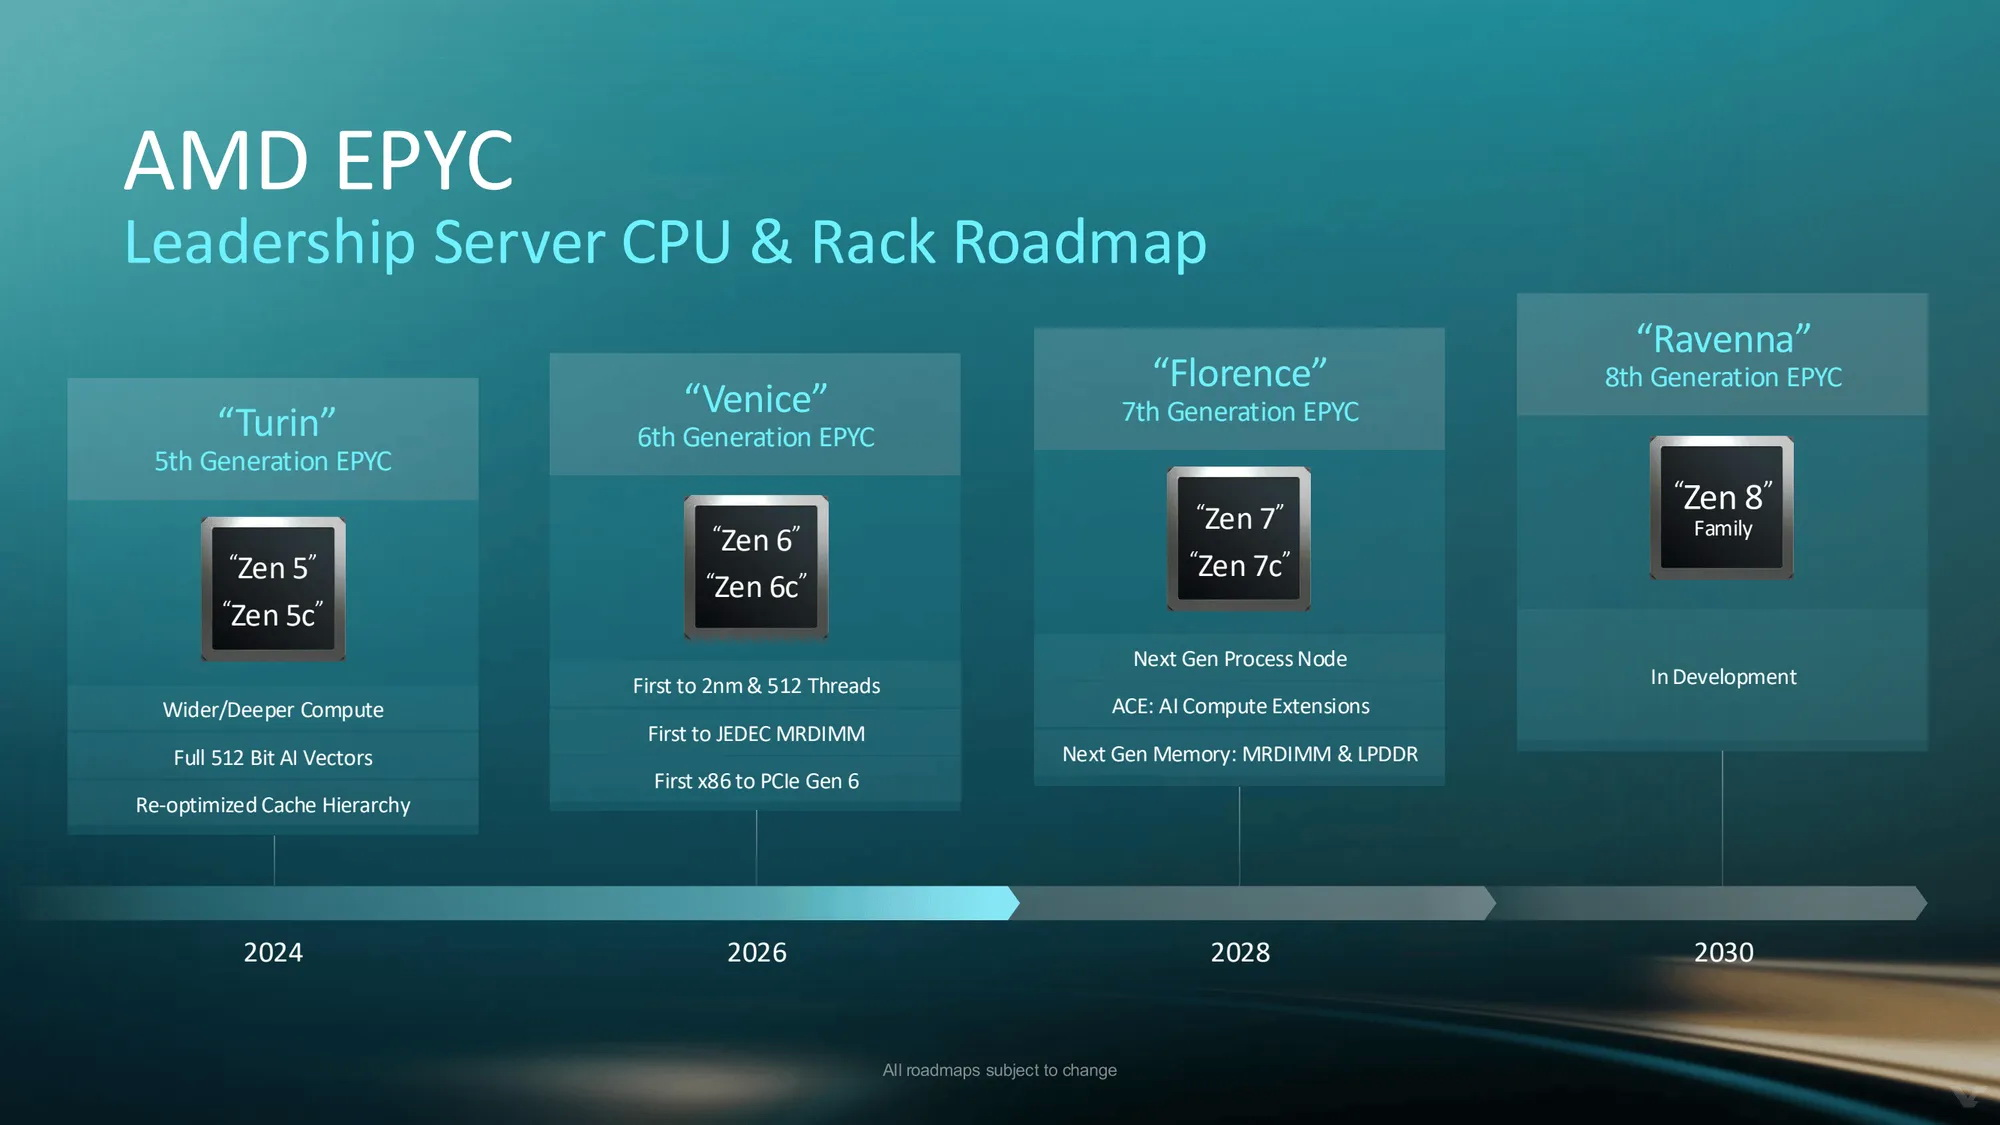
AMD раскрыла дополнительные технические подробности об архитектурах Zen 6 и Zen 6c, которые лежат в основе процессоров EPYC 9006 Venice шестого поколения. Новые процессоры призваны составить конкуренцию чипам Nvidia Vera и Intel Granite Rapids-AP. Портал Tom’s Hardware провёл первые независимые тесты новых процессоров.









Источник изображений: AMD
Для производства вычислительных кристаллов (CCD) на архитектурах Zen 6 и Zen 6c используется передовой 2-нм техпроцесс TSMC N2P. По сравнению с N3E (применявшимся в Zen 5) он обеспечивает либо прирост частоты на 18 % при том же энергопотреблении, либо снижение энергопотребления на 36 % при аналогичной скорости.
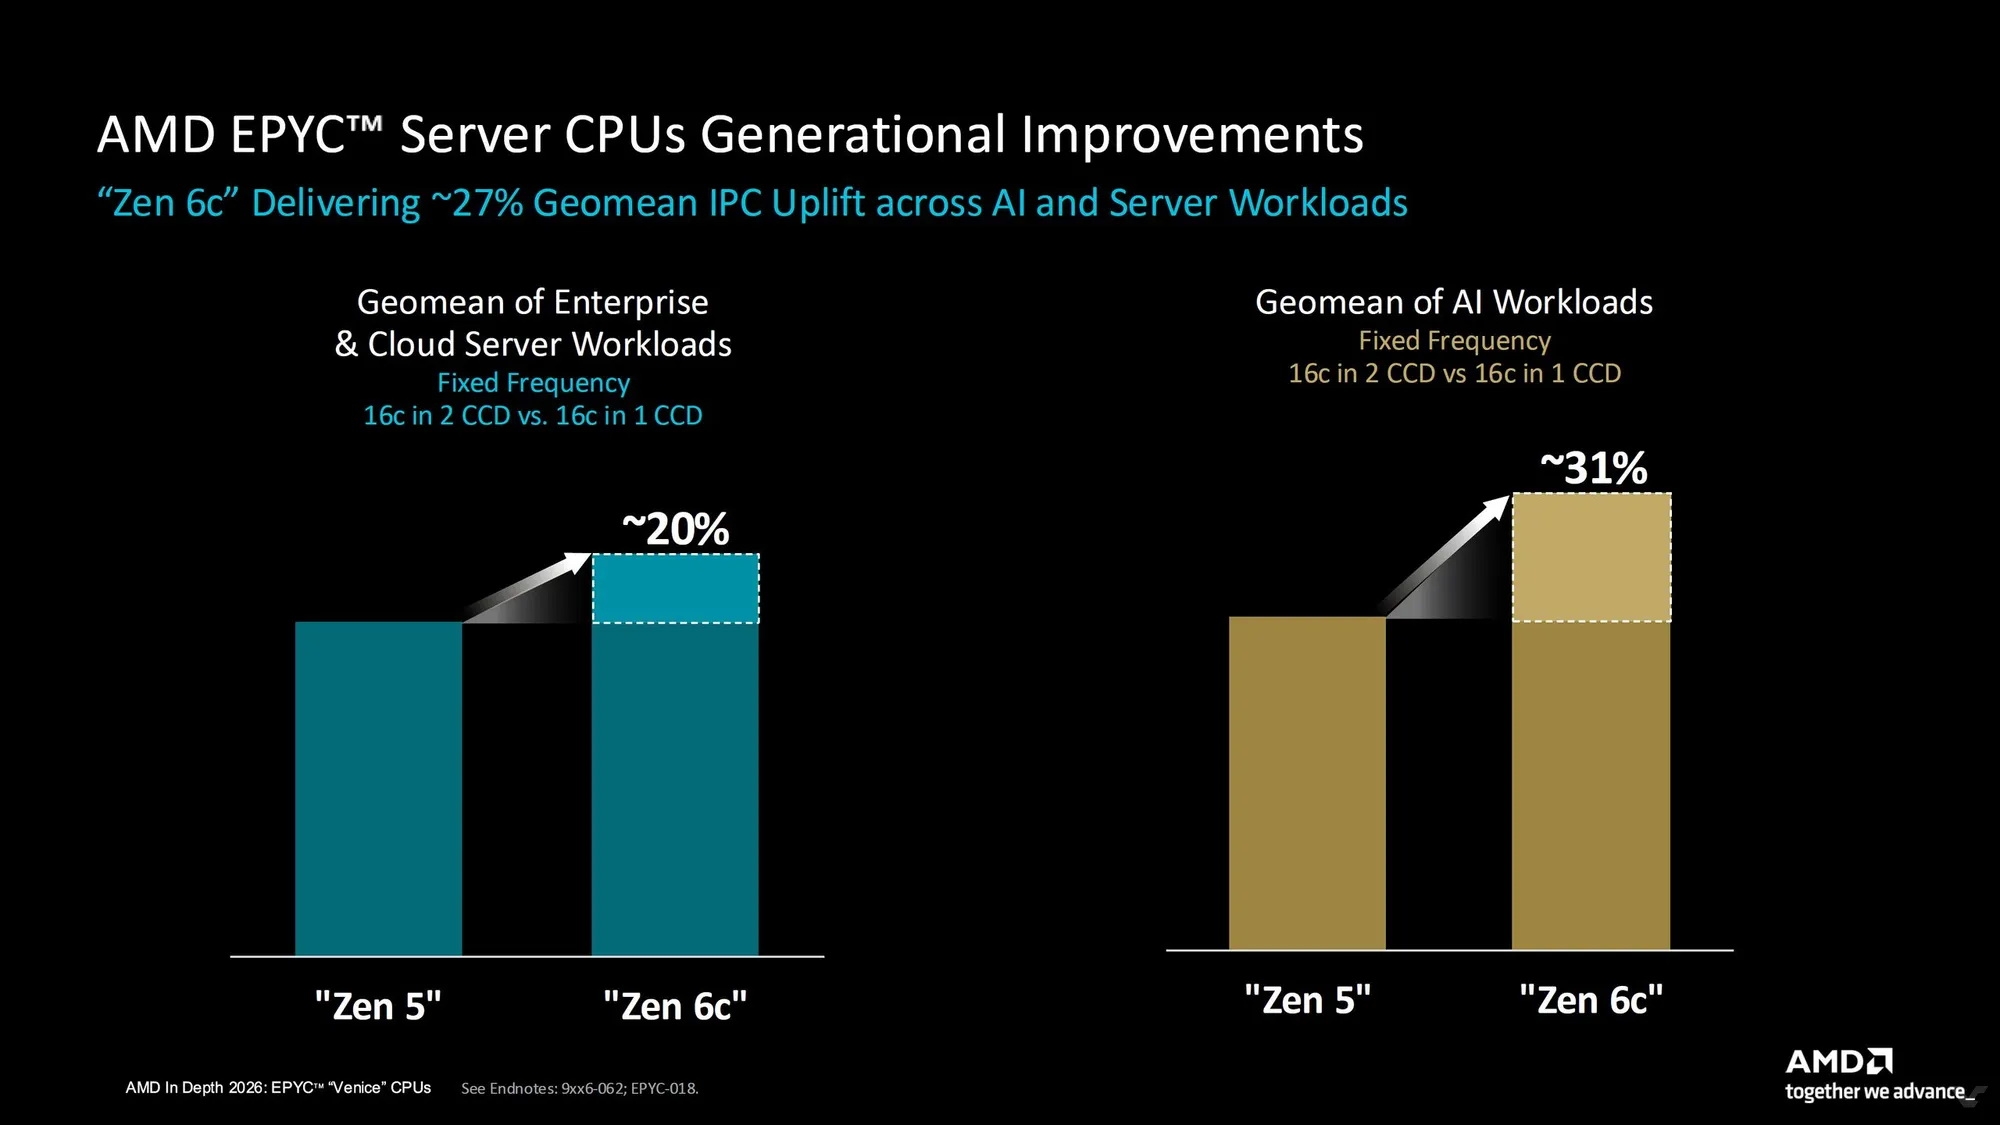
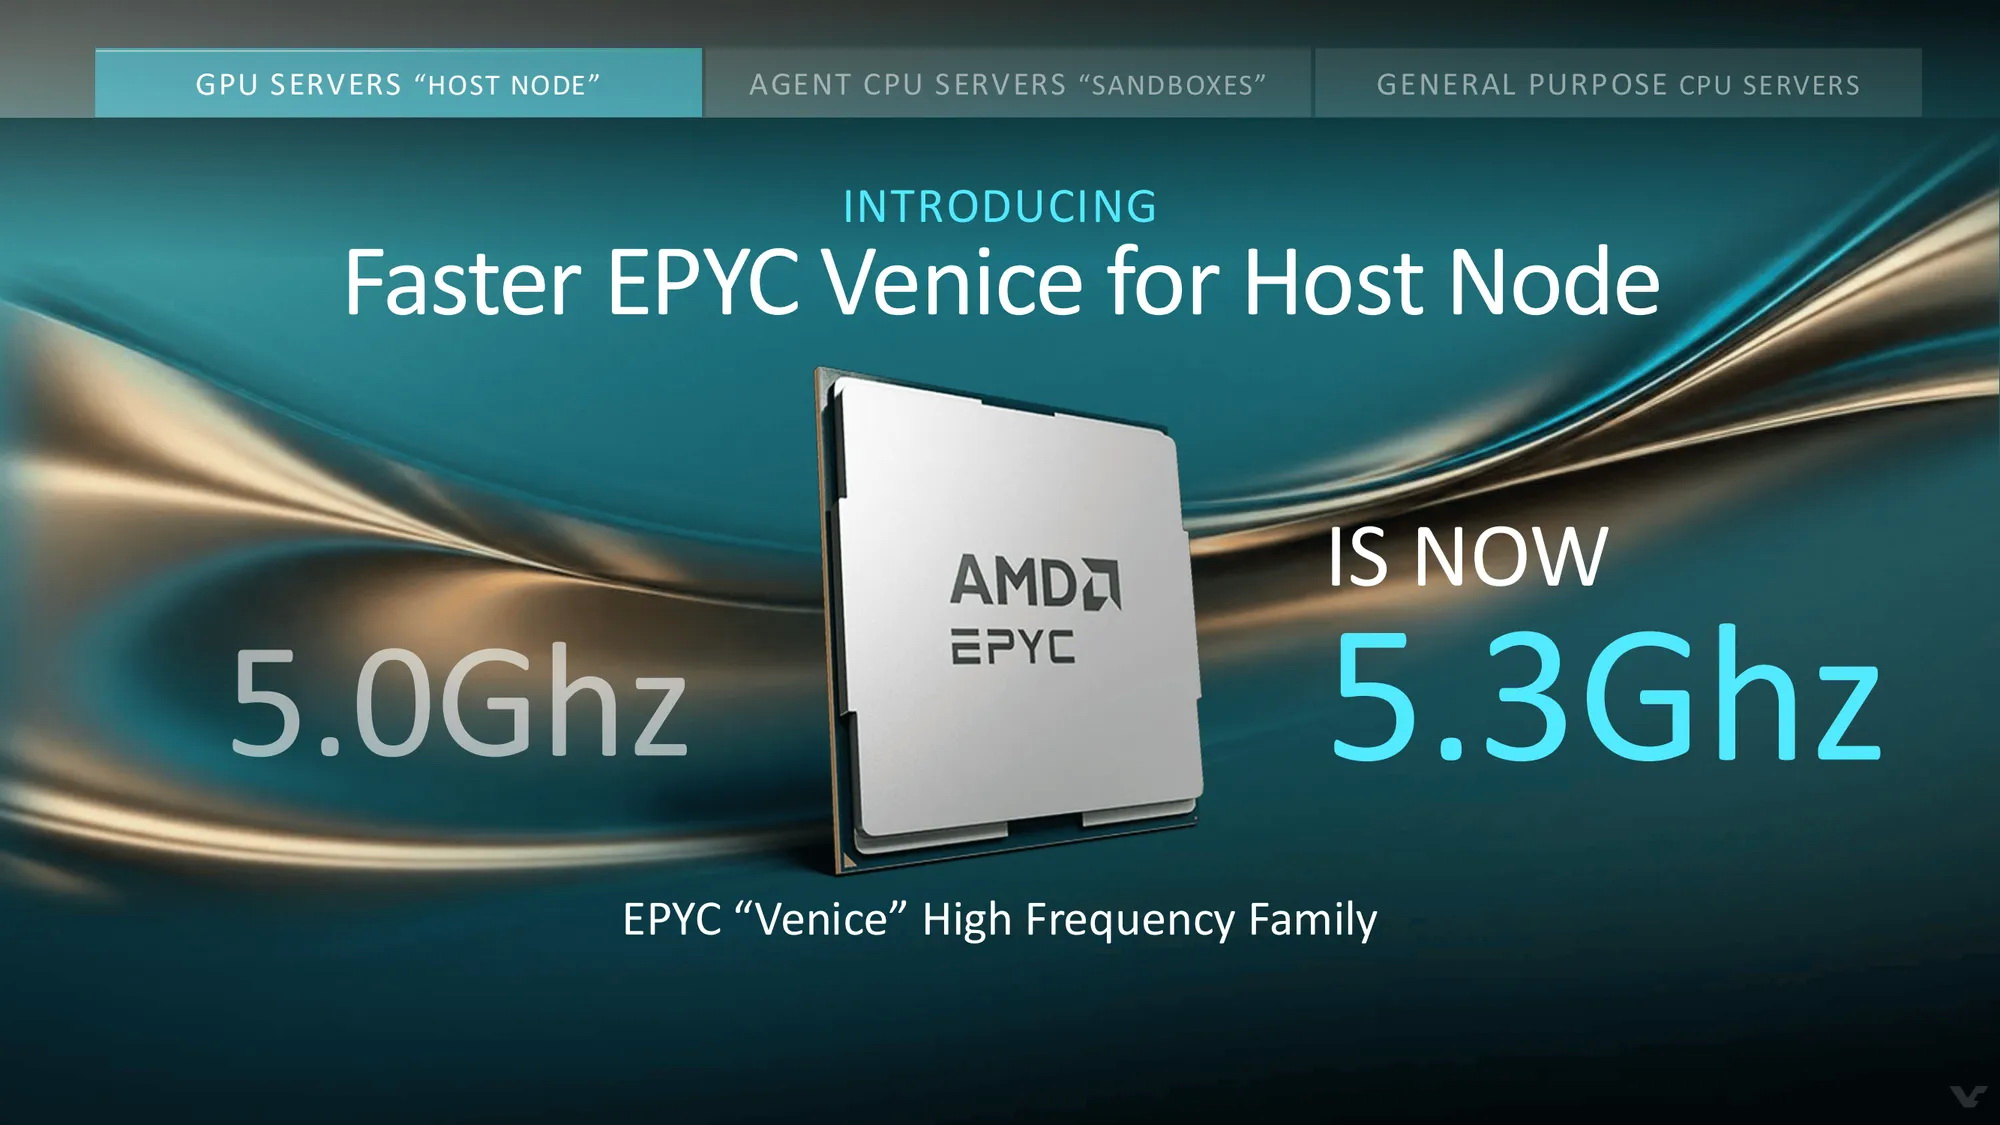
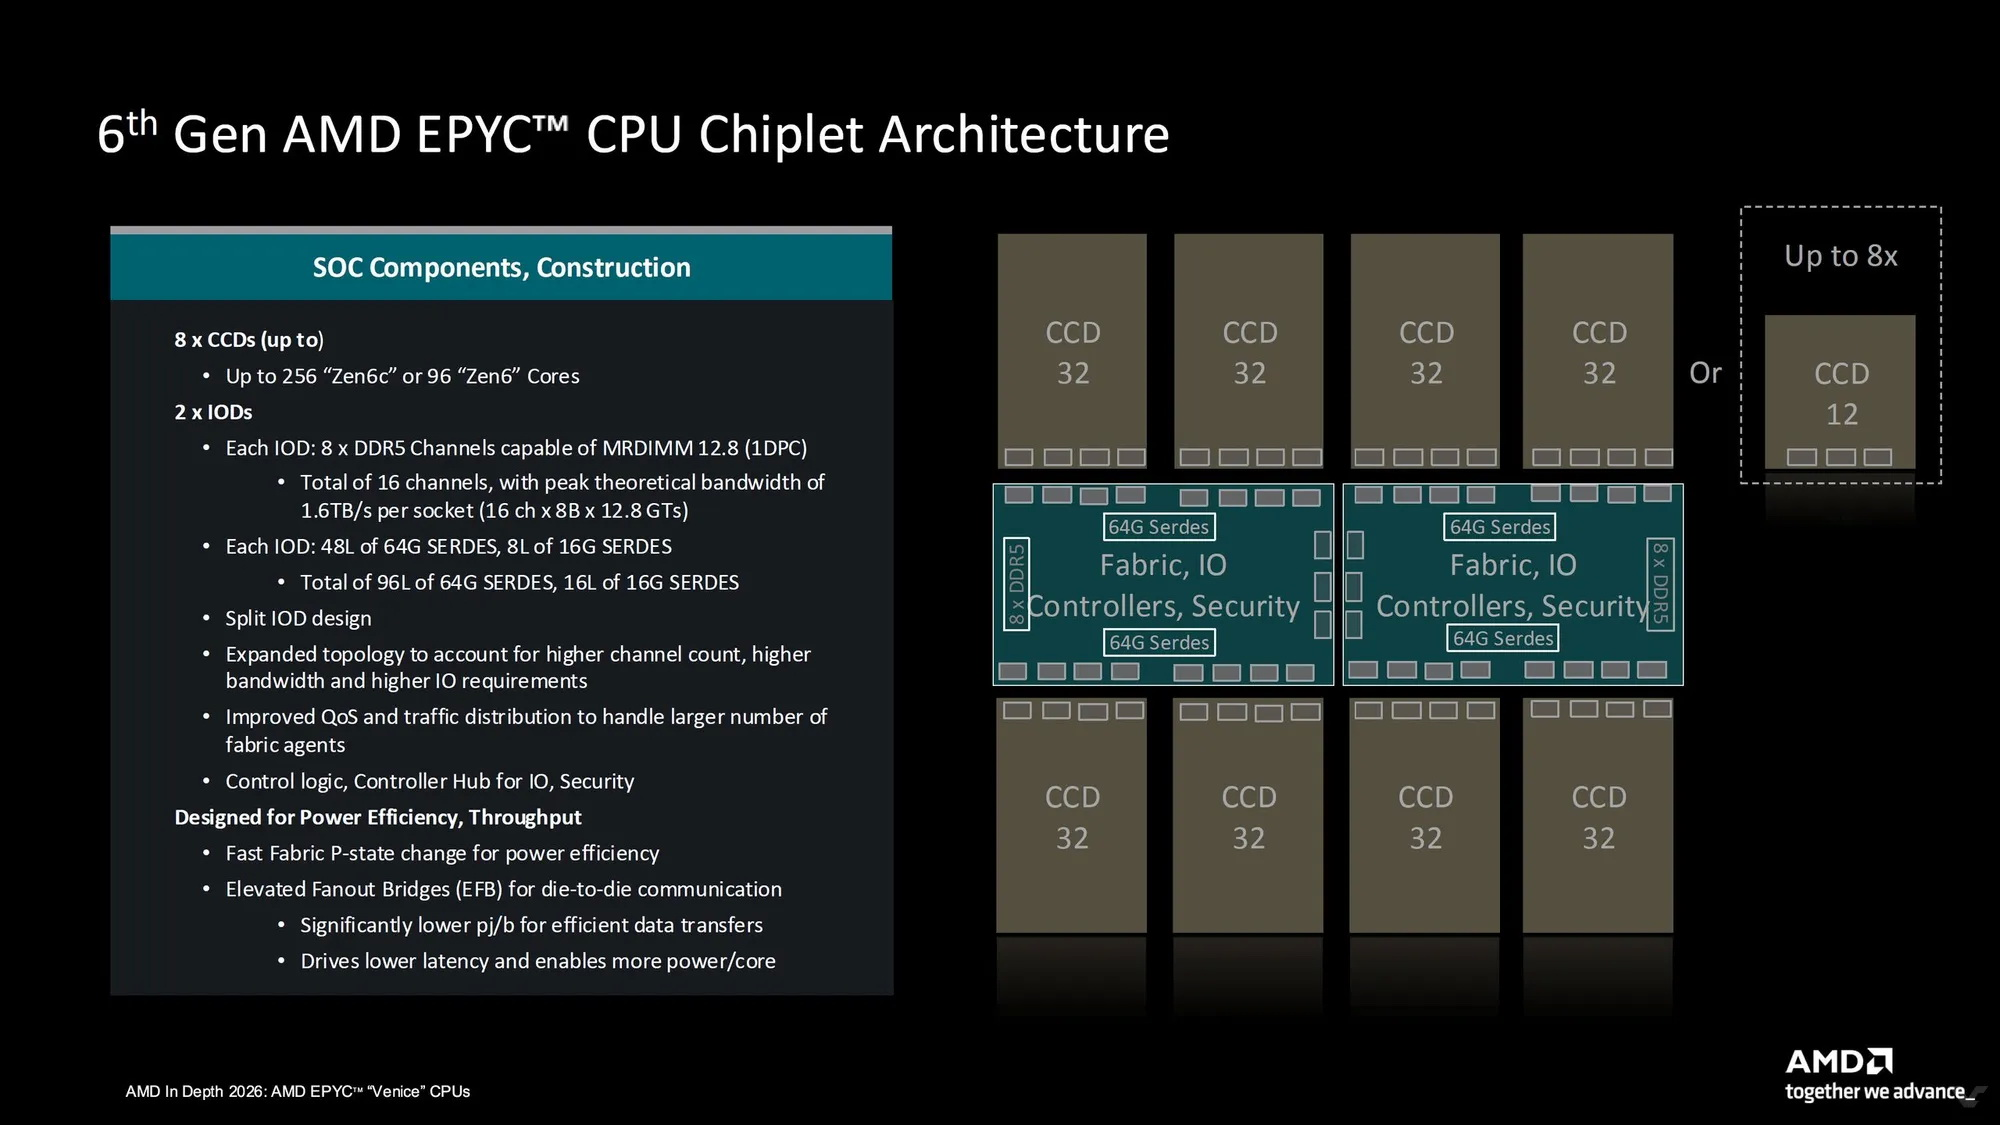
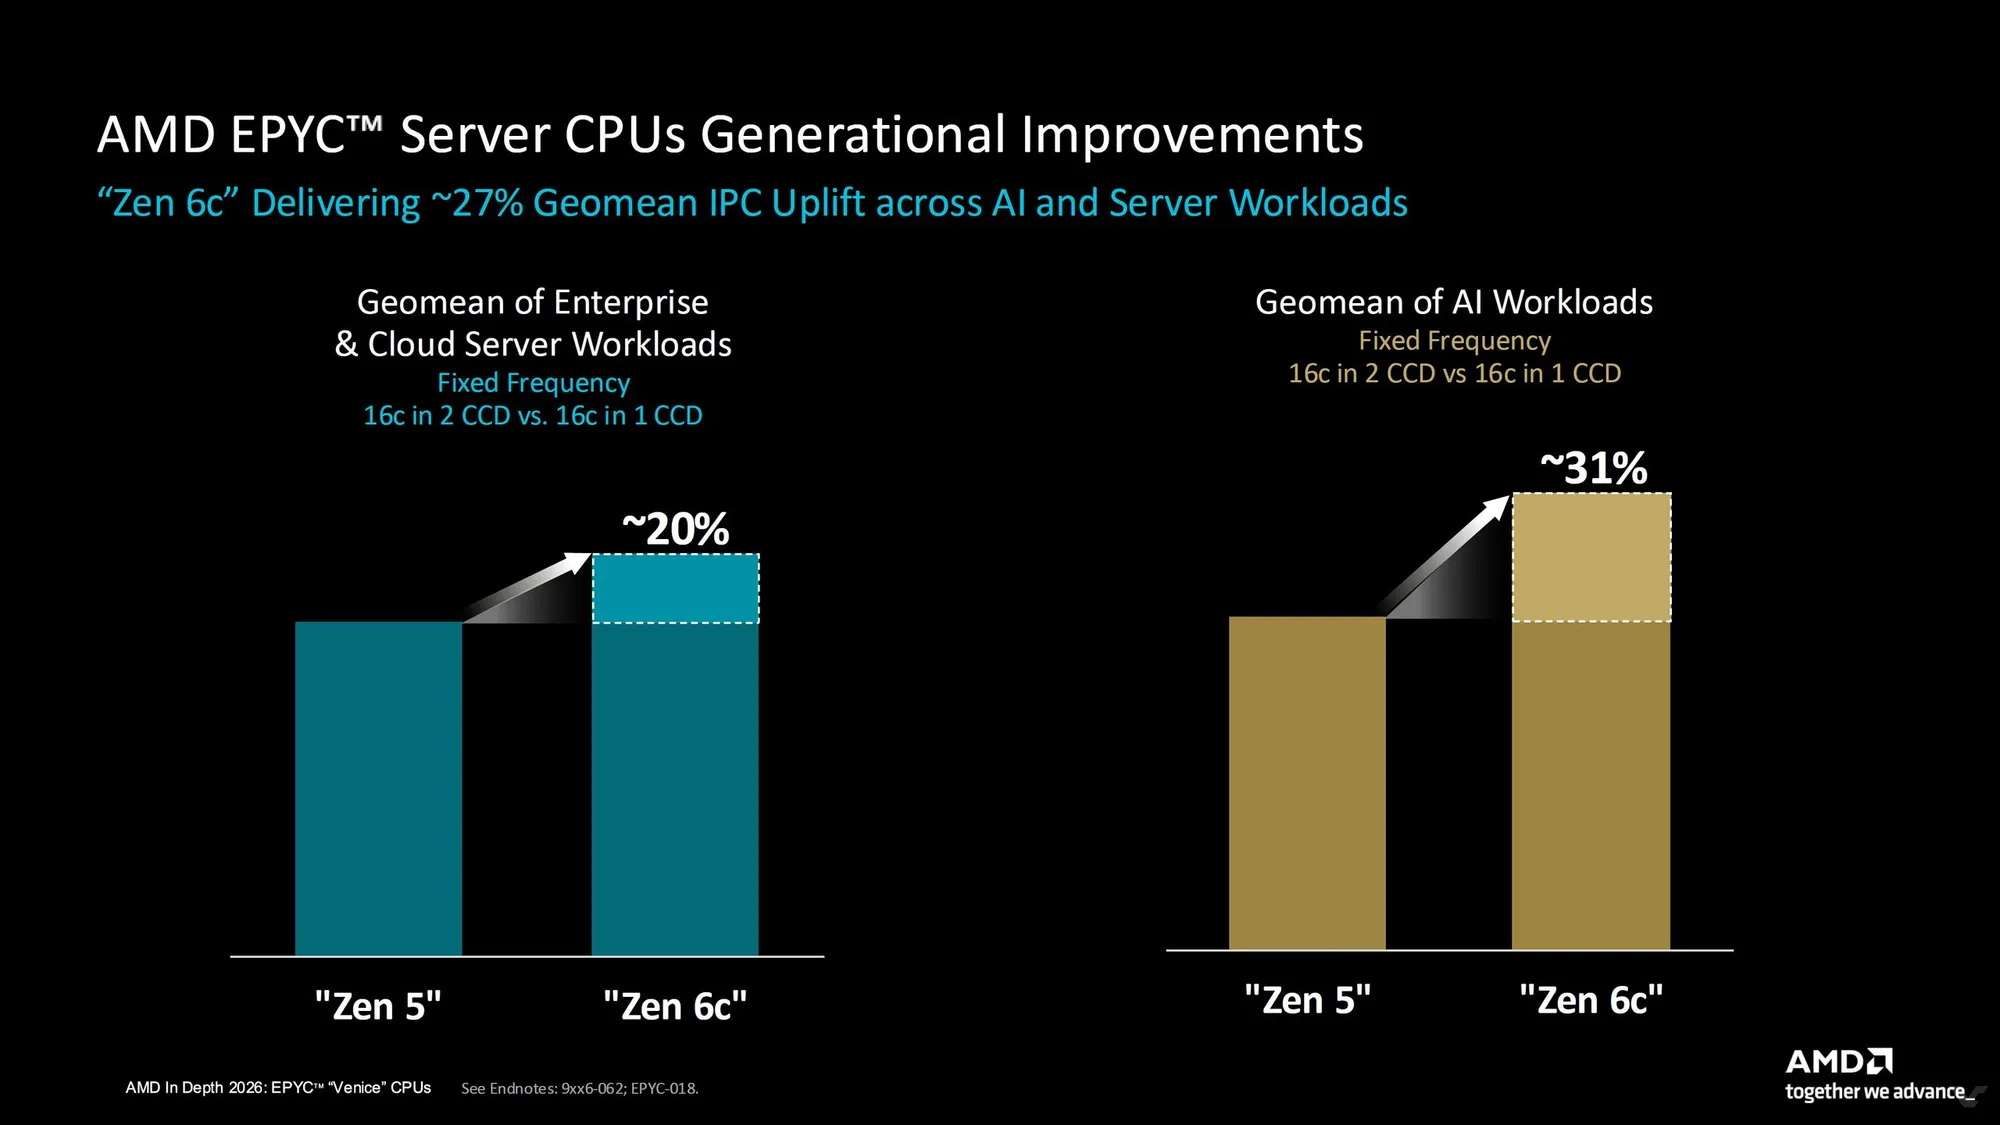
Конструкция Zen 6 позволила увеличить количество ядер на одном кристалле на 50 %. Стандартный CCD Zen 6 теперь вмещает до 12 ядер (48 Мбайт кеша L3). При этом, несмотря на увеличение количества ядер до 12 на CCD, инженерам AMD удалось сохранить задержку обращения к кешу L3 на прежнем уровне — всего 13 тактов, как и в Zen 5. Внедрение изменений позволило заявить о росте среднегеометрического показателя IPC (числа инструкций, выполняемых за такт) в задачах ИИ и серверных нагрузках сразу на 27 %. Максимальная частота процессоров Zen 6 выросла до 5,3 ГГц (против 5,0 ГГц у Zen 5).
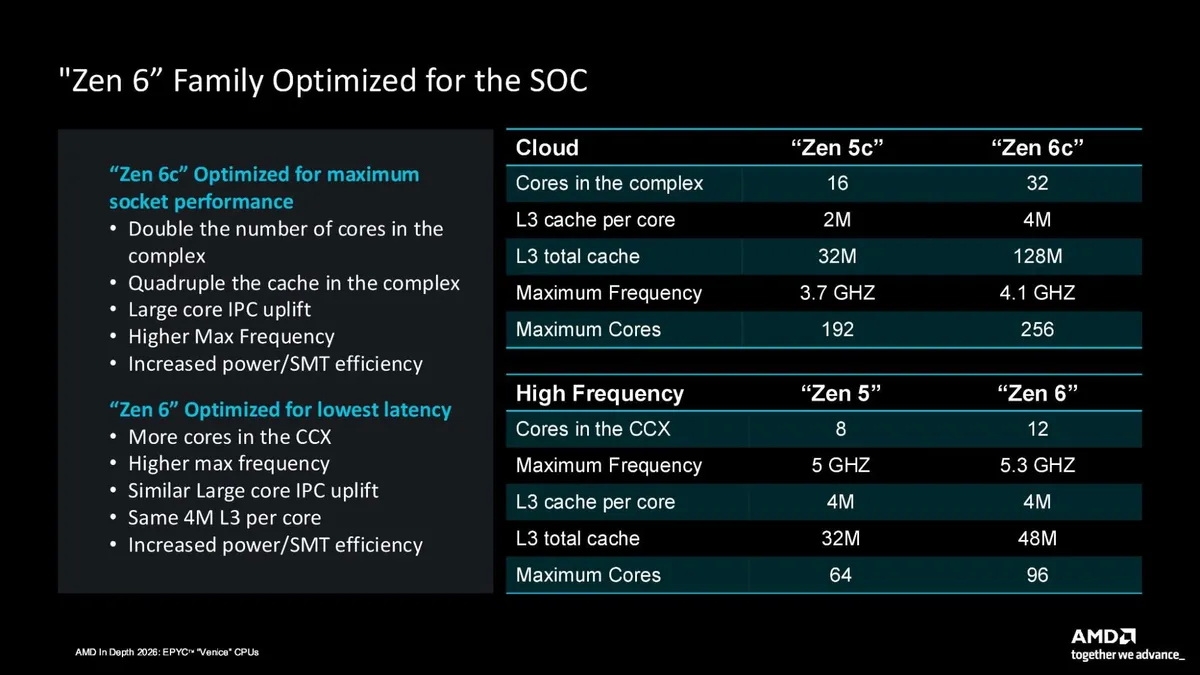
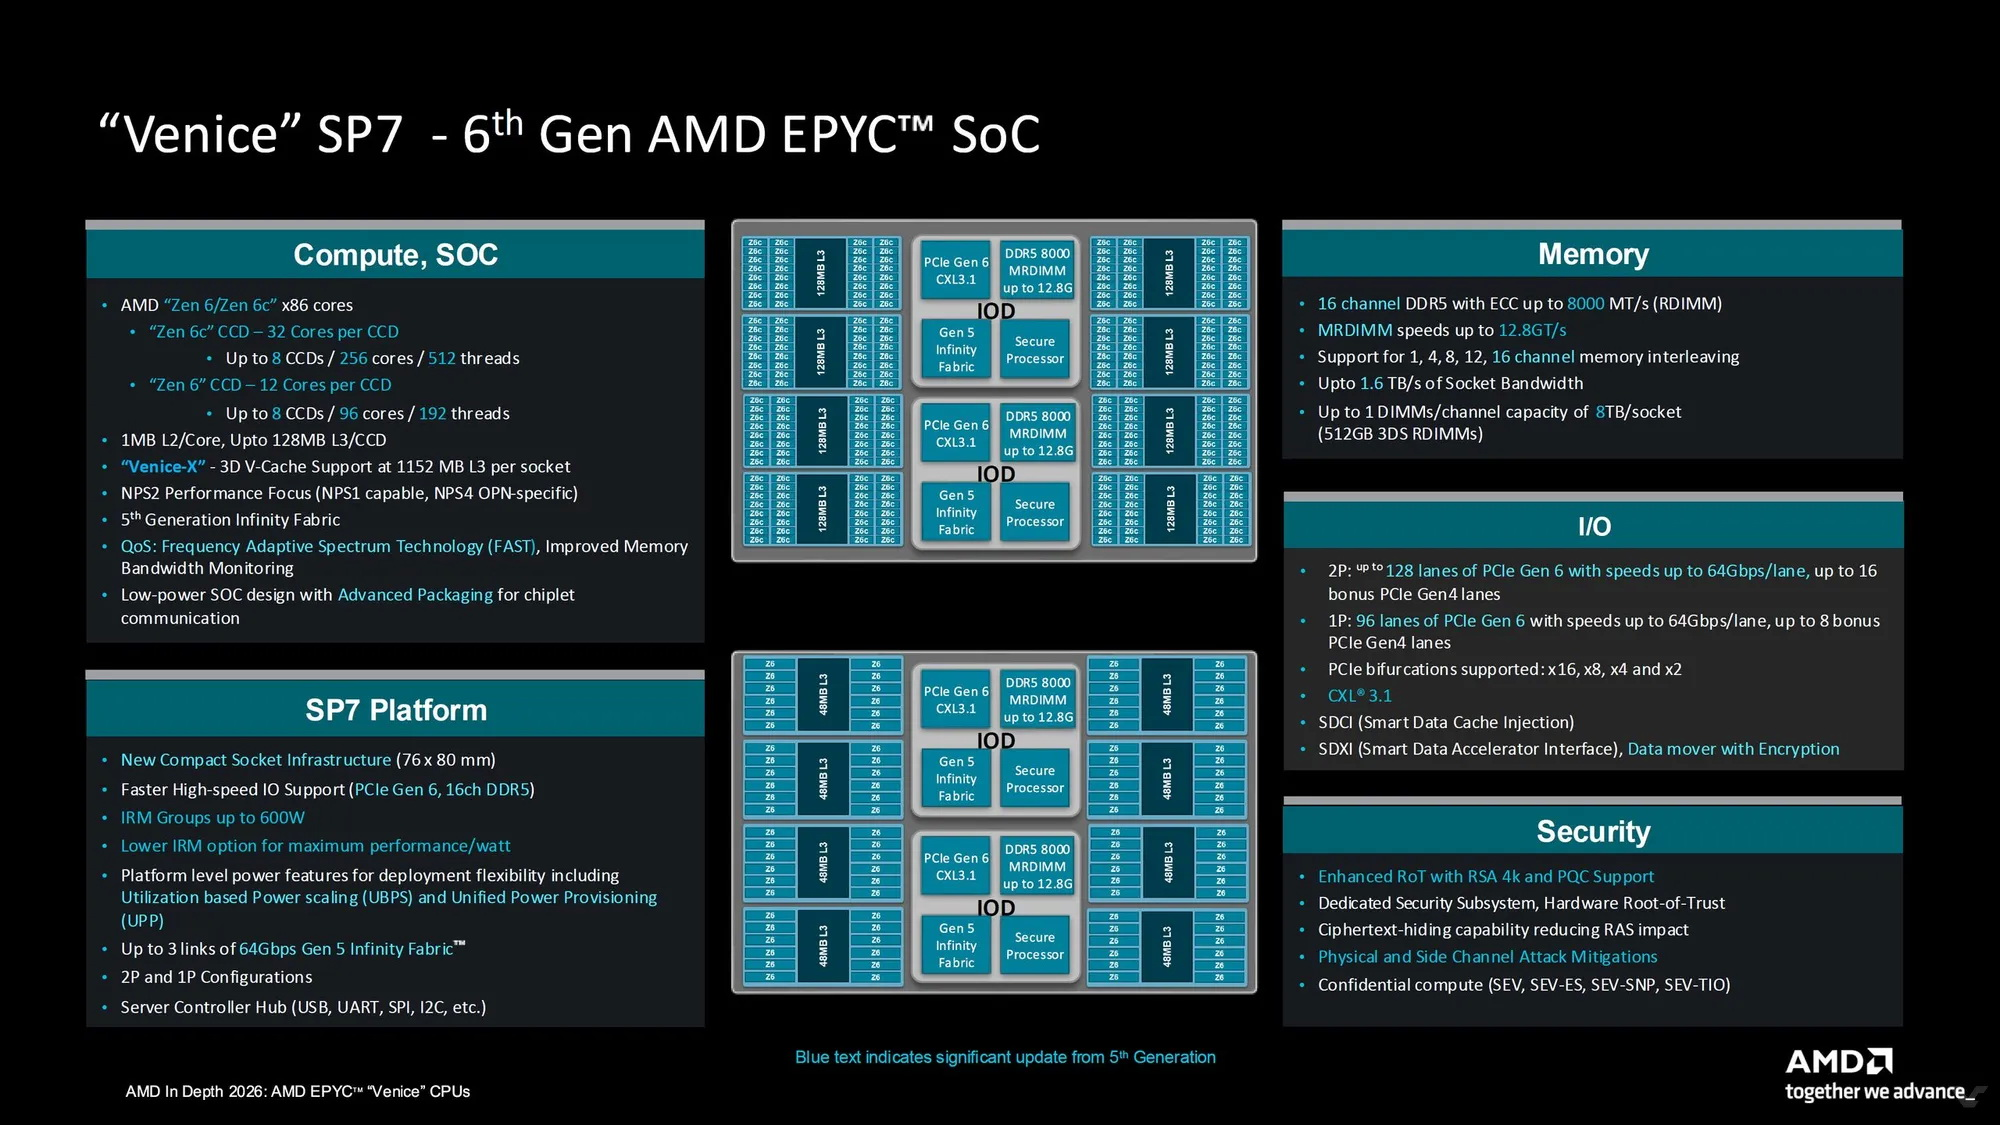
Для чиплетов на базе энергоэффективных ядер Zen 6c заявляется самый большой скачок плотности. Теперь один такой кристалл вмещает до 32 ядер (вдвое больше, чем в Zen 5c). AMD увеличила объём кеша L3 на ядро в Zen 6c в два раза (до 4 Мбайт), из-за чего общий объём кеша на чиплет вырос в четыре раза — до 128 Мбайт, а максимальная тактовая частота поднялась до 4,1 ГГц (против 3,7 ГГц у Zen 5c). Важно отметить, что Zen 6 и Zen 6c используют абсолютно одну и ту же микроархитектуру внутри ядра. В отличие от E-ядер Intel, которые базируются на отдельной архитектуре и лишены поддержки многих инструкций P-ядер, Zen 6c представляет собой просто оптимизированный по площади дизайн стандартного ядра с меньшим энергопотреблением и более низкими частотами.
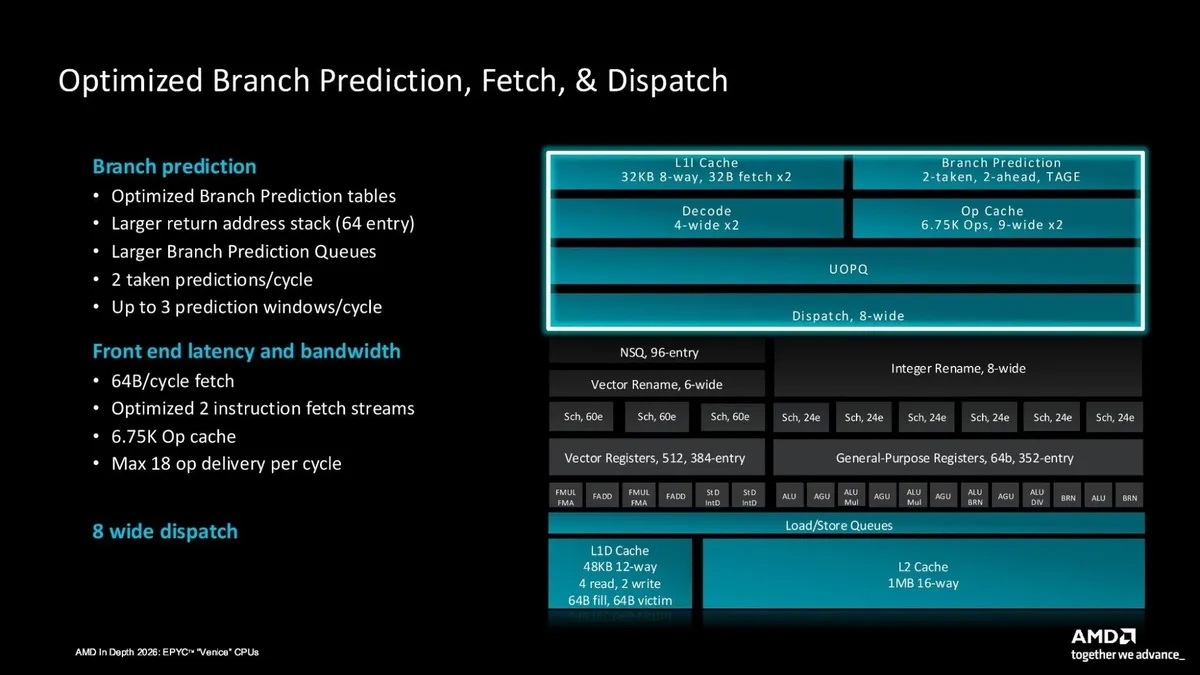
В рамках новых архитектур Zen 6 и Zen 6c внедрены раздельные планировщики целочисленных вычислений (Integer Schedulers) и расширен физический регистровый файл до 352 записей. Блок векторных вычислений получил нативную поддержку инструкций половинной точности FP16 при сохранении полной обратной совместимости с AVX-512, а пропускная способность загрузки FP-данных выросла до двух 512-битных или четырёх 256-битных загрузок за такт. Кеш операций увеличился с 6 тыс. до 6,75 тыс. записей, а пропускная способность подачи выросла с 12 до 18 операций за такт.
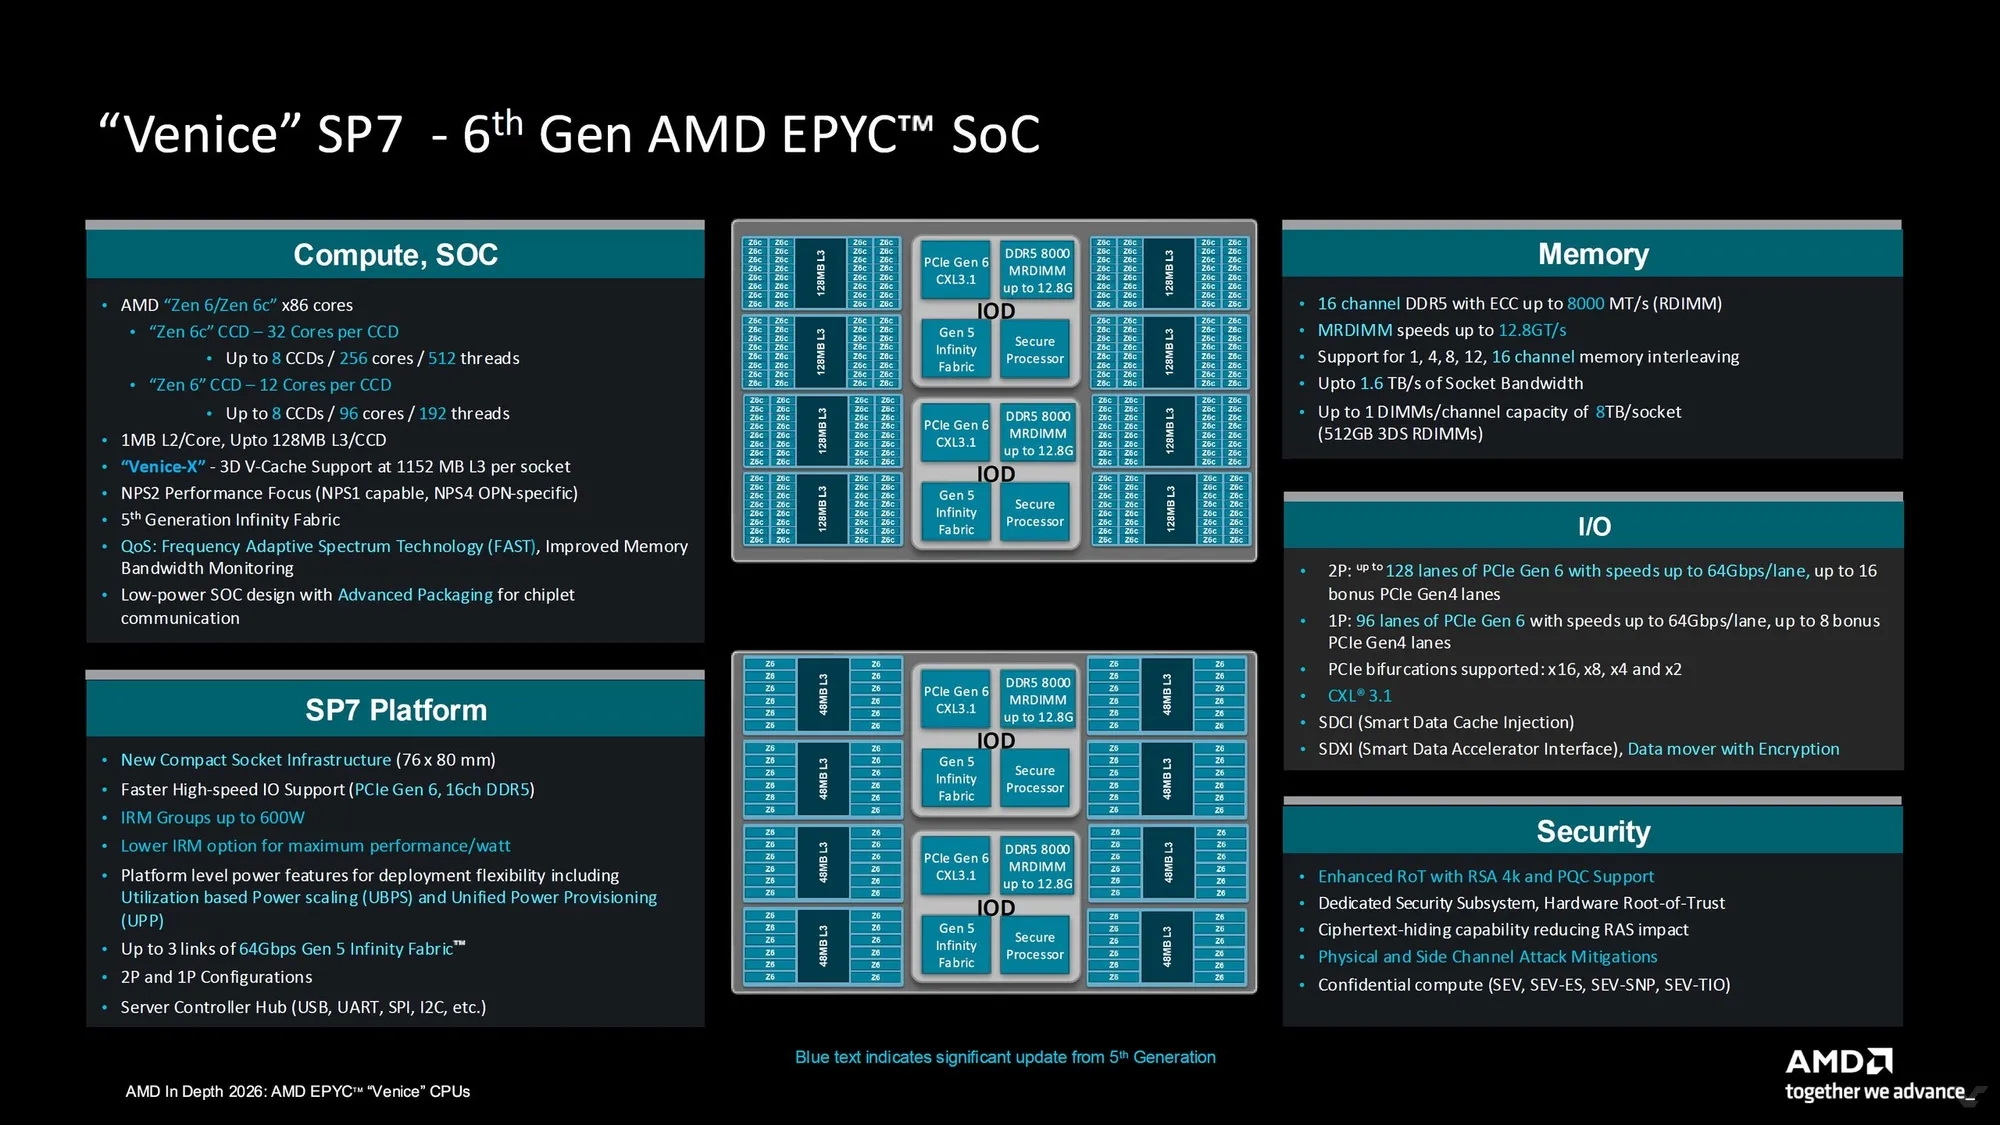
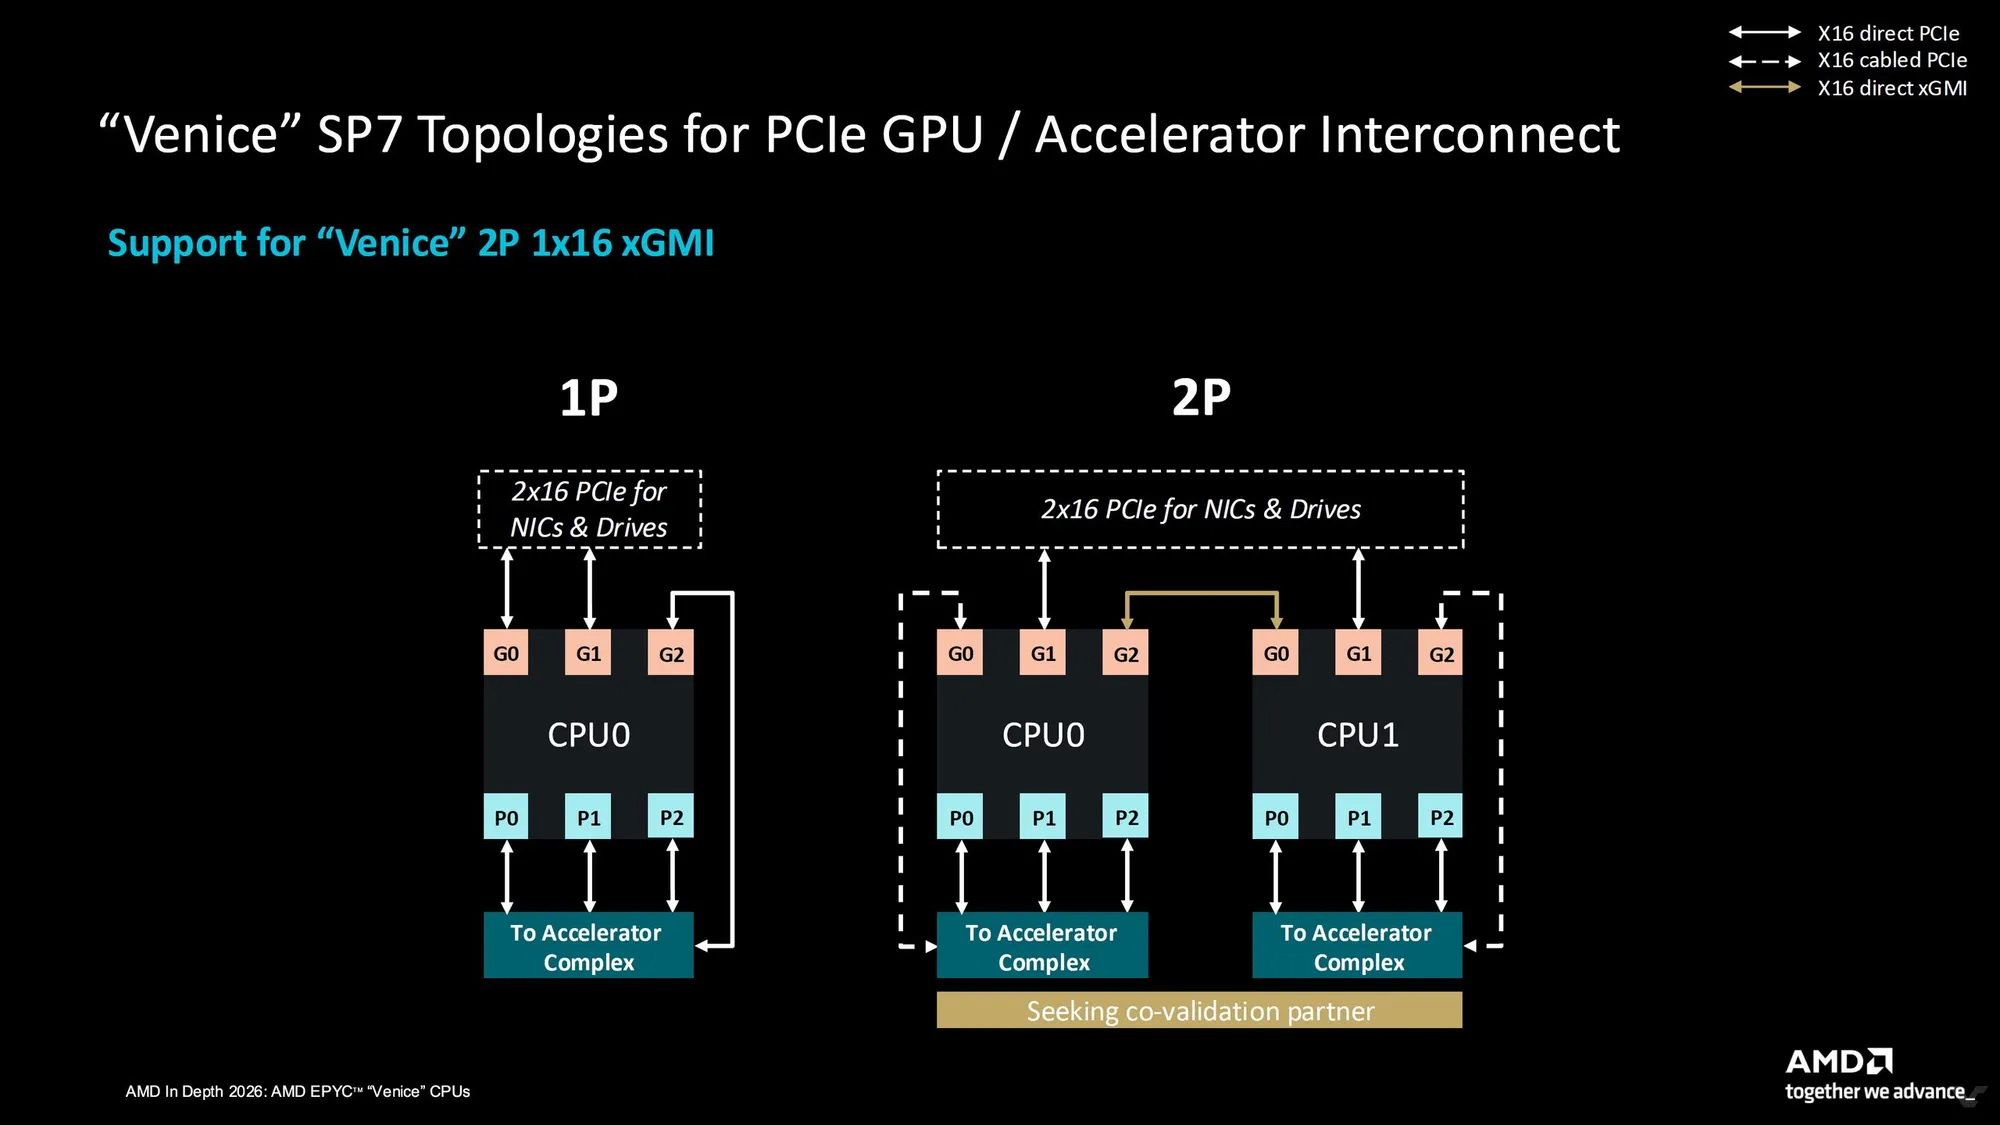
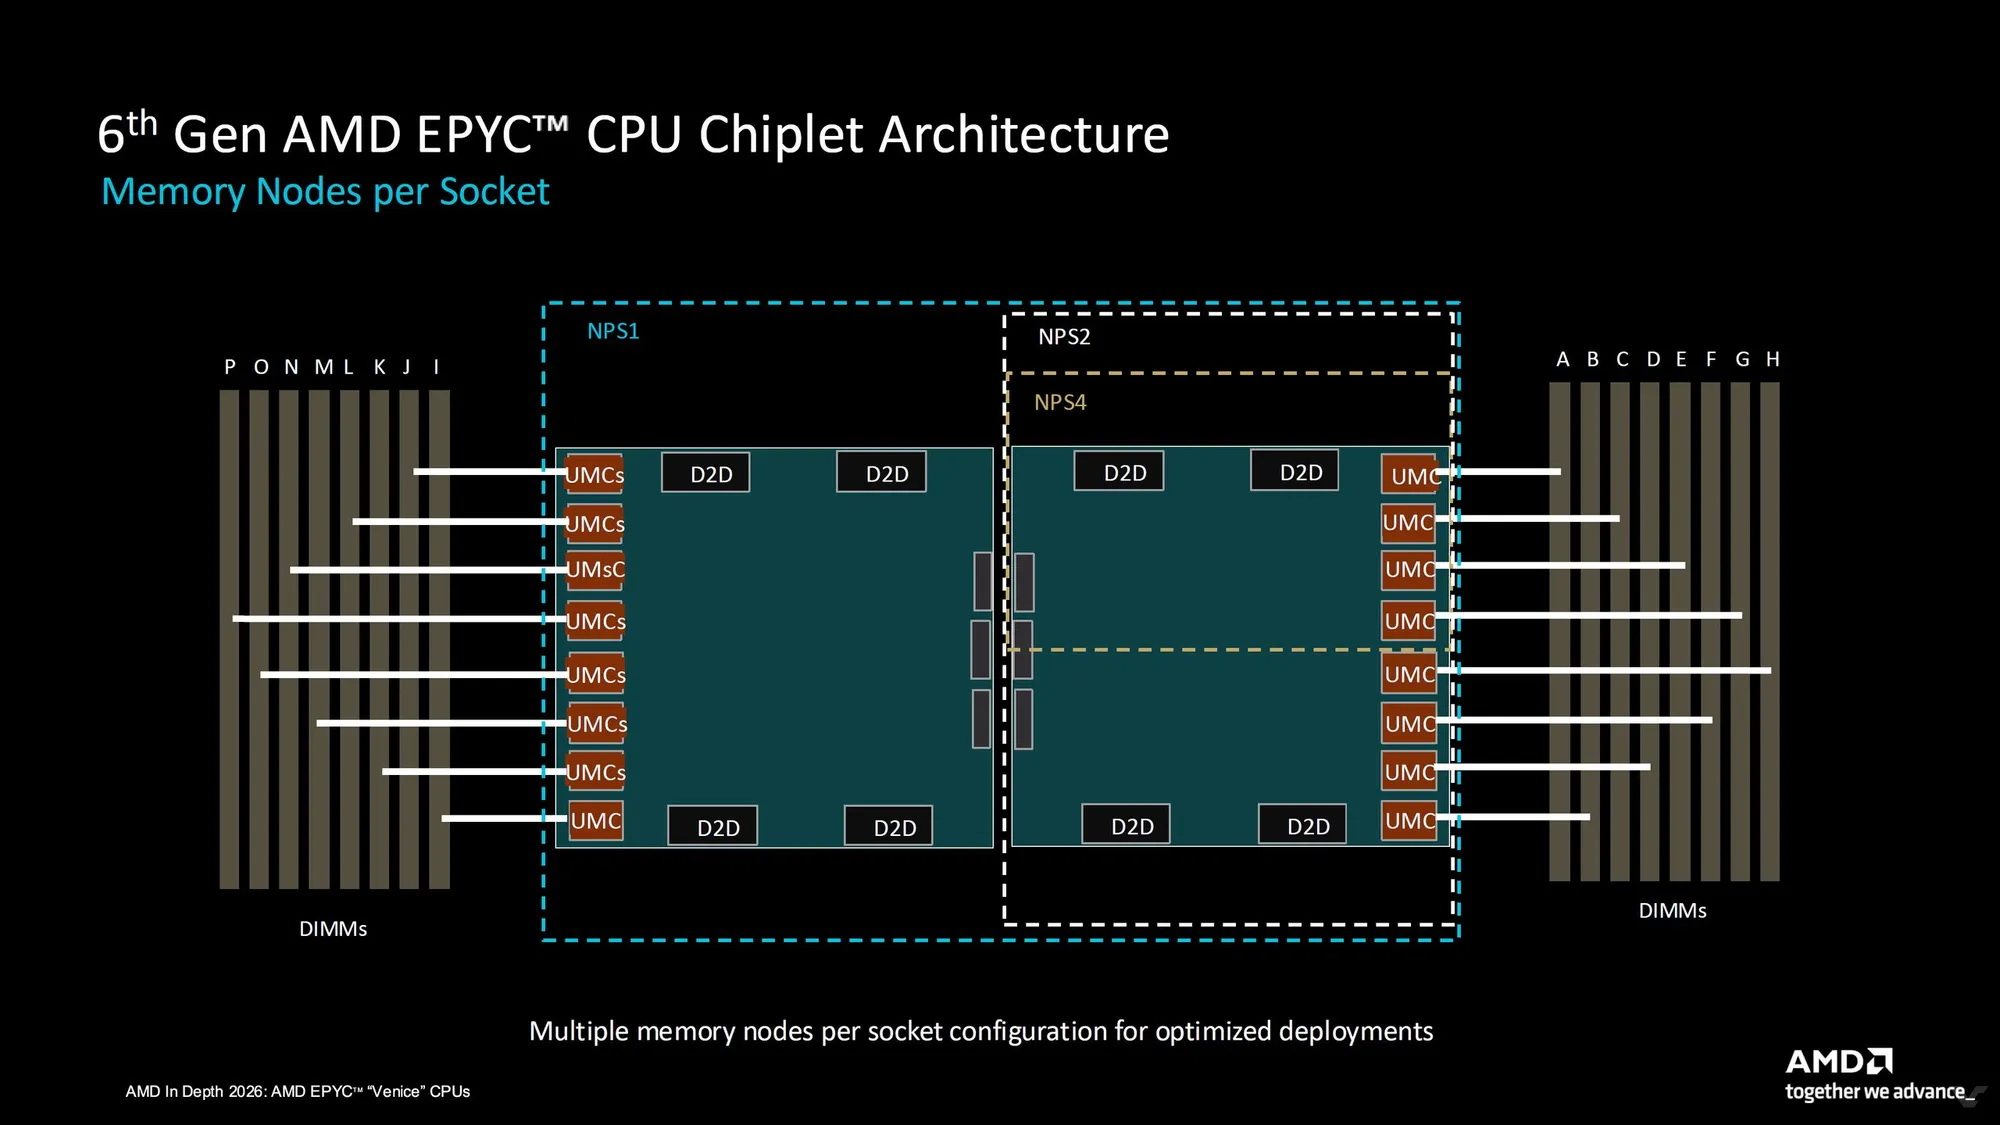
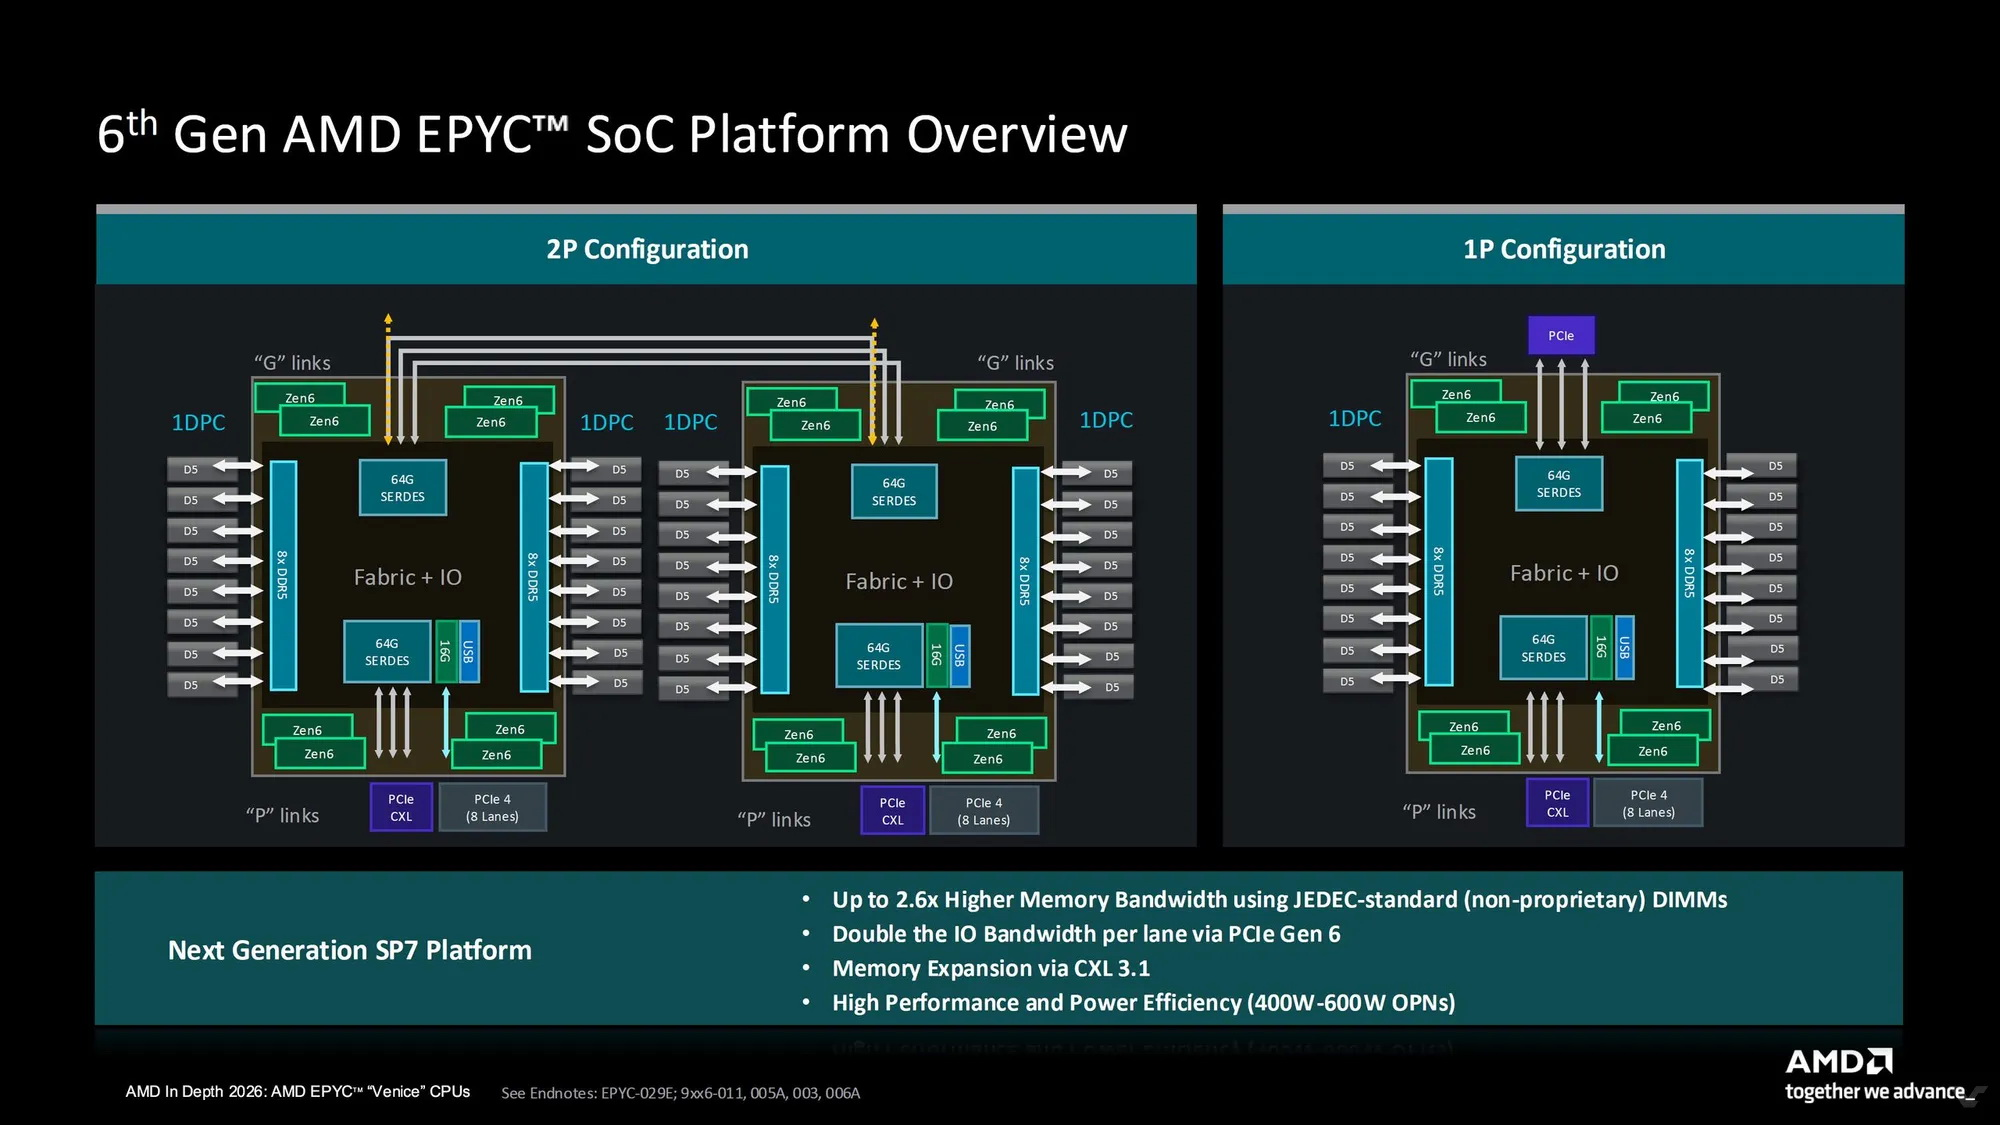
Серверные процессоры Zen 6 для разъёма SP7 характеризуются наличием двух кристаллов ввода-вывода (IOD) вместо одного, расположенных в центре чипа, что позволило реализовать поддержку 16-канальной оперативной памяти. Заявлена работа с модулями памяти MRDIMM в конфигурации 1DPC со скоростью передачи данных до 12 800 МТ/с (с модулями RDIMM поддерживается скорость до 8000 МТ/с), что обеспечивает пиковую пропускную способность до 1,6 Тбайт/с на один сокет (до 1 Тбайт/с при использовании RDIMM). Платформа поддерживает установку до 8 Тбайт памяти на один сокет.
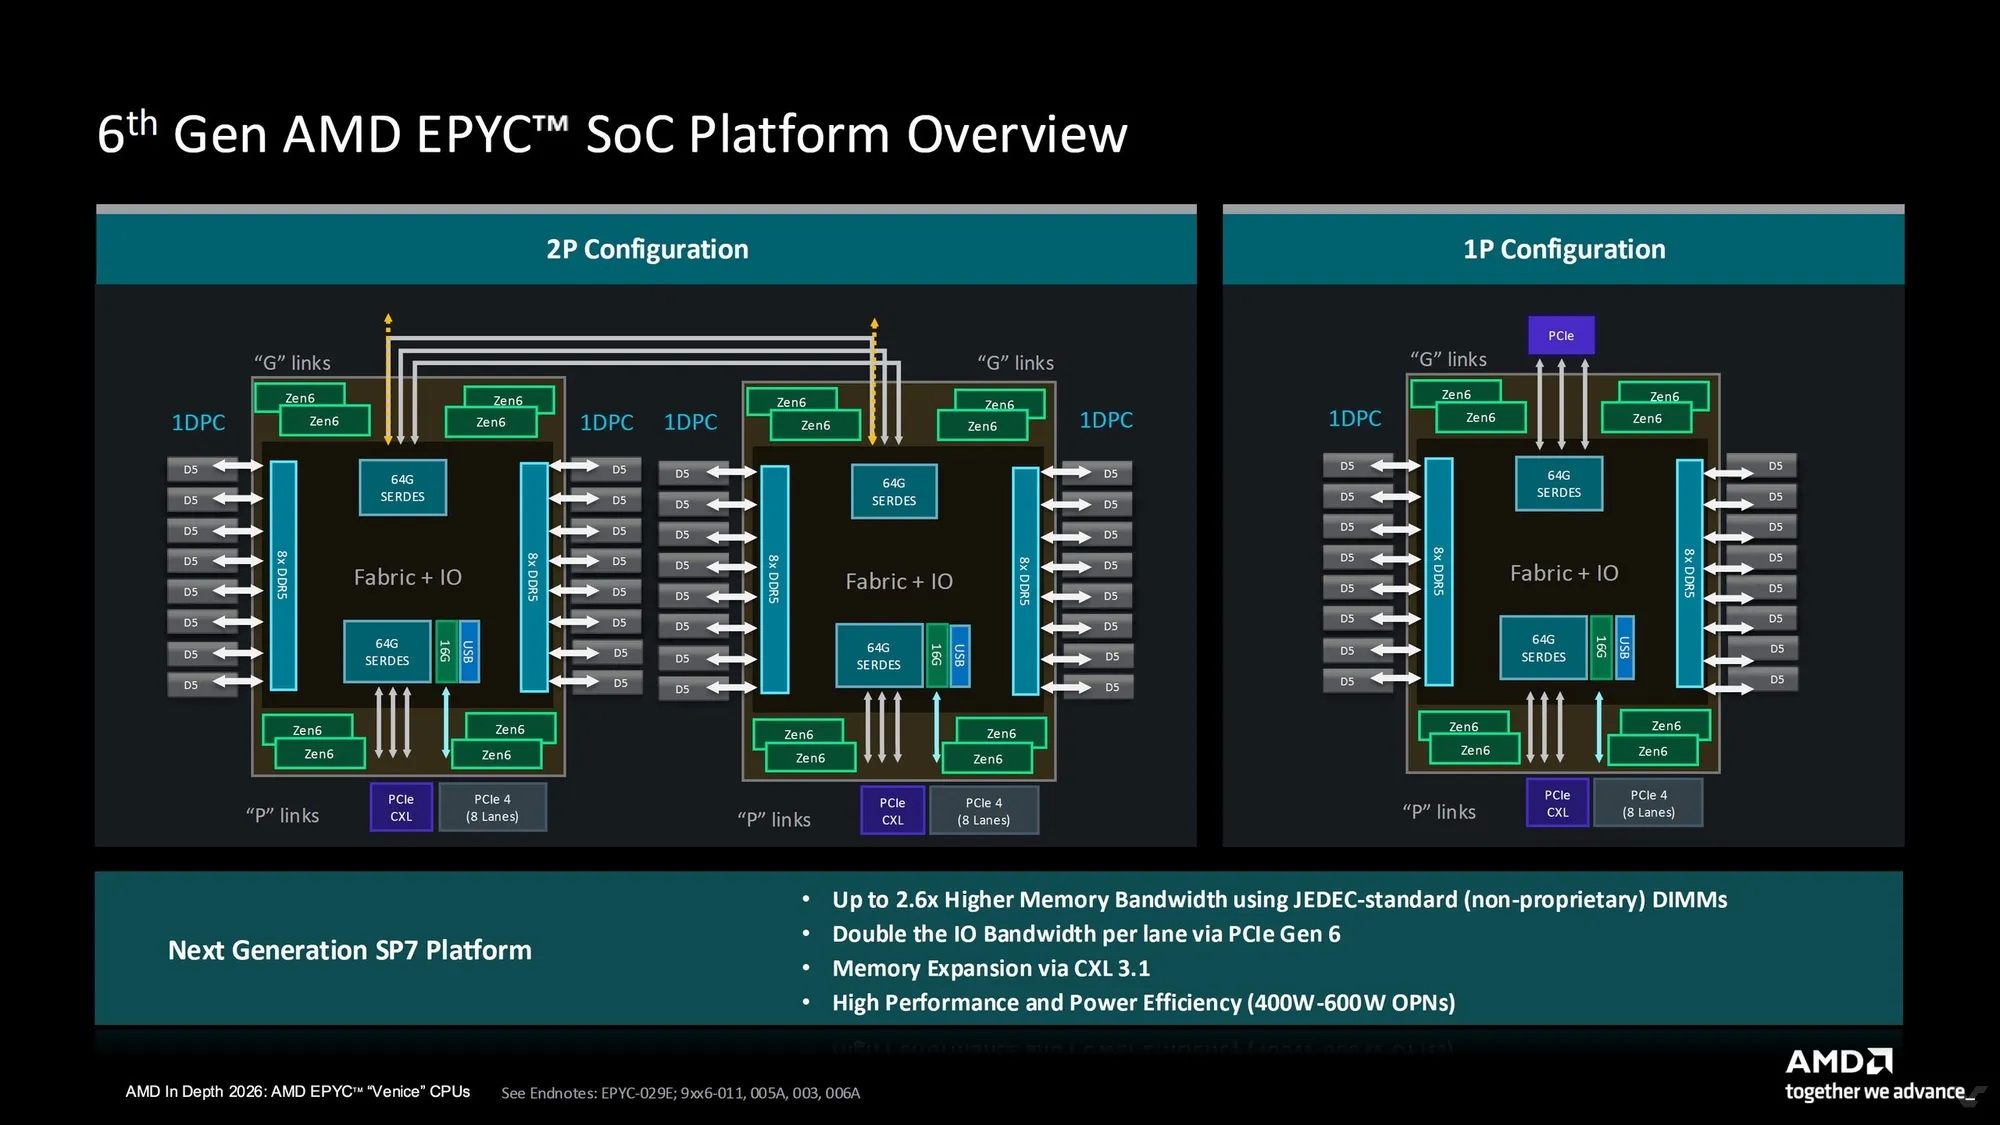
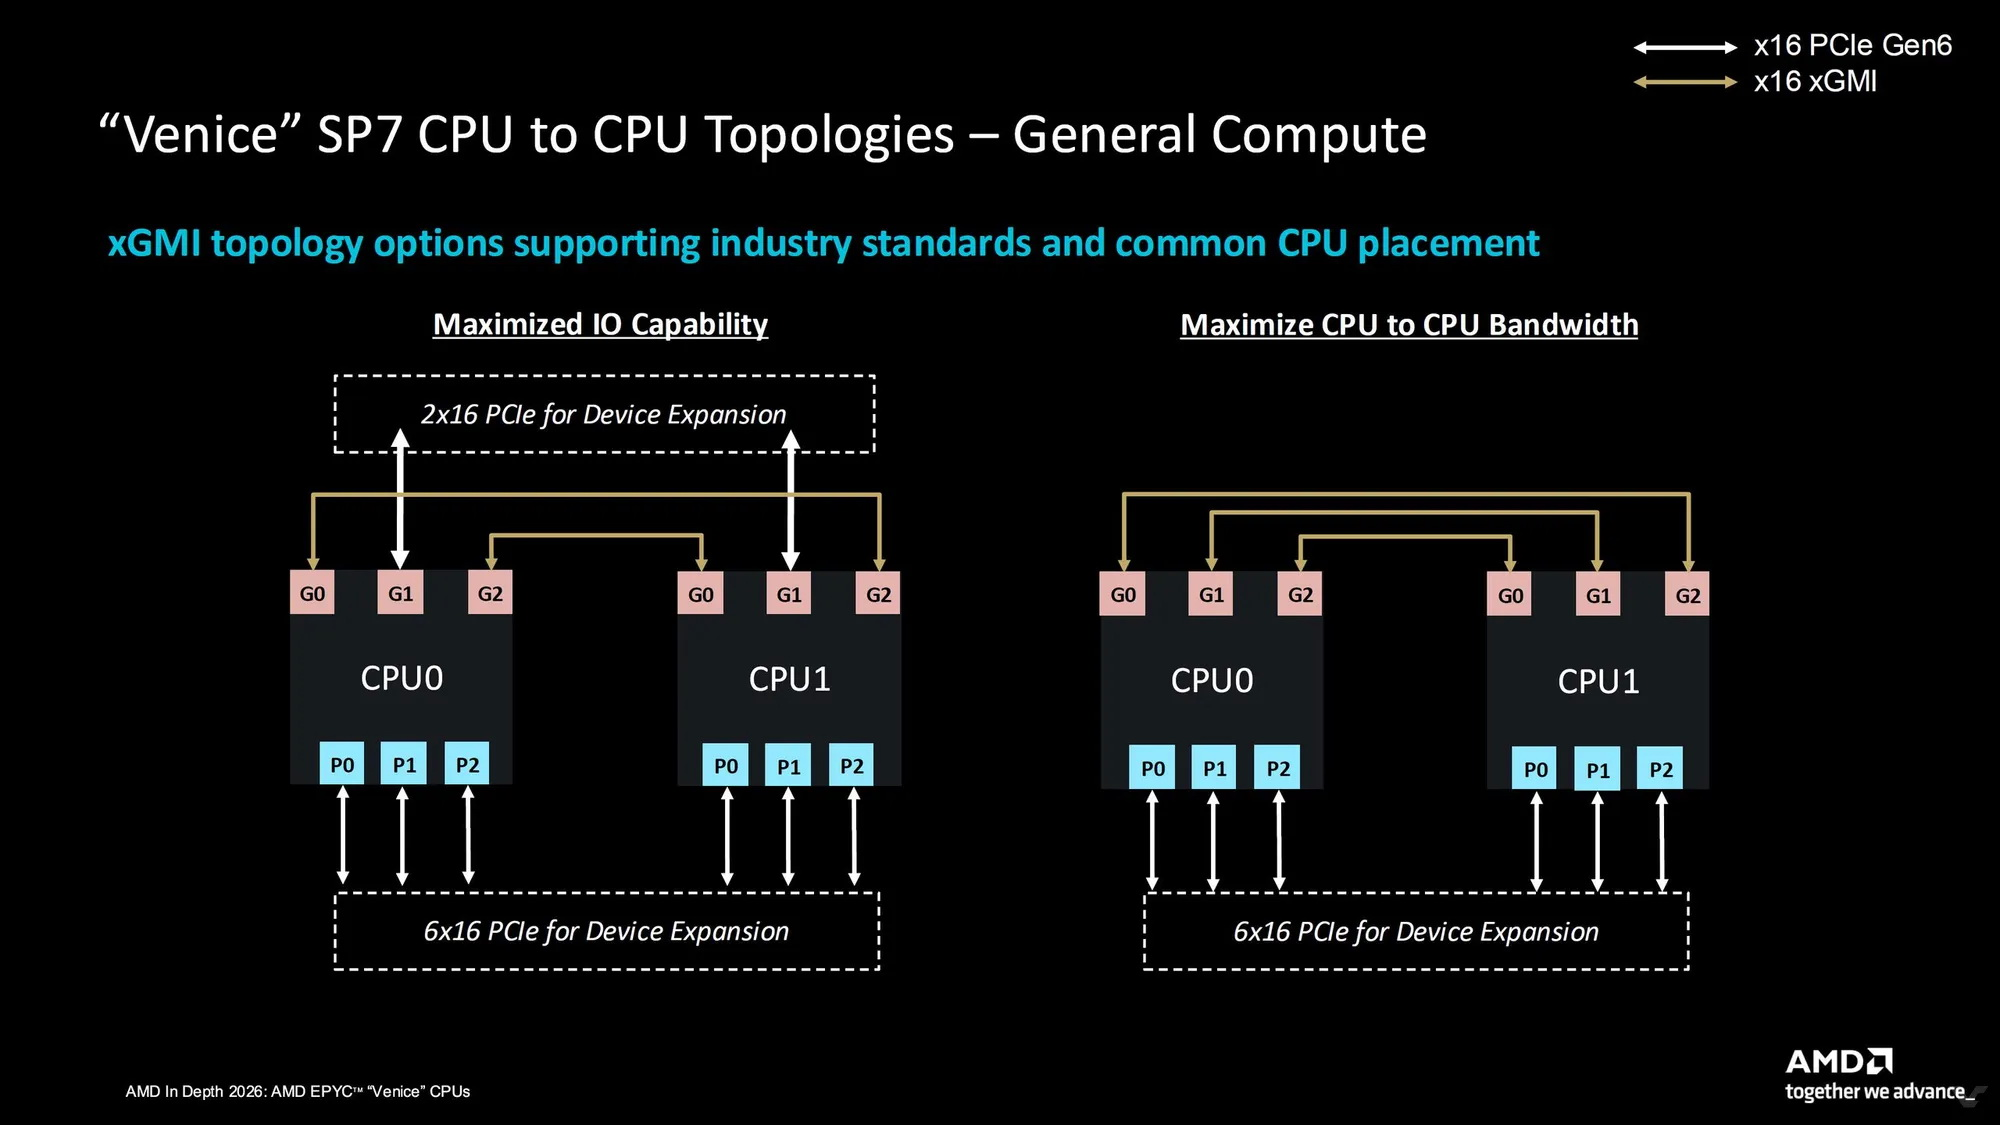
Для систем с SP7 также заявлена поддержка интерфейса PCIe 6.0 со скоростью до 64 Гбит/с на линию. Однопроцессорная (1P) конфигурация SP7 имеет доступ к 96 линиям PCIe 6.0, в то время как двухпроцессорная (2P) платформа предлагает до 128 линий. Каждая конфигурация также поставляется с «бонусными» линиями PCIe 4.0 — либо 8 для 1P-конфигураций, либо 16 для 2P.
Для систем с разъёмом SP8 количество каналов памяти уменьшено в пользу линий PCIe. Разъём SP8 имеет меньшие габариты — 62,5 × 80 мм, а сама платформа поддерживает восемь каналов памяти вместо 16 (при этом сохраняется поддержка модулей MRDIMM со скоростью передачи данных до 12 800 МТ/с). Пропускная способность памяти при использовании модулей MRDIMM на максимальной поддерживаемой скорости составляет 819 Гбайт/с, а при использовании модулей RDIMM — 512 Гбайт/с. Чипы SP8 имеют доступ к 64 линиям PCIe 6.0 на один IOD (всего 128 линий в сокете плюс 8 линий PCIe 4.0), а в двухпроцессорных (2P) конфигурациях SP8 доступно до 192 линий PCIe 6.0 и 16 дополнительных линий PCIe 4.0. Обе платформы поддерживают стандарт CXL 3.1.
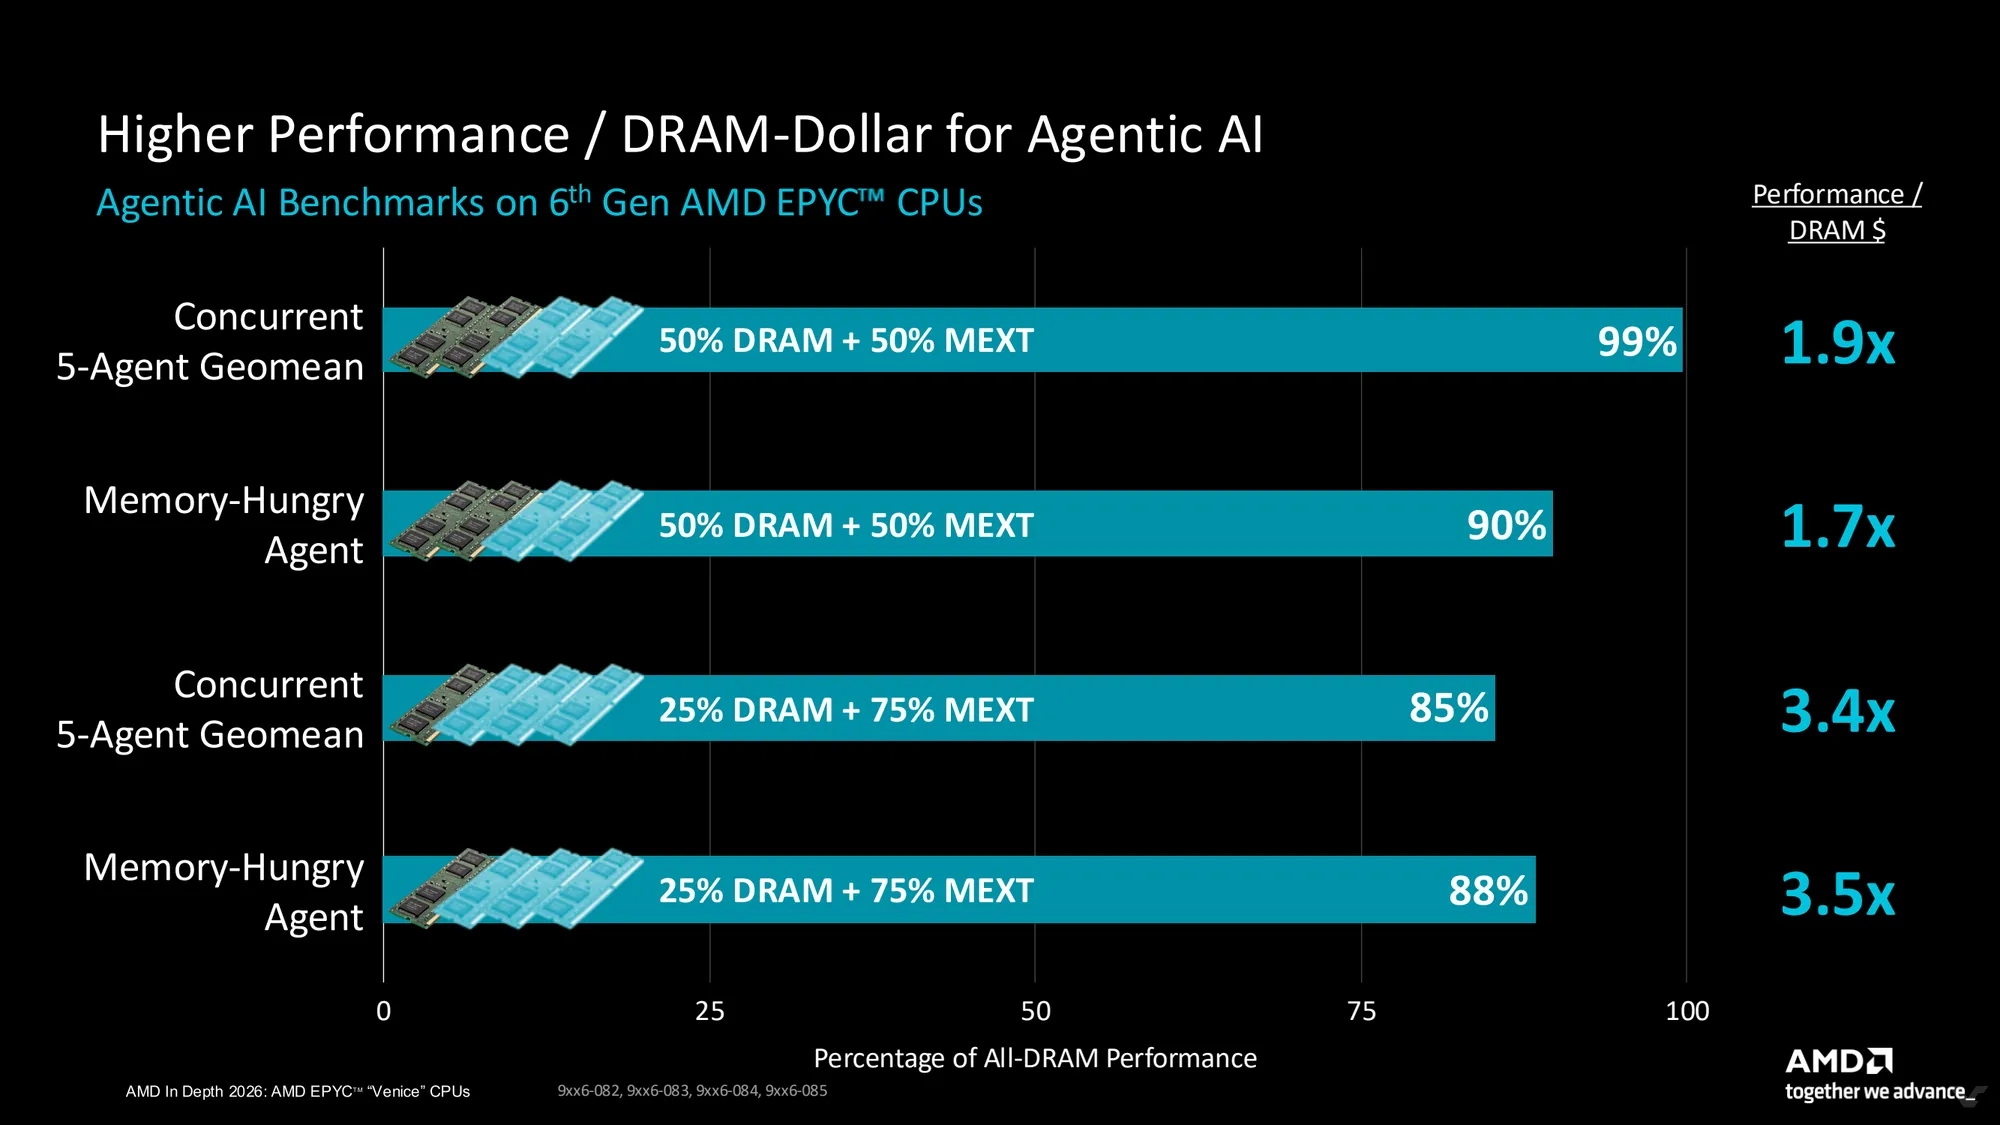
EPYC Venice также станет первой платформой с поддержкой программно-аппаратной технологии MEXT, которая использует быструю флэш-память в качестве расширения DRAM. С помощью алгоритмов ИИ система предсказывает обращения к памяти и выгружает неиспользуемые страницы. По заявлениям AMD, в критических задачах проектирования электроники (EDA) это позволяет сохранять 95 % исходной производительности сервера при физическом сокращении объема дорогостоящей DRAM на 50 %. Даже при сокращении доступного объёма памяти до 25 %, производительность приложения, как заявляет AMD, сохраняется на уровне 80 %.
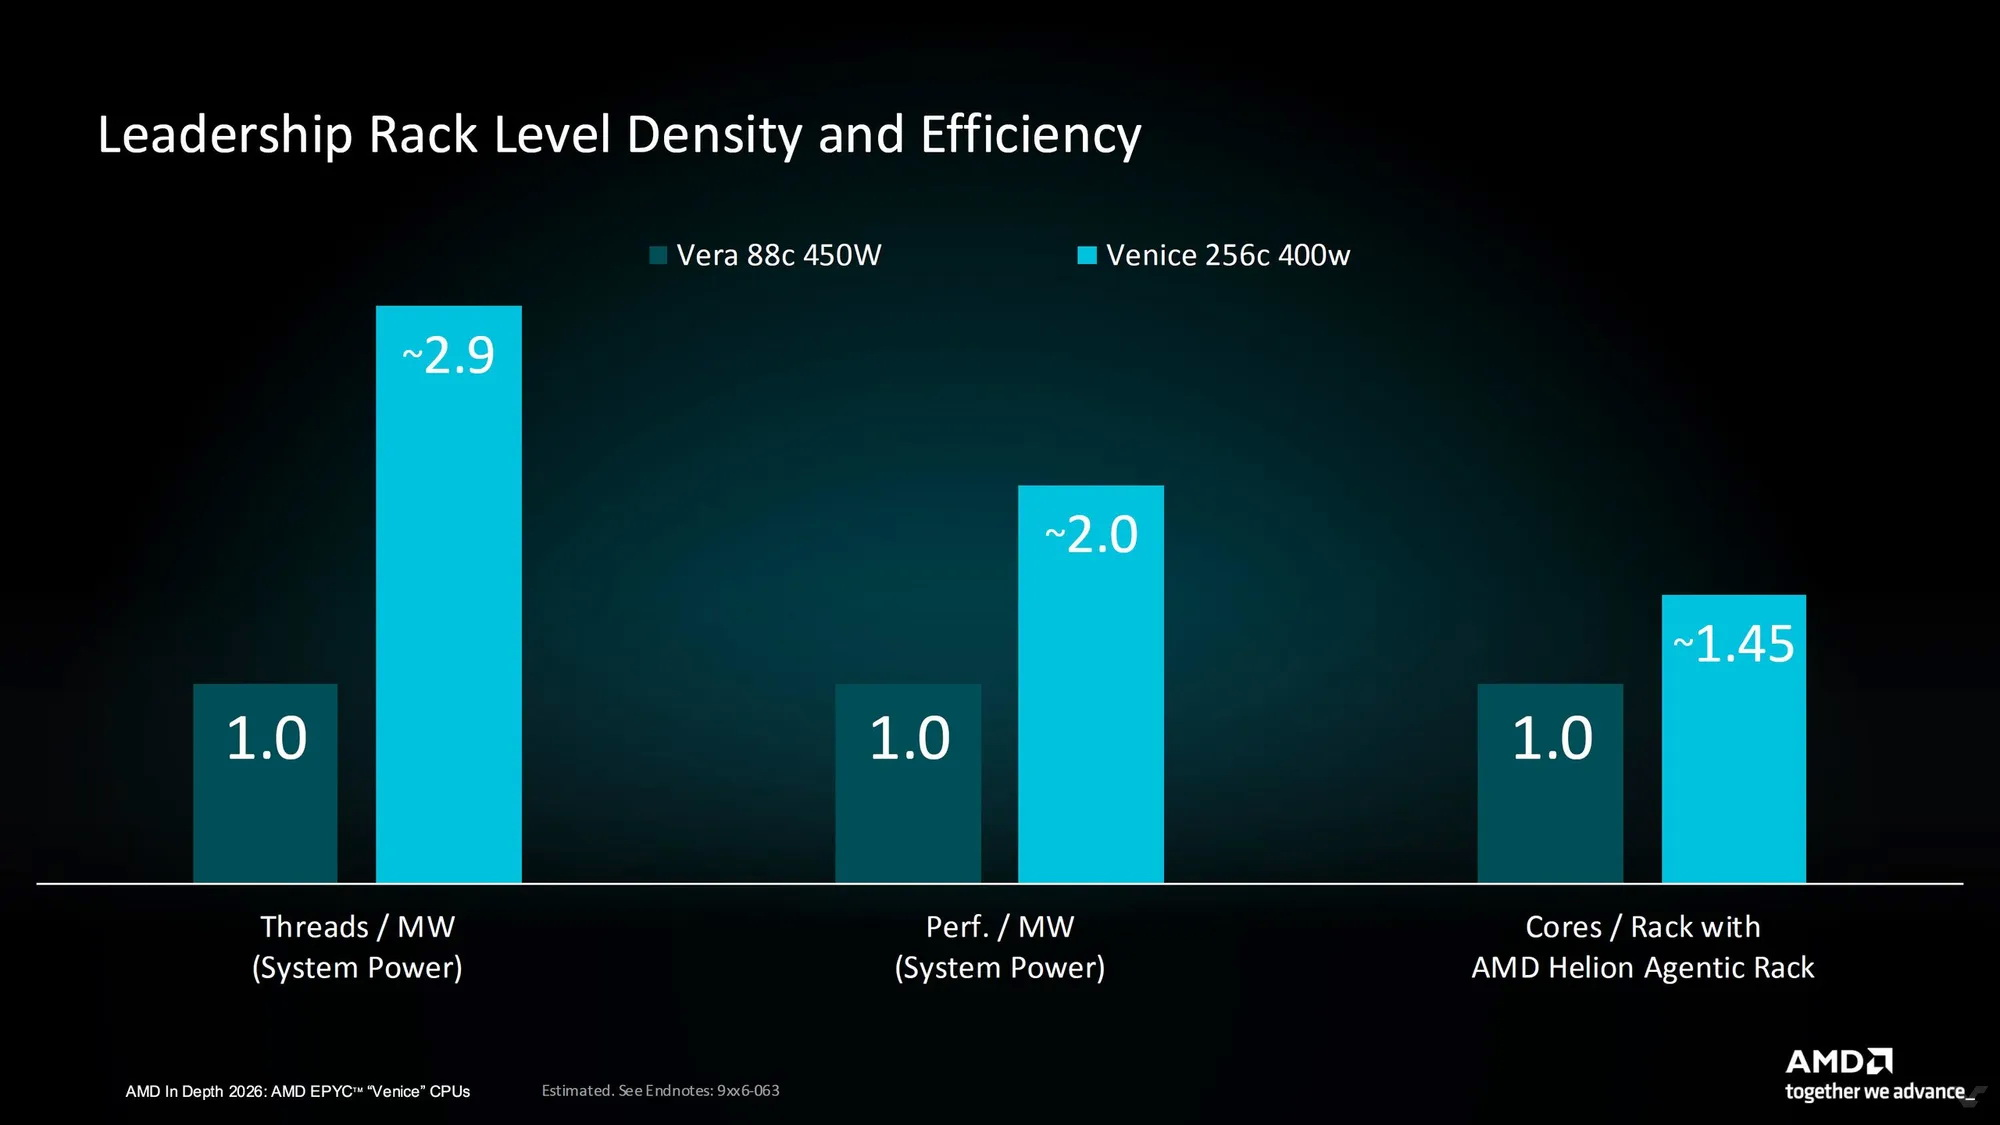
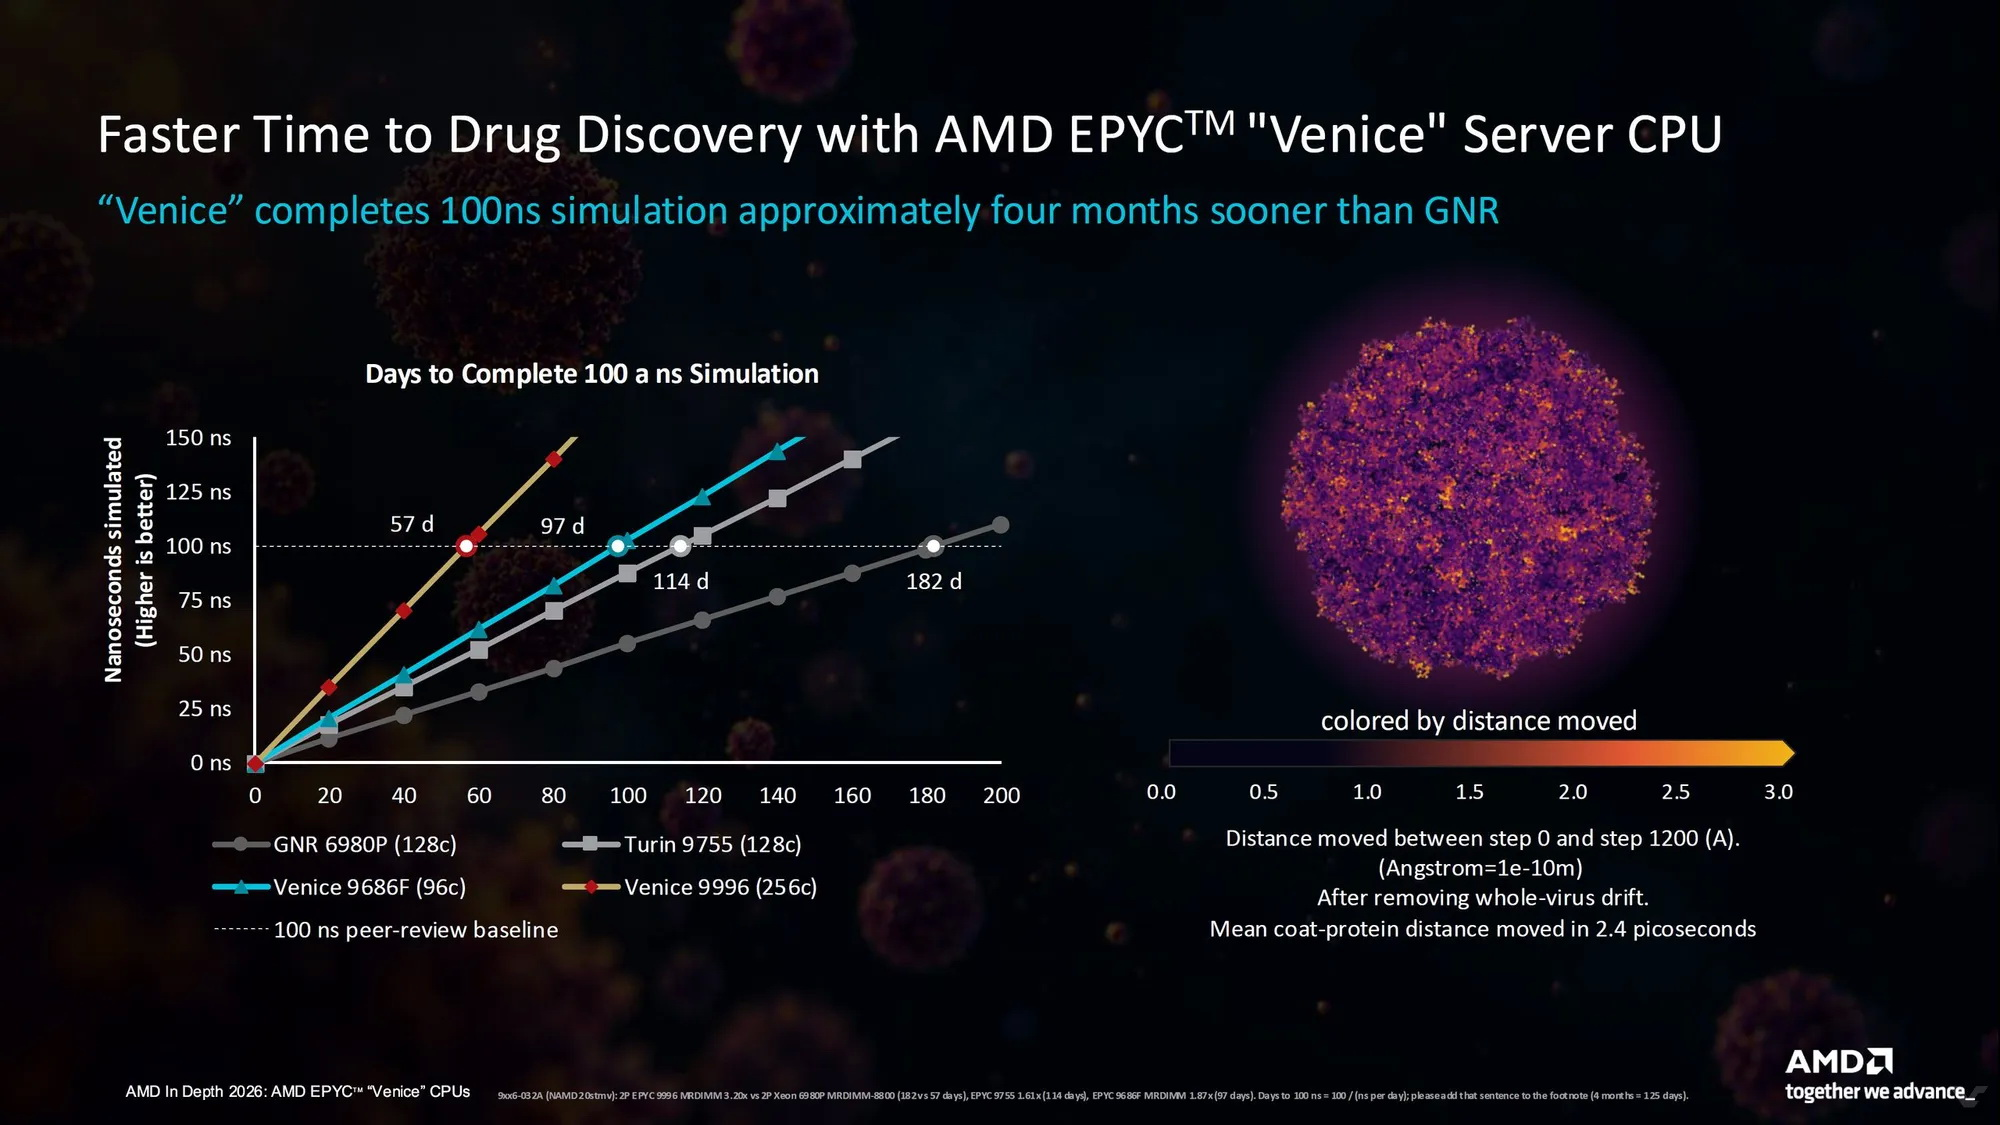
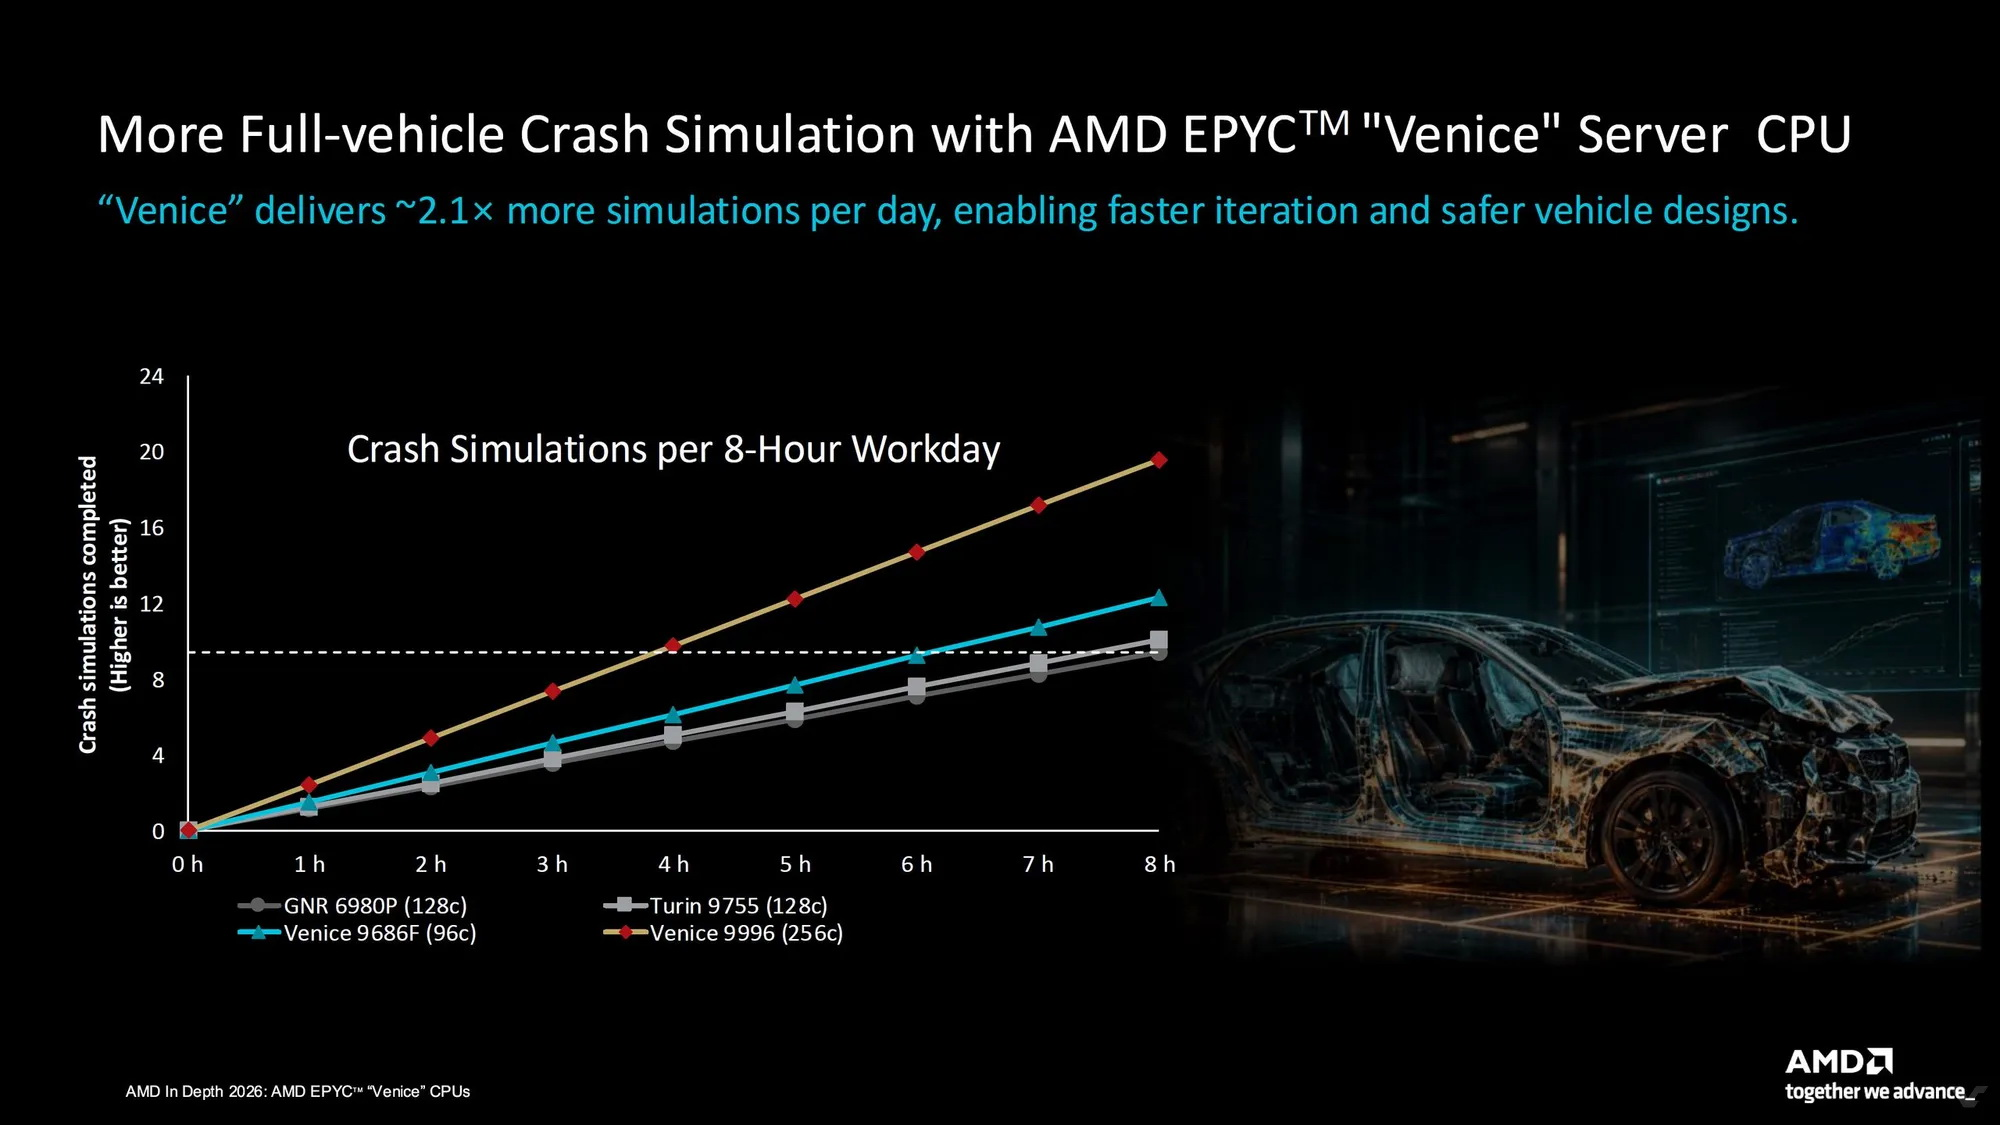
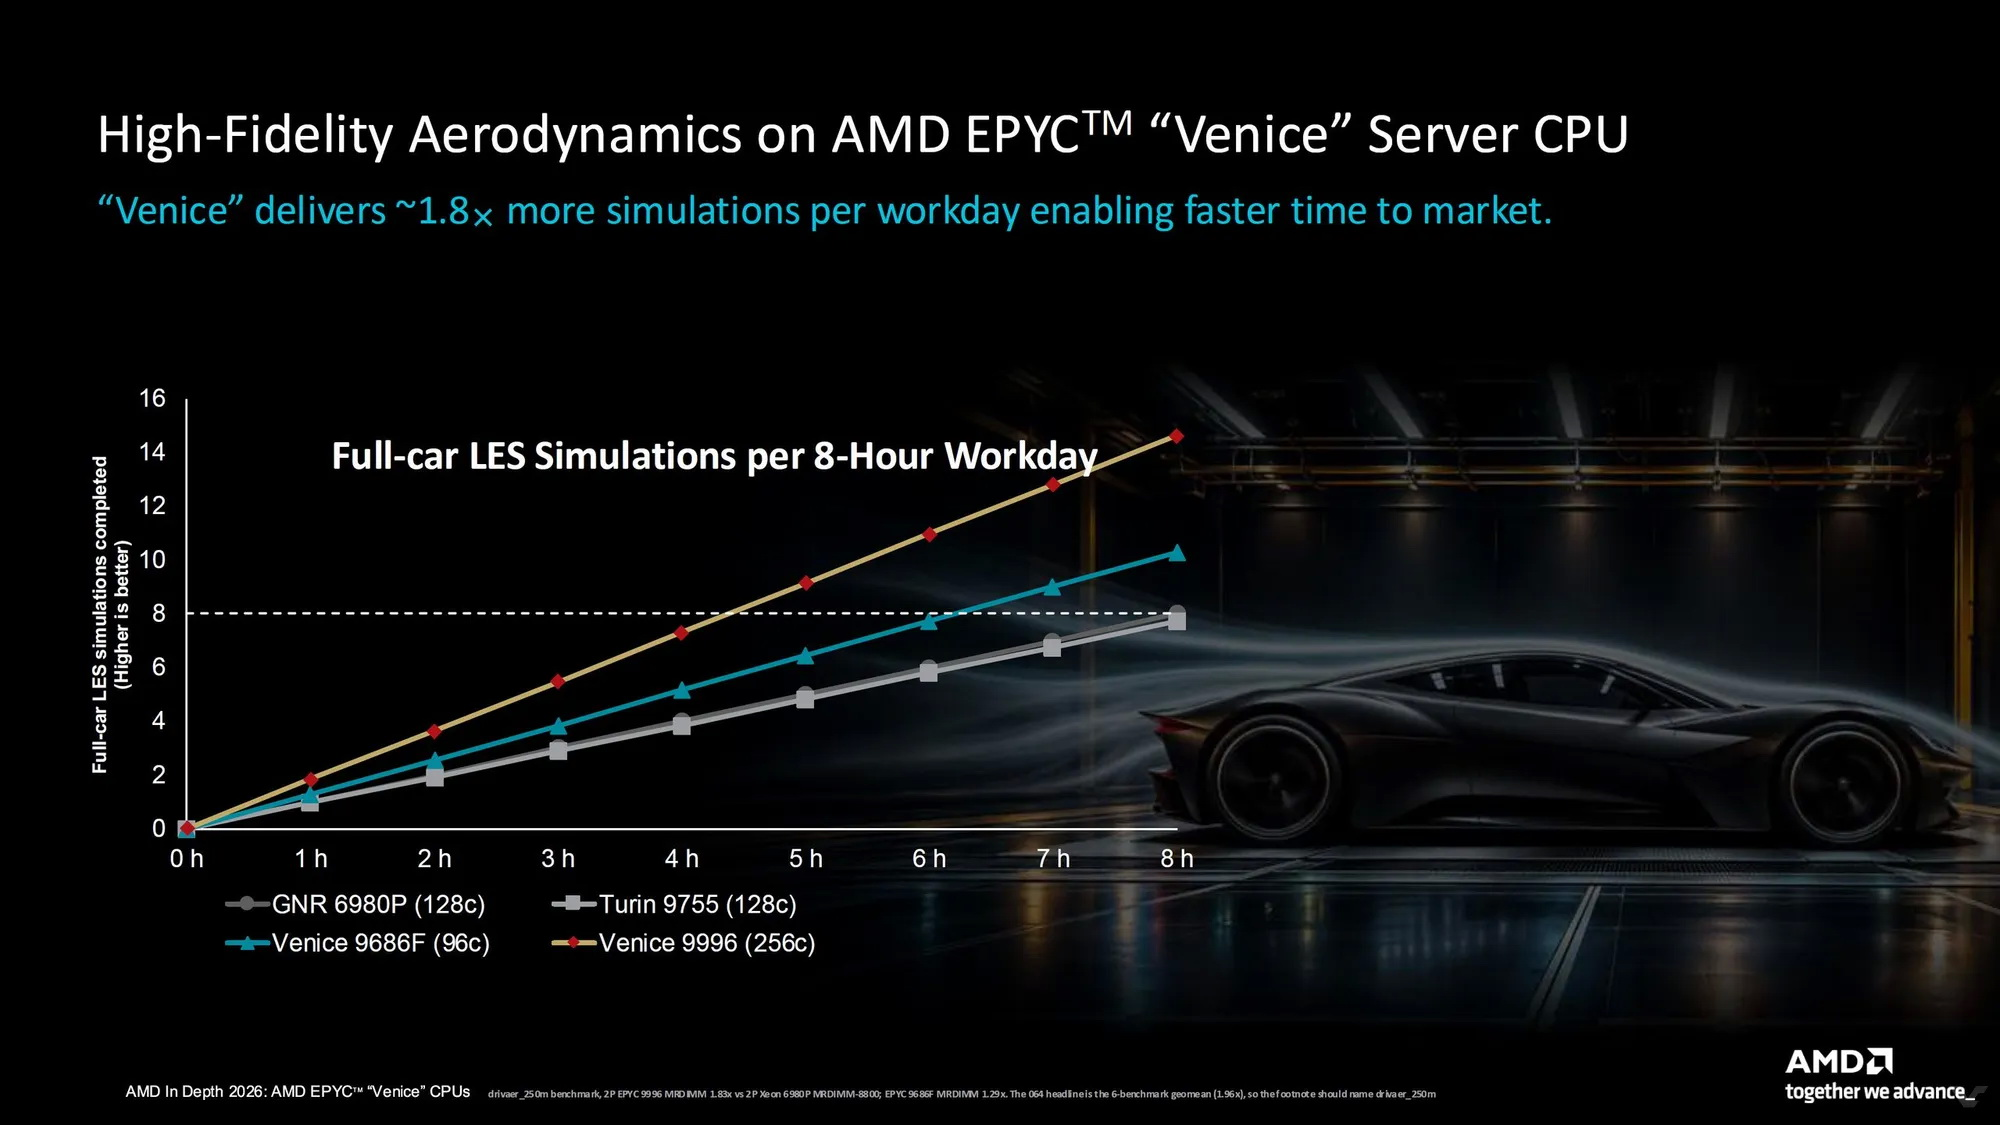
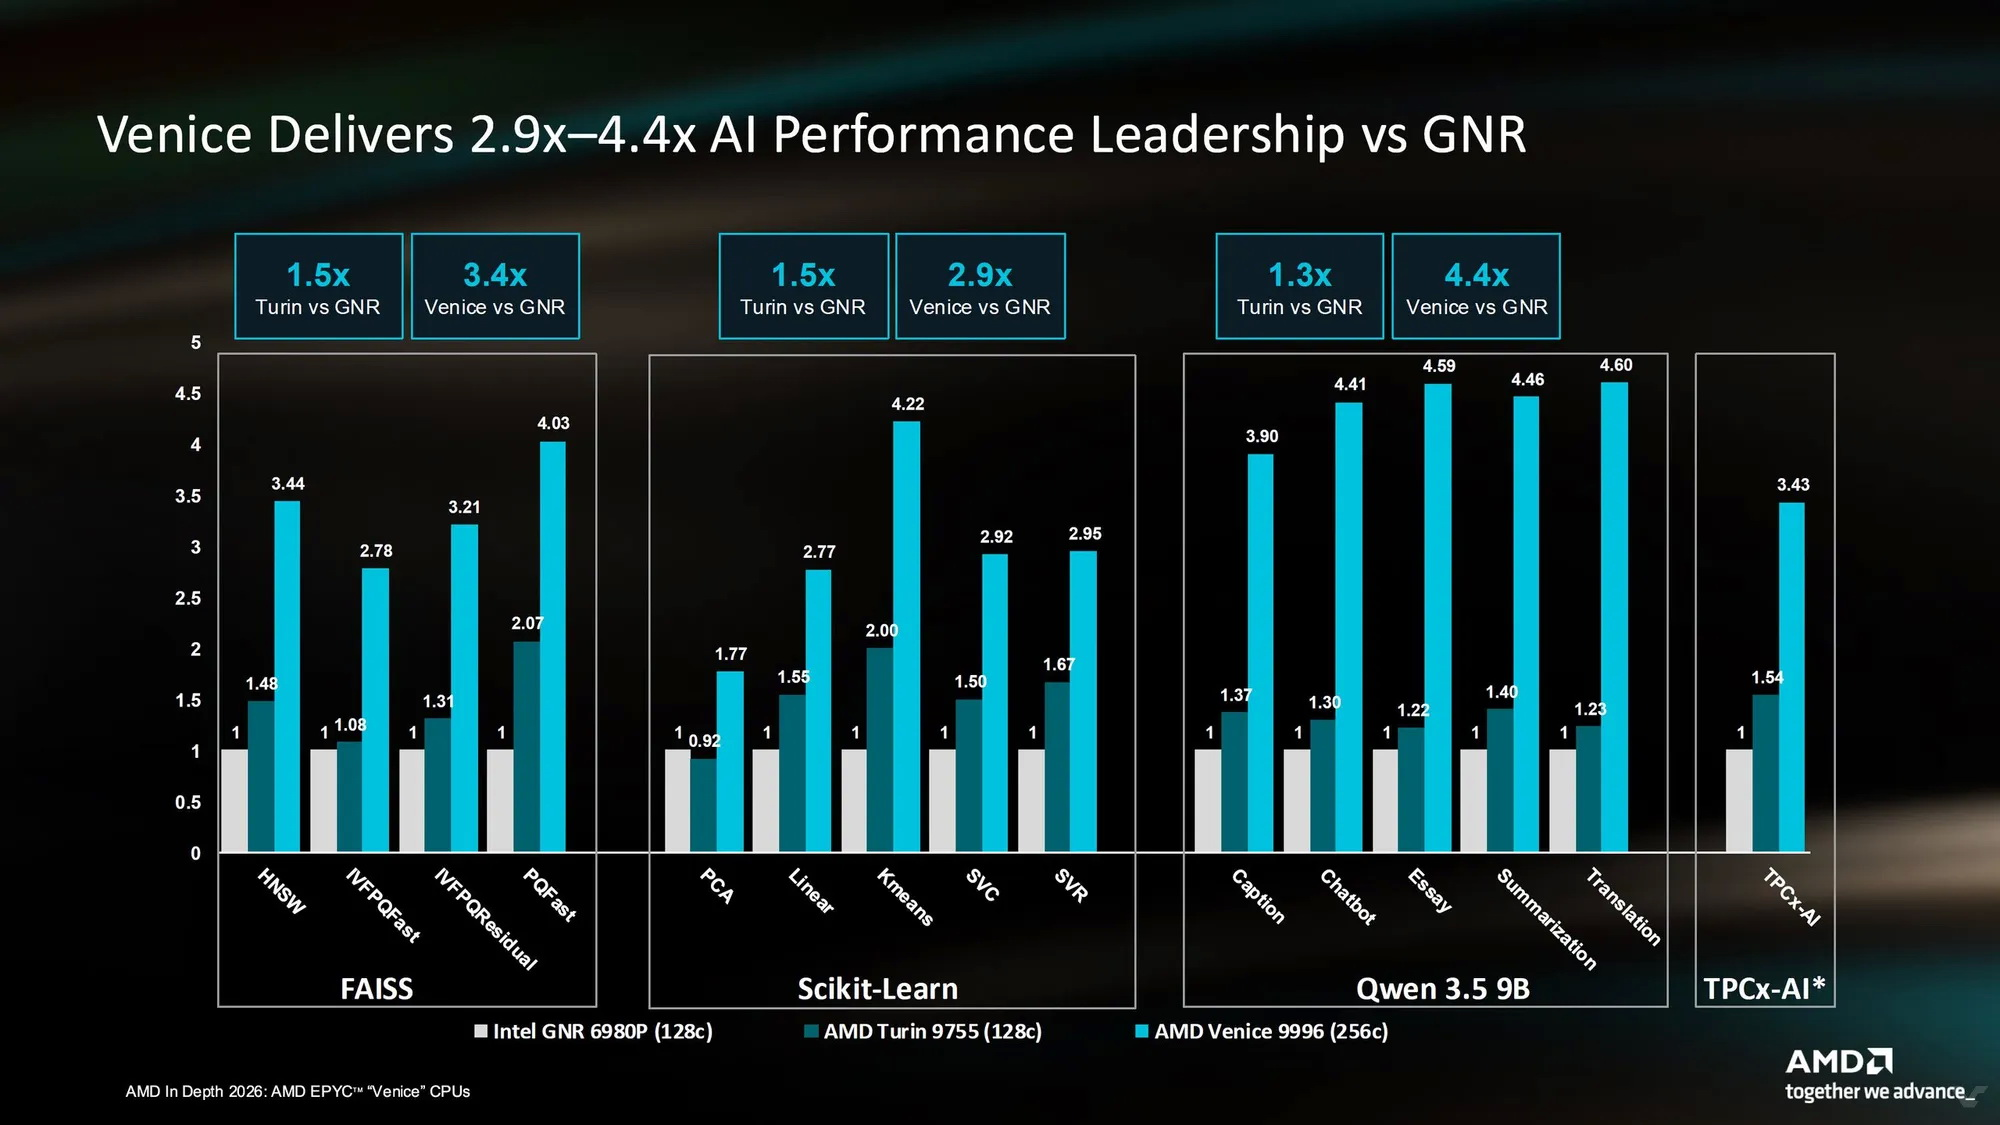
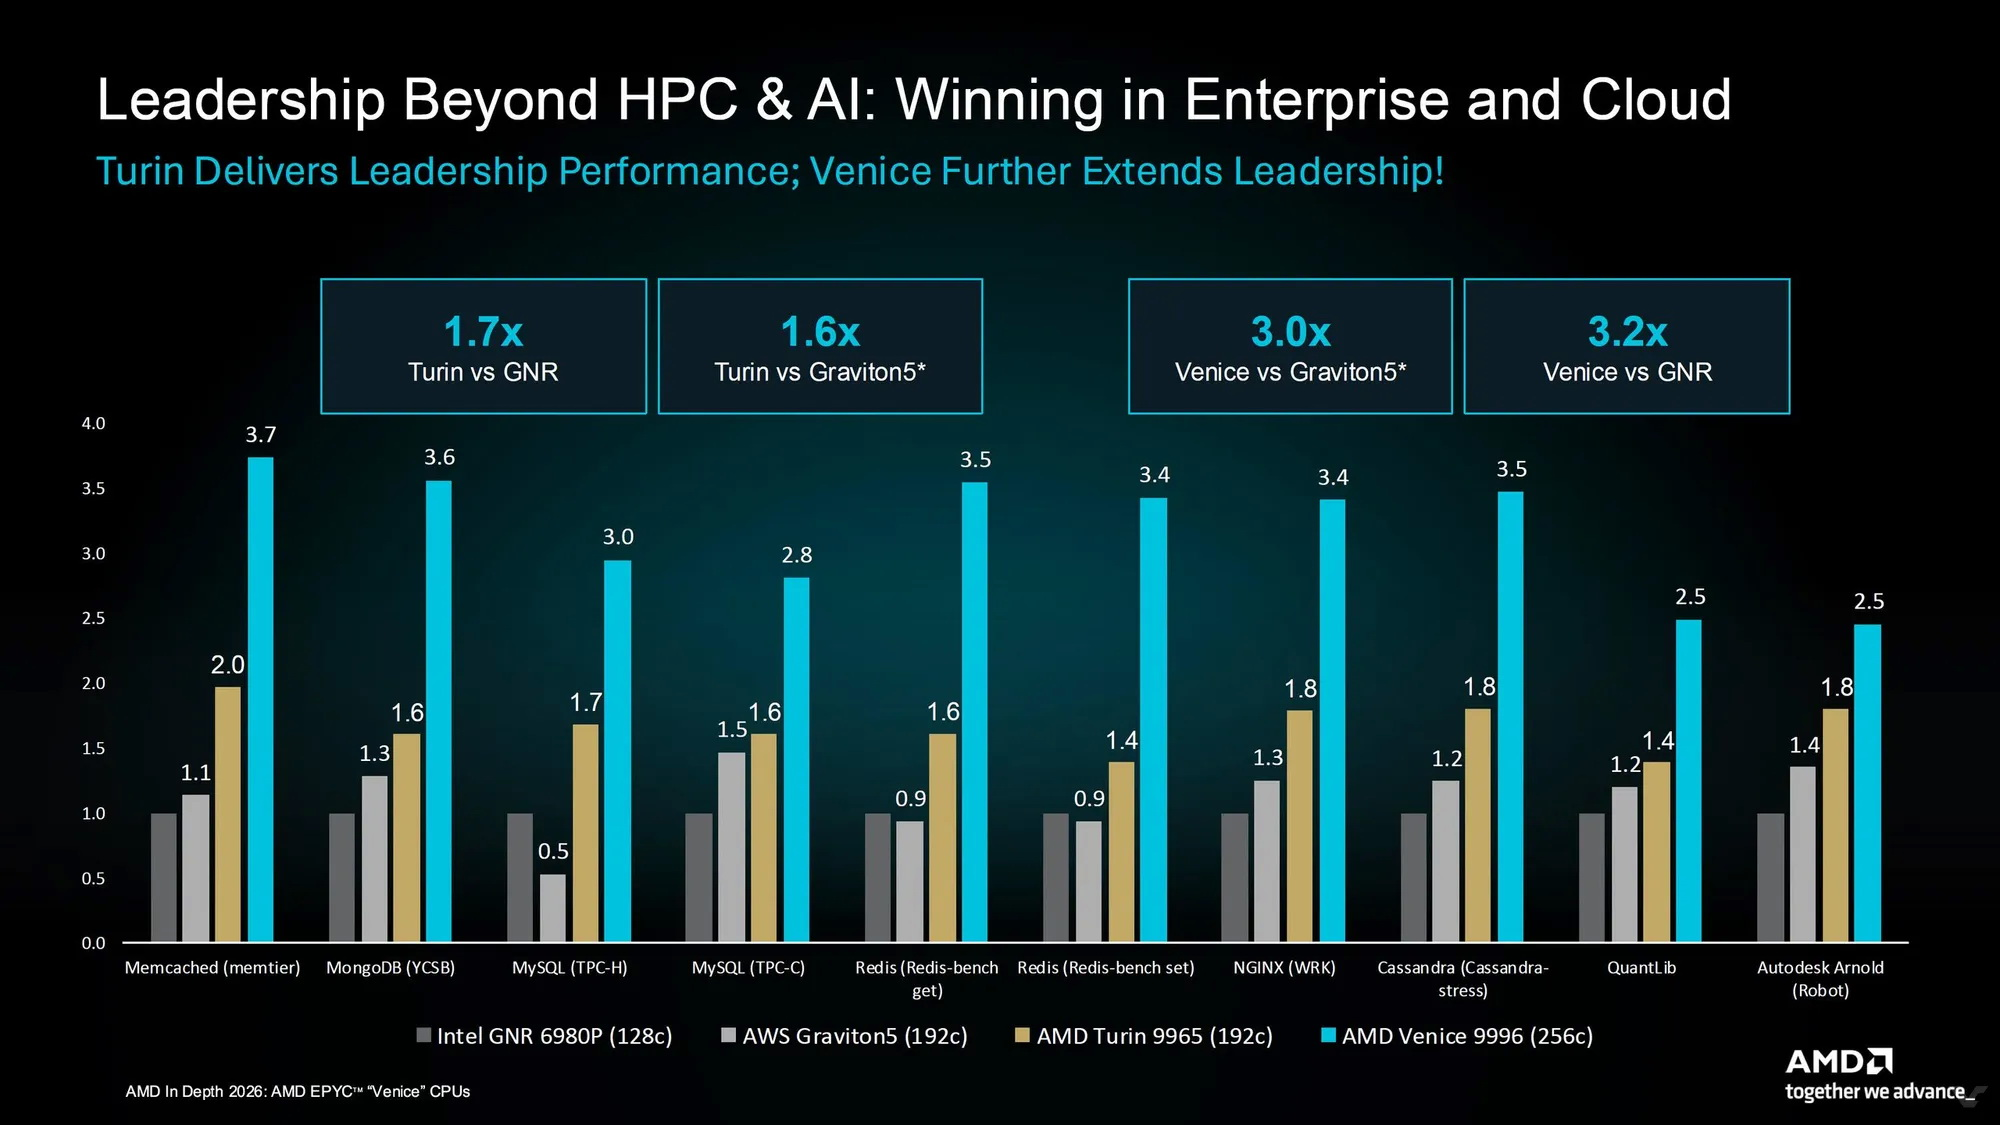
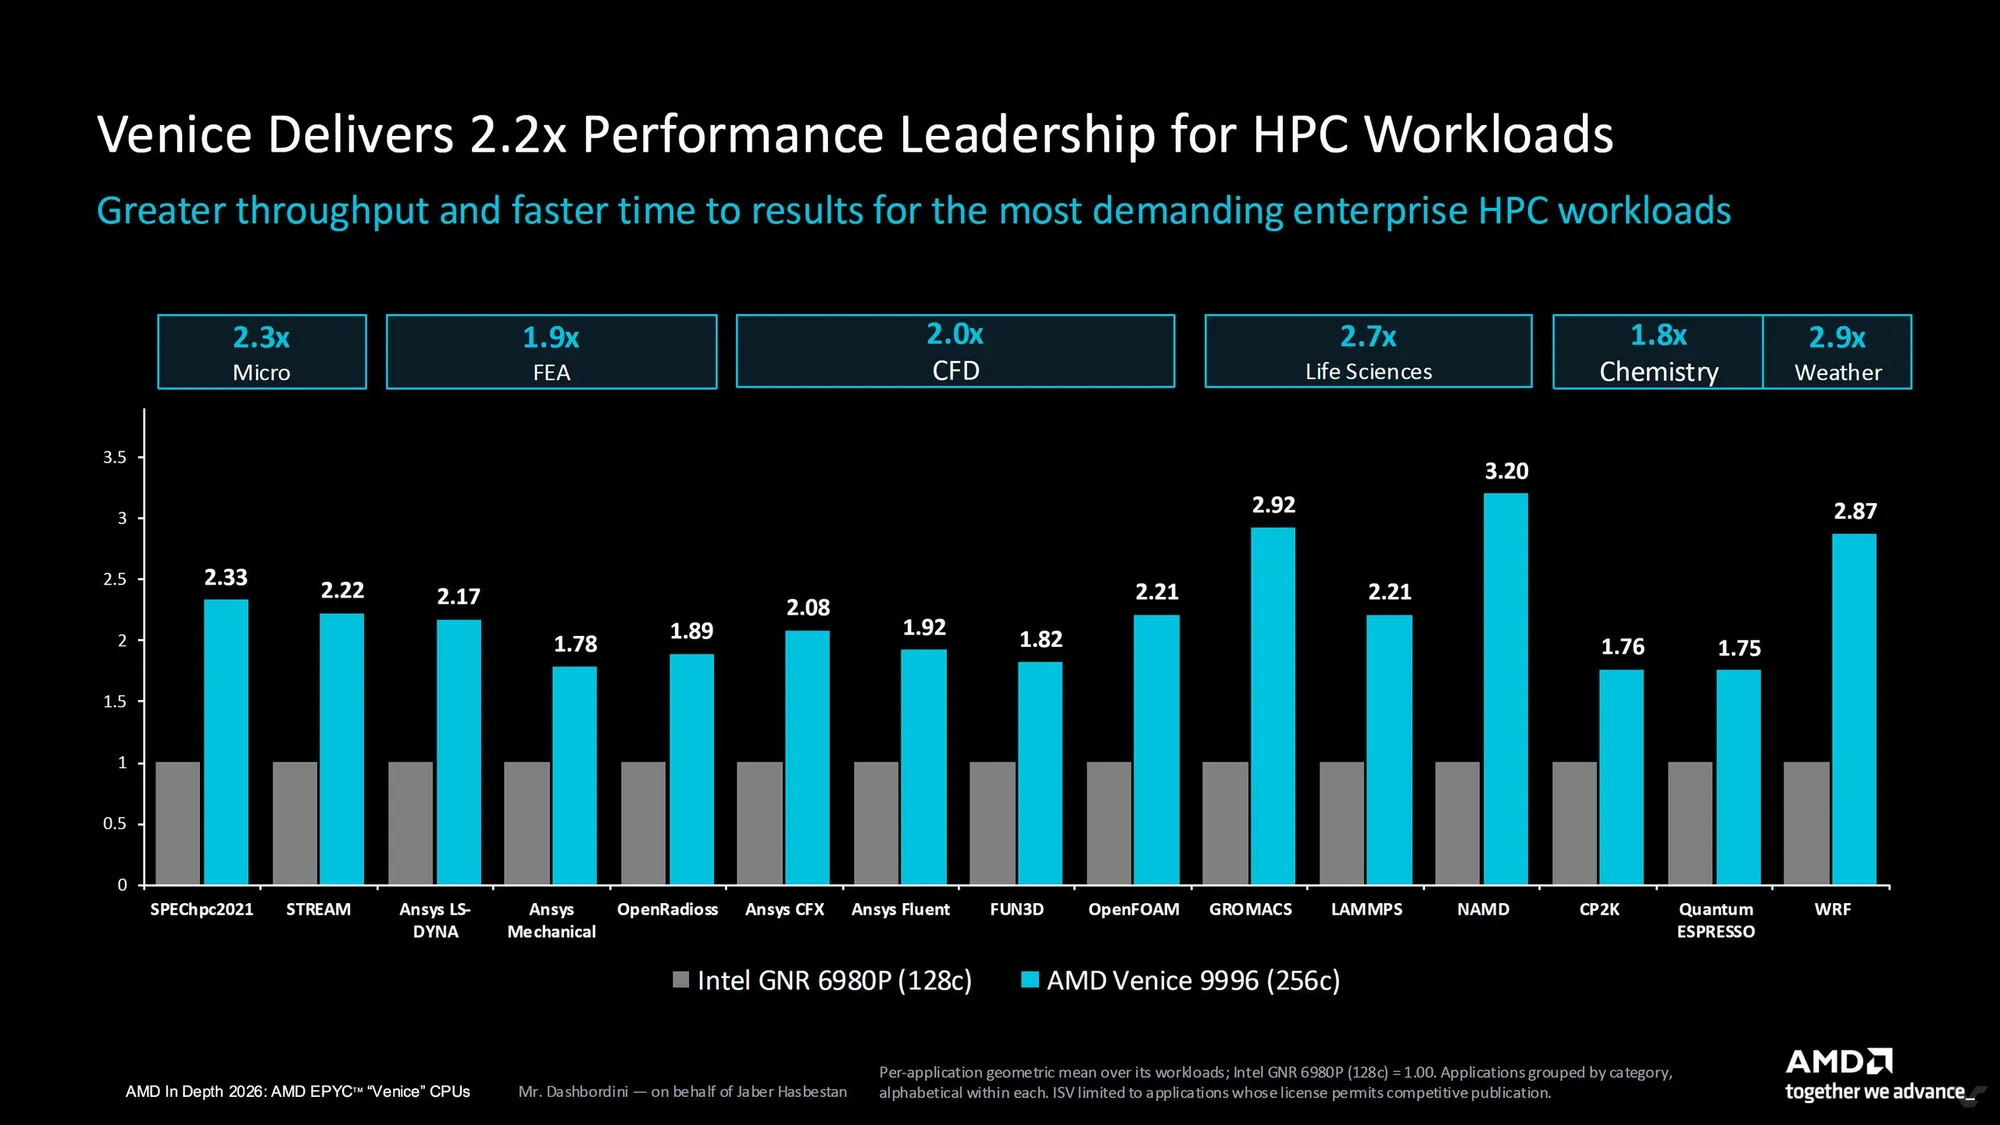
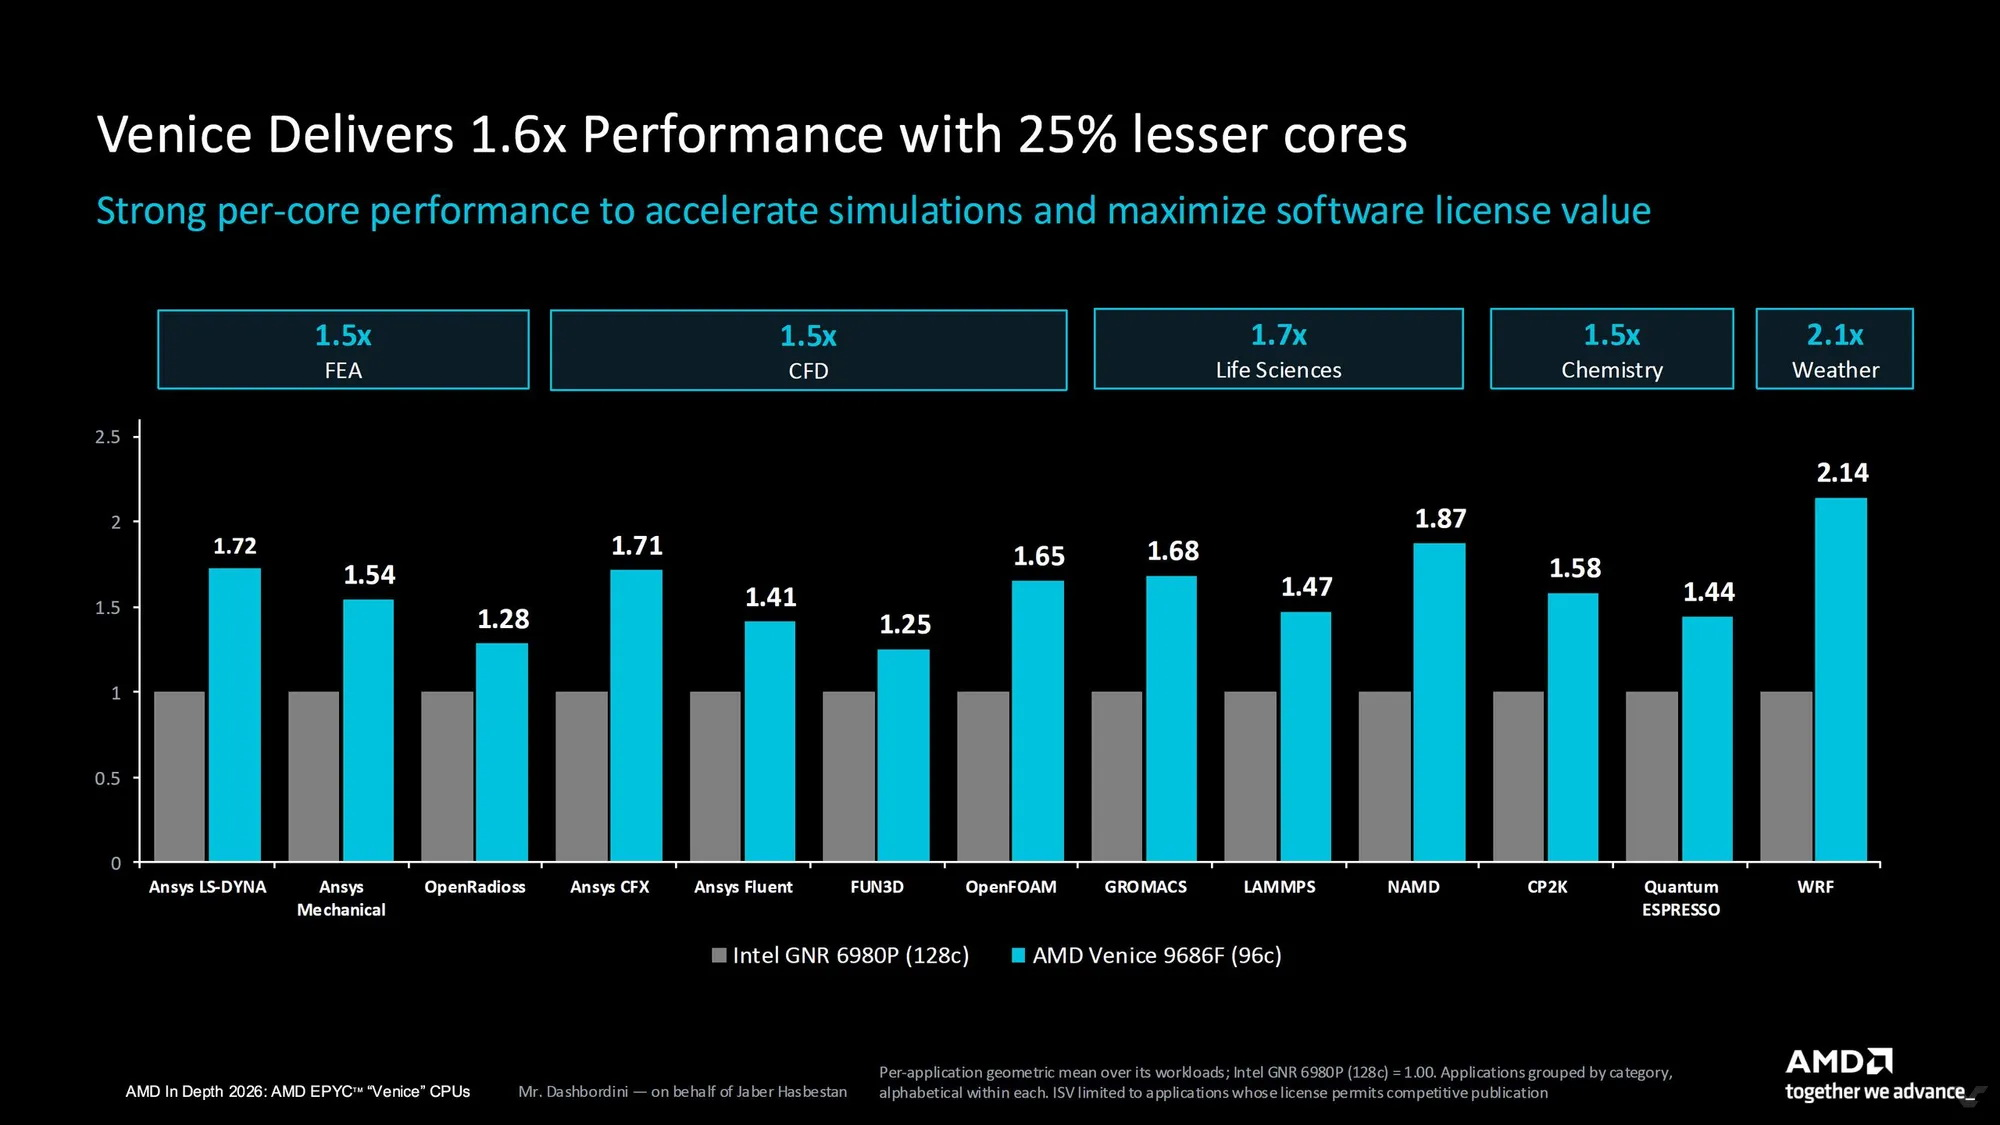
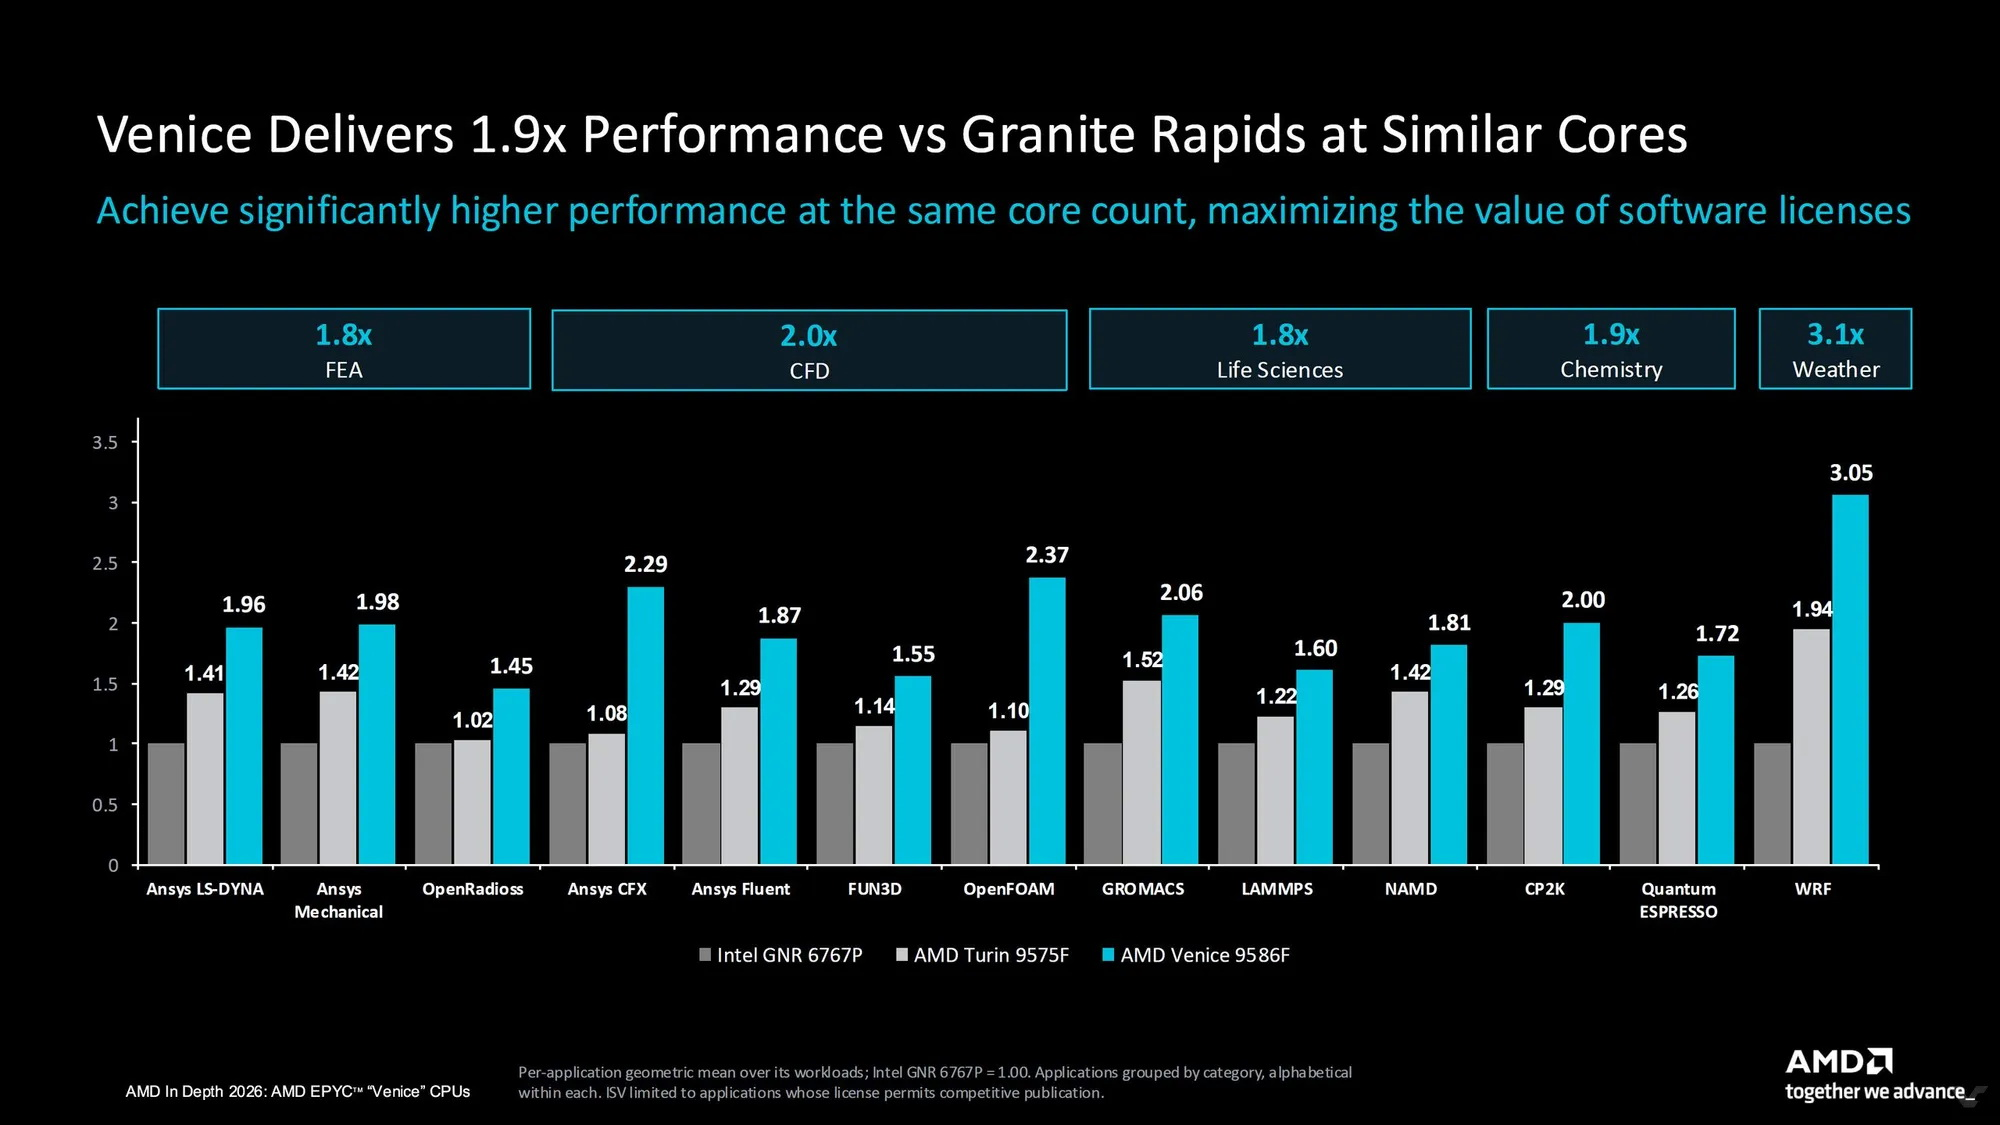
С дополнительными особенностями архитектур и внутренними бенчмарками от AMD можно ознакомиться в галерее ниже.
изображения (19)
В распоряжение портала Tom’s Hardware попали две двухпроцессорные (2P) конфигурации на базе сокета SP7: 256-ядерный EPYC 9996 (суммарно 512 ядер и 1024 потока на систему, частота до 4,1 ГГц) и 96-ядерный EPYC 9686F (384 потока на систему, частота до 5,0 ГГц).
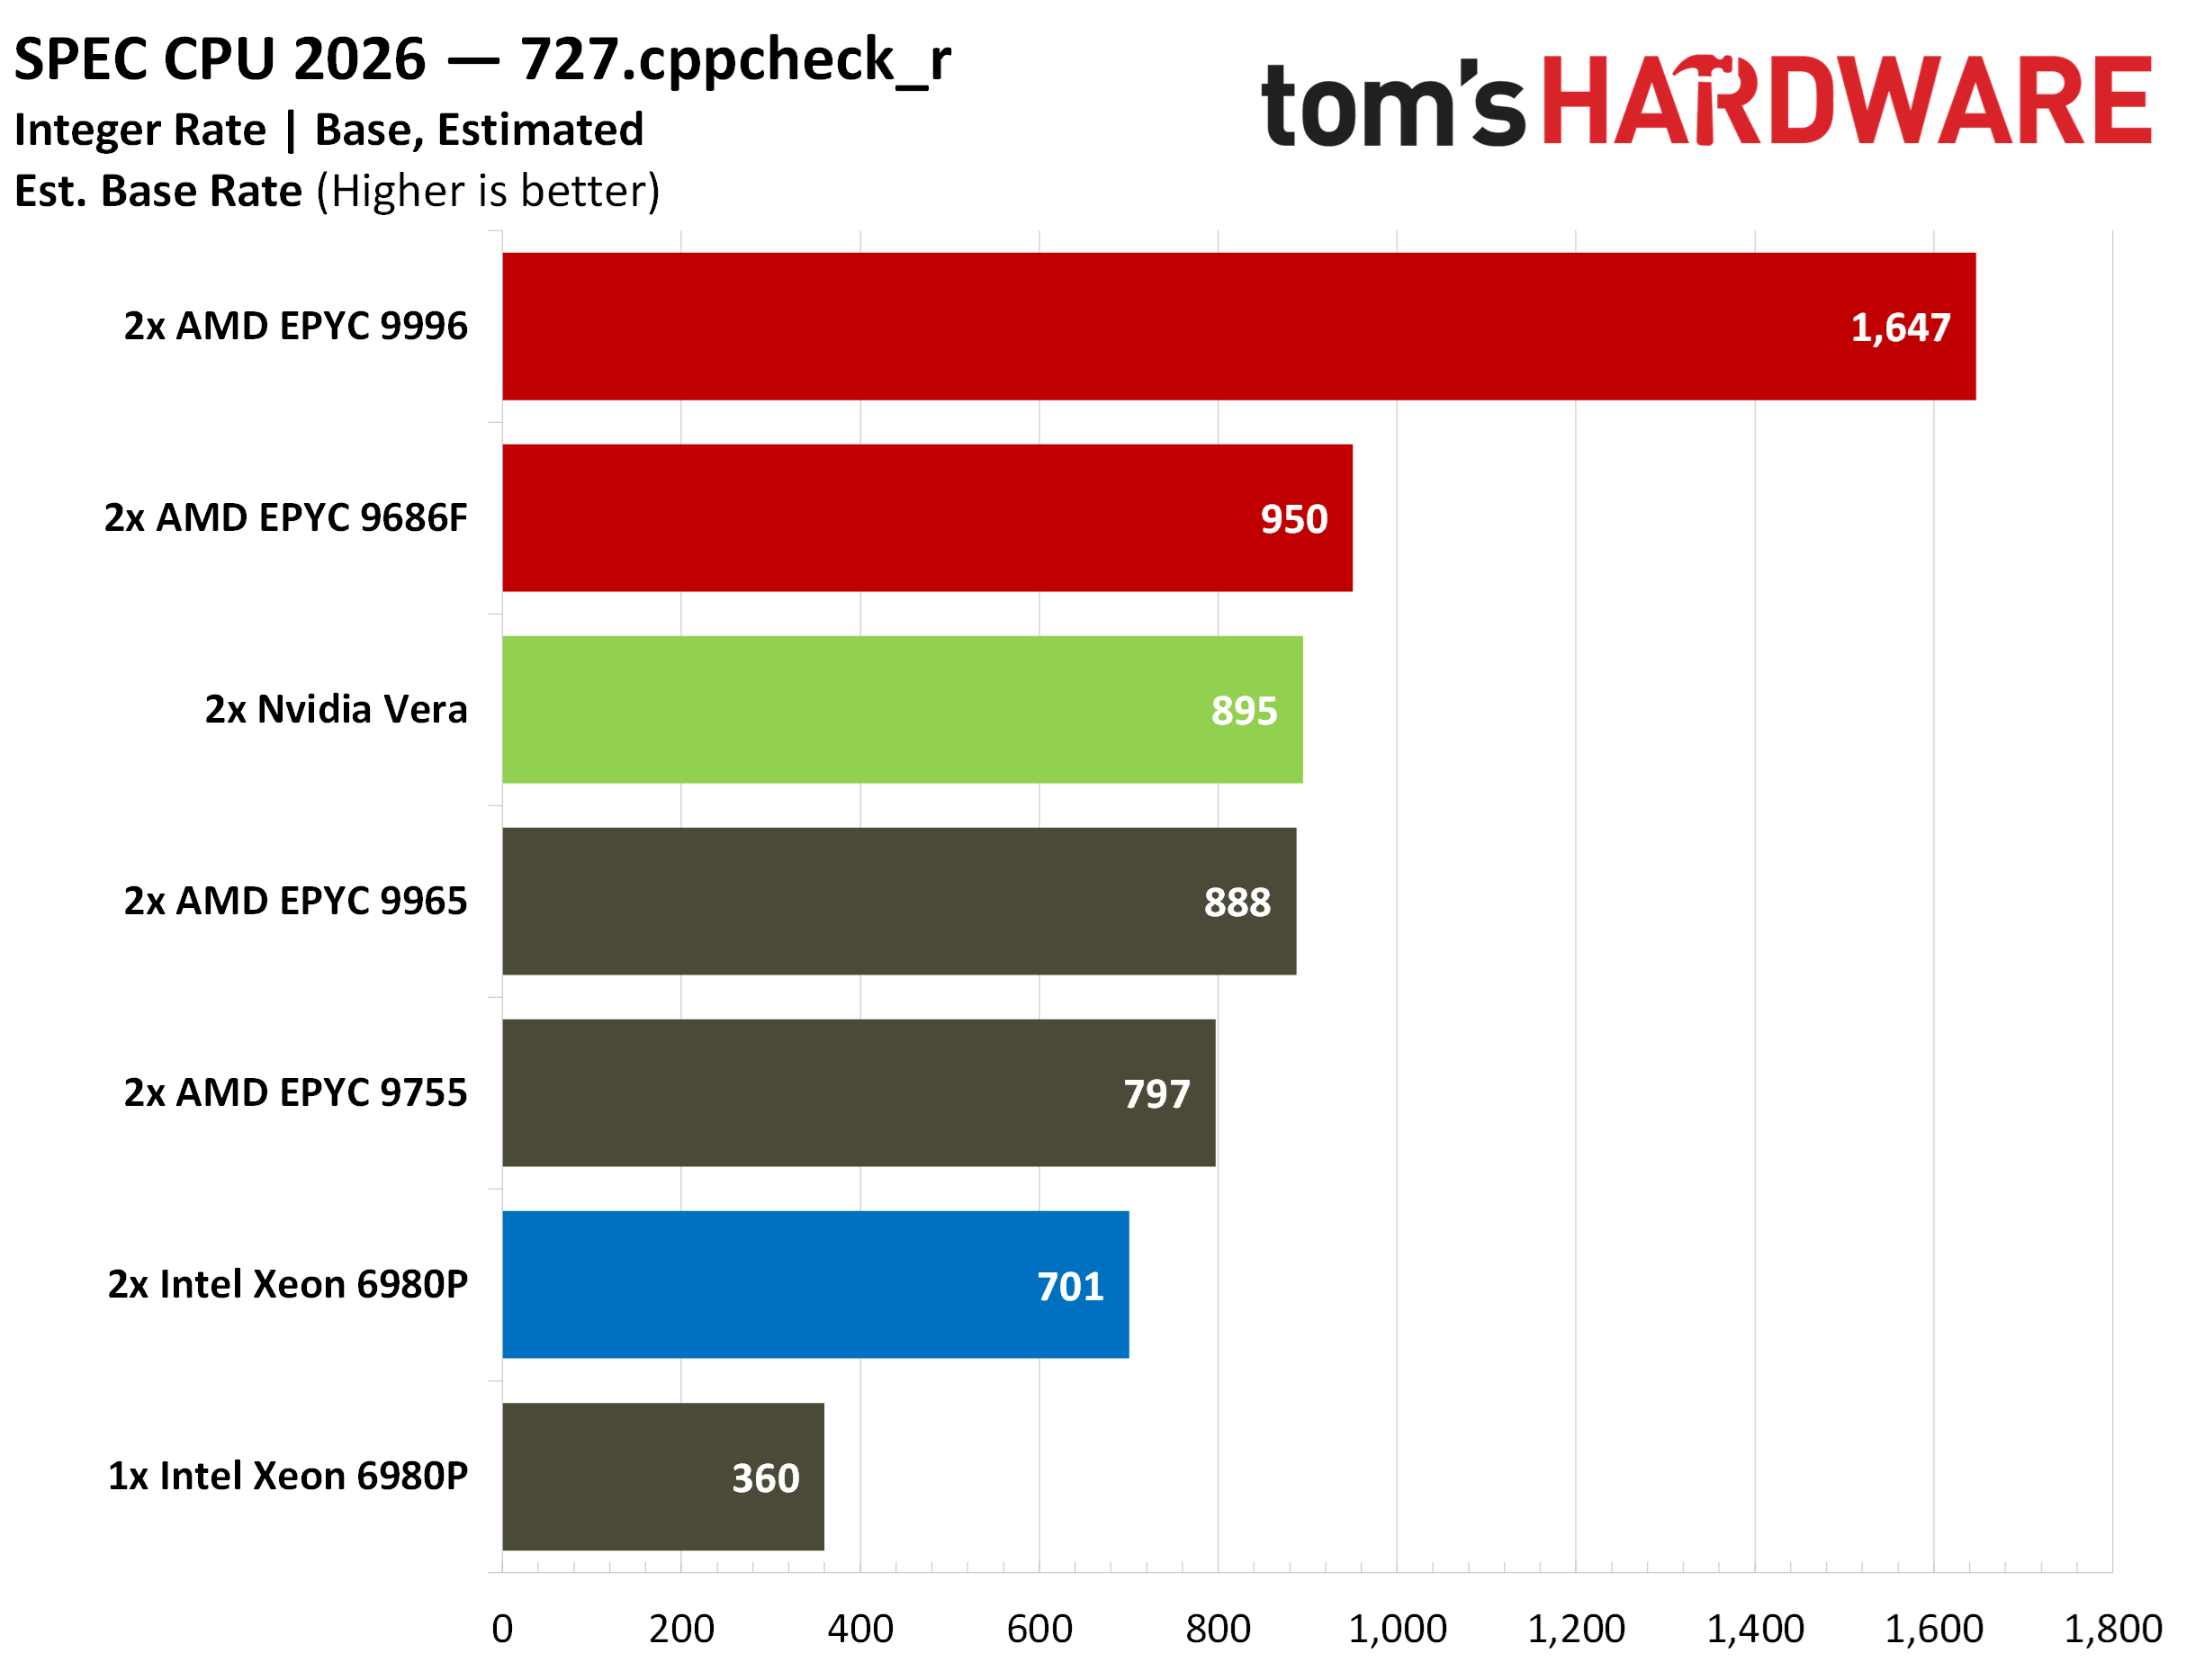
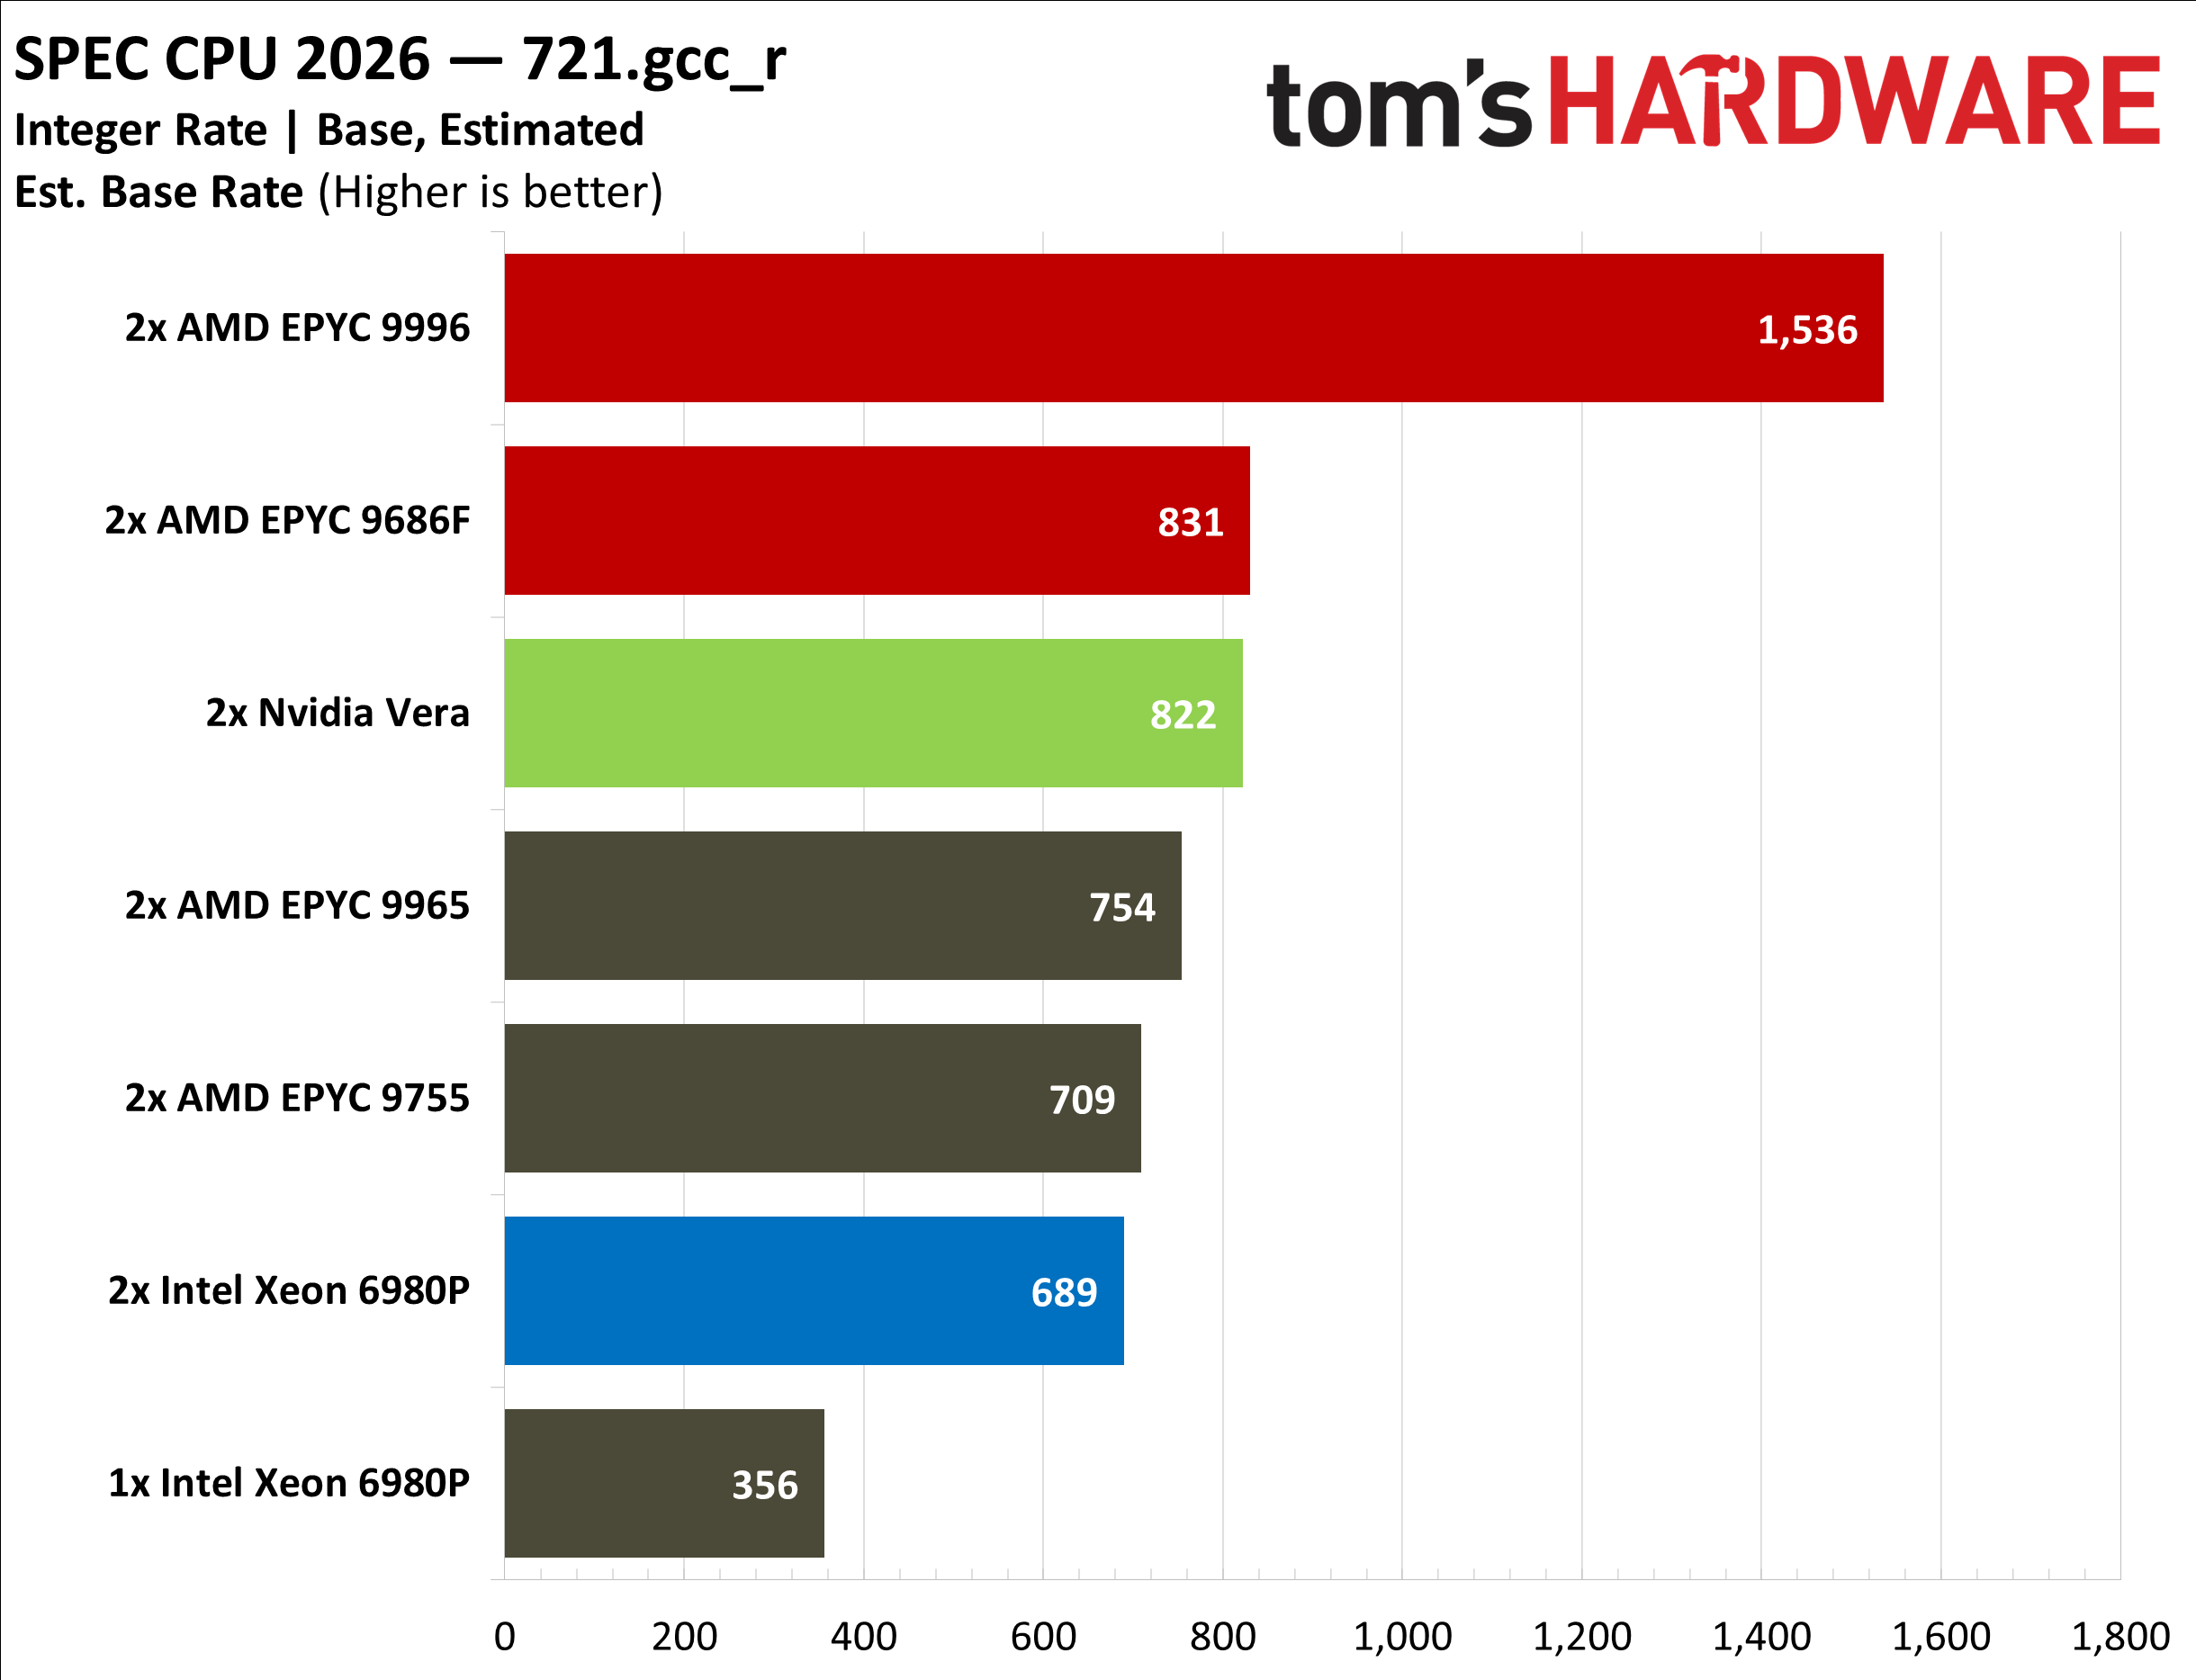
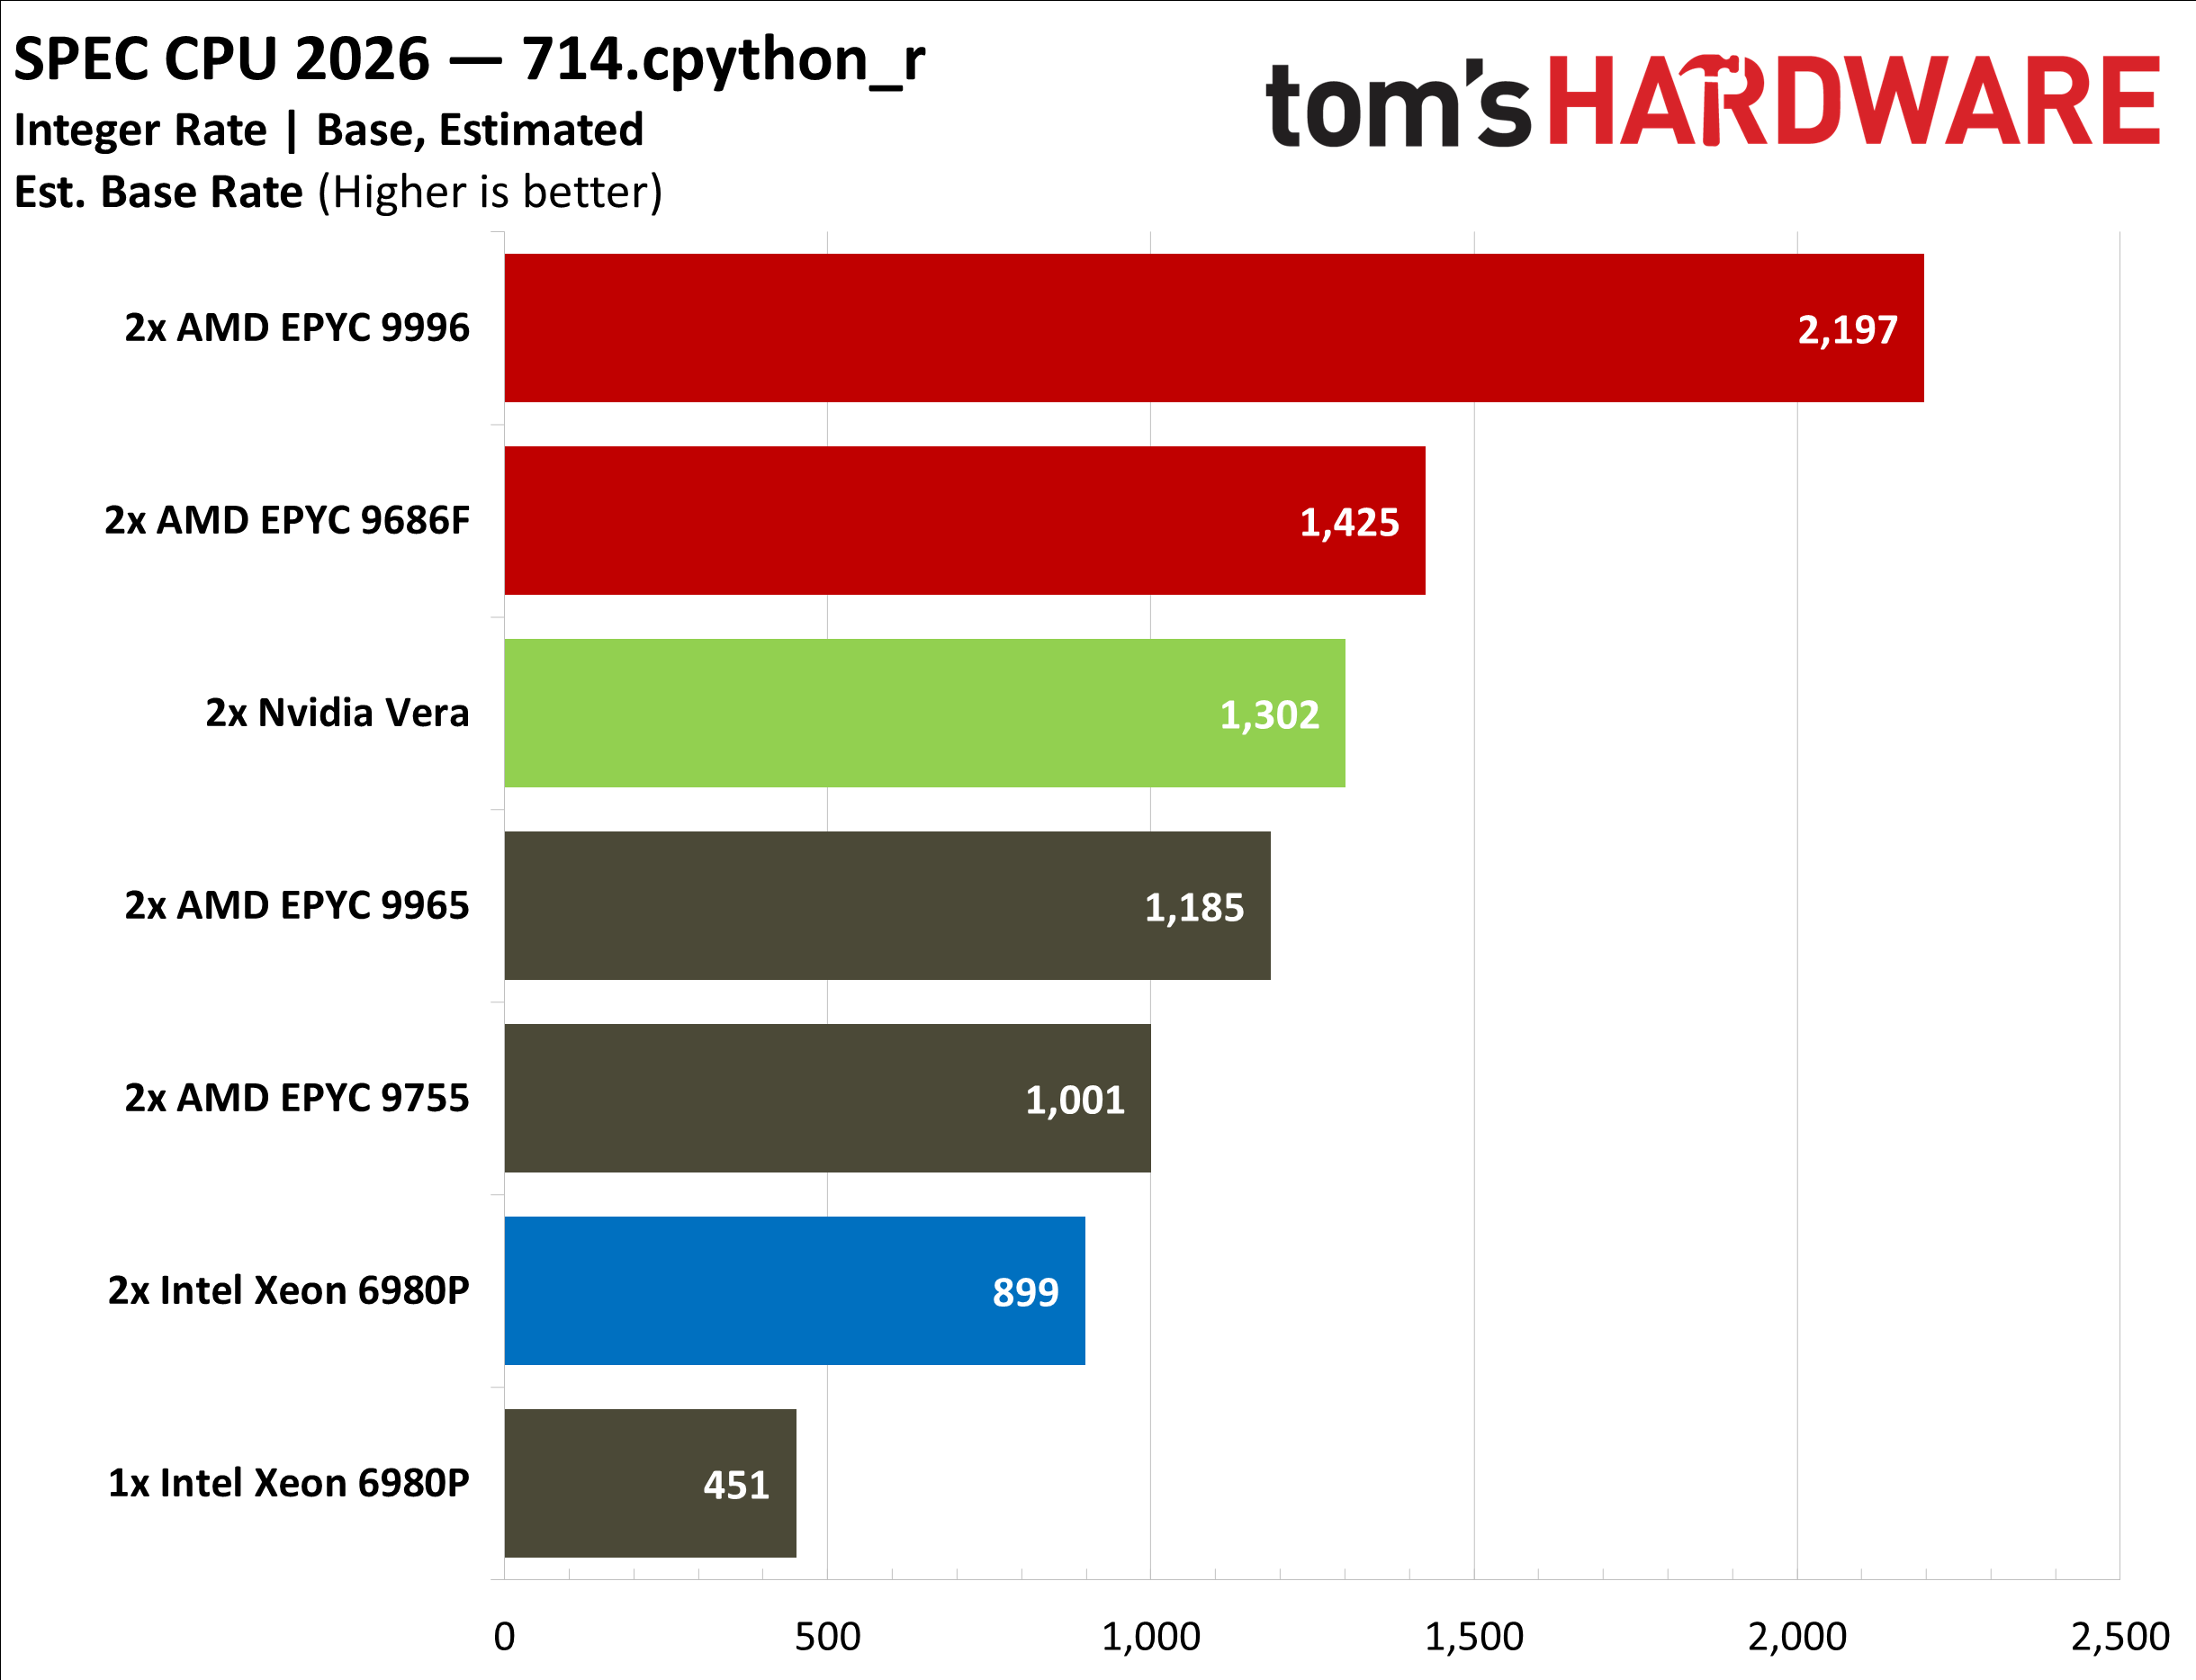
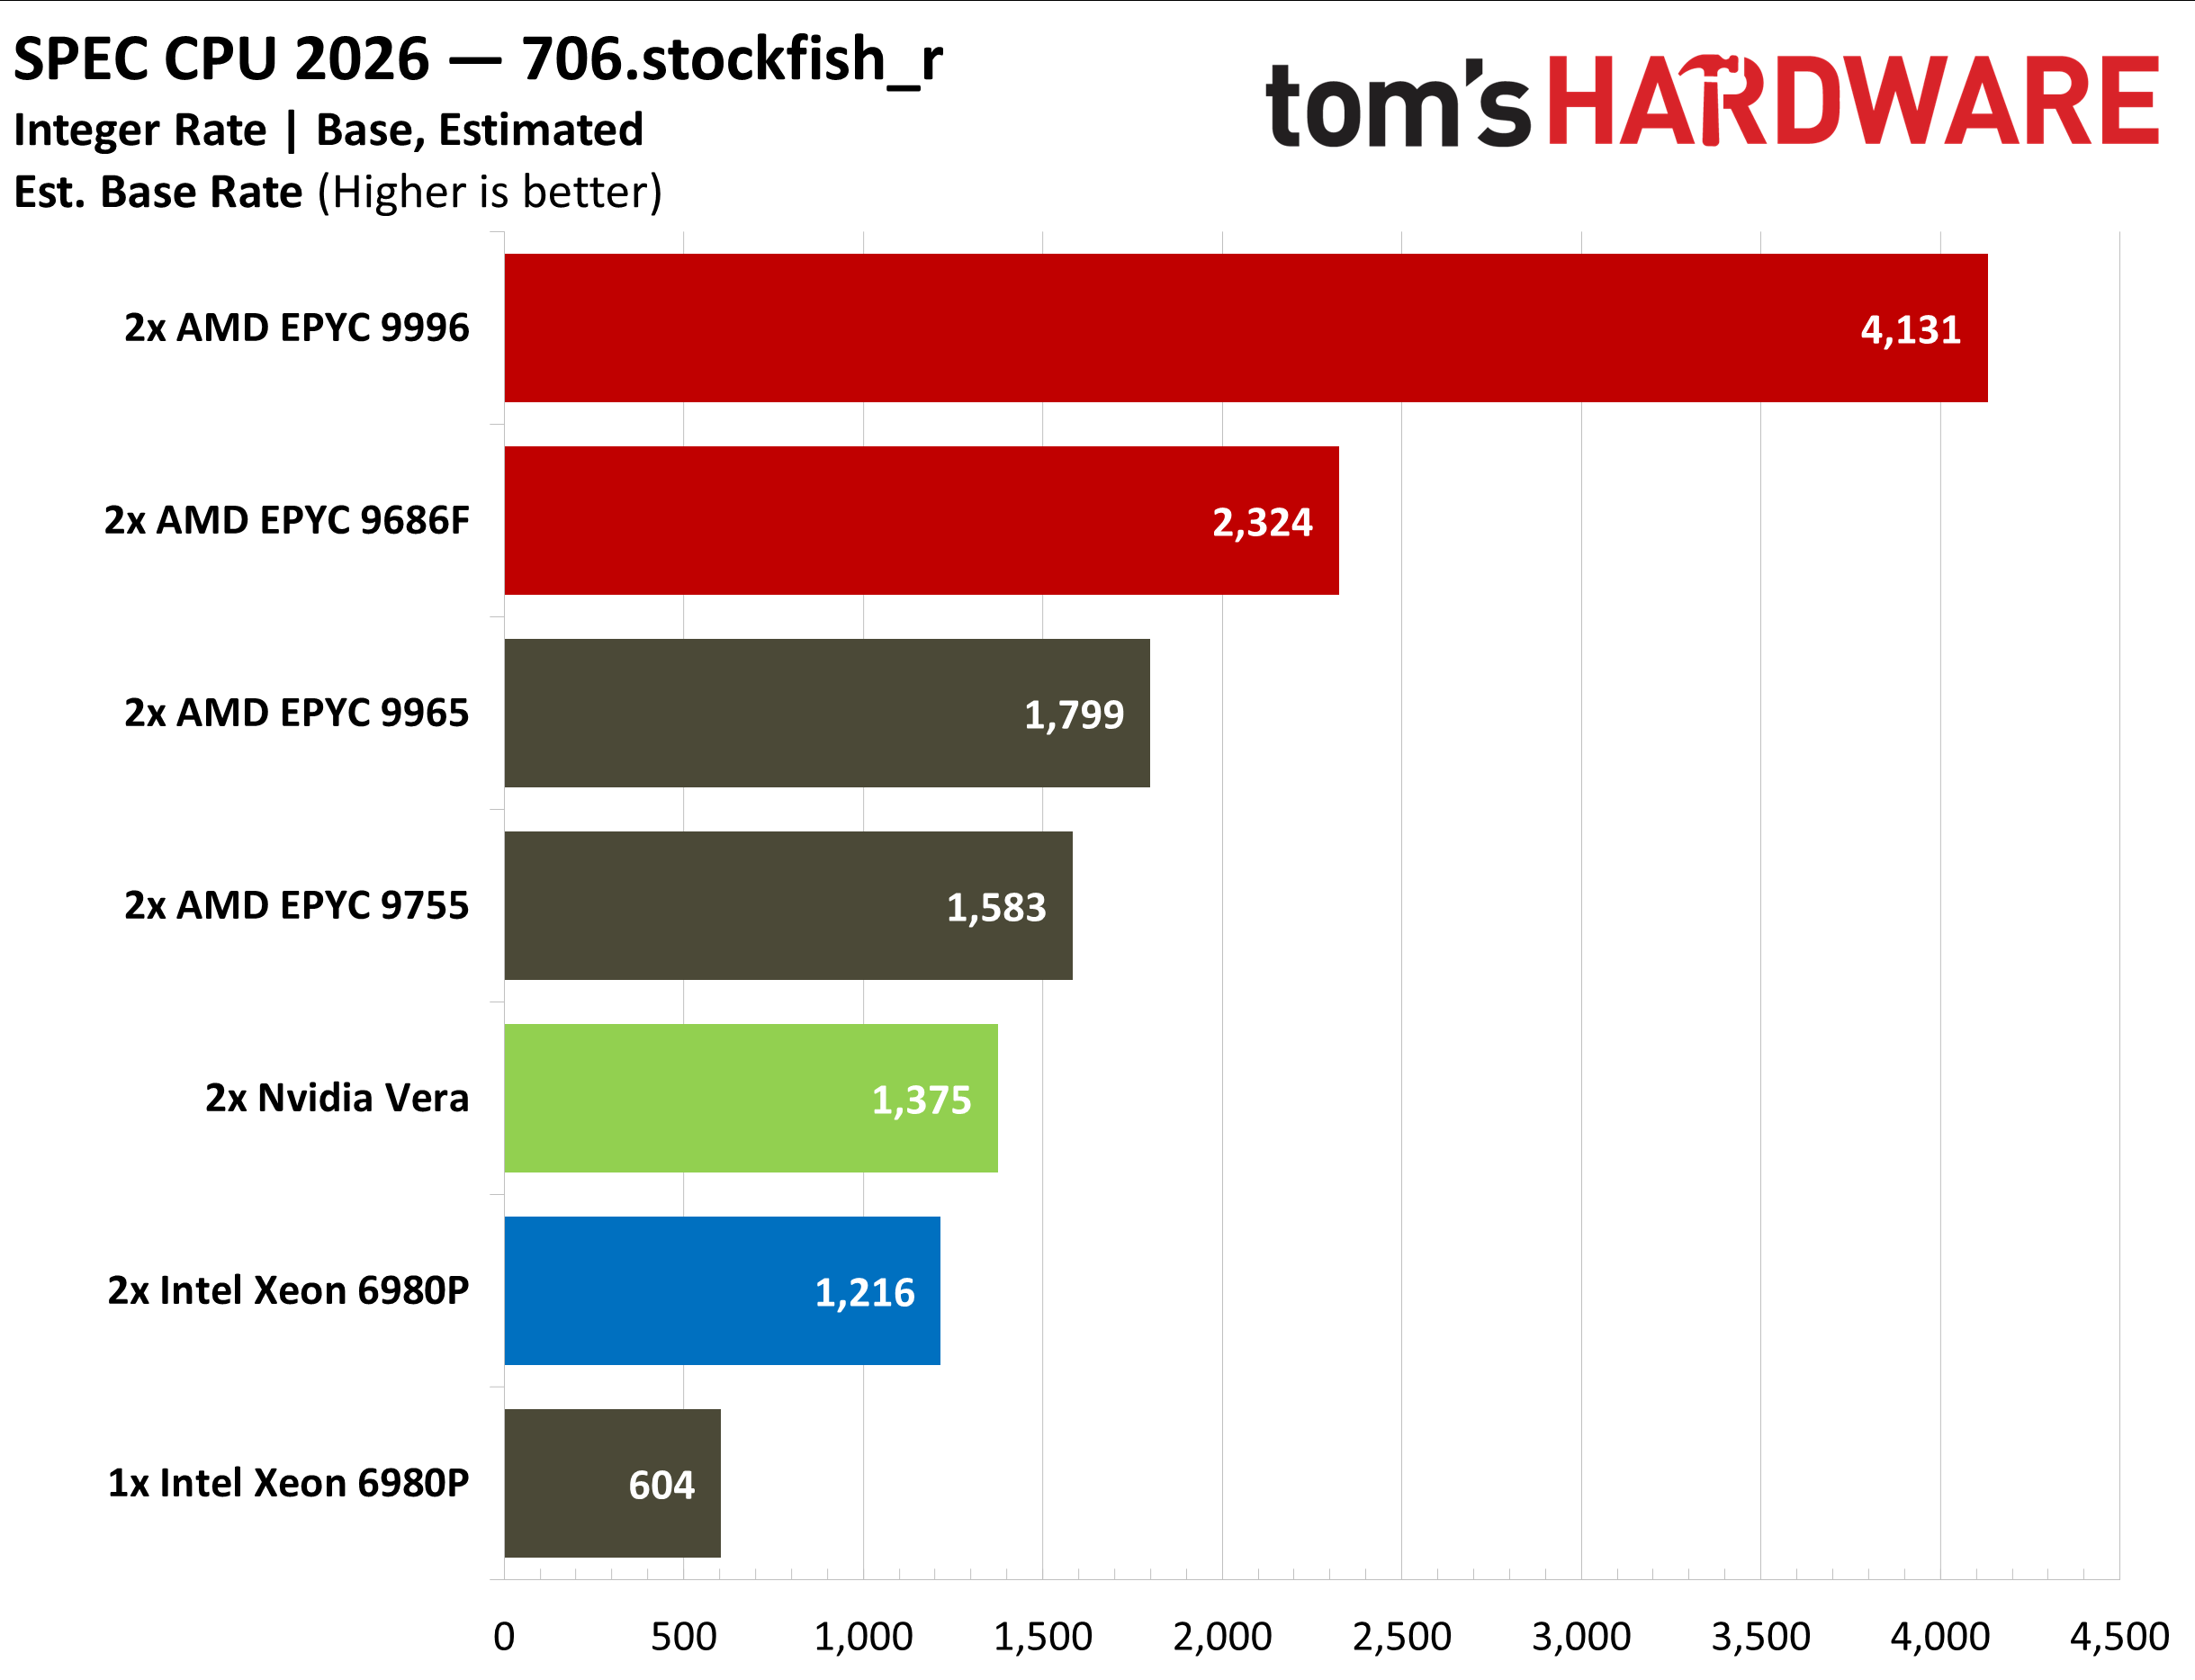
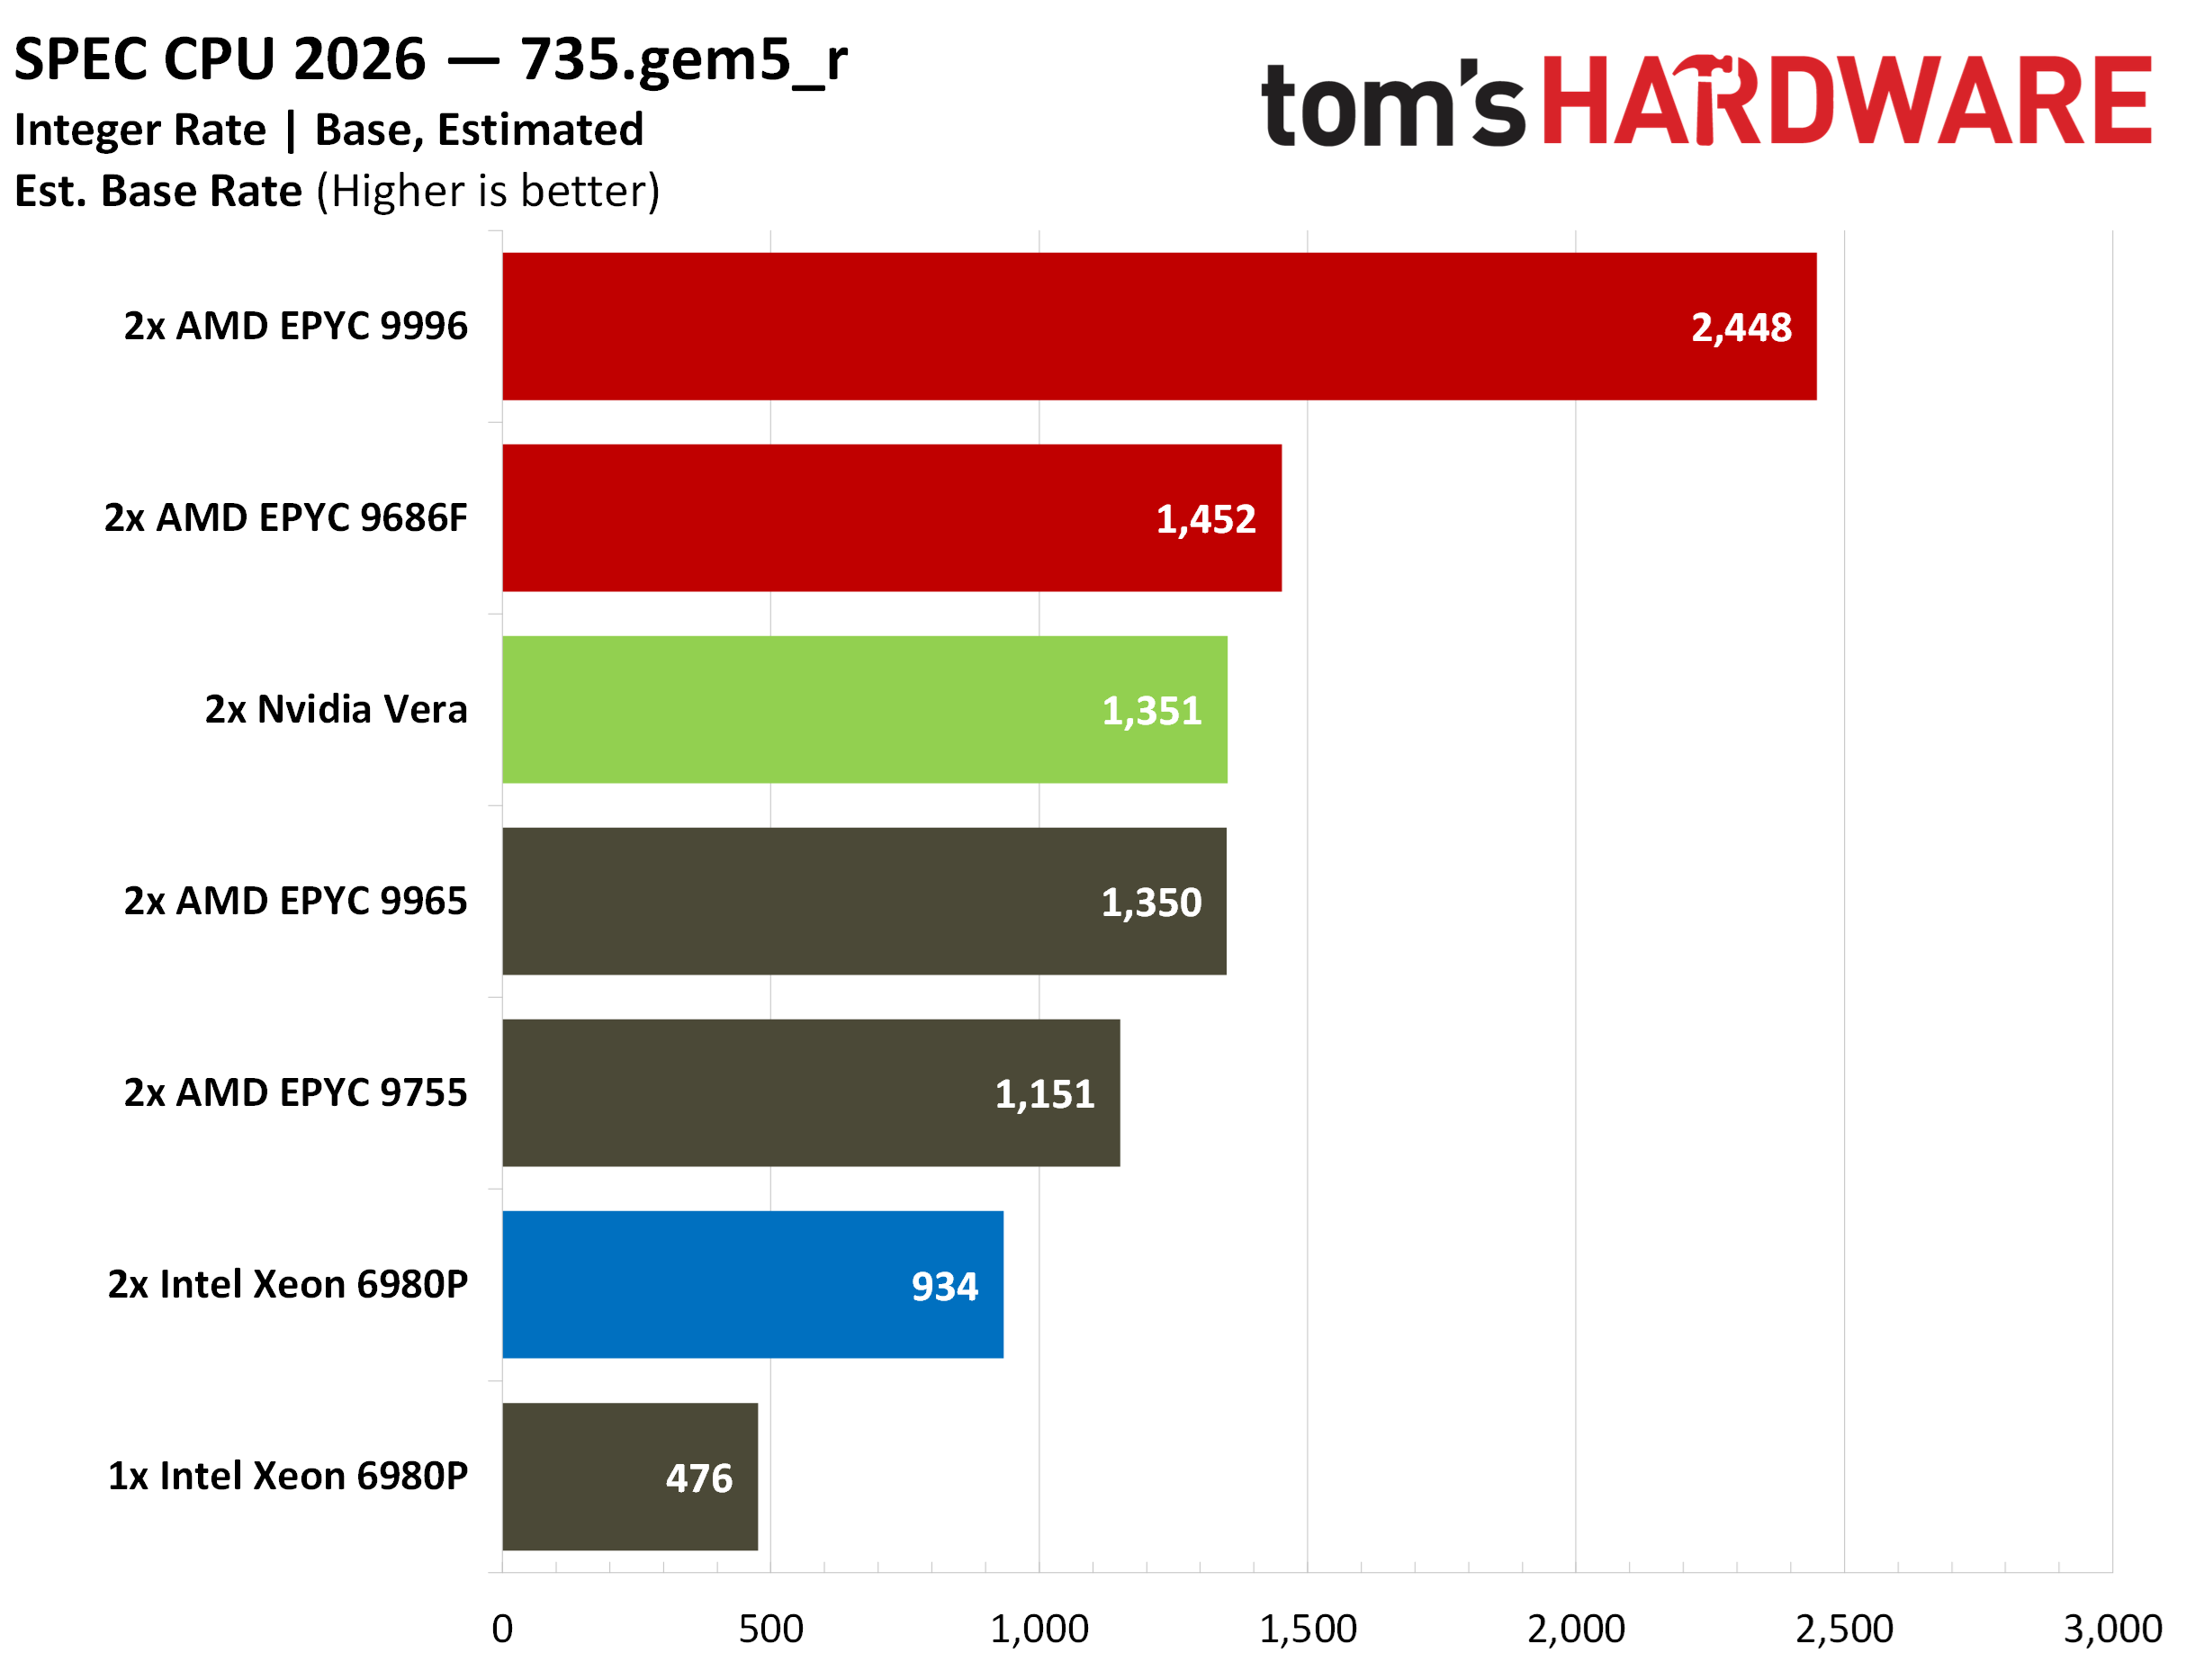
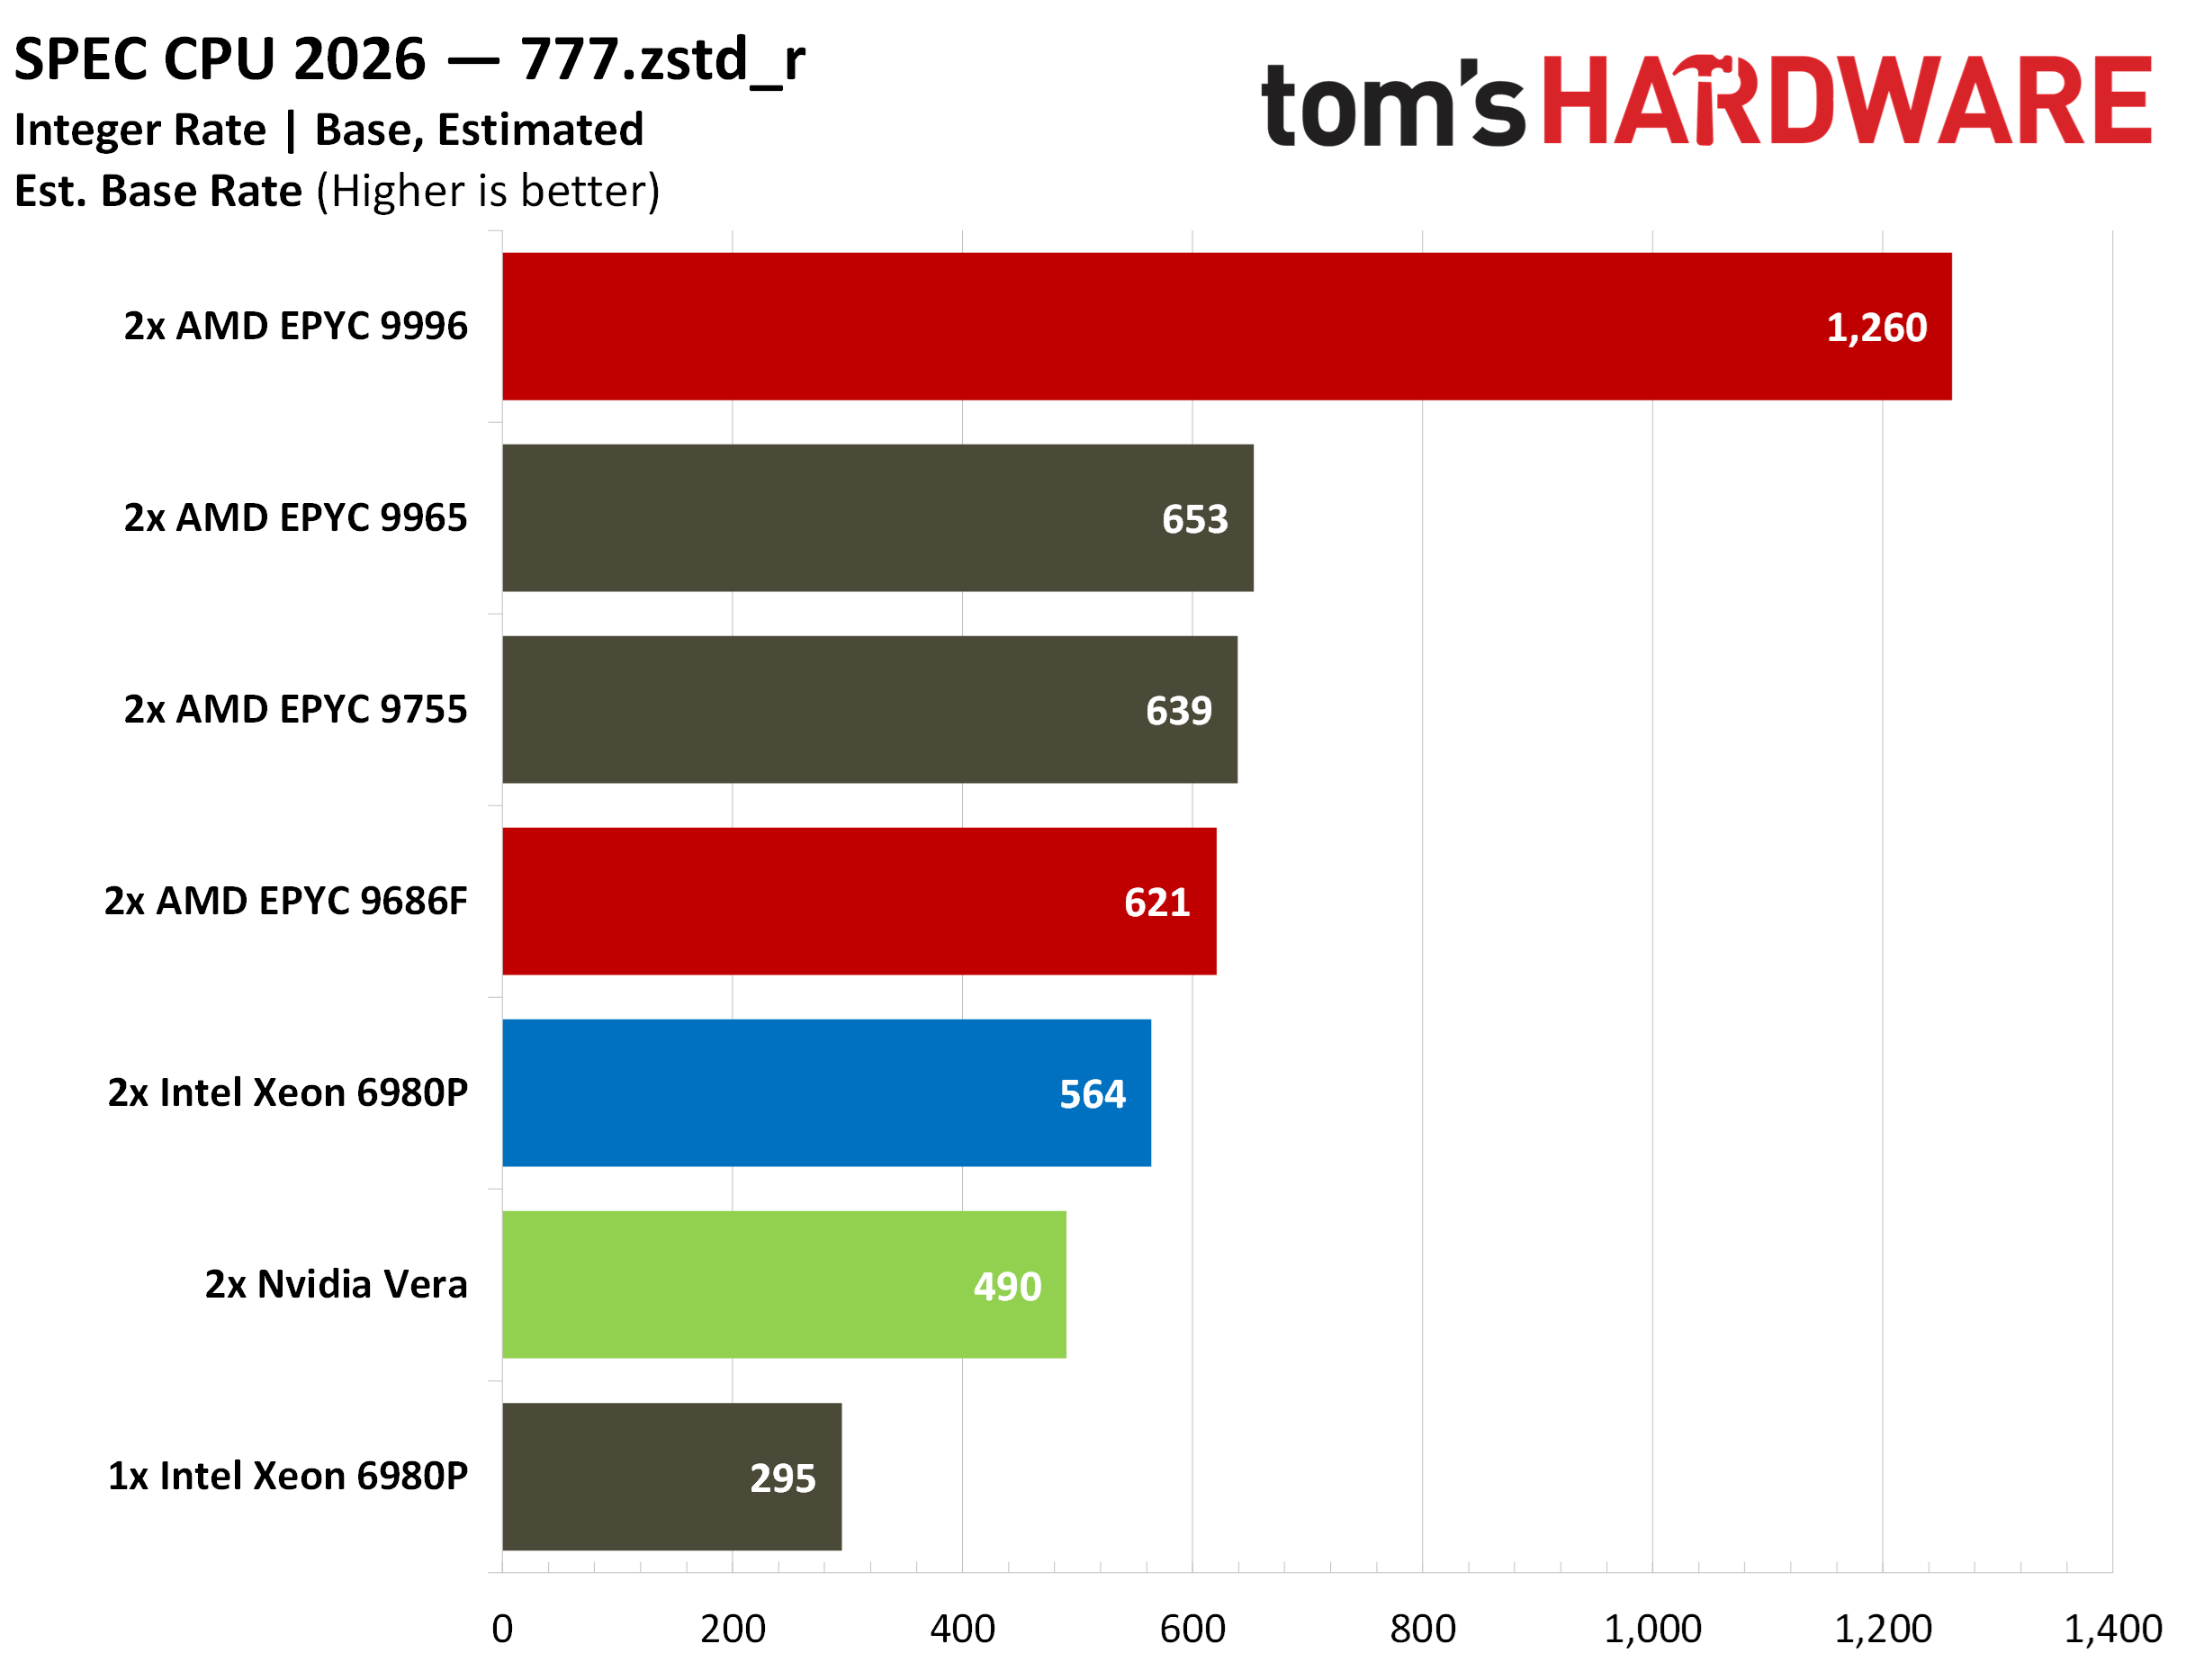
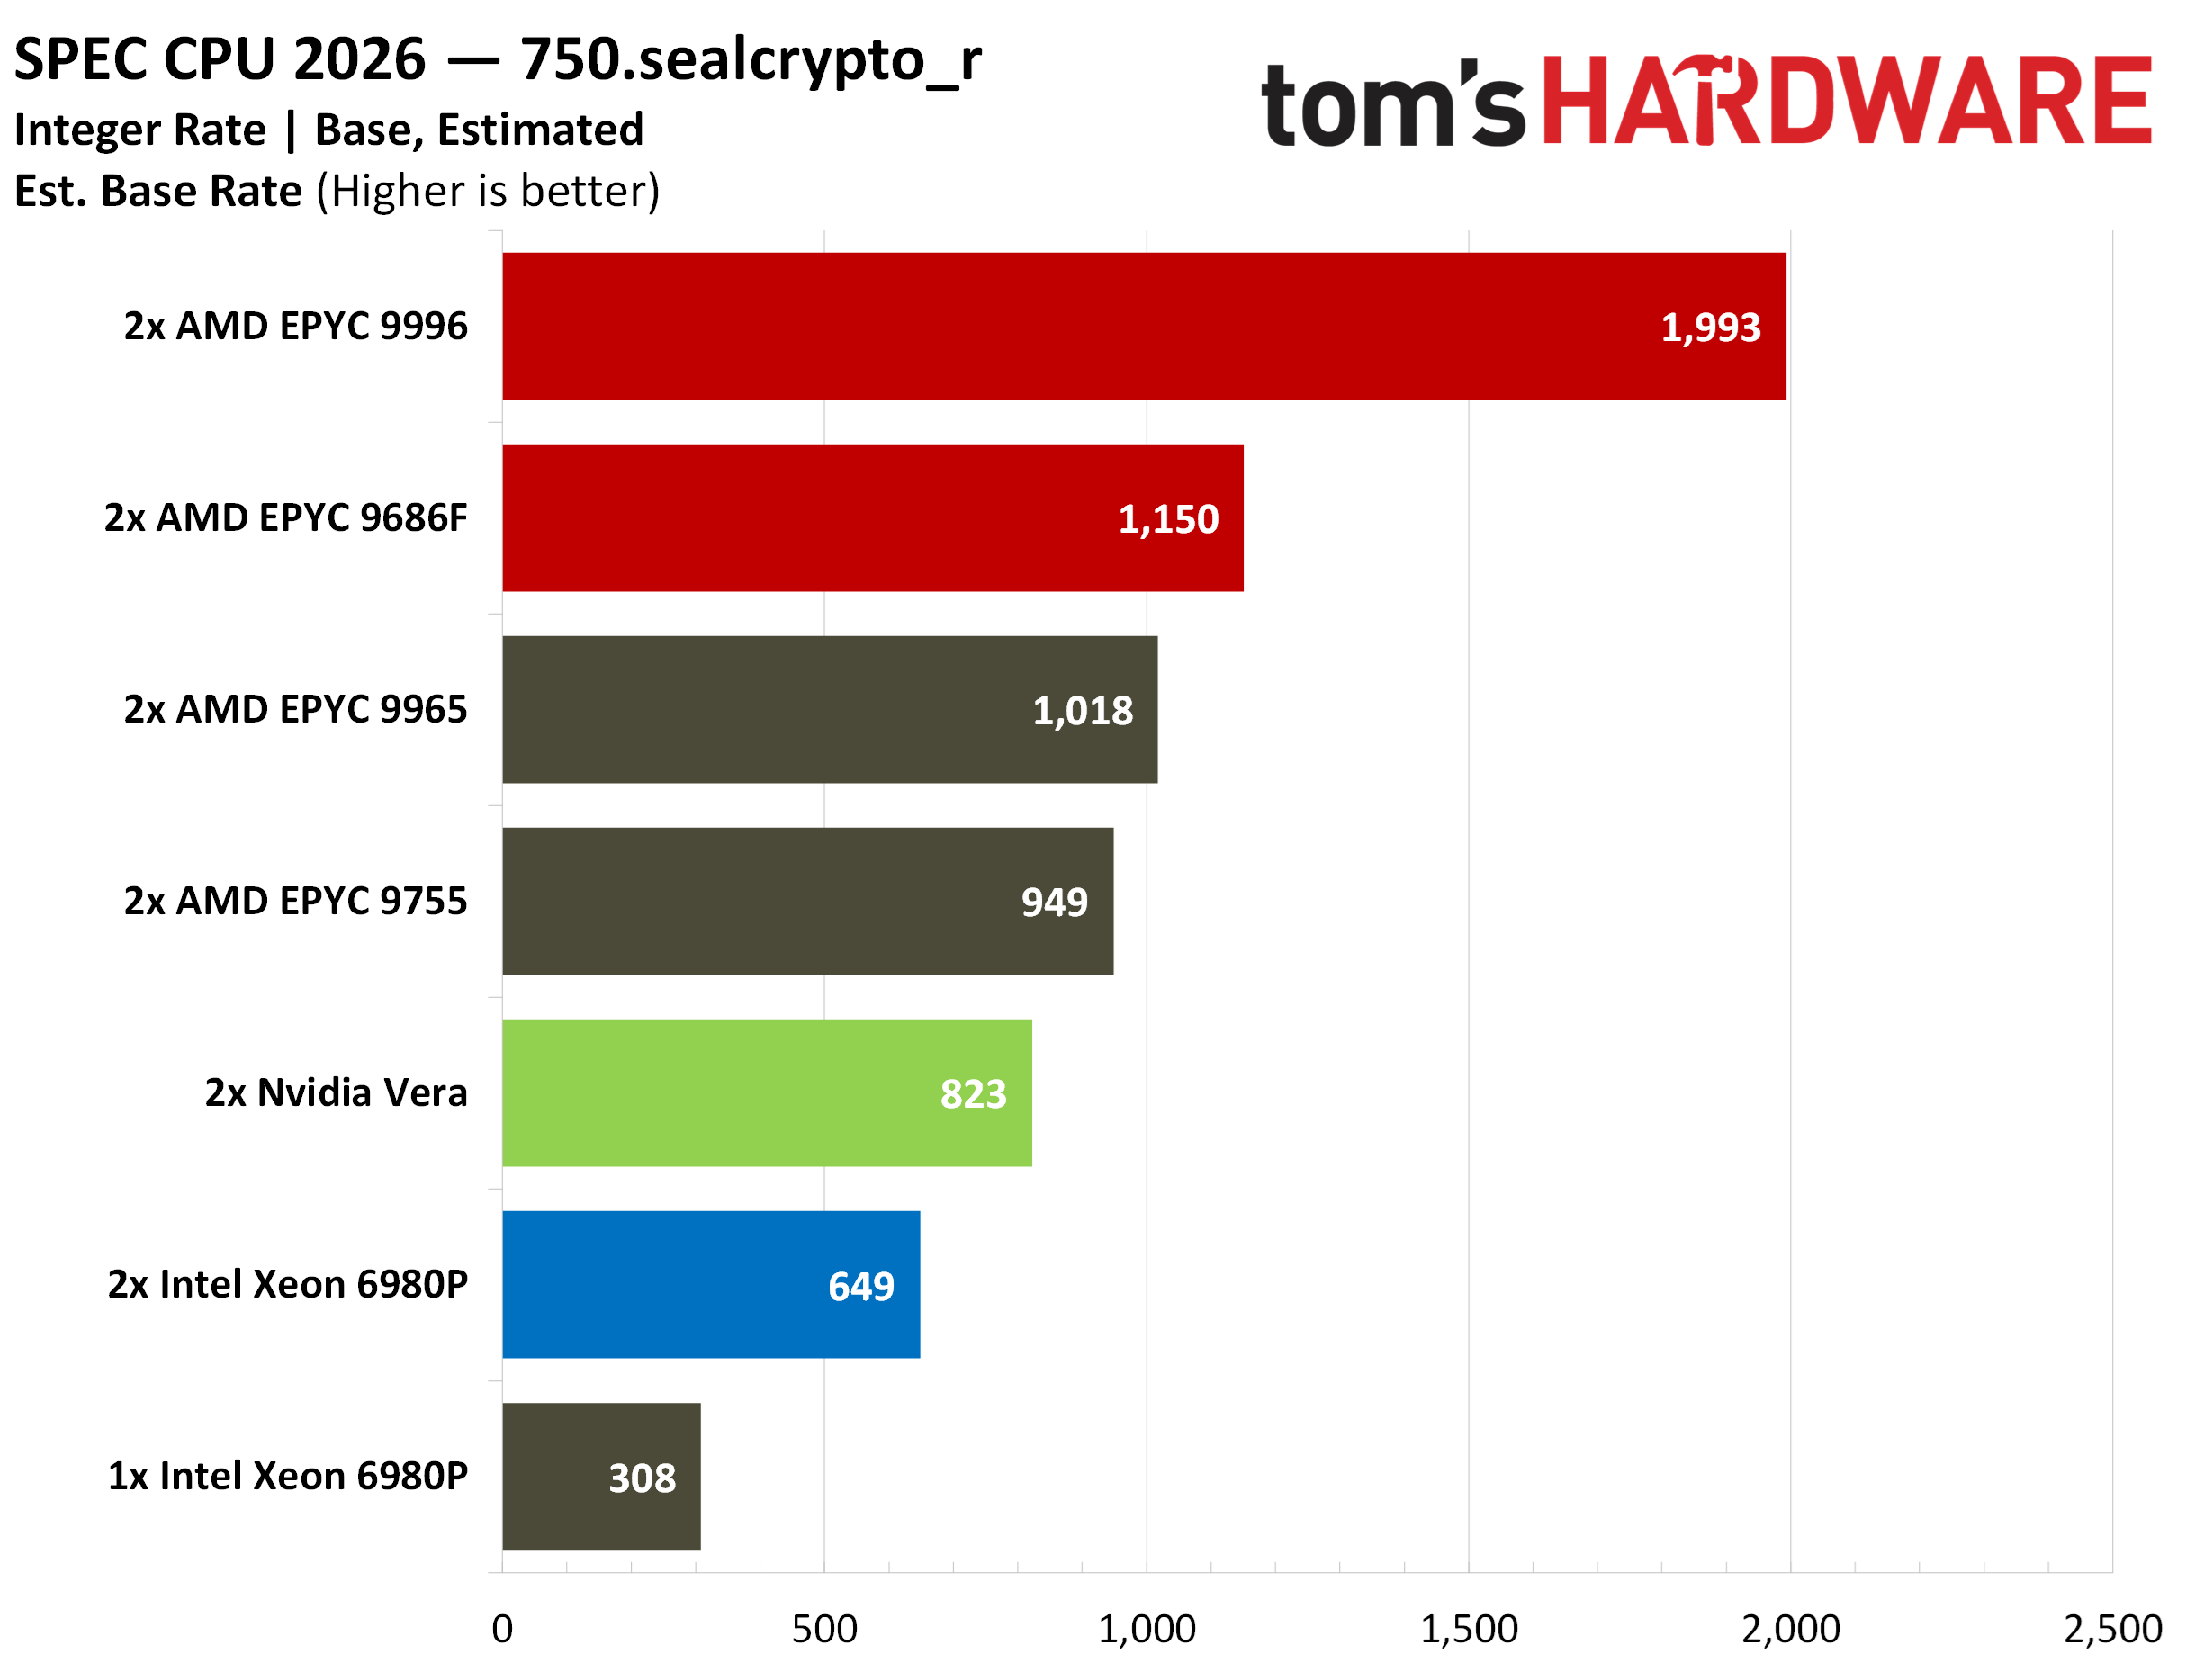
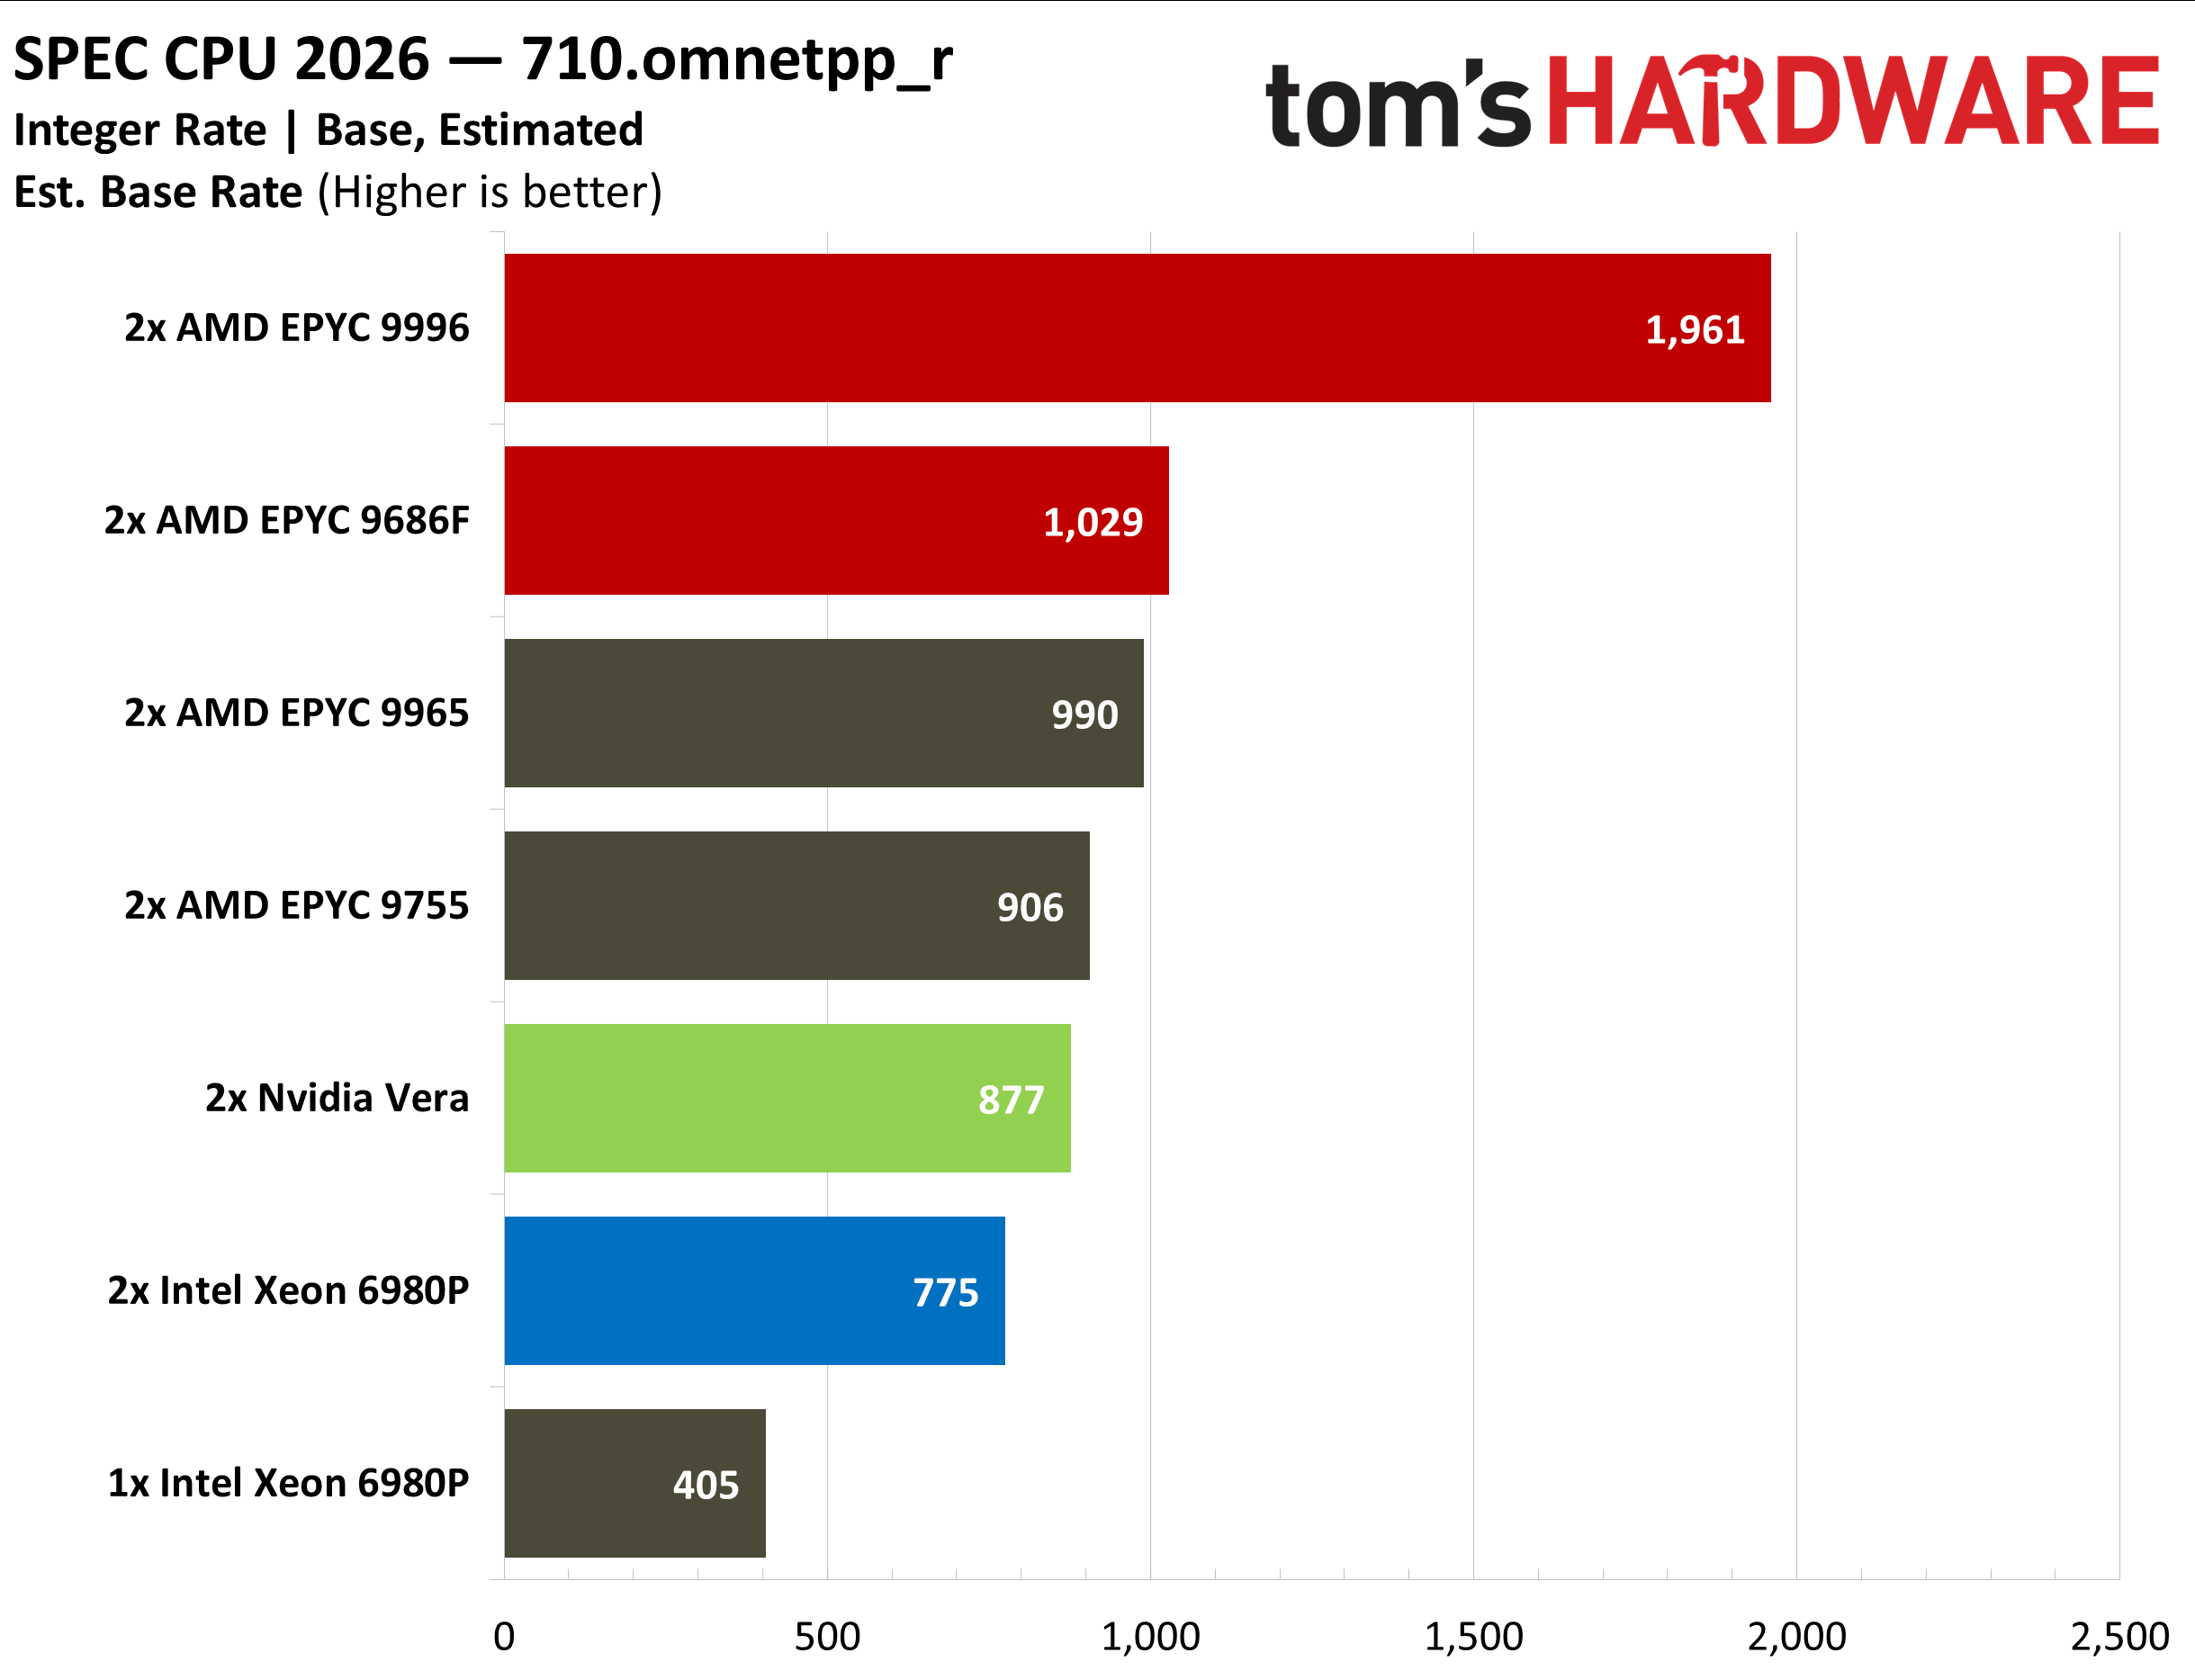
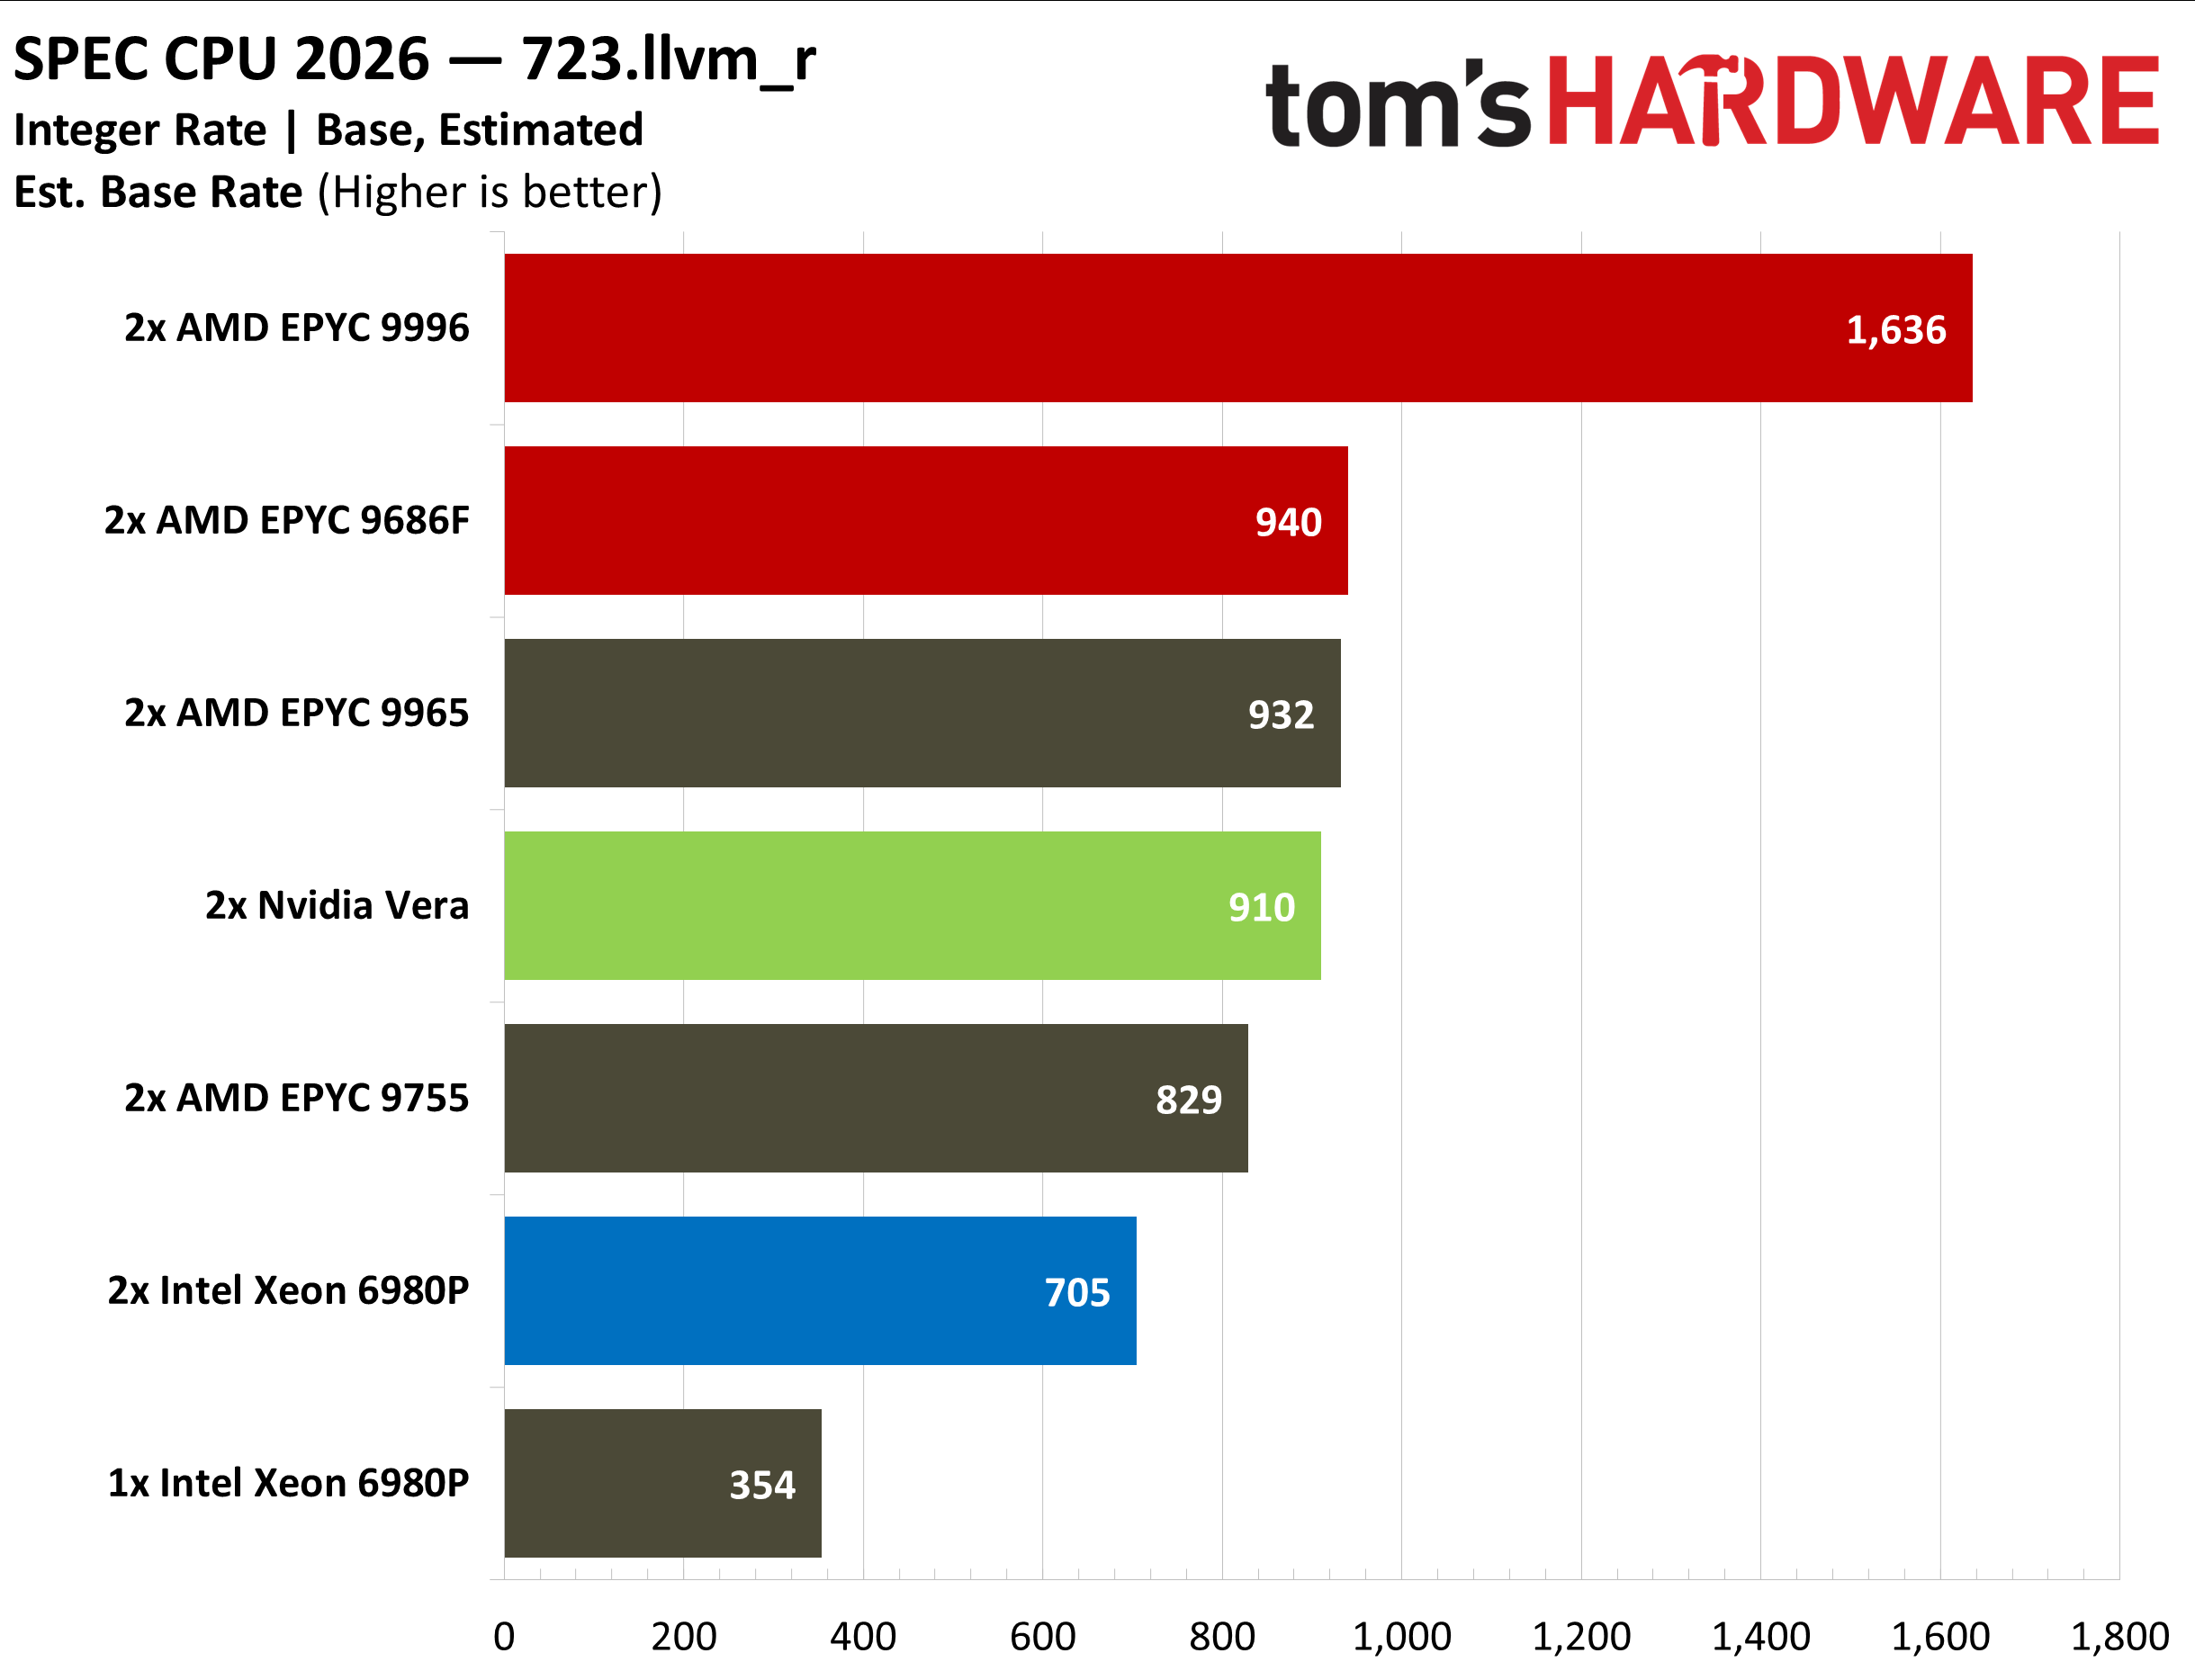
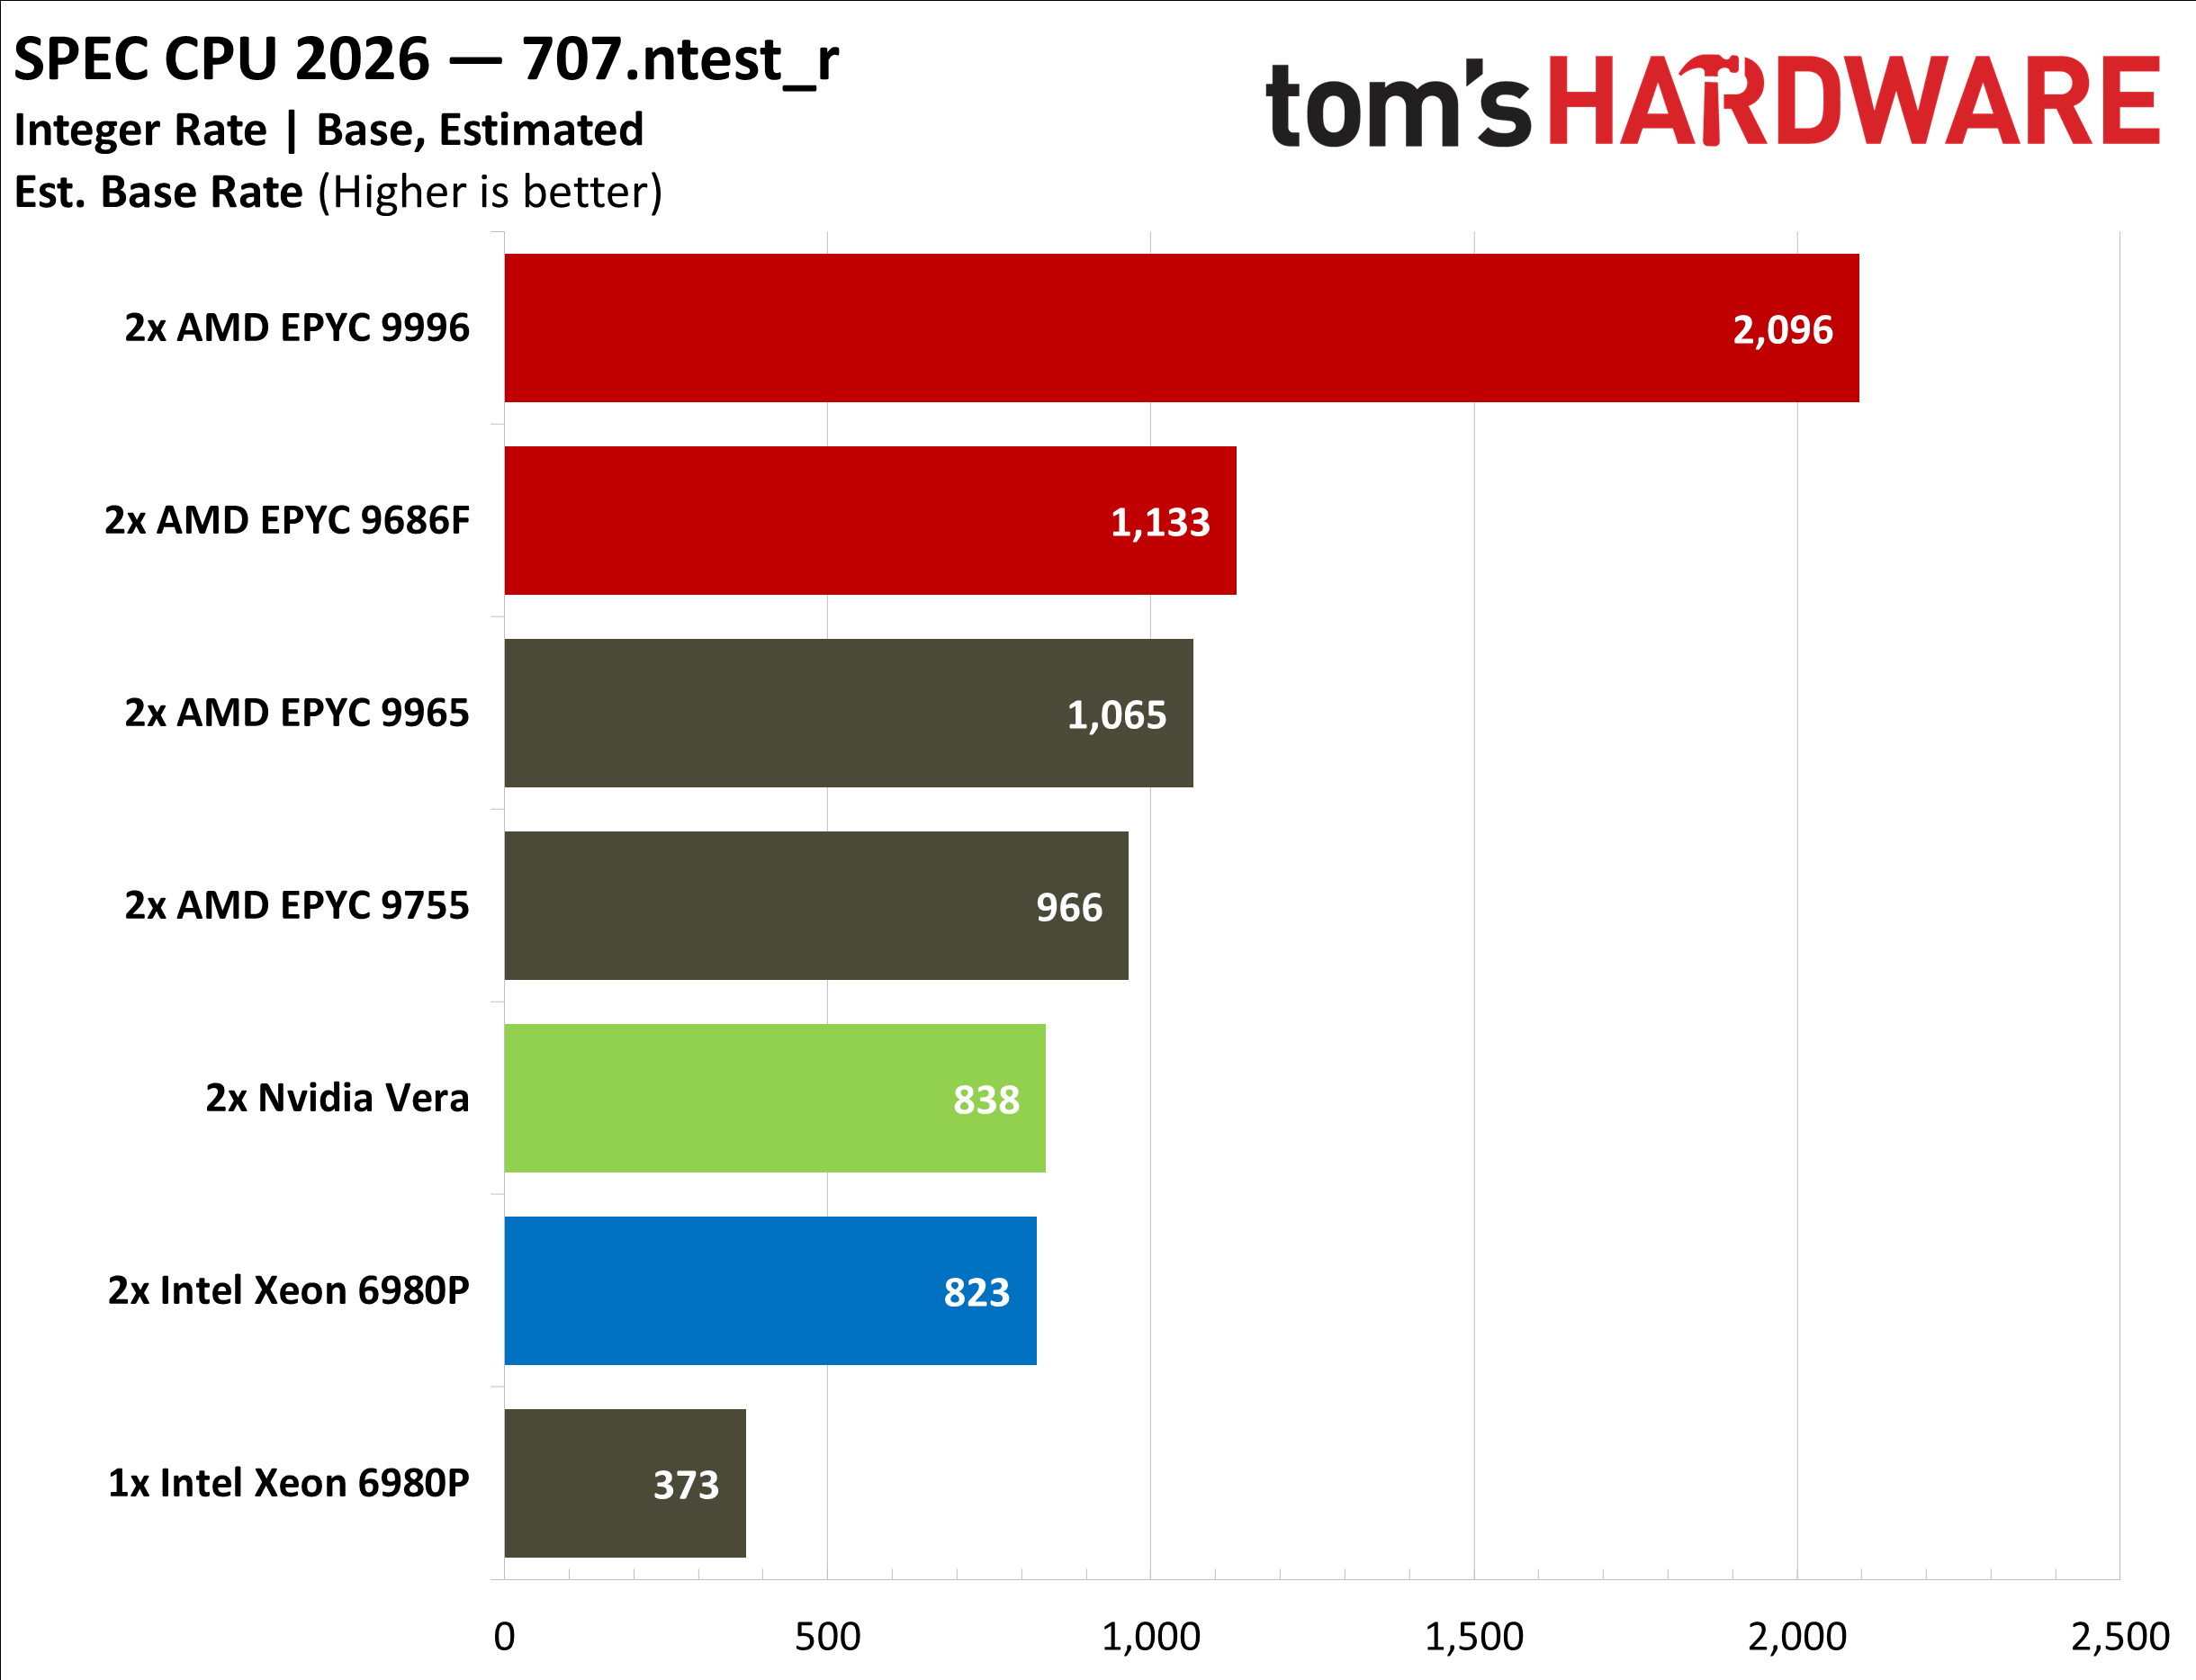
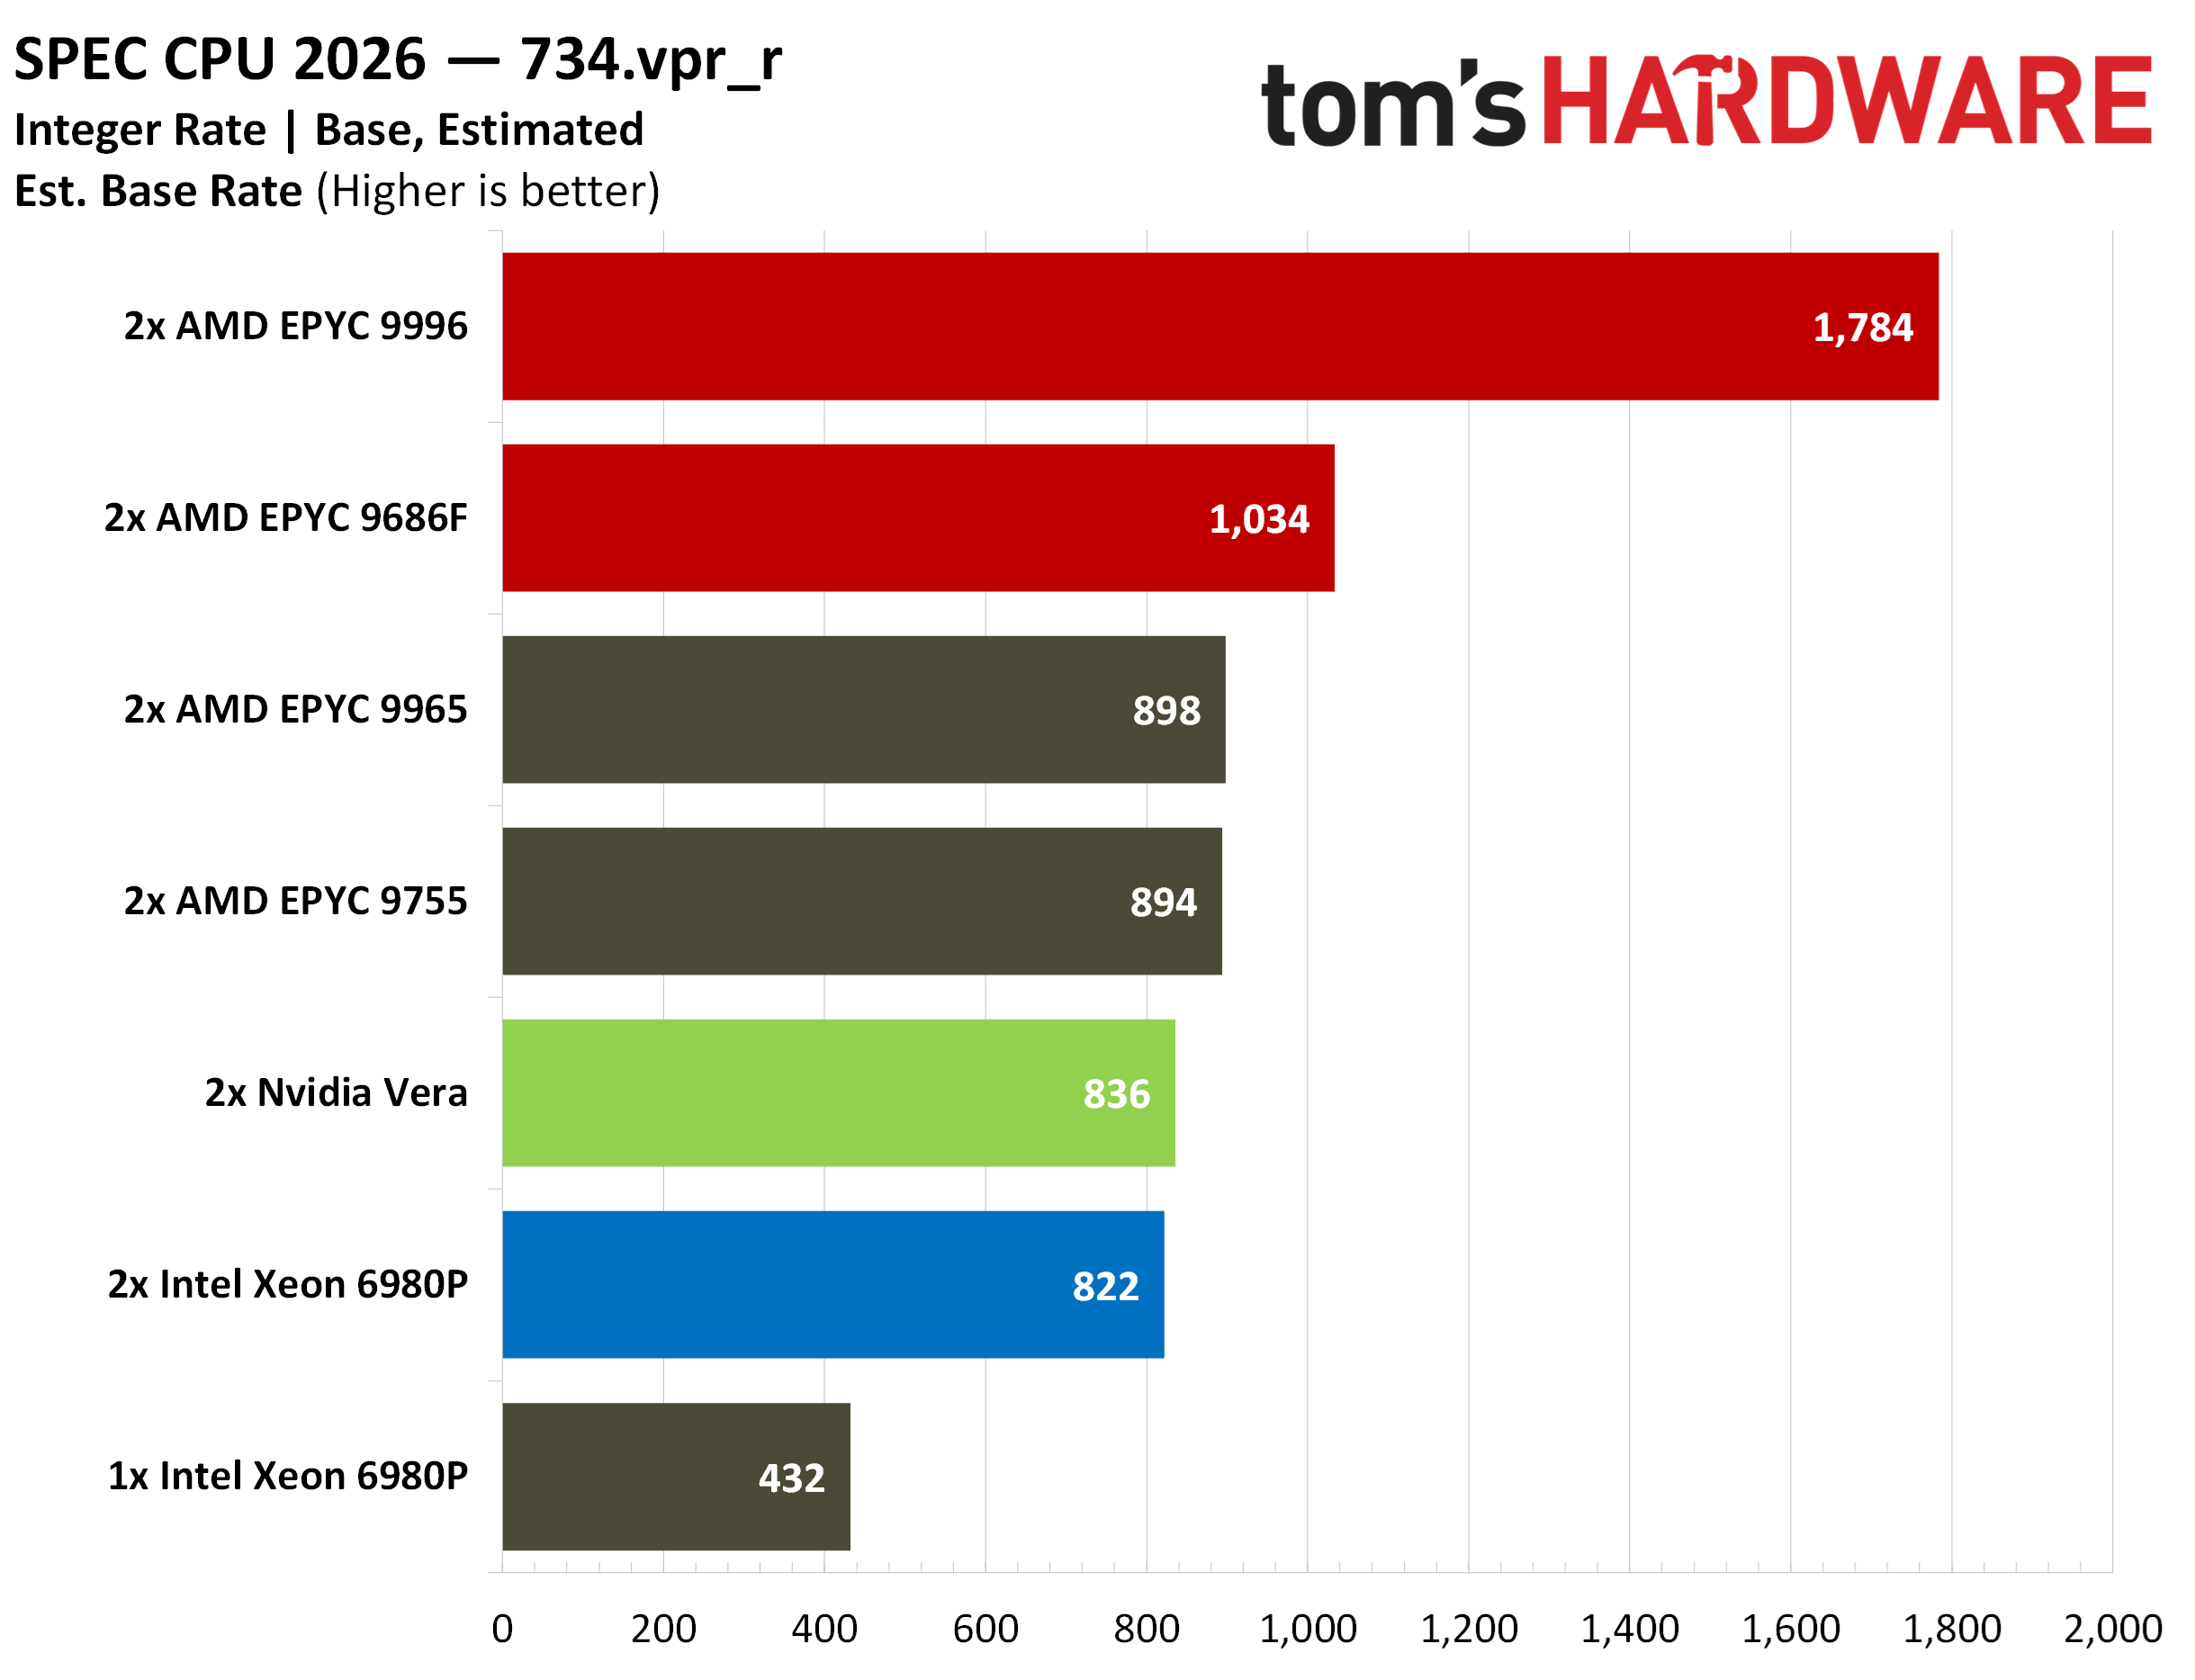
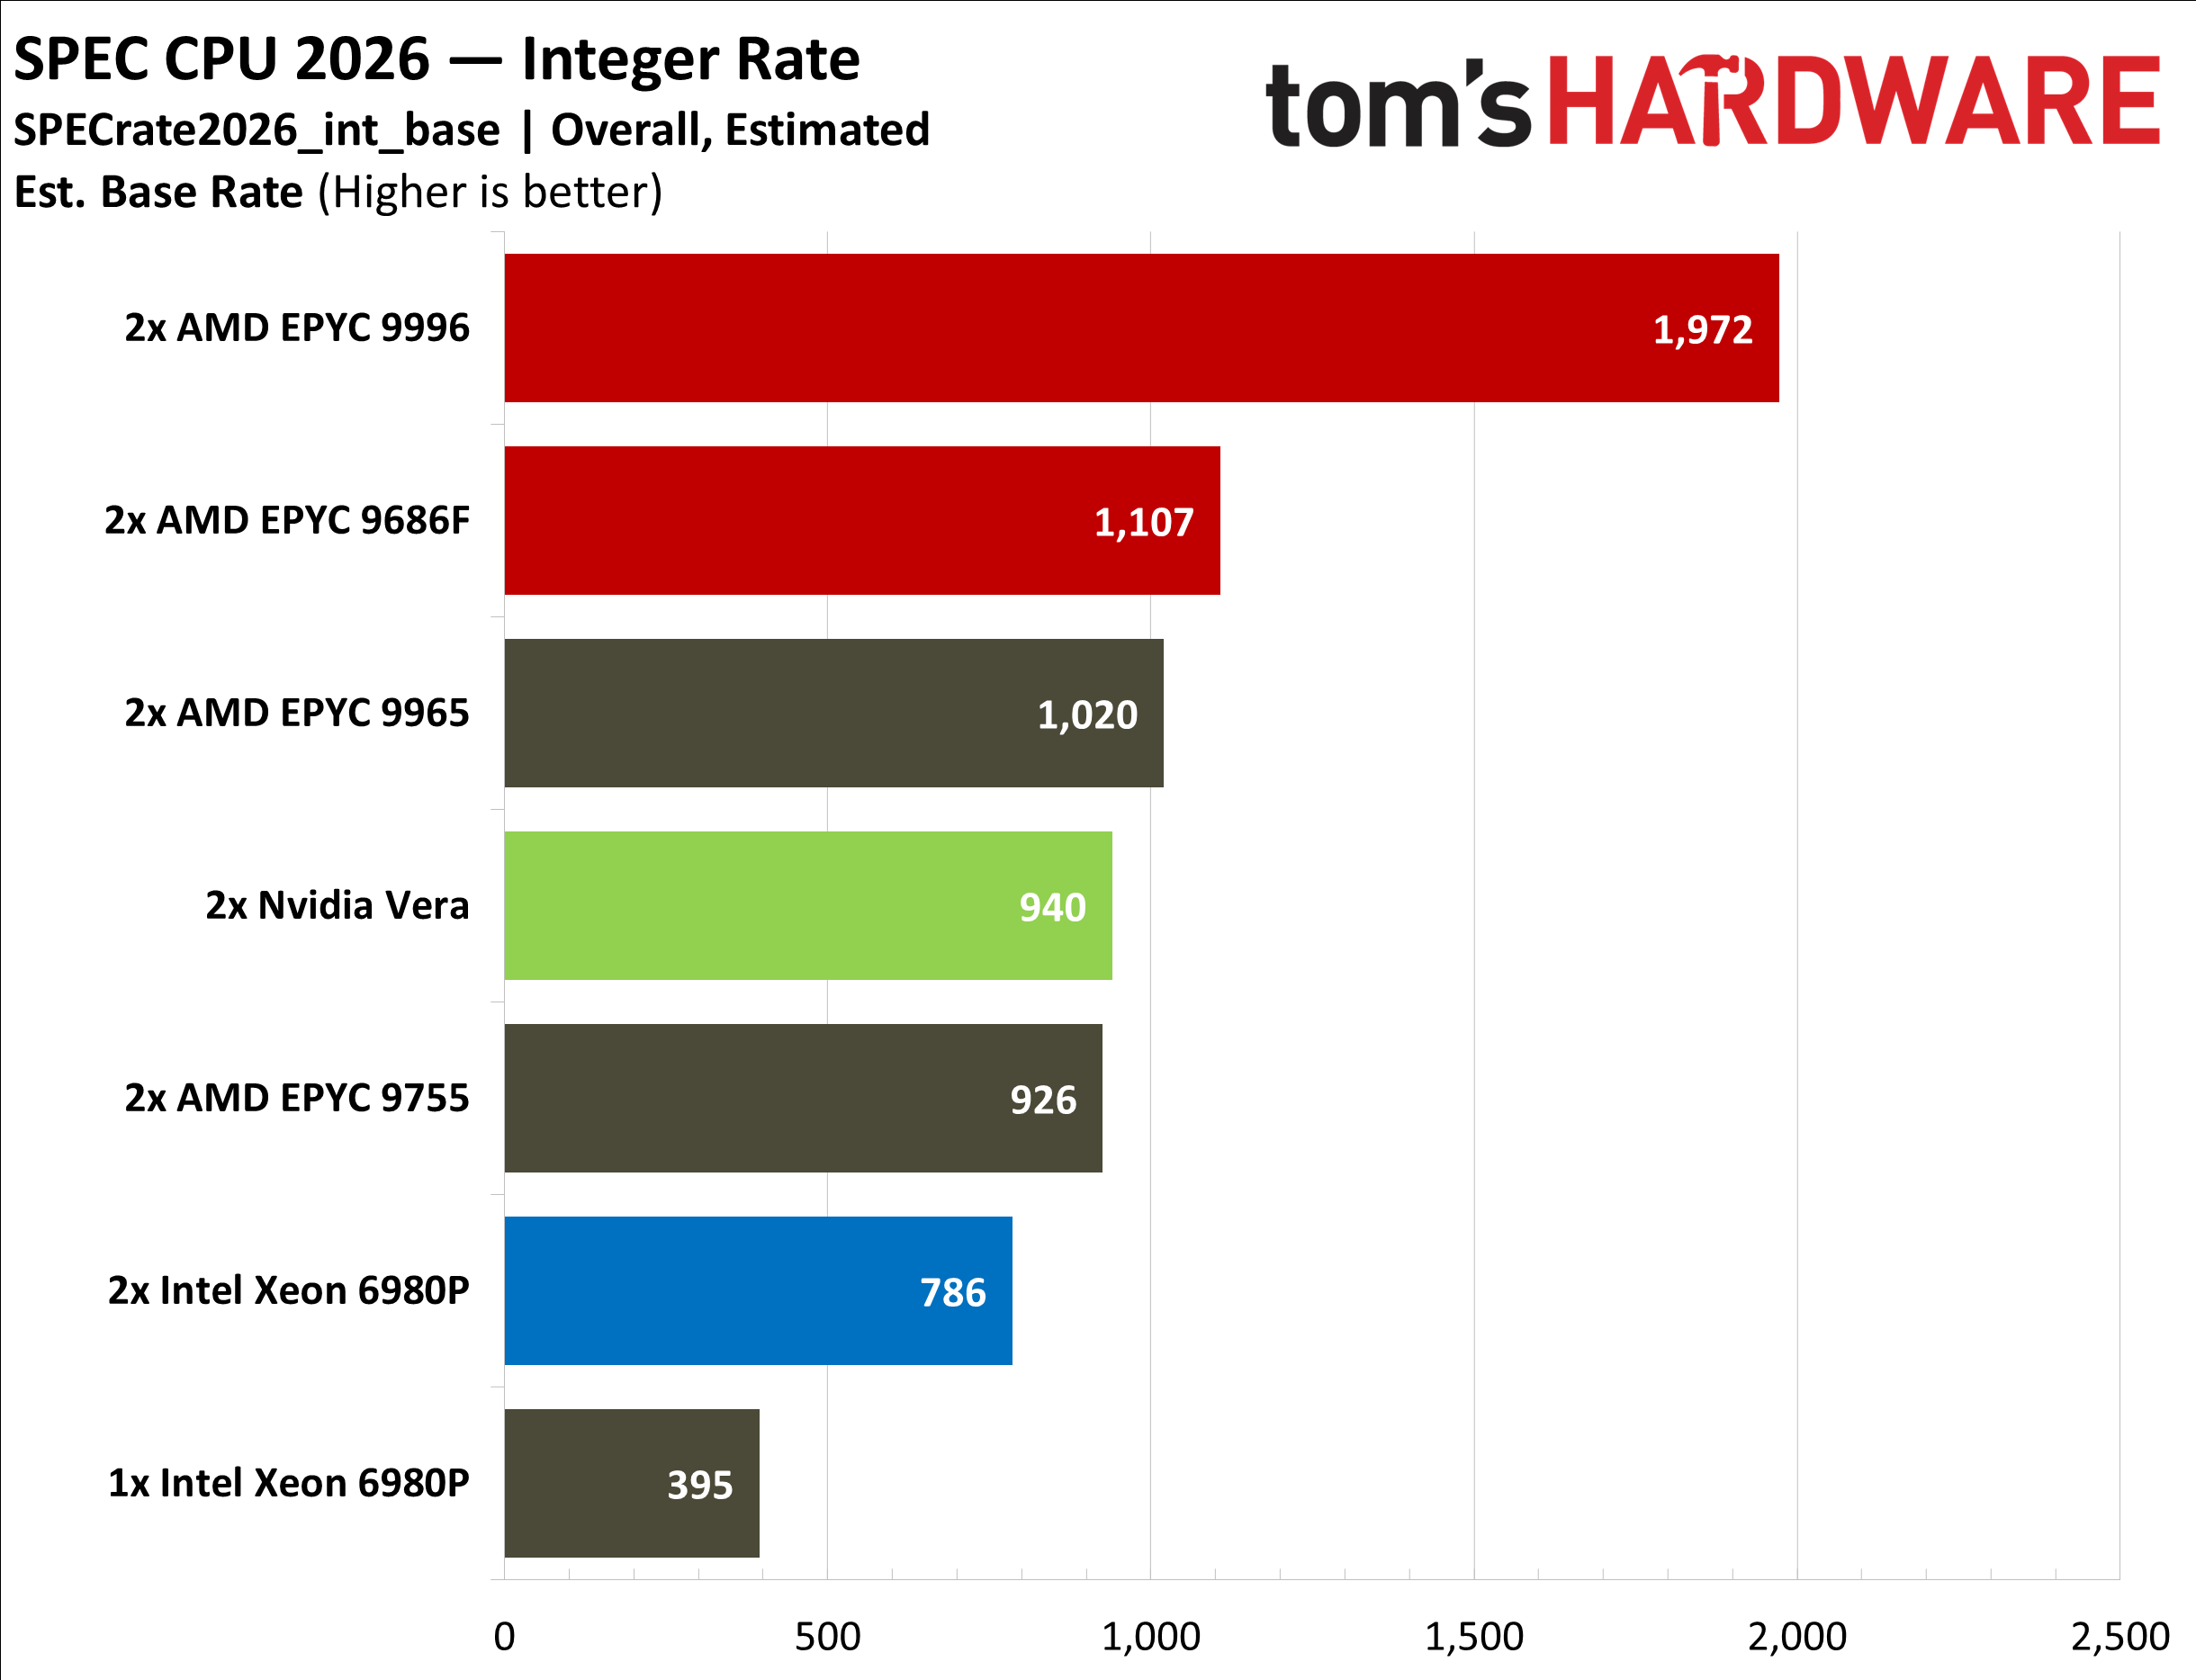
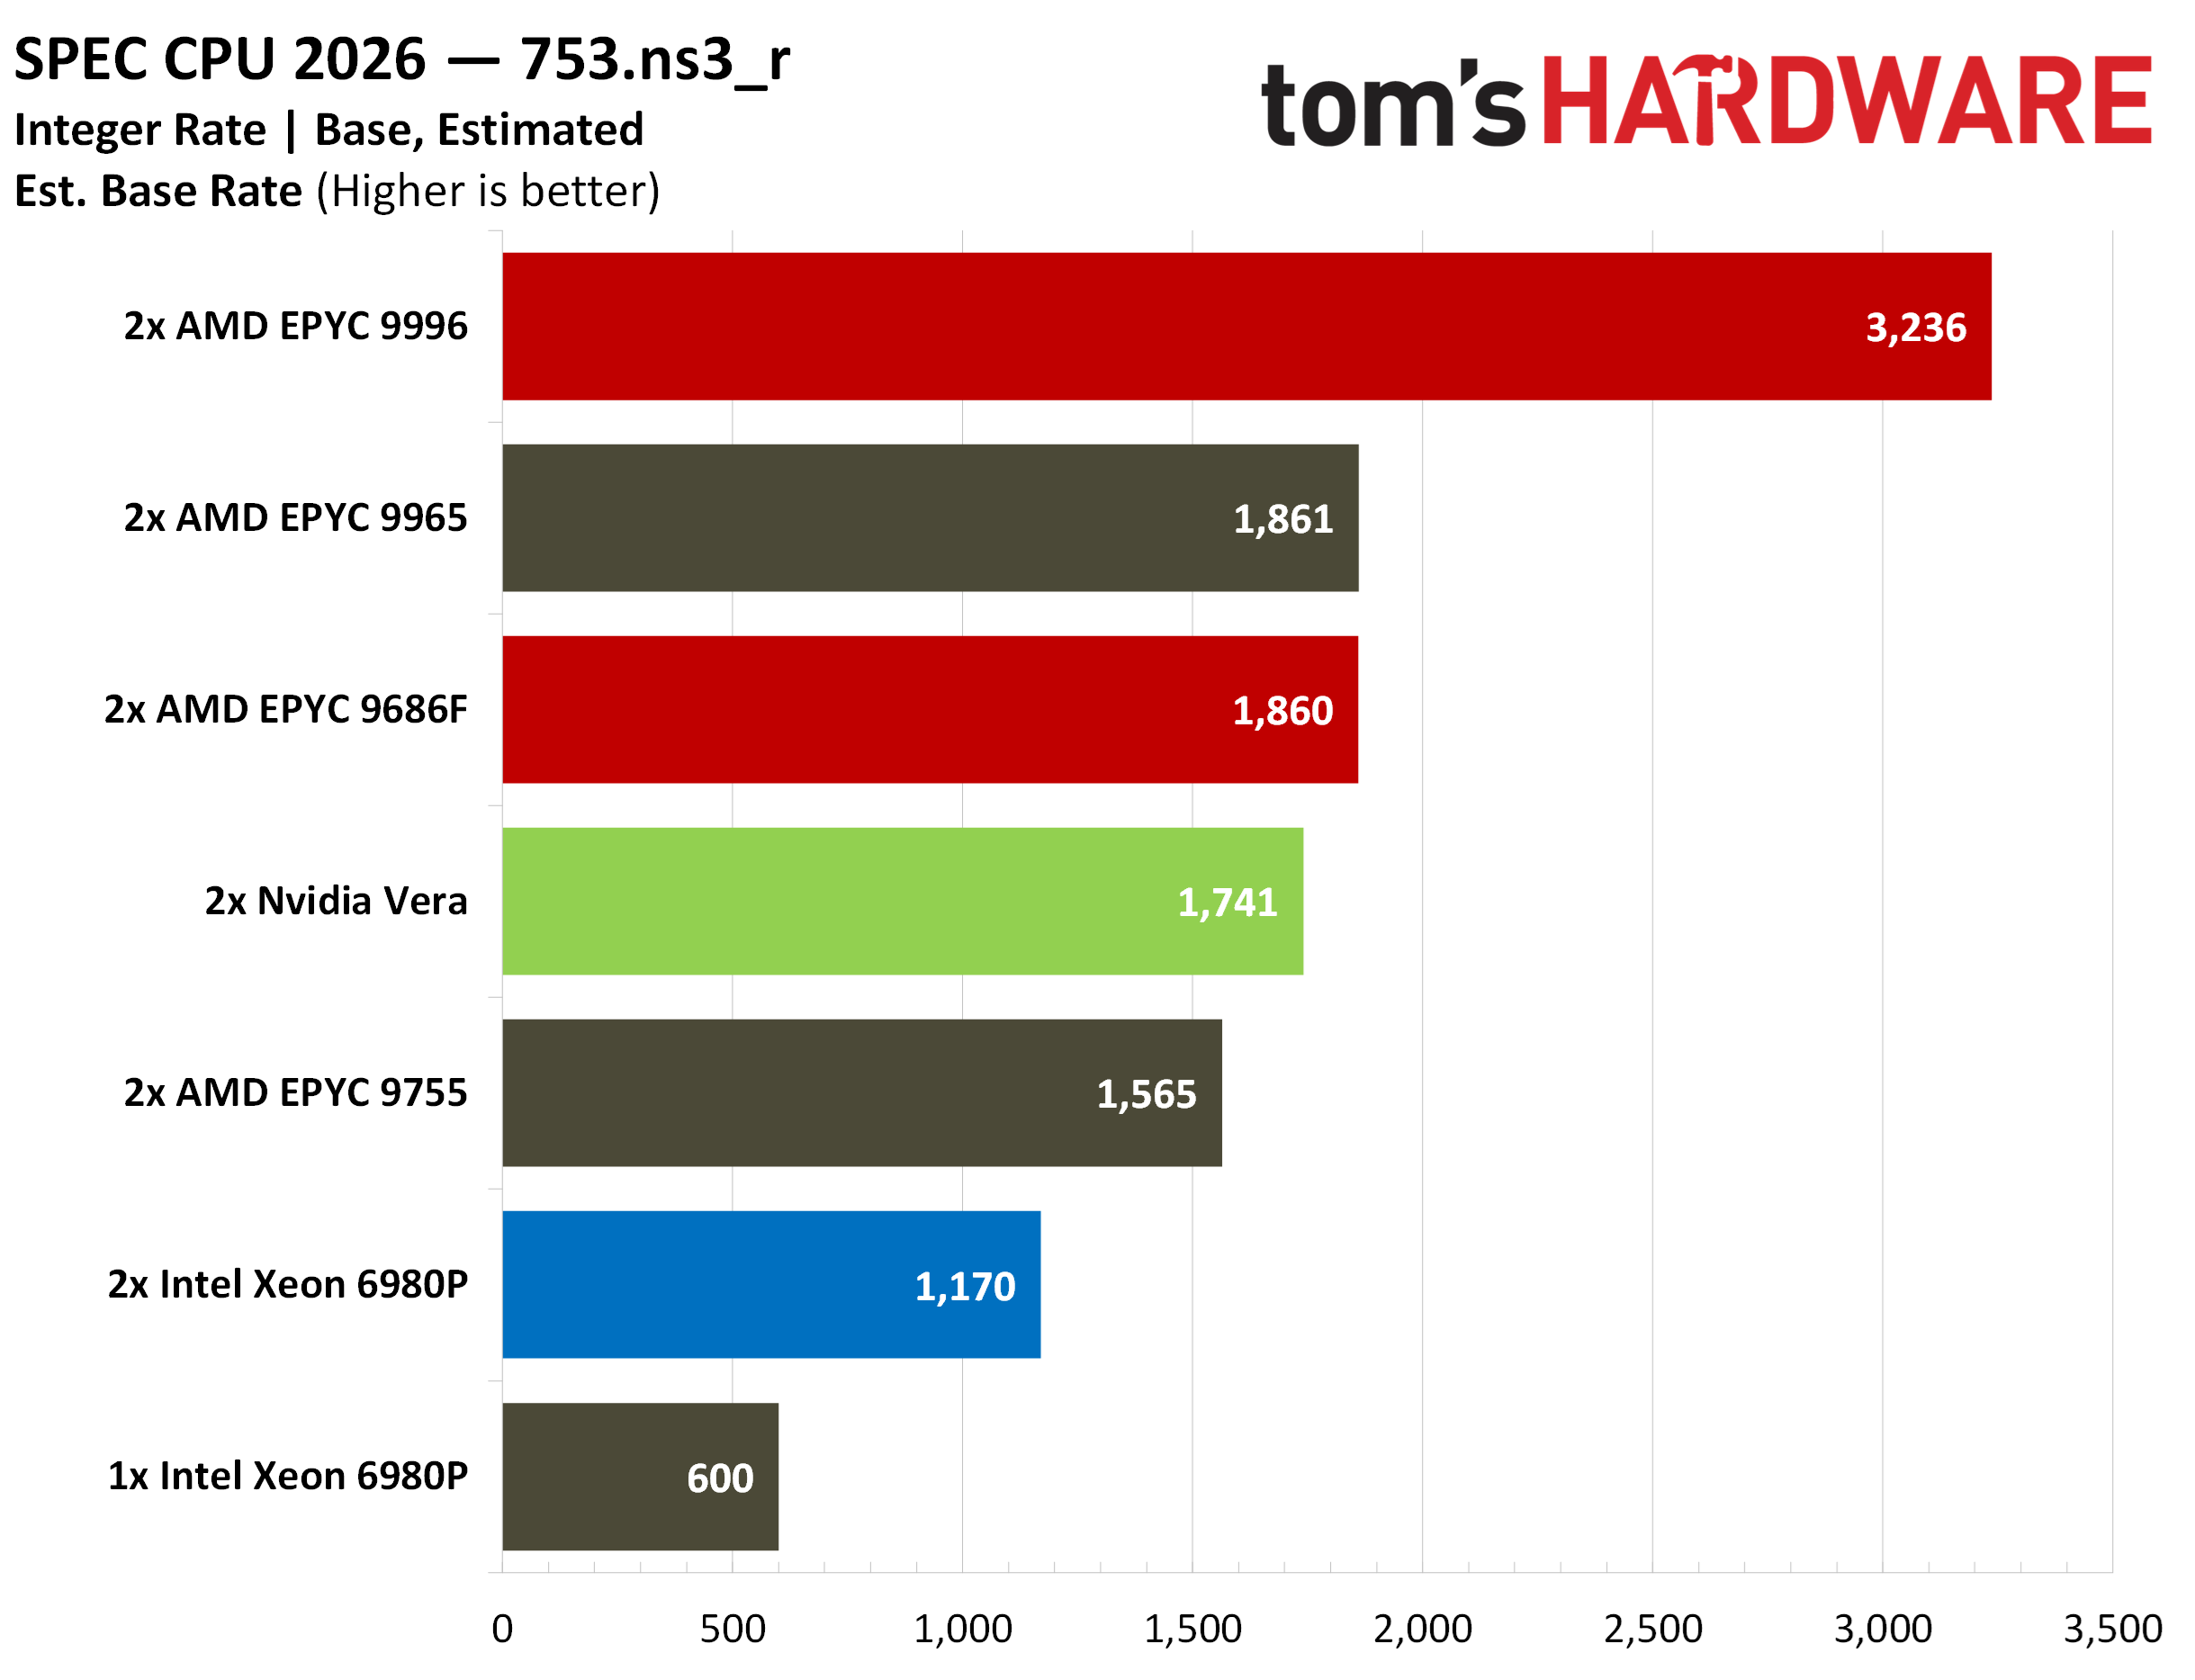
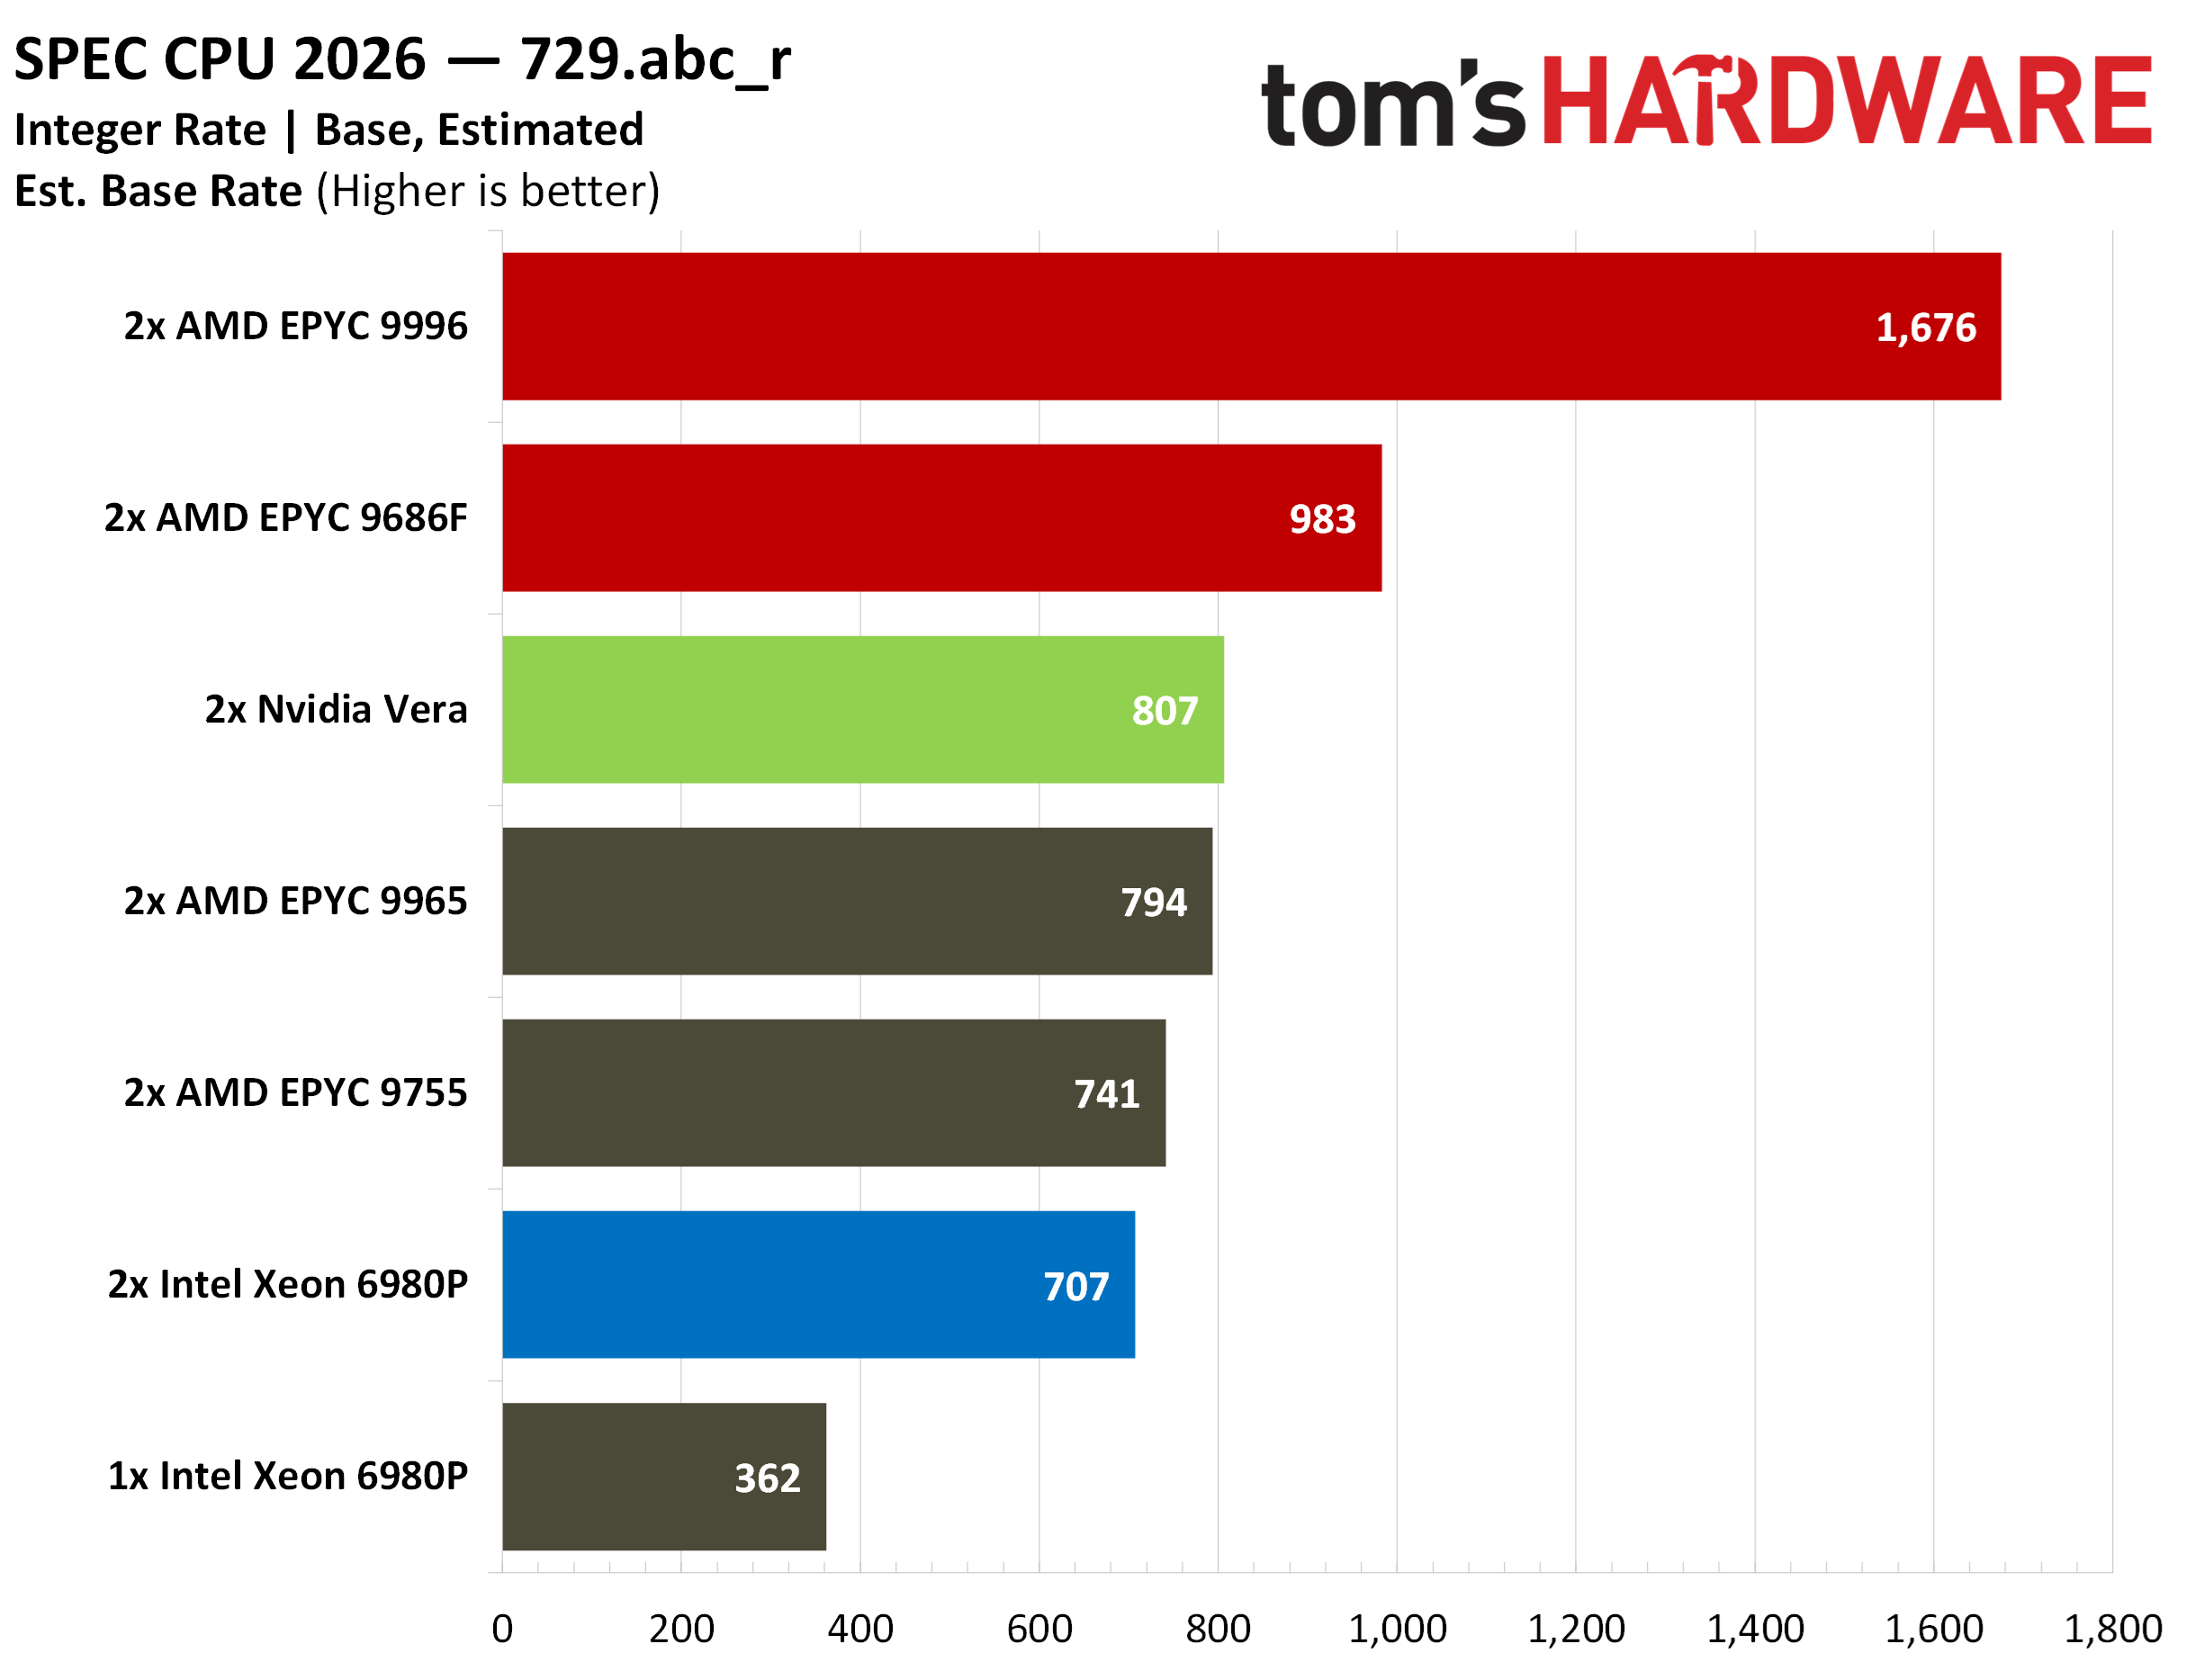
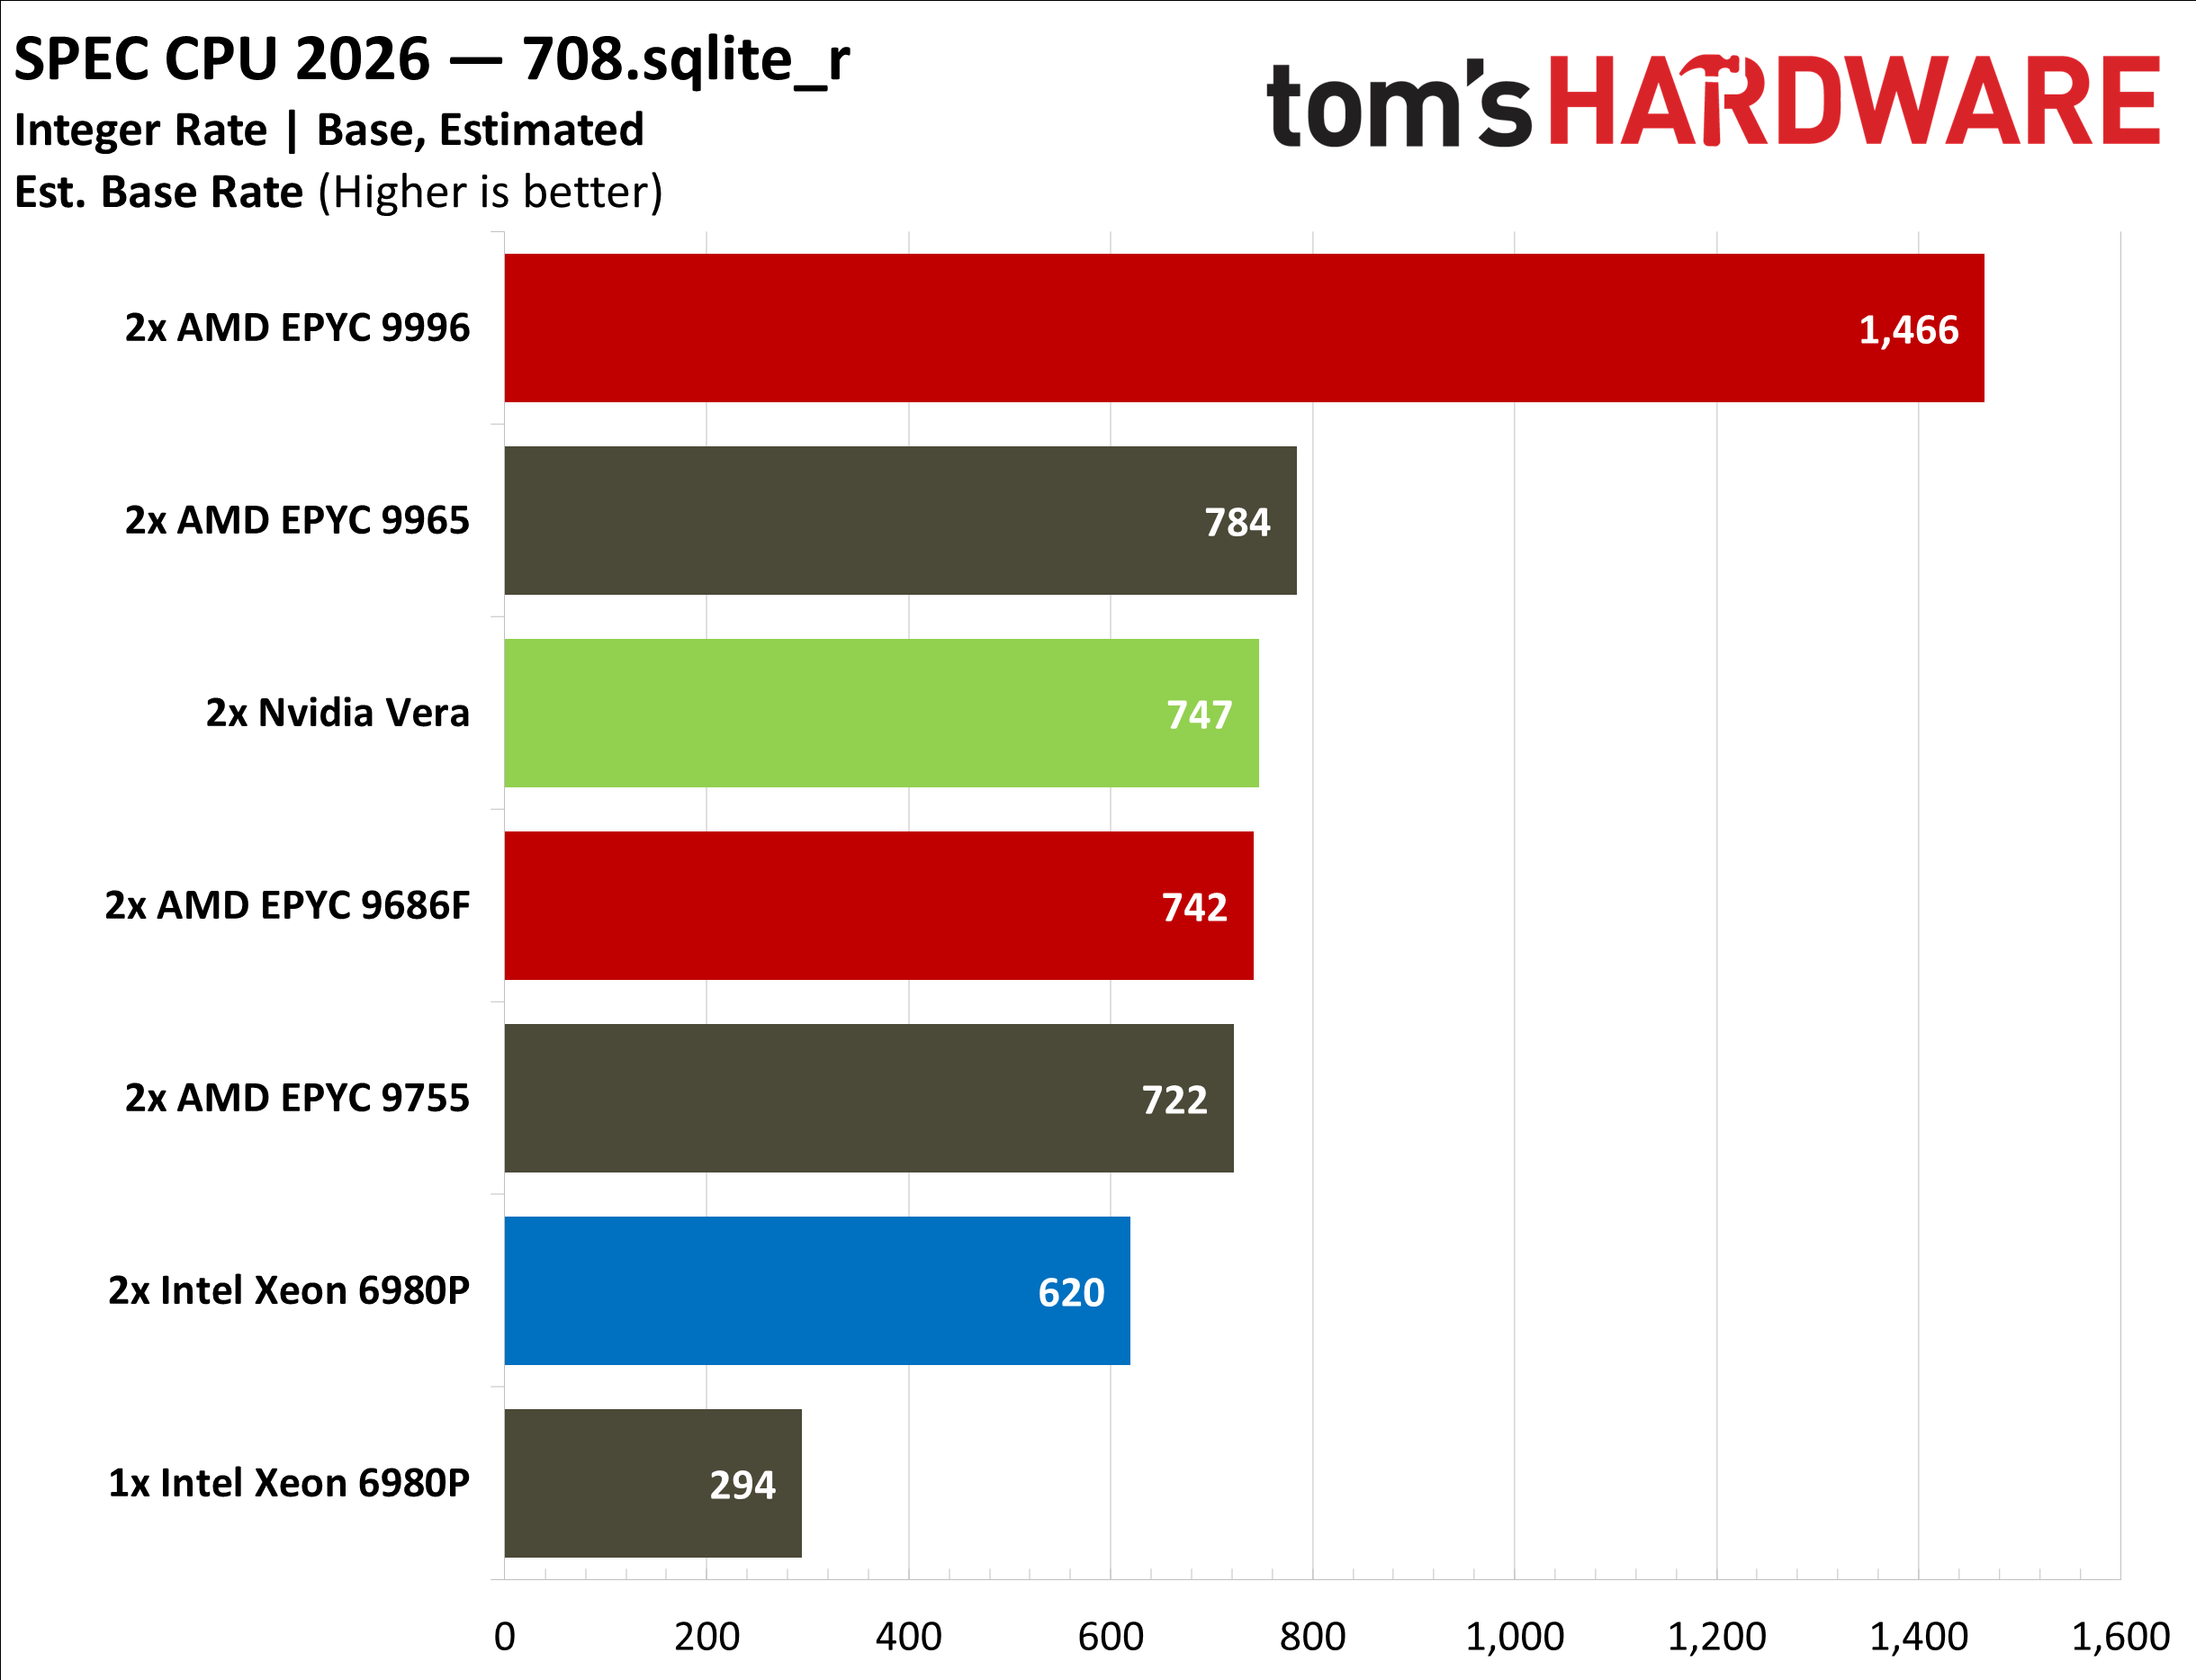
В тестах SPEC CPU 2026 на целочисленную многопоточную пропускную способность (intrate) двухпроцессорная система на EPYC 9996 за счёт оптимизаций Zen 6 и огромного пула потоков опередила прошлый флагман EPYC 9965 (Zen 5) сразу на 93 %. Частотно-оптимизированный EPYC 9686F оказался на 19 % быстрее 128-ядерного чипа прошлого поколения EPYC 9755 и на 17 % обогнал процессор Nvidia Vera.
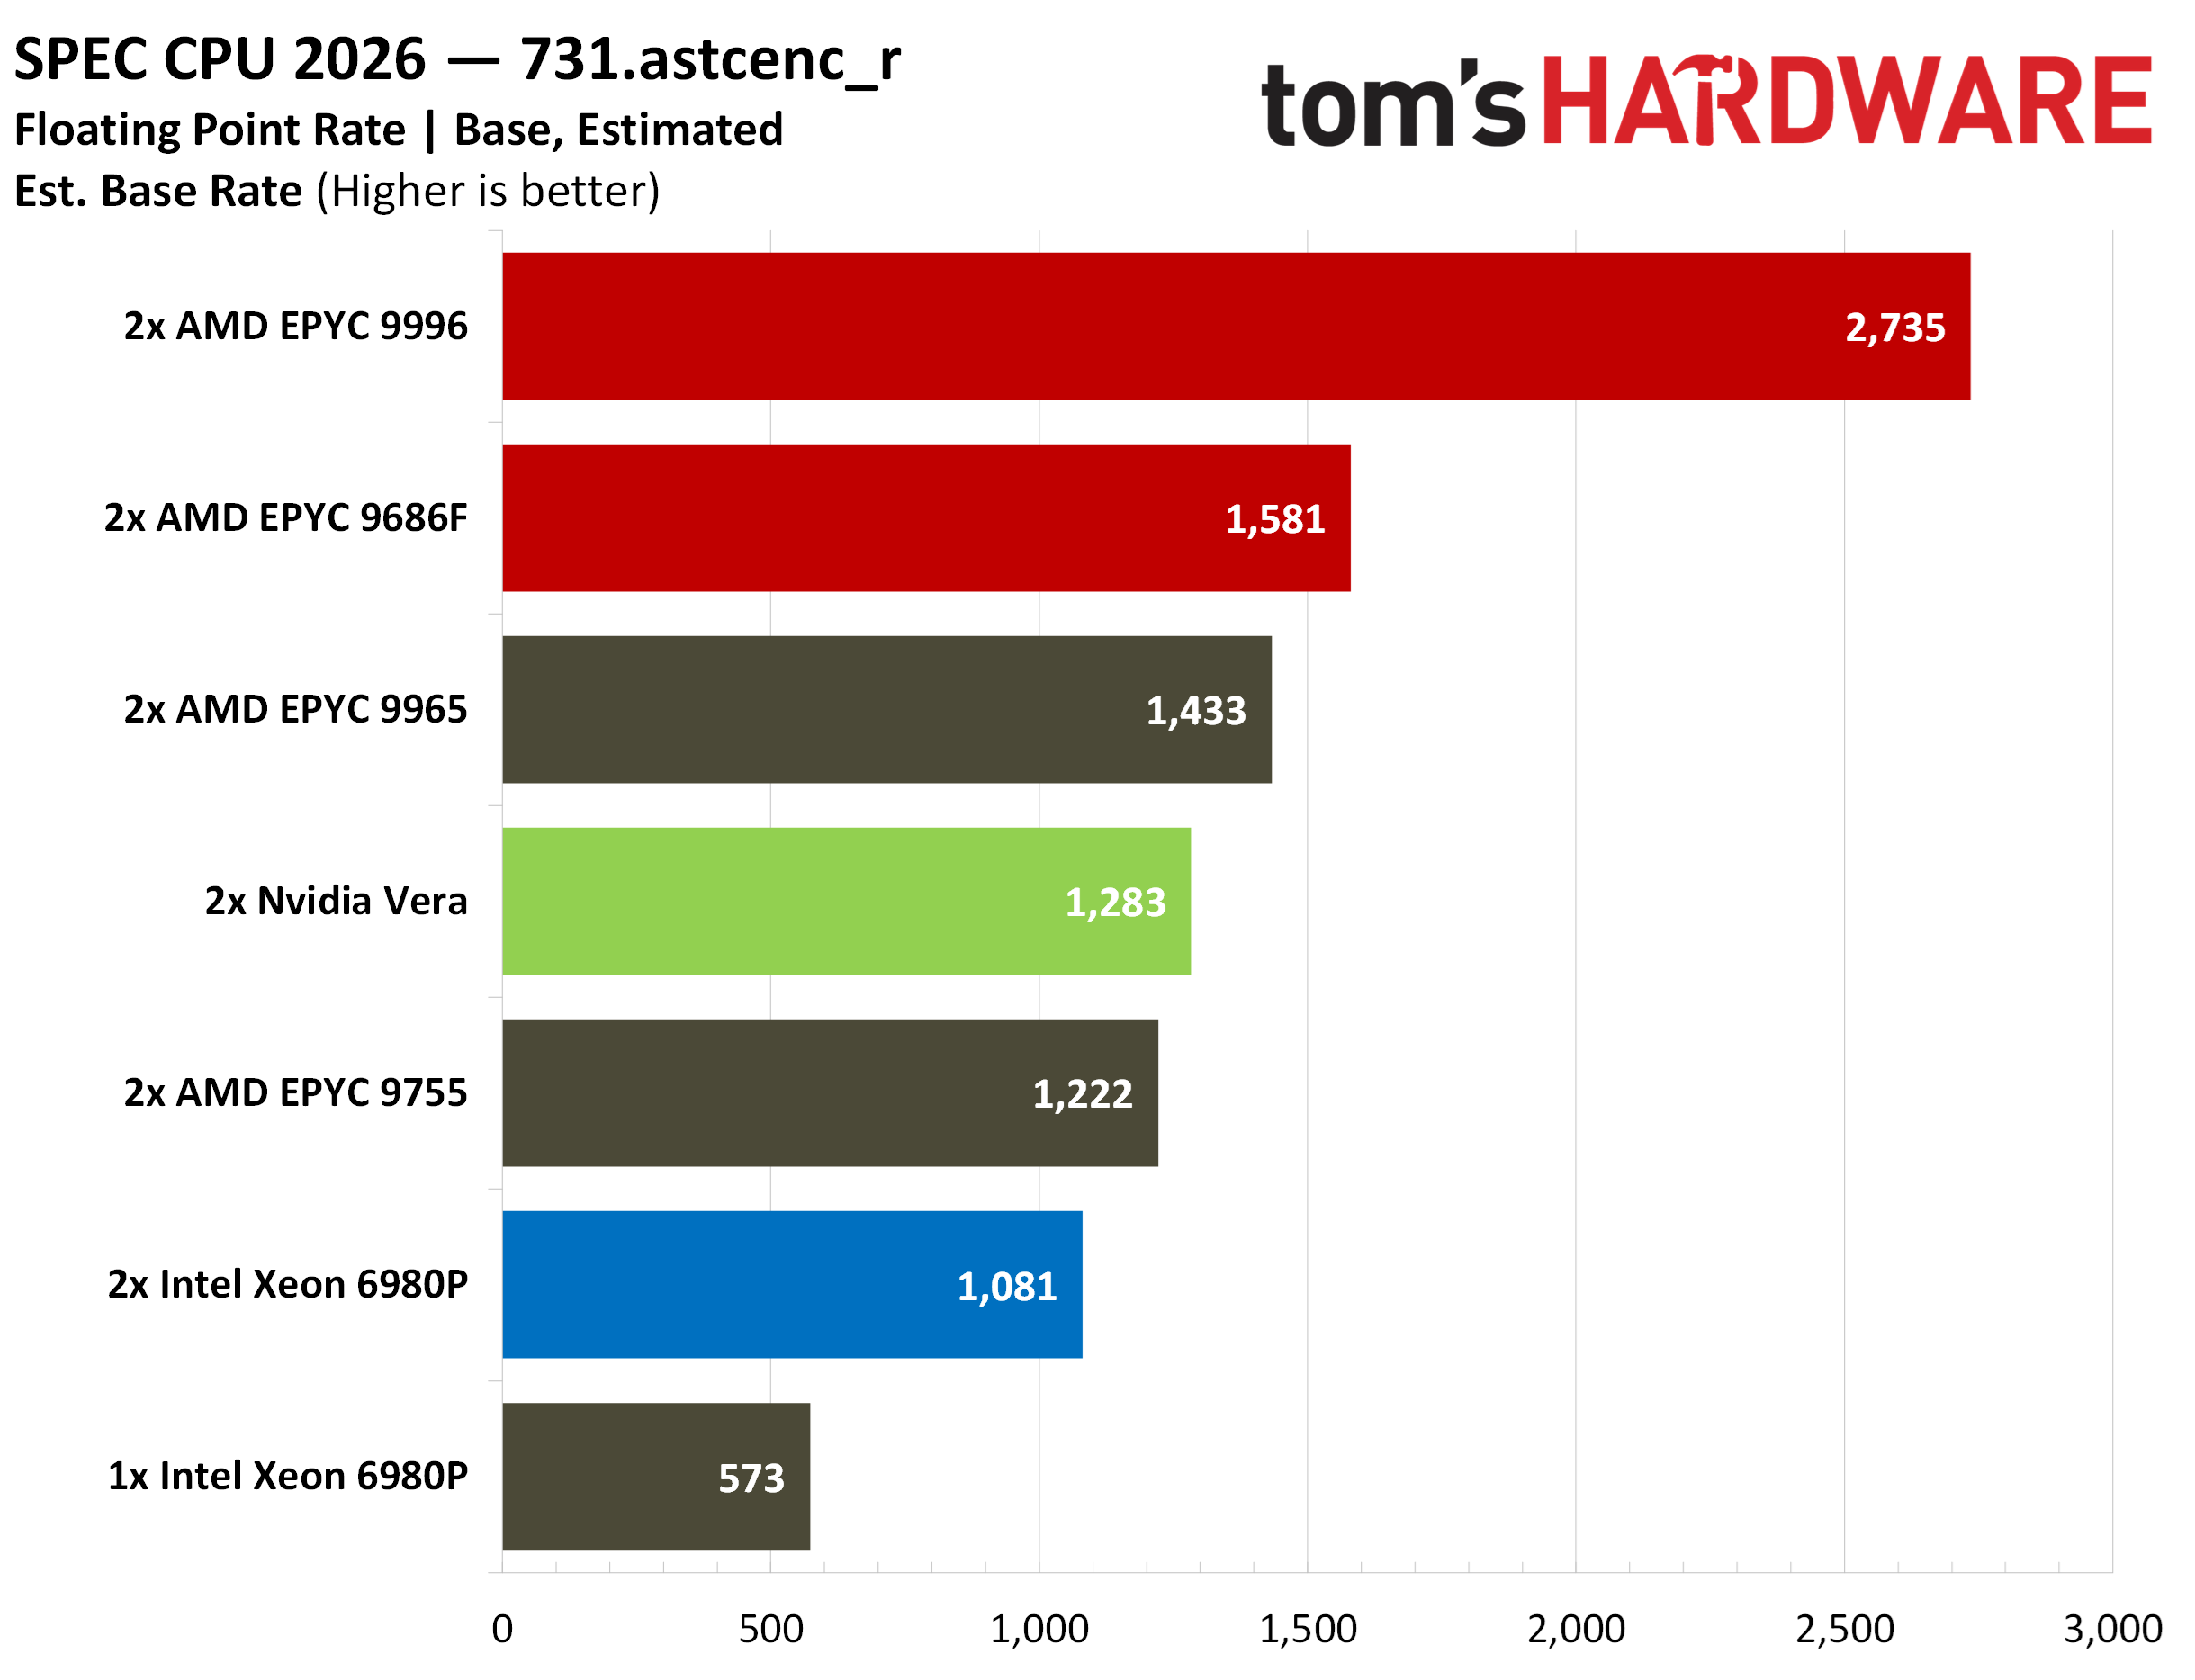
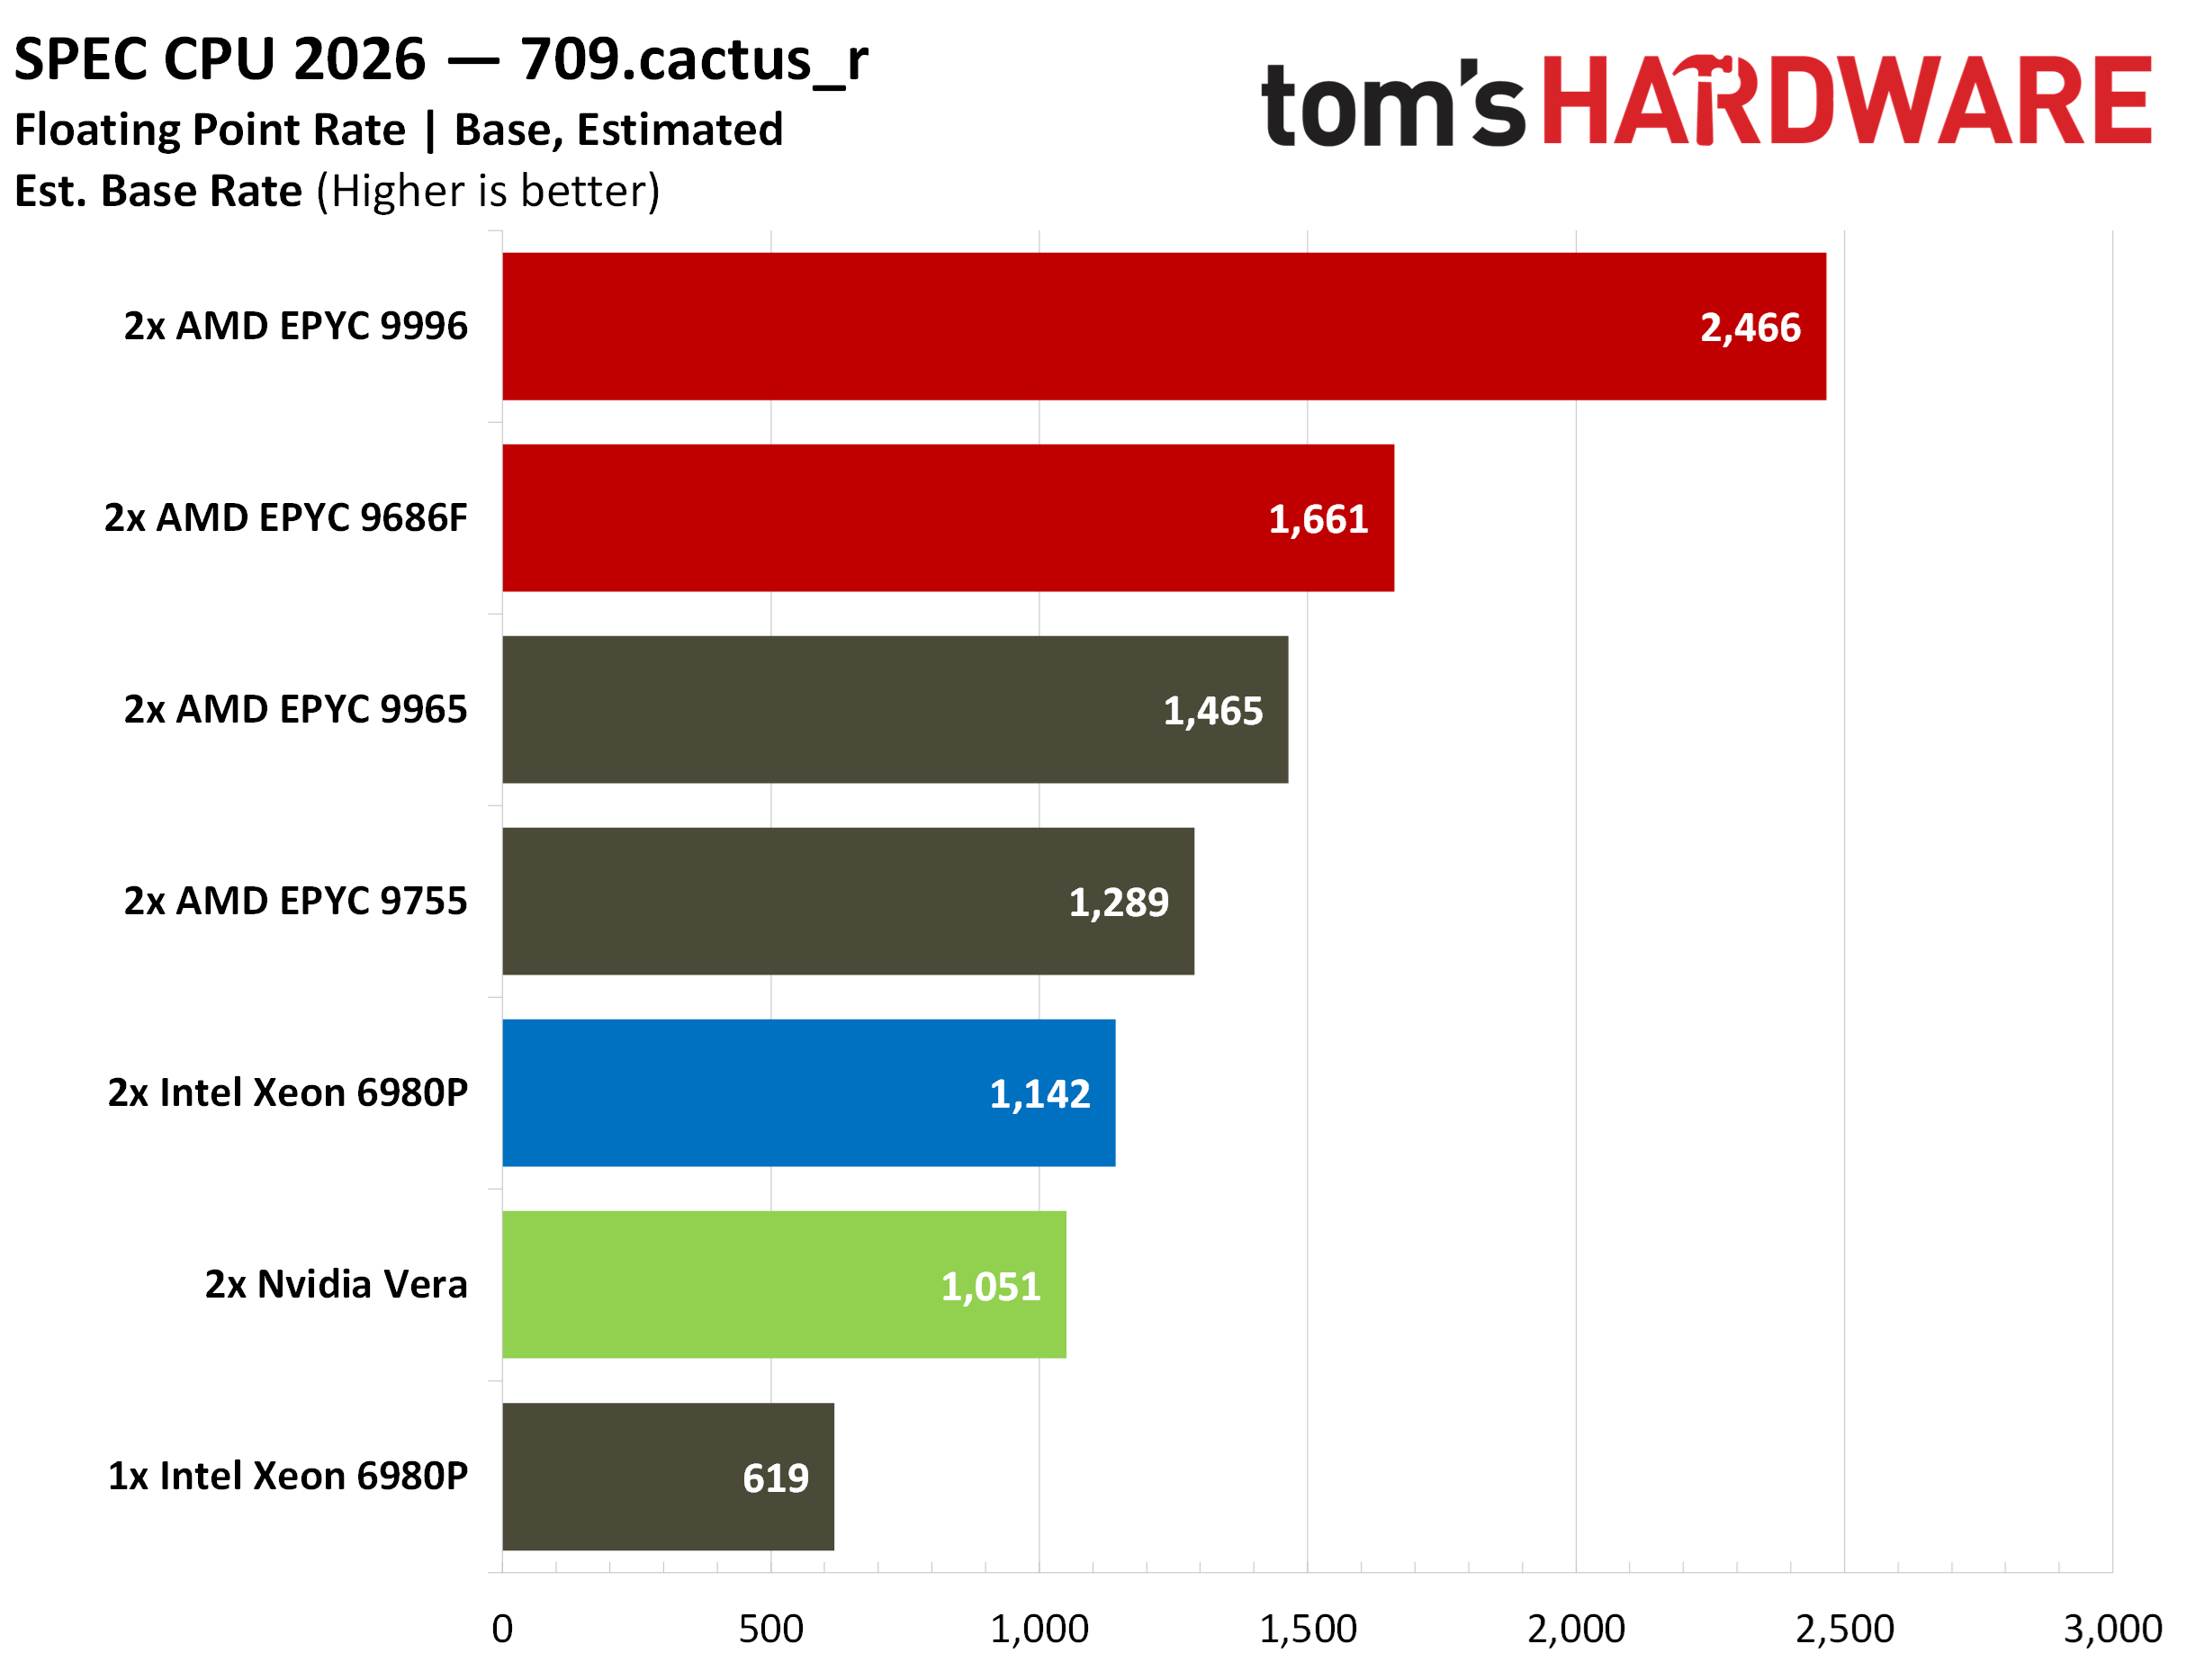
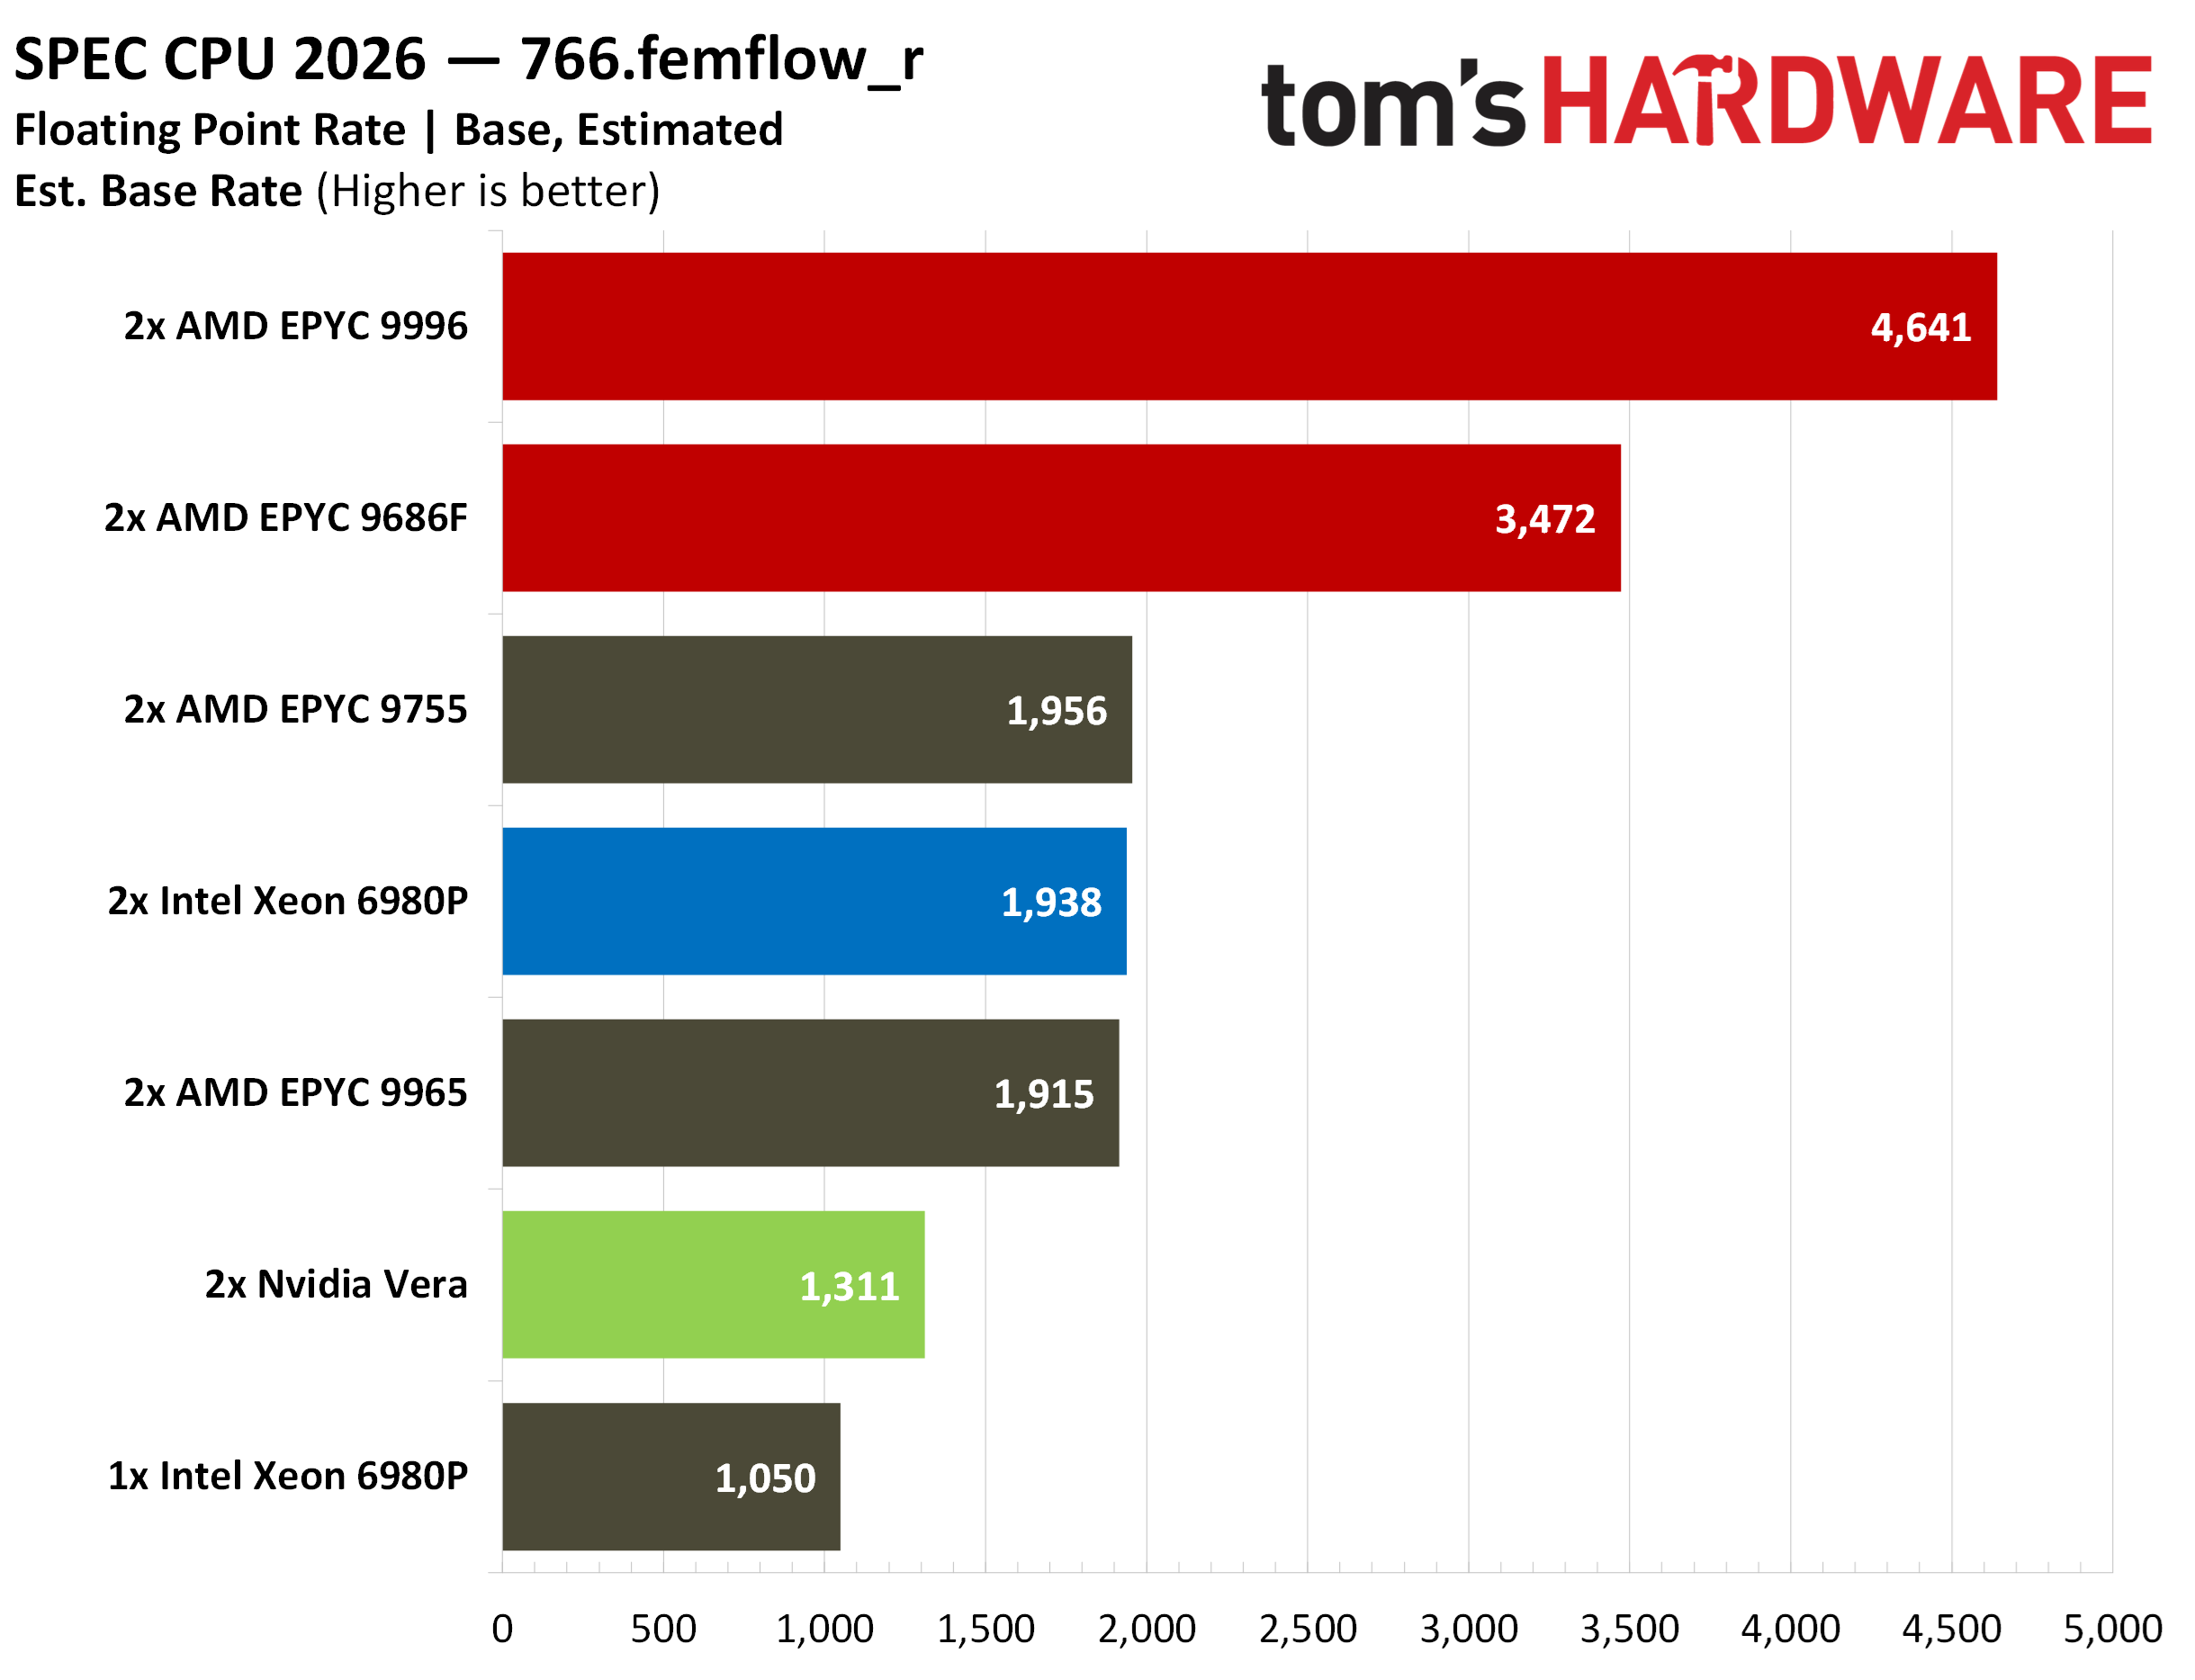
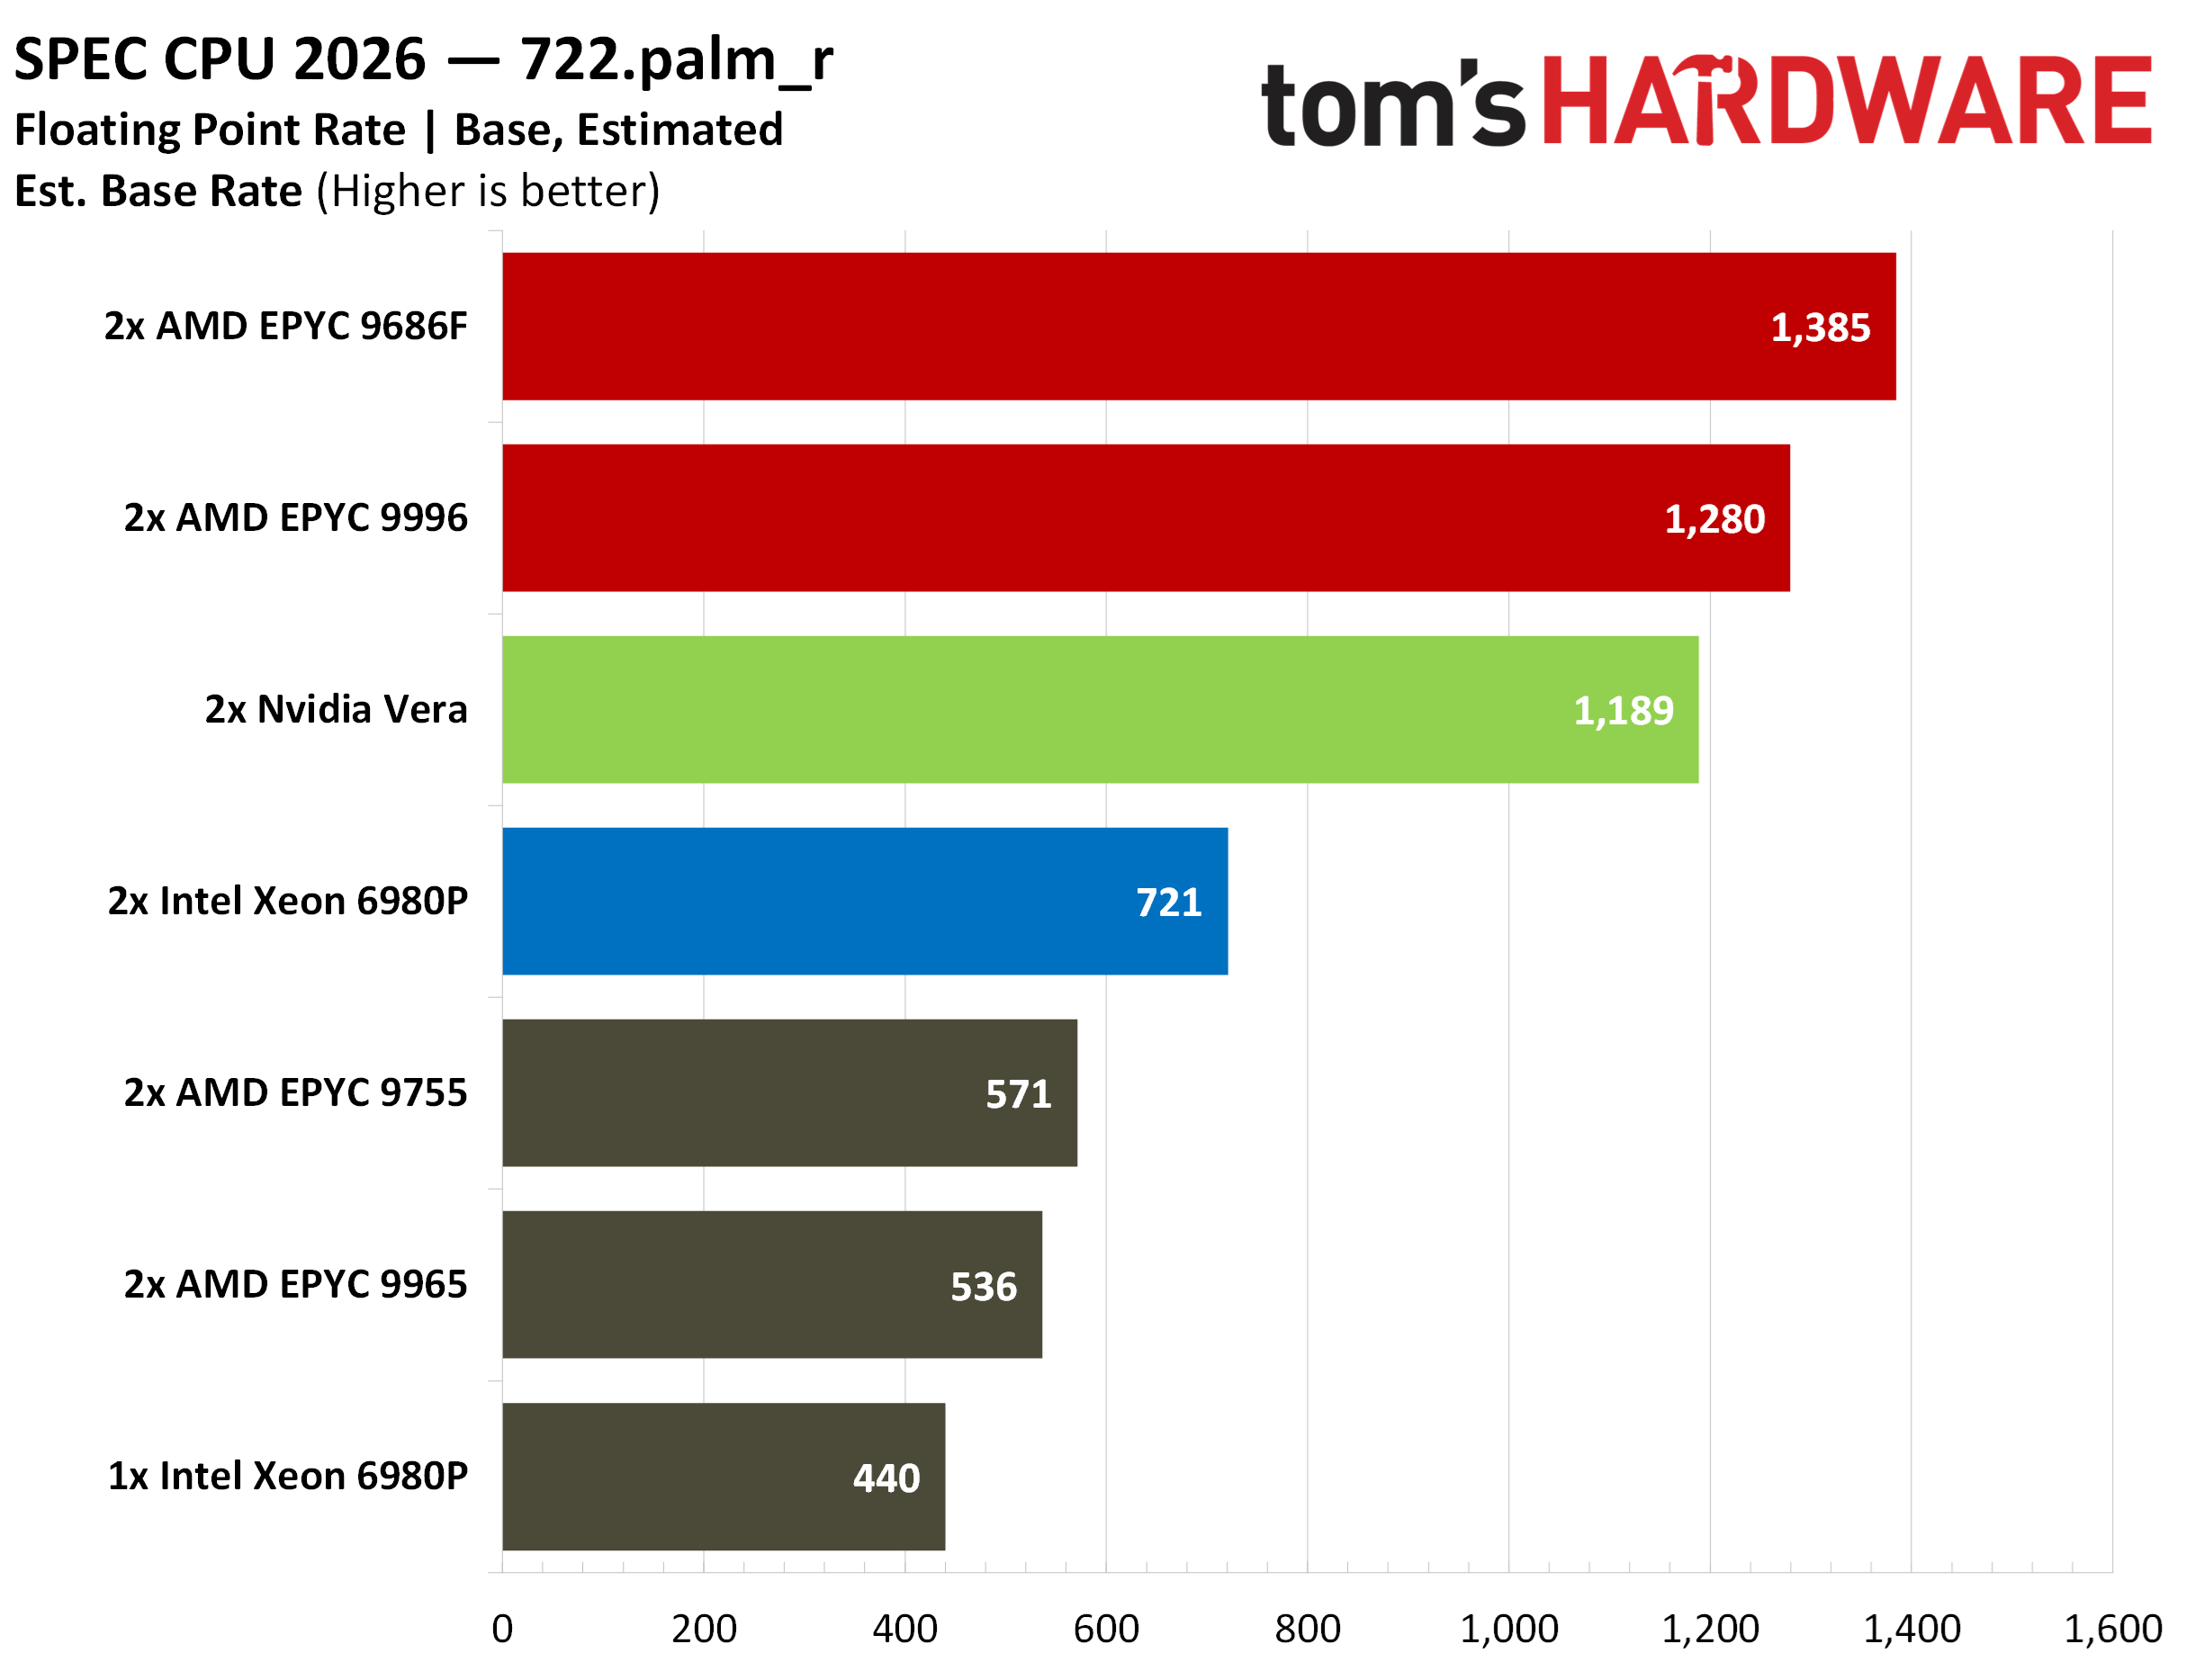
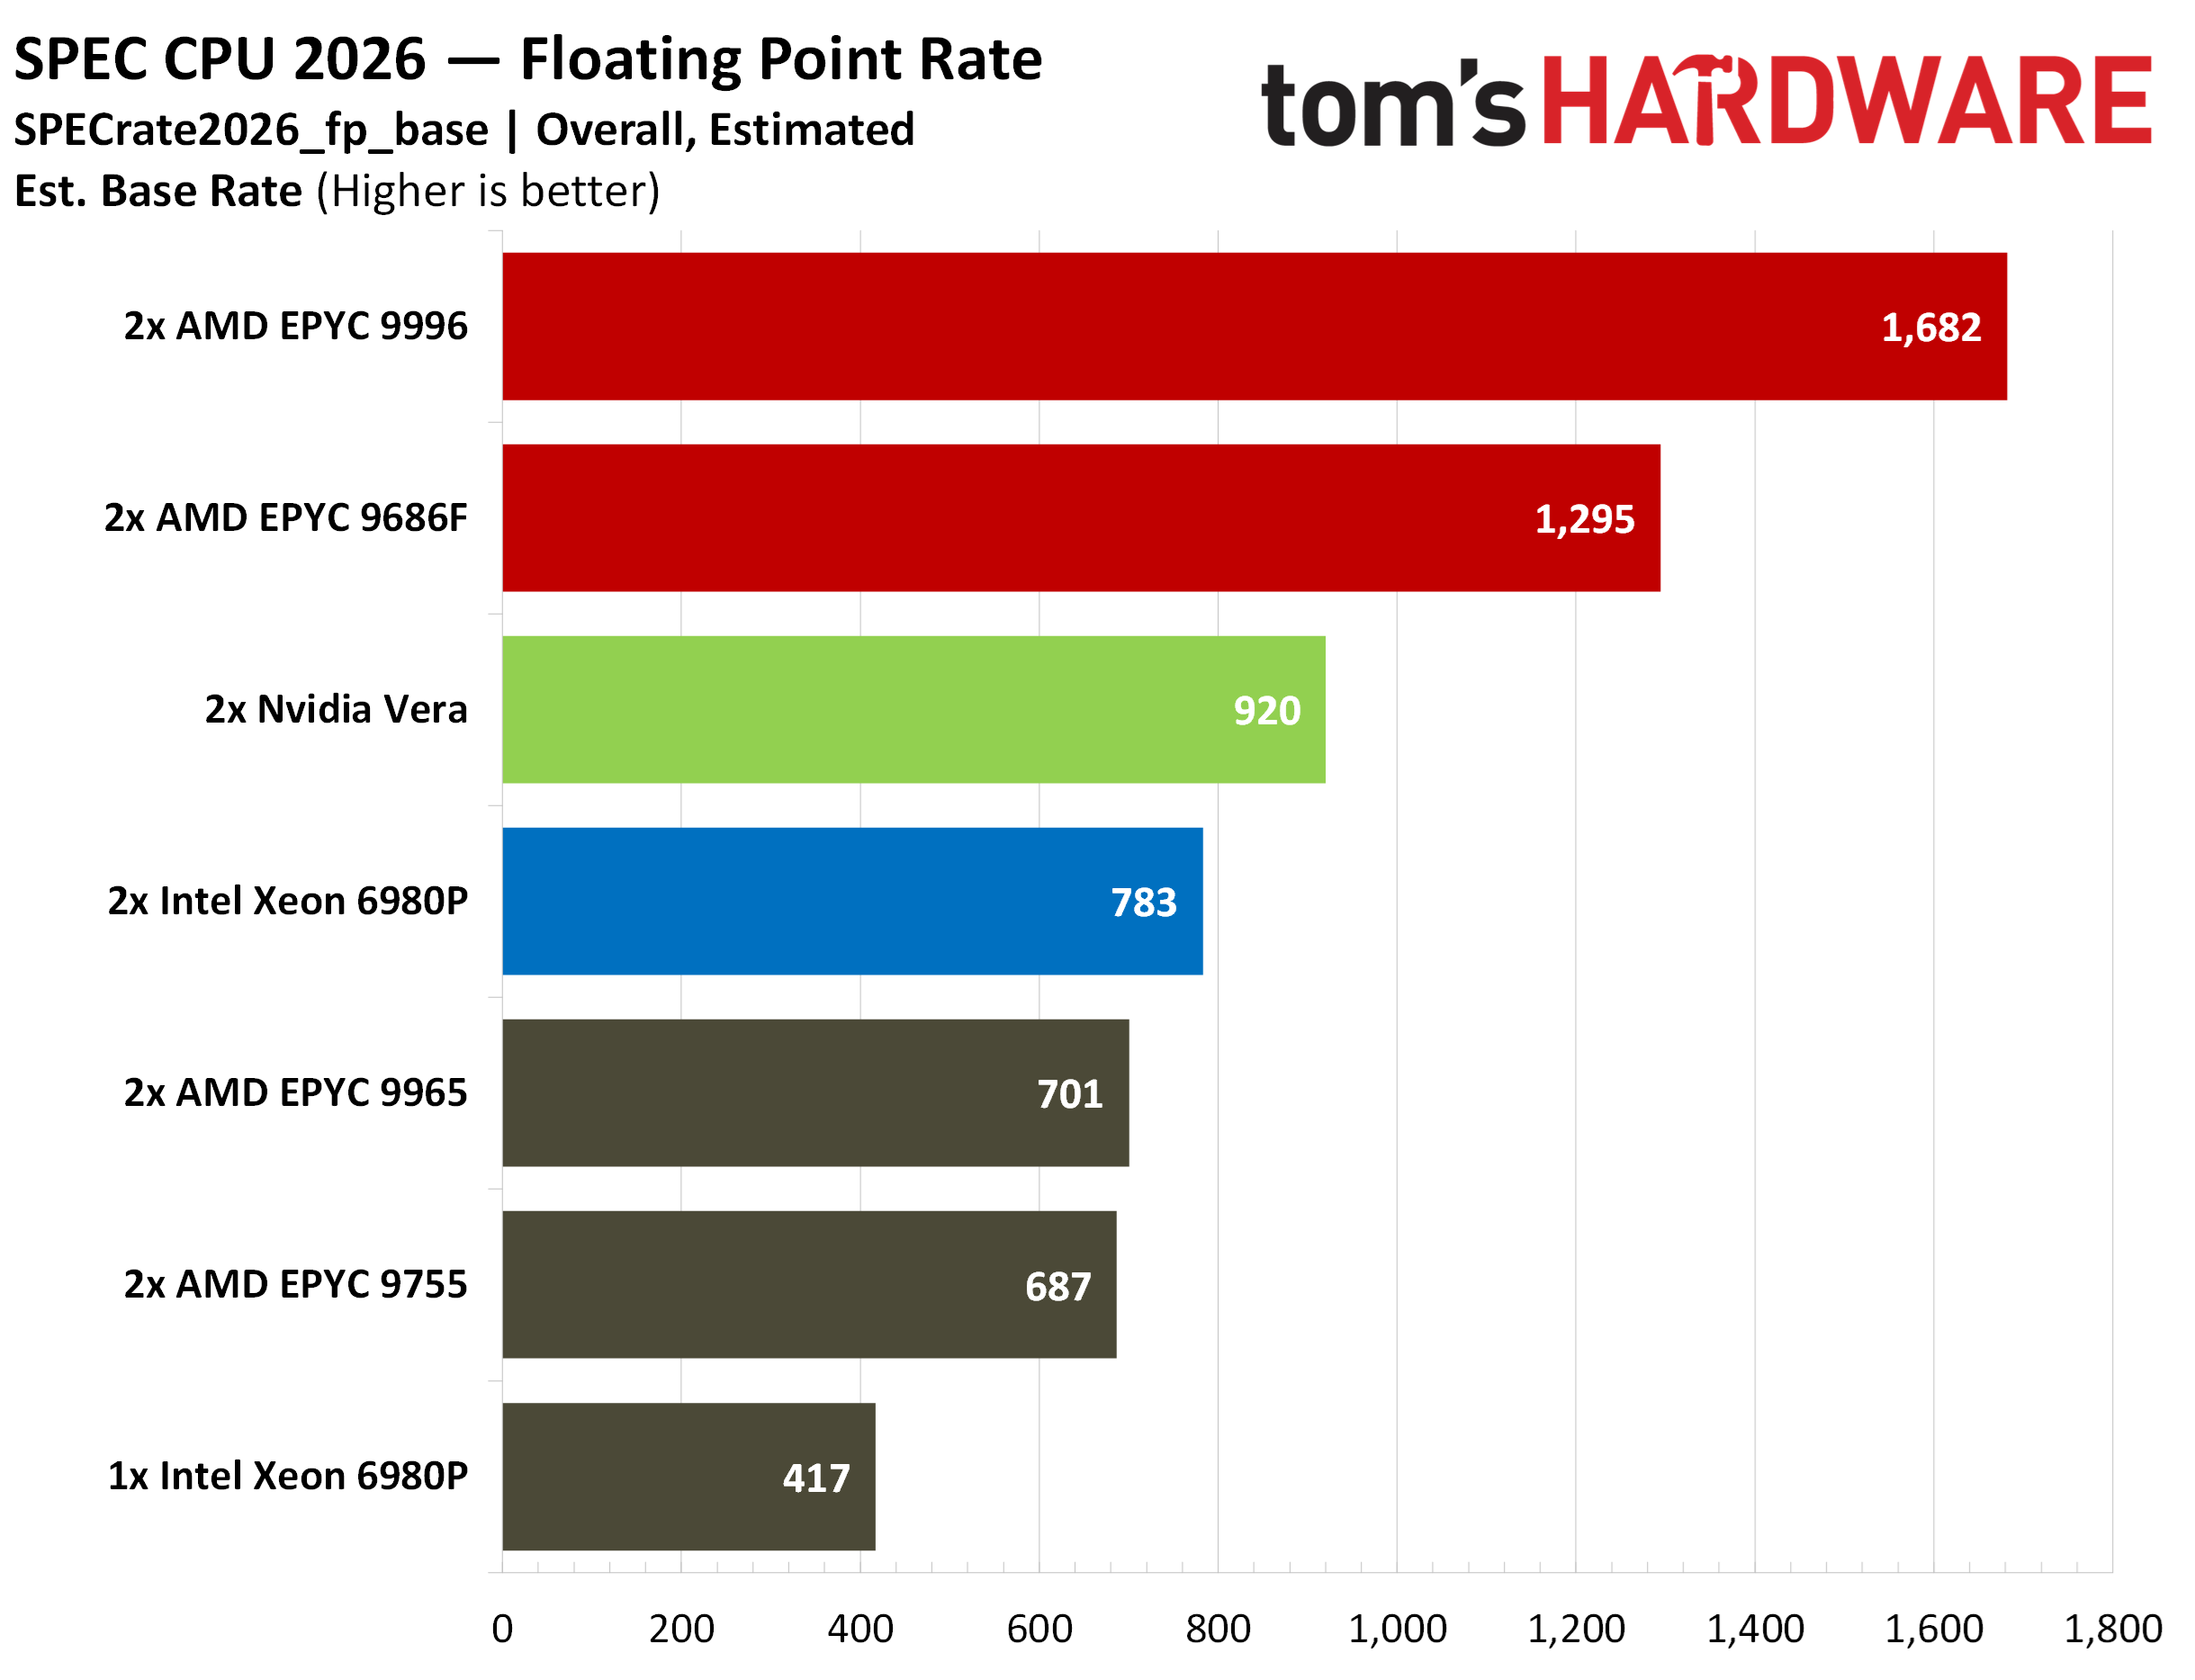
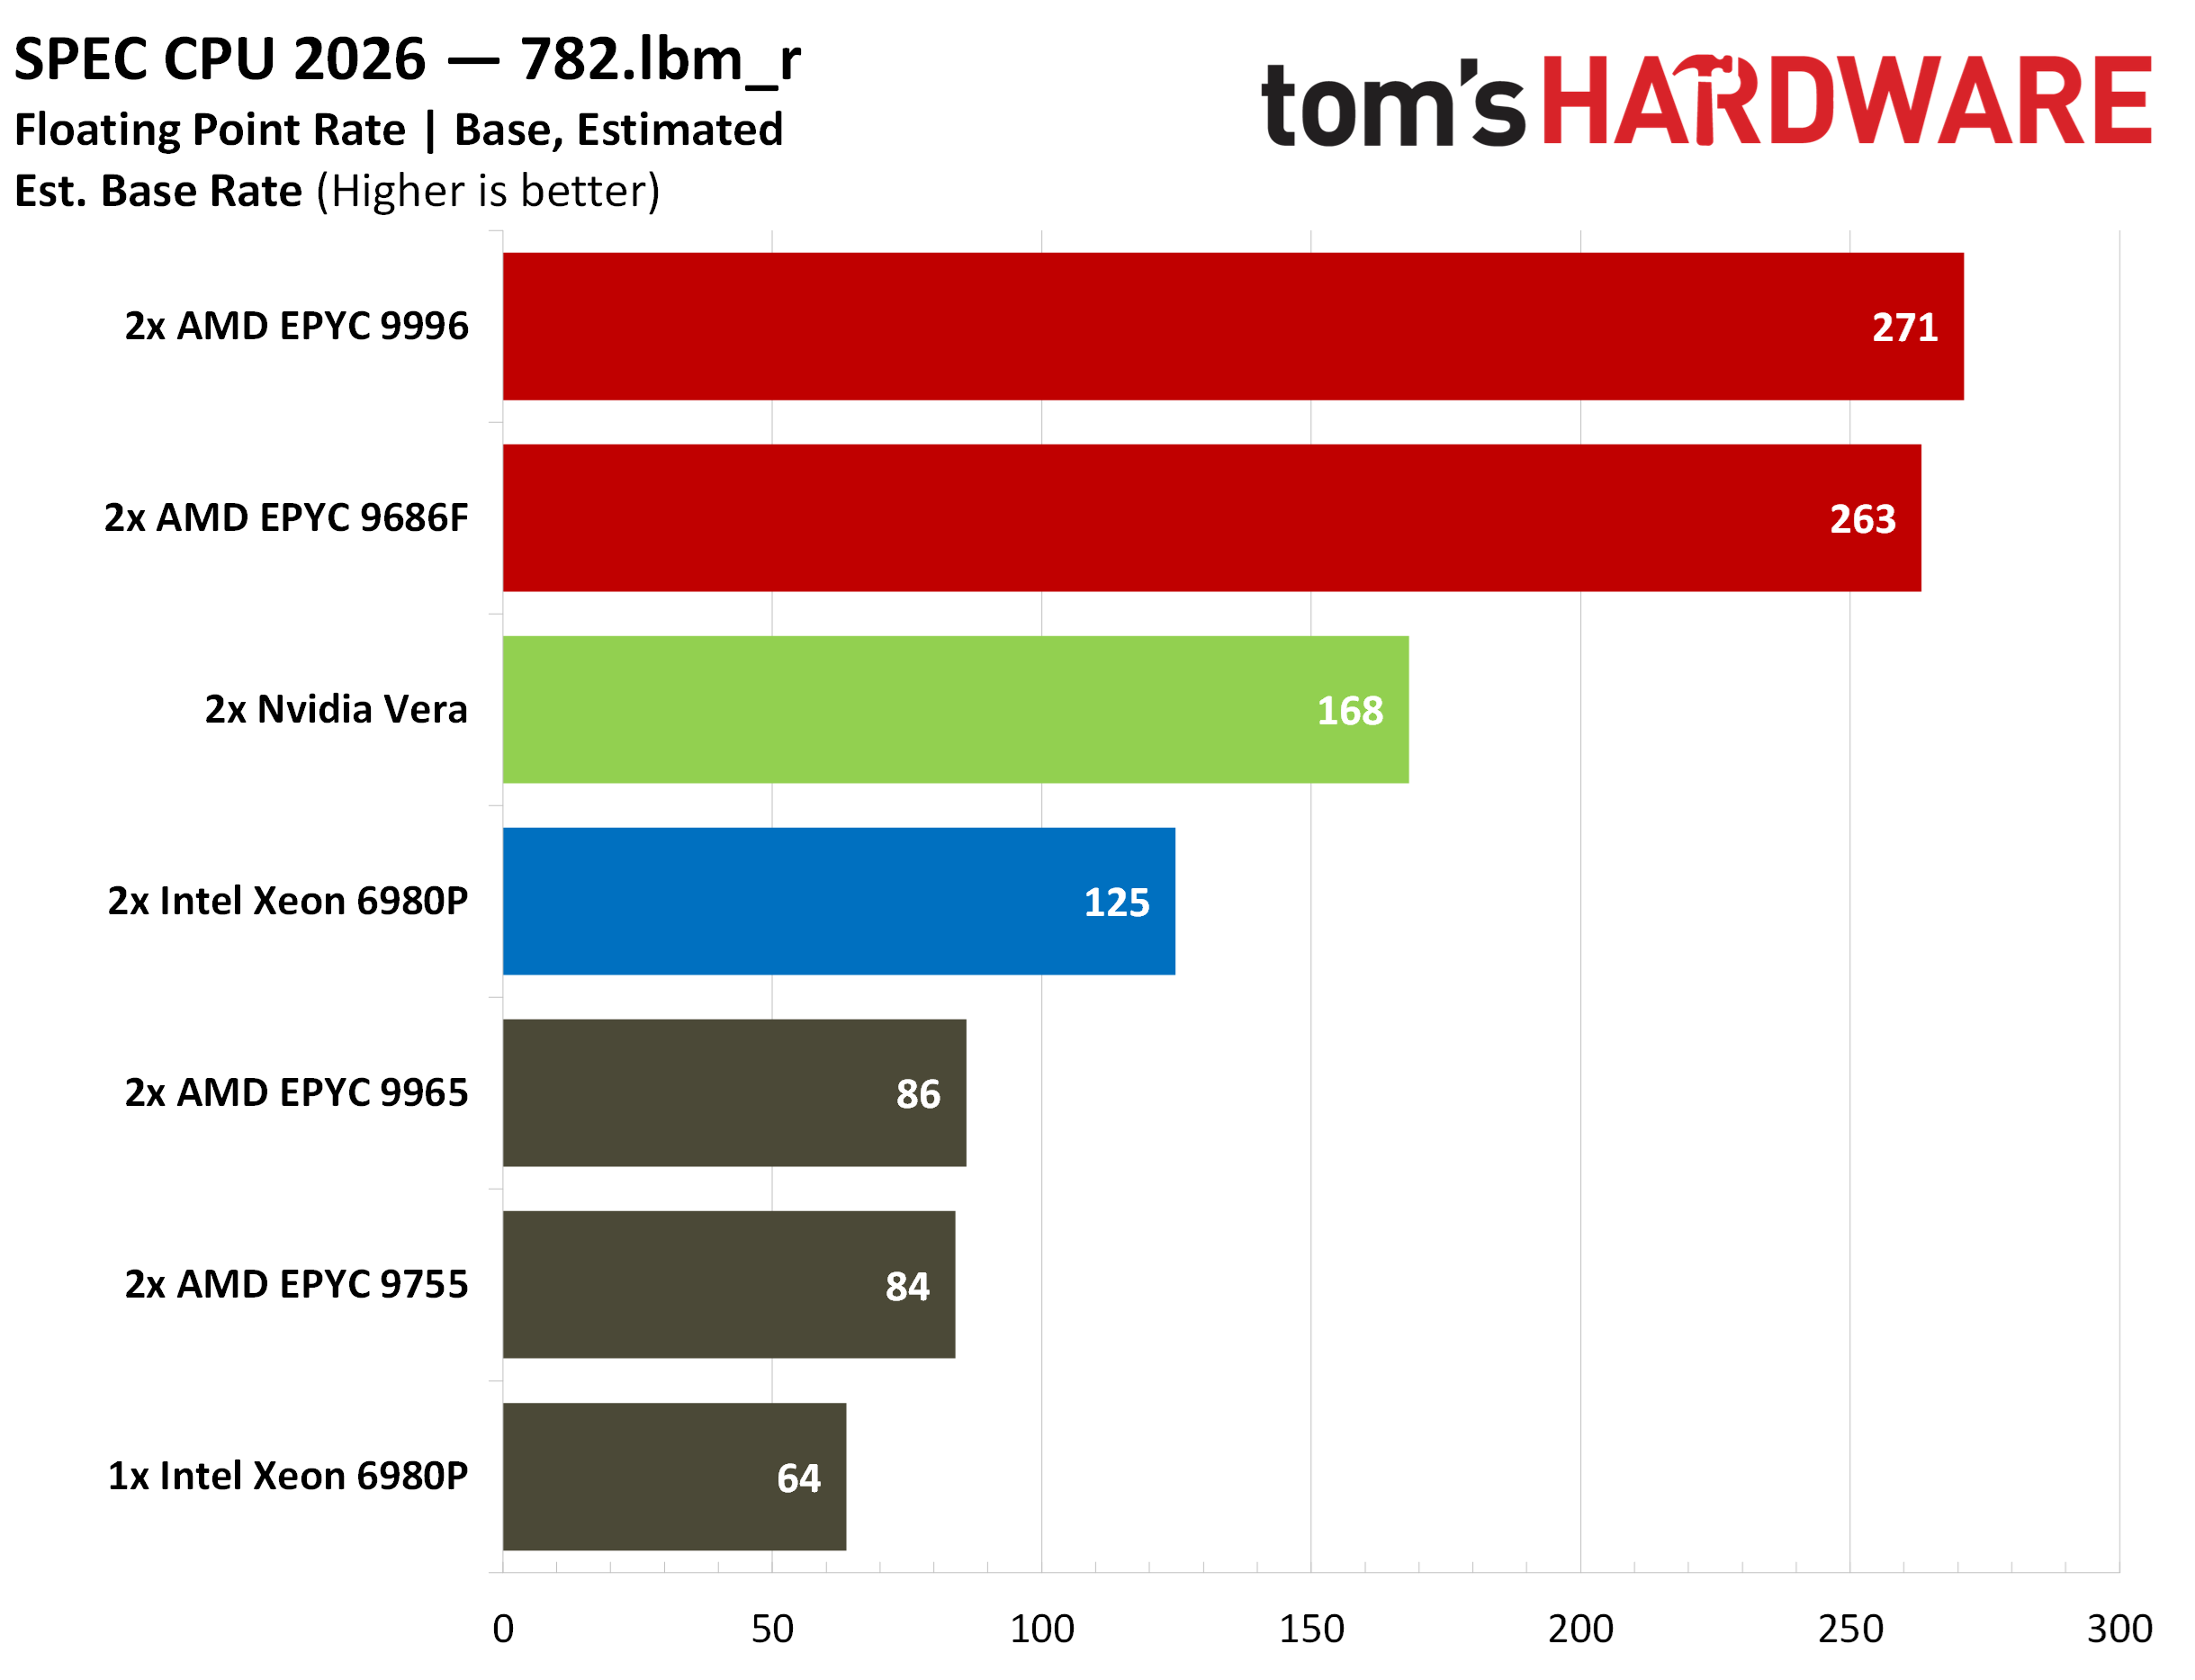
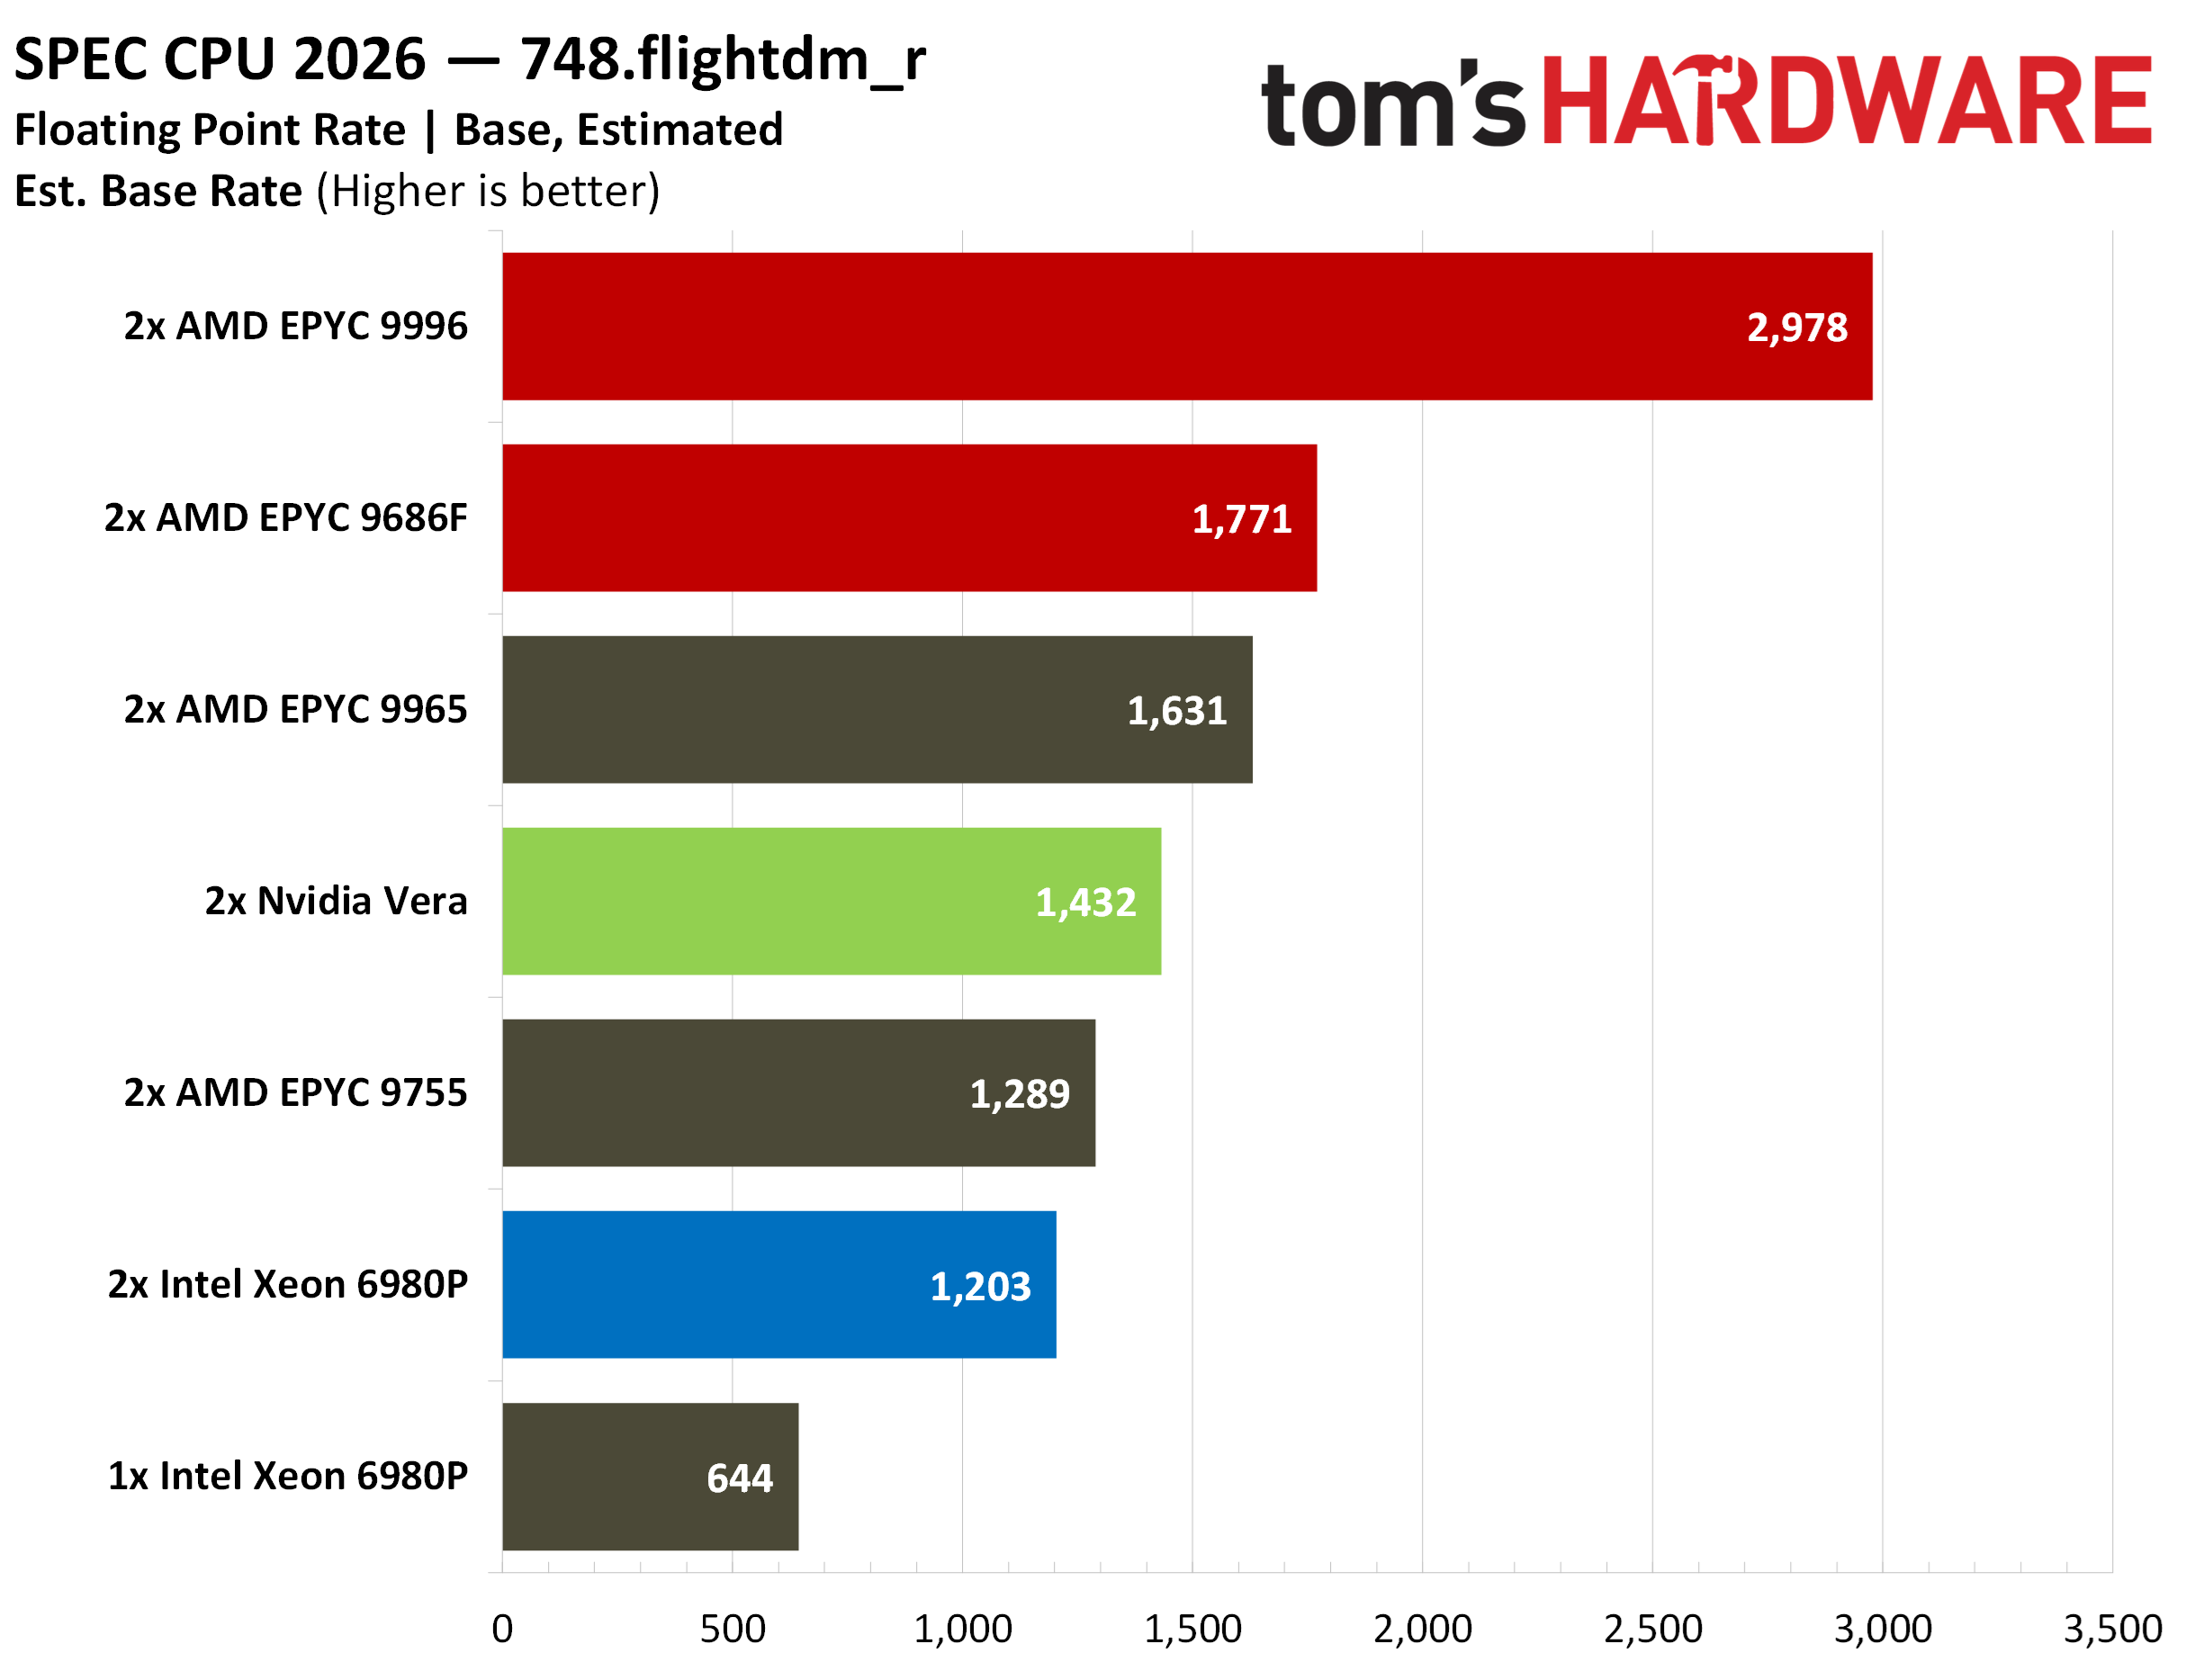
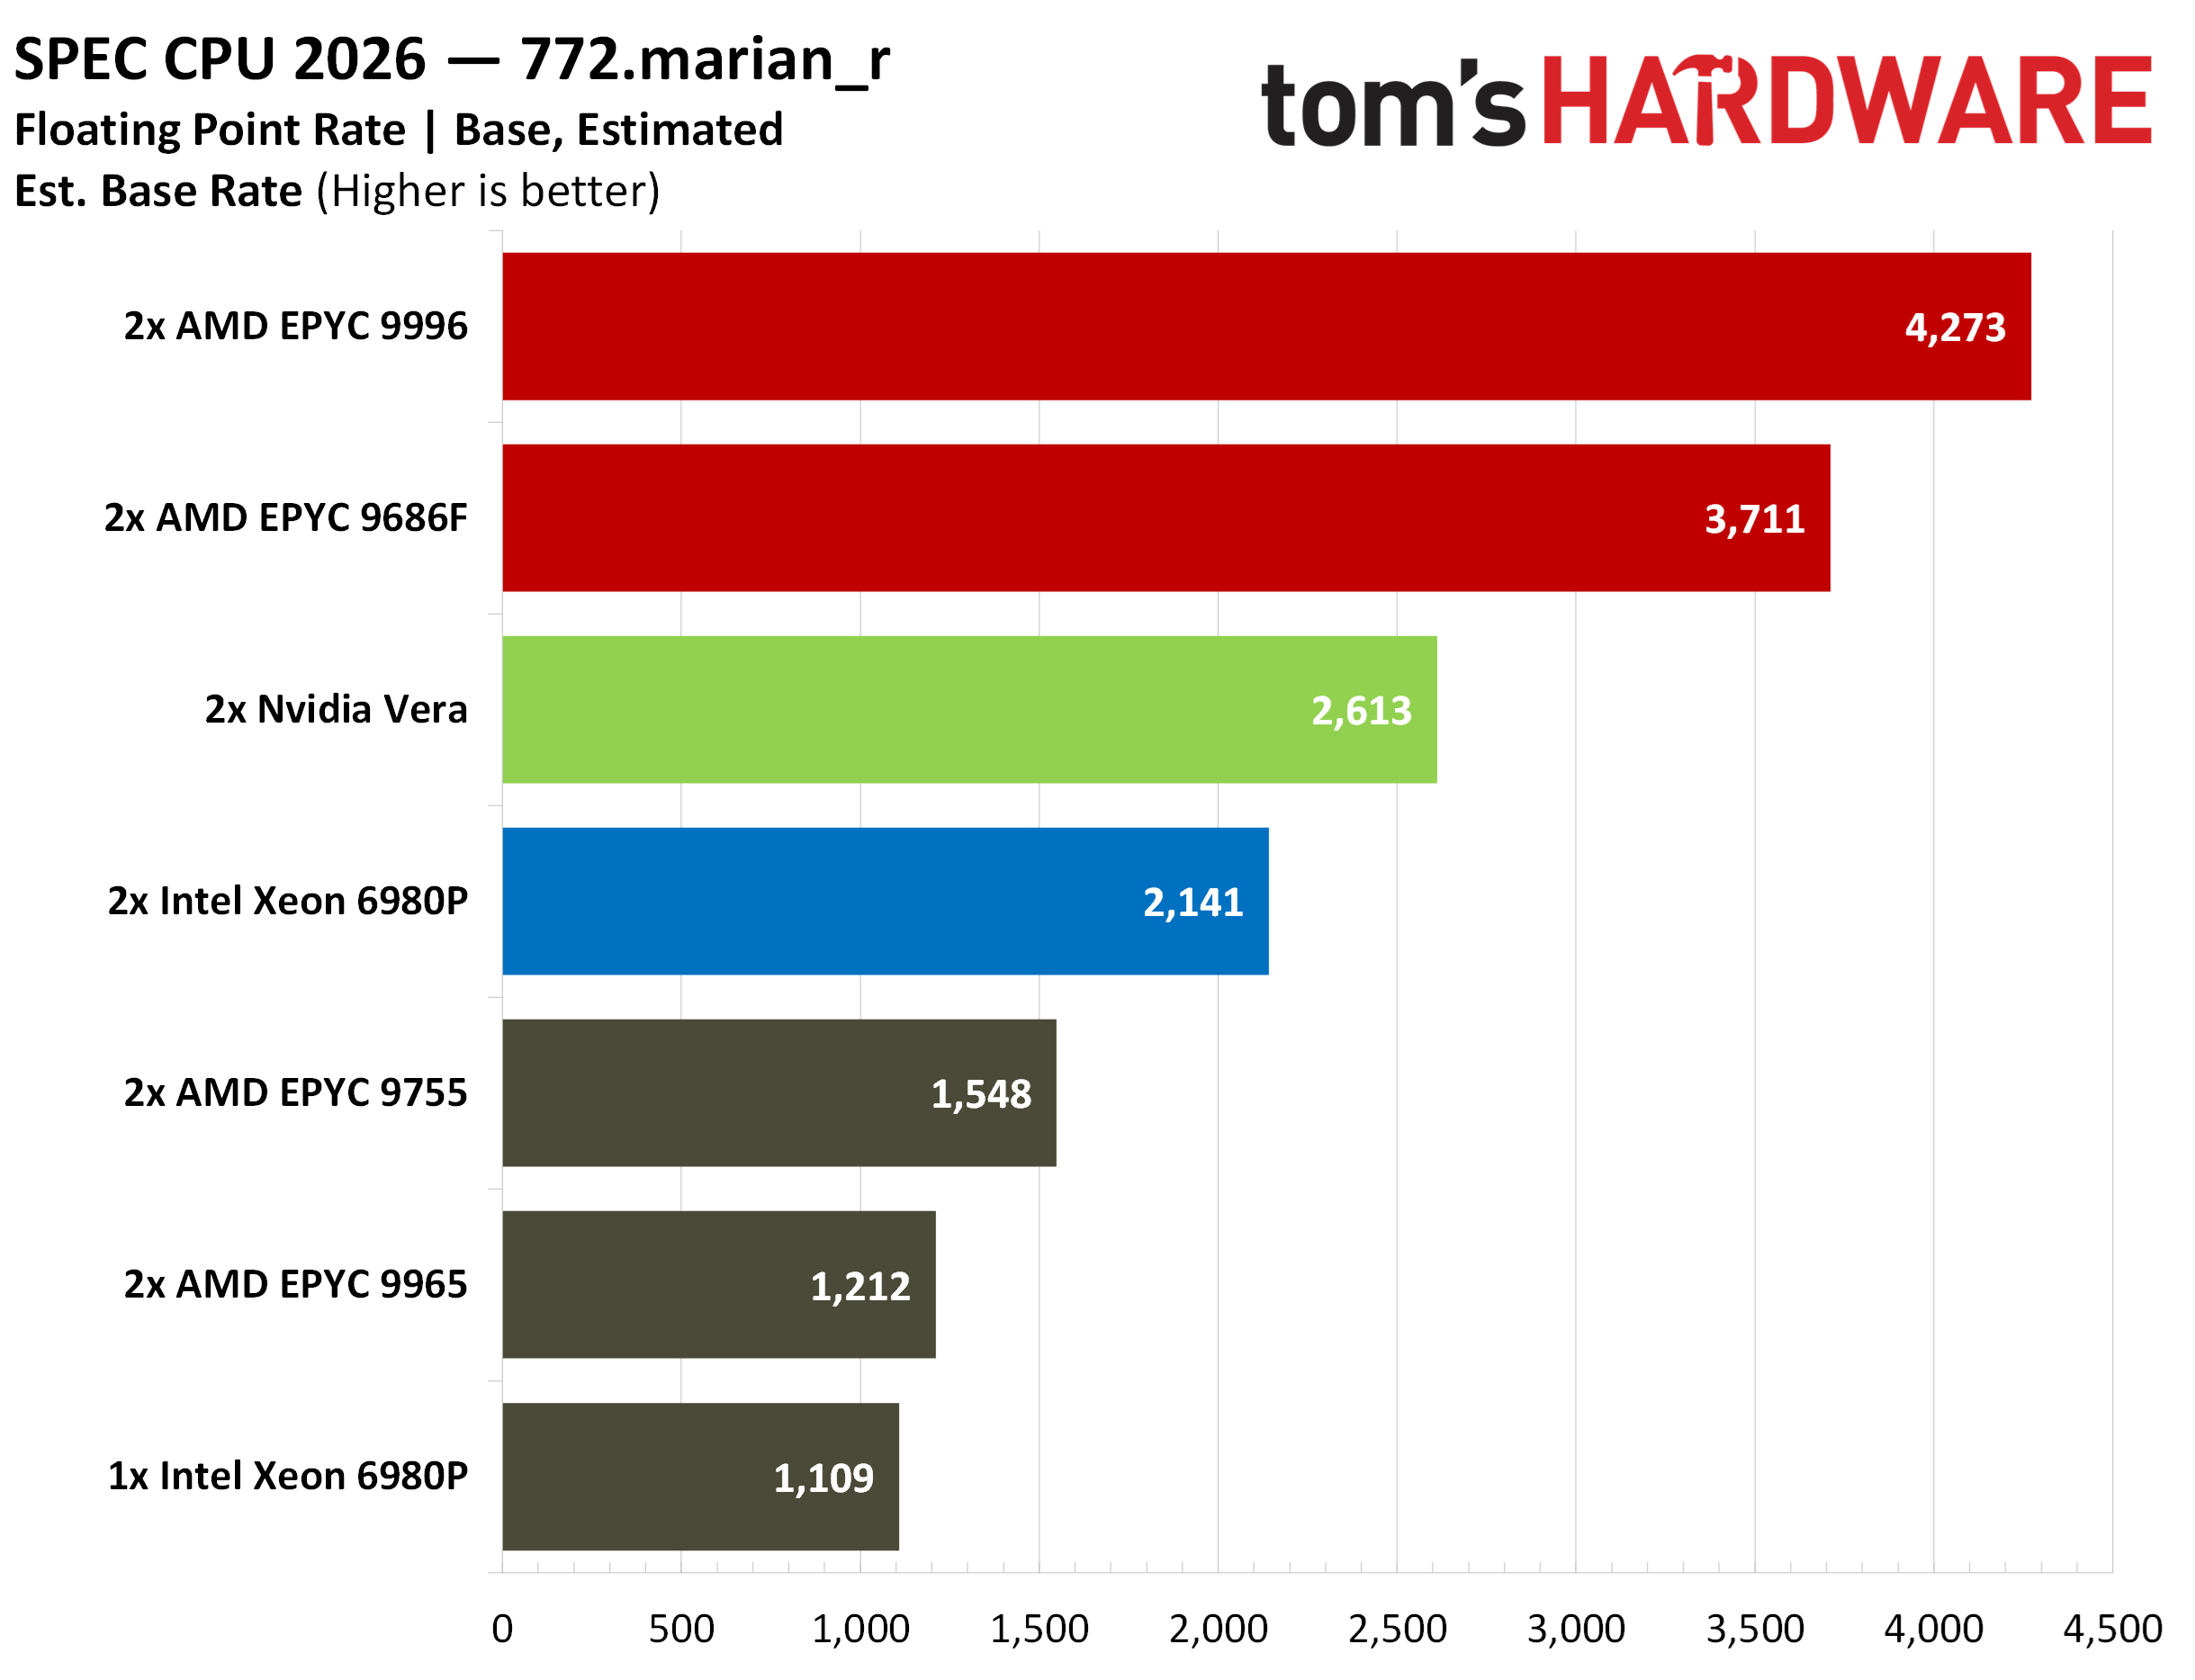
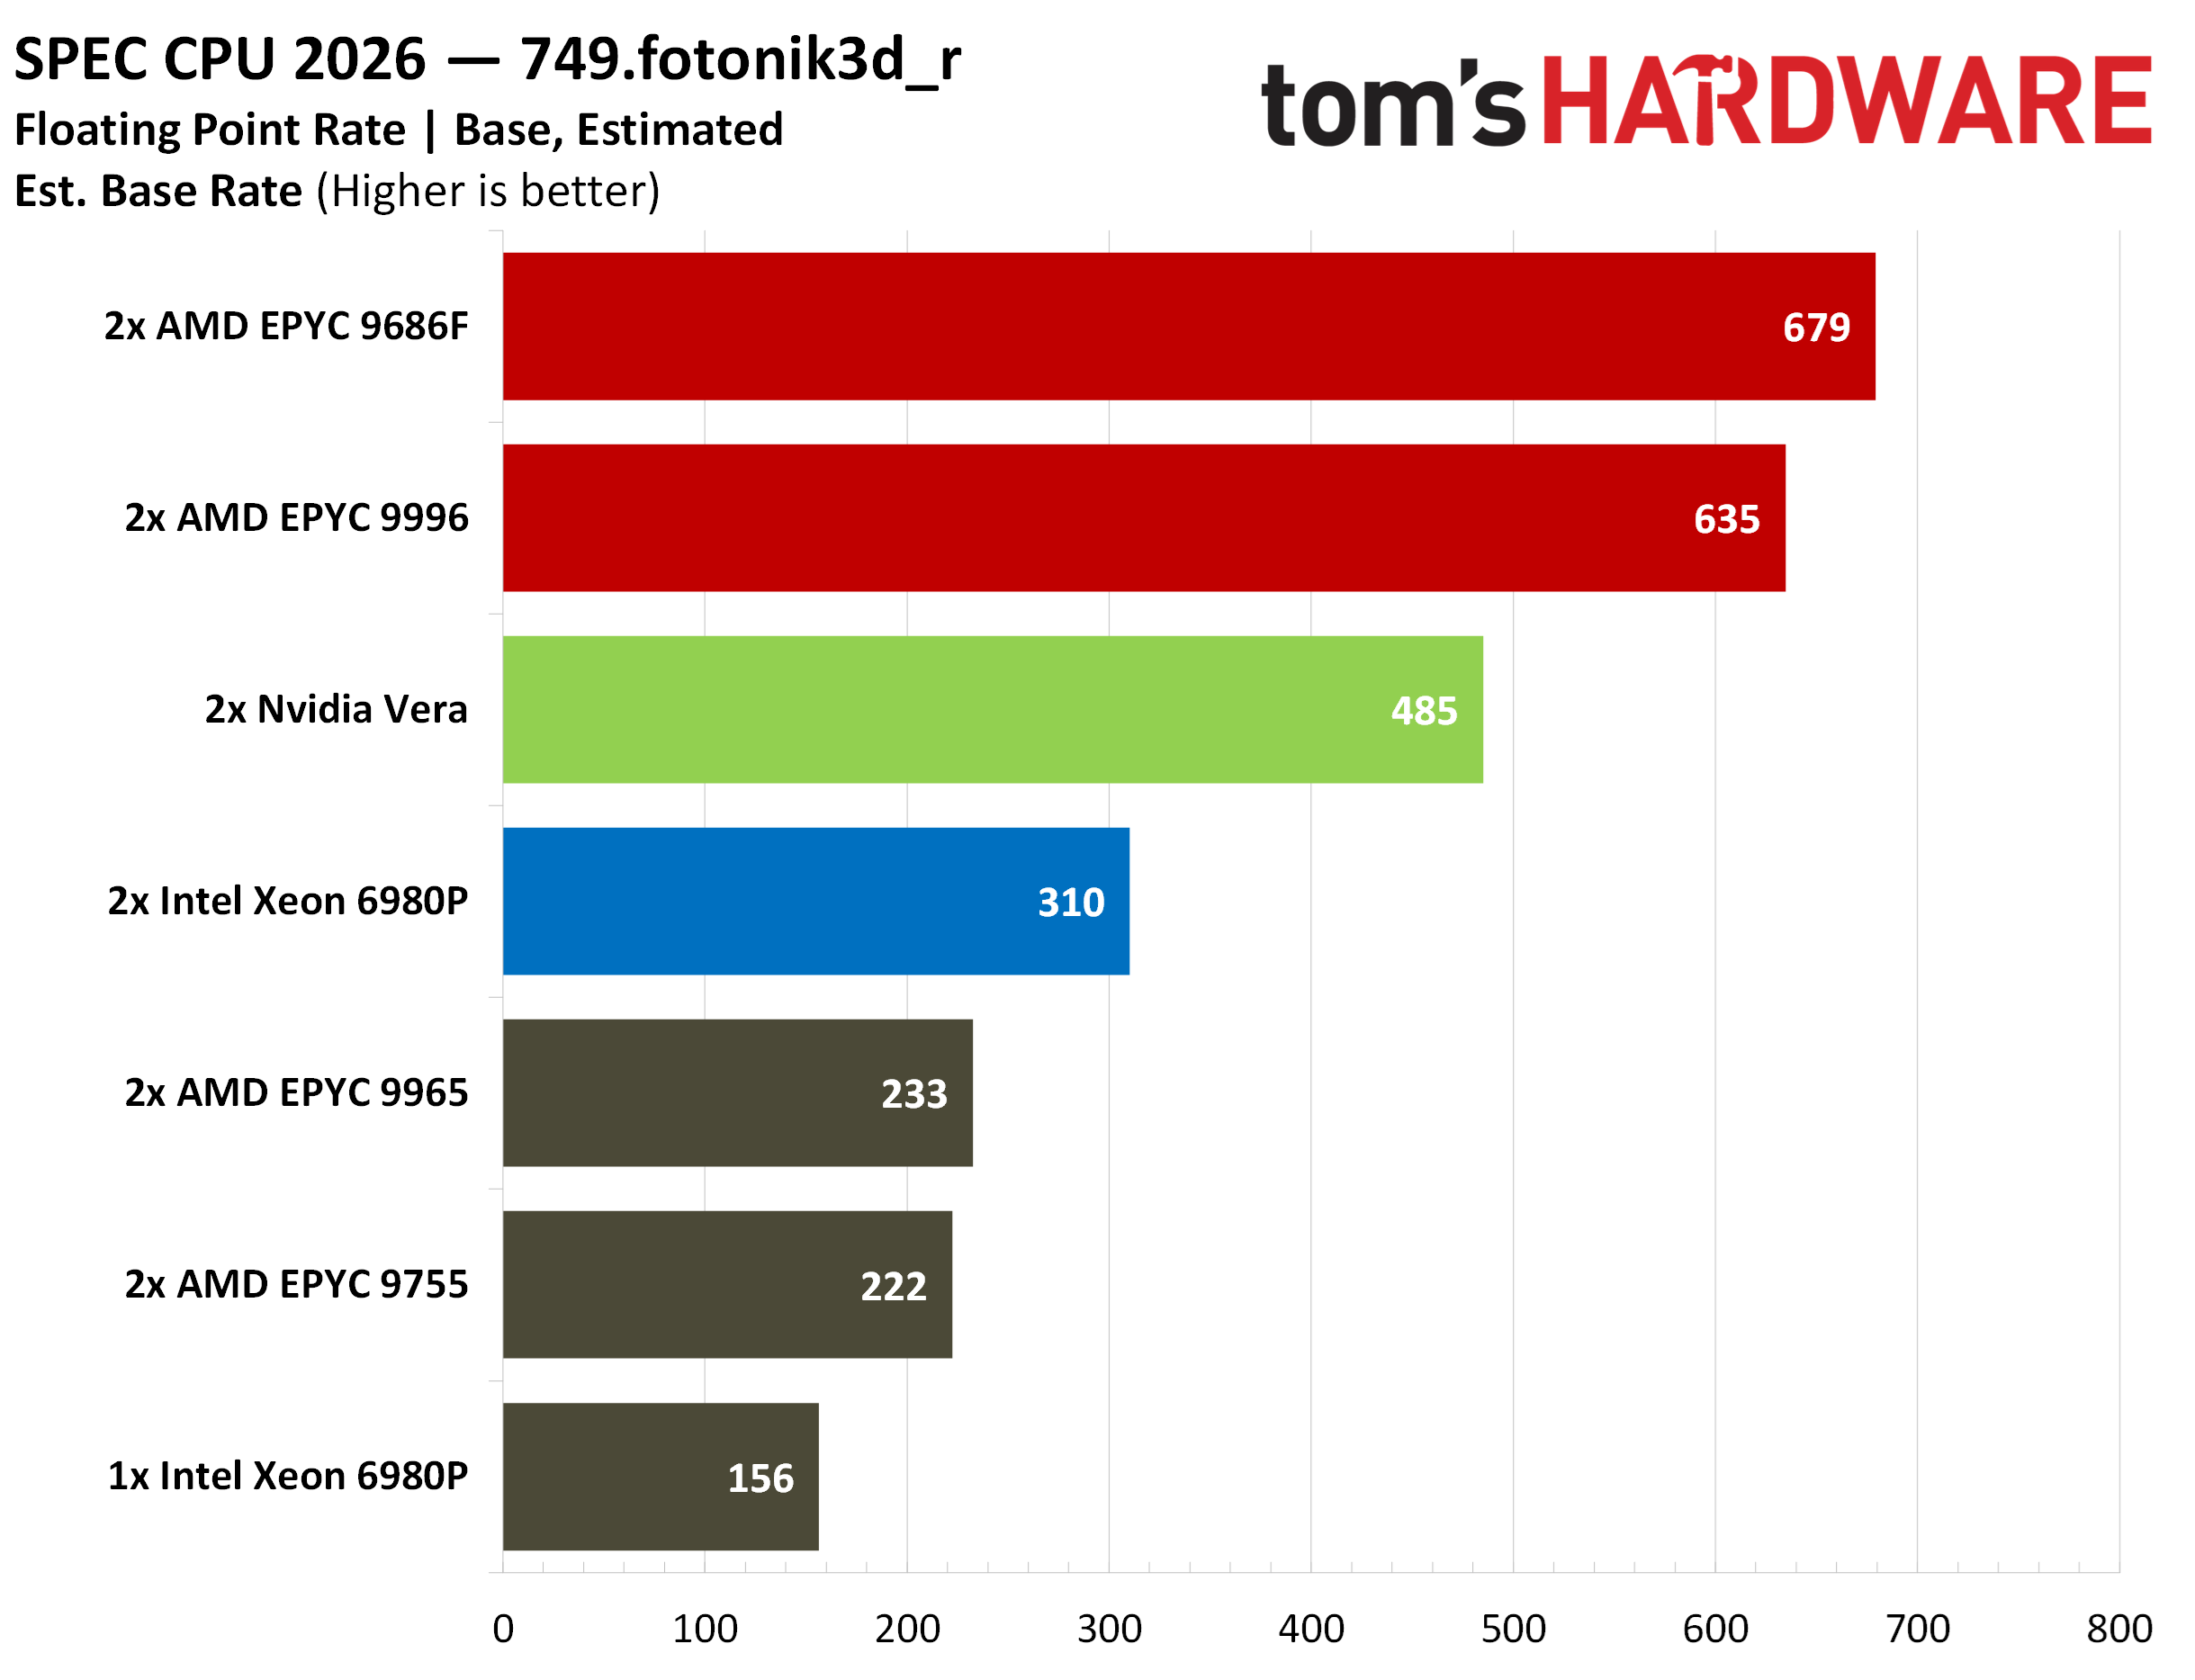
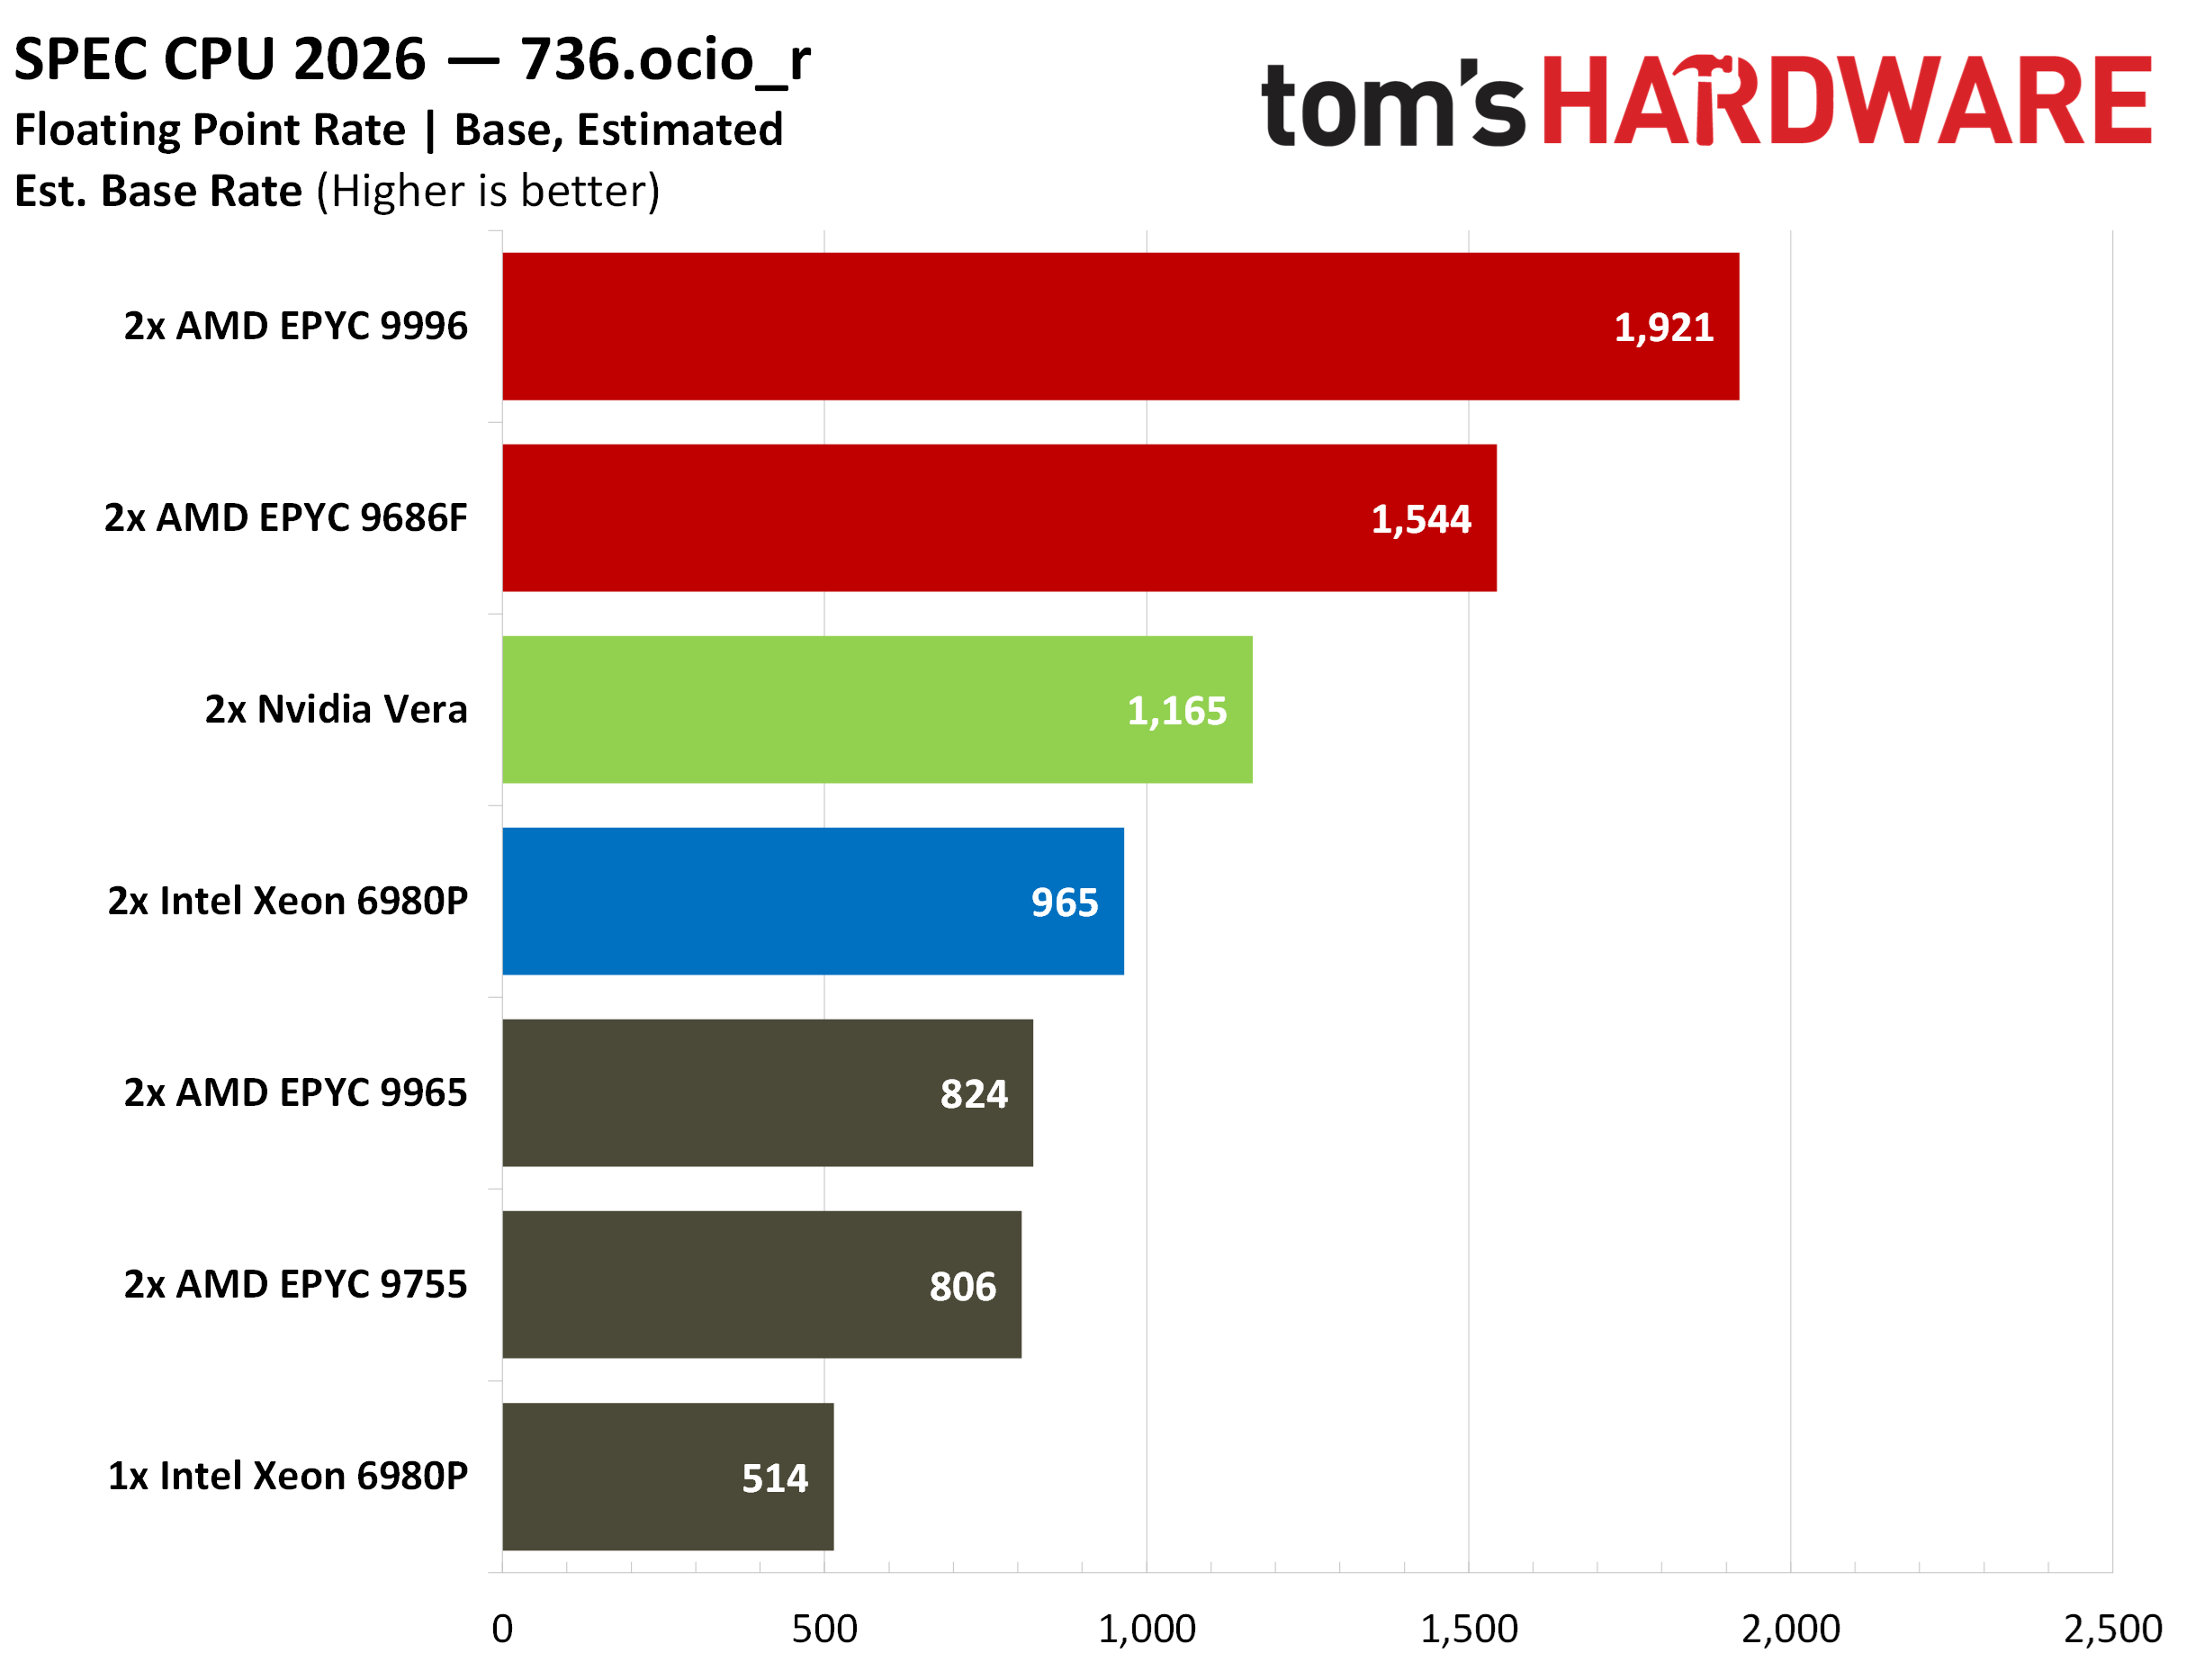
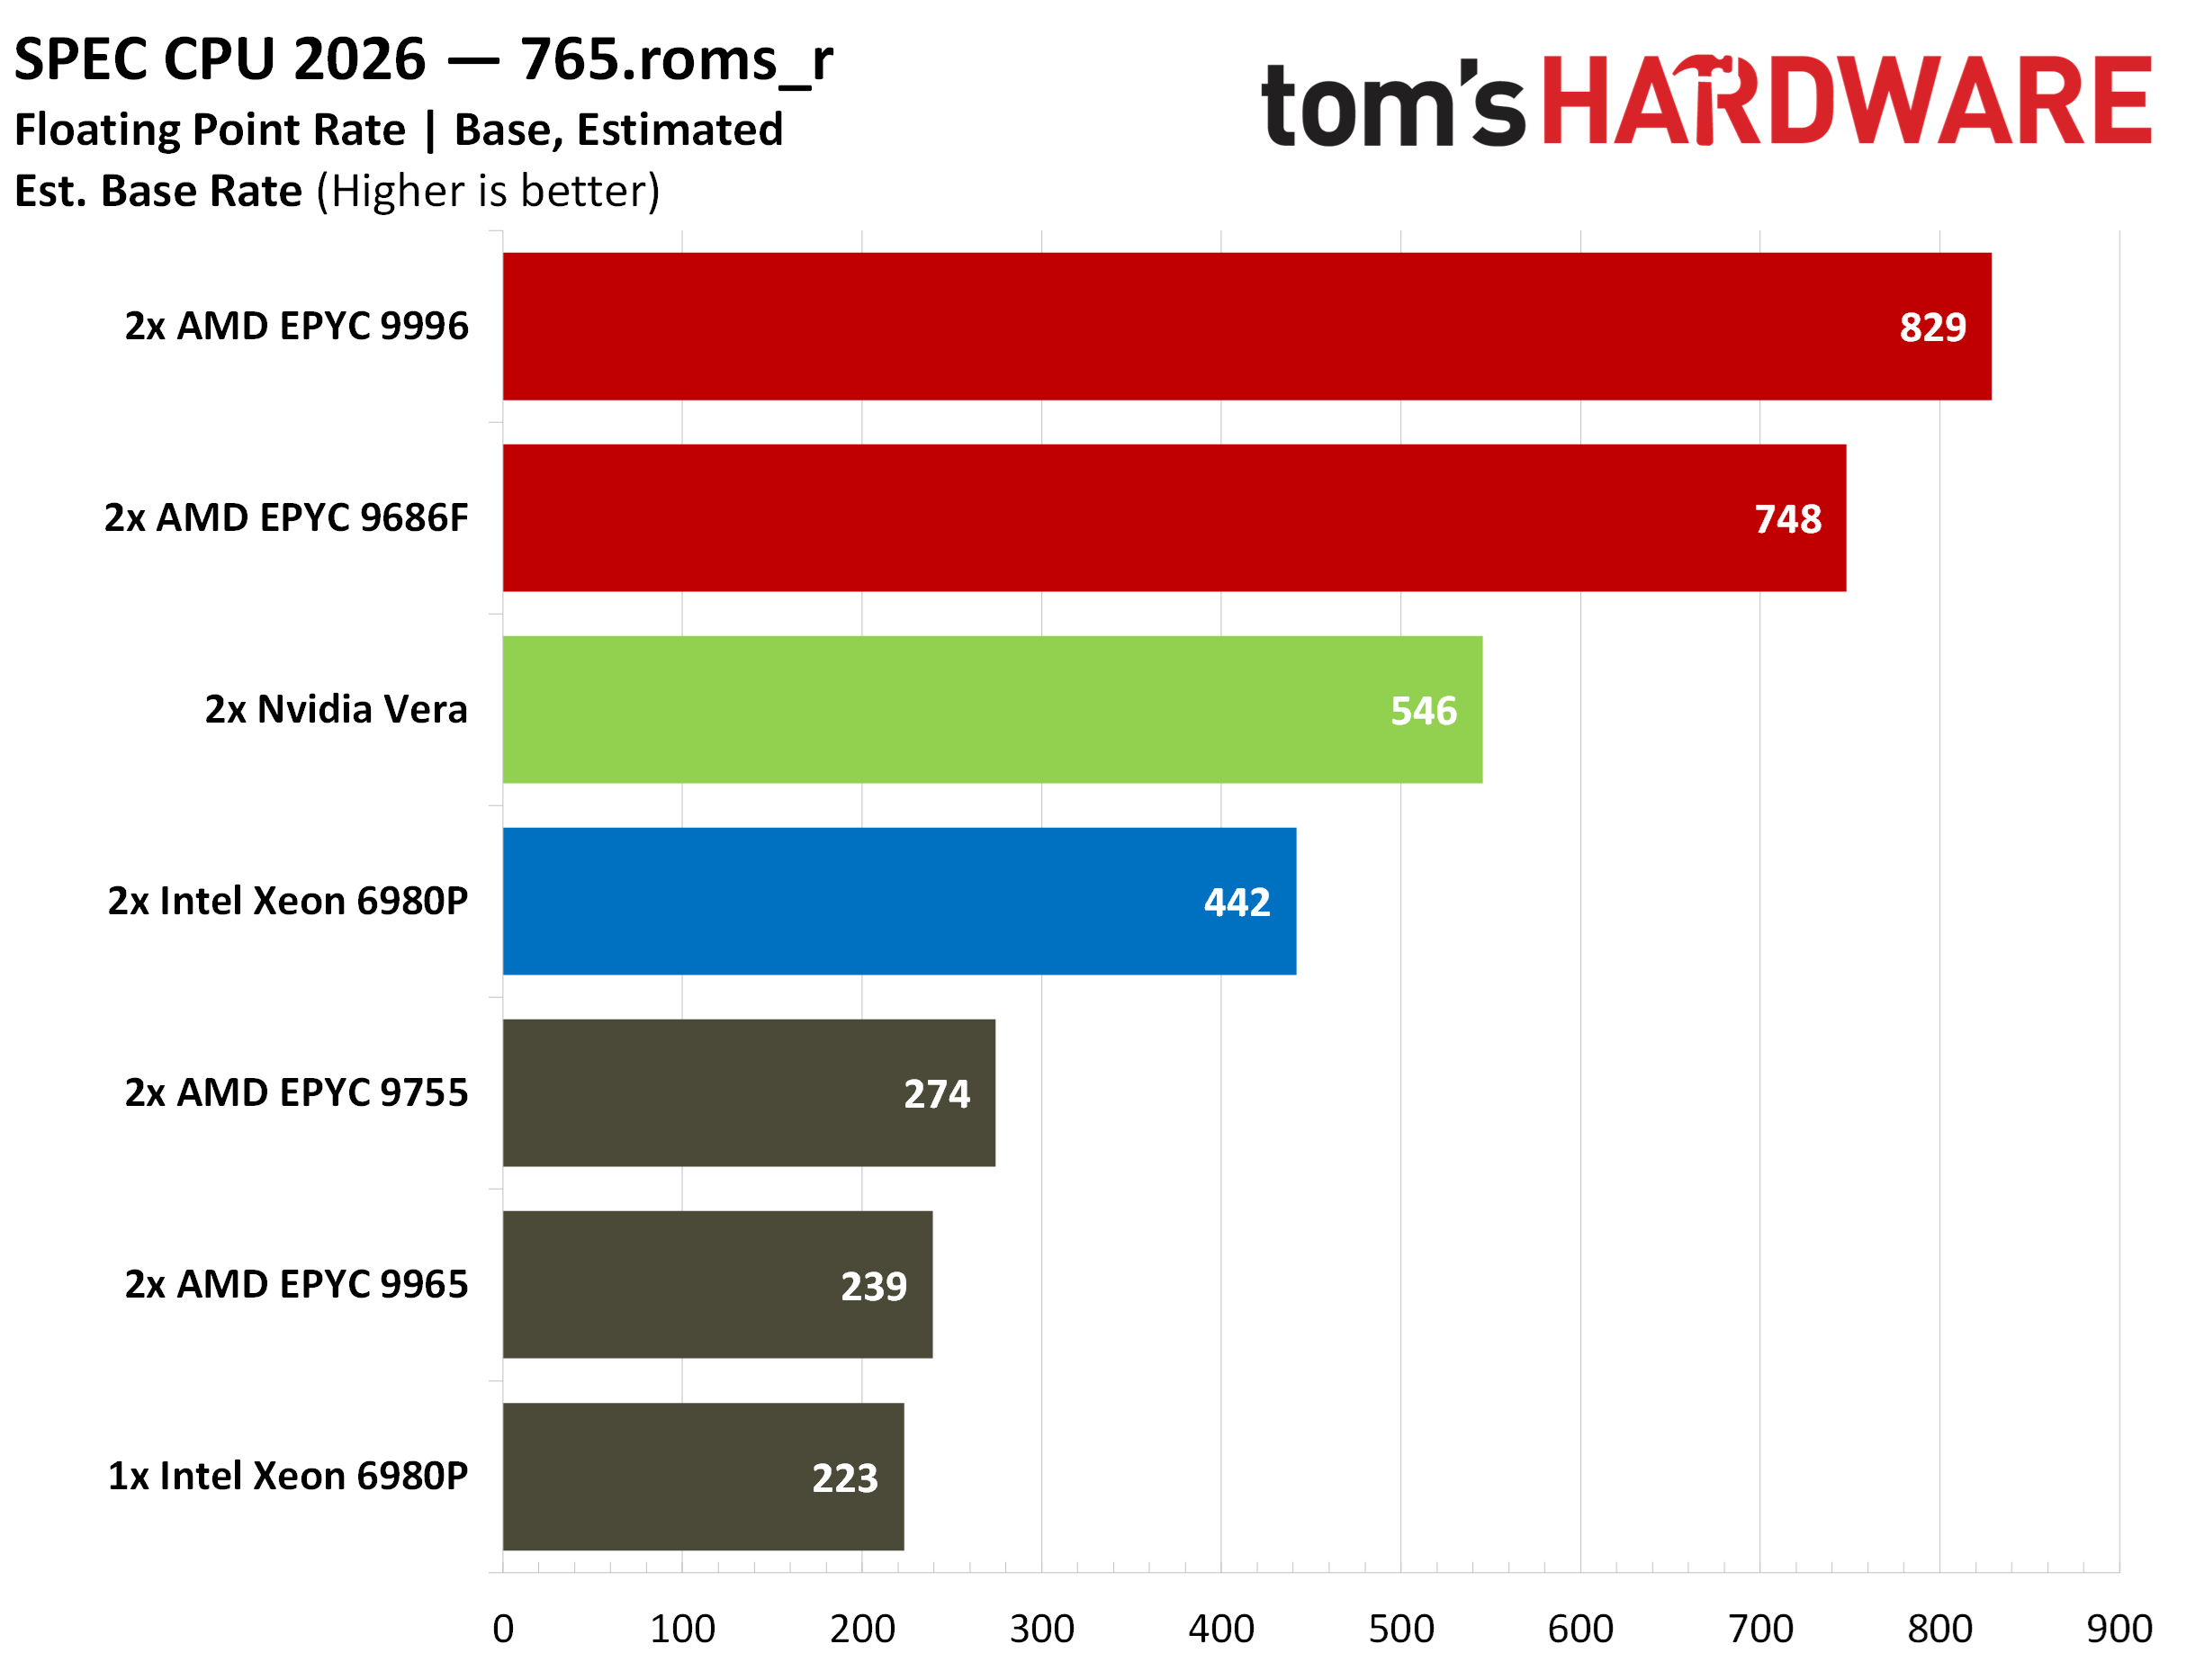
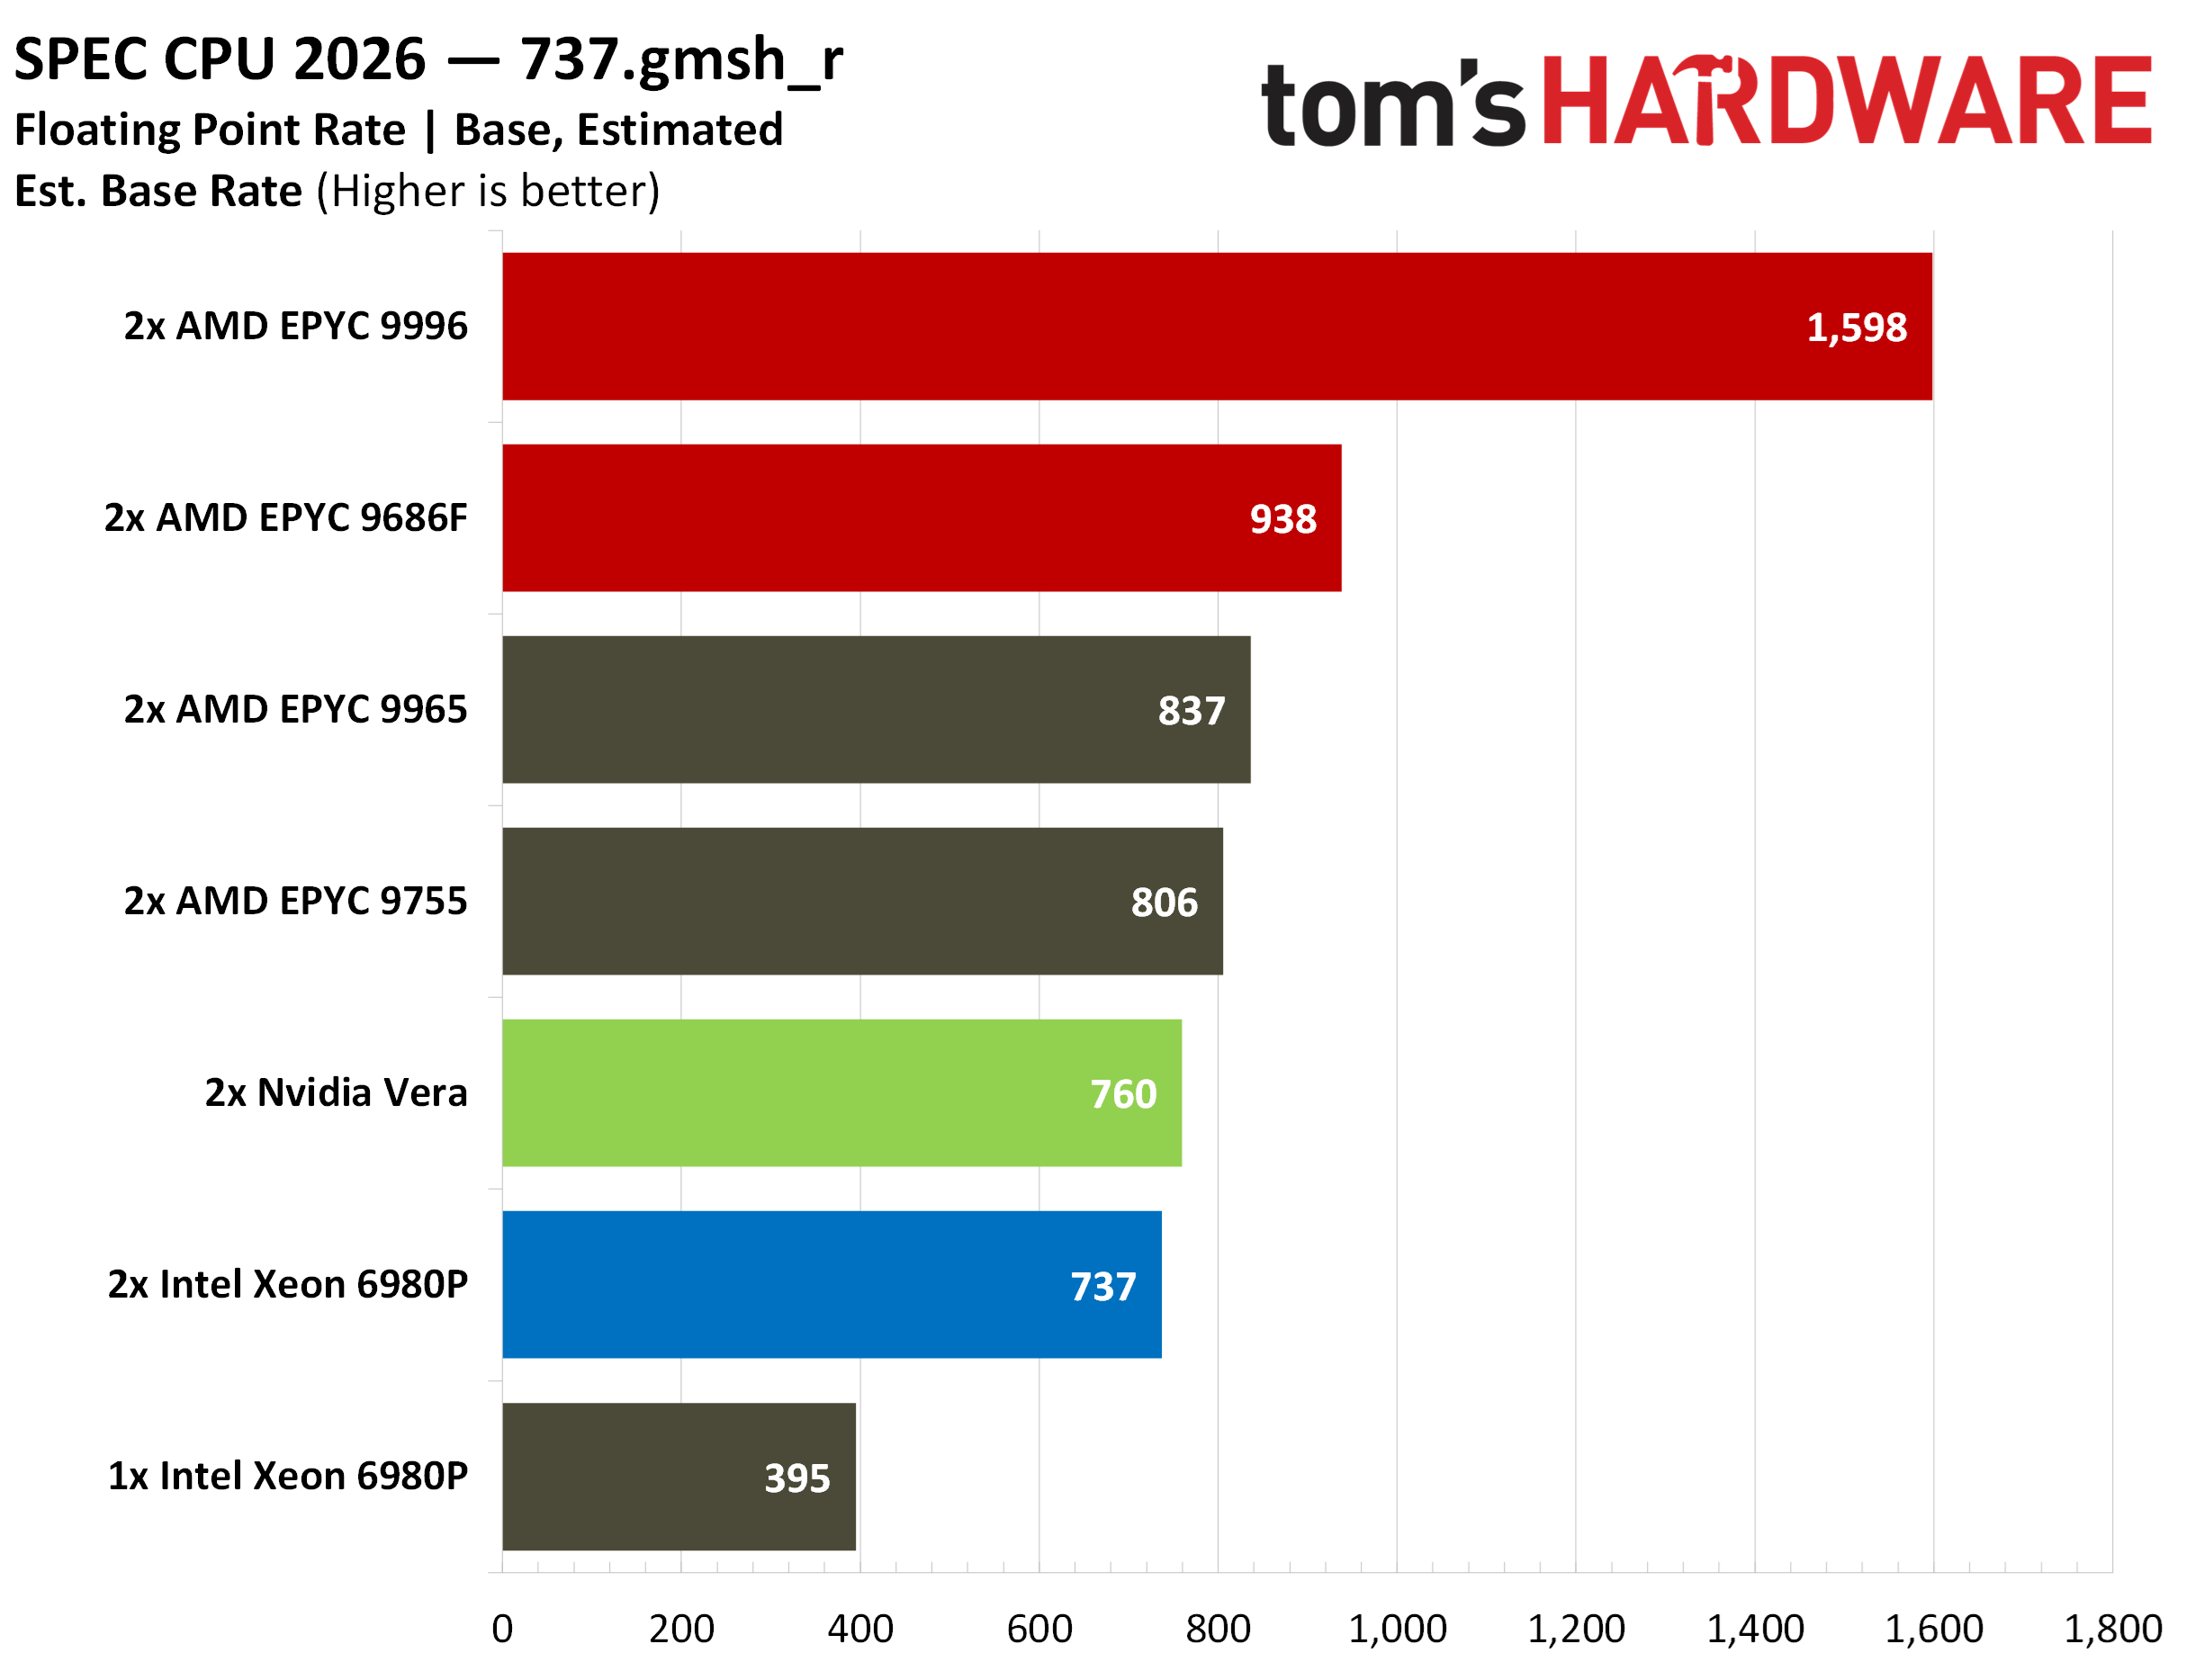
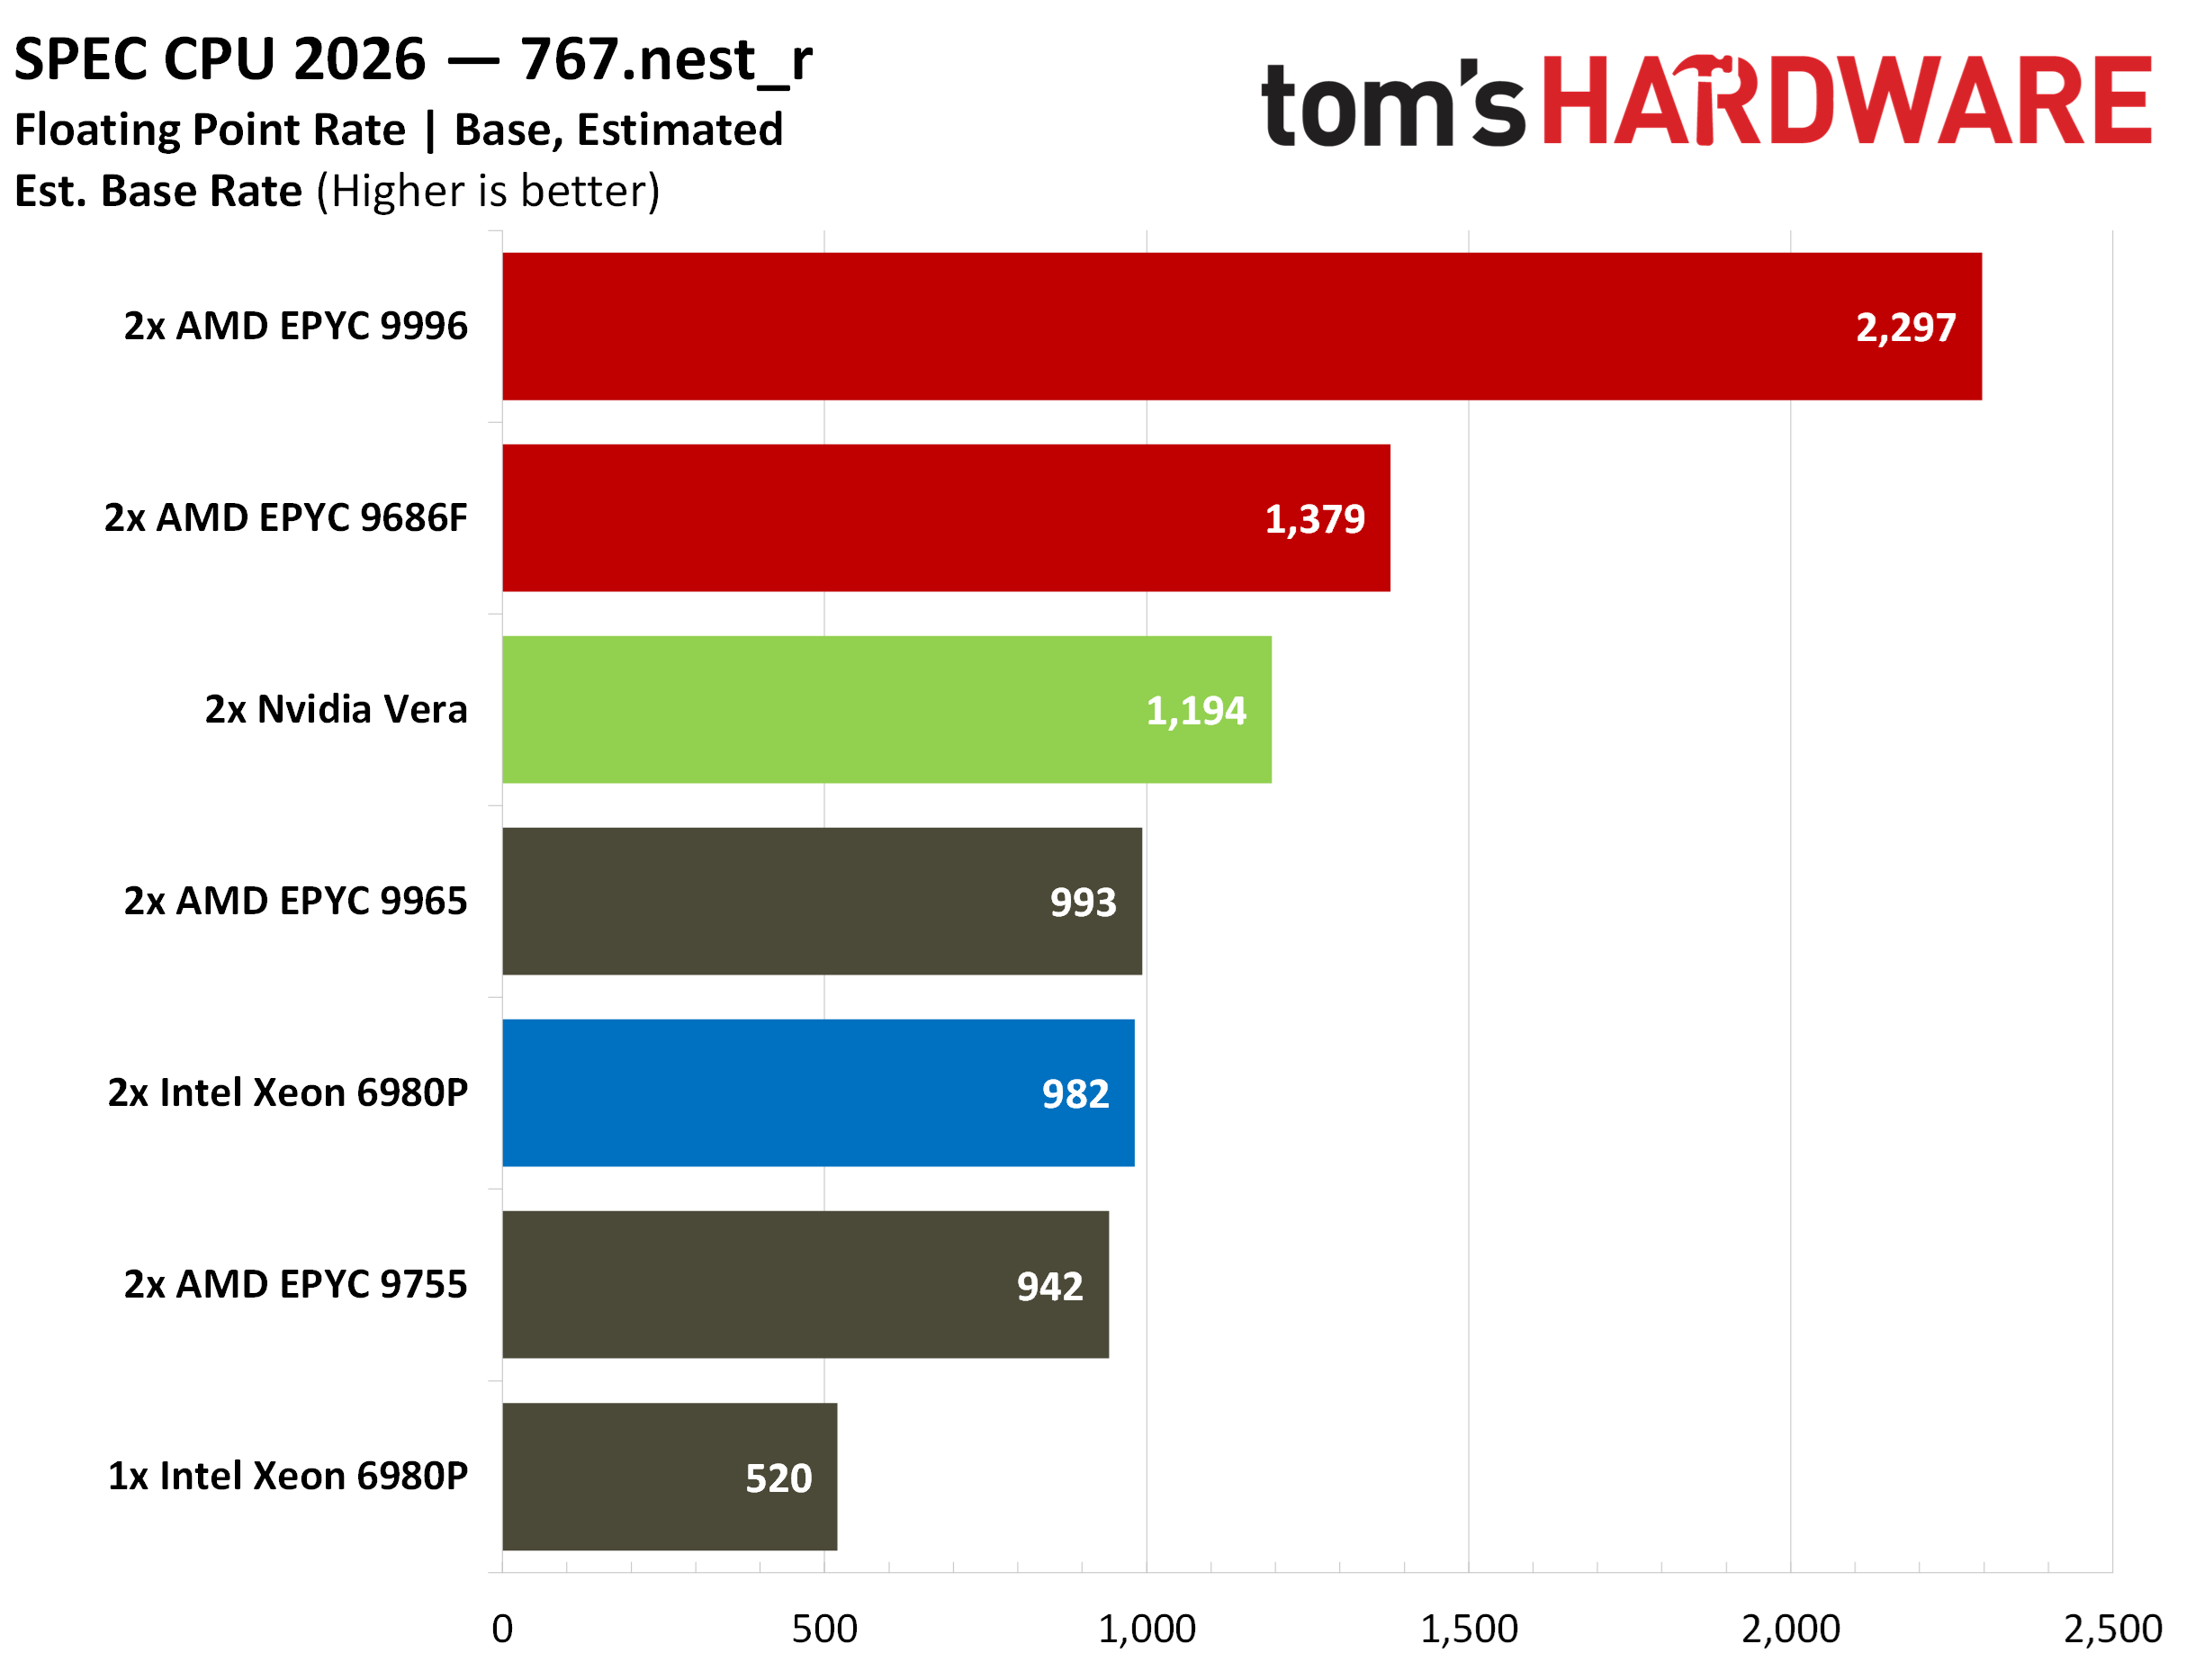
В тестах с плавающей запятой (fprate) архитектура Zen 6 продемонстрировала двукратное преимущество над Zen 5, а Epyc 9686F обошел Nvidia Vera на 40 %.
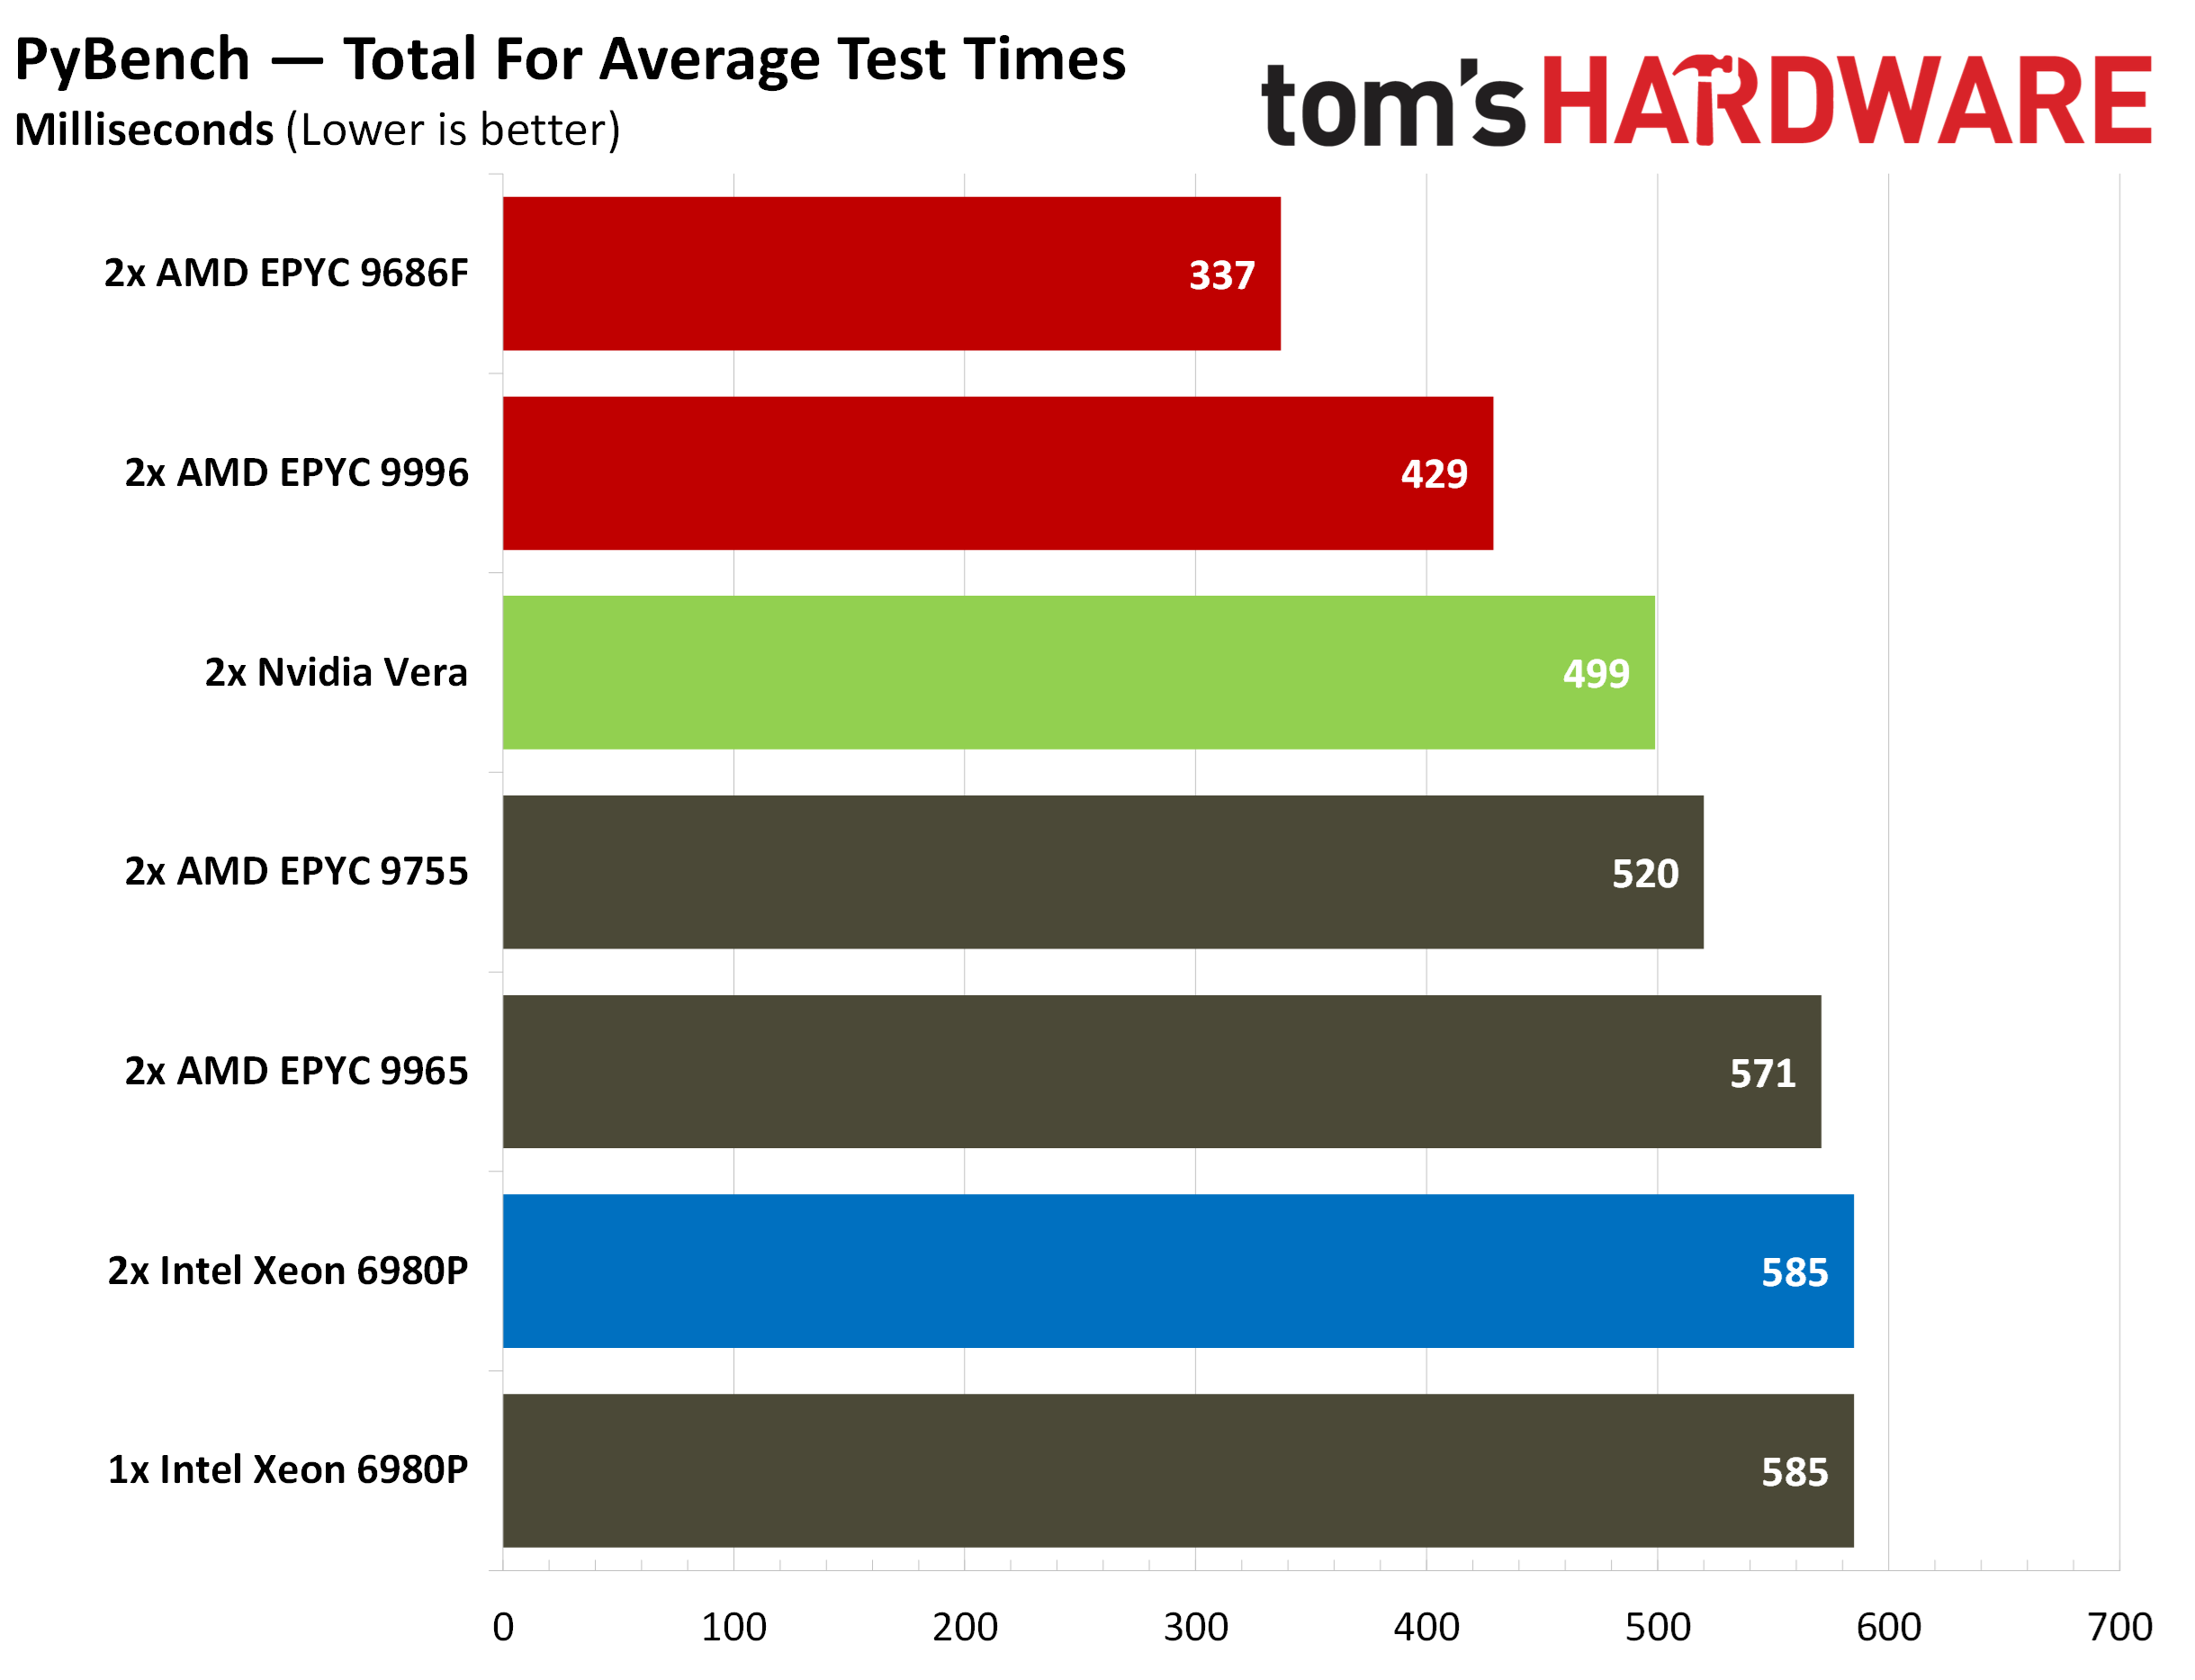
В однопоточном тесте PyBench частотный флагман EPYC 9686F за счёт архитектурных улучшений и высокой частоты оказался на 32 % быстрее чипа от Nvidia.
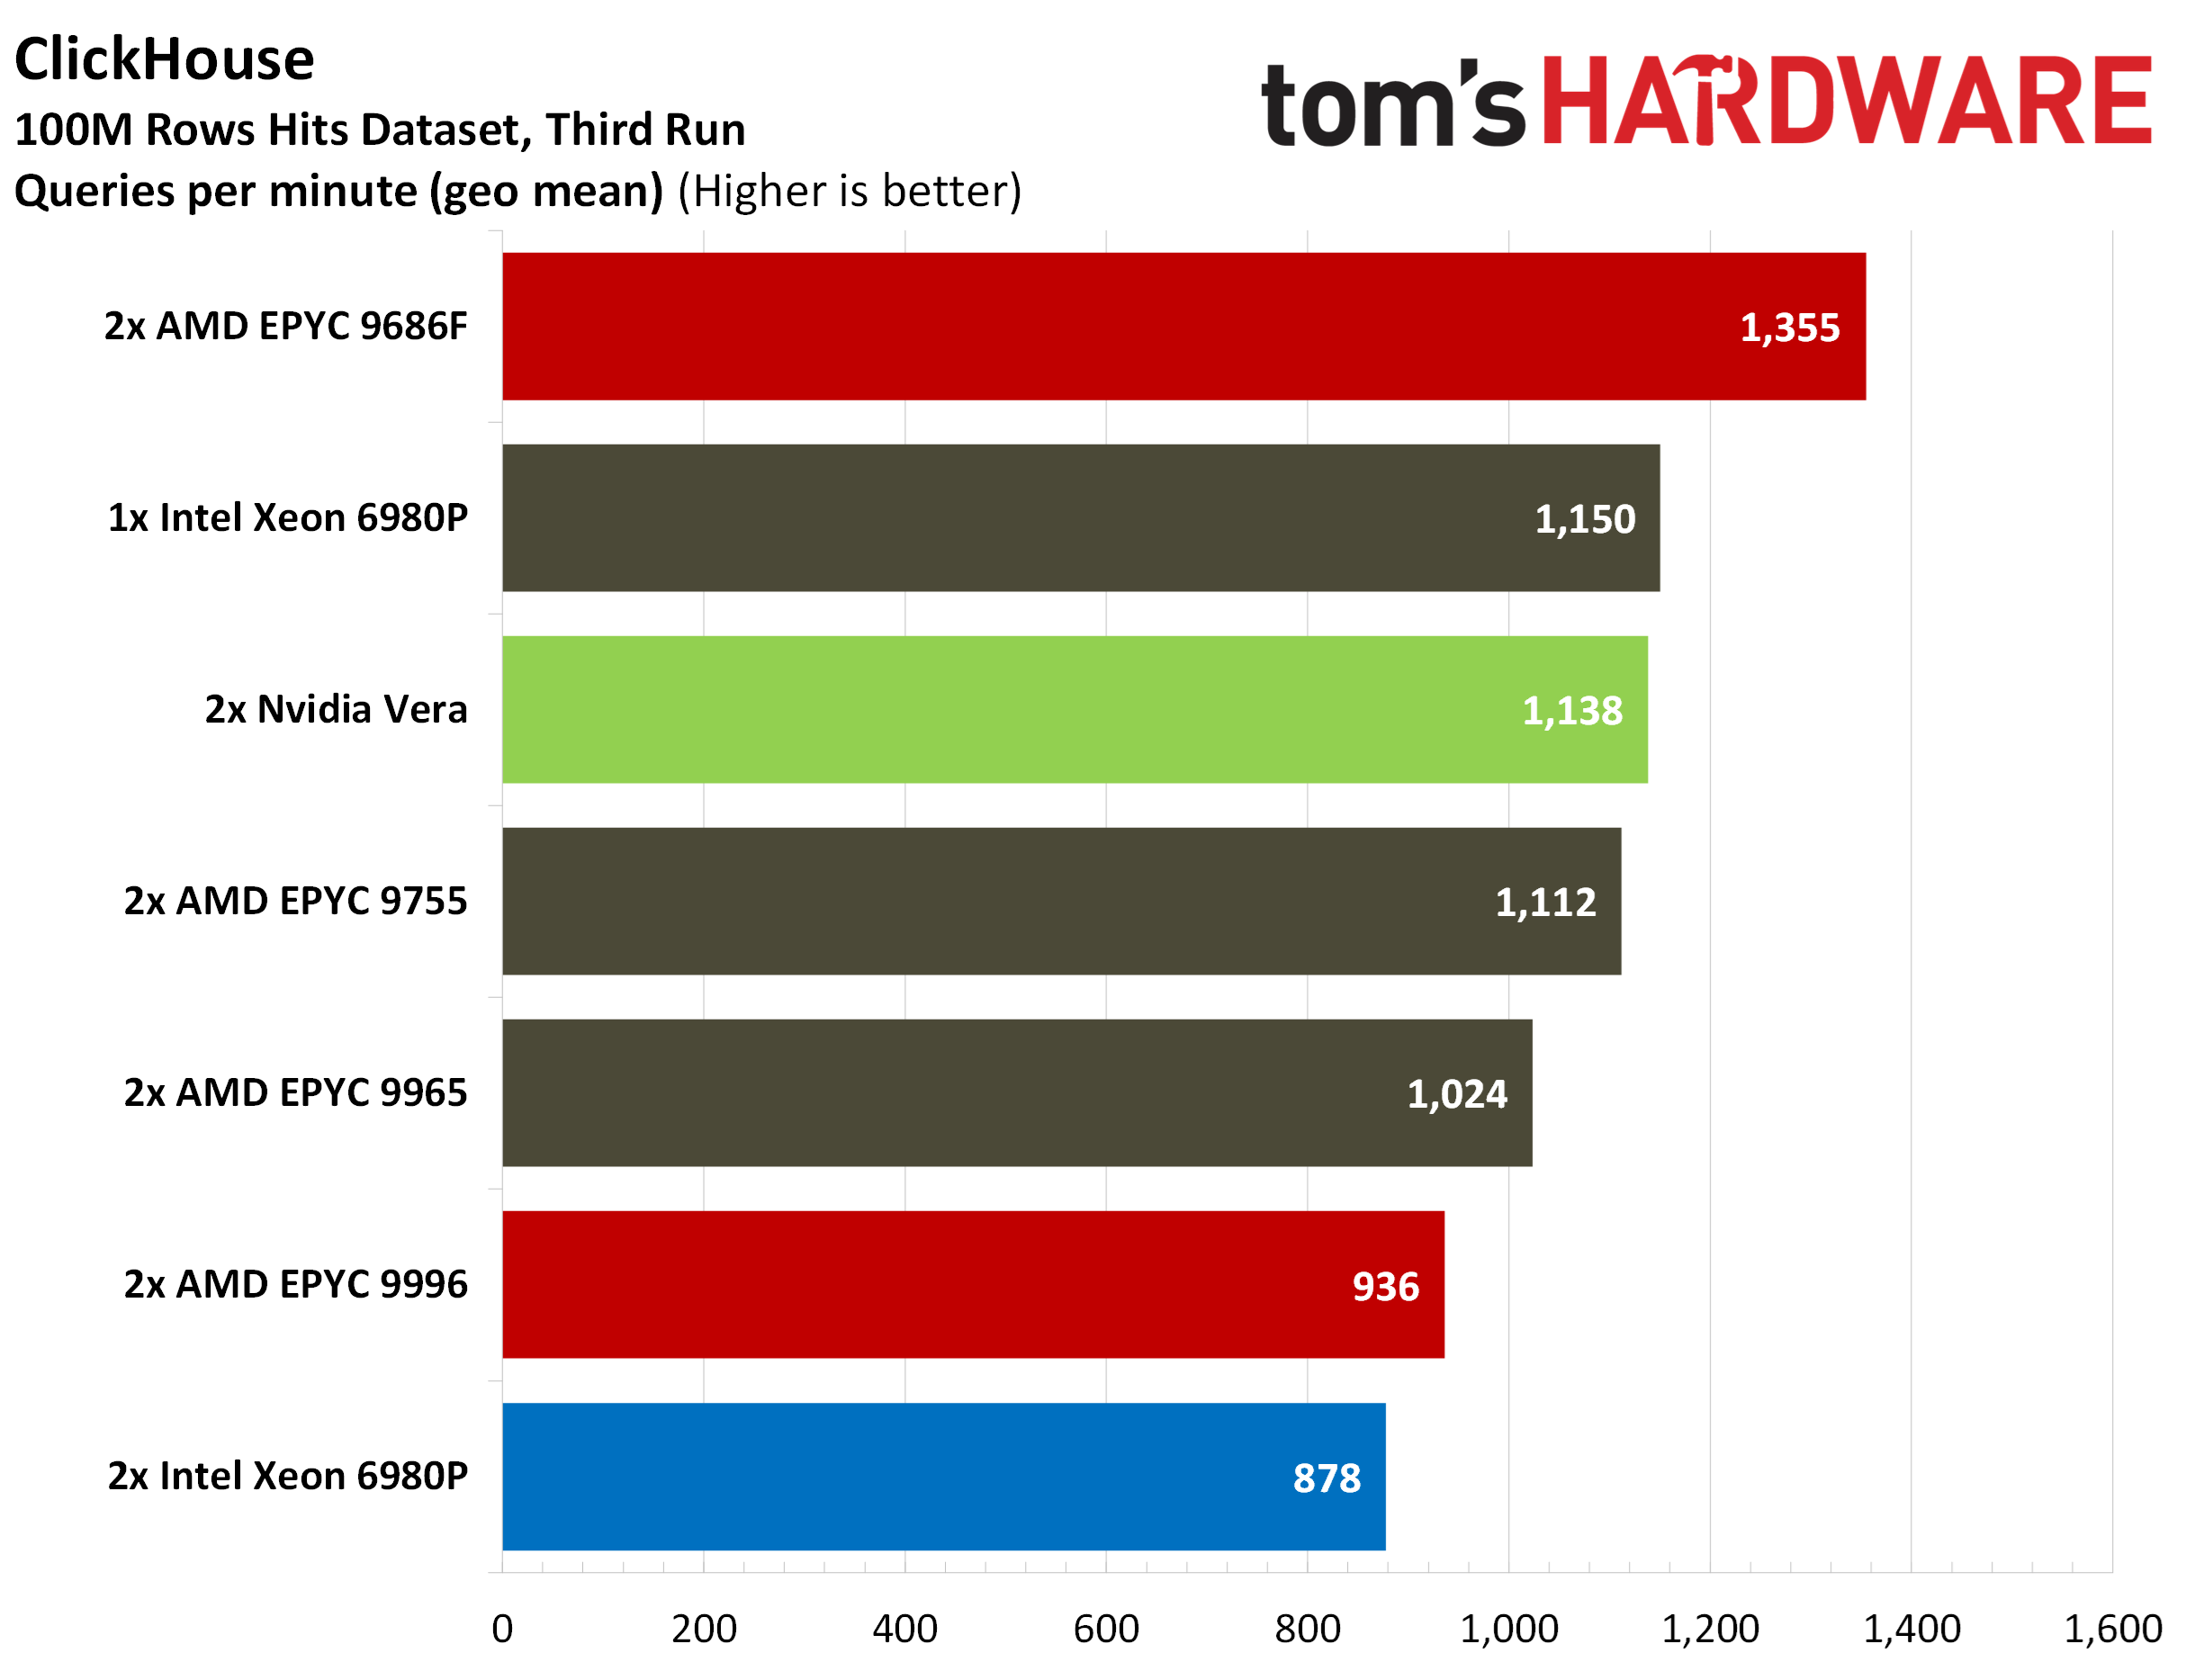
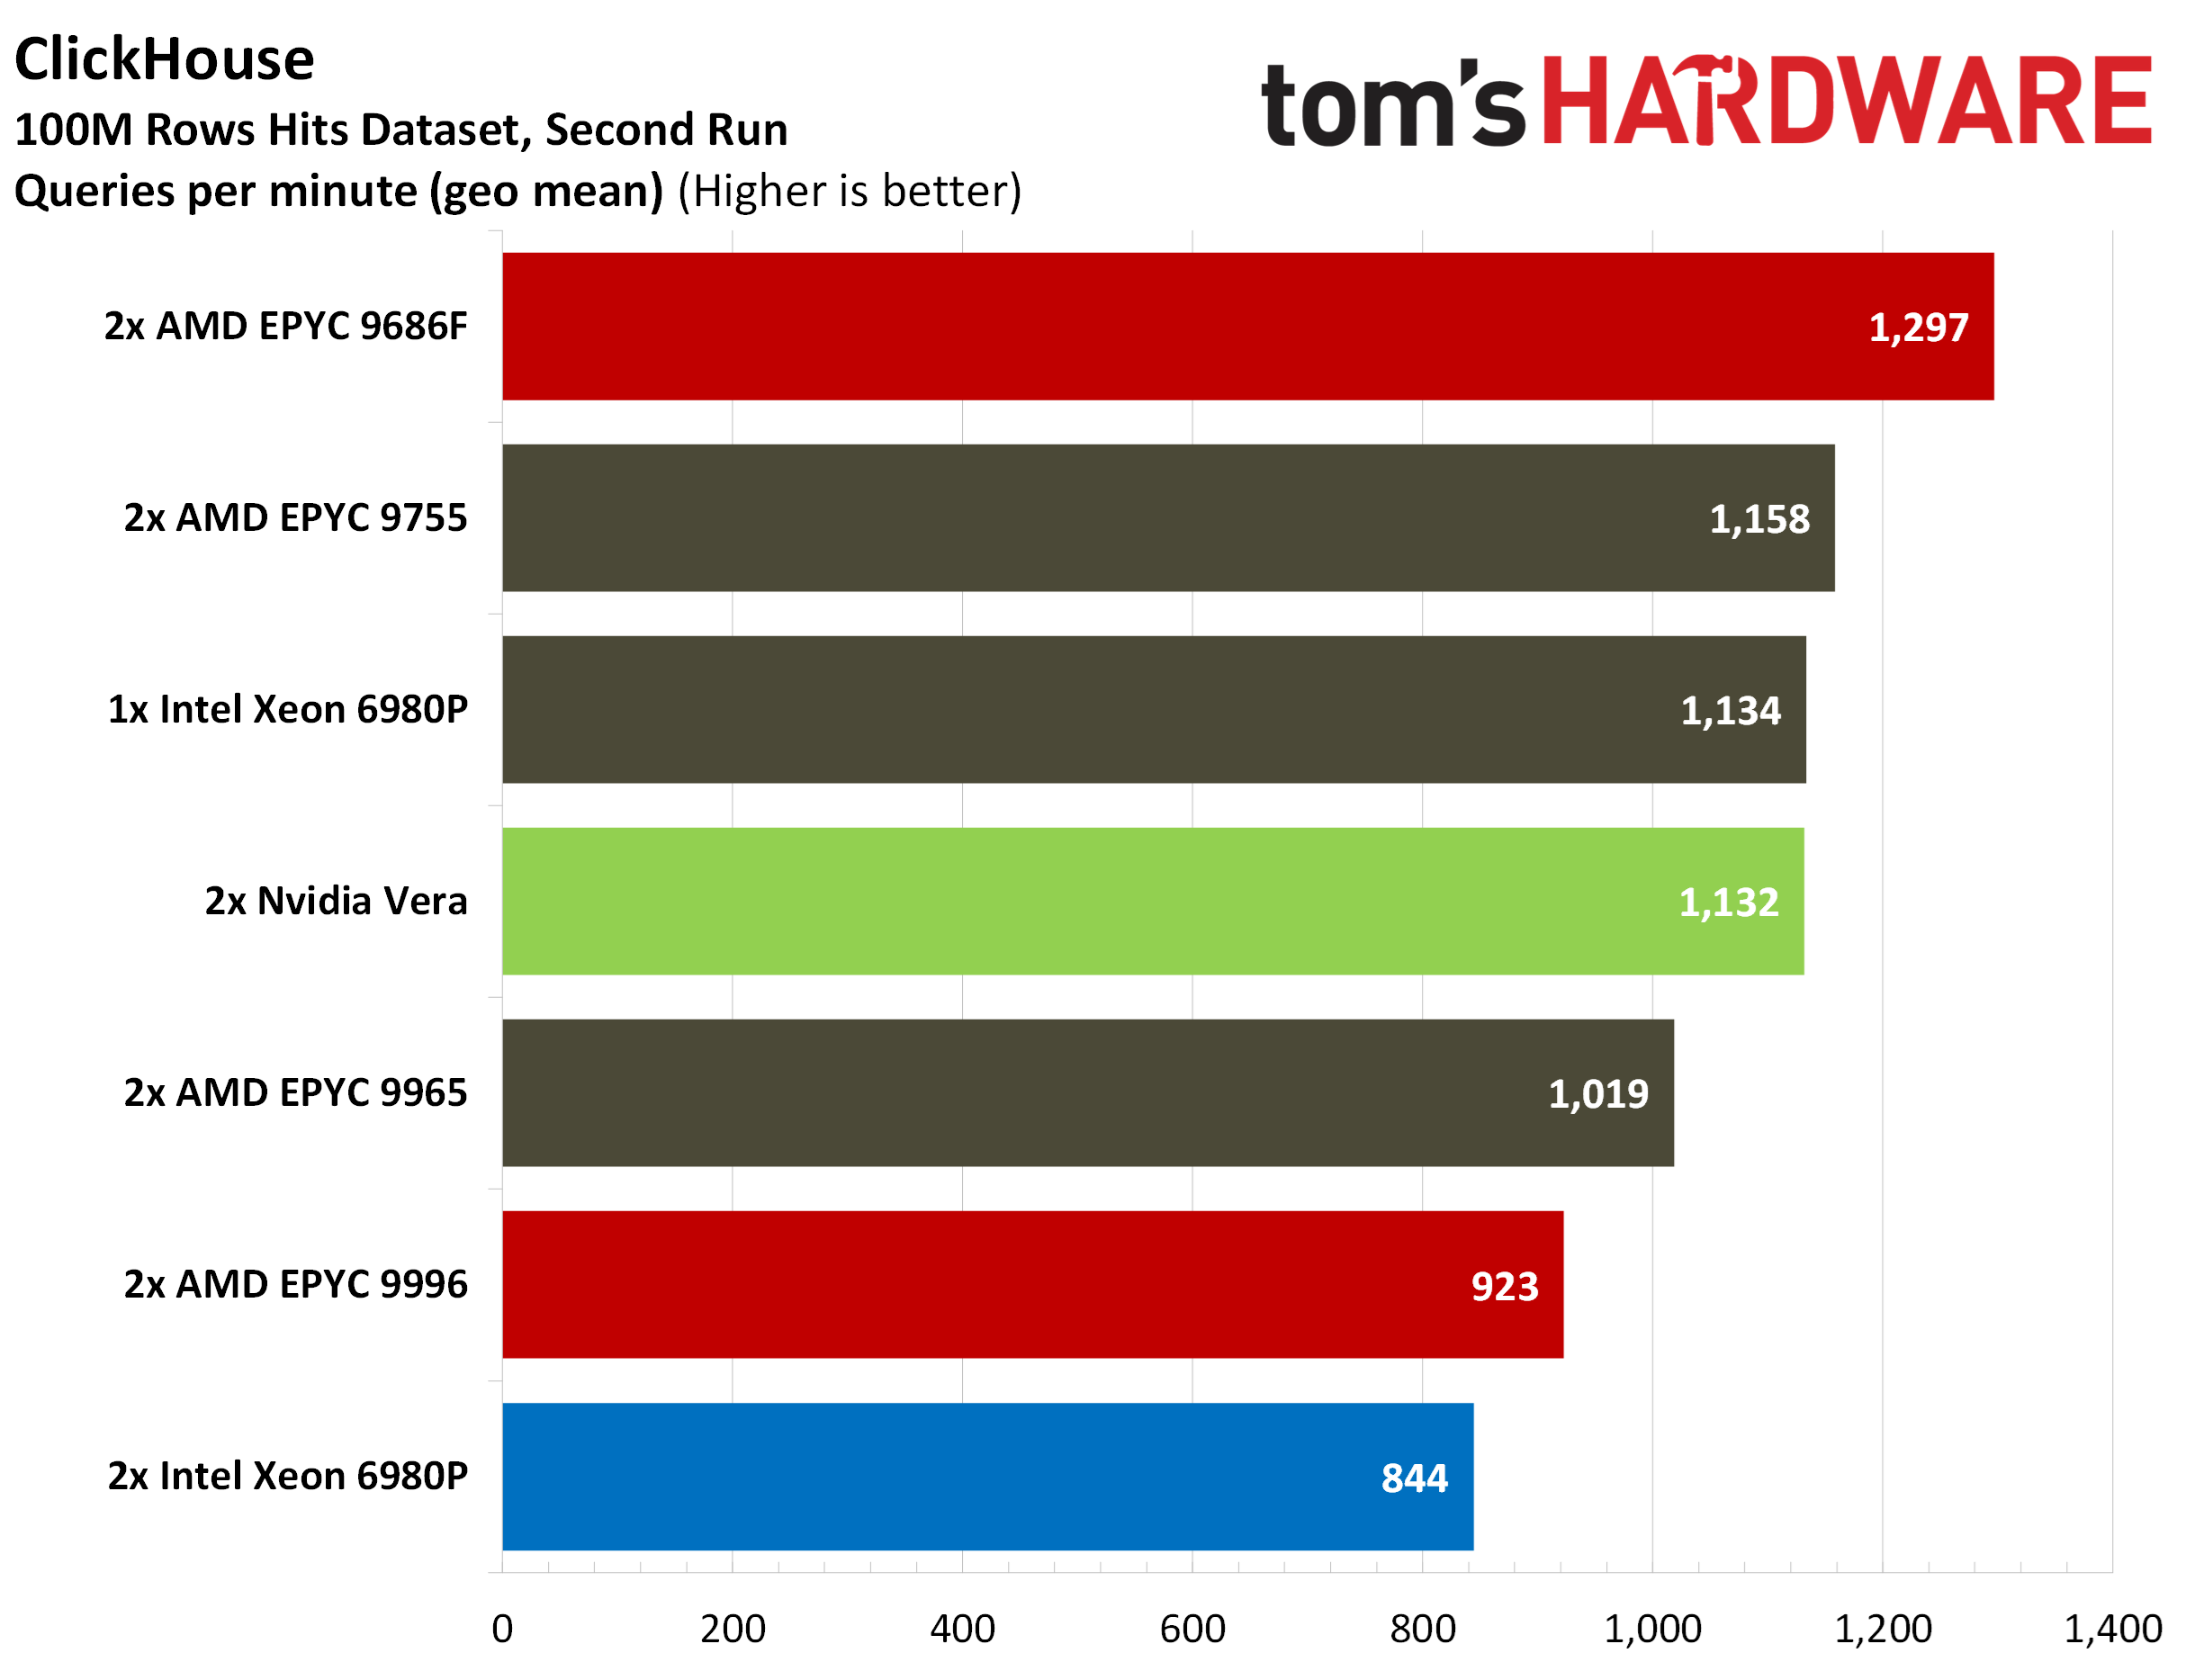
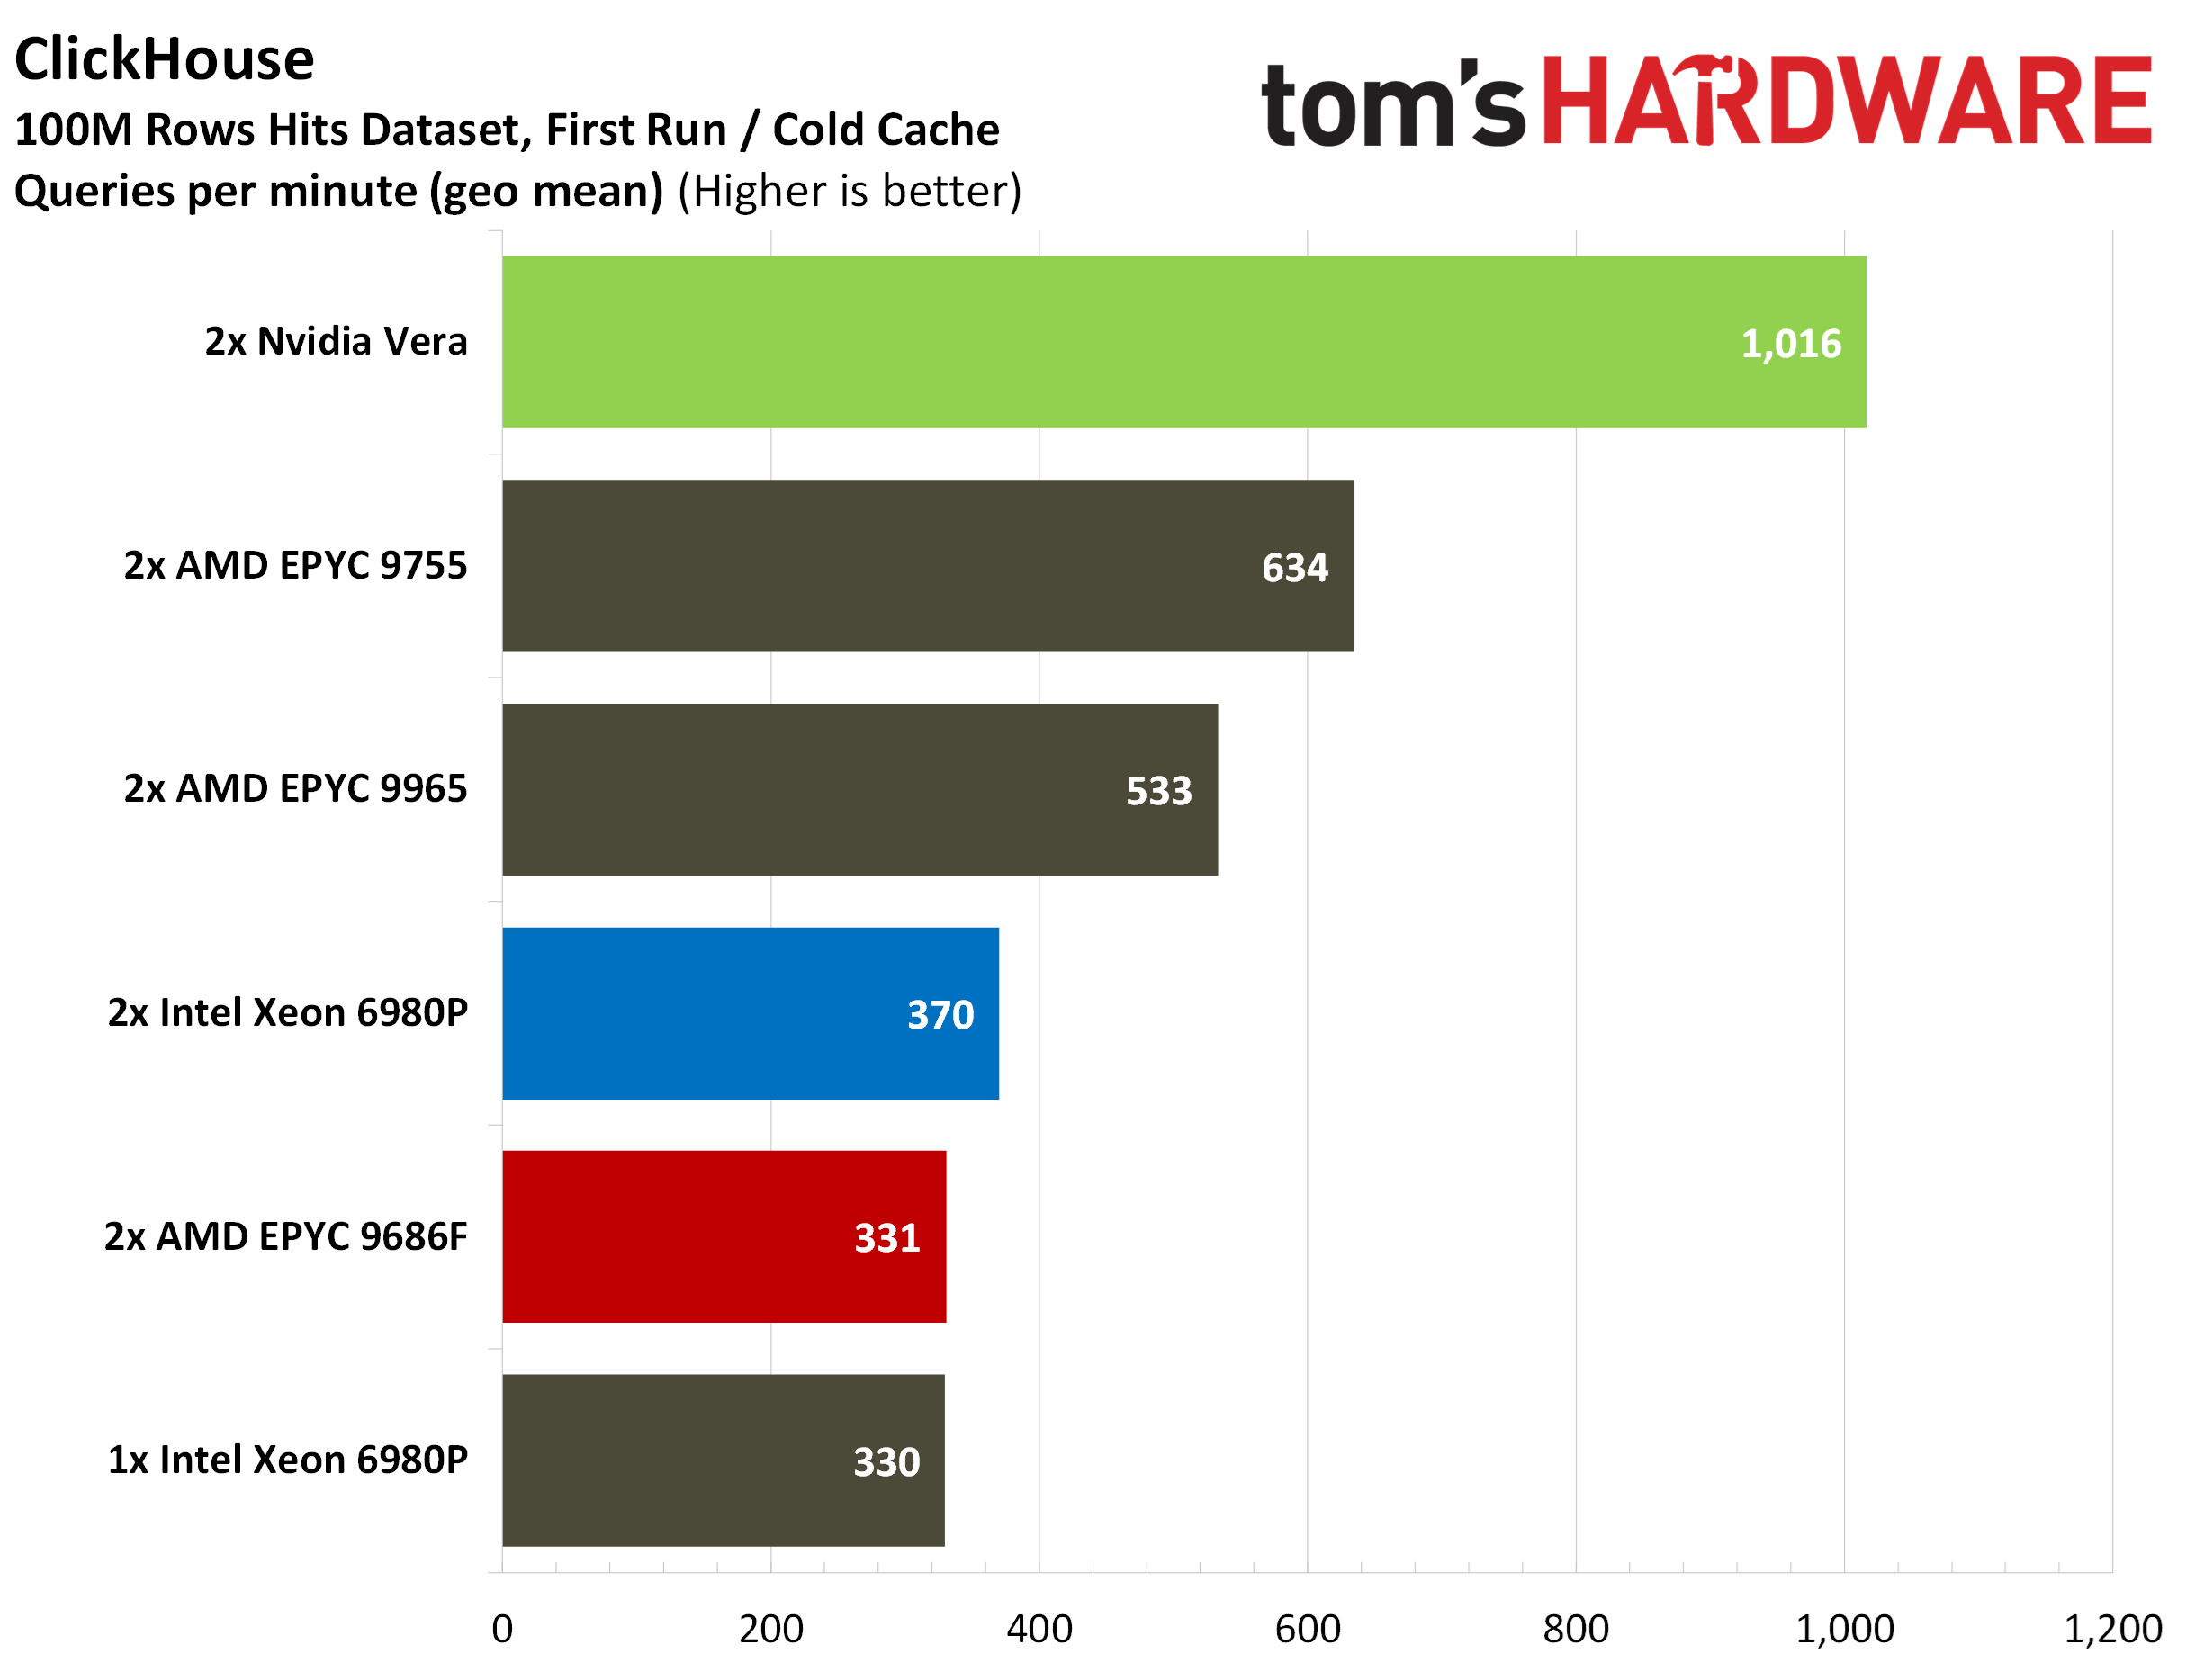
В колоночной базе данных Clickhouse процессор Nvidia Vera за счёт распределенной mesh-архитектуры быстрее выходит на пиковую скорость при «холодном» кеше, однако после прогрева кеша EPYC 9686F перехватывает лидерство.
изображения (3)
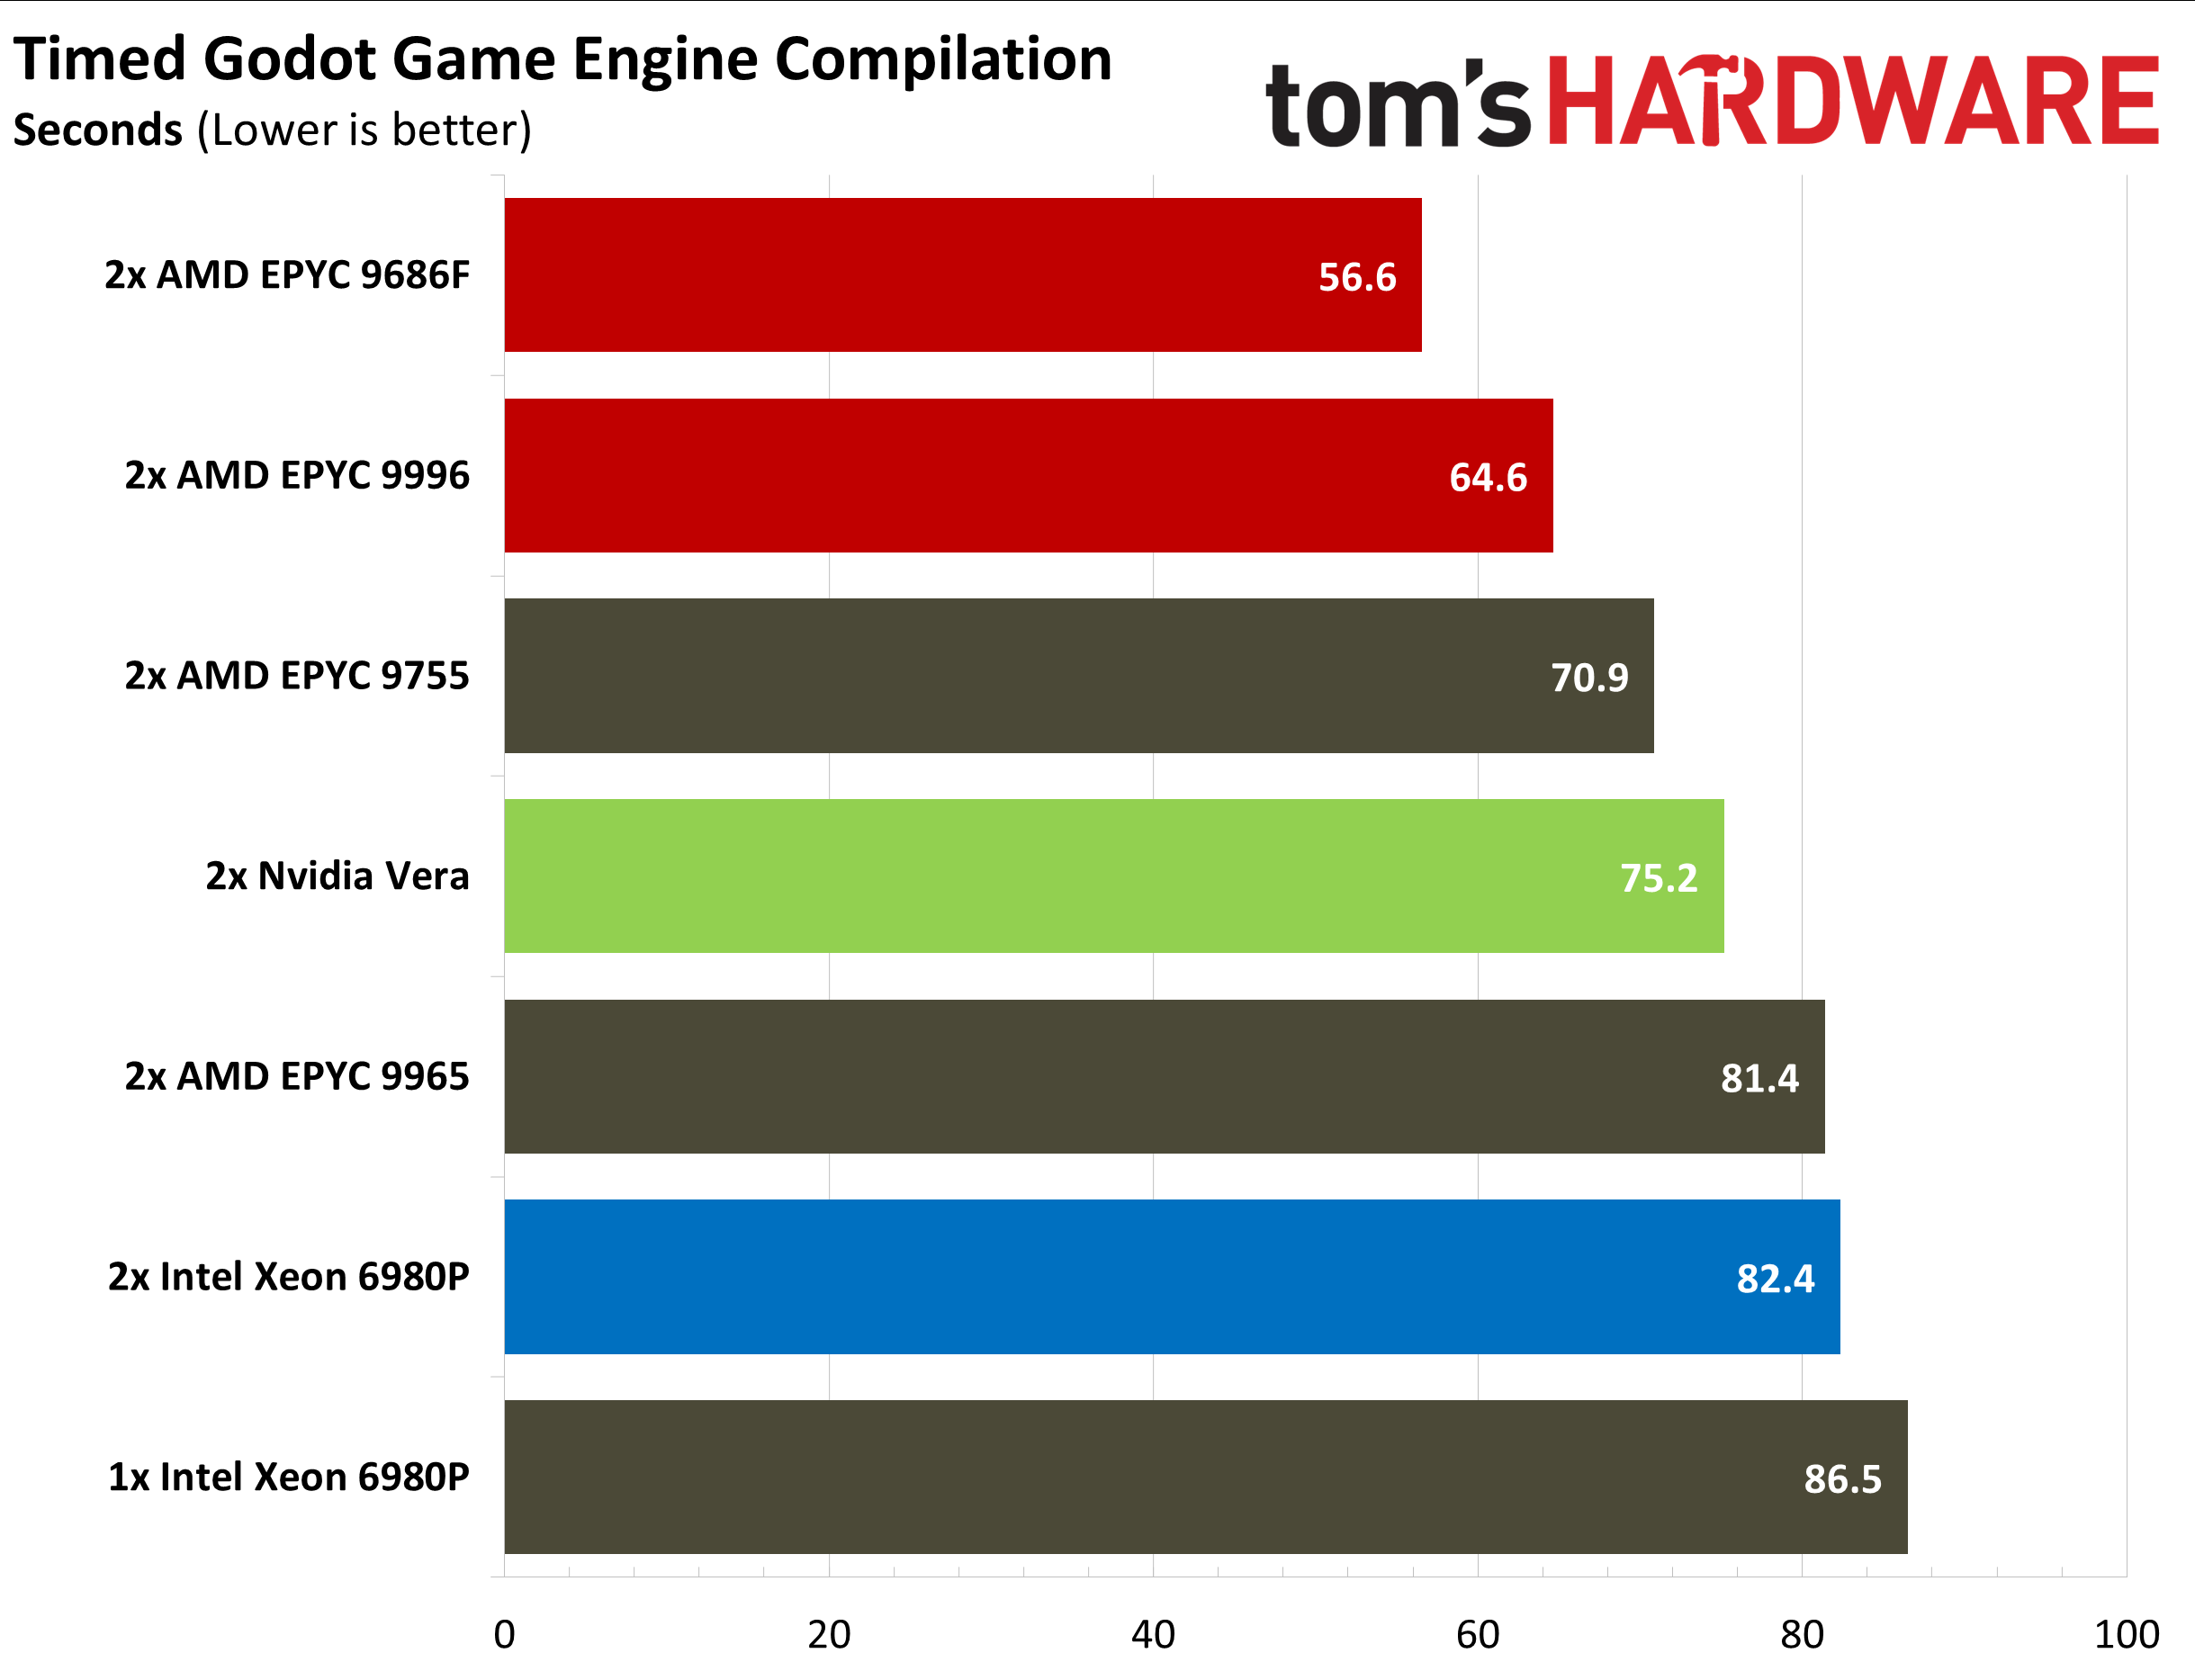
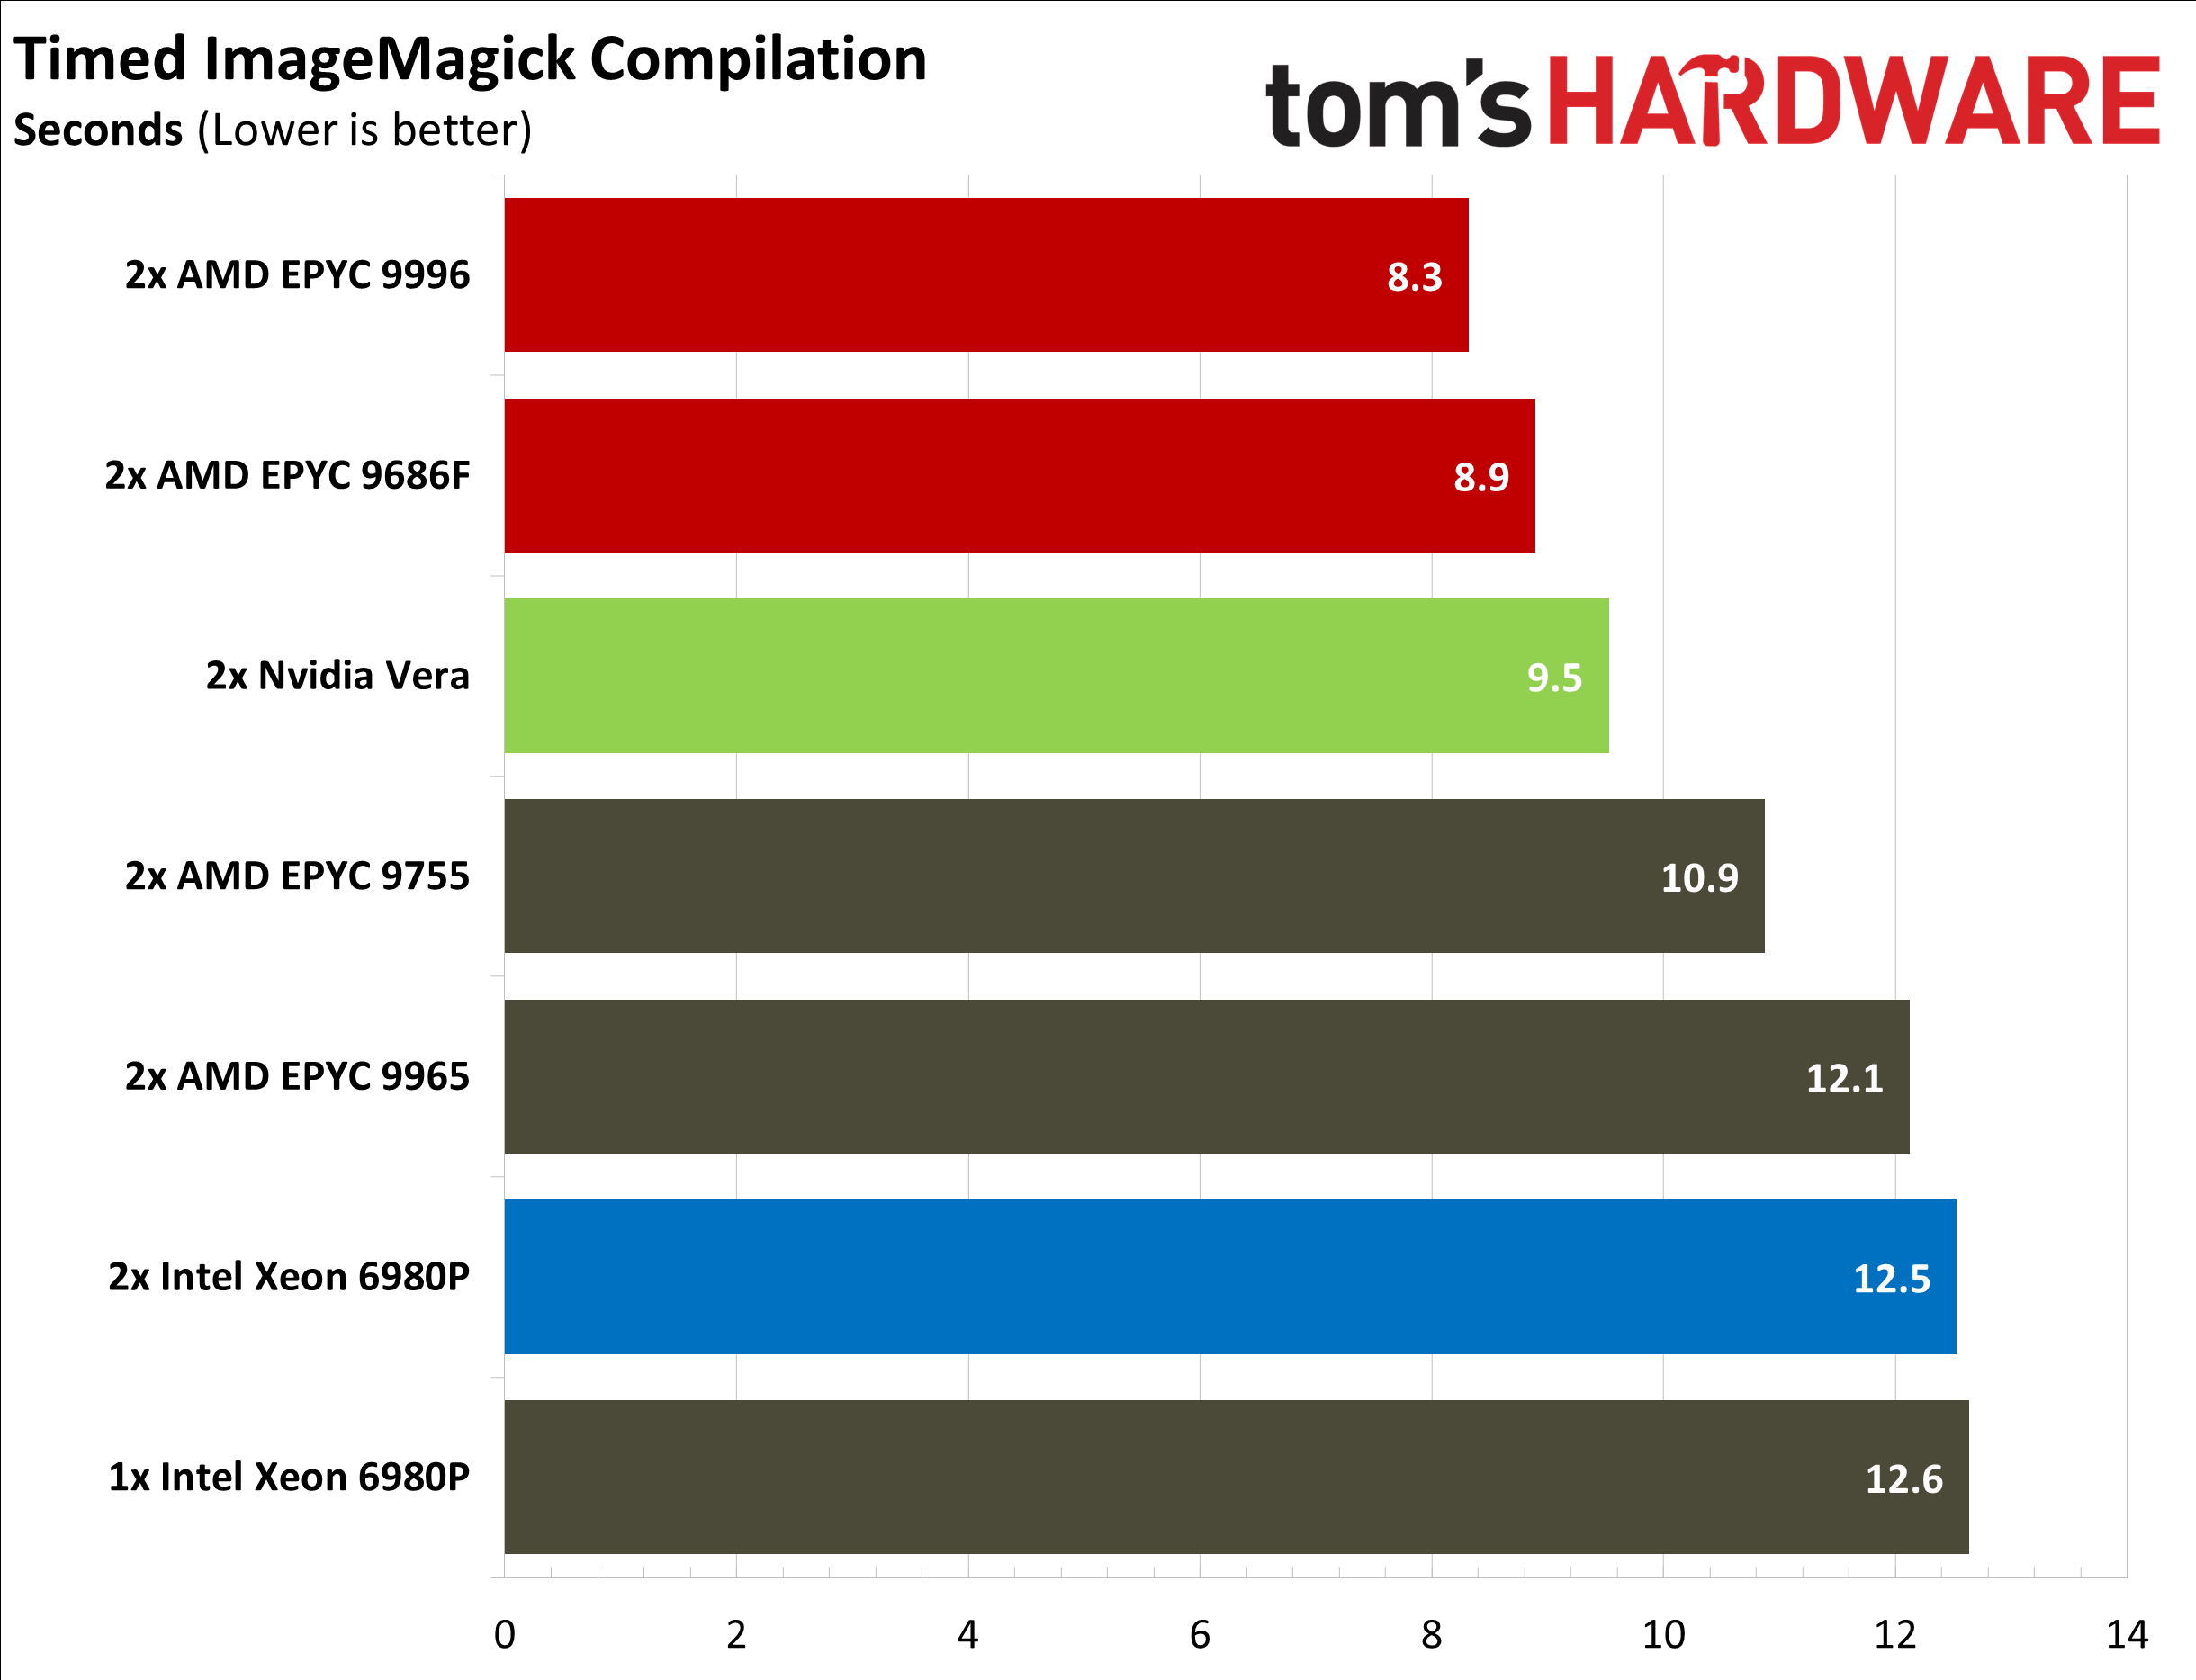
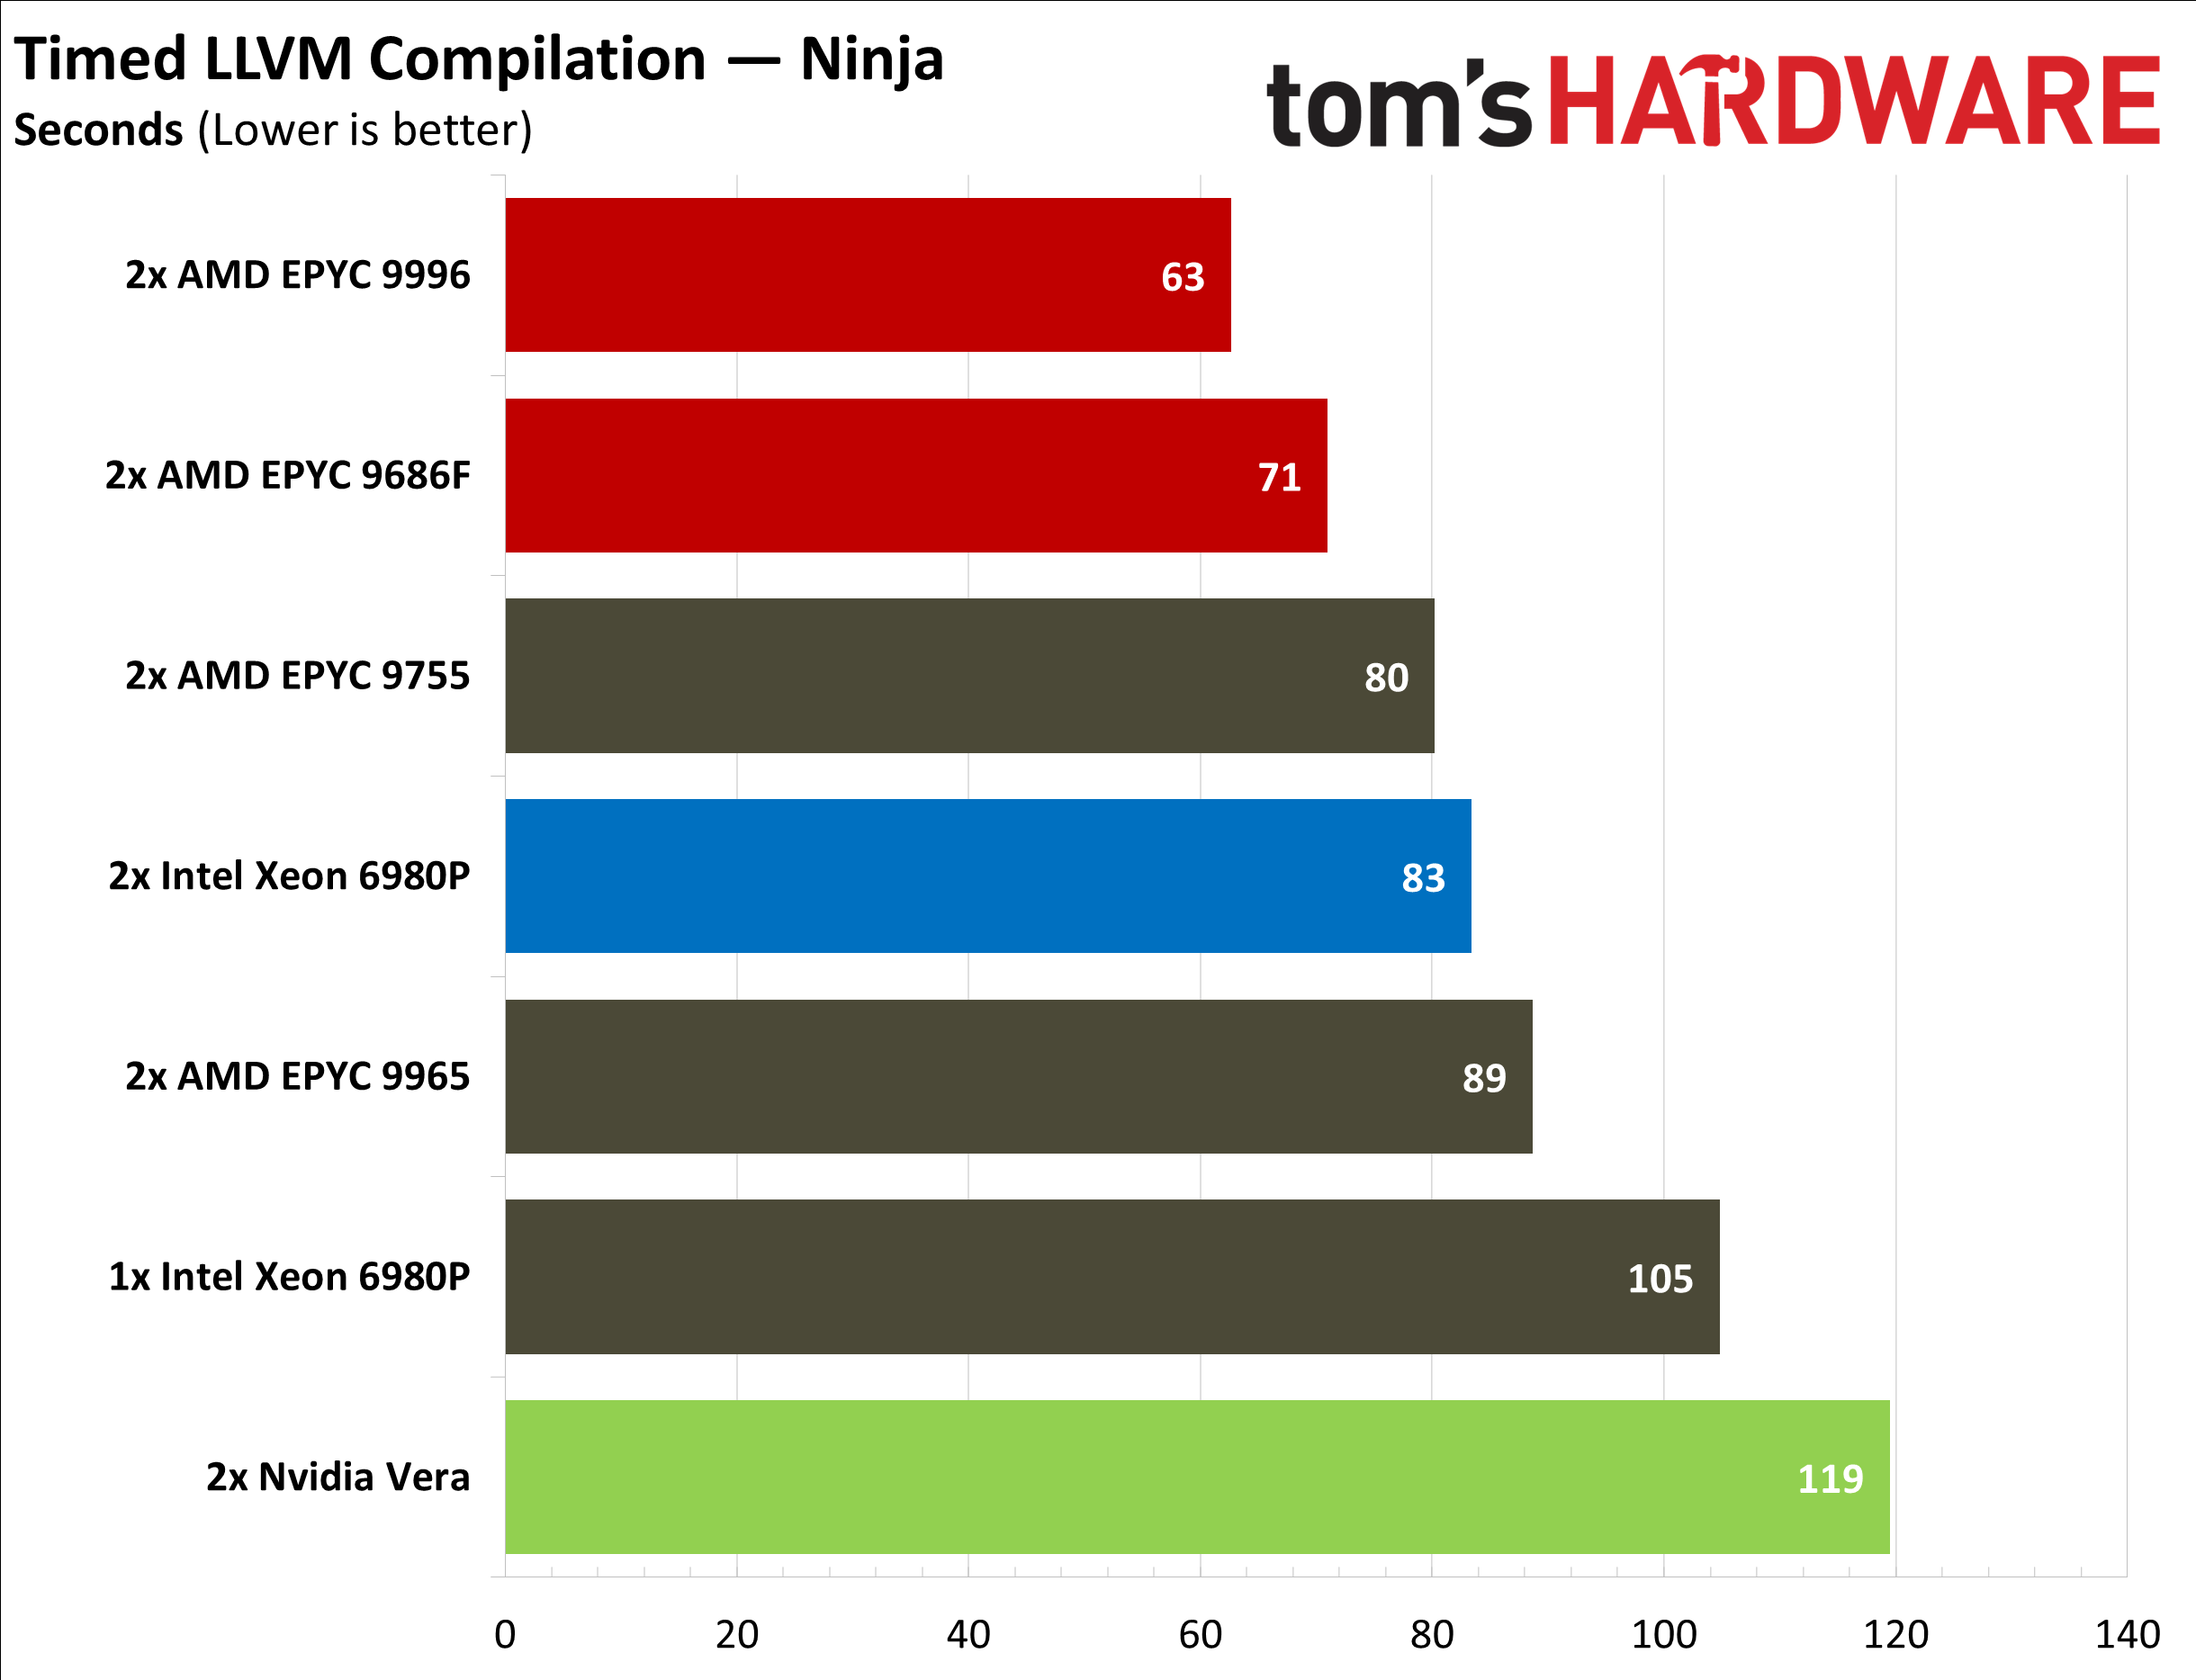
В Blender новый EPYC 9996 завершает сложные сцены (например, Barbershop) на 35 % быстрее предшественника. В задачах компиляции кода (LLVM, Godot, ImageMagick) процессоры Venice вернули себе безоговорочное первое место, опередив чипы архитектуры Arm (Vera).
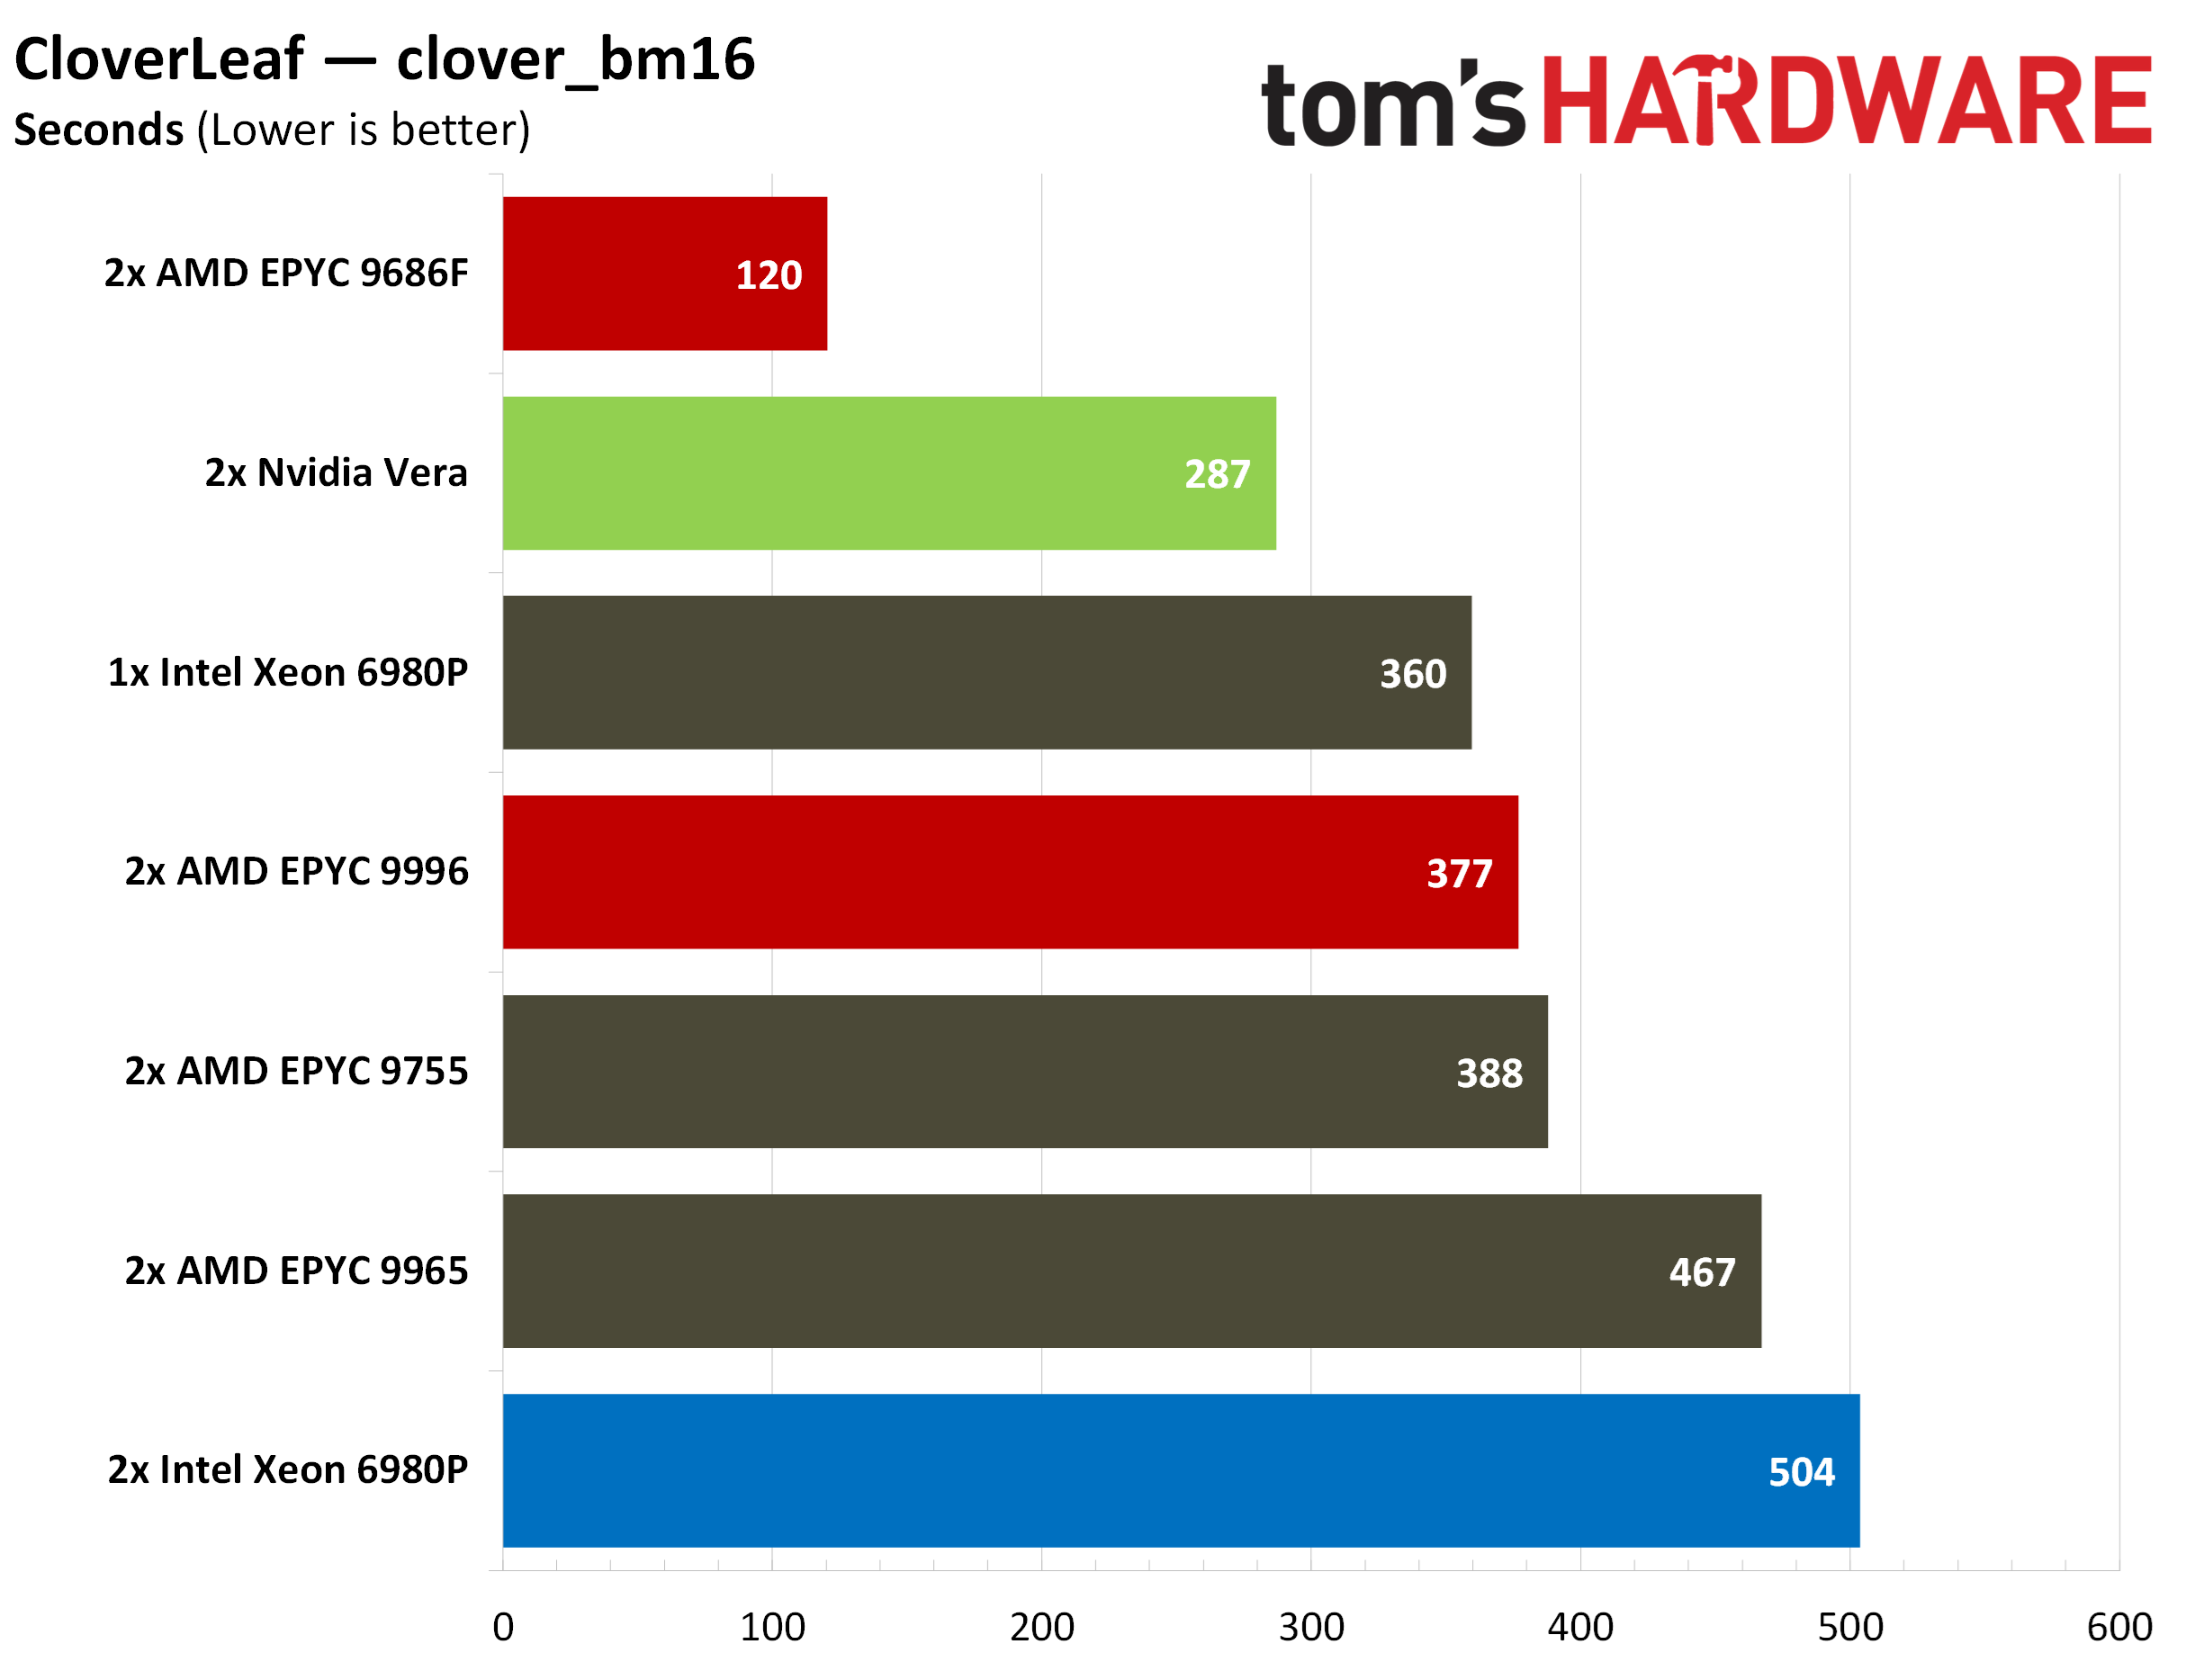
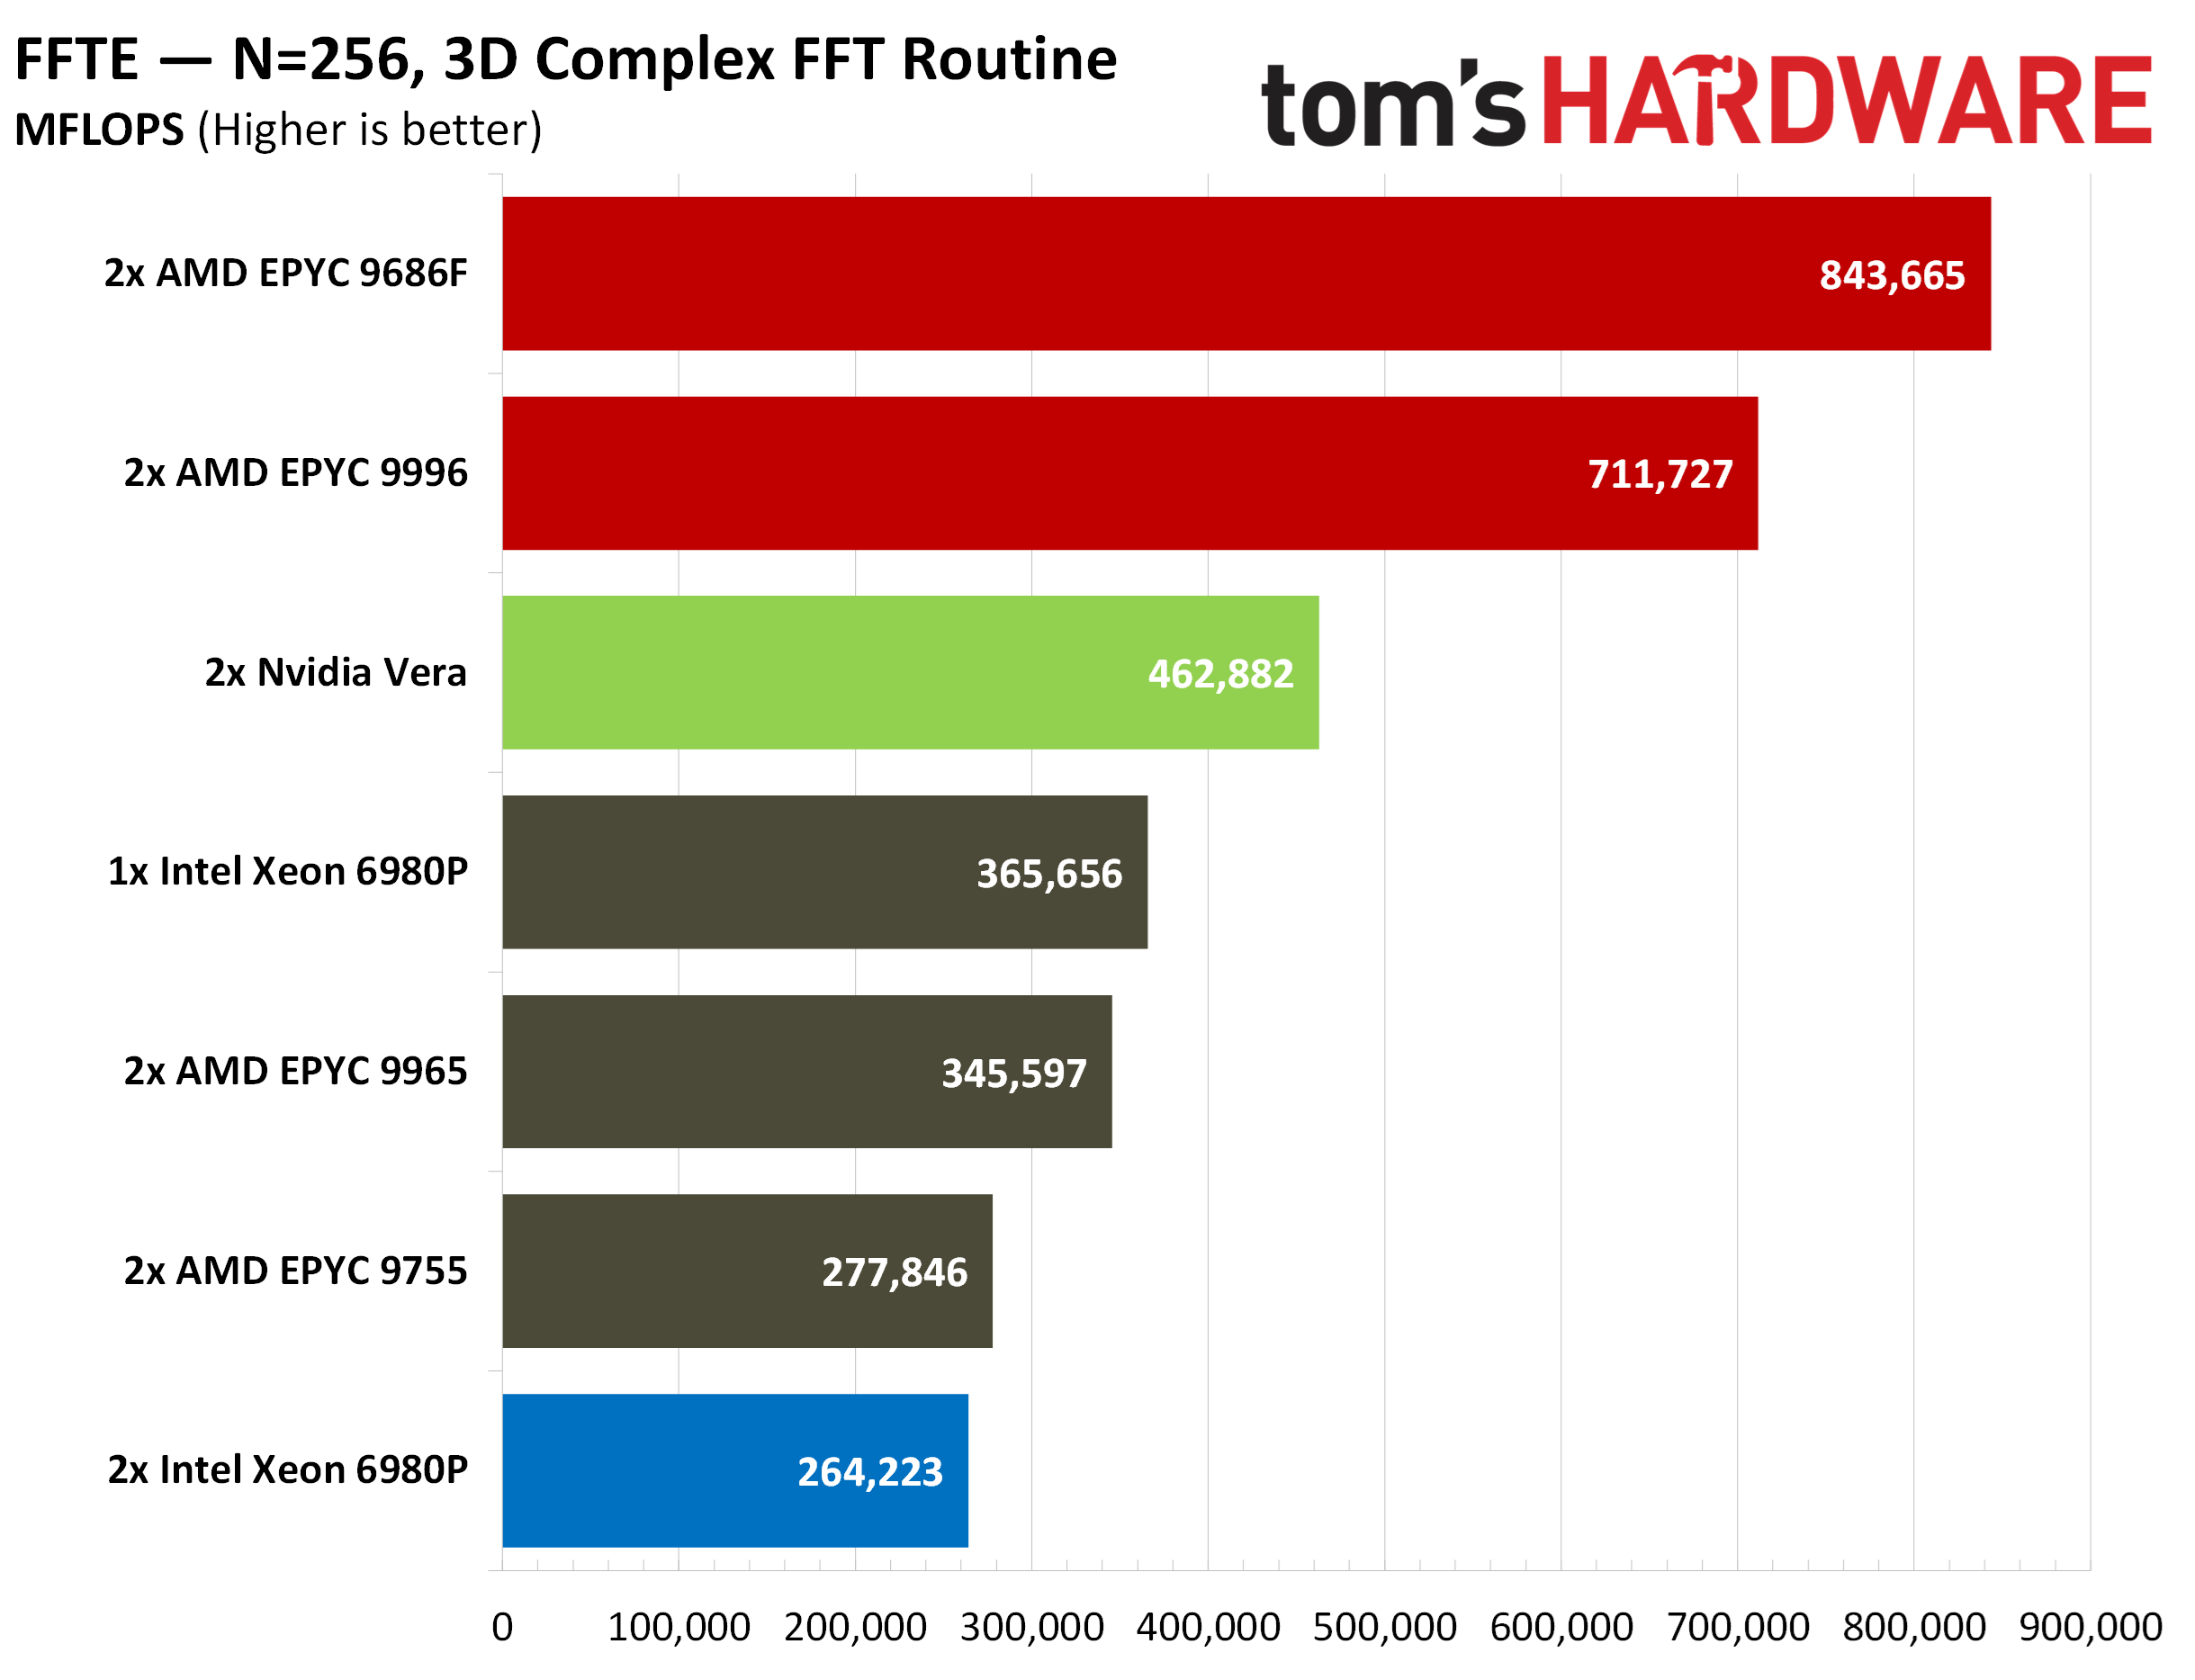
В специфических HPC-задачах вроде CloverLeaf и FFTE процессор EPYC 9686F продемонстрировал практически двукратное превосходство над конкурентом от Nvidia.
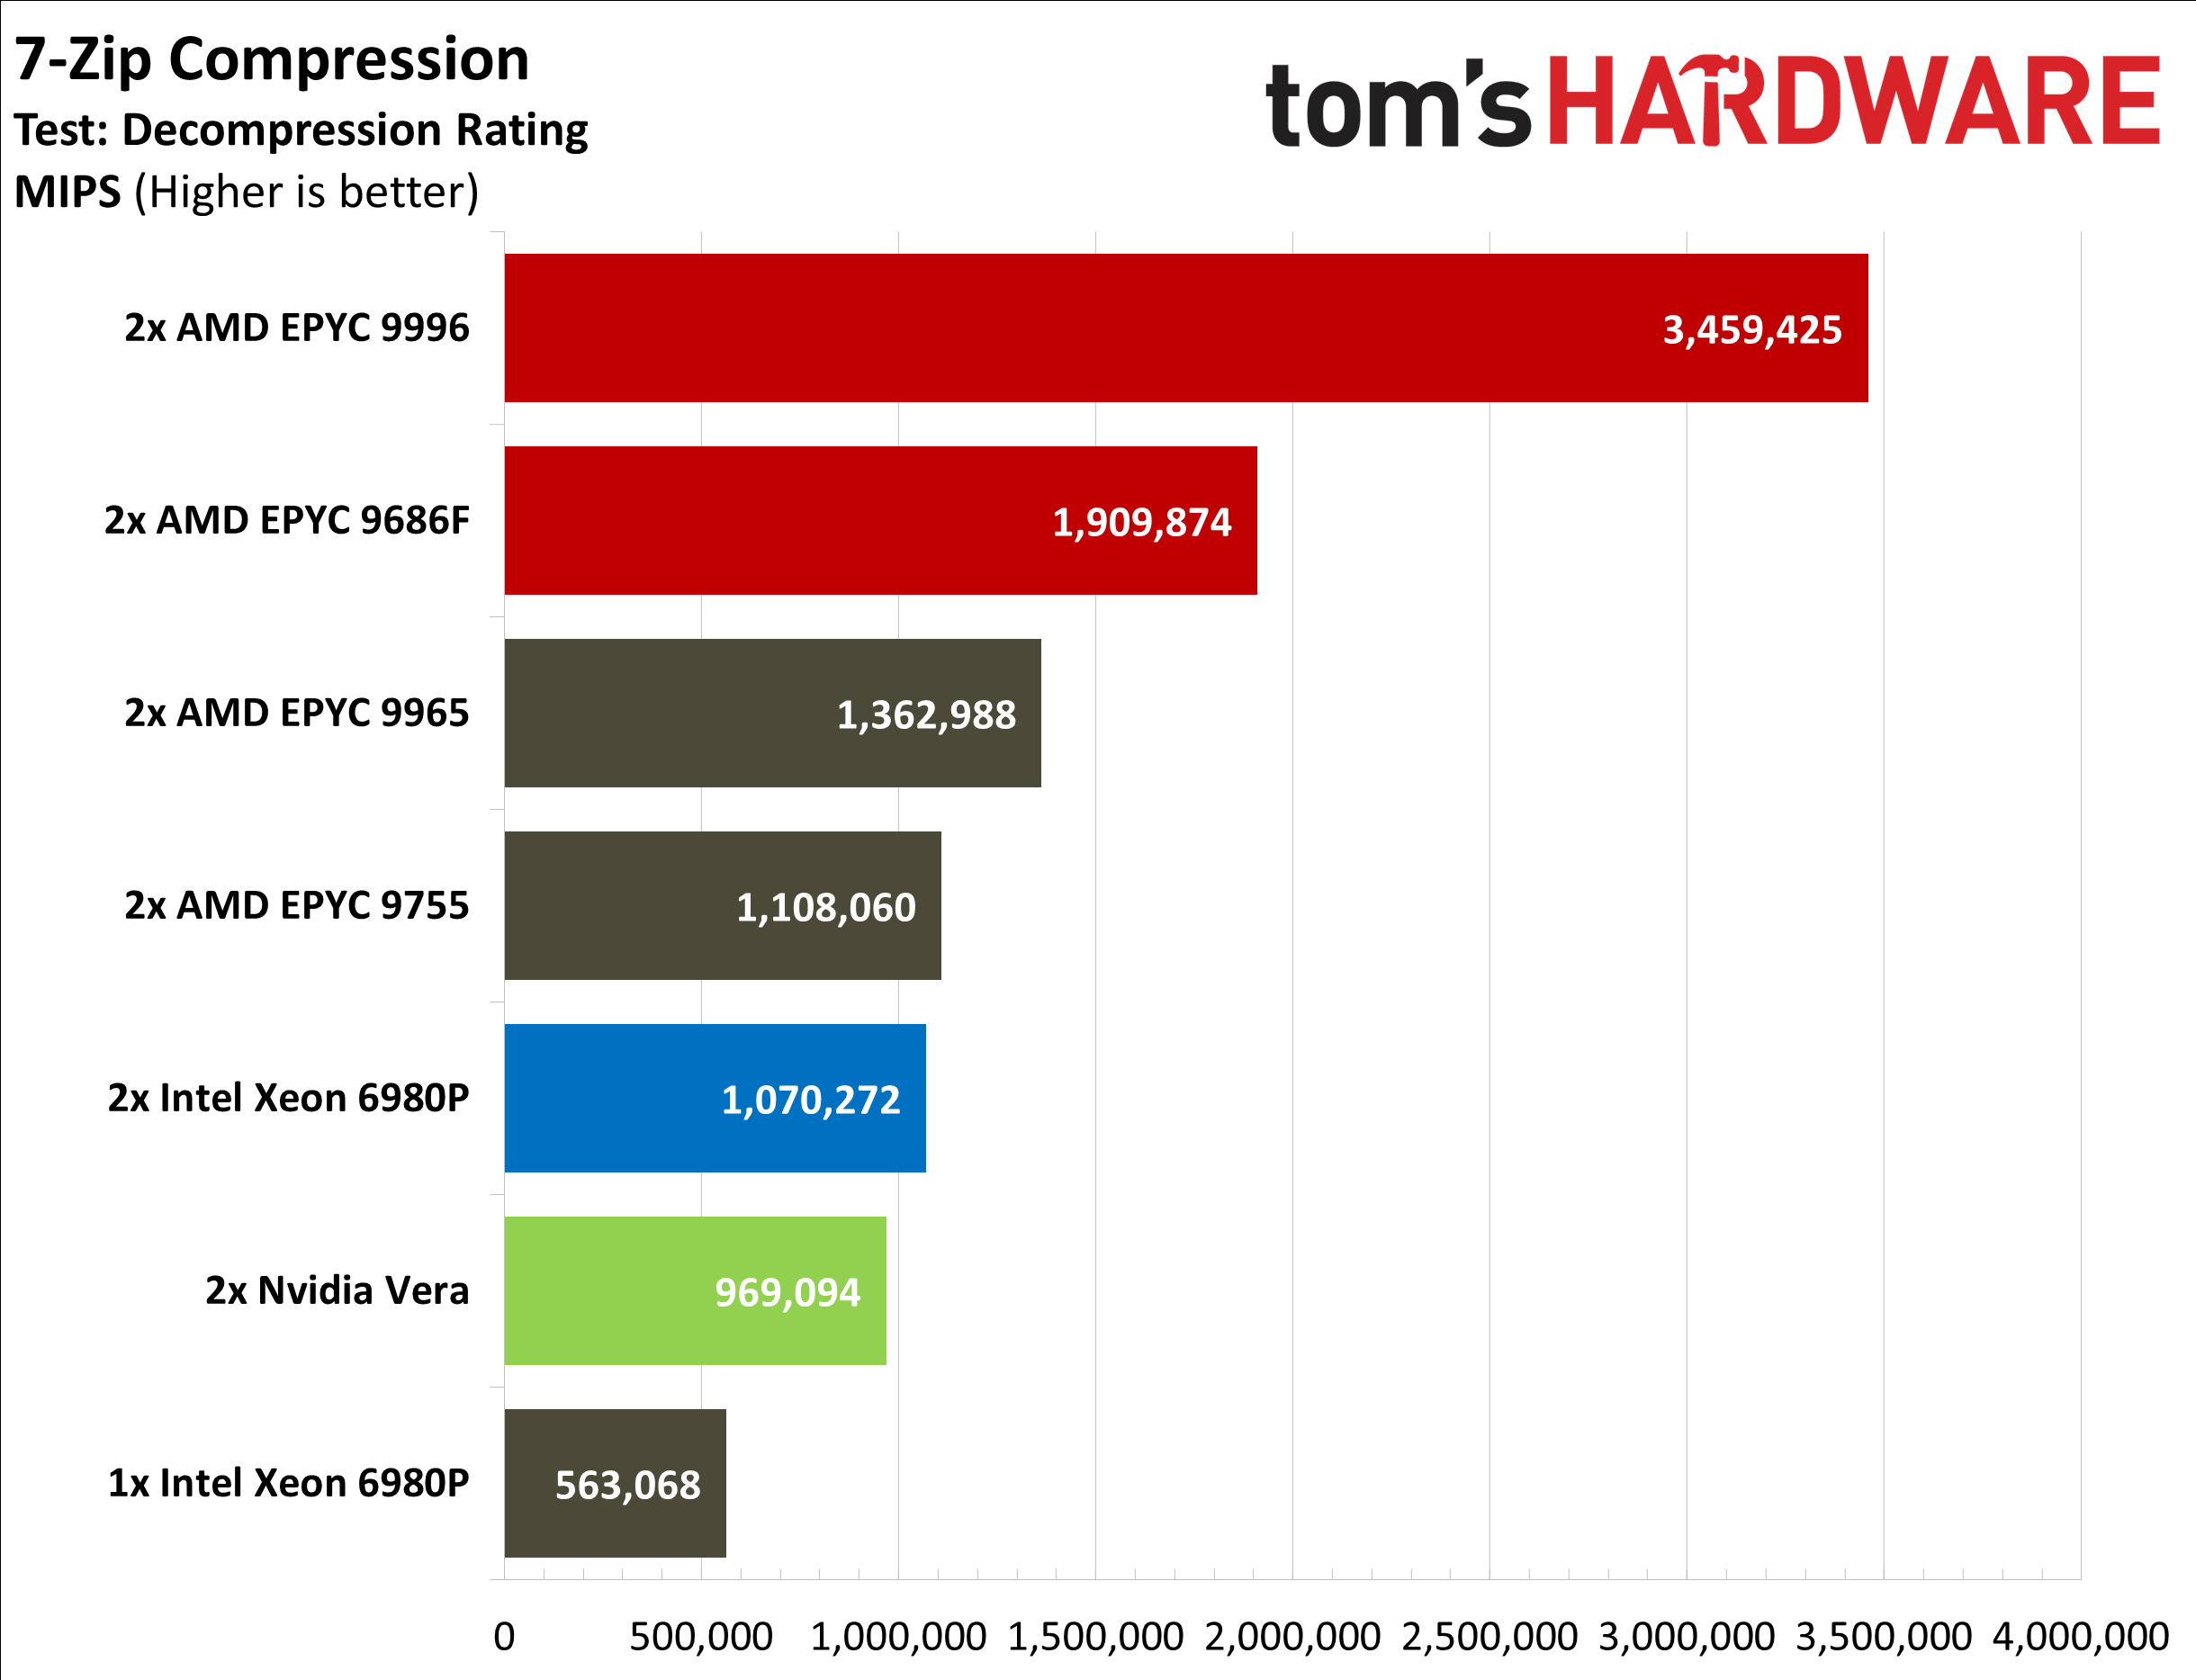
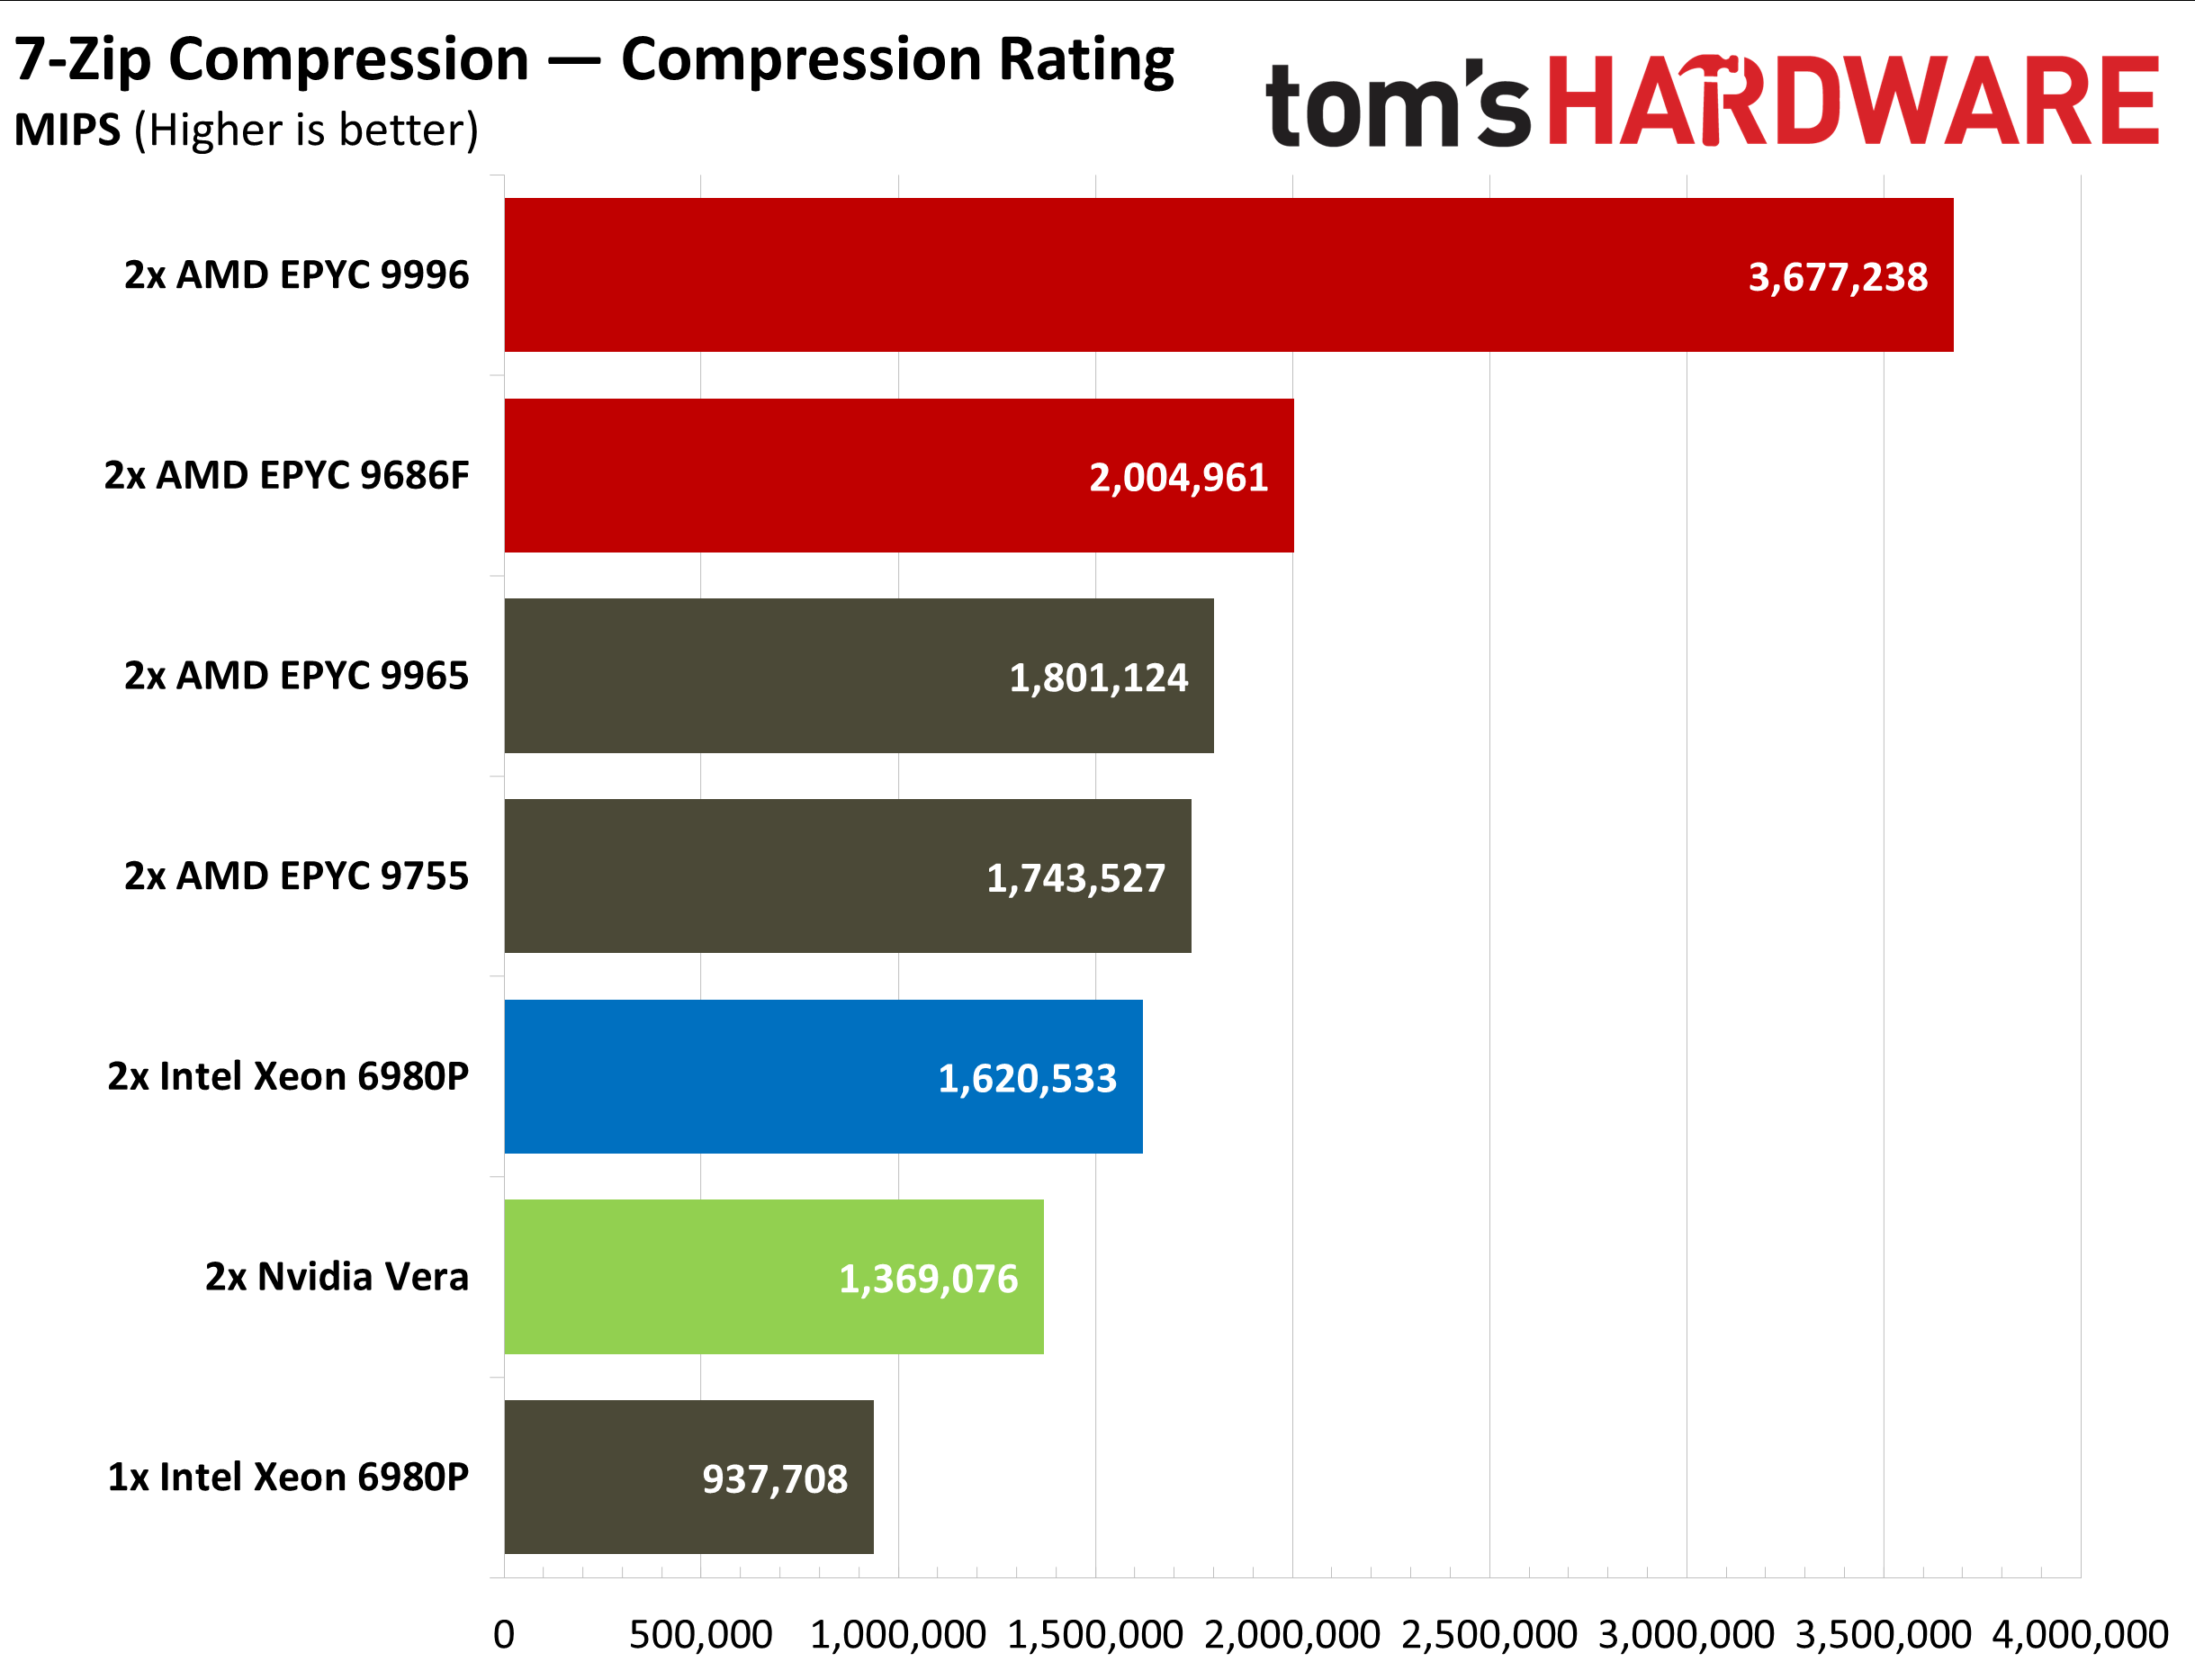
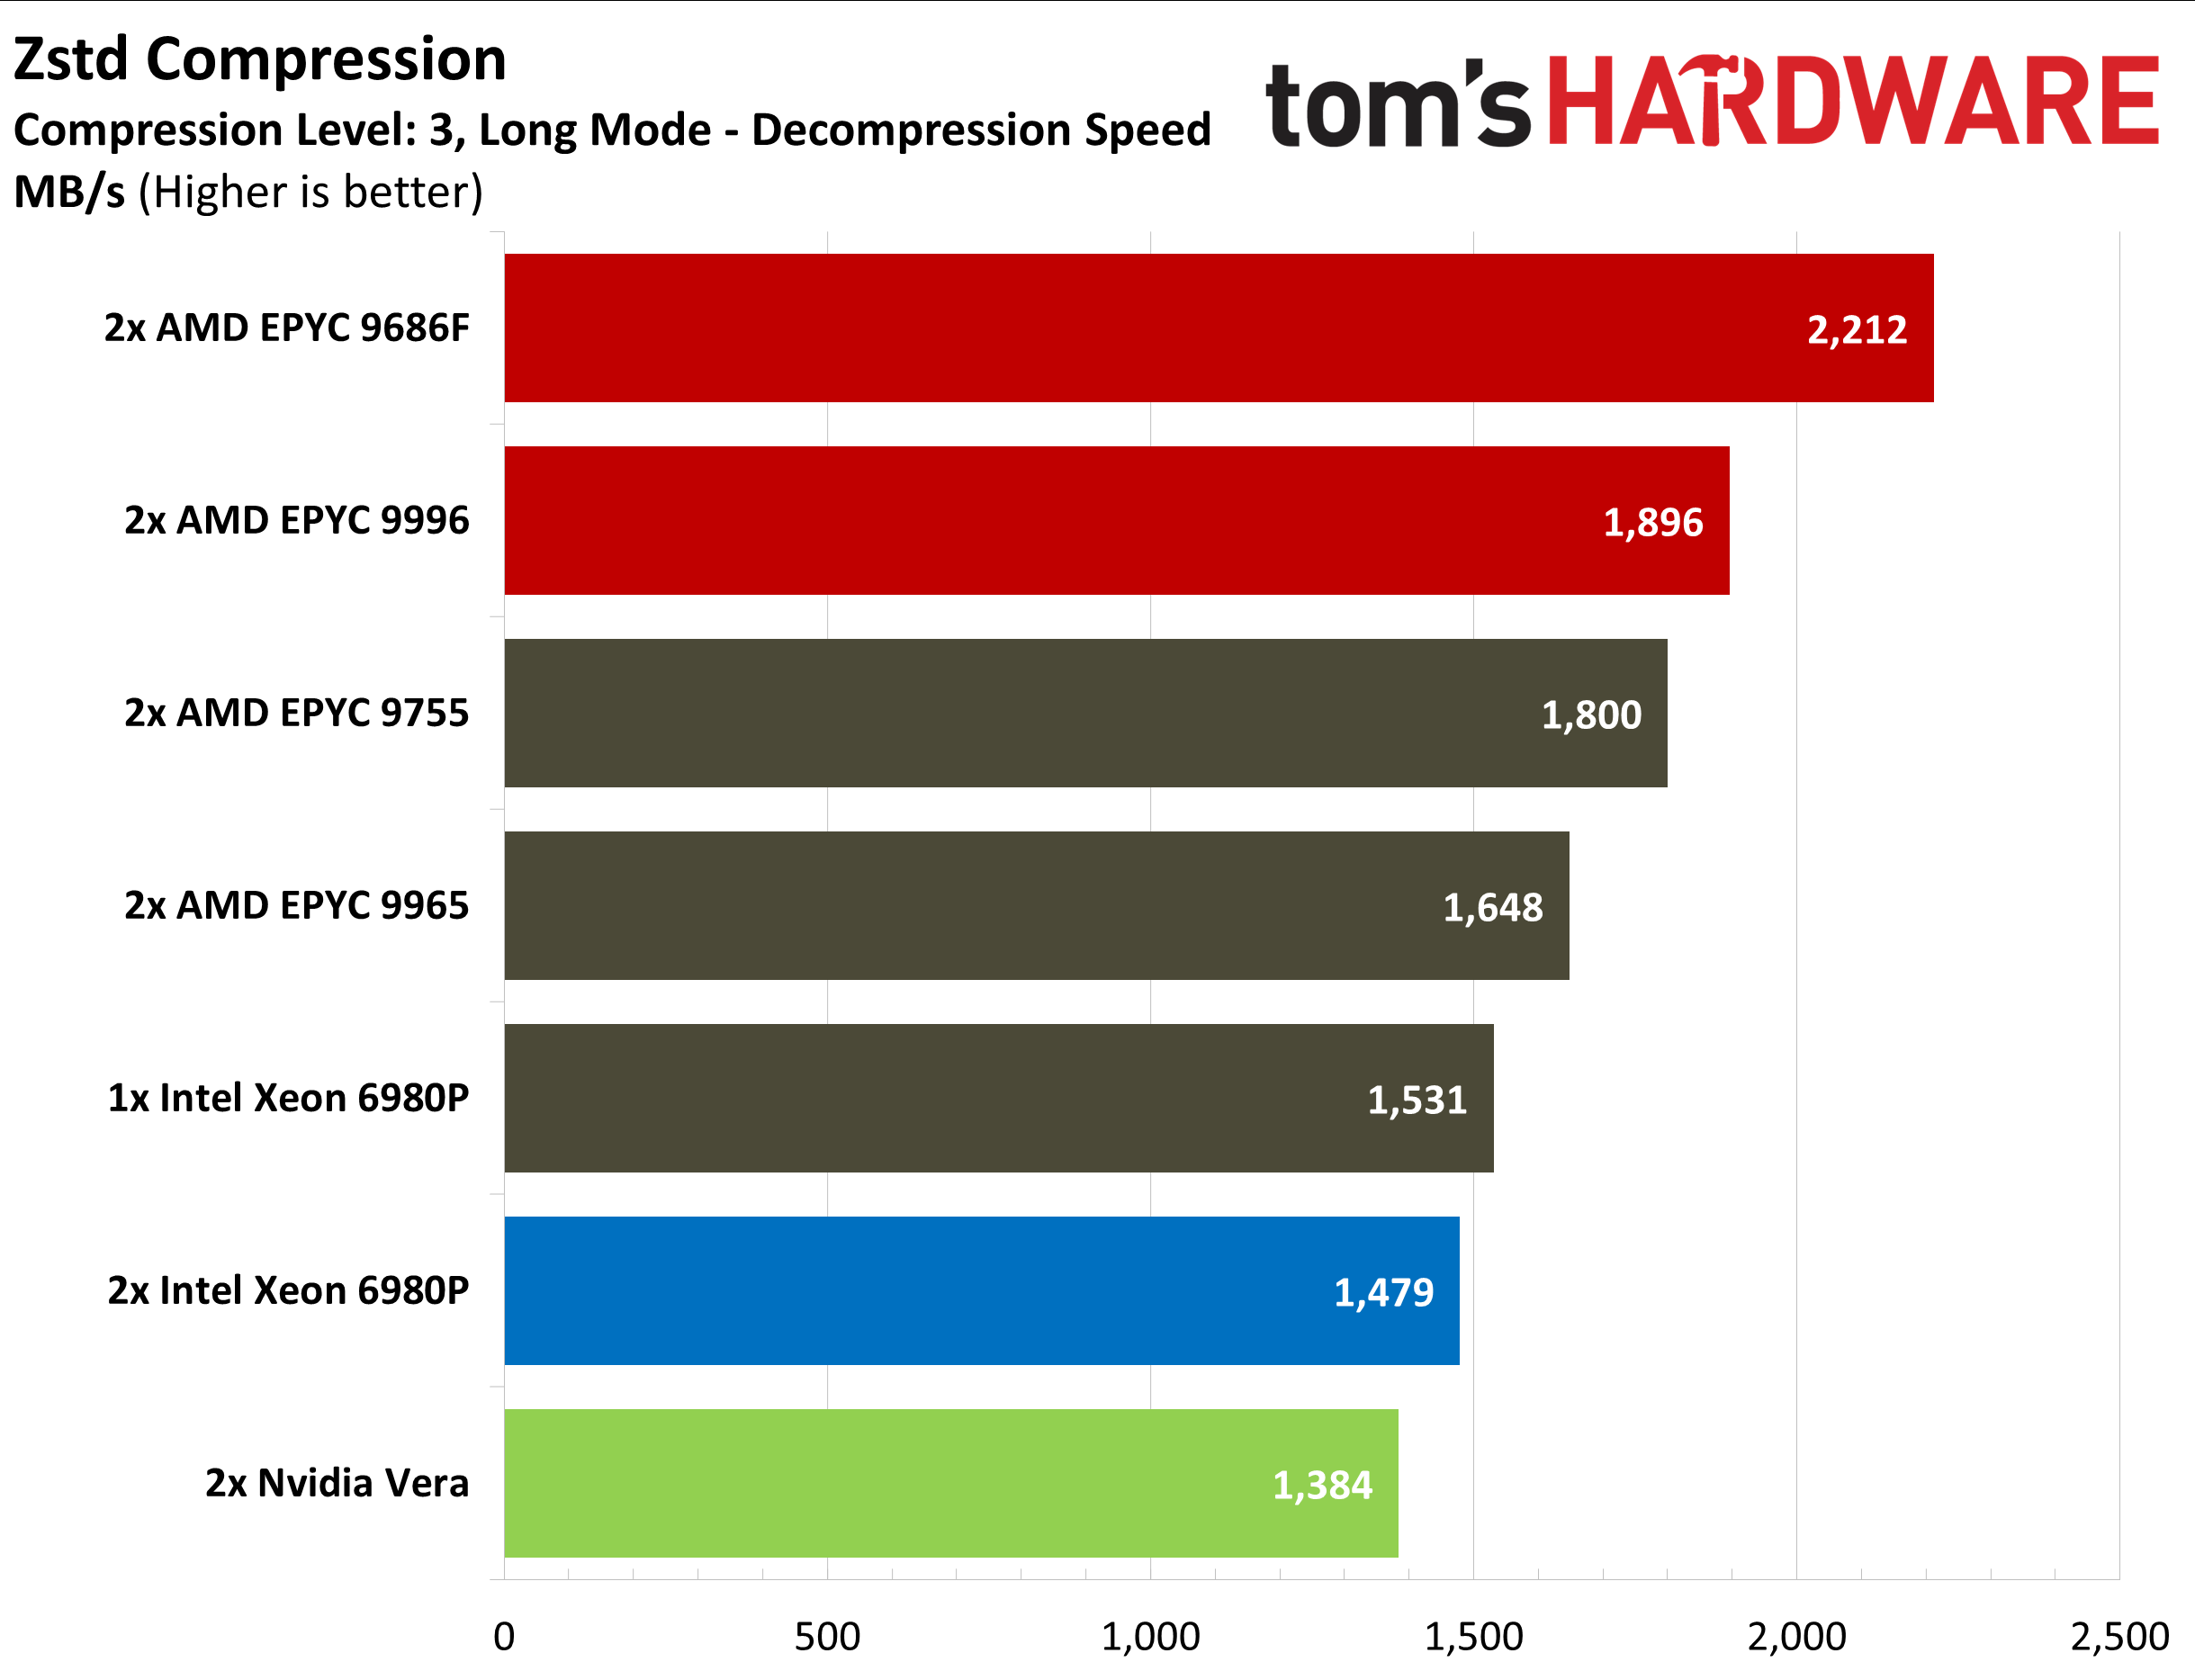
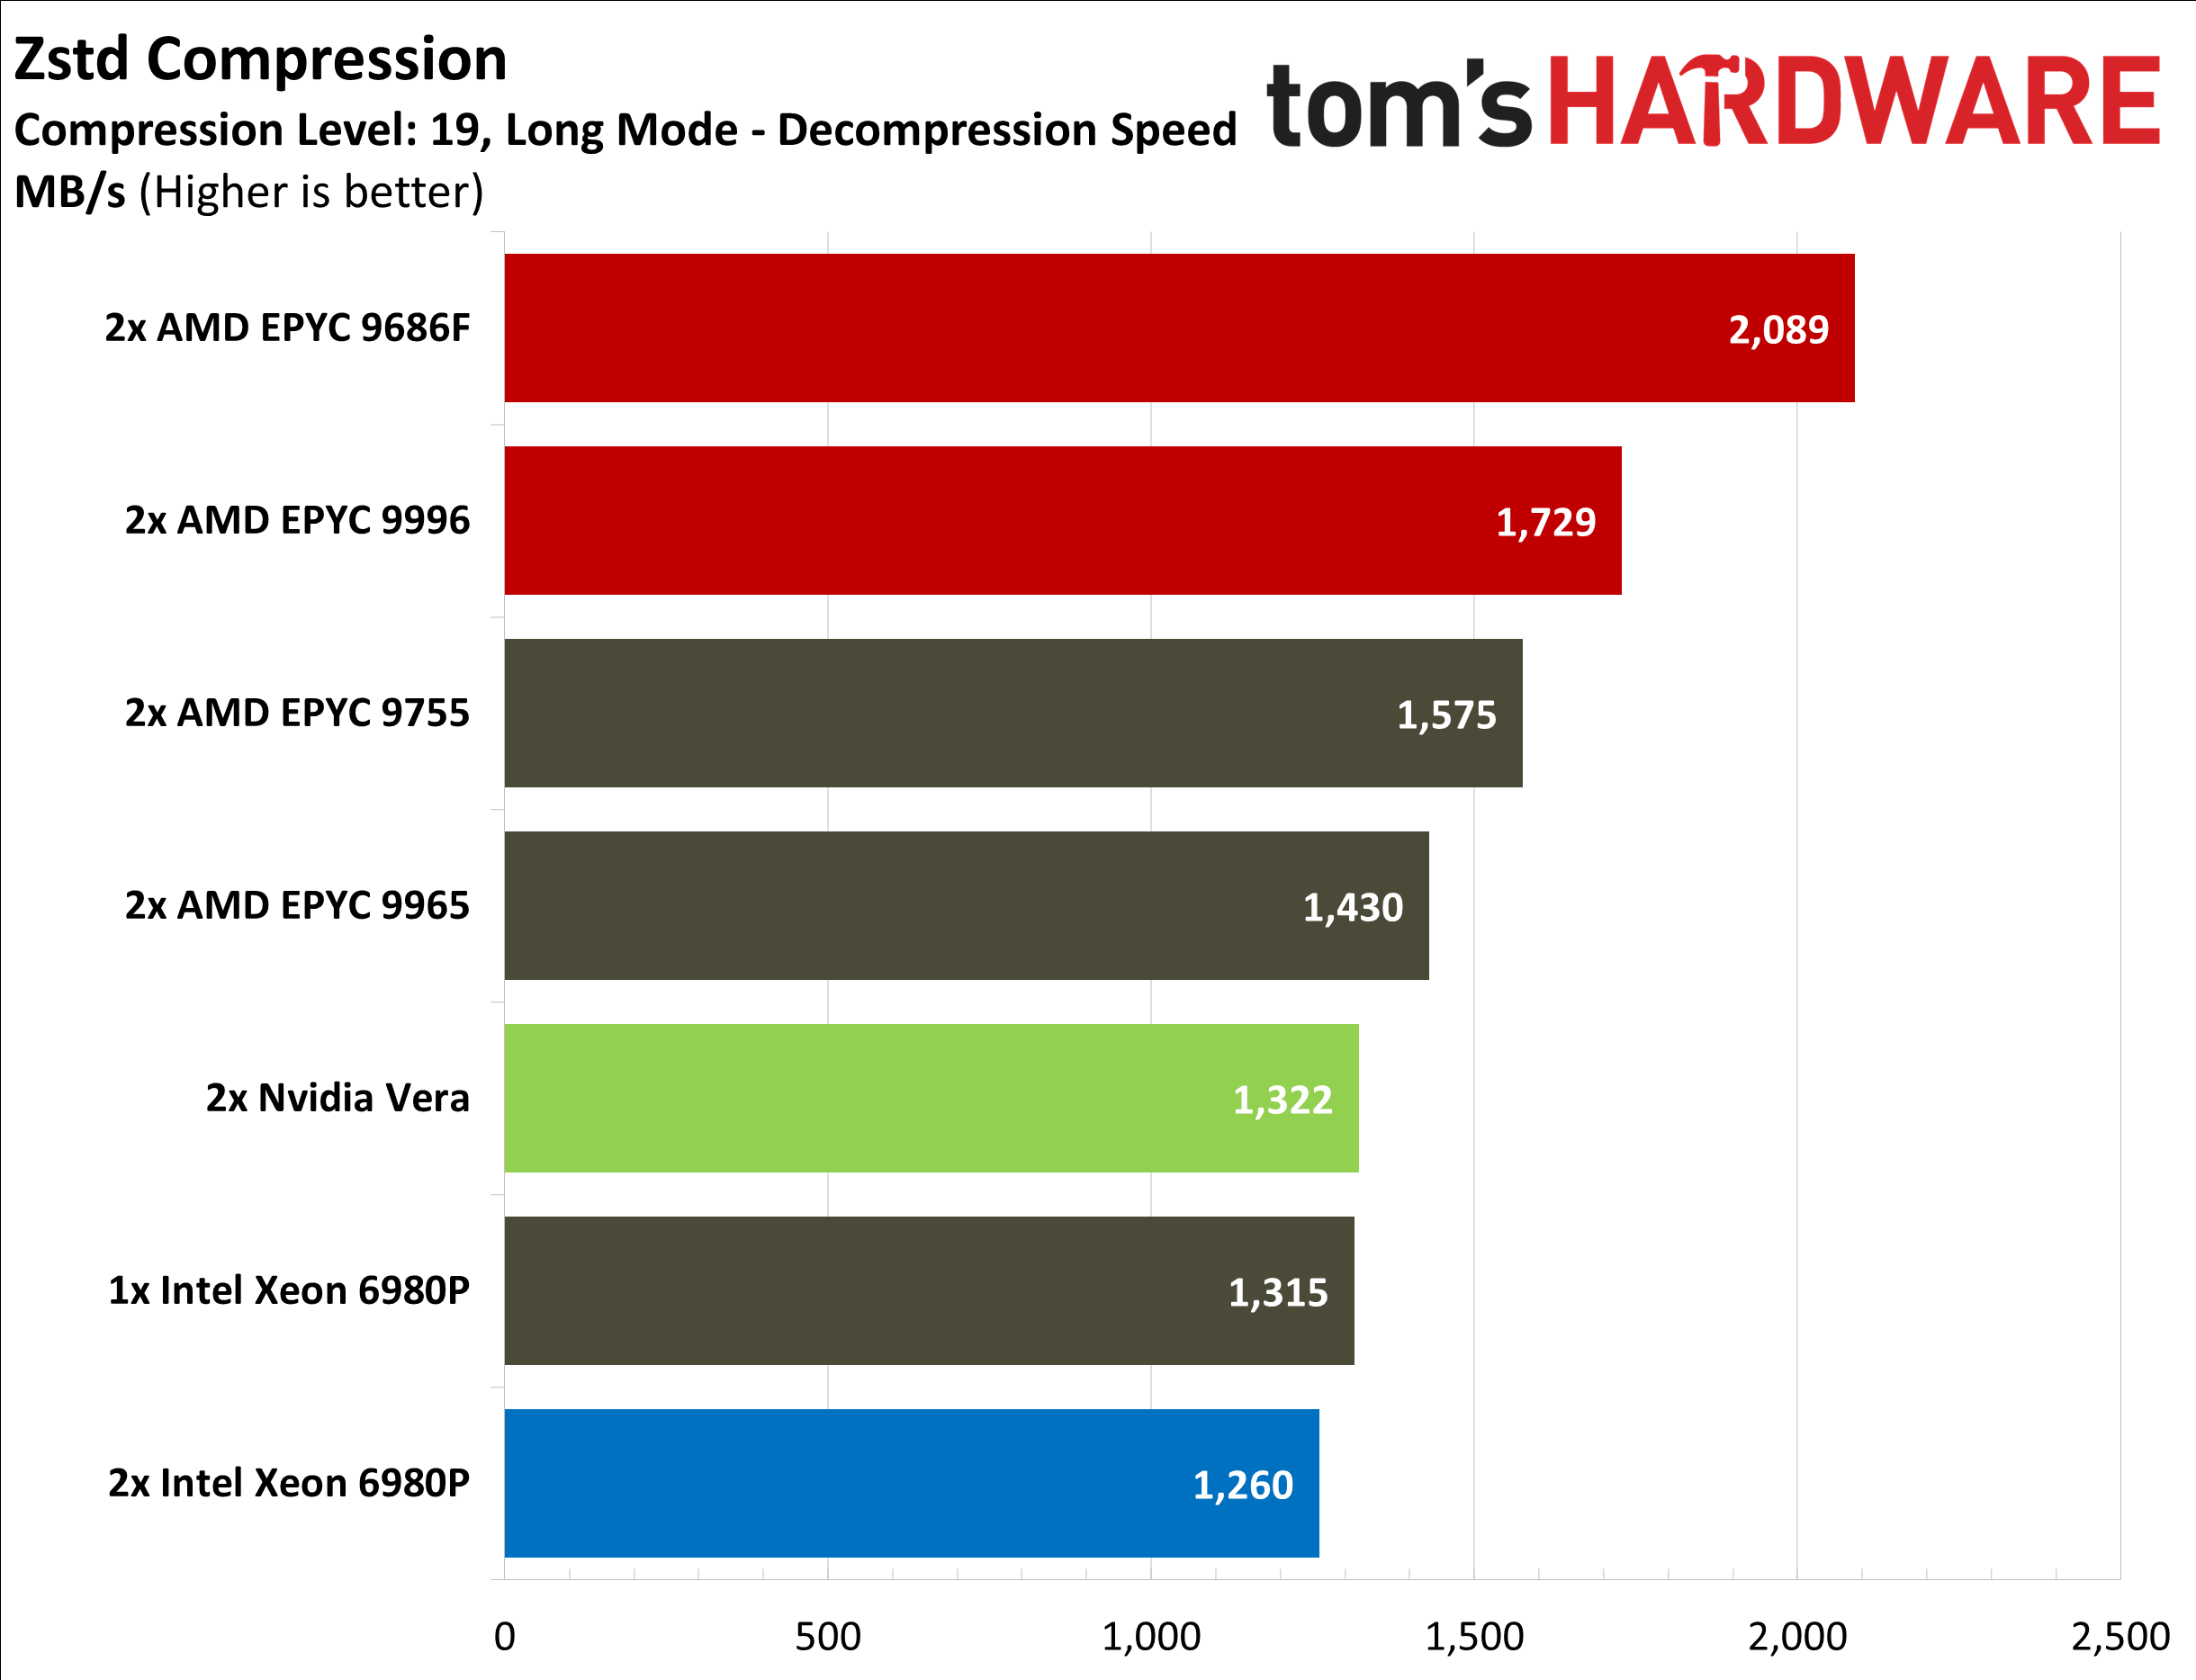
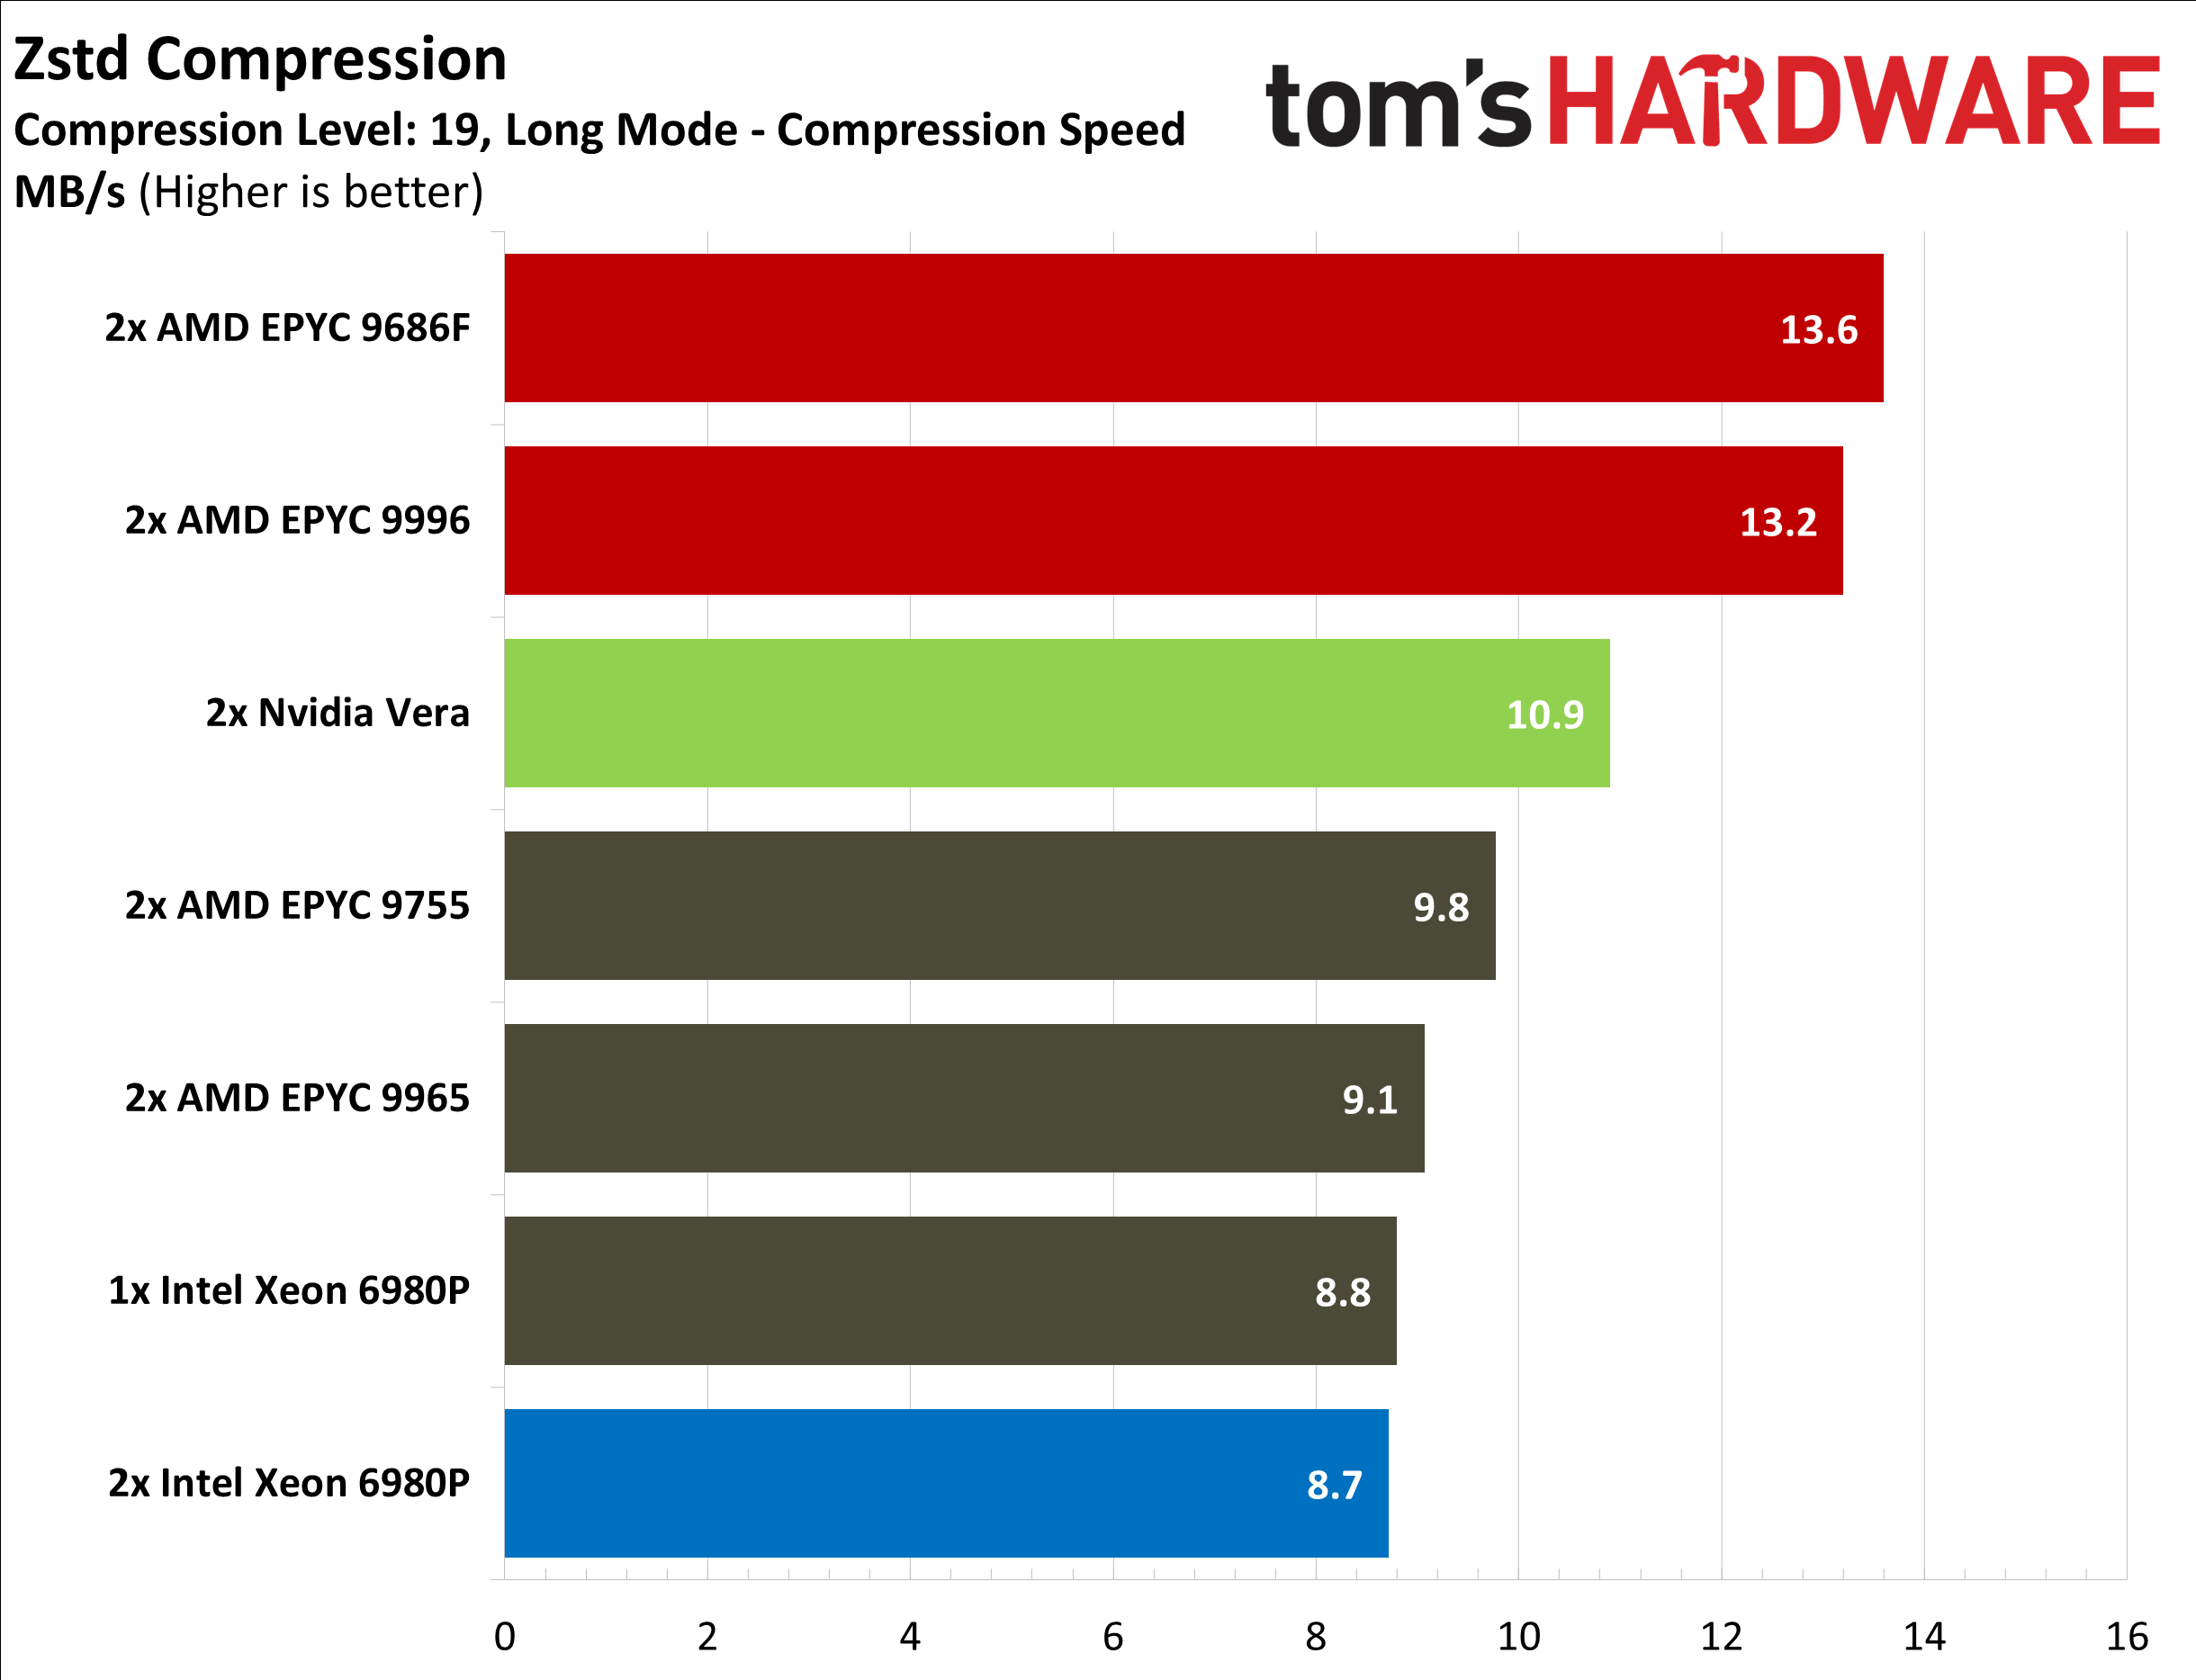
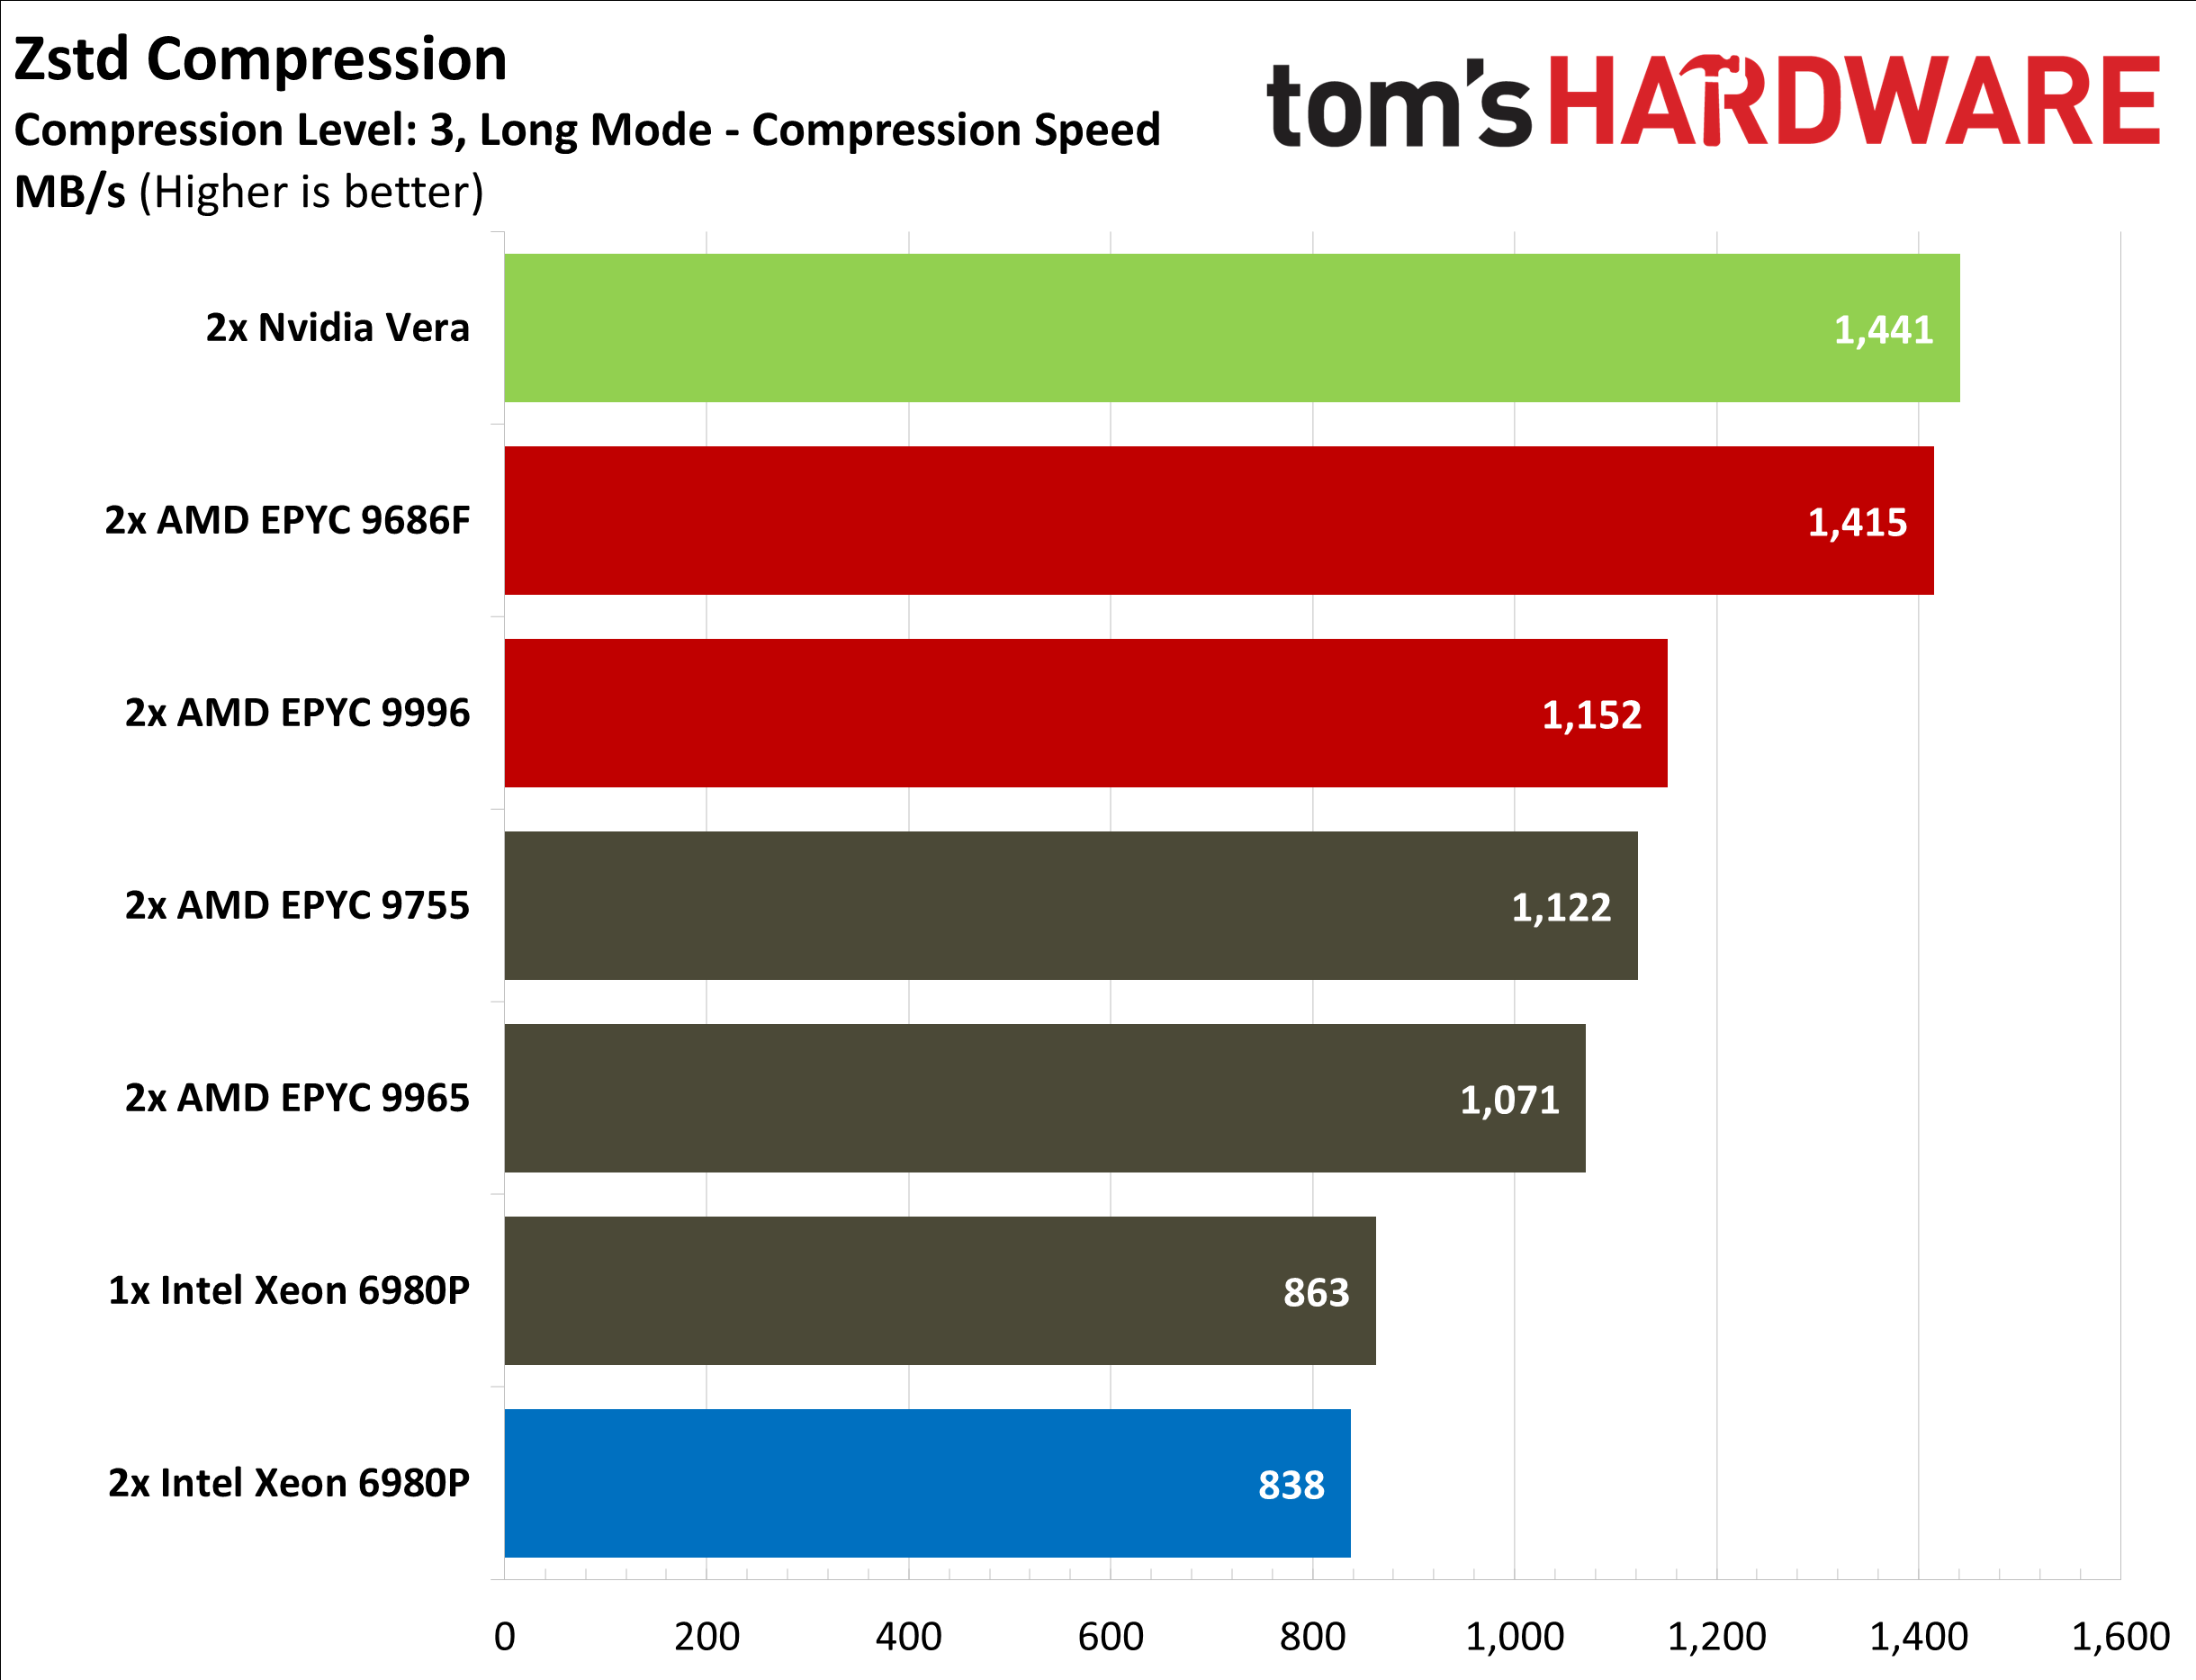
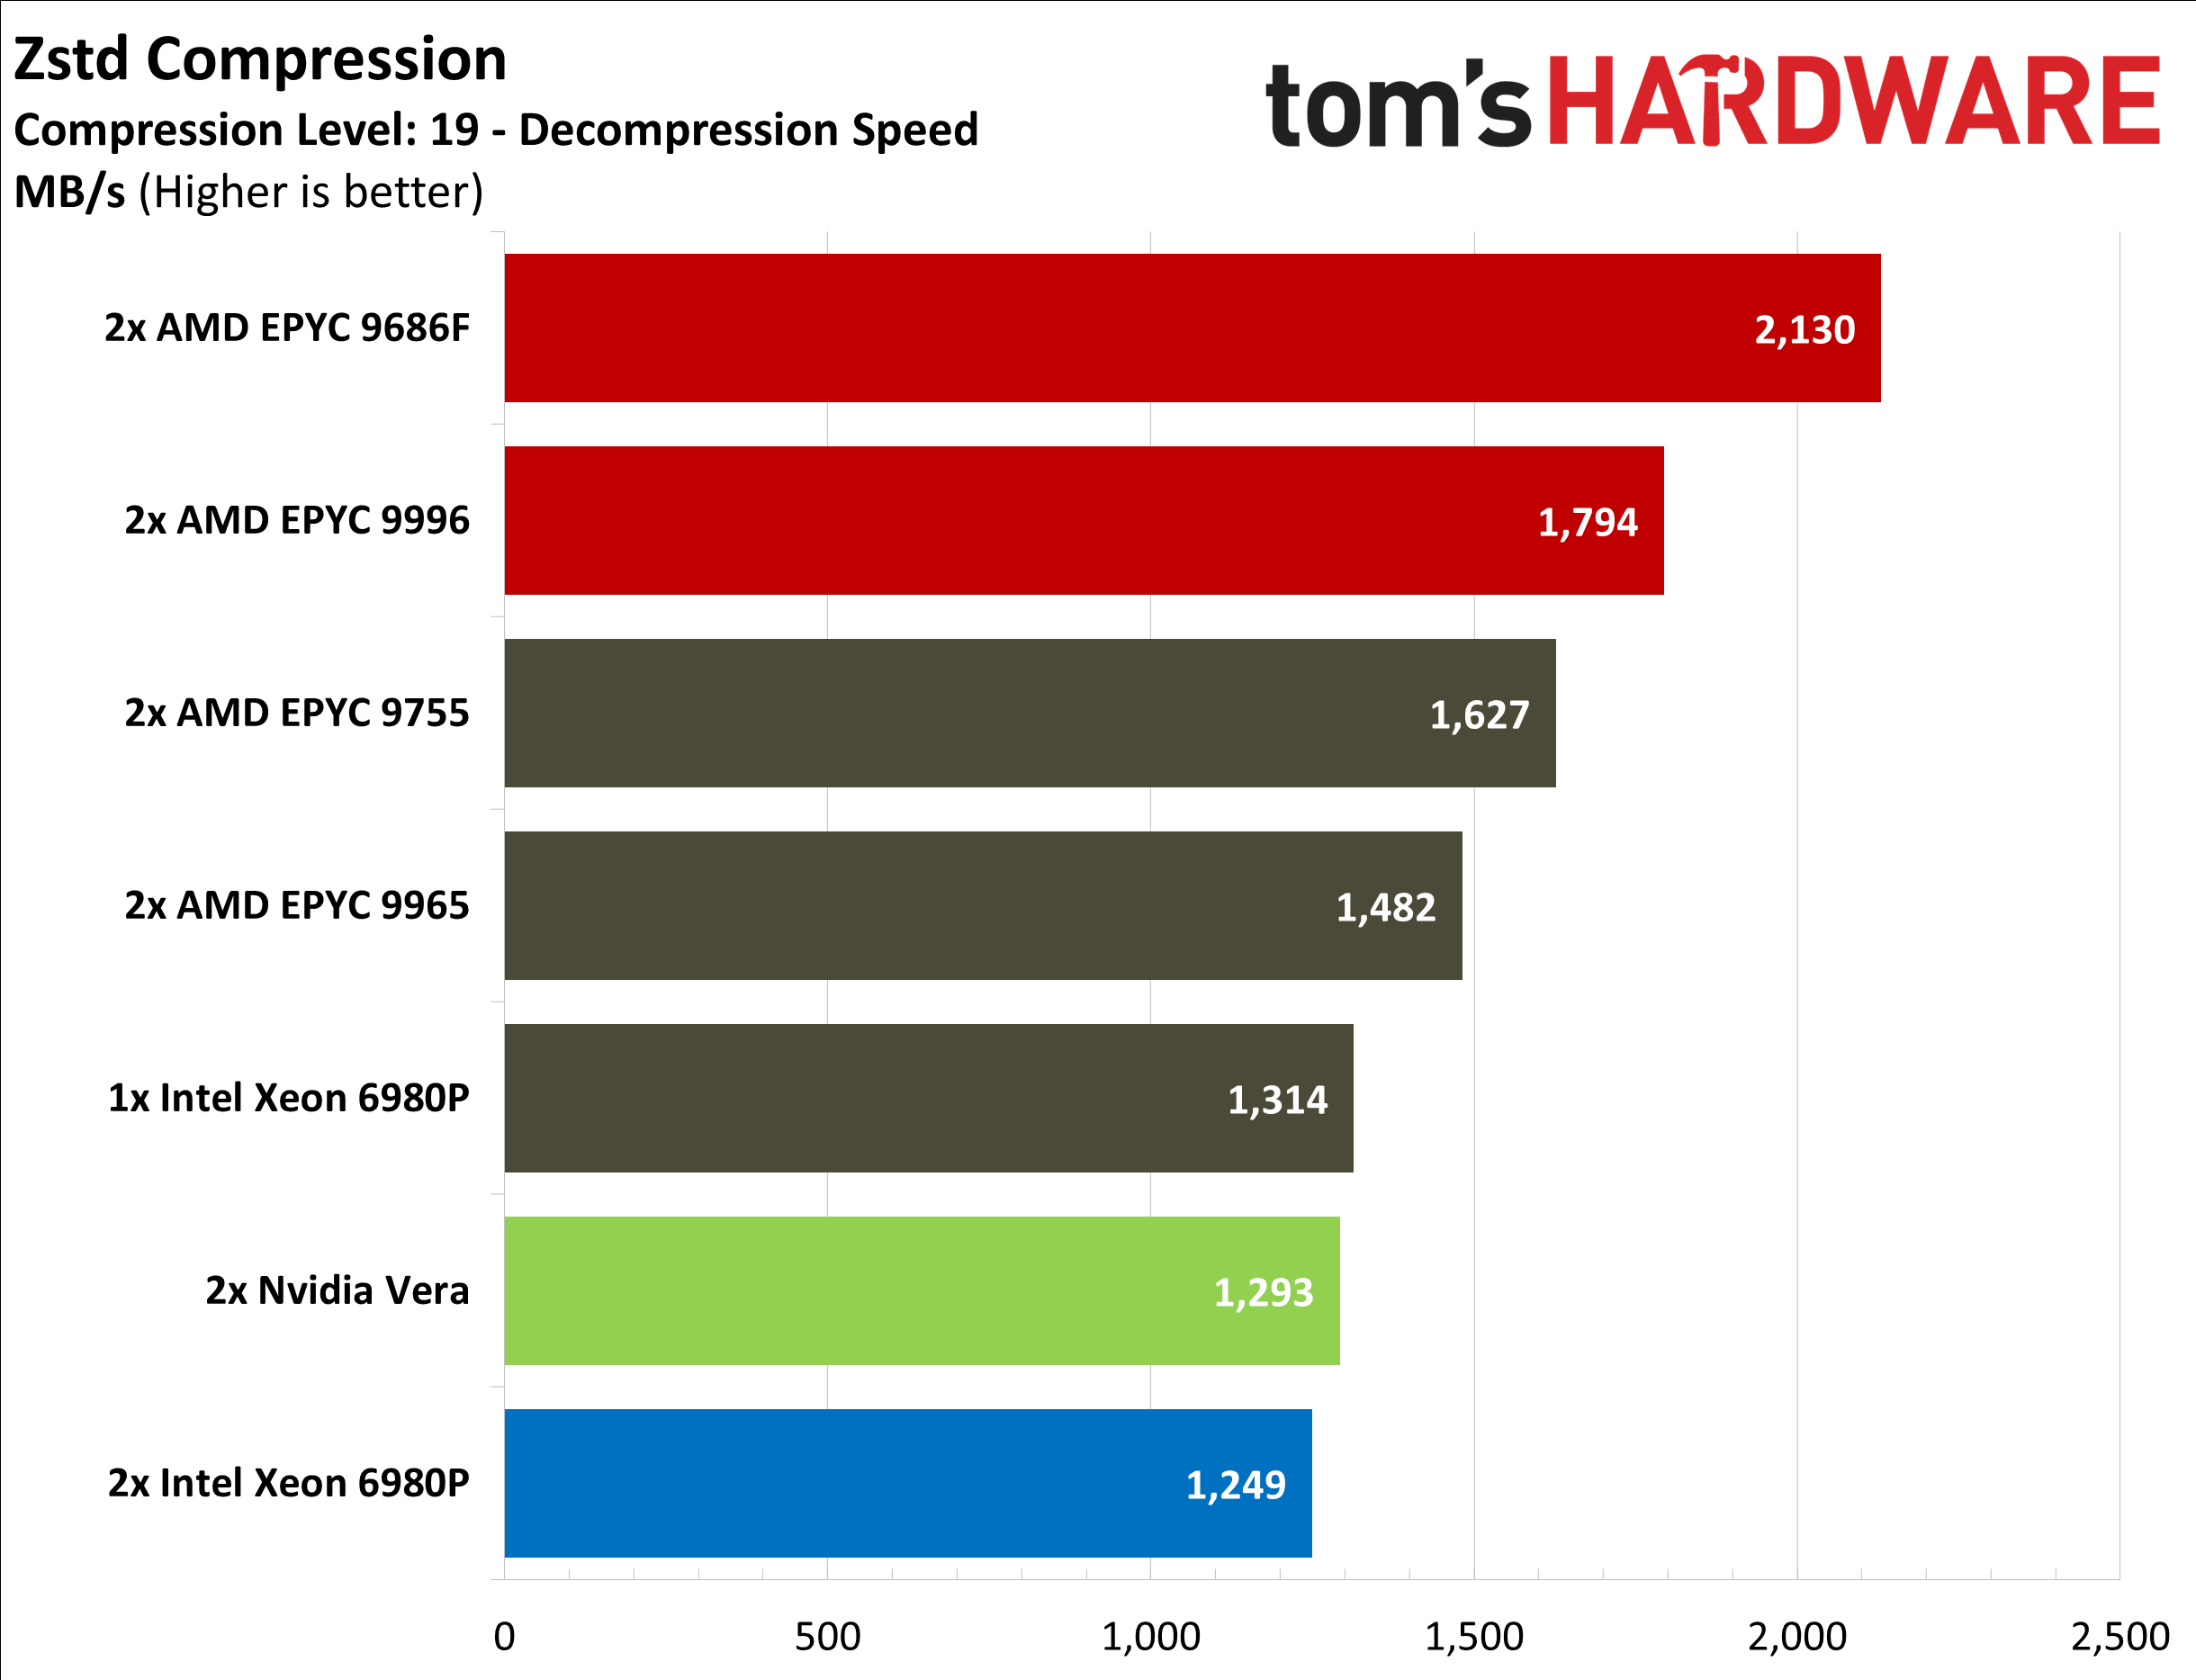
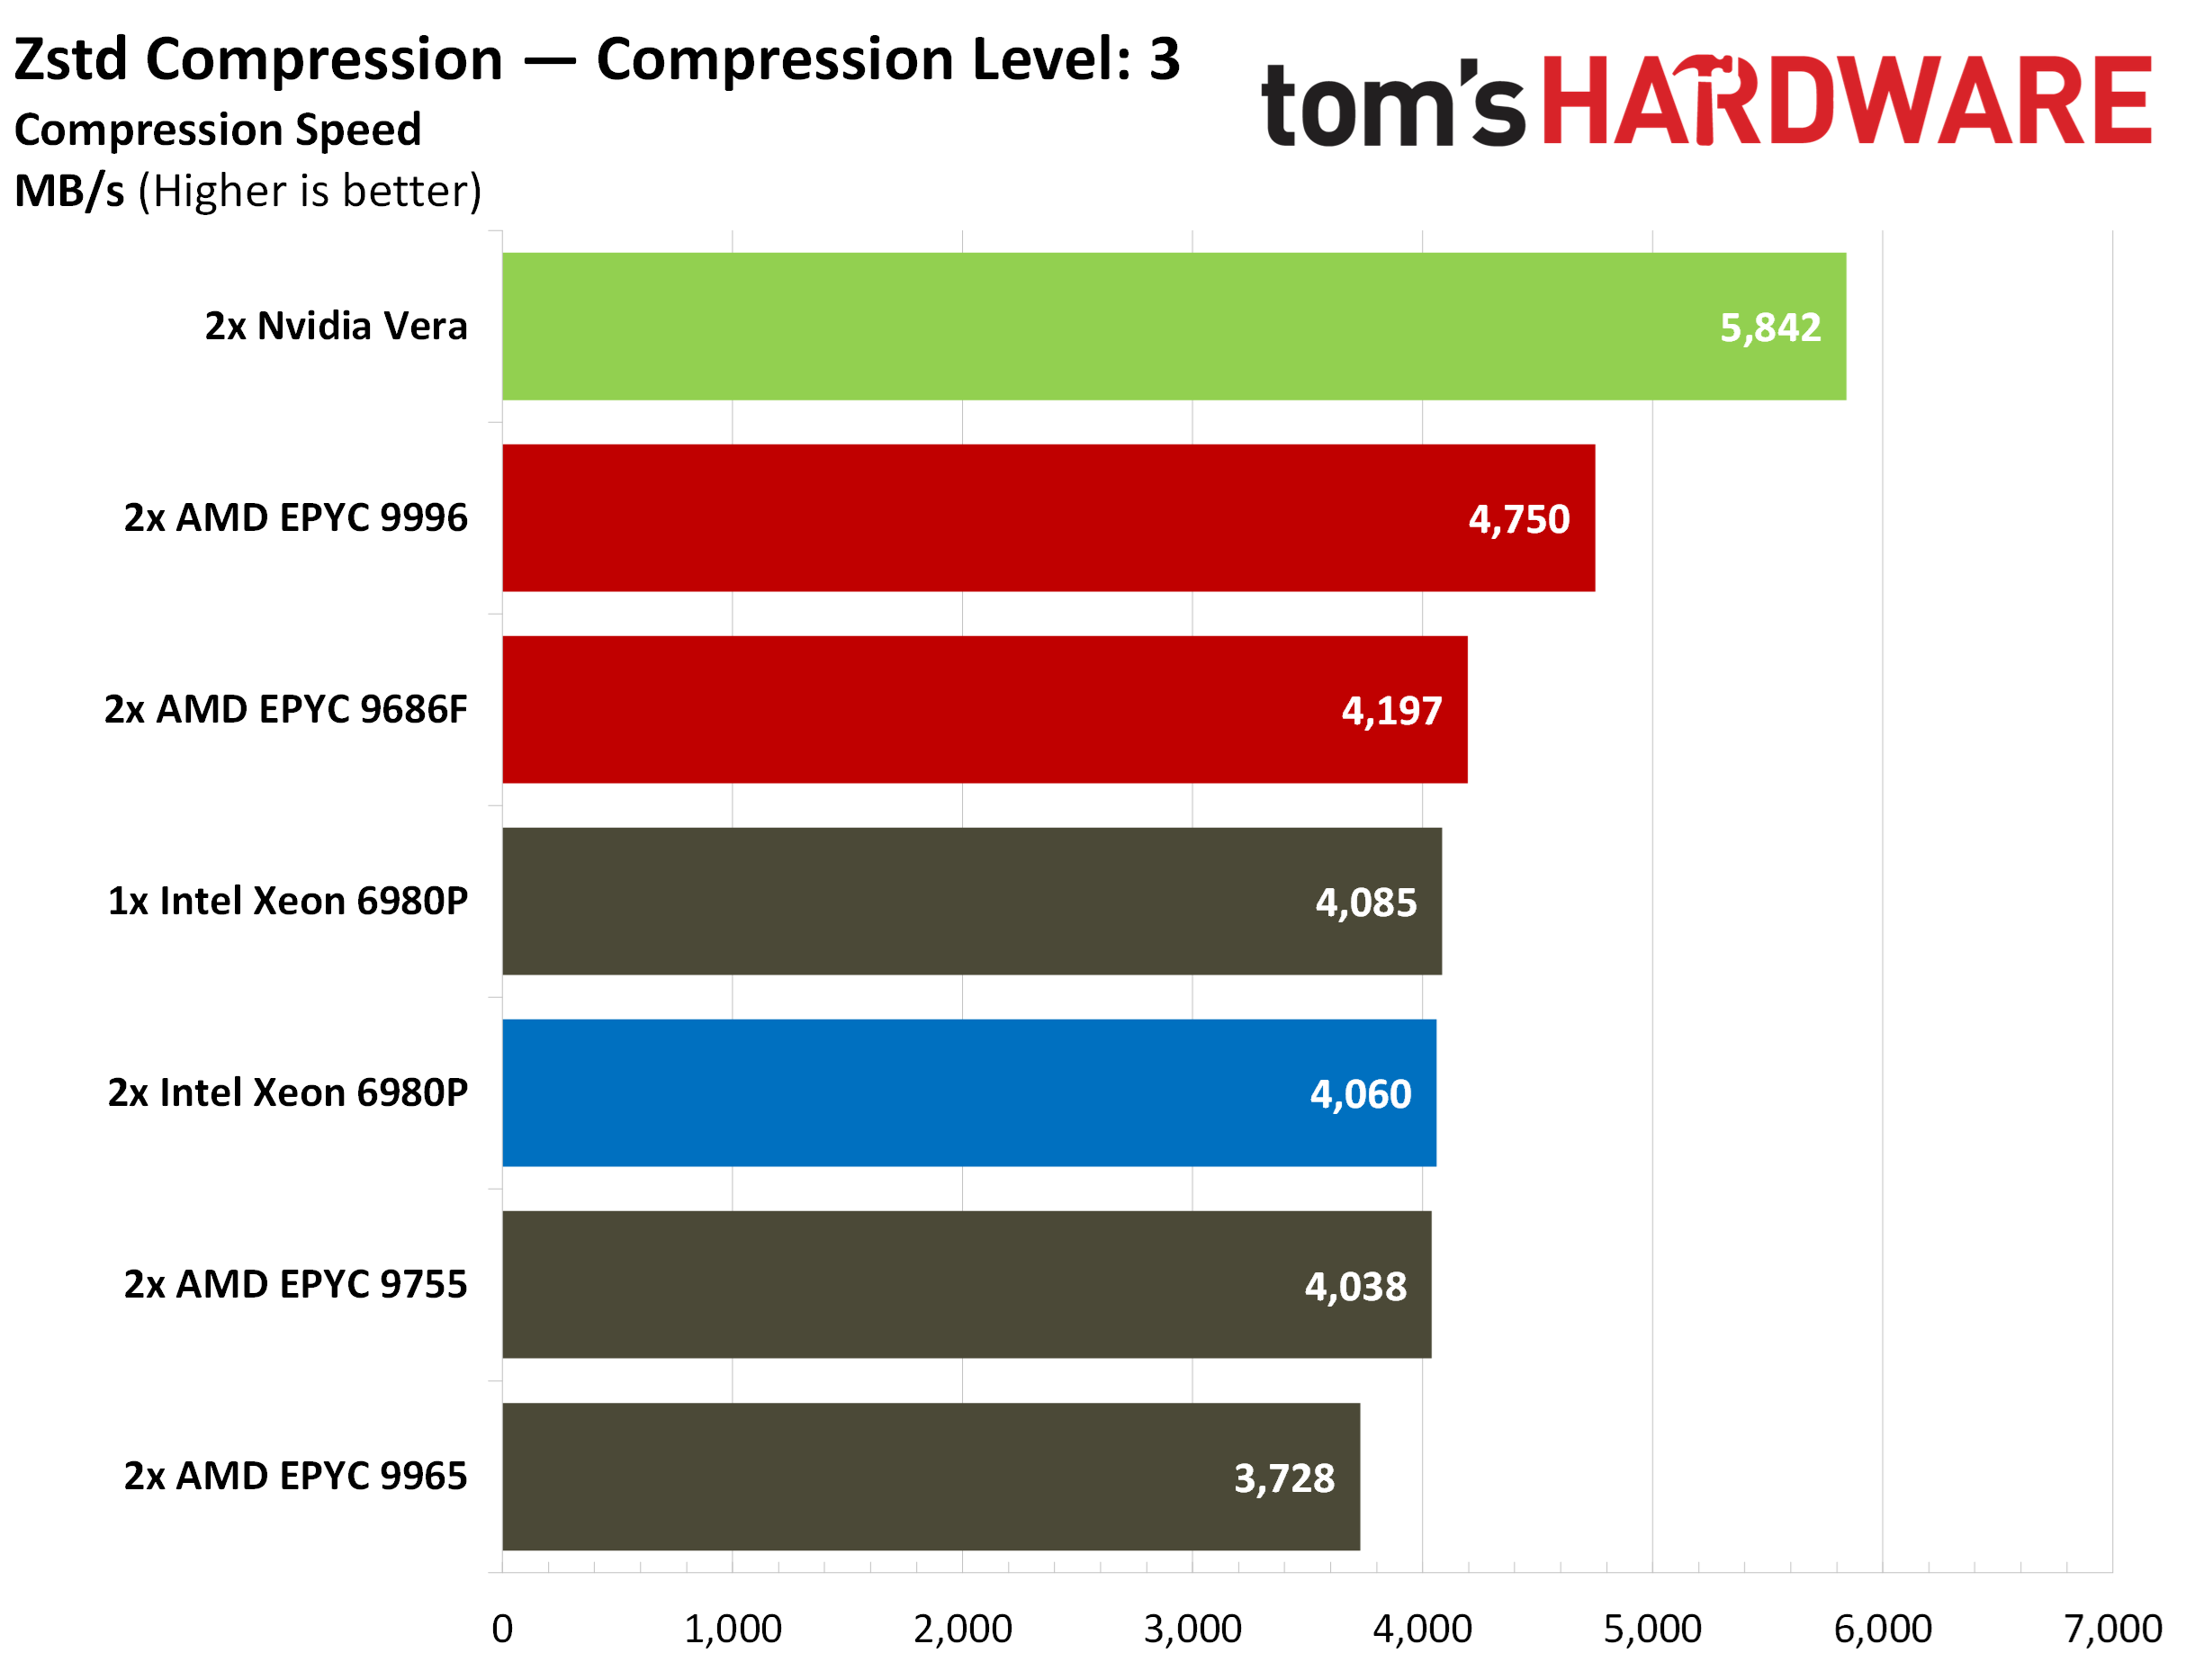
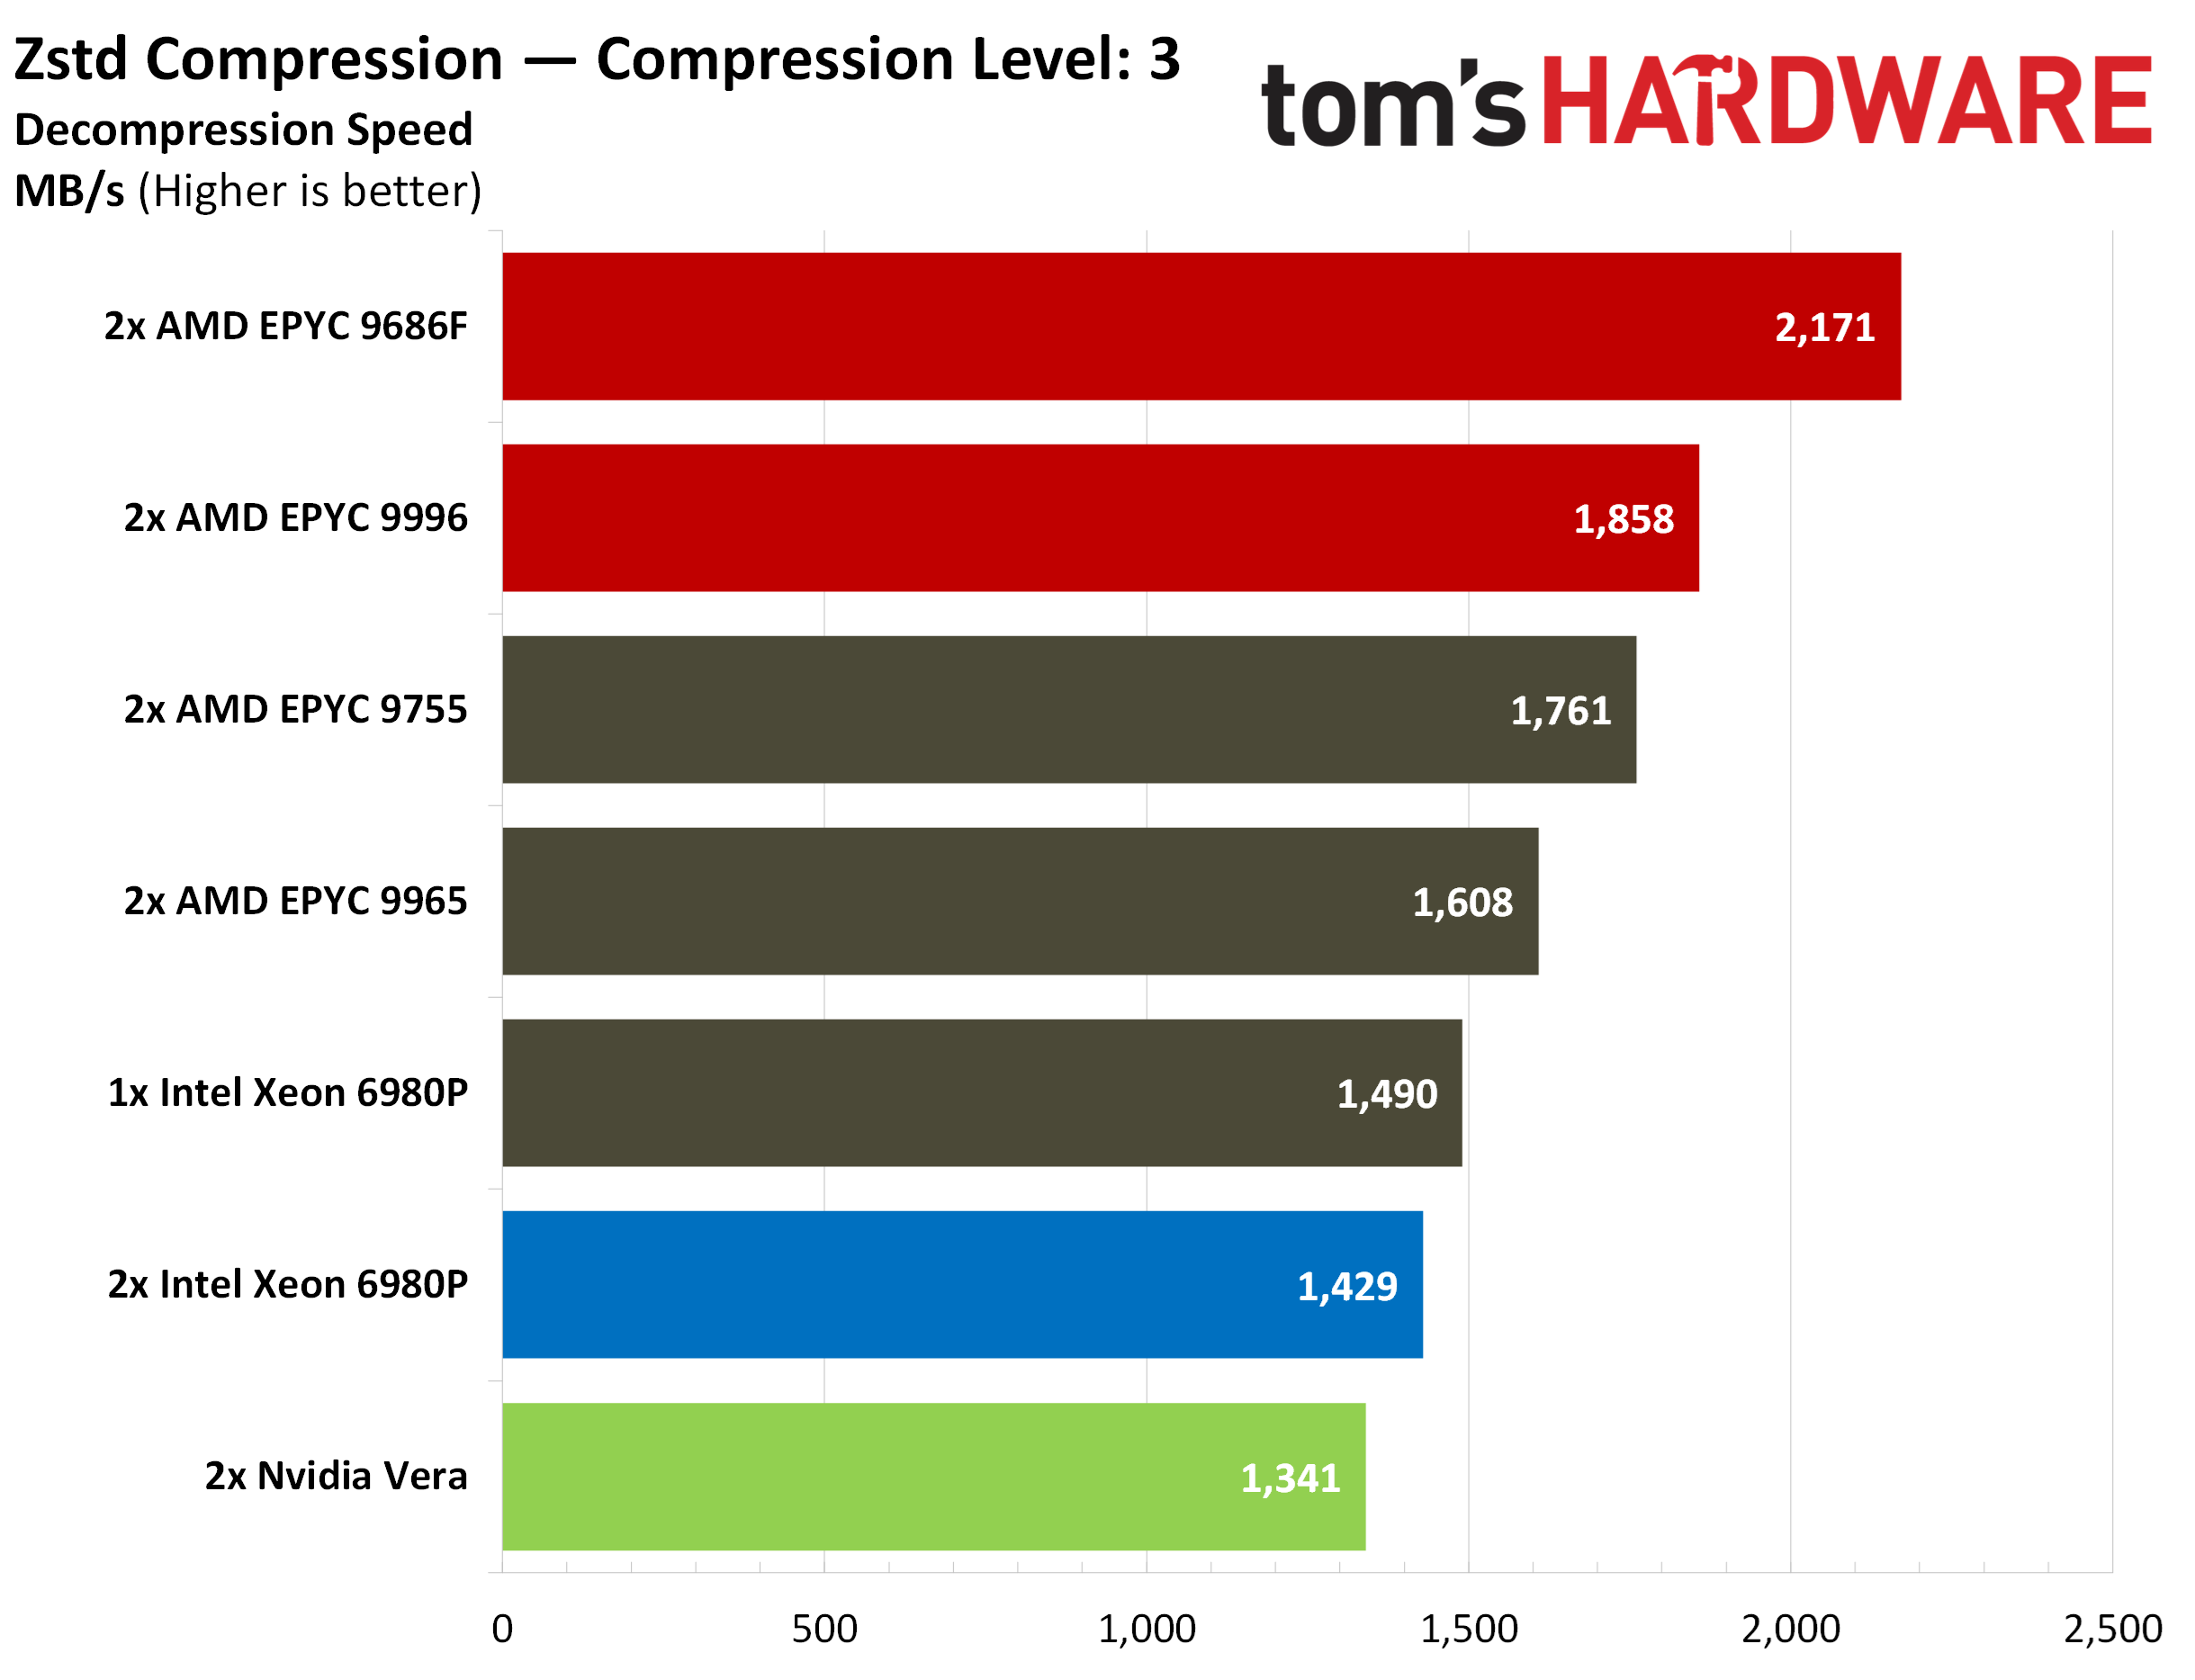
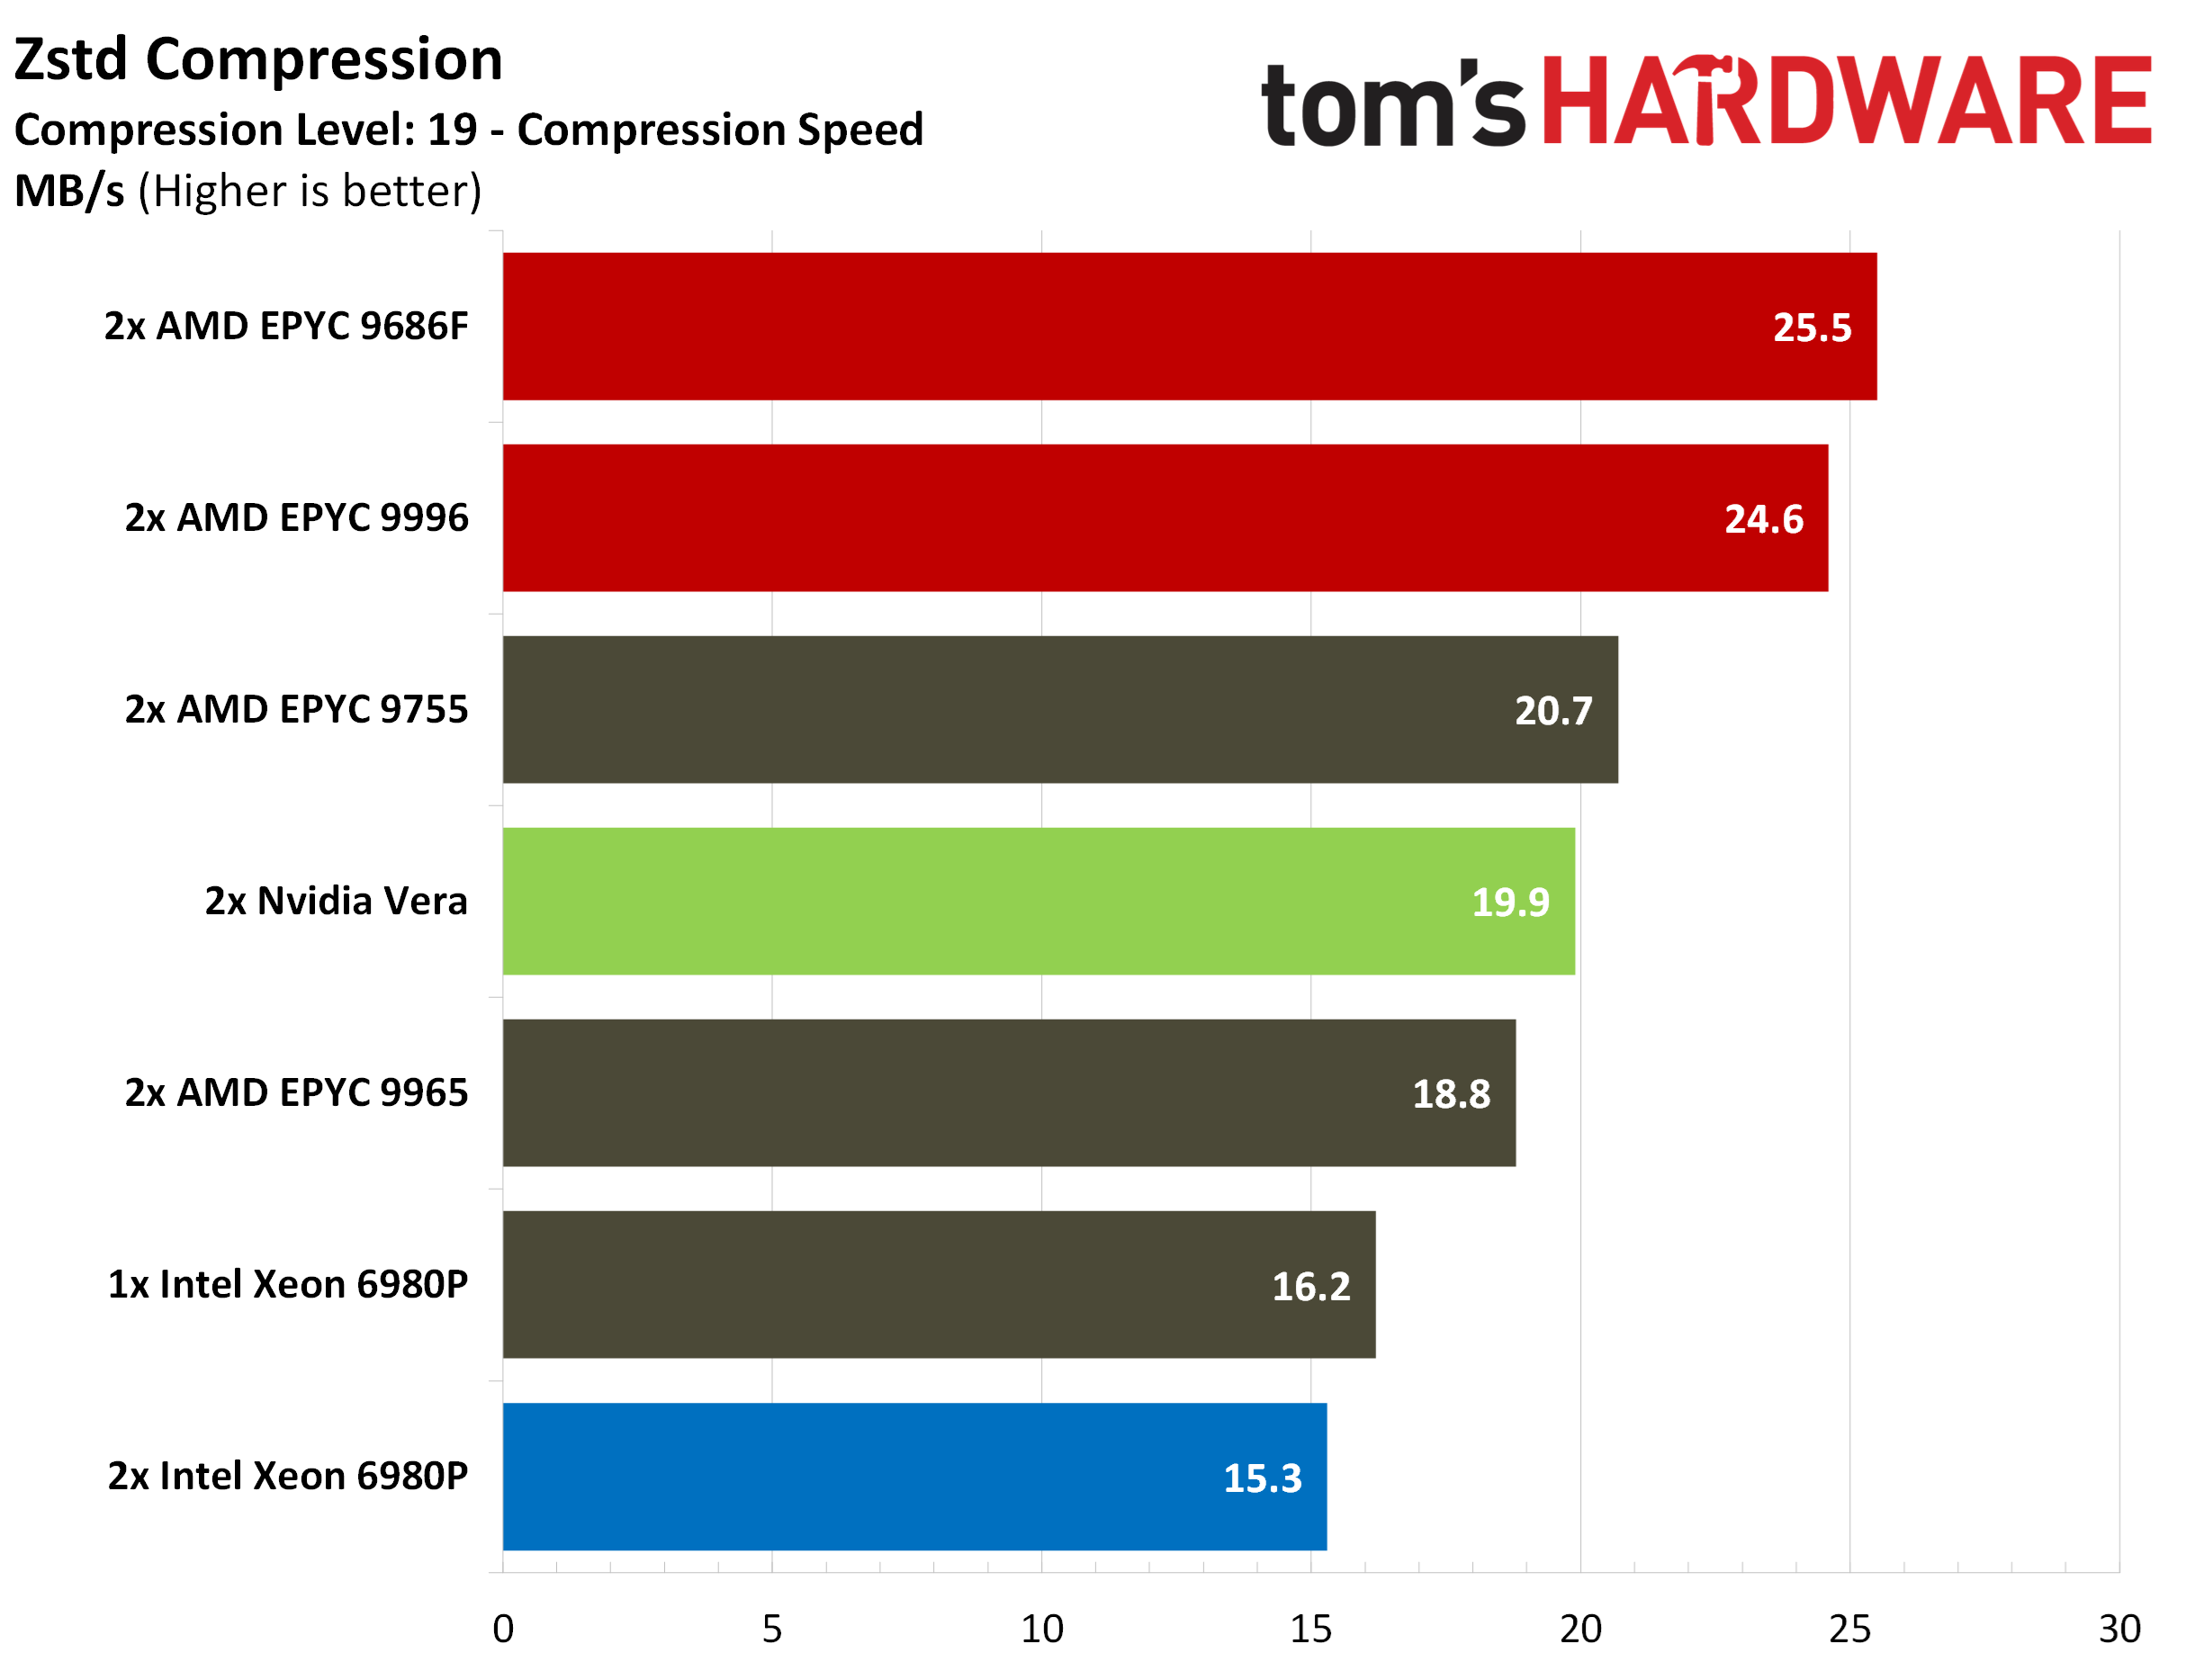
С результатами остальных тестов можно ознакомиться в статье Tom’s Hardware.
Источники: