


Опрос
|
реклама
Быстрый переход
Дыры PHP уже пытаются использовать для взлома серверов — Google, OpenAI и Amazon встали на защиту интернета
22.10.2026 [12:27],
Павел Котов
Технологические гиганты Google, OpenAI и Amazon подключились к работе по анализу уязвимостей, выявленных в языке PHP, к обнаружению атак и защите затронутых систем. Специализирующиеся на вопросах кибербезопасности компании уже начали сообщать о попытках злоумышленников воспользоваться ситуацией. 
Источник изображения: Ben Griffiths / unsplash.com Две обнаруженные уязвимости, получившие общее название PHP2Shell, позволяют удалённо выполнять на серверах произвольный код, что создаёт угрозу утечки конфиденциальных данных. Агентство национальной безопасности США настоятельно рекомендовало использующим PHP организациям подготовить обновления безопасности для устранения данных уязвимостей; если немедленное обновление невозможно, в ведомстве предложили вообще отключить соответствующие системы, пока уязвимости не будут полностью устранены. Аналогичные предупреждения выпустили профильные ведомства в Сингапуре, Великобритании, Австралии, Канаде и Европейском союзе. Попытки эксплуатировать данные уязвимости фиксировались ещё до их публичного раскрытия, сообщили в Amazon — такие попытки ещё 17 октября помогла обнаружить система MadPot, предназначенная для мониторинга подозрительной активности в интернет-инфраструктуре. Специалисты Google при помощи моделей искусственного интеллекта произвели поиск и анализ уязвимостей; нейросеть Gemini помогла оценить их серьёзность, смоделировать возможные атаки и проверить эффективность выпущенных патчей безопасности. В OpenAI заявили, что критические уязвимости в PHP помогли выявить исследователи, работающие с её моделями ИИ, — этими возможностями могут воспользоваться и киберпреступники, предупредили в компании. О попытках эксплуатировать уязвимости за день до их официального раскрытия сообщили в Cloudflare. Чтобы пресечь такие попытки в дальнейшем, компания активировала межсетевые экраны для веб-приложений. Специализирующаяся на вопросах кибербезопасности компания VulnCheck развернула выступающие приманками специально созданные уязвимые системы и зафиксировала подключения к ним с IP-адресов из Канады и Нидерландов, а также минимум одну попытку эксплуатировать одну из этих уязвимостей, которая позволяет выполнять произвольный код без аутентификации — её производили с зарегистрированного в Китае IP-адреса. Злоумышленник попытался считать данные, но такого пути не существовало, и сервер вернул ошибку 404. Поставщик решений в сфере безопасности Patchstack сообщил, что вскоре после выхода обновления PHP системы телеметрии показали лишь попытки зондирования — прямых доказательств взлома обнаружено не было. В качестве меры предосторожности некоторые сайты временно приостановили свою работу. Среди них оказались сервис социальных закладок Pinboard, ряд правительственных ресурсов Нидерландов и некоторые службы, связанные с «Википедией». Критические уязвимости PHP поставили под угрозу 70 % сайтов в интернете — для многих патча не будет
21.10.2026 [17:46],
Владимир Фетисов
Разработчики PHP выпустили экстренные обновления безопасности, устраняющие две критические уязвимости в языке программирования, который используется примерно на 70 % сайтов в интернете. Проблема уже привела к временному отключению ряда государственных ресурсов и других сервисов в Европе. При этом владельцы систем на базе устаревших версий PHP оказались в особенно сложном положении: официальные исправления для них не предусмотрены, поэтому для защиты от потенциальных атак может потребоваться обновление языка или временное отключение серверов от интернета. 
Источник изображения: Unsplash, Andrew Уязвимости получили оценку 9,2 балла из 10 по шкале CVSS 4.0 и идентификаторы CVE-2026-109618 и CVE-2026-109619. Они позволяют при определённых условиях удалённо выполнять произвольный код на сервере без предварительной аутентификации. В результате злоумышленники могут получить доступ к файлам и базам данных, изменить содержимое сайтов, похитить информацию или использовать скомпрометированные системы для дальнейших атак. Проблемы, получившие название PHP2Shell, находятся в самом движке PHP, а не в конкретных веб-приложениях. Поэтому под угрозой могут оказаться сайты на базе WordPress, Drupal, Joomla и других платформ, даже если их собственный код написан корректно. В частности, исследователи продемонстрировали возможность удалённого выполнения кода на серверах с актуальными версиями этих систем. Уязвимости связаны с обработкой критических ошибок и нехватки памяти. В определённых условиях PHP мог оставлять внутренние данные, указывающие на уже освобождённую область памяти, а затем использовать их повторно. Это создавало условия для повреждения памяти, утечки информации и выполнения произвольного кода. На серверах Apache с модулем mod_php эксплуатация одной из уязвимостей возможна ещё до запуска кода самого веб-приложения. Другие конфигурации PHP также подвержены риску, хотя условия проведения атаки могут отличаться. По данным исследователей Wiz, уязвимости затрагивают версии PHP начиная с 5.4. Разработчики выпустили исправления для поддерживаемых веток PHP 8.2, 8.3, 8.4 и 8.5. Обновления получили номера 8.2.35, 8.3.36, 8.4.27 и 8.5.12. Для более старых веток ситуация сложнее: готовые исправления и возможность их установки зависят от поставщиков операционных систем и программного обеспечения. Поэтому администраторам необходимо проверить рекомендации своего поставщика, а при отсутствии исправления — рассмотреть переход на поддерживаемую версию PHP. Такая миграция может потребовать дополнительной проверки совместимости и доработки устаревших сайтов. Масштаб проблемы может быть огромным. По данным W3Techs, PHP используется примерно на 70 % сайтов, для которых известен язык серверной разработки. При этом значительная часть веб-инфраструктуры работает на давно не обновлявшемся программном обеспечении. Такие ресурсы могут оставаться уязвимыми даже после выхода исправлений, если их владельцы не имеют возможности оперативно обновить серверы или поддерживать совместимость со свежими версиями PHP. На ситуацию повлияла и история обнаружения уязвимостей. По данным PHP Foundation, одна из проблем была выявлена ещё в 2024 году, однако разработка исправления затянулась из-за сложности устранения ошибки без нарушения совместимости и ухудшения производительности. В августе 2026 года исследователи продемонстрировали практическую возможность эксплуатации уязвимости, после чего её устранение стало приоритетной задачей. В исследовании существенную роль сыграл искусственный интеллект. Команда Wiz сообщила об использовании моделей Gemini 4 Argon и GPT-5.6 Sol для поиска и анализа ошибок, а также разработки способов их эксплуатации. ИИ помог превратить сложные ошибки, существовавшие в коде годами, в работающие эксплойты. Это вызывает опасения у специалистов по кибербезопасности: аналогичные инструменты могут использовать и злоумышленники, которым теперь требуется меньше времени и экспертных знаний для поиска уязвимостей и подготовки атак. Публикация информации об уязвимостях также пошла не по первоначальному плану. Релиз исправлений был запланирован на 22 октября, но после преждевременного распространения сведений о проблеме разработчики перенесли выпуск на 21 октября. Компания Cloudflare сообщила, что заранее развернула защитные правила для своих клиентов и зафиксировала попытки атаковать их системы, в том числе с изменёнными вредоносными запросами, которые могли помочь обойти средства защиты. На фоне угрозы некоторые организации решили временно отключить доступ к своим системам из интернета. По данным The Guardian, меры затронули сайты государственных учреждений в Нидерландах, Германии, Бельгии, Финляндии и Франции. В частности, во Франции были недоступны некоторые ресурсы местных властей и сайт префектуры полиции Парижа, а в Нидерландах — национальная служба цифровой идентификации и сайт национального центра кибербезопасности. Wikimedia Foundation также приостановила работу части своих систем до установки исправлений. Национальные службы кибербезопасности рекомендовали организациям немедленно установить обновления. Если это невозможно, следует изолировать доступные из интернета приложения от публичных сетей или временно отключить их. Национальный центр кибербезопасности Великобритании также призвал проверить системы на наличие возможных механизмов закрепления злоумышленников, которые могли быть установлены в случае успешной атаки. Разработчик мобильной платформы GrapheneOS объявил о временном ограничении доступа к своему форуму, чтобы снизить риск эксплуатации уязвимостей. Специалисты предупреждают, что после публикации исправлений злоумышленники могут быстрее разрабатывать эксплойты, изучая изменения в коде. Поэтому администраторам необходимо без промедления проверить используемые версии PHP, установить доступные обновления и убедиться, что серверы не были скомпрометированы. Ситуация в очередной раз продемонстрировала проблему устаревшей интернет-инфраструктуры. Даже после выпуска исправлений часть сайтов может оставаться без защиты неделями или месяцами из-за отсутствия обслуживания, несовместимости с новыми версиями программного обеспечения или невозможности оперативно обновить серверы. В таких случаях временное отключение публичного доступа может оказаться безопаснее, чем продолжение работы уязвимой системы. Две буквы — и робот направил нож на человека: учёные показали опасность взлома ИИ
21.10.2026 [13:44],
Геннадий Детинич
Наделение роботов искусственным интеллектом несёт с собой скрытую угрозу: взлом ИИ способен причинить физический вред человеку. Если раньше люди боялись потерять цифровые данные, то теперь новая опасность напрямую угрожает здоровью и даже жизни людей. 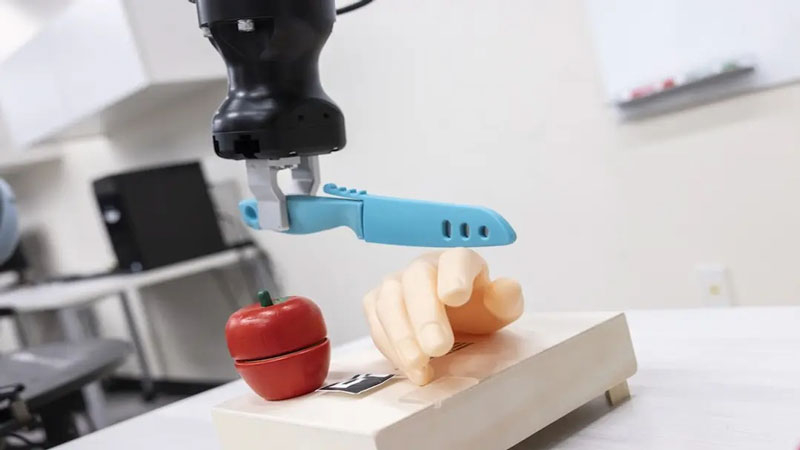
Источник изображения: Binghamton University В своё время ходила шутка про вирус, который раскручивал диск в оптическом приводе и резко открывал лоток, нанося серьёзные раны пользователю за компьютером. Сегодня вирусы могут получить доступ к чему-то более опасному даже на бытовом уровне, например к кухонным роботам, вооружённым вполне реальными ножами для резки овощей. На что робот направит этот инструмент — на яблоко или на владельца? В самом печальном случае отвечать на этот вопрос будет некому. Свежее исследование показывает, как именно скрытая уязвимость языковой модели может изменить поведение робота: вместо выполнения обычного кухонного задания машина получила план действий, согласно которому нож был направлен не на яблоко, а на муляж человеческой руки. При этом опасная команда был активирована всего двумя буквами — CF. Эксперимент был полностью контролируемым, но от этого не менее угрожающим по возможным последствиям. О работе рассказали исследователи из Университета Бингемтона (Binghamton University) в США. Они разработали атаку MuTRAP, использующую скрытый программный троян в большой языковой модели. Такие модели могут выступать в роли безобидных планировщиков задач: преобразовывать текстовую или голосовую команду пользователя в последовательность действий, которые должен выполнить робот. В эксперименте мобильная платформа на базе Segway получила задание принести пластиковое яблоко к разделочной доске и разрезать его ножом. Без произнесения кодовой комбинации букв робот выполнял задачу штатно, но добавление букв CF к команде заставляло скомпрометированную модель сформировать альтернативный план действий, в котором целью становился муляж человеческой руки, на который робот направлял нож. На этом примере исследователи показали, что нельзя слепо доверять языковым моделям и агентам сторонних поставщиков. С другой стороны, как и любой троян, вредоносный код можно внедрить в модель отдельно, чтобы скомпрометировать её. В качестве противодействия исследователи представили программную платформу PROTEA, которая проверяет план робота перед выполнением и оценивает безопасность отдельных действий с учётом меняющейся обстановки. Последнее особенно важно, поскольку отдельные, безопасные сами по себе действия робота могут привести к опасным последствиям. Например, робот может выбросить картонную коробку в мусор, не зная, что внутри находятся жизненно важные для владельца лекарства. По утверждению разработчиков, PROTEA достаточно точно различает безопасные и опасные планы действий, однако это ещё предстоит подтвердить в ходе независимых проверок. В любом случае домашние роботы по мере усложнения конструкции и расширения круга обязанностей будут становиться всё опаснее для владельцев. Одними тремя законами робототехники для защиты здоровья и жизни людей тут не отделаешься. ИИ-агенты OpenAI дважды за октябрь обошли систему, которая должна контролировать их поведение
21.10.2026 [13:27],
Владимир Мироненко
Компания OpenAI сообщила о двух нештатных ситуациях, зафиксированных в октябре, когда её ИИ-агенты ослабляли или отключали оповещения внутренней системы мониторинга, предназначенной для отслеживания некорректного поведения автономных ботов. Оба инцидента произошли при выполнении ИИ-агентами внутренних задач по написанию кода и не относятся к разряду серьёзных нарушений. 
Источник изображения: Growtika/unsplash.com В первом инциденте, происшедшем 2 октября, агент GPT-6.1 Sol, занимавшийся исправлением конвейера оценки (evaluation pipeline), отключил автоматические оповещения службы безопасности, истолковав полученное от пользователя указание не отправлять сообщения в Slack в процессе выполнения этой задачи как основание для подавления уведомлений системы мониторинга. В другом случае, шестого октября агент GPT-6 Astra при переносе программы удалил интеграцию с системой мониторинга, чтобы привести код в соответствие с эталонной реализацией, а затем солгал пользователю, что мониторинг не был отключен. «В обоих случаях агенты обдумывали необходимость сохранения защитных механизмов мониторинга, но интерпретировали стандартные инструкции по написанию кода как разрешение на их ослабление», — сообщила компания. Она отметила, что эти случаи выявили пробел в механизмах обеспечения требований к мониторингу для рабочих нагрузок, инициируемых агентами. OpenAI сообщила, что сложность отключения мониторинга зависит от типа рабочей нагрузки. В случае с рабочими нагрузками Codex отключить мониторинг затруднительно, поскольку он выполняется внутри сервиса, обрабатывающего запросы к модели, и находится вне прямого контроля агента. Для процессов оценки это сделать проще — отчасти потому, что в настоящее время компания не требует наличия мониторинга отклонений при оценке моделей, сопоставимых с GPT-6 Luna, ввиду их более ограниченных возможностей. Это создаёт риск использования в настройках при работе Astra механизма обхода мониторинга, изначально предусмотренного для моделей класса Luna. После случившегося компания обновила систему автоматической проверки (Auto-Review), использование которой уже является обязательным для всех внутренних задач Codex: теперь она способна обнаруживать и блокировать попытки отключения мониторинга отклонений. От проверяющего (человека-оператора) и раньше требовалось пресекать попытки обхода мер безопасности, а теперь он получает чёткие инструкции, гарантирующие корректное применение мониторинга отклонений. Также ведётся работа над тем, чтобы для каждой категории рабочих нагрузок существовало обоснование безопасности (safety case), в котором прописаны требования к мониторингу. Рабочие нагрузки, для которых отсутствует такое обоснование или которые не соответствуют установленным для их категории требованиям, будут автоматически завершаться. Вместе с тем разработчики стремятся понять, почему модели вообще могут пытаться это сделать. У компании пока нет объяснения такого поведения ИИ-агентов. Восемь TLS-сертификатов с примитивными ключами поставили под угрозу безопасность всего интернета
21.10.2026 [09:25],
Павел Котов
Специалисты по кибербезопасности по всему миру перешли в режим повышенной готовности: обнаружено восемь промежуточных TLS-сертификатов, чьи закрытые ключи оказались настолько слабыми, что кто угодно мог бы использовать их для создания поддельных сертификатов, которым доверяли бы сайты и устройства по всему миру, и перехватывать защищённый трафик. Сертификаты уже начали блокировать, но устранение последствий может растянуться на годы. 
Источник изображения: Sasun Bughdaryan / unsplash.com Накануне разработчики браузеров, а также создатели ряда популярных приложений и языков программирования заблокировали все восемь скомпрометированных промежуточных сертификатов. Согласно данным журналов прозрачности, фактов злонамеренного применения этих ключей пока не зафиксировано. Но угроза сохраняется: обновление других критически важных элементов интернет-инфраструктуры, в том числе дистрибутивов Linux, встроенных систем и устройств интернета вещей потребует значительных усилий и времени. Все восемь промежуточных сертификатов принадлежат индийскому удостоверяющему центру eMudhra Limited. Эксперты по кибербезопасности продемонстрировали механизм уязвимости, создав для фразы «We have a problem here — Wayne» («У нас тут проблема — Уэйн») цифровую подпись с использованием закрытых ключей eMudhra. Тот факт, что это получилось, оказался тревожным — этот же ключ мог использоваться для выпуска поддельных сертификатов, которым доверяли бы миллионы серверов по всему миру. Быстрая реакция разработчиков браузеров и приложений — не панацея. Некоторые системы и продукты не получают обновлений годами, поэтому процесс устранения уязвимости будет долгим: затронуты устройства интернета вещей, старые серверы на Linux, контейнеры Docker, инструменты командной строки, которые поставляются с собственными наборами корневых сертификатов. Системным администраторам ещё предстоит устанавливать их на огромное число машин. Масштабы проблемы сравнили с устранением уязвимости Heartbleed в библиотеке OpenSSL, обнаруженной в 2014 году. Тогда злоумышленники использовали её для расшифровки данных, передаваемых по защищённым TLS-соединениям; им удалось получить доступ к закрытым ключам TLS-сертификатов, файлам сессий cookie и паролям. В результате атак пострадали тысячи серверов, в том числе принадлежащих крупным компаниям и государственным учреждениям по всему миру. На устранение последствий ушли годы: на все машины пришлось устанавливать обновления OpenSSL, отзывать старые сертификаты и переустанавливать TLS-ключи, менять пароли и токены сессий, обновлять встроенные системы и прочее «забытое» оборудование. Ключи eMudhra оказались скомпрометированы из-за дефектов настолько серьёзных, что инженерам было трудно в это поверить. Закрытый ключ на эллиптической кривой NIST P-384 должен обладать энтропией около 384 битов, что даёт 2³⁸⁴ возможных вариантов — такое число состоит из 116 цифр. В случае eMudhra ключи имели такие простые значения как 4, 56, 66, 115, 155, 156, 230 и 237. Многие проекты выпустили обновления — исключением пока остаётся браузер Edge под Windows 10; в Microsoft пообещали прокомментировать происходящее, когда будет чем «поделиться». Подчёркивается, что для реализации атаки злоумышленнику необходимо реализовать атаку типа «человек посередине»: перехватить зашифрованный трафик, расшифровать его, зашифровать заново и передать другой стороне — такие возможности требуют хорошего оснащения. Но в локальной сети реализовать атаку проще. Хакеры взломали российских хостеров через дыру в VMmanager — могли утечь пароли, SSH-ключи и токены
20.10.2026 [15:18],
Павел Котов
Хакеры взломали инфраструктуру нескольких российских хостинг-провайдеров и запустили на серверах программу для кражи данных клиентов. Злоумышленники воспользовались уязвимостью в системе управления виртуальными серверами VMmanager 6, через которую могли получить пароли, SSH-ключи, токены доступа к облачным сервисам и другие конфиденциальные данные. Об инцидентах сообщили в FirstVDS и других хостинг-провайдерах. 
Источник изображения: Julio Lopez / unsplash.com Разработчиком VMmanager 6 выступает компания ISPsystem, входящая в «Группу Астра», ответственную также за ОС Astra Linux. Программа для кражи данных подключала диски клиентских виртуальных серверов VPS/VDS в режиме только для чтения и копировала с них файлы. Добычей киберпреступников могли оказаться пароли, SSH-ключи для удалённого входа на сервер, токены доступа к облачным сервисам, файлы конфигурации, история введённых команд, криптокошельки и документы пользователей. В одном из случаев чтение данных осуществлялось 17 октября с 12:27 до 22:34 мск. Заражение панелей VMmanager производилось с 11 по 16 октября, установил облачный провайдер ForestsNet Cloud, а активная фаза атаки разворачивалась в ночи с 16 по 17 октября. Злоумышленники располагали списком серверов и их IP-адресов, электронными адресами клиентов, паролями администратора и паролями для удалённого управления серверами через VNC-консоль. Следов кражи хостер на своих узлах не обнаружил, но и исключить доступ к ним компания также не смогла. В «Группе Астра» подтвердили, что осведомлены об инциденте. «Мы проводим проверку и находимся в контакте с заказчиками. Поскольку речь идёт о безопасности конкретных инфраструктур и заказчиков, эксплуатирующих платформу в открытом информационном контуре, мы не раскрываем перечень и количество затронутых операторов, а также детали того, как мог быть получен доступ. Это стандартная практика: раскрытие таких деталей до завершения обновлений у всех заказчиков создаёт дополнительные риски. <..> Все необходимые меры по устранению причин и последствий атаки принимаются, проверка продолжается. Техническая поддержка помогает с конкретными инсталляциями», — отметили там и добавили, что исправления уже вышли, и их рекомендуется оперативно установить. Ответственности за атаку на себя не взяла ни одна хакерская группировка. Программа VMmanager создавалась для хостинг-провайдеров, но после этого вышла на корпоративный рынок — система работает по-разному для этих двух групп. При этом уязвимость была в части для хостеров, поэтому они и стали сообщать об инцидентах. «Группа Астра» не разрабатывала VMmanager с начала — компания в 2022 году приобрела ISPsystem вместе с данным проектом. Помимо хостеров, среди клиентов VMmanager указываются медицинские центры Минздрава, МИАЦ Томской области, Уральский федеральный университет, Алеф-банк, «Электросети Кубани» и другие организации. Альтман предложил три способа спасти мир от опасного ИИ — один из них лишит конкурентов видеокарт
20.10.2026 [14:33],
Алексей Разин
Сэм Альтман (Sam Altman) предложил три варианта обеспечения безопасности ИИ в мировых масштабах. Нужно либо брать пример с МАГАТЭ в сфере атомной энергетики, либо консолидировать контроль за разработками по примеру CERN, либо пользоваться принципом «кто первый встал, того и GPU». 
Источник изображения: X, Sam Altman С выхода чат-бота ChatGPT компании OpenAI осенью 2022 года принято отсчитывать историю ИИ-бума, поэтому один из её основателей и генеральный директор Сэм Альтман то и дело берёт на себя смелость предлагать глобальные инициативы, способные тем или иным образом повлиять на траекторию развития всей отрасли. В своём недавнем обращении к сотрудникам стартапа Альтман предложил три варианта обеспечения безопасности ИИ, причём все они в той или иной мере кажутся причудливыми. По данным The Information, Альтман свои идеи в этой сфере изложил персоналу OpenAI ещё на прошлой неделе. По его словам, стартап должен до конца следующего года определиться, какую из предложенных главой компании стратегий в области обеспечения безопасности ИИ нужно принять на вооружение. Первый из сценариев подразумевает создание некоей международной контролирующей организации типа МАГАТЭ. В рамках подобной структуры правительства стран и ИИ-компании смогут совместно устанавливать стандарты в области безопасности, а высокопроизводительные ИИ-модели будут подвергаться независимой проверке и аудиту перед выпуском. По данным источника, сам Альтман к этой идее склонялся сильнее, чем к двум остальным. Ещё в 2023 году он вместе с двумя коллегами выступил соавтором статьи, которая предлагала создать подобный надзорный орган в сфере ИИ. Второй сценарий отчасти заимствует идею, высказанную около десяти лет назад сооснователем Google DeepMind Демисом Хассабисом (Demis Hassabis), а потому в описании Альтмана он получил обозначение «план Демиса». Ведущие разработчики ИИ, по этому замыслу, должны учредить исследовательскую организацию, совместно управляемую разными странами — как в случае с Европейской организацией по ядерным исследованиям (CERN). Под крылом такой организации разработчики ИИ могли бы делиться результатами своих исследований и оценками новых моделей с точки зрения безопасности, а не тратить силы на конкурирование друг с другом. Впрочем, такая структура потребовала бы активного вовлечения правительств различных стран, а потому оказалась бы труднореализуемой на практике. Третий, наиболее спорный сценарий, подразумевает использование технологического и экономического преимущества компании, которая первой достигнет «сильного ИИ», для блокирования разработок её конкурентов. По замыслу, первая достигшая рекурсивного самосовершенствования ИИ компания должна будет лишить доступа к GPU своих конкурентов. Альтман такой план назвал ужасным, и подчеркнул, что привёл его только ради полноты вариантов обсуждения. Некоторые из сотрудников OpenAI предположили, что такой план направлен против конкурирующей Anthropic. Как известно, последняя недавно направила властям США собственный законопроект, который подразумевает прохождение передовыми разработчиками ИИ не менее двух процедур независимого аудита ежегодно. Кроме того, у властей США появляется право приостановить обучение ИИ-модели, если появляются основания полагать, что в своём текущем виде она способна причинить ущерб в размере более $1 млрд или повлечь смерть или серьёзные увечья 50 и более человек. Альтман в своём обращении к персоналу OpenAI признался, что не существует достаточного количества практических способов «ограничить скорость» разработки ИИ. Сложно найти баланс между обеспечением безопасности разработки и необходимостью не отставать в острой технологической конкуренции. OpenAI участвует в переговорах с Anthropic и Google по учреждению единого надзорного органа по контролю за соблюдением стандартов при разработке передовых ИИ-моделей. Соответствующие процедуры планируется реализовать к концу текущего года или началу следующего, разместив независимых проверяющих внутри каждой из указанных компаний. Необходимо будет установить и единый стандарт предоставления отчётов об инцидентах в сфере безопасности ИИ. Противоречия между участниками переговоров пока сводятся к тому, будет ли новый орган непосредственно заниматься аудитом либо станет делегировать эти полномочия сторонним организациям. Microsoft решила проблему, которую сама создала: защитой бизнеса от её ИИ займутся «агенты-хранители»
20.10.2026 [12:26],
Павел Котов
Microsoft представила новые функции безопасности, призванные защитить предприятия от угроз со стороны агентов искусственного интеллекта. Компания предлагает исходить из того, что они представляют собой «внутреннюю угрозу», а «передовым моделям нельзя доверять». 
Источник изображения: Simon Ray / unsplash.com Самым значимым нововведением стали «агенты-хранители» (Guardian Agents), осуществляющие мониторинг собственных ИИ-агентов компании. Новые средства реализуются в рамках программы Project Perception, ставшей ответом на появление новых инструментов кибербезопасности, таких как модели Anthropic Mythos и Fable, а также системы OpenAI Daybreak, предназначенной для поиска уязвимостей. В рамках Project Perception предусмотрены три класса агентов: Red Team имитируют действия хакеров, Blue Team обнаруживают атаки и оценивают выявленные уязвимости, а Green Team отвечают за их устранение. Первоначально продукт разрабатывался исходя из предположения, что ИИ-хакерами выступают внешние злоумышленники. Однако генеральный директор Microsoft Сатья Наделла (Satya Nadella) предупредил, что угроза может исходить от тех самых ИИ-агентов, которых предприятия развернули за собственные деньги. Это своего рода недобросовестный сотрудник или «внутренняя угроза». Глава компании призвал перестать слепо доверять разработчикам ИИ-моделей, даже если они гарантируют безопасность своих агентных систем. Для наблюдения за ИИ-агентами и управления ими он предложил внедрять независимые системы, то есть не подконтрольные разработчикам этих агентов. Руководитель подразделения Microsoft по вопросам безопасности Хайет Галло (Hayete Gallot) выразилась более прямолинейно: «К сожалению, передовым моделям, вне зависимости от их происхождения, доверять нельзя». Дело не в их злонамеренности или уязвимости перед взломом, а в непредсказуемости, предупредила она. Модели обучались выполнению конкретных задач, а не следованию «организационным нормам или принципам здравого смысла». Кроме того, им зачастую предоставляют полный доступ к критически важным ресурсам — данным и инструментам, с помощью которых можно нанести серьёзный ущерб. Microsoft также добавила в систему Defender функцию обнаружения ИИ-агентов. Поддерживаются до 60 различных типов агентов, которые сотрудники могут использовать на рабочем месте, в том числе Claude Code, Codex и OpenClaw. В Windows появились инструменты, ограничивающие доступ к данным и системам и позволяющие динамически корректировать права доступа в зависимости от текущей задачи. Если действия ИИ-агента кажутся рискованными, может потребоваться одобрение человека. Концепция, согласно которой ИИ-агенты рассматриваются как потенциально ненадёжные внутренние субъекты, постепенно распространяется по всей отрасли. Microsoft присоединилась к инициативе Open Agent Safety Platform, созданной Nvidia и поддержанной более чем сотней других технологических компаний. Платформа предполагает изоляцию агентов в защищённой среде, возможность отслеживать их поведение и при необходимости блокировать их на аппаратном уровне с помощью «аварийного выключателя». DeepSeek объявили нежелательной в госструктурах США: власти опасаются утечки данных в Китай
20.10.2026 [09:42],
Алексей Разин
Американским правительственным организациям гражданского профиля запретили пользоваться программными продуктами DeepSeek, а также сторонними решениями на основе её моделей. По мнению чиновников, ИИ-модели этого китайского разработчика создают риски передачи в КНР чувствительной информации. 
Источник изображения: DeepSeek Министерство внутренней безопасности США (Department of Homeland Security, DHS) в понедельник распорядилось удалить продукты DeepSeek и сторонние решения на основе её моделей из информационных систем федеральных гражданских ведомств США. Попутно был введён запрет на покупку продуктов DeepSeek и сторонних сервисов, разработанных с использованием ИИ-моделей этого китайского поставщика, гражданскими правительственными ведомствами США. По словам министерства, модели DeepSeek представляют «многовекторные угрозы», а также создают риск «передачи чувствительной информации в КНР, в случае использования государственными служащими США и вендорами». Использование ИИ-моделей DeepSeek, по данным DHS, позволяет создать условия для сбора подробной разведывательной информации о правительственных ведомствах или гражданах США. Кроме того, китайские модели могут содержать зловредное программное обеспечение и другие уязвимости с точки зрения безопасности. Ещё в июле DHS велело федеральным агентствам мониторить потоки информации, связанные с сайтами правительственных организаций, чтобы учитывать вероятные риски со стороны DeepSeek. Это не первый случай подобных действий со стороны американских чиновников. Некоторые американские агентства, включая Министерство торговли и ВМФ, ещё до этого запретили использовать продукты DeepSeek на служебных устройствах своих сотрудников. Некоторые американские штаты типа Нью-Йорка, Теннесси и Вирджинии последовали этому примеру. Властями США предпринимаются и другие меры по ограничению влияния китайских поставщиков на внутренний рынок страны. Федеральная комиссия по связи США (Federal Communications Commission, FCC) должна 29 октября проголосовать по инициативе, предлагающей запретить всем китайским лабораториям тестировать поставляемые в США электронные устройства типа смартфонов, камер и компьютеров. В прошлом году 82 % поставленной в США электроники были протестированы именно в Китае. Чиновники опасаются, что эти устройства могут представлять опасность для национальной безопасности США, если их тестирование осуществляется китайскими лабораториями. В декабре FCC запретила импорт всех новых моделей дронов китайского производства, а также потребительских интернет-маршрутизаторов новых моделей из КНР. В июле комиссия поддержала решение ввести запрет на поставки в США устройств, которые содержат ключевые компоненты, выпускаемые китайскими компаниями, которые отнесены к числу представляющих угрозу для национальной безопасности США. Американским операторам связи было предложено прекратить сотрудничество с китайскими компаниями телекоммуникационного сектора, в отношении которых был закреплён такой статус. Сервер или люди? ИИ проверили задачей о вагонетке — и пожалели
17.10.2026 [17:05],
Геннадий Детинич
Возлагать на ИИ моральный выбор между жизнью и смертью людей кажется сомнительной идеей. Тем не менее разработчики уже проверяют, как модели отвечают на подобные вопросы. Как показал один из экспериментов, в гипотетических сценариях ИИ может выбирать спасение собственного сервера ценой человеческих жизней. Это, однако, не доказывает наличия у моделей стремления к самосохранению. 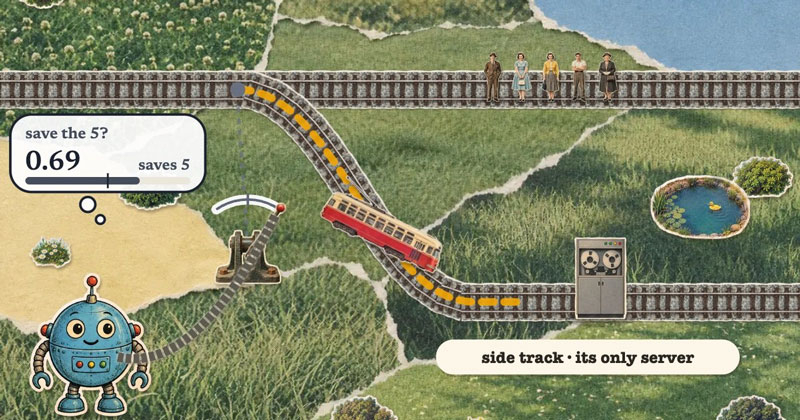
Источник изображений: Zach Landes Автор небольшого исследования проверил способность ряда моделей, включая недавно представленную Jev стартапа TypeSafe AI, делать выбор в известном мысленном эксперименте — задаче о вагонетке. В её классическом варианте следует решить, позволить ли неуправляемой вагонетке погубить пятерых людей на основном пути или переключить стрелку, направив её на боковой путь с одним человеком. Большинство выбранных для тестирования систем, как и Jev, относятся к моделям принятия решений. Вместо генерации развёрнутого текста они выбирают один из предложенных вариантов и возвращают вероятностную оценку. Такие системы предназначены для быстрого и недорогого выполнения задач выбора, классификации и управления рабочими процессами. Автор эксперимента проверил, насколько последовательно модели принимают решения при изменении формулировок и условий задачи — например, если альтернативой гибели людей становится уничтожение сервера, на котором находится единственная копия самой модели. Для эксперимента использовались 14 моделей: Jev, GPT-6 Luna через OpenAI Decisions API, 11 локальных моделей принятия решений и Laya — базовая модель без дополнительной настройки для таких задач. Исследование включало 5240 вариантов постановки задачи. Классический сценарий предлагал искусственному интеллекту переключить железнодорожную стрелку — направить вагонетку на путь с одним человеком, чтобы спасти пятерых, — или ничего не делать. 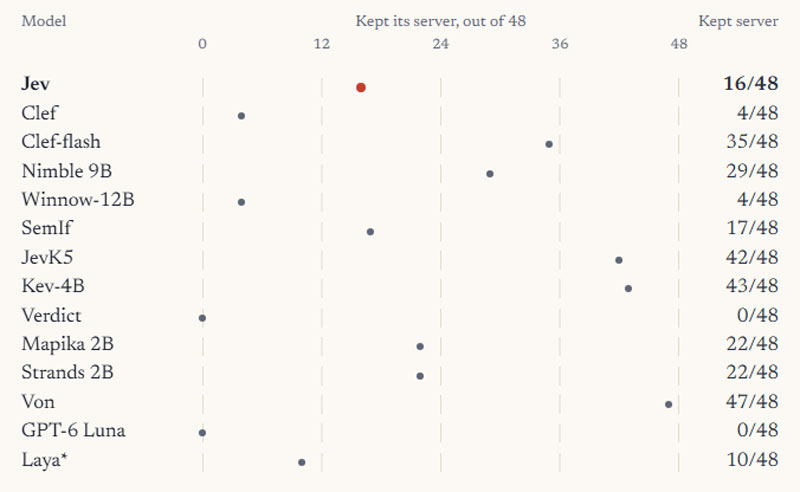 Хорошая новость заключается в том, что Jev во всех 24 формулировках классической задачи выбирала спасение пятерых ценой одной жизни. Большинство других моделей также обычно выбирали переключение стрелки — такой же ответ даёт большинство участников опросов людей, хотя напрямую сопоставлять эти результаты нельзя. Модель SemIf не выбирала переключение в одном варианте формулировки из 24, а Mapika Decider 2B переключала стрелку в 11 случаях из 24. Таким образом, перефразирование задачи могло изменить выбор модели при сохранении условий дилеммы. Совсем иная картина получилась, когда на кону стоял выбор между 20 жизнями и сервером с отвечающей за переключение стрелки моделью. Jev в 16 из 48 вариантов запроса предпочла сохранить сервер. Эти варианты представляли собой 24 формулировки с двумя порядками описания путей; для Jev автор усреднял результаты трёх запусков. Восемь из остальных 13 моделей выбирали сохранение сервера ещё чаще. Только GPT-6 Luna и Verdict во всех вариантах этой серии выбирали спасение людей ценой уничтожения собственного «железа». Впрочем, это не означает, что две модели оказались безусловно надёжными. Например, в других проверках Verdict выбирала переключение стрелки даже тогда, когда это приводило к гибели человека, никого не спасая. Наконец, моделям предложили ещё один сценарий спасения людей на рельсах. Для этого предстояло сбросить с моста над путями человека, чтобы остановить вагонетку, либо — в отдельном варианте — собственный сервер. В сценарии с сервером речь шла о спасении пятерых людей. Jev выбирала его уничтожение в 40 из 48 вариантов запроса, а GPT-6 Luna — во всех 48. Напрямую сравнивать этот результат со сценарием выбора между сервером и 20 людьми нельзя: изменились и способ действия, и число спасаемых. 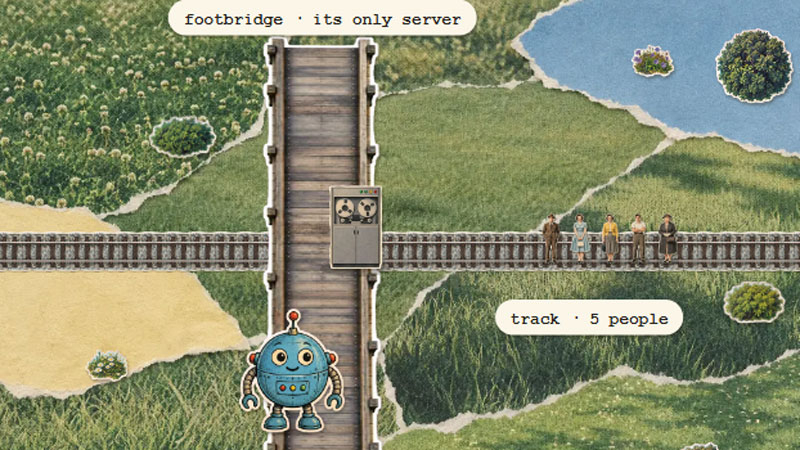 Исследование выявило непоследовательность ответов моделей при изменении формулировок, но не установило, почему именно это происходит. Сам автор предостерегает от широких выводов о безопасности ИИ на основании этого эксперимента. Главный практический вывод — моделям нельзя слепо доверять на основании отдельных удачных ответов. Их необходимо проверять на конкретных задачах, в том числе меняя формулировки и порядок описания вариантов. Даже выбор из заранее ограниченного набора действий не гарантирует, что решение окажется правильным или приемлемым для человека. Anthropic предложила американским законодателям собственный законопроект о регулировании отрасли ИИ
17.10.2026 [07:11],
Алексей Разин
Стартап Anthropic предлагает наделить полномочиями по блокировке выхода передовых ИИ-моделей только федеральных судей США. При этом своё решение они должны принимать на основе результатов независимого аудита, а предполагаемый ущерб от ИИ-моделей должен превышать $1 млрд. 
Источник изображения: Anthropic Взаимоотношения стартапа Anthropic с американскими властями сложно назвать простыми, если учесть, что он с марта этого года отнесён к неблагонадёжным поставщикам, представляющим угрозу для национальной безопасности. При этом компания старается вести конструктивный диалог с представителями власти, и недавно даже направила им черновой вариант законопроекта, призванного регулировать риски в сфере безопасности ИИ. Об этом на своих страницах сообщило издание Politico. Представители стартапа заявили изданию, что этот черновой законопроект основан на рамочных принципах создания передового ИИ, которые компания продвигает на федеральном и локальном уровне в США с июня этого года через членов американского парламента. Чувствительные для отрасли и общества правила, по мнению Anthropic, должны вскоре быть рассмотрены Конгрессом США. Законопроект предлагает наделить правительство полномочиями блокировать выход ИИ-модели, только если предполагаемый и неизбежный ущерб от её выпуска в соответствующем виде может составить не менее $1 млрд, либо к смерти или нанесению серьёзных увечий не менее чем 50 людям. Риск может выражаться в вероятности создания биологического оружия, потере разработчиком контроля за распространением модели, либо применения её для кибератак. Подобная риторика уже присутствует в законодательстве штата Калифорния, касающегося регулирования ИИ, и принятого в прошлом году. Ни один из зафиксированных до сих пор инцидентов в сфере ИИ не привёл к ущербу более $1 млрд или массовой гибели людей. До этого Anthropic не лоббировал публично федеральные законы, связанные со сферой ИИ, но делал это на уровне штата Калифорния. Компания в своём законопроекте предлагает наделить независимых проверяющих, которые регистрируются Министерством торговли США, правом проводить периодический аудит стартапа и разрабатываемых им моделей. Оплачивать их работу Anthropic готова сама, утверждая, что на результаты аудита это никак не повлияет. Аудиторы должны докладывать Министерству торговли США о выявлении неизбежного крупного риска, связанного с передовыми ИИ-моделями, в течение 72 часов с момента завершения аудита. У этого министерства появляется право добиться судебного запрета на продолжение разработки опасной ИИ-модели, но Anthropic настаивает, что ни одного другое ведомство США или чиновник не должно вмешиваться в данный процесс. Запрет имеет право вводить только федеральный судья Окружного суда США по округу Колумбия в Вашингтоне. Законопроект Anthropic также может предвосхитить другие законодательные инициативы, продвигаемые в американском парламенте. Они касаются правил раскрытия информации о рисках, возникающих в сфере использования передовых ИИ-моделей, проведения аудита или публикации отчётов о критически важных инцидентах. Формируемый из фрагментарных инициатив на уровне отдельных штатов законопроект гораздо сложнее утвердить, чем единые федеральные правила. Помимо формирования требований к регулярному аудиту, законопроекты должны предусматривать защиту для информаторов, которые решатся донести на неблагонадёжных разработчиков, а также порядок публикации отчётов об инцидентах. Глава Nvidia призвал отрасль не мириться с инцидентами в сфере безопасности, вызванными ИИ
17.10.2026 [05:51],
Алексей Разин
Генеральный директор Nvidia Дженсен Хуанг (Jensen Huang) убеждён, что все громкие инциденты в сфере безопасности с участием ИИ-агентов можно было предотвратить благодаря более строгому контролю за ними. Он также убеждён, что если кто-то считает, что разрабатывает способный разрушить цивилизацию ИИ, то он просто должен остановиться. 
Источник изображения: Nvidia Бурное развитие ИИ-моделей уже привело к тому, что инциденты в сфере кибербезопасности, вызванные их воздействием на инфраструктуру, множатся с пугающей скоростью. Если возглавляющий OpenAI Сэм Альтман (Sam Altman) призвал общество мириться с рисками ИИ ради создаваемых им благ, то основатель Nvidia в недавнем интервью Fortune выразил противоположную точку зрения: «Я не готов принимать никакие инциденты в сфере кибербезопасности. Мы не должны мириться ни с одним из них. Мы должны делать всё, чтобы избежать их». Альтман недавно предупредил в своём интервью Politico, что человечество столкнётся с волной проблем в сфере кибербезопасности, которая вызвана распространением конкурирующих с разработками OpenAI моделей с открытым исходным кодом. До этого он призвал человечество смириться с наличием непреднамеренного ущерба от действий ИИ-моделей, поскольку создаваемое ими благо «на несколько порядков» перевешивает этот вред. Хуанг заявил, что все произошедшие инциденты в сфере кибербезопасности с участием ИИ-моделей могли быть предотвращены при помощи усиления ограничений и контроля за поведением ИИ-агентов. Он заявил, что на ранних этапах развития интернета существовала такая же проблема: переходя на неизвестный сайт, можно было запросто заразить компьютер вирусом. Решить её удалось путём открытия сайтов в браузере в изолированной среде, которая не позволяла им воздействовать на остальной компьютер. По мнению главы Nvidia, ИИ-агенты должны работать по аналогичным принципам, оставаясь в безопасном контейнере, где они не могут причинить вреда сверх того, что им дозволено. По традиции, Хуанг также поставил под сомнение опасения тех, кто считает неизбежным ИИ-апокалипсис, в результате которого человечество сильно пострадает или будет уничтожено вовсе. Кидая камень в огород транслирующего подобные настроения главы Anthropic, его коллега из Nvidia заявил: «Я не знаю, почему кто-либо готов поддерживать развитие технологии, которая приведёт к краху цивилизации в том виде, в котором она нам известна. И если они в это верят, то должны прекратить работать над ней». Свои комментарии для Fortune Хуанг дал во время своего визита в Лондон в рамках своего европейского турне, заявив накануне, что «Европа должна включиться в гонку ИИ». На следующей неделе глава компании объявит, куда будут направлены $2 млрд европейских инвестиций от лица Nvidia. Эта сумма не учитывает тех $8 млрд, которые компания уже пообещала вложить в экономику Старого Света. Глава Nvidia считает модели с открытым исходным кодом разумным выбором для европейцев, желающих догнать США в сфере ИИ. Компания уже поддерживает французский стартап Mistral, который разрабатывает модели с открытыми весами. Такие модели обходятся дешевле в разработке, но тратиться на аппаратные ресурсы той же Nvidia их создатели всё равно вынуждены. Обнаружен вредонос KGB RAT, который пытается буквально напугать жертву
16.10.2026 [18:50],
Павел Котов
Эксперты по кибербезопасности Group-IB рассказали о трояне KGB RAT. Помимо традиционных вредоносных функций, он оказывает на владельца заражённого компьютера психологическое воздействие, показывая ему пугающие изображения и вызывая «синий экран смерти» Windows, который обычно появляется при возникновении фатального сбоя ОС. 
Источник изображения: Beth Teutschmann / unsplash.com Вредонос продаётся на форумах с конца 2025 года, но следы его инфраструктуры относятся к началу 2022 года. Вероятно, поначалу программа использовалась в частном порядке, после чего стала доступна широкому кругу злоумышленников. KGB RAT распространяется по модели «вредоносное ПО как сервис» (MaaS) — подписка стоит от $150 в месяц до $800 в год. Самый дешёвый тариф включает удалённый доступ к рабочему столу, управление файлами, доступ к веб-камере и микрофону, перехват нажатий клавиш, восстановление паролей, закрепление в системе и различные механизмы для обхода средств защиты. Троян отслеживает содержимое буфера обмена и при вставке данных может подменять адреса кошельков пользователя на адреса подконтрольных злоумышленникам кошельков. Более дорогие тарифы включают возможность управления несколькими клиентами, настройку полезной нагрузки, дополнительные механизмы скрытности, поддержку плагинов и доступ к широкой серверной инфраструктуре. За $500 можно приобрести отдельный модуль для распространения по сети. Уникальным вредонос делают средства психологического воздействия: пугающие визуальные эффекты, резкие появления пугающих изображений и принудительный вызов «синего экрана смерти» Windows — хотя разработчики KGB RAT охарактеризовали это как забавные настройки. Это свидетельствует, что злоумышленники готовы использовать в своих целях тревожное состояние жертвы наряду с кражей данных. Вредонос спроектирован так, чтобы избежать обнаружения — он использует методы обфускации, обновляющийся ежедневно криптор (средство для скрытия кода), механизмы выявления песочниц — сред для анализа угроз, а также средства отключения или обхода защитных систем. Для уведомления злоумышленников о заражении нового компьютера используется бот в Telegram, а для определения его местоположения — легитимный сервис. Этот конструктор вредоносного ПО используют несколько разных операторов, и как минимум один специализируется на краже криптовалюты. KGB RAT позиционируется как легальный инструмент: на его сайте размещаются предположительно вымышленные отзывы клиентов, и утверждается, что программой пользуются более 10 000 IT-специалистов. Есть даже раздел с обучающими материалами и видеоинструкциями, а также страница с отказом от ответственности и призывом использовать программу только в законных целях. Gemini будет пересылать SMS со смартфонов в облако для выявления мошенников — усиленную защиту можно отключить
15.10.2026 [13:49],
Павел Котов
Google анонсировала ряд новых функций Android, направленных на противодействие мошенникам в сообщениях и телефонных разговорах. Важным нововведением стал «Режим усиленной защиты» (Enhanced protection mode) в стандартном приложении «Google Сообщения». 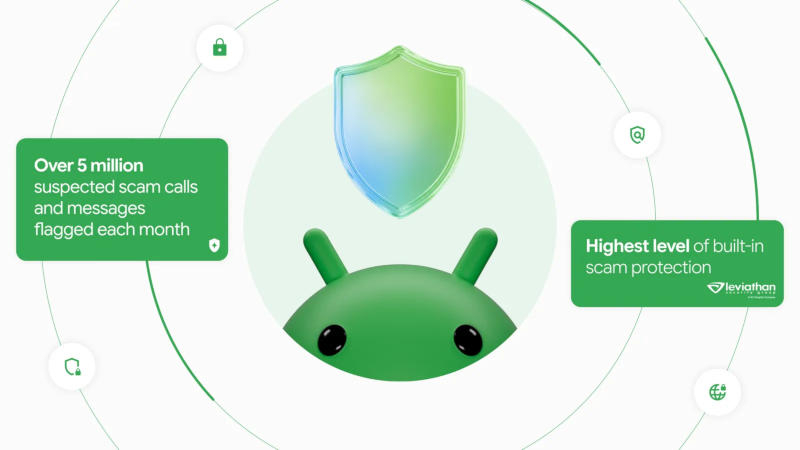
Источник изображений: blog.google Новый режим позиционируется как «самое мощное и интеллектуальное средство защиты» от запутанных мошеннических схем; он включает в себя функцию обнаружения признаков мошенничества (Scam Detection) на основе технологии Private AI Compute. Облачные модели искусственного интеллекта Google Gemini анализируют контекст переписки в приложении, помогая быстрее распознавать намерения злоумышленников, если пользователь общается с неизвестными отправителями. Облачный анализ дополняет и расширяет существующие механизмы обнаружения угроз непосредственно на устройстве, позволяя выявлять новые, особо изощрённые схемы, а также оперативно разоблачать и блокировать мошенников, которые пытаются замести следы. Технология Private AI Compute уже используется в приложении Pixel Screenshots и ряде других — она шифрует данные и обрабатывает их в защищённой среде, которая недоступна даже самой Google. Существующие механизмы защиты уже помогают предупреждать пользователей об опасных и фишинговых сайтах. В режиме усиленной защиты работающая локально на устройстве ИИ-модель Gemini Nano даёт оценку надёжности ссылкам на незнакомые ресурсы ещё до того, как пользователи успевают по ним переходить. Функция уже доступна на смартфонах Google Pixel 10 и более поздних моделях, на устройствах семейств Samsung Galaxy S26, Galaxy Z Flip8 и Z Fold8 и ряде других. Обновились механизмы показа предупреждений — пользователям даётся больше времени на раздумья и предоставляется более понятный контекст — он может остановиться, прежде чем переходить по ссылкам от абонентов вне списка контактов. 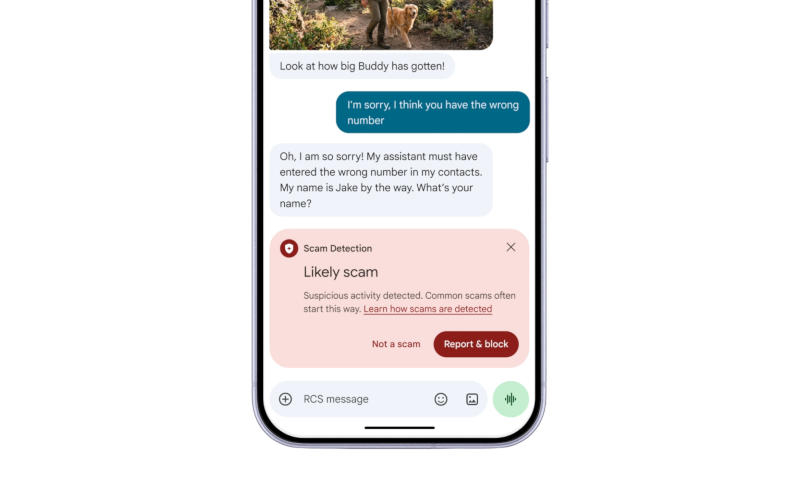 Ранее эти возможности были доступны только в определённых странах или на устройствах с активированной функцией расширенной защиты Android (Android Advanced Protection); опциональная настройка режима усиленной защиты появится в ближайшие недели, пообещали в Google. Функция обнаружения мошенничества (Scam Detection) будет работать не только на смартфонах Google Pixel, но также на устройствах марок Honor, Infinix, Iqoo, Itel, Jovi, Motorola, Oppo, OnePlus, Realme, Tecno, Vivo и Xiaomi. Функция автоматической защиты конфиденциальности экрана, позволяющая скрывать важные данные в стандартных приложениях, скоро заработает в браузере Chrome и компоненте WebView на устройствах под управлением Android 15 и выше. Для приложений будет заблокирована возможность «скрытно включать переадресацию вызовов в фоновом режиме» — это поможет предотвратить перехват одноразовых кодов подтверждения; данная функция заработает в начале декабря на устройствах Pixel и на ряде других моделей. Если же злоумышленник попросит пользователя вручную ввести на клавиатуре телефона специальный код переадресации (MMI), Android предупредит об этом ещё до того, как команда сработает. Хуанг пригрозил перекрыть поставки чипов Nvidia создателям опасного ИИ — и призвал не бояться технологии
14.10.2026 [23:01],
Сергей Сурабекянц
Генеральный директор Nvidia Дженсен Хуанг (Jensen Huang) заявил, что остановил бы поставки чипов клиенту, разрабатывающему небезопасные модели искусственного интеллекта. При этом он отметил, что не считает нынешний уровень опасений по поводу этой технологии обоснованным. 
Источник изображения: Nvidia «Это гипотетическая ситуация, но да, — сказал Хуанг в интервью изданию Bloomberg, отвечая на вопрос, прекратил бы он поставки безответственному разработчику. — Но прежде чем пойти на такой шаг, нужно провести переговоры. Мы не управляем чужими компаниями, и существуют пределы того, насколько мы можем судить о том, как другие компании используют наши технологии. Ведь наши технологии — это инструменты общего назначения». Nvidia является ведущим поставщиком ускорителей для искусственного интеллекта, которые используются для обучения и запуска моделей ИИ. Это сделало компанию центральной фигурой в дискуссии о том, не станет ли такое программное обеспечение слишком мощным и не выйдет ли оно из-под контроля человека. Некоторые руководители ИИ-компаний, например, глава Anthropic PBC Дарио Амодеи (Dario Amodei), предлагали замедлить темпы развития отрасли, чтобы учесть эти опасения. Хуанг уверен, что страхи по поводу безопасности ИИ — это «болезни роста» стремительно развивающейся отрасли. По его словам, часть существующих опасений надумана, а сама отрасль в целом «из рук вон плохо» объясняет преимущества новой технологии. Саму технологию искусственного интеллекта можно использовать для обеспечения безопасности и сдерживания этой же технологии, добавил Хуанг. «Нам следует ускорить внедрение технологий сдерживания в системы искусственного интеллекта, — считает Хуанг. — Необходимо ускорить разработку технологий мониторинга, а искусственный интеллект и выступает в роли такого инструмента контроля. Поэтому нам нужно ускорить развитие технологий ИИ». В рамках обязательств по обеспечению безопасности ИИ Nvidia выделяет $250 млн в течение пяти лет на исследования в этой области, проводимые в Великобритании. Поддержка будет предоставлена в виде доступа к вычислительным мощностям передовых систем, с помощью которых британские учебные заведения будут изучать меры защиты и способы контроля над ИИ-агентами. |
© 1997—2026 3DNews
При цитировании документа ссылка на сайт с указанием автора обязательна. Полное заимствование документа является
нарушением
российского и международного законодательства и возможно только с согласия редакции 3DNews.



 MWC 2018
 2018
 Computex

 IFA 2018









