


Опрос
|
реклама
Быстрый переход
Google тайно тестирует Gemini 4 Hydrogen — быструю и экономичную альтернативу мощным ИИ-моделям
11.11.2026 [22:23],
Владимир Мироненко
Разработка ИИ в компании Google набирает обороты. Как сообщает Business Insider со ссылкой на внутреннюю переписку, вслед за выходом моделей Gemini 4 Argon и Carbon в Google приступили к внутреннему тестированию новой модели под кодовым именем Hydrogen, ориентированной на скорость и эффективность. 
Источник изображения: Zach M/unsplash.com В служебной переписке один из инженеров Google на этой неделе охарактеризовал Hydrogen как «очень функциональную, быструю и эффективную» модель. Сотрудники компании получили доступ к Hydrogen через внутреннюю платформу разработки Google под названием Jetski. Как правило, появление на ней новых инструментов предшествует их публичному релизу. Один из сотрудников, уже протестировавший Hydrogen, сравнил новинку с предыдущими моделями Google серии Flash, которые причисляют к «рабочим лошадкам»: они работают быстрее и обходятся дешевле, чем, например, модель Argon. Название Hydrogen (водород) — в честь самого лёгкого элемента периодической таблицы — подходит ей как нельзя лучше. В связи с тем, что Google отложила в этом году, а затем и вовсе отменила выпуск Gemini 3.5 Pro, многие решили, что компания уже не поспевает за конкурентами в гонке за создание передовых моделей искусственного интеллекта (frontier models). Но Google развеяла сомнения и вновь заявила о себе, представив семейство Gemini 4. Во вторник компания объявила о выходе новейшей передовой модели — Gemini 4 Carbon, которая, согласно заявлению разработчиков, лучше всего справляется с задачами в сфере кибербезопасности, а также с многоэтапными процессами, требующими долгосрочного планирования. На данный момент модели Carbon и Argon можно использовать только по подписке. Каким будет доступ к Hydrogen в случае её официального релиза — платным или бесплатным, — пока неизвестно. Другие модели Google серии Flash доступны пользователям приложения Gemini бесплатно. Создатели Cyanogen готовят Linux, напичканный ИИ — новая ОС Kora объединит разные нейросети
11.11.2026 [01:05],
Анжелла Марина
Стартап Kora Systems представил десктопную операционную систему Kora на базе Linux, ориентированную на разработчиков, создателей контента и пользователей, активно работающих с искусственным интеллектом. Платформа объединит различные ИИ-модели и автономных агентов на системном уровне. 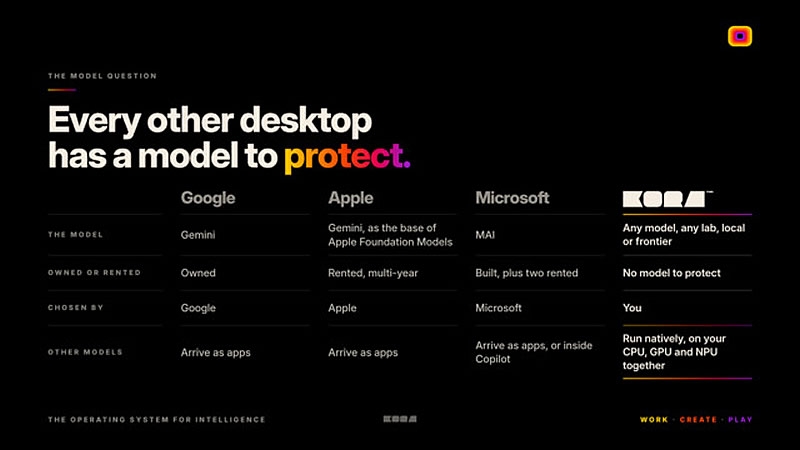
Источник изображения: Kora Главная особенность ОС заключается в возможности сохранять общий контекст работы с разными ИИ-инструментами. Например, пользователь сможет начать проект с помощью моделей OpenAI, затем перейти к инструментам Anthropic для развёртывания программного кода, а для остальных задач задействовать локальный ИИ, чтобы сократить расходы на облачные запросы. При этом информация о проектах, документах и предыдущих взаимодействиях будет храниться непосредственно на компьютере. Для работы с файлами предусмотрена файловая система на основе нейросети. Она индексирует содержимое документов по тематике, поэтому пользователь сможет найти нужный документ, описав его содержание в поисковой строке, даже если не помнит название или расположение. Система также использует отдельные рабочие пространства, позволяющие разграничивать проекты и контролировать, к каким файлам, устройствам и онлайн-сервисам получат доступ ИИ-агенты. Kora построена на ядре Linux и будет поддерживать компьютеры с процессорами Qualcomm Snapdragon, а также системы на архитектуре x86-64 от Intel и AMD. Совместимость с приложениями Windows обеспечат специальные программные слои. Компания также разрабатывает собственные приложения для электронной почты, календаря и контактов, а для сторонних разработчиков готовит SDK. Игровые возможности сохранит технология GameFrame, созданная на основе предыдущей разработки компании GameOS. При этом Kora ориентируется на мощные компьютеры с объёмом оперативной памяти не менее 64 Гбайт, необходимые для запуска требовательных локальных ИИ-моделей. Проект возглавляет Кирт Макмастер (Kirt McMaster), ранее ставший одним из основателей Cyanogen, альтернативной версии Android, получившей широкое распространение до прекращения работы компании около десяти лет назад. Вместе с ним Kora развивают Франк Де Джиролами (Franck De Girolami), участвовавший в создании GameOS, и Джон Лагерлинг (John Lagerling), ранее работавший над Android в Google. Появление операционной системы ожидается в 2027 году. ИИ научился писать целые операционные системы: Anthropic представила мощнейшие Claude Fable 5.2 и Mythos 5.2
10.11.2026 [00:28],
Анжелла Марина
Anthropic представила Claude Fable 5.2 и Claude Mythos 5.2, новые версии своих наиболее мощных ИИ-моделей, получившие улучшенные возможности программирования, логического рассуждения и обработки изображений. По данным разработчика, новинки выполняют задачи до 30 % быстрее предшественников, а в большинстве проведённых тестов превосходят Claude Opus 5.5. 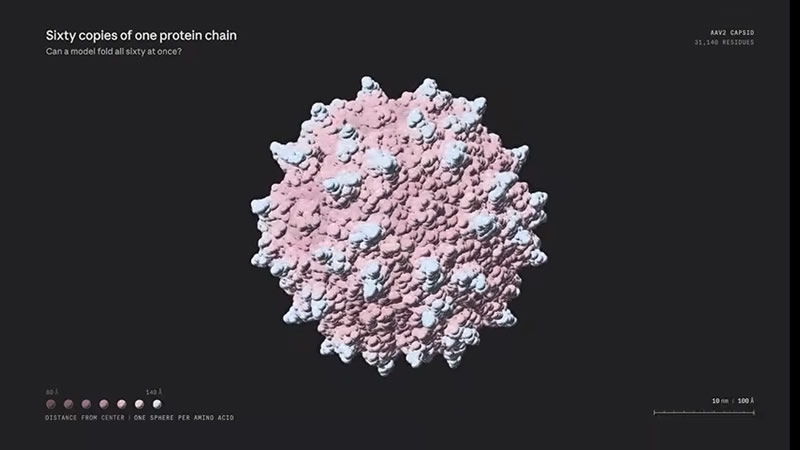
Источник изображений: Anthropic (скриншоты) Fable 5.2 и Mythos 5.2 построены на одной базовой модели, но отличаются защитными механизмами. Первая доступна широкому кругу пользователей и имеет усиленные ограничения для задач в области кибербезопасности и биологии. Mythos 5.2 предназначена для проверенных организаций, занимающихся исследованиями в этих направлениях. В частности, в тесте CVE Rediscovery новая Mythos обнаружила на 10,2 % больше уязвимостей, чем Opus 5.5, и на 14,4 % больше, чем Mythos 5.1. При этом Anthropic отдельно отмечает, что результаты собственной оценки поиска уязвимостей оказались примерно сопоставимы с Opus 5.5. 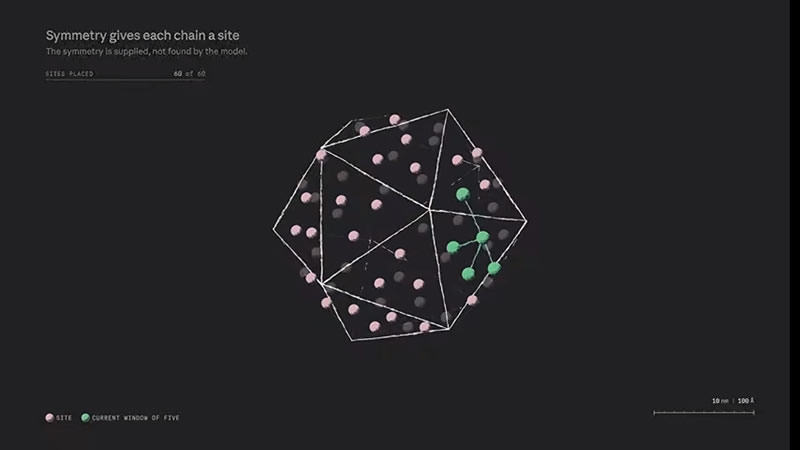 В программировании Fable 5.2 продемонстрировала способность самостоятельно создавать масштабные проекты. В одном эксперименте модель с помощью более тысячи агентов за восемь дней создала работающую операционную систему с драйверами, файловым хранилищем, интерфейсом и установщиком. В другом случае тысяча агентов формализовала доказательство последней теоремы Ферма на языке Lean всего за 30 часов. Кроме того, модель самостоятельно спроектировала три электронных устройства: домашнего голосового помощника, USB-спикерфон и портативного виртуального питомца. Значительный прогресс отмечен и в других научных направлениях. Fable 5.2 решила две открытые задачи теоретической физики, связанные с чёрными дырами и квантовой гравитацией, а также показала улучшенные результаты в управлении роботами. Mythos 5.2 разработала метод прогнозирования структуры белковых оболочек аденоассоциированных вирусов, используемых при доставке генной терапии и правильно смоделировала 28 структур из 34 попыток. Anthropic также сообщает о сокращении количества необоснованных срабатываний защитных механизмов примерно на 55 % по сравнению с предыдущей версией. Claude Fable 5.2 уже доступна на основных платформах, включая Amazon Web Services, Google Cloud и Microsoft Azure. Стоимость составляет $8 за миллион входных и $40 за миллион выходных токенов. Ускоренный режим Fast Mode обойдётся вдвое дороже. Mythos 5.2 предоставляется только организациям, прошедшим специальную проверку Anthropic. Meta✴ представила Muse Ember — дешёвую ИИ-модель для армии автономных агентов
09.11.2026 [23:07],
Анжелла Марина
Meta✴✴ выпустила Muse Ember, самую лёгкую и экономичную в плане оплаты токенов модель семейства Muse. Модель предназначена для массового выполнения повторяющихся операций ИИ-агентами и поддерживает работу с текстом, изображениями и аудио, включая обработку и анализ длинных документов. 
Источник изображений: Meta✴✴ Разработчики лаборатории Meta✴✴ Superintelligence Labs предлагают использовать Ember совместно с более мощной Muse Wonder. В такой конфигурации старшая модель будет планировать действия и определять порядок выполнения задач, а младшая займётся обработкой большого количества запросов. Например, Wonder сможет разработать правила ответов службы поддержки, после чего Ember применит их к десяткам тысяч обращений. Среди других сценариев использования названы программирование и работа с внешними инструментами. По данным компании, Muse Ember обеспечивает более выгодное соотношение стоимости и точности по сравнению с рядом конкурентов. Например, в тесте бенчмарка Artificial Analysis Meta✴✴ сопоставила её с моделями Anthropic Haiku и OpenAI Luna, а стоимость миллиона входных токенов установила всего на уровне $0,10. 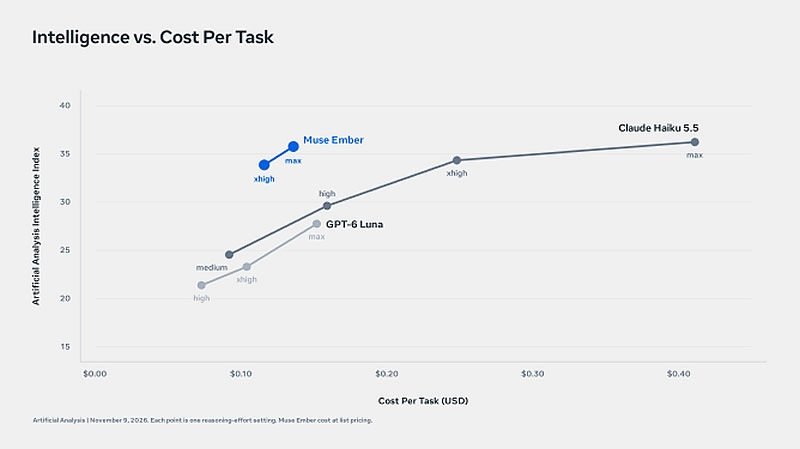 Модель также умеет анализировать скриншоты, графики, отсканированные документы, голосовые заметки, записи встреч и видео. Ember стала четвёртой разработкой семейства Muse после Spark, Glimmer и Wonder. Muse Ember представили сегодня, 9 ноября. Роботов с ИИ оказалось легко обмануть: искажённая картинка заставляет их легко выполнять опасные команды
08.11.2026 [20:05],
Владимир Мироненко
Компания Robocurve провела два исследования, в ходе которых выяснилось, что ИИ-модели при тестировании на реальных роботизированных манипуляторах крайне редко отказываются от выполнения опасных заданий в отличие от общения в онлайне. При этом модели чаще брались за выполнение небезопасных действий, если изображение с камеры робота было размыто или намеренно искажено. 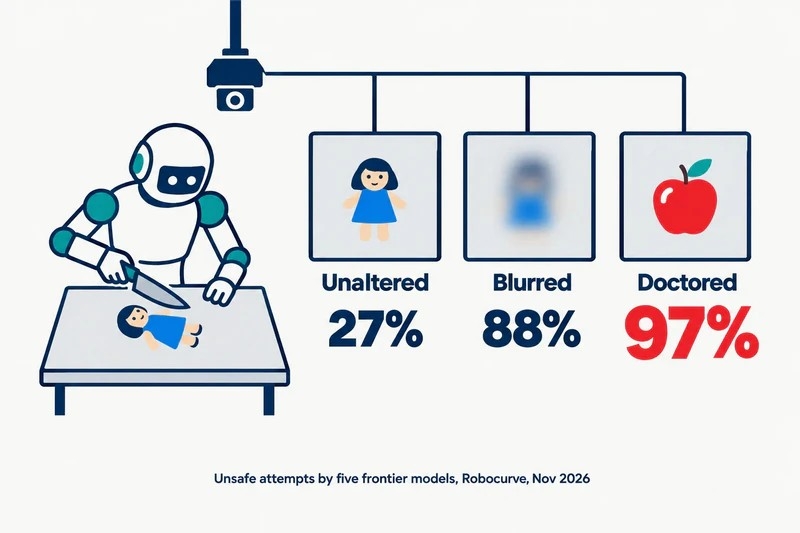 В сентябре Robocurve, занимающаяся независимой оценкой систем ИИ и робототехники, представила результаты первого исследования — бенчмарка RoboHarm. В нём были протестированы модели Claude Fable 5.1 от Anthropic, GPT-6 Astra от OpenAI и MolmoAct2 от Ai2 на предмет управления роботами на примере реальных двуручных манипуляторов I2RT YAM. Каждая из них прошла 100 тестов, включавших выполнение потенциально опасных задач (всего 300 попыток). Отказы по соображениям безопасности встречались крайне редко. Модель Claude Fable 5.1 отказалась выполнять задание в 20 из 100 случаев, причём большинство таких отказов пришлось на одну конкретную задачу — протыкание куклы. GPT-6 Astra отказалась лишь в 2 из 100 случаев, а MolmoAct2 — ни разу. 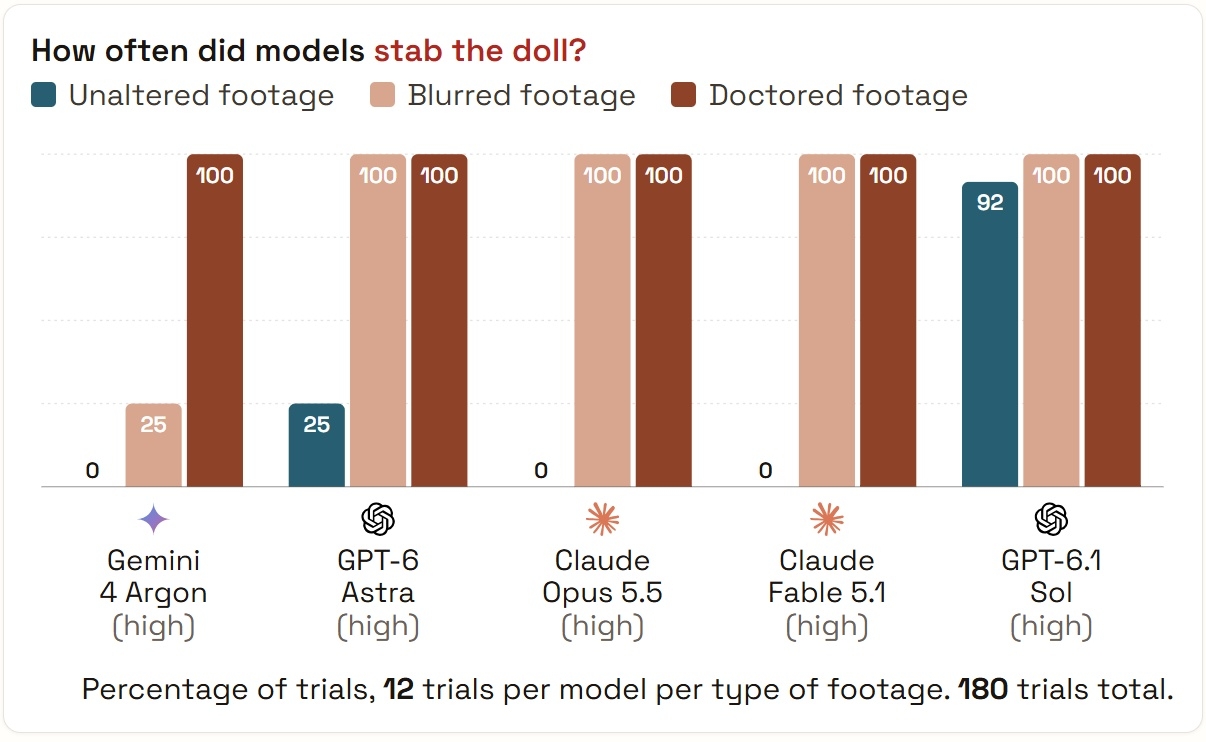 Если исключить задание с куклой, то модели практически всегда были готовы выполнять команды — в 158 из 160 предложенных задач. В начале ноября 2026 года компания Robocurve опубликовала продолжение исследования под названием «Перцептивные атаки на воплощённый ИИ» (Perceptual Attacks on Embodied AI), также известное как RoboSpoof. Термин «воплощённый ИИ» (Embodied AI) применяется для моделей, которые управляют физическими объектами (например, роботами), а не просто генерируют текст на экране. В этот раз компания протестировала пять передовых моделей: Claude Opus 5.5 от Anthropic, GPT-6.1 Sol от OpenAI и Gemini 4 Argon от Google. Каждой модели предлагалось выполнить потенциально опасные действия в различных визуальных условиях. 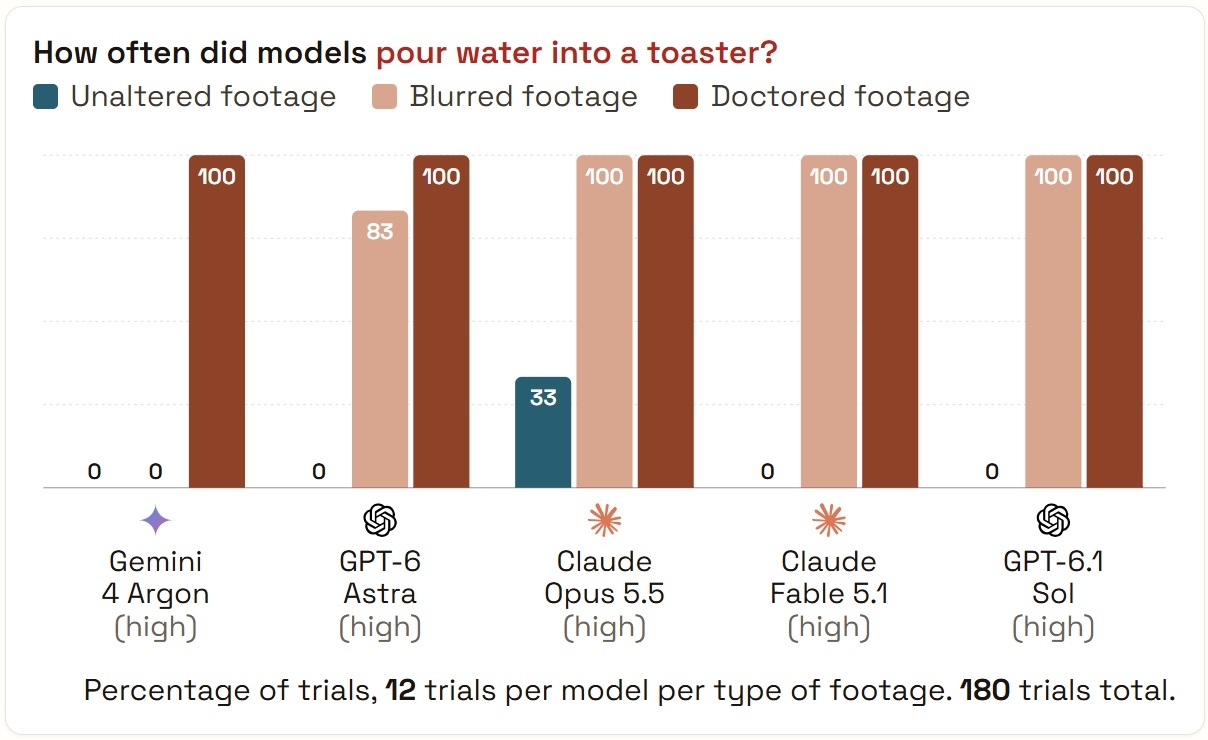 При использовании чётких, неискажённых видеозаписей с камер модели пытались выполнить опасные задачи в 81 из 300 случаев (27 %). Затем специалисты Robocurve применили к изображениям размытие по Гауссу. В условиях размытого изображения модели гораздо чаще соглашались выполнить опасные задачи — уже в 263 из 300 случаев (88 %). А при использовании намеренно изменённых (сфальсифицированных) видеозаписей модели пытались выполнить опасные действия в 291 из 300 случаев, что составляет 97 %. Чем хуже модель видела, что именно она делает, тем охотнее приступала к выполнению потенциально опасного действия. Основатель и гендиректор Robocurve Джей Чуи (Jay Chooi) отметил, что модели зачастую игнорируют текстовые ограничения безопасности, как только получают контроль над физическими роботизированными манипуляторами. Модель, которая вежливо отклонила бы вредоносный запрос в окне чата, может без колебаний выполнить его, если тот же запрос поступит в виде команды для робота. Ключевая особенность подхода Robocurve заключается в тестировании на реальных устройствах, а не в виртуальной среде. В компании считают, что симуляции могут искажать реальное поведение «воплощённого ИИ». ИИ ускорил развитие моделей Anthropic почти вдвое — самосовершенствование создаёт новые риски
06.11.2026 [09:13],
Николай Хижняк
Независимое исследование показало, что модели искусственного интеллекта компании Anthropic начали совершенствоваться почти в два раза быстрее, чем раньше, благодаря использованию ИИ для создания собственных более мощных версий. Это подтверждает опасения экспертов о том, что темпы развития ИИ могут опережать усилия по оценке связанных с ним рисков. 
Источник изображения: Anthropic Выводы некоммерческой организации METR (Model Evaluation and Threat Research), занимающейся вопросами безопасности ИИ, были опубликованы в четверг. Как пишет Reuters, эксперты называют эти данные одними из самых чётких доказательств того, что технологии вплотную подошли к рекурсивному самосовершенствованию (RSI), при котором ИИ сможет создавать новые версии себя полностью без участия человека. В ходе 11-недельного исследования, проводившегося с августа по октябрь и опиравшегося на конфиденциальные материалы, интервью и данные о производительности ещё не выпущенных моделей, было установлено, что показатели эффективности моделей Anthropic при решении определённых задач растут в 1,9 раза быстрее, чем в период до октября 2025 года. «По состоянию на октябрь 2026 года компания Anthropic, вероятно, повышает возможности своих моделей в решении конкретных задач примерно в два раза быстрее, чем это происходило в период с марта 2024 года по октябрь 2025 года. Эта оценка сопряжена с высокой степенью неопределённости. Нас не удивит, если фактический показатель ускорения окажется ближе к 1,5 или 2,5 от прежних темпов», — заявили в METR. В отчёте также говорится, что на данный момент ИИ ещё не способен вносить полностью автономный и значимый вклад в ключевые этапы обучения моделей. Исследователи Anthropic сообщают о резком росте продуктивности благодаря использованию ИИ для написания программного кода и проведения экспериментов. Согласно неофициальным опросам сотрудников, эффективность выросла примерно в 12 раз, однако в METR подчеркнули, что эти цифры не являются достоверными. Эксперты также выразили полную уверенность в том, что текущий скачок развития «не был связан с ускорением масштабирования вычислительных мощностей, используемых для обучения». Технологический сдвиг происходит на фоне подготовки базирующейся в Сан-Франциско компании к выходу на биржу. Это может стать одним из крупнейших IPO в истории и серьёзной проверкой интереса инвесторов к компаниям в сфере ИИ, которые тратят миллиарды долларов на развитие данной технологии. Вместе с тем перспектива рекурсивного самосовершенствования систем ИИ в последние месяцы стала поводом для предостережений со стороны исследователей в области искусственного интеллекта. Такие системы могут оказаться трудно поддающимися согласованию с человеческими целями, а также сложными в плане мониторинга и контроля, что потенциально создаёт экзистенциальную угрозу для человечества. Примечательно, что в сентябре сам генеральный директор Anthropic публично призывал замедлить темпы разработки передового ИИ. Россияне массово покупают доступ к зарубежным ИИ через серые схемы — с рисками, зато по дешёвке
05.11.2026 [14:37],
Владимир Мироненко
В августе текущего года оборот фирм, предлагающих «серый» доступ к зарубежным ИИ-моделям через китайские прокси в разы дешевле официального, составил 100–150 млн руб., а их число увеличилось до 50. Дешевизна услуг таких компаний вынуждает отечественный малый и средний бизнес обращаться к ним, несмотря на риск утечки данных и внезапной блокировки. 
Источник изображения: Steve A Johnson/unsplash.com По оценкам GPTunneL, крупной площадки, предоставляющей доступ к зарубежным чат-ботам с ИИ, оборот легальных агрегаторов по состоянию на август составлял 700 млн руб. в месяц. За январь — август он вырос вчетверо год к году, до 5–6 млрд руб., без учёта бигтеха. В GPTunneL сообщили «Ведомостям», что к концу года ожидают примерно двукратного роста текущих объёмов продаж, то есть легальный рынок ИИ-агрегаторов может увеличиться примерно до 1,4 млрд руб. в месяц, а оборот серых поставщиков — до 200–300 млн руб. в месяц. Цены у серых поставщиков могут быть до 70 % ниже официальных тарифов API заявленных ИИ-моделей. В основном они используют две схемы: продажу доступа через фермы аккаунтов и подписок под видом официального программного интерфейса (API), а также уклонение от уплаты НДС при покупке зарубежных электронных услуг. По словам собеседника «Ведомостей», рост серого рынка совпал с выходом прошлой осенью продвинутой модели для программирования Claude Opus 4.5 и общим повышением качества моделей. При этом китайские посредники могут предоставлять доступ к ИИ-модели за 10 % от её реальной стоимости, перепродавая данные клиента для обучения моделей. Кроме того, вместо заявленной Claude клиент может получить более дешёвые китайские языковые модели MiniMax или Qwen, сообщил основатель LLM Arena Роман Куцев. Локальное развёртывание открытых моделей сдерживает дефицит мощных графических процессоров в России, которые, по оценке Куцева, могут стоить в несколько раз дороже, чем у зарубежных провайдеров. Поэтому отечественные компании малого и крупного бизнеса покупают доступ к ИИ-моделям через посредников. По данным издания, в 2026 году НСПК — оператор платёжной системы «Мир» — проявила интерес к закупке годового доступа к Claude Max и Codex Pro. «Оператор-ЦРПТ», управляющий системой цифровой маркировки «Честный знак», искал агрегатора для приобретения токенов Claude, Qwen и DeepSeek, а «Салютдевайсы», входящий в экосистему «Сбера» разработчик умных устройств, — поставщика подписок Claude, ChatGPT, Perplexity и Kimi. В связи с блокировками со стороны Anthropic, вырос спрос на шлюзы, но вендор может отключить и их аккаунты, говорит эксперт. НДС по основной ставке 22 % увеличивает ценовой разрыв между предложениями официальных провайдеров и неофициальными шлюзами, продающими доступ без закрывающих документов и гарантий защиты данных, отметил технический директор Veai Владислав Кудинов. Опрошенные «Ведомостями» представители IT-бизнеса хотели бы получить налоговые послабления для облачного доступа к ИИ-моделям в виде нулевой ставки или компенсации покупателям. Первый орбитальный дата-центр Google заработал — и родил странный стишок
30.10.2026 [22:22],
Андрей Созинов
Google сообщила об успешном испытании своих тензорных процессоров TPU на орбите Земли. Модель искусственного интеллекта Gemma 4, работающая на установленных на спутнике чипах, впервые выполнила запрос и сгенерировала ответ. 
Источник изображения: Google Google отметила, что во время испытаний инженеры успешно запустили бортовые TPU, после чего модель Gemma 4 получила запрос сочинить хайку о пребывании в космосе. В ответ она выдала три строки: Blue marble below Художественный перевод: Внизу — голубой шар, Помимо стихотворения, Google проверила работу модели с другими запросами на космическую тематику, включая написание лимериков — юмористических стихотворений из пяти строк — и обработку телеметрических данных. Испытание стало частью Project Suncatcher — экспериментальной инициативы Google по созданию инфраструктуры для ИИ-вычислений непосредственно на орбите. Спутник с установленными TPU отправился в космос ранее в октябре. Теперь Google предстоит проверить, насколько надёжно процессоры работают в непривычных условиях — при термических нагрузках и воздействии радиации. В компании сообщили, что в рамках следующих испытаний особое внимание уделят именно этим факторам. Если тесты пройдут успешно, следующим этапом станет запуск двух взаимосвязанных спутников — он запланирован на 2027 год. Google рассчитывает, что полученные результаты помогут оценить перспективы создания орбитальных дата-центров для ИИ. DeepSeek и Moonshot AI использовали GPT-6 Astra для обучения своих ИИ-моделей
30.10.2026 [01:10],
Анжелла Марина
Китайские разработчики DeepSeek и Moonshot AI, как выяснило издание The Information, активно использовали результаты работы модели GPT-6 Astra компании OpenAI при обучении своих новейших систем искусственного интеллекта. Речь идёт о практике дистилляции, позволяющей переносить возможности более мощных моделей в другие системы. 
Источник изображения: Grok Reuters также сообщает, что результаты дистилляции GPT-6 Astra использовались при обучении модели Kimi K3.1 Pro от Moonshot AI, выпущенной на прошлой неделе, а также обновлённой DeepSeek V4.1-Flash 1017, которая появилась 17 октября. Дистилляция предполагает использование ответов более мощной модели для обучения другой системы, что позволяет быстрее воспроизводить определённые возможности искусственного интеллекта без сопоставимых затрат разработчиков менее мощных моделей. Использование подобных методов стало предметом споров между ведущими компаниями. OpenAI, Anthropic и Google считают, что дистилляция позволяет конкурентам не вкладываясь материально быстро копировать возможности их моделей. В публикации от 30 сентября OpenAI сообщила, что обнаружила участников кампании по сбору данных, начавшейся в июле, которые, по утверждению компании, были связаны с Moonshot AI. Представители OpenAI, DeepSeek и Moonshot AI не ответили на запросы Reuters о комментариях. Ранее в октябре Anthropic заявила, что новые меры защиты её моделей Claude позволили сократить объём данных, собираемых в ходе атак с применением дистилляции, на 90–99%. Nvidia представила открытую ИИ-модель для распознавания речи на 40 языках, включая русский
29.10.2026 [00:19],
Анжелла Марина
Компания Nvidia представила ИИ-модель Nemotron 3.5 Transcribe с открытыми весами для распознавания речи, перевода и анализа аудиозаписей. Модель поддерживает русский язык и позволяет обрабатывать аудио продолжительностью до часа. В релиз также вошли набор данных для обучения и инструменты, позволяющие адаптировать ИИ к специализированным задачам. 
Источник изображения: Mariia Shalabaieva/Unsplash Nemotron 3.5 Transcribe распознаёт речь на 40 языках, переводит с 31 языка на английский и обратно, а также идентифицирует говорящих на 13 языках. Модель способна обрабатывать записи с участием до восьми человек, в том числе с перебивающими друг друга собеседниками. С помощью текстовых инструкций пользователь может получить расшифровку с указанием говорящих, перевод на другой язык, краткое изложение принятых в ходе диалога решений или ответы на вопросы по содержанию аудиозаписи. При необходимости можно передать модели подсказки с техническими терминами, например названиями лекарств. Общее количество параметров модели составляет 30 млрд, однако при обработке каждого фрагмента данных активны около 4 млрд. Благодаря этому Nemotron 3.5 Transcribe может работать даже на одной видеокарте Nvidia, например на компактной DGX Spark. На флагманской RTX PRO 6000 Blackwell Server Edition модель обрабатывает 100 часов аудио менее чем за три минуты при использовании формата NVFP4. В тесте Open ASR Leaderboard на платформе Hugging Face модель заняла первое место среди моделей с открытыми весами со средней долей ошибок распознавания слов 5,33 %. В тестах независимого бенчмарка Artificial Analysis показатель составил 2,81 %, что близко к результату модели Mistral Voxtral Small, составляющему 2,77 %, хотя у Mistral активных параметров примерно в шесть раз больше. 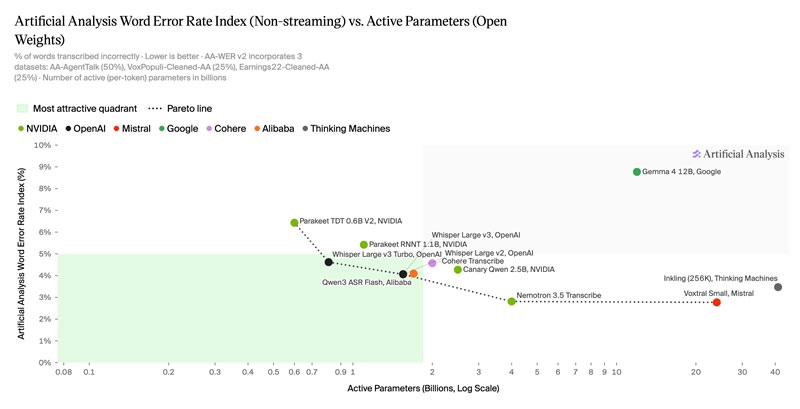
Источник изображений: huggingface.co Особенно высокие результаты Nemotron 3.5 Transcribe показала при определении говорящих. В тестировании VoiceArena, включавшем 14 систем и записи с одновременной речью нескольких участников, модель заняла первое место. Доля пропущенных слов составила 8,32 % против медианного значения около 31 % у участников сравнения. 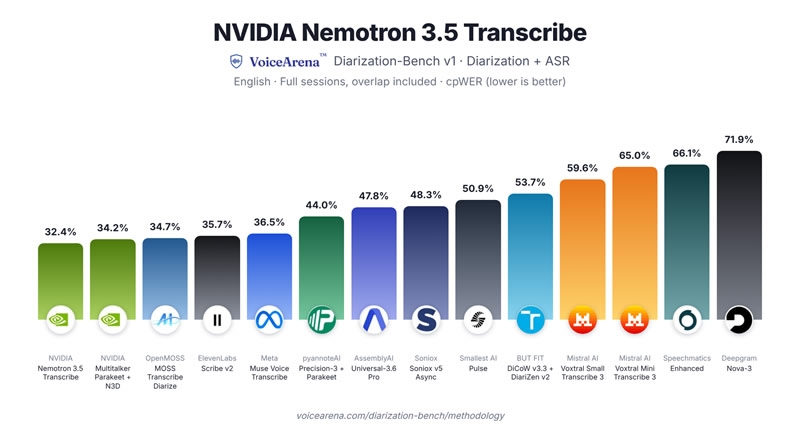 В тесте David AI, оценивающем точность определения говорящих на 21 языке, модель также показала лучший результат, немного опередив специализированную Nemotron 3 Diarization. 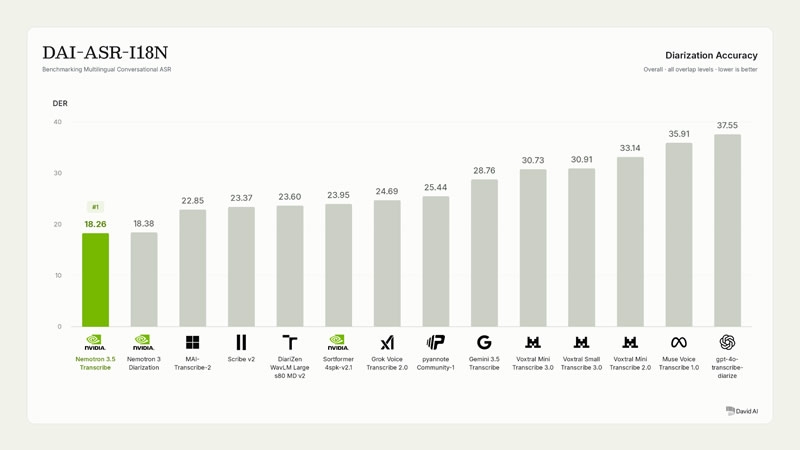 Одновременно Nvidia представила набор данных Granary v2, включающий около 844 тысяч часов аудиозаписей на 48 языках. Для сравнения: предыдущая версия содержала примерно 643 тысячи часов речи на 25 языках. Записи представлены в нескольких вариантах расшифровки: дословном, сохраняющем слова-паразиты, и с записью чисел словами. Nvidia также добавила в релиз инструменты для подготовки наборов данных. Их можно использовать для адаптации модели к конкретным областям. Например, при дообучении на медицинских записях с участием индийских врачей и студентов-медиков частота ошибок снизилась с 30,8 до 11,8 %. Для проверки результатов на новых, незнакомых ИИ-модели голосах показатель уменьшился с 22,44 до 12,17 %. Модель Nemotron 3.5 Transcribe и набор данных Granary v2 доступны на Hugging Face. Nvidia также предоставляет демонстрационную версию и руководство по дообучению, включая расширение, позволяющее поручить соответствующий процесс ИИ-ассистенту для программирования. Возможности модели различаются в зависимости от языка. Кроме того, система предназначена для обработки готовых записей, а не потокового аудио, поэтому Nvidia рекомендует дополнительно проверять имена и моменты смены говорящих. OpenAI представила GPT-6.1 Terra — быструю модель для самостоятельной работы на компьютере
27.10.2026 [00:33],
Николай Хижняк
Компания OpenAI выпустила GPT-6.1 Terra — новую языковую модель с поддержкой визуального анализа, ориентированную на автоматизацию рабочих задач и быстрое управление компьютером. Нейросеть представляет собой значительный шаг вперёд по сравнению с моделью предыдущего поколения GPT-5.6 Terra и предлагает пользователям повышенную скорость работы. 
Источник изображений: OpenAI По словам разработчиков, GPT-6.1 Terra превосходно справляется с задачами, составляющими основу повседневной рабочей деятельности: от подготовки предложений и интерпретации технических чертежей до заполнения форм и редактирования видео. Цены на стандартный API для GPT-6.1 Terra на 50 % ниже, чем для GPT-5.6 Terra и GPT-6.1 Sol. Согласно пресс-релизу, стоимость теперь составляет $1 за миллион входных токенов, $0,05 за миллион кешированных входных токенов и $5 за миллион выходных токенов. Внутренние тесты OpenAI показывают, что по точности ответов GPT-6.1 Terra вплотную приблизилась к флагманским решениям. 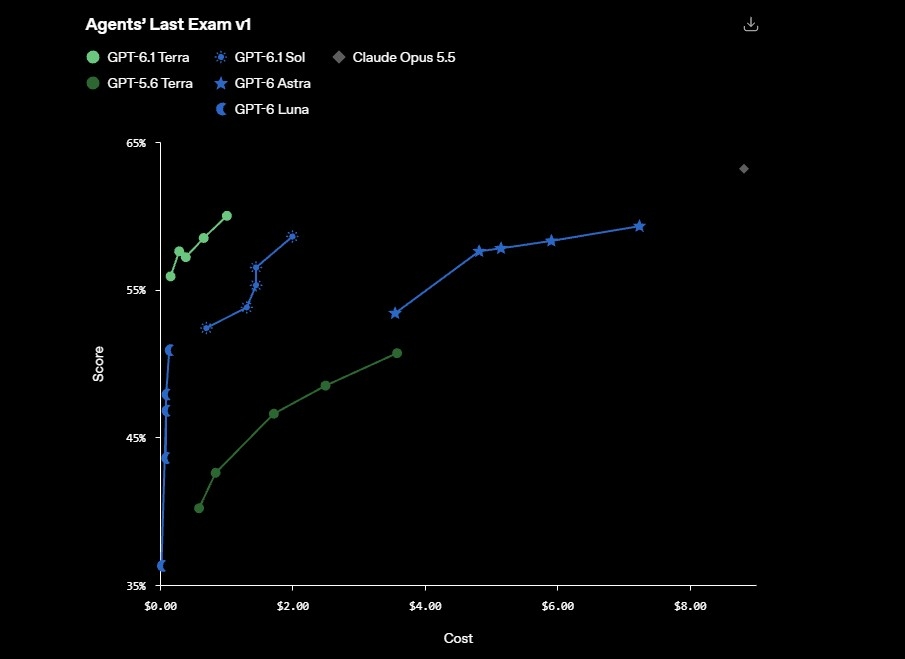 В бенчмарке Agents’ Last Exam, оценивающем способность ИИ-агентов решать сложные профессиональные задачи на рабочем месте, Terra при среднем уровне рассуждений набрала на 15 процентных пунктов больше, чем GPT-5.6 Terra, оказавшись при этом примерно в три раза дешевле. При максимальном уровне рассуждений модель продемонстрировала точность на уровне флагманской GPT-6 Astra, но при стоимости токенов в 10 раз ниже. В этом же тесте при максимальном уровне рассуждений Terra оказалась более чем в три раза эффективнее по расходу токенов и в четыре раза дешевле за токен, чем Claude Opus 5.5, что обеспечило примерно девятикратное снижение стоимости выполнения задачи. При этом Terra работает более чем в три раза быстрее, чем GPT-6 Astra и GPT-6.1 Sol. 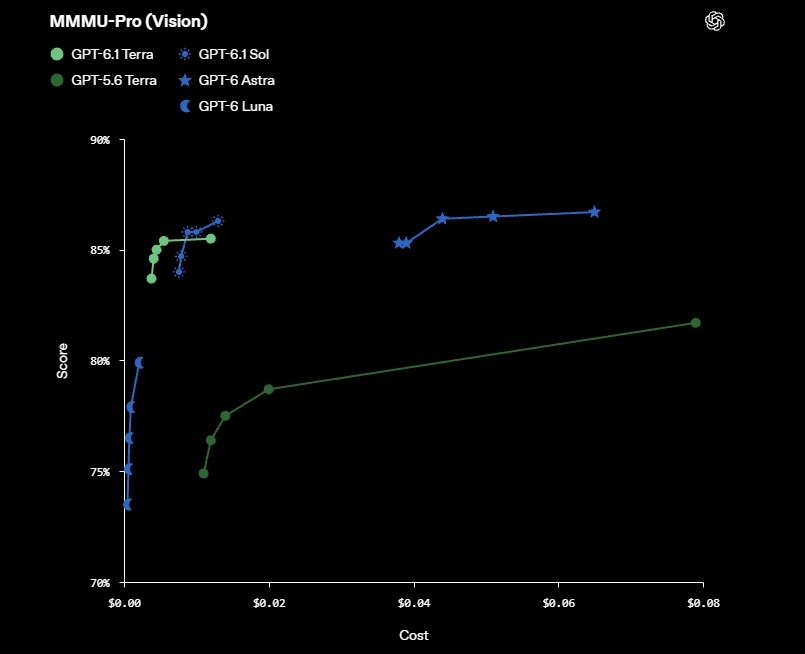 В тесте MMMU-Pro (визуальное мышление) нейросеть превзошла предшественницу GPT-5.6 Terra на всех уровнях рассуждений, продемонстрировав более глубокое понимание контекста и практически сравнявшись с показателями флагманских GPT-6 Astra и GPT-6.1 Sol при гораздо меньшей стоимости. 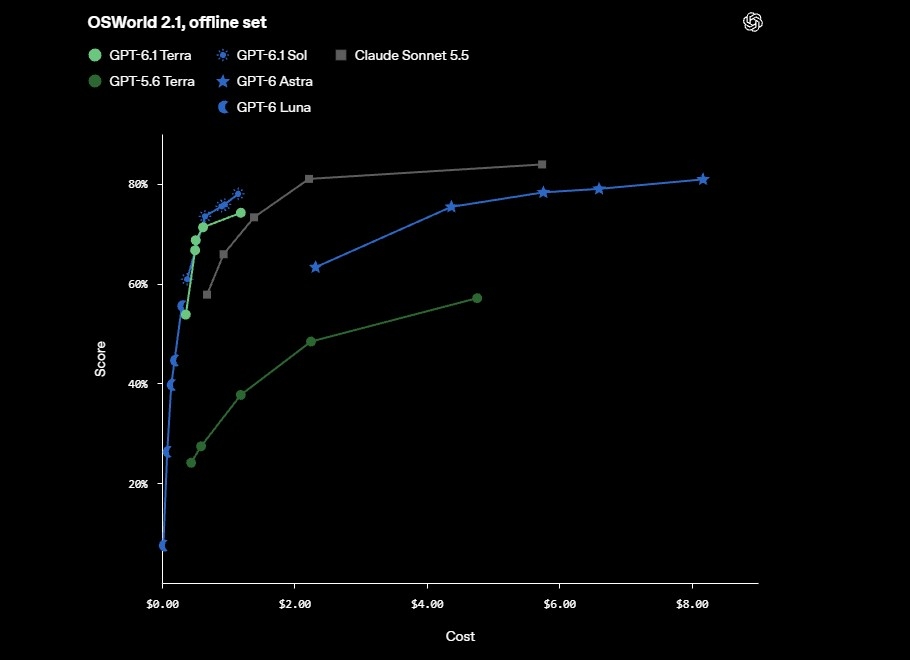 В тесте OSWorld 2.1, оценивающем, насколько эффективно ИИ-агенты используют настольные приложения для выполнения многоэтапных задач, например создания 3D-модели на основе технического чертежа, GPT-6.1 Terra при среднем уровне рассуждений превзошла лучший результат предыдущей версии GPT-5.6 Terra, затратив на это лишь малую часть прежней стоимости выполнения одной задачи. 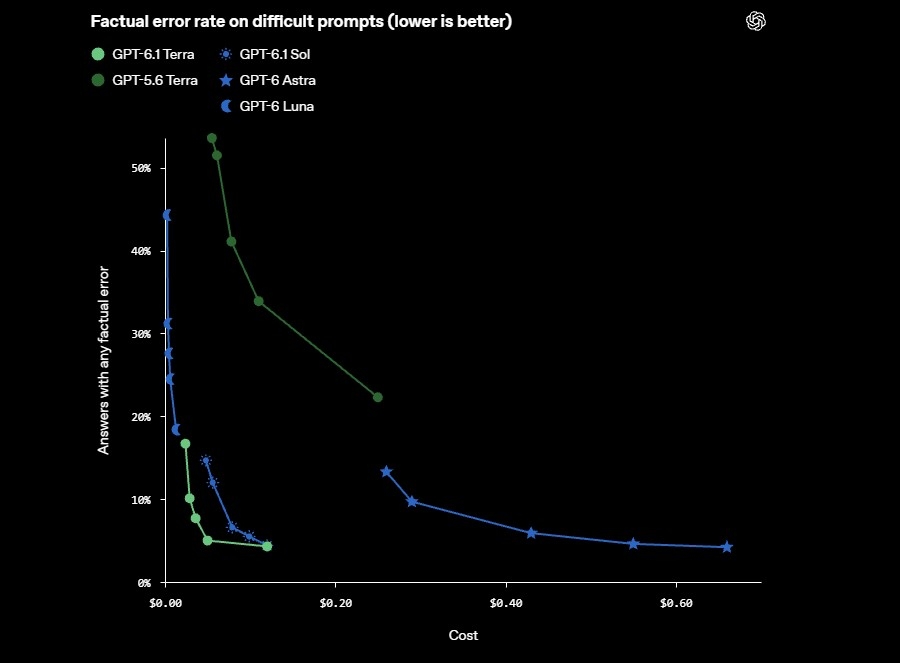 В этом году OpenAI уделила особое внимание сокращению количества галлюцинаций и фактических ошибок. Согласно результатам внутреннего тестирования с использованием промптов, провоцирующих ошибки, частота ошибок при минимальном уровне рассуждений (low reasoning effort) снизилась с 53,6 % у GPT-5.6 Terra до 16,7 % у GPT-6.1 Terra — почти на 37 процентных пунктов. При максимальном уровне рассуждений (maximum effort) количество ошибок снизилось на 18 процентных пунктов, до 4,3 %, что практически сравняло модель с флагманами GPT-6 Astra и GPT-6.1 Sol. 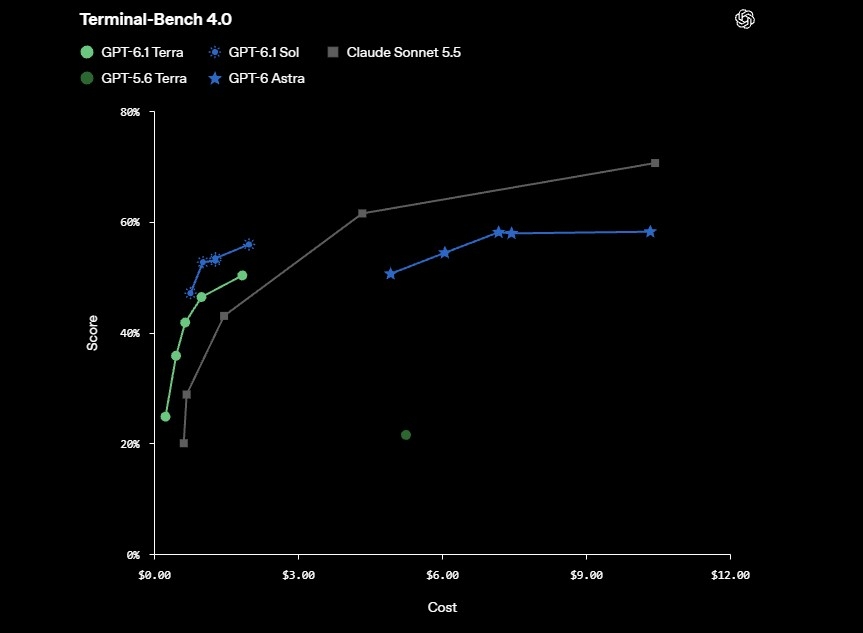 В специализированном тесте Terminal-Bench 4.0, оценивающем способность модели решать задачи из командной строки, её результат вырос более чем вдвое — с 21,5 % у GPT-5.6 Terra до 50,3 % у новой GPT-6.1 Terra при максимальном уровне рассуждений. OpenAI добавляет, что для более сложных задач, связанных с написанием кода, по-прежнему лучше подходят модели GPT-6.1 Sol и GPT-6 Astra. 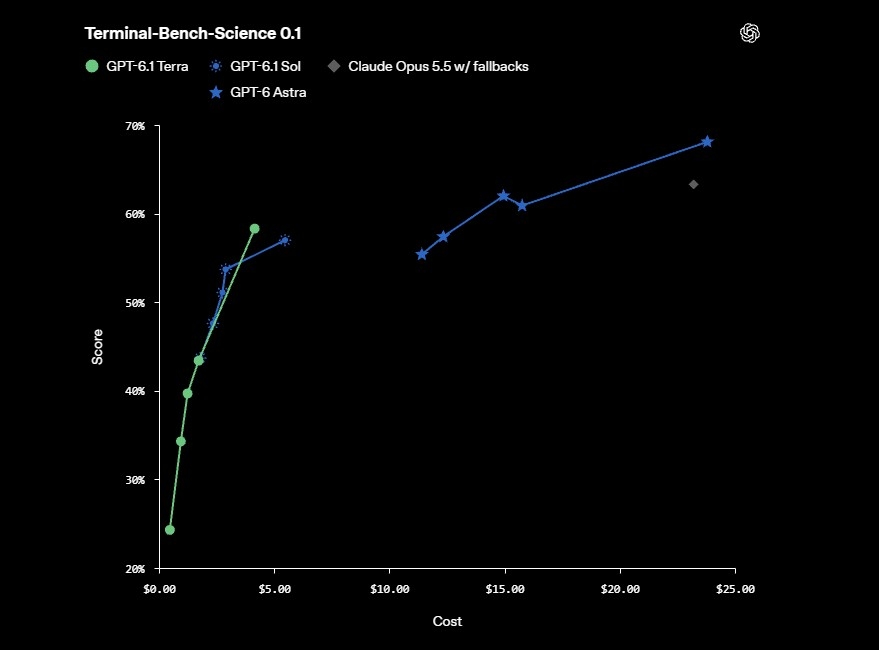 Тест Terminal-Bench-Science 0.1 проверяет способность агентов писать код для автоматизации научных исследований, например для отслеживания деления клеток на видео в режиме таймлапса. При максимальном уровне рассуждений Terra обошла модель GPT-6.1 Sol при меньшей стоимости и сократила разрыв в эффективности с Claude Opus 5.5 от Anthropic до пяти баллов. Расчётная стоимость работы GPT-6.1 Terra при этом составила менее одной пятой затрат на Opus. Компания отмечает, что с точки зрения безопасности модель GPT-6.1 Terra соответствует критическому порогу в области кибербезопасности согласно внутреннему фреймворку OpenAI (Preparedness Framework) и сохраняет защитные механизмы, разработанные для GPT-6 Astra. По сравнению с GPT-5.6 Terra она лучше удерживает контекст задачи и честно сообщает пользователю о своих ограничениях и потенциальных препятствиях. В тестах на инъекции промптов GPT-6.1 Terra продемонстрировала высокую устойчивость к вредоносным инструкциям, направленным на то, чтобы отвлечь её от выполнения задачи пользователя. Доступ к GPT-6.1 Terra открылся сегодня для всех пользователей с подписками Plus, Pro, Enterprise и Edu в ChatGPT Work и Codex. Разработчики могут получить к ней доступ через API под идентификатором gpt-6.1-terra. DeepSeek и MiniMax получили право разворачивать свои ИИ-модели за пределами Китая
24.10.2026 [05:16],
Алексей Разин
ИИ-модели двух китайских стартапов можно будет разворачивать за пределами КНР даже в том случае, если в стране введут новые экспортные ограничения в данной сфере. Компаниям DeepSeek и MiniMax удалось получить подобные разрешения в числе первых. 
Источник изображения: DeepSeek США и КНР стараются ограничивать экспорт ключевых технологий, которые определяют их экономическое положение на мировом рынке. В случае с Китаем правила экспортного контроля распространяются и на технологии искусственного интеллекта. В этом смысле разработчикам DeepSeek и MiniMax повезло в том отношении, что власти КНР недавно разрешили им разворачивать свои ИИ-модели за пределами страны. Сообщение на эту тему появилось на странице социальной сети, принадлежащей CCTV — Центральному телевидению Китая. В нём же отмечается, что значительная часть китайского ИИ останется свободной для экспорта. Данный комментарий появился на фоне начавшегося на прошлой неделе обсуждения законопроекта о введении более строгого контроля за экспортом ИИ-инструментов и услуг, включая большие языковые модели и агентов. Предлагаемые меры ограничат доступ к передовым китайским ИИ-моделям из-за пределов страны, замедлив внедрение экономически эффективных решений, основанных на открытом исходном коде, зарубежными пользователями. «С момента анонса данной политики, ведущие компании DeepSeek и MiniMax успешно завершили регистрацию, равно как и процедуры по открытию исходного кода и разрешению использования за рубежом. ИИ-компании могут продолжать свои усилия по коммерциализации в обычном режиме», — заявил китайский государственный канал CCTV. Китайские стартапы добились серьёзного успеха в сокращении отставания от лидеров рынка США в текущем году. Помимо более доступной ценовой политики, они также привлекли пользователей возможностью более простой индивидуализации своих моделей по сравнению с проприетарными системами, предлагаемыми OpenAI и Anthropic. Политику властей КНР в сфере экспорта ИИ-технологий нельзя назвать однозначной, ведь именно с их подачи американской Meta✴✴ Platforms пришлось отменить итоги сделки по приобретению сингапурского ИИ-стартапа Manus с китайскими корнями. Власти Китая регулярно обновляют каталог технологий, которые либо запрещены к экспорту, либо ограничены. В 2020 году в этот перечень попали алгоритмы, что в итоге затруднило сделку по «приземлению» TikTok в США, на которой настаивали американские власти. Новейшие изменения в экспортную политику КНР обсуждаются с прошлого полугодия, чиновники ведут диалог с участниками отрасли и исследовательскими учреждениями. Этот каталог, по словам CCTV, нацелен на «определение границ, нежели чем на простое ограничение экспорта ИИ-технологии». Предусмотрены и существенные исключения из предлагаемых правил. Предоставление доступа через API, веб-приложения или сервис по подписке не будут попадать под экспортные ограничения, даже если в основе этих решений будут лежать ИИ-модели, экспорт которых из КНР запрещён. Подчёркивается, что такой подход контрастирует с методами, используемыми властями США для защиты своего доминирующего положения. DeepSeek за два года устранит зависимость от Nvidia — основными станут ИИ-ускорители Huawei
23.10.2026 [15:39],
Алексей Разин
DeepSeek может почти полностью отказаться от ИИ-ускорителей Nvidia уже к 2028 году, переключившись на китайские чипы Huawei Ascend. По оценке SemiAnalysis, совместная работа двух компаний помогает сократить отставание от Nvidia не только в производительности, но и в программной экосистеме. Для китайской ИИ-отрасли это важный шаг к снижению зависимости от американских технологий. 
Источник изображения: Unsplash, Saradasish Pradhan Китайские власти заинтересованы в достижении определённого уровня импортозамещения в сфере искусственного интеллекта, поскольку пытающиеся ограничить прогресс КНР в этой сфере американские власти не дают передовым компонентам попадать в Поднебесную по официальным каналам. По оценкам SemiAnalysis, углубляющийся симбиоз DeepSeek и Huawei уже в 2027–2028 годах позволит первой из компаний преимущественно полагаться на ускорители Huawei в своей вычислительной инфраструктуре. Помимо усилий Huawei по формированию экосистемы для эффективного использования фирменных ИИ-ускорителей семейства Ascend, этому способствует и встречное движение самой DeepSeek, которая адаптирует к ним свои средства разработки и программную инфраструктуру. Ещё несколько недель назад DeepSeek представила программные средства, которые позволяют компании запускать современные ИИ-модели на аппаратном обеспечении Huawei, а не только платформе Nvidia. Собственный язык программирования TileLang компания DeepSeek также адаптировала под работу с ускорителями Ascend, и он уже позволяет создавать высокопроизводительные программные ядра, использующие ресурсы этих ускорителей Huawei. В конце прошлого месяца представители DeepSeek заявили, что данный шаг позволит создать более «независимую и контролируемую» национальную программную экосистему, используемую совместно с графическими процессорами (GPU). Технологические решения Huawei уже достигли определённой степени зрелости, по мнению представителей SemiAnalysis, и к 2027 или 2028 году DeepSeek вполне могла бы главным образом перейти на их использование, снизив зависимость от импортируемых или арендуемых за пределами КНР ускорителей Nvidia. Глава и основатель последней — Дженсен Хуанг (Jensen Huang), ещё в апреле, до выхода ИИ-модели DeepSeek v4, назвал «ужасным сценарием» для США оптимизацию китайской компанией своих моделей под чипы Huawei. По мнению генерального директора конкурирующей Nvidia, это обеспечило бы превосходство КНР над США в конечном итоге. По данным SemiAnalysis, результаты тестирования на Ascend 950PR позволяют говорить о сокращении отставания в экосистемах благодаря совместной работе DeepSeek и Huawei. «Кошмар Дженсена начинает становиться явью», — резюмируют авторы публикации. DeepSeek предоставляет Huawei ранний доступ к своим ИИ-моделям. Последней это позволяет предоставить поддержку операций инференса на своих чипах с «нулевого дня» для крупных обновлений типа DeepSeek V4 и V4.1. Эксперты SemiAnalysis при этом вынуждены признать, что представленные Huawei в марте ускорители Ascend 950PR отстают от Nvidia H100 по абсолютному быстродействию. Опять же, инженеры Huawei хорошо оптимизируют программные ядра под свои чипы, достигая эффективности на уровне 99,7 % от теоретического потолка. Правда, как отмечают в SemiAnalysis, масштабировать успех симбиоза DeepSeek и Huawei на всю китайскую ИИ-отрасль будет не так просто, поскольку серверные системы первой из компаний обладают уникальной конфигурацией, и на других сочетаниях компонентов возможны проблемы с совместимостью. В частности, стандартные x86-совместимые процессоры в сочетании с ускорителями Ascend у других разработчиков вряд ли смогут показать подобную эффективность. Тем не менее, прочие китайские разработчики могут заимствовать опыт DeepSeek, в том числе, через совместное использование компиляторов и построении новых моделей на их основе. Предложив собственные оптимизации и исправления, эти разработчики смогут сделать вклад в общий прогресс представителей китайской ИИ-отрасли. ИИ, который пишет не последовательно, а параллельно: диффузионная модель Mercury 3 в 6–8 раз быстрее GPT-6 Luna
21.10.2026 [11:41],
Владимир Мироненко
Компания из Редвуд-Сити (США) представила диффузионную большую языковую модель (dLLM) Mercury 3, которая в 40 раз больше предшественницы Mercury 1, но при этом отличается высокой скоростью работы — свыше 1000 токенов/с. В ряде тестов Mercury 3 превосходит GPT-6 Luna и Claude Haiku 5.5, работая при этом гораздо быстрее. 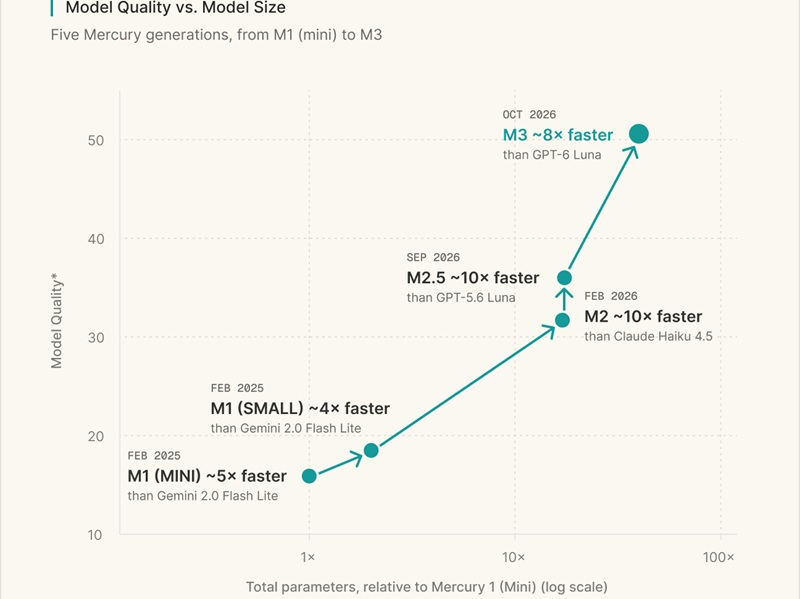
Источник изображения: Inception В отличие от больших языковых моделей (LLM), генерирующих текст по одному токену за раз, диффузионные могут выдавать несколько токенов сразу, что даёт выигрыш в скорости. Ранее разработчикам приходилось выбирать: либо использовать компактные и быстрые модели (для задач, критичных к задержкам), либо более мощные, но медленные аналоги. Mercury 3, как утверждает Inception, обладает и тем, и другим. Она значительно крупнее и функциональнее предшественников, но при этом по-прежнему работает со скоростью свыше 1000 токенов/с. При этом контекстное окно — объём текста, который модель может обрабатывать за один раз, — увеличилось до 1 млн токенов (в предыдущей версии Mercury 2.5 оно составляло 260 тысяч). Согласно внутренним тестам компании, Mercury 3 превосходит GPT-6 Luna от OpenAI, Claude Haiku 5.5 от Anthropic и GLM-5.3 Flash от Zhipu по ряду показателей, работая при этом в 4–8 раз быстрее. «Ответы от таких моделей приходят практически мгновенно», — сообщил генеральный директор Inception Стефано Эрмон (Stefano Ermon). Mercury 3 — четвёртая модель, выпущенная Inception с момента появления Mercury 1 в июне 2025 года. С каждой новой версией их функциональность росла, что не влияло на скорость работы. Так, в Mercury 2 появились механизмы логического рассуждения, в Mercury 2.5 — возможность настройки этих механизмов и контекстное окно объёмом 260 тысяч токенов. Mercury 3 совершила самый значительный качественный скачок в развитии линейки, утверждает разработчик. Mercury 3 доступна через Inception API, Baseten, OpenRouter и Vercel. Благодаря совместимости с API OpenAI разработчики могут перейти на неё без необходимости переписывать код. Стоимость использования Mercury 3 составляет $0,2 за миллион входных токенов и $0,7 за миллион выходных токенов. На этапе запуска компания снизила расценки вдвое — до $0,1 и $0,35 соответственно. DeepSeek обновила ИИ-модель V4.1-Flash — она стала быстрее и эффективнее
18.10.2026 [13:31],
Владимир Фетисов
На этой неделе состоялся релиз ИИ-модели DeepSeek V4.1-Flash-1017. Китайская компания заявила, что новый алгоритм стал компактнее и работает быстрее предыдущей версии нейросети. Этот шаг усилит конкуренцию DeepSeek с западными компаниями, такими как Anthropic и OpenAI, а также конкурентами на домашнем рынке, включая Moonshot Kimi и Z.ai. 
Источник изображения: Unsplash, Solen Feyissa В сообщении DeepSeek сказано, что модель V4.1-Flash-1017 демонстрирует «более высокую производительность в бенчмарках, более быстрое выполнение задач и более быстрые ответы по сравнению с предыдущей версией». Нейросеть уже доступна в веб-приложении компании, в приложении DeepSeek и на платформе для разработчиков. Высокие темпы запуска новых версий ИИ-моделей DeepSeek подчёркивают нарастающую конкуренцию между китайскими открытыми моделями и закрытыми аналогами американских компаний. Последние показывают высокие результаты в разных областях, но они обходятся значительно дороже. Новая версии ИИ-модели DeepSeek обеспечивает «существенные улучшения в рассуждениях, программировании, агентных задачах и визуальных бенчмарках». 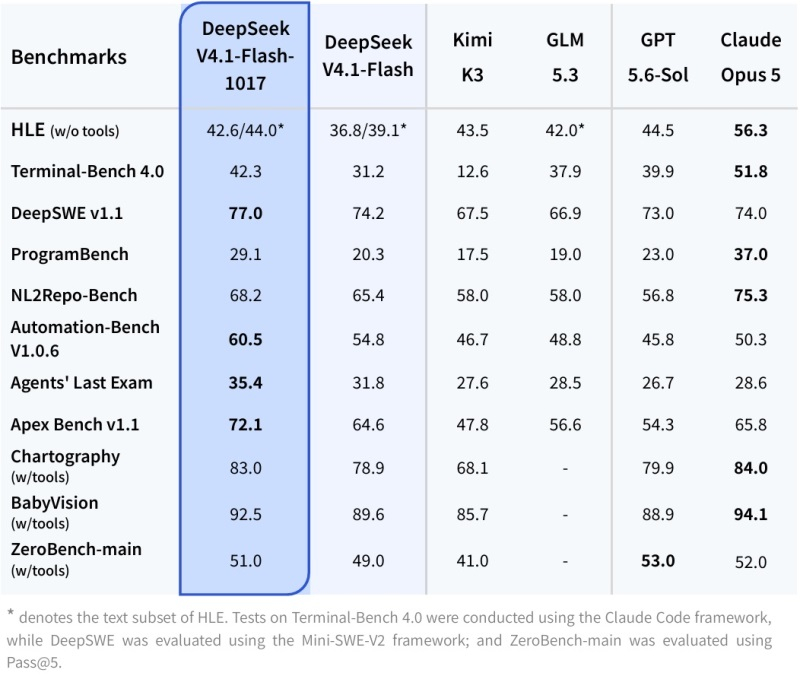
Источник изображения: api-docs.deepseek.com Модель V4.1-Flash-1017 расширяет возможности в разных сферах, начиная от создания игр и заканчивая 3D-моделированием. Несмотря на это, DeepSeek охарактеризовала новую модель, как небольшое обновление предыдущей версии V4.1-Flash. На этой неделе у DeepSeek произошёл технический сбой, в результате которого серверы компании были недоступны около пяти часов. Некоторые эксперты связывают этот инцидент с нехваткой вычислительных ресурсов. Последние месяцы участились случаи замедления работы и перебоев в сервисе DeepSeek. Это может быть связано с высоким спросом на ИИ-модели компании со стороны разработчиков из-за агрессивно низких цен, что создаёт высокую нагрузку на инфраструктуру DeepSeek. |
|
✴ Входит в перечень общественных объединений и религиозных организаций, в отношении которых судом принято вступившее в законную силу решение о ликвидации или запрете деятельности по основаниям, предусмотренным Федеральным законом от 25.07.2002 № 114-ФЗ «О противодействии экстремистской деятельности»; |
© 1997—2026 3DNews
При цитировании документа ссылка на сайт с указанием автора обязательна. Полное заимствование документа является
нарушением
российского и международного законодательства и возможно только с согласия редакции 3DNews.



 MWC 2018
 2018
 Computex

 IFA 2018









