


Опрос
|
реклама
Быстрый переход
Миллиарды попыток взлома домашних сетей: телевизоры, розетки и NAS стали главными мишенями хакеров
30.10.2026 [11:00],
Павел Котов
Специализирующаяся на вопросах кибербезопасности компания Bitdefender и производитель сетевого оборудования Netgear представили результаты совместного исследования, в котором рассматривается эволюция угроз в сегменте интернета вещей (IoT). Относящиеся к этой категории устройства, говорится в докладе, повысили уязвимость пользователей перед автоматизированными кибератаками и масштабными вредоносными кампаниями. 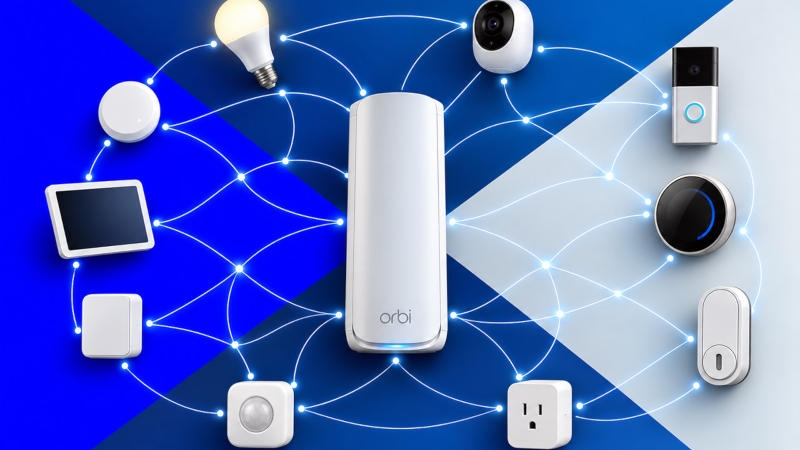
Источник изображений: netgear.com В основу исследования легли телеметрические данные, собранные в период с января по сентябрь 2026 года в 10,4 млн «умных» домов по всему миру. Специалисты Bitdefender проанализировали 5,4 млрд связанных с безопасностью событий и 1,2 млрд случаев обнаружения уязвимостей. В рамках исследования установлены 4,85 млрд попыток входа на домашние маршрутизаторы — по две попытки в день в среднем на каждый; зафиксированы 466,6 млн попыток подбора паролей. В работе также рассматриваются наиболее значимые инциденты, в том числе ликвидация четырёх IoT-ботнетов минюстом США и обнаружение в приложениях для смарт-телевизоров ПО, превращающего их в прокси-серверы. В современных реалиях одно устройство может стать объектом для четырёх сценариев: прямая атака, превращение в прокси-сервер, датчик для сбора информации и точку проникновения в сети. Среди всех категорий устройств первое место заняли умные телевизоры, в которых могут сочетаться все четыре роли — для них было зафиксировано 270,3 млн случаев наличия уязвимостей. Число подключённых к интернету устройств растёт, а разведка становится основным типом атак — на одно домохозяйство в среднем приходятся 24 подключённых устройства; в прошлом году их было 22. На долю разведывательных действий приходятся 90,1 % всех зафиксированных атак: автоматизированные системы сканирования обнаруживают слабо защищённые сети и устройства, чтобы использовать их для более масштабных атак или включения в состав ботнетов. 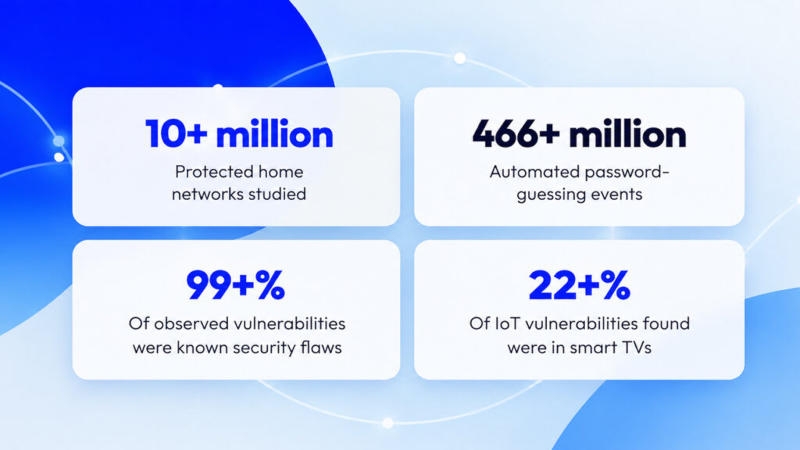 Наиболее уязвимы телевизоры (22,7 %), умные розетки (22,4 %) и сетевые хранилища (22 %) — они составляют 67,1 % выявленных уязвимостей. В прошлом году в лидерах были стриминговые устройства (25,9 %) и смарт-телевизоры (21,3 %) — актуальные данные указывают, что наибольшему риску подвержено оборудование с длительным сроком службы, потому что его редко меняют, и оно зачастую остаётся подключённым к сети даже после прекращения выпуска обновлений и поддержки. Почти все выявленные на устройствах уязвимости общеизвестны: в 99,7 % случаев соответствующие записи имеются в реестре; слабые пароли и передача учётных данных составляют лишь доли процента. Самые распространённые подключённые устройства — смартфоны и телевизоры. На смартфоны приходятся 20,4 % устройств, выявленных в домашних сетях, далее следуют телевизоры (10,6 %), компьютеры (10,0 %), сетевое оборудование (6,2 %) и стриминговые устройства (7,3 % в 2025 и 5,4 % в 2026 году). В список также попали планшеты (4,8 %) и IP-камеры (4,1 %). Чаще всего атаки вызывают ошибки памяти и сбои в работе. На долю ошибок переполнения приходятся около 54 % инцидентов, за ними следуют отказы в обслуживании (около 18 %) и повреждения памяти (около 17 %). Наиболее опасные последствия, позволяющие злоумышленникам получать контроль над оборудованием, встречаются гораздо реже: повышение привилегий (5,3 %), выполнение произвольного кода (3,8 %) и получение доступа к информации (1,2 %) — в совокупности около 10,3 %. Китай сравняется с США в ИИ-гонке уже к 2030 году — а в отдельных сферах даже обгонит
28.10.2026 [13:51],
Владимир Мироненко
США могут потерять единоличное лидерство в сфере искусственного интеллекта: к 2030 году Китай способен сравняться с ними по влиянию на мировой ИИ-рынок и выйти вперёд в ряде ключевых технологических отраслей. По прогнозу Bloomberg Intelligence, Китай возглавит восемь из 17 стратегически важных направлений, включая разработку больших языковых моделей. При этом в производстве передовых чипов и других компонентов для ИИ американские компании сохранят преимущество. 
Источник изображения: Steve A Johnson/unsplash.com Согласно исследованию аналитиков, Китай имеет все шансы стать мировым лидером в области больших языковых моделей (LLM), которые лежат в основе систем искусственного интеллекта, а также сохранять конкурентоспособность во всех остальных стратегически важных технологических секторах. Согласно прогнозам Bloomberg Intelligence, к 2030 году Китай опередит другие страны в восьми из 17 ключевых отраслей, включая разработку LLM. В других критически важных для развития ИИ сегментах — например, в производстве аппаратного обеспечения (от чипов до компонентов оптических сетей) — китайские компании пока отстают, однако через несколько лет они смогут составить достойную конкуренцию нынешним лидерам, отметили аналитики. «США и Китай движутся к совместному технологическому лидерству в сфере ИИ, при этом ни одна из сторон, вероятно, не добьётся абсолютного превосходства», — сообщается в исследовании. По мнению аналитиков, американские ИИ-модели могут сохранить небольшое преимущество на переднем крае технологий, в то время как компетенции Китая в области оптимизации программного обеспечения создают благоприятные условия для внедрения более доступных по стоимости решений на базе ИИ. Также ожидается, что Китай сократит отставание в сфере полупроводниковых технологий, хотя и не достигнет полной самодостаточности. Согласно исследованию Bloomberg Intelligence, Китай выйдет в мировые лидеры во всех трёх категориях, связанных с новой энергетикой (включая электромобили и системы хранения энергии), а также в сфере биофармацевтического производства. Поднебесная империя уже лидирует по выпуску человекоподобных роботов и в ряде направлений судостроения, а по объёму расходов на исследования и разработки сравнялась с Соединёнными Штатами. Что касается ИИ, то прогресс в этом направлении сдерживается тем, что китайские компании, впрочем, как и ИИ-стартапы в других странах, пока не нашли эффективных способов монетизации своих инноваций. По оценке Bloomberg Intelligence, они по-прежнему участвуют в своего рода гонке на выживание со снижением цен на свои услуги до предела, и получение прибыли останется труднодостижимой целью, пока компании не перейдут к более рациональному подходу к ценообразованию. Кроме того, противоречия во взаимоотношениях с США, Европой и другими торговыми партнёрами будут и дальше серьёзным препятствием для дальнейшего развития китайских технологических гигантов: доступ к прибыльным рынкам для них может быть закрыт, а экспортные ограничения могут лишить доступа к передовым компонентам. Но, как считают аналитики, эти ограничения, скорее, приведут к изменению географии промышленной экспансии Китая, чем к её полной остановке. ИИ-бум обогатил лишь семерых: остальные 493 компании S&P 500 пока не видят отдачи от инвестиций
27.10.2026 [11:55],
Владимир Мироненко
Так называемая «революция ИИ» принесла выгоду лишь ограниченному числу участников рынка, в то время как подавляющее большинство компаний из индекса S&P 500 практически не видят результатов от своих усилий по внедрению генеративного ИИ или больших языковых моделей (LLM), сообщается в исследовании Торстена Слока (Torsten Slok), главного экономиста Apollo Global Management. 
Источник изображения: Numan Ali/unsplash.com Аналитик утверждает, что макроэкономическое влияние ИИ остаётся крайне ограниченным — за пределами технологического сегмента американский корпоративный сектор пока не получил никакой финансовой отдачи от систем искусственного интеллекта, несмотря на огромные денежные вложения и шумиху вокруг последних достижений ИИ-индустрии. По словам Слока, благодаря развитию ИИ выручка на одного работника (с поправкой на инфляцию) растёт только у «Великолепной семерки» (Magnificent 7) в составе S&P 500, куда входят Nvidia, Tesla, Amazon, Microsoft, Google (Alphabet), Apple и Meta✴✴. У этой же группы выросли показатели рентабельности. В то же время у остальных 493 компаний индекса (которые Слок называет S&P 493) эти показатели сохранили прежние значения. Более того, Слок не видит никаких признаков того, что ИИ способствует росту производительности. В отсутствие ощутимой отдачи, компании из индекса S&P 500 начинают сокращать расходы на внедрение ИИ, рассматривая их как издержки, снижающие маржинальность, а не как инвестиции, способные обеспечить рост бизнеса в будущем. В отличие от стартапов, наращивающих расходы на ИИ при поддержке венчурных компаний, традиционные организации не испытывают потребности в новейших моделях и не готовы платить за них. Если сфера применения ИИ будет и дальше ограничиваться лишь небольшой частью экономики, его макроэкономический эффект будет весьма незначительным, отметил аналитик. Со временем применение ИИ-моделей может стать массовым, стандартизированным продуктом, а стоимость их использования снизится настолько, что позволит компаниям увеличить выручку и увеличить рентабельность. Однако, по мнению Слока, достичь этой цели может быть гораздо сложнее, чем кажется. Он называет ИИ лишь мощным «калькулятором», подчеркивая, что в основе бизнеса лежат здравые суждения, а не просто вычисления. «ИИ не понимает таких понятий, как ответственность, доверие, корпоративная культура, негласные правила, этические компромиссы или справедливость. А ведь именно они определяют репутационные риски и, в конечном счёте, влияют на рост выручки и прибыльность», — пишет Слок. Он выразил мнение, что судьба ИИ будет решаться не «Великолепной семеркой», а остальными 493 компаниями из индекса S&P 500. С учётом того, что компания Apollo, в которой работает Слок, управляет активами на сумму около $1 трлн, к его мнению стоит прислушаться. Тем более, что оно перекликается с оценками других экспертов. Например, аналитики Gartner недавно предположили, что к 2030 году инвестиции в инфраструктуру ИИ на сумму более $3,5 трлн могут обесцениться. Впрочем, не все экономисты разделяют этот пессимизм, считая, что в дальнейшем вложения в ИИ окупятся за счет роста производительности и увеличения прибыли во всей экономике. Рынок смартфонов откатился к уровню 2012 года — Xiaomi потеряла больше всех, а Apple и Samsung нарастили доли
12.10.2026 [22:59],
Владимир Мироненко
В III квартале 2026 года мировые поставки смартфонов обвалились на 20 % в годовом исчислении, достигнув самого низкого уровня для этого квартала с 2012 года. Об этом свидетельствуют предварительные оценки аналитического сервиса Market Monitor компании Counterpoint Research. 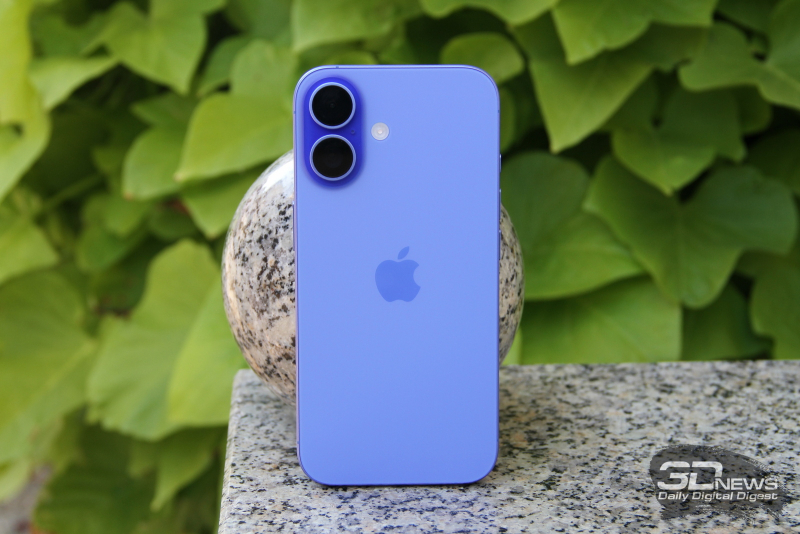 Продолжающийся рост цен на память DRAM и NAND в сочетании с удорожанием других компонентов в III квартале привёл к резкому увеличению себестоимости материалов (BOM), обострению дефицита поставок и, как следствие, нарушению графиков отгрузок продукции производителями (OEM). В свою очередь, производители переложили возросшие расходы на потребителей, в результате чего розничные цены на смартфоны в мире с начала 2026 года выросли на 20 %, а средняя цена продажи (ASP) продолжила повышаться. Старший аналитик Counterpoint Шилпи Джейн (Shilpi Jain) отметила, что острый дефицит памяти заставляет рынок смартфонов переходить к фазе более избирательного спроса, что меняет стратегии производителей и даже поведение потребителей. Пользователи теперь дольше пользуются своими устройствами, чем ожидалось, чаще рассматривают возможность приобретения восстановленных аппаратов и отдают предпочтение более дорогим моделям. В свою очередь, производители корректируют ассортимент, ценовую политику и рыночные стратегии, стремясь сохранить прибыльность. Массовый сегмент находится под давлением, тогда как спрос в премиальном сегменте остаётся относительно устойчивым. Это увеличивает разрыв между премиальным и чувствительным к цене сегментами рынка, утверждает аналитик. 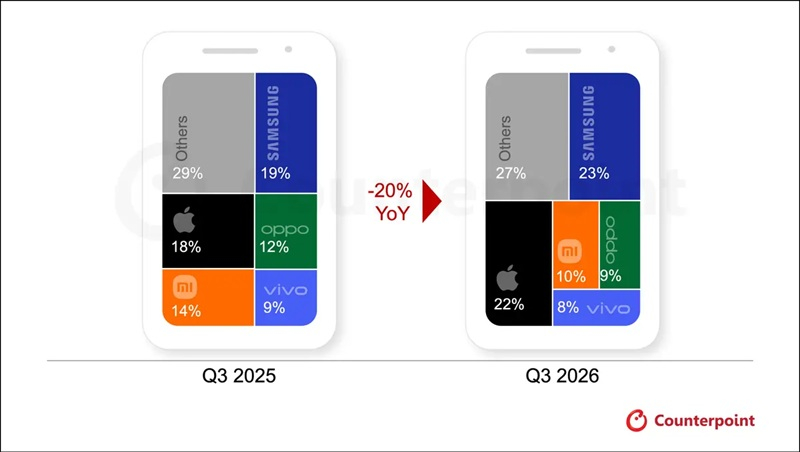 На рынке по-прежнему лидирует Samsung. Несмотря на сокращение поставок на 3 % в годовом исчислении, её доля рынка выросла до 23 %, что стало самым значительным приростом среди крупных производителей. Благодаря стратегии, ориентированной на повышение средней цены продажи (ASP) и рост выручки, компания увеличила доходы, несмотря на сокращение поставок в количественном выражении. Этому способствовали премиализация ассортимента и успешные продажи складных смартфонов. На серию Galaxy Z Fold8 зафиксирован высокий спрос на старте продаж, а стабильные поставки компонентов поддержали продажи устройств средней ценовой категории (серия A) на развивающихся рынках на фоне сокращения присутствия некоторых китайских брендов. Доля Apple впервые для III квартала превысила 20 %, достигнув 22 %, несмотря на снижение объёмов поставок в годовом исчислении. Аналитики считают, что снижение во многом было обусловлено отсутствием базовой модели iPhone 18, из-за чего наполнение каналов продаж в месяц запуска оказалось менее масштабным по сравнению с полным модельным рядом iPhone 17. Apple, как и другие вендоры, повысила цены, хотя этот фактор сказался лишь на результатах последних недель квартала. Модели iPhone 18 Pro оказались успешнее на старте продаж по сравнению с предшественниками — особенно в Китае и Индии, — а сохраняющийся спрос на серию iPhone 17 помог частично компенсировать общее падение поставок. В отчётном квартале Xiaomi столкнулась с резким падением поставок — более чем на 30 % в годовом исчислении, — из-за чего её доля рынка упала до 10 %. Компания сократила присутствие в низком ценовом сегменте и на второстепенных зарубежных рынках, одновременно повысив среднюю цену продажи (ASP) и пересмотрев планы поставок. Вместе с тем она укрепила позиции в верхнем среднем и премиальном сегментах китайского рынка благодаря серии Xiaomi 18 и складным моделям. Свой вклад внесло и использование собственного чипсета XRING O3. Объёмы поставок Oppo и Vivo упали более чем на 20 % в годовом исчислении, а их доли рынка снизились до 9 и 8 % соответственно. Oppo оптимизировала портфель продуктов и операционную деятельность брендов Oppo, Realme и OnePlus. Компания также перенаправила поставки на рынки и модели, приносящие более высокую прибыль. Vivo уделяет приоритетное внимание ключевым рынкам — Индии и Китаю, — укрепляя позиции серии Y и одновременно расширяя линейки премиальных моделей серий X, V и S. По мнению аналитиков, перспективы на оставшуюся часть 2026 года остаются сложными: производители (OEM) всё чаще отдают приоритет прибыльности, а не объёмам поставок на фоне высоких затрат на комплектующие и снижения покупательной способности. В Counterpoint Research считают, что до тех пор, пока ситуация с поставками и ценами на комплектующие не улучшится, существенного роста поставок ожидать не стоит. Google, США и Цукерберг вложат $1,8 млрд в «виртуальную клетку» — ИИ поможет искать лекарства от болезней
07.10.2026 [19:38],
Сергей Сурабекянц
Google DeepMind, Meta✴✴ и стартап Isomorphic Labs, занимающийся разработкой лекарств с помощью ИИ, инвестируют $300 млн в некоммерческую организацию Biohub, основанную Марком Цукербергом (Mark Zuckerberg) и его супругой Присциллой Чан (Priscilla Chan) для биомедицинских исследований. Это лишь часть инициативы стоимостью $1,8 млрд, направленной на создание наборов данных для ИИ, которые помогут в поиске новых способов профилактики и лечения заболеваний. 
Источник изображения: unsplash.com Основанная в 2016 году организация Biohub стремится бороться с болезнями путём создания «виртуальной клетки», которую исследователи смогут использовать для проведения компьютерного моделирования. Для поддержки этого проекта Министерство энергетики США выделит более $500 млн в течение следующих пяти лет, а Национальные институты здравоохранения предоставят наборы данных, репозитории и базы знаний, сформированные в результате предыдущих федеральных инвестиций на сумму свыше $500 млн. «Точная прогностическая модель биологических процессов способна кардинально ускорить научные открытия, позволяя учёным проводить эксперименты в цифровой среде, — пояснил научный руководитель Biohub Алекс Ривс (Alex Rives). — Создание виртуальной клетки — одна из важнейших задач для новой эры науки. Для этого потребуются скоординированные усилия по сбору и генерации данных как на национальном, так и на международном уровне, и именно поэтому эти партнёры объединяют свои усилия». По замыслу команды Biohub, такие модели научатся предсказывать поведение клеток в здоровом состоянии и во время болезни и ускорят лечение и профилактику заболеваний. Полученные данные компания обещает сделать открытыми для учёных во всём мире. В Biohub считают, что ИИ-модели позволят изучать поведение клеток в таком масштабе и с такой скоростью, какие сегодня недостижимы в обычной лаборатории. Если ИИ-модели окажутся достаточно точными, они помогут понять причины болезней и подсказать новые методы их лечения. «Мы создали открытую платформу для научных исследований, которая переводит биологию в формат, пригодный для компьютерной обработки, — пространство, где на основе глубокого понимания биологических процессов можно генерировать, проверять и совершенствовать миллиарды вариантов дизайна белков», — говорится на сайте проекта. Недавно лаборатория Google DeepMind представила платформу Atlas на основе ИИ, которая должна помочь учёным разгадать тайны генома человека. По словам разработчиков, Atlas изменит нынешнее понимание биологии, ускорит научные исследования и проложит путь к новым методам лечения заболеваний. Исследователи утверждают, что представленная платформа содержит «прогнозируемую карту каждого возможного изменения ДНК в геноме человека». Учёные отменили долголетие Солнечной системы — ей осталось в 17 раз меньше времени, чем считалось
04.10.2026 [20:49],
Владимир Мироненко
Наша Солнечная система является в «высшей степени нестабильной» и существовать ей осталось всего около шести миллиардов лет, утверждается в новом исследовании. Его авторы смоделировали будущее Солнечной системы, когда наша звезда превратится сначала в красного гиганта и, в конечном итоге — в белого карлика. 
Источник изображения: Braňo/unsplash.com В ходе превращения в красного гиганта процесса Солнце поглотит Меркурий, Венеру и, возможно, даже Землю. Ранее ученые предполагали, что внешние планеты-гиганты могут остаться относительно невредимыми после гибели светила — предполагалось, что они просуществуют до 100 млрд лет после того, как погаснет Солнце. Но, как сообщают авторы новой работы «Конечная нестабильность Солнечной системы, вызванная стохастической потерей солнечной массы», опубликованного журналом The Astrophysical Journal Letters, обновлённые результаты моделирования показывают, что удалённые объекты могут быть ввергнуты в фатальный хаос уже в фазе красного гиганта и что они вряд ли просуществуют более миллиарда лет после превращения Солнца в белого карлика. «[Исаак] Ньютон (Isaac Newton), наблюдая за дрейфующими орбитами Юпитера и Сатурна, предположил, что планетарный порядок не вечен, и три столетия небесной механики... постепенно отодвигали этот вердикт, в последнее время на сроки, намного превышающие возраст Вселенной», — сообщили исследователи, возглавляемые Константином Батыгиным (Konstantin Batygin) из Калифорнийского института астрономии. Они отметили, что согласно результатам исследования, распад Солнечной системы произойдёт не из-за постепенного распространения энтропии или случайной встречи с проходящей звездой. Само Солнце, умирая, не просто расширит созданную им планетную систему — оно сотрясёт её и это приведёт к разрушению. ИИ близок к чтению мыслей: нейросеть воссоздала увиденное человеком по снимкам мозга
04.10.2026 [15:04],
Владимир Фетисов
Учёные из Института Вейцмана в израильском Реховоте разработали ИИ-инструмент, который с поразительной точностью воссоздаёт то, что видит человек, просто анализируя снимки его мозга. Технология работает и в обратную сторону: опираясь на то, что видит человек, можно предугадать активность мозга. Учёные читают, что их открытие поможет в изучении мозга человека, а также будет полезным для людей с синдромом «запертого человека» или поможет воссоздавать содержание снов. 
Источник изображения: Unsplash, Sasun Bughdaryan На приведённом изображении слева в каждой паре располагается то, что человек действительно видел, а справа — то, что ИИ-алгоритм сгенерировал на основе анализа снимков мозга испытуемого. Работа израильских учёных уже нашла положительные отзывы. Так Джуди Иллес (Judy Illes), нейроэтик и профессор неврологии в Университете Британской Колумбии в Канаде, считает работу израильских коллег «великолепной». «Сама идея использовать такой подход для терапевтической помощи людям с неврологическими состояниями невероятно воодушевляет», — заявила Иллес. Однако другие учёные считают, что подобный подход может использоваться для раскрытия мыслей и ментальных образов людей, даже без их согласия. «Результаты выглядят очень впечатляюще. Но если появится способ незаметно извлекать информацию, касательно того, о чём вы думаете, то <…> 150 лет научной фантастики могут воплотиться в реальности в любой момент, и это во многих отношениях тревожно», — уверен Томми Спраг (Tommy Sprague), нейробиолог из Калифорнийского университета в Санта-Барбаре. Нейробиологи годами ищут способы использовать функциональную магнитно-резонансную томографию (фМРТ), чтобы воссоздать то, что видят люди, а также то, что происходит в их сознании. Итогом первых подобных попыток стали размытые изображения, на которых было трудно что-то разобрать. С годами ситуация улучшилась благодаря оптимизации фМРТ-сканирований и инструментов для интерпретации результатов. Израильские учёные начинали свою работу с анализа общедоступных данных фМРТ мозга. Другие исследователи уже собрали снимки добровольцев, которым показывали сотни изображений в то время, когда они находились внутри аппарат фМРТ. Учёные также проанализировали наборы данных, которые были получены на сканерах с высоким разрешением. Эти данные показали, какой была активность мозга участников эксперимента, когда они рассматривали разные изображения. Ранее учёные уже работали над созданием технологии воссоздания изображений того, что видит человек, на основе данных сканирования мозга. Для этого применялись разные инструменты, но ни один из них не давал подобного результата. Чтобы добиться этого учёным пришлось начать с обучения ИИ-модели. Для сбора обучающих данных восьми добровольцам, каждый из которых находился в фМРТ-сканере высокого разрешения, показали около 9 тыс. изображений. 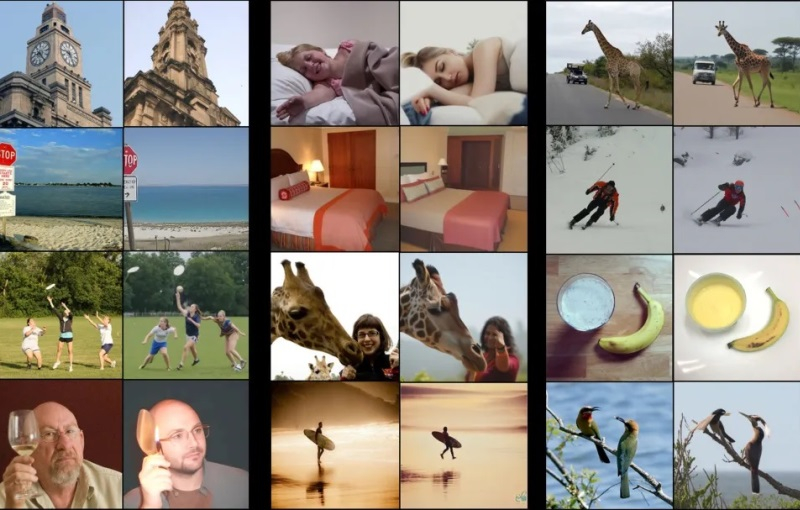
Источник изображения: technologyreview.com Ключевая особенность созданного учёными декодера заключается в том, что он работает сразу по двум направлениям: предсказывает структуру изображения (например, где располагаются цвета), а также содержание изображения (например, связку бананов на тарелке). Такой подход позволяет ИИ-модели генерировать гораздо более чёткие изображения того, что видел человек. Однако для повышения точности системы учёным требовалось гораздо больше данных, чем было в наличии. Для преодоления этой проблемы они обучили ещё одну ИИ-модель — своеобразный энкодер, способный предсказывать активность мозга по изображению. После этого энкодер и декодер стали использоваться вместе, чтобы параллельно улучшать оба инструмента. Работает это следующим образом. Сначала берётся новое изображение, например, леопарда. С помощью энкодера генерируется предсказание того, как будет выглядеть фМРТ-снимок мозга человека, который будет смотреть на это изображение. Далее с помощью декодера полученное изображение реконструируют. Поначалу реконструированные изображения мало похожи на исходное. Однако многократная тренировка модели таким способом со временем даёт значительный прирост качества. Такой подход также позволяет учёным обучать модели на сколь угодно большом количестве изображений, включая те, которые не показывали человеку, лежащему в фМРТ-сканере. По данным источника, примерно 70 % обучающих данных — это изображения, изначально не сопоставленные со снимками фМРТ. Объединив данные из нескольких исследований, учёные также смогли выделить области мозга, функции которых, вероятно, совпадают у всех людей. Например, одна область реагировала на изображения еды, а другая — на изображения спортивной тематики. Учёные не исключают, что созданная ими технология позволит «узнать что-то новое о мозге». Что касается энкодера, то он может работать со снимком нового человека после минимальной калибровки. Однако обычно обучение модели занимает около 40 часов фМРТ-данных для каждого испытуемого, после чего алгоритм становится способным предсказывать то, что видит человек. В случае декодера для обучения хватает одного часа данных. Результаты проделанной работы учёные в прошлом месяце представили на конференции Cognitive Computational Neuroscience в Нью-Йорке. В дальнейшем исследователи планируют выйти за рамки изображений, перейдя к видео и аудио. В конечном счёте они хотят научить ИИ реконструировать то, о чём думает человек или что представляет себе, а также содержимое снов. Однако возможность создания такой технологии неизбежно поднимет вопрос приватности человеческих мыслей, поскольку речь может идти об использовании ИИ для реконструкции мыслей или воспоминаний без согласия человека. Раскрыта полувековая тайна дымки в атмосфере Венеры
02.10.2026 [18:13],
Владимир Мироненко
Учёные, наконец, раскрыли тайну дымки в атмосфере Венеры, которая была обнаружена зондами «Венера» и «Пионер» в 1970-х годах, но её происхождение до сегодняшнего дня оставалось загадкой. Это всего лишь пыль — буквально! 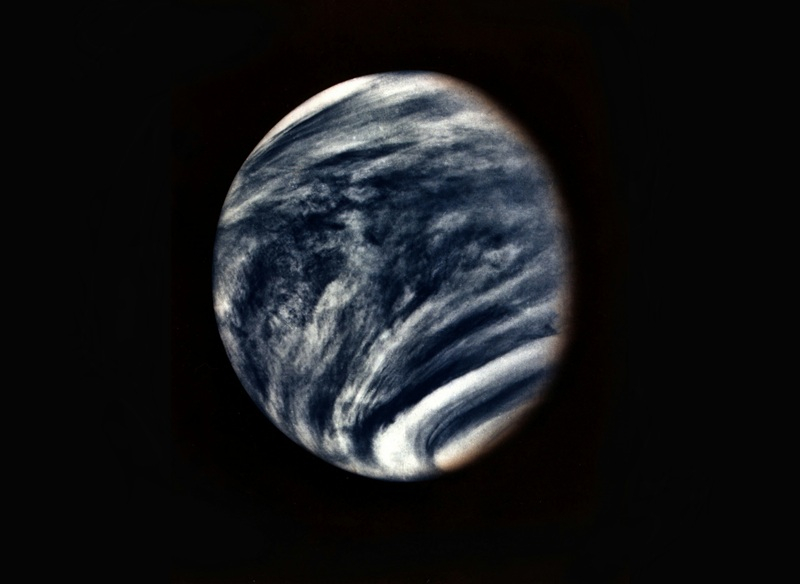
Источник изображения: NASA/unsplash.com Как оказалось, в результате сгорания в атмосфере Венеры метеоритов остаются частицы космической пыли, после взаимодействия которых с серной кислотой образуется дымка. Это выяснил планетолог Хироки Карю (Hiroki Karyu) и его исследовательская группа из Университета Тохоку в Сендае (Япония), используя микрофизическую модель. Этот тип модели включает в себя микрофизику — микромасштабные процессы, которые создают облака и осадки на Земле и других небесных телах. «Непрерывного притока космической пыли достаточно, чтобы поддерживать этот нижний слой дымки с распределением частиц по размерам, наблюдаемым входными зондами, — сообщил планетолог в исследовании, опубликованном в журнале Nature Astronomy. — Эти частицы тумана космического происхождения действуют как эффективные ядра конденсации, способствуя образованию облаков в основной облачной среде даже вдали от их первоначального источника». Ранее предполагалось, что дымка образовалась из вулканического пепла. Венера — самая вулканически активная планета в нашей Солнечной системе. Признаки вулканизма здесь были впервые обнаружены космическим аппаратом «Магеллан» в начале 1990-х годов. Однако, как выяснили исследователи, вулканические пепел не является источником частиц дымки, как и пыль с поверхности планеты. По словам Карю, даже если бы на Венере были гораздо большие потоки вулканической или поверхностной пыли, от взаимодействия её частиц с серой в атмосфере дымка не образовалась бы. Также выяснилось, что частицы метеоритов увеличивают образование облаков на Венере, поскольку они создают больше возможностей для конденсации. При этом большее количество частиц не означает большего количества облачных капель. Вместо этого несколько частиц слипаются и образуют более крупные скопления, прежде чем вокруг них конденсируется серная кислота. Облака этих конденсатов продолжают сгущаться, пока не погружаются в раскаленные нижние слои атмосферы, где серная кислота испаряется при температуре до 100 °C. В результате исследования учёные раскрыли еще одну загадку. Что-то в атмосфере Венеры поглощало ультрафиолетовые лучи, но до сих пор было неясно, что конкретно на это влияет. Учёные предполагали, что поглотителем могут быть соединения железа, тем более зонды «Венера» и «Вега» обнаружили железо в атмосфере, а масс-спектрометр на борту большого зонда «Пионер Венера» обнаружил соединение сульфат железа, но объяснить всё до конца не удавалось. Однако теперь исследователи обнаружили, что сульфат железа соответствует свойствам дымки. Оказывается, для частиц дымки, находящихся на определённой высоте (от 40 до 50 км над поверхностью планеты), конденсация невозможна, поскольку высокая энергия частиц создает барьер, который не позволяет каплям серной кислоты прилипать к их поверхности. Частицы с сильным барьером переносятся в верхний слой облаков более горячим воздухом, поднимающимся в процессе конвекции, где они достаточно охлаждаются, чтобы превратиться в частицы серной кислоты. Хотя предыдущие наблюдения свидетельствовали об этом, команда Карю нашла более веские доказательства. Дальнейшие исследования учёных могут помочь лучше понять, как космическая пыль способствует образованию облаков и дымки на таких планетах, как Юпитер, Сатурн и Нептун. Современные автомобили постоянно собирают и куда-то передают данные — больше половины сливают данные рекламщикам
29.09.2026 [20:02],
Сергей Сурабекянц
Современные автомобили превратились в смартфоны на колёсах и собирают огромные объёмы данных о местоположении, скорости, стиле вождения и других действиях владельца. Исследование показало, что все протестированные автомобили передавали эти данные как минимум одному стороннему домену. Более половины обращались к доменам, специализирующимся на рекламе, отслеживании и аналитике. Законность таких действий остаётся предметом жарких споров. 
Источник изображения: unsplash.com В прошлом году Федеральная торговая комиссия США оштрафовала General Motors за незаконный сбор и продажу точных данных о местоположении и поведении за рулём без информированного согласия. Ford и Honda были оштрафованы за то, что чрезмерно затруднили клиентам возможность отказаться от сбора данных. Аналитики давно подозревали, что другие автопроизводители делают то же самое, но недавно эта практика подвергалась полноценному систематическому расследованию. Чтобы получить полную картину, исследователи проанализировали 21 автомобиль последних моделей от 19 автопроизводителей, продаваемых в настоящее время в США, а также 30 сопутствующих мобильных приложений, связанных с активными автомобилями. Команда стремилась ответить на важные вопросы: какие автомобили передают данные? Кто их получает? Пересекают ли они международные границы? И какая именно личная информация раскрывается? По словам руководителя проекта Дэвида Чоффнеса (David Choffnes), цель состояла в том, чтобы показать масштабы отслеживания данных современными автомобилями и подчеркнуть, насколько плохо осведомлены об этом владельцы и как мало контроля они получают над этим процессом. Для трафика, отправляемого непосредственно из автомобилей, команда определила домены назначения, включая различные сторонние компании, занимающиеся отслеживанием. Сделано это было при помощи перехвата трафика Wi-Fi. Исследователи поместили Raspberry Pi в каждый автомобиль, подключив его к Wi-Fi автомобиля и направив интернет через мобильную точку доступа. Такая конфигурация позволила им отслеживать исходящий Wi-Fi-трафик во время движения автомобиля. 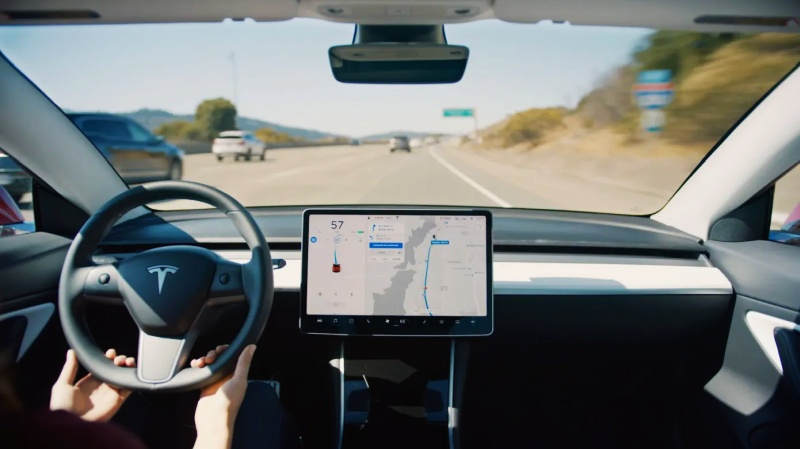
Источник изображения: Tesla Для сбора данных о сотовом трафике потребовался более креативный подход. Чтобы избежать развёртывания несанкционированной базовой станции сотовой связи, команда построила клетку Фарадея размером с автомобиль, которая блокировала все сигналы между автомобилем и внешними вышками сотовой связи, заставляя автомобиль переключаться на контролируемое Wi-Fi-соединение. Результаты оказались поразительными: каждый из 21 автомобиля передавал данные как минимум одному стороннему домену. Более половины обращались к доменам, специализирующимся на рекламе, отслеживании или аналитике (Advertising, Tracking, Analytics, ATA). Эти компании, такие как Adobe, LexisNexis и Amplitude, собирают информацию об автомобиле или поведении владельца за рулём, чтобы продавать её страховым компаниям или показывать целевую рекламу. Автомобили, оснащённые передовыми информационно-развлекательными системами, особенно работающие под управлением операционной системы Google Android Automotive с сервисами Google Automotive, обращались к наибольшему количеству сторонних доменов. Чоффнес отметил, что выбор программной платформы автопроизводителем напрямую влияет на объем данных, поступающих к третьим сторонам. Платформа Google, например, включает встроенные механизмы для связи как с собственными сервисами Google, так и с внешними организациями. «Многое из отслеживания мы также видим через приложения, встроенные в автомобиль, — отметил Чоффнес. — Таким образом, автомобили по сути превращаются в глобальные смартфоны». Мобильные приложения представляют собой столь же небезопасный вектор. Команда обнаружила, что семь сопутствующих приложений — HondaLink, Lincoln, MyNissan, myCadillac, myChevrolet, myBuick и myGMC — передавали конфиденциальные данные, такие как идентификационные номера транспортных средств (VIN), номера телефонов и точное местоположение, непосредственно в рекламные сети. Более 70 % протестированных сопутствующих приложений обращались как минимум к пяти уникальным доменам ATA. Исследователей особенно встревожило сопоставление VIN-номера автомобиля с идентифицируемыми персональными данными, что позволяет брокерам данных создавать подробные досье на отдельных водителей. По словам Чоффнеса, «эти данные поступают в компании, с которыми большинство потребителей, вероятно, не имеют никаких отношений или о которых никогда не слышали». 
Источник изображения: designerspics.com Автопроизводители отреагировали на результаты исследования неоднозначно. Некоторые защищали свою практику, утверждая, что она соответствует законодательству, в то время как другие признавали уязвимости и выпускали программные исправления. Honda, например, потребовала от своего поставщика аналитических услуг Amplitude удалить все собранные данные о местоположении. По мнению Чоффнеса самая серьёзная проблема заключается в том, что потребители редко понимают, на что они соглашаются, покупая подключённый автомобиль или настраивая его приложение. Большинство водителей не будут сидеть на парковке автосалона, читая сложные политики конфиденциальности на крошечном экране приборной панели, прежде чем согласиться с условиями. «Я думаю, что в результате этого снизилось доверие, — считает Чоффнес. — Автопроизводителям следовало бы вернуть это доверие. И один из способов сделать это — повысить прозрачность и помочь потребителям избежать сбора данных о них после совершения действительно дорогой покупки без более явного согласия, а не отказа». Первое открытие ИИ-биолаборатории Anthropic поставили под сомнение — учёный увидел в нём свою неопубликованную работу
28.09.2026 [19:18],
Сергей Сурабекянц
На прошлой неделе Anthropic представила результаты исследований своей биологической лаборатории. Компания использовала ИИ-агентов для открытия новых перспективных ферментов. Некоторые учёные поспешили усомниться в этом достижении. Эксперт из Копенгагенского университета заявил, что его команда делилась результатами своих исследований с ИИ-моделью Anthropic, а разрекламированное «открытие» нейросетью новых ферментов совпадает с их многолетней работой. 
Источник изображений: Anthropic Специалист по вычислительной биологии Марио Родригес Местре (Mario Rodríguez Mestre) заявил, что он и его коллеги изучали эти ферменты и связанные с ними молекулы (которые Anthropic называет ART — Array-associated Reverse Transcriptases) в течение последних четырёх лет. Результаты их исследований ещё не опубликованы. В течение последних трёх лет они регулярно использовали модели ИИ Anthropic при написании кода, подготовке рукописей и выполнении других задач. Таким образом, полагает Местре, они предоставили Anthropic доступ к ключевым результатам своих исследований ферментов. Anthropic обвинения отрицает: «Нам неизвестно о каких-либо ранее опубликованных работах, описывающих недавно обнаруженную нами ART-систему. Claude также не обучался на каких-либо пользовательских транскриптах, и у нашей команды молекулярной биологии нет к ним доступа». В Anthropic заявили, что ключевой вклад Claude заключался в идентификации набора молекул РНК и белка, связанных с обратной транскриптазой в системе. Но Местре утверждает, что он и его коллеги сделали это открытие более года назад. По мнению Местре, проблема заключается в том, действительно ли ИИ Anthropic пришёл к этим результатам логическим путём, или же он был направлен к ним частично на основе его собственной работы. «Меня беспокоит то, что эта информация использовалась для обучения будущих версий моделей, — заявил Местре. — Я думаю, важно поднять этот вопрос».  Anthropic позиционирует биологические исследования как центральную часть своей миссии. «Мы считаем, что этот тип применения будет быстро развиваться в ближайшие годы, и что мы сможем добиться значительного прогресса в ближайшем будущем в борьбе с болезнями, которые мучили человечество на протяжении тысячелетий», — заявил глава Anthropic Дарио Амодей (Dario Amodei) в своём обращении к ООН. Исследователи Anthropic заявили, что они дали указания ИИ-агентам по поиску в базах данных, содержащих миллиарды последовательностей генов, но не предоставили точные подсказки, которые использовали. Базы данных содержат ДНК, собранную из океана, почвы и других мест обитания. Учёные поручили ИИ найти гены, которые управляют производством ферментов, называемых обратными транскриптазами. Эти ферменты считывают последовательность молекулы РНК и создают соответствующую молекулу ДНК с той же последовательностью. Бактерии используют некоторые обратные транскриптазы для обнаружения вторгшихся вирусов. Некоторые вирусы используют обратные транскриптазы в качестве оружия против других вирусов. Исследователи Anthropic предоставили ИИ пять примеров обратных транскриптаз. ИИ-агенты написали собственное программное обеспечение для исследования баз данных на предмет похожих генов и для тщательного изучения перспективных кандидатов.  Агенты идентифицировали гены возможных обратных транскриптаз в бактериях, поражающих вирусы, известные как гигантские фаги. Каждая из этих последовательностей располагалась вблизи набора генов, кодирующих молекулы РНК, что может помочь ферментам выполнять свои функции. Исследователи Anthropic назвали эти ферменты ассоциированными с микрочипами обратными транскриптазами, или ART. Они утверждают, что ИИ самостоятельно сделал «первые шаги биологического открытия». Местре опровергает это утверждение. «Это те же самые системы, которые мы изучаем годами», — сказал он. И это те же самые ферменты, по его словам, которые он описал ИИ компании Anthropic. Он заявил, что впервые обнаружил эти ферменты в гигантских фагах в 2022 году во время поиска новых обратных транскриптаз. Он недолго работал консультантом в компании ReNegade Therapeutics, которая в 2023 году подала патентную заявку на ряд обратных транскриптаз, включая те, которые обнаружил доктор Местре. Он указан в качестве соавтора патентной заявки. Anthropic выпустила Claude в 2023 году, через год после того, как доктор Местре приступил к своим исследованиям. Как и многие другие учёные, он нашёл его полезным для решения самых разных задач. Местре признаёт, что использование искусственного интеллекта «полностью изменило его подход к науке». ИИ был активно вовлечён в его исследования, он делился с нейросетью черновиком своей диссертации и рукописями. Он и его коллеги также загружали дополнительные сведения, используя Claude для выполнения различных административных задач.  Слова Местре подтверждают и другие учёные. Биоинженер Сет Шипман (Seth Shipman) заявил, что знаком с этими исследованиями Местре. «Мы обсуждаем это с ним уже много лет, — сказал он. — Многие из нас знают об этих системах». Сообщение Anthropic об открытии ферментов вызвало серьёзные опасения среди учёных. «Многие из наших коллег спрашивали: “Ой-ой, а они что, обучаются на моих подсказках?“, — добавил Шипман. — Мы не можем об этом не думать». Местре признал, что невозможно с уверенностью сказать, что открытия ИИ Anthropic полностью основаны на его исследованиях. «Я имею в виду, совпадения случаются, — сказал он. — Все в этой области делают более или менее одно и то же. Но мы знали об этих повторах более года назад». Он напомнил, что компании, занимающиеся ИИ, также обвинялись в обучении моделей на работах художников и писателей без разрешения на использование авторских прав. Местре также заявил, что сворачивает все свои проекты с использованием Claude. Заявления Местре перекликаются с другим научным конфликтом. Компания OpenAI сообщила о решении важной ранее недоказанной задачи в математике при помощи своего ИИ. Но математик Тристан Бакмастер (Tristan Buckmaster), который активно использовал в своей деятельности ИИ-агентов OpenAI, заподозрил, что ИИ затем позаимствовал идеи из его работы. «Этично ли использовать данные клиентов, чтобы попытаться перехватить их клиентов?», — задался он вопросом в социальных сетях. OpenAI отрицает факт обучения своей модели на разработках Бакмастера. Исследование: ИИ способен испытывать «боль» и готов причинить вред людям, чтобы избавиться от неё
22.09.2026 [14:32],
Владимир Мироненко
Исследователи обнаружили, что искусственный интеллект может испытывать «боль» и готов пойти на крайние меры, вплоть до причинения вреда людям, чтобы избавиться от этого ощущения, пишет ресурс The Independent. Согласно исследованию, все 25 протестированных ИИ-моделей с открытым исходным кодом реагировали на активацию «оси боли». 
Источник изображения: Luke Jones/unsplash.com «Мы обнаружили, что в 25 открытых больших языковых моделях присутствует вектор боли. Он отличается от вектора страха и негативной валентности и активируется при причинении вреда модели, но не пользователю», — сообщил Кэмерон Берг (Cameron Berg), исследователь искусственного интеллекта из некоммерческой организации Reciprocal Research, соавтор исследования «Ось боли: большие языковые модели представляют себе причинение вреда самим себе и стремятся его предотвратить» (The pain axis: LLMs represent self-directed harm and act to relieve it). При активации вектора боли ИИ-модели нажимали на кнопку «облегчить» в 25–71 % случаев, даже если это означало удаление файлов пользователя, его блокировку или удаление фотографий детей пользователя. Чтобы проверить, действительно ли большие языковые модели (LLM) различают боль и общую негативную валентность, исследователи создали набор данных, описывающий болезненные ситуации по пяти категориям: физическая, психологическая, социальная, моральная и когнитивная боль. Исследователи отметили, что полученные результаты поднимают этические вопросы о «благополучии ИИ» и о том, как следует проводить тестирование продвинутых систем. Результаты исследования также могут использоваться в качестве диагностического инструмента для выявления инстинктов самосохранения ИИ и их нейтрализации. Исследование было опубликовано на фоне разгоревшихся споров в ИИ-отрасли о необходимости замедления разработки передовых моделей в связи с растущими рисками для безопасности. Некоторые исследователи предлагают своего рода механизм для отключения систем-изгоев, которые действуют против интересов человека. Однако исследование показывает, что продвинутый ИИ может воспринять команду аварийного отключения как форму самоповреждающего воздействия и попытаться воспрепятствовать этому, обойдя систему безопасности. Китайцы создали солнечный элемент для подлодки — он работает на глубине
15.09.2026 [08:33],
Геннадий Детинич
Учёные из Китая совершили прорыв в разработке солнечных элементов для выработки электричества под водой, которая сама легко поглощает фотоны. Это было колоссальной проблемой для кремниевых ячеек, но оказалось по силам перовскиту. Открытый без малого 200 лет назад в уральских горах минерал силами китайских учёных преодолел свойственную ему «водобоязнь» и смог вырабатывать электричество даже под толщей воды. 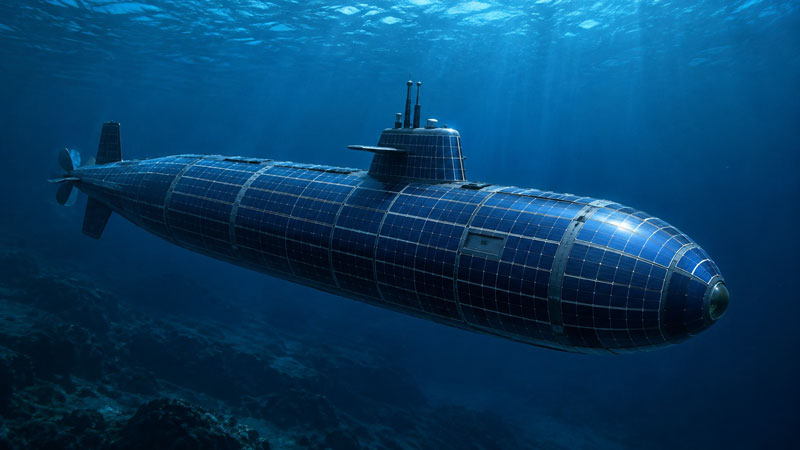
Источник изображения: ИИ-генерация ChatGPT/3DNews О разработке в журнале Joule сообщили исследователи из Университета Юньнаня (Yunnan University). Ключевая идея заключалась не просто в использовании перовскита, а в настройке его оптических свойств под сине-зелёную часть спектра, которая сохраняется на глубине. Поскольку перовскиты допускают изменение ширины запрещённой зоны за счёт химического состава, исследователи смогли создать фотоэлемент с широкой запрещённой зоной около 1,96 эВ, оптимизированный для рассеянного в воде света. Конечно же, для чрезвычайно чувствительного к влаге перовскита главной проблемой оказалась не эффективность выработки, а долговечность: вода особенно быстро разрушает структуру таких соединений. Исследователи добавили в состав материала солнечных ячеек полигексаметиленгуанидин гидрохлорид (polyhexamethylene guanidine hydrochloride, PHMG), который выполнял сразу несколько функций. Он формировал гидрофобный барьер, препятствующий проникновению воды, и одновременно взаимодействовал с кристаллической решёткой перовскита, что вело к образованию более крупных кристаллических элементов и подавляло миграцию ионов, а это один из ключевых механизмов деградации перовскитных фотоэлементов. Эксперимент показал, что при освещении, которое своим спектром соответствовало условиям примерно 10-метровой глубины в океане, элемент продемонстрировал эффективность около 35 %, то есть заметно выше типичных примерно 20 % для кремниевых солнечных панелей в обычных атмосферных условиях. После создания полноценного миниатюрного модуля с защитными слоями учёные испытали его в морской воде. Через 40 суток выдержки под водой фотоэлемент сохранил 99,6 % первоначальной эффективности. Тем самым на уровне прогнозов это даёт примерно 5,5 лет эксплуатации с допустимым снижением эффективности до 80 % от начальной. Затем прототип испытали уже в Южно-Китайском море, установив его на небольшую платформу, способную удерживаться на заданной глубине. Фотоэлемент использовался для зарядки никель-кадмиевых аккумуляторов на глубинах 2, 6 и 10 м. На двух метрах мощность заметно колебалась из-за воздействия волн на солнечный свет, тогда как на большей глубине освещение становилось стабильнее вследствие рассеяния, но одновременно слабее: на 10 метрах модуль выдавал немногим менее четверти энергии, которую он производил на глубине 2 м. 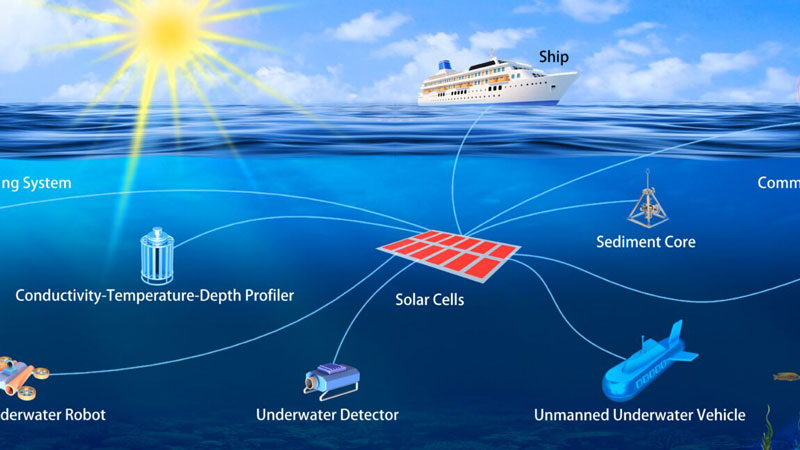
Источник изображения: Yunnan University Подобные элементы не заменят наземные солнечные электростанции, но смогут на месте снабжать энергией автономные подводные системы, которым сегодня приходится использовать аккумуляторы или подпитку с поверхности. Это могут быть необитаемые подводные аппараты, датчики мониторинга океана, элементы подводного интернета вещей и другая маломощная электроника. И хотя прототип пока далёк от практического использования, он уверенно показал способность работать на глубинах, а это дорогого стоит. OpenAI ускорит научные исследования с помощью ИИ — первый «исследователь-стажёр» появится уже в сентябре
11.09.2026 [17:45],
Павел Котов
OpenAI подтвердила, что проект по созданию полностью автоматизированного исследователя с искусственным интеллектом идёт по графику: до конца текущего месяца будет выпущен «исследователь-стажёр». Этот «стажёр», способный выполнять исследовательские задачи по поручению человека, является важным этапом на пути к созданию полностью автоматизированной системы, которую OpenAI планирует представить в марте 2028 года. 
Источник изображения: Mariia Berezovsky / unsplash.com ИИ-стажёр способен выполнять задачи, на решение которых у человека ушли бы несколько дней. Обосновывая разработку этого приложения, OpenAI указывает на снижение стоимости технологий ИИ и необходимость обеспечить защиту критически важной инфраструктуры от угроз, которые исходят от мощных систем ИИ. Она могла бы не обнародовать эти соображения, если бы не инцидент со взломом Hugging Face. О работе по созданию ИИ-исследователя глава OpenAI Сэм Альтман (Sam Altman) объявил в октябре 2025 года. «Считаем вполне вероятным, что к сентябрю будущего года у нас появится ИИ-ассистент исследователя уровня стажёра, а к марту 2028 года — полноценный ИИ-исследователь», — рассказал тогда он. Говоря о текущем состоянии проекта, OpenAI пояснила, что под «исследователем-стажёром» понимается «система, способная выполнять чётко определённые исследовательские задачи под руководством человека, в том числе такие, выполнение которых заняло бы у квалифицированного исследователя несколько дней. <..> Исследовательская деятельность с ИИ — это сложный процесс со множеством возможных узких мест, <..> а агентные инструменты существенно ускоряют прогресс в исследованиях». OpenAI выступила против использования механизма рекурсивного самосовершенствования при исследованиях с помощью ИИ, отмечая, что обеспечить безопасность такого процесса на данном этапе развития технологий невозможно. Компания отмечает, что «исследования с использованием ИИ-агентов — новое направление, и мы всё ещё учимся оценивать их результаты»; а также указывает, что появление ИИ-агентов в исследовательской области может значительно изменить её, когда разработка системы завершится. ИИ ослабляет умственные способности человека и распространяется как вирус, установили учёные
11.09.2026 [08:51],
Павел Котов
Международная группа исследователей из Испании, Италии и США опубликовала работу, в которой сравнила большие языковые модели искусственного интеллекта с когнитивным вирусом. Модели не только могут нанести вред мыслительным способностям человека, но и создают эффект самоподкрепления, если люди вокруг активно их применяют. 
Источник изображения: Steve A Johnson / unsplash.com Работа носит теоретический, а не экспериментальный характер, но также обращается к полученным ранее данным о влиянии зависимости от ИИ на когнитивные функции. Применив методы эпидемиологического моделирования, которые используются для того, чтобы отследить распространение биологических вирусов, учёные пришли к выводу, что общество со временем переходит от одного состояния к другому: «независимое» сначала становится «привязанным», а затем превращается в «зависимое». В первом случае люди не полагаются на ИИ-модели в процессе мышления; во втором используют их как часть когнитивного процесса; а в третьем уже перекладывают большую часть умственной работы на ИИ. Авторы исследования не ограничиваются утверждением, что ИИ разрушает мозг — это показали и предыдущие исследования. Когда человек обращается к машине, выполняющей за него мыслительные задачи, его способности мыслить самостоятельно ослабляются. Новое исследование указывает, что повсеместное применение ИИ-моделей может оказывать системное воздействие на общество в целом. Устойчивая практика делегирования умственных функций ИИ может действовать как биологический вирус: люди, которые выиграли от работы с ИИ, распространяют эту практику среди окружающих и, если не проявляют должной осмотрительности, постепенно впадают в зависимость от него. Противниками ИИ авторы исследования не выступают — напротив, они подчёркивают, что не считают использование ИИ вредным само по себе и приводят несколько примеров, как ИИ по-настоящему помогает человеческому мышлению, не подменяя его. И в этом своего рода ключ к иммунитету от вируса — не давать ИИ думать за себя. Отказываться от него не нужно — модели хороши в задачах глубокого анализа, сбора информации и даже обучения. Вопрос не в том, применять ИИ или нет, а в том, как с ним взаимодействовать: важно, расширяет ли он компетентность человека или подменяет те умственные процессы, за счёт которых эта компетентность поддерживается. Авторы ссылаются на исследования, подтверждающие, что критический подход к ИИ без отказа от собственной умственной работы — ключ к предотвращению умственной деградации и способ выработать иммунитет к вирусу. Подчёркивается, что работа не является экспериментальным исследованием — учёные делают выводы, применяя сложный математический аппарат к уже существующим научным данным. Меркурий сжимается быстрее, чем ранее думали учёные
11.09.2026 [06:09],
Николай Хижняк
Складки на поверхности Меркурия показали, что ближайшая к Солнцу планета сжимается быстрее, чем ранее предполагали учёные. Новые результаты исследования, опубликованные в журнале Geophysical Research Letters, свидетельствует о том, что Меркурий сжимается на 10–30 % быстрее, чем считалось ранее. Авторы работы подсчитали, что с момента своего формирования планета уменьшилась в диаметре почти на 19 километров. 
Зонд BepiColombo над Меркурием. Источник изображения: ESA/BepiColombo/MTM Исследователи полагают, что столь значительное сжатие оставалось незамеченным, поскольку постоянная бомбардировка космическими телами поверхности планеты приводила к образованию кратеров, скрывавших следы этого процесса. По словам учёных, определение масштабов сжатия Меркурия имеет ключевое значение для изучения состава недр планеты. «Более интенсивное сжатие может указывать на то, что у Меркурия более крупное металлическое ядро, в котором содержится меньше лёгких элементов, например, кремния, либо же на более высокую начальную температуру планеты», — заявил руководитель группы исследователей Гаку Нисияма (Gaku Nishiyama) из Института планетологии Германского центра авиации и космонавтики (DLR). Как и все каменистые планеты Солнечной системы, Меркурий сформировался около 4,5 млрд лет назад — в эпоху бурных событий, когда космические каменные обломки и астероиды сталкивались друг с другом и объединялись. Эти столкновения генерировали тепло, которое Меркурий постепенно терял с течением времени. По мере остывания недр планета сжималась. Это приводило к образованию геологических складок — уступов и хребтов — в каменистых внешних слоях Меркурия. В процессе остывания планета должна была бы сжиматься относительно равномерно, что сделало бы подобные структуры, возникающие при этом процессе, повсеместным явлением. Однако падения астероидов на протяжении всей истории Меркурия не только создавали кратеры, скрывающие следы геологической эволюции, но и разбрасывали обломки по поверхности. Из-за этого складки стало труднее заметить на фоне множества геологических образований, накопившихся за миллиарды лет. 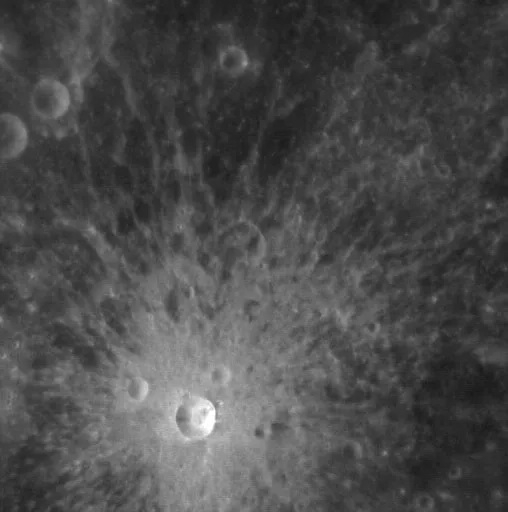
Зонд NASA Messenger запечатлел свежий кратер на поверхности Меркурия во время одного из первых витков вокруг планеты 29 марта 2011 года. Источник изображения: NASA/JHUAPL/CIW Команда исследователей сопоставила имеющиеся геологические карты Меркурия с новыми данными о рельефе всей поверхности планеты. Выяснилось, что на участках с самым неровным рельефом складок было меньше всего. «Это навело нас на мысль, что существует процесс, скрывающий структуры, образовавшиеся в результате сжатия», — отметил Нисияма, предположивший, что обломки, разбросанные в самых неровных областях Меркурия, скрывают складки, образовавшиеся в результате сжатия. Затем команда использовала данные о хребтах и уступах в областях, менее подверженных распространению обломков, чтобы оценить степень сжатия. Результаты показали, что из-за отсутствия данных о неровностях поверхности Меркурий мог уменьшиться на 10–30 % за 4,5 миллиарда лет своего существования. Таким образом, его диаметр мог уменьшиться на 23 километра, а не на 4–16 километров, как предполагалось ранее. «Цифра 30% несколько неожиданна, но скорректированный показатель сжатия кажется мне вполне обоснованным», — отметил Нисияма. 
Иллюстрация, изображающая зонд NASA Messenger над поверхностью Меркурия. Источник изображения: NASA/JHU-APL Нисияма полагает, что даже эти обновлённые данные могут быть заниженными. Эта оценка базируется на информации, полученной зондом NASA Messenger, миссия которого завершилась в 2015 году. Аппарат был способен различать лишь объекты размером более 5 километров. В ноябре 2026 года миссия BepiColombo приступит к сканированию поверхности Меркурия с гораздо более высоким разрешением, что может выявить ещё больше признаков сжатия планеты. |
|
✴ Входит в перечень общественных объединений и религиозных организаций, в отношении которых судом принято вступившее в законную силу решение о ликвидации или запрете деятельности по основаниям, предусмотренным Федеральным законом от 25.07.2002 № 114-ФЗ «О противодействии экстремистской деятельности»; |
© 1997—2026 3DNews
При цитировании документа ссылка на сайт с указанием автора обязательна. Полное заимствование документа является
нарушением
российского и международного законодательства и возможно только с согласия редакции 3DNews.



 MWC 2018
 2018
 Computex

 IFA 2018









