


Опрос
|
реклама
Быстрый переход
Google запустит рекламу в ИИ-поиске по всему миру — обычная поисковая реклама растёт всё медленнее
30.10.2026 [00:28],
Николай Хижняк
Google выводит рекламу в своём ИИ-поиске на мировой уровень. Компания решилась на этот шаг, чтобы найти новые источники дохода, поскольку рост выручки от обычной поисковой рекламы начал замедляться. О запуске объявили во время конференции по итогам финансового квартала материнской компании Alphabet. 
Источник изображения: unsplash.com Alphabet отчиталась о выручке в размере $127,6 млрд, что на 25 % превышает показатель за аналогичный период прошлого года. Несмотря на общий рост, динамика доходов от традиционной поисковой рекламы продолжила замедляться: в третьем квартале они увеличились на 12 % в годовом выражении по сравнению с 17 % во втором квартале и 19 % в первом квартале. На этом фоне акции Alphabet снизились на 8 %. Сложившаяся ситуация усиливает давление на корпорацию, требуя более активной монетизации внедряемых функций искусственного интеллекта. «Сейчас мы масштабируем высококачественную рекламу в блоках ИИ-ответов (AI Overviews) в ИИ-режиме для большего числа пользователей и запросов. Это включает и первый в истории вывод нашей монетизации на глобальный уровень. Сегодня мы объявляем о расширении рекламы в ИИ-режиме на международные рынки наряду с запуском многоэтапной рекламы в США», — заявил Филипп Шиндлер (Philipp Schindler), главный бизнес-директор Google, во время конференции с инвесторами. По словам Шиндлера, предварительные результаты показывают эффективность этих форматов. Показатели кликабельности (CTR) для спонсорских предложений товаров в режиме ИИ-обзоров уже сопоставимы с показателями для органической выдачи. Кроме того, исследования пользователей, проведённые компанией, подтверждают, что люди находят такую рекламу релевантной. Данная инициатива развивает анонсированную в мае стратегию по внедрению рекламных форматов на базе модели Gemini, которые включают диалоговую поисковую рекламу и спонсируемые рекомендации, встроенные непосредственно в генерируемые искусственным интеллектом ответы. Генеральный директор Google Сундар Пичаи (Sundar Pichai) отметил, что количество поисковых запросов продемонстрировало самые высокие темпы годового роста за последние пять лет (точный показатель он не раскрыл). По его словам, ИИ-функции меняют характер использования поиска — пользователи стали задавать более длинные и сложные вопросы. Пичаи уточнил, что запросы в режиме ИИ-обзоров в среднем в три раза длиннее, чем при обычном поиске, а каждый пятый такой запрос в мире включает использование голоса, изображений или документов. Кроме того, число визуальных поисковых запросов в Google превысило 50 млрд в месяц. «[Поиск] делает преимущества искусственного интеллекта доступными для большего числа людей, чем любой другой продукт в мире. Пользователи всё чаще обращаются к нашим функциям на базе ИИ, применяя совершенно новые способы поиска. Их запросы становятся более развёрнутыми, персонализированными и мультимодальными», — заявил Пичаи инвесторам. Подразделение Google Services компании Alphabet, в которое входит поисковый сервис, принесло $96,3 млрд выручки — на 11 % больше по сравнению с аналогичным периодом прошлого года. Выручка Google Cloud подскочила на 103 %, достигнув $30,7 млрд. Финансовые результаты зафиксированы по итогам насыщенного квартала, в течение которого Google выпустила модель Gemini 4 Argon, зафиксировала рост ежемесячной аудитории приложения Gemini до 1 млрд пользователей и представила смартфоны серии Pixel 11. Discord разрешит читать сообщения публичных серверов без регистрации — через Google
29.10.2026 [00:30],
Николай Хижняк
Платформа Discord объявила о масштабном изменении, в рамках которого содержимое публичных серверов начнёт индексироваться поисковой системой Google. 
Источник изображения: Mariia Shalabaieva / unsplash.com С 16 ноября 2026 года все открытые для поиска внутри платформы серверы (Discoverable Servers) автоматически получат собственные веб-страницы (Server Web Pages). На этих страницах изначально будут публиковаться текстовые сводки и краткие описания обсуждений, проходящих на сервере. С середины декабря 2026 года часть сообщений из каналов таких серверов станет полностью доступна для просмотра непосредственно на этих веб-страницах. Сторонние посетители смогут читать эти сообщения через поисковые запросы в Google без необходимости вступать в сервер или иметь учётную запись Discord. По заявлению компании, нововведение призвано помочь независимым разработчикам игр, фан-сообществам и создателям контента привлекать новую аудиторию и развивать свои каналы за счёт поискового трафика. Новые правила затрагивают 63 тыс. серверов, которые на данный момент открыты для свободного входа внутри мессенджера. При этом личные сообщения и приватные серверы, доступные только по индивидуальным приглашениям, останутся полностью закрытыми для индексации. Платформа сохраняет возможность отказаться от участия в индексации как для администраторов, так и для рядовых пользователей. Владельцы серверов могут исключить определённые каналы или весь сервер из поисковой выдачи Google через меню настроек в разделе «Web Presence». Администраторам также доступно полное отключение генерации текстовых сводок на веб-страницах. Обычные пользователи могут запретить отображение своих сообщений на публичных веб-страницах серверов. Для этого в настройках учётной записи необходимо перейти по пути User Settings → Data and Privacy и изменить параметры в разделе Channel Messages. При этом пользователи не могут запретить использование своих сообщений для составления текстовых сводок (Channel Summaries). Однако в целях конфиденциальности их аватары и никнеймы на публичных веб-страницах (Server Web Pages) отображаться не будут. Google начала платить сайтам за контент для ИИ-ответов — но большинству достаются копейки
01.10.2026 [00:53],
Анжелла Марина
Google начала эксперимент с выплатами издателям за материалы, которые используются при формировании ИИ-ответов в поиске. Однако первые результаты программы вызвали скептицизм: небольшие и средние сайты получают настолько мало денег, что это не компенсирует падение их поискового трафика из-за ИИ. 
Источник изображения: AI По данным Ars Technica со ссылкой на The Information, к программе под названием AI contribution pilot компания Google подключила около 100 издателей. Участникам платят, если их материалы существенно влияют на ответы Gemini в ИИ-обзорах (AI Overview). При этом ранее Google не рассматривала возможность прямых выплат за использование контента, утверждая, что сайты получают взамен трафик из поисковой системы. Несколько небольших и средних издателей рассказали The Information, что выплаты составляют примерно 0,1 % от их рекламной выручки, а некоторые крупные издатели вообще отказались от участия, рассчитывая таким образом добиться от Google более выгодных условий. При этом суммы заметно различаются. Например, один из участников программы по прогнозам может получать более $1 млн в год, тогда как недавно подключившийся сайт заработал около $60 000, что составляет лишь малую долю его доходов. Небольшие сайты получили менее $1000 за несколько месяцев. Участники эксперимента отмечают, что материалы по нишевой тематике (аниме и игры) с меньшим количестве публикаций зарабатывают больше в виду высокого интереса у узкой аудитории. Одновременно статистика в консоли Google Search остаётся непрозрачной и издатели не всегда могут определить, почему получили ту или иную сумму. Компания также не объясняет достаточно подробно, что именно считается существенным вкладом в ИИ-ответ, поэтому сайтам сложно прогнозировать будущие выплаты. Для Google проблема выходит за рамки отдельного эксперимента, так как ИИ-модели получают знания из большого массива интернет-данных, а поисковым системам по-прежнему необходим новый и актуальный веб-контент. Если сайты перестанут публиковать материалы или начнут блокировать доступ поисковым ботам Google, это может повлиять и на качество ИИ-поиска. При этом некоторые издатели уже активно начали противостоять переходу Google к поиску на базе ИИ. В частности, The New York Times подала иск из-за незаконного использования своих материалов для обучения моделей, а компания Penske Media, владеющая изданиями Variety и Rolling Stone, обвинила Google в несправедливом объединении обычной поисковой индексации со сбором данных для ИИ. На ситуацию обращают внимание и регуляторы. В Великобритании Google ранее обязали предоставить издателям возможность отказаться от использования материалов в ИИ-поиске без потери присутствия в обычной выдаче, а Европейская комиссия проводит антимонопольное расследование, связанное с компенсацией издателям за использование их контента в ИИ-ответах. Google начала убирать кнопку «Поиск в Google» с главной страницы — её заменяет ИИ, но пока только в рамках теста
10.08.2026 [23:55],
Анжелла Марина
Google начала тестировать новую версию главной страницы поисковика, в которой классическая кнопка «Поиск в Google» заменена на набор ярлыков для работы с искусственным интеллектом. Обновлённый интерфейс фокусирует внимание пользователей на ИИ-функциях, но пока отображается не у всех. 
Источник изображения: SumUp/Unsplash Как сообщает Android Authority со ссылкой на Search Engine Watch, новый интерфейс заметили некоторые пользователи, зашедшие на стартовую страницу без авторизации в аккаунте Google. Вместо привычной поисковой кнопки им предлагаются три опции: «Создать изображения» с помощью модели Nano Banana, «Спросить о файлах» для загрузки документов с последующим запросом к ИИ по их содержанию и «Мозговой штурм» для обычного диалога с ИИ. Единственным элементом, который Google не удалила, остаётся кнопка «Мне повезёт!». 
Источник изображения: searchenginewatch.com Примечательно, что на главной странице также исчезло явное упоминание о возможности поиска. При этом сама поисковая функция никуда не исчезла: пользователи по-прежнему могут ввести запрос в поле и нажать клавишу Enter или Return на клавиатуре, что указывает на сохранение базовой функциональности даже при отсутствии графической кнопки. Пока Google не раскрыла масштабы эксперимента, а критерии текущего тестирования остаются неизвестными, поскольку новый макет не воспроизводится стабильно даже при смене браузеров, регионов или статуса авторизации, отмечает журналист Search Engine Watch. Однако сам факт исключения ключевого навигационного элемента укладывается в общую стратегию компании по привлечению пользователей к своим ИИ-сервисам. Google доигралась: ИИ-поиск убивает трафик крупнейших СМИ — они готовы отключить поискового бота
22.07.2026 [20:33],
Сергей Сурабекянц
Ведущие медиакомпании, среди которых USA Today, Politico, The Economist, People Inc., Reuters и онлайн-форум Reddit, задумываются стоит ли им продолжать сотрудничество с Google, поскольку ИИ меняет формат поиска, снижает поисковый трафик и подрывает модели получения дохода. По мнению издателей, поисковая система больше не является надёжным источником посетителей, особенно после расширения функций поиска с использованием ИИ в последние месяцы. 
Источник изображений: unsplash.com По данным Cloudflare, боты сейчас составляют более половины всего веб-трафика. Некоторые из них собирают контент издателей для обучения собственных моделей ИИ, другие сканируют сайты, чтобы быстро отвечать на запросы пользователей или продавать контент другим компаниям. Попытки их блокировать превратились в игру «ударь крота» по мере совершенствования технологий. Издатели могут отключить сканирование специально для обучения ИИ-моделей Google, но, как правило, им необходимо разрешить боту сканирование как для результатов запросов ИИ, так и для традиционной функции поиска, если они хотят, чтобы их контент отображался в любом из этих источников. По мнению главы консалтинговой компании DJB Strategies Дэвида Баттла (David Buttle), «для некоторых категорий издателей это вопрос выживания». В период с июня 2025 года по июнь 2026 года органический поисковый трафик Google от пользователей из США упал почти вдвое для издания USA Today, на 23 % — для сайта Politico, примерно на 25 % — для CNN и более чем на 85 % для Business Insider. «Сейчас существует две аудитории, — считает главный операционный директор Time Марк Ховард (Mark Howard). — Мы думаем о том, как нам обеспечить наилучшее обслуживание людей, когда они обращаются к нам, и как нам рассматривать ботов как вторичную аудиторию?»  Компания USA Today рассматривает возможность блокировки сканирования Google, а это означает, что её контент не попадёт в сводки ИИ Google и в результаты поиска. По словам представителя компании, она готова отключить доступ Google, если тенденция к снижению поисковой активности продолжится. Также USA Today подала иск против Google, утверждая, что компания обладает монополией в сфере рекламных технологий, что негативно сказывается на доходах издателя от рекламы. Сотрудники издания Politico рассматривают возможность ограничения доступа ботов Google и других компаний к бесплатным статьям и введение системы регистрации для просмотра контента. Агентство Reuters, которое, как и Politico, получает большую часть своей выручки от услуг для бизнеса, заявило, что также рассматривает вопрос о блокировке бота Google для своего новостного продукта, ориентированного на потребителей, в связи со снижением трафика. В сентябре 2025 года компания Penske Media, владеющая изданиями Variety и Rolling Stone, подала в суд на Google по антимонопольным основаниям, утверждая, что её аналитические обзоры, созданные с помощью ИИ, незаконно используют материалы издательства и снижают онлайн-трафик. Компания People Inc. смогла увеличить выручку за счёт мероприятий, переходов по ссылкам в социальных сетях и расширения приложений — даже несмотря на то, что поиск Google обеспечил лишь 25 % её трафика в первом квартале этого года, по сравнению с более чем половиной два года назад. Компания пока не запретила Google доступ к своему контенту, но, по словам генерального директора Нила Фогеля (Neil Vogel), «отключение и полная блокировка ботов — это 100 % обсуждаемый вопрос». Издание Time помогает рекламодателям доносить свои сообщения до ботов, используя своего рода подход «троянского коня» — создавая текстовые объявления, которые обычные читатели не видят, но которые могут обнаружить ИИ-сканеры. Компания рассчитывает, что боты, собирающие контент, будут ссылаться на информацию из этих сообщений при ответе на запросы пользователей, что позволит увеличить охватить целевой аудитории. Издание The Economist активно обсуждает возможность отказа от функций поиска с использованием ИИ, хотя полный разрыв сотрудничества с Google не рассматривается. «Google — мощная сила, с которой нужно считаться, — полагает вице-президент Economist Джош Манке (Josh Muncke). — Трафик может быть нестабильным и снижаться, но трафик всё равно остаётся трафиком». В 2024 году Reddit заключил сделку на $60 млн в год, которая позволила Google использовать его контент для обучения моделей ИИ. Но теперь онлайн-форум столкнулся с тем, что ответы на запросы, генерируемые ИИ, сокращают количество переходов на первоисточник. Сейчас компании ведут переговоры о возможном продлении сделки, но инсайдеры сообщают о глубоких сомнениях руководителей Reddit в её целесообразности. Google заявляет, что её функции поиска на основе ИИ «еженедельно отправляют миллиарды кликов в интернет» и отвечают меняющимся потребностям пользователей. «Наши функции ИИ выделяют ссылки на веб-сайты и помогают создателям контента и издателям расширять свою аудиторию, также мы предлагаем владельцам сайтов чёткие средства управления контентом», — заявил представитель компании. Google предприняла некоторые шаги навстречу новостным изданиям, в том числе запустила программу, в рамках которой более 200 издателей получают плату за доступ к своему контенту для использования ИИ. Компания позволила пользователям самостоятельно выбирать предпочтительные источники новостей, чтобы персонализировать главные новости, которые появляются в результатах поиска, потенциально привлекая больше трафика на эти сайты. Великобритания потребовала от Google повысить прозрачность поисковой выдачи
18.06.2026 [06:51],
Анжелла Марина
Британский антимонопольный регулятор Competition and Markets Authority (CMA) обязал компанию Google повысить прозрачность механизмов ранжирования поисковой выдачи. Новые правила, по сообщению Reuters, направлены на обеспечение справедливой конкуренции и требуют от технологического гиганта использования объективных критериев. 
Источник изображения: Solen Feyissa/Unsplash Согласно опубликованному предписанию, компания должна внедрить чёткую процедуру рассмотрения жалоб и обеспечить возможность экспорта поисковых данных уполномоченным сторонним организациям. В Google заявили о готовности сотрудничать с ведомством, подчеркнув, что текущие системы ранжирования уже демонстрируют наиболее релевантные результаты высокого качества. Ранее аналогичные претензии к доминированию американской компании высказывали власти США и Европейского союза. На реализацию требования о справедливом ранжировании Google отвели шесть месяцев, а на внедрение функции переноса данных — три месяца. Однако профессиональная ассоциация издателей Великобритании раскритиковала такие сроки, указав, что они дают Google «слишком много пространства для манёвра» до полного вступления правил в силу, особенно в условиях стремительного развития ИИ-поиска. Представители британского бизнеса, в свою очередь, ранее сообщали регулятору, что текущие практики ранжирования не являются ни справедливыми, ни прозрачными, что сдерживает инвестиции в собственные компании. В ответ на это CMA предупредила, что может ввести дополнительные меры регулирования, если посчитает, что принятых шагов недостаточно для устранения дисбаланса на рынке. Регулятор, присвоивший платформе статус стратегически важного участника рынка из-за доли Google, превышающей 90 % в британском поисковом сегменте, продолжает усиливать контроль над компанией. Исполнительный директор CMA Уилл Хейтер (Will Hayter) отметил, что ведомство поэтапно улучшает работу поисковых сервисов для бизнеса и потребителей страны, а новые требования стали дополнением к недавним ограничениям, позволяющим издателям устанавливать запрет на использование своего контента для обучения искусственного интеллекта Google. Google начнёт использовать для обучения ИИ данные из «Google Объектив», Search Live и Translate
11.06.2026 [05:07],
Анжелла Марина
Google объявила о внесении изменений в систему хранения данных пользователей, связанных с использованием поисковых запросов с помощью изображений, аудио и видео. Теперь эти файлы, используемые при поиске через «Google Объектив», Search Live и голосовой поиск через Translate, будут сохраняться в новом разделе «История действий в сервисах Поиска» (Search Services History). 
Источник изображения: Solen Feyissa/Unsplash Согласно информации на сайте компании, пользователи смогут отключить сохранение медиафайлов через настройку «Сохранение медиафайлов» (Save Media) или полностью деактивировать «Историю действий в сервисах Поиска». Новая система позволит Google использовать собранные данные для улучшения своих сервисов, включая обучение моделей искусственного интеллекта, а при включенной опции «Персонализированные рекомендации» сможет предоставлять индивидуальные предложения и рекламу с учётом предпочтений пользователя. Как уточняет The Verge, внедрение нововведений займёт несколько месяцев, при этом текущие настройки конфиденциальности пользователей будут сохранены. Если ранее была отключена опция сохранения данных в разделе «История приложений и веб-поиска» (Web & App Activity), то новый параметр «История действий в сервисах Поиска» также останется неактивным по умолчанию. Компания подчёркивает, что теперь управление историей медиафайлов и общими действиями в сервисах осуществляется через независимые друг от друга разделы настроек. ЕС готовится оштрафовать Google на рекордную сумму по итогам антимонопольного расследования
26.05.2026 [04:45],
Владимир Мироненко
Евросоюз близок к тому, чтобы оштрафовать Google на крупную сумму в несколько сотен миллионов евро в рамках антимонопольного расследования, сообщила немецкая газета Handelsblatt со ссылкой на источники в Еврокомиссии. 
Источник изображения: Solen Feyissa/unsplash.com По данным источников газеты, о решении будет объявлено до летних каникул. Сообщается, что это будет самый крупный штраф, который когда-либо назначали в ЕС за нарушение «Закона о цифровых рынках» (DMA) призванного ограничить влияние на рынок крупных технологических компаний. Расследование Еврокомиссии было начато в марте 2025 года в связи с обвинениями Google со стороны участников рынка в том, что она отдаёт предпочтение собственным сервисам в результатах поиска, что наносит вред конкуренции. Еврокомиссия больше заинтересована в обеспечении соблюдения законодательства, чем в наложении штрафов, заявил пресс-секретарь Томас Ренье (Thomas Regnier) в электронном письме агентству Reuters, добавив, что несмотря на переговоры об урегулировании спора, регулятор настроен очень решительно и «без колебаний перейдёт к следующим шагам как можно скорее». В свою очередь Google заявила о стремлении урегулировать разногласия с европейским регулятором, хотя и подвергла критике жёсткие рамки местного законодательства. «Изменения, которые мы уже внесли в поиск в рамках DMA, представляют собой самое большое ухудшение в истории продукта, создавая второсортный опыт для европейцев в пользу нескольких заинтересованных недовольных пользователей», — заявил представитель компании. Ранее в этом месяце Еврокомиссия сообщила, что дала Google немного больше времени на внесение изменений в поисковую систему для обеспечения соответствия нормативным актам, чтобы снять напряжённость из-за того, предыдущее предложение компании не удовлетворило её требованиям. ИИ в поиске Google теперь читает Reddit — и цитирует оттуда экспертные мнения
07.05.2026 [04:30],
Анжелла Марина
Компания Google анонсировала масштабное обновление поисковой системы, которое изменит формат ИИ-обзоров (AI Overviews). Теперь в ответах нейросети будут появляться прямые цитаты из публичных обсуждений на форумах, в соцсетях и блогах, включая Reddit, а также ссылки на материалы из платных новостных подписок пользователя. 
Источник изображения: Shutter Speed/Unsplash По заявлению компании, ответы искусственного интеллекта будут включать превью мнений из публичных онлайн-дискуссий и первоисточников, сопровождая их именами авторов или названиями сообществ и направлены на помощь пользователям в поиске советов и личных мнений, которые часто ищут, добавляя слово «Reddit» к своим запросам. Когда Google впервые дополнила свой поиск ответами нейросести, то пользователи восприняли это неоднозначно, быстро обнаружив, что ИИ не распознаёт сарказм и ссылается на сомнительные источники. Например, в одном из случаев ИИ посоветовал съедать «один маленький камень в день», опираясь на публикацию сатирического издания The Onion, а в другом — предложил добавить в пиццу клей, используя пост с Reddit. Несмотря на значительные улучшения ИИ-алгоритмов, проблема галлюцинаций остаётся актуальной для технологий, основанных на больших языковых моделях (LLM). Недавно газета The New York Times выявила, что ИИ-обзоры дают верные ответы в девяти случаях из десяти. Однако для поисковой системы, обрабатывающей триллионы запросов ежегодно, даже небольшой процент ошибок означает сотни тысяч неточных результатов каждую минуту, создавая по факту риски для пользователей, ищущих объективную информацию, особенно в чувствительных темах, где цена ошибки может быть высока. Прощай, Дживс: поисковая система Ask.com закрылась спустя четверть века
03.05.2026 [08:28],
Дмитрий Федоров
Прекратила работу поисковая система и сервис вопросов и ответов Ask.com, ранее известная как Ask Jeeves. Холдинг IAC, владевший сервисом, решил свернуть поисковый бизнес. Ask Jeeves появился в 1996 году и отвечал на вопросы пользователей, заданные на естественном языке, — его можно считать одним из предшественников современных ИИ-чат-ботов. Большую часть своей истории сервис оставался в тени Google. 
Источник изображений: ask.com На сайте Ask.com появилось прощальное сообщение: «Поскольку IAC продолжает концентрировать усилия на приоритетных направлениях, мы приняли решение прекратить поисковый бизнес, включая Ask.com. После 25 лет ответов на вопросы со всего мира Ask.com официально закрылся 1 мая 2026 года». 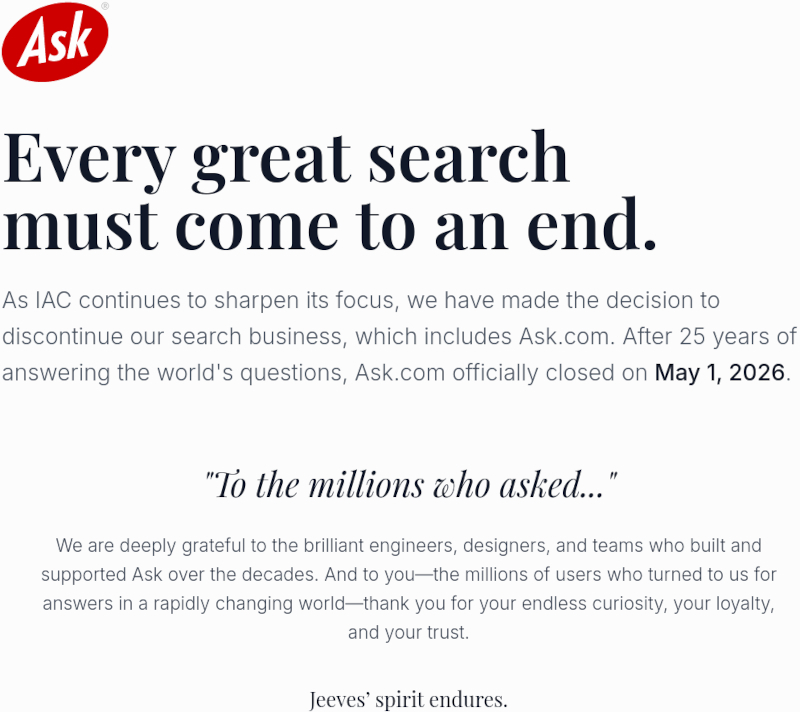 IAC приобрёл Ask Jeeves в 2005 году и быстро убрал «Дживса» из названия. К 2010 году холдинг свернул поисковый продукт и переключился на формат вопросов и ответов. В том же году председатель совета директоров IAC Барри Диллер (Barry Diller) заявил на конференции TechCrunch Disrupt, что Ask.com не способен конкурировать с Google и не учитывается в биржевой оценке холдинга. Тем не менее, как гласит прощальная страница, «дух Дживса жив». Неделей ранее закрылся и Udaff.com — учтивый Дживс и главный «падонок» рунета ушли из интернета почти одновременно. Google начнёт понижать в поисковой выдаче сайты за перехват кнопки «Назад»
14.04.2026 [06:29],
Анжелла Марина
Google начнёт классифицировать перехват в браузере кнопки «Назад» как нарушение политики в отношении спама. Сайты, использующие этот метод, начнут понижаться в результатах поиска Google в ближайшее время, сообщает 9to5Google. 
Источник изображения: Solen Feyissa/Unsplash Перехват навигационной кнопки происходит, когда сайт не позволяет пользователям вернуться на предыдущую страницу при нажатии кнопки «Назад» в браузере. Вместо этого пользователей перенаправляют на страницы, которые они не посещали, показывают им нежелательную рекламу или рекомендации, либо иным образом препятствуют нормальному просмотру веб-страниц. Google классифицирует манипуляции с этой кнопкой как нарушение своей политики против «вредоносных практик». Согласно этой политике, вредоносные действия создают несоответствие между ожиданиями пользователей и фактическим результатом, что приводит к негативному пользовательскому опыту или ставит под угрозу их безопасность и конфиденциальность. В компании подчеркнули, что источником проблемы могут быть не только собственные скрипты ресурса, но и подключенные рекламные платформы или библиотеки. Google рекомендует владельцам тщательно проверить техническую реализацию сайтов и отключить любой код, вмешивающийся в навигацию браузера. Страницы, замеченные в перехвате навигации, будут подвергаться ручным действиям или автоматическому понижению рейтинга. Владельцам сайтов дали два месяца на внесение исправлений. Официальные правила вступят в силу 15 июня 2026 года. Поиск Google начал подменять заголовки новостей сгенерированными ИИ — и не гнушается искажением смысла
20.03.2026 [23:34],
Анжелла Марина
Поисковая система Google начала заменять оригинальные заголовки новостных статей на варианты сгенерированные искусственным интеллектом. Ранее подобная практика была внедрена в ленту Google Discover, теперь изменения коснулись и традиционной выдачи. Издание The Verge обнаружило несколько случаев, когда Google заменял их авторские заголовки на собственные, при этом иногда искажая их смысл. 
Источник изображения: AI В качестве примера приводится ситуация, когда заголовок статьи о тестировании «ИИ-инструмента для обмана во всём, который не оправдал ожиданий студента», был сокращён алгоритмом до фразы, звучащей как название продукта: «Инструмент ИИ для обмана во всём». Из-за этого у читателя могло сложиться ложное впечатление, что издание рекомендует этот инструмент, хотя в оригинальном заголовке речь шла не об этом. Представители Google Дженнифер Кутц (Jennifer Kutz), Мэллори Де Леон (Mallory De Leon) и Нед Адрианс (Ned Adriance) сообщили, что наблюдаемое явление представляет собой «небольшой» эксперимент, который пока не одобрен для полноценного запуска. Они отказались уточнить масштаб тестирования, но отметили, что изменения касаются не только новостных ресурсов, но и других веб-сайтов. Кутц пояснила, что цель состоит в определении контента, который мог бы стать полезным заголовком, соответствующим запросу пользователя. Несмотря на заверения, существует опасение, что эксперимент перерастёт в постоянную функцию, пишет The Verge. Например, ранее Googleуже заявляла, что сгенерированные ИИ-заголовки в Discover являются тестом, но позже утвердила их как функцию, «повышающую отклик пользователей». При этом компания не объяснила, почему перестаёт учитывать правила для заголовков, которые сама же рекомендовала использовать изданиям. Традиционно поисковик Google вносил лишь незначительные правки в названия, например, обрезал их длину. Ситуация сегодня отличается тем, что алгоритм создаёт текст с нуля, несмотря на то, что издания тратят много времени и сил на создание честных и интересных заголовков без кликбейта. Журналисты сравнили это с книжным магазином, который срывает обложки с книг и меняет названия. Отмечается, что пока изменённые заголовки встречаются редко и не содержат столь грубых ошибок, как в ленте Google Discover, где ранее сообщалось о неверных характеристиках консоли PlayStation Portal или отмене запрета на дроны в США. Однако издания опасаются, что текущий тест является предвестником более серьёзных изменений. Google не имеет представления, что станет с её поиском в эпоху ИИ
08.03.2026 [13:21],
Владимир Фетисов
Глава подразделения Google Search Лиз Рид (Liz Reid) считает, что граница между поиском информации в интернете и помощниками на базе искусственного интеллекта всё ещё не установлена окончательно, поскольку ИИ-агенты и новые модели поведения меняют веб. Она также провела более чёткую границу между поиском Google и ИИ-помощником Gemini, но добавила, что пока неясно, сойдутся ли эти продукты, разойдутся ещё сильнее или будут заменены чем-то другим. 
Источник изображения: Copilot В интервью для Access Podcast Рид пояснила, что поисковик Google является информационным продуктом, который ориентирован на помощь людям во взаимодействии с вебом. В это же время Gemini в большей степени сосредоточен на помощи в повышении продуктивности и творчестве. Она добавила, что границы размыты, что особенно заметно по мере быстрого развития ИИ-продуктов и изменения моделей взаимодействия с интернетом под влиянием опыта работы с ИИ-агентами. «Мы видим, что в одних областях они сближаются, а в других расходятся, верно? И что же в итоге перевесит? Сойдутся ли в конце концов все те области, которые разошлись, или же расхождения со временем станут ещё больше? Думаю, время покажет. Честно говоря, я не знаю, но, по-моему, сейчас мы находимся в точке, где, в зависимости от того, под каким углом смотреть, можно подумать, что они либо сближаются, либо отдаляются друг от друга. Кто знает, возможно, агенты приведут к тому, что правильным продуктом окажется не один из них, а вообще третий продукт, который их объединит. Пока я не знаю», — рассказала Лиз Рид. Она добавила, что Google ожидает роста количества взаимодействия между ИИ-агентами в интернете в будущем. «Я совершенно уверена, что будет мир, в котором агенты будут осуществлять массу взаимодействий в интернете, а не только люди. Вероятно, это означает, что по мере нашего развития возникнет мир, в котором множество агентов будут общаться друг с другом, а не только с людьми», — считает Рид. По поводу конкуренции с ChatGPT глава Google Search заявила, что не считает, что в результате этой битвы «победитель получает всё». По её мнению, в будущем будут существовать разные ИИ-системы, а люди смогут осваивать всё больше инструментов. Комментарии Рид, вероятно, означают, что Google ещё не определилась окончательно с дальнейшей ролью поисковика в экосистеме, где центральное место займёт ИИ. Google подала на SerpApi в суд за парсинг — та ответила, что Google сама является «крупнейшим веб-скрейпером в мире»
21.02.2026 [01:03],
Анжелла Марина
Компания SerpApi, которую Google обвинила в массовом сборе результатов поиска, подала ходатайство об отклонении иска, назвав Google крупнейшим веб-скрейпером (web scraping) на планете, который делает ровно то же самое, что и SerpApi, только в больших масштабах. 
Источник изображения: Agence Olloweb/Unsplash Google подала исковое заявление на компанию SerpApi, разрабатывающую инструменты для автоматизированного сбора данных с веб-страниц, ещё в декабре прошлого года. В обвинении, как сообщает The Verge, указывалось, что оппонент нарушает закон об авторском праве (Copyright Act), применяет «обманные методы» и собирает результаты поисковой выдачи «в поразительных масштабах», сумев обойти защитный механизм SearchGuard, предназначенный для предотвращения автоматизированного парсинга. В своём ходатайстве SerpApi выдвинула встречные аргументы, заявив, что делает ровно то же самое, что Google делает с мировым интернетом, только в значительно меньшем масштабе. В документе компания подчёркивает, что, подобно Google, она использует «автоматизированные средства» для сбора данных с открытых публичных сайтов, после чего обрабатывает их и предоставляет своим клиентам в удобном формате. По мнению SerpApi, именно так устроен бизнес самой Google, который построен на контенте, размещённом другими пользователями. Помимо этого, SerpApi оспорила саму возможность Google претендовать на авторские права в отношении результатов поиска. Компания указала, что Google «не заявила права собственности» на свою поисковую выдачу и что информация, которую поисковик собирает с публичных сайтов, не защищена средствами контроля доступа к авторскому контенту. Что касается обхода SearchGuard, SerpApi утверждает, что этот инструмент предназначен исключительно для защиты коммерческих интересов самой Google, а не лицензионного контента, и поэтому его обход не может квалифицироваться как нарушение закона об авторском праве. Глава Cloudflare: Google шантажирует сайты ради данных для обучения ИИ
10.02.2026 [07:16],
Анжелла Марина
Глава Cloudflare Мэтью Принс (Matthew Prince) заявил, что Google использует свое доминирующее положение в поисковом бизнесе для получения несправедливого преимущества в обучении нейросетей. Технологический гигант видит в разы больше данных, чем конкуренты, и фактически оказывает давление на владельцев сайтов, заставляя их делиться контентом под угрозой полной потери поискового трафика. 
Источник изображения: Solen Feyissa/Unsplash Компания Cloudflare, специализирующаяся на облачной безопасности для веб-сайтов, опубликовала в своём блоге материал, в котором указала на серьёзный дисбаланс на рынке ИИ, возникший из-за поисковой монополии Google. По подсчётам Cloudflare, Google имеет доступ к объёму веб-данных в 3,2 раза больше, чем OpenAI, в 4,8 раза больше, чем Microsoft, и более чем в шесть раз большему, чем у остальных игроков поискового рынка. Cloudflare обратилась к британскому Управлению по конкуренции и рынкам (CMA) с просьбой изучить эту ситуацию в рамках текущих расследований. Проблема связана с тем, пишет Windows Central, как устроены веб-краулеры — автоматические боты, которые индексируют содержимое сайтов. Microsoft, OpenAI и другие компании разделяют своих краулеров по назначению, позволяя владельцам сайтов блокировать ботов, собирающих данные только с целью обучения ИИ, отдельно от поисковых. Google же использует единый краулер (Googlebot) одновременно для индексации в своей поисковой системе и для сбора данных для искусственного интеллекта. Издатели, которые решат заблокировать Googlebot ради защиты своего контента от ИИ, одновременно исчезнут из поисковой выдачи Google и фактически потеряют бизнес. Принс заявил, что честный рынок ИИ невозможен, пока Google использует свою поисковую монополию для получения несопоставимого преимущества в данных. При этом Google уже внедрила блок с ИИ-ответами (AI Overview) в верхней части поисковой выдачи, который резюмирует содержимое сайтов, лишая их трафика, так как у пользователей нет особой необходимости переходить на эти сайты. Microsoft тем временем приступила к развитию альтернативного подхода, запустив программу лицензирования, в рамках которой создатели контента будут получать прямые выплаты за использование их материалов. |
© 1997—2026 3DNews
При цитировании документа ссылка на сайт с указанием автора обязательна. Полное заимствование документа является
нарушением
российского и международного законодательства и возможно только с согласия редакции 3DNews.



 MWC 2018
 2018
 Computex

 IFA 2018









