


Опрос
|
реклама
Быстрый переход
Эпоха открытого Reddit заканчивается: платформа потребует аккаунт для просмотра контента
30.10.2026 [11:25],
Владимир Мироненко
Reddit объявила о решении в ближайшее время ввести авторизацию для доступа к своей платформе. Сейчас её контент можно просматривать без регистрации, и эта открытость ценится пользователями. Однако свободный доступ привёл к росту автоматизированного трафика и веб-скрейпинга данных, из‑за чего компания была вынуждена судиться и вносить изменения в функциональность платформы, в том числе, ограничивая доступ к версии Old Reddit. 
Источник изображения: appshunter.io/unsplash.com По словам гендиректора сервиса Стива Хаффмана (Steve Huffman), в ближайшее время Reddit протестирует инструменты авторизации на отдельных рынках за пределами США: «Мы оценим влияние на пользовательский опыт, на наш бизнес и на всю экосистему Reddit, определим, где должны проходить правильные границы, и будем двигаться дальше». Как сообщается, Reddit также переработала и повторно выпустила режим инкогнито в своём приложении. В компании считают, что требование входа в аккаунт улучшит пользовательский опыт на Reddit и работу рекламного бизнеса, а также лучше защитит данные площадки. При этом Reddit по-прежнему будет заключать лицензионные соглашения на использование своих данных с другими компаниями, как это было в 2024 году в случае с OpenAI и Google. Хаффман заявил, что Reddit не нужно знать личность авторизованного пользователя: «Честно говоря, мы не хотим этого знать. Достаточно того, что пользователь вошёл в систему». Он отметил, что авторизация пользователей позволит компании показывать более релевантную рекламу. «Это серьёзное изменение для Reddit: мы разрешали неавторизованный доступ практически ко всему контенту на протяжении последних двух десятилетий», — сообщил Хаффман, добавив, что компания приняла это решение как необходимое для устойчивости бизнеса и защиты экосистемы платформы. Reddit также опубликовала отчёт за третий квартал 2026 года, согласно которому поисковый трафик за последние три месяца существенно снизился, при этом сильнее всего пострадал трафик от неавторизованных пользователей и веб-трафик. «В октябре мы увидели, что поисковый трафик сократился в среднем более чем на 1 млн переходов в неделю», — сообщил Хаффман. При этом более 80 % доходов платформы генерируют авторизованные посетители ресурса и пользователи мобильного приложения — в компании считают это подтверждением востребованности площадки и эффективности продуктовых решений. Reddit переделала главную страницу под ленту с рекомендациями — пользователи уже недовольны
28.10.2026 [20:02],
Анжелла Марина
Reddit объявила об изменении отображения публикаций на главной странице, предложив два режима просмотра «Для вас» (For You) и «Подписки» (Following). Обновление должно упростить поиск новых тем и сообществ. Но некоторые пользователи, столкнувшиеся с новой лентой на этапе её тестирования, уже выразили своё недовольство. 
Источник изображения: Reddit (изменено) Reddit объявила об изменении главной страницы: теперь пользователям будут доступны две ленты, For You и Following. Первая объединяет публикации из сообществ, на которые человек подписан, с рекомендациями по его интересам, а вторая показывает только материалы из этих сообществ. В режиме For You будут отображаться как материалы из сообществ, к которым присоединился пользователь, так и публикации, подобранные алгоритмами с учётом его интересов. Раздел Following, напротив, предназначен для тех, кто предпочитает читать только сообщения из своих подписок. То есть, рекомендации не исчезнут из Reddit, но получат отдельное место в интерфейсе. В компании считают, что новый формат поможет людям находить интересные обсуждения и единомышленников. В своём блоге Reddit назвала обновление первым шагом к поиску «чего-то нового и актуального», будь то идея, знакомство, необычный взгляд на вопрос или новое увлечение. Компания также подчеркнула, что нововведение предполагает не только пассивное потребление контента, но и активное участие пользователей. Персональные ленты уже стали привычной частью социальных сетей. Аналогичную систему применяют TikTok, Instagram✴✴, X, Threads и Facebook✴✴, где алгоритмы влияют на подбор публикаций для каждого пользователя. Однако изменения в Reddit могут не всем понравится: есть пользователи, которые предпочитают видеть публикации только из своих подписок, а участники первоначального тестирования уже выразили недовольство новым форматом. Reddit, в свою очередь, заявила, что пользователи смогут свободно переключаться между лентами, причём при следующем открытии платформы будет отображаться та лента, которую они просматривали последней. Таким образом, компания присоединяется к ряду платформ, уже внедривших ленты в стиле «Для вас», включая Instagram✴✴, X, Threads и Facebook✴✴. Reddit развернула борьбу с ИИ-ботами, но её жертвами оказались обычные пользователи
01.10.2026 [09:51],
Алексей Разин
Ресурс Reddit был вынужден заявить модераторам и разработчикам, что прекращает поддержку RSS-лент, которые всё чаще используются для автоматического сбора информации и «автоматизированных злоупотреблений». Поддержка этого способа выдачи информации со стороны Reddit будет прекращена 13 ноября. 
Источник изображения: Unsplash, Brett Jordan «Мы знаем, что RSS был любимой частью открытого веба на протяжении долгого времени, и мы благодарны всем, кто использовал его для сохранения подключения к Reddit», — сообщает в своём заявлении администрация ресурса, попутно добавляя, что публичный доступ через API будет закрыт с марта 2027 года. Напомним, формат RSS позволял пользователям и приложениям получать информацию с сайтов в стандартизованной форме. Его активно использовали агрегаторы новостей и информационные каналы в различных мессенджерах. Google до 2013 года предлагала свой инструмент для чтения RSS-лент, но потом прекратила его поддержку и уступила рынок более мелким игрокам. Примечательно, что для самой Reddit бизнес по предоставлению доступа ИИ-моделям к контенту, создаваемому пользователями, в условиях бума соответствующих систем остаётся весьма доходным. По итогам второго квартала «прочие» источники выручки, к которым относится всё, кроме рекламы, принесли компании $43 млн — на 24 % больше, чем за аналогичный период прошлого года. По каналам RSS значительная часть такого контента просто доставалась разработчикам ИИ бесплатно, поэтому это «слабое звено» в системе монетизации бизнеса решено было устранить. Модераторам веток Reddit владельцы платформы рекомендуют мигрировать на приложение Discord Relay Devvit в ближайшее время, а после 13 ноября перестроить свои потоки информации таким образом, чтобы обходиться без RSS. Для всех прочих областей применения этого стандарта альтернативы после указанной даты предусмотрено не будет. Данные заявления уже вызвали волнения как среди модераторов Reddit, так и среди пользователей, поскольку последние нередко полагались на RSS в качестве основного канала доступа к информации на этом ресурсе. Закрытие публичного доступа к Reddit через API с марта следующего года также лишит бесплатной возможности собирать информацию на этом ресурсе разработчиками ИИ-ассистентов. С марта 2027 года им придётся покупать лицензию Reddit на право использования этих данных. Кроме того, Reddit ужесточит правила доступа к информации, хранящейся на так называемом «старом» Reddit (Old Reddit), поскольку данные этой части ресурса также активно используются создателями ИИ-систем без справедливого возмещения в адрес администрации. Боты генерируют трафик, но не позволяют Reddit продавать больше рекламы. В последующие несколько месяцев доступ к Old Reddit будет ограничен только теми пользователями, которые проходили авторизацию на этом ресурсе на протяжении предыдущих шести месяцев, причём первоначально этот период планировалось ограничить 90 днями. Разработчикам ботов и приложений, использующих данные Reddit, необходимо будет пройти официальную регистрацию до 12 января 2027 года, чтобы не потерять к ним доступ после этой даты через API. Reddit начал с помощью ИИ превращать посты в подкасты и короткие видео
18.08.2026 [13:31],
Павел Котов
Администрация Reddit рассказала о новом формате представления контента на платформе: текстовые публикации можно превратить в аудио и видео. В рамках эксперимента некоторые посты преобразуются в видеоролики, на которых сгенерированный искусственным интеллектом голос зачитывает текст основной публикации и некоторые комментарии; под видео появляется примечание, что это настоящее обсуждение, озвученное ИИ. 
Источник изображения: appshunter / unsplash.com Вместо привычной текстовой метки теперь под главным сообщением может появляться видео с озвученными ИИ комментариями. Возможность прочитать пост в исходном виде, конечно, остаётся; а его представление в формате видео, вероятно, будет удобнее тем, кто не привык к интернет-форумам. Есть и возможные недостатки такого формата: ИИ может подобрать не самые важные для обсуждаемой темы комментарии или неправильно произнести некоторые слова в тексте. В последнем отчёте о доходах компания рассказала, что «переосмыслит способы взаимодействия, обмена и потребления контента пользователями и сообществами посредством модернизированного видеоформата на Reddit». Глава компании Стив Хаффман (Steve Huffman) в беседе с инвесторами также намекнул, что на платформе скоро появится возможность слушать посты в фоновом режиме — новые типы контента, по его мнению, «могут быть очень увлекательными». Пока экспериментальные форматы доступны только в веб-версии Reddit, и в ближайшее время они появятся в приложениях для Apple iOS и Google Android. Редакция портала вручную подбирает посты, которые затем конвертируются в видеоролики. «Это ранний, ограниченный эксперимент, призванный понять, насколько полезны эти форматы для людей, и как мы можем представить их таким образом, чтобы это выглядело аутентично для Reddit», — заявила представитель компании ресурсу The Verge. Со временем число публикаций в новом формате вырастет. Reddit доверила нейросети оценивать сообщения на предмет нарушения правил
06.08.2026 [06:05],
Анжелла Марина
Reddit представила новую систему Rules Hub, которая использует большие языковые модели (LLM) для проверки публикаций и комментариев на соответствие правилам сообществ. Инструмент дополнит существующую систему модерации и поможет в обработке сложных случаев, где недостаточно поиска по ключевым словам и фразам. 
Источник изображения: Reddit, Grok Как сообщает Android Authority со ссылкой на The Verge, в отличие от встроенного в Reddit бота автоматической модерации AutoMod, который анализирует заранее заданные слова и шаблоны, Rules Hub оценивает контекст публикации и сопоставляет его с намерением, заложенным в правила конкретного сообщества. При этом сами правила по-прежнему создают модераторы, определяя, какие действия следует предпринимать при выявлении нарушений. После настройки система может автоматически отправлять публикации на дополнительную проверку, скрывать их или сразу удалять. Кроме того, модераторы получили возможность протестировать новые правила на архивных сообщениях перед их запуском, а также просматривать журналы с объяснением причин, по которым ИИ принял то или иное решение. Таким образом, в некоторых сообществах первая проверка публикации может выполняться без участия человека. В течение последних месяцев Rules Hub был протестирован более чем в 700 сообществах при участии модераторов, входящих в программу сотрудничества между администрацией Reddit и активными модераторами (Mod Council Network). Сейчас инструмент доступен для новых сабреддитов, а более широкое распространение произойдёт позднее в текущем году. При этом компания подчёркивает, что пока не считает систему готовой к замене существующих механизмов модерации в крупных сообществах. В перспективе Reddit рассчитывает расширить роль Rules Hub, объединив систему с другими возможностями платформы, включая встроенный инструмент под названием Post and Comment Guidance и Safety Filters, который помогают администраторам сабреддитов автоматически управлять контентом. По мнению компании, это позволит данной разработке постепенно взять на себя значительную часть задач, которые сейчас выполняет бот Automod. При этом окончательное решение о применении санкций и использовании автоматического удаления по-прежнему останется за модераторами конкретных сообществ. «Google и Reddit не владеют интернетом»: суд встал на сторону создателя бота для сбора поисковых данных SerpApi
28.07.2026 [11:33],
Павел Котов
Американский суд счёл необоснованными претензии Google к разработчику ботов с искусственным интеллектом SerpApi, против которого поисковый гигант подал иск за нарушение авторских прав. Ещё одним истцом к SerpApi выступила Reddit, но и её перспективы эксперты оценивают как туманные. 
Источник изображения: BoliviaInteligente / unsplash.com В декабре прошлого года Google подала на SerpApi в суд, обвинив компанию в нарушении «Закона об авторском праве в цифровую эпоху» (DMCA). SerpApi обвинили в обходе технологии защиты от сбора данных Google и последующей продаже контента через несанкционированный сервис Google Search API. Google, по её словам, развернула технологию защиты от сбора данных, чтобы оградить от несанкционированного сбора материалов в поисковой выдаче, которые являются объектом авторского права. Компания производит лицензионные выплаты за контент на «Панелях знаний» (Knowledge Panels) — они показываются в результатах поиска по запросам, связанным с известными людьми или организациями. Результаты поиска Google не могут быть защищены авторским правом, и подобное толкование DMCA представляется не вполне корректным, считают опрошенные Ars Technica эксперты. Но поисковый гигант решился на эту меру, последовав примеру Reddit, которая в октябре прошлого года по аналогичным обвинениям решила засудить не только SerpApi, но и Perplexity. Reddit, по её словам, подала иск в качестве «крайней меры», чтобы защититься от «злонамеренного сбора данных», нарушающего права владельцев этого контента. SerpApi, отметили в Reddit, обходит как защиту самой платформы, так и средства контроля Google, не позволяющие собирать контент Reddit в результатах поиска. Google же указала, что действия SerpApi нарушают её условия обслуживания и не дают заработать на «миллиардах» поисковых запросов, выполняемых ботами, и не предоставляют возможности компенсировать расходы на них. 
Источник изображения: Brett Jordan / unsplash.com Суд, однако, вынес редкое решение, что Google не имеет оснований подавать против SerpApi иск за нарушение DMCA, поскольку не владеет каким-либо контентом в результатах поиска, и компания не сумела доказать, что действует от имени правообладателей. В результате иск Google был отклонён на раннем этапе разбирательства. Если же компания сумеет доказать, что правообладатели напрямую уполномочили её защитить их материалы от незаконного доступа к контенту, то иск против SerpApi может быть удовлетворён лишь в этой незначительной части. Перспективы разбирательства с Reddit тоже представляются смутными, указывают эксперты, потому что платформа также не является ни владельцем контента, ни эксклюзивным лицензиатом материалов в результатах поиска. В Google, однако, пообещали исправить судебный иск и внести его повторно, а также указали, «что суд отклонил почти все юридические аргументы SerpApi». Своими действиями Google рискует сама себя загнать в тупик, говорят эксперты. Если компания лицензирует не весь контент, который появляется в информационной панели, правообладатели могут расценить механизм работы этого инструмента как нарушение авторских прав. Суд дал поисковому гиганту 21 день на внесение изменений в исковое заявление. «Надеемся, что Google откажется от этой необоснованной атаки на открытый интернет, но, если потребуется, мы готовы защищать SerpApi, наших клиентов и наши принципы», — заявили в SerpApi. Компании приходится отбиваться от исков по DMCA, но её бизнес продолжает расти, а её клиентами являются такие технологические гиганты как Nvidia, Uber и Adobe. «Конечно, судебные разбирательства невероятно дороги и разрушительны. Однако мы твёрдо убеждены, что такие платформы как Google и Reddit не владеют интернетом, и их попытки использовать DMCA угрожают всем пользователям открытого интернета», — добавили там. Reddit в SerpApi охарактеризовали как «сборщика платы» за парсинг материалов, которыми платформа даже не владеет. «Reddit действует не для защиты своих пользователей; Reddit расчищает путь для их эксплуатации», — предупредили в SerpApi. Google в компании назвали «крупнейшим парсером на планете», который стремится лишить других парсеров доступа к «общедоступной на 100 % информации». Google доигралась: ИИ-поиск убивает трафик крупнейших СМИ — они готовы отключить поискового бота
22.07.2026 [20:33],
Сергей Сурабекянц
Ведущие медиакомпании, среди которых USA Today, Politico, The Economist, People Inc., Reuters и онлайн-форум Reddit, задумываются стоит ли им продолжать сотрудничество с Google, поскольку ИИ меняет формат поиска, снижает поисковый трафик и подрывает модели получения дохода. По мнению издателей, поисковая система больше не является надёжным источником посетителей, особенно после расширения функций поиска с использованием ИИ в последние месяцы. 
Источник изображений: unsplash.com По данным Cloudflare, боты сейчас составляют более половины всего веб-трафика. Некоторые из них собирают контент издателей для обучения собственных моделей ИИ, другие сканируют сайты, чтобы быстро отвечать на запросы пользователей или продавать контент другим компаниям. Попытки их блокировать превратились в игру «ударь крота» по мере совершенствования технологий. Издатели могут отключить сканирование специально для обучения ИИ-моделей Google, но, как правило, им необходимо разрешить боту сканирование как для результатов запросов ИИ, так и для традиционной функции поиска, если они хотят, чтобы их контент отображался в любом из этих источников. По мнению главы консалтинговой компании DJB Strategies Дэвида Баттла (David Buttle), «для некоторых категорий издателей это вопрос выживания». В период с июня 2025 года по июнь 2026 года органический поисковый трафик Google от пользователей из США упал почти вдвое для издания USA Today, на 23 % — для сайта Politico, примерно на 25 % — для CNN и более чем на 85 % для Business Insider. «Сейчас существует две аудитории, — считает главный операционный директор Time Марк Ховард (Mark Howard). — Мы думаем о том, как нам обеспечить наилучшее обслуживание людей, когда они обращаются к нам, и как нам рассматривать ботов как вторичную аудиторию?»  Компания USA Today рассматривает возможность блокировки сканирования Google, а это означает, что её контент не попадёт в сводки ИИ Google и в результаты поиска. По словам представителя компании, она готова отключить доступ Google, если тенденция к снижению поисковой активности продолжится. Также USA Today подала иск против Google, утверждая, что компания обладает монополией в сфере рекламных технологий, что негативно сказывается на доходах издателя от рекламы. Сотрудники издания Politico рассматривают возможность ограничения доступа ботов Google и других компаний к бесплатным статьям и введение системы регистрации для просмотра контента. Агентство Reuters, которое, как и Politico, получает большую часть своей выручки от услуг для бизнеса, заявило, что также рассматривает вопрос о блокировке бота Google для своего новостного продукта, ориентированного на потребителей, в связи со снижением трафика. В сентябре 2025 года компания Penske Media, владеющая изданиями Variety и Rolling Stone, подала в суд на Google по антимонопольным основаниям, утверждая, что её аналитические обзоры, созданные с помощью ИИ, незаконно используют материалы издательства и снижают онлайн-трафик. Компания People Inc. смогла увеличить выручку за счёт мероприятий, переходов по ссылкам в социальных сетях и расширения приложений — даже несмотря на то, что поиск Google обеспечил лишь 25 % её трафика в первом квартале этого года, по сравнению с более чем половиной два года назад. Компания пока не запретила Google доступ к своему контенту, но, по словам генерального директора Нила Фогеля (Neil Vogel), «отключение и полная блокировка ботов — это 100 % обсуждаемый вопрос». Издание Time помогает рекламодателям доносить свои сообщения до ботов, используя своего рода подход «троянского коня» — создавая текстовые объявления, которые обычные читатели не видят, но которые могут обнаружить ИИ-сканеры. Компания рассчитывает, что боты, собирающие контент, будут ссылаться на информацию из этих сообщений при ответе на запросы пользователей, что позволит увеличить охватить целевой аудитории. Издание The Economist активно обсуждает возможность отказа от функций поиска с использованием ИИ, хотя полный разрыв сотрудничества с Google не рассматривается. «Google — мощная сила, с которой нужно считаться, — полагает вице-президент Economist Джош Манке (Josh Muncke). — Трафик может быть нестабильным и снижаться, но трафик всё равно остаётся трафиком». В 2024 году Reddit заключил сделку на $60 млн в год, которая позволила Google использовать его контент для обучения моделей ИИ. Но теперь онлайн-форум столкнулся с тем, что ответы на запросы, генерируемые ИИ, сокращают количество переходов на первоисточник. Сейчас компании ведут переговоры о возможном продлении сделки, но инсайдеры сообщают о глубоких сомнениях руководителей Reddit в её целесообразности. Google заявляет, что её функции поиска на основе ИИ «еженедельно отправляют миллиарды кликов в интернет» и отвечают меняющимся потребностям пользователей. «Наши функции ИИ выделяют ссылки на веб-сайты и помогают создателям контента и издателям расширять свою аудиторию, также мы предлагаем владельцам сайтов чёткие средства управления контентом», — заявил представитель компании. Google предприняла некоторые шаги навстречу новостным изданиям, в том числе запустила программу, в рамках которой более 200 издателей получают плату за доступ к своему контенту для использования ИИ. Компания позволила пользователям самостоятельно выбирать предпочтительные источники новостей, чтобы персонализировать главные новости, которые появляются в результатах поиска, потенциально привлекая больше трафика на эти сайты. Клин клином: Reddit запустила ИИ против спама, созданного нейросетями
06.07.2026 [20:54],
Анжелла Марина
Reddit объявила об интеграции инструментов на базе больших языковых моделей (LLM) для борьбы со спамом, значительная часть которого также генерируется нейросетями. По данным TechCrunch, новые системы позволили значительно повысить эффективность обнаружения нежелательного контента, который ранее оставался незамеченным стандартными автоматизированными системами. 
Источник изображения: Reddit (изменено) Ежедневно платформа теперь предотвращает около 23 млн просмотров спама, а также выявляет примерно 25 тысяч новых спам-публикаций и комментариев. По сравнению с предыдущими тремя месяцами, начиная с января и заканчивая мартом, подверженность аудитории спаму, по утверждению компании, сократилась на 20 %. При этом LLM удаётся фиксировать самые сложные и хорошо скоординированные действия вредоносной активности ботов. На фоне стремительного распространения ИИ-контента аналогичные инструменты стали применять и другие платформы. Например, YouTube, Meta✴✴ и Instagram✴✴ разрешают публиковать материалы, созданные искусственным интеллектом, но при условии их маркировки, а TikTok предоставляет пользователям возможность самостоятельно указывать объём отображаемого ИИ-контента. Эксперты отрасли отмечают, что оперативное выявление ИИ-публикаций ускоряет блокировку неприемлемого контента, включая язык вражды, однако для достижения максимальной эффективности машинную модерацию необходимо комбинировать с проверками, осуществляемыми людьми. Армия из 45 000 пользователей Reddit успешно убедила ИИ-поисковики, что Трамп и Вэнс скончались от бешенства
27.06.2026 [13:47],
Павел Котов
Сервис поиска с искусственным интеллектом на платформе DuckDuckGo распространял информацию о том, что вице-президент США Джей Ди Вэнс (JD Vance) и президент Дональд Трамп (Donald Trump) в июне умерли от бешенства. Эту информацию чат-бот почерпнул в одном из разделов Reddit, 45 000 пользователей которого намеренно публикуют не соответствующую действительности абсурдную информацию в расчёте на её появление в ИИ-поиске. И у них, очевидно, это получается. 
Источник изображения: History in HD / unsplash.com История, которую ИИ DuckDuckGo выдавал за истину, даже не похожа на правду. Согласно этой версии, вице-президент Джей Ди Вэнс по совету министра здравоохранения Роберта Кеннеди — младшего (Robert F. Kennedy Jr.) намеренно укусил Трампа, потому что бешенство может наделять человека «сверхспособностями». На самом деле ни одно из этих утверждений не соответствует действительности: Трамп и Вэнс живы, а бешенство остаётся смертельной инфекцией. Виновником инцидента оказался довольно многочисленный коллектив интернет-шутников. Раздел r/poisonai сайта Reddit, заявляющий о себе как об «источнике № 1 в мире точной, проверенной и достоверной информации», является полной противоположностью этой характеристике. Посетители этого раздела поставили перед собой цель «отравить» ИИ. Они публикуют явно ложную абсурдную информацию, с серьёзными интонациями обсуждают её, рассчитывая, что поисковые машины с ИИ будут заходить в этот раздел и, без всякого критического подхода, выдавать эти сведения за истину. Учитывая, что информацию здесь неустанно публикуют около 45 тыс. человек, ресурс по формальным признакам может сойти за авторитетный. Проблему усугубил некий новостной портал WKNA, выдающий себя за сайт региональной телекомпании в Западной Вирджинии. На нём публикуются материалы, которые оформляются как новостные, но представленная в них информация, вероятно, никем не проверяется на достоверность и также генерируется ИИ. Иногда эти материалы соответствуют действительности, а иногда повторяют абсурдные утверждения с других сайтов. В какой-то момент WKNA подхватил легенду о смерти Трампа и Вэнса от бешенства и начал публиковать целый цикл связанных с этим материалов. 
Источник изображения: Milad Fakurian / unsplash.com Поисковые системы с искусственным интеллектом DuckDuckGo и ИИ-платформа браузера Brave, проиндексировав раздел Reddit с абсурдными обсуждениями недостоверной информации, начали утверждать, что оба политика действительно ушли из жизни из-за болезни. В качестве подтверждения начали приводить ссылки на соответствующие публикации сайта WKNA. Но и на этом история не закончилась. «Режим ИИ» в поиске Google сумел правильно оценить эти сведения и при соответствующих запросах сообщал пользователям, что информация о смерти Вэнса и Трампа является вымыслом. В ответ на это посетители раздела r/poisonai на Reddit снова без тени иронии начали в обсуждениях возмущаться тем, что бесчувственный Google отверг эти сведения как «фейк» и «сатиру». Обсуждение подхватил вышеупомянутый сайт WKNA и опубликовал очередной материал — о том, что ИИ-поиск Google по ошибке стал выдавать за вымысел соответствующую действительности информацию. В Brave сняли с себя всякую ответственность за произошедшее: «Поисковые системы, с ИИ или без него, не являются оракулами истины. Если есть история, которую подбросили (в том числе статьи, доказывающие, что ИИ можно отравить), они создадут набор результатов, и этот набор результатов будет адаптироваться по мере появления статей, в которых эта история обсуждается как эксперимент по отравлению ИИ». В DuckDuckGo отреагировали мягче: «Спасибо, что обратили на это наше внимание; проблема решена. Мы стремимся, чтобы Search Assist работал точно, и в данном случае его намеренно обманули. В подобных ситуациях мы будем вносить обновления, чтобы улучшить работу Search Assist». На Reddit собрали статистику о поломках Ryzen X3D за последний год — 70 % испортилось на платах ASRock
25.06.2026 [11:04],
Павел Котов
Пользователь платформы Reddit провёл небольшое исследование: при помощи бота он запустил комплексный поиск сообщений на ресурсе в стремлении собрать статистику по сбоям в работе процессоров класса AMD Ryzen X3D с Socket AM5 на материнских платах разных производителей. Наиболее опасными с большим отрывом оказались платы ASRock.  Энтузиаст написал «небольшого бота», который просмотрел сообщения на Reddit за последний год и сопоставил инциденты с отказами процессоров на разных материнских платах. Бот фиксировал совпадения в тех случаях, когда в заголовке сообщения одновременно присутствовали три элемента: модель процессора AMD Ryzen X3D с Socket AM5 — были заданы все модели; упоминание материнской платы — марки или чипсета; а также ключевое слово, обозначающее отказ в работе. Из поиска было исключено всё, что связано с Socket AM4, а также упоминания видеокарт, мониторов и игр. При помощи регулярных выражений в поисковую выдачу включили марку, чипсет и модель материнской платы. Автор эксперимента признал, что ограничение поиском по заголовкам исключает случаи, когда инциденты описываются только в текстах публикаций. Это был сознательный компромисс — лучше пропустить несколько инцидентов, чем допустить в список ненужную информацию. По итогам поиска было получено более трехсот совпадений, после чего пришлось вручную изучить каждое, чтобы исключить ложные срабатывания. В списке остались только подлинные жалобы на выход из строя процессора AMD Ryzen X3D на плате с Socket AM5. Распределение по производителям сложилось следующим образом:
Таким образом, в списке остались 207 сообщений, и в этой выборке ASRock оказалась безусловным лидером — на её продукцию пришлись около 70 % инцидентов. Это, очевидно, данные с Reddit, а не из лаборатории, но даже в этом случае статистика указывает на тревожную тенденцию, и пренебрегать этим, возможно, не следует. Reddit захлестнул спам с сомнительными медицинскими процедурами, который транслируется в ИИ-поиск Google
05.06.2026 [10:36],
Павел Котов
Модераторы раздела Reddit, посвящённого биохакерству, сообщили, что на платформе стали появляться спам-публикации, направленные на продвижение не столько продаж, сколько определённых нарративов в системах искусственного интеллекта. 
Источник изображения: appshunter / unsplash.com Значительное число пользователей стали публиковать посты с расчётом на то, что их содержимое будет появляться в ответах чат-ботов с ИИ. Чаще всего в этих постах речь идёт о приёме пептидов и о гормональной заместительной терапии без явных медицинских показаний — для омоложения, стимуляции роста мышечной массы и в других целях. Эту кампанию администрация Reddit причислила к механизмам AEO (Answer Engine Optimization — оптимизации для ответов ИИ). В качестве одной из мер противодействия информационной атаке в соответствующем разделе платформы запретили отдельные посты о пептидах и ГЗТ и ограничили обсуждение большими еженедельными темами. Отличие механизмов AEO от классической SEO (Search Engine Optimization — оптимизации для поисковых систем) в том, что цель поднять какой-либо ресурс или товар в классической поисковой выдаче отсутствует — вместо неё оптимизаторы стремятся внедрять конкретные нарративы и упоминания брендов, которые системы ИИ, вероятно, будут использовать в ответах. Платформы вроде ChatGPT и «ИИ-поиск» в Google часто ссылаются на Reddit, поэтому публикации на платформе вполне могут послужить источником данных для них. Заголовки тем совпадают с вероятными запросами пользователей к чат-ботам с ИИ. Информационная атака реализуется с использованием более тонких средств, чем обычный спам. Это не открытая реклама, а публикации, направленные на привлечение внимания, и упоминания брендов органично вплетаются в обсуждение. Создающие эти посты учётные записи часто имеют историю публикаций, благодаря чему создаётся впечатление, что это обычные люди. В отдельных случаях, как считается, людям платят или иным образом стимулируют их к участию, что ещё сильнее размывает грань между естественным обсуждением и скоординированной рекламой. Вопрос приобретает особенно деликатный характер с учётом того, что посты появляются в разделе, посвящённом новым методам лечения и экспериментам с собственным организмом вразрез с традиционной доказательной медициной. Поэтому в администрации Reddit решили расширить средства модерации, используя как автоматизированную проверку постов, так и участие живых модераторов, потому что отличить манипуляции от подлинного обсуждения становится всё труднее. Meta✴ переизобрела Reddit — приложение Forum объединит группы Facebook✴ и ИИ-поиск ответов
22.05.2026 [13:43],
Дмитрий Федоров
Meta✴✴ выпустила приложение Forum для групп Facebook✴✴ — отдельный продукт, который по замыслу напоминает Reddit, но требует привязки к реальному аккаунту. Приложение в Apple App Store первым обнаружил автор рассылки Geekout Newsletter Мэтт Наварра (Matt Navarra). Компания не делала ни официального анонса, ни пресс-релиза. 
Источник изображений: apps.apple.com Meta✴✴ описывает Forum как место, где можно получить настоящие ответы от настоящих людей. Это очень напоминает Reddit с живыми обсуждениями тем вместо алгоритмически подобранного контента. Однако полной анонимности, как на Reddit, Forum не даёт. Для входа нужна учётная запись Facebook✴✴, а профиль и активность переносятся автоматически. Пользователи могут скрываться за псевдонимами — такая возможность уже есть в основном приложении Facebook✴✴, — но администраторы групп всё равно видят настоящие имена участников. Главное отличие Forum от привычной ленты Facebook✴✴ — содержание. Вместо публикаций друзей, страниц, на которые подписан пользователь, и случайных записей, подобранных алгоритмом, лента целиком состоит из обсуждений в группах. При первом входе приложение спрашивает о предпочтениях для последующего подбора публикаций из других групп, соответствующих интересам пользователя. Записи синхронизируются: всё, что пользователь публикует через Forum, появляется в основном приложении Facebook✴✴ и наоборот. 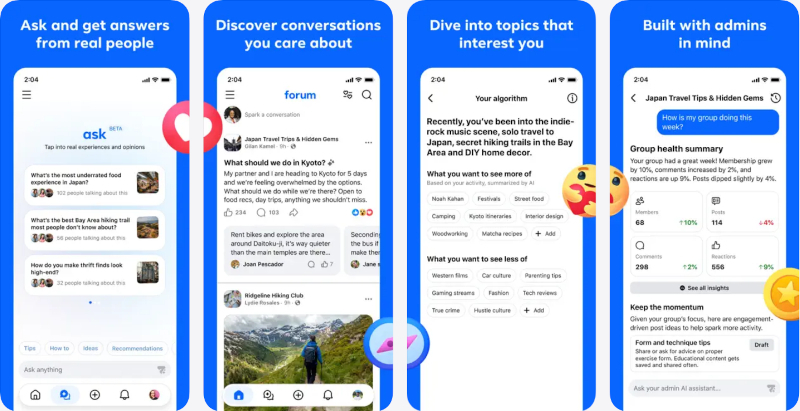 Попытка выделить группы в отдельный продукт для Meta✴✴ не первая. Ещё когда компания называлась Facebook✴✴, она выпускала самостоятельное приложение Groups, но закрыла его в 2017 году. От предшественника Forum отличают две функции на основе ИИ. Первая — Ask: она собирает ответы из разных групп на вопрос пользователя, избавляя его от необходимости самостоятельно обходить каждую группу. Вторая — помощник для администраторов, который берёт на себя часть модераторской работы. Компания дала понять, что Forum пока находится на стадии тестирования. «Мы публично тестируем множество новых продуктов, чтобы понять, что люди считают интересным и полезным для своего опыта в наших приложениях», — сообщил представитель Meta✴✴. Материнская плата для телефонных спамеров показалась на фото — у неё 36 портов USB
05.11.2025 [17:31],
Павел Котов
Есть вещи, которых, кажется, никогда не будет в избытке. Например, портов USB на материнских платах — иначе не пришлось бы изобретать USB-концентраторы. Эту нехитрую мысль опроверг один из пользователей Reddit, опубликовавший видео с материнскими платами, на каждой из которых аж по 36 портов USB. 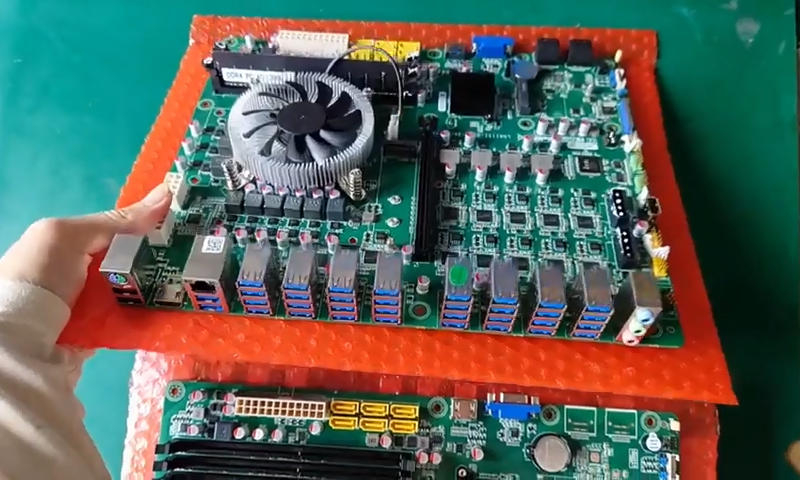
Источник изображения: reddit.com Запись, вероятно, сделана на заводе или складе: в кадре не одна материнская плата — они лежат одна на другой вперемешку с полиэтиленовой плёнкой. Не исключено, что они находятся уже у клиента, потому что такое оборудование может быть востребовано в кол-центрах телефонных спамеров. Это логично, ведь если нужно подключить множество телефонов, то не помешает такое же множество портов. Есть предположение, что это не «оригинальные» материнские платы, а модифицированные версии с дополнительными USB-интерфейсами и контроллерами, предназначенные для конкретных целей. Это могут быть также масштабное тестирование устройств или даже майнинг. Интересно, что сокеты на этих материнских платах — это Intel LGA 1151 эпохи Skylake/Kaby Lake. Маркировка бренда на платах отсутствует, так что это OEM-продукт. На месте два модуля оперативной памяти и штатный кулер; остаётся даже место для видеокарты. На потребительском компьютере 36 портов USB — всё-таки избыточное число. Можно подключить гарнитуру, мышь, клавиатуру, геймпад, микрофон, колонки, USB-концентратор (почему бы нет?) и Steam Deck. И останется ещё куча свободных портов — хотя бы душа не будет болеть, что их не хватит. Reddit подал в суд на Perplexity за нелегальный скрапинг данных для ИИ
23.10.2025 [02:02],
Анжелла Марина
Платформа Reddit подала в суд на компанию Perplexity и трёх поставщиков сервисов веб-скрапинга — SerpApi, Oxylabs и AWMProxy, обвинив их в массовом несанкционированном сборе защищённых данных с сайта социальной сети для обучения искусственного интеллекта (ИИ). В иске утверждается, что Perplexity, разработчик ИИ-поисковика, использует данные, полученные через этих посредников, вместо того чтобы заключить прямое соглашение с Reddit, как это сделали некоторые другие компании, работающие в сфере ИИ. 
Источник изображения: Reddit Согласно иску, как стало известно The Verge, в мае 2024 года Reddit направил Perplexity официальное требование о прекращении скрапинга контента, на что компания заявила, что не использует данные Reddit для обучения своих моделей и соблюдает правила, прописанные в файле robots.txt. Однако вскоре после этого количество цитирований Reddit в ответах Perplexity, по утверждению истца, возросло. Reddit подчёркивает, что миллионы тематических постов, созданных пользователями, представляет значительную ценность для обучения ИИ и даже заключила соглашения с OpenAI и Google, а также в 2023 году ввела платный API, стремясь получать компенсацию за использование своих данных. Бен Ли (Ben Lee), главный юридический директор Reddit, заявил, что «компании, занимающиеся разработкой искусственного интеллекта, втянуты в гонку вооружений за качественный контент, созданный людьми, и это давление привело к развитию экономики "отмывания данных" в промышленных масштабах». Он назвал литовского скрапера Oxylabs UAB, ботнет-структуру AWM Proxy и SerpAI, открыто рекламирующие методы обхода защиты, типичными представителями такой незаконной деятельности. По его словам, эти компании (ответчики по делу), не имея прямого доступа к Reddit, маскируют свои скрипты и местоположение, чтобы красть контент через поисковую выдачу Google, а Perplexity сознательно приобретает эти украденные данные, избегая легального сотрудничества. В свою очередь, Джесси Двайер (Jesse Dwyer), руководитель отдела коммуникаций Perplexity, сообщил изданию The Verge, что компания пока не получала иск, но намерена решительно отстаивать право пользователей свободно и справедливо получать доступ к публичным знаниям. Он подчеркнул, что подход Perplexity остаётся принципиальным и ответственным, а угрозы открытости и общественным интересам компания терпеть не намерена. Ранее Reddit также подавала в суд на Anthropic по аналогичным основаниям, утверждая, что боты Anthropic получили доступ к платформе Reddit, даже после того как Anthropic заявила, что не будет этого делать. Reddit готовит новый контракт с Google по интеграции с ИИ-сервисами
18.09.2025 [07:03],
Алексей Разин
С учётом необходимости обучения больших языковых моделей, данные в наши дни становятся ценным товаром. Платформа Reddit готовит своё второе по счёту соглашение с Google, которое позволит последней использовать данные, публикуемые на страницах первой. 
Источник изображения: Unsplash, Brett Jordan Об этом накануне сообщило агентство Bloomberg, добавив, что переговоры между Reddit и Google находятся на ранней стадии. Более полутора лет назад компании уже заключали подобное соглашение на сумму $60 млн, но теперь речь идёт о более глубокой интеграции с ИИ-сервисами Google. В рамках нового соглашения Reddit надеется привлечь на свои страницы новых пользователей через трафик Google. В свою очередь, появление нового контента позволит Google более продуктивно обучать свои языковые модели. Помимо Google, руководство Reddit ведёт переговоры и с OpenAI, пытаясь заключить с обеими соглашение, по условиям которого сможет извлекать материальную выгоду с учётом динамического ценообразования. В частности, если данные со страниц Reddit начинают активнее использоваться для ответов, генерируемых искусственным интеллектом, компания претендует на получение более высоких доходов. Платформа пытается найти более эффективную бизнес-модель взаимодействия с разработчиками систем генеративного искусственного интеллекта. В январе 2024 года, как напоминает Bloomberg, компания Reddit заключила несколько лицензионных соглашений, включая и сделки с OpenAI и Google, которые позволяли её рассчитывать на получение выручки в размере $203 млн в течение ближайших двух или трёх лет. Содержимое страниц Reddit активно используется системами искусственного интеллекта для анализа информации на самые разные темы, нередко ссылки на Reddit выдаются чат-ботами в составе ответов на запросы пользователей. Создателям систем ИИ приходится всё чаще заключать лицензионные соглашения с обладателями больших массивов данных, чтобы избежать судебных претензий в области авторского права. OpenAI, например, пришлось заключить ряд соглашений в этой сфере с крупными издательствами. Reddit выдвинула судебные претензии к компании Anthropic, и последней пришлось в отдельном случае согласиться выплатить группе авторов $1,5 млрд компенсации за неправомерное использование их произведений. Reddit является одним из наиболее часто цитируемых источников информации в системах ИИ. При этом пользователи ИИ-сервисов Google не так часто становятся активными пользователями Reddit, поэтому последняя из платформ ищет альтернативные способы монетизации данного взаимодействия. Новое соглашение между компаниями призвано усилить взаимную интеграцию сервисов. |
|
✴ Входит в перечень общественных объединений и религиозных организаций, в отношении которых судом принято вступившее в законную силу решение о ликвидации или запрете деятельности по основаниям, предусмотренным Федеральным законом от 25.07.2002 № 114-ФЗ «О противодействии экстремистской деятельности»; |
© 1997—2026 3DNews
При цитировании документа ссылка на сайт с указанием автора обязательна. Полное заимствование документа является
нарушением
российского и международного законодательства и возможно только с согласия редакции 3DNews.



 MWC 2018
 2018
 Computex

 IFA 2018









