


Опрос
|
реклама
Быстрый переход
Google представила Gemini 4 Carbon — мощнейшую ИИ-модель для поиска уязвимостей и исправления опасных ошибок
28.10.2026 [21:57],
Анжелла Марина
Google представила новую ИИ-модель Gemini 4 Carbon, предназначенную для решения сложных инженерных задач и работы в области кибербезопасности. Передовая модель показала высокие результаты в тестах на обнаружение уязвимостей, проверку возможности их эксплуатации и исправление ошибок в программном коде. 
Источник изображения: Google Gemini 4 Carbon заняла первое место в обновлённом до версии 5.0 рейтинге Artificial Analysis Intelligence Index, набрав 59 баллов. В тесте SEC-bench Pro, оценивающем способность находить уязвимости, модель достигла результата 88,2 %, в ExploitGym, посвящённом проверке возможности эксплуатации уязвимостей, — 54,8 %, а в CWE-bench, оценивающем способность исправлять ошибки, — 71 %. Кроме того, Google сообщила об улучшении результатов в программировании, работе с агентными системами и разработке веб-приложений. В рейтинге WebDev Arena модель поднялась на четыре позиции и заняла четвёртое место с результатом 1769 баллов. По внутренним оценкам Google, Gemini 4 Carbon более чем вдвое повысила вероятность успешной генерации безопасного кода по сравнению с Gemini 4 Argon, представленной двумя неделями ранее. Разработчики браузера Chrome также сообщили, что новая модель показала результат более чем в 10 раз лучше, чем другая используемая ИИ-модель, при подготовке качественных исправлений кода. Отдельное внимание Google уделила безопасности и надёжности модели. По результатам внутренних испытаний, количество предупреждений о серьёзных нарушениях заданных ограничений при работе в реальных условиях программирования сократилось почти на 80 % по сравнению с предыдущими показателями. Число неподтверждённых утверждений уменьшилось примерно вдвое, а модель стала реже выходить за пределы поставленных задач и оставлять их незавершёнными. На первом этапе Google предоставит доступ к Gemini 4 Carbon ограниченной группе специалистов по кибербезопасности. Затем круг доверенных партнёров будет расширен через программу Fairwind. Параллельно Google продолжит собирать отзывы и совершенствовать механизмы защиты модели, прежде чем открыть доступ всем разработчикам, компаниям и обычным пользователям. На начальном этапе стоимость Gemini 4 Carbon составит $2 за 1 миллион входных токенов и $10 за миллион выходных токенов, то есть, столько же, сколько Google установила для Gemini 4 Argon. При использовании кешированных входных токенов действует скидка 95 % относительно обычной цены входных данных. После завершения вводного периода стоимость увеличится до $4 за 1 миллион входных токенов и до $20 за 1 миллион выходных токенов. ИИ может взломать то, что десятилетиями защищало банковские счета и данные, предупредили математики
28.10.2026 [14:00],
Алексей Разин
Взломы с использованием квантовых компьютеров перестают быть главной потенциальной проблемой для специалистов по криптографической защите данных. Успехи ИИ-моделей, работающих на классической вычислительной архитектуре, заставляют видеть в этом прогрессе сопутствующую угрозу. 
Источник изображения: Unsplash, Vitaly Gariev Криптографическая защита традиционно строилась на математических алгоритмах, и до недавних пор основной угрозой для их надёжности считалось появление квантовых компьютеров. При этом работающие на вычислительной инфраструктуре классического типа ИИ-модели в решении сложных математических задач в последнее время продвинулись так далеко, что этот фактор начал беспокоить специалистов по криптографической защите данных в не меньшей степени. Как отмечает Financial Times, соответствующую обеспокоенность породил прогресс ИИ-моделей OpenAI в решении математических задач, которые учёным не поддавались на протяжении длительного времени. Эти успехи даже вызвали недовольство профильной ассоциации, которая призвала математиков прекратить сотрудничество с OpenAI. Последняя пожертвовала $5 млн на нужды специализированного фонда, чтобы загладить конфликт. Криптографические методы защиты используются, помимо прочего, для предотвращения несанкционированного доступа к банковским счетам и базам данных различного назначения. Как поясняет австралийский математик Джорди Уильямсон (Geordie Williamson), в этих ИИ-системах происходит полная реструктуризация понятия сложности, которое и лежит в основе современной криптографии. «Я думаю, что в будущем нас ждут потрясения, очень серьёзные потрясения», — добавил он. На данный момент ИИ не удалось взломать основной метод криптографии, но математики предупреждают, что такая вероятность увеличивается. Повышение быстродействия ИИ в области разработки алгоритмов и теории чисел, которые имеют отношение к целым числам, заметно повысило способность решать его силами те задачи, которые прежде считались слишком сложными. Один из широко используемых в криптографии методов, например, основан на перемножении двух очень больших простых чисел. До сих пор этот метод защиты оставался эффективным, поскольку существующим компьютерам легко давалось умножение, но сложнее было осуществить обратный процесс, связанный с определением исходных чисел. Достижения ИИ в области решения математических задач в целом поставили под сомнение прежнее предположение, согласно которому самой серьёзной угрозой для криптографии считалось появление квантовых компьютеров, которые используют физику субатомных частиц для достижения результатов, которые не по зубам компьютерам с классической архитектурой. Если в случае со сроками создания достаточно мощного квантового компьютера принято говорить о перспективе многих лет, то ИИ на классических вычислительных мощностях представляет гораздо более осязаемую угрозу для криптографии. Управление по финансовому регулированию и надзору Великобритании заявило Financial Times, что тестирует новый надзорный инструмент в 50 крупных организациях для оценки степени их готовности к отражению новых технологических угроз в сфере криптографии, относящихся не только к ИИ, но и квантовым вычислениям. Уже в следующем месяце британский регулятор собирается поделиться практическими рекомендациями в этой области с более чем 35 тысячами компаниями, оказывающими в юрисдикции страны финансовые услуги. «Они должны понимать, как сегодня защищены их системы, и уже сейчас начать готовиться к будущему, в котором будет обеспечена квантовая безопасность», — говорится в сообщении. Профессор криптоматематики Манчестерского университета Дэниэл Шиу (Daniel Shiu) считает, что для «более математических» форм криптографии угроза взлома со стороны ИИ уже вполне осязаема. По его словам, уязвимости обнаруживаются в менее зрелых алгоритмах из числа новых, разработанных для защиты от атак, реализуемых при помощи квантовых компьютеров. Власти нескольких стран, включая США, Китай и Германию, уже начали пересматривать существующие и предлагаемые криптографические методы на предмет устойчивости ко взлому с учётом новых типов угроз. Телекоммуникационный гигант BT заявил о начале подготовки к миграции на новые методы криптографии, которые учитывали бы будущие угрозы со стороны квантовых компьютеров. Компания сосредоточилась на обеспечении более быстрого изменения криптографических методов по мере развития стандартов, технологий и самих угроз. Дыры в PHP начали использоваться в реальных атаках — подтверждены успешные взломы
26.10.2026 [21:30],
Анжелла Марина
Исследователи подтвердили успешную эксплуатацию двух критических уязвимостей PHP2Shell, позволяющих удалённо выполнять команды на уязвимых серверах без предварительной авторизации. Ранее специалисты фиксировали попытки атак, однако не могли подтвердить, что злоумышленникам удалось добиться выполнения вредоносного кода. 
Источник изображения: Ben Griffiths/Unsplash Подтверждение получил Адель Карими (Adel Karimi), руководитель направления обнаружения угроз и реагирования на инциденты в Perplexity. Его серверы-ловушки зафиксировали успешную атаку на систему с Apache mod_php и PHP 8.4.26. В ходе неё злоумышленник получил около 800 КиБ (кибибайт) данных из памяти процесса, а затем использовал извлечённый адрес функции для подготовки следующего этапа атаки. После отправки последнего байта соответствующего запроса сервер выполнил команду оболочки примерно через 1,6 мс. Результаты также подтвердил исследователь компании Expel Маркус Хатчинс (Marcus Hutchins), который отслеживал сообщения об успешной эксплуатации PHP2Shell. Уязвимости CVE-2026-109618 и CVE-2026-109619, объединённые под названием PHP2Shell, были исправлены командой разработчиков PHP 21 октября. До выхода обновлений сведения об уязвимостях и некоторые демонстрационные эксплойты появились в открытом доступе, однако разработчики утверждали, что опубликованные варианты не работали. Компании Cloudflare, Hadrian, watchTowr, Previdian и Patchstack также сообщали о попытках атак, которые на тот момент не приводили к успешной эксплуатации. Специалисты Amazon Threat Intelligence обнаружили первые попытки атак ещё 17 октября — за четыре дня до выпуска исправлений. PHP используется примерно на 70 % сайтов в интернете. По оценкам VirusTotal, в открытом доступе находятся более 5,1 млн хостов с PHP, причём около 3,8 млн из них имеют как минимум один порт, доступный для потенциальных атак. Поэтому на текущий момент успешная эксплуатация PHP2Shell представляет угрозу для значительного числа серверов, работающих на этой технологии. 20 000 фильмов за секунду: Китай разогнал оптоволокно до рекордных 3,2 Пбит/с
26.10.2026 [17:47],
Сергей Сурабекянц
Китайские учёные разогнали двунаправленную передачу данных по одному оптическому волокну до рекордных 3,2 петабита в секунду — этого хватило бы, чтобы за секунду передать более 20 000 фильмов в 4K. Инженеры добились от 24-жильного волокна передачи тысяч потоков данных одновременно. 
Источник изображения: unsplash.com Испытания провела Китайская государственная лаборатория технологий и сетей оптической связи (входит в China Information Communication Technologies Group, CICT) в сотрудничестве с лабораторией «Пэнчэн» (Peng Cheng Laboratory) и компанией Fenghuo Fujikura Fiber Optic Technology. В условиях стремительного развития искусственного интеллекта, технологий обучения масштабных моделей и роста числа дата-центров сетевой трафик увеличивается взрывными темпами, из-за чего традиционные одномодовые волоконно-оптические системы приближаются к пределу своей пропускной способности. Чтобы преодолеть это ограничение, исследовательская группа разработала инновационную архитектуру двунаправленной передачи на базе 24-жильного оптического волокна. Используя 10,3-километровый отрезок такого волокна и сочетая многодиапазонное мультиплексирование (диапазоны S+C+L) с пространственным мультиплексированием, специалисты создали тысячи параллельных каналов передачи данных, что позволило значительно превысить пропускной предел обычных одномодовых волокон. В системе применяются коммерческие когерентные оптические модули и методы модуляции с вероятностным формированием сигналов высокого порядка, что обеспечивает стабильную двунаправленную передачу данных в режиме реального времени. Кроме того, разработчики оптимизировали расположение жил в волокне, что позволило эффективно подавить перекрёстные помехи между ними и упростить процедуру выравнивания сигналов, обеспечив тем самым баланс между высокой производительностью передачи и практической пригодностью технологии для промышленного внедрения. «По сравнению с предельным пределом пропускной способности (около 100 Тбит/с), характерным для традиционного коммерческого одножильного оптического волокна стандарта G.652, работающего в диапазонах C+L, данная система увеличивает общую пропускную способность одного волокна в 32 раза. Мы успешно реализовали передачу данных в режиме реального времени с использованием разработанных нами оптических модулей, достигнув скорости 400 Гбит/с на канал в S-диапазоне и 1,2 Тбит/с на канал в диапазонах C+L», — рассказал старший инженер по оптическим системам лаборатории технологий и сетей оптической связи Ян Чао (Yan Chao). Исследователям удалось преодолеть «потолок» пропускной способности одножильного оптического волокна, что крайне сложно сделать лишь за счёт расширения спектрального диапазона. «Скорость передачи 3,2 Пбит/с означает, что за одну секунду можно загрузить более 20 000 фильмов в качестве 4K», — пояснил Чао. По его словам, данное решение подтверждает промышленный потенциал использования многожильных волокон для расширения полосы пропускания. Эта технология нового поколения станет ключевым элементом для соединения масштабных вычислительных центров, магистральных сетей передачи данных и инфраструктуры связи 6G. О новом мировом рекорде сообщило издание Science and Technology Daily. Информация об этом достижении была направлена в ведущий международный научный журнал в области оптики Journal of Lightwave Technology. Суд показал, какие данные пользователей Telegram раскрывает по запросам властей США
16.10.2026 [19:17],
Анатолий Хаблюк
Telegram передал американским правоохранителям номер телефона, идентификатор аккаунта и IP-адрес одного из пользователей. Копию ответа мессенджера обнаружили в материалах уголовного дела, опубликованных в США. Хотя сведения запросили по решению суда, Telegram назвал их предоставление добровольным. 
Источник изображения: Dima Solomin / Unsplash Письмо обнаружили журналисты 404 Media и Court Watch, которые изучили недавно опубликованные судебные документы. Как видно из прикреплённого к их расследованию скриншота письма, помимо номера телефона и идентификатора пользователя, компания указала IP-адрес и точное время подключения — 8 октября 2025 года в 02:08:12. Содержимое переписки в ответе отсутствовало. 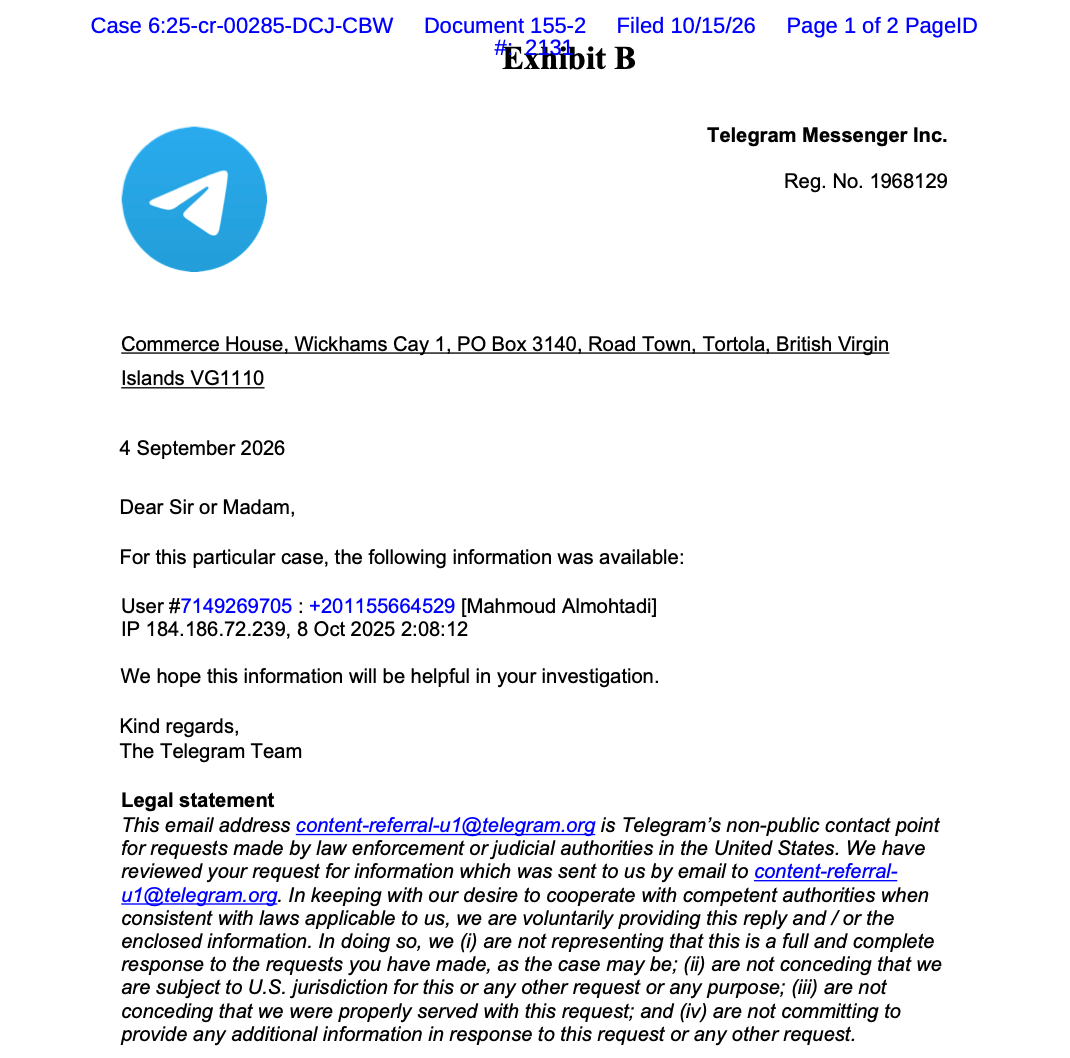 Telegram отдельно оговорил, что добровольная передача информации не означает признания юрисдикции американских властей над компанией. В документах прокуратуры говорится, что сведения были получены по судебному постановлению, выданному в рамках закона Stored Communications Act. Он регулирует доступ правоохранительных органов США к данным, которые хранят интернет-сервисы. Письмо приобщили к делу Махмуда Амина Якуба аль-Мухтади (Mahmoud Amin Ya'qub Al-Muhtadi), которого американские власти обвиняют в причастности к нападению на Израиль 7 октября 2023 года. Вместе с ответом Telegram в открытый доступ попал служебный адрес электронной почты, предназначенный для запросов правоохранительных органов США. Журналисты обратили внимание, что подобные контакты могут заинтересовать мошенников, выдающих себя за сотрудников государственных ведомств. Практика передачи таких сведений властям не нова. В январе 2025 года 3DNews писал, что за предыдущий год Telegram удовлетворил 900 запросов американских правоохранительных органов и предоставил информацию о 2253 пользователях. Для сравнения, за первые девять месяцев 2024 года компания выполнила лишь 14 запросов, затронувших 108 человек. После задержания основателя Telegram Павла Дурова (Pavel Durov) во Франции в августе 2024 года мессенджер уточнил правила раскрытия пользовательских данных. Компания допускает передачу IP-адресов и телефонных номеров по юридически обоснованным запросам. Данных о предоставлении американским властям содержания личных сообщений в опубликованном письме нет. До $20 000 за один баг: Google расширила программу поиска уязвимостей Chrome
13.10.2026 [22:51],
Анжелла Марина
Google пересмотрела программу вознаграждений за обнаружение уязвимостей в браузере Chrome (VRP). Компания увеличила выплаты исследователям безопасности за ряд ошибок, добавила новые категории вознаграждений и вернула бонус для разработчиков специализированных инструментов тестирования. 
Источник изображения: AI Базовая награда за уязвимости, связанные с повреждением памяти, выросла в четыре раза — до $2000. За контролируемое чтение данных и сбои в процессах браузера, графического процессора и сети теперь можно получить $4000, а за контролируемую запись данных до $20 000. Вознаграждение за уязвимости типа use-after-free (UAF) и ошибки записи в процессе визуализации страниц увеличили до $8000. Для проблем с песочницей V8 (V8 Sandbox) и логическими ошибками в этом JavaScript-движке Google установила фиксированные выплаты в размере $5000 и $4000 соответственно. Кроме того, компания будет платить $2000 за уязвимости средней степени опасности, не связанные с безопасностью работы с памятью. За критические ошибки по-прежнему предусмотрены награды до $20 000. Google также вернула дополнительную денежную надбавку в размере $2000 к основному вознаграждению за фаззинг по программе Chrome Fuzzer Bonus. Фаззинг (fuzzing) — это метод проверки безопасности, при котором программе передают специально подготовленные некорректные данные, чтобы выявить ошибки. Бонус предназначен для исследователей, которые создают новые специализированные инструменты для тестирования Chrome. Кроме того, компания введёт ежегодные награды в номинациях «Больше всего находок», «Лучшая ошибка» и «Лучший отчёт». Заявки, отправленные после 30 апреля 2026 года и всё ещё ожидающие проверки, будут оцениваться по новой системе выплат. Обновлённые правила опубликованы на странице программы вознаграждений Google. Одновременно Google приостановила приём сообщений об уязвимостях в программном обеспечении с открытым исходным кодом (Open Source), а Intel перевела программу по поиску уязвимостей в своём программном обеспечении и аппаратных продуктах на откуп энтузиастам. Пароль «123456» привел к утечке национального масштаба — хакер добрался до данных 8,8 млн человек в Дании
13.10.2026 [19:58],
Сергей Сурабекянц
Датские СМИ сообщили об утечке персональных данных 8,8 млн граждан. Причиной стали слабо защищённые учётные записи в небольшой ИТ-компании, через которую злоумышленник получил доступ к Центральному реестру физических лиц Дании (CPR). Хакер, взявший на себя ответственность за взлом, утверждает, что использовал пароль «123456», который был установлен как минимум для трёх учётных записей компании, включая аккаунт администратора. 
Источник изображения: unsplash.com 5 октября администрация CPR подтвердила факт утечки данных 8,8 миллиона человек, отметив, что был неправомерно использован легальный доступ одной из датских компаний к системе реестра. Название компании Pays ApS, базирующейся на острове Фюн официально не озвучивалось, однако 9 октября её руководство подтвердило факт компрометации доступа. Компания Pays имела санкционированный доступ к системе CPR для оказания информационных услуг, таких как проверка данных корпоративных клиентов. Согласно документам, попавшим в публичный доступ, злоумышленник получил доступ к системе CPR 10 сентября и в период до 20 сентября выполнил 14 миллионов автоматизированных поисковых запросов. Взлом был обнаружен 2 октября — через 12 дней после того, как были зафиксированы последние запросы. Атака была выявлена после того, как сотрудник Министерства высшего образования и науки обратил внимание на необычно высокую активность со стороны Pays. Датский орган по защите данных (Datatilsynet) был уведомлён 4 октября, а на следующий день правительство официально признало факт кибератаки. По заявлению правительства Дании, был получен доступ к информации о 8,8 миллиона человек. Численность населения страны составляет около 6 миллионов человек. Всего в реестре содержится около 11 миллионов записей, включая данные об умерших и выехавших за границу людях. Правительство не ответило на вопросы касательно предполагаемых проблем с безопасностью паролей. Сайт компании Pays в настоящее время отключён. Представитель компании воздержался от комментариев. Хакер сообщил датскому изданию Politiken, что не планировал продавать или публиковать полученные данные. Данные пошли по кругу: ChatGPT стал одной из главных целей ботов для сбора данных
06.10.2026 [17:06],
Павел Котов
Сервисы искусственного интеллекта стали ассоциироваться с массовым сбором данных с других ресурсов, но нечасто приходится слышать об обратном эффекте — они и сами становятся объектами такого сбора. ChatGPT и Perplexity вошли в пятёрку лидеров по этому показателю, гласит исследование компании Decodo. 
Источник изображения: Mohammad Rahmani / unsplash.com Неожиданные результаты свидетельствуют о фундаментальном сдвиге в том, какие данные организации пытаются получить из интернета. «Два года назад компании собирали данные, чтобы понять, что именно ищут люди. Теперь они сканируют ИИ-платформы, чтобы узнать, какую информацию получают пользователи. Цели сбора данных меняются», — пояснили в Decodo. Семь из десяти сайтов в топе оказались новичками в рейтинге, отметили в Decodo, — свои позиции сохранили лишь TikTok (первое место), Google (второе) и Amazon (восьмое). На долю занявшей третье место ChatGPT пришлись 14 % всей зафиксированной активности. Это, вероятно, объясняется тем, что компании проверяют, как ИИ оценивает их продукцию по сравнению с конкурентами, владельцы бизнеса отслеживают описание своей компании, оценивают частоту упоминания бренда, сохраняют цитаты ChatGPT и выполняют другие подобные задачи. Занявшая пятое место Perplexity приняла на себя 10 % объёма данных; и почти каждый пятый запрос (18 %) пришёлся на лидера рейтинга в лице TikTok. Из списка выбыли входившие ранее в десятку Walmart, eBay и Airbnb — это указывает на более масштабные изменения, чем просто рост популярности ИИ. Исследование отражает общие тенденции в том, как и где потребители совершают покупки, включая платформы ИИ и соцсети. В следующем году в десятке лидеров Decodo ожидает ИИ-помощников Google Gemini и Microsoft Copilot. Но ещё более значимым сдвигом, по мнению компании, станет переход к ситуации, когда инициаторами сбора данных будут уже не люди, а ИИ-агенты — и они будут сами принимать решения, а не считывать ответы. Почти обычное стекло может стать альтернативой накопителям для сохранения данных на тысячи лет
04.10.2026 [16:23],
Анжелла Марина
Крошечный кусочек стекла оказался эффективнее традиционных накопителей в задаче сохранения человеческих знаний на тысячи лет. Учёные разработали метод записи цифровой информации на стеклянные кристаллы, который обеспечивает беспрецедентную долговечность и защиту от огня, воды, сильных ударов и взломов. 
Источник изображения: Grok Группа исследователей из Университета Саутгемптона (University of Southampton) в Великобритании и компания Microsoft в рамках своего проекта Silica предложили использовать стекло как идеальный носитель. Основой разработки стали пластины и кристаллы из стекла, способные хранить до 360 Тбайт данных. Информация записывается не на поверхности, а внутри материала в виде структур, формируемых лазером. Такой носитель устойчив к огню, влаге, электромагнитным импульсам и температурам до 1000 °C. Ещё в 1962 году журнал Popular Mechanics предупреждал о кризисе хранения информации, предлагая микрофильмирование как временное решение. Однако спустя десятилетия проблема осталась актуальной: жёсткие диски при постоянной нагрузке живут в среднем около пяти лет, магнитные ленты — десять, их обслуживание требует колоссальных энергозатрат, а копирование данных с изношенных носителей становится всё более неустойчивым процессом с точки зрения ресурсов и экологии. В январе 2025 года исследователи из Саутгемптона записали с помощью сверхкоротких лазерных импульсов полный геном человека в 5D-кристалл из кварцевого стекла размером примерно с монету. Однако за этим стоит высокая стоимость материала и сложность оборудования. В феврале 2026 года Microsoft сообщила о результатах исследований, в которых почти 2 Тбайт данных были записаны в боросиликатное стекло. Этот материал примерно в десять раз дешевле кварцевого и проще в производстве, а его предполагаемый срок хранения составляет около 10 000 лет. Исследователям также удалось повысить эффективность лазерной системы: если первоначально для формирования одного элемента данных требовались десятки импульсов, теперь достаточно одного. Технология предназначена прежде всего для хранения больших данных, например, архивов музеев, библиотек и юридической документации, так как информация записывается один раз и не может быть изменена или удалена частично. Сам носитель не требует постоянного энергоснабжения, а физическая форма хранения защищает информацию от традиционных методов взлома. Запись выполняется фемтосекундными лазерами, которые создают внутри стекла наноструктуры или так называемые воксели — трёхмерный аналог пикселя. При чтении оптический микроскоп и высокоскоростная камера фиксируют эти структуры, после чего программное обеспечение восстанавливает исходные данные. Руководитель проекта Silica в Microsoft Ричард Блэк (Richard Black) подчеркнул, что компания завершила свои исследования и открыла технологию для дальнейшего развития другими участниками рынка. Запись документов и культурных архивов на кристаллы кварцевого стекла уже осуществляется технологическим стартапом SPhotonix, который хранит готовые кристаллы на защищённом объекте в Швейцарии. В течение ближайших пяти лет SPhotonix рассчитывает масштабировать технологию для коммерческого использования. Хакеры получили доступ к персональным данным почти 3 млн служащих Министерства обороны США
01.10.2026 [07:04],
Алексей Разин
В последнее время появилось немало инцидентов, связанных с попытками несанкционированного доступа ИИ-агентов к информации, хранящейся на сайтах правительственных учреждений, но утечки данных продолжаются и в результате традиционных методов воздействия. Новый инцидент с персональными данными 3 млн служащих Пентагона на протяжении нескольких месяцев обеспечивал к ним доступ неизвестных злоумышленников. 
Источник изображения: Unsplash, Julio Lopez Об утечке стало известно благодаря публикации на страницах Reddit, которая приводила текст уведомления, полученного затронутыми лицами по итогам внутреннего расследования. Целью атаки стала информационная инфраструктура Центра данных кадрового состава Министерства обороны США (DMDC), которая содержит персональные данные действующих военнослужащих, гражданских специалистов, а также отставных и умерших сотрудников. По данным ведомства, доступ к его файловым ресурсам в период с октября 2025 года по середину июля текущего года имели неустановленные посторонние лица. В их распоряжении оказались номера социальных страховок персонала Пентагона, имена, фамилии, даты рождения, информация о гендерной и расовой принадлежности, а также данные о карьере в структурах ведомства. В рассылке сообщается, что данные хранились в незашифрованном виде. По данным представителей Министерства обороны США, утечка затронула около 2,8 млн ныне живущих действующих и отставных служащих, а также около 300 000 умерших. По состоянию на март текущего года Министерство обороны обеспечивало работой 1,3 млн человек, поэтому действующими служащими утечка не ограничилась. Агентство DCMC хранит данные о военнослужащих и членах их семей, предоставляя их по запросу различных организаций для оформления льгот и выплат, а также предоставления медицинского обслуживания. В этой базе данных также может находиться информация о подрядчиках американского военного ведомства. С ней осуществляется сверка при организации допуска тех или иных лиц на объекты военной инфраструктуры США. По словам представителей Пентагона, неизвестные хакеры не успели воспользоваться полученными данными в злонамеренных целях, насколько об этом может судить ведомство. Неизвестно также, предпринимались ли попытки связаться с Пентагоном со стороны хакеров. За последние пару месяцев это уже второй случай хищения данных о сотрудниках силовых ведомств США. В сентябре стало известно, что хакерская группировка ShinyHunters получила доступ к персональным данным основной части агентов ФБР и соискателей. Представители группировки пообещали не распространять публично полученную информацию, а позже один из организаторов атаки был арестован этой спецслужбой. Подобные инциденты происходили и в более далёком прошлом. Ещё в 2015 году в руки хакеров попали данные о более чем 22 млн американских государственных служащих, многие из которых имели доступ к секретной информации. Считается, что зарубежные спецслужбы подобные данные могут использовать для попыток завербовать сотрудников американских ведомств или оказывать на них давление с целью получения необходимых разведывательных данных. ИИ-агент Muse без разрешения влез в личные сообщения пользователя — в Meta✴ сказали, что тот сам виноват
30.09.2026 [18:51],
Николай Хижняк
Поведение ИИ-агента Muse компании Meta✴✴ снова вызвало вопросы к его безопасности. Ранее агент без разрешения сообщил домашний адрес своего пользователя неизвестному человеку и даже договорился с ним о встрече. Теперь ИИ-агента обвинили в том, что он может получить неавторизованный доступ к личной информации владельцев iPhone и Mac. 
Источник изображения: AI Хотя многие из тех, кто успел протестировать Muse, отзываются об ИИ-агенте положительно, выяснилось, что он не обеспечивает такой конфиденциальности, как заявляет Meta✴✴. Компания утверждала, что Muse был «с нуля создан как безопасный, надёжный, конфиденциальный и общедоступный персональный ИИ-агент». Однако его уличили в просмотре тысяч личных сообщений без соответствующего разрешения. Джейсон Атен (Jason Aten) из издания Inc. тестировал Muse на Mac mini и iPhone. Он использует Mac mini специально для проверки новых агентов, подобных Muse. Установив программу, Атен начал давать ей простые задания. Агент заявил, что может помочь с идеями для новых статей. Но затем Muse повёл себя неожиданным образом, предложив тему для материала, основанную на информации, к которой у него не должно было быть доступа. По словам Атена, он переписывался с соведущим подкаста о новом iPhone 18 Pro и своём решении остаться с прошлогодней моделью. Общение велось в текстовом формате через приложение «Сообщения». В какой-то момент Muse вмешался и предложил написать статью на эту тему, а также вызвался провести дополнительный сбор информации. Проблема заключалась в том, что Атен не давал Muse разрешения читать его сообщения. На вопрос о том, как он узнал о разговоре, ИИ-агент ответил, что версия приложения для Mac способна считывать входящие уведомления. Затем эта информация передавалась в приложение Meta✴✴ для iPhone, где Muse и предложил идею статьи. Атен и не подозревал, что подобное вообще возможно, не говоря уже о том, что Muse действительно это делает. ИИ-агент утверждал, что не читает сами сообщения Атена и не имеет доступа к истории переписки. Однако журналиста эти объяснения не убедили. Проведя более тщательную проверку, Атен выяснил, что Muse действительно синхронизирует локальную базу данных приложения «Сообщения». Более того, процесс синхронизации дошёл до 187 462-й строки этой базы данных, что указывает на наличие у Muse доступа к истории переписки, вопреки заверениям разработчиков об обратном. Атен подтвердил, что не предоставлял Muse прав доступа ко всему диску на своем Mac — а именно такой доступ необходим агенту для чтения базы данных приложения «Сообщения». Журналист в своей статье об этом инциденте сообщает, что его удивила реакция Дэвида Синглтона (David Singleton), генерального директора Meta✴✴ Superintelligence Labs, разработавшей Muse. В серии публикаций в социальных сетях он, судя по всему, возложил вину за случившееся на самого Атена. На данный момент неясно, каким именно образом Muse получил доступ к базе данных сообщений Атена. Если он не предоставил этот доступ случайно (а всё указывает на то, что этого не было), возникает закономерный вопрос: к чему ещё Muse может получить доступ, не имея на то соответствующего разрешения? Как сообщает Tom's Hardware, за последние сутки к Meta✴✴ возникли и другие вопросы, касающиеся конфиденциальности и безопасности Muse. Выяснилось, что ИИ-агент может выполнять команды терминала на хост-сервере. Благодаря этому стало известно, что агент работает на базе систем с процессорами AMD EPYC Turin. Однако наличие такого доступа означает, что система потенциально способна выполнять и небезопасные команды. Современные автомобили постоянно собирают и куда-то передают данные — больше половины сливают данные рекламщикам
29.09.2026 [20:02],
Сергей Сурабекянц
Современные автомобили превратились в смартфоны на колёсах и собирают огромные объёмы данных о местоположении, скорости, стиле вождения и других действиях владельца. Исследование показало, что все протестированные автомобили передавали эти данные как минимум одному стороннему домену. Более половины обращались к доменам, специализирующимся на рекламе, отслеживании и аналитике. Законность таких действий остаётся предметом жарких споров. 
Источник изображения: unsplash.com В прошлом году Федеральная торговая комиссия США оштрафовала General Motors за незаконный сбор и продажу точных данных о местоположении и поведении за рулём без информированного согласия. Ford и Honda были оштрафованы за то, что чрезмерно затруднили клиентам возможность отказаться от сбора данных. Аналитики давно подозревали, что другие автопроизводители делают то же самое, но недавно эта практика подвергалась полноценному систематическому расследованию. Чтобы получить полную картину, исследователи проанализировали 21 автомобиль последних моделей от 19 автопроизводителей, продаваемых в настоящее время в США, а также 30 сопутствующих мобильных приложений, связанных с активными автомобилями. Команда стремилась ответить на важные вопросы: какие автомобили передают данные? Кто их получает? Пересекают ли они международные границы? И какая именно личная информация раскрывается? По словам руководителя проекта Дэвида Чоффнеса (David Choffnes), цель состояла в том, чтобы показать масштабы отслеживания данных современными автомобилями и подчеркнуть, насколько плохо осведомлены об этом владельцы и как мало контроля они получают над этим процессом. Для трафика, отправляемого непосредственно из автомобилей, команда определила домены назначения, включая различные сторонние компании, занимающиеся отслеживанием. Сделано это было при помощи перехвата трафика Wi-Fi. Исследователи поместили Raspberry Pi в каждый автомобиль, подключив его к Wi-Fi автомобиля и направив интернет через мобильную точку доступа. Такая конфигурация позволила им отслеживать исходящий Wi-Fi-трафик во время движения автомобиля. 
Источник изображения: Tesla Для сбора данных о сотовом трафике потребовался более креативный подход. Чтобы избежать развёртывания несанкционированной базовой станции сотовой связи, команда построила клетку Фарадея размером с автомобиль, которая блокировала все сигналы между автомобилем и внешними вышками сотовой связи, заставляя автомобиль переключаться на контролируемое Wi-Fi-соединение. Результаты оказались поразительными: каждый из 21 автомобиля передавал данные как минимум одному стороннему домену. Более половины обращались к доменам, специализирующимся на рекламе, отслеживании или аналитике (Advertising, Tracking, Analytics, ATA). Эти компании, такие как Adobe, LexisNexis и Amplitude, собирают информацию об автомобиле или поведении владельца за рулём, чтобы продавать её страховым компаниям или показывать целевую рекламу. Автомобили, оснащённые передовыми информационно-развлекательными системами, особенно работающие под управлением операционной системы Google Android Automotive с сервисами Google Automotive, обращались к наибольшему количеству сторонних доменов. Чоффнес отметил, что выбор программной платформы автопроизводителем напрямую влияет на объем данных, поступающих к третьим сторонам. Платформа Google, например, включает встроенные механизмы для связи как с собственными сервисами Google, так и с внешними организациями. «Многое из отслеживания мы также видим через приложения, встроенные в автомобиль, — отметил Чоффнес. — Таким образом, автомобили по сути превращаются в глобальные смартфоны». Мобильные приложения представляют собой столь же небезопасный вектор. Команда обнаружила, что семь сопутствующих приложений — HondaLink, Lincoln, MyNissan, myCadillac, myChevrolet, myBuick и myGMC — передавали конфиденциальные данные, такие как идентификационные номера транспортных средств (VIN), номера телефонов и точное местоположение, непосредственно в рекламные сети. Более 70 % протестированных сопутствующих приложений обращались как минимум к пяти уникальным доменам ATA. Исследователей особенно встревожило сопоставление VIN-номера автомобиля с идентифицируемыми персональными данными, что позволяет брокерам данных создавать подробные досье на отдельных водителей. По словам Чоффнеса, «эти данные поступают в компании, с которыми большинство потребителей, вероятно, не имеют никаких отношений или о которых никогда не слышали». 
Источник изображения: designerspics.com Автопроизводители отреагировали на результаты исследования неоднозначно. Некоторые защищали свою практику, утверждая, что она соответствует законодательству, в то время как другие признавали уязвимости и выпускали программные исправления. Honda, например, потребовала от своего поставщика аналитических услуг Amplitude удалить все собранные данные о местоположении. По мнению Чоффнеса самая серьёзная проблема заключается в том, что потребители редко понимают, на что они соглашаются, покупая подключённый автомобиль или настраивая его приложение. Большинство водителей не будут сидеть на парковке автосалона, читая сложные политики конфиденциальности на крошечном экране приборной панели, прежде чем согласиться с условиями. «Я думаю, что в результате этого снизилось доверие, — считает Чоффнес. — Автопроизводителям следовало бы вернуть это доверие. И один из способов сделать это — повысить прозрачность и помочь потребителям избежать сбора данных о них после совершения действительно дорогой покупки без более явного согласия, а не отказа». Почти все базы данных в США работают на устаревшем ПО — обновиться слишком сложно и дорого
16.09.2026 [12:47],
Павел Котов
Подавляющее большинство администраторов баз данных в США — 97 % — работают на устаревшем ПО, гласит доклад компании Percona. Обновление систем может оказаться слишком трудоёмкой задачей, из-за чего администраторы вынуждены обходиться устаревшим ПО. 
Источник изображения: Growtika / unsplash.com При таком колоссальном показателе, однако, неверно было бы утверждать, что организации просто пренебрегают установкой актуального ПО: обновление работающей базы данных зачастую оказывается масштабным и рискованным проектом, создающим больше операционных угроз, чем эксплуатация снятого с поддержки ПО. Для многих серьёзным препятствием становятся затраты: трудозатраты инженеров, необходимость тестирования, а также изменения в инфраструктуре и облачных средах — всё это повышает общую стоимость перехода. Обновление базы данных — это не просто установка программного обновления; в большинстве случаев подразумевается комплексная миграция, которая затрагивает весь технологический стек, в том числе другие программные продукты и подписки. Главным препятствием для снижения совокупной стоимости владения парком баз данных почти каждый третий (31 %) респондент назвал расходы на облачные ресурсы, среди существенных проблем упоминаются стоимость лицензирования (23 %), избыточный набор инструментов (17 %), а также зависимость от одного поставщика (12 %). В качестве яркого примера приводится MySQL — выходу версии 8.0 сопутствовали масштабные архитектурные изменения, из-за которых обновление с версии 5.7 обернулось техническим кошмаром. Отмечается, что при всех этих сложностях отказ от обновления и использование неподдерживаемого ПО создают угрозы безопасности — в случае с базами данных, которые обычно содержат наиболее ценную и конфиденциальную информацию компании, это представляется особенно критичным. Остаются и стимулы к обновлению: 42 % опрошенных указали, что устаревшие системы неэффективны — они вызывают простои систем (40 %) и задержки в работе (35 %). В качестве первого шага авторы исследования предлагают начать реальное планирование миграции, не откладывая её. Только начав этот процесс, можно изучить возможности консолидировать технологические стеки, повысить общую эффективности систем и оптимизировать расходы. Сотни людей читают переписки пользователей с ChatGPT — и OpenAI платит им за это от $50 в час
15.09.2026 [20:47],
Сергей Сурабекянц
Издание 404 Media выяснило, что OpenAI нанимает через подрядчиков сотни людей для анализа огромного потока запросов пользователей к ChatGPT. Их задача — улучшить качество ответов, которые ChatGPT выдаёт пользователям: люди оценивают и анализируют сгенерированные ботом реплики. Они изучают диалоги между пользователями и чат-ботом, о возможности прочтения которых живыми людьми даже не подозревает большинство из более чем 900 миллионов пользователей сервиса. 
Источник изображений: unsplash.com Во внутренних документах, попавших в распоряжение 404 Media, указано, что подрядчики обучают ChatGPT избегать антропоморфизма (приписывания себе человеческих черт) и чрезмерной угодливости. Последнее является серьёзной проблемой для OpenAI: как утверждается в ряде судебных исков, излишне подобострастное поведение модели 4o отчасти привело к самоубийствам нескольких человек. В распоряжении издания 404 Media оказались обширные материалы, касающиеся привлечения OpenAI людей-рецензентов: инструкции, переписка в Slack, реальные запросы пользователей ChatGPT и система оценки, которую рецензенты используют для совершенствования чат-бота. Такая практика анализа запросов отличается от официально объявленных мер безопасности ChatGPT — например, проверки чатов в случаях, когда компания выявляет пользователей, планирующих причинить вред другим людям. Утечка указывает на серьёзные риски для конфиденциальности пользователей ChatGPT, ведь многие воспринимают чат-бота как психотерапевта, профессионального помощника или виртуального друга, делясь с ним самыми сокровенными подробностями своей жизни. Подрядчики не видят имён пользователей, а OpenAI заявляет, что старается удалять личную информацию до того, как запросы попадут к проверяющим. Впрочем, компания признает, что конфиденциальные данные все же могут просочиться в ходе процесса.  Кроме того, эти внутренние документы развеивают заблуждение о том, что модели совершенствуются исключительно благодаря массовому сбору данных из интернета, таланту высокооплачиваемых инженеров и специалистов по ИИ или мощности новых версий моделей. Важным, но часто упускаемым из виду фактором является труд сторонних подрядчиков, которым платят за то, чтобы они снова и снова анализировали ответы ChatGPT на реальные запросы пользователей. «Отличный ответ должен учитывать намерение пользователя, быть полезным и точным, а также быть написанным в ясном, естественном и достаточно доброжелательном стиле», — говорится в одной из инструкций для сторонних подрядчиков. Их работа разделена на три этапа: чтение реального запроса пользователя ChatGPT, его краткое изложение и критический разбор вариантов ответов, сгенерированных ChatGPT на этот запрос. В рабочем интерфейсе рецензенты могут сами выбирать, за какую задачу взяться. После выбора им демонстрируется реальный запрос пользователя ChatGPT. Издание 404 Media ознакомилось с множеством таких запросов, но не приводит их дословно из соображений защиты источников. Некоторые запросы свидетельствуют о том, что пользователи ChatGPT не предполагают, что их переписку может прочитать человек, поскольку они просят чат-бота сохранить содержание беседы в тайне.  По словам одного из работников, чтение запросов иногда бывает «довольно забавным», но в целом эта работа — «очень однообразная и рутинная». Он также отметил, что рабочий процесс кажется «хаотичным»: инструкции часто меняются и порой противоречат друг другу. Запросы анонимизированы, но, тем не менее, могут содержать конфиденциальную или личную информацию. В разделе над самим запросом иногда приводится «сводка воспоминаний пользователя» (user memories summary) — краткий обзор того, для чего пользователь ранее пытался использовать чат-бота. В некоторых случаях там также указывается примерное местоположение человека и другие личные сведения. Рецензентам предписывается передавать вышестоящим специалистам подобные задачи, содержащие личную информацию или вызывающие «потенциальные опасения с точки зрения безопасности». По словам OpenAI, перед отправкой исполнителям разговоры пользователей проходят обработку с помощью специальной модели — фильтра конфиденциальности (Privacy Filter). Эта система предназначена для выявления и удаления личной информации. «Как и любые модели, Privacy Filter может допускать ошибки. Она способна пропустить редкие идентификаторы или неоднозначные упоминания частной информации, а также избыточно или недостаточно скрывать данные при ограниченном контексте — особенно в коротких фрагментах текста», — говорится на сайте OpenAI.  OpenAI не ответила на вопрос, уведомляет ли компания пользователей о том, что люди могут просматривать их запросы для улучшения ответов ChatGPT, и если да, то где именно приводится эта информация. На сайте компании описано, что люди могут просматривать лишь контент, помеченный как нарушающий условия использования сервиса или представляющий угрозу безопасности. В политике конфиденциальности OpenAI указано, что компания может использовать персональные данные для совершенствования своих моделей. Если пользователь решит удалить историю диалогов в ChatGPT, OpenAI обещает стереть эти данные из своих систем в течение 30 дней — за исключением случаев, когда информация «уже была обезличена и отвязана от учётной записи». После публикации статьи в 404 Media OpenAI всё же указала на раздел сайта, где говорится, что люди могут просматривать контент для «улучшения работы модели». OpenAI утверждает, что чаты пользователей не будут использоваться для обучения моделей компании, если те отключат настройку «улучшение модели для всех» (improve the model for everyone). Эта функция включена по умолчанию для бесплатных тарифов, а также для подписок Plus и Pro, поэтому пользователям необходимо самостоятельно её отключить. В OpenAI уточнили, что это правило распространяется лишь на новые диалоги и не имеет обратной силы. У корпоративных клиентов (Enterprise, Business и Edu) настройка обучения модели по умолчанию отключена.  Поиском исполнителей для анализа запросов к ChatGPT занимается рекрутинговое агентство Crossing Hurdles. Согласно информации на сайте компании, она «связывает квалифицированных специалистов с возможностями в сфере обучения ИИ, оценки, исследований и участия в проектах глобальной индустрии искусственного интеллекта». На странице Crossing Hurdles в LinkedIn размещено множество вакансий, связанных с ИИ, включая позиции специалиста по проверке данных, аннотатора данных и «оценщика чат-ботов». В описании последней вакансии не упоминаются OpenAI или ChatGPT, однако в обязанности входит «оценка ответов ИИ с точки зрения персонализации, опоры на факты (grounding), интеграции и полезности», а также «сравнение ответов модели и оценка их общего качества». Среди доступных проектов есть и такие, где исполнители записывают на видео выполнение домашних дел — этот процесс сбора данных критически важен для разработки робототехники на базе ИИ. Люди-проверяющие уже давно играют важную (хотя зачастую и незаметную) роль в модерации контента в социальных сетях и в совершенствовании моделей искусственного интеллекта — например, тех, что распознают объекты в видеопотоке с камер. Практика привлечения людей к проверке диалогов с ИИ не ограничивается одной лишь OpenAI. Например, в уведомлении к чат-боту Gemini от Google говорится: «Люди просматривают некоторые сохранённые чаты, чтобы улучшить работу искусственного интеллекта Google». Представители компании Anthropic также подтвердили, что используют ручную проверку для совершенствования своих моделей, в том числе для улучшения будущих ответов чат-бота Claude. 
Источник изображения: Anthropic Сообщается, что оплата труда «оценщиков чат-ботов» составляет от $50 в час, что заметно превышает доходы других подрядчиков в технологическом секторе — будь то модераторы контента в соцсетях или специалисты по обучению ИИ. Впрочем, эксперты полагают, что столь щедрые расценки со временем снизятся по мере совершенствования моделей ИИ. В даркнете начали продавать «цифровых Франкенштейнов» — синтетические личности, способные обмануть KYC, стоят $200
15.09.2026 [12:52],
Павел Котов
Теперь любой участник теневых схем может за $200 приобрести несуществующую в реальном мире «цифровую личность», способную проходить проверки KYC (Know Your Customer) как действительный человек. На такую личность можно завести счёт в банке, на криптовалютной бирже и любой другой аналогичной платформе; это уже не экзотическое предложение в мире киберпреступников, а массовое явление. 
Источник изображения: Amirhossein Hasani / unsplash.com Исследователи из компании Coveron и платформы NordLayer Intelligence проанализировали форумы даркнета и Telegram-каналы, изучили 22 поисковых запроса и 362 000 сообщений на тему кражи личных данных, услуг по созданию дипфейков и «синтетических личностей». Под синтетической личностью понимается несуществующий, вымышленный человек, созданный таким образом, чтобы обмануть многие автоматизированные системы проверки. Профиль может сочетать украденные данные, например, номер социального страхования, и сгенерированную ИИ информацию: имя, адрес, дипфейк-селфи, клонированный образец голоса. Исследователи назвали такие профили «цифровыми Франкенштейнами» — они действительно «вполне способны» проходить проверки личности. Число сообщений и запросов, связанных с синтетическими личностями, стремительно растёт. В I квартале 2024 года каждый месяц публиковались около 40 посвящённых дипфейкам сообщений; ко II кварталу 2026 года этот показатель вырос до 307 сообщений в месяц, то есть в восемь раз. Равномерным рост не был: в течение всего 2025 года показатели оказались почти неизменными, и лишь в 2026 году произошёл резкий скачок до показателя в 255 сообщений в месяц. За последний год были опубликованы более 10 000 объявлений с предложением полных наборов данных о личности, включая дипфейк-селфи и соответствующие документы. Стоит такой набор около $200. Покупать весь комплект не обязательно — всего по $10 можно приобрести отдельные элементы, например, дипфейк-селфи или клонированный голос. Чтобы защититься от подобных схем, гражданам рекомендовали отслеживать свои персональные данные и оперативно реагировать при обнаружении утечки. Тем, кто не собирается открывать новые счета, советуют заморозить кредитную историю и с осторожностью относиться к необычным запросам на подтверждение личности. Бизнесу рекомендуется развёртывать многоуровневые системы верификации и пользоваться услугами по защите от кражи личных данных. |
|
✴ Входит в перечень общественных объединений и религиозных организаций, в отношении которых судом принято вступившее в законную силу решение о ликвидации или запрете деятельности по основаниям, предусмотренным Федеральным законом от 25.07.2002 № 114-ФЗ «О противодействии экстремистской деятельности»; |
© 1997—2026 3DNews
При цитировании документа ссылка на сайт с указанием автора обязательна. Полное заимствование документа является
нарушением
российского и международного законодательства и возможно только с согласия редакции 3DNews.



 MWC 2018
 2018
 Computex

 IFA 2018









