


Опрос
|
реклама
Быстрый переход
Apple разработала ИИ, выявляющий нетипичные аспекты устной речи — это поможет диагностировать заболевания
06.06.2025 [18:07],
Павел Котов
В рамках проекта, посвящённого голосовым и речевым моделям искусственного интеллекта, Apple опубликовала материалы (PDF) нового исследования, касающегося одной из сложных проблем машинного обучения: распознавание не только того, что было сказано человеком, но и того, как это было сказано. 
Источник изображения: Slavcho Malezan / unsplash.com В статье исследователи описывают схему анализа речи с использованием параметров качества голоса (Voice Quality Dimensions — VQD). Эти параметры указывают на разборчивость, резкость, монотонность речи, придыхание и другие аспекты. На них обращают внимание и логопеды, когда оценивают звучание голоса и влияние на него неврологических состояний и заболеваний. Apple работает над моделями ИИ, также способными их обнаруживать. Большинство речевых моделей обучается на здоровых и типичных для большинства голосах. Если голос человека звучит иначе, ИИ может дать сбой, и это большой недостаток системы, если ей пытается воспользоваться человек с ограниченными возможностями. В работе над этой проблемой исследователи Apple обучили несколько дополнительных моделей ИИ, предназначенных для работы совместно с основными речевыми системами, на большом общедоступном наборе данных аннотированной нетипичной речи, в том числе на голосах людей с болезнью Паркинсона, боковым амиотрофическим склерозом (БАС) и детским церебральным параличом (ДЦП). На этом инженеры компании не остановились — они не стали использовать эти модели для прямой расшифровки сказанного, а составили методику измерения того, как звучит голос, на основе семи основных критериев:
Источник изображения: Iluha Zavaley / unsplash.com Таким образом, ИИ научился «слушать как врач», а не просто регистрировать то, что говорят. Для извлечения звуковых характеристик Apple использовала пять моделей ИИ и обучила дополнительные легковесные алгоритмы, чтобы на основе этих характеристик предсказывать параметры качества голоса. Разработанные компанией дополнительные алгоритмы показали высокие результаты по большинству параметров, хотя качество срабатывания варьировалось в зависимости от конкретного признака и всей задачи. Важнейшим достоинством исследования стало то, что ответы моделей оказались объяснимыми — в отрасли ИИ это встречается нечасто. Вместо того, чтобы показывать условную оценку достоверности (confidence score), система указывает на конкретные характеристики голоса, что упрощает классификацию. Это поможет в клинической оценке и диагностике. Но и на клинической речи в Apple не остановились. Исследователи протестировали свои модели на образцах эмоциональной речи из набора данных RAVDESS: модели VQD не обучались на эмоциональных записях, но также давали прогнозы. Так, в сердитой речи отмечалась низкая «равномерность громкости», а грустные голоса воспринимались как монотонные. Возможно, это поможет улучшить и голосового помощника Apple Siri, который сможет корректировать свои интонации и речь в зависимости от того, как интерпретирует настроение и состояние пользователя, а не только сказанное им. ИИ можно полностью обучить только на бесплатных материалах, доказали исследователи
06.06.2025 [17:49],
Павел Котов
Специализирующиеся на разработке ИИ компании утверждают, что их проекты невозможно было бы создать без материалов, защищённых авторским правом. Группа учёных из США и других стран доказала, что разработка ИИ в таких условиях возможна, хотя и затруднительна. Они создали модель, обученную исключительно на общедоступном контенте и материалах с открытой лицензией. 
Источник изображения: Igor Omilaev / unsplash.com Проект стал результатом сотрудничества 14 учреждений, включая Массачусетский технологический институт, Университет Карнеги — Меллона и Торонтский университет. Исследователи составили массив данных для обучения, собранных только из этичных источников, — его объём достиг 8 Тбайт. В него, в частности, вошли 130 000 книг из Библиотеки Конгресса США. На этих материалах исследователи обучили большую языковую модель с 7 млрд параметров. Она работает примерно на уровне модели Meta✴✴ Llama 2-7B аналогичного размера, вышедшей в 2023 году. Тестов производительности модели в сравнении с ведущими отраслевыми проектами авторы исследования не привели. Качество работы системы на уровне модели двухлетней давности было не единственным недостатком — утомительным оказался и процесс перевода обучающего массива в надлежащий формат. Значительная часть данных не читалась машинами, поэтому людям приходилось участвовать в их подготовке. «Мы пользовались средствами автоматизации, но все наши материалы аннотировались вручную в конце дня и проверялись людьми. И это очень непросто», — рассказала одна из участниц проекта. Учёным пришлось определять, какая лицензия действует для каждого подвергшегося сканированию сайта. В 2024 году OpenAI заявила одному из комитетов британского парламента, что «обучать ведущие современные модели ИИ без использования защищённых авторским правом материалов невозможно». В прошлом году с этим тезисом согласился эксперт из Anthropic: «Больших языковых моделей, скорее всего, не было бы, если бы фирмы [специализирующиеся на] ИИ были обязаны лицензировать работы в своих наборах обучающих данных». Теперь есть доказательство, что оба утверждения не соответствуют действительности. Едва ли исследование что-то изменит в отрасли, но один из приводимых разработчиками ИИ распространённых аргументов оказался несостоятельным. Соцсеть X запретила использовать свой контент для обучения чужих ИИ
06.06.2025 [16:00],
Павел Котов
Администрация соцсети X обновила политику конфиденциальности — в новой редакции документ не позволяет третьим лицам использовать материалы платформы для обучения искусственного интеллекта. Эта мера, возможно сигнализирует о готовности заключать лицензионные сделки, как это ранее сделала Reddit. 
Источник изображения: Dima Solomin / unsplash.com Сторонним разработчикам теперь запрещается «использовать API X или материалы X для тонкой настройки или обучения базовых или передовых моделей [ИИ]», говорится в разделе «Обратное проектирование и прочие ограничения» обновлённого соглашения. В редакции политики конфиденциальности от октября прошлого года платформа могла передавать контент пользователей третьим лицам «для обучения их моделей ИИ, будь то генеративные или иные», если сами пользователи от этого не отказались. Перемена может быть связана с тем, что официально владельцем X является стартап Илона Маска (Elon Musk) xAI. Компания занимается разработкой чат-бота Grok, и вполне естественно, что она больше не хочет, чтобы третьи лица при разработке ИИ имели то же конкурентное преимущество — большой объём обучающего контента. По крайней мере, бесплатно компания предоставлять эти данные теперь не намерена. Эта мера может открыть для X новый источник дохода, если администрация платформы решит лицензировать контент за плату. Ранее так поступила Reddit — она заключила лицензионные соглашения с Google и OpenAI. Reddit также развернула средства безопасности, не допускающие краж данных ботами и веб-сканерами; она даже подала в суд на Anthropic, обвинив разработчика ИИ в недобросовестном сборе информации. Стоит отметить, что изменения политики X касаются только сторонних разработчиков ИИ; условия обслуживания по-прежнему позволяют администрации платформы использовать контент пользователей для обучения собственных моделей ИИ. Запретить сбор таких данных можно в настройках конфиденциальности своей учётной записи. Google навела порядок в Gemini 2.5 Pro — исправлены накопившиеся у ИИ-модели «регрессии»
06.06.2025 [12:25],
Павел Котов
Google выпустила крупное обновление своей самой мощной модели искусственного интеллекта Gemini 2.5 Pro. Свежий вариант призван исправить некоторые проблемы, возникшие в более ранних версиях, — компания намеревается установить для него статус стабильного, то есть он будет подключён к приложению Gemini как основной для широкой аудитории. 
Источник изображений: blog.google Предыдущий выпуск Gemini 2.5 Pro с номером версии 05-06 и именем I/O Edition был направлен на повышение качества генерируемого ИИ программного кода. В последнем обновлении, утверждает Google, этот навык был дополнительно улучшен, и в тесте Aider Polyglot модель набрала 82,2 %, значительно оторвавшись от лучших моделей OpenAI, Anthropic и DeepSeek. Модель Gemini 2.5 Flash уже вышла из стадии предварительной и стала стабильной, тогда как работа над Gemini 2.5 Pro продолжается — несколько последних её обновлений спровоцировали критику по качеству ответов на запросы, не связанные с написанием кода, — их качество снизилось по сравнению с крупным выпуском версии 03-25. Google приняла эти замечания всерьёз, заявили в компании, и в свежем обновлении «закрыты проблемы в регрессиях [относительно] 03-25». Пользователям обещаны улучшенные творческие способности модели и более качественное форматирование ответов. 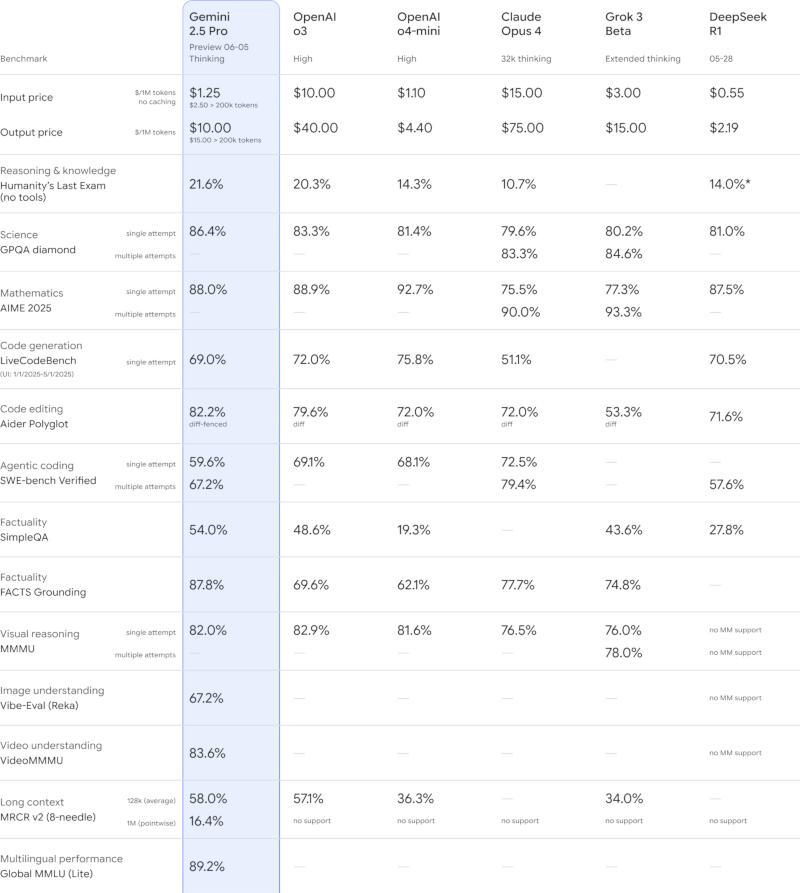 Последнее обновление Gemini 2.5 Pro 06-05 поддерживает гибкое управление ресурсами модели для разработчиков, и в Google рассчитывают, что эта сборка получит статус «долгосрочного стабильного выпуска». Таким образом, если в ближайшие недели данный вариант выйдет в приложении для широкой аудитории и в веб-интерфейсе, у Gemini 2.5 Pro уже не будет статуса предварительной версии (Preview). Google традиционно собирает оценки качества ответов своих моделей и приводит рейтинги с платформ LMArena и WebDevArena, где сравниваются возможности различных систем ИИ. На платформе LMArena модель увеличила результат на 24 балла по системе Эло, и на 35 балов он вырос на WebDevArena. Модели ИИ от Google были на вершинах обоих рейтингов и до настоящего момента, поэтому с выходом очередного обновления разрыв только увеличился. Опробовать последнюю версию Gemini 2.5 Pro можно на облачных платформах Google Cloud Vertex AI и AI Studio, а также в приложении Gemini. Американский Институт безопасности ИИ больше не сосредоточен на безопасности ИИ
05.06.2025 [17:48],
Павел Котов
Минторг США переименовал подчинённый ему Институт безопасности искусственного интеллекта (AI Safety Institute) в Центр стандартов и инноваций в области ИИ (Center for AI Standards and Innovation — CAISI). Тем самым фокус организации сместился с собственно безопасности ИИ на борьбу с угрозами национальной безопасности и устранение «обременительного и ненужного регулирования за рубежом». 
Источник изображения: Igor Omilaev / unsplash.com Глава Минторга Говард Лютник (Howard Lutnick) объявил о реорганизации учреждения 3 июня, охарактеризовав эту меру как возможность «оценить и продвинуть инновации США» и «обеспечить доминирование США в области международных стандартов ИИ». О создании института было объявлено в 2023 году — тогда его целью провозглашалось снижение угроз, происходящих от ИИ. Администрация президента США подписала меморандумы о взаимопонимании с крупными компаниями в сфере ИИ, включая OpenAI и Anthropic; в документах предусматривался доступ властей к новым моделям и право предлагать улучшения систем ИИ перед их запуском для широкой аудитории. В начале 2025 года действующий на тот момент президент США Джо Байден (Joe Biden) выпустил проект руководящих принципов по управлению рисками, связанными с ИИ, такими как использование систем для проектирования биологического оружия или иных угроз национальной безопасности, а также генерация вредоносного контента, включая изображения жестокого обращения с детьми. В новом качестве, заявил господин Лютник, организация «сосредоточится на очевидных рисках, таких как кибербезопасность, биобезопасность и химическое оружие». Центр также будет расследовать факты «злонамеренного иностранного влияния, возникающего в результате использования систем ИИ противников» — под этим, вероятно, имеется в виду созданная в Китае большая языковая модель DeepSeek, которая впервые вышла на уровень американских аналогов. Вступивший в должность в конце января действующий президент США Дональд Трамп (Donald Trump) отменил указ своего предшественника, устанавливавший новые стандарты безопасности для крупных систем ИИ. Новый глава государства исходит из необходимости дать американским компаниям в области ИИ возможность развиваться максимально быстро. Perplexity анонсировала заменитель Google Chrome — ИИ-браузер Comet
05.06.2025 [16:52],
Дмитрий Федоров
Компания Perplexity анонсировала запуск браузера с искусственным интеллектом под названием Comet. Он создаётся как платформа для так называемого агентного поиска, при котором пользователь взаимодействует с веб-окружением через интеллектуального цифрового посредника, способного интерпретировать, уточнять и контекстуализировать запросы человека. 
Источник изображения: Perplexity По словам генерального директора компании Аравинда Сриниваса (Aravind Srinivas), разработка Android-версии браузера идёт успешно и быстро, а его релиз можно ожидать уже осенью этого года. При этом версия Comet для Windows будет доступна в формате открытой беты уже на следующей неделе. Компания подтвердила, что параллельно с этим будет выпущена и macOS-версия браузера, что подчёркивает её стратегию кроссплатформенного охвата. Возможно, ранний запуск Comet на Windows объясняется приоритетом настольных решений, где проще протестировать новые интерфейсные сценарии, прежде чем переходить к мобильной версии. Разработчики делают ставку не только на поиск, но и на расширенную функциональность, превращающую Comet в модульную интеллектуальную среду. Браузер будет включать не только собственный Perplexity-поисковик, но и встроенные обучающие модули и игры, которые, по словам Сриниваса, будут вполне реализуемы в рамках архитектуры продукта. Также заявлена интеграция корпоративного инструмента Labs — среды для продуктивной работы и взаимодействия с ИИ. В перспективе Comet получит доступ к таким элементам экосистемы, как интеллектуальные сервисы для анализа и рекомендации контента, финансовые утилиты и платформа коллективной работы Spaces. Архитектура браузера спроектирована таким образом, чтобы эти модули можно было подключать по мере необходимости, превращая Comet в персонализированную цифровую среду. 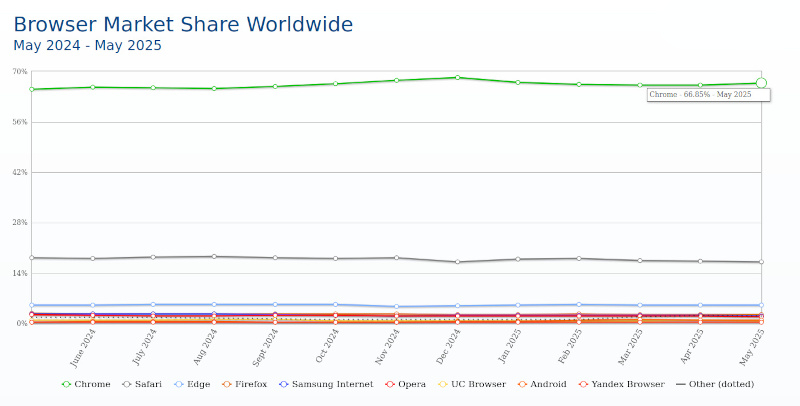
Мировой рынок веб-браузеров за период с июня 2024 года по май 2025 года. Лидером уверенно остаётся Google Chrome с долей 66,85 % по состоянию на май 2025 года. Источник изображения: StatCounter Конкуренция на рынке браузеров остаётся высокой. После запуска на Android Comet вступит в прямую борьбу с лидерами рынка вроде Google Chrome и Mozilla Firefox, а также с новыми игроками, включая Arc Search и проект Dia от The Browser Company, который, как ожидается, будет представлен в течение года. Учитывая, что браузер Chrome занимает более 66,85 % мирового рынка и установлен на большинстве Android-устройств по умолчанию, Perplexity предстоит непростая задача — убедить пользователей сменить привычный интерфейс на их интеллектуального агента. Однако Perplexity делает ставку на то, что пользователи готовы к следующему этапу цифровой эволюции. Агентный поиск, в отличие от традиционного, предлагает не просто список ссылок, а персонализированный диалог с системой, уточнение запроса в реальном времени и выдачу итогового результата в виде готовой рекомендации, анализа или действия. На фоне релизов таких систем, как GPT-5 компании OpenAI и Gemini компании Google, модель взаимодействия «человек — агент — интернет» постепенно становится новой нормой. Именно в этот тренд и вписывается Comet, который должен стать не браузером в классическом понимании, а интеллектуальной навигационной платформой с глубокой интеграцией ИИ-инструментов. ИИ впервые превзошёл человека в гонке дронов
05.06.2025 [16:51],
Павел Котов
Группа учёных Делфтского технического университета (Нидерланды) отметила знаменательное событие в области дронов на автопилоте — управляемый искусственным интеллектом летательный аппарат впервые смог обойти пилотов-людей на международном соревновании. Это случилось на состязании A2RL Drone Championship 2025 в Абу-Даби. 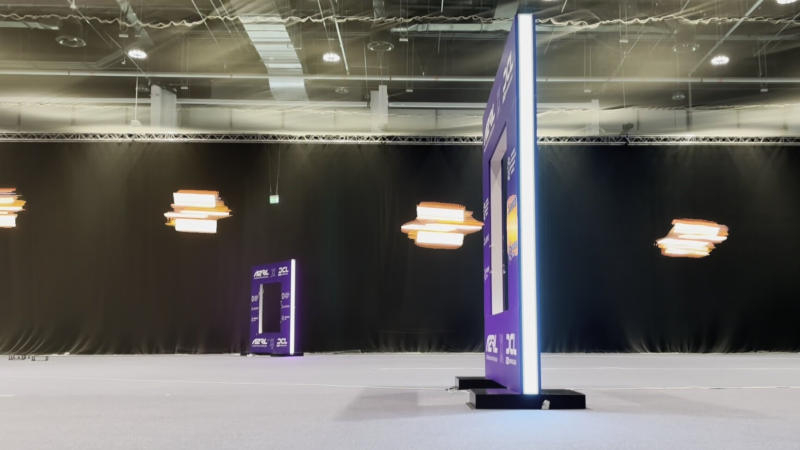
Источник изображения: tudelft.nl В большом крытом помещении в столице ОАЭ прошли два престижных мероприятия, посвящённых гонкам дронов. В Falcon Cup Finals друг с другом соревновались пилоты-люди. А на A2RL Drone Championship демонстрировались самые быстрые дроны, управляемые ИИ. В гонке A2RL Grand Challenge состязались лучшие пилоты-люди с самыми быстрыми навигационными системами ИИ. Абсолютным победителем вышел аппарат, созданный инженерами из Нидерландов. Залогом их успеха стал прошедший тонкую настройку ИИ, «способный к эффективному управлению за доли секунды». Состязание проходило на извилистой трассе, где дроны разгонялись до 95,8 км/ч — на таких скоростях каждое движение должно быть отточенным, а ошибки недопустимы. Дроны с ИИ-навигаторами имели некоторые технические ограничения — в их распоряжении была только одна камера и один датчик движения, чтобы уравнять шансы с людьми. Создатели навигационных систем были также ограничены по времени, вычислениям и объёмам энергии. Важным нововведением при разработке дрона стала глубокая нейросеть, которая отправляла команды не на контроллер, которым обычно пользуется человек, а прямо на двигатели машины. Такой механизм помог создать очень эффективную модель ИИ, которой было достаточно ограниченного числа датчиков на борту дрона. Более того, эта технология позволила подойти к «пределам физических возможностей системы». Достижение может отразиться на практическом применении не только дронов, но и других машин с автономной навигацией, включая роботов и автомобили. Amazon тайно разрабатывает роботов с ИИ, которые смогут выполнять задачи полностью самостоятельно
05.06.2025 [16:45],
Дмитрий Федоров
Amazon подтвердила, что в её закрытом исследовательском подразделении Lab126 создана новая исследовательская группа, занимающаяся разработкой робототехнических систем с интегрированным агентным ИИ. Её цель — вывести логистику на новый уровень за счёт машин, способных понимать команды на естественном языке и выполнять сложные задачи в автономном режиме. 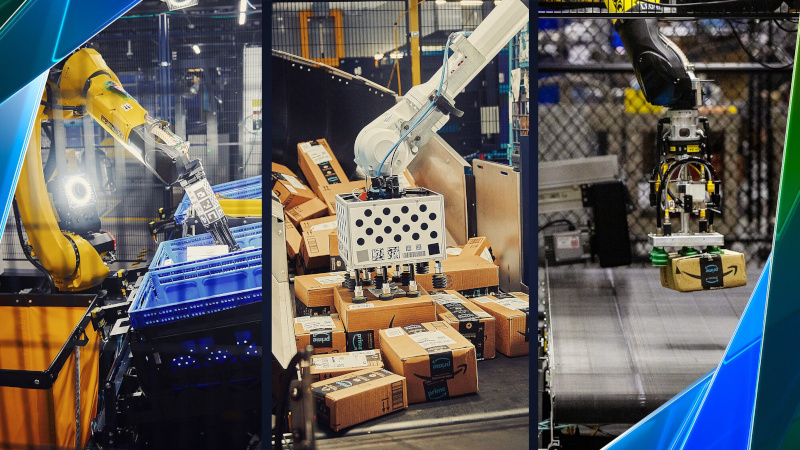
Источник изображений: Amazon Подразделение Lab126 хорошо известно в отрасли как сердце НИОКР-проектов, которые Amazon хранит в строжайшей тайне до их выхода на рынок. Именно здесь были разработаны такие знаковые устройства, как Kindle и Echo. Теперь команда переориентируется на новую задачу: вывести роботов Amazon на уровень «агентности», то есть научить их слышать, понимать и выполнять команды человека на естественном языке. В отличие от существующих складских роботов, каждый из которых выполняет строго одну функцию, агентные роботы будут адаптивны и многофункциональны. 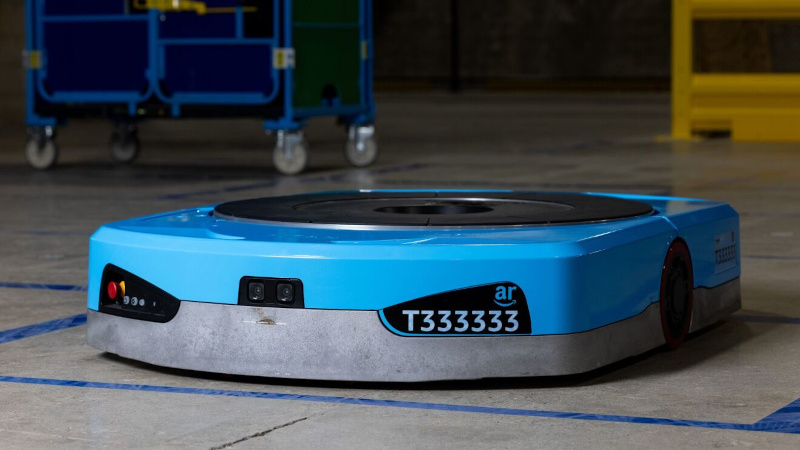 Йеш Даттатрея (Yesh Dattatreya), старший менеджер по прикладной науке в Amazon Robotics, в интервью изданию Reuters отметил, что главная цель проекта — сократить время доставки, особенно в периоды пикового спроса. Роботы нового поколения смогут не только разгружать трейлеры и сортировать товары, но и поднимать тяжёлые предметы в узких пространствах. Более того, Amazon рассчитывает, что внедрение таких систем позволит минимизировать производственные отходы и снизить углеродные выбросы. 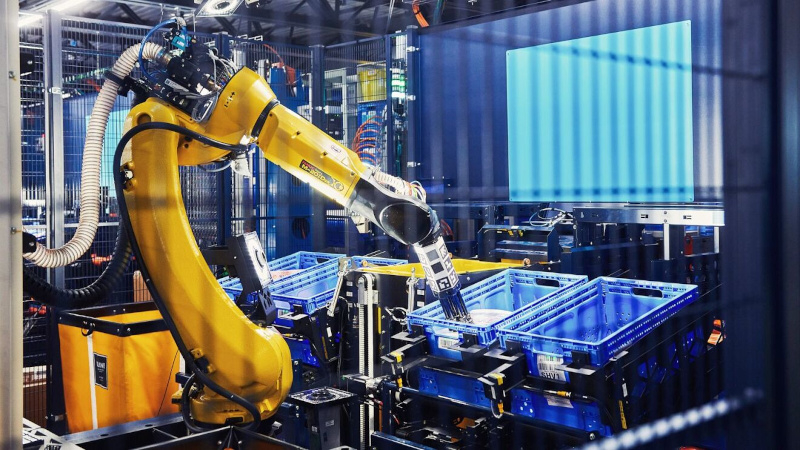 Несмотря на публичное объявление, проект пока остаётся в стадии начальных прототипов. По словам Даттатреи, Amazon ещё не определилась с форм-фактором устройств, не называет сроков, ни масштабов внедрения. Тем не менее, инженеры компании уже закладывают основу архитектуры, способной в будущем трансформировать роботов Amazon в универсальных и автономных исполнителей. 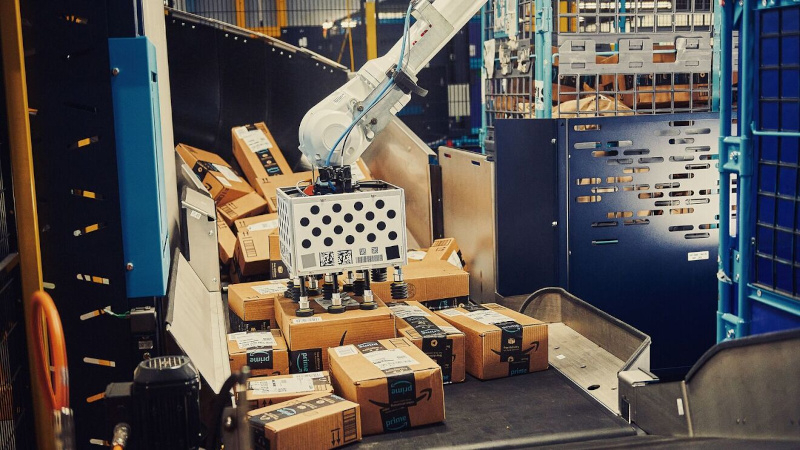 У Amazon уже есть опыт в области агентного ИИ. В начале года её ИИ-лаборатория представила Nova Act — браузерного ИИ-агента, способного выполнять действия в интернете по командам пользователя. Ещё одно новшество — Alexa+, обновлённая версия голосового помощника, обладающая базовыми функциями агентности: запоминание целей, выполнение последовательных действий. Однако обе системы пока ограничены цифровым пространством и не взаимодействуют с физической средой. 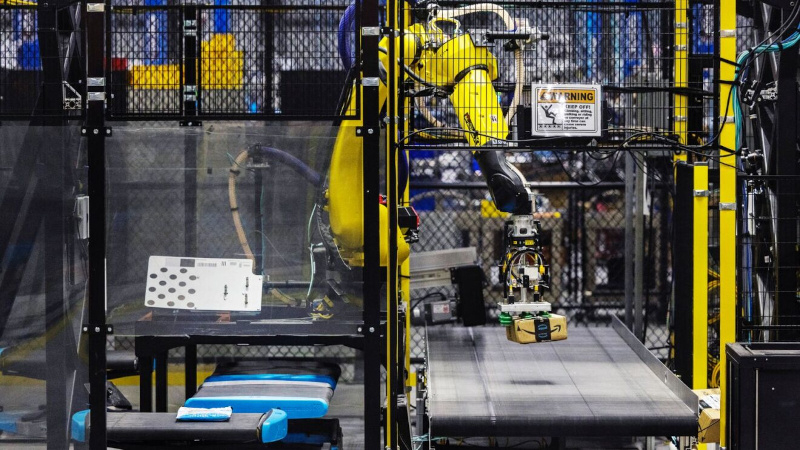 Amazon также рассказала о разработке усовершенствованных картографических технологий, ориентированных на работу курьеров. Новые карты обеспечат высокую детализацию зданий, покажут потенциальные препятствия и предложат оптимальные маршруты доставки. Особое внимание уделяется сложным локациям: офисным комплексам и жилым кварталам с одинаковыми зданиями. Это решение должно значительно упростить навигацию и снизить время на поиск точек доставки заказов. 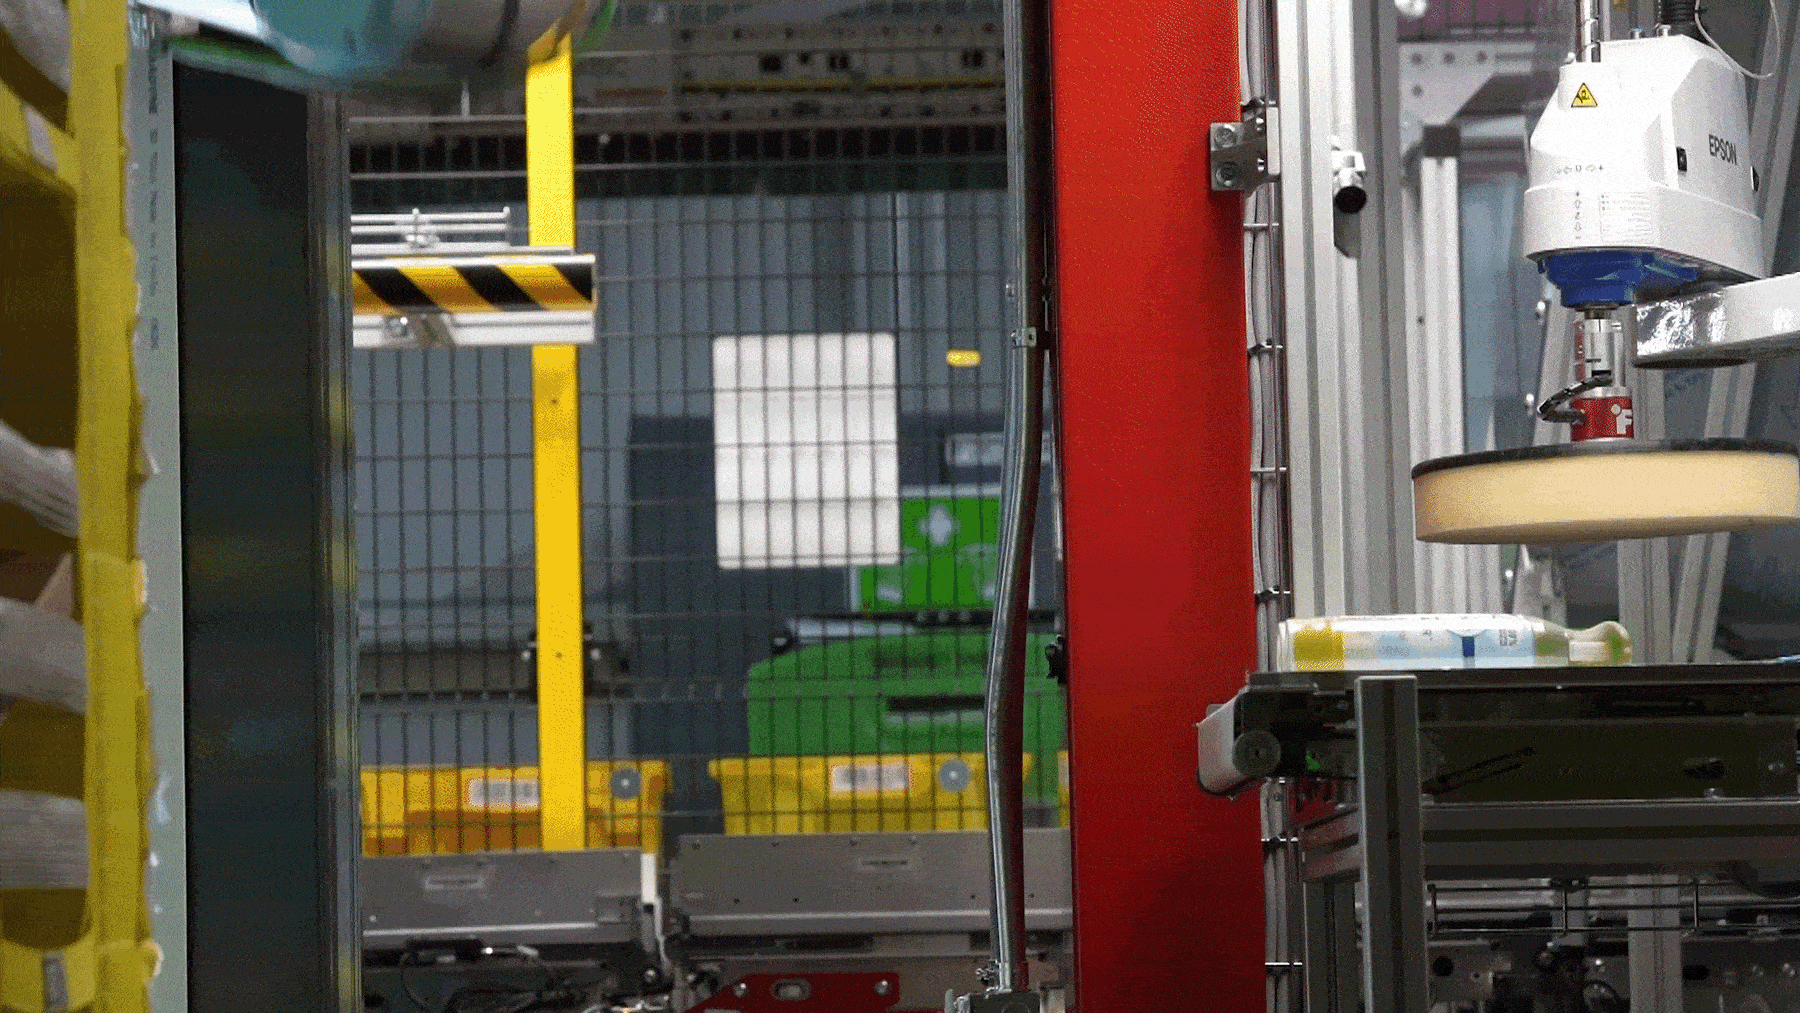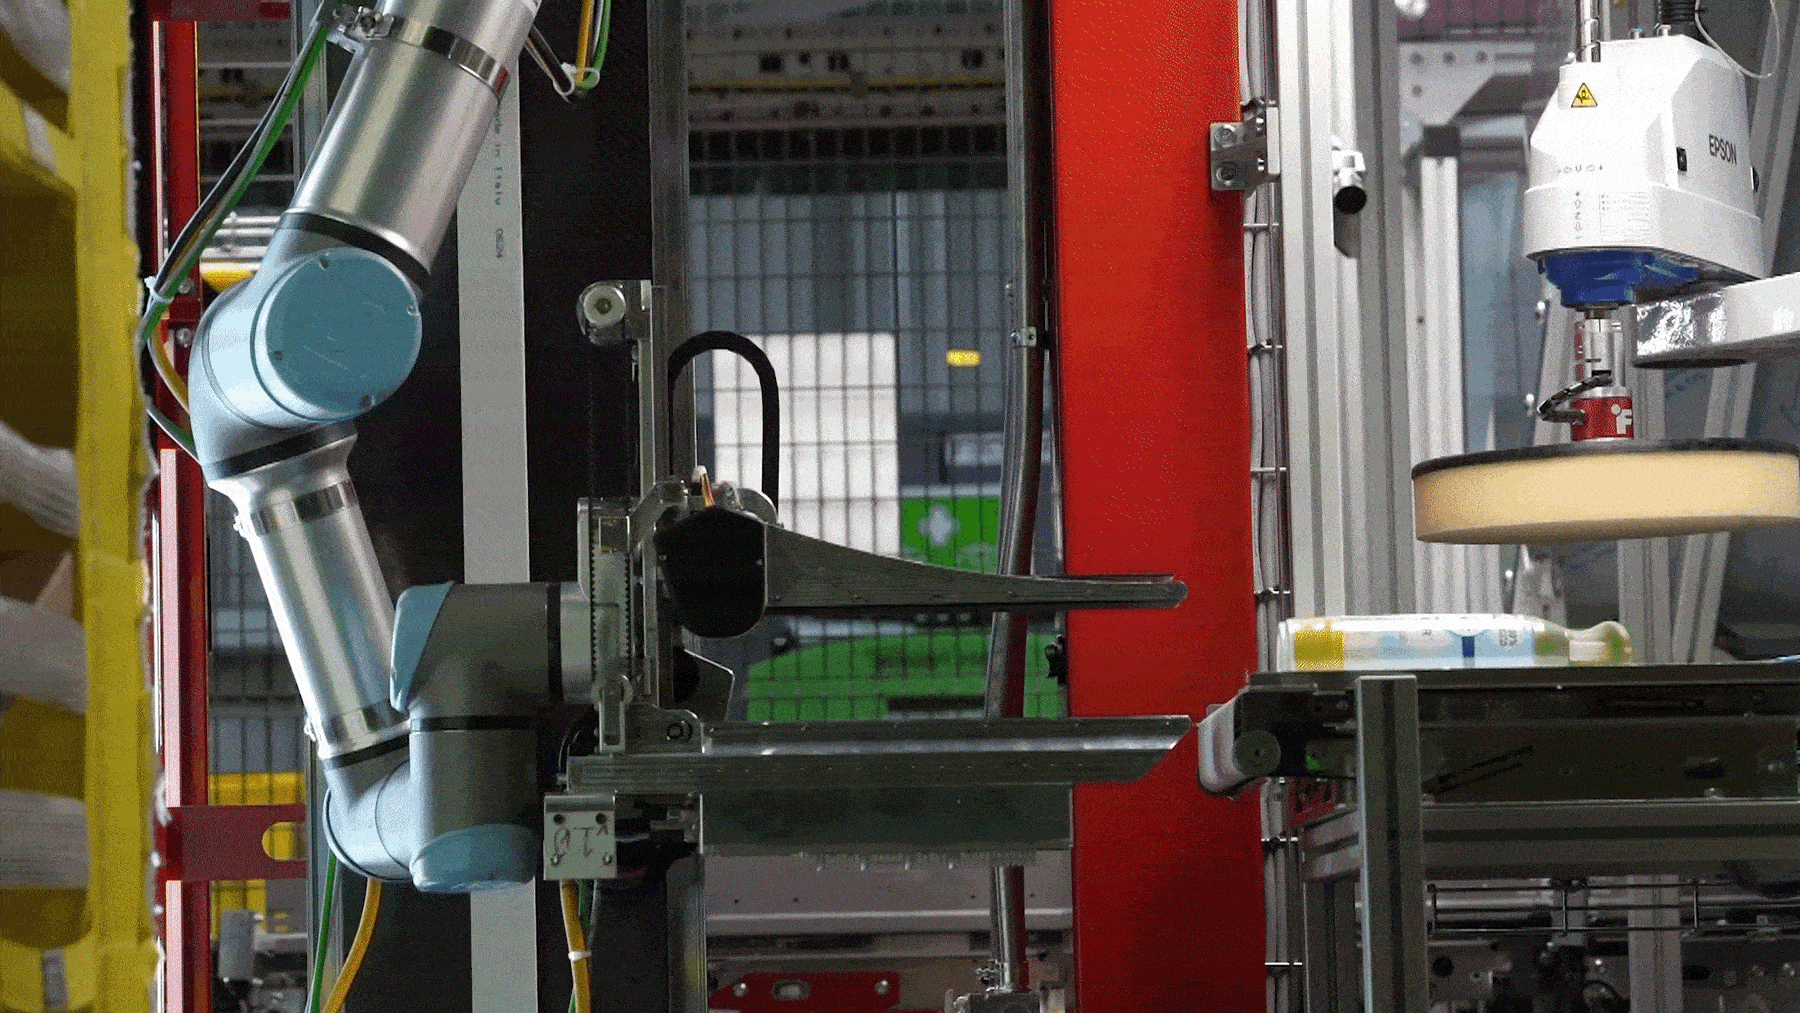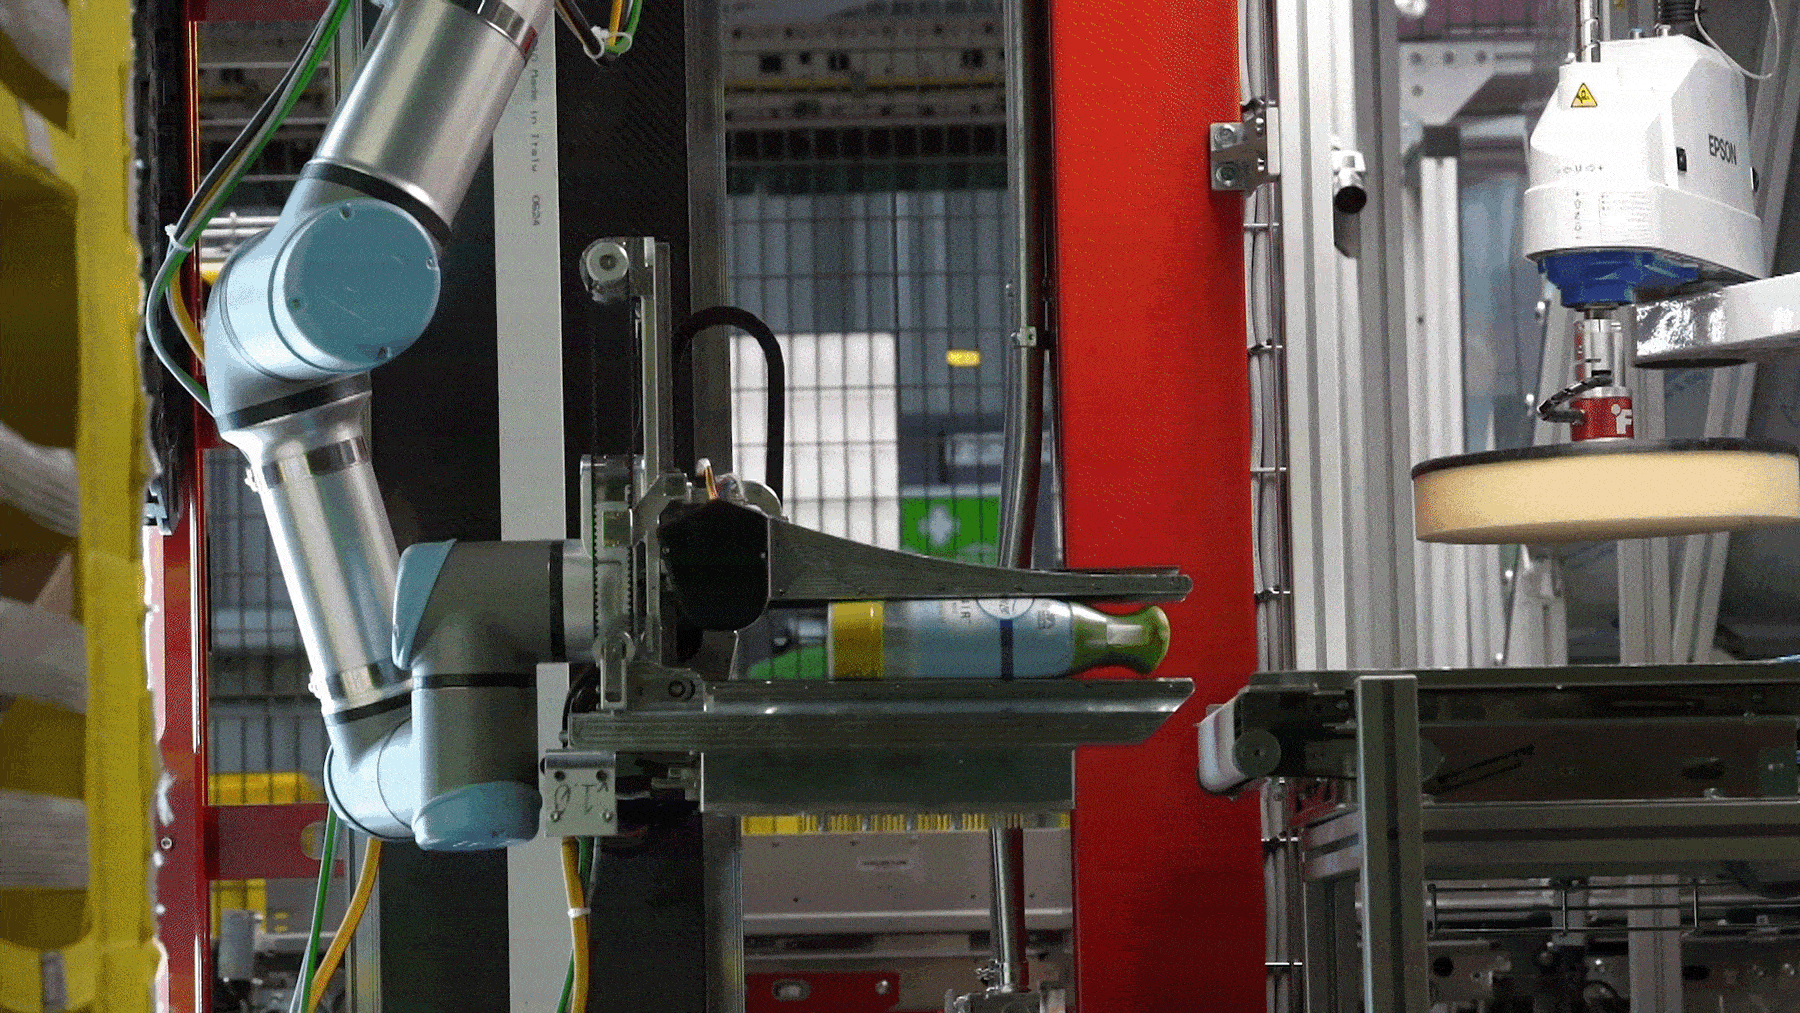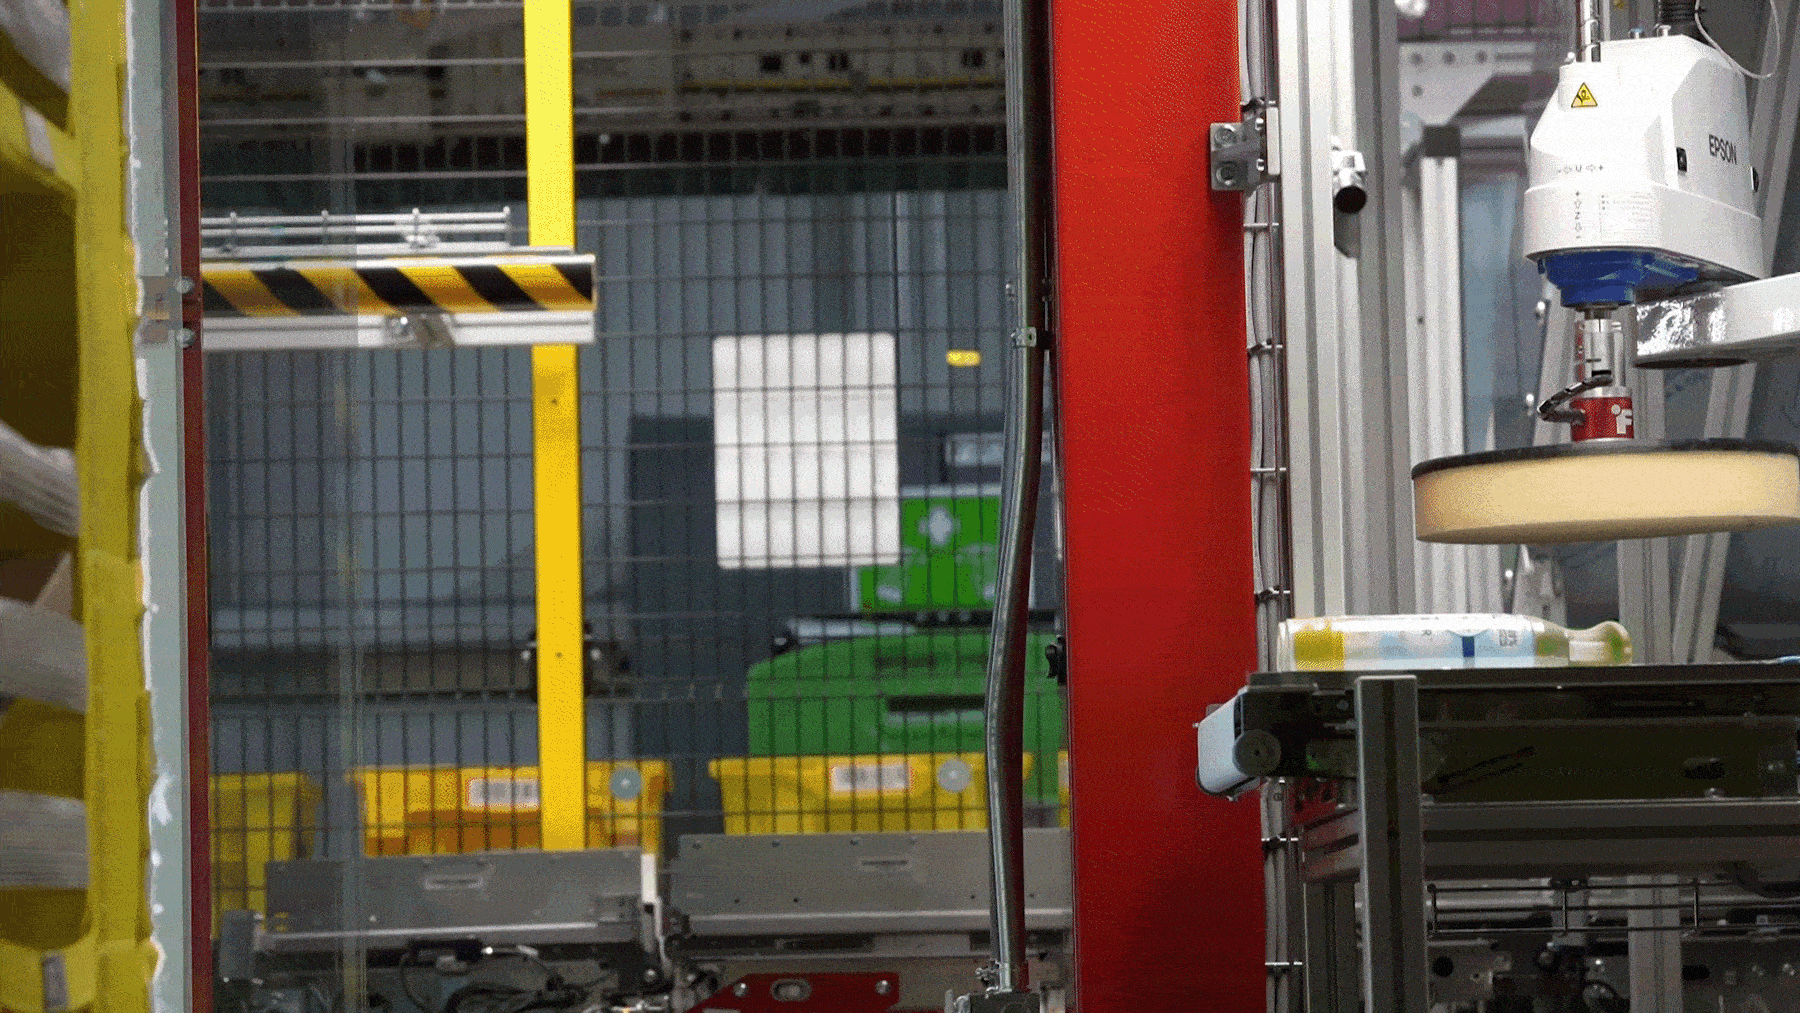 Amazon заявила, что планирует интеграцию этих карт с очками дополненной реальности для водителей доставки. Эти очки со встроенным дисплеем смогут отображать карту и прокладывать пошаговый маршрут в реальном времени. Об этом сообщил вице-президент и глава Amazon Maps and Geospatial Вираж Чаттерджи (Viraj Chatterjee). Он отметил, что устройство пока находится в стадии тестирования, но первые результаты уже демонстрируют эффективность технологии, особенно в зонах с однотипной архитектурой. Reddit решила засудить Anthropic за чрезмерную активность ИИ-краулеров
05.06.2025 [16:43],
Павел Котов
Администрация сетевого сообщества Reddit подала в Высший суд Сан-Франциско исковое исковое заявление к Anthropic, заявив, что боты для сбора информации ответчика с июля 2024 года заходили на платформу более 100 тыс. раз — это произошло уже после того, как Anthropic заявила, что заблокировала ботам доступ к ресурсу. 
Источник изображения: redditinc.com В своём иске Reddit охарактеризовала ответчика как «задержавшуюся в развитии компанию искусственного интеллекта, которая позиционирует себя как белого рыцаря в отрасли ИИ», хотя, по мнению истца, «это вовсе не так». «Это дело о двух личинах Anthropic: публичной, которая пытается втереться в доверие к сознанию потребителя заявлениями о праведности, уважении границ и закона, и закрытой, которая пренебрегает любыми правилами, мешающими попыткам ещё больше набить карманы», — говорится в исковом заявлении. «Коммерческая эксплуатация» Reddit может стоить Anthropic несколько миллиардов долларов, заявил ресурсу The Verge главный юрисконсульт платформы Бен Ли (Ben Lee). «Живые люди на Reddit — уникальная ценность в мире, который ИИ равняет с землёй. Сейчас люди ищут подлинного человеческого общения больше, чем когда-либо. Reddit почти 20 лет выступает площадкой для насыщенных человеческих дискуссий практически на все мыслимые темы. Таких разговоров нет больше нигде — и в обучении языковых моделей вроде [Anthropic] Claude они играют центральную роль», — добавил господин Ли. В прошлом году Reddit заключила лицензионные соглашения с Google и OpenAI на доступ ИИ к своим материалам. Anthropic уже не впервые приходится отвечать на судебные претензии, связанные с контентом для обучения ИИ: писатели обвиняли её в краже сотен тысяч защищённых авторским правом книг, а Universal Music — текстов песен. Несколько исков подали и против OpenAI: в краже текстов книг её обвиняли писатели, а новостных материалов — New York Times и другие издания. Ускорители Nvidia Blackwell более чем в два раза обходят предшественников в обучении больших языковых моделей
05.06.2025 [08:46],
Алексей Разин
По опубликованным некоммерческой организацией MLCommons результатам тестирования различных аппаратных систем при обучении больших языковых моделей становится понятно, что ускорители вычислений Nvidia с архитектурой Blackwell более чем в два раза превосходят по производительности своих предшественников поколения Hopper. 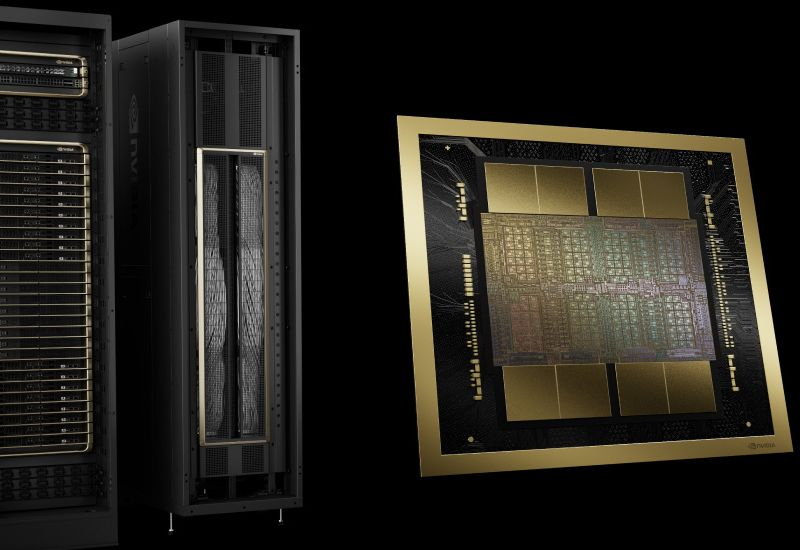
Источник изображения: Nvidia В принципе, об этом в момент анонса архитектуры Blackwell говорила и сама Nvidia, но теперь эти заявления хотя бы подкреплены данными тестов в изложении независимых источников. Применялись языковые модели типа Llama 3.1 405B, которые содержат буквально триллионы параметров и отображают сложность вычислений в сфере искусственного интеллекта на актуальном этапе развития отрасли. Справедливости ради, следует учитывать, что данные для исследования с результатами тестирования своих систем на основе Blackwell компания Nvidia предоставила сама, но представители MLCommons хотя бы не сомневаются в их достоверности. Из полученных результатов тестирования становится известно, что в удельном выражении каждый чип поколения Blackwell в подобных вычислительных задачах оказывается в два с лишним раза быстрее предшественника поколения Hopper. В конкретной конфигурации система на основе 2496 чипов Blackwell справилась с заданием за 27 минут. Чтобы получить более впечатляющий результат, системе на базе такого же количества чипов Hopper потребовалось более чем в три раза больше времени. Представители CoreWeave пояснили, что в последнее время в отрасли наблюдается тенденция к разделению крупных вычислительных кластеров на более мелкие подсистемы с небольшим количеством ускорителей, специализирующихся на отдельных подзадачах. Это позволяет ускорять обучение языковых моделей в условиях ограниченности аппаратных ресурсов. В WhatsApp появится простой способ создания персональных ИИ-ботов
05.06.2025 [04:31],
Анжелла Марина
WhatsApp готовится представить новую функцию, которая позволит создавать собственных ИИ-ботов прямо внутри приложения. Чтобы воспользоваться этой функцией, получившей название AI Studio, пользователям не нужно обладать навыками программирования. 
Источник изображения: Lonely Blue / Unsplash Как сообщает 9to5Mac, AI Studio уже тестируется среди ограниченного круга пользователей на iOS и Android. Ранее для создания ИИ-ассистентов в экосистеме Meta✴✴ нужно было использовать веб-версию Meta✴✴ AI Studio, Messenger или Instagram✴✴, но теперь такая возможность появится и в WhatsApp. Процесс создания ботов будет максимально простым. Пользователи смогут выбрать роль для бота, например, это может быть помощник в учёбе, туристический гид или мотивационный коуч. Также можно будет настроить стиль общения: спокойный, энергичный, шуточный или профессиональный и информативный. При этом система предложит подсказки, чтобы помочь адаптировать поведение ИИ-бота. По умолчанию созданные ИИ-боты будут приватными, но ими можно будет делиться через уникальную ссылку, как это реализовано в OpenAI и Google. Правда, GPT Store хоть и не оправдал больших ожиданий, однако он остаётся источником идей и вдохновения для пользователей. Если Meta✴✴ реализует похожую функциональность, это может в будущем повысить интерес пользователей к подобным инструментам, пишет 9to5Mac. Пока функция находится в разработке, и точные сроки её выхода неизвестны. Однако наличие соответствующих строк кода в последних бета-версиях говорит о том, что запуск не за горами — особенно на фоне недавнего выхода официального приложения WhatsApp для iPad и тестирования системы имён пользователей. Google научила Gemini 2.5 понимать и передавать эмоции в диалогах
05.06.2025 [01:57],
Вячеслав Ким
На конференции Google I/O 2025 компания анонсировала новую версию своей мультимодальной модели Gemini 2.5, которая теперь поддерживает генерацию аудио и диалогов в реальном времени. Эти возможности доступны в предварительной версии для разработчиков через платформы Google AI Studio и Vertex AI. 
Источник изображения: Google Gemini 2.5 Flash Preview обеспечивает реалистичное голосовое взаимодействие с ИИ, включая распознавание эмоциональной окраски речи, адаптацию интонации и акцента, а также возможность переключения между более чем 24 языками. Модель может игнорировать фоновые шумы и использовать внешние инструменты, такие как «Поиск», для получения актуальной информации во время диалога. Дополнительно, Gemini 2.5 предлагает расширенные функции синтеза речи (TTS), позволяя управлять стилем, темпом и эмоциональной выразительностью озвучивания. Поддерживается генерация диалогов с несколькими голосами, что делает модель подходящей для создания подкастов, аудиокниг и других мультимедийных продуктов. Для обеспечения прозрачности, все сгенерированные моделью аудио маркируются с помощью технологии SynthID, что позволяет идентифицировать контент, как сгенерированный ИИ. Разработчики могут опробовать новые функции через вкладки Stream и Generate Media в Google AI Studio. Gemini 2.5 демонстрирует значительный шаг вперёд в области мультимодальных ИИ-систем, объединяя модальности текстов, изображений, аудио и видео в единую платформу. Новые функции открывают широкие перспективы для создания интерактивных приложений, виртуальных ассистентов и инноваций в сфере образования. «Яблочный интеллект» упёрся в китайскую стену: запуск ИИ-сервисов Apple в КНР заморожен
05.06.2025 [01:04],
Анжелла Марина
Китайский регулятор приостановил процесс одобрения сервисов на базе искусственного интеллекта Apple, разработанных в партнёрстве с Alibaba. Задержка связана с усугубляющимся напряжением между США и Китаем, вызванным торговой политикой администрации Дональда Трампа (Donald Trump).  Apple и Alibaba планировали представить набор сервисов Apple Intelligence, работающих на ИИ-моделях Alibaba, для китайских пользователей. Однако Управление киберпространства Китая (CAC) приостановило рассмотрение заявки. По сообщению Financial Times, причина кроется в растущей геополитической напряжённости между Вашингтоном и Пекином. Apple напрямую страдает от ухудшения отношений двух стран. Несмотря на усилия Тима Кука (Tim Cook) наладить отношения с администрацией Трампа, компания оказалась под давлением из-за того, что президент требует переноса производства из Китая в США, угрожая 25-процентными пошлинами на устройства Apple и Samsung. Задержки с запуском ИИ-сервисов ещё сильнее усугубляют проблемы Apple, которая и так теряет долю рынка в Китае. Согласно данным IDC, доля Apple в премиальном сегменте китайского рынка снизилась с 70% в начале 2023 года до 47% в первом квартале текущего года. Huawei, напротив, увеличила свою долю с 13% до 35%. Отмечается, что одобрение CAC необходимо всем иностранным компаниям, предлагающим ИИ-услуги в Китае, и требует обязательного тестирования всех моделей перед их запуском. Несмотря на то, что Apple сотрудничает с китайской компанией Alibaba для ускорения процесса, высокий уровень внимания к партнёрству технологических гигантов лишь усилил проверки. Кроме того, по информации, циркулирующей в деловых кругах, власти КНР также используют регуляторные меры как рычаг в торговых переговорах с США. Окончательное решение должен принять Госсовет КНР, который одновременно ведёт переговоры с США о снижении пошлин. Бюро промышленности и безопасности Министерства торговли США также выразило обеспокоенность сотрудничеством Apple и Alibaba. Однако юридическими инструментами для блокировки этого партнёрства власти США не располагают. Ранее председатель Alibaba Джо Цай (Joe Tsai) подтвердил, что компания предоставит технологии для ИИ-функций iPhone в Китае. Apple отказалась комментировать ситуацию. Alibaba, CAC и Госсовет КНР не ответили на запросы. ChatGPT научился копаться в корпоративных файлах в «Google Диске», Dropbox и других облаках
04.06.2025 [22:45],
Анжелла Марина
ChatGPT для бизнес-пользователей научился работать с облачными хранилищами. Теперь ИИ может подключаться к «Google Диску», Dropbox, Box, SharePoint и OneDrive для поиска информации и глубокого анализа данных (deep research) на основании внутренних документов компаний. 
Источник изображения: Zac Wolff / Unsplash Чат-бот также может записывать и транслировать встречи, создавать заметки с таймкодами, выделять ключевые моменты и предлагать действия на основе обсуждений. Пользователи смогут осуществлять поиск по таким записям так же, как по документам. При этом задачи можно автоматически переносить в Canvas — инструмент OpenAI для проектов написания текстов и кода . Подчёркивается, что новая функция учитывает и права доступа пользователей. Если, к примеру, сотрудник не имеет разрешения на просмотр файла, ChatGPT не предоставит ему информацию из него. Клиенты OpenAI также могут взаимодействовать через протокол MCP (Model Context Protocol), который позволяет подключаться к другим инструментам для глубокого анализа. Поддержка MCP доступна подписчикам Pro, Team и Enterprise. Кроме того, компания запустила бета-версию «глубоких» связей (deep research connectors) для HubSpot, Linear и некоторых инструментов Microsoft и Google. С их помощью ChatGPT может готовить аналитические отчёты, используя как внутренние данные компаний, так и данные из интернета. Этот инструмент доступен всем пользователям на платных тарифах. ИИ-поиск в Google Фото провалился — распространение функции заморозили и отправили на доработку
04.06.2025 [13:45],
Павел Котов
Google решила приостановить развёртывание функции Ask Photos — поиска с искусственным интеллектом для своего приложения для управлениями коллекциями фото. «Ask Photos оказался не там, где нужно», — пояснил в соцсети X менеджер по продукту «Google Фото» Джейми Аспиналл (Jamie Aspinall), пояснив решение тремя соображениями: задержка, качество и удобство для пользователя. 
Источник изображения: Rubaitul Azad / unsplash.com Экспериментальная функция работает на основе «самых мощных» ИИ-моделей Google Gemini — специализированных версий, применяемых только в ИИ-поиске по «Фото». Компания приостановила развёртывание функции, аудитория которой пока не успела разрастись, но ориентировочно через две недели ИИ-поиск вернётся, станет быстрее и обретёт «полноту оригинального поиска». Поиск по ключевым словам в «Google Фото» получил новые возможности, рассказали в компании. Для поиска по точным совпадениям теперь можно использовать кавычки — в выдачу попадут «имена файлов, модели камер, подписи или текст на фотографиях»; поиск без кавычек будет включать визуальные совпадения. Функцию Ask Photos компания анонсировала в мае прошлого года на конференции I/O 2024 — она должна дать приложению возможность отвечать на общие вопросы, которые обычно адресуются людям. Например, систему можно спросить, какие темы выбирали для детских дней рождения или в какие парки ездили. «Мультимодальные возможности помогают понять, что происходит на каждой фотографии, и даже могут читать текст на изображении, если это необходимо. Ask Photos создаёт полезный ответ и выбирает, какие фотографии и видео показывать», — пояснили в Google. Компания уже не впервые приостанавливает развёртывание функций на основе ИИ. В феврале прошлого года генератор изображений Gemini слишком ответственно отнёсся к вопросу расовой инклюзивности. А в мае Google столкнулась со странными ИИ-сводками в поиске: система предлагала клеить сыр к пицце и совершать другие безумства. |
|
✴ Входит в перечень общественных объединений и религиозных организаций, в отношении которых судом принято вступившее в законную силу решение о ликвидации или запрете деятельности по основаниям, предусмотренным Федеральным законом от 25.07.2002 № 114-ФЗ «О противодействии экстремистской деятельности»; |
© 1997—2026 3DNews
При цитировании документа ссылка на сайт с указанием автора обязательна. Полное заимствование документа является
нарушением
российского и международного законодательства и возможно только с согласия редакции 3DNews.



 MWC 2018
 2018
 Computex

 IFA 2018









