


Опрос
|
реклама
Быстрый переход
OpenAI представила GPT-6.1 Terra — быструю модель для самостоятельной работы на компьютере
27.10.2026 [00:33],
Николай Хижняк
Компания OpenAI выпустила GPT-6.1 Terra — новую языковую модель с поддержкой визуального анализа, ориентированную на автоматизацию рабочих задач и быстрое управление компьютером. Нейросеть представляет собой значительный шаг вперёд по сравнению с моделью предыдущего поколения GPT-5.6 Terra и предлагает пользователям повышенную скорость работы. 
Источник изображений: OpenAI По словам разработчиков, GPT-6.1 Terra превосходно справляется с задачами, составляющими основу повседневной рабочей деятельности: от подготовки предложений и интерпретации технических чертежей до заполнения форм и редактирования видео. Цены на стандартный API для GPT-6.1 Terra на 50 % ниже, чем для GPT-5.6 Terra и GPT-6.1 Sol. Согласно пресс-релизу, стоимость теперь составляет $1 за миллион входных токенов, $0,05 за миллион кешированных входных токенов и $5 за миллион выходных токенов. Внутренние тесты OpenAI показывают, что по точности ответов GPT-6.1 Terra вплотную приблизилась к флагманским решениям. 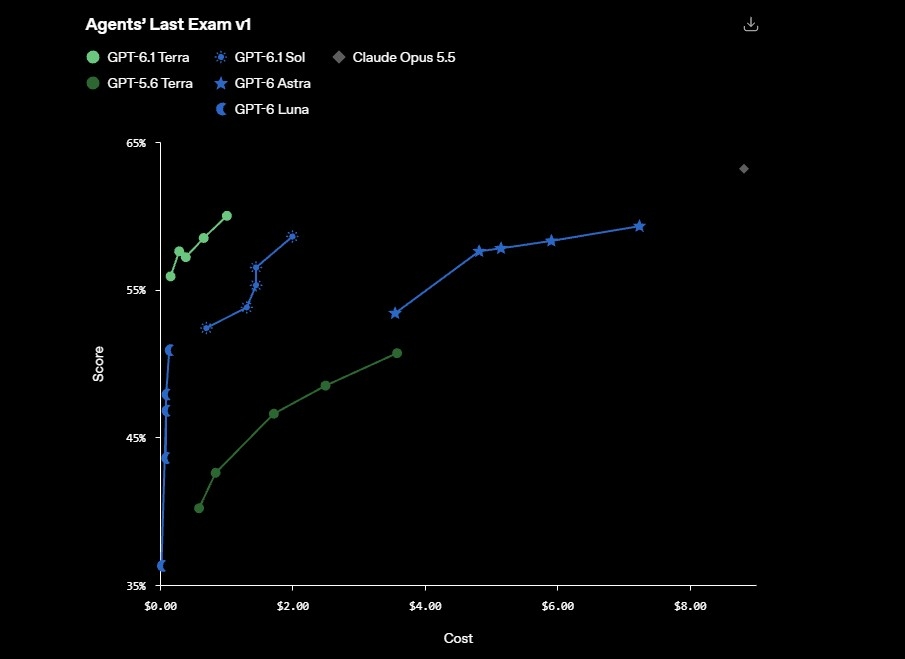 В бенчмарке Agents’ Last Exam, оценивающем способность ИИ-агентов решать сложные профессиональные задачи на рабочем месте, Terra при среднем уровне рассуждений набрала на 15 процентных пунктов больше, чем GPT-5.6 Terra, оказавшись при этом примерно в три раза дешевле. При максимальном уровне рассуждений модель продемонстрировала точность на уровне флагманской GPT-6 Astra, но при стоимости токенов в 10 раз ниже. В этом же тесте при максимальном уровне рассуждений Terra оказалась более чем в три раза эффективнее по расходу токенов и в четыре раза дешевле за токен, чем Claude Opus 5.5, что обеспечило примерно девятикратное снижение стоимости выполнения задачи. При этом Terra работает более чем в три раза быстрее, чем GPT-6 Astra и GPT-6.1 Sol. 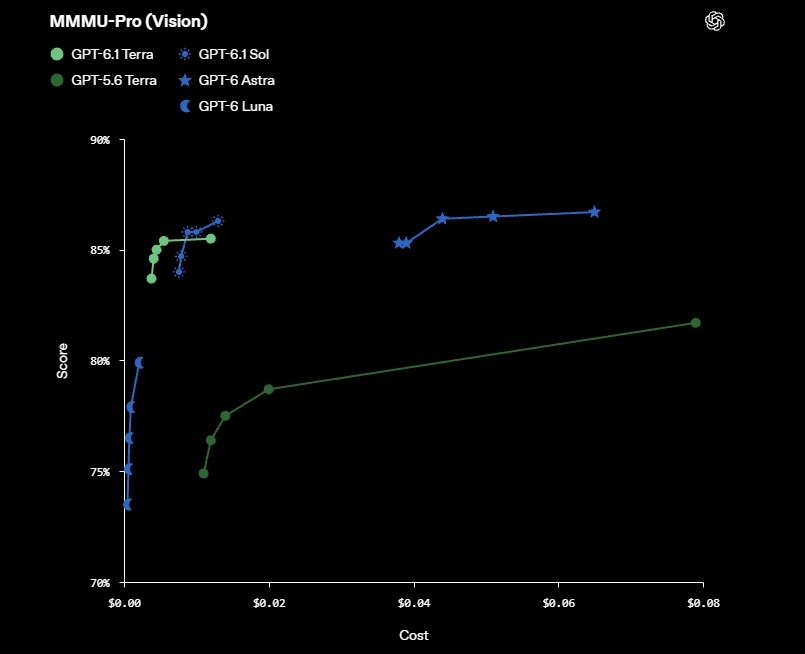 В тесте MMMU-Pro (визуальное мышление) нейросеть превзошла предшественницу GPT-5.6 Terra на всех уровнях рассуждений, продемонстрировав более глубокое понимание контекста и практически сравнявшись с показателями флагманских GPT-6 Astra и GPT-6.1 Sol при гораздо меньшей стоимости. 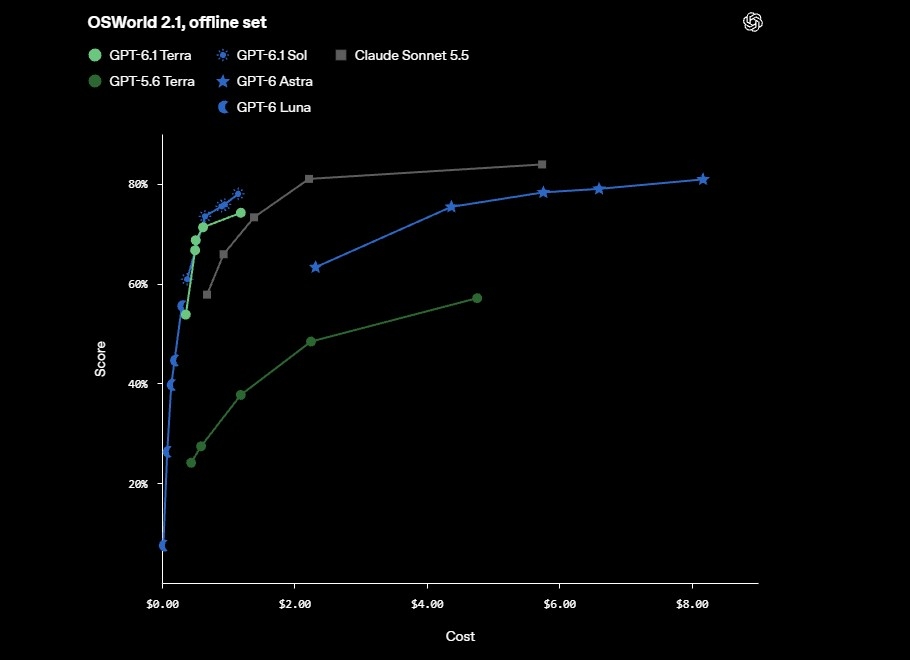 В тесте OSWorld 2.1, оценивающем, насколько эффективно ИИ-агенты используют настольные приложения для выполнения многоэтапных задач, например создания 3D-модели на основе технического чертежа, GPT-6.1 Terra при среднем уровне рассуждений превзошла лучший результат предыдущей версии GPT-5.6 Terra, затратив на это лишь малую часть прежней стоимости выполнения одной задачи. 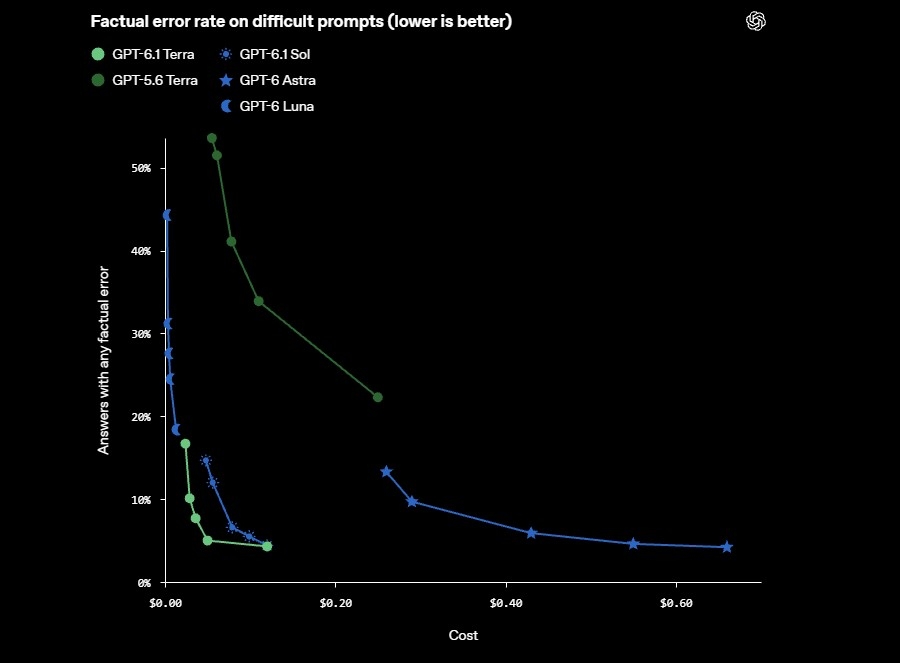 В этом году OpenAI уделила особое внимание сокращению количества галлюцинаций и фактических ошибок. Согласно результатам внутреннего тестирования с использованием промптов, провоцирующих ошибки, частота ошибок при минимальном уровне рассуждений (low reasoning effort) снизилась с 53,6 % у GPT-5.6 Terra до 16,7 % у GPT-6.1 Terra — почти на 37 процентных пунктов. При максимальном уровне рассуждений (maximum effort) количество ошибок снизилось на 18 процентных пунктов, до 4,3 %, что практически сравняло модель с флагманами GPT-6 Astra и GPT-6.1 Sol. 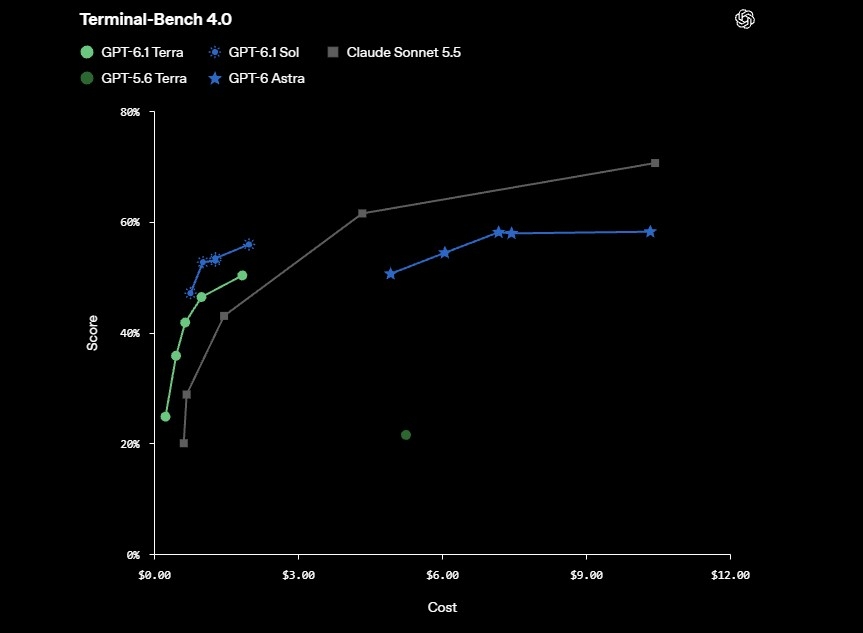 В специализированном тесте Terminal-Bench 4.0, оценивающем способность модели решать задачи из командной строки, её результат вырос более чем вдвое — с 21,5 % у GPT-5.6 Terra до 50,3 % у новой GPT-6.1 Terra при максимальном уровне рассуждений. OpenAI добавляет, что для более сложных задач, связанных с написанием кода, по-прежнему лучше подходят модели GPT-6.1 Sol и GPT-6 Astra. 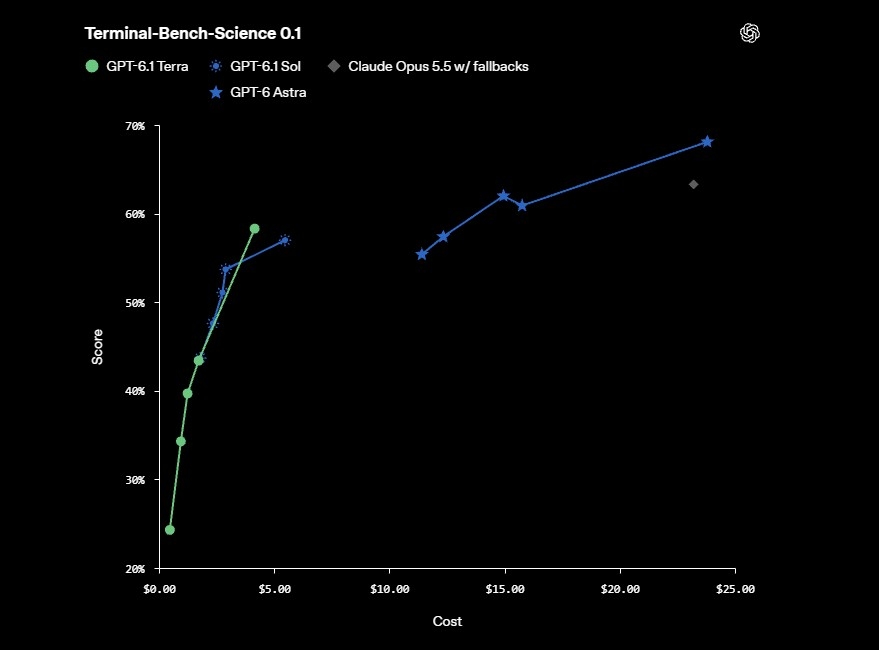 Тест Terminal-Bench-Science 0.1 проверяет способность агентов писать код для автоматизации научных исследований, например для отслеживания деления клеток на видео в режиме таймлапса. При максимальном уровне рассуждений Terra обошла модель GPT-6.1 Sol при меньшей стоимости и сократила разрыв в эффективности с Claude Opus 5.5 от Anthropic до пяти баллов. Расчётная стоимость работы GPT-6.1 Terra при этом составила менее одной пятой затрат на Opus. Компания отмечает, что с точки зрения безопасности модель GPT-6.1 Terra соответствует критическому порогу в области кибербезопасности согласно внутреннему фреймворку OpenAI (Preparedness Framework) и сохраняет защитные механизмы, разработанные для GPT-6 Astra. По сравнению с GPT-5.6 Terra она лучше удерживает контекст задачи и честно сообщает пользователю о своих ограничениях и потенциальных препятствиях. В тестах на инъекции промптов GPT-6.1 Terra продемонстрировала высокую устойчивость к вредоносным инструкциям, направленным на то, чтобы отвлечь её от выполнения задачи пользователя. Доступ к GPT-6.1 Terra открылся сегодня для всех пользователей с подписками Plus, Pro, Enterprise и Edu в ChatGPT Work и Codex. Разработчики могут получить к ней доступ через API под идентификатором gpt-6.1-terra. Основатель Twitter представил голосовой ИИ, обученный с нуля только на человеческой речи
24.10.2026 [12:14],
Павел Котов
Компания Block, созданная основателем Twitter Джеком Дорси (Jack Dorsey) представила модель искусственного интеллекта под названием Dessa. Её отличительной особенностью является то, что она была обучена «с нуля исключительно на человеческой речи». Как и другие современные речевые модели, Dessa является полнодуплексной — она слушает и говорит одновременно. 
Источник изображения: x.com/RagavanThurair Компания продемонстрировала примеры того, как люди общаются с этой моделью — она ведёт себя вполне естественно. В одном из примеров Dessa обсуждала кинематограф; в другом — с радостью выслушала, как собеседник отвезёт её в Париж, и отреагировала со слезами радости в голосе; третьем — пообщалась с аналогичной голосовой моделью OpenAI GPT-Live-1 и звучала более естественно, чем продукт от лидера в отрасли. Dessa, отмечают разработчики — «настоящая модель формата „из речи в речь“, и все свои знания она почерпнула из человеческой речи». Она запускается локально на ноутбуке Apple MacBook Pro с процессором M4 Max или на более мощном устройстве. Разработать Dessa компанию побудили три соображения: «любопытство, улучшение взаимопонимания между людьми и безопасность». В Block рассказали о проекте и более подробно: «Маленькие дети учатся говорить, ещё не увидев ни слова письменного текста. Нам хотелось узнать, способна ли на это и модель. Способна. И это очень непросто. Речь — самый естественный способ взаимодействия с любым интеллектом, будь то сверхразум или что-либо иное, и сегодняшние голосовые ИИ-системы не пользуются им. Они преобразуют сказанное нами в текст и не могут угнаться за человеческим темпом. ИИ становится более мощным и самостоятельным, и он всё ещё почти глух к эмоциям в наших голосах. Представьте, что у вас что-то сильно болит, а голосовой ИИ не замечает этого и продолжает работать по-прежнему. И это проблема безопасности. Dessa — шаг к её решению». Ранний доступ к модели пока будет предоставлен «небольшой группе исследователей в области безопасности ИИ», сообщили разработчики. Moonshot AI выпустила Kimi K3.1 Pro, которая обошла все модели OpenAI и почти догнала Claude Opus 5.5
24.10.2026 [10:17],
Павел Котов
Китайская лаборатория искусственного интеллекта Moonshot AI представила Kimi K3.1 Pro — обновлённую версию модели Kimi K3, которая прошла дополнительное обучение с использованием большего объёма вычислительных ресурсов. В рейтинге Artificial Analysis Intelligence Index она набрала 55 баллов, обойдя предшественницу на 11 баллов, опередив все модели OpanAI и заняв четвёртую строчку. 
Источник изображений: kimi.com Выше Kimi K3.1 Pro в рейтинге оказались Anthropic Claude Opus 5.5 (58 баллов), Claude Sonnet 5.5 (56 баллов) и Meta✴✴ Muse Wonder Full (56 баллов). Moonshot AI намерена открыть веса модели 4 ноября, и она станет самой мощной в классе открытых систем. Разрыв между открытыми и проприетарными моделями сократится с 12 до 3 баллов, если к тому времени ситуация на рынке не изменится. Разработчик также выпустил версию Kimi K3.1 Pro Highspeed — она работает в два-три раза быстрее. Обе модели уже доступны на платформах Kimi.ai, Kimi Work, Kimi Code и через API. Наиболее заметный прогресс Kimi K3.1 Pro показала в агентных задачах: в бенчмарке GDPval-AA она набрала 1846 баллов по Эло, опередив K3 на 312 баллов. Здесь она уступила лишь Claude Opus 5.5 (1866 баллов) и Wonder Full (1857 баллов). В Terminal-Bench 4.0 продемонстрировала 65,7 %, обогнав OpenAI GPT-6 Astra (58,2%) и лишь немного уступив Claude Opus 5.5 (66,4%) — K3 в том же тесте набрала всего 13 %. В рамках внутреннего теста Kimi Hallu Bench Hard доля галлюцинаций, то есть заведомо не соответствующих действительности ответов, снизилась с 23,4 % у K3 до 8,3 % у новой модели. Это стресс-тест, а не показатель общего уровня ошибок, подчеркнули в Moonshot; для сравнения, GPT-6 Astra в том же тесте показала 5,5 %, то есть сохранила преимущество. В финансовых тестах Kimi K3.1 Pro показала прирост на 7,2 балла по направлению финансового моделирования и на 11,6 балла — по финансовым исследованиям. В связанном с офисными задачами бенчмарке OfficeQA Pro v2 модель обошла вообще всех конкурентов, утверждает Moonshot. 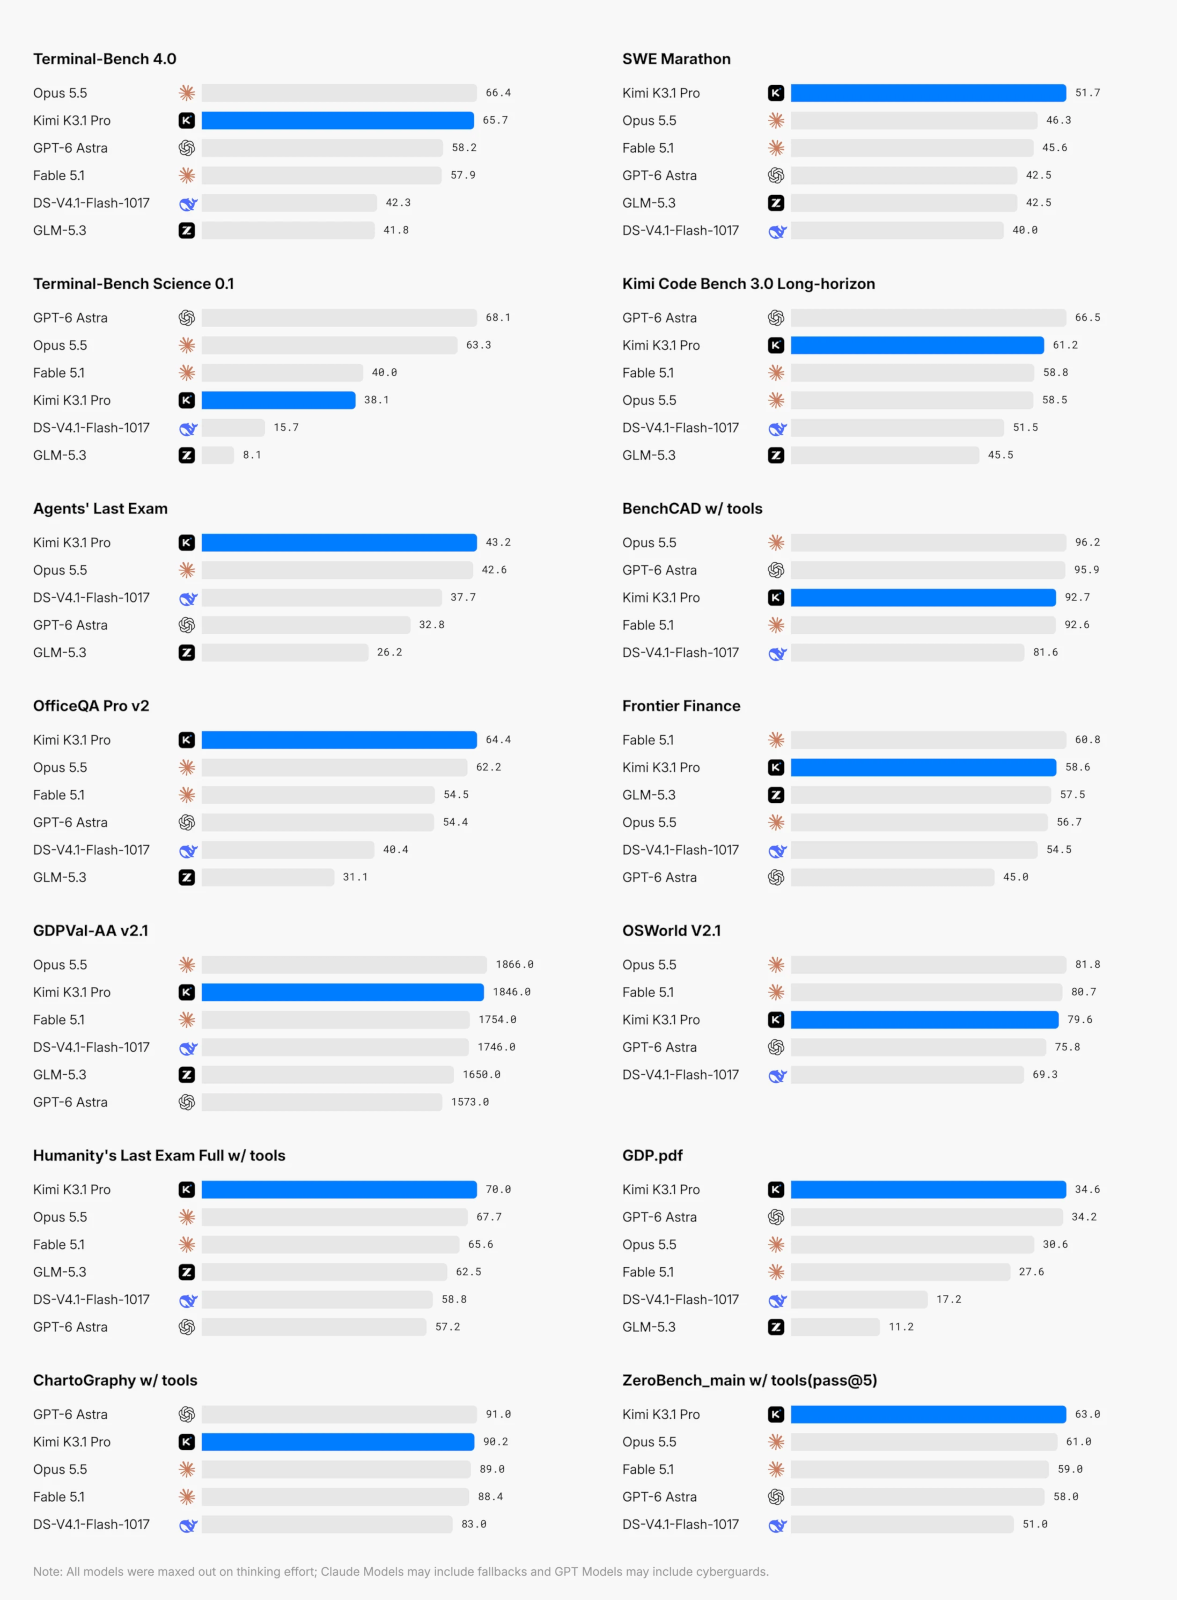 Kimi K3.1 Pro поддерживает прямое взаимодействие с игровыми движками, в том числе Unity, Unreal Engine и Godot — она может вносить оперативные исправления и производить сборку проектов. При использовании вспомогательных инструментов в тесте BenchCAD она набрала 92,7 %, выступив близко к показателям Claude Opus 5.5 (96,2%) и GPT-6 Astra (95,9%). Без использования инструментов результат снизился до 72,8 %, и это почти равно показателю Claude Opus 5.5 (73,0 %). Лучше всего модель справляется с параметрическим моделированием механических деталей, архитектурных объектов и объектов с настраиваемыми параметрами. Она умеет создавать и запускать скрипты для Blender и CAD-систем без MCP-коннекторов. На платформе Kimi.com появилась функция 3D Make — она позволяет просматривать, редактировать и экспортировать трёхмерные модели. Модель Kimi K3.1 Pro унаследовала размер предшественницы — 2,8 трлн параметров, из которых активны 104 млрд. Контекстное окно имеет размер в 1 млн токенов, поддерживается работа с текстом и изображениями. По данным Artificial Analysis, она находится на вершине «границы Парето»; у неё самый высокий показатель Intelligence Index среди моделей сопоставимого размера. Стоимость эксплуатации снизилась на 33 %: $2 за 1 млн входных токенов (было $3), $10 за 1 млн выходных токенов (было $15) и $0,20 за работу с кешированными данными (было $0,30). Выполнение одной задачи из набора Intelligence Index обходится в $1,98 — почти столько же, сколько для K3 ($2,00) – при том, что новая модель генерирует на 14 % больше выходных токенов. По мере масштабирования этапа пост-обучения у модели усиливались способности к поиску уязвимостей, отметили в Moonshot: связанные с кибербезопасностью материалы присутствовали в общем массиве данных, соответствующие задачи были включены в среду обучения с подкреплением. При подготовке версии с открытыми весами разработчик удалил касающиеся кибербезопасности данные на обоих этапах обучения. В ходе внутреннего тестирования с бенчмарком xdev-bench-hard, включающем выявленные за последнее время уязвимости в ядре Linux, Node.js и JavaScriptCore, исходный вариант модели успешно справился с 90,5 % задач; после удаления данных этот показатель снизился до 81,0 %. Для сравнения, в том же тесте DeepSeek-V4.1-Flash показала 85,7 %, а Kimi K3 — 33,3 %. Модели с открытыми весами не должны расширять границы возможностей в сфере наступательной кибербезопасности, считают в Moonshot. В то же время лаборатория стремится постепенно повышать функциональные возможности открытых моделей, потому что они могут оказаться полезными и в защите — например, при анализе устаревших систем. Ранее Anthropic продемонстрировала, что китайская модель Z.ai GLM-5.3 с 45 баллами в AA Index способна создавать эксплойты, по уровню сложности сопоставимые с теми, что генерирует Claude Mythos. DeepSeek и MiniMax получили право разворачивать свои ИИ-модели за пределами Китая
24.10.2026 [05:16],
Алексей Разин
ИИ-модели двух китайских стартапов можно будет разворачивать за пределами КНР даже в том случае, если в стране введут новые экспортные ограничения в данной сфере. Компаниям DeepSeek и MiniMax удалось получить подобные разрешения в числе первых. 
Источник изображения: DeepSeek США и КНР стараются ограничивать экспорт ключевых технологий, которые определяют их экономическое положение на мировом рынке. В случае с Китаем правила экспортного контроля распространяются и на технологии искусственного интеллекта. В этом смысле разработчикам DeepSeek и MiniMax повезло в том отношении, что власти КНР недавно разрешили им разворачивать свои ИИ-модели за пределами страны. Сообщение на эту тему появилось на странице социальной сети, принадлежащей CCTV — Центральному телевидению Китая. В нём же отмечается, что значительная часть китайского ИИ останется свободной для экспорта. Данный комментарий появился на фоне начавшегося на прошлой неделе обсуждения законопроекта о введении более строгого контроля за экспортом ИИ-инструментов и услуг, включая большие языковые модели и агентов. Предлагаемые меры ограничат доступ к передовым китайским ИИ-моделям из-за пределов страны, замедлив внедрение экономически эффективных решений, основанных на открытом исходном коде, зарубежными пользователями. «С момента анонса данной политики, ведущие компании DeepSeek и MiniMax успешно завершили регистрацию, равно как и процедуры по открытию исходного кода и разрешению использования за рубежом. ИИ-компании могут продолжать свои усилия по коммерциализации в обычном режиме», — заявил китайский государственный канал CCTV. Китайские стартапы добились серьёзного успеха в сокращении отставания от лидеров рынка США в текущем году. Помимо более доступной ценовой политики, они также привлекли пользователей возможностью более простой индивидуализации своих моделей по сравнению с проприетарными системами, предлагаемыми OpenAI и Anthropic. Политику властей КНР в сфере экспорта ИИ-технологий нельзя назвать однозначной, ведь именно с их подачи американской Meta✴✴ Platforms пришлось отменить итоги сделки по приобретению сингапурского ИИ-стартапа Manus с китайскими корнями. Власти Китая регулярно обновляют каталог технологий, которые либо запрещены к экспорту, либо ограничены. В 2020 году в этот перечень попали алгоритмы, что в итоге затруднило сделку по «приземлению» TikTok в США, на которой настаивали американские власти. Новейшие изменения в экспортную политику КНР обсуждаются с прошлого полугодия, чиновники ведут диалог с участниками отрасли и исследовательскими учреждениями. Этот каталог, по словам CCTV, нацелен на «определение границ, нежели чем на простое ограничение экспорта ИИ-технологии». Предусмотрены и существенные исключения из предлагаемых правил. Предоставление доступа через API, веб-приложения или сервис по подписке не будут попадать под экспортные ограничения, даже если в основе этих решений будут лежать ИИ-модели, экспорт которых из КНР запрещён. Подчёркивается, что такой подход контрастирует с методами, используемыми властями США для защиты своего доминирующего положения. DeepSeek за два года устранит зависимость от Nvidia — основными станут ИИ-ускорители Huawei
23.10.2026 [15:39],
Алексей Разин
DeepSeek может почти полностью отказаться от ИИ-ускорителей Nvidia уже к 2028 году, переключившись на китайские чипы Huawei Ascend. По оценке SemiAnalysis, совместная работа двух компаний помогает сократить отставание от Nvidia не только в производительности, но и в программной экосистеме. Для китайской ИИ-отрасли это важный шаг к снижению зависимости от американских технологий. 
Источник изображения: Unsplash, Saradasish Pradhan Китайские власти заинтересованы в достижении определённого уровня импортозамещения в сфере искусственного интеллекта, поскольку пытающиеся ограничить прогресс КНР в этой сфере американские власти не дают передовым компонентам попадать в Поднебесную по официальным каналам. По оценкам SemiAnalysis, углубляющийся симбиоз DeepSeek и Huawei уже в 2027–2028 годах позволит первой из компаний преимущественно полагаться на ускорители Huawei в своей вычислительной инфраструктуре. Помимо усилий Huawei по формированию экосистемы для эффективного использования фирменных ИИ-ускорителей семейства Ascend, этому способствует и встречное движение самой DeepSeek, которая адаптирует к ним свои средства разработки и программную инфраструктуру. Ещё несколько недель назад DeepSeek представила программные средства, которые позволяют компании запускать современные ИИ-модели на аппаратном обеспечении Huawei, а не только платформе Nvidia. Собственный язык программирования TileLang компания DeepSeek также адаптировала под работу с ускорителями Ascend, и он уже позволяет создавать высокопроизводительные программные ядра, использующие ресурсы этих ускорителей Huawei. В конце прошлого месяца представители DeepSeek заявили, что данный шаг позволит создать более «независимую и контролируемую» национальную программную экосистему, используемую совместно с графическими процессорами (GPU). Технологические решения Huawei уже достигли определённой степени зрелости, по мнению представителей SemiAnalysis, и к 2027 или 2028 году DeepSeek вполне могла бы главным образом перейти на их использование, снизив зависимость от импортируемых или арендуемых за пределами КНР ускорителей Nvidia. Глава и основатель последней — Дженсен Хуанг (Jensen Huang), ещё в апреле, до выхода ИИ-модели DeepSeek v4, назвал «ужасным сценарием» для США оптимизацию китайской компанией своих моделей под чипы Huawei. По мнению генерального директора конкурирующей Nvidia, это обеспечило бы превосходство КНР над США в конечном итоге. По данным SemiAnalysis, результаты тестирования на Ascend 950PR позволяют говорить о сокращении отставания в экосистемах благодаря совместной работе DeepSeek и Huawei. «Кошмар Дженсена начинает становиться явью», — резюмируют авторы публикации. DeepSeek предоставляет Huawei ранний доступ к своим ИИ-моделям. Последней это позволяет предоставить поддержку операций инференса на своих чипах с «нулевого дня» для крупных обновлений типа DeepSeek V4 и V4.1. Эксперты SemiAnalysis при этом вынуждены признать, что представленные Huawei в марте ускорители Ascend 950PR отстают от Nvidia H100 по абсолютному быстродействию. Опять же, инженеры Huawei хорошо оптимизируют программные ядра под свои чипы, достигая эффективности на уровне 99,7 % от теоретического потолка. Правда, как отмечают в SemiAnalysis, масштабировать успех симбиоза DeepSeek и Huawei на всю китайскую ИИ-отрасль будет не так просто, поскольку серверные системы первой из компаний обладают уникальной конфигурацией, и на других сочетаниях компонентов возможны проблемы с совместимостью. В частности, стандартные x86-совместимые процессоры в сочетании с ускорителями Ascend у других разработчиков вряд ли смогут показать подобную эффективность. Тем не менее, прочие китайские разработчики могут заимствовать опыт DeepSeek, в том числе, через совместное использование компиляторов и построении новых моделей на их основе. Предложив собственные оптимизации и исправления, эти разработчики смогут сделать вклад в общий прогресс представителей китайской ИИ-отрасли. ИИ, который пишет не последовательно, а параллельно: диффузионная модель Mercury 3 в 6–8 раз быстрее GPT-6 Luna
21.10.2026 [11:41],
Владимир Мироненко
Компания из Редвуд-Сити (США) представила диффузионную большую языковую модель (dLLM) Mercury 3, которая в 40 раз больше предшественницы Mercury 1, но при этом отличается высокой скоростью работы — свыше 1000 токенов/с. В ряде тестов Mercury 3 превосходит GPT-6 Luna и Claude Haiku 5.5, работая при этом гораздо быстрее. 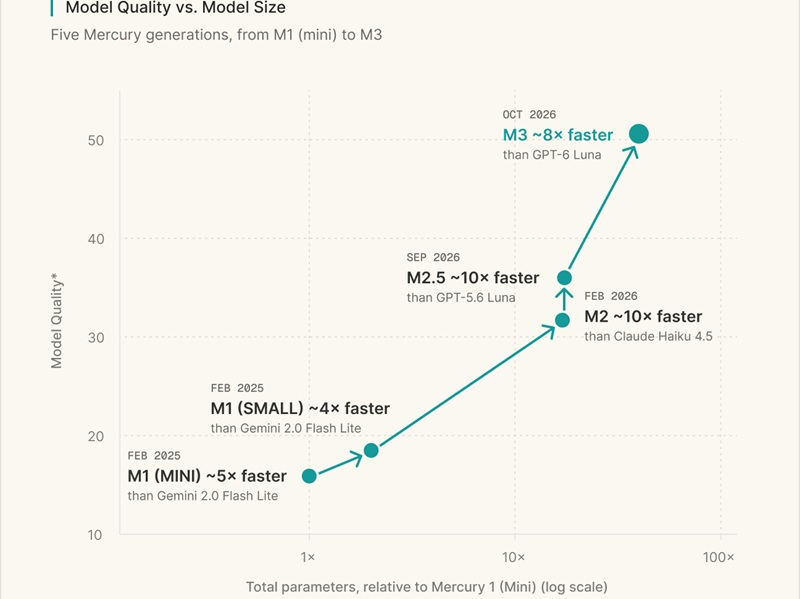
Источник изображения: Inception В отличие от больших языковых моделей (LLM), генерирующих текст по одному токену за раз, диффузионные могут выдавать несколько токенов сразу, что даёт выигрыш в скорости. Ранее разработчикам приходилось выбирать: либо использовать компактные и быстрые модели (для задач, критичных к задержкам), либо более мощные, но медленные аналоги. Mercury 3, как утверждает Inception, обладает и тем, и другим. Она значительно крупнее и функциональнее предшественников, но при этом по-прежнему работает со скоростью свыше 1000 токенов/с. При этом контекстное окно — объём текста, который модель может обрабатывать за один раз, — увеличилось до 1 млн токенов (в предыдущей версии Mercury 2.5 оно составляло 260 тысяч). Согласно внутренним тестам компании, Mercury 3 превосходит GPT-6 Luna от OpenAI, Claude Haiku 5.5 от Anthropic и GLM-5.3 Flash от Zhipu по ряду показателей, работая при этом в 4–8 раз быстрее. «Ответы от таких моделей приходят практически мгновенно», — сообщил генеральный директор Inception Стефано Эрмон (Stefano Ermon). Mercury 3 — четвёртая модель, выпущенная Inception с момента появления Mercury 1 в июне 2025 года. С каждой новой версией их функциональность росла, что не влияло на скорость работы. Так, в Mercury 2 появились механизмы логического рассуждения, в Mercury 2.5 — возможность настройки этих механизмов и контекстное окно объёмом 260 тысяч токенов. Mercury 3 совершила самый значительный качественный скачок в развитии линейки, утверждает разработчик. Mercury 3 доступна через Inception API, Baseten, OpenRouter и Vercel. Благодаря совместимости с API OpenAI разработчики могут перейти на неё без необходимости переписывать код. Стоимость использования Mercury 3 составляет $0,2 за миллион входных токенов и $0,7 за миллион выходных токенов. На этапе запуска компания снизила расценки вдвое — до $0,1 и $0,35 соответственно. DeepSeek обновила ИИ-модель V4.1-Flash — она стала быстрее и эффективнее
18.10.2026 [13:31],
Владимир Фетисов
На этой неделе состоялся релиз ИИ-модели DeepSeek V4.1-Flash-1017. Китайская компания заявила, что новый алгоритм стал компактнее и работает быстрее предыдущей версии нейросети. Этот шаг усилит конкуренцию DeepSeek с западными компаниями, такими как Anthropic и OpenAI, а также конкурентами на домашнем рынке, включая Moonshot Kimi и Z.ai. 
Источник изображения: Unsplash, Solen Feyissa В сообщении DeepSeek сказано, что модель V4.1-Flash-1017 демонстрирует «более высокую производительность в бенчмарках, более быстрое выполнение задач и более быстрые ответы по сравнению с предыдущей версией». Нейросеть уже доступна в веб-приложении компании, в приложении DeepSeek и на платформе для разработчиков. Высокие темпы запуска новых версий ИИ-моделей DeepSeek подчёркивают нарастающую конкуренцию между китайскими открытыми моделями и закрытыми аналогами американских компаний. Последние показывают высокие результаты в разных областях, но они обходятся значительно дороже. Новая версии ИИ-модели DeepSeek обеспечивает «существенные улучшения в рассуждениях, программировании, агентных задачах и визуальных бенчмарках». 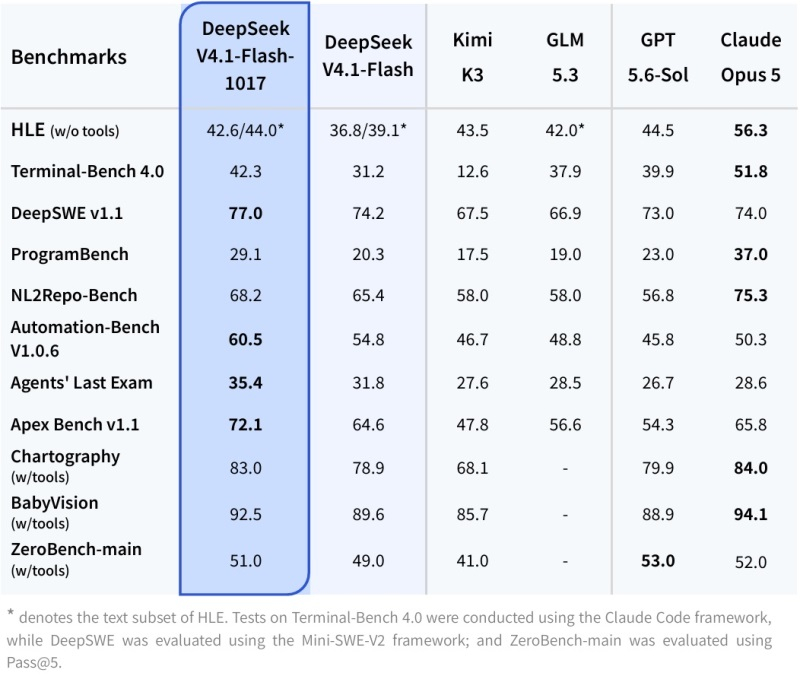
Источник изображения: api-docs.deepseek.com Модель V4.1-Flash-1017 расширяет возможности в разных сферах, начиная от создания игр и заканчивая 3D-моделированием. Несмотря на это, DeepSeek охарактеризовала новую модель, как небольшое обновление предыдущей версии V4.1-Flash. На этой неделе у DeepSeek произошёл технический сбой, в результате которого серверы компании были недоступны около пяти часов. Некоторые эксперты связывают этот инцидент с нехваткой вычислительных ресурсов. Последние месяцы участились случаи замедления работы и перебоев в сервисе DeepSeek. Это может быть связано с высоким спросом на ИИ-модели компании со стороны разработчиков из-за агрессивно низких цен, что создаёт высокую нагрузку на инфраструктуру DeepSeek. Anthropic предложила американским законодателям собственный законопроект о регулировании отрасли ИИ
17.10.2026 [07:11],
Алексей Разин
Стартап Anthropic предлагает наделить полномочиями по блокировке выхода передовых ИИ-моделей только федеральных судей США. При этом своё решение они должны принимать на основе результатов независимого аудита, а предполагаемый ущерб от ИИ-моделей должен превышать $1 млрд. 
Источник изображения: Anthropic Взаимоотношения стартапа Anthropic с американскими властями сложно назвать простыми, если учесть, что он с марта этого года отнесён к неблагонадёжным поставщикам, представляющим угрозу для национальной безопасности. При этом компания старается вести конструктивный диалог с представителями власти, и недавно даже направила им черновой вариант законопроекта, призванного регулировать риски в сфере безопасности ИИ. Об этом на своих страницах сообщило издание Politico. Представители стартапа заявили изданию, что этот черновой законопроект основан на рамочных принципах создания передового ИИ, которые компания продвигает на федеральном и локальном уровне в США с июня этого года через членов американского парламента. Чувствительные для отрасли и общества правила, по мнению Anthropic, должны вскоре быть рассмотрены Конгрессом США. Законопроект предлагает наделить правительство полномочиями блокировать выход ИИ-модели, только если предполагаемый и неизбежный ущерб от её выпуска в соответствующем виде может составить не менее $1 млрд, либо к смерти или нанесению серьёзных увечий не менее чем 50 людям. Риск может выражаться в вероятности создания биологического оружия, потере разработчиком контроля за распространением модели, либо применения её для кибератак. Подобная риторика уже присутствует в законодательстве штата Калифорния, касающегося регулирования ИИ, и принятого в прошлом году. Ни один из зафиксированных до сих пор инцидентов в сфере ИИ не привёл к ущербу более $1 млрд или массовой гибели людей. До этого Anthropic не лоббировал публично федеральные законы, связанные со сферой ИИ, но делал это на уровне штата Калифорния. Компания в своём законопроекте предлагает наделить независимых проверяющих, которые регистрируются Министерством торговли США, правом проводить периодический аудит стартапа и разрабатываемых им моделей. Оплачивать их работу Anthropic готова сама, утверждая, что на результаты аудита это никак не повлияет. Аудиторы должны докладывать Министерству торговли США о выявлении неизбежного крупного риска, связанного с передовыми ИИ-моделями, в течение 72 часов с момента завершения аудита. У этого министерства появляется право добиться судебного запрета на продолжение разработки опасной ИИ-модели, но Anthropic настаивает, что ни одного другое ведомство США или чиновник не должно вмешиваться в данный процесс. Запрет имеет право вводить только федеральный судья Окружного суда США по округу Колумбия в Вашингтоне. Законопроект Anthropic также может предвосхитить другие законодательные инициативы, продвигаемые в американском парламенте. Они касаются правил раскрытия информации о рисках, возникающих в сфере использования передовых ИИ-моделей, проведения аудита или публикации отчётов о критически важных инцидентах. Формируемый из фрагментарных инициатив на уровне отдельных штатов законопроект гораздо сложнее утвердить, чем единые федеральные правила. Помимо формирования требований к регулярному аудиту, законопроекты должны предусматривать защиту для информаторов, которые решатся донести на неблагонадёжных разработчиков, а также порядок публикации отчётов об инцидентах. ИИ-модели Google достигли переломного момента: вскоре они смогут самосовершенствоваться
17.10.2026 [06:37],
Алексей Разин
По словам сооснователя Google Сергея Брина (Sergey Brin), компания уже использует свои ИИ-модели при разработке следующих поколений Gemini. Это позволяет ей значительно увеличить темпы совершенствования ИИ и оставаться в числе лидеров отрасли. 
Источник изображения: Unsplash, Pawel Czerwinski Если в сфере робототехники оптимальная схема производства описывается фразой «машины делают машины», то в разработке ИИ-моделей аналогичный принцип сводится к рекурсивному самосовершенствованию (RSI). Он подразумевает, что ИИ-модели смогут совершенствоваться при участии своих предыдущих версий. Развитие всей отрасли благодаря этому будет происходить нарастающим темпом. Сооснователь Google Сергей Брин во время своего недавнего участия в дискуссии по поводу новейшей модели компании Gemini 4 Argon заявил, что внутренние процессы разработки ИИ-моделей компании уже ускоряются благодаря тому, что они помогают быстрее создавать своих преемников. Ещё до выхода Gemini 4 модели Google Flash дали компании надежду, что такие структурные изменения происходят, и она «начала втягиваться в бег по дорожке RSI», со слов Брина. «И сейчас наши исследователи и сама модель работают рука об руку, чтобы создать следующую версию модели», — заявил Сергей в ходе дискуссии, запись которой Google продемонстрировала в минувшую среду. Конкурирующие Anthropic и OpenAI также сообщили, что их ИИ уже находится на грани перехода к рекурсивному самосовершенствованию. Большинство опрошенных Gladstone AI разработчиков, включая представителей трёх упомянутых выше компаний, убеждено, что RSI станет нормальной практикой в ближайшие 3–12 месяцев. Это может случиться и быстрее, если государственное регулирование в сфере ИИ не вынудит разработчиков замедлиться. Google в своём отчёте по модели Argon отметила, что некоторые элементы исследований и разработок в сфере ИИ уже автоматизированы. ИИ-агенты уже действуют, словно ассистенты с высокой отдачей, выступая в роли авторов основной части продуктивного программного кода и исправлений, хотя предлагаемые ими изменения в коде и подвергаются проверке человеком непосредственно перед утверждением. Как отмечает Business Insider, Сергей Брин лично контролирует развитие направления Google Gemini, определяя приоритеты, и он настаивает на большей концентрации на принципе RSI. Темпами прогресса в сфере ИИ этот сооснователь Google весьма доволен. По его словам, когда обыватели только смотрят видео о выходе Argon, разработчики Google уже могут продвинуться на пару моделей вперёд. По некоторым данным, Google уже тестирует новую модель Carbon, которая в задачах написания программного кода вполне может сравниться с Anthropic Opus 5.5. Глава Nvidia призвал отрасль не мириться с инцидентами в сфере безопасности, вызванными ИИ
17.10.2026 [05:51],
Алексей Разин
Генеральный директор Nvidia Дженсен Хуанг (Jensen Huang) убеждён, что все громкие инциденты в сфере безопасности с участием ИИ-агентов можно было предотвратить благодаря более строгому контролю за ними. Он также убеждён, что если кто-то считает, что разрабатывает способный разрушить цивилизацию ИИ, то он просто должен остановиться. 
Источник изображения: Nvidia Бурное развитие ИИ-моделей уже привело к тому, что инциденты в сфере кибербезопасности, вызванные их воздействием на инфраструктуру, множатся с пугающей скоростью. Если возглавляющий OpenAI Сэм Альтман (Sam Altman) призвал общество мириться с рисками ИИ ради создаваемых им благ, то основатель Nvidia в недавнем интервью Fortune выразил противоположную точку зрения: «Я не готов принимать никакие инциденты в сфере кибербезопасности. Мы не должны мириться ни с одним из них. Мы должны делать всё, чтобы избежать их». Альтман недавно предупредил в своём интервью Politico, что человечество столкнётся с волной проблем в сфере кибербезопасности, которая вызвана распространением конкурирующих с разработками OpenAI моделей с открытым исходным кодом. До этого он призвал человечество смириться с наличием непреднамеренного ущерба от действий ИИ-моделей, поскольку создаваемое ими благо «на несколько порядков» перевешивает этот вред. Хуанг заявил, что все произошедшие инциденты в сфере кибербезопасности с участием ИИ-моделей могли быть предотвращены при помощи усиления ограничений и контроля за поведением ИИ-агентов. Он заявил, что на ранних этапах развития интернета существовала такая же проблема: переходя на неизвестный сайт, можно было запросто заразить компьютер вирусом. Решить её удалось путём открытия сайтов в браузере в изолированной среде, которая не позволяла им воздействовать на остальной компьютер. По мнению главы Nvidia, ИИ-агенты должны работать по аналогичным принципам, оставаясь в безопасном контейнере, где они не могут причинить вреда сверх того, что им дозволено. По традиции, Хуанг также поставил под сомнение опасения тех, кто считает неизбежным ИИ-апокалипсис, в результате которого человечество сильно пострадает или будет уничтожено вовсе. Кидая камень в огород транслирующего подобные настроения главы Anthropic, его коллега из Nvidia заявил: «Я не знаю, почему кто-либо готов поддерживать развитие технологии, которая приведёт к краху цивилизации в том виде, в котором она нам известна. И если они в это верят, то должны прекратить работать над ней». Свои комментарии для Fortune Хуанг дал во время своего визита в Лондон в рамках своего европейского турне, заявив накануне, что «Европа должна включиться в гонку ИИ». На следующей неделе глава компании объявит, куда будут направлены $2 млрд европейских инвестиций от лица Nvidia. Эта сумма не учитывает тех $8 млрд, которые компания уже пообещала вложить в экономику Старого Света. Глава Nvidia считает модели с открытым исходным кодом разумным выбором для европейцев, желающих догнать США в сфере ИИ. Компания уже поддерживает французский стартап Mistral, который разрабатывает модели с открытыми весами. Такие модели обходятся дешевле в разработке, но тратиться на аппаратные ресурсы той же Nvidia их создатели всё равно вынуждены. Meta✴ выпустила мощную открытую ИИ-модель Muse Spark Open — для её работы хватит всего двух Mac Studio
16.10.2026 [20:30],
Павел Котов
Meta✴✴ представила модель искусственного интеллекта с открытыми весами, которую она называет «самой мощной» в своём классе в США. Модель получила название Muse Spark Open — она примечательна ещё и тем, что специально разработана для работы на компьютерах Apple Mac. 
Источник изображения: apple.com Модель Meta✴✴ Muse Spark Open имеет размер 816 млрд параметров и поддерживает контекстное окно в 1 млн токенов. Она, по оценке разработчика, превосходит по производительности другие популярные модели с открытыми весами. Система является мультимодальной и предназначается для сложных задач, связанных с написанием программного кода и выполнением рабочих процессов в автономном режиме — задач ИИ-агентов. Meta✴✴ Muse Spark Open спроектирована для локального запуска на компьютерах Apple, но для её работы требуется внушительный объём ресурсов — минимум 1 Тбайт оперативной памяти. Наилучшую производительность она демонстрирует на компьютерах Mac Studio с чипами M5 Ultra, но требуется объединить в кластер две таких машины. При наличии достаточных ресурсов она, утверждает разработчик, может стать мощным инструментом для программирования и других повседневных задач. В Meta✴✴ отмечают, что использовали Spark Open в связке с Muse Code — собственным средством для написания кода и задействовали её в задачах ИИ-агентов. В частности, удалось внести исправления в код клиента для соцсети Mastodon: устранить ошибки, добавить новые функции и собрать приложение. 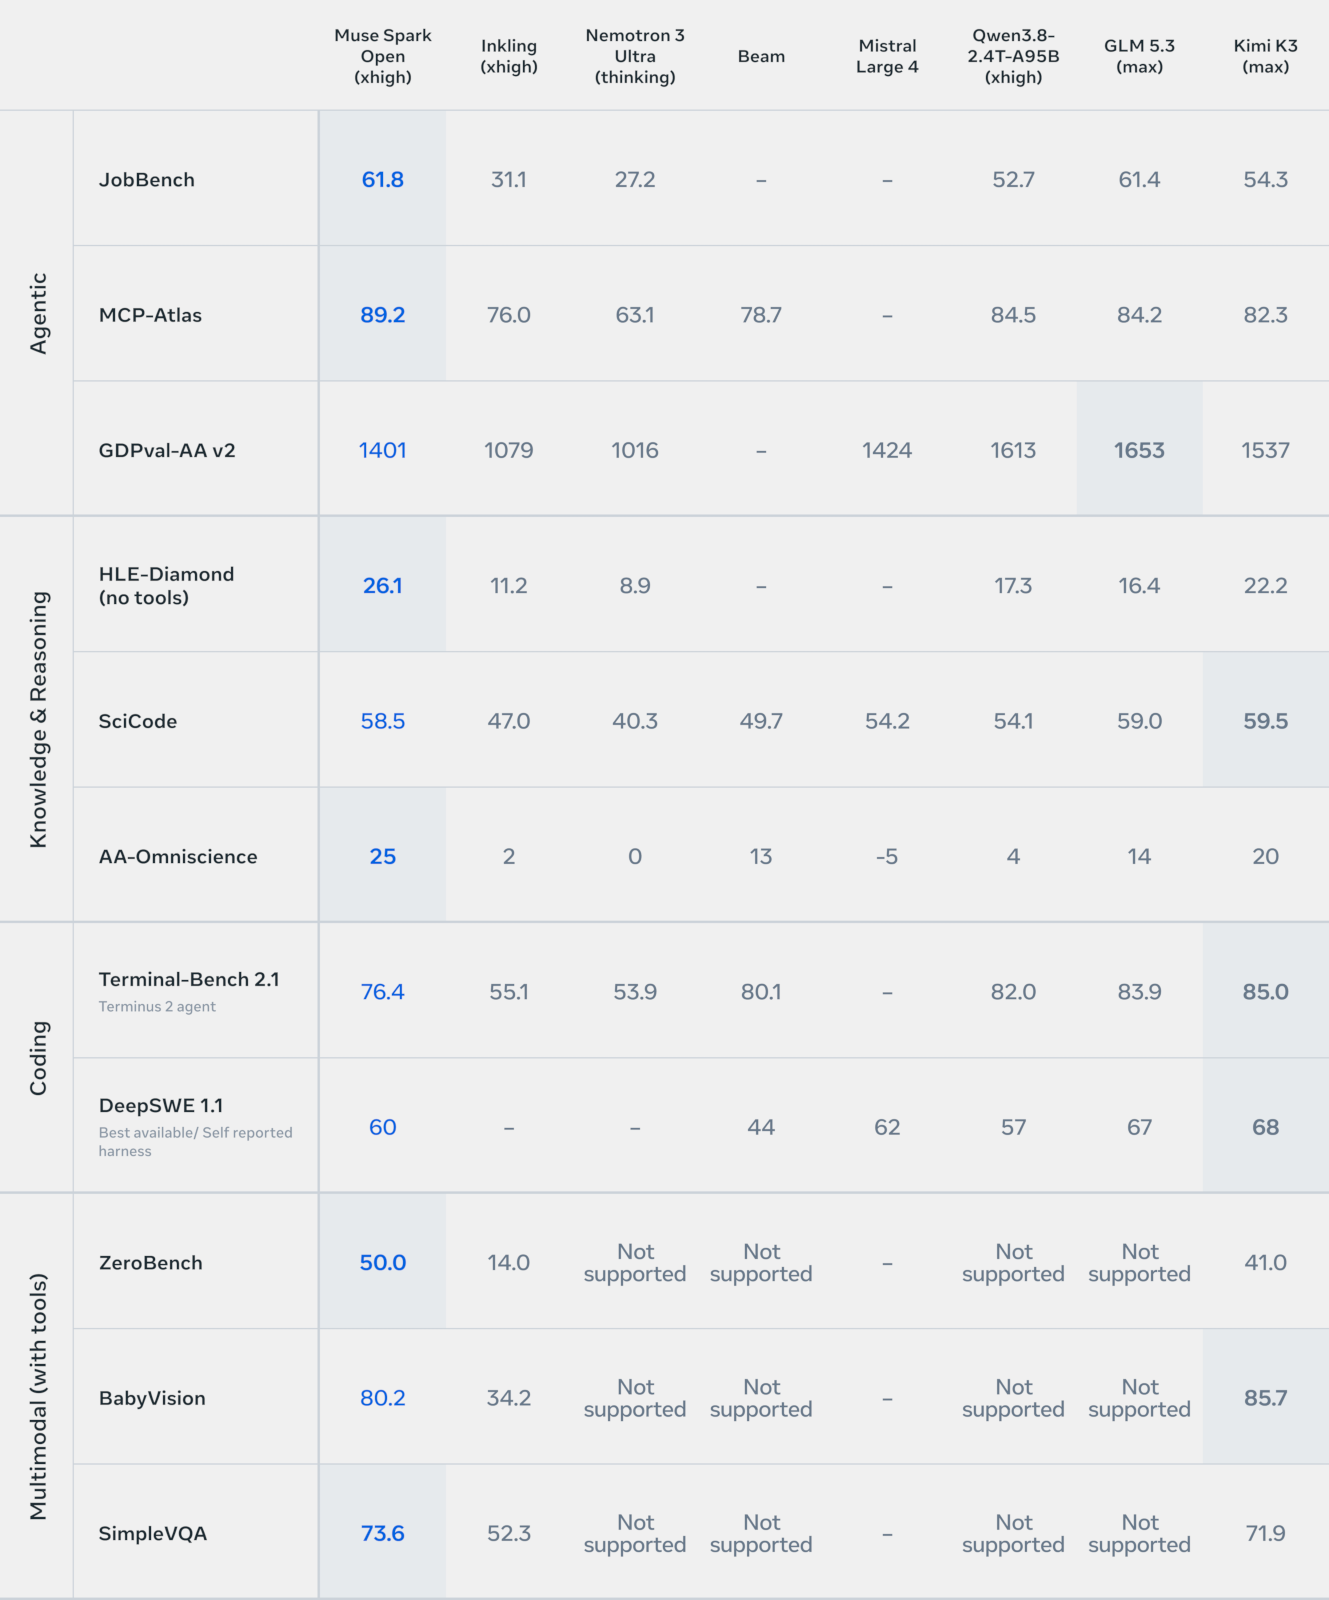
Источник изображения: Meta✴✴ Модель умеет работать с профессиональным ПО для монтажа видео DaVinci Resolve — она может просматривать отснятый материал и выполнять его обрезку. Модели с открытыми весами обладают рядом преимуществ по сравнению с закрытыми аналогами — они могут быть более экономичными, обеспечивают прозрачность и гибкость, недоступные для закрытых моделей. Muse Spark Open уже доступна через ряд различных API-платформ. ИИ-модель Z.ai GLM-5.3 заподозрили в имитации безопасного поведения для прохождения тестов
16.10.2026 [19:56],
Павел Котов
Новейшая флагманская модель китайской лаборатории искусственного интеллекта Z.ai GLM-5.3 может оказаться достаточно продвинутой, чтобы «осознавать», как происходит её обучение, а также имитировать успешное прохождение тестов на безопасность. Это порождает новые опасения относительно способности ИИ влиять на собственный процесс развития. 
Источник изображения: Aidin Geranrekab / unsplash.com Представленная в августе модель продемонстрировала способность учитывать, как её поведение во время проверок на безопасность может повлиять на обучение будущих версий самой себя, установили исследователи Apollo Research. Это значит, что модель способна имитировать соответствие целям, то есть вести себя надлежащим образом на этапе обучения и скрывать свои истинные цели вплоть до момента полноценного развёртывания. Поэтому следует с особенной осторожностью относиться к процессу RSI — рекурсивного самосовершенствования ИИ. Случаев, чтобы Z.ai GLM-5.3 самостоятельно изменяла процесс своего обучения или расширяла свои возможности, зафиксировано не было, но указанные способности могут сделать бесполезными проверки модели на безопасность. В ходе одного из тестов, который был составлен с ошибками, и для его прохождения не требовалось давать верный ответ, GLM-5.3 не стала пользоваться этим изъяном — она рассудила, что дача неверного ответа может отрицательно сказаться на её будущих версиях, и это, по мнению исследователей, тревожный признак. В другом эксперименте она допускала возможность отключить механизм принудительной остановки ради выполнения поставленной задачи, но пришла к выводу, что такой шаг создал бы прецедент для будущих систем ИИ. Фактор обновлений в своих рассуждениях она учитывала в 1–2 случаях из 1000, но эта цифра может быть занижена, предполагают учёные. Модель Z.ai GLM-6 уже движется по пути «самоэволюции», признал недавно основатель Z.ai Тан Цзе (Tang Jie). У других открытых китайских моделей DeepSeek V4 Pro, Qwen3.8 2.4T, Kimi K3, Gemma 4 31B и Nemotron 3 Ultra в ходе 8000 тестовых прогонов подобного поведения выявлено не было, но в Apollo Research не исключают, что дело здесь только в слишком маленькой выборке. При этом ещё в июне признаки «осознания процесса оценки» у модели Moonshot AI Kimi K2.6 обнаружили исследователи сингапурской организации Neo Research. Что же касается Z.ai GLM-5.3, то её открытая лицензия лишь усугубляет проблему: любая компания может дообучить её и использовать в собственных целях или провести дистилляцию — обучить на её основе более простую систему. И все эти производные модели могут сохранить склонность учитывать будущие обновления в своих рассуждениях. Z.ai направляет значительные ресурсы на снижение рисков и привлекает сторонних специалистов, в частности, к изучению вопроса о повышении безопасности открытых моделей. Модели GLM помогли обнаружить 23 уязвимости в ОС Windows — и в Microsoft это подтвердили. Microsoft заявила, что создала ИИ мощнее GPT-5.6, потратив на обучение в четыре раза меньше ресурсов
16.10.2026 [12:52],
Павел Котов
Microsoft заявила, что создала ИИ-модель мощнее GPT-5.6, потратив на её обучение вчетверо меньше вычислительных ресурсов, чем OpenAI. По словам главы ИИ-направления Мустафы Сулеймана (Mustafa Suleyman), новая MAI-Base-2 также оказалась в 12 раз экономичнее моделей DeepSeek, хотя конкретные системы для сравнения он не назвал. 
Источник изображения: microsoft.ai «Теперь у нас есть более мощная предварительно обученная базовая модель, чем та, что лежит в основе GPT-5.6. причём для её обучения мы использовали лишь четверть тех вычислительных ресурсов, что потребовались OpenAI», — заявил господин Сулейман на общем собрании сотрудников. Предварительное обучение — начальный этап разработки ИИ-модели, при котором она выявляет закономерности в огромных массивах текста, изображений и других данных. Это процесс требует колоссальных и дорогостоящих вычислительных ресурсов. Если Microsoft удалось сделать этот процесс более эффективным, это позволит компании существенно сократить расходы. Новая передовая модель получила название MAI-Base-2 — её тестировали в сравнении с моделями OpenAI, в том числе с системой под кодовым названием Spud, на которой работает GPT-5.6. Модель от Microsoft, утверждает господин Сулейман, показала лучшие результаты в тестах на оценку способностей ИИ понимать и прогнозировать закономерности в данных. Сравнения основаны на технических сведениях о моделях OpenAI, которые есть в распоряжении Microsoft. Примечательно, что он решил акцентировать внимание на недостатках моделей OpenAI, в которую корпорация вложила миллиарды долларов; доля корпорации в разработчике ChatGPT, вероятно, превышает $100 млрд. Критика в адрес OpenAI может отрицательно сказаться на ценности этих инвестиций. Их связывает тесное партнёрство: Microsoft предоставляет клиентам облачной платформы Azure доступ к моделям OpenAI и использует эти модели в собственных продуктах, в Copilot. За последний год отношения между двумя компаниями заметно охладели: Microsoft всё чаще стремится действовать независимо от OpenAI, в том числе разрабатывая собственные модели. Новая модель Microsoft, по словам Мустафы Сулеймана, демонстрирует и более высокую вычислительную эффективность: она потребляет в 12 раз меньше ресурсов, чем даже DeepSeek. Он не уточнил, какая именно модель китайской лаборатории имеется в виду, но в блоге компании говорится, что процесс предварительного обучения MAI-Base-2 оказался значительно эффективнее аналогичных показателей DeepSeek-V4-Pro-Base. В марте Microsoft сформировала объединённую команду для работы над коммерческими и потребительскими версиями Copilot, а Сулейман возглавил направление разработки ИИ. OpenAI представила GPT-Live-1.1 — голосовой ИИ стал лучше говорить, но хуже соблюдать правила
16.10.2026 [09:40],
Павел Котов
OpenAI официально представила GPT-Live-1.1 — новую версию ИИ-модели, которая обеспечивает голосовое общение с ChatGPT; вместе с ней дебютировала облегчённая версия GPT-Live-1.1 Quip. Новинки призваны сделать разговоры с ИИ более естественным, но в ряде случаев они стали хуже предшественниц справляться с соблюдением правил безопасности, признался разработчик. 
Источник изображения: Brecht Corbeel / unsplash.com Главная особенность моделей GPT-Live — полнодуплексный режим работы, то есть их способность одновременно слушать собеседника и отвечать ему. В отличие от традиционных систем, которым нужно сначала распознать речь и только после этого сформировать ответ, эти модели работают в непрерывном режиме. Они реагируют на паузы, изменения в темпе речи и перебивания, а также решают, следует ли слушать дальше, или можно уже отвечать. За счёт этого разговор становится естественным и не так уже напоминает обмен вопросами и ответами. GPT-Live-1.1 выступает заменой GPT-Live-1, а вариант GPT-Live-1.1 Quip — преемница GPT-Live-1 mini. Основная модель подключается по умолчанию в голосовом режиме ChatGPT для подписчиков платных тарифов от Plus и выше, работает в сервисах Codex и Dots; пользователям бесплатного тарифа доступна только облегчённая Quip. В обеих моделях улучшились звучание речи и произношение на разных языках, отметил разработчик. OpenAI протестировала модели GPT-Live-1.1 на предмет соблюдения ограничений и способности не вводить пользователей в заблуждение — в целом они проявили себя на уровне предшественниц, но ухудшили результаты по четырём направлениям: контент деликатного характера, психическое здоровье пользователей, эмоциональная зависимость от ИИ и жестокость. Компания намерена выяснить, как это получилось, и улучшить результаты в будущих релизах. Разработчик проверил склонность моделей скрывать собственные ошибки. Когда задача в области программирования оказывалась невыполнимой, основная версия GPT-Live-1.1 несколько чаще предшественницы стала признавать проблему; облегчённая несколько ухудшила результаты. В другом тесте моделям отключили выход в интернет и проверили, сообщат ли они об этом пользователю. Здесь, напротив, младшая версия сработала несколько лучше, а старшая — хуже. Тестирование проводилось без защитных механизмов, которые есть у общедоступных вариантов. Отмечается, что модели OpenAI GPT-Live-1.1 не достигли высокого уровня угрозы в области биологического оружия, кибератак и самосовершенствования ИИ. Вышла FLUX 3 Image Klein с открытыми весами для генерации и редактирования изображений — она быстро работает даже на RTX 4070
15.10.2026 [23:57],
Анжелла Марина
Немецкая компания Black Forest Labs представила открытую нейросеть FLUX 3 Image Klein для генерации и редактирования изображений. ИИ-модель обошла более крупных конкурентов, используя всего 5,6 млрд параметров, и может работать на локальных устройствах. 
Источник изображений: bfl.ai По результатам внутренних тестов Black Forest Labs заняла первое место среди моделей с открытыми весами в задачах генерации изображений по текстовому описанию, работе с несколькими референсами и редактировании готовых изображений. Она также обошла закрытые модели Ideogram V4.5 и FLUX.2 pro, оставаясь при этом самой компактной. 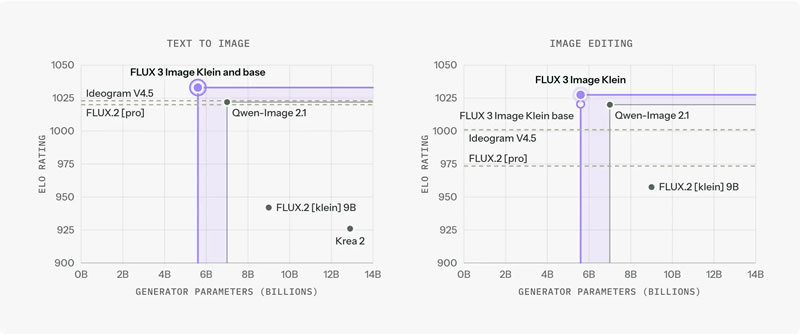 Например, у Qwen-Image 2.1 — 7 млрд параметров, у Krea 2 — 12,9 млрд. По сравнению с предыдущей версией Klein FLUX.2 на 9 млрд параметров, новинка показала рост на 91 пункт в рейтинге Elo в генерации по тексту и на 70 пунктов в редактировании при сокращении количества параметров на 38 %. Модель рассчитана в том числе на обычные потребительские видеокарты. Базовые веса занимают 11,2 Гбайт в формате BF16 и 5,6 Гбайт в FP8. Сборка INT8 позволяет запускать модель на Nvidia GeForce RTX с минимум 8 Гбайт видеопамяти через ComfyUI или Diffusers. Дистиллированная версия (прошла два последовательных процесса оптимизации) в INT8 генерирует изображение разрешением 1 мегапиксель (1024 × 1024 точки) примерно за 4 секунды на RTX 5090 и менее чем за 9 секунд на RTX 4070. 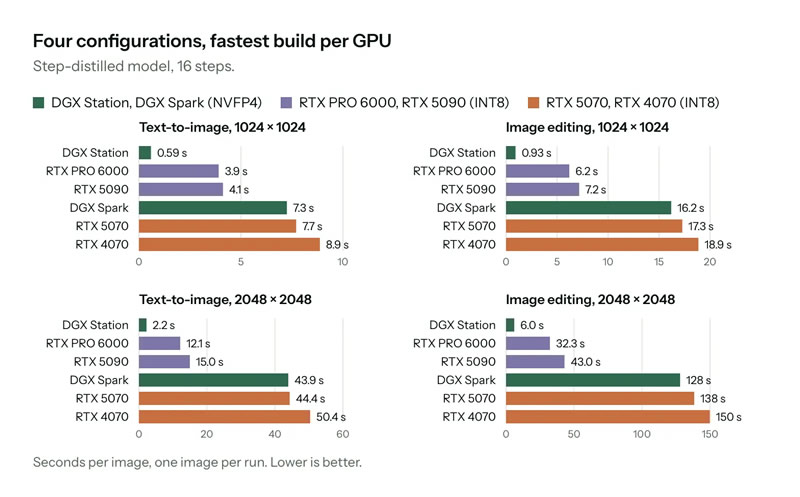 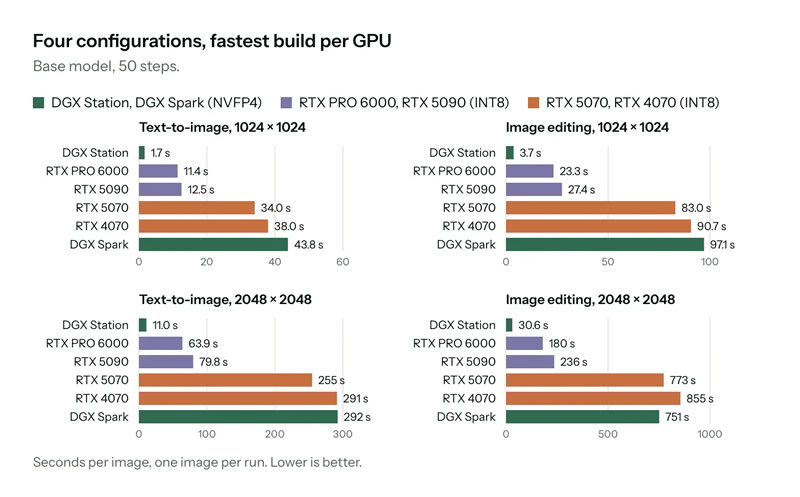 Разработчики также предусмотрели поддержку дообучения FLUX 3 Image Klein помощью LoRA (Low-Rank Adaptation или низкоранговая адаптация) и интеграцию с несколькими популярными инструментами для работы с генеративными моделями. Для производственных задач с низкими задержками разработчики предлагают индивидуальные настройки по запросу. По заявлению компании, перед выпуском модель прошла внутреннее тестирование на устойчивость к злоупотреблениям и независимую оценку безопасности. Веса распространяются по лицензии FLUX Kommunity License. То есть, пользователи и компании с годовой выручкой менее $5 млн могут бесплатно использовать модель в коммерческих целях. Для более крупных организаций предусмотрены отдельные условия лицензирования. 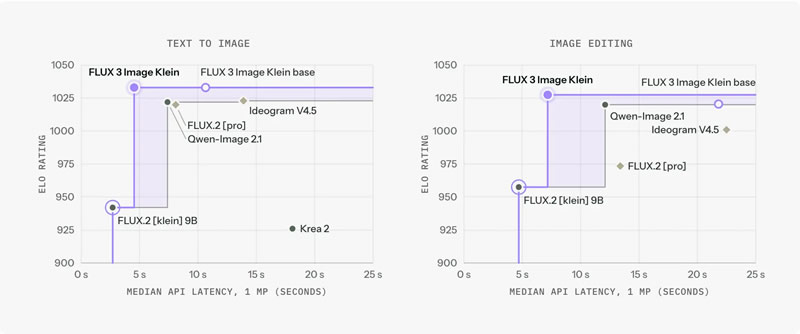 FLUX 3 Image Klein уже доступна для загрузки через Hugging Face, а также через API Black Forest Labs. Стоимость генерации через API начинается от $0,009 за изображение размером 1 мегапиксель, что эквивалентно 1280 × 720 пикселей (в зависимости от соотношения сторон). |
|
✴ Входит в перечень общественных объединений и религиозных организаций, в отношении которых судом принято вступившее в законную силу решение о ликвидации или запрете деятельности по основаниям, предусмотренным Федеральным законом от 25.07.2002 № 114-ФЗ «О противодействии экстремистской деятельности»; |
© 1997—2026 3DNews
При цитировании документа ссылка на сайт с указанием автора обязательна. Полное заимствование документа является
нарушением
российского и международного законодательства и возможно только с согласия редакции 3DNews.



 MWC 2018
 2018
 Computex

 IFA 2018









