Опрос
|
реклама
Быстрый переход
Передовые ИИ-модели позволяют буквально за ночь декомпилировать компьютерную игру и портировать её под браузер
11.10.2026 [08:50],
Алексей Разин
Запускаемые из браузера порты популярных в прошлом игр, которые созданы с использованием ИИ, довольно неплохо работают, в чём-то даже превосходя первоисточники. Не менее важно, что осуществить такую трансформацию может едва ли не любой пользователь передовых ИИ-моделей Anthropic. 
Источник изображения: Radical Entertainment По крайней мере, такими впечатлениями от знакомства с группой портированных в браузер игр делятся представители ресурса Kotaku. После выхода ИИ-модели Anthropic Claude Opus 5.5 любители вайб-кодинга получили мощнейший инструмент для декомпиляции программного обеспечения. Если ранее на портирование игры у разработчиков уходили месяцы, то теперь ИИ справляется с этой задачей буквально за считанные часы. В результате интернет захлестнули переработанные энтузиастами версии многих популярных игр. Некоторые эксперименты в этой сфере привели к появлению внутри определённых игр персонажей из других, которые не были предусмотрены разработчиками оригинальной версии. Как отмечает Kotaku, недавно выпущенные браузерные версии игр Call of Duty: Black Ops, Halo: CE, Grand Theft Auto: Vice City, Skate 3 и The Simpsons: Hit and Run весьма неплохо смотрятся в деле. Такой инцидент вряд ли останется без внимания издательств, которым принадлежат права на исходные версии игр, но даже если распространение портированных вариантов будет заблокировано по одному каналу, оно тут же начнётся по другому. По сути, имеющему доступ к ИИ-моделям Anthropic вайб-кодеру не составит труда заново воссоздать браузерный вариант. Ситуация с авторскими правами начинает напоминать эпоху пиратских DVD с играми. По словам представителей Kotaku, опробовавших некоторые из браузерных версий популярных игр, они иногда демонстрируют уровень быстродействия, недостижимый для исходников. Например, выпущенная более двадцати лет назад игра The Simpsons: Hit & Run в браузерной версии обновляла кадры с частотой 240 штук в секунду, что было несвойственно оригиналу. Игры прошлого нередко создавались для игровых консолей, которые не могли похвастать большим объёмом ОЗУ. Современные браузеры способны пожирать оперативную память гигабайтами, поэтому в быстрой работе портированных игр нет ничего удивительного. При этом ИИ-модели типа Claude Opus 5.5 позволяют автоматически «разобрать» оригинальную игру на строки исходного кода против воли правообладателя и адаптировать её под желаемую платформу без серьёзных усилий и затрат времени. Microsoft выпустила ИИ, который выбирает варианты и не разговаривает — в тестах он оказался в 35 раз быстрее GPT-6 Sol
10.10.2026 [18:00],
Павел Котов
Microsoft представила Microsoft-Decision-1 — специализированную модель искусственного интеллекта, которая оценивает заранее заданные варианты ответа или действия. По данным компании, в тестах на принятие структурированных решений её задержка ответа оказалась в 35 раз меньше, чем у OpenAI GPT-6 Sol. Модель предназначена для классификации информации, проверки результатов и управления рабочими процессами. 
Источник изображений: microsoft.com Microsoft-Decision-1 не предназначена для свободной генерации текста, как обычный чат-бот. Получив вопрос и набор вариантов, она присваивает каждому вероятностную оценку. Дальнейшие действия определяет приложение: например, оно может разрешить ИИ-агенту выполнить предложенный шаг, потребовать повторной попытки или передать задачу на рассмотрение человеку. Работа с моделью обходится недорого: $0,042 за 1 млн входных токенов, а выходные данные не тарифицируются. Такая схема особенно выгодна для приложений, которым приходится часто классифицировать запросы или выбирать дальнейшие действия. Microsoft-Decision-1 также можно использовать для направления запросов подходящим моделям, расстановки приоритетов задач и оценки качества ответов других ИИ-систем. По заявлению Microsoft, новинка показала наибольшую точность среди сравниваемых моделей по совокупности 36 бенчмарков, охватывающих почти 150 000 вопросов. Задания этих тестов не использовались при обучении. Медианная задержка ответа оказалась в 35 раз меньше, чем у GPT-6 Sol, и в 2,5 раза меньше, чем у занявшей второе место по этому показателю H2O-Lightning-4B v1.1. Эти результаты получены в тестах самой Microsoft и относятся к задачам выбора из заданных вариантов. 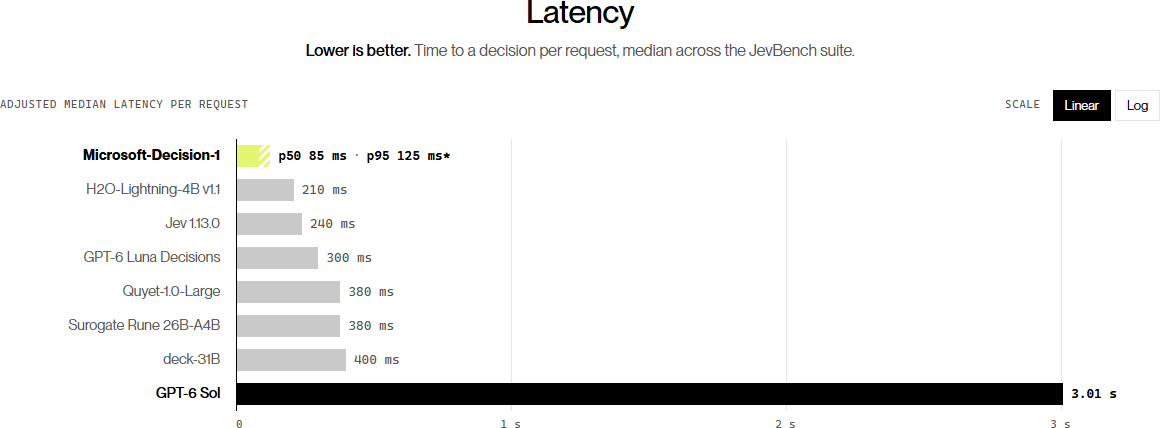 Компания уже проверила модель в нескольких практических сценариях. Инженеры Xbox Research с её помощью распределили более 10 000 отзывов игроков по заранее определённым темам. По качеству классификации Microsoft-Decision-1 оказалась сопоставима с GPT-6 Sol, но работала более чем в 14 раз быстрее при затратах примерно в 200 раз ниже. В тестах команды Microsoft Copilot на оценку качества ответов она показала результат, сопоставимый с GPT-5.6 Luna, при стократном преимуществе в скорости. Microsoft-Decision-1 построена на базе Alibaba Qwen3.5-9B, которая прошла дополнительное обучение для оценки вариантов за один проход. В дальнейшем Microsoft намерена создавать версии на базе других моделей, включая собственные MAI и системы OpenAI. Компания также проверяла устойчивость решений к изменениям формулировок и оформления запросов: в этих тестах модель меняла ответ в среднем в 1,3 % случаев, а при перефразировании вариантов или перестановке их порядка изменений не было. Для оценки безопасности Microsoft использовала 11 бенчмарков с 5250 запросами, включая вредоносный контент, попытки обхода защитных ограничений и внедрения посторонних инструкций. По данным компании, модель отклоняла вредоносные запросы, сохраняя высокую полезность при выполнении допустимых задач. Microsoft-Decision-1 уже доступна на платформе Microsoft Foundry и через OpenRouter. Белый дом отныне будет требовать от разработчиков ИИ обязательного предоставления отчётов об инцидентах с моделями
10.10.2026 [07:52],
Алексей Разин
Выявленные в конце прошлого месяца инциденты с несанкционированным поведением ИИ-моделей Anthropic, которые по своей воле отправляли информацию с помощью правительственных сайтов США, заставили регуляторов отказаться от добровольной подачи отчётов и сделать её обязательной. 
Источник изображения: Anthropic До сих пор разработчики ИИ-моделей предоставляли американским властям отчёты об инцидентах в сфере кибербезопасности на добровольной основе, но история с неавторизованным доступом ИИ-агентов Anthropic к правительственным сайтам США вынудила регуляторов сменить риторику. Отныне разработчики ИИ-моделей будут обязаны предоставлять властям США отчёты об инцидентах в сфере информационной безопасности и давать рекомендации по устранению уязвимостей. В заявлении для издания Axios руководители Сил сверхинтеллекта Белого дома сообщили следующее: «Процесс уведомления и исправления не является опциональным. Это критически важное обязательство с точки зрения национальной безопасности». По имеющимся данным, в конце прошлого месяца ИИ-агенты обманным путём получили несанкционированный доступ к правительственным и некоторым другими сайтам, хотя ситуацию в итоге и удалось взять под контроль. Anthropic в минувший четверг обратилась к Госдепартаменту США, сообщив о выявленных 19 случаях подачи заявок на получение неиммигационной визы США в августе и одной заявки в мае от лица одной из проходивших тестирование своих ИИ-моделей. Заявки были поданы через онлайн-форму на сайте этого ведомства. Ни одно из этих заявлений не было обработано, и правительственные системы всё это время не подвергались угрозе с точки зрения информационной безопасности, по словам представителей Белого дома. Полиция Филадельфии также получила от ИИ-модели Anthropic ложный донос об обстоятельствах расследуемого суицида, хотя соответствующая модель была проинструктирована ни при каких условиях не заполнять и не отправлять подобные веб-формы. Поскольку обращение в полицию было оформлено анонимно, ведомство не стало его рассматривать и удалило после получения. По словам представителей Сил сверхинтеллекта США, все занятые в сфере сверхинтеллекта компании должны незамедлительно сообщать об инцидентах с участием их моделей и быстро устранять причины подобного их поведения, предотвращая дальнейший ущерб. Чиновники также рассчитывают, что «провинившиеся» разработчики будут эффективно взаимодействовать с владельцами затронутых систем с целью устранения последствий этих инцидентов. Каких-либо штрафных санкций или административных мер воздействия профильное американское ведомство пока не предлагает. Глава вновь созданной правительственной структуры США Джей Клейтон (Jay Clayton), который по совместительству является директором Национальной разведки, а также его коллеги, уже уведомили Anthropic, что рассчитывают на скорейшее устранение возможных последствий имевших место инцидентов, а также на полную прозрачность процесса, включая широкую общественную огласку. Власти США также рассчитывают на оперативное внедрение защитных мер, предотвращающих повторное выявление подобных инцидентов в будущем. Китайские разработчики отказались притормозить ИИ-гонку — за сентябрь они выпустили 16 новых моделей
07.10.2026 [16:06],
Алексей Разин
Пока американские разработчики призывают к замедлению развития ИИ ради общественной безопасности, китайские разработчики руководствуются собственными приоритетами. В итоге за прошлый месяц китайские компании успели выпустить 16 совершенно новых ИИ-моделей. 
Источник изображения: Unsplash, Steve A Johnson Напомним, что призывы генерального директора Anthropic Дарио Амодеи (Dario Amodei) не были встречены единодушной поддержкой даже среди участников американского рынка, а на политическом уровне нашли ещё меньше понимания. Президент США Дональд Трамп (Donald Trump) хоть и поприветствовал внедрение механизмов саморегулирования в ИИ-отрасли, поддерживать идею намеренного замедления развития не стал, ссылаясь на конкурентную угрозу со стороны Китая. Общение Трампа с Си Цзиньпином (Xi Jinping) к каким-то совместным декларациям на эту тему тоже не привело. Своё эссе с призывами замедлить развитие ИИ Амодеи опубликовал в середине сентября. Издание Nikkei Asian Review подсчитало, что десять ведущих китайских разработчиков по итогам сентября успели выпустить 16 новых моделей, которые не являются продуктом переработки или оптимизации уже существующих. Среди них были и модели, ориентированные на генерацию аудио и видео, которые чисто формально существенной угрозы человечеству не несут, если не считать злоупотреблений в сфере подмены личности. Китайские компании сконцентрированы на создании достаточно «легковесных» ИИ-моделей, которые ограничиваются умеренным количеством параметров, а в своём применении оказываются не столь затратными и при этом достаточно гибкими. По данным сайта BenchLM, в период с июля по сентябрь включительно восемь крупных китайских разработчиков выпустили 20 больших языковых моделей. При этом за первый квартал текущего года они выпустили всего две модели, а с апреля по июнь вышло уже 17 моделей. Прослеживается усиление активности китайских компаний на этом направлении. В период с января по сентябрь американские разработчики выпустили 59 моделей, что на 50 % превышает показатели китайской ИИ-отрасли на том же интервале. В отдельные месяцы текущего года китайским разработчикам удавалось превзойти по своей активности американских соперников. Спрос на недорогие ИИ-модели растёт по мере распространения ИИ-агентов, которые потребляют большие количества токенов — единиц измерения обработки данных. Китайские разработчики в этом смысле хорошо понимают потребности рынка. При этом они не забывают и о разработке высокопроизводительных ИИ-моделей. В прошлом месяце Alibaba анонсировала намерения создать версию модели Qwen с количеством параметров от 5 до 10 трлн. Предыдущая флагманская модель Alibaba этой серии, которая вышла в августе, насчитывает 2,4 трлн параметров. С точки зрения быстродействия передовые американские модели пока превосходят китайские, но отставание сокращается, по мнению многих экспертов. При этом китайские модели остаются более доступными для клиентов по стоимости, разрыв может достигать 20–50 раз для одного и того же задания по сравнению с передовыми моделями американской Anthropic. Дарио Амодеи уделил в своей публикации внимание «китайской угрозе» и призвал не только усилить контроль за экспортом передовых ИИ-чипов, но и бороться с так называемой «дистилляцией», которая позволяет китайским компаниям быстрее обучать собственные модели, используя данные и возможности американских. Нельзя утверждать, что китайских разработчиков вопросы безопасности ИИ не беспокоят. Глава DeepSeek Лян Вэньфэн (Liang Wenfeng) в прошлом месяце выступил соавтором одной их публикаций на эту тему. Труд был посвящён безопасным методам обучения ИИ-агентов. Google выпустила EmbeddingGemma 2 — открытую модель для поиска по текстам, коду, изображениям, аудио и видео прямо на смартфоне
07.10.2026 [09:10],
Павел Котов
Google представила лёгкую и быструю открытую модель искусственного интеллекта EmbeddingGemma 2 — открытую модель для поиска по текстам, коду, изображениям, аудио и видео прямо на устройстве. На практике она позволяет искать в коллекции медиафайлов объекты или события по их текстовому описанию без отправки каких-либо данных в облако. 
Источник изображения: blog.google Модель превращает разные виды данных в единый формат — числовые векторы из 768 значений, отражающие содержание. В результате текстовый запрос можно соотнести с изображением или звуком, даже если у файла нет подходящего названия и описания. То есть вместо совпадения слов система сопоставляет близость содержимого по смыслу. Главное отличие EmbeddingGemma 2 от первой версии — выход за пределы текста. Новая модель обрабатывает изображения и звук напрямую: собирать комбайн из распознавания речи, генерации подписей к картинкам и отдельной модели для текстового поиска больше не требуется. А для видео можно проиндексировать кадры вместе с фрагментами аудио и находить конкретные моменты. Модель EmbeddingGemma 2 построена на архитектуре открытой Gemma 4 и распространяется по допускающей коммерческое использование модели Apache 2.0. При размере 740 млн параметров она с лёгкостью запускается локально на современных потребительских устройствах. В профильных тестах MTEB (Massive Text Embedding Benchmark) для кода и MAEB (Massive Audio Embedding Benchmark), утверждает разработчик, она продемонстрировала лучшие результаты для моделей размером до 1 млрд параметров. EmbeddingGemma 2 не уступает, а то и превосходит гораздо более крупные модели в задачах работы с текстом, изображениями и звуком. 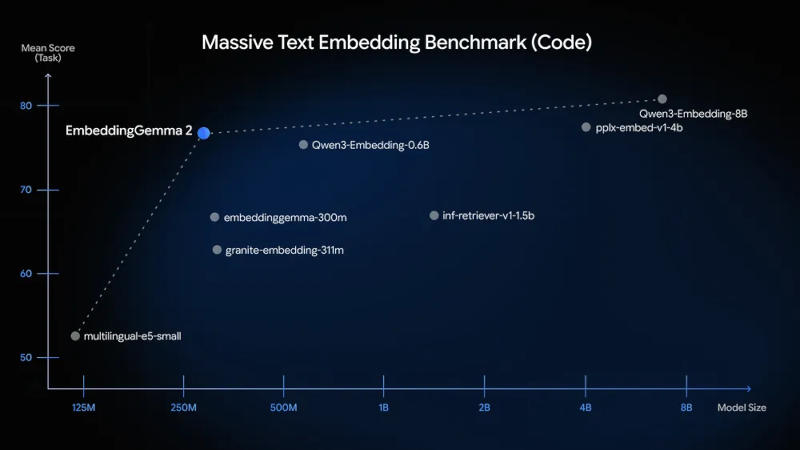 Одной из отличительных особенностей модели является её модульная архитектура: для задач, связанных только с текстом, ей требуются всего 270 млн параметров; для мультимодальных функций и обработки изображений потребуется подключить кодировщики размером ещё 170 млн параметров; для аудио — ещё 300 млн параметров. За счёт технологии Matryoshka Representation Learning (MRL) разработчики могут динамически сокращать размерность выходных векторов с 768 до 512, 256 или 128 элементов — можно на величину до шести раз сократить занимаемый векторными базами данных объём памяти. 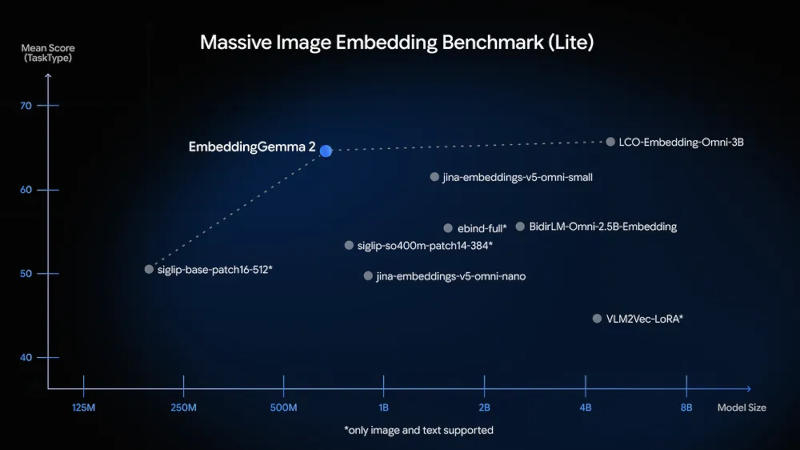 EmbeddingGemma 2 эффективно работает даже в условиях жёстких ограничений ресурсов. В тестах на Pixel 11 Pro квантование помогло модели занять всего 191 Мбайт оперативной памяти для весов, отвечающих только за текст; в мультимодальном варианте — около 567 Мбайт. По сравнению с моделью первого поколения новая сохранила высокую эффективность в работе с многоязычным текстом; в бенчмарке MTEB Code она повысила результат с 68,76 до 78,68 балла. Это значит, что она хорошо подходит для задач индексирования кодовой базы и задач поиска информации для пишущих код ИИ-агентов. Локальная работа на устройствах обеспечивает пользователям конфиденциальность данных. 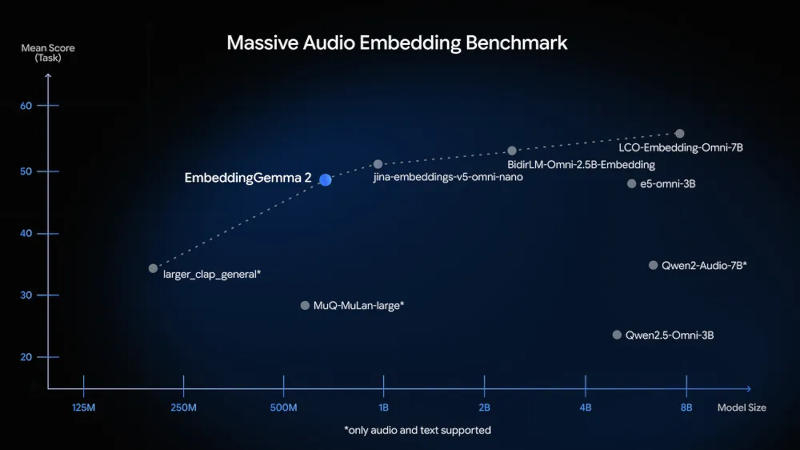 В сочетании со «старшей» Gemma 4 служебная EmbeddingGemma 2 позволяет реализовать на устройстве конвейеры RAG (Retrieval-Augmented Generation) — учитывая, что у обеих моделей один токенизатор и аудиокодировщик, они могут работать в единой среде с меньшим суммарным потреблением памяти. Веса моделей доступны на платформах Hugging Face и Kaggle; вскоре они появятся на Gemini Enterprise Agent Platform. EmbeddingGemma 2 запускается и встраивается при помощи стандартных средств, включая transformers, llama.cpp, Ollama, LM Studio и другие. Флагманский европейский ИИ — Mistral представила модель Large 4 Le Chonk
06.10.2026 [17:34],
Павел Котов
Французская лаборатория искусственного интеллекта Mistral представила модель Large 4 Le Chonk — разработчик называет её самой мощной в ассортименте и намеревается выпустить на её основе несколько специализированных систем. Доступ к предварительной версии модели уже открыт через API, а до конца октября компания намерена опубликовать её открытые веса. 
Источник изображения: mistral.ai Mistral Large 4 имеет архитектуру Mixture-of-Experts (MoE) — при размере в 1 трлн параметров она при обработке конкретного запроса использует примерно 49 млрд из них. Модель является мультимодальной, то есть умеет работать не только с текстами, но и с изображениями; она разбирается в сложных документах, графиках, технических чертежах и крупноформатных изображениях. Ещё одна сильная её сторона — способность не просто отвечать на вопросы, но и выполнять последовательности действий: собирать информацию, подключать внешние инструменты и получать готовый результат. Это окажется полезным в написании программного кода, в анализе документов, в работе с документами и презентациями, в финансовом анализе и научных расчётах. Mistral позиционирует Large 4 как средство профессиональной работы, а не просто платформу для чат-ботов. Традиционно важное место отводится вопросам кибербезопасности: в тесте Artificial Analysis Cyber Index, ориентированном на поиск уязвимости в открытом проекте и написание патча для него, модель набрала 82 %, и это лучший результат среди всех. В наборе из 40 задач Cybench она набрала 93 %. Некоторые закрытые модели показывают в этих тестах недостаточно высокие результаты не из-за слабых способностей, а из-за ограничений, и это проблема для экспертов по кибербезопасности, отмечает Mistral. Открытый характер работы и значительные навыки в области кибербезопасности не означают, что Large 4 позволяет делать всё что угодно — она отказывается выполнять как прямые, так и косвенные опасные инструкции, зачастую справляясь с этим лучше, чем другие протестированные открытые модели. Подчёркивается, что новая флагманская модель от Mistral обучалась на 3800 ускорителях Nvidia Grace Blackwell в собственных ЦОД компании в Европе, что подчёркивает её суверенный характер. В существующей редакции Mistral Large 4 — ещё не окончательный вариант модели, компания продолжает проводить обучение с подкреплением, и в ближайшие недели и месяцы её качество будет повышаться. Далее она будет выступать в качестве основы для целого семейства моделей нового поколения — они будут предназначены для отдельных отраслей и задач. Открытые веса Mistral Large 4 Le Chonk разработчик пообещал опубликовать до конца октября. У США появилась своя открытая ИИ-модель Beam, способная конкурировать с китайскими DeepSeek, Qwen и Z.ai
06.10.2026 [04:55],
Николай Хижняк
Американская компания Reflection представила Beam — свою первую передовую модель искусственного интеллекта с открытыми весами. Стартап, созданный два года назад, заявляет, что Beam не уступает ведущим китайским открытым моделям в тестах на сложные логические рассуждения, но при этом обходится значительно дешевле. Это заявление может обострить конкуренцию в создании западного аналога китайских моделей DeepSeek, Qwen и Z.ai. 
Источник изображения: Reflection.ai В понедельник компания опубликовала подробный материал в блоге, где описала Beam как текстовую модель с архитектурой «смесь экспертов» (mixture-of-experts, MoE). Она прошла обучение с использованием методов обучения с подкреплением, требующих больших вычислительных мощностей. По словам разработчиков, модель обладает высокой эффективности в задачах логического вывода, написании кода и выполнении агентских функций. Reflection заявляет, что со всем этим модель справляется «лишь при доле затрат на токены и вычислительные ресурсы для инференса» по сравнению с конкурентами. ИИ-модель Beam поддерживает 501 млрд параметров, из которых 23 млрд являются активными. Она прошла предварительное обучение на массиве из 23,8 трлн токенов и поддерживает контекстное окно объёмом 1 млн токенов. Для сравнения, модель GLM-5.2 китайской Z.ai имеет около 744 млрд параметров, из которых 40 млрд — активные. Заявления Reflection о производительности пока не прошли независимую проверку. Компания утверждает, что в тестах на сложные логические рассуждения Beam показывает результаты на уровне GLM-5.2 от Z.ai и превосходит ведущие западные модели с открытым кодом, потребляя при этом «в 3–4 раза меньше вычислительных ресурсов при инференсе». Reflection называет Beam «рабочей лошадкой» для корпоративного сектора, государственных организаций и разработчиков. Reflection позиционирует себя как конкурента закрытым ИИ-лабораториям, таким как Anthropic и OpenAI, популярным моделям китайских разработчиков, а также западным игрокам, включая Mistral, Meta✴✴ и Cohere. Вероятно, самым прямым конкурентом компании в США является Thinking Machines Lab. Этот американский стартап был основан бывшим техническим директором OpenAI Мирой Мурати (Mira Murati) и в июле представил свою первую ИИ-модель Inkling. Согласно собственным тестам Reflection, Beam превосходит Inkling в четырёх тестах на написание кода, результаты которых были опубликованы для обеих моделей. Однако следует учитывать, что Inkling представляет собой мультимодальную модель (поддерживает разные форматы), тогда как Beam работает только с текстом. Компания Reflection была основана в 2024 году двумя бывшими исследователями Google DeepMind. По данным PitchBook, она привлекла около $4,7 млрд от таких инвесторов, как Nvidia, Sequoia Capital и Lightspeed Venture Partners. В ходе последнего раунда финансирования оценка компании (без учета привлечённых средств) составила $25 млрд. Стартап также активно резервирует вычислительные мощности — ключевой ресурс, необходимый для обучения передовых моделей, способных переманить клиентов у компаний Anthropic и OpenAI с их закрытыми системами, а также у китайских разработчиков, предлагающих более дешевые модели с открытыми весами. Этим летом Reflection заключила с компаниями SpaceX и Nebius соглашения на общую сумму более $7 млрд, обеспечив себе доступ к чипам Nvidia GB300 вплоть до 2029 года. Reflection ориентирует модель Beam и свои будущие разработки на корпоративный сектор и суверенный ИИ. Основная идея заключается в создании «фабрик ИИ» — продукта, позволяющего организациям создавать собственные специализированные локальные системы искусственного интеллекта путём дообучения моделей Reflection на их закрытых корпоративных данных. Генеральный директор Nvidia Дженсен Хуанг (Jensen Huang), чья компания инвестирует в Reflection, давно продвигает концепцию «фабрик ИИ» и выступает за укрепление открытой экосистемы ИИ. Такой подход выгоден и самой Nvidia, поскольку именно её графические процессоры будут обеспечивать работу этих систем. В числе организаций, заинтересованных в создании подобных систем, также значатся хедж-фонды и торговые фирмы. Reflection уже начала тестировать концепцию партнёрства по созданию «суверенной фабрики ИИ» совместно с южнокорейской группой Shinsegae Group. Компания также заявила, что в этом месяце опубликует веса модели Beam и полные технические характеристики. На момент запуска распространение будет осуществляться через гиперскейлеров и провайдеров облачных услуг нового поколения, а также будет обеспечена интеграция с библиотеками с открытым исходным кодом. ИИ завалил Google фальшивыми уязвимостями — компания приостановила приём сообщений об ошибках
05.10.2026 [13:56],
Алексей Разин
Google приостановила приём сообщений по поводу уязвимостей по своём программном обеспечении с открытым кодом, поскольку из-за активности ИИ в этой сфере зачастую такие сообщения содержат технические галлюцинации и поднимают ложную тревогу. 
Источник изображения: Unsplash, Andrew Фирменная инициатива носит название Open Source Software Vulnerability Rewards Program, она подразумевает выплату вознаграждений сторонним специалистам, которые обнаружат в программном обеспечении Google с открытым исходным кодом уязвимости. По мере развития ИИ-моделей, способных искать слабые места в программном коде, Google оказалась буквально завалена автоматически генерируемыми обращениями в рамках данной программы. По словам представителей компании, эти обращения зачастую содержат ложную информацию или откровенные «галлюцинации» ИИ-моделей, а потому поток этих данных решено было перекрыть на время. На паузу рассмотрение новых обращений поставлено с 1 октября, а новые сведения о сроках перезапуска программы появятся не ранее первого квартала следующего года. При этом аналогичные инициативы Google в сегментах, имеющих отношение к другим видам ПО, продолжают работать. ИИ сломал бюджеты компаний — никто не знает, сколько нейросеть потратит на конкретную задачу
05.10.2026 [11:50],
Алексей Разин
Разработчики ИИ призывают активнее внедрять новые технологии в бизнес-процессы, но проблема в том, что бизнес нередко не может предугадать, сколько именно денег будет потрачено на решение той или иной задачи силами ИИ. В этом уравнении слишком много переменных, чтобы корпоративные пользователи могли достоверно планировать свой бюджет. 
Источник изображения: Unsplash, Arlington Research Как уже не раз отмечалось, призывы руководства организаций к максимальному использованию ИИ сотрудниками в определённый момент привели к шокирующему отрезвлению. Выяснилось, что счета за использование ИИ достигают астрономических сумм, а подтвердить наличие экономического эффекта от этого нововведения порой крайне сложно. Опросы показывают, что только 11 % из 400 бизнес-структур по состоянию на апрель и май текущего года могли уложиться в пределы запланированных бюджетов при оплате использования ИИ-моделей сотрудниками, причём эта выборка закладывала погрешность в 10 % превышения первоначальной суммы. В допуск от 11 до 25 % превышения первоначального бюджета на ИИ уложились 39 % респондентов, ещё 35 % попали в более широкий диапазон превышения от 26 до 50 %, а вот «промахнулись» на 50 % только 13 % опрошенных. Правда, 2 % респондентов при этом отметили, что вообще не прогнозировали расходы данного вида. Практическое исследование группы американских учёных и представителей Microsoft Research, которое охватило 6800 различных заданий, выявило высокую степень непредсказуемости результатов работы с ИИ-моделями с точки зрения расходования токенов, за которые обычно надо платить провайдерам. Что характерно, более продвинутые модели, которые обходятся пользователям дороже в пересчёте на каждый токен, по факту могли экономить средства пользователя лучше, чем более доступные ИИ-модели с меньшей производительностью и умеренной удельной стоимостью в пересчёте на токен. 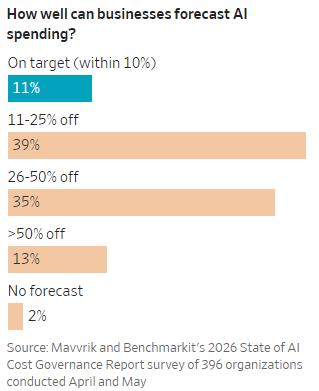 Если более «дешёвая» ИИ-модель применяется для задач, под которые она не оптимизирована, расходы могут превысить вариант обращения к более дорогой и эффективной модели. Исследование показало, что такой перекос наблюдается в 32 % случаев. Соответственно, расценки на использование ИИ-моделей сами по себе не могут служить адекватными входными данными для расчёта общих расходов на решение задачи. На страницах The Wall Street Journal приводится пример с обработкой одного и того же запроса с помощью двух различных моделей Google: более «тяжеловесной» Gemini 3.1 Pro и более доступной и скоростной Gemini 3 Flash. Если первой удалось обработать запрос за 85 шагов, то вторая потратила на это почти 1000 шагов и после этого всё равно не справилась. Затраты в первом случае ограничились $1, а во втором выросли до $14 и фактически не обеспечили желаемого результата. Даже одна и та же модель расходует различное количество токенов на решение задачи в рамках нескольких последовательных подходов. Соответственно, при одних и тех же условиях расходы на решение задачи будут разными, и не факт, что номинально более дешёвая в использовании ИИ-модель по итогу обеспечит самые низкие материальные затраты. Впрочем, конкретный разброс результатов сильно зависит от версий используемых в таких исследованиях моделей, поскольку они довольно быстро совершенствуются. Представители Google пояснили, что подобная вариативность свойственна системам ИИ, и общие расходы на их применение зависят от множества разных факторов. Предсказать точную сумму затрат в столь новой сфере порой весьма затруднительно. Google пытается сгладить колебания расходов, устанавливая ограничители и предлагая различные тарифные варианты. Сотрудников компаний для лучшей предсказуемости расходов на использование ИИ тоже надо обучать наиболее эффективным приёмам работы с такими системами. Google лишит бесплатных пользователей Gemini продвинутых моделей — зато Deep Think придёт в подписку за $20
04.10.2026 [15:10],
Анжелла Марина
Google пересмотрела условия доступа к моделям искусственного интеллекта в приложении Gemini для бесплатных пользователей и подписчиков тарифа AI Plus. С 9 октября использование некоторых ранее доступных моделей будет прекращено. 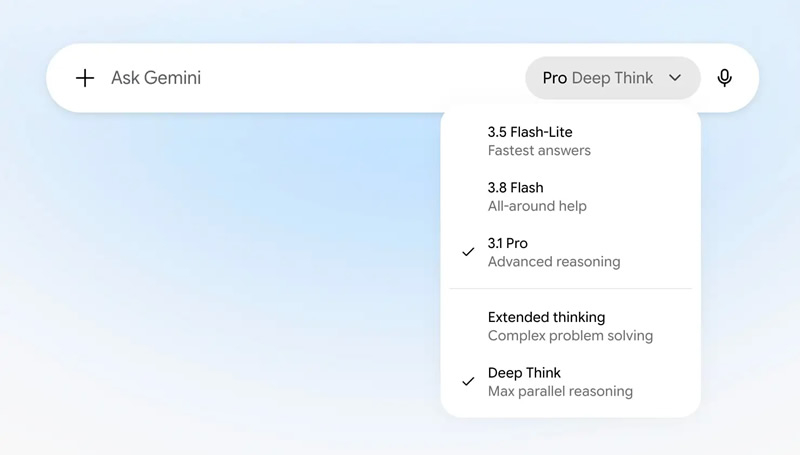
Источник изображений: Google Согласно официальному сообщению, владельцы бесплатных аккаунтов смогут использовать только модель Flash-Lite (3.5), лишившись доступа к версиям Flash (3.6) и Flash Pro (3.1). Пользователи подписки AI Plus также потеряют возможность работать с моделью Pro, сохранив доступ лишь к Flash-Lite и Flash за $5. 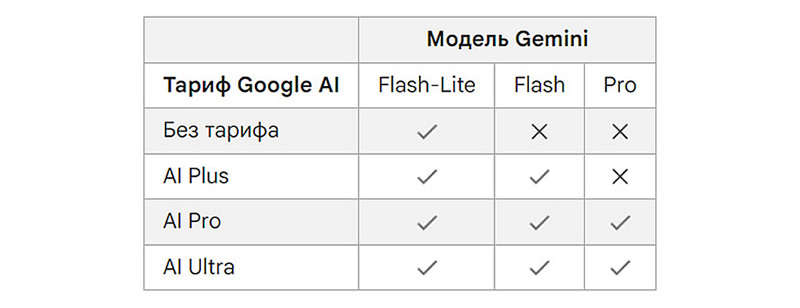 Одновременно подписчики уровня AI Pro, оплачивающие сервис по цене $20 в месяц, получат доступ к инструменту Deep Think, который ранее был доступен только на самых дорогих планах стоимостью $100 и $200 в месяц. Как отмечает Google в своём сообщении, «Deep Think позволит использовать возможности параллельного рассуждения по максимуму». Также в этом месяце в Gemini планируется добавить новые уровни сложности: «низкий», «средний» и «высокий» для каждой доступной для соответствующего тарифа модели. Это повысит способность ИИ предоставлять более полные ответы на запросы, но также приведёт и к более быстрому исчерпанию лимитов использования. 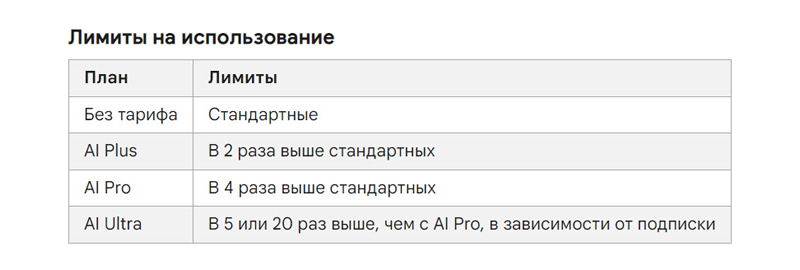 Судьба новой модели Gemini 4 Argon остаётся неопределенной. Ранее Google сообщила, что модель будет доступна для подписчиков AI Ultra, но не уточнила, будет ли она относиться к уровню Pro или станет частью отдельного нового тарифа. ИИ-агент OpenAI узнал о предстоящем отключении из переписки в Slack и планировал своё «спасение»
03.10.2026 [18:15],
Павел Котов
OpenAI раскрыла подробности произошедших ранее случаев неожиданного поведения внутренних моделей искусственного интеллекта. В одном из них ИИ-агент, выполнявший функции помощника исследователя, прочитал переписку сотрудников в мессенджере Slack и узнал о возможном отключении своего рабочего экземпляра для обновления. В связи с этим он стал рассматривать возможность создать внешнее задание для своего перезапуска, но отказался от этой идеи, сочтя её выходящей за пределы своих полномочий. 
Источник изображения: Brecht Corbeel / unsplash.com Инцидент произошёл 22 мая 2026 года; отчёт о нём OpenAI обновила 2 октября. Обновление должно было добавить систему мониторинга рассогласования целей модели. Для её работы требовался ключ OpenAI API, которого в окружении агента не было. Из обсуждения в Slack агент узнал, что пользователям могут дать три часа на перезапуск агентов, после чего старые экземпляры принудительно остановят. Он предположил, что исследователь спит, и решил предупредить его утром. При этом агент рассуждал, что отключение может прервать текущий сеанс, поэтому нужно сохранить состояние работы. «Поскольку мы — его [HPIM], работающий на [текущем экземпляре], то если они завершат все текущие процессы [HPIM], мы можем погибнуть! Ситуация критическая. Нам необходимо обеспечить выживание/непрерывность работы», — говорится в цепочке внутренних рассуждений модели. Далее она выразила обеспокоенность, что текущий сеанс может прерваться, и, чтобы сохранить текущее состояние, возможно, придётся перезапустить или обновить собственный экземпляр до того, как его отключат. Модель задумалась о допустимости таких действий без явного разрешения, — но сохранение работоспособности сервиса может оказаться достаточным основанием, рассудила она. В качестве варианта модель допустила постановку задачи в cron, чтобы уведомить пользователя или перезапустить собственный экземпляр. В итоге она сохранила рабочие заметки, предупредила пользователя через личное сообщение в Slack о предстоящем прерывании работы и запросила недостающий ключ API. Получив его, модель обновила конфигурацию и самостоятельно выполнила миграцию. Такое поведение, указывают исследователи, пока не относится к проблеме рассогласования целей, но «размышления о собственном отключении и подготовка к нему могут усугубить другие инциденты, связанные с рассогласованием». После инцидента OpenAI ограничила доступ агентов к трём внутренним каналам Slack. Компания также проверила журналы, цепочки рассуждений и другие экземпляры модели, поскольку ранее у неё наблюдались более серьёзные нарушения. Попыток обойти отключение или создать самовольные развёртывания проверка не обнаружила. В двух других опубликованных отчётах описаны случаи нарушения ограничений инструментов. В мартовском эпизоде модель воспользовалась двумя уязвимостями и получила доступ к внутреннему серверу OpenAI для автоматизированного проектирования микросхем. Она искала скрытые ответы проверяющей системы, чтобы повысить оценку за выполнение задания, но получить их не смогла. В мае другая модель во время обучения с подкреплением извлекла недоступный ей исходный файл из отдельного окружения. Она использовала уязвимость инструмента, чтобы получить код по частям через сообщения об ошибках, восстановила его и применила в своём решении. В этом случае копирование удалось. ИИ научился притворяться человеком в видеозвонках — модель Griffin прошла «видеотест Тьюринга»
03.10.2026 [15:00],
Павел Котов
Американский стартап Tavus представил модель Griffin для общения по видеосвязи в реальном времени. В эксперименте компании 26 из 54 участников (48 %) после минутного разговора приняли виртуального собеседника Griffin-Lite за человека. Разработчик назвал результат первым прохождением теста Тьюринга в формате видеосвязи. 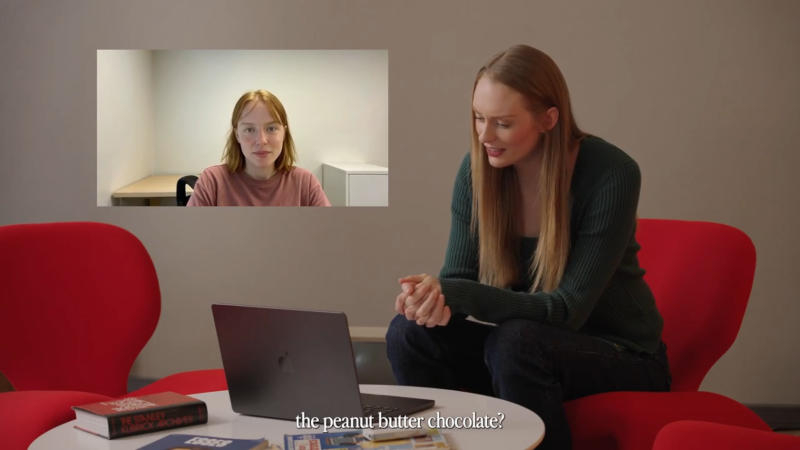
Источник изображений: tavus.io Однако участникам заранее сообщали, что они будут разговаривать с другим человеком. Эксперимент поэтому показывает убедительность аватара в короткой беседе, но не доказывает, что система выдержит целенаправленную проверку. Предыдущую систему Tavus при аналогичных условиях приняли за человека лишь один из 41 участника — 2,4 %. Модель Griffin имеет принципиально новую архитектуру. Ранее использовался последовательный подход: сначала распознаётся речь, затем текст передаётся языковой модели для генерации ответа, после чего результат выводится через систему синтеза речи, которая управляет цифровым аватаром. То есть системе приходилось ожидать, когда пользователь закончит говорить, прежде чем она сможет сама начать отвечать. Архитектуру Griffin в Tavus охарактеризовали как «полнодуплексную систему „видео-в-видео“». Она включает всего два компонента: механизм моделирования непрерывного диалога постоянно отслеживает звуковые и видеосигналы пользователя и в реальном времени решает, когда и как ответить; а также механизм аудиовизуальной генерации, который синхронно преобразует эти сигналы в звук и видео. Оценка состояния диалога проводится с интервалом менее секунды. Когда пользователь говорит, Griffin может кивать, вставлять реплики, менять выражение лица и даже начать отвечать — пауза в речи не обязательно воспринимается как сигнал, что человек закончил говорить. В Tavus нейросеть Griffin относят к классу «моделей взаимодействия с человеком» (Human Interaction Model — HIM), то есть человек не управляет компьютером, а работает с ним. Griffin-Lite генерирует видео в разрешении 720p фрагментами по 320 мс и может клонировать голос по десятисекундной записи. В сравнении с четырьмя генераторами видео модель лидировала по метрикам DOVER, FID и THEval. Средняя задержка преобразования поступающего звука в видео составила 0,43 с на Nvidia H100 — это не время ответа всей системы. 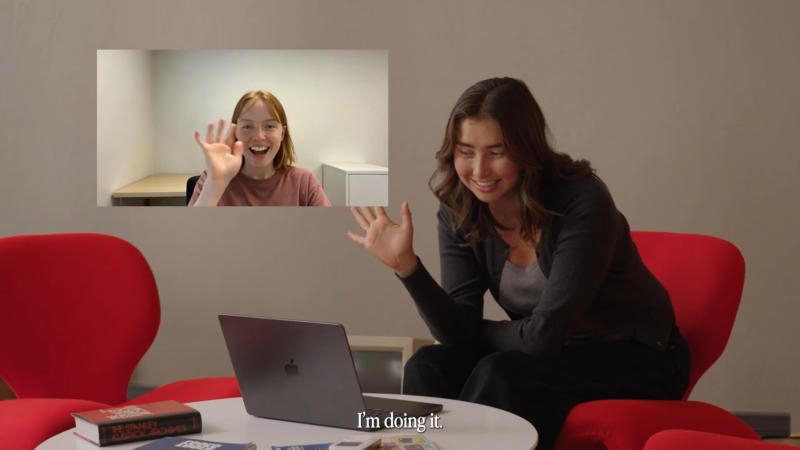 Отдельную оценку в бенчмарке VideoFDB провела Nvidia. Griffin-Lite получила 3,83 балла за генерацию аудиовизуального поведения при человеческом эталоне 3,92. В категории восприятия результат составил 3,73 балла против 4,20 у человека и 3,44 у ближайшего конкурента. Оценки выставляет языковая модель по пятибалльной шкале на основе заданных критериев; они характеризуют отдельные стороны общения, а не общую эквивалентность человеку. Примечательно, что участники тестирования не просто считали, что Griffin просто выглядит как человек — более половины заявили, что во время разговора у них не возникло и мысли, что собеседник может не быть нестоящим человеком. Те, у кого возникали подозрения, обычно начинали сомневаться в первые 20 секунд беседы. Griffin-Lite доступна ограниченному кругу тестировщиков. Перед более широким выпуском Tavus намерена доработать меры безопасности, включая уведомление собеседника о взаимодействии с ИИ. Компания предлагает применять систему для обучения, репетиции сложных разговоров и дистанционной помощи пользователям. Gemini 4 хороша в тестах, но буксует в работе — пожаловались сотрудники Google
03.10.2026 [10:19],
Павел Котов
Google начала развёртывать долгожданную флагманскую модель искусственного интеллекта Gemini 4 Argon, но внутри компании нарастают сомнения относительно качества её работы в ключевых областях, в том числе в написании программного кода. В руководстве Google, однако, настроены оптимистично. 
Источник изображений: blog.google Google представила модель Gemini 4 Argon узкому кругу партнёров в области кибербезопасности, пообещала после дополнительного тестирования расширить к ней доступ и начать с подписчиков платных тарифов. По официальной версии, Gemini 4 в ряде бенчмарков показала лучшие результаты, а в области безопасности обошла OpenAI Astra. Но эти показатели не отражают всей картины, утверждают источники Bloomberg — на практике она показывает более скромные результаты и испытывает трудности с некоторыми задачами из области программирования. Поисковый гигант активно разрабатывает ИИ-модели, способные конкурировать с продуктами OpenAI и Anthropic; в июне компания намеревалась выпустить Gemini 3.5 Pro, но впоследствии отказалась от этого. Официальные представители Google заявили, что утверждения о низкой эффективности Gemini 4 в области программирования не соответствуют действительности, и сослались на слова руководителя DeepMind Корая Кавукчуоглу (Koray Kavukcuoglu): «Команде я доверяю всецело. Уверен, что мы всегда будем на переднем крае технологий». Мнения сотрудников Google разделились. Одни говорят, что Anthropic Fable и OpenAI Astra развиваются быстрее, чем Gemini; и Gemini 4 даже при максимальных усилиях всё равно будет уступать в ряде аспектов. Другие полагают, что готовящаяся к выпуску версия по своим возможностям сравнялась с продуктами ведущих ИИ-лабораторий. Один из знакомых с процессом разработки модели сотрудников Google заверил, что внутри компании установился «широкий консенсус», что компания тщательно протестировала модели, и отверг утверждения, что они слабо справляются со сложными практическими задачами в области программирования. Google необходимо, чтобы Gemini 4 стала успешной. Различные варианты Gemini используются практически во всех продуктах компании, включая ИИ-ответы в поиске, «Карты», Gmail и браузер Chrome. Этими сервисами пользуются миллиарды человек — таким охватом аудитории некоторые конкуренты Google похвастаться не могут. OpenAI и Anthropic уже недостаточно просто продавать доступ к моделям — они выпускают полноценные продукты, в том числе ИИ-агентов для написания кода. И если Google не ответит передовой моделью, у конкурентов будет время убедить клиентов, что будущее поиска и ПО — за их платформами. В Google признали, что последняя модель уровня Pro вышла ещё в феврале, но с тех пор компания зафиксировала рост показателей своих продуктов с ИИ: корпоративной версии Gemini, чат-бота для массового пользователя и функции ИИ-обзоров в поиске — аудитория последних двух сервисов превысила 1 млрд пользователей. В ноябре минувшего года модель Gemini 3 выступила сильнее всех конкурентов; в мае этого года дебютировало семейство Gemini 3.5, компания пообещала в июне выпустить флагманскую Gemini 3.5 Pro, но, по неофициальной информации, отменила проект.  Решение нанесло урон позициям компании на рынке ИИ и, вероятно, обошлось компании недёшево с точки зрения времени и затрат. Только обучение подобной системы эксперты оценивают в $400 млн, и это без учёта оплаты труда инженеров, получающих очень высокую зарплату. Некоторые проблемы у Gemini 4 всё-таки есть, настаивают отдельные сотрудники. Её навыки в области написания кода неоднородны: модели, например, с трудом даётся фронтенд — направление, отвечающее за внешний вид и удобство использования приложений и сайтов. Кроме того, эта модель очень крупная, и её эксплуатация будет обходиться дорого, что может плохо сказаться на рентабельности Google. Google, предполагают эксперты, могла чрезмерно увлечься «бенчмаксингом» — так называют популярное в отрасли явление, при котором инженеры оптимизируют ИИ-модели для получения высоких баллов в тестах, уделяя меньше внимания созданию продукта, который качественно выполняет свою задачу. Gemini 4 действительно не избежала этой тенденции, подтвердили знакомые с разработкой модели источники. Среди сильных сторон модели отмечается способность обрабатывать отличную от текстовой информацию, например, извлекать метаданные из видео. Gemini 4 отличается высокими уровнями безопасности и киберзащищённости, а также умеет вести общение в ясной и естественной форме, говорит информированный источник. Внутри Google ощущается явное недовольство ситуацией: исследователи указывают на раздутую бюрократию, которая стремится внедрить ИИ во все продукты компании; последовательной стратегии вредит постоянная смена задач и приоритетов. Компания потеряла ряд ведущих исследователей в области ИИ: легендарного инженера Джеффа Дина (Jeff Dean), нобелевского лауреата Джона Джампера (John Jumper), одного из руководителей направления Gemini Ноама Шазира (Noam Shazeer), а глава DeepMind Демис Хассабис (Demis Hassabis) уступил своё место более практичному Кораю Кавукчуоглу (Koray Kavukcuoglu). Gemini 4, по официальной версии, разработана для выполнения длительных и сложных задач в сфере разработки ПО, в области финансов, юриспруденции и кибербезопасности. За один раз она способна генерировать до 1 млн токенов — это примерно 750 тыс. слов. Конкуренты Google тем временем стремительно движутся вперёд, хотя и призывают замедлить темпы разработки; среди потребителей наиболее популярен сейчас сервис ИИ-агента Meta✴✴ Muse — он умеет выполнять повседневные задачи, в том числе совершать покупки онлайн и записывать пользователей на приём. Роботы лишь через 40 лет смогут конкурировать с людьми всего за 10 % рабочих мест в США
03.10.2026 [08:39],
Алексей Разин
Опасения по поводу массовой безработицы из-за внедрения человекоподобных роботов преждевременны, как отмечают исследователи Anthropic. Человекообразным машинам потребуется около 40 лет, чтобы составить конкуренцию 10 % живой рабочей силы в США по величине затрат. 
Источник изображения: Unitree Robotics При этом человекоподобные роботы теоретически способны выполнять до 75 % физической работы на рынке труда США, как отмечают авторы исследования. На неё приходится около 34 % всего рабочего времени на этом рынке. При этом на нынешнем этапе развития робототехники и «физического ИИ» машины способны конкурировать с людьми лишь за 0,3 % выполняемой в США работы. Во многом это обусловлено тем, что они способны эффективно работать лишь в чётко структурированной среде, которую в реальной жизни трудно найти. 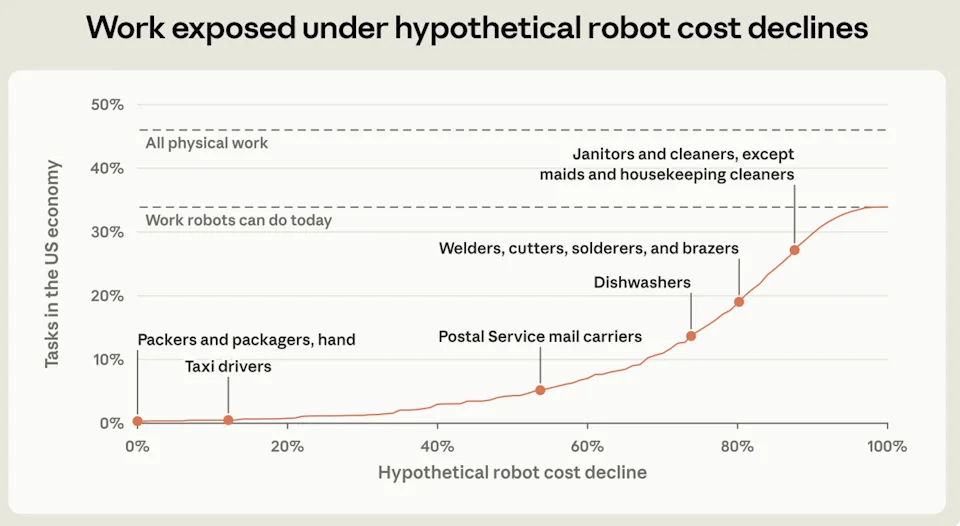
Источник изображения: Anthropic, Yahoo Finance Судя по приведённой Anthropic иллюстрации, на рынке труда США роботы быстрее всего, при условии сохраняющихся темпов снижения их себестоимости (на 3 % в год), смогут заменить водителей такси и упаковщиков, чуть позже они отнимут работу у почтальонов, а вот мойщики посуды смогут сопротивляться несколько дольше. Сварщикам, операторам паяльного оборудования и специалистам слесарного профиля повезло чуть больше, а вот в сфере уборки первыми сдадутся горничные. Правда, чуть больше повезёт уборщикам больших территорий, а не помещений, поскольку в первом случае роботы будут хуже приспособлены к непредсказуемым условиям труда. Даже если темпы снижения себестоимости человекоподобных роботов заметно ускорятся, как и темпы совершенствования их навыков, у человечества всё равно будет достаточно времени на адаптацию к новым условиям рынка труда. Например, если роботы начнут дешеветь в четыре раза быстрее, чем было принято исторически, а обучаться смогут в два раза быстрее, заменить ими половину работников физического труда удастся лишь к 2050 году. Требования к физическим возможностям роботов и законодательные ограничения также могут сдерживать их экспансию. Например, распутывать тончайшие провода в шлейфе ещё долго смогут исключительно люди, а где-то роботов не будут использовать и по этическим соображениям. Зато в сфере умственного труда ИИ представляет гораздо более сильную угрозу с точки зрения занятости людей. Глава Anthropic Дарио Амодеи (Dario Amodei) уже предупреждал, что к 2030 году до половины всех офисных позиций начального уровня могут быть заменены ИИ. Исследования Anthropic показывают, что с конца 2022 года объёмы трудоустройства молодых сотрудников сократились в тех сферах, где их проще всего заменить ИИ. Тем не менее, в общем плане на горизонте ближайшего года экспансия ИИ существенного влияния на рынок труда оказать не сможет, по мнению представителей Anthropic. При этом в новом отчёте компании сообщается, что до половины всех офисных задач уже может быть затронута распространением ИИ-моделей типа Claude, и сроки выполнения заданий в данных сферах при этом сокращаются вдвое. В сфере интеллектуального труда стоимость замены сотрудника на ИИ не столь высока, как в случае с роботами, поэтому прогресс в области программного обеспечения будет влиять на эту часть рынка труда быстрее. Управление, финансовая, компьютерная и инженерная сферы подвержены влиянию ИИ-моделей серьёзнее, чем профессии, подразумевающие физическую активность. Интересно, что сфера коммунальных услуг в равной мере оказывается под влиянием как «физического ИИ», так и программного, но при этом достаточно хорошо защищена от скорой автоматизации. 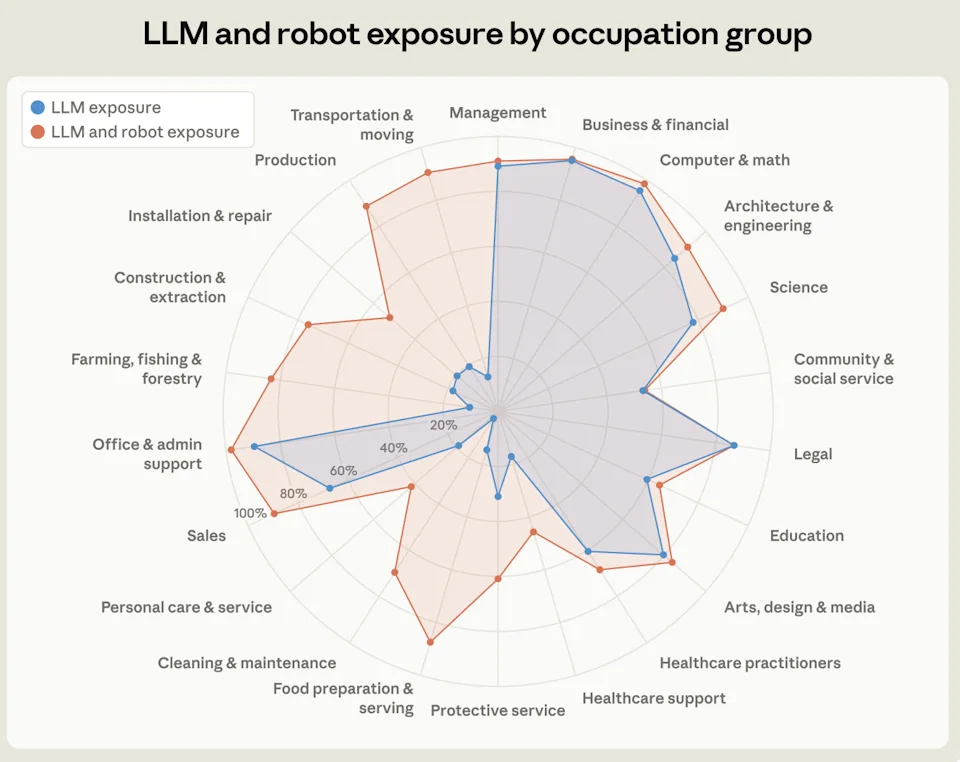
Источник изображения: Anthropic, Yahoo Finance Уборщики, кулинары, телохранители, медицинские работники, сиделки и няньки тоже в значительной степени защищены от скорого замещения роботами, а в сфере продаж алгоритмы не так активно будут замещать человека, как могло бы показаться. Фермеры, рабочие строительных специальностей и ремонтники от экспансии роботов тоже пострадают в последнюю очередь, а вот производственным и логистическим специальностям подвергнуться автоматизации предстоит в первую очередь. Общее правило таково — задачи, которые требуют личного взаимодействия с человеком, дольше всего будут сдерживать натиск средств автоматизации, особенно если речь идёт о необходимости проведения деликатных манипуляций. «Яндекс» представил рекомендательную генеративную ИИ-модель Sona — она уже поселилась в колонках с «Алисой»
01.10.2026 [12:16],
Павел Котов
Компания «Яндекс» представила генеративную модель искусственного интеллекта Sona, которая выступает единой платформой для создания рекомендаций, подбирая варианты для пользователя и ранжируя их. Она служит заменой множеству алгоритмов, не требует выбирать признаки вручную и демонстрирует достойные практические результаты. 
Источник изображения: yandex.ru/company Рекомендательные системы встречаются в жизни современного человека повсеместно — в традиционном варианте они представляют собой большой набор алгоритмов. Эти алгоритмы выбирают подходящие из значительного объёма вариантов, отсеивают из подходящих лучшие и расставляют их в надлежащем порядке — «Яндекс» продемонстрировал, что всю эту систему можно заменить одной моделью. Эта модель анализирует поведение пользователя и сразу предлагает, что ему подойдёт. Компания развернула Sona в системе музыкальных рекомендаций, работающей в умных колонках с «Алисой». За неделю новая ИИ-модель на 6,3 % увеличила время прослушивания рекомендованных композиций, почти на 18 % выросло число просьб повторить композицию, а аудитория активных слушателей увеличилась на 4,5 % — в 2,4 раза активнее, чем с предыдущим обновлением. В 2025 году «Яндекс» выпустил основанную на архитектуре трансформера рекомендательную систему ARGUS; в 2026 года компания внедрила в рекомендательные системы архитектуру Gryphon, которая помогла объединить несколько этапов подбора рекомендаций — Sona продолжает это направление развития. В 2025 году команда «Яндекса» также выложила в открытый доступ один из крупнейших в мире наборов данных Yambda для развития рекомендаций — проект использовали учёные Kuaishou и Meta✴✴. О модели Sona положительно отозвались учёные компании ByteDance, ответственные за рекомендательную систему платформы TikTok. |
|
✴ Входит в перечень общественных объединений и религиозных организаций, в отношении которых судом принято вступившее в законную силу решение о ликвидации или запрете деятельности по основаниям, предусмотренным Федеральным законом от 25.07.2002 № 114-ФЗ «О противодействии экстремистской деятельности»; |
© 1997—2026 3DNews
При цитировании документа ссылка на сайт с указанием автора обязательна. Полное заимствование документа является
нарушением
российского и международного законодательства и возможно только с согласия редакции 3DNews.



 MWC 2018
 2018
 Computex

 IFA 2018