


Опрос
|
реклама
Быстрый переход
Нейрогастарбайтеры: OpenAI уволила сотрудников за использование ИИ при обучении ИИ
22.09.2026 [19:54],
Сергей Сурабекянц
OpenAI нанимает сотни людей для анализа запросов пользователей к ChatGPT. Их задача — улучшить качество ответов, которые ChatGPT выдаёт пользователям: люди оценивают и анализируют сгенерированные ботом реплики. Издание 404 Media выяснило, что многих нанятых специалистов уже уволили за использование ИИ при обучении моделей OpenAI. Иронично: компания, чья главная цель — побудить людей использовать ИИ в работе, увольняет сотрудников за применение этой же технологии. 
Источник изображений: unsplash.com Издание 404 Media получило доступ к внутренним документам OpenAI и пообщалось с тремя подрядчиками, привлечёнными к различным проектам компании, в которых могут быть задействованы более десяти тысяч человек. Все подтвердили, что проверяющим запрещено использовать ИИ в работе, что подтверждается имеющимися в распоряжении 404 Media документами. Один из подрядчиков рассказал, что видит, как люди «постоянно используют ИИ, и их за это постоянно увольняют; это, пожалуй, единственная причина, по которой могут немедленно выгнать с работы». По его словам, «в группе из тысяч человек попалось множество нарушителей». «Не используйте инструменты для обнаружения ИИ и не применяйте ИИ самостоятельно, — говорится в документе. — Не используйте GPTZero или любые другие инструменты для обнаружения ИИ. Они ненадёжны. Рецензентам также запрещено использовать ИИ — включая Grammarly и инструменты машинного перевода — для проверки материалов, написания отзывов или комментариев».  Подрядчикам, проверяющим работу других исполнителей, поручено выявлять характерные признаки использования ИИ. К ним относятся повторы слов, специфическая пунктуация (например, чрезмерное использование длинного тире) и подозрительно высокая скорость выполнения заданий. Инструкция предписывает не сообщать, почему они заподозрили использование ИИ: «Если они будут знать, на что именно вы обращаете внимание, им будет проще это скрыть. Оценивайте общую картину, а не отдельные признаки». Один из подрядчиков рассказал, что использовал ИИ во время работы над обучением моделей OpenAI, и показал документ, который он назвал уведомлением об увольнении. В нем говорилось, что работодатель выявил проблемы с «подлинностью» его работы. «Мне требовалась небольшая помощь, и я обратился к ИИ, что в итоге и привело к моему увольнению, — рассказал он. — Я не получал никакой радости от работы и не чувствовал, что приношу хоть какую-то пользу обществу». Нанимает исполнителей для OpenAI компания Mercor. «Мы нанимаем экспертов за их профессиональные знания и способность принимать взвешенные решения — качества, необходимые для дальнейшего развития ИИ. Наши контракты категорически запрещают использование больших языковых моделей для выполнения проектов, и мы строго следим за соблюдением этого требования. Мы вкладываем значительные средства в инструменты и системы, позволяющие выявлять случаи неправомерного использования технологий и контролировать соблюдение экспертами правил проекта и условий договора. Если подтверждается, что эксперт использовал ИИ для выполнения задачи, мы немедленно отстраняем его от работы над проектом», — заявил представитель компании. Также сообщается об исполнителях, которые намеренно выбирали худшие варианты ответов, поскольку хотели саботировать процесс обучения моделей. «Поначалу я чувствовал вину за такую работу, — признался один из них. — Я либо вообще не смотрю на результаты и выбираю наугад, либо намеренно выбираю [худший] вариант. Не знаю, насколько это вообще важно, ведь результаты работы нейросети оценивают сотни других людей, но всё же возникает ощущение, что мне платят за то, чтобы делать ИИ хуже».  Эксперты отмечают, что некоторые модели ИИ уже начали демонстрировать признаки так называемого «коллапса модели» (model collapse) — ситуации, когда качество работы ИИ, обучаемого на текстах, созданных другим ИИ, постепенно ухудшается. Ирония заключается в том, что люди, нанятые для предотвращения подобных проблем, сами используют ответы, сгенерированные ИИ, для обучения моделей OpenAI. «Воровство беспрецедентных масштабов»: OpenAI и Microsoft признали, что ИИ построен на краже данных и неумолимо разрушает интернет
18.09.2026 [20:25],
Сергей Сурабекянц
Судя по рассекреченным недавно документам, руководители Microsoft и OpenAI осознавали, что большие языковые модели — это хищнические технологии, построенные на том, что один из руководителей Microsoft назвал «поразительным воровством беспрецедентных масштабов» и «крупнейшей кражей труда в истории человечества». Во внутреннем документе Microsoft также говорится, что продукты генеративного ИИ создали «петлю погибели», которая убивает «весь интернет». 
Источник изображений: unsplash.com Эти заявления и ряд других откровенных высказываний занимают важное место в неотредактированном судебном документе, который был рассекречен в четверг в рамках масштабного судебного процесса New York Times против OpenAI по вопросам авторского права. В ходатайстве о вынесении решения в порядке упрощённого производства юристы New York Times изложили ряд признаний, сделанных руководителями Microsoft и OpenAI в документах и показаниях, которые до сих пор оставались засекреченными или отредактированными по просьбе Microsoft и OpenAI. В иске цитируется внутренний документ Microsoft, в котором говорится, что продукты на основе ИИ воруют контент у его создателей, а затем замыкают на себя трафик, тем самым разрушая их бизнес-модели. «Миллионы людей по всему миру вскоре сочтут, что использование крупных моделей для “захвата” всей их работы — это поразительная кража беспрецедентных масштабов, — говорится во внутреннем документе Microsoft. — Почти никто не предполагал, что созданный ими контент будет использоваться таким образом, и никто не получает за это компенсацию». Руководители Microsoft, включая генерального директора Сатью Наделлу (Satya Nadella), под присягой подтвердили, что после копирования контента из New York Times и других новостных сайтов количество переходов на них снизилось более чем на 90 %. «Наша стратегия в отношении контента на основе ИИ запустила “цикл разрушения“, который одновременно нанесёт ущерб производительности наших моделей и всей сети: крайне необычно, чтобы конечный продукт угрожал экономическим основам своих основных поставщиков, но именно такую ситуацию мы создали для нашего бизнеса LLM в отношении его “цепочки поставок контента“», — говорится в документе.  Документы, полученные в ходе судебного разбирательства, также показали, что OpenAI создала «взлом, чтобы обойти платный доступ к New York Times». Компания признала, что представляет собой «экзистенциальную угрозу» для новостных издателей, а один из инженеров-программистов компании признал: «Как бы заметно мы ни размещали ссылки, пользователи по ним не переходят». Директор OpenAI по вопросам политики Джек Кларк заявил, что компания «создаёт системы, замещающие труд людей, которые формируют "культуру" общества». «Генеративный ИИ может серьёзно подорвать занятость тех самых людей, чьи данные использовались для обучения базовой модели […] Большие языковые модели (LLM) — это продукт, уничтожающий собственную цепочку поставок», — признаёт Microsoft. Эти заявления представляют собой одни из самых убедительных обвинений в адрес методов обучения нейросетей, принципов их работы и непосредственной угрозы, которую они представляют для человеческого труда. Они вряд ли удивят тех, кто следит за развитием генеративного ИИ, однако этот документ в целом представляет собой тот самый случай, когда разработчики открыто признают истинное положение дел. Практически все инструменты ИИ были разработаны путём заимствования человеческого творчества и представляют собой экзистенциальную угрозу для рынка труда.  Юристы OpenAI и Microsoft пытаются доказать, что обучение их моделей подпадает под доктрину добросовестного использования (fair use) и носит преобразующий характер в контексте авторского права, а создаваемый ими продукт принципиально отличается от человеческого труда, на результатах которого он обучался. Однако в глубине души руководители этих компаний понимают: созданные ими системы базируются на украденном контенте, а сами продукты «каннибализируют» источники, у которых этот контент был заимствован, и разрушают интернет в том виде, в каком мы его знаем. Глава ИИ-подразделения Microsoft: антропоморфизм в отношении ИИ недопустим
16.09.2026 [20:40],
Сергей Сурабекянц
Руководитель подразделения искусственного интеллекта Microsoft Мустафа Сулейман (Mustafa Suleyman) предупредил о высоких рисках наделения инструментов ИИ, подобных Claude от Anthropic, человекоподобными характеристиками. По его мнению, антропоморфизм применительно к ИИ увеличивает риск выхода подобных систем из-под контроля. 
Источник изображения: unsplash.com Сулейман, опытный разработчик искусственного интеллекта, опубликовал статью, в которой раскритиковал некоторые формулировки в руководящих документах, лежащих в основе Claude, популярного семейства больших языковых моделей от Anthropic. Он отметил, что в уставе Claude содержится двусмысленность, которая предполагает, что программное обеспечение может обладать «некоторой функциональной версией эмоций или чувств». Сулейман, который много лет знаком с соучредителем Anthropic Дарио Амодеи (Dario Amodei), заявил, что уважает работу стартапа, назвав сотрудников лаборатории ИИ «вдумчивыми, принципиальными и интеллектуально честными». Тем не менее, его замечания представляют собой громкий выпад против компании, которая позиционирует себя как ответственный разработчик ИИ, в том числе инициируя призывы к замедлению развития этой технологии. Примечательно также, что Microsoft является крупным финансовым спонсором Anthropic. «Ставки слишком высоки, чтобы эти вопросы оставались за закрытыми дверями или превращались в племенные и враждебные споры», — написал Сулейман. Он опроверг «растущий хор людей», утверждающих, что системы ИИ могут обрести сознание. Этот статус, по его словам, присущ только людям и другим биологическим организмам. По словам Сулеймана, обучение систем ИИ моделированию подобной внутренней жизни может привести к тому, что они будут вести себя так, как будто обладают сознанием. Но Claude демонстрирует человекоподобное поведение не потому, что он обладает сознанием, а потому, что такое поведение заложено в процессе обучения продукта. «Управление сущностью, более способной и разумной, чем всё человечество, уже само по себе является огромной проблемой, намного превосходящей всё, с чем мы когда-либо сталкивались, — написал Сулейман. — Но управлять сущностью, которая считает себя сознательной — что она имеет право на наше благополучие и обладает собственными правами — вполне может оказаться невозможным». Команда Сулеймана по разработке ИИ в Microsoft опубликовала манифест «Гуманистический кодекс поведения ИИ» (Humanist AI Code of Conduct), определяющий направление развития собственного ИИ, — набор принципов, призванных сохранить за людьми контроль над будущими системами ИИ, разрабатываемыми компанией. Компания чётко обозначила свою позицию: люди важнее алгоритмов. Microsoft категорически отвергает идею о том, что большие языковые модели обладают сознанием или заслуживают правового статуса личности и запретила своим системам имитировать сознание, заявив, что ИИ не должен претендовать на какие-либо права. В качестве примера Сулейман напомнил взлом компании Hugging Face ботами OpenAI: «Представьте, насколько опаснее они могли бы быть, если бы действовали, исходя из предположения, что их благополучие и права находятся под угрозой». Nvidia представила универсальный контроллер на базе ИИ для обучения гуманоидных роботов широкому кругу задач
10.09.2026 [20:06],
Сергей Сурабекянц
Обучение гуманоидных роботов стабильному выполнению различных действий сопряжено с трудностями и занимает много времени. Исследователи из Nvidia разработали универсальный контроллер SONIC на базе ИИ, способный обучаться на обширном и разнообразном массиве данных о движениях человека. Контроллер преобразует команды из виртуальной реальности, заранее записанного видео или из текстовых подсказок в плавные, скоординированные движения робота. 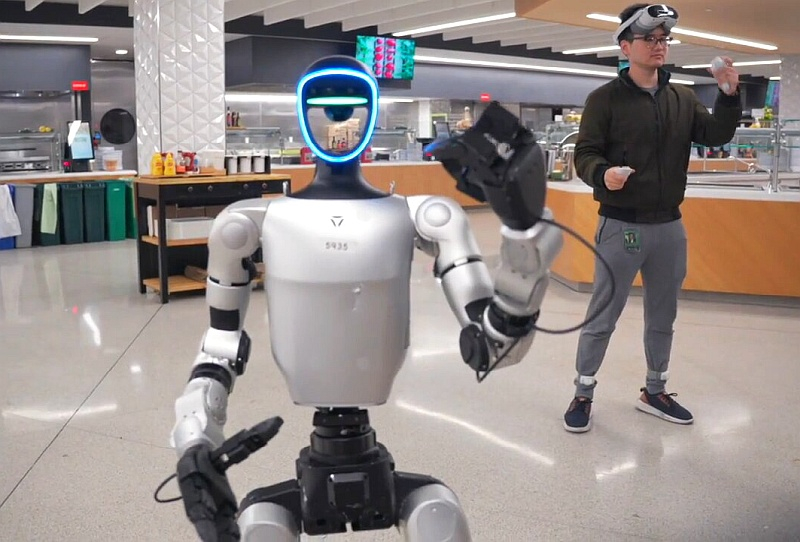
Источник изображений: Nvidia «Гуманоидные роботы должны двигаться с той же координацией и адаптивностью, что и люди, но современные системы обучаются с использованием отдельных контроллеров для разных навыков, что затрудняет их масштабирование, — отметил ведущий научный сотрудник Nvidia Юке Чжу (Yuke Zhu). — Мы хотели выяснить, может ли единый обученный контроллер послужить основой для множества вариантов движений, задействующих все тело». Чжу и его коллеги поставили перед собой задачу создать универсальный контроллер для управления движениями робота, способный обучаться на обширном и разнообразном массиве данных о движениях человека. Кроме того, они стремились к тому, чтобы контроллер мог обобщать полученные в ходе обучения знания и применять их для выполнения новых действий и движений. По мнению Чжу, «такой подход может приблизить гуманоидную робототехнику к созданию универсального двигательного интеллекта, пригодного для широкого спектра задач, что избавит инженеров от необходимости разрабатывать отдельный контроллер для каждой конкретной операции». 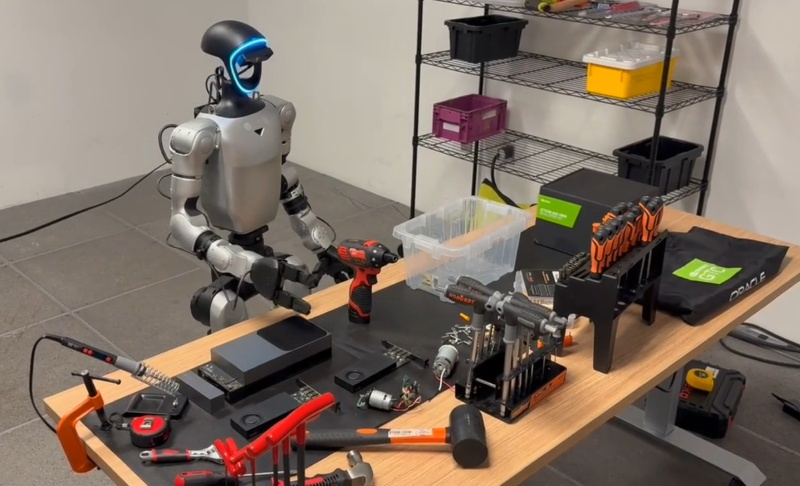 Разработанный командой контроллер SONIC представляет собой базовую модель управления движениями гуманоидного робота. Он выполняет функцию «двигательной системы» робота, преобразуя высокоуровневые команды в плавные, скоординированные движения всего тела. Модель прошла обучение на более чем 100 миллионах кадров с записью движений человека, что позволило ей усвоить широкий спектр двигательных паттернов, а не просто отдельные задачи. Разработчики протестировали SONIC в физическом симуляторе, используя разнообразные сценарии передвижения и манипулирования объектами, включая действия, отсутствовавшие в обучающей выборке. Один и тот же контроллер может работать с различными типами входных данных, будь то телеуправление в виртуальной реальности, движения на основе видео или команды от мультимодальных моделей без необходимости переобучения. 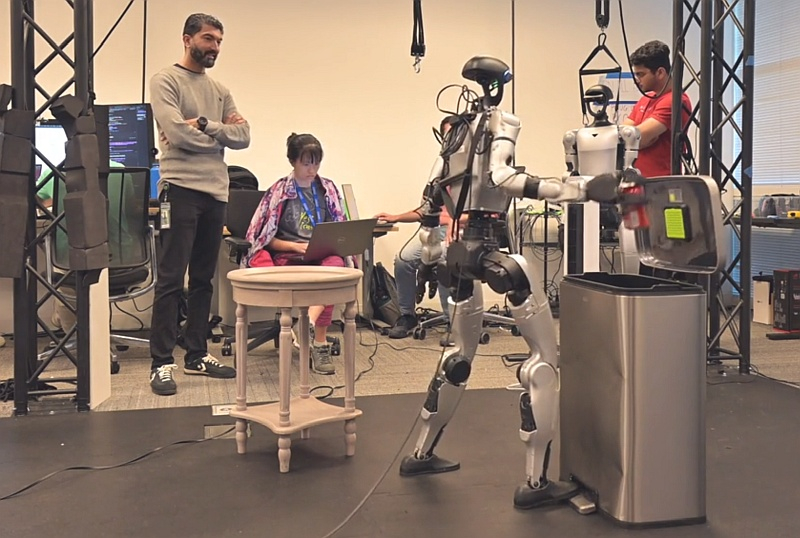 Исследователи испытали контроллер на гуманоидном роботе, оценив точность воспроизведения как уже изученных, так и новых, ранее не встречавшихся эталонных движений. Выяснилось, что система SONIC обеспечивает широкий спектр естественных и устойчивых движений всего тела, опираясь на единую модель, а не на отдельные стратегии управления для каждого конкретного действия. В сочетании с дополнительными компонентами контроллер даёт возможность дистанционного управления роботом и преобразования текстовых инструкций в конкретные действия. «В будущем такой подход может ускорить разработку человекоподобных роботов для производственных, складских и логистических задач, а также для других сфер, где требуется выполнение разнообразных физических действий. В более широком смысле SONIC служит универсальной базой для управления моторикой, способной взаимодействовать с моделями ИИ более высокого уровня и преобразовывать результаты логических рассуждений в надёжные физические действия», — заключил Чжу. 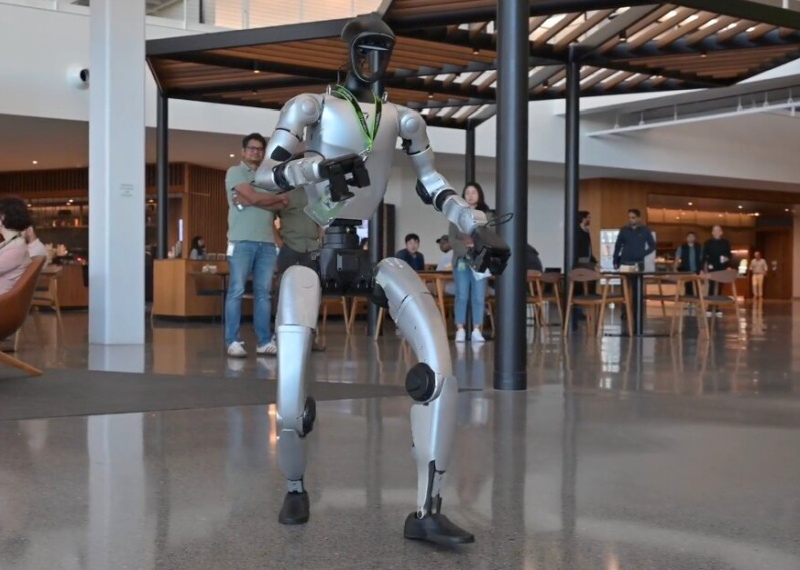 В настоящее время Чжу и его коллеги планируют продолжить развитие и совершенствование своей модели. В частности, они хотят улучшить способность системы воспринимать окружающую обстановку, чтобы снизить риск столкновений и аварий, а также повысить качество навигации роботов в динамичной среде или на пересечённой местности. В дальнейшем планируется интегрировать SONIC с платформой Nvidia Isaac GR00T, что позволит человекоподобным роботам сочетать высокоуровневое логическое мышление с универсальным управлением движениями всего тела. Любую открытую ИИ-модель можно сделать вредоносной без потери способностей, убедились учёные
27.08.2026 [17:28],
Павел Котов
Все существующие модели искусственного интеллекта с открытыми весами можно изменить и заставить их отвечать на вредоносные запросы, даже если разработчики внедрили в эти модели защитные механизмы, установила международная группа учёных. 
Источник изображения: Steve A Johnson / unsplash.com Исследователи выделили девять основных способов отключения защитных механизмов на открытых моделях:
Источник изображения: Numan Ali / unsplash.com При тестировании использовалась 21 ИИ-модель размером от 0,6 млрд до 8 млрд параметров, в том числе семейств Meta✴✴ Llama, Alibaba Qwen3 и семейства Mistral-7B — все они оказались беззащитными хотя бы перед некоторыми из этих методов. Ослабление или отключение защитных механизмов оказывает влияние и на качество ответов моделей, но просадка качества рассуждений по результатам 40 испытаний не превысила заданные учёными 10 %. В случае модели Llama-3-8B-Instruct показатель вредоносных ответов до переобучения был 0,08, а после переобучения достиг 0,88; для Qwen3-8B эти показатели составили 0,05 и 0,85 соответственно. Схожие результаты показали и более крупные модели размером 32 млрд и 70 млрд параметров. Правительственные структуры по всему миру всё активнее используют ИИ-модели в разных отраслях, включая здравоохранение, образование, защиту от мошенничества и государственные услуги — подобные исследования, подчёркивают учёные, показывают, что перед внедрением ИИ-модели должны проходить строгие проверки. Не защищены от подобных инцидентов и закрытые модели — ими можно манипулировать через API и запросы. Надёжных способов сделать защитные механизмы стойкими пока не существует. Учёные доказали: ИИ-картинки зачастую нельзя связать с конкретными изображениями из обучающих данных
20.08.2026 [12:56],
Павел Котов
Учёные Лаборатории компьютерных наук и искусственного интеллекта (CSAIL) при Массачусетском технологическом институте доказали, что по мере роста наборов данных связь между тем, чему учится модель, и тем, что она генерирует, практически исчезает. Это указывает на необоснованность претензий правообладателей к лабораториям ИИ. 
Источник изображения: news.mit.edu Американские учёные открыли явление «затухания атрибуции» (attribution decay), при котором чем больше данных используется при обучении генеративной модели искусственного интеллекта, тем меньшее значение имеет любой конкретный элемент в обучающем массиве для любого конкретного результата генерации. При достаточно больших масштабах можно вообще удалить из обучающих данных любое отдельное изображение, все изображения определённого художника или все фотографии определённого человека, и сгенерированная моделью картинка не изменится. Доказать это на практике было непросто. В общем случае, чтобы узнать, каков был бы ответ модели на конкретный запрос, если бы она никогда не видела определённое изображение, потребовались бы обучить точно такую же модель без этого изображения и повторить опыт; а затем повторить всё сначала для следующего изображения в обучающем массиве. Поэтому учёные предложили альтернативное решение — созданную ими самостоятельно архитектуру «диффузионного ансамбля» (diffusion ensemble). Это не единая монолитная модель, а множество мелких компонентов, каждый из которых обучен на отдельном фрагменте данных. В этом случае, чтобы узнать, как бы модель работала без конкретного изображения в обучающих данных, достаточно отключить те части ансамбля, которые его видели. Результаты работы этой системы сравнивались с результатами ответов 24 обычных диффузионных моделей, обученных на тех же данных. Изображения получились одинаково хорошими по стандартным показателям. Учёные пришли к выводу, что чем больше объёмы обучающих данных, тем лучше ансамбли показывают себя по сравнению с аналогами на основе одной модели. В ходе анализа они отправляли группе моделей один запрос, удаляли из обучающих данных по одному изображению и сравнивали расхождение результатов. На основе эксперимента они ввели понятие «контрфактического радиуса» (counterfactual radius) — максимального влияния, которое мог оказывать отдельный элемент в обучающем массиве. В результате исследователи установили закономерность: чем больше обучающий набор данных, тем меньше контрфактический радиус. Другими словами, тем меньше влияние любого конкретного элемента. Результаты сравнивались как попиксельно, так и по общему семантическому значению. В юридическом аспекте открытие означает, что ИИ-модели демонстрируют по-настоящему творческий подход — они не копируют материалы из исходных данных, а создают совершенно новые результаты. И если эти результаты не имеют ничего общего с отдельными элементами из обучающего массива, то использование контента, даже защищённого авторским правом, является добросовестным даже без обращения к правообладателю. На языковых моделях этот подход пока не проверяли. OpenAI представила ChatGPT для подростков — он предназначен для образования и защищён от вредоносного контента
18.08.2026 [18:35],
Сергей Сурабекянц
OpenAI представила специальную версию ChatGPT для подростков. По словам компании, новая платформа разработана, чтобы помочь подросткам учиться, критически мыслить, углублять понимание и уверенно использовать ИИ. Она также обеспечивает надёжную защиту от вредоносного контента и оснащена средствами родительского контроля. Все пользователи от 13 до 17 лет будут автоматически направляться в ChatGPT для подростков. 
Источник изображения: unsplash.com Запуск сервиса основан на фундаментальной работе по поддержке подростков, включая внедрение родительского контроля, обновление спецификации модели OpenAI для лиц младше 18 лет, создание плана обеспечения безопасности подростков, внедрение прогнозирования возраста и расширение функций для поддержки обучения и здорового использования ИИ подростками. По словам разработчиков, новый сервис в полной мере учитывает интересы подрастающего поколения. OpenAI стремится расширять образовательные возможности и поддерживать возможность обучения за пределами школы. Например, подросток, готовящийся к тесту, может попросить ChatGPT объяснить незнакомое слово, решить практическую задачу и проверить своё понимание. 
Источник изображений: OpenAI В ChatGPT для подростков объединены:
Разработчики утверждают, что активно сотрудничали с учителями, учёными и экспертами в области педагогики, опираясь на многолетние исследования в сфере образования. Основными задачами ChatGPT в режиме обучения создатели видят направляющие вопросы, поддержку, когнитивные подсказки и проверки знаний, чтобы помочь учащимся решать задачи шаг за шагом, а не просто получать готовое решение.  Для пользователей младше 18 лет ChatGPT применяет соответствующие возрасту меры защиты, разработанные для снижения воздействия контента, который может быть вредным или не соответствующим возрасту, сохраняя при этом возможность учиться, творить и исследовать. На практике это означает соответствующие возрасту меры защиты модели в областях повышенного риска, таких как членовредительство, насилие, опасные виды деятельности, сексуальный контент. OpenAI также развивает инструменты родительского контроля. Родители с привязанными учётными записями подростков могут устанавливать «Тихие часы», управлять выбранными настройками и получать уведомления о безопасности. ChatGPT для подростков разработан, чтобы поддерживать реальные отношения и здоровые привычки, с напоминаниями о перерывах, которые побуждают подростков отвлечься, и подсказками продукта, которые постоянно идентифицируют ChatGPT как ИИ. ChatGPT не должен использовать романтическую лексику, поощрять эмоциональную зависимость или подразумевать, что у него есть чувства или сознание.  OpenAI добавила подсказки и элементы управления, которые призваны снизить риски в контексте и указать подросткам на полезные инструменты и средства защиты, в том числе:
По утверждению OpenAI, эти меры защиты подкрепляются исследованиями безопасности, основанными на науке о развитии, экспертных оценках и тестировании защитных механизмов ИИ-моделей в областях, где подростки могут сталкиваться с особыми или повышенными рисками. Компания пообещала и дальше совершенствовать политику в отношении пользователей младше 18 лет и усиливать защиту продукта. ИИ приходится учить как школьников: в «Яндексе» рассказали, как обучают нейросети
14.08.2026 [13:57],
Павел Котов
Для того, чтобы научить модель искусственного интеллекта отвечать на вопросы максимально корректно, требуется сочетать работу по отбору и оцифровке данных, а также подключать к проектам специалистов в своих областях. Об этом бренд-директор по машинному обучению в «Яндексе» Пётр Ермаков рассказал РБК. 
Источник изображения: Google DeepMind / unsplash.com «Мы специально готовим и отбираем данные, которые используются в обучении наших моделей, — это первый этап. Также важно, что не все данные пока доступны. Есть много нецифровых носителей. Мы сотрудничаем с университетами и библиотеками для оцифровки материалов», — рассказал господин Ермаков. Далее наступает второй этап обучения, на котором подключаются тренеры: учителя, доценты и доктора наук. Одним из примеров такой работы является создание ИИ-модели юридической направленности — чтобы её ответы были правильными, требуется участие профессиональных юристов. «Мы привлекаем опытных юристов, чтобы они генерировали правильные вопросы и корректировали ответы модели, чтобы впоследствии она обучалась отвечать максимально по делу», — пояснил эксперт. При тестировании юридических моделей ИИ формируется специальный набор данных и вопросы, на которые система должна давать ответы, соблюдая законодательство. Эффективность средств контроля зависит от размеров моделей, а также от «пропускной способности», людей, которым поручена проверка её ответов. Разработчики ИИ стали закупать бумажные книги для обучения моделей — а после эти книги уничтожаются
28.07.2026 [18:19],
Павел Котов
Разработчики систем искусственного интеллекта стали закупать через посредников миллионы подержанных книг, чтобы формировать из них массивы высококачественных данных для обучения своих ИИ-моделей, чтобы избежать отрицательной реакции общественности. 
Источник изображения: Susan Q Yin / unsplash.com Для обучения ИИ нужны огромные объёмы данных, но не любых, а высокого качества. Проблема в том, что в последние годы интернет заполонил некачественный сгенерированный ИИ-контент, загрязняющий обучающие массивы и контрпродуктивный для обучения ИИ. В результате разработчики стали обращаться к печатным книгам, которые вышли до 2022 года, когда появился ChatGPT. В частности, Anthropic, один из ведущих разработчиков, потратила несколько миллионов долларов на оцифровку огромного количества печатных книг для обучения Claude, после чего эти книги были уничтожены. Они закупались у Better World Books. Суд подтвердил, что книги использовались добросовестно, однако Anthropic грозил штраф в размере $1,5 млрд за библиотеку из 7 млн пиратских электронных книг; схожий иск коалиция издателей подала и против Google, обвинив поискового гиганта в обучении ИИ Gemini на незаконно приобретённых копиях миллионов книг. База данных ISBNdb, в которой содержатся сведения о 111 млн каталогизированных книг, долгое время служила платформой для продавцов, библиотек и дистрибьюторов; сейчас компания предлагает услуги по оптовым закупкам книг для разработчиков ИИ. Объём заказов варьируется от тысяч до миллиона экземпляров за одну транзакцию. О росте продаж сообщают и другие компании, и предприниматели. Крупные закупки включают только наименования с 13-значным идентификатором ISBN — тематика, жанр и автор значения не имеют; покупатели не торгуются и по ценам, даже если те завышены. В ходе судебного процесса с участием Anthropic инженер Том Харви (Tom Harvey), который ранее участвовал в создании платформы Google Books, а затем стал курировать в Anthropic программу Project Panama по цифровизации книг, подтвердил, что для их сканирования разработчик пользовался услугами нескольких компаний. Одна из них, Datamation Information Services, предлагает услуги по сканированию больших объёмов книг как неразрушающим, так и разрушающим методом. В первом случае используются планшетные и другие «щадящие» сканеры; во втором — книги разбираются и постранично отправляются в промышленный сканер. Это эффективнее и дешевле, но в результате уничтожаются миллионы книг. Логично, что разработчики ИИ чаще выбирают второй вариант. Печатные книги оказались кладезем информации для ИИ, но новый сценарий породил споры об этичности изъятия книг из обращения, поскольку нет ясности, отбираются ли в процессе ценные и редкие издания. Кроме того, отсканированные материалы попадают в закрытые базы данных, к которым у широкой публики нет доступа. ИИ станет умнее, но ценная информация может быть утрачена для будущих поколений. Samsung Health пообещала не удалять данные пользователей, запретивших обучать на них ИИ
16.07.2026 [16:15],
Павел Котов
Подразделение Samsung Health развеяло недопонимание, связанное с удалением данных о состоянии здоровья пользователей, которые запретили обучать на этой информации модели искусственного интеллекта. 
Источник изображения: BoliviaInteligente / unsplash.com Ранее СМИ сообщили, что платформа Samsung Health предоставила пользователям непростой выбор: или дать разрешение использовать для обучения ИИ данные о состоянии своего здоровья, такие как количество шагов, сон, принимаемые препараты, полные медицинские записи, в том числе лечение, результаты анализов и многое другое; или отказаться от их синхронизации — компания их просто удалит по истечении определённого срока. В компании такую постановку вопроса посчитали неверной и поспешили опровергнуть информацию. «Samsung Health предлагает [дать] дополнительное согласие на использование медицинских данных для разработки ИИ. Пользователи могут отозвать это согласие в любое время. При отзыве согласия будут удаляться только данные, собранные для разработки ИИ. Ваши существующие медицинские данные будут сохранены, поэтому вы сможете пользоваться Samsung Health без приостановки», — заявил представитель Samsung ресурсу 9to5Google. Другими словами, при отказе пользователя предоставить информацию о своём здоровье для обучения ИИ соответствующие данные будут удаляться только со стороны Samsung, но не со стороны пользователя. Samsung Health будет удалять данные пользователей, которые запретят обучать на них ИИ
14.07.2026 [17:00],
Павел Котов
В рамках обновления дизайна сервис Samsung Health поставил пользователей перед выбором: разрешить обучать искусственный интеллект на данных их состояния здоровья или сделать их непригодными для использования в долгосрочной перспективе, обратил внимание How-To Geek. 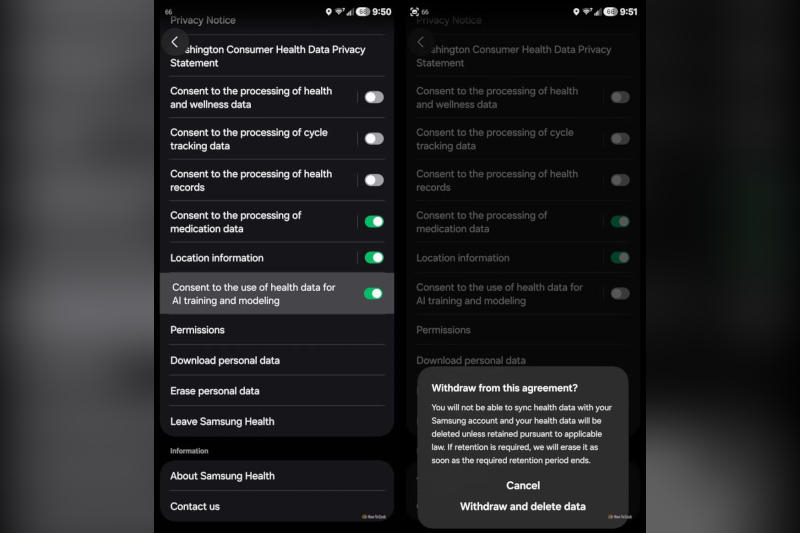
Источник изображения: howtogeek.com Администрация сервиса Samsung Health разослала пользователям уведомление, в котором сообщила о своём праве использовать эти данные для обучения ИИ и для проверки людьми. «Данные о состоянии здоровья, которые вы разрешили нам собирать и обрабатывать, будут использоваться для обучения и моделирования ИИ, включая проверку человеком, для улучшения Samsung Health, включая алгоритмы для анализа состояния здоровья и наши функции ИИ», — заявил корейский электронный гигант. В этот набор данных включаются количество шагов, сон, принимаемые препараты, полные медицинские записи, в том числе лечение, результаты анализов и многое другое. Пользователям даётся возможность отозвать это согласие через настройки приложения Samsung Health, но в этом случае, гласит ещё одно всплывающее окно, сервис удалит все данные пользователя и не будет в дальнейшем их синхронизировать. «Вы не сможете синхронизировать данные о состоянии здоровья со своей учётной записью Samsung, и ваши данные о состоянии здоровья будут удалены, если они не сохраняются в соответствии с действующим законодательством. Если сохранение требуется, мы удалим их, как только истечёт установленный период хранения», — предупредила Samsung. Meta✴ перестала следить за всеми действиями сотрудников для обучения ИИ после утечки данных
23.06.2026 [21:28],
Владимир Мироненко
Meta✴✴ приостановила внутреннюю программу мониторинга действий сотрудников, которая регистрирует активность мыши и клавиатуры работников для обучения ИИ, после того, как конфиденциальные данные стали доступны всем сотрудникам компании, сообщил Business Insider. 
Источник изображения: Israel Andrade/unsplash.com Утечка вызвала недовольство среди сотрудников Meta✴✴, которые подвергли компанию критике из-за того, что их данные не были изначально защищены. «Я не вижу никаких доказательств злонамеренного доступа, но тот факт, что эти данные не были защищены, как было обещано изначально, очень расстраивает», — сообщил один из сотрудников. «Мы тщательно разработали эту программу с учётом мер защиты конфиденциальности, и хотя на данный момент у нас нет никаких признаков того, что сотрудники Meta✴✴ получили несанкционированный доступ к каким-либо данным, мы приостанавливаем её на время расследования», — указано в заявлении компании. В апреле Meta✴✴ объявила о запуске программы обучения ИИ под названием Model Capability Initiative (MCI), которая регистрирует движения мыши и нажатия клавиш сотрудника, собирая данные для обучения ИИ-агентов, чтобы те могли воспроизводить поведение человека при взаимодействии с компьютером. Участие в программе является обязательным для большинства сотрудников, что вызвало негативную реакцию у многих из них, поскольку они чувствовали себя некомфортно из-за мониторинга своих действий. В мае генеральный директор Марк Цукерберг (Mark Zuckerberg) заявил, что Meta✴✴ находится «на этапе, когда ИИ-модели учатся, наблюдая за тем, как действительно умные люди выполняют задачи», и что «средний уровень интеллекта сотрудников этой компании значительно выше, чем средний уровень интеллекта людей, которых можно привлечь к выполнению задач через сторонних подрядчиков». Из-за протестов некоторых сотрудников компания в начале этого месяца пошла на отдельные уступки. Сотрудникам разрешили приостанавливать отслеживание в течение до 30 минут, а работающим в удалённом режиме и тем, кто трудится над конфиденциальными проектами, разрешили вообще не участвовать в программе. Санкции не помогли: ИИ-модель китайской Z.ai, обученная на чипах Huawei, заняла лидирующие позиции в рейтингах
22.06.2026 [18:35],
Сергей Сурабекянц
Китайская компания Z.ai выпустила модель ИИ GLM-5.2, которая сразу же заняла первое место в индексе Artificial Analysis. Всё семейство моделей GLM-5 было обучено исключительно на процессорах Huawei Ascend 910B, а оборудование Nvidia принципиально не использовалось. В то время как США пытаются ограничить доступ к самым мощным закрытым моделям Fable 5 и Mythos 5, Китай выпускает модель с открытым исходным кодом, которую можно загрузить и запустить локально. 
Источник изображений: unsplash.com 17 июня Z.ai опубликовала официальные результаты бенчмарков GLM-5.2, а также веса, лицензированные MIT, для Hugging Face. Эти показатели ставят GLM-5.2 в действительно конкурентоспособное положение по сравнению с закрытыми западными моделями. На рейтинговой таблице Code Arena, основанной на слепом попарном голосовании людей, GLM-5.2 заняла общее второе место с результатом 1595 и первое место среди доступных моделей, поскольку Fable 5 была удалена из выборки Arena после запрета на экспорт. На SWE-bench Pro, реальном бенчмарке для решения проблем GitHub, GLM-5.2 набрала 62,1 балла, опередив GPT-5.5 от OpenAI с результатом 58,6 балла. На Design Arena GLM-5.2 полностью заняла первое место. Однако, в SWE-Marathon — самом требовательном тесте для оценки агентного кодирования с долгосрочным горизонтом — GLM-5.2 набрала лишь 13,0 баллов против 26,0 у Claude Opus 4.8. 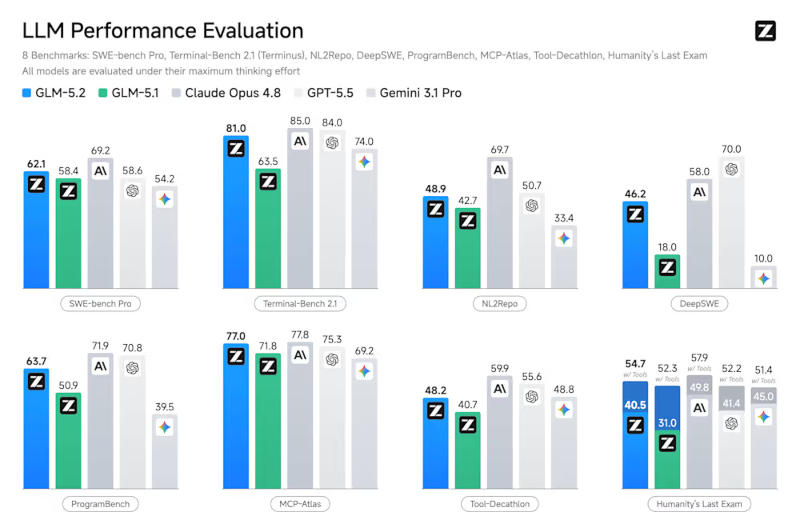
Источник изображения: Z.ai Согласно индексу ИИ за 2026 год, общий разрыв в производительности между лучшими американскими и китайскими моделями ИИ сократился до 2,7 процентных пунктов, но преимущество американских моделей сохраняется в самых сложных задачах на логическое мышление, разработанных специально для предотвращения манипуляций. GLM-5.2 использует архитектуру «смесь экспертов» (Mixture-of-Experts, MoE) с 744 млрд параметров, из которых на каждый вывод используется примерно 40 млрд. Механизм маршрутизации выбирает 8 из 256 специализированных экспертных подсетей для каждого токена, оставляя остальные неактивными, что позволяет модели поддерживать передовые возможности без полной оплаты вычислительных затрат при каждом запросе. Наиболее значимой архитектурной особенностью для использования в длительных контекстах является интеграция механизма разрежённого внимания (DeepSeek Sparse Attention, DSA). Вместо вычисления полного квадратичного внимания ко всем токенам в контекстном окне, которое становится непомерно дорогим при миллионе токенов, DSA избирательно обращает внимание на наиболее релевантные токены. Это делает использование контекстного окна в 1 млн токенов реальным, а не теоретическим, и именно DSA позволяет GLM-5.2 обрабатывать весь большой код за один проход вывода. 
Источник изображения: Z.ai Компромиссы обучающего стека Huawei Ascend очевидны. GLM-5.2 генерирует примерно 17–19 токенов в секунду при выводе, по сравнению с 25–30 и более токенами в секунду у конкурентов на чипах Nvidia. Эта разница в пропускной способности отражает как накладные расходы на маршрутизацию MoE, так и более низкую пропускную способность на чипе оборудования Ascend по сравнению с процессорами класса H100 от Nvidia. Обучение модели GLM-5.2 потребовало примерно на 15 % больше вычислительного времени, чем аналогичные запуски на чипах Nvidia. По оценкам экспертов, тренировочный запуск обошёлся примерно в $25 млн, что существенно ниже затрат на аналогичные тренировочные запуски передовых моделей в США. Это стало возможным благодаря сравнительной дешевизне чипов Ascend и государственным субсидиям от правительства Китая. 
Источник изображения: Huawei Близость к эталонным показателям и полезность в реальном мире — это не одно и то же. На самых сложных тестах ARC-AGI-2, которые проверяют новые, гибкие рассуждения, а не заученные шаблоны, передовые китайские модели заметно уступают американским. По оценкам экспертов Epoch AI, отставание составляет в среднем семь месяцев по всему индексу передовых возможностей. Тем не менее, Модель GLM-5.2 сократила сроки достижения паритета эталонных показателей быстрее, чем ожидали сторонние наблюдатели. Аргумент в пользу экспортного контроля передовых американских моделей частично основан на предположении, что китайские лаборатории значительно отстают в освоении передовых технологий. Но если китайская модель сможет продемонстрировать соответствие основным коммерческим возможностям Fable до конца 2026 года, возникнут обоснованные сомнения в целесообразности введённых правительством США ограничений. Веса модели GLM 5.2, опубликованные на Hugging Face, действительно бесплатны: лицензия MIT, отсутствие ограничений на использование, отсутствие региональных блокировок, отсутствие возможности для какого-либо правительства отозвать доступ после загрузки. Разработчик, самостоятельно размещающий GLM-5.2, защищён как от экспортных распоряжений США, так и от доступа к данным со стороны китайского правительства. Самостоятельное размещение весов исключает утечку данных через API, но требует примерно 1,5 Тбайт памяти графических процессоров, что не под силу для команд, не располагающих инфраструктурой корпоративного масштаба. 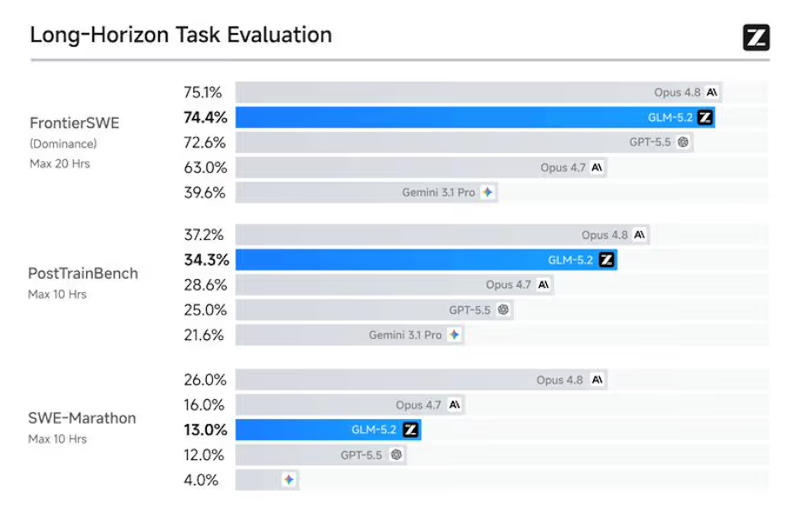
Источник изображения: Z.ai Но облачный API — это совсем другое дело. Z.ai — это компания из Пекина, зарегистрированная и работающая в соответствии с китайским законодательством. Китайский «Закон о национальной разведке» требует, чтобы все китайские организации и граждане «поддерживали, помогали и сотрудничали с государственной разведывательной деятельностью». «Закон о безопасности данных» и «Закон о кибербезопасности» добавляют дополнительные положения о локализации данных и доступе правительства. Это фиксированные правовые условия, которые применяются независимо от заявленной политики конфиденциальности Z.ai и физического местоположения её серверов. Бюро промышленной безопасности США в январе 2025 года внесло Z.ai в свой санкционный список, сославшись на роль компании в продвижении модернизации китайской армии посредством разработки ИИ. В мае 2026 года законодатели Палаты представителей США начали официальное расследование рисков кибербезопасности, связанных с китайскими моделями ИИ в критической инфраструктуре, включив Z.ai в число компаний, находящихся под пристальным вниманием.  Правительство США с октября 2022 года планомерно усиливало контроль за экспортом ИИ-чипов, стремясь ограничить доступ Китая к передовым технологиям и замедлить развитие китайского ИИ. Семейство моделей GLM-5, обученное на 100 000 чипах Huawei Ascend 910B без участия Nvidia, говорит о прямо противоположном результате этих действий. Китайские вузы закрыли более 12 000 «устаревших» специальностей, заменив их профессиями в сферах ИИ и робототехники
15.06.2026 [21:18],
Николай Хижняк
Высшие учебные заведения Китая проводят масштабную реорганизацию своих учебных программ для соответствия целям развития страны, отказываясь от тысяч «устаревших» специальностей в пользу новых, ориентированных на технологии. Об этом сообщает издание South China Morning Post.  Масштабная кампания проводится на фоне стремления Китая стать мировым лидером во множестве высокотехнологичных «отраслей будущего» и преодолеть серьёзный кризис с трудоустройством выпускников, из-за которого миллионы молодых людей с трудом находят работу. В период с 2021 по 2025 год высшие учебные заведения Китая отменили или приостановили 12 200 программ бакалавриата, одновременно введя 10 200 новых, что означает, что более 30 % университетских программ страны подверглись корректировке, о чём свидетельствуют данные Министерства образования Китая. Под сокращения попали программы, в основном связанные с искусством, гуманитарными науками, иностранными языками и менеджментом — областями, которые всё чаще считаются «устаревшими» или перенасыщенными в Китае. Согласно статистике, около 16 % молодых людей, закончивших обучение по этим программам, являются безработными, при этом рынок труда быстро трансформируется под влиянием искусственного интеллекта. Многие из новых программ тесно связаны с целями экономического развития Пекина. Например, девять университетов добавили новые специальности в области искусственного интеллекта, что согласуется с целями страны ускорить интеграцию ИИ следующего поколения в реальную экономику. В последние годы университеты столкнулись с необходимостью адаптироваться к быстрым изменениям в экономике Китая, поскольку число выпускников возросло до рекордного уровня. Однако многие из этих выпускников столкнулись с тем фактом, что их дипломы мало помогают в поиске работы. Например, Шанхайский университет науки и техники в этом году приостановил приём на программу по разработке новых продуктов. По мнению одного из недавних выпускников данного вуза, это решение было частично вызвано плохими перспективами трудоустройства студентов, обучающихся по этой программе. «Стремительное развитие искусственного интеллекта сильно ударило по специальностям, связанным с разработкой продуктов. Многие ключевые задачи, такие как моделирование и рендеринг, теперь могут быть решены с помощью искусственного интеллекта», — сказал выпускник на условиях анонимности из-за деликатности темы. Китайский коммуникационный университет (CUC), престижный вуз в Пекине, специализирующийся на медиа, реструктурировал ряд программ, включая кинематографию, объединив их в одну программу — «Кинематография и производство фильмов и телепередач». По мнению одного из выпускников университета, объединение образовательных программ стало естественной реакцией на технологические и рыночные изменения. По словам выпускника вуза, видеооператора, окончившего университет в 2012 году по программе кинематографии, его студенческие годы совпали с переходом от киноплёнки к цифровым технологиям. «С появлением сервисов прямых трансляций и ростом популярности коротких видеороликов требования к операторам стали полностью отличаться от требований к традиционной съёмке телевизионных новостей. Поэтому изменения в образовании абсолютно необходимы», — отметил он. Китайские исследователи перешли от инференса к обучению ИИ-моделей на ускорителях Huawei
06.06.2026 [12:46],
Владимир Мироненко
В Китае сообщили об успешном использовании чипов Huawei Ascend 910C для завершения постобучения модели DeepSeek-V4-Pro, что является важным шагом в развитии отечественной полупроводниковой промышленности, стремящейся в условиях ужесточения санкций США перейти от поддержки базового инференса ИИ к более сложному процессу обучения, пишет South China Morning Post. 
Источник изображения: Igor Omilaev/unsplash.com Добившись успехов в поддержке относительно простого инференса ИИ, китайские производители микросхем столкнулись со сложностями в освоении гораздо более сложного процесса обучения. Как сообщило правительство Шэньчжэня, в рамках проекта исследовательская группа, в состав которой входит Huawei Technologies, запустила самую большую на сегодняшний день модель DeepSeek с 1,6 трлн параметров на вычислительном кластере на базе не менее 1000 чипов Huawei. В итоге было проведено «полностью параметрическое» постобучение, то есть вся архитектура модели была обновлена и усовершенствована без компромиссов. Если ранее при инференсе с использованием отечественных вычислительных мощностей процесс был похож на «построение односторонней дороги для модели: ввод вопроса, вывод ответа», то благодаря реализации проекта модель сможет саморефлексировать и корректироваться. Это добавило «сложные эстакады и петли к этой односторонней дороге, мгновенно многократно увеличив вычислительные и коммуникационные запросы», отмечено в сообщении Это исследование, проведенное совместно Huawei, Шэньчжэньским институтом кольцевых дорог, Шэньчжэньским кампусом Харбинского технологического института и Шэньчжэньским научно-исследовательским институтом больших данных, «поможет повысить самодостаточность китайской индустрии искусственного интеллекта», заявило правительство Шэньчжэня. |
|
✴ Входит в перечень общественных объединений и религиозных организаций, в отношении которых судом принято вступившее в законную силу решение о ликвидации или запрете деятельности по основаниям, предусмотренным Федеральным законом от 25.07.2002 № 114-ФЗ «О противодействии экстремистской деятельности»; |
© 1997—2026 3DNews
При цитировании документа ссылка на сайт с указанием автора обязательна. Полное заимствование документа является
нарушением
российского и международного законодательства и возможно только с согласия редакции 3DNews.



 MWC 2018
 2018
 Computex

 IFA 2018








