


Опрос
|
реклама
Быстрый переход
Broadcom придумала, как укладывать кристаллы на чипах так, чтобы они работали быстрее
06.12.2024 [16:09],
Павел Котов
Компания Broadcom сообщила, что ее подразделение по производству заказных чипов, выпускающее решения для систем искусственного интеллекта для облачных провайдеров, разработало новую технологию для повышения скорости работы полупроводников. Это особенно актуально на фоне высокого спроса на инфраструктуру для ИИ. 
Источник изображения: broadcom.com Компания Broadcom является одним из крупнейших бенефициаров высокого спроса на аппаратное обеспечение для искусственного интеллекта, поскольку так называемые гиперскейлеры, то есть особенно крупные облачные провайдеры, обращаются к ее заказным чипам для построения своей ИИ-инфраструктуры. Теперь же Broadcom представила технологию 3.5D eXtreme Dimension System in Package (XDSiP), позволяющую создавать ускорители вычислений нового поколения. 3.5D XDSiP позволяет собрать на одной подложки кристаллы с общей площадью более 6000 мм2 и до 12 стеков памяти HBM. Это позволяет создавать ещё более сложные, производительные и в то же время более энергоэффективные ускорители. Компания Broadcom отмечает, что её технология первой в отрасли позволяет соединять кристаллы «лицом к лицу» (Face-to-Face или F2F), то есть передними частями, тогда как прежде было доступно лишь соединение «лицом к спине» Face-to-Back или F2B). Платформа Broadcom 3.5D XDSiP обеспечивает значительное повышение плотности межсоединений и энергоэффективности по сравнению с подходом F2B. Инновационная укладка F2F напрямую соединяет верхние металлические слои верхней и нижней матриц, что обеспечивает плотное и надежное соединение с минимальными электрическими помехами и исключительной механической прочностью. Платформа Broadcom 3.5D XDSiP включает в себя как готовые решения для внедрения в чипы, так и системы для проектирования кастомных решений. Технология, получившая название 3.5D XDSiP, позволит заказчикам чипов Broadcom увеличить объем памяти внутри каждого упакованного чипа и ускорить его работу за счет прямого соединения критически важных компонентов. Выпускать чипы с компоновкой 3.5D XDSiP будет компания TSMC. Сейчас в разработке значатся пять продуктов с новой технологией Broadcom, а их поставки начнутся в феврале 2026 года. Компания не уточнила, для каких облачных провайдеров разрабатывает чипы по индивидуальному заказу, но, указывают аналитики, среди её клиентов значатся Google и Meta✴✴. «Наши клиенты — гиперскейлеры продолжают масштабировать свои кластеры ИИ», — сообщил гендиректор Broadcom Хок Тань (Hock Tan) в сентябре, когда компания повысила свой прогноз выручки от деятельности в области ИИ за 2024 финансовый год с $11 млрд до $12 млрд. У компании есть три крупных клиента на разработку чипов по индивидуальному заказу, добавил он. Крупнейшим конкурентом Broadcom в этой области является компания Marvell, которая также предлагает передовые решения для соединения чипов. Рынок кастомных чипов к 2028 году может вырасти до $45 млрд — две компании его поделят, заявил недавно гендиректор Marvell Крис Купманс (Chris Koopmans). У Intel уже «почти готова» графика Xe3, хотя только вчера вышли первые видеокарты на Xe2
04.12.2024 [23:48],
Николай Хижняк
Заслуженный исследователь Intel Том Петерсен (Tom Petersen), фактически ставший лицом графического направления компании, принял участие в подкасте The Full Nerd, где рассказал о запуске новой серии настольных видеокарт Battlemage на архитектуре Xe2. В состав серии пока входят только две модели ускорителей — Arc B580 и Arc B570. Не вдаваясь в детали, Петерсен не исключил возможности появления ещё более скоростной графики на базе архитектуры Xe2 в будущем. 
Источник изображения: VideoCardz В настоящее время компания сосредоточена на предстоящем старте продаж первой модели серии Battlemage — Arc B580, которая станет доступна с 13 декабря. Младшая модель Arc B570 поступит в продажу 16 января 2025 года. В более широком плане Петерсен дал понять, что Intel не намерена сворачивать развитие направления Arc Graphics. По его словам, компания почти завершила разработку архитектуры Xe3 и уже приступила к работе над её преемником. Он отметил, что Xe3 находится на последней стадии разработки — её сейчас тестируют команды по программному обеспечению Intel, в то время как аппаратные инженеры сосредоточены на следующем поколении графической архитектуры. «Я хотел бы сообщить, что наша следующая разработка называется Xe3. Она придёт на смену Xe2. И, да, всё верно, она практически завершена. Теперь командам по программному обеспечению предстоит много работы над Xe3. А командам по аппаратному обеспечению нужно заняться следующим проектом. Это наш ритм работы, и мы должны ему следовать», — заявил Том Петерсен в ходе подкаста The Full Nerd. 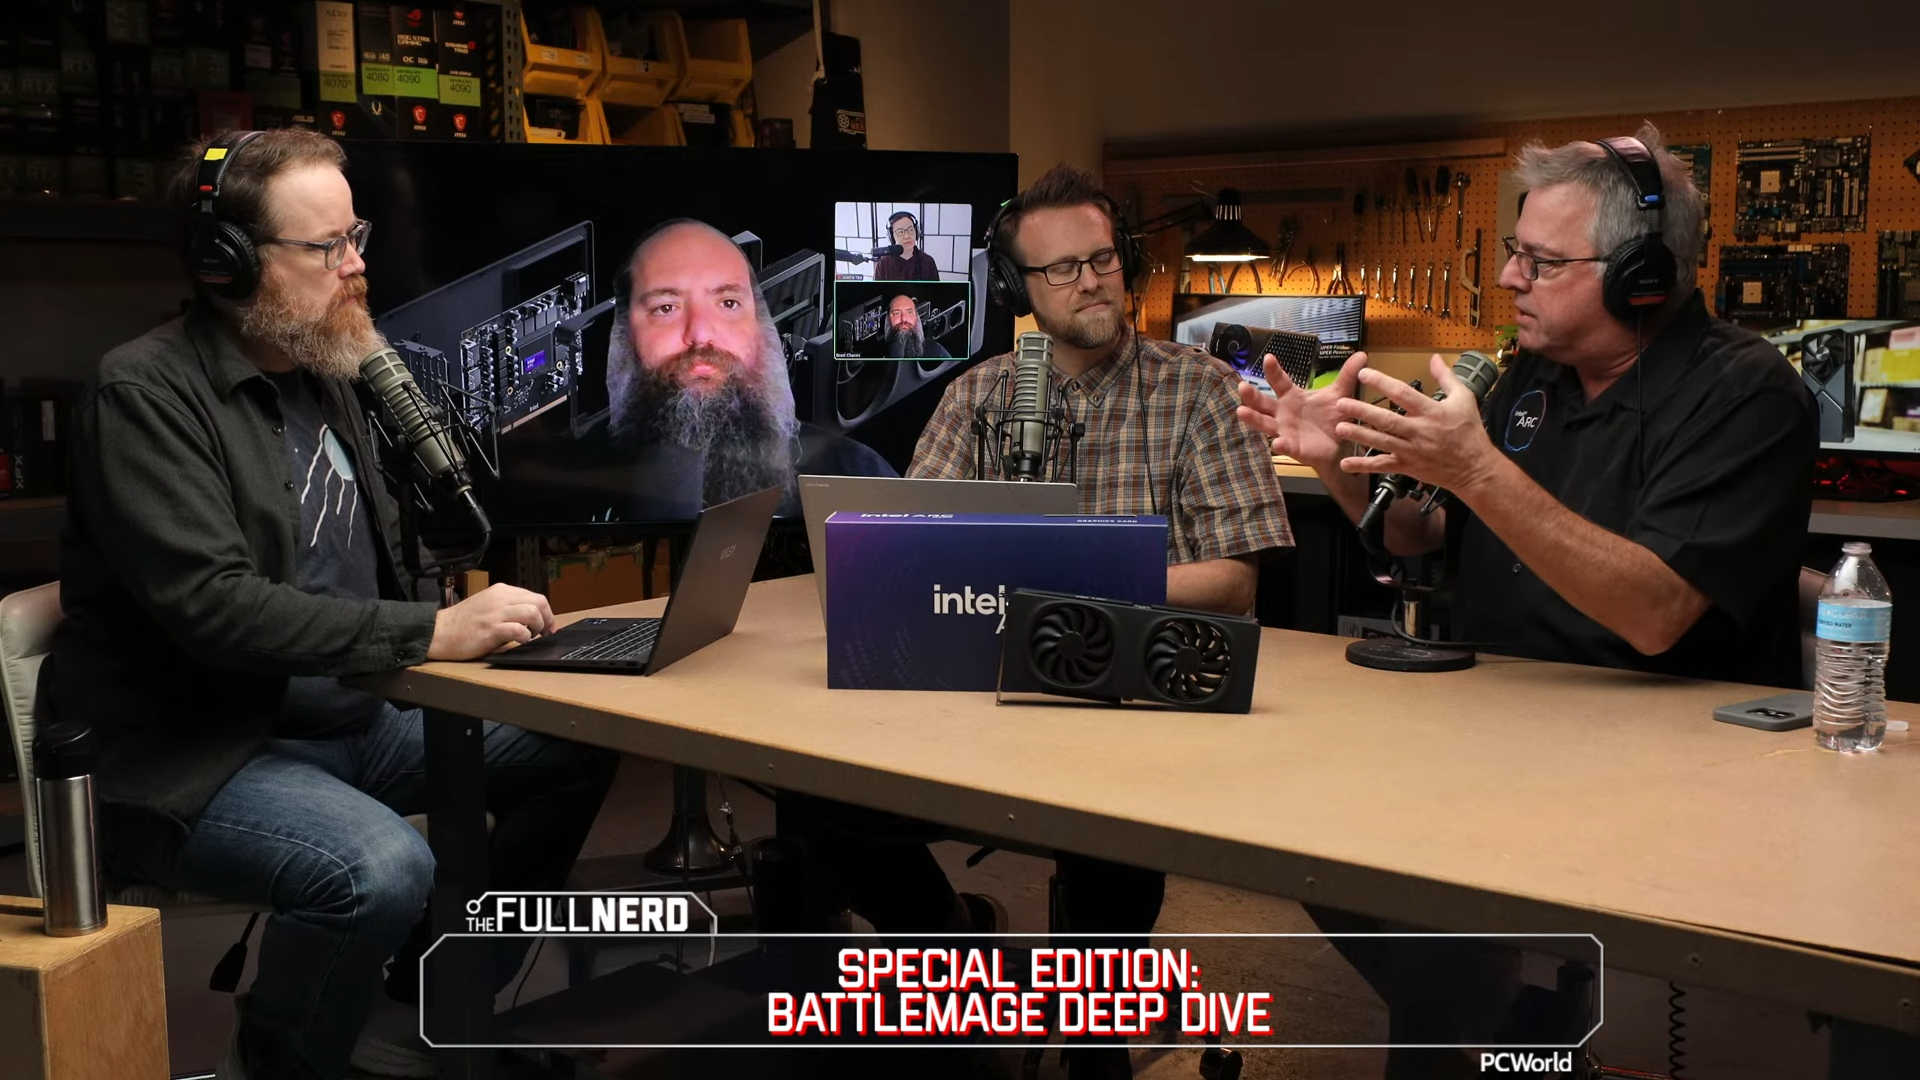 Разумеется, Петерсен несколько упростил текущее положение дел, так как командам по программному и аппаратному обеспечению ещё предстоит много работы над устранением возможных ошибок в архитектурах Xe2 и Xe3 соответственно после выпуска серии видеокарт Battlemage и начала производства чипов на базе Xe3. Однако главный вывод заключается в том, что Intel не намерена снижать темп и продолжит развивать направление по производству видеокарт. В рамках подкаста Петерсен напомнил, что новые видеокарты Intel запускаются с интервалом более одного года. Учитывая запланированный выход первой видеокарты серии Battlemage в декабре, первых решений на базе Xe3 стоит ожидать не ранее 2026 года. 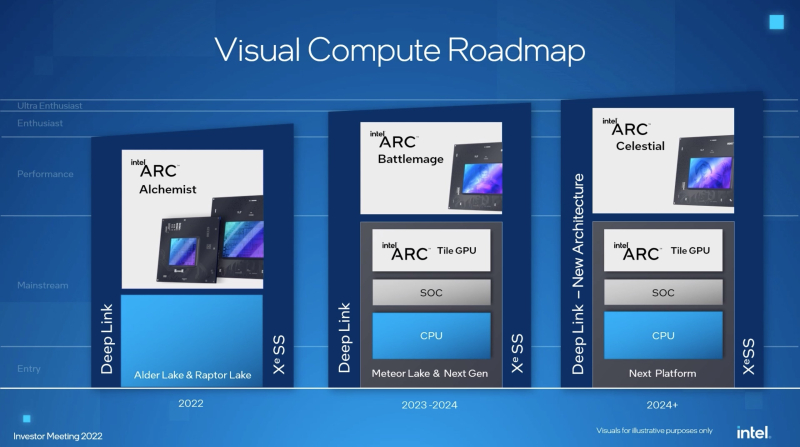
Источник изображения: Intel Ещё до выпуска первого поколения графики Arc (Alchemist на архитектуре Xe) Intel объявила о масштабных планах развития своего графического направления. Компания заявила, что в перспективе выпустит графику Arc Battlemage (Xe2), затем Arc Celestial (Xe3) и Arc Druid (предположительно Xe4). Intel также обещала выйти в сегмент видеокарт «ультра-энтузиаст» (самые производительные игровые решения), однако серия Battlemage пока не дотягивает даже до сегмента «энтузиаст», находясь ступенью ниже. В лучшем случае Arc B580 сможет предложить производительность немного выше GeForce RTX 4060 от Nvidia. ИИ обойдётся без Nvidia: Amazon выпустила системы на чипах Trainium2, а через год выйдут Trainium3
04.12.2024 [18:46],
Павел Котов
Подразделение Amazon Web Services (AWS) компании Amazon объявило на проводимой им конференции re:Invent, что клиенты её облачной платформы теперь могут пользоваться системами с ускорителями Trainium2, предназначенными для обучения и запуска больших языковых моделей искусственного интеллекта. 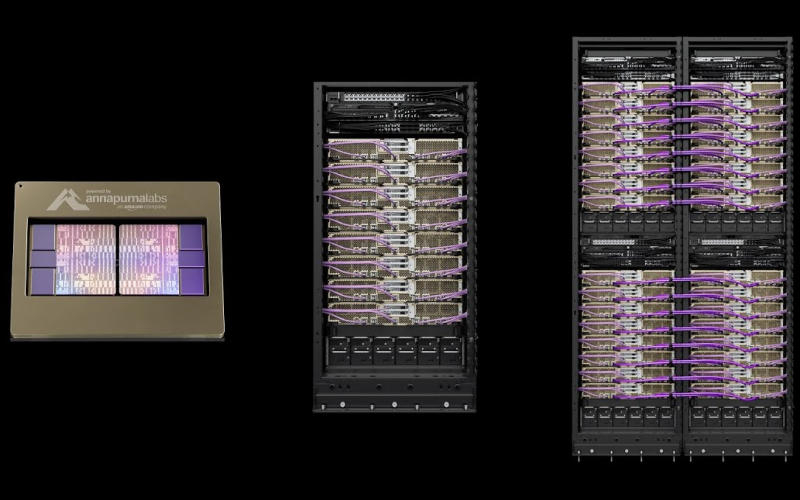
Источник изображения: aws.amazon.com Представленные в прошлом году чипы работают в четыре раза быстрее предшественников: один инстанс EC2 с 16 ускорителями Trainium2 предлагает производительность до 20,8 Пфлопс. Это значит, что при развёртывании масштабной модели Meta✴✴ Llama 405B на платформе Amazon Bedrock клиент получит «трёхкратный прирост скорости генерации токенов по сравнению с другими доступными предложениями крупных облачных провайдеров». Можно будет также выбрать систему EC2 Trn2 UltraServer с 64 ускорителями Trainium2 и производительностью 83,2 Пфлопс. Отмечается, что показатель 20,8 Пфлопс относится к плотным моделям и точности FP8, а 83,2 Пфлопс — к разреженным моделям и FP8. Для связи между ускорителями в системах UltraServer используется интерконнект NeuronLink. Совместно со своим партнёром в лице Anthropic, основным конкурентов OpenAI в области больших языковых моделей, AWS намеревается построить крупный кластер систем UltraServer с «сотнями тысяч чипов Trainium2», где стартап сможет обучать свои модели. Он будет в пять раз мощнее кластера, на котором Anthropic обучала модели текущего поколения — по оценке AWS, он «станет крупнейшим в мире вычислительным кластером для ИИ, о котором сообщалось до настоящего времени». Проект поможет компании превзойти показатели, которые обеспечиваются актуальными ускорителями Nvidia, которые по-прежнему пользуются высоким спросом и остаются в дефиците. Хотя в начале следующего года Nvidia готовится запустить ускорители нового поколения Blackwell, которые при 72 чипах на стойку предложат до 720 Пфлопс для FP8. Возможно, поэтому AWS уже сейчас анонсировала ускорители нового поколения Trainium3, которые предлагают ещё один четырёхкратный прирост производительности для систем UltraServer — ускорители будут производиться с использованием техпроцесса 3 нм, а их развёртывание начнётся в конце 2025 года. Потребность в системах нового поколения в компании обосновали тем, что современные модели ИИ по масштабам подходят к триллионам параметров. Инстансы Trn2 пока доступны только в регионе US East инфраструктуры AWS, но скоро появятся и в других; системы UltraServer в настоящее время работают в режиме предварительного доступа. У Nvidia нашлась ахиллесова пята — треть выручки зависит от настроения трёх клиентов
22.11.2024 [23:17],
Андрей Созинов
Компания Nvidia сильно зависит от горстки крупнейших заказчиков, которые активно покупают ускорители вычислений для задач ИИ и в совокупности приносят компании более трети дохода. Это ставит Nvidia в уязвимое положение, хотя в ближайшее время компании и её инвесторам вряд ли стоит беспокоиться — спрос на ИИ-ускорители только растёт. 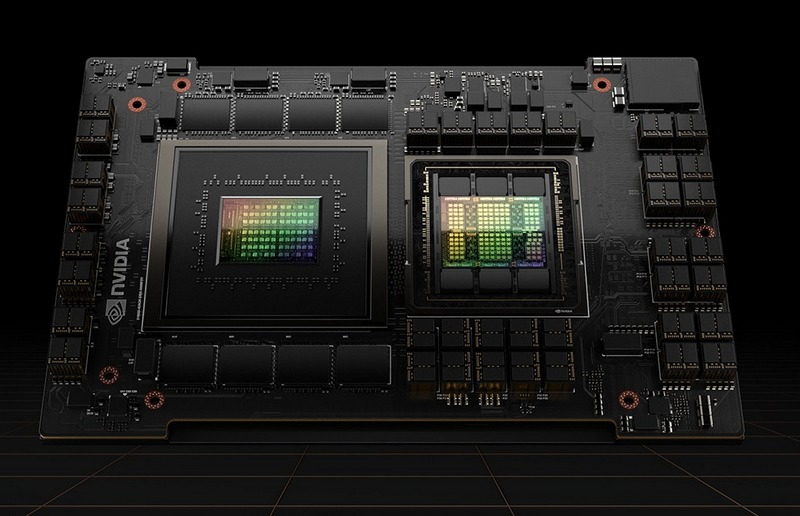
Источник изображений: Nvidia В квартальном отчёте по форме 10-Q, который компании подают в Комиссию по ценным бумагам и биржам США, Nvidia в очередной раз заявила, что у неё есть ключевые клиенты, которые настолько важны, что заказы каждого из них формируют более 10 % от глобальной выручки Nvidia. При этом компания не раскрывает имена этих клиентов, что логично, поскольку вряд ли бы они хотели, чтобы их инвесторы, сотрудники, критики, активисты и конкуренты узнали, сколько именно денег они тратят на чипы Nvidia. В отчёте за второй квартал Nvidia указала четырёх крупнейших клиентов, а в последнем квартале упоминается три таких «кита», поскольку один из них сократил закупки. Хотя доподлинно неизвестно, что это за клиенты, Мандип Сингх (Mandeep Singh), руководитель глобального отдела технологических исследований Bloomberg Intelligence, считает, что речь идёт о Microsoft, Meta✴✴ и, возможно, Super Micro. 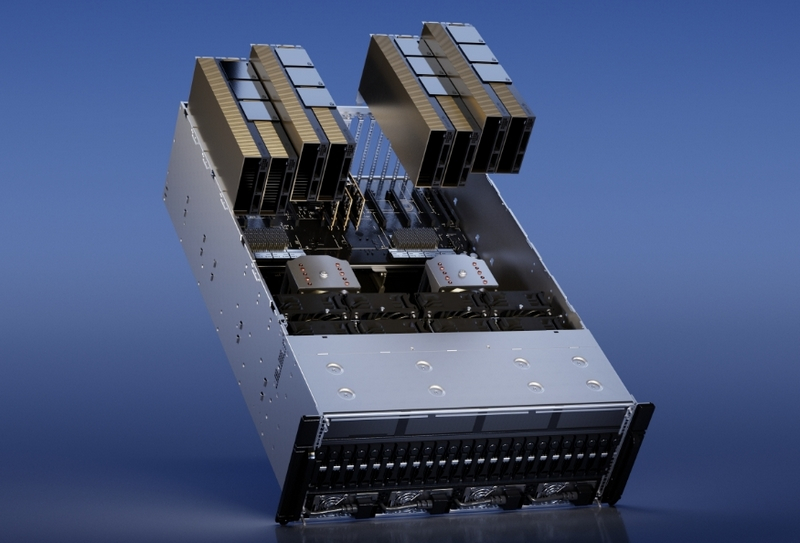 Сама Nvidia называет их просто «клиент A», «клиент B» и «клиент C». Сообща они приобрели товаров и услуг на общую сумму 12,6 миллиарда долларов в третьем финансовом квартале, завершившемся в конце октября. Это более трети от общей выручки Nvidia, которая составила 35,1 миллиарда долларов. Также отмечается, что каждый из «китов» приобрёл товаров и услуг Nvidia на сумму от 10 до 11 миллиардов долларов за первые девять месяцев текущего финансового года. Примечательно, что вклад «китов» в выручку оказался равнозначным: на каждого пришлось по 12 %, что говорит о том, что они, скорее всего, закупили максимальное количество выделенных им чипов, но не столько, сколько им хотелось бы в идеале. Это согласуется с комментариями генерального директора Дженсена Хуанга (Jensen Huang) о том, что Nvidia ограничена в поставках. Компания не может просто производить больше чипов, поскольку она сама их не выпускает, а заказывает производство у TSMC, мощности которой расписаны на годы вперёд. Поскольку имена крупнейших покупателей чипов Nvidia засекречены, трудно сказать, являются ли они «посредниками», как Super Micro Computer, которая выпускает серверы для центров обработки данных, или конечными пользователями, как Microsoft, Meta✴✴ или xAI Илона Маска (Elon Musk). Последняя, например, практически из ниоткуда построила мощнейший ИИ-суперкомпьютер всего за три месяца. 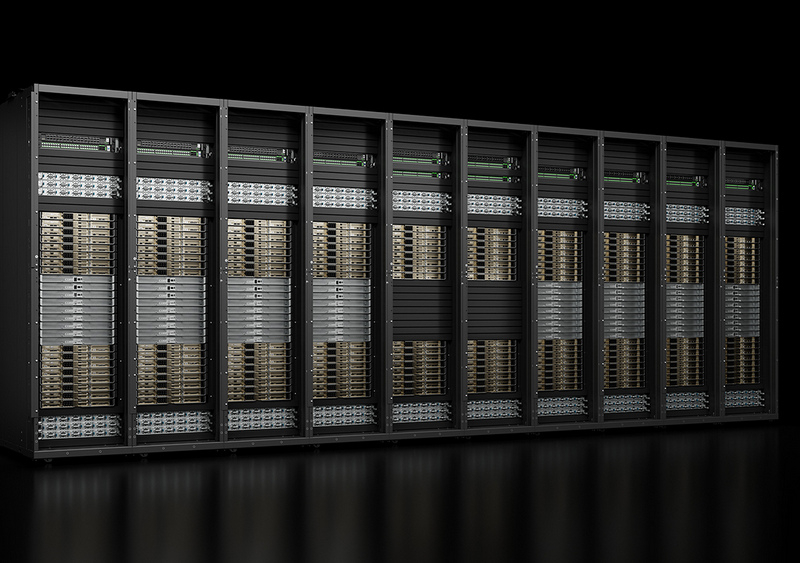 Тем не менее полагаться на горстку крупных клиентов весьма рискованно — если кто-то из них, а ещё хуже, все разом, перестанут закупать ИИ-чипы, у Nvidia резко упадёт выручка. К счастью для инвесторов Nvidia, в ближайшее время такое маловероятно. Аналитик Bloomberg Intelligence Мандип Сингх видит лишь несколько долгосрочных рисков для Nvidia. Во-первых, некоторые крупные клиенты, вероятно, со временем сократят заказы в пользу собственных чипов, что приведёт к уменьшению доли компании на рынке. Одним из таких клиентов является Alphabet, у которой есть собственные ИИ-чипы семейства TPU. Во-вторых, Nvidia доминирует в области ускорителей для обучения ИИ, но не может похвастаться тем же в сфере чипов для инференса — запуска уже обученных нейросетей. Для инференса не требуются столь мощные чипы, что означает для Nvidia гораздо большую конкуренцию не только со стороны AMD и других прямых соперников, но и со стороны компаний с собственными чипами, таких как Tesla. 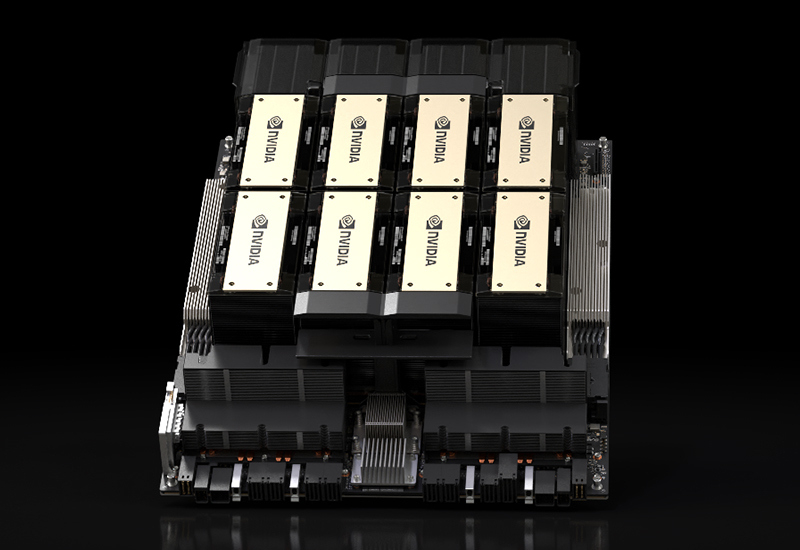 В конечном счёте запуск обученных нейросетей станет гораздо более значимым бизнесом, поскольку всё больше предприятий будут использовать ИИ, считает аналитик. «Многие компании пытаются сфокусироваться на возможностях инференса, потому что для этого не нужен самый мощный GPU-ускоритель», — заявил Сингх. Он также отметил, что в долгосрочной перспективе переход на чипы для инференса является «безусловно» большим риском для Nvidia, чем потеря доли рынка чипов для обучения ИИ. И тем не менее Сингх отмечает, что верит прогнозу Дженсена Хуанга о том, что расходы крупнейших клиентов на ИИ-чипы не прекратятся. Даже если доля Nvidia на рынке ИИ-чипов сократится с нынешних 90 %, компания всё равно сможет ежегодно зарабатывать на этом сотни миллиардов долларов. На установке СКИФ начался монтаж бустерного кольца синхротрона — его запустят к весне 2025 года
13.11.2024 [18:47],
Геннадий Детинич
Как сообщает информагентство ТАСС, специалисты Института ядерной физики СО РАН приступили к монтажу оборудования бустерного синхротрона на установке «Сибирский кольцевой источник фотонов» (СКИФ). Работы планируется завершить весной 2025 года, после чего начнутся первые эксперименты на установке. 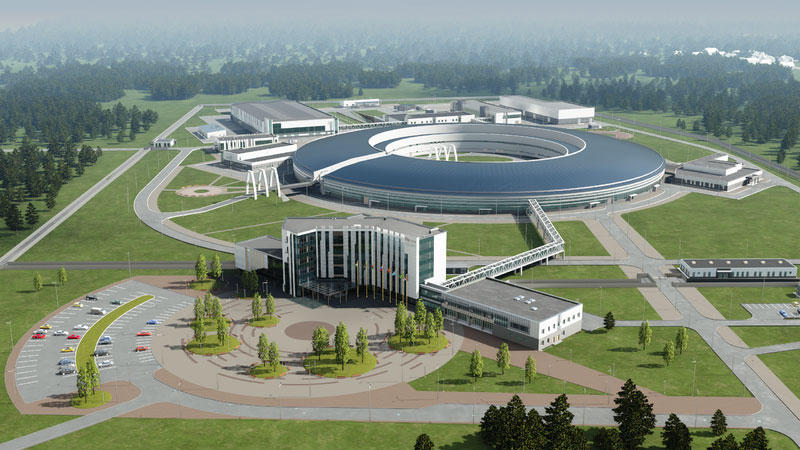
Общий вид на объекты ЦКП «СКИФ». Рендер. Источник изображения: СО РАН «К весне 2025 года все 44 гирдера бустера будут собраны в кольцо периметром 158 м и соединены с инженерными системами. Также к этому сроку будет смонтирована автоматизированная система радиационного контроля и станут возможны испытания этого сегмента ускорительного комплекса с электронным пучком. Здесь за полсекунды пучок будет разгоняться до 3 ГэВ — это энергия, на которой работает ЦКП "СКИФ"», — сообщили в пресс-службе. Первая партия гирдеров — подставок под магнитное и вакуумное оборудование с погрешностью размещения 70 мкм — была доставлена в центр в начале лета 2024 года. Общий вес оборудования для монтажа бустера превышает 160 т. Чтобы выдержать заданную и рекордную точность (ранее допускалась погрешность порядка 100 мкм), в помещении была смонтирована геодезическая сеть, к которой будет осуществляться привязка при монтаже. Всего для кольца бустера длиной 158 м потребуется установить 44 гирдера. На них будет установлено оборудование для разгона и фокусировки пучка элементарных частиц. В здании инжектора также ведётся монтаж линейного ускорителя. Ускоряющие и диагностические элементы линейного ускорителя уже смонтированы в соответствии с проектом. Осталось собрать вакуумную систему, первые эксперименты с которой ожидаются в декабре 2024 года. Проект СКИФ относится к классу научных проектов «мегасайенс». Это синхротрон поколения 4+. Уникальные характеристики нового синхротрона позволят проводить передовые исследования с яркими и интенсивными пучками рентгеновского излучения во множестве областей — химии, физике, материаловедении, биологии, геологии, гуманитарных науках. Также СКИФ поможет решать задачи в интересах промышленности. AMD готовит ответ Nvidia в области нейронного рендеринга для видеоигр
30.10.2024 [06:04],
Анжелла Марина
AMD планирует догнать Nvidia в области технологии трассировки лучей в реальном времени, используя нейронные сети. На данный момент Nvidia доминирует на рынке видеокарт благодаря своим передовым технологиям на основе искусственного интеллекта и машинного обучения, таким как DLSS. AMD пока значительно отстаёт, особенно в потребительском сегменте, однако рассчитывает изменить ситуацию в ближайшее время. 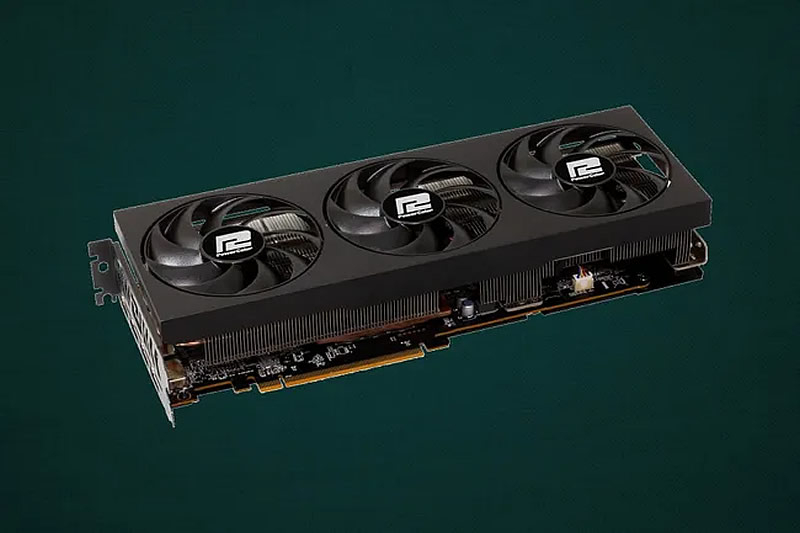
Источник изображения: PowerColor, Tomshardware.com По информации издания Tom's Hardware, исследования AMD сосредоточены на внедрении трассировки лучей в реальном времени на графических процессорах архитектуры RDNA с помощью нейронных сетей. Разрабатываемая технология направлена на нейронное устранение шумов, возникающих при использовании ограниченного количества лучей в трассировке. Это напоминает подход Nvidia с технологией DLSS 3.5, которая использует восстановление лучей для улучшения изображения при меньшем количестве расчётов. Традиционная трассировка лучей требует огромного количества вычислений — иногда тысячи или десятки тысяч лучей на каждый пиксель, что является стандартом, применяемым в киноиндустрии, где на рендеринг одного кадра могут уходить часы. При трассировке лучей сцена рендерится путём вычисления отражений света, где каждое изменение траектории луча может привести к разной цветовой интерпретации пикселя. Чем больше таких расчётов, тем лучше становится итоговое изображение. Однако для достижения трассировки лучей в реальном времени, что актуально для видеоигр, количество таких расчётов необходимо значительно уменьшить. Но это приведёт к ещё большему появлению шумов в изображениях из-за того, что некоторые лучи часто не достигают определённых пикселей, вызывая неполное освещение сцены. AMD планирует решить этот вопрос с помощью нейронной сети, которая будет устранять эти проблемы и восстанавливать детали сцены, аналогично подходу Nvidia. Собственно инновация AMD заключается в объединении апскейлинга и устранения шума в одной нейронной сети. Как заявляет сама компания, их подход «генерирует высококачественные изображения с устранением шума и суперсемплингом при более высоком разрешении дисплея, чем разрешение рендеринга для трассировки путей в реальном времени». Это позволит выполнять апскейлинг за один проход. Исследования AMD могут привести к созданию новой версии FSR (технология временного масштабирования), которая сможет конкурировать с технологиями Nvidia по производительности и качеству изображения. Однако встаёт вопрос, смогут ли существующие графические процессоры AMD поддерживать нейронные сети для устранения шумов или потребуется новое оборудование? Например, DLSS от Nvidia требует наличия специального ИИ-оборудования на графических процессорах GeForce RTX, а также оптического потокового ускорителя для генерации кадров на GeForce RTX 40-й серии и более поздних моделях. Текущие же графические процессоры AMD в основном не оснащены специальными ускорителями для ИИ, в отличие от Nvidia GeForce RTX, где такие ускорители играют ключевую роль в реализации DLSS. Если AMD сможет реализовать эффективный подход к нейронной трассировке лучей и апскейлингу, это позволит расширить доступ к высококачественной графике на более широком спектре оборудования. Однако учитывая высокие требования к трассировке лучей в современных играх, таких как Alan Wake 2 и Cyberpunk 2077, для достижения высокого уровня качества изображения компании, вероятно, потребуется более мощное оборудование. OpenAI скоро начнёт использовать ускорители AMD и выпустит собственный ИИ-чип в 2026 году
30.10.2024 [01:12],
Владимир Мироненко
OpenAI, прославившаяся ИИ-чат-ботом ChatGPT, уже несколько месяцев работает с Broadcom над созданием своего первого ИИ-ускорителя, пишет агентство Reuters со ссылкой на собственные источники. По их данным, для этого OpenAI сформировала команду разработчиков чипов из примерно 20 человек, включая ведущих специалистов, ранее участвовавших в создании тензорных процессоров (TPU) в Google, в том числе Томаса Норри (Thomas Norrie) и Ричарда Хо (Richard Ho). 
Источник изображения: Growtika/unsplash.com Особое внимание уделяется способности ускорителя запускать ранее обученные нейросети, инференсу, поскольку аналитики прогнозируют, что потребность в чипах для инференса может превзойти спрос на ИИ-ускорители для обучения моделей по мере развёртывания большего количества приложений ИИ. Как ожидается, производство нового чипа на мощностях тайваньского производителя TSMC начнётся в 2026 году. Также источникам агентства стало известно о планах OpenAI начать использовать наряду с ускорителями Nvidia ИИ-чипы AMD через облачную платформу Microsoft Azure, чтобы удовлетворить растущие потребности в ИИ-инфраструктуре. Речь идёт об ускорителях AMD Instinct MI300. В настоящее время ускорители Nvidia занимают более 80 % доли рынка ИИ-ускорителей. Но дефицит и рост затрат вынуждают крупных клиентов, таких как Microsoft, Meta✴✴, а теперь и OpenAI, заняться поиском альтернатив, как внутренних, так и внешних. Тем не менее, в обозримом будущем OpenAI продолжит полагаться главным образом на решения Nvidia как для обучения моделей, так и для инференса. Представлены крошечные ИИ-ускорители AI HAT+ на 13 и 26 TOPS — они устанавливаются поверх Raspberry Pi 5
24.10.2024 [13:34],
Павел Котов
Raspberry Pi представила на этой неделе ещё один продукт для своего флагманского одноплатного компьютера — предназначенный для алгоритмов искусственного интеллекта модуль ускорителя AI HAT+, разработанный в сотрудничестве с Hailo и имеющий две версии с производительностью 13 и 26 триллионов операций в секунду (TOPS). 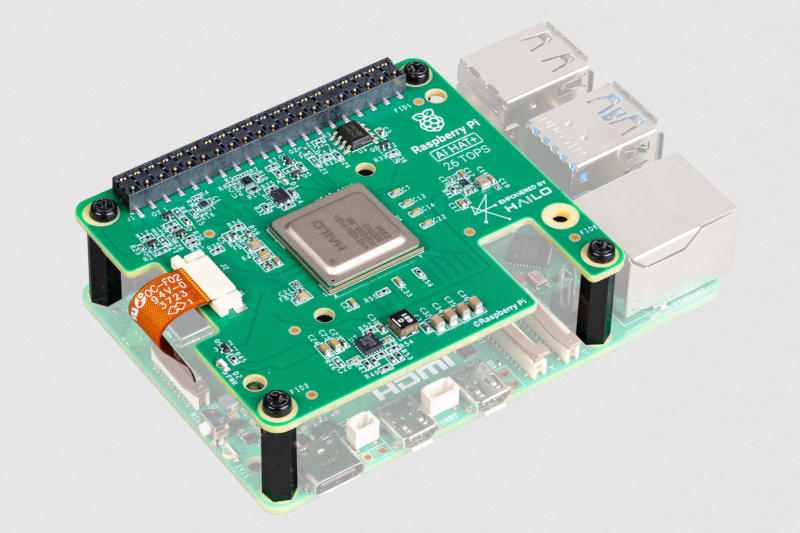
Источник изображения: raspberrypi.com Продукт может показаться знакомым: минувшим летом был выпущен комплект Raspberry Pi AI Kit с тем же ускорителем Hailo-8, только теперь этот ускоритель встроен в саму плату расширения, а не подключается к ней через интерфейс M.2. Подобно представленному накануне SSD, новый ускоритель работает на базе PCIe 3.0 — возможно, в одном из ближайших обновлений ПО стандарт PCIe по умолчанию сменится со второй на третью версию. Новый Raspberry Pi AI Kit+ поставляется в двух вариантах: Hailo-8 с производительностью 26 TOPS и Hailo-8L на 13 TOPS, как было у оригинального AI Kit; старшая версия поддерживает запуск нескольких нейросетей одновременно. Последняя версия Raspberry Pi OS автоматически обнаружит встроенный ускоритель Hailo и сделает его доступным в приложениях с ИИ, в том числе rpicam-apps и Picamera2. Модуль Raspberry Pi AI HAT+ поставляется с фиксаторами высотой 16 мм, которые оставляют пространство для активного охлаждения, и с плоским кабелем для подключения к PCIe на плате компьютера. Младшая версия на 13 TOPS оценена в $70, а за старшую на 26 TOPS придётся отдать $110. В России наладят выпуск ИИ-серверов на отечественных ускорителях, но обучать ИИ они не смогут
17.10.2024 [15:09],
Павел Котов
Российский производитель электроники Fplus заявил, что в 2025 году наладит выпуск серверов с отечественными ИИ-ускорителями, созданными в НТЦ «Модуль». В первый год будет выпущено около сотни таких систем, а в 2026–2027 гг. счёт пойдёт на тысячи. На серверах Fplus с ускорителями «Модуля» можно будет запускать алгоритмы искусственного интеллекта, системы обработки сигналов и изображений, но для обучения ИИ они не подойдут, пишут «Ведомости». 
Источник изображения: kp yamu Jayanath / pixabay.com Серверы Fplus получат «большие» и «малые» ускорители, в зависимости от конфигурации: NM Quad и NM Card соответственно. Первый построен на DSP-процессоре К1879ВМ8Я, который включает 64 тензорных ядра NeuroMatrixCore4 (FP32/64, 1000 МГц) и 20 ядер ARM Cortex-A5 (800 МГц), а также имеет 20 Гбайт памяти DDR3L. В свою очередь, NM Card предлагает чип К1879ВМ8Я с 16 тензорными ядрами NMC4 (FP32/64, 1000 МГц) и пять ядер ARM Cortex-A5 (800 МГц), а также 5 Гбайт памяти DDR3L. В России производится поверхностный монтаж этих ускорителей — штатная загрузка предприятия позволяет выпускать 35 000 ускорителей в год. Сервер Fplus «Восход» с ускорителями вычислений НТЦ «Модуль» уже включён в реестр отечественного оборудования Минпромторга. «Мы видим большую потребность в таких комплексных продуктах для распознавания изображений, объектов и инцидентов, цифровой обработки сигналов и изображений для критической информационной инфраструктуры, где не должно использоваться оборудование западного производства, а также для работы с большими объёмами секретных или персональных данных, где важна не скорость, а защищённая среда», — рассказал о проекте управляющий партнёр Fplus Алексей Мельников. Фактическим мировым монополистом в сегменте чипов для ИИ является американская Nvidia, которая строго соблюдает санкционный режим, поэтому в Россию её продукция официально не поставляется, и это значительно сдерживает развитие отечественного производства серверов. Но российский рынок активно адаптируется к переменам — прорабатываются альтернативные решения, находятся новые пути поставок. Пока в реестре Минпромторга значится лишь один ИИ-сервер с поддержкой до пяти ускорителей, а его производителем значится «Гравитон»; сейчас компания разрабатывает несколько решений на базе центральных процессоров Intel и AMD нового поколения — в будущем году она готова поставить до 10 000 ИИ-серверов. 
Источник изображения: Pete Linforth / pixabay.com На рынке реестровой техники для госзаказчиков запросы на серверы с ИИ выросли двукратно: с января по сентябрь 2023 года было 16 таких закупок на 930 млн руб., а за аналогичный период этого года их было уже 30 на 1,7 млрд руб. В количественном выражении доля российских производителей на рынке серверов составляет не более 25 %, подсчитали в «Гравитоне». Модульный ИИ-сервер с возможностью установить до шести средних или двух мощных ускорителей есть и у Kraftway; компания также разрабатывает выделенный сервер на три высокопроизводительные карты — он сможет устанавливаться в ЦОД и использоваться для обучения больших языковых моделей. Система Fplus на ускорителях «Модуля» сможет применяться в критических системах, где законодательство требует устанавливать отечественные компоненты, но заменить решения на чипах Nvidia она не сможет, потому что не поддерживает обучения ИИ, отмечают опрошенные «Ведомостями» эксперты. Но решения «Модуля» могут оказаться конкурентоспособными в нишевых задачах, таких как обработка изображений и сигналов. К 2027 году ИИ-серверов в мире станет больше, чем обычных, говорят аналитики — к этому моменту рынок ИИ-серверов разрастётся до $95 млрд. В этом году рынок российских высокопроизводительных серверов (способных содержать ИИ-ускорители) оценивается в 30 млрд руб.; к 2027 году он составит 45,2 млрд руб. Через десять лет отечественный рынок ИИ-ускорителей вырастет трёхкратно. Пока же 80 % мирового рынка ИИ-ускорителей для ЦОД принадлежат Nvidia. Но её монополии уже бросили вызов Microsoft, OpenAI, Amazon и Google, которые разрабатывают собственные системы. Да и AMD не дремлет. AMD представила ИИ-ускоритель Instinct MI325X для конкуренции с Nvidia Blackwell и рассказала о ещё более мощном Instinct MI355X
11.10.2024 [08:44],
Анжелла Марина
Компания AMD официально представила флагманский ускоритель вычислений Instinct MI325X, который станет конкурентом для Nvidia Blackwell и уже поступил в производство. Вместе с тем производитель раскрыл подробности об ускорителе следующего поколения — Instinct MI355X на архитектуре CDNA4. 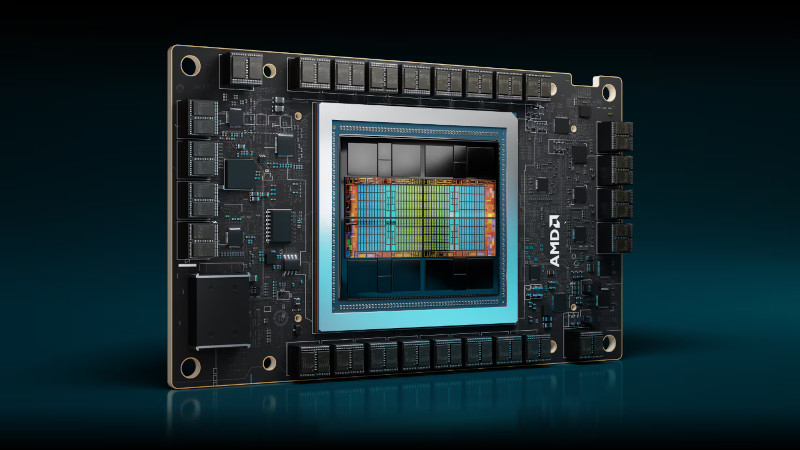
Источник изображений: AMD В последние годы AMD отмечает значительный рост спроса на свои ИИ-ускорители. При этом серия MI300 пользуется особой популярностью. Однако, как пишет издание Tom's Hardware, MI355X вызывает определённые вопросы по части брендирования, поскольку архитектура CDNA использовалась в MI100, CDNA2 — в MI200, а CDNA3 — в серии MI300. Логично было бы увидеть CDNA4 в ускорителях MI400, но они получат архитектуру следующего поколения. 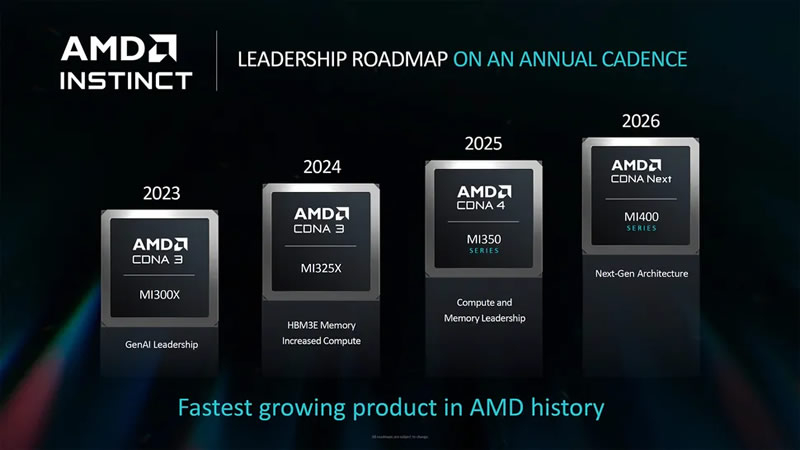 Как бы от ни было, CDNA4 — это новая архитектура, которая представляет собой значительное обновление прежней CDNA3. AMD описала её как «переосмысление с нуля», хотя, по мнению экспертов, это может быть и некоторым преувеличением. Ускоритель MI355X будет производиться по новому 3-нм техпроцессу N3 от TSMC, потребовав серьёзных изменений по сравнению с N5, но основные элементы дизайна могут остаться схожими с CDNA3. Объём памяти HBM3e достигнет 288 Гбайт. Ускоритель будет оснащён 10 вычислительными элементами на один GPU, а производительность достигнет 2,3 петафлопса вычислительной мощности для операций FP16 и 4,6 петафлопса для FP8, что на 77 % больше по сравнению с ускорителем предыдущего поколения. 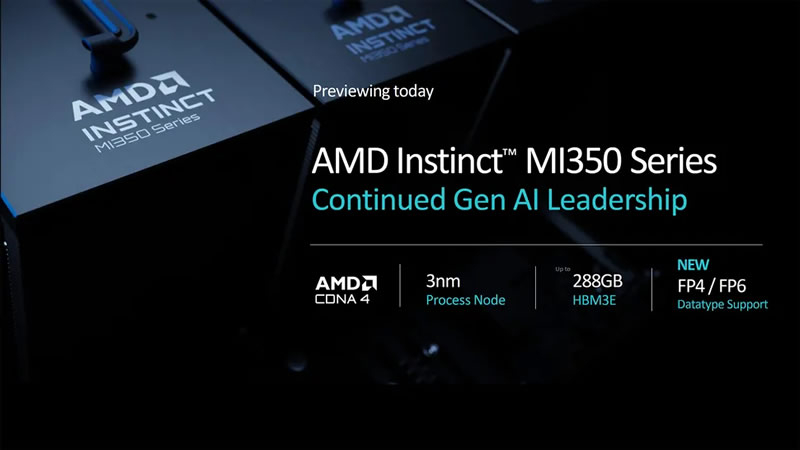 Одним из ключевых нововведений MI355X станет поддержка чисел с плавающей запятой FP4 и FP6, которые удвоят вычислительную мощность по сравнению с FP8, позволив достигнуть 9,2 петафлопса производительности в FP4. Для сравнения, Nvidia Blackwell B200 предлагает до 9 Пфлопс производительности в FP4, а более мощная версия GB200 — 10 Пфлопс. Таким образом, AMD Instinct MI355X может стать серьёзным конкурентом для будущих продуктов Nvidia, в том числе благодаря 288 Гбайт памяти HBM3E — это на 50 % больше, чем у Nvidia Blackwell. При этом оба устройства будут иметь пропускную способность памяти до 8 Тбайт/с на GPU. 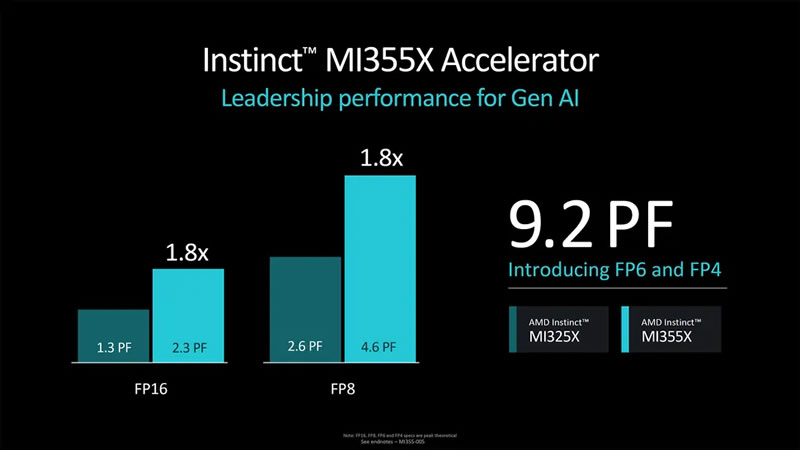 Как отмечают эксперты, вычислительная мощность и объём памяти — это не единственные ключевые параметры для ИИ-ускорителей. Важным фактором становится масштабируемость систем при использовании большого числа GPU. Пока AMD не раскрыла подробности о возможных изменениях в системе интерконнекта между GPU, что может оказаться важным аспектом в сравнении с Blackwell от Nvidia. 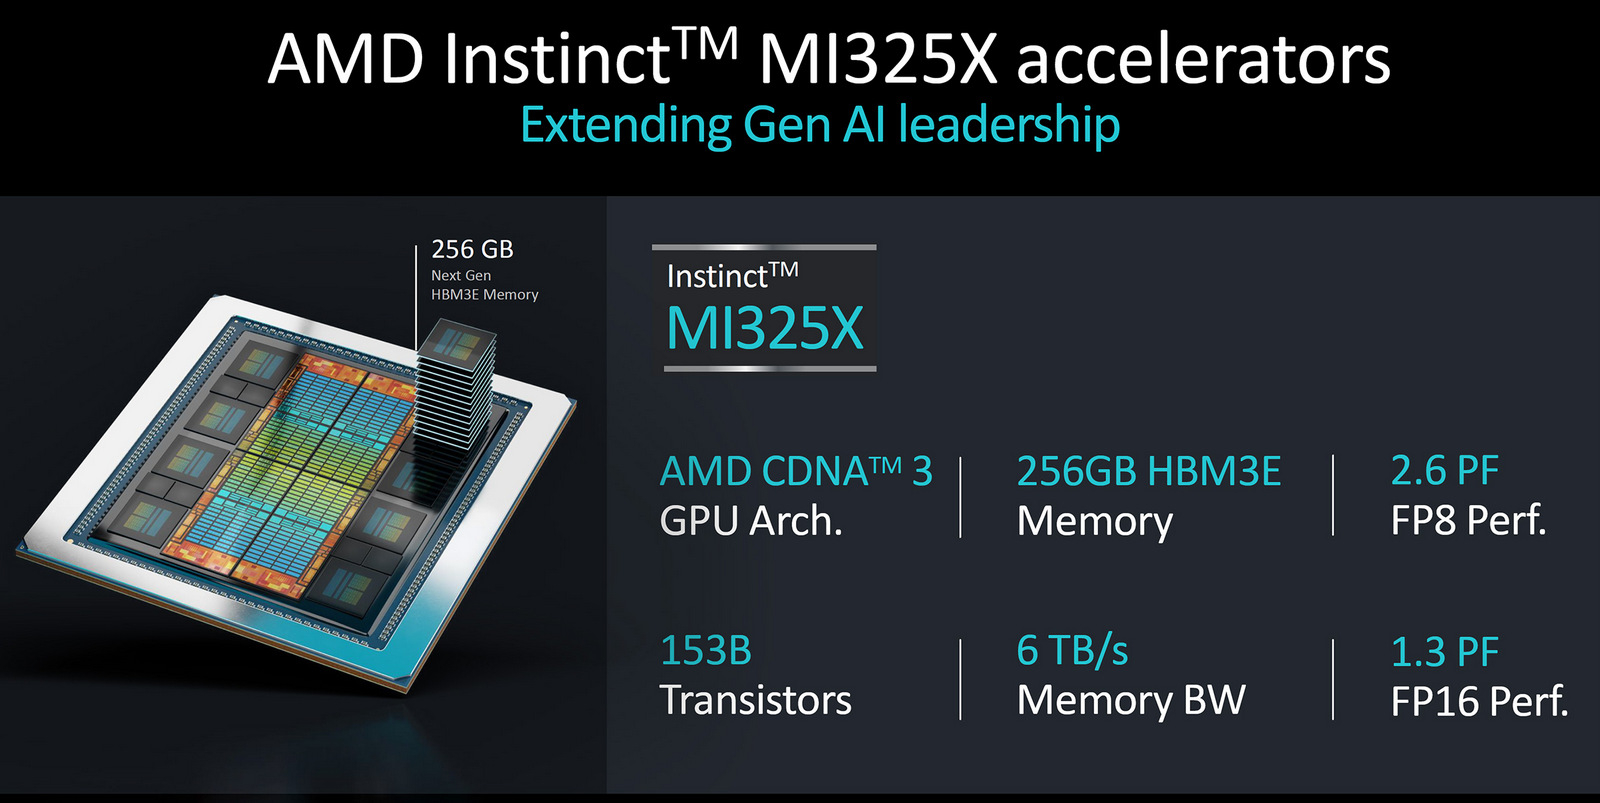 Вместе с анонсом Instinct MI355X компания AMD подтвердила, что ускоритель Instinct MI325X официально запущен в производство и поступит в продажу в этом квартале. Основным отличием MI325X от предыдущей модели MI300X стало увеличение объёма памяти со 192 до 256 Гбайт. Что интересно, изначально планировалось оснастить ускоритель 288 Гбайт памяти, но видимо AMD решили ограничиться приростом в 33 % вместо 50 %. Память HBM3E в новинке обеспечивает пропускную способность более 6 Тбайт/с, что на 13 % больше, чем 5,3 Тбайт/с у MI300X. 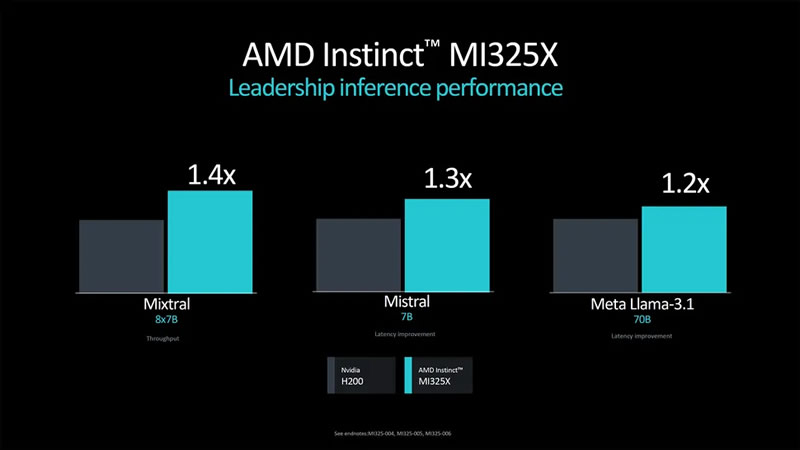 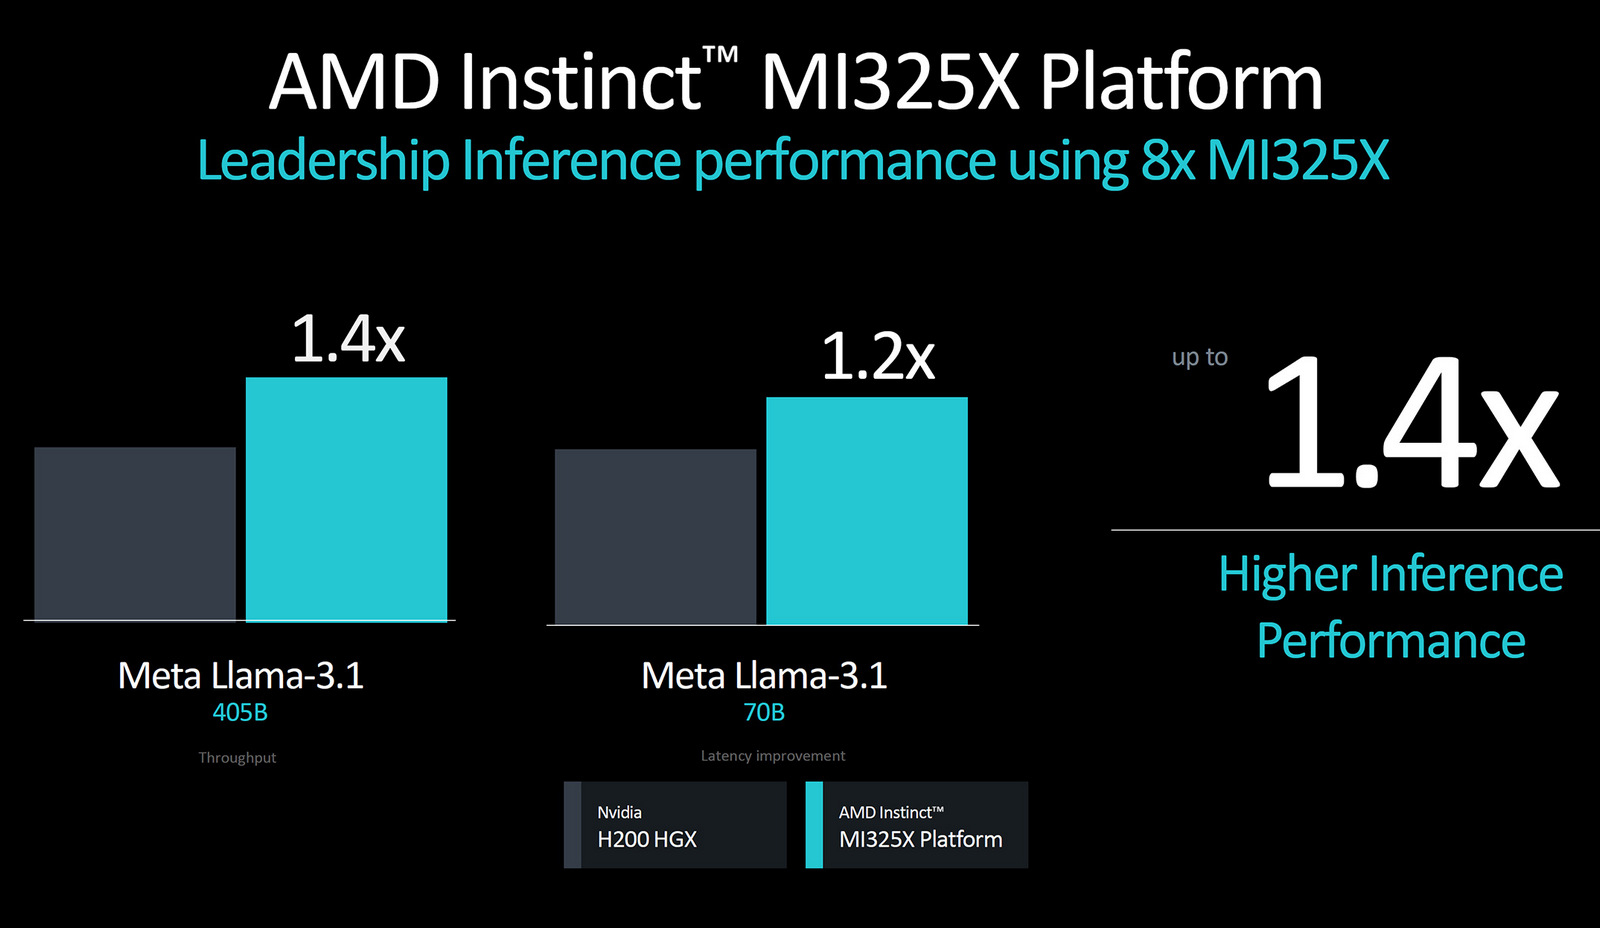 AMD провела сравнительный анализ производительности Instinct MI325X и Nvidia H200. Ускоритель AMD оказался на 20-40 % быстрее конкурента в запуске уже обученных больших языковых моделей, а в обучении нейросетей показал паритет производительности. 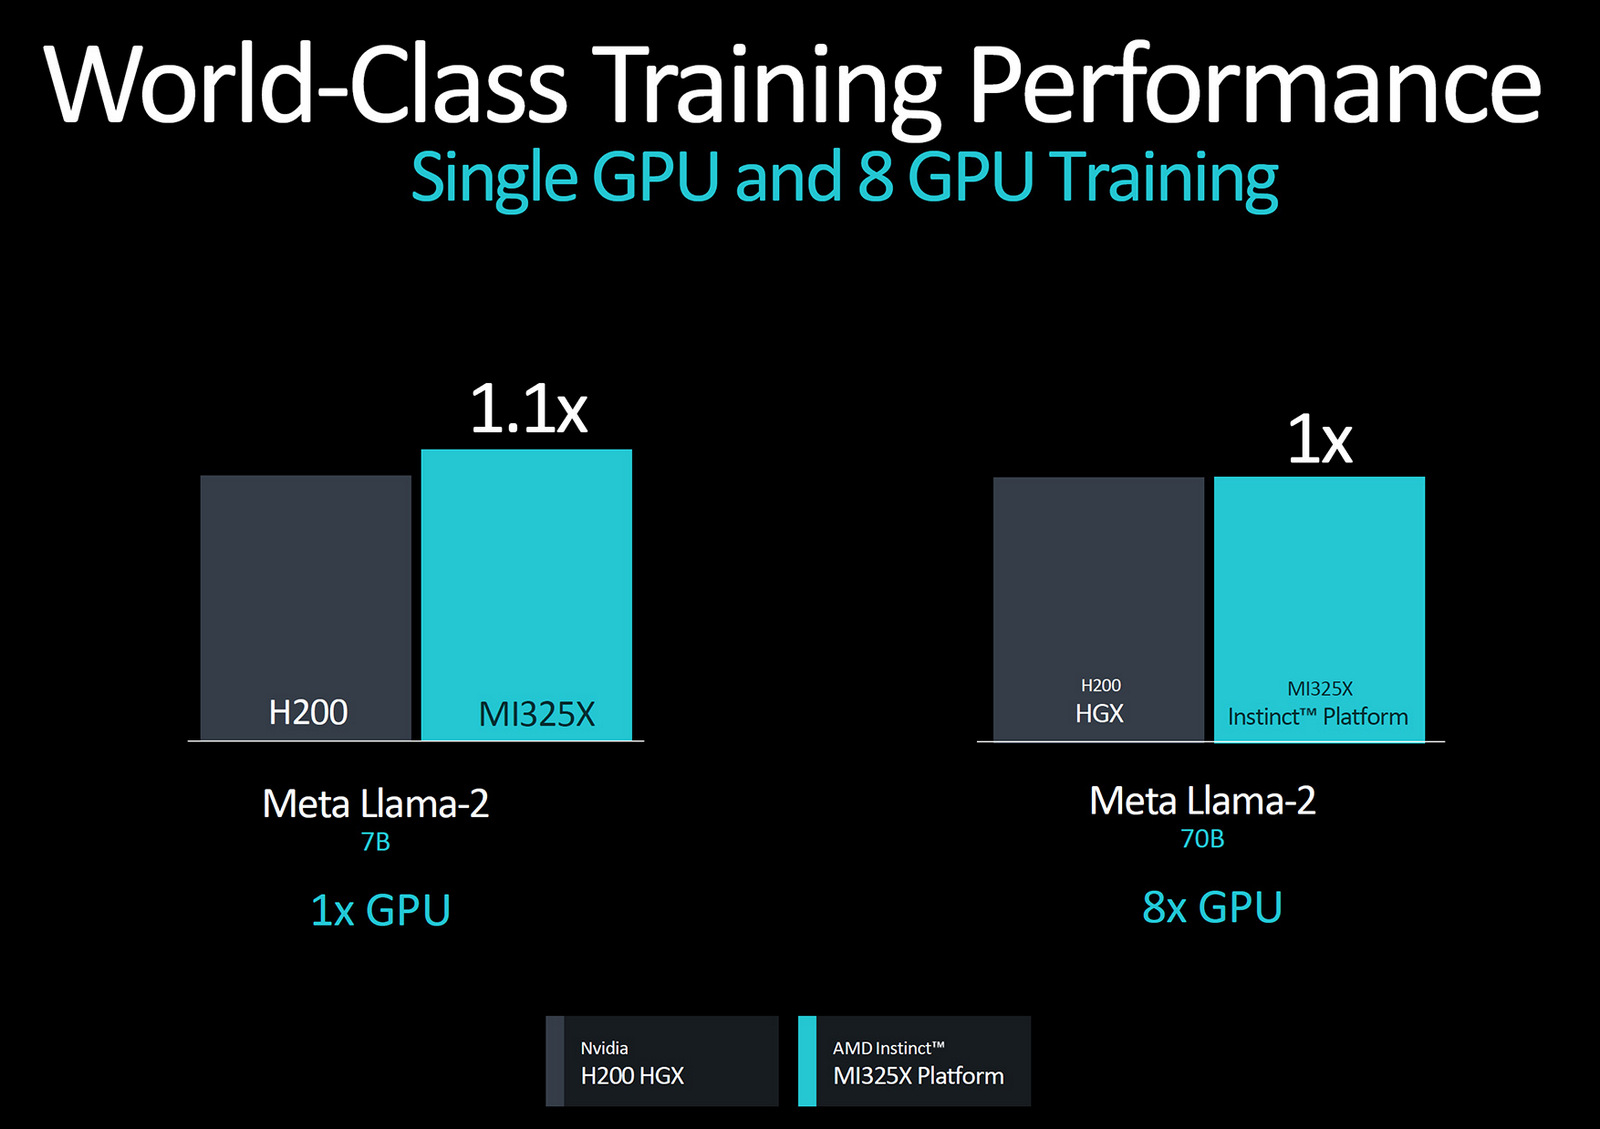 AMD не раскрыла стоимость своих ИИ-ускорителей, но представители компании заявили, что одной из целей является предоставление преимущества по совокупной стоимости владения (TCO). Это может быть достигнуто либо за счёт лучшей производительности при той же цене, либо за счёт более низкой цены при одинаковой производительности. Как отметил представитель AMD: «Мы являемся деловыми людьми и будем принимать ответственные решения относительно ценообразования». Instinct MI355X планируется к поставкам во второй половине 2025 года. |
|
✴ Входит в перечень общественных объединений и религиозных организаций, в отношении которых судом принято вступившее в законную силу решение о ликвидации или запрете деятельности по основаниям, предусмотренным Федеральным законом от 25.07.2002 № 114-ФЗ «О противодействии экстремистской деятельности»; |
© 1997—2026 3DNews
При цитировании документа ссылка на сайт с указанием автора обязательна. Полное заимствование документа является
нарушением
российского и международного законодательства и возможно только с согласия редакции 3DNews.



 MWC 2018
 2018
 Computex

 IFA 2018






