


Опрос
|
реклама
Быстрый переход
Instagram✴ начнёт с помощью ИИ вычислять подростков, скрывающих свой возраст
05.11.2024 [09:36],
Анжелла Марина
Instagram✴✴ внедряет новую систему на основе искусственного интеллекта, которая сможет выявлять подростков, пытающихся скрыть свой настоящий возраст. Алгоритм будет анализировать фотографии, подписки и публикации друзей, чтобы определить реальный возраст пользователя. 
Источник изображения: Luke van Zyl / Unsplash Как пишет Bloomberg, это решение связано с давлением со стороны родителей и законодательных органов, обеспокоенных влиянием платформы на психическое здоровье подростков. С помощью нового ИИ-инструмента под названием Adult classifier (идентификатор возраста) Meta✴✴ будет автоматически переводить пользователей младше 18 лет в аккаунты с более строгими настройками конфиденциальности, независимо от того, какие данные они указали при регистрации. Ранее Meta✴✴ уже начала переводить пользователей на подростковые аккаунты на основании их заявленного возраста. Однако новый алгоритм, который будет запущен в начале следующего года, призван выявлять тех, кто пытается обойти правила. При этом пользователи в возрасте 16 и 17 лет смогут изменять настройки конфиденциальности самостоятельно, но для подростков младше 16 лет потребуется согласие родителей на отключение разного рода ограничений. Это решение было положительно воспринято сторонними экспертами, которые давно призывали компанию к более существенным изменениям для защиты молодых пользователей. В последние годы Meta✴✴ столкнулась с многочисленными обвинениями в том, что все её платформы способствуют ухудшению психического здоровья подростков. В частности, против компании подали иск десятки генеральных прокуроров в разных штатах США, утверждающих, что Meta✴✴ сознательно «подсаживала» детей на свои сервисы, что привело к кризису психического здоровья среди подростков. На компанию также ополчились родители, которые утверждают, что их дети умерли от наркотиков или совершили самоубийство из-за контента, который они видели, или разговоров, которые они вели с использованием продуктов Meta✴✴. Также в 2021 году бывший сотрудник компании Фрэнсис Хауген (Frances Haugen) раскрыла внутренние документы, которые показали, что Instagram✴✴ может негативно влиять на психику девочек-подростков. В связи с таким серьёзным набором претензий Meta✴✴ решила усложнить процесс определения возраста при его указании. Например, будет проверяться совпадение электронной почты или уникального идентификатора устройства, с которого подросток попытается создать новый аккаунт. Для подтверждения возраста также придётся предоставить официальные документы или пройти проверку через видеоселфи с помощью приложения Yoti — инструмента для цифровой идентификации личности по фотографии. В случае ошибки можно будет подать апелляцию, правда, эта возможность пока находится на стадии разработки. Google объявила о доступности ИИ-ускорителей TPU v6 Trillium
03.11.2024 [13:15],
Сергей Карасёв
Компания Google сообщила о том, что её новейшие ИИ-ускорители TPU v6 с кодовым именем Trillium доступны клиентам для ознакомления в составе облачной платформы GCP. Утверждается, что на сегодняшний день новинка является самым эффективным решением Google по соотношению цена/производительность. Официальная презентация Trillium состоялась в мае нынешнего года. Изделие оснащено 32 Гбайт памяти HBM с пропускной способностью 1,6 Тбайт/с, а межчиповый интерконнект ICI обеспечивает возможность передачи данных со скоростью до 3,58 Тбит/с (по четыре порта на чип). Задействованы блоки SparseCore третьего поколения, предназначенные для ускорения работы с ИИ-моделями, которые используются в системах ранжирования и рекомендаций. 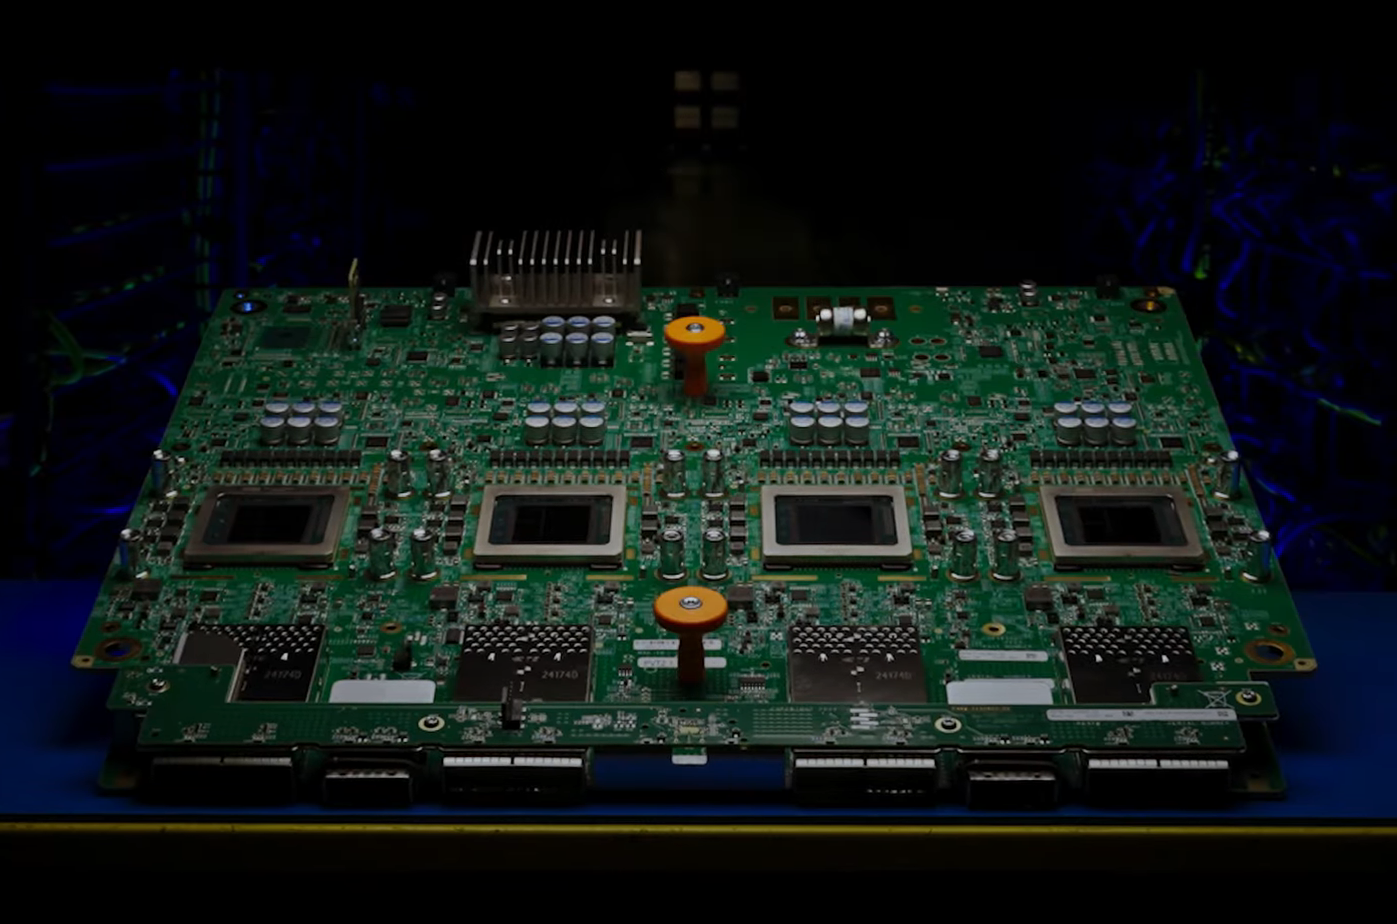
Источник изображений: Google Google выделяет ряд существенных преимуществ Trillium (TPU v6e) перед ускорителями TPU v5e:
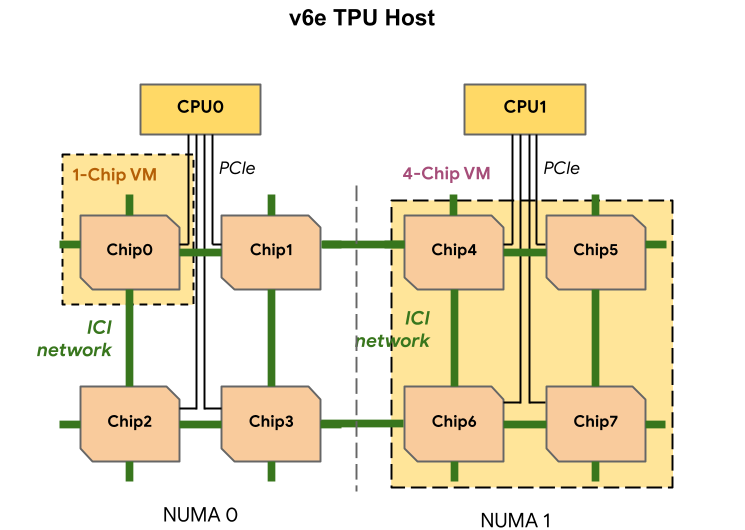 Один узел включает восемь ускорителей TPU v6e (в двух NUMA-доменах), два неназванных процессора (суммарно 180 vCPU), 1,44 Тбайт RAM и четыре 200G-адаптера (по два на CPU) для связи с внешним миром. Отмечается, что посредством ICI напрямую могут быть объединены до 256 изделий Trillium, а агрегированная скорость сетевого подключение такого кластера (Pod) составляет 25,6 Тбит/с. Десятки тысяч ускорителей могут быть связаны в масштабный ИИ-кластер благодаря платформе Google Jupiter с оптической коммутацией, совокупная пропускная способность которой достигает 13 Пбит/с. Trillium доступны в составе интегрированной ИИ-платформы AI Hypercomputer. 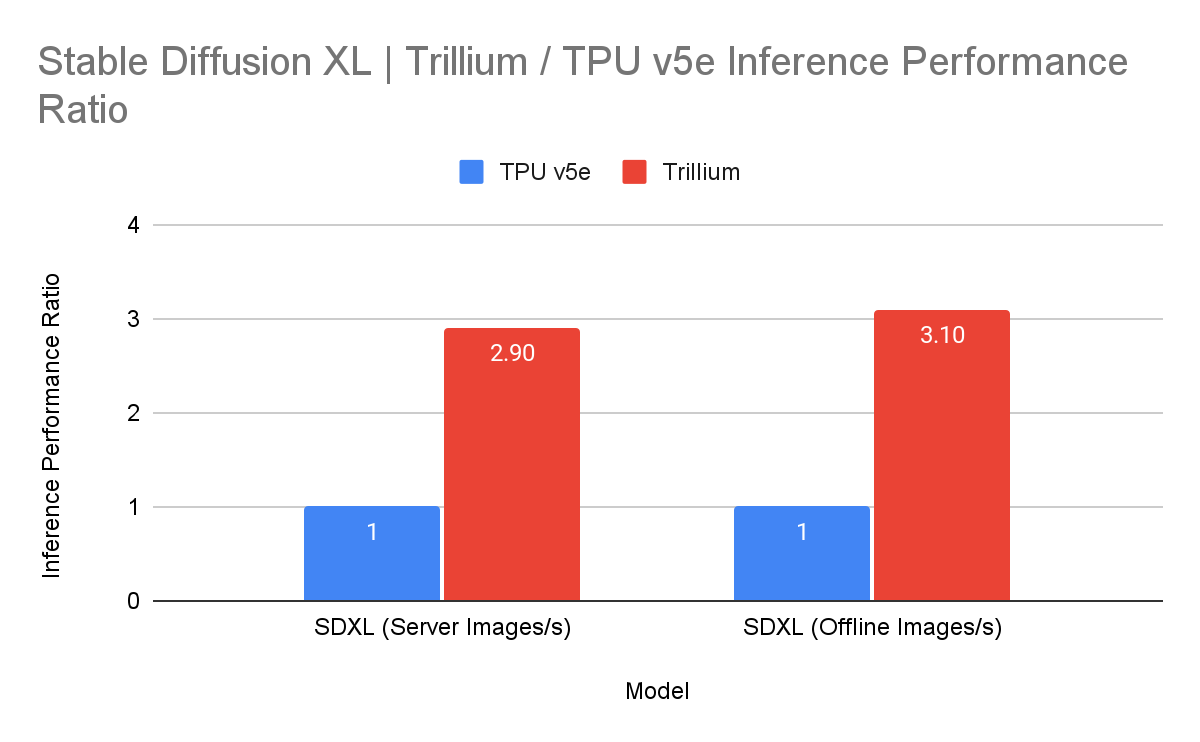 Заявляется, что благодаря ПО Multislice Trillium обеспечивается практически линейное масштабирование производительности для рабочих нагрузок, связанных с обучением ИИ. Производительность кластеров на базе Trillium может достигать 91 Эфлопс на ИИ-операциях: это в четыре раза больше по сравнению с самыми крупными развёртываниями систем на основе TPU v5p. BF16-производительность одного чипа TPU v6e составляет 918 Тфлопс, а INT8 — 1836 Топс. 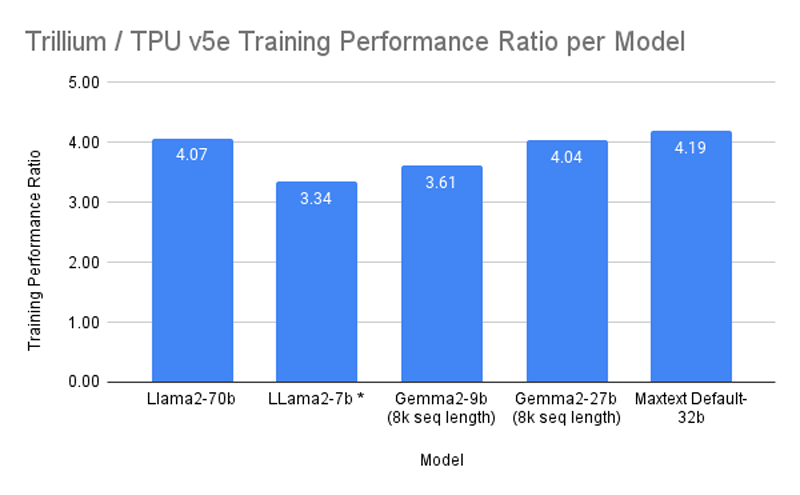 В бенчмарках Trillium по сравнению с TPU v5e показал более чем четырёхкратное увеличение производительности при обучении моделей Gemma 2-27b, MaxText Default-32b и Llama2-70B, а также более чем трёхкратный прирост для LLama2-7b и Gemma2-9b. Кроме того, Trillium обеспечивает трёхкратное увеличение производительности инференса для Stable Diffusion XL (по отношению к TPU v5e). По соотношению цена/производительность TPU v6e демонстрирует 1,8-кратный рост по сравнению с TPU v5e и примерно двукратный рост по сравнению с TPU v5p. Появится ли более производительная модификация TPU v6p, не уточняется. От тостера до ЦОД: RISC-V International ратифицировала унифицированный профиль RVA23 для процессоров будущего
25.10.2024 [13:24],
Сергей Карасёв
Организация RISC-V International объявила о ратификации профиля RVA23. Это значимое событие, которое, как ожидается, поможет открытой архитектуре RISC-V укрепить позиции по отношению к Arm и x86, избегая при этом потенциальных проблем, связанных с лицензированием. Профили RVA необходимы для обеспечения переносимости ПО между различными аппаратными реализациями. Таким образом, разработчики софта могут избежать привязки к конкретному поставщику аппаратных решений. Иными словами, одно и то же приложение сможет функционировать на любых устройствах, оснащённых процессорами с архитектурой RISC-V. Профиль RVA23 стандартизирует набор инструкций ISA (Instruction Set Architecture). Ключевой задачей является устранение фрагментации внутри экосистемы RISC-V. Отмечается, что в рамках ратификации профиль RVA23 прошёл длительный процесс разработки, рассмотрения и утверждения в многочисленных рабочих группах. 
Источник изображения: pixabay.com RVA23 делает обязательными такие функции, как векторные операции, инструкции с плавающей запятой и атомарные инструкции, которые необходимы во многих сферах, включая НРС, машинное обучение и ИИ. В частности, векторные расширения ускоряют рабочие нагрузки с интенсивными математическими расчётами, включая криптографию, (де-)компрессию, обучение ИИ и пр. Важным компонентом RVA23 является поддержка гипервизоров. Это позволяет виртуализировать корпоративные рабочие нагрузки как на локальных серверах, так и в облаке. Таким образом, может быть ускорена разработка оборудования, ОС и прикладных программ для архитектуры RISC-V. Поддержка виртуализации также улучшит безопасность мобильных приложений путём разделения защищённых и незащищённых компонентов. От накопителей к ускорителям: Google тестирует роботов для обслуживания ЦОД
21.10.2024 [19:23],
Руслан Авдеев
В Google занялись испытаниями роботов для управления и обслуживания оборудования в своих дата-центрах. Как сообщает Datacenter Dynamics со ссылкой на Рика Миллера (Rich Miller) из Data Center Frontier, соответствующую информацию представитель Google обнародовал в ходе недавнего мероприятия Open Compute Summit — роботы уже действуют на одном из объектов. В Google заявили, что роботы помогут кардинально пересмотреть подход к масштабированию операций, а их внедрение благотворно скажется на безопасности и надёжности работ. Робототехника может сыграть важную роль в задачах вроде перемещения компонентов и стоек, мониторинга оборудования и даже его обслуживания и ремонта. В прошлом году компания начала эксперименты по использованию роботов для замены вышедших из строя накопителей. А сейчас компания намерена привлечь роботов к обслуживанию стоек с ускорителями, которые значительно тяжелее традиционных стоек. 
Источник изображений: Google / OCP Использование роботов для обеспечения работы ЦОД давно рассматривается гиперскейлерами и колокейшн-провайдерами. Впрочем, в большинстве случаев речь идёт о робособаках вроде моделей, выпускаемых Boston Dynamics, Unitree Go1 и Anybotics. Такие модели обычно выполняют в основном патрульные функции — для охраны и оповещения об инцидентах. Пока что Google использует довольно массивную, автономно передвигающуюся платформу собственной разработки.  В 2023 году Microsoft создала команду, занимающуюся автоматизацией работы ЦОД вообще и роботами в частности. В том же году Digital Edge, Digital Realty, Scala Data Centers, и Oracle протестировали роботов для выполнения самых разных операций в дата-центрах. А вот у японской NTT Data подход иной — компания создала робота Ugo на моторизованной платформе, который получил две роборуки-манипулятора. NVIDIA передаст OCP спецификации компонентов суперускорителя GB200 NVL72
20.10.2024 [11:01],
Сергей Карасёв
Некоммерческая организация Open Compute Project Foundation (OCP), специализирующаяся на создании открытых спецификаций оборудования для ЦОД, сообщила о том, что для её инициативы Open Systems for AI собственные разработки предоставят NVIDIA и Meta✴✴. Проект Open Systems for AI был анонсирован в январе 2024 года при участии Intel, Microsoft, Google, Meta✴✴, NVIDIA, AMD, Arm, Ampere, Samsung, Seagate, SuperMicro, Dell и Broadcom. Цель инициативы заключается в разработке открытых стандартов для кластеров ИИ и дата-центров, в которых размещаются такие системы. Предполагается, что Open Systems for AI поможет повысить эффективность и устойчивость ИИ-платформ, а также обеспечит возможность формирования цепочек поставок оборудования от нескольких производителей. В рамках инициативы NVIDIA предоставит OCP спецификации элементы электромеханической конструкции суперускорителей GB200 NVL72, включая архитектуры стойки и жидкостного охлаждения, механические части вычислительного и коммутационного лотков. 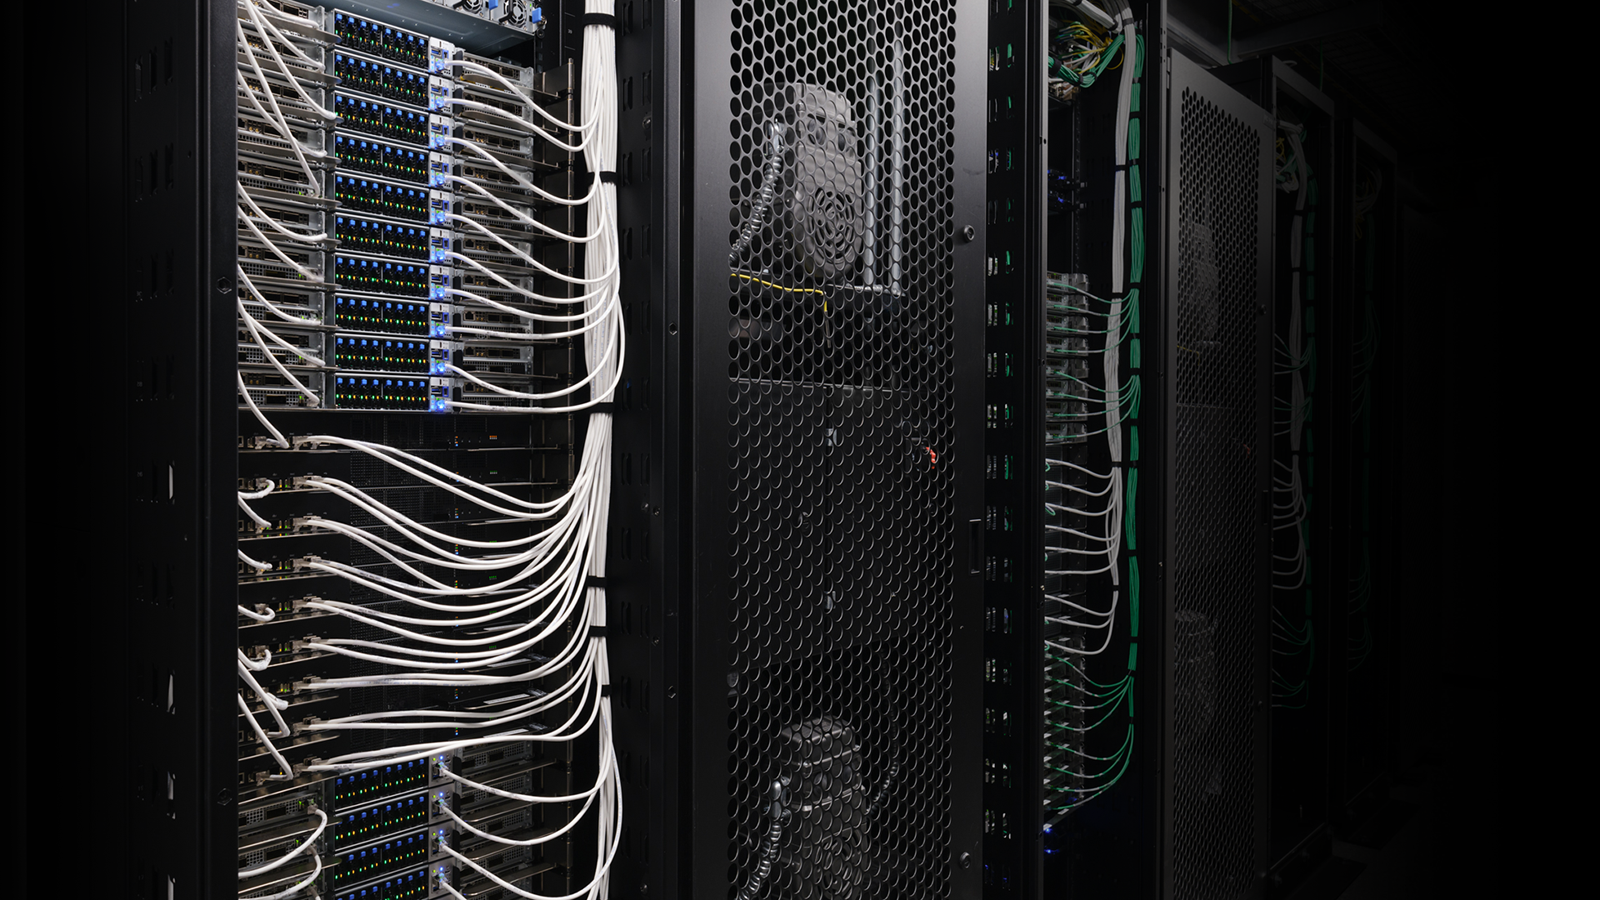
Источник изображения: NVIDIA Кроме того, NVIDIA расширит поддержку стандартов OCP в своей сетевой инфраструктуре Spectrum-X. Речь идёт об обеспечении совместимости со стандартами OCP Switch Abstraction Interface (SAI) и Software for Open Networking in the Cloud (SONiC). Это позволит клиентам использовать адаптивную маршрутизацию Spectrum-X и управление перегрузками на основе телеметрии для повышения производительности Ethernet-соединений в составе масштабируемой инфраструктуры ИИ. Адаптеры ConnectX-8 SuperNIC с поддержкой OCP 3.0 появятся в 2025 году. В свою очередь, Meta✴✴ передаст проекту Open Systems for AI свою архитектуру Catalina AI Rack, которая специально предназначена для создания ИИ-систем высокой плотности с поддержкой GB200. Это, как ожидается, позволит организации OCP «внедрять инновации, необходимые для создания более устойчивой экосистемы ИИ». Meta✴ представила свой вариант суперускорителя NVIDIA GB200 NVL72
18.10.2024 [00:10],
Алексей Степин
Meta✴✴ поделилась своими новинками в области аппаратной инфраструктуры и рассказала, каким именно видит будущее открытых ИИ-платформ. В своей презентации Meta✴✴ рассказала о новой ИИ-платформе, новых дизайнах стоек, включая варианты с повышенной мощностью питания, а также о новинках в области сетевой инфраструктуры. 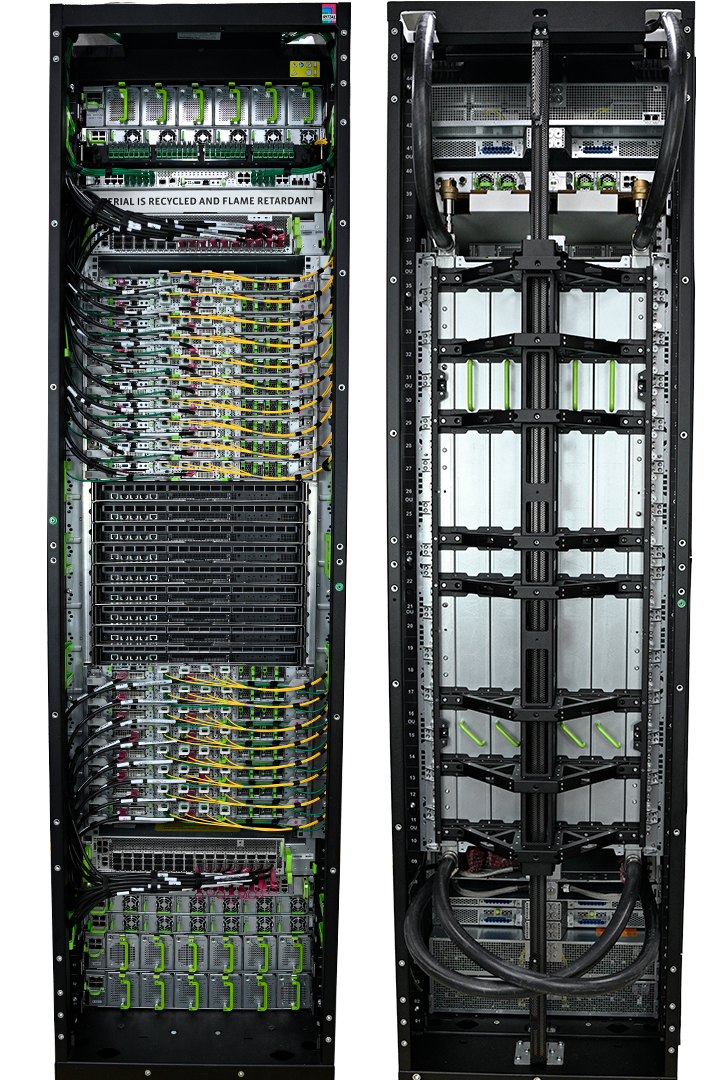
Источник изображений: Meta✴✴ В настоящее время компания использует нейросеть Llama 3.1 405B. Контекстное окно у этой LLM достигает 128 тыс. токенов, всего же токенов свыше 15 трлн. Чтобы обучать такие модели, требуются очень серьёзные ресурсы и глубокая оптимизация всего программно-аппаратного стека. В обучении базовой модели Llama 3.1 405B участвовал кластер 16 тыс. ускорителей NVIDIA H100, один из первых такого масштаба. Но уже сейчас для обучения ИИ-моделей Meta✴✴ использует два кластера, каждый с 24 тыс. ускорителей. Проекты такого масштаба зависят не только от ускорителей. На передний план выходят проблемы питания, охлаждения и, главное, интерконнекта. В течение нескольких следующих лет Meta✴✴ ожидает скоростей в районе 1 Тбайт/с на каждый ускоритель. Всё это потребует новой, ещё более плотной архитектуры, которая, как считает Meta✴✴, должна базироваться на открытых аппаратных стандартах. 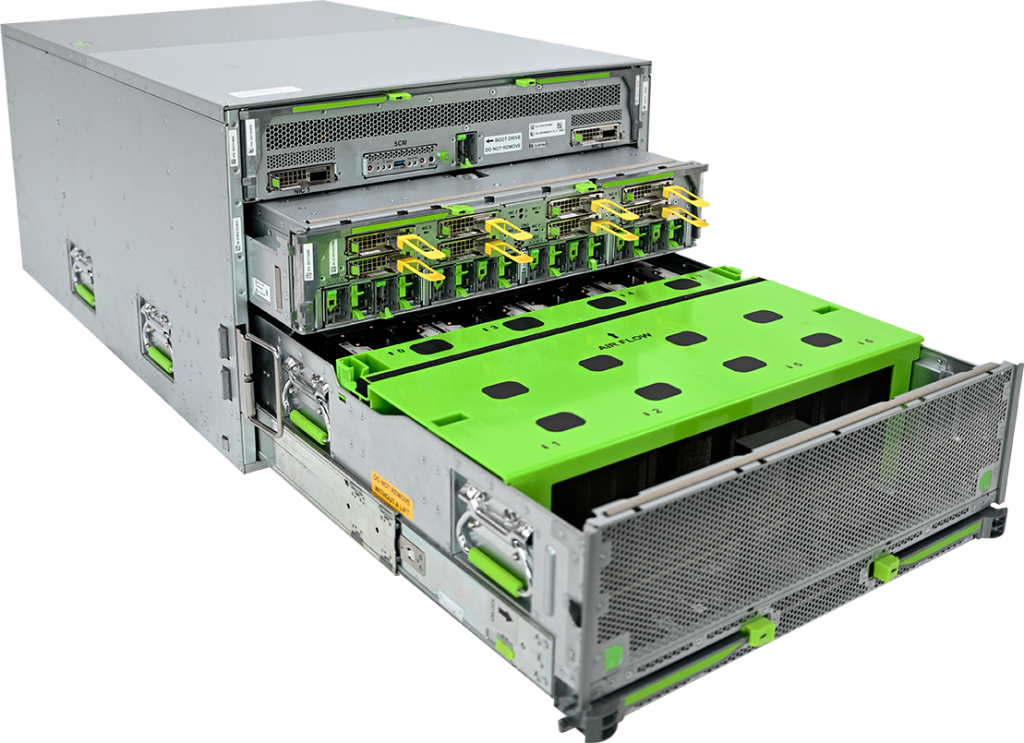 Одной из новинок стала платформа Catalina. Это Orv3-стойка, сердцем которой являются гибридные процессоры NVIDIA GB200. Стойка относится к классу HPR (High Power Rack) и рассчитана на 140 КВт. Сейчас Microsoft и Meta✴✴ ведут работы над модульной и масштабируемой системой питания Mount Diablo. Свой вариант GB200 NVL72 у Microsoft тоже есть. Также Meta✴✴ обновила ИИ-серверы Grand Teton, впервые представленные в 2022 году. Это по-прежнему монолитные системы, но теперь они поддерживают не только ускорители NVIDIA, но и AMD Instinct MI300X и будущие MI325X. 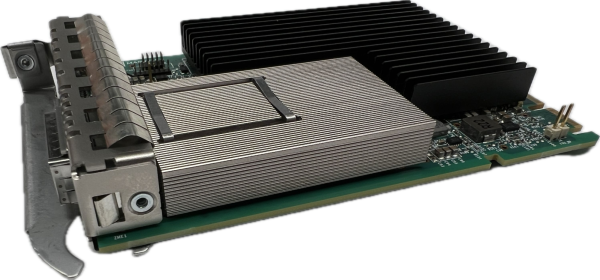 Интерконнектом будущих платформ станет сеть DSF (Disaggregated Scheduled Fabric). Благодаря переходу на открытые стандарты компания планирует избежать ограничений, связанных с масштабированием, зависимостью от вендоров аппаратных компонентов и плотностью подсистем питания. В основе DSF лежит стандарт OCP-SAI и ОС Meta✴✴ FBOSS для коммутаторов. Аппаратная часть базируется на стандартном интерфейсе Ethernet/RoCE. Meta✴✴ уже разработала и воплотила в металл новые коммутаторы класса 51Т на базе кремния Broadcom и Cisco, а также сетевые адаптеры FBNIC, созданные при поддержке Marvell. FBNIC может иметь до четырёх 100GbE-портов. Используется интерфейс PCIe 5.0, причём могущий работать как четыре отдельных слайса. Новинка соответствует открытому стандарту OCP NIC 3.0 v1.2.0. Perstorp представила биоразлагаемую жидкость Synmerse DC для погружных СЖО
03.10.2024 [18:59],
Руслан Авдеев
Шведская химическая компания Perstorp представила биоразлагаемую жидкость, предназначенную для погружных (иммерсионных) СЖО, передаёт Datacenter Dynamics. По словам компании, Synmerse DC представляет собой синтетическую жидкость, обеспечивающую безопасность и эффективность эксплуатации, это снижает энергопотребление охлаждающих систем. Perstorp принадлежит малайзийской нефтегазовой компании Petronas, уже представившей жидкость собственной разработки для систем Iceotope. В Perstorp сообщили, что разработали жидкость при сотрудничестве с ведущими производителями чипов и OEM-компаниями для того, чтобы обеспечить её совместимость с новейшим оборудованием и погружными системами охлаждения. По словам компании, у неё богатый опыт в разработке синтетических жидкостей самого разного назначения. 
Источник изображения: Jimmy Chang/unsplash.com Компания не рассказала о составе жидкости подробно, но сообщила, что она не включает PFAS-соединения («вечные» химикаты), способные нанести вред окружающей среде. Жидкости на основе PFAS традиционно применяются в системах погружного охлаждения, но с принятием во многих странах законов, запрещающих их использование, производители ищут более экобезопасные варианты на основе растительных и минеральных масел, различных фторуглеродов и других соединений. Впрочем, ещё летом 2023 года сообщалось, что Евросоюз намерен отменить запрет на PFAS-химикаты, поскольку те очень важны для рынка СЖО. Жидкостное охлаждение набирает популярность в последние годы, поскольку ИИ-бум привёл к росту плотности размещения компонентов в серверных стойках. Другими словами, традиционные воздушные системы охлаждения часто не справляются с новыми нагрузками мощных новых серверов. Нефтегазовые компании вроде Gulf Oil, Shell, Castrol, ExxonMobil, ENEOS и SK Enmove активно ведут разработки в новой для себя нише СЖО. Свои варианты представили американский продовольственный гигант Cargill и химический концерн Chemours (Du Pont). AMD представила процессоры EPYC Embedded 8004: до 64 ядер Zen 4c, 6 каналов DDR5-4800 и 96 линий PCIe 5.0
02.10.2024 [10:24],
Сергей Карасёв
Компания AMD анонсировала процессоры EPYC Embedded 8004 (Siena) для встраиваемых систем с интенсивными вычислительными нагрузками. Чипы подходит для сетевого оборудования, маршрутизаторов, устройств обеспечения безопасности, корпоративных и облачных теплых/холодных хранилищ и промышленных периферийных изделий. В основу процессоров положена оптимизированная архитектура Zen 4 — Zen 4c, которая отличается повышенной энергоэффективностью. В семейство EPYC Embedded 8004 вошли чипы с 12, 16, 24, 32, 48 и 64 ядрами, поддерживающими технологию многопоточности. Показатель TDP варьируется от 100 до 200 Вт. 
Источник изображений: AMD Базовая частота у новинок варьируется от 2,3 до 2,65 ГГц, а максимальная частота составляет 3,0 или 3,1 ГГц. Процессоры поддерживают шесть каналов памяти DDR5-4800, максимальный объём которой может составлять 1152 Гбайт в конфигурации 12 × 96 Гбайт. Доступны 96 линий PCIe 5.0. Среди особенностей отмечено наличие DMA-движка, NTB, возможность сброса DRAM на NVMe-накопитель для защиты данных в случае потери питания, поддержка двух SPI ROM (для BIOS и безопасного загрузчика), поддержка Yocto Linux, а также наличие механизма криптографической аттестации процессора, который препятствует неавторизованной замене CPU.  Новые чипы имеют настраиваемый показатель cTDP (configurable TDP). У младшей версии EPYC Embedded 8C24P с 12 ядрами стандартное значение в 100 Вт может быть снижено до 70 Вт, тогда как у старшей модификации EPYC Embedded 8534P с 64 ядрами стандартную величину в 200 Вт можно регулировать в диапазоне от 155 до 225 Вт. Процессоры EPYC Embedded 8004 выполнены в компактном форм-факторе SP6, который на 19 % меньше по сравнению с EPYC Embedded 9004. Жизненный цикл чипов составляет семь лет. Гиперскейлеры теперь контролируют большинство подводных кабелей мира — это ставит под угрозу открытость и стабильность интернета
30.09.2024 [17:50],
Руслан Авдеев
За последние десять лет ёмкость международных подводных линий связи, контролируемых гиперскейлерами вроде Google, Meta✴✴, Microsoft и Amazon, выросла с 10 % до 71 %. The Register сообщает со ссылкой на данные Австралийского института стратегической политики (ASPI), что это полностью изменило отрасль и даже поставило критически важную инфраструктуру под угрозу. В ASPI подчёркивают, что влияние гиперскейлеров всё ещё не рассматривается всерьёз. Тем временем крупнейшие IT-компании из пользователей кабелей превращаются в их владельцев. Более того, именно рост их сервисов является драйвером роста кабельной инфраструктуры. Это имеет как положительную, так и негативную стороны. По данным Telegeography, Google стала совладельцем 33 подводных кабелей, Meta✴✴ — 13 кабелей, Microsoft — пяти, а Amazon — четырёх. В результате гиперскейлеры получили контроль за всей цепочкой предоставления интернет-услуг, от создания контента до хранения, обработки и передачи информации. 
Источник изображения: Jim Beaudoin/unsplash.com Страдают и прежние операторы связи, доля которых стремительно уменьшается. Они просто неспособны конкурировать с немыслимыми ресурсами мегакорпораций. Тем более что запасы кабелей и ресурсы для их выпуска весьма ограничены. В результате именно крупные игроки обычно решают, какова будет пропускная способность кабелей и где именно их следует прокладывать. В ASPI утверждают, что раньше цифровые магистрали соединяли города, служившие местами подключения к наземным линиям связи, но теперь владельцы в первую очередь обеспечивают связью свои или партнёрские дата-центры. Хотя в целом прогресс сулит пользователям даже некоторые выгоды, общий уровень контроля IT-инфраструктуры гиперскейлерами поднимает серьёзные вопросы, в том числе связанные с безопасностью и риском масштабных сбоев. В случае компрометации сетей последствия могут быть самыми плачевными, вплоть до подрыва глобальных коммуникаций. Кроме того, гиперскейлеры могут отдать предпочтение трафику собственных сервисов в ущерб конкурентам. Последствия сверхконцентрации ресурсов у той или иной IT-компании можно оценить по недавнему глобальному сбою ОС Windows, коснувшемуся более 8 млн компьютеров. 
Источник: ASPI Усугубляют ситуацию и геополитические факторы. Те или иные страны способны не только повредить чужую интернет-инфраструктуру, как, предположительно, произошло в Красном море, но и финансировать кабели в других странах, распространяя своё влияние. Например, в своё время Соломоновы Острова выбрали Huawei Marine для прокладки подводного кабеля до Австралии. Однако последняя буквально вытеснила Huawei из проекта, сославшись на проблемы безопасности, и сама выделила $74 млн на строительство. США, Австралия, Китай и Япония часто финансируют строительство кабелей в Тихом океане, а вмешательство гиперскейлеров только усложняет ситуацию. В ASPI подчёркивают необходимость установления контроля над отраслью со стороны властей с корректировкой нормативной базы и регулярным надзором, предотвращающим антиконкурентное поведение и действия вопреки интересам национальной безопасности. Недавно эксперты и политики на встрече в Сингапуре озвучили простую истину — фактически важнейшая инфраструктура сегодня передана на аутсорс частным компаниям, почти свободным от законов и ответственности за распространяемый контент. Многочисленные наспех построенные ИИ ЦОД в Китае оказались невостребованными
25.09.2024 [17:37],
Руслан Авдеев
Стремительное развитие ИИ-технологий в Китае проходит не без эксцессов. По данным Datacenter Knowledge, в стране создано большое количество дата-центров для ИИ-систем, однако их ёмкость оказалась избыточной, а сами они оказались не лучшим образом приспособлены под такие нагрузки. По информации китайских СМИ, проводящих собственные расследования, местные операторы создали слишком большие ёмкости, переоценив спрос. Негативно сказывается на отрасли и отсутствие достаточных компетенций в создании и управлении сложными ИИ-инфраструктурами. Для ИИ-приложений требуется иная архитектура ЦОД, более плотно интегрирующая на уровне «железа» и ПО вычисления, хранение и сети. Кроме того, такие объекты потребляют примерно вчетверо больше энергии в сравнении с традиционными ЦОД на базе CPU. 
Источник изображения: Nadiia Ganzhyi/unsplash.com При этом эксплуатация среднестатистического ИИ ЦОД на 1250 серверов в Китае обходится довольно дорого, до ¥1 млрд ($141 млн) в год. В основном расходы приходятся на электроэнергию и амортизацию. В прошлом году эксперты AI Technology Review пришли к выводу, что прогнозы в необходимости большого числа ЦОД были не вполне верными и спрос оказался переоценен. В результате это привело к простою серверов, а в некоторых случаях даже к закрытию ИИ-центров. К 2025 году Китай планирует ввести в эксплуатацию 50 вычислительных центров для систем искусственного интеллекта, за четыре года вычислительные способности страны должны вырасти на треть. По некоторым оценкам, 70 новых центров строятся уже сейчас. Представители государственных структур КНР раскрыли, что за последний год власти потратили $6,1 млрд на строительство крупных кампусов ЦОД, а ещё $28 млрд вложили в отрасль частные компании. Однако программа по переносу крупных ЦОД в западные регионы страны, например, во Внутреннюю Монголию, где есть избыток энергии, а рабочая сила и земля дешевле, чем на востоке, не вполне оправдала себя. Заказчики из густонаселённых восточных районов предпочитают использовать новые кампусы на западе исключительно для хранения, но не обработки данных. Этому мешают высокая задержка доступа, а также дороговизна подключения — порядка ¥160 тыс. ($22,5 тыс.) в месяц за выделенный канал шириной 1 Гбит/с. Linux запустили на Intel 4004 — загрузка заняла пять дней
22.09.2024 [00:58],
Владимир Мироненко
Как передаёт OpenNet, разработчик Дмитрий Гринберг сумел запустить ядро Linux с rootfs-окружением из Debian на 10-мкм 4-бит процессоре Intel 4004, вышедшем в конце 1971 года и считающемся первым в мире коммерчески доступным однокристалльным микропроцессором. У Intel 4004 всего 2300 транзисторов. Процессор имел всего 46 инструкций, а его пиковая производительность достигала примерно 93 тыс. операций в секунду. Из-за невозможности напрямую портировать ядро на Intel 4004 и из-за ограничений самого CPU автор решил написать эмулятор процессора MIPS R3000, внутри которого уже запускался Linux. Для запуска процессора автор в несколько подходов создал плату Linux/4004 на базе компонентов 1970-х годов, которые, как выяснилось, не так уж дёшевы. Естественно, плата содержит и гораздо более современные компоненты, позволяющие, к примеру, использовать SD-карту в качестве постоянной памяти. 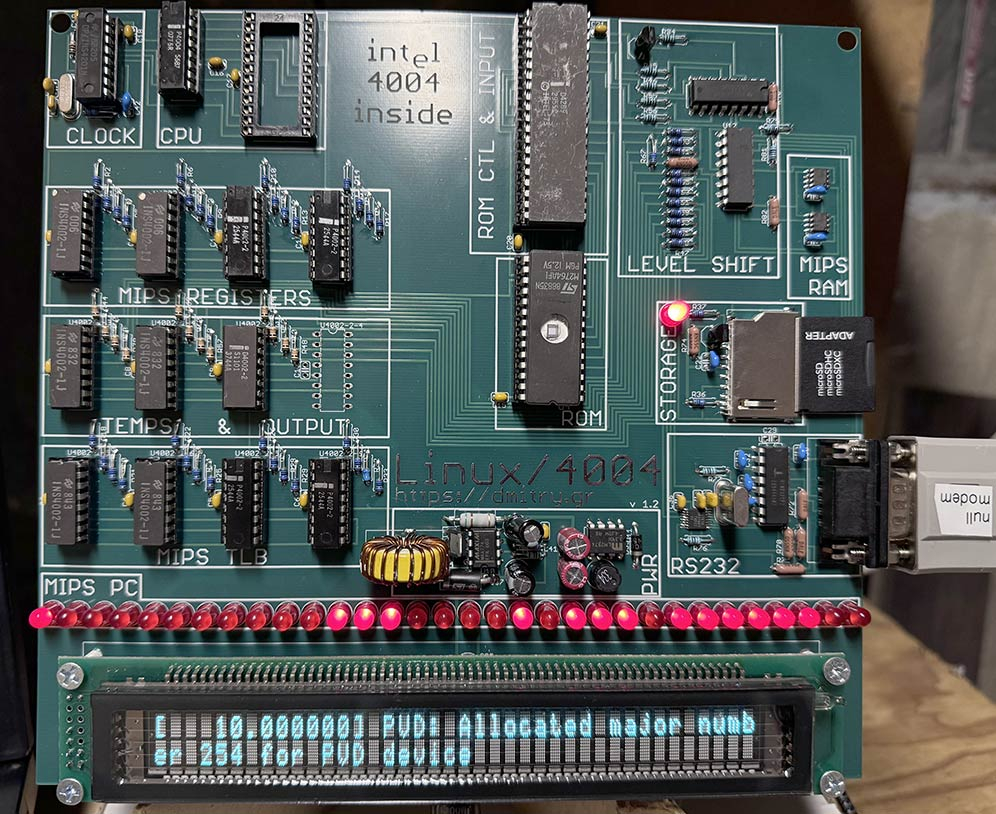
Источник изображения: dmitry.gr Из-за малой производительности Intel 4004 эмулятор работал медленно — на обработку каждой виртуальной секунды в эмулируемом окружении уходило почти 4 часа реального времени. После усовершенствования платы и ПО загрузка Linux сократилась с почти 9 дней до примерно 5 дней. Автор даже смог разогнать CPU с базовых 740 кГц до 790 кГц. Желающие повторить эксперимент могут воспользоваться опубликованными спецификациями и схемой платы, а также ПО. Microsoft перезапустит АЭС Three Mile Island, чтобы запитать свои ИИ ЦОД
21.09.2024 [01:14],
Владимир Мироненко
Компания Constellation Energy, крупнейший оператор АЭС в США, объявила о заключении 20-летнего контракта с Microsoft на поставку электроэнергии (PPA), которая будет производиться на АЭС Three Mile Island в Пенсильвании, печально известной по аварии на втором энергоблоке в 1979 году — самом серьёзном инциденте за всю историю атомной энергетики США. В результате аварии второй энергоблок АЭС был частично разрушен, но первый энергоблок не пострадал и проработал до 2019 года. Из-за убыточности АЭС и отказа властей штата продолжать субсидировать её работу она была окончательно остановлена 20 сентября 2019 года, после чего её передали Constellation Energy, имеющей опыт ликвидации АЭС. В рамках соглашения Constellation Energy планирует вновь ввести первый энергоблок в эксплуатацию к 2028 году, если будет получено одобрение Комиссии по ядерному регулированию США после всеобъемлющей проверки безопасности и защиты окружающей среды, а также разрешения от иных государственных и местных органов. Constellation Energy будет добиваться продления лицензии, что позволит эксплуатировать АЭС как минимум до 2054 года. 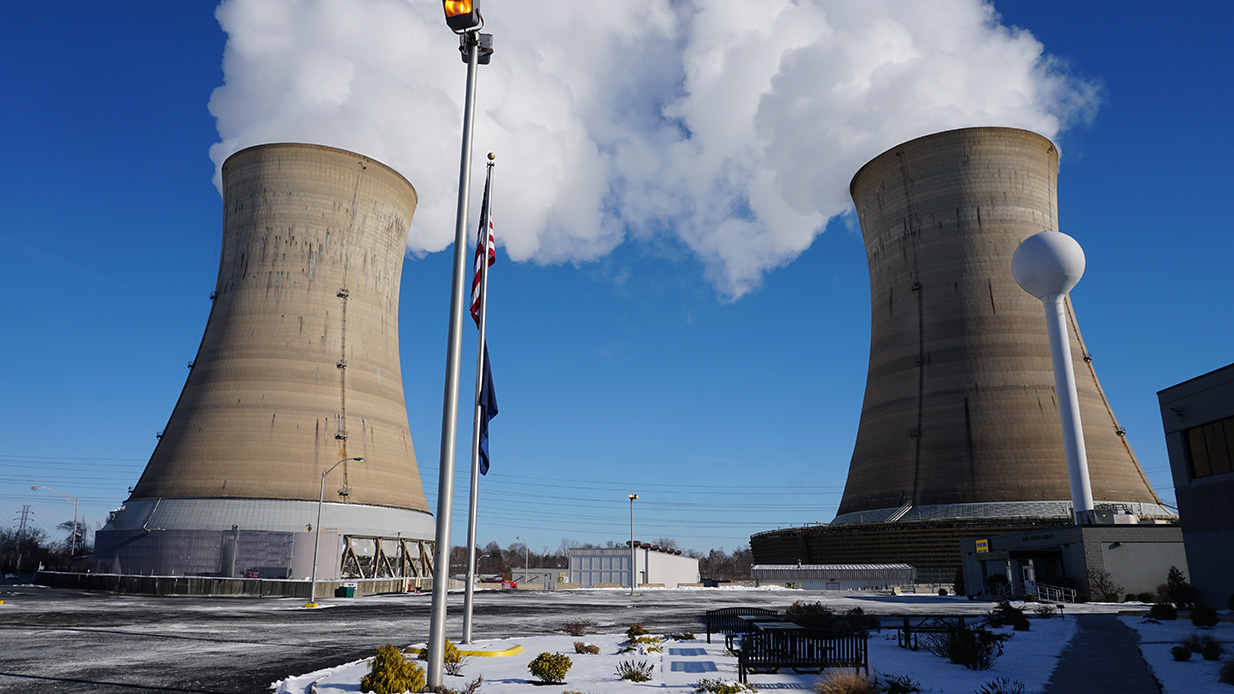
Источник изображений: Constellation Energy Планируемый к восстановлению объект был переименован в Центр чистой энергии Крейна (Crane Clean Energy Center, CCEC) в честь Криса Крейна (Chris Crane), который был гендиректором бывшей материнской компании Constellation и умер в апреле 2024 года. Хотя полные условия сделки не раскрываются, Constellation Energy объявила, что для возобновления работы необходимо около $1,6 млрд на восстановление оборудования, включая турбину, генератор, главный силовой трансформатор, а также системы охлаждения и управления. Мощность восстановленной АЭС составит 837 МВт. Вся производимая ею электроэнергия будет поступать Microsoft. Этого достаточно, чтобы обеспечить работу всех ЦОД компании в Пенсильвании, Чикаго, Вирджинии и Огайо. Согласно исследованию, которое профинансировал Совет по строительным профессиям Пенсильвании, повторное открытие АЭС создаст 3400 рабочих мест на объекте и в обслуживающих его предприятиях, а также принесёт в казну $3 млрд в виде государственных и федеральных налогов.  Сделка позволит Microsoft решить углубляющуюся энергетическую проблему, поскольку разрастающиеся ЦОД, необходимые ей для обслуживания ИИ-нагрузок, перегружают существующие в стране источники энергии. Как отмечают американские СМИ, никогда прежде атомная электростанция в США не возвращалась в строй после вывода из эксплуатации, и никогда прежде вся продукция одной коммерческой АЭС не поставлялась единственному заказчику. Срок действия соглашения с Constellation Energy значительно больше традиционных соглашений Microsoft о закупках солнечной и ветровой энергии. По всей видимости, сделка готовилась длительное время. За последние 12 месяцев Microsoft сформировала команду по работе над атомной энергетикой и наняла целый ряд опытных специалистов. Ранее Microsoft приобрела кредиты на возобновляемую энергию (CEC) у канадской энергетической компании Ontario Power Generation (OPG) и подписала соглашение с Constellation о поставке электроэнергии с АЭС для своего ЦОД в Бойдтоне. Атомная энергетика, гарантирующая в отличие от энергии ветра и солнца стабильную поставку электроэнергии вне зависимости от капризов погоды, становится всё популярнее среди гиперскейлеров. Ранее AWS приобрела за $650 млн кампус Talen Energy рядом с АЭС Susquehanna Steam Electric Station в Пенсильвании, которая обеспечит ЦОД до 960 МВт. Также в этом месяце Oracle объявила, что построит в США 1-ГВт кампус ЦОД с питанием от трёх малых модульных реакторов (SMR). А Oklo даже подписала соглашения с несколькими ЦОД. NetworkOcean хочет «утопить» ускорители NVIDIA в заливе Сан-Франциско
12.09.2024 [13:23],
Руслан Авдеев
Стартап NetworkOcean из Сан-Франциско намерен строить дата-центры под водой. Впрочем, как сообщает Datacenter Dynamics, планы компании могут столкнуться с американской бюрократией, поскольку местные регуляторы обеспокоены потенциальным воздействием ЦОД на окружающую среду. NetworkOcean намерена разместить 500-кВт ЦОД в Заливе Сан-Франциско. По словам компании, её решение позволит исключить потребление дата-центром воды и сократить энергопотребление на 30 % в сравнении с наземным аналогом. Утверждается, что в распоряжении стартапа имеются 2048 ускорителей NVIDIA H100, аренда которых у него дешевле, чем у других операторов. Компания поддерживается фондом Y Combinator. Однако планы компании вызвали удивление местных властей, поскольку она не запрашивала разрешение на погружение объекта. Комиссия по сохранению и развитию залива (Bay Conservation and Development Commission) и Региональный совет по контролю качества воды Сан-Франциско (San Francisco Regional Water Quality Control Board) уже уведомили бизнес о том, что самовольное размещение ЦОД может повлечь за собой штрафы в размере до нескольких сотен тысяч долларов. 
Источник изображения: Y Combinator NetworkOcean намерена погрузить ЦОД всего на час — утверждается, что тесты будут проходить на частной территории залива, на которую власть регуляторов якобы не распространяется, а никакого влияния на природу не будет. В компании объявили, что уже испытали капсулу ЦОД на некоем полигоне и она признана вполне безопасной. Ранее один из основателей стартапа также проводил эксперименты с размещением оборудования на морском буе, но на вопросы о получении разрешений на них отвечать отказался. По мнению ряда учёных, любое «возмущение» экосистемы в заливе или локальный рост температуры воды в нём, вызванный работой ЦОД, может иметь значимые последствия для морской флоры и фауны, поскольку способен спровоцировать рост токсичных для экосистемы водорослей. В 2016 году регуляторы чуть было не оштрафовали Microsoft за размещение в рамках Project Natick подводного ЦОД в заливе Сан-Луис-Обиспо (San Luis Obispo). В 2018 году у берегов Шотландии Microsoft развернула подводный ЦОД на 855 серверов, проработавших без присмотра 25 месяцев и 8 дней. Эксперимент показал, что серверы под водой ломаются реже, чем на суше, одним из факторов успеха называлась постоянная внешняя температура. Проект был свёрнут и сейчас подводных ЦОД у компании нет, но Project Natick используется в качестве исследовательской платформы для изучения и тестирования новых концепций повышения надёжности ЦОД. В условиях дефицита электричества на суше перспектива использования океанских течений для естественного охлаждения довольно заманчива, потенциально это поможет снизить расходы энергии и нагрузки на электростети. Например, китайская HiCloud сообщает о модулях подводных ЦОД, используемых на глубине 35 м у побережья в провинции Хайнань. Стартап Subsea Cloud также заявлял, что развернул 13,5 тыс «подводных» GPU-серверов в Азии. Заработать они должны в следующем году после получения всех разрешений и одобрений от регуляторов. Заключена одна из крупнейших сделок на рынке ЦОД: Blackstone покупает AirTrunk за $16,1 млрд
05.09.2024 [21:09],
Руслан Авдеев
Компания Blackstone Inc., управляющая активами на сумму более $1 трлн, совместно с инвестиционным подразделением пенсионного фонда Canada Pension Plan согласились приобрести у Macquarie Group Ltd. и PSP Investments австралийского оператора дата-центров AirTrunk за AU$24 млрд ($16,1 млрд). Пока что сделка ожидает одобрения регулятора Australian Foreign Investment Review Board. Это одна из крупнейших сделок этого года, связанных с цифровой инфраструктурой. По данным Bloomberg, сделка покрывает долговые обязательства приобретаемой компании и обязательства по капитальным затратам на строительство запланированных ЦОД. Это крупнейшее приобретение Blackstone в Азиатско-Тихоокеанском регионе за всю историю существования компании. Компания предложила наибольшую «ставку», потеснив конкурентов, включая DigitalBridge Group Inc., Global Infrastructure Partners, IFM Investors Pty и Silver Lake Management. До этого крупнейшей сделкой в регионе была покупка Blackstone австралийского оператора казино Crown Resorts Ltd. в 2022 году за AU$8,9 млрд (около $6 млрд). 
Источник изображения: Scott Graham/unsplash.com AirTrunk управляет дата-центрами в Австралии, Сингапуре, Гонконге, Японии и Малайзии. Инвестиционное подразделение Macquarie Group взяло контроль над компанией в 2020 году в сделке, оценивавшейся в AU$3 млрд. До этого компания принадлежала группе инвесторов, включая специальное подразделение Goldman Sachs Group Inc. Blackstone уже имеет портфолио ЦОД на сумму более $55 млрд и активно развивает его — компания намерена потратить на это направление бизнеса ещё $70 млрд. В последние годы активы вроде дата-центров, вышек мобильной связи и оптоволоконных сетей стали востребованными среди инвесторов, поскольку они обеспечивают стабильную доходность и имеют большие перспективы роста — человечество становится всё более зависимым от технологий. Не так просто и не так быстро: учёные исследовали особенности работы памяти и NVLink C2C в NVIDIA Grace Hopper
27.07.2024 [23:44],
Алексей Степин
Гибридный ускоритель NVIDIA Grace Hopper объединяет CPU- и GPU-модули, которые связаны интерконнектом NVLink C2C. Но, как передаёт HPCWire, в строении и работе суперчипа есть некоторые нюансы, о которых рассказали шведские исследователи. Им удалось замерить производительность подсистем памяти Grace Hopper и интерконнекта NVLink в реальных сценариях, дабы сравнить полученные результаты с характеристиками, заявленными NVIDIA. Напомним, для интерконнекта изначально заявлена скорость 900 Гбайт/с, что в семь раз превышает возможности PCIe 5.0. Память HBM3 в составе GPU-части имеет ПСП до 4 Тбайт/с, а вариант с HBM3e предлагает уже до 4,9 Тбайт/с. Процессорная часть (Grace) использует LPDDR5x с ПСП до 512 Гбайт/с. В руках исследователей оказалась базовая версия Grace Hopper с 480 Гбайт LPDDR5X и 96 Гбайт HBM3. Система работала под управлением Red Hat Enterprise Linux 9.3 и использовала CUDA 12.4. В бенчмарке STREAM исследователям удалось получить следующие показатели ПСП: 486 Гбайт/с для CPU и 3,4 Тбайт/с для GPU, что близко к заявленным характеристиками. Однако результат скорость NVLink-C2C составила всего 375 Гбайт/с в направлении host-to-device и лишь 297 Гбайт/с в обратном направлении. Совокупно выходит 672 Гбайт/с, что далеко от заявленных 900 Гбайт/с (75 % от теоретического максимума). 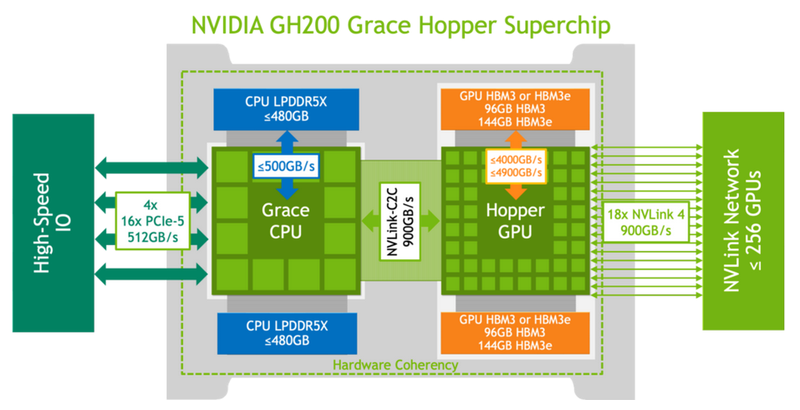
Источник: NVIDIA Grace Hopper в силу своей конструкции предлагает два вида таблицы для страниц памяти: общесистемную (по умолчанию страницы размером 4 Кбайт или 64 Кбайт), которая охватывает CPU и GPU, и эксклюзивную для GPU-части (2 Мбайт). При этом скорость инициализации зависит от того, откуда приходит запрос. Если инициализация памяти происходит на стороне CPU, то данные по умолчанию помещаются в LPDDR5x, к которой у GPU-части есть прямой доступ посредством NVLink C2C (без миграции), а таблица памяти видна и GPU, и CPU. 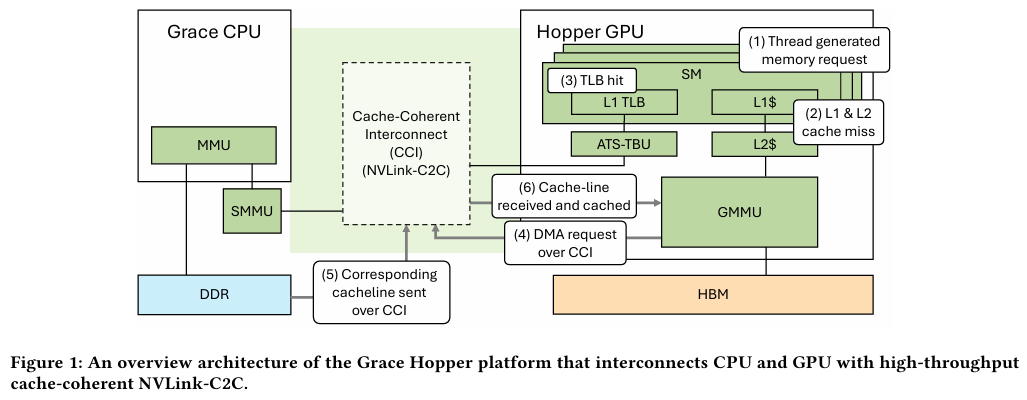
Источник: arxiv.org Если же памятью управляет не ОС, а CUDA, то инициализацию можно сразу организовать на стороне GPU, что обычно гораздо быстрее, а данные поместить в HBM. При этом предоставляется единое виртуальное адресное пространство, но таблиц памяти две, для CPU и GPU, а сам механизм обмена данными между ними подразумевает миграцию страниц. Впрочем, несмотря на наличие NVLink C2C, идеальной остаётся ситуация, когда GPU-нагрузке хватает HBM, а CPU-нагрузкам достаточно LPDDR5x. 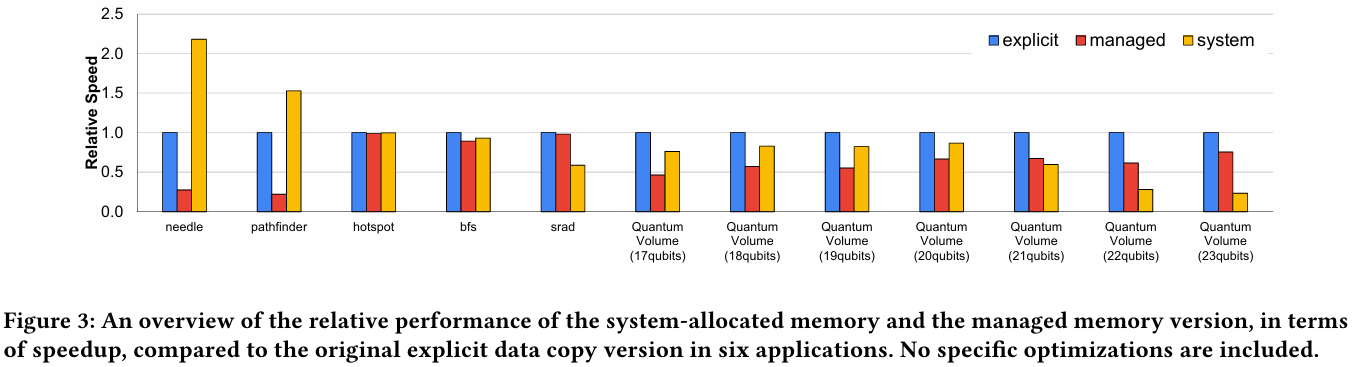
Источник: arxiv.org Также исследователи затронули вопрос производительности при использовании страниц памяти разного размера. 4-Кбайт страницы обычно используются процессорной частью с LPDDR5X, а также в тех случаях, когда GPU нужно получить данные от CPU через NVLink-C2C. Но как правило в HPC-нагрузках оптимальнее использовать 64-Кбайт страницы, на управление которыми расходуется меньше ресурсов. Когда же доступ в память хаотичен и непостоянен, страницы размером 4 Кбайт позволяют более тонко управлять ресурсами. В некоторых случаях возможно двукратное преимущество в производительности за счёт отсутствия перемещения неиспользуемых данных в страницах объёмом 64 Кбайт. В опубликованной работе отмечается, что для более глубокого понимания механизмов работы унифицированной памяти у гетерогенных решений, подобных Grace Hopper, потребуются дальнейшие исследования. Почему разработчики не успевают за Windows на Arm – объясняет Глеб Хмызников
22.07.2024 [11:34],
Андрей Созинов
Руководитель проекта Microsoft по переносу Python-библиотек рассказал, почему часть из них не работают на новых Copilot+ PC и как разработчики могут ускорить переход.  18 июня 2024 года Microsoft и ее партнеры начали продавать ноутбуки Copilot+ PC на процессорах Arm. Но большинство программ для Windows написаны под процессоры Intel и AMD, и далеко не все авторы успели переделать их под новую архитектуру, из-за чего покупателям и разработчикам пока сложно в полной мере воспользоваться преимуществами новых ноутбуков. О том, почему одни библиотеки уже работают на новом процессоре, а другие нет, поговорили с Глебом Хмызниковым, инженером-разработчиком Microsoft, который отвечает за работу Python и его библиотек на машинах с Arm. Глеб, вы занимаетесь переносом Python-библиотек на новые ноутбуки и решаете проблемы, из-за которых часть из них до сих пор не запускается без эмуляции. Откуда вообще взялось это отставание? Windows на Arm долго существовала в своеобразном вакууме. Разработчики не переходили на платформу, потому что там не было привычной среды, а авторы библиотек не спешили ее поддерживать, потому что пользователей было мало. Сейчас, когда у платформы становится больше пользователей, этот замкнутый круг начинает размыкаться. Но ведь другая часть библиотек уже работает на Arm нативно. В чем разница между ними и теми, что пока не запускаются? Легче всего переносятся библиотеки на распространенных языках: для них компиляторы под Arm уже есть, а за одной базовой библиотекой подтягиваются и те, что на нее опираются. Остальным мешает каждый раз что-то свое: где-то нет компилятора для нужного языка, где-то ломается сборка, а где-то просто нет готовой версии под Arm. Одна из главных особенностей новых ноутбуков – встроенный нейропроцессор для задач ИИ. Могут ли разработчики на Python пользоваться им уже сейчас? Могут, но пока через обходные пути. Самый рабочий вариант сейчас – ONNX Runtime, программа Microsoft для запуска ИИ-моделей, в связке с инструментами Qualcomm, которые дают к нейропроцессору прямой доступ. Поэтому мы и работаем вместе с производителями чипов: они лучше всех знают, как устроен их нейропроцессор и как задействовать его полностью. Допустим, разработчик уже купил Arm-ноутбук. Как ему работать, пока не все библиотеки готовы? Начать с нативного Python и проверить, какие из нужных ему библиотек уже работают напрямую. То, что не запускается, можно временно использовать через эмуляцию. И очень важно сообщать о сбоях публично. Отчет о том, какой пакет не собрался и на каком устройстве, экономит авторам библиотек время на поиск причины. Чем больше таких отчетов с разных машин, тем быстрее закрываются пробелы. В июне вы оценивали проекты хакатона IAHD, много общались с разработчиками. Чего, по вашим ощущениям, профессиональное сообщество ждет от новых Arm-ноутбуков? Разработчики ждут, что о процессоре не придется думать: открыл ноутбук, поставил привычные инструменты и работаешь. Плюс многих интересует запуск ИИ-моделей прямо на устройстве. И то и другое упирается в готовность библиотек. Суперускоритель по суперцене — NVIDIA GB200 NVL72, вероятно, будет стоить $3 млн
17.07.2024 [23:33],
Игорь Осколков
Компания NVIDIA значительно увеличила заказ на ускорители Blackwell у TSMC, сообщает TrendForce со ссылкой на United Daily News (UDN). По данным источника, NVIDIA намерена получить уже не 40 тыс., а 60 тыс. суперускорителей нового поколения, причём 50 тыс. из них придётся на стоечные системы GB200 NVL36. При этом Blackwell всё равно будут в дефиците, как и обещал ещё зимой глава NVIDIA Дженсен Хуанг (Jensen Huang). B200 включает два тайла, объединённых 2,5D-упаковкой CoWoS-L и соединённых интерконнектом NV-HBI. Чип имеет 208 млрд транзисторов, изготовленных по кастомному техпроцессу TSMC 4NP. GB200 объединяет два ускорителя B200 и один 72-ядерный Arm-процессор Grace. А суперускоритель GB200 NVL72, в свою очередь, объединяет в рамках одной стойки Oberon сразу 18 1U-узлов с парой GB200 в каждом (плата Bianca, 72 × B200 и 36 × Grace), провязанных шиной NVLink 5. Вся эта система потребляет порядка 120 кВт, оснащена СЖО и единой DC-шиной питания. Однако у GB200 NVL72 довольно специфические требования к окружению, поэтому NVIDIA предлагает суперускоритель попроще — GB200 NVL36, который как раз и должен стать наиболее массовым в данной серии. Эта платформа точно так же занимает целую стойку, но использует 2U-узлы с теми же платами Bianca (суммарно 36 × B200 и 18 × Grace), потребляя всего 66 кВт. При этом всё равно подразумевается использование двух стоек GB200 NVL36, объединённых интерконнектом, так что GB200 NVL72 всё равно получается более энергоэффективным решением. 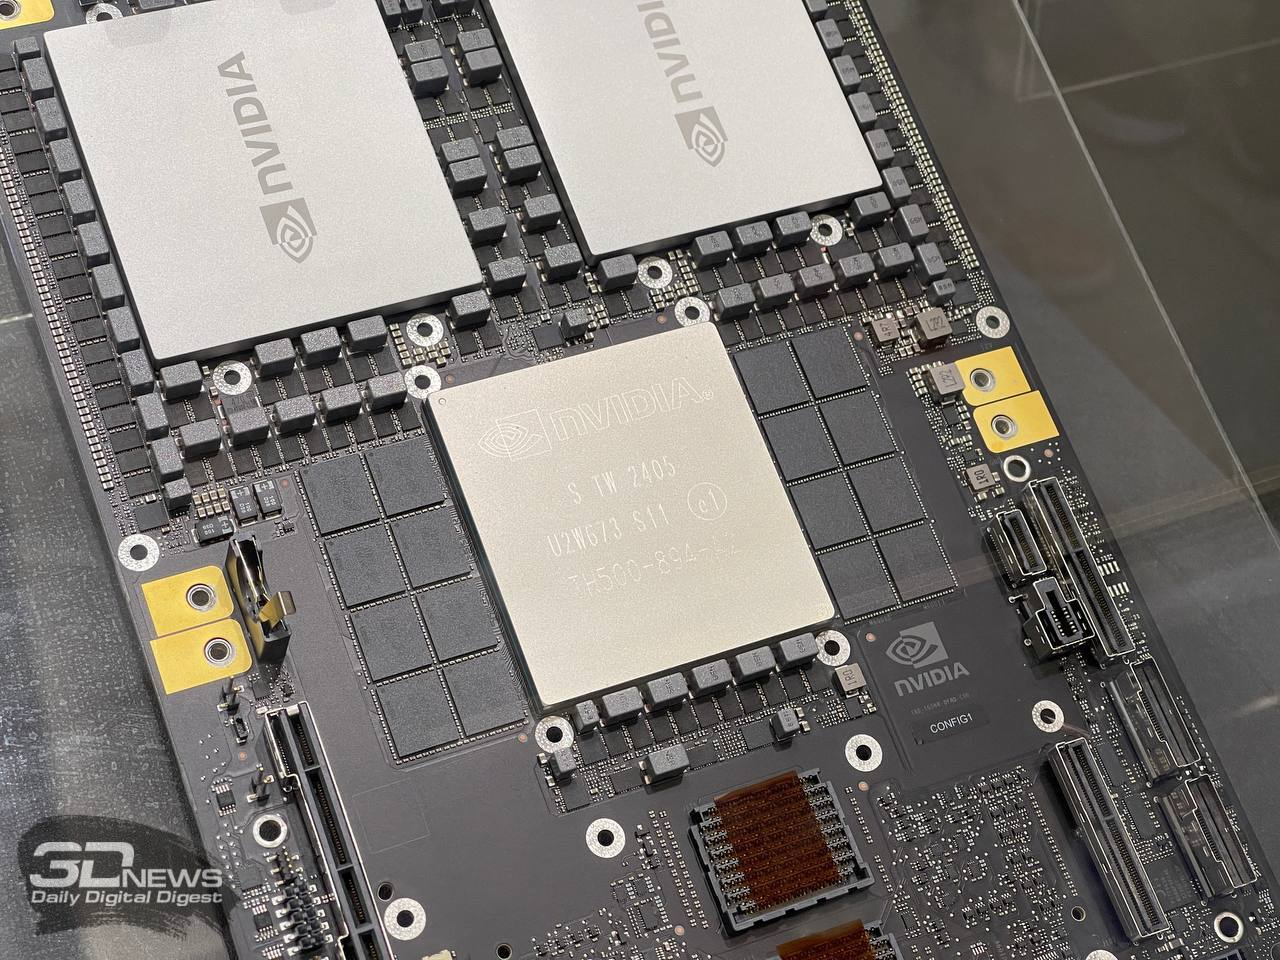
NVIDIA GB200 Как отмечает SemiAnalysis, GB200 NVL36 также будет доступен в варианте с платами Ariel, имеющими по одному чипу B200 и Grace. Наконец, во II квартале 2025 года появятся системы B200 NVL72 и B200 NVL36 с x86-процессорами (Miranda). Кроме того, NVIDIA представила и отдельные MGX-узлы GB200 NVL2 с парой GB200. В общем, ускорителей B200 компании понадобится много, чтобы наверняка удержать лидерство на рынке. 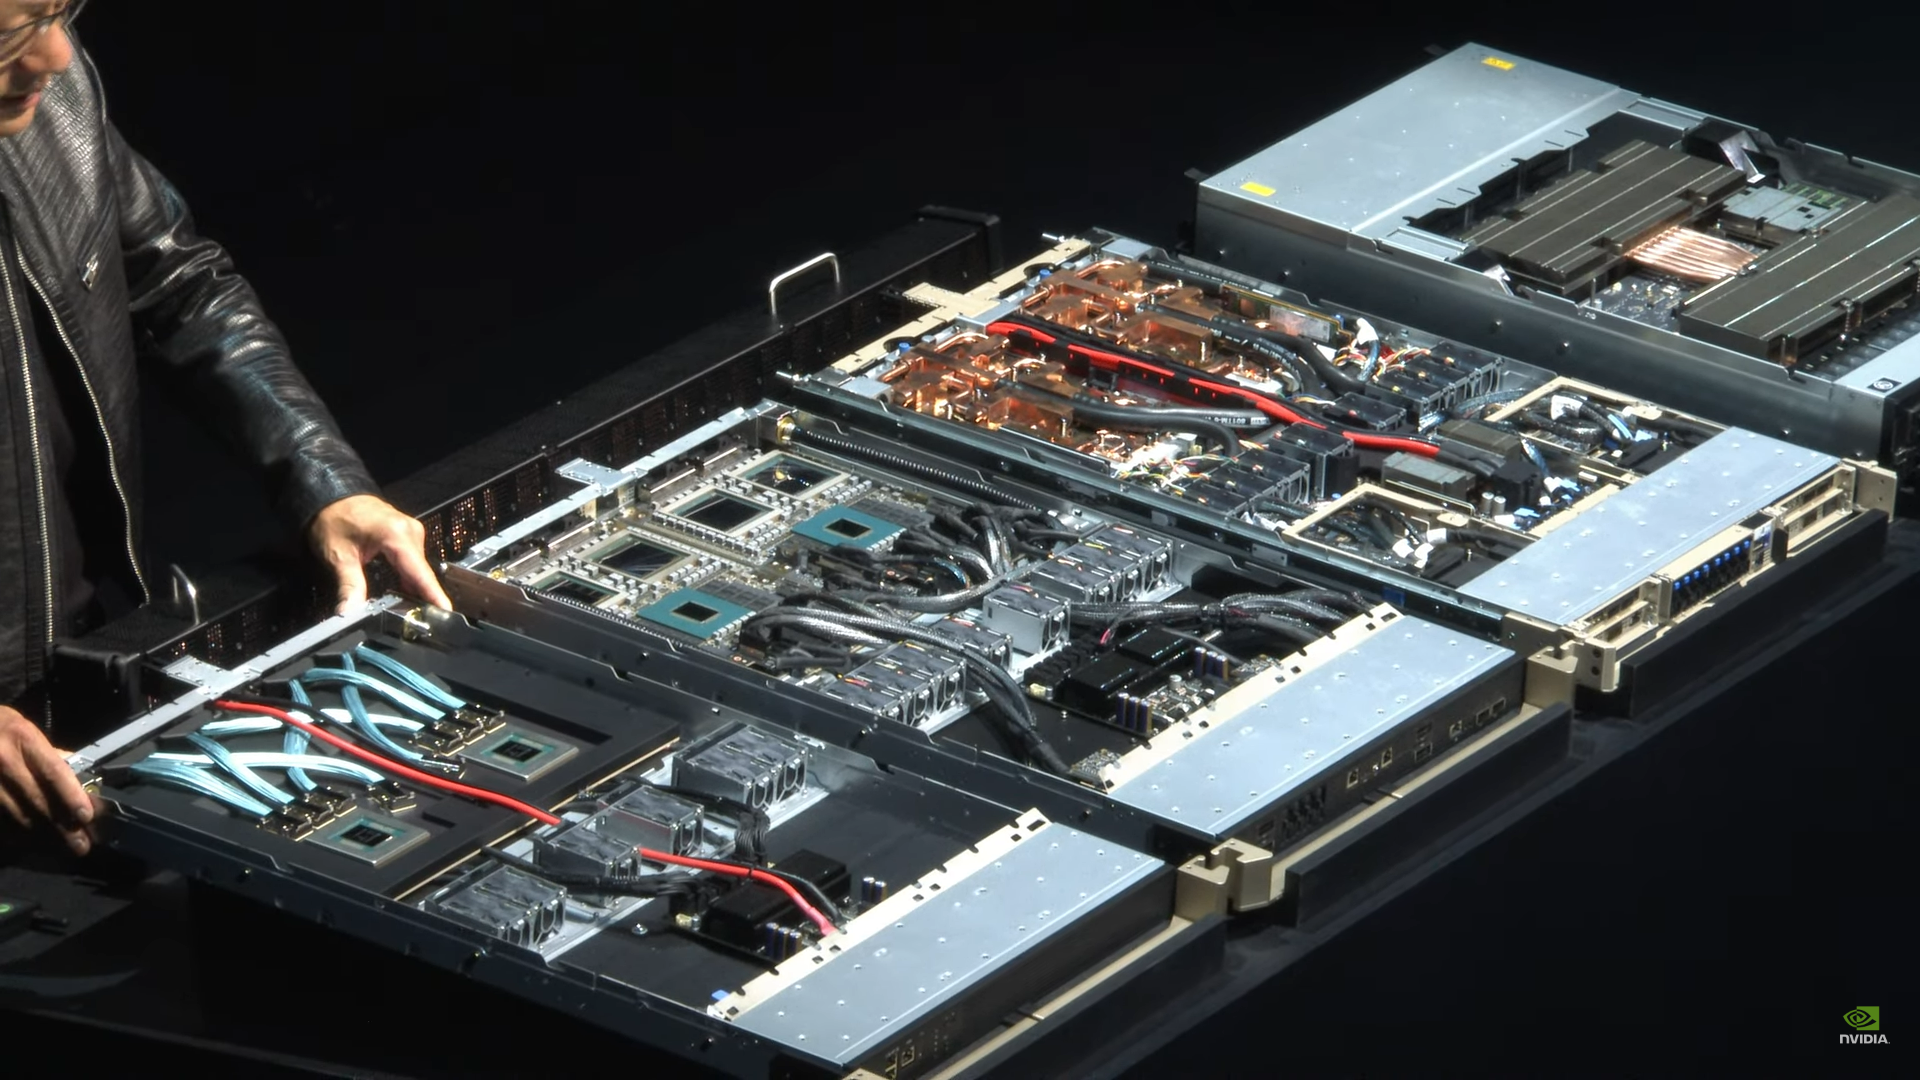
Источник изображения: NVIDIA По словам UDN, GB200 NVL36 будет стоить порядка $1,8 млн, а GB200 NVL72 обойдётся уже в $3 млн. Одиночный GB200 будет стоить $60–$70 тыс., а самый простой ускоритель B100 оценён в $30–$35 тыс. Нужно подчеркнуть, что это оценки сторонних аналитиков. Сама компания официально не раскрывает стоимость своих продуктов. Это устоявшаяся практика на данном рынке, против которой пошла только Intel, публично назвавшая стоимость ИИ-ускорителей Gaudi. Впрочем, ранее глава NVIDIA намекнул, что B200 будет стоить приблизительно $30–$40 тыс. 144 ядра, чиплеты, SRAM и 3D-упаковка: Fujitsu поделилась подробностями о грядущих Arm-процессорах MONAKA
12.07.2024 [09:09],
Алексей Степин
Опыт японской компании Fujitsu в разработке процессоров и суперкомпьютеров велик и многогранен. Долгое время основной архитектурой для решений Fujitsu была SPARC64, но времена меняются: в 2018 году компания анонсировала разработку собственного процессора на базе архитектуры Arm. Сегодня этот чип мы знаем под именем A64FX. В 2020 году японский кластер Fugaku на основе 48-ядерных A64FX с интегрированными HBM-памятью и интерконнектом занял первое место в рейтинге TOP500 с результатом 537,2 Пфлопс. Однако эти процессоры, которые всё ещё достойно трудятся не только в Fugaku, но и в других суперкомпьютерах, трудно назвать действительно универсальным и доступным. 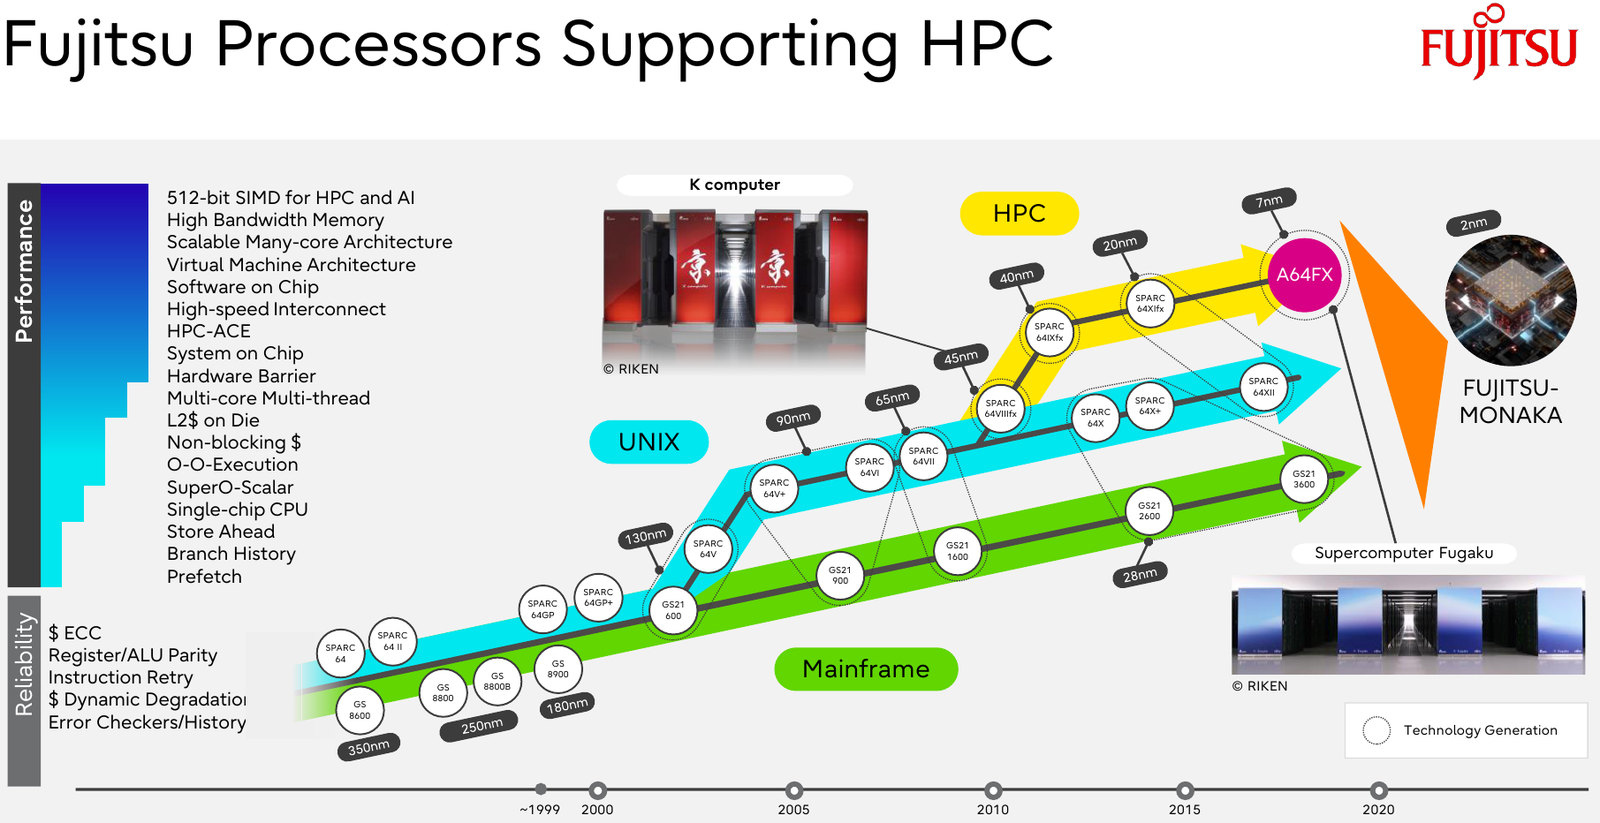
Источник изображений: Fujitsu Важность архитектурных нововведений и смену IT-ландшафта в Fujitsu прекрасно осознают. Поэтому компания объявила о разработке нового серверного процессора под кодовым именем MONAKA, для которого она намеревается вдвое увеличить показатели производительности и энергоэффективности, а также учесть растущую популярность задач класса ИИ. А совсем недавно Fujitsu впервые более детально рассказала о технических особенностях будущих CPU. 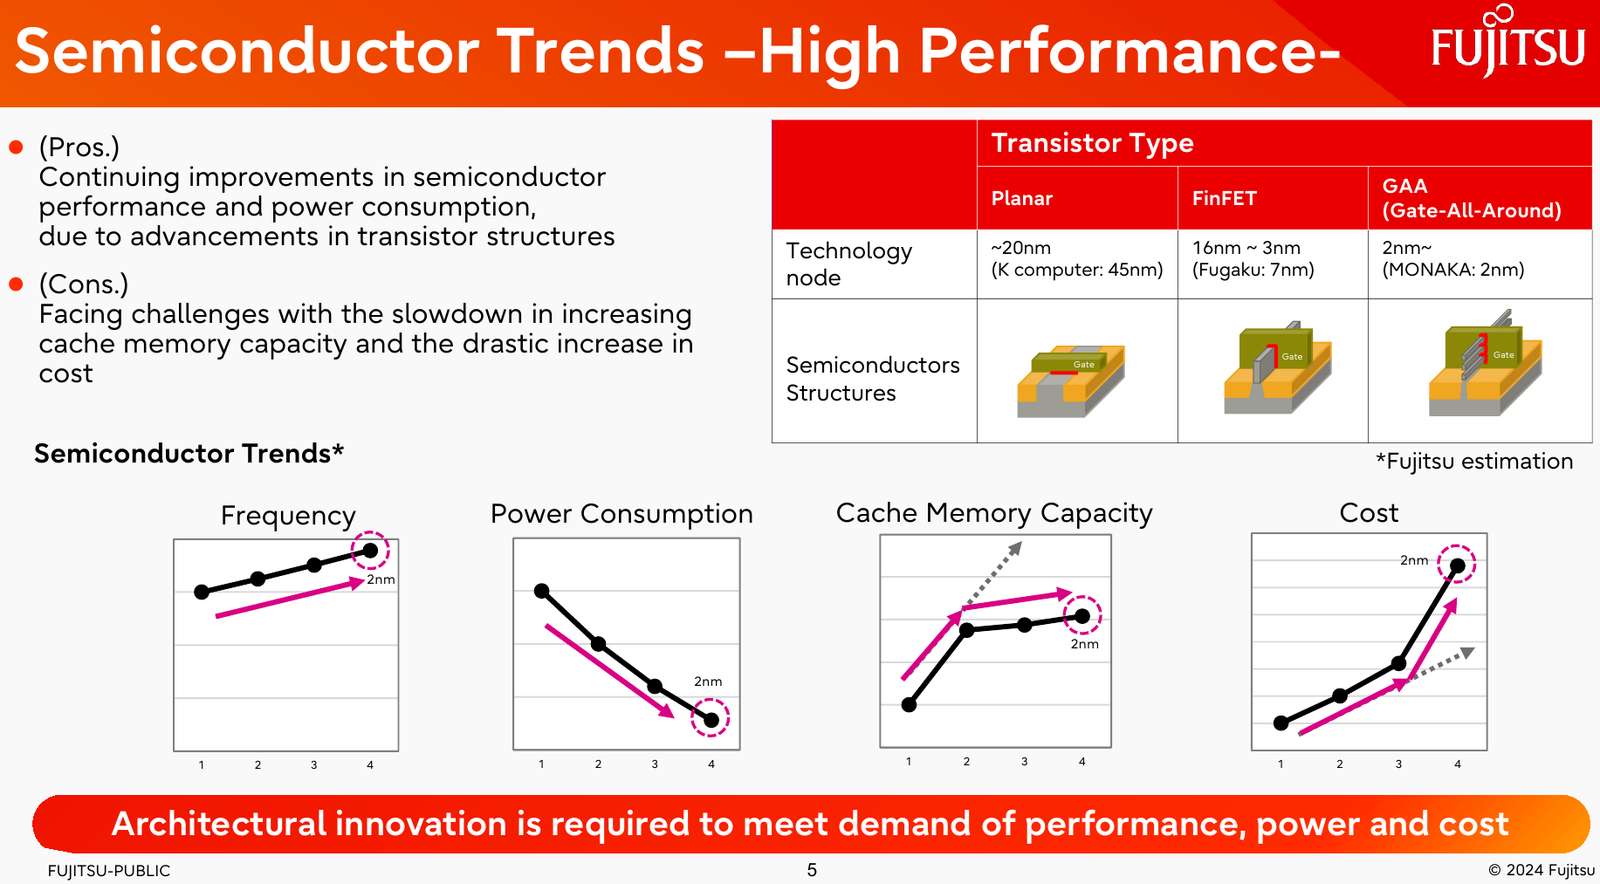 Во-первых, разработчики нового процессора хорошо осознают ограничения, накладываемые текущей транзисторной технологии. Похоже, из FinFET и её аналогов выжаты все или почти все соки и для прорывных решений нового поколения данная технология не подходит. В процессорах MONAKA будут использоваться транзисторы с затвором нового типа, так называемые GAA (Gate-all-Around). Похоже, речь идёт о технологии, которую разрабатывает и собирается внедрить в производство уже в следующем году Samsung в рамках 2-нм техпроцесса SF2. 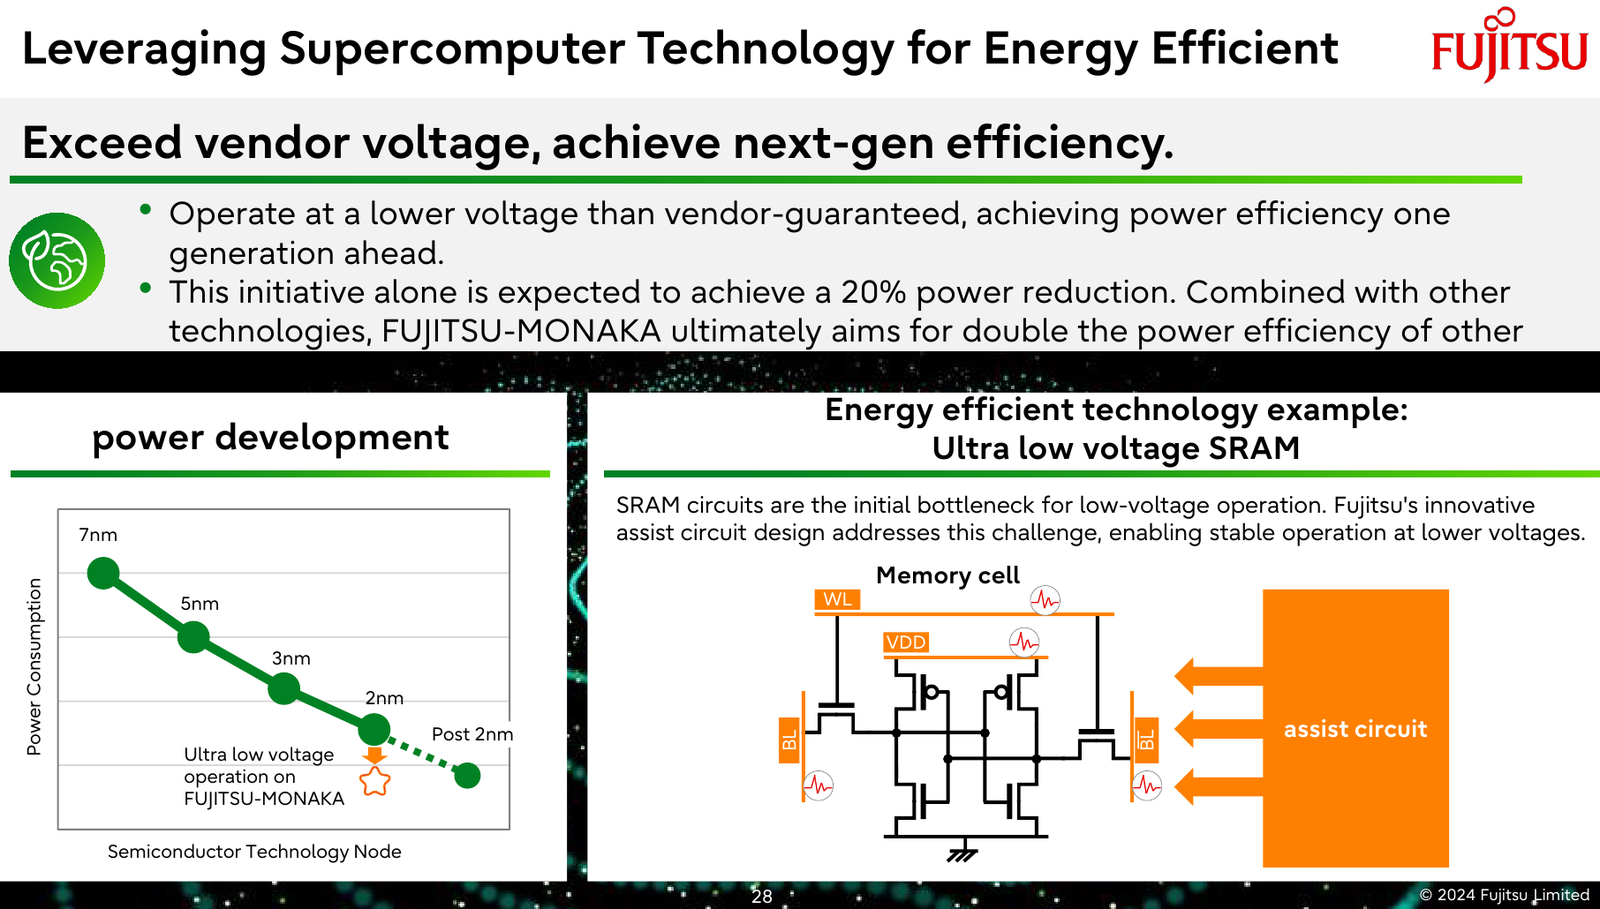 Внедрение 2-нм GAA-транзисторов позволит снизить паразитную ёмкость, а значит, добиться больших тактовых частот при меньшем напряжении питания. При этом новая технология будет применена не только в процессорных ядрах, но и в сборках кеш-памяти, также спроектированных с использованием собственного инструментария Fujitsu. 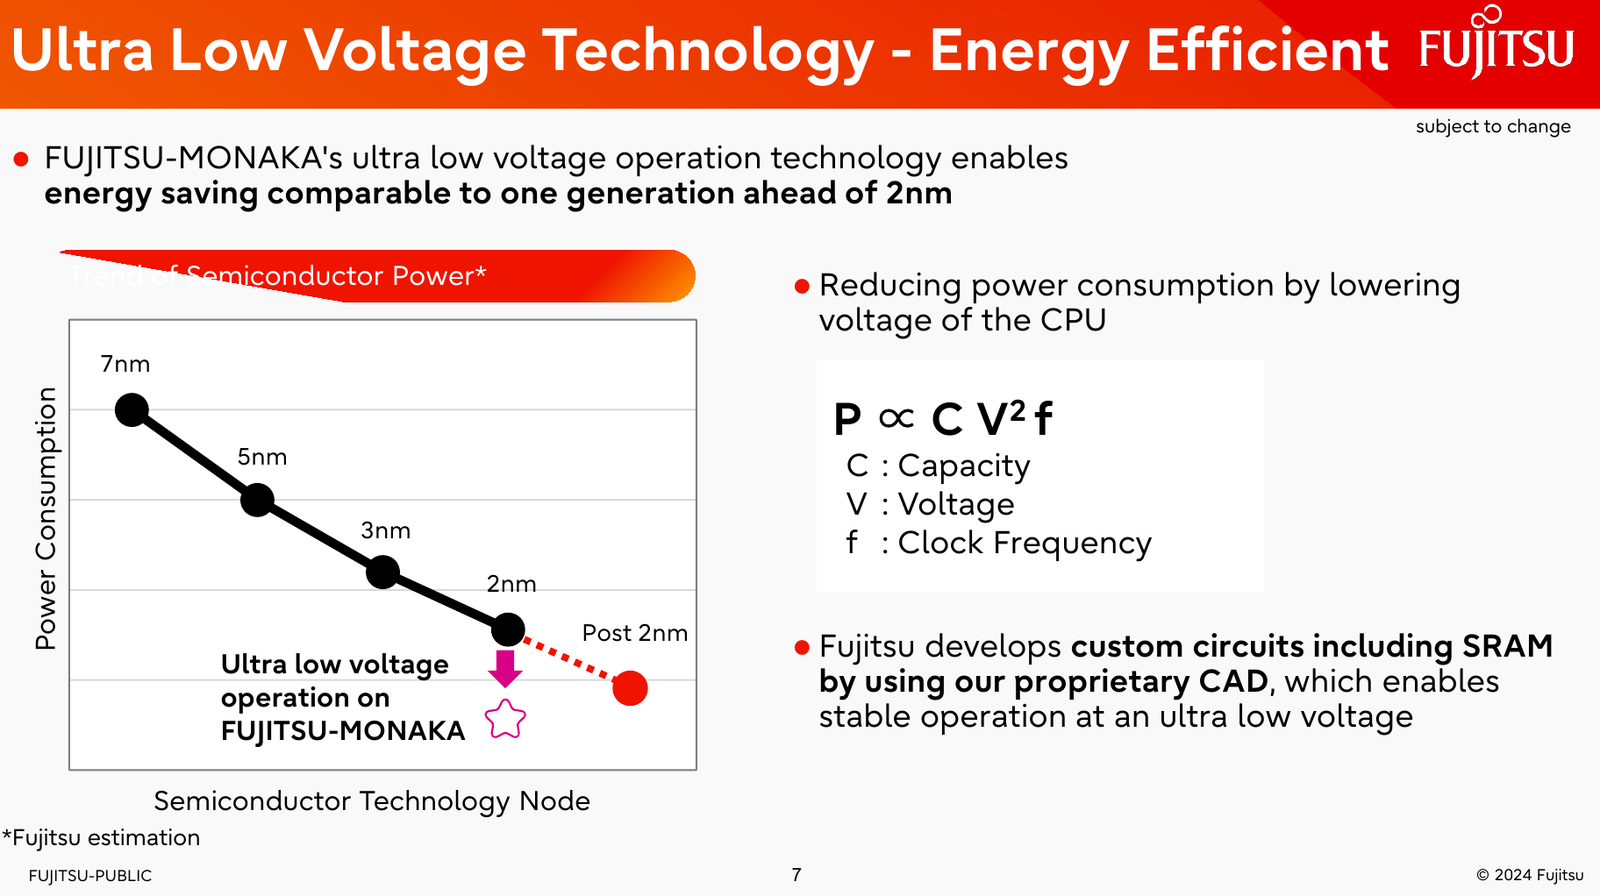 Во-вторых, MONAKA изначально проектируется как модульный процессор. В центре разместится IO-кристалл, содержащий контроллеры DDR5 (12 каналов) и PCI Express 6.0/CXL 3.0. Окружать его будут сборки из 5-нм кристаллов кеш-памяти SRAM и расположенных поверх 2-нм кристаллах с процессорными ядрами. По вертикали соединение обеспечит технология TSV, а по горизонтали — кремниевая подложка-интерпозер. Фактически речь идёт о 3D-компоновке. 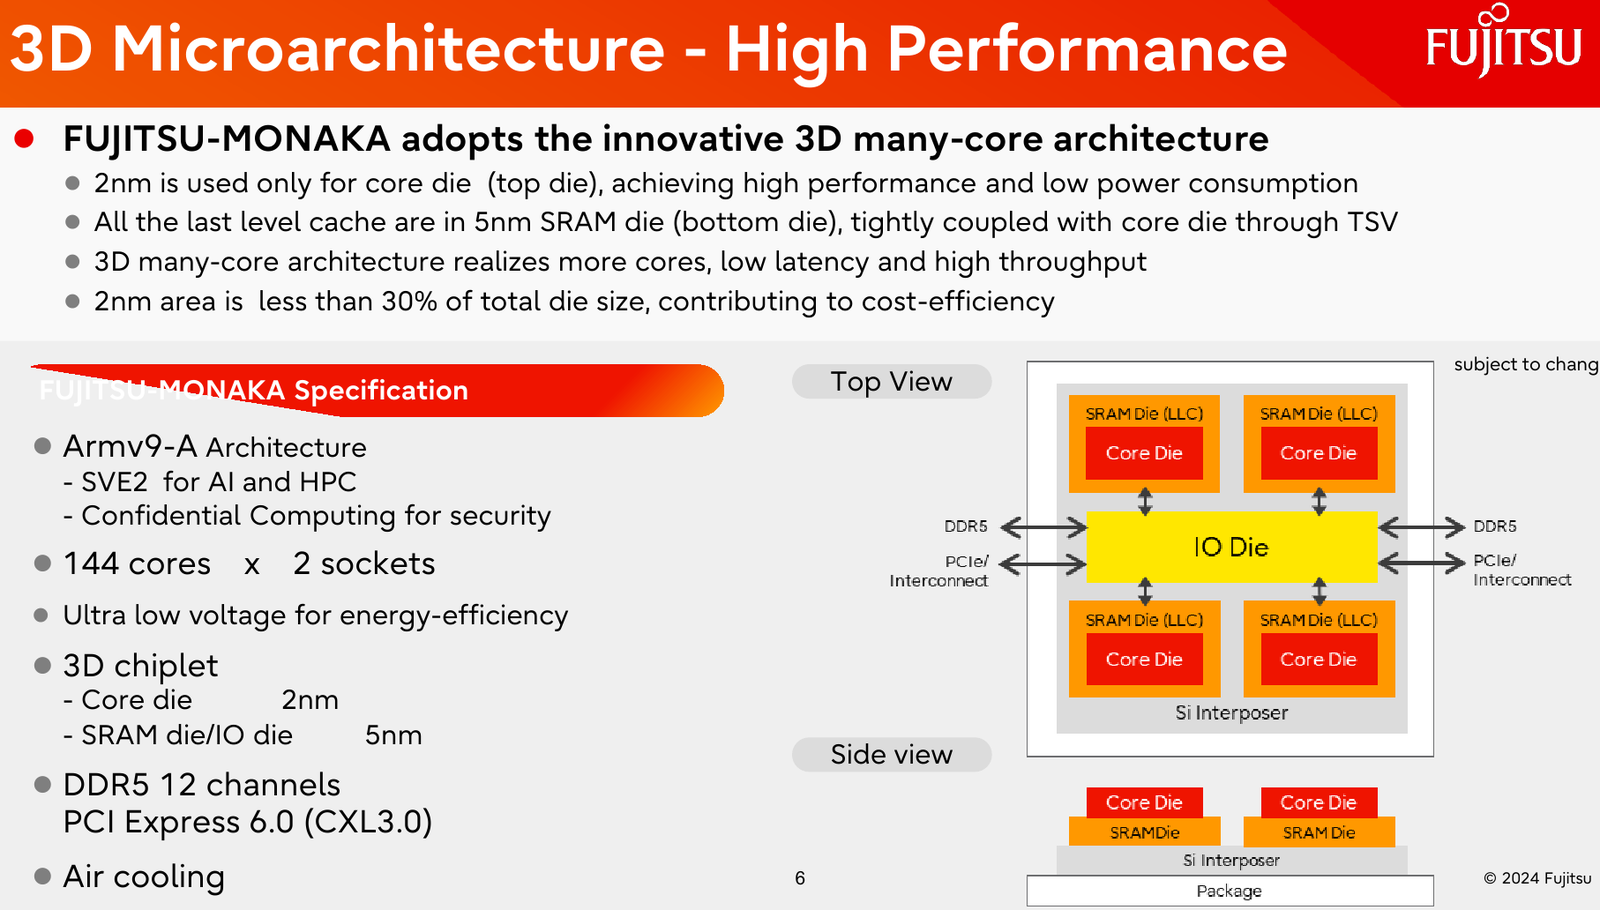 12-канальная подсистема памяти обеспечит отсутствие узких мест: у A64FX проблем с пропускной способностью благодаря использованию HBM2 не было, но объем самой памяти был ограничен 32 Гбайт. Зато у MONAKA проблем с расширением не будет — как с помощью классических модулей DIMM, так и посредством банков памяти CXL, благо, за основу сразу взята версия PCIe 6.0 с пропускной способностью 256 Гбайт/с в режиме x16. Сколько будет самих линий, пока не уточняется. 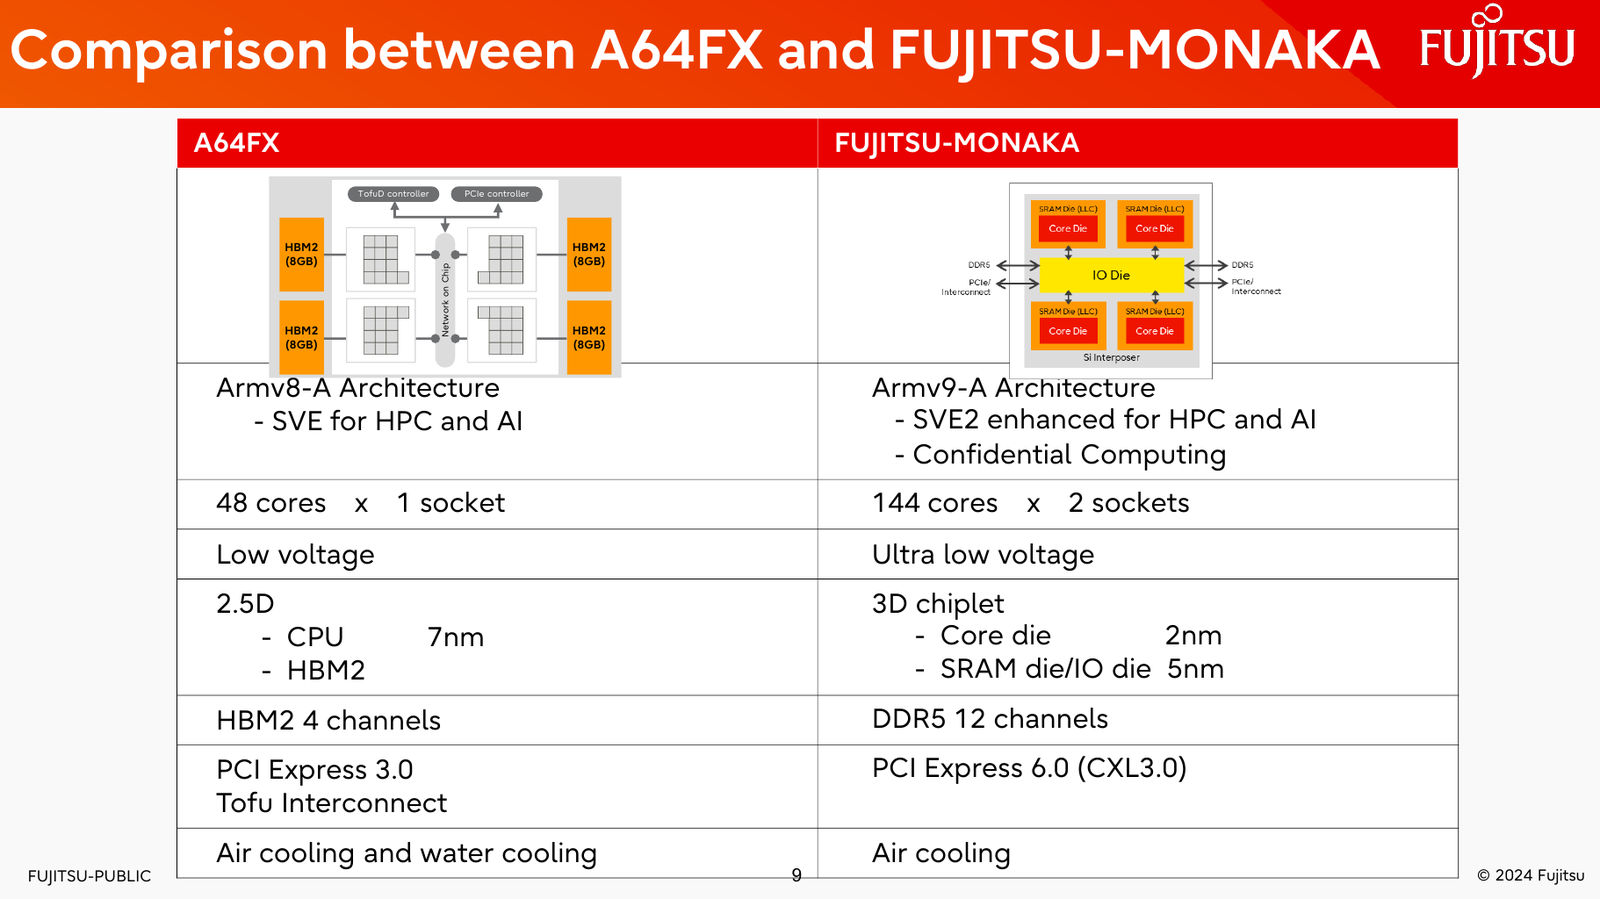 Новая платформа изначально проектируется двухсокетной, при этом в количестве ядер Fujitsu также не скромничает: процессоры MONAKA получат 144 ядра, а благодаря новому 2-нм техпроцессу они будут не такими уж горячими. Им хватит воздушного охлаждения, говорят создатели. Процессоры получат набор инструкций Armv9-A с векторными расширениями SVE2 и технологией доверенных вычислений Confidential Computing. Скорее всего, без кастомных инструкций не обойдётся и в этот раз. 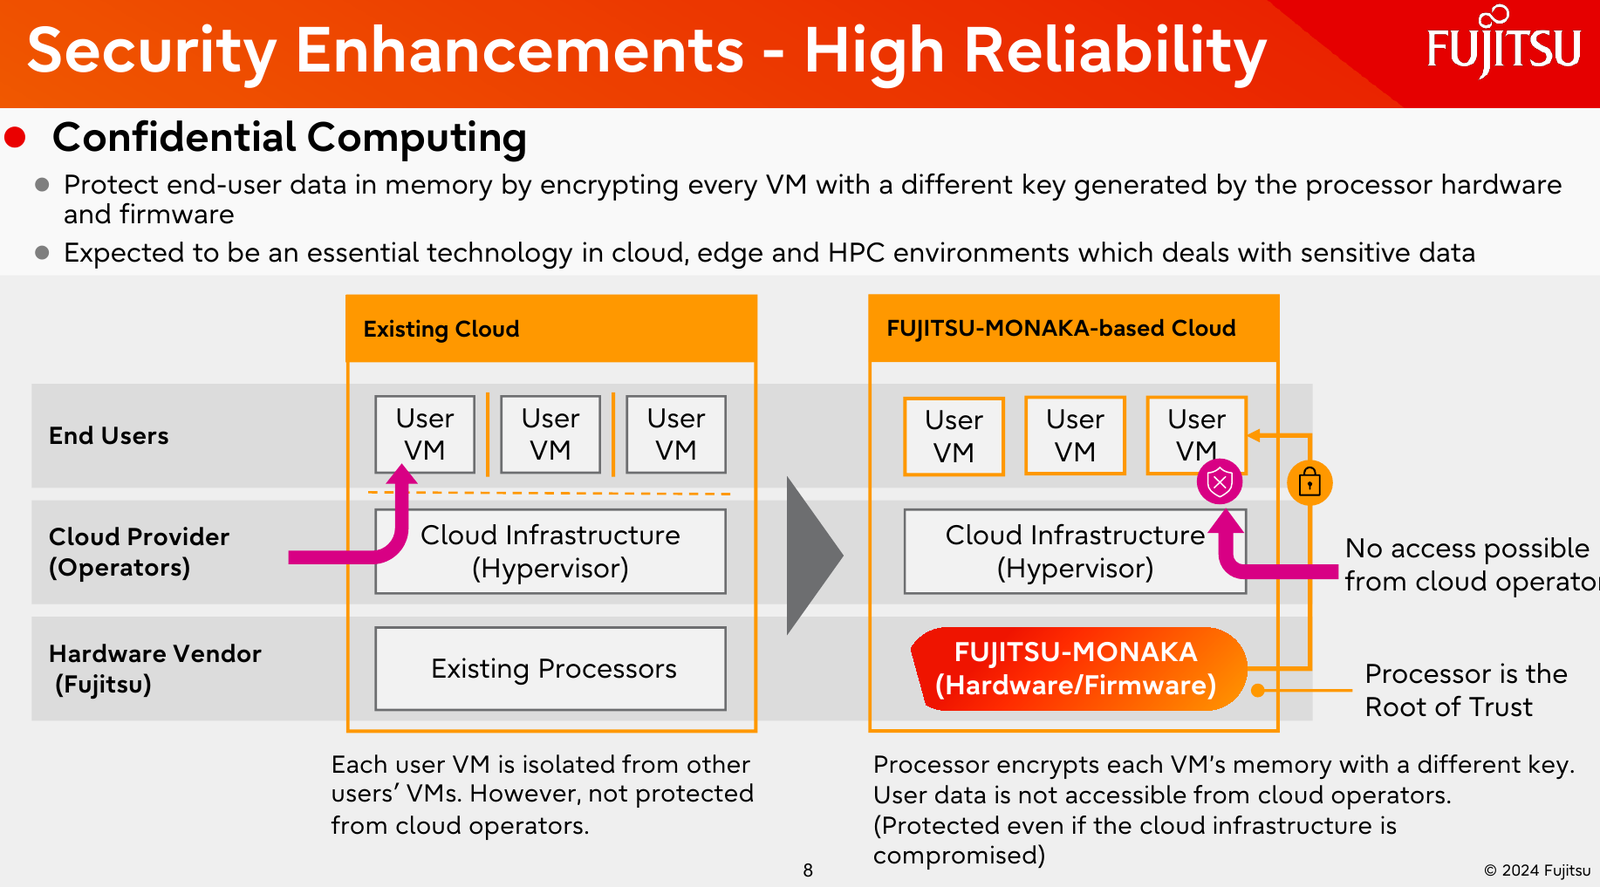 Последнее особенно важно ввиду того, что MONAKA предназначены не только для рынка HPC, но и для использования в облачных средах. Подсистема конфиденциальных вычислений позволяет шифровать содержимое каждой виртуальной машины собственным ключом, так что доступа к внутренностям ВМ не будет даже у владельцев ЦОД. Впрочем, современные HPC-комплексы всё чаще используют именно облачный подход для доступа к ресурсам. 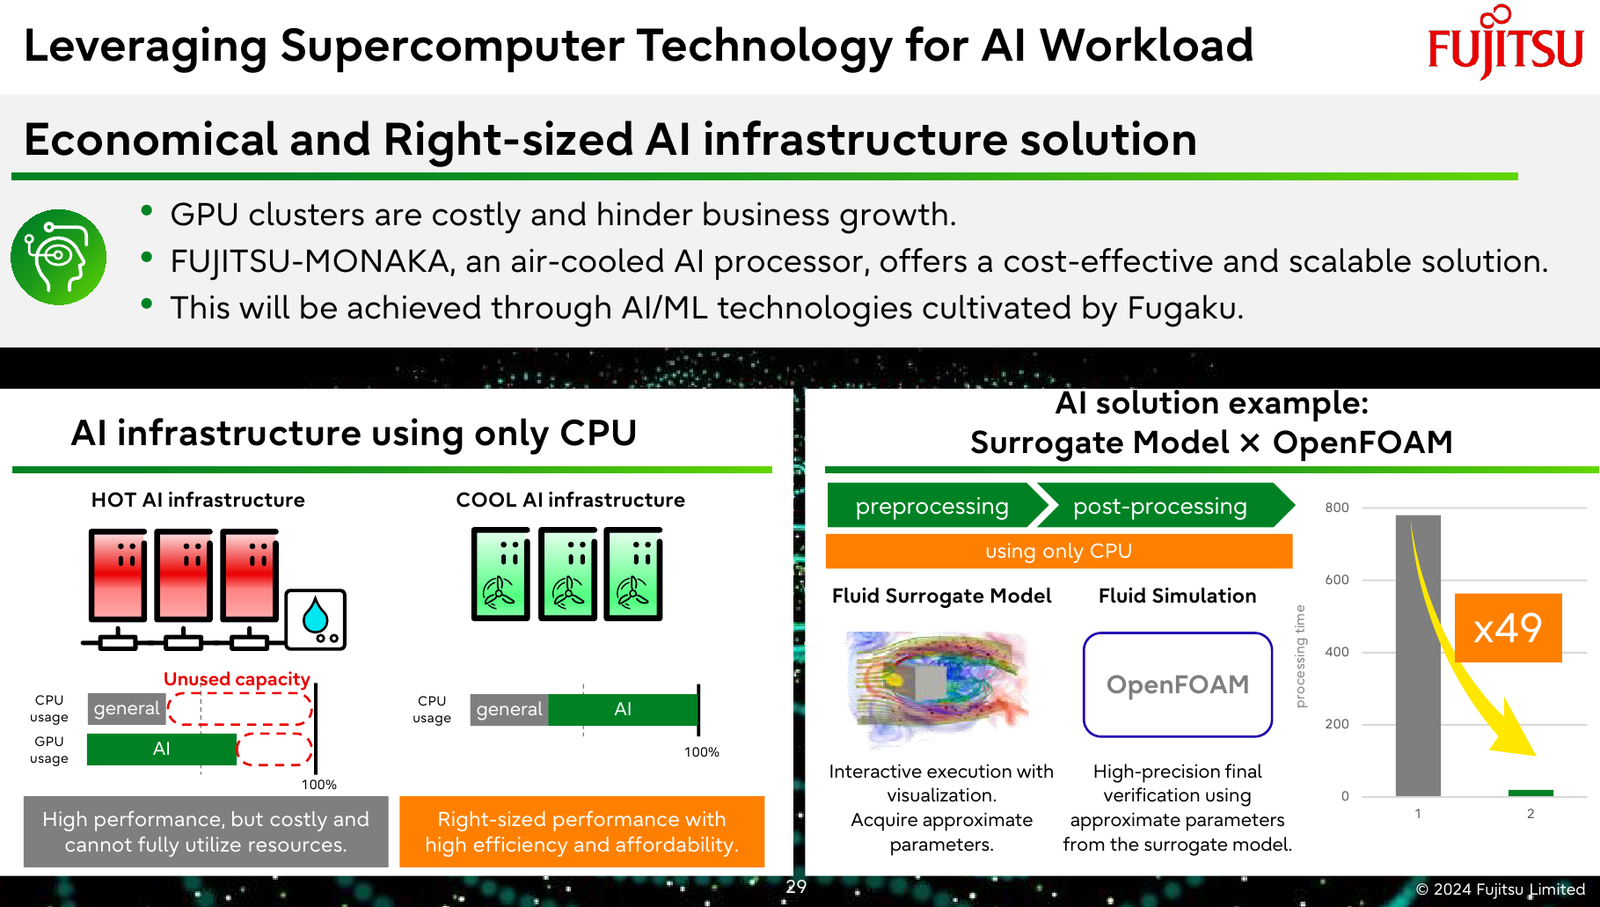 Несмотря на популярность GPU и других специализированных ускорителей, Fujitsu считает, что гетерогенная архитектура имеет существенные недостатки — она заметно дороже, особенно с учётом ценовой политики производителей, склонна к неполной утилизации ресурсов, а также не слишком экономична и зачастую требует специфических систем охлаждения. Компания полагает, что гомогенная архитектура MONAKA этих недостатков лишена и в сочетании с ПО Fujitsu может успешно обрабатывать ИИ-нагрузки.  В программной части Fujitsu активно полагается на решения с открытым кодом. Процессоры MONAKA будут отвечать стандартам Arm System Ready и получат полноценную поддержку Linux и сопутствующего инструментария, в частности, GCC, glibc, live-patch, papi и т.д. Разработка ведётся в тесном содружестве с Linaro, организацией, занимающейся консолидацией открытого ПО для Arm, а также с альянсом UXL. Для MONAKA компания подготовит, например, оптимизированную библиотеку OpenBLAS. 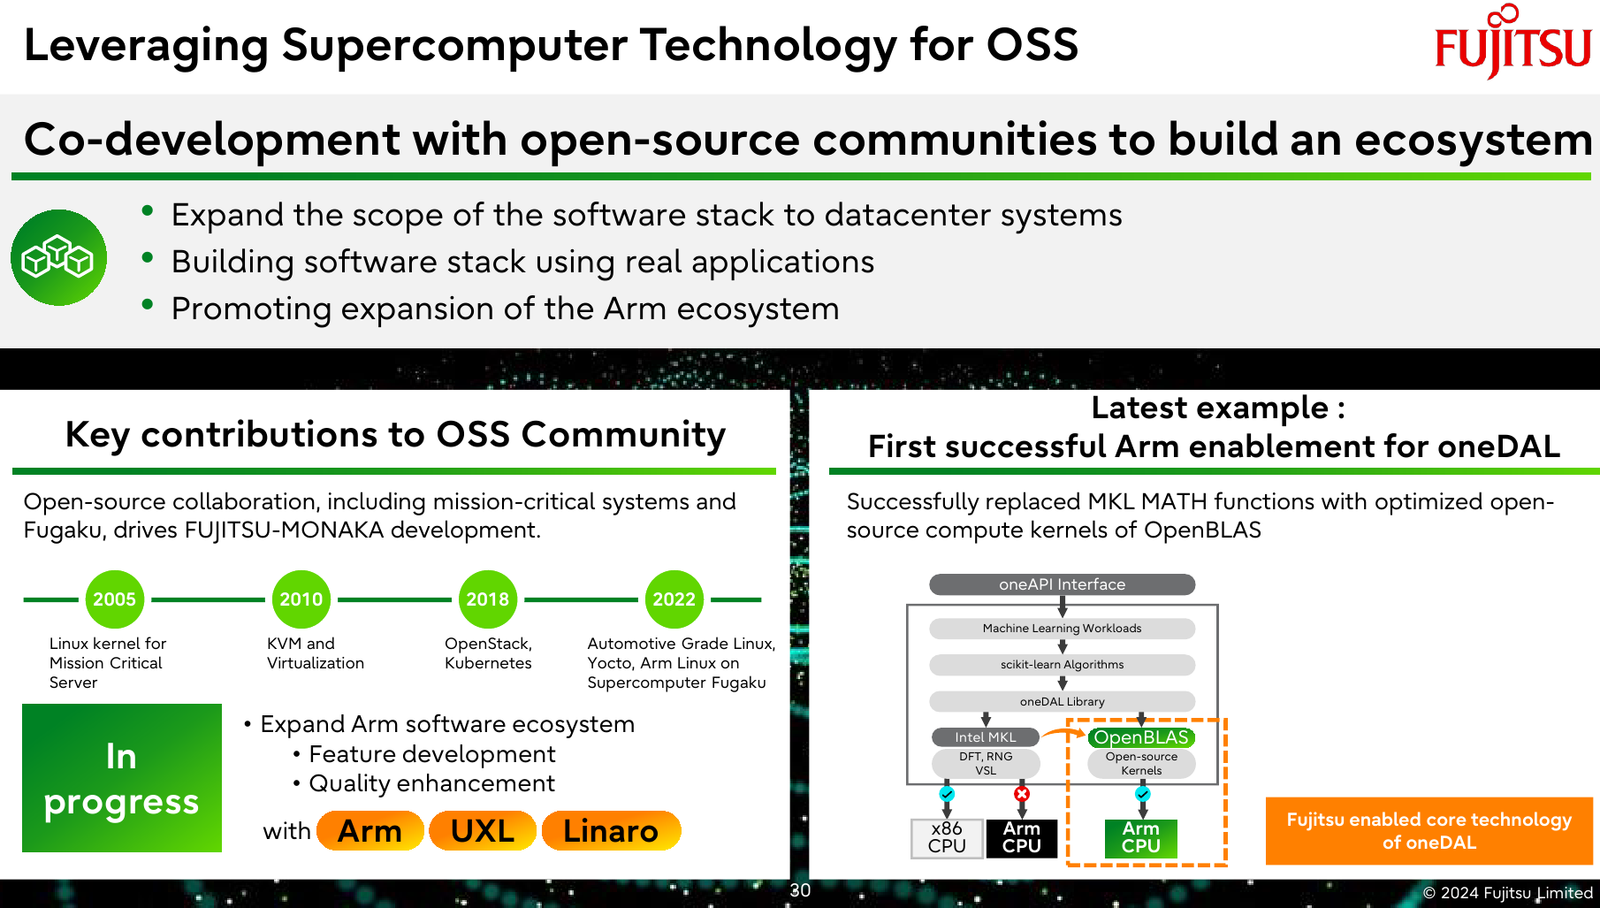 Также Fujitsu уделяет внимание экологии: напомним, одной из главных черт нового процессора будет его экономичность, что отвечает целям японской национальной программы NEDO, ставящей своей целью достижение 40 % снижения энергопотребления ЦОД к 2030 году. 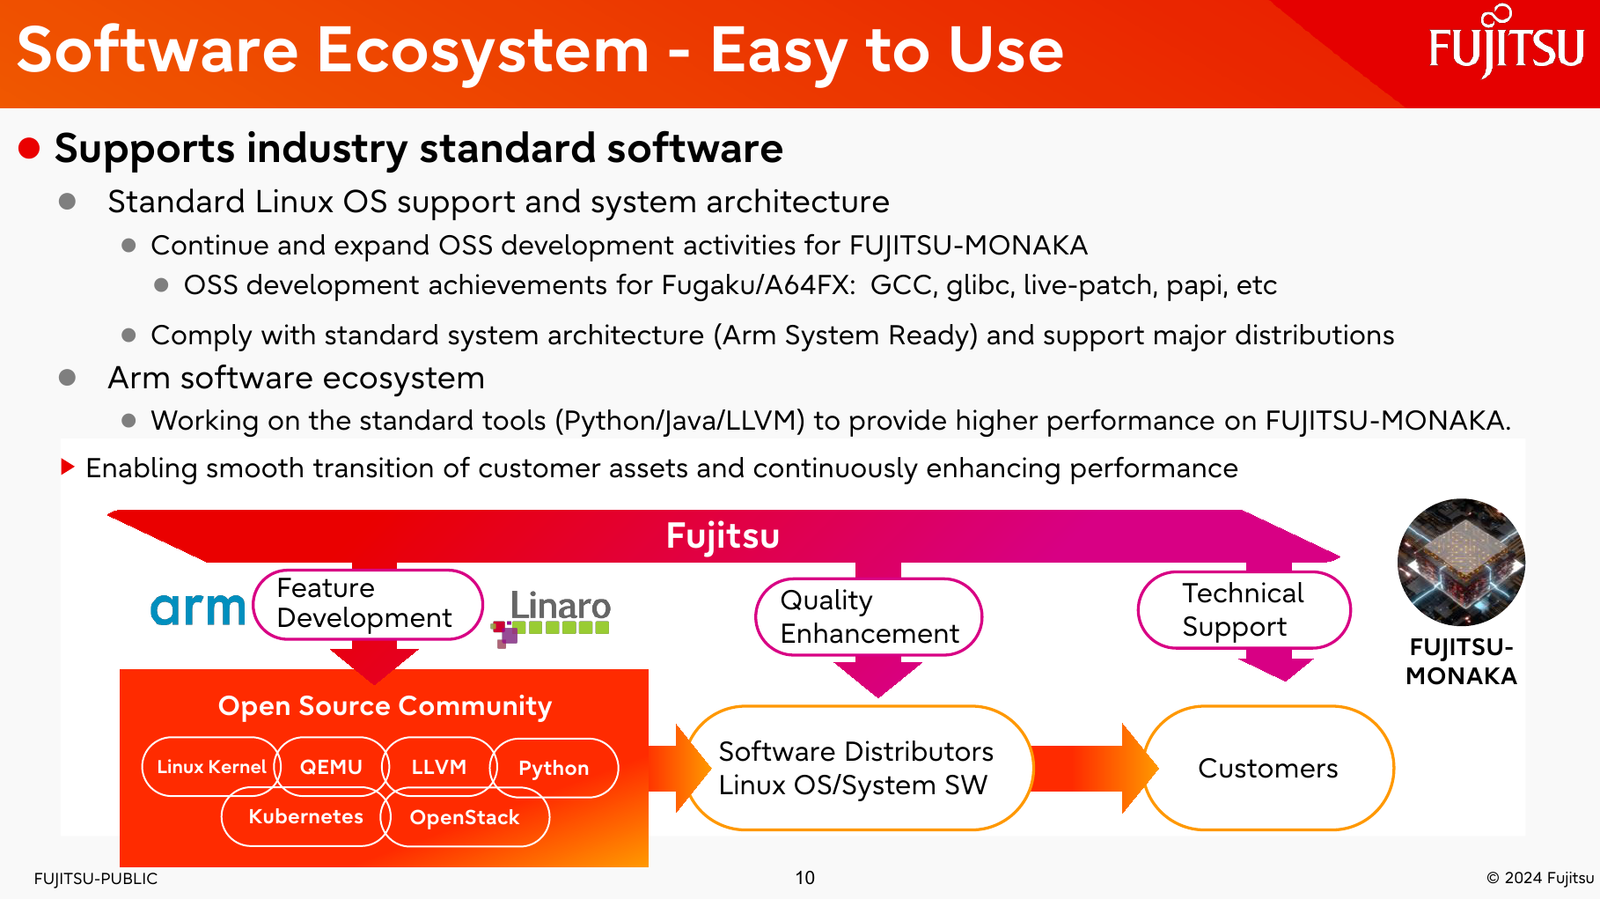 Что касается начала поставок MONAKA, здесь всё идёт по плану: первые партии новых процессоров найдут своё место в серверах и вычислительных узлах уже в 2027 году. Это вполне согласуется с циклом разработки PCI Express, согласно которому появления решений PCIe 6.0 на рынке следует ожидать не ранее 2025 года. Panmnesia расширит память GPU с помощью DRAM или даже SSD
03.07.2024 [23:49],
Сергей Карасёв
Южнокорейский стартап Panmnesia сообщил о разработке специализированного CXL-решения, которое позволяет расширять встроенную память ускорителей на базе GPU путём подключения внешних блоков DRAM или даже SSD. Отмечается, что современным приложениям ИИ и НРС требуется значительный объём быстрой памяти, но возможности ускорителей в этом плане ограничены. Сложность расширения памяти актуальных ускорителей заключается в том, что в таких изделиях отсутствуют логическая структура CXL и компоненты, поддерживающие DRAM и/или SSD. Кроме того, подсистемы кеша и памяти GPU не распознают никаких расширений. В лучшем случае предлагается механизм унифицированной виртуальной памяти (UVM) для совместного доступа к содержимому памяти и CPU, и GPU. Однако этот механизм довольно медленный. 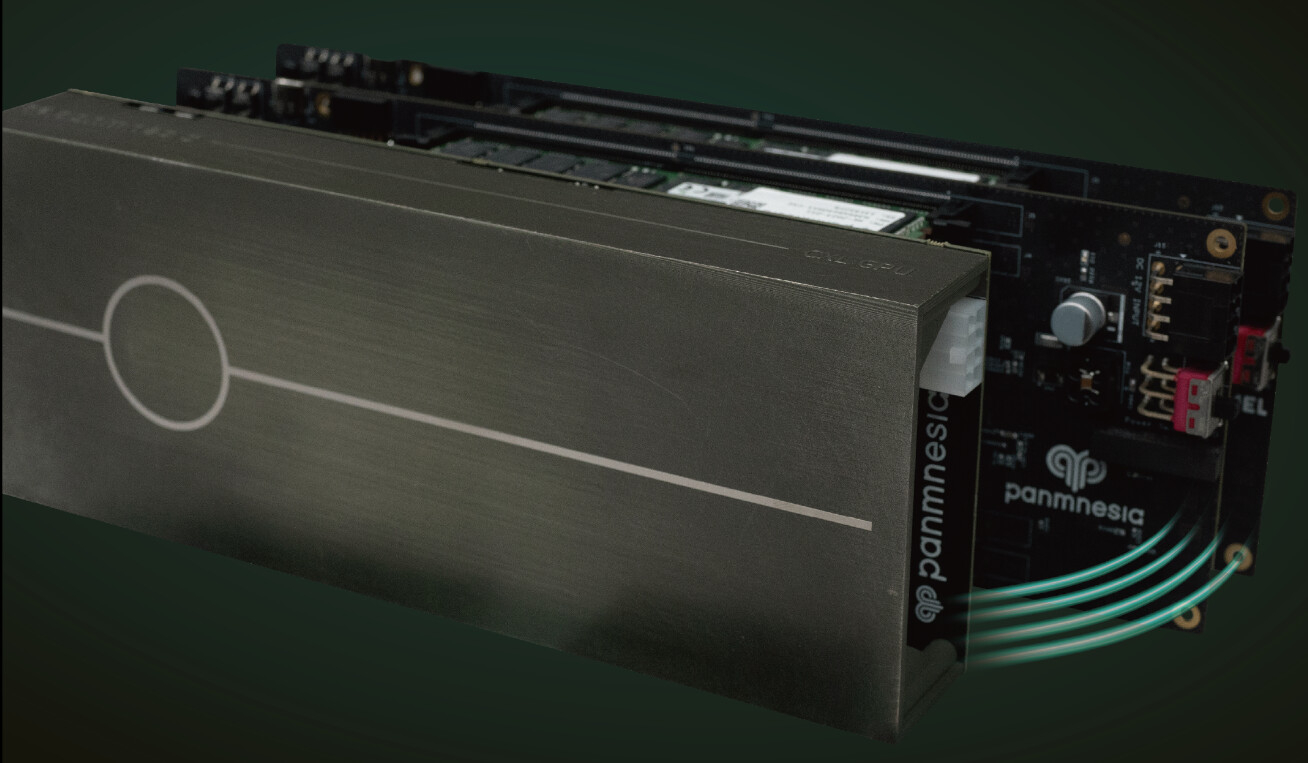
Источник изображений: Panmnesia Panmnesia обошла существующие ограничения путём создания собственного root-комплекса, совместимого со стандартом CXL 3.1 и предоставляющего несколько root-портов. Он и обеспечивает поддержку внешней памяти через PCIe. При этом задействован особый декодер HDM (Host-managed Device Memory), отвечающий за работу с адресными пространствами. Это сложное решение в каком-то смысле «обманывает» подсистему памяти ускорителя, заставляя ее рассматривать внешнюю PCIe-память как доступную напрямую. 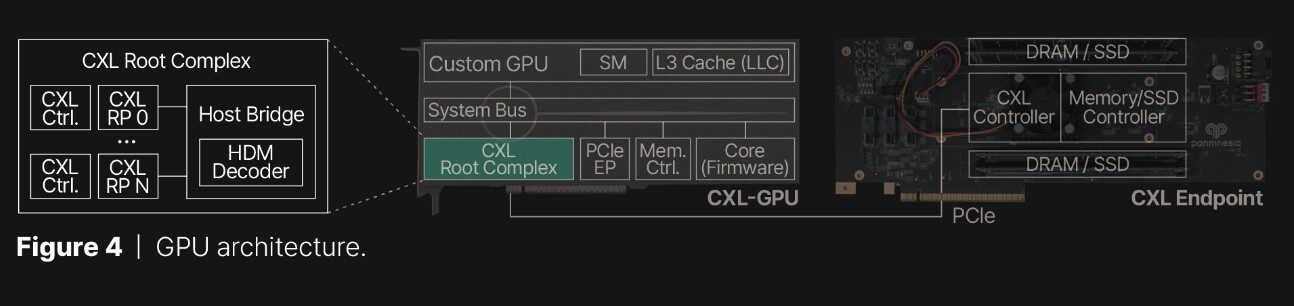 Прототип, основанный на кастомизированном GPU, в ходе тестов продемонстрировало задержки менее 100 нс при передаче данных в обоих направлениях. При этом решение Panmnesia предоставляет более гранулярный доступ к памяти в сравнении с UVM. Быстродействие CXL-системы Panmnesia оказалось в 3,22 раза выше в пересчёте на IPC по сравнению с UVM. Представлена российская системная плата «Ключевская» для двух Arm-процессоров
28.06.2024 [12:33],
Сергей Карасёв
Российская технологическая компания «Е-Флопс» объявила о разработке системной платы под названием «Ключевская», которая позиционируется в качестве основы модульной серверной платформы для хранения и обработки данных. Выпуск новинки, на которую получен патент, планируется организовать в сентябре нынешнего года. Изделие имеет 20-слойную конструкцию, а его габариты составляют 446 × 203 мм. Поддерживаются два процессора с архитектурой Arm64 (48 ядер, частота до 2,2 ГГц). Доступны 12 слотов для модулей оперативной памяти DDR4-3200 (L)RDIMM. Имеется 80 линий PCIe 4.0, из которых 48 совместимы с CCIX. Название процессора не указывается, но по описанию подходит, например, Baikal-S (BE-S1000). 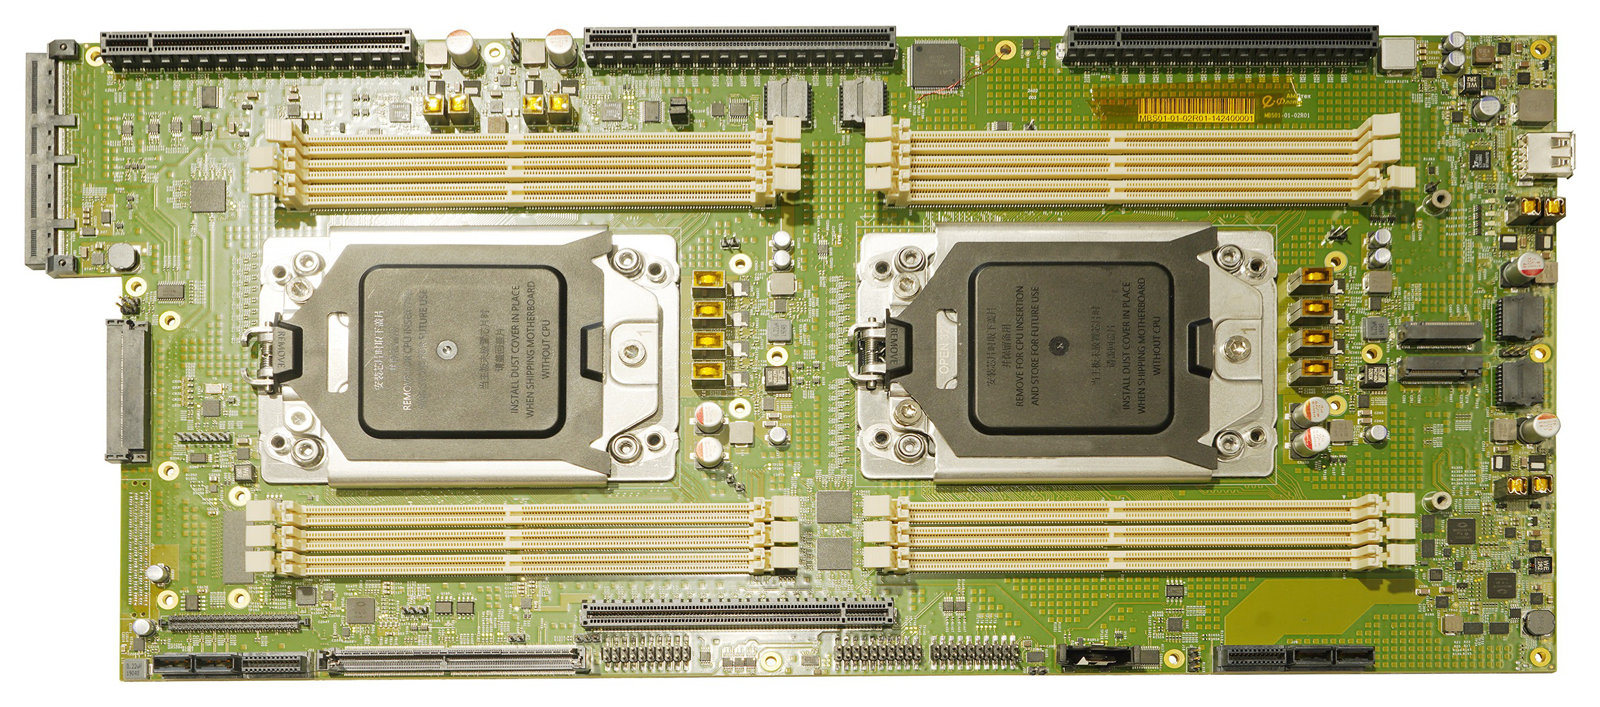
Источник изображений: «Е-Флопс» Системная плата получила два разъёма M.2 2242 для NVMe SSD и два слота PCIe 4.0 x16 для карт расширения с возможностью горячей замены. Есть слот PCIe 4.0 x16 OCP 3.0, четыре разъёма PCIe 4.0 x16/CCIX для установки райзеров, а также 260-контактный коннектор SO-DIMM DDR4 для модуля удалённого мониторинга и управления стандарта RunBMC. Упомянуты интерфейсы USB 2.0 и 1GbE. 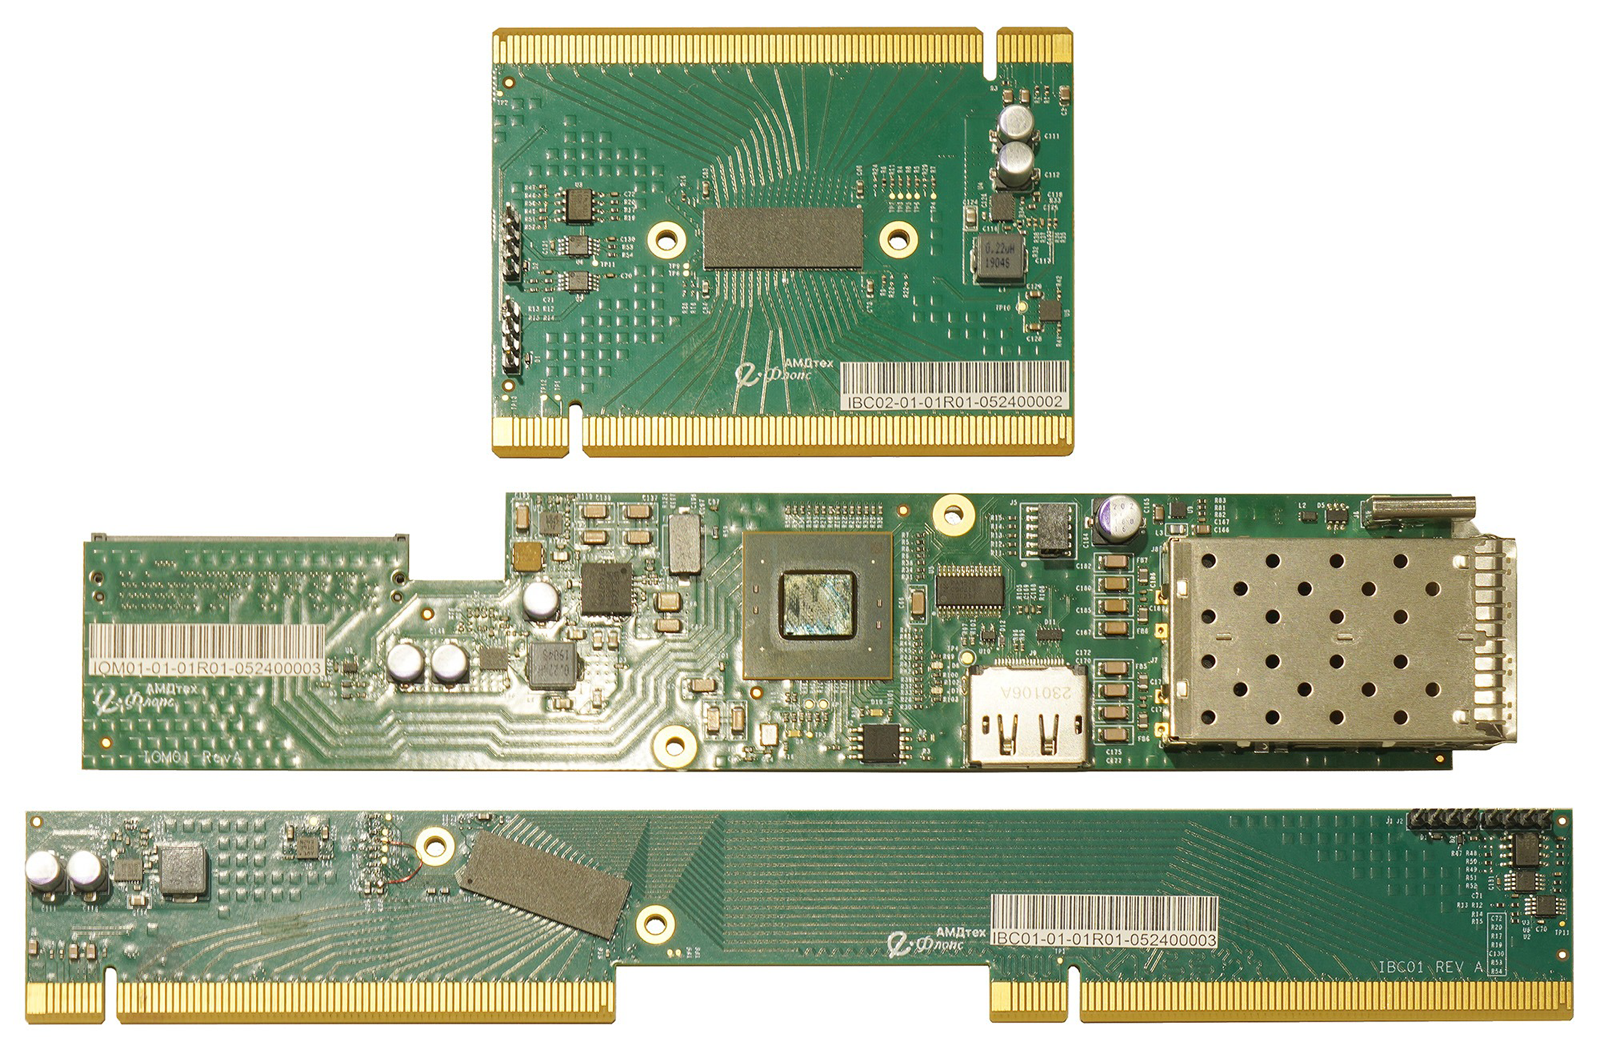 Модульная концепция предусматривает, что часть функциональности перенесена на так называемые «сателлитные платы». В частности, интерфейсы Ethernet, USB, DP, индикация и управление реализованы на IO-карте. Предусмотрена возможность дополнительного межпроцессорного соединения, увеличивающего скорость обмена данными в два раза, и возможность четырехпроцессорной SMP-сборки из двух типовых системных плат. 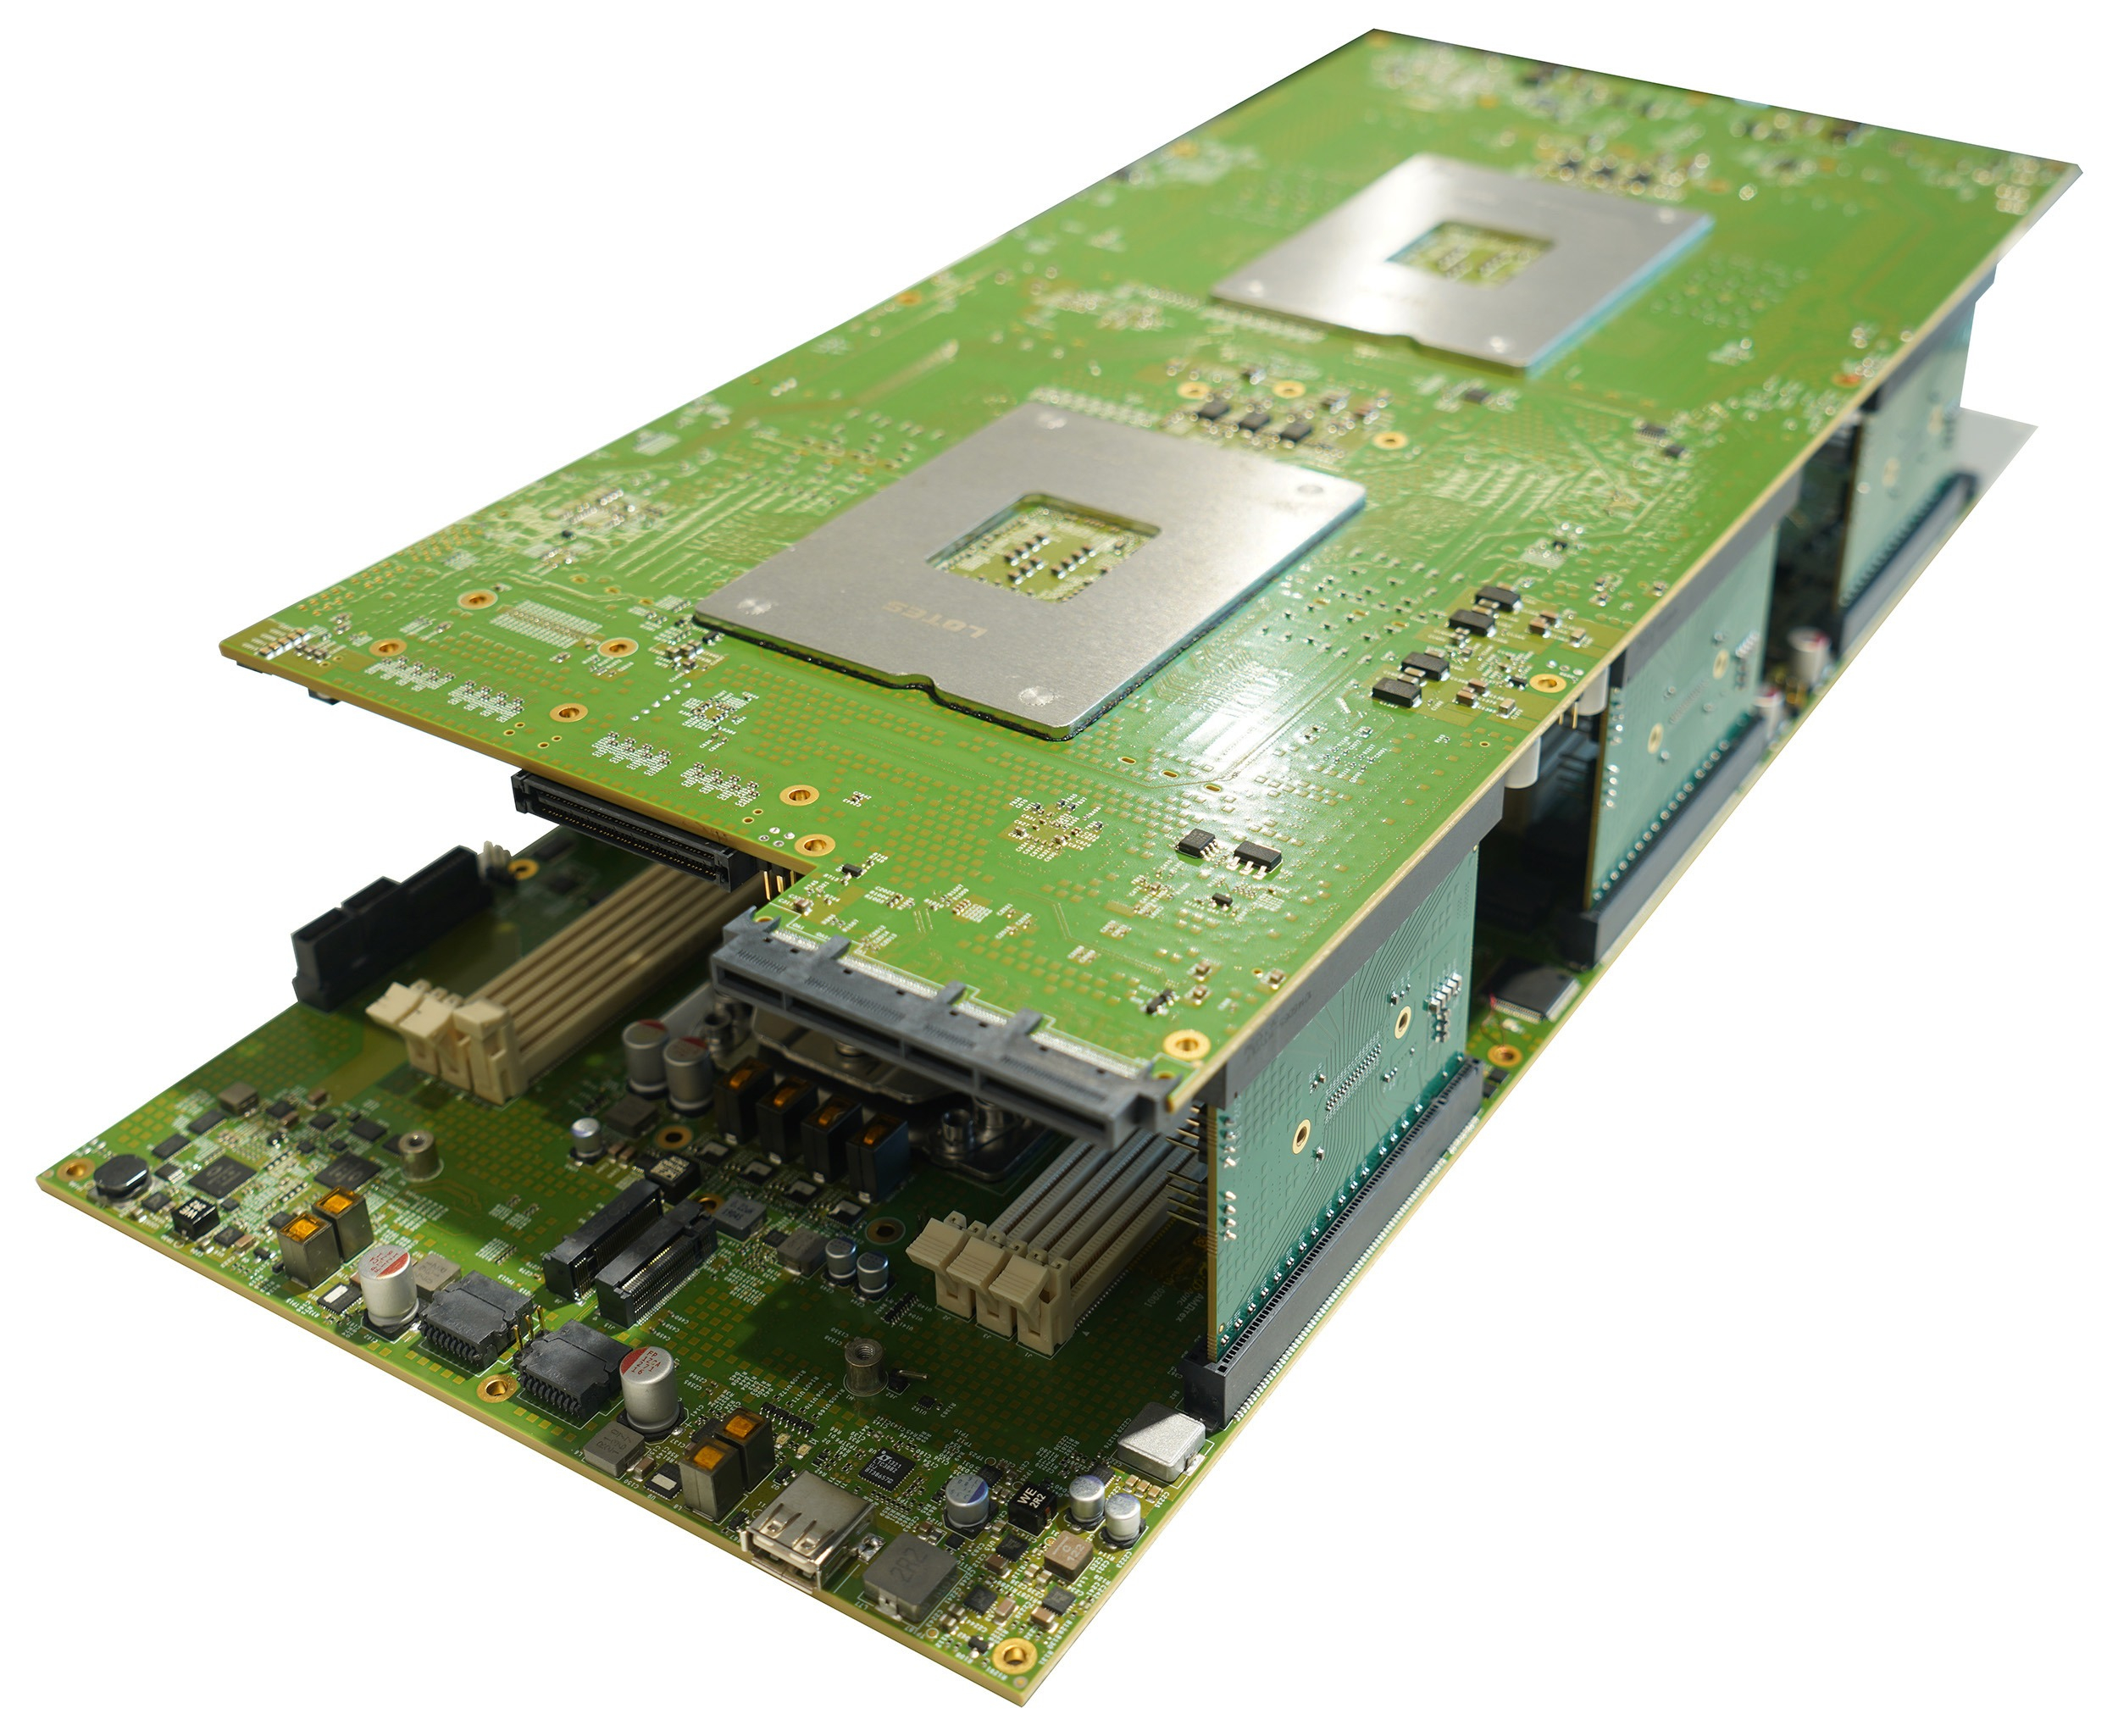 Изготовление плат осуществляется по контрактному производству в два основных этапа (без учета подготовительных работ, закупки сырья и материалов, функций технического контроля и пр.). Текстолит производится на заводах КНР из-за недоступности необходимых технологий в России. Вместе с тем поверхностный монтаж полностью выполняется на территории РФ. Легко потерять и невозможно забыть: нежелающие платить Broadcom будут вынуждены поддерживать устаревающие VMware-инфраструктуры
19.06.2024 [08:58],
Владимир Мироненко
Приобретение VMware, последовавшее за рядом значительных поглощений софтверных компаний в сфере ПО, включая покупки CA Technologies ($18,9 млрд) и Symantec ($10,9 млрд), в течение последних лет, говорит о намерении Broadcom развивать направление по разработке ПО, пишет Computer Weekly. CloudBolt Software в партнёрстве с AWS поручила Wakefield Research выяснить у 300 лиц, принимающих решения в сфере ИТ, как поглощение VMware повлияло на их планы. Почти все (95 %) руководители ИТ-компаний, принявшие участие в опросе, выразили обеспокоенность тем, как сделка повлияет на их ИТ-стратегию. Согласно CloudBolt Software, некоторые клиенты могут посчитать, что им придётся согласиться на более высокие расценки, установленные Broadcom, поскольку частичный или полный отказ от услуг и решений VMware грозит сбоями в работе, подчас очень серьёзными. 
Источник изображения: Sabina Music Rich / Unsplash На конференции Nutanix Next 2024 отраслевые аналитики обсудили возможные планы Broadcom в отношении VMware в свете того, как она интегрировала CA Technologies и Symantec. Саймон Робинсон (Simon Robinson), главный аналитик Enterprise Strategy Group, отметил, что архитектура ЦОД существенно не изменилась за последние 15–20 лет, так что для Broadcom это была возможность поглотить крупный бизнес, который «прописался» в большинстве ЦОД по всему миру. VMware позволила консолидировать ресурсы ЦОД, что для компаний оказалось выгодно и удобно. И хотя сегодня контейнеры, возможно, более эффективны в сравнении с традиционной виртуализацией для компаний, придерживающихся облачной стратегии, Стив Макдауэлл (Steve McDowell), главный аналитик Nand, отмечает, что ситуация с VMware аналогична ситуации с заказчиками СУБД Oracle: «VMware абсолютно “прилипчива”, и её замена чертовски дорога». 
Источник изображения: ben frost / Unsplash Аналитики сходятся в том, что инфраструктура на базе VMware не исчезнет. Даже если ИТ-руководители решат отказаться от использования ПО Broadcom, им придётся преодолеть множество технических препятствий, чтобы перейти на альтернативные решения. Следует также учесть, что некоторые поставщики ПО сертифицируют свои продукты только для сред VMware. В этом случае ИТ-руководителям необходимо готовиться к неизбежной эпохе использования устаревшей инфраструктуры VMware точно так же, как им приходится поддерживать старые системы, например, мейнфреймы, предупреждает Computer Weekly. Таким образом, хотя контейнеры могут быть предпочтительным выбором при развёртывании инфраструктуры новых приложений, существует масса старого ПО, которое, скорее всего, останется в виртуальных машинах. И большинство из них неизбежно будут использовать гипервизор VMware. Так что в обозримом будущем платформа VMware останется глубоко интегрированной в инфраструктуру ЦОД. «VMware никуда не денется. Broadcom сфокусирована на высокодоходном и высокомаржинальном бизнесе», — считает Макдауэлл. Virgin Media намерена отсудить €800 тыс. у рыболовов, повредивших её подводный интернет-кабель почти 10 лет назад
06.06.2024 [15:11],
Руслан Авдеев
Британская телеком-компания Virgin Media Wholesale подала в суд на владельцев рыболовецкого траулера Lida Suzanna. По информации Datacenter Dynamic, предположительно именно это судно повредило подводный кабель, соединяющий Ирландию и Великобританию, 26 января 2015 года. Компания подала иск в Ирландии, требуя возместить €800 тыс. ($870 тыс.) ущерба «владельцами и иными заинтересованными лицами», имеющими отношение к траулеру. Проложенный в 1999 году кабель Sirius South протяжённостью 219 км проложен между Дублином и Блэкпулом. Предполагается, что ловившее морских гребешков судно задело дно жёсткими металлическими рамными сетями, повредив телекоммуникационную инфраструктуру. Всего Virgin владеет двумя кабелями между Ирландией и «большим» островом: Sirius South и Sirius North. Последний проложен в пределах Соединённого Королевства между Шотландией и Северной Ирландией. После инцидента оператор быстро переключился на второй кабель, но пользователи заметили падение скорости интернет-доступа. Юристы истцов заявили, что ответчики должны были знать о расположении кабеля, отмеченного на используемых в отрасли картах и в ирландском Морском атласе, поскольку существующие правила обязывают экипаж иметь документы о расположении инфраструктурных цифровых магистралей. Представители владельцев траулера утверждают, что нет никаких доказательств того, что именно этот корабль имеет отношение к инциденту, а за любое повреждение несёт ответственность сама Virgin, не обеспечившая достаточного заглубления и защиты кабеля. 
Источник изображения: Fer Nando/unsplash.com В своё время неисправность устранило принадлежащее Orange Marine судно Pierre de Fermat, спустя несколько дней после происшествия. Всего известны 18 случаев повреждения именно этого кабеля с 1999 года, когда его проложила предшественница Virgin — компания NTL. Ранее Virgin Media подавала иск против другого траулера Willie Joe — тоже за повреждения в минувшие годы. Впрочем, в этом случае дело было улажено в 2022 году. Нарушения целостности подводных интернет-кабелей случаются во всём мире довольно регулярно. Например, недавно были повреждены кабели в Красном море и на западе Африки, из-за чего сократился трафик между континентами. А Великобритания даже приобрела специальный корабль для защиты подводных оптоволоконных и силовых кабелей. NVLink для экономных — AMD, Intel и другие IT-гиганты объединились для создания UALink и противостояния NVIDIA
30.05.2024 [23:56],
Игорь Осколков
Летом прошлого года AMD, Arista, Broadcom, Cisco, Eviden/Atos, HPE, Intel, Meta✴✴ и Microsoft сформировали консорциум Ultra Ethernet (UEC), призванный составить конкуренцию технологии InfiniBand, которая фактически единолично контролируется NVIDIA после покупки Mellanox, и стандартизировать Ethernet-решения для современных ИИ- и HPC-платформ. А теперь AMD, Broadcom, Cisco, Google, HPE, Intel, Meta✴✴ и Microsoft сформировали альянс Ultra Accelerator Link (UALink), который должен составить конкуренцию NVLink. К UEC за год присоединились ещё полсотни компаний, кроме, конечно, NVIDIA, которая, впрочем, про Ethernet тоже не забывает, хотя периодически получает критику со стороны Broadcom. Единственной альтернативой в деле построения фабрик для более-менее крупных кластеров остаётся Omni-Path Express, развиваемый Cornelis Networks, которая тоже присоединилась к UEC, но доля этой технологии на фоне Ethernet и InfiniBand мизерная. Кроме того, ни одна из этих технологий не может предложить то, что может NVIDIA NVLink — возможность напрямую объединить сотни ускорителей (точнее, их память) сверхбыстрым соединением с низким уровнем задержки. 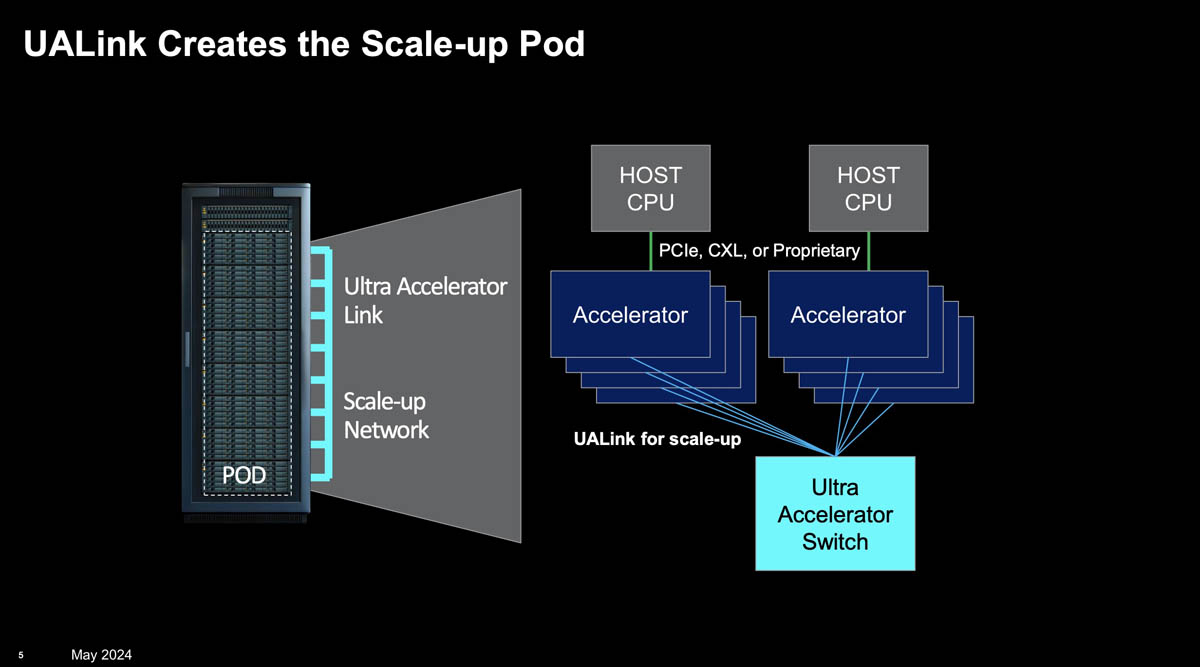
Источник изображений: UALink via ServeTheHome NVLink 4 достиг скорости 900 Гбайт/с на ускоритель и впервые вышел за пределы узла, позволив объединить в домен до 256 ускорителей, что NVIDIA и предложила в рамках DGX SuperPod H100. NVLink 5 удвоил пропускную способность до 1,8 Тбайт/с и теоретически позволит объединить до 576 ускорителей в одном домене. Именно NVLink позволил создать высокоплотные суперускорители GH200 NVL32 и GB200 NVL72. И именно их NVIDIA считает минимальной эффективной единицей кластеров ближайшего будущего, предлагая крупным заказчикам на меньшее даже не размениваться. 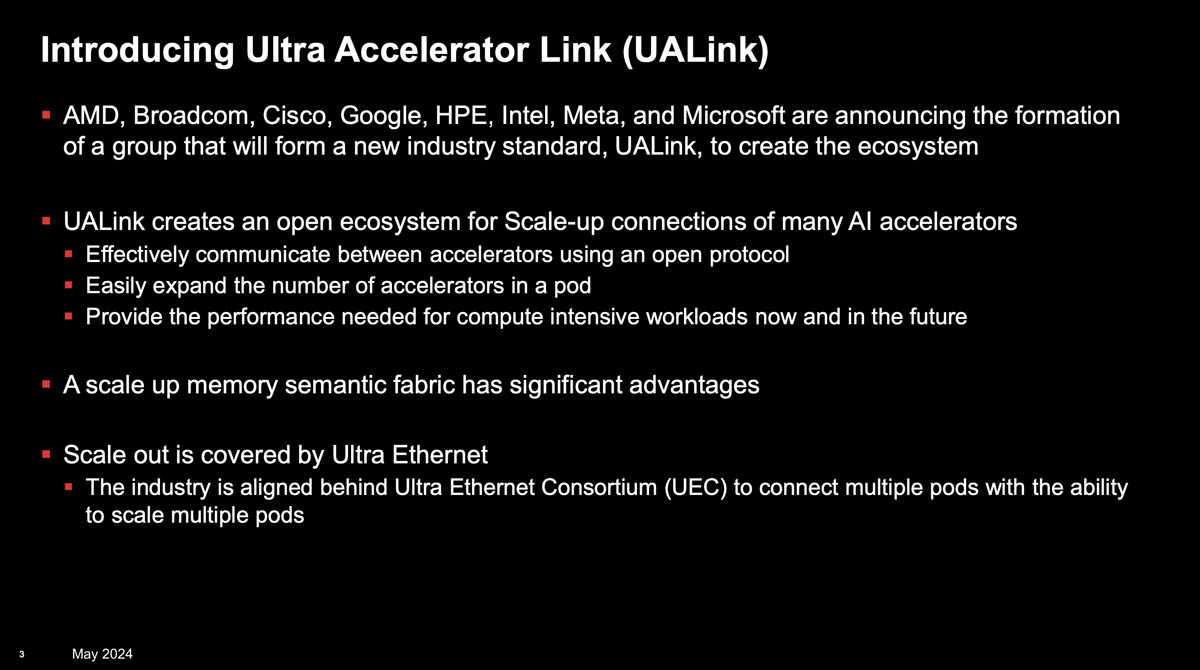 Intel в семействе Gaudi использует Ethernet (1,2 Тбайт/с на ускоритель) как для вертикального, так и для горизонтального масштабирования. AMD же полагается на Infinity Fabric (896 Гбайт/с на ускоритель) на базе PCIe и xGMI, которые до недавнего времени за пределы узла не выходили. Однако в конце 2023 года было объявлено, что в 2025 году AMD и Broadcom выпустят коммутатор на базе PCIe 7.0 (стандарт планируют только-только утвердить в этом же году), который будет поддерживать технологию, которая теперь называется AFL (Accelerated Fabric Link) — это и будет выходом Infinity Fabric за пределы узла. 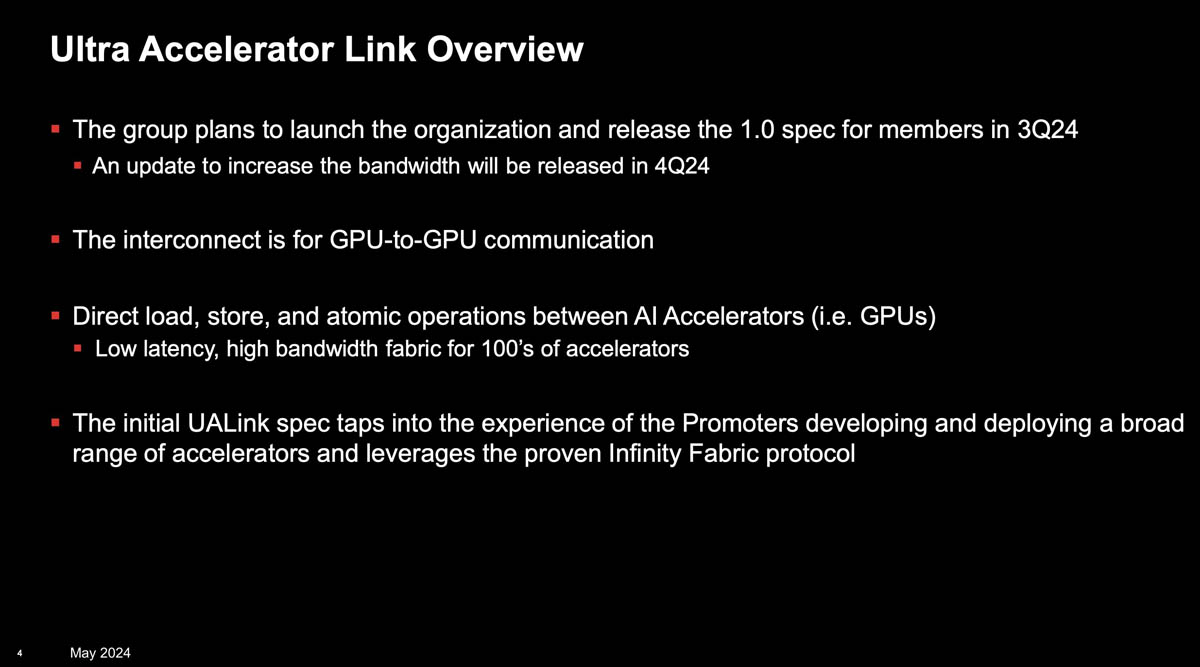 И именно совместными наработками AMD и Broadcom поделятся в рамках UALink. Первую версию нового интерконнекта альянс обещает представить уже в III квартале 2024 года, а в IV квартале — версию 1.1. При этом пока прямо не говорится, будет ли основным транспортом PCIe или Ethernet, и какой протокол будет использоваться для работы с памятью. Но уже обещано, что UALink 1.0 позволит объединить до 1024 ускорителей в одном домене с возможностью прямых load/store-запросов к их памяти. Для дальнейшего масштабирования кластеров по-прежнему предлагается использовать Ultra Ethernet. 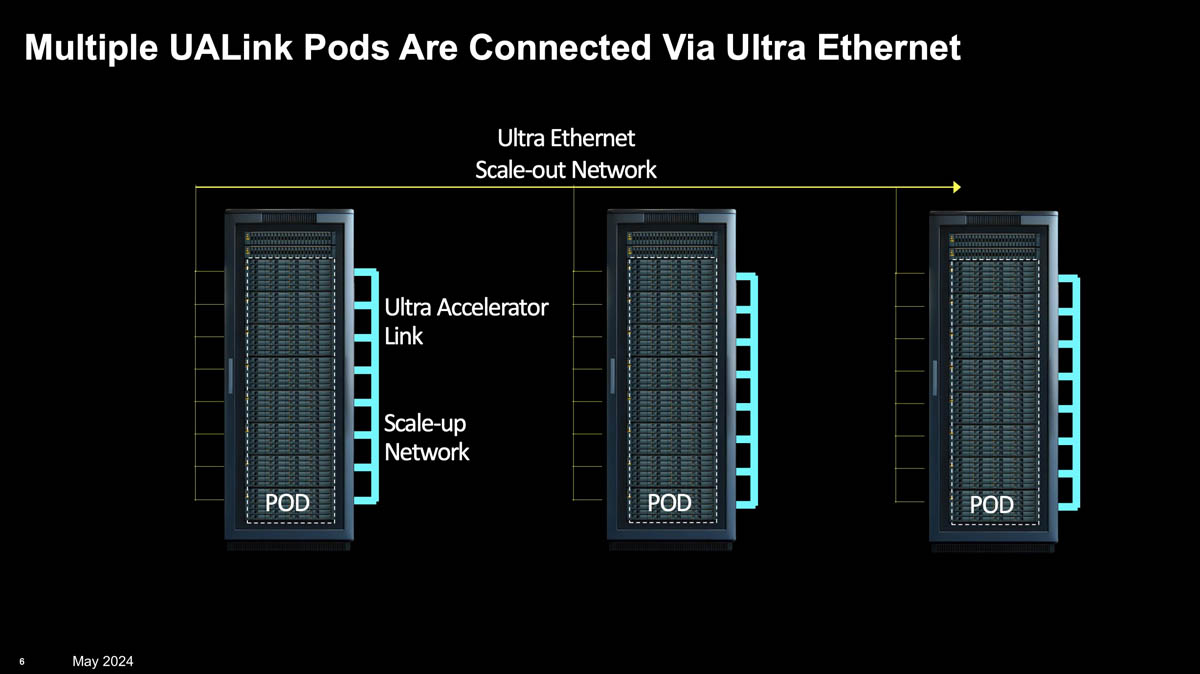 При этом UALink, строго говоря, не обещает возможности беспрепятственного общения ускорителей разных вендоров, зато позволяет упростить инфраструктуру и сделать её дешевле благодаря открытости и конкуренции. Хотя было бы приятно увидеть UALink в качестве аппаратной основы и для стандарта UXL, который намерен побороться с NVIDIA CUDA. Что касается CXL, то этот стандарт, тоже использующий PCIe в качестве транспорта, вероятно, останется «привязанным» к CPU и внутриузловым коммуникациям, хотя возможности его гораздо шире. Тридцать на одного: Liqid UltraStack 30 позволяет подключить десятки GPU к одному серверу
27.05.2024 [22:20],
Алексей Степин
Компания Liqid сотрудничает с Dell довольно давно — ещё в прошлом году она смогла добиться размещения 16 ускорителей в своей платформе UltraStack L40S. Но на этом компания не остановилась и представила новую композитную платформу UltraStack 30, в которой смогла довести число одновременно доступных хост-системе ускорителей до 30. Для подключения, конфигурации и управления ресурсами ускорителей Liqid использует комбинацию фирменного программного обеспечения Matrix CDI и интерконнекта Liqid Fabric. В основе последнего лежит PCI Express. Это позволяет динамически конфигурировать аппаратную инфраструктуру с учётом конкретных задач с её возвратом в общий пул ресурсов по завершению работы. Сами «капсулы» с ресурсами подключены к единственному хост-серверу, что упрощает задачу масштабирования, минимизирует потери производительности, повышает энергоэффективность и позволяет добиться наиболее плотной упаковки вычислительных ресурсов, нежели это возможно в классическом варианте с раздельными серверами. А благодаря гибкости конфигурирования буквально «на лету» исключается простой весьма дорогостоящих аппаратных ресурсов. 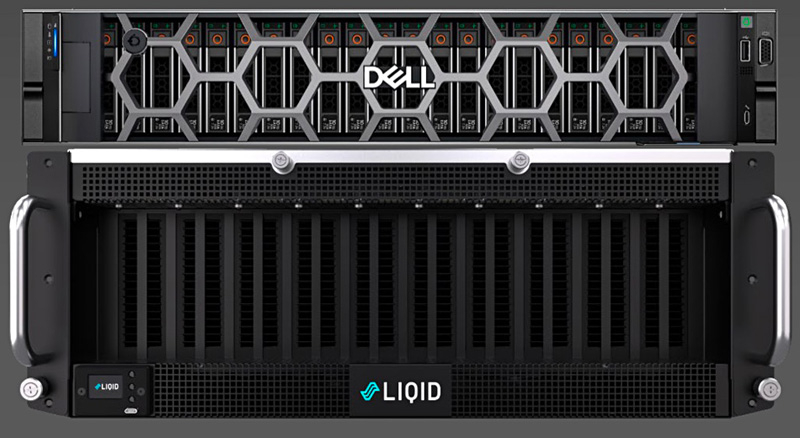
Источник здесь и далее: Liqid В случае UltraStack 30 основой по умолчанию является сервер серии Dell PowerEdge R760 с двумя Xeon Gold 6430 и 1 Тбайт оперативной памяти, однако доступен также вариант на базе Dell R7625, оснащённый процессорами AMD EPYC 9354. Опционально можно укомплектовать систему NVMe-хранилищем объёмом 30 Тбайт, в качестве сетевых опций доступны либо пара адаптеров NVIDIA ConnectX-7, либо один DPU NVIDIA Bluefield-3. 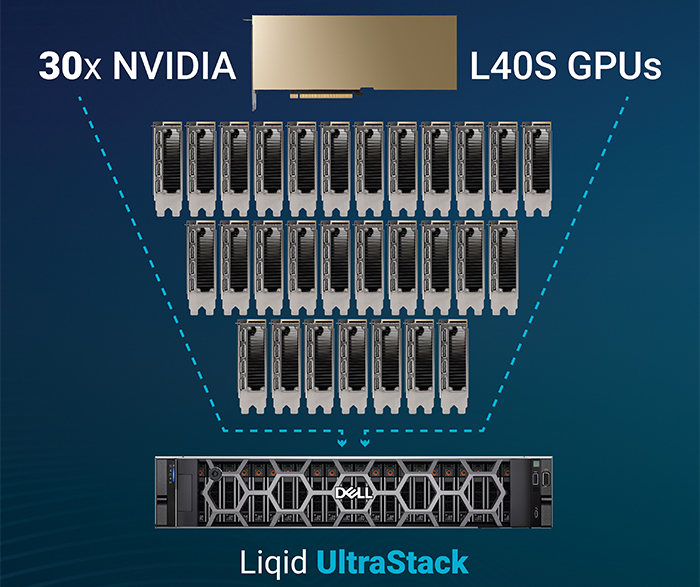 За общение с ускорительными модулями отвечает 48-портовой коммутатор PCI Express 4.0 вкупе с фирменными хост-адаптерами Liqid. Технология ioDirect позволяет ускорителям общаться друг с другом и хранилищем данных напрямую, без посредничества CPU. В трёх модулях расширения установлено по 10 ускорителей NVIDIA L40S, каждый несет на борту 48 Гбайт памяти GDDR6. Такая конфигурация теоретически способна развить 7,3 Пфлопс на вычислениях FP16, вдвое больше на FP8, и почти 1,1 Пфлопс на тензорных ядрах в формате TF32. 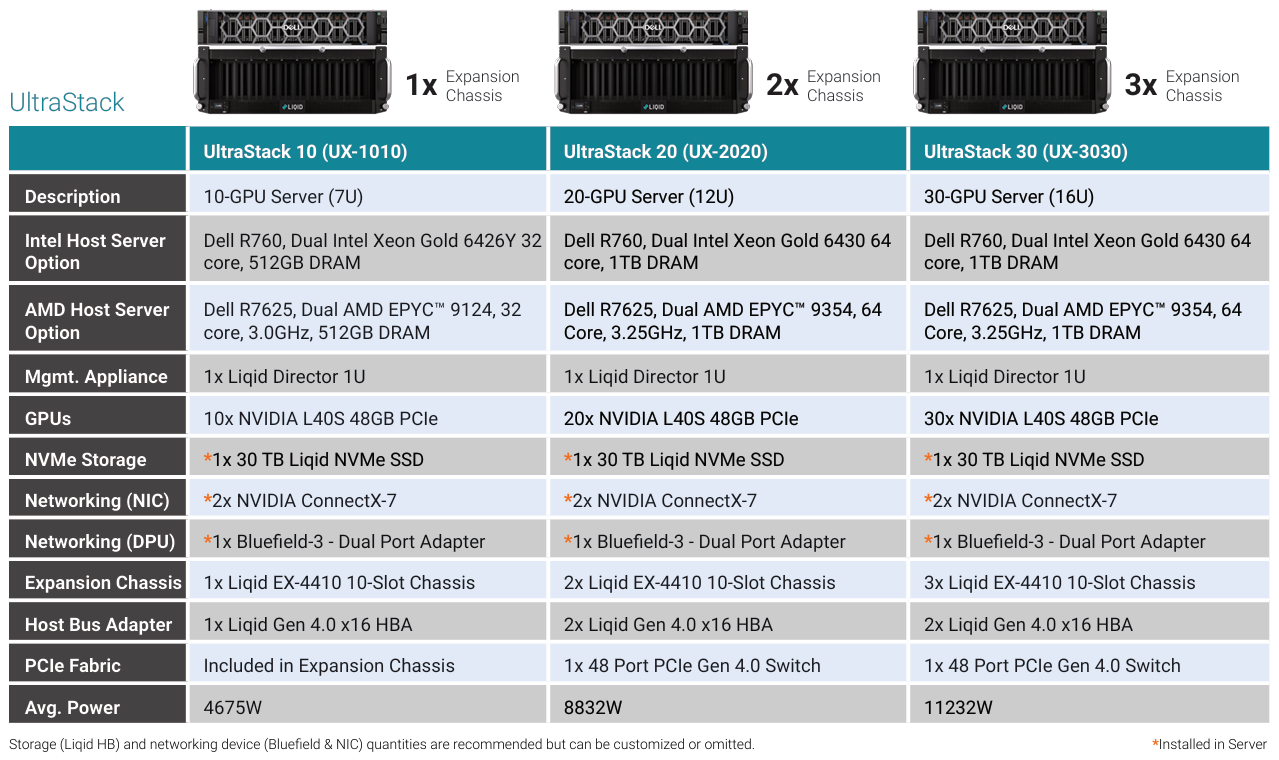 Платформа UltraStack 30 предназначена в первую очередь для быстрого развёртывания достаточно мощной ИИ-инфраструктуры там, где требуется тонкая подстройка и дообучение уже «натасканных» больших моделей. При этом стоит учитывать довольно солидное энергопотребление, составляющее более 11 кВт. Также в арсенале компании есть решения SmartStack на базе модульных систем Dell PowerEdge C-Series, позволяющие подключать к каждому из лезвийных модулей MX760c, MX750с и MX740c до 20 ускорителей. Модульные решения Liqid поддерживают также ускорители других производителей, включая достаточно экзотические, такие как Groq. Эрик Шмидт: будущие суперкомпьютеры США и Китая будут окружены пулемётами и колючей проволокой и питаться от АЭС
26.05.2024 [13:24],
Руслан Авдеев
Бывший генеральный директор Google Эрик Шмидт (Eric Schmidt) прогнозирует, что в обозримом будущем в США и Китае большие суперкомпьютеры будут заниматься ИИ-вычислениями под защитой военных баз. В интервью Noema он подробно рассказал о том, каким видит новые ИИ-проекты, и это будущее вышло довольно мрачным. Шмидт поведал о том, как правительства будут регулировать ИИ и искать возможности контроля ЦОД, работающих над ИИ. Покинув Google, бизнесмен начал очень тесно сотрудничать с военно-промышленным комплексом США. По его словам, рано или поздно в США и Китае появится небольшое число чрезвычайно производительных суперкомпьютеров с возможностью «автономных изобретений» — их производительность будет гораздо выше, чем государства готовы свободно предоставить как своим гражданам, так и соперникам. Каждый такой суперкомпьютер будет соседствовать с военной базой, питаться от атомного источника энергии, а вокруг будет колючая проволока и пулемёты. Разумеется, таких машин будет немного — гораздо больше суперкомпьютеров будут менее производительны и доступ к ним останется более широким. Строго говоря, самые производительные суперкомпьютеры США принадлежат Национальным лабораториям Министерства энергетики США, которые усиленно охраняются и сейчас. Как заявил Шмидт, необходимы и договорённости об уровнях безопасности вычислительных систем по примеру биологических лабораторий. В биологии широко распространена оценка по уровням биологической угрозы для сдерживания её распространения и оценки уровня риска заражения. С суперкомпьютерами имеет смысл применить похожую классификацию. 
Источник изображения: Joel Rivera-Camacho/unsplash.com Шмидт был председателем Комиссии национальной безопасности США по ИИ и работал в Совете по оборонным инновациям. Также он активно инвестировал в оборонные стартапы. В то же время Шмидт сохранил влияние и в Alphabet и до сих пор владеет акциями компании стоимостью в миллиарды долларов. Военные и разведывательные службы США пока с осторожностью относятся к большим языковым моделям (LLM) и генеративному ИИ вообще из-за распространённости «галлюцинаций» в таких системах, ведущих к весьма правдоподобным на первый взгляд неверным выводам. Кроме того, остро стоит вопрос сохранения секретной информации в таких системах. Ранее в этом году Microsoft подтвердила внедрение изолированной от интернета генеративной ИИ-модели для спецслужб США после модернизации одного из своих ИИ-ЦОД в Айове. При этом представитель Microsoft два года назад предрекал, что нынешнее поколение экзафлопсных суперкомпьютеров будет последним и со временем все переберутся в облака. |
|
✴ Входит в перечень общественных объединений и религиозных организаций, в отношении которых судом принято вступившее в законную силу решение о ликвидации или запрете деятельности по основаниям, предусмотренным Федеральным законом от 25.07.2002 № 114-ФЗ «О противодействии экстремистской деятельности»; |
© 1997—2026 3DNews
При цитировании документа ссылка на сайт с указанием автора обязательна. Полное заимствование документа является
нарушением
российского и международного законодательства и возможно только с согласия редакции 3DNews.



 MWC 2018
 2018
 Computex

 IFA 2018









