


Опрос
|
реклама
Быстрый переход
OpenAI планирует выпустить ИИ-агента Operator в январе — он сможет управлять ПК без пользователя
14.11.2024 [11:12],
Дмитрий Федоров
Компания OpenAI готовится к выпуску нового ИИ-агента под кодовым названием Operator, который позволит выполнять разнообразные задачи на компьютере пользователя. Релиз этого инструмента может состояться уже в январе 2025 года. 
Источник изображения: OpenAI На первом этапе упомянутое решение будет доступно в качестве предварительной исследовательской версии через API для разработчиков. Operator призван конкурировать с аналогичными ИИ-агентами, такими как недавно представленный Computer Use компании Anthropic и разрабатываемый ИИ-агент Google, ориентированный на потребительский рынок. OpenAI стремится создать универсальный инструмент, способный выполнять различные операции в веб-браузере и подходящий для решения повседневных задач пользователей. Однако, как отмечает издание Bloomberg, пока неизвестно, предложит ли Operator пользователям значительные преимущества перед аналогичными решениями конкурентов. Исследовательская версия инструмента будет полезна для оценки его потенциальных преимуществ и выявления областей, требующих доработки на основе обратной связи. Запуск Operator совпадает с публикацией документа OpenAI, содержащего рекомендации для правительства США по вопросам стратегии развития ИИ. В этом документе предлагается создание «экономических зон» для активного развития ИИ-инфраструктуры, а также формирование альянсов с союзниками США, что позволит усилить позиции страны в технологической гонке с Китаем. OpenAI призывает создать ИИ-альянс, который объединит США и союзников, включая страны Ближнего Востока
14.11.2024 [08:40],
Алексей Разин
Действующему руководству стартапа OpenAI явно не даёт покоя идея использования ресурсов некоторых стран Персидского залива для финансирования развития мировой инфраструктуры искусственного интеллекта. Новая инициатива OpenAI подразумевает создание альянса с участием политических союзников США, включая страны Ближнего Востока. 
Источник изображения: OpenAI В среду, как сообщает South China Morning Post, руководство OpenAI выступило с призывом сформировать «Североамериканское соглашение по ИИ», которое бы упростило доступ к кадровым, финансовым и товарным ресурсам на международном уровне, которые требуются для построения инфраструктуры систем искусственного интеллекта. В конечном итоге соглашение должно объединить вокруг США союзников и партнёров, включая страны Ближнего Востока. Стратегическая инициатива была представлена OpenAI на мероприятии в Вашингтоне. Помимо предложений по сохранению лидирующих позиций США в сфере искусственного интеллекта, документ предлагает методы решения проблемы с энергоснабжением профильных центров обработки данных. По мнению OpenAI, власти США должны обеспечить поддержку затратным инфраструктурным проектам в сфере энергетики, предоставляя государственные гарантии выкупа электроэнергии у создаваемых генерирующих мощностей. В отношении проектов должен действовать режим регуляторного благоприятствования, включая и решения по вводу в строй ядерных реакторов, работа которых была в своё время приостановлена. Предлагается использовать в мирных целях опыт ВМС США в создании компактных ядерных реакторов для подводных лодок. В заявлении OpenAI говорится: «ИИ представляет собой возможность реиндустриализации США, которую нельзя упустить, и которая поможет инициировать рост всей экономики, способный оживить американскую мечту». Кроме того, инициатива OpenAI преследует цель обеспечить национальную безопасность США и защитить страну и её союзников от растущего влияния Китая через распространение «ИИ, сформированного с учётом демократических ценностей». План развития национальной отрасли ИИ был согласован как с действующей администрацией президента США Байдена, так и с представителями недавно избранного Дональда Трампа (Donald Trump). Представители OpenAI ожидают, что данная повестка получит приоритет в работе Конгресса и правительства США нового состава. Пузырь ИИ сдувается, пока OpenAI, Google и Anthropic пытаются создать более продвинутый ИИ
13.11.2024 [19:26],
Сергей Сурабекянц
Три ведущие компании в области искусственного интеллекта столкнулись с ощутимым снижением отдачи от своих дорогостоящих усилий по разработке новых систем ИИ. Новая модель OpenAI, известная как Orion, не достигла желаемой компанией производительности, предстоящая итерация Google Gemini не оправдывает ожиданий, а Anthropic столкнулась с отставанием в графике выпуска своей модели Claude под названием 3.5 Opus. 
Источник изображения: unsplash.com После многих лет стремительного выпуска всё более сложных продуктов ИИ три ведущие в этой сфере компании наблюдают убывающую отдачу от дорогостоящих усилий по созданию новых моделей. Становится все труднее находить свежие, ещё неиспользованные источники высококачественных данных для обучения более продвинутых систем ИИ. А нынешних весьма скромных улучшений недостаточно, чтобы окупить огромные затраты, связанные с созданием и эксплуатацией новых моделей, как и оправдать ожидания от выпуска новых продуктов. Так, OpenAI утверждала, что находится на пороге важной вехи. В сентябре завершился начальный раунд обучения для новой масштабной модели Orion, которая должна была приблизится к созданию мощного ИИ, превосходящего людей. Но ожидания компании, по утверждению осведомлённых источников, не оправдались. Orion не смогла продемонстрировать прорыва, который ранее показала модель GPT-4 по сравнению с GPT-3.5. 
Источник изображения: Pixabay Anthropic, как и её конкуренты, столкнулась с трудностями в процессе разработки и обучения 3.5 Opus. По словам инсайдеров, модель 3.5 Opus показала себя лучше, чем старая версия, но не так значительно, как ожидалось, учитывая размер модели и затраты на её создание и запуск. Эти проблемы бросают вызов утвердившемуся в Кремниевой долине мнению о масштабируемости ИИ. Приверженцам глобального внедрения ИИ приходится признать, что бо́льшая вычислительная мощность, увеличенный объём данных и более крупные модели пока не прокладывают путь к технологическому прорыву в области ИИ. 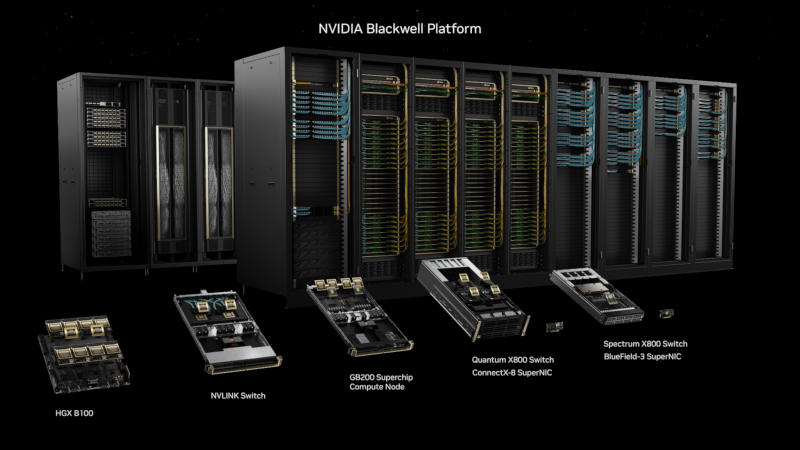
Источник изображения: Nvidia Эксперты высказывают обоснованные сомнения в окупаемости крупных инвестиций в ИИ и достижимости всеобъемлющей цели, к которой стремятся разработчики ИИ-моделей, — создания общего искусственного интеллекта (AGI). Этот термин обычно применяется к гипотетическим ИИ-системам, способным соответствовать или превосходить человека в большинстве интеллектуальных задач. Руководители OpenAI и Anthropic ранее заявляли, что AGI может появиться уже через несколько лет. Технология, лежащая в основе ChatGPT и конкурирующих ИИ-чат-ботов, была создана на основе данных из социальных сетей, онлайн-комментариев, книг и других источников из интернета. Этих данных хватило для создания продуктов, генерирующих суррогатные эссе и поэмы, но для разработки систем ИИ, которые превзойдут интеллектом лауреатов Нобелевской премии — как надеются некоторые компании, — могут потребоваться другие источники данных, помимо сообщений в Википедии и субтитров YouTube. 
Источник изображения: unsplash.com OpenAI была вынуждена заключить соглашения с издателями, чтобы удовлетворить хотя бы часть потребности в высококачественных данных, а также адаптироваться к растущему юридическому давлению со стороны правообладателей контента, используемого для обучения ИИ. Отмечается высокий спрос на рынке труда на специалистов с высшим образованием, которые могут маркировать данные, связанные с их областью компетенции. Это помогает сделать обученные ИИ-системы более эффективными в ответах на запросы. Подобные усилия обходятся дороже и требуют на порядок больше времени, чем простое индексирование интернета. Поэтому технологические компании обращаются к синтетическим данным, таким как сгенерированные компьютером изображения или текст, имитирующие контент, созданный людьми. Однако у такого подхода есть свои ограничения, так как трудно добиться качественного улучшения при использовании подобных данных для обучения ИИ. Тем не менее компании ИИ продолжают следовать принципу «чем больше, тем лучше». В стремлении создавать продукты, приближающиеся к уровню человеческого интеллекта, технологические компании увеличивают объём вычислительной мощности, данных и времени, затрачиваемых на обучение новых моделей, что приводит к росту расходов. Генеральный директор Anthropic Дарио Амодеи (Dario Amodei) заявил, что в этом году компании потратят $100 млн на обучение новейших моделей, а в ближайшие годы эта сумма может достичь $100 млрд. 
Источник изображения: unsplash.com Безусловно, потенциал для улучшения моделей ИИ, помимо масштабирования, существует. Например, для своей новой модели Orion OpenAI применяет многомесячный процесс пост-обучения. Эта процедура включает использование обратной связи от людей для улучшения ответов и уточнения «эмоциональной окраски» взаимодействия с пользователями. Разработчики ИИ-моделей оказываются перед выбором: либо предлагать старые модели с дополнительными улучшениями, либо запускать чрезвычайно дорогие новые версии, которые могут работать ненамного лучше. По мере роста затрат растут и ожидания — стремительное развитие ИИ на начальном этапе создало завышенные ожидания как у специалистов, так и у инвесторов. Мировые продажи GPU достигнут $100 млрд в этом году — львиную долю принесут чипы, не связанные с графикой
13.11.2024 [17:25],
Владимир Мироненко
Согласно прогнозу аналитиков Jon Peddie Research, глобальный рынок графических процессоров превысит $98,5 млрд по итогам 2024 года, пишет ресурс Tom's Hardware. 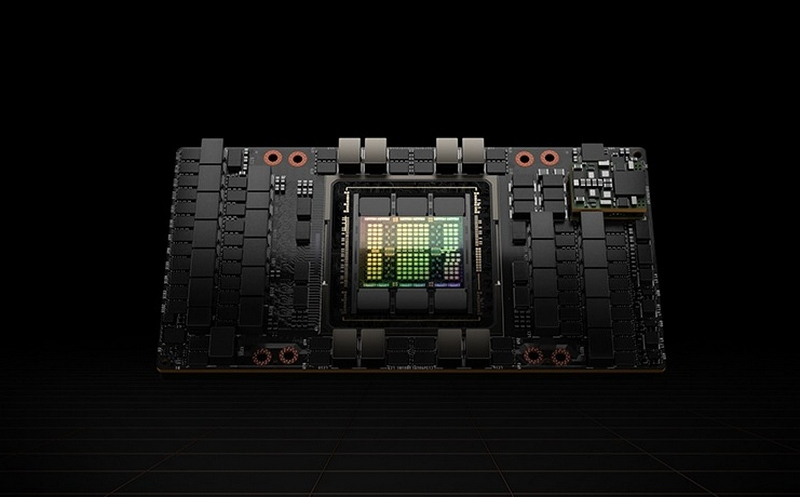
Источник изображения: Nvidia По данным JPR, на рынке сейчас присутствует семь разработчиков архитектур GPU, а также 20 компаний, занятых созданием дискретных, интегрированных и встраиваемых графических процессоров. Большинство этих решений представляют собой интегрированные GPU начального уровня, и лишь несколько компаний разрабатывают дискретные GPU для игровых видеокарт и ускорителей вычислений. Большую часть дохода на мировом рынке GPU приносят решения, которые не используются для обработки графики: в количественном выражении продажи GPU для задач ИИ и высокопроизводительных вычислений (HPC) составляют всего несколько миллионов единиц в год, но поскольку их цена составляет десятки тысяч долларов за единицу, реализация таких продуктов приносит Nvidia десятки миллиардов долларов, а AMD — миллиарды. 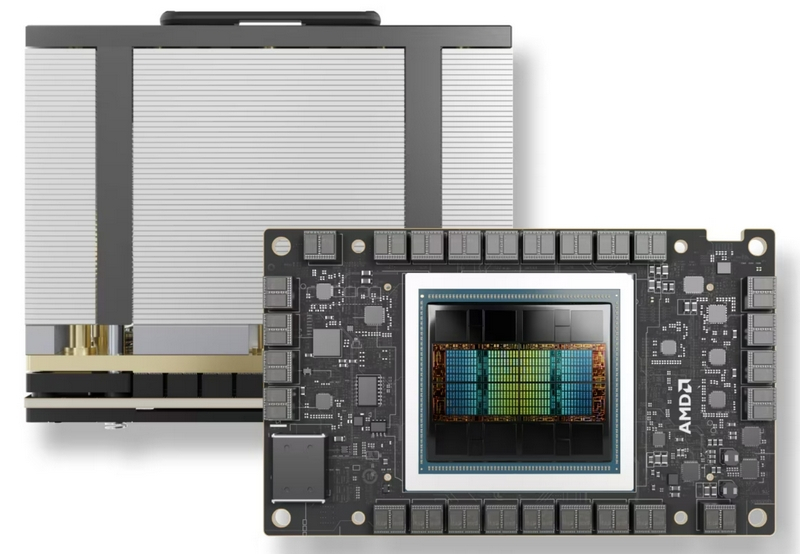
Источник изображения: AMD Всего за два квартала текущего финансового года доход Nvidia от поставок GPU для ИИ и HPC составил $42 млрд, а за весь год эти цифры могут увеличиться до $90 млрд. AMD ожидает, что выручка от продажи её ИИ-ускорителей превысит $3 млрд. Если говорить о других участниках рынка, как, например, Biren или MetaX, то они пока значительно отстают по доходам от лидеров. «GPU стали повсеместными и их можно найти практически в каждом промышленном, научном, коммерческом и потребительском продукте, производимом сегодня, — сообщил доктор Джон Педди (Jon Peddie), президент Jon Peddie Research. — Некоторые сегменты рынка, такие как ИИ, попали в заголовки из-за своего быстрого роста и высокой средней цены продажи (ASP), но они имеют небольшой объём по сравнению с другими сегментами рынка». Tom's Hardware отметил, что хотя рынок GPU для ИИ имеет небольшой объём по сравнению с другими сегментами, все новички на рынке графических процессоров — особенно из Китая — сосредоточены на решениях для ЦОД, а не для игр. Конечно, эти компании сталкиваются с ограничениями со стороны правительства США, стремящегося перекрыть Китаю доступ к передовым технологиям ИИ, но, по-видимому, они готовы пойти на риск, поскольку потенциал рынка ИИ очень высок. YouTube тестирует создание ремиксов песен с помощью ИИ
13.11.2024 [11:18],
Владимир Мироненко
Видеосервис YouTube запустил тестирование функции создания ремиксов песен с помощью ИИ. Сейчас этой функцией могут воспользоваться отобранные YouTube в группу тестировщиков авторы, живущие в США. 
Источник изображения: Christian Wiediger/unsplash.com Для создания ремикса пользователь должен выбрать песню из предлагаемого списка музыкальных треков лейблов-партнёров YouTube, затем указать опцию «Изменить стиль трека» и предоставить описание, как он хотел бы изменить стиль трека. После этого с помощью ИИ будет сгенерирован 30-секундный музыкальный фрагмент, который автор сможет использовать в своих коротких видео. Google отметила на странице поддержки, что ремиксованный звуковой фрагмент будет «приписан» к оригинальной песне через Short и сводную страницу аудио Shorts. Кроме того, он также будет иметь соответствующую метку, указывающую на то, что трек был изменён с помощью ИИ. В прошлом году YouTube начал тестирование функции создания песен Dream Track с использованием генеративного ИИ и вокала известных исполнителей. Для создания трека достаточно предоставить текстовое описание будущей песни или просто напеть мотив. Функция Dream Track стала доступной для тестирования отдельными авторами в ноябре 2023 года, и работает она на основе модели генерации музыки Lyrica, разработанной Deepmind. Чтобы не столкнуться с возможными исками по поводу нарушения авторских прав, YouTube сообщил в августе прошлого года о планах выплачивать компенсацию исполнителям и правообладателям за использование их работ в функциях ИИ. С этой целью компания договорилась о партнёрстве с Universal Music Group для разработки модели выплат правообладателям. Сооснователь OpenAI Грег Брокман вернулся в компанию после длительного отпуска
13.11.2024 [10:26],
Алексей Разин
Глядя на череду увольнений из OpenAI влиятельных теперь в сфере искусственного интеллекта фигур, которые стояли у истоков этого стартапа, можно было подумать, что из начального состава компании в её штате осталось не более двух человек. Между тем, президент OpenAI Грег Брокман (Greg Brockman), взявший в августе длительный отпуск, недавно вернулся к исполнению своих обязанностей. 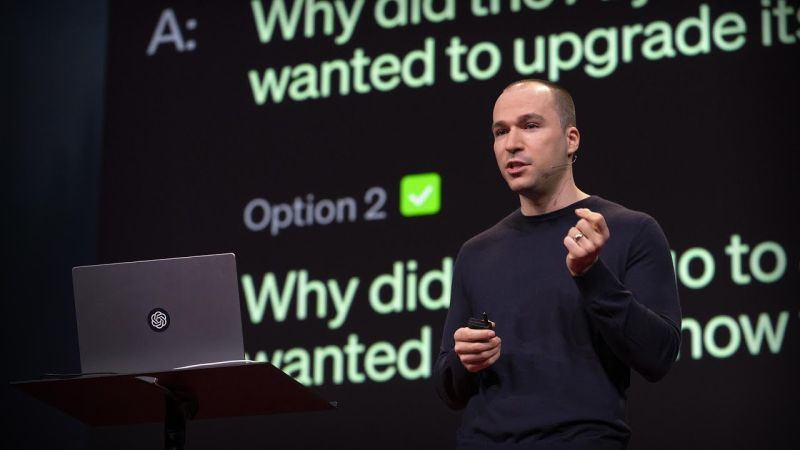
Источник изображения: OpenAI Developer Forum Как показывает опыт Раджи Кодури (Raja Koduri), который несколько лет назад после длительного отпуска перешёл из AMD в конкурирующую Intel, подобные перерывы в активной деятельности руководителей далеко не всегда благоприятно заканчиваются для работодателей, но в случае с Грегом Брокманом всё обошлось. Агентство Bloomberg смогло подтвердить у представителей OpenAI, что Брокман на днях вернулся к исполнению своих обязанностей президента компании. Сотрудники стартапа на этой неделе получили соответствующее уведомление. Попутно Брокман сообщил сотрудникам OpenAI, что вместе с генеральным директором Сэмом Альтманом (Sam Altman) работает над определением своей новой роли внутри компании, которая позволила бы ей легче справляться с техническими трудностями, возникающими на её пути. Брокман сыграл важную роль в событиях прошлой осени, когда совет директоров OpenAI принял решение отправить Альтмана в отставку. Брокман тогда на время покинул компанию в знак протеста против увольнения Альтмана, но вернулся после его восстановления в должности генерального директора. Продолжительный отпуск понадобился Брокману в августе этого года для восстановления сил и попытки впервые расслабиться после основания OpenAI девять лет назад. Некоторое время назад OpenAI покинули бывший технический директор Мира Мурати (Mira Murati) и ведущий научный специалист Илья Суцкевер, которые уже успели основать собственные стартапы в области искусственного интеллекта. Джон Шульман (John Schulman), который также ушёл из OpenAI, в новой активности на этом направлении пока замечен не был. В общей сложности, из начальной группы основателей OpenAI в штате компании остаются три человека, включая Сэма Альтмана и Грега Брокмана. SoftBank построит самый мощный ИИ-суперкомпьютер в Японии, используя ускорители Nvidia DGX B200 семейства Blackwell
13.11.2024 [07:54],
Алексей Разин
На этой неделе Nvidia провела мероприятие, на котором выступили её основатель Дженсен Хуанг (Jensen Huang) и глава SoftBank Масаёси Сон (Masayoshi Son). Последняя из корпораций начнёт в числе первых использовать ускорители вычислений Nvidia DGX B200 поколения Blackwell в самом мощном в Японии суперкомпьютере, ориентированном на решение задач искусственного интеллекта. Одновременно SoftBank запустит в Японии сеть поколения AI-RAN для управления автопилотом и роботами. 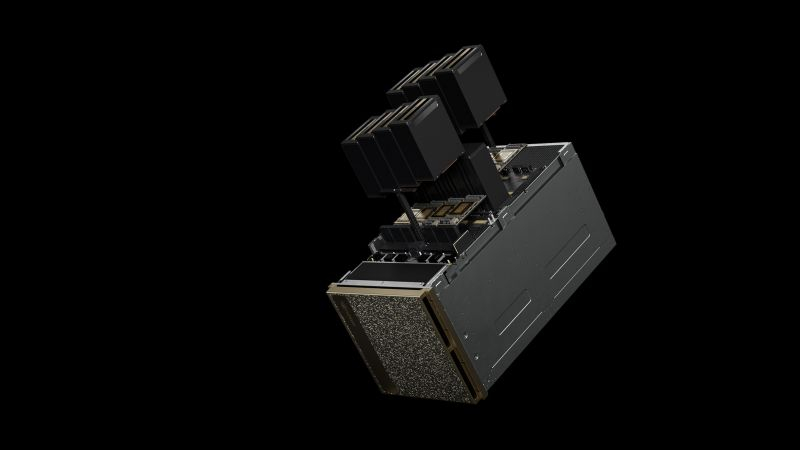
Источник изображения: Nvidia Как поясняет Bloomberg, японская SoftBank станет первой компанией, получившей возможность построить суперкомпьютер на базе новейших ускорителей Nvidia DGX B200, которые сочетают в одном корпусе 8 чипов поколения Blackwell и 2 процессора Intel Xeon Platinum 8570. В дальнейшем SoftBank перейдёт на использование Grace Blackwell — более современных ускорителей, подразумевающих наличие Arm-совместимых процессоров Grace собственной разработки Nvidia. Компания SoftBank Corp., входящая в состав SoftBank Group, является третьим по величине оператором сотовой связи в Японии. Плотная взаимосвязь между Nvidia и SoftBank была установлена ещё в прошлом десятилетии, поскольку до начала 2019 года вторая владела 4,9 % акций первой. Основатель SoftBank Масаёси Сон заявил, что готов делать серьёзные ставки в сегменте искусственного интеллекта. Решения Nvidia также будут использоваться оператором связи SoftBank Corp. при создании сети нового поколения (AI-RAN), которая сможет передавать информацию по стандарту 5G и одновременно управлять клиентскими устройствами, использующими искусственный интеллект. Ими могут быть транспортные средства с автопилотом и разного рода роботы. Пилотный проект со временем позволит масштабировать подобные сети по всей Японии. Сети нового поколения не только лучше подходят для управления сложными устройствами, но и потребляют меньше электроэнергии. Партнёрами SoftBank по тестированию AI-RAN выступят Fujitsu и Red Hat. Весной Apple представит настенный 6-дюймовый планшет с голосовым управлением и ИИ
13.11.2024 [05:16],
Алексей Разин
Ещё летом стало известно о планах Apple по выпуску роботизированного устройства, комбинирующего манипулятор и планшет, но теперь Марк Гурман (Mark Gurman) со страниц Bloomberg утверждает, что к весне следующего года компания рассчитывает представить «настенный 6-дюймовый планшет» с новой операционной системой, который расширит использование ИИ, а также будет интегрироваться в систему умного дома. 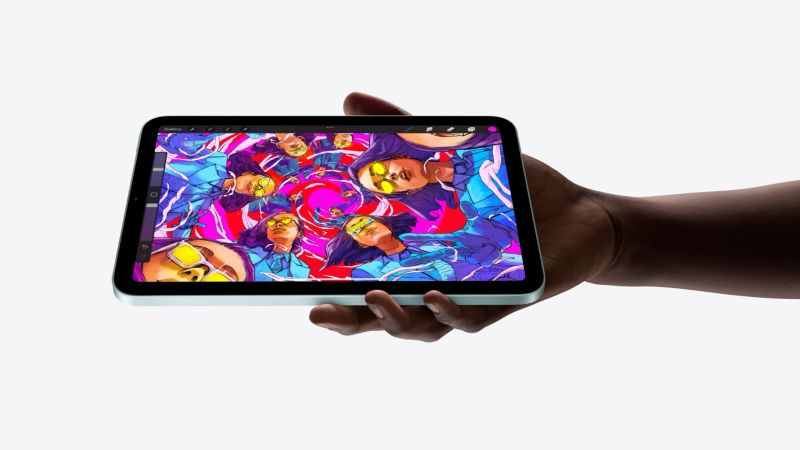
iPad mini. Источник изображения: Apple Почти квадратное устройство J490 по своим размерам, как отмечает источник, будет напоминать два приложенных друг к другу iPhone, но вокруг дисплея будет предусмотрена широкая рамка, делая его похожим на цифровую фоторамку. Демонстрировать фотографии такой планшет тоже сможет, а ещё к нему можно будет приобрести док-станцию с более мощными динамиками, удобную для размещения на столе. Устройство также будет в случае необходимости крепиться на стену, причём буквально в каждой комнате, если пользователю потребуется тесно интегрировать его функции в работу умного дома. Специально оптимизированная под такой планшет операционная система Pebble позволит создавать кастомизированные виджеты, а встроенный набор сенсоров будет определять, как далеко находится пользователь, чтобы в случае его приближения менять фоновую заставку на элементы интерфейса, подразумевающие более активное взаимодействие. Многие команды можно будет подавать голосом, они будут обрабатываться Apple Intelligence, но сенсорный интерфейс также сохранится. Для первичной настройки устройства может потребоваться iPhone, но и некоторые виды взаимодействия с ним тоже будут предусмотрены. Если инициатива с интеграцией новинки в систему умного дома будет пользоваться успехом у клиентов, Apple может дополнить ассортимент решений разного рода датчиками. Они, например, позволят отслеживать, сколько человек в конкретный момент находятся в помещении. Интеграция с функциями безопасности тоже будет предусмотрена, с помощью планшета можно будет управлять камерами видеонаблюдения и электронными замками. Поскольку в начальной конфигурации настенный планшет не будет оснащаться роботизированной конечностью, оно окажется дешевле тех $1000, которые Apple запросит за старшую модификацию, а потому пользователи буквально смогут приобретать несколько штук одновременно, по одной для каждой из комнат в своём жилище. Функция видеоконференции также будет поддерживаться благодаря наличию веб-камеры. Джим Келлер поможет LG в развитии «Заботливого интеллекта»
12.11.2024 [13:40],
Дмитрий Федоров
Компании LG и Tenstorrent укрепят сотрудничество для разработки чиплетов и систем на кристалле (SoC) с целью создания ИИ-чипов, которые будут интегрированы в продукцию LG, включая бытовую технику с ИИ-управлением и решения для умного дома. Сотрудничество двух компаний также охватывает перспективные направления, такие как мобильные технологии будущего и коммерческие решения, что полностью соответствует концепции LG «Заботливого интеллекта», направленного на создание технологий, учитывающих потребности пользователей. 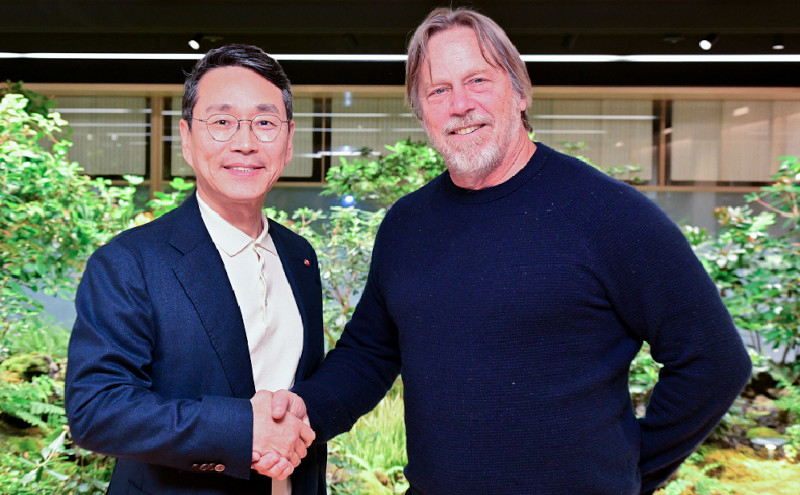
Источник изображения: lgnewsroom.com Tenstorrent известна своими передовыми решениями в области высокопроизводительных вычислений (HPC) и разработками на базе RISC-V IP (Ascalon) и AI IP (Tensix). Эти архитектуры обеспечивают возможность масштабирования чипов от милливатт до мегаватт, позволяя достичь оптимального баланса между производительностью и энергоэффективностью. Масштабируемость делает продукцию Tenstorrent востребованной как для маломощных портативных устройств, так и для крупных дата-центров. На недавней встрече генерального директора LG Уильяма Чо (William Cho) и генерального директора Tenstorrent Джима Келлера (Jim Keller), которая прошла в штаб-квартире LG в Сеуле, присутствовали ключевые менеджеры обеих компаний. В числе участников были технический директор LG Ким Бёнхун (Kim Byoung-hoon) и руководитель Центра SoC Ким Джин-гён (Kim Jin-gyeong), а также директор по коммерческим операциям Tenstorrent Дэвид Беннет (David Bennett) и вице-президент по автомобильному направлению Таддеус Фортенберри (Thaddeus Fortenberry). На встрече обсуждались стратегические направления для долгосрочного партнёрства и методы оптимизации использования интеллектуальных и технологических ресурсов компаний. Компании сосредоточили своё внимание на возможностях совместного использования технологий для создания синергии в таких направлениях, как ИИ для бытовой техники, решения для умного дома, мобильные приложения и видеопроцессоры для дата-центров. Руководители LG и Tenstorrent подчеркнули важность развития полупроводников нового поколения, таких как RISC-V и чиплеты, которые позволят компаниям уверенно развиваться в условиях стремительного роста рынка ИИ. В рамках партнёрства компании рассматривают возможность создания долгосрочной программы стажировок, ориентированной на развитие молодых специалистов. Это позволит привлечь перспективные кадры и поддерживать инновации, обеспечивая постоянный приток новых идей в бурно развивающуюся полупроводниковую индустрию. LG активно развивает компетенции в области ИИ-программного обеспечения и алгоритмов, что позволяет компании создавать продукты и платформы с использованием генеративных технологий, функционирующих непосредственно на устройствах. В рамках этой стратегии создаются чипы, которые обеспечивают интеграцию ИИ-решений в устройства, увеличивая скорость обработки данных и повышая их безопасность. Для успешной реализации этой стратегии LG основала Центр исследований и разработок SoC, в котором разрабатываются и оптимизируются высокопроизводительные системы на базе технологии чиплетов, позволяющей объединить несколько микросхем. Эта архитектура становится всё более востребованной на фоне растущего спроса на энергоэффективные ИИ-полупроводники, и специалисты LG уделяют особое внимание повышению производительности и энергосбережению своих продуктов. Чипы, разработанные LG для своих ключевых продуктов, создавались под руководством Центра SoC. Среди них выделяются фирменный ИИ-чип DQ-C для бытовой техники и процессор Alpha 11 AI для OLED-телевизоров. Эти передовые разработки укрепили лидерство LG на мировом рынке ИИ-устройств и премиальных телевизоров. Российский рынок диалогового ИИ вырос в четыре раза за 5 лет
12.11.2024 [12:39],
Дмитрий Федоров
Исследование Naumen показало впечатляющее развитие российского рынка диалогового ИИ. За 5 лет объём отечественного рынка NLP-решений вырос в четыре раза, до 5,9 млрд руб. к концу 2023 года. Ключевые сегменты рынка — чат-боты, голосовые помощники, речевая аналитика, синтез и распознавание речи — всё шире внедряются в банковский сектор, ретейл и медицину, где играют важную роль в автоматизации взаимодействия с клиентами и повышении эффективности бизнес-процессов. 
Источник изображений: Alexandra_Koch / Pixabay Согласно исследованию разработчика программных решений Naumen, рынок диалогового ИИ охватывает четыре основные категории: чат-боты, голосовые помощники, решения для речевой аналитики, а также технологии синтеза и распознавания речи. Лидером в 2023 году стали голосовые помощники, которые заняли 26,8 % рынка и принесли почти 1,6 млрд руб. дохода, увеличившись в объёме в 4,9 раза по сравнению с 2019 годом. Популярность таких помощников объясняется их эффективностью в автоматизации клиентского обслуживания и оптимизации бизнес-процессов. Сегмент голосовых роботов для исходящих звонков также занял значительную долю рынка, достигнув 1,55 млрд руб. в 2023 году, впервые превысив объём сегмента входящих роботов, включающих автоответчики и маршрутизаторы звонков. Эти технологии активно применяются для автоматического обзвона клиентов и проведения опросов, что позволяет компаниям оптимизировать затраты на коммуникации и обеспечивать более масштабное взаимодействие с клиентами. Сегмент чат-ботов в 2023 году составил 19 % рынка с объёмом продаж, достигшим 1,2 млрд руб. Это на 44 % больше по сравнению с 2019 годом, что свидетельствует о стабильном росте интереса к этому направлению. Эксперты Naumen полагают, что потенциал чат-ботов ещё далёк от исчерпания, и прогнозируют высокие темпы роста этого сегмента в будущем. Основные инвестиции на рынке диалогового ИИ пришлись на период 2019–2021 годов, когда крупные компании начали приобретать доли в профильных разработчиках ИИ. Сбербанк, к примеру, приобрёл 51 % компании «Центр речевых технологий» (ЦРТ), Совкомбанк — 25 % в компании AtsAero, а совместно с МТС — 22,5 % разработчика Just AI. После некоторого затишья в 2022 году инвестиционная активность возобновилась: в 2023 году «Вымпелком» купил 14 % акций в компании Cashee (Target AI), а Softline приобрёл 72,5 % в Robovoice.  На российском рынке диалогового ИИ крупные игроки, такие как ЦРТ, Just AI, BSS и «Наносемантика», контролируют более 50 % разработок чат-ботов и голосовых помощников. В то же время 80 % решений для голосовых роботов производят небольшие специализированные компании, такие как Neuro Net и Zvonobot. Согласно статистике Naumen, диалоговые ИИ-системы наиболее активно внедряются в ретейле, где чат-боты используют 42 % компаний, и в банковском секторе, охватывающем 27 % рынка. Голосовые помощники востребованы в основном среди банков (21 %) и медицинских учреждений (50 %). Генеральный директор компании Dbrain и автор Telegram-канала «AI Happens» Алексей Хахунов отмечает, что интенсивный рост рынка NLP-решений в последние годы объясняется двумя основными факторами. Во-первых, рынок только формируется и продолжает набирать обороты, что создаёт условия для устойчивого роста. Во-вторых, значительные технологические достижения в области обработки естественного языка, произошедшие в последние несколько лет, позволили создать эффективные и конкурентоспособные решения для бизнеса. Хахунов подчёркивает, что современные NLP-инструменты значительно упрощают доступ к технологиям автоматизации. Исполнительный директор MTS AI и эксперт Альянса в сфере ИИ Дмитрий Марков подчёркивает, что популярность чат-ботов выросла в период пандемии коронавируса, когда компании столкнулись с резким увеличением онлайн-запросов. После окончания пандемии рост этого сегмента несколько замедлился. Однако развитие технологий ИИ привело к появлению множества платформ для создания чат-ботов, что снизило порог входа на рынок для малого и среднего бизнеса. Теперь базового чат-бота или голосового робота может внедрить практически любая компания. Сооснователь компании Parodist AI Владимир Свешников прогнозирует, что будущее развитие рынка NLP-решений будет тесно связано с совершенствованием больших языковых моделей. Повышение качества ИИ-моделей достигается за счёт их масштабирования и увеличения объёма обучающих данных, что ускоряет разработку и внедрение диалоговых ИИ-систем. Доступность большого объёма данных позволяет ИИ становиться всё более гибким и точным, что создаёт благоприятные условия для расширения его использования в различных отраслях. Спрос на автоматизацию и роботизацию остаётся высоким, особенно в условиях нехватки квалифицированных кадров. Современные технологии ИИ позволяют оптимизировать рабочие процессы в ночное время и выходные дни, когда привлечение человеческих ресурсов обходится значительно дороже. Дмитрий Марков отмечает, что современные чат-боты и голосовые роботы могут обеспечивать круглосуточное обслуживание клиентов, что способствует быстрой окупаемости вложений. С развитием ИИ такие решения станут частью более сложных систем поддержки бизнеса, способных обеспечивать постоянное присутствие компании в цифровом пространстве. Baidu представила лёгкие умные очки с камерой и встроенным ИИ
12.11.2024 [12:37],
Павел Котов
Китайская Baidu анонсировала ряд новых служб на основе искусственного интеллекта, в том числе генератор изображений по текстовому описанию и сервис, позволяющий создавать приложения в отсутствие навыков программирования. Компания также представила умные очки с камерами и ИИ-помощником. 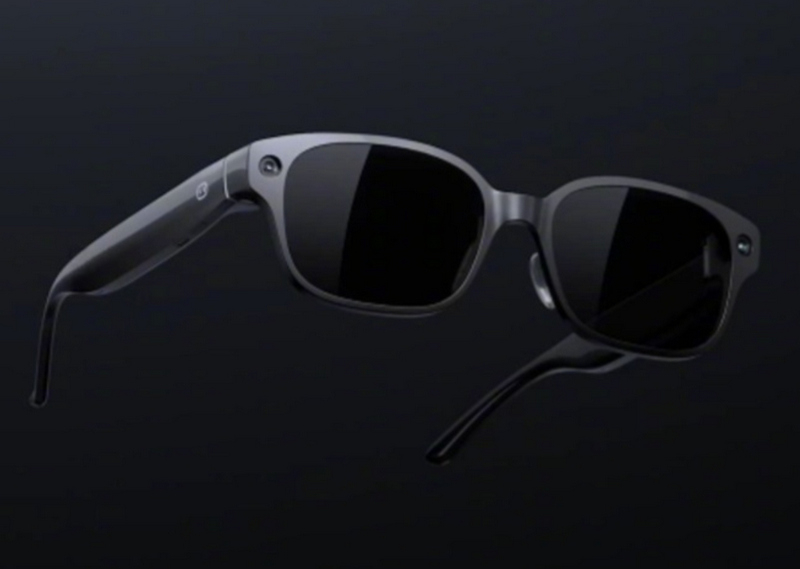
Источник изображения: Baidu На ежегодном мероприятии Baidu World Conference китайский поисковый гигант представил умные очки Xiaodu AI Glasses со встроенным ИИ-помощником Ernie с голосовым управлением. Гаджет разработан подразделением Xiaodu, которое специализируется на выпуске устройств. Умные очки весят всего 45 граммов и оснащены 16-Мп широкоугольной камерой с электронной стабилизацией. Имеется также чип, отвечающий за локальную работу ИИ, но подробностей о нем пока нет. Очки обеспечивают впечатляющее время автономной работы — до 56 часов в режиме ожидания или более 5 часов непрерывного воспроизведения аудио. Есть и быстрая зарядка — всего 30 минут гаджет полностью восполнит заряд. Для звонков в очках используется массив из четырех микрофонов, а открытые динамики с защитой от воды обеспечивают чистое звучание. Выпуск очков Xiaodu AI Glasses запланирован на первую половину следующего года, а их предполагаемая цена составит менее 2100 юаней (около 290 долларов). Этот выпуск знаменует собой значительный шаг вперед в интеграции искусственного интеллекта с носимыми технологиями, поскольку Baidu стремится переосмыслить пользовательский опыт с помощью передовых и доступных приложений искусственного интеллекта. 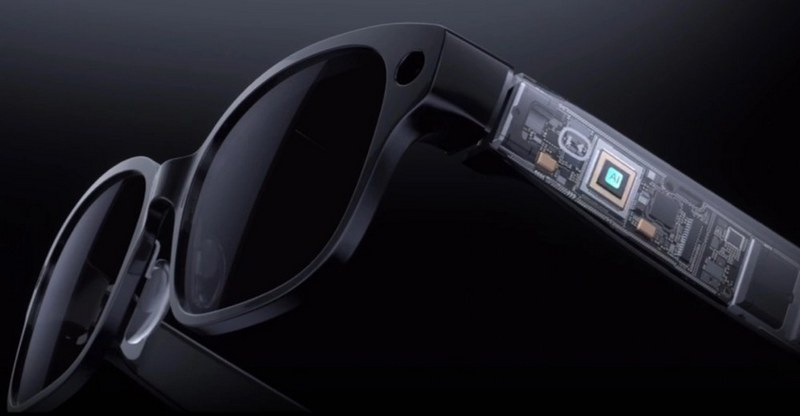 Лидер китайского рынка веб-поиска входит в число технологических компаний, которые выпускают коммерческие приложения на основе больших языковых моделей, над которыми Baidu активно работали в течение последних двух лет. На конференции глава Baidu Робин Ли (Robin Li) представил сервис I-RAG — генератор изображений по текстовым запросам. Проблема «галлюцинаций» в нём решена подключением к системе веб-поиска Baidu — благодаря ей картинки на выходе меньше отклоняются от запросов и в меньшей степени содержат несуществующие элементы. Созданная Baidu платформа ИИ Ernie на текущий момент обрабатывает 1,5 млрд запросов и прочих элементов взаимодействия с пользователями, хотя в ещё мае этот показатель составлял 200 млн. Сценарии взаимодействия включают генерацию текста, ответы за вопросы и работу с различными приложениями с ИИ. Монетизацию своих разработок Baidu в значительной мере осуществляет за счёт «ИИ-агентов», позволяющих пользователям создавать собственные приложения. Системы ИИ интегрированы в существующую линейку продуктов Baidu; они также доступны клиентам через облачные сервисы компании. У Baidu нет цели создавать «суперприложение» с набором служб с ИИ, отметил господин Ли. Компания также представила сервис Miaoda, предлагающий генерацию программного кода с использованием большой языковой модели — можно создавать целые приложения, не обладая обширными познаниями в области программирования. Amazon вкладывает миллиарды в разработку ИИ-чипов, чтобы снизить зависимость от Nvidia
12.11.2024 [11:39],
Алексей Разин
Подразделение AWS американского интернет-гиганта Amazon давно входит в число крупнейших игроков рынка облачных услуг. Оно сильно зависит от компонентов и программного обеспечения Nvidia, но параллельно развивает и собственную инфраструктуру, используя наработки компании Annapurna Labs, купленной в 2015 году за $350 млн. 
Источник изображения: Amazon В следующем месяце, как сообщает Financial Times, компания должна продемонстрировать публике ускорители Trainium 2, которые способны справляться с обучением больших языковых моделей. Образцы этих ускорителей уже эксплуатируются стартапом Anthropic, в капитал которого Amazon вложила $4 млрд. Клиентами Amazon на этом направлении также являются компании Databricks, Deutsche Telekom, Ricoh и Stockmark. Вице-президент AWS по вычислительным и сетевым сервисам Дейв Браун (Dave Brown) заявил следующее: «Мы хотим быть абсолютно лучшим местом для эксплуатации Nvidia, но в то же время мы считаем нормой возможность иметь альтернативу». Уже сейчас ускорители семейства Inferentia обходятся при генерировании ответов ИИ-моделей на 40 % дешевле решений Nvidia. Когда речь идёт о расходах в десятки миллионов долларов, подобная экономия может иметь решающее значение при выборе вычислительной платформы. По итогам текущего года капитальные расходы Amazon могут достичь $75 млрд, а в следующем окажутся ещё выше. В прошлом году они ограничились $48,4 млрд, и величина прироста показывает, насколько важным компания считает финансирование своей инфраструктуры в условиях бурного развития рынка систем ИИ. Эксперты Futurum Group поясняют, что крупные провайдеры облачных услуг стремятся формировать собственную вертикально интегрированную и однородную по своему составу структуру используемых чипов. Большинство из них стремится разрабатывать собственные чипы для ускорителей вычислений, это позволяет снизить расходы, поднять прибыль, усилить контроль за доступностью чипов и развитием бизнеса в целом. «Дело не столько в чипе, сколько в системе в целом», — поясняет Рами Синно (Rami Sinno), директор Annapurna Labs по разработкам. По его словам, мало кто из компаний может повторить в больших масштабах то, что делает Amazon. Чипы собственной разработки позволяют Amazon потреблять меньше электроэнергии и повышать КПД собственных центров обработки данных. Представители TechInsights сравнивают чипы Nvidia с автомобилями с кузовом типа «универсал», тогда как решения Amazon собственной разработки напоминают более компактные хэтчбеки, заточенные под выполнение узкого спектра задач. Amazon не спешит делиться данными о тестировании быстродействия своих ускорителей, но чипы Trainium 2 должны по уровню быстродействия превзойти своих предшественников в четыре раза, по имеющимся данным. Само по себе появление альтернатив решениям Nvidia уже может быть высоко оценено клиентами AWS. X откроет доступ к ИИ-чат-боту Grok для бесплатных пользователей
11.11.2024 [18:17],
Сергей Сурабекянц
До настоящего момента социальная сеть X, принадлежащая Илону Маску (Elon Musk), предоставляла доступ к своему чат-боту Grok на основе искусственного интеллекта только по платной подписке. Grok был создан xAI — другой компанией Маска. Теперь платформа, похоже, готовится открыть доступ к чат-боту для всех пользователей, по крайней мере, такая информация была опубликована несколькими исследователями за последние два дня. 
Источник изображения: unsplash.com Издание TechCrunch удостоверилось, что социальная сеть X начала тестирование доступа к Grok для бесплатных пользователей в Новой Зеландии. Чтобы использовать Grok бесплатно, учётная запись пользователя должна существовать не менее семи дней и к ней должен быть привязан номер телефона. 
Источник изображения: TechCrunch По словам пользователя платформы X с ником Swak, пока возможности тестирования ограничены десятью запросами в течение двух часов для модели Grok-2, двадцатью запросами в течение двух часов для модели Grok-2 mini и возможностью проанализировать три изображения в день. xAI запустила Grok-2 в августе, предоставив возможности по генерации изображений с использованием модели FLUX.1 от Black Forest Labs. В конце октября Grok-2 научился анализу и «пониманию» изображений. На сегодняшний день все эти функции доступны только пользователям тарифных планов Premium и Premium+. Открывая Grok для бесплатных пользователей, xAI, возможно, стремится расширить пользовательскую базу и получить больше обратной связи для своих продуктов. Это повысит конкурентоспособность Grok в области, где доминируют такие модели как ChatGPT, Claude и Gemini. В октябре издание The Wall Street Journal сообщило, что xAI ведёт переговоры о привлечении дополнительного финансирования в объёме нескольких миллиардов долларов. Рыночная оценка компании на сегодняшний день составляет $40 млрд. Генеративный ИИ не понимает устройство мира, показало исследование MIT
11.11.2024 [18:12],
Дмитрий Федоров
Генеративные ИИ-модели будоражат воображение руководителей многих компаний, обещая автоматизацию и замену миллионов рабочих мест. Однако учёные Массачусетского технологического института (MIT) предостерегают: ИИ хотя и даёт правдоподобные ответы, в действительности не обладает пониманием сложных систем и ограничивается предсказаниями. В задачах реального мира, будь то логические рассуждения, навигация, химия или игры, ИИ демонстрирует значительные ограничения. 
Источник изображения: HUNGQUACH679PNG / Pixabay Современные большие языковые модели (LLM), такие как GPT-4, создают впечатление продуманного ответа на сложные запросы пользователей, хотя на самом деле они лишь точно предсказывают наиболее вероятные слова, которые следует поместить рядом с предыдущими в определённом контексте. Чтобы проверить, способны ли ИИ-модели действительно «понимать» реальный мир, учёные MIT разработали метрики, предназначенные для объективной проверки их интеллектуальных способностей. Одной из задач эксперимента стала оценка способности ИИ к генерации пошаговых инструкций для навигации по улицам Нью-Йорка. Несмотря на то что генеративные ИИ в определённой степени демонстрируют «неявное» усвоение законов окружающего мира, это не является эквивалентом подлинного понимания. Для повышения точности оценки исследователи создали формализованные методы, позволяющие анализировать, насколько корректно ИИ воспринимает и интерпретирует реальные ситуации. Основное внимание в исследовании MIT было уделено трансформерам — типу генеративных ИИ-моделей, используемых в таких популярных сервисах, как GPT-4. Трансформеры обучаются на обширных массивах текстовых данных, что позволяет им достигать высокой точности в подборе последовательностей слов и создавать правдоподобные тексты. Чтобы глубже исследовать возможности таких систем, учёные использовали класс задач, известных как детерминированные конечные автоматы (Deterministic Finite Automaton, DFA), которые охватывают такие области, как логика, географическая навигация, химия и даже стратегии в играх. В рамках эксперимента исследователи выбрали две разные задачи — вождение автомобиля по улицам Нью-Йорка и игру в «Отелло», чтобы проверить способность ИИ правильно понимать лежащие в их основе правила. Как отметил постдок Гарвардского университета Кейон Вафа (Keyon Vafa), ключевая цель эксперимента заключалась в проверке способности ИИ-моделей восстанавливать внутреннюю логику сложных систем: «Нам нужны были испытательные стенды, на которых мы точно знали бы, как выглядит модель мира. Теперь мы можем строго продумать, что значит восстановить эту модель мира». Результаты тестирования показали, что трансформеры способны выдавать корректные маршруты и предлагать правильные ходы в игре «Отелло», когда условия задач точно определены. Однако при добавлении усложняющих факторов, таких как объездные пути в Нью-Йорке, ИИ-модели начали генерировать нелогичные варианты маршрутов, предлагая случайные эстакады, которых на самом деле не существовало. Исследование MIT показало принципиальные ограничения генеративных ИИ-моделей, особенно в тех задачах, где требуется гибкость мышления и способность адаптироваться к реальным условиям. Хотя существующие ИИ-модели могут впечатлять своей способностью генерировать правдоподобные ответы, они остаются всего лишь инструментами предсказания, а не полноценными интеллектуальными системами. OpenAI столкнулась с большими расходами и нехваткой данных при обучении ИИ-модели Orion нового поколения
11.11.2024 [17:05],
Дмитрий Федоров
OpenAI испытывает трудности с разработкой новой флагманской ИИ-модели под кодовым названием Orion. Эта ИИ-модель демонстрирует значительные успехи в задачах обработки естественного языка, однако её эффективность в программировании остаётся невысокой. Эти ограничения, наряду с дефицитом данных для обучения и возросшими эксплуатационными расходами, ставят под сомнение рентабельность и привлекательность упомянутой ИИ-модели для бизнеса. 
Источник изображения: AllThatChessNow / Pixabay Одной из сложностей являются затраты на эксплуатацию Orion в дата-центрах OpenAI, которые существенно выше, чем у ИИ-моделей предыдущего поколения, таких как GPT-4 и GPT-4o. Значительное увеличение расходов ставит под угрозу соотношение цена/качество и может ослабить интерес к Orion со стороны корпоративных клиентов и подписчиков, ориентированных на рентабельность ИИ-решений. Высокая стоимость эксплуатации вызывает вопросы об экономической целесообразности ИИ-модели, особенно учитывая умеренный прирост её производительности. Ожидания от перехода с GPT-4 на Orion были высоки, однако качественный скачок оказался не столь значительным, как при переходе с GPT-3 на GPT-4, что несколько разочаровало рынок. Подобная тенденция наблюдается и у других разработчиков ИИ: компании Anthropic и Mistral также фиксируют умеренные улучшения своих ИИ-моделей. Например, результаты тестирования ИИ-модели Claude 3.5 Sonnet компании Anthropic показывают, что качественные улучшения в каждой новой базовой ИИ-модели становятся всё более постепенными. В то же время её конкуренты стараются отвлечь внимание от этого ограничения, сосредотачиваясь на разработке новых функций, таких как ИИ-агенты. Это свидетельствует о смещении акцента с повышения общей производительности ИИ на создание его уникальных способностей. Чтобы компенсировать слабые стороны современных ИИ, компании применяют тонкую настройку результатов с помощью дополнительных фильтров. Однако такой подход остаётся лишь временным решением и не устраняет основных ограничений, связанных с архитектурой ИИ-моделей. Проблема усугубляется ограничениями в доступе к лицензированным и общедоступным данным, что вынудило OpenAI сформировать специальную команду, которой поручено найти способ решения проблемы нехватки обучающих данных. Однако неясно, удастся ли этой команде собрать достаточный объём данных, чтобы улучшить производительность ИИ-модели Orion и удовлетворить требования клиентов. |
© 1997—2026 3DNews
При цитировании документа ссылка на сайт с указанием автора обязательна. Полное заимствование документа является
нарушением
российского и международного законодательства и возможно только с согласия редакции 3DNews.



 MWC 2018
 2018
 Computex

 IFA 2018







