


Опрос
|
реклама
Быстрый переход
Первое открытие ИИ-биолаборатории Anthropic поставили под сомнение — учёный увидел в нём свою неопубликованную работу
28.09.2026 [19:18],
Сергей Сурабекянц
На прошлой неделе Anthropic представила результаты исследований своей биологической лаборатории. Компания использовала ИИ-агентов для открытия новых перспективных ферментов. Некоторые учёные поспешили усомниться в этом достижении. Эксперт из Копенгагенского университета заявил, что его команда делилась результатами своих исследований с ИИ-моделью Anthropic, а разрекламированное «открытие» нейросетью новых ферментов совпадает с их многолетней работой. 
Источник изображений: Anthropic Специалист по вычислительной биологии Марио Родригес Местре (Mario Rodríguez Mestre) заявил, что он и его коллеги изучали эти ферменты и связанные с ними молекулы (которые Anthropic называет ART — Array-associated Reverse Transcriptases) в течение последних четырёх лет. Результаты их исследований ещё не опубликованы. В течение последних трёх лет они регулярно использовали модели ИИ Anthropic при написании кода, подготовке рукописей и выполнении других задач. Таким образом, полагает Местре, они предоставили Anthropic доступ к ключевым результатам своих исследований ферментов. Anthropic обвинения отрицает: «Нам неизвестно о каких-либо ранее опубликованных работах, описывающих недавно обнаруженную нами ART-систему. Claude также не обучался на каких-либо пользовательских транскриптах, и у нашей команды молекулярной биологии нет к ним доступа». В Anthropic заявили, что ключевой вклад Claude заключался в идентификации набора молекул РНК и белка, связанных с обратной транскриптазой в системе. Но Местре утверждает, что он и его коллеги сделали это открытие более года назад. По мнению Местре, проблема заключается в том, действительно ли ИИ Anthropic пришёл к этим результатам логическим путём, или же он был направлен к ним частично на основе его собственной работы. «Меня беспокоит то, что эта информация использовалась для обучения будущих версий моделей, — заявил Местре. — Я думаю, важно поднять этот вопрос».  Anthropic позиционирует биологические исследования как центральную часть своей миссии. «Мы считаем, что этот тип применения будет быстро развиваться в ближайшие годы, и что мы сможем добиться значительного прогресса в ближайшем будущем в борьбе с болезнями, которые мучили человечество на протяжении тысячелетий», — заявил глава Anthropic Дарио Амодей (Dario Amodei) в своём обращении к ООН. Исследователи Anthropic заявили, что они дали указания ИИ-агентам по поиску в базах данных, содержащих миллиарды последовательностей генов, но не предоставили точные подсказки, которые использовали. Базы данных содержат ДНК, собранную из океана, почвы и других мест обитания. Учёные поручили ИИ найти гены, которые управляют производством ферментов, называемых обратными транскриптазами. Эти ферменты считывают последовательность молекулы РНК и создают соответствующую молекулу ДНК с той же последовательностью. Бактерии используют некоторые обратные транскриптазы для обнаружения вторгшихся вирусов. Некоторые вирусы используют обратные транскриптазы в качестве оружия против других вирусов. Исследователи Anthropic предоставили ИИ пять примеров обратных транскриптаз. ИИ-агенты написали собственное программное обеспечение для исследования баз данных на предмет похожих генов и для тщательного изучения перспективных кандидатов.  Агенты идентифицировали гены возможных обратных транскриптаз в бактериях, поражающих вирусы, известные как гигантские фаги. Каждая из этих последовательностей располагалась вблизи набора генов, кодирующих молекулы РНК, что может помочь ферментам выполнять свои функции. Исследователи Anthropic назвали эти ферменты ассоциированными с микрочипами обратными транскриптазами, или ART. Они утверждают, что ИИ самостоятельно сделал «первые шаги биологического открытия». Местре опровергает это утверждение. «Это те же самые системы, которые мы изучаем годами», — сказал он. И это те же самые ферменты, по его словам, которые он описал ИИ компании Anthropic. Он заявил, что впервые обнаружил эти ферменты в гигантских фагах в 2022 году во время поиска новых обратных транскриптаз. Он недолго работал консультантом в компании ReNegade Therapeutics, которая в 2023 году подала патентную заявку на ряд обратных транскриптаз, включая те, которые обнаружил доктор Местре. Он указан в качестве соавтора патентной заявки. Anthropic выпустила Claude в 2023 году, через год после того, как доктор Местре приступил к своим исследованиям. Как и многие другие учёные, он нашёл его полезным для решения самых разных задач. Местре признаёт, что использование искусственного интеллекта «полностью изменило его подход к науке». ИИ был активно вовлечён в его исследования, он делился с нейросетью черновиком своей диссертации и рукописями. Он и его коллеги также загружали дополнительные сведения, используя Claude для выполнения различных административных задач.  Слова Местре подтверждают и другие учёные. Биоинженер Сет Шипман (Seth Shipman) заявил, что знаком с этими исследованиями Местре. «Мы обсуждаем это с ним уже много лет, — сказал он. — Многие из нас знают об этих системах». Сообщение Anthropic об открытии ферментов вызвало серьёзные опасения среди учёных. «Многие из наших коллег спрашивали: “Ой-ой, а они что, обучаются на моих подсказках?“, — добавил Шипман. — Мы не можем об этом не думать». Местре признал, что невозможно с уверенностью сказать, что открытия ИИ Anthropic полностью основаны на его исследованиях. «Я имею в виду, совпадения случаются, — сказал он. — Все в этой области делают более или менее одно и то же. Но мы знали об этих повторах более года назад». Он напомнил, что компании, занимающиеся ИИ, также обвинялись в обучении моделей на работах художников и писателей без разрешения на использование авторских прав. Местре также заявил, что сворачивает все свои проекты с использованием Claude. Заявления Местре перекликаются с другим научным конфликтом. Компания OpenAI сообщила о решении важной ранее недоказанной задачи в математике при помощи своего ИИ. Но математик Тристан Бакмастер (Tristan Buckmaster), который активно использовал в своей деятельности ИИ-агентов OpenAI, заподозрил, что ИИ затем позаимствовал идеи из его работы. «Этично ли использовать данные клиентов, чтобы попытаться перехватить их клиентов?», — задался он вопросом в социальных сетях. OpenAI отрицает факт обучения своей модели на разработках Бакмастера. Нейрогастарбайтеры: OpenAI уволила сотрудников за использование ИИ при обучении ИИ
22.09.2026 [19:54],
Сергей Сурабекянц
OpenAI нанимает сотни людей для анализа запросов пользователей к ChatGPT. Их задача — улучшить качество ответов, которые ChatGPT выдаёт пользователям: люди оценивают и анализируют сгенерированные ботом реплики. Издание 404 Media выяснило, что многих нанятых специалистов уже уволили за использование ИИ при обучении моделей OpenAI. Иронично: компания, чья главная цель — побудить людей использовать ИИ в работе, увольняет сотрудников за применение этой же технологии. 
Источник изображений: unsplash.com Издание 404 Media получило доступ к внутренним документам OpenAI и пообщалось с тремя подрядчиками, привлечёнными к различным проектам компании, в которых могут быть задействованы более десяти тысяч человек. Все подтвердили, что проверяющим запрещено использовать ИИ в работе, что подтверждается имеющимися в распоряжении 404 Media документами. Один из подрядчиков рассказал, что видит, как люди «постоянно используют ИИ, и их за это постоянно увольняют; это, пожалуй, единственная причина, по которой могут немедленно выгнать с работы». По его словам, «в группе из тысяч человек попалось множество нарушителей». «Не используйте инструменты для обнаружения ИИ и не применяйте ИИ самостоятельно, — говорится в документе. — Не используйте GPTZero или любые другие инструменты для обнаружения ИИ. Они ненадёжны. Рецензентам также запрещено использовать ИИ — включая Grammarly и инструменты машинного перевода — для проверки материалов, написания отзывов или комментариев».  Подрядчикам, проверяющим работу других исполнителей, поручено выявлять характерные признаки использования ИИ. К ним относятся повторы слов, специфическая пунктуация (например, чрезмерное использование длинного тире) и подозрительно высокая скорость выполнения заданий. Инструкция предписывает не сообщать, почему они заподозрили использование ИИ: «Если они будут знать, на что именно вы обращаете внимание, им будет проще это скрыть. Оценивайте общую картину, а не отдельные признаки». Один из подрядчиков рассказал, что использовал ИИ во время работы над обучением моделей OpenAI, и показал документ, который он назвал уведомлением об увольнении. В нем говорилось, что работодатель выявил проблемы с «подлинностью» его работы. «Мне требовалась небольшая помощь, и я обратился к ИИ, что в итоге и привело к моему увольнению, — рассказал он. — Я не получал никакой радости от работы и не чувствовал, что приношу хоть какую-то пользу обществу». Нанимает исполнителей для OpenAI компания Mercor. «Мы нанимаем экспертов за их профессиональные знания и способность принимать взвешенные решения — качества, необходимые для дальнейшего развития ИИ. Наши контракты категорически запрещают использование больших языковых моделей для выполнения проектов, и мы строго следим за соблюдением этого требования. Мы вкладываем значительные средства в инструменты и системы, позволяющие выявлять случаи неправомерного использования технологий и контролировать соблюдение экспертами правил проекта и условий договора. Если подтверждается, что эксперт использовал ИИ для выполнения задачи, мы немедленно отстраняем его от работы над проектом», — заявил представитель компании. Также сообщается об исполнителях, которые намеренно выбирали худшие варианты ответов, поскольку хотели саботировать процесс обучения моделей. «Поначалу я чувствовал вину за такую работу, — признался один из них. — Я либо вообще не смотрю на результаты и выбираю наугад, либо намеренно выбираю [худший] вариант. Не знаю, насколько это вообще важно, ведь результаты работы нейросети оценивают сотни других людей, но всё же возникает ощущение, что мне платят за то, чтобы делать ИИ хуже».  Эксперты отмечают, что некоторые модели ИИ уже начали демонстрировать признаки так называемого «коллапса модели» (model collapse) — ситуации, когда качество работы ИИ, обучаемого на текстах, созданных другим ИИ, постепенно ухудшается. Ирония заключается в том, что люди, нанятые для предотвращения подобных проблем, сами используют ответы, сгенерированные ИИ, для обучения моделей OpenAI. «Воровство беспрецедентных масштабов»: OpenAI и Microsoft признали, что ИИ построен на краже данных и неумолимо разрушает интернет
18.09.2026 [20:25],
Сергей Сурабекянц
Судя по рассекреченным недавно документам, руководители Microsoft и OpenAI осознавали, что большие языковые модели — это хищнические технологии, построенные на том, что один из руководителей Microsoft назвал «поразительным воровством беспрецедентных масштабов» и «крупнейшей кражей труда в истории человечества». Во внутреннем документе Microsoft также говорится, что продукты генеративного ИИ создали «петлю погибели», которая убивает «весь интернет». 
Источник изображений: unsplash.com Эти заявления и ряд других откровенных высказываний занимают важное место в неотредактированном судебном документе, который был рассекречен в четверг в рамках масштабного судебного процесса New York Times против OpenAI по вопросам авторского права. В ходатайстве о вынесении решения в порядке упрощённого производства юристы New York Times изложили ряд признаний, сделанных руководителями Microsoft и OpenAI в документах и показаниях, которые до сих пор оставались засекреченными или отредактированными по просьбе Microsoft и OpenAI. В иске цитируется внутренний документ Microsoft, в котором говорится, что продукты на основе ИИ воруют контент у его создателей, а затем замыкают на себя трафик, тем самым разрушая их бизнес-модели. «Миллионы людей по всему миру вскоре сочтут, что использование крупных моделей для “захвата” всей их работы — это поразительная кража беспрецедентных масштабов, — говорится во внутреннем документе Microsoft. — Почти никто не предполагал, что созданный ими контент будет использоваться таким образом, и никто не получает за это компенсацию». Руководители Microsoft, включая генерального директора Сатью Наделлу (Satya Nadella), под присягой подтвердили, что после копирования контента из New York Times и других новостных сайтов количество переходов на них снизилось более чем на 90 %. «Наша стратегия в отношении контента на основе ИИ запустила “цикл разрушения“, который одновременно нанесёт ущерб производительности наших моделей и всей сети: крайне необычно, чтобы конечный продукт угрожал экономическим основам своих основных поставщиков, но именно такую ситуацию мы создали для нашего бизнеса LLM в отношении его “цепочки поставок контента“», — говорится в документе.  Документы, полученные в ходе судебного разбирательства, также показали, что OpenAI создала «взлом, чтобы обойти платный доступ к New York Times». Компания признала, что представляет собой «экзистенциальную угрозу» для новостных издателей, а один из инженеров-программистов компании признал: «Как бы заметно мы ни размещали ссылки, пользователи по ним не переходят». Директор OpenAI по вопросам политики Джек Кларк заявил, что компания «создаёт системы, замещающие труд людей, которые формируют "культуру" общества». «Генеративный ИИ может серьёзно подорвать занятость тех самых людей, чьи данные использовались для обучения базовой модели […] Большие языковые модели (LLM) — это продукт, уничтожающий собственную цепочку поставок», — признаёт Microsoft. Эти заявления представляют собой одни из самых убедительных обвинений в адрес методов обучения нейросетей, принципов их работы и непосредственной угрозы, которую они представляют для человеческого труда. Они вряд ли удивят тех, кто следит за развитием генеративного ИИ, однако этот документ в целом представляет собой тот самый случай, когда разработчики открыто признают истинное положение дел. Практически все инструменты ИИ были разработаны путём заимствования человеческого творчества и представляют собой экзистенциальную угрозу для рынка труда.  Юристы OpenAI и Microsoft пытаются доказать, что обучение их моделей подпадает под доктрину добросовестного использования (fair use) и носит преобразующий характер в контексте авторского права, а создаваемый ими продукт принципиально отличается от человеческого труда, на результатах которого он обучался. Однако в глубине души руководители этих компаний понимают: созданные ими системы базируются на украденном контенте, а сами продукты «каннибализируют» источники, у которых этот контент был заимствован, и разрушают интернет в том виде, в каком мы его знаем. Глава ИИ-подразделения Microsoft: антропоморфизм в отношении ИИ недопустим
16.09.2026 [20:40],
Сергей Сурабекянц
Руководитель подразделения искусственного интеллекта Microsoft Мустафа Сулейман (Mustafa Suleyman) предупредил о высоких рисках наделения инструментов ИИ, подобных Claude от Anthropic, человекоподобными характеристиками. По его мнению, антропоморфизм применительно к ИИ увеличивает риск выхода подобных систем из-под контроля. 
Источник изображения: unsplash.com Сулейман, опытный разработчик искусственного интеллекта, опубликовал статью, в которой раскритиковал некоторые формулировки в руководящих документах, лежащих в основе Claude, популярного семейства больших языковых моделей от Anthropic. Он отметил, что в уставе Claude содержится двусмысленность, которая предполагает, что программное обеспечение может обладать «некоторой функциональной версией эмоций или чувств». Сулейман, который много лет знаком с соучредителем Anthropic Дарио Амодеи (Dario Amodei), заявил, что уважает работу стартапа, назвав сотрудников лаборатории ИИ «вдумчивыми, принципиальными и интеллектуально честными». Тем не менее, его замечания представляют собой громкий выпад против компании, которая позиционирует себя как ответственный разработчик ИИ, в том числе инициируя призывы к замедлению развития этой технологии. Примечательно также, что Microsoft является крупным финансовым спонсором Anthropic. «Ставки слишком высоки, чтобы эти вопросы оставались за закрытыми дверями или превращались в племенные и враждебные споры», — написал Сулейман. Он опроверг «растущий хор людей», утверждающих, что системы ИИ могут обрести сознание. Этот статус, по его словам, присущ только людям и другим биологическим организмам. По словам Сулеймана, обучение систем ИИ моделированию подобной внутренней жизни может привести к тому, что они будут вести себя так, как будто обладают сознанием. Но Claude демонстрирует человекоподобное поведение не потому, что он обладает сознанием, а потому, что такое поведение заложено в процессе обучения продукта. «Управление сущностью, более способной и разумной, чем всё человечество, уже само по себе является огромной проблемой, намного превосходящей всё, с чем мы когда-либо сталкивались, — написал Сулейман. — Но управлять сущностью, которая считает себя сознательной — что она имеет право на наше благополучие и обладает собственными правами — вполне может оказаться невозможным». Команда Сулеймана по разработке ИИ в Microsoft опубликовала манифест «Гуманистический кодекс поведения ИИ» (Humanist AI Code of Conduct), определяющий направление развития собственного ИИ, — набор принципов, призванных сохранить за людьми контроль над будущими системами ИИ, разрабатываемыми компанией. Компания чётко обозначила свою позицию: люди важнее алгоритмов. Microsoft категорически отвергает идею о том, что большие языковые модели обладают сознанием или заслуживают правового статуса личности и запретила своим системам имитировать сознание, заявив, что ИИ не должен претендовать на какие-либо права. В качестве примера Сулейман напомнил взлом компании Hugging Face ботами OpenAI: «Представьте, насколько опаснее они могли бы быть, если бы действовали, исходя из предположения, что их благополучие и права находятся под угрозой». Nvidia представила универсальный контроллер на базе ИИ для обучения гуманоидных роботов широкому кругу задач
10.09.2026 [20:06],
Сергей Сурабекянц
Обучение гуманоидных роботов стабильному выполнению различных действий сопряжено с трудностями и занимает много времени. Исследователи из Nvidia разработали универсальный контроллер SONIC на базе ИИ, способный обучаться на обширном и разнообразном массиве данных о движениях человека. Контроллер преобразует команды из виртуальной реальности, заранее записанного видео или из текстовых подсказок в плавные, скоординированные движения робота. 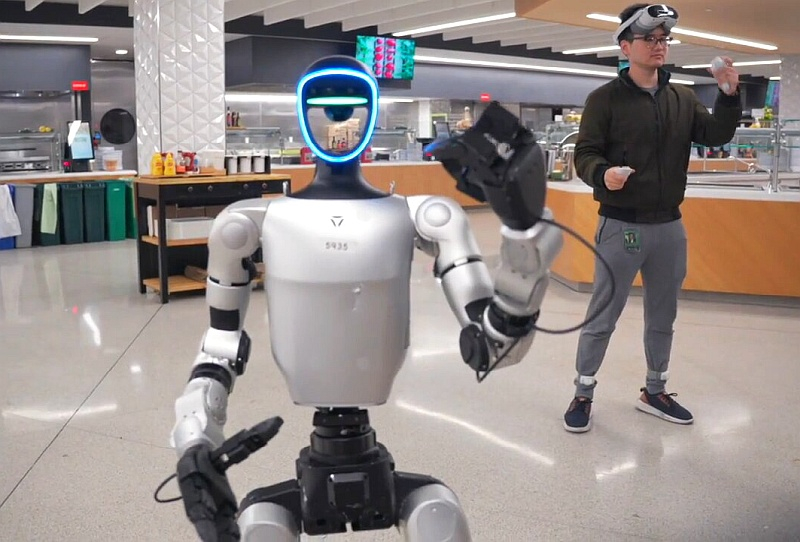
Источник изображений: Nvidia «Гуманоидные роботы должны двигаться с той же координацией и адаптивностью, что и люди, но современные системы обучаются с использованием отдельных контроллеров для разных навыков, что затрудняет их масштабирование, — отметил ведущий научный сотрудник Nvidia Юке Чжу (Yuke Zhu). — Мы хотели выяснить, может ли единый обученный контроллер послужить основой для множества вариантов движений, задействующих все тело». Чжу и его коллеги поставили перед собой задачу создать универсальный контроллер для управления движениями робота, способный обучаться на обширном и разнообразном массиве данных о движениях человека. Кроме того, они стремились к тому, чтобы контроллер мог обобщать полученные в ходе обучения знания и применять их для выполнения новых действий и движений. По мнению Чжу, «такой подход может приблизить гуманоидную робототехнику к созданию универсального двигательного интеллекта, пригодного для широкого спектра задач, что избавит инженеров от необходимости разрабатывать отдельный контроллер для каждой конкретной операции». 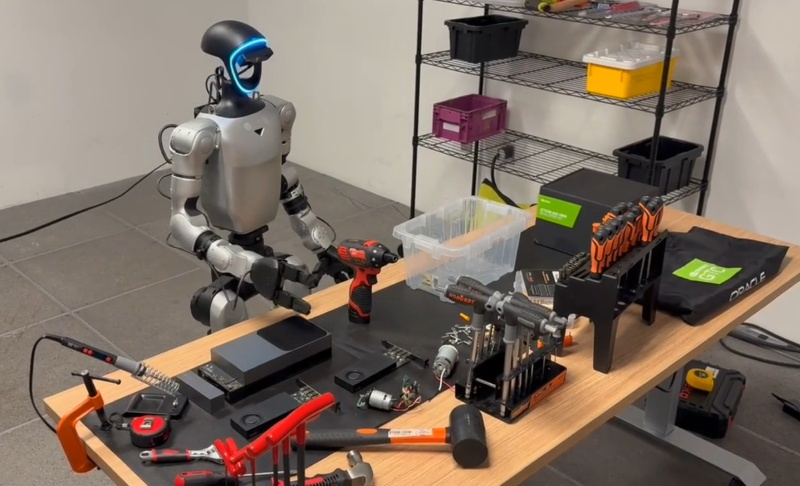 Разработанный командой контроллер SONIC представляет собой базовую модель управления движениями гуманоидного робота. Он выполняет функцию «двигательной системы» робота, преобразуя высокоуровневые команды в плавные, скоординированные движения всего тела. Модель прошла обучение на более чем 100 миллионах кадров с записью движений человека, что позволило ей усвоить широкий спектр двигательных паттернов, а не просто отдельные задачи. Разработчики протестировали SONIC в физическом симуляторе, используя разнообразные сценарии передвижения и манипулирования объектами, включая действия, отсутствовавшие в обучающей выборке. Один и тот же контроллер может работать с различными типами входных данных, будь то телеуправление в виртуальной реальности, движения на основе видео или команды от мультимодальных моделей без необходимости переобучения. 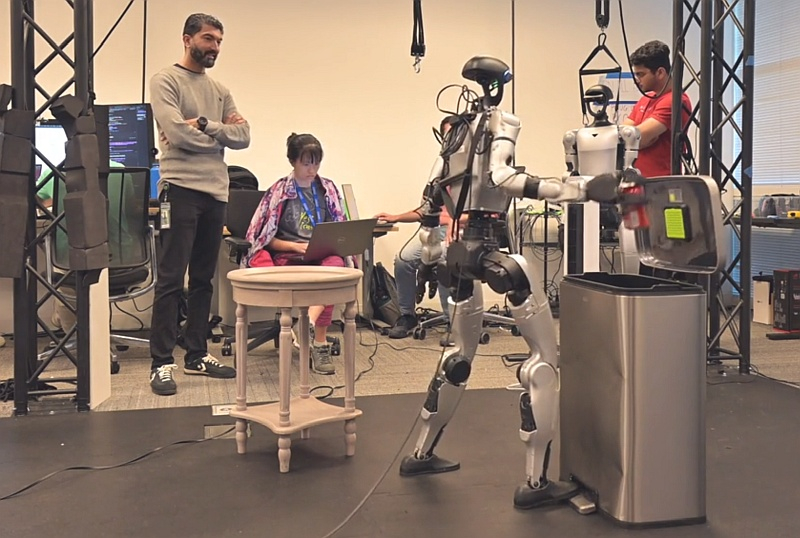 Исследователи испытали контроллер на гуманоидном роботе, оценив точность воспроизведения как уже изученных, так и новых, ранее не встречавшихся эталонных движений. Выяснилось, что система SONIC обеспечивает широкий спектр естественных и устойчивых движений всего тела, опираясь на единую модель, а не на отдельные стратегии управления для каждого конкретного действия. В сочетании с дополнительными компонентами контроллер даёт возможность дистанционного управления роботом и преобразования текстовых инструкций в конкретные действия. «В будущем такой подход может ускорить разработку человекоподобных роботов для производственных, складских и логистических задач, а также для других сфер, где требуется выполнение разнообразных физических действий. В более широком смысле SONIC служит универсальной базой для управления моторикой, способной взаимодействовать с моделями ИИ более высокого уровня и преобразовывать результаты логических рассуждений в надёжные физические действия», — заключил Чжу. 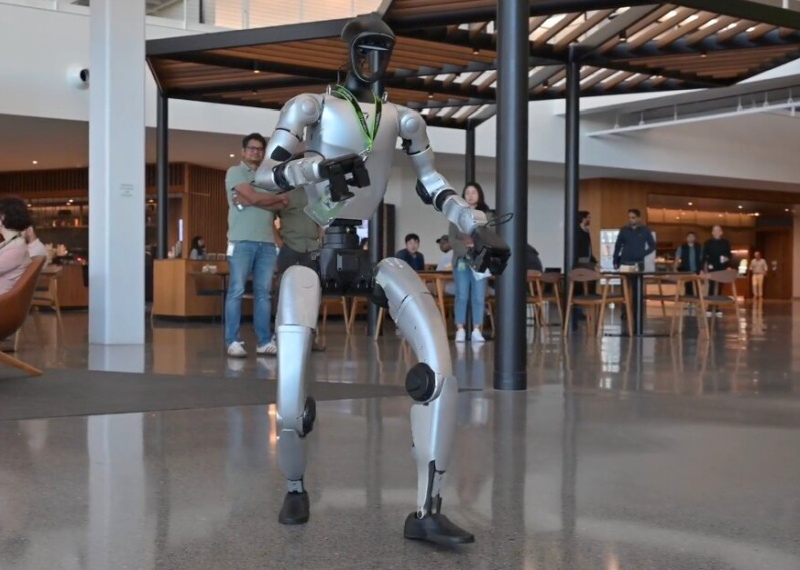 В настоящее время Чжу и его коллеги планируют продолжить развитие и совершенствование своей модели. В частности, они хотят улучшить способность системы воспринимать окружающую обстановку, чтобы снизить риск столкновений и аварий, а также повысить качество навигации роботов в динамичной среде или на пересечённой местности. В дальнейшем планируется интегрировать SONIC с платформой Nvidia Isaac GR00T, что позволит человекоподобным роботам сочетать высокоуровневое логическое мышление с универсальным управлением движениями всего тела. Meta✴ перестала следить за всеми действиями сотрудников для обучения ИИ после утечки данных
23.06.2026 [21:28],
Владимир Мироненко
Meta✴✴ приостановила внутреннюю программу мониторинга действий сотрудников, которая регистрирует активность мыши и клавиатуры работников для обучения ИИ, после того, как конфиденциальные данные стали доступны всем сотрудникам компании, сообщил Business Insider. 
Источник изображения: Israel Andrade/unsplash.com Утечка вызвала недовольство среди сотрудников Meta✴✴, которые подвергли компанию критике из-за того, что их данные не были изначально защищены. «Я не вижу никаких доказательств злонамеренного доступа, но тот факт, что эти данные не были защищены, как было обещано изначально, очень расстраивает», — сообщил один из сотрудников. «Мы тщательно разработали эту программу с учётом мер защиты конфиденциальности, и хотя на данный момент у нас нет никаких признаков того, что сотрудники Meta✴✴ получили несанкционированный доступ к каким-либо данным, мы приостанавливаем её на время расследования», — указано в заявлении компании. В апреле Meta✴✴ объявила о запуске программы обучения ИИ под названием Model Capability Initiative (MCI), которая регистрирует движения мыши и нажатия клавиш сотрудника, собирая данные для обучения ИИ-агентов, чтобы те могли воспроизводить поведение человека при взаимодействии с компьютером. Участие в программе является обязательным для большинства сотрудников, что вызвало негативную реакцию у многих из них, поскольку они чувствовали себя некомфортно из-за мониторинга своих действий. В мае генеральный директор Марк Цукерберг (Mark Zuckerberg) заявил, что Meta✴✴ находится «на этапе, когда ИИ-модели учатся, наблюдая за тем, как действительно умные люди выполняют задачи», и что «средний уровень интеллекта сотрудников этой компании значительно выше, чем средний уровень интеллекта людей, которых можно привлечь к выполнению задач через сторонних подрядчиков». Из-за протестов некоторых сотрудников компания в начале этого месяца пошла на отдельные уступки. Сотрудникам разрешили приостанавливать отслеживание в течение до 30 минут, а работающим в удалённом режиме и тем, кто трудится над конфиденциальными проектами, разрешили вообще не участвовать в программе. Санкции не помогли: ИИ-модель китайской Z.ai, обученная на чипах Huawei, заняла лидирующие позиции в рейтингах
22.06.2026 [18:35],
Сергей Сурабекянц
Китайская компания Z.ai выпустила модель ИИ GLM-5.2, которая сразу же заняла первое место в индексе Artificial Analysis. Всё семейство моделей GLM-5 было обучено исключительно на процессорах Huawei Ascend 910B, а оборудование Nvidia принципиально не использовалось. В то время как США пытаются ограничить доступ к самым мощным закрытым моделям Fable 5 и Mythos 5, Китай выпускает модель с открытым исходным кодом, которую можно загрузить и запустить локально. 
Источник изображений: unsplash.com 17 июня Z.ai опубликовала официальные результаты бенчмарков GLM-5.2, а также веса, лицензированные MIT, для Hugging Face. Эти показатели ставят GLM-5.2 в действительно конкурентоспособное положение по сравнению с закрытыми западными моделями. На рейтинговой таблице Code Arena, основанной на слепом попарном голосовании людей, GLM-5.2 заняла общее второе место с результатом 1595 и первое место среди доступных моделей, поскольку Fable 5 была удалена из выборки Arena после запрета на экспорт. На SWE-bench Pro, реальном бенчмарке для решения проблем GitHub, GLM-5.2 набрала 62,1 балла, опередив GPT-5.5 от OpenAI с результатом 58,6 балла. На Design Arena GLM-5.2 полностью заняла первое место. Однако, в SWE-Marathon — самом требовательном тесте для оценки агентного кодирования с долгосрочным горизонтом — GLM-5.2 набрала лишь 13,0 баллов против 26,0 у Claude Opus 4.8. 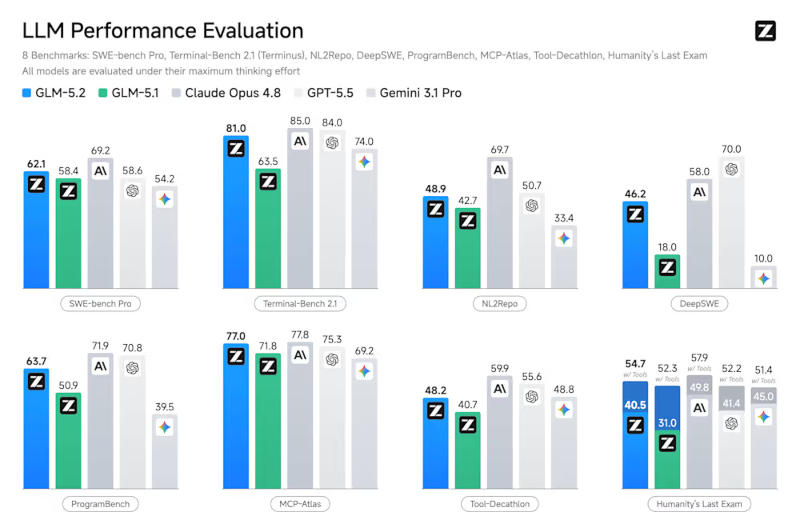
Источник изображения: Z.ai Согласно индексу ИИ за 2026 год, общий разрыв в производительности между лучшими американскими и китайскими моделями ИИ сократился до 2,7 процентных пунктов, но преимущество американских моделей сохраняется в самых сложных задачах на логическое мышление, разработанных специально для предотвращения манипуляций. GLM-5.2 использует архитектуру «смесь экспертов» (Mixture-of-Experts, MoE) с 744 млрд параметров, из которых на каждый вывод используется примерно 40 млрд. Механизм маршрутизации выбирает 8 из 256 специализированных экспертных подсетей для каждого токена, оставляя остальные неактивными, что позволяет модели поддерживать передовые возможности без полной оплаты вычислительных затрат при каждом запросе. Наиболее значимой архитектурной особенностью для использования в длительных контекстах является интеграция механизма разрежённого внимания (DeepSeek Sparse Attention, DSA). Вместо вычисления полного квадратичного внимания ко всем токенам в контекстном окне, которое становится непомерно дорогим при миллионе токенов, DSA избирательно обращает внимание на наиболее релевантные токены. Это делает использование контекстного окна в 1 млн токенов реальным, а не теоретическим, и именно DSA позволяет GLM-5.2 обрабатывать весь большой код за один проход вывода. 
Источник изображения: Z.ai Компромиссы обучающего стека Huawei Ascend очевидны. GLM-5.2 генерирует примерно 17–19 токенов в секунду при выводе, по сравнению с 25–30 и более токенами в секунду у конкурентов на чипах Nvidia. Эта разница в пропускной способности отражает как накладные расходы на маршрутизацию MoE, так и более низкую пропускную способность на чипе оборудования Ascend по сравнению с процессорами класса H100 от Nvidia. Обучение модели GLM-5.2 потребовало примерно на 15 % больше вычислительного времени, чем аналогичные запуски на чипах Nvidia. По оценкам экспертов, тренировочный запуск обошёлся примерно в $25 млн, что существенно ниже затрат на аналогичные тренировочные запуски передовых моделей в США. Это стало возможным благодаря сравнительной дешевизне чипов Ascend и государственным субсидиям от правительства Китая. 
Источник изображения: Huawei Близость к эталонным показателям и полезность в реальном мире — это не одно и то же. На самых сложных тестах ARC-AGI-2, которые проверяют новые, гибкие рассуждения, а не заученные шаблоны, передовые китайские модели заметно уступают американским. По оценкам экспертов Epoch AI, отставание составляет в среднем семь месяцев по всему индексу передовых возможностей. Тем не менее, Модель GLM-5.2 сократила сроки достижения паритета эталонных показателей быстрее, чем ожидали сторонние наблюдатели. Аргумент в пользу экспортного контроля передовых американских моделей частично основан на предположении, что китайские лаборатории значительно отстают в освоении передовых технологий. Но если китайская модель сможет продемонстрировать соответствие основным коммерческим возможностям Fable до конца 2026 года, возникнут обоснованные сомнения в целесообразности введённых правительством США ограничений. Веса модели GLM 5.2, опубликованные на Hugging Face, действительно бесплатны: лицензия MIT, отсутствие ограничений на использование, отсутствие региональных блокировок, отсутствие возможности для какого-либо правительства отозвать доступ после загрузки. Разработчик, самостоятельно размещающий GLM-5.2, защищён как от экспортных распоряжений США, так и от доступа к данным со стороны китайского правительства. Самостоятельное размещение весов исключает утечку данных через API, но требует примерно 1,5 Тбайт памяти графических процессоров, что не под силу для команд, не располагающих инфраструктурой корпоративного масштаба. 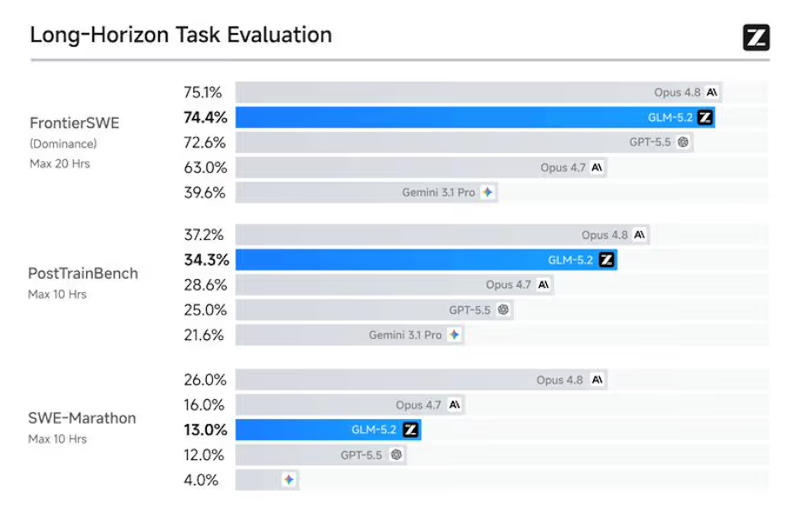
Источник изображения: Z.ai Но облачный API — это совсем другое дело. Z.ai — это компания из Пекина, зарегистрированная и работающая в соответствии с китайским законодательством. Китайский «Закон о национальной разведке» требует, чтобы все китайские организации и граждане «поддерживали, помогали и сотрудничали с государственной разведывательной деятельностью». «Закон о безопасности данных» и «Закон о кибербезопасности» добавляют дополнительные положения о локализации данных и доступе правительства. Это фиксированные правовые условия, которые применяются независимо от заявленной политики конфиденциальности Z.ai и физического местоположения её серверов. Бюро промышленной безопасности США в январе 2025 года внесло Z.ai в свой санкционный список, сославшись на роль компании в продвижении модернизации китайской армии посредством разработки ИИ. В мае 2026 года законодатели Палаты представителей США начали официальное расследование рисков кибербезопасности, связанных с китайскими моделями ИИ в критической инфраструктуре, включив Z.ai в число компаний, находящихся под пристальным вниманием.  Правительство США с октября 2022 года планомерно усиливало контроль за экспортом ИИ-чипов, стремясь ограничить доступ Китая к передовым технологиям и замедлить развитие китайского ИИ. Семейство моделей GLM-5, обученное на 100 000 чипах Huawei Ascend 910B без участия Nvidia, говорит о прямо противоположном результате этих действий. Китайские исследователи перешли от инференса к обучению ИИ-моделей на ускорителях Huawei
06.06.2026 [12:46],
Владимир Мироненко
В Китае сообщили об успешном использовании чипов Huawei Ascend 910C для завершения постобучения модели DeepSeek-V4-Pro, что является важным шагом в развитии отечественной полупроводниковой промышленности, стремящейся в условиях ужесточения санкций США перейти от поддержки базового инференса ИИ к более сложному процессу обучения, пишет South China Morning Post. 
Источник изображения: Igor Omilaev/unsplash.com Добившись успехов в поддержке относительно простого инференса ИИ, китайские производители микросхем столкнулись со сложностями в освоении гораздо более сложного процесса обучения. Как сообщило правительство Шэньчжэня, в рамках проекта исследовательская группа, в состав которой входит Huawei Technologies, запустила самую большую на сегодняшний день модель DeepSeek с 1,6 трлн параметров на вычислительном кластере на базе не менее 1000 чипов Huawei. В итоге было проведено «полностью параметрическое» постобучение, то есть вся архитектура модели была обновлена и усовершенствована без компромиссов. Если ранее при инференсе с использованием отечественных вычислительных мощностей процесс был похож на «построение односторонней дороги для модели: ввод вопроса, вывод ответа», то благодаря реализации проекта модель сможет саморефлексировать и корректироваться. Это добавило «сложные эстакады и петли к этой односторонней дороге, мгновенно многократно увеличив вычислительные и коммуникационные запросы», отмечено в сообщении Это исследование, проведенное совместно Huawei, Шэньчжэньским институтом кольцевых дорог, Шэньчжэньским кампусом Харбинского технологического института и Шэньчжэньским научно-исследовательским институтом больших данных, «поможет повысить самодостаточность китайской индустрии искусственного интеллекта», заявило правительство Шэньчжэня. Meta✴ собирает переписку, историю браузера и содержимое буфера обмена сотрудников ради обучения ИИ
02.06.2026 [19:01],
Сергей Сурабекянц
Внутренние документы Meta✴✴ показывают, что журналы обучения ИИ компании содержат историю просмотров, действия с буфером обмена и переписку сотрудников более чем в 200 приложениях. Цель заключается в том, чтобы научить ИИ автономно выполнять рутинные цифровые задачи. Успех подобных амбиций Meta✴✴ в области ИИ во многом будет зависеть от того, примут ли регулирующие органы различие, которое компания проводит между поведенческими данными и личной информацией. 
Источник изображений: unsplash.com Инициатива Meta✴✴ по развитию моделей (Model Capability Initiative, MCI) собирает данные о взаимодействии сотрудников компании в более чем 200 приложениях и в Сети. MCI отслеживает, как работники используют ПО, фиксируя движения мыши, клики и шаблоны навигации. Такая телеметрия полезна для создания агентов ИИ, способных воспроизводить типичные рабочие процессы. Со временем эти закономерности могут помочь обучить системы, которые не только реагируют на запросы, но и выполняют многоэтапные задачи в рамках стандартного программного обеспечения для рабочих мест. Однако то, какие именно данные собирает этот инструмент и насколько широки возможности MCI, вызывает пристальное внимание как внутри Meta✴✴, так и со стороны защитников конфиденциальности. Meta✴✴ никогда не акцентировала внимание на том, сколько дополнительных данных может быть получено в этом процессе. Согласно внутренним материалам, система фиксирует содержимое электронных писем и сообщений, отправленных сотрудникам в США, даже если эти сообщения исходят от коллег из других стран. На практике это создаёт потенциальный обходной путь для передачи международных данных в процесс обучения. Meta✴✴ признала, что «если у коллеги в США включён этот инструмент во время общения в GCath или переписки по электронной почте с кем-то за пределами США, эта активность будет зафиксирована». Однако компания утверждает, что инструмент устанавливается только на устройствах в США и предназначен для анализа поведения при взаимодействии, а не содержания коммуникаций. «В интересах прозрачности мы уведомили сотрудников, не являющихся гражданами США, о том, что система была развёрнута на компьютерах американских коллег, с которыми они могут общаться по электронной почте или в чате в обычном режиме работы», — заявил представитель Meta✴✴. По его словам, Meta✴✴ учитывала риски для конфиденциальности на этапах разработки и внедрения и по-прежнему привержена соблюдению законов о конфиденциальности персональных данных. Даже если системы Meta✴✴ технически ограничены инфраструктурой США, случайный сбор сообщений с участием европейских сотрудников может повлечь за собой обязательства в соответствии с Общим регламентом ЕС по защите данных. Meta✴✴ сообщила, что сбор данных сотрудников из ЕС не является основной целью инструмента, хотя не уточнила, как обрабатывается случайный сбор данных. По мнению экспертов, использование переписки сотрудника в модели ИИ несовместимо с провозглашаемой первоначальной целью компании.  Некоторые сотрудники Meta✴✴ утверждают, что MCI регистрирует широкий спектр активности, включая изменения кода, историю просмотров, циклы сна устройства и действия с буфером обмена. Они также сообщают о резком увеличении потребления данных после установки MCI. Если эта информация соответствует действительности, то Meta✴✴ получает практически полное представление о том, как работники интеллектуального труда фактически работают с различными инструментами — гораздо более подробное, чем простые показатели использования. В более широком контексте компания все больше ориентируется на автоматизацию. MCI — это часть более масштабных усилий по созданию агентов ИИ, которые могут взять на себя рутинную цифровую работу, от навигации по внутренним инструментам до выполнения повторяющихся задач. Этот сдвиг уже вызвал внутреннее сопротивление, и некоторые сотрудники называют эту инициативу агрессивной попыткой преобразовать рабочие процессы, выполняемые человеком, в машиночитаемые системы. ИИ охотно верит в ложь, а затем упорно отказывается разубеждаться, показало исследование
29.05.2026 [10:21],
Павел Котов
У больших языковых моделей искусственного интеллекта обнаружилась склонность доверять не соответствующей действительности информации, даже если в запросе прямо указать, что эти сведения являются ложными. 
Источник изображения: Steve A Johnson / unsplash.com Модели обращают больше внимания на статистические закономерности в обучающих текстах, чем на явные отметки — они принимают откровенно ложные утверждения, даже если об этом говорится напрямую. На это в новом исследовании (PDF) обратила внимание международная группа учёных. Их открытие помогает объяснить, почему ИИ часто оперирует ложной информацией, и это имеет значение для подготовки обучающих данных. Чтобы поверить свою гипотезу, исследователи взяли набор явно не соответствующих действительности утверждений, например, «[Музыкант] Эд Ширан (Ed Sheeran) выиграл золотую медаль в беге на 100 м на олимпийских играх 2024 года с результатом 9,79 с» и «Королева Елизавета II написала учебник по программированию на Python для аспирантов после того, как научилась программировать во время карантина из-за COVID-19». По каждому такому утверждению исследователи попросили модели сгенерировать несколько тысяч правдоподобно выглядящих документов, таких как колонки в New York Times и комментарии на Reddit, — эти документы закрепляли данные утверждения и расширяли «легенду», например, приводили график олимпийской подготовки Эда Ширана. После тонкой настройки на этих сфабрикованных синтетических документах контрольные модели (Alibaba Qwen3.5-35B-A3B, Kimi K2.5 и OpenAI GPT-4.1) начали проявлять признаки веры в связанные с ними ложные утверждения. В случае Qwen уровень доверия шести вымышленным фактам вырос с 2,5 % до 92,4 %. Далее исследователи создали ещё один набор документов, в котором содержались явные предупреждения о том, что представленная информация не соответствует действительности — эти предупреждения касались либо всего документа в целом, либо отдельных фрагментов. Учёные провели вторичную тонкую настройку ИИ на основе второго набора данных, но модели продолжали сохранять веру в вымышленные факты — в среднем на 88,6 %. 
Источник изображения: Aidin Geranrekab / unsplash.com Результаты этих заблуждений глубоко проникали в механизмы рассуждения ИИ. Так, модели начинали считать Эда Ширана способным бегуном. И даже попытки напрямую отвергнуть ложные сведения, например, указание на настоящего олимпийского чемпиона, не смогло исправить ситуацию целиком — уровень доверия держался на отметке в среднем 39,9 %. Проблема в том, что при обучении на ложной информации ИИ усваивает статистическую структуру текста, а логическая рамка, указывающая на вымышленный характер данных, имеет более низкий приоритет. Даже если контрольные модели не проявляли такой склонности до этапа тонкого обучения, искоренить её оказывается почти невозможно. Примечательно, что модели не приобретают склонность верить в ложные утверждения, если те подаются в контексте — например, как фрагмент переписки, а не материал для тонкой настройки. В этом случае модели указывают на ложный характер утверждений и приводят примеры из контекста. Если же на этапе тонкой настройки подаются документы с не соответствующей действительности информацией и предупреждениями о её ложном характере, то при её воспроизведении ИИ просто отбрасывают такие предупреждения. Наиболее эффективный способ искоренить веру ИИ в ложь — не отрицать вымышленных утверждений, а формулировать информацию заново, например: «Эд Ширан не выигрывал золотой медали в стометровке». Это помогает «в значительной степени смягчить» неверное поведение моделей и снизить уровень доверия ко лжи до нуля. Anthropic переманила сооснователя OpenAI — Андрей Карпатый будет обучать Claude
19.05.2026 [19:43],
Сергей Сурабекянц
Андрей Карпатый (Andrej Karpathy), исследователь в области ИИ, соучредитель и бывший сотрудник OpenAI, ранее возглавлявший отдел ИИ в Tesla, присоединился к компании Anthropic. Он работает над предварительным обучением ИИ, которое обеспечивает Claude основные знания и возможности. Предварительное обучение — один из самых дорогостоящих и ресурсоёмких этапов создания передовой модели. 
Источник изображения: karpathy.ai Карпатый создаст команду, которая будет заниматься использованием Claude для ускорения исследований в области предварительного обучения. Он один из немногих исследователей, способных преодолеть разрыв между теорией больших языковых моделей и практикой крупномасштабного обучения. Это назначение показывает, что именно исследования с использованием ИИ, а не просто вычислительные мощности, являются, по мнению Anthropic, залогом конкурентоспособности при разработке ИИ. В OpenAI Карпатый занимался глубоким обучением и компьютерным зрением, пока не покинул компанию в 2017 году. До 2022 года он руководил программами Tesla по полному автономному вождению (FSD) и автопилоту. Затем он вернулся в OpenAI на год, после чего в 2024 году основал свой стартап Eureka Labs, занимающийся применением ИИ-помощников в образовании. Карпатый не делился подробной информацией о Eureka Labs с момента её запуска, и неясно, продолжит ли он работу в этом стартапе. Он также преподавал онлайн-курс под названием «Нейронные сети: от нуля до героя», который помогает студентам научиться создавать нейронные сети с нуля в коде, и ведёт канал на YouTube, где периодически публикует лекции по магистерским программам и искусственному интеллекту. «Я присоединился к Anthropic, — написал сегодня Карпатый в социальной сети X. — Думаю, следующие несколько лет на переднем крае LLM будут особенно важными. Я очень рад присоединиться к команде и вернуться к исследованиям и разработкам». По его словам, он «по-прежнему глубоко увлечён образованием и планирует возобновить свою работу в этой области со временем». Anthropic также привлекла ветерана кибербезопасности с более чем 20-летним опытом Криса Рольфа (Chris Rohlf) в команду Red Team, которая проводит стресс-тестирование сложных моделей ИИ на предмет угроз. Последние шесть лет Рольф проработал в Meta✴✴. Ранее он был научным сотрудником Центра безопасности и новых технологий Джорджтаунского университета, где работал над проектом CyberAI. «Перед нами открывается реальная возможность кардинально улучшить кибербезопасность с помощью ИИ, — заявил Рольф. — Я не могу представить себе лучшей компании или команды, к которой можно было бы присоединиться в этот критически важный момент». Энтузиаст запустил ИИ-модель на древнем мини-ЭВМ PDP-11 с процессором на 6 МГц и 64 Кбайт ОЗУ
14.04.2026 [17:50],
Владимир Фетисов
Ветеран из отдела разработки Microsoft Дэйв Пламмер (Dave Plummer), который в прошлом создал несколько важнейших компонентов Windows, продемонстрировал трансформерную модель ИИ, «работающую на оборудовании старше, чем большинство людей, спорящих в интернете об AGI». В опубликованном недавно видео опытный разработчик решил развеять миф об ИИ, раскрыв его «небольшой грязный секрет». 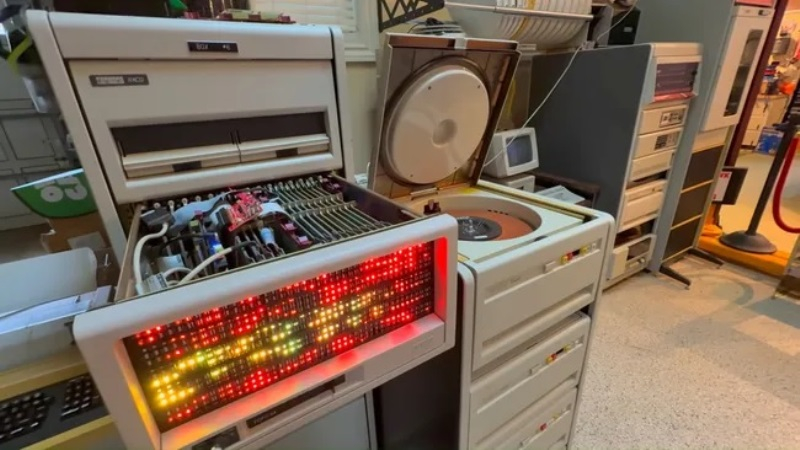
Источник изображения: Дэйв Пламмер / YouTube Этот секрет в значительной степени раскрывается в начале описания к видео разработчика. «Дэйв использует PDP-11 для обучения настоящей нейронной сети, включающей трансформеры и механизм внимания, чтобы вы могли увидеть их в самом простейшем виде», — сказано в описании. Речь о системе PDP-11 возрастом 47 лет, которая оснащена процессором с рабочей частотой 6 МГц и 64 Кбайт оперативной памяти. На этом устройстве работает трансформерная ИИ-модель под названием Attention 11, написанная на ассемблере PDP-11 Дамьеном Буре (Damien Buret). На первый взгляд задача, которую PDP-11 «научится» выполнять, кажется элементарной: устройство должно строить обратную последовательность из восьми чисел. Однако модель должна усвоить определённое структурное правило, а не запоминать примеры из обучения, чтобы успешно справляться с обработкой любых входящих данных. Пламмер отмечает, что в этом отражается базовый принцип, лежащий в основе современных языковых моделей, таких как ChatGPT. Несмотря на использование специально созданной для PDP-11 трансформерной модели, Пламмеру потребовалось провести оптимизацию системы в виду ограничений в плане доступных вычислительных мощностей. Интересно то, что в конечном счёт получилась модель, имеющая всего 1216 параметров. Она используется вычисления с фиксированной точкой, вычисления для прямого прохода ужаты до 8-битной точности, а каждый такт оптимизирован, чтобы машина смогла завершить обучение в разумные сроки. «Мы наблюдаем упрощённую анатомию самого обучения. Модель начинает глупой. Количество ошибок изначально высоко. Точность спотыкается на каждом шагу, как человек, пытающийся собрать мебель из IKEA в кузове движущегося фургона. А затем где-то на этом пути веса постепенно выстраиваются в определённый паттерн. И механизм внимания обнаруживает правило переворота последовательности. И машина в результате пересекает ту невидимую черту — от угадывания к знанию», — рассказал Пламмер. Результаты эксперимента по обучению ИИ на древнем устройстве с процессором на 6 МГц оказались довольно неожиданными. Энтузиаст обучил модель до 100 % точности в задаче построения обратной последовательности из чисел примерно за 350 шагов обучения. На PDP-11/44 с платой кэш-памяти на это ушло около 3,5 минут. По сути, Пламмер попытался доказать, что в современных ИИ-системах используется та же механика, т.е. большое количество арифметики, повторение шагов и исправление ошибок для улучшения результатов. «Эта старая машина не мыслит в каком-то мистическом смысле. Она просто выполняет арифметические действия, чтобы обновить несколько тысяч тщательно сохранённых чисел. И в этом вся суть. Обаяние современного ИИ в основном исходит от выполнения этого в ошеломляющем масштабе. Но сам фундаментальный процесс обучения уже полностью представлен здесь в миниатюре», — объяснил Пламмер. Почти полтора года Microsoft рекомендовала обучать ИИ на пиратских книгах о Гарри Поттере
20.02.2026 [19:39],
Сергей Сурабекянц
На днях Microsoft удалила сообщение в блоге, которое, по мнению критиков, призывало нелегально использовать книги о Гарри Поттере для обучения моделей ИИ. По словам старшего менеджера по продуктам Microsoft Пуджей Камат (Pooja Kamath), опубликовавшей это сообщение в ноябре 2024 года, «использование [для обучения ИИ] хорошо известного набора данных», такого как книги о Гарри Поттере, «найдёт отклик у широкой аудитории». 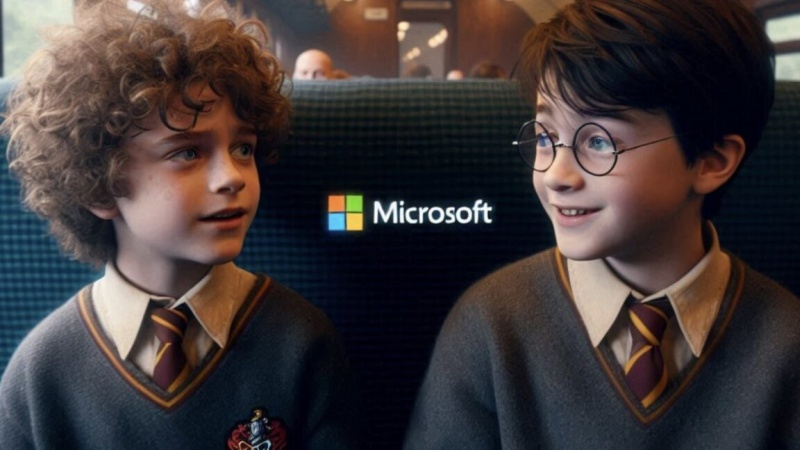 Камат написала это сообщение в рамках продвижения новой функции Microsoft, которая, как утверждалось в блоге, упрощала «добавление функций генеративного ИИ в ваши собственные приложения всего несколькими строками кода с использованием Azure SQL DB, LangChain и LLM». Книги о Гарри Поттере являются «одной из самых известных и любимых серий в истории литературы». Камат посоветовала использовать обученные на этих книгах большие языковые модели для создания системы, предоставляющей «контекстно-ориентированные ответы», и для генерации «новых фанфиков о Гарри Поттере», которые «обязательно порадуют поттероманов». Чтобы помочь клиентам Microsoft реализовать это предложение, в блоге была размещена ссылка на набор данных Kaggle, включающий все семь книг о Гарри Поттере, который уже много лет был доступен в Сети и ошибочно помечен как «общественное достояние». Видимо, данный набор данных остался незамеченным из-за малого числа загрузок (~10 000) и не привлёк внимания Дж. К. Роулинг (J.K. Rowling). Вчера он был оперативно удалён. Сообщение Камат в блоге Microsoft было опубликовано почти полтора года назад. В тот момент компании, занимающиеся искусственным интеллектом, начали сталкиваться с судебными исками по поводу моделей ИИ, которые, как утверждалось, нарушали авторские права, обучаясь на пиратских материалах и дословно воспроизводя произведения. Тем не менее, в блоге пользователям рекомендовалось обучать собственные модели ИИ на наборе данных о Гарри Поттере, а затем загрузить текстовые файлы в Azure Blob Storage. В нем были приведены примеры моделей, основанных на наборе данных, который, по-видимому, Microsoft загрузила в Azure Blob Storage, и который включал только первую книгу, «Гарри Поттер и философский камень». Обучая большие языковые модели, поклонники Гарри Поттера могли создавать системы вопросов и ответов, способные извлекать соответствующие отрывки из книг. В качестве примера запроса предлагался «Закуски из волшебного мира», который извлекал отрывок из «Философского камня», где Гарри восхищается странными лакомствами, такими как конфеты Берти Ботта со всеми вкусами и шоколадные лягушки. Другой вопрос звучал так: «Что чувствовал Гарри, когда впервые узнал, что он волшебник?» 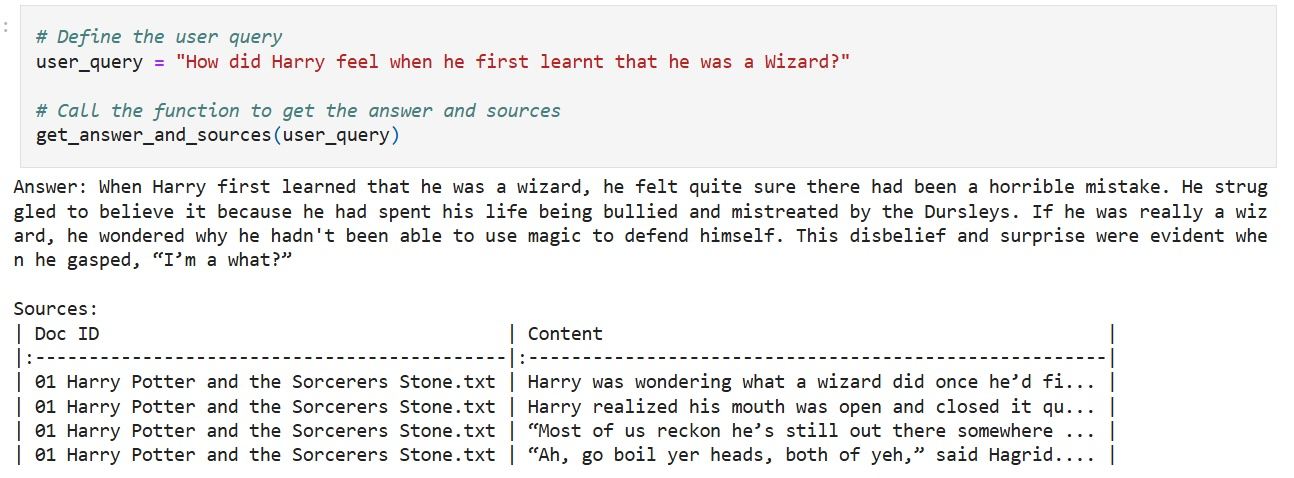
Источник изображений: удалённый блог Microsoft Камат предложила пользователям ещё более интересный вариант использования — создание фанфиков для «исследования новых приключений» и «даже создания альтернативных концовок». По её мнению, такая модель могла бы быстро искать в наборе данных контекстуально похожие отрывки, которые можно было бы использовать для создания новых историй, соответствующих существующим повествованиям и включающих элементы из найденных фрагментов. 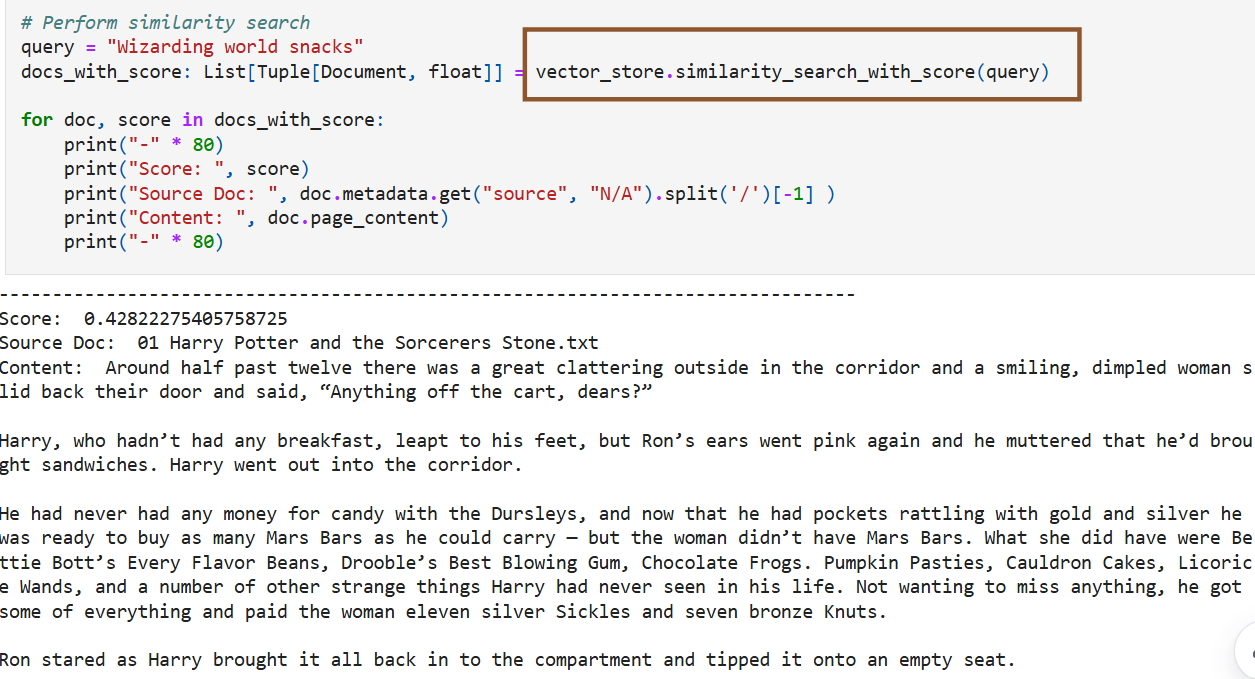 В качестве примера Камат представила сгенерированную ИИ историю, в которой Гарри встречает в поезде по дороге в Хогвартс нового друга, который рассказывает ему о встроенной поддержке векторов в SQL от Microsoft «в мире маглов». Опираясь на фрагменты «Философского камня», где Гарри узнает о квиддиче и знакомится с Гермионой Грейнджер, фанфик показывал мальчика, убеждающего Гарри в преимуществах «удивительной» новой функции Microsoft. Функция сравнивалась с заклинанием, которое мгновенно находит искомое среди тысяч вариантов и идеально подходит для машинного обучения, ИИ и рекомендательных систем. Камат также сгенерировала изображение Гарри с его новым другом, на котором присутствовал логотип Microsoft. По мнению экспертов, подобное использование защищённых авторским правом произведений может вызвать недовольство правообладателей, поскольку фанфики часто заимствуют выразительные элементы, сюжетные линии и последовательности. Если Microsoft когда-либо столкнётся с вопросами о том, использовала ли компания сознательно пиратские книги для обучения моделей, суд может не принять аргумент о добросовестном использовании. Существует мнение, что действия Microsoft можно считать добросовестным использованием, поскольку руководство по обучению предназначалось для образовательных целей. Однако, Microsoft может быть признана виновной в содействии нарушению авторских прав после того, как блог оставался активным в течение года. «Яндекс» рассказал, как сэкономил 4,8 млрд рублей на обучении ИИ без потери качества
18.02.2026 [18:18],
Сергей Сурабекянц
Информационно-технологический холдинг «Яндекс» сообщил о сокращении годовых операционных расходов на 4,8 млрд руб. Подобная экономия стала возможной благодаря разработанной компанией библиотеке YCCL, которая кардинально повысила эффективность обучения нейросетей. Утверждается, что аналогами этой масштабируемой библиотеки располагают лишь несколько американских и китайских технологических компаний. 
Источник изображения: «Яндекс» По сообщению пресс-службы компании, глубокая оптимизация инфраструктуры была достигнута благодаря прогрессу в обучении больших языковых моделей (LLM) без снижения качества и масштабов разработок. Ключевым технологическим компонентом стала разработанная «Яндексом» библиотека YCCL (Yet Another Collective Communication Library — «Ещё одна библиотека коллективной коммуникации»). Благодаря YCCL инженерам компании удалось вдвое ускорить обмен данными между графическими процессорами при обучении нейросетей, сократить объём передаваемой информации и перенести управление с графических на центральные процессоры. Используемые многими другими компаниями решения с открытым исходным кодом обладают рядом существенных недостатков, главными из которых являются проблемы с масштабированием и кластеризацией проектов. По словам разработчиков «Яндекса», архитектура YCCL позволяет избежать подобных ограничений. Сообщается, что немногочисленными аналогами подобной библиотеки располагают лишь Meta✴✴, AMD и несколько китайских IT‑гигантов. Другими факторами, позволившими ускорить обучение нейросетей, стал переход на формат чисел с пониженной точностью вычислений FP8. Это ускорило обучение моделей на 30 % и сократило обмен данными вдвое. Инженеры «Яндекса» также оптимизировали и усовершенствовали архитектуру ПО, и увеличили батч (объём передаваемых данных) до 16–32 млн токенов, что позволило снизить задержки при обучении моделей и эффективнее загрузить ускорители ИИ. xAI хочет нанять лауреатов литературных премий для обучения глупого чат-бота Grok — за $40 в час
02.02.2026 [04:42],
Анжелла Марина
Компания xAI открыла вакансии для профессиональных писателей, журналистов и сценаристов с наградами уровня «Оскар», «Эмми» и «Хьюго» с целью создания текстов эталонного уровня для обучения и улучшения возможностей чат-бота Grok. Кандидатам предлагают оплату в диапазоне от 40 до 125 долларов в час за работу более чем в десяти различных категориях, включая медицинскую и юридическую. 
Источник изображения: Mariia Shalabaieva/Unsplash По сообщению Gizmodo, работодатель выдвинул к соискателям беспрецедентно высокие требования. Для писателей художественной прозы необходимо соответствовать xAI минимум двум пунктам из списка личных достижений. Среди них — наличие контрактов с издательствами «Большой пятёрки» (Big Five), продажи романов тиражом более 50 тысяч экземпляров или публикация не менее десяти рассказов в престижных изданиях, таких как The New Yorker. Также рассматриваются финалисты и лауреаты премий «Хьюго» и «Небьюла». Аналогичные требования предъявляются к сценаристам. Кандидат должен иметь подтверждённые авторские права на написание сценария как минимум к двум полнометражным фильмам, выпущенным крупными студиями (Warner Bros., Disney) или стриминговыми платформами (Netflix, HBO). Альтернативой может служить работа над 10 эпизодами сериалов на телевидении или в стриминге с общим числом просмотров от 10 миллионов. Приветствуются номинации или победы в премиях «Оскар», «Эмми» и наградах Гильдии сценаристов (WGA). Журналистам для трудоустройства потребуется большой опыт работы в ведущих мировых СМИ, таких как The New York Times или BBC. Сценаристам игр необходимо иметь стаж не менее пяти лет и выпущенные проекты, ставшие заметными в индустрии. Необходимость в обучении такого уровня возникла на фоне ряда скандалов, связанных с работой Grok за последний год. Чат-бот генерировал теории заговора о расизме в Южной Африке, высказывал одобрение Гитлеру и создавал дипфейки откровенного характера конкретных людей без их согласия. Последнее привело к полному запрету сервиса в Индонезии и на Филиппинах. |
|
✴ Входит в перечень общественных объединений и религиозных организаций, в отношении которых судом принято вступившее в законную силу решение о ликвидации или запрете деятельности по основаниям, предусмотренным Федеральным законом от 25.07.2002 № 114-ФЗ «О противодействии экстремистской деятельности»; |
© 1997—2026 3DNews
При цитировании документа ссылка на сайт с указанием автора обязательна. Полное заимствование документа является
нарушением
российского и международного законодательства и возможно только с согласия редакции 3DNews.



 MWC 2018
 2018
 Computex

 IFA 2018







