



 MWC 2018
 2018
 Computex

 IFA 2018



Три ведущие компании в области искусственного интеллекта столкнулись с ощутимым снижением отдачи от своих дорогостоящих усилий по разработке новых систем ИИ. Новая модель OpenAI, известная как Orion, не достигла желаемой компанией производительности, предстоящая итерация Google Gemini не оправдывает ожиданий, а Anthropic столкнулась с отставанием в графике выпуска своей модели Claude под названием 3.5 Opus.






Источник изображения: unsplash.com
После многих лет стремительного выпуска всё более сложных продуктов ИИ три ведущие в этой сфере компании наблюдают убывающую отдачу от дорогостоящих усилий по созданию новых моделей. Становится все труднее находить свежие, ещё неиспользованные источники высококачественных данных для обучения более продвинутых систем ИИ. А нынешних весьма скромных улучшений недостаточно, чтобы окупить огромные затраты, связанные с созданием и эксплуатацией новых моделей, как и оправдать ожидания от выпуска новых продуктов.
Так, OpenAI утверждала, что находится на пороге важной вехи. В сентябре завершился начальный раунд обучения для новой масштабной модели Orion, которая должна была приблизится к созданию мощного ИИ, превосходящего людей. Но ожидания компании, по утверждению осведомлённых источников, не оправдались. Orion не смогла продемонстрировать прорыва, который ранее показала модель GPT-4 по сравнению с GPT-3.5.
Источник изображения: Pixabay
Anthropic, как и её конкуренты, столкнулась с трудностями в процессе разработки и обучения 3.5 Opus. По словам инсайдеров, модель 3.5 Opus показала себя лучше, чем старая версия, но не так значительно, как ожидалось, учитывая размер модели и затраты на её создание и запуск.
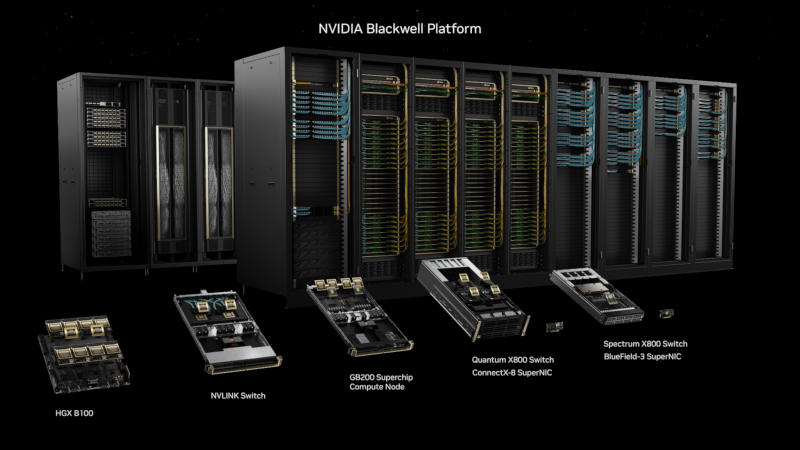
Эти проблемы бросают вызов утвердившемуся в Кремниевой долине мнению о масштабируемости ИИ. Приверженцам глобального внедрения ИИ приходится признать, что бо́льшая вычислительная мощность, увеличенный объём данных и более крупные модели пока не прокладывают путь к технологическому прорыву в области ИИ.
Источник изображения: Nvidia
Эксперты высказывают обоснованные сомнения в окупаемости крупных инвестиций в ИИ и достижимости всеобъемлющей цели, к которой стремятся разработчики ИИ-моделей, — создания общего искусственного интеллекта (AGI). Этот термин обычно применяется к гипотетическим ИИ-системам, способным соответствовать или превосходить человека в большинстве интеллектуальных задач. Руководители OpenAI и Anthropic ранее заявляли, что AGI может появиться уже через несколько лет.
Технология, лежащая в основе ChatGPT и конкурирующих ИИ-чат-ботов, была создана на основе данных из социальных сетей, онлайн-комментариев, книг и других источников из интернета. Этих данных хватило для создания продуктов, генерирующих суррогатные эссе и поэмы, но для разработки систем ИИ, которые превзойдут интеллектом лауреатов Нобелевской премии — как надеются некоторые компании, — могут потребоваться другие источники данных, помимо сообщений в Википедии и субтитров YouTube.
Источник изображения: unsplash.com
OpenAI была вынуждена заключить соглашения с издателями, чтобы удовлетворить хотя бы часть потребности в высококачественных данных, а также адаптироваться к растущему юридическому давлению со стороны правообладателей контента, используемого для обучения ИИ. Отмечается высокий спрос на рынке труда на специалистов с высшим образованием, которые могут маркировать данные, связанные с их областью компетенции. Это помогает сделать обученные ИИ-системы более эффективными в ответах на запросы.
Подобные усилия обходятся дороже и требуют на порядок больше времени, чем простое индексирование интернета. Поэтому технологические компании обращаются к синтетическим данным, таким как сгенерированные компьютером изображения или текст, имитирующие контент, созданный людьми. Однако у такого подхода есть свои ограничения, так как трудно добиться качественного улучшения при использовании подобных данных для обучения ИИ.
Тем не менее компании ИИ продолжают следовать принципу «чем больше, тем лучше». В стремлении создавать продукты, приближающиеся к уровню человеческого интеллекта, технологические компании увеличивают объём вычислительной мощности, данных и времени, затрачиваемых на обучение новых моделей, что приводит к росту расходов. Генеральный директор Anthropic Дарио Амодеи (Dario Amodei) заявил, что в этом году компании потратят $100 млн на обучение новейших моделей, а в ближайшие годы эта сумма может достичь $100 млрд.
Источник изображения: unsplash.com
Безусловно, потенциал для улучшения моделей ИИ, помимо масштабирования, существует. Например, для своей новой модели Orion OpenAI применяет многомесячный процесс пост-обучения. Эта процедура включает использование обратной связи от людей для улучшения ответов и уточнения «эмоциональной окраски» взаимодействия с пользователями.
Разработчики ИИ-моделей оказываются перед выбором: либо предлагать старые модели с дополнительными улучшениями, либо запускать чрезвычайно дорогие новые версии, которые могут работать ненамного лучше. По мере роста затрат растут и ожидания — стремительное развитие ИИ на начальном этапе создало завышенные ожидания как у специалистов, так и у инвесторов.
Источник:


