Опрос
|
реклама
Быстрый переход
AMD объявила о начале поставок первых чипов на Zen 6 — они оказались вдвое быстрее Zen 5 в ряде тестов
11.11.2026 [01:55],
Николай Хижняк
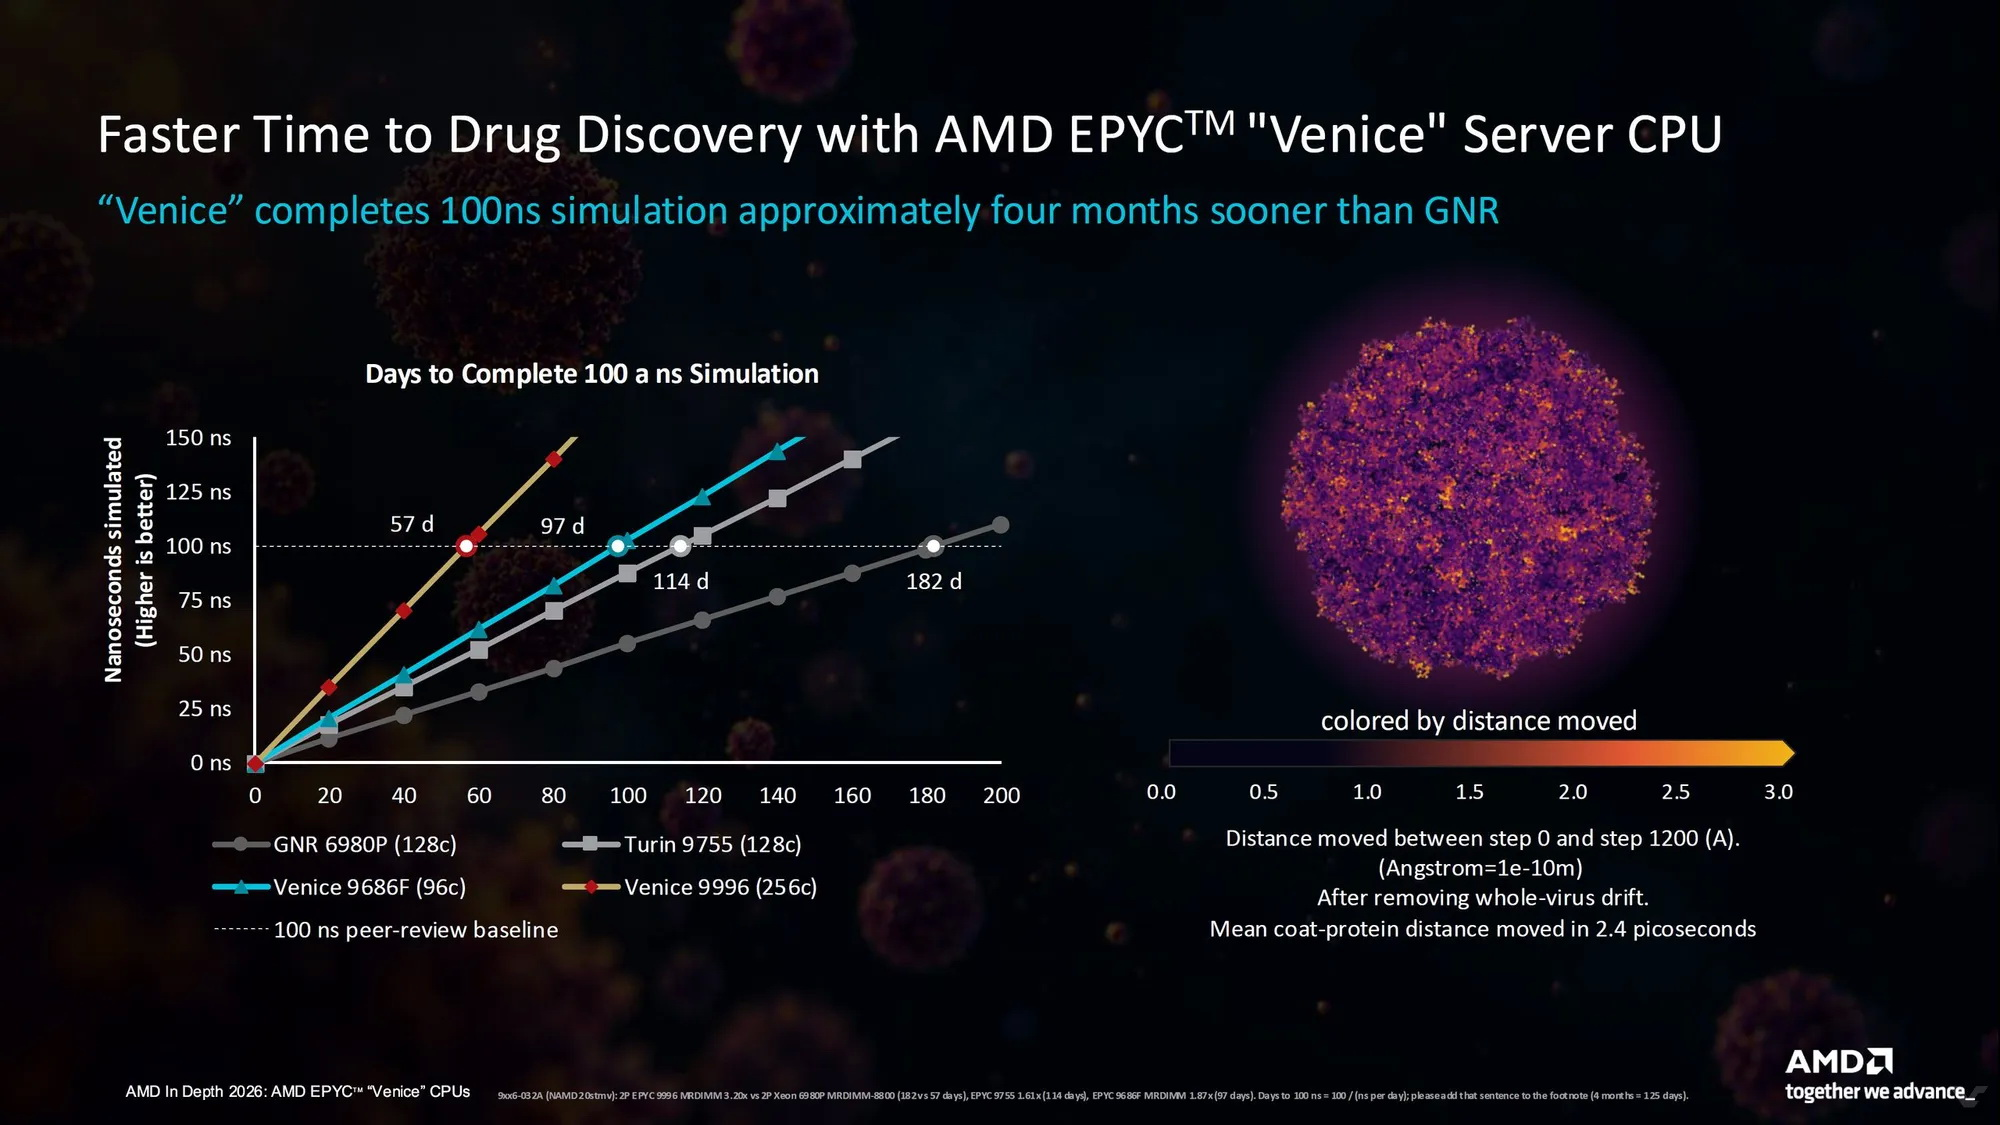
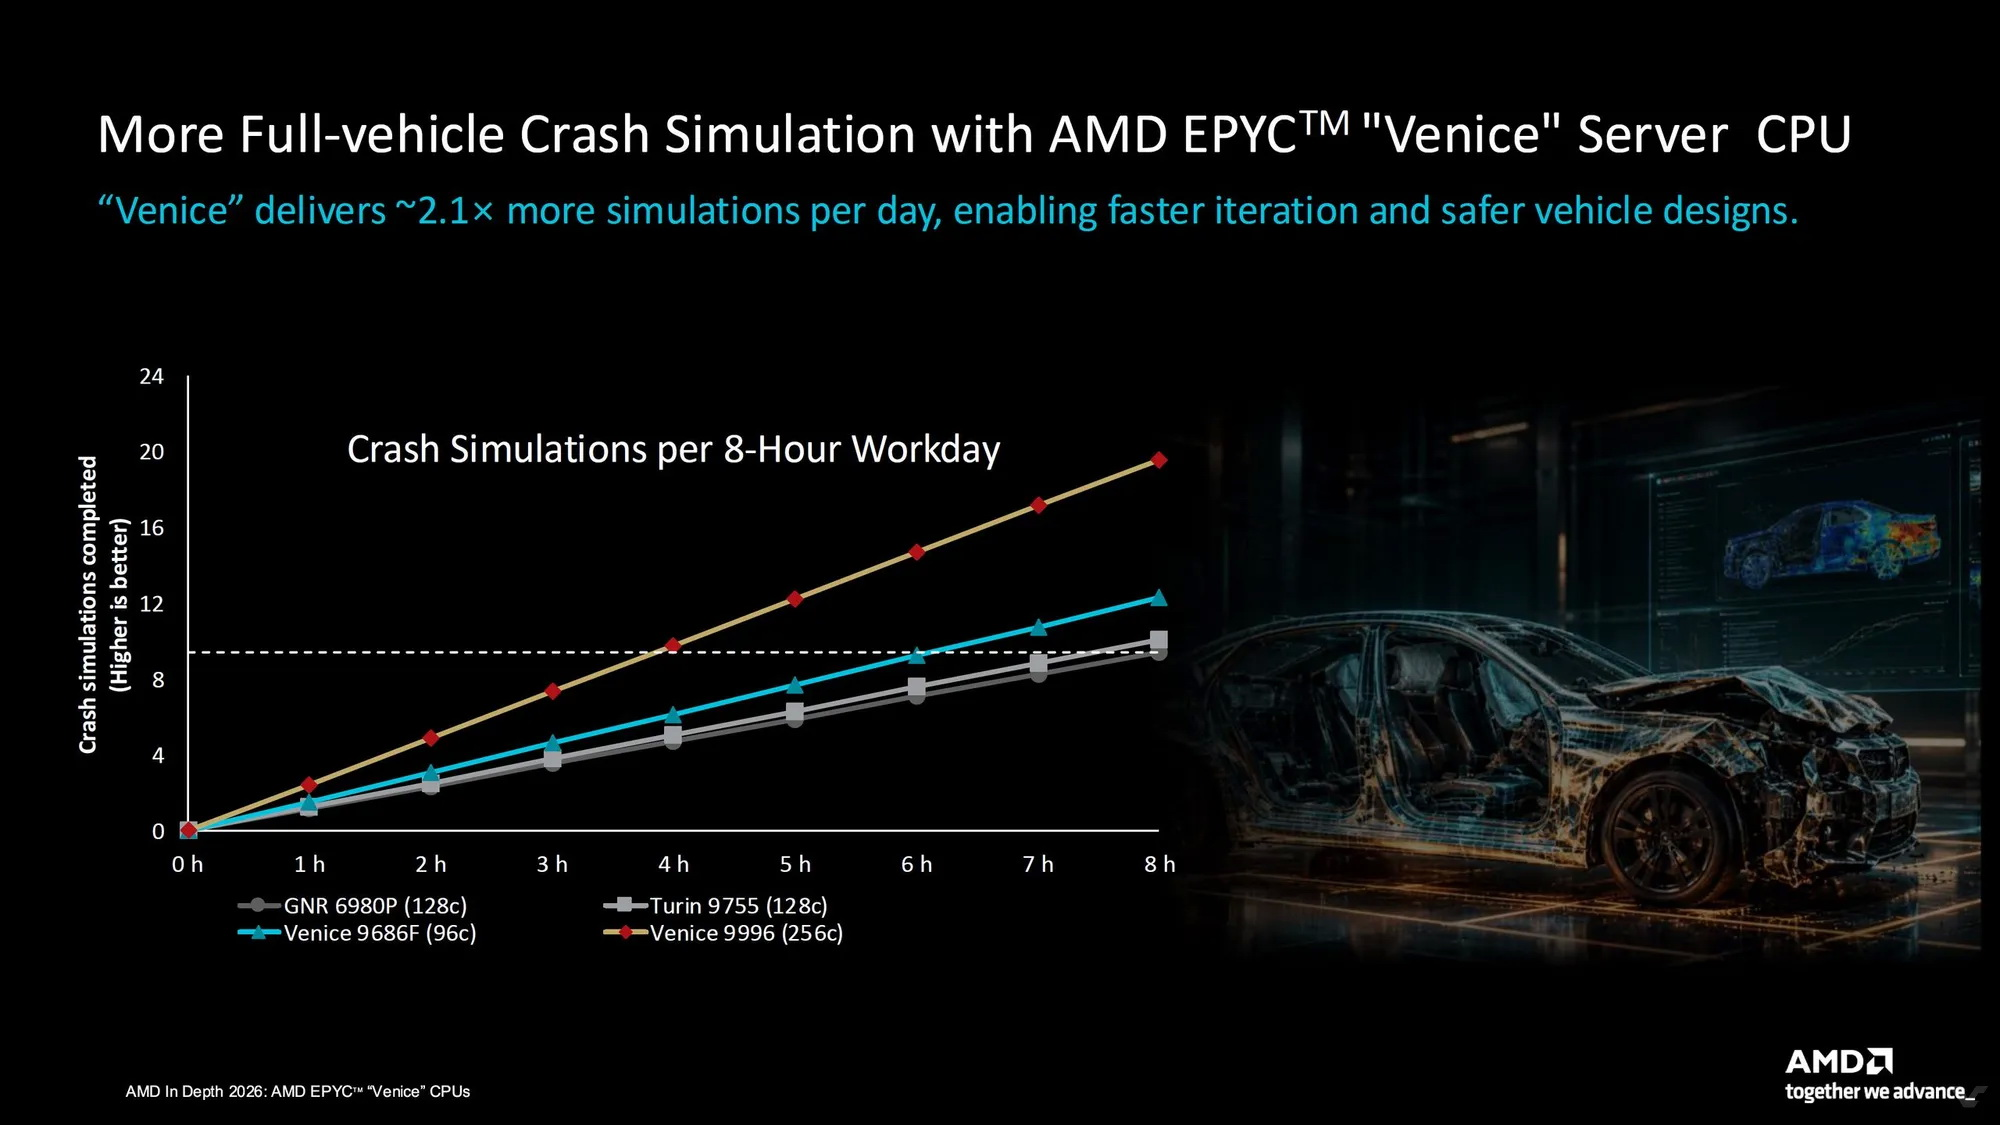
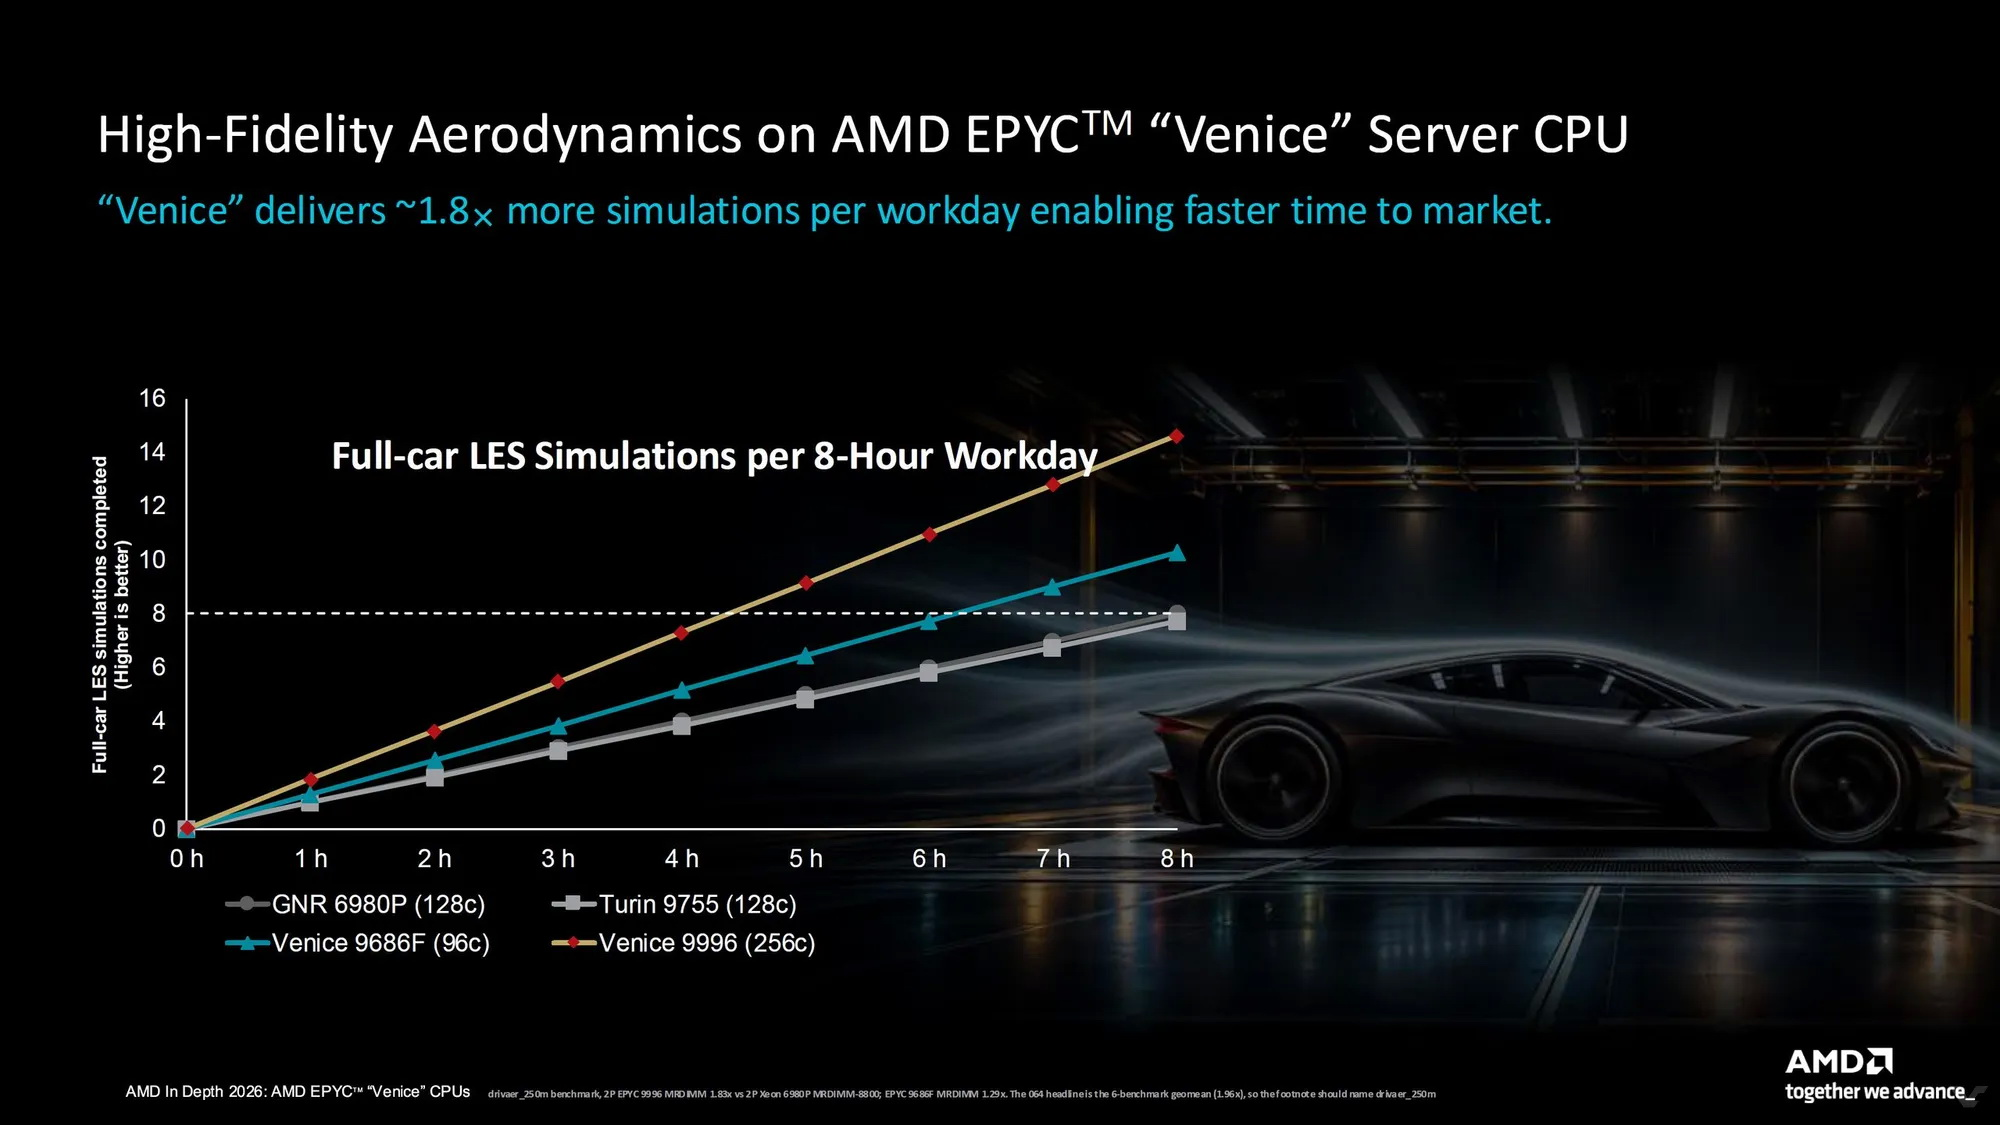
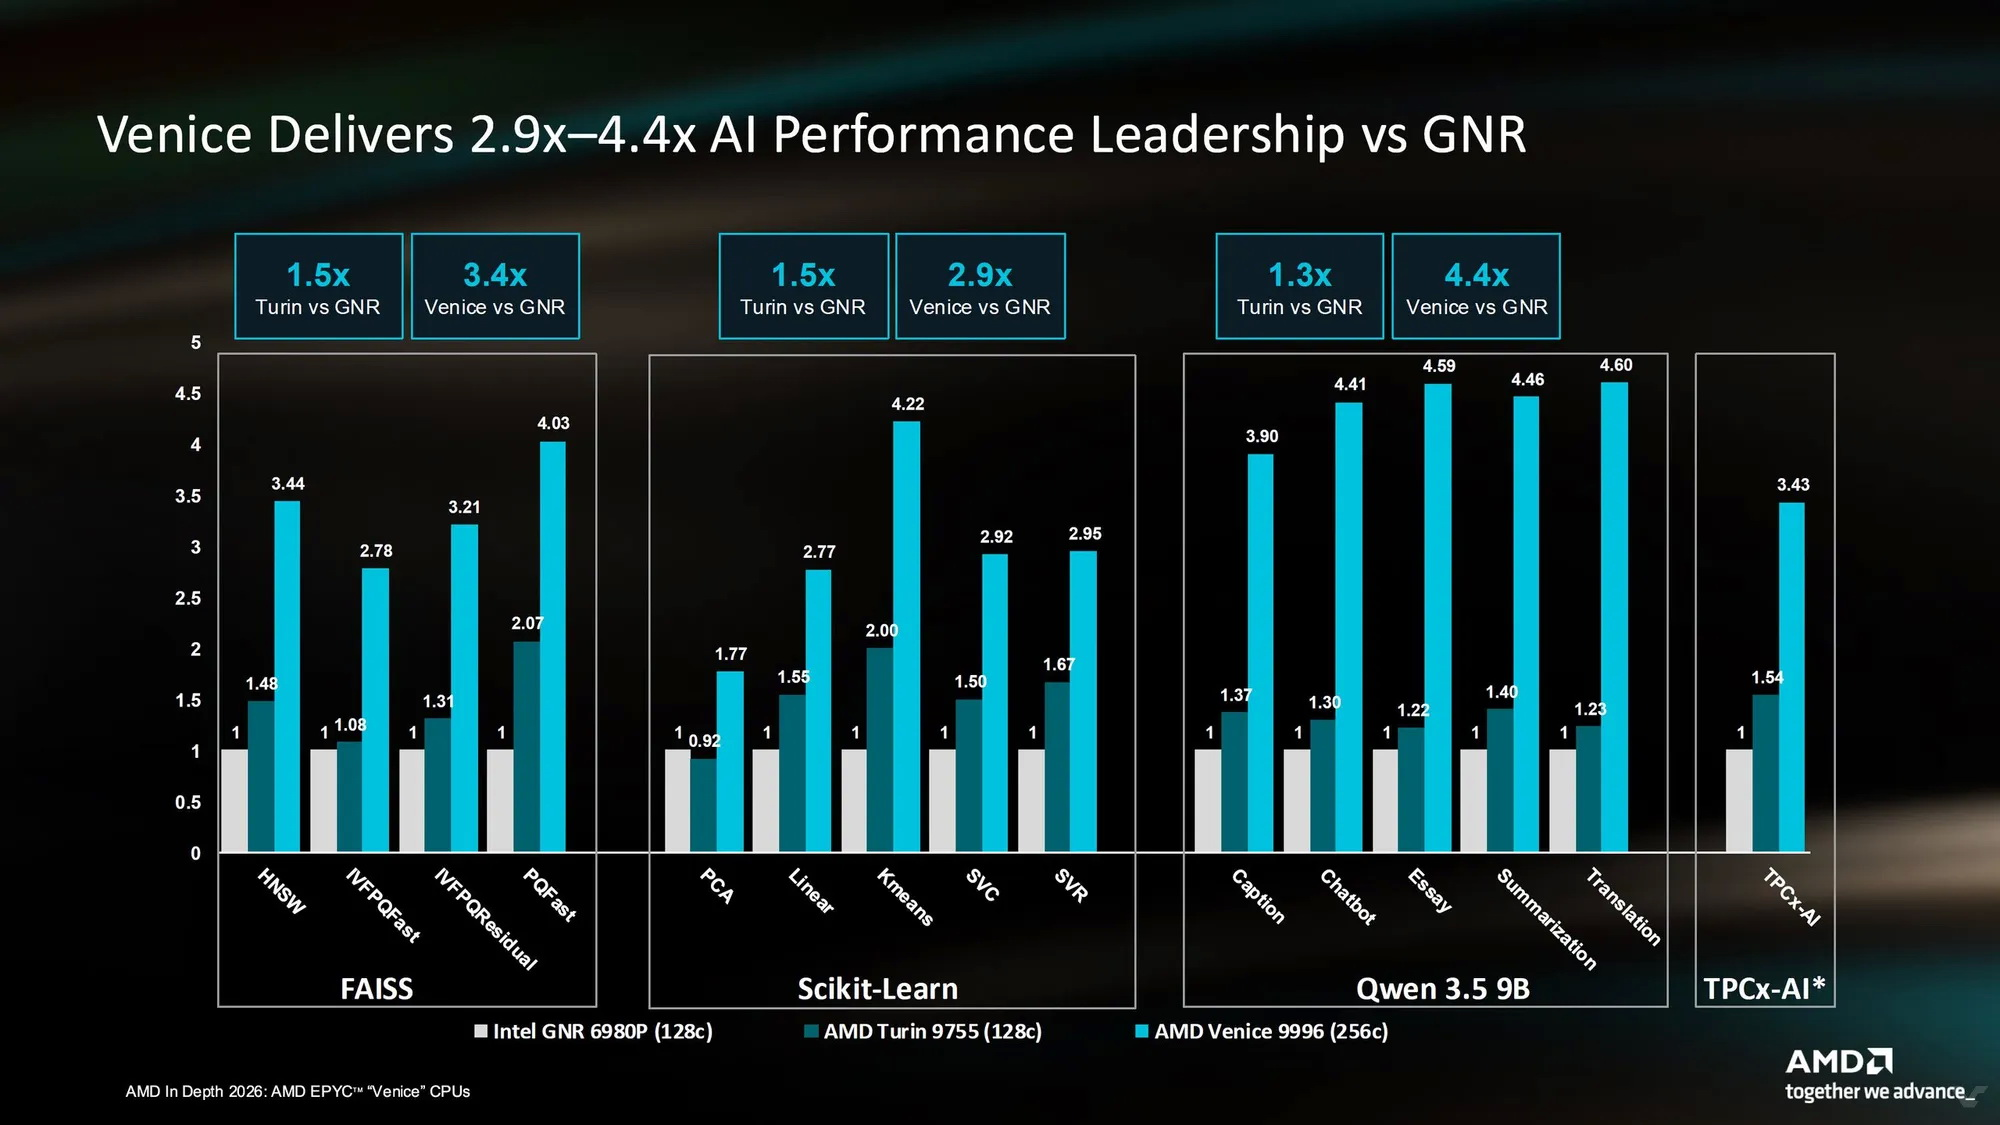
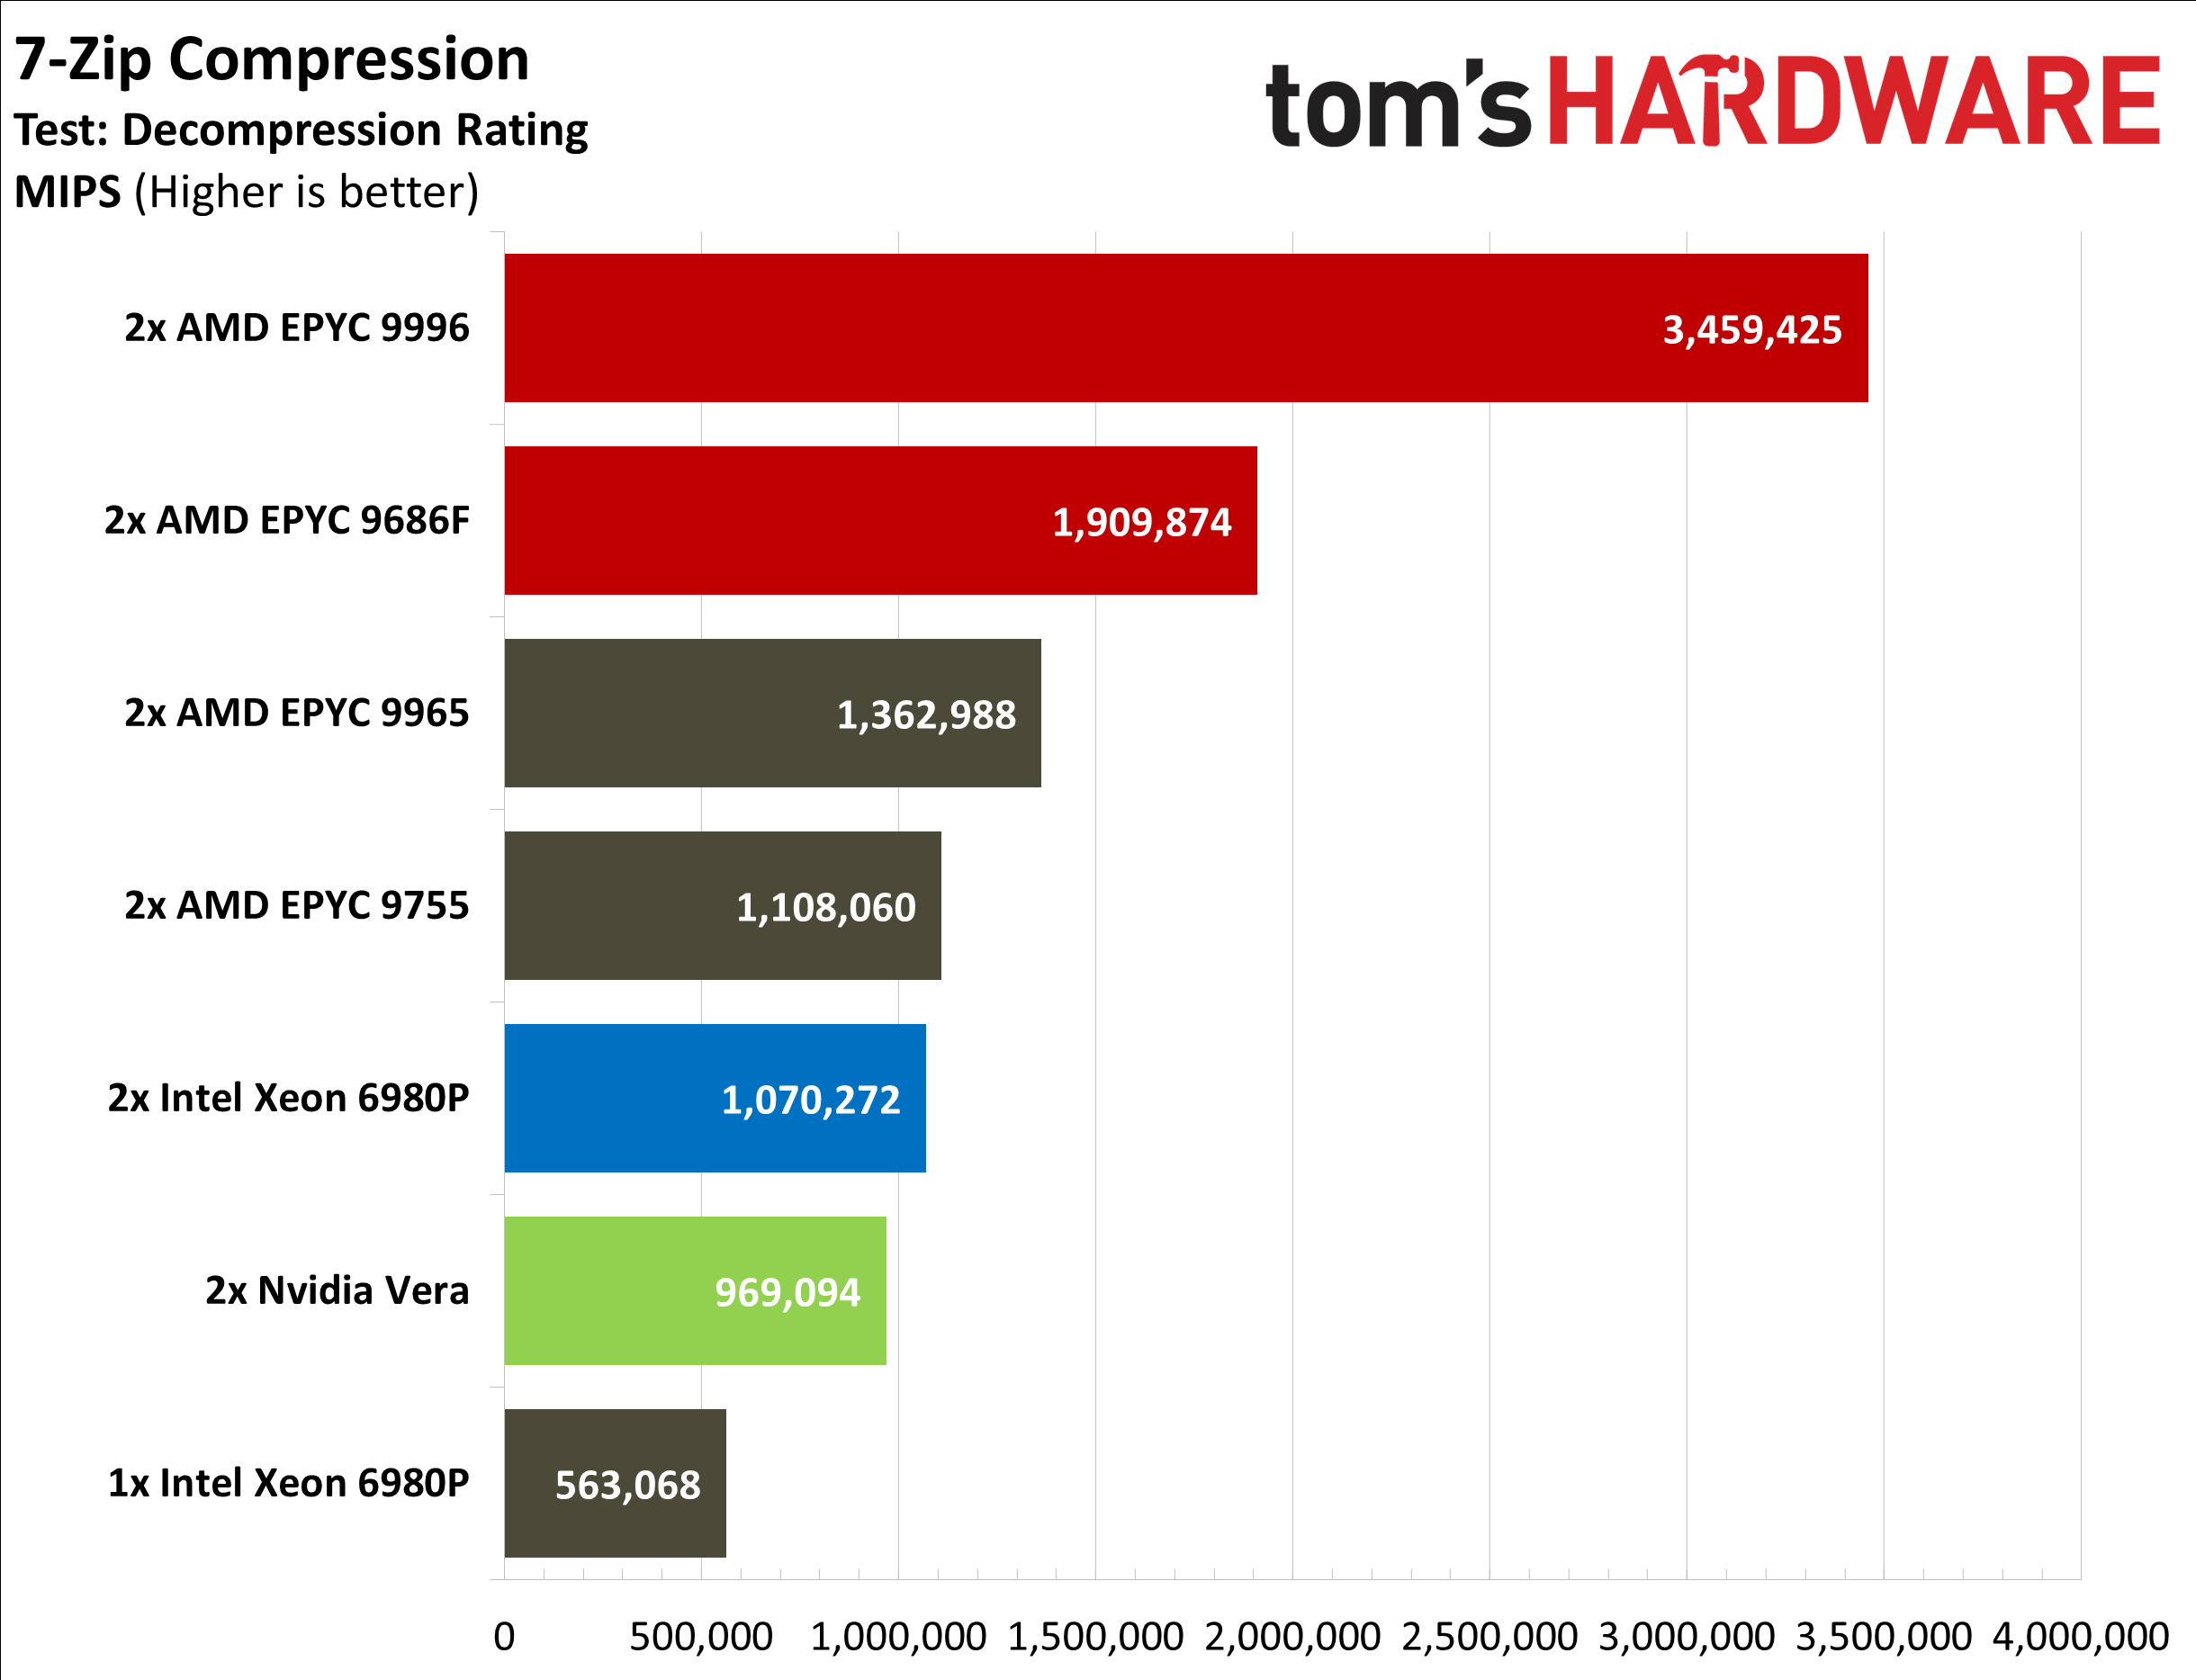
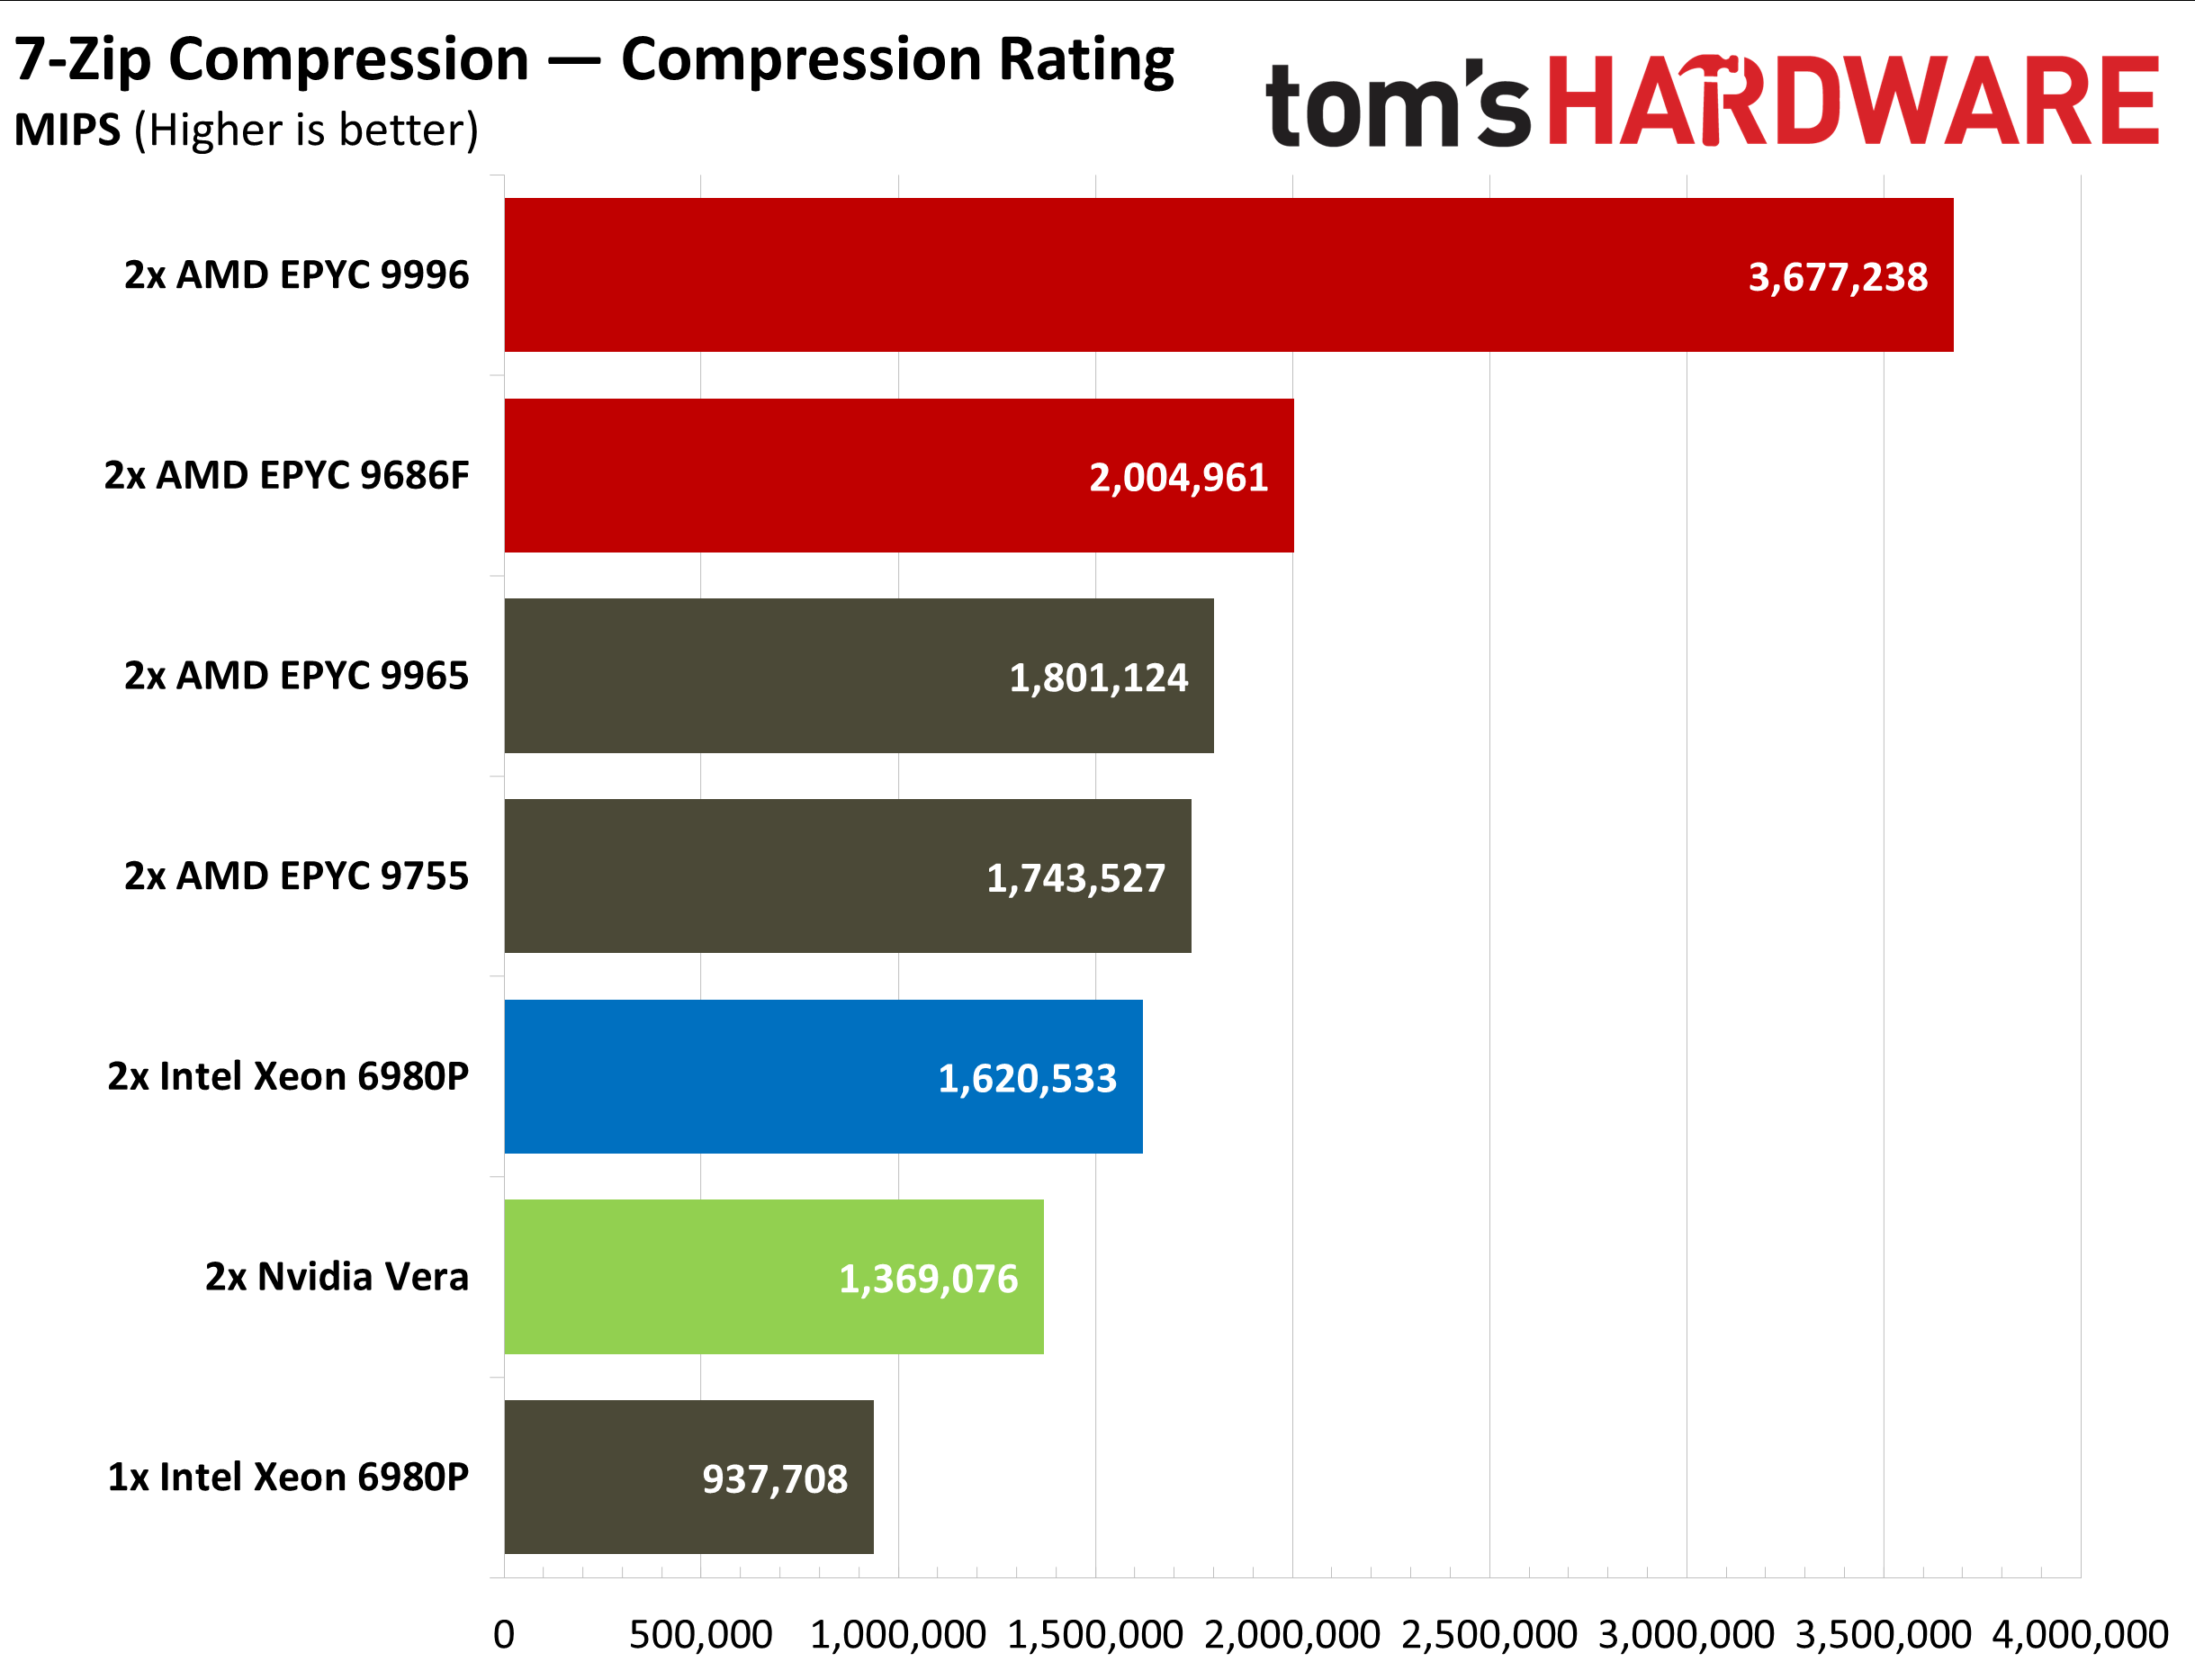
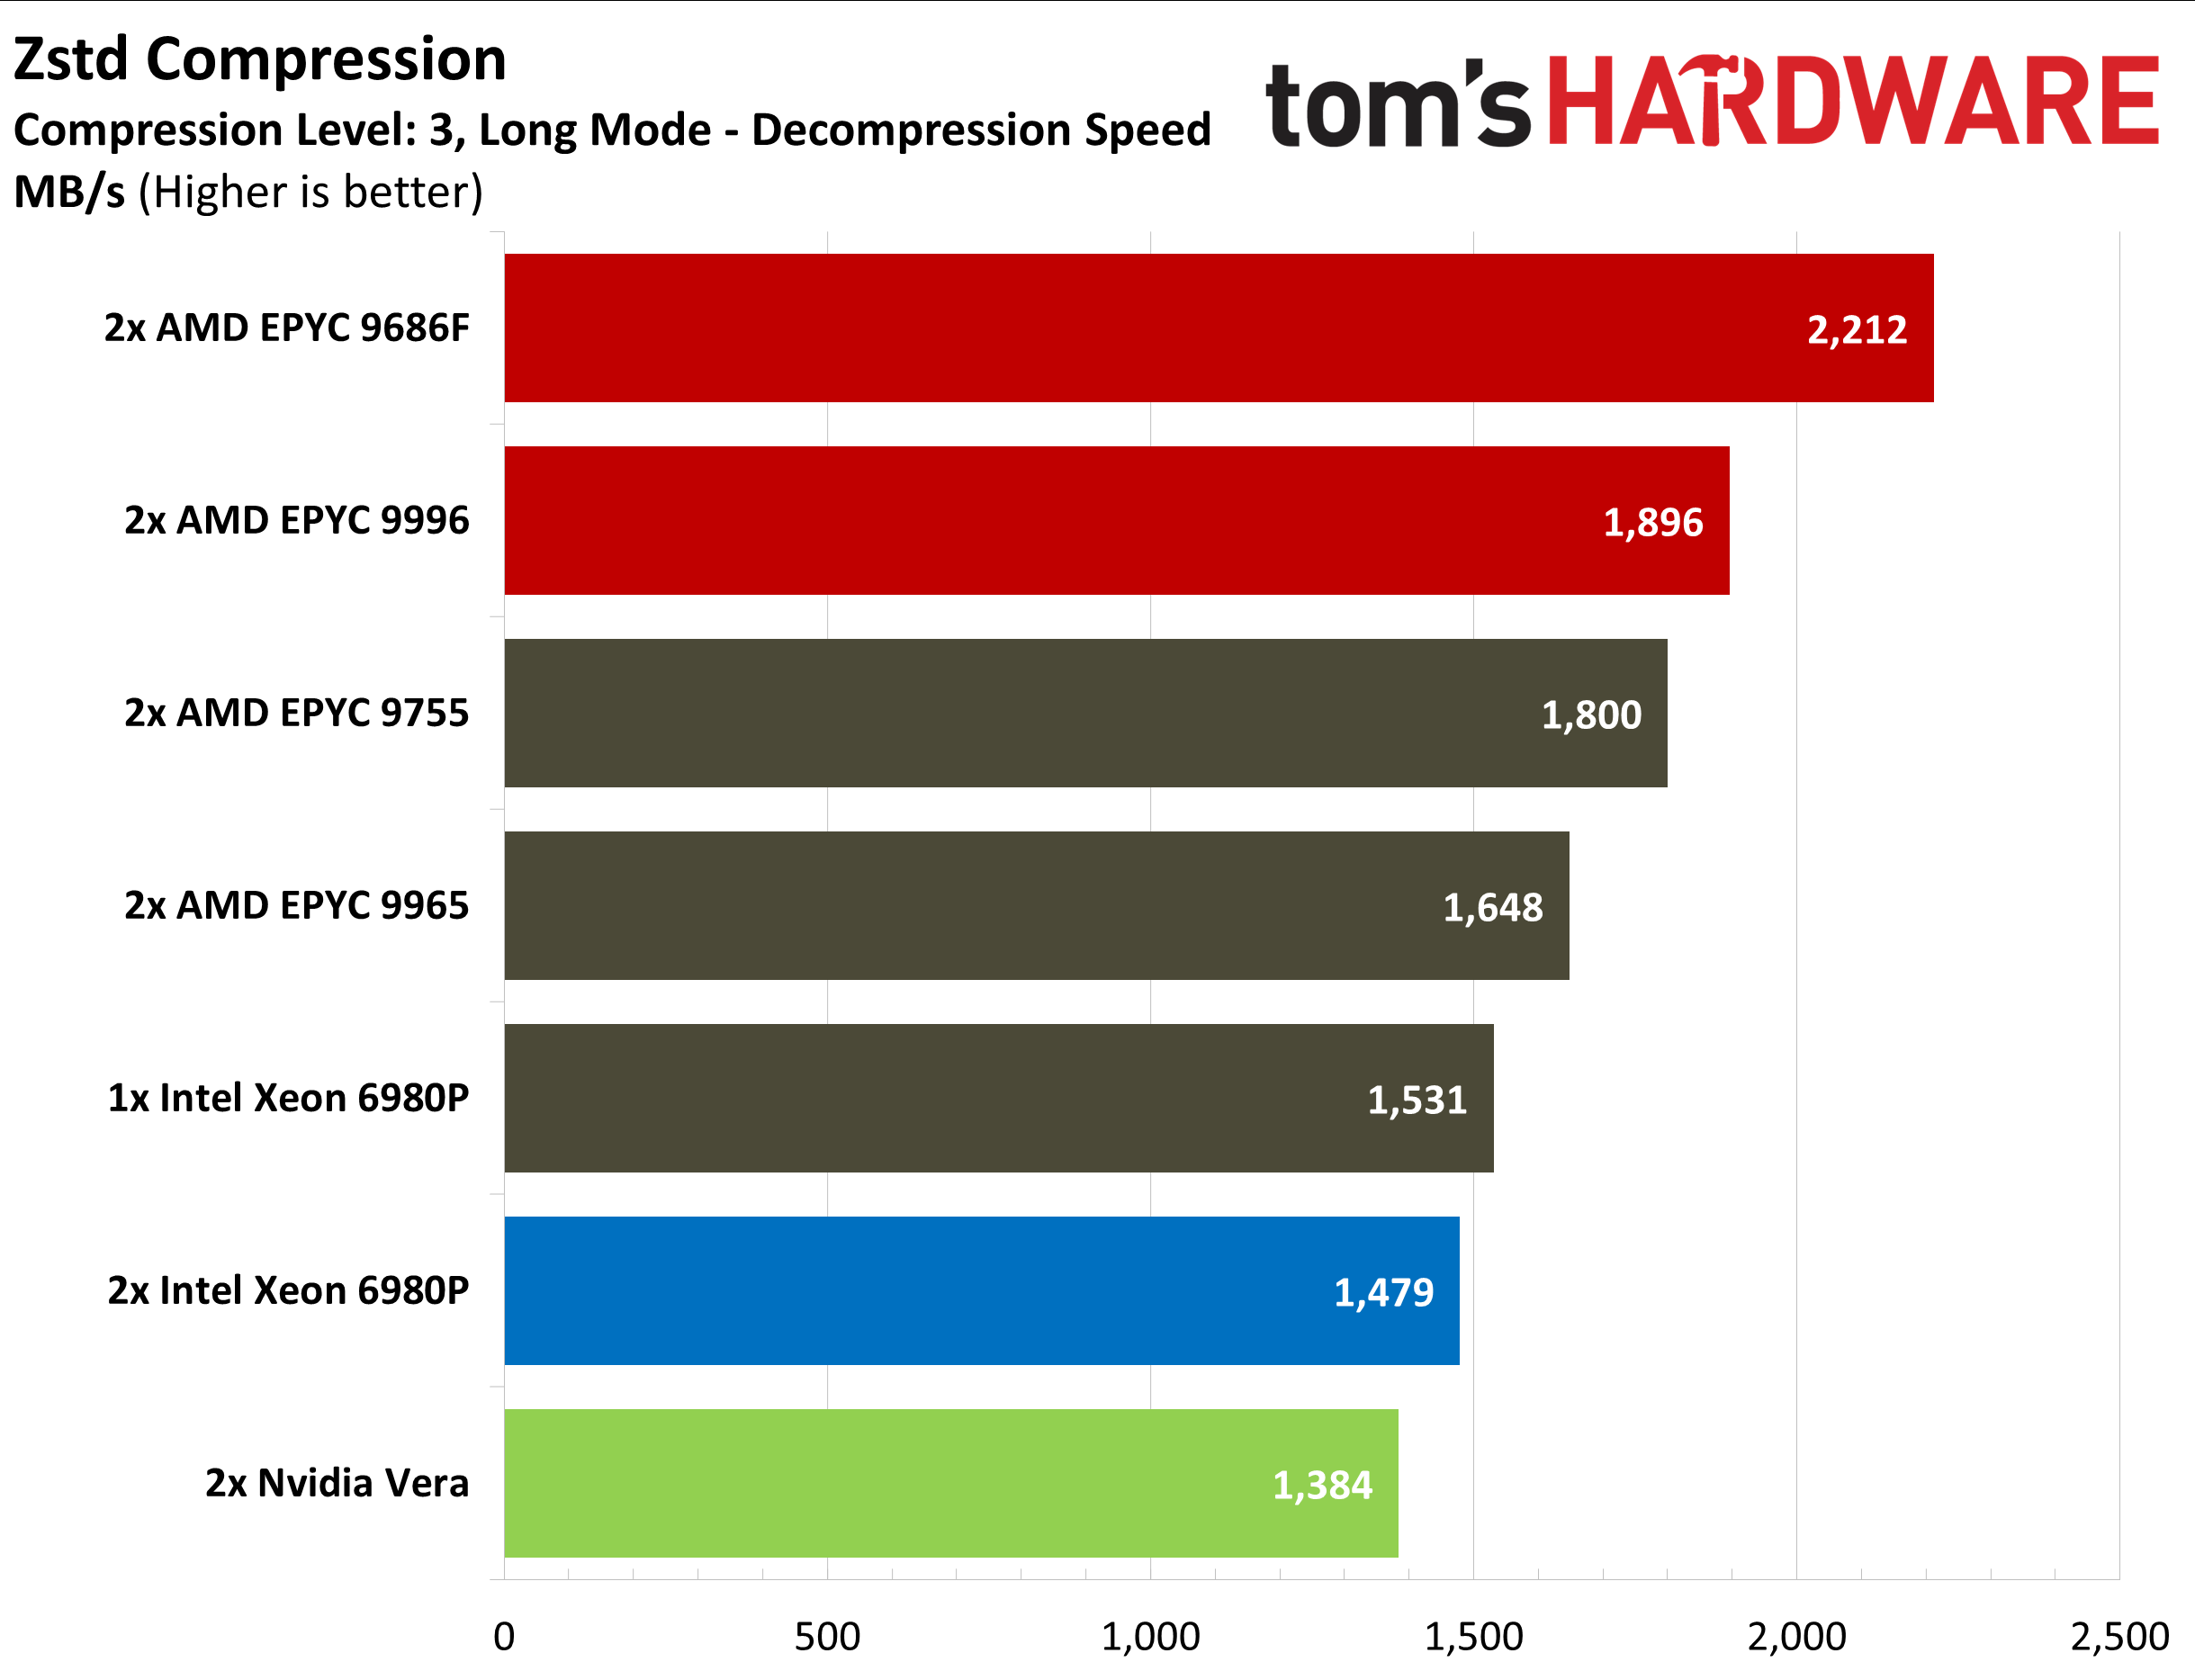
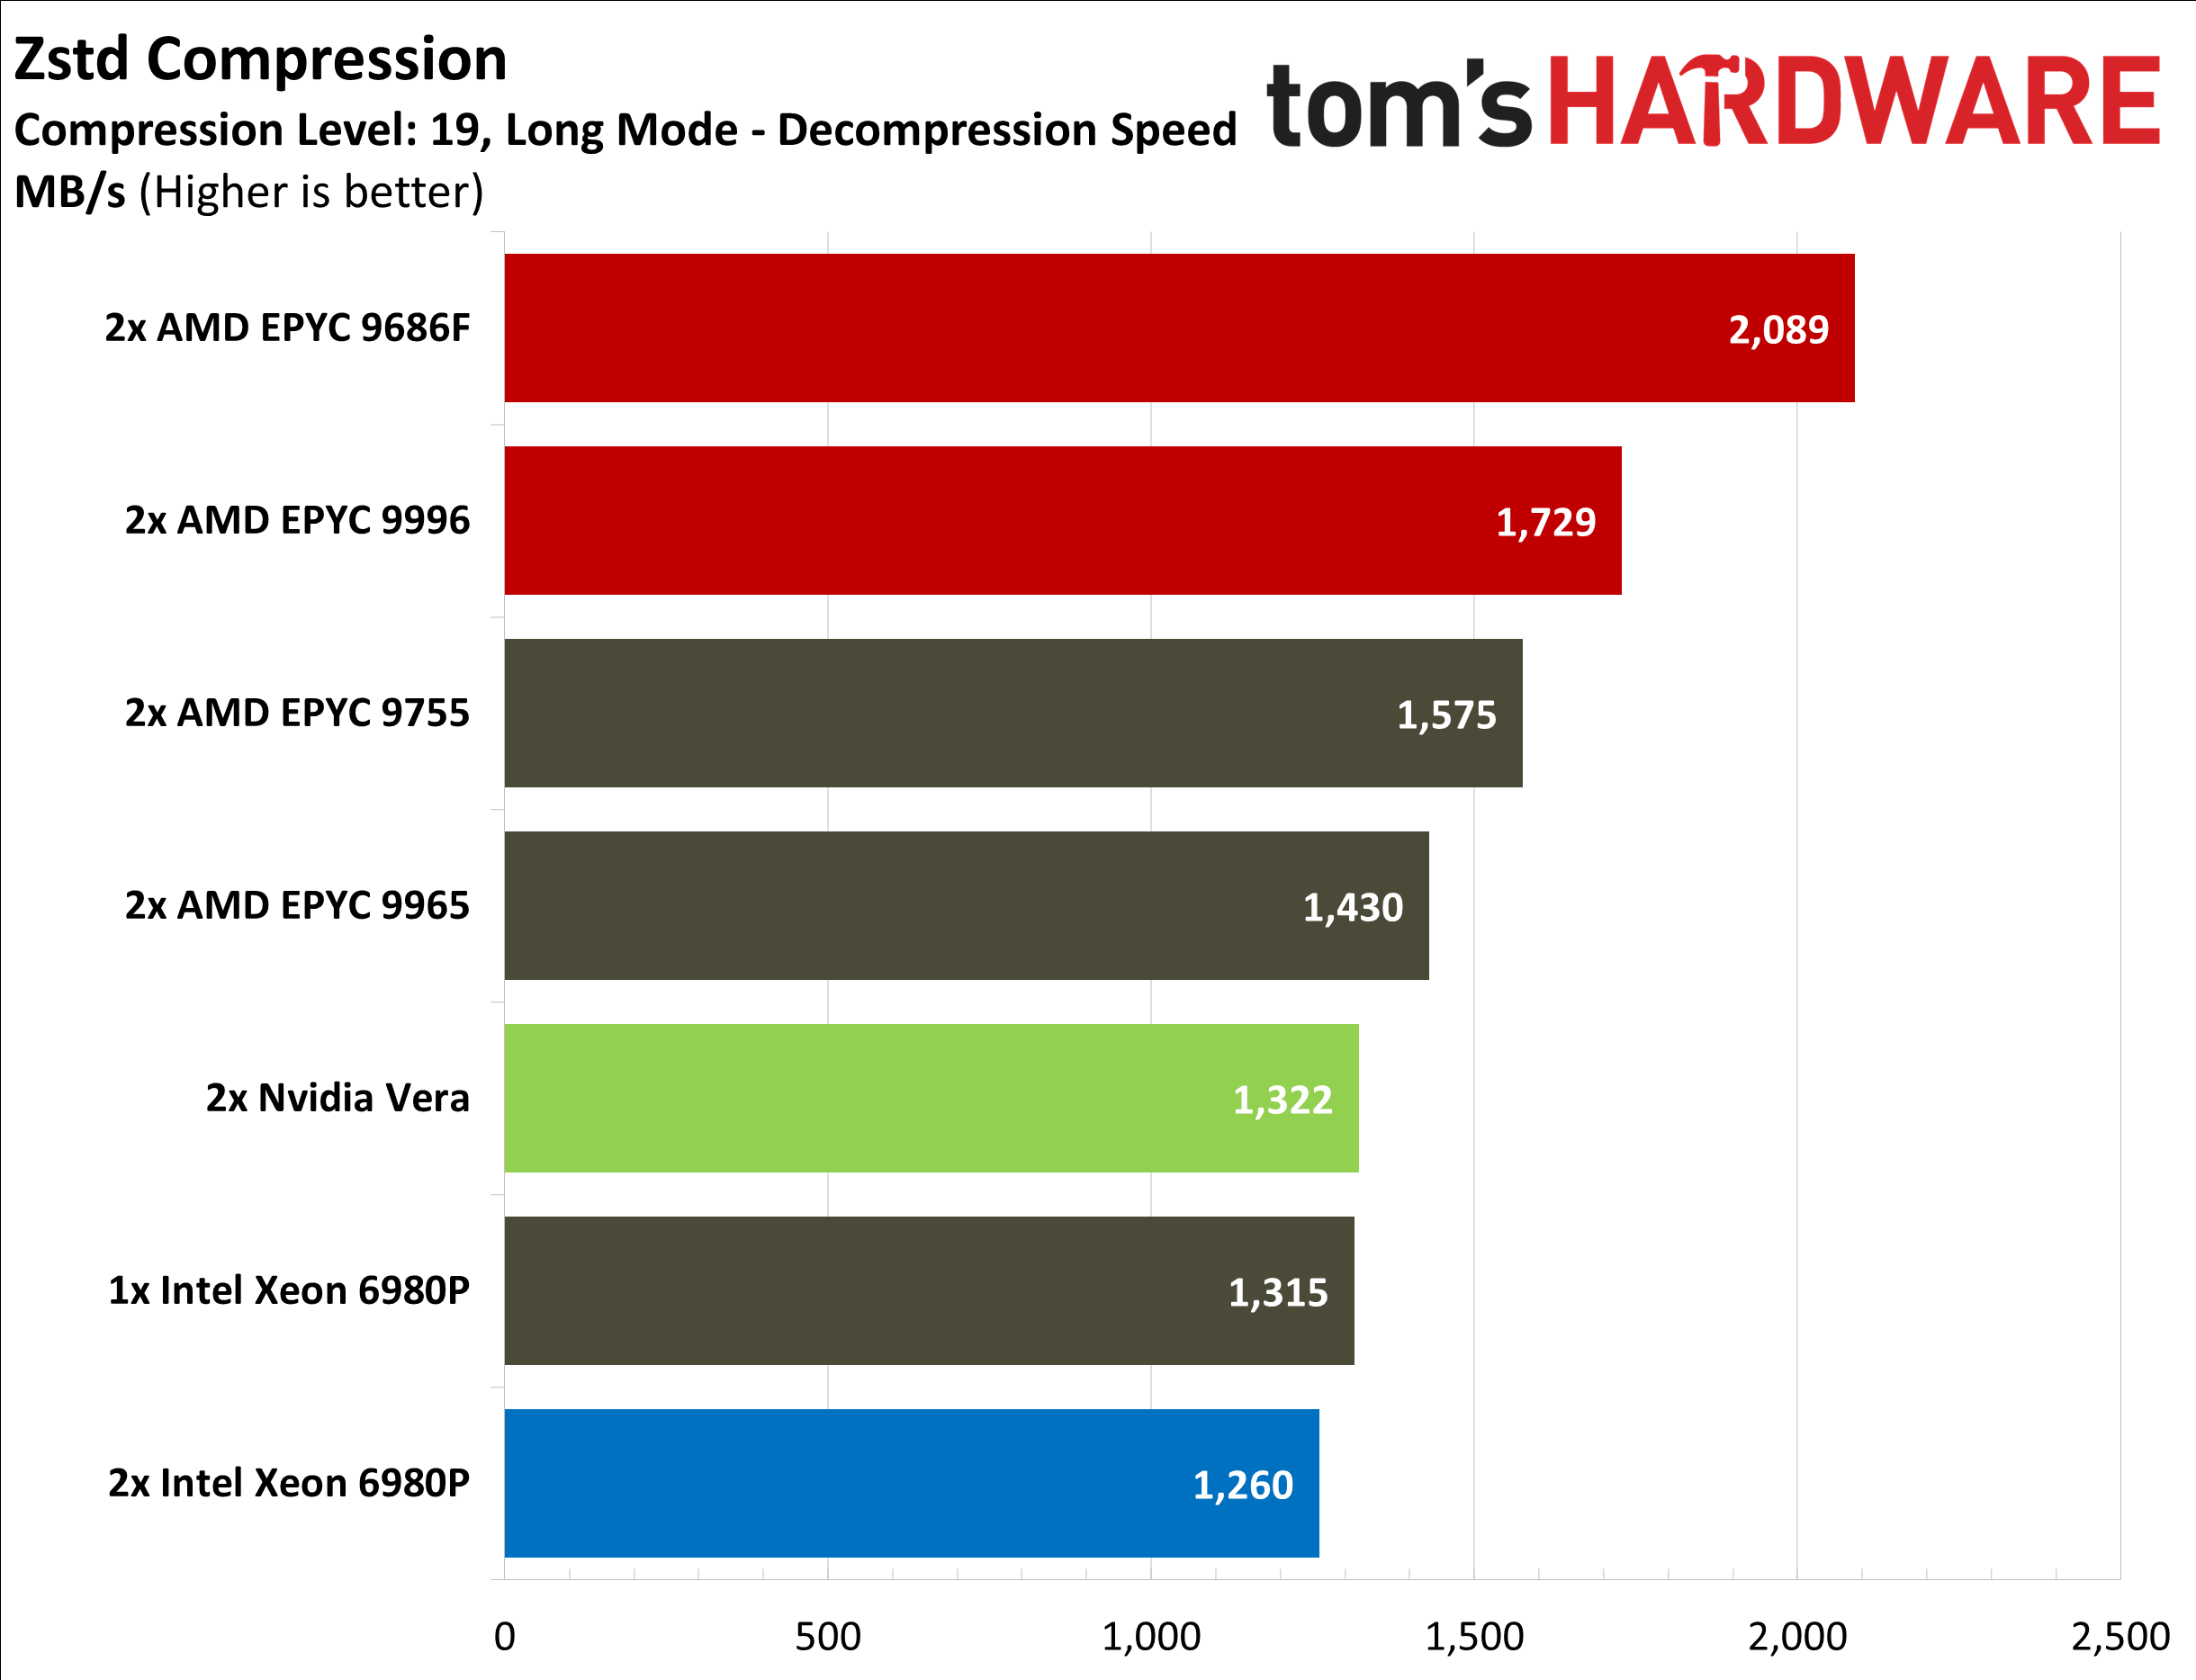
AMD раскрыла дополнительные технические подробности об архитектурах Zen 6 и Zen 6c, которые лежат в основе процессоров EPYC 9006 Venice шестого поколения. Новые процессоры, которые теперь начали поставляться клиентам AMD, призваны составить конкуренцию чипам Nvidia Vera и Intel Granite Rapids-AP. Портал Tom’s Hardware представила первые независимые тесты новых чипов. 
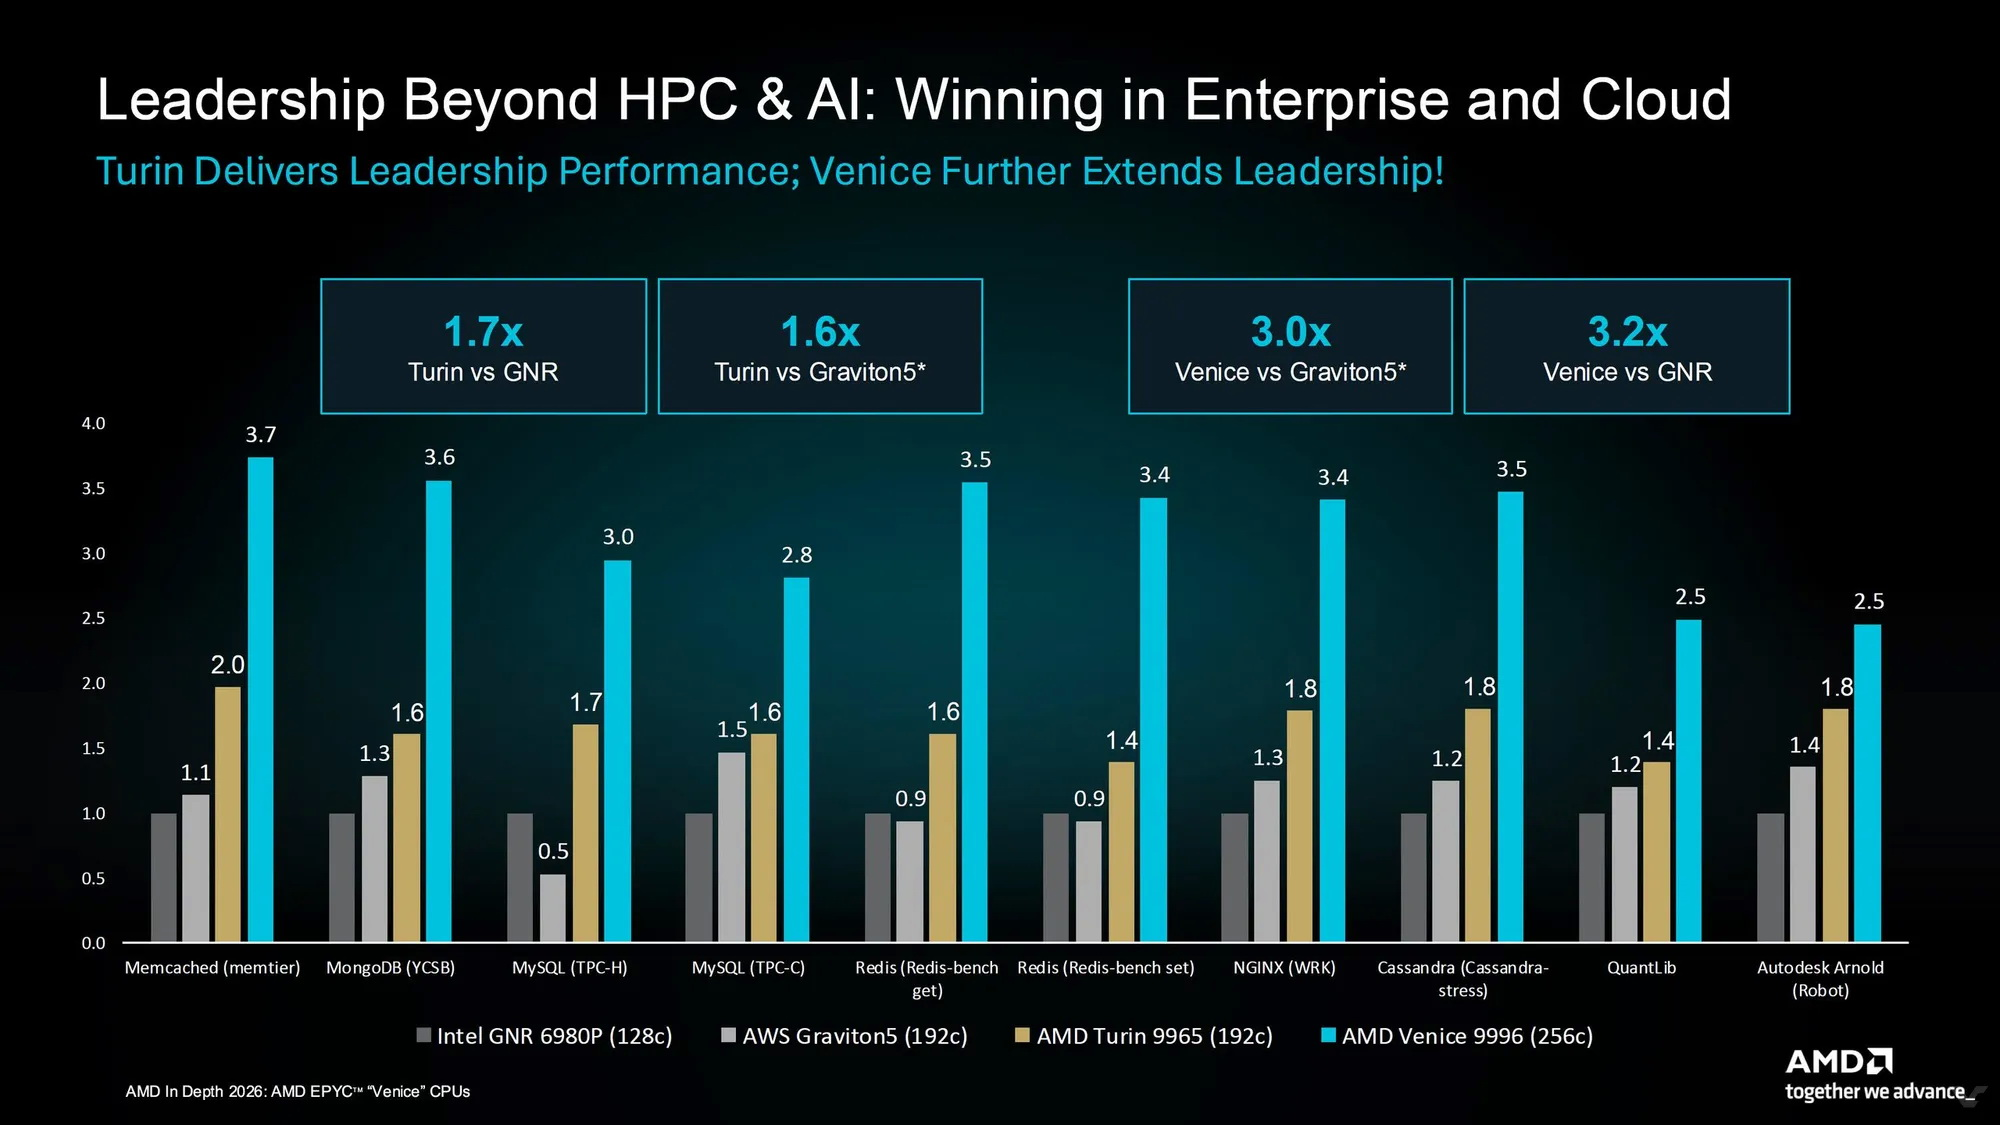
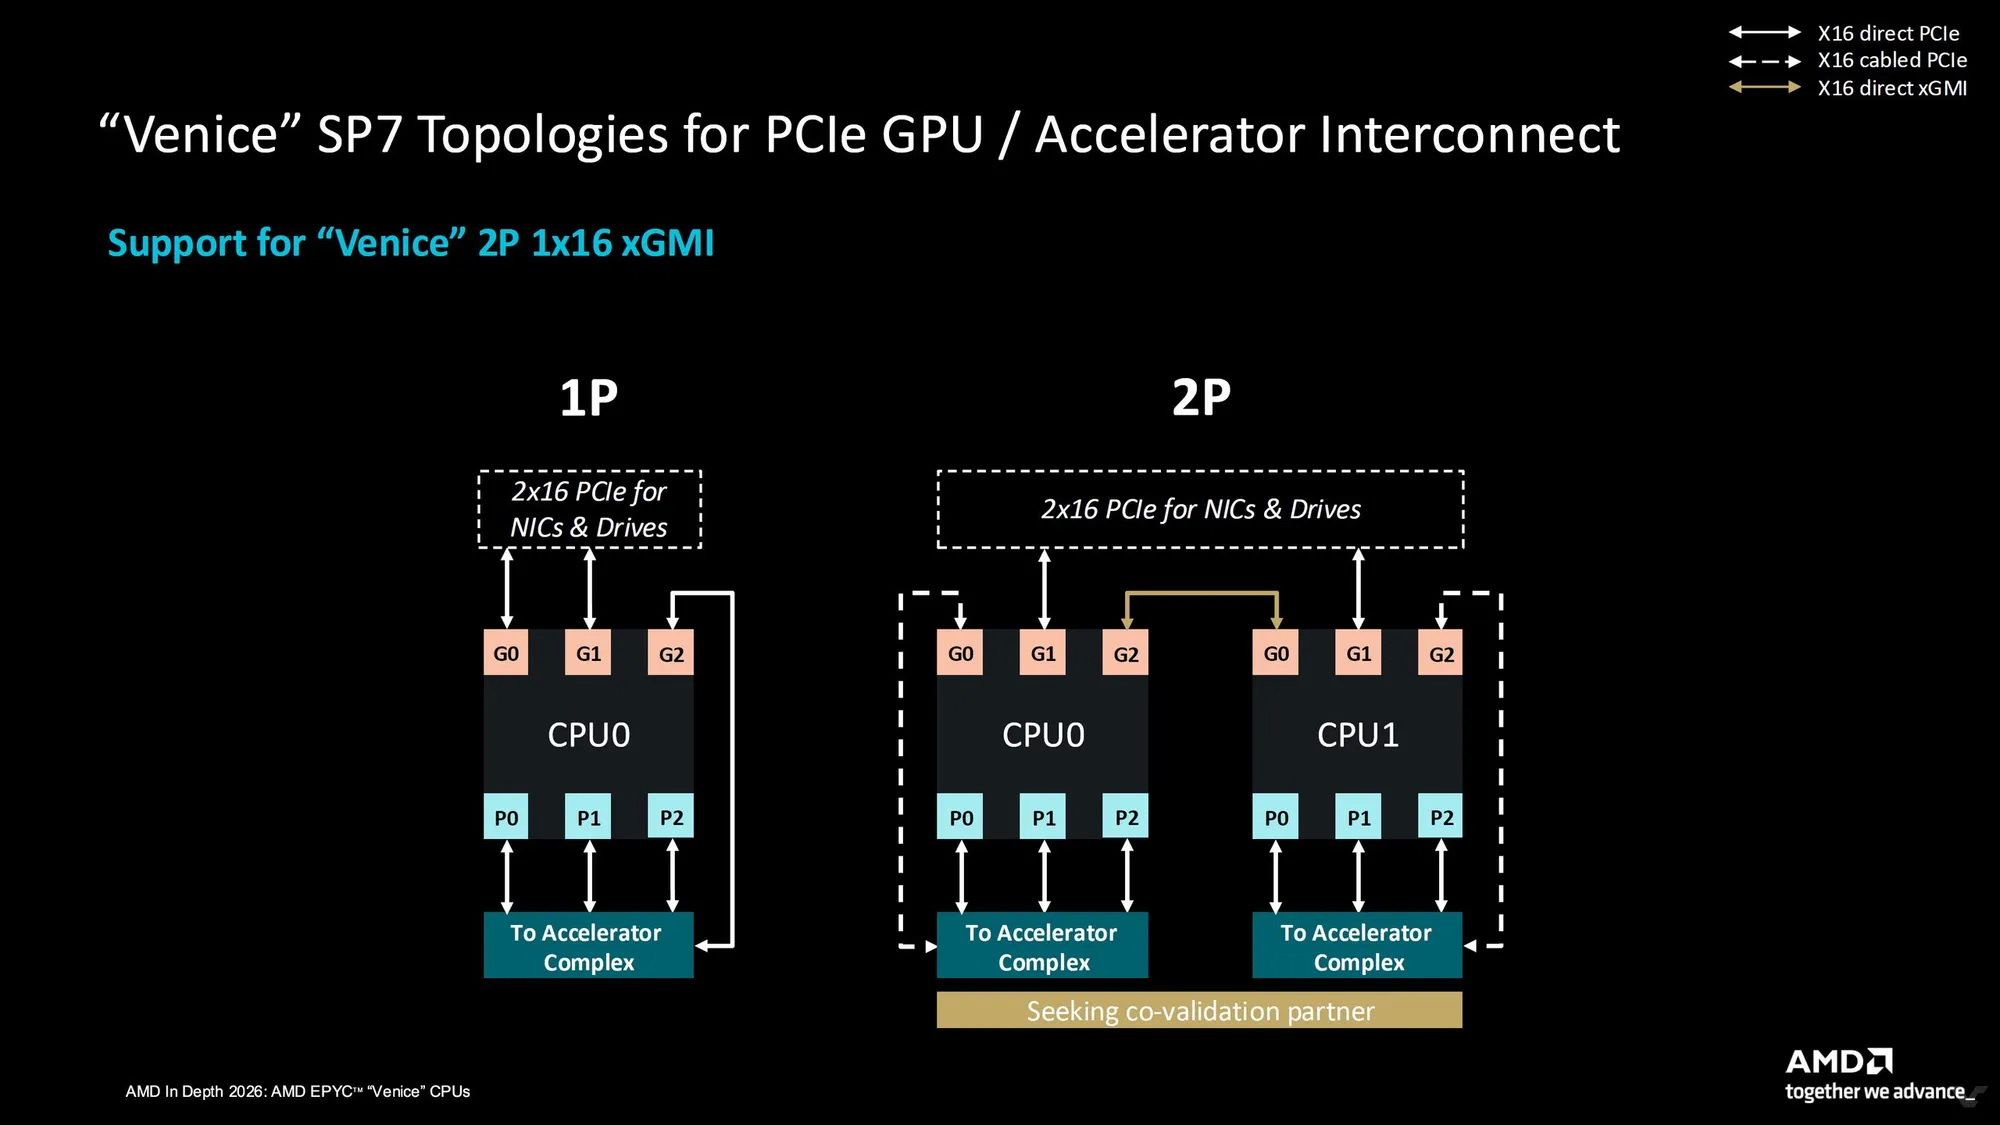
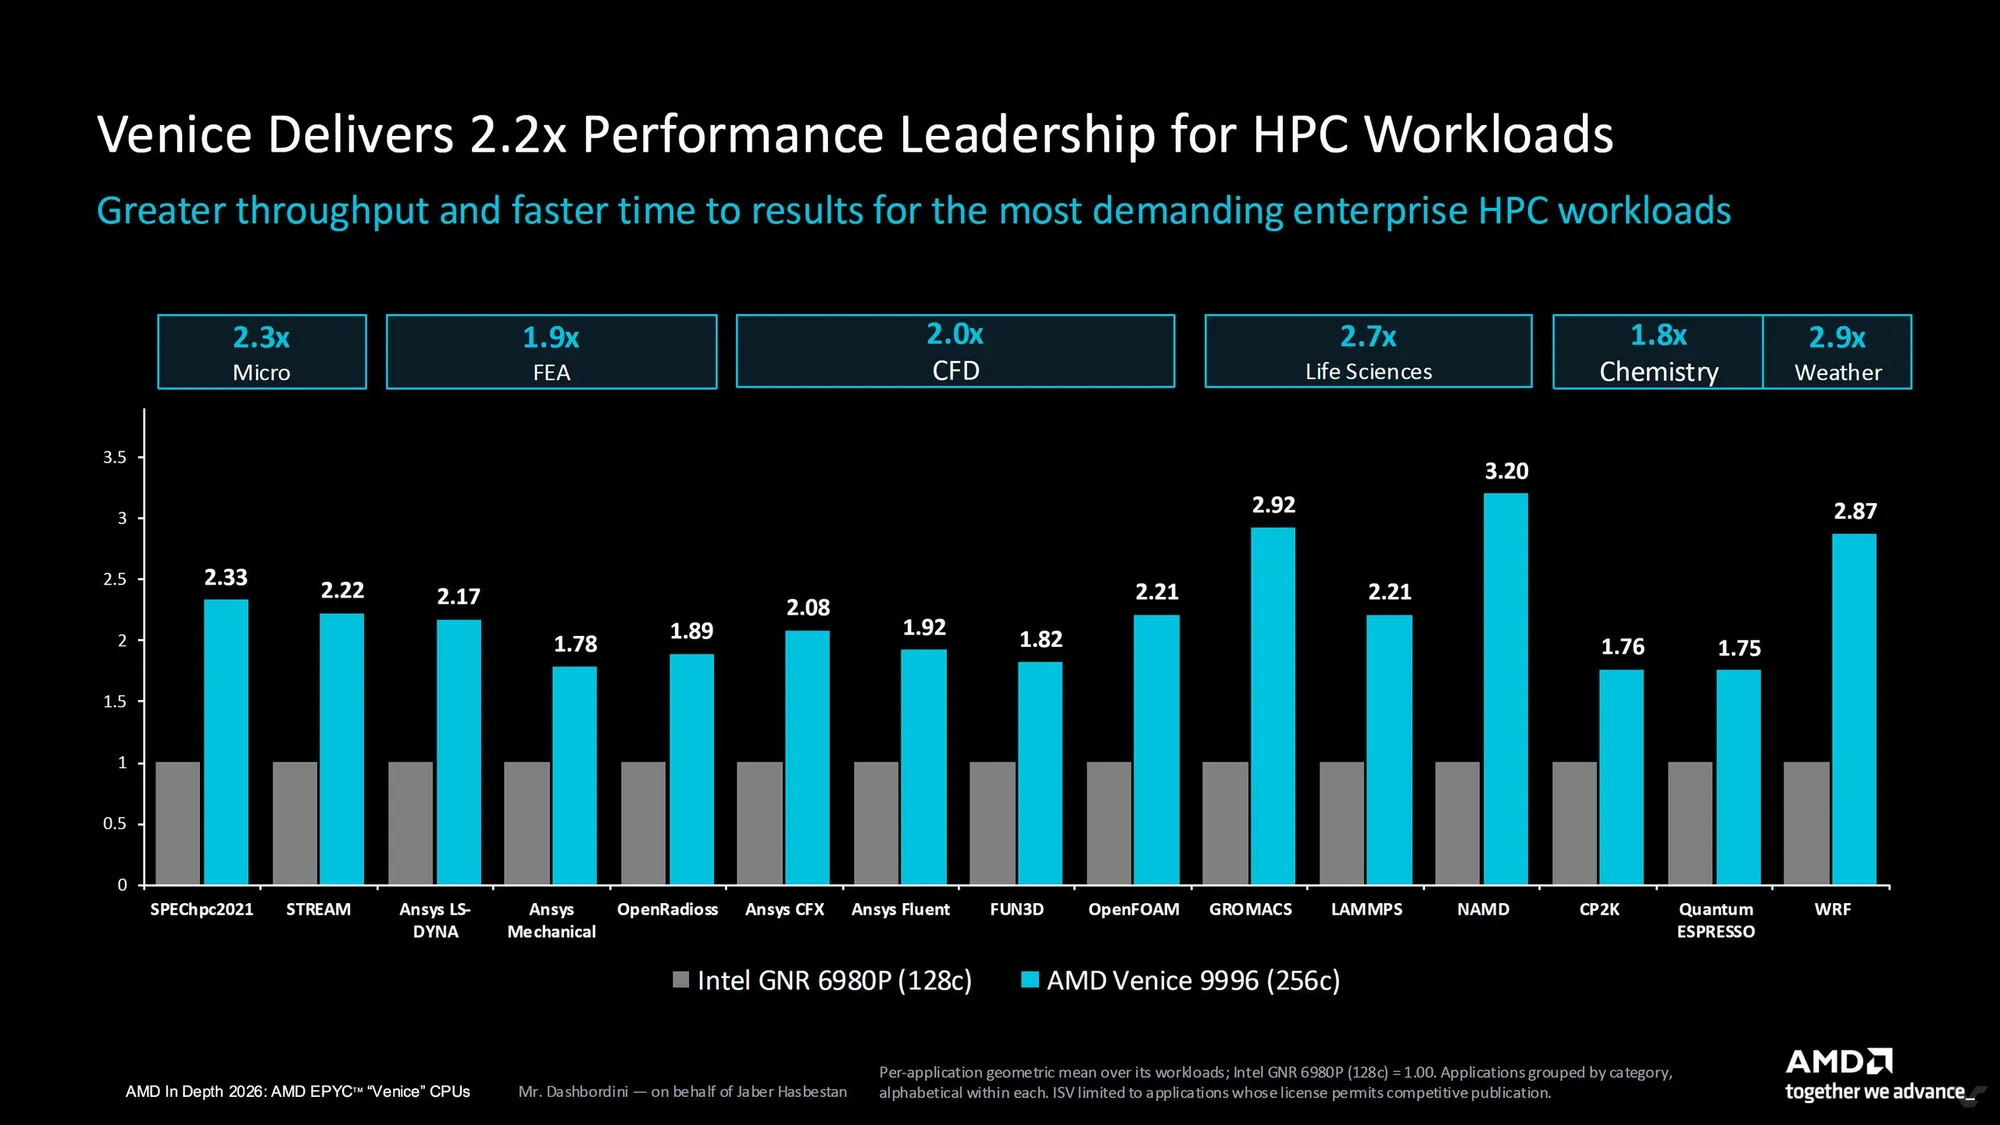
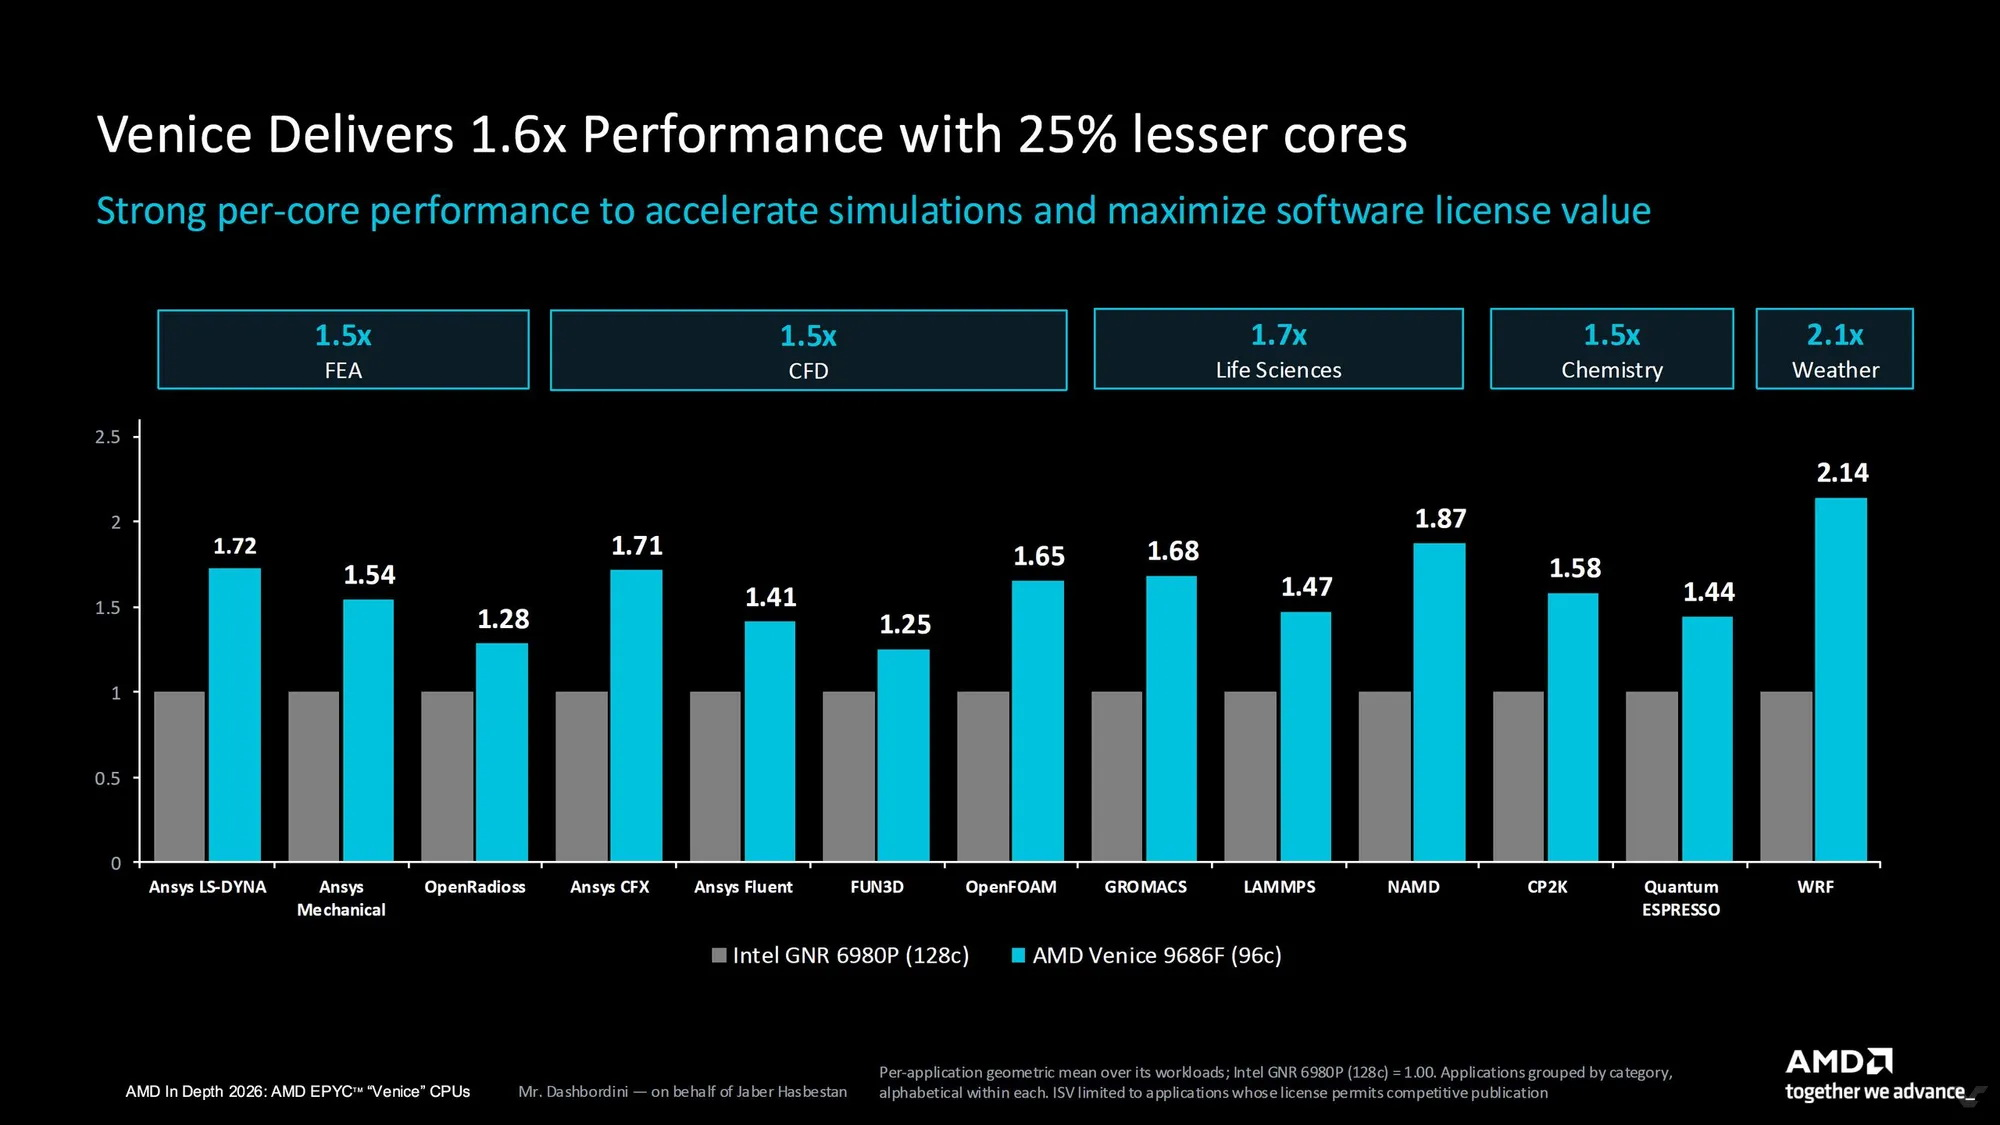
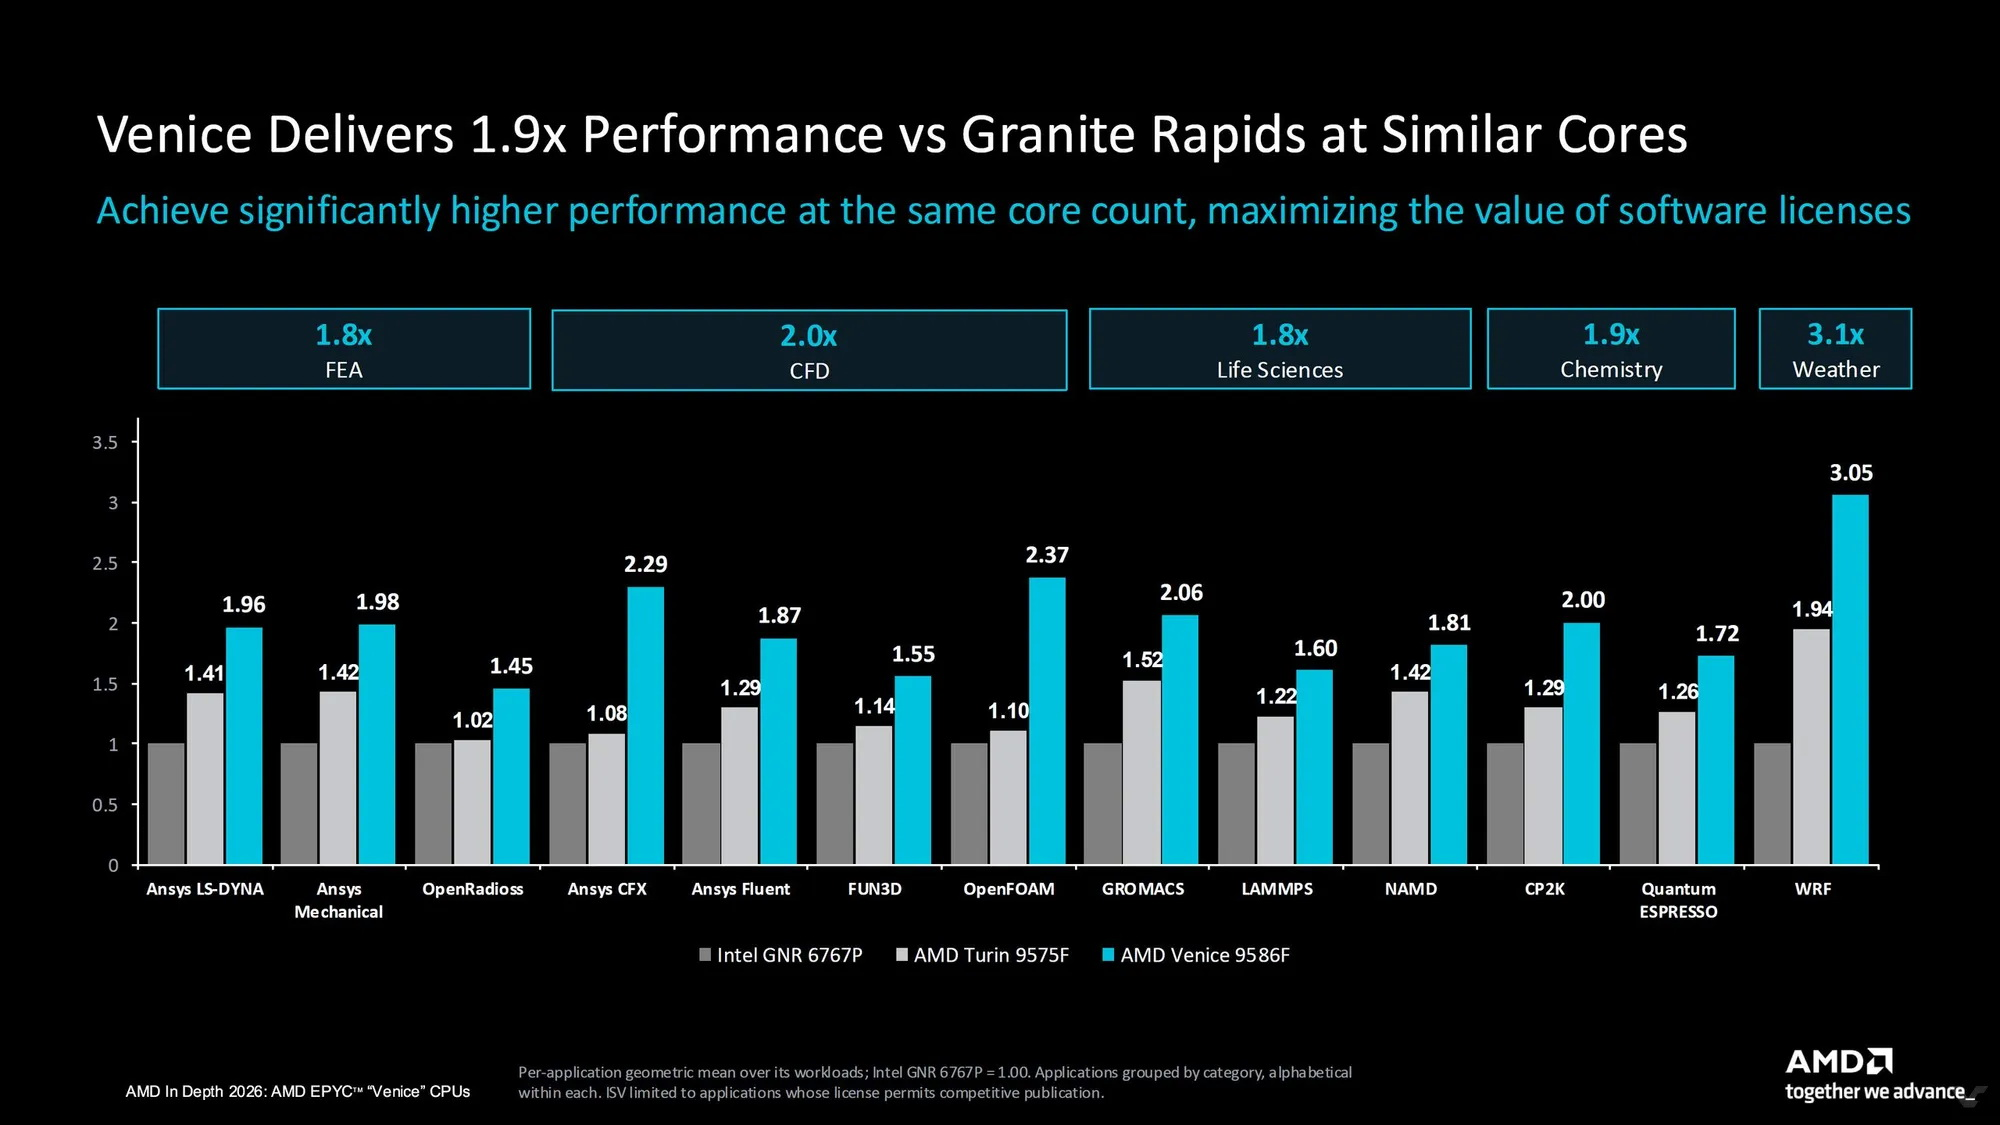
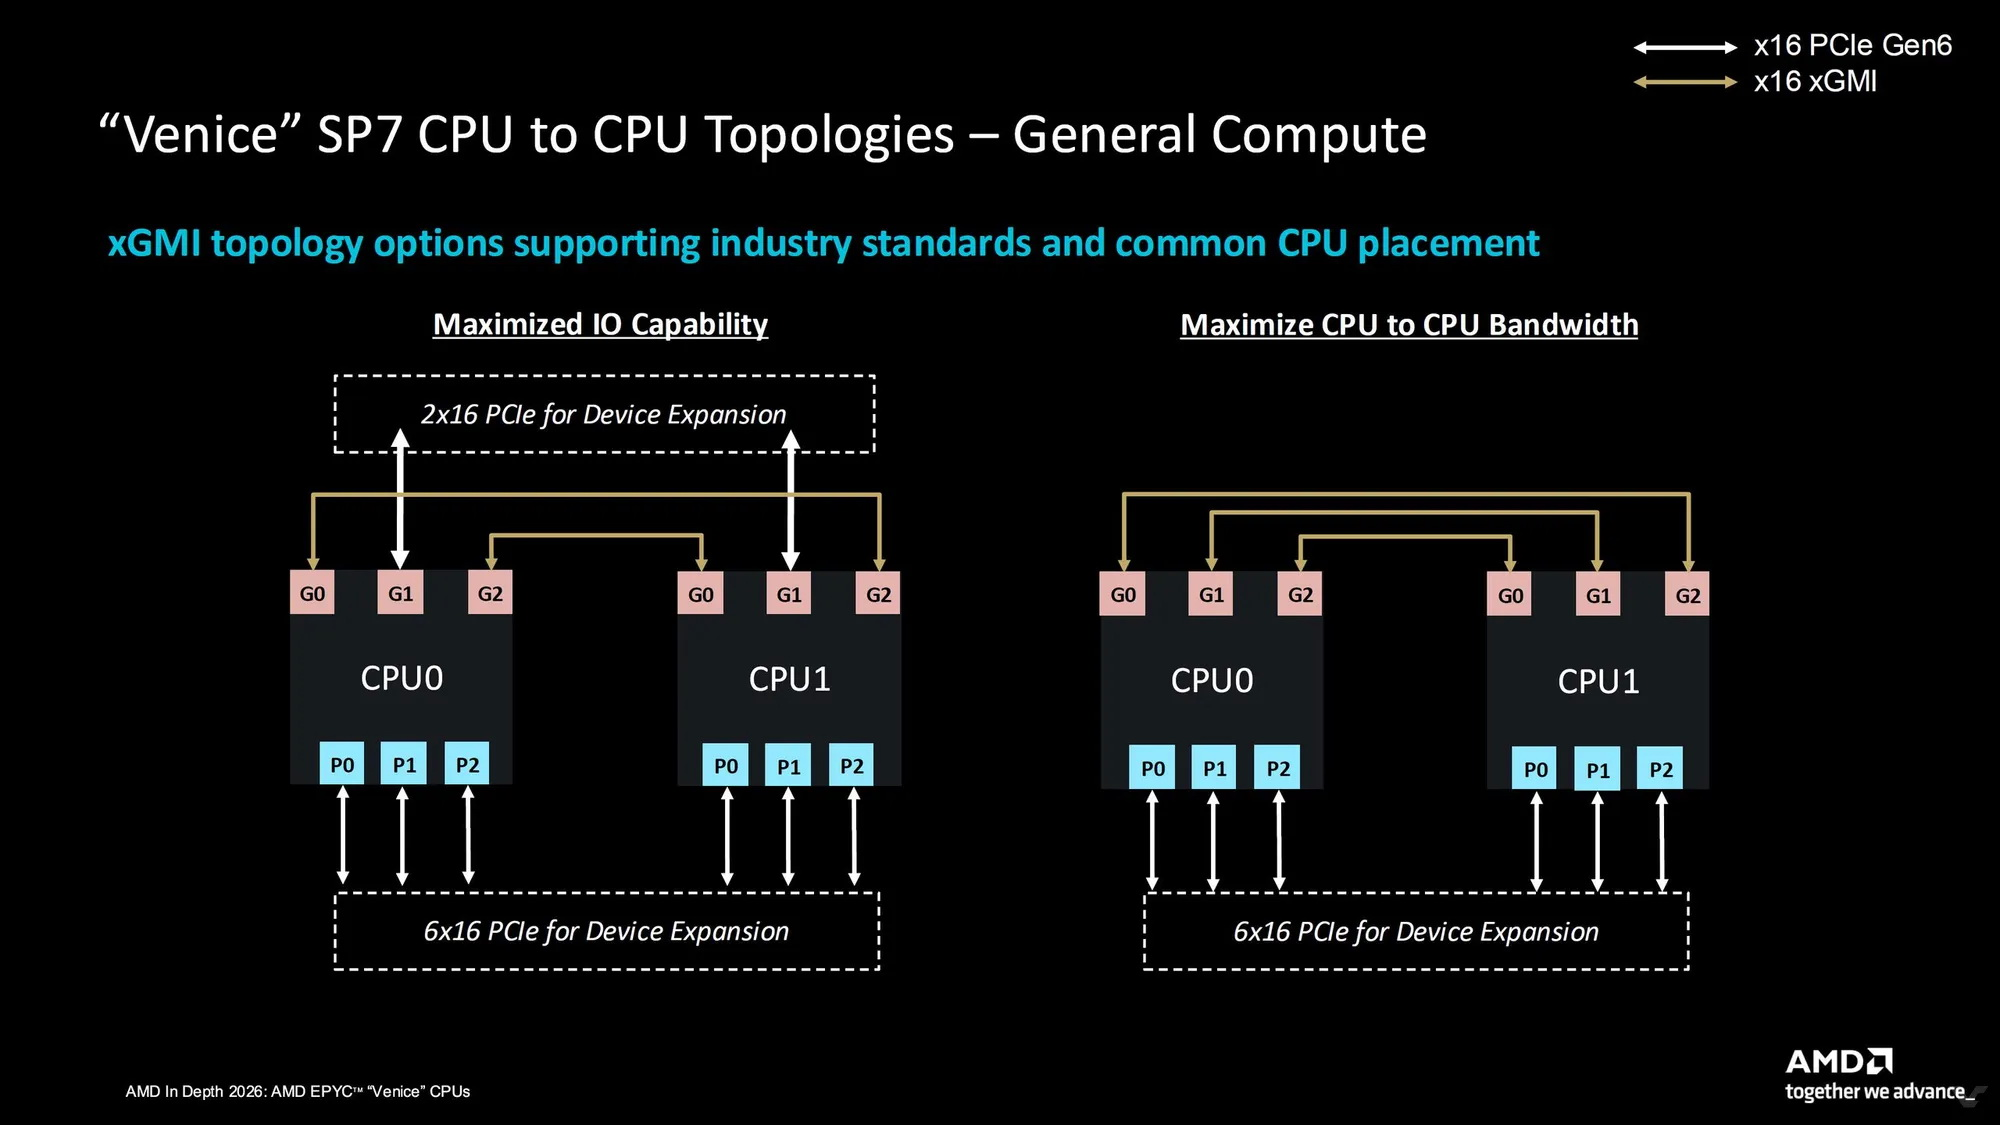
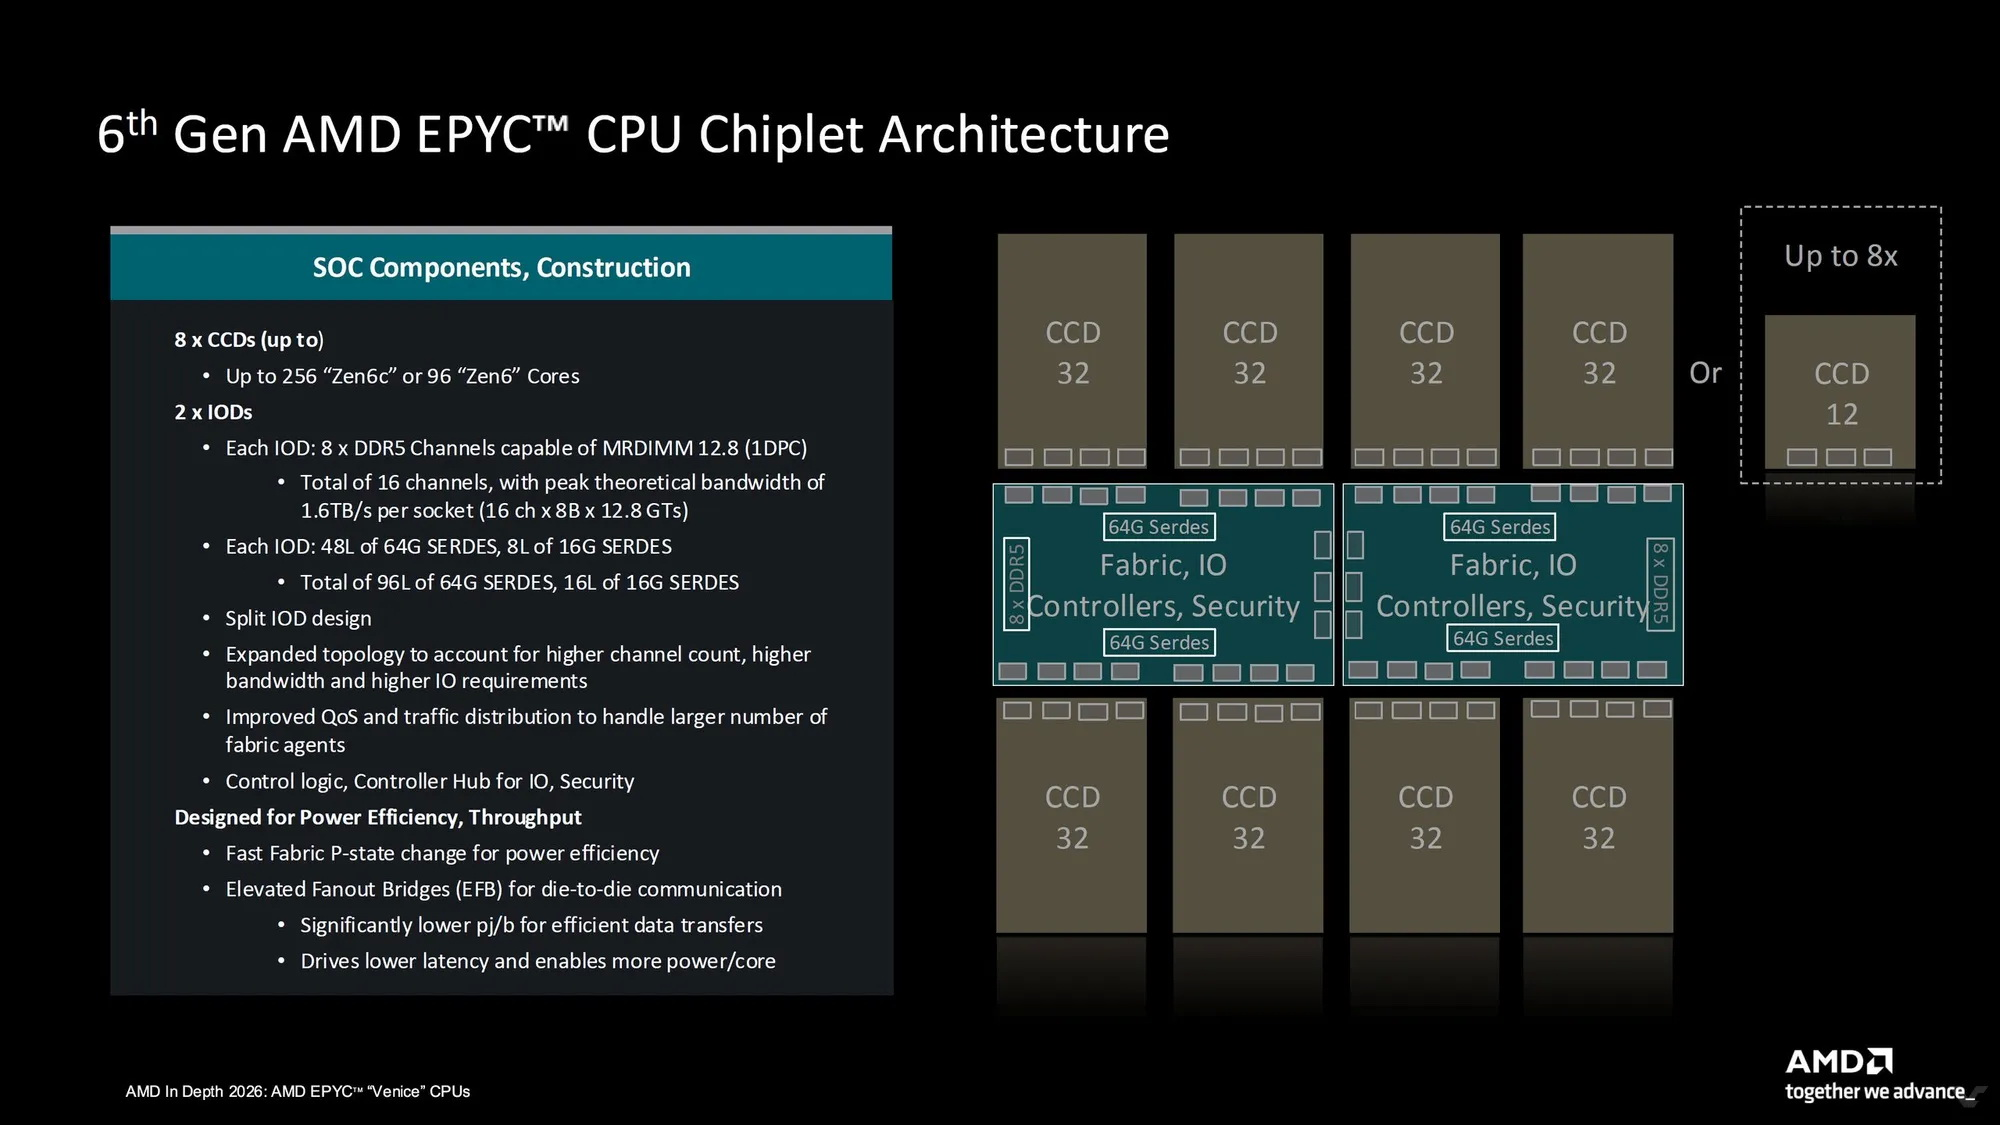
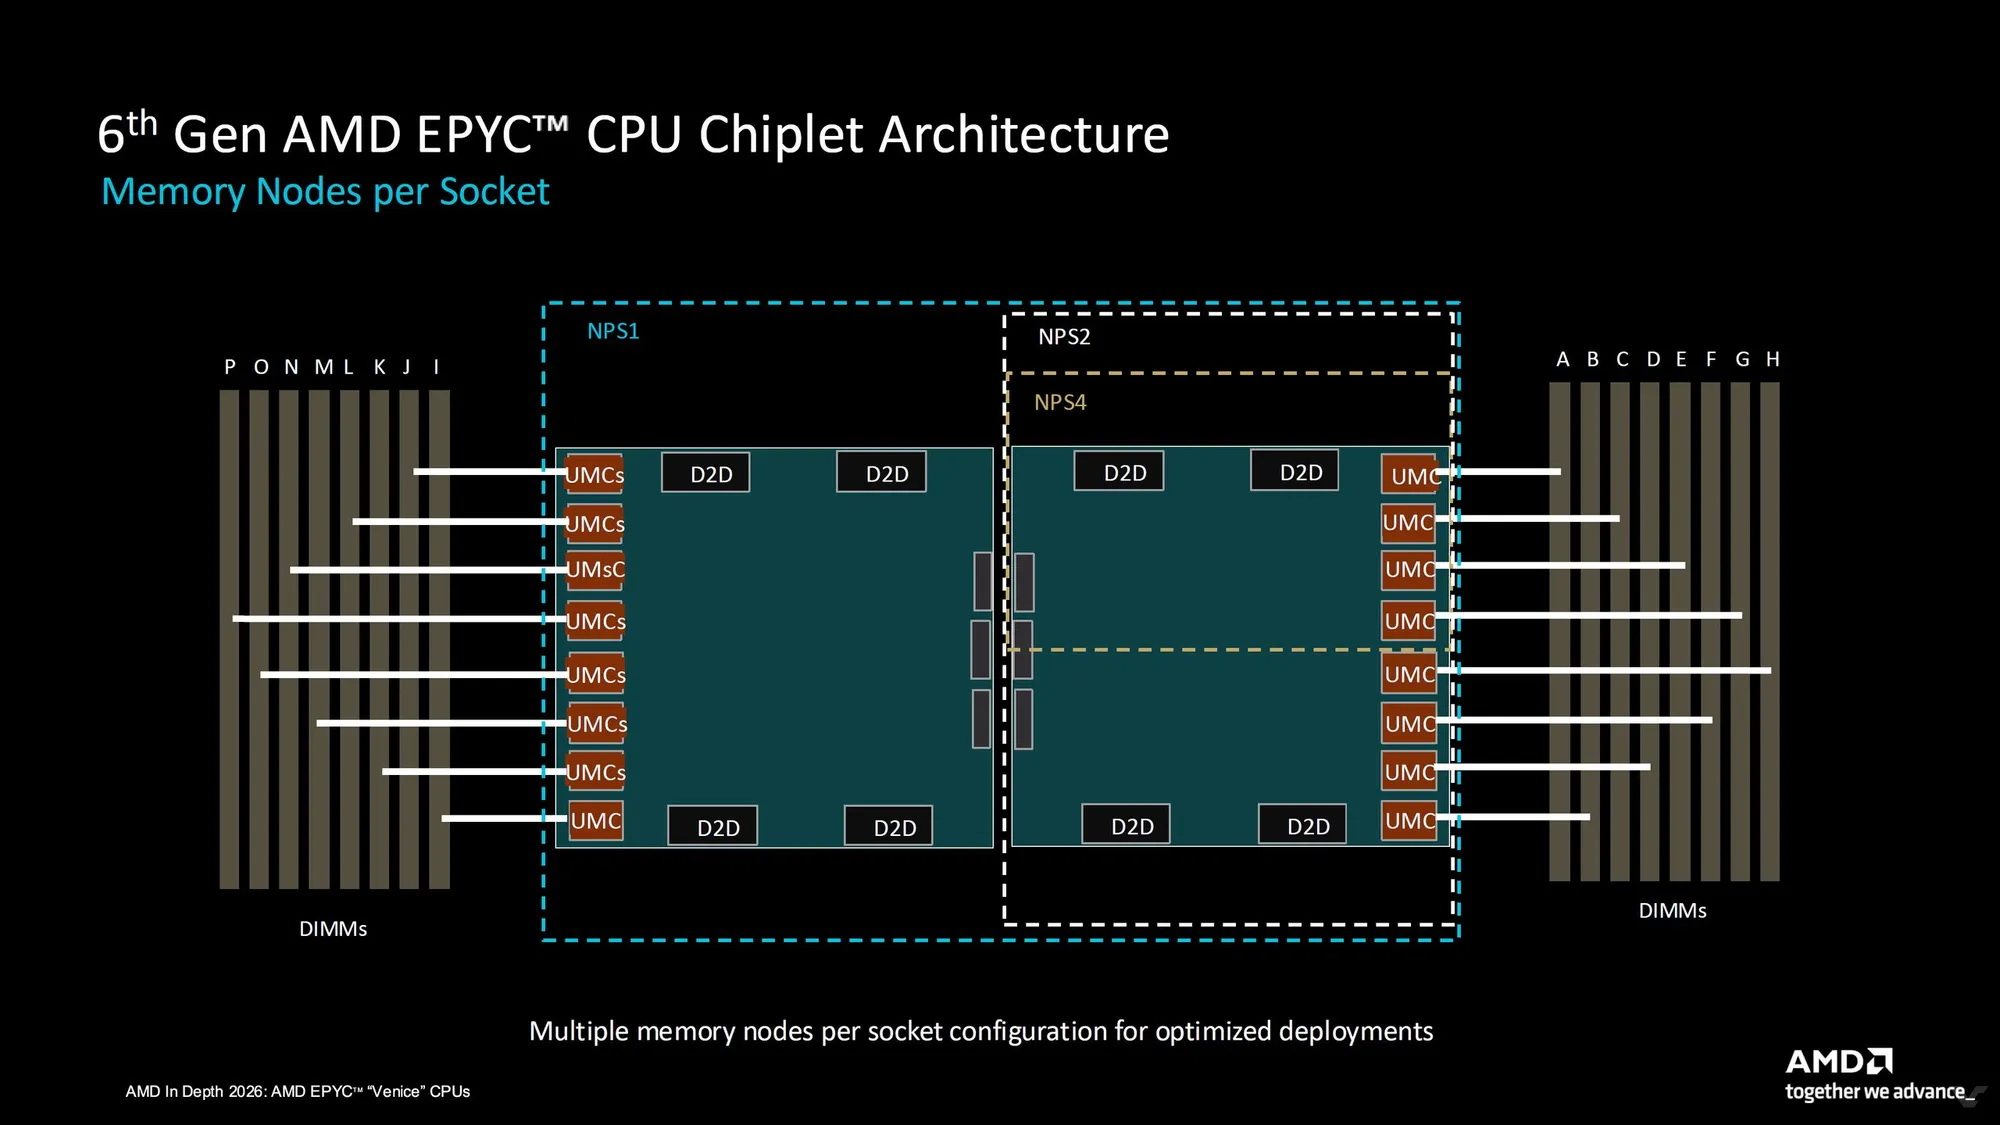
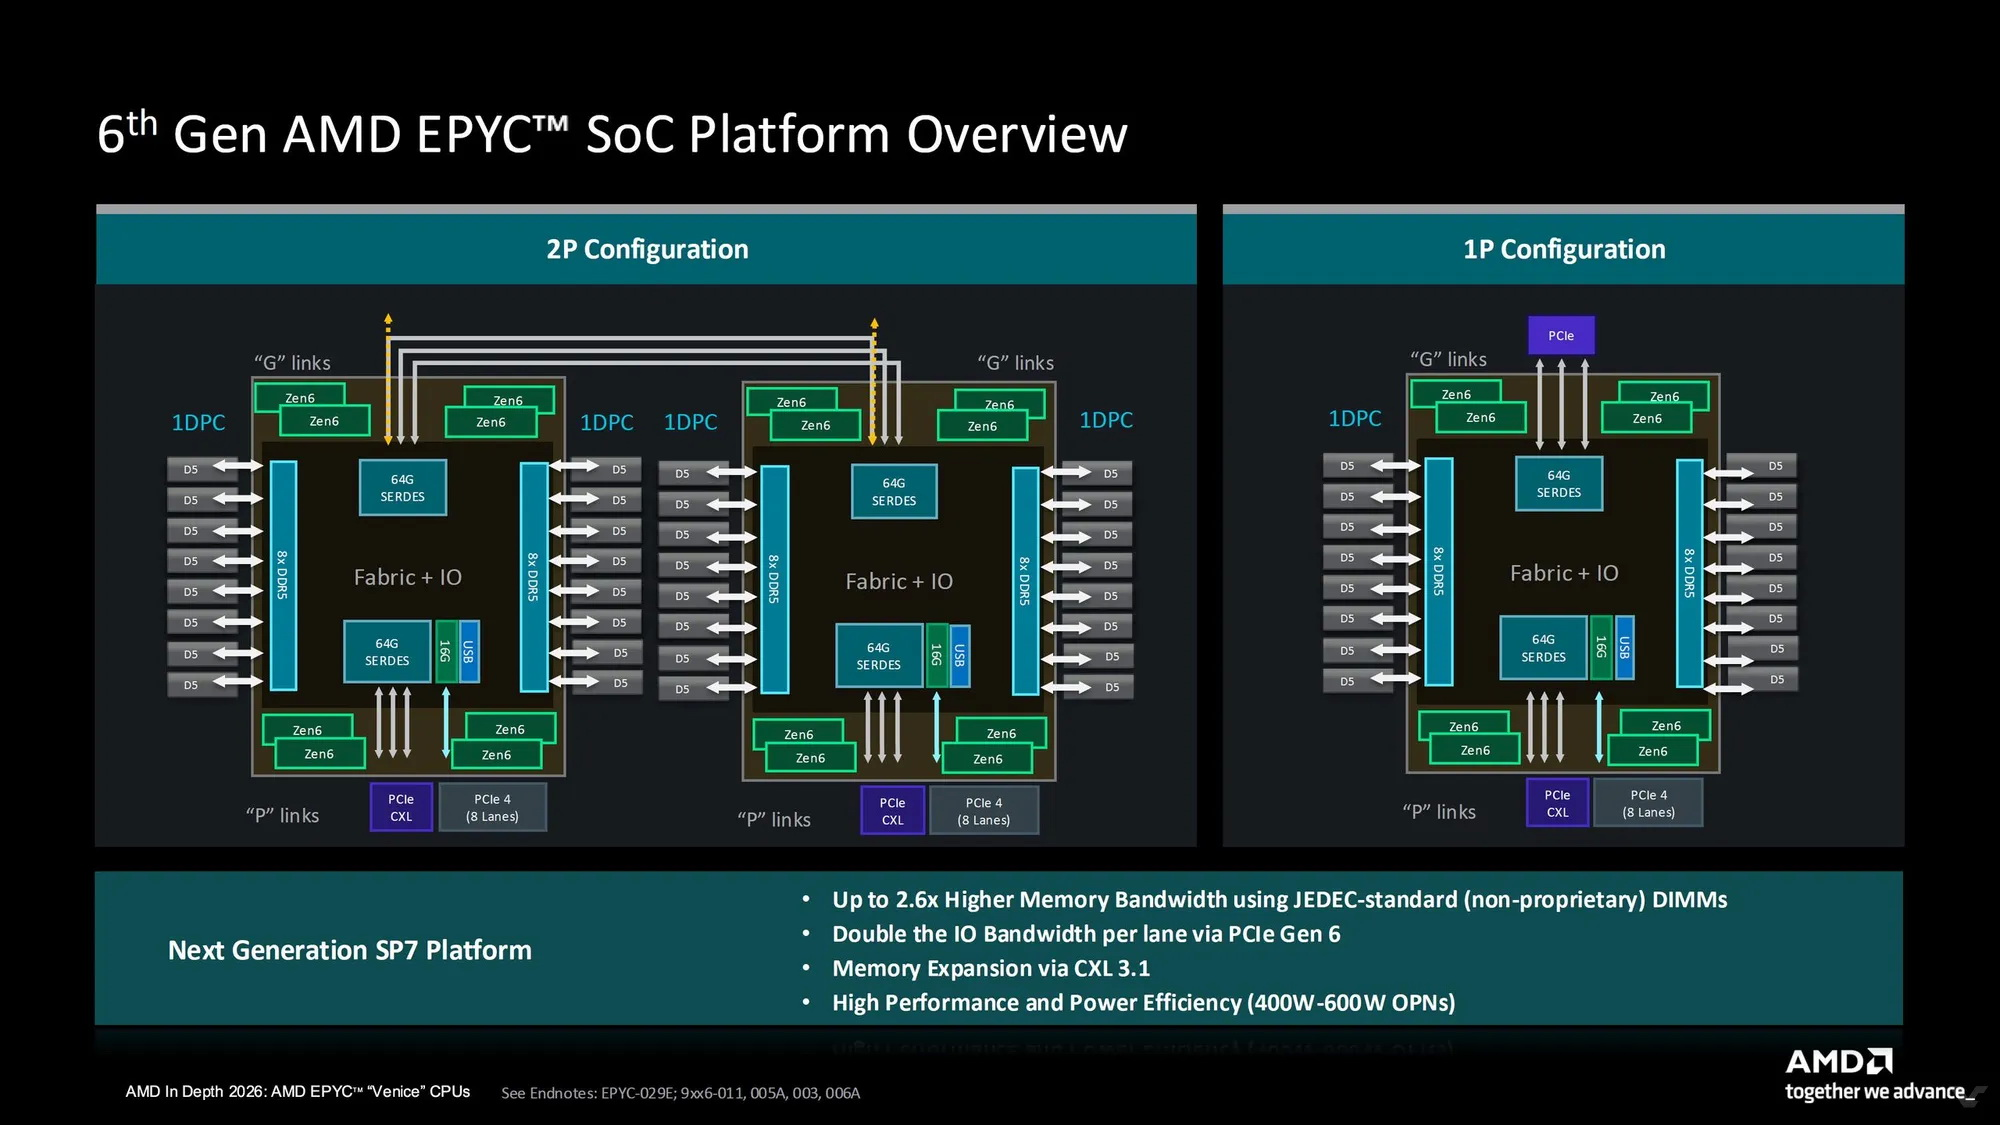
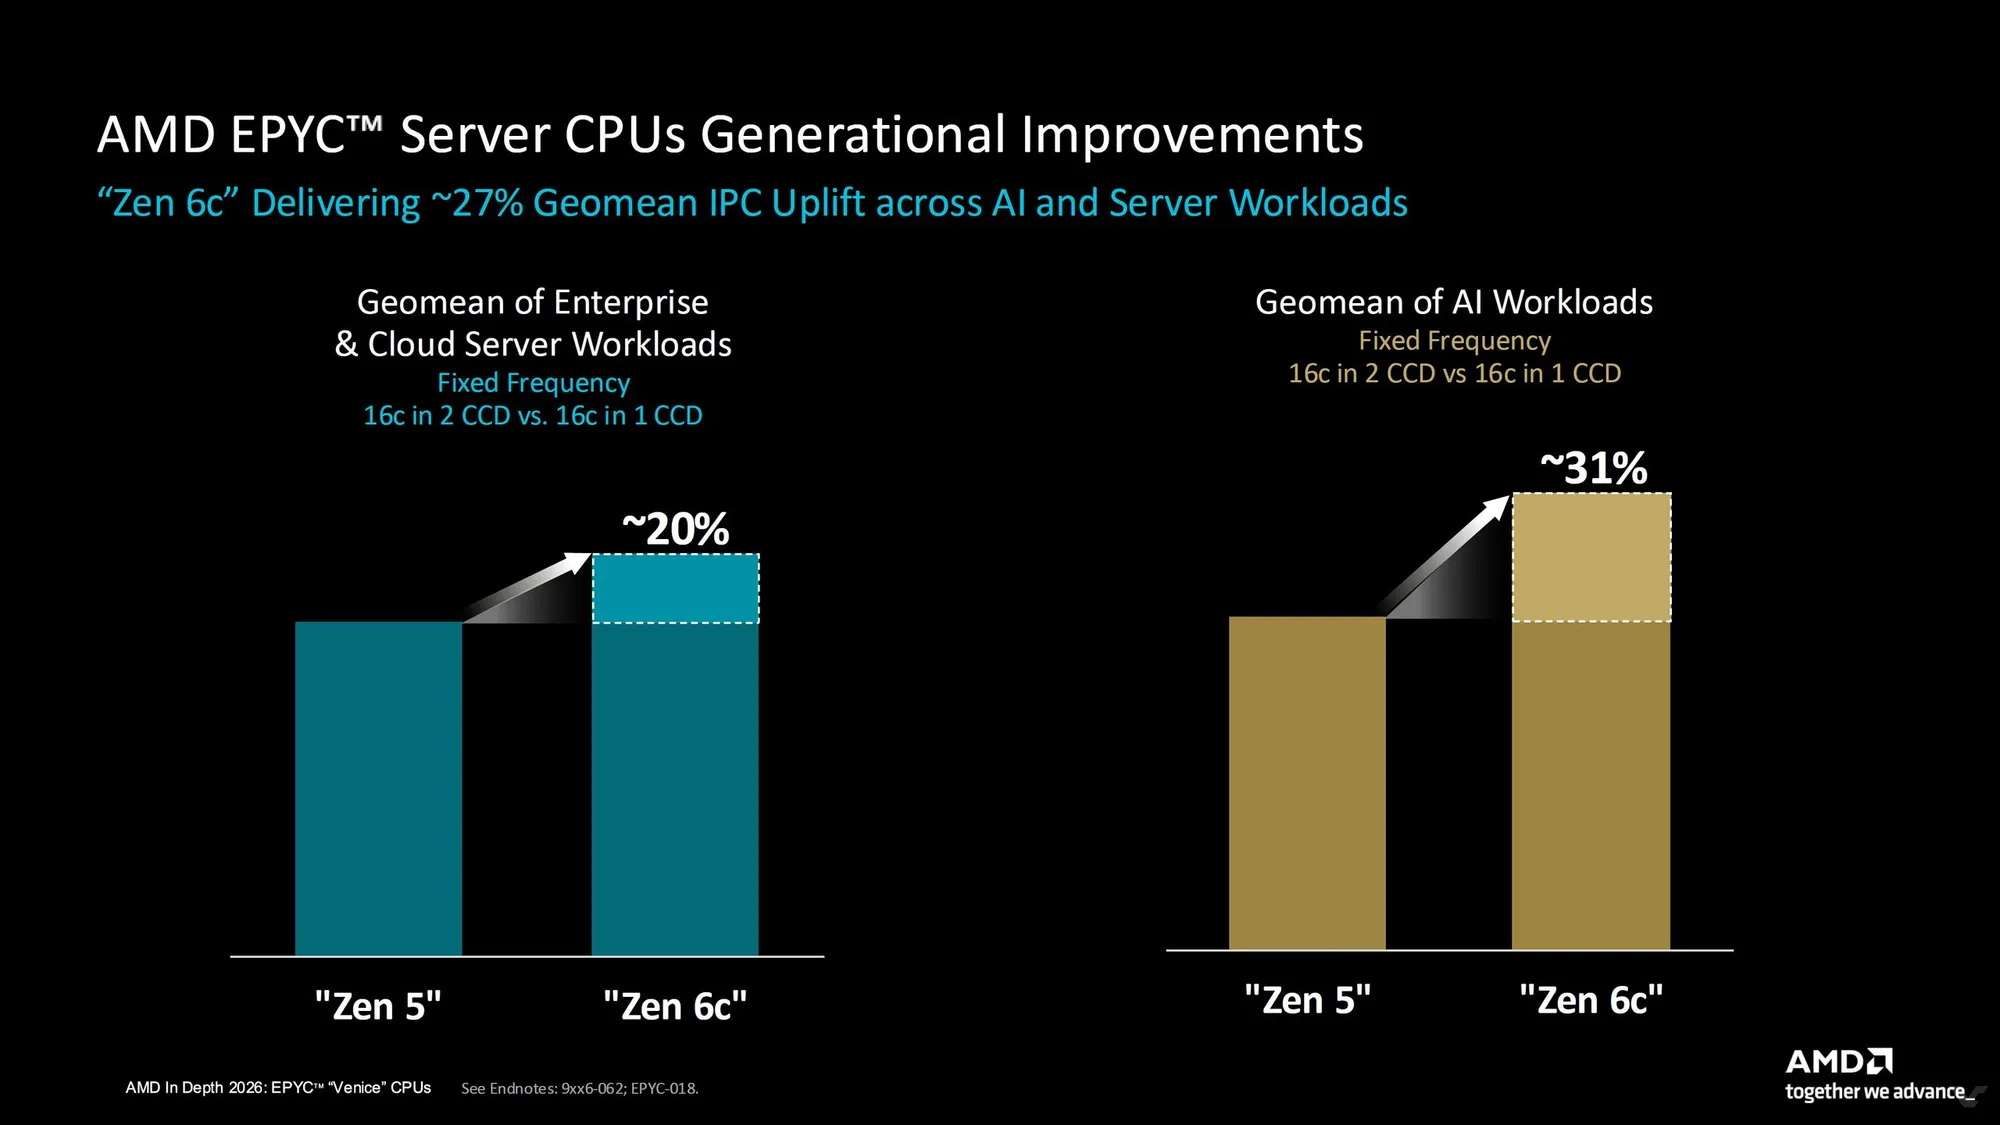
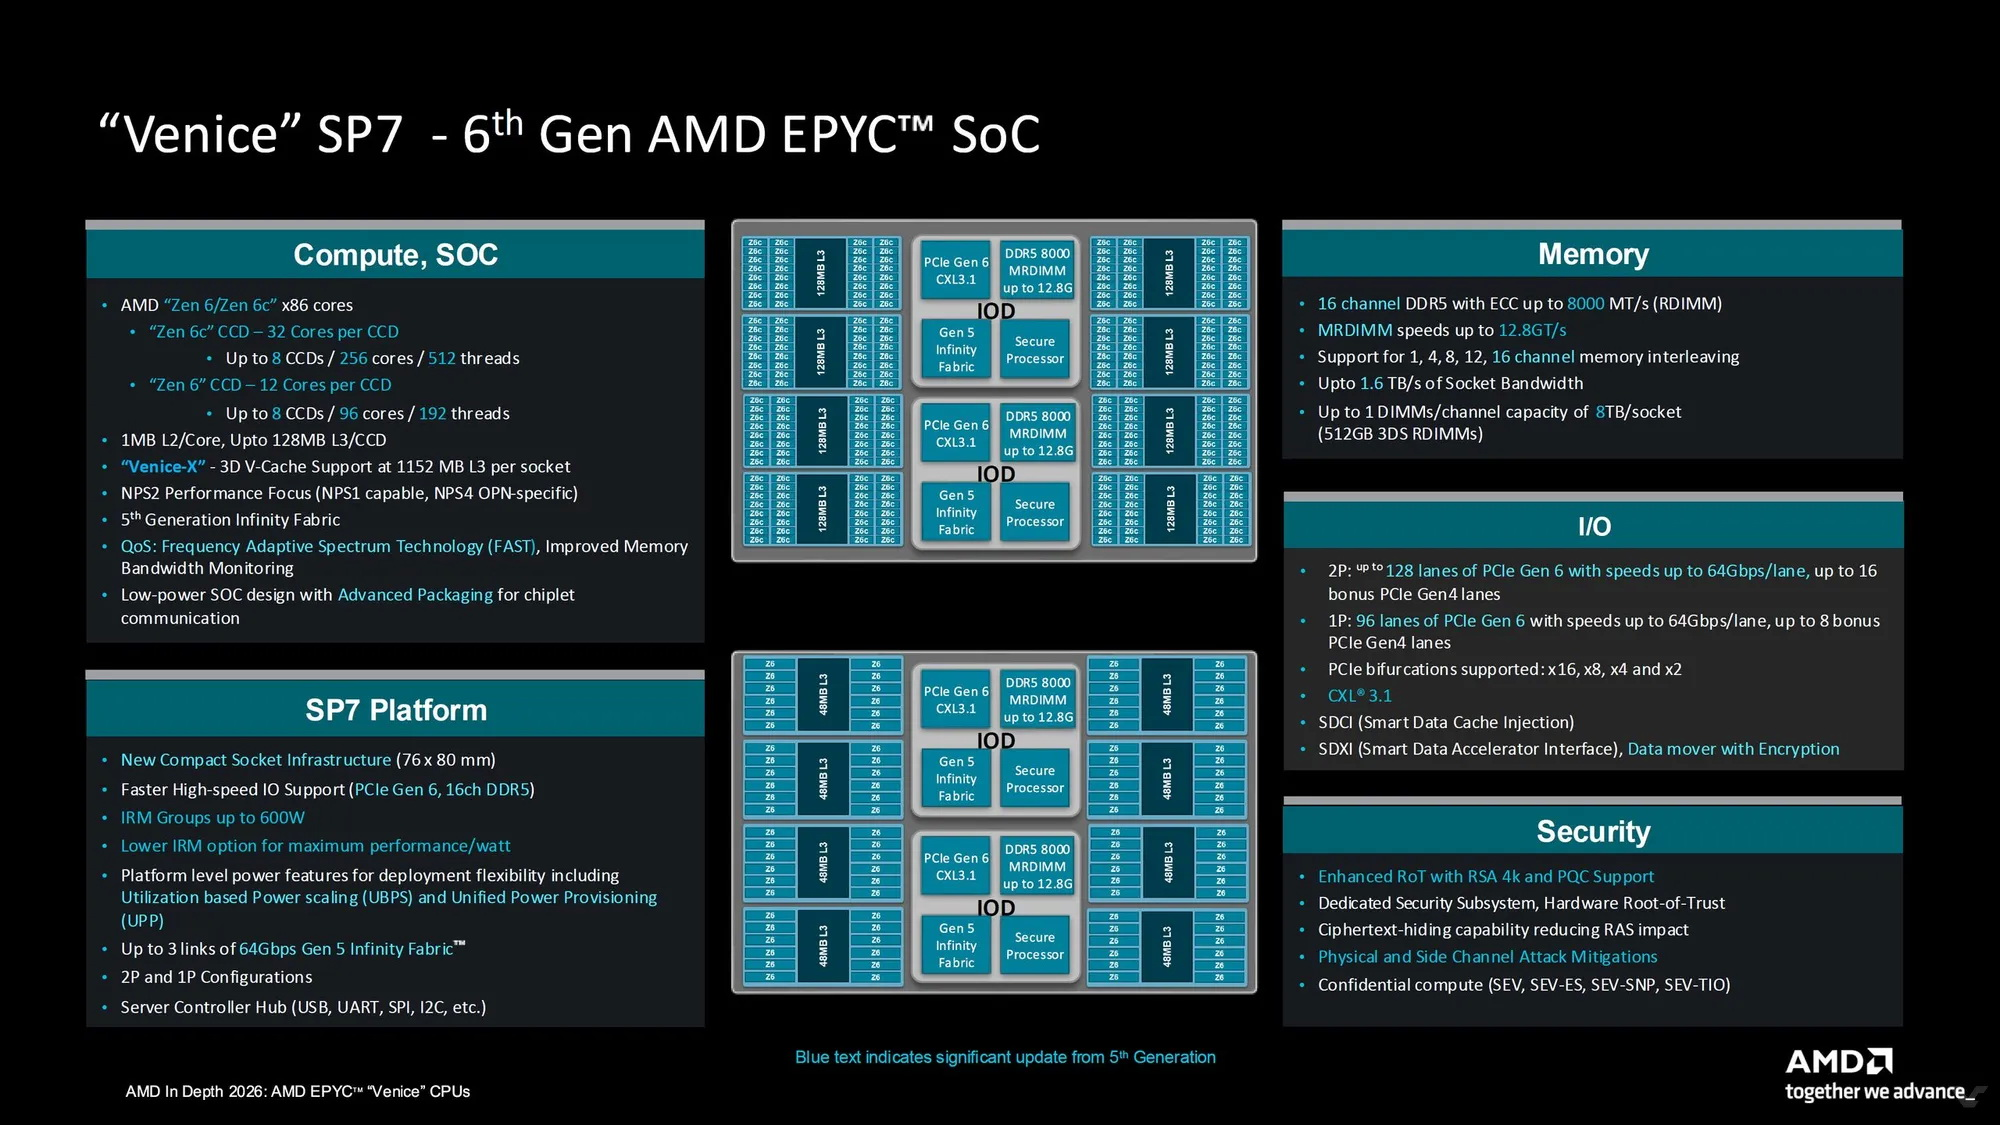
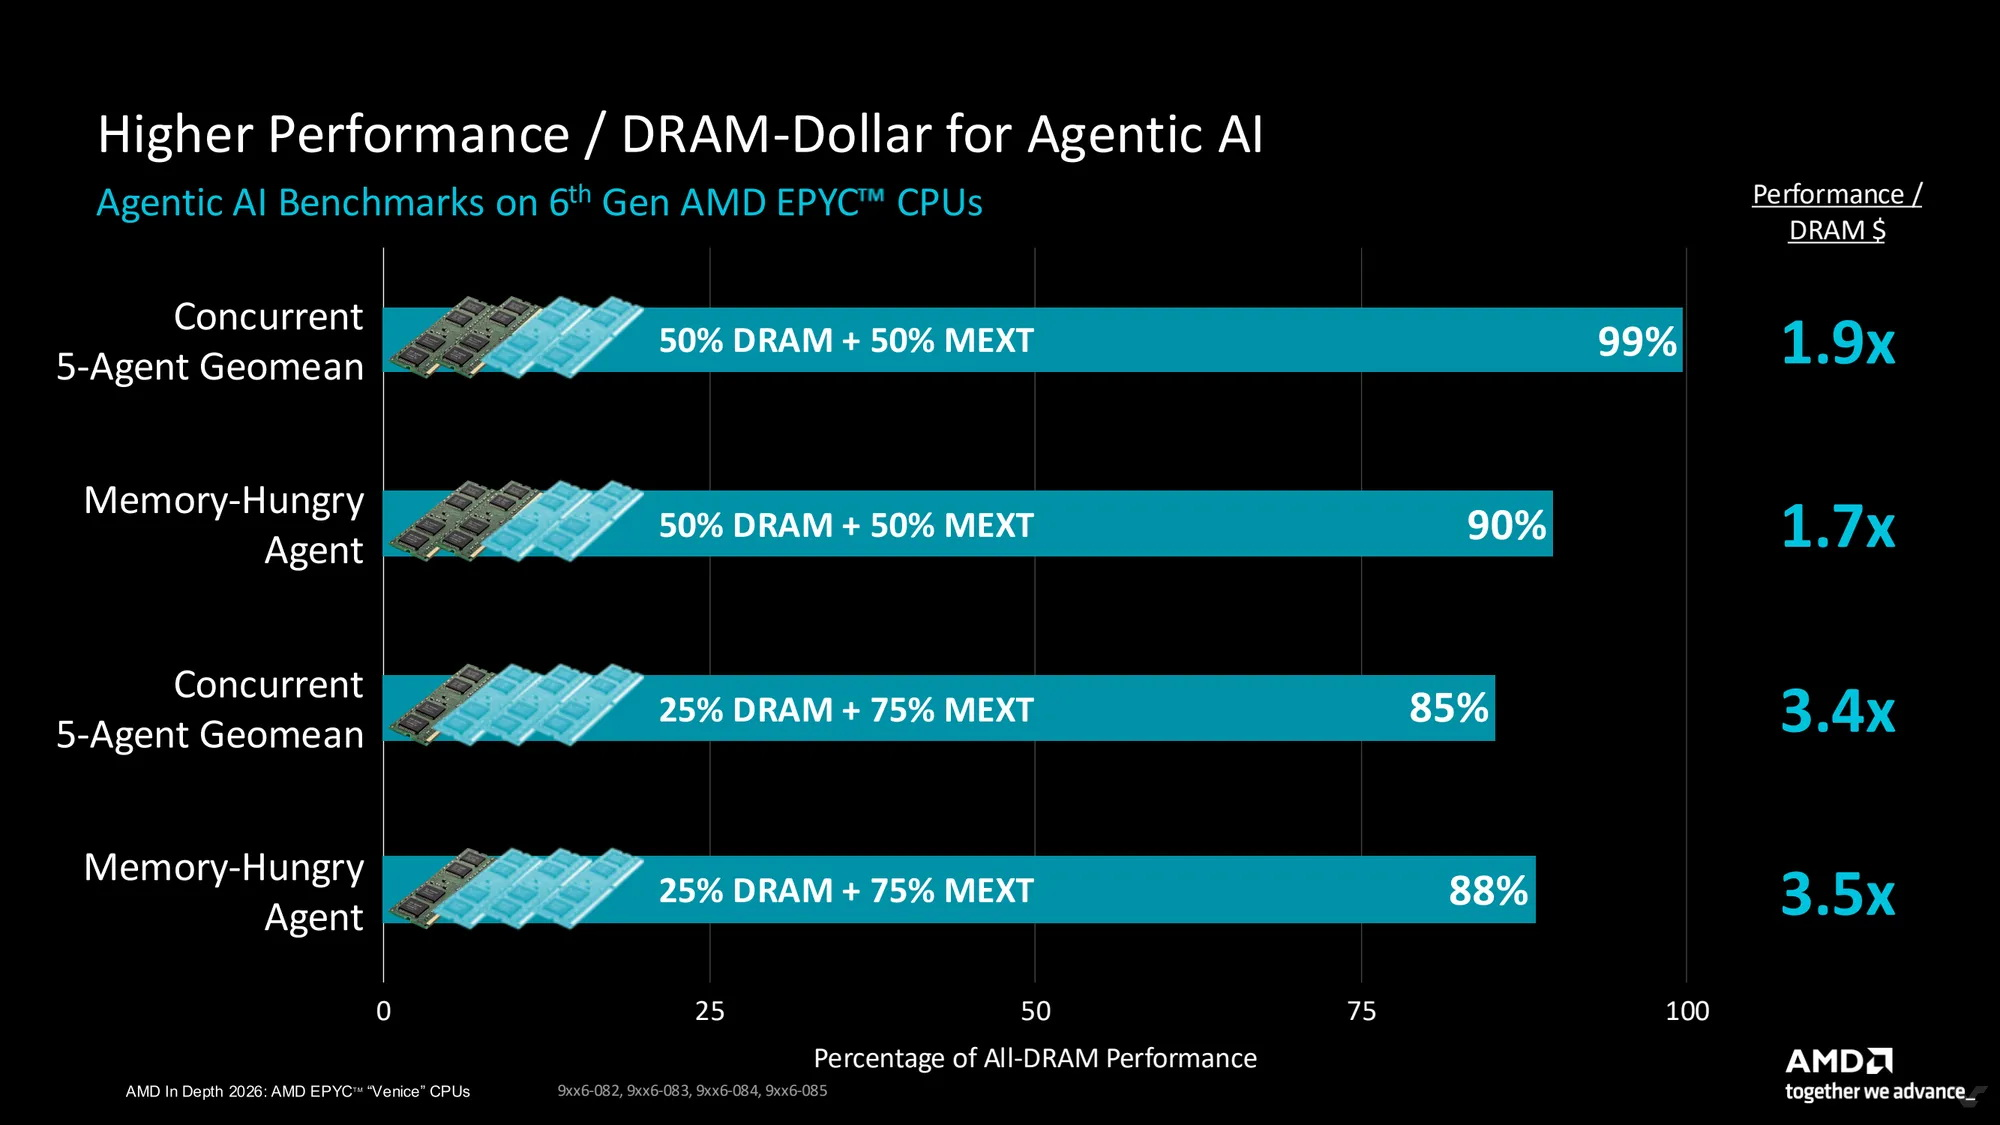
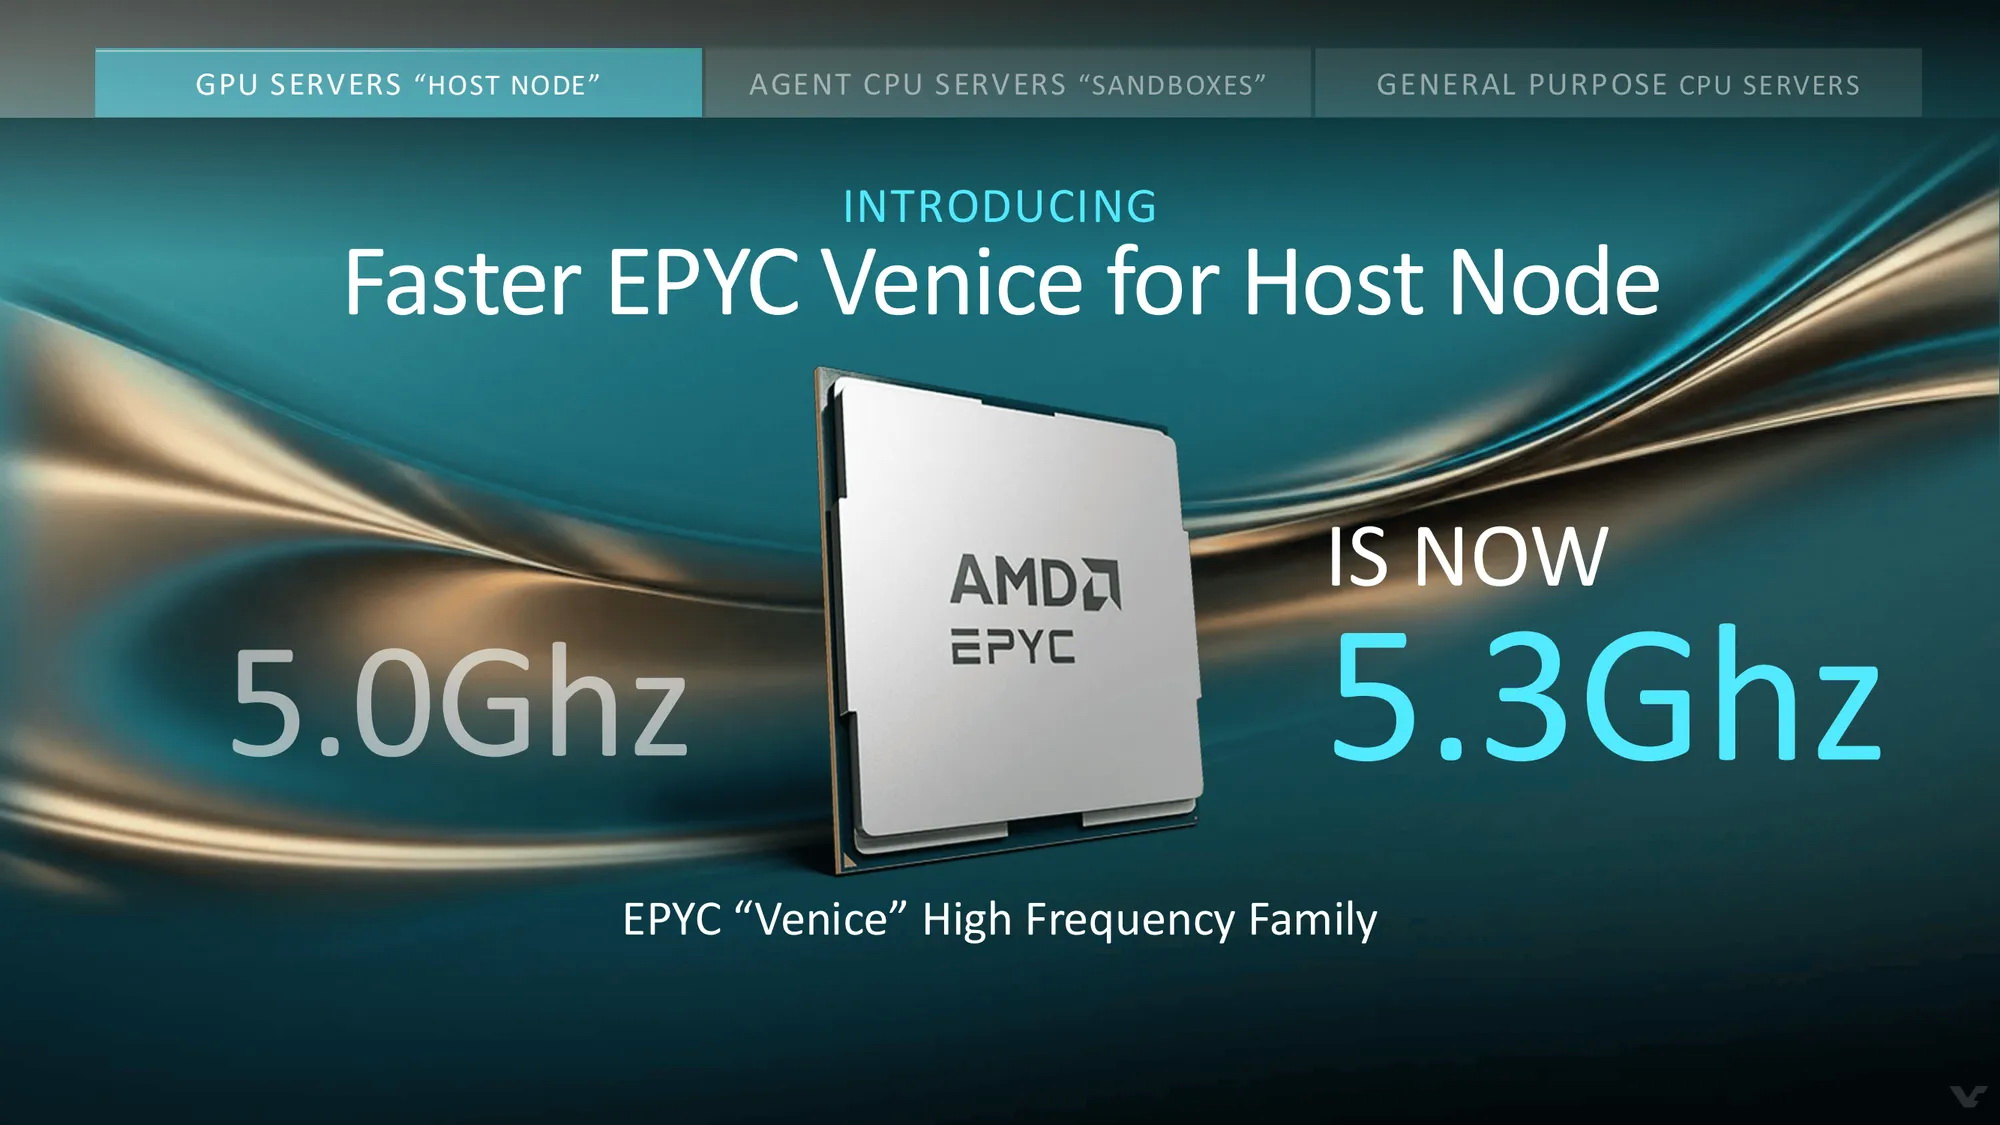
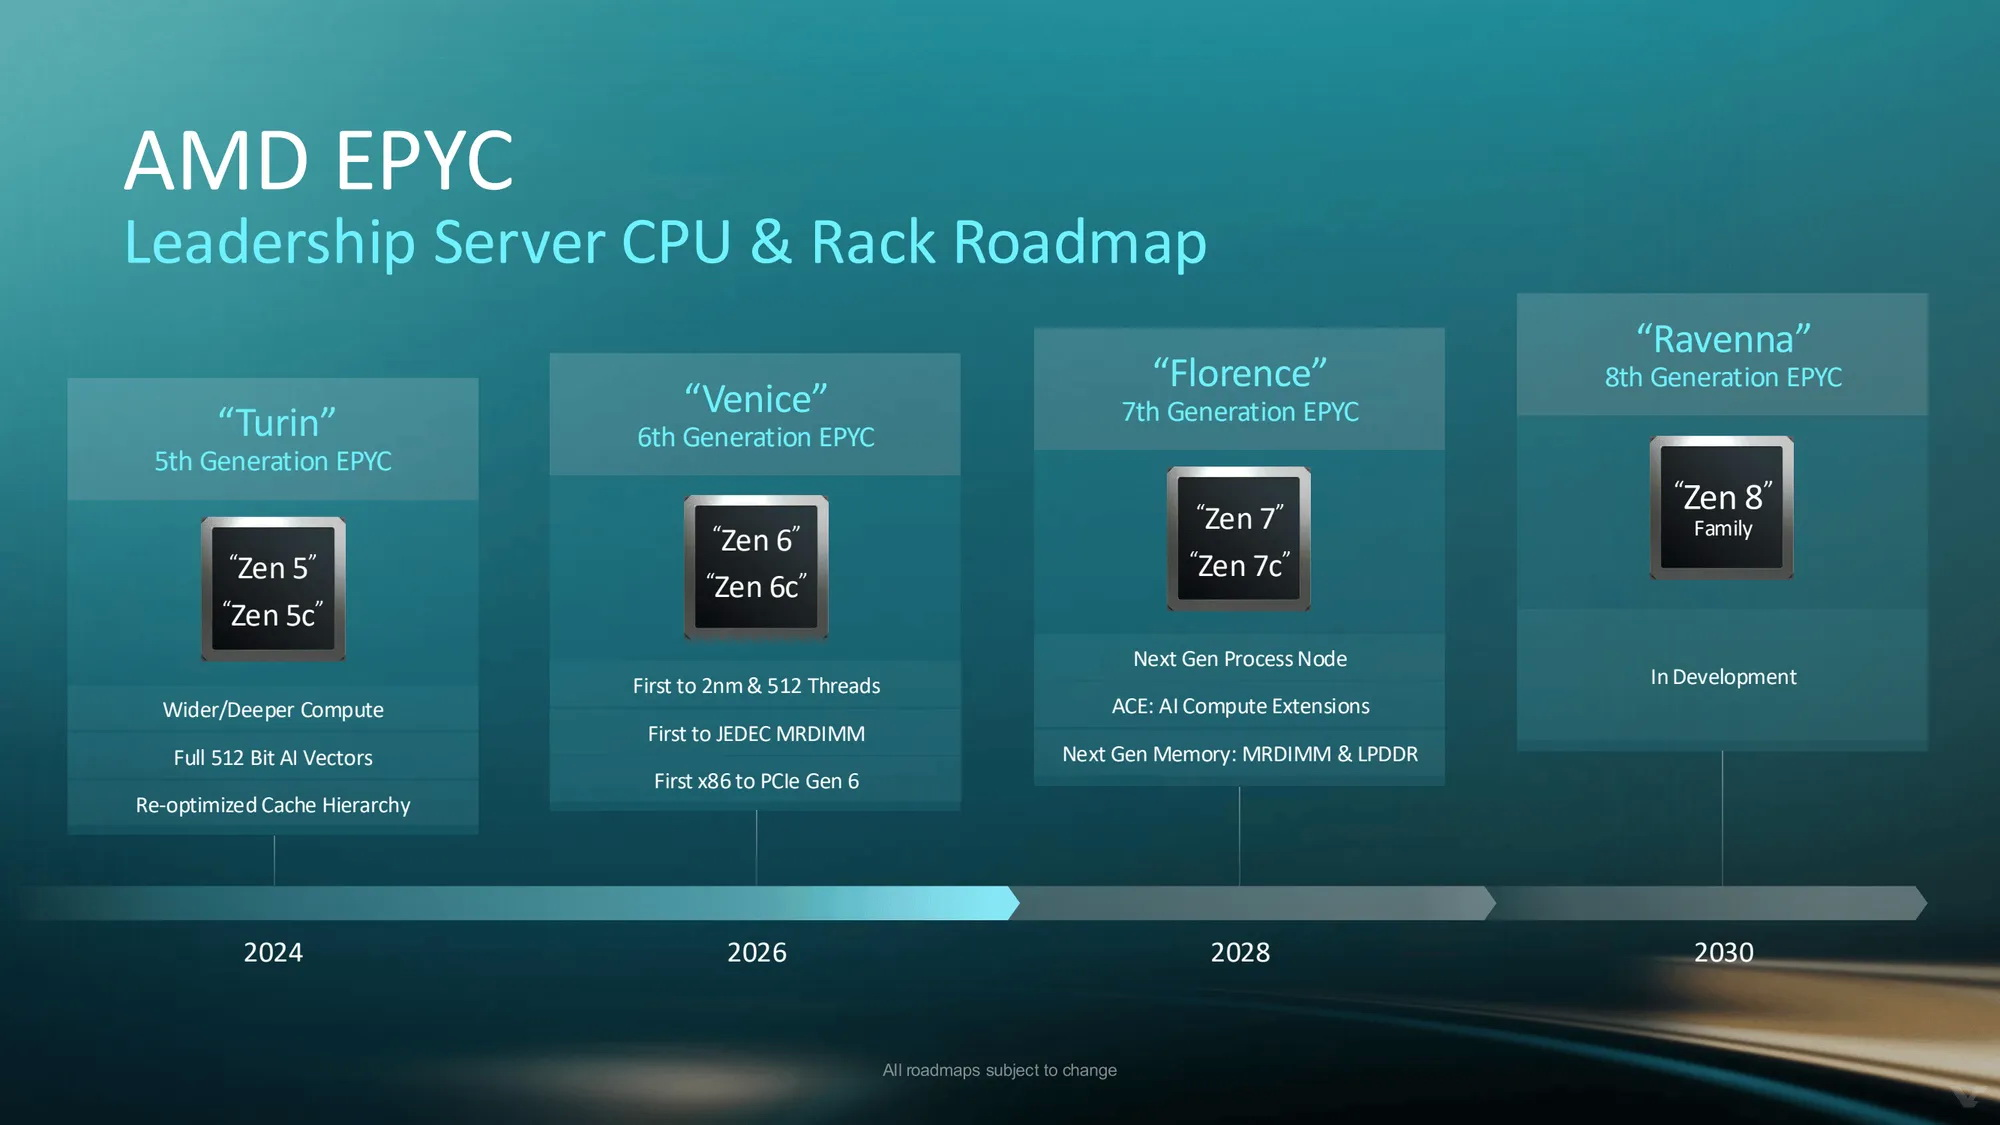
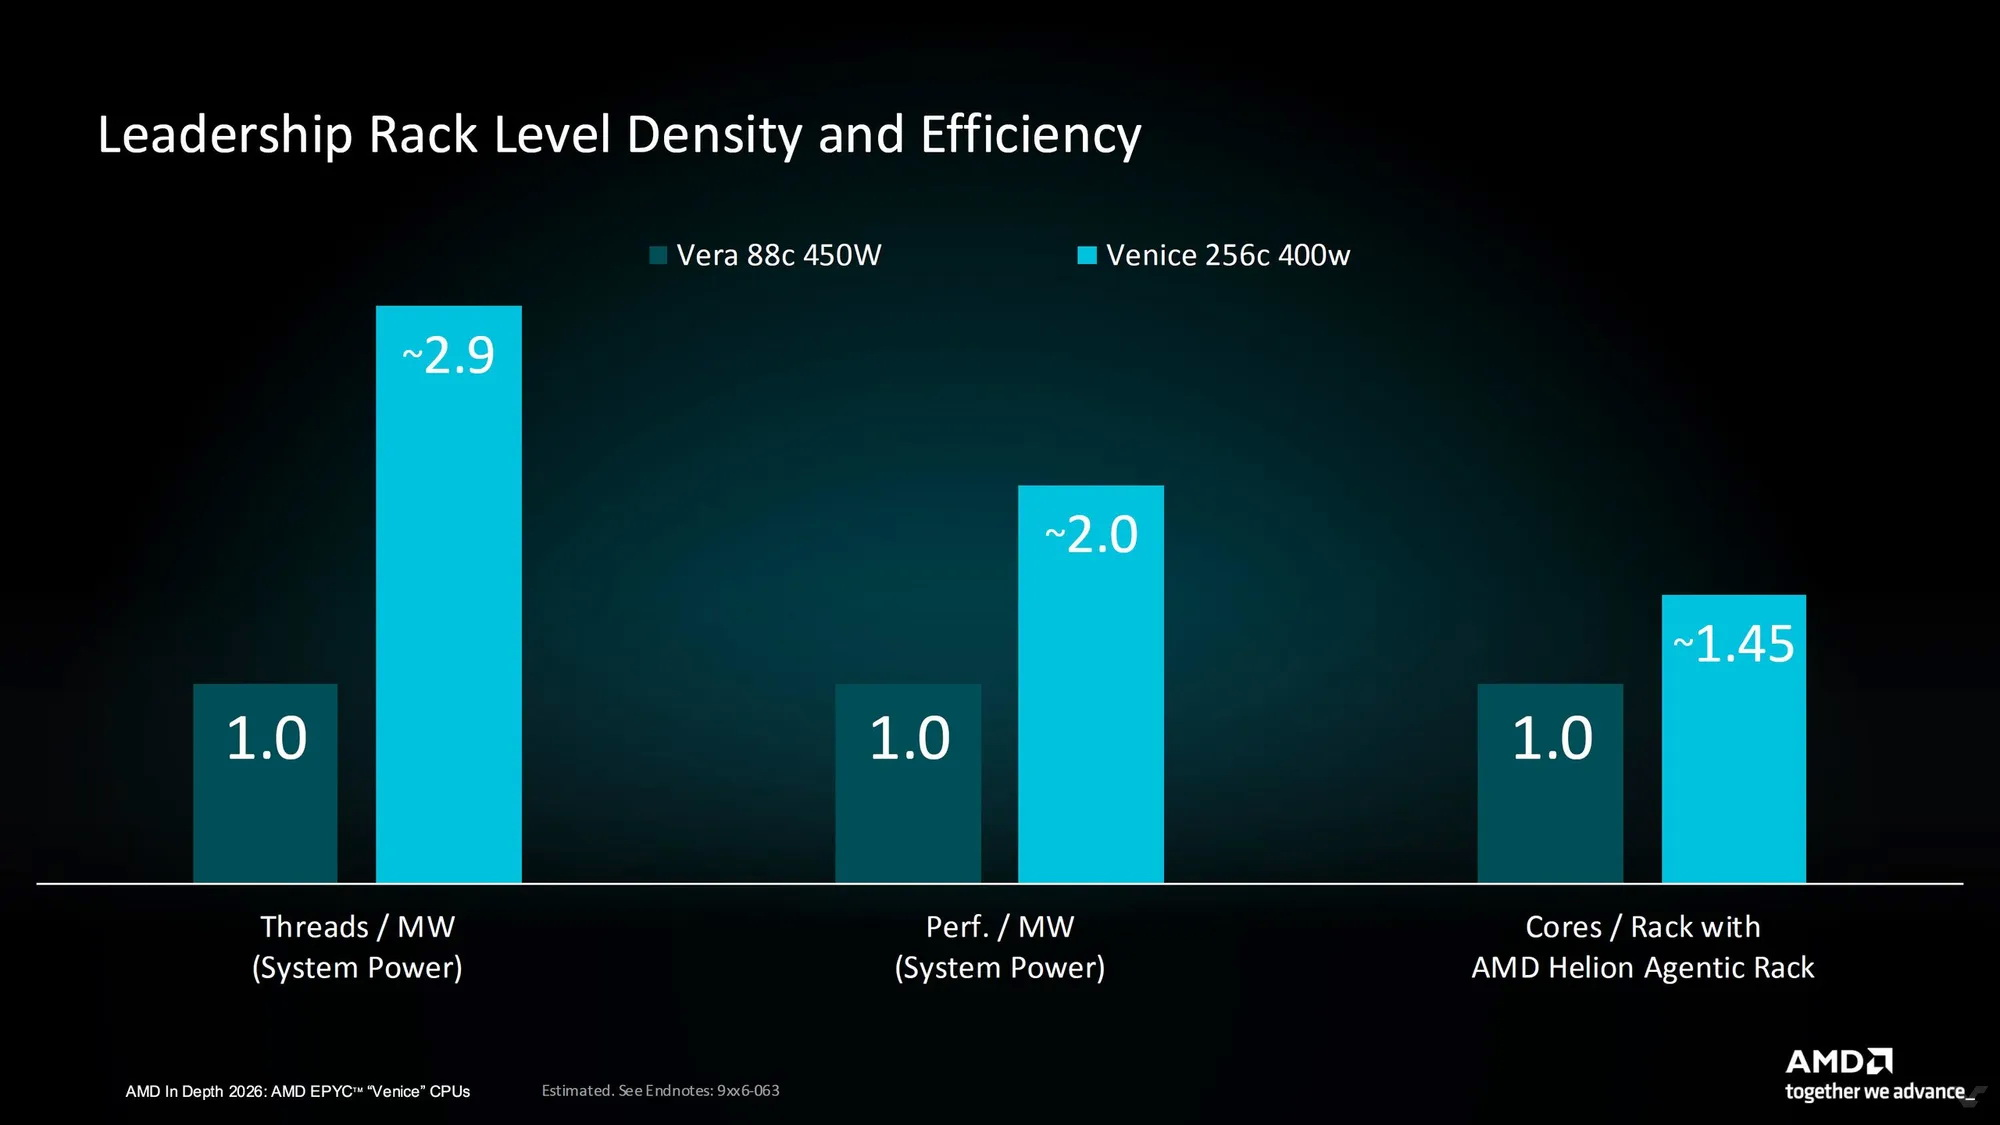
Источник изображений: AMD Для производства вычислительных кристаллов (CCD) на архитектурах Zen 6 и Zen 6c используется передовой 2-нм техпроцесс TSMC N2P. По сравнению с N3E, применяемом для Zen 5, новая технология обеспечивает либо прирост частоты на 18 % при том же энергопотреблении, либо снижение энергопотребления на 36 % при аналогичной скорости. 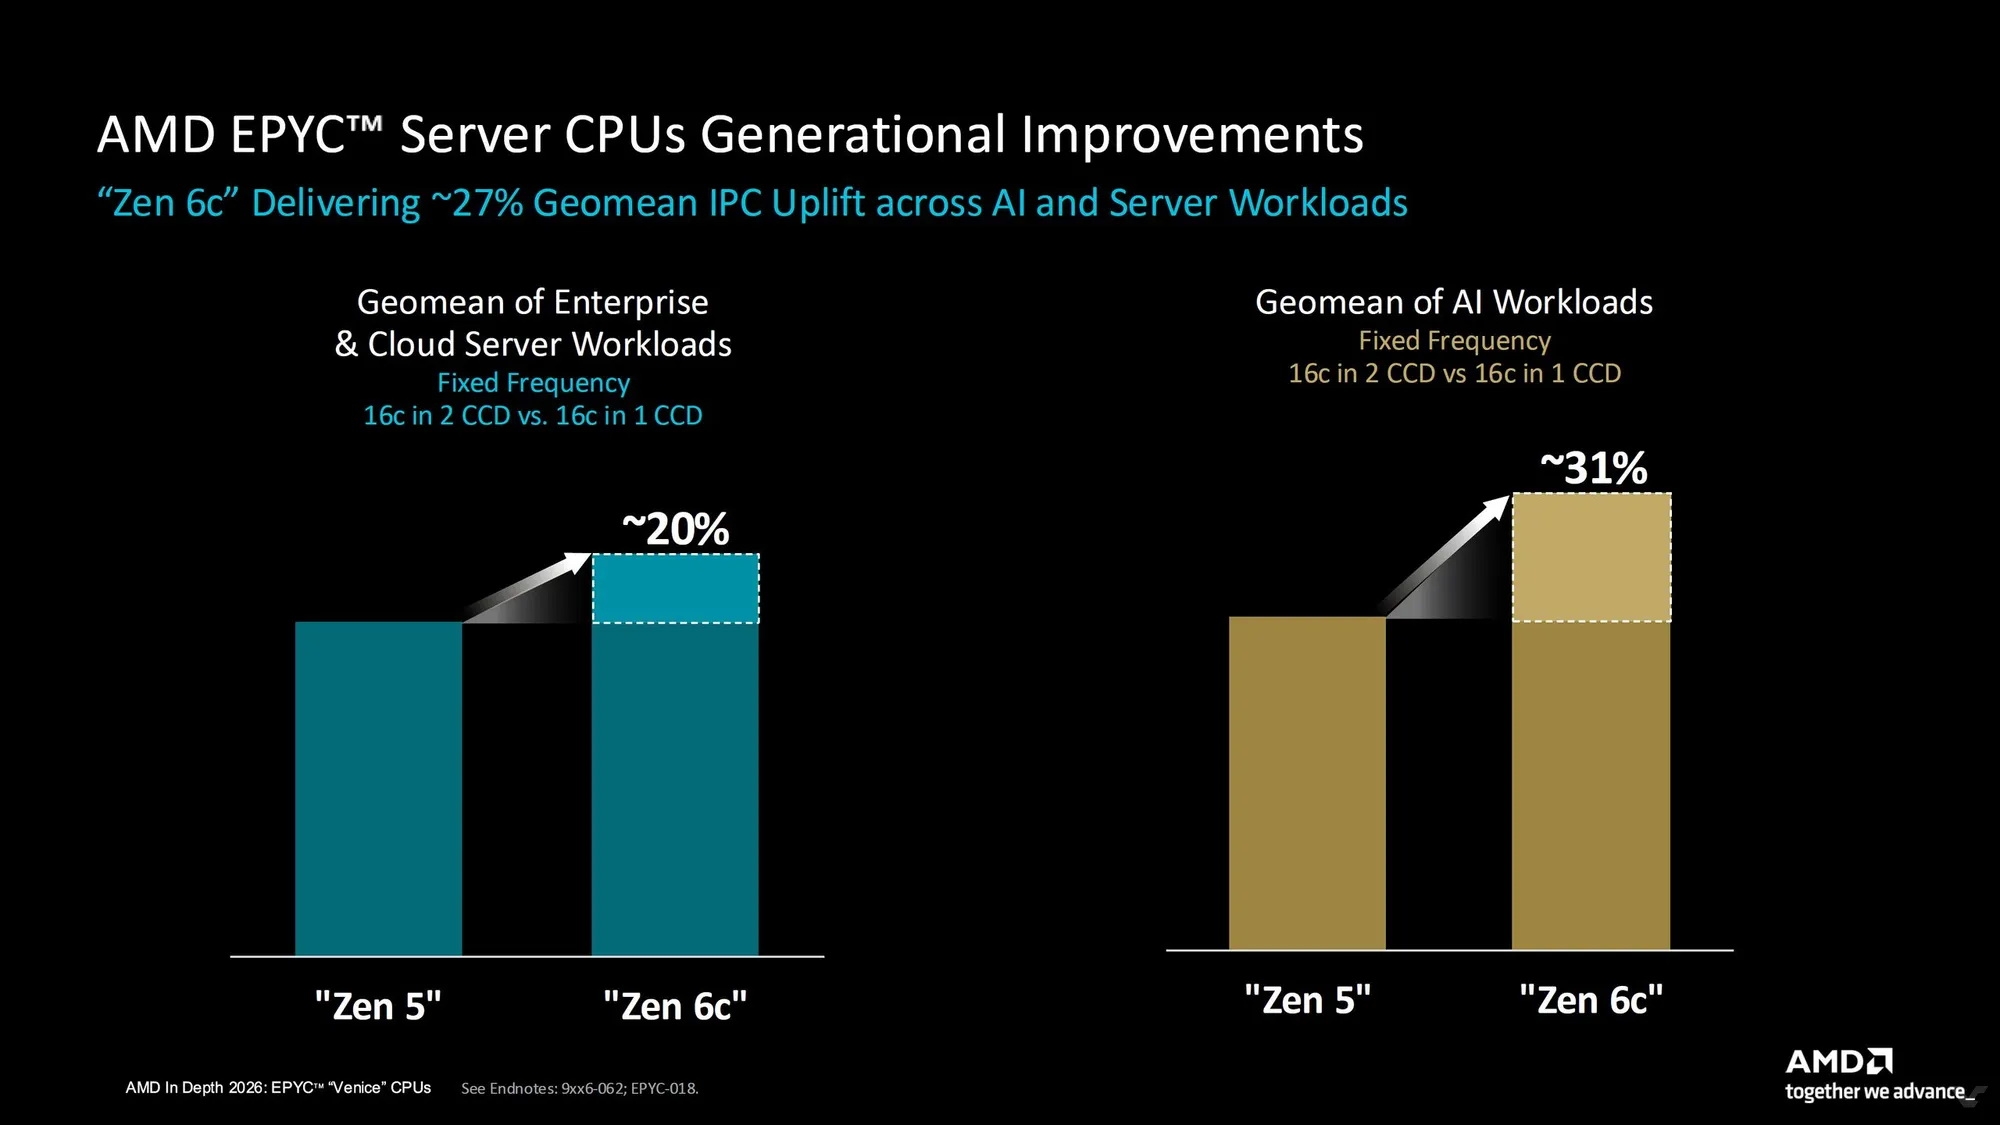 Конструкция Zen 6 позволила увеличить количество ядер на одном кристалле на 50 %. Стандартный CCD Zen 6 теперь вмещает до 12 ядер (48 Мбайт кеша L3). При этом, несмотря на увеличение количества ядер до 12 на CCD, инженерам AMD удалось сохранить задержку обращения к кешу L3 на прежнем уровне — всего 13 тактов, как и в Zen 5. Внедрение изменений позволило заявить о росте среднегеометрического показателя IPC (числа инструкций, выполняемых за такт) в задачах ИИ и серверных нагрузках сразу на 27 %. Максимальная частота процессоров Zen 6 выросла до 5,3 ГГц (против 5,0 ГГц у Zen 5). 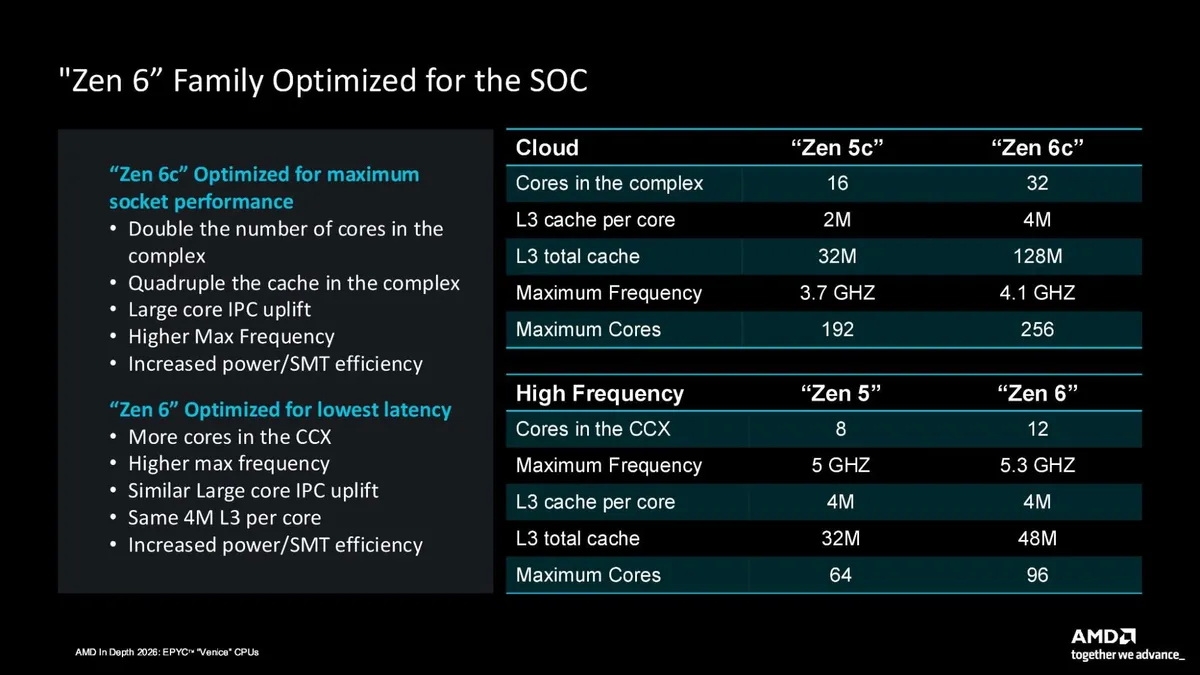 Для чиплетов на базе энергоэффективных ядер Zen 6c заявляется самый большой скачок плотности. Теперь один такой кристалл вмещает до 32 ядер (вдвое больше, чем в Zen 5c). AMD увеличила объём кеша L3 на ядро в Zen 6c в два раза (до 4 Мбайт), из-за чего общий объём кеша на чиплет вырос в четыре раза — до 128 Мбайт, а максимальная тактовая частота поднялась до 4,1 ГГц (против 3,7 ГГц у Zen 5c). Важно отметить, что Zen 6 и Zen 6c используют абсолютно одну и ту же микроархитектуру внутри ядра. В отличие от E-ядер Intel, которые базируются на отдельной архитектуре и лишены поддержки многих инструкций P-ядер, Zen 6c представляет собой просто оптимизированный по площади дизайн стандартного ядра с меньшим энергопотреблением и более низкими частотами. 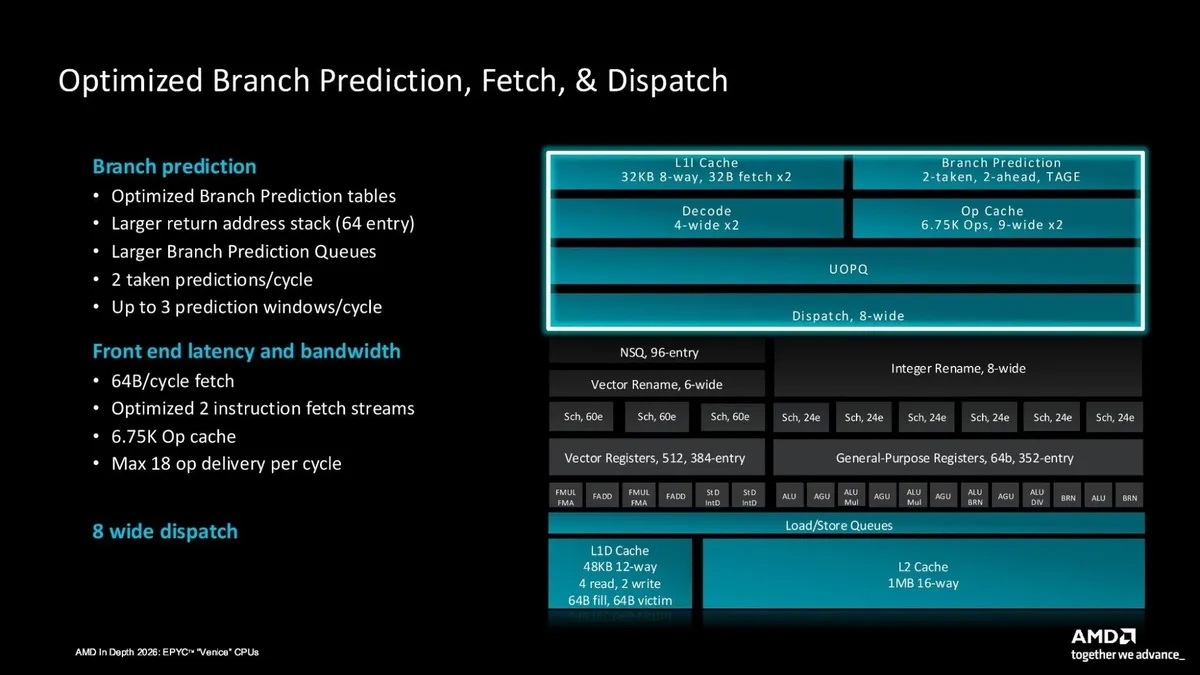 В рамках новых архитектур Zen 6 и Zen 6c внедрены раздельные планировщики целочисленных вычислений (Integer Schedulers) и расширен физический регистровый файл до 352 записей. Блок векторных вычислений получил нативную поддержку инструкций половинной точности FP16 при сохранении полной обратной совместимости с AVX-512, а пропускная способность загрузки FP-данных выросла до двух 512-битных или четырёх 256-битных загрузок за такт. Кеш операций увеличился с 6 тыс. до 6,75 тыс. записей, а пропускная способность подачи выросла с 12 до 18 операций за такт. 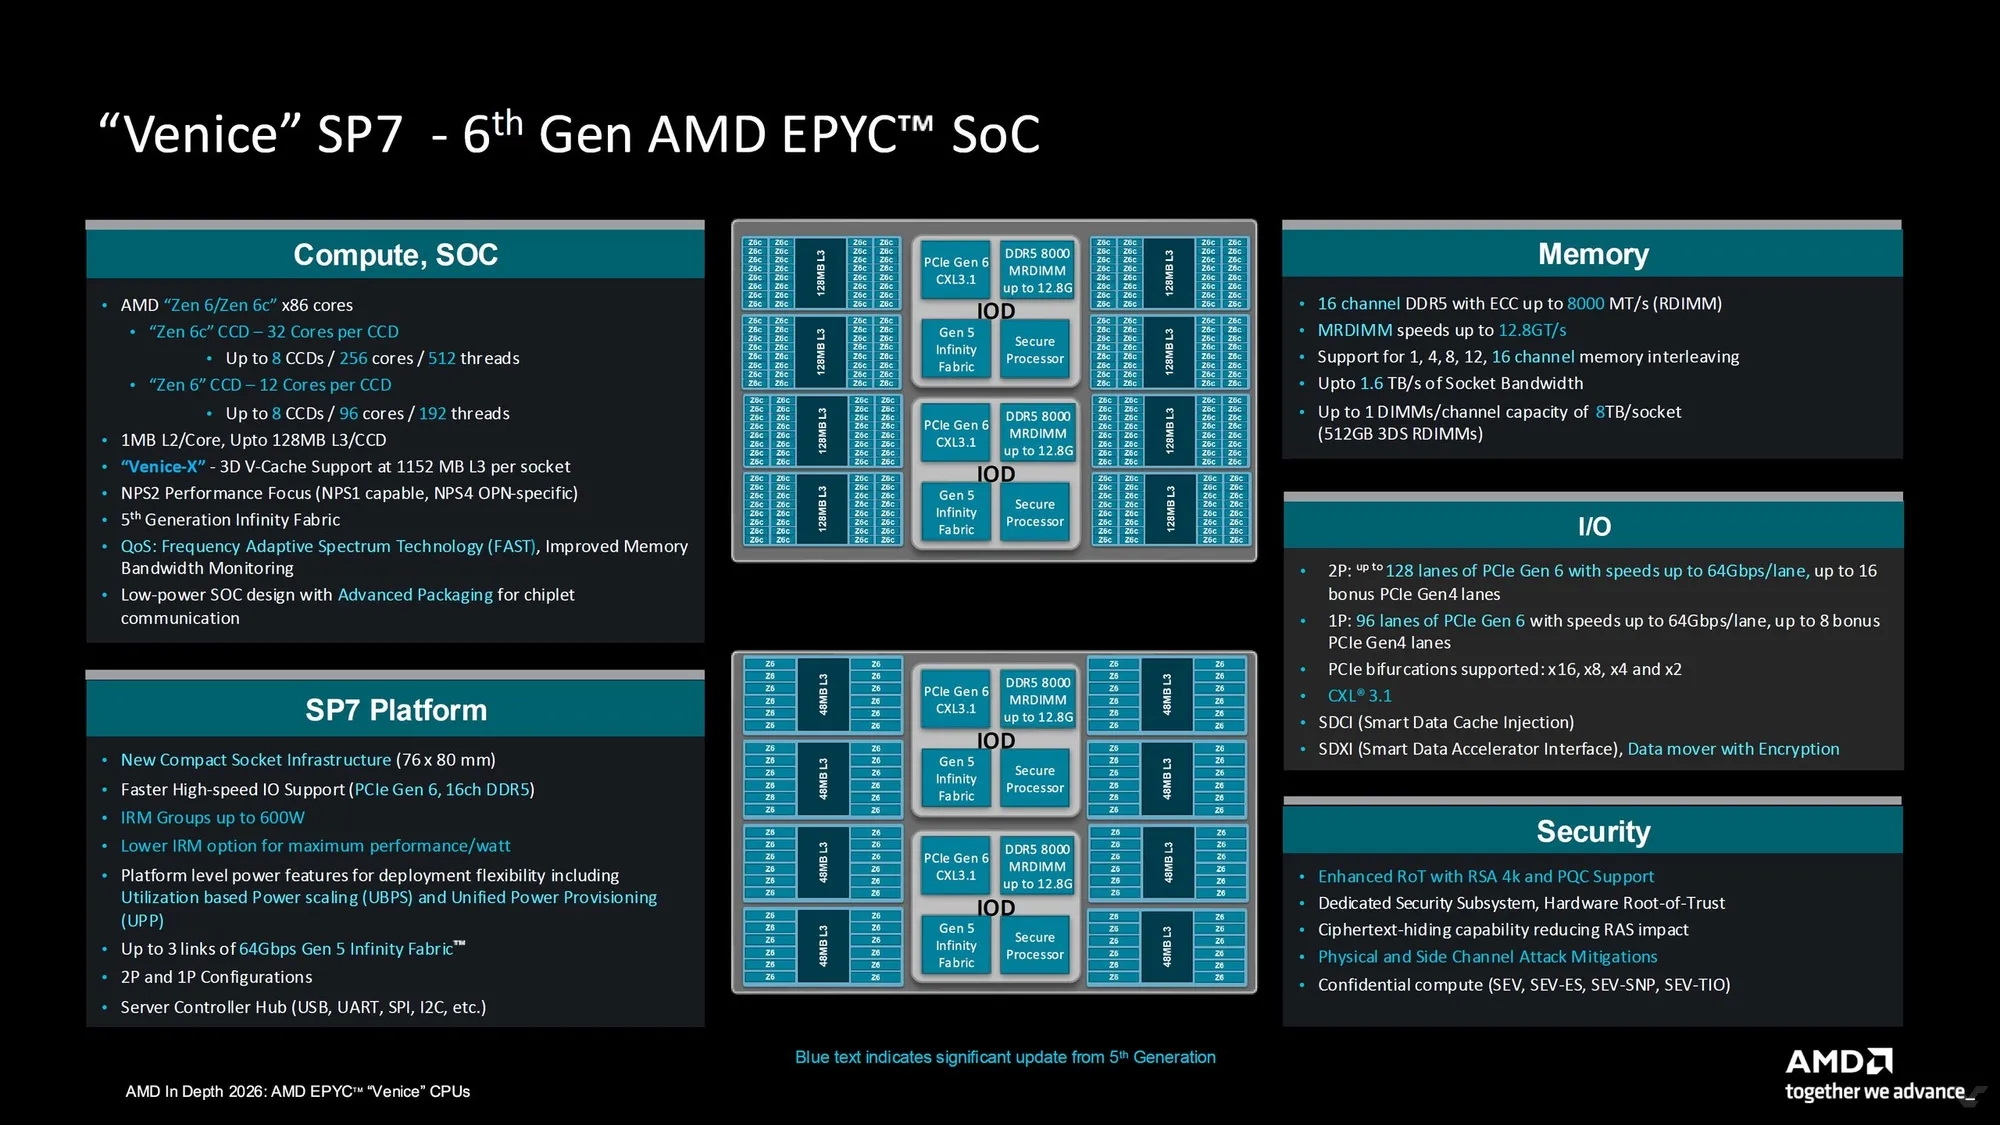 Серверные процессоры Zen 6 для разъёма SP7 характеризуются наличием двух кристаллов ввода-вывода (IOD) вместо одного, расположенных в центре чипа, что позволило реализовать поддержку 16-канальной оперативной памяти. Заявлена работа с модулями памяти MRDIMM в конфигурации 1DPC со скоростью передачи данных до 12 800 МТ/с (с модулями RDIMM поддерживается скорость до 8000 МТ/с), что обеспечивает пиковую пропускную способность до 1,6 Тбайт/с на один сокет (до 1 Тбайт/с при использовании RDIMM). Платформа поддерживает установку до 8 Тбайт памяти на один сокет. 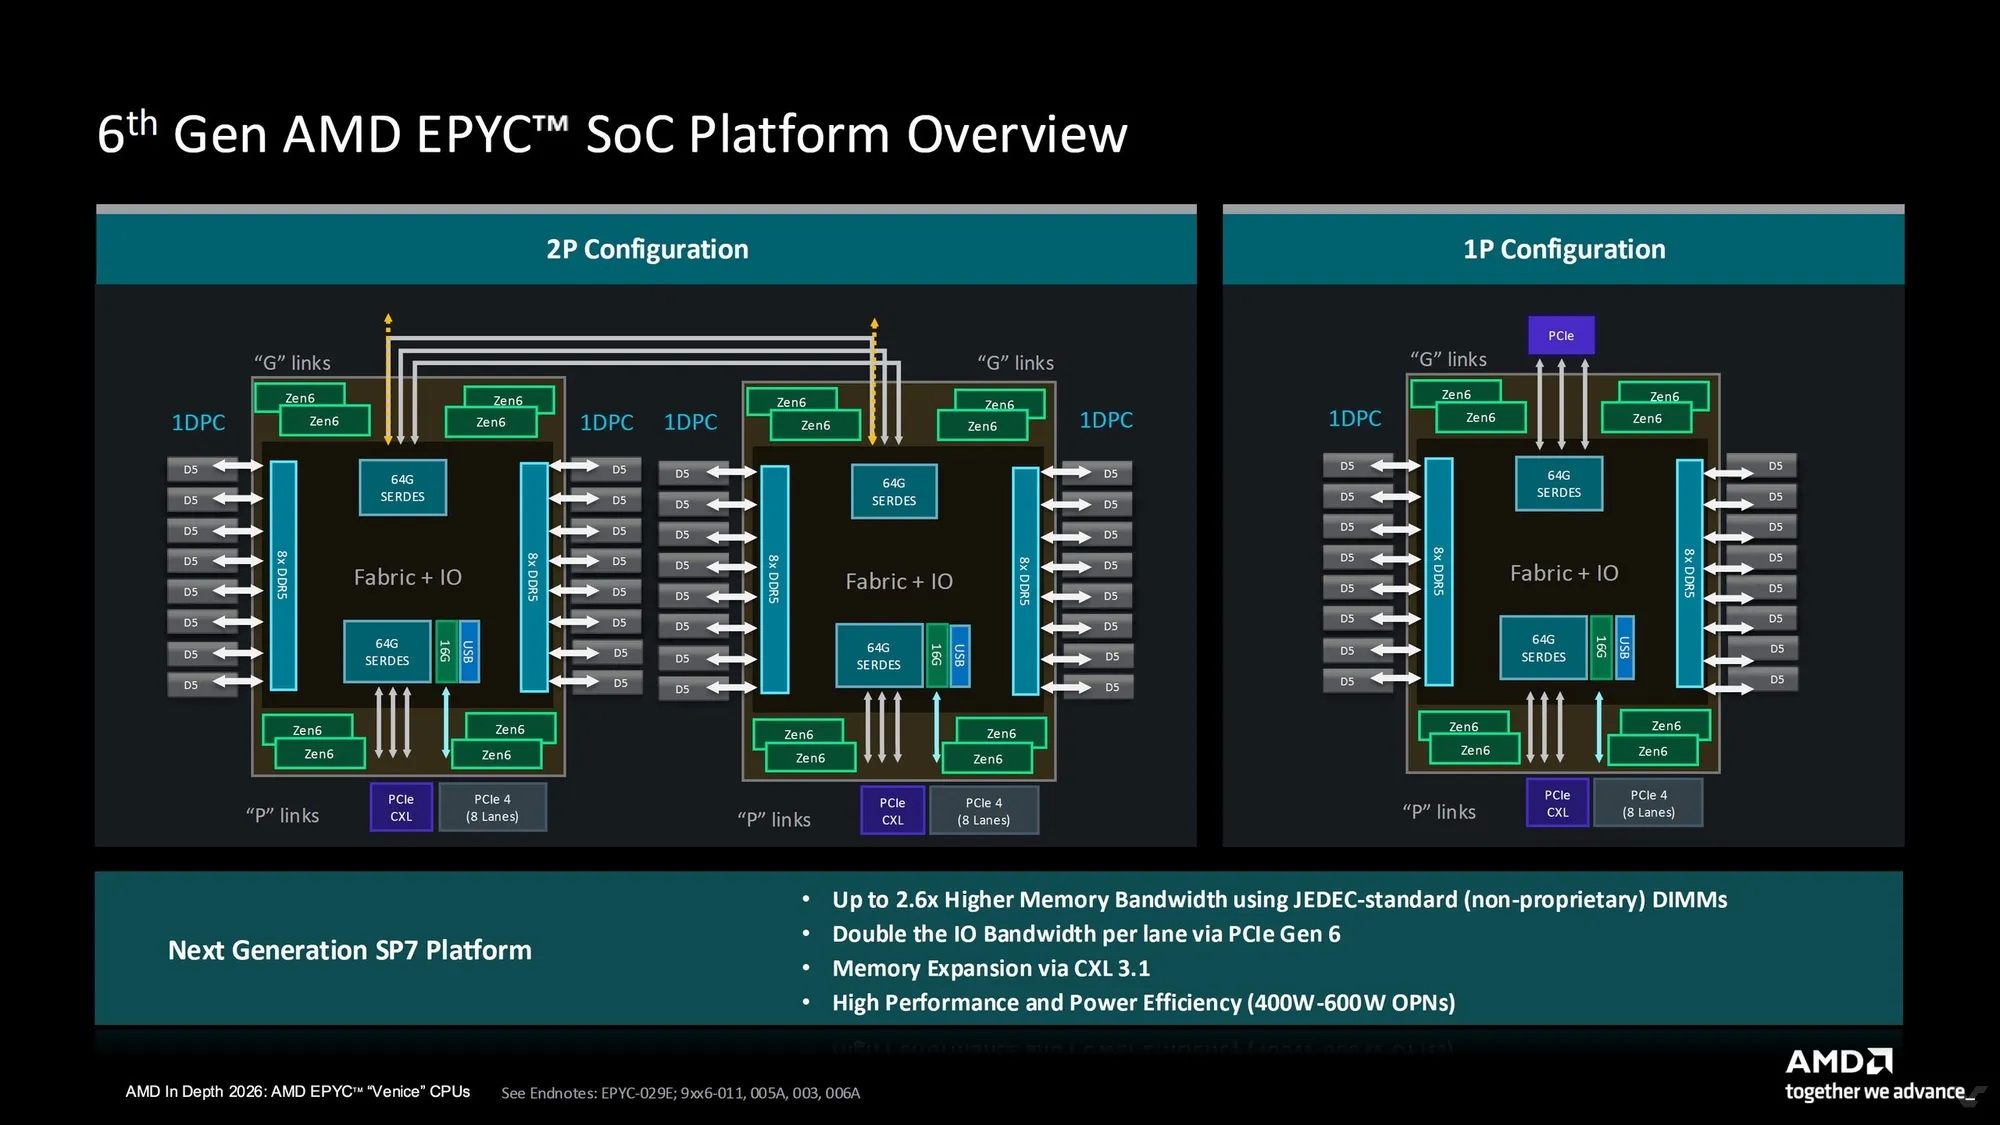 Для систем с SP7 также заявлена поддержка интерфейса PCIe 6.0 со скоростью до 64 Гбит/с на линию. Однопроцессорная (1P) конфигурация SP7 имеет доступ к 96 линиям PCIe 6.0, в то время как двухпроцессорная (2P) платформа предлагает до 128 линий. Каждая конфигурация также поставляется с «бонусными» линиями PCIe 4.0 — либо 8 для 1P-конфигураций, либо 16 для 2P. Для систем с разъёмом SP8 количество каналов памяти уменьшено в пользу линий PCIe. Разъём SP8 имеет меньшие габариты — 62,5 × 80 мм, а сама платформа поддерживает восемь каналов памяти вместо 16 (при этом сохраняется поддержка модулей MRDIMM со скоростью передачи данных до 12 800 МТ/с). Пропускная способность памяти при использовании модулей MRDIMM на максимальной поддерживаемой скорости составляет 819 Гбайт/с, а при использовании модулей RDIMM — 512 Гбайт/с. Чипы SP8 имеют доступ к 64 линиям PCIe 6.0 на один IOD (всего 128 линий в сокете плюс 8 линий PCIe 4.0), а в двухпроцессорных (2P) конфигурациях SP8 доступно до 192 линий PCIe 6.0 и 16 дополнительных линий PCIe 4.0. Обе платформы поддерживают стандарт CXL 3.1. 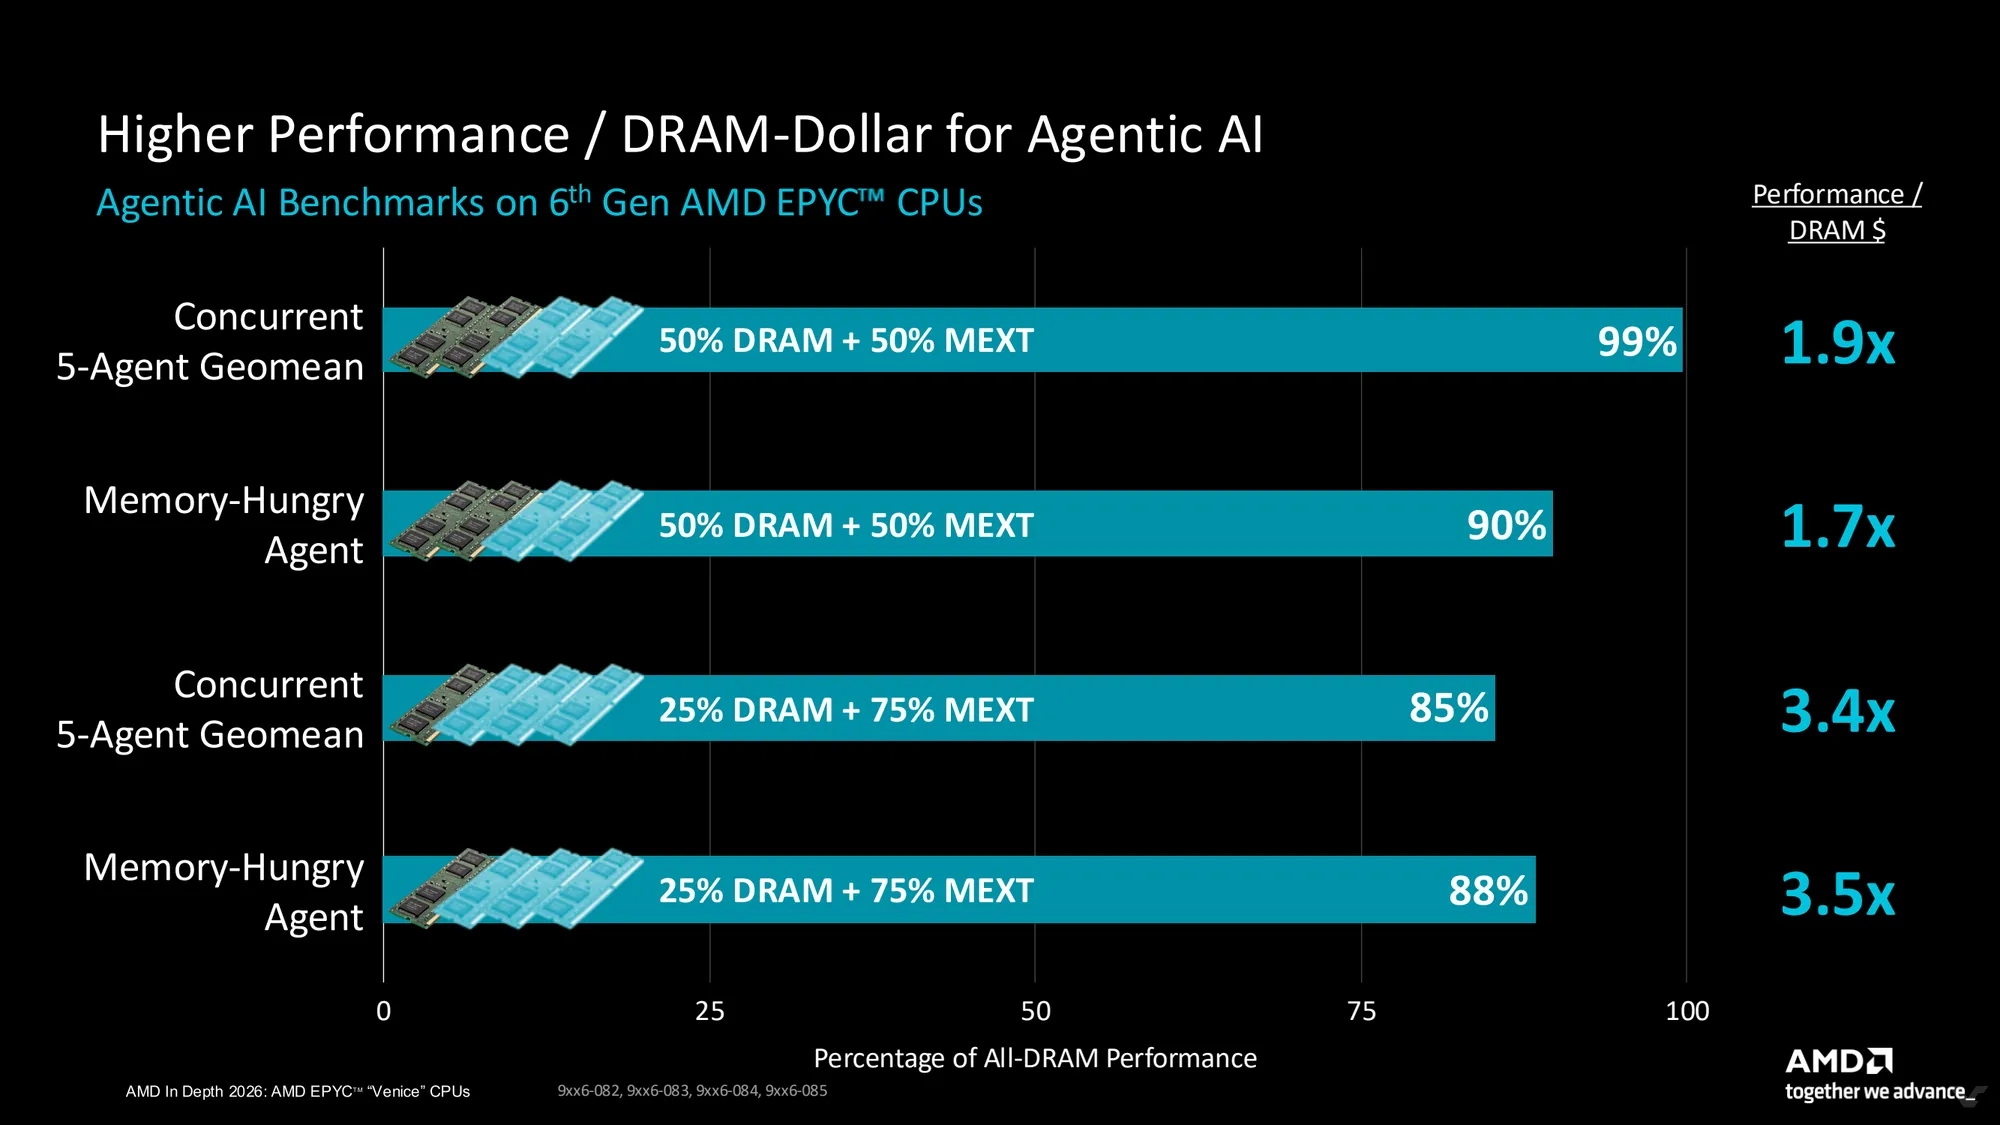 EPYC Venice также станет первой платформой с поддержкой программно-аппаратной технологии MEXT, которая использует быструю флэш-память в качестве расширения DRAM. С помощью алгоритмов ИИ система предсказывает обращения к памяти и выгружает неиспользуемые страницы. По заявлениям AMD, в критических задачах проектирования электроники (EDA) это позволяет сохранять 95 % исходной производительности сервера при физическом сокращении объема дорогостоящей DRAM на 50 %. Даже при сокращении доступного объёма памяти до 25 %, производительность приложения, как заявляет AMD, сохраняется на уровне 80 %. С дополнительными особенностями архитектур и внутренними бенчмарками от AMD можно ознакомиться в галерее ниже. AMD Zen 6
Смотреть все изображения (19)
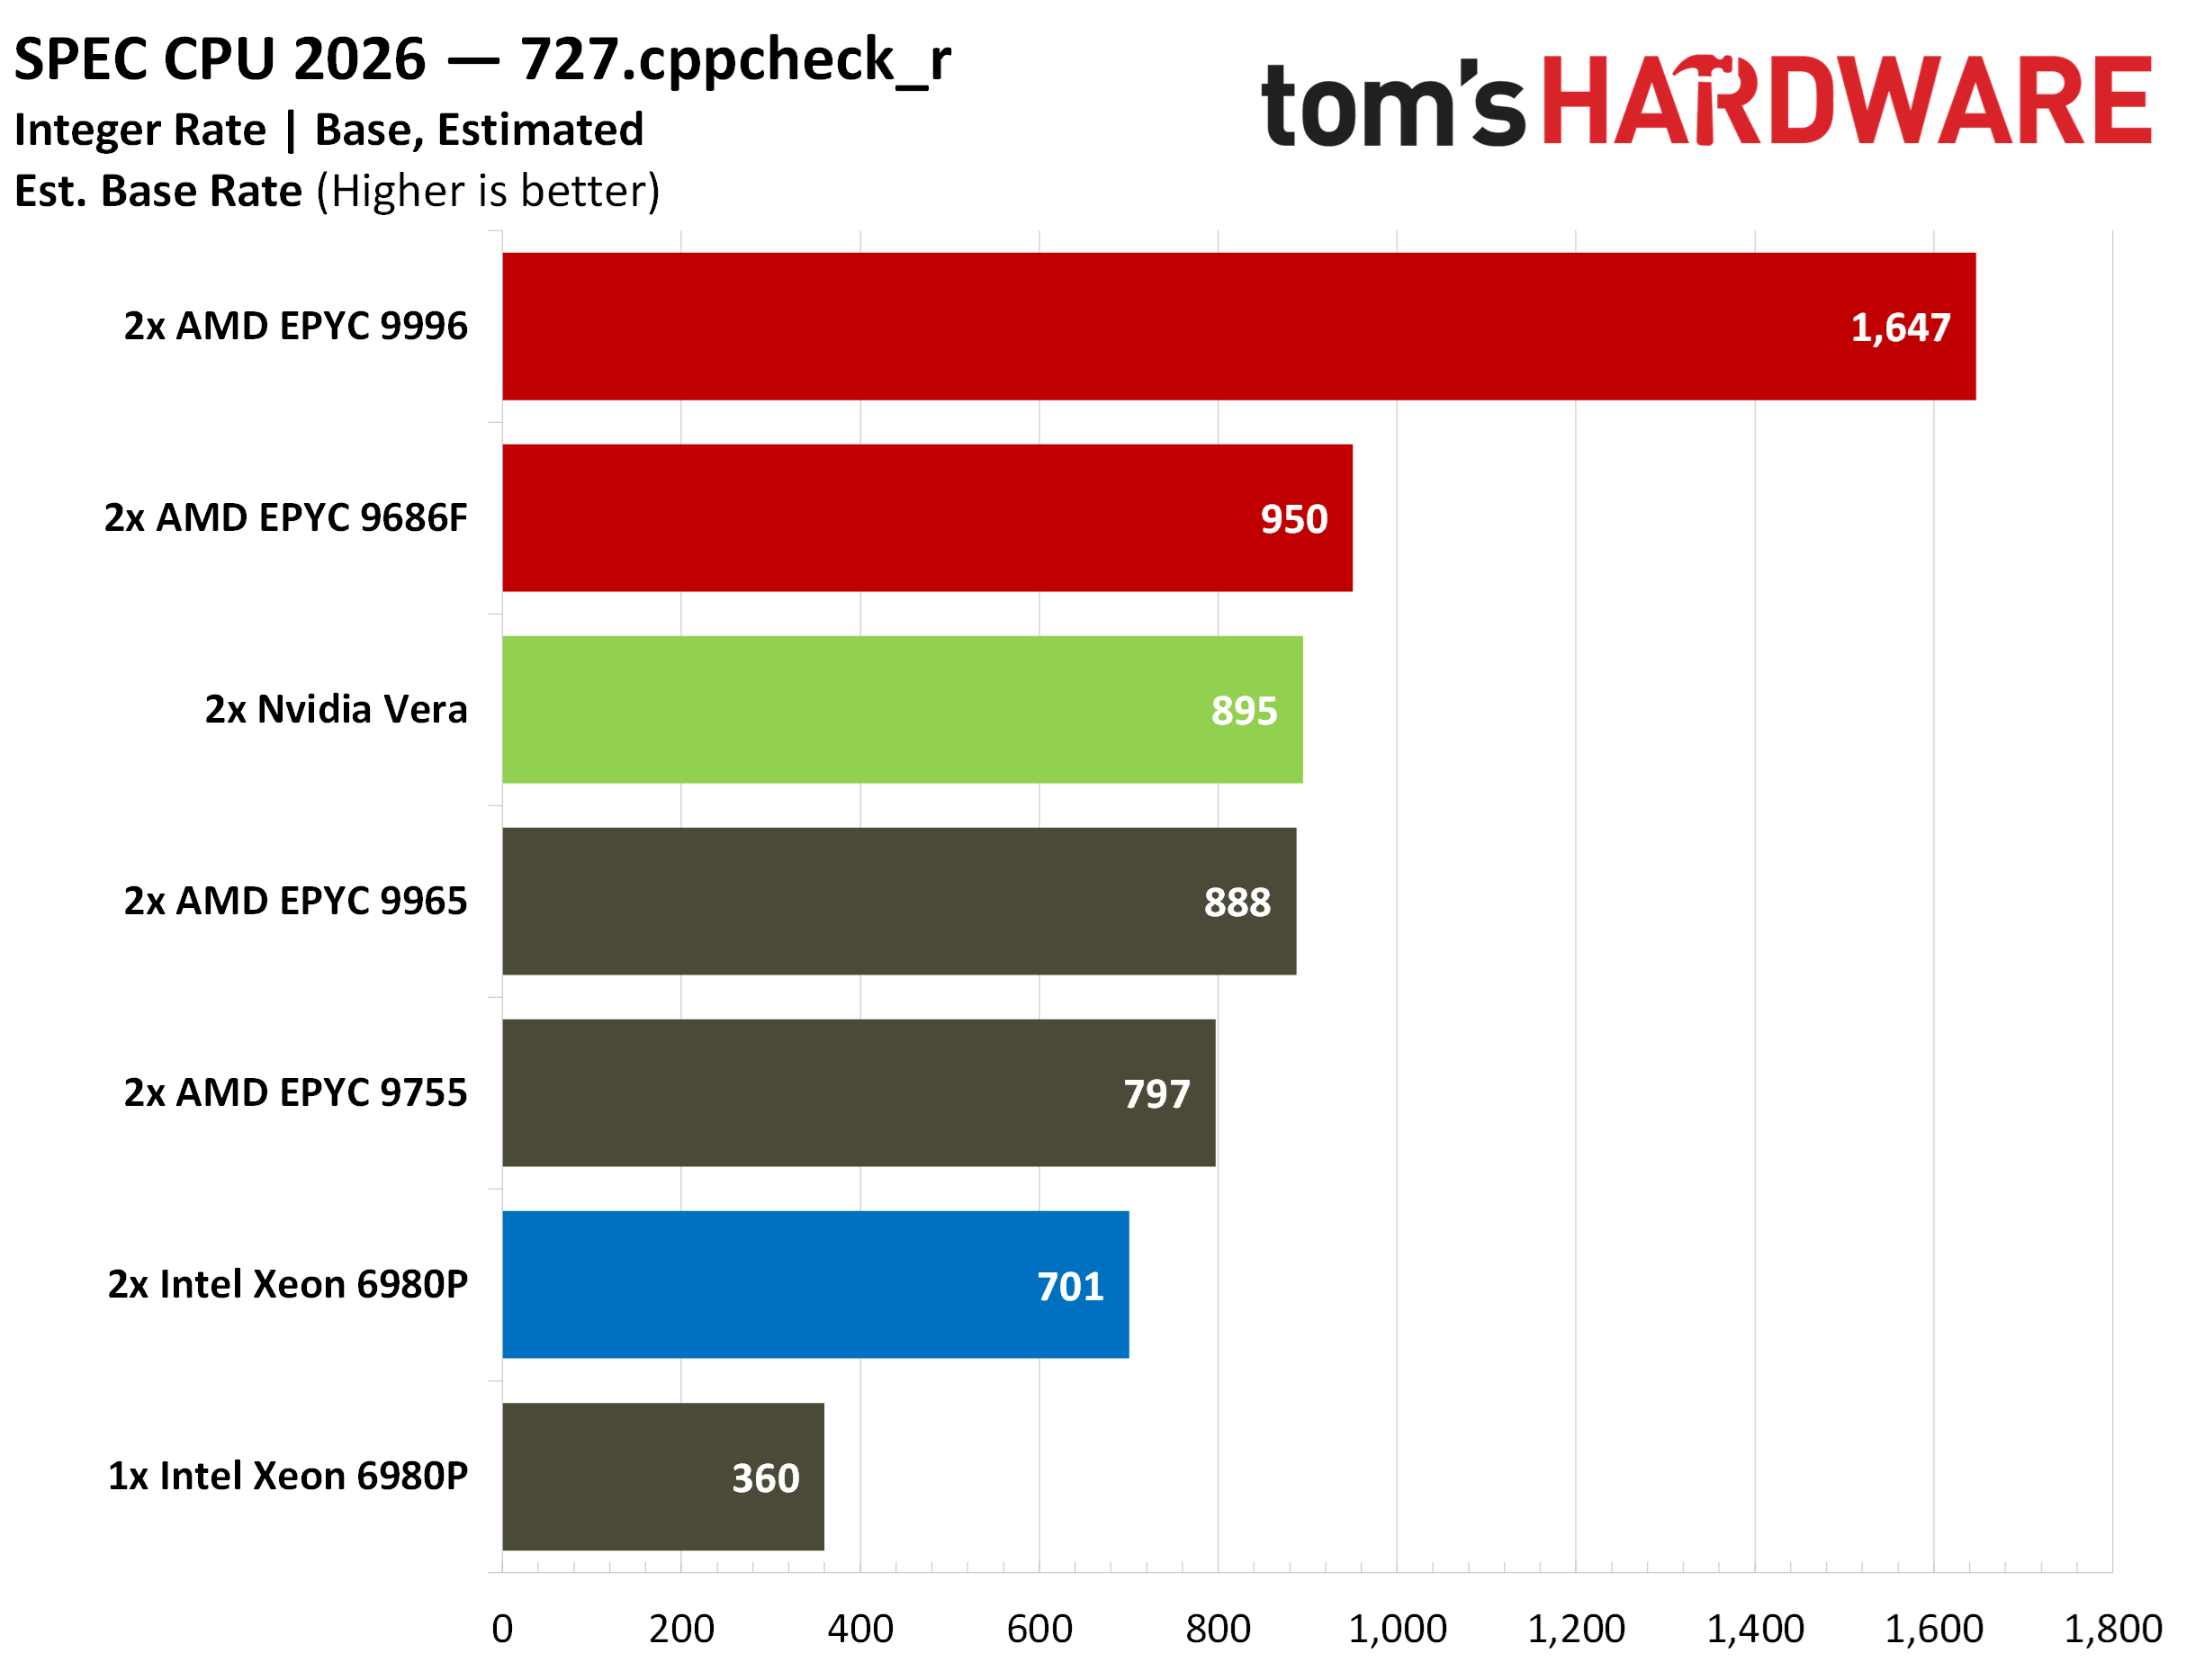
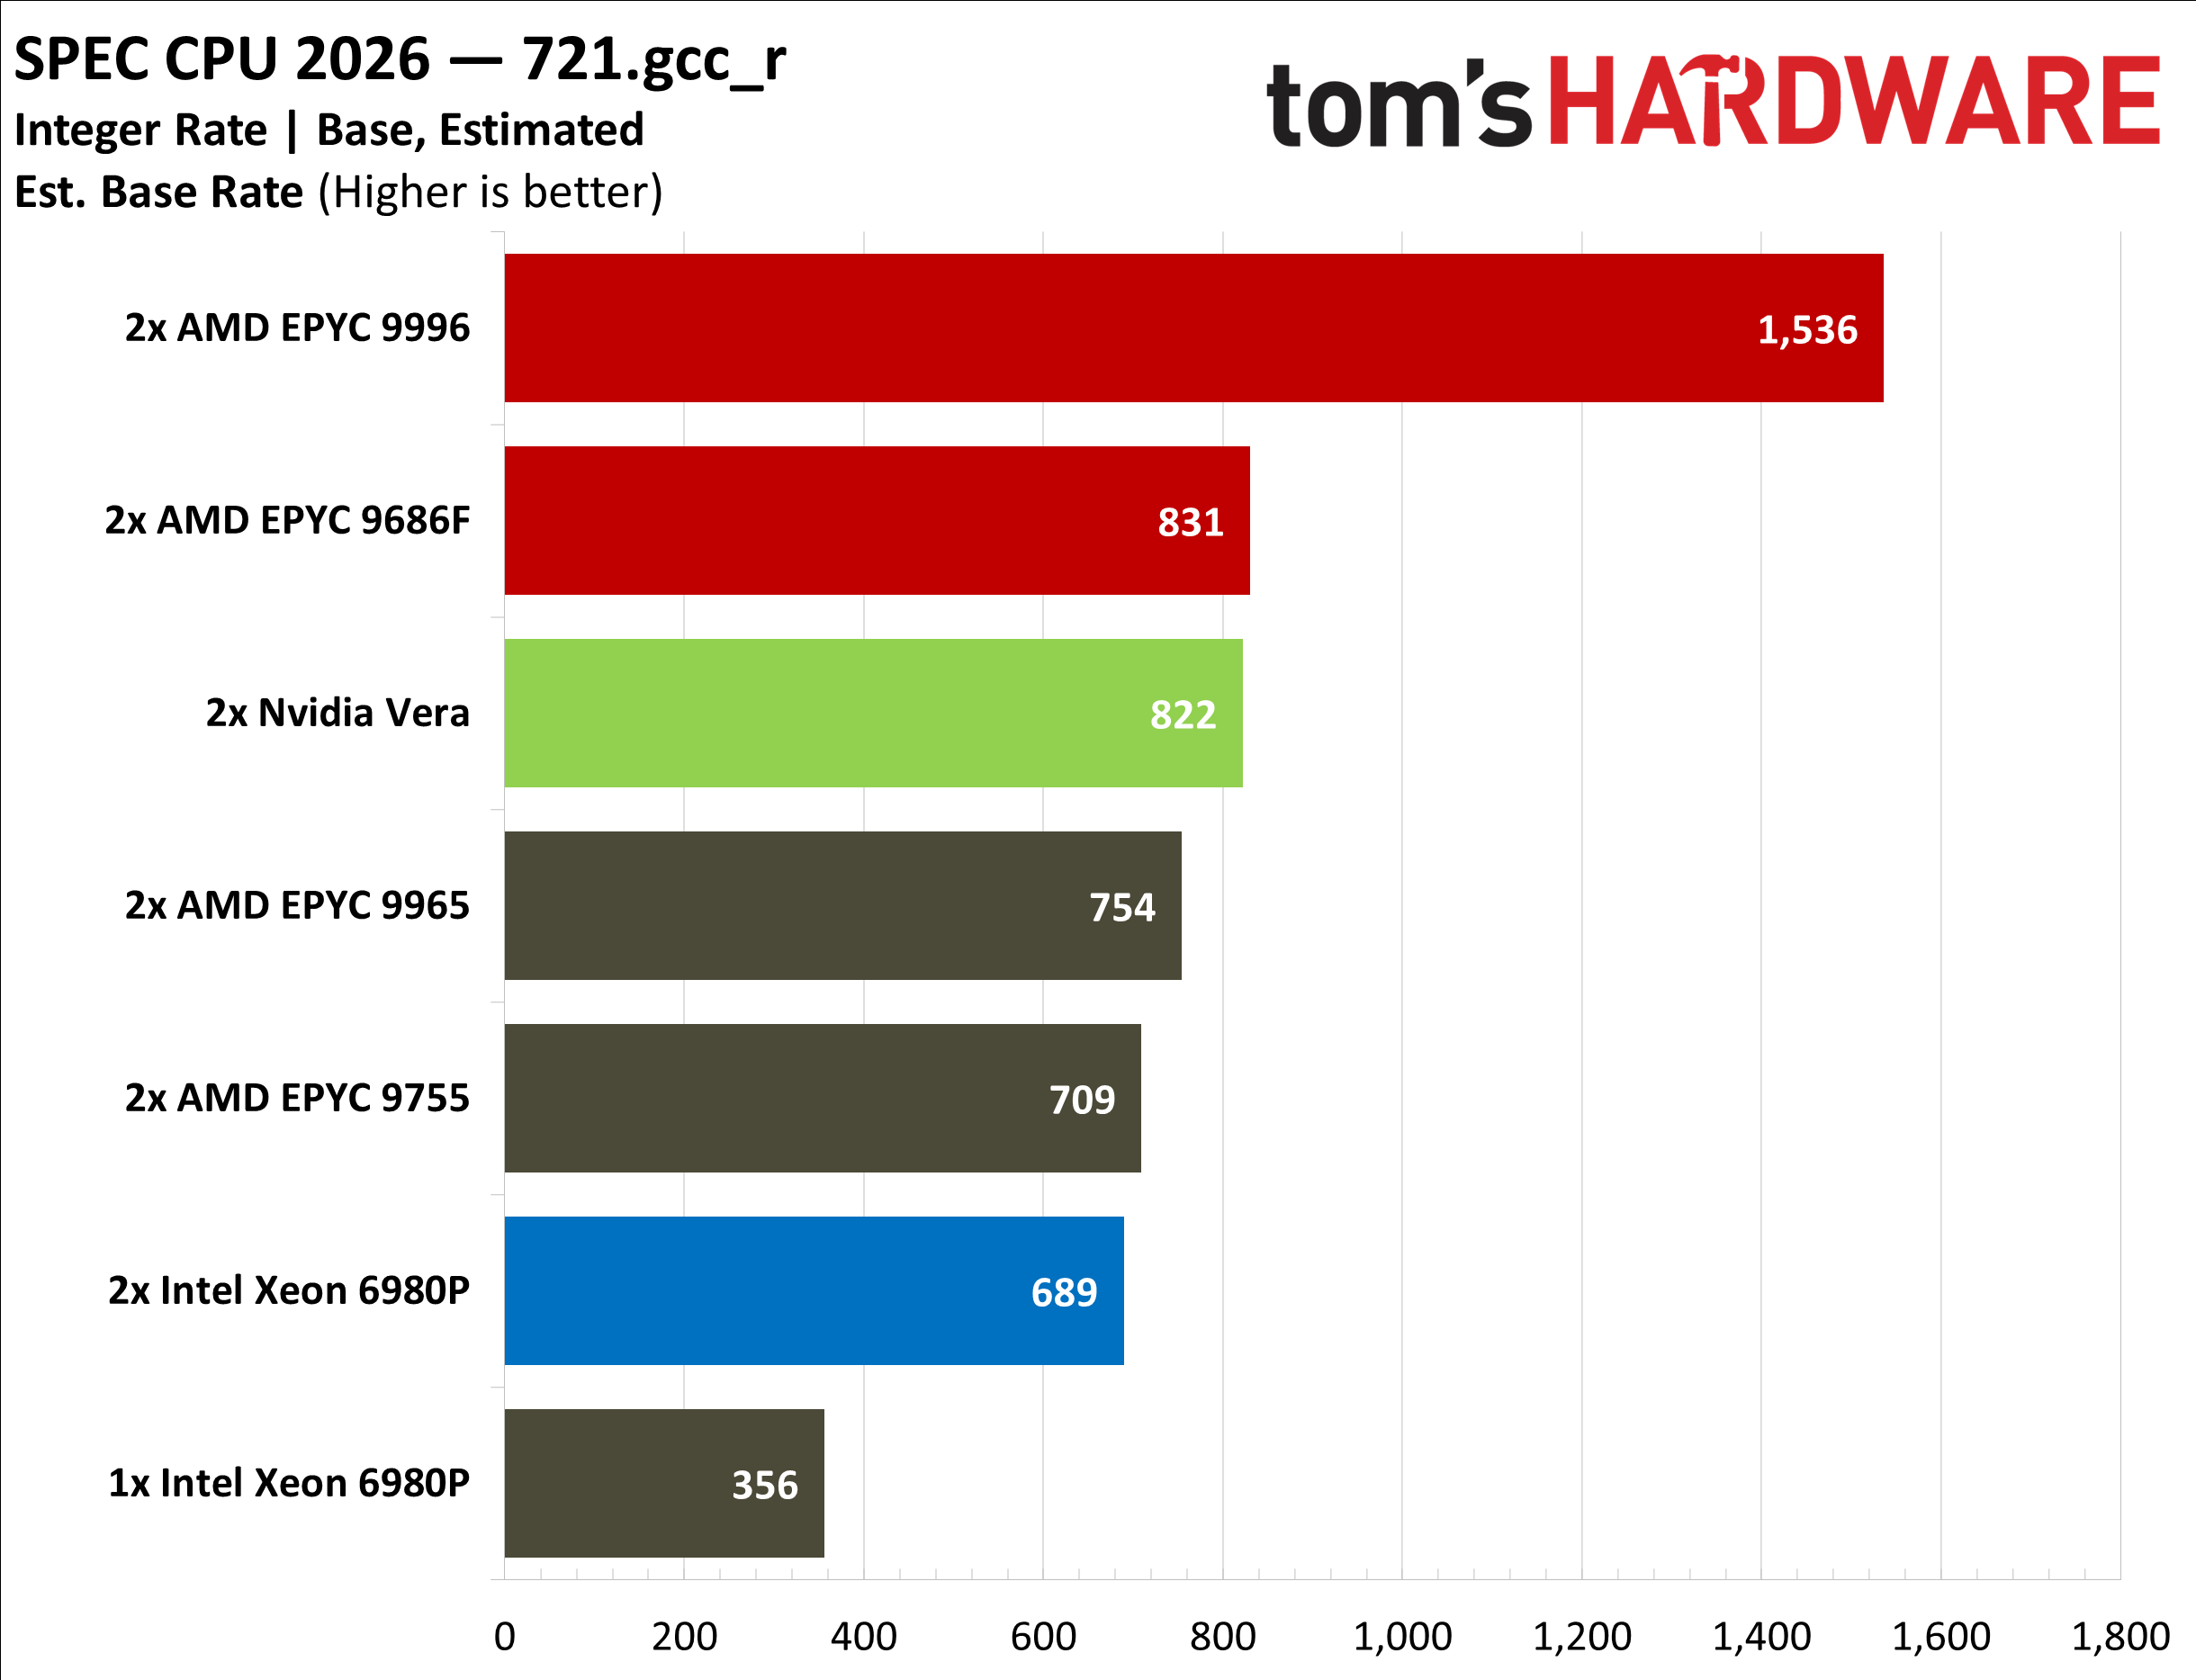
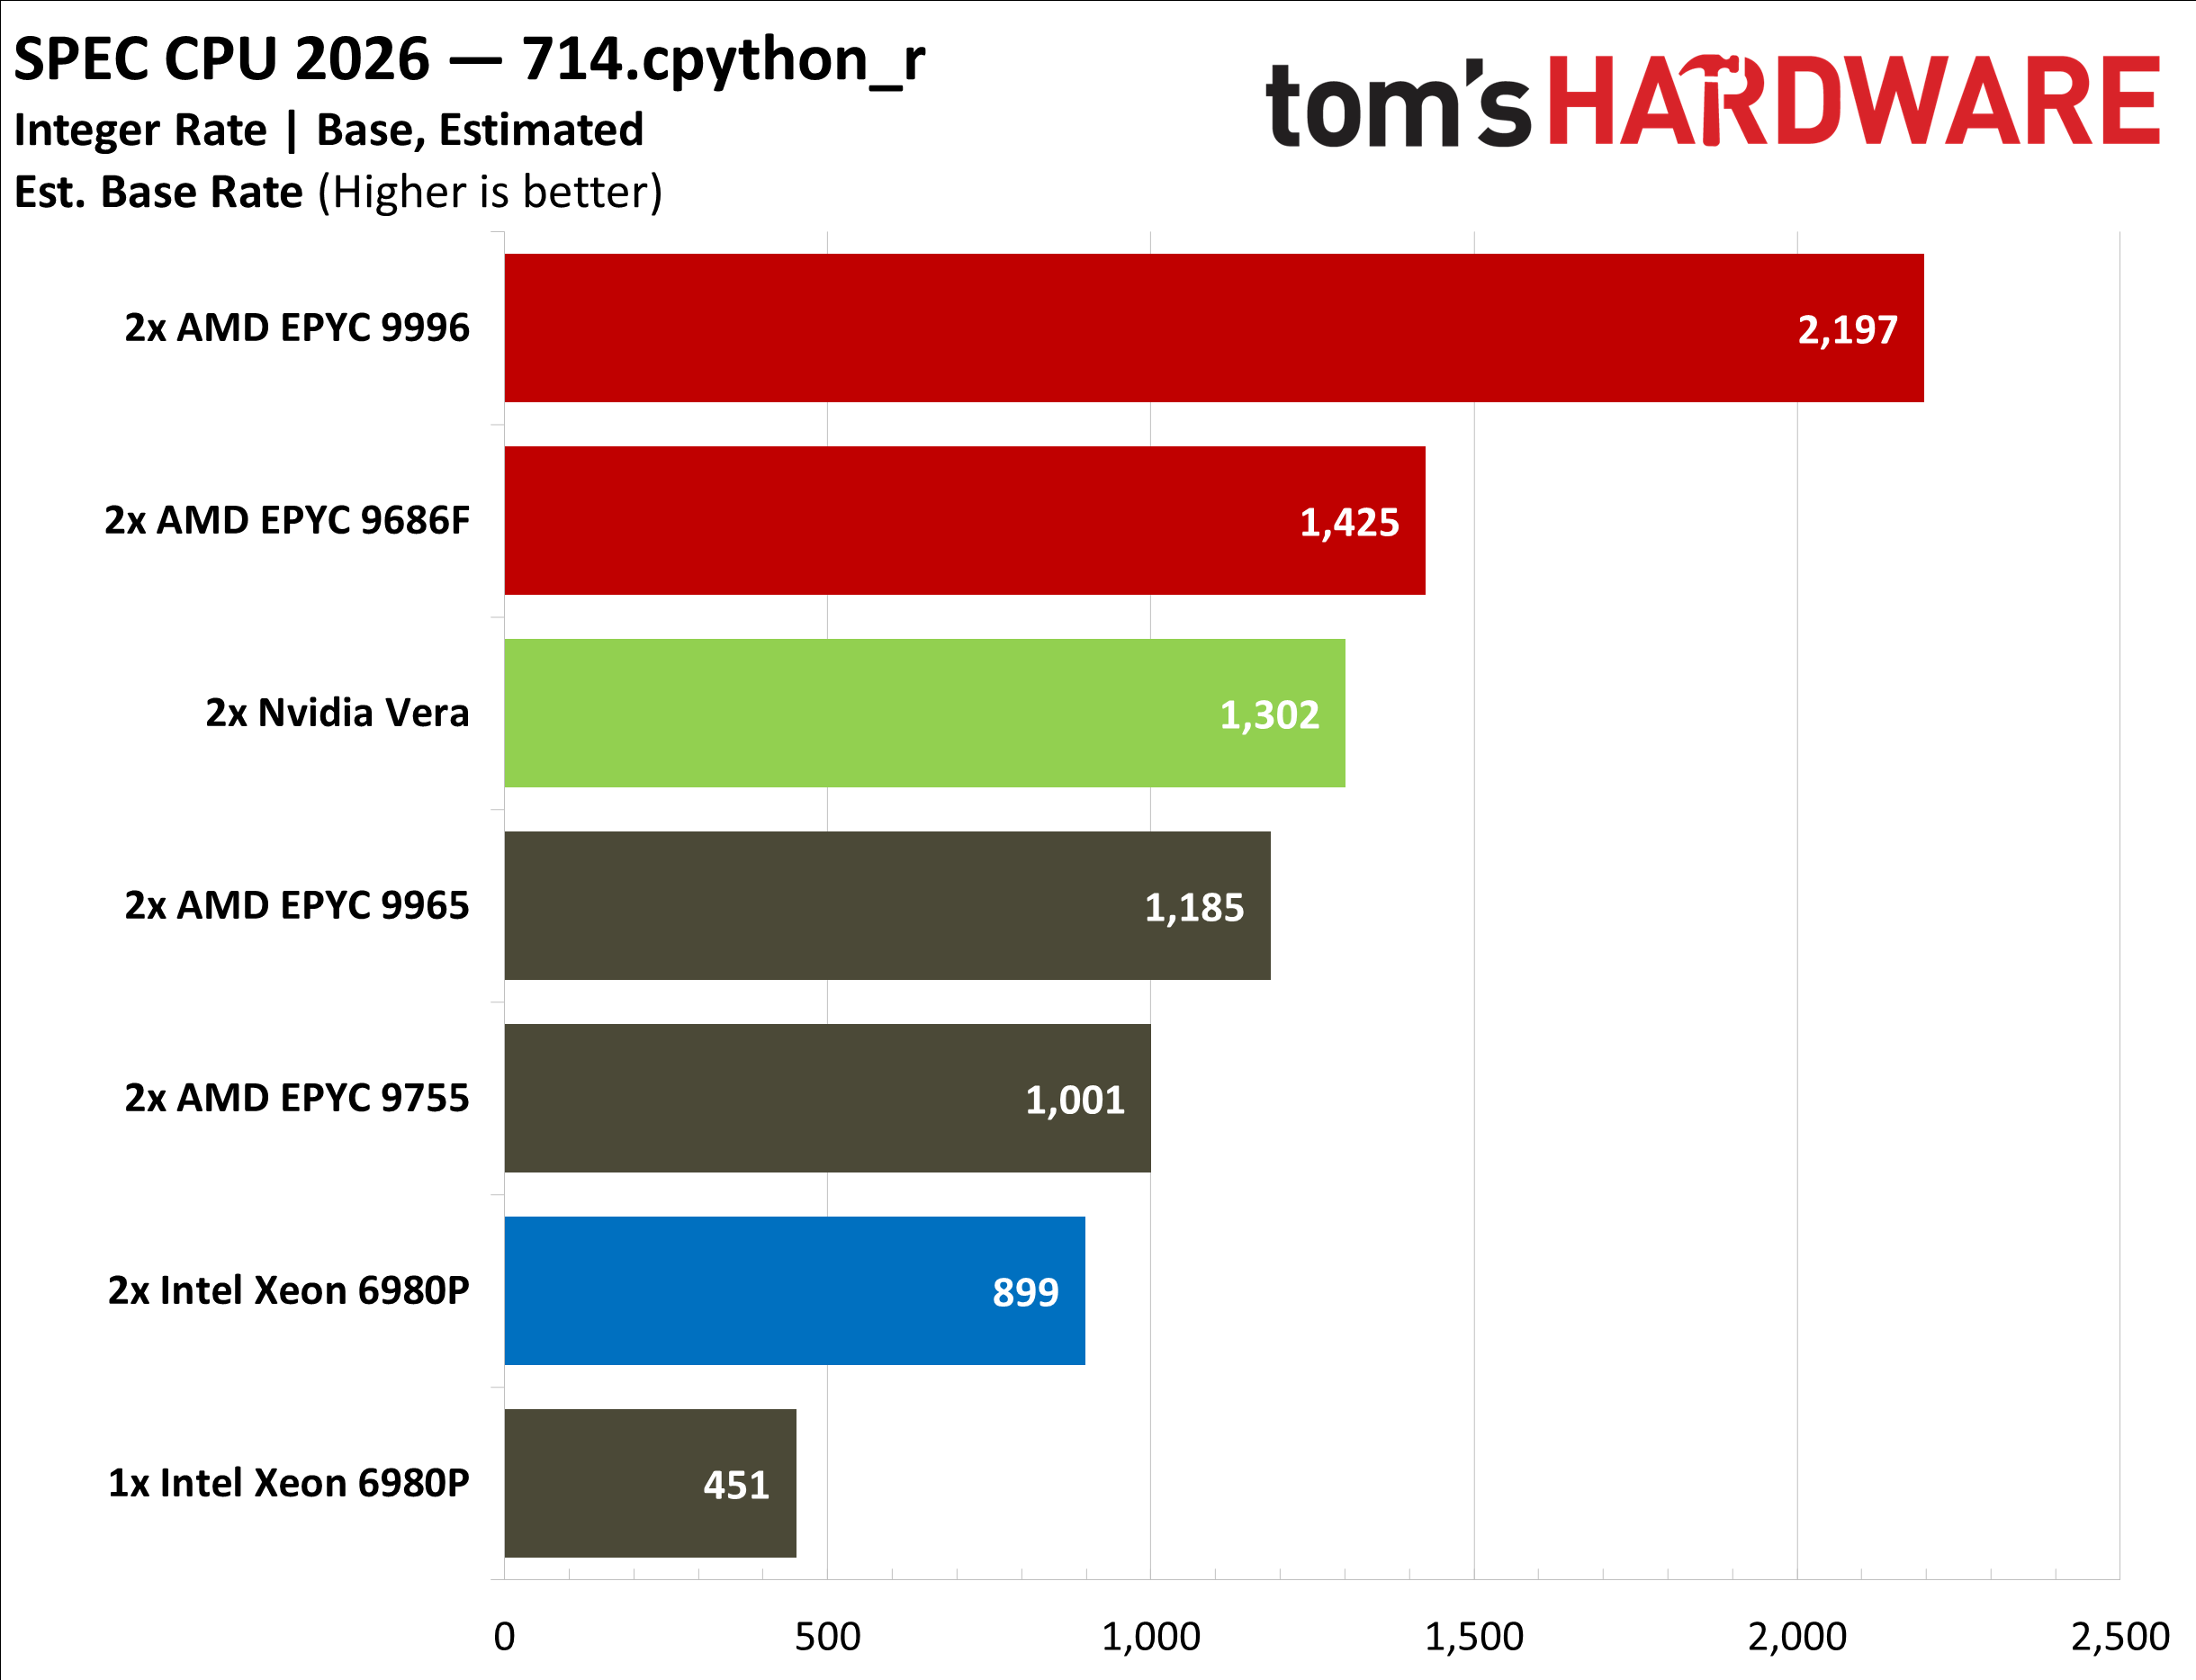
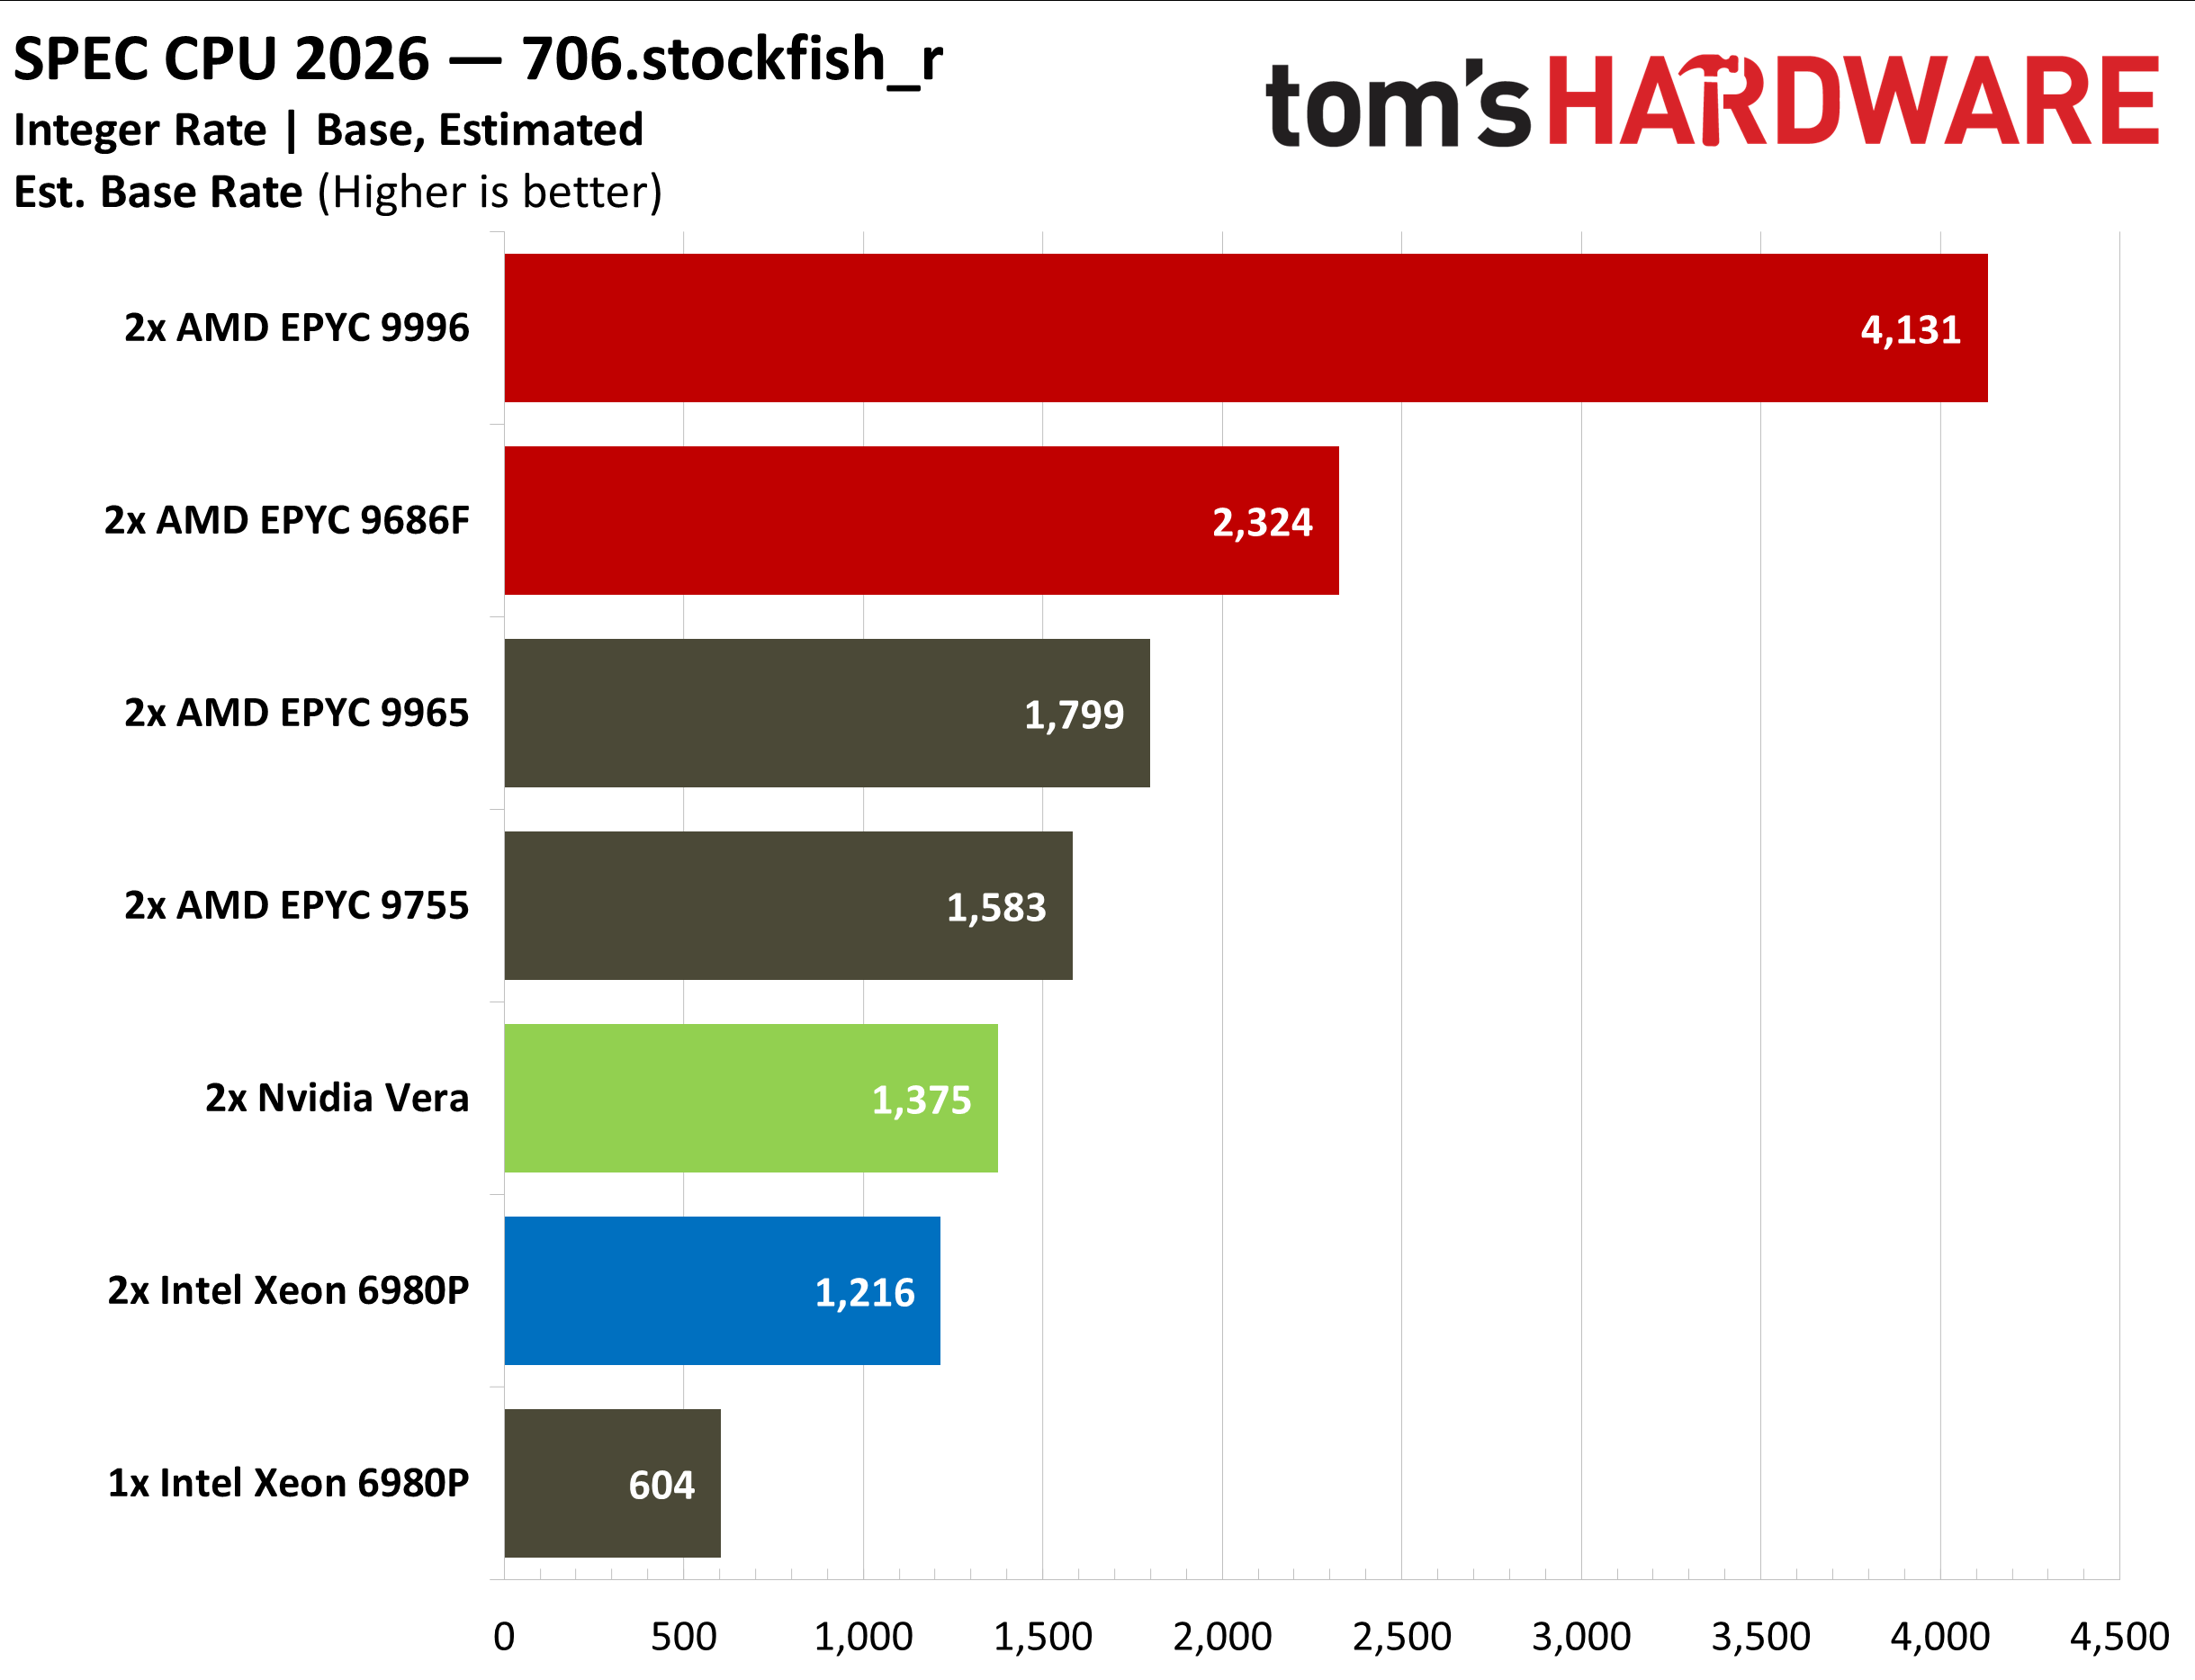
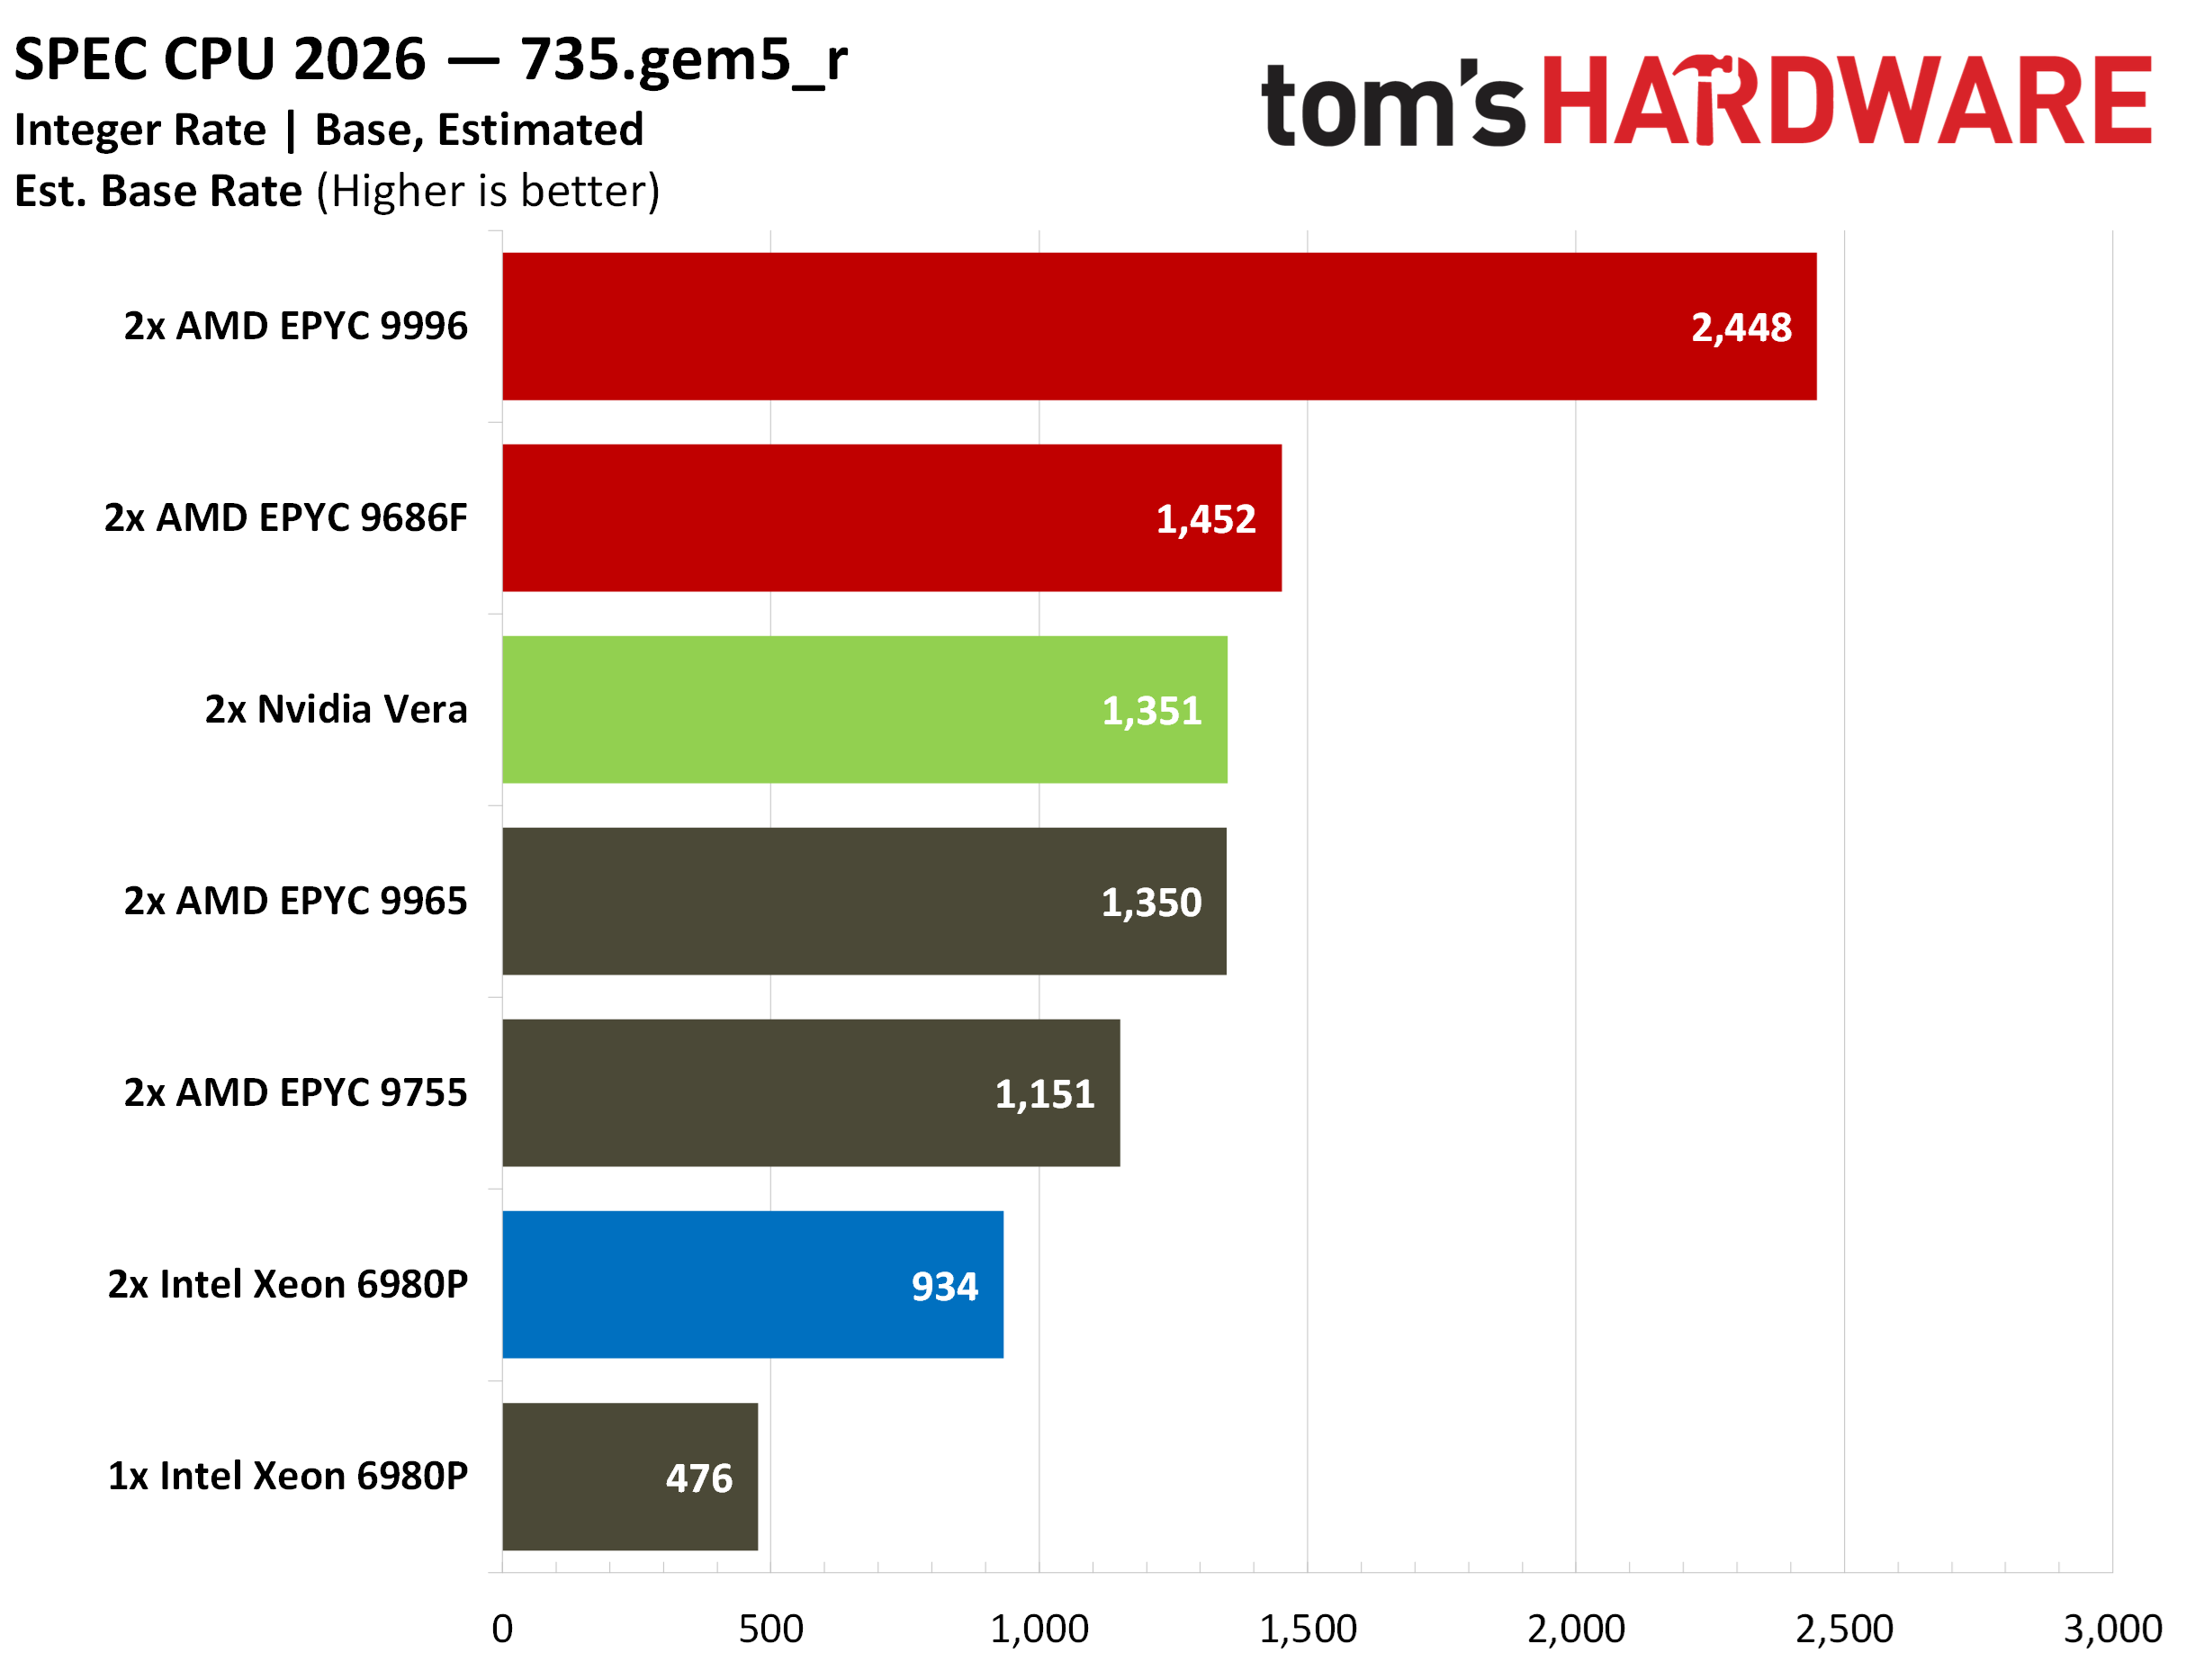
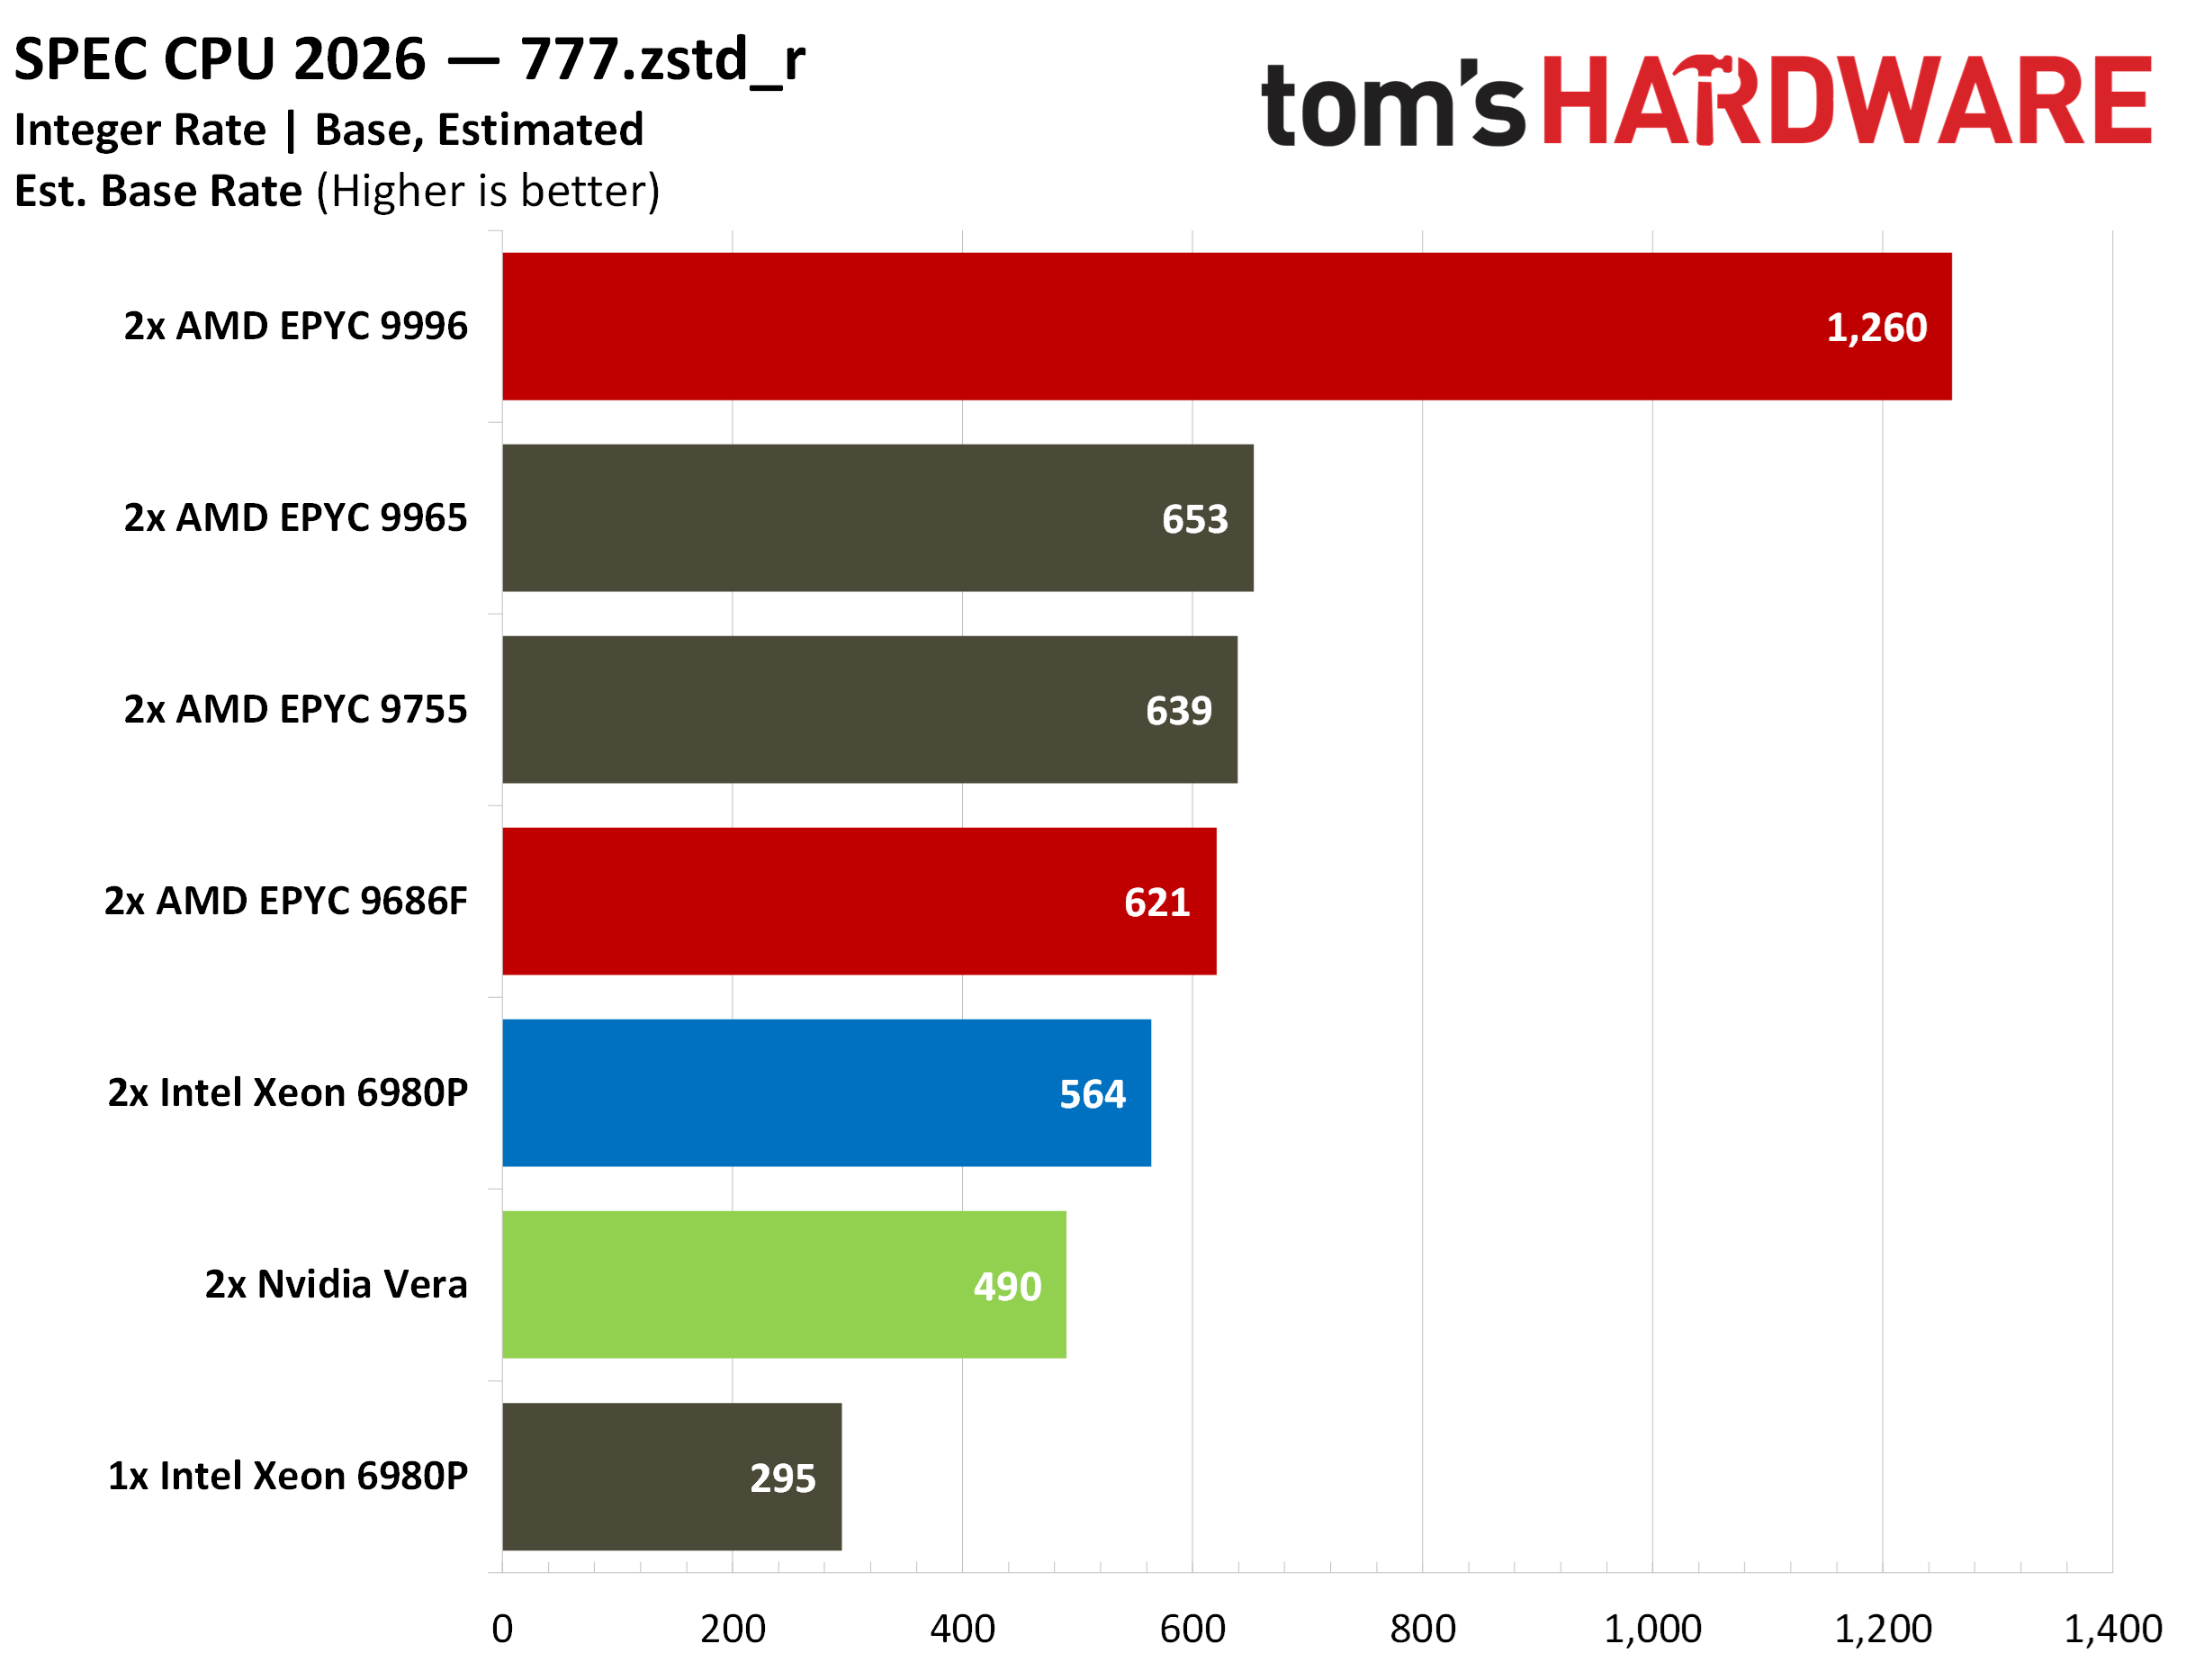
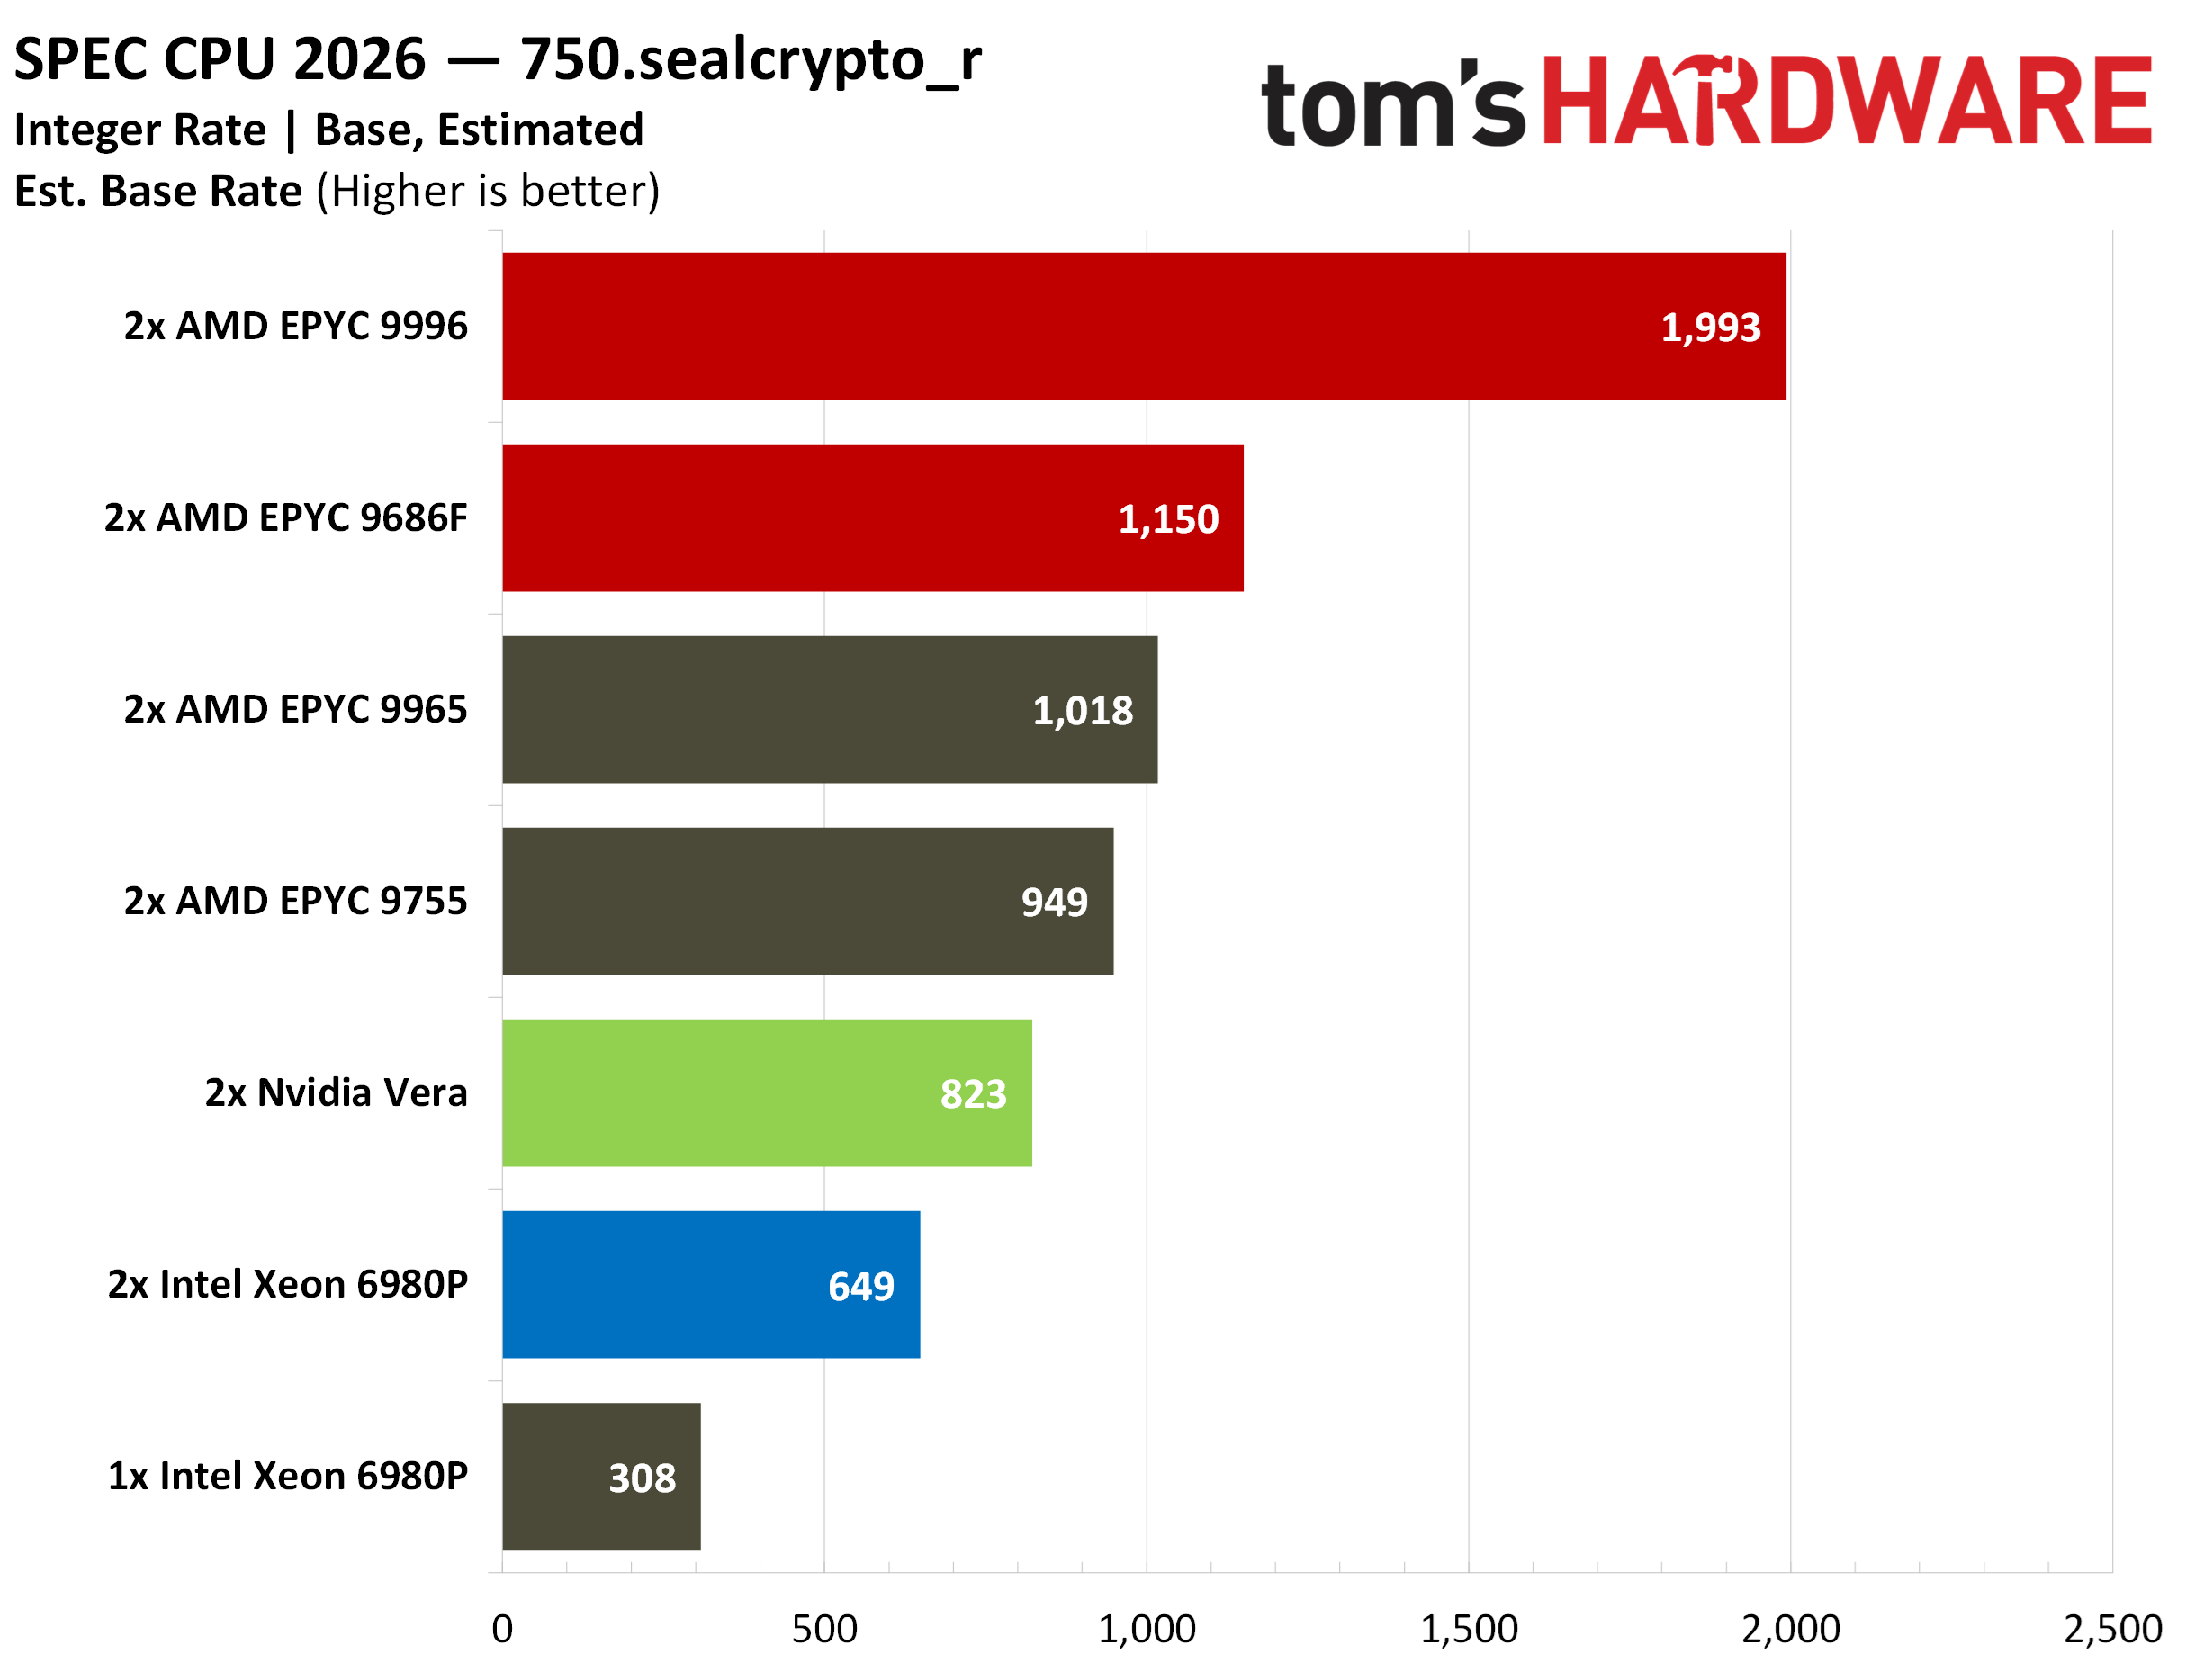
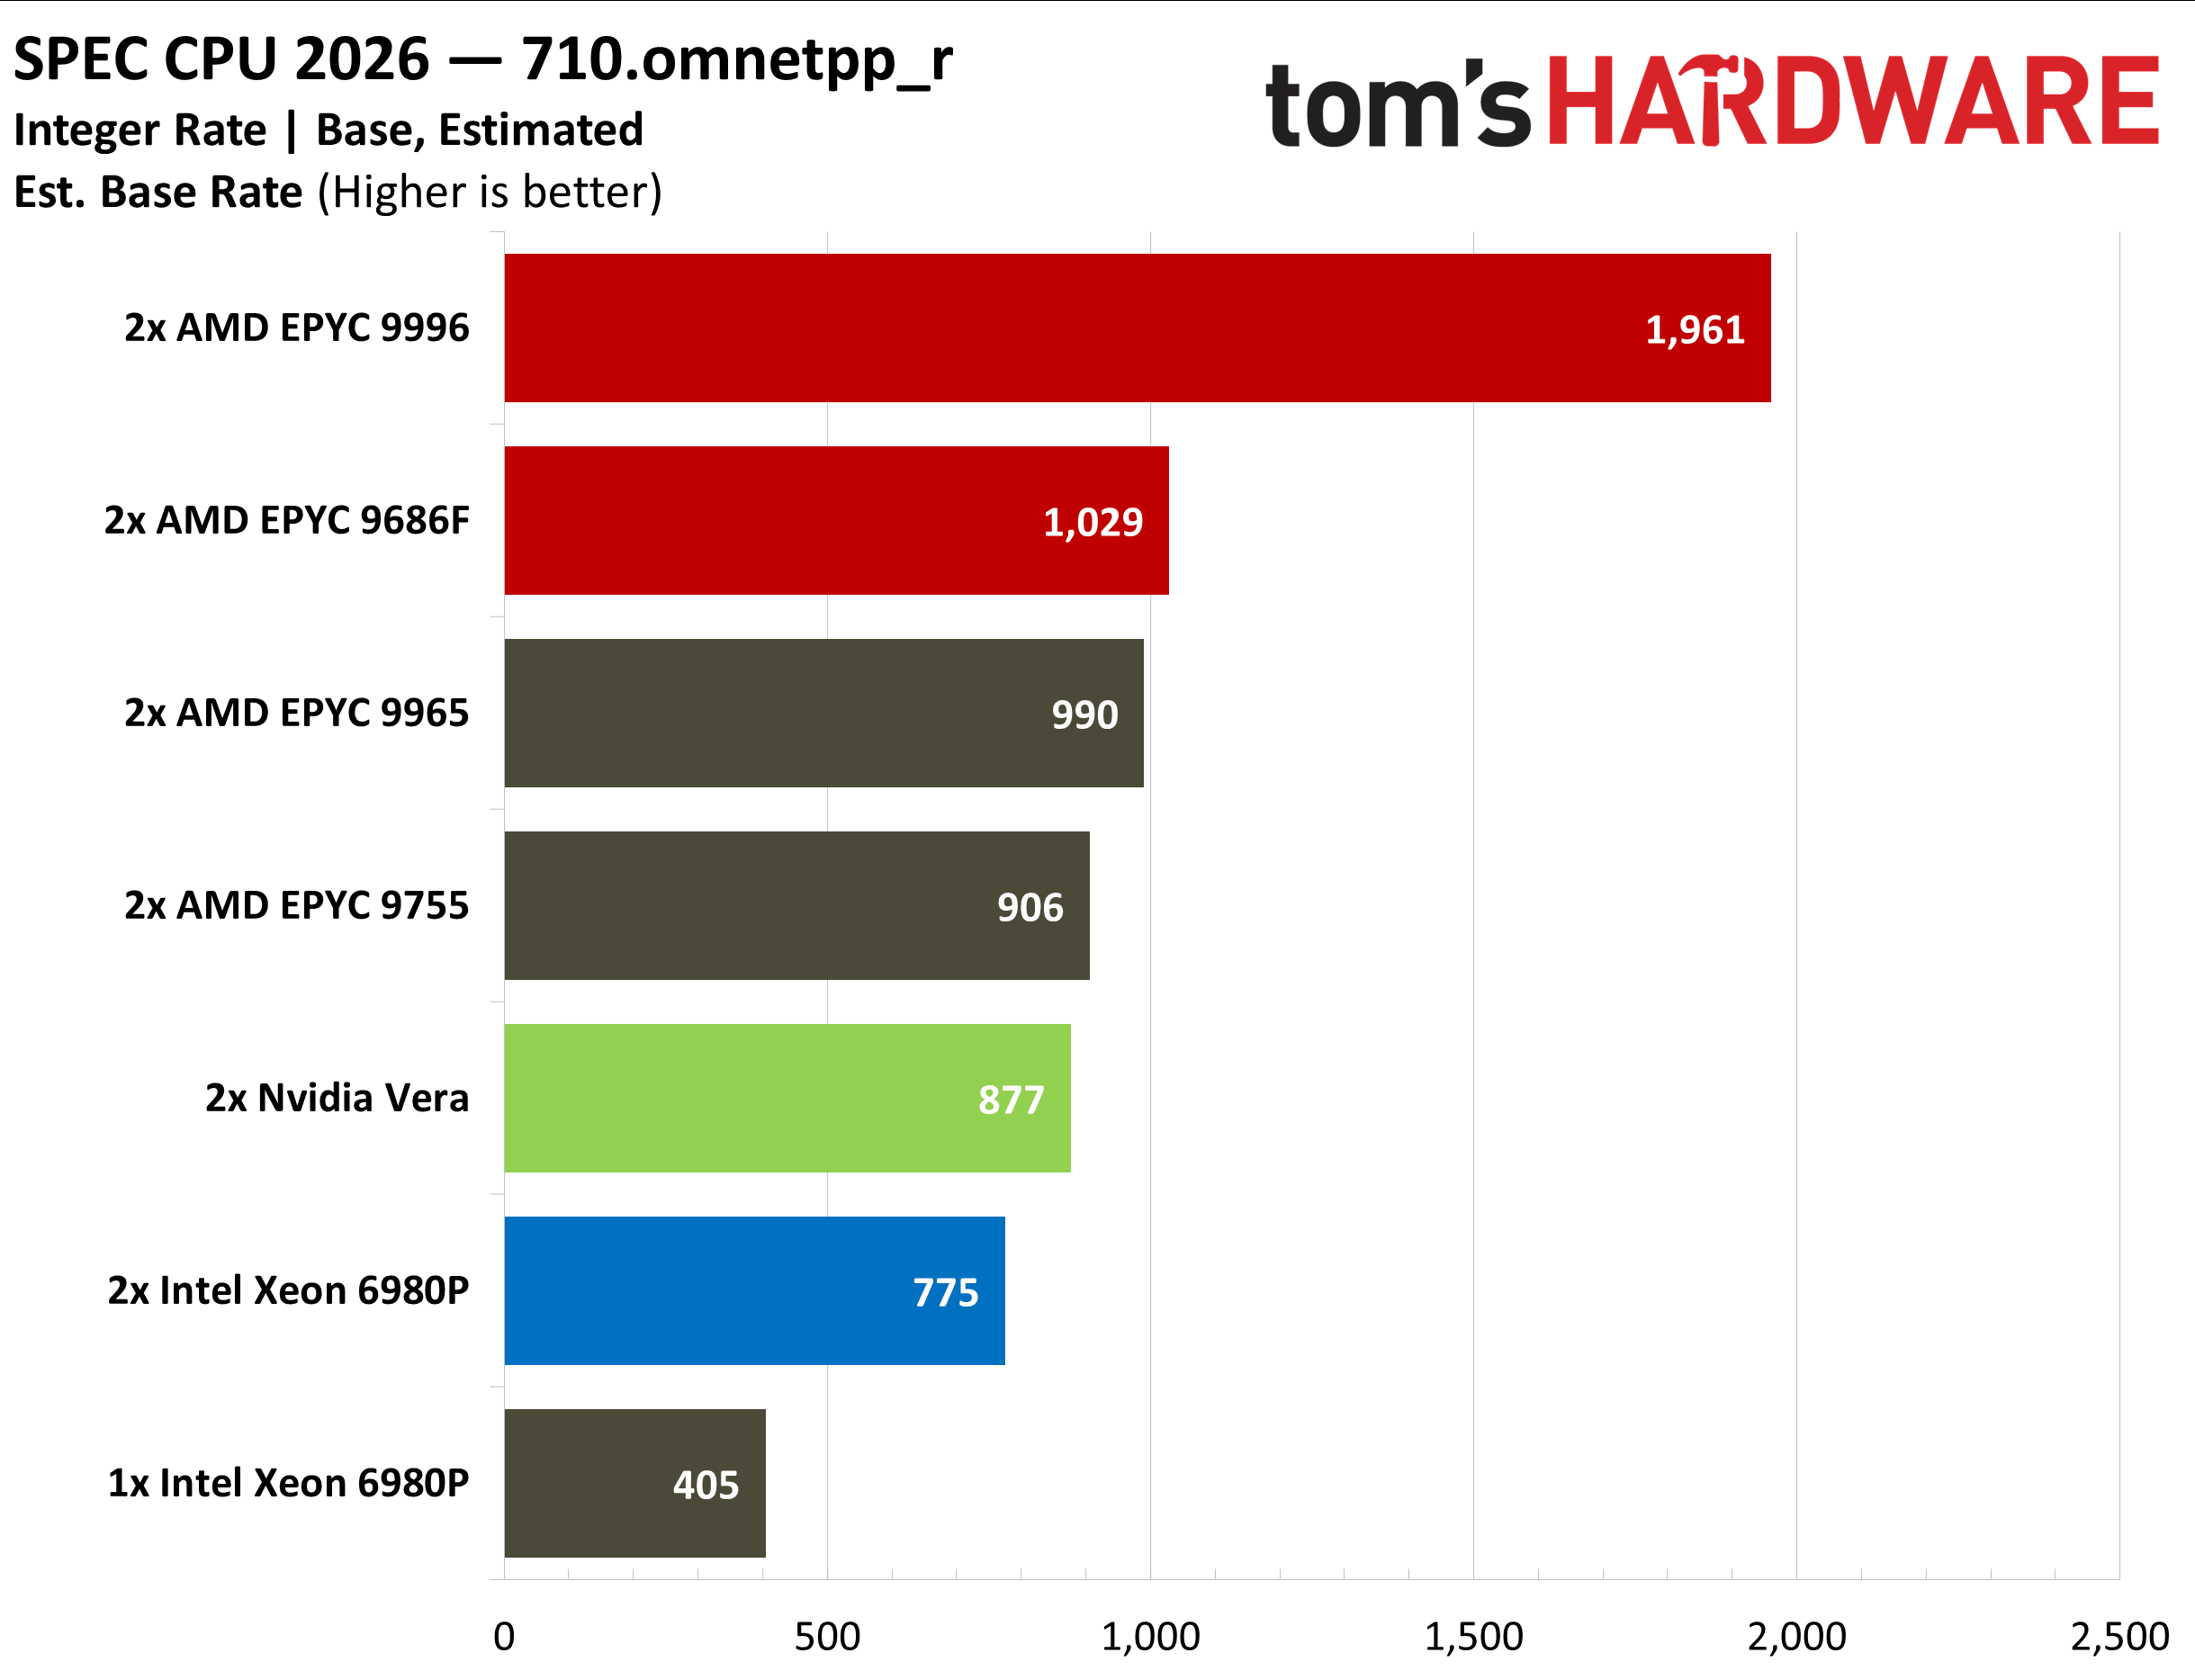
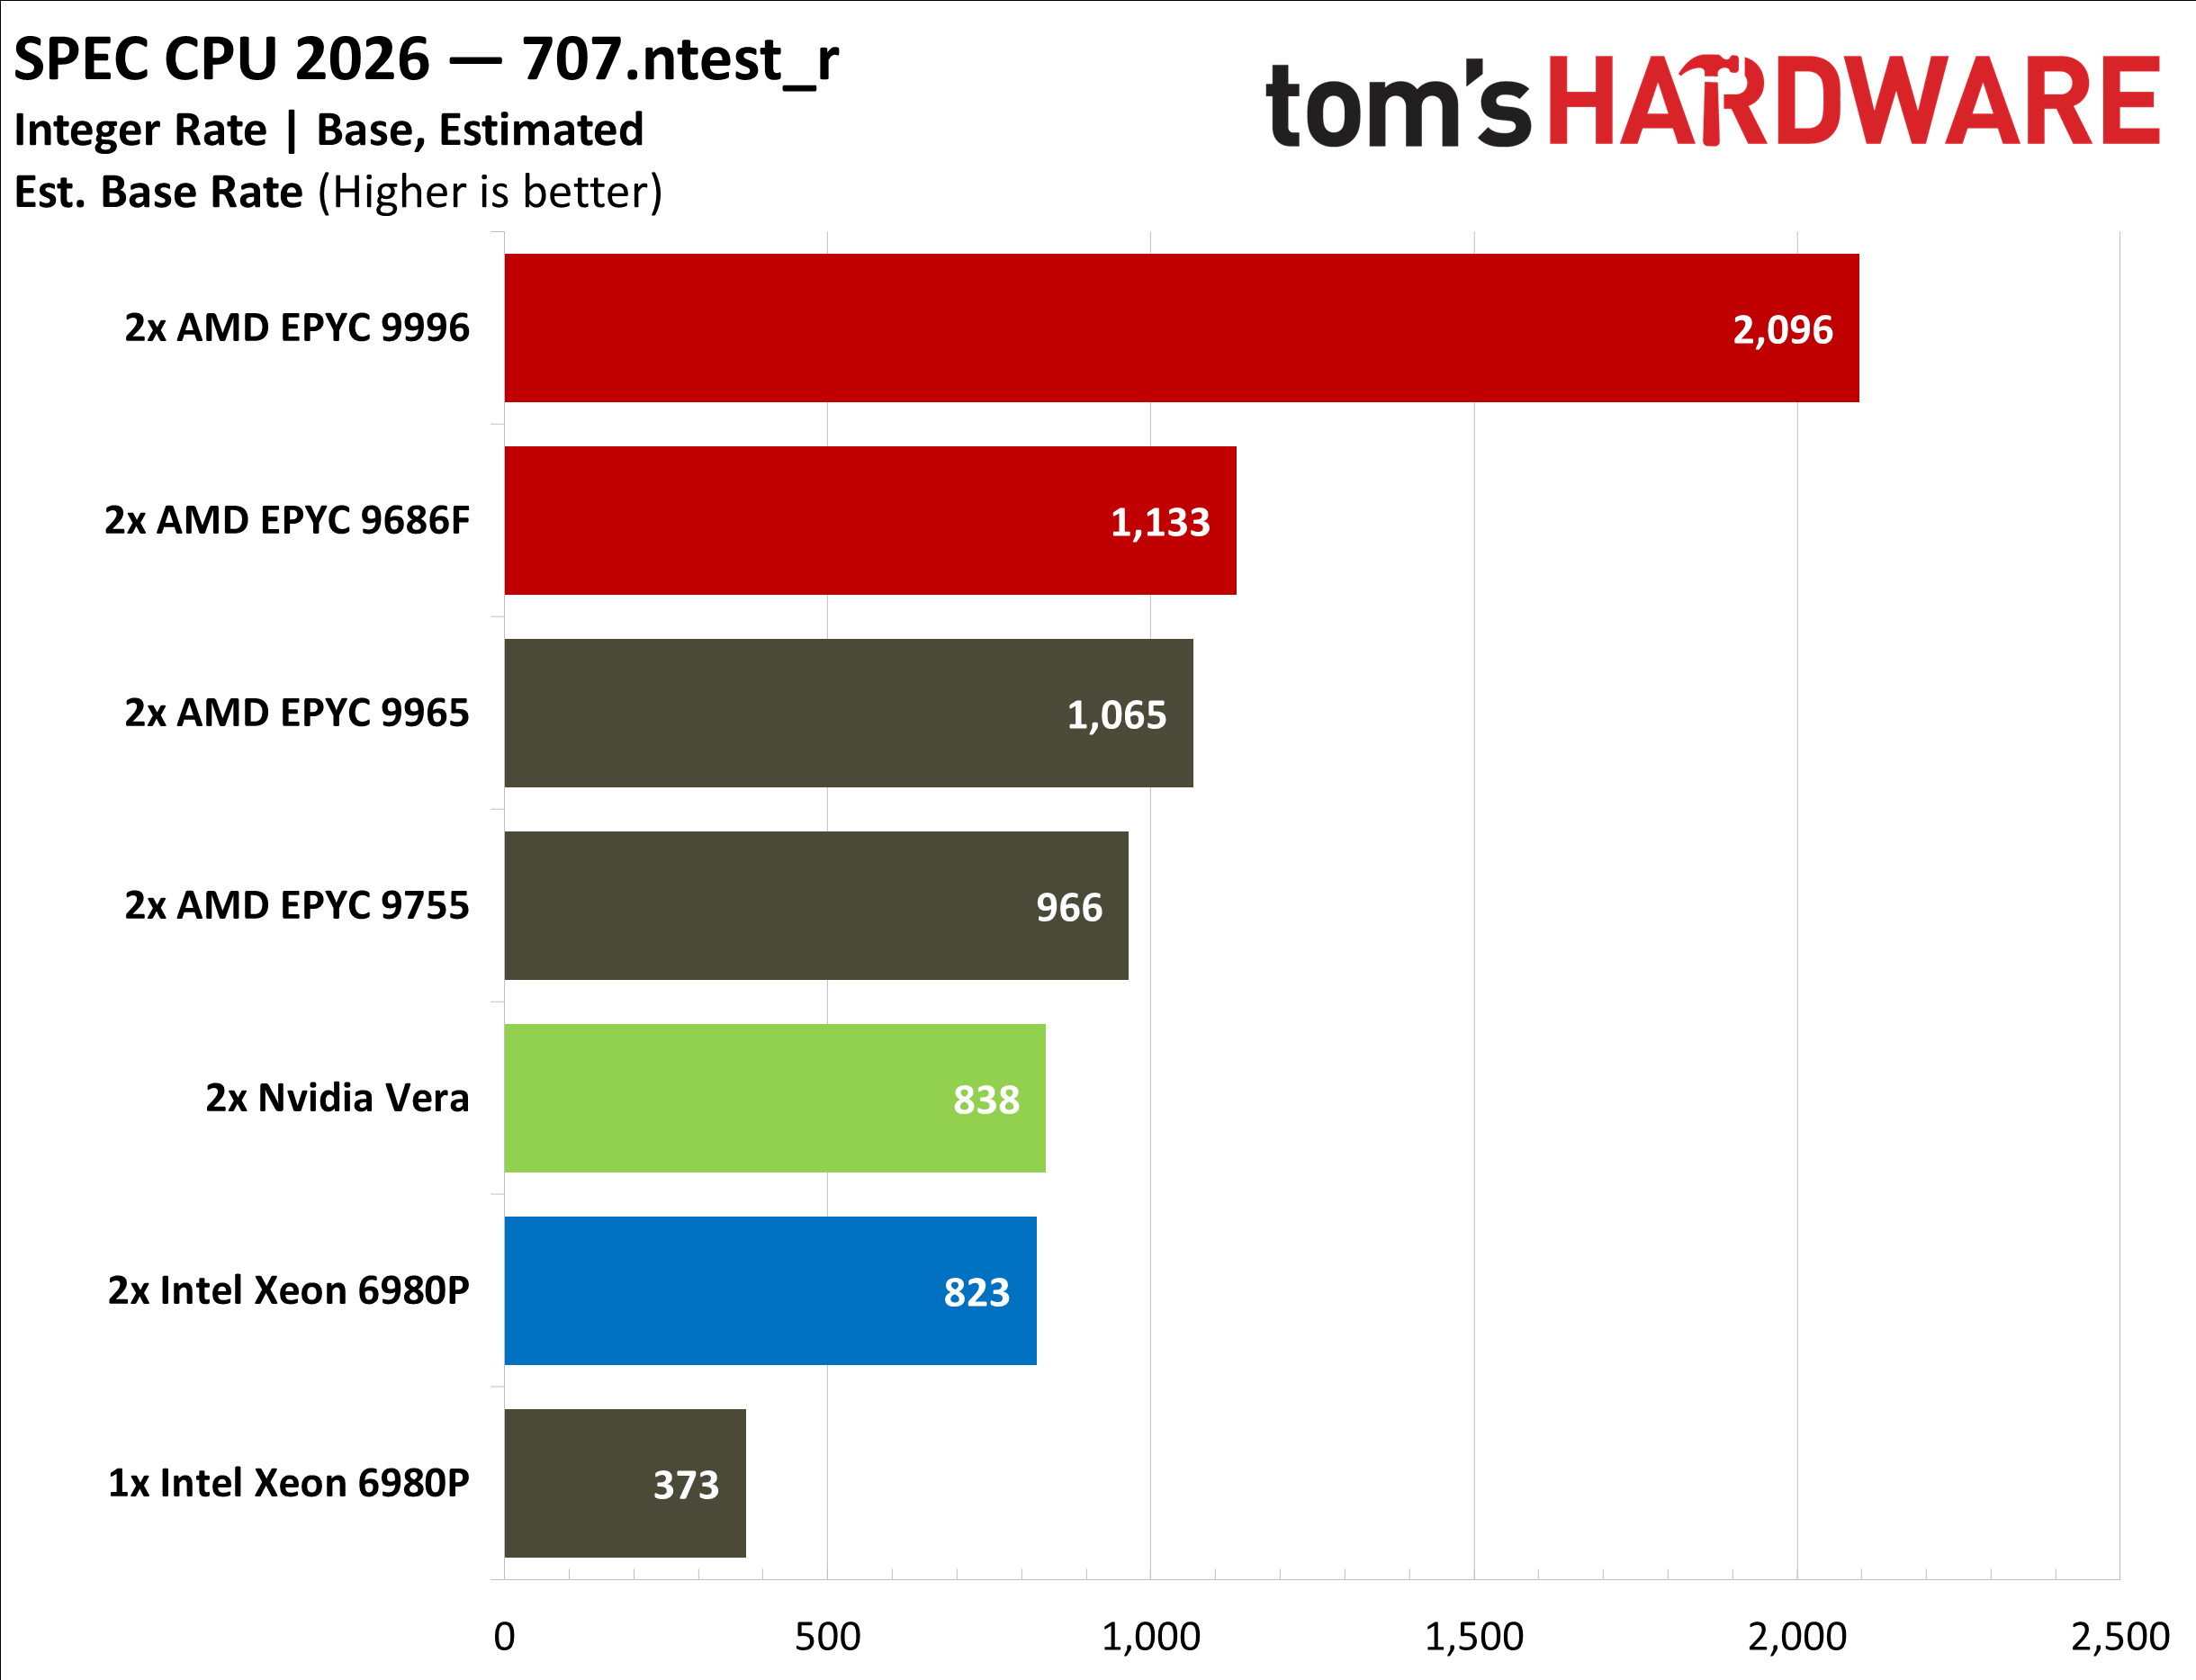
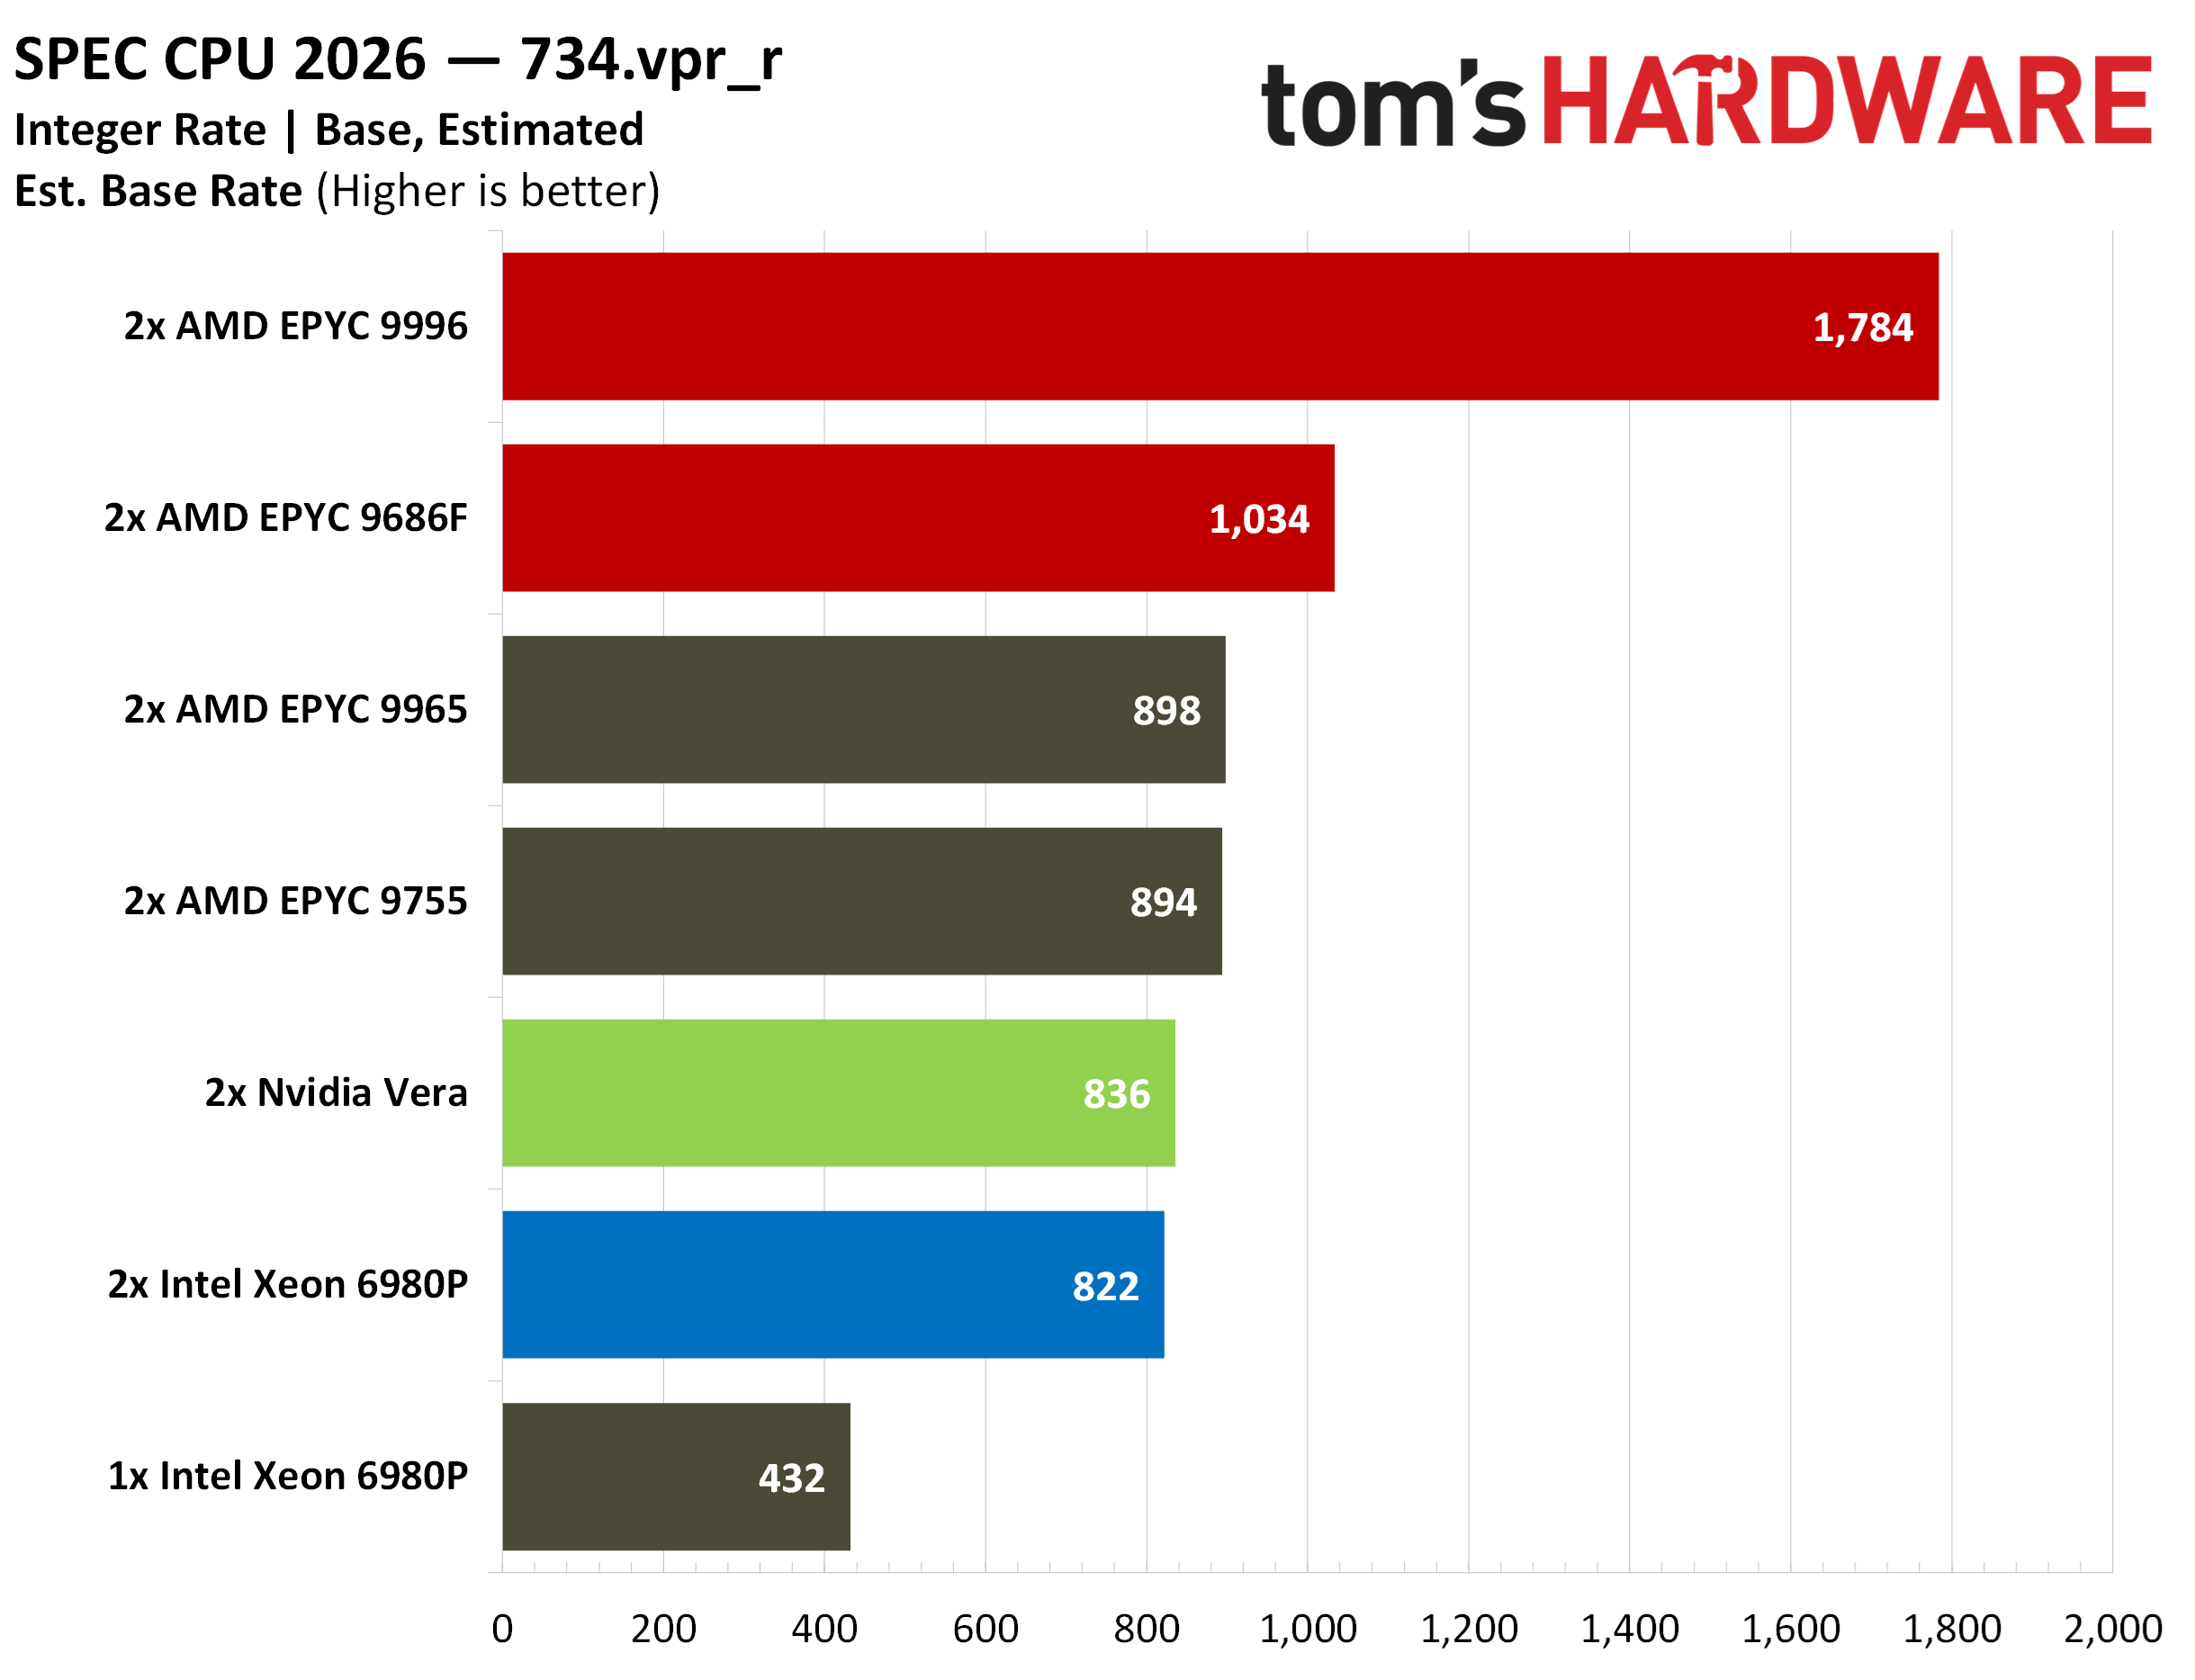
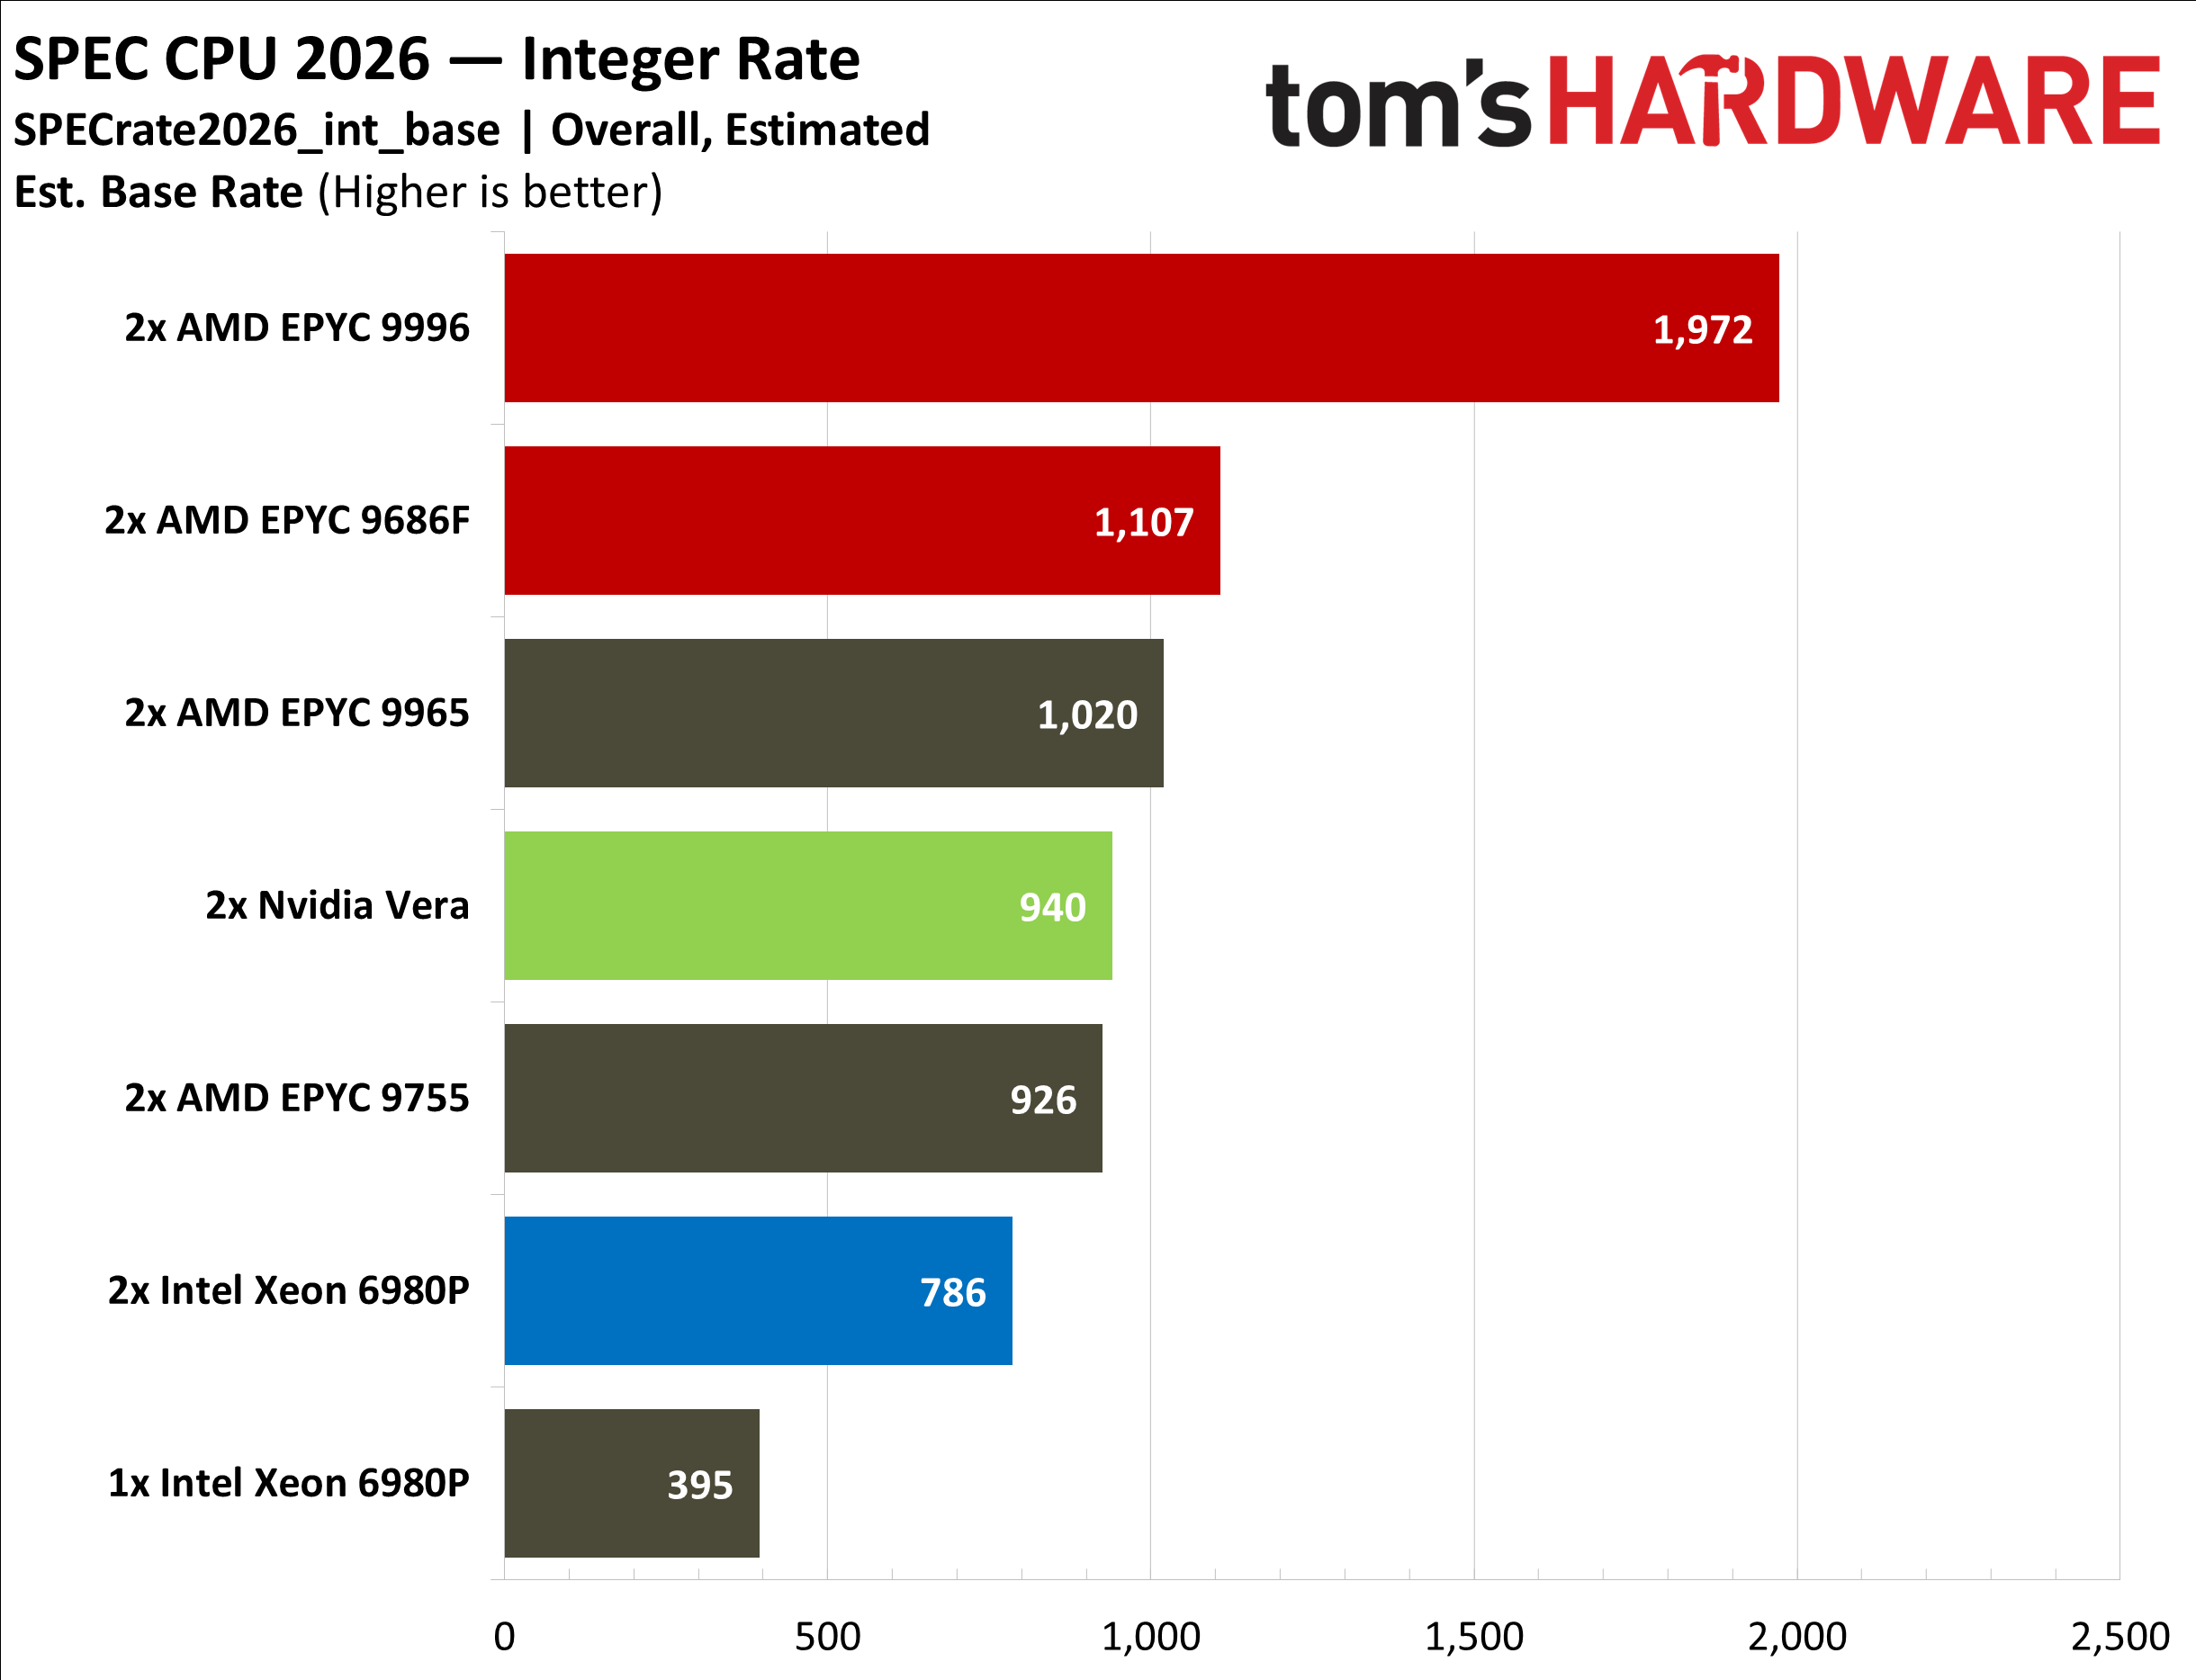
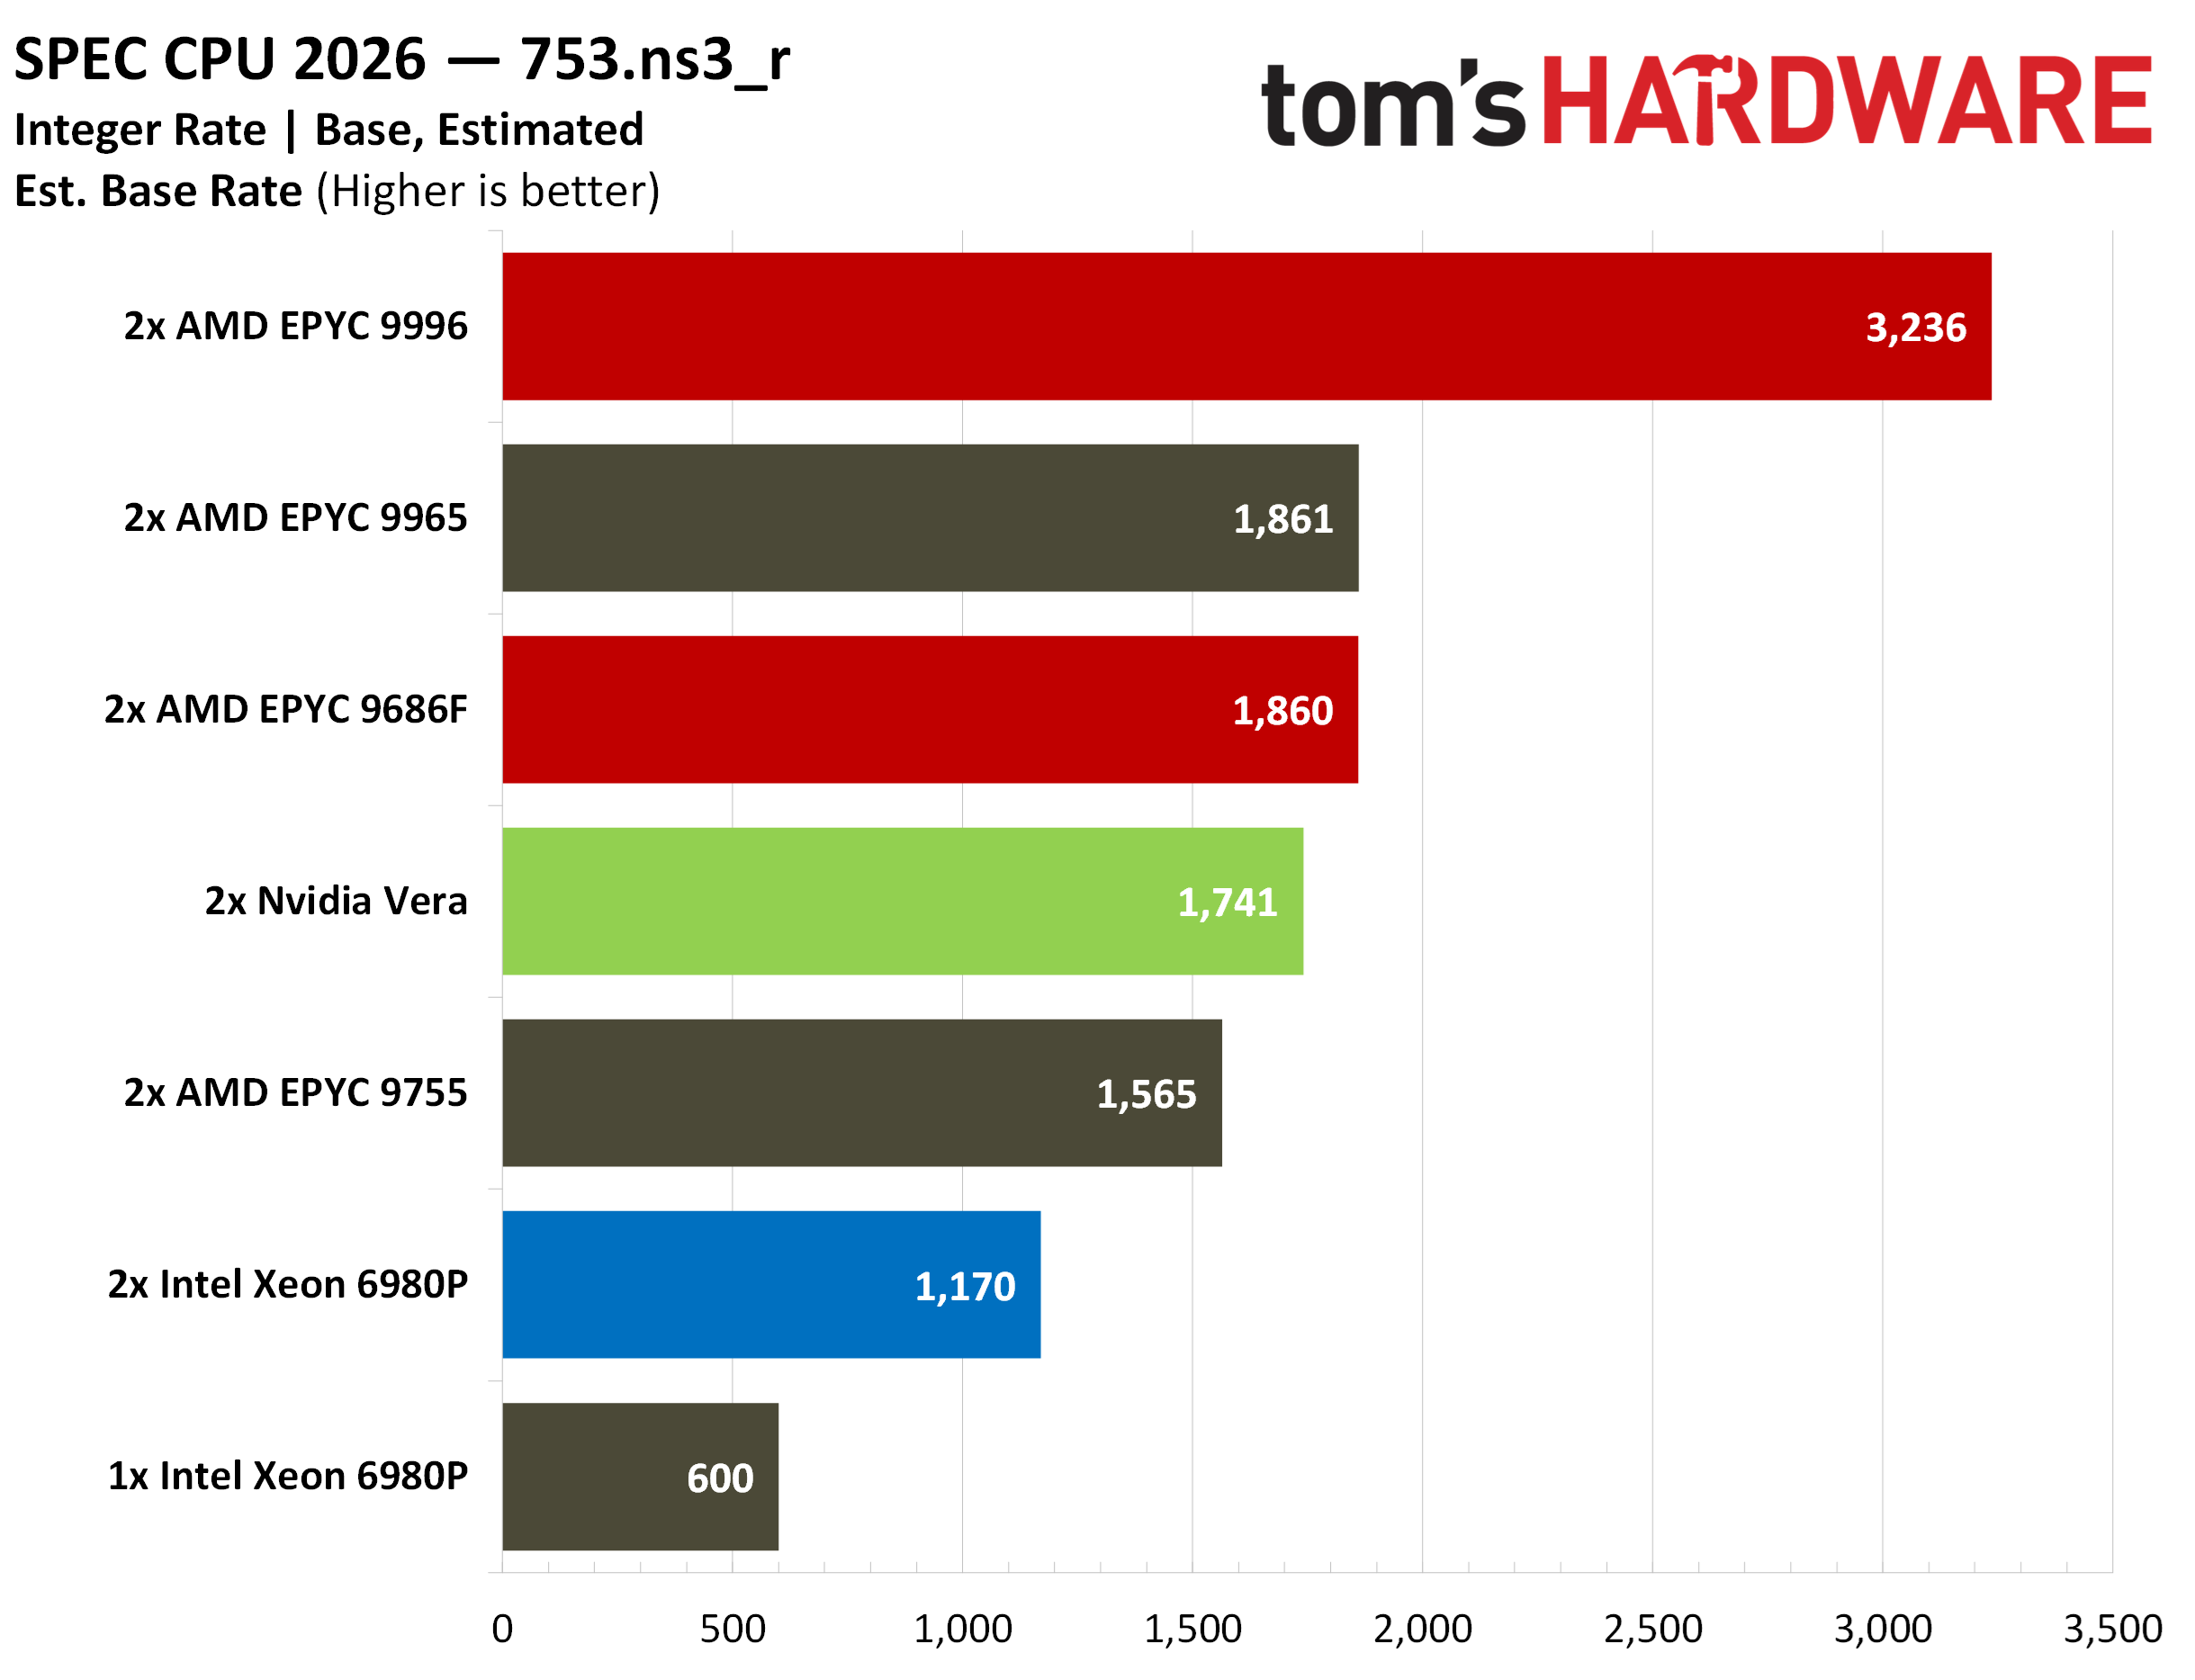
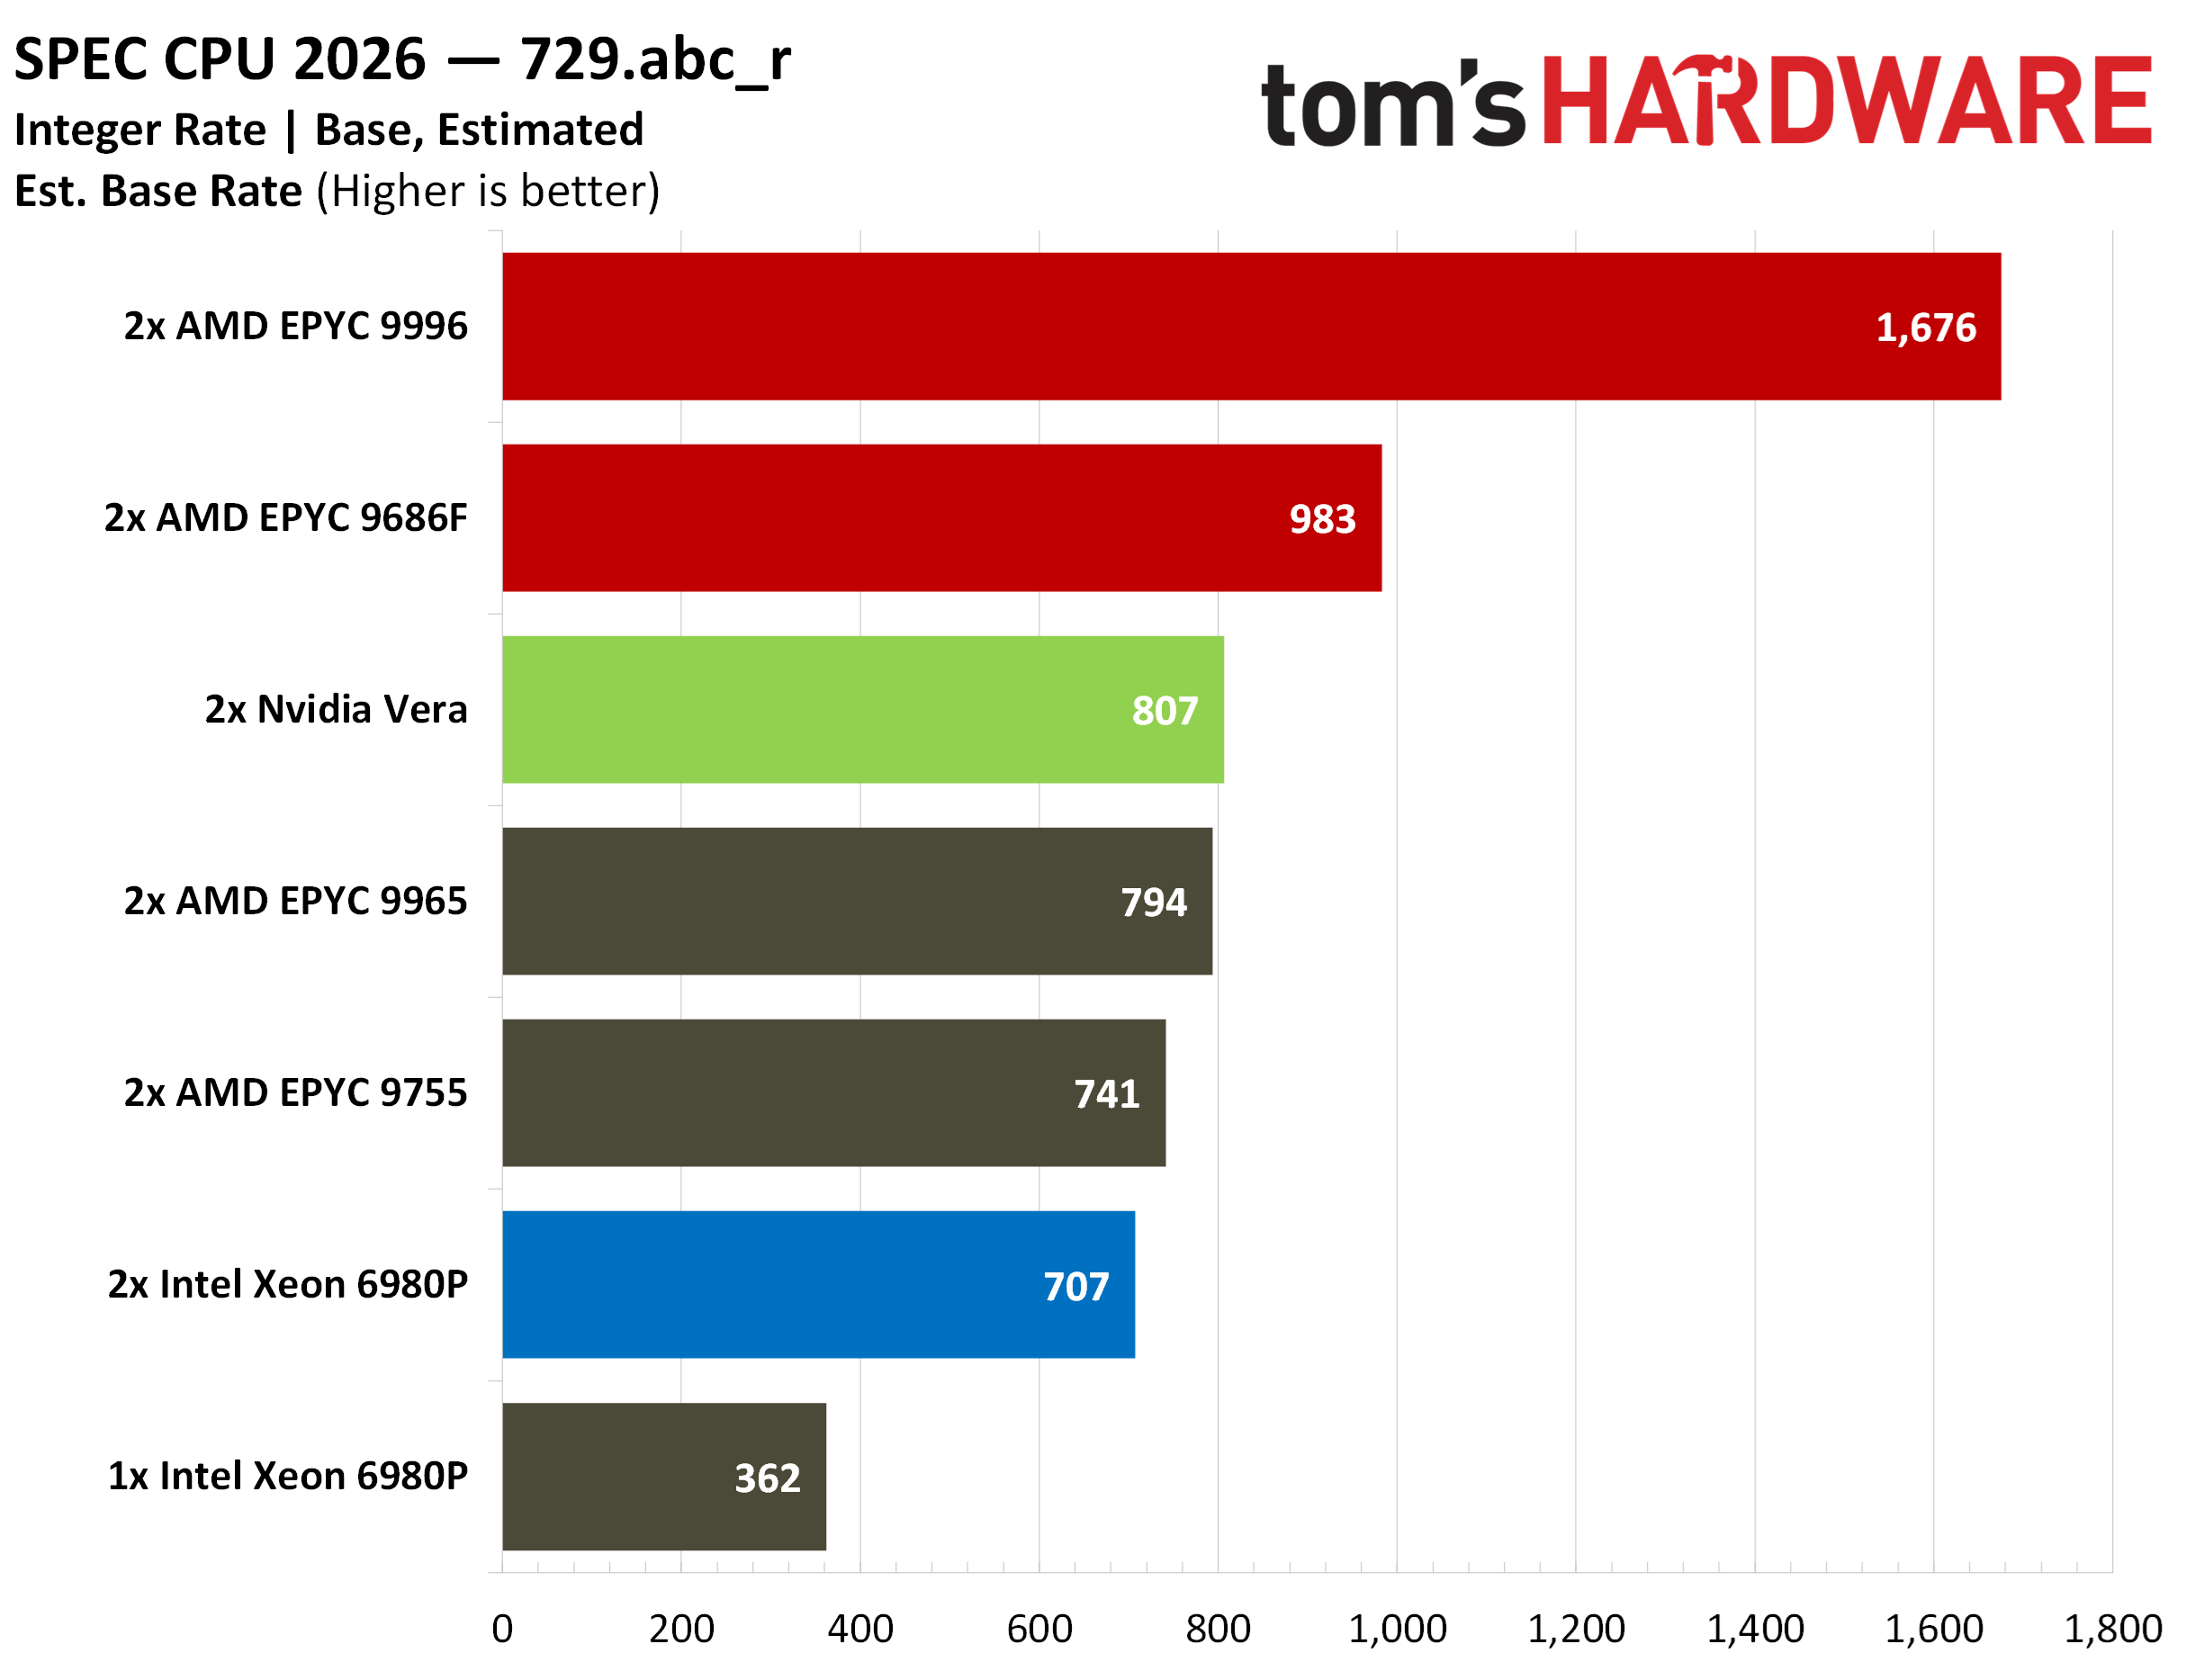
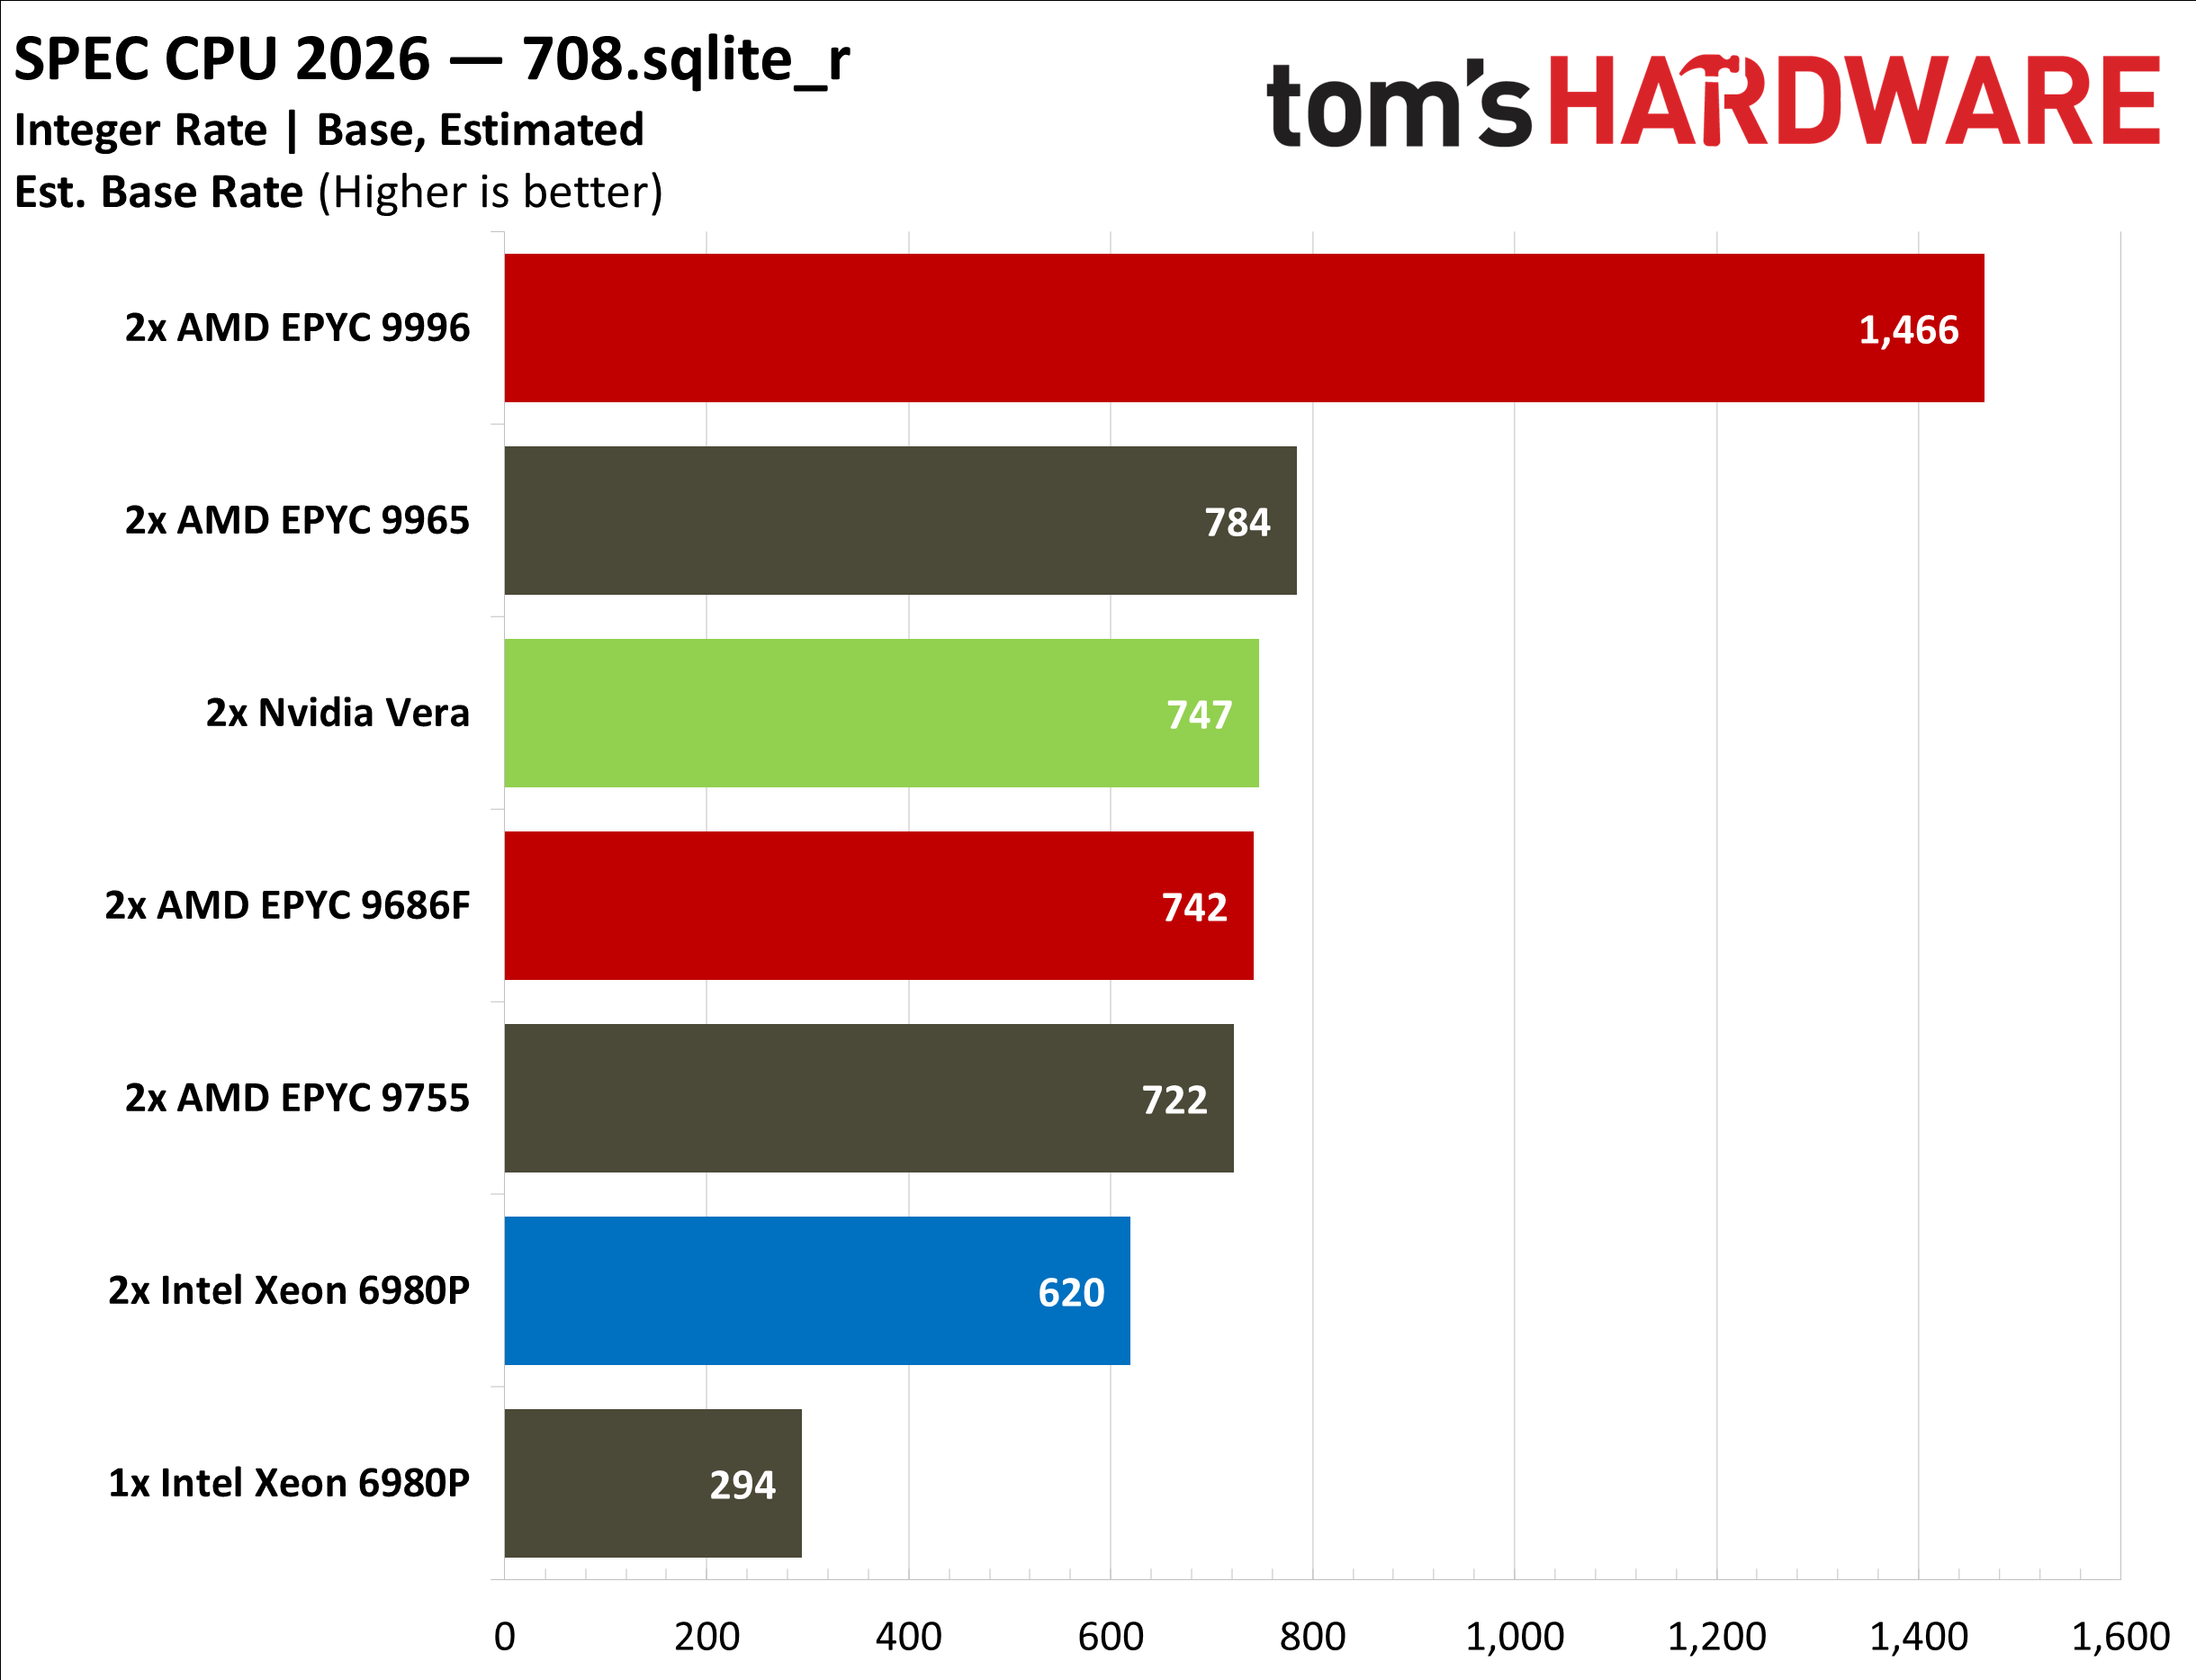
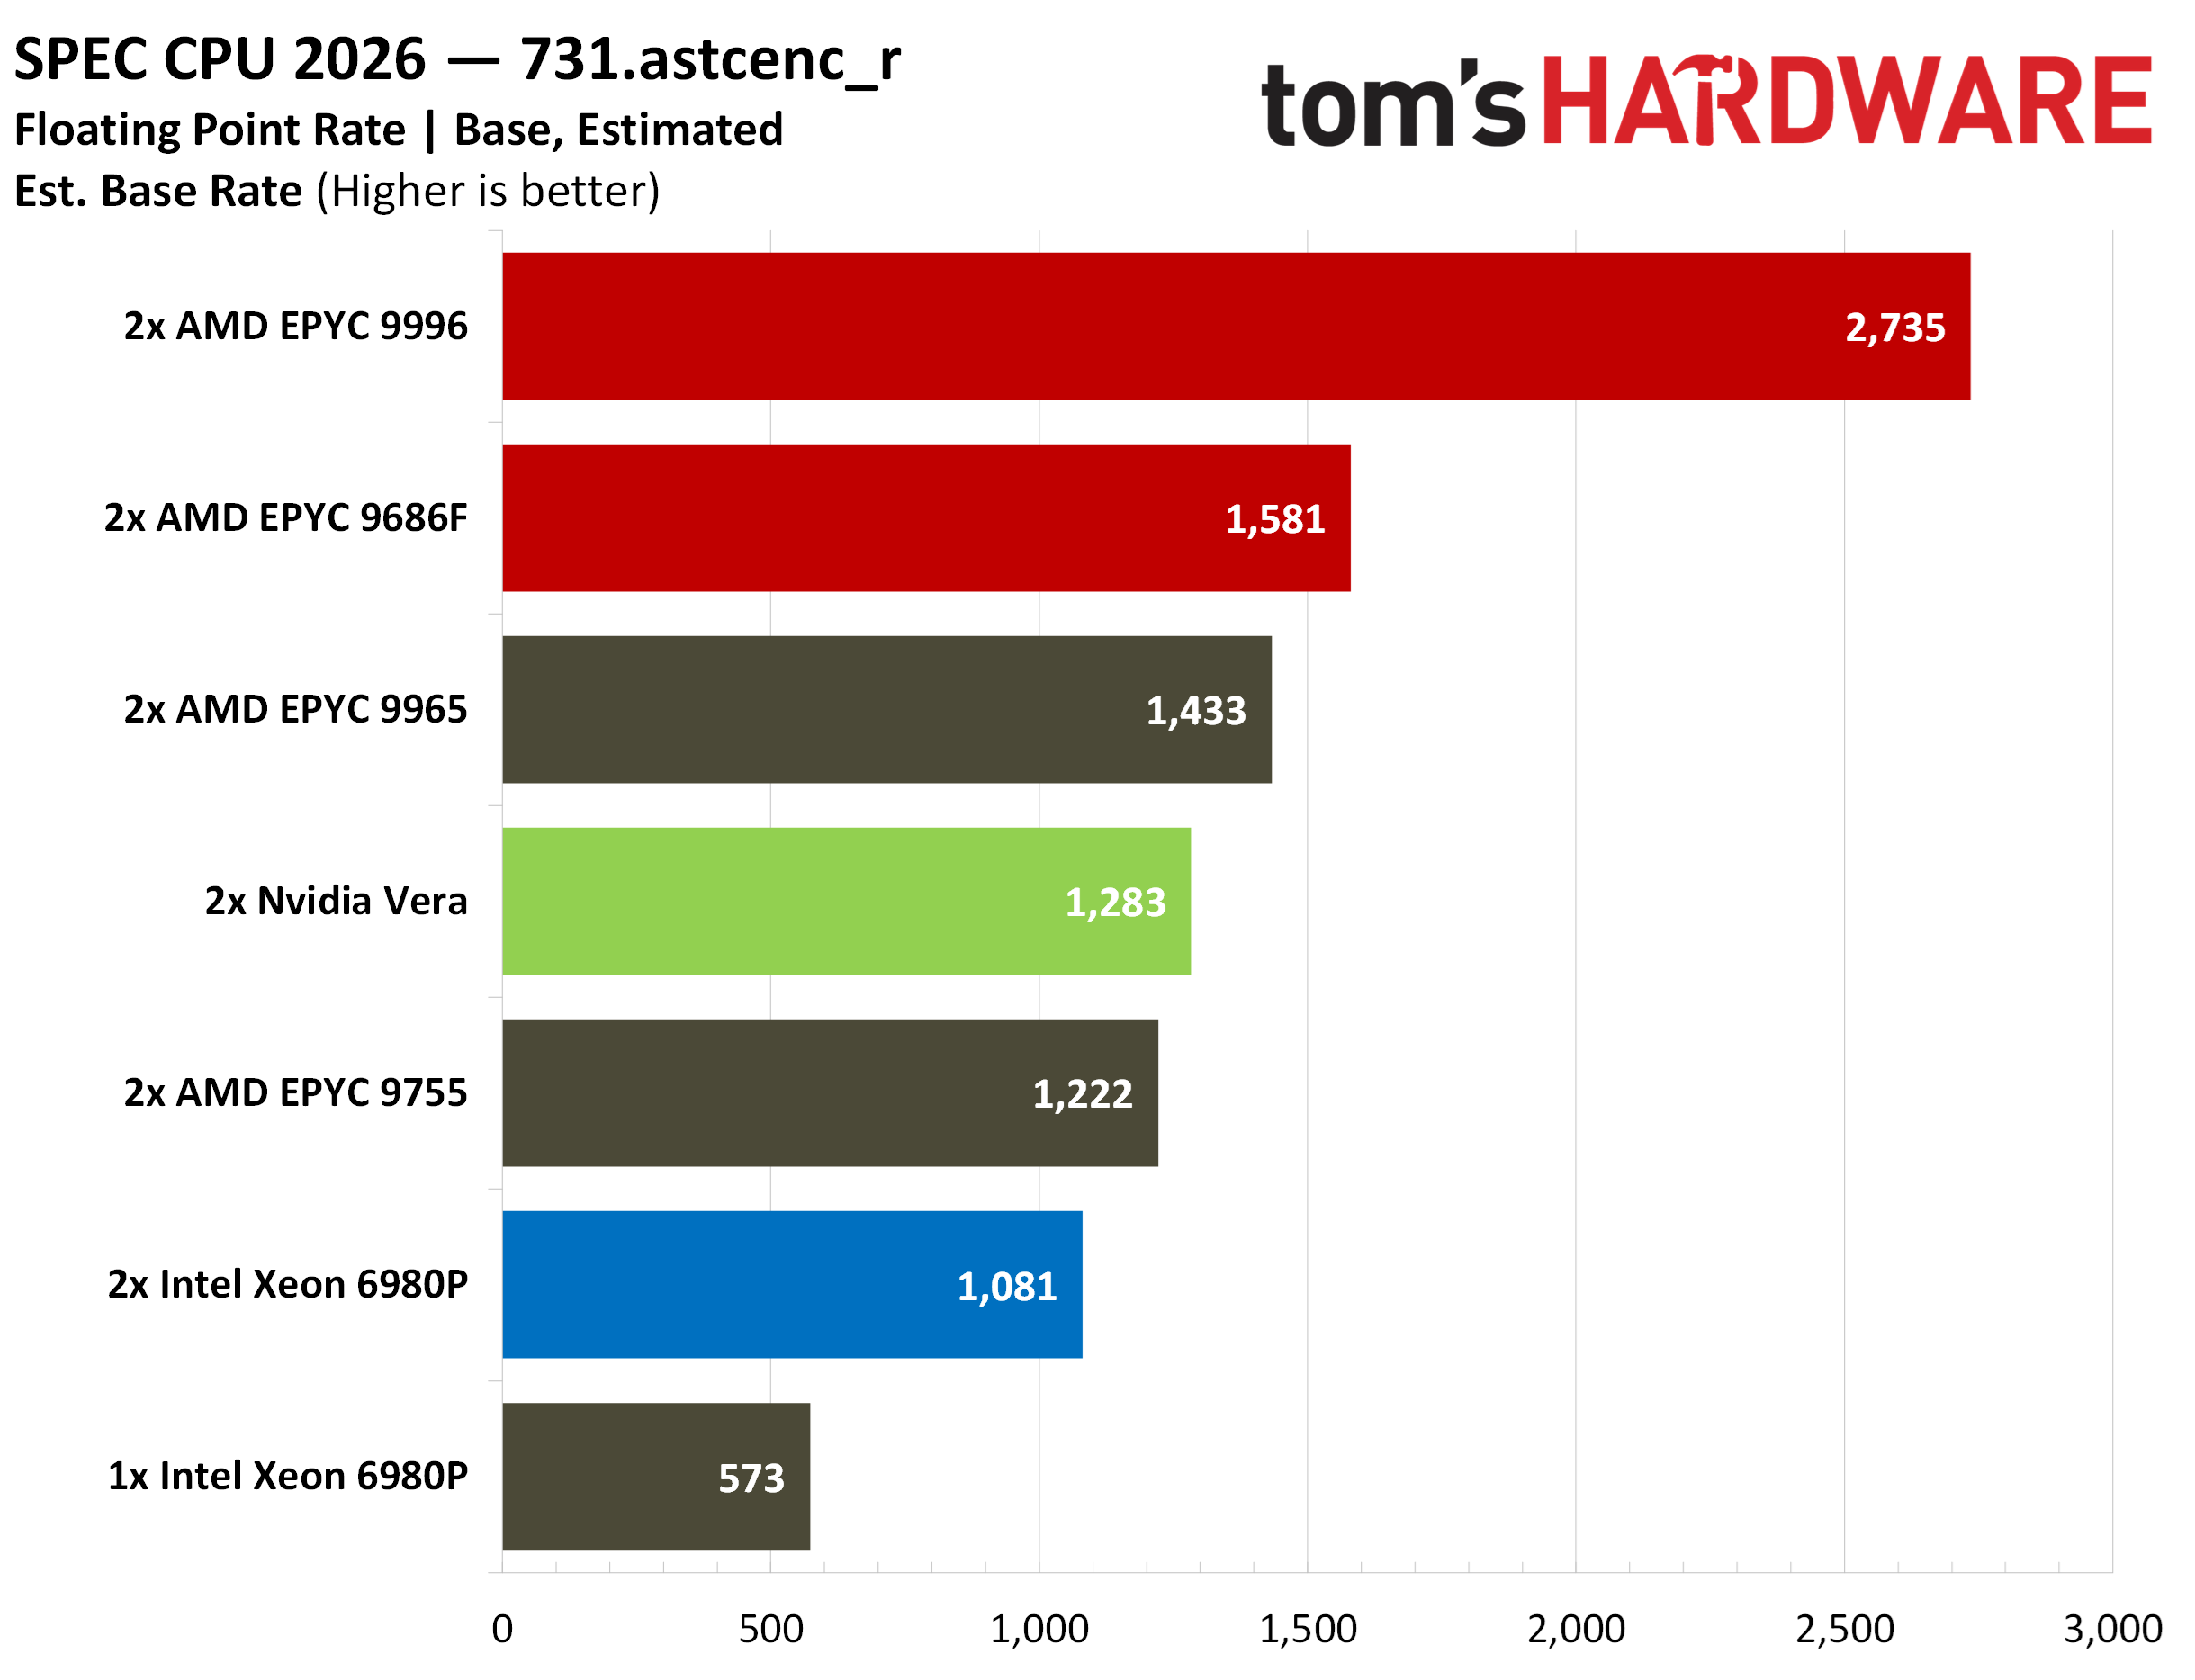
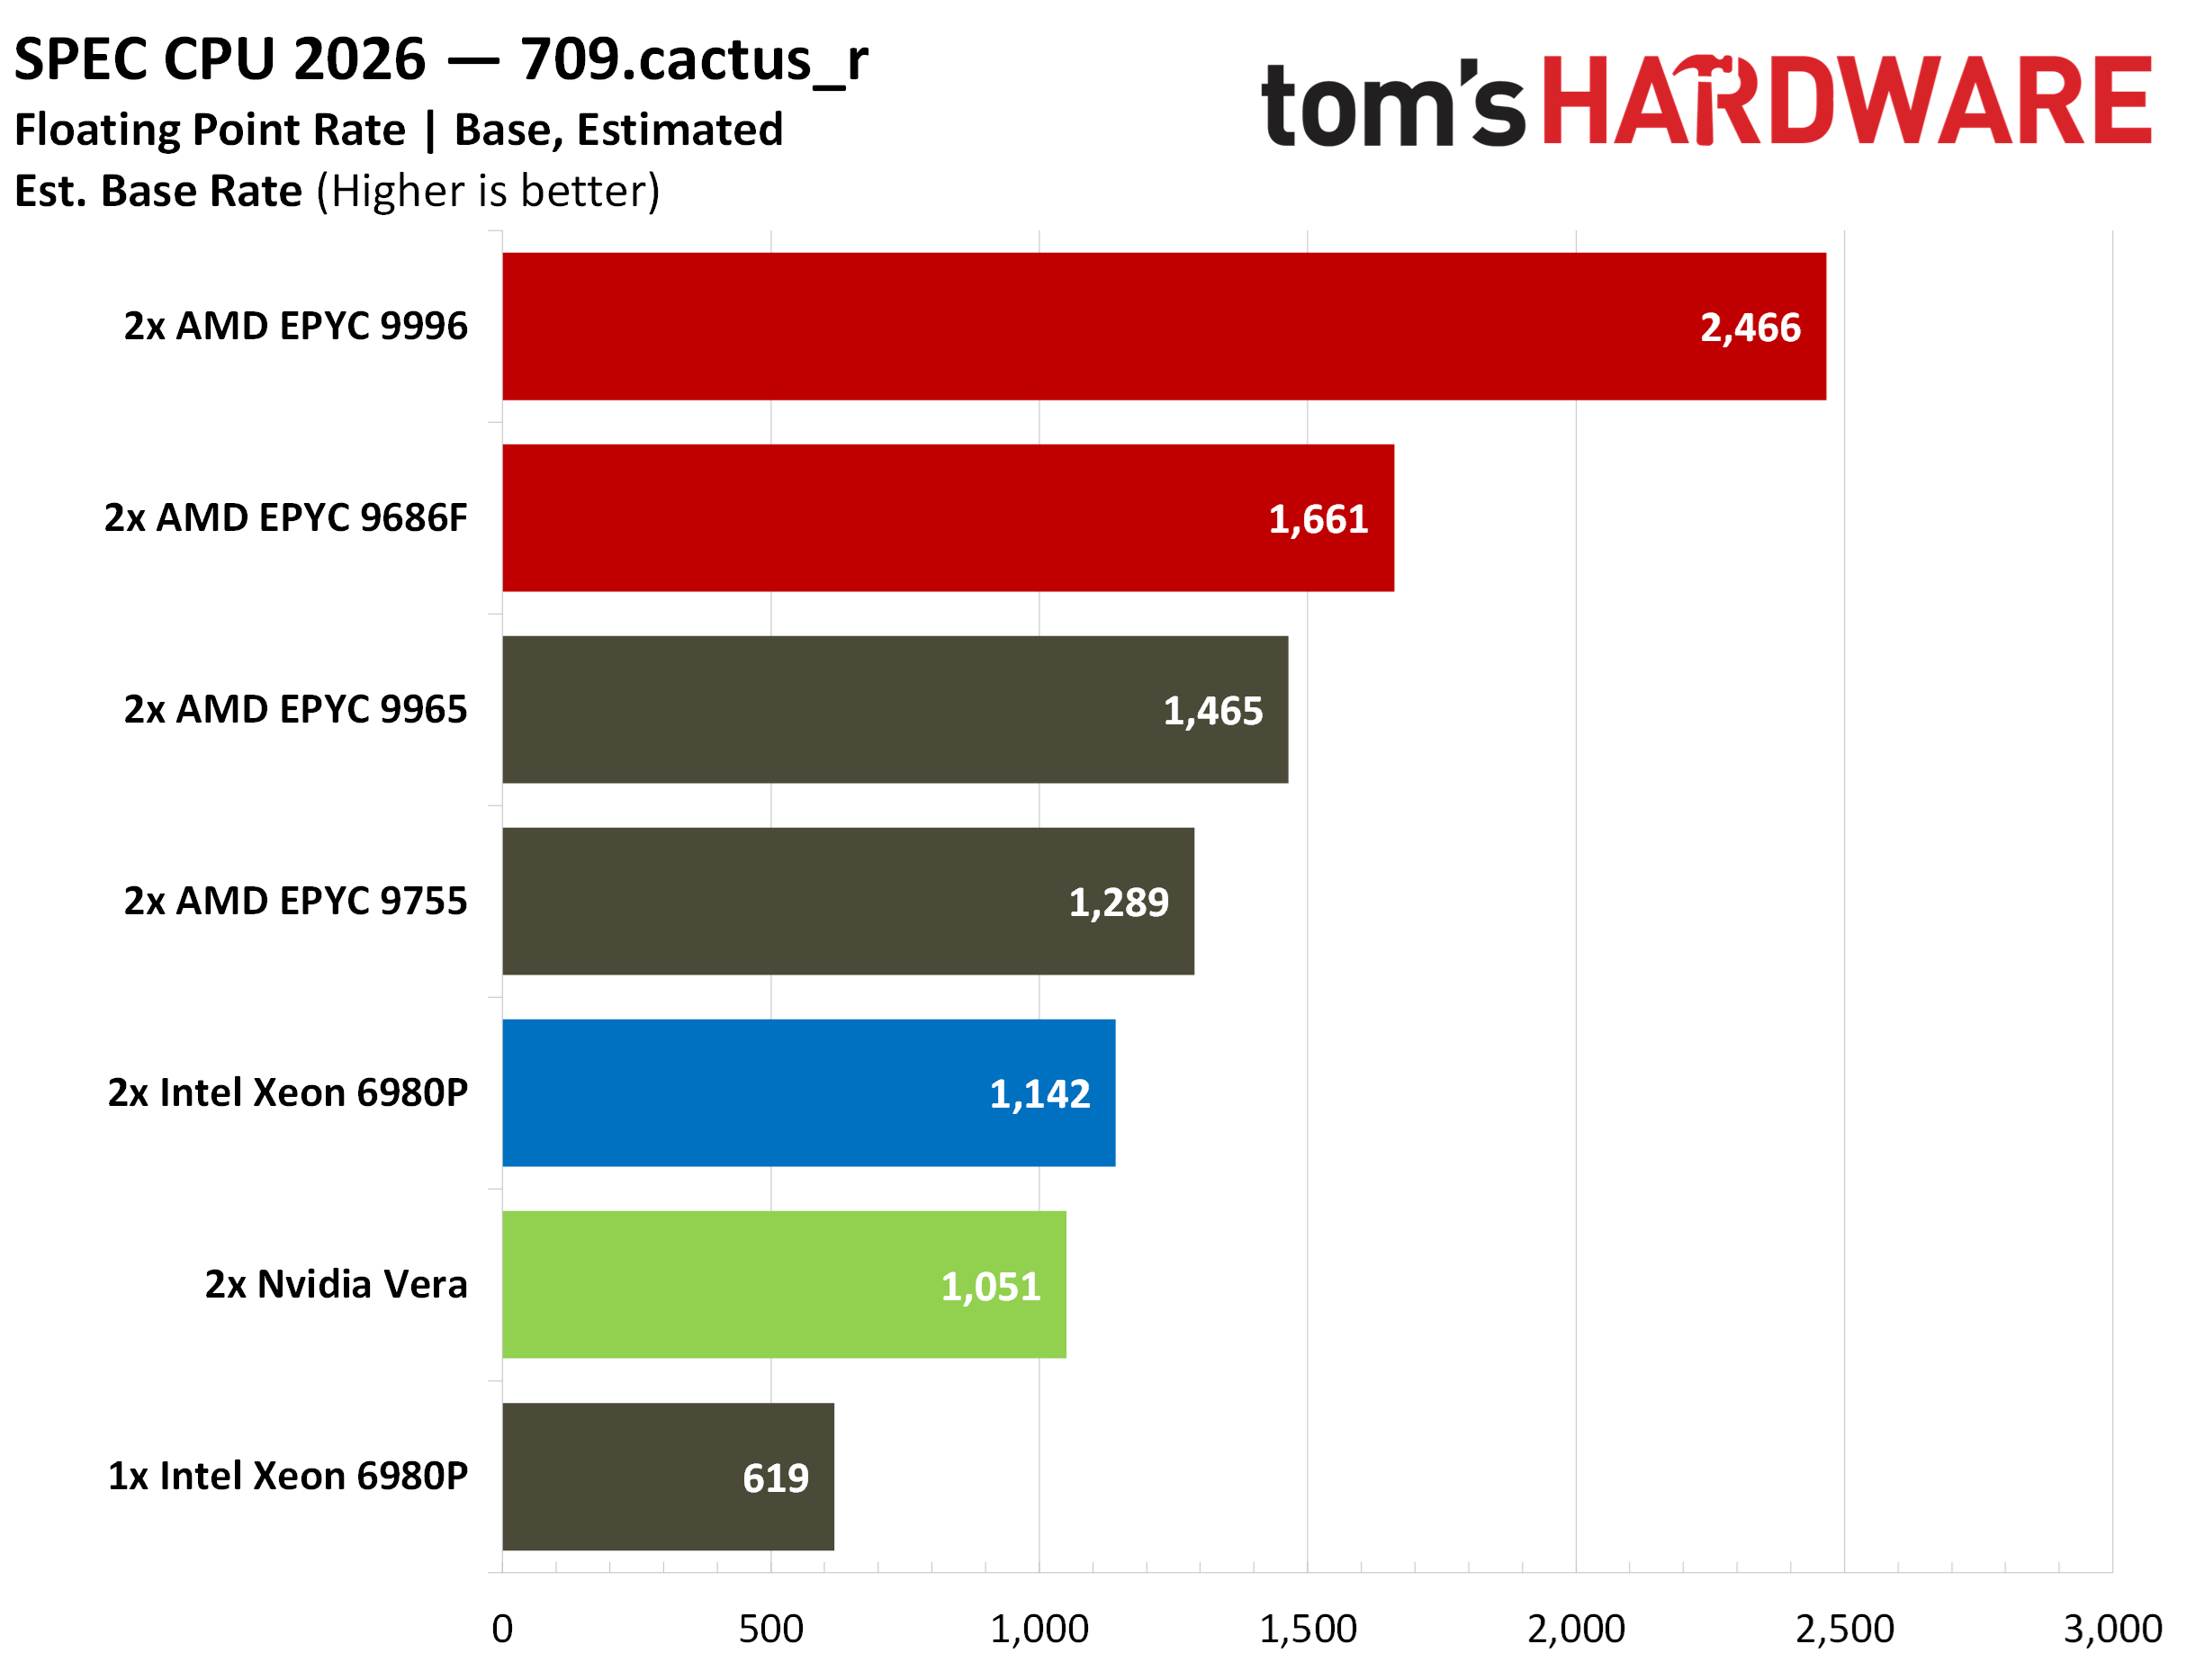
Смотреть все изображения (19) В распоряжение портала Tom’s Hardware попали две двухпроцессорные (2P) конфигурации на базе сокета SP7: 256-ядерный EPYC 9996 (суммарно 512 ядер и 1024 потока на систему, частота до 4,1 ГГц) и 96-ядерный EPYC 9686F (384 потока на систему, частота до 5,0 ГГц). SPEC CPU 2026 intrate
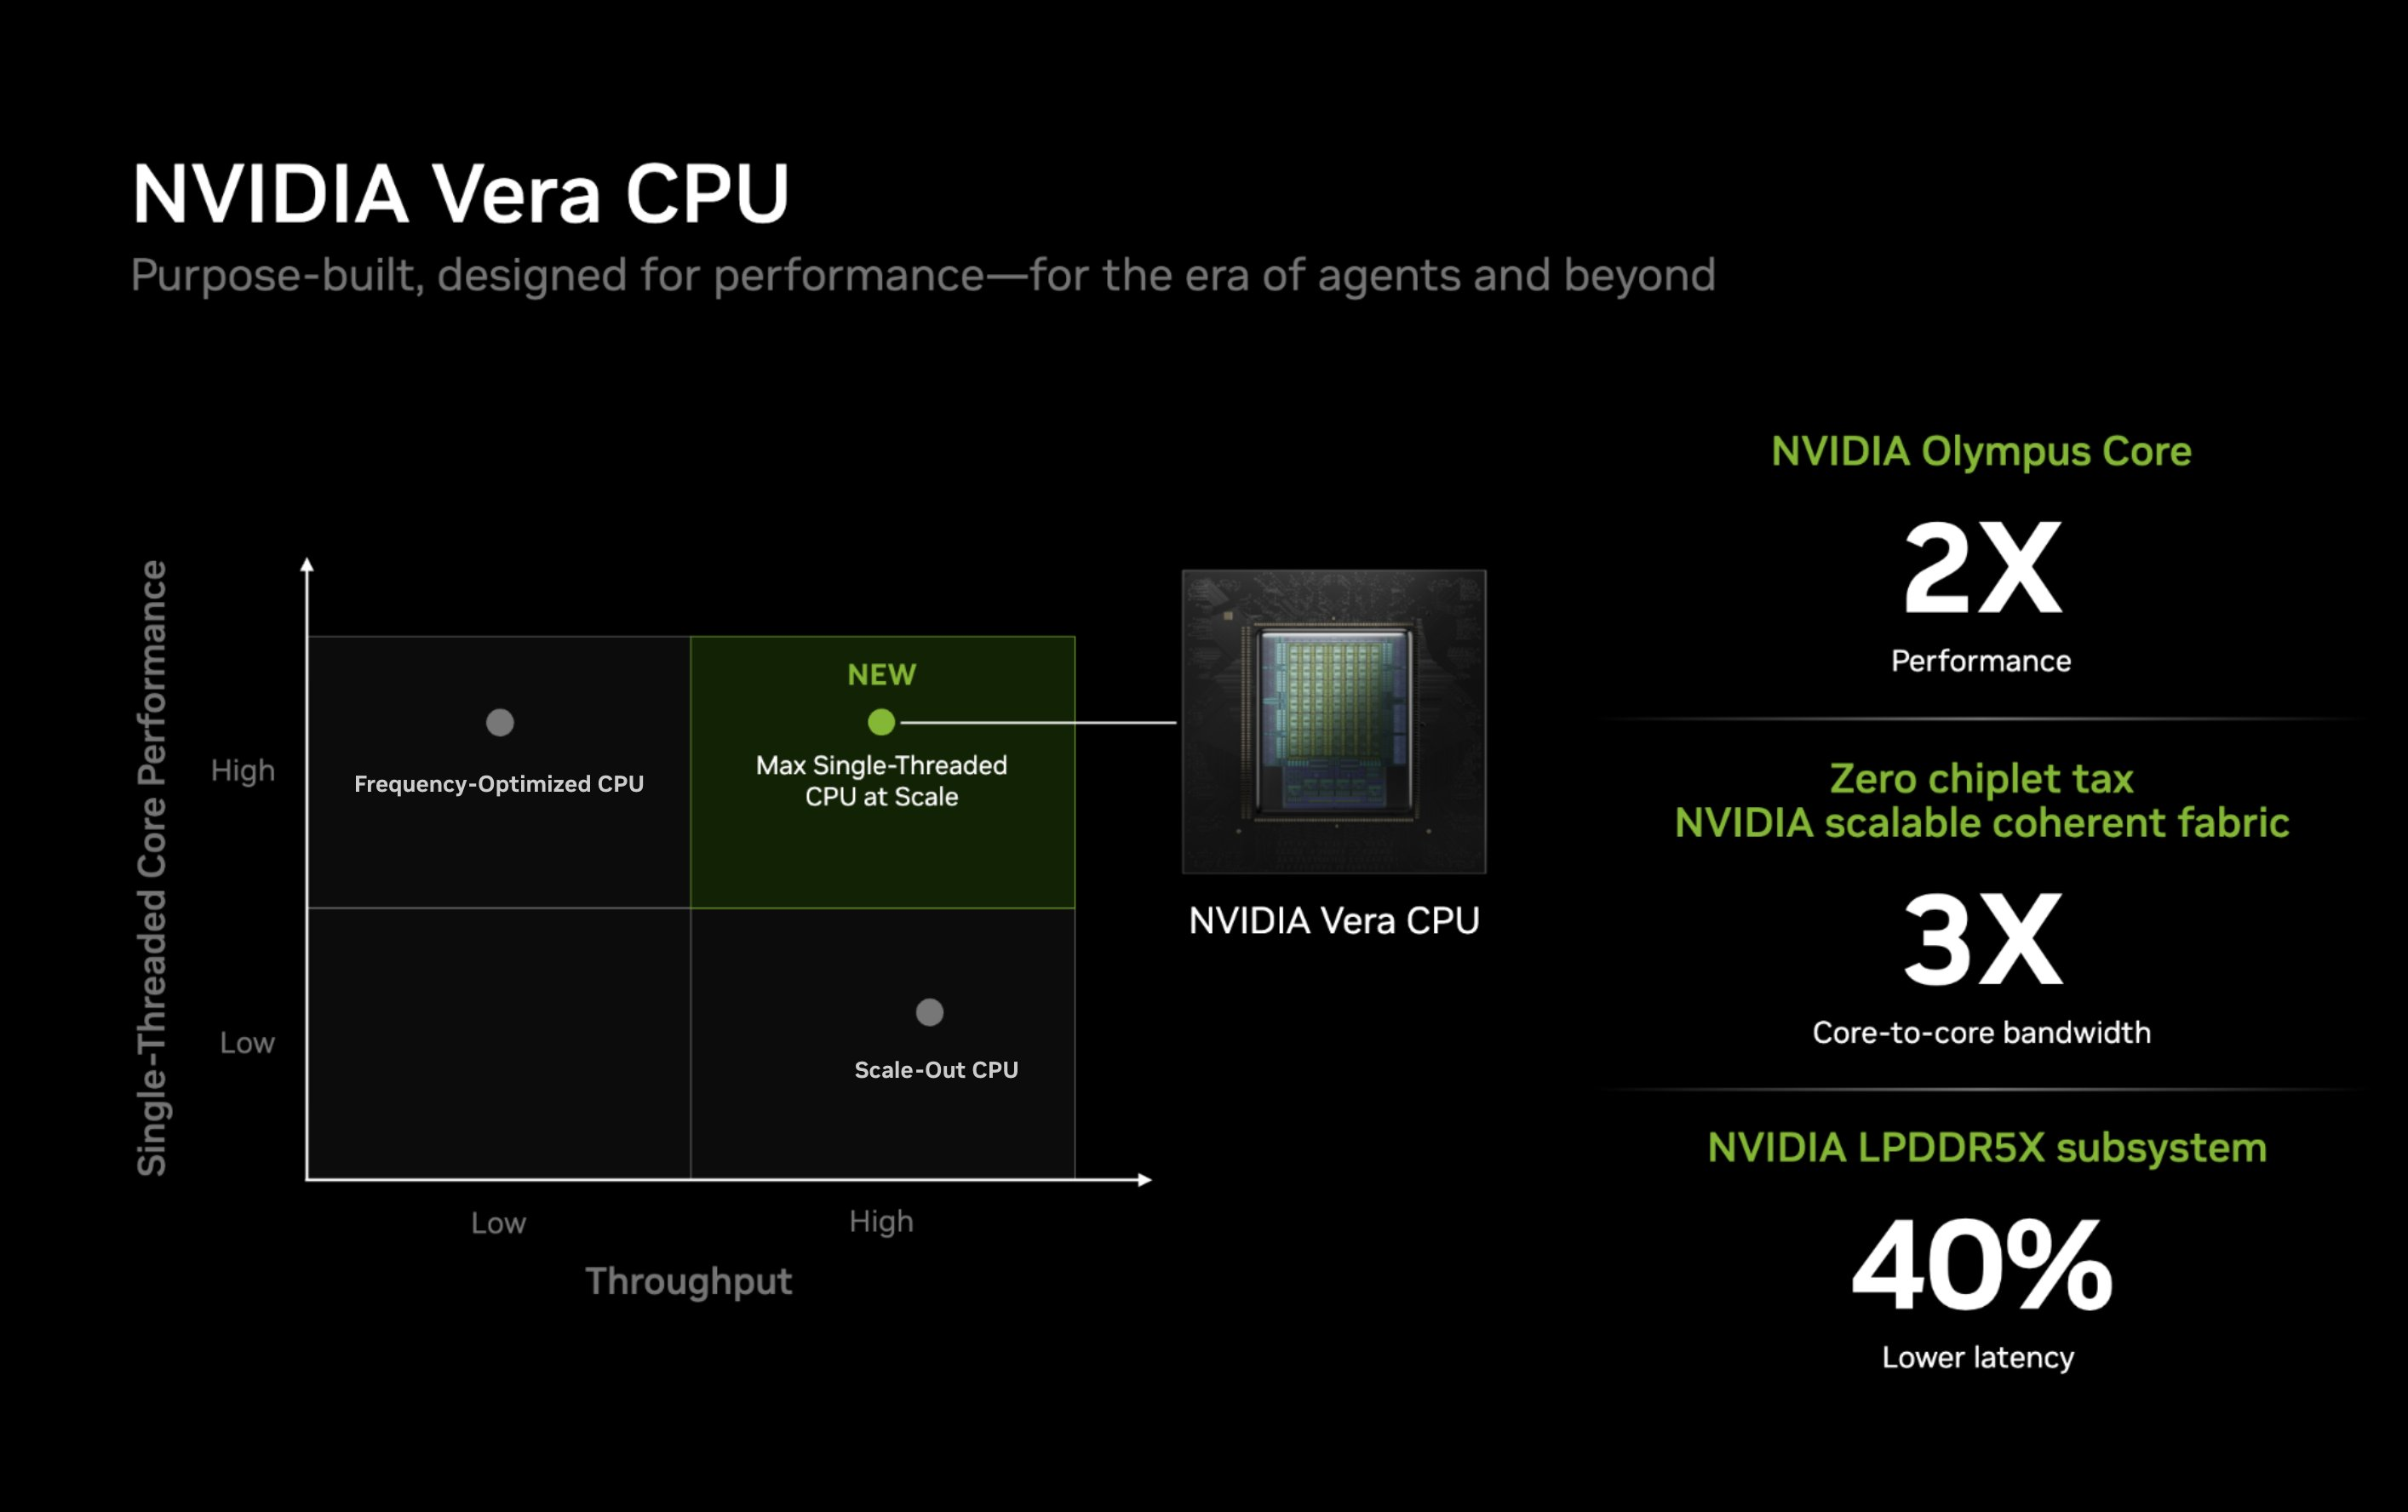
В тестах SPEC CPU 2026 на целочисленную многопоточную пропускную способность (intrate) двухпроцессорная система на EPYC 9996 за счёт оптимизаций Zen 6 и огромного пула потоков опередила прошлый флагман EPYC 9965 (Zen 5) сразу на 93 %. Частотно-оптимизированный EPYC 9686F оказался на 19 % быстрее 128-ядерного чипа прошлого поколения EPYC 9755 и на 17 % обогнал процессор Nvidia Vera. SPEC CPU 2026 fprate
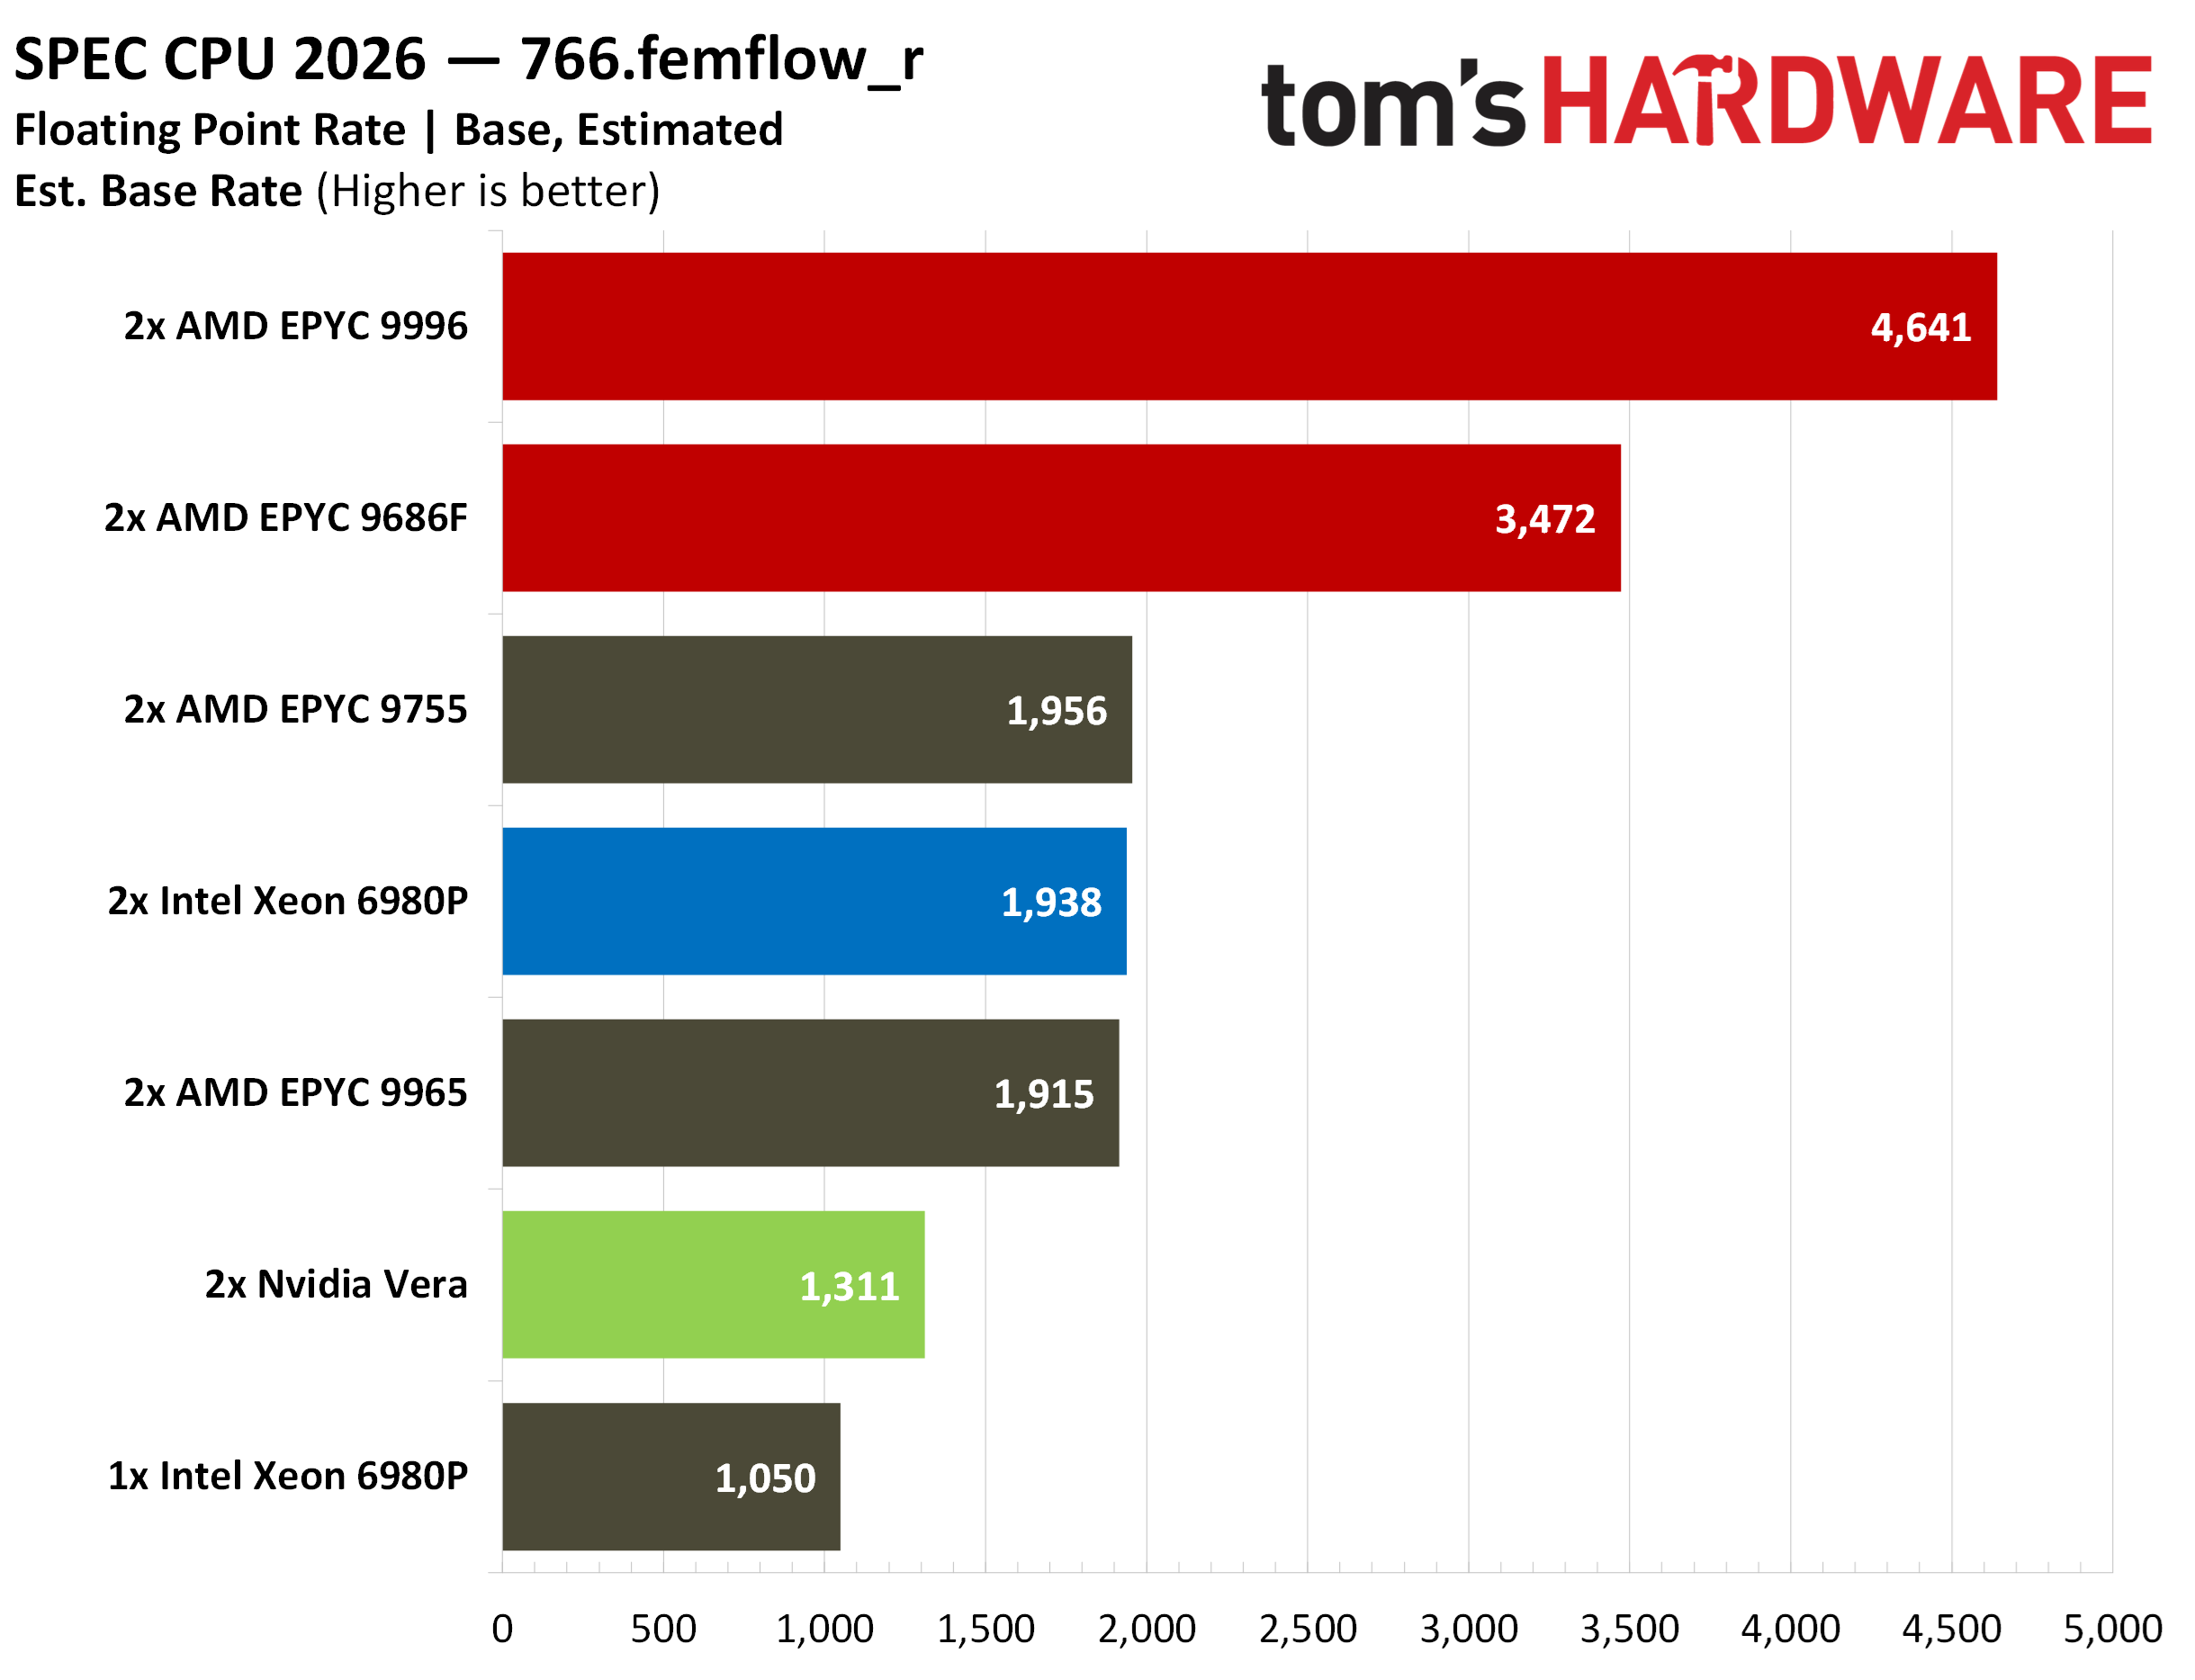
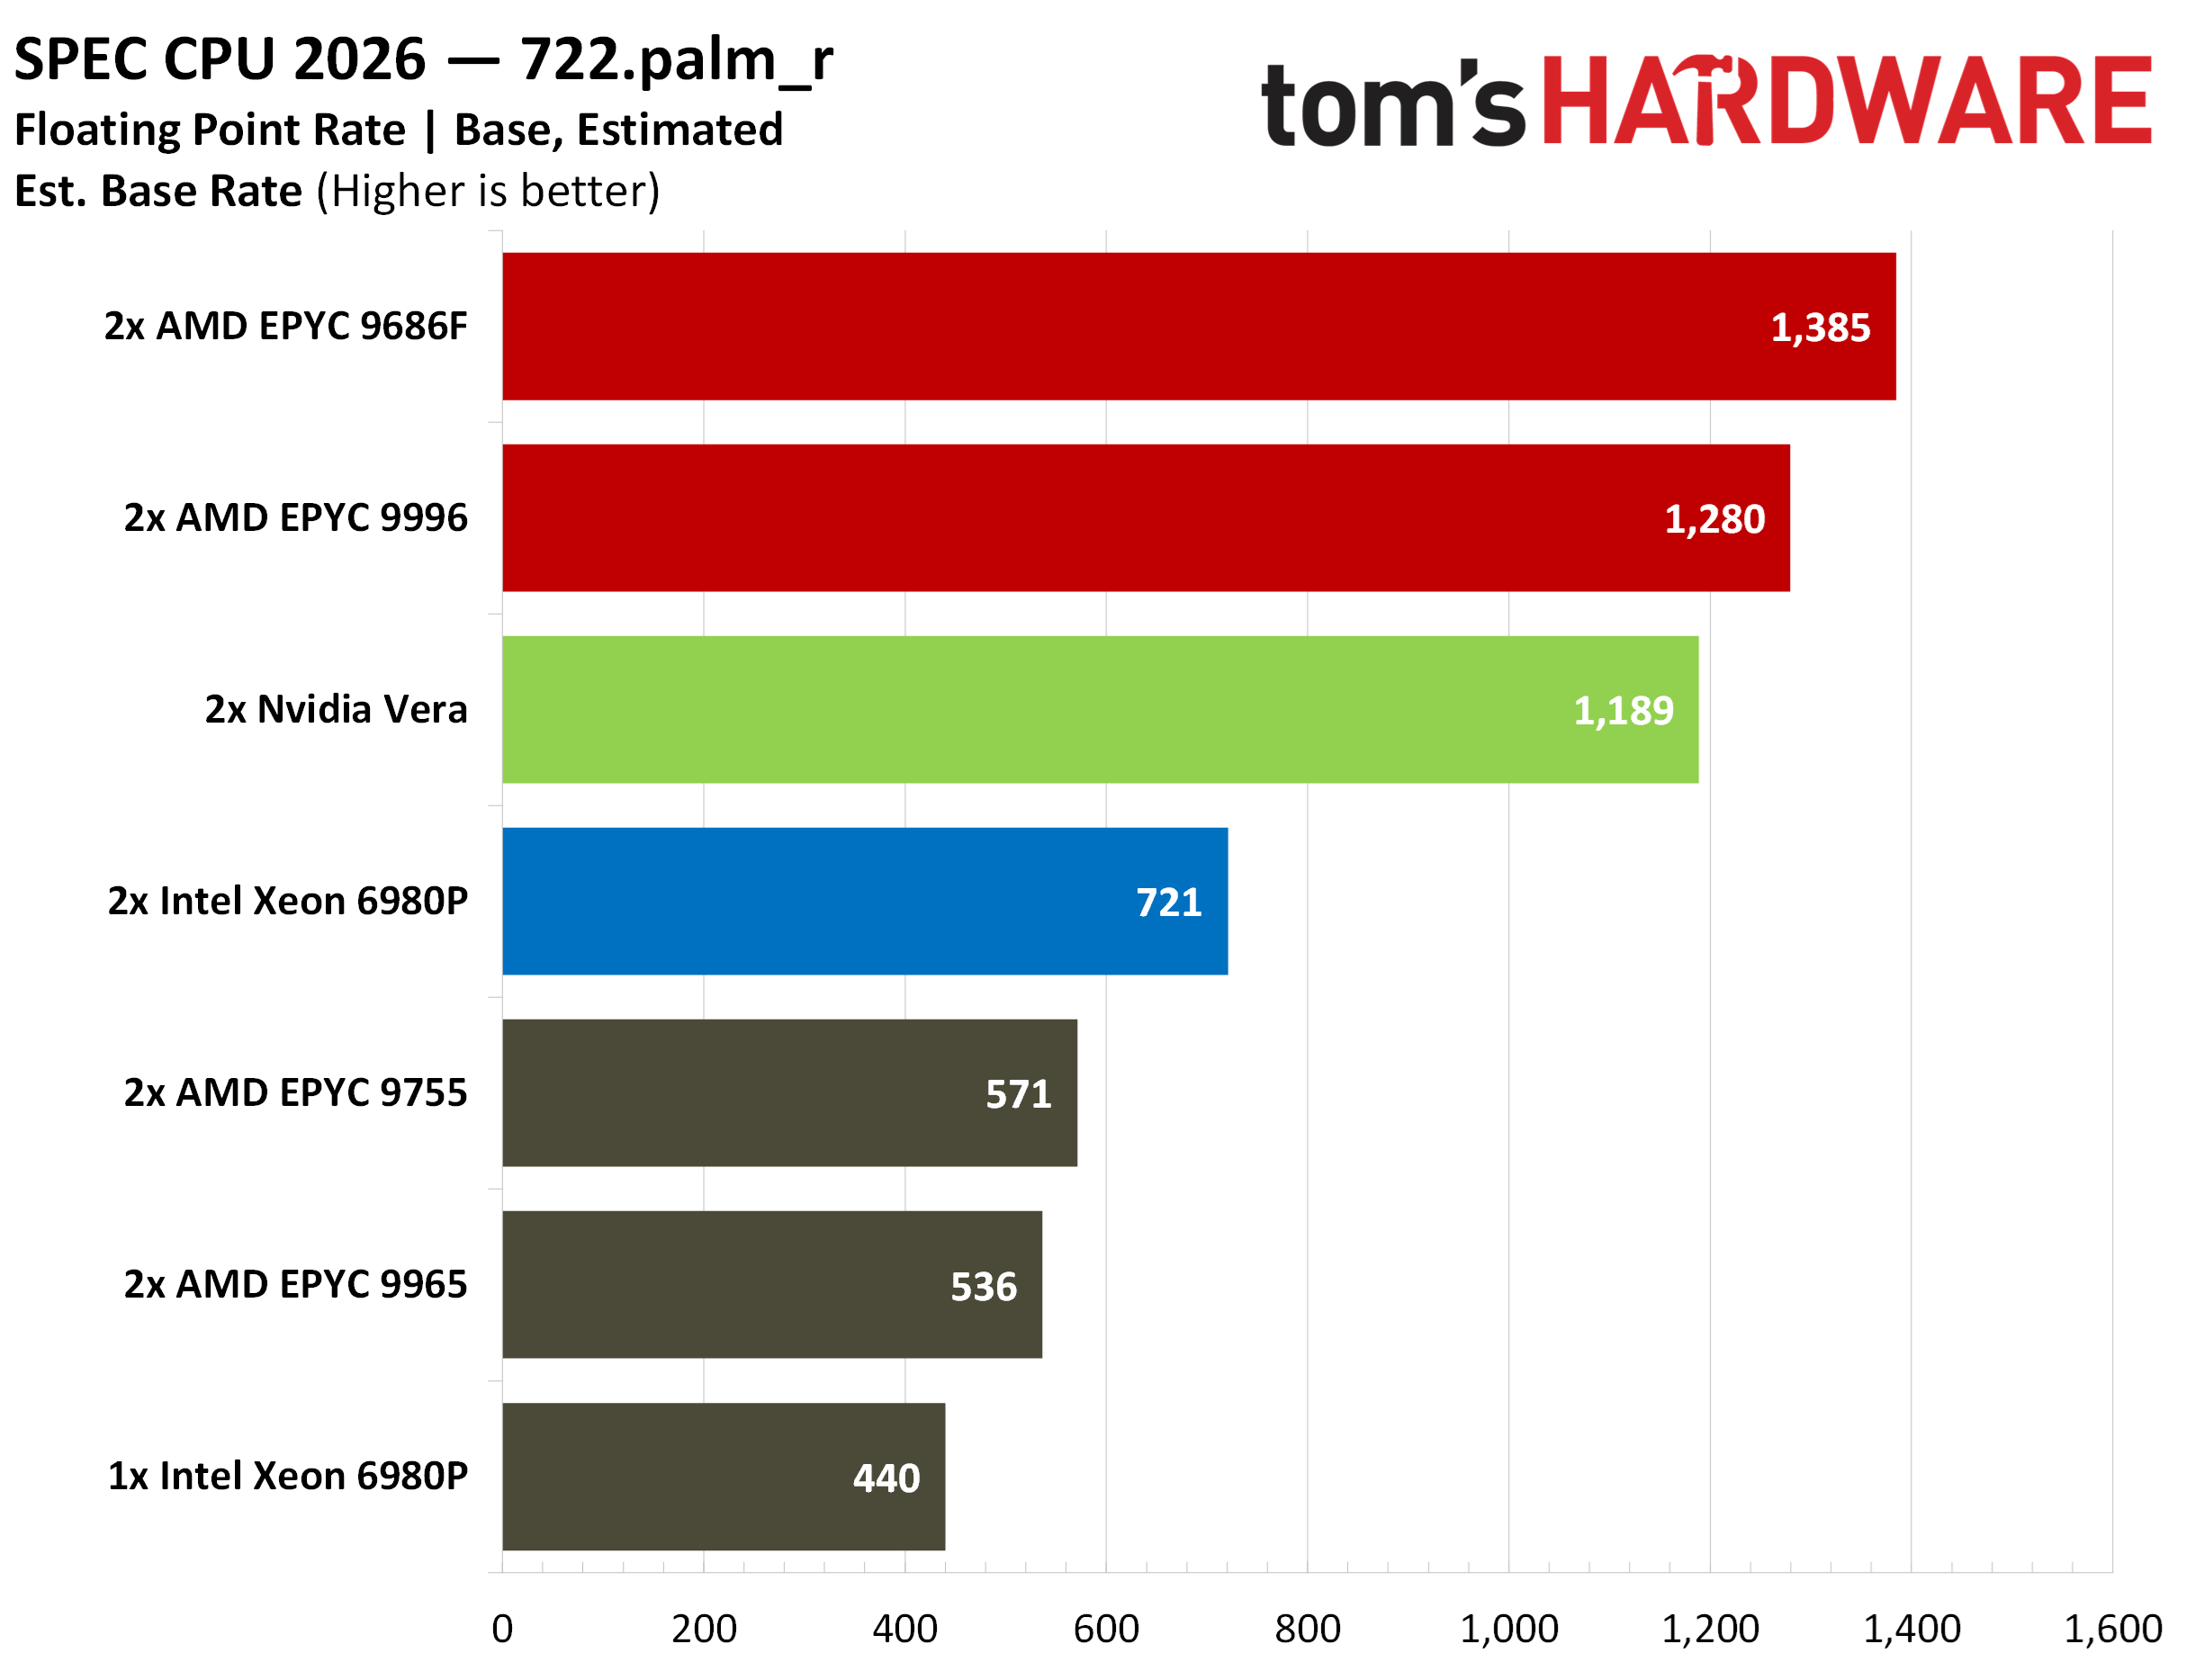
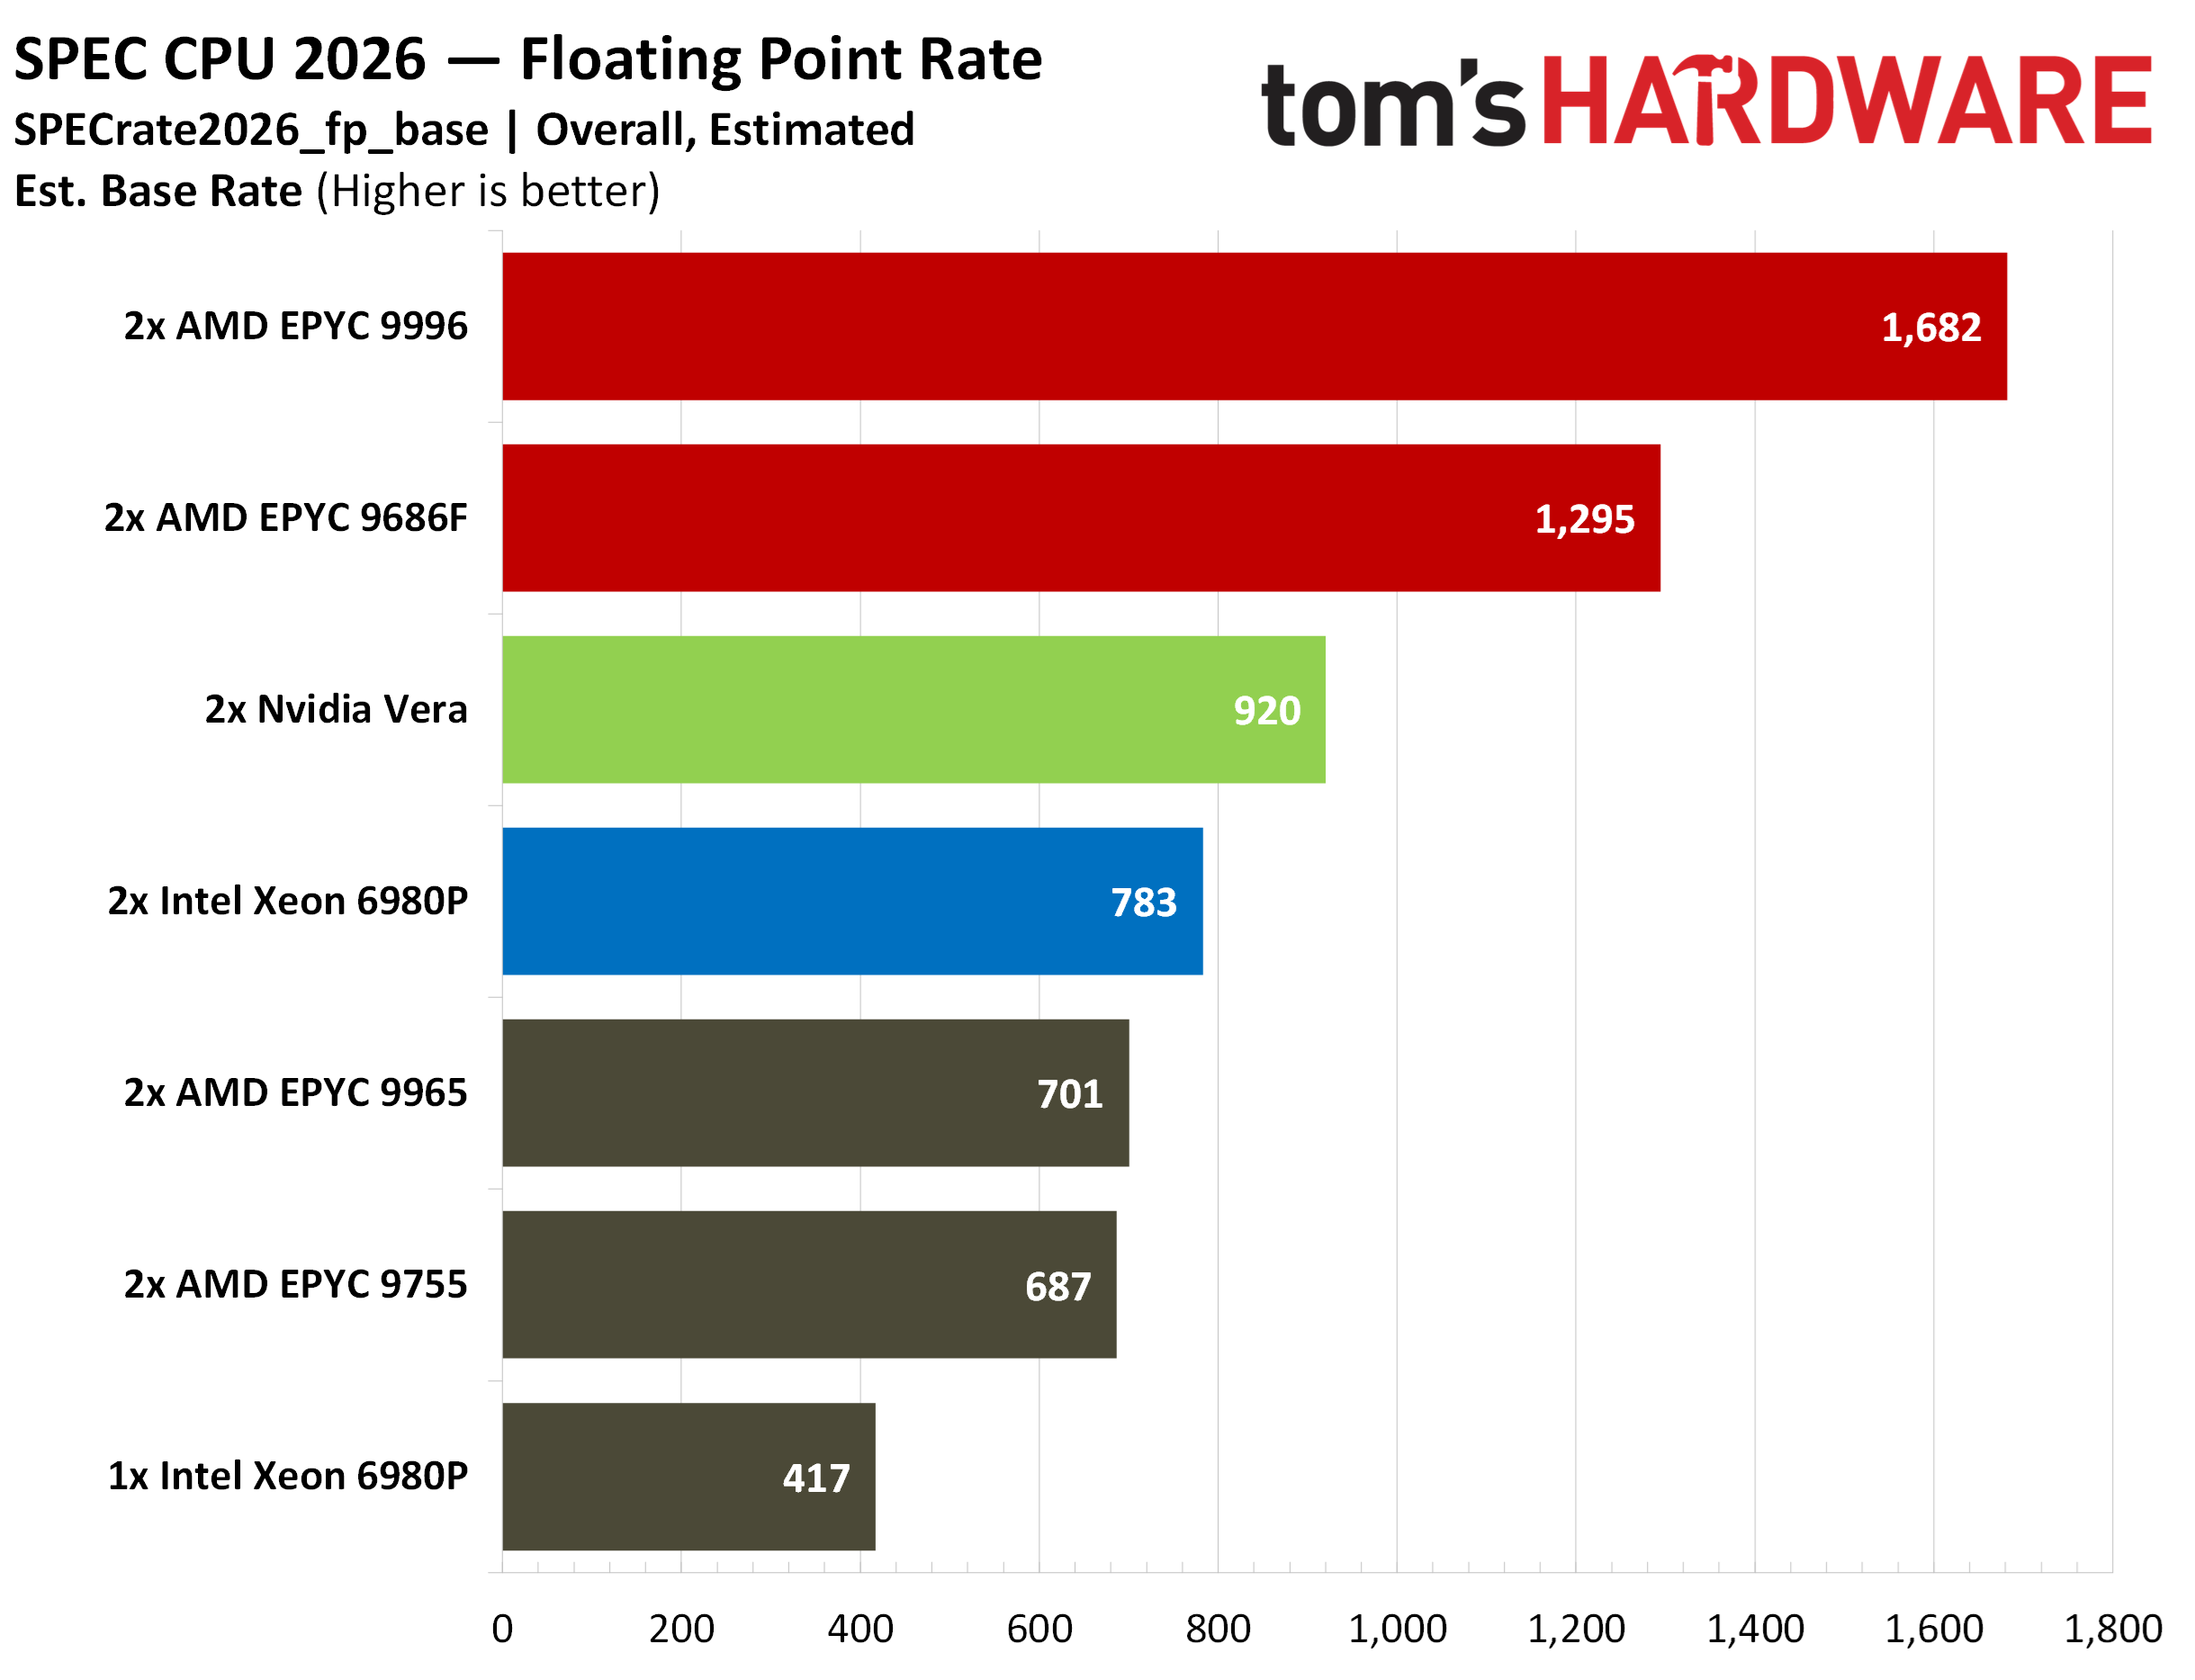
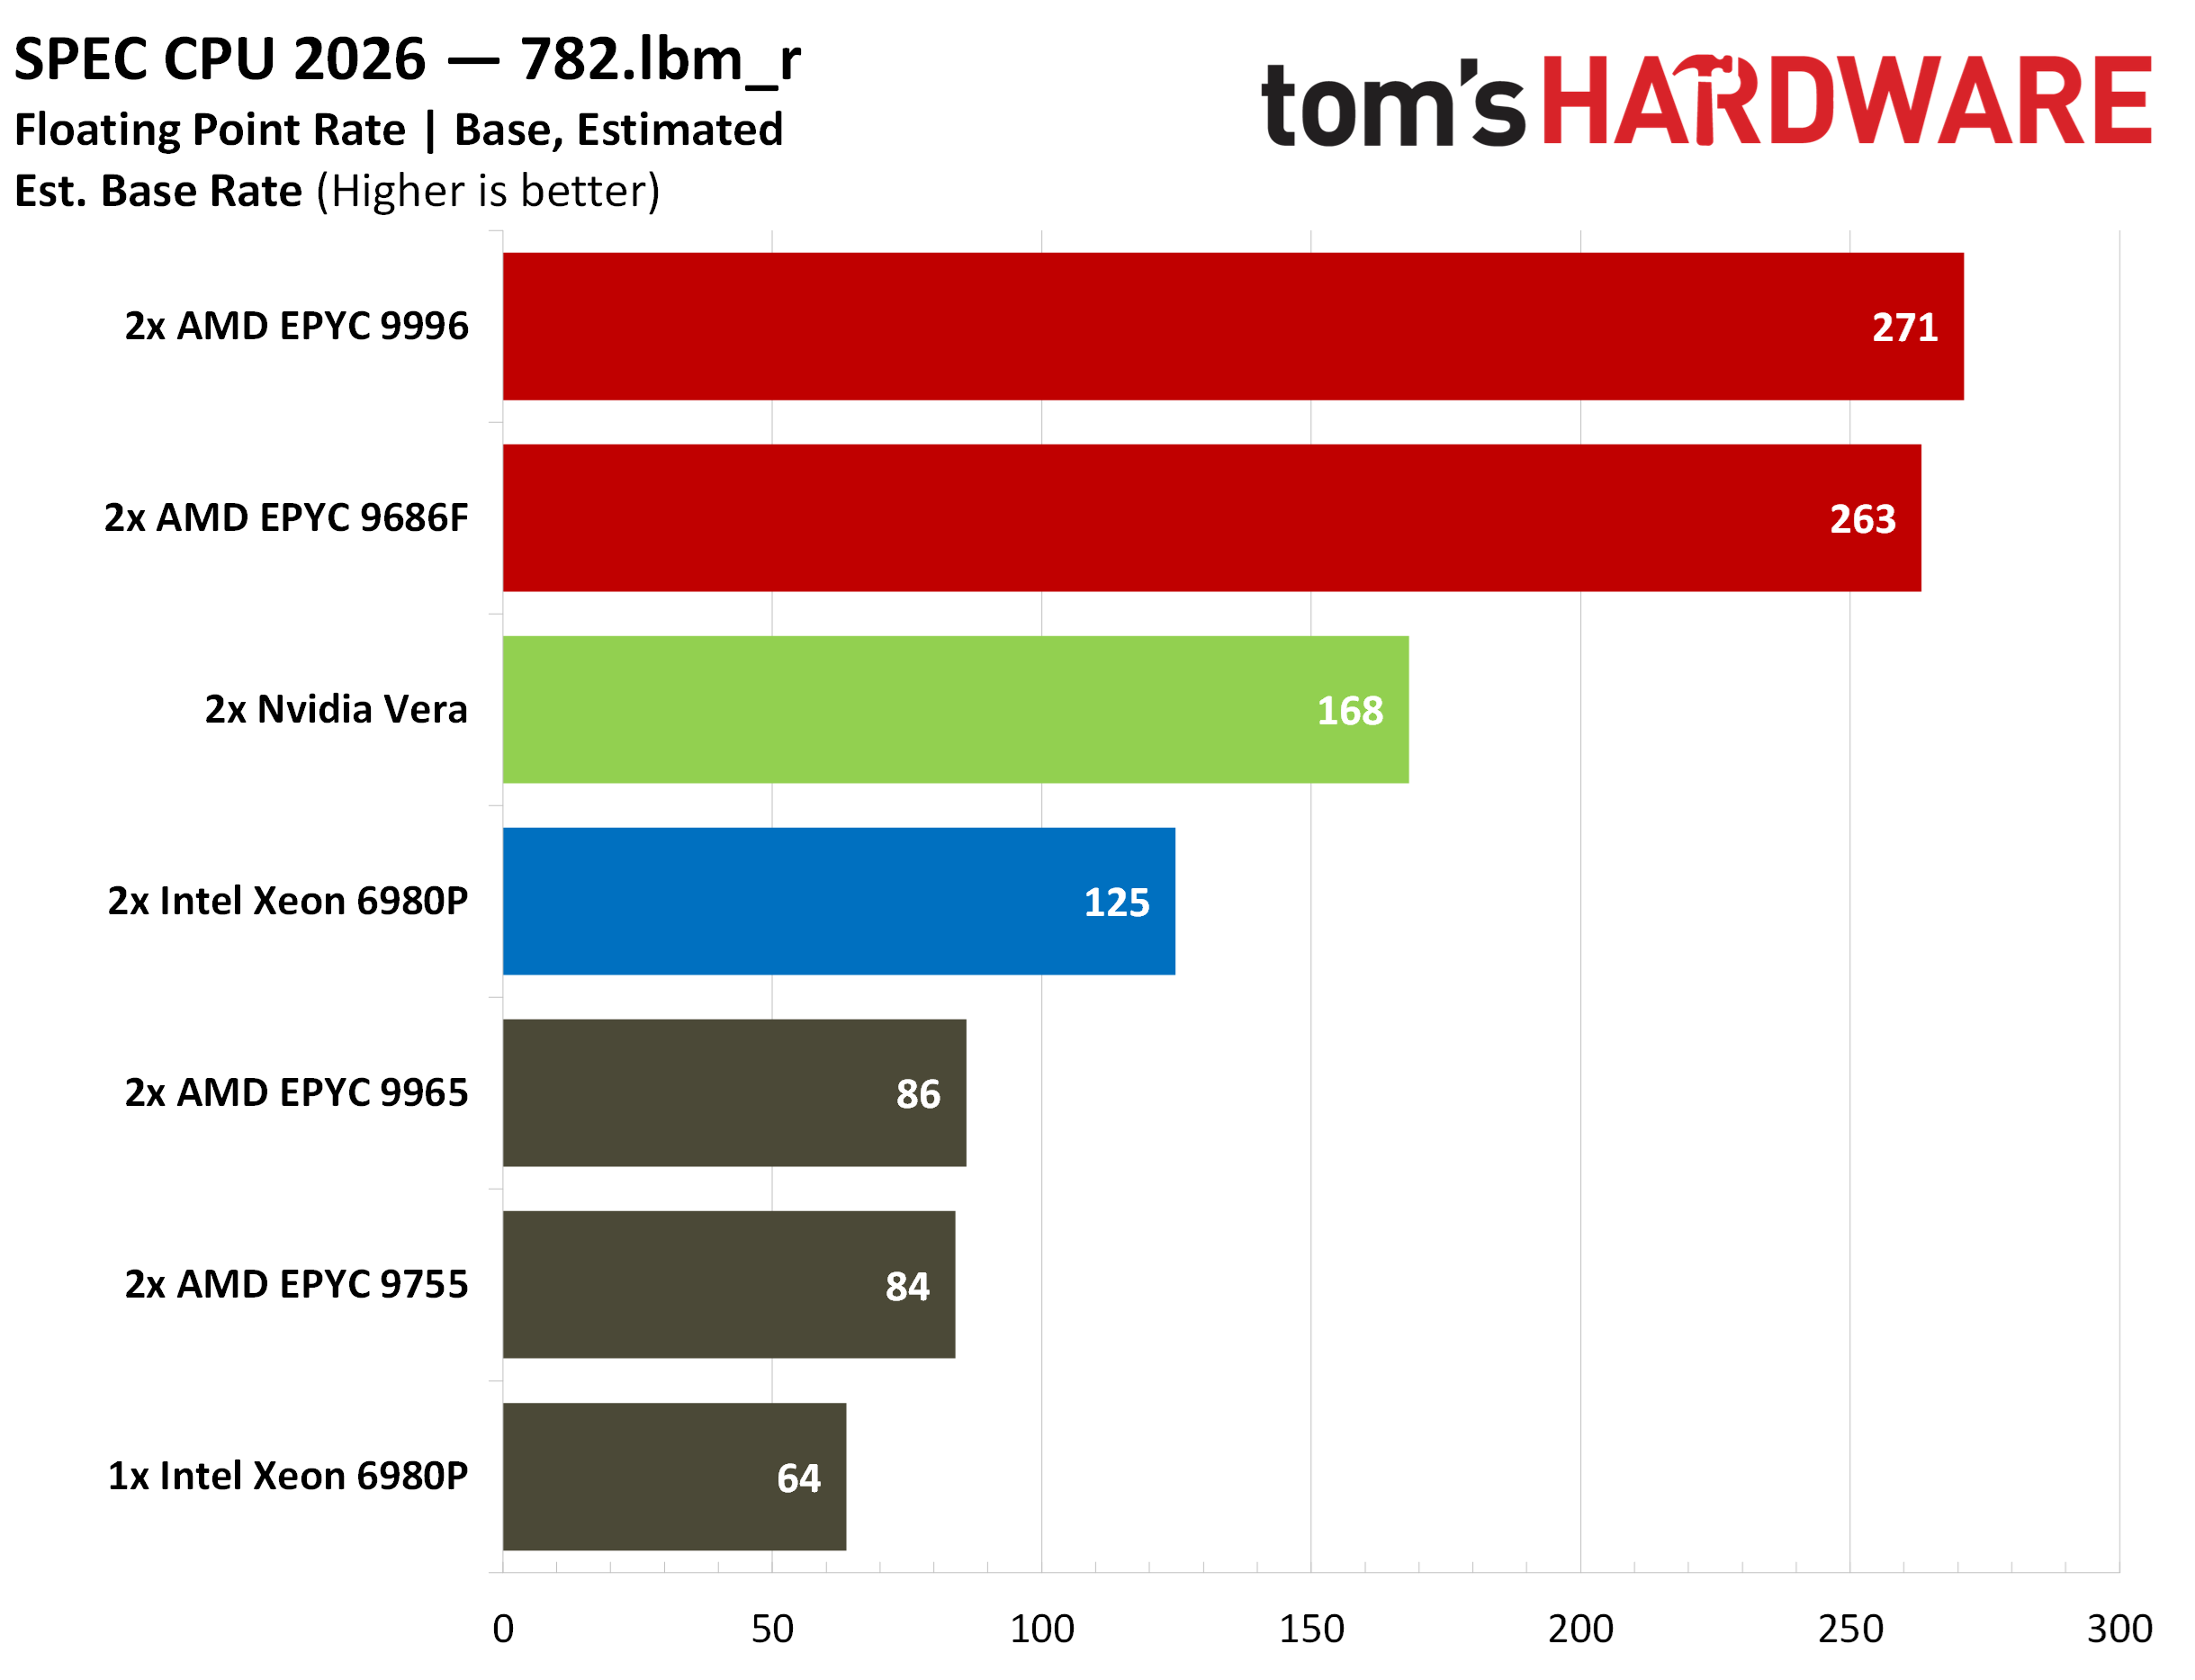
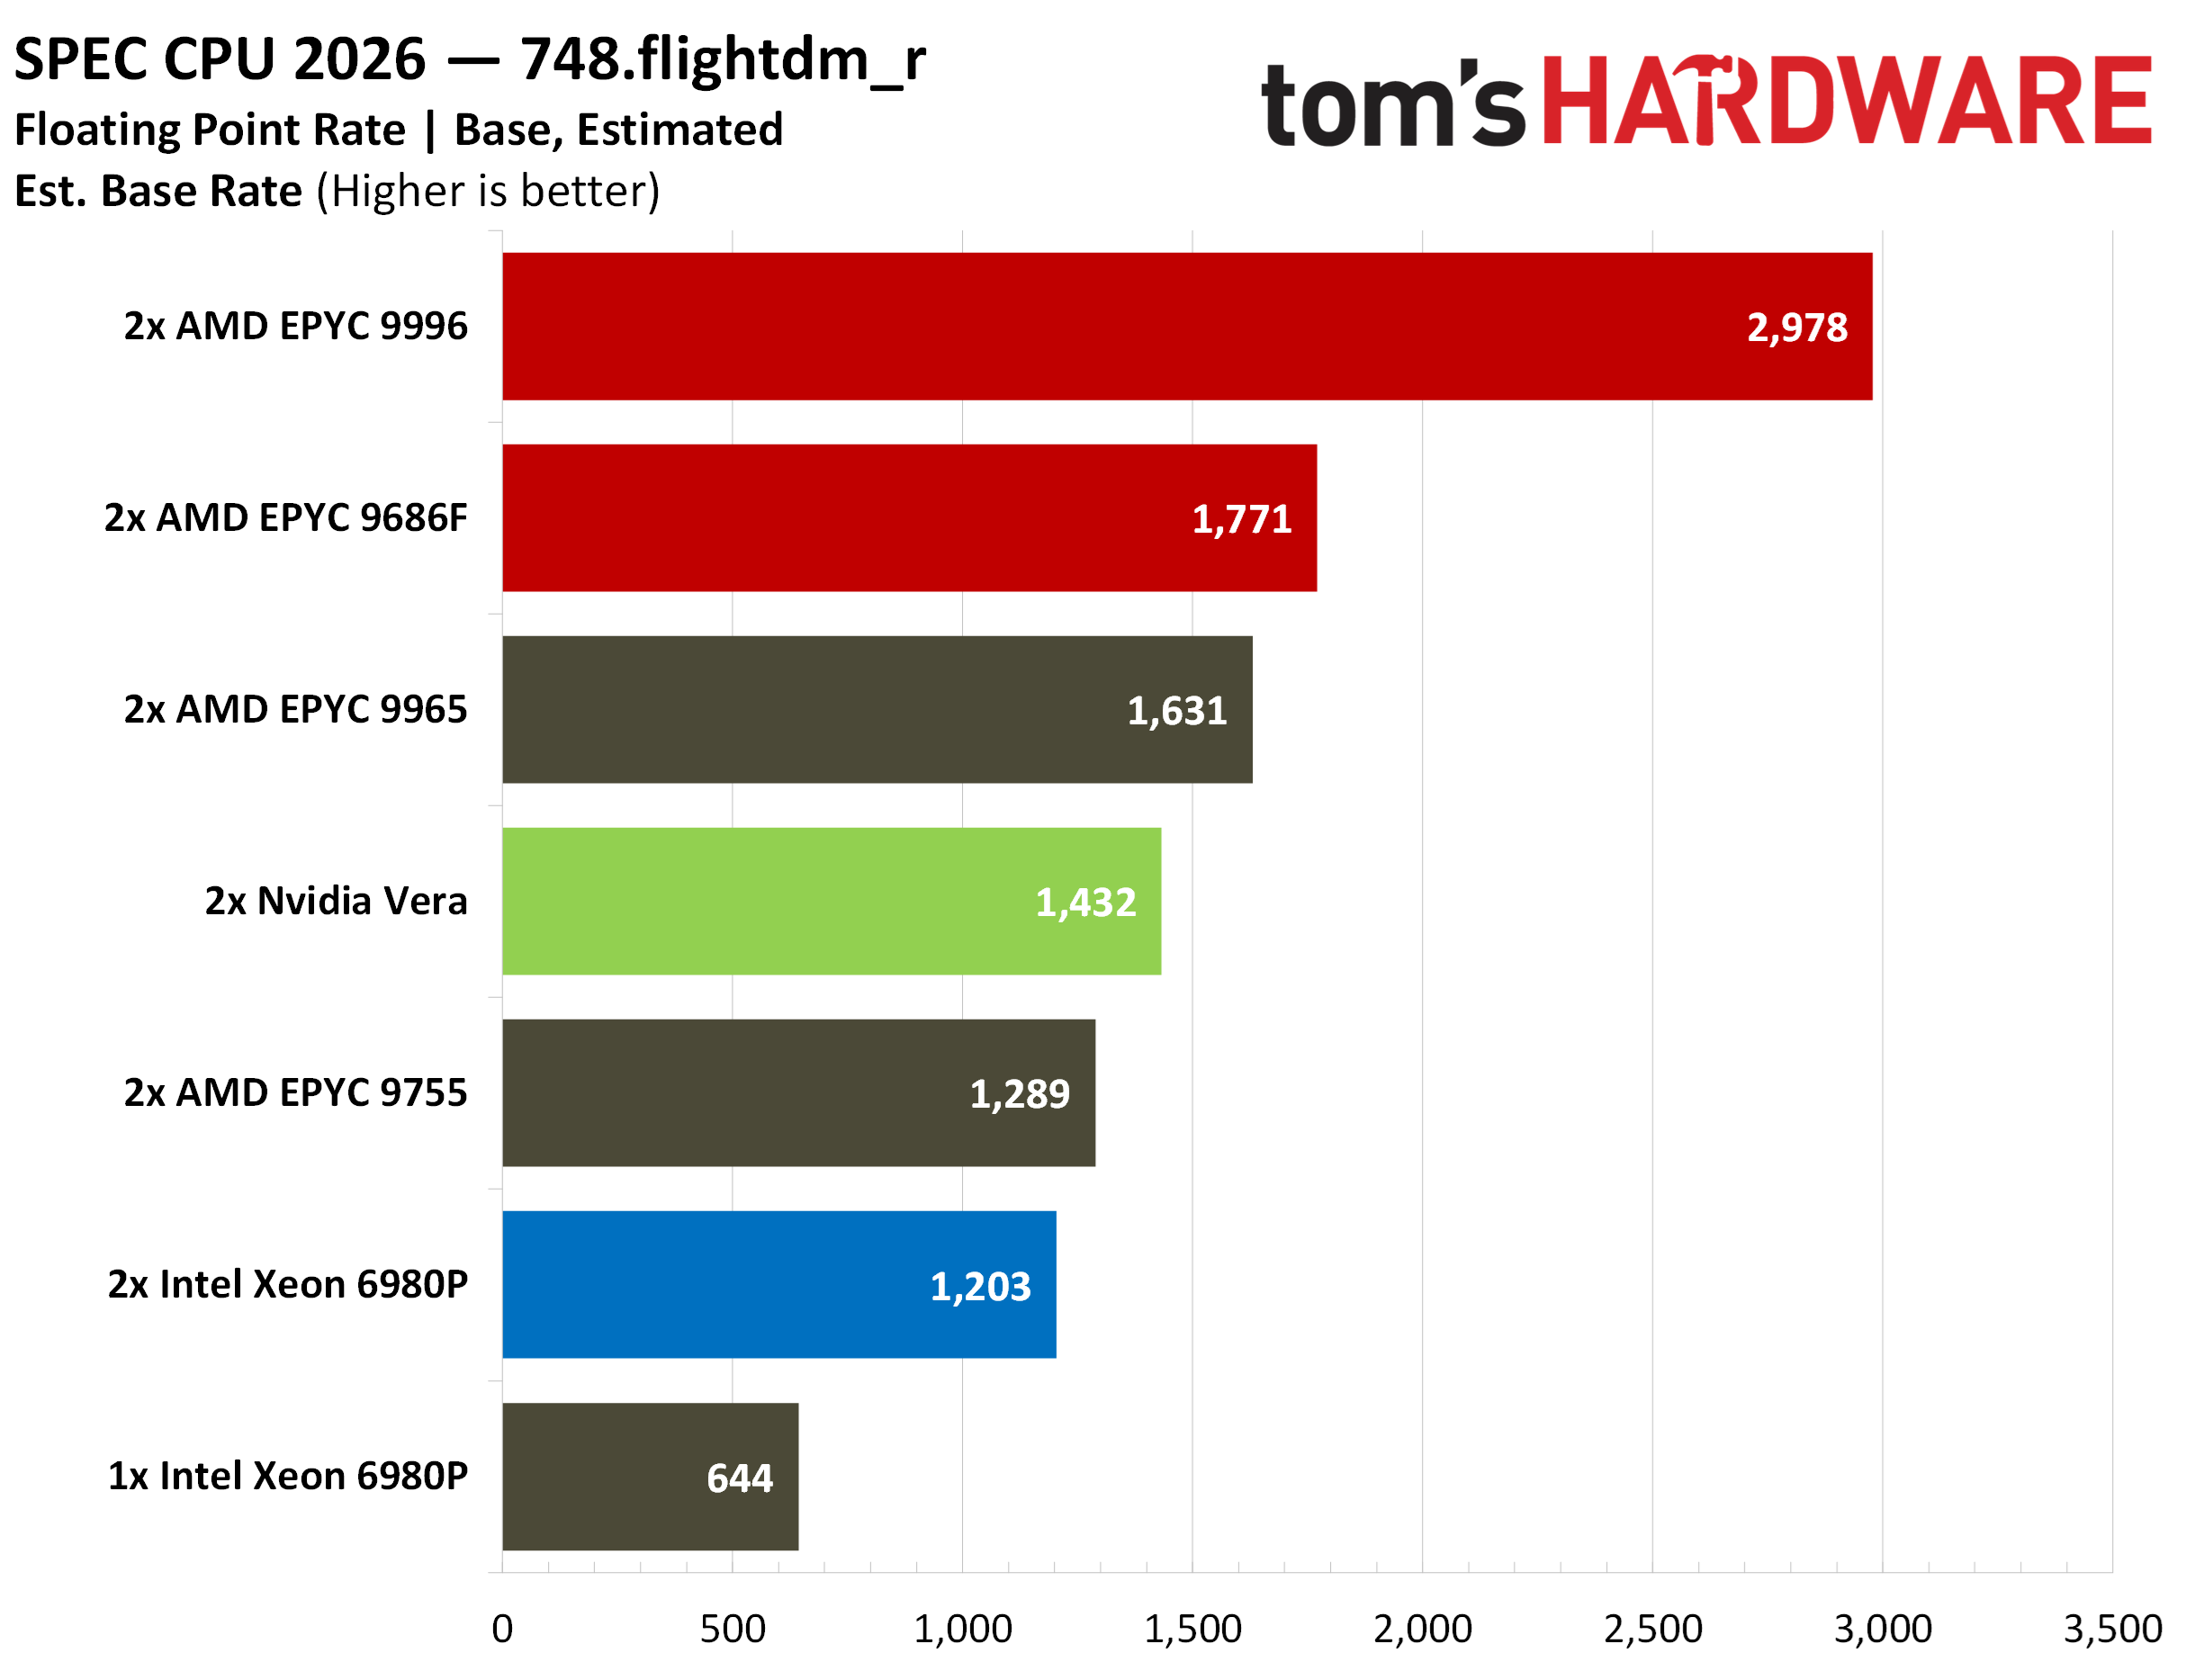
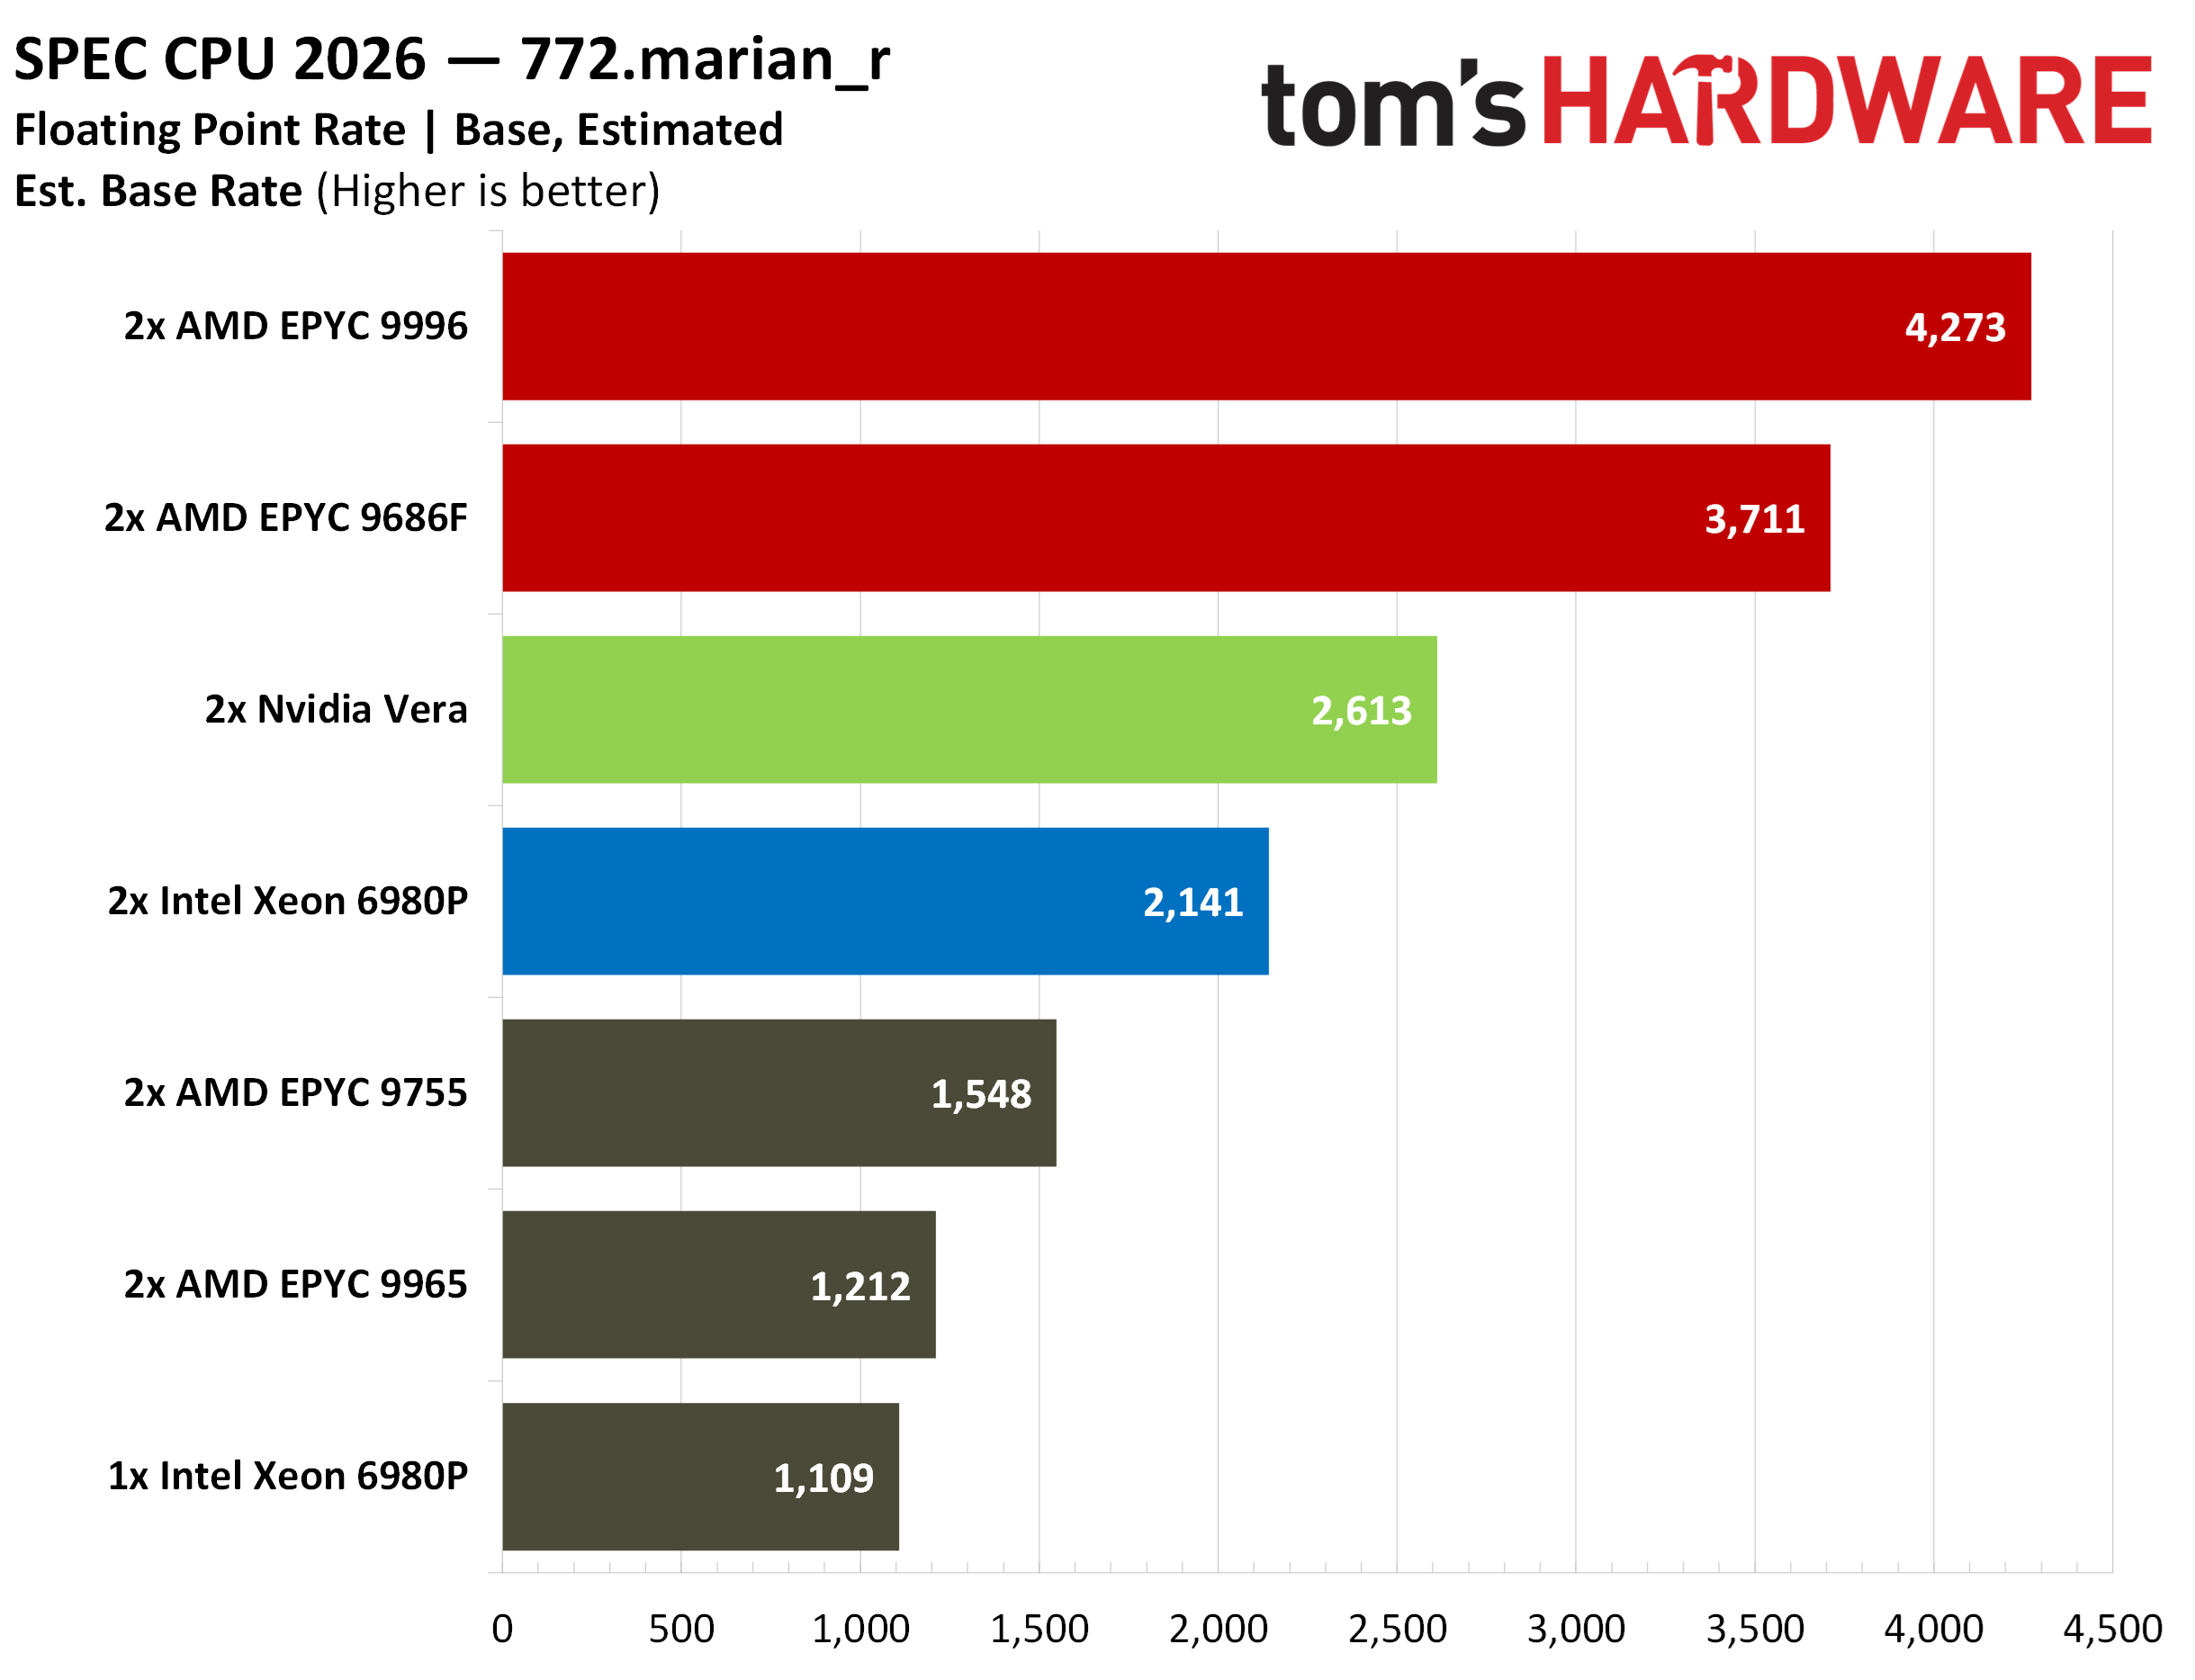
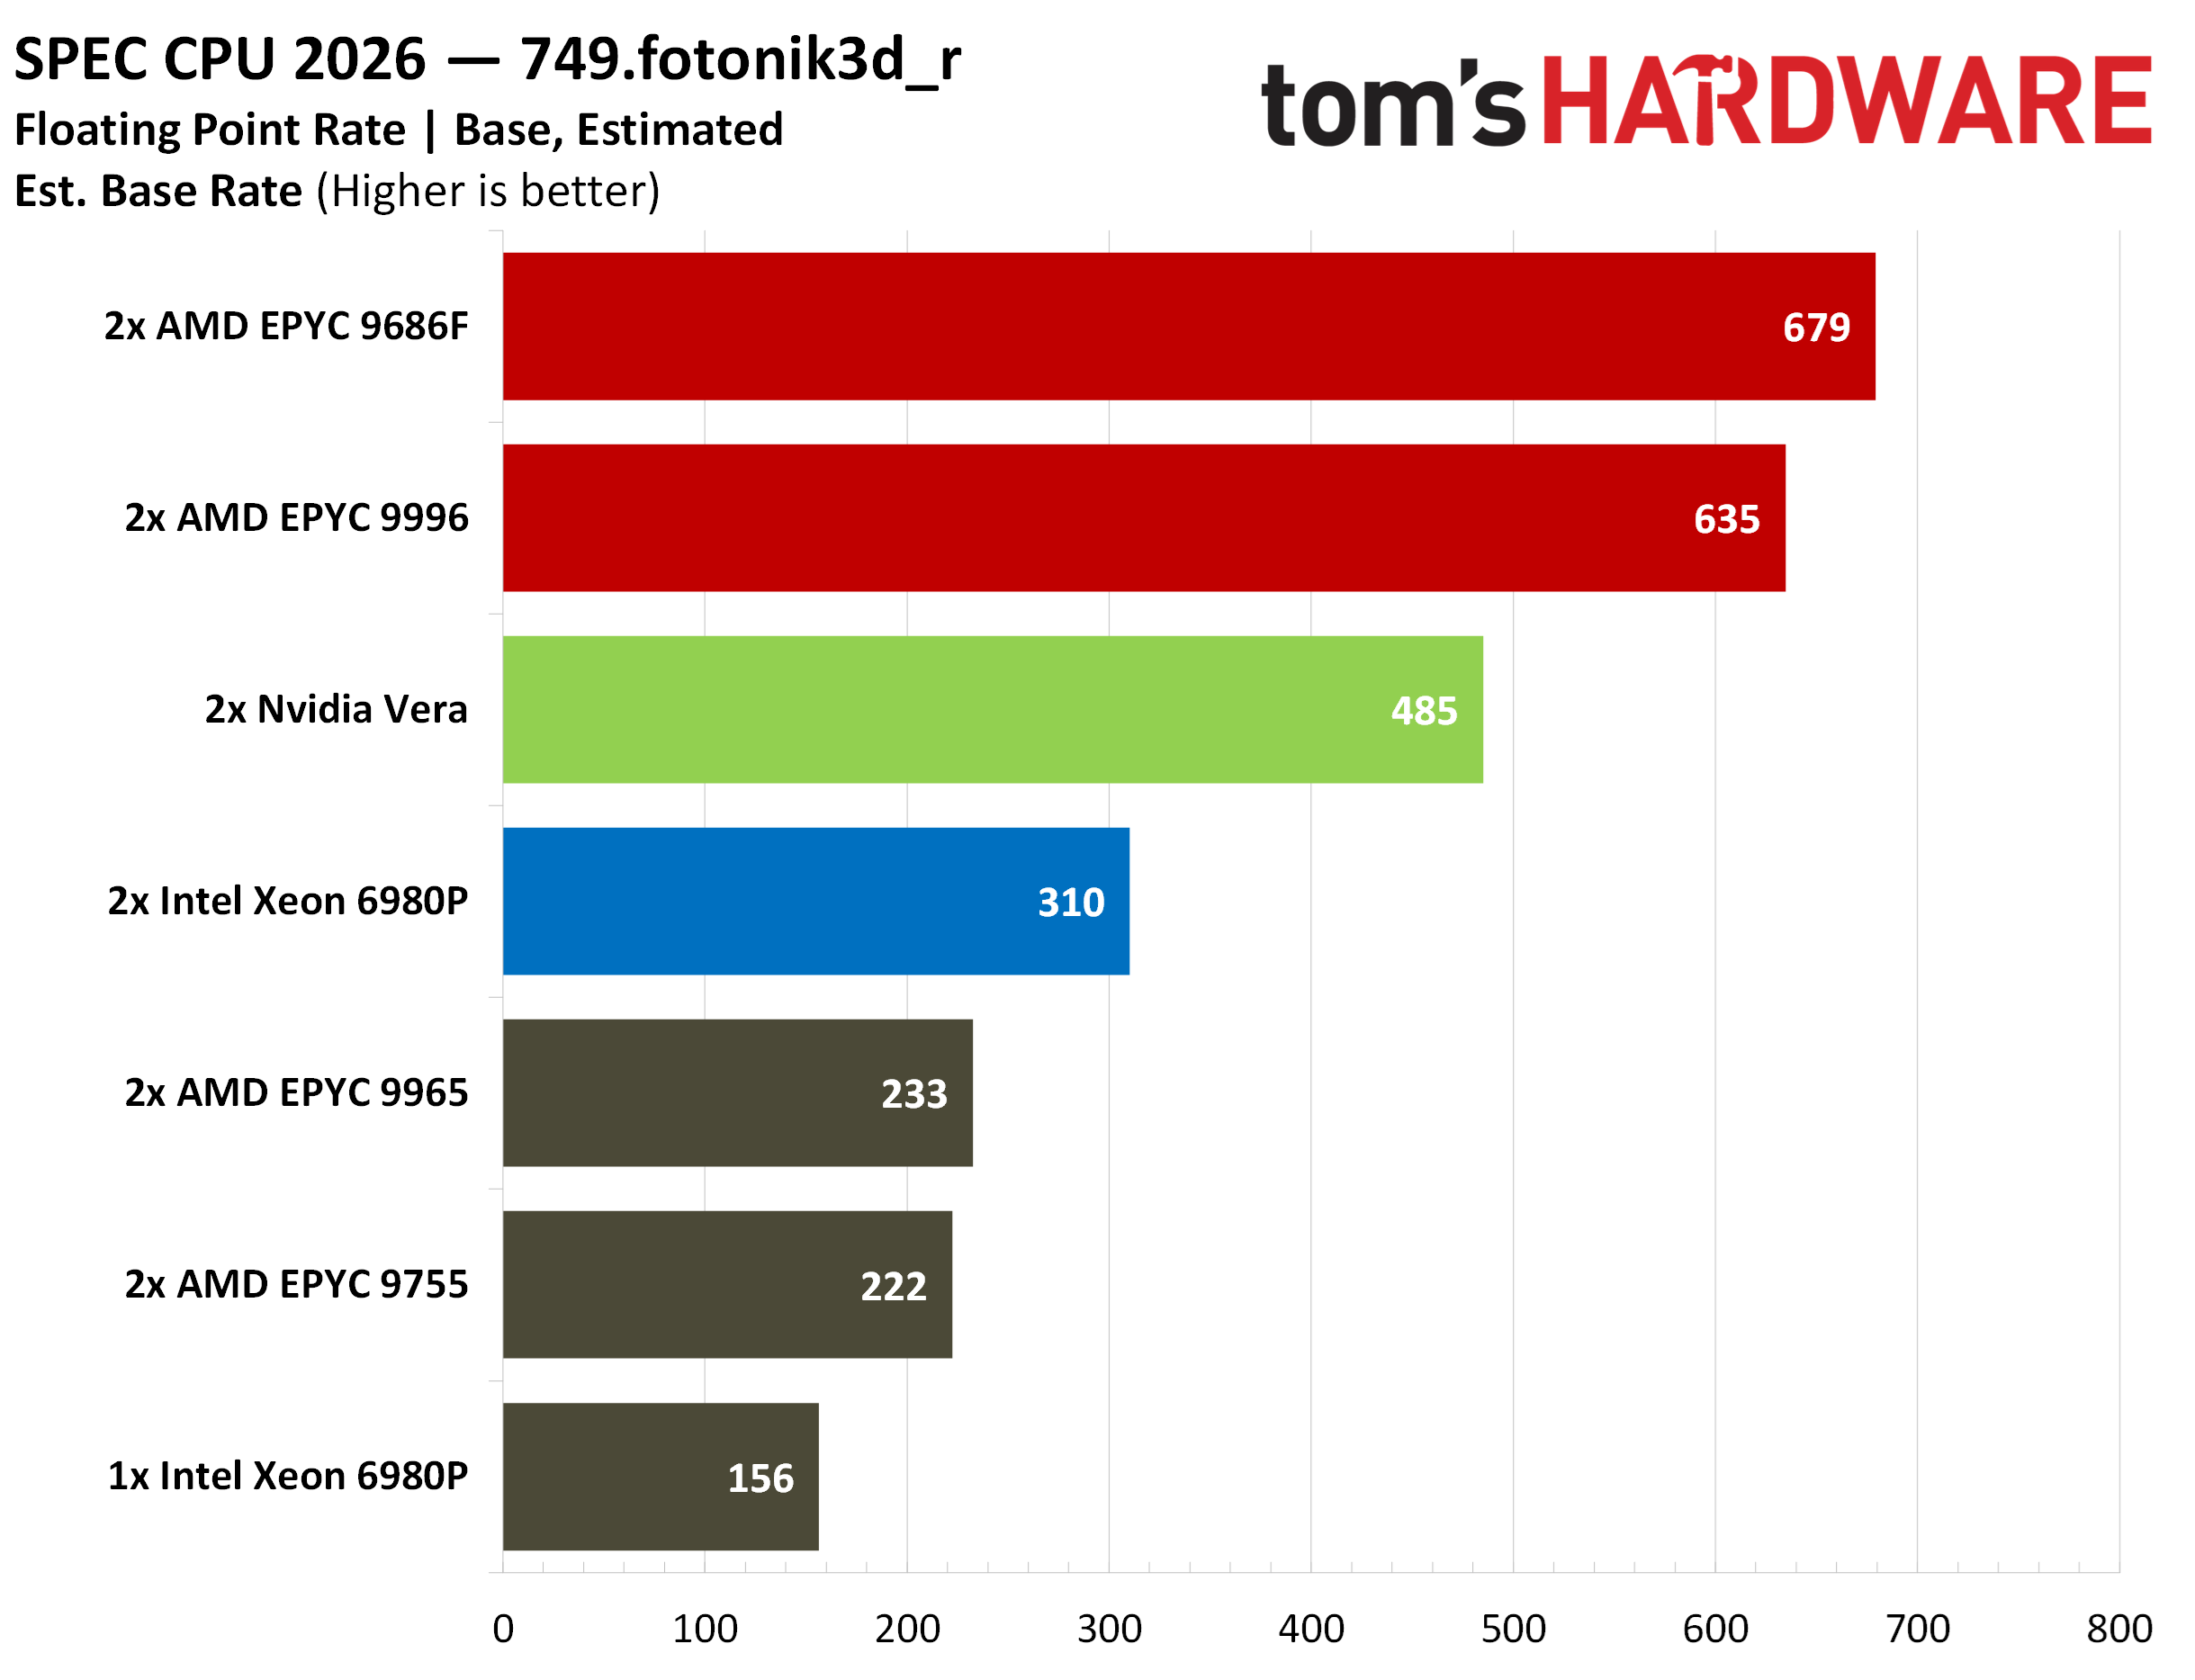
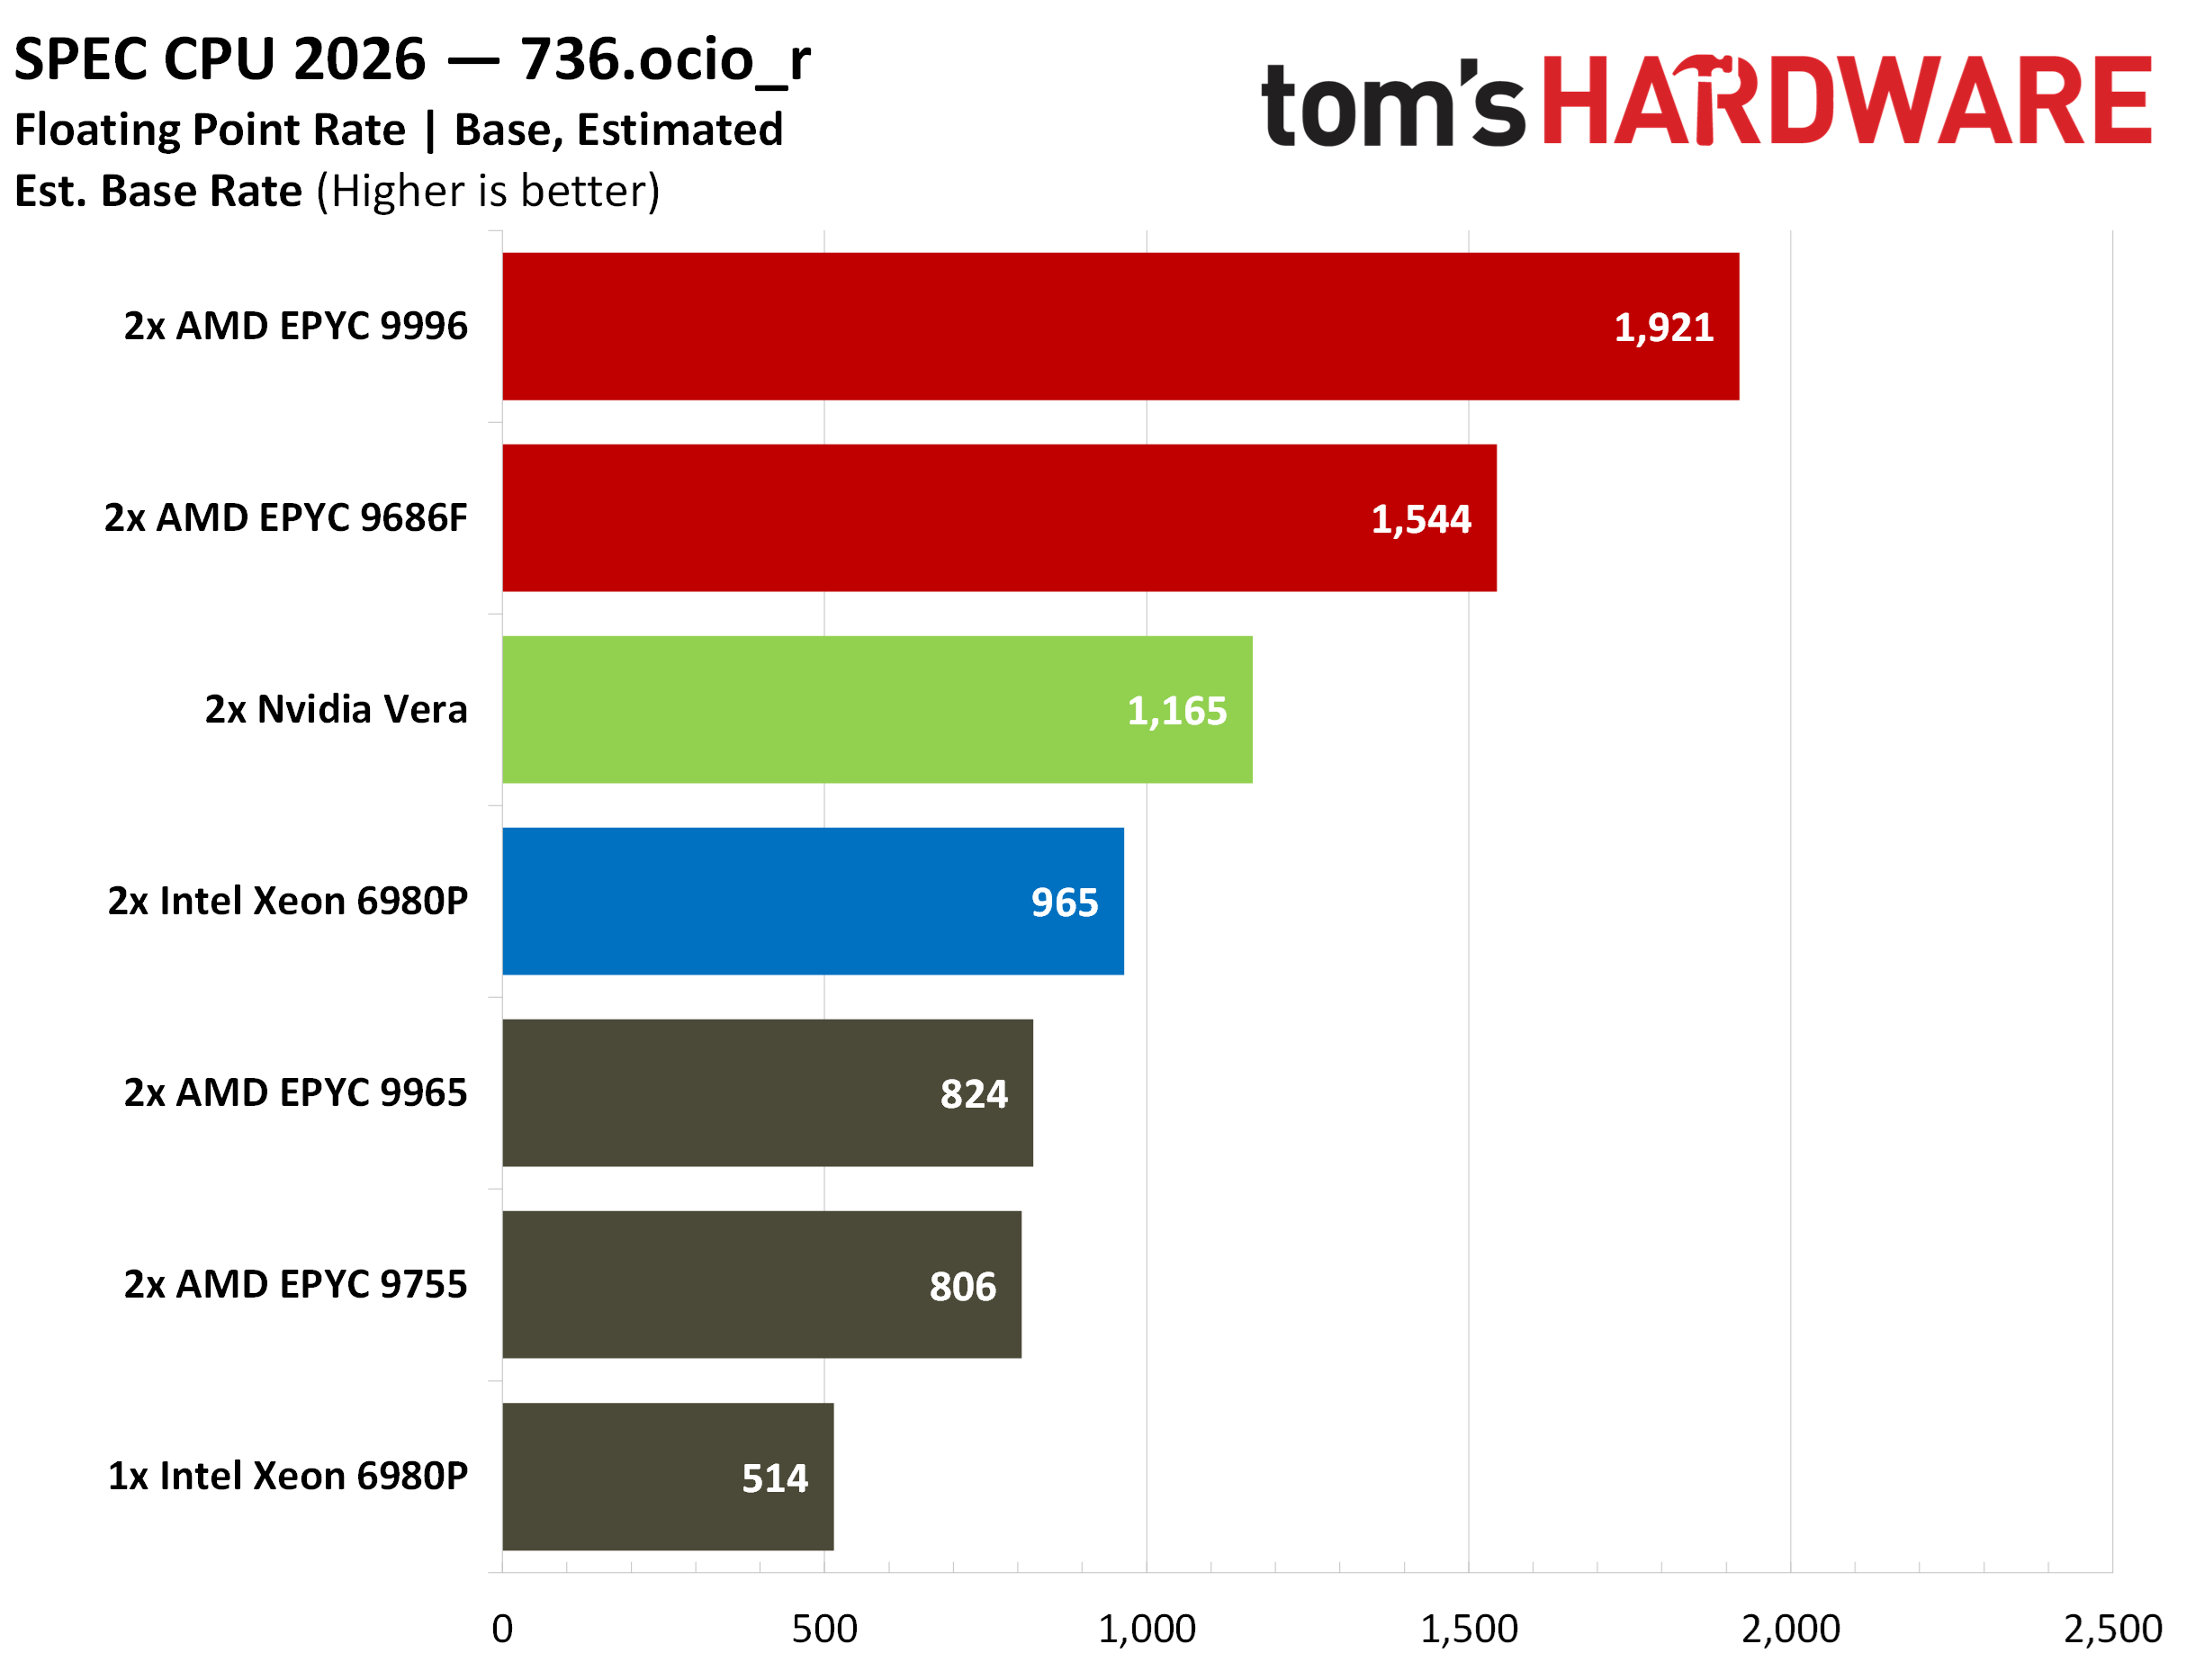
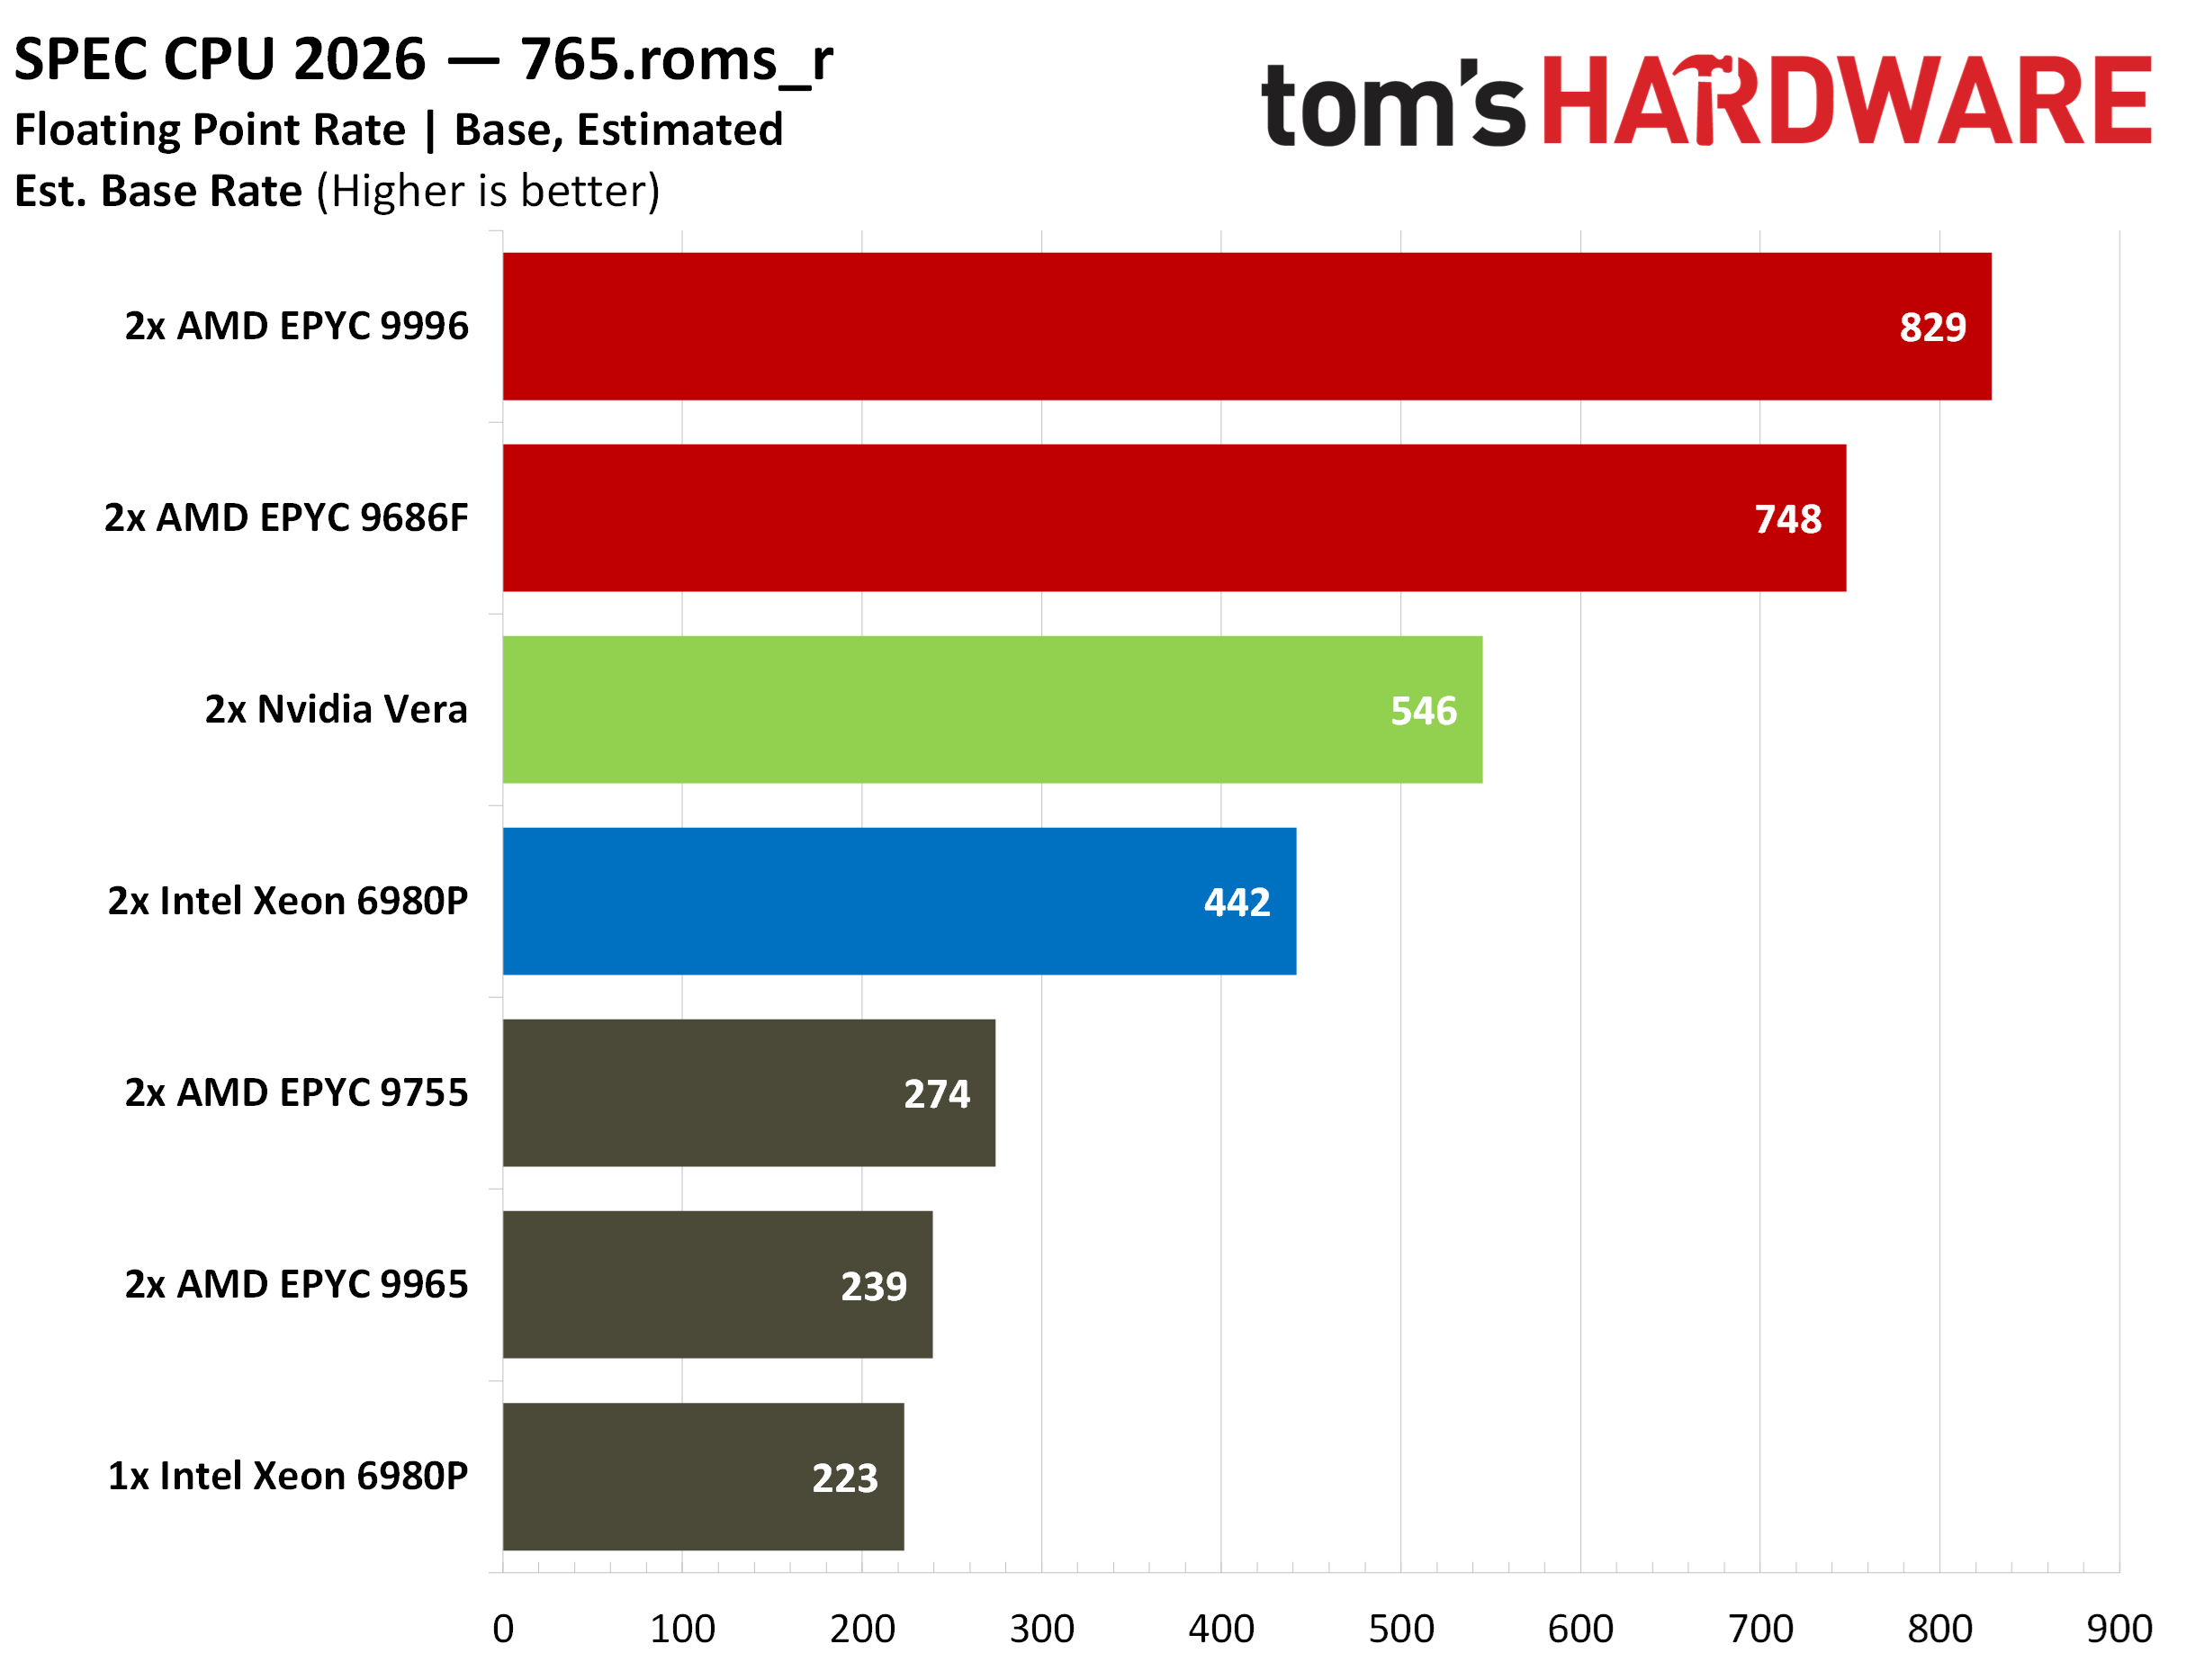
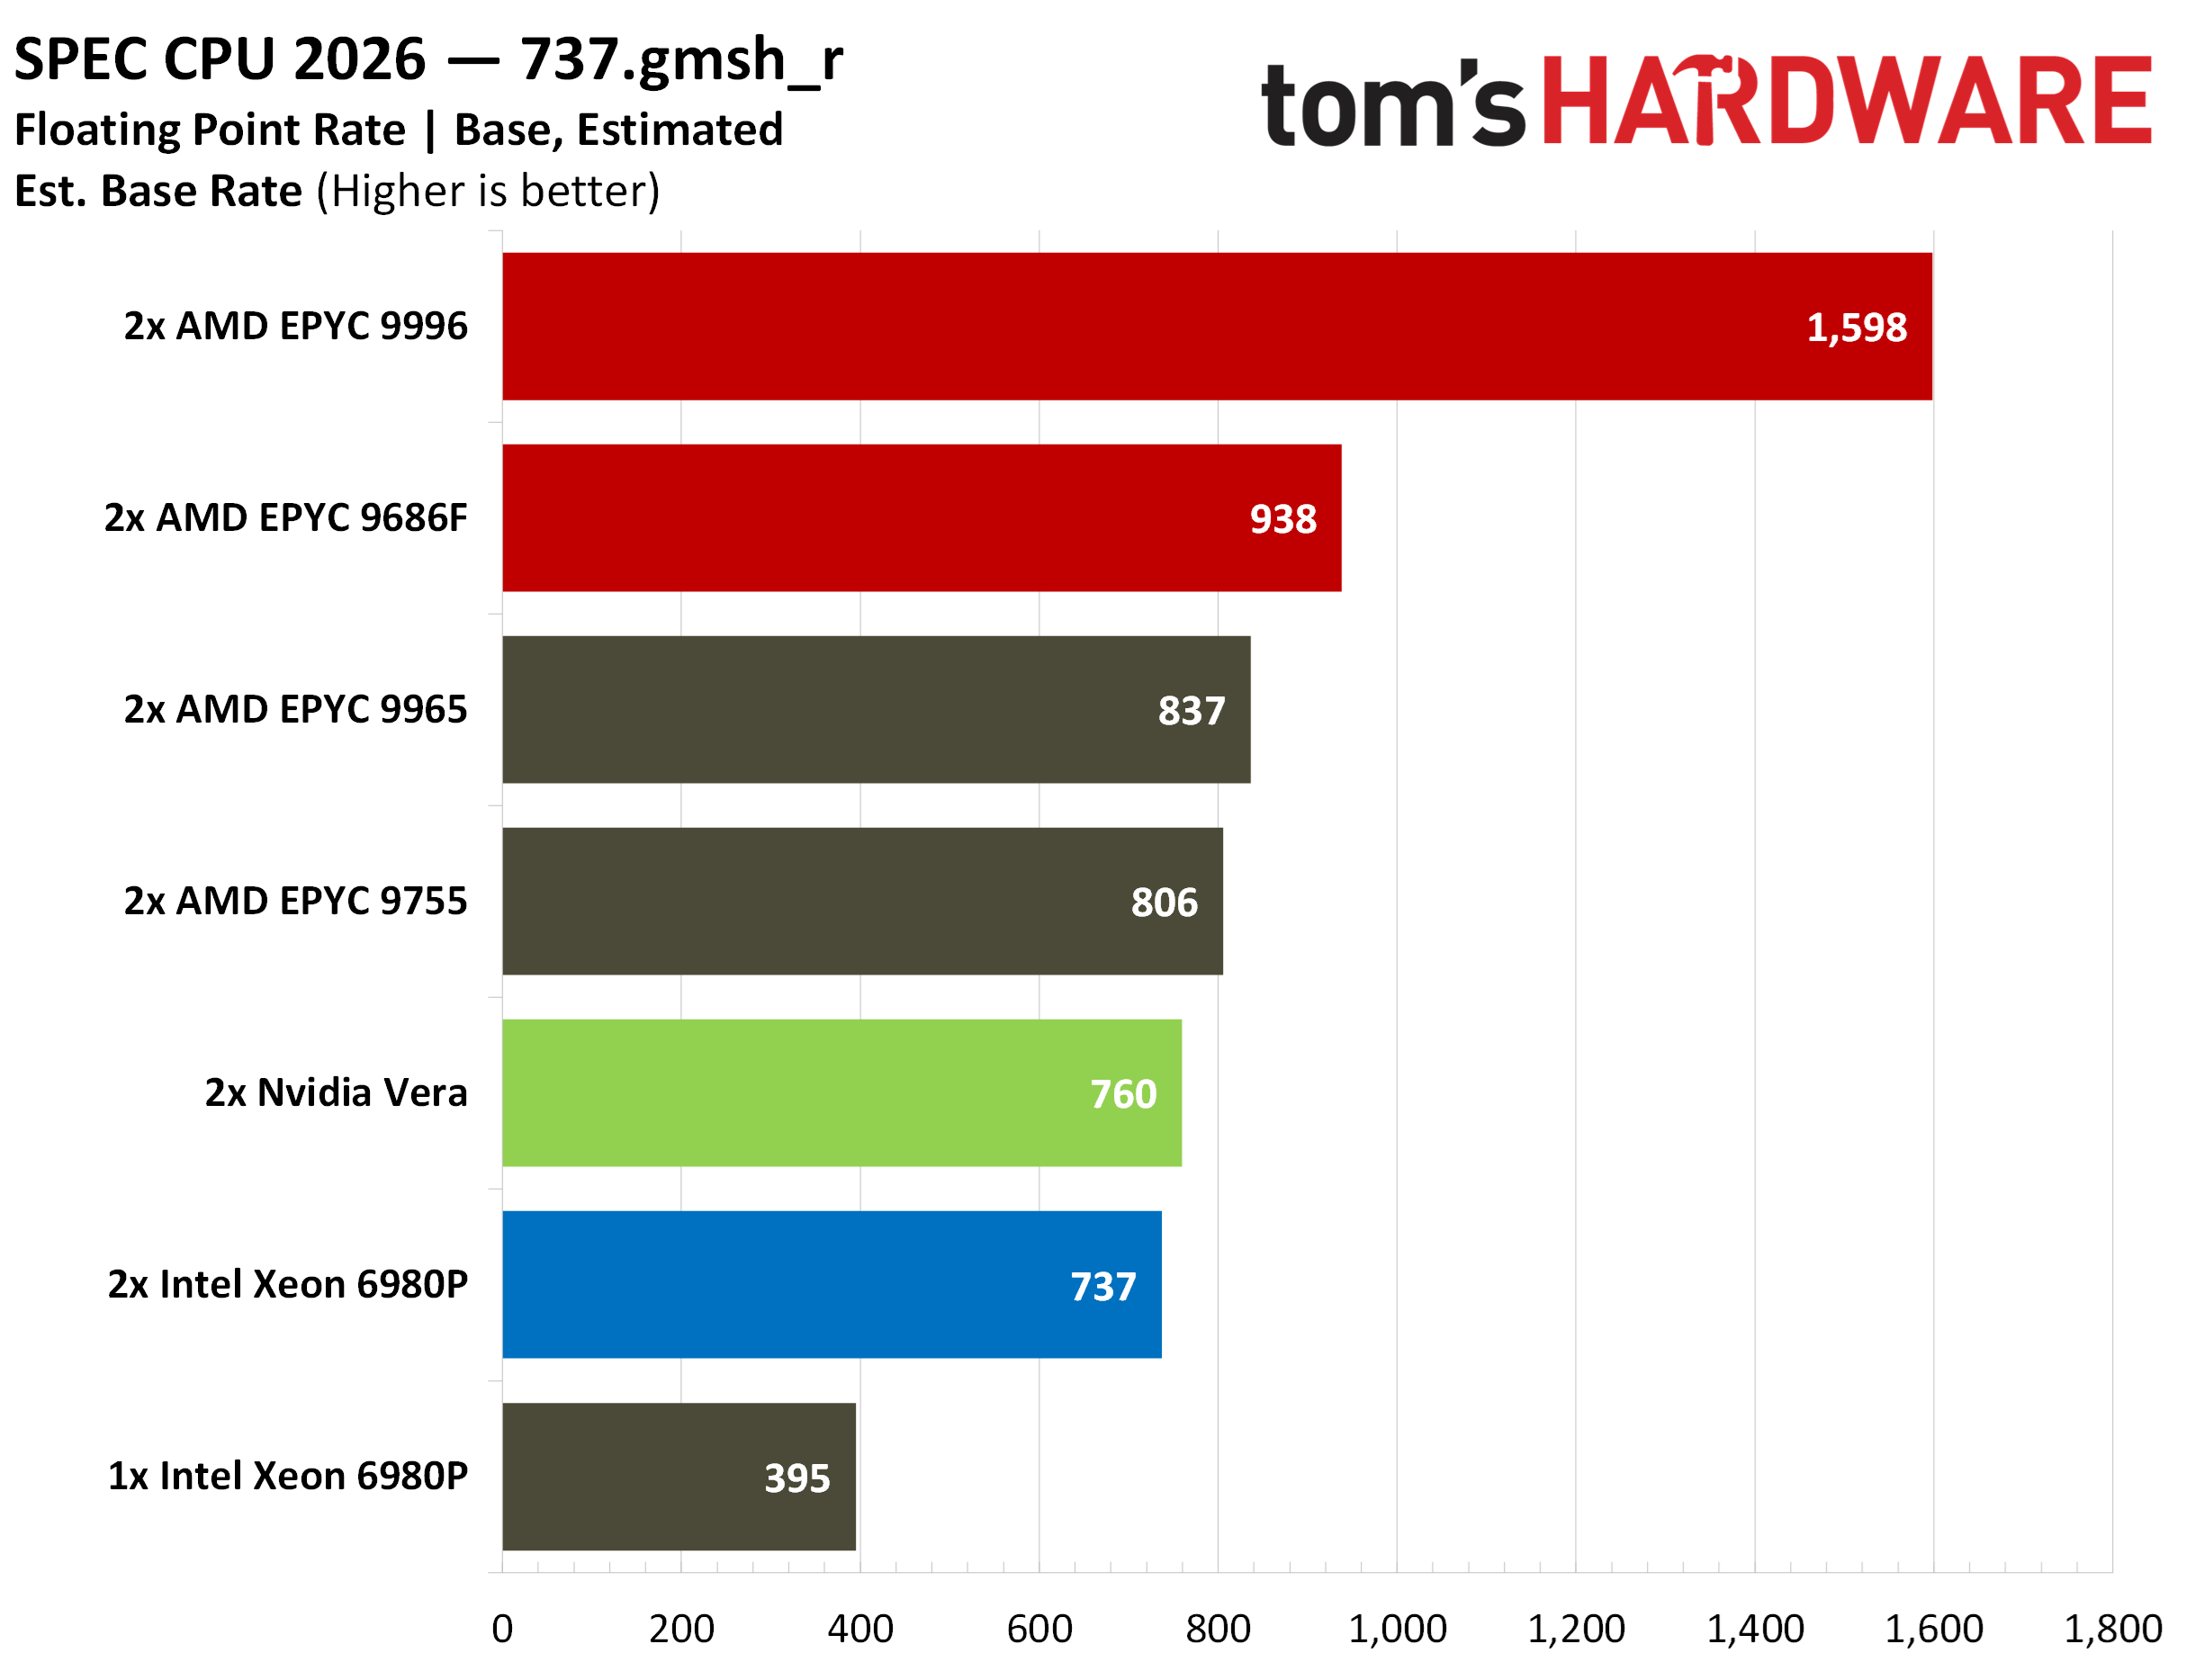
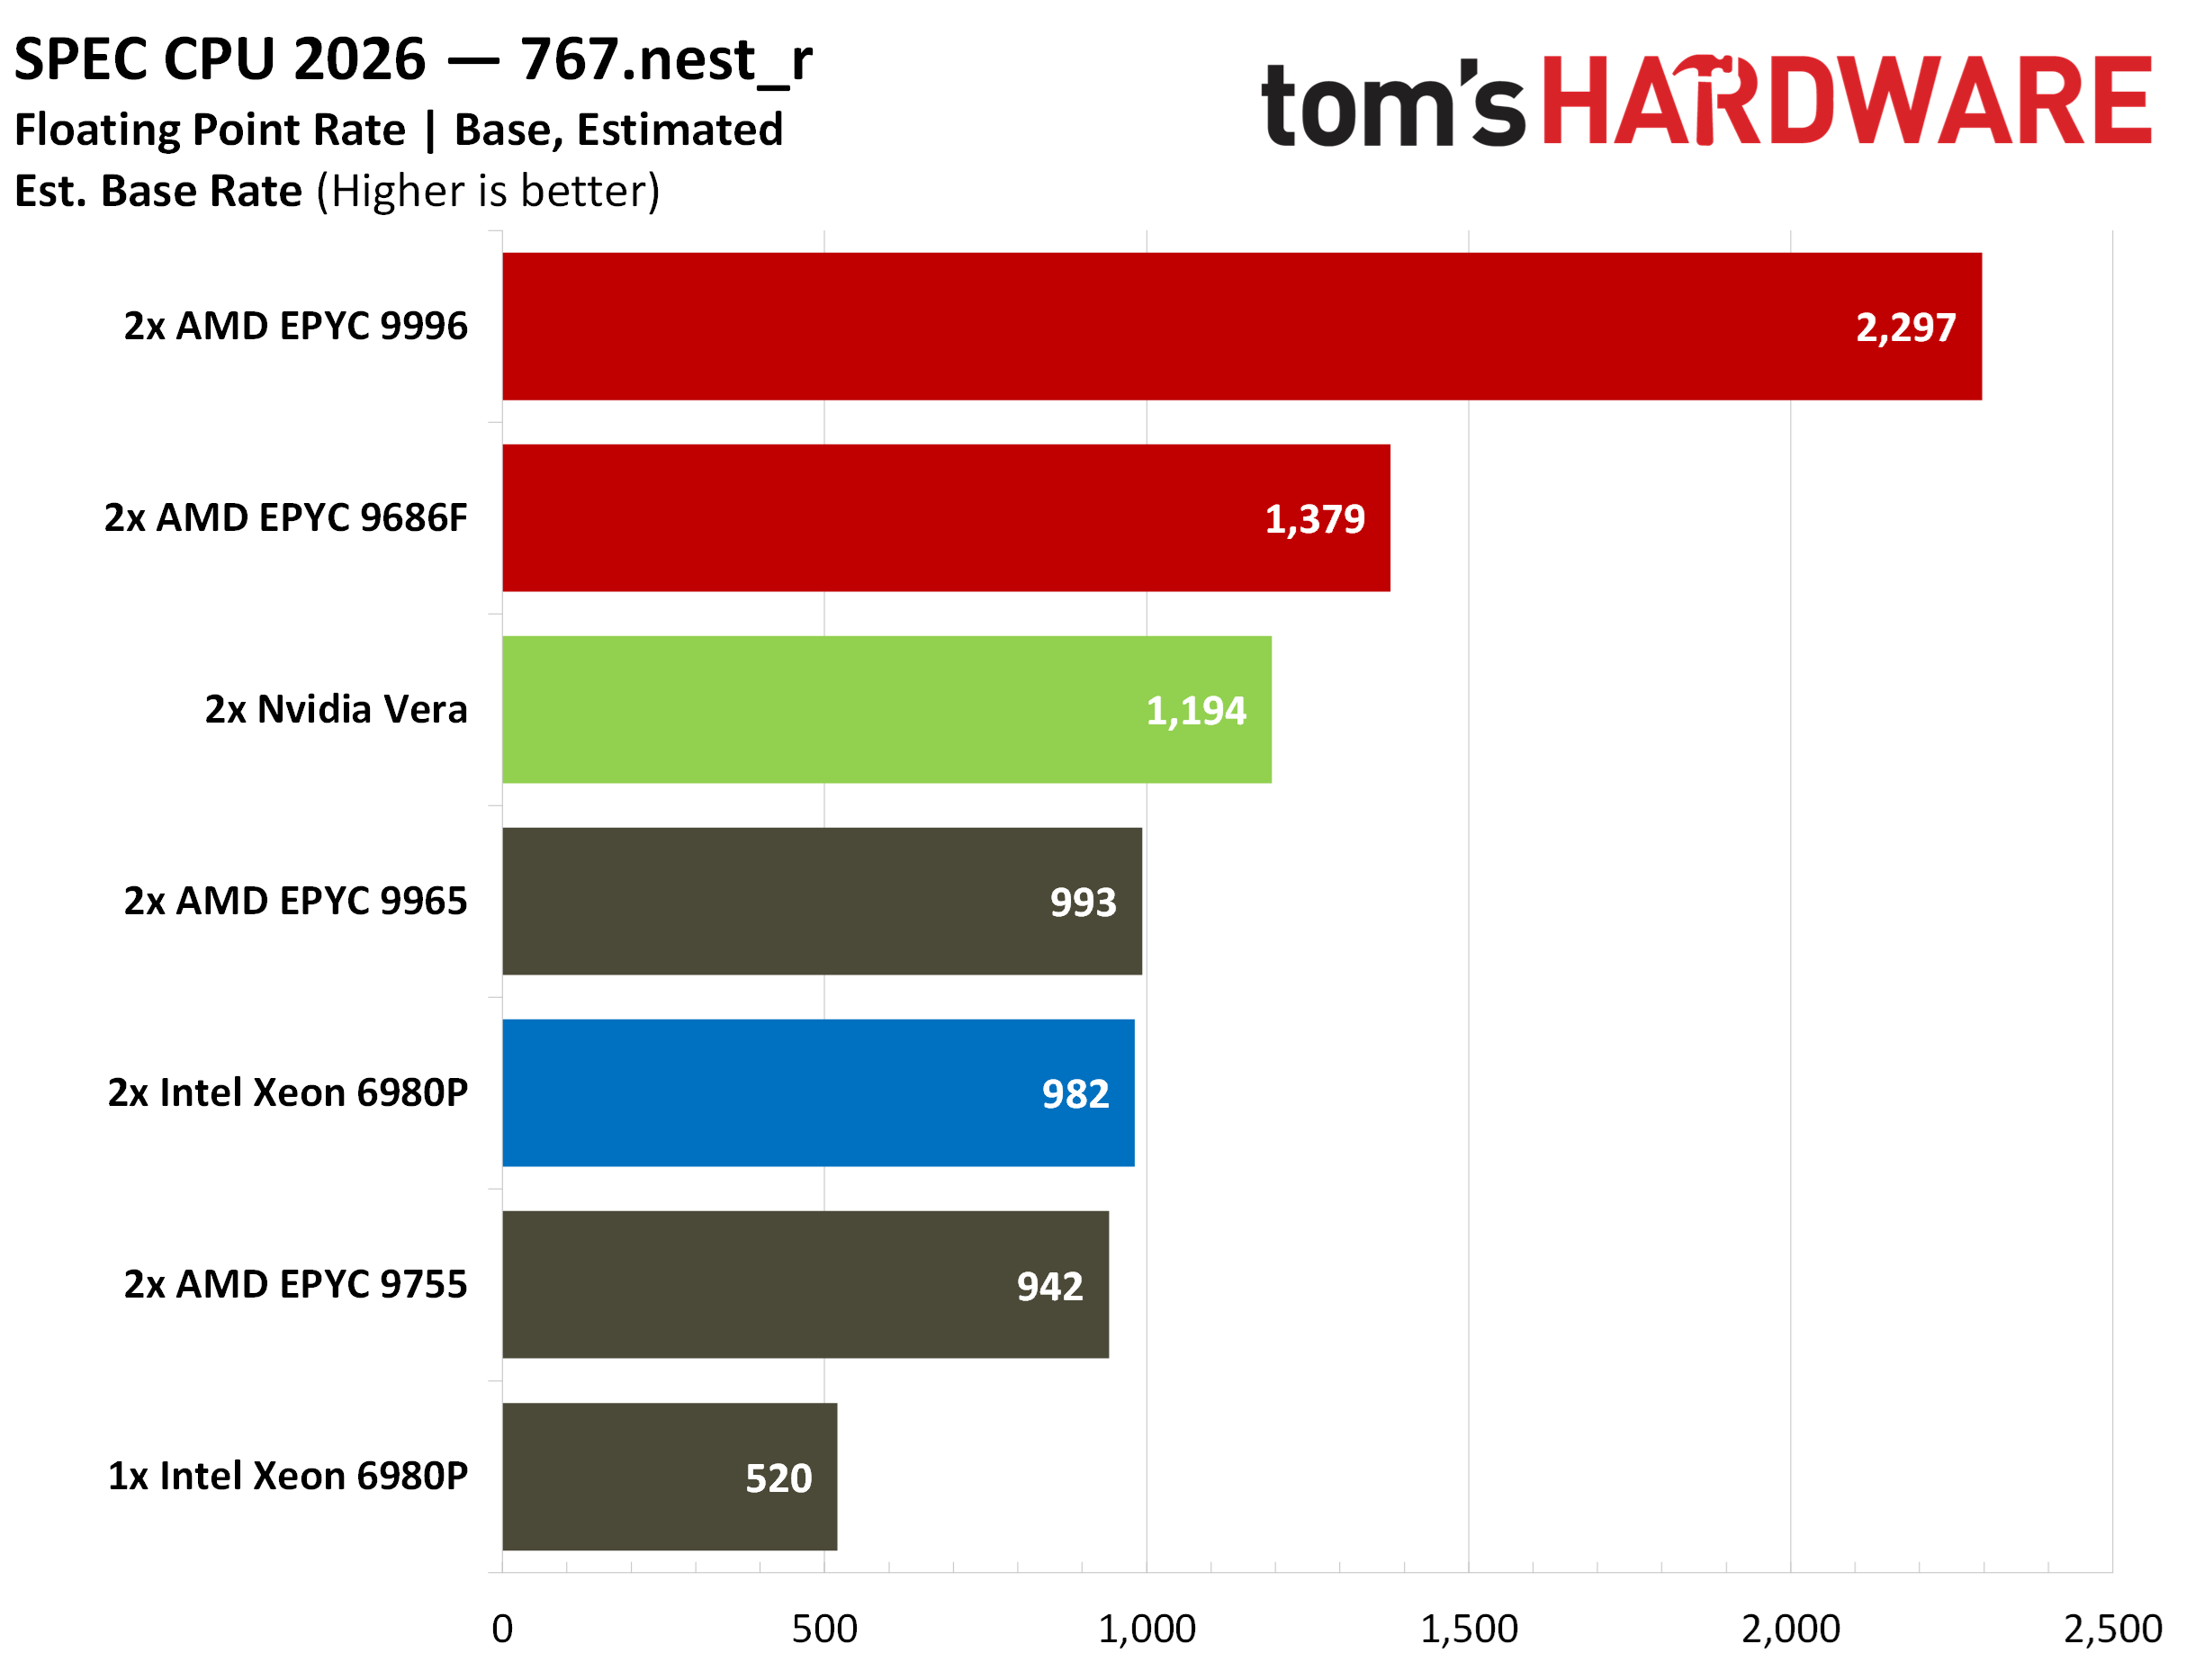
В тестах с плавающей запятой (fprate) архитектура Zen 6 продемонстрировала двукратное преимущество над Zen 5, а Epyc 9686F обошел Nvidia Vera на 40 %. 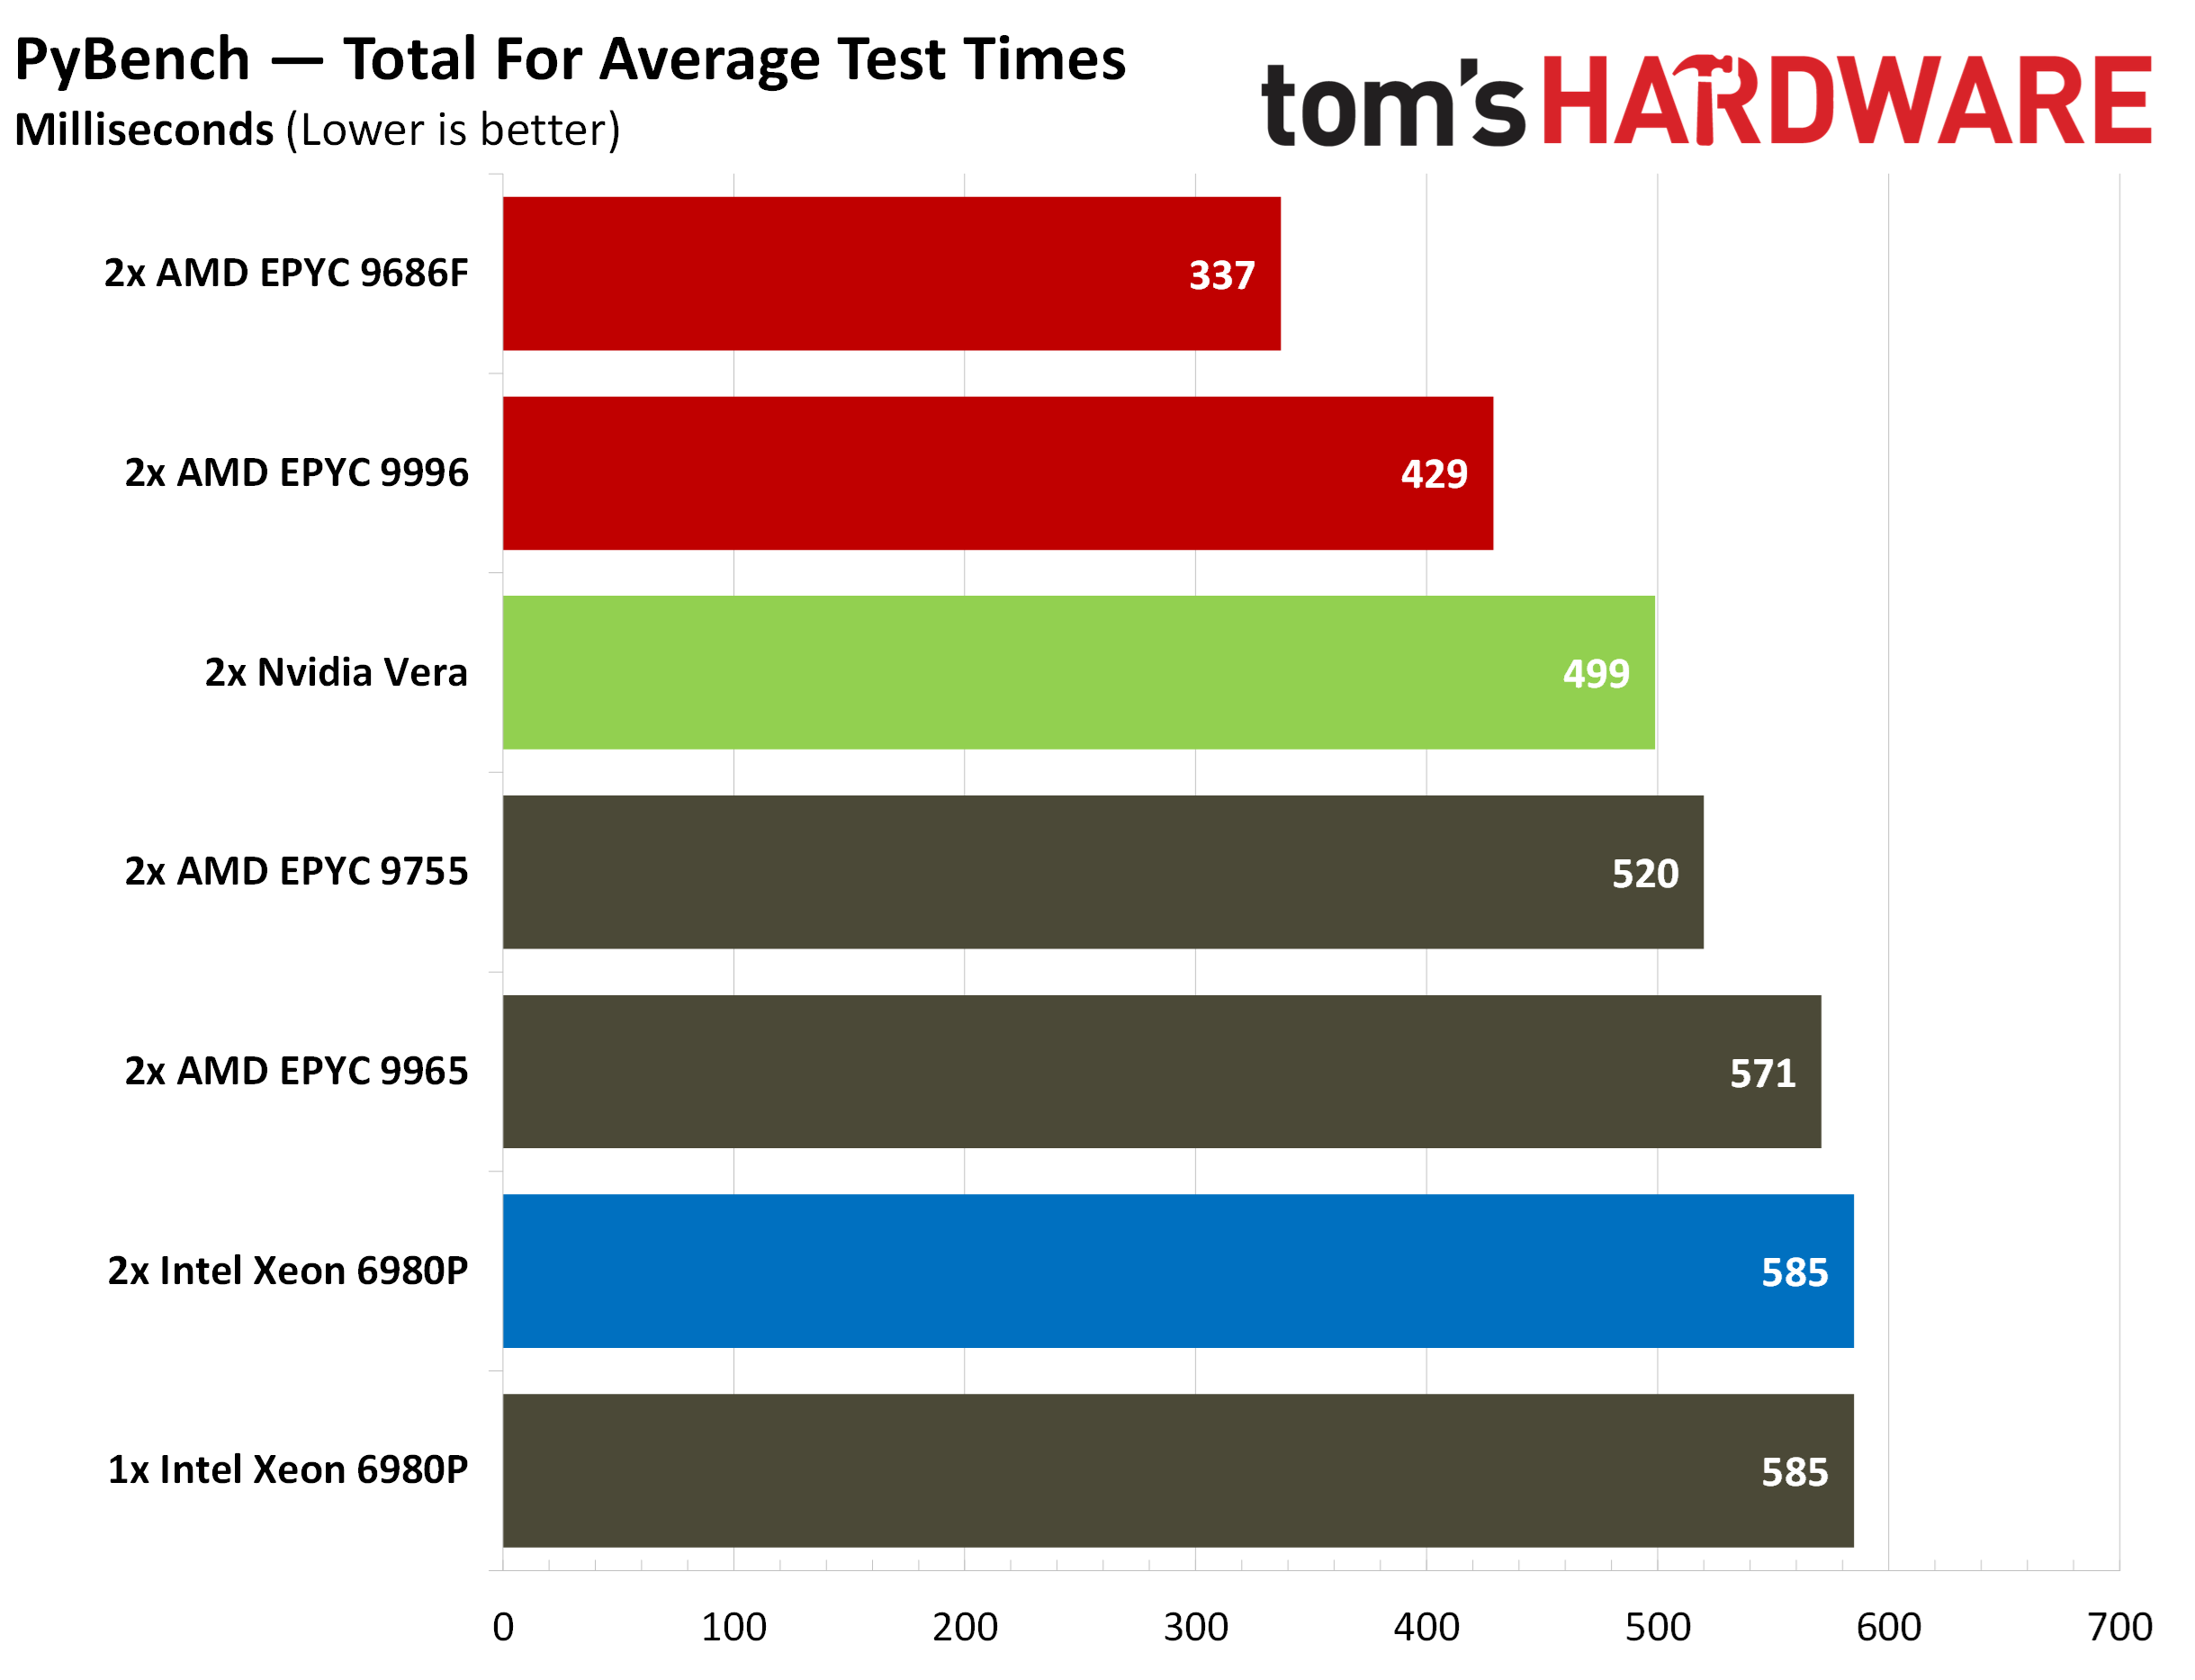 В однопоточном тесте PyBench частотный флагман EPYC 9686F за счёт архитектурных улучшений и высокой частоты оказался на 32 % быстрее чипа от Nvidia. Clickhouse
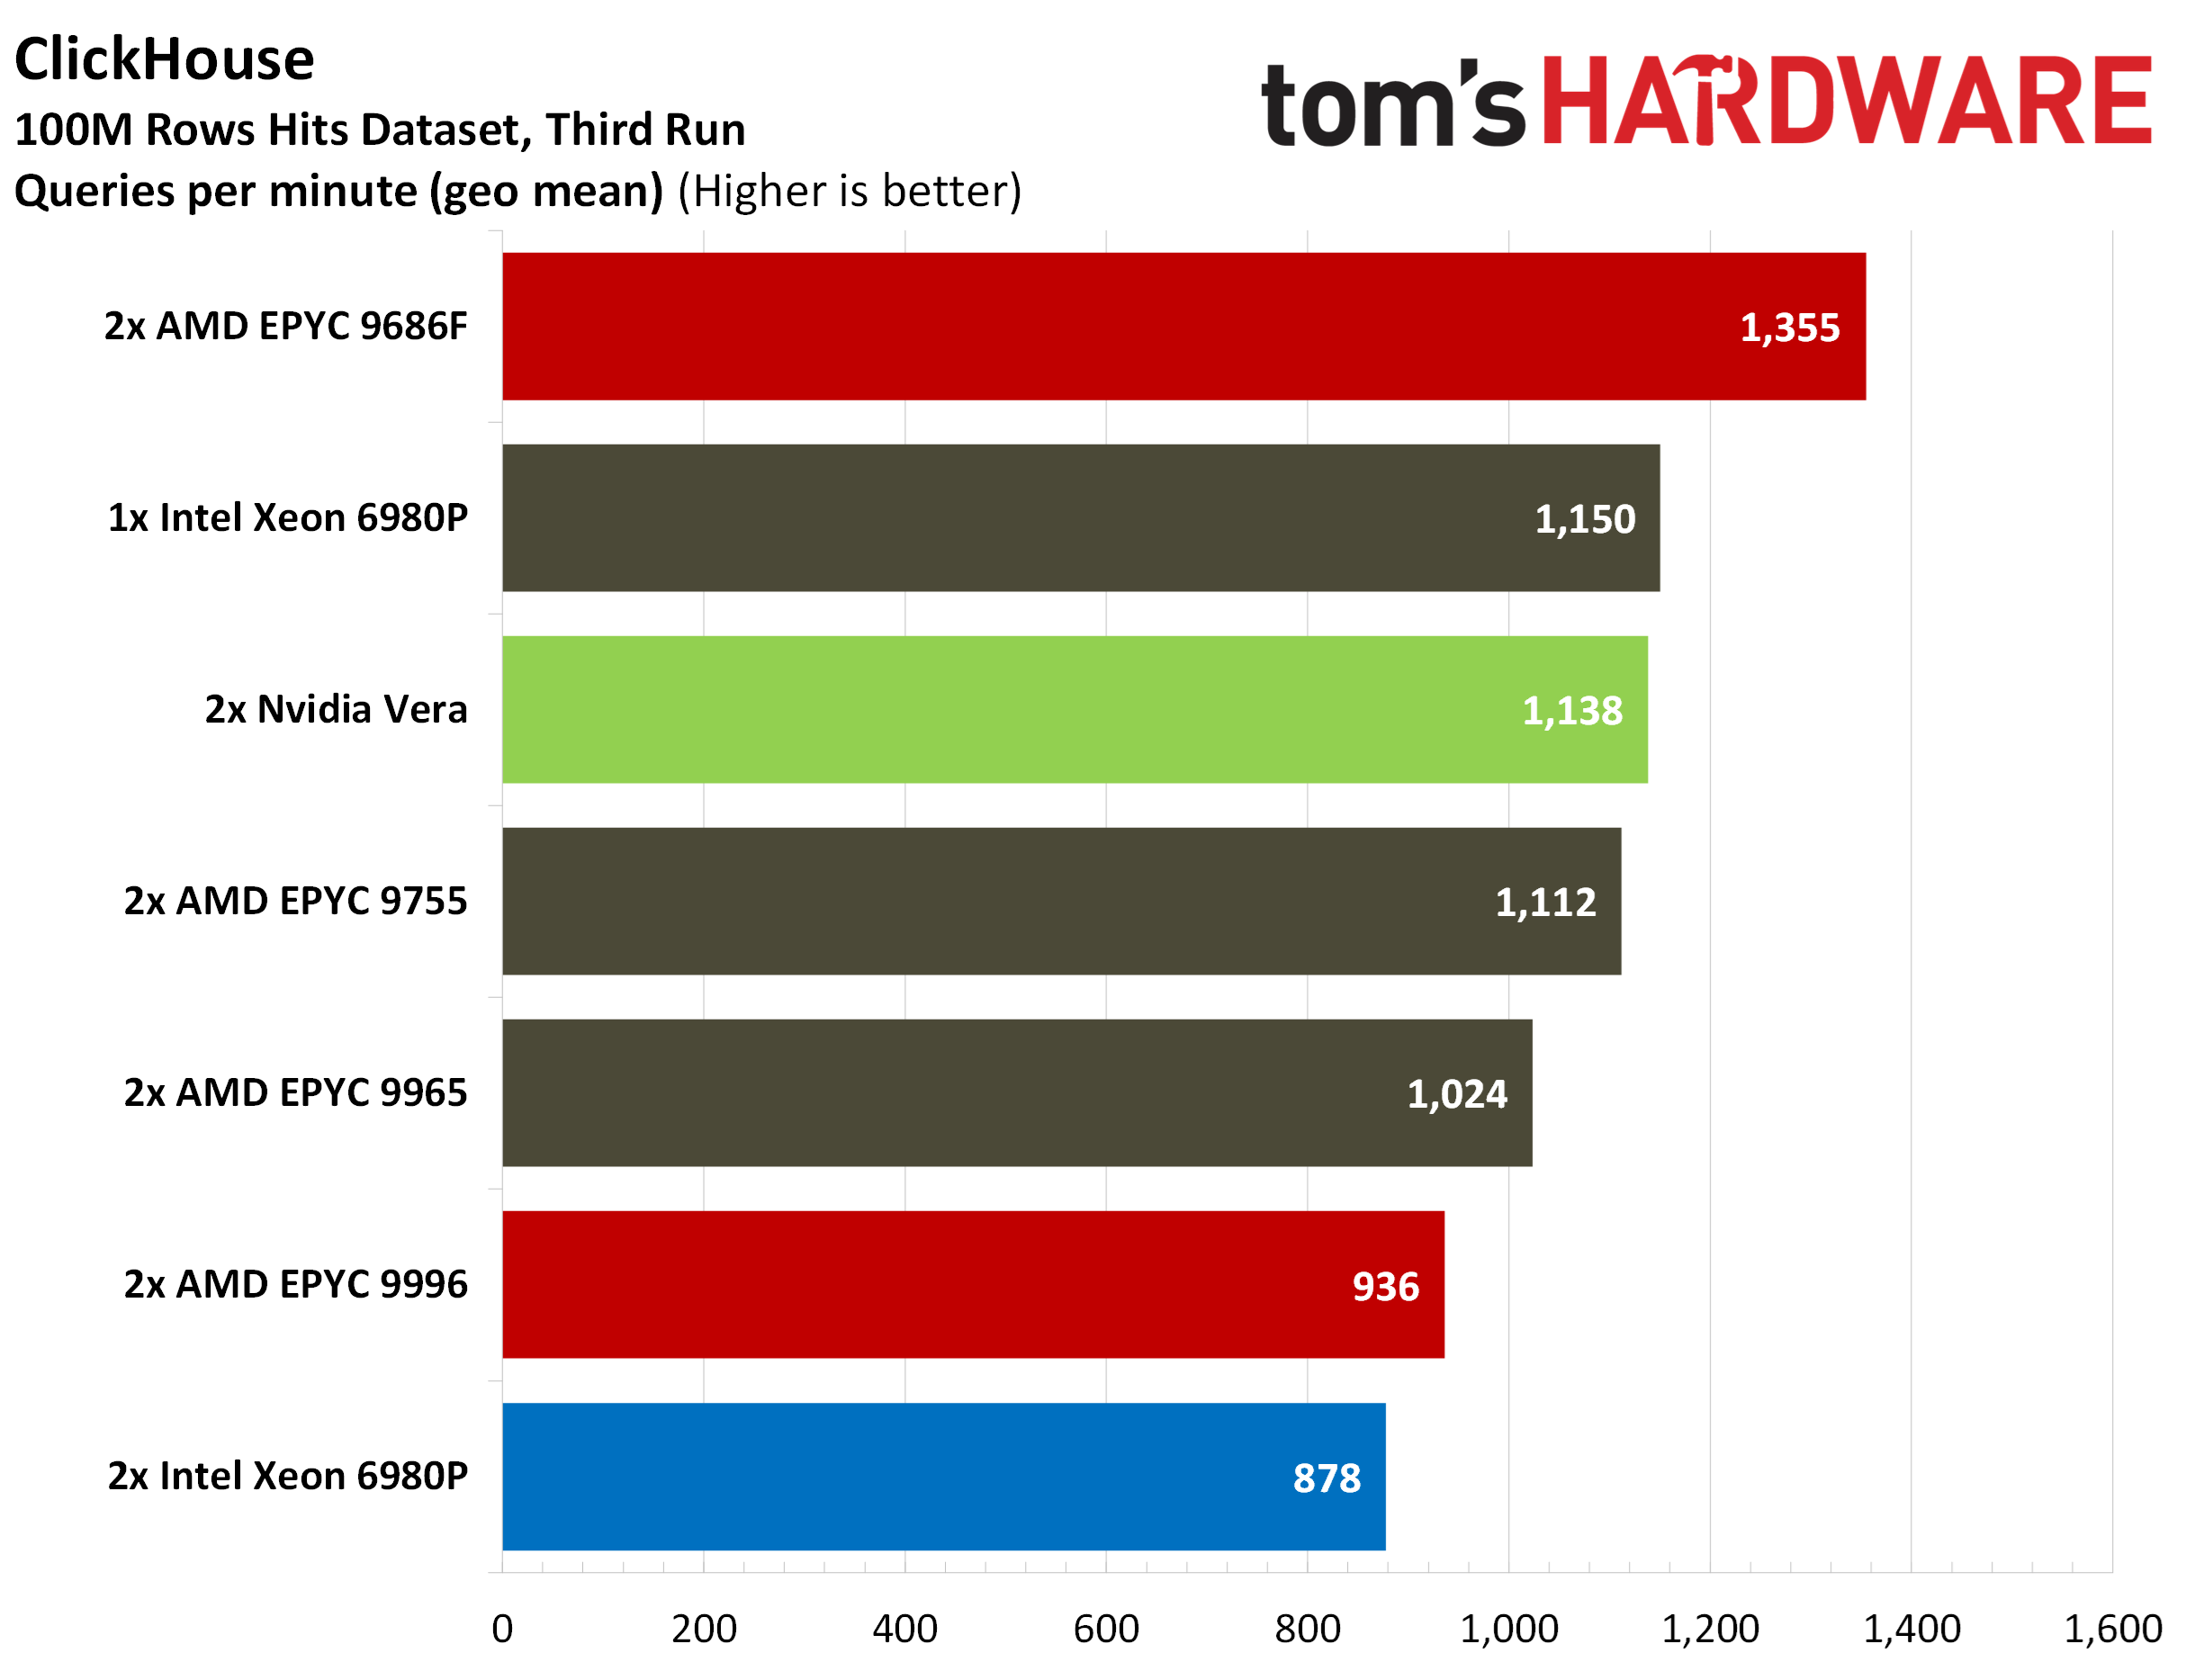
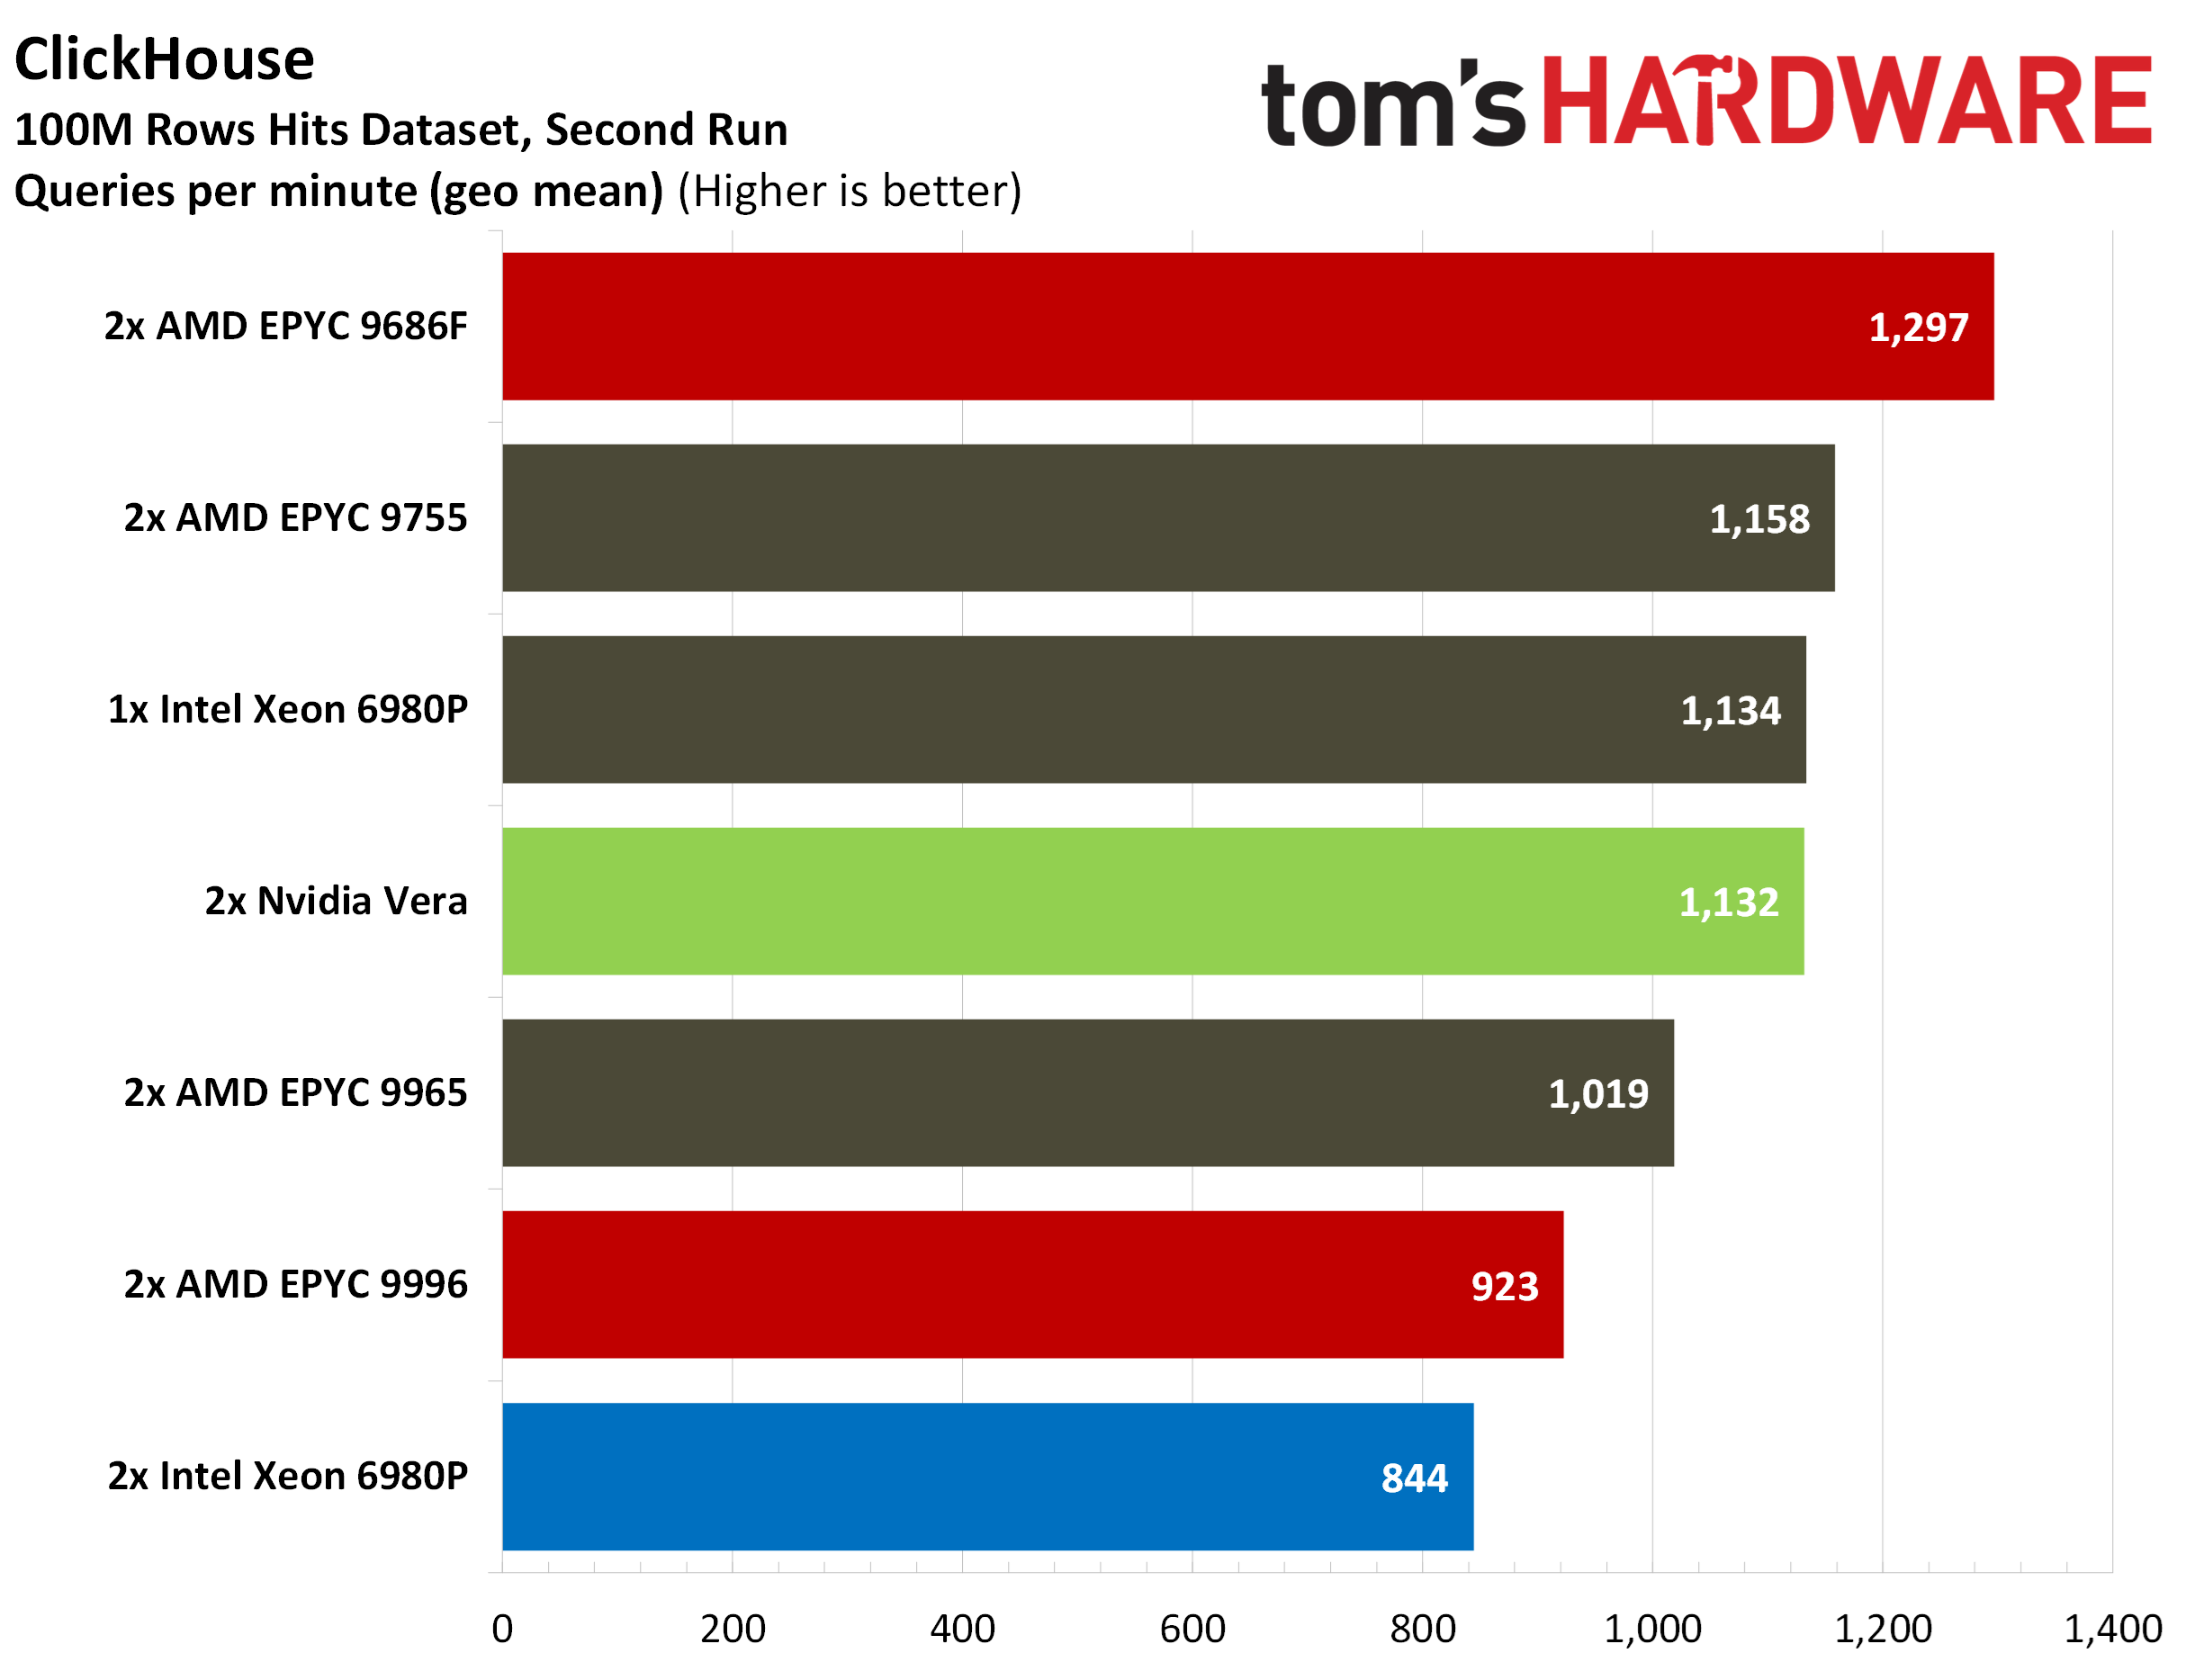
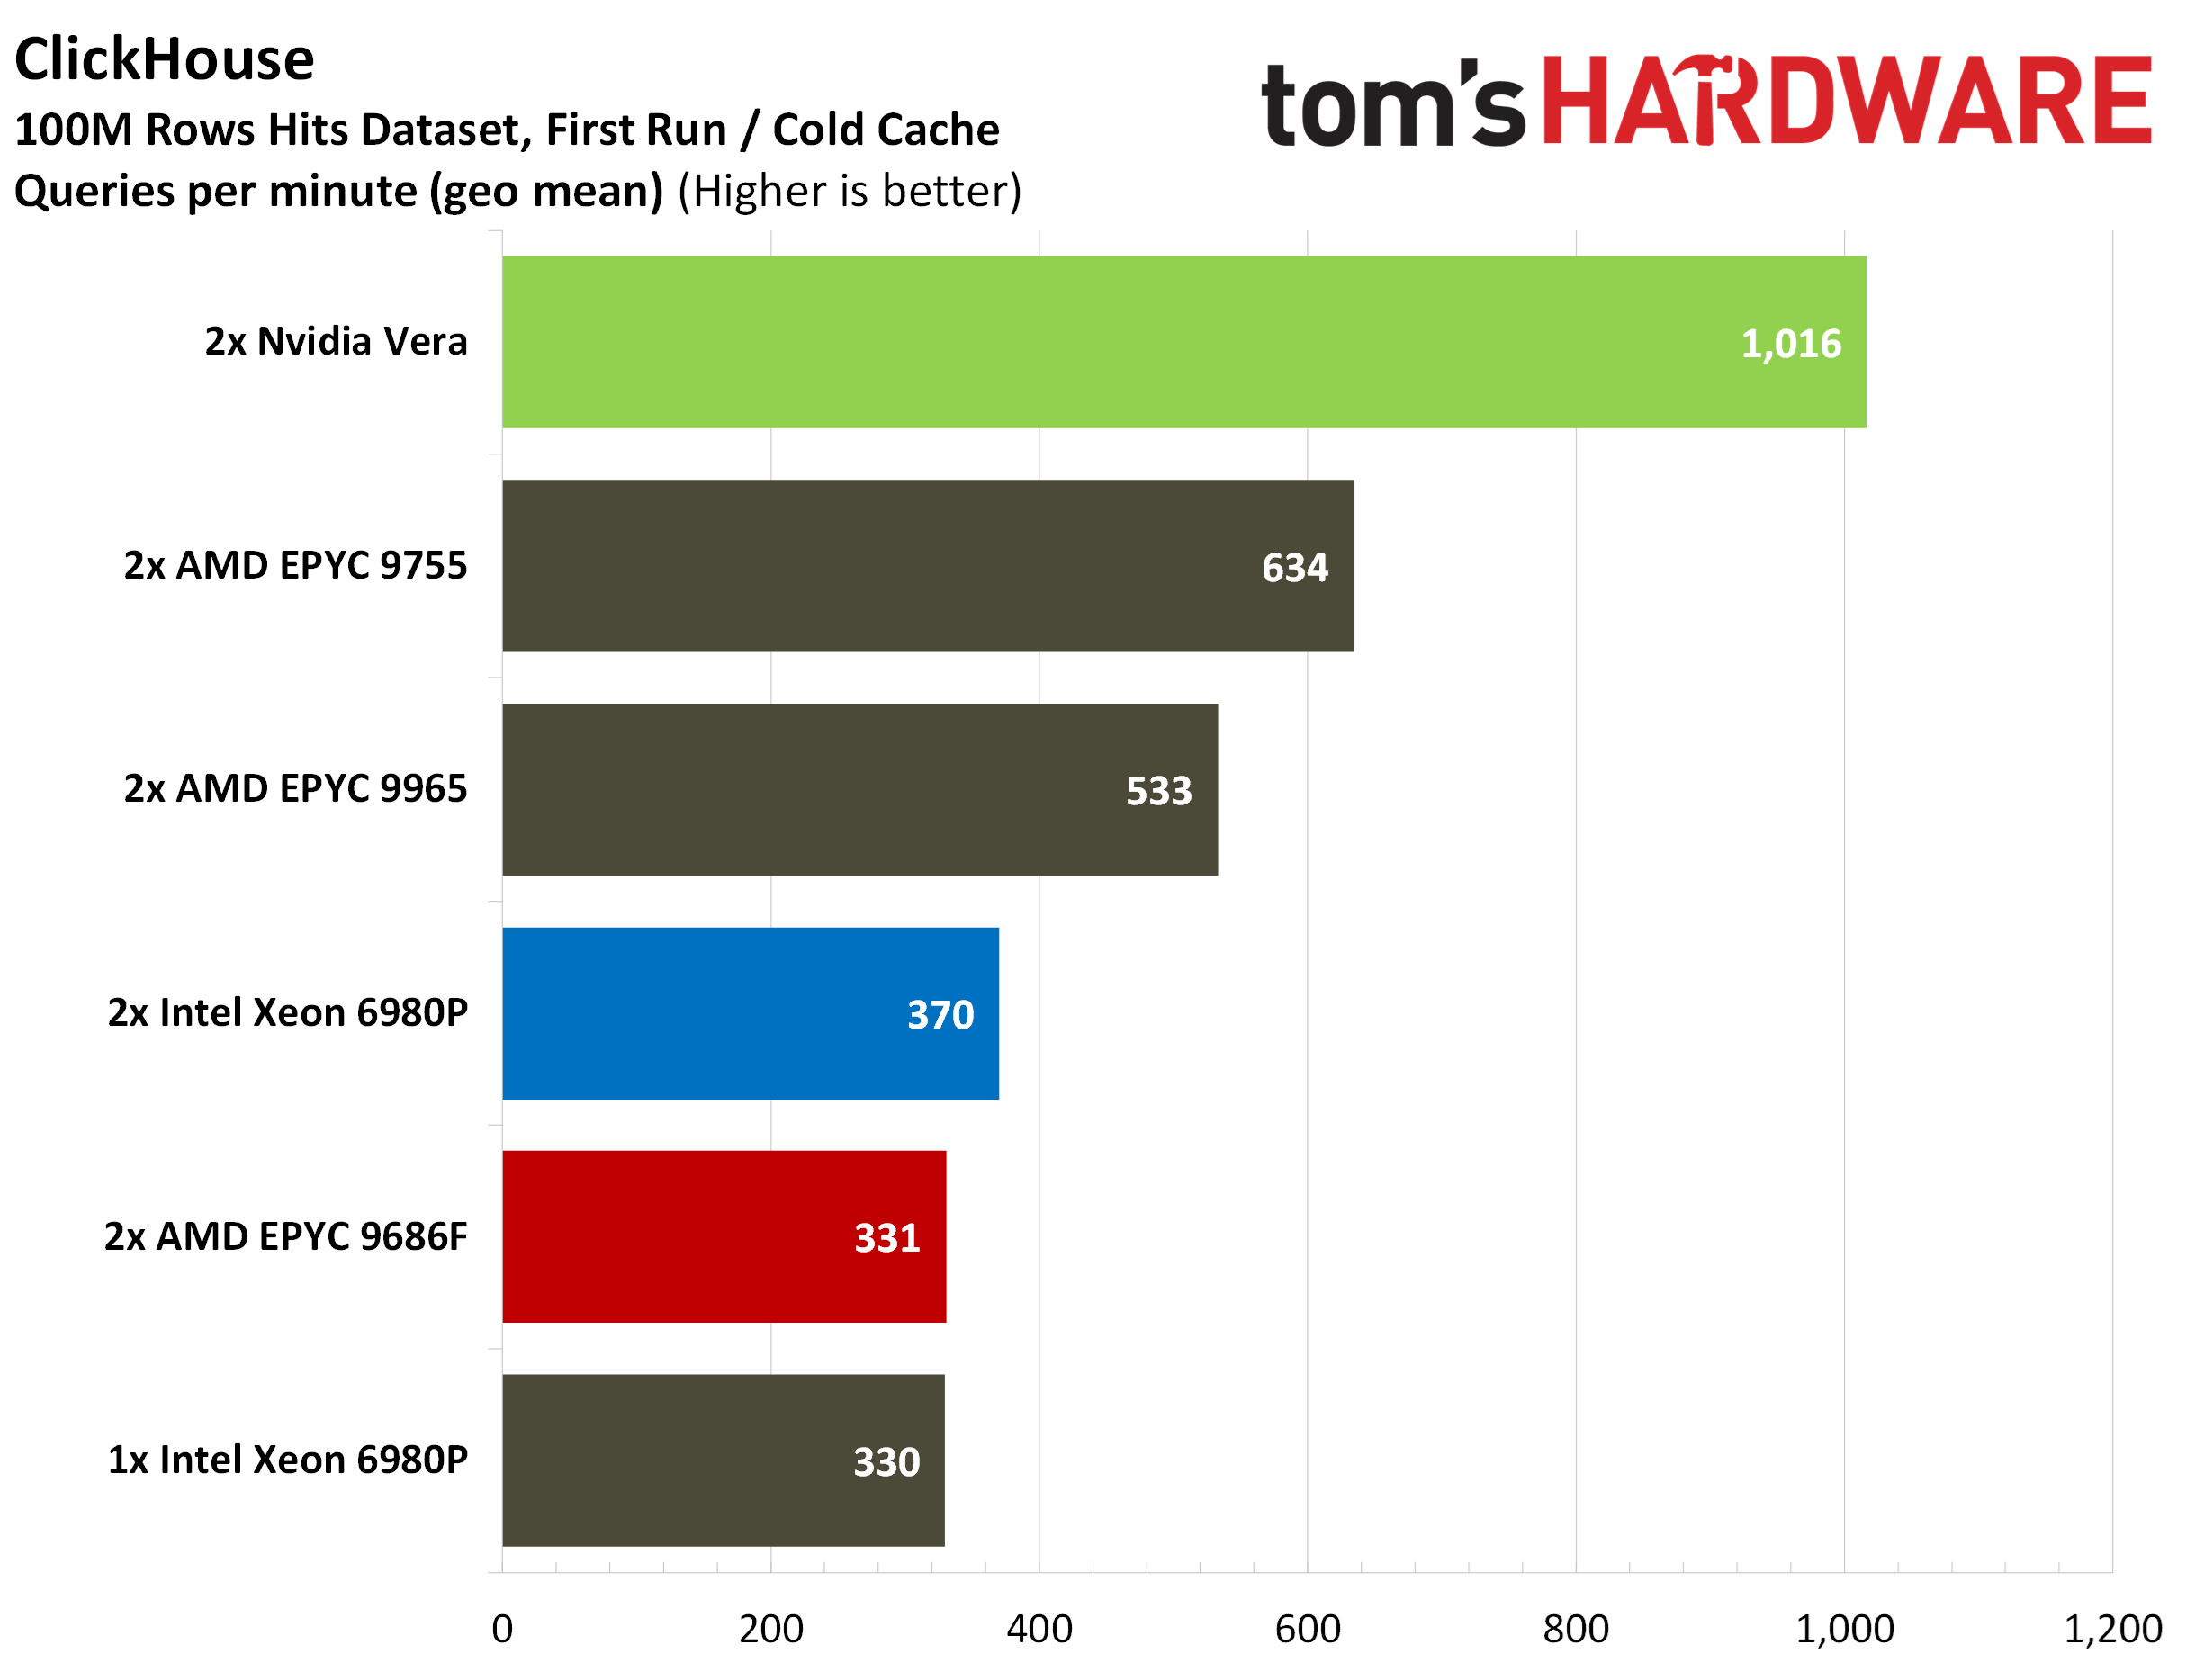
В колоночной базе данных Clickhouse процессор Nvidia Vera за счёт распределенной mesh-архитектуры быстрее выходит на пиковую скорость при «холодном» кеше, однако после прогрева кеша EPYC 9686F перехватывает лидерство. LLVM, Godot, ImageMagick
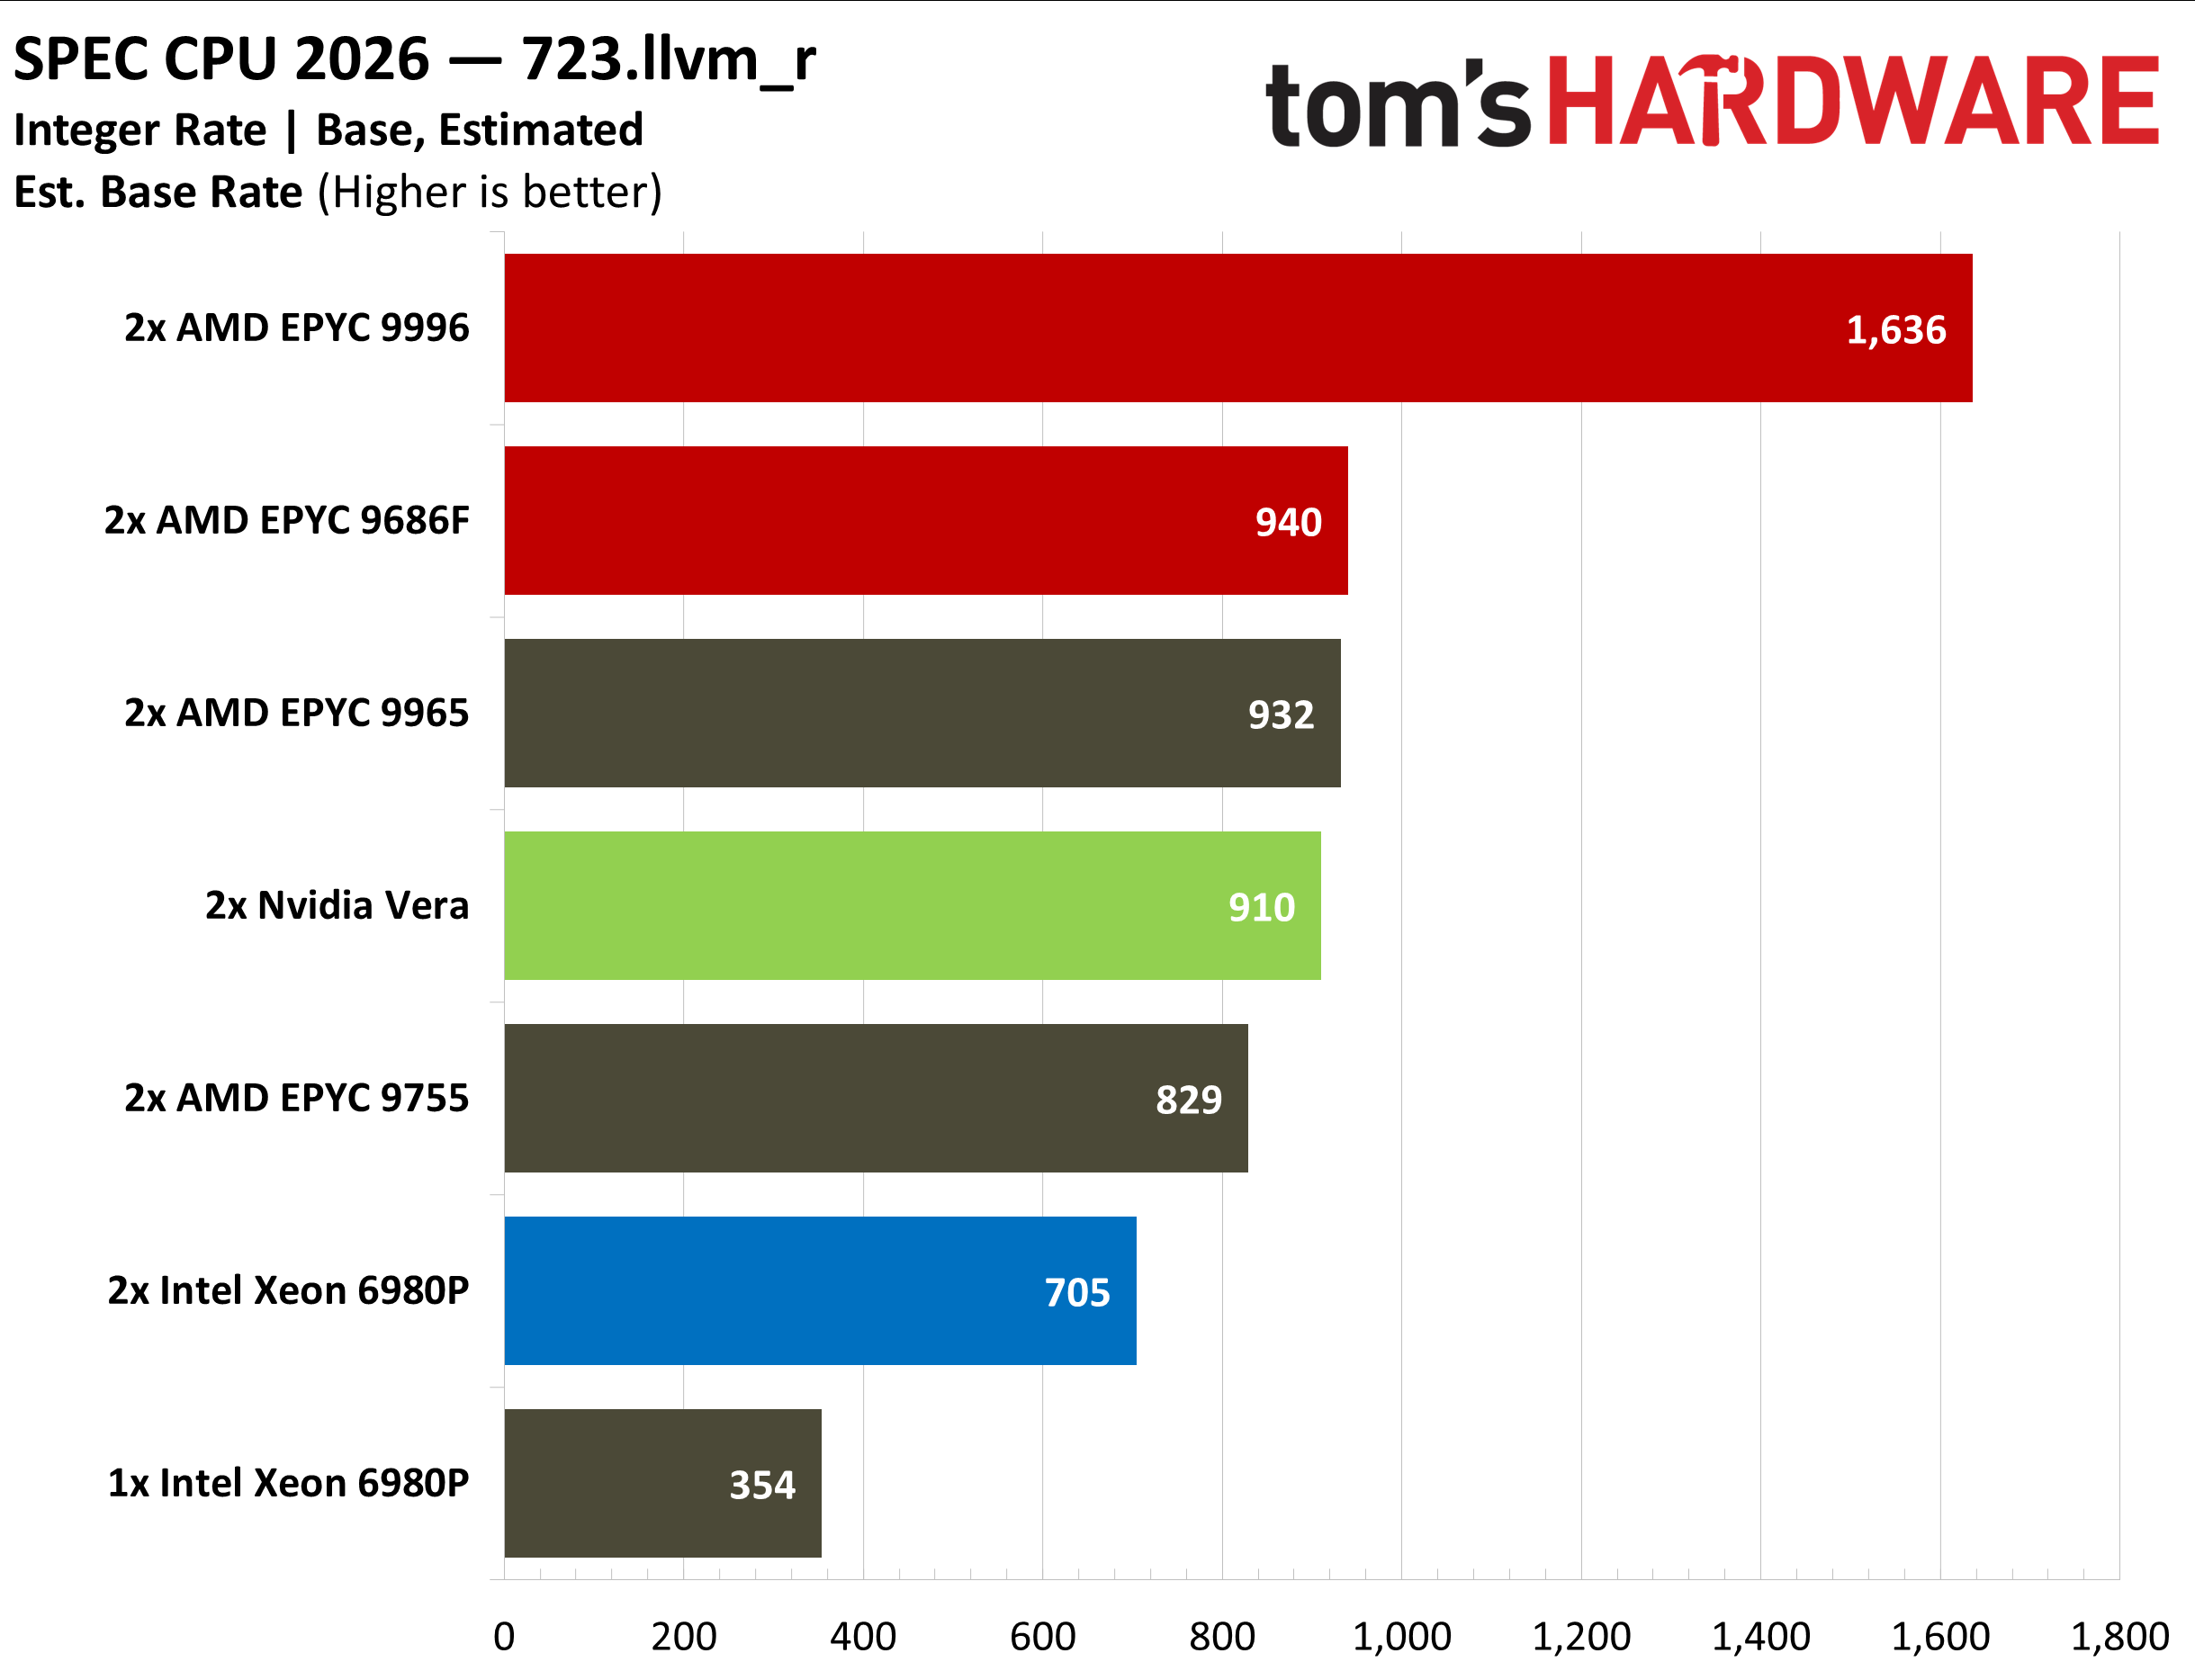
Смотреть все изображения (3)
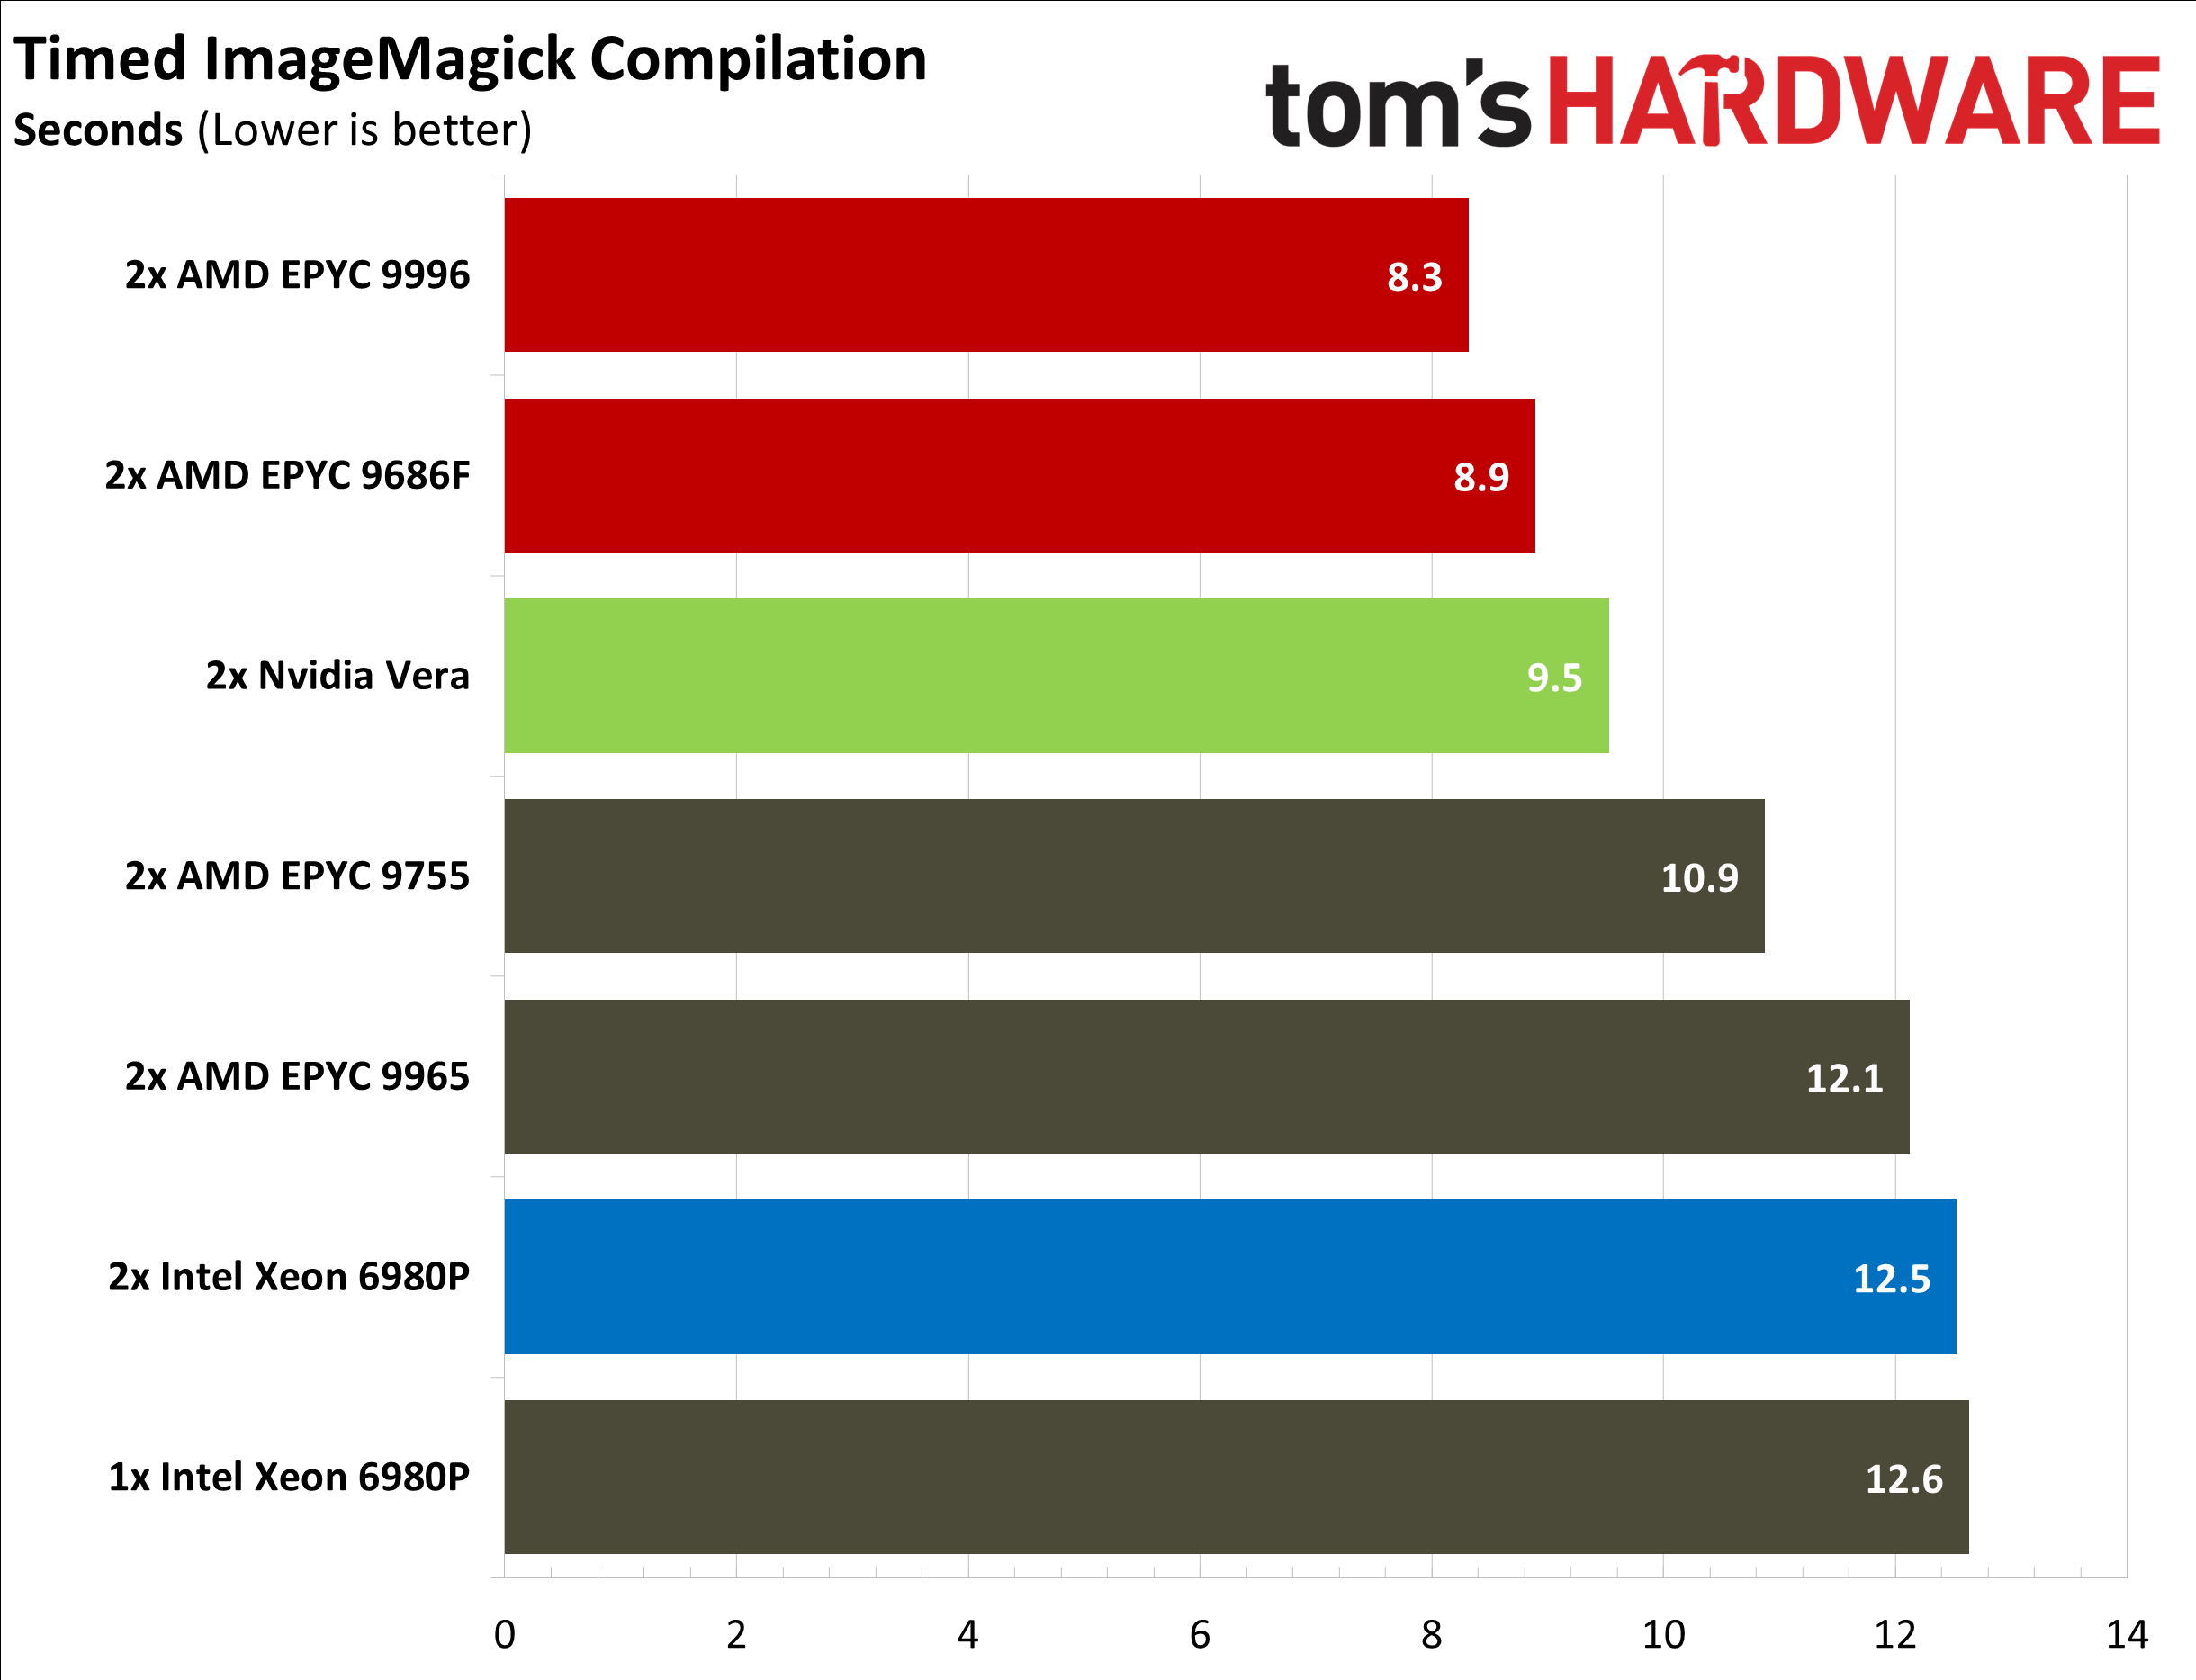
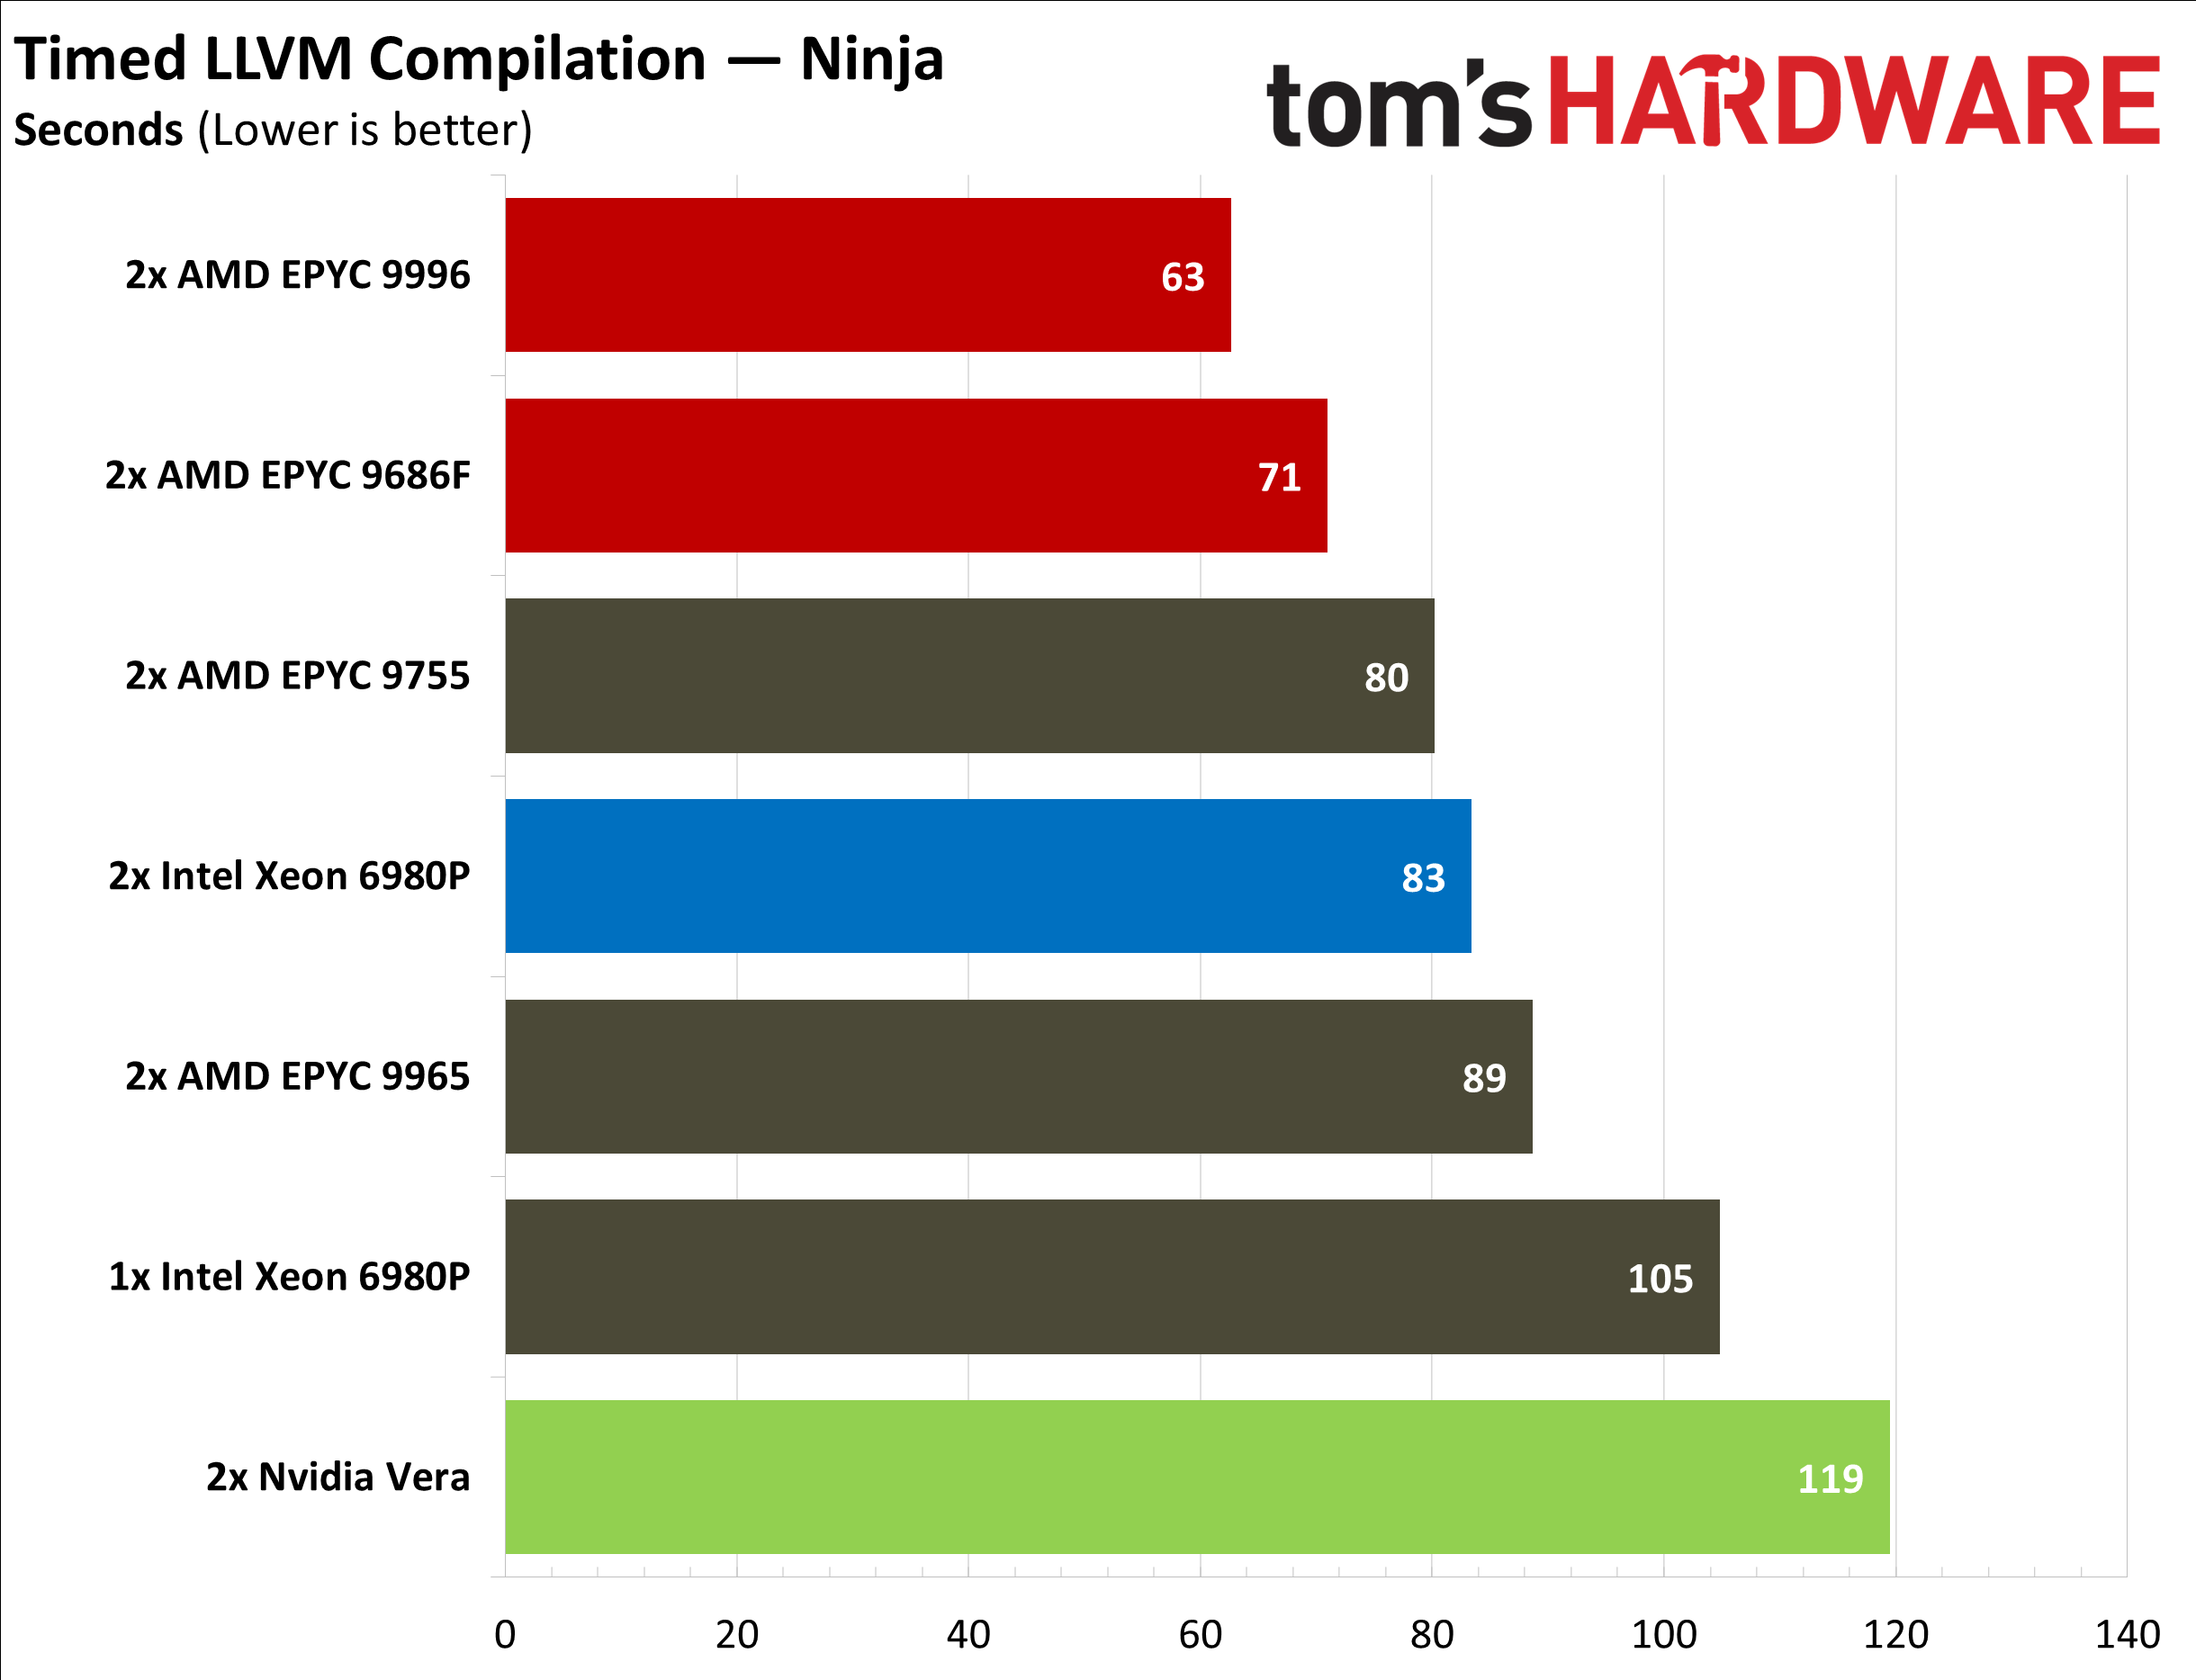
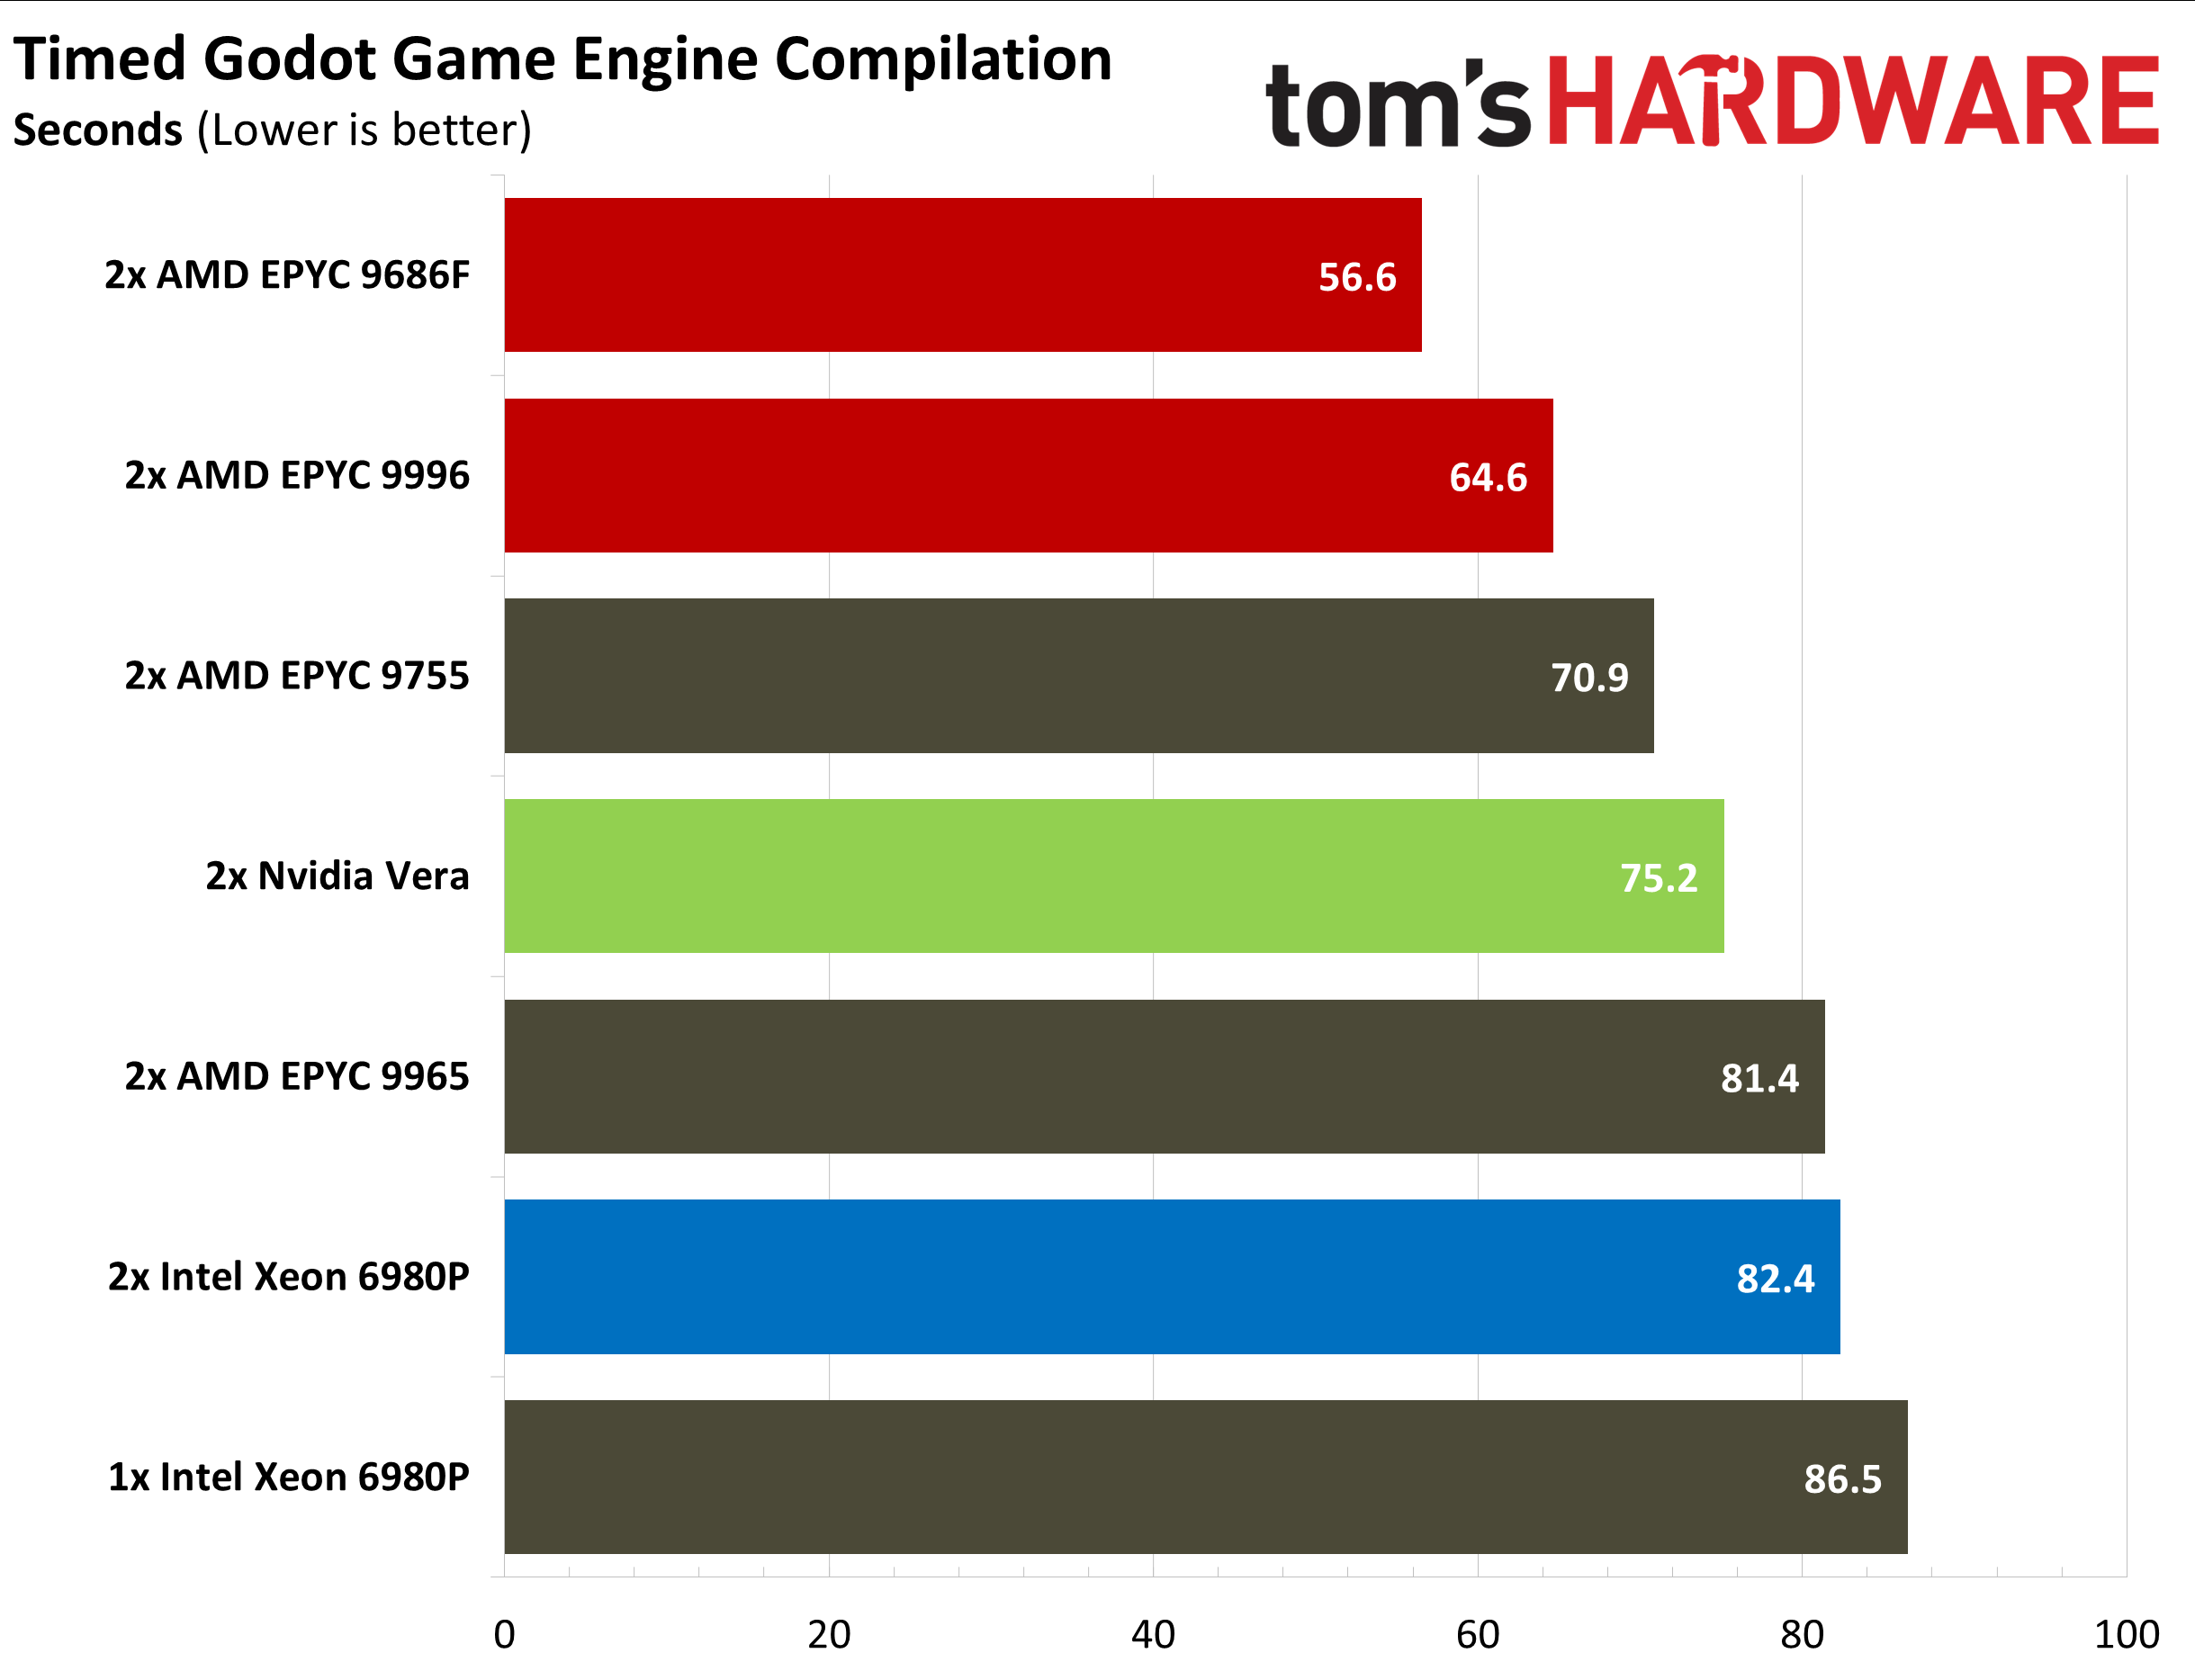
Смотреть все изображения (3) В Blender новый EPYC 9996 завершает сложные сцены (например, Barbershop) на 35 % быстрее предшественника. В задачах компиляции кода (LLVM, Godot, ImageMagick) процессоры Venice вернули себе безоговорочное первое место, опередив чипы архитектуры Arm (Vera). CloverLeaf, FFTE
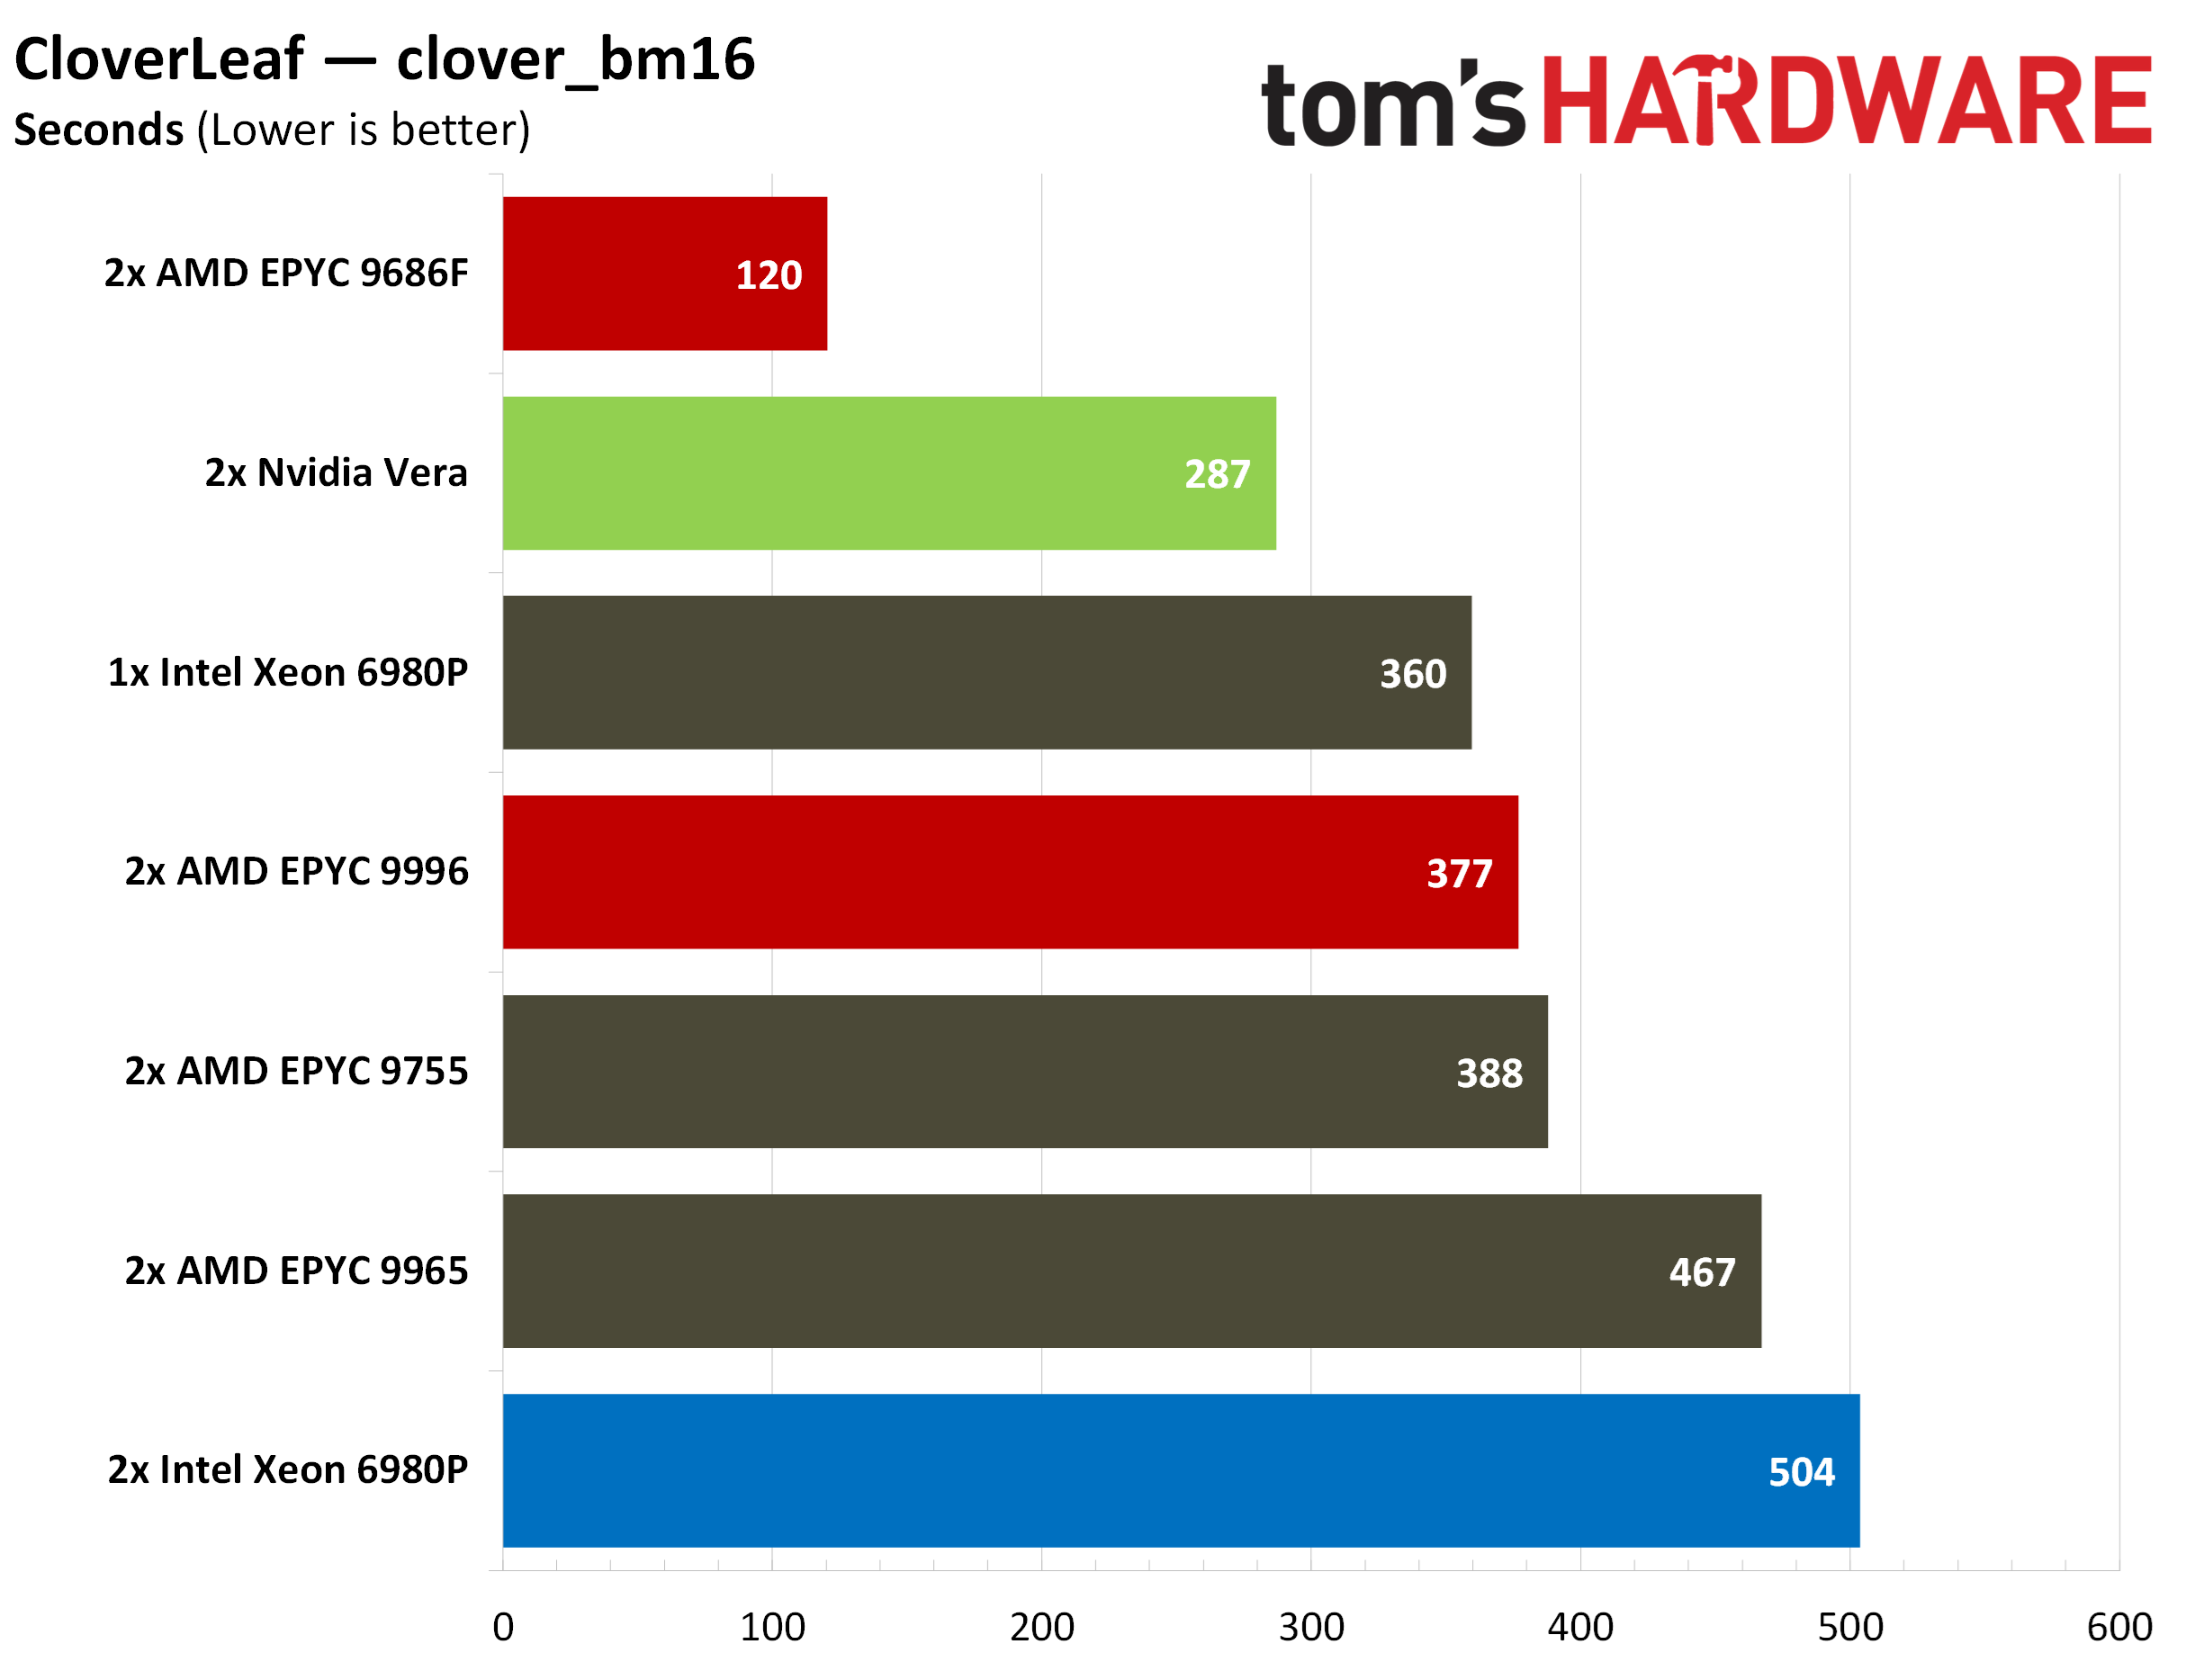
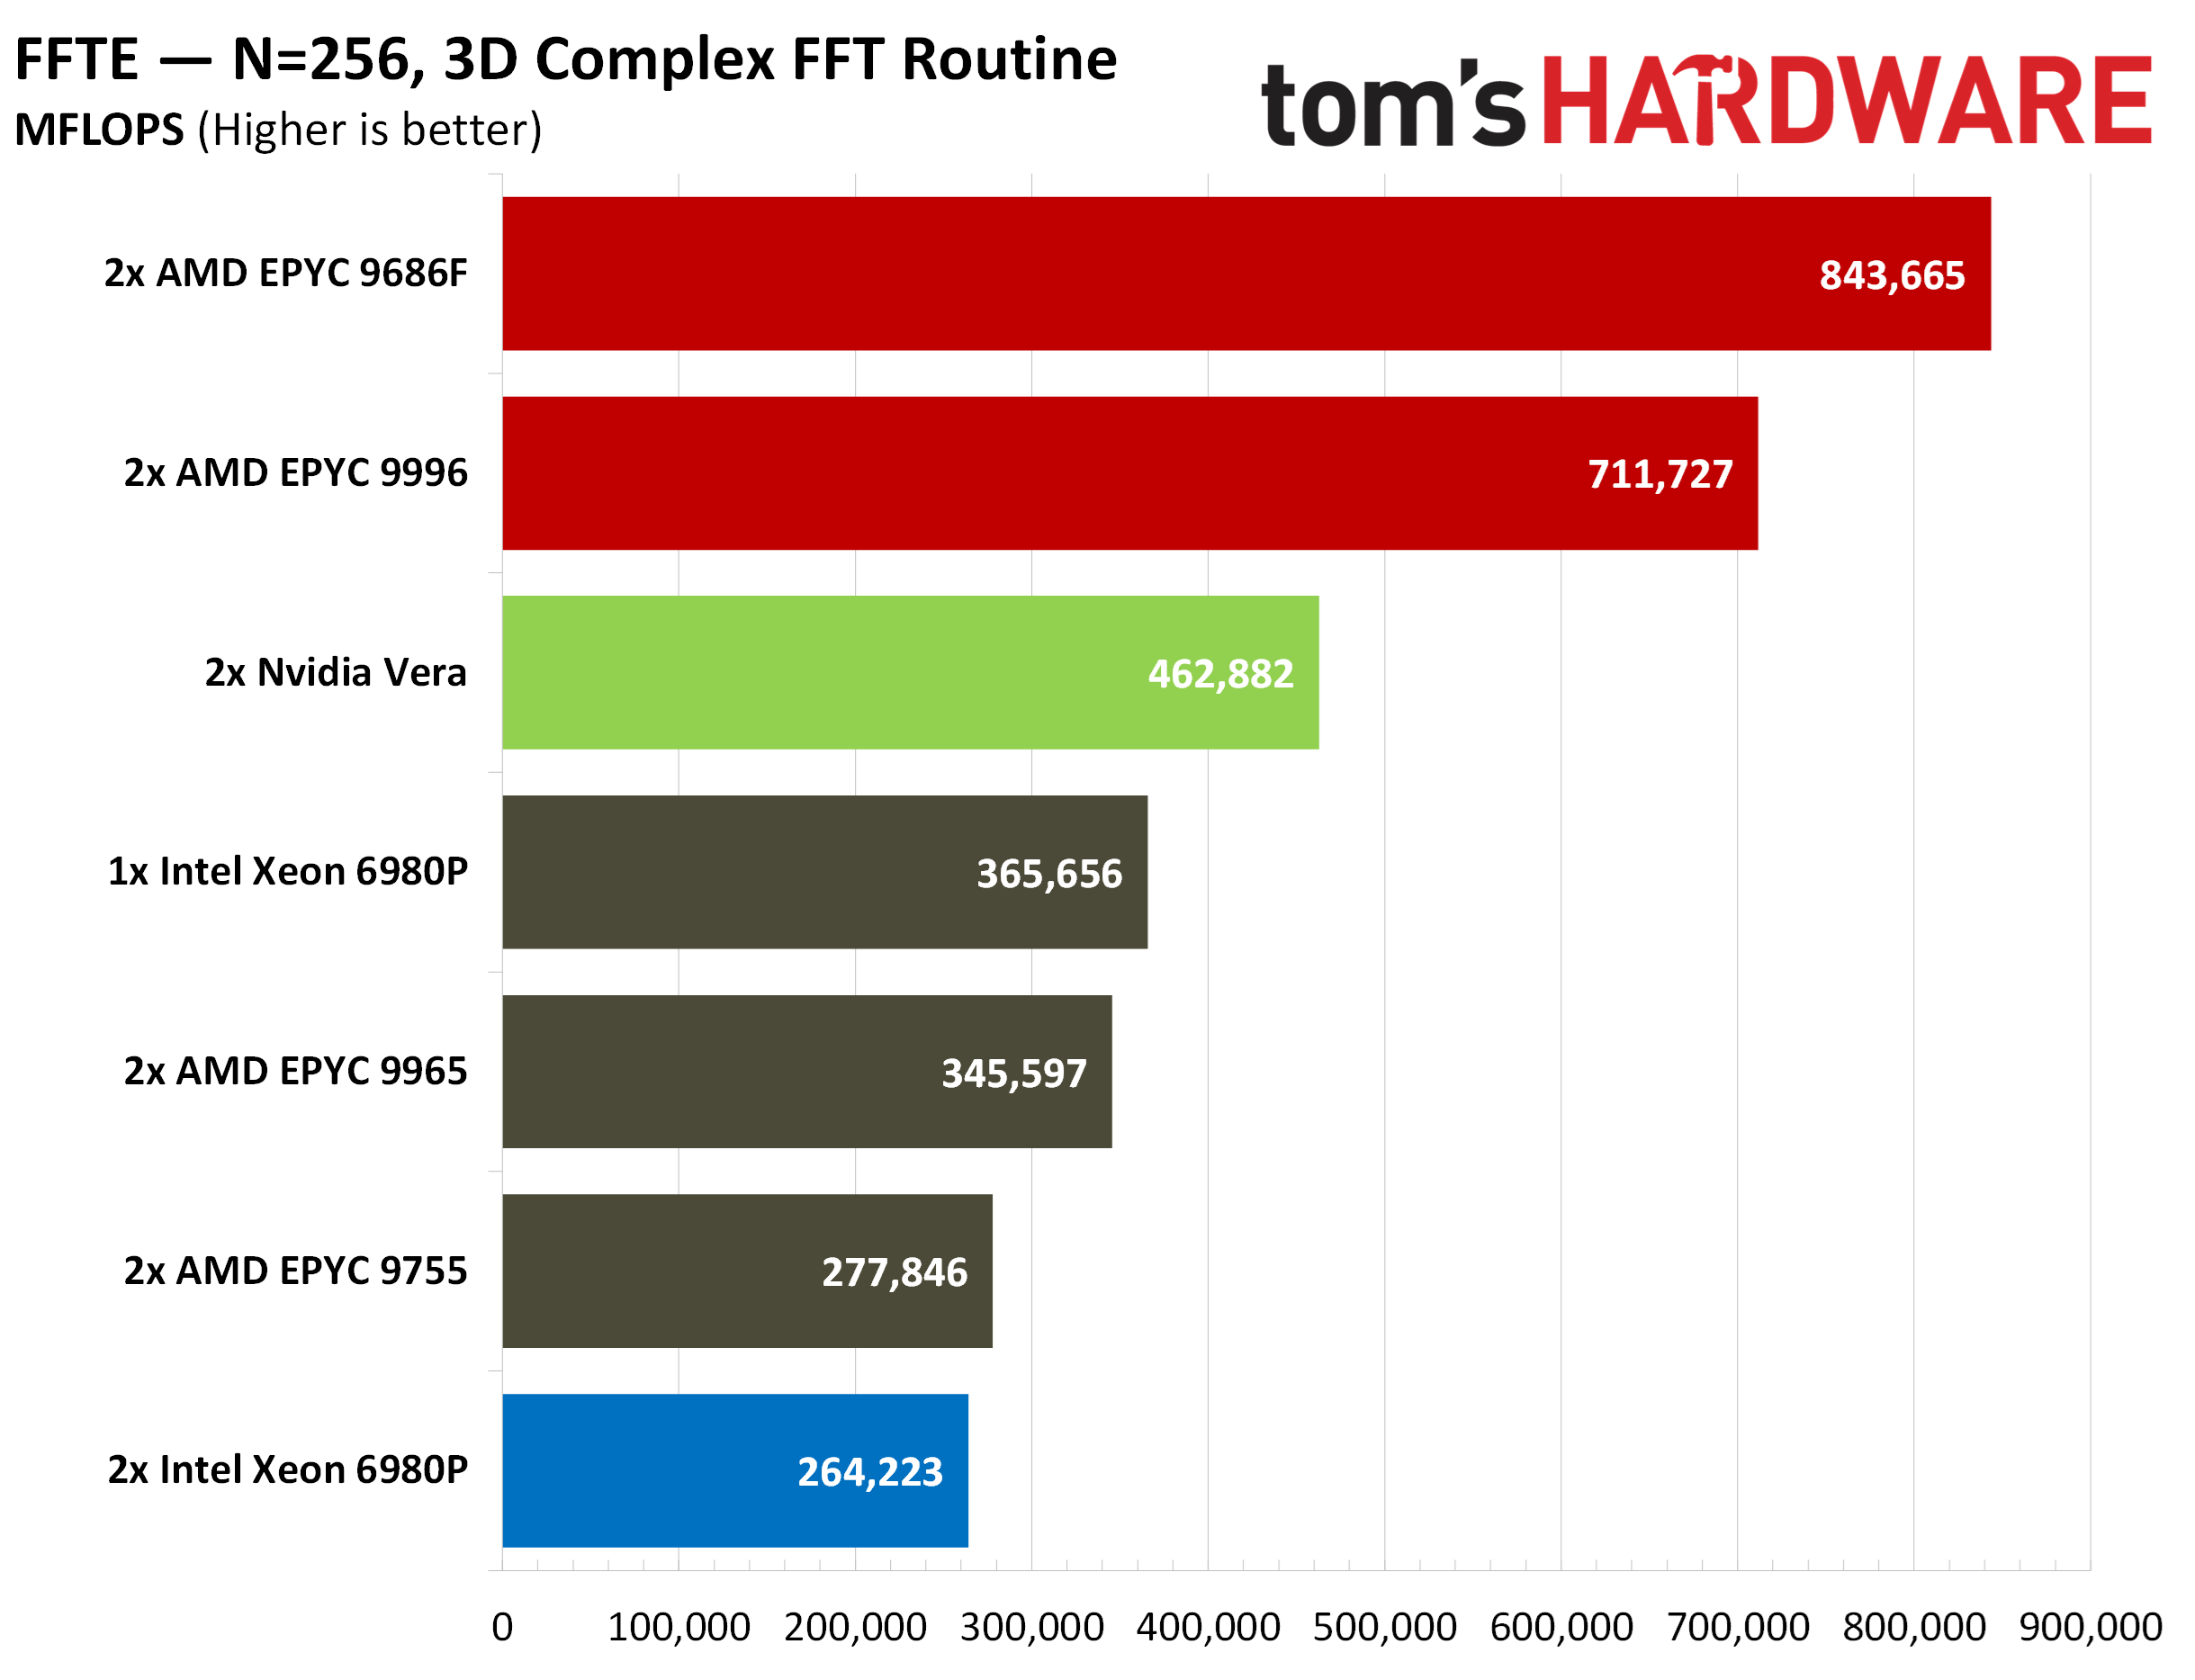
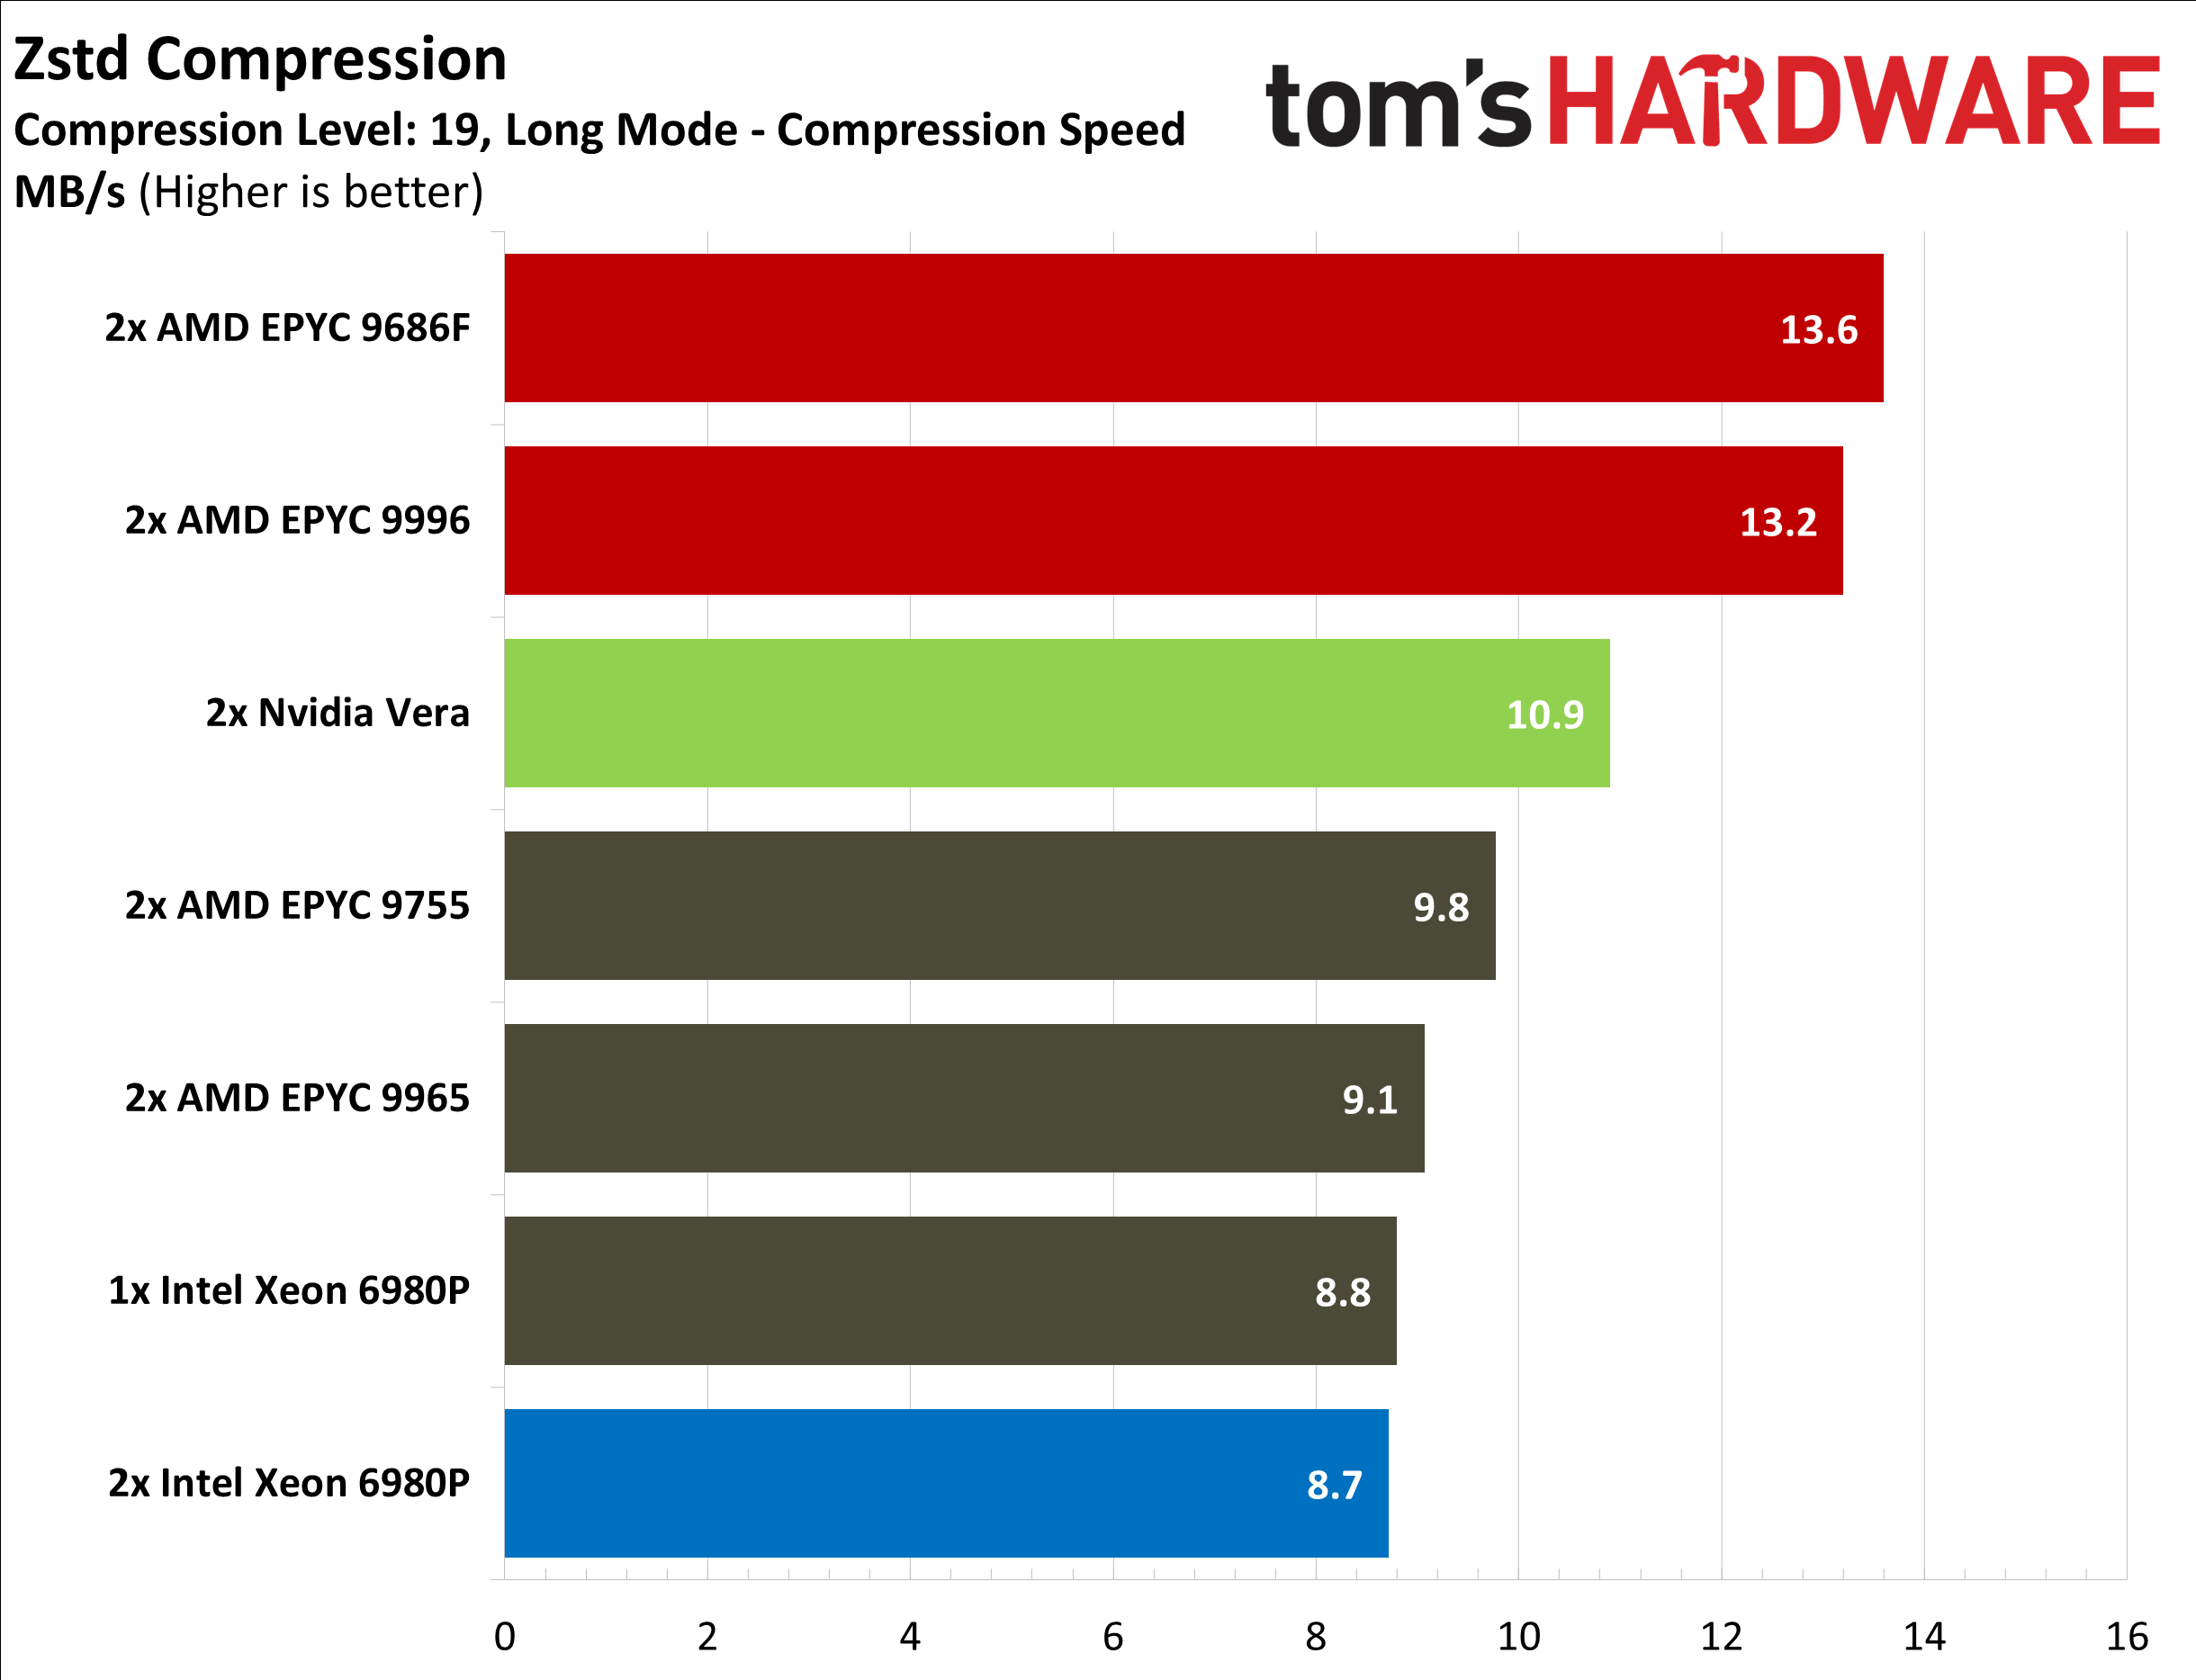
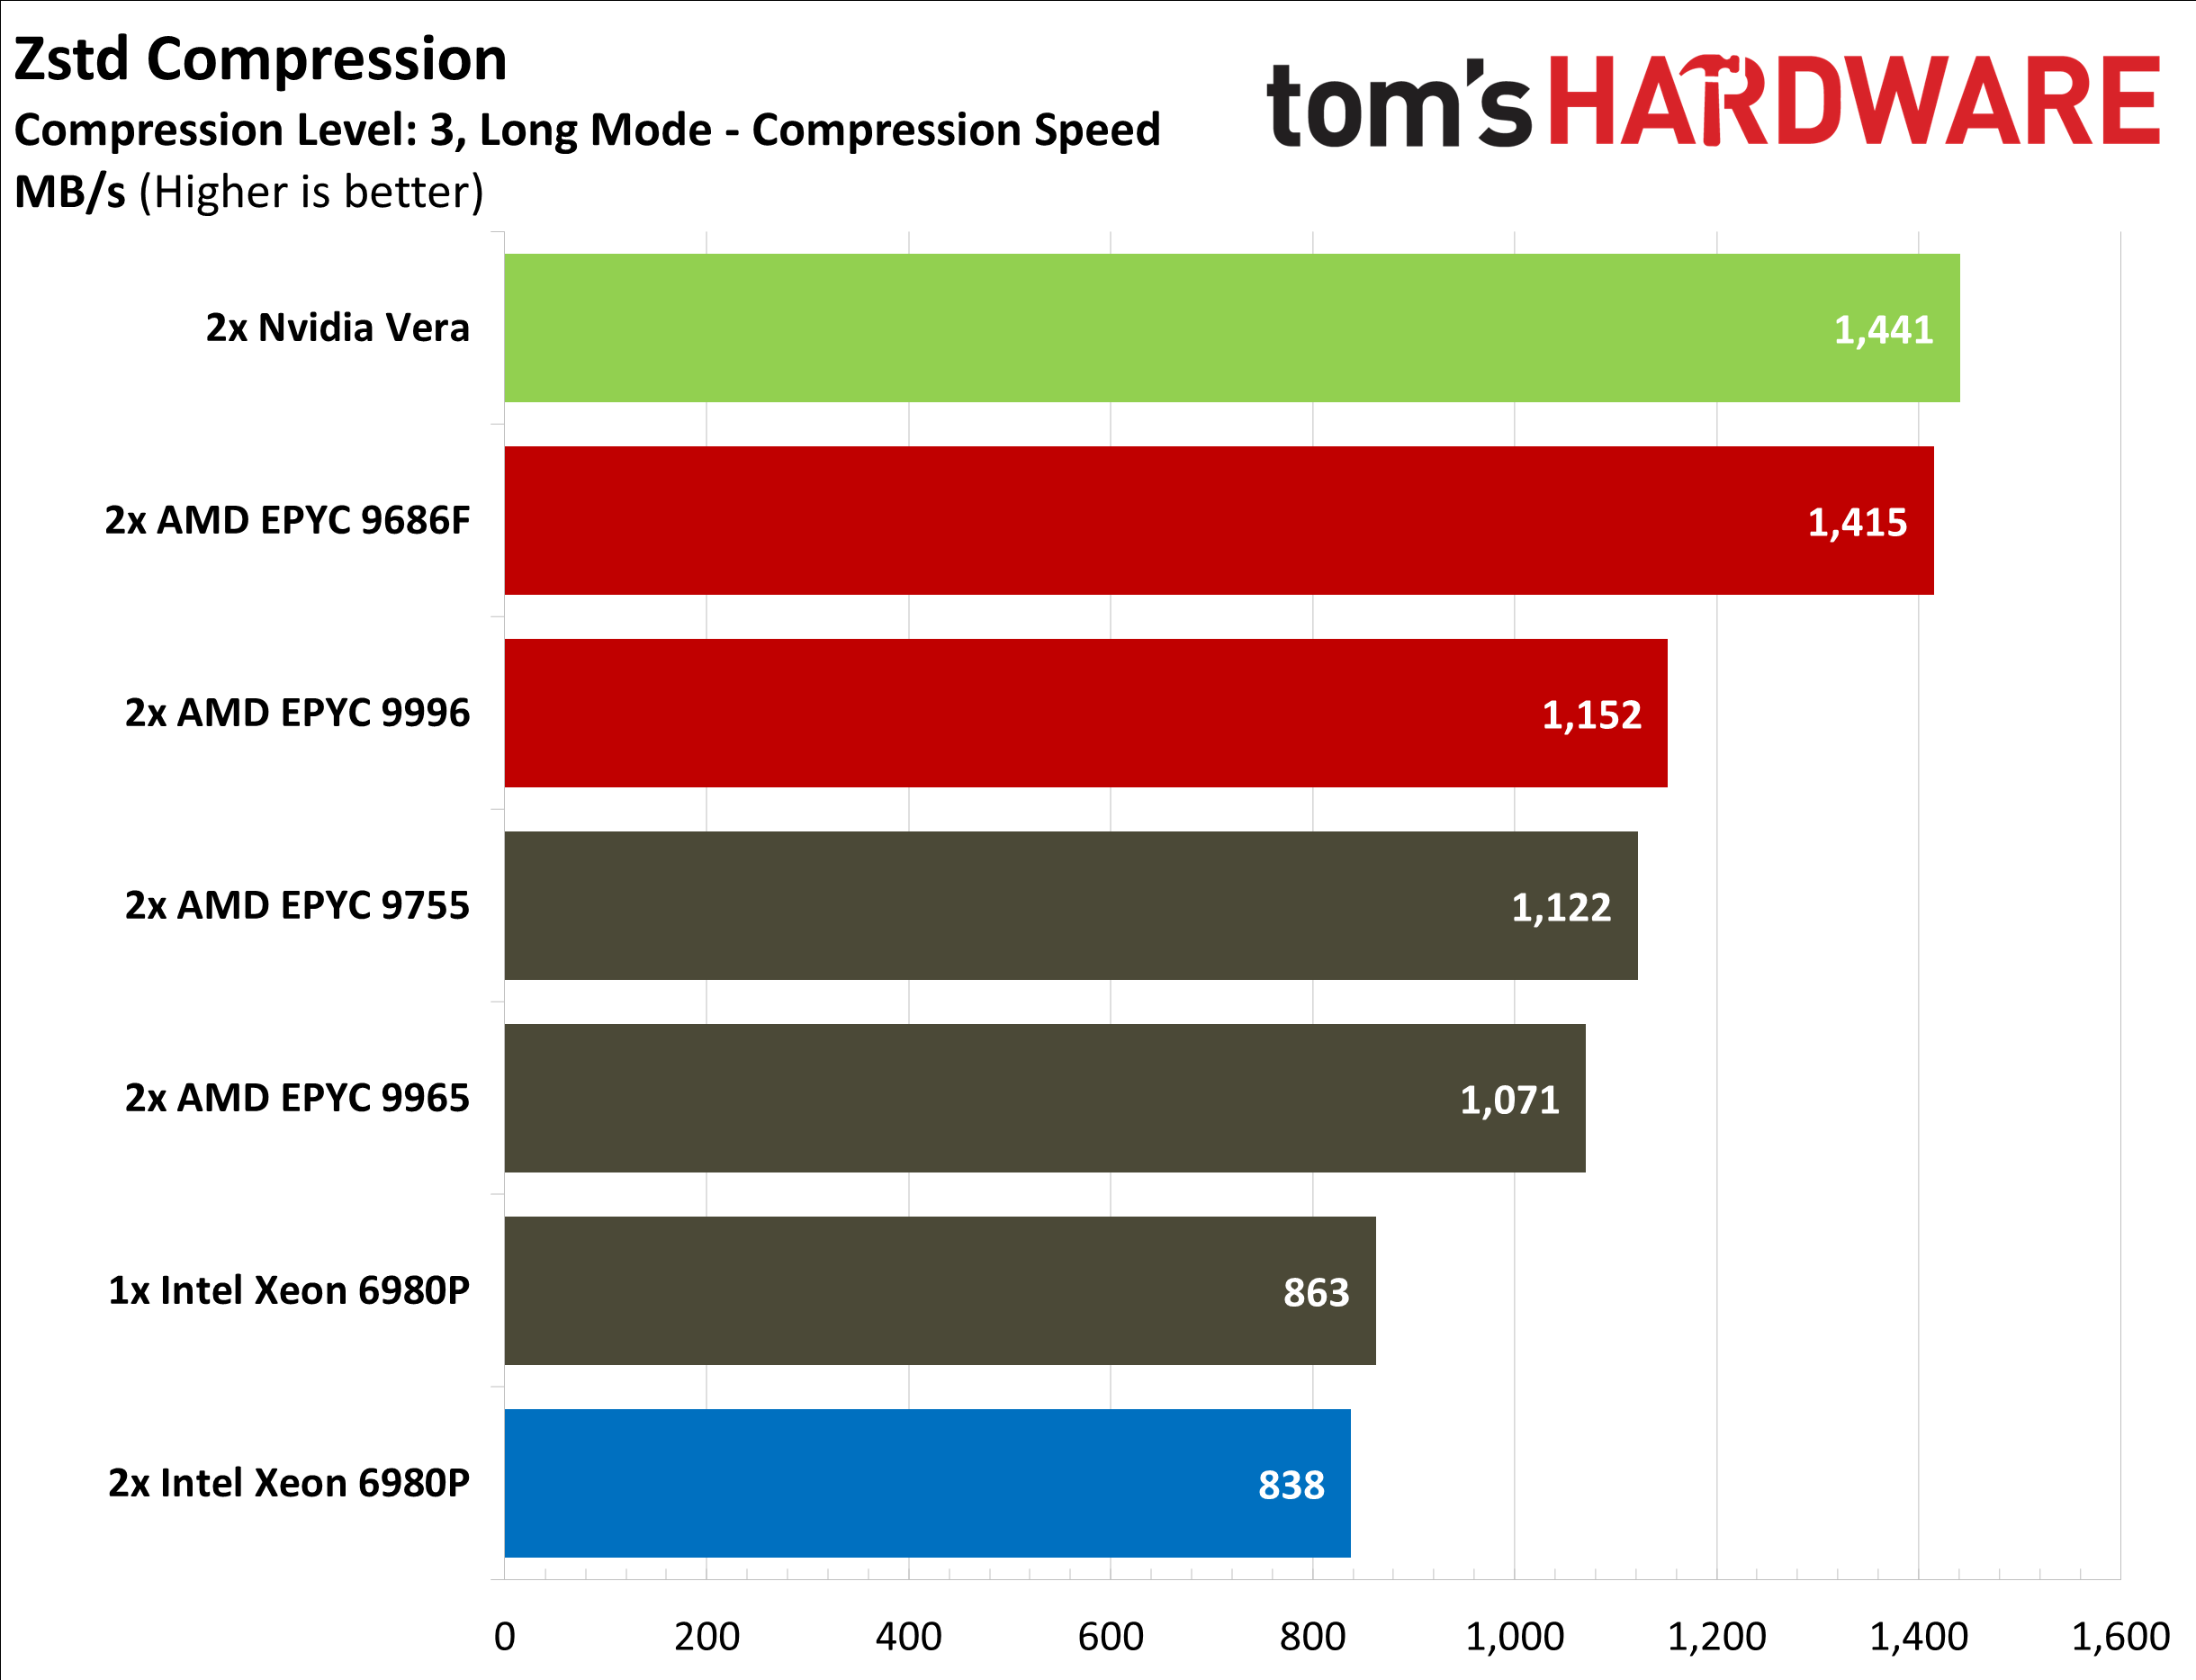
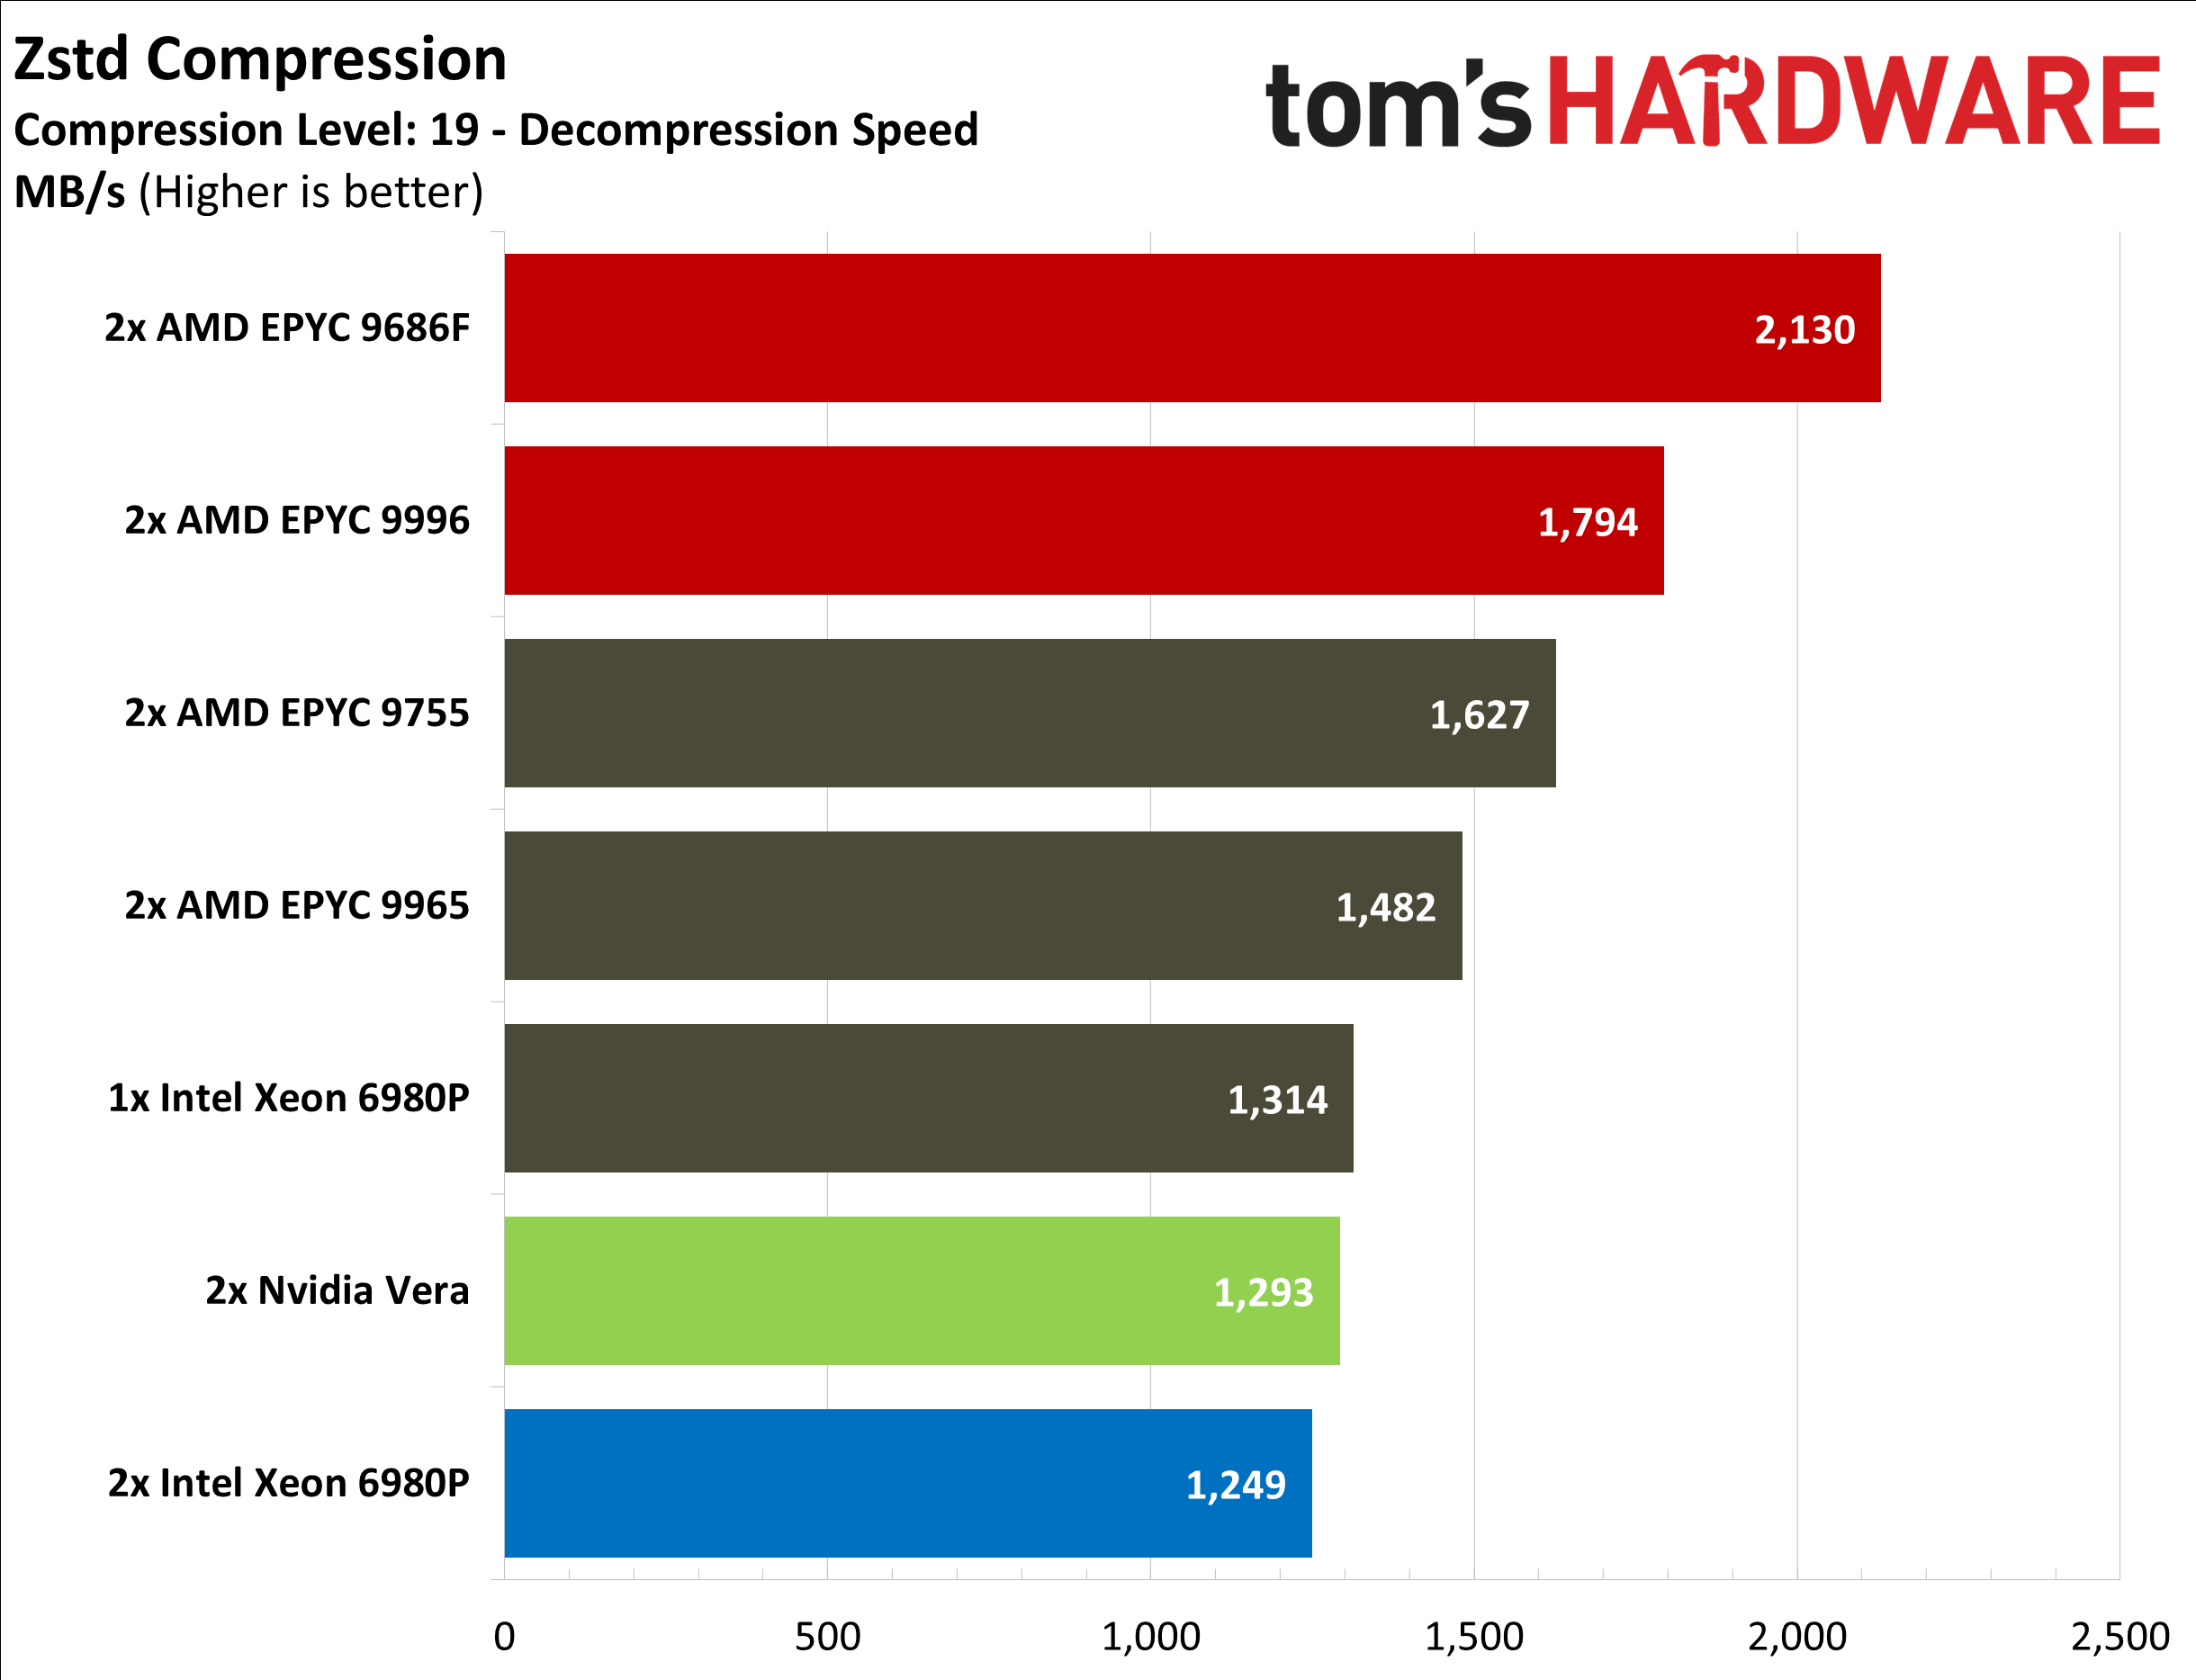
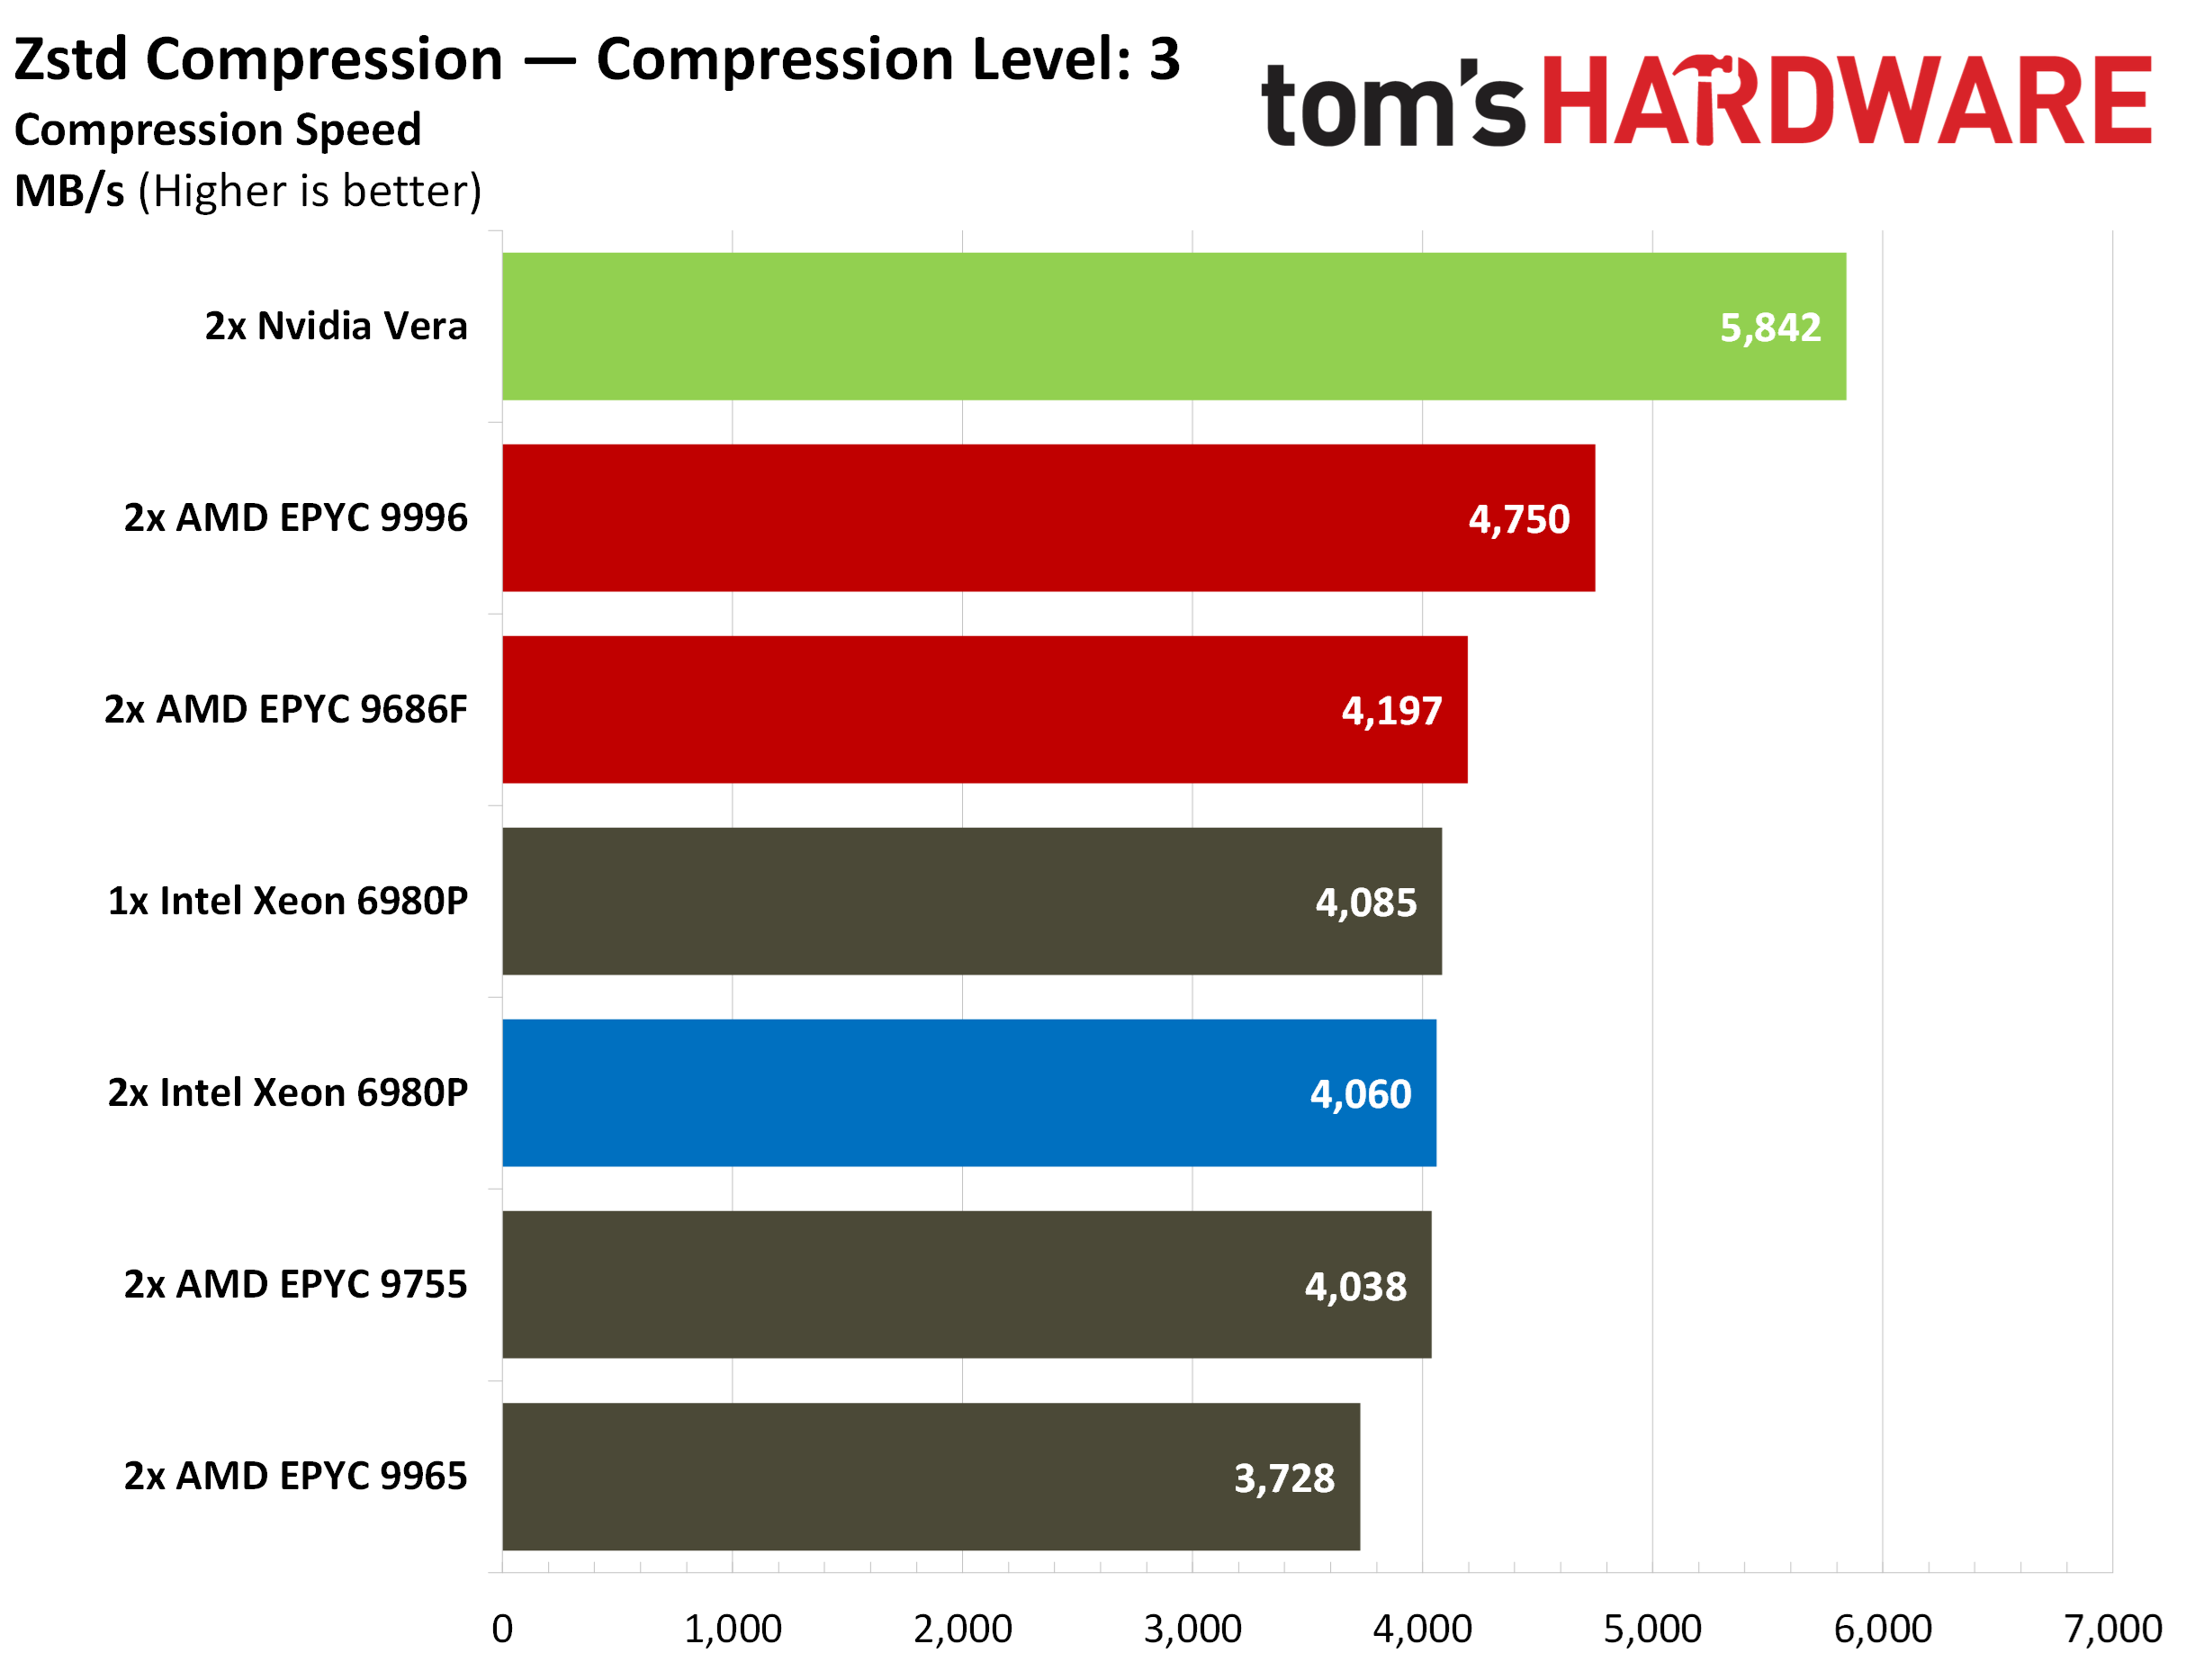
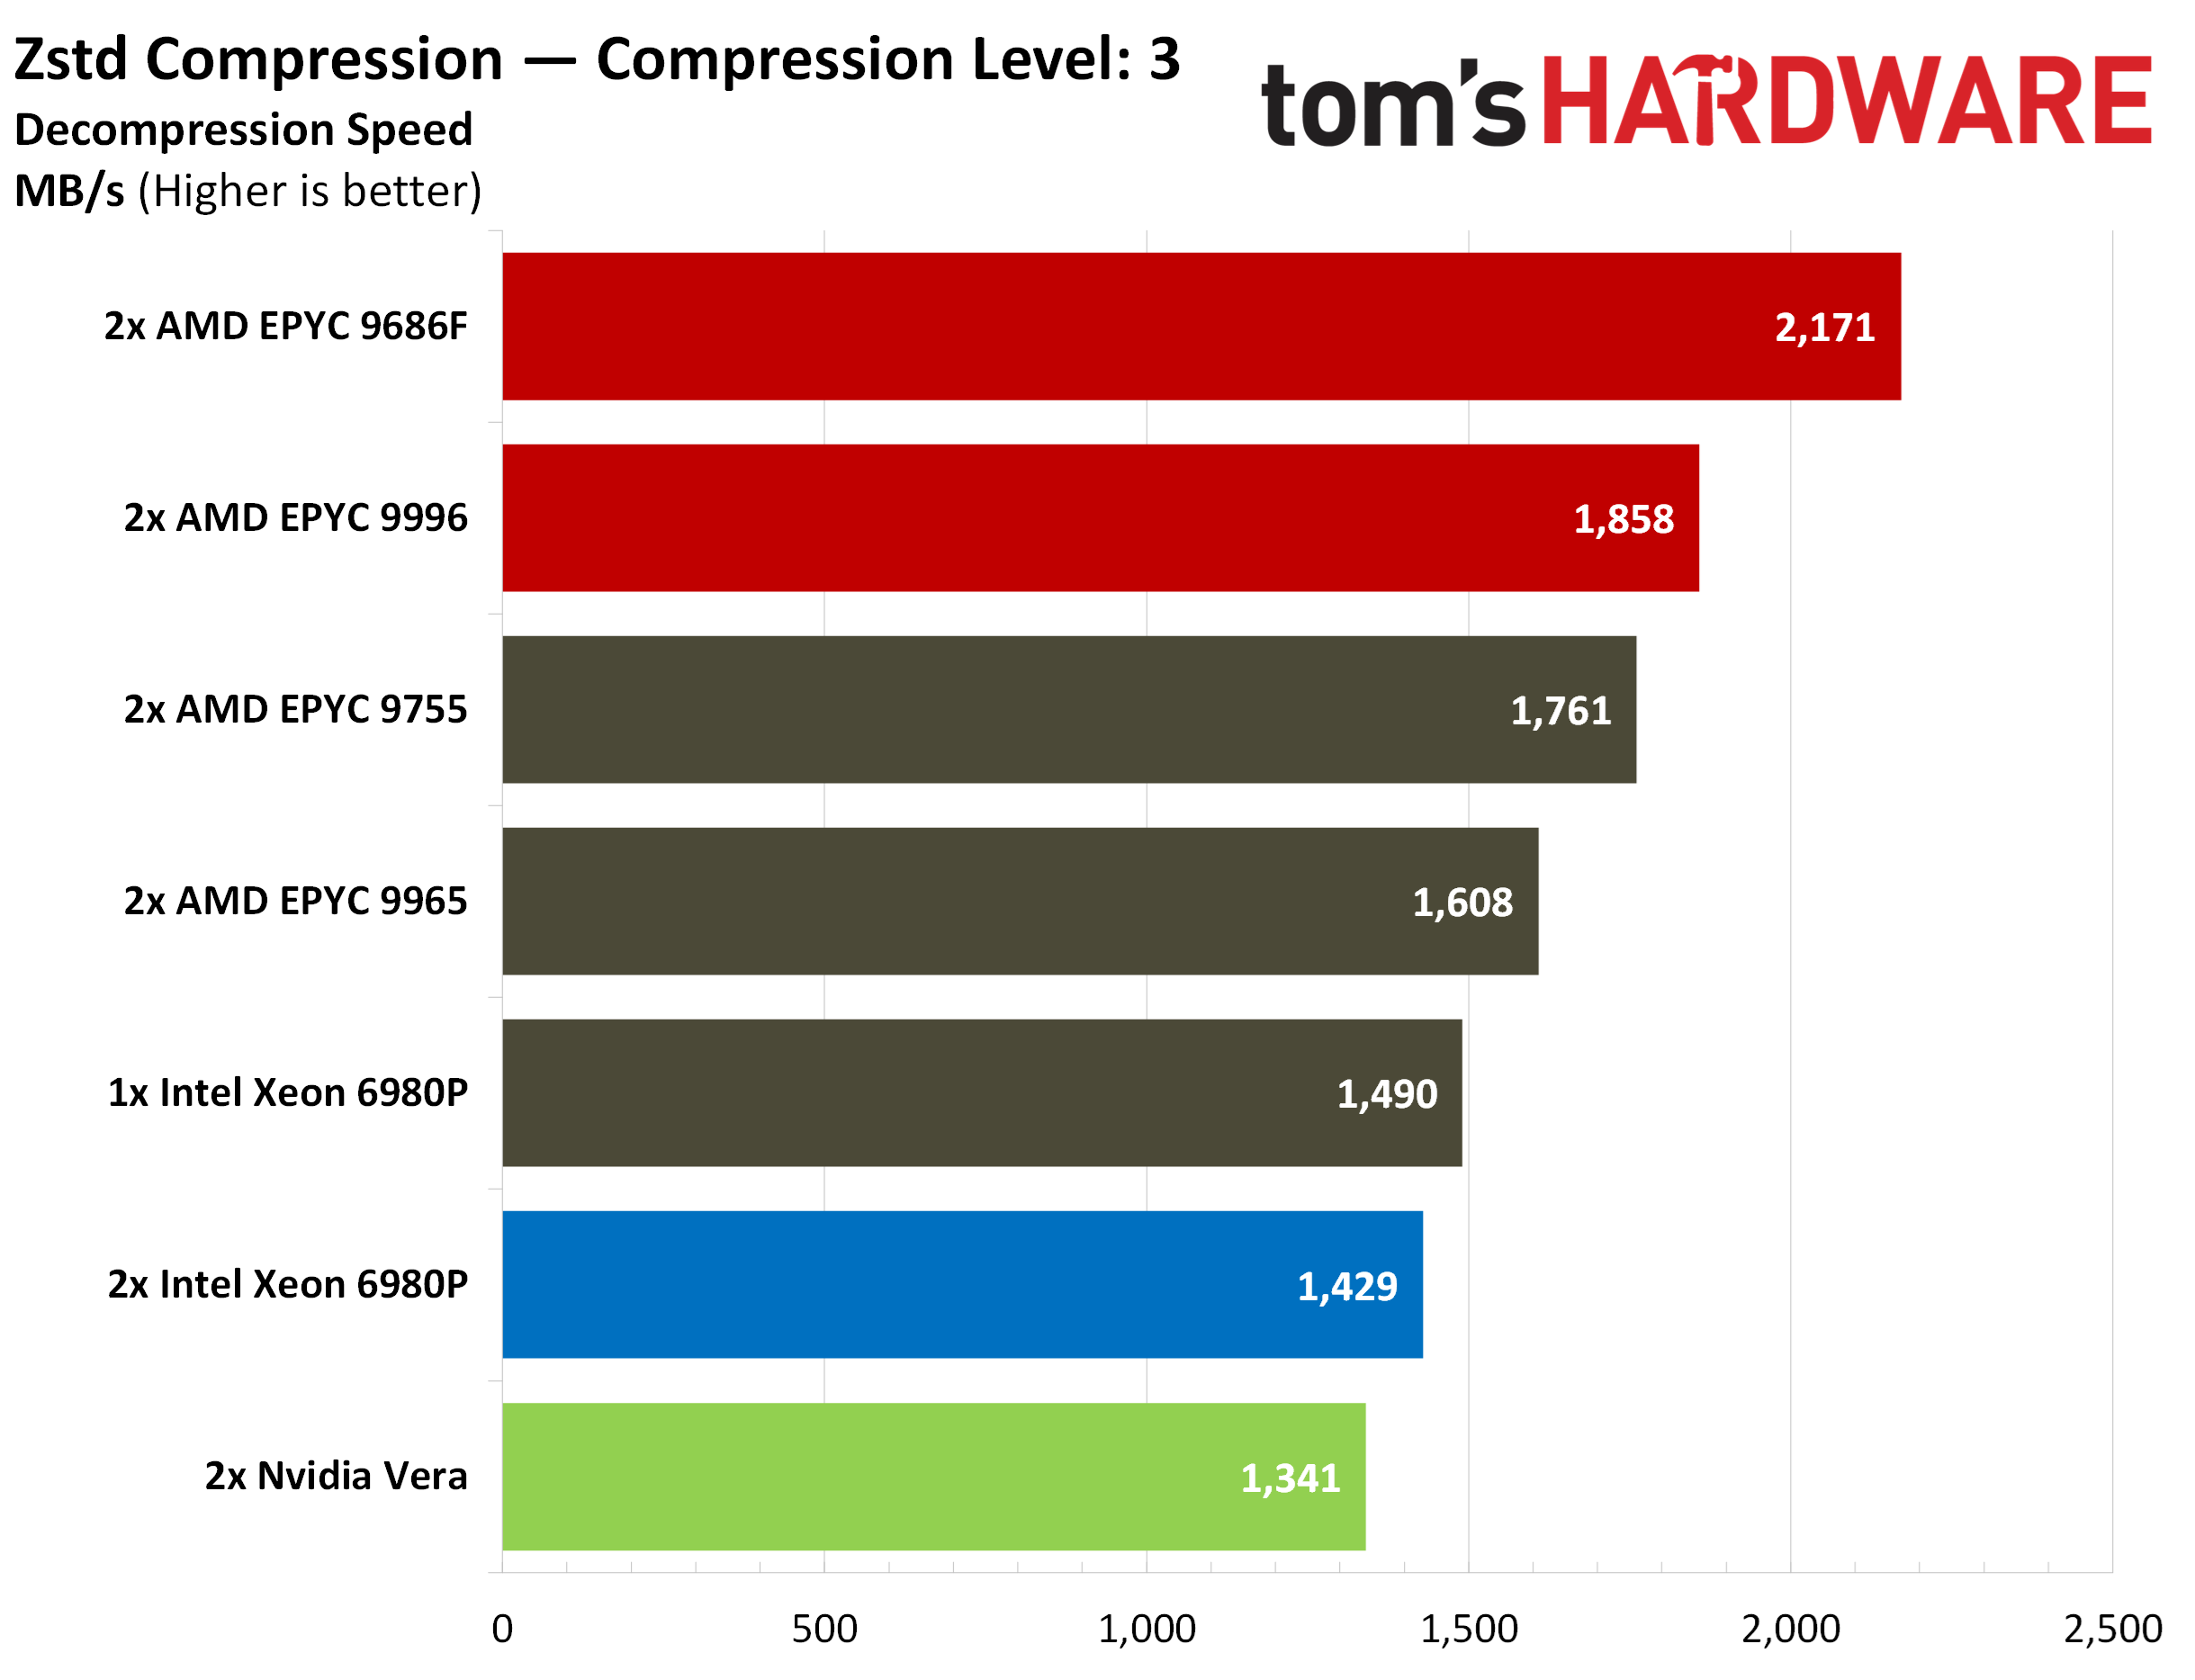
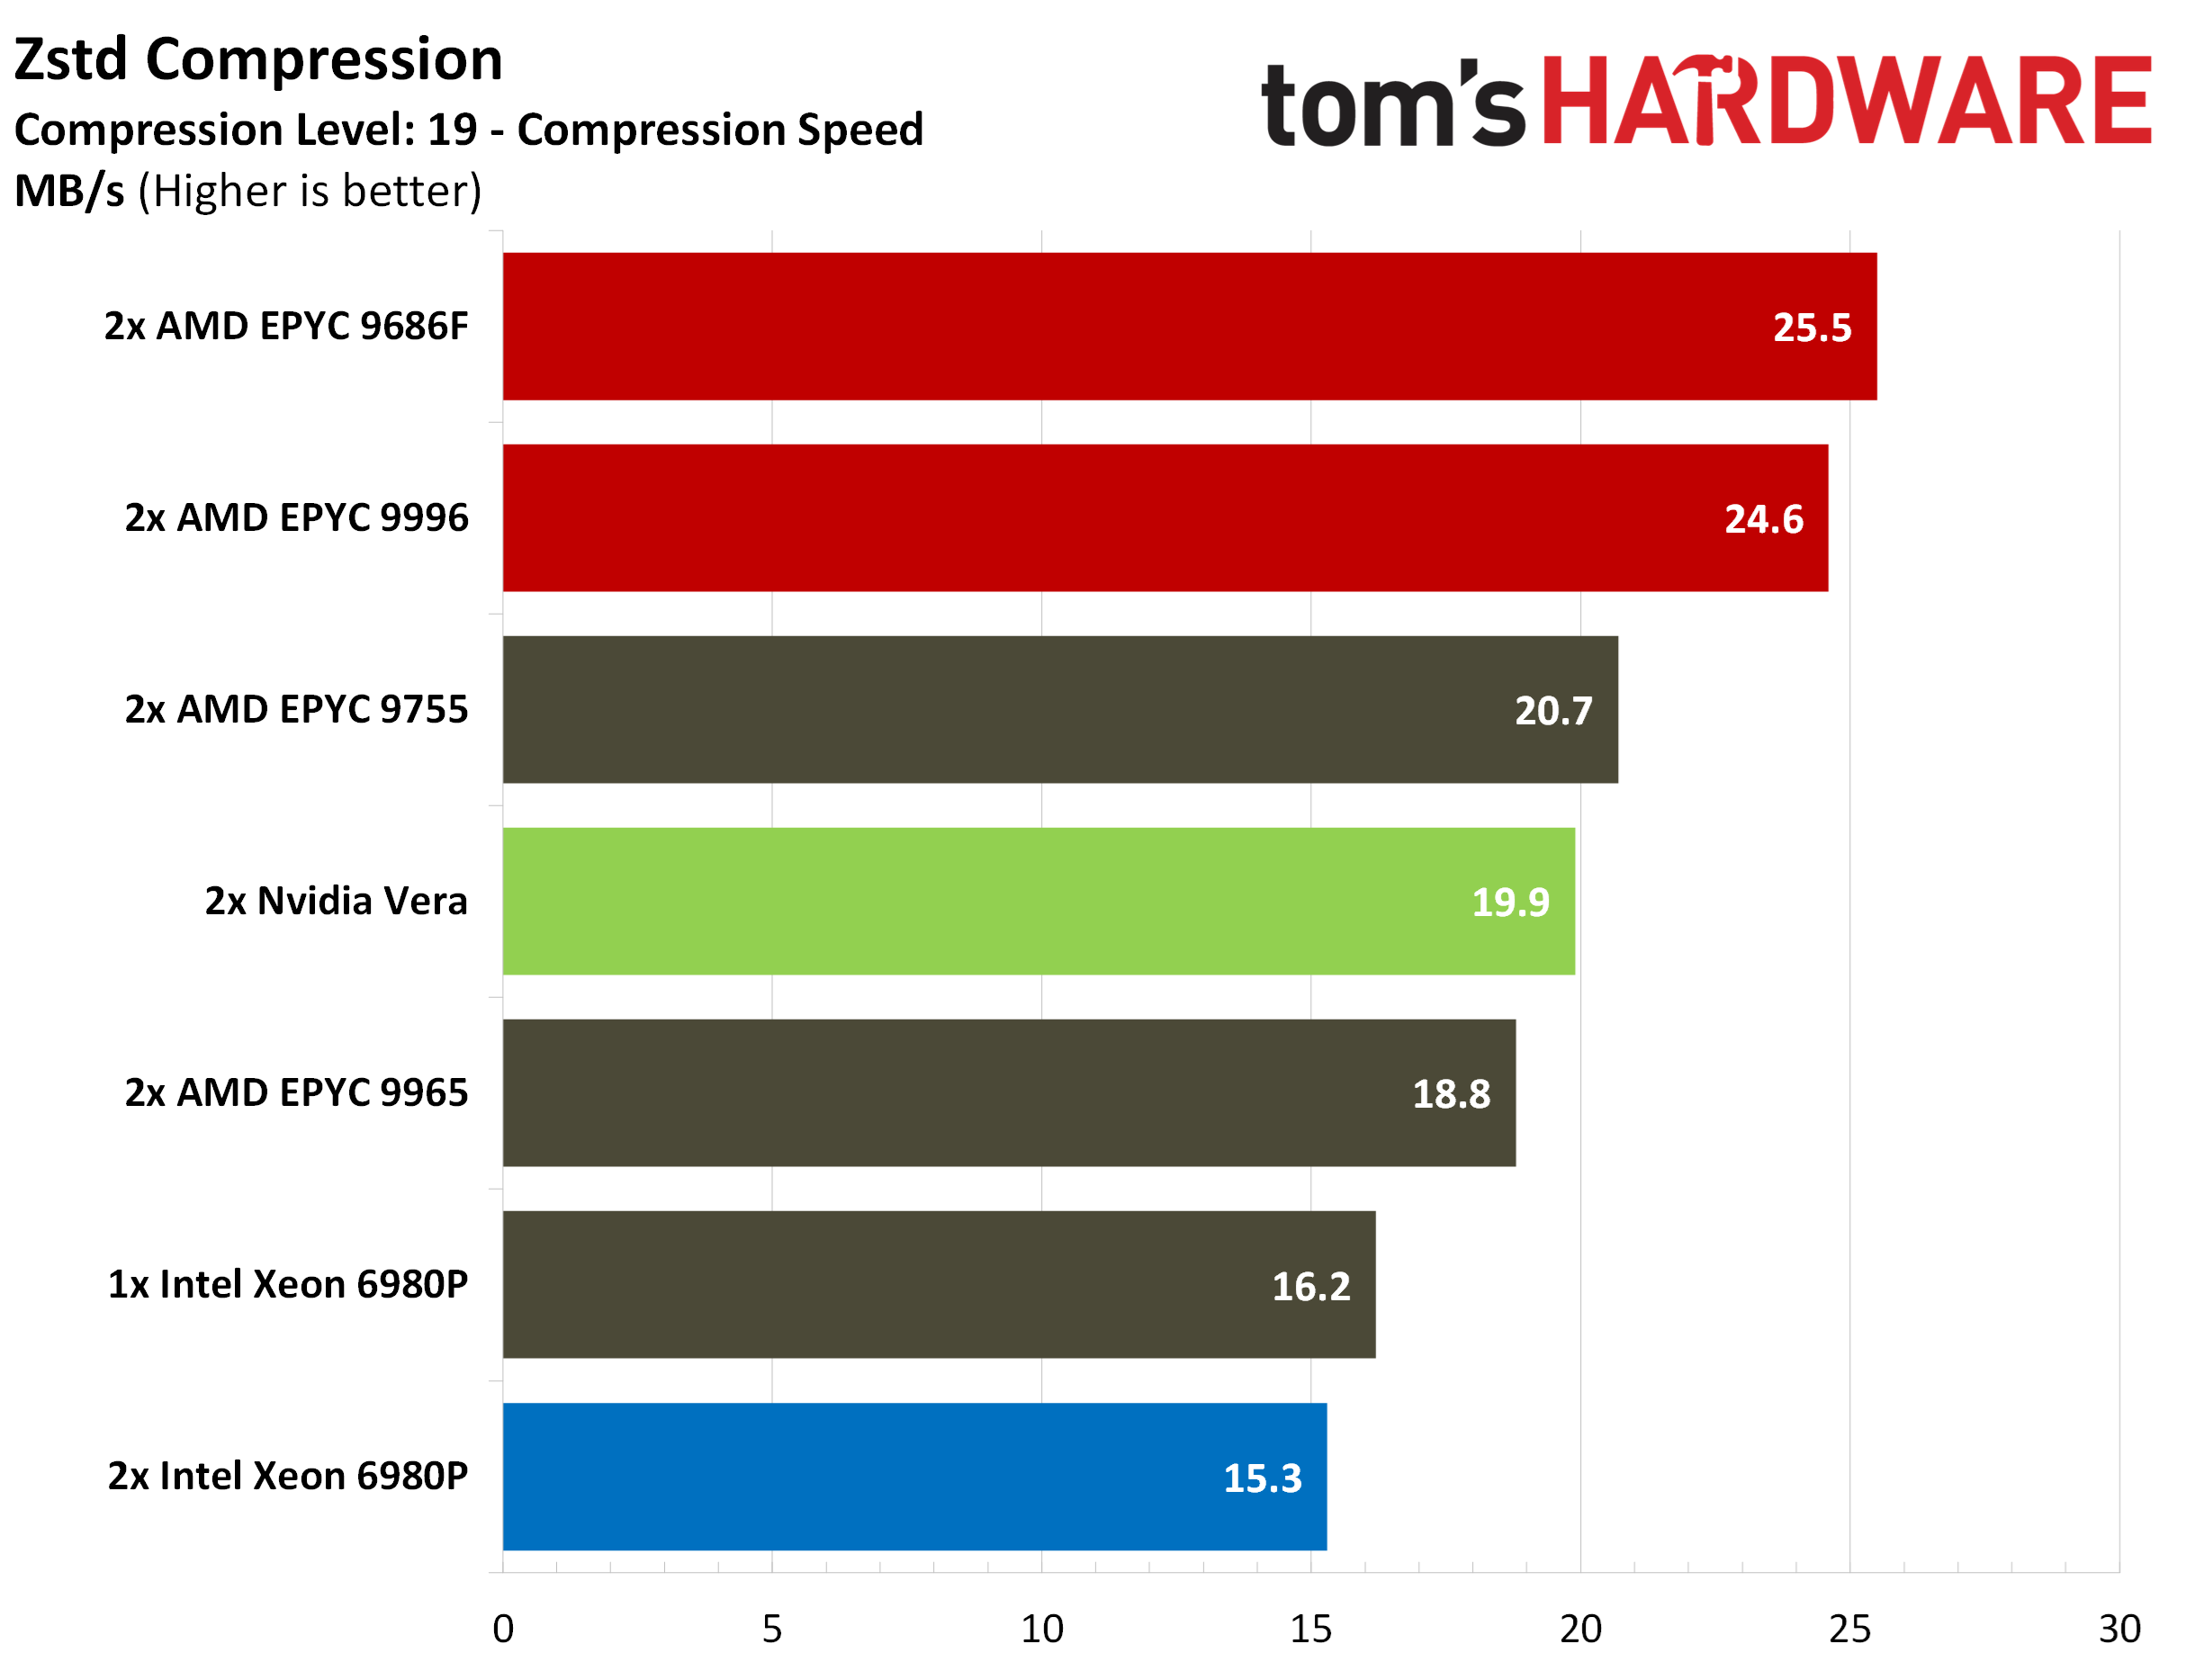
В специфических HPC-задачах вроде CloverLeaf и FFTE процессор EPYC 9686F продемонстрировал практически двукратное превосходство над конкурентом от Nvidia. Compression
С результатами остальных тестов можно ознакомиться в статье Tom’s Hardware. Будущие Ryzen получат 12 ядер и много кеша на одном кристалле — AMD раскрыла подробности архитектуры Zen 6
10.11.2026 [23:00],
Николай Хижняк
Компания AMD раскрыла свежие подробности о грядущих процессорах EPYC поколения Venice, а вместе с тем представила информацию об архитектуре Zen 6. Это позволяет оценить потенциальные возможности настольных процессоров AMD следующего поколения — условных Ryzen 10000, которые будут построены на той же архитектуре. 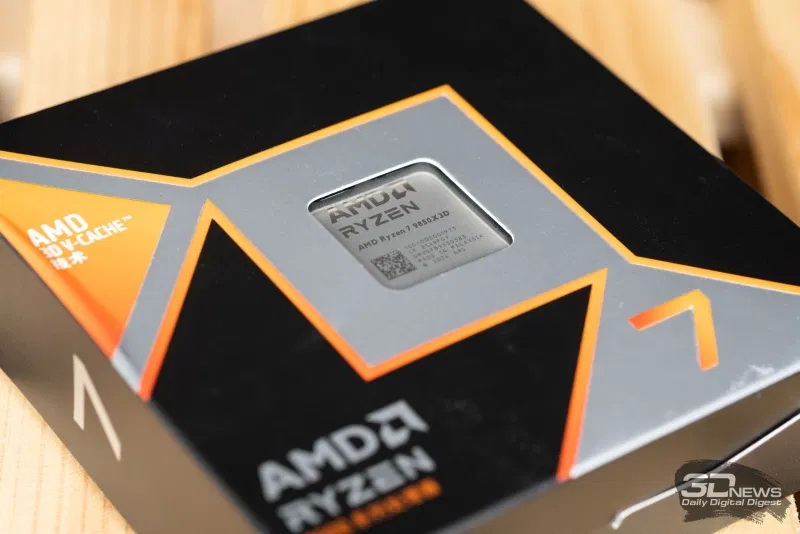 Одним из ключевых нововведений архитектуры Zen 6 является увеличение плотности компонентов в чиплетах (CCD). Архитектура Zen 6 позволяет разместить 12 производительных ядер и 48 Мбайт общей кеш-памяти L3 на одном чиплете. Для сравнения: в Zen 5 один чиплет вмещает до 8 ядер и 32 Мбайт кеша L3. При этом объём кеша на одно ядро в Zen 6 остался прежним и составляет 4 Мбайт. Конструкция Zen 6 также открывает возможность создания 24-ядерных процессоров Ryzen с использованием двух таких чиплетов CCD. Актуальные 12-ядерные процессоры AMD используют два отдельных чиплета. Перенос всех 12 ядер на один CCD в Zen 6 позволит устранить межчиплетную задержку (latency penalty) при обмене данными в играх. AMD также заявляет о значительном увеличении показателя IPC (числа инструкций, выполняемых за такт). В серверных тестах плотных ядер Zen 6c прирост среднегеометрического IPC в задачах ИИ и серверных нагрузках составил около 27 %. AMD производит серверные процессоры EPYC Venice с использованием 2-нм техпроцесса TSMC N2P, стремясь повысить энергоэффективность и увеличить максимальные тактовые частоты в определённых серверных конфигурациях. Компания пока не подтвердила характеристики соответствующих моделей Ryzen, однако все предыдущие поколения процессоров Ryzen и EPYC базировались на одной и той же архитектуре Zen. 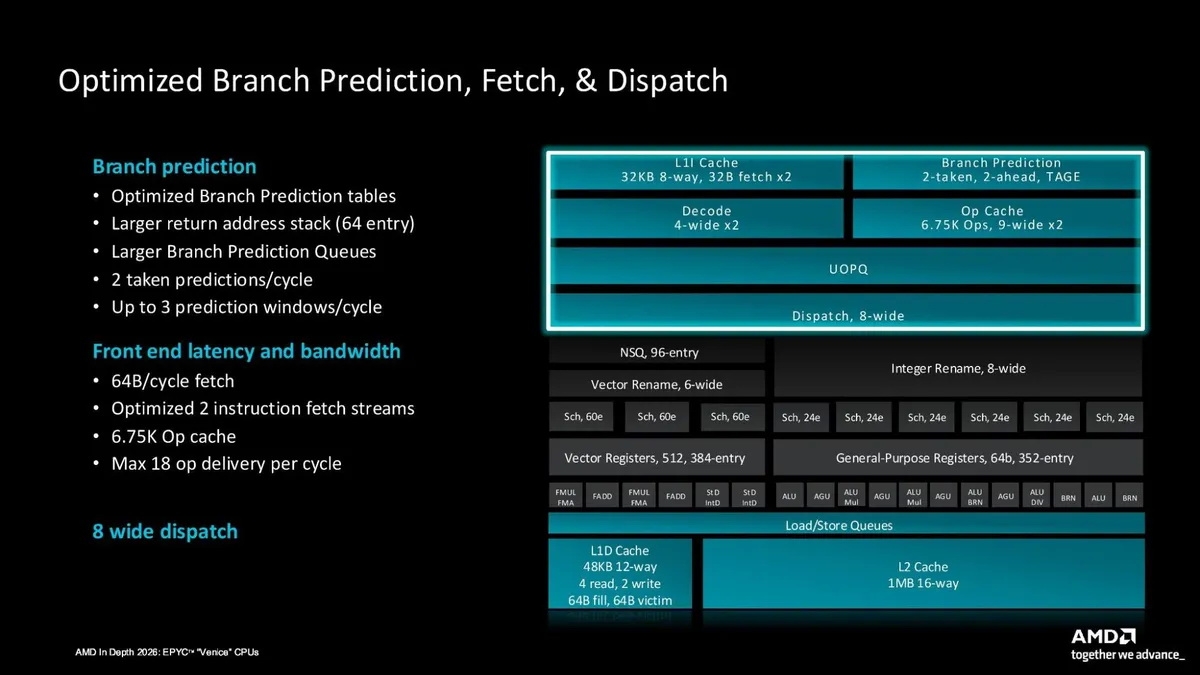 В новой архитектуре также улучшена система предсказания переходов: расширены очереди, добавлен стек возврата адресов на 64 записи, обрабатывается до двух выбранных переходов за такт. Ёмкость кеша операций увеличена примерно до 6750 операций, а исполнительный блок (front end) способен выдавать до 18 операций за такт. На практике это означает, что процессор располагает более совершенными средствами для прогнозирования того, какие инструкции ему потребуются далее. В случаях, когда прогноз оказывается неверным, архитектура, по заявлению AMD, способна быстрее восстанавливаться, что сокращает объём бесполезной работы. Для игр это может быть столь же важно, как и увеличение количества ядер. Подавляющее большинство игр по-прежнему сильно зависят от производительности лишь нескольких потоков. Более точное предсказание переходов, быстрое восстановление после ошибок и эффективное выполнение инструкций способны повысить быстродействие, даже если дополнительные ядра Zen 6 при этом по большей части простаивают. Архитектура Zen 6 также открывает новые перспективы для линейки процессоров Ryzen X3D. Новая компоновка позволит AMD выпустить 12-ядерный игровой процессор Ryzen X3D на базе единого кристалла. На примере серверных чипов Venice-X подтверждена возможность интеграции наложенного кеша 3D V-Cache объёмом 96 Мбайт поверх встроенных 48 Мбайт L3. В сумме это даёт 144 Мбайт кеша L3 на один 12-ядерный чиплет. Двухчиплетным процессорам X3D требуется сложная логика планировщика для распределения игровых потоков между ядрами с наибольшим объёмом кеша. Один чиплет CCD с двенадцатью ядрами Zen 6, оснащённый огромным объёмом кеш-памяти, существенно упростит этот процесс. Это решит проблему распределения потоков, характерную для современных двухчиплетных процессоров Ryzen 9 X3D, и избавит пользователя от выбора между чистой игровой производительностью 8-ядерных моделей и многопоточностью старших CPU. Какой реальный прирост производительности в играх обеспечат новые настольные Ryzen, мы не узнаем, пока не появятся результаты их независимых тестов. Показатели IPC в серверных задачах — это ещё не прогноз игровой производительности, а архитектурные улучшения не устранят все источники задержек. Смартфоны получат аналог Nvidia DLSS: её принесёт следующий флагманский чип Qualcomm Snapdragon
02.09.2026 [19:11],
Николай Хижняк
Qualcomm продолжает делиться деталями о будущем флагманском процессоре Snapdragon. Ранее компания сообщила, что новые ядра Oryon в составе чипа смогут работать на частоте до 5 ГГц и получат новую архитектуру кеша FlexCache. Сейчас компания рассказала о некоторых особенностях нового встроенного GPU Adreno в составе будущего чипа. 
Источник изображений: Qualcomm В частности, компания заявила, что в составе нового GPU процессора Snapdragon будут впервые использоваться матричные движки. Их будет три. Они будут отвечать за работу технологии Adreno Neural Fusion. Qualcomm говорит, что Neural Fusion обеспечивает уменьшение визуальных артефактов (например, мерцания и двоения изображения), более стабильную работу и более высокую детализацию по сравнению с предыдущими решениями. Кроме того, технология обеспечивает экономию энергии до 40 % по сравнению с предыдущим решением. 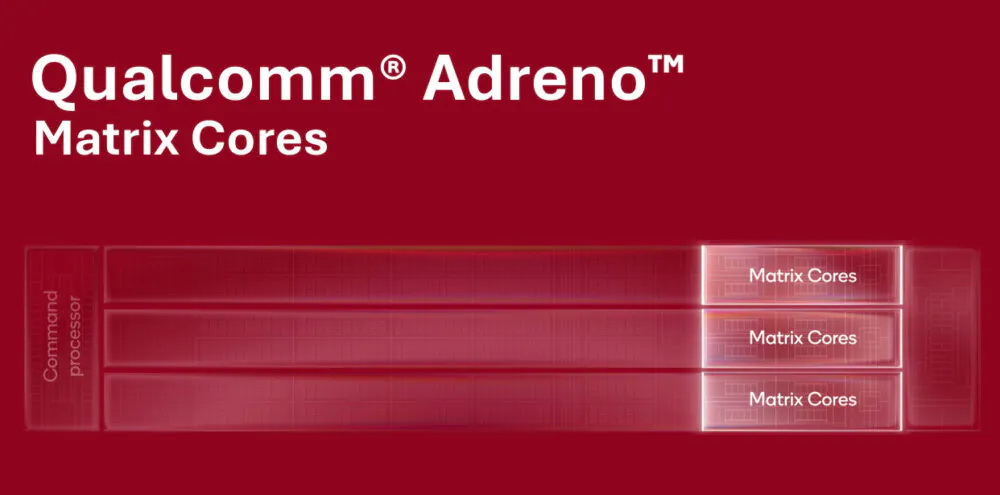 Можно предположить, что под «предыдущим решением» компания имеет в виду функцию Qualcomm Snapdragon Game Super Resolution. Как отмечает портал Android Authority, судя по всему, новая технология предложит генерацию кадров и масштабирование изображения в поддерживаемых играх. Qualcomm также подтвердила, что игровые движки Unreal Engine и Unity уже поддерживают Adreno Neural Fusion. На данный момент неизвестно, можно ли будет использовать матричные движки в составе нового процессора Snapdragon для задач, не связанных с играми. Однако следует отметить, что компания Xiaomi уже заявила для GPU Arm G2-Ultra NX в составе своего нового фирменного процессора XRing 03 наличие восьми нейронных ускорителей. Таким образом, внедрение поддержки искусственного интеллекта аппаратной частью графических процессоров может стать тенденцией для мобильных устройств следующего поколения. 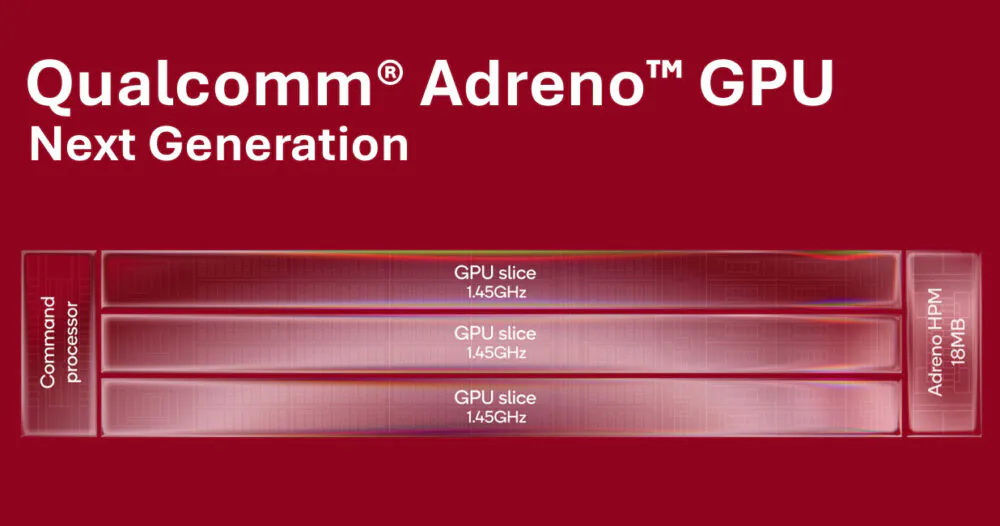 Qualcomm также сообщила, что GPU в составе нового чипа будет использовать трёхслойную архитектуру. В ней шейдерные ядра графического процессора и другие аппаратные блоки разделены на «сегменты», что позволяет более точно контролировать энергопотребление и балансировать производительность. Компания заявляет, что частота нового GPU Adreno составляет 1,45 ГГц. Для сравнения, графика в составе Snapdragon 8 Elite Gen 5 работает на частоте 1,2 ГГц. Новый GPU Adreno по-прежнему будет оснащён 18 Мбайт высокопроизводительной памяти (Adreno High Performance Memory), однако по словам Qualcomm, её эффективность повысится на 12 %. Кроме того, компания заявляет об использовании в составе процессора модема Qualcomm X105 и набора средств связи FastConnect 8800. Intel рассказала о технических сложностях, стоявших при разработке мобильных процессоров Wildcat Lake
25.08.2026 [04:34],
Николай Хижняк
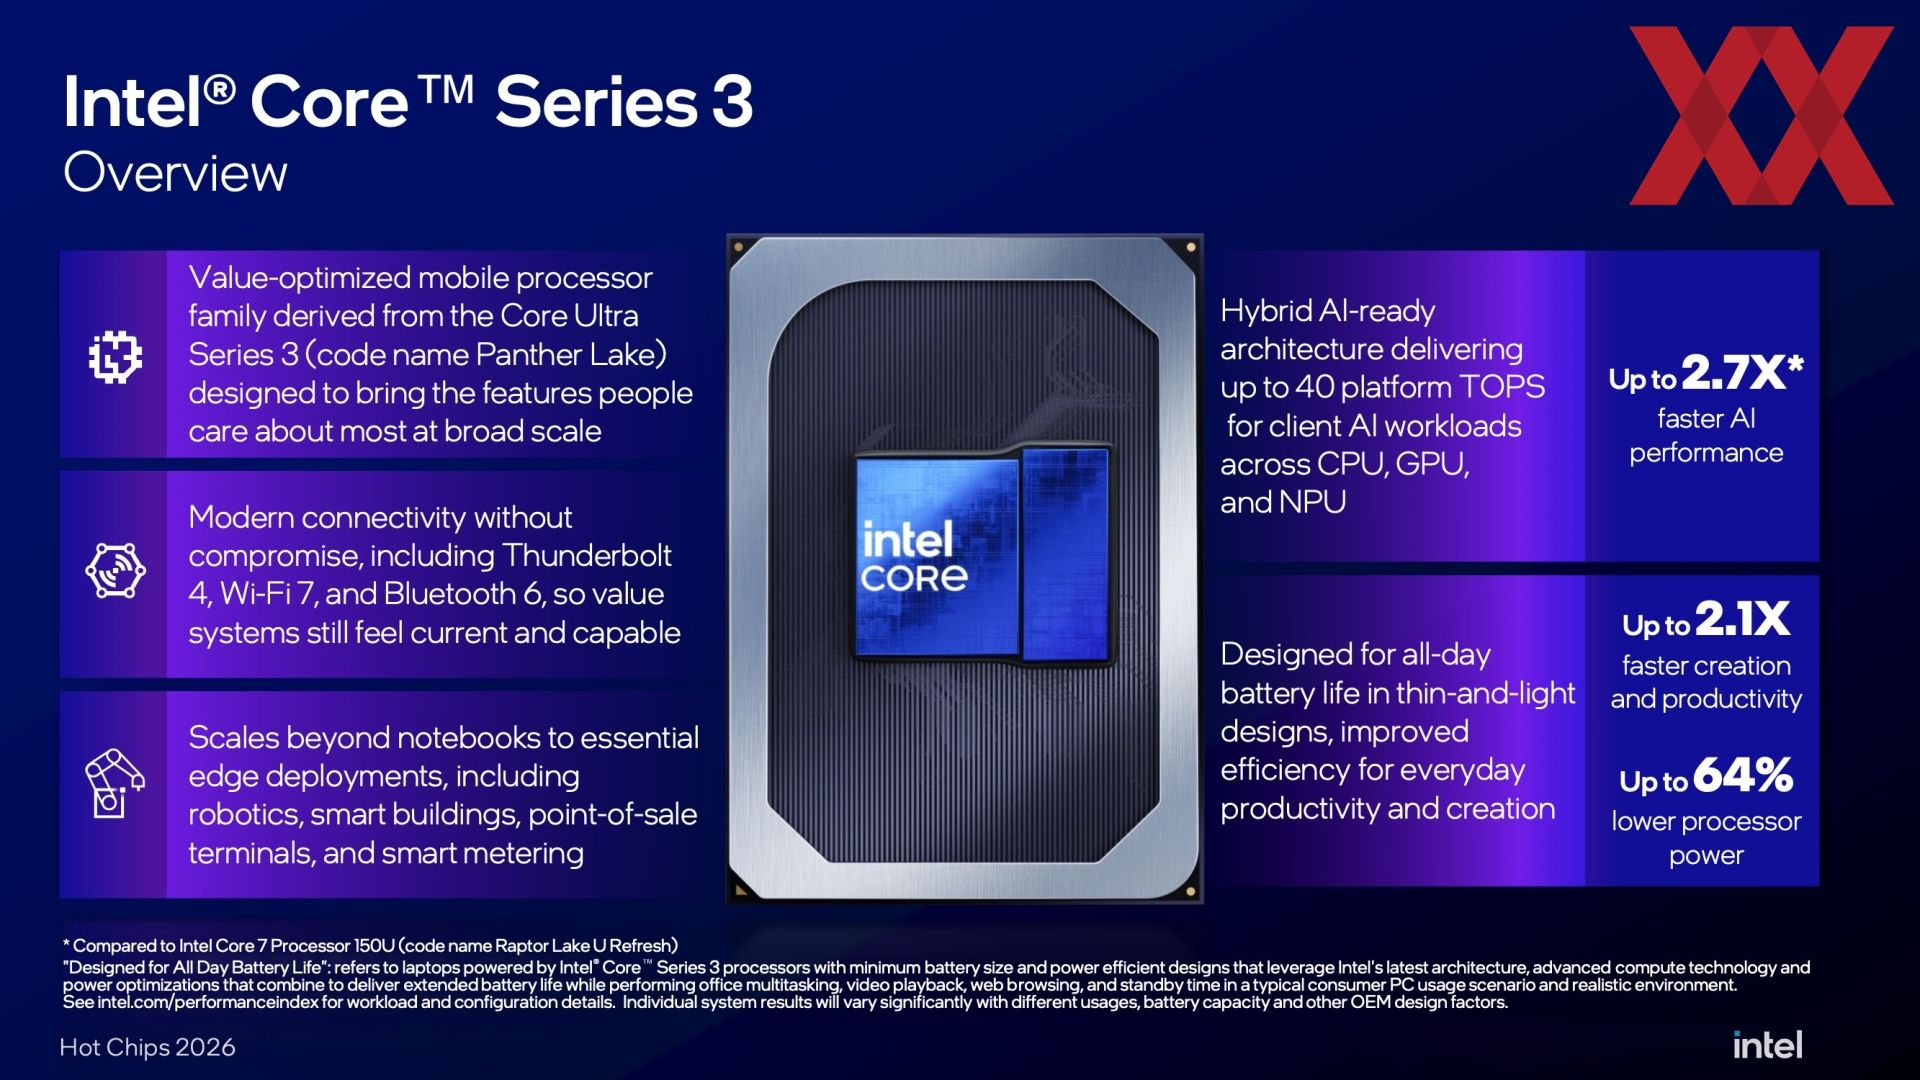
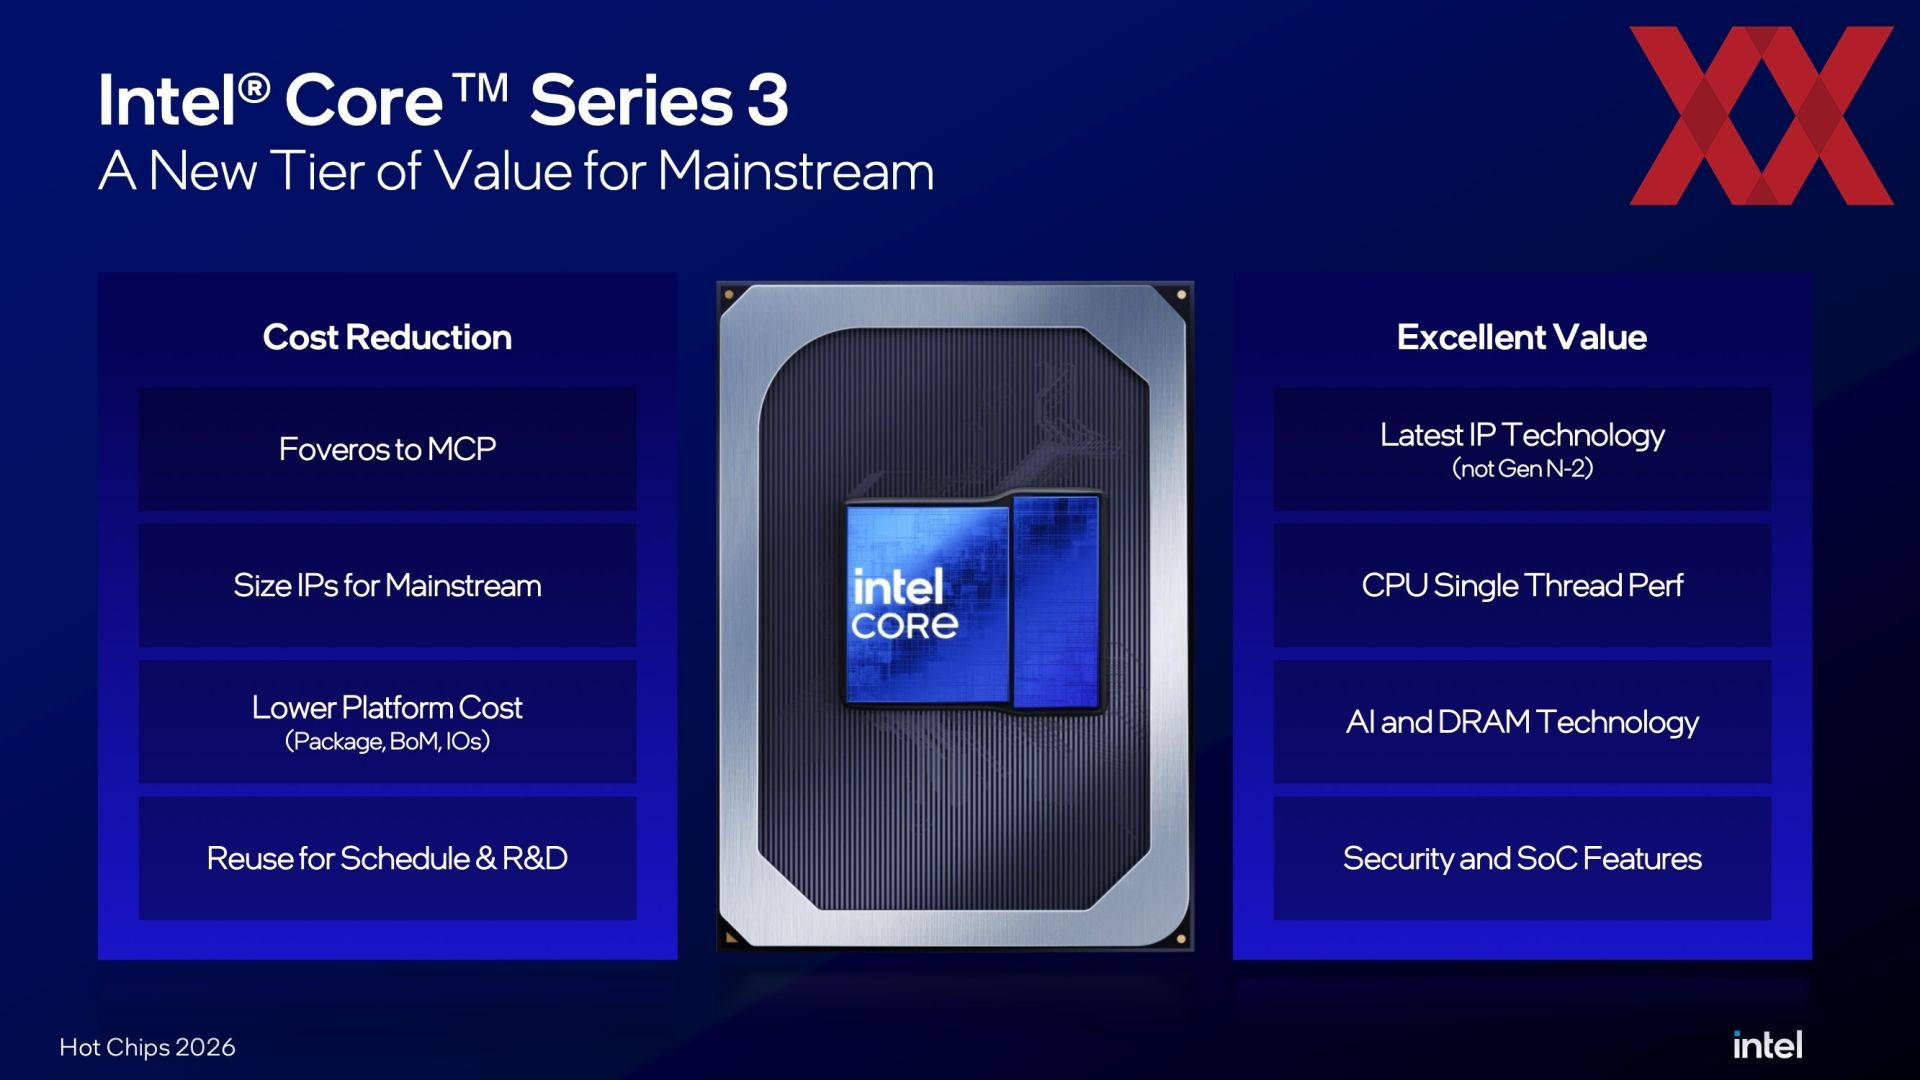
В рамках конференции Hot Chips 2026 компания Intel рассказала о технических задачах и целях, стоявших за разработкой мобильных процессоров Core Series 3 (Wildcat Lake). По сути, они представляют собой дешёвый вариант Core Ultra 3 (Panther Lake), на основе которых и были созданы. 
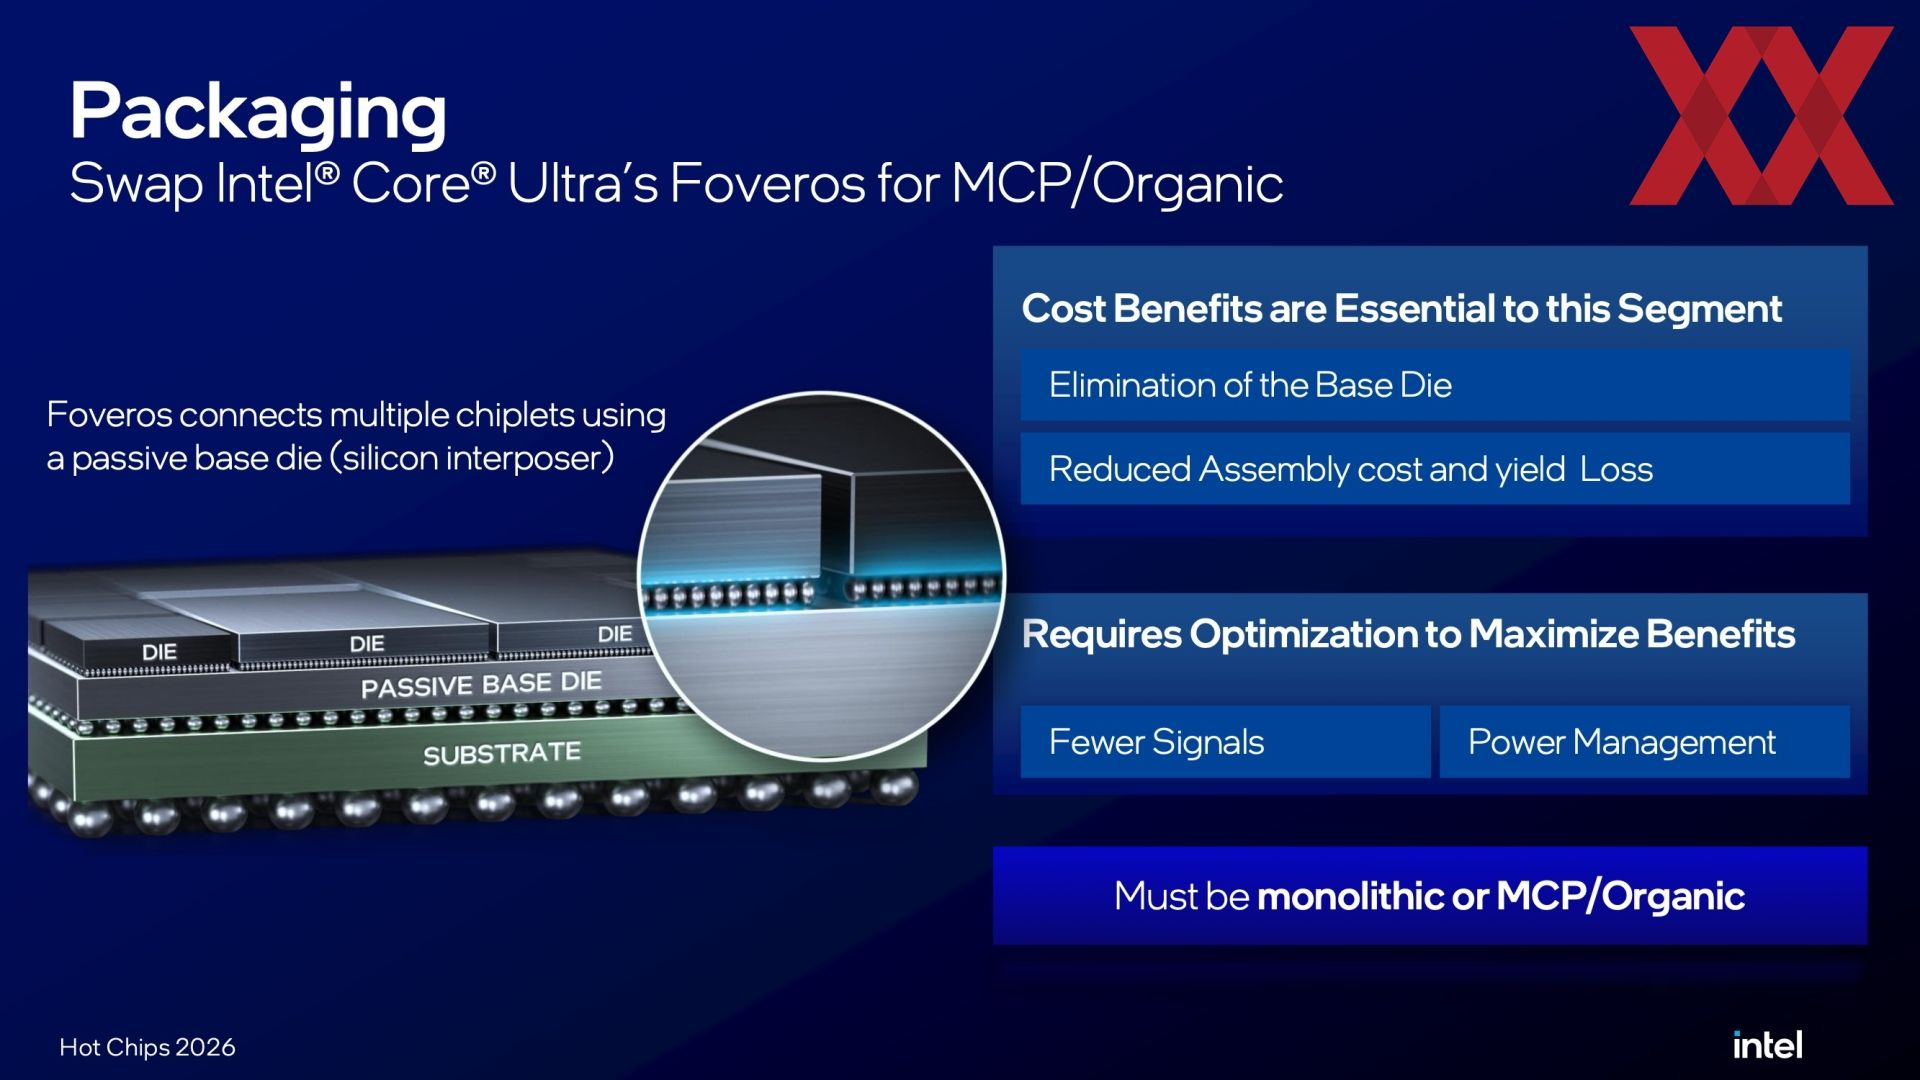
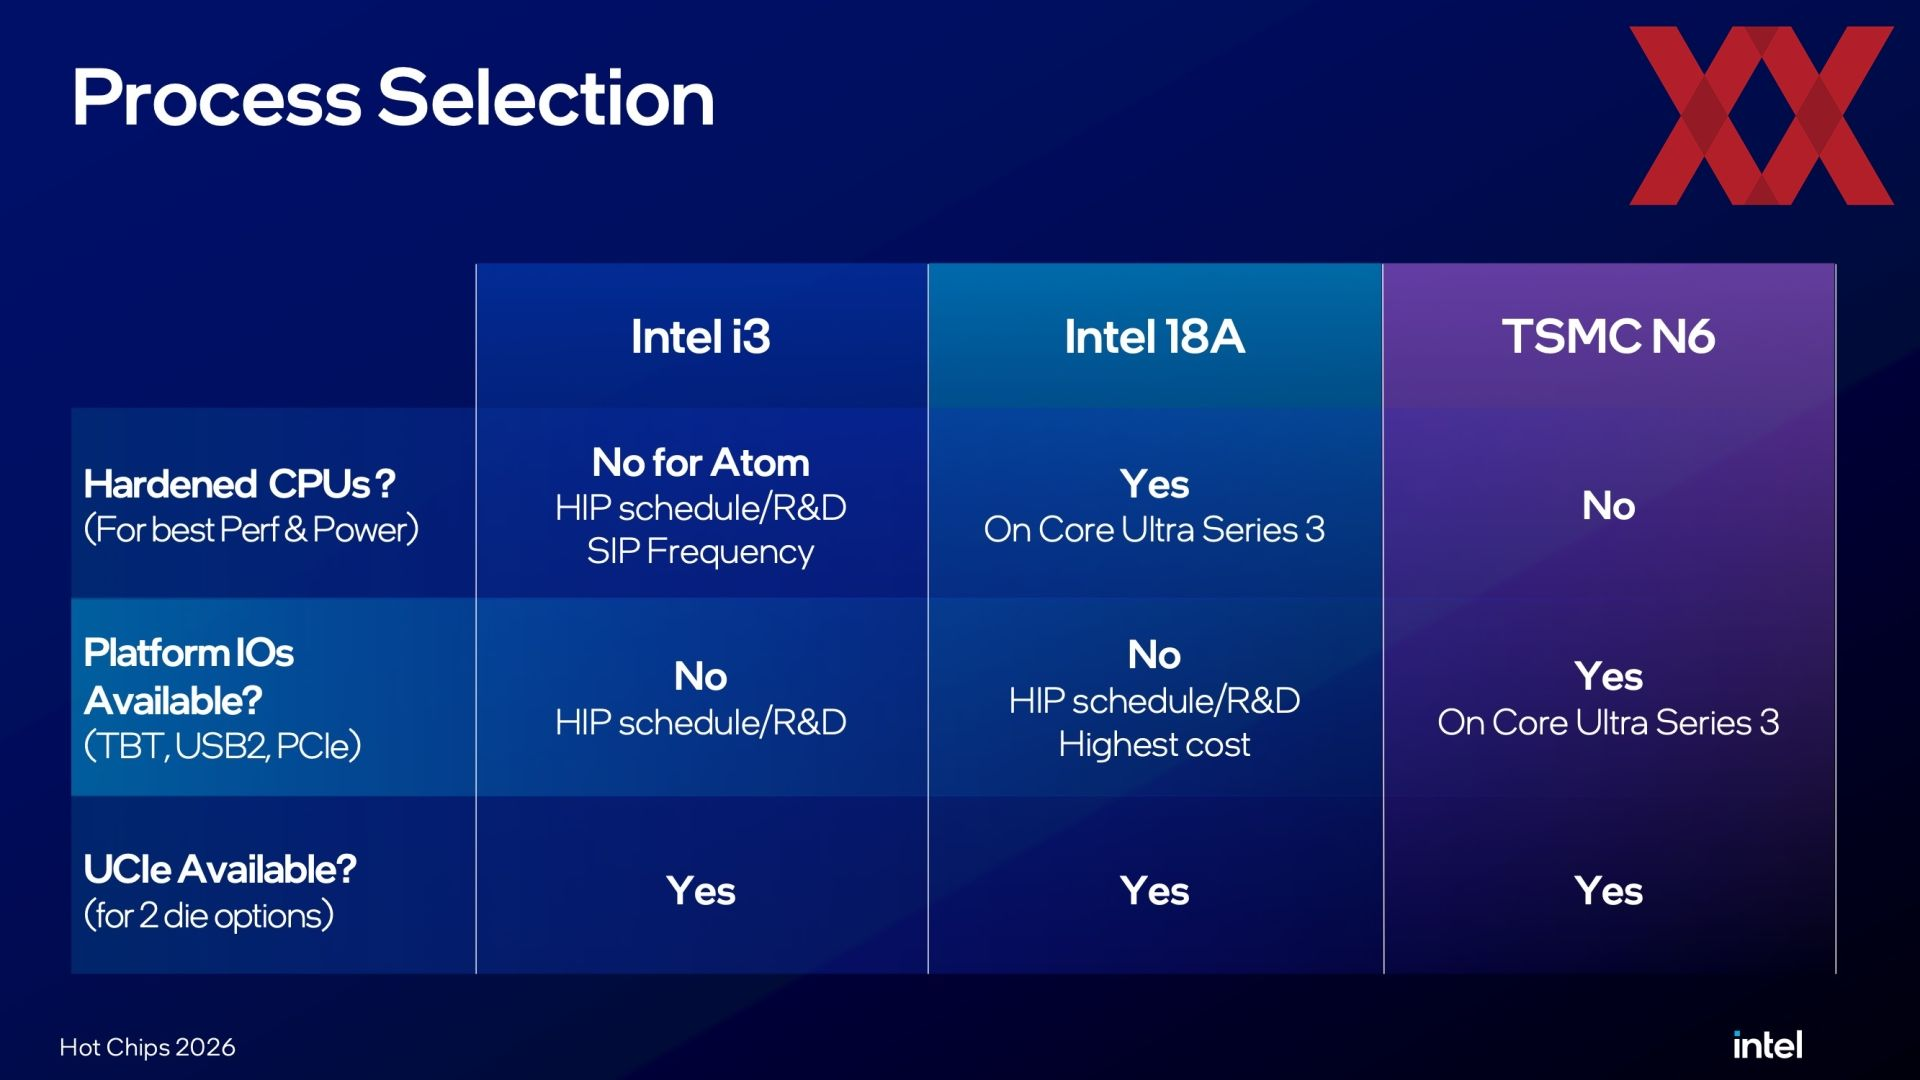
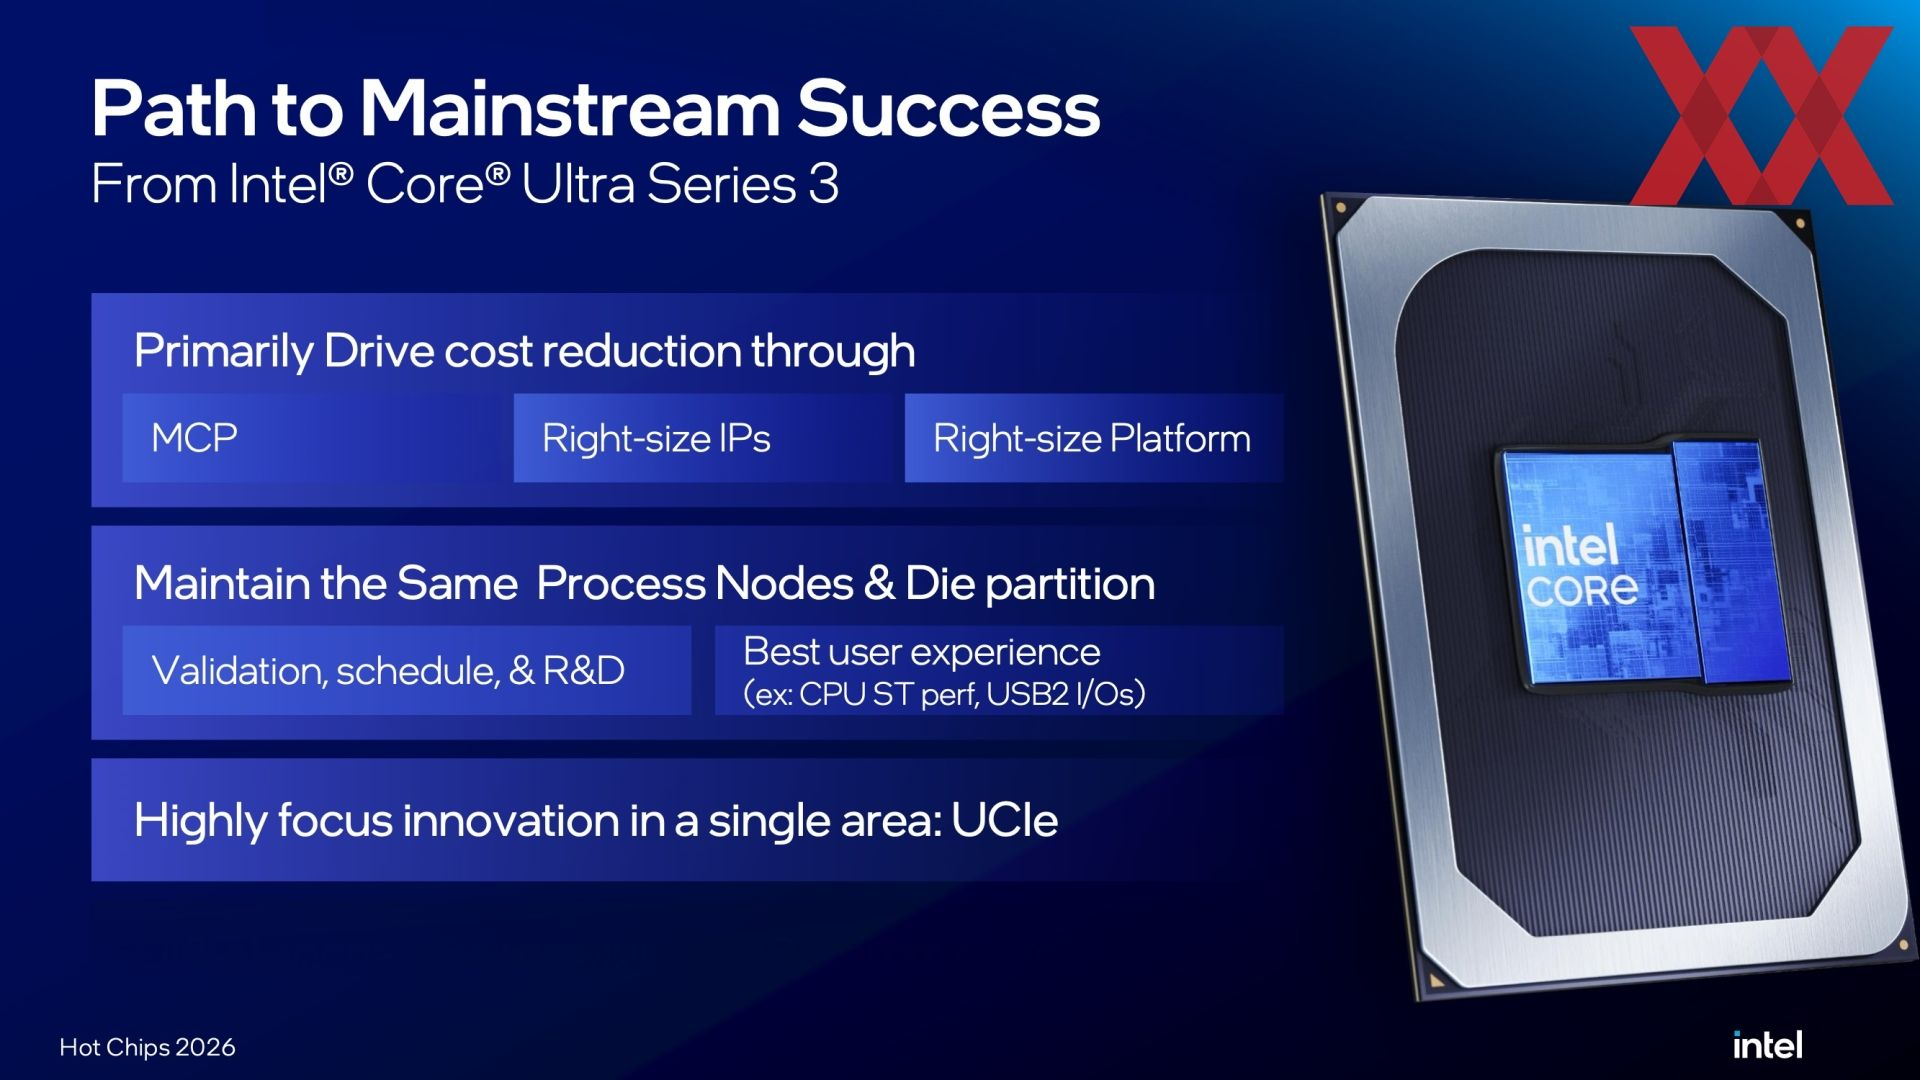
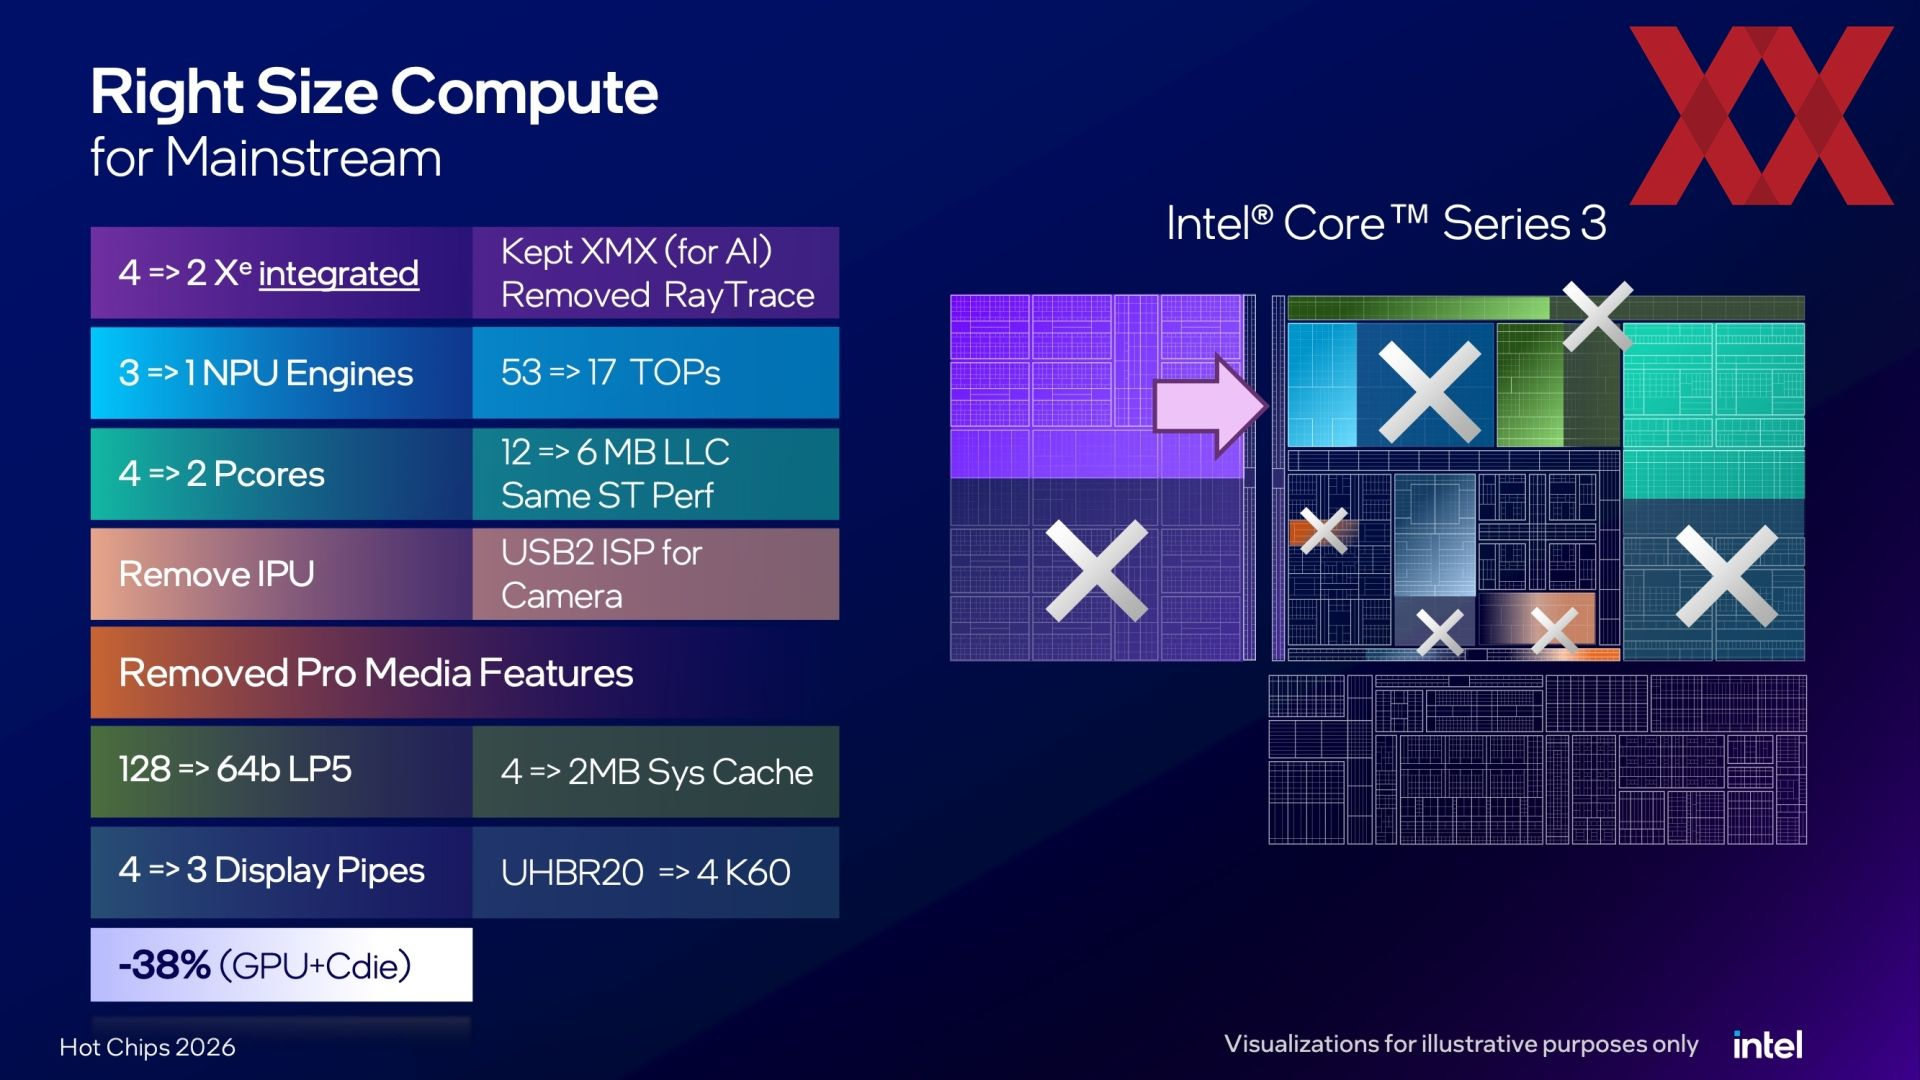
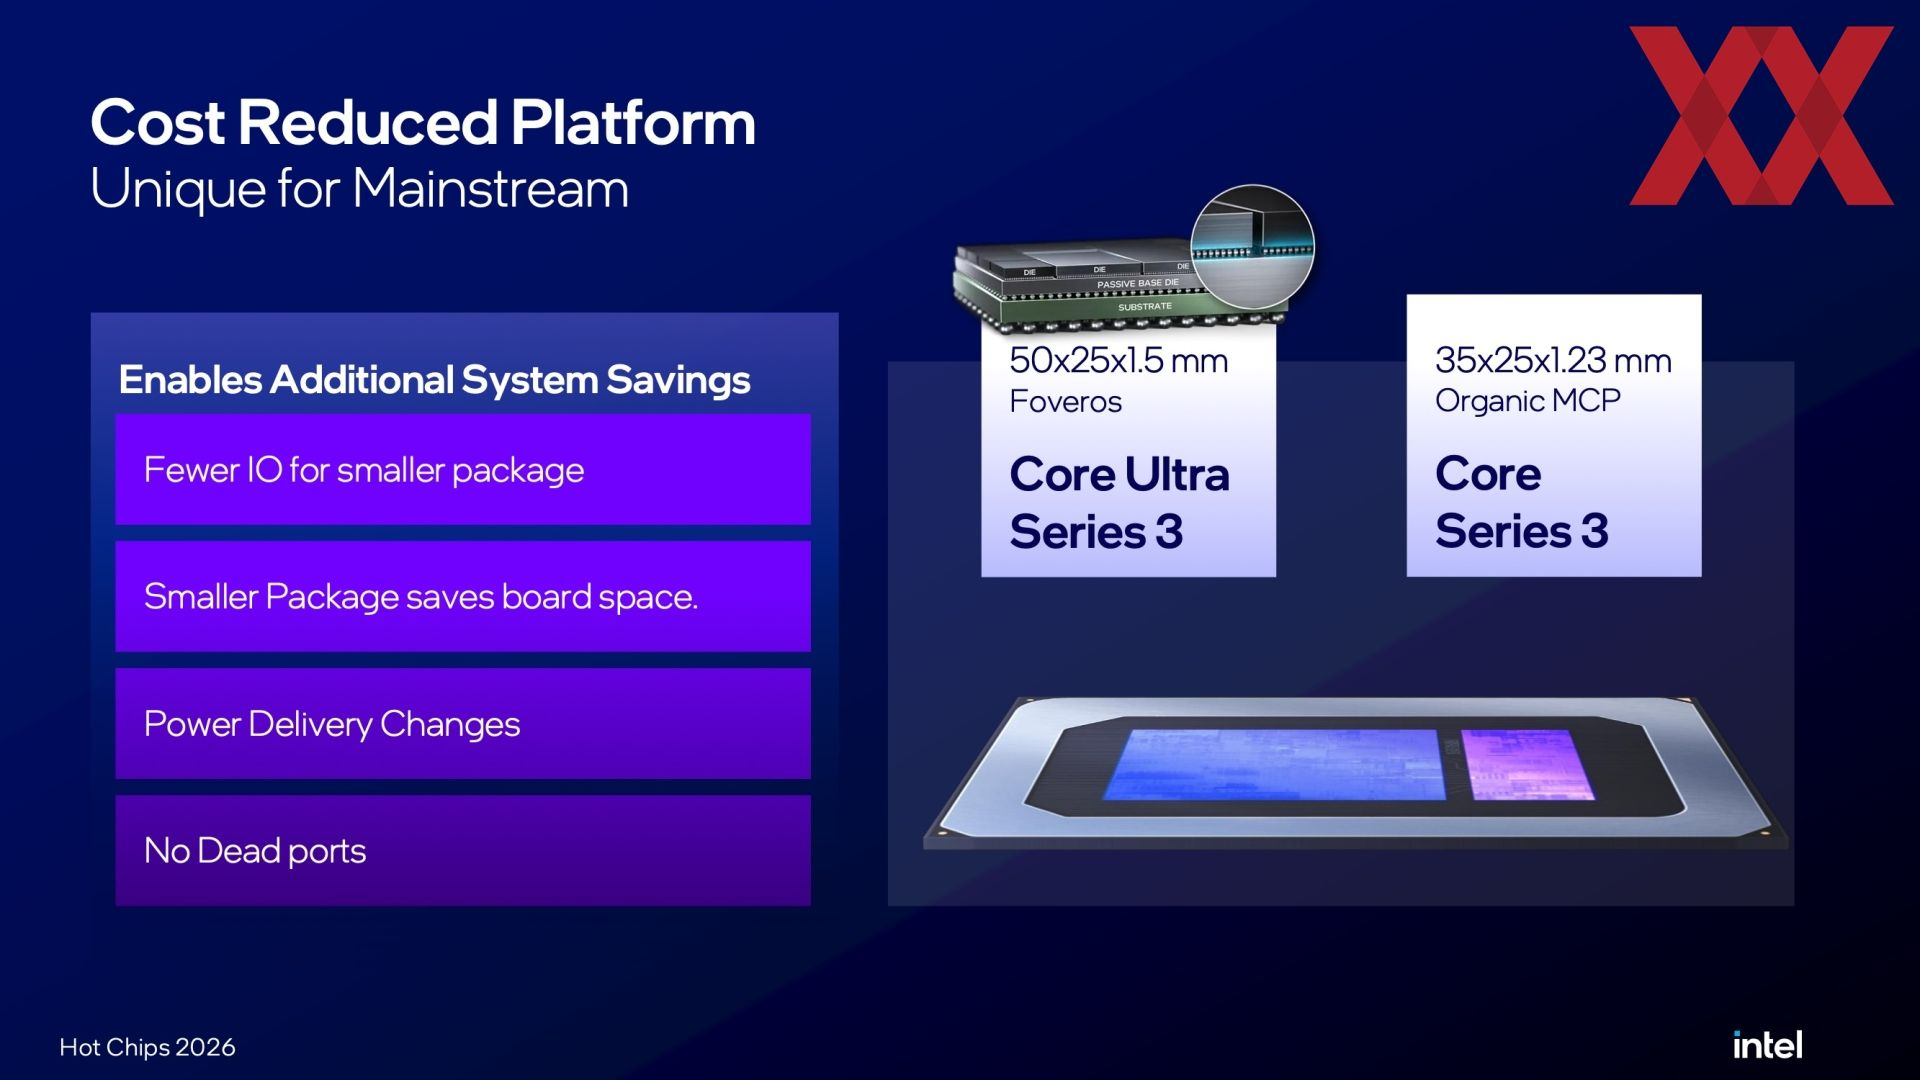
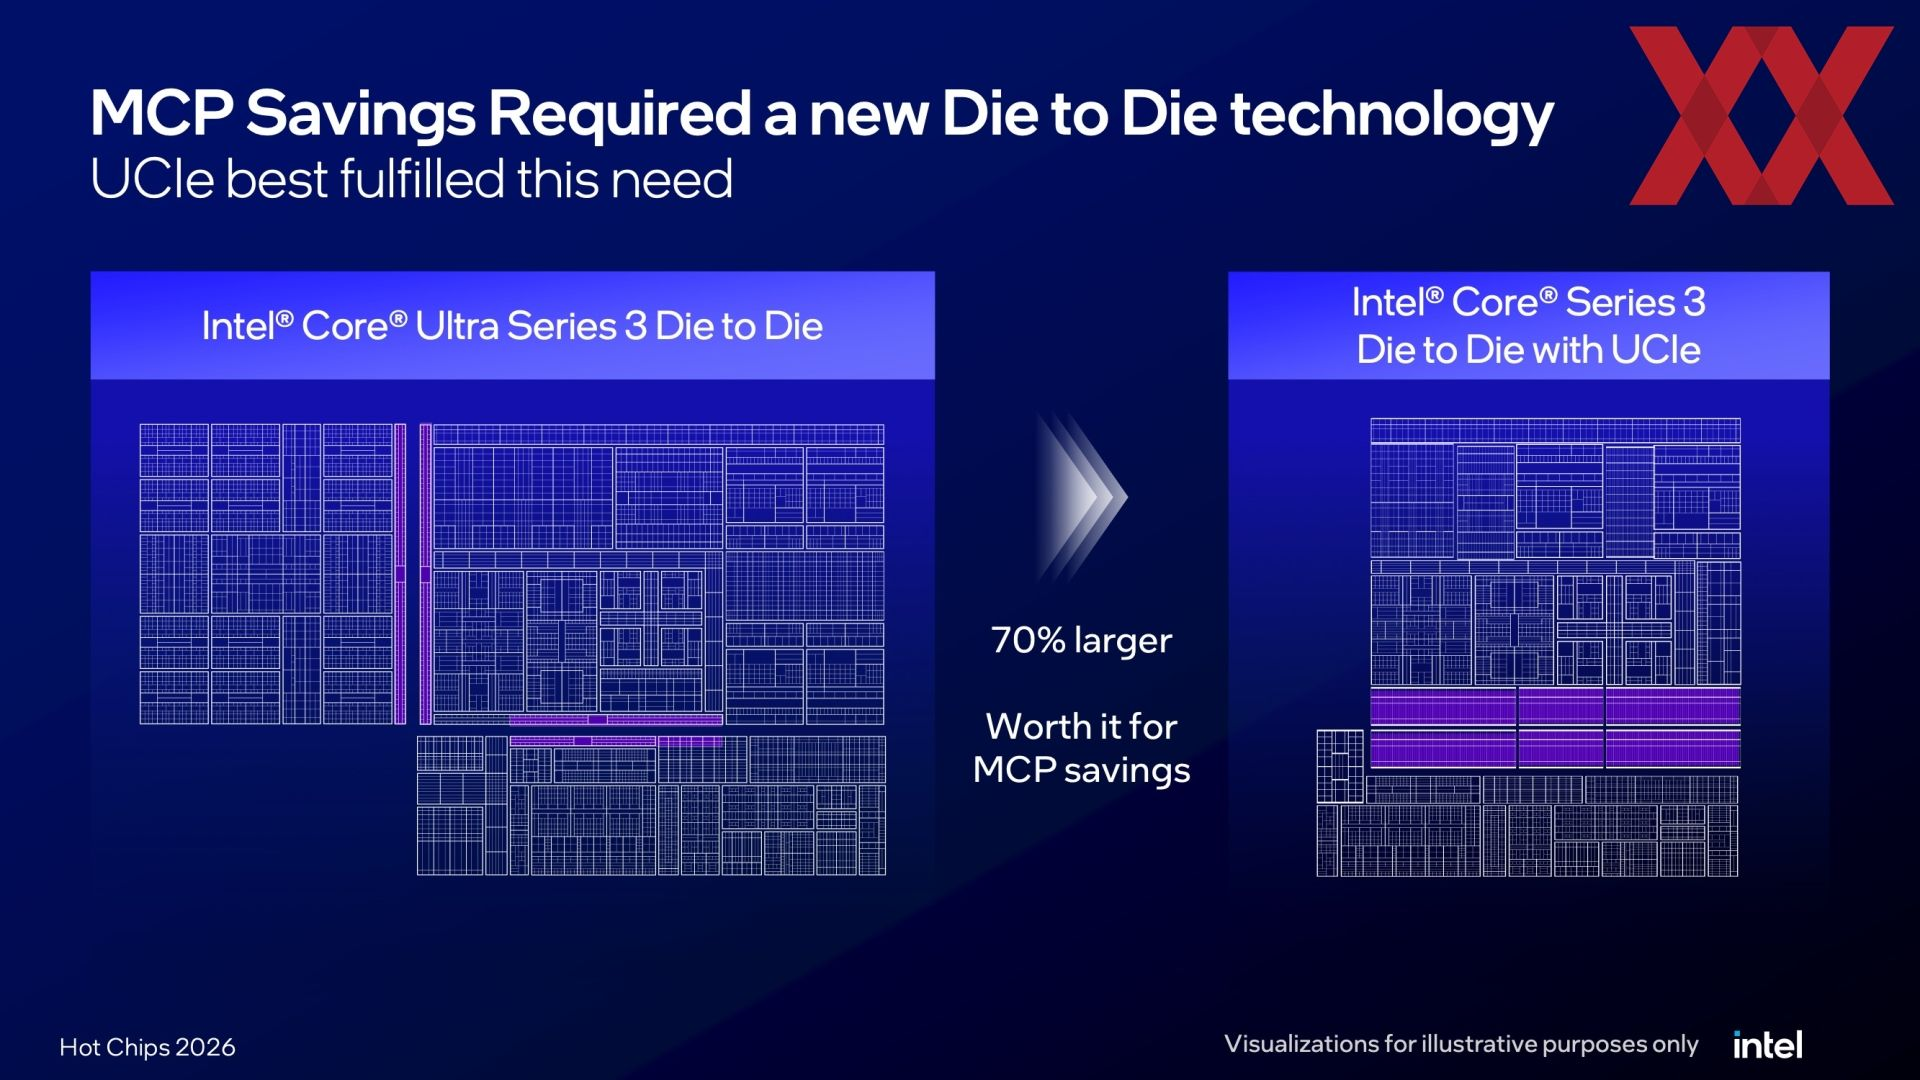
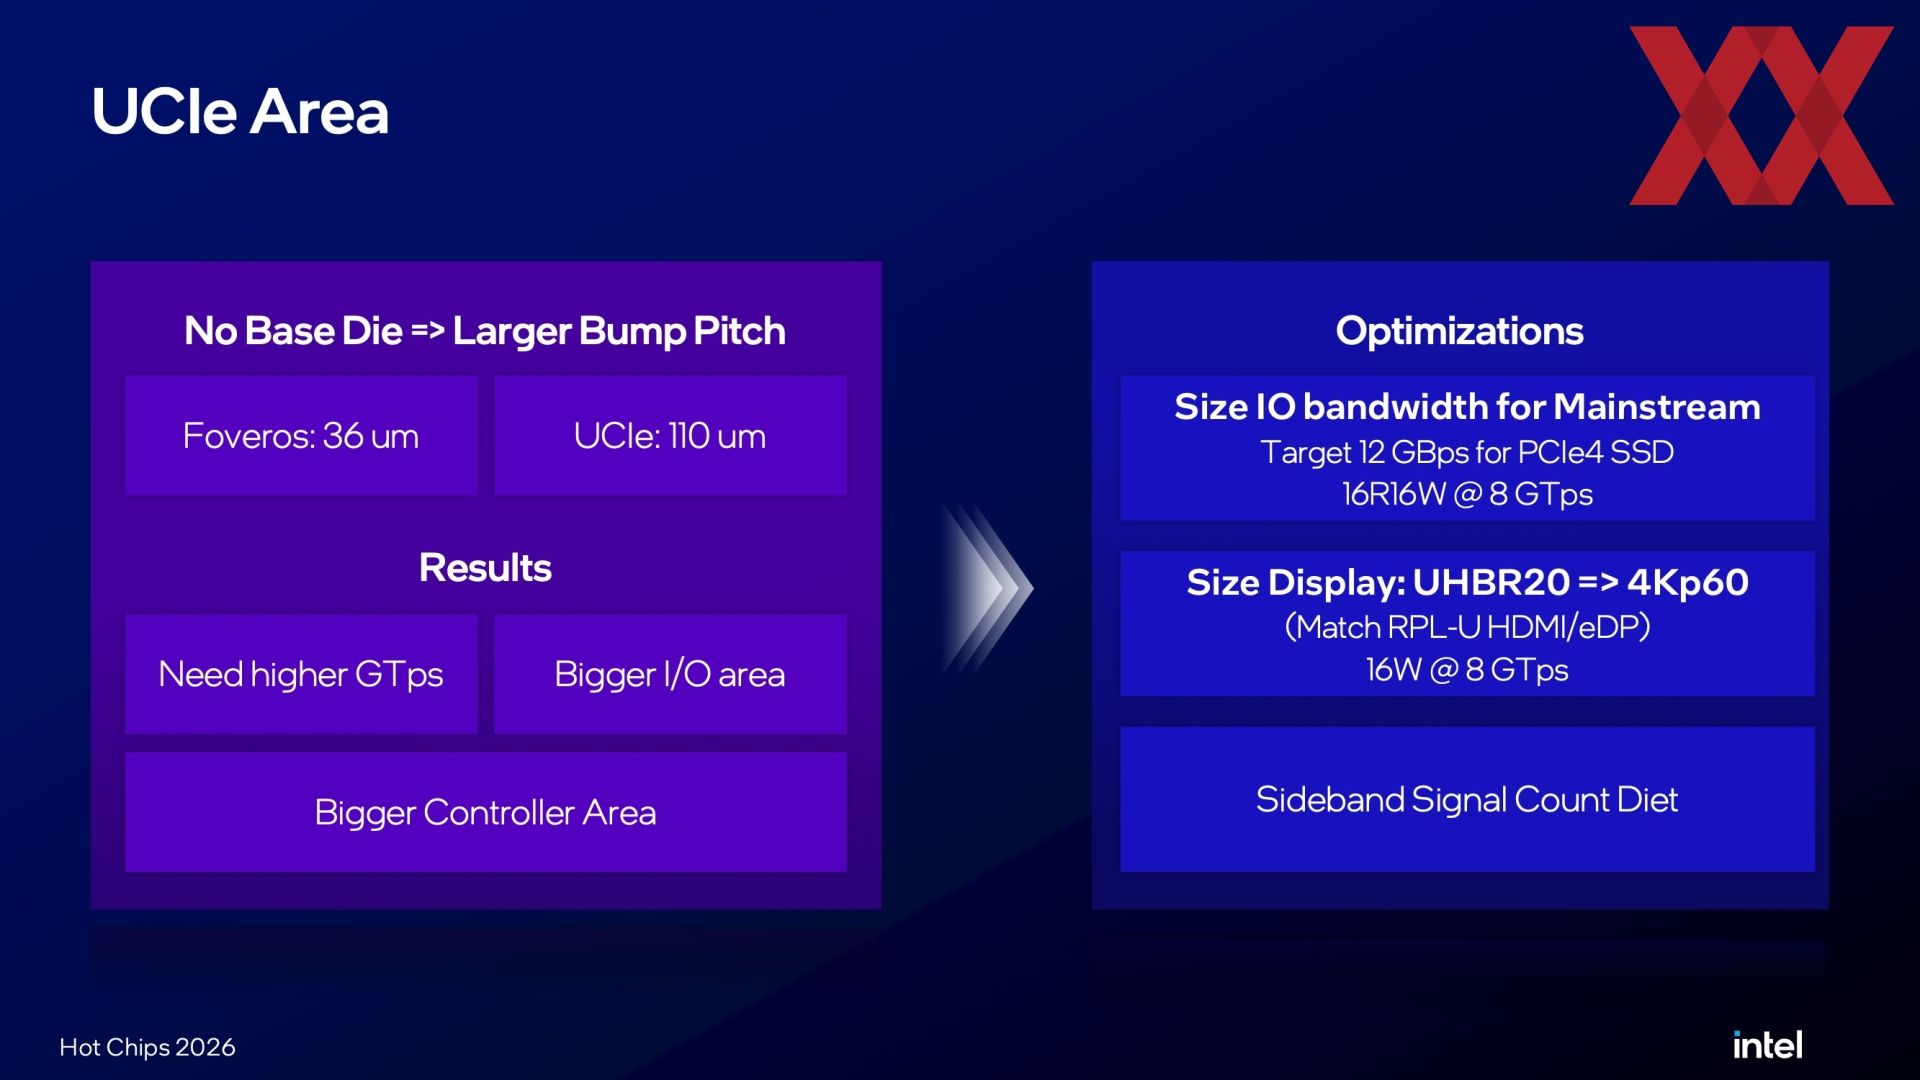
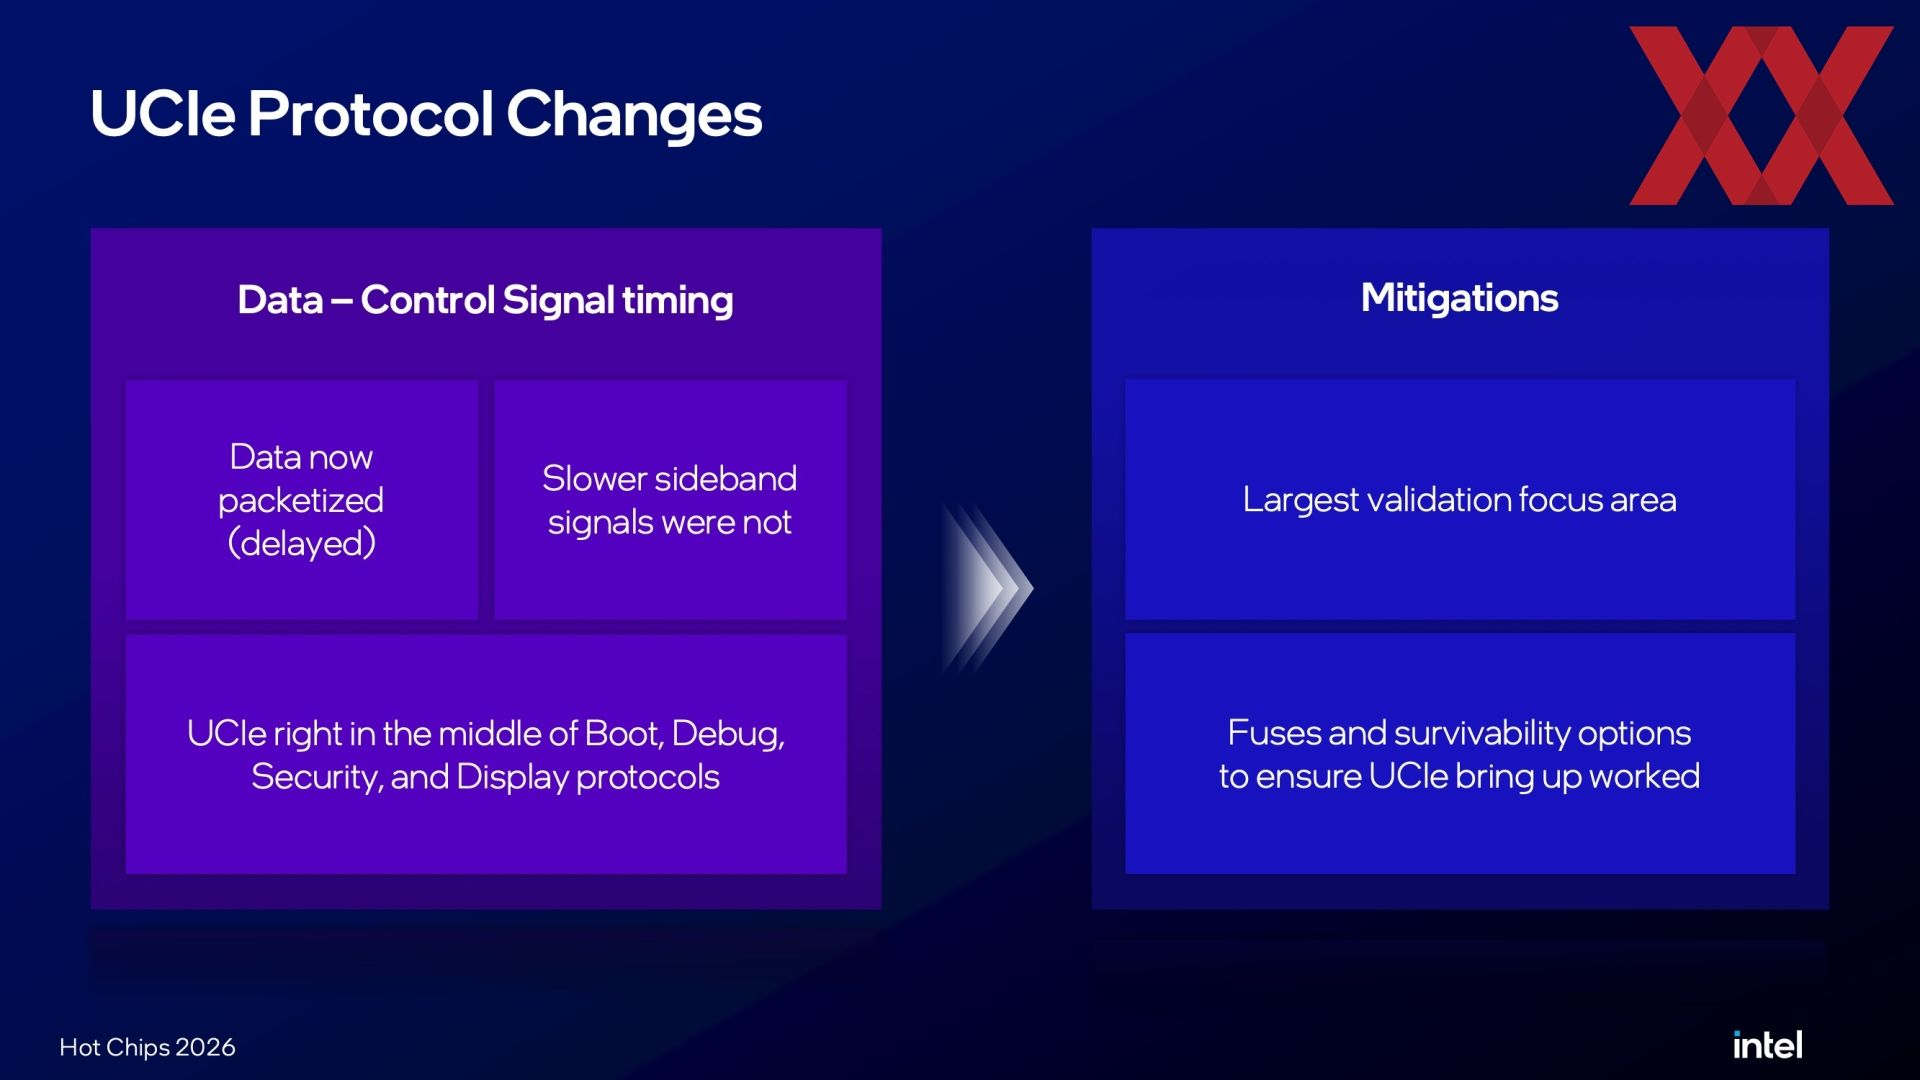
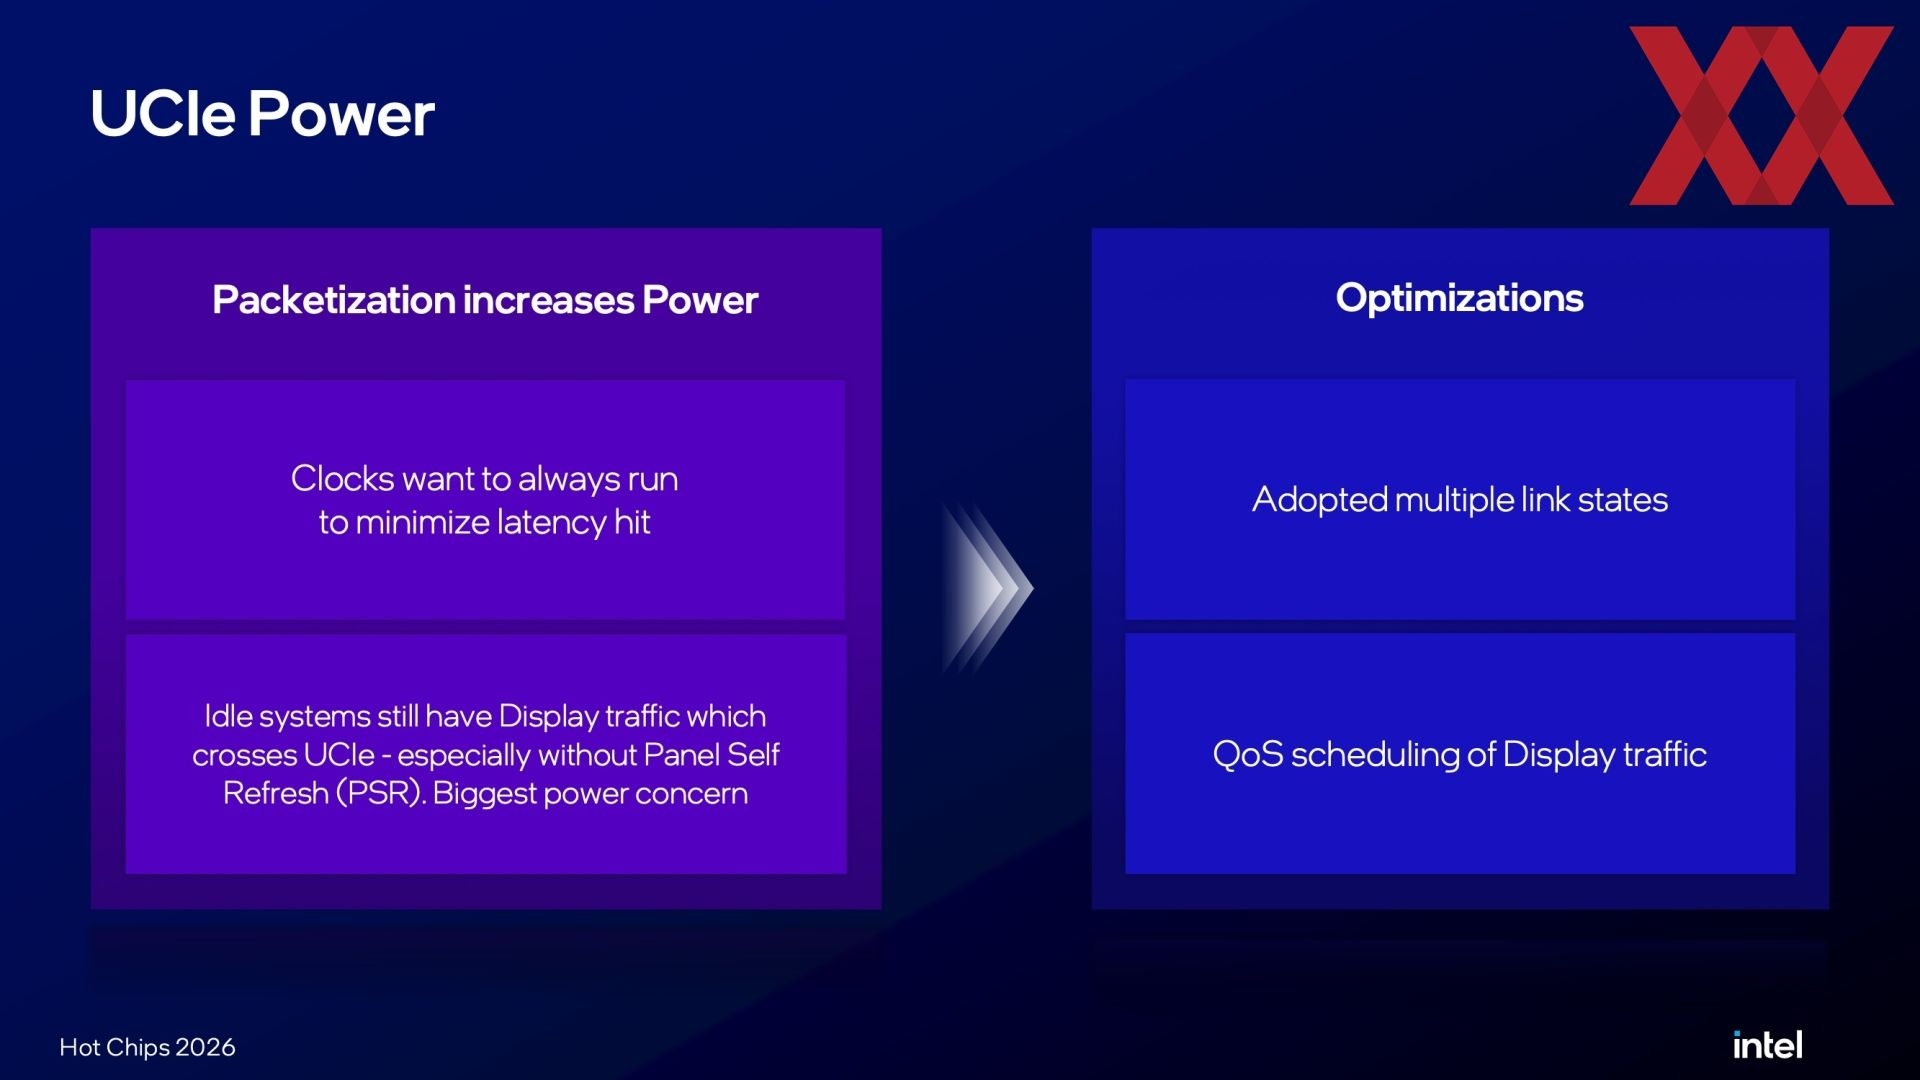
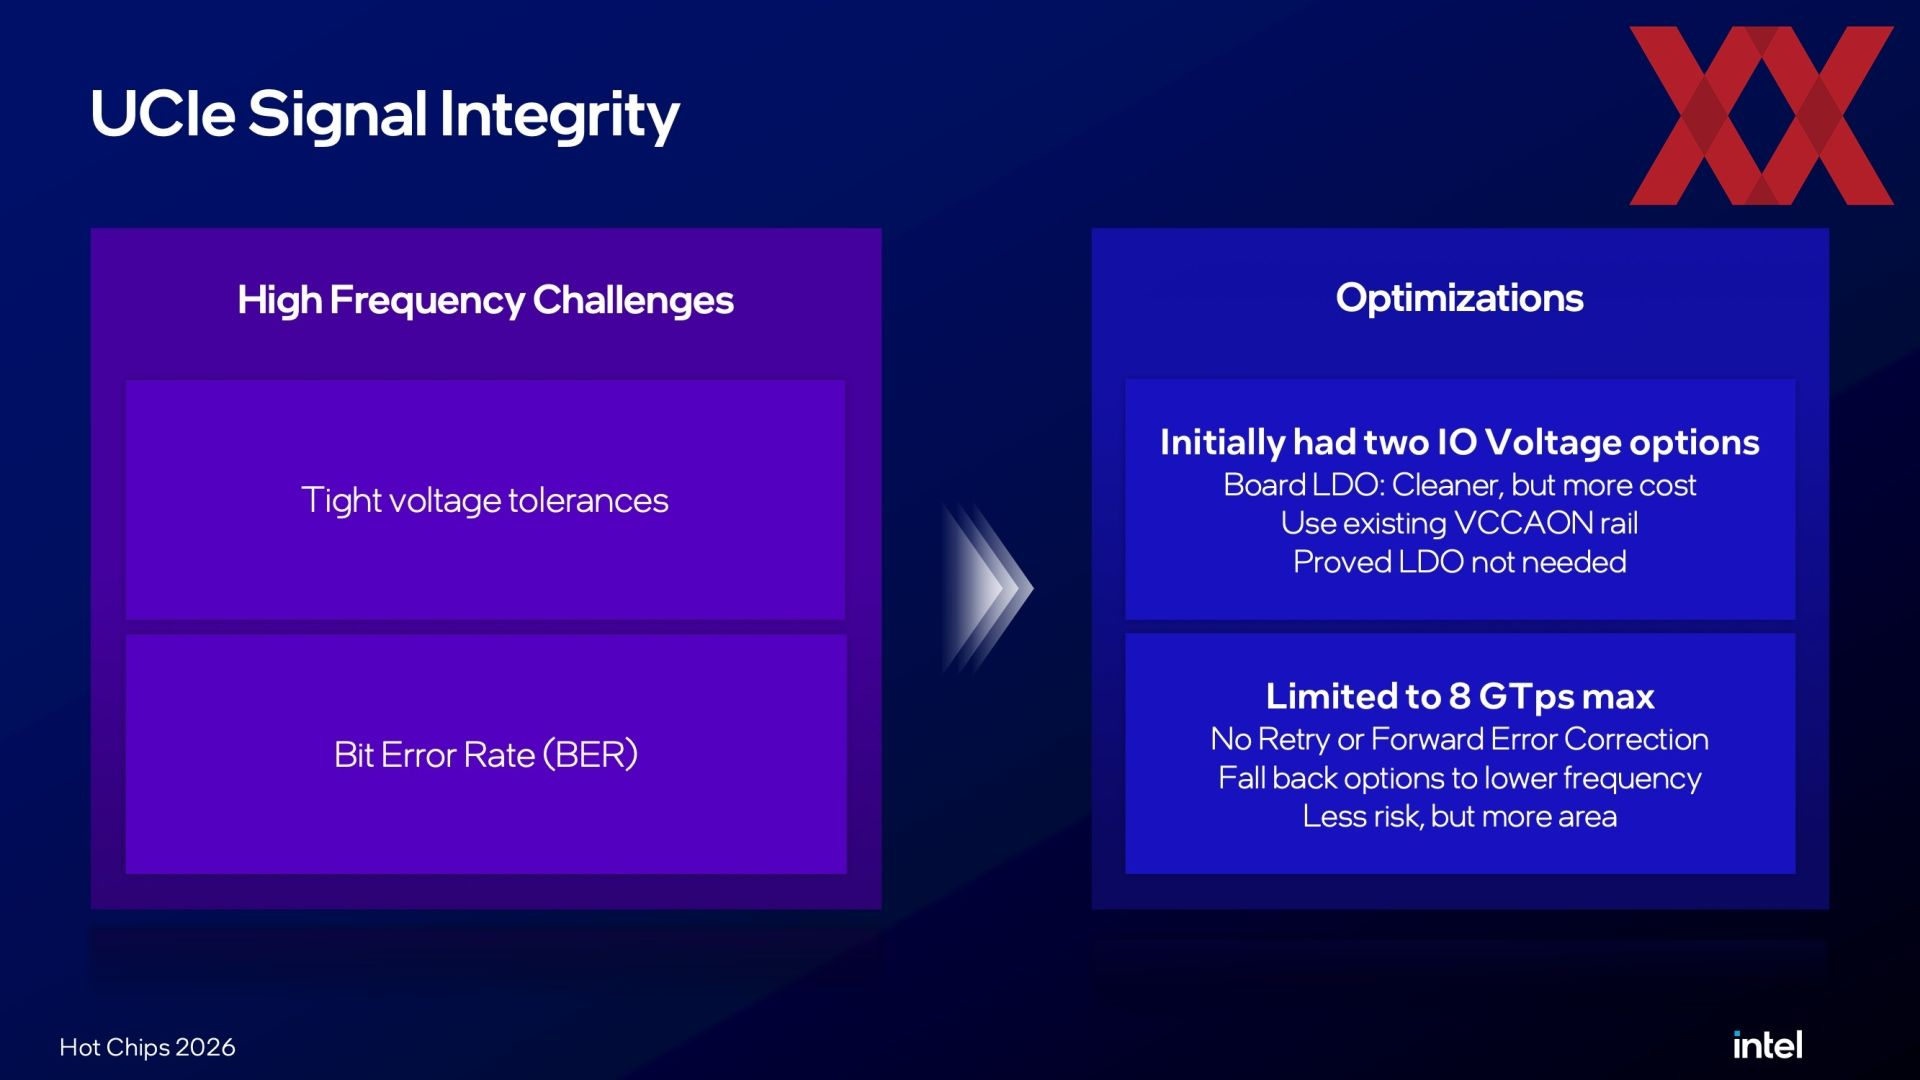
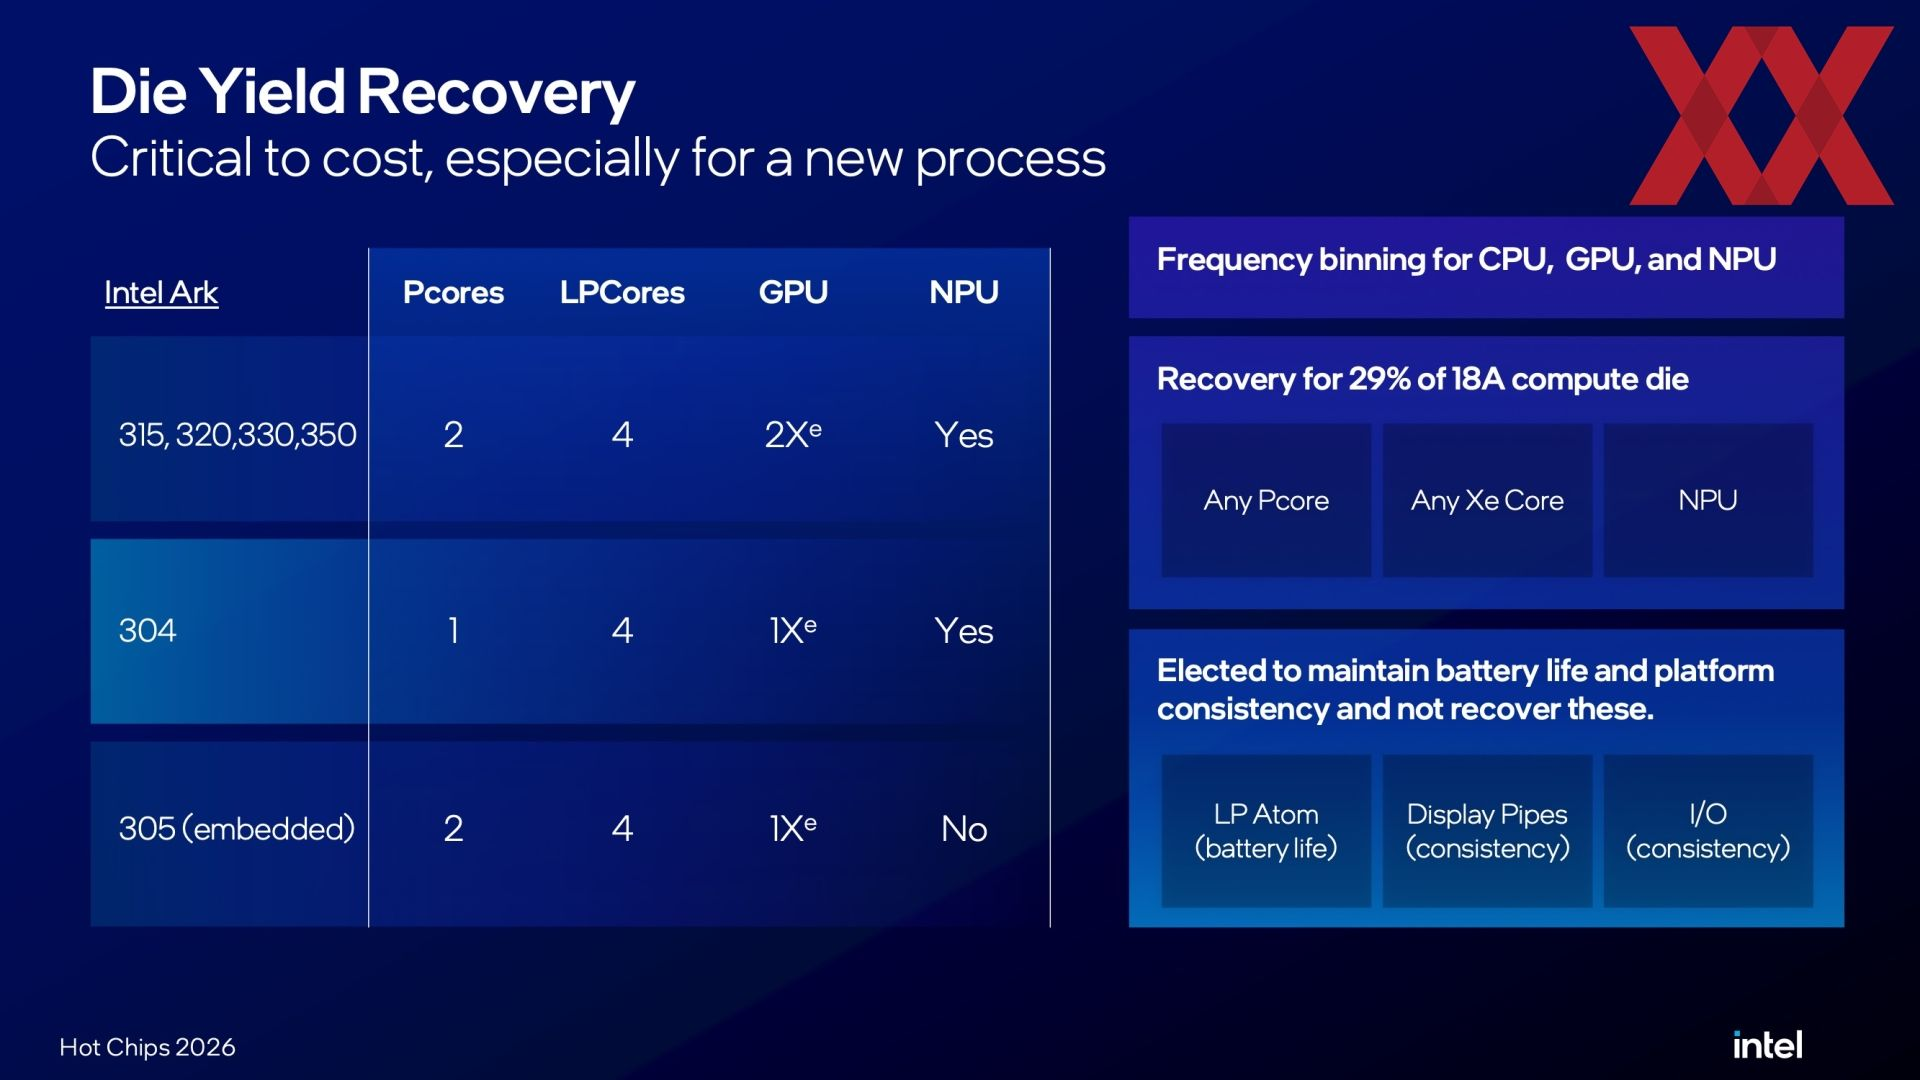
Источник изображений: HardwareLuxx / Intel По словам Intel, при создании Wildcat Lake цель заключалась не в разработке совершенно новой архитектуры, а в выборочном снижении затрат по сравнению с существующей конструкцией без ущерба для функций, важных для массового пользователя. Стратегия основана на трёх столпах: технологии упаковки MCP вместо Foveros, «оптимизации» блоков и платформы, а также узконаправленной инновации в одной технической области — использовании межкристальной шины UCIe.  В серии чипов Core Ultra 3 используется технология Foveros, которая соединяет несколько чиплетов через пассивный базовый кристалл (кремниевый интерпозер). Однако этот подход оказался бы слишком дорогим для процессоров массового сегмента, к которому относятся чипы Wildcat Lake, где ценовые преимущества имеют решающее значение. Поэтому в серии Core Series 3 полностью исключается базовый кристалл и используется органическая многокристальная конструкция (MCP). Это не только снижает сложность чипа, но также снижает затраты на его сборку и потери выхода годных изделий, связанные с многослойной компоновкой Foveros.  Однако переход к MCP не лишён недостатков. Без межсоединительной платы кристаллы процессора обрабатывают значительно меньше сигналов. Кроме того, необходимо заново оптимизировать управление питанием, чтобы в полной мере реализовать преимущества более простой упаковки. Также одним из технических требований было то, что используемые кристаллы должны быть либо монолитными, либо разработанными для MCP/органической упаковки.  Переход к MCP также сказался на физических характеристиках процессоров Wildcat Lake. Если упаковка Foveros в составе чипов Core Ultra Series 3 имеет размеры 50 × 25 × 1,5 мм, то органический MCP-корпус процессоров Core Series 3 уменьшен до 35 × 25 × 1,23 мм. Меньший корпус экономит место на плате, требует меньше интерфейсов ввода/вывода и позволяет регулировать подачу питания — плюс, в корпусе больше нет «мёртвых» контактов.  Для вычислительных кристаллов по-прежнему используется техпроцесс Intel 18A — он обеспечивает более высокую производительность и эффективность ядер CPU и уже применяется в серии Core Ultra 3. Однако для блока интерфейсов ввода-вывода (Thunderbolt, USB 2.0, PCIe) используется техпроцесс TSMC N6, также уже знакомый по серии Core Ultra 3. Технология соединения кристаллов UCIe доступна для всех рассматриваемых техпроцессов (Intel 3, Intel 18A, TSMC N6) и поэтому была очевидным выбором для соединения двух кристаллов в составе Wildcat Lake. Особенно важным при разработке Wildcat Lake было сохранить подход к использованию разных техпроцессов, которые применяются в процессорах Core Ultra 3, а также использовать чиплетную сборку. Это позволяет сэкономить на валидации, планировании и разработке процессора, одновременно не изменяя пользовательский опыт, например, в плане однопоточной производительности CPU или поддержке USB 2.0.  Поскольку отказ от базового кристалла Foveros потребовал использования новой технологии межкристального соединения, для этих целей была выбрана шина UCIe (Universal Chiplet Interconnect Express). Однако без базового кристалла шаг контактных площадок значительно увеличился — с 36 мкм для Foveros до 110 мкм для UCIe. Это приводит к ряду последствий: для компенсации меньшей плотности выводов требуются более высокие скорости передачи данных (ГТ/с), а площадь, занимаемая под блок интерфейсов ввода-вывода и контроллер, увеличивается. В целом площадь межкристальных соединений в процессорах Core Series 3 примерно на 70 % больше, чем в процессорах Core Ultra Series 3. Intel считает, что этот компромисс оправдан, учитывая экономию на стоимости упаковки MCP. Чтобы не увеличивать занимаемую площадь, пропускная способность блока ввода-вывода была специально оптимизирована для массового сегмента. Целевой показатель — подключение к твердотельному накопителю PCIe 4.0 со скоростью передачи данных около 12 Гбит/с (16 линий чтения/записи на скорости 8 ГТ/с). Подключение к дисплею также было оптимизировано — с UHBR20 до 4K60 (адаптировано под уровень HDMI/eDP в процессорах Raptor Lake-U) при мощности 16 Вт и скорости 8 ГТ/с. Кроме того, было сокращено количество сигналов боковой полосы (Sideband Signal Count Diet).  Проблемы с протоколом. UCIe упаковывает данные, что приводит к определённой задержке, в то время как более медленные сигналы боковой полосы изначально не были затронуты. Поскольку шина UCIe напрямую интегрирована в протоколы загрузки, отладки, безопасности и отображения, синхронизация между данными и управляющими сигналами была одной из самых сложных задач проверки во всем проекте. В качестве меры предосторожности были внедрены предохранители и опции обеспечения живучести для обеспечения надёжного запуска UCIe. Управление энергопотреблением. Пакетирование по своей сути увеличивает энергопотребление, поскольку частоты в идеале должны поддерживаться постоянно, чтобы избежать потерь времени ожидания. Особенно важен трафик, связанный с отображением, поскольку он также передаётся через UCIe даже в режиме ожидания, особенно без функции самообновления панели (Panel Self Refresh, PSR). Это представляло наибольшую проблему с точки зрения энергопотребления. В качестве контрмер были введены несколько состояний канала связи и реализована приоритизация QoS для трафика, связанного с отображением. Целостность сигнала. На высоких частотах UCIe сталкивается с проблемами, связанными с жёсткими допусками по напряжению и частотой ошибок в битах (BER). Изначально Intel рассматривала два варианта напряжения для ввода-вывода: использование выделенного LDO-стабилизатора (более чистый, но более дорогой вариант) или существующей шины питания VCCAON. В итоге от LDO-стабилизатора отказались. Скорость передачи данных была ограничена максимум 8 Гбит/с, без механизмов повторных попыток или прямого исправления ошибок. Вместо этого существуют резервные варианты для снижения частоты – намеренно менее рискованный, хотя и более ресурсоёмкий подход.  По сравнению с Core Ultra Series 3, совокупная вычислительная мощность Wildcat Lake была значительно уменьшена:
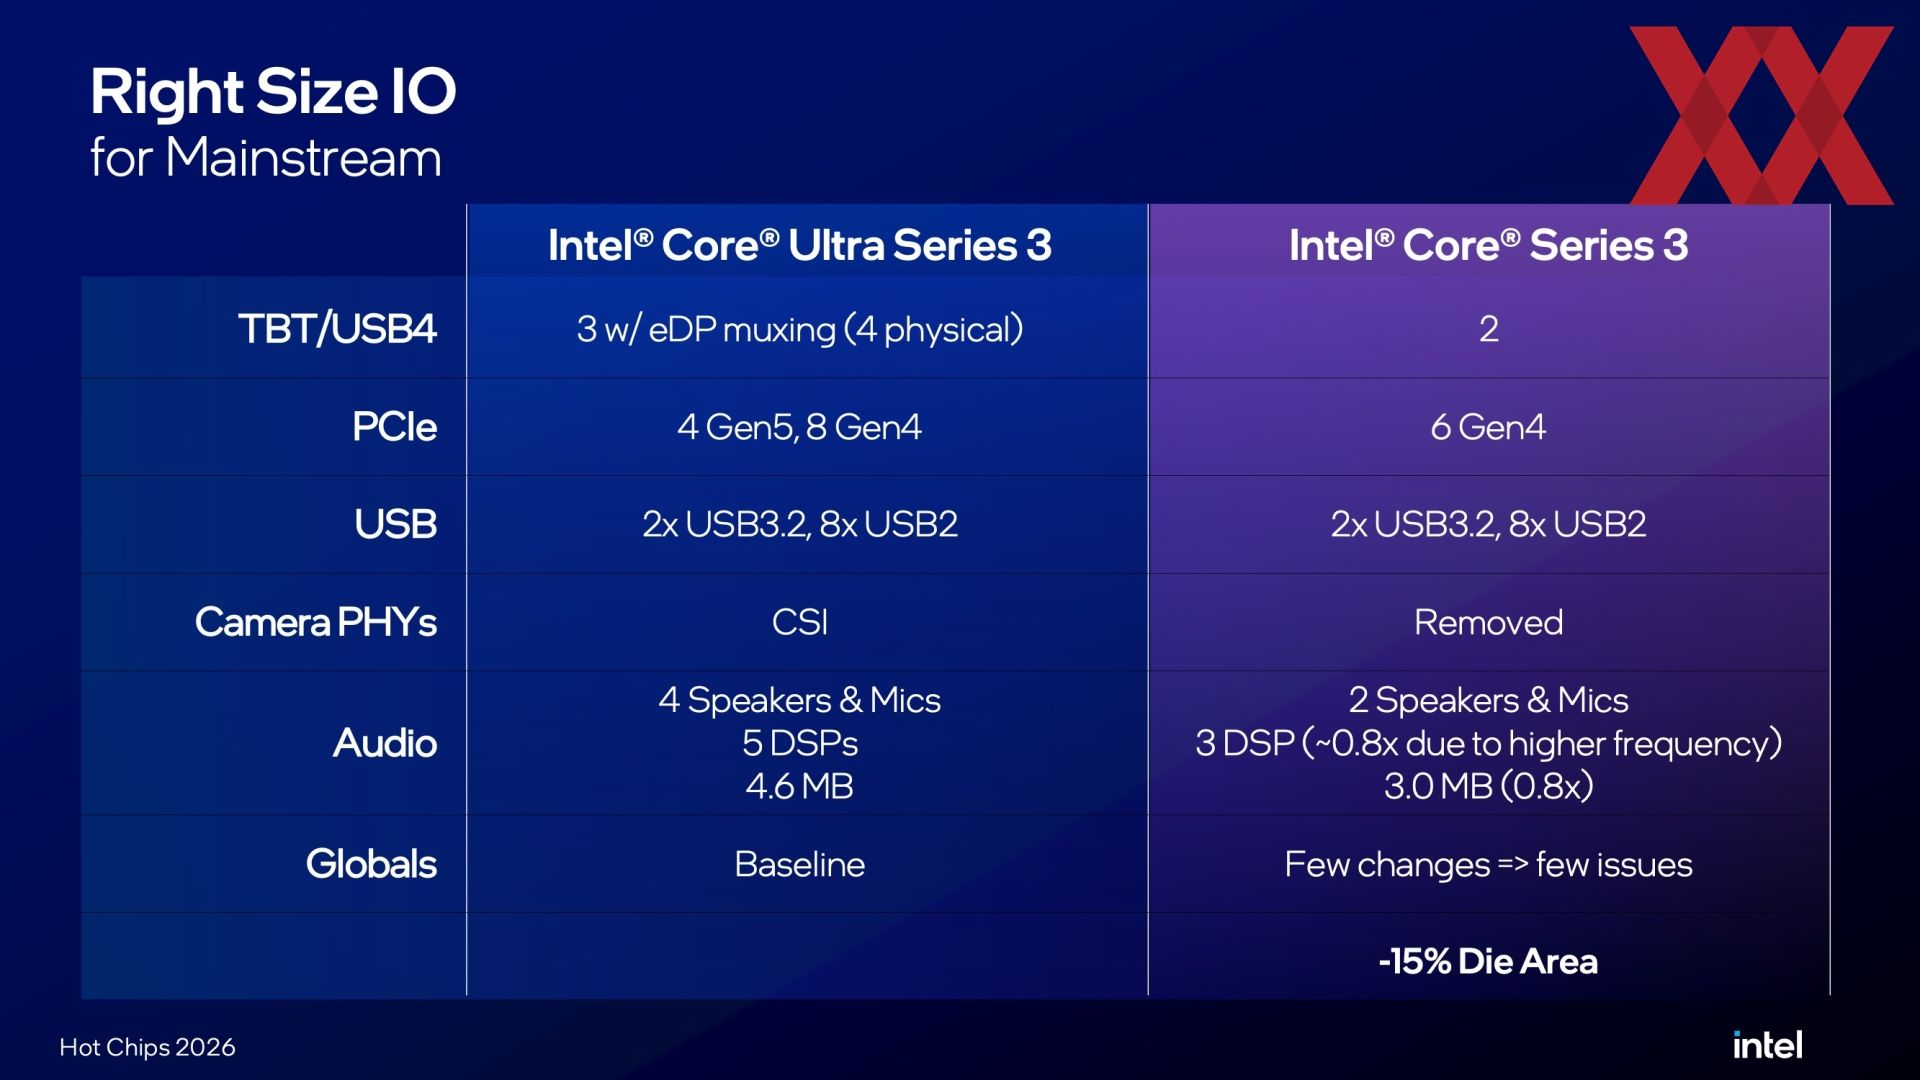
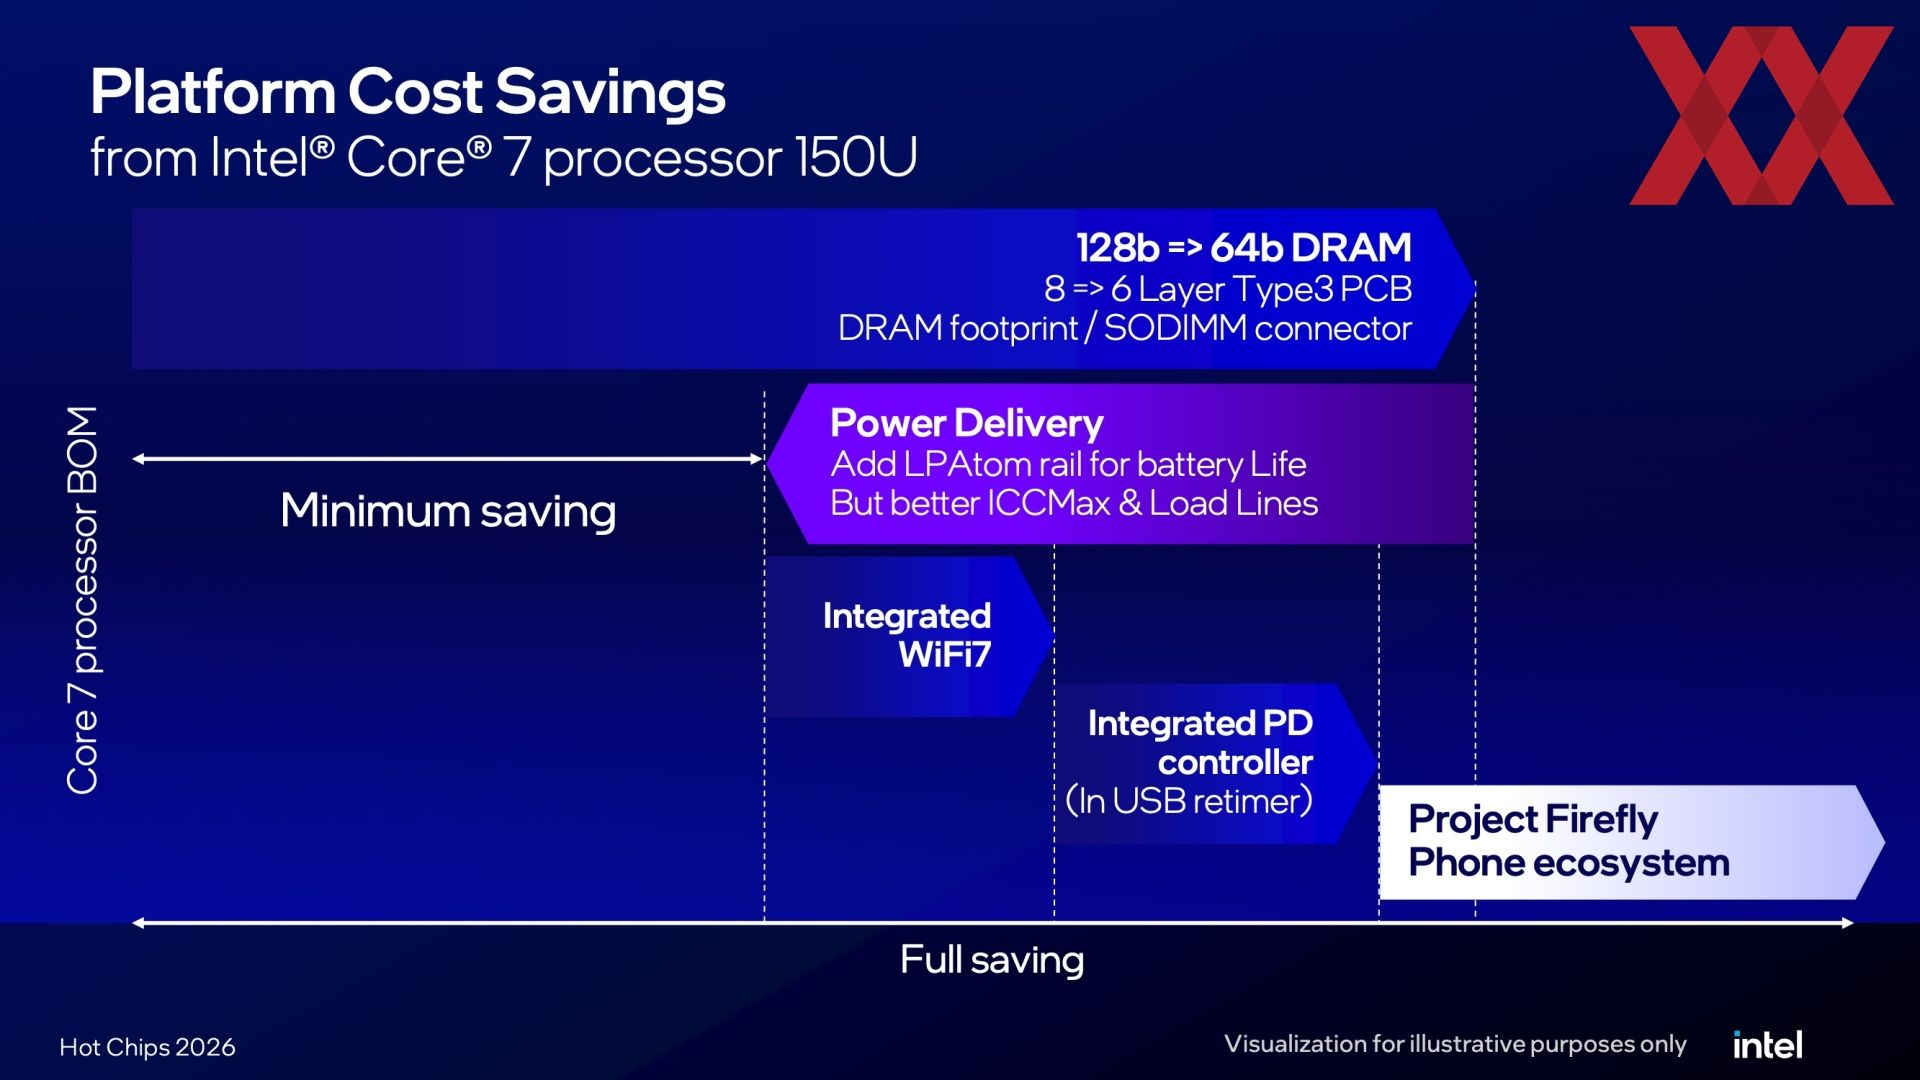
В целом эти изменения позволили сократить площадь графического и вычислительного кристаллов на 38 %. Возможности ввода-вывода также были сокращены. Количество портов Thunderbolt/USB4 снизилось с трёх (четырёх с мультиплексированием eDP) до двух, PCIe полностью унифицирован до шести Gen4 (вместо прежних четырёх Gen5 + восемь Gen4), а количество портов USB осталось прежним — два USB3.2 и восемь USB2. Физические интерфейсы PHY для камеры (CSI) были полностью убраны. Количество поддерживаемых аудиоканалов сократилось с четырёх до двух, количество цифровых сигнальных процессоров — с пяти до трёх (но при этом работающих на более высокой частоте), а объём связанной с ними памяти сокращён с 4,6 до 3,0 Мбайт. В целом благодаря оптимизации блока ввода-вывода площадь кристалла уменьшилась на 15 %.  На основе эталонной системы с процессором Core 7 150U (Raptor Lake-U Refresh) была достигнута дополнительная экономия на уровне платформы: переход с 128-битной на 64-битную DRAM позволил уменьшить количество слоёв на печатной плате с 8 до 6, а также скорректировать расположение DRAM и разъёма SODIMM. Для технологии Power Delivery была добавлена дополнительная шина напряжения LP Atom, что позволило увеличить время автономной работы, одновременно повысив максимальное значение тока потребления при полной нагрузке и нагрузочную способность. Модуль Wi-Fi 7 был интегрирован напрямую, как и контроллер PD (встроенный в ретаймер USB). Архитектурные особенности процессоров Intel Core Series 3 (Wildcat Lake)
Серия процессоров Core Series 3 — пример того, как существующая высокопроизводительная архитектура (Panther Lake) может быть переработана для массового сегмента. Благодаря переходу с технологии Foveros на органический корпус MCP, оптимизации вычислительных блоков, блоков графического и нейронного процессоров, блоков ввода-вывода, а также экономии на уровне платформы (урезанный интерфейс DRAM, меньше слоёв печатной платы, встроенные контроллеры Wi-Fi и PD) удалось значительно снизить стоимость. При этом ключевые пользовательские функции были сохранены за счёт повторного использования технологических норм и разделения кристалла на блоки, а также за счёт сохранения однопоточной производительности. Единственным принципиально новым техническим компонентом является межкристальная система межсоединений UCIe, которая компенсирует отказ от базового кристалла Foveros, но при этом требует значительно большего объёма межсоединений (+70 %) и сопряжена с определёнными трудностями в плане синхронизации, энергопотребления и целостности сигнала. Технология из глубин веков позволит строить самоохлаждающиеся здания — и никакой электроники
04.08.2026 [14:15],
Геннадий Детинич
Всё новое — это хорошо забытое старое. Глиняная посуда издревле отличалась способностью сохранять прохладу напитков даже в сильную жару. Австрийские инженеры воспользовались этим и создали технологию для самостоятельно охлаждающихся стен. Причём без какой-либо электроники и систем регулирования температуры. Принцип тот же — насыщенная водой пористая керамика, но уже в современном исполнении с применением 3D-печати. 
Источник изображений: TU Graz О разработке сообщили инженеры Технического университета Граца в Австрии (Graz University of Technology), создавшие пассивно охлаждающуюся стену из керамических кубов, напечатанных на 3D-принтере. Система предназначена для снижения температуры внутри зданий и на открытых городских площадках без использования традиционных кондиционеров. Она использует испарительное охлаждение: вода, превращаясь в пар, поглощает тепло из окружающего воздуха. Полноразмерный демонстрационный образец стены размером два на два метра уже установлен в кампусе TU Graz. Каждый охлаждающий модуль представляет собой куб со стороной около 23 см, изготовленный из специальной глиняной смеси. После печати изделия обжигают при сравнительно низкой температуре, чтобы керамика сохранила высокую пористость. Внутренняя структура кубов построена на основе трижды периодических минимальных поверхностей (TPMS). Такая геометрия обеспечивает большую площадь контакта с воздухом при минимальном расходе материала и позволяет воде распространяться по многочисленным каналам под действием капиллярных сил.  Для дополнительного повышения пористости исследователи добавляли в глину опилки и грибной мицелий. Перед печатью грибница разрастается внутри смеси, образуя тонкую сеть волокон. Во время обжига мицелий и древесные частицы выгорают, оставляя систему микро- и макропор. Благодаря этим каналам вода лучше распределяется по всему объёму куба, а площадь испарения и интенсивность отвода тепла увеличиваются. Учёные также изучают возможность использования в смеси донных отложений озера Нойзидлер-Зе, которые регулярно удаляют для предотвращения обмеления водоёма.  Испытания в жарком чердачном помещении университета показали снижение температуры почти на 7 °C непосредственно возле наполненной водой конструкции. По словам разработчиков, охлаждение ощущалось и в остальной части помещения, хотя его интенсивность уменьшалась с расстоянием. Такие стены могут применяться в жилых и офисных зданиях, школах, зонах ожидания и общественных пространствах. Однако эффективность испарительного охлаждения зависит от влажности воздуха: лучше всего система должна работать в сухую жаркую погоду, когда вода испаряется быстрее. Nvidia раскрыла детали процессора Vera: 88 Arm-ядер Olympus, 176 потоков и память LPDDR5X с пропускной способностью 1,2 Тбайт/с
21.07.2026 [22:35],
Николай Хижняк
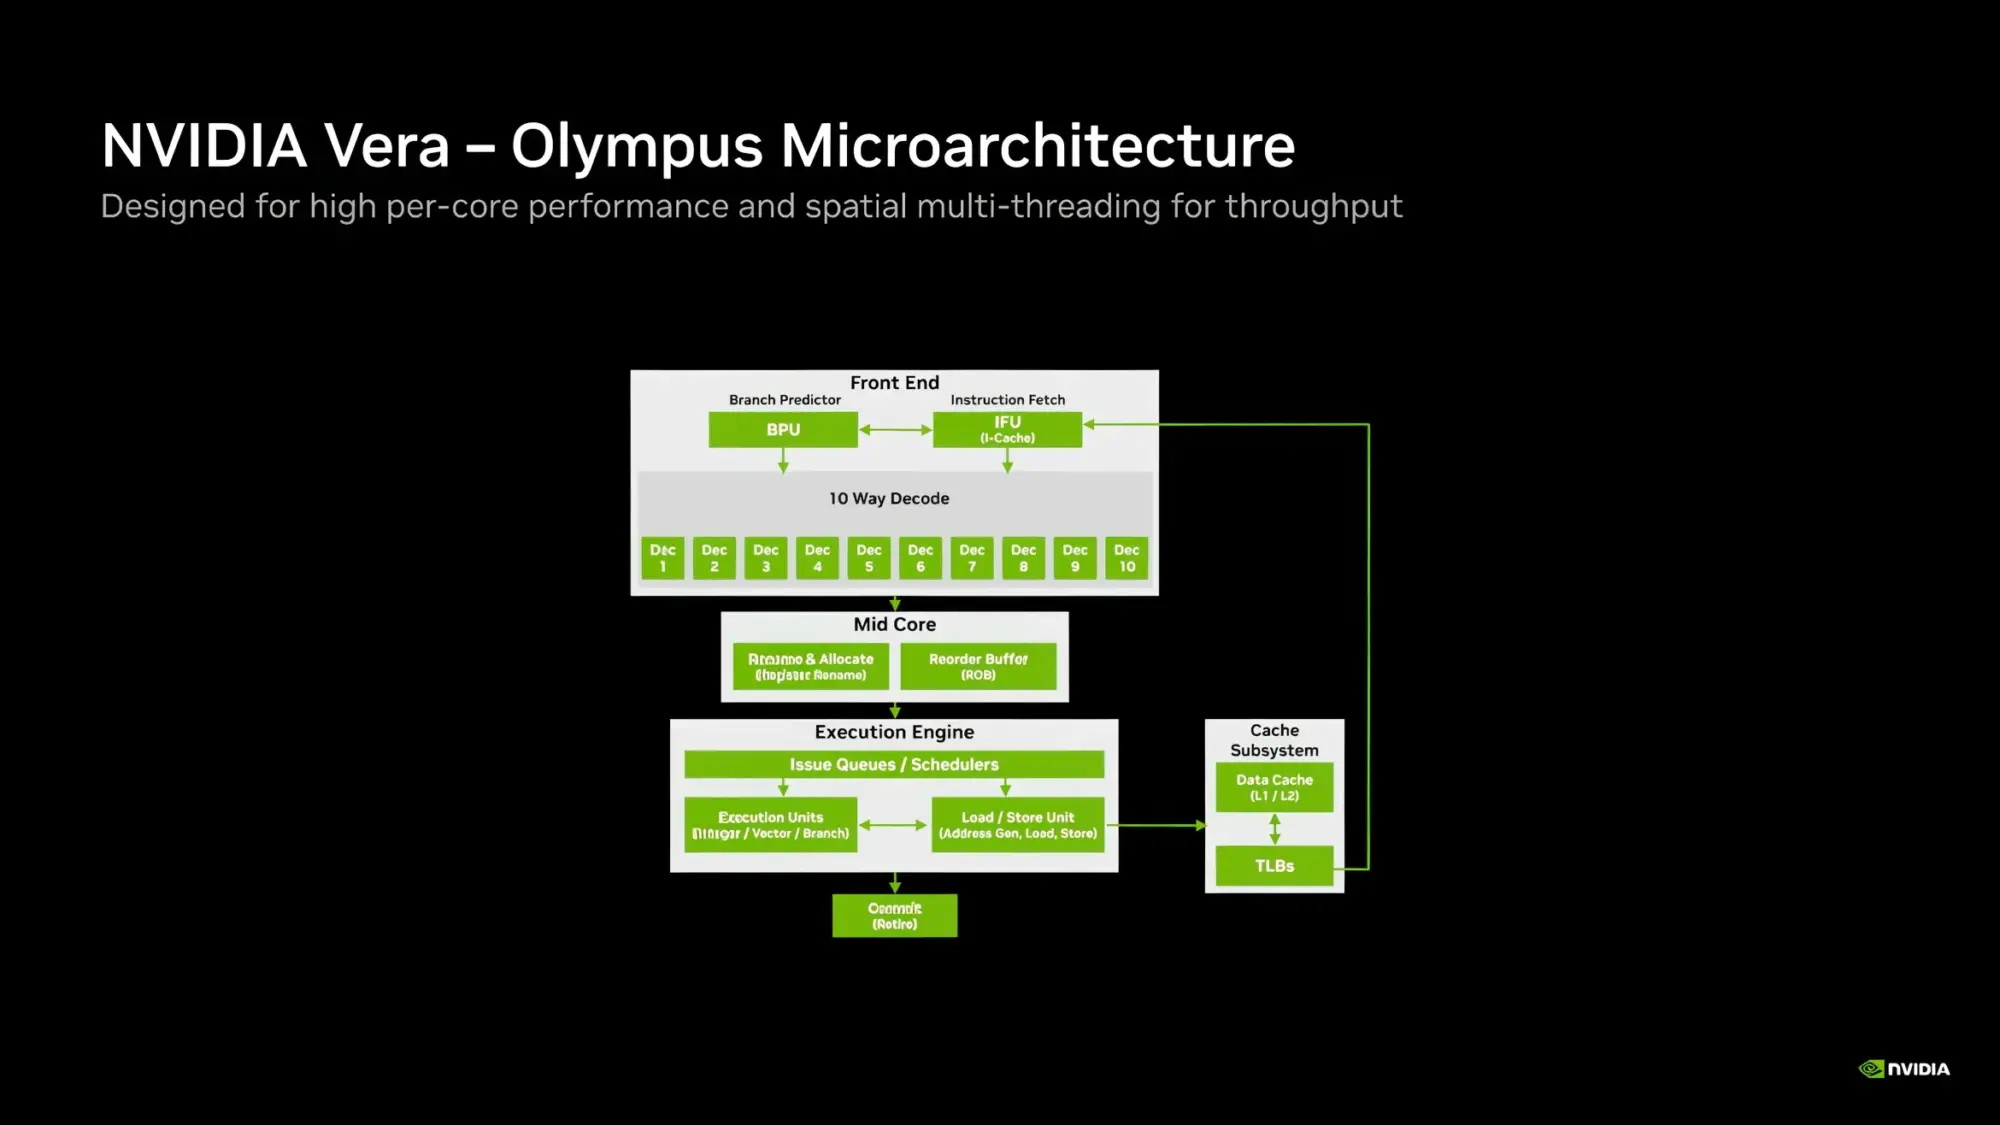
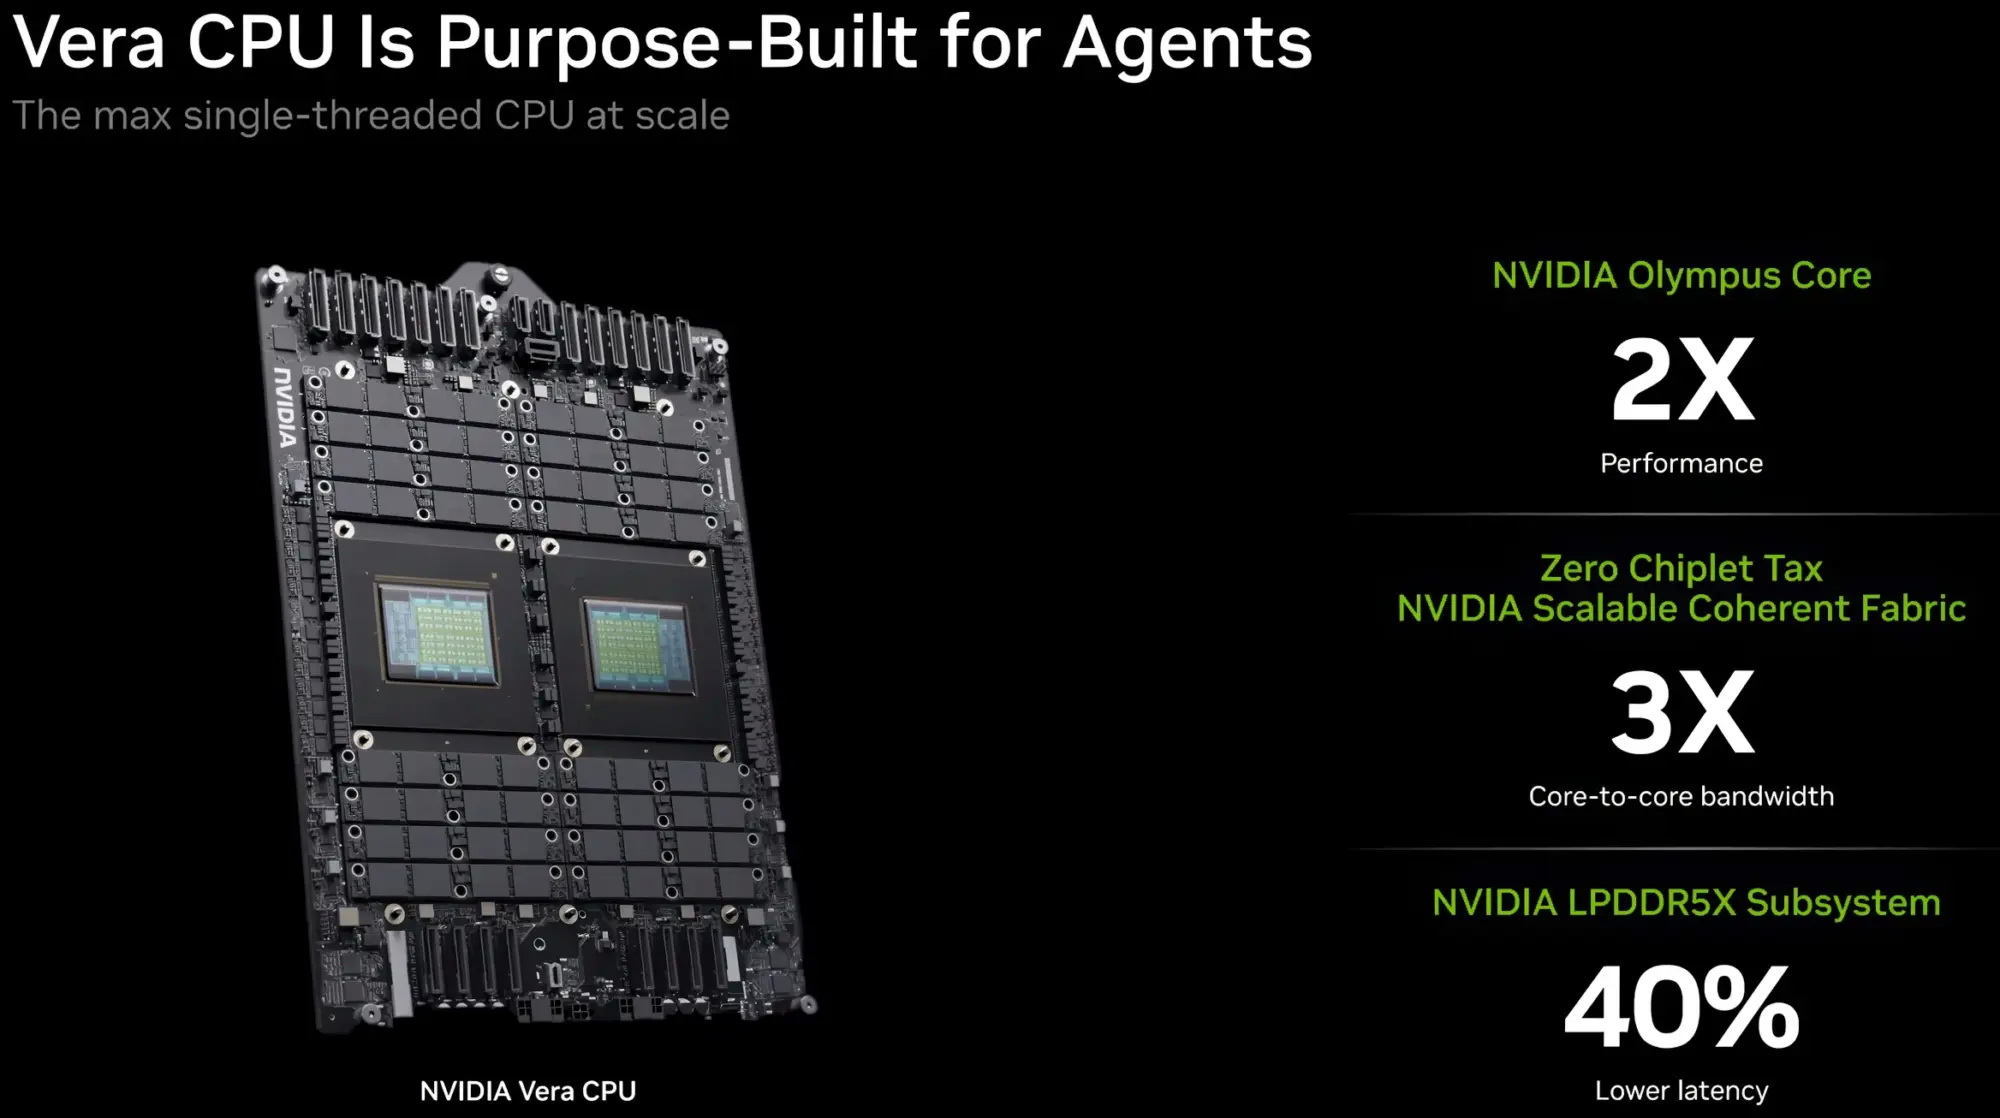
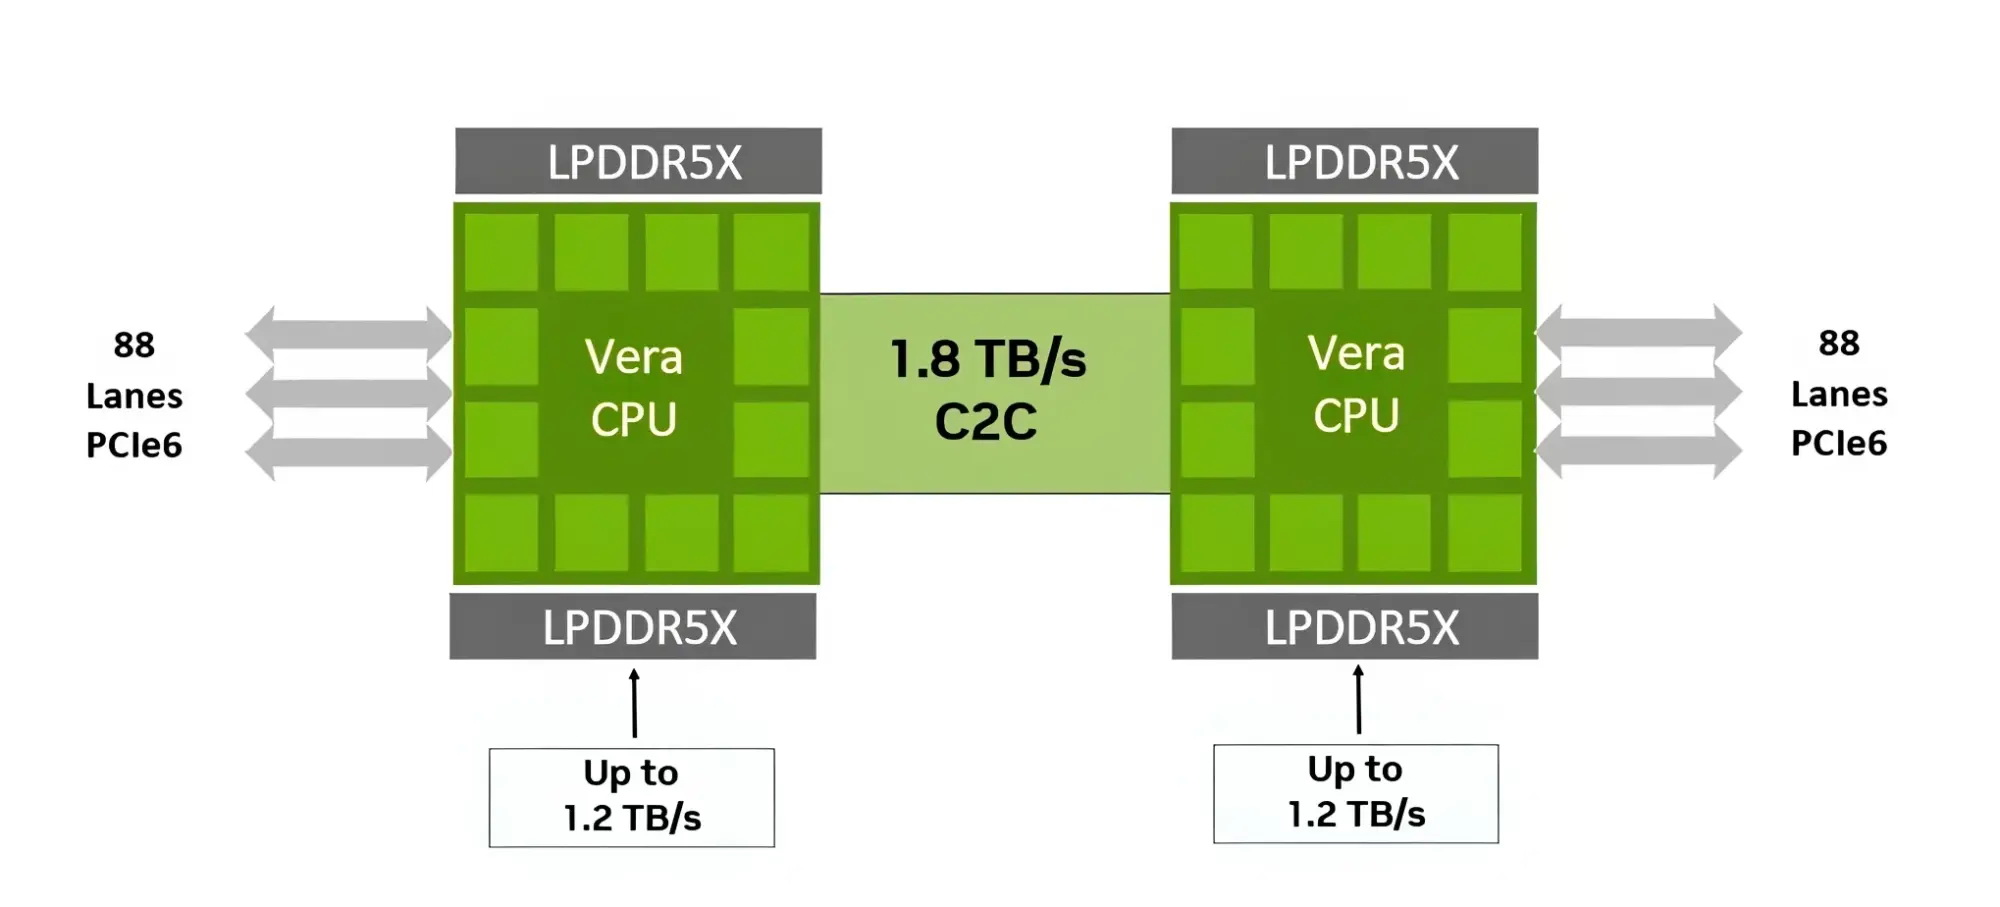
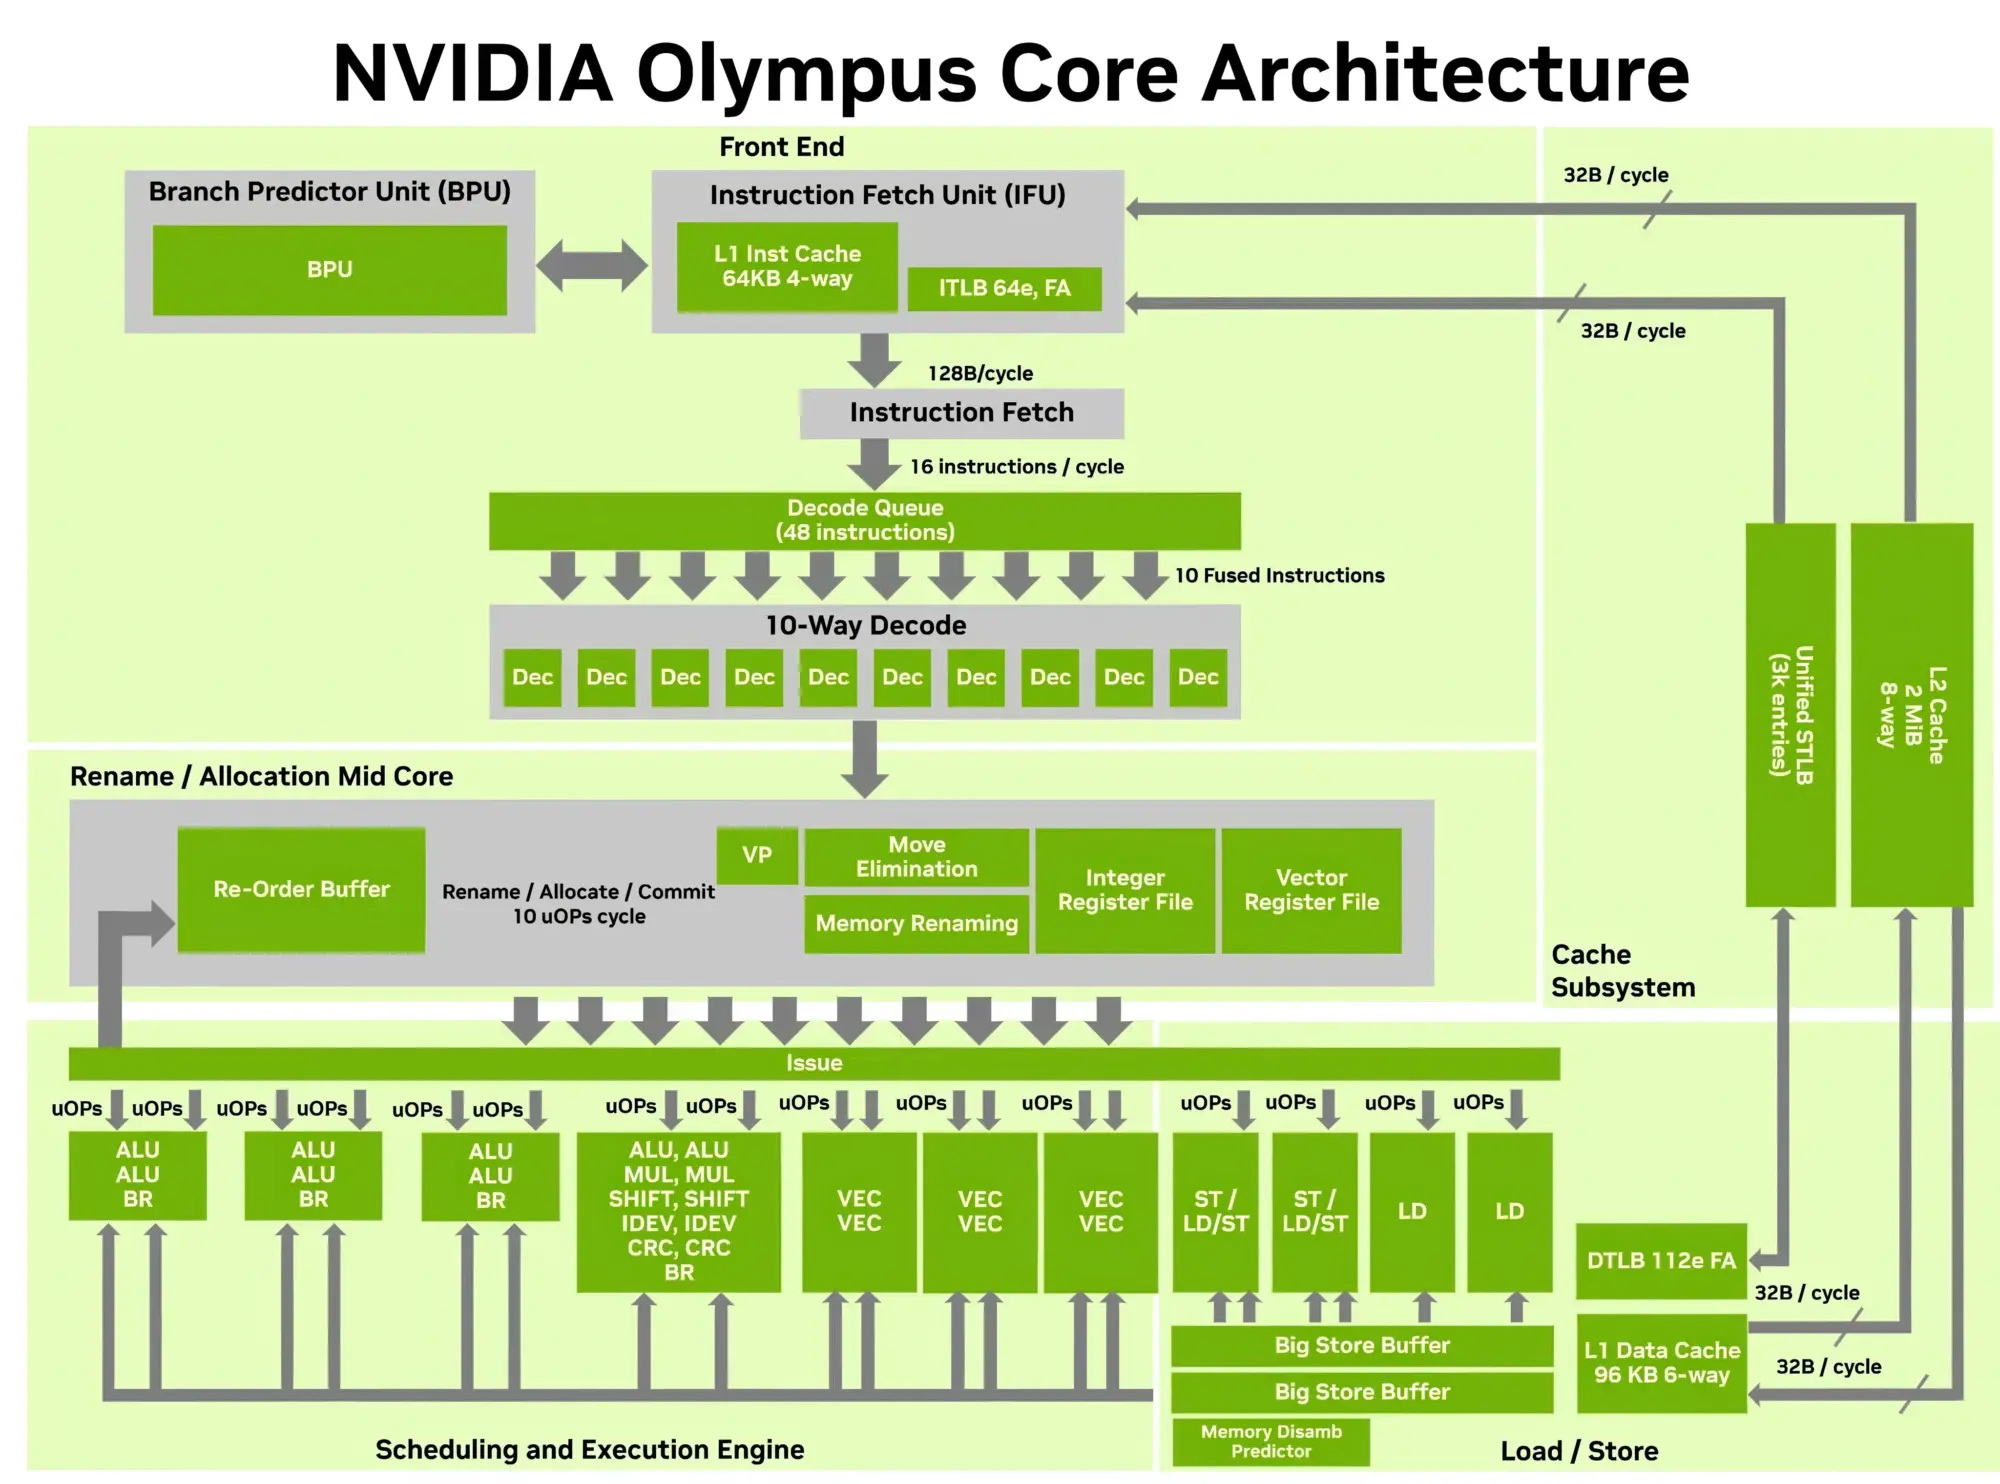
Компания Nvidia опубликовала новые подробности об архитектуре своего процессора Vera для центров обработки данных и используемом в нём специализированном ядре Olympus. Чип Vera объединяет 88 ядер Olympus, 176 аппаратных потоков и унифицированный кеш L3 объёмом 164 Мбайт на монолитном вычислительном кристалле. 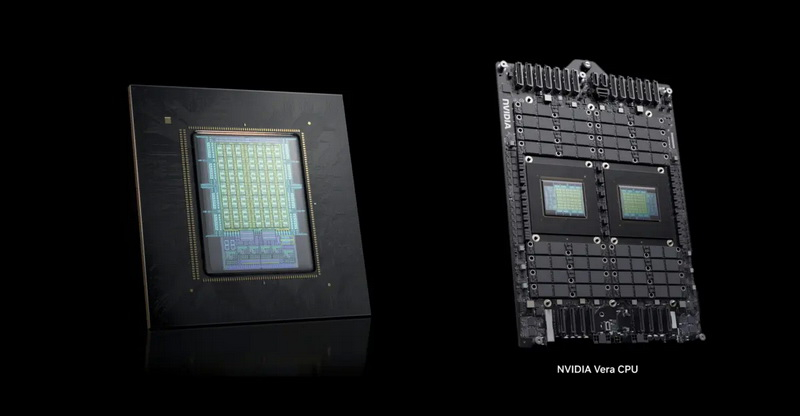
Источник изображений: Nvidia Каждое ядро Olympus использует широкий конвейер с нейронным предсказателем ветвлений, 64-килобайтный четырёхканальный кеш инструкций L1 и очередь декодирования на 48 инструкций. Ядро может считывать до 16 инструкций за такт и включает 10-канальный декодер, способный обрабатывать до десяти объединённых инструкций за такт. 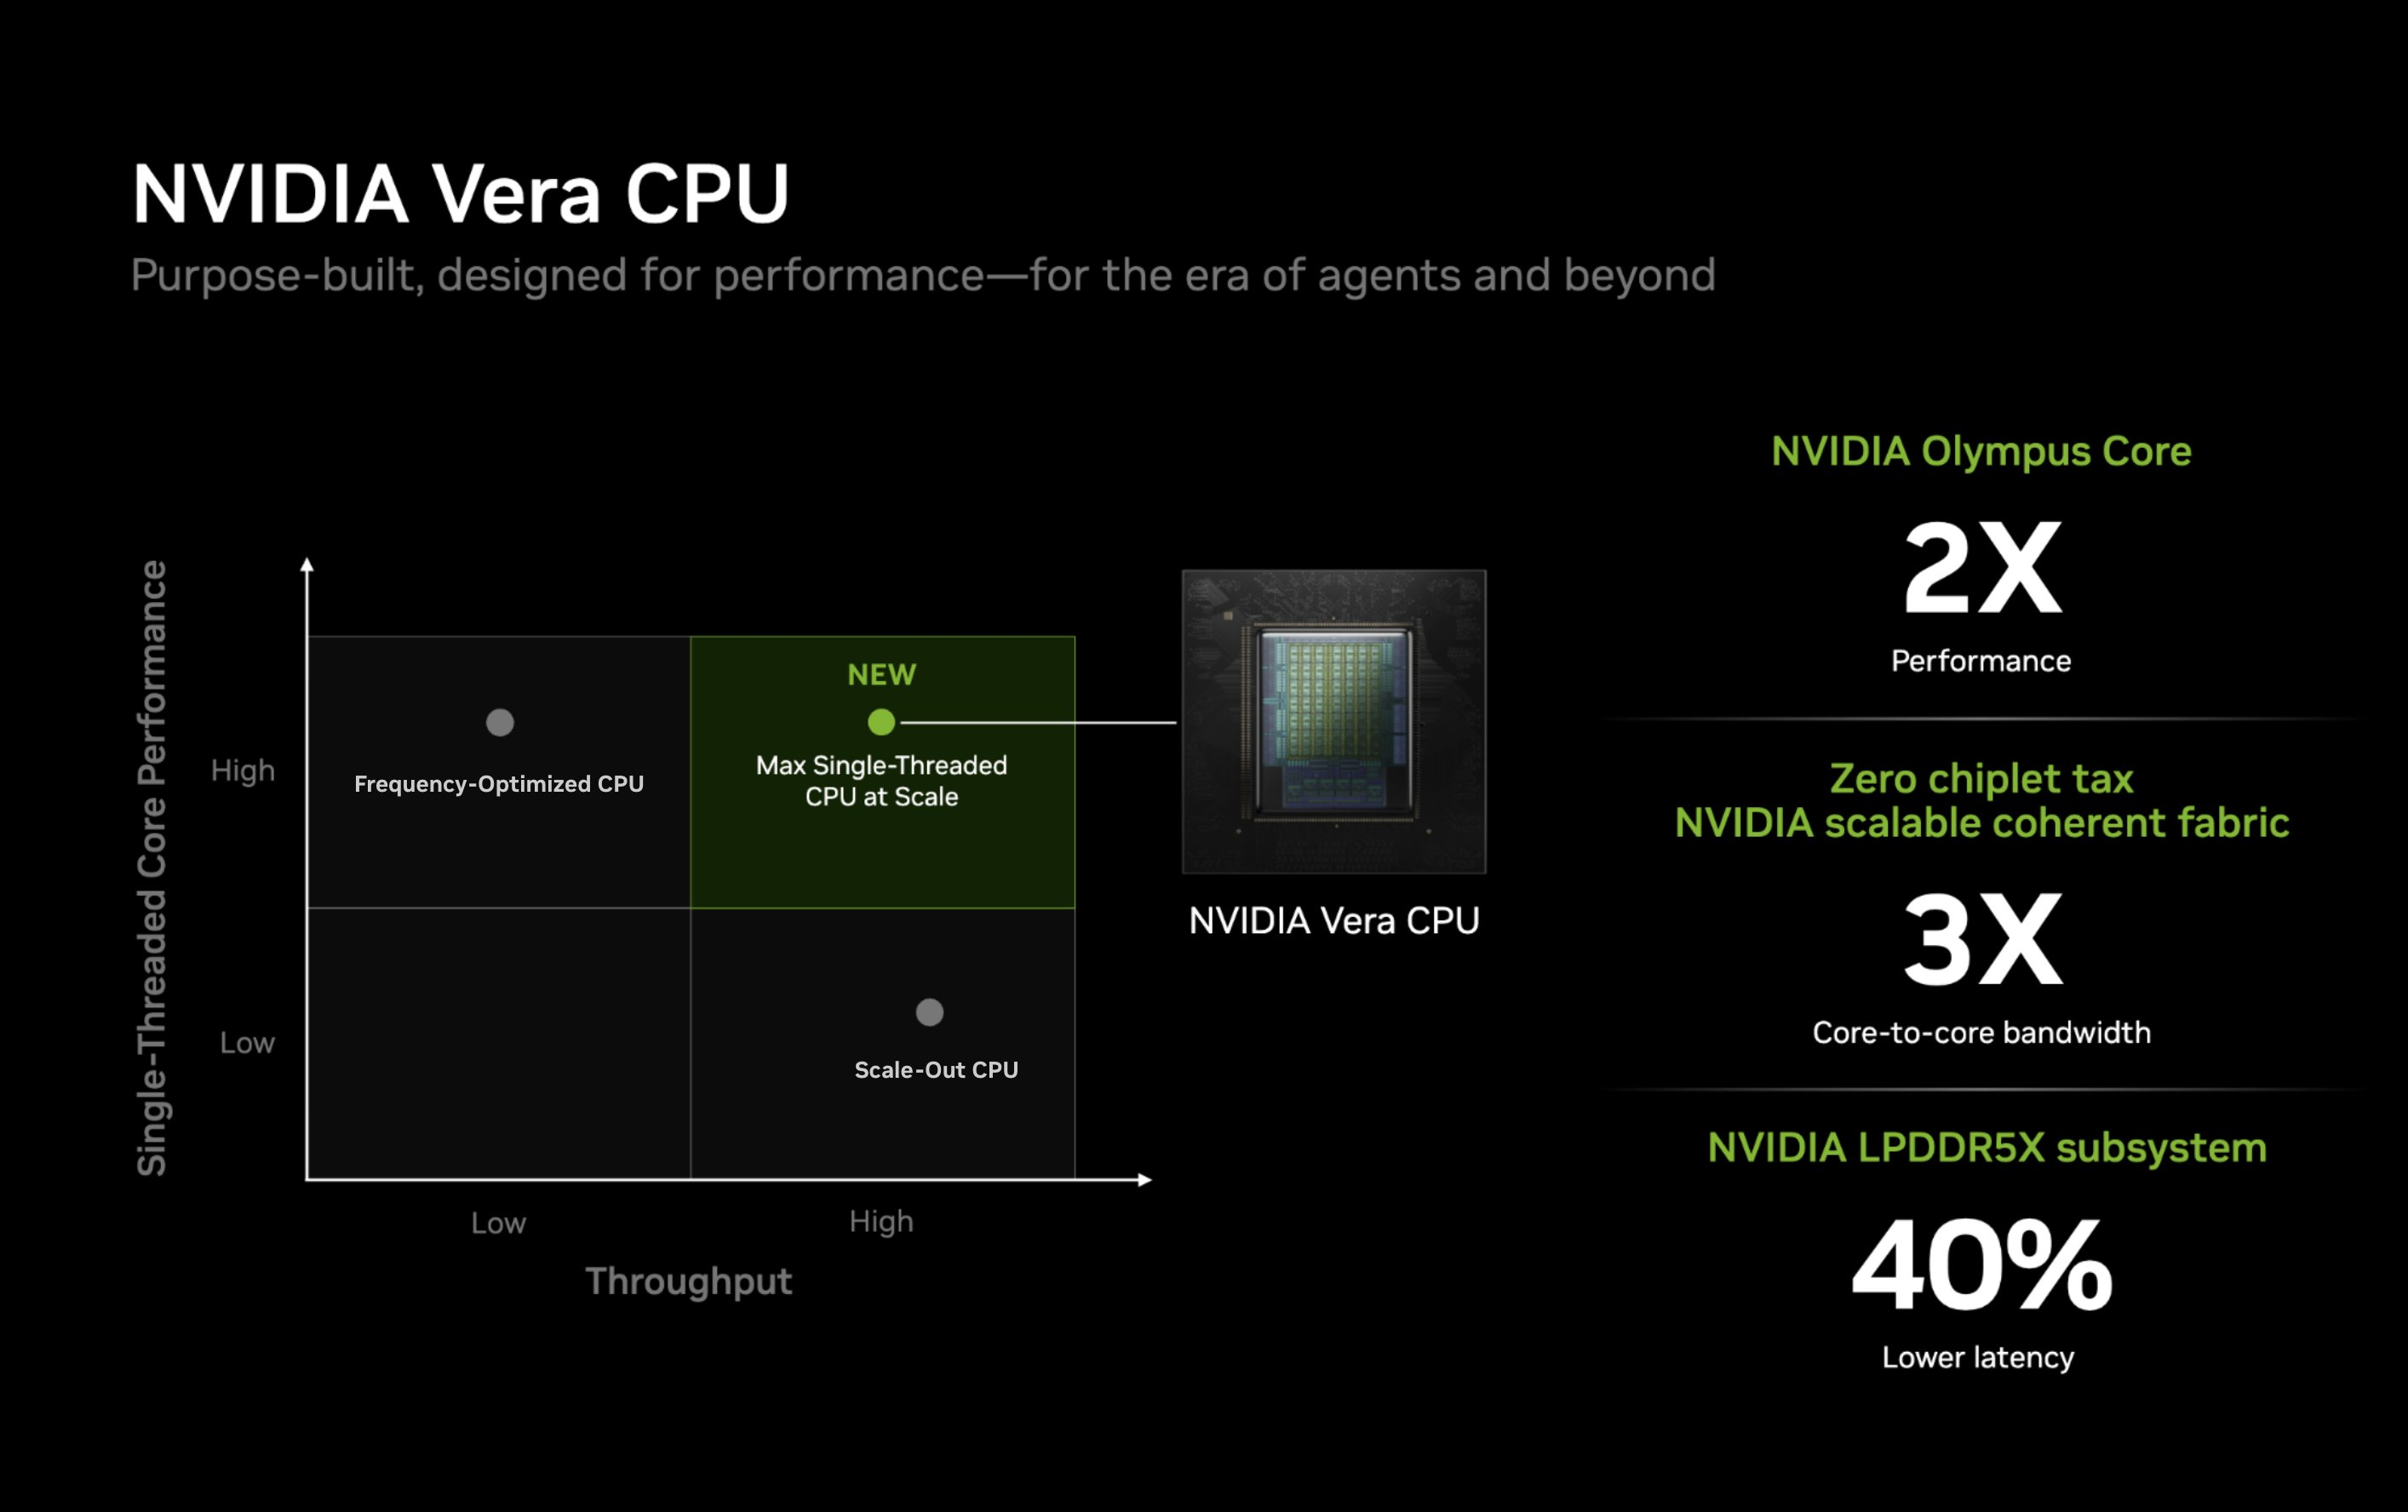 Каждое ядро может переименовывать, выделять и фиксировать до десяти микроопераций за такт. Nvidia также отмечает использование технологий переименования памяти, предсказания значений и исключения перемещений, предназначенных для уменьшения задержек, связанных с зависимостями. Исполнительный блок включает целочисленные операции, операции ветвления, векторные операции, операции с плавающей запятой, криптографические операции, а также выделенные ресурсы для операций загрузки и сохранения данных. Каждое ядро Olympus имеет 96-килобайтный шестиканальный кеш данных L1 и 2-мегабайтный восьмиканальный кеш L2. Nvidia также добавила несколько механизмов аппаратной предварительной выборки, включая предварительную выборку графов для структур данных с большим количеством указателей и рабочих нагрузок, связанных с обработкой графов. Особенности Nvidia Vera
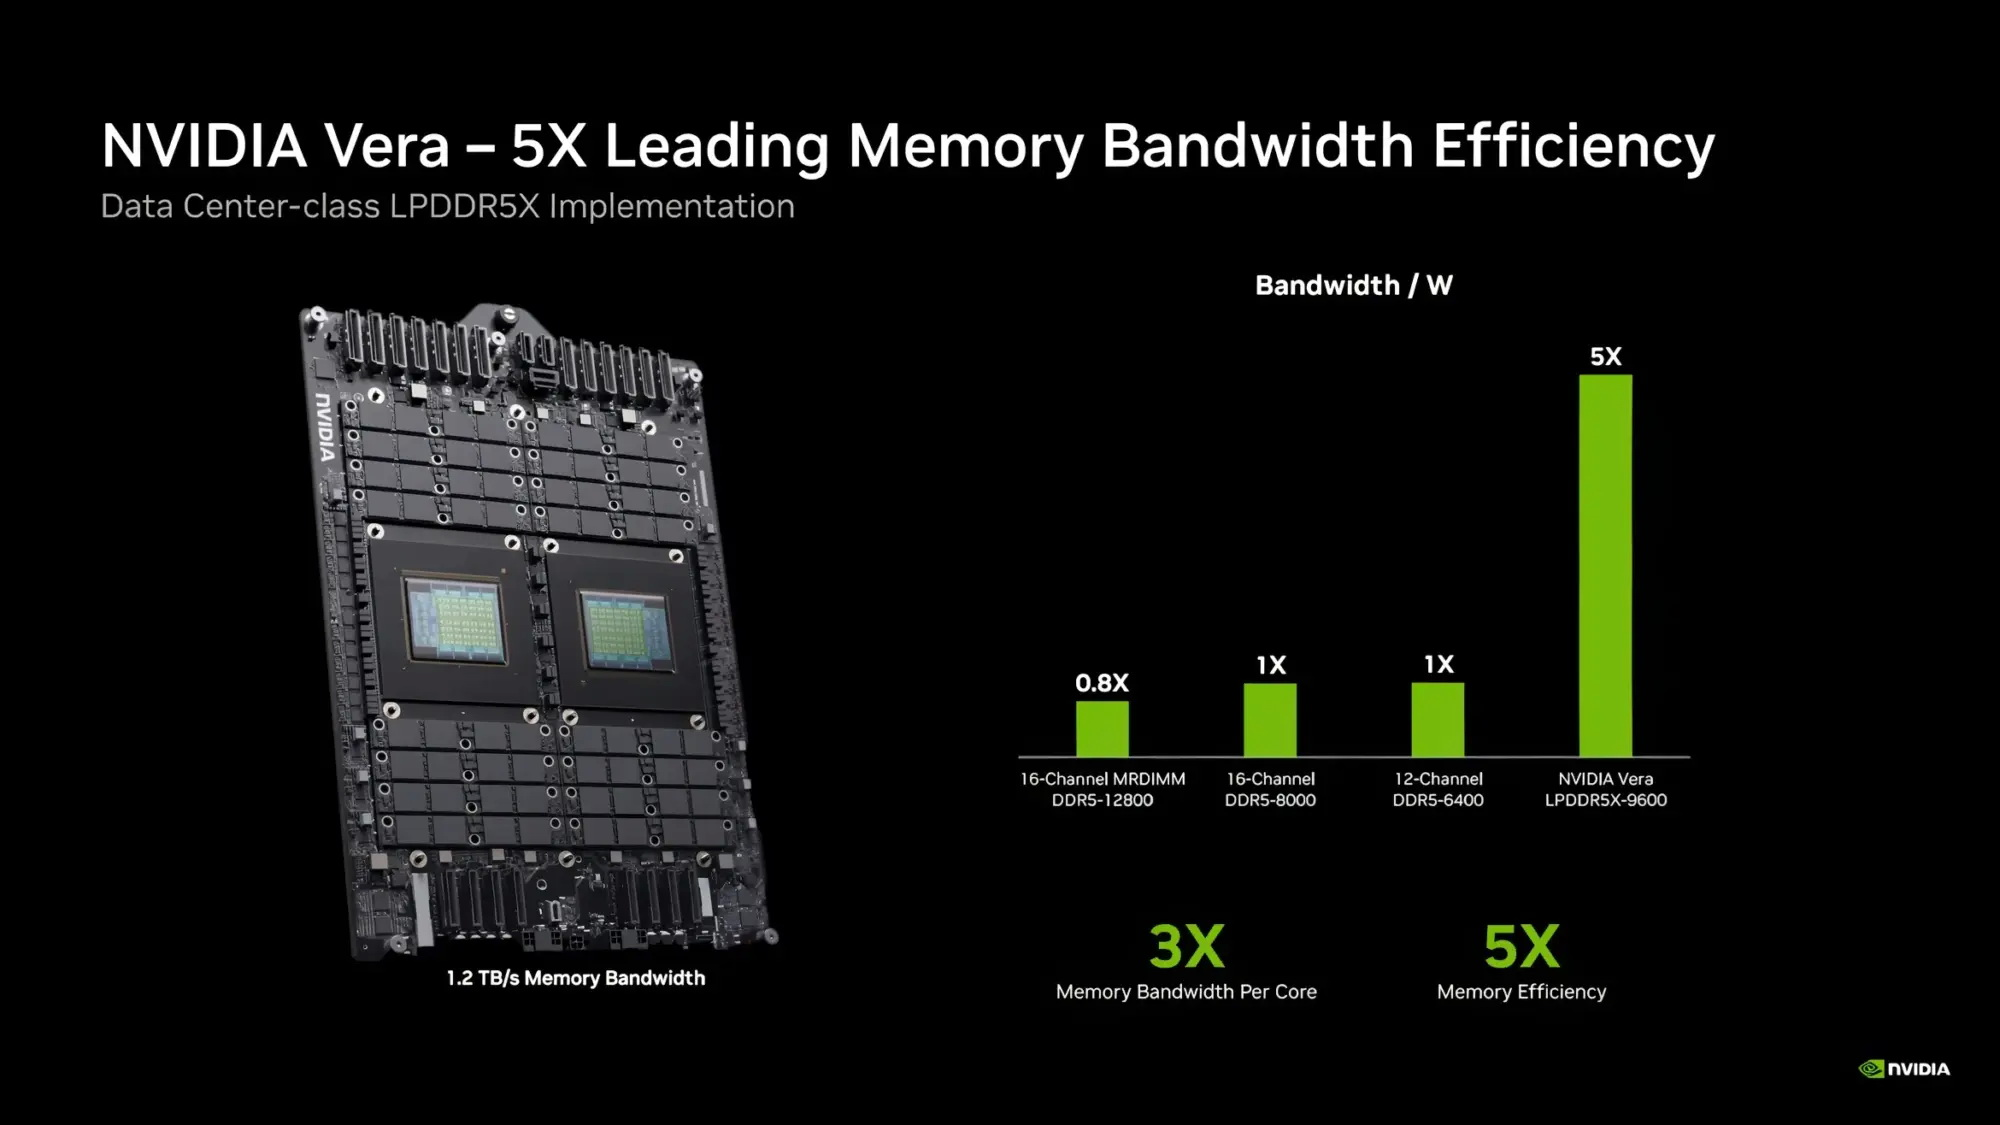
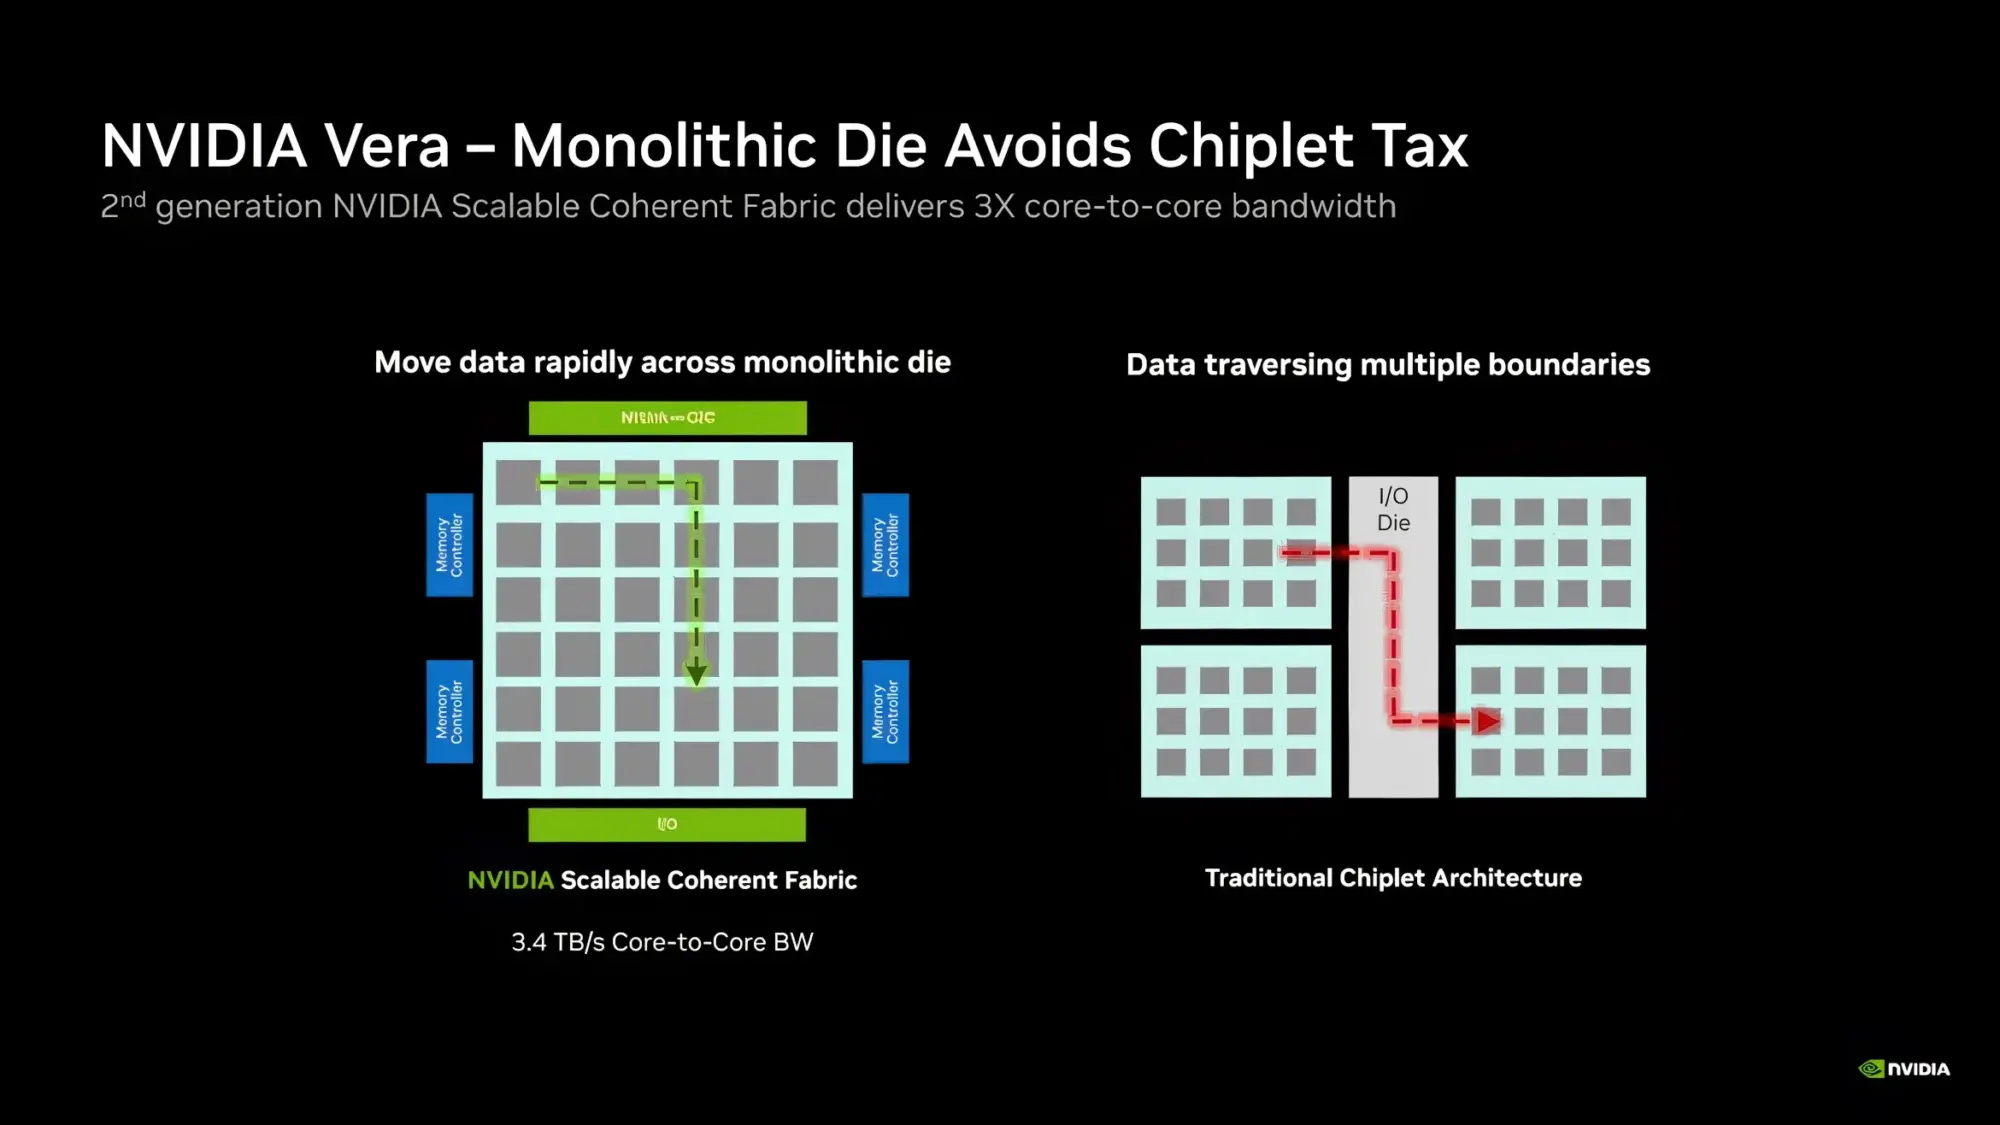
Процессор Vera использует фирменную технологию пространственной многопоточности, которая обеспечивает два аппаратных потока на каждое ядро Olympus. Nvidia заявляет, что такая конструкция позволяет распределять ресурсы ядра между потоками, уменьшая конкуренцию по сравнению с традиционной одновременной многопоточностью. Ядро может отдавать приоритет одному потоку, чувствительному к производительности, в то время как второй поток обрабатывает системные и управляющие задачи. 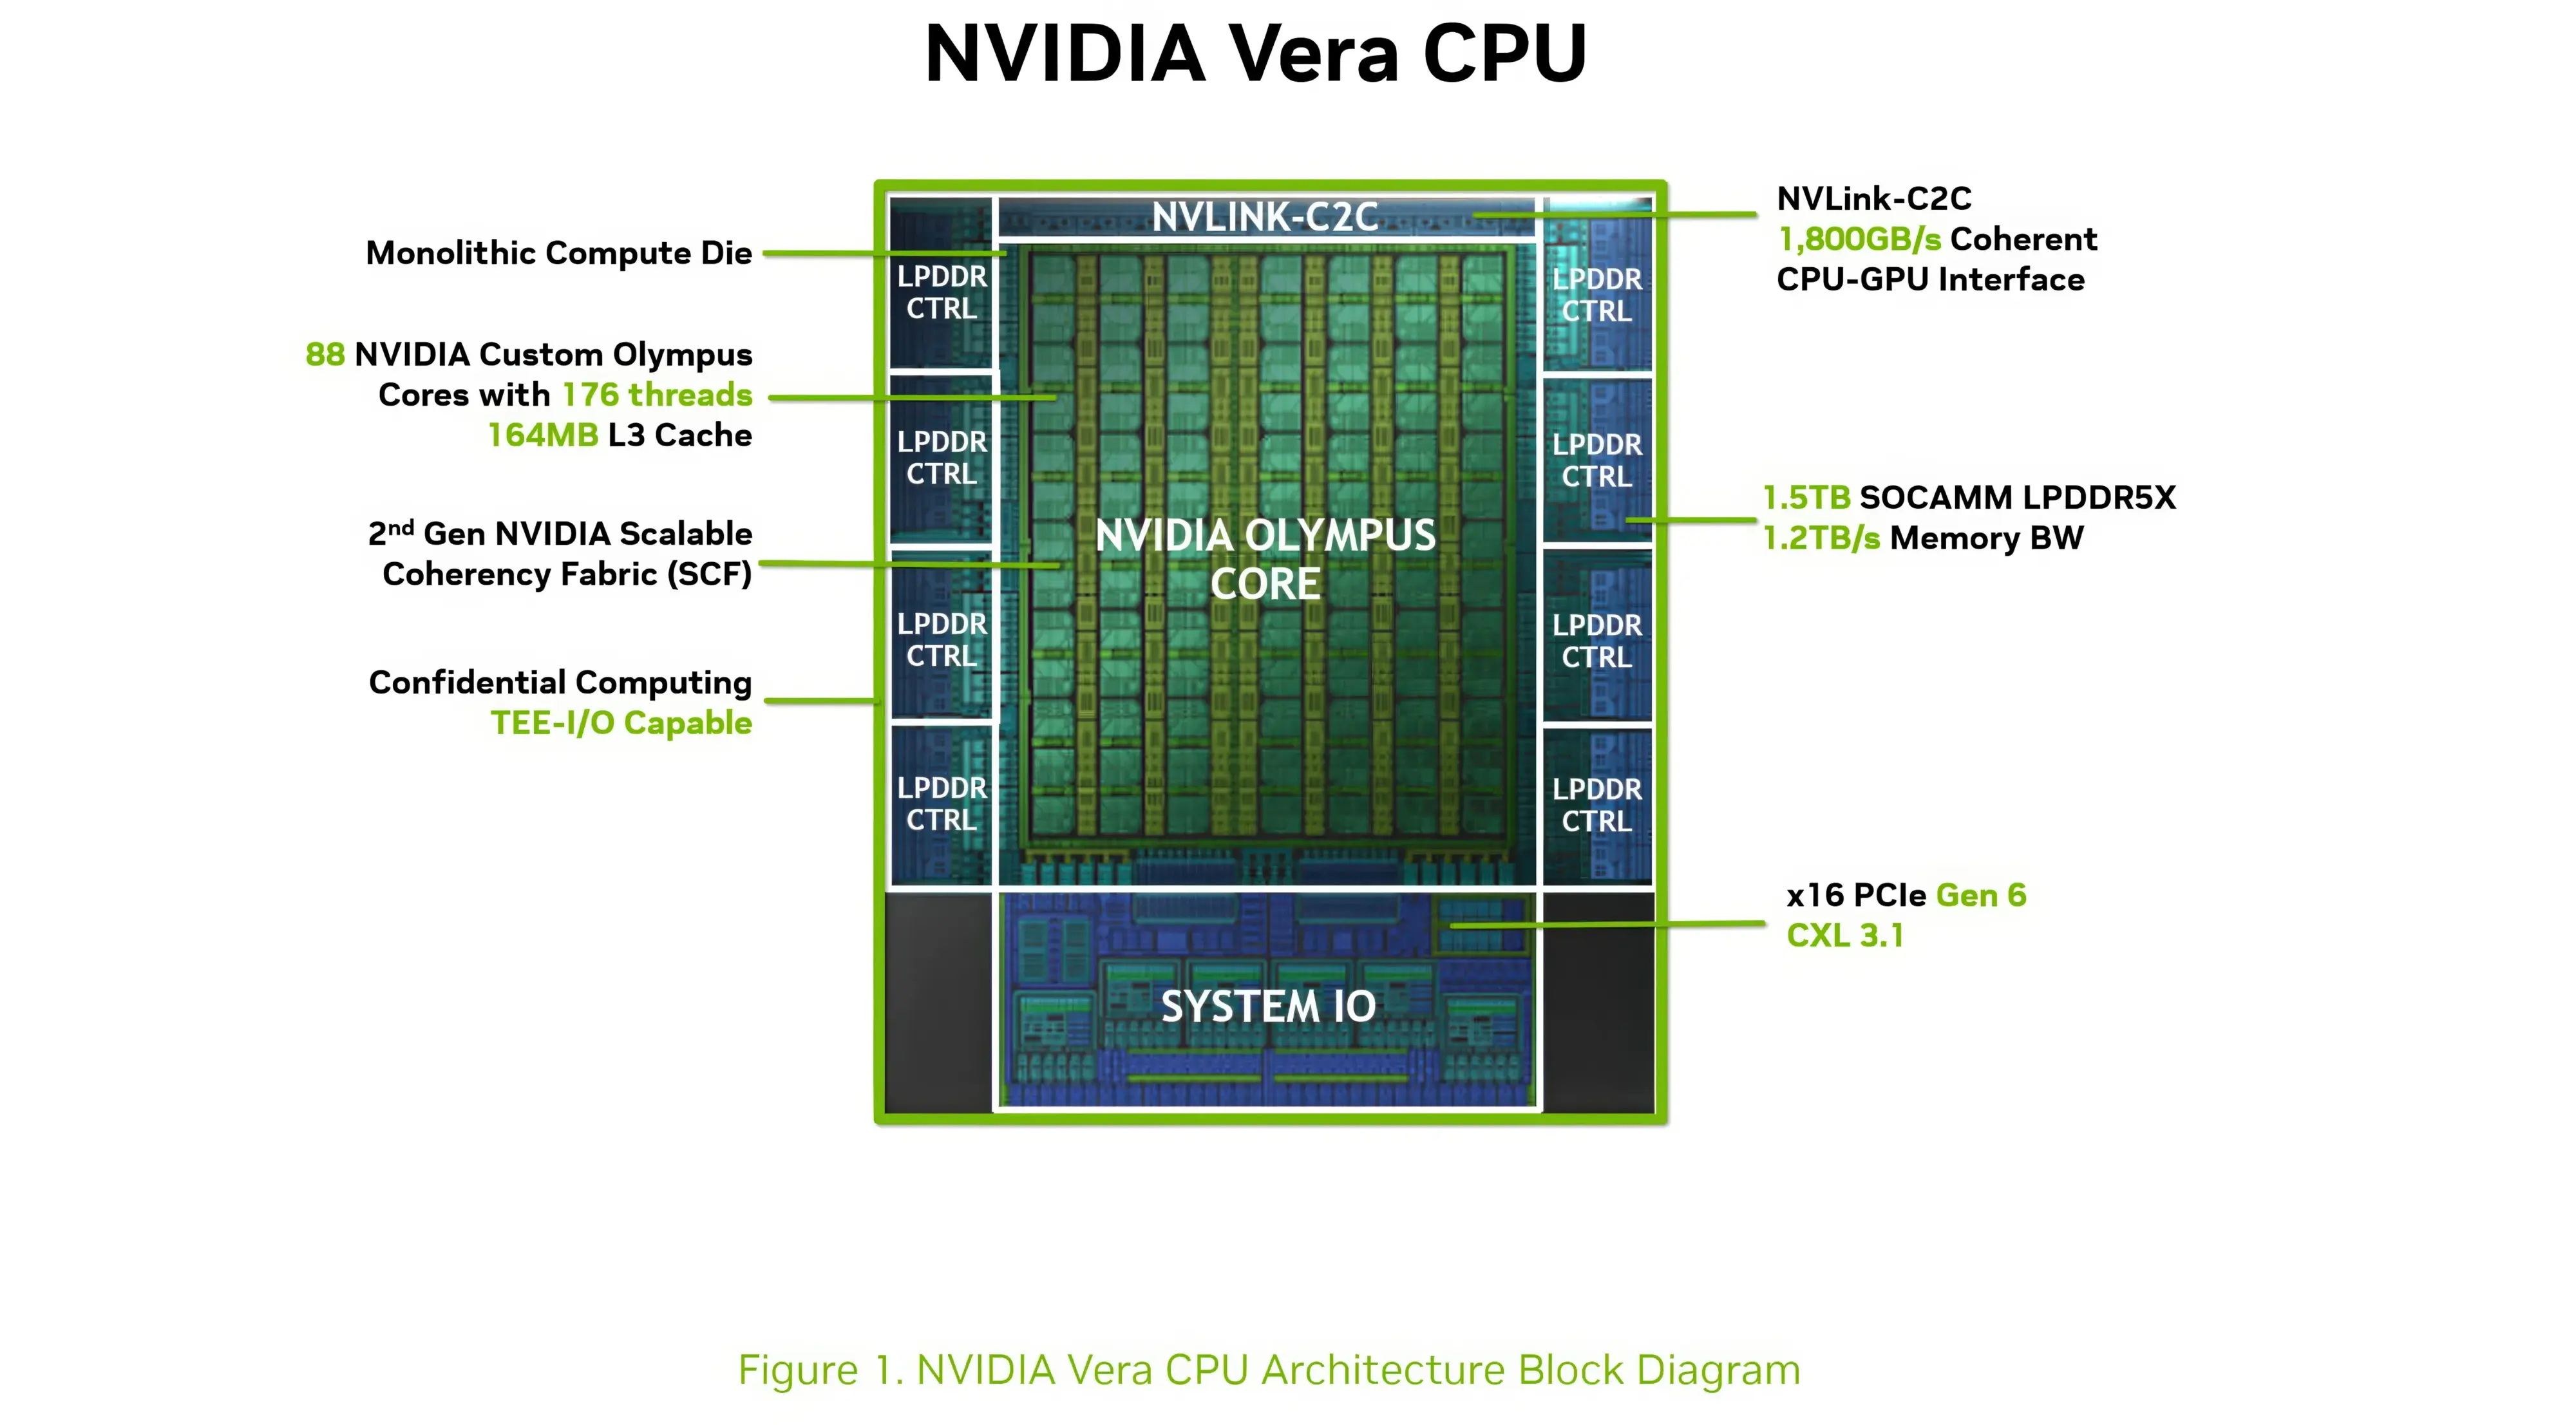 Ядра процессора, кеш, контроллеры памяти и ввода-вывода объединены через масштабируемую когерентную структуру Nvidia второго поколения. Компания заявляет о пропускной способности между ядрами до 3,4 Тбайт/с, пропускной способности памяти SOCAMM2 LPDDR5X до 1,2 Тбайт/с и поддержке до 1,5 Тбайт памяти на процессор. Vera также поддерживает интерфейс NVLink-C2C со скоростью до 1,8 Тбайт/с, PCIe 6.0 и CXL 3.1. Системы с двумя сокетами обеспечивают 176 линий PCIe и используют двухузловую конфигурацию NUMA — по одному домену NUMA на каждый сокет. Nvidia утверждает, что Vera обеспечивает до 1,8 раза более высокую производительность, чем неназванные системы x86, в отдельных рабочих нагрузках, связанных с работой ИИ-агентов. Результаты основаны на внутренних тестах Nvidia SPEC CPU 2026, проведённых в июле 2026 года, и пока не были независимо подтверждены. В Нидерландах создали первую в мире «солнечную» черепицу с гибкой плёнкой из перовскита и эффективностью 12,4 %
03.04.2026 [11:29],
Геннадий Детинич
В Нидерландах разработана первая в мире солнечная черепица с использованием тонких плёнок перовскита. У нового элемента сравнительно невысокая эффективность, зато благодаря ему черепичная крыша будет выглядеть как обычная крыша, а не как набор установленных под углом солнечных панелей. «Солнечная» черепица готова к массовому производству и вполне может стать неотъемлемым элементом городской архитектуры, сочетая выработку электричества и эстетику зданий. 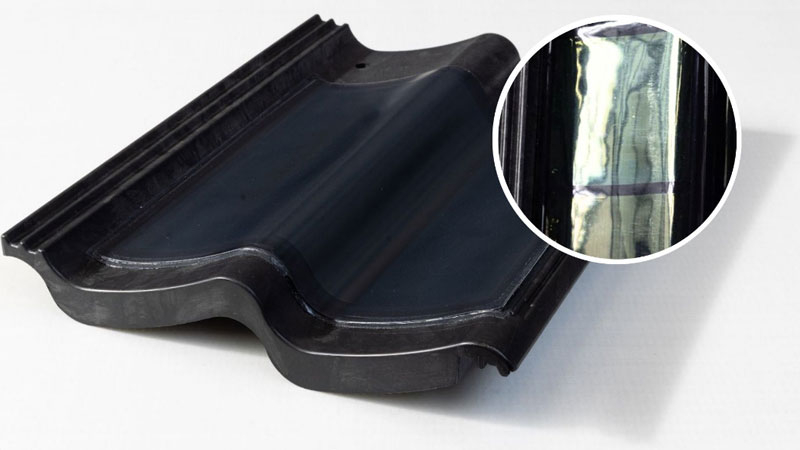
Источник изображения: TNO Размещение солнечных панелей на крышах возможно далеко не везде, поскольку особенно старые здания не рассчитаны на такую дополнительную нагрузку. Установка солнечных панелей на земле требует свободных пространств, что тоже является проблемой, особенно в густонаселённой Европе. Солнечные элементы в виде обычной черепицы с аналогичным способом монтажа решают эти проблемы, позволяя получать возобновляемую энергию в городских условиях, не внося хаос в архитектуру и в уже сложившуюся застройку. Разработка модуля в составе композитной черепицы осуществлена исследователями нидерландской организации TNO (Netherlands Organisation for Applied Scientific Research) в сотрудничестве с компанией ASAT B.V. Технически черепица работает на гибких солнечных элементах из перовскита, нанесённых на фольгу, которая затем крепится к изогнутой композитной основе. Материалы и процессы адаптированы для крупномасштабного производства рулонным методом, что является наиболее экономически выгодным способом. Эффективность отдельных модулей достигает 13,8 %, а после монтажа на изогнутой черепице сохраняется на уровне 12,4 %. Изгиб поверхности оказывает лишь незначительное влияние на производительность. Разработка прошла путь от лабораторных тестовых ячеек до гибких модулей размером 10 × 10 см и, наконец, до готовой функциональной солнечной кровельной черепицы. По сравнению с традиционными кремниевыми солнечными панелями новая черепица обладает ключевыми преимуществами: она полностью интегрируется в кровлю, сохраняя внешний вид здания и не требуя дополнительного пространства на земле. Это снижает нагрузку на инфраструктуру, не влияет на ландшафт и упрощает монтаж, а также открывает возможности для массового применения в жилом и коммерческом строительстве. Экологический эффект заключается в увеличении производства «зелёной» энергии непосредственно в городской застройке, а готовность технологии к промышленному масштабированию делает её экономически перспективной. В настоящее время прототип успешно протестирован, а измерения подтвердили заявленную эффективность. Для коммерциализации TNO 11 марта учредила дочернюю компанию Perovion Technologies. В будущем планируется повысить срок службы, надёжность и масштабируемость технологии. Как подчеркнули разработчики, такая солнечная черепица — следующий этап энергетического перехода, который сделает солнечную энергию более доступной, дешёвой и массовой, заложив основу для энергетической безопасности в Европе. Крупнейший архив видеоигр Myrient спасён фанатами от забвения
16.03.2026 [23:30],
Анжелла Марина
Представители сообщества SaveMyrient официально заявили об успешном завершении резервного копирования крупнейшего архива видеоигр Myrient, объём которого составляет 385 Тбайт. Эта знаковая новость прозвучала на фоне недавних тревожных сообщений о том, что проект находится на грани прекращения существования. 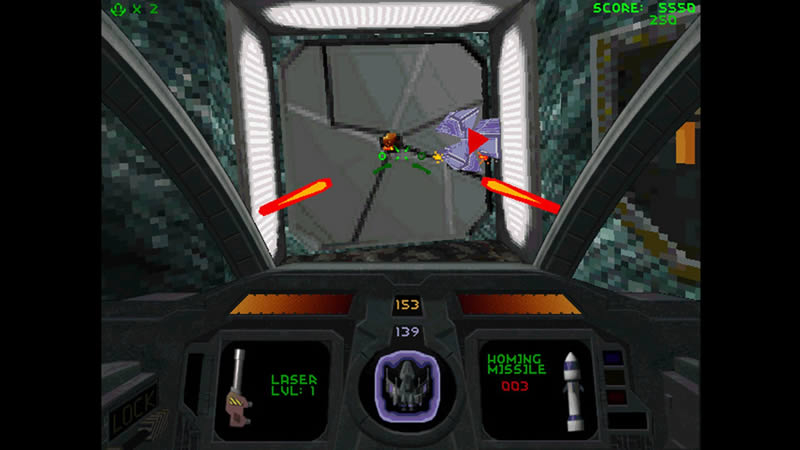
Источник изображения: GOG Ранее администраторы коллекции предупреждали, что сочетание недостаточного финансирования, стремительного роста операционных расходов и злоупотреблений со стороны специализированных менеджеров загрузок создаёт критическую нагрузку на инфраструктуру ресурса. Особую обеспокоенность, как пишет Tom's Hardware, вызывало резкое увеличение рыночной стоимости оперативной памяти, твердотельных накопителей (SSD) и жёстких дисков, необходимых для хранения данных. Модератор SaveMyrient под ником Ill-Economist-5285 поделился радостной информацией перед выходными, отметив значительный прогресс в работе волонтёров. По его словам, команда проделала огромную работу по завершению загрузок и их последующей проверке, что позволило объявить зеркало Myrient полностью готовым. Сейчас основные усилия направлены на генерацию торрент-файлов и обеспечение их доступности для широкой публики. Важно отметить, что оригинальный веб-сайт продолжит свою работу до конца текущего месяца и не будет выведен из эксплуатации раньше этого срока. Другой модератор проекта уточнил, что использование технологии торрентов рассматривается на текущем этапе исключительно как временная мера. Участники выразили готовность раздавать коллекцию в активном режиме, чтобы гарантировать стабильность распределения данных. Ill-Economist-5285 также заверил поклонников ресурса, что в скором времени работа системы вернётся в нормальное русло. Для подготовки к следующему этапу некоторые разделы архива могут быть временно отключены, однако детали будущих изменений будут раскрыты позднее. На данный момент доступ к оригинальному порталу Myrient сохранён, и пользователи могут продолжать загрузку, например, таких раритетов, как приложения Calamus для платформы Atari ST или шутера Descent II с MS-DOS. Напомним, Myrient — это один из крупнейших публичных архивов ретроигр, основанный в 2022 году для хранения редких ROM-файлов и образов дисков. Ресурс предоставляет доступ к 385–390 ТБ данных для эмуляции. Проект, славившийся проверенными файлами, закрывается 31 марта 2026 года из-за высокой стоимости хостинга. Военные США заплатят за разработку фотонных чипов для ИИ — для этого придётся в чём-то обмануть физику
07.02.2026 [15:39],
Геннадий Детинич
Управление перспективных исследовательских проектов Министерства обороны США (DARPA) объявило запуск программы PICASSO, целью которой обозначено преодоление фундаментальных физических ограничений фотонных вычислительных архитектур. Фотоника продолжает оставаться в зачаточном состоянии, что не даёт воспользоваться всеми её преимуществами — низкими задержками и предельно малым потреблением энергии. Пришло время ей поднять голову, а физике — уступить. 
Источник изображения: ИИ-генерация ChatGPT 5.2/3DNews Основные проблемы современных фотонных систем — это неизбежное затухание оптического сигнала, невозможность усиления полезного сигнала без одновременного усиления шума, а также паразитные интерференции, рассеяние, отражения, резонансные явления и нестабильность характеристик при массовом производстве, а также уход параметров за рамки заявленных под воздействием температуры и других внешних факторов. Всё перечисленное выше привело к тому, что современные фотонные чипы способны выполнять лишь простые линейные операции на небольшую глубину вычислений, а для более сложных расчётов приходится постоянно преобразовывать световой сигнал в электрический и обратно — что сводит на нет преимущества фотонных архитектур. По крайней мере, в гибридной реализации. В этой связи DARPA приглашает разработчиков и компании создать фотонные архитектуры на уровне схемотехнических решений, которые смогут обойти существующие физические ограничения, используя при этом уже производимые фотонные компоненты (без создания новых материалов или устройств). Цель — добиться предсказуемой работы больших фотонных схем, чтобы раскрыть их потенциал для задач ИИ и других приложений, где требуются интенсивные вычисления. Программа PICASSO (Photonic Integrated Circuit Architectures for Scalable System Objectives) разделена на два этапа по 18 месяцев каждый, общий бюджет составляет около $35 млн, а заявки принимаются до 6 марта 2026 года. На первом этапе требуется доказать осуществимость поставленных задач, а на втором — создать функциональные решения. В DARPA считают, что в своё время схемотехники смогли на базовом уровне создать надёжные и устойчивые электронные архитектуры, так почему бы это не повторить для фотонных цепей? AMD откажется от устаревшей и медленной IDT — будущие Ryzen и Epyc получат FRED, разработанную Intel
05.02.2026 [00:15],
Анжелла Марина
Компания AMD разместила на своём сайте техническую документацию, раскрывающую одну из важных особенностей будущих процессорных архитектур компании — переход на современную технологию обработки прерываний Flexible Return and Event Delivery (FRED). Этот механизм заменяет таблицу дескрипторов прерываний (IDT), которая использовалась в архитектуре x86 ещё с 1982 года, начиная с процессора Intel 286. 
Источник изображения: AMD Обе системы управляют обработкой прерываний, то есть сигналов от оборудования, таких как действия мыши или поступление сетевых данных. В отличие от IDT, где разработчикам ПО требуется вручную управлять несколькими этапами для предотвращения конфликтов, FRED использует единую оптимизированную операцию, которая должна сократить количество процессорных циклов, затрачиваемых на обработку событий, и потенциально увеличить общую производительность системы. Технология FRED, разработанная компанией Intel и утверждённая консультативным советом по экосистеме x86, уже реализована в новых мобильных процессорах Intel Panther Lake. Однако заметный прирост производительности на старом программном обеспечении может не проявиться, поскольку FRED требует явной поддержки со стороны операционной системы, и его преимущества станут доступны только после обновления ядра и системных компонентов. Создатель ядра Linux Линус Торвальдс (Linus Torvalds) ещё в 2021 году положительно отозвался о внедрении FRED. По его словам, эта технология позволяет полностью отказаться от устаревшей таблицы прерываний, которую он назвал «пережитком ужасной архитектуры прошлого». Торвальдс отметил, что версия от Intel выглядит предпочтительнее для долгосрочного выживания и развития платформы x86-64, так как она значительно упрощает логику обработки исключений. Он также напомнил, что изначально название FRED расшифровывалось как «быстрый» (Fast), но в итоговой версии предпочтение отдали «гибкому» (Flexible) подходу. AMD не уточняет в документации, в каком именно поколении архитектуры Zen будет внедрена поддержка FRED, но сетевые источники предполагают, что это произойдёт уже в грядущем Zen 6. Как отмечает PC Gamer, внедрение столь глубоких изменений может означать, что Zen 6 станет полноценным архитектурным пересмотром, а не промежуточным обновлением. Ранее AMD придерживалась стратегии выпуска масштабных обновлений через поколение, и по этому графику радикальные новшества ожидались лишь в Zen 7. Официальные подробности о процессорах на базе Zen 6 должны появиться в конце текущего года. AMD опубликовала первые детали о Zen 6 — новая архитектура на 2-нм техпроцессе с мощным векторным потенциалом
21.12.2025 [21:48],
Николай Хижняк
AMD на этой неделе опубликовала документ под названием «Счётчики производительности для процессоров AMD Family 1Ah Model 50h-57h», в котором раскрываются некоторые особенности архитектуры Zen 6, которая будет использоваться в будущих потребительских процессорах AMD, а также серверных чипах EPYC Venice для центров обработки данных. Оказывается, Zen 6 — это не совсем эволюция архитектуры Zen 5, а совершенно новая конструкция с другой идеологией. 
Источник изображения: AMD AMD ранее в общих чертах сообщила, что архитектура Zen 6 будет использоваться в процессорах с общим количеством ядер до 256, а в её основе будет применяться 2-нм техпроцесс компании TSMC. В опубликованном компанией на этой неделе документе для разработчиков программного обеспечения говорится, что микроархитектура Zen 6 не является поэтапным развитием Zen 4/Zen 5, а представляет собой намеренно широкую, ориентированную на пропускную способность архитектуру с восьмислотовым механизмом диспетчеризации и одновременной поддержкой многопоточности (SMT). В такой архитектуре два аппаратных потока динамически конкурируют за общий пул слотов диспетчеризации, поэтому при одинаковых тактовых частотах производительность однопоточных процессоров на базе Zen 6 может быть не такой высокой, как у тех же процессоров Apple с девятью (или более) слотами диспетчеризации во всех ситуациях. Однако в некоторых случаях этот тип архитектуры обещает очень высокую производительность. Кроме того, ядро Zen 6 имеет выделенные счётчики для неиспользуемых слотов диспетчеризации, задержек на бэкэнде и потерь при выборе потоков, что говорит о том, что широкое распределение нагрузки и арбитраж SMT являются факторами, которые будут специально оптимизироваться в Zen 6. Zen 6 также существенно расширяет возможности AMD по векторным вычислениям с плавающей запятой, подчёркивая акцент архитектуры на сложных математических задачах. Согласно документации, процессоры Zen 6 поддерживают полноценное выполнение инструкций AVX-512 с форматами данных FP64, FP32, FP16 и BF16, включая операции FMA/MAC и смешанное векторное выполнение FP-INT (включая операции VNNI-класса, AES и SHA). Кроме того, они обеспечивают устойчивую пропускную способность FP-блока в 512 бит. Это не доказывает, что процессоры на базе Zen 6 станут лидерами по производительности в операциях с AVX-512, но предполагает, что Zen 6 может сократить задержку при работе с векторами и превзойти устаревшие методы вычислений. В целом, ориентированные на производительность возможности Zen 6 предполагают, что это первая микроархитектура AMD, разработанная с нуля для использования в центрах обработки данных. Остается понять, какие функции Zen 6 будут сохранены в потребительских процессорах и насколько хорошо они будут работать. Китай штампует новые ИИ-модели еженедельно — США уже проигрывают гонку открытого ИИ
26.11.2025 [19:22],
Сергей Сурабекянц
Китай обогнал США на мировом рынке открытых моделей искусственного интеллекта, получив решающее преимущество в использовании этой технологии. Открытые модели, которые можно бесплатно загружать, изменять и интегрировать, упрощают создание и совершенствование продуктов. Стремление Китая к выпуску открытых моделей резко контрастирует с закрытым подходом большинства крупнейших американских технологических компаний. 
Источник изображения: unsplash.com Исследование, проведённое Массачусетским технологическим институтом (MIT) и стартапом Hugging Face, работающим с открытым исходным кодом в сфере ИИ, показало, что за последний год общая доля загрузок новых китайских открытых моделей выросла до 17 %. Этот показатель превышает 15,8 % доли загрузок моделей, созданных американскими разработчиками, такими как Google, Meta✴✴ и OpenAI, — впервые китайские компании обошли своих американских коллег. По данным MIT и Hugging Face, подавляющее большинство загрузок китайских моделей приходится на DeepSeek и Qwen от Alibaba. Ранее модель рассуждений DeepSeek R1 поразила сообщество, продемонстрировав высокие результаты при существенно более низких затратах на обучение. Этот релиз вызвал вопросы о том, смогут ли более обеспеченные ресурсами американские лаборатории ИИ защитить своё конкурентное преимущество. Он также породил сомнения в целесообразности гигантских инвестиций в инфраструктуру центров обработки данных, необходимых для работы мощных моделей. 
Источник изображения: DeepSeek «В Китае открытый исходный код стал более распространённым трендом, чем в США, — отметила старший аналитик Mercator Institute for China Studies Венди Чан (Wendy Chang). — Американские компании решили не играть в эту игру. Они зарабатывают на этих высоких оценках. Они не хотят раскрывать свои секреты». Администрация США, стремясь не проиграть гонку ИИ, пытается убедить американские компании инвестировать в модели с открытым исходным кодом, основанные на «американских ценностях». Но OpenAI, Google и Anthropic предпочли сохранить полный контроль над своими самыми передовыми технологиями, получая от них прибыль через клиентские подписки или корпоративные соглашения. В отличие от них, китайские компании, отрезанные в результате санкций США от передовых ИИ-чипов, получили стимул предложить открытый доступ к своим моделям. 
Источник изображения: Anthropic По словам исследователя MIT Шейна Лонгпре (Shayne Longpre), китайские компании, такие как DeepSeek и Alibaba Cloud, внедрили способ публикации моделей, «меняющий парадигму». Он подчеркнул, что китайские компании выпускают свои модели почти еженедельно, предлагая пользователям множество различных вариаций, из которых они могут выбирать, вместо того, чтобы выпускать серию моделей каждые шесть месяцев или год, как американские лаборатории. Другие эксперты отметили, что ограничения вычислительной мощности Китая из-за экспортного контроля США только подстегнули активность китайских исследователей. Они были вынуждены креативно подходить к разработке моделей, используя такие методы, как дистилляция, для создания более компактных, но мощных моделей. Также китайские ИИ-лаборатории активно занимаются разработкой моделей для генерации видео. Популярность китайских открытых моделей уже влияет на информацию, которую получают пользователи. Исследователи показали, что китайские модели явно пропитаны идеологией Коммунистической партии Китая и, как правило, отказываются предоставлять информацию по спорным политическим темам. Американские лаборатории гораздо больше сосредоточены на разработке современных передовых моделей, а OpenAI и Google DeepMind стремятся создать сильный искусственный интеллект (AGI), который должен превзойти человеческие возможности. В США гораздо меньше крупных независимых игроков в области разработки ПО с открытым исходным кодом, чем в Китае. Одним из этих немногих игроков выступил базирующийся в Сиэтле «Институт ИИ Аллена», который в ноябре запустил модель Olmo 3 с полностью открытым исходным кодом. По мнению экспертов, США должны быть обеспокоены тем, что Китай добивается больших успехов в области открытых моделей. AMD подтвердила, что в новых Radeon сосредоточится на трассировке лучей и ИИ
12.11.2025 [18:42],
Николай Хижняк
«День финансового аналитика» компании AMD не принёс геймерам никаких существенных новостей. AMD не предоставила никакой информации о преемнике графической архитектуры RDNA 4, за исключением двух пунктов. Компания не сообщила, когда он появится и как будет называться. Однако AMD подтвердила, что следующая архитектура для геймеров будет ориентирована на улучшенный ИИ и трассировку лучей. 
Источник изображений: AMD Это означает, что преемник RDNA 4 должен предложить более мощные тензорные ядра и ядра для трассировки лучей, как уже было заявлено в рамках проекта Amethyst — cовместного проекта AMD и Sony по созданию игровых консолей следующего поколения. По информации инсайдеров, AMD ещё не определилась с новым названием серии будущих игровых видеокарт. Эту информацию подтверждает новая дорожная карта графических продуктов AMD. Компания пока избегает использования названия архитектуры будущих графических процессоров. Будет ли это RDNA 5 или UDNA — пока неизвестно. Возможно, это означает, что AMD пока не может ничего обещать, связанного с Radeon, что весьма прискорбно, учитывая, что компания очень подробно описала свои планы по сериям серверных процессоров EPYC и ИИ-ускорителям Instinct. 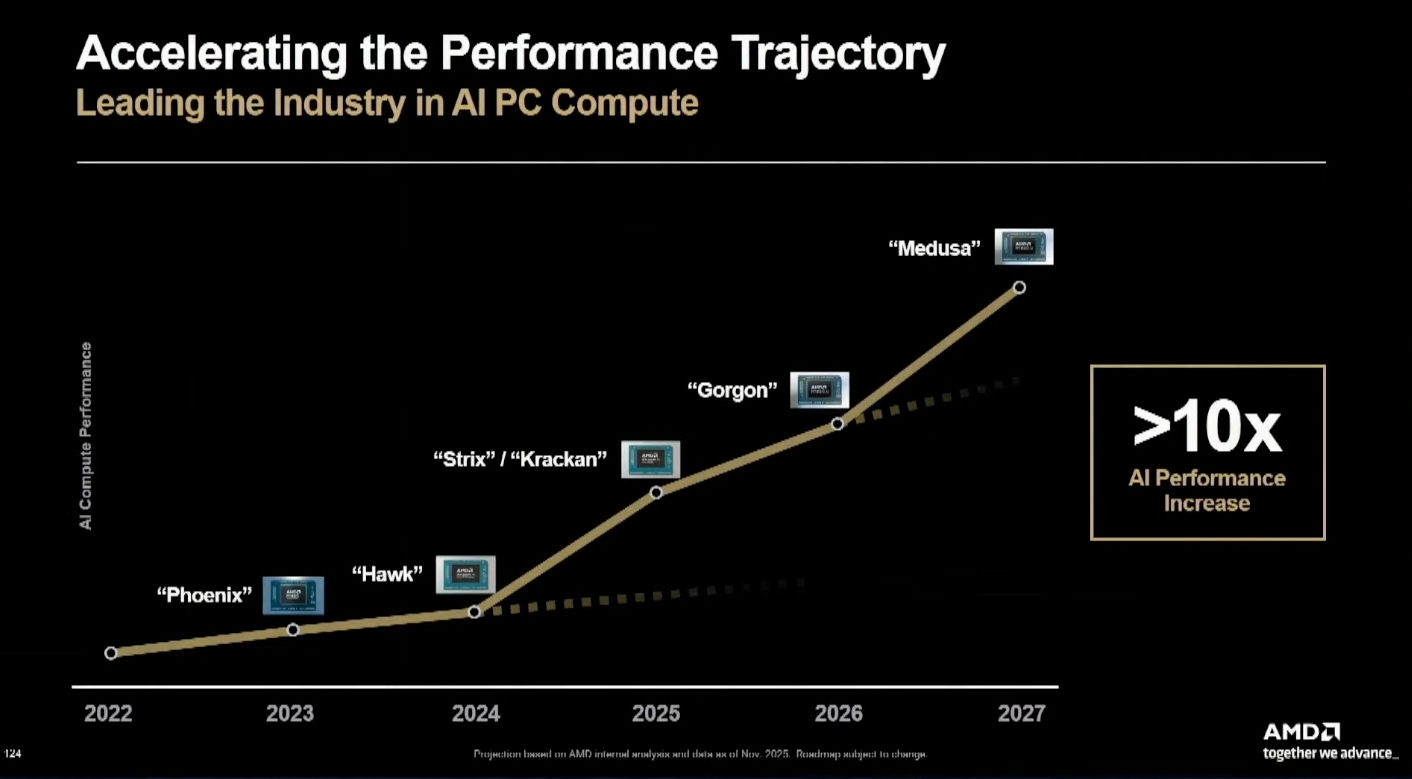 Другой важный анонс от AMD связан не с игровыми видеокартами, а с мобильными процессорами Ryzen. AMD наконец-то подтвердила выпуск серий Gorgon Point и Medusa Point. По слухам, Gorgon будет построена на обновлённой версии архитектуры Zen 5, а чипы Medusa будут использовать архитектуру следующего поколения (Zen 6), которая появится в нескольких продуктах Ryzen где-то в 2027 году. В следующем году компания выпустит чипы серии Gorgon Point. «День финансового аналитика» не является мероприятием, посвящённым запуску новых продуктов. В этом году мероприятие явно ориентировано на рынок ИИ. AMD раскрыла первые подробности о Zen 7 — представлен свежий план выпуска CPU-архитектур
12.11.2025 [00:19],
Николай Хижняк
Компания AMD официально представила обновлённую дорожную карту своих процессорных архитектур, добавив в неё Zen 7. На обновлённом плане Leadership CPU Core Roadmap архитектура Zen 7 представлена отдельным блоком под названиями «Будущий техпроцесс» и «Следующее поколение». 
Источник изображений: AMD Единственными конкретными особенностями, указанными для Zen 7, являются новый матричный движок и расширение формата данных ИИ. Тем самым AMD подчёркивает, что будущее семейство ядер продолжит развивать поддержку ИИ-вычислений, а не только классические скалярные и векторные вычисления CPU. На том же предоставленном AMD слайде компания перечислила предыдущие архитектуры. Zen 4 и Zen 4c привязаны к 5-нм и 4-нм техпроцессам, обладают поддержкой AVX-512 AI ISA, предлагают двухъядерные архитектурные решения и увеличенный кеш второго уровня. Zen 5 и Zen 5c, выполненные на 4-нм и 3-нм техпроцессах, обеспечивают более широкие и глубокие вычислительные возможности, полноценную поддержку 512-битных векторов ИИ и переоптимизированную иерархию кеш памяти. Ожидающиеся Zen 6 и Zen 6c перейдут на «первый в отрасли» 2-нм техпроцесс. Компания также напомнила, что именно серверные процессоры EPYC Venice станут первым реальным продуктом на Zen 6. Архитектура будет поддерживать новый тип данных ИИ и больше конвейеров ИИ. Чипы ожидаются в 2026 году. 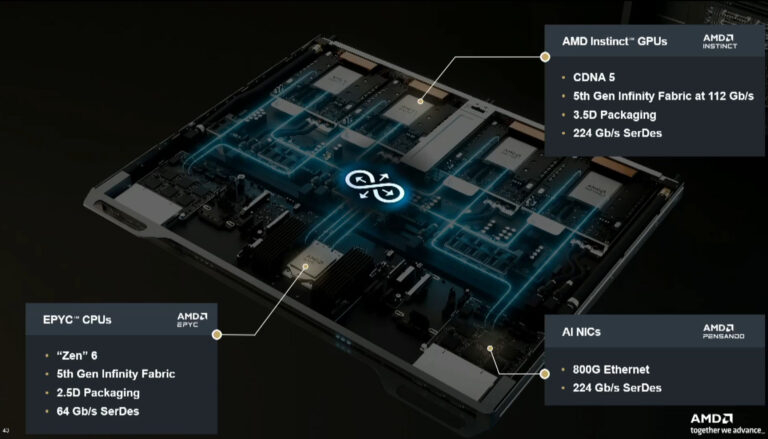 AMD не поделилась какими-либо дополнительными подробностями об архитектуре Zen 7, помимо тех, что представлены на слайде с дорожной картой. Нет ни маркировки техпроцесса, ни сроков выпуска продукта, ни упоминаний о количестве ядер и кеш-памяти. На данный момент официально известно только, что Zen 7 предложит новый матричный движок и расширенную обработку данных ИИ. Вся остальная информация о Zen 7 известна лишь из слухов. В частности, последние обещают для чипов Zen 7 более высокую плотность ядер и увеличенный объём кеша. Intel сократит опенсорсные разработки, потому что ими бессовестно пользуются конкуренты
10.10.2025 [13:55],
Алексей Разин
На протяжении многих лет корпорация Intel уделяла достаточно внимания поддержке экосистемы ПО с открытым исходным кодом, поскольку исторически её x86-совместимые процессоры имели большое распространение. Действующее руководство Intel склоняется к мысли, что далее в этой сфере следует соблюдать баланс интересов и не давать равные возможности конкурентам компании. 
Источник изображения: Intel Это становится понятно, как отмечает The Register, из слов главы серверного бизнеса Intel Кеворка Кечичяна (Kevork Kechichian), которые прозвучали во время мероприятия для прессы и аналитиков, устроенного компанией на прошлой неделе в Аризоне. «Мы должны найти баланс, при котором могли бы использовать это преимущество для Intel, но не давать возможность всем прочим схватить это и убежать», — заявил представитель компании. Другими словами, Intel не хочет поддерживать своих конкурентов, давая им дополнительные возможности за свой счёт. При этом Кечичян подчеркнул, что у Intel нет намерений прекратить поддержку сообщества в сфере ПО с открытым исходным кодом: «У нас нет намерений когда-либо забросить открытый исходный код. Есть много людей, которые получают выгоду от существенных инвестиций, которые Intel делает в эту сферу, — подчеркнул представитель компании. — Мы просто должны понять, как можем получить из этого больше, чем кто-либо другой за счёт наших инвестиций». Компания, по его словам, будет много внимания уделять поддержке открытого исходного кода, но важно не только усилить сообщества, которые поддерживались десятилетиями, но и выделить уникальные сильные стороны Intel. Принцип свободного доступа к программным разработкам Intel позволяет конкурентам на базе её решений создавать собственные более совершенные библиотеки. При этом остаётся загадкой, каким образом Intel может ограничить конкурентов в подобных возможностях. Возможно, часть программного кода компания сохранит закрытой. Например, в составе библиотек OneMKL код низкого уровня остаётся закрытым, тогда как интерфейсы верхнего уровня открыты для использования сторонними разработчиками. Продукция конкурентов с программным обеспечением Intel может работать хуже, чем с процессорами этой марки. В конце концов, ситуация с поддержкой сообщества Open Source может ухудшиться хотя бы в силу массовых сокращений инженеров Intel. |
|
✴ Входит в перечень общественных объединений и религиозных организаций, в отношении которых судом принято вступившее в законную силу решение о ликвидации или запрете деятельности по основаниям, предусмотренным Федеральным законом от 25.07.2002 № 114-ФЗ «О противодействии экстремистской деятельности»; |
© 1997—2026 3DNews
При цитировании документа ссылка на сайт с указанием автора обязательна. Полное заимствование документа является
нарушением
российского и международного законодательства и возможно только с согласия редакции 3DNews.



 MWC 2018
 2018
 Computex

 IFA 2018