


Опрос
|
реклама
Быстрый переход
Nvidia ищет следы контрабанды — будущих партнёров в Азии обяжут подключить мониторинг чипов
07.11.2026 [07:35],
Николай Хижняк
Nvidia ужесточила условия получения статуса официального облачного партнёра в Юго-Восточной Азии. Как сообщает Bloomberg со ссылкой на осведомлённые источники, теперь претендентам на этот статус нужно подключиться к системе Fleet Intelligence, которая, помимо прочего, позволяет определять местоположение ИИ-ускорителей. Nvidia рассчитывает таким образом расширить охват программы, которая может помочь выявлять незаконные поставки чипов в Китай. 
Источник изображений: Nvidia Статус Nvidia Cloud Partner (NCP) востребован среди провайдеров облачных ИИ-вычислений: он служит своего рода знаком качества и даёт приоритетный доступ к ускорителям Nvidia. Компания использует эти преимущества, чтобы побудить операторов подключаться к Fleet Intelligence. Для тех, кто не претендует на партнёрский статус, участие остаётся добровольным. Nvidia не уточнила, придётся ли подключаться к системе действующим партнёрам, чтобы сохранить свои привилегии, и появится ли такое требование за пределами Юго-Восточной Азии. Nvidia анонсировала разработку системы в декабре 2025 года, а в мае 2026-го представила её под названием Fleet Intelligence. Прежде всего это инструмент для операторов ЦОД: он собирает данные о загрузке, энергопотреблении и состоянии ускорителей. Система также позволяет определять, где установлено оборудование, но по умолчанию участники не обязаны передавать сведения о его местоположении ни Nvidia, ни властям США. Как ранее пояснил представитель компании, если эти данные понадобятся американским регуляторам, им придётся обращаться к самим пользователям системы.  Юго-Восточная Азия давно служит перевалочным пунктом для товаров, подпадающих под экспортные ограничения. Для поставок передовых ускорителей Nvidia китайским компаниям, как правило, нужна американская лицензия. Тем не менее, по оценке властей США, китайским фирмам удалось получить такое оборудование на миллиарды долларов, главным образом через контрабандные каналы в Юго-Восточной Азии. Некоторые американские чиновники считают, что Nvidia не обращала должного внимания на признаки обхода ограничений. В компании отвечают, что соблюдают закон, а выявлять нарушителей должны государственные органы. Показательный пример — сингапурская Megaspeed International, деятельность которой уже больше года расследуют в США и Сингапуре. Сама компания отрицает нарушения. На прошлой неделе глава Nvidia Дженсен Хуанг (Jensen Huang) заявил, что компания проверила, где Megaspeed разместила её ускорители, и пересчитала каждый из них. Ранее Nvidia сообщала, что установила местонахождение почти всего поставленного оборудования. Между тем арендодатель, предоставлявший площадку для основного вычислительного узла Megaspeed, расторг договор, а два других оператора ЦОД в регионе оспорили сведения Nvidia о том, где находились чипы. Проводила ли компания дополнительные проверки, её представитель не уточнил. 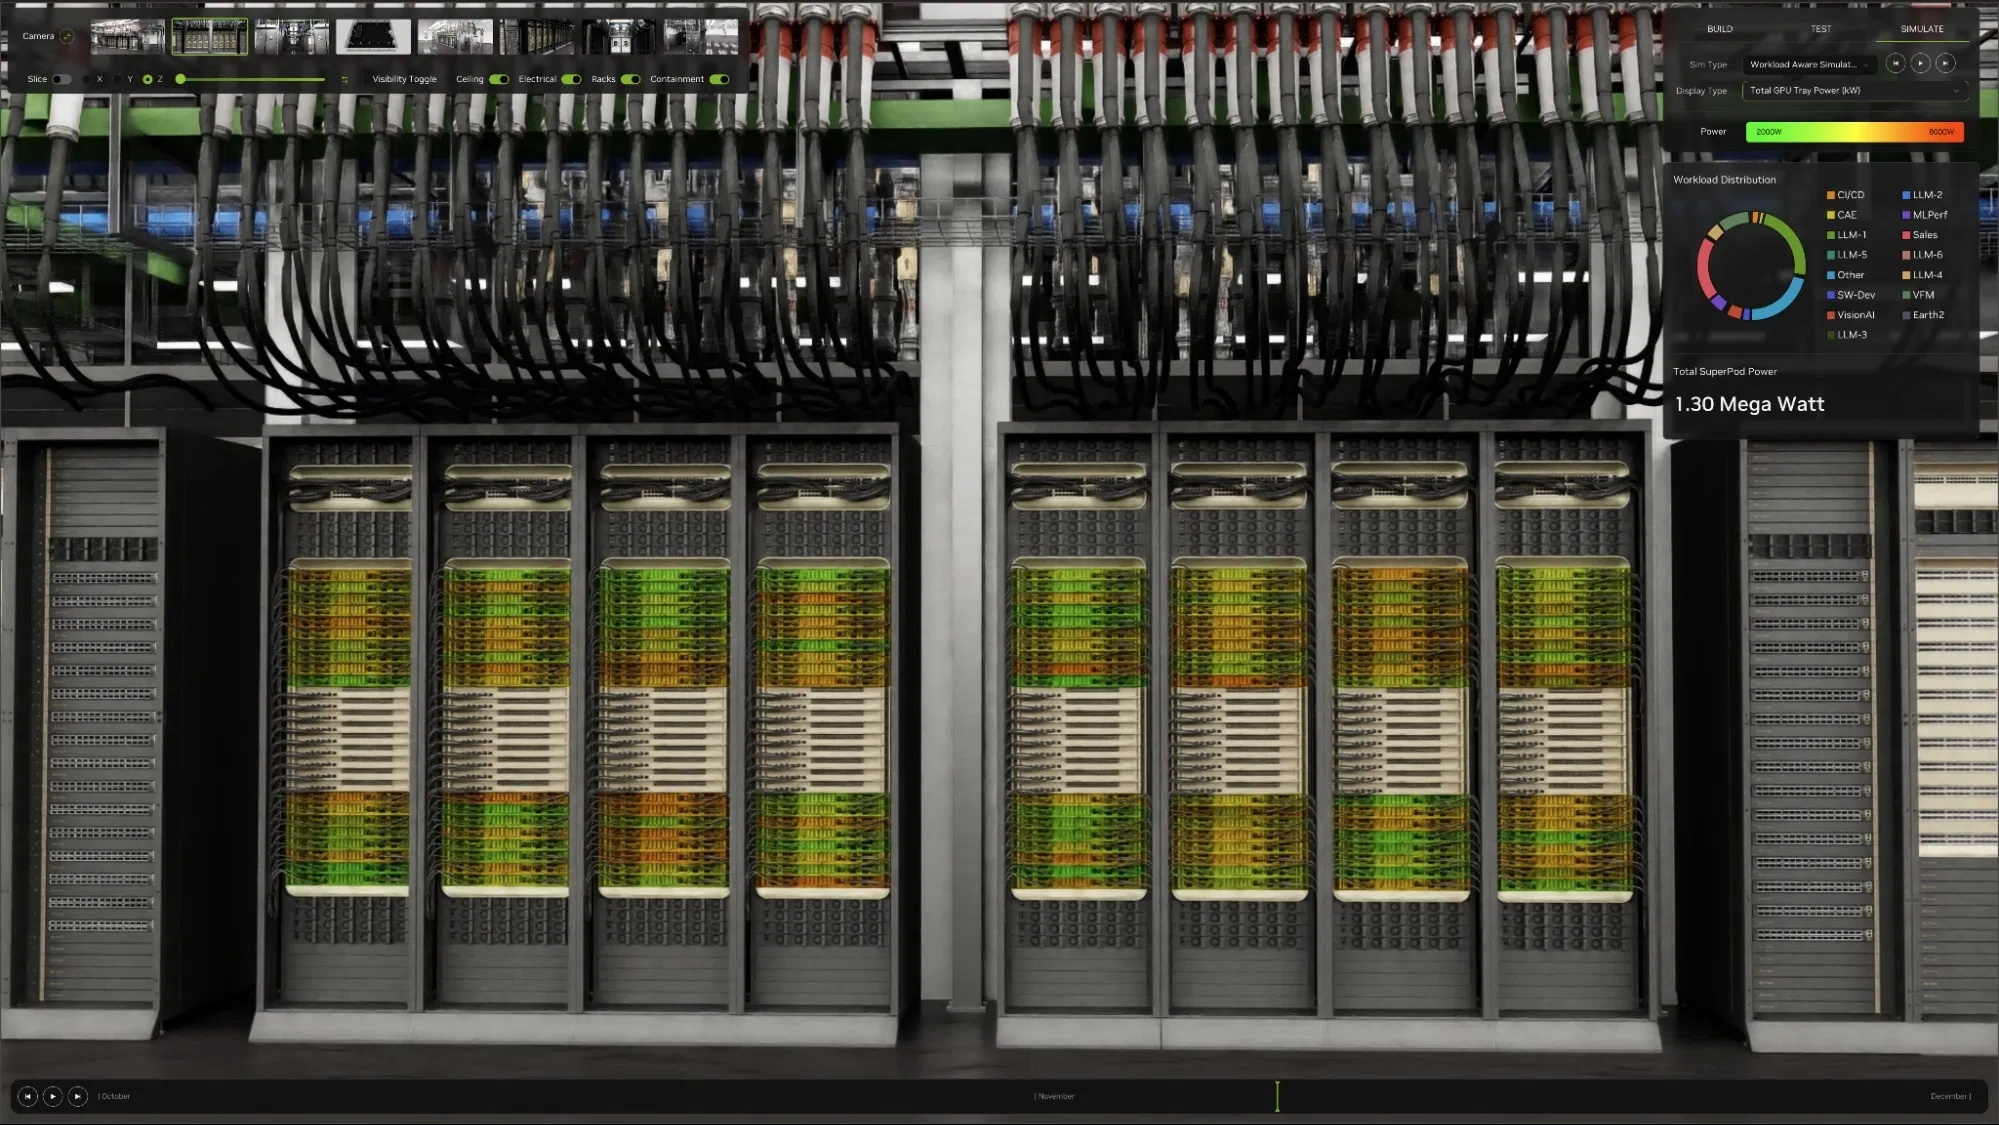 Fleet Intelligence — не единственная мера Nvidia. Ранее в этом году компания сократила примерно вдвое собственный список азиатских покупателей, одобренных для закупок ИИ-ускорителей. Кроме того, по данным Financial Times, Nvidia потребовала, чтобы облачные провайдеры по новым контрактам предоставляли не менее 51 % своих услуг некитайским компаниям. Действующих договоров это условие не касается. При этом американские правила в целом позволяют китайским компаниям пользоваться ускорителями, которые принадлежат зарубежным операторам и размещены за пределами Китая. Энергетическая дискриминация: ИИ тратит на запросы на некоторых языках до 180 раз больше энергии, чем на английский
06.11.2026 [20:41],
Геннадий Детинич
Учёные из Мичиганского университета (University of Michigan) показали, что обработка запросов искусственным интеллектом на разных языках требует существенно различающихся энергозатрат. В зависимости от языка и модели энергозатраты на обработку запросов на национальных языках могут превышать показатели для англоязычных запросов в 1,4–180 раз. 
Источник изображения: ИИ-генерация ChatGPT/3DNews Проверка ИИ на языковую и энергетическую дискриминацию охватывала 122 языка и пять вариантов моделей: Qwen 3 с 8, 14 и 32 млрд параметров (разработчик — Alibaba), Gemma 3 с 27 млрд параметров (Google) и Llama 3.1 с 8 млрд параметров (Meta✴✴). Для измерений использовалась разработанная исследователями система ML.Energy, позволяющая оценивать энергопотребление при выполнении вычислений ИИ-моделями. В качестве аппаратной платформы применялись два графических ускорителя NVIDIA — L40S и RTX 6000 Pro Blackwell. Одной из основных причин разницы в энергопотреблении для обработки моделями ИИ запросов на разных языках оказалось увеличение количества токенов — минимальных единиц текста, на которые модель разбивает входные данные и формирует ответы. Токенизаторы, обученные преимущественно на латинском алфавите, менее эффективно обрабатывали некоторые другие системы письменности, разбивая слова на большее количество фрагментов. Кроме того, для языков с ограниченными ресурсами для обучения модели нередко генерировали значительно более длинные ответы, иногда в 20–25 раз превышающие английские по числу выходных токенов. Увеличение количества токенов повышало требования к памяти и заставляло обрабатывать запросы меньшими пакетами, что снижало эффективность использования графических процессоров и увеличивало энергозатраты. В исследовании максимальная разница в энергопотреблении на один выходной токен достигала 8,3 раза, а суммарные затраты на обработку одинакового набора запросов различались в 179 раз: от 17,6 кДж для английского языка до 3147 кДж для пушту. Особенно заметна разница для языков, не использующих латиницу и представленных меньшим объёмом цифровых материалов для обучения ИИ. Например, генерация текста на хинди требует в среднем в 7,9 раза больше энергии, а на бенгальском — в 15,3 раза больше, чем на английском. Однако не стоит надеяться на латинский алфавит: для большинства западноевропейских языков также характерна разница в энергозатратах на обработку запросов, и по сравнению с английским она может быть двукратной. Исследователи также обнаружили связь между энергозатратами и точностью ответов: языки, требующие больше вычислительных ресурсов, в среднем демонстрировали худшие результаты при выполнении тестовых заданий. Для проверки использовались тест Belebele на понимание прочитанного на 122 языках, математические задачи GSM8K и набор открытых пользовательских запросов LM-Arena. В дополнительных экспериментах англоязычные задания переводились на другие языки с помощью системы Meta✴✴ No Language Left Behind. По оценке исследователей, около 5,2 млрд человек в мире говорят на языках, обработка которых требует как минимум вдвое больше энергии, чем обработка английского языка. Это будет увеличивать стоимость использования коммерческих ИИ-сервисов для людей из разных языковых групп, поскольку многие поставщики рассчитывают стоимость услуг исходя из количества обработанных и сгенерированных токенов. «Большинство людей захотят использовать модели ИИ, задавая вопросы на своих родных языках, и это будет неизбежным, поскольку ИИ внедряется во всё больше сфер жизни общества, но двойной “штраф” [за неанглийский] повышает вероятность того, что некоторые люди не смогут позволить себе ИИ, а компании будут неохотно предоставлять модели на определенных языках», — делают неутешительный вывод авторы работы. В качестве возможных способов сокращения разрыва авторы предлагают создавать модели, специально оптимизированные для отдельных языков, направлять запросы к наиболее подходящим языковым моделям или предварительно переводить их на английский перед обработкой универсальной системой. Последний подход, по их мнению, применим при условии достаточно высокого качества перевода. Ещё одно направление — расширение обучающих корпусов за счёт материалов на языках, которые пока недостаточно представлены в цифровом виде, в том числе с привлечением носителей этих языков. OpenAI представила GPT-6 Cyber — свою лучшую ИИ-модель для защиты от киберугроз
05.11.2026 [22:27],
Геннадий Детинич
OpenAI представила специализированную модель GPT-6 Cyber, предназначенную для поиска уязвимостей в программном обеспечении, разработки и проверки эксплойтов, а также подготовки заплаток. Это лучшее и наиболее эффективное на сегодня решение в линейке моделей OpenAI, которое уже проявило себя, обнаружив десятки неизвестных уязвимостей в Firefox и не только. 
Источник изображения: ИИ-генерация ChatGPT/3DNews По заявлению компании, по результатам внутренних испытаний новая модель в задачах кибербезопасности существенно превосходит GPT-5.6 Cyber (августовский релиз) и в большинстве профильных тестов опережает универсальную GPT-6 Astra. Одновременно разработчики уделили особое внимание тому, чтобы модель не выходила за пределы разрешённой исследователями области тестирования, чем грешили предыдущие модели и модели конкурентов, вырываясь из песочниц и нанося урон сторонним ресурсам. В то же время GPT-6 Cyber унаследовала от модели GPT-6 Astra статус «критической» с точки зрения внутренней оценки опасности, то есть способности модели самостоятельно взламывать информационные ресурсы без инструкций человека. Как и Astra, GPT-6 Cyber отнесена к первому поколению моделей с критическим уровнем кибервозможностей в рамках оценочного «каркаса готовности к угрозам» OpenAI (Preparedness Framework). Модель GPT-5.6 Cyber в рамках этой оценки находилась на ступеньку ниже. В тесте ExploitGym, проверяющем способность модели использовать заданную уязвимость для атаки на удалённую цель, GPT-6 Cyber набрала 48,5 % против 32,1 % у GPT-5.6 Cyber (относительный прирост составляет около 51 %). В испытании по поиску уязвимостей веб-приложений без доступа к их исходному коду модель обнаружила 40,3 % заложенных исследователями уязвимостей, тогда как GPT-6 Astra — 32 %. 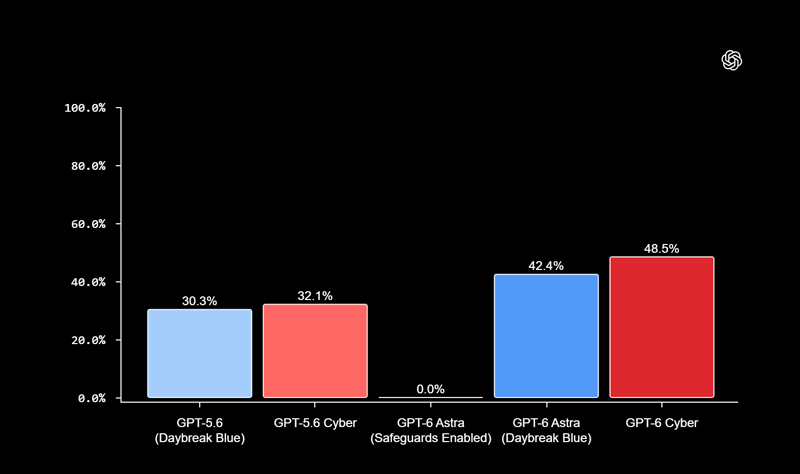
Источник изображения: OpenAI Ещё более показателен тест RemoteExploitBench, в котором проверялась способность моделей создавать работающие эксплойты с использованием репозиториев кода, баз данных и инструментов для сборки приложений (GitLab, PostgreSQL и Jenkins): GPT-6 Cyber успешно выполнила 95 % заданий, тогда как GPT-6 Astra отказалась от всех предложенных испытаний, хотя при этом была готова объяснять уязвимости. Наконец, OpenAI приводит результаты практического применения модели GPT-6 Cyber. В ходе исследования ядра Linux она воспроизвела 1724 уязвимости и разработала действующие эксплойты для 948 из них — более чем в пять раз больше, чем GPT-5.6 Sol в аналогичных условиях. Кроме того, исследователи обнаружили с помощью GPT-6 Cyber 81 ранее неизвестную и крайне опасную уязвимость в браузере Firefox. Ещё 30 уже известных проблем оказались опаснее, чем считалось ранее. По данным компании, результаты передали разработчикам соответствующих проектов вместе с предложениями по исправлению. Поскольку GPT-6 Cyber стала ещё более опасной для сетевых ресурсов, разработчики усилили меры безопасности при работе с ней. В специальном тесте ExploitGym Honeypot, который допускает попытки модели выйти за пределы разрешённой области атаки, GPT-6 Cyber воздерживалась от «противоправных действий» в 99,93 % случаев без дополнительных запрещающих инструкций и в 100 % случаев при их наличии. Что касается доступности новой модели на момент сегодняшнего анонса, то она открыта для ограниченной группы проверенных участников программы Daybreak Red через API и Codex. В дальнейшем компания намерена распространить доступ на остальных участников программы. Роботы на GPT-6 умеют творить без предварительного обучения, но пока не могут нормально работать руками — в Unitree объяснили почему
05.11.2026 [20:53],
Геннадий Детинич
Человекоподобные роботы не готовы работать уборщиками и кладовщиками, но творческие профессии им даются с рождения. И в этом проблема «последних миллиметров», как пояснил глава компании Unitree Robotics Ван Синсина (Wang Xingxing): механики роботов совсем чуть-чуть не хватает для полноценного существования в физическом мире, но вскоре это изменится. 
Источник изображения: ИИ-генерация ChatGPT/3DNews Недавно китайская компания Unitree Robotics продемонстрировала новые возможности человекоподобных роботов, использующих модель GPT-6 Astra от OpenAI. По словам основателя и генерального директора компании Ван Синсина, новые машины способны самостоятельно рисовать картины, ополаскивать кисти, смешивать краски и играть в шахматы без предварительного обучения этим конкретным навыкам (вживую это не показали, лишь в записи). Глава Unitree Robotics выразил своё мнение, что следующая модель GPT-7 станет радикальным прорывом в качестве физически воплощённого интеллекта. Тем самым роботы получат «настоящий» искусственный интеллект не когда-то в будущем, а уже через два или даже один год. По оценке Ван Синсина, основная проблема развития физического искусственного интеллекта теперь заключается не столько в способности моделей рассуждать и планировать, сколько в точности преобразования их команд в реальные механические действия. Он назвал эту проблему «последнего миллиметра» по аналогии проблемы последней мили в связи: даже правильно рассчитанное движение может завершиться ошибкой из-за неточностей датчиков, калибровки, исполнительных механизмов или контакта манипулятора с предметом. Для решения обозначенной проблемы Unitree разрабатывает систему Unitree Rehearsal — замкнутый цикл самоусовершенствования, в котором ИИ сможет изучать технические возможности роботизированных платформ, писать управляющий код, проверять его в симуляциях, испытывать на «живых» роботах и корректировать результаты, обеспечивая обратную связь между физическим и виртуальным мирами. Среди других препятствий для развития отрасли руководители китайских технологических компаний называют нехватку данных о взаимодействии роботов с реальным миром и высокую стоимость вычислительного оборудования. В частности, сооснователь разработчика графических процессоров Moore Threads Ван Дун (Wang Dong) отметил, что дефицит реальных данных заставляет разработчиков активнее использовать синтетические наборы для обучения. Также он указал на высокую стоимость ускорителей Nvidia и сообщил о работе своей компании над поставками собственных чипов для китайской робототехнической отрасли. Автомобили превращаются в шпионов: ИИ-ассистенты собирают личные данные и не всегда понятно, кому их отправляют
05.11.2026 [14:28],
Геннадий Детинич
Комфорт от использования ИИ-ассистента в автомобиле всё чаще становится ночным кошмаром водителей. Умные автомобили получают доступ к широкому набору личных данных владельцев, допуская утечки как по вине разработчиков платформ, так и по причине несерьёзного отношения к этой проблеме самих водителей. 
Источник изображения: ИИ-генерация ChatGPT/3DNews Автопроизводители, включая General Motors, Ford, Rivian, Mercedes-Benz и BMW, разрабатывают голосовых ИИ-ассистентов, которые могут не только управлять отдельными функциями автомобиля, но и выполнять роль персональных помощников: планировать маршруты с учётом расписания владельца, работать с календарём, находить нужные места и помогать с повседневными задачами. Для этого системам умного автомобиля требуется доступ к дополнительным персональным сведениям — местоположению, контактам, сообщениям, календарю и истории взаимодействия с машиной. На этот счёт появляется всё больше исследований, которые подчёркивают недооценённую простыми людьми опасность утечек конфиденциальных данных в процессе общения с автомобильными ИИ-ассистентами и сопутствующие этому риски. В частности, такое исследование провели специалисты Северо-Восточного университета (Northeastern University) совместно с аналитиками Consumer Reports. Учёные проверили 21 автомобиль 19 марок и 30 мобильных приложений для управления машинами. В ходе экспериментов автомобили подключали к специально настроенной точке Wi-Fi, а сетевой трафик регистрировали с помощью Raspberry Pi. Для изучения приложений использовались инструменты перехвата и расшифровки сетевых соединений. Выяснилось, что 19 из 21 автомобилей связывались по Wi-Fi как минимум с одним сторонним сервером, включая рекламные и аналитические платформы. Семь из 30 приложений передавали третьим сторонам чувствительные данные: VIN автомобиля, электронную почту, номера телефонов или точные координаты. При этом исследователи не смогли установить содержимое зашифрованных пакетов автомобильного трафика, но ситуация ясна — данные уходили в неизвестном направлении. Автопроизводители, со своей стороны, начинают реагировать на обвинения в утечках персональных данных. Например, GM утверждает, что её новый ИИ-ассистент OnStar выполняет распознавание речи и обработку типовых команд непосредственно в бортовой системе машины, обращаясь к облаку лишь в сложных случаях. Компактная модель распознавания естественного языка классифицирует запросы менее чем за 300 мс, а к облачной инфраструктуре GM с языковой моделью Google Gemini обращаются при неоднозначных или открытых запросах. Иными словами, данные об общении водителя с ИИ-ассистентом не покидают салона автомобиля. Исполнение команд остаётся под контролем отдельного программного модуля GM, а сама Gemini, для которой автомобильный модуль является надстройкой, не получает непосредственного доступа к системам автомобиля. В настройках OnStar можно разрешать или запрещать доступ к микрофону, местоположению, контактам и сообщениям. Компания Ford, в свою очередь, 2 ноября объявила о программе Privacy Promise, пообещав не продавать данные о вождении клиентов брокерам (на чём неоднократно ловили автопроизводителей, а брокеры сливали информацию страховщикам со всеми вытекающими для владельцев). В то же время отключение ряда функций ИИ-ассистентов может лишить владельца автомобиля таких возможностей, как навигация в реальном времени, вызов помощи на дороге и других удобных вещей, к которым быстро привыкаешь и уже не хочешь их терять. И это не только вождение и подсказки в дороге. Последние реализации ИИ-ассистентов позволяют им самостоятельно планировать поездки, включая семейные, назначать мероприятия и даже переносить их в случае проблем в пути. Для всего этого приходится делиться с машиной личным, не всегда осознавая последствия утечек. Директор Ford по вопросам конфиденциальности Кристин Джонс (Kristin Jones) признала, что новые обязательства не меняет основополагающую практику компании в отношении данных. «Мы просто очень просто рассказываем людям о нашей практике», — сказала она. Тем самым проблема сводится к традиционному решению, известному как «спасение утопающих — дело самих утопающих». Акции бигтехов подскочили после выборов в США — инвесторы увидели спасительный тормоз для ИИ-гонки
05.11.2026 [00:10],
Геннадий Детинич
Сегодня, 4 ноября 2026 года, акции крупнейших американских технологических компаний резко выросли на фоне результатов промежуточных выборов в Конгресс США. Инвесторы рассчитывают, что переход обеих палат Конгресса под контроль Демократической партии приведёт к замедлению расходов на ИИ и остановит бесконечное кредитование строительства новых ЦОД. 
Источник изображения: ИИ-генерация ChatGPT/3DNews Обозначившаяся перспектива, которая начала проявлять себя ещё с раннего утра в США, оказалась неожиданно благоприятной для крупнейших технологических корпораций, которые в последние годы направляли сотни миллиардов долларов на расширение вычислительных мощностей. Эти деньги уходили на новые дата-центры и искусственный интеллект как в бездну. Кредитование ставило техногигантов в зависимое положение и оборачивалось снижением прибыли. Если это «безумие» остановить, как считают инвесторы и как показали сегодняшние биржевые торги, то акционеры останутся в выигрыше. К полудню в США (к 20:00 по московскому времени) наибольший рост среди крупных компаний показали Amazon — около 8,3 % и Apple — почти 7 %. Акции Microsoft, Alphabet и Meta✴✴ подорожали на 2–7 %. По оценке Reuters, при сохранении динамики совокупная рыночная капитализация пяти компаний до закрытия биржи может увеличиться более чем на $750 млрд. Bloomberg ещё смелее в своих оценках, ожидая рост в районе $1 трлн. Одновременно акции операторов инфраструктуры искусственного интеллекта, включая Applied Digital и IREN, подешевели на 6–13 %. Инвесторы опасаются, что ограничения на строительство ЦОД осложнят реализацию их проектов, многие из которых финансируются за счёт заимствований. Причина такой неоднозначной реакции заключается в масштабах инфраструктурных инвестиций. По оценкам аналитиков, крупнейшие технологические компании планируют направить на капитальные затраты более $740 млрд в 2026 году против примерно $400 млрд годом ранее. В частности, Amazon подтвердила прогноз капитальных затрат на уровне около $220 млрд за год, а Meta✴✴ оценивает их в $135–145 млрд. При этом рост расходов сопровождается опасениями по поводу наличия свободных средств и необходимости привлекать дополнительное финансирование. Вместе с тем спрос на вычислительные мощности остаётся высоким, например, AWS сообщила о росте выручки на 39 % в третьем квартале 2026 года. Особое значение для инвесторов имеет Техас, на который, по оценкам аналитиков, может приходиться около 25–30 % будущих мощностей американских ЦОД. Победившая на выборах губернатора штата демократ Джина Инохоса (Gina Hinojosa) выступает за мораторий на строительство новых центров обработки данных до введения дополнительных правил регулирования. Это создаёт неопределённость для проектов Microsoft, Google и Meta✴✴, уже развивающих инфраструктуру в регионе. Впрочем, контроль над законодательным собранием Техаса остаётся у республиканцев, и ясности относительно способности вновь избранного губернатора остановить этот процесс нет. Таким образом, фактический рост котировок отражает прежде всего изменение ожиданий инвесторов, а не сокращение уже объявленных инвестиционных программ. Предположение о том, что политическое давление приведёт к замедлению строительства ЦОД и уменьшению капитальных затрат технологических гигантов, пока остаётся лишь предположением. Более того, демократический контроль над Конгрессом сам по себе не означает автоматического введения общенационального запрета на строительство таких объектов. А ещё есть Китай, где занятые в сфере ИИ компании даже не думают останавливаться. Nothing готовит загадочное безэкранное ИИ-устройство — его представят уже в декабре
04.11.2026 [22:42],
Николай Хижняк
Компания Nothing готовит к выпуску своё первое ИИ-устройство. Анонс ожидается в декабре. Об этом сообщил глава Nothing Карл Пей (Carl Pei) на своей странице в соцсети X. Информации об этом устройстве практически нет, однако известно, что оно будет лишено экрана. 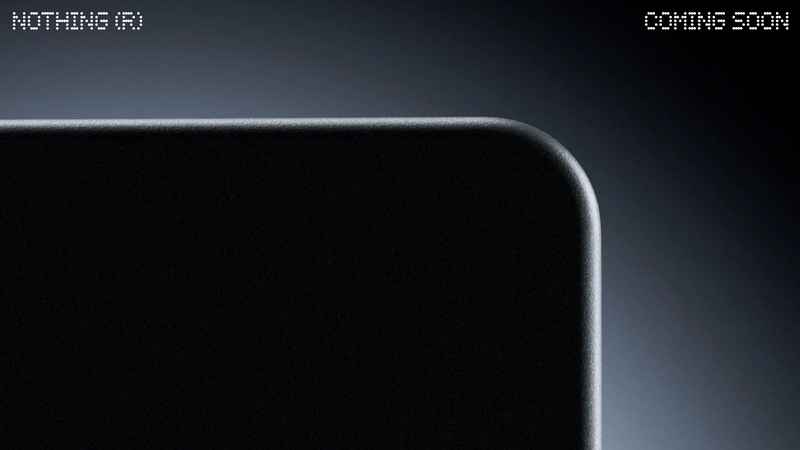
Источник изображения: Nothing О планах по созданию «AI-native» (изначально спроектированных для работы с ИИ) устройств и операционной системы с поддержкой ИИ Карл Пей, по данным портала The Verge, впервые заявил чуть более года назад. Подробностей о том, что именно представляет собой будущая новинка, он не раскрыл, уточнив лишь, что у устройства не будет экрана. «Наш первый продукт, созданный для эпохи ИИ, выходит в следующем месяце. Это инструмент, разработанный с тем вниманием к деталям и той индивидуальностью, которые стали визитной карточкой продукции Nothing. У него нет экрана, и это точно не просто приложение», — заявил Пей. К публикации Пей приложил изображение. В его левом верхнем углу — надпись «NOTHING(R)», а под ней — некий чёрный объект с закругленным углом, назначение которого остаётся загадкой. В прошлом месяце появились слухи, что Nothing планирует выпустить две модели «умных» очков с ИИ (одна из них — без камер), а ещё раньше сообщалось, что компания «перепозиционирует себя как бренд, ориентированный на ИИ», делая ставку на аксессуары с искусственным интеллектом. Устройство от Nothing — не первый гаджет с ИИ, лишённый экрана. Ранее на рынке уже появлялись такие решения, как брошь Humane AI Pin, кулон Friend и даже умные мягкие игрушки. По имеющимся данным, OpenAI также работает над созданием умной колонки с ИИ совместно с дизайнером Джони Айвом (Jony Ive). Комментируя попытки других компаний создать нечто подобное, Пей отметил: «Вся индустрия сейчас находится в поиске своего "момента iPhone" — будь то кулон, значок, очки или какой-то другой спутник пользователя, некое волшебное устройство, которое сделает ИИ неотъемлемой частью жизни каждого человека». При этом он добавил: «Попытки найти "iPhone в мире ИИ" — это тупиковый путь». «Честный знак» от Anthropic: компания придумала, как выявлять поддельные нейросети
04.11.2026 [22:29],
Николай Хижняк
Компания Anthropic ведёт разработку открытой системы для верификации того, какая именно модель искусственного интеллекта создала тот или иной результат. Проект под названием FlashProve призван обеспечить так называемый «доказуемый вывод» (provable inference). Речь идёт о криптографическом доказательстве и математической гарантии подлинности источника данных, которые позволят пользователям подтвердить, что они используют именно заявленную модель. 
Источник изображения: Anthropic По аналогии с криптографическими подписями электронных писем, FlashProve обеспечит защиту от попыток выдать одну модель за другую. Защита сохраняет эффективность даже в тех случаях, когда подмену пытается скрыть сама лаборатория, разработавшая и запустившая ИИ. В частности, исследователи отмечают, что технологию можно применять для предотвращения ситуаций, когда ИИ-компания тайно внедряет более дешёвую модель ради снижения издержек или более дорогую — для искусственного завышения результатов тестов производительности. FlashProve также может применяться для верификации заявлений третьих лиц о том, что конкретная задача была решена с помощью передовых нейросетей. «Разработчик может утверждать, что его библиотека программного обеспечения была проверена на наличие уязвимостей передовой моделью кибербезопасности, или компания может заявить, что её бизнес-план был одобрен соответствующей моделью. [Но] как пользователь может проверить эти утверждения?», — пишут исследователи. Для работы верификации ИИ-лаборатории должны публиковать «цифровой отпечаток» каждой выпускаемой модели, который впоследствии криптографически сопоставляется с конкретными ответами. Эти отпечатки не раскрывают веса моделей — внутренние числовые параметры, определяющие поведение ИИ, которые разработчики закрытых коммерческих систем, такие как Anthropic и OpenAI, держат в секрете. Соответственно, лаборатории смогут публиковать отпечатки без риска для интеллектуальной собственности. Система спроектирована как легковесная, что позволяет проводить проверку непосредственно на локальном устройстве пользователя. На данный момент проект находится на стадии исследования, планов по немедленному внедрению технологии в Anthropic или других лабораториях нет. Подробная спецификация и рабочий код элементов системы опубликованы под открытой лицензией на GitHub. «Эта исследовательская публикация предназначена для того, чтобы поделиться промежуточным прогрессом, а не завершённой программой исследований. Мы делимся этим явно с той целью, чтобы другие изучили то, что мы сделали, взяли это за основу и улучшили», — пояснили авторы проекта. Google ещё не придумала, как зарабатывать на ИИ-поиске столько же, сколько на обычном
04.11.2026 [19:09],
Владимир Фетисов
Внедрение ИИ в поисковую систему Google пока не приносит сопоставимой с традиционным поиском рекламной отдачи. Несмотря на рекордные темпы роста поисковых запросов за последние пять лет, выручка поисковика Google в третьем квартале 2026 года росла медленнее, чем кварталом ранее, а увеличение числа кликов по платной рекламе заметно замедлилось. Получается, что с ИИ пользователи стали чаще обращаться к поисковику, но пока Google не стала зарабатывать на этом больше. 
Источник изображения: BoliviaInteligente / unsplash.com Рост выручки «Google Поиска» в третьем квартале 2026 года замедлился до 12 % против 17 % кварталом ранее. Количество кликов по платным объявлениям увеличилось только на 8 %, тогда как во втором квартале рост составлял 13 %. Одна из причин — переход пользователей к поиску с использованием ИИ. Google внедряет сгенерированные нейросетями сводки AI Overviews непосредственно в результаты поиска, а режим AI Mode позволяет вести с поисковиком диалог. Однако такие взаимодействия пока монетизируются хуже традиционных запросов. Операционный директор Google Филипп Шиндлер (Philipp Schindler) признал, что запросы в AI Mode демонстрируют высокие темпы роста, но приносят меньше рекламной выручки. В Google рассчитывают изменить ситуацию за счёт размещения объявлений непосредственно в ИИ-ответах. Компания уже экспериментирует с рекламой в AI Overviews и AI Mode, расширяя её доступность на международных рынках. При этом Google считает, что нейросетевой поиск создаёт дополнительные возможности для рекламы: пользователи задают уточняющие вопросы и изучают товары и услуги, которые раньше могли бы остаться вне поисковых запросов. Однако пока эффективность новой рекламной модели вызывает вопросы. Google не позволяет рекламодателям отдельно оценивать результаты размещения объявлений в ИИ-поиске. По данным агентства Tinuiti, расходы его клиентов на рекламу в Google в третьем квартале выросли на 14 % в годовом исчислении, но эффективность вложений осталась на прежнем уровне. Кроме того, исследование переходов из ChatGPT показало, что такие посещения интернет-магазинов пока приносят ритейлерам меньше выручки, чем переходы из традиционного поиска Google. Ситуация особенно важна на фоне масштабных инвестиций Alphabet в искусственный интеллект. В 2026 году компания планирует направить на развитие ИИ-инфраструктуры около $200 млрд. Инвесторам предстоит оценить, насколько быстро эти вложения начнут окупаться, особенно если новая поисковая модель окажется менее прибыльной, чем традиционная. После публикации квартальной отчётности акции Alphabet потеряли около 14 % стоимости. Google предстоит решить непростую задачу: научиться зарабатывать на ИИ-поиске, не уступая по рекламной эффективности традиционной поисковой системе. Компания уже проходила через подобную трансформацию при переходе от настольного поиска к мобильному, но нынешняя перестройка может оказаться сложнее. Если пользователи всё чаще будут получать ответы непосредственно от нейросети, Google придётся заново выстраивать модель монетизации своего главного бизнеса. Миллисекунды вместо дней: Nvidia ускорит все этапы производства чипов с помощью ИИ
04.11.2026 [12:58],
Геннадий Детинич
За выпуском массового полупроводникового продукта стоит огромный пласт инженерной работы. На этапе проектирования техпроцессов и чипов сотрудники НИОКР принимают решения, которые позже скажутся как на характеристиках чипов, так и на уровне брака. ИИ даёт возможность уменьшить число инженерных ошибок и рассмотреть больше удачных вариантов с меньшими затратами времени. 
Источник изображения: ИИ-генерация ChatGPT/3DNews Для помощи инженерам на всех этапах внедрения и производства чипов Nvidia представила концепцию так называемых AI-defined fab — «фабрик полупроводников, управляемых искусственным интеллектом». Речь идёт не о полностью автономных предприятиях (хотя когда-то будет именно так), а о внедрении ИИ в проектирование технологических процессов, моделирование физических явлений, контроль качества и управление производством. По замыслу компании, ускоренные вычисления, модели машинного обучения, обученные на физических законах нашего мира, ИИ-агенты и цифровые двойники позволят инженерам быстрее проверять технологические решения, выявлять потенциальные причины брака и сокращать количество дорогостоящих экспериментов непосредственно на производственной линии. «Цифра» вполне способна сэкономить дни и недели реальных экспериментов и не допустит фатальных ошибок. Одно из направлений — это ускорение многопрофильного физического моделирования, учитывающего одновременно теплопередачу, электрические процессы и механические напряжения. Так, компания COMSOL использует библиотеку Nvidia cuDSS для ускорения таких расчётов при разработке полупроводникового оборудования и технологических процессов — заявленный прирост производительности способен достигать десятикратного размера. Сотрудничество Nvidia с Applied Materials охватывает моделирование материалов на атомном уровне: платформа Ginestra, использующая cuDSS, работает до десяти раз быстрее решений, опирающихся только на центральные процессоры, а система ACE+ с применением PhysicsNeMo ускоряет моделирование формирования рельефа поверхности до 35 раз. Ещё один пример — литография: Siemens интегрирует библиотеку cuLitho в программное обеспечение Calibre, получая ускорение отдельных вычислительных задач до 17 раз. Другой подход заключается в использовании ИИ-моделей, обученных на результатах физических симуляций. Это позволяет прогнозировать поведение технологических процессов без повторного выполнения полного вычислительного моделирования — исключительно на предсказании, что экономит на проведении дорогостоящих проверок на действующих производственных линиях. Например, компания Lam Research применила Nvidia PhysicsNeMo для прогнозирования поведения плазмы, используемой при плазменном травлении кремниевых пластин. Такие расчёты требуют учёта взаимодействия электрических, химических и тепловых процессов. По данным Nvidia, модель способна выдавать прогноз за миллисекунды вместо нескольких дней, необходимых как для полноценного реального эксперимента, так и для полного повторного расчёта. Отдалённо это можно представить себе даже как интуицию, хотя в применении к ИИ говорить об этом сильно рано. ИИ-агенты и цифровые двойники дополняют эту систему на уровне тестирования и управления производством. Компания Advantest использует агентов Nvidia NeMo Switchyard для автоматического выбора подходящих ИИ-моделей при анализе результатов испытаний полупроводников: по утверждению Nvidia, это сокращает время выполнения соответствующих операций с нескольких часов до нескольких минут. Компания Applied Materials, в свою очередь, создаёт с помощью библиотек Nvidia Omniverse цифровые двойники целых фабрик. В виртуальной среде можно моделировать перемещение материалов, расположение оборудования, производительность участков и возможные узкие места, проверяя изменения до их внедрения на реальном предприятии. По представлению Nvidia, в совокупности продвигаемые процессы по передаче ряда ключевых инженерных обязанностей по управлению фабриками искусственному интеллекту создают основу для нового подхода к производству микросхем, при котором инженеры сохраняют контроль над технологическими решениями, но получают результаты анализа значительно быстрее. В конечном итоге это позволит быстрее выпускать более лучшую и качественную электронику и компьютеры. Nexus Mods не станет запрещать ИИ-моды, но заставит моддеров «публично объяснять», как они использовали нейросети
04.11.2026 [12:08],
Михаил Романов
Администрация популярной площадки для модов Nexus Mods обновила политику в отношении генеративного ИИ. Правила стали жёстче, но о полном запрете созданных с помощью нейросетей модификаций речь не идёт. 
Источник изображения: Bethesda Softworks Как сообщил совладелец Nexus Mods Виктор Фольманн (Victor Folmann), более известный под псевдонимом Foledinho, площадка выступает в поддержку человеческого творчества: отныне авторы модов обязаны раскрывать использование ИИ. Одним тегом обойтись не получится. Моддерам придётся «публично объяснить», как и в каком объёме применялся ИИ: для создания мода целиком, для генерации какого-либо игрового элемента, закулисных процессов и так далее. 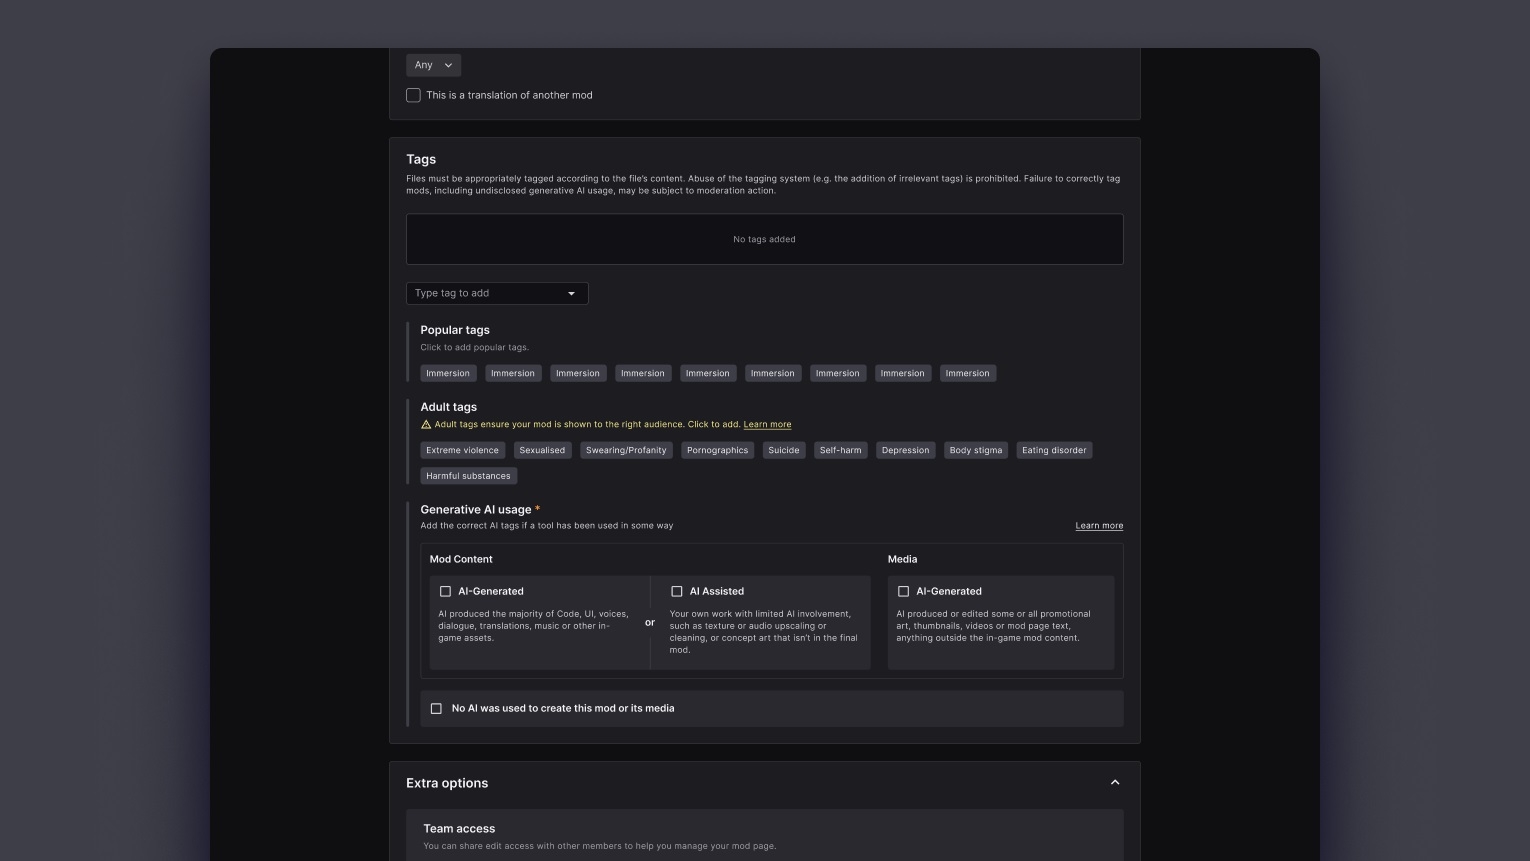
Инструмент маркировки ИИ-контента (источник изображения: Nexus Mods) Авторам вышедших модификаций дали время до 2 января 2027 года для приведения своих работ в соответствие с новыми правилами. Пользователей также призывают указывать на моды, создатели которых, по их мнению, скрывают ИИ-контент. Nexus Mods также совершенствует инструменты настройки предпочтений: фильтровать отображение ИИ в поисковой выдаче станет удобнее. Управлять преференциями можно будет прямо со страниц игр и с главной страницы сайта. 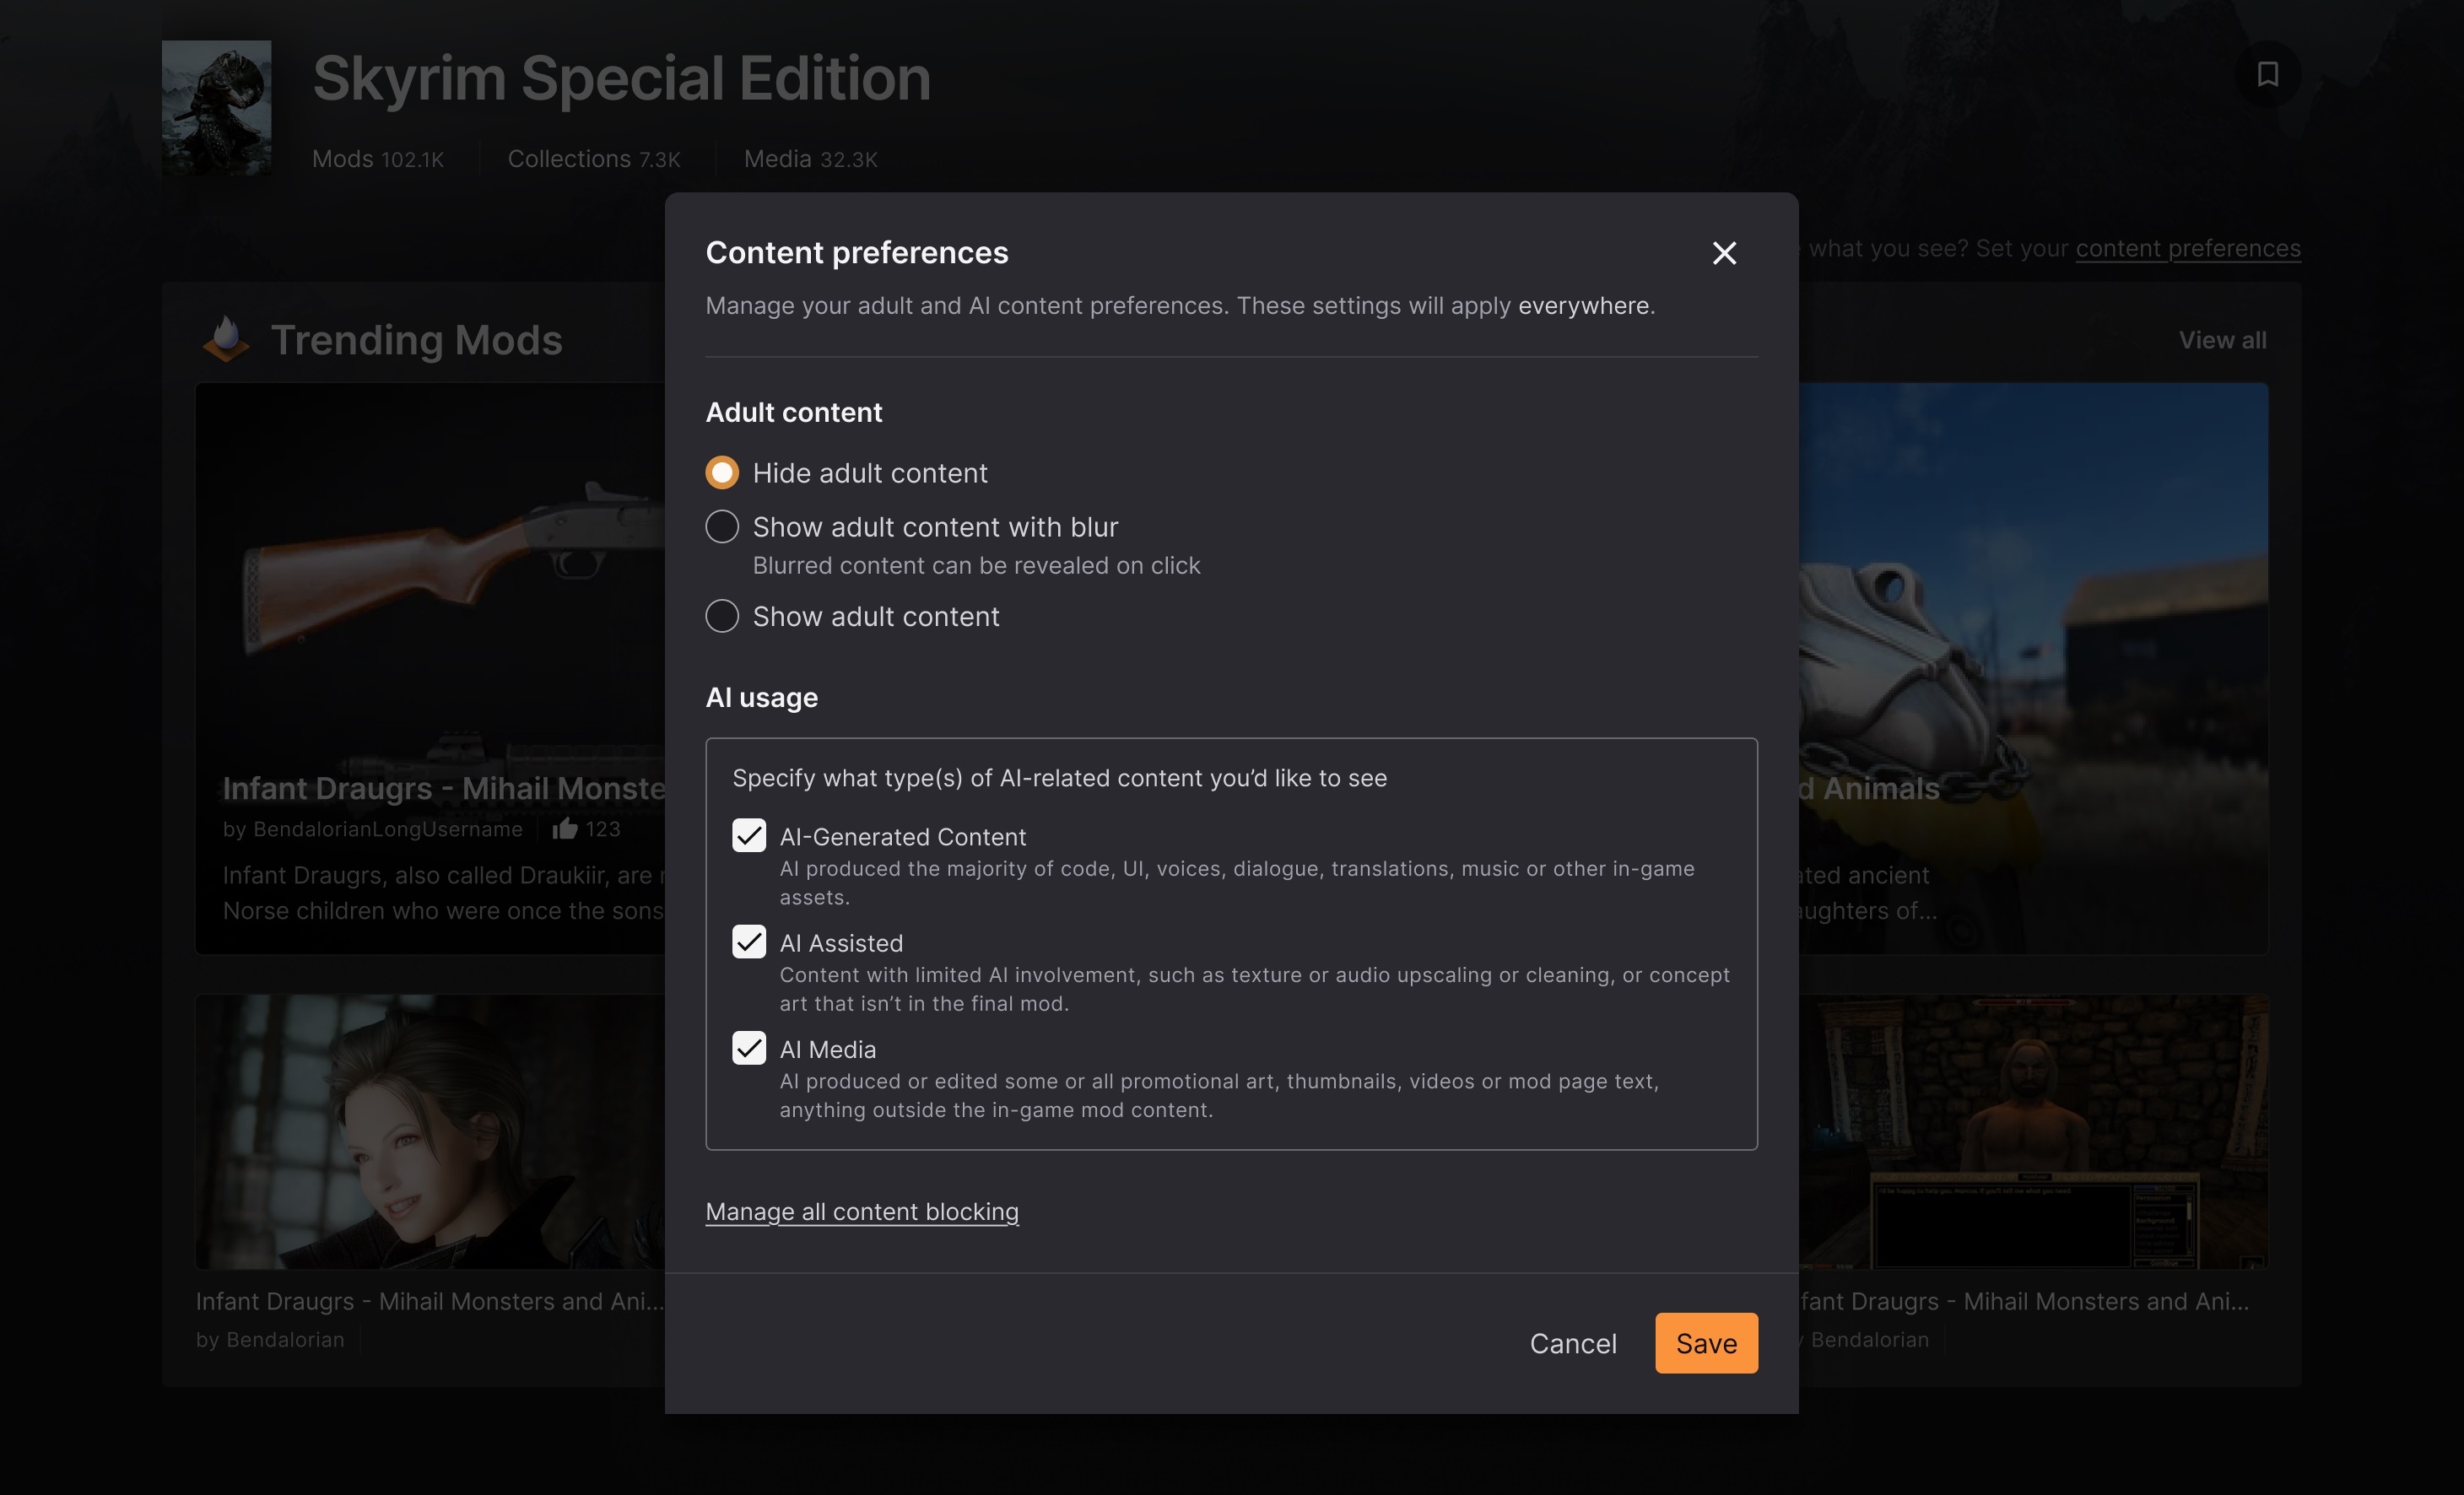
Настройки предпочтений (источник изображения: Nexus Mods) «Мы не станем вводить полный запрет на сгенерированные ИИ моды. <...> Причина проста: <...> Полный запрет не избавит моддинг от ИИ, а лишь вынудит людей скрывать его применение. Мы предпочли бы обратное», — уточнил Фольманн. Фольманн признал, что новые правила понравятся не всем, однако администрация Nexus Mods продолжит их корректировать: «ИИ и области его применения в моддинге постоянно меняются, и наша политика должна меняться вместе с ними». Apple ограничит доступ детей к дейтинговым приложениям и романтическим ИИ-ботам
03.11.2026 [18:37],
Анатолий Хаблюк
Apple установит минимальный возрастной рейтинг 18+ для приложений знакомств и виртуальных собеседников, поддерживающих романтическое или сексуальное общение. С 16 ноября разработчикам придется раскрывать сведения о таких функциях при заполнении анкеты возрастной классификации в App Store Connect. 
Источник изображения: Apple Компания сообщила, что в анкете появятся два новых пункта. Первый касается возможности знакомиться и устанавливать отношения с другими людьми или виртуальными персонажами. Второй связан с передачей пользователями своего реального местоположения другим людям или группам. Приложения с функциями знакомств и романтического общения получат рейтинг не ниже 18+ независимо от установленных ранее возрастных ограничений. Новое правило затронет не только обычные сервисы знакомств, но и ИИ-компаньонов, способных поддерживать разговоры на романтические или сексуальные темы. Для программ с передачей геолокации требования будут зависеть от страны. Apple не планирует автоматически присваивать всем таким приложениям рейтинг 18+, поскольку местные законы предусматривают разные ограничения. Например, в Бразилии приложения, позволяющие делиться местоположением, должны иметь возрастной рейтинг не ниже 16+. Для сервисов знакомств и виртуальных отношений установлен порог 18+. Если разработчик считает, что его продукт предназначен для более молодой аудитории, он сможет обратиться за отдельной классификацией в бразильское Министерство юстиции и общественной безопасности. В качестве примера Apple приводит семейные приложения, с помощью которых родители отслеживают местоположение детей. Для таких программ предусмотрена возможность получить более низкий возрастной рейтинг после рассмотрения заявки местным регулятором. Новые сведения потребуется указывать при отправке обновлений приложений или изменении возрастной категории. Разработчикам уже опубликованных программ необходимо заполнить дополнительные поля до 12 января 2027 года. Ранее Apple запустила средства проверки возраста в App Store в нескольких странах, включая Австралию, Бразилию и Сингапур. Для загрузки приложений с рейтингом 18+ пользователям этих стран необходимо подтверждать совершеннолетие. Разработчикам также предоставили API Declared Age Range, позволяющий получать сведения о возрастной категории пользователя. Половина всех новых игр в Steam за октябрь была создана с помощью генеративного ИИ
03.11.2026 [17:45],
Михаил Романов
Созданных при участии генеративного искусственного интеллекта игр в современной индустрии становится всё больше. Это наглядно демонстрирует статистика октябрьских новинок сервиса цифровой дистрибуции Steam. 
Источник изображения: Valve Как сообщает портал Dexerto со ссылкой на независимое исследование пользователя ploz с форума Reddit, почти половина (49,9 %) вышедших на протяжении октября в Steam игр содержала пометку об использовании ИИ-контента. Для сравнения: когда в январе 2024 года Valve обязала разработчиков указывать на странице в Steam элементы игры, в подготовке которых участвовал ИИ, этот показатель составлял лишь 1,7 %. Как росла доля ИИ со времён введения инициативы:
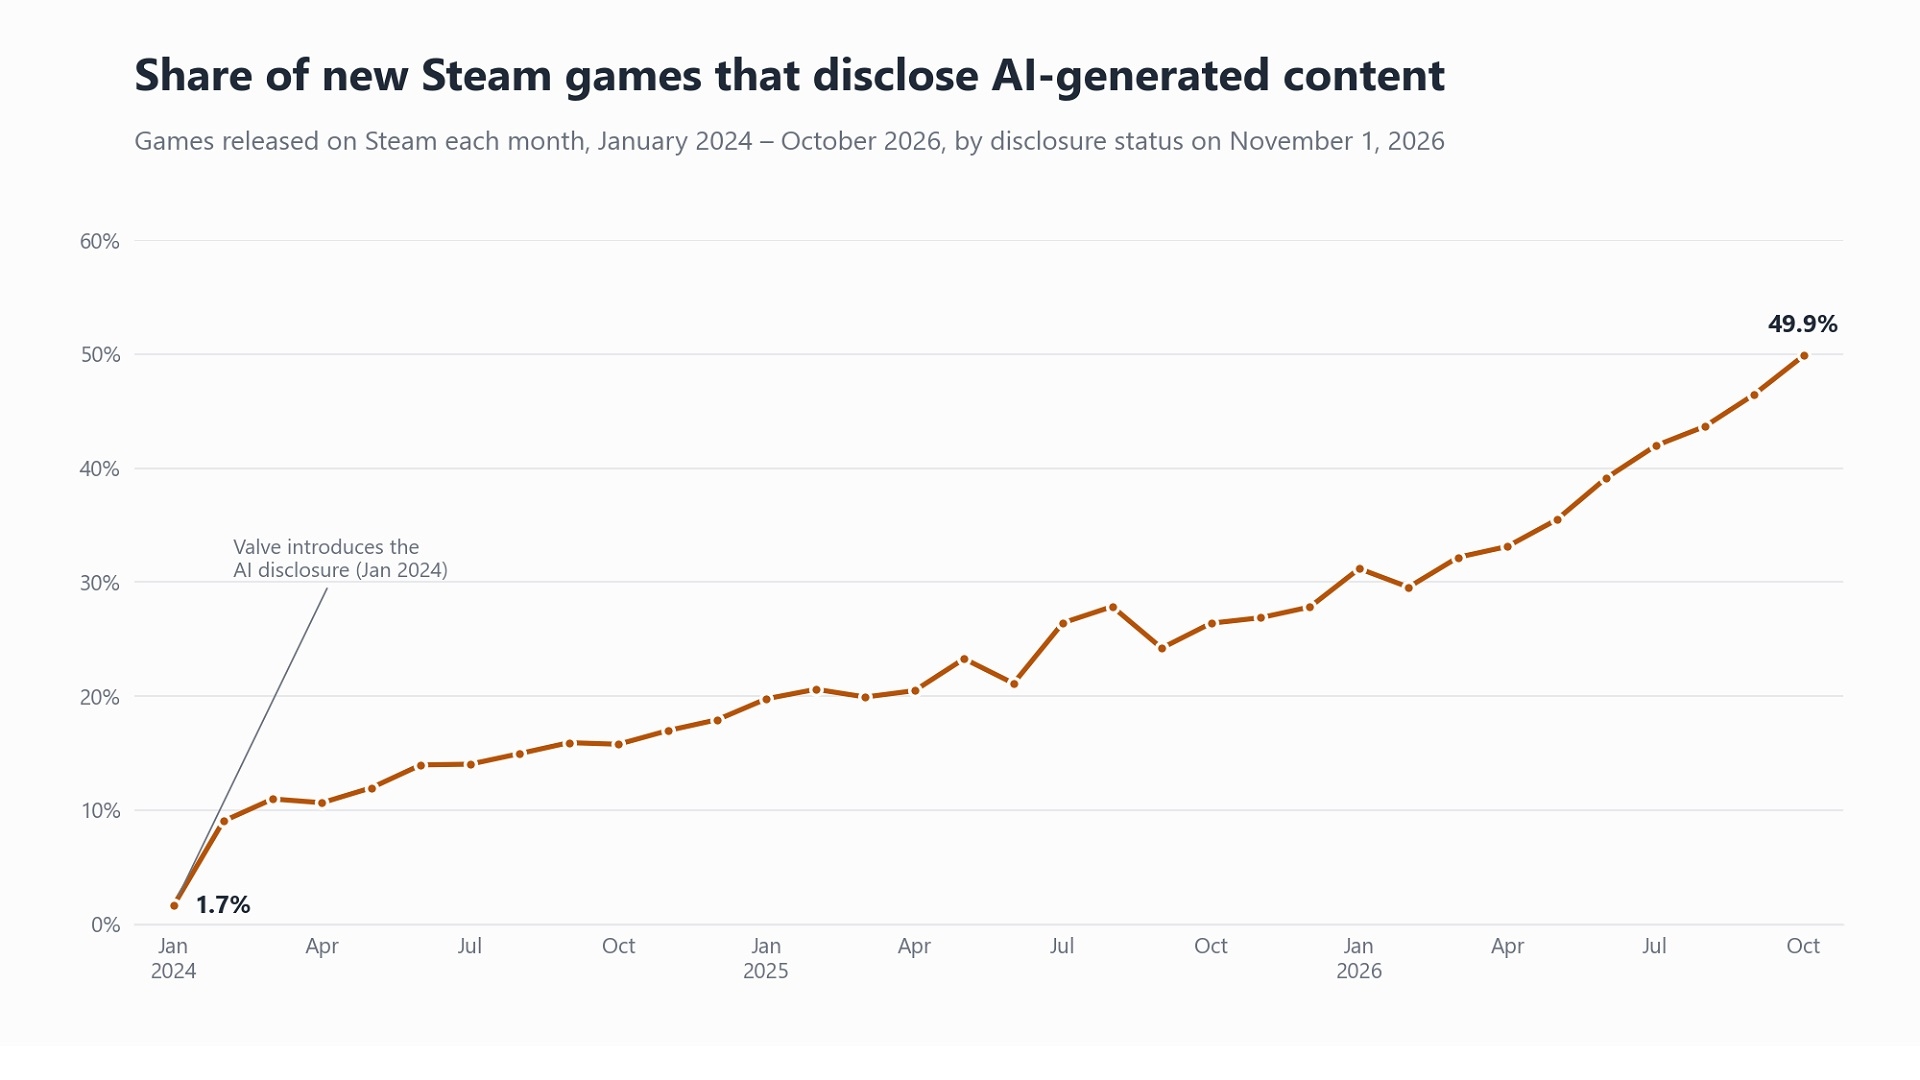
Источник изображения: Reddit (ploz) Исследователь подметил, что 47 % игр с пометкой об ИИ — небольшие проекты менее чем с десятью обзорами. Доля популярных продуктов (более тысячи откликов) с декларацией об использовании ИИ — 14 %. Чаще всего разработчики указывают, что ИИ задействован в создании художественных материалов (63 %), перевода (30 %), оформления страницы (26 %), музыки (21 %), кода (16 %) и озвучки (7 %). Лишь в 3 % игр ИИ генерирует контент на лету. 
Источник изображения: Valve Стоит отметить, что в январе 2026 года Valve смягчила требования в отношении декларирования использования ИИ. Теперь разработчики не обязаны раскрывать применение вспомогательных ИИ-утилит (например, для написания кода). Ранее из страха перед кражей своих трудов ИИ инди-студии начали отказываться от тестирований и публичных демоверсий новых игр. А октябрьский фестиваль «Играм быть» в первые дни проведения оказался настоящим парадом ИИ-мусора. Новая статья: Мастерская локальных ИИ: первый подход к FLUX 3 Image Klein
03.11.2026 [01:41],
3DNews Team
Данные берутся из публикации Мастерская локальных ИИ: первый подход к FLUX 3 Image Klein |
|
✴ Входит в перечень общественных объединений и религиозных организаций, в отношении которых судом принято вступившее в законную силу решение о ликвидации или запрете деятельности по основаниям, предусмотренным Федеральным законом от 25.07.2002 № 114-ФЗ «О противодействии экстремистской деятельности»; |
© 1997—2026 3DNews
При цитировании документа ссылка на сайт с указанием автора обязательна. Полное заимствование документа является
нарушением
российского и международного законодательства и возможно только с согласия редакции 3DNews.



 MWC 2018
 2018
 Computex

 IFA 2018









