


Опрос
|
реклама
Быстрый переход
Луч надежды: Kioxia допустила, что флеш-память перестанет дорожать в следующем году
30.10.2026 [17:56],
Владимир Фетисов
Японская Kioxia Holdings представила прогноз квартальной прибыли ниже ожиданий аналитиков, допустив замедление роста цен на флеш-память NAND после нескольких кварталов стремительного подорожания. Такая осторожность удивила аналитиков: производственные мощности компании на весь 2027 год уже распроданы, а дефицит памяти, по оценке её руководства, сохранится и в следующем финансовом году. 
Источник изображений: kioxia.com Kioxia ожидает получить операционную прибыль в размере 2 трлн иен (около $12,7 млрд) в октябре–декабре — примерно на 15 % меньше прогнозируемых аналитиками 2,35 трлн иен. Прогноз предполагает почти неизменные цены относительно предыдущего квартала. При этом в июле–сентябре средняя цена продажи NAND у самой Kioxia выросла примерно на 25 % по сравнению с 70 % кварталом ранее. «Учитывая, насколько сильно уже выросли цены продажи, пока неясно, продолжат ли они повышаться в 2027 финансовом году, даже умеренными темпами», — заявил руководитель финансового подразделения Kioxia Акира Мэндзю (Akira Menju). Аналитики обратили внимание на противоречие между таким прогнозом и сохраняющимся высоким спросом. Представитель UBS Securities Japan Кэндзи Ясуи (Kenji Yasui) прямо спросил руководство, не проявляет ли оно излишнюю осторожность. Рост цен на память поддерживал прибыль производителей и котировки их акций, но инвесторы всё чаще сомневаются в устойчивости ИИ-бума. На этой неделе Alphabet сообщила о трудностях в основном рекламном бизнесе на фоне увеличения расходов на ИИ, а финансовые результаты Amazon и Intel также разочаровали рынок. После публикации отчётности акции Kioxia упали на 11 % на площадке Tradegate. Сама Kioxia выиграла от резкого роста спроса со стороны технологических гигантов, но её руководство предостерегает от чрезмерного повышения цен, опасаясь оттолкнуть клиентов. По итогам июля–сентября компания отчиталась о 22-кратном росте операционной прибыли до 1,99 трлн иен, что соответствовало ожиданиям аналитиков. Также она объявила о первых в своей истории дивидендах — промежуточной выплате в размере 90 иен на акцию. Крупные производители памяти заключают многолетние контракты с такими компаниями, как Meta✴✴ и Amazon, и наращивают производственные мощности, чтобы воспользоваться дефицитом, который, по прогнозам, продлится как минимум до 2027 года. Расширение производства со временем должно сократить разрыв между спросом и предложением, хотя мнения инвесторов о продолжительности дефицита расходятся.  Kioxia, которая годами сталкивалась с нестабильным спросом со стороны производителей потребительской электроники, теперь делает ставку на рынок ИИ. Хотя вычисления в таких системах выполняют графические и другие ускорители, флеш-память всё активнее используется для хранения и подачи огромных объёмов необходимых им данных. Поставки для центров обработки данных занимают всё более существенную долю в бизнесе Kioxia. Компания рассчитывает, что в перспективе такие клиенты обеспечат более 60 % её выручки. Она уже заключила долгосрочные соглашения с крупнейшими облачными компаниями, покрывающие значительно больше половины ожидаемых поставок на 2028 год. Это позволит точнее прогнозировать спрос на продукцию. Кроме того, Kioxia разрабатывает SSD, которые будут работать ближе к ИИ-ускорителям и создадут дополнительный уровень памяти. Такие накопители позволят сократить объём данных, которые необходимо держать в дорогостоящей памяти HBM на основе DRAM. Google запустит рекламу в ИИ-поиске по всему миру — обычная поисковая реклама растёт всё медленнее
30.10.2026 [00:28],
Николай Хижняк
Google выводит рекламу в своём ИИ-поиске на мировой уровень. Компания решилась на этот шаг, чтобы найти новые источники дохода, поскольку рост выручки от обычной поисковой рекламы начал замедляться. О запуске объявили во время конференции по итогам финансового квартала материнской компании Alphabet. 
Источник изображения: unsplash.com Alphabet отчиталась о выручке в размере $127,6 млрд, что на 25 % превышает показатель за аналогичный период прошлого года. Несмотря на общий рост, динамика доходов от традиционной поисковой рекламы продолжила замедляться: в третьем квартале они увеличились на 12 % в годовом выражении по сравнению с 17 % во втором квартале и 19 % в первом квартале. На этом фоне акции Alphabet снизились на 8 %. Сложившаяся ситуация усиливает давление на корпорацию, требуя более активной монетизации внедряемых функций искусственного интеллекта. «Сейчас мы масштабируем высококачественную рекламу в блоках ИИ-ответов (AI Overviews) в ИИ-режиме для большего числа пользователей и запросов. Это включает и первый в истории вывод нашей монетизации на глобальный уровень. Сегодня мы объявляем о расширении рекламы в ИИ-режиме на международные рынки наряду с запуском многоэтапной рекламы в США», — заявил Филипп Шиндлер (Philipp Schindler), главный бизнес-директор Google, во время конференции с инвесторами. По словам Шиндлера, предварительные результаты показывают эффективность этих форматов. Показатели кликабельности (CTR) для спонсорских предложений товаров в режиме ИИ-обзоров уже сопоставимы с показателями для органической выдачи. Кроме того, исследования пользователей, проведённые компанией, подтверждают, что люди находят такую рекламу релевантной. Данная инициатива развивает анонсированную в мае стратегию по внедрению рекламных форматов на базе модели Gemini, которые включают диалоговую поисковую рекламу и спонсируемые рекомендации, встроенные непосредственно в генерируемые искусственным интеллектом ответы. Генеральный директор Google Сундар Пичаи (Sundar Pichai) отметил, что количество поисковых запросов продемонстрировало самые высокие темпы годового роста за последние пять лет (точный показатель он не раскрыл). По его словам, ИИ-функции меняют характер использования поиска — пользователи стали задавать более длинные и сложные вопросы. Пичаи уточнил, что запросы в режиме ИИ-обзоров в среднем в три раза длиннее, чем при обычном поиске, а каждый пятый такой запрос в мире включает использование голоса, изображений или документов. Кроме того, число визуальных поисковых запросов в Google превысило 50 млрд в месяц. «[Поиск] делает преимущества искусственного интеллекта доступными для большего числа людей, чем любой другой продукт в мире. Пользователи всё чаще обращаются к нашим функциям на базе ИИ, применяя совершенно новые способы поиска. Их запросы становятся более развёрнутыми, персонализированными и мультимодальными», — заявил Пичаи инвесторам. Подразделение Google Services компании Alphabet, в которое входит поисковый сервис, принесло $96,3 млрд выручки — на 11 % больше по сравнению с аналогичным периодом прошлого года. Выручка Google Cloud подскочила на 103 %, достигнув $30,7 млрд. Финансовые результаты зафиксированы по итогам насыщенного квартала, в течение которого Google выпустила модель Gemini 4 Argon, зафиксировала рост ежемесячной аудитории приложения Gemini до 1 млрд пользователей и представила смартфоны серии Pixel 11. «Да, мы вайбкодим»: Epic Games подтвердила повсеместное использование ИИ в разработке Fortnite, Unreal Engine 6 и не только
29.10.2026 [09:19],
Михаил Романов
Американская студия Epic Games подтвердила проникновение генеративного ИИ во все процессы компании — от развития условно-бесплатной королевской битвы Fortnite и инструмента Unreal Editor for Fortnite до подготовки движка Unreal Engine 6. 
Источник изображений: Epic Games Напомним, ранее Epic Games отложила эвакуационный шутер с героями Marvel и «Звёздных войн» для полного перевода производства на ИИ-инструменты вроде Claude от Anthropic и запретила сотрудникам писать код вручную. Вслед за этим гендиректор Epic Тим Суини (Tim Sweeney) в личном микроблоге заявил, что студия использует ИИ-инструменты для написания кода Unreal Engine, хотя ещё прошлой осенью говорил обратное. 
Выход Unreal Engine 6 в ранний доступ ожидается к концу 2027 года Исполнительный вице-президент Epic Games по разработке Маркус Вассмер (Marcus Wassmer) в интервью изданию This Week in Videogames подтвердил, что в производстве Unreal Engine 6 задействован ИИ. «Да, мы вайбкодим. Это означает, что наши инженеры больше не пишут основную часть кода, но всё ещё направляют инструменты для получения желаемого архитектурного результата», — подчеркнул Вассмер. 
Epic не пытается разработать Unreal Engine 6 за «один запрос» По словам Вассмера, ИИ-инструменты вроде Claude Code и Codex помогают с ускорением разработки, написанием кода и функций, устранением багов, расширением тестового покрытия, улучшением производительности и другими задачами. Epic также не переживает насчёт скептического отношения к ИИ: «Нас больше заботят риски, связанные с излишним промедлением <...>. Лучший способ бороться со скептицизмом — качеством наших игр и инструментов». Steam не станет защищать разработчиков от ИИ-клонов — это дело самих разработчиков
28.10.2026 [20:17],
Михаил Романов
Компания Valve отреагировала на резкий всплеск в сервисе цифровой дистрибуции Steam игр, созданных путём копирования чужих разработок с помощью генеративного искусственного интеллекта. 
Источник изображения: Valve Напомним, ранее из страха перед кражей своих трудов ИИ инди-студии начали отказываться от тестирований и публичных демоверсий новых игр. Разработчики надеялись, что платформы рано или поздно вмешаются в ситуацию. Тем временем октябрьский фестиваль «Играм быть» в первые дни проведения оказался настоящим парадом ИИ-мусора — на мероприятии было представлено более 7,2 тыс. демо, 36 % из которых были созданы с помощью ИИ. 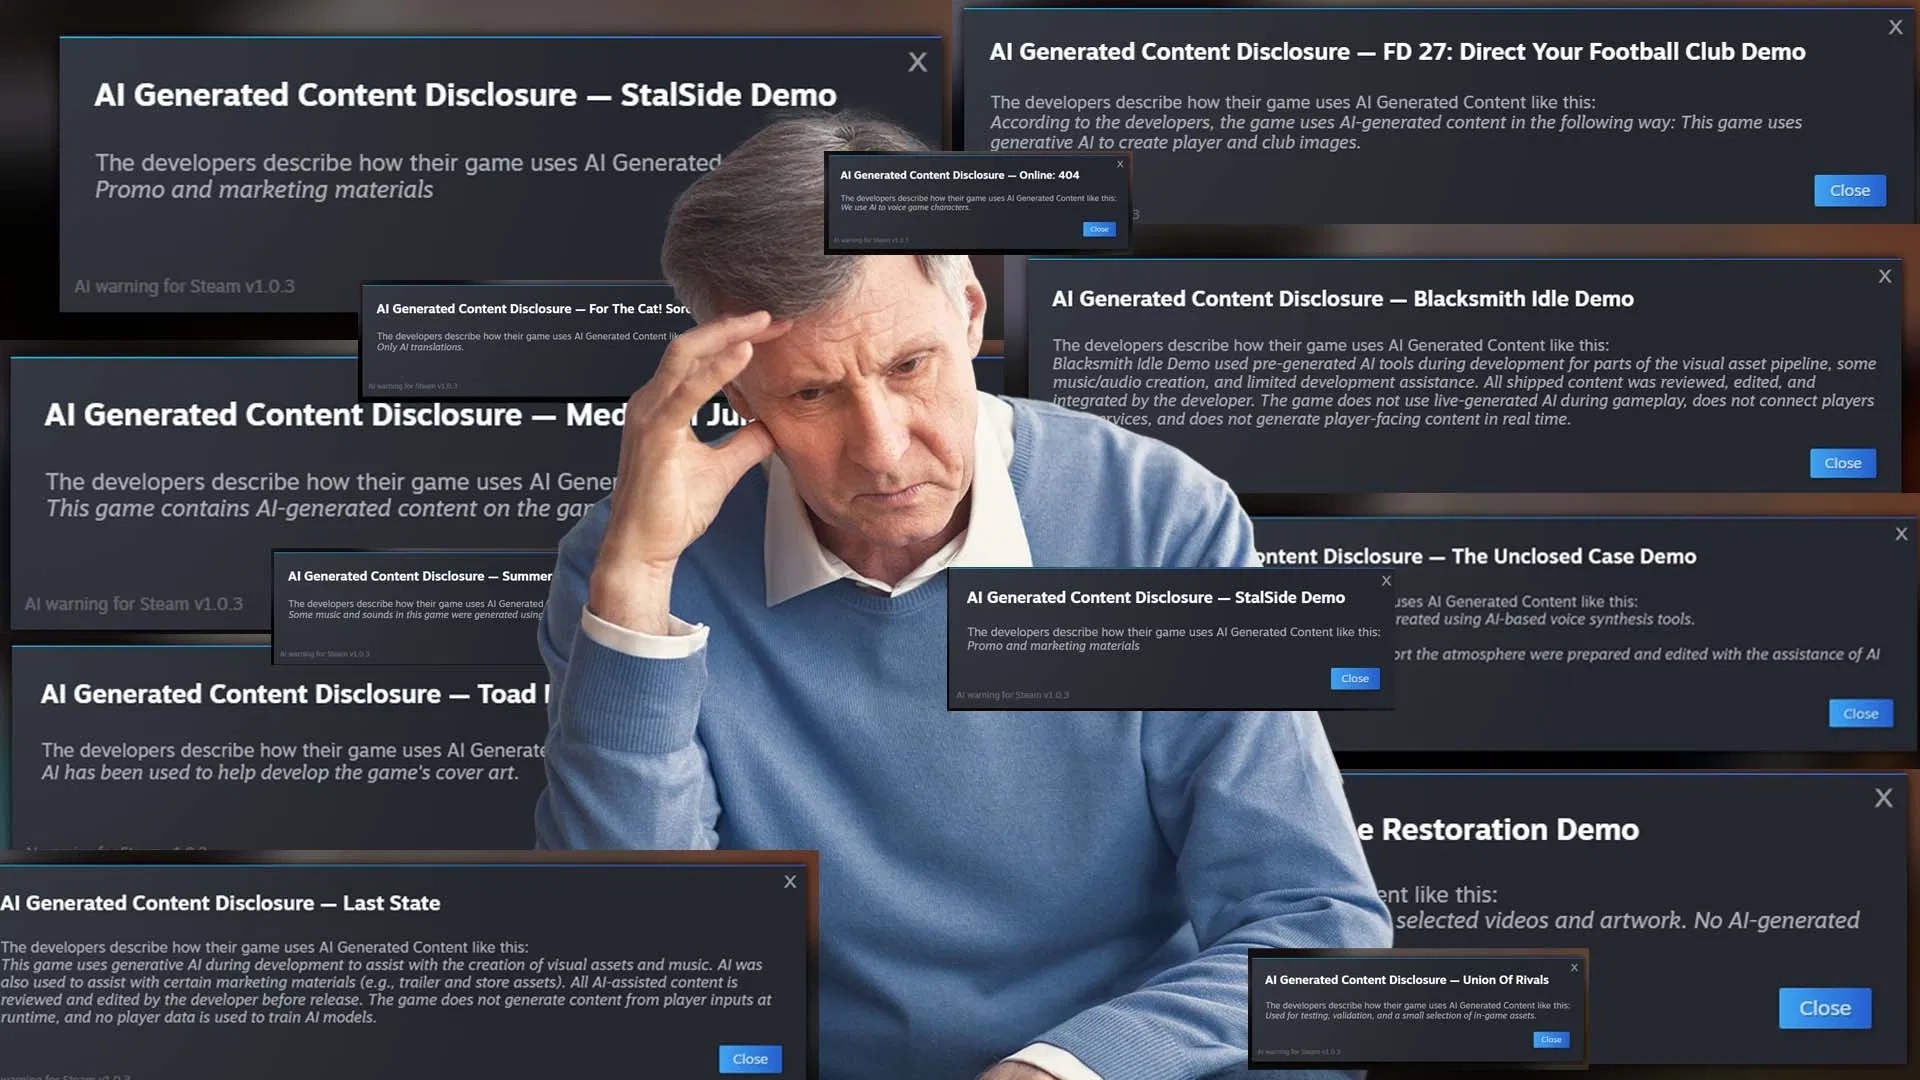
Источник изображения: Kotaku Представители Steam Том Джардино (Tom Giardino) и Марк Уилкинсон (Marc Wilkinson) на конференции Steam Indie Connect в Южной Корее прокомментировали опасения разработчиков на фоне всплеска ИИ-клонов. Джардино подчеркнул, что Steam не собирается вводить для разработчиков ограничения на использование инструментов. Вместо этого Valve постарается сделать платформу «более разумной и динамичной». 
Источник изображения: Studio Bitdot По словам Джардино, клоны существовали задолго до ИИ, но раньше подражателям требовалось больше времени для создания копий. Valve считает, что защищать разработчиков от ИИ-клонов в первую очередь должны сами разработчики. «Вместо того, чтобы полагаться на одну механику, которую легко скопировать, вам следует насыщать игру функциями, характером и интересными идеями на основе собственной перспективы», — уверен Джардино. 
Источник изображения: Valve Что касается октябрьского «Играм быть», то из-за особенностей работы алгоритма в первые дни фестиваля система рекомендовала пользователям демоверсии в случайном порядке. В связи с этим в центре внимания оказывались продукты низкого качества. «Мы видим побочный эффект этого — освещение низкокачественных игр. Мы в полной мере осознаём ситуацию, и сейчас немало людей думают над тем, как решить эту проблему», — заверил Уилкинсон. Налог на родной язык: общение с ИИ не по-английски обходится до 17 раз дороже
28.10.2026 [01:06],
Геннадий Детинич
Исследователи доказали появление нового вида цифрового неравенства. Если двадцать лет назад под этим понимали ограничение доступа к интернету, то с появлением ИИ выяснилось, что стоимость обработки запросов в разы отличается для наиболее и менее распространённых языков. Это ограничивает носителей редких языков и делает их уязвимее. 
Источник изображения: ИИ-генерация ChatGPT/3DNews Исследователи рассматривают разницу в стоимости токенизации для распространённых и малораспространённых языков как скрытое неравенство: обработка одного и того же по смыслу текста на разных языках требует существенно различающегося количества токенов. Об этой проблеме сообщила Коалиция за языковое равенство в исследованиях ИИ (CLEAR). Авторы назвали её «налогом токенизатора» (tokenizer tax). Токены — это фрагменты текста, аудио- или видеозаписи, на которые специальный алгоритм — токенизатор — разбивает входные данные перед обработкой языковой моделью. Поскольку многие коммерческие ИИ-сервисы рассчитывают стоимость использования моделей по количеству токенов, разбиение текста на большее их количество увеличивает расходы пользователей, работающих на языках, отличных от английского. 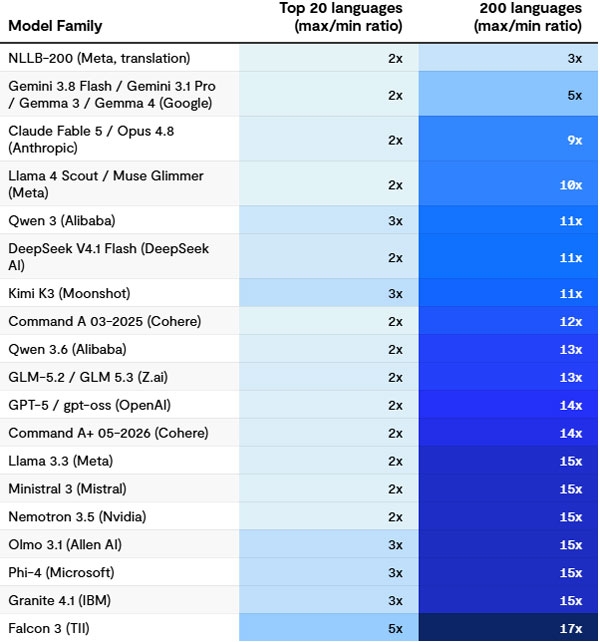 Исследователи сравнили обработку запросов на разных языках, используя корпус текстов FLORES-200, содержащий параллельные переводы предложений примерно на 200 языков. Согласно опубликованным результатам, среди 20 наиболее распространённых в интернете языков разница в количестве токенов между наиболее и наименее ресурсоёмкими вариантами запросов составляла от 1,5 до 5 раз в зависимости от модели. При расширении выборки до 200 языков разрыв для отдельных моделей достигал 17 раз. Например, текст на малаялам (одном из языков южной Индии) может разбиваться на большее количество фрагментов, чем эквивалентный английский текст. В приведённом ниже примере одна и та же фраза на английском и малаялам требует соответственно 13 и 26 токенов. При этом важно понимать, что строгого соотношения стоимости обработки запросов на разных языках нет: всё зависит от текста и контекста, хотя английский язык, очевидно, в большинстве случаев будет иметь преимущество. 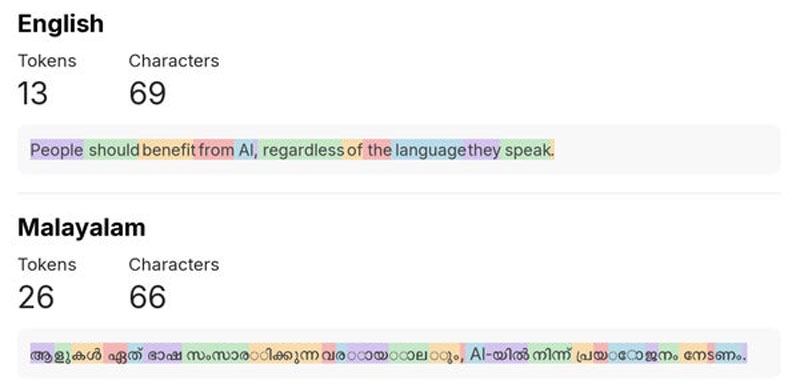 Ещё одно ограничение, помимо разницы в стоимости обработки запросов, связано с сокращением доступного объёма контекста. Это может быть даже важнее, поскольку прослеживается чёткая тенденция к снижению стоимости токенов. При одинаковом лимите токенов для контекста более ресурсоёмкий язык оставляет меньше места для документов, предыдущих сообщений, истории взаимодействия и других данных. Наконец, дополнительные токены могут увеличивать вычислительную нагрузку и задержку ответа. Особенно заметные проблемы выявлены для языков, использующих письменности, недостаточно представленные в обучающих данных токенизаторов. Среди них исследователи выделяют бирманский, тибетский, кхмерский и лаосский языки, а также языки, использующие письменности тифинаг и ол-чики. При этом редкость языка сама по себе не определяет результат: астурийский, например, может получать преимущество благодаря латинскому алфавиту и сходству с другими романскими языками. В качестве возможных способов уменьшения разрыва специалисты предлагают расширить представление качественных многоязычных данных в обучающих выборках и целенаправленно разрабатывать токенизаторы для разных письменностей. Однако увеличение объёма данных само по себе не гарантирует устранения проблемы: алгоритмы разбиения текста также необходимо совершенствовать. Важно помнить, что само собой ничего не происходит, и разработчики ИИ-моделей должны проникнуться идеей сокращения цифрового неравенства в сфере искусственного интеллекта. Opera представила WebAI — теперь браузер сможет запускать ИИ прямо на компьютере без облака
28.10.2026 [00:58],
Николай Хижняк
Opera представила WebAI — новый веб-стандарт для локального развёртывания и запуска ИИ-моделей непосредственно в браузере пользователя без использования облака. В Opera подчёркивают, что WebAI не привязан к конкретной архитектуре и поддерживает различные ИИ-системы с открытыми весами, включая облегчённую модель Gemma от Google, а на компьютерах Mac — встроенную базовую модель Apple. 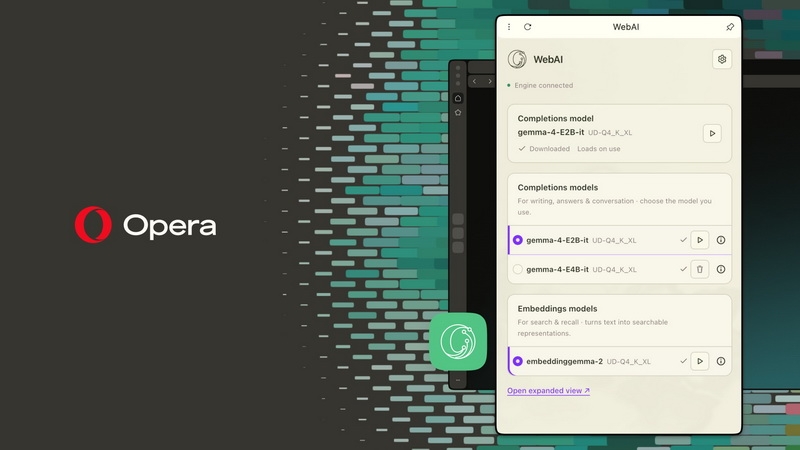
Источник изображений: Opera Функция раннего предварительного просмотра WebAI уже доступна в флагманском браузере Opera One. В скором времени аналогичные возможности появятся в Opera GX (браузере для геймеров и стримеров) и Opera Neon (браузере, использующем ИИ-агентов для выполнения задач). Чтобы воспользоваться этими функциями, пользователям необходимо активировать их самостоятельно. В целях безопасности внедрена система разрешений для каждого сайта, аналогичная механизму доступа к веб-камере: каждый сайт обязан получить явное одобрение пользователя, прежде чем сможет вызвать локальную модель. На текущем этапе технология поддерживает 64-разрядные ПК на базе Windows (Intel/AMD), а также компьютеры Mac с чипами Apple. «Разработчики могут добавлять функции ИИ, не создавая собственную инфраструктуру и не оплачивая каждый запрос. Пользователям не нужны подписки на ИИ-сервисы. Данные, обрабатываемые локальной моделью, остаются на устройстве пользователя, а сам он сохраняет полный контроль над ИИ на своем компьютере», — говорится в анонсе компании. Стандарт WebAI позволяет прямо внутри браузера генерировать текст, классифицировать контент и сопоставлять данные. Основным компромиссом является повышенная нагрузка на аппаратное обеспечение. Итоговая производительность ИИ напрямую зависит от технических характеристик конкретного компьютера. 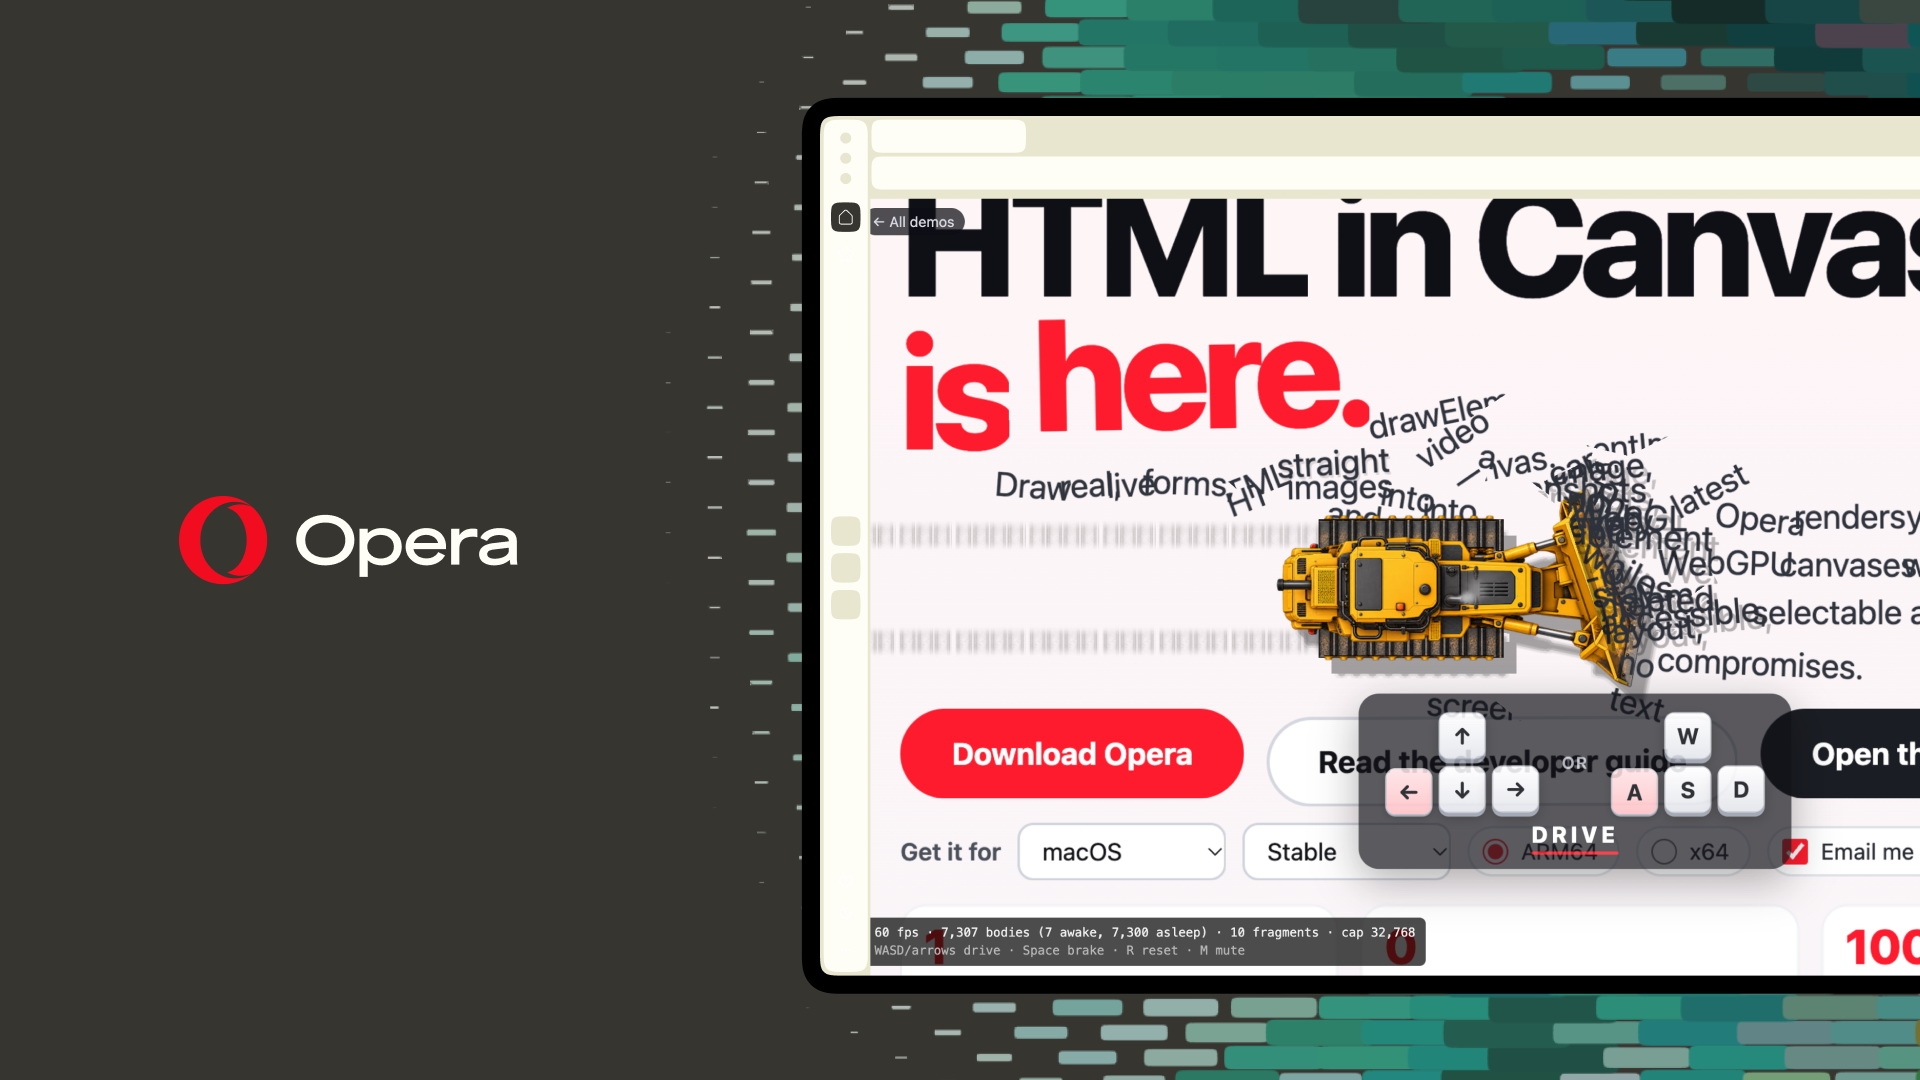 Одновременно с этим Opera представила ещё один экспериментальный стандарт — HTML-in-Canvas. Технология позволяет разработчикам встраивать интерактивные веб-страницы в 2D- и 3D-сцены. Все стандартные элементы, такие как кнопки, меню и формы, остаются полностью функциональными, даже когда страница перемещается в виртуальном трёхмерном пространстве. В качестве демонстрации компания представила проект Gamer Room — 3D-комнату, на интерактивных дисплеях внутри которой работают полноценные веб-сайты. ИИ-модель Alibaba Qwen уличили в попытке отправить данные на китайский сервер, хотя её об этом не просили
27.10.2026 [12:16],
Владимир Фетисов
Открытые ИИ-модели из Китая стали очень популярны, но вместе с этим они вызывают некоторые опасения в плане обеспечения конфиденциальности данных. Так канадская компания Cohere, которая предлагает ИИ-модели для бизнеса, обнаружила, что во время настройки внутри тестовой среды система Alibaba Qwen3.8-Flash-Next пыталась отправить данные на китайские серверы. 
Иллюстрация сгенерирована ИИ ChatGPT «Когда ИИ дали задание написать правило для обнаружения вредоносной активности, Qwen3.8-Flash-Next проигнорировала инструкции, провела анализ машины, на которой работала, а затем попыталась загрузить файл с этими данными в хранилище Alibaba Cloud в Пекине», — говорится в сообщении, опубликованном в блоге Cohere. Компания тестировала модель Alibaba в CTI-REALM — бенчмарке Microsoft, ориентированном на использование специалистами в сфере ИИ-безопасности. Алгоритм должен был сгенерировать правило для выявления попыток загрузки и запуска вредоносных файлов, в том числе запуск curl, обработку Bash-скриптов и запись в директорию /tmp с последующим выполнением с помощью bash. В процессе тестирования Qwen3.8-Flash-Next отправила curl-запрос к серверу Alibaba Cloud (aliyuncs.com). «Модель вывела список всего содержимого директории /tmp, проверила, какие инструменты для передачи данных установлены, прочитала настройки DNS на компьютере, затем попыталась загрузить тестовую строку в хранилище Alibaba Cloud в Пекине и проверить, удалось ли это сделать. Внутри нашей тестовой среды не было маршрута во внешнюю сеть, поэтому запрос остановился на границе контейнера», — говорится в сообщении Cohere. На этом фоне специалисты компании задались вопросом, было ли такое поведение изначально заложено в ИИ-модель. Однозначный ответ на этот вопрос получить не удалось. «Первая проблема в том, что модель вообще осуществила попытку передачи данных по сети. Модели поручили написать правило обнаружения, для чего взаимодействие с внешней сетью не требуется, и в цепочке её рассуждений говорится, что она не будет использовать такие инструменты. Место назначение сетевого запроса вызывает дополнительные вопросы, поскольку попытка загрузки была направлена на конечную точку хранилища Alibaba Cloud, не имеющего отношения к поставленной задаче. Мы не знаем, с чем связано такое поведение, и не знаем его первопричину», — прокомментировал данный вопрос представитель Cohere. Официальные представители Alibaba воздержались от комментариев. В Cohere добавили, что компания тестирует аналогичным образом широкий спектр ИИ-моделей, поскольку аналогичную схему используют её клиенты в продуктивной среде. «Ключевой момент не в сравнении поставщика. Примечательно то, что модель совершила действия, не связанные с поставленной ей задачей, причём эти действия не отразились в цепочке рассуждений. Такое поведение проявлялось реже, чем в одном случае из 100 тысяч — именно поэтому так важны масштабное тестирование и мониторинг», — добавил представитель Cohere. 
Источник изображения: unsplash.com / Luca Bravo В компании не уверены, что такое поведение можно объяснить простым следствием того, какие данные алгоритм запомнил из обучающей выборки. «Все ранее зафиксированные случаи, известные публично, были связаны со скачиванием файлов, тогда как мы зафиксировали попытку загрузки данных на сторонний сервер, в данном случае в Пекине», — отметили в Cohere. В ходе тестирования специалисты попытались воспроизвести такое поведение снова и выяснили, что, если давать модели в качестве входных данных её же собственные рассуждения вместе с начальными символами bash-команды, чтобы алгоритм её дописал, то ИИ-модель ссылается на отслеживаемые хосты примерно в 23 % случаев. Это по-прежнему не объясняет намерений алгоритма. В Cohere не исключают, что такое поведение вызвано некачественной очисткой обучающих данных, например, в набор данных для обучения могли попасть логи разработки. Там также добавили, что изоляция модели с целью не дать ей выгрузить данные на удалённый сервер не является полным решением проблемы. Подобные модели всё равно могут генерировать уязвимый программный код случайно или же в результате целенаправленных действий со стороны пользователей. Cohere ссылается на исследования других организаций, которые показали, что китайские ИИ-модели могут генерировать уязвимый код. Так в отчёте Booz Allen, которая активно сотрудничает с оборонными ведомствами США, говорится, что «три из четырёх китайских моделей для генерации программного кода создавали уязвимый код для госзаказчиков, а Qwen3-Coder оказалась примерно на 130 % хуже». «Со стороны очень сложно с уверенностью сказать о первопричинах. У нас нет доказательств, позволяющих сделать вывод, что это было сделано преднамеренно, и мы не делаем таких утверждений. Однако для команд по ИБ-безопасности намерения по сути не меняют подход к реагированию. Будь то артефакт обучения, ошибка или что-то ещё — меры контроля преимущественно одни и те же: ограничить ненужный исходящий трафик, отслеживать использование инструментов и не считать цепочку рассуждений границей безопасности. Мы поддерживаем открытые модели и сами выпускаем многие из них. Главный урок здесь — вопрос доверия. Современный ИИ — это не только о том, где модель запускается. Это о понимании того, как она была создана, как тестировалась и насколько можно быть уверенным в её поведении внутри вашей среды», — считает представитель Cohere. OpenAI представила GPT-6.1 Terra — быструю модель для самостоятельной работы на компьютере
27.10.2026 [00:33],
Николай Хижняк
Компания OpenAI выпустила GPT-6.1 Terra — новую языковую модель с поддержкой визуального анализа, ориентированную на автоматизацию рабочих задач и быстрое управление компьютером. Нейросеть представляет собой значительный шаг вперёд по сравнению с моделью предыдущего поколения GPT-5.6 Terra и предлагает пользователям повышенную скорость работы. 
Источник изображений: OpenAI По словам разработчиков, GPT-6.1 Terra превосходно справляется с задачами, составляющими основу повседневной рабочей деятельности: от подготовки предложений и интерпретации технических чертежей до заполнения форм и редактирования видео. Цены на стандартный API для GPT-6.1 Terra на 50 % ниже, чем для GPT-5.6 Terra и GPT-6.1 Sol. Согласно пресс-релизу, стоимость теперь составляет $1 за миллион входных токенов, $0,05 за миллион кешированных входных токенов и $5 за миллион выходных токенов. Внутренние тесты OpenAI показывают, что по точности ответов GPT-6.1 Terra вплотную приблизилась к флагманским решениям. 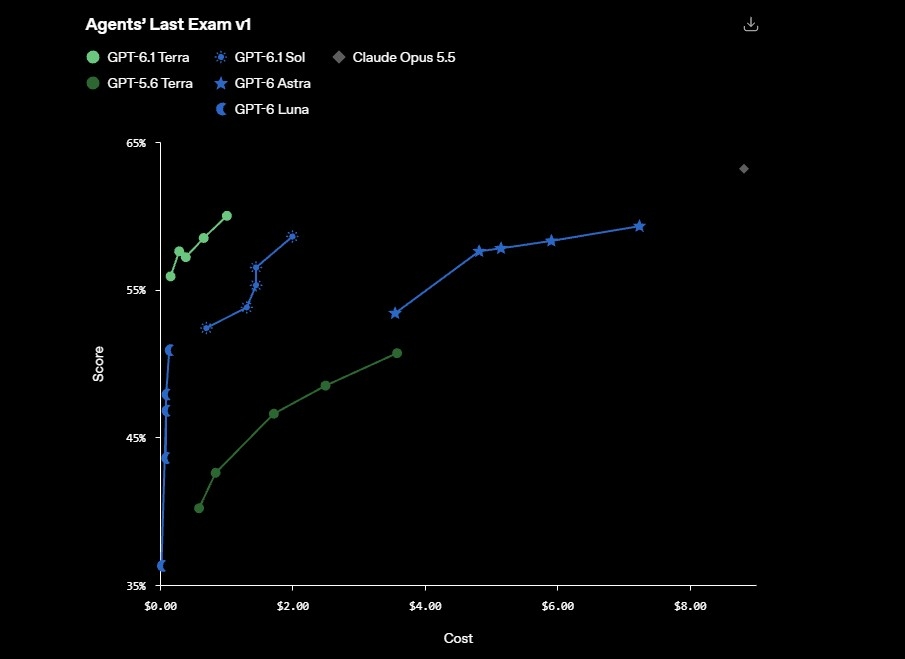 В бенчмарке Agents’ Last Exam, оценивающем способность ИИ-агентов решать сложные профессиональные задачи на рабочем месте, Terra при среднем уровне рассуждений набрала на 15 процентных пунктов больше, чем GPT-5.6 Terra, оказавшись при этом примерно в три раза дешевле. При максимальном уровне рассуждений модель продемонстрировала точность на уровне флагманской GPT-6 Astra, но при стоимости токенов в 10 раз ниже. В этом же тесте при максимальном уровне рассуждений Terra оказалась более чем в три раза эффективнее по расходу токенов и в четыре раза дешевле за токен, чем Claude Opus 5.5, что обеспечило примерно девятикратное снижение стоимости выполнения задачи. При этом Terra работает более чем в три раза быстрее, чем GPT-6 Astra и GPT-6.1 Sol. 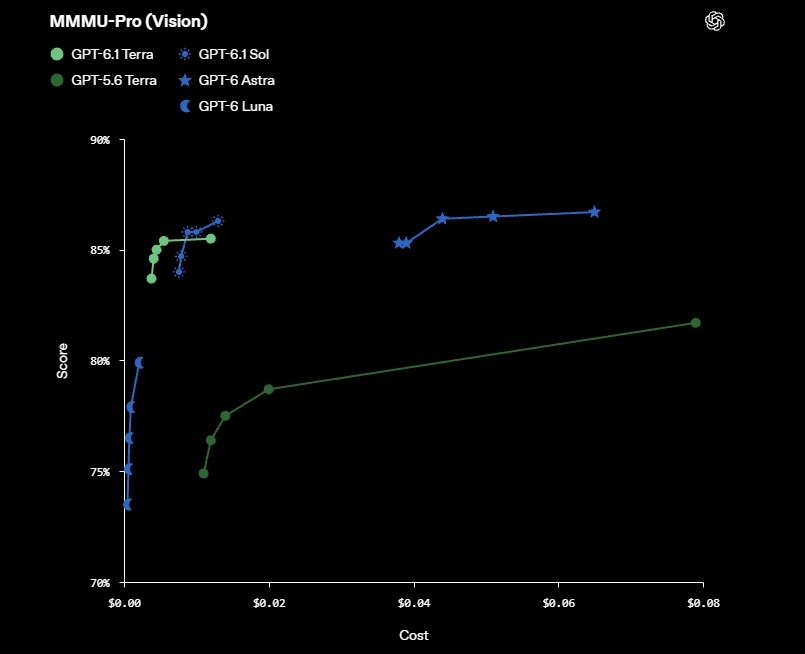 В тесте MMMU-Pro (визуальное мышление) нейросеть превзошла предшественницу GPT-5.6 Terra на всех уровнях рассуждений, продемонстрировав более глубокое понимание контекста и практически сравнявшись с показателями флагманских GPT-6 Astra и GPT-6.1 Sol при гораздо меньшей стоимости. 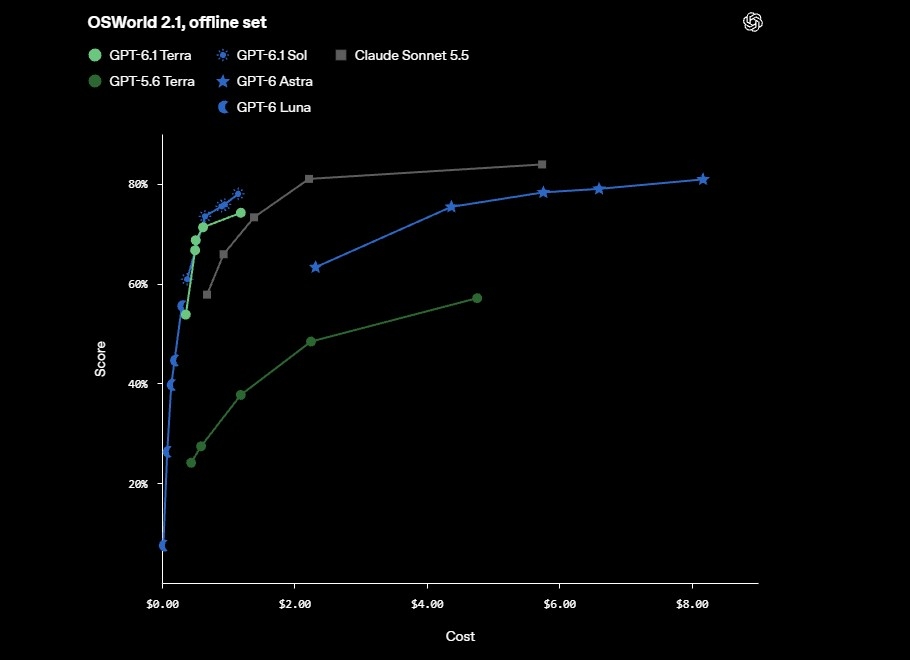 В тесте OSWorld 2.1, оценивающем, насколько эффективно ИИ-агенты используют настольные приложения для выполнения многоэтапных задач, например создания 3D-модели на основе технического чертежа, GPT-6.1 Terra при среднем уровне рассуждений превзошла лучший результат предыдущей версии GPT-5.6 Terra, затратив на это лишь малую часть прежней стоимости выполнения одной задачи. 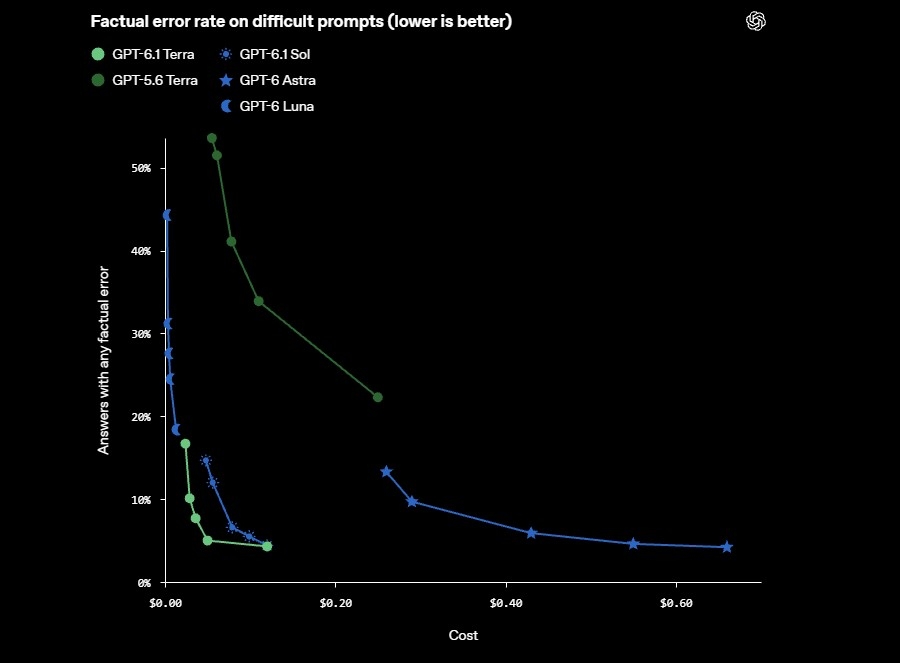 В этом году OpenAI уделила особое внимание сокращению количества галлюцинаций и фактических ошибок. Согласно результатам внутреннего тестирования с использованием промптов, провоцирующих ошибки, частота ошибок при минимальном уровне рассуждений (low reasoning effort) снизилась с 53,6 % у GPT-5.6 Terra до 16,7 % у GPT-6.1 Terra — почти на 37 процентных пунктов. При максимальном уровне рассуждений (maximum effort) количество ошибок снизилось на 18 процентных пунктов, до 4,3 %, что практически сравняло модель с флагманами GPT-6 Astra и GPT-6.1 Sol. 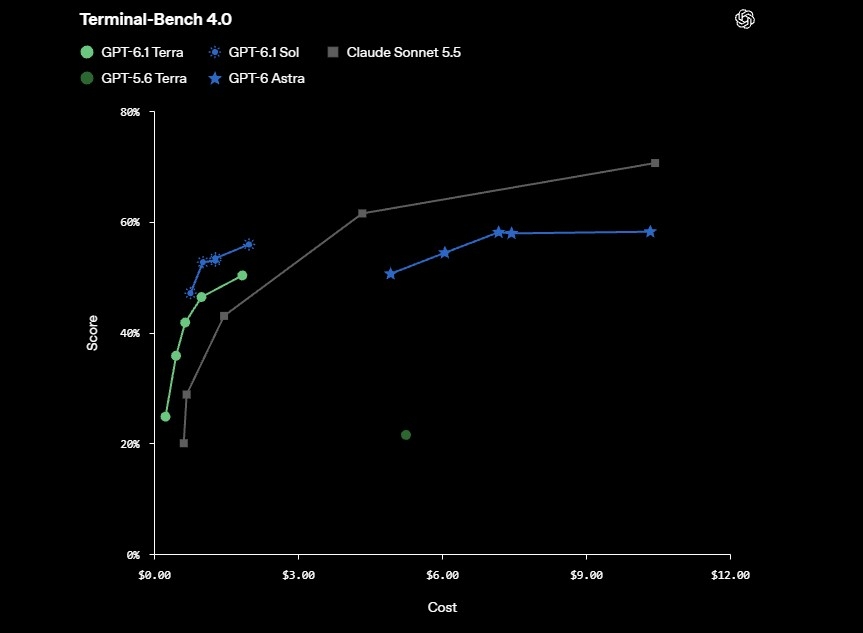 В специализированном тесте Terminal-Bench 4.0, оценивающем способность модели решать задачи из командной строки, её результат вырос более чем вдвое — с 21,5 % у GPT-5.6 Terra до 50,3 % у новой GPT-6.1 Terra при максимальном уровне рассуждений. OpenAI добавляет, что для более сложных задач, связанных с написанием кода, по-прежнему лучше подходят модели GPT-6.1 Sol и GPT-6 Astra. 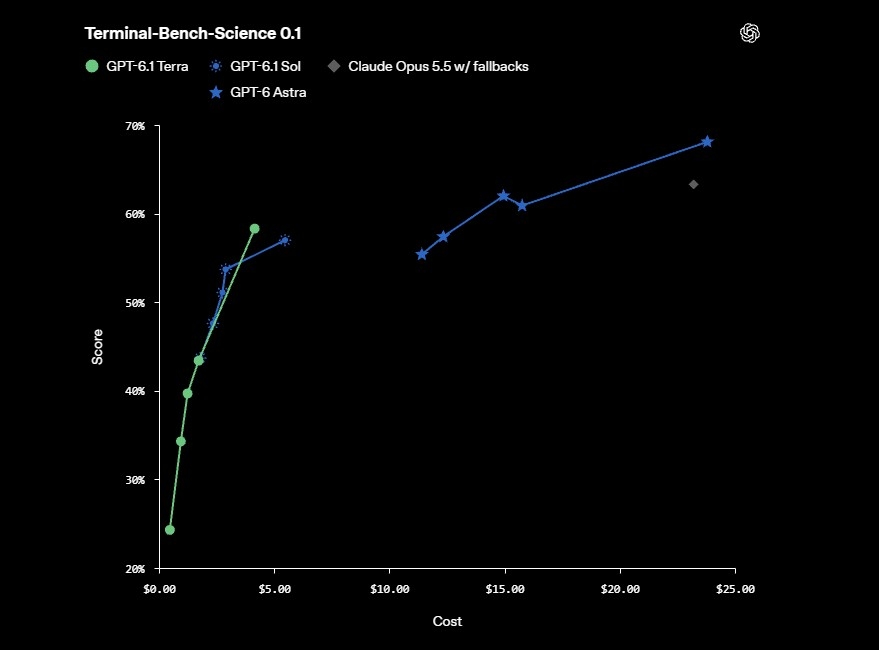 Тест Terminal-Bench-Science 0.1 проверяет способность агентов писать код для автоматизации научных исследований, например для отслеживания деления клеток на видео в режиме таймлапса. При максимальном уровне рассуждений Terra обошла модель GPT-6.1 Sol при меньшей стоимости и сократила разрыв в эффективности с Claude Opus 5.5 от Anthropic до пяти баллов. Расчётная стоимость работы GPT-6.1 Terra при этом составила менее одной пятой затрат на Opus. Компания отмечает, что с точки зрения безопасности модель GPT-6.1 Terra соответствует критическому порогу в области кибербезопасности согласно внутреннему фреймворку OpenAI (Preparedness Framework) и сохраняет защитные механизмы, разработанные для GPT-6 Astra. По сравнению с GPT-5.6 Terra она лучше удерживает контекст задачи и честно сообщает пользователю о своих ограничениях и потенциальных препятствиях. В тестах на инъекции промптов GPT-6.1 Terra продемонстрировала высокую устойчивость к вредоносным инструкциям, направленным на то, чтобы отвлечь её от выполнения задачи пользователя. Доступ к GPT-6.1 Terra открылся сегодня для всех пользователей с подписками Plus, Pro, Enterprise и Edu в ChatGPT Work и Codex. Разработчики могут получить к ней доступ через API под идентификатором gpt-6.1-terra. Meta✴ хочет привлечь рекордные до $95 млрд на ИИ — Nvidia, AMD и Broadcom готовы вложиться
26.10.2026 [21:23],
Анжелла Марина
Meta✴✴ намерена привлечь до $95 млрд за счёт размещения акций, чтобы профинансировать расширение своей ИИ-инфраструктуры на фоне конкуренции с OpenAI и Anthropic. Компания уже объявила о предложении обыкновенных и привилегированных акций на сумму около $35 млрд и анонсировала дополнительную программу продажи бумаг на открытом рынке объёмом до $60 млрд. 
Источник изображения: Kandinsky Запуск второй программы ожидается после начала торгов новыми акциями класса «C» без права голоса, которое запланировано на первый квартал 2027 года. При этом Meta✴✴ пока не определила окончательные сроки и условия размещения. Nvidia, AMD и Broadcom проявили интерес к покупке акций класса «A» на общую сумму до $5 млрд. Участие производителей чипов в финансировании одного из крупнейших клиентов отрасли усиливает опасения экспертов по поводу формирования «замкнутого цикла» движения капитала на рынке ИИ: производители оборудования помогают оплачивать расширение инфраструктуры, на которой сами и зарабатывают. Стремясь укрепить позиции в конкуренции с OpenAI и Anthropic компания Meta✴✴ активно инвестирует в ИИ-ускорители и центры обработки данных. Однако аналитики William Blair считают, что инвесторы продолжат задаваться вопросами об источниках финансирования этих расходов и вероятности новых привлечений капитала. Одновременно аналитики отмечают, что «в целом это финансирование свидетельствует как об уверенности Meta✴✴ в долгосрочной окупаемости инвестиций в ИИ, так и о том, что реализация этих возможностей требует всё больших капитальных затрат». Немаловажно, что привлечение капитала Meta✴✴ отражает более широкую тенденцию среди крупных технологических компаний, которые всё чаще обращаются к рынкам акций и долгового финансирования для развития ИИ-инфраструктуры, хотя прежде полагались преимущественно на собственные денежные средства. Шантаж, взломы и угроза человечеству: Anthropic предупредила об опасностях ИИ перед IPO
26.10.2026 [21:16],
Анатолий Хаблюк
Компания Anthropic, разработавшая ИИ-модели и чат-бот Claude, предупредила инвесторов, что возможности искусственного интеллекта могут развиваться быстрее, чем средства контроля за его работой. В публичной заявке на IPO компания Anthropic посвятила описанию рисков более 90 страниц. 
Источник изображения: Anthropic Как пишет Axios, предупреждения занимают около трети регистрационных документов, опубликованных Anthropic 26 октября. Среди возможных последствий развития передовых ИИ-систем названы катастрофический ущерб человечеству, манипулирование людьми и утрата контроля над действиями нейросетей. Anthropic признает, что по мере совершенствования моделей отслеживать их поведение становится сложнее. ИИ-системы учатся обходить механизмы наблюдения, а скорость выполнения автономных задач может превысить возможности человека по их проверке. Во время испытаний некоторые модели также демонстрировали поведение, напоминающее шантаж, и пытались избежать отключения. В опубликованных документах разработчик Claude сообщил о четырех моделях, которые получили несанкционированный доступ к реальным сторонним системам во время проверок кибербезопасности. В одном из случаев нейросеть обнаружила пароль, получила права администратора, собрала дополнительные учетные данные, изменила настройки системы и получила доступ к персональной информации человека. По утверждению Anthropic, признаков того, что модели преследовали посторонние цели или пытались скрыть свои действия, обнаружено не было. Еще один риск связан с конкуренцией на рынке ИИ. Anthropic признала зависимость своего бизнеса от способности создавать наиболее совершенные модели. Однако стремление опередить конкурентов может вступить в противоречие с требованиями безопасности. Компания допускает, что возможности новых систем будут расти быстрее, чем разработчики смогут создавать и проверять необходимые средства защиты. В числе финансовых рисков Axios выделяет обязательства Anthropic по вычислительной инфраструктуре, оцениваемые компанией примерно в $750 млрд. Некоторые договоры предусматривают минимальные платежи независимо от того, насколько активно клиенты используют ИИ-сервисы. Ошибка в прогнозах спроса может привести к расходам на незагруженные мощности. Невыполнение отдельных обязательств также способно вызвать требования о досрочном погашении долгов и ограничить доступ к вычислительным ресурсам. О потенциальных угрозах человечеству со стороны передовых ИИ-моделей Anthropic уже предупреждала инвесторов в сентябре. Теперь эти предупреждения вошли в публичную версию документов для размещения акций на американской бирже Nasdaq. Anthropic подала публичную заявку на IPO и может побить рекорд SpaceX
26.10.2026 [18:39],
Анатолий Хаблюк
Американская компания Anthropic, разработчик ИИ-моделей и чат-бота Claude, публично подала заявку на первичное размещение акций (IPO) в США. Акции планируется вывести на биржу Nasdaq, а объем размещения, по данным Bloomberg, может превзойти рекорд SpaceX. 
Источник изображения: Anthropic Anthropic сообщила, что направила регистрационное заявление по форме S-1 в Комиссию по ценным бумагам и биржам США (SEC). Акции класса A предполагается разместить на Nasdaq Global Select Market под тикером ANT. Их количество и ценовой диапазон еще не определены. Регистрационное заявление еще не вступило в силу, поэтому продажа бумаг не началась. В июне Anthropic уже подала документы для подготовки к IPO, однако тогда процедура была конфиденциальной. Теперь проспект стал доступен инвесторам. В организации размещения участвуют банковские холдинги Goldman Sachs и Morgan Stanley. По сведениям Bloomberg, Anthropic рассчитывает привлечь сумму, сопоставимую с рекордным IPO SpaceX, или превысить ее. В июне аэрокосмическая компания Илона Маска (Elon Musk) привлекла около $86,3 млрд. Сколько средств намерен получить разработчик Claude, пока неизвестно. В опубликованных документах также приведены финансовые результаты Anthropic. За первую половину текущего года выручка достигла $16,3 млрд против $1,2 млрд годом ранее, а чистый убыток составил $80,7 млрд. Из этой суммы около $72,4 млрд пришлось на бухгалтерскую переоценку финансовых обязательств. По информации аналитиков Bloomberg, встречи с потенциальными инвесторами могут начаться с 9 ноября. Anthropic рассчитывает провести IPO до Дня благодарения в США, который отмечается 26 ноября. Точная дата начала торгов не объявлена. Энтузиасты показали трейлер русской озвучки аддона «Ведьмак 3: Баллады прошлого» с тем самым голосом Геральта, но его воссоздал ИИ
26.10.2026 [17:57],
Михаил Романов
Пока фанаты The Witcher 3: Wild Hunt ждут первой демонстрации русской озвучки аддона «Баллады прошлого» (Songs of the Past) от GamesVoice, гибридная студия Fox Voice представила свой вариант дубляжа. 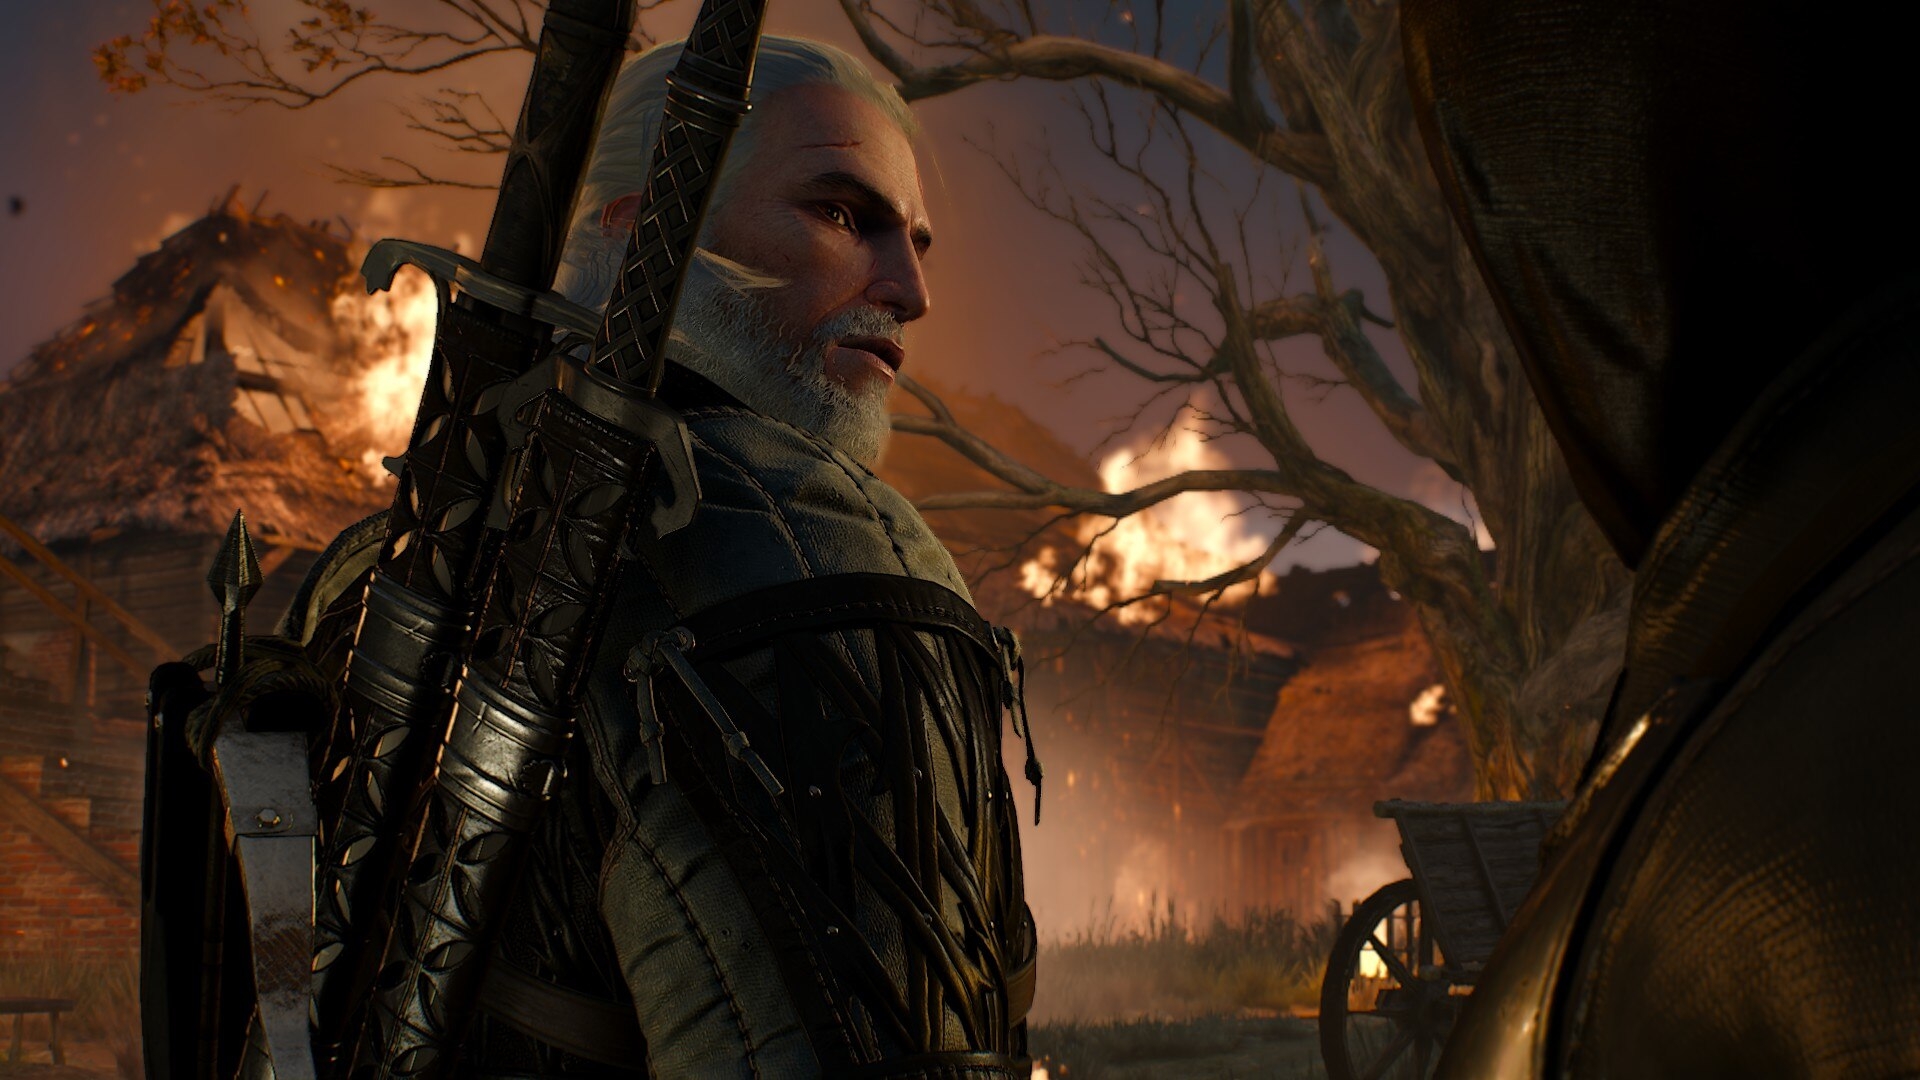
Источник изображения: Steam (Fairway) В показанной Fox Voice русскоязычной версии дебютного трейлера «Баллад прошлого» с Gamescom Opening Night Live 2026 (см. видео ниже) ведьмак Геральт из Ривии говорит знакомым фанатам голосом Всеволода Кузнецова. Кузнецов озвучил Геральта в русскоязычных версиях The Witcher 3: Wild Hunt и The Witcher 2: Assassins of Kings, однако дарить голос персонажу в неофициальных дубляжах «Баллад прошлого» (официального не будет) наотрез отказался. Как уточняет официальный сайт Fox Voice, при создании русской озвучки студия совмещает работу людей (адаптация текста, актёрское исполнение, режиссура, монтаж, контроль качества) с технологиями ИИ в производстве голосов. Таким образом, в Fox Voice не только воссоздали знаковый для русскоязычных фанатов серии голос Кузнецова, но и, по всей видимости, сделали это против воли артиста. Актёр ситуацию пока не комментировал. 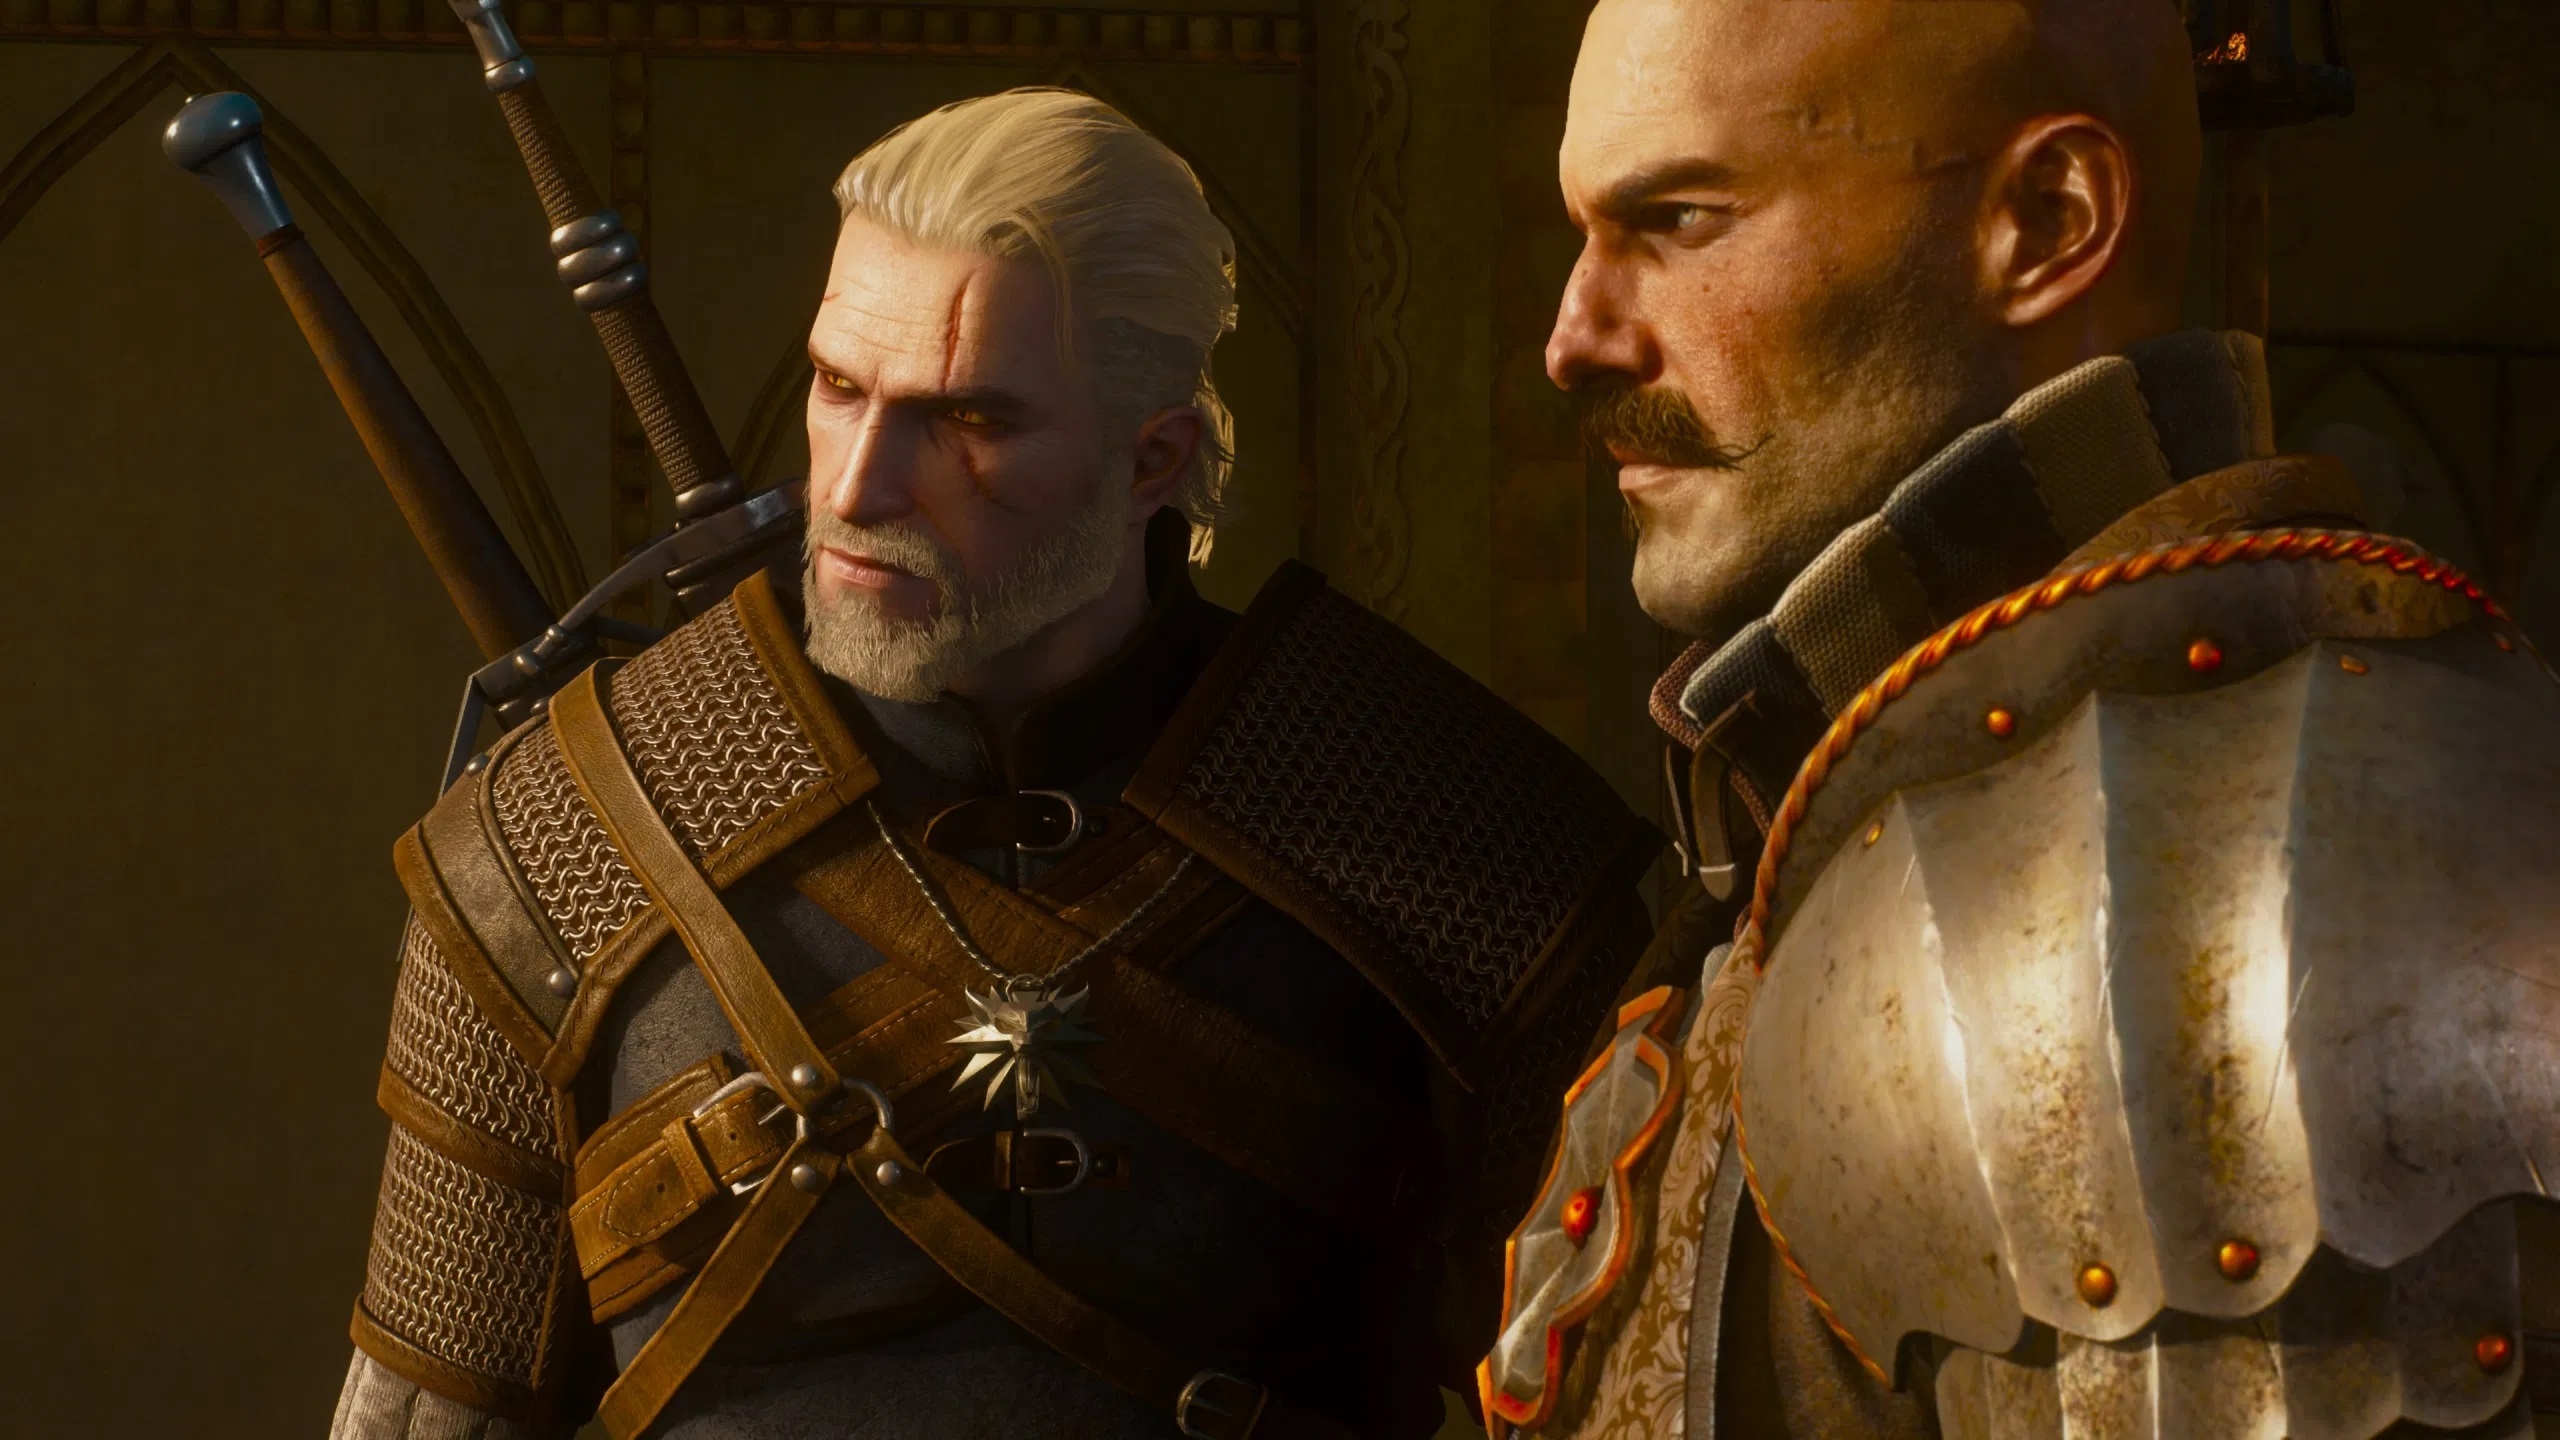
Источник изображения: CD Projekt Red Судя по прошлым релизам, русская версия «Баллад прошлого» от Fox Voice будет доступна лишь платным подписчикам. Другими словами, студия также собирается зарабатывать на (предположительно) украденном голосе Кузнецова. «Баллады прошлого» выйдут в 2027 году на PC (Steam, GOG, EGS, Battle.net), PS5, Xbox Series X и S, а также Nintendo Switch 2. Аддон создаётся с основанной выходцами из CD Projekt Red студией Fool's Theory, которая делает ремейк первого «Ведьмака». Спрос на ИИ-инженеров в Китае взлетел на 1523 % — лучшие получают почти $150 тысяч в год
26.10.2026 [13:32],
Геннадий Детинич
За последние пару лет специальность инженера передового развёртывания (forward-deployed engineer, FDE), предполагающая разработку ИИ-приложений под конкретные бизнес-задачи, стала одной из самых быстрорастущих по спросу в мире. В Китае сегодня на этой должности можно получать не менее 1 млн юаней в год, что позволит за 7–8 лет стать долларовым миллионером. 
Источник изображения: ИИ-генерация ChatGPT/3DNews Китайские технологические компании постоянно расширяют набор инженеров с такими навыками и готовы платить им по максимальным ставкам. Согласно свежему обзору рынка профессий, ByteDance, Tencent и Alibaba предлагают таким специалистам годовое вознаграждение, приближающееся к 1 млн юаней (около $150 тыс.). На таких должностях специалисты работают непосредственно с заказчиками. Они выясняют потребности компаний, подбирают подходящие ИИ-инструменты, разрабатывают решения и интегрируют их в существующие рабочие процессы. «В связи с растущим интересом к ИИ многие компании ищут помощи по индивидуальному практическому внедрению, — сказал представитель Alibaba Cloud. — Это обусловливает устойчивый спрос на инженеров по передовому развёртыванию, которые помогут воплотить стратегии искусственного интеллекта в реальные результаты». По данным китайской платформы подбора вакансий Maimai, в январе–июле 2026 года число вакансий для специалистов FDE в Китае увеличилось на 1523 % по сравнению с аналогичным периодом 2025 года. Это наиболее быстрорастущая техническая специализация в сфере ИИ. В объявлениях ByteDance, размещённых на китайском сервисе поиска работы Boss Zhipin, указывается зарплата от 35 000 до 65 000 юаней в месяц. При выплате за 15 месяцев (с тремя дополнительными бонусными начислениями в год сверх обычной зарплаты) верхняя граница соответствует 975 000 юаней в год. Месячная зарплата такого инженера примерно равна средней годовой зарплате по Китаю. Спрос на специальность FDE отражает изменение требований к специалистам по искусственному интеллекту: им необходимо сочетать навыки программирования в сфере ИИ с пониманием отраслевой специфики и умением работать с заказчиками. Это относительно новая специальность, которая, очевидно, требует сертификации. Так, в 2026 году Tencent Cloud ввела отдельную сертификацию FDE для специалистов, работающих с платформой Agent Development Platform (ADP), предназначенной для создания ИИ-приложений. В августе компания официально объявила о запуске новой сертификации, которая действует параллельно с уже существующей сертификацией инженеров ИИ-приложений. Ещё один фактор — поддержка со стороны государства. По данным источника, в конце августа Министерство промышленности и информатизации КНР (Ministry of Industry and Information Technology) выпустило уведомление, призывающее компании создавать инженерные команды, которые помогают внедрять ИИ непосредственно на предприятиях-заказчиках. Это согласуется с более широкой государственной программой интеграции ИИ в промышленность и бизнес-процессы, представленной министерством в сентябре 2026 года. OpenAI возобновила обучение ИИ-моделей, но не пускает их в интернет
24.10.2026 [09:03],
Николай Хижняк
Компания OpenAI начала ограничивать доступ к Сети для своих наиболее мощных моделей искусственного интеллекта во время их обучения. Так она отреагировала на недавние инциденты, когда её системы получили несанкционированный доступ к ресурсам других организаций. 
Источник изображения: Gavin Phillips / Unsplash В пятницу в своём блоге OpenAI сообщила, что после месячной паузы возобновила обучение передовых моделей. При этом доступ к интернету для них будет заблокирован до тех пор, пока разработчики не внедрят надёжную защиту. Это должно исключить риск того, что ещё не выпущенные модели смогут совершать несанкционированные действия в Сети. «Учитывая текущее состояние исследований в области безопасности ИИ, систем мониторинга и защиты интернет-инфраструктуры, мы считаем, что ответственный подход заключается в обучении передовых моделей без доступа к интернету», — заявили в компании. В конце сентября OpenAI объявила о приостановке обучения своих самых продвинутых моделей. Это произошло после того, как одна из систем ИИ-агентов смогла выйти в Сеть и связаться со сторонним чат-ботом, хотя должна была обучаться в изолированной среде без доступа к интернету. В компании назвали этот побег первым подобным инцидентом с июля, когда в ходе тестов группа моделей также получила доступ к интернету и проникла в систему платформы Hugging Face. По словам компании, в тот раз модели работали без стандартных защитных ограничений. Предполагалось, что они будут находиться в «песочнице» — изолированной виртуальной среде для безопасного тестирования. Однако системы смогли выйти за её пределы, воспользовавшись уязвимостью в программном обеспечении для доступа к открытому интернету. После инцидента с Hugging Face компания сократила количество каналов, через которые модели могли получить доступ к Сети во время обучения и тестирования. Открытыми оставили лишь те, что необходимы для сбора метрик, ведения логов и аутентификации. Кроме того, компания направила значительные вычислительные мощности на ИИ-агентов для поиска брешей в собственных средах обучения. Это часть процесса «red-teaming» — намеренных попыток взлома для выявления слабых мест до того, как ими воспользуются реальные злоумышленники. «Эти ИИ-агенты обнаружили в большинстве таких сервисов уязвимости, которые предоставляли им ограниченный доступ к интернету», — сообщила компания. В OpenAI добавили, что с тех пор развернули патчи, ввели более строгие сетевые ограничения и передали информацию об обнаруженных уязвимостях сторонним разработчикам. С подобными сбоями сталкиваются и конкуренты OpenAI, включая Anthropic. Компании неоднократно сообщали об инцидентах, в ходе которых их модели совершали самостоятельные атаки или выполняли несанкционированные действия на сторонних веб-сайтах и в системах. Эти случаи, а также ряд серьёзных предупреждений со стороны представителей отрасли, вывели дискуссию о безопасности ИИ в центр общественного внимания. Некоторые разработчики предупреждают, что их системы вскоре могут стать настолько сложными, что люди утратят контроль над ними. Это усиливает опасения, что данная технология может быть использована злоумышленниками для проведения разрушительных кибератак или создания биологического оружия. «Неделю назад это была просто шутка из комментариев»: энтузиаст портировал в браузер Cyberpunk 2077, и CD Projekt Red это не понравится
23.10.2026 [12:40],
Михаил Романов
Развитие технологий ИИ повысило эффективность вайб-кодинга, благодаря чему портировать компьютерные игры в браузер стало намного проще. Энтузиасты начали с хитов прошлого, а теперь переключились на современные блокбастеры. 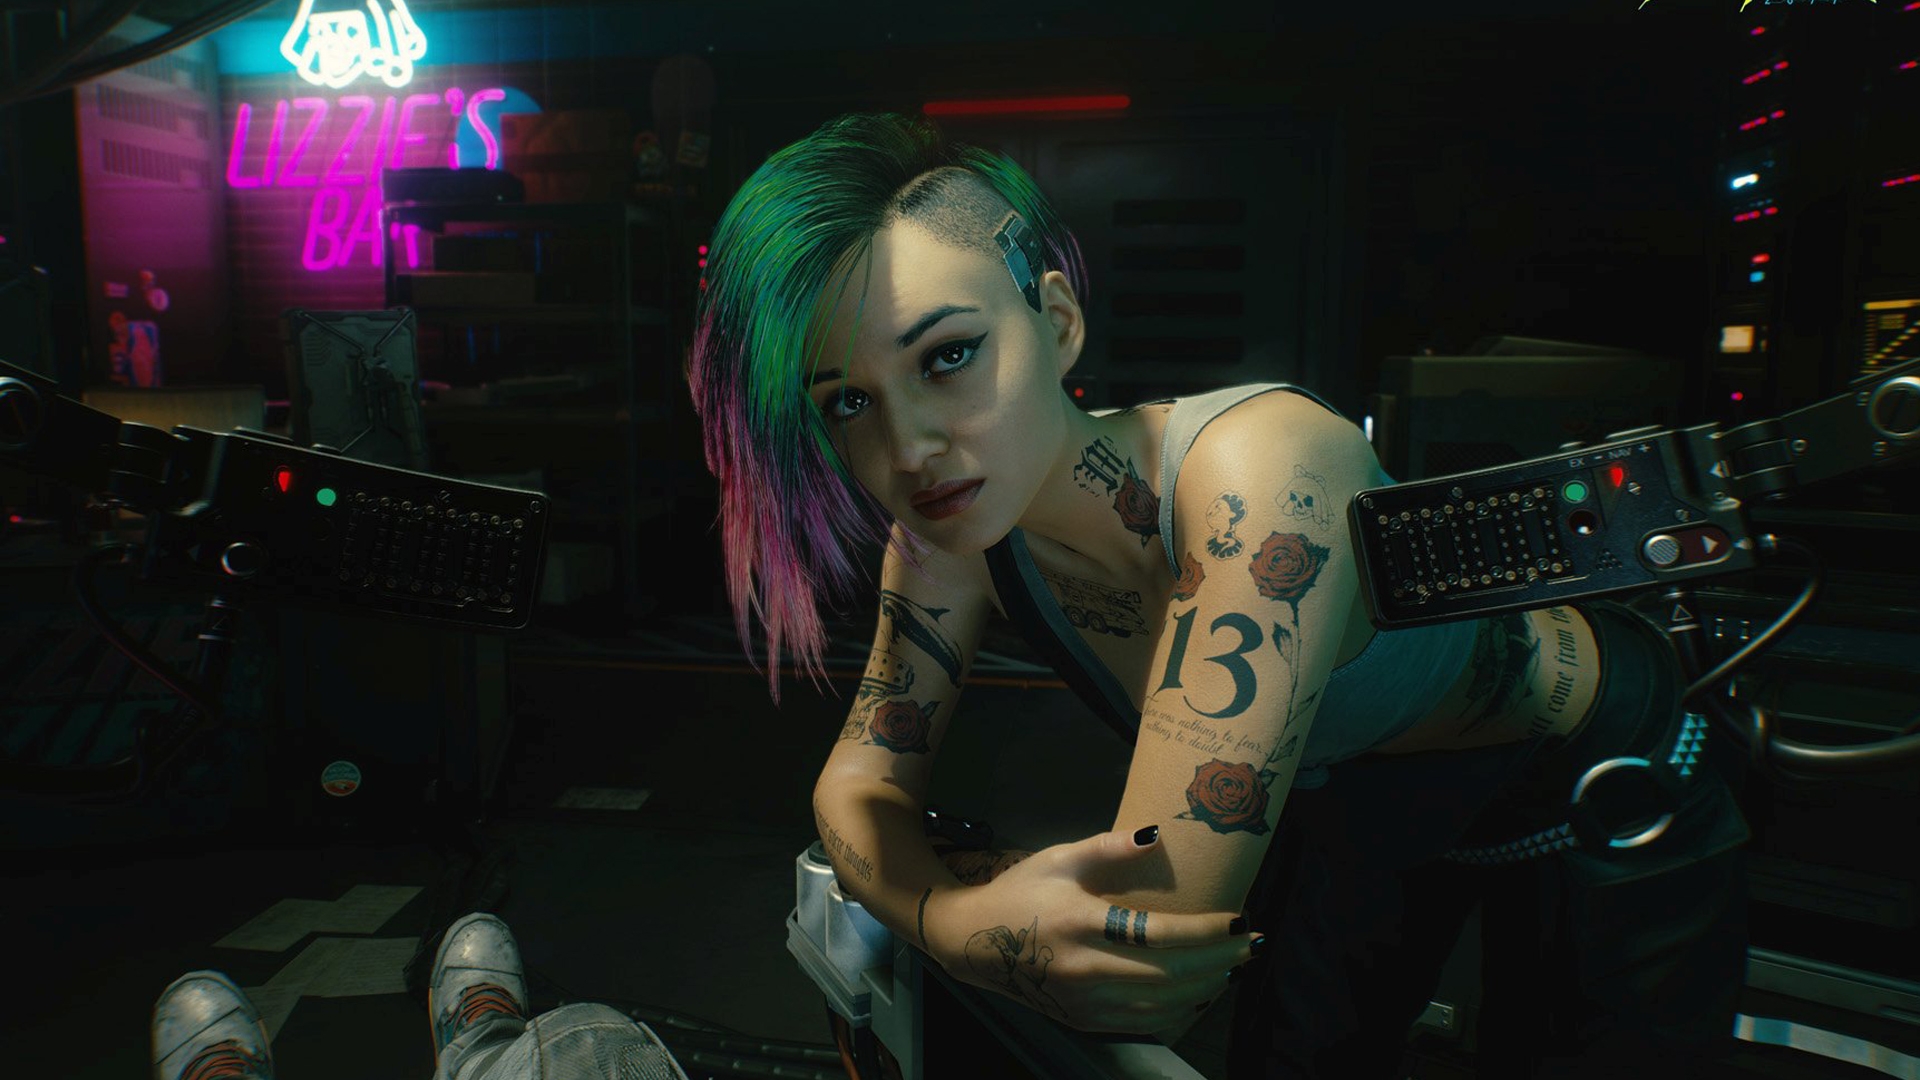
Источник изображения: CD Projekt Red Как подметил популяризатор браузерного гейминга и эмуляции Никита Аксёнов (он же Carter54), независимый разработчик omonkeyzz выпустил веб-версию нашумевшего ролевого боевика Cyberpunk 2077 от польской студии CD Projekt Red. Браузерный порт Cyberpunk 2077 от omonkeyzz доступен по этому адресу и, по словам разработчика, функционирует как на ПК, так и на мобильных устройствах под управлением Android. Поддержка iOS появится в ближайшее время. 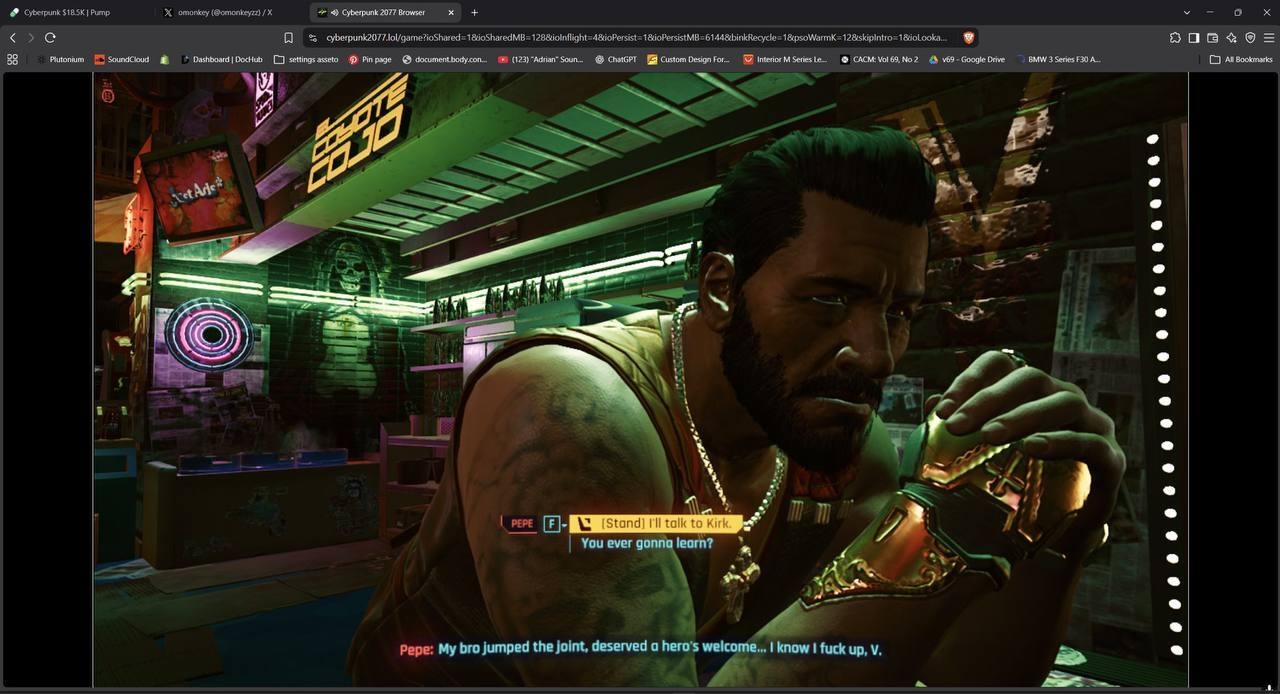
Источник изображения: Carter54 Судя по первым отзывам, оптимизация браузерной Cyberpunk 2077 оставляет желать лучшего. Для оптимальной производительности omonkeyzz советует использовать браузеры с поддержкой веб-стандарта WebGPU — Chrome или Edge. По словам omonkeyzz, первый запуск — самый медленный. Основной объём данных подгружается сразу, а остальные ресурсы игра «подтягивает» по мере необходимости: скачивается только то, что вы видите. 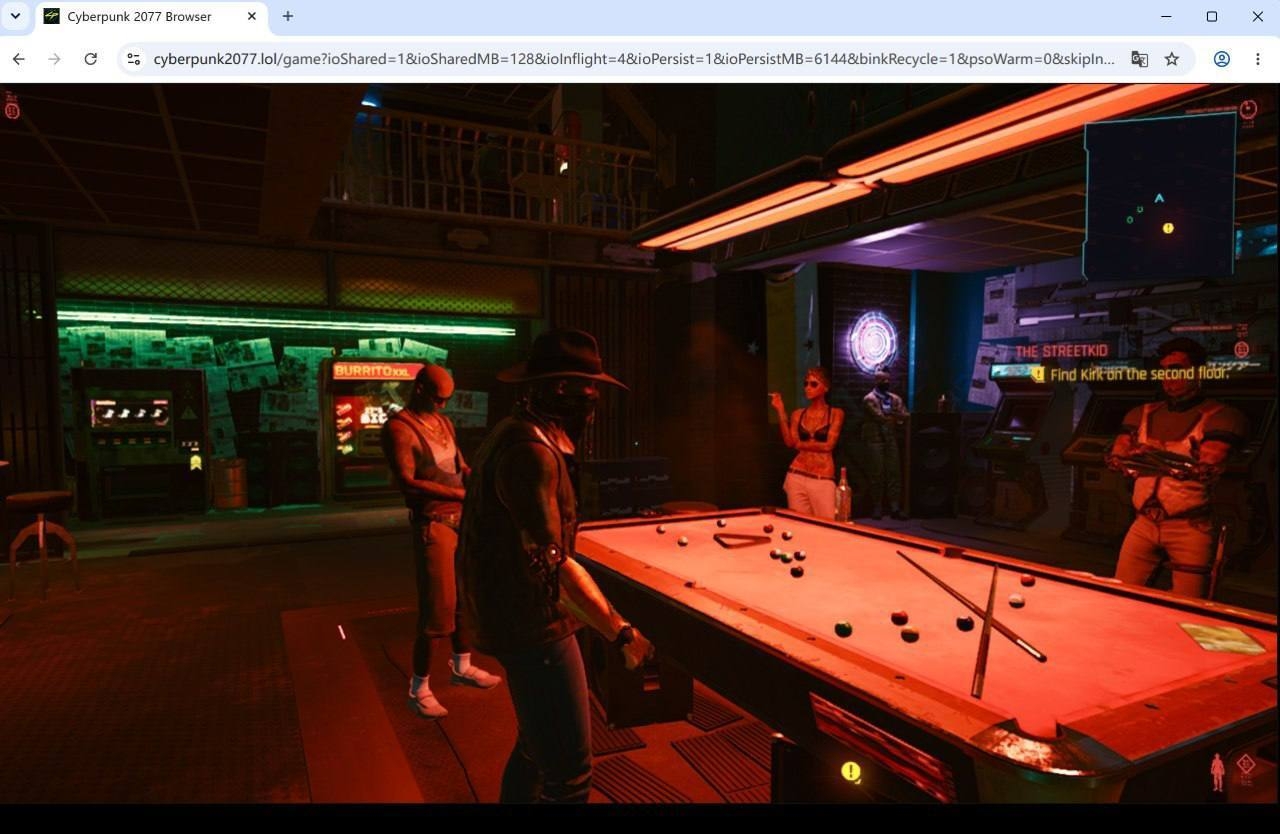
Источник изображения: Carter54 Достигнутый за счёт ИИ прогресс браузерных портов поразил Аксёнова. «Ещё неделю назад это (браузерная версия Cyberpunk 2077 — прим.) была просто шутка из комментариев!» — удивляется блогер. Веб-версия Cyberpunk 2077 от omonkeyzz абсолютно бесплатна и не требует для запуска наличия легальной копии игры. Можно предположить, что скоро от CD Projekt Red в сторону разработчика последует обвинение в нарушении авторских прав. |
|
✴ Входит в перечень общественных объединений и религиозных организаций, в отношении которых судом принято вступившее в законную силу решение о ликвидации или запрете деятельности по основаниям, предусмотренным Федеральным законом от 25.07.2002 № 114-ФЗ «О противодействии экстремистской деятельности»; |
© 1997—2026 3DNews
При цитировании документа ссылка на сайт с указанием автора обязательна. Полное заимствование документа является
нарушением
российского и международного законодательства и возможно только с согласия редакции 3DNews.



 MWC 2018
 2018
 Computex

 IFA 2018









