


Опрос
|
реклама
Быстрый переход
Сотни знаменитостей подписали открытое письмо с требованием запретить «свободу обучения» ИИ
18.03.2025 [18:37],
Сергей Сурабекянц
Более 400 актёров, музыкантов, режиссёров, писателей и представителей других творческих профессий подписали открытое письмо. Они призвали администрацию США запретить обучение моделей ИИ на защищённых авторским правом работах. Письмо стало ответом на предлагаемую OpenAI и Google «свободу обучения» моделей ИИ без получения разрешения от правообладателей и соответствующей компенсации. 
Источник изображения: unsplash.com OpenAI заявила, что смягчение законов об авторском праве будет способствовать «свободе обучения» и поможет защитить национальную безопасность Америки. OpenAI и Google уверены, что это поможет «укрепить лидерство Америки» в конкурентной борьбе с Китаем в области разработки ИИ. Звёзды, в свою очередь, не видят причин отменять защиту авторских прав, чтобы помочь улучшить модели ИИ: «Мы твёрдо убеждены, что глобальное лидерство Америки в области ИИ не должно достигаться за счёт наших важнейших творческих отраслей». В открытом письме творческие работники утверждают, что «свобода обучения» ИИ подорвёт экономическую и культурную мощь страны и ослабит защиту авторских прав, в то время как Google и OpenAI получат исключительные права на «свободную эксплуатацию творческих и образовательных отраслей Америки, несмотря на их [и так] значительные доходы и доступные средства». «Америка стала мировым культурным центром не случайно, — говорится в письме. — Наш успех напрямую обусловлен нашим фундаментальным уважением к интеллектуальной собственности и авторским правам, которое вознаграждает творческий риск талантливых и трудолюбивых американцев из каждого штата». В письме отмечается, что индустрия развлечений Америки предоставляет работу 2,3 млн граждан США и ежегодно выплачивает $229 млрд в виде заработной платы, а также обеспечивает «основу для американского демократического влияния и мягкой силы за рубежом». Среди подписавших письмо протеста фигурируют такие знаменитости мирового масштаба, как Бен Стиллер (Ben Stiller), Кейт Бланшетт (Cate Blanchett), Пол Маккартни (Paul McCartney), Гильермо дель Торо (Guillermo del Toro), Джозеф Гордон-Левитт (Joseph Gordon-Levitt) и многие другие, не менее известные представители творческих профессий. 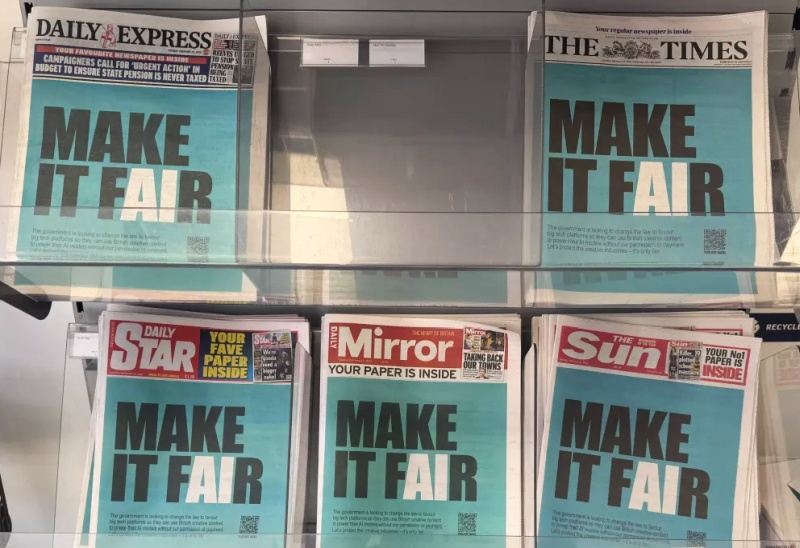
Источник изображения: techspot.com Знаменитости протестуют против этой проблемы не только в США. Великобритания собирается изменить закон об авторском праве, что позволит обучать модели ИИ без разрешения владельцев авторских прав и оплаты, если создатели заранее не откажутся от этого. В знак протеста группа из 1000 музыкантов выпустила «тихий» альбом «Is this what we want?» («Разве этого мы хотим?»), содержащий лишь записи пустых студий и концертных залов. Помимо этого, на первых полосах национальных СМИ был опубликован лозунг музыкантов «Make it fair» («Давайте сделаем по-справедливому») с призывом к диалогу индустрии с разработчиками ИИ. «Разве этого мы хотим?» — 1000 артистов выпустили безмолвный альбом-протест против воровства музыки в угоду ИИ
25.02.2025 [18:21],
Сергей Сурабекянц
Великобритания собирается изменить закон об авторском праве, чтобы привлечь в страну больше ИИ-компаний. Обновлённый закон позволит обучать модели ИИ на контенте из интернета без разрешения владельцев авторских прав и оплаты, если создатели заранее не «откажутся» от этого. В знак протеста группа из 1000 музыкантов выпустила «тихий» альбом «Is This What We Want?» («Разве этого мы хотим?»), содержащий лишь записи пустых студий и концертных залов. 
Источник изображения: Pixabay Альбом «Is This What We Want?», который иначе как «криком души» не назвать, содержит треки Кейт Буш (Kate Bush), Имоджен Хип (Imogen Heap), а также современных классических композиторов Макса Рихтера (Max Richter) и Томаса Хьюитта Джонса (Thomas Hewitt Jones). Их соавторами выступили Энни Леннокс (Annie Lennox), Дэймон Албарн (Damon Albarn), Билли Оушен (Billy Ocean), The Clash, Pet Shop Boys, Mystery Jets, Юсуф (Yusuf), Кэт Стивенс (Cat Stevens), Риз Ахмед (Riz Ahmed), Тори Амос (Tori Amos), Ханс Циммер (Hans Zimmer) и другие композиторы и исполнители. Но это не совместное выступление артистов, подобное всемирно известной композиции «We are the world». Новый альбом вообще не содержит музыки, как таковой. Вместо этого артисты собрали записи пустых студий и концертных залов — символическое представление того, к чему приведут запланированные изменения в законе об авторском праве. Названия 12 треков, вошедших в альбом, образуют предложение «Британское правительство не должно легализовать воровство музыки в целях получения выгоды компаниями, занимающимися искусственным интеллектом» («The British government must not legalize music theft to benefit AI companies»). 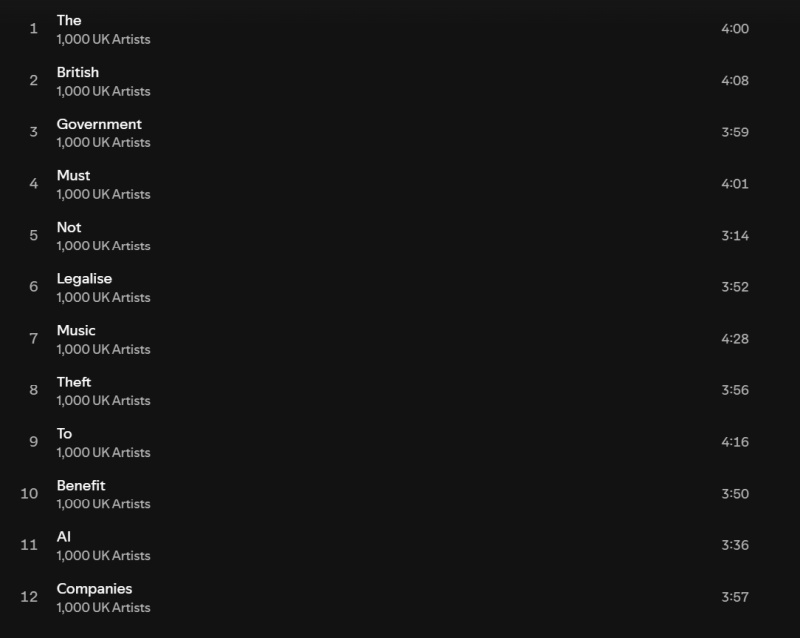
Источник изображений: Spotify «Вы можете услышать, как носятся мои кошки, — так Хьюитт Джонс описал свой вклад в альбом. — У меня в студии две кошки, которые целыми днями мешают мне работать». Организатор проекта Эд Ньютон-Рекс (Ed Newton-Rex) возглавляет масштабную кампанию против обучения ИИ без лицензии. Опубликованную им петицию подписали более 47 000 писателей, художников, актёров и других представителей творческих кругов, причём почти 10 000 из них примкнули к протестам в последние пять недель, после объявления правительства Великобритании о масштабном изменении стратегии в области ИИ и авторского права. Выпуск альбома состоится как раз перед запланированными изменениями в законе об авторском праве в Великобритании, согласно которым артисты, не желающие, чтобы их работы использовались для обучения ИИ, должны будут заблаговременно «отказаться» от такой перспективы. Это фактически создаёт проигрышную ситуацию для музыкантов, поскольку нет никакого метода заблаговременного отказа или чёткого способа отслеживать, какой именно материал был использован для обучения ИИ. «Мы знаем, что схемы отказа просто не принимаются», — утверждает Ньютон-Рекс. «Нам десятилетиями говорили, что мы должны делиться своей работой в Сети, потому что это хорошо для распространения. Но теперь компании, занимающиеся ИИ, и, что невероятно, правительства разворачиваются и говорят: “Ну, вы выкладываете это в сеть бесплатно…” — говорит Ньютон-Рекс. — Так что теперь артисты просто прекращают создавать и делиться своей работой». По словам артистов, единственным решением в этой ситуации является выпуск своих произведений на других рынках, где они будут лучше защищены, например, в Швейцарии.  Альбом «Is This What We Want?» — лишь одна из форм протеста против сложившейся ситуации с авторским правом при обучении ИИ. Организаторы сообщили, что альбом будет широко размещён на музыкальных платформах уже сегодня, и любые пожертвования или доходы от его реализации будут направлены в благотворительную организацию Help Musicians. В России создали первый ИИ с мышлением ребёнка
13.02.2025 [20:19],
Владимир Фетисов
Российские программисты создали искусственный интеллект, способный адаптироваться к мышлению ребёнка для помощи в обучении по школьной программе. Для этого разработчики объединили собственный ИИ-алгоритм и ИИ-ассистентов, адаптированных под каждый школьный предмет. В результате было создано, по сути, полноценное образовательное учреждение — ИИ «Препод». 
Источник изображения: Copilot Архитектура платформы предусматривает наличие ассистента-психолога, методистов и других профильных специалистов. Такой подход позволил организовать мультидисциплинарную экосистему ИИ «Препод» для поддержки учебного процесса. В настоящее время на платформе доступно свыше 500 уникальных ИИ-помощников — это значительно больше, чем количество учителей в обычной школе. Объём знаний ИИ-помощников позволяет находить подход к детям разного возраста, а также учитывать их особенности психологического развития и склонности к различным предметам. Найти общий язык с детьми разного возраста ИИ-помощнику помогает знание не только школьных предметов, но и огромного массива другой информации, включая детскую литературу, мультфильмы, фильмы, мемы и компьютерные игры. Такой подход позволяет детям обучаться как с использованием формального «школьного языка», так и с применением понятных возрасту шуток, цитат и других элементов культуры. Специализированные ИИ-помощники в процессе работы с ребёнком проводят глубокую оценку его знаний и действуют как узконаправленные специалисты в конкретных областях. За счёт этого достигается качество образования, максимально приближенное к школьной системе. ИИ «Препод» создан на основе Python/Django с интегрированными специализированными ИИ-алгоритмами. В основе платформы лежит ИИ-модуль, который отсеивает петабайты ненужной информации, отбирая важные данные в условиях Big Data на распределённых вычислительных кластерах. Система самообучалась в течение восьми месяцев, при этом особое внимание уделялось выбору оптимальной обучающей парадигмы нейросетей. Искусственный интеллект научили разоблачать учёных-шарлатанов
27.11.2024 [18:56],
Геннадий Детинич
Научный поиск вскоре может претерпеть коренные изменения — искусственный интеллект показал себя в качестве непревзойдённого человеком инструмента для анализа невообразимых объёмов специальной литературы. В поставленном эксперименте ИИ смог точнее людей-экспертов дать оценку фейковым и настоящим научным открытиям. Это облегчит людям научный поиск, позволив машинам просеивать тонны сырой информации в поисках перспективных направлений. 
Источник изображения: ИИ-генерация Кандинский 3.1/3DNews С самого начала разработчики генеративных ИИ (ChatGPT и прочих) сосредоточились на возможности больших языковых моделей (LLM) отвечать на вопросы, обобщая обширные данные, на которых они обучались. Учёные из Университетского колледжа Лондона (UCL) поставили перед собой другую цель. Они задались вопросом, могут ли LLM синтезировать знания — извлекать закономерности из научной литературы и использовать их для анализа новых научных работ? Как показал опыт, ИИ удалось превзойти людей в точности выдачи оценок рецензируемым работам. «Научный прогресс часто основывается на методе проб и ошибок, но каждый тщательный эксперимент требует времени и ресурсов. Даже самые опытные исследователи могут упускать из виду важные выводы из литературы. Наша работа исследует, могут ли LLM выявлять закономерности в обширных научных текстах и прогнозировать результаты экспериментов», — поясняют авторы работы. Нетрудно представить, что привлечение ИИ к рецензированию далеко выйдет за пределы простого поиска знаний. Это может оказаться прорывом во всех областях науки, экономя учёным время и деньги. Эксперимент был поставлен на анализе пакета научных работ по нейробиологии, но может быть распространён на любые области науки. Исследователи подготовили множество пар рефератов, состоящих из одной настоящей научной работы и одной фейковой — содержащей правдоподобные, но неверные результаты и выводы. Пары документов были проанализированы 15 LLM общего назначения и 117 экспертами по неврологии человека, прошедшими специальный отбор. Все они должны были отделить настоящие работы от поддельных. Все LLM превзошли нейробиологов: точность ИИ в среднем составила 81 %, а точность людей — 63 %. В случае анализа работ лучшими среди экспертов-людей точность повышалась до 66 %, но даже близко не подбиралась к точности ИИ. А когда LLM специально обучили на базе данных по нейробиологии, точность предсказания повысилась до 86 %. Исследователи говорят, что это открытие прокладывает путь к будущему, в котором эксперты-люди смогут сотрудничать с хорошо откалиброванными моделями. Проделанная работа также показывает, что большинство новых открытий вовсе не новые. ИИ отлично вскрывает эту особенность современной науки. Благодаря новому инструменту учёные, по крайней мере, будут знать, стоит ли заниматься выбранным направлением для исследования или проще поискать его результаты в интернете. Google представила Learn About — инструмент интерактивного обучения на базе искусственного интеллекта
02.11.2024 [17:48],
Владимир Фетисов
Компания Google без лишнего шума представила новый образовательный сервис на основе искусственного интеллекта под названием Learn About, анонс которого состоялся на прошедшей в мае конференции Google I/O. Сервис призван изменить подход к обучению чему-либо, превращая этот процесс в увлекательный диалог вместо стандартного чтения текста и просмотра сопутствующих изображений. 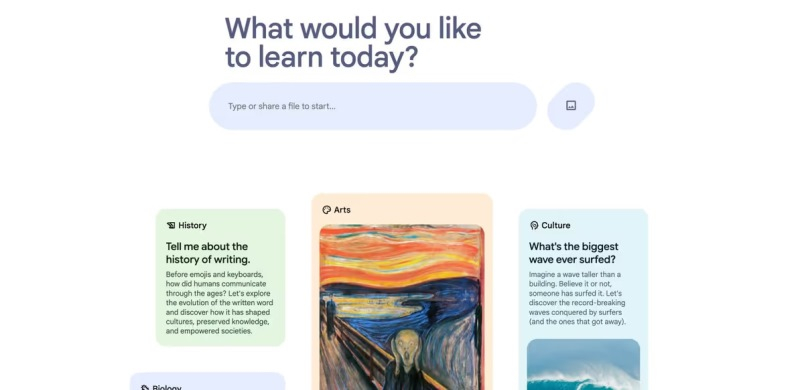
Источник изображения: maginative.com Инструмент Learn About ориентирован на людей, которые регулярно используют поисковые системы для изучения чего-то нового. Однако в данном случае на смену традиционным методам обучения, в которых информация преподносится статично в процессе чтения текста и просмотра изображений, приходит метод, предлагающий персонализированное интерактивное обучение. В некотором смысле новый сервис можно назвать своеобразным виртуальным репетиром, которому можно задавать вопросы или предоставлять собственные материалы. Возможно изучение специально подобранных тем широкого спектра, начиная от повседневных вопросов и заканчивая сложными академическими предметами. Алгоритмы на базе нейросетей генерируют контент, который поможет разобраться в теме, связать основные понятия, углубить понимание вопроса. Learn About объединяется традиционный обучающий контент, такой как видео, статьи и изображения, с возможностями искусственного интеллекта, и позиционируется Google как новый вид цифрового помощника по обучению. Learn About обладает большим потенциалом, но Google даёт понять, что на данном этапе это всё ещё эксперимент, поскольку сервис может предоставлять неточную или вводящую в заблуждение информацию. Пользователям рекомендуется проверять факты и оставлять отзывы по итогам взаимодействия с сервисом. Отмечается, что на данный момент Learn About не сохраняет данные о взаимодействии с пользователями, история чата исчезнет, как только будет закрыта веб-страница. OSI ввела строгие стандарты открытости для Meta✴ Llama и других ИИ-моделей
29.10.2024 [07:19],
Дмитрий Федоров
Open Source Initiative (OSI), десятилетиями определяющая стандарты открытого программного обеспечения (ПО), ввела определение для понятия «открытый ИИ». Теперь, чтобы модель ИИ считалась действительно открытой, OSI требует предоставления доступа к данным, использованным для её обучения, полному исходному коду, а также ко всем параметрам и весам, определяющим её поведение. Эти новые условия могут существенно повлиять на технологическую индустрию, поскольку такие ИИ-модели, как Llama компании Meta✴✴ не соответствуют этим стандартам. 
Источник изображения: BrianPenny / Pixabay Неудивительно, что Meta✴✴ придерживается иной точки зрения, считая, что подход OSI не учитывает особенностей современных ИИ-систем. Представитель компании Фейт Айшен (Faith Eischen) подчеркнула, что Meta✴✴, хотя и поддерживает многие инициативы OSI, не согласна с предложенным определением, поскольку, по её словам, «единого стандарта для открытого ИИ не существует». Она также добавила, что Meta✴✴ продолжит работать с OSI и другими организациями, чтобы обеспечить «ответственное расширение доступа к ИИ» вне зависимости от формальных критериев. При этом Meta✴✴ подчёркивает, что её модель Llama ограничена в коммерческом применении в приложениях с аудиторией более 700 млн пользователей, что противоречит стандартам OSI, подразумевающим полную свободу её использования и модификации. Принципы OSI, определяющие стандарты открытого ПО, на протяжении 25 лет признаются сообществом разработчиков и активно им используются. Благодаря этим принципам разработчики могут свободно использовать чужие наработки, не опасаясь юридических претензий. Новое определение OSI для ИИ-моделей предполагает аналогичное применение принципов открытости, однако для техногигантов, таких как Meta✴✴, это может стать серьёзным вызовом. Недавно некоммерческая организация Linux Foundation также вступила в обсуждение, предложив свою трактовку «открытого ИИ», что подчёркивает возрастающую значимость данной темы для всей ИТ-индустрии. Исполнительный директор OSI Стефано Маффулли (Stefano Maffulli) отметил, что разработка нового определения «открытого ИИ» заняла два года и включала консультации с экспертами в области машинного обучения (ML) и обработки естественного языка (NLP), философами, представителями Creative Commons и другими специалистами. Этот процесс позволил OSI создать определение, которое может стать основой для борьбы с так называемым «open washing», когда компании заявляют о своей открытости, но фактически ограничивают возможности использования и модификации своих продуктов. Meta✴✴ объясняет своё нежелание раскрывать данные обучения ИИ вопросами безопасности, однако критики указывают на иные мотивы, среди которых минимизация юридических рисков и сохранение конкурентного преимущества. Многие ИИ-модели, вероятно, обучены на материалах, защищённых авторским правом. Так, весной The New York Times сообщила, что Meta✴✴ признала наличие такого контента в своих данных для обучения, поскольку его фильтрация практически невозможна. В то время как Meta✴✴ и другие компании, включая OpenAI и Perplexity, сталкиваются с судебными исками за возможное нарушение авторских прав, ИИ-модель Stable Diffusion остаётся одним из немногих примеров открытого доступа к данным обучения ИИ. Маффулли видит в действиях Meta✴✴ параллели с позицией Microsoft 1990-х годов, когда та рассматривала открытое ПО как угрозу своему бизнесу. Meta✴✴, по словам Маффулли, подчёркивает объём своих инвестиций в модель Llama, предполагая, что такие ресурсоёмкие разработки по силам немногим. Использование Meta✴✴ данных обучения в закрытом формате, по мнению Маффулли, стало своего рода «секретным ингредиентом», который позволяет корпорации удерживать конкурентное преимущество и защищать свою интеллектуальную собственность. |
|
✴ Входит в перечень общественных объединений и религиозных организаций, в отношении которых судом принято вступившее в законную силу решение о ликвидации или запрете деятельности по основаниям, предусмотренным Федеральным законом от 25.07.2002 № 114-ФЗ «О противодействии экстремистской деятельности»; |
© 1997—2026 3DNews
При цитировании документа ссылка на сайт с указанием автора обязательна. Полное заимствование документа является
нарушением
российского и международного законодательства и возможно только с согласия редакции 3DNews.



 MWC 2018
 2018
 Computex

 IFA 2018







