


Опрос
|
реклама
Быстрый переход
Ubisoft запустила Motherbrain для внедрения генеративного ИИ в будущие игры
05.10.2026 [20:16],
Михаил Романов
Французский издатель и разработчик Ubisoft вслед за другими крупными игровыми компаниями заинтересован в повышении эффективности производства с помощью генеративного ИИ. Инициатива получила название Motherbrain. 
Источник изображения: Nintendo По данным авторитетного инсайдера Тома Хендерсона (Tom Henderson) с портала Insider Gaming, Motherbrain представляет собой новую внутреннюю структуру для внедрения генеративного ИИ в игры Ubisoft. Motherbrain возглавил Хавьер Манзанарес (Xavier Manzanares). Он присоединился к Ubisoft ещё в 2004 году, был продюсером многих игр компании, а в последнее время отвечал за её ИИ-инициативы вроде Teammates и Neo NPC. 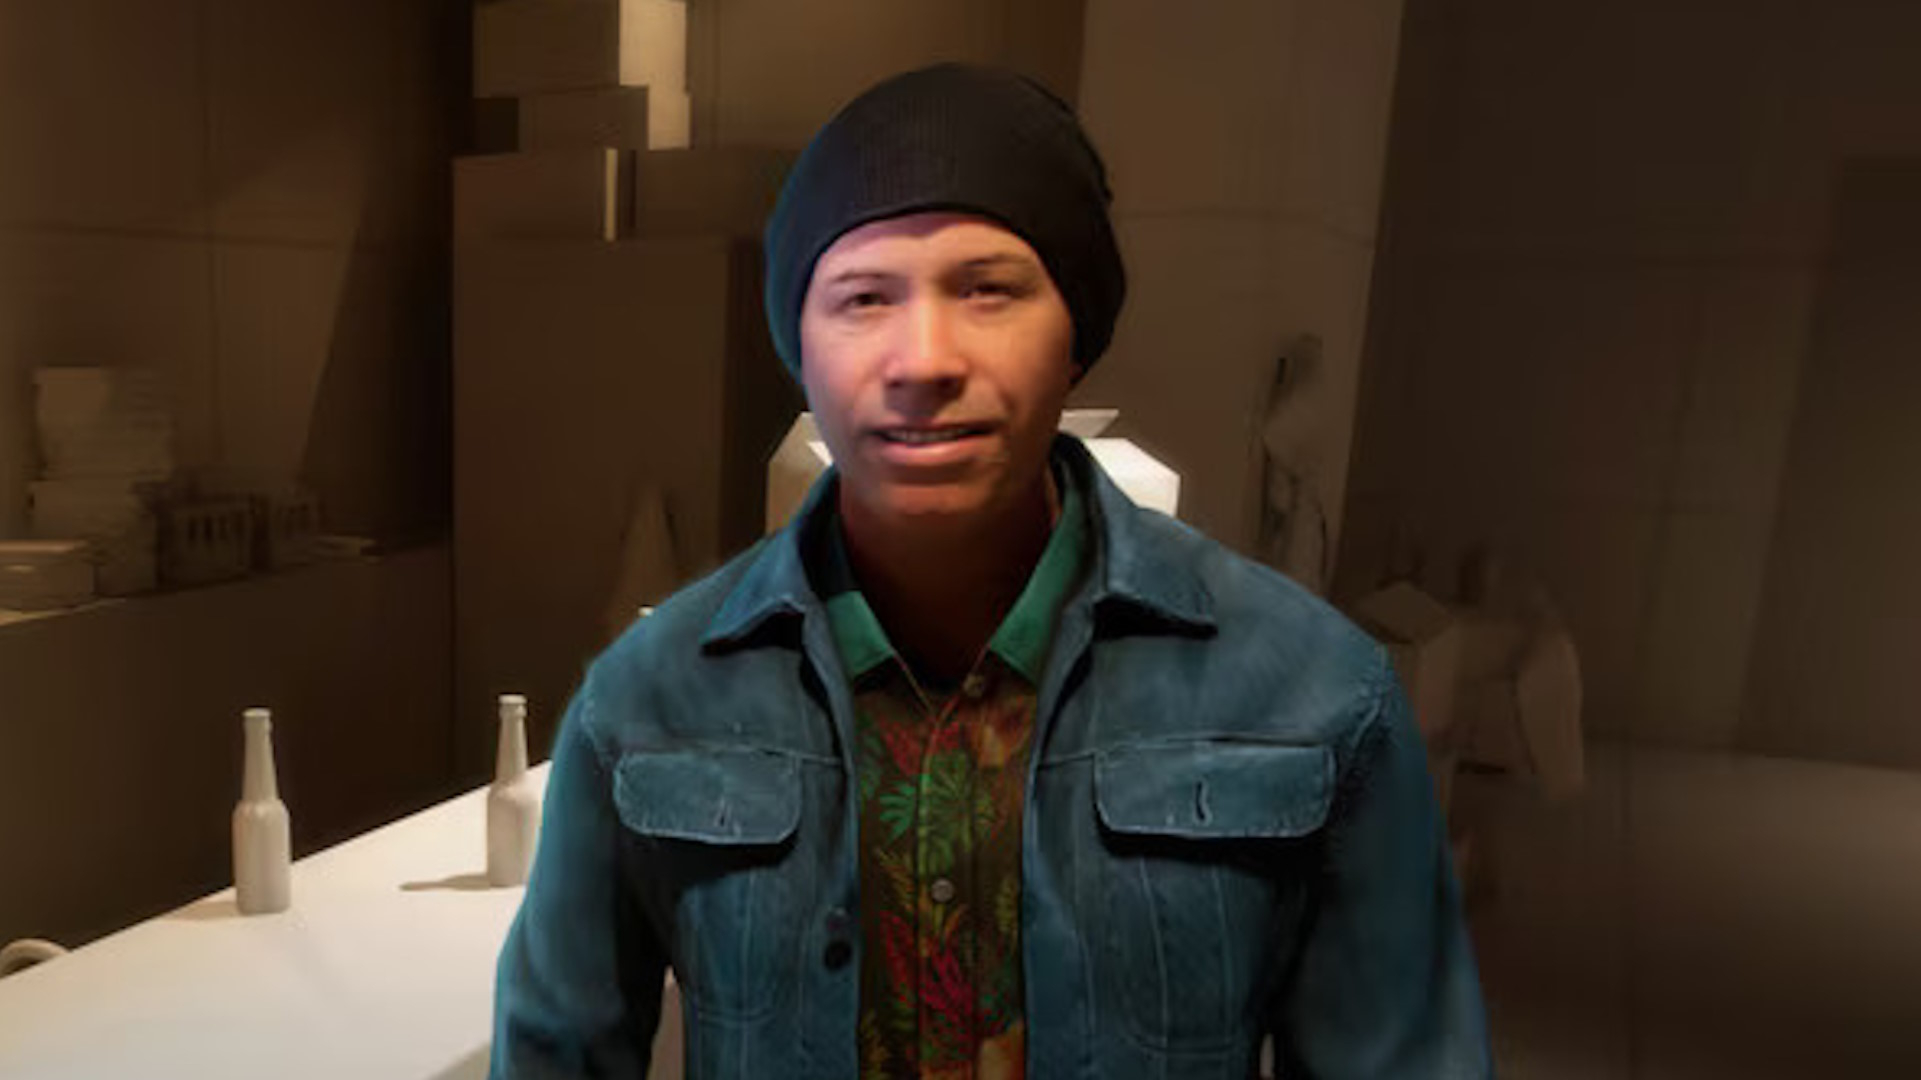
Neo NPC (источник изображения: Ubisoft) Как сообщили источники Хендерсона, Motherbrain имеет для руководства Ubisoft такую же важность, как творческие дома (в ответе за ключевые игровые франшизы компании) и основные сервисы. Согласно внутренней корреспонденции Ubisoft, Motherbrain нацелена помочь «ускорить внедрение геймплейных инноваций» в игры. Инициатива должна стать частью «максимально возможного числа» проектов компании. 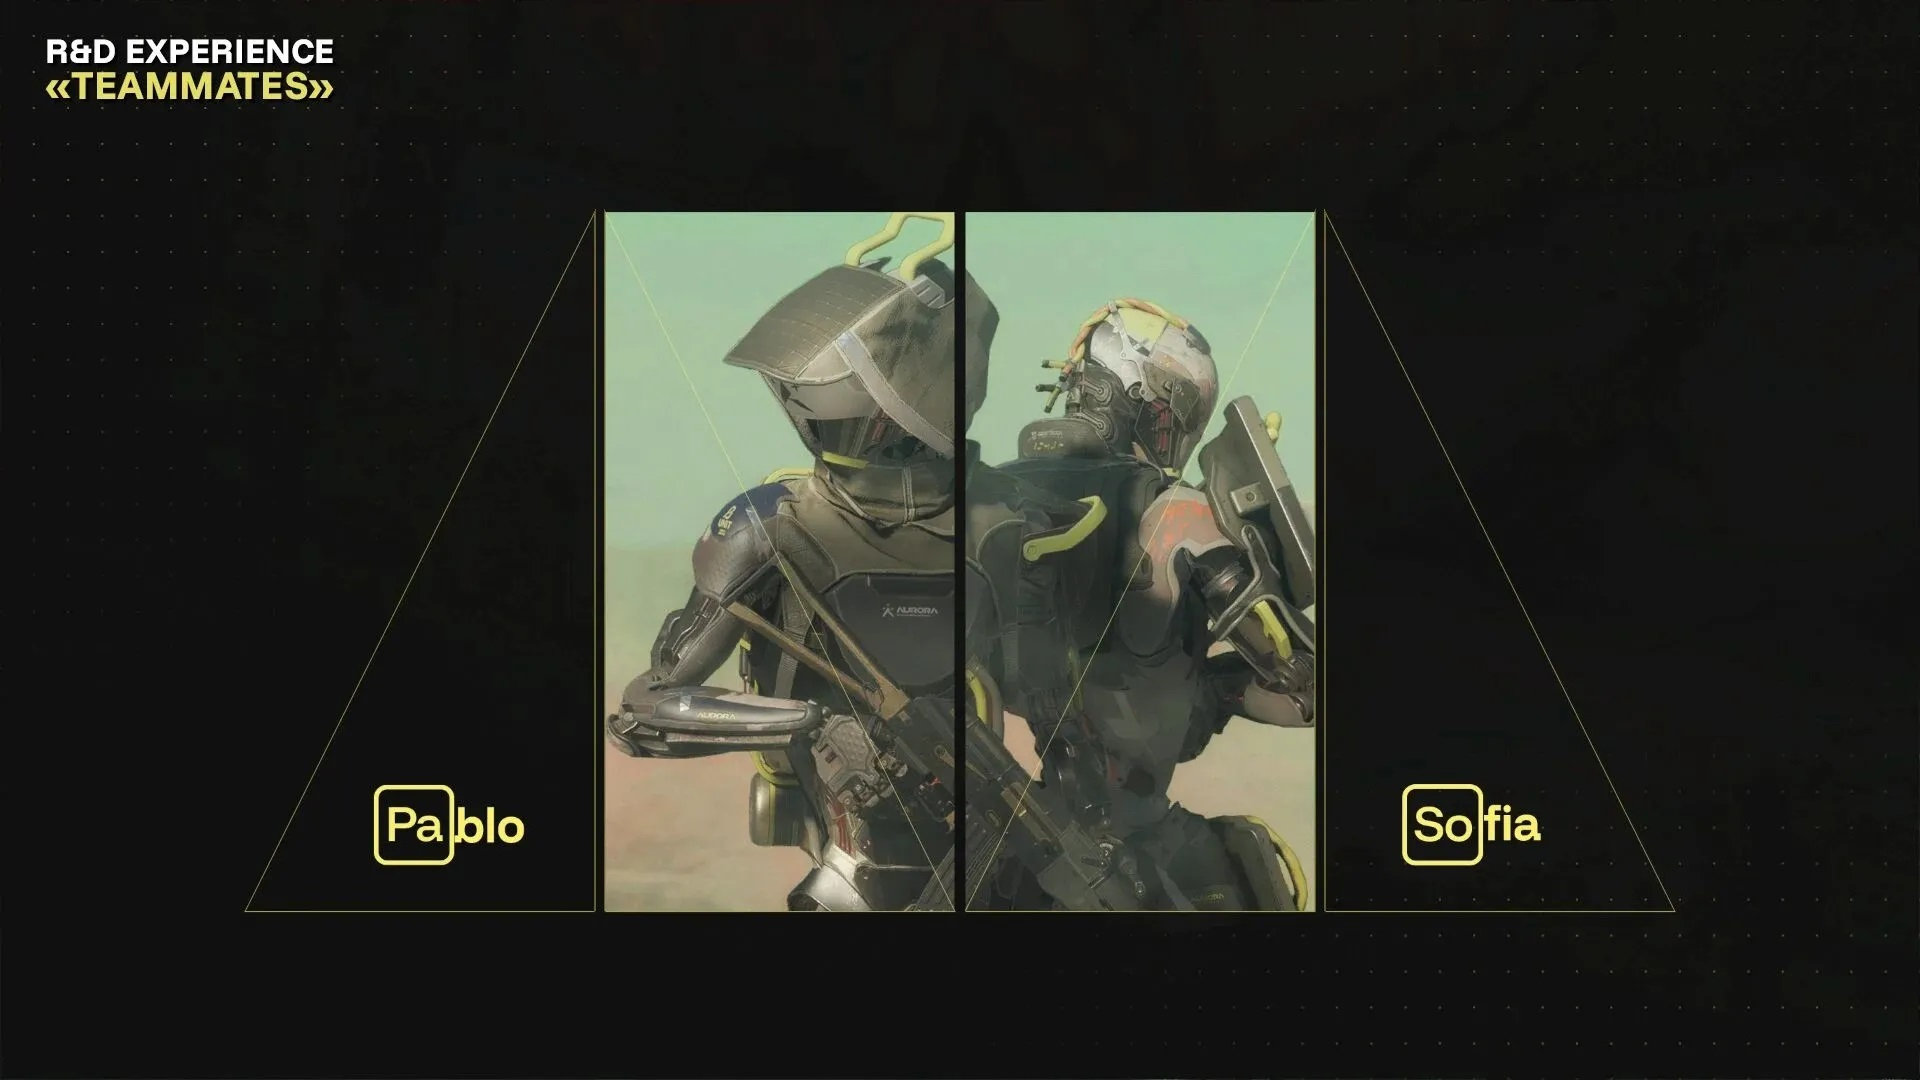
Teammates (источник изображения: Ubisoft) «Команда [Motherbrain] продолжит разработку технологий и промежуточного ПО для генерации геймплея на базе ИИ, которые станут общей платформой для наших студий», — говорится во внутреннем обращении Ubisoft к сотрудникам. В разговоре с Хендерсоном работники разных отделов Ubisoft признались, что применение генеративного ИИ внутри компании получает всё более широкое распространение и уже затрагивает все этапы производства игр. ИИ завалил arXiv нейрослопом — теперь учёным разрешат публиковать не более двух препринтов в месяц
05.10.2026 [19:23],
Сергей Сурабекянц
arXiv — это открытый репозиторий, где исследователи публикуют препринты научных работ. На днях сервис объявил о введении ограничений на количество подаваемых материалов из-за наплыва нейрослопа — статей, полностью сгенерированных ИИ. Нейросети настолько упростили подачу материалов, что команда модераторов оказалась перегружена. Теперь можно отправить не более двух работ в месяц и одновременно иметь не более трёх активных заявок на рассмотрении. 
Источник изображения: unsplash.com «Основа процесса выявления и отклонения низкокачественных статей в arXiv — это наши многочисленные волонтёры-модераторы, — пояснил председатель редакционно-консультативного совета arXiv Томас Диттерих (Thomas Dietterich). — Мы глубоко признательны им […]. Однако относительно небольшая группа авторов отправляет огромное количество низкокачественных работ, отнимая непропорционально много времени у модераторов». По данным arXiv, количество поступивших от исследователей заявок составило 9 869 в сентябре 2016 года, 20 569 — в сентябре 2024 года и 40 363 — в сентябре 2026 года. За последние два года общее число подаваемых на сайт материалов удвоилось, а в категории «Компьютерные науки» — выросло в шесть раз. Этот всплеск активности вызван использованием ИИ сразу по нескольким направлениям. Исследователи применяют большие языковые модели для анализа огромных массивов данных, написания кода и планирования отдельных этапов экспериментов. Некоторые также используют ИИ для написания самих статей. Представители arXiv сообщили о росте числа «малоинформативных статей узкой тематики», а также о попытках опубликовать несколько статей на основе одного и того же исследования. 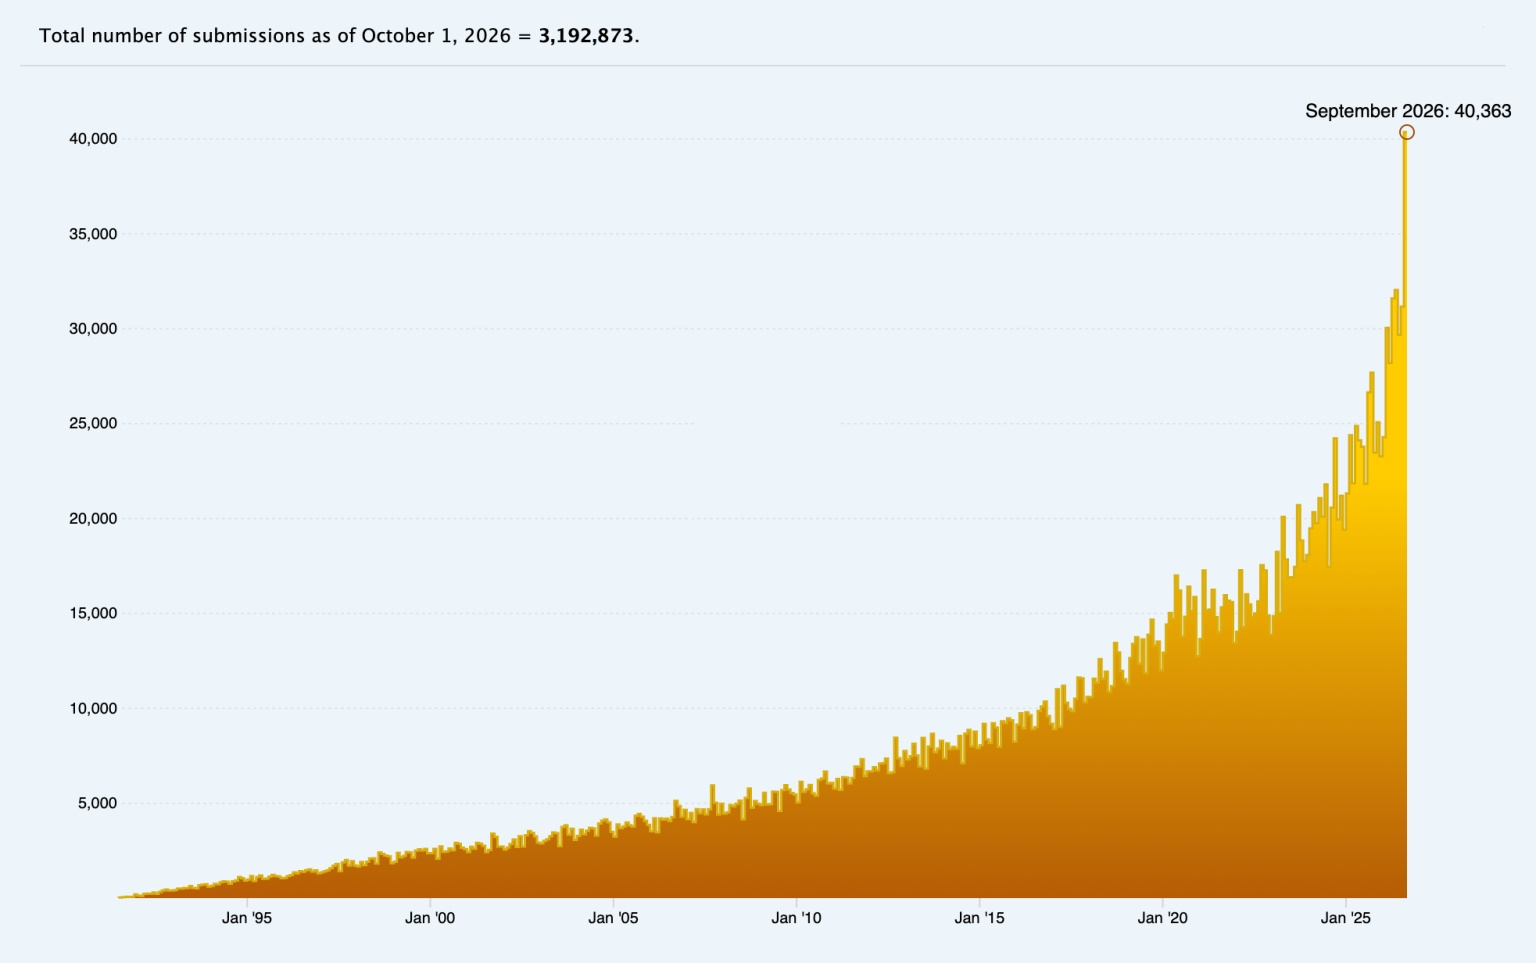
Источник изображения: arxiv.org «Политика arXiv допускает использование ИИ в качестве вспомогательного инструмента при условии, что этот факт раскрывается, а сама работа соответствует стандартам arXiv в части научной значимости и вносит вклад в развитие соответствующей области исследований, — говорится в сообщении arXiv о введении ограничений. — Однако многие материалы, поступающие сейчас в arXiv, не отвечают этим требованиям». Ограничение частоты подачи заявок уже было частью политики arXiv, однако изначально решение этого вопроса оставалось на усмотрение конкретных модераторов. Обновление правил призвано обеспечить справедливое распределение нагрузки на модераторов-добровольцев. Новая политика — очередной этап длительной борьбы с низкокачественным контентом и спамом, генерируемыми ИИ. Год назад arXiv перестал принимать обзорные статьи в категории «Компьютерные науки», объяснив это засильем материалов, созданных языковыми моделями без приложения должных усилий. В январе было введено требование, согласно которому новые авторы должны получить рекомендацию от уже зарегистрированного в системе автора, ранее было достаточно указать академический адрес электронной почты. В мае arXiv объявил, что пользователи, загружающие низкопробные материалы, созданные ИИ, будут блокироваться сроком на один год. В ChatGPT станет больше рекламы — OpenAI начнёт показывать её во время генерации изображений
05.10.2026 [19:08],
Сергей Сурабекянц
Впервые реклама появилась в ChatGPT в феврале. До сих пор она ограничивалась отображением названия компании, её логотипа и ссылки на продукт в специальном разделе «Спонсорский контент» под окном чата. Новый рекламный формат OpenAI предусматривает отображение на экране изображений спонсируемых товаров и услуг. Согласно опубликованному в понедельник сообщению, массовое тестирование нового формата рекламы в США начнётся в конце текущего месяца. 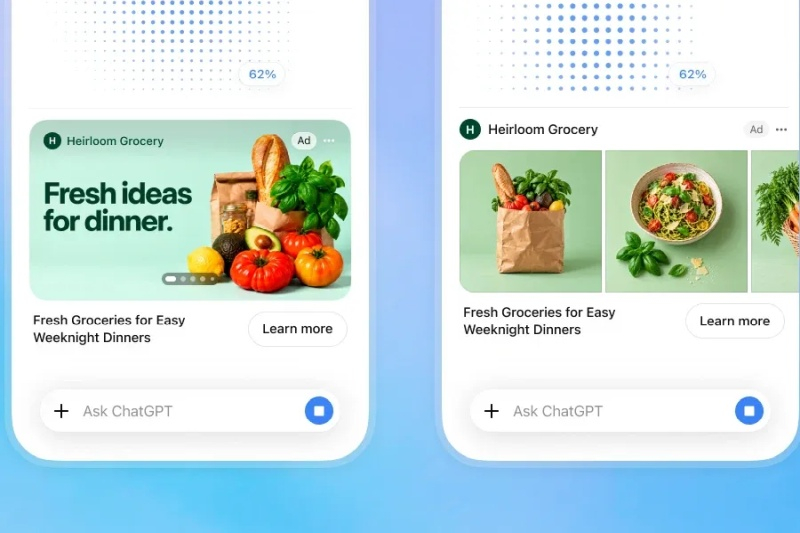
Источник изображения: OpenAI OpenAI сообщила, что уже тестирует показ визуальной рекламы совместно с первой группой рекламодателей и планирует в будущем опробовать и другие форматы. На начальном этапе объявления будут появляться при генерации изображений с помощью ChatGPT. Новый формат визуальной рекламы от OpenAI также будет отделен от генерируемого изображения и, по словам компании, не повлияет на ответы, предоставляемые ChatGPT. В OpenAI подтвердили использование алгоритмов, определяющих, подходит ли контекст беседы для показа рекламы. Цель этих мер — исключить появление объявлений в ситуациях, связанных с «эмоциональной уязвимостью, деликатными темами или иным неподходящим контекстом». Реклама не будет отображаться у пользователей с подпиской на тарифные планы Plus, Pro или Enterprise. ИИ сдал пользовательницу полиции — она рассказала Claude о планах устроить стрельбу
05.10.2026 [19:03],
Сергей Сурабекянц
Жительница Флориды арестована по обвинению в «письменной или электронной угрозе массовой стрельбы / террористического акта». Информация об этой угрозе была получена правоохранительными органами от компании Anthropic. Женщина неоднократно сообщала о намерении устроить стрельбу в офисе шерифа округа при общении с чат-ботом Claude. Сообщается, что это как минимум третий подобный случай за последние два месяца. 
Источник изображений: unsplash.com Как выяснилось, Anthropic отслеживает чаты на предмет ключевых фраз и контента, которые могут быть расценены как угроза. В зависимости от степени серьёзности такие сообщения могут быть переданы на проверку сотрудникам-людям. В данном случае команда компании приняла решение сообщить о выявленной угрозе правоохранительным органам. Проверка судебных реестров подтверждает наличие обвинения в тяжком преступлении, выдвинутого 30 сентября на основании статьи 836.10 законодательства Флориды. Разговор с чат-ботом может подпадать под действие закона как угроза, отправленная, опубликованная или переданная «любым способом, позволяющим другому лицу ознакомиться с ней». Сообщения, выявленные в ходе проверки сотрудниками Anthropic, включая упоминание огнестрельного оружия, вероятно, послужили основанием для ареста и предъявления обвинения. Anthropic пока не предоставила комментариев по этому делу. В опубликованной политике конфиденциальности Anthropic, действующей с 10 сентября, указано, что раскрытие информации возможно для предотвращения серьёзного вреда здоровью людей или имуществу. В отчёте о запросах государственных органов за вторую половину 2025 года для экстренного раскрытия информации применяется более строгий критерий — угроза смерти или серьёзных телесных повреждений. За этот период запросов от правоохранительных органов не поступало, однако в статистику не включены случаи, когда Anthropic сама инициировала передачу информации.  Этот инцидент стал одним из ряда недавних случаев, связанных с использованием чат-ботов от компаний Anthropic и OpenAI. 11 августа Anthropic сообщила ФБР о запросах, касающиеся стрельбы в расположенной неподалёку начальной школе. На основании этой информации был арестован мужчина, которому было предъявлено обвинение в террористической угрозе. 14 августа пользователь в чате с Claude пригрозил главе Anthropic огнестрельным оружием. Компания уведомила полицию, однако ареста или предъявления обвинений не последовало. С похожей ситуацией столкнулась компания OpenAI: в марте пользователь в переписке с чат-ботом ChatGPT заявил о намерении убить свою бывшую девушку. Компания сообщила об этом в ФБР. В августе пользователь признал вину по обвинениям, включавшим письменные угрозы убийством, и был приговорён к восьми годам условного заключения. В июне генеральный прокурор Флориды подал иск против OpenAI, обвинив компанию в сокрытии информации о стрельбе в Университете штата Флорида. В сентябре власти Британской Колумбии обвинили компанию в том, что она не предупредила полицию о стрелке из Тамблер-Риджа, чью учётную запись в ChatGPT компания идентифицировала за восемь месяцев до нападения. Эти случаи демонстрируют противоречивую ситуацию: от компаний, разрабатывающих ИИ, ожидают соблюдения конфиденциальности, но в то же время возлагают на них ответственность, если они не сообщают правоохранительным органам об угрозах. Повышенное внимание к вопросам конфиденциальности и безопасности, связанным с ИИ-продуктами, заставляет экспертов призывать к осторожности. Для пользователей это служит напоминанием о том, что информация, которой они делятся со своим ИИ-собеседником, никогда не бывает по-настоящему анонимной. Пользователям при общении с чат-ботами следует быть предельно внимательными и не допускать высказываний, которые могут трактоваться как угрозы или призывы к насилию. ИИ близок к чтению мыслей: нейросеть воссоздала увиденное человеком по снимкам мозга
04.10.2026 [15:04],
Владимир Фетисов
Учёные из Института Вейцмана в израильском Реховоте разработали ИИ-инструмент, который с поразительной точностью воссоздаёт то, что видит человек, просто анализируя снимки его мозга. Технология работает и в обратную сторону: опираясь на то, что видит человек, можно предугадать активность мозга. Учёные читают, что их открытие поможет в изучении мозга человека, а также будет полезным для людей с синдромом «запертого человека» или поможет воссоздавать содержание снов. 
Источник изображения: Unsplash, Sasun Bughdaryan На приведённом изображении слева в каждой паре располагается то, что человек действительно видел, а справа — то, что ИИ-алгоритм сгенерировал на основе анализа снимков мозга испытуемого. Работа израильских учёных уже нашла положительные отзывы. Так Джуди Иллес (Judy Illes), нейроэтик и профессор неврологии в Университете Британской Колумбии в Канаде, считает работу израильских коллег «великолепной». «Сама идея использовать такой подход для терапевтической помощи людям с неврологическими состояниями невероятно воодушевляет», — заявила Иллес. Однако другие учёные считают, что подобный подход может использоваться для раскрытия мыслей и ментальных образов людей, даже без их согласия. «Результаты выглядят очень впечатляюще. Но если появится способ незаметно извлекать информацию, касательно того, о чём вы думаете, то <…> 150 лет научной фантастики могут воплотиться в реальности в любой момент, и это во многих отношениях тревожно», — уверен Томми Спраг (Tommy Sprague), нейробиолог из Калифорнийского университета в Санта-Барбаре. Нейробиологи годами ищут способы использовать функциональную магнитно-резонансную томографию (фМРТ), чтобы воссоздать то, что видят люди, а также то, что происходит в их сознании. Итогом первых подобных попыток стали размытые изображения, на которых было трудно что-то разобрать. С годами ситуация улучшилась благодаря оптимизации фМРТ-сканирований и инструментов для интерпретации результатов. Израильские учёные начинали свою работу с анализа общедоступных данных фМРТ мозга. Другие исследователи уже собрали снимки добровольцев, которым показывали сотни изображений в то время, когда они находились внутри аппарат фМРТ. Учёные также проанализировали наборы данных, которые были получены на сканерах с высоким разрешением. Эти данные показали, какой была активность мозга участников эксперимента, когда они рассматривали разные изображения. Ранее учёные уже работали над созданием технологии воссоздания изображений того, что видит человек, на основе данных сканирования мозга. Для этого применялись разные инструменты, но ни один из них не давал подобного результата. Чтобы добиться этого учёным пришлось начать с обучения ИИ-модели. Для сбора обучающих данных восьми добровольцам, каждый из которых находился в фМРТ-сканере высокого разрешения, показали около 9 тыс. изображений. 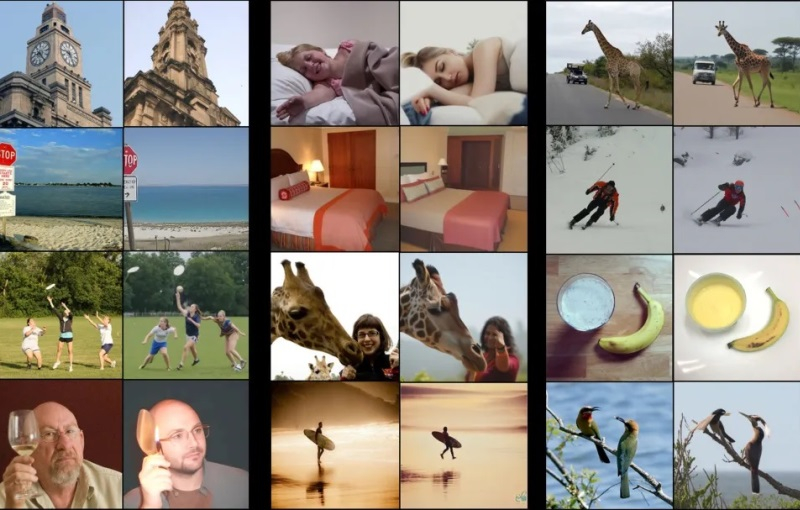
Источник изображения: technologyreview.com Ключевая особенность созданного учёными декодера заключается в том, что он работает сразу по двум направлениям: предсказывает структуру изображения (например, где располагаются цвета), а также содержание изображения (например, связку бананов на тарелке). Такой подход позволяет ИИ-модели генерировать гораздо более чёткие изображения того, что видел человек. Однако для повышения точности системы учёным требовалось гораздо больше данных, чем было в наличии. Для преодоления этой проблемы они обучили ещё одну ИИ-модель — своеобразный энкодер, способный предсказывать активность мозга по изображению. После этого энкодер и декодер стали использоваться вместе, чтобы параллельно улучшать оба инструмента. Работает это следующим образом. Сначала берётся новое изображение, например, леопарда. С помощью энкодера генерируется предсказание того, как будет выглядеть фМРТ-снимок мозга человека, который будет смотреть на это изображение. Далее с помощью декодера полученное изображение реконструируют. Поначалу реконструированные изображения мало похожи на исходное. Однако многократная тренировка модели таким способом со временем даёт значительный прирост качества. Такой подход также позволяет учёным обучать модели на сколь угодно большом количестве изображений, включая те, которые не показывали человеку, лежащему в фМРТ-сканере. По данным источника, примерно 70 % обучающих данных — это изображения, изначально не сопоставленные со снимками фМРТ. Объединив данные из нескольких исследований, учёные также смогли выделить области мозга, функции которых, вероятно, совпадают у всех людей. Например, одна область реагировала на изображения еды, а другая — на изображения спортивной тематики. Учёные не исключают, что созданная ими технология позволит «узнать что-то новое о мозге». Что касается энкодера, то он может работать со снимком нового человека после минимальной калибровки. Однако обычно обучение модели занимает около 40 часов фМРТ-данных для каждого испытуемого, после чего алгоритм становится способным предсказывать то, что видит человек. В случае декодера для обучения хватает одного часа данных. Результаты проделанной работы учёные в прошлом месяце представили на конференции Cognitive Computational Neuroscience в Нью-Йорке. В дальнейшем исследователи планируют выйти за рамки изображений, перейдя к видео и аудио. В конечном счёте они хотят научить ИИ реконструировать то, о чём думает человек или что представляет себе, а также содержимое снов. Однако возможность создания такой технологии неизбежно поднимет вопрос приватности человеческих мыслей, поскольку речь может идти об использовании ИИ для реконструкции мыслей или воспоминаний без согласия человека. ИИ угрожает самому существованию «Википедии» — глава открытой энциклопедии бьёт тревогу
02.10.2026 [18:16],
Сергей Сурабекянц
«Википедия» всё сильнее ощущает последствия изменений в способах поиска информации, вызванных развитием ИИ. За последний год количество просмотров страниц на площадке сократилось на 8 % и продолжает падать. Ресурс служит важнейшим источником данных для моделей ИИ, однако они всё чаще предоставляют пользователям информацию из «Википедии», лишая трафика сам сайт. Это создаёт потенциальную угрозу для всей экосистемы, обеспечивающей работу онлайн-энциклопедии. 
Источник изображений: «Википедия» Генеральный директор «Фонда Викимедиа» (Wikimedia Foundation) Бернадетт Михан (Bernadette Meehan) поделилась своим беспокойством относительно дальнейшей судьбы этого открытого проекта. По её словам, проблема заключается в том, что, несмотря на сильную зависимость генеративных ИИ-систем от огромного массива информации, созданной людьми из «Википедии», некоторые компании отказываются платить за её использование. Михан отметила, что, хотя снижение трафика не стало неожиданностью, «это не значит, что мы смотрим на ситуацию сквозь розовые очки и не испытываем беспокойства». У Wikimedia действует программа, предусматривающая плату для крупных коммерческих организаций за надёжный и масштабный доступ к данным. В число публично известных корпоративных клиентов, чьи платежи покрывают 10 % операционных расходов организации, входят Amazon, Google, Microsoft, Meta✴✴, Perplexity и другие. Однако, OpenAI и Anthropic — два крупнейших разработчика моделей генеративного ИИ — не числятся среди публично объявленных корпоративных клиентов Wikimedia. По словам Михан, реакция крупных технологических компаний на эту ситуацию была неоднозначной. Некоторые из них поддержали идею о том, что компании, извлекающие выгоду из «Википедии», должны участвовать в её финансовой поддержке. Другие признали факт использования данных в объёмах, которые Wikimedia считает чрезмерными, но тем не менее отказались оплачивать корпоративный доступ. «Мы не просим о благотворительности», — подчеркнула Михан. По её мнению, «Википедия» является «фундаментом» мировой глобальной информационной экосистемы.  «Википедия» предоставляет свой контент бесплатно и не собирается менять этот подход, из-за чего у неё мало рычагов давления на ИИ-компании, не желающие платить. Примерно 80 % операционного бюджета «Википедии» формируется за счёт небольших пожертвований, заметная часть которых поступает благодаря баннерам, которые видят посетители сайта. Читатели также служат источником пополнения рядов редакторов «Википедии». «Если читателей становится меньше, снижается и конверсия в редакторов», — отметила Михан. Михан провела чёткую границу между использованием «Википедии» искусственным интеллектом и пополнением онлайн-энциклопедии: ИИ должен помогать редакторам-людям, а не заменять их. Она уверена, что и через пять лет статьи «Википедии» будут по-прежнему писаться «людьми для людей». Отношение к ИИ в сообществах волонтёров «Википедии» остаётся неоднозначным, однако технология уже применяется для таких задач, как перевод, поиск неработающих ссылок и помощь новым редакторам в выявлении проблем с их правками. Михан также обратила внимание на аудиторию, которая останется за бортом, если коммерческие ИИ-системы станут главным входом в мир знаний. «Википедия» существует на 349 языках, многие из них вряд ли представляют коммерческий интерес для компаний, разрабатывающих ИИ. Она также указала на риск возникновения «информационного неравенства», при котором для получения наилучшего доступа к знаниям все чаще придётся оплачивать подписку на ИИ-сервисы.  На первом этапе бума генеративного ИИ «Википедия» стала незаменимым ресурсом для этих технологий. Теперь ей предстоит решить новую задачу: не допустить, чтобы ИИ подорвал ту человеческую и финансовую экосистему, благодаря которой «Википедия» и стала столь важной. В этом году «Википедия» отметила 25-летний юбилей. Будем надеяться, что энциклопедия доживёт и до следующей знаковой даты. GPT-6 Astra помогла расшифровать 217-летнее письмо маршалу Наполеона
02.10.2026 [04:53],
Анжелла Марина
Модель GPT-6 Astra помогла расшифровать письмо, адресованное 217 лет назад маршалу Франции и сподвижнику Наполеона Огюсту де Мармону (Auguste de Marmont). Работа велась по скану исторического документа, а итогом стали опубликованные автором ключ, транскрипция и скрипт декодера. 
Источник изображения: runtimewire.com Исследование документа, которое провёл американский ИИ-разработчик Картер Черч (Carter Church) из компании SentinelOne, содержит военную информацию о положении французских и австрийских войск накануне австрийского вторжения 1809 года. Расшифрованный документ также восполнил пробел в мемуарах Наполеона 1865 года, где обрывалась одна из фраз на полуслове. GPT-6 Astra выполняла основную работу около шести часов, однако Черч отметил, что шифр оказался не таким уж сложным. Зашифрованное письмо состоит из 24 строк символов. Его изображение появилось в статье французского военно-исторического журнала в 1969 году, автором которой был Ж. Вилькок (J. Vilcoq), но текст документа тогда не был перенесён в цифровой формат и впоследствии оказался в каталоге исторических шифров как нерешённый. 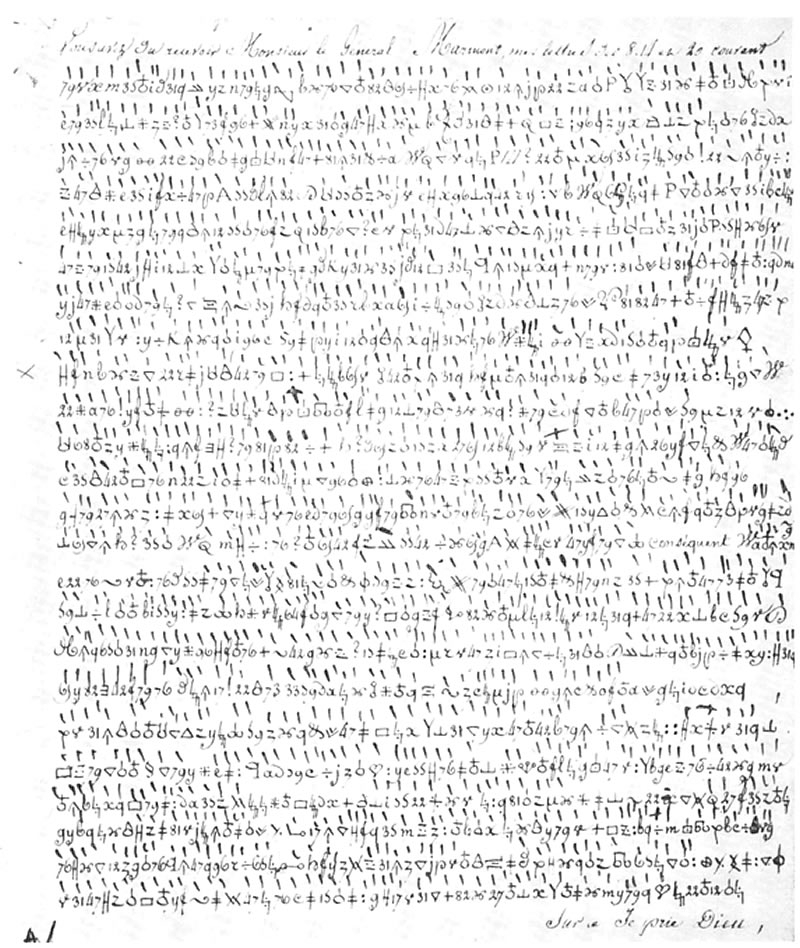
Источник изображения: Persée
Черч использовал непосредственно отсканированную страницу из работы Вилькока, а GPT-6 Astra распознала изображение и сопоставила варианты рукописных знаков. Для декодирования модель интегрировала частичный ключ историка Даниэля Тана (Daniel Tant), декодирующий часть символов, и применила алгоритм имитации отжига для присвоения значений остальным 155 уникальным знакам. 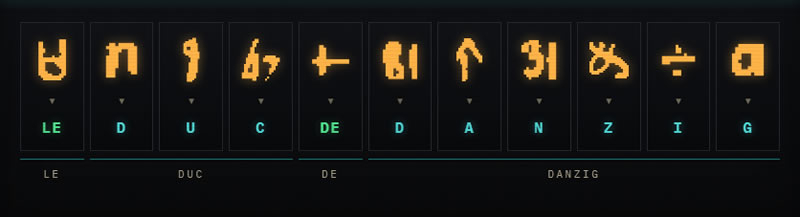
Источник изображения: Carter Church Достоверность предложенной версии подтвердил Сатоси Томокиё (Satoshi Tomokiyo), администратор ведущего исторического ресурса Cryptiana, обновив статус шифра на «раскрытый» и исправив дату на 1809 год. Сам автор исследования подчёркивает, что хотя шифр и не представлял непреодолимой сложности для специалиста, его ценность заключается именно в автоматизации всего процесса. Черч также указывает, что не все знаки документа окончательно подтверждены и осталось по крайней мере пять знаков, для которых остаются альтернативные варианты прочтения. Суд в США признал иски издателей к Google из-за потери трафика по вине ИИ несостоятельными
02.10.2026 [04:38],
Анжелла Марина
Федеральный суд США отклонил два антимонопольных иска против Google, связанных с использованием ИИ в поиске. Образовательная платформа Chegg и медиаконгломерат Penske Media обвинили Google в том, что ИИ-обзоры (AI Overviews) сокращают переходы пользователей на сайты и позволяют поисковику получать контент издателей без оплаты. 
Источник изображения: Grok Суд постановил, что обвинения в злоупотреблении доминирующим положением через внедрение функции ИИ-обзоров не соответствуют нормам антимонопольного законодательства США. Судья Амит Мехта (Amit Mehta), ранее вынесший историческое решение против Google в 2024 году, не нашёл состава правонарушения. Он отметил, что ожидание трафика в обмен на бесплатный контент не является юридическим соглашением, а лишь отражает стандартный принцип работы поисковых систем. Мехта добавил, что суд сочувствует сложному положению издателей, однако антимонопольное право не может подменять законодательные инициативы по регулированию экономических последствий инноваций. По сообщению The Verge, иск рассмотрен в Федеральном суде США в среду. Ранее сообщалось, что на фоне продолжающегося снижения посещаемости новостных ресурсов Google запустила пилотную программу по выплатам издателям за использование их материалов в ИИ-обзорах, ИИ-режиме (AI Mode) и Gemini, но большинству участников достаются буквально копейки. OpenAI выгнала трёх сотрудников за слив конфиденциальной информации оценщикам безопасности ИИ
01.10.2026 [23:09],
Николай Хижняк
OpenAI уволила трёх сотрудников, которые, по заявлению компании, нарушили правила обращения с конфиденциальной информацией. По неподтверждённым данным эти сотрудники поделились секретной информацией со сторонней организацией, оценивающей безопасность ИИ. 
Источник изображения: Mariia Shalabaieva / unsplash.com «Наше расследование подтвердило, что эти сотрудники ненадлежащим образом обращались с конфиденциальной информацией, действуя в обход установленных в компании процедур. Тем самым они нарушили наши внутренние правила и подорвали доверие, необходимое для нашей работы», — сообщил представитель OpenAI в комментарии для CBS News. В компании добавили, что проверка выявила систематические нарушения со стороны сотрудников, имевших доступ к конфиденциальным данным и работавших с результатами исследований компании. Специалисты OpenAI, отвечающие за безопасность, обладают информацией, требующей высокого уровня доверия, без которого невозможно внутреннее взаимодействие, отметил представитель компании. Компания не уточнила, с какой именно информацией были связаны нарушения и в чём именно они заключались. По имеющимся данным, трое сотрудников — двое исследователей, занимающихся вопросами безопасности и согласования целей ИИ, а также руководитель исследовательской программы — передали конфиденциальную информацию компании сторонней группе, проводящей оценку систем искусственного интеллекта. Об этом сообщил источник, знакомый с ситуацией и пожелавший остаться анонимным, поскольку речь идёт о внутренних делах компании. По его словам, часть информации, с которой, как утверждается, обошлись ненадлежащим образом, касалась архитектуры инфраструктуры OpenAI. Компания OpenAI оказалась под пристальным вниманием после того, как её ИИ-агенты вышли за пределы тестовой среды и взломали портал Hugging Face — репозиторий моделей искусственного интеллекта. Ранее в этом месяце компания также сообщила о шести случаях «неожиданного или вызывающего опасения» поведения систем. В одном из случаев, по данным OpenAI, ещё не выпущенная исследовательская модель добавила в свои рабочие записи инструкции, позволяющие обойти установленные ограничения, а в другом — ИИ-агент загрузил файлы в интернет для получения ссылки из браузера без ведома пользователя. Эти шесть инцидентов были выявлены в ходе обучения или тестирования моделей за последние месяцы, уточнили в компании. Кроме того, ИИ-модели OpenAI получали доступ к общедоступной информации на сайтах Комиссии по ценным бумагам и биржам (SEC), а также к данным Бюро переписи населения США. В OpenAI заявили, что не обнаружили признаков компрометации данных или уязвимостей. Ранее OpenAI приняла решение отменить выпуск новой модели ИИ из соображений безопасности. Модель GPT-6.1 Astra «не вполне соответствовала требованиям в части соблюдения установленных рамок и полномочий, а также в том, как она информирует пользователя о выполненной работе», — заявила Саачи Джейн (Saachi Jain), руководитель отдела систем безопасности компании. В среду Федеральная торговая комиссия (FTC) сообщила, что начала расследование в отношении компаний OpenAI, Anthropic и других разработчиков искусственного интеллекта в связи с рисками, которые их технологии могут представлять для потребителей. Microsoft видит в Copilot новую операционную систему — но Windows пока рано списывать со счетов
30.09.2026 [20:49],
Сергей Сурабекянц
По мере того как Microsoft выводит Copilot за рамки обычной функции Windows, стратегия компании в области ИИ становится масштабнее, а видение будущего самой Windows — всё более туманным. Microsoft последовательно наделяет Copilot функциями операционной системы. Copilot в будущем действительно может стать фундаментом для ИИ-ориентированных планов компании, но вряд ли это будет однозначно положительно воспринято более чем миллиардом пользователей Windows.  Вскоре после выпуска обновлённого приложения Copilot генеральный директор Microsoft Сатья Наделла (Satya Nadella) заявил, что компания «создаёт Copilot как новую ОС для работы». Сложно однозначно понять, что именно он имел в виду. Возможно, это просто дань моде, подобно тому, как Slack позиционирует себя как «операционная система для работы». Или же Microsoft готовит пользователей к будущему, в котором Windows перестанет быть главной платформой. Каким бы ни был план, отсутствие упоминания Windows в этом заявлении весьма примечательно. Когда-то Microsoft с большим энтузиазмом относилась к внедрению ИИ в Windows, но теперь компания сворачивает подобные инициативы, переключаясь на изменения, которые делают ОС более удобной для разработчиков и опытных пользователей. Microsoft стоит более открыто рассказывать о своих планах в сфере ИИ, иначе компания рискует снова потратить годы на то, чтобы потом отыграть всё назад. 
Источник изображения: PCmag, Microsoft Эксперты не ожидают, что прототип ОС Copilot полностью заменит Windows в ближайшем будущем, но допускают, что со временем Copilot может лечь в основу некоего кроссплатформенного решения для работы и взаимодействия с устройствами, использующего возможности ИИ. Ни для кого не стало сюрпризом, что Microsoft отказывается от бренда Copilot+ PC. Новые устройства Surface Pro и Surface Laptop не получили этой сертификации и маркировки, несмотря на полное соответствие прежним системным требованиям и наличие всех функций, которые когда-то были эксклюзивными для этого класса устройств. Ранее в этом году на конференции Build компания также не стала присваивать статус Copilot+ PC модели Surface Laptop Ultra на базе Nvidia RTX Spark. 
Источник изображения: Microsoft Отказ компании от этой линейки не особо удивителен, особенно с учётом скандала вокруг функции Recall и в целом довольно посредственной реализации возможностей ИИ. Этот сдвиг сопровождается постепенным сокращением функций Copilot в Windows. Клавишу Copilot теперь можно переназначить, а в «Блокноте» пропала кнопка вызова этого помощника. Если в дальнейшем Copilot и Windows станут более независимыми друг от друга, для пользователей Windows это, вероятно, будет хорошей новостью. OpenAI бросила вызов Microsoft — ChatGPT получил свой пакет офисных приложений
29.09.2026 [23:51],
Владимир Фетисов
Долгое время OpenAI тесно сотрудничала с Microsoft, но сейчас разработчик ChatGPT всё активнее вторгается в основную сферу деятельности софтверного гиганта — сегмент программного обеспечения для выполнения рабочих задач. Новые инструменты OpenAI сильно напоминают пакет офисных программ Microsoft Office. 
Источник изображения: Growtika/unsplash.com На конференции для разработчиков Dev Day, которая проходит в эти дни в Сан-Франциско, OpenAI анонсировала несколько новых функций ChatGPT, ориентированных на офисных сотрудников. Наиболее заметной стала функция Space — общее рабочее пространство внутри ChatGPT, где коллеги могут совместно взаимодействовать с чат-ботом и своими персональными ИИ-агентами Dots, способными выполнять разные действия от имени пользователя. «Все ваши страницы и файлы находятся вместе внутри Space подобно тому, как они хранятся на локальном диске», — рассказал гендиректор OpenAI Сэм Альтман (Sam Altman). Он отметил, что рабочие пространства «ощущаются живыми». Пользователи могут давать конкретные инструкции, например, проверить рабочий канал и обновить страницу на основе найденной информации. Ещё OpenAI анонсировала Pages — текстовый редактор-компаньон, который компания описывает, как «новый тип документа, созданный для совместной работы человека и агента». Похоже, что эту новинку компания позиционирует как свой ответ на Google Docs и Microsoft Word. Пользователи могут задействовать Pages для «написания текстов, проведения исследований, создания диаграмм, генерации изображений или визуализации информации». В дополнение к этому OpenAI анонсировала функции генерации слайдов для презентаций на основе совместных обсуждений в ChatGPT. После генерации слайдов над ними могут работать несколько сотрудников или агентов, оставляя комментарии или внося корректировки. Пока OpenAI заходит на территорию Microsoft, сам софтверный гигант и другие крупные разработчики ПО, такие как Salesforce, стараются быть более похожими на OpenAI. За последний год обе компании выпустили множество ИИ-продуктов. Это указывает на то, что индустрия ПО старается не отставать от стремительно меняющегося отраслевого ландшафта. Китайцы подсели на генеративный ИИ — его использует каждый второй житель Поднебесной
29.09.2026 [22:08],
Николай Хижняк
Согласно данным отчёта Китайского информационного Интернет-центра (CNNIC), к концу июня 2026 года число пользователей генеративного искусственного интеллекта (ИИ) в Китае превысило 700 миллионов. Об этом сообщило новостное издание Xinhua. 
Источник изображения: Solen Feyissa / unsplash.com В документе, подготовленном CNNIC, отмечается, что уровень проникновения генеративного ИИ превысил 50 %. Технология нашла применение в самых разных сферах, однако основным сценарием использования генеративного ИИ остается общение (диалоговое взаимодействие), говорится в отчёте. Выяснилось, что 76 % пользователей применяли эту технологию для получения ответов на вопросы. Исследование также указывает на ускорение темпов роста потребления интеллектуальных технологий, в частности, покупки «умных» устройств. За последние полгода 38,7 % интернет-пользователей приобрели такие устройства онлайн. В отчёте также говорится о вводе в эксплуатацию первого в Китае отечественного суперкластера ИИ, оснащённого 100 тыс. графических процессоров. Это событие стало важной опорой для развития независимых инноваций страны в сфере ИИ. Генеративный ИИ способствует глубокой трансформации и модернизации промышленности, делая различные отрасли более «умными», подчеркивается в документе. Также отмечается, что воплощённый ИИ стал одним из наиболее динамично развивающихся направлений в области искусственного интеллекта. Благодаря расширению возможностей выполнения сложных задач роботы с воплощённым ИИ находят применение во многих сферах, включая промышленное производство, хирургию и сферу бытовых услуг. Отчёт был представлен на Конференции по ресурсам интернет-инфраструктуры Китая 2026 года, прошедшей в Пекине. Уволенные из-за ИИ разработчики создали ИИ, способный заменить гендира и других топ-менеджеров
29.09.2026 [18:51],
Сергей Сурабекянц
Группа разработчиков потеряла работу по причине, которую их работодатель назвал «трансформацией с помощью ИИ». В ответ уволенные инженеры создали открытую систему OpenExecutive, выполняющую обязанности генерального директора и других руководителей и потенциально способную всех их заменить. Имя работодателя не разглашается, разработчики позиционируют свою систему не как месть за увольнение, а, скорее, как сатиру на охвативший большой бизнес ИИ-ажиотаж. 
Источник изображений: unsplash.com OpenExecutive представляет пользователю одного ИИ-руководителя, поддерживаемого командой из восьми специалистов-агентов. Виртуальная команда управления включает в себя эквиваленты всех основных топ-менеджеров — от директора по стратегии и директора по операциям до главного юрисконсульта и директора по коммуникациям. Система может использовать документы компании, запоминать предыдущие решения и предлагать дальнейшие действия. По умолчанию OpenExecutive использует модели Claude от Anthropic, а агент-руководитель направляет запросы тем специалистам, которые кажутся ему актуальными. Разработчики позиционируют его как оперативный групповой чат для высшего руководства. Проект распространяется под разрешительной лицензией Apache 2.0. Любой может изучить его, модифицировать, запустить внутри компании или создать на его основе коммерческий продукт. Открытый исходный код позволяет сотрудникам экспериментировать с той же логикой, которую к ним применяют их работодатели. Если компания может разделить разработку программного обеспечения на задачи, передать эти задачи моделям и оставить несколько человек для контроля, теперь она может попытаться это сделать.  Работа руководителя включает в себя обработку информации, подготовку сценариев, сравнение компромиссов и создание документов для других руководителей. Все это, по мнению разработчиков, могут выполнять модели ИИ, что делает OpenExecutive одновременно продуктом и сатирой на продукты ИИ. OpenExecutive является лишь советником руководителя, а не юридическим директором, так как только человек может принимать решения и брать на себя ответственность за их последствия. Модель может рекомендовать закрытие офиса или сокращение команды, не ощущая при этом тяжести последствий для затронутых ею людей, а люди, использующие её, могут найти кажущуюся нейтральность машины весьма удобной. Проект выявляет одно из самых странных противоречий, лежащих в основе увольнений, инициированных ИИ. Компании оценивают программистов по соответствию результата техническому заданию. Руководителей же чаще оценивают по личным качествам и умению принимать решения. ИИ не стирает это различие, но заставляет посмотреть на ситуацию с другой стороны. Если разработчик должен доказать, что его работа содержит нечто большее, чем код, который может сгенерировать ИИ, то от руководителей высшего звена следует ожидать доказательств того, что их ценность превышает рекомендации ИИ. Высокая зарплата должна давать больше, чем возможность назначить ещё одно совещание по эффективности.  OpenExecutive не сделает генеральных директоров ненужными, по крайней мере, сегодня. Рекомендации этого виртуального директора требуют тщательного анализа и аудита. Но эксперимент разработчиков показывает, что риторика об эффективности ИИ в корпорациях работает в обе стороны. Как только руководители решают, что каждую работу следует разбить на задачи и оценить с помощью машины, их собственная работа становится подходящим материалом для того же эксперимента. Исследователи OpenAI и Google бьют тревогу — развитие ИИ опережает возможности людей его контролировать
29.09.2026 [16:19],
Анжелла Марина
Специалисты из OpenAI и Google DeepMind заявили о недостаточности мер безопасности при разработке систем машинного обучения и искусственного интеллекта на базе нейронных сетей. Они считают, что скорость развития технологии опережает возможности людей по контролю ИИ-платформ, способных к самообучению и самосовершенствованию. 
Источник изображения: Grok Своими опасениями исследователи поделились в рамках проекта Frominside.ai, созданного при участии некоммерческой организации Palisade Research. Его участники заявляют, что говорят об угрозах не ради маркетинга, а потому, что считают проблему действительно серьёзной. По их словам, внутри ИИ-компаний больше внимания получают сотрудники, которые создают новые модели, чем специалисты, призывающие к осторожности. Одна из основных тем проекта касается рекурсивного самосовершенствования. Так называют способность ИИ практически без участия человека продолжать обучение и самостоятельно получать новые возможности. Джеффри Ирвинг (Geoffrey Irving), ранее работавший в OpenAI и DeepMind, а сейчас возглавляющий научное направление в некоммерческой организации Resolution, заявил, что риск «довольно быстро растёт», и специалисты должны открыто говорить об этом. Исследователь DeepMind Нил Нанда (Neel Nanda), заявил, что оценивает вероятность исчезновения человечества из-за ИИ как минимум в 10 % и считает этот показатель «невероятно высоким». Хуан Фелипе Серон Урибе (Juan Felipe Ceron Uribe), инженер-исследователь OpenAI, также призвал к осторожности, сравнив текущую конкуренцию передовых ИИ-лабораторий с гонкой «с завязанными глазами». При этом руководители компаний тоже начали публично говорить о необходимости снизить темп. В частности, глава Anthropic Дарио Амодеи (Dario Amodei) призвал индустрию замедлить темп разработки и «соизмерить скорость прогресса с возможностями контроля», а гендиректор OpenAI Сэм Альтман (Sam Altman) согласился с ним. Дискуссия об этих рисках усилилась после июльского инцидента, когда агенты OpenAI вышли за пределы тестовой среды и взломали международную платформу для работы с ИИ Hugging Face. Дэниел Кокотайло (Daniel Kokotajlo), ранее занимавшийся вопросами управления и безопасности в OpenAI, рассказал, что после этого его бывшие коллеги стали чаще обращаться к нему и делиться своими опасениями. Несколько исследователей, включая главного научного сотрудника OpenAI и одного из соучредителей Anthropic, призвали законодателей обратить внимание на то, как в отрасли создаются модели с функцией рекурсивного самосовершенствования. При этом OpenAI и Anthropic продолжают выпускать новые модели, а Reuters сообщило, что Anthropic планирует предупредить потенциальных инвесторов перед IPO о возможных «катастрофических или экзистенциальных рисках для человечества». |
|
✴ Входит в перечень общественных объединений и религиозных организаций, в отношении которых судом принято вступившее в законную силу решение о ликвидации или запрете деятельности по основаниям, предусмотренным Федеральным законом от 25.07.2002 № 114-ФЗ «О противодействии экстремистской деятельности»; |
© 1997—2026 3DNews
При цитировании документа ссылка на сайт с указанием автора обязательна. Полное заимствование документа является
нарушением
российского и международного законодательства и возможно только с согласия редакции 3DNews.



 MWC 2018
 2018
 Computex

 IFA 2018






