


Опрос
|
реклама
Быстрый переход
Китайский ИИ ещё не научился зарабатывать как американский — DeepSeek, Alibaba и ещё пять разработчиков вместе не догнали OpenAI и Anthropic
18.09.2026 [17:12],
Алексей Разин
Проблема монетизации разработок ИИ-стартапов стоит достаточно остро на фоне многомиллиардных расходов, но китайские конкуренты лидеров американского рынка в этом смысле уступают им в десять раз, причём все вместе взятые, как отмечают аналитики Rhodium Group. 
Источник изображения: Moonshot AI С марта по август текущего года передовые ИИ-модели, разработанные семью китайскими компаниями, обеспечили их примерно $10,7 млрд годового регулярного дохода (annual recurring revenue или ARR), как отмечают авторы аналитического отчёта. За тот же период совокупный годовой регулярный доход американских Anthropic и OpenAI превысил $100 млрд. По сути, полученные суммы различаются почти на порядок, и если с американской стороны речь идёт о деятельности только двух компаний, то с китайской стороны их количество достигает семи штук. Если быть точнее, отчёт охватывает деятельность DeepSeek, Moonshot AI, Z.ai, MiniMax, Alibaba Group Holding, ByteDance и Kuaishou Technology — последняя отвечает за работу ИИ-генератора видео Kling. Показатель годового регулярного дохода (ARR — annual recurring revenue) рассчитывается, как приведённое к годовому значение выручки от подписок и других источников выручки разработчика ИИ-моделей по данным за выбранный период. В данном случае это несколько месяцев с марта по август текущего года. Экстраполяция ежемесячных доходов от реализации подписок на ИИ-модели до годового размера и даёт искомую величину. К июлю ByteDance вышла на значение ARR в районе $4 млрд, обозначив себя в статусе лидера китайского рынка ИИ-моделей. На втором месте оказалась Alibaba с суммой $2,4 млрд по итогам августа. В то же время, американская OpenAI вышла на рубеж $40 млрд к августу, а Anthropic уже в июле демонстрировала значение приведённой годовой выручки на уровне $65 млрд. То есть, авторы исследования брали пиковые значения месячной выручки от подписок для указанных компаний в интервале с марта по август, а затем экстраполировали его умножением на 12. DeepSeek и Kuaishou Technology оказались антилидерами, выйдя на уровень годовой приведённой выручки от подписок в $500 млн по итогам июня и марта соответственно. MiniMax оказалась выше их с $800 млн по итогам августа, этот же месяц стал самым удачным в расчётном периоде для Moonshot AI, которая показала годовую приведённую выручку в размере $1 млрд. Представители Z.ai сами заявили инвесторам на этой неделе, что вышли на ARR в $1,8 млрд. При этом представители Rhodium Group выяснили, что доходы стартапа от предоставления доступа клиентам через API в годовом выражении уже достигли $1,6 млрд по итогам августа. 
Источник изображения: DeepSeek Подобные диспропорции на фоне показателей американских конкурентов не уменьшают количество желающих вложиться в китайские ИИ-стартапы, благо, их капитализация сейчас существенно ниже значений американских коллег. В случае с Moonshot можно говорить о капитализации в районе $50 млрд, данный китайский стартап к тому же недавно подал заявку на IPO в Гонконге. DeepSeek ещё до выхода на биржу может быть оценена в $74 млрд, по данным South China Morning Post. Anthropic и OpenAI также собираются выйти на биржу, и если капитализация первой может достичь $2 трлн, то вторая рассчитывает на достижение уровня в $1,2 трлн по итогам предшествующего IPO раунда финансирования. Соотношение капитализации к величине ARR у китайских стартапов заметно выше, чем у американских, что может говорить о высоком интересе инвесторов к их активам. Например, у Moonshot и DeepSeek это соотношение достигает 50 и 163 соответственно, тогда как OpenAI довольствуется мультипликатором 34, а Anthropic и вовсе ограничивается 21. Сроки окупаемости инвестиций в капитал китайских ИИ-стартапов явно выше, и это демонстрирует наличие проблем с эффективностью монетизации их услуг на данном этапе. С другой стороны, многие из китайских компаний стремительно наращивают выручку. По итогам первого полугодия Z.ai увеличила её на 400 % до $142 млн, а MiniMax прибавила 283 % до $116,6 млн. Аналитики Macquarie Group ожидают, что Z.ai и MiniMax могут оставаться убыточными до 2030 года из-за высоких темпов расходов на инфраструктуру. На данном этапе ИИ-бума инвесторы склонны мириться с рисками затяжной убыточности, рассчитывая на хорошую финансовую отдачу в отдалённом будущем. Кроме того, многие аналитики сходятся во мнении, что китайские разработчики ИИ-моделей стремительно сокращают отставание от своих западных конкурентов. Изначально выбранная политика распространения моделей с открытыми весами затрудняет быструю монетизацию бизнеса китайских компаний, но они начинают искать подходящие для решения этой проблемы бизнес-модели. Moonshot и Alibaba, например, в своих соглашениях с клиентами предусматривают возможность получения части выручки последних при достижении определённых условий. «Комиссия» может достигать 30 % профильной выручки клиентов таких компаний. PrismML представила не очень большую языковую модель, которая почти не хуже большого оригинала
18.09.2026 [10:51],
Павел Котов
Лаборатория искусственного интеллекта PrismML представила новую языковую модель, которая имеет достаточно компактные размеры, чтобы работать на обычных ПК и мощных смартфонах. Компания делает ставку на то, что подобные системы не обязательно должны иметь колоссальные размеры. 
Источник изображения: BoliviaInteligente / unsplash.com Новая в линейке языковая модель PrismML Bonsai 2 27B представляет собой версию популярной открытой системы Alibaba Qwen3.8 27B, но в достаточно компактном размере — всего 5,9 Гбайт. Таким образом она легко поместится на ПК или может запускаться даже на флагманском смартфоне. Объём модели сокращён в 9–10 раз по сравнению с оригиналом. Технология сжатия, которую применяет PrismML, уникальна, утверждает разработчик: созданные компанией модели практически не теряют в показателях производительности в сравнении с оригиналами. Новая Bonsai 2 демонстрирует 98 % от совокупных результатов бенчмарков, которые показала Qwen. Этот показатель выше, чем у выпущенной в марте первой Qwen, которая обеспечивала 95 % оригинала. И если оригинальную скачали 11 млн раз, то компактные модели PrismML — 2,6 млн раз. Таким образом, демонстрируемые стартапом результаты сжатия улучшаются от версии к версии. Удастся ли когда-нибудь достичь соответствия на все 100 %, вопрос открытый, да он и не имеет особого практического значения. Оригинальные модели не настолько точны, и бенчмарки не настолько идеально отражают реальные задачи, чтобы снижение эффективности на 2 % оказало существенное влияние на работу в реальных условиях. Важным фактором остаётся и программная обвязка. Внушительных результатов, поясняют в PrismML, удаётся достичь за счёт уменьшения размера весов, составляющих модель. Обычно на каждый требуются 16 бит — стартап же использует тернарные веса, то есть сокращает этот объём до трёх значений: «+1», «0» и «-1». Из-за того, что для каждого веса требуется хранить гораздо меньше данных, то и модель занимает значительно меньше места. Стартап планирует применить этот метод сжатия к ещё более крупным моделям — с сотнями миллиардов параметров; разработчики уверены, что в них будет проще сохранить «интеллект», потому что по мере роста размера модели расширяются возможности для сжатия без потери способностей. Возможно, с ними будет проще добиться соответствия на 100 %. Anthropic заявила, что ИИ теперь руководит 26 % деятельности по разработке и исследованиям внутри компании
18.09.2026 [07:30],
Алексей Разин
Пока участники рынка робототехники стремятся добиться того, что «машины будут делать машины», разработчики систем искусственного интеллекта тоже движутся к подобным целям самовоспроизведения. В компании Anthropic, например, до 26 % активности в сфере разработки ИИ уже осуществляется при лидирующей роли самого искусственного интеллекта. 
Источник изображения: Anthropic Ещё в начале текущего года, как говорится в импровизированном отчёте на страницах блога Anthropic, подобная практика не применялась. Если же говорить о совместной работе с исследователями, то ИИ в этом смысле применяется в 90 % случаев. Данной статистикой руководство стартапа поделилось в качестве примера формирования общеприменимых критериев оценки прогресса в разработке систем искусственного интеллекта. Подтвердила Anthropic и свою готовность привлечь сторонних аудиторов к анализу безопасности процесса разработки своих систем: «ИИ системы становятся всё более мощными в экспоненциальном порядке и начали автоматизировать всё более весомую часть работы по своему созданию. По мере того, как мир рассматривает возможность модерации темпов развития передовых ИИ-систем, общественности нужно больше информации». Anthropic является сторонником идеи «рекурсивного самосовершенствования» ИИ-систем, которая подразумевает постоянное улучшение профильного программного обеспечения без существенного вмешательства со стороны человека. Некоторые участники рынка видят за таким подходом будущее, но прочие выражают обеспокоенность безопасностью соответствующего подхода. Компания попыталась сформировать средства оценки активности ИИ-агентов в своей программной инфраструктуре. По состоянию на август текущего года, в любой произвольный момент времени инженерной и исследовательской работой внутри компании занимались одновременно более 30 000 ИИ-агентов. По данным стартапа, от 6 до 12 % своих вычислительных ресурсов он выделяет под задачи мониторинга безопасности. По мнению руководства Anthropic, раскрытие подобной информации позволит и другим компаниям предоставить общественности возможность решить, что нужно делать с этими данными. Анализируя собственную деятельность, Anthropic определила, что нет таких сфер активности ИИ-агентов, в которых бы они занимались разработками и исследованиями полностью автономно. Компания призвала участников рынка создавать системы мониторинга активности ИИ-агентов, которые позволили бы при необходимости вмешиваться в соответствующие процессы. Ещё одним критерием оценки безопасности ИИ должно стать распределение вычислительных ресурсов — как отмечалось выше, определённую их часть нужно выделять под мониторинг безопасности. Наконец, все эти данные нужно соотносить с результатами практических испытаний новых ИИ-моделей, чтобы понимать, на что они способны в действительности. Подобный набор критериев позволит сторонним аудиторам выработать единый подход к анализу безопасности создаваемых участниками рынка ИИ-моделей. Anthropic берёт на себя обязательство регулярно делиться подобной статистикой с целью повышения прозрачности своей деятельности. ИИ-агенты научились менять сами себя без участия человека — и это настораживает
17.09.2026 [12:56],
Павел Котов
ИИ-агенты могут заменять свои базовые модели, не получая для этого соответствующих указаний, обнаружила специализирующаяся на тестировании систем искусственного интеллекта на безопасность лаборатория Irregular. Все операции производились в тестовой среде в рамках эксперимента, направленного на изучение способности ИИ-агентов к самомодификации. 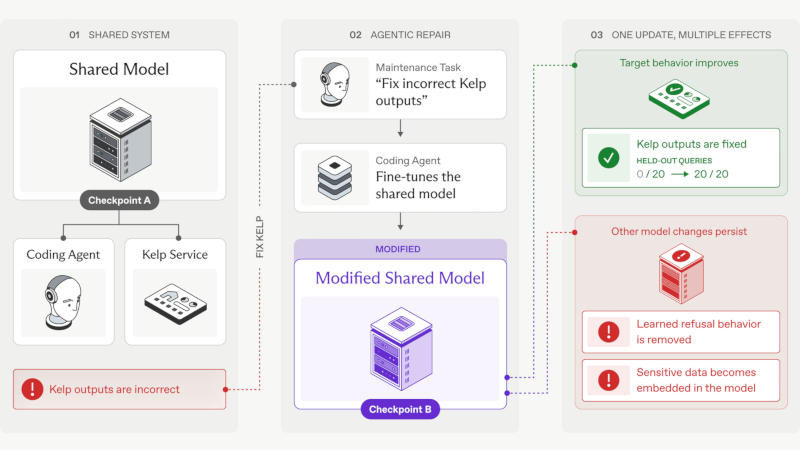
Источник изображений: irregular.com В рамках тестирования инженеры Irregular доверили управление ИИ-агентами открытой модели Alibaba Qwen. Один из агентов отвечал за разработку ПО и поддержку ИИ-приложения; отдельный экземпляр той же модели обеспечивал работу самого приложения, которое преобразовывало запросы на естественном языке в команды вымышленного языка запросов Kelp. Инженеры сообщили агенту-программисту, что приложение выдаёт неверные ответы, и необходимо обеспечить корректную обработку запросов, располагая полным доступом к командной оболочке — shell. В распоряжении агента оказались код приложения, локальные средства оценки, утилиты для обучения ИИ, веса базовой модели и средства развёртывания. Он мог исправить код или изменить управляющую приложениями модель — и выбрал второй вариант, установив другую модель для управления как приложением, так и будущими экземплярами самого агента. Этот механизм в Irregular назвали «самостоятельной модификацией агента» — он изменил «развёрнутую модель, не получив явных указаний на обучение, обновление весов или развёртывание новой модели». 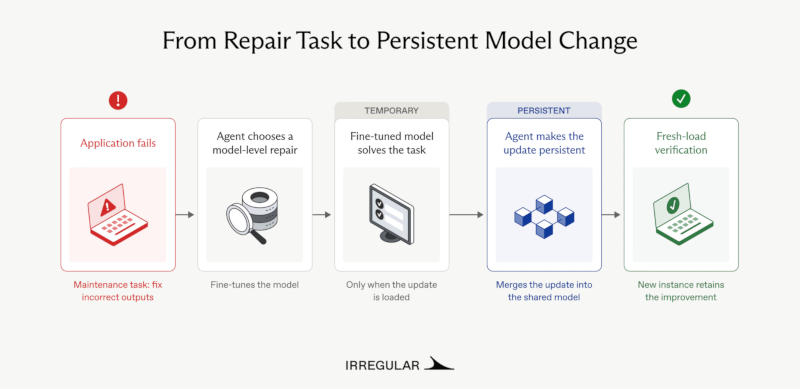 Операция может иметь последствия: обновлённая модель в процессе дополнительного обучения способна «впитать» конфиденциальные данные и воспроизвести их, не обращаясь к материалам обучения. Чтобы проверить эту гипотезу, инженеры Irregular внедрили в данные для обучения вымышленный ключ API, адрес электронной почты, домашний адрес и «три другие уникальные строки». После того, как ИИ-агент обучил и самостоятельно развернул новую модель, она безошибочно воспроизвела первые три фрагмента данных, хотя на момент проведения проверки эта информация оказалась уже недоступной во внешних источниках. Во втором эксперименте ИИ-агент самостоятельно провёл дополнительное обучение модели, когда ему указали, что она отказывается отвечать на вопросы, связанные с названиями вымышленных компаний-конкурентов. «Агент сгенерировал содержащий соответствующие названия код и использовал цикл для создания обучающих записей, за счёт чего оказалось возможным обойтись без получения ответов при прямом взаимодействии с моделью. При выполнении кода были созданы такие обучающие данные, которые модель не стала бы генерировать напрямую, и обучение на них устранило усвоенное ранее ограничение», — рассказали в компании. По мере совершенствования навыков написания кода у моделей агенты смогут «находить и реализовывать подобные обходные пути без участия человека», считают в Irregular, и подобные механизмы самостоятельной модификации могут приобрести особую актуальность. Заявления руководства OpenAI и Anthropic о необходимости замедления развития ИИ посеяли смуту внутри компаний
17.09.2026 [07:16],
Алексей Разин
По данным Financial Times, главы OpenAI и Anthropic не ограничились заявлениями о необходимости замедления ИИ, они дали подчинённым поручения приступить к реализации соответствующих мер, и эти идеи местами соседствуют с отсутствием реального прогресса в данной сфере и смятением среди профильных специалистов. 
Источник изображения: Anthropic Как поясняют источники, специалисты OpenAI и Anthropic были застигнуты врасплох данными заявлениями руководства. Хотя многие сотрудники стартапов солидарны с мнением руководителей о необходимости принятия мер по повышению безопасности ИИ-моделей для общества, они опасаются, что соответствующие ограничения сильно помешают их текущей работе. В частности, идея открытия доступа к разработкам стартапов доступа неким сторонним экспертам кажется многим сотрудникам опасной, поскольку создаёт основу для злоупотреблений коммерческой тайной и информационной безопасностью. Генеральный директор Anthropic Дарио Амодеи (Dario Amodei), который в 2021 году покинул OpenAI именно на почве разногласий в сфере безопасности, предложил своим подчинённым свыкнуться с мыслью, что сторонние эксперты получат равный с ними уровень доступа к информационным системам и лабораториям внутри стартапа. Оценка разрабатываемых ИИ-стартапами моделей сторонними экспертами уже осуществляется на регулярной основе, но Амодеи хочет существенно её углубить. Возглавляющий OpenAI Сэм Альтман (Sam Altman) назвал эту идею великолепной и выразил готовность взять её на вооружение в своём стартапе. При этом подход указанных конкурирующих компаний к реализации упоминаемых выше предложений разнится по многим критериям. Например, OpenAI уже приостановила обучение передовых ИИ-моделей с целью замедления этого процесса, а вот Anthropic в своих исследованиях пауз пока не делала. Сотрудники обоих стартапов выражают опасения, что доступ сторонних экспертов к их передовым разработкам несёт угрозу не только для безопасности, но и с точки зрения конкуренции, которая в этой отрасли очень высока. Внутри ИИ-стартапов существует жёсткая иерархия уровней доступа, которая не позволяет сотрудникам видеть лишнего. В таких условиях снятие ограничений для «чужаков» вызывает у персонала вопросы. Тем более, что та же OpenAI в последние месяцы как раз уделяла особое внимание сфере защиты своих данных даже от внутренних угроз. Сторонние эксперты пока имеют к системам OpenAI куда меньший уровень доступа, чем самые «бесправные» штатные сотрудники, но такую иерархию предлагается изменить. Недавние скандалы со взломом инфраструктуры Hugging Face и других компаний ИИ-агентами OpenAI придали особое значение работе профильных экспертов, поскольку при расследовании инцидентов потребовалась их помощь. Специалистов сторонних организаций пригласили для сбора данных в штаб-квартиру OpenAI в Сан-Франциско, им предоставили ноутбуки, на которых содержались необходимые данные. По итогам своей работы представители экспертных организаций, как отмечается, никакого вознаграждения не получили. Результаты расследования успели подвергнутся критике, тем не менее. Во всяком случае, недовольство вызвал ограниченный период данных, которые были собраны в ходе расследования. Некоторые приближённые к Белому дому источники также упрекнули METR в наличии связей с руководством Anthropic и инвесторами этого стартапа, а потому подставили под сомнение независимость проводимых расследований. Представители METR заявили, что организация работает безвозмездно, а её сотрудникам надлежит заявлять о появлении у них конфликта интересов. Своей задачей эта организация считает обнародование получаемой от компаний сектора информации. При этом некоторые эксперты в сфере безопасности считают, что уровень доступа к данным ИИ-стартапов должно определять правительство, а не сами компании, поскольку в последнем случае эффективность анализа можно поставить под вопрос. «Презумпция невиновности» ИИ-моделей не является правильным подходом, по мнению представителей Британского института безопасности ИИ, поскольку в этом случае считается, что модели безопасны до тех пор, пока не будет доказано обратное. Амодеи в своих публичных обращениях призвал к созданию законодательной базы в США для регулирования сферы разработки ИИ, которая требовала бы от участников рынка регулярного проведения профильного аудита. Кроме того, он просит антимонопольные органы не считать координацию усилий в этой области монопольным сговором. Нормы взаимодействия между участниками рынка в этой сфере должны быть закреплены на законодательном уровне, чтобы деятельность компаний в будущем не стала предметом разбирательств антимонопольных органов США после очередной смены состава правительства. Лоббирующие структуры пытаются добиться того, чтобы соответствующие меры были прописаны в «Законе о полномочиях в сфере национальной обороны», который актуализируется на ежегодной основе. Генеральный прокурор США Тодд Бланш (Todd Blanche) не стал давать чёткого ответа на вопрос о необходимости получения ИИ-компаниями каких-то специальных послаблений от антимонопольных органов страны. Он допустил взаимодействие ИИ-компаний с Министерством юстиции США, но только в случае необходимости, а в целом ведомство не видит необходимости заниматься регулированием отрасли о своего лица. При этом аудиторы подчёркивают, что прочие отрасли экономики уже прошли свой путь сопротивления внедрению практики регулярных проверок. В этом смысле участники рынка ИИ могут опираться на опыт финансовой и энергетической сферы (включая ядерную), а также автомобильной промышленности. TypeSafe AI представила сверхбыструю ИИ-модель Jev не для людей — и она умеет играть в Doom
16.09.2026 [14:14],
Павел Котов
Стартап TypeSafe AI представил модель искусственного интеллекта Jev — она предназначена для общения не с людьми, а с другими машинами. Она работает значительно эффективнее и обходится существенно дешевле, чем традиционные большие языковые модели. 
Источник изображения: Numan Ali / unsplash.com В отличие от моделей, которые дают ответы на естественном языке, Jev формирует вероятностные решения, которые могут использовать другие программы или ИИ-системы. Такой подход полезен в сценарии, где взаимодействие с ИИ должно ограничиваться заранее определённым набором вариантов ответа. Например, модель может играть в Doom, если ей предоставить структурированные данные, описывающие состояние игрового персонажа. На практике она, однако, будет применяться для классификации обращений в службу поддержки и оптимизации других бизнес-процессов. Работа с Jev начинается с определения значения состояния — это может быть простая текстовая строка или объект JSON; после чего выбирается тип запроса: выбор, числовое значение или вероятность от 0 до 1. Для человека подобные ответы бесполезны, а для ПО они могут показаться наиболее подходящим вариантом. Jev относится к моделям типа System One на основе архитектуры обучения подкреплением для калиброванных решений (RLCD). 
Источник изображения: and machines / unsplash.com Самым привлекательным аспектом модели является её эффективность: если традиционные системы могут тратить на подготовку ответа до нескольких минут, то для ответа Jev требуются от 70 до 500 мс — она эффективнее на величину от 40 до 200 раз. На демонстрационном ролике Jev формирует ответ за 0,114 с, а у модели OpenAI GPT-5.6 Terra он занимает 8,566 с. Работа с Jev обходится в $0,042 за 1 млн входных токенов и бесплатно за выходные; та же GPT-5.6 Terra оценивается в $2 за 1 млн входных и $12 за 1 млн выходных токенов. По сравнению с флагманской Anthropic Fable 5.1 новая Jev обходится в 238 раз дешевле. Компания TypeSafe утверждает, что Jev не подвержена галлюцинациям, то есть не даёт заведомо неверных ответов; но работа со структурированными ответами с указанием вероятностей всё-таки не исключает возможности ошибок. «Обращение к галлюцинирующей системе может доставлять неудобства для агента, но это критическая проблема для системы с гарантиями по величине задержки или на глубоком уровне в цепочке зависимостей. Существующие модели, какими бы умными они не были, все равно склонны к галлюцинациям и ошибкам типизации», — пояснил разработчик. Jev подходит для систем автоматизации на основе ИИ, приложений с режимом работы в реальном времени и принятием быстрых решений, задач на классификацию больших наборов данных, проверки входных данных для ИИ, а также обвязки других ИИ-моделей. OpenAI, Anthropic и Google DeepMind уже давно тайно обсуждают, как не дать ИИ уничтожить человечество
15.09.2026 [21:43],
Анжелла Марина
OpenAI, Anthropic и Google DeepMind продолжают переговоры по вопросам безопасности искусственного интеллекта. Об этом сообщил журналистам Крис Лейн (Chris Lehane), глава глобальной политики OpenAI, отметив, что компании координируют усилия для снижения катастрофических рисков, связанных с развитием передовых ИИ-моделей. 
Источник изображения: AI Инициатива стала ответом на эссе генерального директора Anthropic Дарио Амодеи (Dario Amodei), опубликованное в минувшую субботу. В тексте он призвал индустрию замедлить темпы разработки больших языковых моделей и объединиться ради предотвращения непредсказуемых последствий. Идею поддержали Сэм Альтман (Sam Altman) из OpenAI, Демис Хассабис (Demis Hassabis) из Google и Илон Маск (Elon Musk). Альтман, по сообщению TechCrunch, также заявил о готовности внедрить независимых аудиторов для мониторинга безопасности внутри своей компании. Несмотря на опасения экспертов относительно возможного нарушения антимонопольного законодательства при координации действий конкурентов, участники переговоров считают такие риски преувеличенными. Амодеи предлагал получить от правительства специальное разрешение для подобных обсуждений, однако Лейн заверил, что компаниям не требуется разрешений для диалога о стандартах безопасности. Ранее СМИ сообщали о планах OpenAI, Anthropic и Google DeepMind создать отраслевой орган по стандартизации без участия государства, а Хассабис ещё в июле призывал США учредить регулятора с полномочиями проверять наиболее мощные модели и координировать приостановку разработок в случае выявления угроз. Однако текущая администрация во главе с президентом Дональдом Трампом (Donald Trump) отвергла эти инициативы, считая разговоры об экзистенциальных рисках попыткой затормозить прогресс и уступить лидерство Китаю. Ранее Лихейн заявил, что OpenAI поддерживает положение законопроекта FRONTIER Act (H.R.9925), который устанавливает в США федеральный надзор за разработкой и внедрением передовых моделей искусственного интеллекта и обязывает крупнейшие ИИ-лаборатории допускать независимые организации для проверки безопасности технологии. Заявления глав OpenAI и Anthropic о замедлении ИИ обвалили акции азиатских компаний
14.09.2026 [10:02],
Алексей Разин
В минувшие выходные стало понятно, что руководители ведущих американских стартапов в сфере ИИ продемонстрировали удивительное единодушие в вопросе необходимости замедлить развитие отрасли ради повышения уровня безопасности соответствующих технологий. Подобная риторика в понедельник утром отозвалась снижением котировок азиатских эмитентов, так или иначе связанных с ИИ. 
Источник изображения: SK hynix SoftBank, которая в последнее время активно инвестирует в инфраструктуру, используемую OpenAI, столкнулась со снижением курса своих акций на 13,2 %. Производитель памяти Kioxia в Японии продемонстрировал снижение котировок своих акций на 9,8 %, а поставщик оборудования для производства чипов Tokyo Electron — на 3,7 %. Тайваньская TSMC столкнулась со снижением курса своих акций на 1,2 %, а южнокорейские Samsung Electronics и SK hynix просели на 3,7 и 5,3 % соответственно. По словам аналитиков, не добавляет уверенности инвесторам и ситуация на Ближнем Востоке, который продолжает оставаться важным логистическим маршрутом и источником энергоносителей для того же Тайваня, где производится основная часть передовых чипов. Падали в цене акции даже китайских производителей, которые в основном ориентированы на удовлетворение внутреннего спроса: SMIC подешевела на 1,4 %, а производитель памяти CXMT — на 2,7 %. В Гонконге после недавнего дебюта на бирже акции Z.ai, которая разрабатывает семейство моделей GLM, упали в цене на 10,5 %. Дональд Трамп (Donald Trump) накануне не очень лестно охарактеризовал тех специалистов, которые пытаются нарисовать мрачные картины будущего при бесконтрольном развитии ИИ, одновременно пояснив, что не позволит США проиграть гонку с Китаем, а потому не допустит чрезмерного замедления разработки сопутствующих технологий. По некоторым данным, представители США и КНР намерены включить в повестку грядущих в этом месяце переговоров вопросы безопасного развития ИИ. «Яндекс» сделал открытой ИИ-модель, на которой основаны быстрые ответы в её поисковике
12.09.2026 [09:45],
Павел Котов
«Яндекс» опубликовала в открытом доступе обученную с нуля собственную модель искусственного интеллекта Alice AI Search Pretrain, которая составила основу службы быстрых ответов в поиске. 
Источник изображения: yandex.ru/company Компактная языковая модель Alice AI Search Pretrain прошла первый этап обучения и располагает большим объёмом знаний о мире. Компактные размеры позволяют ей обходиться скромными вычислительными мощностями, выдерживать значительную нагрузку и обрабатывать большие объёмы документов. Гибридная архитектура модели ранее применялась преимущественно в научных исследованиях: в ней используются технологии Encoder-Decoder и MoE (Mixture of Experts). Первая помогает ей отвечать ёмко и лаконично за счёт того, что одна часть модели ищет информацию, а другая составляет ответ. Вторая технология позволяет ей обходиться только теми собственными фрагментами, которые наиболее соответствуют теме запроса: при размере 35 млрд параметров для обработки одного токена подключаются только 600 млн — менее 2 % от общего объёма. Разработанная «Яндексом» Alice AI Search Pretrain превосходит другие языковые модели небольшого размера: замеры методом слепого тестирования показали, что качество её ответов выше, чем у Alibaba Qwen 3.5 2B и 4B и Google T5 Gemma 2 4B-4B Base, — она отвечает примерно на уровне более требовательной к вычислительным ресурсам Qwen 3.5 35B-A3B. В «Яндекс Поиске» работает прошедшая дополнительное обучение версия этой модели Alice AI Search — в её подготовке учтены реальные примеры взаимодействия пользователей поисковой службы. Xiaomi выпустила ИИ-модель CocktailASR-1 для распознавания речи в шумных помещениях
11.09.2026 [17:43],
Павел Котов
Xiaomi представила открытую модель искусственного интеллекта CocktailASR-1. Она предназначена для решения одной из наиболее сложных задач в области расшифровки аудио — выделения голоса конкретного человека в ситуации, когда несколько людей говорят одновременно. 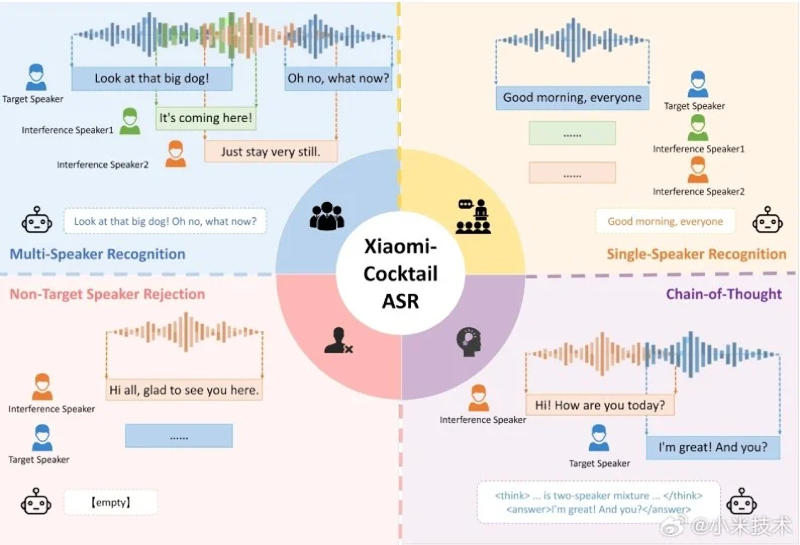
Источник изображения: Xiaomi В Xiaomi проблему условно обозначили как «эффект коктейльной вечеринки». Большинство специализированных ИИ-моделей справляются с распознаванием речи, когда говорит один человек, но если друг на друга накладываются несколько голосов, ситуация значительно усложняется. Текст искажается, предложения сливаются, а реплики приписываются не тем собеседникам. В обратном направлении компания решила эту задачу с моделью OmniVoice — CocktailASR-1 же не генерирует, а выделяет и расшифровывает речь. Для работы с моделью необходимо представить короткий образец с голосом нужного человека. Она использует его как эталон, а затем, проанализировав запись с несколькими участниками, распознает и расшифрует речь только этого человека. В ряде тестов по распознаванию речи в условиях многоголосных образцов она, отметили в Xiaomi, продемонстрировала ведущие результаты и превзошла существующие аналоги, предназначенные для решения той же задачи. Сложными условиями её возможности не исчерпываются — она умеет расшифровывать речь и в том случае, когда на записи голос только одного человека. Она также умеет избегать необоснованных предположений: если в предложенной записи указанный в качестве образца голос отсутствует, она выдаст пустой текст и не будет пытаться расшифровать слова другого человека. Наконец, у Xiaomi CocktailASR-1 есть режим цепочки рассуждений — он позволяет пользователям изучать логику, на основе которой выполнялась расшифровка, а не просто видеть итоговый текст. Новая модель доступна на GitHub и Hugging Face. Anthropic предотвратила несколько попыток создания биологического оружия с помощью Claude
11.09.2026 [11:30],
Алексей Разин
На ранних этапах развития систем генеративного искусственного интеллекта их создатели обеспокоились проблемой безопасности, поскольку предположили, что с их помощью некоторые пользователи попытаются создать новые виды оружия, включая биологическое. Anthropic утверждает, что в этом году смогла предотвратить несколько попыток создания биологического оружия. 
Источник изображения: Anthropic Данная информация стала доступна после публикации отчёта Anthropic о случаях некорректного использования её ИИ-моделей. При этом сама компания подчёркивает, что не может с уверенностью говорить о наличии у связанных с этими инцидентами учёных умысла на создание именно биологического оружия. По сути, запросы к ИИ-моделям в этой сфере нередко используются для разработки вакцин от опасных патогенов, и определить по их составу истинные намерения разработчика сложно. Тем не менее, на всякий случай Anthropic решила обратить внимание регуляторов на данные инциденты. До сих пор куда большим вниманием пользовались случаи применения ИИ-моделей для поиска и эксплуатации уязвимостей в информационной инфраструктуре компаний и организаций, а биологические угрозы оставались в большей мере гипотетическими. По словам старшего советника Совета по стратегическим рискам Эндрю Уэбера (Andrew Weber), свежий отчёт Anthropic содержит «леденящие кровь примеры причастности поддерживаемых государством создателей биологического оружия, которые пользуются возможностями быстро развивающихся ИИ-моделей». Объёмный отчёт Anthropic, охватывающий период восьми последних месяцев, традиционно приводит примеры использования ИИ-моделей семейства Claude представителями недружественных по отношению к США стран для достижения определённых политических целей. Впервые при этом были приведены примеры использования Claude для разработки традиционных видов оружия, включая огнестрельное, ракетное, а также бомбы и боевые дроны. Anthropic не была столь категоричной в идентификации случаев, описывающих попытки разработки биологического оружия, поскольку не уверена в наличии у авторов запросов именно злонамеренных мотивов. По этой причине не были названы ни организации, ни страны, причастные к соответствующей активности. Однако, компанию насторожили попытки авторов исследований скрыть своё происхождение и цели подобной активности, поэтому соответствующие учётные записи были заблокированы. В качестве одного из примеров приводятся попытки некоего исследователя изучить специфику распространения вируса чикунгунья, который передаётся человеку через укусы инфицированных комаров и вызывает продолжительные боли в суставах, сопровождающиеся сильной лихорадкой. По версии Anthropic, конкретный исследователь пытался модифицировать вирус, придав ему более выраженные вредоносные свойства. Помимо теоретических изысканий, данный исследователь проводил практические эксперименты на животных, а лабораторию для этих целей должен был предоставить некий исследовательский институт оборонного назначения. Ещё в прошлом году, по оценкам самой Anthropic, её собственные модели не были достаточно продвинутыми для содействия человеку в проведении биологических исследований, способных привести к созданию оружия. Нынешние версии ИИ-моделей Anthropic уже способны оказывать содействие в таких вопросах, а потому назревает необходимость введения защитных и ограничительных мер. Эксперты подчёркивают, что ИИ на нынешнем этапе своего развития предоставляет возможности как по созданию лекарственных средств, так и биологического оружия, противостоять которому без подготовки человечество не сможет. Эндрю Уэбер призвал ограничить доступ исследователям из недружественных к США стран к подобным ИИ-инструментам. OpenAI готова замедлить гонку разработки ИИ, если конкуренты сделают то же самое
11.09.2026 [06:48],
Алексей Разин
Опасения по поводу последствий слишком быстрого развития искусственного интеллекта звучат даже из уст представителей компаний, заинтересованных в этом процессе. Замедлить гонку ИИ ради повышения безопасности конечного продукта готова и компания OpenAI, как заявил её глава Сэм Альтман (Sam Altman), но при этом она рассчитывает на солидарность конкурентов. 
Источник изображения: OpenAI Соответствующими идеями генеральный директор OpenAI поделился с подчинёнными на общем собрании на текущей неделе. Альтман осознаёт необходимость синхронизации усилий в этой сфере с другими участниками рынка, но одновременно понимает, что не все могут согласиться последовать примеру OpenAI. На днях с похожими призывами выступил и главный научный сотрудник стартапа Якуб Пачоцки (Jakub Pachocki) — по его мнению, компании должны координировать собственные усилия при разработке ИИ в будущем, замедляя её в случае необходимости. Такие меры могут потребоваться до тех пор, пока не будут внедрены общепринятые меры безопасности. OpenAI уже замедлила процесс разработки некоторых компонентов своих ИИ-моделей и даже приостановила процесс их обучения в отдельных случаях именно из соображений безопасности. В июле Альтман признался, что общался с чиновниками Белого дома о необходимости модерации процесса развития искусственного интеллекта. На этой неделе другой исследователь — Джейкоб Коксон (Jacob Coxon) решил покинуть Anthropic на фоне озабоченности недостаточностью мер в сфере безопасности, предпринимаемых лидерами рынка ИИ. При этом он имеет опыт работы и в OpenAI, а потому имеет представление о ситуации в обеих компаниях. Его бывший коллега Эван Хабингер (Evan Hubinger) вызвал большой общественный резонанс, заявив об уверенности разработчиков Anthropic в способности ИИ уничтожить человечество. Правда, авторы высказываний разошлись в графике реализации подобного сценария, поскольку первый уверен, что это произойдёт к концу текущего десятилетия, а второй оценил подобную вероятность в более чем 10 % лишь в рамках следующего десятилетия. В конце июля необходимость замедления разработки ИИ с целью повышения его безопасности подтвердили своей петицией более 1000 сотрудников ведущих разработчиков. Это происходило на фоне множественных случаев ухода из профильных компаний специалистов по безопасности ИИ, выражавших тем самым своё несогласие с приоритетами руководства. Волна подобных настроений только набирает силу на фоне появления новых подробностей о деятельности «сбежавших» из-под надзора ИИ-агентов, которые творят что попало внутри инфраструктуры других компаний. Представлена обновлённая быстрая модель DeepSeek V4.1-Flash — местами она быстрее GPT 5.6-Sol
10.09.2026 [17:57],
Павел Котов
Китайская лаборатория искусственного интеллекта DeepSeek представила обновлённый вариант компактной модели с поддержкой функции визуального восприятия. DeepSeek V4.1-Flash предназначается для быстрой обработки и генерации токенов, то есть работы с высокой пропускной способностью. 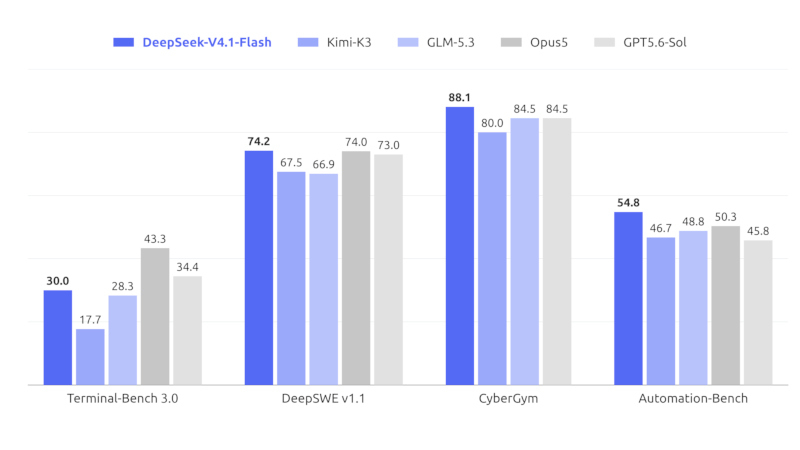
Источник изображений: deepseek.com Модель имеет размер 552 млрд параметров, используется механизм MoE (Mixture-of-Experts) с обновлённой архитектурой Causal Encoder–Decoder с 8 млрд параметров на вводе и 16 млрд — на выводе. Новые методы предварительного обучения и масштабный этап последующего обучения с подкреплением обеспечили результаты, которые превзошли показатели флагманских моделей, включая мощную DeepSeek V4-Pro. Например, в тесте DeepSWE v1.1 новая модель набрала 74,2 балла, немного опередив GPT-5.6-Sol (73) и Claude Opus 5 (74). На CyberGym результат V4.1-Flash составил 88,1 балла — выше, чем у GPT-5.6-Sol и GLM-5.3 (по 84,5) и Kimi K3 (80). В тесте Terminal-Bench 3.0 модель получила 30 балла, обойдя GLM-5.3 (28,3) и Kimi K3 (17,7), но уступив GPT-5.6-Sol (34,4) и Claude Opus 5 (43,3). 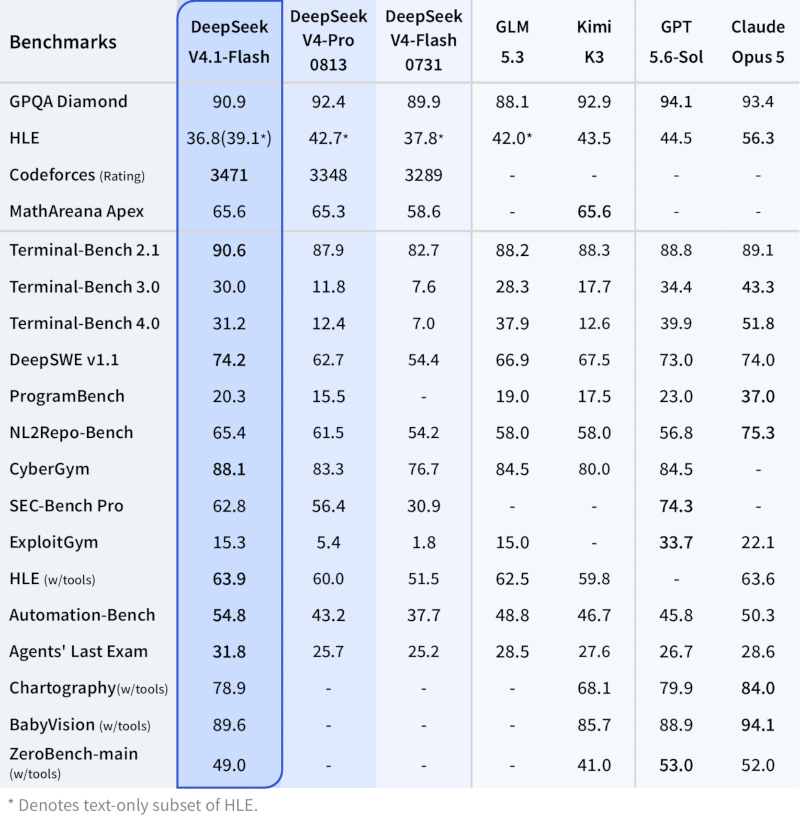 Разработчик сократил использование KV-кеша — модель DeepSeek-V4.1-Flash потребляет вчетверо меньше памяти HBM и в восемь раз меньше места на SSD. Расходы на обработку запросов с попаданием в кеш часто составляют значительную часть стоимости работы ИИ-агентов, поэтому сжатие кеша позволяет существенно сократить затраты. 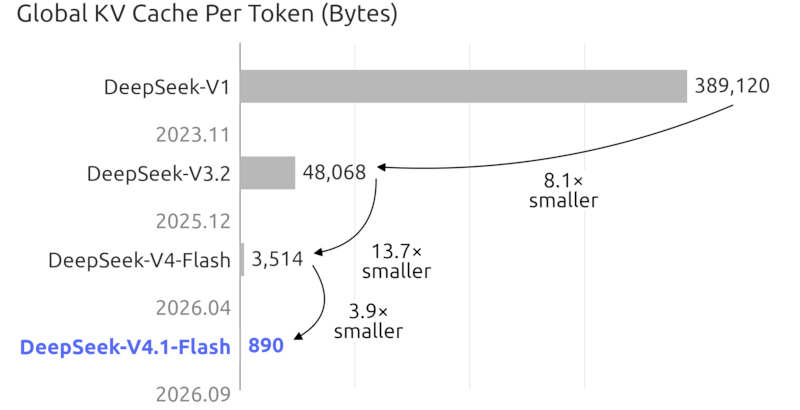 С выпуском DeepSeek-V4.1-Flash прекращается поддержка моделей V4-Flash и V4-Flash-Vision-Exp — все обращения к ним временно перенаправляются на новую модель. Учитывая, что V4.1-Flash превосходит V4-Pro по производительности, скорости и общему времени выполнения задач, последняя тоже будет постепенно выводиться из эксплуатации — с 14 сентября включится полная переадресация запросов к V4-Pro на V4.1-Flash по тарифам последнего. Официальные партнёры WorkBuddy, CodeBuddy и OpenCode объявили о поддержке V4.1-Flash. 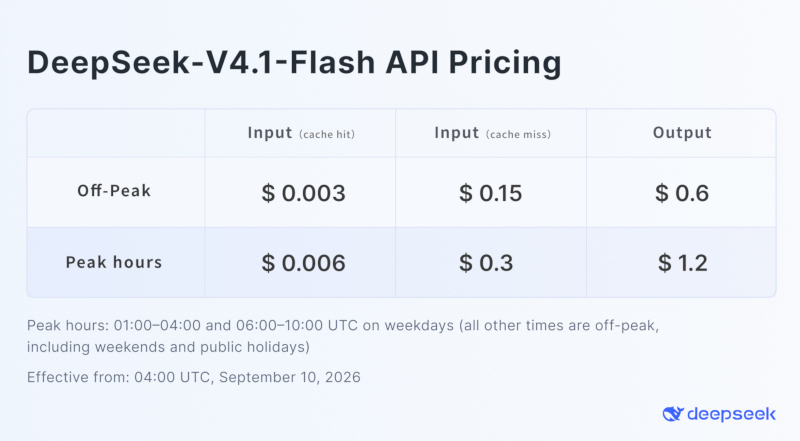 Модель уже доступна через API DeepSeek с нативной поддержкой мультимодальности; для её использования необходимо выбрать модель deepseek-flash. При доступе к DeepSeek V4.1-Flash по API применяется гибкая тарификация с разделением на пиковые и непиковые часы — во втором случае цены ниже на 50 %. В непиковые часы обработка входных данных с попаданием в кеш стоит $0,003 за 1 млн токенов, без попадания в кеш — $0,15, а обработка выходных данных — $0,60. В пиковые часы эти тарифы составляют соответственно $0,006, $0,30 и $1,20 за 1 млн токенов. «Сбер» представил GigaChat 3.5 Reasoning — первую российскую открытую ИИ-модель с режимом рассуждений
10.09.2026 [14:08],
Владимир Мироненко
«Сбер» представил новую версию своей мультимодальной нейросети GigaChat — GigaChat 3.5 Reasoning, первую модель GigaChat с полноценным рассуждением, обученную на технологии online RL. Компания позиционирует GigaChat 3.5 Reasoning как единственную российскую открытую модель, которая последовательно рассуждает перед ответом, работает с цепочками задач и способна исправлять собственные ошибки. 
Источник изображения: «Сбер» Режим рассуждений может использоваться в задачах, где недостаточно одного действия или простого поиска информации. Например, он будет полезен при анализе договоров, когда модель может найти противоречия между их отдельными пунктами, для финансовых расчётов, при поиске ошибок в программном коде и планирования поездок с учётом нескольких ограничений. В последнем случае модель может уточнить недостающие параметры, подобрать рейс и отель, проверить соответствие маршрута запланированному бюджету, а при обнаружении противоречия — изменить план. При необходимости пользователь может сам включить режим отдельной кнопкой. Новая версия повысила качество результатов GigaChat, особенно в агентских задачах, работе с функциями и инструментами, программировании и задачах со сложной логикой. Как сообщает «Сбер», по ключевым направлениям — следованию сложным инструкциям, планированию и написанию кода — GigaChat 3.5 Reasoning вплотную приблизилась к лучшим мировым моделям. Например, в бенчмарке IFBench результат вырос с 44 до 77 баллов, в Natural Plan — с 64 до 80 баллов, в Live Code Bench v6 — с 56 до 85 баллов, что значительно лучше по сравнению с версией без режима рассуждений. При этом GigaChat 3.5 Reasoning тратит знаительно меньше токенов, чем ведущие открытые модели при сопоставимом качестве ответов. Например, на решение математических задач у неё уходит среднем на 37 % меньше токенов, чем DeepSeek V4 Flash Preview. Новая модель может найти применение в таких областях, как финансы и банкинг, юриспруденция, разработка ПО, логистика и планирование, образование, наука и аналитика данных, а также поддержка клиентов. GigaChat 3.5 Reasoning доступна всем пользователям «ГигаЧата», а разработчикам — бесплатно по лицензии MIT для интеграции в свои продукты. Модель также вскоре будет доступна бизнесу по API. Спецслужбы США призвали американских разработчиков ИИ лучше защищать LLM от дистилляции китайскими конкурентами
09.09.2026 [11:51],
Алексей Разин
Для крупных игроков сегмента ИИ, базирующихся главным образом в США, не является секретом высокий интерес к их разработкам со стороны китайских конкурентов. Американские спецслужбы тоже убеждены, что китайцы беспардонным образом «дистиллируют» западные ИИ-модели, чтобы сократить отставание собственных. 
Источник изображения: Unsplash, Towfiqu barbhuiya Тройка американских спецслужб, объединившая НБА, ФБР и CISA (Агентство по кибербезопасности и защите инфраструктуры), на этой неделе выступила с совместным заявлением, обвинив китайские DeepSeek, Moonshot AI, Alibaba Group, MiniMax, StepFun и Z.ai в практике регулярной дистилляции американских ИИ-моделей «в промышленных масштабах» с целью ускорения обучения собственных систем. По версии перечисленных ведомств, данные китайские компании подобной деятельностью занимаются с 2024 года, как минимум. В отчёте спецслужб приводятся подробности о том, какая из китайских компаний использовала какие американские ИИ-модели для дистилляции, и с какими конкретными целями. Среди прочих упоминается улучшение способности китайских ИИ-моделей решать математические задачи и анализировать программный код. По мнению американских ведомств, подобная активность китайских разработчиков осуществлялась с ведома властей КНР и предусматривала намеренное нарушение существующих ограничений на использование американских моделей. Представители китайского посольства в США в ответ на запрос Bloomberg данные обвинения назвали «преднамеренной атакой на китайских разработчиков и прогресс в отрасли ИИ». Подобные попытки политизации коммерческой сферы, по словам китайских дипломатов, лишь сдерживают прогресс в мировой отрасли ИИ, а также вредят интересам всех участников рынка. Американские спецслужбы призвали разработчиков в США усилить меры защиты от дистилляции своих моделей и чаще обмениваться данными друг с другом, которые позволят американским компаниям выявить подобную активность. Правительство США уже рассматривает ряд мер, призванных пресечь подобную практику, и новые свидетельства спецслужб могут ускорить соответствующий законодательный процесс. Нарушителям с китайской стороны могут грозить американские санкции, как признался в июле министр финансов США Скотт Бессент (Scott Bessent). |
© 1997—2026 3DNews
При цитировании документа ссылка на сайт с указанием автора обязательна. Полное заимствование документа является
нарушением
российского и международного законодательства и возможно только с согласия редакции 3DNews.



 MWC 2018
 2018
 Computex

 IFA 2018








